Cuối năm 2022, ba nhà nghiên cứu Yaniv Leviathan, Matan Kalman và Yossi Matias tại Google Research ở Israel đăng lên arXiv bài báo Fast Inference from Transformers via Speculative Decoding. Họ tuyên bố tìm được cách giúp LLM trả lời nhanh gấp đôi hoặc gấp ba với claim rằng output của phương pháp này không thay đổi so với thông thường, giữ nguyên chính xác phân phối xác suất ban đầu.
Đầu năm 2023, một nhóm khác tại DeepMind do Charlie Chen dẫn đầu công bố bài báo Accelerating Large Language Model Decoding with Speculative Sampling với thuật toán cốt lõi của họ gần như giống hệt. Tuy nhiên nhóm tác giả ghi chú rõ rằng công trình được thực hiện độc lập và cùng thời điểm với nhóm Leviathan.

Các khái niệm
Token
Khi ta gõ câu hỏi vào ChatGPT hay Claude, model không đọc từng chữ cái hay từng từ. Nó đọc token, là những mảnh văn bản có kích thước không đều nhau.
Ví dụ, câu tiếng Anh:
"The capital of France is Paris."
Sau khi qua tokenizer (một bộ chia chữ thành token), có thể trở thành:
["The", " capital", " of", " France", " is", " Paris", "."]
Mỗi token được gán một ID số duy nhất đại diện cho mảnh văn bản đó. Ví dụ " Paris" có ID 12437 và "." có ID 13
Với tiếng Việt, tokenizer có thể hoạt động khác một chút
"Hôm nay trời rất đẹp"
→ ["Hôm", " nay", " tr", "ời", " rất", " đẹp"]
Một từ tiếng Việt có dấu có thể bị chia thành 2-3 token. Đây là lý do model xử lý tiếng Việt thường tốn thêm token hơn tiếng Anh cho cùng một nội dung.
Forward pass
Khi model nhận một chuỗi token, nó sẽ chạy chuỗi này qua hàng chục lớp (layers) mạng neural tính toán nối tiếp nhau. Quá trình này được gọi là forward pass.
Input: "Hôm nay trời rất"

Forward pass qua 32 layer của model...

Output: bảng điểm cho ~100.000 token trong vocabulary
  "đẹp"    45%
  "nóng"   25%
  "lạnh"   20%
  "xanh"    3%
  ...       7%
Bảng điểm này được gọi là probability distribution (phân phối xác suất). Nó cho biết model đánh giá token nào có khả năng đứng tiếp theo cao nhất cùng với tỷ lệ phần trăm tương ứng.
Tổng tất cả xác suất luôn bằng 100%. Thay vì khẳng định một đáp án đúng, model chỉ đưa ra khả năng phần trăm cho từng trường hợp, như 45% cho từ “đẹp”, 25% cho từ “nóng”, hoặc 20% cho từ “lạnh”.
Chọn token: greedy vs sampling
Sau khi có bảng xác suất, cần một quy tắc chọn token nào sẽ được dùng.
Greedy: chọn token có xác suất cao nhất.
"đẹp" 45%  ← luôn chọn cái này
"nóng" 25%
"lạnh" 20%
Với cùng một input, phương pháp greedy luôn cho ra output giống hệt nhau. Đây là cách tiếp cận deterministic và dễ dự đoán.
Sampling: chọn ngẫu nhiên theo tỷ lệ xác suất.
45% trường hợp → chọn "đẹp"
25% trường hợp → chọn "nóng"
20% trường hợp → chọn "lạnh"
Việc này giống như tung một con xúc xắc 100 mặt với 45 mặt ghi “đẹp”, 25 mặt “nóng” và 20 mặt “lạnh”. Mỗi lần tung sẽ cho ra kết quả khác nhau nhưng vẫn bám sát tỷ lệ tổng thể.
Sampling được dùng khi muốn output đa dạng, để cùng một câu hỏi mỗi lần trả lời hơi khác nhau. Nhiều chatbot dùng sampling (hoặc sampling với temperature thấp) để câu trả lời bớt máy móc.
Sự phân biệt này quan trọng vì speculative decoding phải bảo đảm output cuối cùng khớp hoàn toàn với target model, bất kể model dùng greedy hay sampling. Việc này khá đơn giản với greedy nhưng lại đòi hỏi một thuật toán phức tạp hơn nhiều đối với sampling, chi tiết sẽ được nói rõ ở phần tiếp.
Autoregressive
Cách làm ban đầu của các LLM Model là autoregressive, hay sinh token tuần tự, nghĩa là token phía sau luôn phụ thuộc vào token phía trước.
Ví dụ sinh 3 token:
Lần 1:
  Input:  "The capital of France is"
  Model chạy forward pass...
  Output: " Paris"

Lần 2:
  Input:  "The capital of France is Paris"
  Model chạy forward pass...
  Output: "."

Lần 3:
  Input:  "The capital of France is Paris."
  Model chạy forward pass...
  Output: <END>
Bởi vì rõ ràng theo một cách suy nghĩ đơn giản, các từ tiếp theo ta muốn nghĩ ra nên có sự phụ thuộc vào từ trước đó.
Sự phụ thuộc này tạo ra một chuỗi tuần tự bắt buộc:
Token 1 → cần biết token 1 để tính token 2
Token 2 → cần biết token 2 để tính token 3
Token 3 → cần biết token 3 để tính token 4
...
Vấn đề thời gian
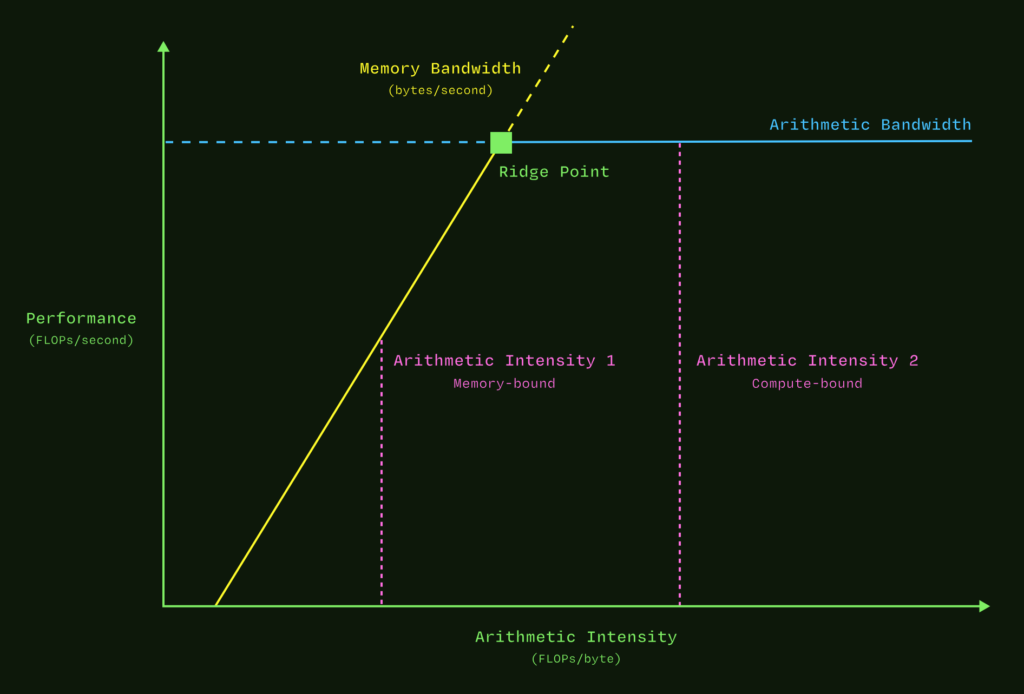
Một model có 70B tham số (parameters) đồng nghĩa với việc hệ thống phải đọc 70 tỷ con số trọng số từ bộ nhớ GPU mỗi lần chạy.
Để sinh một token mới, GPU phải:
- Đọc 70 tỷ trọng số từ bộ nhớ
- Thực hiện phép nhân ma trận với token đầu vào
- Lặp lại qua 32 layers
- Ra một bảng xác suất
GPU hiện đại như H100 có sức mạnh tính toán khổng lồ, lên tới hàng trăm nghìn tỷ phép tính mỗi giây. Phần lớn khả năng này bị lãng phí khi hệ thống chỉ xử lý một token. Sau khi đọc xong 70 tỷ trọng số, GPU chỉ áp dụng chúng cho một vị trí rồi bỏ qua, sau đó lại phải đọc lại ngần ấy trọng số cho vị trí tiếp theo.
Giống như ta mở quyển từ điển 70 tỷ trang, đọc hết, chỉ để tra một từ. Rồi đóng sách, mở lại, đọc hết 70 tỷ trang, tra một từ nữa.
Quá trình này được gọi là trạng thái memory-bound, nơi tốc độ hệ thống bị giới hạn bởi tốc độ đọc bộ nhớ thay vì tốc độ tính toán. GPU lúc này rơi vào trạng thái “đói việc” vì khả năng tính toán dư thừa nhưng dữ liệu không được nạp đủ nhanh.
Đây chính là kẽ hở mà speculative decoding khai thác.
Hidden state
Mỗi token đi qua một layer của Transformer sẽ tạo ra một vector số chứa khoảng 4.096 hoặc 8.192 giá trị. Có thể hiểu đơn giản dãy số này mô phỏng mức độ hiểu của model về toàn bộ bối cảnh tại thời điểm này. Có thể đọc thêm bài sau:
Token "is" đi qua:
  Layer 1  → hidden state h¹  (4096 số)
  Layer 2  → hidden state h²  (4096 số)
  ...
  Layer 32 → hidden state h³² (4096 số)
Mỗi layer tinh chỉnh hidden state, thêm vào nó sự hiểu biết sâu hơn. Có thể là layer đầu có thể nắm cú pháp, layer giữa hiểu ngữ nghĩa, layer cuối tổng hợp toàn bộ. Hidden state cuối cùng là h³² sẽ đi qua lớp chuyển đổi LM head để biến vector 4096 số thành bảng xác suất cho khoảng 100.000 token:
h³² (4096 số)
     ↓
  LM head
     ↓
Bảng xác suất cho mọi token tiếp theo
  " Paris"   80%
  " Lyon"     5%
  " located"  3%
  ...
Ý tưởng cốt lõi “Đoán trước, kiểm tra sau” (draft-verify)
Đến đây, chúng ta đã biết nguyên nhân LLM sinh token chậm là do hệ thống phải chạy model lớn cho từng token một, trong khi GPU lại đang lãng phí phần lớn sức mạnh tính toán.
Speculative decoding được xây dựng dựa trên một nhận xét đơn giản nhưng cực kỳ hiệu quả:
Rất nhiều token tiếp theo thực ra rất dễ đoán, ví dụ như dấu chấm, dấu phẩy, dấu ngoặc, xuống dòng, cú pháp JSON, các cụm từ thông dụng, hoặc phần lặp lại từ prompt. Model lớn không cần phải vất vả tính toán cho từng token hiển nhiên như vậy.
Từ đó ta có một hệ thống sơ khai speculative decoding bao gồm hai thành phần:
Draft model (drafter): Model nhỏ hơn nhiều, ví dụ loại 1B parameters. Nó nhanh hơn dù chất lượng kém hơn. Nhiệm vụ của nó chỉ là đề xuất các token dự tuyển (candidate) và hoàn toàn không có quyền quyết định output cuối cùng.
Target model (model lớn): Đây là model ta thật sự muốn dùng, ví dụ loại 70B parameters. Nó cho ra chất lượng cao nhưng chậm. Điểm mấu chốt là output cuối cùng gửi cho người dùng bắt buộc phải giống hệt output của model này.
Một vòng speculative decoding
Ta hãy thử đi qua lại ví dụ ban đầu
Prompt: "The capital of France is"
Giả sử target model (70B) sẽ sinh ra: " Paris" "." <END>
Bước 1: Drafter đề xuất 4 candidate
Draft model nhỏ (1B) chạy autoregressive, nghĩa là nó cũng phải sinh từng token một giống như target:
Draft pass 1: "The capital of France is"          → " Paris"
Draft pass 2: "The capital of France is Paris"     → "."
Draft pass 3: "The capital of France is Paris."    → " It"
Draft pass 4: "The capital of France is Paris. It" → " is"
Dù có 4 draft pass, thời gian xử lý sẽ nhanh hơn vì model nhỏ.
Những token này mới chỉ là các candidate nội bộ và chưa token nào được gửi cho người dùng.
Candidate: [" Paris", ".", " It", " is"]
Bước 2: Target kiểm tra cả 4 candidate trong MỘT pass
Target model sẽ nhận toàn bộ chuỗi candidate:
Input: ["The", " capital", " of", " France", " is",
        " Paris", ".", " It", " is"]
                  └── 4 candidate ──┘
Sau đó, target chạy một forward pass duy nhất trên toàn bộ input để tính xác suất cho từng vị trí:
- The capital of France is
- The capital of France is Paris
- The capital of France is Paris.
- The capital of France is Paris. It
Lúc này ta có thể chạy song song, với việc giả định rằng: nếu model sẽ sinh ra cả đoạn như vậy thì token tiếp theo sẽ là gì
Sau "The capital of France is"              → target chọn " Paris"
Sau "The capital of France is Paris"        → target chọn "."
Sau "The capital of France is Paris."       → target chọn <END>
Sau "The capital of France is Paris. It"    → target chọn khác
Bước 3: So sánh từ trái sang phải
Vị trí  Draft       Target       Kết quả
  1     " Paris"    " Paris"     ✓ Accept
  2     "."         "."          ✓ Accept
  3     " It"       <END>        ✗ Reject (dùng <END> từ target)
  4     " is"       —            ✗ Discard (không kiểm tra)
Tại vị trí số 3, draft đề xuất ” It” nhưng target lại yêu cầu <END>. Vì draft sai nên hệ thống sẽ bỏ ” It” và sử dụng <END> từ target. Token thứ 4 là ” is” cũng bị loại bỏ do nó được tính toán dựa trên ” It”, mà ” It” thì đã bị loại.
Kết quả vòng này:
Output: " Paris" "." <END>
Kết quả này hoàn toàn khớp với output mà target tự sinh ra. Giả sử với tốc độ là
Một target pass (70B): ~20 ms Một draft pass (1B): ~0.5 ms
Về mặt thời gian:
Cách thường:  3 target pass = 3 × 20 = 60 ms
Speculative:  4 draft pass + 1 target verify
              = 2 + 22 = 24 ms

Speedup: 60 / 24 ≈ 2.5×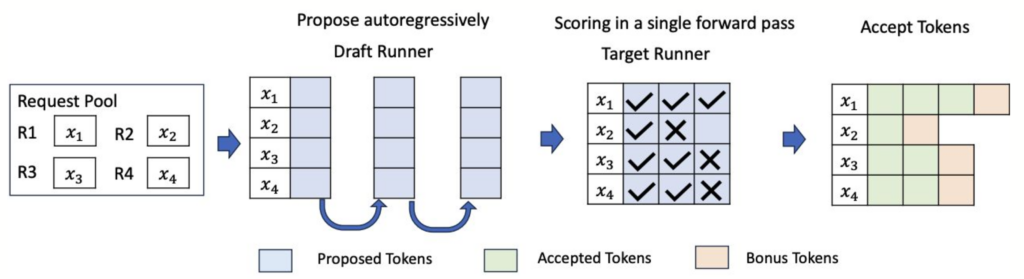
Tại sao target kiểm tra được nhiều vị trí trong một lần?
Chúng ta đã thống nhất rằng việc sinh token phải tuần tự vì token sau phụ thuộc vào token trước. Vậy target làm cách nào để kiểm tra 4 vị trí song song?
Sự khác biệt nằm ở hai khái niệm: sinh (generate) và chấm điểm (score/verify).
Khi sinh: Token tương lai chưa tồn tại. Model bắt buộc phải đoán token đầu tiên, sau đó mới có dữ liệu để đoán token thứ hai. Tính tuần tự này là thực tế và không thể phá vỡ.
Khi chấm điểm: Drafter đã cung cấp sẵn cả 4 candidate. Target không cần phải tìm kiếm chúng nữa. Việc của nó chỉ là tính xem nếu đây là token tiếp theo thì xác suất sẽ là bao nhiêu.
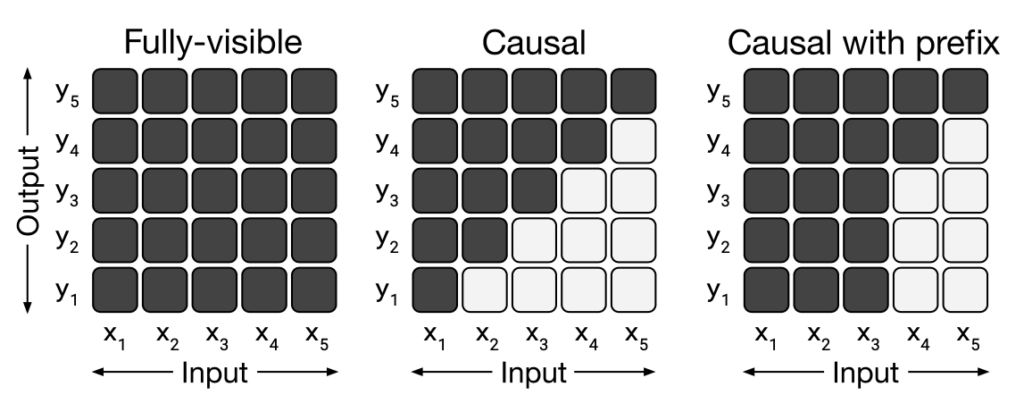
Mạng Transformer có một cơ chế mang tên causal mask. Trong cùng một forward pass, cơ chế này hoạt động như sau:
Vị trí " Paris" chỉ thấy: prefix (prefix ở đây là cả câu trước đó - The capital ....)
Vị trí "."      chỉ thấy: prefix + " Paris"
Vị trí " It"    chỉ thấy: prefix + " Paris" + "."
Vị trí " is"    chỉ thấy: prefix + " Paris" + "." + " It"
Mỗi vị trí chỉ có thể nhìn được các vị trí trước nó mà không thể nhìn các vị trí sau. Nhờ cơ chế này, kết quả tính toán tại mỗi vị trí hoàn toàn trùng khớp với việc chạy riêng lẻ từng vị trí một.
Hơn nữa, do toàn bộ input đã có giá trị cụ thể từ các candidate có sẵn, GPU có thể tính toán tất cả các vị trí song song trong cùng một phép nhân ma trận lớn.
Đây chính xác là loại phép tính mà Transformer thực hiện khi xử lý prompt ban đầu trong giai đoạn gọi là prefill. Quá trình verification ở đây gần giống một đoạn prefill ngắn với 4 token thay vì hàng trăm token.
Thêm vào đó, do GPU đang trong trạng thái memory-bound khi giải mã một token, việc đọc 70 tỷ trọng số để xử lý 4 token không tốn kém hơn bao nhiêu so với việc xử lý 1 token. Trọng số đằng nào cũng đã được đọc lên, GPU chỉ việc dùng luôn cho cả 4 vị trí.
Chi phí verify 4 candidate ≈ chi phí sinh 1 token
(Dù không chính xác tuyệt đối nhưng cùng chung một bậc chi phí)
Dù vậy, cần lưu ý là nếu ” It” bị từ chối tại vị trí thứ 3, kết quả tại vị trí thứ 4 cũng sẽ tự động bị bỏ. Nguyên nhân là do vị trí 4 được tính toán với điều kiện ” It” tồn tại. Một khi ” It” đã bị loại bỏ, bối cảnh thực tế (prefix) đã thay đổi hoàn toàn.
Draft model kém hơn target, vậy chất lượng output có giảm không?
Câu trả lời là không. Draft model 1B đúng là sẽ kém hơn target 70B và các đề xuất candidate của nó hoàn toàn có thể sai lệch. Tuy nhiên, output của draft không bao giờ được gửi thẳng cho người dùng.
Hãy tưởng tượng drafter là một thực tập sinh phụ trách viết bản nháp, còn target là tổng biên tập có quyền ký duyệt. Thực tập sinh có thể mắc lỗi, nhưng điều đó không thành vấn đề vì mọi văn bản đều phải qua tay tổng biên tập kiểm tra trước khi xuất bản.
Quy tắc áp dụng rất đơn giản:
Nếu draft token = token target chọn:
    dùng draft token (vì nó bằng target token)

Nếu draft token ≠ token target chọn:
    bỏ draft token
    dùng target token thay thế
Dù trong trường hợp nào đi nữa, token được hệ thống chốt (commit) luôn luôn giống hệt token mà target chọn.
Chuyện gì xảy ra nếu draft đoán sai ngay từ token đầu tiên?
Ví dụ draft đề xuất chuỗi candidate sau:
"Lyon" "is" "beautiful"
Khi target tiến hành kiểm tra vị trí đầu tiên:
Draft:  "Lyon"
Target: "Paris"
→ Reject "Lyon"
→ Discard "is" và "beautiful"
→ Output "Paris" từ target
Vòng lặp tiếp theo sẽ bắt đầu lại từ "...is Paris" để draft thử lại lần nữa.
Kết quả lúc này vẫn hoàn toàn giống với output của target. Tuy nhiên, vòng chạy vừa rồi không hề mang lại tốc độ nào, thậm chí nó còn chậm hơn so với mức baseline do hệ thống phải tốn thêm thời gian chạy draft.
Speculative = 2ms (draft) + 22ms (verify) = 24 ms
Baseline    = 20 ms (khi chỉ chạy 1 target pass)

→ Chậm hơn 4ms
Qua đó có thể thấy chất lượng của draft chỉ ảnh hưởng đến tốc độ, chứ không làm suy giảm chất lượng đầu ra:
Draft tốt  → chất lượng bằng target, tốc độ nhanh
Draft kém  → chất lượng bằng target, ít nhanh hơn hoặc thậm chí chậm hơn baseline
Tại sao model nhỏ vẫn hữu ích khi năng lực của nó kém hơn?
Từ “kém hơn” không đồng nghĩa với việc model nhỏ đoán sai mọi token. Khi phần tiền tố (prefix) đã rõ ràng, rất nhiều token thực tế cực kỳ dễ đoán trước:
Dấu chấm kết thúc một câu hoàn chỉnh
Dấu phẩy nối trong danh sách
Dấu ngoặc đóng nối tiếp sau ngoặc mở
Ký tự xuống dòng sau mỗi đoạn văn
Các thành phần cú pháp JSON như dấu hai chấm, ngoặc vuông, ngoặc nhọn
Các thành phần cú pháp code như dấu chấm phẩy, từ khóa return, dấu ngoặc nhọn đóng
Các cụm từ liên kết thông dụng như "in order to", "for example"
Những đoạn văn bản lặp lại từ prompt trong tác vụ chỉnh sửa code hoặc viết lại câu
Model lớn thực sự chỉ cần thiết để giải quyết những vị trí khó, ví dụ như:
Lựa chọn đáp án trong các bài toán reasoning logic
Thực hiện các phép tính toán học
Chốt tên riêng, số liệu cụ thể hay hành động chính xác
Quyết định cấu trúc câu ở những vị trí còn mơ hồ
Drafter không cần phải thông minh ngang ngửa target. Nhiệm vụ của nó chỉ là đoán trúng trùng khớp với target đủ thường xuyên. Khi tỷ lệ trúng đủ cao, lượng target pass tiết kiệm được sẽ bù đắp dư dả cho lượng chi phí dùng để chạy draft.
Modified rejection sampling
Phần trước đã giải thích trường hợp greedy, nơi target luôn chọn token có xác suất cao nhất nên việc so sánh rất đơn giản. Tuy nhiên, nhiều ứng dụng LLM thực tế lại dùng sampling. Đây là lúc speculative decoding thực sự bộc lộ sự phức tạp.
Vấn đề mới
Với phương pháp greedy, target chỉ có một token đúng duy nhất là token có xác suất cao nhất:
Target:  60% Paris, 30% London, 10% Rome
Greedy → luôn chọn Paris
Việc so sánh lúc này vô cùng dễ dàng:
Draft Paris  → accept
Draft London → reject, thay bằng Paris
Thế nhưng với sampling, target không khẳng định “đáp án là Paris”. Target yêu cầu một tỷ lệ phân bổ:
60% trường hợp phải ra Paris
30% trường hợp phải ra London
10% trường hợp phải ra Rome
Lúc này, cả Paris, London và Rome đều là những output hợp lệ. Hệ thống không có token “sai”, nó chỉ có tỷ lệ.
Vấn đề nảy sinh là draft model thường có phân phối khác với target:
              Target p     Draft q
Paris           60%          50%
London          30%          40%
Rome            10%          10%
Nếu ta lấy thẳng output của draft, phân phối sẽ là 50/40/10, hoàn toàn sai lệch so với phân phối mục tiêu 60/30/10 của target.
Ngược lại, nếu ta chỉ accept khi draft khớp với lựa chọn ưu tiên nhất của target (Paris), những lần draft đề xuất London sẽ luôn bị reject. Output cuối cùng sẽ biến thành 100% Paris. Như vậy, ta vô tình biến sampling thành greedy.
Bởi vậy, chúng bản cần một phương pháp cho phép tái sử dụng token từ draft mà vẫn giữ nguyên được phân phối của target.
Giải pháp
Thay vì phân tích một lần chạy đơn lẻ, bạn hãy thử tưởng tượng ta chạy hệ thống 1.000 lần với cùng một prefix để xem output tạo ra tỷ lệ gì.
Dựa trên phân phối q, draft sẽ đề xuất:
Paris:  ~500 lần  (vì q(Paris) = 50%)
London: ~400 lần  (vì q(London) = 40%)
Rome:   ~100 lần  (vì q(Rome) = 10%)
Trong khi đó, target muốn output cuối cùng bám sát phân phối p:
Paris:  ~600 lần  (vì p(Paris) = 60%)
London: ~300 lần  (vì p(London) = 30%)
Rome:   ~100 lần  (vì p(Rome) = 10%)
Hãy làm một phép so sánh trực tiếp:
Paris:
  Draft có 500, target cần 600
  → Draft THIẾU Paris → accept toàn bộ 500

London:
  Draft có 400, target chỉ cần 300
  → Draft THỪA 100 London → chỉ accept 300 trong số 400

Rome:
  Draft có 100, target cần 100
  → Vừa đủ → accept toàn bộ 100
Tỷ lệ accept cụ thể cho từng token được tính như sau:
Paris:  accept 500/500 = 100%
        tính: p/q = 60%/50% = 1.20 → min(1, 1.20) = 1 ✓

London: accept 300/400 = 75%
        tính: p/q = 30%/40% = 0.75 → min(1, 0.75) = 0.75 ✓

Rome:   accept 100/100 = 100%
        tính: p/q = 10%/10% = 1.00 → min(1, 1.00) = 1 ✓
Công thức tổng quát:
accept_probability(token) = min(1, p(token) / q(token))Ý nghĩa trực tiếp của công thức này là:
- Nếu draft đưa token ít hơn hoặc bằng lượng target cần, hệ thống sẽ nhận hết.
- Nếu draft đưa token vượt quá mức cần thiết, hệ thống chỉ nhận đúng tỷ lệ mà target cần.
Khi reject thì lấy token từ đâu?
Sau bước accept, chúng ta có:
Paris:  500 (accept hết)
London: 300 (accept 300/400, reject 100)
Rome:   100 (accept hết)

Tổng accept: 900
Tổng reject: 100
Trong khi đó target cần:
Paris: 600 → còn thiếu 100
London: 300 → đã đủ
Rome: 100 → đã đủ
Như vậy, 100 trường hợp bị reject bắt buộc phải được dùng để bổ sung chính xác phần còn thiếu. Trong ví dụ này, toàn bộ chúng phải là Paris.
Nhiều người sẽ thắc mắc tại sao không reject rồi lấy mẫu (sample) lại từ target? Thử hình dung nếu 100 trường hợp reject lại được lấy mẫu từ target theo tỷ lệ 60/30/10, chúng ta sẽ có:
Thêm: Paris 60, London 30, Rome 10
Kết quả sẽ là:
Paris:  500 + 60 = 560  (cần 600 → sai)
London: 300 + 30 = 330  (cần 300 → sai)
Rome:   100 + 10 = 110  (cần 100 → sai)
Quá trình này sai lệch hoàn toàn vì London và Rome đã đủ số lượng (quota) nhưng hệ thống lại tự động bổ sung thêm.
Do đó, quá trình sửa lỗi (correction) phải được lấy từ phần target còn thiếu, hay còn gọi là residual distribution:
residual(token) = max(0, p(token) - q(token))

Paris:  max(0, 0.60 - 0.50) = 0.10
London: max(0, 0.30 - 0.40) = 0    ← đã đủ
Rome:   max(0, 0.10 - 0.10) = 0    ← đã đủ
Sau khi chuẩn hóa residual, tỷ lệ Paris sẽ là 100%. Mọi lượt reject đều được tự động sửa thành Paris.
Kết quả cuối cùng:
Paris:  500 + 100 = 600  ✓
London: 300              ✓
Rome:   100              ✓
Toàn bộ thuật toán (algorithm) cho một token
Thuật toán tổng thể sẽ diễn ra như sau:
1. Draft tạo distribution q
2. Sample candidate x từ q
3. Target tạo distribution p
4. Tính: accept_prob = min(1, p(x)/q(x))
5. Sinh random u trong khoảng [0,1]
6. Nếu u ≤ accept_prob:
       output x
   Nếu u > accept_prob:
       sample correction từ normalize(max(0, p-q))
       output correction
Với cách thiết kế này, dù đi qua nhánh accept hay reject thì output cuối cùng vẫn luôn giữ đúng phân phối p.
Áp dụng thuật toán
Giả sử draft sinh ra chuỗi 4 token:
D1, D2, D3, D4
Kèm theo phân phối draft tại từng vị trí:
q1, q2, q3, q4
Sau một lượt kiểm tra (pass), target trả về phân phối:
p1, p2, p3, p4
Quá trình kiểm tra sẽ tiến hành từ trái sang phải:
- Vị trí 1: Tính khả năng accept của D1 bằng công thức
min(1, p1(D1)/q1(D1)). Nếu hệ thống đồng ý accept, ta chuyển sang xét vị trí 2. - Vị trí 2: Vì D1 đã được accept, cả target và draft hiện đang xử lý trên cùng một prefix. D2 sẽ được tính tỷ lệ accept tương tự.
- Vị trí 3: Nếu hệ thống reject D3, nó sẽ trích xuất sample correction từ residual, đồng thời tự động hủy cả D3 và D4, chính thức kết thúc vòng kiểm tra này.
- Nếu cả 4 token đều được accept: Do lượt kiểm tra từ target vẫn còn lưu trữ kết quả phân phối sau D4, hệ thống có thể lấy thêm 1 bonus token trực tiếp từ target. Một vòng xử lý nhờ đó có thể tạo ra tối đa 5 token (4 từ draft cộng 1 bonus).
Ý tưởng phác thảo rồi kiểm duyệt (draft-then-verify) dành riêng cho phương pháp greedy đã từng xuất hiện trước đây. Một trong những công trình tiêu biểu là Blockwise Parallel Decoding của nhóm tác giả Stern, Shazeer, Uszkoreit tại hội nghị NeurIPS 2018.
Cách xử lý với greedy khá cơ bản:
Draft = target argmax → accept
Khác → reject
Tuy nhiên, điểm mới mẻ trong những bài báo năm 2022-2023 không chỉ nằm ở việc vận dụng model nhỏ để đề xuất token. Điểm đột phá thực sự chính là:
Chúng ta có thể tận dụng lại mẫu sinh ra từ model nhỏ, loại bỏ khi sai và bổ sung đúng mức tỷ lệ (probability) còn thiếu. Bằng cách đó, toàn bộ output vẫn giữ nguyên tính chuẩn xác so với phân phối của model lớn, kể cả khi dùng phương pháp lấy mẫu ngẫu nhiên (stochastic sampling).
Các biến thể
Phiên bản speculative decoding nguyên bản hoạt động tốt nhưng vẫn tồn tại nhiều giới hạn. Từ năm 2023 đến giữa năm 2026, hàng chục biến thể đã ra đời để khắc phục từng điểm yếu cụ thể.
Vấn đề 1: Model nhỏ phải tự hiểu lại toàn bộ context
Đây là vấn đề lớn nhất và nhóm biến thể giải quyết vấn đề này cũng đóng vai trò quan trọng nhất hiện tại, tiêu biểu là EAGLE.
Trong speculative decoding nguyên bản, draft model là một LLM nhỏ hoàn toàn độc lập. Việc nó phải tự đọc và hiểu lại toàn bộ bối cảnh thông qua các layer riêng gây lãng phí lớn về thời gian và bộ nhớ.
Vấn đề là target model đã chạy rồi. Nó đã xử lý prefix qua 32 layer và tạo ra các hidden state chứa đầy đủ thông tin context. Vậy tại sao drafter không tận dụng luôn nguồn thông tin đó thay vì phải tính toán lại từ đầu?
Đó chính là ý tưởng cốt lõi của EAGLE (Efficient Adaptive Generation via Leveraged hidden-state Estimation).
Cơ chế hoạt động của EAGLE
Hãy quay lại khái niệm hidden state ở Phần I. Khi target xử lý token "I" qua 32 layer, nó tạo ra một hidden state chuẩn xác h_I dưới dạng vector 4096 số chứa toàn bộ thông tin bối cảnh.
Target dùng h_I để dự đoán token tiếp theo:
h_I
 ↓
LM head
 ↓
" love" (80%), " am" (7%), " think" (5%), ...
 ↓
Chọn " love"
Thông thường, để biết token đứng ngay sau " love", target bắt buộc phải chạy " love" qua toàn bộ 32 layer:
embedding(" love") + KV cache("I")
        ↓
32 Transformer layers
        ↓
h_love (exact hidden state)
        ↓
LM head
        ↓
" coffee" (65%), " tea" (15%), ...
Bước này rất tốn kém, mất khoảng 20ms cho mỗi token.
EAGLE thay thế bước này bằng cách sử dụng:
h_I (exact hidden state target đã tạo)
+
embedding(" love") (token vừa được chọn)
        ↓
MỘT draft decoder layer nhỏ
        ↓
ĥ_love (bản ước lượng hidden state)
        ↓
Chính LM head của target
        ↓
candidate " coffee"
EAGLE tạo ra một vector ẩn gần đúng (ĥ_love), sau đó dùng chính LM head của target để biến vector đó thành xác suất dự đoán token.
Ký hiệu ĥ dùng để chỉ bản ước lượng. EAGLE đoán hidden state mà target có khả năng sẽ tạo ra, dù độ chính xác không đạt mức 100%.
Tại sao EAGLE cần cả hidden state và token embedding?
Từ điểm xuất phát h_I, target có thể chọn ra nhiều token khác nhau:
"I love" (nếu chọn " love")
"I am"   (nếu chọn " am")
"I think" (nếu chọn " think")
Phần văn bản nối tiếp (continuation) trong tương lai phụ thuộc hoàn toàn vào việc token nào thực sự được chọn. Nếu chỉ cung cấp h_I cho EAGLE mà giấu đi token được chọn, hệ thống sẽ không biết phải rẽ theo nhánh nào.
h_I:              chứa thông tin "context trước token mới"
embedding(" love"): cho biết "token nào vừa thực sự được chọn"
EAGLE kết hợp cả hai yếu tố này để ước lượng hidden state tiếp theo một cách chuẩn xác hơn.
Cách EAGLE sinh ra chuỗi token
Sau bước đầu tiên để có được ĥ_love và candidate " coffee", EAGLE tiếp tục quy trình:
ĥ_love + embedding(" coffee")
        ↓
EAGLE decoder
        ↓
ĥ_coffee
        ↓
LM head
        ↓
candidate "."
Và tiếp tục với:
ĥ_coffee + embedding(".")
        ↓
EAGLE decoder
        ↓
ĥ_dot
        ↓
LM head
        ↓
candidate tiếp theo
EAGLE vẫn giữ bản chất autoregressive nên cần nhiều draft pass. Điểm khác biệt là mỗi pass chỉ chạy qua một draft layer nhỏ thay vì toàn bộ 32 target layer.
EAGLE pass 1 → ĥ_love   → " coffee"   (~0.3ms)
EAGLE pass 2 → ĥ_coffee → "."         (~0.3ms)
EAGLE pass 3 → ĥ_dot    → next        (~0.3ms)
ĥ_love chỉ là một bản ước lượng nên nó có thể khác với h_love thực tế.
Nếu sự khác biệt nằm trong phạm vi cho phép:
LM_head(h_love)  → " coffee"
LM_head(ĥ_love)  → " coffee"
→ Candidate đúng
Nếu sự khác biệt quá lớn:
LM_head(h_love)  → " coffee"
LM_head(ĥ_love)  → " tea"
→ Candidate sai → target verify bắt lỗi → reject " tea", dùng " coffee"
Giống như mọi biến thể speculative decoding khác, mọi lỗi sai đều sẽ bị bắt lại.
Từ EAGLE đến EAGLE-3: Loại bỏ feature regression
EAGLE nguyên bản đặt ra yêu cầu khá khắt khe:
draft output ĥ phải gần với exact target feature h
Cách làm này được gọi là feature regression vì nó ép drafter phải tạo ra một vector giống hệt target.
EAGLE-3 nhận ra rằng mục tiêu thực sự không phải là việc tái tạo chính xác hidden state. Mục tiêu duy nhất là:
LM head(draft state) → dự đoán đúng target token
Draft state không bị bắt buộc phải giống hệt exact target feature. Nó chỉ cần tạo ra đúng xác suất token khi đi qua LM head là đủ.
EAGLE-3 còn bổ sung một cải tiến khác. Thay vì chỉ sử dụng top-layer feature, nó thu thập hidden state từ nhiều layer khác nhau (low, mid, high) rồi kết hợp (fuse) lại:
low-layer feature   l
mid-layer feature   m
high-layer feature  h
        ↓ concatenate
FC projection
        ↓
fused feature g
Mỗi layer chứa một loại thông tin khác nhau. Ví dụ layer đầu nắm bắt cú pháp, layer giữa xử lý ngữ nghĩa và layer cuối có nhiệm vụ tổng hợp. EAGLE-3 tận dụng toàn bộ lượng thông tin này.
Vấn đề 2: EAGLE vẫn cần quá nhiều draft pass tuần tự
Dù mỗi pass của EAGLE-3 rất rẻ, việc sinh ra 7 draft token vẫn đòi hỏi 7 pass tuần tự:
pass 1 → D1
pass 2 → D2
...
pass 7 → D7
Để khắc phục, một hướng đi mới đã xuất hiện: tạo ra toàn bộ draft token trong một pass duy nhất thông qua parallel drafting.
Tại sao chúng ta có thể làm song song (parallel)?
Quay lại nhận xét ở Phần 2 cơ chế attention không ép buộc quá trình sinh text (generation) phải diễn ra tuần tự. Thứ thực sự tạo ra tính tuần tự bắt buộc là vòng lặp phản hồi (feedback loop):
model output → sample token → token embedding mới → model chạy tiếp
Parallel drafter loại bỏ hoàn toàn vòng lặp đó. Thay vì chờ đợi kết quả token D1 rồi mới bắt đầu tính D2, hệ thống đặt các biến tạm (placeholder) vào vị trí của D2:
Position 1: [anchor embedding, target context]  ← dữ liệu đã biết
Position 2: [MASK embedding, learned hidden]     ← biến tạm
Position 3: [MASK embedding, learned hidden]     ← biến tạm
Position 4: [MASK embedding, learned hidden]     ← biến tạm
Vector MASK embedding không phải là token tương lai thật mà chỉ là một dạng đại diện được drafter học hỏi trong quá trình huấn luyện.
Cả 4 vị trí này sẽ đi qua drafter cùng một lúc:
4 input positions
        ↓
Lightweight draft layers xử lý trong một forward pass
        ↓
4 output states
        ↓
LM head
        ↓
[D1, D2, D3, D4]
Dĩ nhiên, sự đánh đổi ở đây là D2 không thể biết D1 thực sự được chọn là gì vì D1 chưa được lấy mẫu (sample) khi D2 đang được tính. Token càng nằm xa anchor thì khả năng đoán sai càng cao.
Nhờ thiết kế này, mọi draft layer đều có thể truy cập thẳng vào target context chứ không chỉ riêng layer đầu tiên.
Vấn đề 3: Làm sao khi không muốn train drafter?
Các biến thể vừa nhắc tới (như EAGLE hay P-EAGLE) đều đòi hỏi phải huấn luyện drafter, hoặc ít nhất cũng cần một model nhỏ đi kèm như phiên bản gốc. Vậy nếu chúng ta không muốn huấn luyện thêm bất cứ thứ gì thì sao?
Phương pháp Prompt Lookup Decoding (PLD) hoặc n-gram matching ra đời nhằm tìm kiếm các đoạn văn bản (continuation) đã từng xuất hiện trong prompt ban đầu hoặc các output trước đó.
Lấy ví dụ, giả sử prompt chứa đoạn mã cũ sau:
function calculateTotal(items) {
    let total = 0;
    for (const item of items) {
        total += item.price;
    }
    return total;
}
Khi yêu cầu output sửa lại đoạn function này để thêm tính thuế (tax), hệ thống sẽ chủ động dò tìm phần token trùng lặp giữa output đang sinh và phần prompt. Sau đó, nó tự động đề xuất phần tiếp theo bởi vì thông thường output sẽ sao chép phần lớn nội dung code cũ.
prefix matching trong prompt/output history
        ↓
candidate continuation
        ↓
target verify
Hệ thống hoàn toàn không dùng neural drafter. Nhờ đó, máy chủ không tốn tài nguyên huấn luyện, không gánh thêm GPU weights và không tốn bộ nhớ.
Cách làm này tỏ ra đặc biệt hiệu quả trong các tác vụ như chỉnh sửa code, tóm tắt nội dung hay viết lại câu, nơi phần output chủ yếu dựa trên input.
Tuy nhiên, nó lại khá yếu trong các đoạn chat mở (open-ended) vì câu trả lời thường không liên quan nhiều đến input ban đầu
Vấn đề 4: Gánh nặng khi giữ thêm model riêng và hướng đi Self-speculative decoding
Thay vì phải gánh thêm một model nhỏ bên ngoài, một hướng tiếp cận khác là dùng chính target model nhưng chạy với số lượng layer ít hơn.
Với phương pháp LayerSkip, hệ thống dùng model 32 layer nhưng chỉ chạy draft bằng 8 layer đầu tiên:
Draft:
  Layer 1 → ... → Layer 8 → LM head → draft token

Verify:
  Lấy Hidden state từ layer 8 của draft tokens
  → Layer 9 → ... → Layer 32 → LM head → target prediction
Tuy nhiên, bản chất các hidden state ở layer 8 vốn không được thiết kế để chạy thẳng qua LM head. Vì vậy, LayerSkip phải thay đổi lại cả công thức huấn luyện:
- Layer dropout: Trong lúc huấn luyện, hệ thống sẽ ngẫu nhiên bỏ qua một số layer. Việc này ép model phải học cách hoạt động ổn định kể cả khi thiếu vài layer ở khúc sau.
- Early-exit loss: Bổ sung hàm loss tại các layer trung gian để LM head có thể quen với việc đọc hiểu hidden state từ nhiều độ sâu khác nhau chứ không chỉ dựa dẫm vào layer cuối.