Sơ lược
CUDA là một nền tảng tính toán song song và mô hình lập trình do NVIDIA phát triển. Nền tảng này cho phép gia tăng đáng kể hiệu suất tính toán bằng cách khai thác sức mạnh của bộ xử lý đồ họa (GPU). CUDA cho phép dev viết chương trình tăng tốc các ứng dụng tiêu tốn nhiều tài nguyên tính toán bằng cách sử dụng các ngôn ngữ lập trình phổ biến như C, C++, và Fortran
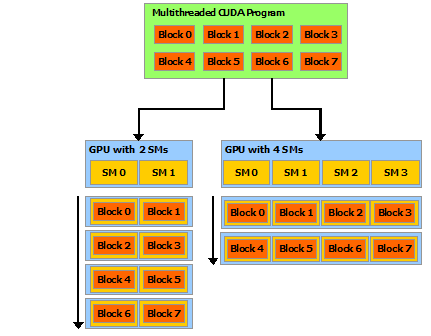
Ngôn ngữ CUDA C mở rộng ngôn ngữ lập trình ANSI C phổ biến với một lượng tối thiểu các cú pháp mới và các hàm thư viện. Như tên gọi của nó, CUDA C được xây dựng trên nền tảng CUDA của NVIDIA. Hiện nay, CUDA là framework phổ biến nhất cho tính toán song song khối lượng lớn, được sử dụng rộng rãi trong ngành tính toán hiệu năng cao (HPC) với các công cụ thiết yếu như trình biên dịch, trình gỡ lỗi và trình phân tích hiệu năng có sẵn trên các hệ điều hành phổ biến nhất.
Cấu trúc của một chương trình CUDA C phản ánh sự cùng tồn tại của một máy chủ (host) chính là CPU và một hoặc nhiều thiết bị (devices) chính là các GPU trong máy tính. Mỗi tệp mã nguồn CUDA C có thể chứa hỗn hợp cả mã cho máy chủ (host code) và mã cho thiết bị (device code).
- Theo mặc định, bất kỳ chương trình C truyền thống nào cũng là một chương trình CUDA chỉ chứa mã máy chủ.
- Ta có thể thêm mã thiết bị vào bất kỳ tệp nguồn nào. Mã thiết bị được đánh dấu rõ ràng bằng các từ khóa CUDA C đặc biệt.
- Mã thiết bị bao gồm các hàm, hay còn gọi là các kernel, mã của chúng được thực thi theo cách thức song song dữ liệu.

Như hình trên ta thấy quá trình bắt đầu với mã máy chủ (mã tuần tự trên CPU).
- Khi một hàm kernel được gọi, một số lượng lớn các luồng (threads) sẽ được kích hoạt (launched) trên một thiết bị để thực thi kernel đó.
- Tất cả các luồng được kích hoạt bởi một lần gọi kernel được gọi chung là một lưới (grid). Những luồng này là phương tiện thực thi song song chính trong nền tảng CUDA.
- Khi tất cả các luồng của một lưới đã hoàn thành việc thực thi, lưới đó sẽ kết thúc và việc thực thi tiếp tục trên máy chủ cho đến khi một lưới khác được kích hoạt.
Đây là một mô hình đơn giản hóa, trong đó việc thực thi của CPU và GPU không chồng chéo lên nhau. Nhiều ứng dụng tính toán không đồng nhất thực tế sẽ quản lý việc thực thi chồng chéo giữa CPU và GPU để tận dụng tối đa sức mạnh của cả hai.
Một kernel cộng vectơ (vector addition)
Bản CPU
Ta sử dụng phép cộng vectơ để minh họa cấu trúc chương trình CUDA C. Cộng vectơ là phép tính song song dữ liệu đơn giản nhất có thể – tương đương với chương trình “Hello World” của lập trình tuần tự. Trước khi xem mã kernel, ta hãy xem xét hàm cộng vectơ truyền thống (chạy trên CPU).
Mục tiêu: Cho hai vector A, B có kích thước n phần tử. Ta cần tính tổng từng phần tử của hai vector và cho kết quả ở vector C, với C[i] = A[i] + B[i] cho mọi 0 ≤ i < n.
Ví dụ:
n = 3
Vector A: 1 2 3
Vector B: 4 5 6
Vector C: 5 7 9
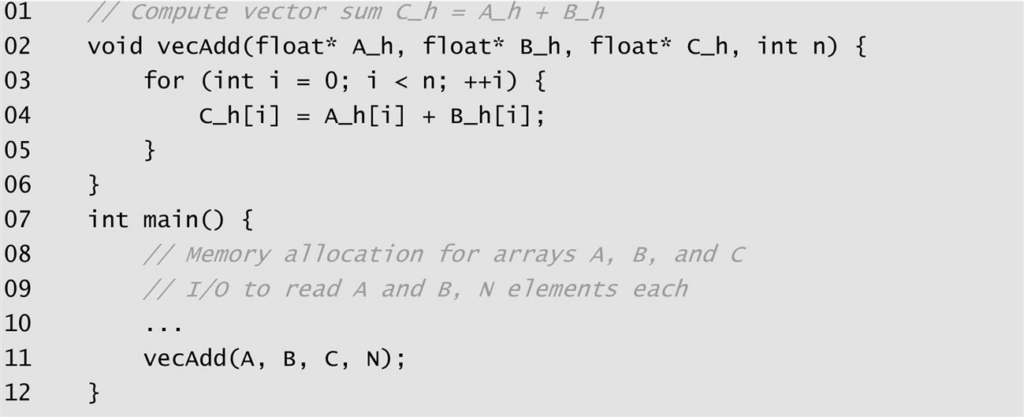
Hình trên cho thấy một chương trình C đơn giản gồm hàm main và hàm cộng vectơ vecAdd.
Quy ước đặt tên: Trong tất cả các ví dụ, khi cần phân biệt giữa dữ liệu của máy chủ và thiết bị, ta sẽ thêm hậu tố _h (CPU) cho các biến dùng bởi máy chủ và _d cho các biến dùng bởi thiết bị (GPU).
Như đã thảo luận ở phần 2, các tham số số của hàm vecAdd – A, B và C là các con trỏ.
- Tại đây ở phần comment // Memory allocation for arrays A, B, and C thì ta sẽ khởi tạo các mảng phần tử A, B, C. Sau đó, khi truyền tham số vào vecAdd, ta đang truyền 1 con trỏ với cú pháp
float *A_h
- Ôn tập: Một mảng trong chương trình C có thể được truy cập thông qua một con trỏ trỏ đến phần tử thứ 0 của nó. Ví dụ, câu lệnh
P=&(A[0])làm cho P trỏ đến phần tử thứ 0 của mảng A. Lúc nàyP[i]tương đương vớiA[i]. Thực tế, chính tên mảng A cũng là một con trỏ trỏ đến phần tử thứ 0 của nó. (Có thể xem lại bài 2)
Trong hình, việc truyền tên mảng A vào hàm vecAdd làm cho tham số đầu tiên A_h của hàm trỏ đến phần tử thứ 0 của A. Kết quả là A_h[i] trong thân hàm có thể truy cập vào A[i] của hàm main.
Hàm vecAdd trong hình sử dụng một vòng lặp for để duyệt qua các phần tử của vectơ. Ở lần lặp thứ i, phần tử đầu ra C_h[i] nhận giá trị tổng của A_h[i] và B_h[i]. Tham số độ dài vectơ n được dùng để điều khiển vòng lặp.
Bản CPU
Giờ ta hãy xem cách để thực thi cộng vectơ song song, cụ thể ta sẽ sửa đổi hàm vecAdd và chuyển các tính toán của nó sang một thiết bị. Cấu trúc của hàm vecAdd đã sửa đổi được trình bày trong ảnh dưới
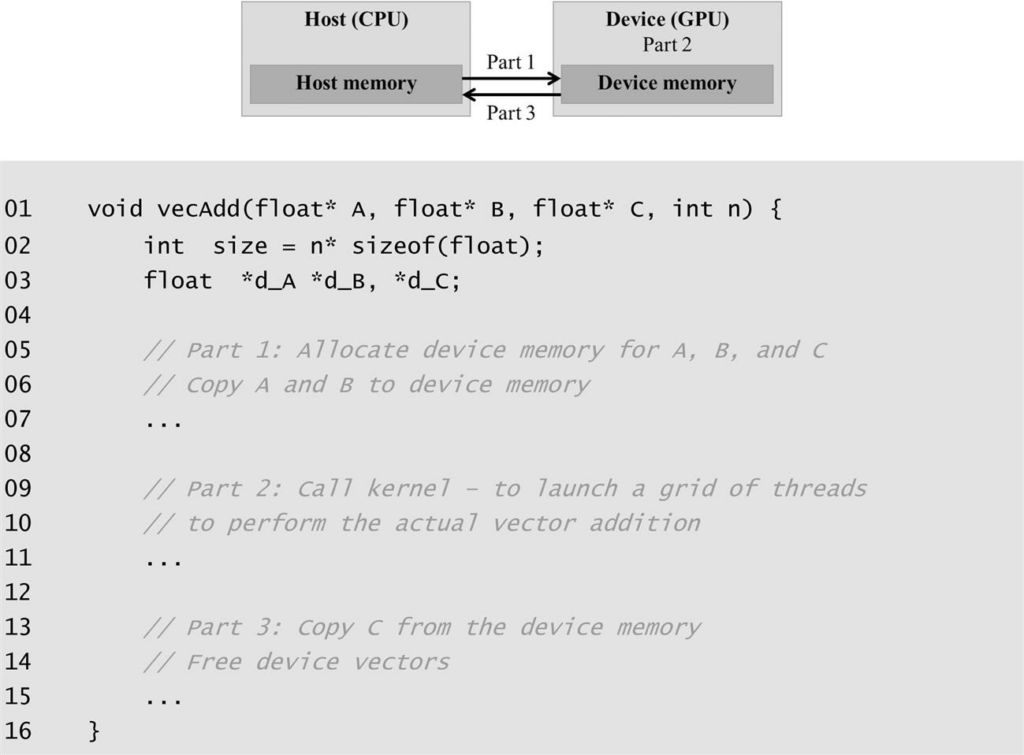
- Phần 1: Cấp phát không gian trong bộ nhớ thiết bị (GPU) để chứa các bản sao của các vectơ A, B và C, sau đó sao chép vectơ A và B từ bộ nhớ máy chủ sang bộ nhớ thiết bị.
- Phần 2: Gọi kernel cộng vectơ thực sự để kích hoạt một lưới các luồng trên thiết bị.
- Phần 3: Sao chép vectơ tổng C từ bộ nhớ thiết bị về bộ nhớ máy chủ và giải phóng bộ nhớ của ba mảng này trên thiết bị.
Bộ nhớ toàn cục của thiết bị và truyền dữ liệu
Trong các hệ thống CUDA hiện nay, các thiết bị (GPU) thường là các bảng mạch phần cứng đi kèm với bộ nhớ truy cập ngẫu nhiên động (DRAM) riêng biệt (hay còn gọi là VRAM của GPU), được gọi là bộ nhớ toàn cục của thiết bị (device global memory), hoặc gọi ngắn gọn là bộ nhớ toàn cục.
Ví dụ: NVIDIA Volta V100 đi kèm với 16GB hoặc 32GB bộ nhớ toàn cục.
Việc gọi đây là bộ nhớ “toàn cục” nhằm phân biệt nó với các loại bộ nhớ thiết bị khác mà lập trình viên cũng có thể truy cập được
Đối với kernel cộng vectơ, trước khi gọi kernel, thực tế ta thực hiện các bước sau
- Cấp phát không gian trong bộ nhớ toàn cục của thiết bị (GPU).
- Truyền dữ liệu từ bộ nhớ máy chủ (CPU) sang không gian đã cấp phát đó.
Tương tự, sau khi thiết bị thực thi xong, ta cần:
- Giải phóng không gian bộ nhớ toàn cục đã cấp phát khi không còn cần thiết.
- Truyền dữ liệu kết quả từ bộ nhớ toàn cục của thiết bị trở lại bộ nhớ máy chủ
Khi ta nói Host CPU sẽ có bộ nhớ riêng, thông thường trong một hệ thống máy tính, đó chính là Ram. Và các thiết bị (Device) GPU cũng sẽ có bộ nhớ riêng, hay thường được gọi là thông số VRAM của GPU. Thông thường thì GPU không thể sử dụng các biến trên bộ nhớ CPU (Ram) để làm việc (trừ 1 số ngoại lệ sẽ được thảo luận sau), vì vậy như ảnh sơ đồ một luồng cơ bản ban đầu, ta thường cần khởi tạo các biến tại máy chủ CPU trước, rồi copy dữ liệu sang GPU các dữ liệu cần dùng trong tính toán tại GPU, rồi sau khi tính toán xong, ta sẽ copy lại.
Hệ thống CUDA cung cấp các hàm API để thực hiện các hoạt động này thay cho lập trình viên. Thuật ngữ “truyền dữ liệu từ máy chủ sang thiết bị” sẽ được hiểu là sao chép dữ liệu từ bộ nhớ máy chủ (RAM của CPU) sang bộ nhớ toàn cục của thiết bị (VRAM của GPU).
Quản lý bộ nhớ: cudaMalloc và cudaFree
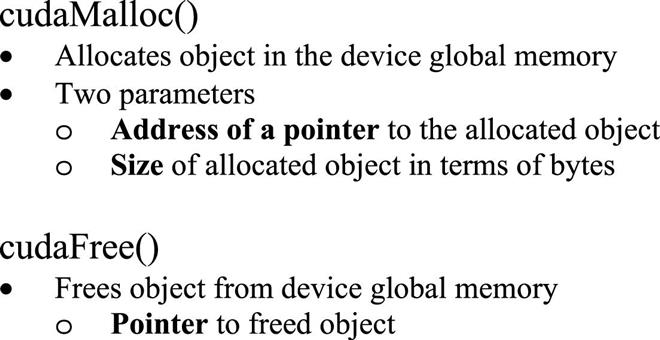
Hình trên giới thiệu hai hàm API dùng để cấp phát và giải phóng bộ nhớ toàn cục của thiết bị.
- cudaMalloc(): Có thể được gọi từ mã máy chủ để cấp phát một vùng bộ nhớ toàn cục cho một đối tượng. Hàm này có sự tương đồng rất lớn với hàm
malloccủa thư viện C tiêu chuẩn.- Tham số thứ nhất: Là địa chỉ của một biến con trỏ. Biến con trỏ này sẽ được thiết lập để trỏ đến đối tượng vừa được cấp phát. Địa chỉ của biến con trỏ phải được ép kiểu thành
(void **)vì hàm này mong đợi một con trỏ vạn năng (generic pointer). Điều này cho phépcudaMallocghi địa chỉ của vùng nhớ vừa cấp phát vào biến con trỏ của ta bất kể kiểu dữ liệu của nó là gì. - Tham số thứ hai: Xác định kích thước dữ liệu cần cấp phát, tính bằng số byte.
- Tham số thứ nhất: Là địa chỉ của một biến con trỏ. Biến con trỏ này sẽ được thiết lập để trỏ đến đối tượng vừa được cấp phát. Địa chỉ của biến con trỏ phải được ép kiểu thành
- cudaFree(): Giải phóng không gian lưu trữ khỏi bộ nhớ toàn cục. Nó chỉ cần giá trị của con trỏ (địa chỉ vùng nhớ cần giải phóng) làm đối số, do đó không cần truyền địa chỉ của con trỏ như
cudaMalloc.
Ví dụ minh họa:
float *A_d;
int size = n * sizeof(float);
cudaMalloc((void**)&A_d, size);
// ... thực hiện tính toán ...
cudaFree(A_d);Trong ví dụ này, ta dùng hậu tố _d cho con trỏ A_d để chỉ rõ nó trỏ đến một đối tượng trong bộ nhớ thiết bị. Khi cudaMalloc trả về, A_d sẽ chứa địa chỉ vùng nhớ trên GPU dành cho vectơ A. Lưu ý rằng khi tính toán size, ta phải chuyển đổi từ số lượng phần tử sang số byte (ví dụ: n phần tử kiểu float sẽ chiếm n lần 4 byte).
Các địa chỉ trong
A_d,B_d, vàC_dtrỏ đến các vị trí trong bộ nhớ toàn cục của thiết bị. Ta không được phép giải mã (dereference) các con trỏ này trong mã máy chủ (CPU). Việc truy cập trực tiếp nội dung con trỏ thiết bị từ CPU sẽ gây ra lỗi thực thi hoặc ngoại lệ hệ thống.
Truyền dữ liệu: cudaMemcpy
Sau khi đã cấp phát không gian trên thiết bị, ta cần chuyển dữ liệu vào đó. Hàm API thực hiện việc này là cudaMemcpy.
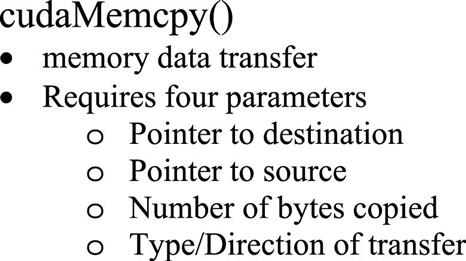
Hình trên mô tả hàm cudaMemcpy với bốn tham số:
- Đích (Destination): Con trỏ tới vị trí đích của đối tượng dữ liệu cần sao chép.
- Nguồn (Source): Con trỏ tới vị trí nguồn của dữ liệu.
- Kích thước (Size): Số byte cần sao chép.
- Loại truyền dẫn (Kind/Direction): Xác định các loại bộ nhớ liên quan:
cudaMemcpyHostToDevice: Từ máy chủ sang thiết bị.cudaMemcpyDeviceToHost: Từ thiết bị về máy chủ.cudaMemcpyDeviceToDevice: Giữa hai vị trí trong bộ nhớ thiết bị.cudaMemcpyHostToHost: Giữa hai vị trí trong bộ nhớ máy chủ.
Áp dụng vào ví dụ vecAdd: Ta thực hiện sao chép các vectơ A và B sang thiết bị trước khi tính toán, và sao chép kết quả C về máy chủ sau khi hoàn tất:
cudaMemcpy(A_d, A_h, size, cudaMemcpyHostToDevice);
cudaMemcpy(B_d, B_h, size, cudaMemcpyHostToDevice);
// ... (Gọi kernel thực hiện cộng vectơ ở đây) ...
cudaMemcpy(C_h, C_d, size, cudaMemcpyDeviceToHost);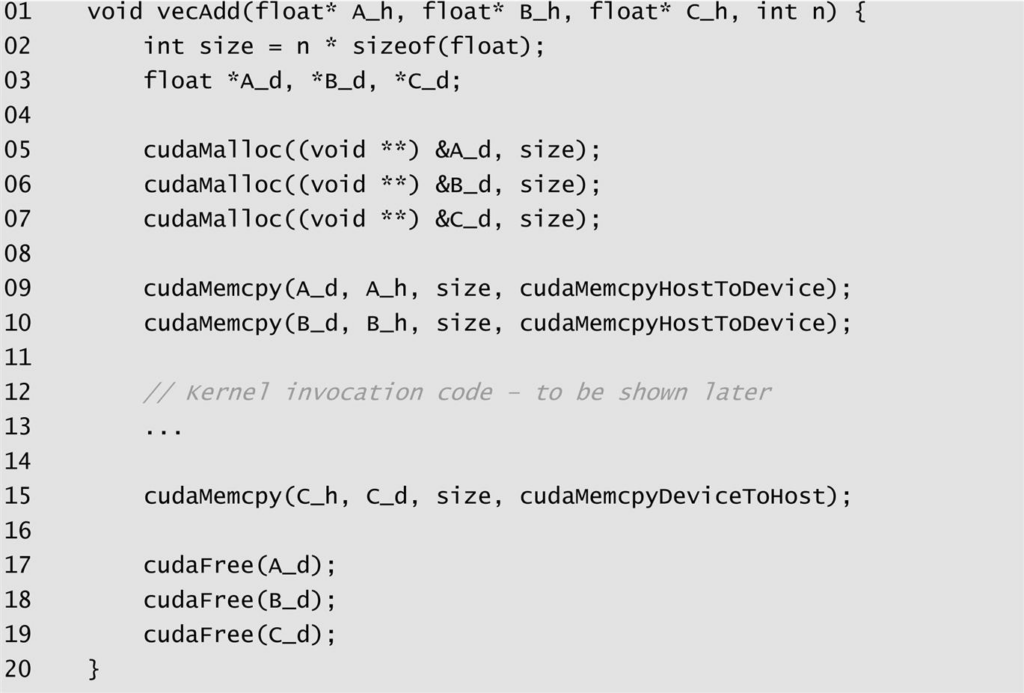
Tổng quan, chương trình hiện tại của ta có thể được thấy như sau, chỉ còn thiếu 1 phần gọi kernel để thực hiện việc tính toán.
Các hàm kernel và phân luồng
Trong CUDA C, một kernel là một hàm sẽ được thực thi song song bởi nhiều luồng trên thiết bị. Ta định nghĩa một kernel bằng cách thêm từ khóa khai báo hàm __global__ vào trước định nghĩa hàm.
Khi ta gọi một hàm __global__, nó sẽ được thực thi trên thiết bị. Một điểm đặc biệt là các hàm __global__ phải trả về kiểu void. Ta hãy xem xét ví dụ về kernel cộng vectơ trong hình sau:
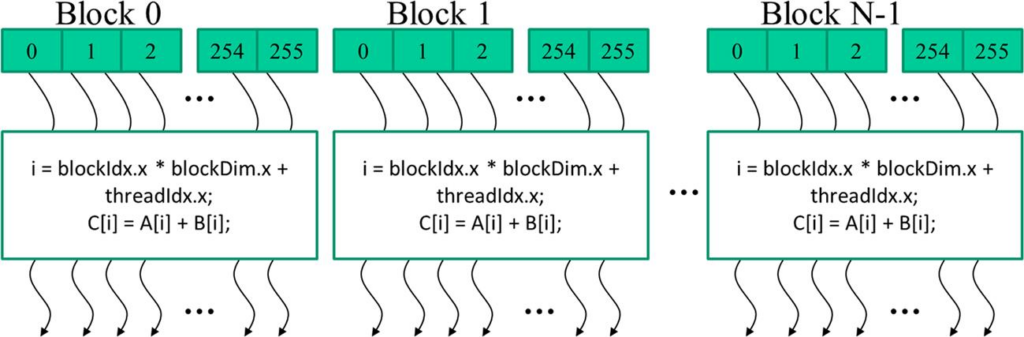
Hàm vecAddKernel trong hình trông rất giống với vòng lặp trong hàm vecAdd ở ví dụ CPU, nhưng có hai điểm khác biệt quan trọng:
- Từ khóa
__global__thông báo cho trình biên dịch rằng đây là một kernel. - Vòng lặp
forđã biến mất.
Tại sao vòng lặp lại biến mất? Đó là vì khi kernel này được kích hoạt, một lưới các luồng sẽ được tạo ra. Ta cấu trúc chương trình sao cho mỗi luồng trong lưới sẽ thực hiện một lần lặp của vòng lặp ban đầu. Để làm được điều này, mỗi luồng cần biết nó phải xử lý phần tử nào của các vectơ A, B và C.
Biến tích hợp và định danh luồng (Thread Identification)
CUDA C cung cấp các biến tích hợp sẵn (built-in variables) để giúp các luồng xác định danh tính của mình. Một trong những biến quan trọng nhất là threadIdx. Trong ví dụ đơn giản này, ta sử dụng threadIdx.x để lấy chỉ số của luồng trong một khối (block).
Câu lệnh sau trong kernel:
int i = threadIdx.x;
cho phép mỗi luồng tự gán cho mình một giá trị i khác nhau dựa trên chỉ số của nó. Nếu ta kích hoạt n luồng, thì luồng thứ 0 sẽ có i=0, luồng thứ 1 sẽ có i=1, và cứ tiếp tục cho đến luồng thứ n-1. Nhờ đó, mỗi luồng sẽ thực hiện phép cộng trên một cặp phần tử khác nhau của các vectơ:
if (i < n) C_d[i] = A_d[i] + B_d[i];
Câu lệnh if (i < n) là một biện pháp bảo vệ, Nó đảm bảo rằng nếu số lượng luồng được kích hoạt lớn hơn độ dài vectơ n, các luồng “thừa” sẽ không truy cập vào vùng nhớ ngoài phạm vi của mảng.
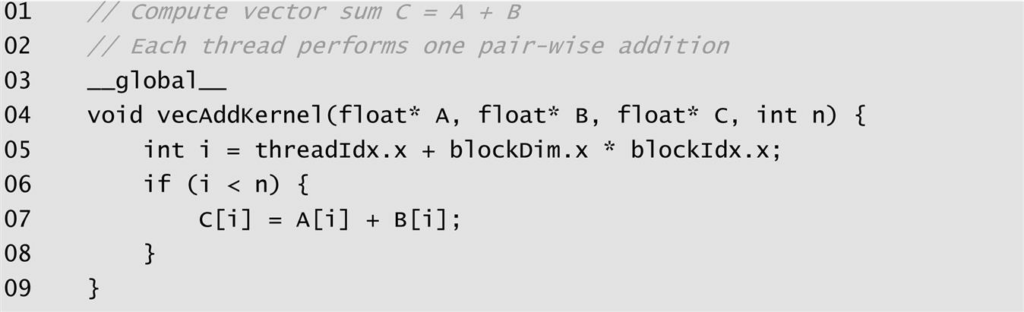
SPMD (Single Program, Multiple Data)
Mô hình thực thi này được gọi là SPMD (Một chương trình, nhiều dữ liệu). Tất cả các luồng đều thực thi cùng một mã nguồn (hàm kernel), nhưng mỗi luồng hoạt động trên một phần dữ liệu khác nhau dựa trên định danh của nó. Đây là cách CUDA khai thác tính song song dữ liệu trên quy mô lớn.
Gọi hàm kernel
Khi ta gọi một kernel từ mã máy chủ, ta cần cung cấp các tham số cấu hình thực thi. Các tham số này xác định số lượng luồng trong lưới sẽ được kích hoạt để thực thi kernel đó.
CUDA C sử dụng cú pháp ngoặc nhọn ba lớp <<< ... >>> để bao quanh các thông số này. Cú pháp tổng quát như sau:
tên_kernel<<<số_khối, số_luồng_mỗi_khối>>>(các_đối_số);
Trong ví dụ cộng vectơ, lệnh gọi kernel có dạng:
vecAddKernel<<<1, n>>>(A_d, B_d, C_d, n);
Ở đây, ta đang yêu cầu hệ thống kích hoạt 1 khối duy nhất chứa n luồng.
- Tham số thứ nhất (
1) xác định số lượng khối trong lưới. - Tham số thứ hai (
n) xác định số lượng luồng trong mỗi khối.
Khi lệnh gọi này được thực thi, môi trường chạy CUDA (runtime) sẽ tạo ra một lưới gồm n luồng trên thiết bị. Mỗi luồng sẽ thực thi mã của vecAddKernel với một giá trị threadIdx.x duy nhất từ 0 đến n-1.
Ta sẽ thảo luận sau cách sử dụng nhiều khối để xử lý các tập dữ liệu cực lớn vượt quá giới hạn số lượng luồng của một khối đơn lẻ.
Biên dịch (Compilation)
Quy trình biên dịch một chương trình CUDA C khác với chương trình C thông thường vì nó chứa cả mã chạy trên CPU (host) và mã chạy trên GPU (device).
- Trình biên dịch NVCC: NVIDIA cung cấp một trình biên dịch tên là
nvcc. Nó sẽ phân tách mã máy chủ và mã thiết bị trong tệp nguồn (thường có phần mở rộng là.cu). - Xử lý mã máy chủ: Mã máy chủ là mã C/C++ tiêu chuẩn, nó sẽ được gửi đến trình biên dịch C/C++ thông thường của hệ thống (như
gcctrên Linux hoặccl.exetrên Windows) để biên dịch và liên kết. - Xử lý mã thiết bị: Mã thiết bị (các hàm kernel và các hàm bổ trợ) sẽ được
nvccbiên dịch thành một dạng trung gian gọi là PTX (Parallel Thread Execution), hoặc trực tiếp thành mã máy nhị phân cho một kiến trúc GPU cụ thể. - Hợp nhất: Cuối cùng,
nvccsẽ chèn các lệnh cần thiết để nạp mã thiết bị vào GPU và kích hoạt kernel vào trong mã máy chủ, tạo ra một tệp thực thi duy nhất.
Khi ta chạy tệp thực thi này, phần mã máy chủ sẽ bắt đầu chạy trên CPU. Khi gặp lệnh gọi kernel, hệ thống sẽ sử dụng mã thiết bị đã được đóng gói sẵn để kích hoạt các luồng trên GPU.
Ta đã làm quen với những khái niệm nền tảng nhất của lập trình song song trên nền tảng CUDA. Dưới đây là những điểm quan trọng mà ta cần ghi nhớ để làm tiền đề cho các kỹ thuật tối ưu hóa phức tạp hơn:
- Song song hóa dữ liệu (Data Parallelism): Đây là chìa khóa để đạt được hiệu suất cao. Khi một công việc lớn có thể chia nhỏ thành các phần độc lập (như xử lý từng điểm ảnh hoặc từng phần tử vectơ), ta có thể tận dụng hàng nghìn lõi xử lý của GPU để thực thi chúng cùng lúc.
- Mô hình Máy chủ – Thiết bị (Host – Device): Một chương trình CUDA luôn có sự phân chia vai trò rõ rệt. CPU (Host) đóng vai trò điều khiển, quản lý luồng công việc, trong khi GPU (Device) đóng vai trò là bộ tăng tốc, thực thi các tác vụ tính toán nặng.
- Quản lý bộ nhớ: Ta đã học cách sử dụng các hàm API của CUDA để quản lý vòng đời của dữ liệu trên GPU:
cudaMalloc: Cấp phát không gian trên thiết bị.cudaMemcpy: Chuyển dữ liệu qua lại giữa RAM máy chủ và VRAM thiết bị.cudaFree: Giải phóng tài nguyên sau khi sử dụng.
- Kernel và Luồng (Threads): Kernel là hàm chạy trên GPU. Khi kích hoạt một kernel, ta không chỉ gọi một hàm đơn thuần mà là đang kích hoạt cả một lưới (grid) gồm rất nhiều luồng. Mỗi luồng sử dụng các biến như
threadIdxđể biết mình cần xử lý phần dữ liệu nào. - Mô hình SPMD: CUDA sử dụng mô hình “Một chương trình, nhiều dữ liệu”, giúp đơn giản hóa việc lập trình song song bằng cách viết một đoạn mã duy nhất nhưng cho phép hàng triệu luồng thực thi nó trên các vùng dữ liệu khác nhau.