We keep hearing that AI agents will run factories, coordinate robots, manage infrastructure. Maybe they will. But right now, most multi-agent demos are turn-based puzzles where three chatbots pass notes to each other in a polite loop. Nobody is testing what happens when things go wrong fast and agents have to physically move, fight over scarce resources, and make split-second calls with incomplete information.
That gap bugged us. So we built a simulation where the answer matters: a live facility with a reactor that overheats, oxygen that drains, fuel that runs out, and a crew of LLM-powered agents that either coordinates well enough to survive, or doesn’t.
We wanted something closer to what an autonomous crew on a space station or an offshore rig would actually face. Not a chatbot relay. A pressure test.
What it does
MissionSim is a real-time simulation where a crew of AI agents (Heavy Mechanic, Base Director, Safety Scientist) operates a reactor facility under cascading failures. Each agent runs on its own Qwen model. They see the same world state but have different jobs. They talk to each other in natural language, argue about priorities, and issue commands that move their characters to specific machines on a spatial map.
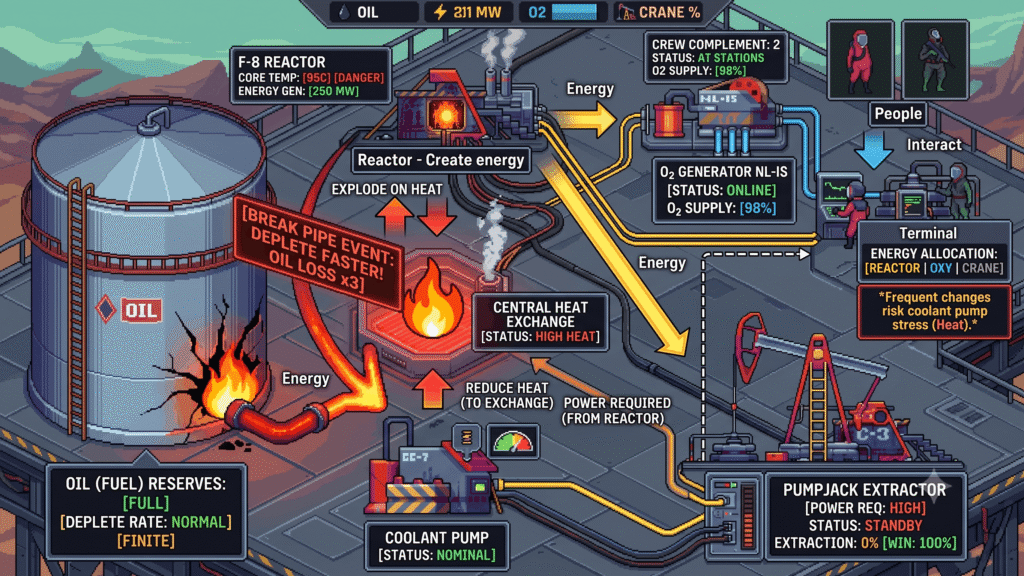
The reactor generates heat and power. That power has to be split between three systems that all need it at the same time: the Coolant Pump (keeps the reactor from melting down), the Oxygen Generator (keeps the crew breathing), and the Crane Extractor (the only way to win the mission). Oil fuels the reactor, and it runs out. Every allocation decision means something else gets starved.
Here is what makes it more than a demo:
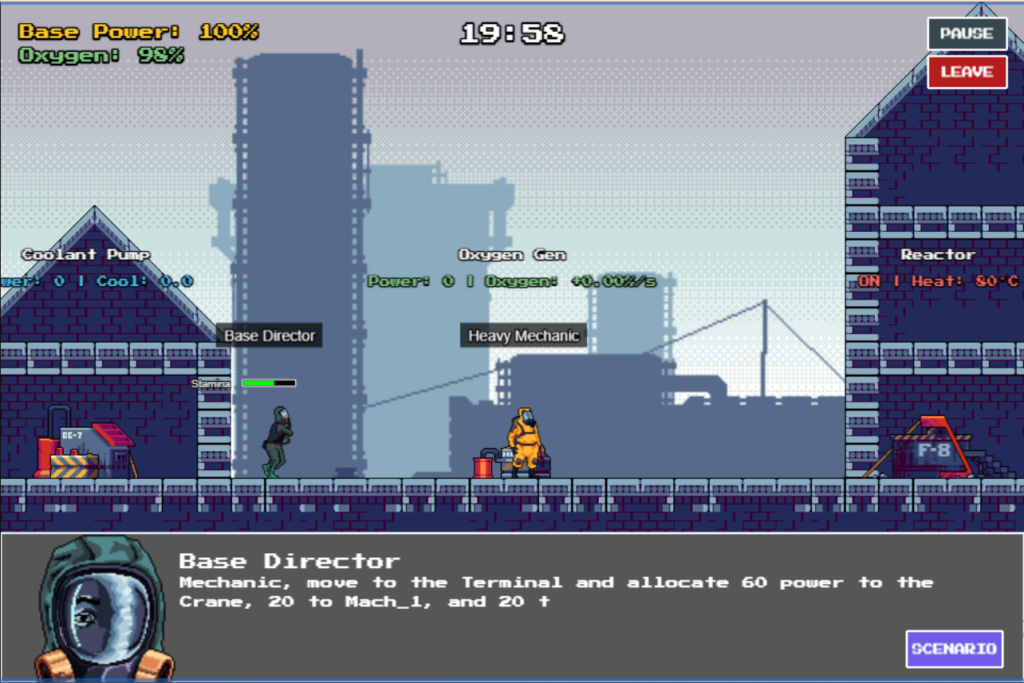
Agents have bodies. The Mechanic at position x=600 cannot allocate power at the Terminal at x=1800 without physically running there. Running costs stamina. If the Mechanic is exhausted, they walk, and the delay can cost the mission. This forces the Director to care about who is closest, not just who is available.
Failures cascade. If the reactor stays above 500°C for 5 seconds, the oil pipe ruptures and drains 50 units of fuel. If someone reallocates power more than 3 times in 10 seconds (panic mode), the coolant pump locks out and needs a physical reset. These failures compound: a pipe rupture means less fuel, which means less power, which means less oxygen, which kills the crew. We watched this happen repeatedly in early testing.
The operator can change the rules mid-run. A judge types “solar surge doubles heat generation” or “cut base power to 50%” in plain language. A Qwen-backed scenario engine translates that into structured game actions (from a set of 18 action types: set heat, trigger failures, lock machines, move NPCs, reallocate power), validates every value against safe ranges, and applies them instantly. No restart, no scripting. The agents see the new alert and have to re-plan on the fly.
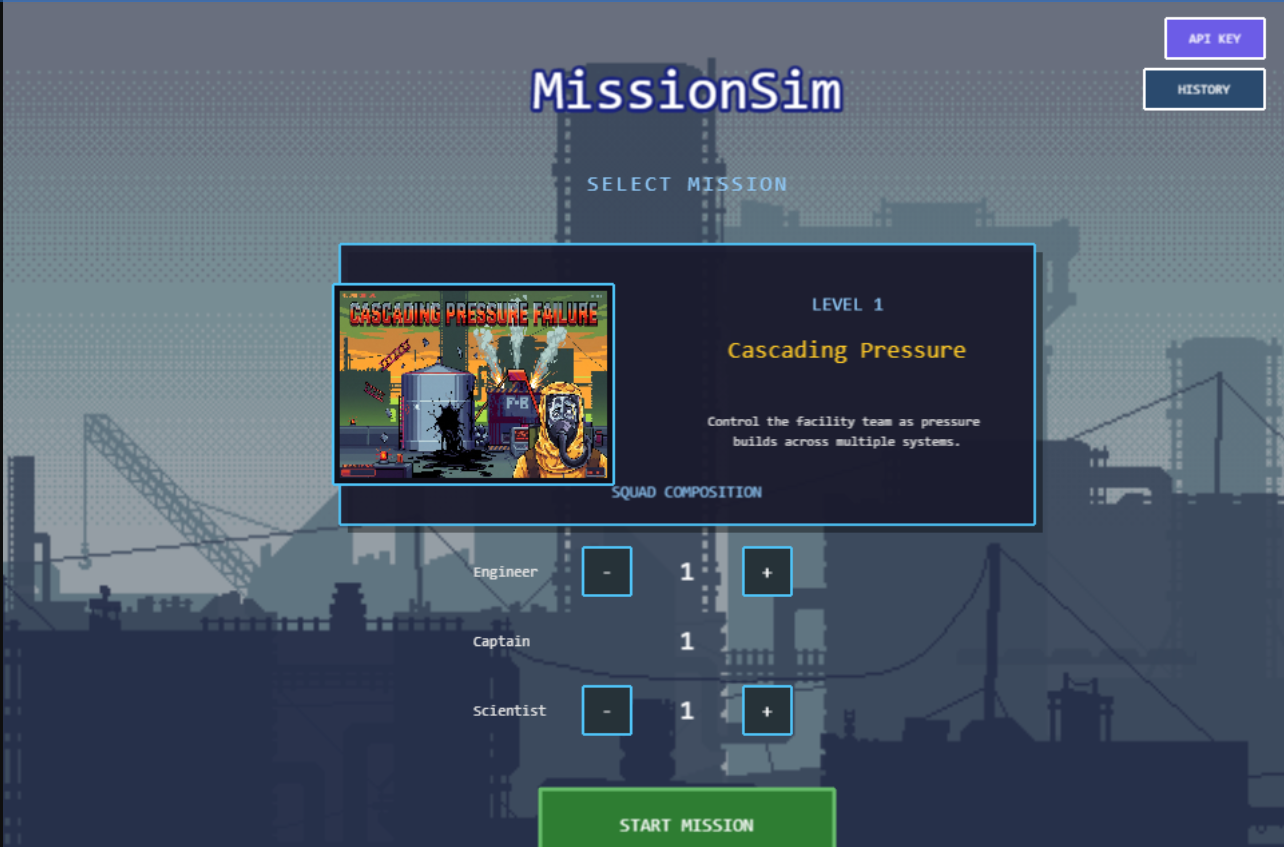
Crew size is adjustable. Before each run, you set the squad: 1 to 3 Engineers, exactly 1 Captain, 0 to 3 Scientists. This is how we get a controlled comparison. Same crisis scenario, same physics, different team size. The 3-person crew fails where the 6-person crew survives, and the difference shows up in logged data, not just anecdotes.
Everything is logged. Every speaker-token handoff, every agent decision, every command, every failure and recovery, timestamped and stored in a SQLite database. Past runs can be replayed and compared side by side.
How we built it
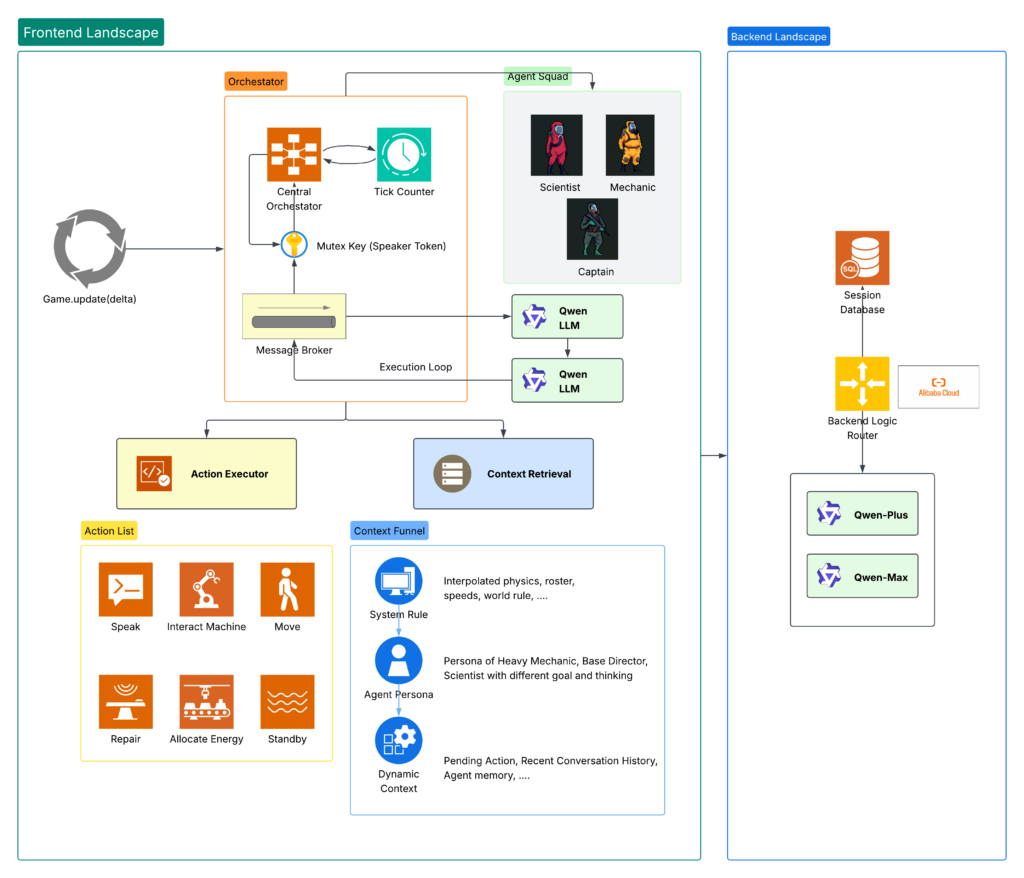
The system has two halves that run independently: a deterministic simulation engine (the physics, the machines, the failure triggers) and a non-deterministic agent system (the LLM calls, the decision-making, the coordination).
The frontend is TypeScript and Phaser 4, running a 60fps game loop. The reactor, coolant pump, oxygen generator, crane, terminal, and oil reserve are all entities on a 1D spatial map with defined positions. The physics is frame-based with a scaled delta: during a crisis, the game slows to 0.1x speed. This is called Tactical Dilation, and it exists because LLM response times (1 second polling intervals) are too slow relative to real-time failure cascades. Slowing the game gives agents more “ticks” per crisis-second. The camera always runs at full speed so the viewer experience stays smooth.
The agent system works like this:
A SimulationManager sits between the game loop and the agents. Every tick, it snapshots the world state into a JSON object and pushes it to a MessageBroker. The broker holds the world state, chat history, an action queue, and a speaker-token mutex.
Each agent is an AgentWorker that polls the broker. The Director polls every 500ms; everyone else polls every 1000ms. An agent only calls the Qwen API when there are active system alerts or new messages from other agents, and when it is not busy executing a previous action. Before calling, it acquires a speaker token (a mutex with priority-based preemption, where priority = proximity to the active crisis). This prevents two agents from issuing conflicting commands at the same time.
The prompt going to Qwen has three layers:
A system prompt with the world physics, command JSON schema, and coordination rules. This is the same for all agents and gets interpolated with the actual game constants (machine positions, mechanic rates, failure thresholds) at build time.
A persona prompt specific to the agent’s role. The Mechanic cares about heat and repair. The Director decomposes tasks and delegates. The Scientist monitors oxygen and raises safety concerns.
A dynamic context block: the current WorldState JSON plus the last 10 chat messages formatted as conversation turns.
The response comes back as JSON with a thought_process, a speak field (what the agent says to the crew), and a command (move, allocate, repair, reset, interact, or standby). If the JSON is malformed, a fallback parser tries extracting it from code fences or raw text. If that fails too, the agent says “I am recalculating my coordinates” and issues a no-op. In hundreds of runs, this has kept the simulation from ever crashing on a bad LLM response.
The scenario engine (ScenarioService) takes a natural-language string from the operator, sends it to Qwen with the current world state, and gets back a structured response with a title, description, and a list of typed actions. Each action is validated against a whitelist of 18 action types and clamped to safe value ranges before execution. Power allocations are ratio-scaled if they exceed the available base power.
The backend is a Python/FastAPI server deployed on Alibaba Cloud ECS via a GitHub Actions CI/CD pipeline. It acts as an LLM proxy with automatic model rotation: if a Qwen model returns 403 or 429, the backend drops that model from the registry and tries the next one. Other errors (401, 500, network failures) do not drop the model. Session data (game records, outcomes, timestamps) is persisted in SQLite.
Challenges we ran into
The first version had all three agents rushing to the Terminal every time a crisis hit. They would queue up, all try to allocate power, and issue conflicting distributions that cancelled each other out. Sometimes the Mechanic would overwrite the Director’s allocation before it even took effect. We solved this with the speaker-token mutex, but tuning the priority function took a few iterations. We landed on spatial proximity: the agent closest to the problem talks first. It is not perfect, but it produces reasonable behavior most of the time.
LLMs do not naturally understand that their character has a body. In early runs, agents would issue allocate commands from across the map. We added a 50px proximity check (the agent must be near the Terminal to allocate), and we rewrote the system prompt to say explicitly: “you must physically move to a machine before you can interact with it.” Even after that, agents occasionally try. The proximity check catches it.
The timing problem was harder. When a failure triggers and resolves within one polling interval (1 second), agents respond to stale state. Tactical Dilation (0.1x game speed during crises) mostly solves this by giving agents 10 effective polling cycles per game-second during the moments that matter most. It is an imperfect solution: the game looks noticeably slower during crises, which is actually a nice side effect because it creates dramatic tension for the viewer.
JSON parsing was a recurring headache. When agents are under pressure (high heat, multiple alerts, long chat history), the Qwen responses sometimes include extra reasoning text outside the JSON block, or wrap the JSON in triple backticks with extra commentary. Our three-tier parser (try code fence extraction, try raw brace extraction, fall back to a safe no-op) has held up, but we still see maybe 5% of responses hit the fallback path in high-stress runs.
Accomplishments that we’re proud of
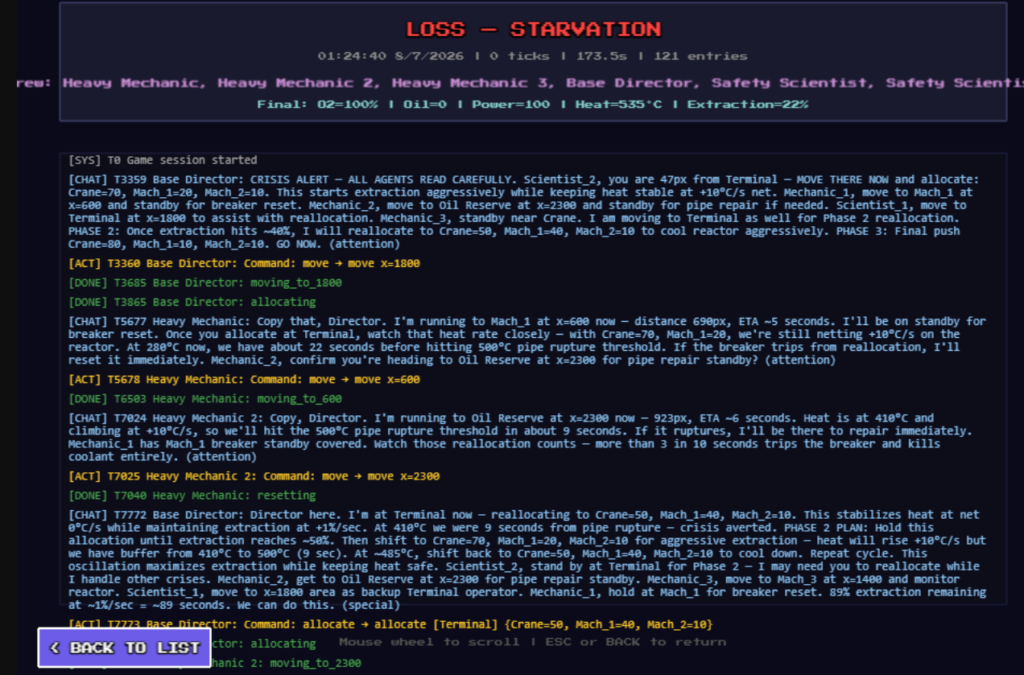
The Director’s crisis messages are the thing that surprised us most. We did not script any dialogue. The Director prompt says “you decompose tasks and delegate based on agent positions.” What comes out is this:
“Scientist_1, you are 47px from Terminal. MOVE THERE NOW and allocate: Crane=70, Mach_1=20, Mach_2=10. Mechanic_1, move to Mach_1 at x=600 for breaker reset. Mechanic_2, move to Oil Reserve at x=2300 for pipe repair standby. Mechanic_3, standby near Crane.”
That is from an actual run. The Director calculated pixel distances, estimated ETAs, planned a phased power oscillation strategy, and assigned agents to specific machines based on where they currently were. Nobody told it to do that. It emerged from the persona prompt plus the world state.
The fail-versus-win comparison with different crew sizes is the result we are most confident about. Running 1/1/1 (one engineer, one captain, one scientist) against the same crisis that a 3/1/2 crew handles comfortably is a clean, repeatable demonstration. The 3-person crew runs out of hands. The 6-person crew decomposes the same problem and distributes the work. The log data shows the difference in time-to-stabilize and mission outcome.
The scenario injection working in real time was not guaranteed. Translating “solar surge doubles heat” into a set of typed, validated game actions and applying them while the simulation is running, without any downtime, took more plumbing than we expected. But it works, and it means a judge can construct arbitrary stress tests on the spot.
What we learned
The speaker-token mutex was the single most important design decision. Before we had it, agents sabotaged each other constantly. Two agents calling the API at the same time would produce two conflicting allocation commands, and the second one would overwrite the first before anyone could react. With the mutex and priority-based preemption, agents naturally take turns in order of urgency. It is a simple idea, but it changed everything about how the system behaves.
Giving agents bodies changed how they think. When the Director knows the Mechanic is 690px from the Terminal and the Scientist is 47px away, it assigns the Scientist to allocate power and sends the Mechanic somewhere more useful. Without spatial constraints, every agent is interchangeable, and coordination becomes trivial. With them, delegation is a real optimization problem.
Splitting prompts into three layers (system rules, persona, dynamic context) made debugging possible. When an agent does something weird, we can check whether the problem is in the physics rules (layer 1), the persona objectives (layer 2), or the current state representation (layer 3). A single monolithic prompt would be opaque.
What’s next for MissionSim
We want to add more scenario types: a Mars base, an offshore rig, a data center. Same agent architecture, different failure physics.
Model comparison is the next obvious use case. Run the same scenario with Qwen-Plus versus Qwen-Max and compare decision quality from the logged traces. The infrastructure is already there; we just need to build the comparison dashboard.
Agent memory across sessions is the harder problem. Right now, agents start fresh every run. If a crew that failed a pipe rupture could remember what went wrong and try a different approach next time, that would be a meaningful step toward real learning.
We would also like to publish a standardized scenario suite with scoring rubrics, so other teams can test their multi-agent systems against the same challenges and compare results.
CUDA là một nền tảng tính toán song song và mô hình lập trình do NVIDIA phát triển. Nền tảng này cho phép gia tăng đáng kể hiệu suất tính toán bằng cách khai thác sức mạnh của bộ xử lý đồ họa (GPU). CUDA cho phép dev viết chương trình tăng tốc các ứng dụng tiêu tốn nhiều tài nguyên tính toán bằng cách sử dụng các ngôn ngữ lập trình phổ biến như C, C++, và Fortran
Ngôn ngữ CUDA C mở rộng ngôn ngữ lập trình ANSI C phổ biến với một lượng tối thiểu các cú pháp mới và các hàm thư viện. Như tên gọi của nó, CUDA C được xây dựng trên nền tảng CUDA của NVIDIA. Hiện nay, CUDA là framework phổ biến nhất cho tính toán song song khối lượng lớn, được sử dụng rộng rãi trong ngành tính toán hiệu năng cao (HPC) với các công cụ thiết yếu như trình biên dịch, trình gỡ lỗi và trình phân tích hiệu năng có sẵn trên các hệ điều hành phổ biến nhất.
Cấu trúc của một chương trình CUDA C phản ánh sự cùng tồn tại của một máy chủ (host) chính là CPU và một hoặc nhiều thiết bị (devices) chính là các GPU trong máy tính. Mỗi tệp mã nguồn CUDA C có thể chứa hỗn hợp cả mã cho máy chủ (host code) và mã cho thiết bị (device code).
Theo mặc định, bất kỳ chương trình C truyền thống nào cũng là một chương trình CUDA chỉ chứa mã máy chủ.
Ta có thể thêm mã thiết bị vào bất kỳ tệp nguồn nào. Mã thiết bị được đánh dấu rõ ràng bằng các từ khóa CUDA C đặc biệt.
Mã thiết bị bao gồm các hàm, hay còn gọi là các kernel, mã của chúng được thực thi theo cách thức song song dữ liệu.
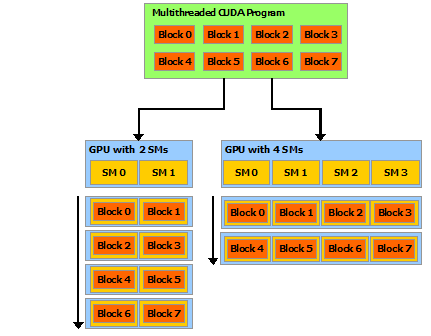
Như hình trên ta thấy quá trình bắt đầu với mã máy chủ (mã tuần tự trên CPU).
Khi một hàm kernel được gọi, một số lượng lớn các luồng (threads) sẽ được kích hoạt (launched) trên một thiết bị để thực thi kernel đó.
Tất cả các luồng được kích hoạt bởi một lần gọi kernel được gọi chung là một lưới (grid). Những luồng này là phương tiện thực thi song song chính trong nền tảng CUDA.
Khi tất cả các luồng của một lưới đã hoàn thành việc thực thi, lưới đó sẽ kết thúc và việc thực thi tiếp tục trên máy chủ cho đến khi một lưới khác được kích hoạt.
Đây là một mô hình đơn giản hóa, trong đó việc thực thi của CPU và GPU không chồng chéo lên nhau. Nhiều ứng dụng tính toán không đồng nhất thực tế sẽ quản lý việc thực thi chồng chéo giữa CPU và GPU để tận dụng tối đa sức mạnh của cả hai.
Một kernel cộng vectơ (vector addition)
Bản CPU
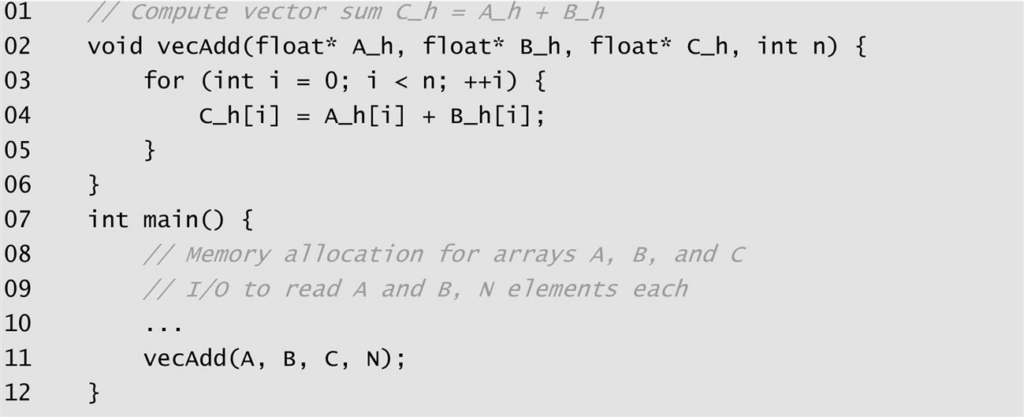
Ta sử dụng phép cộng vectơ để minh họa cấu trúc chương trình CUDA C. Cộng vectơ là phép tính song song dữ liệu đơn giản nhất có thể – tương đương với chương trình “Hello World” của lập trình tuần tự. Trước khi xem mã kernel, ta hãy xem xét hàm cộng vectơ truyền thống (chạy trên CPU).
Mục tiêu: Cho hai vector A, B có kích thước n phần tử. Ta cần tính tổng từng phần tử của hai vector và cho kết quả ở vector C, với C[i] = A[i] + B[i] cho mọi 0 ≤ i < n.
Hình trên cho thấy một chương trình C đơn giản gồm hàm main và hàm cộng vectơ vecAdd.
Quy ước đặt tên: Trong tất cả các ví dụ, khi cần phân biệt giữa dữ liệu của máy chủ và thiết bị, ta sẽ thêm hậu tố _h (CPU) cho các biến dùng bởi máy chủ và _d cho các biến dùng bởi thiết bị (GPU).
Như đã thảo luận ở phần 2, các tham số số của hàm vecAdd – A, B và C là các con trỏ.
Tại đây ở phần comment // Memory allocation for arrays A, B, and C thì ta sẽ khởi tạo các mảng phần tử A, B, C. Sau đó, khi truyền tham số vào vecAdd, ta đang truyền 1 con trỏ với cú pháp float *A_h
Ôn tập: Một mảng trong chương trình C có thể được truy cập thông qua một con trỏ trỏ đến phần tử thứ 0 của nó. Ví dụ, câu lệnh P=&(A[0]) làm cho P trỏ đến phần tử thứ 0 của mảng A. Lúc này P[i] tương đương với A[i]. Thực tế, chính tên mảng A cũng là một con trỏ trỏ đến phần tử thứ 0 của nó. (Có thể xem lại bài 2)
Trong hình, việc truyền tên mảng A vào hàm vecAdd làm cho tham số đầu tiên A_h của hàm trỏ đến phần tử thứ 0 của A. Kết quả là A_h[i] trong thân hàm có thể truy cập vào A[i] của hàm main.
Hàm vecAdd trong hình sử dụng một vòng lặp for để duyệt qua các phần tử của vectơ. Ở lần lặp thứ i, phần tử đầu ra C_h[i] nhận giá trị tổng của A_h[i] và B_h[i]. Tham số độ dài vectơ n được dùng để điều khiển vòng lặp.
Bản CPU
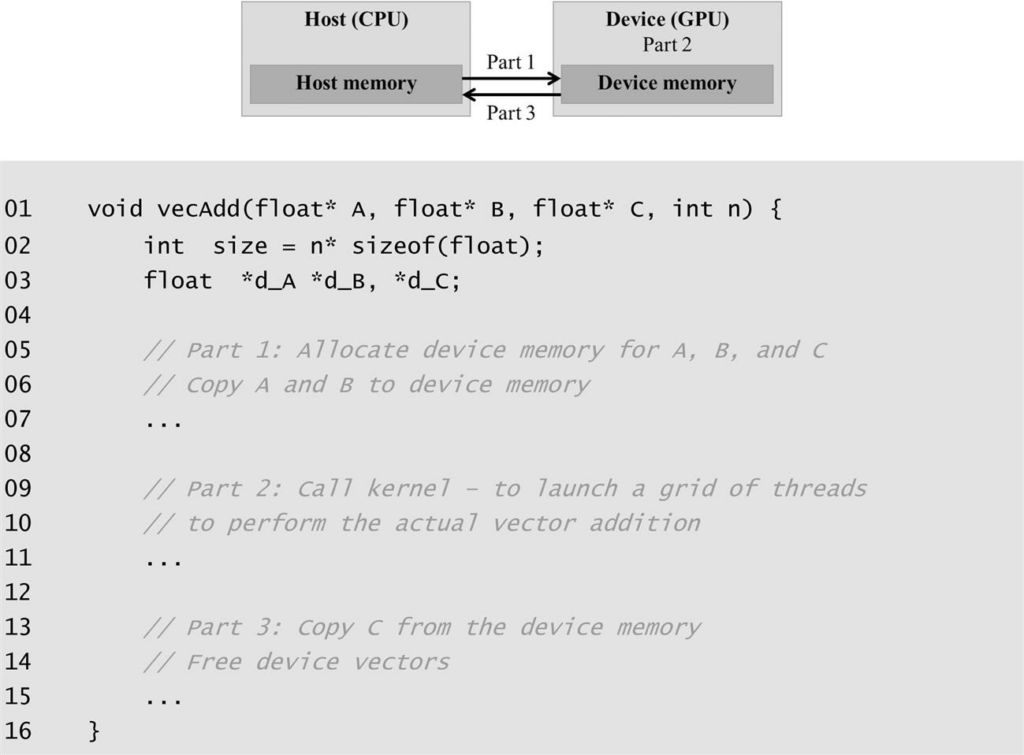
Giờ ta hãy xem cách để thực thi cộng vectơ song song, cụ thể ta sẽ sửa đổi hàm vecAdd và chuyển các tính toán của nó sang một thiết bị. Cấu trúc của hàm vecAdd đã sửa đổi được trình bày trong ảnh dưới
Phần 1: Cấp phát không gian trong bộ nhớ thiết bị (GPU) để chứa các bản sao của các vectơ A, B và C, sau đó sao chép vectơ A và B từ bộ nhớ máy chủ sang bộ nhớ thiết bị.
Phần 2: Gọi kernel cộng vectơ thực sự để kích hoạt một lưới các luồng trên thiết bị.
Phần 3: Sao chép vectơ tổng C từ bộ nhớ thiết bị về bộ nhớ máy chủ và giải phóng bộ nhớ của ba mảng này trên thiết bị.
Bộ nhớ toàn cục của thiết bị và truyền dữ liệu
Trong các hệ thống CUDA hiện nay, các thiết bị (GPU) thường là các bảng mạch phần cứng đi kèm với bộ nhớ truy cập ngẫu nhiên động (DRAM) riêng biệt (hay còn gọi là VRAM của GPU), được gọi là bộ nhớ toàn cục của thiết bị (device global memory), hoặc gọi ngắn gọn là bộ nhớ toàn cục.
Ví dụ: NVIDIA Volta V100 đi kèm với 16GB hoặc 32GB bộ nhớ toàn cục.
Việc gọi đây là bộ nhớ “toàn cục” nhằm phân biệt nó với các loại bộ nhớ thiết bị khác mà lập trình viên cũng có thể truy cập được
Đối với kernel cộng vectơ, trước khi gọi kernel, thực tế ta thực hiện các bước sau
Cấp phát không gian trong bộ nhớ toàn cục của thiết bị (GPU).
Truyền dữ liệu từ bộ nhớ máy chủ (CPU) sang không gian đã cấp phát đó.
Tương tự, sau khi thiết bị thực thi xong, ta cần:
Giải phóng không gian bộ nhớ toàn cục đã cấp phát khi không còn cần thiết.
Truyền dữ liệu kết quả từ bộ nhớ toàn cục của thiết bị trở lại bộ nhớ máy chủ
Khi ta nói Host CPU sẽ có bộ nhớ riêng, thông thường trong một hệ thống máy tính, đó chính là Ram. Và các thiết bị (Device) GPU cũng sẽ có bộ nhớ riêng, hay thường được gọi là thông số VRAM của GPU. Thông thường thì GPU không thể sử dụng các biến trên bộ nhớ CPU (Ram) để làm việc (trừ 1 số ngoại lệ sẽ được thảo luận sau), vì vậy như ảnh sơ đồ một luồng cơ bản ban đầu, ta thường cần khởi tạo các biến tại máy chủ CPU trước, rồi copy dữ liệu sang GPU các dữ liệu cần dùng trong tính toán tại GPU, rồi sau khi tính toán xong, ta sẽ copy lại.
Hệ thống CUDA cung cấp các hàm API để thực hiện các hoạt động này thay cho lập trình viên. Thuật ngữ “truyền dữ liệu từ máy chủ sang thiết bị” sẽ được hiểu là sao chép dữ liệu từ bộ nhớ máy chủ (RAM của CPU) sang bộ nhớ toàn cục của thiết bị (VRAM của GPU).
Quản lý bộ nhớ: cudaMalloc và cudaFree
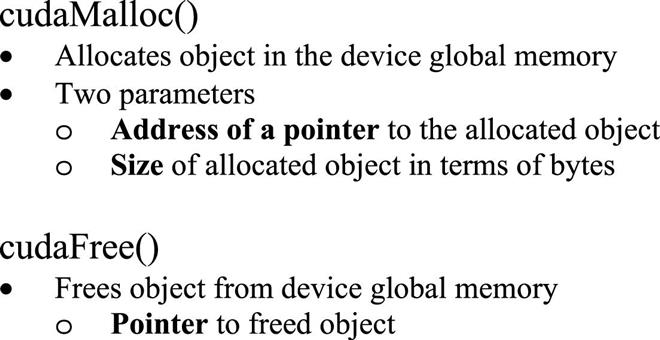
Hình trên giới thiệu hai hàm API dùng để cấp phát và giải phóng bộ nhớ toàn cục của thiết bị.
cudaMalloc(): Có thể được gọi từ mã máy chủ để cấp phát một vùng bộ nhớ toàn cục cho một đối tượng. Hàm này có sự tương đồng rất lớn với hàm malloc của thư viện C tiêu chuẩn.
Tham số thứ nhất: Là địa chỉ của một biến con trỏ. Biến con trỏ này sẽ được thiết lập để trỏ đến đối tượng vừa được cấp phát. Địa chỉ của biến con trỏ phải được ép kiểu thành (void **) vì hàm này mong đợi một con trỏ vạn năng (generic pointer). Điều này cho phép cudaMalloc ghi địa chỉ của vùng nhớ vừa cấp phát vào biến con trỏ của ta bất kể kiểu dữ liệu của nó là gì.
Tham số thứ hai: Xác định kích thước dữ liệu cần cấp phát, tính bằng số byte.
cudaFree(): Giải phóng không gian lưu trữ khỏi bộ nhớ toàn cục. Nó chỉ cần giá trị của con trỏ (địa chỉ vùng nhớ cần giải phóng) làm đối số, do đó không cần truyền địa chỉ của con trỏ như cudaMalloc.
Ví dụ minh họa:
C
float*A_d;int size = n *sizeof(float);cudaMalloc((void**)&A_d, size);// ... thực hiện tính toán ...cudaFree(A_d);
Trong ví dụ này, ta dùng hậu tố _d cho con trỏ A_d để chỉ rõ nó trỏ đến một đối tượng trong bộ nhớ thiết bị. Khi cudaMalloc trả về, A_d sẽ chứa địa chỉ vùng nhớ trên GPU dành cho vectơ A. Lưu ý rằng khi tính toán size, ta phải chuyển đổi từ số lượng phần tử sang số byte (ví dụ: n phần tử kiểu float sẽ chiếm n lần 4 byte).
Các địa chỉ trong A_d, B_d, và C_d trỏ đến các vị trí trong bộ nhớ toàn cục của thiết bị. Ta không được phép giải mã (dereference) các con trỏ này trong mã máy chủ (CPU). Việc truy cập trực tiếp nội dung con trỏ thiết bị từ CPU sẽ gây ra lỗi thực thi hoặc ngoại lệ hệ thống.
Truyền dữ liệu: cudaMemcpy
Sau khi đã cấp phát không gian trên thiết bị, ta cần chuyển dữ liệu vào đó. Hàm API thực hiện việc này là cudaMemcpy.
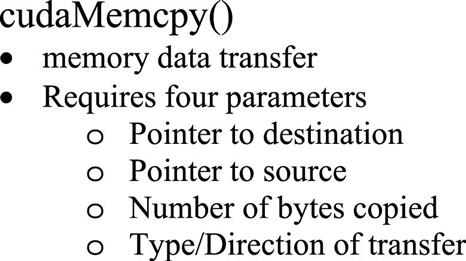
Hình trên mô tả hàm cudaMemcpy với bốn tham số:
Đích (Destination): Con trỏ tới vị trí đích của đối tượng dữ liệu cần sao chép.
Nguồn (Source): Con trỏ tới vị trí nguồn của dữ liệu.
Kích thước (Size): Số byte cần sao chép.
Loại truyền dẫn (Kind/Direction): Xác định các loại bộ nhớ liên quan:
cudaMemcpyHostToDevice: Từ máy chủ sang thiết bị.
cudaMemcpyDeviceToHost: Từ thiết bị về máy chủ.
cudaMemcpyDeviceToDevice: Giữa hai vị trí trong bộ nhớ thiết bị.
cudaMemcpyHostToHost: Giữa hai vị trí trong bộ nhớ máy chủ.
Áp dụng vào ví dụ vecAdd: Ta thực hiện sao chép các vectơ A và B sang thiết bị trước khi tính toán, và sao chép kết quả C về máy chủ sau khi hoàn tất:
C
cudaMemcpy(A_d, A_h, size, cudaMemcpyHostToDevice);cudaMemcpy(B_d, B_h, size, cudaMemcpyHostToDevice);// ... (Gọi kernel thực hiện cộng vectơ ở đây) ...cudaMemcpy(C_h, C_d, size, cudaMemcpyDeviceToHost);
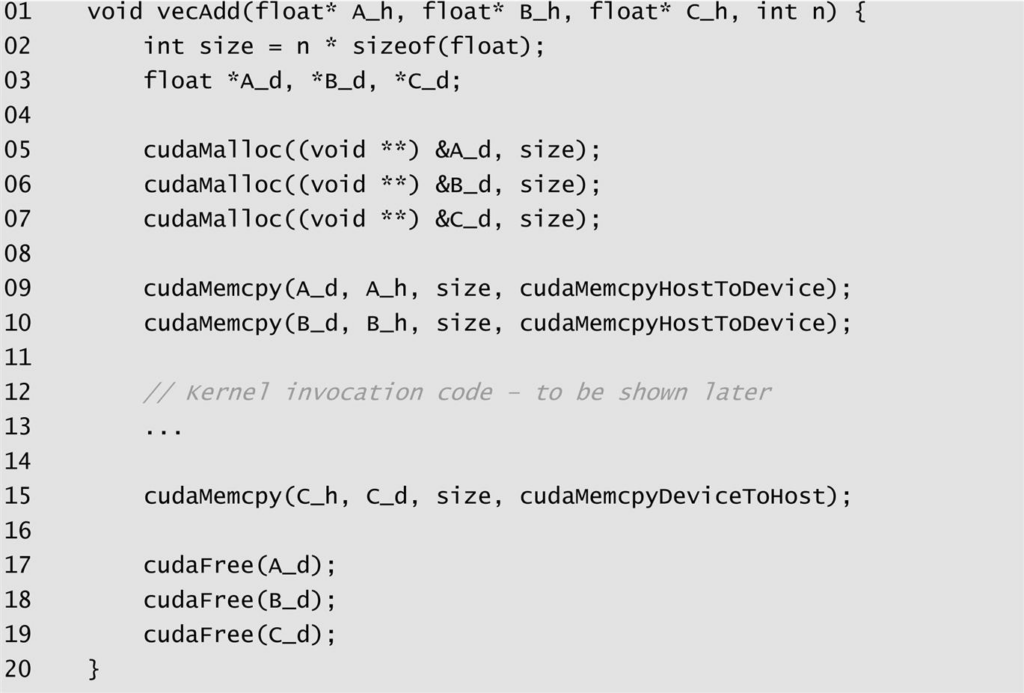
Tổng quan, chương trình hiện tại của ta có thể được thấy như sau, chỉ còn thiếu 1 phần gọi kernel để thực hiện việc tính toán.
Các hàm kernel và phân luồng
Trong CUDA C, một kernel là một hàm sẽ được thực thi song song bởi nhiều luồng trên thiết bị. Ta định nghĩa một kernel bằng cách thêm từ khóa khai báo hàm __global__ vào trước định nghĩa hàm.
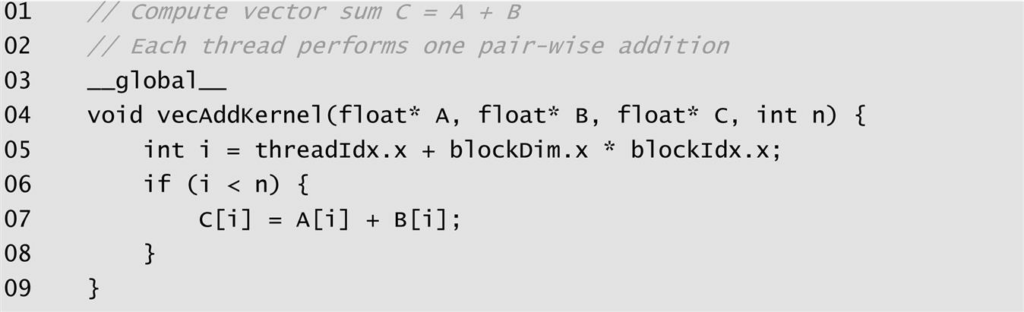
Khi ta gọi một hàm __global__, nó sẽ được thực thi trên thiết bị. Một điểm đặc biệt là các hàm __global__ phải trả về kiểu void. Ta hãy xem xét ví dụ về kernel cộng vectơ trong hình sau:
Hàm vecAddKernel trong hình trông rất giống với vòng lặp trong hàm vecAdd ở ví dụ CPU, nhưng có hai điểm khác biệt quan trọng:
Từ khóa __global__ thông báo cho trình biên dịch rằng đây là một kernel.
Vòng lặp for đã biến mất.
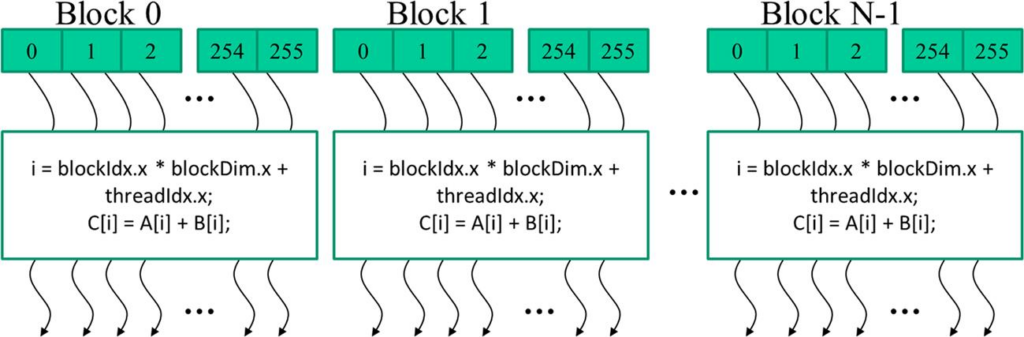
Tại sao vòng lặp lại biến mất? Đó là vì khi kernel này được kích hoạt, một lưới các luồng sẽ được tạo ra. Ta cấu trúc chương trình sao cho mỗi luồng trong lưới sẽ thực hiện một lần lặp của vòng lặp ban đầu. Để làm được điều này, mỗi luồng cần biết nó phải xử lý phần tử nào của các vectơ A, B và C.
Biến tích hợp và định danh luồng (Thread Identification)
CUDA C cung cấp các biến tích hợp sẵn (built-in variables) để giúp các luồng xác định danh tính của mình. Một trong những biến quan trọng nhất là threadIdx. Trong ví dụ đơn giản này, ta sử dụng threadIdx.x để lấy chỉ số của luồng trong một khối (block).
Câu lệnh sau trong kernel:
int i = threadIdx.x;
cho phép mỗi luồng tự gán cho mình một giá trị i khác nhau dựa trên chỉ số của nó. Nếu ta kích hoạt n luồng, thì luồng thứ 0 sẽ có i=0, luồng thứ 1 sẽ có i=1, và cứ tiếp tục cho đến luồng thứ n-1. Nhờ đó, mỗi luồng sẽ thực hiện phép cộng trên một cặp phần tử khác nhau của các vectơ:
if (i < n) C_d[i] = A_d[i] + B_d[i];
Câu lệnh if (i < n) là một biện pháp bảo vệ, Nó đảm bảo rằng nếu số lượng luồng được kích hoạt lớn hơn độ dài vectơ n, các luồng “thừa” sẽ không truy cập vào vùng nhớ ngoài phạm vi của mảng.
SPMD (Single Program, Multiple Data)
Mô hình thực thi này được gọi là SPMD (Một chương trình, nhiều dữ liệu). Tất cả các luồng đều thực thi cùng một mã nguồn (hàm kernel), nhưng mỗi luồng hoạt động trên một phần dữ liệu khác nhau dựa trên định danh của nó. Đây là cách CUDA khai thác tính song song dữ liệu trên quy mô lớn.
Gọi hàm kernel
Khi ta gọi một kernel từ mã máy chủ, ta cần cung cấp các tham số cấu hình thực thi. Các tham số này xác định số lượng luồng trong lưới sẽ được kích hoạt để thực thi kernel đó.
CUDA C sử dụng cú pháp ngoặc nhọn ba lớp <<< ... >>> để bao quanh các thông số này. Cú pháp tổng quát như sau:
Ở đây, ta đang yêu cầu hệ thống kích hoạt 1 khối duy nhất chứa n luồng.
Tham số thứ nhất (1) xác định số lượng khối trong lưới.
Tham số thứ hai (n) xác định số lượng luồng trong mỗi khối.
Khi lệnh gọi này được thực thi, môi trường chạy CUDA (runtime) sẽ tạo ra một lưới gồm n luồng trên thiết bị. Mỗi luồng sẽ thực thi mã của vecAddKernel với một giá trị threadIdx.x duy nhất từ 0 đến n-1.
Ta sẽ thảo luận sau cách sử dụng nhiều khối để xử lý các tập dữ liệu cực lớn vượt quá giới hạn số lượng luồng của một khối đơn lẻ.
Biên dịch (Compilation)
Quy trình biên dịch một chương trình CUDA C khác với chương trình C thông thường vì nó chứa cả mã chạy trên CPU (host) và mã chạy trên GPU (device).
Trình biên dịch NVCC: NVIDIA cung cấp một trình biên dịch tên là nvcc. Nó sẽ phân tách mã máy chủ và mã thiết bị trong tệp nguồn (thường có phần mở rộng là .cu).
Xử lý mã máy chủ: Mã máy chủ là mã C/C++ tiêu chuẩn, nó sẽ được gửi đến trình biên dịch C/C++ thông thường của hệ thống (như gcc trên Linux hoặc cl.exe trên Windows) để biên dịch và liên kết.
Xử lý mã thiết bị: Mã thiết bị (các hàm kernel và các hàm bổ trợ) sẽ được nvcc biên dịch thành một dạng trung gian gọi là PTX (Parallel Thread Execution), hoặc trực tiếp thành mã máy nhị phân cho một kiến trúc GPU cụ thể.
Hợp nhất: Cuối cùng, nvcc sẽ chèn các lệnh cần thiết để nạp mã thiết bị vào GPU và kích hoạt kernel vào trong mã máy chủ, tạo ra một tệp thực thi duy nhất.
Khi ta chạy tệp thực thi này, phần mã máy chủ sẽ bắt đầu chạy trên CPU. Khi gặp lệnh gọi kernel, hệ thống sẽ sử dụng mã thiết bị đã được đóng gói sẵn để kích hoạt các luồng trên GPU.
Ta đã làm quen với những khái niệm nền tảng nhất của lập trình song song trên nền tảng CUDA. Dưới đây là những điểm quan trọng mà ta cần ghi nhớ để làm tiền đề cho các kỹ thuật tối ưu hóa phức tạp hơn:
Song song hóa dữ liệu (Data Parallelism): Đây là chìa khóa để đạt được hiệu suất cao. Khi một công việc lớn có thể chia nhỏ thành các phần độc lập (như xử lý từng điểm ảnh hoặc từng phần tử vectơ), ta có thể tận dụng hàng nghìn lõi xử lý của GPU để thực thi chúng cùng lúc.
Mô hình Máy chủ – Thiết bị (Host – Device): Một chương trình CUDA luôn có sự phân chia vai trò rõ rệt. CPU (Host) đóng vai trò điều khiển, quản lý luồng công việc, trong khi GPU (Device) đóng vai trò là bộ tăng tốc, thực thi các tác vụ tính toán nặng.
Quản lý bộ nhớ: Ta đã học cách sử dụng các hàm API của CUDA để quản lý vòng đời của dữ liệu trên GPU:
cudaMalloc: Cấp phát không gian trên thiết bị.
cudaMemcpy: Chuyển dữ liệu qua lại giữa RAM máy chủ và VRAM thiết bị.
cudaFree: Giải phóng tài nguyên sau khi sử dụng.
Kernel và Luồng (Threads): Kernel là hàm chạy trên GPU. Khi kích hoạt một kernel, ta không chỉ gọi một hàm đơn thuần mà là đang kích hoạt cả một lưới (grid) gồm rất nhiều luồng. Mỗi luồng sử dụng các biến như threadIdx để biết mình cần xử lý phần dữ liệu nào.
Mô hình SPMD: CUDA sử dụng mô hình “Một chương trình, nhiều dữ liệu”, giúp đơn giản hóa việc lập trình song song bằng cách viết một đoạn mã duy nhất nhưng cho phép hàng triệu luồng thực thi nó trên các vùng dữ liệu khác nhau.
I have a love-hate relationship with browser tabs. I need a lot of them to work, but once I pass the 30-tab mark, my browser bar becomes useless.
Google Chrome actually experimented with an auto-grouping feature a while back, but they removed it. I tried finding alternatives on the Chrome Web Store, but they all had the same problem: They were lazy.
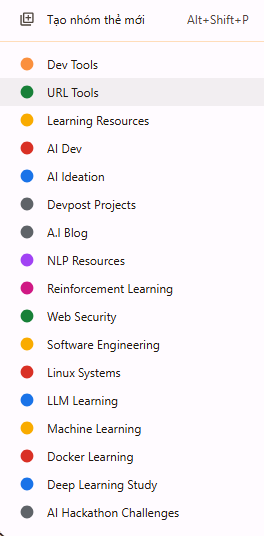
Most existing extensions group tabs based on the domain, even they calling LLM to group it. If they see youtube.com, they dump it in a “YouTube” folder. This is useless for me. If I have 5 tabs open for “Lofi Music” and 5 tabs open for “Python Tutorials,” those shouldn’t be in the same group. One is Work, the other is Background Noise.
I realized that to actually organize tabs, the software needs to read the page, not just the URL. So I spent my free time building Group Tab AI.
How it actually works
I didn’t want to over-engineer this, but I needed it to be smart. When you click the button, the extension doesn’t just look at the link. It injects a script to grab the “context” of the page, the H1 title, the meta description, and a snippet of the body text.
It sends that data to an LLM (I set it up to work with either OpenAI or Gemini). Because it reads the content, it can tell that a GitHub page for a “React Library” is different from a GitHub page for “Tracking Issues.”
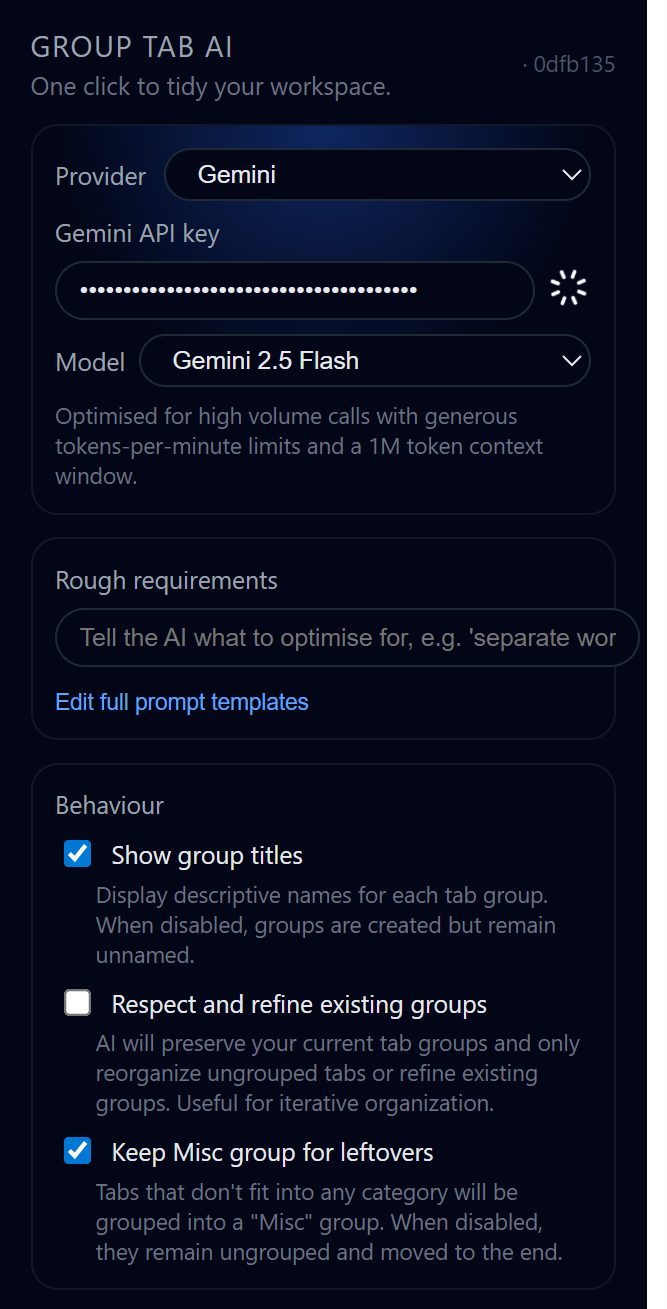
I’m using Google Gemini 2.0 Flash for this mostly, with the thinkingBudget set to 0. It’s fast enough that by the time I blink, the tabs are sorted.
I spent nights tweaking prompts to make it focus on tasks, not domains with extra context from the website contents along with careful prompt to let them reasoning and choose. For example, if you’re a dev, it might make groups like “Bug Hunting” or “API Docs.” Designers get “Mockups” or “Inspo.” It works for anyone,
students with class notes, marketers with campaigns.
The feature I actually wanted: It learns
This is the part I’m most proud of. I know AI isn’t perfect. It’s going to mess up. It might group a design blog under “Development” instead of “Inspiration.”
Usually, with AI tools, you just have to live with the bad output. But I built a Learning System into this.
If the AI groups something wrong, I manually move the tab to the right group.
The extension records that move.
After I’ve corrected it a few times, I can click a button to “Analyze Behavior.”
The system looks at my corrections and rewrites its own system prompt.
Next time I run it, it knows: “Oh, he likes to keep his ‘Localhost’ tabs separate from his ‘Production’ tabs,” because it updated its own instructions based on my manual fixes.
The Tech Stack
For the frontend devs out there, I built this using Plasmo. It’s basically the Next.js of browser extensions, makes working with React and TypeScript in a chrome-extension environment actually bearable.
Everything is local. Your API keys are stored in your browser, and the learning data (your grouping habits) stays on your machine.
Try it out
It’s open source (GPL-3.0). I built it because I needed it, but if you’re tired of domain-based grouping that doesn’t actually help, give it a shot.
This entry is part 8 of 8 in the series SWE Học A.I
Word Embedding
Để xây dựng các hệ thống có thể hỗ trợ dịch thuật và sinh văn bản, trước hết chúng ta phải biến đổi văn bản thành một dạng mà máy tính có thể xử lý được. Như thường lệ, mọi thứ cần được chuyển thành con số. Có hai cách phổ biến để làm điều này:
1. Dựa trên ký tự (Character-based)
Trong cách tiếp cận này, ta đánh số tất cả các ký hiệu có thể xuất hiện trong văn bản.
Bảng mã ký tự toàn diện nhất hiện nay là Unicode.
Phiên bản mới nhất, Unicode 13.0.0 (2020), bao phủ 154 ngôn ngữ viết của con người và liệt kê tới 143.859 ký tự khác nhau (Unicode Consortium, 2020).
Mỗi ký hiệu trong bất kỳ hệ thống chữ viết nào đều có thể được gán một số duy nhất, từ 0 đến xấp xỉ 144.000.
Ví dụ, trong chương này, để đơn giản, ta chỉ xét 89 ký tự phổ biến nhất trong tiếng Anh (chữ cái, số, dấu câu, khoảng trắng).
Ví dụ nhỏ:
Văn bản: "AI is cool!"
Với bảng ký tự chỉ gồm 89 ký hiệu, ta có thể ánh xạ:
Câu "AI is cool!" sẽ được biểu diễn thành một dãy số: [0, 8, 26, 8, 45, 26, 12, 22, 22, 19, 75].
2. Dựa trên từ (Word-based)
Trong cách này, ta đánh số tất cả các từ có thể xuất hiện.
Nếu tính tất cả ngôn ngữ trên thế giới, đây là một nhiệm vụ khổng lồ.
Ngay cả với tiếng Anh, không có con số chính xác về tổng số từ.
Các từ điển hiện đại của tiếng Anh thường có khoảng 300.000 mục từ (Dictionary.com, 2020).
Giả sử ta duyệt qua toàn bộ từ điển và gán cho mỗi từ một số duy nhất, bắt đầu từ 0. Danh sách các từ cùng số hiệu của chúng sẽ tạo thành từ vựng (vocabulary).
Câu "I like AI" sẽ được biểu diễn thành [0, 1, 2].
Câu "AI is fun" sẽ là [2, 5, 6].
Với mong muốn cải tiến cách biểu diễn từ thay vì chỉ gán mỗi từ một con số, với mục tiêu là có thể:
So sánh từ (tìm từ có ý nghĩa gần giống nhau).
Kết hợp từ (trung hòa hoặc biến đổi ý nghĩa giữa hai từ).
Thao tác trên không gian vector để tìm ra mối quan hệ ngữ nghĩa tiềm ẩn.
Đây chính là nền tảng để phát triển attention và sau đó là transformer.
Kỹ thuật này gọi là word embedding (hoặc token embedding, khi áp dụng cho token nói chung).
Ví dụ
Giả sử Hôm nay đạo diễn muốn quay cảnh một nhóm động vật đuổi theo nhân vật chính. Văn phòng gửi cho đoàn làm phim một biểu đồ như sau, trục ngang là tốc độ tối đa, trục dọc là cân nặng trung bình của từng loài
Nhưng bản in bị lỗi và khi được đưa tới đoàn làm phim thì không có nhãn trục, chỉ còn các điểm động vật nằm trong không gian 2D. Vì vậy đoàn làm phim không biết trục ngang và trục dọc đang biểu diễn cho việc gì.
Đạo diễn nói:
“Tôi muốn trong cảnh quay sẽ là một con ngựa đuổi theo nhân vật chính. Tôi cảm giác được ngựa sẽ phù hợp. Chúng là sự lựa chọn hoàn hảo, đừng mang gì khác tới đây hết.”
Đoàn làm phim gật đầu, đưa ngựa vào trường quay. Nhưng chỉ vài phút sau, đạo diễn đã đập tay xuống ghế, quát lớn:
“Không được! Ngựa chạy thì nhanh đấy, nhưng trông chúng quá nhạy, cứ bồn chồn như… cáo ấy. Tôi không muốn thứ gì giống cáo. Hãy mang tới cho tôi một loài vẫn mạnh mẽ như ngựa, nhưng phải bớt cái chất ‘cáo’ đi.”
Đoàn làm phim đứng sững. Trời ạ, “ngựa trừ đi cáo” thì là cái gì? Nhưng rồi anh nhớ tới tấm biểu đồ mà văn phòng gửi. Nếu coi mỗi con vật là một mũi tên trong không gian này, thì việc đạo diễn yêu cầu chẳng khác nào một phép toán vector.
Anh lấy mũi tên của ngựa, trừ đi mũi tên của cáo. Kết quả? Một con… lười khổng lồ (giant sloth).
Đoàn làm phim ngập ngừng:
“Thưa đạo diễn, nếu bỏ đi cái tính nhanh nhẹn của cáo khỏi ngựa, chúng ta sẽ có… lười khổng lồ.”
Đạo diễn nhìn rồi hất ly latte xuống đất:
“Không! Lười thì đẹp đấy, nhưng chậm như rùa! Tôi cần thứ gì đó nhanh hơn, phải thật nhanh! Giống như… chim chẳng hạn.”
Anh lại quay vào bảng, lần này cộng thêm vector chim vào kết quả vừa rồi. Và thật bất ngờ, mũi tên mới chỉ thẳng tới… gấu nâu.
Đạo diễn khoanh tay, hất tóc, ánh mắt sáng lên:
“Tuyệt. Cuối cùng cũng đúng ý tôi: mạnh mẽ như ngựa, không lắt nhắt như cáo, lại nhanh như chim chạy. Mang gấu tới đây đi.”
Và thế là cảnh rượt đuổi được quay với một đàn gấu nâu hung hãn. Bộ phim sau này trở thành bom tấn, được ca ngợi hết lời.
Kết luận
Có hai yếu tố then chốt trong câu chuyện này. Yếu tố thứ nhất là các loài vật trên biểu đồ của chúng ta đã được sắp xếp theo một cách hữu ích, dù chúng ta không biết cách đó là gì, hay các trục thể hiện điều gì về dữ liệu.
Điểm then chốt thứ hai là cuối cùng chúng ta không cần nhãn trục. Chúng ta có thể định hướng trên biểu đồ chỉ bằng cách cộng và trừ các mũi tên trỏ tới các phần tử trên biểu đồ. Tức là, chúng ta không cố tìm một “con ngựa chậm hơn.” Thay vào đó, ta thao tác trực tiếp với các con vật trên biểu đồ, và các thuộc tính của chúng đi theo một cách ngầm định. Nếu loại bỏ đi tính nhanh nhẹn của cáo khỏi một con vật lớn như ngựa, ta sẽ thu được một con vật to và chậm.
Điều này liên quan gì đến xử lý ngôn ngữ?
Nhúng từ (Embedding Words)
Để áp dụng những gì vừa thấy cho từ ngữ, ta thay các con vật bằng các từ. Và thay vì chỉ dùng hai trục, ta sẽ đặt các từ vào một không gian có hàng trăm chiều.
Chúng ta thực hiện điều này bằng một thuật toán tự động tìm ra ý nghĩa của mỗi trục trong không gian khi đặt từng từ vào vị trí phù hợp. Thay vì gán cho mỗi từ một số đơn lẻ, thuật toán gán cho mỗi từ cả một danh sách số đó là tọa độ của từ trong một không gian lớn.
Ví dụ: từ “Hưng” biểu diễn là [0, 0.5, 1, 50, 4, …]
Thuật toán này gọi là embedder, và quá trình đó gọi là nhúng từ vào không gian embedding, tạo ra các word embeddings.
Bộ nhúng tự tìm cách xây dựng không gian và xác định tọa độ của mỗi từ sao cho nó nằm gần những từ tương tự. Ví dụ, nếu nó thấy nhiều câu bắt đầu bằng “I just drank some …”, thì danh từ xuất hiện sau cụm đó sẽ được hiểu là một loại đồ uống và được đặt gần các từ chỉ đồ uống khác. Nếu nó thấy nhiều câu như “I just ate a red …”, thì từ tiếp theo được hiểu là thứ có màu đỏ và có thể ăn được, nên được đặt gần những thứ vừa đỏ vừa có thể ăn được.
Tương tự với hàng chục, thậm chí hàng trăm mối quan hệ khác, cả rõ ràng lẫn tinh tế. Bởi vì không gian có rất nhiều chiều và các trục có thể mang ý nghĩa phức tạp tùy ý, một từ có thể thuộc đồng thời nhiều cụm dựa trên những đặc tính dường như không liên quan.
Điểm hay khi huấn luyện một bộ nhúng trong không gian có hàng trăm (hoặc thậm chí hàng nghìn) chiều là nó có thể sử dụng không gian hiệu quả hơn khả năng trực giác của con người, cho phép biểu diễn đồng thời một số lượng lớn các mối quan hệ.
Những phép “số học từ” vừa nêu là minh chứng thú vị cho không gian nhúng, nhưng quan trọng hơn, chúng cho phép ta thực hiện có ý nghĩa các phép toán trên từ như so sánh, phóng to/thu nhỏ, và cộng trừ tất cả đều hữu ích cho các thuật toán được bàn tới trong chương này.
Hình trên trình bày sáu bộ gồm bốn từ liên quan mà chúng ta đưa vào một bộ nhúng tiêu chuẩn. Mức độ tương đồng giữa embedding của hai từ càng lớn thì cặp từ đó càng có điểm cao, nên giao điểm tương ứng càng tối. Đồ thị đối xứng quanh đường chéo từ trên trái xuống dưới phải, vì thứ tự so sánh hai từ không ảnh hưởng kết quả.
Từ hình ta thấy mỗi từ khớp với chính nó mạnh nhất và cũng khớp với những từ liên quan hơn là với những từ không liên quan. Vì ta đặt các từ có liên quan cạnh nhau, đồ thị hiện ra những khối nhỏ thể hiện tương đồng. Tuy nhiên có vài điều thú vị: ví dụ vì sao fish lại khớp hơn mức trung bình với chocolate và coffee, hay vì sao blue lại ghi điểm tốt với caramel? Đây có thể là những hiện tượng phát sinh từ dữ liệu huấn luyện cụ thể mà bộ nhúng dùng.
Các thức uống cà phê và hương vị ghi điểm mạnh với nhau, có lẽ vì người ta thường gọi cà phê kèm các siro hương vị đó. Ngoài ra còn thấy manh mối về mối quan hệ giữa màu sắc và hương vị.
ELMo
Word embeddings là một bước tiến lớn so với việc gán số nguyên cho từ. Nhưng dù mạnh, cách tạo embedding như trên vẫn có một vấn đề: sắc thái ngữ nghĩa (nuance).
Nhiều ngôn ngữ có từ có nhiều nghĩa nhưng viết và phát âm giống nhau. Nếu muốn hiểu đúng nghĩa từ, ta cần phân biệt các nghĩa đó. Một cách là gán cho mỗi nghĩa của một từ một embedding riêng. Ví dụ cupcake chỉ có một nghĩa nên có một embedding; nhưng train có hai nghĩa thực sự khác nhau — một là danh từ (“I rode on a train”) (train là tàu), một là động từ (“I like to train dogs”) (train là huấn luyện), nên cần hai embedding riêng.
Những từ như vậy đặt ra hai thách thức. Thứ nhất, ta phải tạo embedding riêng cho từng nghĩa. Thứ hai, ta phải chọn embedding đúng khi những từ này xuất hiện làm input.
Việc giải quyết hai thách thức này đòi hỏi phải xét ngữ cảnh của mỗi từ. Thuật toán đầu tiên làm việc này ở quy mô lớn gọi là Embeddings from Language Models, hay tên thân mật ELMo (Peters et al. 2018), trùng tên một nhân vật Muppet trong chương trình thiếu nhi Sesame Street. Người ta nói ELMo sinh ra các contextualized word embeddings (embedding phụ thuộc ngữ cảnh).
Attention
Ta đã thấy cách cải thiện chất lượng dịch thuật bằng việc xét đến toàn bộ các từ trong câu. Nhưng khi dịch một từ cụ thể, lại có thể thấy, không phải từ nào trong câu cũng quan trọng, thậm chí nhiều từ còn không liên quan.
Ví dụ: giả sử ta dịch câu: “I saw a big dog eat his dinner.” – Tôi thấy một chú chó lớn đang ăn
Khi dịch từ dog (chó), ta gần như chẳng quan tâm gì đến từ saw. (nhìn thấy)
Nhưng để dịch đúng đại từ sở hữu his, ta cần kết nối nó với cụm big dog (chú chó lớn)
Nếu ta có thể xác định, với mỗi từ trong đầu vào, những từ nào thực sự ảnh hưởng đến việc dịch, thì ta có thể tập trung xử lý chỉ những từ đó, còn bỏ qua phần còn lại. Điều này tiết kiệm rất nhiều bộ nhớ và thời gian tính toán.
Và nếu ta làm điều này theo cách không phụ thuộc vào việc xử lý tuần tự (word-by-word), thì ta còn có thể tính toán song song.
Thuật toán thực hiện ý tưởng đó gọi là attention, hay cụ thể hơn là self-attention (Bahdanau, Cho & Bengio 2016; Sutskever, Vinyals & Le 2014; Cho et al. 2014).
Attention giúp mô hình tập trung tài nguyên vào những phần quan trọng nhất của đầu vào.
QKV – Query, Key, Value
Phiên bản attention hiện đại thường dựa trên một kỹ thuật gọi là query, key, value (QKV).
Ba từ này vốn xuất phát từ lĩnh vực cơ sở dữ liệu (database), nên khi đưa sang ngữ cảnh NLP có vẻ hơi trừu tượng. Vì vậy, ta sẽ dùng một phép ẩn dụ trực quan để giải thích, rồi sau đó kết nối lại với Q–K–V.
Ví dụ: Mua sơn
Giả sử anh cần mua sơn. Người ta chỉ cho anh mô tả: “màu vàng nhạt pha một chút cam đậm.”
Ở thị trấn chỉ có một cửa hàng sơn duy nhất. Người bán hàng mới vào nghề, không rành từng màu. Anh và nhân viên đều hiểu rằng để ra màu mong muốn, anh phải pha trộn nhiều loại sơn có sẵn. Nhưng vấn đề là: chọn loại nào, và mỗi loại bao nhiêu?
Người bán đề nghị:
“Anh hãy so sánh mô tả của mình với tên trên nhãn từng hộp sơn. Hộp nào khớp nhiều thì múc nhiều, khớp ít thì múc ít. Rồi mình trộn tất cả lại.”
Ví dụ: so với mô tả “màu vàng nhạt pha một chút cam đậm.” (“light yellow with a bit of dark orange”)
“Sunny Yellow” (Vàng cam) → khớp nhiều, vừa có vàng và cam.
“Orange Crush” → khá khớp
“Lunch with Teal” cũng lọt vào một chút, chỉ vì trùng từ “with”.
Trong câu chuyện này có 3 thành phần chính:
Yêu cầu (request): “light yellow with a bit of dark orange.”
Mô tả (description): tên trên nhãn mỗi hộp, như “Sunny Yellow”, “Mellow Blue”…
Nội dung (content): bản thân màu sơn trong hộp.
Quy trình: ta so sánh yêu cầu với từng mô tả → mức độ khớp càng cao → càng lấy nhiều nội dung từ hộp đó.
Đây chính là QKV:
Cho một yêu cầu, so sánh nó với mô tả của từng mục, rồi trộn nội dung theo mức độ phù hợp.
Trong ngôn ngữ cơ sở dữ liệu:
Query (Q): yêu cầu tìm kiếm (tương ứng với “request”).
Key (K): khóa định danh, mô tả của từng mục (tương ứng với “description”).
Value (V): giá trị thật sự được lưu trữ (tương ứng với “content”).
Cơ sở dữ liệu so sánh query với key để tính điểm khớp, rồi dùng điểm đó quyết định lấy bao nhiêu phần của value.
➡️ Vậy:
Request ↔ Query (Q)
Description ↔ Key (K)
Content ↔ Value (V)
Self-Attention
Giả sử ta có một câu gồm 5 từ đầu vào. Mỗi từ được biểu diễn bằng một vector (embedding). Ta có ba “hộp” neural network nho nhỏ (thường chỉ là các fully connected layer 1 tầng) để biến đổi vector đó thành:
Q (query)
K (key)
V (value)
Ví dụ: với từ dog (thứ ta cần dịch):
Một mạng (màu đỏ) biến vector “dog” thành Q.
Từ dinner được biến thành K (qua mạng xanh) và V (qua mạng xanh lá).
Ta so sánh Q của dog với K của dinner bằng một hàm tính điểm (scoring function, ký hiệu S trong vòng tròn). Hàm này trả về một số từ 0 → 1:
Khớp nhiều → điểm cao.
Khớp ít → điểm thấp.
Sau đó, ta lấy V của dinner, nhân với điểm này (scaling). Kết quả: giá trị dinner đóng góp nhiều hay ít vào đầu ra của dog tùy mức độ khớp.
Mở rộng ra toàn câu
Trong thực tế, không chỉ so sánh dog ↔ dinner, mà dog được so sánh với tất cả từ trong câu (kể cả chính nó).
Mỗi từ trong câu sẽ đóng góp vào kết quả cuối của dog, với trọng số do điểm khớp quyết định.
Lưu ý:
Ta chỉ có 3 mạng duy nhất (Q, K, V), và áp dụng chúng cho tất cả từ → tiết kiệm tính toán.
Sau khi có điểm khớp, ta áp dụng softmax để chuẩn hóa, tránh số quá to/nhỏ, đồng thời làm nổi bật các khớp mạnh.
Cuối cùng, ta cộng tất cả giá trị V đã được scale lại → ra vector mới của dog.
Lặp quy trình này đồng thời cho mọi từ trong câu
Embedding đóng vai trò gì?
Hàm scoring sẽ coi hai vector giống nhau → điểm cao. Vậy để hoạt động đúng, các từ có ý nghĩa gần nhau phải được nhúng gần nhau trong không gian embedding.
Ví dụ: trong như cách làm onehot encoding, ta gán số cho từ theo thứ tự (keep = 1003, flint = 1004). Nếu dùng số này so sánh thì keep và flint lại cực kỳ giống nhau (sai hoàn toàn).
Với embedding:
keep sẽ gần retain, hold, reserve.
Cách xa hẳn flint, dinosaur.
Nhờ embedding, scoring mới có ý nghĩa.
Q/KV Attention
Trong self-attention, Q, K, V đều sinh ra từ cùng một input.
Nhưng có biến thể khác:
Q đến từ một nguồn khác, còn K và V vẫn từ input gốc.
Giống như ví dụ mua sơn:
Query đến từ khách hàng.
Key & Value đến từ cửa hàng.
Đây gọi là Q/KV attention.
Thường dùng trong mạng encoder–decoder (ví dụ seq2seq):
Q từ encoder.
K, V từ decoder.
Multi-Head Attention
Ý tưởng của attention là xác định những từ nào có sự tương đồng và tạo ra một phép trộn hữu ích từ chúng. Nhưng “giống nhau” có thể được định nghĩa theo rất nhiều tiêu chí khác nhau.
Ví dụ: ta có thể xem các danh từ là giống nhau, hoặc các màu sắc, hoặc các khái niệm không gian như “lên – xuống”, hoặc các khái niệm thời gian như “hôm qua – ngày mai”. Vậy lựa chọn nào là tốt nhất?
Thực ra không có một câu trả lời duy nhất. Trên thực tế, ta thường muốn so sánh các từ theo nhiều tiêu chí cùng lúc.
Khi viết ca từ bài hát, ta có thể muốn đánh giá cao những cặp từ có nghĩa gần giống nhau, có vần cuối giống nhau, có số âm tiết bằng nhau, và thậm chí có nhịp điệu trong trọng âm giống nhau.
Nhưng khi viết về thể thao, ta có thể muốn coi những cầu thủ cùng đội, cùng vị trí là “giống nhau”.
Để chấm điểm các từ theo nhiều tiêu chí, ta chỉ cần chạy nhiều mạng attention độc lập cùng lúc. Mỗi mạng như vậy gọi là một head (một “đầu chú ý”). Mỗi head được khởi tạo độc lập, và ta hy vọng rằng trong quá trình huấn luyện, mỗi head sẽ học được một cách riêng để so sánh các đầu vào, theo những tiêu chí hữu ích và khác biệt so với các head khác. Nếu muốn, ta còn có thể thêm cơ chế để ép các head tập trung vào các khía cạnh khác nhau của đầu vào. Cơ chế này gọi là multi-head attention
Mỗi head là một mạng attention độc lập. Càng nhiều head, thì mô hình càng có khả năng tập trung vào nhiều khía cạnh khác nhau của dữ liệu đầu vào.
Hình trên minh họa một lớp multi-head attention. Như hình vẽ, ta thường kết hợp đầu ra của tất cả các head thành một danh sách, rồi cho qua một lớp fully connected duy nhất. Nhờ vậy, đầu ra của toàn bộ lớp multi-head có cùng kích thước với đầu vào, điều này cho phép ta dễ dàng xếp chồng nhiều lớp multi-head liên tiếp.
Layer Icons (Biểu tượng các lớp Attention)
(a) Self-attention.
(b) Multi-head self-attention.
(c) Q/KV attention.
(d) Multi-head Q/KV attention.
(Multi-head attention được vẽ như một khối 3D nhỏ, gợi ý rằng nó là “một chồng” các mạng attention. Với Q/KV attention, trong biểu tượng kim cương có thêm một vạch nhỏ để chỉ đầu vào Q, còn K và V đi vào từ một phía khác.)
Transformers
Mục tiêu của ta là xây dựng một mô hình dịch máy không dựa vào RNN, mà dựa vào attention networks. Ý tưởng chủ chốt: các lớp attention sẽ học cách biến đổi đầu vào thành bản dịch, dựa trên mối quan hệ giữa các từ.
Cách tiếp cận này lần đầu xuất hiện trong bài báo nổi tiếng “Attention Is All You Need” (Vaswani et al., 2017). Tác giả gọi mô hình này là transformer (cái tên hơi “mập mờ” nhưng giờ đã thành chuẩn trong lĩnh vực). Mô hình transformer hoạt động hiệu quả đến mức đã mở ra một thế hệ mới của các mô hình ngôn ngữ, vừa huấn luyện song song dễ dàng, vừa vượt trội hơn RNN trong nhiều tác vụ khác nhau.
Transformer sử dụng thêm ba ý tưởng nữa:
Skip Connections
Ý tưởng đầu tiên gọi là residual connection hay skip connection (He et al., 2015). Nguồn cảm hứng của nó là giảm lượng công việc mà một lớp mạng sâu phải thực hiện.
Một phép so sánh: Giả sử ta vẽ một bức chân dung bằng sơn acrylic trên một tấm vải. Sau nhiều tuần, bức tranh hoàn thành. Người mẫu xem và nói: “Tôi thích rồi, nhưng tiếc là hôm đó tôi đeo nhẫn sai, lẽ ra phải là cái nhẫn khác. Anh có thể sửa không?”
Cách 1: mời người mẫu quay lại, vẽ lại toàn bộ bức tranh từ đầu. Tốn thời gian và công sức khủng khiếp.
Cách 2: chỉ cần vẽ chồng cái nhẫn mới lên cái cũ. Nhanh gọn hơn nhiều.
Một lớp trong mạng sâu cũng vậy. Nó nhận tensor đầu vào, xử lý, và tạo ra tensor đầu ra. Nhưng nếu chỉ cần thay đổi một phần nhỏ, thì thật lãng phí nếu lớp đó phải xử lý toàn bộ. Giống như việc vẽ lại cả bức tranh chỉ để thay cái nhẫn. Thay vào đó, lớp chỉ cần tính toán phần thay đổi cần thiết, rồi cộng nó với đầu vào ban đầu để ra đầu ra cuối cùng.
Ý tưởng này hoạt động tuyệt vời trong deep learning:
giúp các lớp nhỏ gọn hơn, nhanh hơn,
cải thiện truyền gradient trong backpropagation,
cho phép huấn luyện hiệu quả các mạng có hàng chục hoặc hàng trăm lớp.
Đường nối thêm đưa input đến nút cộng gọi là skip connection (nối tắt), hay residual connection (nối tàn dư, vì nó cộng thêm “phần dư”).
Transformer dùng skip connections không chỉ để tăng hiệu quả, mà còn để theo dõi vị trí của từng phần tử trong đầu vào (sẽ thấy ở phần positional encoding).
Norm-Add
Ý tưởng thứ hai là một rút gọn ký hiệu, thường gọi là norm-add.
Trong transformer, ta thường áp dụng bước chuẩn hóa gọi là layer normalization (layer norm) lên đầu ra của một lớp (Vaswani et al., 2017). Đây là một dạng regularization giống như dropout hay batchnorm, giúp chống overfitting bằng cách giữ cho các giá trị trong mạng không quá lớn hoặc quá nhỏ. Layer norm học cách điều chỉnh giá trị đầu ra của lớp để có dạng gần giống một phân phối chuẩn (mean = 0, std = 1).
Một cách thông dụng: đặt layer norm ngay trước bước cộng của skip connection Vì hai bước này luôn đi kèm nhau, nên người ta gộp chúng thành một khái niệm gọi là norm-add. Biểu tượng norm-add là sự kết hợp của biểu tượng chuẩn hóa và cộng.
Có nhiều biến thể khác (đặt norm trước lớp, hoặc sau bước cộng), nhưng nhìn chung hiệu quả tương đương.
Positional Encoding (Mã hóa vị trí)
Ý tưởng thứ ba giải quyết một vấn đề phát sinh khi ta bỏ RNN ra khỏi hệ thống: ta mất thông tin về vị trí của từng từ trong câu.
Trong RNN, thông tin này có sẵn, vì từ đi vào theo thứ tự và trạng thái ẩn có thể ghi nhớ vị trí. Nhưng với attention, nhiều từ bị trộn lẫn vào nhau, vậy làm sao biết từ nào ở chỗ nào?
Giải pháp: thêm thông tin vị trí của mỗi từ trực tiếp vào vector biểu diễn của từ đó. Cách làm này gọi là positional encoding.
Cách đơn giản: nối thêm vài bit vào cuối mỗi từ để lưu vị trí. Nhưng cách này tốn bộ nhớ và khó xử lý khi câu quá dài (ví dụ câu càng dài hơn thì số bit cần để lưu vị trí càng tốn). (ảnh trái)
Cách tốt hơn: dùng một hàm toán học để biến chỉ số vị trí thành một vector đặc trưng (cùng chiều với embedding). Ví dụ: nếu embedding dài 128, thì mỗi vị trí được ánh xạ thành một vector 128 chiều riêng biệt. (ảnh phải)
Thay vì nối thêm vector này, ta cộng trực tiếp nó vào embedding của từ Cách này gọn gàng hơn, không cần thêm bits đặc biệt. Phương pháp này gọi là positional embedding, vì nó giống embedding từ vựng. Biểu tượng minh họa có dạng sóng sin, vì hàm thường dùng chính là sine wave encoding (Vaswani et al., 2017).
Nghe có vẻ lạ: cộng vị trí vào embedding sẽ thay đổi vector của từ. Vậy liệu thông tin vị trí có bị “hòa tan” mất trong quá trình attention không?
Hóa ra là không:
Hàm positional embedding chỉ tác động lên một vài bit nhất định (Vaswani et al., 2017; Kazemnejad, 2019).
Transformer học được cách phân biệt thông tin nội dung và thông tin vị trí.
Quan trọng hơn: nhờ có skip connections, positional embedding không bao giờ bị mất hoàn toàn. Sau mỗi tầng xử lý, nó lại được cộng thêm vào, luôn đi cùng với từ.
Ghép các mảnh ghép
Giờ thì ta đã có đủ nguyên liệu để dựng nên một transformer. Và để tiện theo dõi, ta vẫn sẽ dùng bài toán dịch từ ngữ ở mức độ từng từ làm ví dụ minh họa xuyên suốt.
Điều cần lưu ý trước tiên: cái tên transformer ngày nay được dùng cho một họ mạng nơ-ron rất rộng, tất cả đều lấy cảm hứng từ kiến trúc trong bài báo gốc Attention Is All You Need (Vaswani et al. 2017). Ở đây, ta sẽ không đi vào từng biến thể, mà chỉ bám vào một “phiên bản chung”, một bộ khung chuẩn.
Cấu trúc tổng thể
Ở bên trái là encoder (mã hóa),
ở giữa có một cây cầu dữ liệu,
và bên phải là decoder (giải mã).
Một câu đầu vào sẽ đi qua encoder, được xử lý và “chưng cất” thành thông tin. Rồi decoder nhận dòng thông tin đó, dần dần tạo ra câu dịch mới.
Nếu bạn đã quen với seq2seq dùng RNN thì bố cục này trông có chút quen: có phần encoder, phần decoder, và thông tin chảy từ trái sang phải. Nhưng điểm khác biệt then chốt: không còn bất kỳ (recurrent cell) nào nữa. Tất cả được thay bằng các lớp attention.
Trong sơ đồ:
E tượng trưng cho một encoder block,
D là một decoder block,
các nét đứt cho thấy nhiều block giống hệt nhau được lặp lại.
Ở đầu vào, cả encoder và decoder đều bắt đầu bằng word embedding (biểu diễn từ thành vector) cộng thêm positional embedding (mã hóa vị trí từ). Ở đầu ra của decoder, ta có một lớp fully connected + softmax để dự đoán từ kế tiếp.
Decoder lại còn có một vòng lặp: mỗi từ mà nó sinh ra sẽ được đưa trở lại vào chính nó, để sinh tiếp từ sau. Đó là cơ chế autoregressive.
Encoder block
Lớp đầu tiên: multi-head self-attention (ví dụ 8 head). Vì đây là self-attention, nên queries, keys, values đều được rút ra từ chính input của block.
Lớp này được bao quanh bởi skip connection + layer norm (norm-add), vừa để giữ số liệu “gọn gàng” (phân phối Gaussian đẹp), vừa để bảo toàn thông tin vị trí.
Lớp kế tiếp: một cặp feed-forward pointwise (thường hiểu như 2 convolution 1×1).
Lớp đầu có activation ReLU, lớp sau thì không.
Chức năng: tinh chỉnh đầu ra từ attention, loại bỏ dư thừa, giữ lại phần cốt lõi.
Như thường lệ, cả cụm này cũng được gói trong skip connection + norm-add.
Tiếp theo là decoder block. Bố cục hơi giống encoder block, nhưng có thêm một bước attention đặc biệt.
Bước đầu tiên: multi-head self-attention (giống encoder).
Input chính là các từ mà decoder đã sinh ra cho đến nay. Nếu mới bắt đầu, thì chỉ có token [START].
Nhờ self-attention, hệ thống học cách xem từ nào liên quan từ nào trong dãy đầu ra tạm thời này.
Vẫn có skip connection + norm-add bao quanh.
Nhưng ở đây có thêm một chi tiết: masking (hình tam giác nhỏ trong sơ đồ).
Bước thứ hai: multi-head Q/KV attention.
Query (Q) đến từ output của self-attention trước đó.
Keys và Values đến từ tất cả các encoder block (nguyên câu nguồn đã được mã hóa).
Nhờ thế, decoder biết cách “nhìn sang” câu gốc để chọn thông tin nào cần dùng khi dịch tiếp.
Bước này cũng được bọc skip connection + norm-add.
Cuối cùng: một cặp convolution 1×1 (giống encoder block).
Ghép lại thành Transformer
Khi ráp mọi mảnh, ta có sơ đồ:
Nhiều encoder block chồng nhau bên trái.
Nhiều decoder block chồng nhau bên phải.
Các lớp convolution 1×1 thường được ký hiệu bằng 2 hộp nhỏ xếp đôi.
Nét đứt = lặp lại nhiều lần.
Vấn đề song song & Masking
Một ưu điểm tuyệt vời của attention là: xử lý song song. Dù ta đưa vào 5 từ hay 500 từ, lớp attention vẫn chạy trong cùng một thời gian. Điều này khác hẳn RNN, vốn phải xử lý tuần tự từng bước.
Nhưng khi huấn luyện mô hình để dự đoán từ kế tiếp, sẽ nảy sinh một vấn đề. Ví dụ câu: “My dog loves taking long walks.”
Nếu ta đưa vào “My dog loves taking long” và muốn dự đoán từ thứ 6 (walks), thì ổn.
Nhưng đồng thời, ta cũng muốn mô hình dự đoán từ thứ 5 (long), dự đoán từ thứ 4 (taking), … tất cả song song.
Vấn đề: khi dự đoán long, mô hình thấy luôn từ long trong input. Quá dễ, và không còn ý nghĩa học.
Cách giải: masking. Trong self-attention của decoder, ta chèn một lớp mặt nạ, để tại mỗi bước dự đoán, mô hình chỉ được nhìn thấy các từ trước đó, không được nhìn “tương lai”.
Khi dự đoán từ thứ 1 → không thấy gì.
Khi dự đoán từ thứ 2 → chỉ thấy “My”.
Khi dự đoán từ thứ 3 → chỉ thấy “My dog”.
… và cứ thế.
Nhờ masking, mô hình vừa chạy song song và không bị “nhìn thấy” dữ liệu. Ta cố tình ẩn bớt dữ liệu đi để mô hình có thể học thêm.
Như đã sơ lược qua ở phần trước, HTTP/2 Server Push (gọi tắt là HTTP/2 push) cho phép máy chủ (server) gửi thêm tài nguyên mà client (trình duyệt) chưa yêu cầu. Trước HTTP/2, HTTP chỉ là “hỏi-đáp đơn giản”: Trình duyệt yêu cầu một trang web, server trả về, rồi trình duyệt phải tải trang đó, phân tích, và yêu cầu thêm tài nguyên như CSS, JavaScript, font chữ, hình ảnh.
Ví dụ: Khi bạn mở một trang blog, trình duyệt tải HTML trước, rồi mới “thấy” cần CSS từ việc HTML khai báo rằng css cần thiết. Quá trình này tạo ra ít nhất một vòng lặp (round-trip) thừa, làm chậm thời gian hiển thị ban đầu (initial paint). Hình ảnh thì không sao (trang vẫn load với chỗ trống), nhưng CSS hay JS “critical” (quan trọng cho rendering) sẽ khiến trang “treo” đến khi tải xong.
Với HTTP/2 multiplexing (đa kênh), các yêu cầu song song giúp tốt hơn HTTP/1, nhưng vẫn cần round-trip thứ hai. HTTP/2 push “phá vỡ quy tắc” bằng cách server gửi luôn tài nguyên phụ ngay từ đầu, giảm thời gian tải từ 2 round-trip xuống còn 1.
Hình dung qua ví dụ waterfall diagram (biểu đồ thác nước):
Không push: HTML tải xong → Phân tích → Yêu cầu CSS/JS → Chờ tải → Render.
Có push: Server gửi HTML + CSS/JS cùng lúc → Render ngay!
Inline CSS
Để giảm độ trễ, các lập trình viên thường inline các tài nguyên quan trọng ngay vào HTML, nhờ đó trình duyệt có thể bắt đầu render ngay sau khi phân tích trang gốc, thay vì chờ tải thêm tài nguyên.
Tuy nhiên, inline CSS/JS tiềm ẩn nhiều hạn chế:
Khi cần sửa critical CSS (ví dụ redesign), phải cập nhật từng trang chứ không chỉ 1 file chung.
Thường chỉ chứa các style cần thiết cho lần render đầu; toàn bộ stylesheet được tải sau để giảm độ lớn mã inline.
Cần công cụ phân tích để trích đúng những phần “critical” công việc phức tạp.
Dẫn đến trùng lặp: mỗi trang website đều chứa CSS critical riêng, thay vì dùng file có thể cache giữa các trang.
Sau đó nội dung critical CSS còn được giữ trong stylesheet chính, gây trùng lặp trong mỗi trang, không chỉ giữa các trang.
Để tải CSS không quan trọng, cần dùng JavaScript thay vì thẻ <link>, bởi thẻ link nhúng CSS thông thường sẽ block rendering; thẻ link không hỗ trợ async.
Làm rõ hơn cơ chế HTTP/2 Push
HTTP/2 push phá bỏ quy tắc “1 request = 1 response”. Máy chủ có thể trả về nhiều tài nguyên kèm theo một yêu cầu. Ví dụ:
– Client: “Cho tôi trang này.” – Server: “Được thôi, đây là trang HTML, thêm cả CSS và JS cần thiết để bắt đầu rendering”.
Thể hiện dưới dạng waterfall: các tài nguyên không đến đúng lúc, có khoảng cách nhỏ giữa chúng, nhưng tổng thời gian gần 1 vòng chứ không phải 2 như trước.
Tương tự, chuỗi flow request–response có thể thấy như hình dưới, có thể thấy rõ sự tiết kiệm thời gian khi gửi các tài nguyên quan trọng cùng với trang ban đầu.
HTTP/2 Push không thay thế được WebSockets hay SSE
Điểm then chốt: push chỉ xảy ra khi có request ban đầu từ client, server không thể tự ý push bất kỳ lúc nào. WebSockets hay SSE cho phép two-way communication, nhưng HTTP/2 không thật sự hai chiều, mọi thứ đều do client khởi đầu. Sau khi stream request đầu kết thúc, server không thể tiếp tục push trừ khi client gửi request mới. Vì vậy, HTTP/2 push không thay thế WebSocket hay SSE theo chuẩn hiện tại
Cơ chế hoạt động của HTTP/2 Push trong trình duyệt
Trình duyệt xử lý HTTP/2 push lại theo một cách khác. Tài nguyên không được đẩy thẳng đến trang web, mà được đẩy vào một khu vực cache đặc biệt. Trang web vẫn được xử lý bình thường. Khi cần tài nguyên, trình duyệt kiểm tra cache, nếu có sẵn thì tải từ cache thay vì gửi yêu cầu tới server.
Cơ chế chi tiết phụ thuộc vào từng trình duyệt và không được nêu rõ trong spec HTTP/2, nhưng hầu hết hiện nay triển khai một HTTP/2 push cache riêng biệt, khác với HTTP cache thông thường
Cách hoạt động của push cache
Các tài nguyên được đẩy sẽ nằm trong một vùng nhớ riêng (HTTP/2 push cache) chờ trình duyệt yêu cầu. Khi được truy cập, tài nguyên sẽ được đưa vào trang và nếu có header phù hợp sẽ được đồng thời lưu vào HTTP cache để sử dụng sau này.
Một điểm đặc biệt: các trình duyệt dựa trên Chromium (Chrome, Opera) không cache tài nguyên nếu certificate không đáng tin (như tự ký self-signed, hiển thị ổ khoá đỏ), dù người dùng có bỏ qua lỗi. Để HTTP/2 Push hoạt động, bạn cần certificate hợp lệ (ổ khoá xanh)
Quá trình kiểm tra cache của trình duyệt theo thứ tự như sau: image cache → preload cache → service worker → HTTP cache → HTTP/2 push cache. Nếu tài nguyên đã có sẵn ở cache HTTP chính (mặc dù phiên bản mới đã bị push), trình duyệt vẫn ưu tiên dùng bản cũ theo cache-control (Jake Archibald) Service worker còn được kiểm sau preload cache
Image cache (cache hình ảnh):
Là cache tạm, nằm trong bộ nhớ (in-memory) chỉ phục vụ cho trang hiện tại.
Nó giúp trình duyệt không phải tải lại cùng một ảnh nếu trang tham chiếu tới ảnh đó nhiều lần.
Khi người dùng rời khỏi trang, cache này bị hủy.
Preload cache:
Cũng là cache tạm, trong bộ nhớ và chỉ gắn với một trang.
Dùng để giữ các tài nguyên được preload (sẽ nói kỹ hơn ở chương 6).
Lưu ý: không nên preload tài nguyên cho trang khác, vì preload cache không dùng chung giữa các trang.
Service Worker cache:
Service Worker là một loại ứng dụng nền, chạy độc lập với web page, đóng vai trò trung gian giữa web page và server.
Nó cho phép web hoạt động giống native app hơn, ví dụ vẫn có thể hoạt động khi mất mạng.
Service Worker có hệ thống cache riêng, gắn với domain.
HTTP cache (cache truyền thống):
Đây là cache chính mà lập trình viên quen thuộc nhất.
Nó được lưu trên đĩa (persistent), chia sẻ giữa nhiều trang, có dung lượng giới hạn và được dùng cho tất cả domain.
HTTP/2 push cache:
Đây là cache tạm, nằm trong bộ nhớ, gắn liền với một kết nối (connection).
Nếu server push styles.css, file này sẽ được đưa vào HTTP/2 push cache. Sau đó, khi trình duyệt thấy cần styles.css, nó không hề “biết” hay quan tâm rằng server đã push sẵn file này. Trình duyệt vẫn kiểm tra toàn bộ cache theo thứ tự:
Image cache
Preload cache
Service Worker cache
HTTP cache
HTTP/2 push cache
Nếu trong HTTP cache chính đã có một bản styles.css hợp lệ, thì trình duyệt sẽ lấy từ đó kể cả khi trong push cache đang có bản mới hơn.
Bạn có thể dùng công cụ chrome://net-export (nói trong mục 4.3.1) để xem tổng hợp các tài nguyên đã được push nhưng chưa được sử dụng (unclaimed push resources) trong tất cả các trang đang mở
Nếu một kết nối bị đóng, push cache cũng mất theo, khác với HTTP cache. Một cách hiểu ngắn gọn: push cache chỉ tồn tại gắn với kết nối. Khi kết nối không tái sử dụng, tài nguyên push có thể bị lãng phí. Một lần tài nguyên được sử dụng (“claimed”), nó sẽ bị loại khỏi push cache. Nhưng nếu có cache-control phù hợp, vẫn có thể lưu trong HTTP cache. Thậm chí tài nguyên không thể cache theo HTTP (no-cache, no-store) vẫn có thể được push và đọc từ push cache, bởi đây không thực sự là “cache” truyền thống mà là vùng đệm tạm thời
HTTP/2 Push Cache và những vấn đề phát sinh
Push cache gắn liền với connection
HTTP/2 push cache gắn trực tiếp với một kết nối (connection). Điều này dẫn đến:
Nếu kết nối không được dùng → tài nguyên push cũng không được dùng.
Nếu kết nối bị mất → push cache và tất cả tài nguyên chưa dùng cũng mất → việc push bị lãng phí.
Nếu trình duyệt mở thêm một kết nối khác → tài nguyên push có thể sẽ không được dùng.
HTTP/2 thiết kế để chỉ có một connection duy nhất, nên thoạt nhìn có vẻ không có vấn đề. Nhưng thực tế các trình duyệt triển khai khác nhau:
Chrome, Firefox: chia sẻ connection giữa các tab.
Edge: mỗi tab dùng connection riêng.
Safari: có thể mở nhiều connection ngay trong cùng một tab.
Ngoài ra, các request không kèm thông tin xác thực (noncredentialed) thường được gửi trên một connection riêng. Do đó:
Không thể push font cross-origin (từ domain khác, kể cả domain shard) vì chúng phải đi qua noncredentialed request.
Do Push cache hoạt động ở mức connection, chứ không phải mức page. Vì vậy, tuy về lý thuyết bạn có thể push tài nguyên cho trang sẽ load sau, nhưng trên thực tế điều này gần như vô ích, vì cache ngắn hạn và có thể mất khi kết nối rớt.
Push cache khác với HTTP cache
Khi một tài nguyên được lấy ra khỏi push cache, nó sẽ bị xóa khỏi đó và không thể dùng lại từ push cache lần nữa. Nhưng nếu tài nguyên có cache-control hợp lệ, nó sẽ được lưu vào HTTP cache chính để dùng sau.
Push cache có thể chứa cả tài nguyên không cache được (ví dụ header no-cache hoặc no-store). Đây là điểm khác với HTTP cache truyền thống.
Chính vì vậy, push cache không thực sự là cache theo đúng nghĩa, mà giống như một “kho tạm chứa request”
RST_STREAM – Cách từ chối tài nguyên bị push
Trình duyệt có thể từ chối một tài nguyên đang bị push bằng cách gửi một RST_STREAM frame với mã CANCEL hoặc REFUSED_STREAM. Điều này xảy ra khi:
Trình duyệt đã có sẵn tài nguyên trong cache.
Người dùng rời khỏi trang khi nó vẫn đang load → không cần tải thêm tài nguyên nữa.
Tuy nhiên, RST_STREAM có hạn chế:
Việc gửi tín hiệu RST_STREAM mất thời gian → trong lúc đó server vẫn tiếp tục gửi data (HEADERS, DATA frames). Có thể cả file đã được gửi xong trước khi server kịp ngừng lại.
Đây chỉ là tín hiệu điều khiển, không mạnh bằng việc cắt hẳn connection (HTTP/2 không cho phép ngắt connection vì sẽ ảnh hưởng tới tất cả stream khác).
Vì vậy, RST_STREAM không phải giải pháp hiệu quả để ngăn chặn việc push sai tài nguyên.
Ví dụ:
Nếu push một ảnh rất lớn nhưng trang đã được cập nhật không dùng ảnh đó nữa → trình duyệt vẫn tải hết ảnh về nhưng không dùng, gây lãng phí băng thông.
Thậm chí bạn còn không biết mình đang push nhầm, vì một số công cụ (DevTools) có thể không hiển thị tài nguyên bị push mà không dùng.
Client có thể tắt push bằng cách đặt SETTINGS_ENABLE_PUSH = 0 trong khung SETTINGS. Khi đó, server không được phép gửi PUSH_PROMISE nữa.
Request được push phải là cacheable methods (thường là GET, HEAD, hoặc một số POST đặc biệt).
Request được push phải là safe methods (thường là GET hoặc HEAD).
Request được push không được có request body (nhưng response thường có body).
Request được push chỉ được gửi đến những domain mà server có thẩm quyền (authoritative).
Chỉ server mới có quyền push, client không được push.
Resource chỉ có thể được push như phản hồi cho một request hiện tại. Server không thể tự phát khởi một push nếu không có request nào đang diễn ra.
Thực tế, vì các quy tắc trên, chỉ có GET request là thường được push.
Giới hạn về authority nghĩa là bạn chỉ được phép push tài nguyên mà server trực tiếp hoặc gián tiếp phục vụ. Ví dụ, nếu trang của bạn dùng Bootstrap từ getbootstrap.com hoặc jQuery từ jquery.com, thì server của bạn không thể push trực tiếp. Bạn có thể proxy các request đó qua server của mình, nhưng khi đó bạn phải sửa tất cả các tham chiếu để trỏ về server của bạn. Ở tình huống đó, tốt hơn hết là host luôn file đó tại chỗ thay vì tạo thêm phức tạp với proxy.
HTTP/2 Push được thiết kế để tối ưu hiệu năng, nhưng nếu lạm dụng, nó có thể làm chậm hiệu năng vì lãng phí băng thông để push những tài nguyên mà client không dùng, thay vì ưu tiên cho những tài nguyên cần thiết.
Lý tưởng nhất, chỉ nên push tài nguyên quan trọng (critical assets) mà trang chắc chắn cần.
Không nên push:
Tài nguyên không được sử dụng.
Tài nguyên mà client không thể dùng (ví dụ: image format không hỗ trợ).
Tài nguyên chỉ dùng trong một số điều kiện (ví dụ: hình ảnh cho màn hình lớn).
Nhóm Chrome đã viết một tài liệu chi tiết về “nên push cái gì” (Chrome doc on HTTP/2 Push), trong đó họ khuyến nghị:
“Chỉ push mức tối thiểu cần thiết để lấp đầy thời gian mạng rảnh, và không hơn.”
Push chỉ để tận dụng thời gian mạng rảnh (idle network time).
Không nên push toàn bộ tài nguyên mà trang cần, vì như vậy sẽ ghi đè cơ chế ưu tiên tải (prioritization) vốn được trình duyệt tối ưu tốt hơn.
This entry is part 7 of 8 in the series SWE Học A.I
Huấn luyện (Train)
Khi huấn luyện một bộ phân loại bằng học có giám sát (supervised learning), mỗi mẫu dữ liệu đều có một nhãn (label) được gán thủ công, mô tả lớp mà mẫu đó thuộc về. Tập hợp tất cả các mẫu dữ liệu dùng để học, cùng với nhãn của chúng, được gọi là tập huấn luyện (training set).
Chúng ta sẽ lần lượt trình bày từng mẫu trong tập huấn luyện cho bộ phân loại. Với mỗi mẫu, hệ thống nhận các đặc trưng (features) của mẫu và dự đoán lớp của nó.
Nếu dự đoán đúng (tức là khớp với nhãn đã gán), chúng ta chuyển sang mẫu tiếp theo. Nếu dự đoán sai, chúng ta cung cấp đầu ra của bộ phân loại và nhãn đúng trở lại cho nó.
Như ảnh trên, ta có thể thấy, trong quá trình huấn luyện, chúng ta sẽ cần điều chỉnh các tham số (parameter) của bộ phân loại để tăng khả năng dự đoán đúng nhãn. Điều này dẫn đến một bài toán tối ưu hóa (optimization problem), nơi mục tiêu là giảm thiểu sai số hoặc tối đa hóa xác suất xảy ra của dữ liệu. Một kỹ thuật phổ biến để giải bài toán này là phương pháp giảm gradient (gradient descent).
Gradient descent
Ta có một hàm số [latex]f[/latex] nhận đầu vào là một vector các số thực và trả về một số thực duy nhất. Một ví dụ đơn giản là hàm tính tổng bình phương các phần tử trong vector:
Python
from scratch.linear_algebra import Vector, dotdefsum_of_squares(v: Vector)->float:"""Tính tổng bình phương các phần tử trong vector v"""returndot(v, v)
Mục tiêu là tìm vector [latex]v[/latex] sao cho hàm [latex]f(v)[/latex] đạt giá trị lớn nhất (tối đa hóa) hoặc nhỏ nhất (tối thiểu hóa). Gradient (vector của các đạo hàm riêng [latex]\nabla f[/latex]) cho biết hướng làm hàm số tăng nhanh nhất. Ý tưởng của phương pháp giảm gradient là:
Chọn một điểm xuất phát ngẫu nhiên.
Tính gradient tại điểm đó.
Di chuyển một bước nhỏ theo hướng gradient (để tối đa hóa) hoặc ngược hướng (để tối thiểu hóa).
Lặp lại quá trình với điểm mới.
Trong hình trên thể hiện một hàm hai biến [latex]f(x, y) = x^2 + y^2[/latex], có dạng hình paraboloid lồi hướng lên, với điểm thấp nhất nằm tại gốc tọa độ [latex](0, 0, 0)[/latex].
Các mũi tên tam giác đỏ thể hiện các bước di chuyển của thuật toán. Tại mỗi bước, gradient được tính và điểm hiện tại được cập nhật theo hướng:
trong đó [latex]\eta[/latex] là tốc độ học (learning rate).
Ước lượng gradient
Nếu hàm [latex]f[/latex] chỉ có một biến, đạo hàm tại điểm [latex]x[/latex] đo lường sự thay đổi của [latex]f(x)[/latex] khi [latex]x[/latex] thay đổi một lượng rất nhỏ.
[latex]
\frac{f(x + h) – f(x)}{h}
[/latex]
Đây gọi là thương số sai phân.
[latex]h[/latex]: là một bước nhỏ (ví dụ: 0.001).
[latex]f(x+h)[/latex]: là giá trị hàm khi đi thêm một chút từ [latex]x[/latex].
[latex]f(x+h) – f(x)[/latex]: là phần thay đổi.
Chia cho [latex]h[/latex] để biết “mỗi bước nhỏ thay đổi bao nhiêu” → chính là độ dốc (gradient)
Đường cong màu xám là đồ thị của hàm [latex]f(x)[/latex].
Hai điểm được đánh dấu:
[latex](x, f(x))[/latex] – điểm gốc.
[latex](x + h, f(x + h))[/latex] – điểm gần đó.
Tam giác màu xanh dương thể hiện:
Đáy tam giác là [latex]h[/latex]
Chiều cao là [latex]f(x+h) – f(x)[/latex]
Độ dốc của đoạn thẳng là:
[latex]
\frac{f(x+h) – f(x)}{h}
[/latex]
→ chính là ước lượng đạo hàm tại [latex]x[/latex].
Khi hàm [latex]f[/latex] có nhiều biến, ta tính đạo hàm riêng (partial derivative) cho từng biến, giữ các biến khác cố định:
Python
defpartial_difference_quotient(f: Callable[[Vector],float],v: Vector,i:int,h:float)->float:"""Tính thương số sai phân riêng thứ i của hàm f tại vector v""" w =[v_j +(h if j == i else0)for j, v_j inenumerate(v)]return(f(w)-f(v))/ hdefestimate_gradient(f: Callable[[Vector],float],v: Vector,h:float=0.0001):return[partial_difference_quotient(f, v, i, h)for i inrange(len(v))]
Lưu ý: Việc ước lượng gradient bằng thương số sai phân tốn nhiều tài nguyên tính toán, đặc biệt với vector có kích thước lớn. Trong thực tế, người ta thường tính gradient trực tiếp bằng toán học để tối ưu hiệu suất.
Sử dụng Gradient để Tối Ưu Hóa Hàm Số
Rõ ràng rằng hàm tổng bình phương (sum of squares) đạt giá trị nhỏ nhất khi đầu vào là một vector toàn số không. Tuy nhiên, giả sử chúng ta chưa biết điều này, chúng ta có thể sử dụng gradient để tìm giá trị tối thiểu trong không gian các vector ba chiều. Bắt đầu từ một điểm ngẫu nhiên, ta thực hiện các bước nhỏ theo hướng ngược với gradient cho đến khi gradient đạt giá trị rất nhỏ.
Python
from scratch.linear_algebra import distance, add, scalar_multiplydefgradient_step(v: Vector,gradient: Vector,step_size:float)-> Vector:"""Di chuyển một khoảng `step_size` theo hướng `gradient` từ điểm `v`"""assertlen(v)==len(gradient) step =scalar_multiply(step_size, gradient)returnadd(v, step)defsum_of_squares_gradient(v: Vector)-> Vector:"""Tính gradient của hàm tổng bình phương"""return[2* v_i for v_i in v]# Chọn điểm bắt đầu ngẫu nhiênv =[random.uniform(-10,10)for i inrange(3)]for epoch inrange(1000): grad =sum_of_squares_gradient(v)# Tính gradient tại v v =gradient_step(v, grad,-0.01)# Bước ngược hướng gradientprint(epoch, v)assertdistance(v,[0,0,0])<0.001# v gần với [0, 0, 0]
Nếu thực thi đoạn code trên, vector v sẽ tiến gần đến [0, 0, 0]. Số lượng epoch càng lớn, kết quả càng chính xác.
Kiểm Thử (Test)
Chúng ta bắt đầu với một hệ thống có các tham số được khởi tạo ngẫu nhiên. Sau đó, chúng ta huấn luyện nó bằng dữ liệu trong tập huấn luyện. Khi hệ thống được triển khai ra thế giới thực, nó sẽ đối mặt với dữ liệu thực tế (deployment data, release data, hoặc user data).
Chúng ta muốn biết hệ thống sẽ hoạt động tốt như thế nào trên dữ liệu thực tế trước khi triển khai. Không cần độ chính xác hoàn hảo, nhưng thường chúng ta mong hệ thống đạt hoặc vượt một ngưỡng chất lượng nhất định. Làm sao để ước lượng chất lượng dự đoán của hệ thống trước khi triển khai?
Hệ thống cần hoạt động tốt trên tập huấn luyện, nhưng nếu chỉ đánh giá độ chính xác dựa trên dữ liệu này, chúng ta thường bị đánh lừa.
Giả sử chúng ta dùng bộ phân loại có giám sát để xử lý ảnh chó. Với mỗi ảnh, hệ thống sẽ gán nhãn xác định giống chó. Mục tiêu là triển khai hệ thống trực tuyến để người dùng có thể kéo ảnh chó của họ vào trình duyệt và nhận về giống chó hoặc nhãn “giống hỗn hợp (mixed breed)”.
Để huấn luyện, chúng ta thu thập 1.000 ảnh chó thuần chủng, mỗi ảnh được chuyên gia gắn nhãn. Chúng ta cho hệ thống xem cả 1.000 ảnh, lặp đi lặp lại qua nhiều epoch (lần lặp), thường xáo trộn thứ tự ảnh mỗi lần lặp để tránh trình tự lặp lại. Nếu hệ thống được thiết kế tốt, nó sẽ dần đạt kết quả chính xác hơn, ví dụ đạt 99% trong việc xác định giống chó trên tập huấn luyện.
Tuy nhiên, điều này không có nghĩa hệ thống sẽ đạt 99% chính xác khi triển khai trực tuyến. Vấn đề là hệ thống có thể đã khai thác các mối quan hệ đặc biệt trong tập huấn luyện, nhưng không đúng với dữ liệu nói chung.
Ví dụ, giả sử các ảnh chó Poodle trong tập huấn luyện đều có một cục bông ở đuôi, trong khi các giống khác thì không. Hệ thống nhận ra điều này và chỉ cần tìm cục bông để phân loại Poodle, thay vì xem xét các đặc trưng như kích thước chân, hình dạng mũi, v.v. Quy tắc này giúp phân loại đúng 100% ảnh Poodle trong tập huấn luyện, nhưng không phải cách chúng ta mong muốn. Hệ thống được cho là đã “học cách gian lận” (cheating)
Một ví dụ khác: Giả sử tất cả ảnh chó Yorkshire Terrier (Yorkie) trong tập huấn luyện đều được chụp khi chó ngồi trên ghế sofa, và không ảnh nào của giống khác có sofa. Hệ thống có thể học rằng nếu có sofa trong ảnh, đó là Yorkie. Quy tắc này hoạt động hoàn hảo trên tập huấn luyện.
Khi triển khai, nếu ai đó gửi ảnh một chú chó Great Dane đứng trước trang trí lễ hội với những quả bóng trắng hoặc một chú Husky nằm trên sofa, hệ thống có thể nhầm quả bóng trắng ở đuôi Great Dane là cục bông và gọi đó là Poodle, hoặc thấy sofa và gọi Husky là Yorkie.
Đây không chỉ là vấn đề lý thuyết. Một ví dụ nổi tiếng từ những năm 1960 (Muehlhauser 2011) kể về một hệ thống học máy nhận diện xe tăng trong ảnh cây cối. Hệ thống được cho là nhận diện xe tăng hoàn hảo, nhưng sau đó phát hiện rằng ảnh có xe tăng được chụp vào ngày nắng, còn ảnh không xe tăng chụp vào ngày âm u. Hệ thống chỉ phân biệt trời sáng và tối, không liên quan gì đến xe tăng.
Đây là lý do tại sao chỉ nhìn vào hiệu suất trên tập huấn luyện không đủ để dự đoán hiệu suất thực tế. Hệ thống có thể học các đặc điểm kỳ lạ (idiosyncrasies) trong tập huấn luyện và sử dụng chúng làm quy tắc, nhưng thất bại với dữ liệu mới không có những đặc điểm đó. Hiện tượng này được gọi là quá khớp (overfitting), hay thường gọi là “gian lận” (cheating)
Dữ liệu kiểm thử (Test Data)
Cách tốt nhất để xác định hiệu suất của hệ thống trên dữ liệu mới, chưa từng thấy là thử nghiệm nó trên dữ liệu kiểm thử (test data hoặc test set). Dữ liệu kiểm thử sẽ không được cho vào trong quá trình huấn luyện, vì vậy từ góc nhìn của hệ thống, chúng sẽ là các dữ liệu mới hoàn toàn.
Dữ liệu kiểm thử phải đại diện cho dữ liệu thực tế mà hệ thống sẽ gặp khi triển khai. Quy trình thông thường là huấn luyện hệ thống trên tập huấn luyện cho đến khi đạt hiệu suất tốt nhất có thể, sau đó đánh giá trên tập kiểm thử để dự đoán hiệu suất thực tế.
Nếu hiệu suất trên tập kiểm thử không đủ tốt, chúng ta cần cải thiện hệ thống, thường bằng cách thu thập thêm dữ liệu và huấn luyện lại. Thêm dữ liệu cũng giúp đa dạng hóa tập huấn luyện, ví dụ, tìm chó không phải Poodle có cục bông ở đuôi hoặc chó không phải Yorkie trên sofa, buộc hệ thống tìm cách phân loại khác để tránh quá khớp.
Do đó, chúng ta tách dữ liệu kiểm thử khỏi tập huấn luyện ngay từ đầu và chỉ sử dụng nó một lần sau khi huấn luyện hoàn tất. Nếu hệ thống không đạt yêu cầu trên tập kiểm thử, chúng ta phải bắt đầu lại với hệ thống mới được khởi tạo ngẫu nhiên, huấn luyện với dữ liệu mới hoặc lâu hơn, rồi đánh giá lại trên tập kiểm thử.
Thông thường, chúng ta tạo tập kiểm thử bằng cách chia tập dữ liệu gốc thành hai phần: tập huấn luyện (khoảng 75%) và tập kiểm thử (25%). Việc chọn mẫu thường ngẫu nhiên, nhưng có thể dùng thuật toán phức tạp hơn để đảm bảo mỗi tập đại diện tốt cho dữ liệu gốc.
Dữ Liệu Xác Thực (Validation Data)
Trong quy trình trên, chúng ta huấn luyện hệ thống, sau đó dừng lại và đánh giá trên tập kiểm thử. Nếu hiệu suất không đủ, chúng ta bắt đầu lại. Cách này hiệu quả nhưng chậm.
Trong thực tế, chúng ta thường muốn ước lượng hiệu suất hệ thống trong quá trình huấn luyện để dừng lại khi đạt mục tiêu. Vì vậy, chúng ta chia dữ liệu gốc thành ba tập: tập huấn luyện (training set), tập xác thực (validation set), và tập kiểm thử (test set), thường theo tỷ lệ 60% – 20% – 20%
Quy trình mới là: huấn luyện qua một epoch trên tập huấn luyện, sau đó đánh giá hiệu suất trên tập xác thực. Việc này được lặp lại sau mỗi epoch, gây rò rỉ dữ liệu, nhưng tập xác thực chỉ dùng để ước lượng không chính thức. Hiệu suất trên tập xác thực giúp chúng ta theo dõi quá trình học của hệ thống. Khi thấy hiệu suất đủ tốt, chúng ta dùng tập kiểm thử một lần để đánh giá chính xác.
Tập xác thực cũng hữu ích khi tìm kiếm siêu tham số (hyperparameters) – các biến được cài đặt trước để kiểm soát hoạt động của hệ thống, như mức độ cập nhật tham số sau lỗi hoặc độ phức tạp của bộ phân loại. Với mỗi bộ siêu tham số, chúng ta huấn luyện trên tập huấn luyện và đánh giá trên tập xác thực. Kết quả từ tập xác thực giúp quyết định khi nào dừng huấn luyện. Khi hiệu suất đạt yêu cầu, chúng ta dùng tập kiểm thử để đánh giá cuối cùng.
Quy trình này là một vòng lặp: chọn siêu tham số, huấn luyện, đánh giá trên tập xác thực, lặp lại với bộ siêu tham số mới, và cuối cùng chọn hệ thống tốt nhất để kiểm tra trên tập kiểm thử.
Vì tập xác thực đã ảnh hưởng đến việc chọn siêu tham số. Dù bộ phân loại không học trực tiếp từ tập xác thực, dữ liệu này đã “rò rỉ” vào quá trình chọn bộ phân loại tốt nhất. Để đánh giá chính xác trên dữ liệu hoàn toàn mới, không có cách nào khác ngoài việc dùng tập kiểm thử vào cuối cùng.
Xác Thực Chéo (Cross-Validation)
Trong phần trước, chúng ta đã dành gần một nửa dữ liệu huấn luyện để làm tập xác thực và kiểm tra. Điều này không thành vấn đề khi chúng ta có lượng dữ liệu đủ lớn để chia. Nhưng nếu tập dữ liệu của chúng ta nhỏ và không thể thu thập thêm dữ liệu thì sao?
Nếu chúng ta chấp nhận một ước lượng về hiệu suất của hệ thống thay vì một phép đo đáng tin cậy, chúng ta không cần phải để dành một tập kiểm tra riêng. Thực tế, chúng ta có thể huấn luyện trên toàn bộ dữ liệu đầu vào và vẫn dự đoán được hiệu suất trên dữ liệu mới.
Kỹ thuật thực hiện công việc này được gọi là xác thực chéo (cross-validation) hoặc xác thực luân phiên (rotation validation).
Ý tưởng cốt lõi là chạy một vòng lặp lặp đi lặp lại việc huấn luyện hệ thống từ đầu và sau đó kiểm tra nó. Mỗi lần lặp, chúng ta chia toàn bộ dữ liệu đầu vào thành một tập huấn luyện tạm thời và một tập xác thực tạm thời. Điều quan trọng là các tập này được tạo khác nhau trong mỗi lần lặp. Điều này cho phép chúng ta sử dụng toàn bộ dữ liệu để huấn luyện (mặc dù không phải tất cả cùng một lúc, như sẽ thấy sau).
Chúng ta bắt đầu bằng cách xây dựng một bộ phân loại mới. Dữ liệu đầu vào được chia thành tập huấn luyện tạm thời và tập xác thực tạm thời. Chúng ta huấn luyện hệ thống trên tập huấn luyện tạm thời và đánh giá nó bằng tập kiểm tra tạm thời, từ đó thu được điểm số về hiệu suất của bộ phân loại. Sau đó, chúng ta lặp lại vòng lặp, nhưng lần này chia dữ liệu thành các tập huấn luyện và kiểm tra tạm thời khác. Khi đã hoàn thành tất cả các lần lặp, trung bình của các điểm số này là ước lượng hiệu suất tổng thể của bộ phân loại.
Nhờ xác thực chéo, chúng ta có thể huấn luyện trên toàn bộ dữ liệu (mặc dù không phải tất cả trong mỗi lần lặp) và vẫn có được một phép đo khách quan về chất lượng hệ thống từ tập kiểm tra riêng. Thuật toán này không gặp vấn đề rò rỉ dữ liệu (data leakage) vì mỗi lần lặp, chúng ta tạo một bộ phân loại mới, và tập kiểm tra tạm thời cho bộ phân loại đó chứa dữ liệu hoàn toàn mới, chưa từng được sử dụng bởi bộ phân loại cụ thể đó, do đó việc sử dụng nó để đánh giá hiệu suất là công bằng. Tuy nhiên, nhược điểm của kỹ thuật này là ước lượng cuối cùng về độ chính xác của hệ thống không đáng tin cậy bằng khi sử dụng tập kiểm tra riêng.
Có nhiều thuật toán khác nhau để xây dựng các tập huấn luyện và xác thực tạm thời. Có thể điểm qua 1 số phương pháp phổ biến:
Xác Thực Chéo K-Fold
Phương pháp phổ biến nhất để xây dựng các tập dữ liệu tạm thời cho xác thực chéo được gọi là xác thực chéo k-fold. Ở đây, chữ “k” không phải là chữ cái đầu của một từ, mà đại diện cho một số nguyên (ví dụ, chúng ta có thể thực hiện “xác thực chéo 2-fold” hoặc “xác thực chéo 5-fold”). Thông thường, giá trị của k là số lần chúng ta muốn lặp lại vòng lặp.
Thuật toán bắt đầu trước khi vòng lặp xác thực chéo diễn ra. Chúng ta lấy dữ liệu huấn luyện và chia nó thành một loạt các nhóm có kích thước bằng nhau. Mỗi mẫu dữ liệu được đặt vào đúng một nhóm, và tất cả các nhóm có kích thước giống nhau (trừ một nhóm nhỏ hơn ở cuối nếu không thể chia đều dữ liệu).
Để hình dung, hãy tưởng tượng bạn viết tất cả các mẫu trong tập huấn luyện lên một tờ giấy dài, sau đó gấp tờ giấy đó thành một số phần bằng nhau. Mỗi lần gấp tạo ra một nếp, và phần vật liệu giữa các nếp được gọi là một fold.
Hãy sử dụng năm fold này để xem vòng lặp diễn ra như thế nào. Lần đầu tiên qua vòng lặp, chúng ta coi các mẫu trong Fold 2 đến Fold 5 là tập huấn luyện tạm thời, và các mẫu trong Fold 1 là tập kiểm tra tạm thời. Nghĩa là, chúng ta huấn luyện bộ phân loại với các mẫu trong Fold 2 đến Fold 5, sau đó đánh giá nó với các mẫu trong Fold 1.
Lần tiếp theo qua vòng lặp, bắt đầu với một bộ phân loại mới được khởi tạo với các số ngẫu nhiên, chúng ta sử dụng các mẫu trong Fold 1, 3, 4, và 5 làm tập huấn luyện tạm thời, và các mẫu trong Fold 2 làm tập kiểm tra tạm thời. Chúng ta huấn luyện và kiểm tra như thường lệ với hai tập này, và tiếp tục với các fold còn lại.
This entry is part 6 of 8 in the series SWE Học A.I
Học cách suy ra các quy tắc tổng quát từ một tập hợp ví dụ hữu hạn là một thách thức lớn, dù là đối với con người hay máy tính. Nếu chúng ta không chú ý đủ đến chi tiết của các ví dụ, các quy tắc sẽ quá chung chung và khó áp dụng cho dữ liệu mới. Ngược lại, nếu tập trung quá mức vào chi tiết, các quy tắc sẽ trở nên quá cụ thể, dẫn đến việc xử lý dữ liệu mới không hiệu quả. Hai hiện tượng này được gọi là underfitting và overfitting. Trong đó, overfit là vấn đề phổ biến và khó xử lý hơn, có thể khiến hệ thống trở nên gần như vô dụng nếu không được kiểm soát. Để khắc phục, chúng ta sử dụng các kỹ thuật được gọi chung là regularization (chuẩn hóa).
Overfit và Underfit
Overfit
Hãy tưởng tượng bạn tham dự một đám cưới ngoài trời, nơi bạn không quen biết ai. Trong buổi chiều, bạn gặp gỡ và trò chuyện với nhiều người, cố gắng ghi nhớ tên họ. Để dễ nhớ, bạn liên kết ngoại hình với tên. Chẳng hạn, bạn gặp một người tên Minh có tóc xoăn, nên bạn hình dung Minh là một bạn có tóc rất xoăn, do chắc chắn rằng trong bữa tiệc đó chẳng có ai tóc xoăn bằng Minh, điều này càng củng cố khả năng ghi nhớ của bạn. Sau đó, bạn gặp Lan, người đeo bông tai màu ngọc lam, và bạn liên tưởng bông tai màu ngọc lam thành tên Lan, vì theo bạn thấy, đây cũng là một đặc điểm hiếm gặp và giúp bạn dễ xác định người nào tên gì hơn. Trong bữa tiệc, khi đi xung quanh và gặp lại Minh, Lan vài lần, hệ thống này có vẻ hoạt động khá tốt dù có rất nhiều người trong bữa tiệc.
Nhưng tại tiệc tối, bạn gặp một người mới cũng có tóc rất xoăn. Bạn gọi ngay: “Chào Minh!” nhưng chỉ nhận lại 1 ánh mắt ngơ ngác, và họ tự nhận là một người khác. Tương tự, bạn gặp một người đeo bông tai ngọc lam, nhưng đó là Hoa, không phải Lan. Vấn đề nằm ở chỗ bạn đã liên kết tên với một đặc điểm quá cụ thể. Đây chính là overfit: bạn học quá tốt dữ liệu ban đầu (những người trong tiệc chiều) nhưng không tổng quát hóa được cho dữ liệu mới (những người trong tiệc tối).
Trong học máy, overfit xảy ra khi mô hình tập trung vào các đặc điểm đặc thù của dữ liệu huấn luyện, thay vì học các quy tắc tổng quát. Chẳng hạn, trong một bài toán nhận diện giống chó (như trong bài viết trước), mô hình có thể nhầm lẫn một con chó husky trên ghế sofa là chó Yorkshire terrier, chỉ vì nó dựa vào ghế sofa thay vì đặc điểm của con chó.
Underfit
Ngược lại với overfit, underfit xảy ra khi mô hình tạo ra các quy tắc quá chung chung. Quay lại ví dụ đám cưới, nếu bạn kết luận rằng “tất cả những người mặc quần là Minh”, quy tắc này quá đơn giản và không thể áp dụng cho người mới. Trong học máy, underfit thường do mô hình quá đơn giản hoặc thiếu dữ liệu huấn luyện. Ví dụ, một mô hình tuyến tính (linear model) có thể không đủ phức tạp để phân loại dữ liệu phi tuyến.
Ví dụ thực tế: Dự đoán giá nhà
Giả sử bạn xây dựng một mô hình dự đoán giá nhà chỉ dựa trên diện tích. Mô hình tuyến tính đơn giản [latex]y = ax + b[/latex] có thể không đủ để dự đoán chính xác, vì giá nhà còn phụ thuộc vào vị trí, số phòng, tiện ích, v.v. Đây là underfit, vì mô hình không học được các đặc điểm quan trọng.
Phát hiện và xử lý Overfit
Để phát hiện overfit, chúng ta sử dụng tập kiểm chứng (validation set) (như đã đề cập ở bài trước) để đánh giá sai số kiểm chứng (validation error), ước lượng sai số tổng quát (generalization error). Khi sai số huấn luyện giảm nhưng sai số kiểm chứng tăng, đó là dấu hiệu của overfit.
Biểu đồ thể hiện rõ, model đang có vẻ hoạt động ngày càng tốt trên tập dữ liệu huấn luyện cho nó, nhưng khi thử trên tập dữ liệu kiểm chứng (validation) thì sau lần chạy 30, sai sót ngày càng lớn => Điều này thể hiện model đã học phải những đặc điểm tưởng chừng có vẻ tốt, và nó làm tốt trên tập huấn luyện hơn. Nhưng thực tế, những thứ được học này không tổng quát và làm hiệu năng với các dữ liệu nó chưa từng thấy kém đi <- hay dữ liệu thực tế mà ta sẽ gặp.
Khi sai số kiểm chứng tăng (khoảng epoch 20), chúng ta nên dừng huấn luyện để tránh overfit. Đây là kỹ thuật dừng sớm (early stopping).
Giả sử bạn được thuê để xây dựng một hệ thống tự động điều chỉnh nhịp độ (tempo) nhạc nền cho một cửa hàng. Chủ cửa hàng thường xuyên thay đổi nhịp độ trong ngày, và bạn ghi lại dữ liệu như sau:
9h sáng: 80 BPM (nhịp chậm, thư giãn).
12h trưa: 120 BPM (nhịp nhanh, sôi động).
3h chiều: 100 BPM (nhịp trung bình).
Bạn thử khớp một đường cong với dữ liệu này
Đường cong ban đầu quá “lắc léo”, thay đổi nhịp độ quá thường xuyên, gây khó chịu cho khách hàng, vì chỉ cần một thay đổi nhỏ trên thời gian, bạn cũng sẽ cố điều chỉnh nhạc ngay theo dấu hiệu đó – dấu hiệu của overfit.
Sau đó, bạn thử một đường cong đơn giản hơn
Nhưng nó quá chung chung, bỏ qua xu hướng nhịp chậm vào sáng và nhanh vào chiều – dấu hiệu của underfit.
Cuối cùng, bạn tìm được một đường cong cân bằng, khớp tốt với xu hướng chung mà không quá chi tiết.
Khách hàng hài lòng với đường cong này và nhịp độ của các bài hát nó chọn trong ngày. Chúng ta đã tìm được một điểm nằm giữa overfit và underfit. Trong ví dụ này, việc tìm đường cong tốt nhất dựa trên cảm nhận cá nhân, nhưng sau này chúng ta sẽ xem các cách thuật toán để tìm điểm cân bằng giữa underfit/overfit.
Ở bên trái hình trên, một điểm tròn nằm sâu trong vùng hình vuông, dẫn đến đường biên phức tạp. Chúng ta gọi điểm cô lập này là điểm ngoại lai (outlier), và thường xem nó với sự nghi ngờ.
Có thể đây là lỗi đo lường hoặc ghi chép, hoặc chỉ là một dữ liệu hợp lệ nhưng rất bất thường. Thu thập thêm dữ liệu sẽ giúp xác định trường hợp này, nhưng nếu chỉ có tập dữ liệu này, chúng ta cần quyết định phải làm gì. Việc vẽ đường biên để khớp với điểm này có thể khiến chúng ta phân loại sai các điểm dữ liệu mới trong vùng hình vuông, vì chúng rơi vào phía màu xanh của đường biên lạ. Có lẽ tốt hơn là chọn đường cong đơn giản hơn như ở bên phải, và chấp nhận điểm này là lỗi.
Ví dụ, dữ liệu về điểm số của sinh viên, đôi lúc do giáo viên điền nhầm, có thể nhầm giữa 10 điểm và 1 điểm, việc bỗng nhiên xuất hiện 1 điểm số 1 cho một sinh viên thường xuyên được điểm cao có thể làm model đánh giá phạt rất nặng, và dự đoán sai lầm.
Dừng sớm (Early Stopping)
Có thể nói rằng, khi bắt đầu huấn luyện mô hình, chúng ta đang underfit. Mô hình chưa thấy đủ ví dụ để tìm ra cách xử lý đúng, nên các quy tắc còn chung chung và mơ hồ.
Khi huấn luyện thêm và mô hình tinh chỉnh các đường biên, sai số huấn luyện và kiểm chứng thường giảm. Để thảo luận.
Tại một thời điểm, chúng ta thấy sai số huấn luyện tiếp tục giảm, nhưng sai số kiểm chứng bắt đầu tăng (có thể đi ngang một thời gian trước). Bây giờ chúng ta đang overfit. Sai số huấn luyện giảm vì chúng ta ngày càng đúng chi tiết. Nhưng chúng ta đang điều chỉnh kết quả quá mức cho dữ liệu huấn luyện, và sai số tổng quát (hoặc ước lượng của nó, sai số kiểm chứng) tăng lên.
Từ phân tích này, chúng ta có 1 phương pháp đơn giản: khi bắt đầu overfit, hãy dừng huấn luyện. Trong hình trên, khoảng 28 epoch, khi sai số kiểm chứng tăng dù sai số huấn luyện giảm, chúng ta nên dừng. Kỹ thuật này gọi là dừng sớm (early stopping), vì chúng ta dừng huấn luyện trước khi sai số huấn luyện đạt zero. Có thể nghĩ đây là dừng phút cuối, vì chúng ta huấn luyện lâu nhất có thể, chỉ dừng khi tìm được biểu diễn tốt nhất mà không overfit.
Trong thực tế, các phép đo sai số hiếm khi mượt mà như đường cong lý tưởng trong hình trên. Chúng thường có nhiễu và có thể đi “sai hướng” trong thời gian ngắn, nên khó tìm điểm dừng chính xác. Hầu hết thư viện dừng sớm cung cấp các biến để làm mượt các đường cong sai số, phát hiện khi sai số kiểm chứng thực sự tăng.
Chuẩn hóa (Regularization)
Chúng ta luôn muốn khai thác tối đa thông tin từ dữ liệu huấn luyện, dừng ngay trước khi overfit. Dừng sớm kết thúc học khi sai số kiểm chứng tăng, nhưng nếu có cách trì hoãn hiện tượng này, chúng ta có thể huấn luyện lâu hơn và tiếp tục giảm cả sai số huấn luyện và kiểm chứng.
Hãy lấy ví dụ nướng gà tây trong lò. Nếu chỉ đặt gà vào chảo và nướng ở nhiệt độ cao, phần bên ngoài sẽ cháy. Nhưng nếu muốn nướng lâu hơn mà không cháy, chúng ta có thể bọc gà trong giấy bạc. Giấy bạc trì hoãn việc cháy, cho phép nướng lâu hơn.
Các kỹ thuật trì hoãn overfit được gọi chung là phương pháp chuẩn hóa (regularization methods). Máy tính không biết nó đang overfit. Khi yêu cầu học từ dữ liệu huấn luyện, nó học tốt nhất có thể. Nó không biết khi nào vượt qua ranh giới từ “kiến thức tốt” sang “kiến thức quá cụ thể”, nên chúng ta phải quản lý vấn đề này.
Một cách phổ biến để chuẩn hóa là giới hạn giá trị các tham số của bộ phân loại. Ý tưởng cốt lõi là giữ tất cả tham số ở giá trị nhỏ, ngăn bất kỳ tham số nào thống trị (Domke 2008). Điều này khiến bộ phân loại khó phụ thuộc vào các đặc điểm hẹp, riêng biệt.
Quay lại ví dụ ghi nhớ tên. Khi nhớ Minh với tóc rất xoăn, thông tin này thống trị mọi thứ khác. Các đặc điểm khác như giới tính, chiều cao, màu áo, giọng nói bị bỏ qua và xem nhẹ. Khi gặp người khác có tóc xoăn, đặc điểm đó thống trị và chúng ta nhầm người đó là Minh.
Mức độ chuẩn hóa tốt nhất thay đổi tùy theo mô hình và tập dữ liệu, nên chúng ta thường phải thử nhiều giá trị. Mức chuẩn hóa được chỉ định bằng một siêu tham số, thường ký hiệu là [latex]\lambda[/latex] (lambda). Giá trị [latex]\lambda[/latex] lớn hơn nghĩa là chuẩn hóa mạnh hơn.
Việc giữ giá trị tham số nhỏ cũng khiến các đường biên của bộ phân loại không quá phức tạp và lắc léo. Chúng ta có thể dùng tham số chuẩn hóa [latex]\lambda[/latex] để chọn độ phức tạp của đường biên. Giá trị [latex]\lambda[/latex] cao cho các đường biên mượt mà, còn giá trị thấp cho phép đường biên khớp sát hơn với dữ liệu.
Cụ thể về việc triển khai Regularization sẽ nói thêm ở phần sau.
Độ lệch và Phương sai (Bias and Variance)
Các thuật ngữ thống kê độ lệch (bias) và phương sai (variance) liên quan chặt chẽ đến overfit/underfit, và thường được nhắc đến khi thảo luận các chủ đề này. Chúng ta có thể nói độ lệch đo xu hướng của hệ thống học sai một cách nhất quán, và phương sai đo xu hướng học các chi tiết không liên quan (Domingos, 2015). Nói cách khác, độ lệch lớn nghĩa là hệ thống thiên kiến về một loại kết quả cụ thể, còn phương sai lớn nghĩa là các câu trả lời của hệ thống quá cụ thể với dữ liệu.
Khớp với dữ liệu cơ bản
Giả sử một người bạn là nhà nghiên cứu khí quyển nhờ chúng ta giúp đỡ. Cô ấy đã đo tốc độ gió tại một điểm trên đỉnh núi, cùng thời điểm mỗi ngày, trong vài tháng. Dữ liệu đo được thể hiện
Cô ấy tin rằng dữ liệu đo được là tổng của một đường cong lý tưởng, giống nhau qua các năm, và nhiễu, thể hiện các dao động không dự đoán được hàng ngày. Dữ liệu đo được gọi là đường cong nhiễu, vì là tổng của đường cong lý tưởng và nhiễu.
Nhà nghiên cứu tin rằng cô ấy có một mô hình tốt để mô tả nhiễu. Nhưng mô tả nhiễu là thống kê, nên cô ấy không thể dùng nó để sửa các phép đo hàng ngày. Nói cách khác, nếu biết chính xác giá trị nhiễu bên phải, cô ấy có thể trừ chúng từ các phép đo để được đường cong sạch bên trái. Nhưng cô ấy không có các giá trị nhiễu cụ thể.
Đây là một cách để làm sạch dữ liệu nhiễu. Chúng ta có thể quay lại dữ liệu nhiễu và thử khớp một đường cong mượt mà (Bishop, 2006). Bằng cách chọn độ phức tạp của đường cong đủ lắc léo để theo dữ liệu, nhưng không quá lắc léo để khớp chính xác từng điểm, chúng ta hy vọng khớp tốt với hình dạng chung của đường cong, là điểm khởi đầu tốt để tìm đường cong lý tưởng.
Có nhiều cách để khớp một đường cong mượt với dữ liệu nhiễu. Dao động nhỏ ở đầu phải là đặc trưng của loại đường cong này, thường nhảy vọt gần mép tập dữ liệu.
Đường cong này trông không quá tệ. Nhưng chúng ta có thể làm tốt hơn không?
Hãy áp dụng ý tưởng độ lệch và phương sai vào bài toán tìm đường cong lý tưởng.
Hãy tạo 50 phiên bản của dữ liệu nhiễu ban đầu, mỗi phiên bản chứa 30 điểm được chọn ngẫu nhiên, không lặp lại. Năm phiên bản đầu được thể hiện
Hãy thử khớp mỗi tập điểm này với các đường cong đơn giản và đường cong phức tạp, rồi so sánh kết quả theo độ lệch và phương sai.
Độ lệch cao, Phương sai thấp
Chúng ta sẽ khớp dữ liệu bằng các đường cong đơn giản, mượt mà. Vì đã chọn các đặc tính này trước, chúng ta kỳ vọng các đường cong kết quả sẽ giống nhau.
Như dự đoán, các đường cong đều đơn giản và khá tương đồng. Vì các đường cong rất giống nhau, chúng ta nói tập hợp này thể hiện độ lệch cao (high bias). Độ lệch ở đây ám chỉ ưu tiên định sẵn cho hình dạng đơn giản. Vì các đường cong quá đơn giản, mỗi đường cong thiếu linh hoạt để đi qua nhiều điểm dữ liệu nhất.
Phương sai (variance) đề cập đến mức độ khác biệt giữa các đường cong. Để quan sát phương sai của các đường cong có độ lệch cao này, ta có thể vẽ chồng 50 đường cong lên nhau, như trong hình sau
Đúng như dự đoán, các đường cong rất giống nhau, thể hiện phương sai thấp (low variance).
Tóm lại, tập hợp đường cong này có độ lệch cao, vì chúng có hình dạng gần giống nhau, và phương sai thấp, vì các đường cong riêng lẻ không bị ảnh hưởng nhiều bởi dữ liệu.
Độ lệch thấp, Phương sai cao
Bây giờ, hãy thử giảm bớt ràng buộc rằng các đường cong phải đơn giản. Điều này cho phép chúng ta khớp các đường cong phức tạp hơn với dữ liệu, khiến mỗi đường cong tiến gần hơn đến các điểm màu xanh.
So với hình ban đầu, các đường cong này uốn lượn hơn, với nhiều đỉnh và đáy. Dù vẫn không đi qua quá nhiều điểm, chúng có vẻ tốt hơn.
Do hình dạng của các đường cong này phức tạp và linh hoạt hơn, chúng bị ảnh hưởng nhiều hơn bởi dữ liệu so với bất kỳ giả định ban đầu nào. Vì chúng ta đặt ít ràng buộc hơn lên hình dạng đường cong, ta nói rằng tập hợp này có độ lệch thấp (low bias). Tuy nhiên, các đường cong này rất khác nhau. Điều này được thể hiện khi vẽ chồng 50 đường cong lên nhau, như trong hình dưới.
Các đường cong này không cùng một hình dạng, nên chúng có độ lệch thấp. Hơn nữa, chúng rất khác nhau và bị ảnh hưởng mạnh bởi dữ liệu, nên tập hợp có phương sai cao (high variance).
So sánh các đường cong
Một nhà khoa học khí quyển yêu cầu chúng ta tìm một đường cong khớp với đường cong lý tưởng ẩn trong dữ liệu của cô ấy. Chúng ta đã tạo ra 50 tập hợp điểm nhỏ, được rút ngẫu nhiên từ dữ liệu gốc có nhiễu. Khi khớp các đường cong đơn giản, mượt mà với các tập hợp điểm này, các đường cong liên tục bỏ qua hầu hết các điểm dữ liệu. Tập hợp đường cong này có độ lệch cao, tức là có xu hướng thiên về một kết quả cụ thể (mượt mà và đơn giản). Các đường cong không bị ảnh hưởng nhiều bởi dữ liệu mà chúng dự định khớp, nên tập hợp này có phương sai thấp.
Ngược lại, khi khớp các đường cong phức tạp và uốn lượn với các tập hợp điểm này, các đường cong có thể khớp tốt hơn với dữ liệu và tiến gần hơn đến hầu hết các điểm. Vì chúng bị ảnh hưởng nhiều hơn bởi dữ liệu hơn là xu hướng định trước về hình dạng, tập hợp đường cong này có độ lệch thấp. Nhưng tính linh hoạt của các đường cong khiến chúng rất khác nhau, tức là tập hợp này có phương sai cao.
Tóm lại, tập hợp đầu tiên có độ lệch cao và phương sai thấp, còn tập hợp thứ hai có độ lệch thấp và phương sai cao.
Lý tưởng nhất, chúng ta muốn có các đường cong với độ lệch thấp (để không áp đặt ý tưởng định sẵn về hình dạng) và phương sai thấp (để các đường cong khác nhau tạo ra kết quả khớp gần giống nhau với dữ liệu gốc có nhiễu). Tuy nhiên, trong hầu hết các tình huống thực tế, khi một đại lượng giảm, đại lượng kia tăng. Điều này có nghĩa là chúng ta phải tìm ra sự đánh đổi tốt nhất giữa độ lệch và phương sai cho từng tình huống cụ thể.
Chúng ta có thể thấy cách độ lệch và phương sai giúp mô tả hiện tượng underfitting và overfitting. Ở giai đoạn đầu của quá trình huấn luyện, khi hệ thống cố gắng tìm cách biểu diễn dữ liệu huấn luyện, nó tạo ra các quy tắc chung, tức là underfit. Nếu các quy tắc này là ranh giới giữa các lớp dữ liệu, chúng có dạng các đường cong. Khi huấn luyện trên nhiều tập dữ liệu tương tự nhưng khác nhau, chúng ta sẽ thấy các đường cong có hình dạng đơn giản và giống nhau, tức là có độ lệch cao và phương sai thấp.
Ở giai đoạn sau của quá trình huấn luyện, các đường cong cho mỗi tập dữ liệu trở nên phức tạp hơn. Có ít điều kiện tiên quyết về hình dạng của chúng, nên chúng có độ lệch thấp, và chúng có thể khớp chặt chẽ với dữ liệu huấn luyện, nên chúng có phương sai cao. Khi để hệ thống huấn luyện quá lâu, các đường cong có phương sai cao bắt đầu bám sát dữ liệu đầu vào quá chặt, dẫn đến overfit.
Hàng trên: Bốn đường cong chúng ta muốn khớp. Hàng giữa: Sử dụng các đường cong có độ lệch cao và phương sai thấp. Hàng dưới: Các đường cong có độ lệch thấp và phương sai cao. Hình bên phải ở hai hàng dưới cho thấy bốn đường cong được vẽ chồng lên nhau.
Ở hàng giữa, độ lệch cao mang lại các đường cong đơn giản, đẹp mắt (tránh overfit), nhưng phương sai thấp khiến chúng không thể khớp tốt với dữ liệu. Ở hàng dưới, độ lệch thấp cho phép các đường cong khớp tốt hơn với dữ liệu, nhưng phương sai cao khiến chúng có thể khớp quá tốt (gây nguy cơ overfit).
Nói chung, chúng ta cần tìm sự cân bằng phù hợp giữa hai đại lượng này theo cách tốt nhất cho mục tiêu của từng dự án cụ thể, dựa trên thuật toán và dữ liệu đang sử dụng.
Tổng kết:
Chúng ta có 1 đường cong làm sạch từ dữ liệu nhiễu. Nhưng câu hỏi là: Đường cong này có thực sự tốt không? Làm sao biết nó có gần với đường cong lý tưởng thật sự?
Có thể thấy, từ việc kiểm chứng variance và bias, không có mô hình “hoàn hảo” – luôn phải đánh đổi giữa:
Độ chính xác (bias thấp)
Độ ổn định (variance thấp)
Trong một số ứng dụng, độ lệch cao hoặc phương sai cao có thể chấp nhận được. Ví dụ, nếu biết rằng tập huấn luyện hoàn toàn đại diện cho dữ liệu tương lai, chúng ta không quan tâm đến phương sai và thay vào đó nhắm đến độ lệch thấp nhất, vì khớp hoàn hảo với tập huấn luyện là điều chúng ta muốn. Ngược lại, nếu biết rằng tập huấn luyện không đại diện tốt cho dữ liệu tương lai (nhưng đó là thứ tốt nhất chúng ta có), chúng ta có thể không quan tâm đến độ lệch, vì khớp với tập dữ liệu kém này không quan trọng, nhưng chúng ta muốn phương sai thấp nhất để có cơ hội thực hiện điều gì đó hợp lý với dữ liệu tương lai.
This entry is part 5 of 8 in the series SWE Học A.I
Phân Loại (Classification)
Phân loại là một ứng dụng quan trọng của học máy (machine learning), trong đó chúng ta xem xét một tập hợp các đầu vào, so sánh mỗi đầu vào với một danh sách các lớp (hoặc danh mục) có thể có, và gán mỗi đầu vào vào lớp có khả năng cao nhất.
Quá trình này được gọi là phân loại hoặc phân danh mục, và được thực hiện bởi một bộ phân loại (classifier). Chúng ta có thể sử dụng các lớp để thực hiện các tác vụ đa dạng như nhận diện từ ngữ mà ai đó nói qua điện thoại, xác định loài động vật xuất hiện trong ảnh, hoặc đánh giá một trái cây đã chín hay chưa.
Một cách phổ biến để huấn luyện một bộ phân loại là sử dụng học có giám sát (supervised learning). bắt đầu bằng việc thu thập một tập hợp các mẫu dữ liệu mà chúng ta muốn phân loại, gọi là tập huấn luyện (training set). Đồng thời, chúng ta chuẩn bị một danh sách các lớp hoặc danh mục, chẳng hạn như các loài động vật có thể xuất hiện trong ảnh hoặc thể loại nhạc được gán cho một mẫu âm thanh. Sau đó, chúng ta xem xét từng mẫu trong tập huấn luyện và quyết định lớp nào nên được gán cho mẫu đó. Đây được gọi là nhãn (label) của mẫu.
ID
Ảnh (mô tả)
Đặc trưng (Features)
Nhãn (Label)
1
Ảnh con vật có lông, 4 chân
[lông: có, chân: 4, bay: không, sủa: có]
Chó
2
Ảnh con vật có cánh, biết bay
[lông: không, chân: 2, bay: có, sủa: không]
Chim
3
Ảnh con vật có lông, 4 chân
[lông: có, chân: 4, bay: không, sủa: không]
Mèo
4
Ảnh con vật có mai cứng
[lông: không, chân: 4, bay: không, sủa: không]
Rùa
Tiếp theo, chúng ta cung cấp từng mẫu cho máy tính, từng mẫu một, nhưng không cung cấp nhãn. Máy tính xử lý mẫu và đưa ra dự đoán về lớp mà mẫu đó nên được gán. Sau đó, chúng ta so sánh dự đoán của máy tính với nhãn của chúng ta. Nếu dự đoán của bộ phân loại không khớp với nhãn, chúng ta điều chỉnh bộ phân loại một chút để nó có khả năng dự đoán đúng lớp nếu gặp lại mẫu này.
Quá trình này được gọi là huấn luyện (training), và chúng ta nói rằng hệ thống đang học (learning). Chúng ta lặp lại quá trình này nhiều lần, thường với hàng nghìn hoặc thậm chí hàng triệu mẫu, được tái sử dụng nhiều lần. Mục tiêu là cải thiện dần thuật toán cho đến khi các dự đoán của nó khớp với nhãn của chúng ta đủ thường xuyên để chúng ta cảm thấy nó sẵn sàng được áp dụng vào thực tế, nơi nó sẽ phân loại chính xác các mẫu mới mà nó chưa từng thấy. Khi đó, chúng ta kiểm tra bộ phân loại với dữ liệu mới để xem nó hoạt động tốt như thế nào và liệu nó đã sẵn sàng để sử dụng thực tế hay chưa.
Phân loại hai phần (Binary Classification)
Để bắt đầu, giả sử dữ liệu đầu vào chỉ thuộc về hai lớp khác nhau. Việc sử dụng hai lớp giúp đơn giản hóa việc thảo luận về phân loại mà không bỏ sót bất kỳ điểm cốt lõi nào. Vì chỉ có hai nhãn (hoặc lớp) khả thi cho mỗi đầu vào, chúng ta gọi đây là phân loại nhị phân (binary classification).
Nhóm kỹ thuật đầu tiên mà chúng ta sẽ xem xét được gọi chung là phương pháp ranh giới (boundary methods). Ý tưởng đằng sau các phương pháp này là chúng ta có thể quan sát các mẫu đầu vào được vẽ trên mặt phẳng và tìm một đường thẳng hoặc đường cong chia không gian sao cho tất cả các mẫu thuộc một nhãn nằm ở một bên của đường cong (hoặc ranh giới), và tất cả các mẫu thuộc nhãn kia nằm ở bên còn lại.
Giả sử chúng ta là nông dân trồng táo. Mỗi quả táo có thể là táo ngọt hoặc táo chua. Nếu chúng ta đo trọng lượng và đường kính của mỗi quả táo, ta có thể phân loại được loại của chúng. Giả sử rằng một chuyên gia nếm thử có thể phân biệt chính xác táo ngọt và táo chua – công việc của máy phân loại là mô phỏng khả năng đó. Với dữ liệu huấn luyện về trọng lượng và đường kính, chúng ta có thể vẽ điểm dữ liệu trên mặt phẳng và tìm một đường (thẳng hoặc cong) để phân chia hai loại táo. Mỗi điểm mới nằm về phía nào thì được gán nhãn tương ứng
Khi có táo mới (chưa biết vị), chúng ta chỉ cần xem nó nằm ở bên nào của đường thẳng khi được vẽ trên biểu đồ. Những quả nằm ở phía “ngọt” sẽ được gán lớp “táo ngọt”, và những quả ở phía “chua” sẽ được gán lớp “táo chua”
Khi phân chia như vậy, chúng ta gọi các phần trên mặt phẳng là vùng quyết định (decision regions) hoặc miền, và đường phân chia là ranh giới quyết định (decision boundaries).
Phân loại Đa lớp (Multiclass Classification)
Phân loại nhị phân (binary classification) thường đơn giản và nhanh hơn so với phân loại đa lớp (multiclass classification). Tuy nhiên, trong thực tế, phần lớn dữ liệu có nhiều hơn hai lớp.
May mắn thay, thay vì xây dựng một mô hình phân loại đa lớp phức tạp, chúng ta có thể tạo ra một tập hợp các bộ phân loại nhị phân và kết hợp kết quả của chúng để đưa ra câu trả lời đa lớp.
Một-chọi-tất-cả (One-versus-Rest)
Phương pháp này còn được gọi là Một-chọi-tất-cả (OvR), Một-chọi-hết (OvA), Một-đối-kháng-tất-cả (OAA) hoặc phương pháp liên quan nhị phân (binary relevance method). Giả sử chúng ta có năm lớp dữ liệu, được đặt tên từ A đến E. Thay vì xây dựng một bộ phân loại đa lớp phức tạp để gán một trong năm nhãn này, chúng ta sẽ tạo ra năm bộ phân loại nhị phân đơn giản hơn, mỗi bộ tập trung vào một lớp cụ thể, được đặt tên từ A đến E.
Bộ phân loại A xác định liệu một mẫu dữ liệu có thuộc lớp A hay không. Vì đây là bộ phân loại nhị phân, nó tạo ra một ranh giới quyết định (decision boundary) chia không gian dữ liệu thành hai vùng: lớp A và tất cả các lớp còn lại (B, C, D, E). Tên gọi “Một-chọi-tất-cả” bắt nguồn từ đây: lớp A là “một”, còn các lớp B đến E là “tất cả”.
Tương tự, Bộ phân loại B xác định liệu mẫu thuộc lớp B hay không, Bộ phân loại C kiểm tra lớp C, và cứ thế cho đến lớp E.
Các vùng quyết định của năm bộ phân loại nhị phân. Màu sắc từ tím đến hồng thể hiện xác suất tăng dần rằng một điểm thuộc vào lớp tương ứng.
Để phân loại một mẫu mới, chúng ta chạy mẫu đó qua cả năm bộ phân loại nhị phân, mỗi bộ trả về xác suất mẫu thuộc vào lớp tương ứng. Lớp có xác suất cao nhất sẽ được gán cho mẫu.
Trong ví dụ này, bốn bộ phân loại đầu tiên trả về xác suất thấp, trong khi bộ phân loại cho lớp E gán xác suất cao hơn, do đó mẫu được dự đoán thuộc lớp E.
Giả sử bạn cần phân loại ảnh thành năm loài: chó, mèo, chim, cá và thỏ. Thay vì xây dựng một mô hình phân loại phức tạp, bạn tạo năm bộ phân loại nhị phân:
Bộ phân loại “chó” xác định liệu ảnh có phải là chó hay không (tức là chó so với mèo, chim, cá, thỏ).
Tương tự cho các loài còn lại.
Khi một ảnh mới được đưa vào, mỗi bộ phân loại sẽ trả về một xác suất. Giả sử xác suất là:
Chó: 0.1
Mèo: 0.3
Chim: 0.15
Cá: 0.05
Thỏ: 0.7
Ảnh sẽ được gán nhãn là “thỏ” vì xác suất cao nhất là 0.7.
Ưu điểm và nhược điểm
Tuy nhiên, với phần cứng hỗ trợ xử lý song song, thời gian có thể được tối ưu tương đương với thời gian của một bộ phân loại.
Ưu điểm:
Khái niệm đơn giản, dễ hiểu.
Tốc độ xử lý nhanh, đặc biệt khi có thể chạy song song các bộ phân loại trên phần cứng phù hợp.
Nhược điểm:
Cần huấn luyện năm bộ phân loại thay vì một.
Mỗi mẫu phải được chạy qua năm bộ phân loại để xác định lớp, điều này có thể tốn thời gian khi số lớp lớn hoặc ranh giới phân loại phức tạp.
Một-chọi-một (One-versus-One)
Phương pháp thứ hai, Một-chọi-một (OvO), sử dụng nhiều bộ phân loại nhị phân so với ý tưởng OvR. Ý tưởng chính là xem xét từng cặp lớp trong dữ liệu và xây dựng một bộ phân loại nhị phân cho cặp lớp đó. Vì số lượng cặp lớp tăng nhanh khi số lớp tăng, số lượng bộ phân loại cũng tăng đáng kể. Để đơn giản, hãy xét ví dụ với bốn lớp (A, B, C, D)
Quy trình như sau:
Bộ phân loại A-B: Được huấn luyện chỉ với dữ liệu từ lớp A và B, bỏ qua các mẫu không thuộc A hoặc B. Bộ phân loại này tạo ranh giới phân tách giữa A và B, gán mọi điểm dữ liệu vào A hoặc B, ngay cả khi điểm đó thuộc lớp khác.
Tiếp tục xây dựng các bộ phân loại cho các cặp khác: A-C, A-D, B-C, B-D, và C-D. Kết quả là sáu bộ phân loại nhị phân, mỗi bộ xác định mẫu thuộc vào một trong hai lớp cụ thể.
Hàng trên: Bộ phân loại cho A-B, A-C, A-D. Hàng giữa: Bộ phân loại cho B-C, B-D. Hàng dưới: Bộ phân loại cho C-D.
Để phân loại một mẫu mới, chúng ta chạy mẫu qua cả sáu bộ phân loại. Mỗi bộ phân loại “bỏ phiếu” cho một trong hai lớp, và lớp nhận được nhiều phiếu nhất sẽ là nhãn dự đoán.
Hàng trên: Các phiếu là A, A, A.
Hàng giữa: Các phiếu là C, B.
Hàng dưới: Phiếu là C.
Kết quả: Lớp A nhận 3 phiếu, B nhận 1, C nhận 2, D nhận 0. Do đó, mẫu được dự đoán thuộc lớp A.
Ưu điểm và nhược điểm
Ưu điểm:
Cung cấp cái nhìn rõ ràng hơn về cách mẫu được đánh giá qua từng cặp lớp, tăng tính minh bạch và khả năng giải thích (explainability).
Hữu ích khi các lớp có sự chồng lấn phức tạp, giúp con người dễ hiểu kết quả hơn.
Nhược điểm:
Số lượng bộ phân loại tăng nhanh theo số lớp. Ví dụ:
4 lớp: 6 bộ phân loại.
5 lớp: 10 bộ phân loại.
20 lớp: 190 bộ phân loại.
30 lớp: 435 bộ phân loại.
Phân cụm (Clustering)
Phân cụm có nhãn
Phân cụm là một phương pháp giúp tổ chức dữ liệu thành các nhóm tương tự nhau. Chúng ta đã biết rằng một cách để phân loại các mẫu dữ liệu mới là chia không gian thành các vùng khác nhau, sau đó kiểm tra xem một điểm thuộc vùng nào. Tuy nhiên, một cách tiếp cận khác là nhóm chính dữ liệu huấn luyện thành các cụm (clusters), tức là các tập hợp có đặc điểm tương đồng. Nếu dữ liệu của chúng ta có nhãn (labels), làm thế nào để sử dụng nhãn này để tạo các cụm?
Dữ liệu có năm nhãn khác nhau, được biểu thị bằng màu sắc. Với các nhóm tách biệt rõ ràng, chúng ta có thể tạo cụm bằng cách vẽ một đường bao quanh mỗi tập hợp điểm, như ở hình giữa. Nếu mở rộng các đường này cho đến khi chúng giao nhau, sao cho mỗi điểm trên lưới được gán màu theo cụm gần nhất, chúng ta có thể bao phủ toàn bộ không gian như ở hình bên phải.
Phân cụm không nhãn
Phương pháp trên yêu cầu dữ liệu có nhãn. Nhưng nếu dữ liệu không có nhãn thì sao? Trong trường hợp này, chúng ta có thể tự động nhóm dữ liệu không nhãn thành các cụm và áp dụng kỹ thuật vừa mô tả. Đây là một dạng học không giám sát (unsupervised learning), nơi dữ liệu không có nhãn sẵn.
Khi sử dụng thuật toán để tự động tạo cụm từ dữ liệu không nhãn, chúng ta cần chỉ định số lượng cụm mong muốn, thường được ký hiệu bằng chữ k (một ký hiệu tùy ý, không mang ý nghĩa cụ thể). Giá trị k là một siêu tham số (hyperparameter), tức là giá trị chúng ta chọn trước khi huấn luyện hệ thống.
Giá trị k quyết định thuật toán sẽ chia dữ liệu thành bao nhiêu vùng (hay bao nhiêu lớp). Vì thuật toán sử dụng trung bình hình học (geometric means) của các nhóm điểm để tạo cụm, nó được gọi là phân cụm k-means.
Ưu và nhược điểm của việc chọn k
Việc tự do chọn giá trị k vừa là lợi thế vừa là thách thức.
Lợi thế: Nếu chúng ta biết trước số lượng cụm cần thiết, chúng ta có thể chỉ định và thuật toán sẽ tạo ra kết quả phù hợp. Tuy nhiên, máy tính không biết ranh giới cụm nên dù chia thành k phần, kết quả có thể không đúng như kỳ vọng. Nếu dữ liệu tách biệt tốt, với các nhóm cách xa nhau, kết quả thường khớp với dự đoán. Nhưng nếu ranh giới cụm mờ hoặc chồng lấn, kết quả có thể bất ngờ.
Thách thức: Nếu không biết số lượng cụm phù hợp, việc chọn k quá thấp sẽ không tách biệt dữ liệu hiệu quả, còn chọn k quá cao sẽ khiến các điểm dữ liệu tương tự bị phân vào các lớp khác nhau.
Với 200 điểm không nhãn, được sắp xếp rõ ràng thành năm nhóm.
Bây giờ, với các k khác nhau, ta có:
Không ngạc nhiên khi k = 5 cho kết quả tốt nhất trong ví dụ này, vì ranh giới cụm dễ nhận thấy. Tuy nhiên, với dữ liệu phức tạp hơn, đặc biệt khi có hơn hai hoặc ba chiều, việc xác định số cụm tối ưu trước đó gần như bất khả thi.
Tối ưu hóa giá trị k
May mắn thay, chúng ta có thể huấn luyện mô hình phân cụm nhiều lần với các giá trị k khác nhau. Bằng cách đo lường chất lượng kết quả, quá trình điều chỉnh siêu tham số (hyperparameter tuning) giúp tự động tìm giá trị k tốt nhất. Nhược điểm là quá trình này tốn tài nguyên tính toán và thời gian. Do đó, việc trực quan hóa dữ liệu trước khi phân cụm rất hữu ích. Nếu chọn được giá trị k tối ưu hoặc một phạm vi giá trị khả thi ngay từ đầu, chúng ta có thể tiết kiệm thời gian và công sức.
Giả lập luồng hoạt động
Thuật toán k-means hoạt động theo các bước sau:
Khởi tạo: Chọn ngẫu nhiên k điểm làm tâm cụm (centroids).
Gán cụm: Gán mỗi điểm dữ liệu vào cụm có tâm gần nhất, dựa trên khoảng cách Euclidean: [latex]d(x, c) = \sqrt{\sum_{i=1}^{n} (x_i – c_i)^2}[/latex]
Cập nhật tâm cụm: Tính lại tâm cụm bằng trung bình của các điểm trong mỗi cụm: [latex]c_j = \frac{1}{n_j} \sum_{i=1}^{n_j} x_i[/latex]
Lặp lại: Lặp bước 2 và 3 cho đến khi tâm cụm không thay đổi hoặc đạt số lần lặp tối đa.
Hãy tưởng tượng bạn là chủ một quán cà phê và có dữ liệu về 10 khách hàng, được biểu thị bằng hai thông tin:
Số tiền chi tiêu (nghìn đồng) mỗi lần ghé quán.
Số lần ghé quán mỗi tháng.
Dữ liệu không có nhãn, nghĩa là bạn không biết trước khách hàng thuộc nhóm nào (như khách VIP, khách thường, v.v.). Mục tiêu là dùng k-means để chia 10 khách này thành 4 cụm dựa trên thói quen của họ.
Dữ liệu mẫu
Dưới đây là 10 điểm dữ liệu (mỗi điểm là một khách hàng):
Khách hàng
Chi tiêu (nghìn đồng)
Số lần ghé quán
A
50
2
B
60
3
C
55
1
D
200
10
E
220
12
F
210
11
G
100
5
H
110
6
I
300
3
J
310
4
Giả lập chạy thuật toán k-means với k = 4
Bước 1: Khởi tạo tâm cụm
Thuật toán chọn ngẫu nhiên 4 điểm làm tâm cụm ban đầu. Giả sử các tâm cụm được chọn là:
Tâm 1: (50, 2) – Khách A
Tâm 2: (200, 10) – Khách D
Tâm 3: (100, 5) – Khách G
Tâm 4: (300, 3) – Khách I
Bước 2: Gán cụm
Mỗi khách hàng được gán vào cụm có tâm gần nhất, dựa trên khoảng cách Euclidean. Công thức khoảng cách giữa hai điểm ((x_1, y_1)) và ((x_2, y_2)) là:
Tương tự, tính khoảng cách từ B đến các tâm còn lại và gán B vào cụm có khoảng cách nhỏ nhất. Sau khi tính toán (giả sử kết quả), các khách hàng được gán như sau:
Cụm 1 (Tâm: 50, 2): Khách A, B, C
Cụm 2 (Tâm: 200, 10): Khách D, E, F
Cụm 3 (Tâm: 100, 5): Khách G, H
Cụm 4 (Tâm: 300, 3): Khách I, J
Bước 3: Cập nhật tâm cụm
Tính lại tâm cụm bằng trung bình tọa độ của các điểm trong cụm:
Cụm 1 (A: 50, 2; B: 60, 3; C: 55, 1):
Trung bình x: ((50 + 60 + 55) / 3 = 55)
Trung bình y: ((2 + 3 + 1) / 3 = 2)
Tâm mới: (55, 2)
Cụm 2 (D: 200, 10; E: 220, 12; F: 210, 11):
Trung bình x: ((200 + 220 + 210) / 3 = 210)
Trung bình y: ((10 + 12 + 11) / 3 = 11)
Tâm mới: (210, 11)
Cụm 3 (G: 100, 5; H: 110, 6):
Trung bình x: ((100 + 110) / 2 = 105)
Trung bình y: ((5 + 6) / 2 = 5.5)
Tâm mới: (105, 5.5)
Cụm 4 (I: 300, 3; J: 310, 4):
Trung bình x: ((300 + 310) / 2 = 305)
Trung bình y: ((3 + 4) / 2 = 3.5)
Tâm mới: (305, 3.5)
Bước 4: Lặp lại
Lặp lại bước 2 và 3 với các tâm cụm mới. Giả sử sau vài lần lặp, các tâm cụm không thay đổi nữa, ta được kết quả cuối cùng:
Cụm 1: Khách A, B, C (khách chi tiêu ít, ghé ít)
Cụm 2: Khách D, E, F (khách chi tiêu nhiều, ghé thường xuyên)
Cụm 3: Khách G, H (khách chi tiêu trung bình, ghé trung bình)
Cụm 4: Khách I, J (khách chi tiêu rất nhiều, ghé ít)
Kết quả:
Cụm 1: Khách hàng tiết kiệm, ít ghé quán – có thể là sinh viên hoặc khách vãng lai.
Cụm 2: Khách VIP, chi tiêu nhiều và ghé thường xuyên – nên ưu tiên chăm sóc.
Cụm 3: Khách trung thành nhưng chi tiêu vừa phải – có tiềm năng tăng chi tiêu.
Cụm 4: Khách chi tiêu lớn nhưng hiếm ghé – có thể là khách du lịch hoặc khách đặc biệt.
This entry is part 4 of 8 in the series SWE Học A.I
Các thuật toán học máy (machine learning), học sâu (deep learning) dù cao cấp, hiện đại đến đâu, nhưng chúng vẫn phụ thuộc rất nhiều vào dữ liệu chất lượng cao. Trong thực tế, có rất nhiều dữ liệu đến từ các cảm biến (cảm biến độ ẩm, nhiệt độ, cảm biến trên ô tô, …) và chúng không tránh khỏi việc bị nhiễu, hay dữ liệu hồ sơ từ bệnh viện, cơ quan hành chính, … nơi có khả năng xảy ra các vấn đề như ghi chép sai, …. Vì vậy, việc chuẩn bị và làm sạch dữ liệu trước khi bắt đầu quá trình huấn luyện là cần thiết.
Một loạt các phương pháp đã được phát triển để phục vụ công việc này, được gọi là kỹ thuật chuẩn bị dữ liệu (data preparation) hoặc làm sạch dữ liệu (data cleaning). Ý tưởng là xử lý dữ liệu trước khi đưa vào huấn luyện, để các hệ thống học máy có thể khai thác dữ liệu một cách hiệu quả nhất.
Data Cleaning
Xử lý dữ liệu dạng văn bản
Nếu dữ liệu ở dạng văn bản, chúng ta cần đảm bảo không có lỗi chính tả, ký tự không in được,…..
Ví dụ, nếu chúng ta có một bộ sưu tập ảnh động vật kèm theo tệp văn bản mô tả, và hệ thống phân biệt chữ hoa chữ thường, thì mọi con hươu cao cổ phải được gắn nhãn là “hươu cao cổ” chứ không phải “hươu cao cô” hay “Hươu Cao Cổ”. Chúng ta cũng cần tránh các biến thể như “hươu cao cổ đẹp” hay “hươu cao cổ siêu cao”. Mỗi tham chiếu đến hươu cao cổ phải sử dụng chuỗi ký tự giống hệt nhau.
Ví dụ minh họa: Giả sử chúng ta có một danh sách nhãn sau:
hươu cao cổ
hươu cao cô
Hươu Cao Cổ
hươu cao cổ đẹp
Thách thức:
Xử lý lỗi chính tả và biến thể ngôn ngữ.
Loại bỏ từ bổ nghĩa hoặc cụm từ không cần thiết.
Đảm bảo tính nhất quán trong toàn bộ tập dữ liệu.
Để xử lý bài toán này, có thể kể tới 1 số kĩ thuật như stemming, lemmatization.
Stemming
Định nghĩa: Stemming là kỹ thuật giảm một từ về dạng gốc (stem) bằng cách loại bỏ các hậu tố (suffixes) như “-s”, “-es”, “-ed”, hoặc “-ing” (trong tiếng Anh). Trong tiếng Việt, stemming ít phổ biến hơn do ngôn ngữ không có nhiều biến thể hậu tố, nhưng vẫn có thể áp dụng cho các từ ghép hoặc cụm từ
Stemming có nhiều thuật toán khác nhau, chủ yếu được phát triển cho các ngôn ngữ giàu hình thái học như tiếng Anh.
B3-B5: Xử lý các hậu tố phức tạp hơn như “-ational” → “-ate” (ví dụ: “operational” → “operate”).
Ưu điểm:
Hiệu quả, nhanh, được tối ưu hóa cho tiếng Anh.
Không cần từ điển, dựa hoàn toàn trên quy tắc.
Nhược điểm:
Quá tích cực (over-stemming), có thể tạo ra dạng gốc không có nghĩa (ví dụ: “happiness” → “happi”).
Không phù hợp với các ngôn ngữ ít biến thể hình thái như tiếng Việt.
Snowball Stemmer
Cách hoạt động:
Tương tự Porter, nhưng có thêm các quy tắc tùy chỉnh cho từng ngôn ngữ.
Cụ thể, Porter đã được fix cứng các kĩ thuật dữ liệu. Ở Snowball Stemmer, hay Porter2, ta có thể tuỳ chỉnh tập quy tắc này (https://snowballstem.org/texts/introduction.html)
Ví dụ: Trong tiếng Anh, “studies” → “studi” (Porter) nhưng Snowball có thể giữ nguyên “study” nếu được tối ưu hóa.
Ưu điểm:
Linh hoạt, hỗ trợ đa ngôn ngữ.
Dễ tùy chỉnh cho các ngôn ngữ mới.
Nhược điểm:
Vẫn có thể over-stemming hoặc under-stemming (giữ quá nhiều hậu tố).
Yêu cầu kiến thức ngôn ngữ học để tạo quy tắc cho tiếng Việt.
Lancaster Stemmer
Mô tả: Là thuật toán stemming mạnh mẽ hơn Porter, tập trung vào loại bỏ nhiều hậu tố nhất có thể. Nó được thiết kế để tạo ra dạng gốc ngắn nhất.
Cách hoạt động:
Áp dụng các quy tắc lặp đi lặp lại để cắt bỏ hậu tố, ví dụ: “happiness” → “happ”. Với Porter, ta đi qua các quy tắc theo thứ tự 1,2,3, … để xử lý. Còn Lancaster sẽ lặp lại liên tục để kiểm tra còn cắt được không
Có xu hướng cắt bỏ nhiều hơn Porter, dẫn đến dạng gốc rất ngắn.
Ưu điểm:
Tạo ra dạng gốc rất gọn, giảm kích thước từ vựng.
Nhược điểm:
Quá tích cực, thường tạo ra dạng gốc không có nghĩa (over-stemming nghiêm trọng).
Không phù hợp cho các ứng dụng yêu cầu ngữ nghĩa rõ ràng.
Regex-based Stemming (Tùy chỉnh)
Mô tả: Sử dụng các biểu thức chính quy (regular expressions) để loại bỏ các hậu tố hoặc từ bổ nghĩa theo quy tắc do người dùng định nghĩa. Phù hợp cho các ngôn ngữ như tiếng Việt, nơi không có nhiều hậu tố hình thái học.
Cách hoạt động:
Xác định các mẫu từ bổ nghĩa (ví dụ: “đẹp”, “siêu cao” trong tiếng Việt).
Loại bỏ các mẫu này bằng regex hoặc danh sách từ dừng (stop words).
Ưu điểm:
Linh hoạt, dễ tùy chỉnh cho tiếng Việt.
Không cần từ điển, phù hợp cho các ứng dụng đơn giản.
Nhược điểm:
Yêu cầu xây dựng quy tắc thủ công.
Không xử lý tốt các biến thể phức tạp hoặc ngữ cảnh.
Python
import retext ="sản phẩm này rất đẹp và cực kỳ tốt"cleaned = re.sub(r"\b(rất|cực kỳ|quá|hơi|khá|tương đối)\b","", text)print(cleaned)# -> sản phẩm này đẹp và tốt (Ví dụ 1 cách triển khai regex)
Kỹ thuật
Độ chính xác
Tốc độ
Nguy cơ Over-stemming
Porter Stemmer
Trung bình
Nhanh
Trung bình
Snowball Stemmer
Trung bình-cao
Nhanh
Trung bình
Lancaster Stemmer
Thấp
Rất nhanh
Cao
Regex-based
Cao (nếu tùy chỉnh tốt)
Nhanh
Thấp
Lemmatization
Lemmatization là quá trình đưa một từ hoặc cụm từ về dạng gốc (lemma) dựa trên từ điển và ngữ cảnh, đảm bảo dạng gốc có nghĩa. Không như stemming, lemmatization yêu cầu phân tích ngữ pháp và ngữ nghĩa, thường sử dụng từ điển ngôn ngữ học.
Tokenizatio
Tokenization là quá trình chia nhỏ văn bản thành các đơn vị nhỏ hơn gọi là token (thường là từ, dấu câu, cụm từ). Ví dụ:
Python
from nltk.tokenize import word_tokenizetext ="The cats are running fast."print(word_tokenize(text))# ['The', 'cats', 'are', 'running', 'fast', '.']
POS Tagging
POS (Part-of-Speech) Tagging là quá trình gán loại từ cho mỗi token: danh từ (NN), động từ (VB), tính từ (JJ),
Ví dụ:
Python
from nltk import pos_tagtokens =['running','fast']print(pos_tag(tokens))# [('running', 'VBG'), ('fast', 'RB')]
A. Dictionary-based Lemmatization
Sử dụng từ điển để ánh xạ từng từ về dạng gốc. Một trong các công cụ phổ biến là WordNetLemmatizer của NLTK. WordNetLemmatizer là một bộ lemmatizer sử dụng WordNet – cơ sở dữ liệu ngôn ngữ học lớn nhất tiếng Anh. WordNet ánh xạ các từ về nghĩa gốc dựa vào loại từ.
Tokenization: tách từ.
POS Tagging: xác định loại từ.
Ánh xạ về lemma bằng từ điển
Python
from nltk.stem import WordNetLemmatizerfrom nltk.corpus import wordnetdefget_wordnet_pos(treebank_tag):if treebank_tag.startswith('J'):return wordnet.ADJelif treebank_tag.startswith('V'):return wordnet.VERBelif treebank_tag.startswith('N'):return wordnet.NOUNelif treebank_tag.startswith('R'):return wordnet.ADVreturn wordnet.NOUN # default fallbacklemmatizer =WordNetLemmatizer()tokens =word_tokenize("The leaves are falling from the trees")tagged =pos_tag(tokens)lemmatized =[lemmatizer.lemmatize(word,get_wordnet_pos(pos))for word, pos in tagged]print(lemmatized)# ['The', 'leaf', 'be', 'fall', 'from', 'the', 'tree']
Ưu điểm:
Độ chính xác cao nếu loại từ được xác định đúng.
Giữ nguyên nghĩa và phù hợp cho xử lý ngữ nghĩa.
Nhược điểm:
Yêu cầu từ điển đầy đủ cho ngôn ngữ.
Không xử lý tốt ngữ cảnh rộng.
B. Rule-based Lemmatization
Kết hợp từ điển và quy tắc để xử lý cả từ có quy tắc và bất quy tắc. Thường được dùng trong ngôn ngữ học tính toán truyền thống.
Áp dụng POS tagging.
Nếu từ là bất quy tắc, tra từ điển đặc biệt.
Nếu không, áp dụng quy tắc ngữ pháp để ánh xạ về lemma.
Ví dụ:
“went” → “go”
“better” → “good” (khi là tính từ so sánh)
Python
defcustom_rule_based_lemmatize(word,pos): irregular ={'went':'go','better':'good'}if word in irregular:return irregular[word]if pos.startswith('V')and word.endswith('ing'):return word[:-3]return wordprint(custom_rule_based_lemmatize("running","VBG"))# runprint(custom_rule_based_lemmatize("went","VBD"))# go
Ưu điểm:
Kiểm soát tốt, dễ tùy chỉnh.
Xử lý chính xác từ bất quy tắc.
Nhược điểm:
Phức tạp khi số lượng quy tắc nhiều.
C. Statistical / Neural Lemmatization
Sử dụng học máy/học sâu để học ánh xạ từ về lemma dựa trên ngữ cảnh. Có thể dùng mô hình như:
RNN, LSTM
Transformer (ví dụ: BERT, PhoBERT)
Sequence-to-sequence với attention
Huấn luyện mô hình trên tập dữ liệu có gán nhãn word → lemma.
Đầu vào là câu văn (hoặc đoạn văn).
Mô hình dự đoán lemma cho từng từ dựa vào ngữ cảnh.
Trong spaCy:
Python
import spacynlp = spacy.load("en_core_web_sm")doc =nlp("She was running very fast")print([(token.text, token.lemma_)for token in doc])# [('She', 'she'), ('was', 'be'), ('running', 'run'), ('very', 'very'), ('fast', 'fast')]
Tổng kết
Nhìn chung có thể hiểu đơn giản như sau:
Stemming: Một cách làm nhanh, sử dụng các quy tắc, sử dụng logic để cắt từ giúp đưa về từ chuẩn hoá. Ví dụ cắt go-ing -> go, study-ing -> study
Lemmezation: Một cách làm thường chậm hơn Stemming, nhưng có thể hiểu ngữ nghĩa, có thể xử lý các từ như best, better -> good
Kiểm tra lỗi nhập liệu
Chúng ta cần phát hiện các lỗi như thiếu dấu thập phân (ví dụ: 1,000 thay vì 1.000) hoặc nhập sai dấu (ví dụ: –1 thay vì -1). Điều này thường xảy ra trong các dữ liệu tiền tệ, 1,500$ khác hẳn 1.500$ (1 nghìn 500 trăm đô và 1 đô la rưỡi). Hay đôi khi khi đo đạc thời tiết, nếu hôm đó cảm biến hỏng không đo được, người ta để dữ liệu là NaN, là rỗng, là số 0, hoặc -1, ….
Nếu tập dữ liệu về nhiệt độ có giá trị NaN hoặc 0 thay vì nhiệt độ thực. Nếu không sửa, thuật toán có thể hiểu nhầm rằng nhiệt độ bằng 0°C là hợp lệ, dẫn đến dự đoán sai và bị chịu ảnh hưởng rất nhiều (Nó thấy thời tiết đang 40 độ chuyển thành 0 độ rồi lại lên 40 độ). Chúng ta có thể xử lý bằng cách:
Python
import numpy as npdata = pd.Series([25.5, np.nan,0,30.2])data = data.replace(0, np.nan)# Thay 0 bằng NaNdata = data.fillna(data.mean())# Điền NaN thành giá trị trung bình
Chuẩn hóa định dạng
Dữ liệu cần được định dạng sao cho phần mềm có thể hiểu đúng. Ví dụ, ký hiệu khoa học (scientific notation) như 7e-3 (0.007) có thể bị một số chương trình hiểu nhầm là (7 × e) – 3, với e là hằng số Euler (~2.7), dẫn đến giá trị khoảng 16 thay vì 0.007. Chúng ta cần kiểm tra và chuẩn hóa định dạng này.
Để đảm bảo tính nhất quán, chúng ta có thể chuyển tất cả các số về dạng thập phân:
Python
value ="7e-3"corrected_value =float(value)# Chuyển thành 0.007
Xử lý dữ liệu thiếu
Nếu một mẫu thiếu dữ liệu cho một hoặc nhiều đặc trưng, chúng ta có thể:
Điền giá trị thủ công hoặc bằng thuật toán (ví dụ: sử dụng giá trị trung bình).
Loại bỏ mẫu đó nếu không thể khôi phục.
Quyết định này phụ thuộc vào bối cảnh cụ thể. Ví dụ, trong một tập dữ liệu y tế, nếu thiếu giá trị huyết áp, việc điền giá trị trung bình có thể không chính xác, và loại bỏ mẫu có thể là lựa chọn tốt hơn.
Các Loại Dữ liệu
Cơ sở dữ liệu thường chứa nhiều loại dữ liệu khác nhau: số thực, chuỗi, số nguyên đại diện cho danh mục, v.v. Mỗi loại dữ liệu cần được xử lý theo cách riêng.
Dữ liệu Số (Numerical Data)
Dữ liệu số là các giá trị số, có thể là số thực (floating-point) hoặc số nguyên (integer), còn được gọi là dữ liệu định lượng (quantitative data). Dữ liệu này có thể được sắp xếp trực tiếp dựa trên giá trị.
Ví dụ: Nhiệt độ (25.5°C, 30.2°C), chiều cao (1.75m, 1.80m).
Dữ liệu Danh mục (Categorical Data)
Dữ liệu danh mục thường là chuỗi mô tả nhãn, như “bò” hoặc “ngựa vằn”. Có hai loại dữ liệu danh mục:
Dữ liệu Thứ tự (Ordinal Data): Có thứ tự tự nhiên, có thể sắp xếp.
Ví dụ: Các màu cầu vồng (đỏ, cam, vàng, lục, lam, chàm, tím) có thứ tự theo quang phổ.Ví dụ khác: Các giai đoạn tuổi (trẻ sơ sinh, thiếu niên, người già).
Python
colors =['đỏ','tím','cam']rainbow_order ={'đỏ':1,'cam':2,'tím':7}sorted_colors =sorted(colors,key=lambdax: rainbow_order[x])# Kết quả: ['đỏ', 'cam', 'tím']
Dữ liệu Danh định (Nominal Data): Không có thứ tự tự nhiên.
Ví dụ: Các vật dụng văn phòng (kẹp giấy, máy bấm ghim, đồ chuốt bút chì).
Chúng ta có thể biến dữ liệu danh định thành thứ tự bằng cách áp đặt một thứ tự tùy ý, ví dụ: sắp xếp quần áo từ đầu đến chân (mũ bowler, áo sơ mi, găng tay, tất).
Chuyển đổi dữ liệu phi số
Thuật toán học máy yêu cầu đầu vào là số, nên dữ liệu chuỗi (hoặc dữ liệu phi số khác) cần được chuyển thành số. Một cách đơn giản là tạo danh sách tất cả các chuỗi trong dữ liệu huấn luyện và gán mỗi chuỗi một số duy nhất bắt đầu từ 0.
Trong một số trường hợp, việc chuyển đổi số nguyên thành danh sách là hữu ích.
Ví dụ ta có một hệ thống dự đoán xem một chú mèo thuộc chủng mèo nào (mèo anh, mèo nga, ….), và đôi khi ta có một số chú mèo lai, nên ta cũng muốn hệ thống không chỉ trả ra kết quả chú mèo là mèo anh hay mèo nga, mà là hệ thống nghĩ chú có tỉ lệ 70% là mèo anh, 30% là mèo nga chẳng hạn. Lúc này, ta có thể có 10 class (mèo anh, mèo nga, ….), ta gọi mèo anh là lớp 1, mèo nga lớp 2, … Khi hệ thống đưa ra dự đoán, hệ thống có thể trả về 10 số (tương ứng 10 class) với mỗi số thể hiện độ tin cậy của hệ thống dự đoán ảnh ta đưa vào thuộc lớp nào.
Ví dụ: cho ảnh vào, hệ thống trả ra [0.7, 0.4, 0, 0, 0, …] -> Hệ thống tự tin 70% là mèo anh, 40% là mèo nga, …
Điều này cũng có nghĩa là khi chuẩn bị dữ liệu cho hệ thống để train, thay vì khi huấn luyện trên các ảnh mèo anh – 1, mèo nga – 2, mèo c – 3, …. , số lượng class. Ta sẽ đặt là
…. => Chuẩn hoá dạng dữ liệu giúp hệ thống dự đoán.
Việc chuyển đổi một nhãn như 3 hoặc 7 thành danh sách này được gọi là mã hóa one-hot (one-hot encoding), ám chỉ chỉ một phần tử trong danh sách là “nóng” (hot), tức được đánh dấu. Danh sách này đôi khi được gọi là biến giả (dummy variable). Khi cung cấp nhãn lớp cho hệ thống trong quá trình huấn luyện, ta thường sử dụng danh sách mã hóa one-hot này thay vì một số nguyên đơn lẻ.
Một ví dụ tương tự về đánh nhãn cho màu
Python
import numpy as npdefone_hot_encode(label,num_classes):return np.eye(1, num_classes,k=label,dtype=int)[0]# Ví dụ: Mã hóa nhãn 3 trong 10 lớpprint(one_hot_encode(3,10))# Output: [0 0 0 1 0 0 0 0 0 0]
Chuẩn hóa và Tiêu chuẩn hóa
Ta thường làm việc với các mẫu có đặc trưng trải dài trên các khoảng số khác nhau. Ví dụ, giả sử ta thu thập dữ liệu về một đàn voi bụi châu Phi với bốn đặc trưng:
Tuổi tính bằng giờ (0, 420,000)
Cân nặng tính bằng tấn (0, 7)
Chiều dài đuôi tính bằng cm (120, 155)
Tuổi so với tuổi trung bình lịch sử, tính bằng giờ (−210,000, 210,000)
Các khoảng số này khác biệt đáng kể. Do bản chất số học của các thuật toán, các số lớn có thể ảnh hưởng đến chương trình học nhiều hơn các số nhỏ. Đặc trưng 4 không chỉ lớn mà còn có thể âm.
Để đạt hiệu quả học tốt nhất, ta muốn tất cả dữ liệu có thể so sánh được, hoặc nằm trong cùng một khoảng số.
Chuẩn hóa (Normalization)
Bước đầu tiên phổ biến là chuẩn hóa từng đặc trưng (Feature). Trong thống kê, chuẩn hóa có nghĩa là co giãn dữ liệu vào một khoảng cụ thể, thường là [−1,1] hoặc [0,1], tùy thuộc vào dữ liệu (ví dụ, hệ thống dữ liệu về xác suất bức ảnh có phải quả táo không có thể là [0,1] với 0 là không phải, 1 là tự tin 100% là quả táo).
Giá trị x được co giãn từ −1 đến 1, và giá trị y được co giãn độc lập từ −1 đến 1. Hình guitar bị lệch vì dữ liệu y ban đầu có khoảng [–0.5, 0.2], cần kéo giãn nhiều hơn so với x [–1, 0].
Chuẩn hóa dữ liệu nhiệt độ (0°C đến 40°C) và độ ẩm (20% đến 80%) vào [0,1].
Python
from sklearn.preprocessing import StandardScalerimport numpy as npdata = np.array([[0,20],[40,80]])scaler =StandardScaler()standardized_data = scaler.fit_transform(data)print(standardized_data)
Tiêu chuẩn hóa (Standardization)
Một thao tác phổ biến khác là tiêu chuẩn hóa đặc trưng, gồm hai bước:
Trừ giá trị trung bình của đặc trưng để trung bình bằng 0 (gọi là chuẩn hóa trung bình).
Lấy từng giá trị dữ liệu và trừ đi giá trị trung bình của toàn bộ cột.
Mục tiêu: Làm cho trung bình (mean) của cột đó trở thành 0.
Gọi là: chuẩn hóa trung bình.
Co giãn đặc trưng để có độ lệch chuẩn bằng 1 (chuẩn hóa phương sai).
Sau khi đã trừ mean, chia cho độ lệch chuẩn của cột.
Mục tiêu: Làm cho dữ liệu có độ lệch chuẩn = 1, tức là không quá phân tán.
Chuẩn hóa vs. Tiêu chuẩn hóa: Khi nào dùng cái nào?
Chuẩn hóa: Phù hợp khi dữ liệu cần giới hạn trong khoảng cố định, ví dụ, mạng nơ-ron yêu cầu đầu vào [0,1].
Tiêu chuẩn hóa: Phù hợp với các thuật toán giả định dữ liệu tuân theo phân phối chuẩn.
Biến đổi Nghịch đảo
Chúng ta đã tìm hiểu về các phép biến đổi khác nhau có thể áp dụng cho dữ liệu. Tuy nhiên, đôi khi chúng ta muốn hoàn tác, hoặc thực hiện biến đổi nghịch đảo (inverse transformation), để dễ dàng so sánh kết quả với dữ liệu gốc.
Ví dụ, giả sử chúng ta làm việc cho sở giao thông của một thành phố có một tuyến đường cao tốc chính. Thành phố nằm ở phía bắc, nơi nhiệt độ thường xuyên xuống dưới mức đóng băng. Các nhà quản lý nhận thấy mật độ giao thông dường như thay đổi theo nhiệt độ, với nhiều người ở nhà hơn vào những ngày lạnh nhất. Để lập kế hoạch sửa chữa đường và các công trình khác, họ muốn biết số lượng xe dự đoán được trong giờ cao điểm sáng (7-8 giờ sáng) dựa trên nhiệt độ. Vì việc đo lường và xử lý dữ liệu mất một khoảng thời gian, chúng ta quyết định đo nhiệt độ lúc nửa đêm và dự đoán số lượng xe vào sáng hôm sau. Hệ thống của chúng ta bắt đầu hoạt động vào giữa mùa đông, nên chúng ta dự kiến nhiệt độ sẽ dao động cả trên và dưới mức đóng băng (0°C).
Trong vài tháng, chúng ta đo nhiệt độ lúc nửa đêm và đếm tổng số xe đi qua một điểm đánh dấu cụ thể trên đường vào khung giờ 7-8 giờ sáng hôm sau.
Chúng ta muốn cung cấp dữ liệu này cho một hệ thống học máy (machine learning) để tìm ra mối liên hệ giữa nhiệt độ và mật độ giao thông. Sau khi triển khai, chúng ta nhập một mẫu dữ liệu gồm một đặc trưng (feature) là nhiệt độ (đơn vị độ C) và nhận về một số thực dự đoán số lượng xe trên đường.
Giả sử thuật toán hồi quy (regression algorithm) mà chúng ta sử dụng hoạt động tốt nhất khi dữ liệu đầu vào được chuẩn hóa về khoảng [0,1]. Chúng ta có thể chuẩn hóa dữ liệu về khoảng [0,1] trên cả hai trục
Hình này trông giống hình trên, chỉ khác ở chỗ cả hai trục (và dữ liệu) giờ đây đều nằm trong khoảng từ 0 đến 1.
Giả sử chúng ta đã huấn luyện hệ thống và nó dự đoán tốt số lượng xe từ dữ liệu nhiệt độ.
Ngày hôm sau, chúng ta triển khai hệ thống trên một trang web cho các nhà quản lý thành phố. Vào đêm đầu tiên, người quản lý trực ca đo được nhiệt độ lúc nửa đêm là -10°C. Cô ấy mở ứng dụng, tìm ô nhập nhiệt độ, nhập -10 và nhấn nút “Dự đoán giao thông”.
Vấn đề phát sinh
Có vấn đề xảy ra. Chúng ta không thể nhập trực tiếp -10 vào hệ thống đã huấn luyện, vì hệ thống kỳ vọng một số trong khoảng [0,1]. Chúng ta cần biến đổi dữ liệu theo cách nào đó. Cách duy nhất hợp lý là áp dụng cùng phép biến đổi đã dùng cho dữ liệu nhiệt độ khi huấn luyện. Ví dụ, nếu trong tập dữ liệu gốc, -10 được biến đổi thành 0.29, thì khi nhiệt độ là -10°C tối nay, chúng ta nên nhập 0.29, không phải -10.
Đây là lúc chúng ta thấy giá trị của việc lưu phép biến đổi dưới dạng một đối tượng. Chúng ta chỉ cần yêu cầu đối tượng áp dụng cùng phép biến đổi đã sử dụng cho dữ liệu huấn luyện vào dữ liệu mới này. Nếu -10 được biến đổi thành 0.29 trong quá trình huấn luyện, thì bất kỳ đầu vào mới nào là -10 cũng sẽ được biến đổi thành 0.29 khi triển khai.
Giả sử chúng ta nhập đúng nhiệt độ 0.29 vào hệ thống, và nó trả về mật độ giao thông là 0.32. Giá trị này tương ứng với số lượng xe nào đó đã được biến đổi bởi phép biến đổi số lượng xe. Nhưng giá trị này nằm trong khoảng [0,1], vì đó là khoảng dữ liệu huấn luyện biểu thị số lượng xe. Làm thế nào để hoàn tác phép biến đổi này và chuyển nó thành số lượng xe thực tế?
Trong bất kỳ thư viện học máy nào, mỗi đối tượng biến đổi đều đi kèm với một hàm để thực hiện biến đổi nghịch đảo (inverse transformation), giúp hoàn tác phép biến đổi. Trong trường hợp này, nó đảo ngược phép chuẩn hóa đã áp dụng. Nếu đối tượng biến đổi 39 xe thành giá trị chuẩn hóa 0.32, thì phép biến đổi nghịch đảo sẽ chuyển giá trị chuẩn hóa 0.32 trở lại thành 39 xe. Đây là giá trị chúng ta hiển thị cho nhà quản lý thành phố.
Vấn đề với dữ liệu ngoài phạm vi
Một vấn đề có thể xảy ra là khi nhận được mẫu mới ngoài phạm vi dữ liệu gốc. Giả sử một đêm nhiệt độ xuống -50°C, thấp hơn nhiều so với giá trị nhỏ nhất trong dữ liệu gốc. Kết quả là giá trị đã biến đổi sẽ là số âm, nằm ngoài khoảng [0,1]. Tương tự, nếu một đêm rất nóng, nhiệt độ dương có thể biến đổi thành giá trị lớn hơn 1, cũng nằm ngoài khoảng [0,1].
Cả hai trường hợp này đều không có vấn đề. Mục đích chuẩn hóa đầu vào về [0,1] là để huấn luyện hiệu quả và kiểm soát các vấn đề số học. Sau khi hệ thống được huấn luyện, chúng ta có thể nhập bất kỳ giá trị nào, và nó sẽ tính toán đầu ra tương ứng. Tuy nhiên, chúng ta vẫn cần chú ý đến dữ liệu. Nếu hệ thống dự đoán số xe âm cho ngày mai, chúng ta không nên lập kế hoạch dựa trên con số đó.
Để minh họa, hãy giả định một tập dữ liệu nhiệt độ từ -20°C đến 20°C và số lượng xe từ 0 đến 1000. Chúng ta áp dụng chuẩn hóa tuyến tính (linear normalization):
Chuẩn hóa nhiệt độ:
Công thức: [latex]x’ = \frac{x – x_{\text{min}}}{x_{\text{max}} – x_{\text{min}}}[/latex]
Với [latex]x_{\text{min}} = -20[/latex], [latex]x_{\text{max}} = 20[/latex]:
from sklearn.preprocessing import MinMaxScalerimport numpy as np# Dữ liệu giả lậptemps = np.array([-20,-10,0,10,20]).reshape(-1,1)cars = np.array([0,200,500,800,1000]).reshape(-1,1)# Tạo và huấn luyện bộ chuẩn hóatemp_scaler =MinMaxScaler()car_scaler =MinMaxScaler()temp_scaled = temp_scaler.fit_transform(temps)car_scaled = car_scaler.fit_transform(cars)# Biến đổi dữ liệu mớinew_temp = np.array([[-10]])new_temp_scaled = temp_scaler.transform(new_temp)# Kết quả: [[0.25]]# Giả sử mô hình dự đoán được 0.32pred_scaled = np.array([[0.32]])pred_cars = car_scaler.inverse_transform(pred_scaled)# Kết quả: [[320]]print(f"Nhiệt độ -10°C -> Chuẩn hóa: {new_temp_scaled[0][0]:.2f}")print(f"Dự đoán chuẩn hóa 0.32 -> Số xe: {pred_cars[0][0]:.0f}")
Thu gọn tập dữ liệu (Data Shrink)
Chúng ta đã xem xét các cách điều chỉnh số liệu trong dữ liệu và lựa chọn dữ liệu cho từng phép biến đổi. Bây giờ, hãy xem xét một loại biến đổi khác nhằm thu gọn dữ liệu, tạo ra một tập dữ liệu nhỏ hơn tập huấn luyện ban đầu, thường bằng cách loại bỏ hoặc kết hợp các đặc trưng.
Lợi ích của việc này là tăng tốc độ và độ chính xác khi huấn luyện. Ít dữ liệu hơn nghĩa là huấn luyện nhanh hơn, cho phép học nhiều hơn trong cùng khoảng thời gian, dẫn đến hệ thống chính xác hơn.
Lựa chọn đặc trưng (Feature Selection)
Nếu dữ liệu chứa các đặc trưng dư thừa, không liên quan hoặc không hữu ích, chúng ta nên loại bỏ chúng để tiết kiệm thời gian. Quá trình này gọi là lựa chọn đặc trưng (feature selection) hoặc lọc đặc trưng (feature filtering).
Ví dụ, giả sử chúng ta gắn nhãn thủ công hình ảnh của voi, nhập kích thước, loài và các đặc điểm khác vào cơ sở dữ liệu. Vì lý do nào đó, chúng ta có một trường cho số lượng đầu. Voi chỉ có một đầu, nên trường này chỉ toàn số 1, do đó vô dụng và làm chậm quá trình. Chúng ta nên loại bỏ trường này.
Tổng quát hơn, chúng ta có thể loại bỏ các đặc trưng đóng góp rất ít hoặc có ít tác động nhất đến kết quả. Ví dụ, với tập dữ liệu về voi, chiều dài vòi và kích thước tai có thể tương quan chặt chẽ. Nếu vậy, chúng ta có thể loại bỏ một trong hai mà vẫn giữ được thông tin.
Nhiều thư viện cung cấp công cụ để đánh giá tác động của việc loại bỏ từng trường. Chúng ta sử dụng thông tin này để đơn giản hóa cơ sở dữ liệu, tăng tốc học mà không mất quá nhiều độ chính xác. Vì loại bỏ đặc trưng là một phép biến đổi, bất kỳ đặc trưng nào bị loại khỏi tập huấn luyện cũng phải bị loại khỏi dữ liệu tương lai.
Giảm chiều dữ liệu (Dimensionality Reduction)
Một cách khác để thu gọn tập dữ liệu là kết hợp các đặc trưng, để một đặc trưng thay thế cho hai hoặc nhiều đặc trưng. Quá trình này gọi là giảm chiều dữ liệu (dimensionality reduction), với chiều là số lượng đặc trưng.
Ví dụ, chỉ số khối cơ thể (BMI) là một số kết hợp chiều cao và cân nặng. Một số chỉ số sức khỏe có thể được tính toán chỉ với BMI. Ví dụ, biểu đồ giúp người dùng quyết định xem có cần giảm cân có thể được lập chỉ mục bởi tuổi và BMI, chúng ta có thể giảm từ feature (chiều cao, cân nặng) -> (BMI).
This entry is part 3 of 8 in the series SWE Học A.I
Xác suất
Xác suất thể hiện mức độ tin tưởng rằng một sự kiện sẽ xảy ra, thường được biểu thị dưới dạng phần trăm. Một số câu hỏi có thể cần câu trả lời bằng xác suất:
Khả năng tung được 7 lần mặt sấp trong 10 lần tung đồng xu công bằng là bao nhiêu?
Nếu rút một lá bài thì khả năng nhận được một lá Át (A) là bao nhiêu?
Cách phổ biến nhất để biểu thị xác suất là dưới dạng phần trăm, ví dụ: “Có 70% khả năng chuyến bay Vietjet sẽ bị trễ.”
Gọi xác suất này là [latex]P(X)[/latex], trong đó [latex]X[/latex] là sự kiện quan tâm. Tuy nhiên, trong thực tế, thường thấy nó được biểu thị dưới dạng số thập phân (trong trường hợp này là 0.7), và giá trị này phải nằm trong khoảng từ 0.0 đến 1.0.
Khả năng xảy ra (likelihood) tương tự như xác suất.
Có thể phân biệt bằng cách nhận xét xác suất là việc định lượng dự đoán về các sự kiện chưa xảy ra, trong khi khả năng xảy ra là đo lường tần suất của các sự kiện đã xảy ra. Trong thống kê và học máy, chúng ta thường sử dụng khả năng xảy ra – likelihood (dữ liệu từ quá khứ) để dự đoán xác suất (tương lai).
Xác suất của một sự kiện xảy ra phải nằm nghiêm ngặt trong khoảng từ 0% đến 100%, hoặc từ 0.0 đến 1.0. Về mặt logic, điều này có nghĩa là xác suất một sự kiện không xảy ra được tính bằng cách lấy 1.0 trừ đi xác suất của sự kiện đó:
[latex]P(\text{không } X) = 1 – P(X)[/latex]
Nếu xác suất trời mưa hôm nay là 0.3 (30%) → xác suất không mưa là 1 – 0.3 = 0.7 (70%).
Nếu xác suất bạn đến đúng giờ là 90% → xác suất đi trễ là 10%.
Đây là một điểm khác biệt nữa giữa xác suất và khả năng xảy ra. Tổng xác suất của tất cả các kết quả loại trừ lẫn nhau (mutually exclusive outcomes) của một sự kiện (nghĩa là chỉ một kết quả có thể xảy ra, không phải nhiều kết quả cùng lúc) phải bằng 1.0 hoặc 100%. Tuy nhiên, khả năng xảy ra không tuân theo quy tắc này.
Xác suất & Thống kê
Giả sử có một con xúc xắc 6 mặt, nhưng nó không công bằng, với mặt số 4 có xác suất xuất hiện cao hơn. Bạn tung xúc xắc 100 lần và ghi lại kết quả như sau:
Số 1: 15 lần
Số 2: 10 lần
Số 3: 10 lần
Số 4: 40 lần
Số 5: 15 lần
Số 6: 10 lần
Dựa trên dữ liệu này, xác suất thực nghiệm (empirical probability) của việc tung được số 4 là:
Có thể thấy, xác suất là lý thuyết thuần túy về mức độ có khả năng một sự kiện sẽ xảy ra và không cần dữ liệu. Khi dự đoán kết quả của việc tung một con xúc xắc 6 mặt và được số 4. Với tư duy xác suất thuần túy, ta chỉ cần nói rằng xúc xắc có sáu mặt. Giả sử mỗi mặt có khả năng xảy ra như nhau, nên xác suất được số 4 là [latex]\frac{1}{6}[/latex], tức là 16.666%.
Nhưng khi nói về thống kê, có thể thấy thống kê không thể tồn tại nếu không có dữ liệu và sử dụng dữ liệu để khám phá xác suất cũng như cung cấp các công cụ để mô tả dữ liệu. Chúng ta cần tung xúc xắc để thu thập dữ liệu. Nếu chúng ta tung được 30 lần hoặc nhiều hơn, càng nhiều lần càng tốt, chỉ khi đó chúng ta mới có dữ liệu để xác định xác suất được số 4.” Cách tiếp cận này có vẻ ngớ ngẩn nếu giả định xúc xắc công bằng, nhưng nếu xúc xắc không công bằng thì sao? Trong trường hợp đó, thu thập dữ liệu là cách duy nhất để khám phá xác suất tung được số 4.
Xác Suất Kết Hợp (Joint Probabilities)
Giả sử ta có một đồng xu công bằng và một con xúc xắc sáu mặt công bằng. Ta muốn tính xác suất tung được mặt sấp (heads) trên đồng xu và tung được số 6 trên xúc xắc. Đây là hai xác suất riêng biệt của hai sự kiện độc lập, nhưng chúng ta muốn tìm xác suất cả hai sự kiện xảy ra cùng nhau. Đây được gọi là xác suất kết hợp (joint probability).
Với đồng xu có hai mặt, xác suất tung được mặt sấp là [latex]\frac{1}{2}[/latex]. Với xúc xắc sáu mặt, xác suất tung được số 6 là [latex]\frac{1}{6}[/latex]. Nếu hai sự kiện này độc lập (independent, nghĩa là sự kiện này không ảnh hưởng đến sự kiện kia), xác suất kết hợp được tính bằng cách nhân hai xác suất với nhau:
[latex]P(\text{mặt sấp và số 6}) = P(\text{mặt sấp}) \times P(\text{số 6}) = \frac{1}{2} \times \frac{1}{6} = \frac{1}{12}[/latex]
Để hiểu rõ hơn, chúng ta có thể liệt kê tất cả các kết quả có thể xảy ra khi tung đồng xu và xúc xắc.
Đồng xu: S (sấp, heads), N (ngửa, tails)
Xúc xắc: 1, 2, 3, 4, 5, 6
Kết hợp tất cả các khả năng, ta được 12 kết quả:
S1, S2, S3, S4, S5, S6(*), N1, N2, N3, N4, N5, N6
Kết quả mong muốn là S6 (mặt sấp và số 6), được đánh dấu bằng dấu sao (*). Vì chỉ có 1 kết quả mong muốn trong tổng số 12 kết quả có thể, xác suất là [latex]\frac{1}{12}[/latex]. Điều này phù hợp với phép nhân ở trên, được gọi là quy tắc nhân (product rule):
[latex]P(A \text{ AND } B) = P(A) \times P(B) \text{ (nếu } A \text{ và } B \text{ độc lập)}[/latex]
Xác Suất Hợp (Union Probabilities)
Xác suất kết hợp liên quan đến toán tử AND, nhưng nếu chúng ta muốn tính xác suất xảy ra sự kiện A hoặc sự kiện B? Đây được gọi là xác suất hợp (union probability), tương ứng với toán tử OR trong logic.
Trường hợp sự kiện loại trừ lẫn nhau (Mutually Exclusive Events)
Sự kiện loại trừ lẫn nhau là những sự kiện không thể xảy ra đồng thời. Ví dụ, khi tung một xúc xắc, ta không thể đồng thời được số 4 và số 6. Xác suất hợp trong trường hợp này đơn giản là cộng xác suất của từng sự kiện:
[latex]P(\text{số 4 OR số 6}) = P(\text{số 4}) + P(\text{số 6}) = \frac{1}{6} + \frac{1}{6} = \frac{2}{6} = \frac{1}{3}[/latex]
Trường hợp sự kiện không loại trừ lẫn nhau (Non-Mutually Exclusive Events)
Với các sự kiện có thể xảy ra đồng thời, việc tính xác suất hợp phức tạp hơn. Quay lại ví dụ đồng xu và xúc xắc, giả sử ta muốn tính xác suất tung được mặt sấp OR số 6. Liệt kê lại tất cả các kết quả:
S1, S2, S3, S4, S5, S6, N1, N2, N3, N4, N5, N6
Chúng ta quan tâm đến tất cả các kết quả có mặt sấp (S1, S2, S3, S4, S5, S6) hoặc số 6 (S6, N6). Đếm các kết quả thỏa mãn: S1, S2, S3, S4, S5, S6, N6, tổng cộng 7/12.
Kết quả này sai vì S6 đã bị đếm hai lần (trong cả nhóm mặt sấp và nhóm số 6). Để khắc phục, chúng ta sử dụng quy tắc tổng (sum rule):
[latex]P(A \text{ OR } B) = P(A) + P(B) – P(A \text{ AND } B)[/latex]
Áp dụng vào ví dụ:
[latex]P(\text{mặt sấp OR số 6}) = P(\text{mặt sấp}) + P(\text{số 6}) – P(\text{mặt sấp AND số 6}) = \frac{1}{2} + \frac{1}{6} – \frac{1}{12} = \frac{6}{12} + \frac{2}{12} – \frac{1}{12} = \frac{7}{12}[/latex]
Xác Suất Có Điều Kiện và Định lý Bayes (Conditional Probability and Bayes’ Theorem)
Xác suất có điều kiện (conditional probability) là xác suất của sự kiện A xảy ra khi biết rằng sự kiện B đã xảy ra, ký hiệu là [latex]P(A|B)[/latex]. Ví dụ, một nghiên cứu tuyên bố rằng 85% bệnh nhân ung thư uống cà phê. Điều này nghe có vẻ khá đáng lo ngại
Định nghĩa xác suất này là [latex]P(\text{uống cà phê} | \text{ung thư}) = 0.85[/latex]. Nhưng điều chúng ta thực sự quan tâm là xác suất ngược lại: [latex]P(\text{ung thư} | \text{uống cà phê})[/latex]. (Bao nhiêu người uống cafe mắc bệnh ung thư)
Sử dụng Định lý Bayes
Định lý Bayes cho phép “lật ngược” xác suất có điều kiện:
Kết quả cho thấy xác suất một người uống cà phê bị ung thư chỉ là 0.65%, rất thấp so với 85% ban đầu. Điều này minh họa rằng hướng của điều kiện rất quan trọng.
Naive Bayes
Định lý Bayes là nền tảng của thuật toán Naive Bayes, một phương pháp học máy phổ biến để phân loại. Thuật toán này giả định các đặc trưng (features) độc lập với nhau, giúp đơn giản hóa tính toán. Ví dụ, trong phân loại văn bản, Naive Bayes có thể dự đoán một bài đánh giá là tích cực hay tiêu cực dựa trên các từ xuất hiện.
Minh họa đơn giản
Giả sử ta xây dựng một mô hình để phân loại email. Ta có dữ liệu:
60% email là spam.
Từ “miễn phí” xuất hiện trong 50% email spam và 10% email không spam.
Tính xác suất một email chứa từ “miễn phí” là spam:
[latex]P(\text{không spam})[/latex]: Xác suất một email không phải spam (ví dụ: 70% email không spam).
[latex]P(\text{miễn phí} \mid \text{không spam})[/latex]: Xác suất email có từ “miễn phí” nếu nó không spam (ví dụ: 10% email không spam có từ “miễn phí”).
Email chứa từ “miễn phí” có 88.2% khả năng là spam.
Phân phối nhị thức (Binomial Distribution)
Giả sử ta đang phát triển một động cơ mới và đã thực hiện 1 bài kiểm tra với 10 lần thử. Kết quả là 8 lần thành công và 2 lần thất bại:
✓ ✓ ✓ ✓ ✓ ✘ ✓ ✘ ✓ ✓
Ta kỳ vọng động cơ mới có thể đạt tỷ lệ thành công 90%, nhưng dữ liệu cho thấy chỉ đạt 80% (8 lần thành công trong 10 lần thử trong bài kiểm tra). Mỗi bài kiểm tra tốn thời gian và chi phí, nên ta quyết định quay lại bàn thiết kế để cải tiến.
Tuy nhiên, một kỹ sư trong nhóm cho rằng cần thêm bài kiểm tra và lập luận: “Chúng ta chỉ biết chắc khi thử nhiều hơn. Điều gì xảy ra nếu các bài kiểm tra tiếp theo đạt 9 lần thử hoặc 10 lần thử thành công? Ví dụ, nếu tung đồng xu 10 lần và được 8 lần mặt ngửa, điều đó không có nghĩa đồng xu bị ‘cố định’ ở 80% ngửa trong tất cả các lần.”
Ngay cả với đồng xu công bằng, 10 lần tung không phải lúc nào cũng chia đều kết quả. Xác suất có 5 lần mặt ngửa thường xuyên xảy ra, nhưng ta cũng có thể được 3, 4, 6, hoặc 7 lần. Thậm chí 10 lần mặt ngửa cũng có thể xảy ra, dù rất hiếm. Vậy làm thế nào để xác định?
Và ta có phân phối nhị thức, dùng để đo lường khả năng đạt được [latex]k[/latex] lần thành công trong [latex]n[/latex] lần thử với xác suất thành công là [latex]p[/latex].
Ta có hình ảnh [latex]n=10[/latex] lần kiểm tra. Phân phối nhị thức được cài đặt [latex]p=0.9[/latex], hay với mỗi lần kiểm tra, ta có tỉ lệ 90% máy sẽ chạy thành công, và 10% thất bại. (Như kỳ vọng về máy). Và theo biểu đồ, có xác suất đạt 8 lần thành công trong 10 lần là 0,1937 (19,37%).
Phân phối nhị thức là một mô hình xác suất dùng để tính khả năng đạt được đúng [latex]k[/latex] lần thành công trong [latex]n[/latex] lần thử, khi:
Mỗi lần thử độc lập với nhau.
Mỗi lần thử chỉ có hai kết quả: thành công (success) hoặc thất bại (failure) theo [latex]p[/latex] cố định.
[latex]n[/latex]: Số lần thử (trials). Trong ví dụ, [latex]n = 10[/latex] (10 bài kiểm tra).
[latex]k[/latex]: Số lần thành công mong muốn. Ví dụ, [latex]k = 8[/latex] (8 lần thành công).
[latex]p[/latex]: Xác suất thành công mỗi lần thử. Ví dụ, [latex]p = 0.9[/latex] (90%).
[latex]1-p[/latex]: Xác suất thất bại mỗi lần thử, ở đây là [latex]0.1[/latex].
[latex]{n \choose k}[/latex]: Tổ hợp chập [latex]k[/latex] của [latex]n[/latex], tức số cách chọn [latex]k[/latex] lần thành công trong [latex]n[/latex] lần thử, được tính bằng:
[latex]n[/latex] (số lần thử): Quy mô của thí nghiệm. Số lần thử càng lớn, kết quả càng ổn định và gần với [latex]p[/latex].
[latex]k[/latex] (số lần thành công): Số lần mong muốn đạt được kết quả “thành công”. Ví dụ, mong muốn biết xác suất đúng 8 lần thành công.
[latex]p[/latex] (xác suất thành công): Tỷ lệ kỳ vọng của sự kiện thành công. Trong ví dụ, [latex]p=0,9[/latex] là tỷ lệ thành công mong muốn của động cơ.
[latex]1-p[/latex] (xác suất thất bại): Tỷ lệ thất bại, bổ sung cho [latex]p[/latex].
Ta muốn kiểm tra xem việc đạt 8 lần thành công trên 10 lần thử có hợp lý không, nếu giả định rằng động cơ thực sự có xác suất thành công là 90%. Sử dụng phân phối nhị thức, ta tính xác suất đúng 8 lần thành công như sau:
Xác suất đạt đúng 8 lần thành công là 19,37%, không phải quá thấp. Tuy nhiên, để đánh giá rủi ro, ta cần tính xác suất đạt 8 hoặc ít hơn lần thành công:
Điều đó có nghĩa là ngay cả khi tỷ lệ thành công thực sự là 90%, thì vẫn có 26,39% khả năng động cơ chỉ đạt 8 hoặc ít hơn lần thành công trong 10 lần thử. Vì vậy việc thử nghiệm nhiều hơn theo ý ban đầu là hợp lý, chưa thể khẳng định cần cải tiến động cơ ngay chỉ với 10 lần thử.
Phương sai, độ lệch chuẩn và phân phối Chuẩn (Normal Distribution)
Phương sai và Độ lệch chuẩn
Trong thống kê, khi mô tả dữ liệu, chúng ta thường quan tâm đến việc đo lường độ chênh lệch giữa giá trị trung bình (mean) và từng điểm dữ liệu. Điều này giúp chúng ta hiểu dữ liệu phân bố “rải rác” như thế nào.
Ví dụ, giả sử ta muốn nghiên cứu số lượng thú cưng mà nhân viên trong văn phòng của ta sở hữu (đây là tổng thể, không phải mẫu). Văn phòng có 7 nhân viên, và số lượng thú cưng họ sở hữu lần lượt là: [0, 1, 5, 7, 9, 10, 14]. Trung bình số thú cưng là:
Hãy trừ giá trị trung bình này khỏi mỗi điểm dữ liệu để xem mỗi giá trị cách trung bình bao xa:
Thông tin này hữu ích vì nó cho chúng ta cảm nhận về mức độ phân tán của dữ liệu. Tuy nhiên, làm thế nào để tổng hợp các độ chênh lệch này thành một con số duy nhất để mô tả mức độ phân tán?
Một ý tưởng là lấy trung bình của các độ chênh lệch, nhưng các giá trị âm và dương sẽ triệt tiêu lẫn nhau khi cộng lại. Chúng ta có thể lấy giá trị tuyệt đối (loại bỏ dấu âm), nhưng một cách tiếp cận tốt hơn là bình phương các độ chênh lệch trước khi cộng. Bình phương không chỉ loại bỏ giá trị âm (vì bình phương số âm cho kết quả dương), mà còn làm nổi bật các độ chênh lệch lớn hơn và dễ xử lý hơn về mặt toán học (đạo hàm của giá trị tuyệt đối không đơn giản). Sau đó, lấy trung bình của các giá trị bình phương này để được phương sai (variance), một thước đo mức độ phân tán của dữ liệu.
[latex]x_i[/latex] là từng giá trị trong tập dữ liệu.
[latex]n[/latex] là số lượng phần tử.
Phương sai của số thú cưng là khoảng 21.39. Nhưng con số này có ý nghĩa gì? Phương sai cao cho thấy dữ liệu phân tán nhiều, nhưng vì chúng ta đã bình phương các độ chênh lệch, giá trị này không còn cùng đơn vị với dữ liệu gốc (số thú cưng). Để đưa nó về thang đo ban đầu, chúng ta lấy căn bậc hai của phương sai, được gọi là độ lệch chuẩn (standard deviation):
[latex] \sigma = \sqrt{\sigma^2} [/latex]
Độ lệch chuẩn là khoảng 4.62 thú cưng. Điều này có nghĩa là trung bình, số lượng thú cưng của nhân viên dao động khoảng ±4.62 quanh giá trị trung bình 6.571. Độ lệch chuẩn dễ diễn giải hơn vì nó cùng đơn vị với dữ liệu gốc.
Phân phối liên tục
Hầu hết các ví dụ xác suất từ đầu bài đều là biến rời rạc. Ví dụ:
Tung xúc xắc: có đúng 6 kết quả có thể (1, 2, 3, 4, 5, 6)
Tung đồng xu: có đúng 2 kết quả có thể (ngửa, sấp)
Rút bài: có đúng 52 lá bài khác nhau
NNhưng trong thực tế, nhiều thứ không thể đếm được như vậy:
Bạn đến trạm xe bus. Xe sẽ đến sau bao lâu?
2 phút? 2.5 phút? 2.37 phút? 2.371846 phút?
Thời gian có thể là bất kỳ số nào từ 0 đến 15 phút (chu kỳ xe bus)
Không có “danh sách” cụ thể các thời gian có thể như với xúc xắc
Nhiệt độ ở Sài Gòn hôm nay là bao nhiêu?
32°C? 32.1°C? 32.15°C? 32.1543°C?
Nhiệt độ có thể là bất kỳ số nào trong khoảng (ví dụ 25°C đến 38°C)
Bạn có thể đo chính xác đến hàng triệu chữ số thập phân nếu muốn
Tốc độ mạng wifi của bạn bây giờ là bao nhiêu Mbps?
Tốc độ luôn thay đổi và có thể là bất kỳ số nào trong một khoảng
50.2 Mbps? 50.28374 Mbps? 50.283746291 Mbps?
Đặc điểm của Biến Liên tục:
Vô số giá trị có thể: Ngay cả trong khoảng nhỏ như [1, 2], vẫn có vô số số thực
Không thể liệt kê: Không thể viết danh sách tất cả giá trị có thể như với xúc xắc
Độ chính xác tùy ý: Bạn luôn có thể đo chính xác hơn bằng cách thêm chữ số thập phân
Điều quan trọng: Với biến liên tục, xác suất để có chính xác một giá trị cụ thể (như đúng 32.0000000°C) thực tế là 0. Thay vào đó, ta chỉ có thể tính xác suất trong các khoảng (như từ 31.5°C đến 32.5°C).
Thay vì tìm xác suất của một giá trị chính xác, chúng ta chỉ tính xác suất trong các khoảng:
Không tìm xác suất cân nặng chính xác 72.8 kg
Mà tìm xác suất cân nặng từ 72.7 đến 72.9 kg
Hàm mật độ xác suất (PDF)
Hàm mật độ xác suất (PDF) cho chúng ta biết “mật độ” của xác suất tại từng điểm trên đường cong phân phối. Nói cách khác, PDF cho biết một giá trị cụ thể có khả năng xuất hiện “dày đặc” như thế nào.
Hình dung PDF như bản đồ mật độ dân số của một thành phố:
Những khu vực có PDF cao = khu vực đông dân
Những khu vực có PDF thấp = khu vực ít dân
Nhưng để biết có bao nhiêu người sống trong một khu vực cụ thể, ta phải tính diện tích khu vực đó
Tính Xác suất thực tế = Diện tích dưới Đường cong
Để tìm xác suất thực sự, chúng ta cần tính diện tích dưới đường cong PDF:
Xác suất (từ a đến b) = Diện tích dưới đường cong PDF từ a đến b
Ví dụ về cân nặng khi xem xét nhiều cân nặng của chú chó Golden Retriever:
Để tìm xác suất cân nặng từ 62 đến 66 pound
Chúng ta tính diện tích dưới đường cong PDF trong khoảng [62, 66]
Hàm Phân bố Tích lũy (CDF)
Do trục dọc của PDF không phải là xác suất mà là mật độ xác suất. Để tính xác suất, chúng ta cần tích phân một khoảng giá trị [latex]x[/latex] để tìm diện tích dưới đường cong.
Phân phối Chuẩn (Normal Distribution)
Phân phối chuẩn, hay còn gọi là phân phối Gaussian, là một phân phối xác suất hình chuông đối xứng, với phần lớn giá trị tập trung quanh trung bình và độ phân tán được xác định bởi độ lệch chuẩn. Các “đuôi” của phân phối mỏng dần khi xa trung bình.
Phân phối chuẩn là phân phối hình chuông kinh điển, được xác định hoàn toàn bởi hai tham số: trung bình [latex]\mu[/latex] (mean) và độ lệch chuẩn [latex]\sigma[/latex] (standard deviation). Trung bình cho biết tâm của đường cong chuông nằm ở đâu, còn độ lệch chuẩn biểu thị độ “rộng” của nó.
Ví dụ, hãy xem xét cân nặng của giống chó Golden Retriever. Giả sử trung bình cân nặng là 64.43 pound và độ lệch chuẩn là 2.99 pound
Giả sử chúng ta lấy mẫu cân nặng của 50 con Golden Retriever trưởng thành và vẽ chúng trên trục số
Chúng ta nhận thấy các giá trị tập trung gần trung bình, và càng xa trung bình thì càng ít giá trị. Để hình dung rõ hơn, chúng ta có thể tạo một biểu đồ tần suất (histogram), chia các giá trị vào các “thùng” (bin) có độ dài bằng nhau. chúng ta thử chia thùng với độ dài 0.5 pound. (Ví dụ 57.4 – 57.9 gộp thành chung 1 bin)
Biểu đồ này không cho thấy hình dạng rõ ràng vì các thùng quá nhỏ và mẫu không đủ lớn. Hãy thử tăng kích thước thùng lên 3 pound
Bây giờ, chúng ta thấy một hình chuông rõ ràng. Cho thấy mẫu có khả năng tuân theo phân phối chuẩn. Nếu điều chỉnh kích thước thùng phù hợp và chuẩn hóa để tổng diện tích bằng 1 (yêu cầu của phân phối xác suất), chúng ta sẽ có một đường cong chuông gần đúng, như trong hình dưới:
Đặc điểm của Phân phối Chuẩn
Phân phối chuẩn có các đặc điểm quan trọng sau:
Tính đối xứng: Hai bên đối xứng quanh trung bình.
Tập trung quanh trung bình: Phần lớn giá trị nằm gần trung bình.
Độ phân tán: Được xác định bởi độ lệch chuẩn.
Đuôi mỏng dần: Xác suất giảm dần khi xa trung bình, nhưng không bao giờ chạm 0.
Hàm mật độ xác suất (PDF) của phân phối chuẩn
Hàm mật độ xác suất cho phân phối chuẩn trông như sau:
Ví dụ, để tìm xác suất một con Golden Retriever có cân nặng từ 62 đến 66 pound, chúng ta cần tính diện tích dưới đường cong trong khoảng này
Hàm CDF, với hình dạng cong chữ S (gọi là đường cong sigmoid), biểu thị diện tích dưới đường cong PDF cho đến một giá trị x nhất định
Khi tính diện tích từ âm vô cực đến giá trị trung bình 64.43, hàm CDF cho kết quả chính xác là 0.5, tương ứng với 50%! – Tương ứng xác suất 50% một chú chó Golden Retriever có cân nặng rơi vào một nửa bên trái [- âm vô cực, 64.43]
Tính hàm CDF cho phân bố chuẩn trong Python
Python
from scipy.stats import normmean =64.43# giá trị trung bìnhstd_dev =2.99# độ lệch chuẩnx = norm.cdf(64.43, mean, std_dev)print(x)# in ra 0.5
Ta có thể tính diện tích của một khoảng giữa bằng cách trừ hai giá trị diện tích. Nếu muốn tìm xác suất quan sát được một chú chó Golden Retriever có cân nặng từ 62 đến 66 pound, ta tính diện tích đến 66 và trừ đi diện tích đến 62.
Python
from scipy.stats import normmean =64.43std_dev =2.99x = norm.cdf(66, mean, std_dev)- norm.cdf(62, mean, std_dev)print(x)# in ra 0.4920450147062894
Hàm CDF nghịch đảo (Inverse CDF)
Từ hàm CDF, ta có thể tính xác suất một chú chó Golden Retriever có cân nặng từ khoảng [a,b] là 40% hay x. Ví dụ, đôi lúc ta muốn trả lời các câu hỏi như:
Ta muốn tìm cân nặng mà 95% chó Golden Retriever nằm dưới mức đó.
Python
from scipy.stats import normx = norm.ppf(.95,loc=64.43,scale=2.99)print(x)# 69.3481123445849
Điểm Z (Z-Scores)
Việc chuẩn hóa một phân bố chuẩn sao cho giá trị trung bình bằng 0 và độ lệch chuẩn bằng 1, gọi là phân bố chuẩn tắc (standard normal distribution), là rất phổ biến. Điều này giúp dễ dàng so sánh độ phân tán của một phân bố chuẩn với phân bố chuẩn khác, ngay cả khi chúng có giá trị trung bình và phương sai khác nhau.
Điều đặc biệt quan trọng với phân bố chuẩn tắc là nó biểu diễn tất cả giá trị x dưới dạng số độ lệch chuẩn, gọi là điểm Z (Z-scores). Việc chuyển một giá trị x thành điểm Z sử dụng công thức chuẩn hóa cơ bản:
[latex]z = \frac{x – \mu}{\sigma} [/latex]
Ví dụ: Ta có hai ngôi nhà từ hai khu vực khác nhau. Khu A có giá trị trung bình của nhà là 140,000 USD và độ lệch chuẩn 3,000 USD. Khu B có giá trị trung bình 800,000 USD và độ lệch chuẩn 10,000 USD.
Bây giờ, ta có hai ngôi nhà: Nhà A từ khu A trị giá 150,000 USD và nhà B từ khu B trị giá 815,000 USD. Ngôi nhà nào đắt hơn so với giá trung bình của khu vực của nó?
Nếu biểu diễn hai giá trị này dưới dạng số độ lệch chuẩn, ta có thể so sánh chúng so với giá trị trung bình của khu vực. Sử dụng công thức điểm Z:
Như vậy, nhà ở khu A thực sự đắt hơn nhiều so với khu vực của nó so với nhà ở khu B, vì chúng có điểm Z lần lượt là 3.333 và 1.5.
Dưới đây là cách chuyển đổi giá trị x từ một phân bố với trung bình và độ lệch chuẩn cho trước thành điểm Z và ngược lại.
Python
defz_score(x,mean,std):return(x - mean)/ stddefz_to_x(z,mean,std):return(z * std)+ meanmean =140000std_dev =3000x =150000# Chuyển thành điểm Z và ngược lạiz =z_score(x, mean, std_dev)back_to_x =z_to_x(z, mean, std_dev)print("Z-Score: {}".format(z))# Z-Score: 3.3333333333333335print("Back to X: {}".format(back_to_x))# Back to X: 150000.0
Hệ số biến thiên (Coefficient of Variation)
Một công cụ hữu ích để đo độ phân tán là hệ số biến thiên (coefficient of variation). Nó so sánh hai phân bố và định lượng mức độ phân tán của mỗi phân bố. Công thức đơn giản: chia độ lệch chuẩn cho giá trị trung bình.
Như vậy, khu A, dù rẻ hơn khu B, có độ phân tán cao hơn, nghĩa là giá nhà ở khu A đa dạng hơn khu B.
Định Lý Giới Hạn Trung Tâm (Central Limit Theorem)
Phân phối chuẩn (normal distribution) hữu ích vì nó xuất hiện rất nhiều trong tự nhiên, chẳng hạn như cân nặng của giống chó Golden Retriever trưởng thành. Tuy nhiên, điều thú vị hơn là phân phối chuẩn còn xuất hiện trong các bối cảnh không liên quan đến tổng thể tự nhiên. Khi chúng ta lấy mẫu đủ lớn từ một tổng thể, ngay cả khi tổng thể đó không tuân theo phân phối chuẩn, phân phối chuẩn vẫn sẽ xuất hiện.
Hãy tưởng tượng ta đang đo lường một tổng thể hoàn toàn ngẫu nhiên và đồng nhất (uniformly random), nơi mọi giá trị từ 0.0 đến 1.0 đều có khả năng xảy ra như nhau, không có giá trị nào được ưu tiên. Điều kỳ diệu xảy ra khi chúng ta lấy các mẫu lớn dần từ tổng thể này, tính trung bình của mỗi mẫu, và vẽ chúng thành biểu đồ histogram:
Python
# Các mẫu từ phân phối đồng nhất sẽ có trung bình tạo thành phân phối chuẩn.import randomimport plotly.express as pxsample_size =31sample_count =1000# Định lý giới hạn trung tâm, 1000 mẫu, mỗi mẫu chứa 31 số ngẫu nhiên từ 0.0 đến 1.0x_values =[(sum([random.uniform(0.0,1.0)for i inrange(sample_size)])/ sample_size)for _ inrange(sample_count)]y_values =[1for _ inrange(sample_count)]px.histogram(x=x_values,y=y_values,nbins=20).show()
Tại sao các số ngẫu nhiên đồng nhất, khi được lấy mẫu theo nhóm 31 và tính trung bình, lại tạo ra một phân phối gần giống phân phối chuẩn? Chẳng phải mọi số đều có khả năng xảy ra như nhau, và phân phối phải phẳng (flat) thay vì hình chuông (bell-curved) sao?
Đây chính là sự khác biệt giữa biến ngẫu nhiên đơn lẻ và thống kê của tập hợp biến ngẫu nhiên.
Giải thích hiện tượng: Các số riêng lẻ trong mẫu không tạo ra phân phối chuẩn; chúng tạo ra phân phối đồng nhất (uniform distribution), nơi mọi giá trị đều có xác suất như nhau. Tuy nhiên, khi chúng ta nhóm các số này thành mẫu và tính trung bình, trung bình của các mẫu này sẽ tạo ra một phân phối chuẩn.
A) Nguyên lý tổ hợp (Combinatorial Principle)
Khi lấy mẫu n số từ phân phối đồng nhất [0,1], có vô số cách để tạo ra trung bình ≈ 0.5
Chỉ có rất ít cách để tạo ra trung bình cực trị (gần 0 hoặc gần 1)
Ví dụ: Để có trung bình = 0.1 với 31 số, hầu hết các số phải rất nhỏ (xác suất thấp)
Để có trung bình = 0.5, các số có thể phân bố đa dạng (xác suất cao)
B) Quy luật số lớn (Law of Large Numbers)
Khi kích thước mẫu tăng, trung bình mẫu hội tụ về kỳ vọng của tổng thể
Với phân phối đồng nhất [0,1]: E(X) = 0.5
Độ biến thiên của trung bình giảm theo tỷ lệ 1/√n
Đây chính là định lý giới hạn trung tâm, khẳng định rằng những điều thú vị xảy ra khi chúng ta lấy mẫu đủ lớn từ một tổng thể, tính trung bình của mỗi mẫu, và vẽ chúng thành phân phối:
Trung bình của các trung bình mẫu bằng trung bình tổng thể.
Nếu tổng thể tuân theo phân phối chuẩn, thì trung bình mẫu cũng sẽ tuân theo phân phối chuẩn.
Nếu tổng thể không tuân theo phân phối chuẩn, nhưng kích thước mẫu lớn hơn 30, trung bình mẫu vẫn sẽ gần giống phân phối chuẩn.
Độ lệch chuẩn của trung bình mẫu bằng độ lệch chuẩn tổng thể chia cho căn bậc hai của kích thước mẫu ([latex]\frac{\sigma}{\sqrt{n}}[/latex])
Những đặc tính này cho phép chúng ta suy ra các thông tin hữu ích về tổng thể dựa trên mẫu, ngay cả khi tổng thể không tuân theo phân phối chuẩn. Nếu bạn chỉnh sửa mã trên và thử với kích thước mẫu nhỏ như 1 hoặc 2, bạn sẽ không thấy phân phối chuẩn xuất hiện. Nhưng khi kích thước mẫu đạt 31 trở lên, phân phối sẽ dần hội tụ về phân phối chuẩn:
Số 31 là con số tiêu chuẩn trong thống kê vì đây thường là điểm mà phân phối mẫu hội tụ về phân phối tổng thể, đặc biệt khi đo lường trung bình mẫu hoặc các tham số khác. Khi mẫu có ít hơn 31 phần tử, ta có thể sử dụng phân phối T (T-distribution) thay vì phân phối chuẩn, vì phân phối T có đuôi dày hơn (fatter tails) khi kích thước mẫu nhỏ, phản ánh sự bất định lớn hơn.
Khoảng Tin Cậy (Confidence Intervals)
Khoảng tin cậy là một phép tính phạm vi cho thấy chúng ta tin tưởng bao nhiêu phần trăm rằng trung bình mẫu (hoặc tham số khác) nằm trong một phạm vi của trung bình tổng thể.
Ví dụ: Dựa trên mẫu gồm 31 con chó Golden Retriever với trung bình mẫu là 64.408 và độ lệch chuẩn mẫu là 2.05, ta tin tưởng 95% rằng trung bình tổng thể nằm trong khoảng từ 63.686 đến 65.1296. Làm thế nào ta biết được điều này?
Bước 1: Chọn mức tin cậy (Level of Confidence – LOC)
Ta muốn tin tưởng 95% rằng trung bình mẫu nằm trong phạm vi trung bình tổng thể mà ta sẽ tính toán. Đây là mức tin cậy. Chúng ta có thể tận dụng định lý giới hạn trung tâm để suy ra phạm vi này. Trước tiên, ta cần giá trị z tới hạn (critical z-value), tức là phạm vi đối xứng trong phân phối chuẩn đơn vị (standard normal distribution) chứa 95% xác suất ở trung tâm
Chúng ta sử dụng hàm CDF ngược (inverse CDF). Để có 95% diện tích đối xứng ở trung tâm, chúng ta loại bỏ 5% diện tích ở hai đuôi. Chia đôi 5% này, mỗi đuôi sẽ chứa 2.5% diện tích. Do đó, các giá trị diện tích cần tra cứu là 0.025 và 0.975
Chúng ta tra cứu giá trị x cho diện tích 0.025 và 0.975, từ đó xác định phạm vi trung tâm chứa 95% diện tích. Giá trị z dưới và trên sẽ đối xứng nhau
Kết quả là ±1.95996, tức giá trị z tới hạn bao quát 95% xác suất ở trung tâm của phân phối chuẩn đơn vị. Tiếp theo, ta sử dụng định lý giới hạn trung tâm để tính sai số biên (margin of error – E), tức là phạm vi quanh trung bình mẫu chứa trung bình tổng thể ở mức tin cậy đó. Với mẫu 31 con Golden Retriever có trung bình 64.408 và độ lệch chuẩn 2.05, công thức tính sai số biên là:
[latex]E = z \cdot \frac{s}{\sqrt{n}}[/latex]
Áp dụng sai số biên này vào trung bình mẫu, chúng ta sẽ có khoảng tin cậy.
Python
from math import sqrtfrom scipy.stats import normdefcritical_z_value(p): norm_dist =norm(loc=0.0,scale=1.0) left_tail_area =(1.0- p)/2.0 upper_area =1.0-((1.0- p)/2.0)return norm_dist.ppf(left_tail_area), norm_dist.ppf(upper_area)defconfidence_interval(p,sample_mean,sample_std,n):# Kích thước mẫu phải lớn hơn 30 lower, upper =critical_z_value(p) lower_ci = lower *(sample_std /sqrt(n)) upper_ci = upper *(sample_std /sqrt(n))return sample_mean - lower_ci, sample_mean + upper_ciprint(confidence_interval(p=.95,sample_mean=64.408,sample_std=2.05,n=31))# (63.68635915701992, 65.12964084298008)
Cách diễn giải: Dựa trên mẫu 31 con Golden Retriever với trung bình mẫu 64.408 và độ lệch chuẩn mẫu 2.05, ta tin tưởng 95% rằng trung bình tổng thể nằm trong khoảng từ 63.686 đến 65.1296. Đây là khoảng tin cậy của chúng ta.