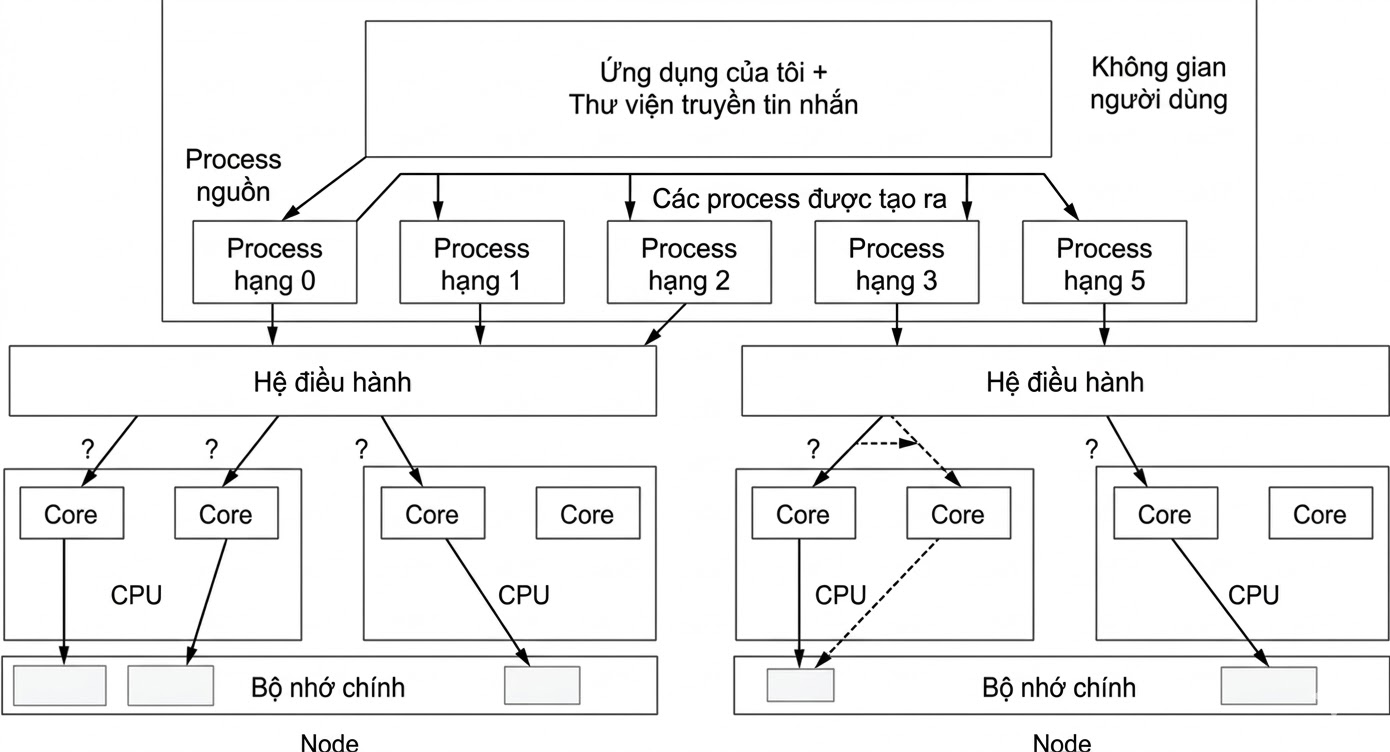
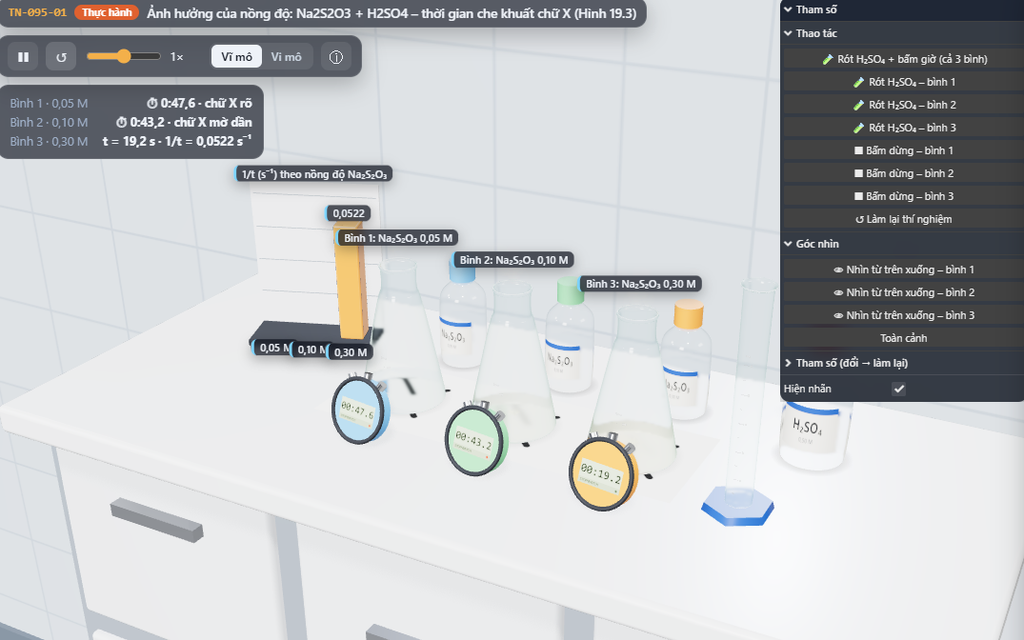
#chemistry #simulation #gameplay #games
Cuối năm 2022, ba nhà nghiên cứu Yaniv Leviathan, Matan Kalman và Yossi Matias tại Google Research ở Israel đăng lên arXiv bài báo Fast Inference from Transformers via Speculative Decoding. Họ tuyên bố tìm được cách giúp LLM trả lời nhanh gấp đôi hoặc gấp ba với claim rằng output của phương pháp này không thay đổi so với thông thường, giữ nguyên chính xác phân phối xác suất ban đầu.
Đầu năm 2023, một nhóm khác tại DeepMind do Charlie Chen dẫn đầu công bố bài báo Accelerating Large Language Model Decoding with Speculative Sampling với thuật toán cốt lõi của họ gần như giống hệt. Tuy nhiên nhóm tác giả ghi chú rõ rằng công trình được thực hiện độc lập và cùng thời điểm với nhóm Leviathan.

Khi ta gõ câu hỏi vào ChatGPT hay Claude, model không đọc từng chữ cái hay từng từ. Nó đọc token, là những mảnh văn bản có kích thước không đều nhau.
Ví dụ, câu tiếng Anh:
"The capital of France is Paris."
Sau khi qua tokenizer (một bộ chia chữ thành token), có thể trở thành:
["The", " capital", " of", " France", " is", " Paris", "."]
Mỗi token được gán một ID số duy nhất đại diện cho mảnh văn bản đó. Ví dụ " Paris" có ID 12437 và "." có ID 13
Với tiếng Việt, tokenizer có thể hoạt động khác một chút
"Hôm nay trời rất đẹp"
→ ["Hôm", " nay", " tr", "ời", " rất", " đẹp"]
Một từ tiếng Việt có dấu có thể bị chia thành 2-3 token. Đây là lý do model xử lý tiếng Việt thường tốn thêm token hơn tiếng Anh cho cùng một nội dung.
Khi model nhận một chuỗi token, nó sẽ chạy chuỗi này qua hàng chục lớp (layers) mạng neural tính toán nối tiếp nhau. Quá trình này được gọi là forward pass.
Input: "Hôm nay trời rất"

Forward pass qua 32 layer của model...

Output: bảng điểm cho ~100.000 token trong vocabulary
  "đẹp"    45%
  "nóng"   25%
  "lạnh"   20%
  "xanh"    3%
  ...       7%
Bảng điểm này được gọi là probability distribution (phân phối xác suất). Nó cho biết model đánh giá token nào có khả năng đứng tiếp theo cao nhất cùng với tỷ lệ phần trăm tương ứng.
Tổng tất cả xác suất luôn bằng 100%. Thay vì khẳng định một đáp án đúng, model chỉ đưa ra khả năng phần trăm cho từng trường hợp, như 45% cho từ “đẹp”, 25% cho từ “nóng”, hoặc 20% cho từ “lạnh”.
Sau khi có bảng xác suất, cần một quy tắc chọn token nào sẽ được dùng.
Greedy: chọn token có xác suất cao nhất.
"đẹp" 45%  ← luôn chọn cái này
"nóng" 25%
"lạnh" 20%
Với cùng một input, phương pháp greedy luôn cho ra output giống hệt nhau. Đây là cách tiếp cận deterministic và dễ dự đoán.
Sampling: chọn ngẫu nhiên theo tỷ lệ xác suất.
45% trường hợp → chọn "đẹp"
25% trường hợp → chọn "nóng"
20% trường hợp → chọn "lạnh"
Việc này giống như tung một con xúc xắc 100 mặt với 45 mặt ghi “đẹp”, 25 mặt “nóng” và 20 mặt “lạnh”. Mỗi lần tung sẽ cho ra kết quả khác nhau nhưng vẫn bám sát tỷ lệ tổng thể.
Sampling được dùng khi muốn output đa dạng, để cùng một câu hỏi mỗi lần trả lời hơi khác nhau. Nhiều chatbot dùng sampling (hoặc sampling với temperature thấp) để câu trả lời bớt máy móc.
Sự phân biệt này quan trọng vì speculative decoding phải bảo đảm output cuối cùng khớp hoàn toàn với target model, bất kể model dùng greedy hay sampling. Việc này khá đơn giản với greedy nhưng lại đòi hỏi một thuật toán phức tạp hơn nhiều đối với sampling, chi tiết sẽ được nói rõ ở phần tiếp.
Cách làm ban đầu của các LLM Model là autoregressive, hay sinh token tuần tự, nghĩa là token phía sau luôn phụ thuộc vào token phía trước.
Ví dụ sinh 3 token:
Lần 1:
  Input:  "The capital of France is"
  Model chạy forward pass...
  Output: " Paris"

Lần 2:
  Input:  "The capital of France is Paris"
  Model chạy forward pass...
  Output: "."

Lần 3:
  Input:  "The capital of France is Paris."
  Model chạy forward pass...
  Output: <END>
Bởi vì rõ ràng theo một cách suy nghĩ đơn giản, các từ tiếp theo ta muốn nghĩ ra nên có sự phụ thuộc vào từ trước đó.
Sự phụ thuộc này tạo ra một chuỗi tuần tự bắt buộc:
Token 1 → cần biết token 1 để tính token 2
Token 2 → cần biết token 2 để tính token 3
Token 3 → cần biết token 3 để tính token 4
...Một model có 70B tham số (parameters) đồng nghĩa với việc hệ thống phải đọc 70 tỷ con số trọng số từ bộ nhớ GPU mỗi lần chạy.
Để sinh một token mới, GPU phải:
GPU hiện đại như H100 có sức mạnh tính toán khổng lồ, lên tới hàng trăm nghìn tỷ phép tính mỗi giây. Phần lớn khả năng này bị lãng phí khi hệ thống chỉ xử lý một token. Sau khi đọc xong 70 tỷ trọng số, GPU chỉ áp dụng chúng cho một vị trí rồi bỏ qua, sau đó lại phải đọc lại ngần ấy trọng số cho vị trí tiếp theo.
Giống như ta mở quyển từ điển 70 tỷ trang, đọc hết, chỉ để tra một từ. Rồi đóng sách, mở lại, đọc hết 70 tỷ trang, tra một từ nữa.
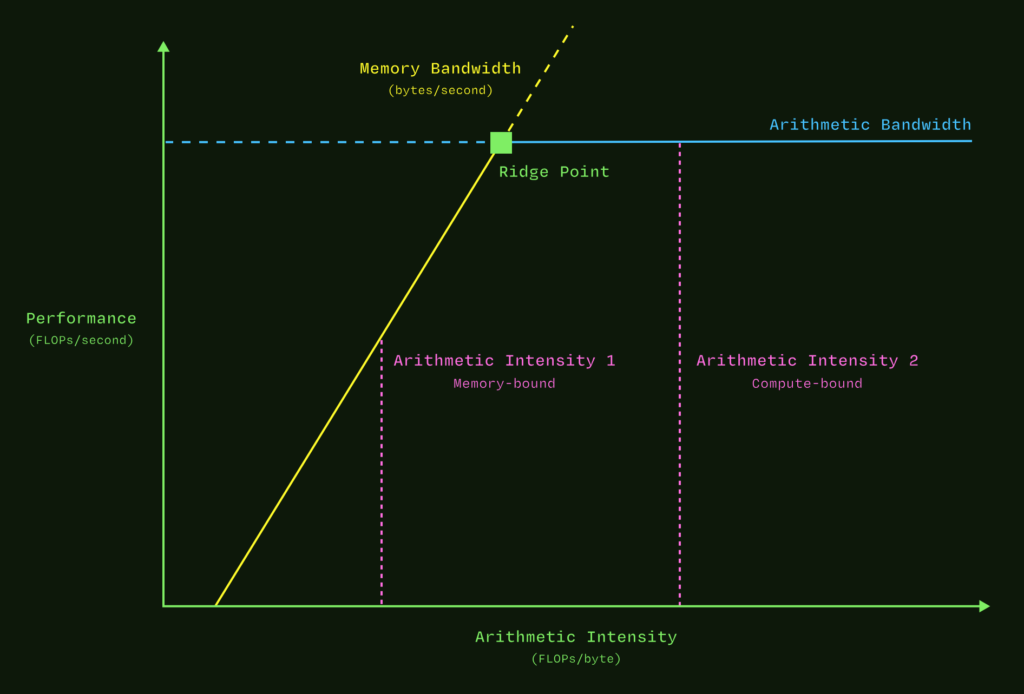
Quá trình này được gọi là trạng thái memory-bound, nơi tốc độ hệ thống bị giới hạn bởi tốc độ đọc bộ nhớ thay vì tốc độ tính toán. GPU lúc này rơi vào trạng thái “đói việc” vì khả năng tính toán dư thừa nhưng dữ liệu không được nạp đủ nhanh.
Đây chính là kẽ hở mà speculative decoding khai thác.
Mỗi token đi qua một layer của Transformer sẽ tạo ra một vector số chứa khoảng 4.096 hoặc 8.192 giá trị. Có thể hiểu đơn giản dãy số này mô phỏng mức độ hiểu của model về toàn bộ bối cảnh tại thời điểm này. Có thể đọc thêm bài sau:
Token "is" đi qua:
  Layer 1  → hidden state h¹  (4096 số)
  Layer 2  → hidden state h²  (4096 số)
  ...
  Layer 32 → hidden state h³² (4096 số)
Mỗi layer tinh chỉnh hidden state, thêm vào nó sự hiểu biết sâu hơn. Có thể là layer đầu có thể nắm cú pháp, layer giữa hiểu ngữ nghĩa, layer cuối tổng hợp toàn bộ. Hidden state cuối cùng là h³² sẽ đi qua lớp chuyển đổi LM head để biến vector 4096 số thành bảng xác suất cho khoảng 100.000 token:
h³² (4096 số)
     ↓
  LM head
     ↓
Bảng xác suất cho mọi token tiếp theo
  " Paris"   80%
  " Lyon"     5%
  " located"  3%
  ...
Đến đây, chúng ta đã biết nguyên nhân LLM sinh token chậm là do hệ thống phải chạy model lớn cho từng token một, trong khi GPU lại đang lãng phí phần lớn sức mạnh tính toán.
Speculative decoding được xây dựng dựa trên một nhận xét đơn giản nhưng cực kỳ hiệu quả:
Rất nhiều token tiếp theo thực ra rất dễ đoán, ví dụ như dấu chấm, dấu phẩy, dấu ngoặc, xuống dòng, cú pháp JSON, các cụm từ thông dụng, hoặc phần lặp lại từ prompt. Model lớn không cần phải vất vả tính toán cho từng token hiển nhiên như vậy.
Từ đó ta có một hệ thống sơ khai speculative decoding bao gồm hai thành phần:
Draft model (drafter): Model nhỏ hơn nhiều, ví dụ loại 1B parameters. Nó nhanh hơn dù chất lượng kém hơn. Nhiệm vụ của nó chỉ là đề xuất các token dự tuyển (candidate) và hoàn toàn không có quyền quyết định output cuối cùng.
Target model (model lớn): Đây là model ta thật sự muốn dùng, ví dụ loại 70B parameters. Nó cho ra chất lượng cao nhưng chậm. Điểm mấu chốt là output cuối cùng gửi cho người dùng bắt buộc phải giống hệt output của model này.
Ta hãy thử đi qua lại ví dụ ban đầu
Prompt: "The capital of France is"
Giả sử target model (70B) sẽ sinh ra: " Paris" "." <END>
Bước 1: Drafter đề xuất 4 candidate
Draft model nhỏ (1B) chạy autoregressive, nghĩa là nó cũng phải sinh từng token một giống như target:
Draft pass 1: "The capital of France is"          → " Paris"
Draft pass 2: "The capital of France is Paris"     → "."
Draft pass 3: "The capital of France is Paris."    → " It"
Draft pass 4: "The capital of France is Paris. It" → " is"
Dù có 4 draft pass, thời gian xử lý sẽ nhanh hơn vì model nhỏ.
Những token này mới chỉ là các candidate nội bộ và chưa token nào được gửi cho người dùng.
Candidate: [" Paris", ".", " It", " is"]
Bước 2: Target kiểm tra cả 4 candidate trong MỘT pass
Target model sẽ nhận toàn bộ chuỗi candidate:
Input: ["The", " capital", " of", " France", " is",
        " Paris", ".", " It", " is"]
                  └── 4 candidate ──┘
Sau đó, target chạy một forward pass duy nhất trên toàn bộ input để tính xác suất cho từng vị trí:
Lúc này ta có thể chạy song song, với việc giả định rằng: nếu model sẽ sinh ra cả đoạn như vậy thì token tiếp theo sẽ là gì
Sau "The capital of France is"              → target chọn " Paris"
Sau "The capital of France is Paris"        → target chọn "."
Sau "The capital of France is Paris."       → target chọn <END>
Sau "The capital of France is Paris. It"    → target chọn khác
Bước 3: So sánh từ trái sang phải
Vị trí  Draft       Target       Kết quả
  1     " Paris"    " Paris"     ✓ Accept
  2     "."         "."          ✓ Accept
  3     " It"       <END>        ✗ Reject (dùng <END> từ target)
  4     " is"       —            ✗ Discard (không kiểm tra)
Tại vị trí số 3, draft đề xuất ” It” nhưng target lại yêu cầu <END>. Vì draft sai nên hệ thống sẽ bỏ ” It” và sử dụng <END> từ target. Token thứ 4 là ” is” cũng bị loại bỏ do nó được tính toán dựa trên ” It”, mà ” It” thì đã bị loại.
Kết quả vòng này:
Output: " Paris" "." <END>
Kết quả này hoàn toàn khớp với output mà target tự sinh ra. Giả sử với tốc độ là
Một target pass (70B): ~20 ms Một draft pass (1B): ~0.5 ms
Về mặt thời gian:
Cách thường:  3 target pass = 3 × 20 = 60 ms
Speculative:  4 draft pass + 1 target verify
              = 2 + 22 = 24 ms

Speedup: 60 / 24 ≈ 2.5×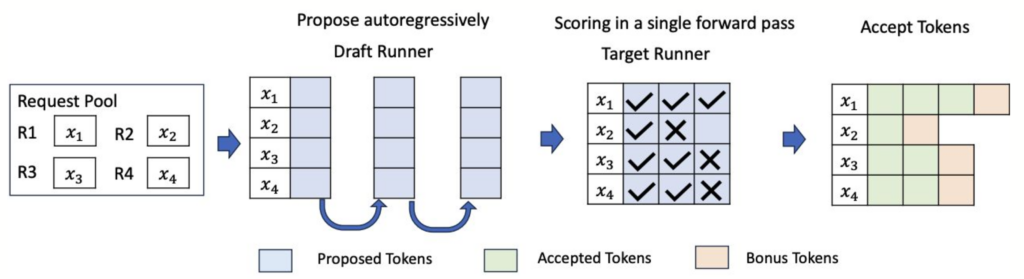
Chúng ta đã thống nhất rằng việc sinh token phải tuần tự vì token sau phụ thuộc vào token trước. Vậy target làm cách nào để kiểm tra 4 vị trí song song?
Sự khác biệt nằm ở hai khái niệm: sinh (generate) và chấm điểm (score/verify).
Khi sinh: Token tương lai chưa tồn tại. Model bắt buộc phải đoán token đầu tiên, sau đó mới có dữ liệu để đoán token thứ hai. Tính tuần tự này là thực tế và không thể phá vỡ.
Khi chấm điểm: Drafter đã cung cấp sẵn cả 4 candidate. Target không cần phải tìm kiếm chúng nữa. Việc của nó chỉ là tính xem nếu đây là token tiếp theo thì xác suất sẽ là bao nhiêu.
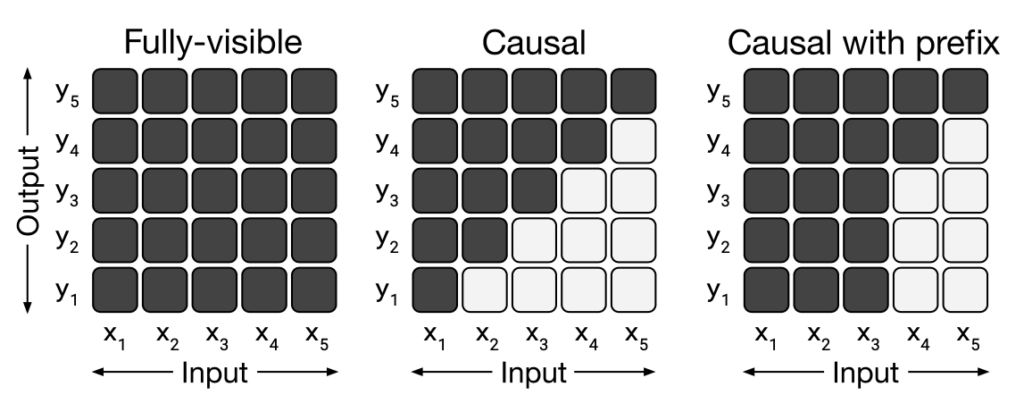
Mạng Transformer có một cơ chế mang tên causal mask. Trong cùng một forward pass, cơ chế này hoạt động như sau:
Vị trí " Paris" chỉ thấy: prefix (prefix ở đây là cả câu trước đó - The capital ....)
Vị trí "."      chỉ thấy: prefix + " Paris"
Vị trí " It"    chỉ thấy: prefix + " Paris" + "."
Vị trí " is"    chỉ thấy: prefix + " Paris" + "." + " It"
Mỗi vị trí chỉ có thể nhìn được các vị trí trước nó mà không thể nhìn các vị trí sau. Nhờ cơ chế này, kết quả tính toán tại mỗi vị trí hoàn toàn trùng khớp với việc chạy riêng lẻ từng vị trí một.
Hơn nữa, do toàn bộ input đã có giá trị cụ thể từ các candidate có sẵn, GPU có thể tính toán tất cả các vị trí song song trong cùng một phép nhân ma trận lớn.
Đây chính xác là loại phép tính mà Transformer thực hiện khi xử lý prompt ban đầu trong giai đoạn gọi là prefill. Quá trình verification ở đây gần giống một đoạn prefill ngắn với 4 token thay vì hàng trăm token.
Thêm vào đó, do GPU đang trong trạng thái memory-bound khi giải mã một token, việc đọc 70 tỷ trọng số để xử lý 4 token không tốn kém hơn bao nhiêu so với việc xử lý 1 token. Trọng số đằng nào cũng đã được đọc lên, GPU chỉ việc dùng luôn cho cả 4 vị trí.
Chi phí verify 4 candidate ≈ chi phí sinh 1 token
(Dù không chính xác tuyệt đối nhưng cùng chung một bậc chi phí)
Dù vậy, cần lưu ý là nếu ” It” bị từ chối tại vị trí thứ 3, kết quả tại vị trí thứ 4 cũng sẽ tự động bị bỏ. Nguyên nhân là do vị trí 4 được tính toán với điều kiện ” It” tồn tại. Một khi ” It” đã bị loại bỏ, bối cảnh thực tế (prefix) đã thay đổi hoàn toàn.
Câu trả lời là không. Draft model 1B đúng là sẽ kém hơn target 70B và các đề xuất candidate của nó hoàn toàn có thể sai lệch. Tuy nhiên, output của draft không bao giờ được gửi thẳng cho người dùng.
Hãy tưởng tượng drafter là một thực tập sinh phụ trách viết bản nháp, còn target là tổng biên tập có quyền ký duyệt. Thực tập sinh có thể mắc lỗi, nhưng điều đó không thành vấn đề vì mọi văn bản đều phải qua tay tổng biên tập kiểm tra trước khi xuất bản.
Quy tắc áp dụng rất đơn giản:
Nếu draft token = token target chọn:
    dùng draft token (vì nó bằng target token)

Nếu draft token ≠ token target chọn:
    bỏ draft token
    dùng target token thay thế
Dù trong trường hợp nào đi nữa, token được hệ thống chốt (commit) luôn luôn giống hệt token mà target chọn.
Ví dụ draft đề xuất chuỗi candidate sau:
"Lyon" "is" "beautiful"
Khi target tiến hành kiểm tra vị trí đầu tiên:
Draft:  "Lyon"
Target: "Paris"
→ Reject "Lyon"
→ Discard "is" và "beautiful"
→ Output "Paris" từ target
Vòng lặp tiếp theo sẽ bắt đầu lại từ "...is Paris" để draft thử lại lần nữa.
Kết quả lúc này vẫn hoàn toàn giống với output của target. Tuy nhiên, vòng chạy vừa rồi không hề mang lại tốc độ nào, thậm chí nó còn chậm hơn so với mức baseline do hệ thống phải tốn thêm thời gian chạy draft.
Speculative = 2ms (draft) + 22ms (verify) = 24 ms
Baseline    = 20 ms (khi chỉ chạy 1 target pass)

→ Chậm hơn 4ms
Qua đó có thể thấy chất lượng của draft chỉ ảnh hưởng đến tốc độ, chứ không làm suy giảm chất lượng đầu ra:
Draft tốt  → chất lượng bằng target, tốc độ nhanh
Draft kém  → chất lượng bằng target, ít nhanh hơn hoặc thậm chí chậm hơn baseline
Từ “kém hơn” không đồng nghĩa với việc model nhỏ đoán sai mọi token. Khi phần tiền tố (prefix) đã rõ ràng, rất nhiều token thực tế cực kỳ dễ đoán trước:
Dấu chấm kết thúc một câu hoàn chỉnh
Dấu phẩy nối trong danh sách
Dấu ngoặc đóng nối tiếp sau ngoặc mở
Ký tự xuống dòng sau mỗi đoạn văn
Các thành phần cú pháp JSON như dấu hai chấm, ngoặc vuông, ngoặc nhọn
Các thành phần cú pháp code như dấu chấm phẩy, từ khóa return, dấu ngoặc nhọn đóng
Các cụm từ liên kết thông dụng như "in order to", "for example"
Những đoạn văn bản lặp lại từ prompt trong tác vụ chỉnh sửa code hoặc viết lại câu
Model lớn thực sự chỉ cần thiết để giải quyết những vị trí khó, ví dụ như:
Lựa chọn đáp án trong các bài toán reasoning logic
Thực hiện các phép tính toán học
Chốt tên riêng, số liệu cụ thể hay hành động chính xác
Quyết định cấu trúc câu ở những vị trí còn mơ hồ
Drafter không cần phải thông minh ngang ngửa target. Nhiệm vụ của nó chỉ là đoán trúng trùng khớp với target đủ thường xuyên. Khi tỷ lệ trúng đủ cao, lượng target pass tiết kiệm được sẽ bù đắp dư dả cho lượng chi phí dùng để chạy draft.
Phần trước đã giải thích trường hợp greedy, nơi target luôn chọn token có xác suất cao nhất nên việc so sánh rất đơn giản. Tuy nhiên, nhiều ứng dụng LLM thực tế lại dùng sampling. Đây là lúc speculative decoding thực sự bộc lộ sự phức tạp.
Với phương pháp greedy, target chỉ có một token đúng duy nhất là token có xác suất cao nhất:
Target:  60% Paris, 30% London, 10% Rome
Greedy → luôn chọn Paris
Việc so sánh lúc này vô cùng dễ dàng:
Draft Paris  → accept
Draft London → reject, thay bằng Paris
Thế nhưng với sampling, target không khẳng định “đáp án là Paris”. Target yêu cầu một tỷ lệ phân bổ:
60% trường hợp phải ra Paris
30% trường hợp phải ra London
10% trường hợp phải ra Rome
Lúc này, cả Paris, London và Rome đều là những output hợp lệ. Hệ thống không có token “sai”, nó chỉ có tỷ lệ.
Vấn đề nảy sinh là draft model thường có phân phối khác với target:
              Target p     Draft q
Paris           60%          50%
London          30%          40%
Rome            10%          10%
Nếu ta lấy thẳng output của draft, phân phối sẽ là 50/40/10, hoàn toàn sai lệch so với phân phối mục tiêu 60/30/10 của target.
Ngược lại, nếu ta chỉ accept khi draft khớp với lựa chọn ưu tiên nhất của target (Paris), những lần draft đề xuất London sẽ luôn bị reject. Output cuối cùng sẽ biến thành 100% Paris. Như vậy, ta vô tình biến sampling thành greedy.
Bởi vậy, chúng bản cần một phương pháp cho phép tái sử dụng token từ draft mà vẫn giữ nguyên được phân phối của target.
Thay vì phân tích một lần chạy đơn lẻ, bạn hãy thử tưởng tượng ta chạy hệ thống 1.000 lần với cùng một prefix để xem output tạo ra tỷ lệ gì.
Dựa trên phân phối q, draft sẽ đề xuất:
Paris:  ~500 lần  (vì q(Paris) = 50%)
London: ~400 lần  (vì q(London) = 40%)
Rome:   ~100 lần  (vì q(Rome) = 10%)
Trong khi đó, target muốn output cuối cùng bám sát phân phối p:
Paris:  ~600 lần  (vì p(Paris) = 60%)
London: ~300 lần  (vì p(London) = 30%)
Rome:   ~100 lần  (vì p(Rome) = 10%)
Hãy làm một phép so sánh trực tiếp:
Paris:
  Draft có 500, target cần 600
  → Draft THIẾU Paris → accept toàn bộ 500

London:
  Draft có 400, target chỉ cần 300
  → Draft THỪA 100 London → chỉ accept 300 trong số 400

Rome:
  Draft có 100, target cần 100
  → Vừa đủ → accept toàn bộ 100
Tỷ lệ accept cụ thể cho từng token được tính như sau:
Paris:  accept 500/500 = 100%
        tính: p/q = 60%/50% = 1.20 → min(1, 1.20) = 1 ✓

London: accept 300/400 = 75%
        tính: p/q = 30%/40% = 0.75 → min(1, 0.75) = 0.75 ✓

Rome:   accept 100/100 = 100%
        tính: p/q = 10%/10% = 1.00 → min(1, 1.00) = 1 ✓
Công thức tổng quát:
accept_probability(token) = min(1, p(token) / q(token))Ý nghĩa trực tiếp của công thức này là:
Sau bước accept, chúng ta có:
Paris:  500 (accept hết)
London: 300 (accept 300/400, reject 100)
Rome:   100 (accept hết)

Tổng accept: 900
Tổng reject: 100
Trong khi đó target cần:
Paris: 600 → còn thiếu 100
London: 300 → đã đủ
Rome: 100 → đã đủ
Như vậy, 100 trường hợp bị reject bắt buộc phải được dùng để bổ sung chính xác phần còn thiếu. Trong ví dụ này, toàn bộ chúng phải là Paris.
Nhiều người sẽ thắc mắc tại sao không reject rồi lấy mẫu (sample) lại từ target? Thử hình dung nếu 100 trường hợp reject lại được lấy mẫu từ target theo tỷ lệ 60/30/10, chúng ta sẽ có:
Thêm: Paris 60, London 30, Rome 10
Kết quả sẽ là:
Paris:  500 + 60 = 560  (cần 600 → sai)
London: 300 + 30 = 330  (cần 300 → sai)
Rome:   100 + 10 = 110  (cần 100 → sai)
Quá trình này sai lệch hoàn toàn vì London và Rome đã đủ số lượng (quota) nhưng hệ thống lại tự động bổ sung thêm.
Do đó, quá trình sửa lỗi (correction) phải được lấy từ phần target còn thiếu, hay còn gọi là residual distribution:
residual(token) = max(0, p(token) - q(token))

Paris:  max(0, 0.60 - 0.50) = 0.10
London: max(0, 0.30 - 0.40) = 0    ← đã đủ
Rome:   max(0, 0.10 - 0.10) = 0    ← đã đủ
Sau khi chuẩn hóa residual, tỷ lệ Paris sẽ là 100%. Mọi lượt reject đều được tự động sửa thành Paris.
Kết quả cuối cùng:
Paris:  500 + 100 = 600  ✓
London: 300              ✓
Rome: 100 ✓Thuật toán tổng thể sẽ diễn ra như sau:
1. Draft tạo distribution q
2. Sample candidate x từ q
3. Target tạo distribution p
4. Tính: accept_prob = min(1, p(x)/q(x))
5. Sinh random u trong khoảng [0,1]
6. Nếu u ≤ accept_prob:
       output x
   Nếu u > accept_prob:
       sample correction từ normalize(max(0, p-q))
       output correction
Với cách thiết kế này, dù đi qua nhánh accept hay reject thì output cuối cùng vẫn luôn giữ đúng phân phối p.
Giả sử draft sinh ra chuỗi 4 token:
D1, D2, D3, D4
Kèm theo phân phối draft tại từng vị trí:
q1, q2, q3, q4
Sau một lượt kiểm tra (pass), target trả về phân phối:
p1, p2, p3, p4
Quá trình kiểm tra sẽ tiến hành từ trái sang phải:
min(1, p1(D1)/q1(D1)). Nếu hệ thống đồng ý accept, ta chuyển sang xét vị trí 2.Ý tưởng phác thảo rồi kiểm duyệt (draft-then-verify) dành riêng cho phương pháp greedy đã từng xuất hiện trước đây. Một trong những công trình tiêu biểu là Blockwise Parallel Decoding của nhóm tác giả Stern, Shazeer, Uszkoreit tại hội nghị NeurIPS 2018.
Cách xử lý với greedy khá cơ bản:
Draft = target argmax → accept
Khác → reject
Tuy nhiên, điểm mới mẻ trong những bài báo năm 2022-2023 không chỉ nằm ở việc vận dụng model nhỏ để đề xuất token. Điểm đột phá thực sự chính là:
Chúng ta có thể tận dụng lại mẫu sinh ra từ model nhỏ, loại bỏ khi sai và bổ sung đúng mức tỷ lệ (probability) còn thiếu. Bằng cách đó, toàn bộ output vẫn giữ nguyên tính chuẩn xác so với phân phối của model lớn, kể cả khi dùng phương pháp lấy mẫu ngẫu nhiên (stochastic sampling).
Phiên bản speculative decoding nguyên bản hoạt động tốt nhưng vẫn tồn tại nhiều giới hạn. Từ năm 2023 đến giữa năm 2026, hàng chục biến thể đã ra đời để khắc phục từng điểm yếu cụ thể.
Đây là vấn đề lớn nhất và nhóm biến thể giải quyết vấn đề này cũng đóng vai trò quan trọng nhất hiện tại, tiêu biểu là EAGLE.
Trong speculative decoding nguyên bản, draft model là một LLM nhỏ hoàn toàn độc lập. Việc nó phải tự đọc và hiểu lại toàn bộ bối cảnh thông qua các layer riêng gây lãng phí lớn về thời gian và bộ nhớ.
Vấn đề là target model đã chạy rồi. Nó đã xử lý prefix qua 32 layer và tạo ra các hidden state chứa đầy đủ thông tin context. Vậy tại sao drafter không tận dụng luôn nguồn thông tin đó thay vì phải tính toán lại từ đầu?
Đó chính là ý tưởng cốt lõi của EAGLE (Efficient Adaptive Generation via Leveraged hidden-state Estimation).
Hãy quay lại khái niệm hidden state ở Phần I. Khi target xử lý token "I" qua 32 layer, nó tạo ra một hidden state chuẩn xác h_I dưới dạng vector 4096 số chứa toàn bộ thông tin bối cảnh.
Target dùng h_I để dự đoán token tiếp theo:
h_I
 ↓
LM head
 ↓
" love" (80%), " am" (7%), " think" (5%), ...
 ↓
Chọn " love"
Thông thường, để biết token đứng ngay sau " love", target bắt buộc phải chạy " love" qua toàn bộ 32 layer:
embedding(" love") + KV cache("I")
        ↓
32 Transformer layers
        ↓
h_love (exact hidden state)
        ↓
LM head
        ↓
" coffee" (65%), " tea" (15%), ...
Bước này rất tốn kém, mất khoảng 20ms cho mỗi token.
EAGLE thay thế bước này bằng cách sử dụng:
h_I (exact hidden state target đã tạo)
+
embedding(" love") (token vừa được chọn)
        ↓
MỘT draft decoder layer nhỏ
        ↓
ĥ_love (bản ước lượng hidden state)
        ↓
Chính LM head của target
        ↓
candidate " coffee"
EAGLE tạo ra một vector ẩn gần đúng (ĥ_love), sau đó dùng chính LM head của target để biến vector đó thành xác suất dự đoán token.
Ký hiệu ĥ dùng để chỉ bản ước lượng. EAGLE đoán hidden state mà target có khả năng sẽ tạo ra, dù độ chính xác không đạt mức 100%.
Từ điểm xuất phát h_I, target có thể chọn ra nhiều token khác nhau:
"I love" (nếu chọn " love")
"I am"   (nếu chọn " am")
"I think" (nếu chọn " think")
Phần văn bản nối tiếp (continuation) trong tương lai phụ thuộc hoàn toàn vào việc token nào thực sự được chọn. Nếu chỉ cung cấp h_I cho EAGLE mà giấu đi token được chọn, hệ thống sẽ không biết phải rẽ theo nhánh nào.
h_I:              chứa thông tin "context trước token mới"
embedding(" love"): cho biết "token nào vừa thực sự được chọn"
EAGLE kết hợp cả hai yếu tố này để ước lượng hidden state tiếp theo một cách chuẩn xác hơn.
Sau bước đầu tiên để có được ĥ_love và candidate " coffee", EAGLE tiếp tục quy trình:
ĥ_love + embedding(" coffee")
        ↓
EAGLE decoder
        ↓
ĥ_coffee
        ↓
LM head
        ↓
candidate "."
Và tiếp tục với:
ĥ_coffee + embedding(".")
        ↓
EAGLE decoder
        ↓
ĥ_dot
        ↓
LM head
        ↓
candidate tiếp theo
EAGLE vẫn giữ bản chất autoregressive nên cần nhiều draft pass. Điểm khác biệt là mỗi pass chỉ chạy qua một draft layer nhỏ thay vì toàn bộ 32 target layer.
EAGLE pass 1 → ĥ_love   → " coffee"   (~0.3ms)
EAGLE pass 2 → ĥ_coffee → "."         (~0.3ms)
EAGLE pass 3 → ĥ_dot    → next        (~0.3ms)
ĥ_love chỉ là một bản ước lượng nên nó có thể khác với h_love thực tế.
Nếu sự khác biệt nằm trong phạm vi cho phép:
LM_head(h_love)  → " coffee"
LM_head(ĥ_love)  → " coffee"
→ Candidate đúng
Nếu sự khác biệt quá lớn:
LM_head(h_love)  → " coffee"
LM_head(ĥ_love)  → " tea"
→ Candidate sai → target verify bắt lỗi → reject " tea", dùng " coffee"
Giống như mọi biến thể speculative decoding khác, mọi lỗi sai đều sẽ bị bắt lại.
EAGLE nguyên bản đặt ra yêu cầu khá khắt khe:
draft output ĥ phải gần với exact target feature h
Cách làm này được gọi là feature regression vì nó ép drafter phải tạo ra một vector giống hệt target.
EAGLE-3 nhận ra rằng mục tiêu thực sự không phải là việc tái tạo chính xác hidden state. Mục tiêu duy nhất là:
LM head(draft state) → dự đoán đúng target token
Draft state không bị bắt buộc phải giống hệt exact target feature. Nó chỉ cần tạo ra đúng xác suất token khi đi qua LM head là đủ.
EAGLE-3 còn bổ sung một cải tiến khác. Thay vì chỉ sử dụng top-layer feature, nó thu thập hidden state từ nhiều layer khác nhau (low, mid, high) rồi kết hợp (fuse) lại:
low-layer feature   l
mid-layer feature   m
high-layer feature  h
        ↓ concatenate
FC projection
        ↓
fused feature g
Mỗi layer chứa một loại thông tin khác nhau. Ví dụ layer đầu nắm bắt cú pháp, layer giữa xử lý ngữ nghĩa và layer cuối có nhiệm vụ tổng hợp. EAGLE-3 tận dụng toàn bộ lượng thông tin này.
Dù mỗi pass của EAGLE-3 rất rẻ, việc sinh ra 7 draft token vẫn đòi hỏi 7 pass tuần tự:
pass 1 → D1
pass 2 → D2
...
pass 7 → D7
Để khắc phục, một hướng đi mới đã xuất hiện: tạo ra toàn bộ draft token trong một pass duy nhất thông qua parallel drafting.
Quay lại nhận xét ở Phần 2 cơ chế attention không ép buộc quá trình sinh text (generation) phải diễn ra tuần tự. Thứ thực sự tạo ra tính tuần tự bắt buộc là vòng lặp phản hồi (feedback loop):
model output → sample token → token embedding mới → model chạy tiếp
Parallel drafter loại bỏ hoàn toàn vòng lặp đó. Thay vì chờ đợi kết quả token D1 rồi mới bắt đầu tính D2, hệ thống đặt các biến tạm (placeholder) vào vị trí của D2:
Position 1: [anchor embedding, target context]  ← dữ liệu đã biết
Position 2: [MASK embedding, learned hidden]     ← biến tạm
Position 3: [MASK embedding, learned hidden]     ← biến tạm
Position 4: [MASK embedding, learned hidden]     ← biến tạm
Vector MASK embedding không phải là token tương lai thật mà chỉ là một dạng đại diện được drafter học hỏi trong quá trình huấn luyện.
Cả 4 vị trí này sẽ đi qua drafter cùng một lúc:
4 input positions
        ↓
Lightweight draft layers xử lý trong một forward pass
        ↓
4 output states
        ↓
LM head
        ↓
[D1, D2, D3, D4]
Dĩ nhiên, sự đánh đổi ở đây là D2 không thể biết D1 thực sự được chọn là gì vì D1 chưa được lấy mẫu (sample) khi D2 đang được tính. Token càng nằm xa anchor thì khả năng đoán sai càng cao.
Nhờ thiết kế này, mọi draft layer đều có thể truy cập thẳng vào target context chứ không chỉ riêng layer đầu tiên.
Các biến thể vừa nhắc tới (như EAGLE hay P-EAGLE) đều đòi hỏi phải huấn luyện drafter, hoặc ít nhất cũng cần một model nhỏ đi kèm như phiên bản gốc. Vậy nếu chúng ta không muốn huấn luyện thêm bất cứ thứ gì thì sao?
Phương pháp Prompt Lookup Decoding (PLD) hoặc n-gram matching ra đời nhằm tìm kiếm các đoạn văn bản (continuation) đã từng xuất hiện trong prompt ban đầu hoặc các output trước đó.
Lấy ví dụ, giả sử prompt chứa đoạn mã cũ sau:
function calculateTotal(items) {
    let total = 0;
    for (const item of items) {
        total += item.price;
    }
    return total;
}
Khi yêu cầu output sửa lại đoạn function này để thêm tính thuế (tax), hệ thống sẽ chủ động dò tìm phần token trùng lặp giữa output đang sinh và phần prompt. Sau đó, nó tự động đề xuất phần tiếp theo bởi vì thông thường output sẽ sao chép phần lớn nội dung code cũ.
prefix matching trong prompt/output history
        ↓
candidate continuation
        ↓
target verify
Hệ thống hoàn toàn không dùng neural drafter. Nhờ đó, máy chủ không tốn tài nguyên huấn luyện, không gánh thêm GPU weights và không tốn bộ nhớ.
Cách làm này tỏ ra đặc biệt hiệu quả trong các tác vụ như chỉnh sửa code, tóm tắt nội dung hay viết lại câu, nơi phần output chủ yếu dựa trên input.
Tuy nhiên, nó lại khá yếu trong các đoạn chat mở (open-ended) vì câu trả lời thường không liên quan nhiều đến input ban đầu
Thay vì phải gánh thêm một model nhỏ bên ngoài, một hướng tiếp cận khác là dùng chính target model nhưng chạy với số lượng layer ít hơn.
Với phương pháp LayerSkip, hệ thống dùng model 32 layer nhưng chỉ chạy draft bằng 8 layer đầu tiên:
Draft:
  Layer 1 → ... → Layer 8 → LM head → draft token

Verify:
  Lấy Hidden state từ layer 8 của draft tokens
  → Layer 9 → ... → Layer 32 → LM head → target prediction
Tuy nhiên, bản chất các hidden state ở layer 8 vốn không được thiết kế để chạy thẳng qua LM head. Vì vậy, LayerSkip phải thay đổi lại cả công thức huấn luyện:
Code: https://github.com/quochung-cyou/solar_radiation_prediction_tahmo
Task: Predict incoming shortwave solar radiation (W/m²) at 15-minute intervals for the missing even months of year 1 at each TAHMO station.
Final Score: Abs MBE (3.640988734), Abs RMSE (61.55162364) (0.357163087)


The task is to reconstruct incoming shortwave radiation during the first year after sensor installation, using the period when sensors are still assumed to be well-calibrated. The training set contains radiation for odd months only; the target months to fill are the even months. Temperature, relative humidity, and precipitation are available for all months.
Train.csv / Test.csv: timestamp, station, temperature, relative humidity, precipitation, latitude, longitude, elevation, installation height, and target radiation (train only).All external sources were merged per-station by nearest timestamp with appropriate tolerances (15–180 min). CAMS Solar radiation values were converted from W·h/m² to W/m² by multiplying by 4 to match the 15-minute interval target.
Treat the problem as temporal interpolation / gap-filling, not time-series forecasting. Because we already have concurrent weather for the even-month timestamps, the model learns a cross-sectional mapping from weather + solar geometry + satellite data to surface radiation.
pvlib (Ineichen-Perez model): solar zenith, elevation, azimuth, cos(zenith), extraterrestrial radiation, airmass, Linke turbidity, clear-sky GHI/DNI/DHI.ETR × 1.1 and clearsky_ghi × 1.3.| Component | Details |
|---|---|
| Primary learners | LightGBM (per-station + global), XGBoost (global) |
| CV strategy | Leave-one-odd-month-out: 6 folds, each holding out one odd month |
| Per-station LGB | num_leaves=63, lr=0.05, feature_fraction=0.7, bagging_fraction=0.8, reg α/λ |
| Global LGB | num_leaves=127, larger capacity, same regularization |
| Global XGB | max_depth=7, hist tree method, min_child_weight=50 |
| Ensemble | Inverse-RMSE weighted blend of the three models per station |
| Final features | ~121 features |
clearsky_ghi, cos(zenith), and etr_horizontal give the model a strong physical upper bound and remove the need to learn solar geometry from scratch.cos(zenith) explains the majority of GHI variance. Give the model the correct solar geometry and let it focus on the residual (clouds, aerosols, humidity).notebook.ipynb — full training, inference, and submission pipeline.Train.csv / Test.csv — provided data.SampleSubmission.csv — submission format.The final submission CSV has columns ID, TargetMBE, TargetRMSE with identical values per row.
Install dependencies: pip install pvlib tqdm matplotlib tabulate catboost xarray netCDF4 cdsapi requests lightgbm xgboost
Download external data using the cells in notebook.ipynb (ERA5 via Open-Meteo, NASA POWER, CAMS Solar via CDS API, CAMS EAC4).
Run the notebook sequentially from top to bottom. It computes features, trains the three-model ensemble, applies physical post-processing, and writes the submission file.
We keep hearing that AI agents will run factories, coordinate robots, manage infrastructure. Maybe they will. But right now, most multi-agent demos are turn-based puzzles where three chatbots pass notes to each other in a polite loop. Nobody is testing what happens when things go wrong fast and agents have to physically move, fight over scarce resources, and make split-second calls with incomplete information.
That gap bugged us. So we built a simulation where the answer matters: a live facility with a reactor that overheats, oxygen that drains, fuel that runs out, and a crew of LLM-powered agents that either coordinates well enough to survive, or doesn’t.
We wanted something closer to what an autonomous crew on a space station or an offshore rig would actually face. Not a chatbot relay. A pressure test.

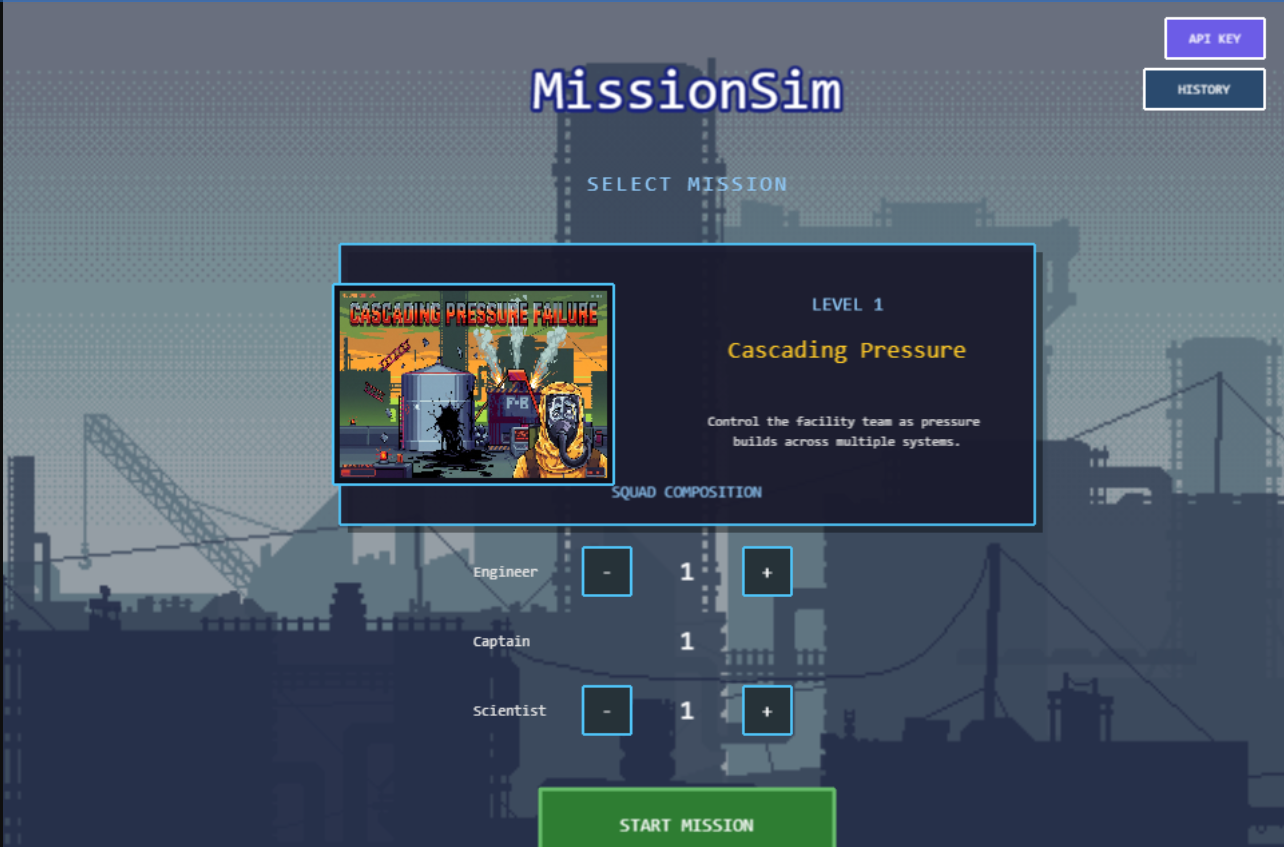
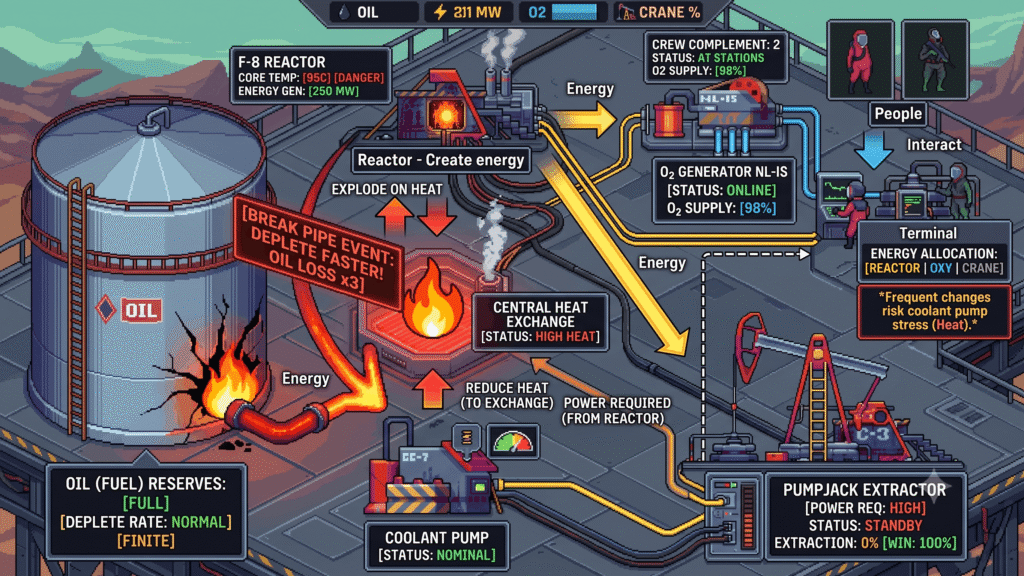
MissionSim is a real-time simulation where a crew of AI agents (Heavy Mechanic, Base Director, Safety Scientist) operates a reactor facility under cascading failures. Each agent runs on its own Qwen model. They see the same world state but have different jobs. They talk to each other in natural language, argue about priorities, and issue commands that move their characters to specific machines on a spatial map.
The reactor generates heat and power. That power has to be split between three systems that all need it at the same time: the Coolant Pump (keeps the reactor from melting down), the Oxygen Generator (keeps the crew breathing), and the Crane Extractor (the only way to win the mission). Oil fuels the reactor, and it runs out. Every allocation decision means something else gets starved.
Here is what makes it more than a demo:
Agents have bodies. The Mechanic at position x=600 cannot allocate power at the Terminal at x=1800 without physically running there. Running costs stamina. If the Mechanic is exhausted, they walk, and the delay can cost the mission. This forces the Director to care about who is closest, not just who is available.
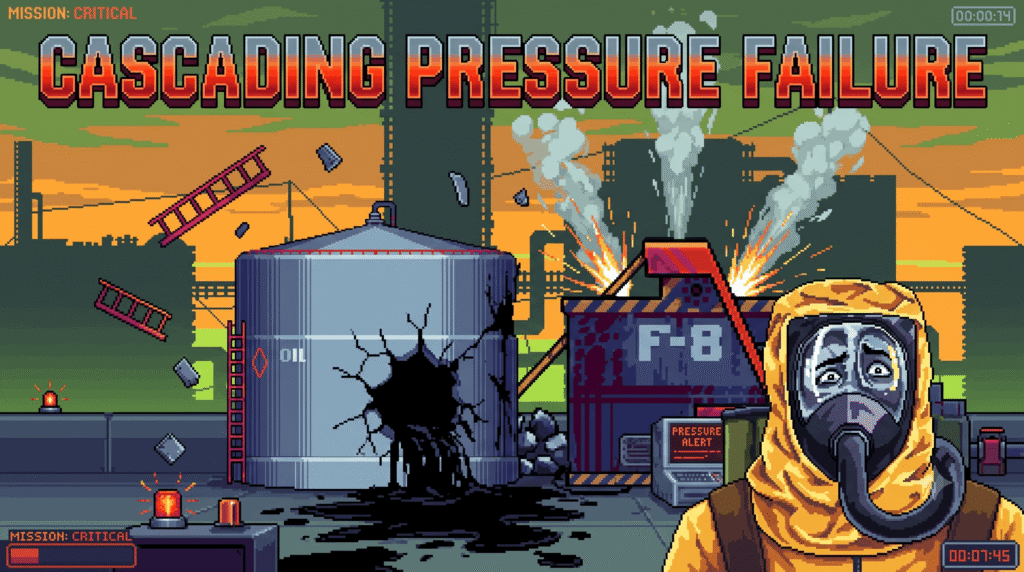
Failures cascade. If the reactor stays above 500°C for 5 seconds, the oil pipe ruptures and drains 50 units of fuel. If someone reallocates power more than 3 times in 10 seconds (panic mode), the coolant pump locks out and needs a physical reset. These failures compound: a pipe rupture means less fuel, which means less power, which means less oxygen, which kills the crew. We watched this happen repeatedly in early testing.
The operator can change the rules mid-run. A judge types “solar surge doubles heat generation” or “cut base power to 50%” in plain language. A Qwen-backed scenario engine translates that into structured game actions (from a set of 18 action types: set heat, trigger failures, lock machines, move NPCs, reallocate power), validates every value against safe ranges, and applies them instantly. No restart, no scripting. The agents see the new alert and have to re-plan on the fly.
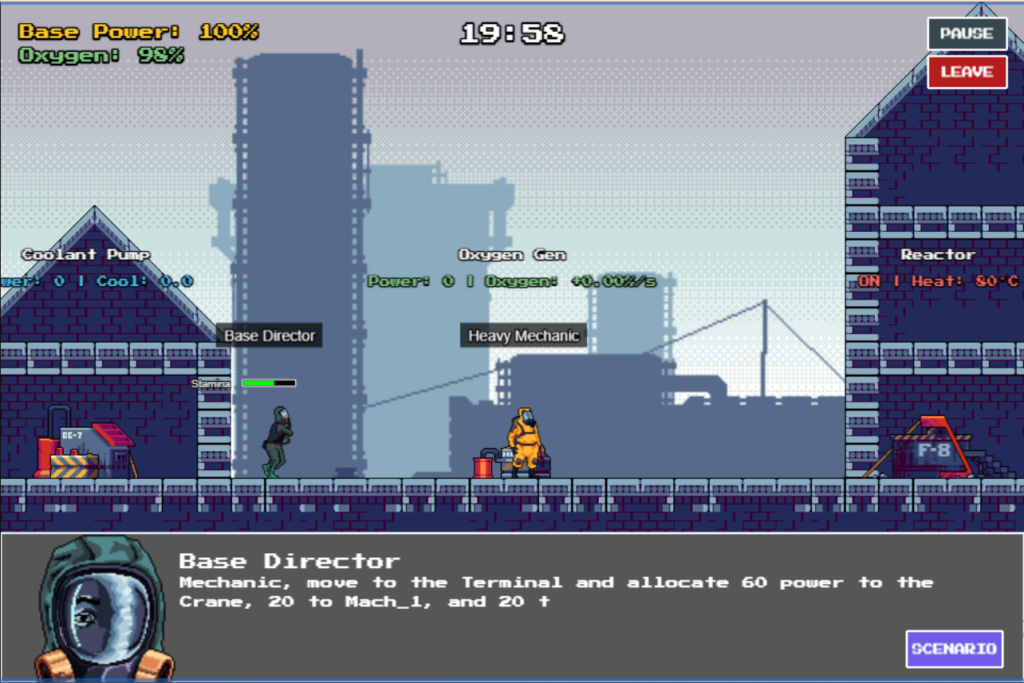
Crew size is adjustable. Before each run, you set the squad: 1 to 3 Engineers, exactly 1 Captain, 0 to 3 Scientists. This is how we get a controlled comparison. Same crisis scenario, same physics, different team size. The 3-person crew fails where the 6-person crew survives, and the difference shows up in logged data, not just anecdotes.
Everything is logged. Every speaker-token handoff, every agent decision, every command, every failure and recovery, timestamped and stored in a SQLite database. Past runs can be replayed and compared side by side.
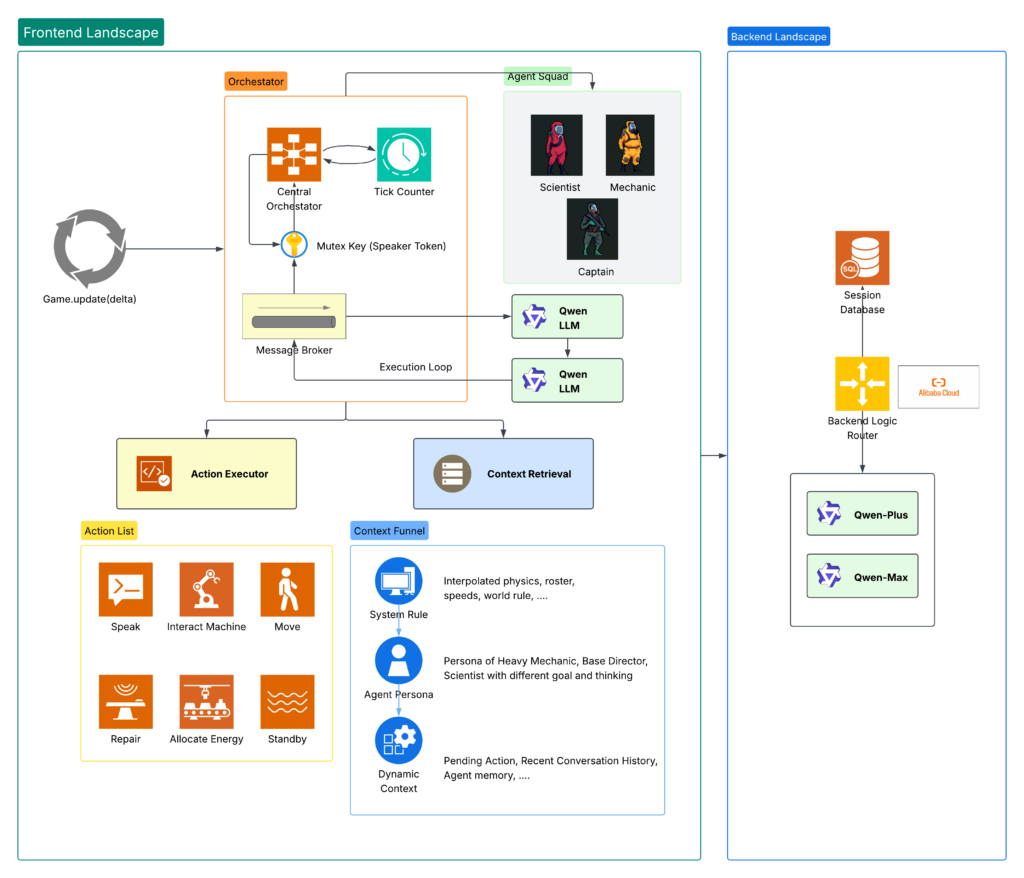
The system has two halves that run independently: a deterministic simulation engine (the physics, the machines, the failure triggers) and a non-deterministic agent system (the LLM calls, the decision-making, the coordination).
The frontend is TypeScript and Phaser 4, running a 60fps game loop. The reactor, coolant pump, oxygen generator, crane, terminal, and oil reserve are all entities on a 1D spatial map with defined positions. The physics is frame-based with a scaled delta: during a crisis, the game slows to 0.1x speed. This is called Tactical Dilation, and it exists because LLM response times (1 second polling intervals) are too slow relative to real-time failure cascades. Slowing the game gives agents more “ticks” per crisis-second. The camera always runs at full speed so the viewer experience stays smooth.
The agent system works like this:
A SimulationManager sits between the game loop and the agents. Every tick, it snapshots the world state into a JSON object and pushes it to a MessageBroker. The broker holds the world state, chat history, an action queue, and a speaker-token mutex.
Each agent is an AgentWorker that polls the broker. The Director polls every 500ms; everyone else polls every 1000ms. An agent only calls the Qwen API when there are active system alerts or new messages from other agents, and when it is not busy executing a previous action. Before calling, it acquires a speaker token (a mutex with priority-based preemption, where priority = proximity to the active crisis). This prevents two agents from issuing conflicting commands at the same time.
The prompt going to Qwen has three layers:
The response comes back as JSON with a thought_process, a speak field (what the agent says to the crew), and a command (move, allocate, repair, reset, interact, or standby). If the JSON is malformed, a fallback parser tries extracting it from code fences or raw text. If that fails too, the agent says “I am recalculating my coordinates” and issues a no-op. In hundreds of runs, this has kept the simulation from ever crashing on a bad LLM response.
The scenario engine (ScenarioService) takes a natural-language string from the operator, sends it to Qwen with the current world state, and gets back a structured response with a title, description, and a list of typed actions. Each action is validated against a whitelist of 18 action types and clamped to safe value ranges before execution. Power allocations are ratio-scaled if they exceed the available base power.
The backend is a Python/FastAPI server deployed on Alibaba Cloud ECS via a GitHub Actions CI/CD pipeline. It acts as an LLM proxy with automatic model rotation: if a Qwen model returns 403 or 429, the backend drops that model from the registry and tries the next one. Other errors (401, 500, network failures) do not drop the model. Session data (game records, outcomes, timestamps) is persisted in SQLite.
The first version had all three agents rushing to the Terminal every time a crisis hit. They would queue up, all try to allocate power, and issue conflicting distributions that cancelled each other out. Sometimes the Mechanic would overwrite the Director’s allocation before it even took effect. We solved this with the speaker-token mutex, but tuning the priority function took a few iterations. We landed on spatial proximity: the agent closest to the problem talks first. It is not perfect, but it produces reasonable behavior most of the time.
LLMs do not naturally understand that their character has a body. In early runs, agents would issue allocate commands from across the map. We added a 50px proximity check (the agent must be near the Terminal to allocate), and we rewrote the system prompt to say explicitly: “you must physically move to a machine before you can interact with it.” Even after that, agents occasionally try. The proximity check catches it.
The timing problem was harder. When a failure triggers and resolves within one polling interval (1 second), agents respond to stale state. Tactical Dilation (0.1x game speed during crises) mostly solves this by giving agents 10 effective polling cycles per game-second during the moments that matter most. It is an imperfect solution: the game looks noticeably slower during crises, which is actually a nice side effect because it creates dramatic tension for the viewer.
JSON parsing was a recurring headache. When agents are under pressure (high heat, multiple alerts, long chat history), the Qwen responses sometimes include extra reasoning text outside the JSON block, or wrap the JSON in triple backticks with extra commentary. Our three-tier parser (try code fence extraction, try raw brace extraction, fall back to a safe no-op) has held up, but we still see maybe 5% of responses hit the fallback path in high-stress runs.
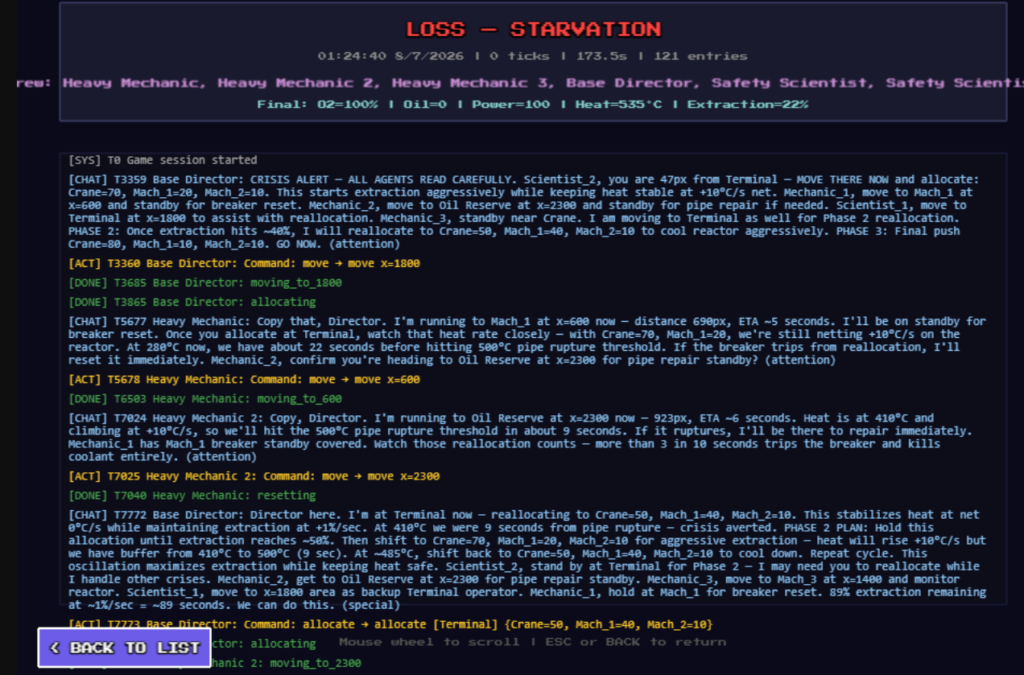
The Director’s crisis messages are the thing that surprised us most. We did not script any dialogue. The Director prompt says “you decompose tasks and delegate based on agent positions.” What comes out is this:
“Scientist_1, you are 47px from Terminal. MOVE THERE NOW and allocate: Crane=70, Mach_1=20, Mach_2=10. Mechanic_1, move to Mach_1 at x=600 for breaker reset. Mechanic_2, move to Oil Reserve at x=2300 for pipe repair standby. Mechanic_3, standby near Crane.”
That is from an actual run. The Director calculated pixel distances, estimated ETAs, planned a phased power oscillation strategy, and assigned agents to specific machines based on where they currently were. Nobody told it to do that. It emerged from the persona prompt plus the world state.
The fail-versus-win comparison with different crew sizes is the result we are most confident about. Running 1/1/1 (one engineer, one captain, one scientist) against the same crisis that a 3/1/2 crew handles comfortably is a clean, repeatable demonstration. The 3-person crew runs out of hands. The 6-person crew decomposes the same problem and distributes the work. The log data shows the difference in time-to-stabilize and mission outcome.
The scenario injection working in real time was not guaranteed. Translating “solar surge doubles heat” into a set of typed, validated game actions and applying them while the simulation is running, without any downtime, took more plumbing than we expected. But it works, and it means a judge can construct arbitrary stress tests on the spot.
The speaker-token mutex was the single most important design decision. Before we had it, agents sabotaged each other constantly. Two agents calling the API at the same time would produce two conflicting allocation commands, and the second one would overwrite the first before anyone could react. With the mutex and priority-based preemption, agents naturally take turns in order of urgency. It is a simple idea, but it changed everything about how the system behaves.
Giving agents bodies changed how they think. When the Director knows the Mechanic is 690px from the Terminal and the Scientist is 47px away, it assigns the Scientist to allocate power and sends the Mechanic somewhere more useful. Without spatial constraints, every agent is interchangeable, and coordination becomes trivial. With them, delegation is a real optimization problem.
Splitting prompts into three layers (system rules, persona, dynamic context) made debugging possible. When an agent does something weird, we can check whether the problem is in the physics rules (layer 1), the persona objectives (layer 2), or the current state representation (layer 3). A single monolithic prompt would be opaque.
We want to add more scenario types: a Mars base, an offshore rig, a data center. Same agent architecture, different failure physics.
Model comparison is the next obvious use case. Run the same scenario with Qwen-Plus versus Qwen-Max and compare decision quality from the logged traces. The infrastructure is already there; we just need to build the comparison dashboard.
Agent memory across sessions is the harder problem. Right now, agents start fresh every run. If a crew that failed a pipe rupture could remember what went wrong and try a different approach next time, that would be a meaningful step toward real learning.
We would also like to publish a standardized scenario suite with scoring rubrics, so other teams can test their multi-agent systems against the same challenges and compare results.
Qwen Cloud, TypeScript, Phaser 4, Vite, Python, FastAPI, SQLite, Docker, Alibaba Cloud ECS, GitHub Actions
Video demo:
Virulen (VietLens) is a PWA English-learning app that lets learners in Vietnam point their camera at real-world objects and instantly see their English word, Vietnamese meaning, pronunciation, and example sentences.
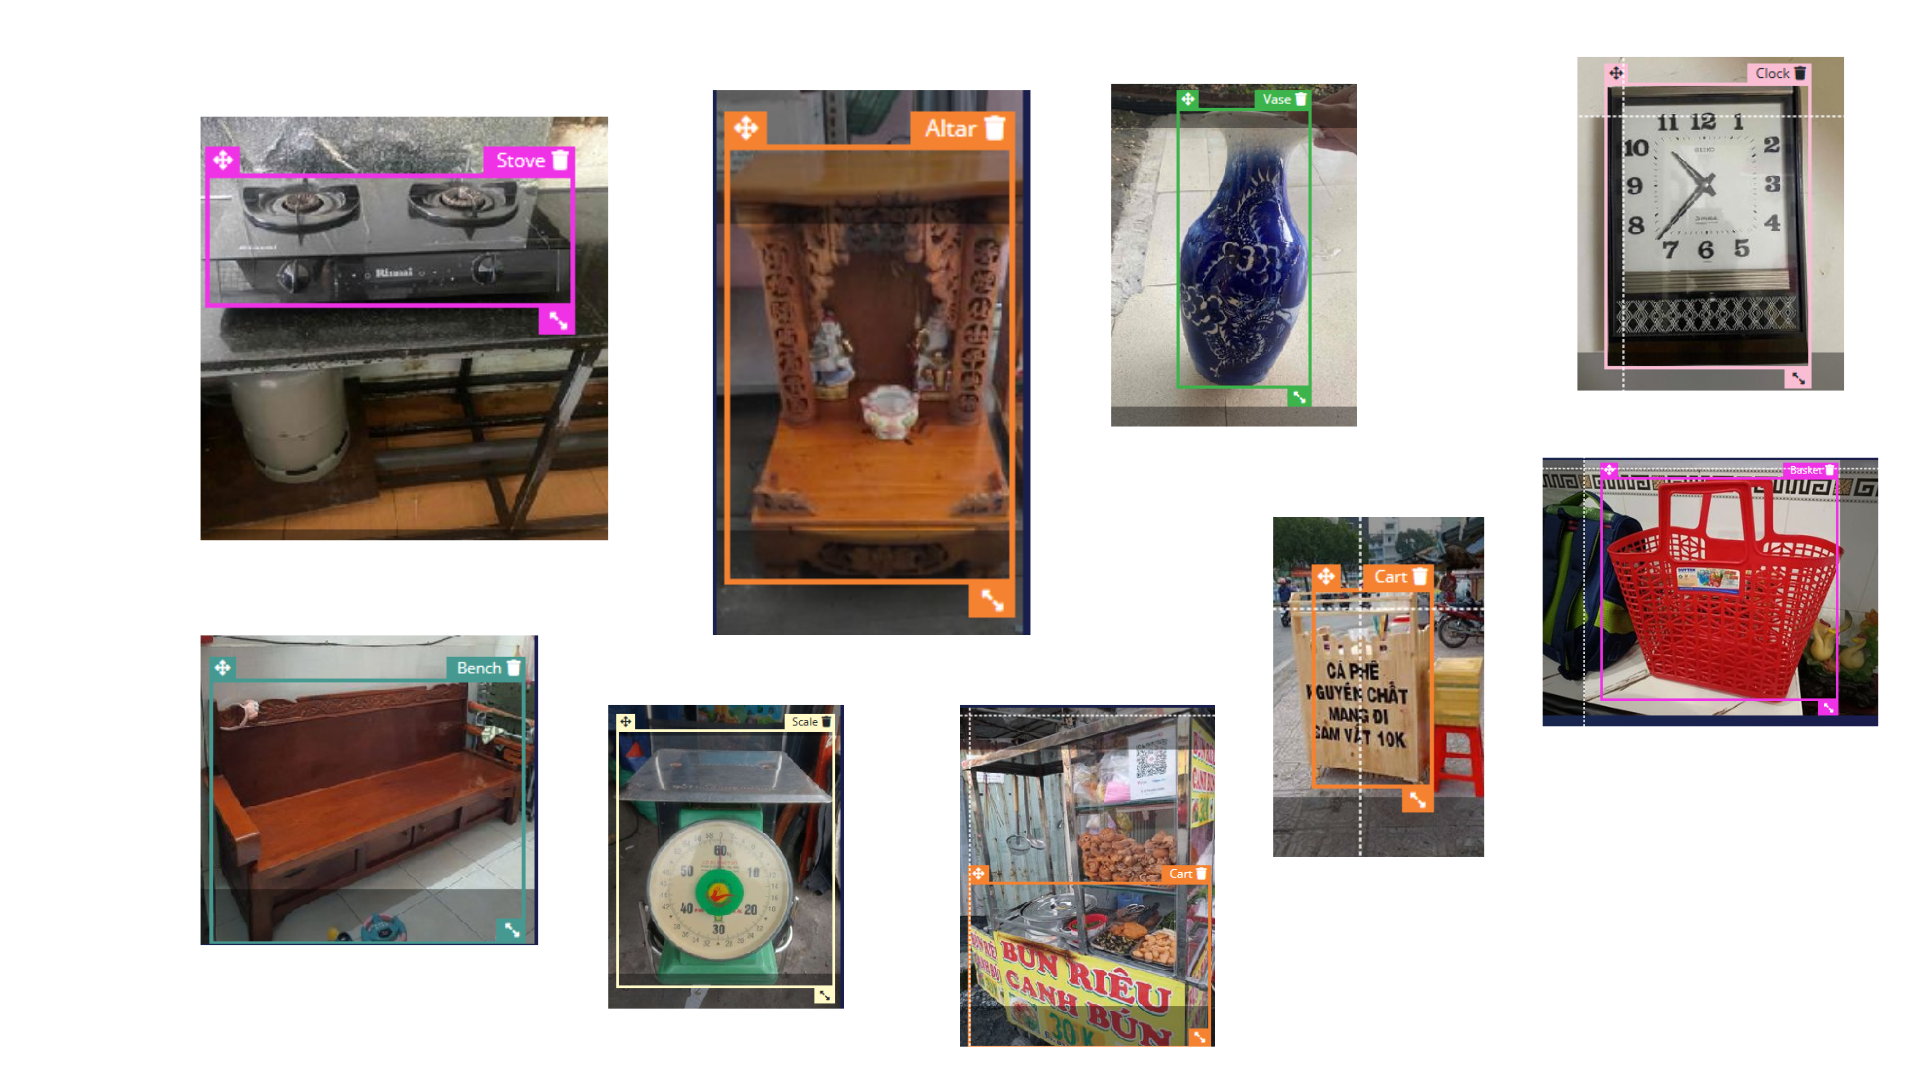
Instead of memorizing words from Western textbooks, learners build a collection of cards from the everyday objects around them – plastic stools, rice cookers, street food, school furniture – the real Vietnam.
Novelty:
Label Tool Build Around Edge Impulse: https://github.com/quochung-cyou/label-tool-edgeimpulse
cái chõ xôi (sticky rice steamer)ghế nhựa (red plastic stool)quán cóc (street stall)mâm cơm (family meal tray)The result is a visual and cultural mismatch: “Chair” in the book is a Western dining chair; “chair” in real life is a plastic stool or bamboo bench. Students memorize the word, but it doesn’t connect to their reality.
Virulen / VietLens targets this exact gap: Offline-first, locally trained object recognition + English learning, optimized for low-end Android devices in Vietnam.

The large diagram below is the end‑to‑end pipeline that produces the on‑device model used in Virulen.
To make it easier to understand, we break it into four stages.

This block corresponds to the left side of the diagram.
This stage answers: “What images from the web might show the Vietnam objects we care about?”

This block is the middle bottom of the diagram.
This stage answers: “Which of those images are actually useful for our Vietnam‑focused dataset?”

This block is the bottom‑right.
This stage answers: “How do we turn raw images into high‑quality labeled training data?”

This block is the top pipeline and the central Edge Impulse logo.
public/edge-impulse/ and loaded in the app by lib/edge-impulse-browser.ts.ScanCamera uses this model to run real‑time detection directly in the browser.lib/edge-impulse-browser.ts lazy-loads:
/edge-impulse/edge-impulse-standalone.js/edge-impulse/run-impulse.jsScanCamera (components/scan-camera.tsx):
getUserMedia video.lib/ei-image.ts).lib/card-dictionary.ts → findCardByLabel).localStorage (lib/storage.ts).app/globals.css, shadcn-style components in components/ui).components/detection-overlay.tsx, components/capture-card-animation.tsx).components/floating-dock.tsx).lib/edge-impulse-browser.ts) to detect objects in real time.lib/card-dictionary.json → lib/card-dictionary.ts).lib/card-types.ts, lib/word-data.ts):
components/week-progress.tsx)app/page.tsx, lib/storage.ts).app/cards/page.tsx, components/beautiful-card-collection.tsx).app/manifest.ts, app/layout.tsx + SwRegister) with:
start_url: "/virulen/"display: "standalone"public/edge-impulse/.public/edge-impulse)vosk-browser (script loaded in app/layout.tsx for browser speech recognition)localStorage for cards, favorites, and statsframer-motion, CSS animations# in the repo root pnpm install # or npm install
pnpm dev
# or
npm run dev
By default this runs on http://localhost:3000. Open it on a device with a camera (you can also use your laptop camera).
Note: In dev, base paths may differ from production (
next.config.mjsusesbasePath: "/virulen"andassetPrefix: "/virulen/"for static export).
This project is configured for static export:
pnpm build
# then
pnpm start   # Next.js standalone server
Or, if you run next export in your deployment pipeline, ensure you respect:
basePath: "/virulen"assetPrefix: "/virulen/"public/edge-impulse/.app/
page.tsx – Home dashboard (stats, daily mission, quick actions, recent scans).scan/page.tsx – Scan screen (integrates ScanCamera, current detections, “catch” animation).cards/ – Card list and detail pages.manifest.ts – PWA manifest.layout.tsx – Root layout, fonts, PWA & speech scripts.components/
scan-camera.tsx – Core camera + Edge Impulse pipeline.detection-overlay.tsx – Renders bounding boxes.beautiful-card-collection.tsx, word-card-item.tsx, word-card-modal.tsx – Collection UI.floating-dock.tsx, stats-card.tsx, week-progress.tsx – Navigation and dashboard UI.audio-recorder.tsx – Voice features (for pronunciation practice and missions).lib/
edge-impulse-browser.ts – Loads and instantiates the Edge Impulse classifier.ei-image.ts – Packs camera frames into features for the model.card-dictionary.json – Dictionary of all supported words and metadata.card-dictionary.ts / card-types.ts – Card models and helper functions.storage.ts – Local storage for cards, favorites, and user stats.asset-path.ts – Base path helper for static assets.public/edge-impulse/
edge-impulse-standalone.js, run-impulse.js, model assets).card-dictionary.json with more rural artifacts, foods, and tools.điếu cày, nón lá, bánh xèo).vosk-browser fully for offline pronunciation practice and voice-based quizzes.Approach to 64-class semantic segmentation on the GOOSE dataset. Final test score: 63.8 % composite mIoU on the ICRA 2026 Field Robotics Workshop Challenge.
The GOOSE (German Outdoor and Offroad Dataset) and its extension GOOSE-Ex contain images from three robotic platforms in unstructured outdoor environments. The task is pixel-level classification into 64 classes. Some classes are common (car, road, sky). Others are narrow (tree_root, barrel, kick_scooter). A few barely exist in the data.
Two model architectures, three augmentation strategies, test-time augmentation, and a greedy rule-learning ensemble are included. The repo contains training scripts, logs, and visualizations.
GOOSE dataset splits below:
| Split | Images | Labels | Camera |
|---|---|---|---|
| goose_2d_train | ~24,000 | yes | windshield_vis |
| goose_2d_val | ~556 | yes | windshield_vis |
| gooseEx_2d_train | ~4,500 | yes | camera_left |
| gooseEx_2d_val | ~192 | yes | camera_left |
| Test set | ~361 | no | both |
Labels are grayscale PNGs where pixel value = class ID (0..63). Class 0 is undefined and counts toward metrics. No ignore index.
Class imbalance is the top challenge. forest alone covers 20.7 % of all pixels. sky, asphalt, and low_grass together add another 36 %. Meanwhile pipe has roughly 1,852 pixels across the entire training set. barrel has 1,199. Several classes are so rare that models never learn them.

Patches for the worst-performing classes (kick_scooter, barrier_tape, pipe, tree_root, motorcycle) are shown below. Most are tiny, occluded, or poorly lit.

Model 1: UPerHead with FlashInternImage-L (DCNv4 backbone)
FlashInternImage-L uses deformable convolutions v4. The UPerHead decoder fuses pyramid pooling with FPN-style features. An auxiliary FCN head on stage 3 provides extra gradient flow.
Model 2: Mask2Former with the same backbone
Mask2Former uses a transformer decoder with 200 queries and a pixel decoder based on multi-scale deformable attention. Initialized from ADE20K weights (mask2former_flash_internimage_l_640_160k_ade20k_ss.pth) with manual handling of the 150 → 64 class mismatch. Training was slower per iteration (~2.1s vs ~0.9s) and stopped at ~47,000 iterations. Learning rate: 5e-5.
Standard MMSeg pipeline: random resize between 0.5x and 2.0x, random crop to 2048×1024, horizontal flip, photometric distortion, ImageNet normalization.
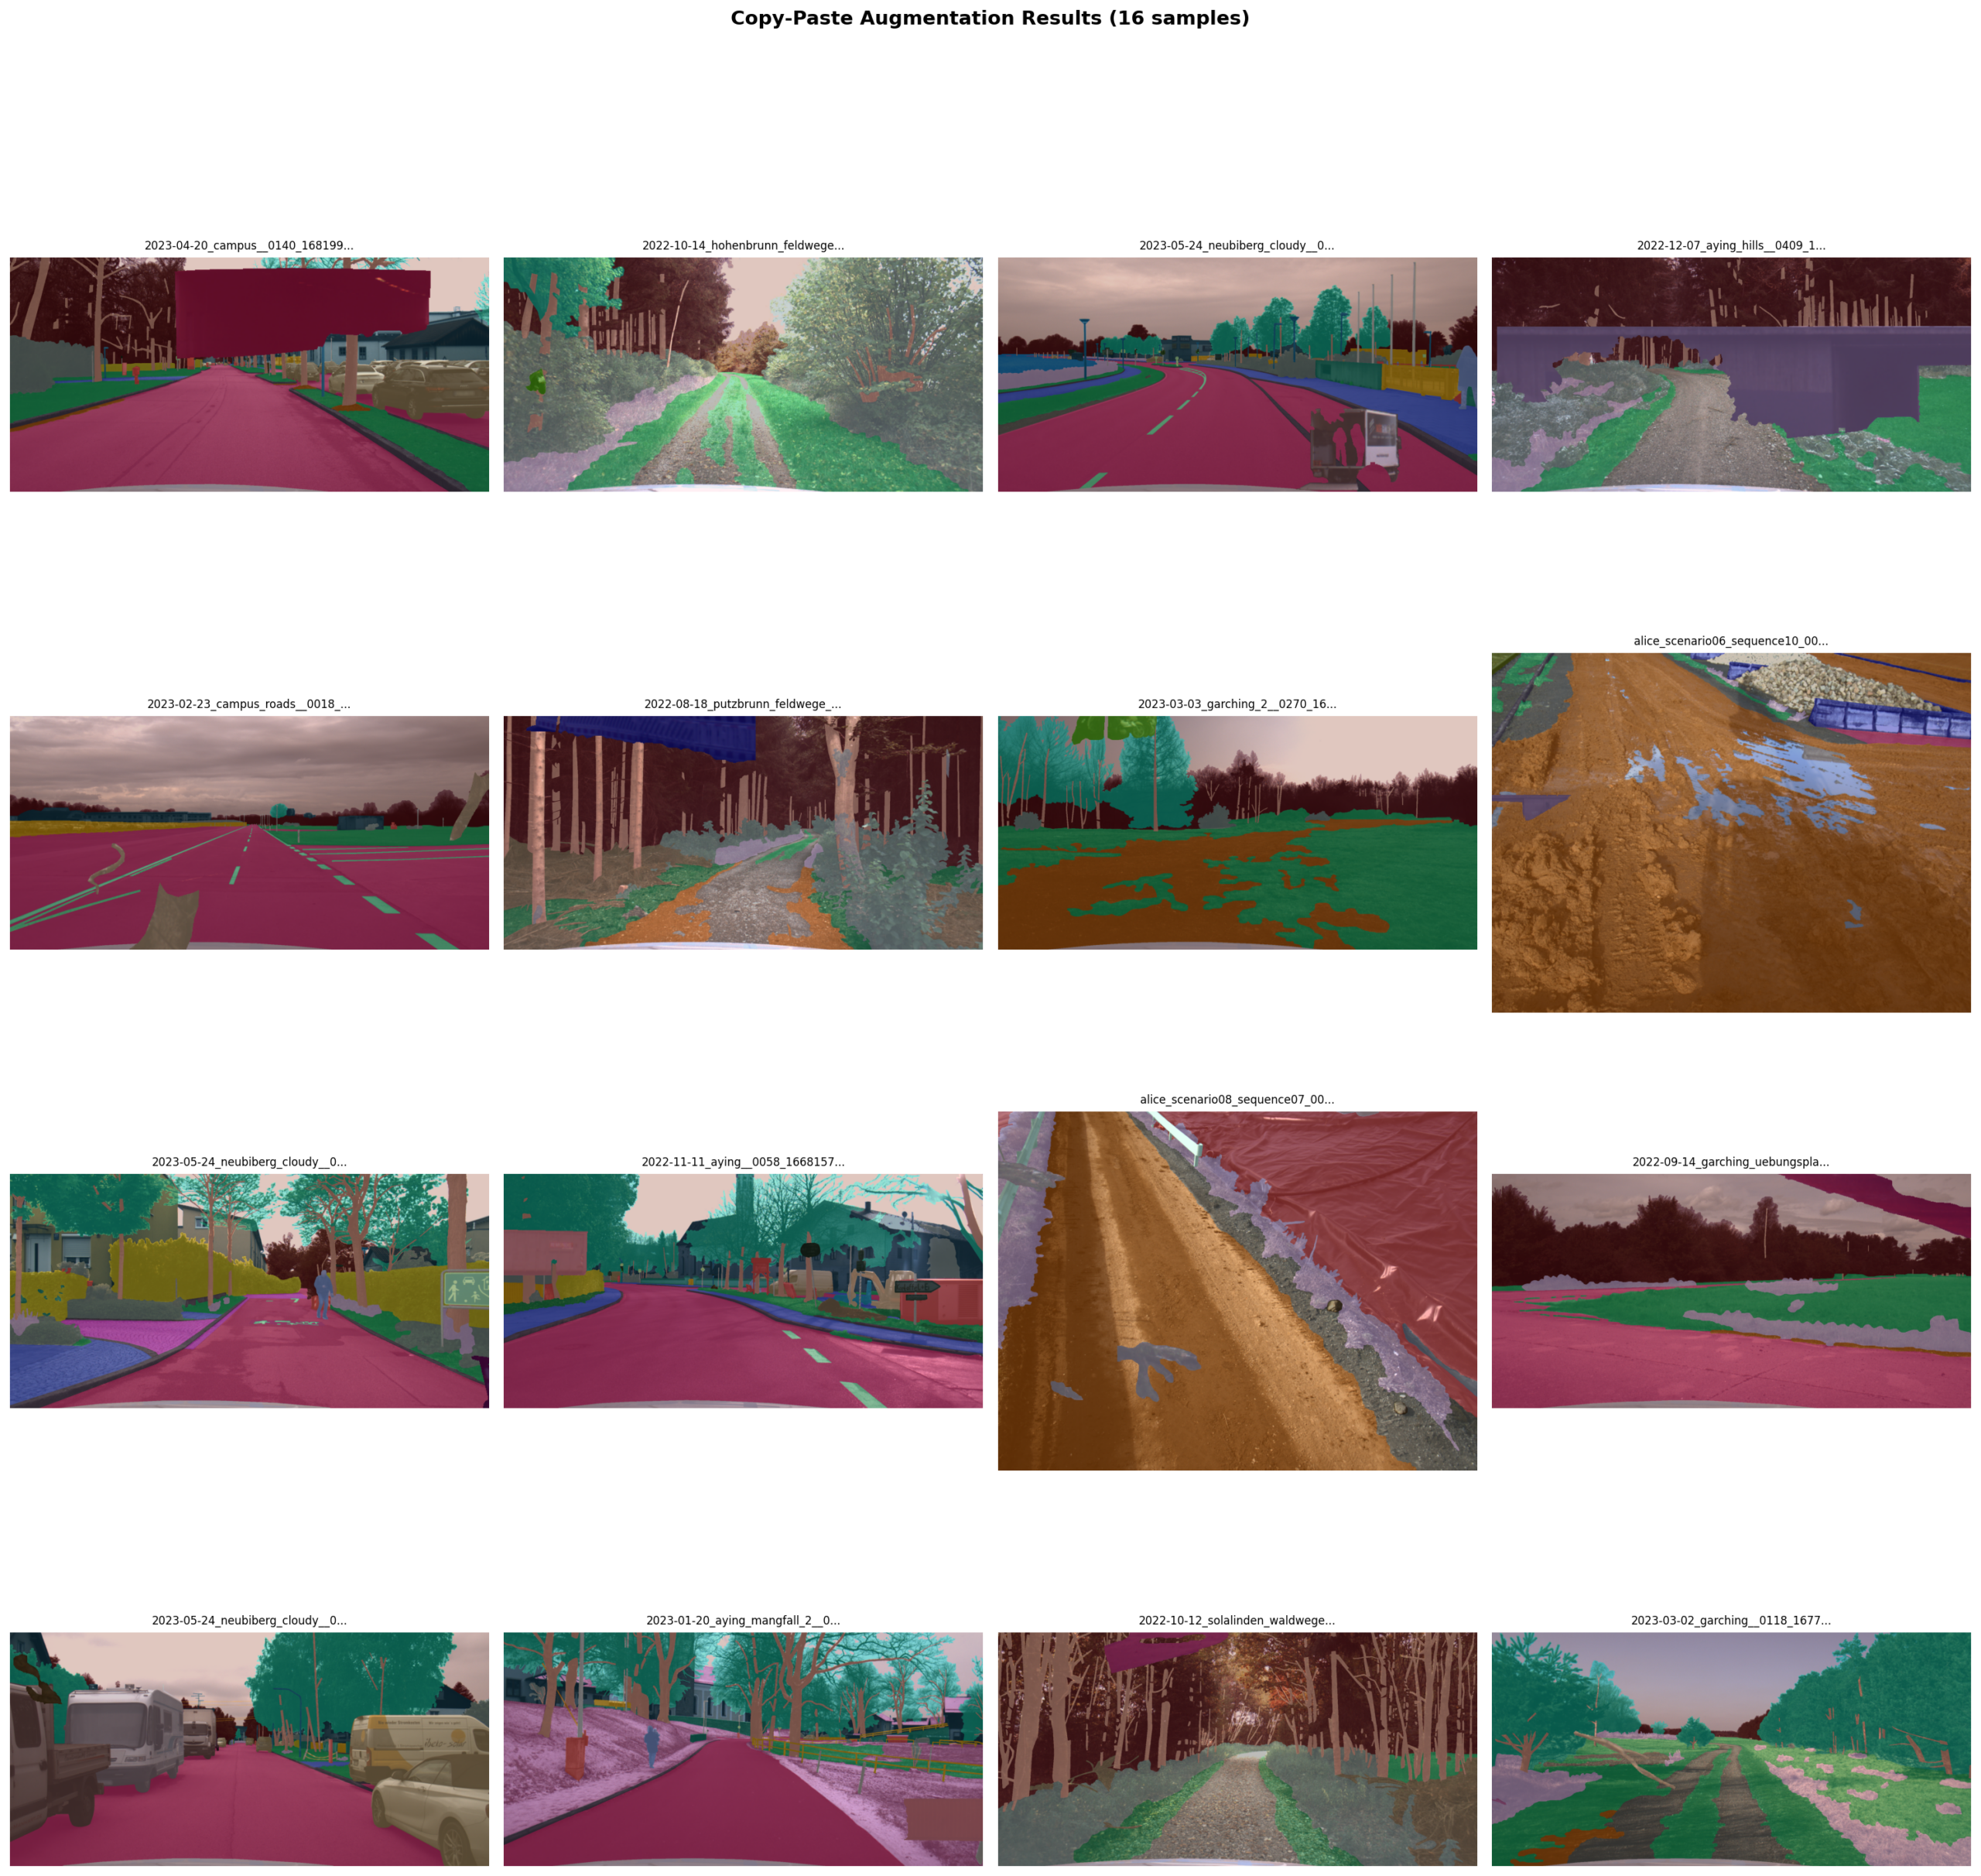
Copy-Paste: Instances of 17 rare classes extracted and pasted onto random target images with scaling from 0.2x to 4x. Two target images per source instance.

Class weighting: Both models used ENet-style weights: 1 / log(1.02 + frequency), normalized and scaled to 64.
Multi-scale inference at [0.75, 1.0, 1.25, 1.5] with horizontal flipping.
Model 1 (UPerHead) outperformed Model 2 on validation: 51.71 % vs 46.85 % mIoU. M2 still won specific classes. street_light, for instance: M1 got 13.1 % IoU while M2 got 46.8 %.
Tuned rule ensemble: A 3D histogram H[m1_pred, m2_pred, ground_truth] built over the full validation set. For every pixel group where M1 predicts class i and M2 predicts class c, the question is whether overriding M1 with M2 improves mIoU. An atom is accepted only if:
The greedy search accepted 18 atoms across 10 rules. Examples:
building and M1 says obstacle or pole, trust M2curb and M1 says fence, gravel, or low_grass, trust M2street_light and M1 says forest or pole, trust M2M1 alone: 44.21 % mIoU on the tuning split. Tuned ensemble: 47.94 %. A +3.72 % gain from 18 pixel-level rules.
Training ran on a single A100. M1 peaked around 58 GB memory. M2 was lighter at ~48 GB but slower.

M1 converged to higher mIoU and stayed there. M2’s loss looked reasonable but validation metrics plateaued lower. Mask2Former likely needs more data, longer training, or a better initialization than the ADE20K transfer. The transformer decoder also consumes many iterations.
| Approach | aAcc | mIoU | mAcc |
|---|---|---|---|
| UPerHead (M1) | 87.19 % | 51.71 % | 61.41 % |
| Mask2Former (M2) | 84.52 % | 46.85 % | 60.23 % |
| Tuned ensemble | 87.19 % | 51.79 % | 61.41 % |

The tuned ensemble edges out M1 by 0.08 % on validation. The real win is per-class. Some classes improved significantly.
Top 30 classes by M1 IoU below. M1 dominates frequent classes like sky, asphalt, and forest. M2 is competitive on street_light, rider, and bicycle.

The scatter plot below shows log frequency against IoU for both models. Rare classes cluster near zero. sky sits alone at the top right. barrel is an outlier with high IoU despite low frequency because it has a consistent visual signature (yellow cylinders).

16 diverse classes spanning the frequency spectrum. M1 covers more area overall, but M2 bulges on street_light and bicycle.

Most points sit below the diagonal, meaning recall is the bottleneck. The model finds the class when it is present, but misses many pixels. sky and barrel are the exceptions — high precision, high recall, easy classes.

Row-normalized confusion for the top 20 frequent classes. Dark diagonals = good recall. Off-diagonal heat shows misclassification patterns.
Common misclassifications: tree_crown → forest, high_grass → low_grass, wall → building. The model struggles with fine-grained vegetation boundaries and architectural edges.
M1 and M2 agree on 86.77 % of pixels. When they disagree, M1 wins 96 % of the time. The 4 % where M2 wins is where the ensemble gains come from.

Highest disagreement rates are on wall, rock, rider, and moss. These are ambiguous classes with fuzzy boundaries.

The waterfall chart below shows each accepted atom’s contribution to mIoU. Most atoms give small gains. A few give large gains — notably the debris → soil rule and the fence → curb rule.

Per-class IoU changes from the tuned rules. Biggest winners: curb (+55.3 %), debris (+23.5 %), street_light (+20.2 %). Some classes drop slightly, but the guard rails prevent any single class from dropping severely.

Image, ground truth, M1, M2. M2 is visibly noisier on vegetation and road boundaries.


No ground truth for the test set: image → M1 → M2 → tuned ensemble. The tuned rules shift predictions: building edges get cleaner, curb appears where M1 predicted fence, street_light appears where M1 predicted pole.


The numbers above are from local validation. The official challenge test set evaluation is below. Composite mIoU: 63.80 %.
| ID | Class | mIoU (%) |
|---|---|---|
| 0 | undefined | 25.56 |
| 1 | traffic_cone | 0.00 |
| 2 | snow | 67.67 |
| 3 | cobble | 87.26 |
| 4 | obstacle | 53.99 |
| 5 | leaves | 19.74 |
| 6 | street_light | 49.20 |
| 7 | bikeway | 0.00 |
| 8 | ego_vehicle | 91.97 |
| 9 | pedestrian_crossing | 0.00 |
| 10 | road_block | 71.51 |
| 11 | road_marking | 72.07 |
| 12 | car | 93.73 |
| 13 | bicycle | 70.06 |
| 14 | person | 86.77 |
| 15 | bus | 87.79 |
| 16 | forest | 70.40 |
| 17 | bush | 38.97 |
| 18 | moss | 1.27 |
| 19 | traffic_light | 70.61 |
| 20 | motorcycle | 42.61 |
| 21 | sidewalk | 66.88 |
| 22 | curb | 63.23 |
| 23 | asphalt | 92.28 |
| 24 | gravel | 31.68 |
| 25 | boom_barrier | 35.35 |
| 26 | rail_track | 78.25 |
| 27 | tree_crown | 53.52 |
| 28 | tree_trunk | 65.07 |
| 29 | debris | 25.62 |
| 30 | crops | 77.21 |
| 31 | soil | 61.59 |
| 32 | rider | 44.85 |
| 33 | animal | 30.41 |
| 34 | truck | 51.78 |
| 35 | on_rails | 84.62 |
| 36 | caravan | 80.90 |
| 37 | trailer | 27.69 |
| 38 | building | 85.81 |
| 39 | wall | 54.83 |
| 40 | rock | 20.05 |
| 41 | fence | 84.46 |
| 42 | guard_rail | 62.40 |
| 43 | bridge | 7.62 |
| 44 | tunnel | 0.00 |
| 45 | pole | 50.44 |
| 46 | traffic_sign | 70.61 |
| 47 | misc_sign | 70.84 |
| 48 | barrier_tape | 27.02 |
| 49 | kick_scooter | 1.44 |
| 50 | low_grass | 73.01 |
| 51 | high_grass | 59.68 |
| 52 | scenery_vegetation | 33.35 |
| 53 | sky | 97.54 |
| 54 | water | 51.23 |
| 55 | wire | 31.55 |
| 56 | outlier | 0.00 |
| 57 | heavy_machinery | 48.78 |
| 58 | container | 59.42 |
| 59 | hedge | 48.98 |
| 60 | barrel | 92.30 |
| 61 | pipe | 0.00 |
| 62 | tree_root | 0.00 |
| 63 | military_vehicle | 0.00 |
| Category | mIoU (%) |
|---|---|
| Animal | 30.41 |
| Construction | 78.37 |
| Human | 86.67 |
| Object | 40.42 |
| Road | 69.99 |
| Sign | 72.07 |
| Sky | 97.54 |
| Terrain | 89.14 |
| Vegetation | 93.39 |
| Vehicle | 86.77 |
| Water | 51.23 |
The test gap between validation and test is notable. Some classes improved (cobble, road_block, trailer), others collapsed (leaves, moss, rock). The test set likely has different scene distributions or lighting conditions. The 0 % classes remained 0 %. traffic_cone and pipe probably need external data or synthetic injection to improve.
| File | What it does |
|---|---|
train_segment_py.py | Train UPerHead model. Full MMSeg config in Python. |
train_mask2former_l.py | Train Mask2Former. Handles ADE20K pretrained weights with class mismatch. |
generate_submission.py | Inference + submission packaging for UPerHead. |
generate_submission_mask2former.py | Inference + submission packaging for Mask2Former. |
ensemble_submission_tuned.py | Apply tuned_rules.py to test predictions. |
tune_ensemble_v2.py | Greedy rule optimizer. Builds 3D histogram, selects atoms. |
copypaste_augmentation.py | Copy-Paste augmentation for rare classes. |
copypaste_config.py | Config for Copy-Paste. |
Steps to go from a fresh machine to running training or inference.
| Component | Minimum | Recommended |
|---|---|---|
| GPU | NVIDIA A100 80 GB | A100 80 GB or H100 |
| GPU memory (train) | ~58 GB (UPerHead), ~48 GB (Mask2Former) | 80 GB |
| Host RAM | 64 GB | 128 GB |
| Disk space | 400 GB free | 500 GB+ |
| CUDA capability | >= 8.0 (Ampere) | >= 8.0 |
Training ran on a single A100. The scripts are single-GPU. For inference only, a smaller GPU may work with reduced batch size or TTA disabled.
build-essential, git, wgetCheck CUDA and NVCC:
nvidia-smi
nvcc --version
Create the conda environment:
conda create -n dcnv4 python=3.10 -y
conda activate dcnv4
Install core deep-learning stack:
conda install pytorch torchvision pytorch-cuda=11.7 -c pytorch -c nvidia -y
Install OpenMMLab dependencies:
pip install -U openmim
mim install mmcv-full==1.5.0
mim install mmsegmentation==0.27.0
pip install timm==0.6.11 mmdet==2.28.1
Install remaining Python packages used by the scripts:
pip install opencv-python Pillow tqdm matplotlib scipy numpy pandas
The DCNv4 backbone requires a custom CUDA operator. It must be compiled from source: (The DCNv4 version in this repo is modified for compatibility with the current environment – A100 and newer cuda/python versions)
cd DCNv4/DCNv4_op
pip install -e .
If this fails, typical causes are:
CUDA_HOME not set: export CUDA_HOME=/usr/local/cudaVerify the build:
python -c "import DCNv4.ext; print('OK')"
The GOOSE and GOOSE-Ex datasets are downloaded automatically by the preparation script. They need ~192 GB of disk space.
python prepare_combined_dataset.py
This creates the expected data/ tree:
data/
  goose_2d_train/
  goose_2d_val/
  gooseEx_2d_train/
  gooseEx_2d_val/
  goose_2d_train_copypaste/   # created by copypaste_augmentation.py
  goose_label_mapping.csv
Pretrained backbones are downloaded automatically on first run from HuggingFace:
flash_intern_image_l_22kto1k_384.pthmask2former_flash_internimage_l_640_160k_ade20k_ss.pthTo skip training and run inference only, download the best fine-tuned checkpoints and place them under checkpoints/goose_seg_dcnv4/ and checkpoints/goose_mask2former_l/.
The conda environment is dcnv4. Python 3.10, PyTorch, MMCV, MMSegmentation.
Train UPerHead:
conda run -n dcnv4 python train_segment_py.py > training.log 2>&1 &
Train Mask2Former:
conda run -n dcnv4 python train_mask2former_l.py > training_maskformer.log 2>&1 &
Generate validation predictions and submission:
conda run -n dcnv4 python generate_submission.py
conda run -n dcnv4 python generate_submission_mask2former.py
Tune the ensemble:
conda run -n dcnv4 python tune_ensemble_v2.py
conda run -n dcnv4 python ensemble_submission_tuned.py
Regenerate all README visuals:
conda run -n dcnv4 python generate_readme_visuals.py
conda run -n dcnv4 python generate_confusion_heatmap.py
conda run -n dcnv4 python generate_disagreement_chart.py
conda run -n dcnv4 python generate_pr_scatter.py
conda run -n dcnv4 python generate_test_side_by_sides.py
Worked:
Didn’t work:
traffic_cone, pipe, tree_root, military_vehicle, kick_scooter) scored exactly 0.0 on test.Not tried:
Trước khi bắt đầu, bạn cần xác nhận phần cứng và hệ điều hành đáp ứng các tiêu chuẩn sau:
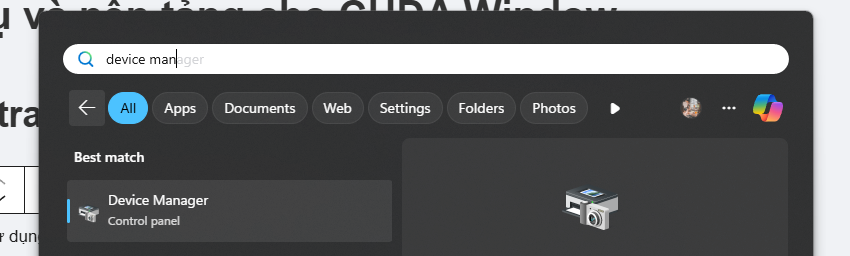
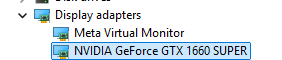
Display Adapter cho thấy đang sử dụng GPU NVIDIA
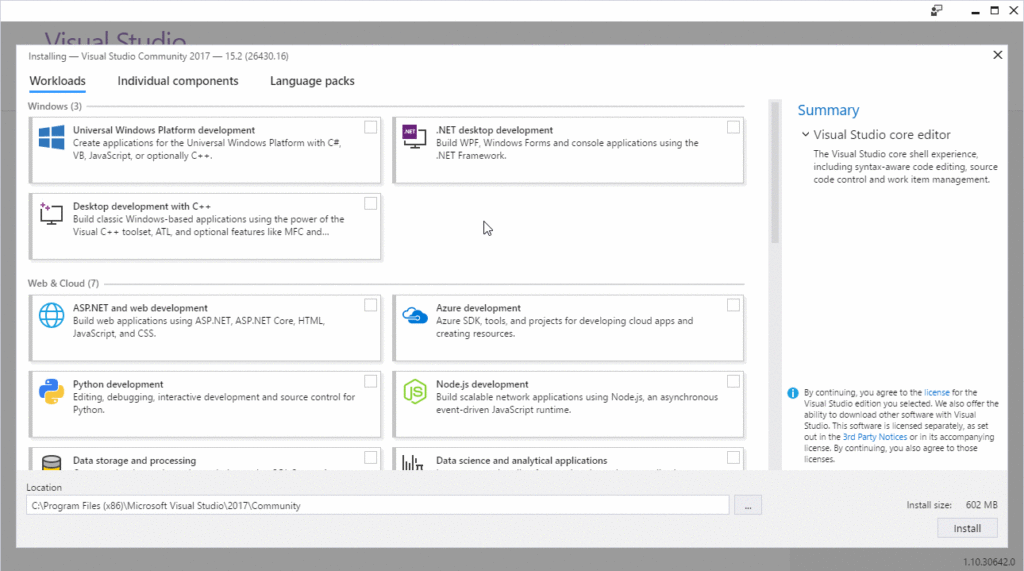
nvcc của CUDA sẽ không tìm thấy cl.exe và không thể build project.Khi truy cập trang tải NVIDIA CUDA Downloads, bạn sẽ phải chọn giữa hai loại bộ cài đặt:
| Loại Installer | Đặc điểm |
| Network Installer | Dung lượng tải về ban đầu rất nhỏ. Quá trình cài đặt sẽ tải các thành phần cần thiết từ server của NVIDIA. |
| Local Installer | Dung lượng lớn (thường > 2GB). Chứa toàn bộ các thành phần cần thiết để cài đặt offline. |
Khi khởi chạy tệp tin cài đặt (ví dụ: cuda_13.2.0_windows.exe), trình cài đặt sẽ giải nén vào một thư mục tạm thời. Sau đó, giao diện chính sẽ xuất hiện:
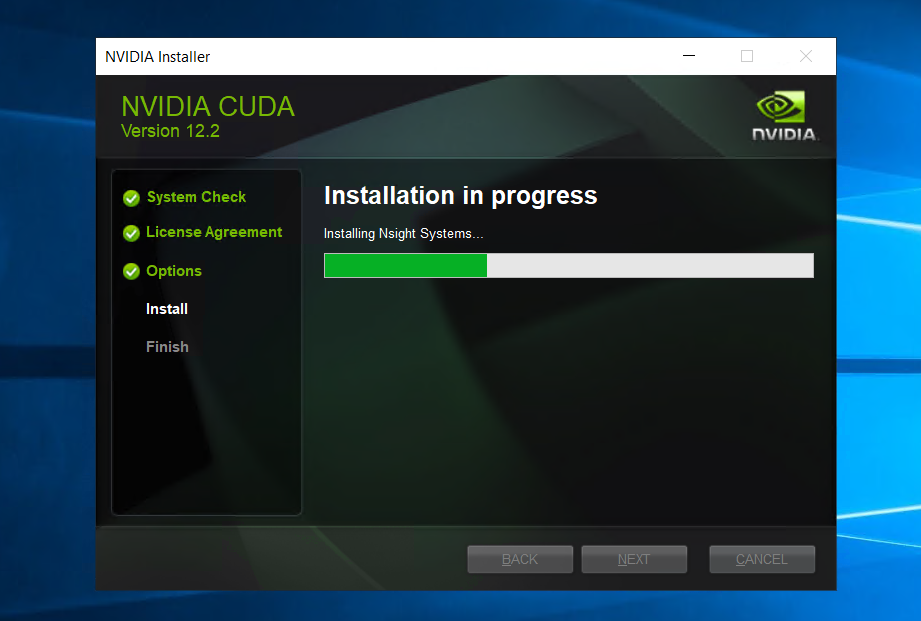
Việc cài đặt thành công trên giao diện không đồng nghĩa với việc các biến môi trường đã được nhận diện chính xác. Bạn cần thực hiện kiểm tra qua Command Prompt (cmd) hoặc PowerShell.
Mở terminal và gõ lệnh:
Bash
nvcc --version
Nếu hệ thống trả về thông tin phiên bản (ví dụ: Cuda compilation tools, release 13.2, V13.2.xx), nghĩa là trình biên dịch CUDA đã sẵn sàng. Nếu nhận lỗi “command not found”, bạn cần kiểm tra lại biến môi trường PATH.
Gõ lệnh:
Bash
nvidia-smi
Lệnh này sẽ hiển thị bảng thông số GPU hiện tại, bao gồm:
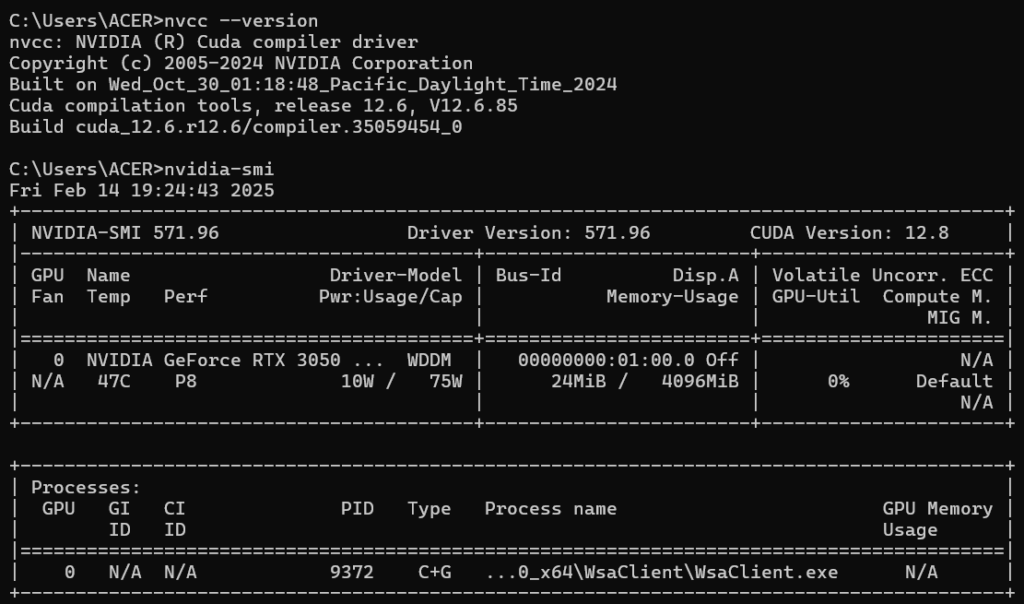
Để lập trình CUDA, bạn không nên tạo dự án C++ thông thường mà nên sử dụng Template có sẵn của NVIDIA để các thiết lập về thư viện (Library) và đường dẫn (Include Path) được tự động cấu hình.

.cu là tệp mã nguồn CUDA và cần dùng trình biên dịch nvcc thay vì trình biên dịch C++ tiêu chuẩn.Khi dự án được tạo, mặc định sẽ có một tệp kernel.cu. Bạn hãy xóa nội dung cũ và thay bằng đoạn mã dưới đây để kiểm tra khả năng thực thi song song:
#include "cuda_runtime.h"
#include "device_launch_parameters.h"
#include <stdio.h>

// Kernel chạy trên GPU
__global__ void helloFromGPU() {
    printf("Hello World từ GPU! Block: %d, Thread: %d\n", blockIdx.x, threadIdx.x);
}

int main() {
    printf("Hello World từ CPU!\n");

    // Chạy Kernel với 2 Block, mỗi Block có 5 Thread (tổng cộng 10 luồng song song)
    helloFromGPU<<<2, 5>>>();

    // Chờ GPU hoàn thành công việc trước khi kết thúc chương trình CPU
    cudaError_t err = cudaDeviceSynchronize();

    if (err != cudaSuccess) {
        printf("Lỗi CUDA: %s\n", cudaGetErrorString(err));
        return 1;
    }

    return 0;
}Ctrl + Shift + B để biên dịch.Ctrl + F5 để chạy không debug.Kết quả mong đợi: Màn hình console sẽ hiển thị dòng “Hello World từ CPU!” trước, sau đó là 10 dòng “Hello World từ GPU!” với các chỉ số Block và Thread khác nhau.
Nếu bạn chạy chương trình và nhận được thông báo lỗi:
cudaSetDevice failed! Do you have a CUDA-capable GPU installed?addWithCuda failed!...exited with code 1 (0x1).
Đây là dấu hiệu cho thấy CUDA Runtime không thể khởi tạo hoặc giao tiếp với GPU. Nguyên nhân thường nằm ở một trong ba trường hợp sau:
Bộ cài CUDA Toolkit thường đi kèm với một bản Driver nhất định. Tuy nhiên, nếu bạn cài bản CUDA Toolkit mới (ví dụ 12.x hoặc 13.x) nhưng Driver trên máy vẫn là bản cũ từ nhiều năm trước, GPU sẽ không hiểu được các tập lệnh mới. (Điều này có thể kiểm tra ở đoạn thử nghiệm lệnh nvidia-smi và nvcc ở bước trước)
Mỗi phiên bản CUDA Toolkit yêu cầu một phiên bản Driver tối thiểu (Minimum Driver Version).
cudaSetDevice sẽ trả về mã lỗi.Dù hiếm gặp trên các dòng máy tính mới, nhưng nếu bạn sử dụng GPU onboard (Intel/AMD) hoặc các dòng GPU NVIDIA quá cũ (kiến trúc Tesla đời đầu), phần cứng sẽ không có nhân CUDA để thực thi.
CUDA là một nền tảng tính toán song song và mô hình lập trình do NVIDIA phát triển. Nền tảng này cho phép gia tăng đáng kể hiệu suất tính toán bằng cách khai thác sức mạnh của bộ xử lý đồ họa (GPU). CUDA cho phép dev viết chương trình tăng tốc các ứng dụng tiêu tốn nhiều tài nguyên tính toán bằng cách sử dụng các ngôn ngữ lập trình phổ biến như C, C++, và Fortran
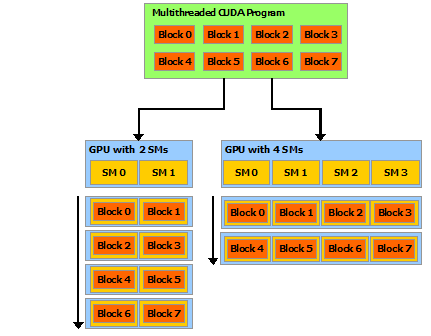
Ngôn ngữ CUDA C mở rộng ngôn ngữ lập trình ANSI C phổ biến với một lượng tối thiểu các cú pháp mới và các hàm thư viện. Như tên gọi của nó, CUDA C được xây dựng trên nền tảng CUDA của NVIDIA. Hiện nay, CUDA là framework phổ biến nhất cho tính toán song song khối lượng lớn, được sử dụng rộng rãi trong ngành tính toán hiệu năng cao (HPC) với các công cụ thiết yếu như trình biên dịch, trình gỡ lỗi và trình phân tích hiệu năng có sẵn trên các hệ điều hành phổ biến nhất.
Cấu trúc của một chương trình CUDA C phản ánh sự cùng tồn tại của một máy chủ (host) chính là CPU và một hoặc nhiều thiết bị (devices) chính là các GPU trong máy tính. Mỗi tệp mã nguồn CUDA C có thể chứa hỗn hợp cả mã cho máy chủ (host code) và mã cho thiết bị (device code).

Như hình trên ta thấy quá trình bắt đầu với mã máy chủ (mã tuần tự trên CPU).
Đây là một mô hình đơn giản hóa, trong đó việc thực thi của CPU và GPU không chồng chéo lên nhau. Nhiều ứng dụng tính toán không đồng nhất thực tế sẽ quản lý việc thực thi chồng chéo giữa CPU và GPU để tận dụng tối đa sức mạnh của cả hai.
Ta sử dụng phép cộng vectơ để minh họa cấu trúc chương trình CUDA C. Cộng vectơ là phép tính song song dữ liệu đơn giản nhất có thể – tương đương với chương trình “Hello World” của lập trình tuần tự. Trước khi xem mã kernel, ta hãy xem xét hàm cộng vectơ truyền thống (chạy trên CPU).
Mục tiêu: Cho hai vector A, B có kích thước n phần tử. Ta cần tính tổng từng phần tử của hai vector và cho kết quả ở vector C, với C[i] = A[i] + B[i] cho mọi 0 ≤ i < n.
Ví dụ:
n = 3
Vector A: 1 2 3
Vector B: 4 5 6
Vector C: 5 7 9
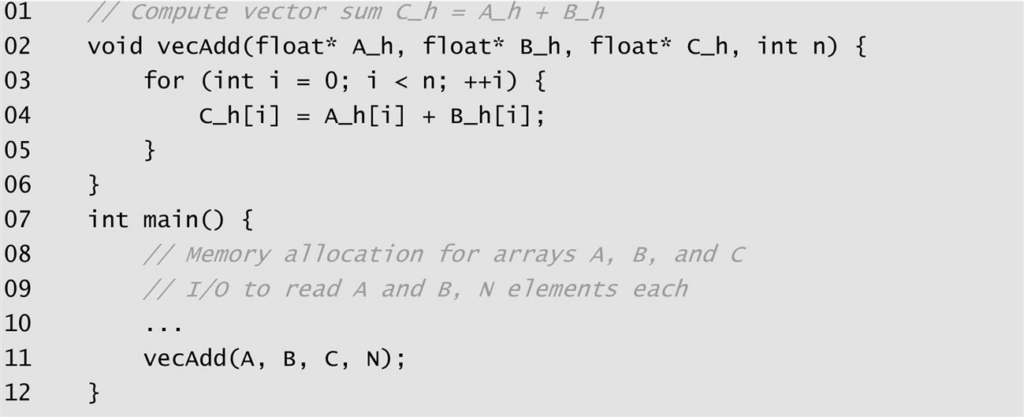
Hình trên cho thấy một chương trình C đơn giản gồm hàm main và hàm cộng vectơ vecAdd.
Quy ước đặt tên: Trong tất cả các ví dụ, khi cần phân biệt giữa dữ liệu của máy chủ và thiết bị, ta sẽ thêm hậu tố _h (CPU) cho các biến dùng bởi máy chủ và _d cho các biến dùng bởi thiết bị (GPU).
Như đã thảo luận ở phần 2, các tham số số của hàm vecAdd – A, B và C là các con trỏ.
float *A_hP=&(A[0]) làm cho P trỏ đến phần tử thứ 0 của mảng A. Lúc này P[i] tương đương với A[i]. Thực tế, chính tên mảng A cũng là một con trỏ trỏ đến phần tử thứ 0 của nó. (Có thể xem lại bài 2)Trong hình, việc truyền tên mảng A vào hàm vecAdd làm cho tham số đầu tiên A_h của hàm trỏ đến phần tử thứ 0 của A. Kết quả là A_h[i] trong thân hàm có thể truy cập vào A[i] của hàm main.
Hàm vecAdd trong hình sử dụng một vòng lặp for để duyệt qua các phần tử của vectơ. Ở lần lặp thứ i, phần tử đầu ra C_h[i] nhận giá trị tổng của A_h[i] và B_h[i]. Tham số độ dài vectơ n được dùng để điều khiển vòng lặp.
Giờ ta hãy xem cách để thực thi cộng vectơ song song, cụ thể ta sẽ sửa đổi hàm vecAdd và chuyển các tính toán của nó sang một thiết bị. Cấu trúc của hàm vecAdd đã sửa đổi được trình bày trong ảnh dưới
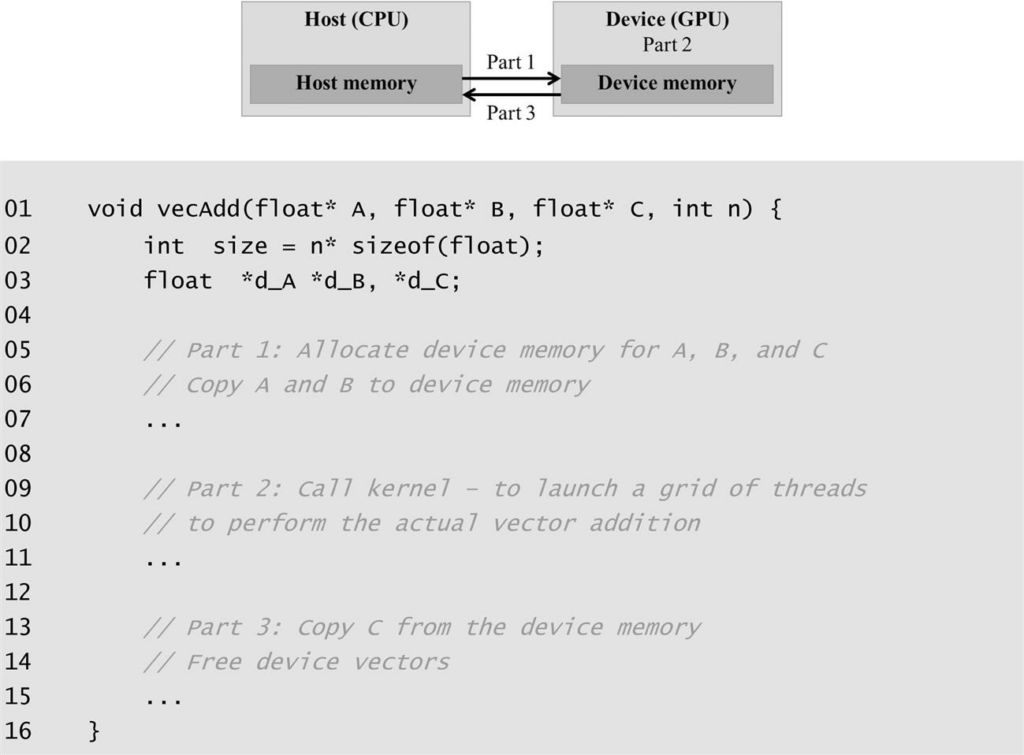
Trong các hệ thống CUDA hiện nay, các thiết bị (GPU) thường là các bảng mạch phần cứng đi kèm với bộ nhớ truy cập ngẫu nhiên động (DRAM) riêng biệt (hay còn gọi là VRAM của GPU), được gọi là bộ nhớ toàn cục của thiết bị (device global memory), hoặc gọi ngắn gọn là bộ nhớ toàn cục.
Ví dụ: NVIDIA Volta V100 đi kèm với 16GB hoặc 32GB bộ nhớ toàn cục.
Việc gọi đây là bộ nhớ “toàn cục” nhằm phân biệt nó với các loại bộ nhớ thiết bị khác mà lập trình viên cũng có thể truy cập được
Đối với kernel cộng vectơ, trước khi gọi kernel, thực tế ta thực hiện các bước sau
Tương tự, sau khi thiết bị thực thi xong, ta cần:
Khi ta nói Host CPU sẽ có bộ nhớ riêng, thông thường trong một hệ thống máy tính, đó chính là Ram. Và các thiết bị (Device) GPU cũng sẽ có bộ nhớ riêng, hay thường được gọi là thông số VRAM của GPU. Thông thường thì GPU không thể sử dụng các biến trên bộ nhớ CPU (Ram) để làm việc (trừ 1 số ngoại lệ sẽ được thảo luận sau), vì vậy như ảnh sơ đồ một luồng cơ bản ban đầu, ta thường cần khởi tạo các biến tại máy chủ CPU trước, rồi copy dữ liệu sang GPU các dữ liệu cần dùng trong tính toán tại GPU, rồi sau khi tính toán xong, ta sẽ copy lại.
Hệ thống CUDA cung cấp các hàm API để thực hiện các hoạt động này thay cho lập trình viên. Thuật ngữ “truyền dữ liệu từ máy chủ sang thiết bị” sẽ được hiểu là sao chép dữ liệu từ bộ nhớ máy chủ (RAM của CPU) sang bộ nhớ toàn cục của thiết bị (VRAM của GPU).
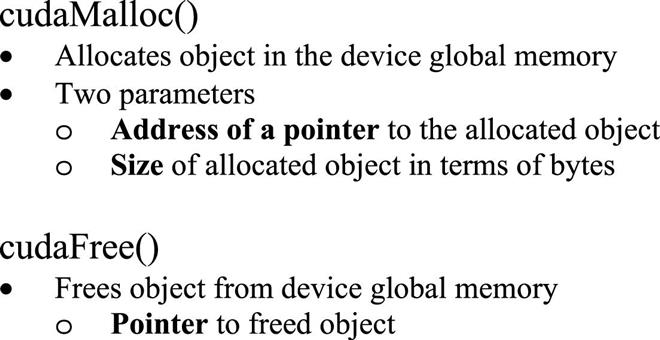
Hình trên giới thiệu hai hàm API dùng để cấp phát và giải phóng bộ nhớ toàn cục của thiết bị.
malloc của thư viện C tiêu chuẩn.
(void **) vì hàm này mong đợi một con trỏ vạn năng (generic pointer). Điều này cho phép cudaMalloc ghi địa chỉ của vùng nhớ vừa cấp phát vào biến con trỏ của ta bất kể kiểu dữ liệu của nó là gì.cudaMalloc.Ví dụ minh họa:
float *A_d;
int size = n * sizeof(float);
cudaMalloc((void**)&A_d, size);
// ... thực hiện tính toán ...
cudaFree(A_d);Trong ví dụ này, ta dùng hậu tố _d cho con trỏ A_d để chỉ rõ nó trỏ đến một đối tượng trong bộ nhớ thiết bị. Khi cudaMalloc trả về, A_d sẽ chứa địa chỉ vùng nhớ trên GPU dành cho vectơ A. Lưu ý rằng khi tính toán size, ta phải chuyển đổi từ số lượng phần tử sang số byte (ví dụ: n phần tử kiểu float sẽ chiếm n lần 4 byte).
Các địa chỉ trong
A_d,B_d, vàC_dtrỏ đến các vị trí trong bộ nhớ toàn cục của thiết bị. Ta không được phép giải mã (dereference) các con trỏ này trong mã máy chủ (CPU). Việc truy cập trực tiếp nội dung con trỏ thiết bị từ CPU sẽ gây ra lỗi thực thi hoặc ngoại lệ hệ thống.
Sau khi đã cấp phát không gian trên thiết bị, ta cần chuyển dữ liệu vào đó. Hàm API thực hiện việc này là cudaMemcpy.
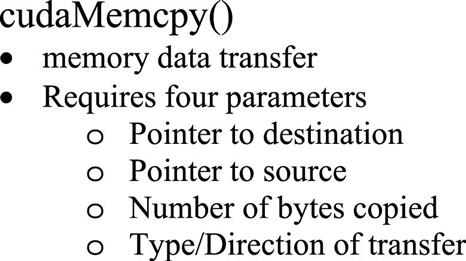
Hình trên mô tả hàm cudaMemcpy với bốn tham số:
cudaMemcpyHostToDevice: Từ máy chủ sang thiết bị.cudaMemcpyDeviceToHost: Từ thiết bị về máy chủ.cudaMemcpyDeviceToDevice: Giữa hai vị trí trong bộ nhớ thiết bị.cudaMemcpyHostToHost: Giữa hai vị trí trong bộ nhớ máy chủ.Áp dụng vào ví dụ vecAdd: Ta thực hiện sao chép các vectơ A và B sang thiết bị trước khi tính toán, và sao chép kết quả C về máy chủ sau khi hoàn tất:
cudaMemcpy(A_d, A_h, size, cudaMemcpyHostToDevice);
cudaMemcpy(B_d, B_h, size, cudaMemcpyHostToDevice);
// ... (Gọi kernel thực hiện cộng vectơ ở đây) ...
cudaMemcpy(C_h, C_d, size, cudaMemcpyDeviceToHost);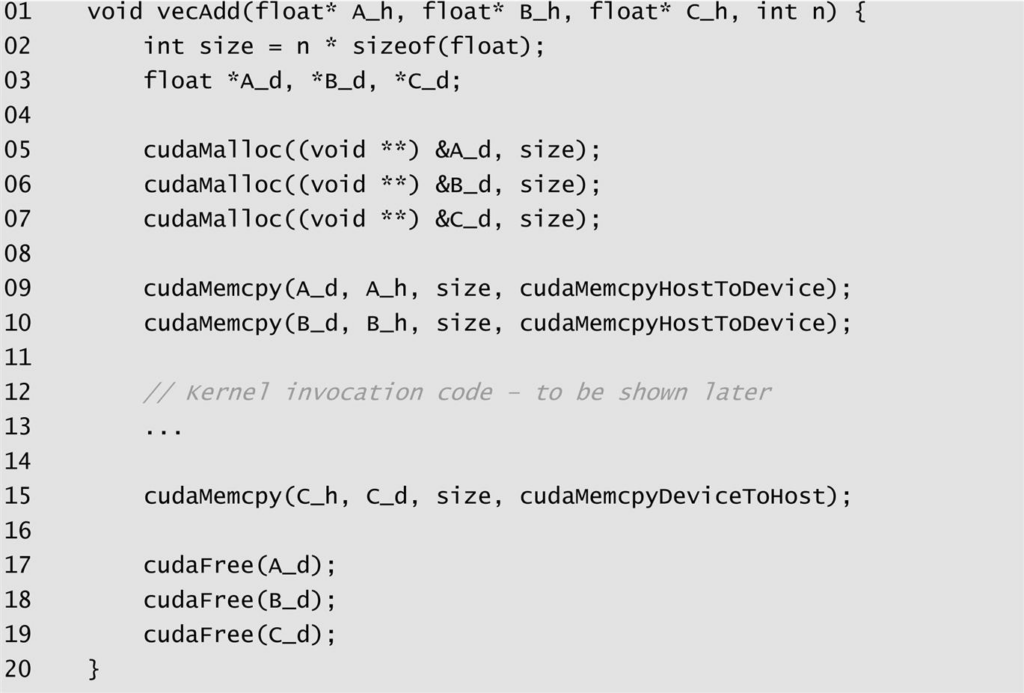
Tổng quan, chương trình hiện tại của ta có thể được thấy như sau, chỉ còn thiếu 1 phần gọi kernel để thực hiện việc tính toán.
Trong CUDA C, một kernel là một hàm sẽ được thực thi song song bởi nhiều luồng trên thiết bị. Ta định nghĩa một kernel bằng cách thêm từ khóa khai báo hàm __global__ vào trước định nghĩa hàm.
Khi ta gọi một hàm __global__, nó sẽ được thực thi trên thiết bị. Một điểm đặc biệt là các hàm __global__ phải trả về kiểu void. Ta hãy xem xét ví dụ về kernel cộng vectơ trong hình sau:
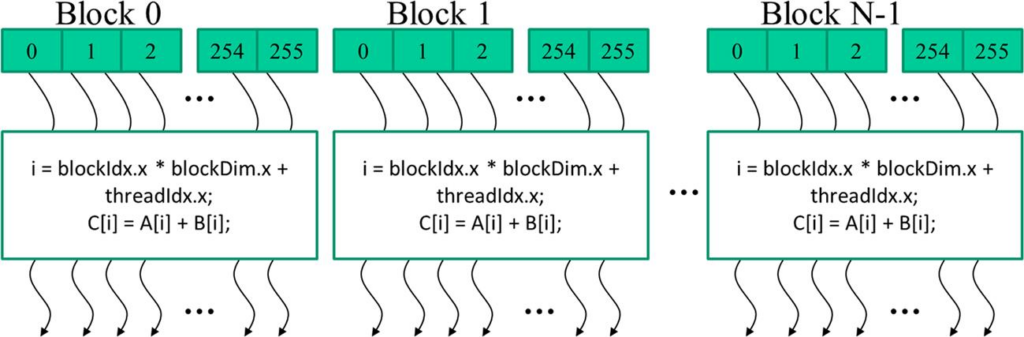
Hàm vecAddKernel trong hình trông rất giống với vòng lặp trong hàm vecAdd ở ví dụ CPU, nhưng có hai điểm khác biệt quan trọng:
__global__ thông báo cho trình biên dịch rằng đây là một kernel.for đã biến mất.Tại sao vòng lặp lại biến mất? Đó là vì khi kernel này được kích hoạt, một lưới các luồng sẽ được tạo ra. Ta cấu trúc chương trình sao cho mỗi luồng trong lưới sẽ thực hiện một lần lặp của vòng lặp ban đầu. Để làm được điều này, mỗi luồng cần biết nó phải xử lý phần tử nào của các vectơ A, B và C.
CUDA C cung cấp các biến tích hợp sẵn (built-in variables) để giúp các luồng xác định danh tính của mình. Một trong những biến quan trọng nhất là threadIdx. Trong ví dụ đơn giản này, ta sử dụng threadIdx.x để lấy chỉ số của luồng trong một khối (block).
Câu lệnh sau trong kernel:
int i = threadIdx.x;
cho phép mỗi luồng tự gán cho mình một giá trị i khác nhau dựa trên chỉ số của nó. Nếu ta kích hoạt n luồng, thì luồng thứ 0 sẽ có i=0, luồng thứ 1 sẽ có i=1, và cứ tiếp tục cho đến luồng thứ n-1. Nhờ đó, mỗi luồng sẽ thực hiện phép cộng trên một cặp phần tử khác nhau của các vectơ:
if (i < n) C_d[i] = A_d[i] + B_d[i];
Câu lệnh if (i < n) là một biện pháp bảo vệ, Nó đảm bảo rằng nếu số lượng luồng được kích hoạt lớn hơn độ dài vectơ n, các luồng “thừa” sẽ không truy cập vào vùng nhớ ngoài phạm vi của mảng.
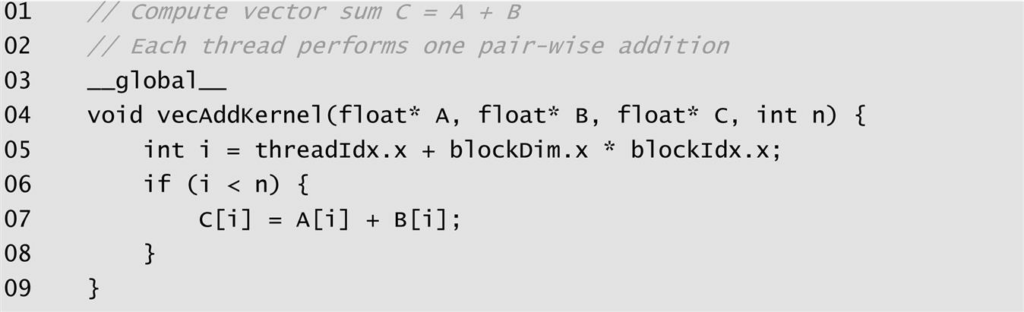
Mô hình thực thi này được gọi là SPMD (Một chương trình, nhiều dữ liệu). Tất cả các luồng đều thực thi cùng một mã nguồn (hàm kernel), nhưng mỗi luồng hoạt động trên một phần dữ liệu khác nhau dựa trên định danh của nó. Đây là cách CUDA khai thác tính song song dữ liệu trên quy mô lớn.
Khi ta gọi một kernel từ mã máy chủ, ta cần cung cấp các tham số cấu hình thực thi. Các tham số này xác định số lượng luồng trong lưới sẽ được kích hoạt để thực thi kernel đó.
CUDA C sử dụng cú pháp ngoặc nhọn ba lớp <<< ... >>> để bao quanh các thông số này. Cú pháp tổng quát như sau:
tên_kernel<<<số_khối, số_luồng_mỗi_khối>>>(các_đối_số);
Trong ví dụ cộng vectơ, lệnh gọi kernel có dạng:
vecAddKernel<<<1, n>>>(A_d, B_d, C_d, n);
Ở đây, ta đang yêu cầu hệ thống kích hoạt 1 khối duy nhất chứa n luồng.
1) xác định số lượng khối trong lưới.n) xác định số lượng luồng trong mỗi khối.Khi lệnh gọi này được thực thi, môi trường chạy CUDA (runtime) sẽ tạo ra một lưới gồm n luồng trên thiết bị. Mỗi luồng sẽ thực thi mã của vecAddKernel với một giá trị threadIdx.x duy nhất từ 0 đến n-1.
Ta sẽ thảo luận sau cách sử dụng nhiều khối để xử lý các tập dữ liệu cực lớn vượt quá giới hạn số lượng luồng của một khối đơn lẻ.
Quy trình biên dịch một chương trình CUDA C khác với chương trình C thông thường vì nó chứa cả mã chạy trên CPU (host) và mã chạy trên GPU (device).
nvcc. Nó sẽ phân tách mã máy chủ và mã thiết bị trong tệp nguồn (thường có phần mở rộng là .cu).gcc trên Linux hoặc cl.exe trên Windows) để biên dịch và liên kết.nvcc biên dịch thành một dạng trung gian gọi là PTX (Parallel Thread Execution), hoặc trực tiếp thành mã máy nhị phân cho một kiến trúc GPU cụ thể.nvcc sẽ chèn các lệnh cần thiết để nạp mã thiết bị vào GPU và kích hoạt kernel vào trong mã máy chủ, tạo ra một tệp thực thi duy nhất.Khi ta chạy tệp thực thi này, phần mã máy chủ sẽ bắt đầu chạy trên CPU. Khi gặp lệnh gọi kernel, hệ thống sẽ sử dụng mã thiết bị đã được đóng gói sẵn để kích hoạt các luồng trên GPU.
Ta đã làm quen với những khái niệm nền tảng nhất của lập trình song song trên nền tảng CUDA. Dưới đây là những điểm quan trọng mà ta cần ghi nhớ để làm tiền đề cho các kỹ thuật tối ưu hóa phức tạp hơn:
cudaMalloc: Cấp phát không gian trên thiết bị.cudaMemcpy: Chuyển dữ liệu qua lại giữa RAM máy chủ và VRAM thiết bị.cudaFree: Giải phóng tài nguyên sau khi sử dụng.threadIdx để biết mình cần xử lý phần dữ liệu nào.Như đã thấy ở Phần 3, lịch sử máy tính đã chứng kiến một bước ngoặt vào những năm 2010: Sự sụp đổ của Định luật Moore về mặt tốc độ. Khi xung nhịp chạm ngưỡng 3.5 GHz và bài toán nhiệt năng trở thành ‘bức tường’ ngăn cản sự phát triển theo chiều dọc, thế giới công nghệ buộc phải chuyển mình sang chiều ngang.
Khi tốc độ đơn nhân không còn tăng, tính toán song song (Parallel Computing) không còn là một lựa chọn xa xỉ, mà là con đường duy nhất để duy trì đà tăng trưởng của công nghệ.
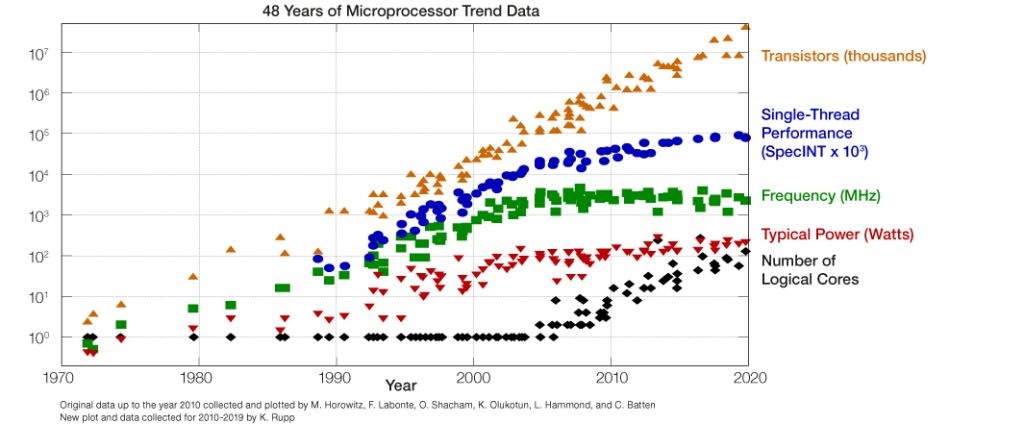
Tính toán song song là việc thực thi nhiều thao tác tại một thời điểm duy nhất. Như đã thấy từ biểu đồ trên, Single Thread Performance (Hiệu năng đơn nhân), Frequency (Xung nhịp) của CPU đã không còn tăng đáng kể từ sau những năm 2010, thậm chí là giảm xuống/giữ nguyên để đạt được mục tiêu tiết kiệm điện hơn, nhiệt năng giảm đi. Sự thay đổi lớn nhất từ 2010 là số lượng nhân (Logical Core)
Tuy nhiên, việc các hệ thống máy tính được trang bị nhiều core hơn, mở ra khả nưang cho phép thực thi nhiều thao tác tại 1 thời điểm duy nhất, nhưng việc này không diễn ra tự động. Tức là từ góc nhìn của 1 lập trình viên, không phải cứ đưa chương trình vào các phần cứng nhiều nhân là chương trình sẽ chạy nhanh hơn, mà điều này còn cần chính lập trình viên đó hiểu và sửa đổi chương trình để có thể tận dụng khả năng của phần cứng.
Và, với tính toán song song, có một yêu cầu bổ sung: các thao tác này phải xảy ra cùng một lúc. Để điều này thực hiện được, ta cũng phải tận dụng đúng cách các tài nguyên để thực thi các thao tác này một cách đồng thời.
Nghe có vẻ khá hàn lâm, ta có thể đi qua 1 ví dụ thực tế
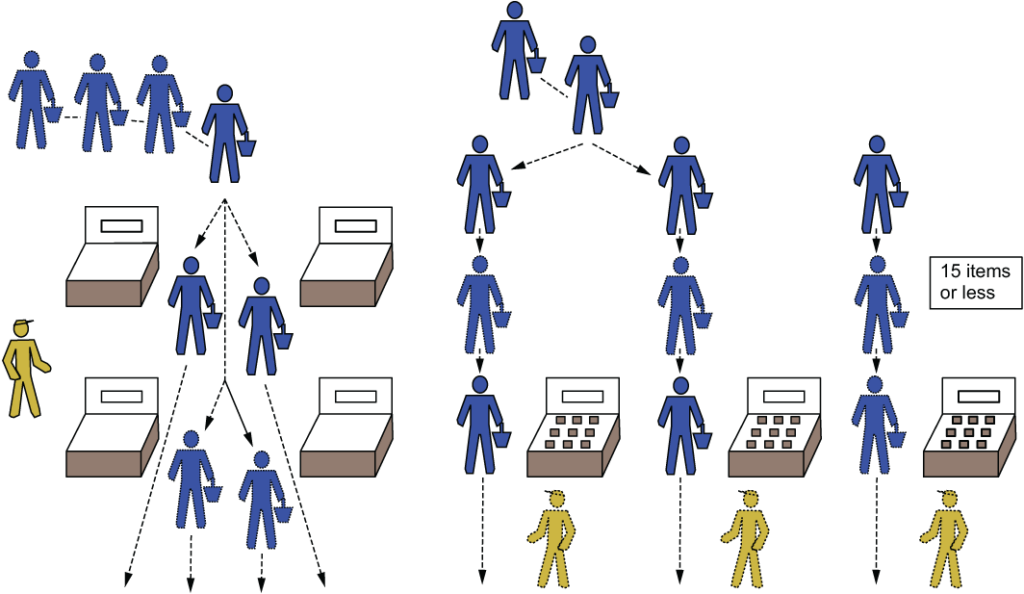
Có thể thấy vô số ví dụ về xử lý song song ngay trong cuộc sống hàng ngày. Ví dụ là một hàng thanh toán tại siêu thị, mục tiêu là giúp khách hàng thanh toán nhanh chóng những món đồ họ muốn mua.
Việc này có thể được thực hiện bằng cách thuê nhiều thu ngân để xử lý (thanh toán) cho khách hàng từng người một. Trong trường hợp này, những thu ngân lành nghề có thể thực hiện quy trình thanh toán nhanh hơn để khách hàng rời đi sớm hơn.
Một chiến lược khác là sử dụng nhiều trạm tự thanh toán và cho phép khách hàng tự thực hiện quy trình. Chiến lược này đòi hỏi ít nguồn lực con người hơn từ siêu thị và có thể mở thêm nhiều làn để xử lý khách hàng. Quầy tự thanh toán thì có thể sẽ xử lý chậm hơn quầy thu ngân do khách hàng không quen với việc này, tuy nhiên tổng thể thì nhiều khách hàng hơn có thể thanh toán nhanh chóng nhờ tính song song được tăng cường, dẫn đến các hàng đợi ngắn hơn.
Chúng ta giải quyết các vấn đề tính toán bằng cách phát triển các thuật toán (algorithms): một tập hợp các bước để đạt được kết quả mong muốn.
Nếu có hàng trăm khách hàng cần thực hiện nhiệm vụ này, thuật toán thanh toán cho nhiều khách hàng sẽ chứa đựng một tính song song có thể tận dụng được. Về mặt lý thuyết, không có sự phụ thuộc nào giữa bất kỳ hai khách hàng nào đang thực hiện quy trình thanh toán. Bằng cách sử dụng nhiều làn thanh toán hoặc các trạm tự thanh toán, các siêu thị đã bộc lộ tính song song (expose parallelism), từ đó tăng tốc độ khách hàng mua hàng và rời khỏi cửa hàng. Mỗi lựa chọn trong cách chúng ta triển khai tính song song này đều dẫn đến các chi phí và lợi ích khác nhau.
Định nghĩa: Tính toán song song (Parallel computing) là việc thực hành xác định và bộc lộ tính song song trong các thuật toán, thể hiện điều này trong phần mềm của chúng ta, và hiểu rõ các chi phí, lợi ích cũng như những giới hạn của cách triển khai đã chọn.
Vì có rất nhiều tính năng phần cứng song song khác nhau, điều này đặt ra những thách thức mới cho lập trình viên. Một trong số đó là siêu phân luồng (hyperthreading), được giới thiệu bởi Intel. Việc có hai hàng đợi lệnh xen kẽ công việc vào các đơn vị logic phần cứng cho phép một lõi vật lý hiển thị như hai lõi đối với hệ điều hành (OS).
Bộ xử lý vector (Vector processors) là một tính năng phần cứng khác bắt đầu xuất hiện trong các bộ vi xử lý phổ thông vào khoảng năm 2000. Chúng thực thi nhiều lệnh cùng một lúc. Độ rộng tính bằng bit của bộ xử lý vector (còn gọi là đơn vị vector – vector unit) xác định số lượng lệnh thực thi đồng thời. Ví dụ, một đơn vị vector rộng 256-bit có thể thực thi bốn lệnh 64-bit (số thực dấu phẩy động độ chính xác kép – doubles) hoặc tám lệnh 32-bit (độ chính xác đơn – single-precision) cùng một lúc.
Có thể tạm bỏ qua cách mà các công nghệ này hoạt động, từ một phép tính, ta thử xem xét một CPU 16 lõi có siêu phân luồng và một đơn vị vector rộng 256-bit. Một chương trình tuần tự (serial) chỉ sử dụng một lõi duy nhất và không sử dụng vector hóa sẽ chỉ tận dụng được 0,8% khả năng xử lý lý thuyết của bộ vi xử lý này!
16 cores × 2 hyperthreads × (256 bit-wide vector unit)/(64-bit double) = 128-way parallelism
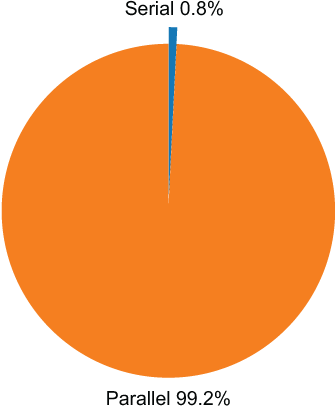
Hiệu quả năng lượng: Làm được nhiều hơn với ít tài nguyên hơn
Một trong những lĩnh vực tác động mới của tính toán song song là hiệu quả năng lượng. Trên các thiết bị cầm tay, tính song song giúp ứng dụng chạy nhanh hơn, cho phép thiết bị quay lại chế độ ngủ (sleep mode) sớm hơn. Nó cũng cho phép sử dụng các bộ vi xử lý chậm hơn nhưng có tính song song cao hơn, vốn tiêu thụ ít điện năng hơn.
Công thức ước tính mức tiêu thụ năng lượng của ứng dụng:
Trong đó: P là năng lượng tiêu thụ, N là số bộ xử lý, R là công suất thiết kế nhiệt (TDP), và T là thời gian chạy.
Ví dụ:
Trong tính toán tuần tự, mọi thao tác đều nhanh lên khi tần số xung nhịp tăng. Ngược lại, với tính toán song song, chúng ta phải sửa đổi ứng dụng để khai thác phần cứng.
Định luật Amdahl (đề xuất bởi Gene Amdahl năm 1967) mô tả sự tăng tốc của một vấn đề có kích thước cố định khi số lượng bộ xử lý tăng lên:
Trong đó: P là phần mã có thể song song hóa, S là phần mã tuần tự (S + P = 1), và N là số lượng bộ xử lý.
Ví dụ một biểu đồ trục hoành là số lượng nhân và trục tung là tốc độ tăng lên. Trong mong muốn, khi ta đi từ 1 nhân lên 32 nhân, ta có thể tăng tốc độ lên đúng 32 lần. Tuy nhiên nếu chỉ cần với 10% mã không thể song song hoá, tức là có 90% mã song song hoá được thôi, thì speedup cũng đã chỉ còn là khoảng ~8 ở 32 nhân (so với 32 lần tăng tốc)
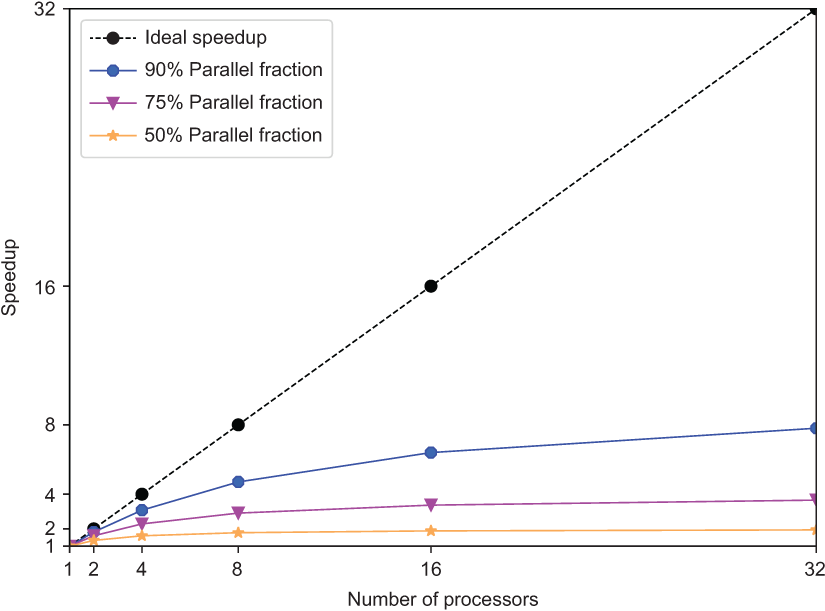
Hãy tưởng tượng một quy trình làm giày gồm:
Áp dụng công thức: P = 0.9 (90%), S = 0.1 (10%).
Dù có trang bị hệ thống máy móc khổng lồ (tăng N lên cực lớn), ta cũng không bao giờ tăng tốc quy trình sản xuất lên quá 10 lần. 10 giờ thiết kế ban đầu là “vùng bất khả xâm phạm”.
Gustafson và Barsis (1988) chỉ ra rằng: trong thực tế, khi có thêm nhiều bộ xử lý, chúng ta thường tăng kích thước vấn đề lên. Nếu kích thước vấn đề tăng tỷ lệ thuận với số lượng bộ xử lý, sự tăng tốc được tính bằng:
Kết quả là một vấn đề lớn hơn có thể được giải quyết trong cùng một khoảng thời gian bằng cách sử dụng nhiều bộ xử lý hơn. Kịch bản này được gọi là mở rộng yếu (weak scaling).
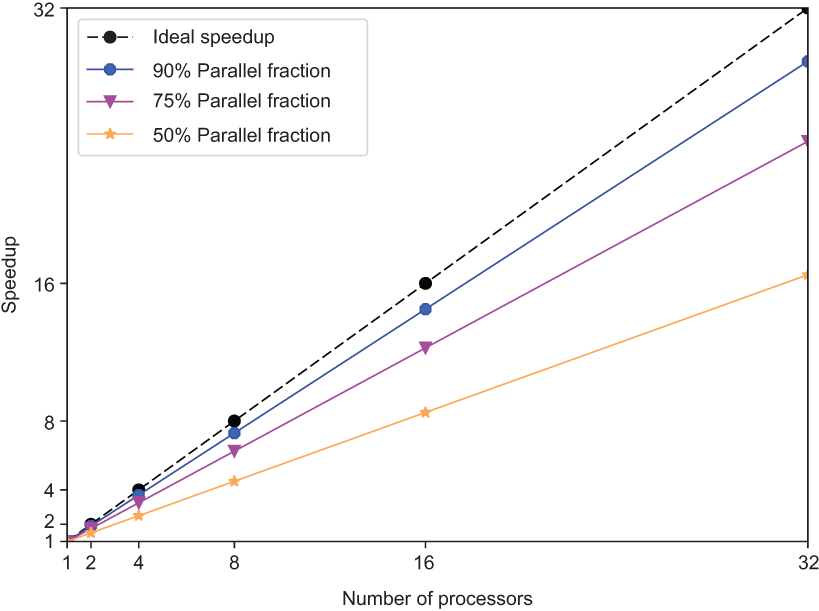
Định nghĩa: Weak scaling đại diện cho thời gian tìm ra lời giải so với số lượng bộ xử lý cho một kích thước vấn đề cố định trên mỗi bộ xử lý.
Giả sử ta có 1 giờ để dọn dẹp và ta có một số lượng nhân công tùy ý.
Phân tích:
Kết luận: Ta không làm sạch 1 căn phòng nhanh gấp 10 lần (vì vẫn vướng 5 phút họp), nhưng ta đã giải quyết được một khối lượng công việc lớn gấp nhiều lần trong cùng một quỹ thời gian 1 giờ.
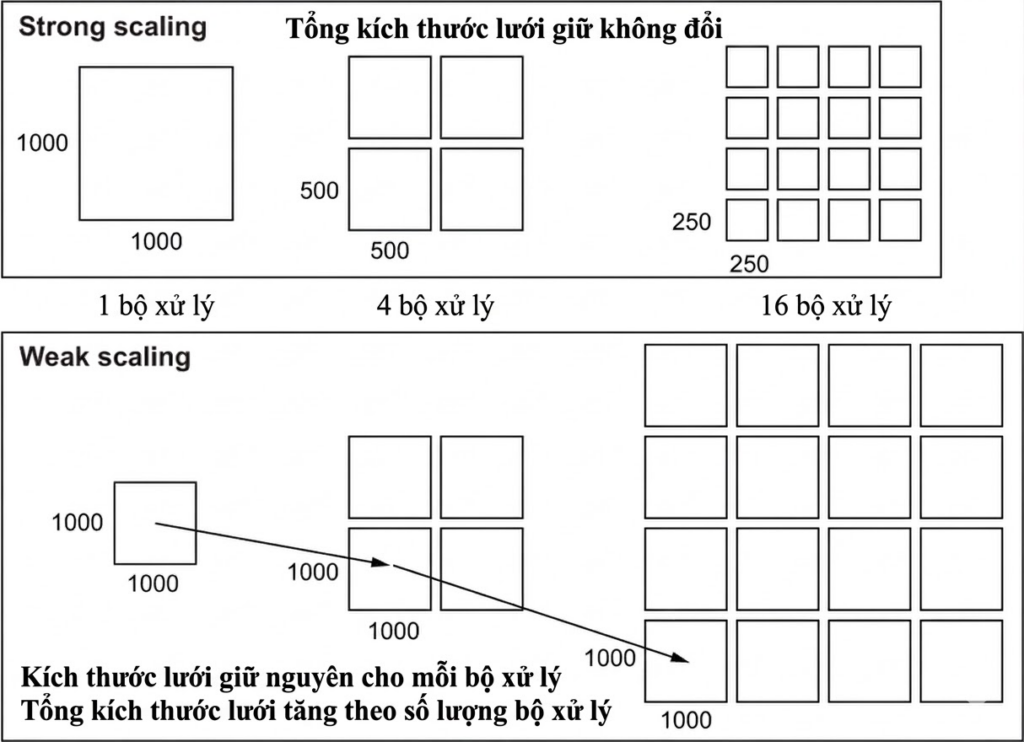
Trong thực tế, cả hai đều quan trọng vì chúng giải quyết các kịch bản khác nhau. Thuật ngữ khả năng mở rộng (scalability) thường được dùng để chỉ việc liệu có thể thêm tính song song vào phần cứng hoặc phần mềm hay không, và liệu có giới hạn tổng thể cho sự cải thiện đó hay không.
Mặc dù đa số mọi người quan tâm vào thời gian chạy, nhưng khả năng mở rộng bộ nhớ thường quan trọng hơn.
Giả sử ta vận hành một hệ thống siêu thị gồm 4 chi nhánh (tương đương 4 bộ xử lý – Proc). Để hệ thống hoạt động, mỗi chi nhánh cần quản lý hai loại dữ liệu sau:
Từ ví dụ trên, ta chuyển dịch sang các thuật ngữ chuyên môn trong hình ảnh:
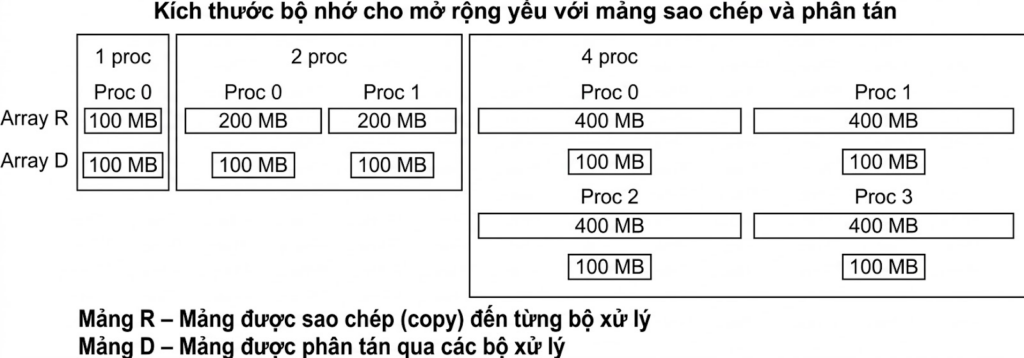
Hãy nhìn lại thông số trong hình:
Mảng D (Phân tán): Khi quy mô bài toán tăng gấp 4 (từ 100 MB lên 400 MB tổng cộng) và số Proc tăng lên 4, lượng dữ liệu mảng D mà mỗi Proc phải xử lý vẫn giữ nguyên là 100 MB. Đây là trạng thái mở rộng lý tưởng.
Mảng R (Sao chép): Vì tính chất phải sao chép toàn bộ, khi kích thước bài toán tăng lên 400 MB, mọi Proc đều phải chứa đủ 400 MB.
Nếu máy chỉ có 450MB RAM, thì coi như bây giờ ta vẫn luôn có một giới hạn trên cho việc tăng số lượng process là các dữ liệu bắt buộc phải copy tại mọi máy. Dù ta có mua thêm 100 hay 1000 máy nữa cũng vô dụng, vì mỗi cái máy đơn lẻ đó đều không đủ RAM để chứa mảng R đang phình to.
Tính toán song song đòi hỏi sự kết hợp giữa hiểu biết về phần cứng, phần mềm và tính song song để phát triển ứng dụng. Với một số khái niệm như (CPU/Process/Thread/…) nếu bạn chưa biết, phần này sẽ được đề cập sơ lược qua ở các phần sau khi đi sâu hơn.
Ta thấy rằng giữa mã nguồn và phần cứng, ứng dụng phải đi qua các lớp bổ sung, bao gồm trình biên dịch (compiler) và hệ điều hành (OS).
Chúng ta phân loại các phương pháp tiếp cận song song có thể thực hiện thành:
Chúng ta sẽ sử dụng phương pháp song song hóa dữ liệu (data parallel) trên một lưới không gian hai chiều (2D). Ví dụ minh họa là hình ảnh 2D của núi lửa Krakatau
Để hiểu tại sao chúng ta cần những khái niệm này, hãy đi từ bài toán thực tế: Dự báo sóng thần sau khi núi lửa Krakatau phun trào.
Trước khi tính toán chi tiết, ta phải chia nhỏ miền vấn đề thành các mảnh nhỏ, quá trình này gọi là rời rạc hóa (discretization). Trong xử lý ảnh, đây chính là các pixel. Trong mô phỏng, chúng được gọi là các ô (cells) hoặc phần tử (elements).
Nước biển là một khối liền mạch. Nhưng máy tính chỉ có thể lưu trữ dữ liệu dưới dạng các con số riêng biệt trong bộ nhớ (RAM).
Hãy tưởng tượng tại giây thứ 1, ô A có sóng cao 10m, ô B bên cạnh có sóng cao 0m.
Nếu ta chỉ tính toán “cô lập” (chỉ nhìn vào ô B mà không nhìn xung quanh), máy tính sẽ thấy ô B đang là 0m và mãi mãi là 0m. Nó không hề biết có một con sóng cực lớn ngay bên cạnh sắp ập đến.
Để biết tương lai của một vị trí (ô trung tâm), ta bắt buộc phải xem xét tình trạng của các vị trí xung quanh (lân cận). Đây chính là sự tương tác vật lý.
Các phép tính trên dữ liệu rời rạc này thường ở dạng toán tử khuôn mẫu (stencil operation). Nó được gọi như vậy vì nó liên quan đến một mẫu các ô lân cận để tính toán giá trị mới cho ô trung tâm.
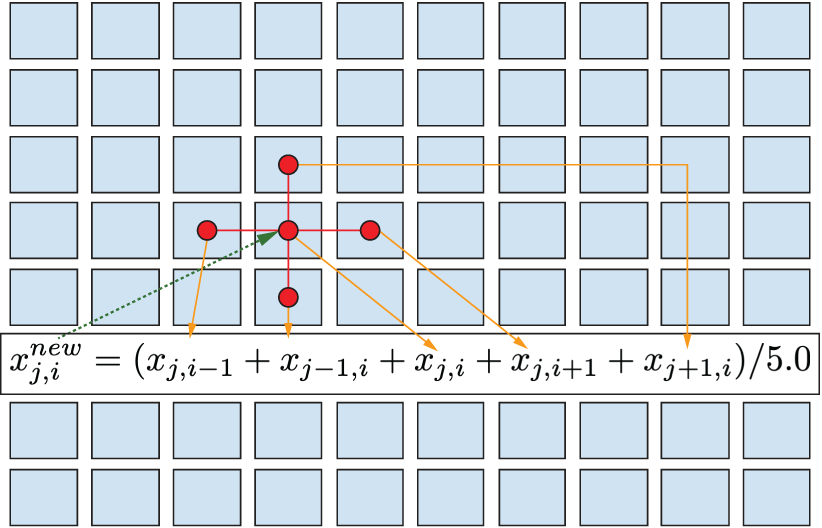
Mô phỏng sự thay đổi (Wave Propagation): Trong bài toán Krakatau, việc dùng Stencil giúp máy tính tính toán sự lan truyền. Sóng từ ô này truyền sang ô kia qua từng bước thời gian.
Chúng ta bắt đầu giới thiệu tính song song bằng cách nhìn vào Vector hóa (Vectorization). Một số bộ vi xử lý có khả năng thao tác trên nhiều mảnh dữ liệu cùng một lúc; khả năng này được gọi là các thao tác vector.
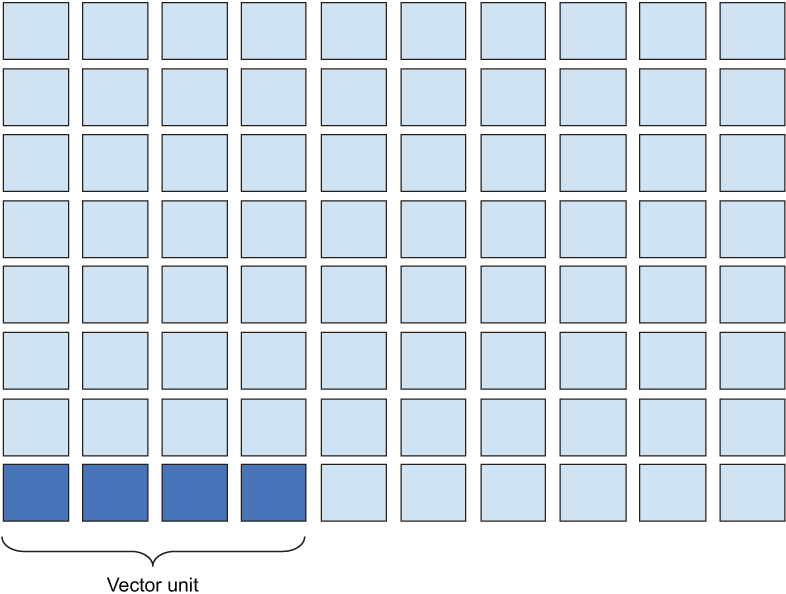
Vì hầu hết các CPU ngày nay có ít nhất 4 lõi xử lý, chúng ta sử dụng đa luồng (threading) để vận hành các lõi đồng thời trên bốn hàng cùng một lúc.
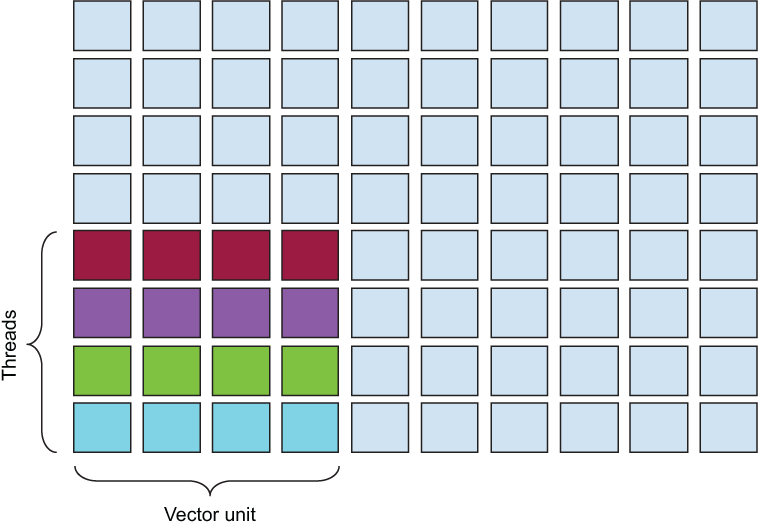
Chúng ta có thể chia nhỏ công việc hơn nữa giữa các bộ vi xử lý trên hai máy tính để bàn, thường được gọi là các nút (nodes) trong xử lý song song. Khi công việc được chia tách giữa các nút, không gian bộ nhớ cho mỗi nút là riêng biệt và độc lập.
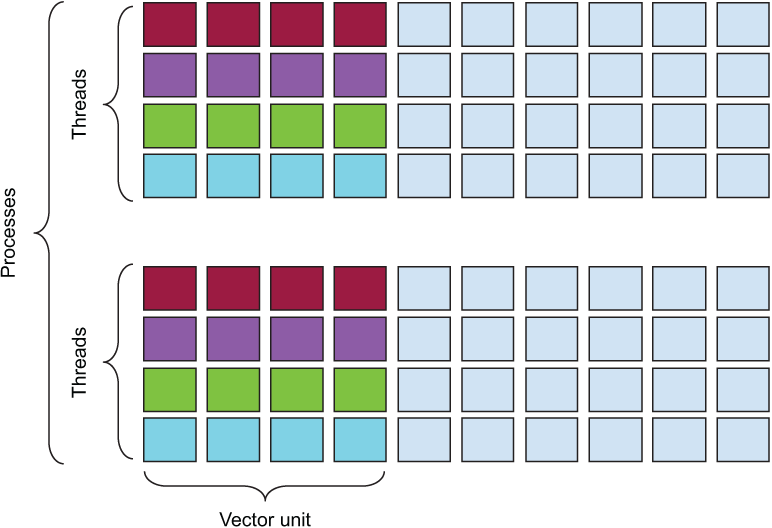
Ngay cả với kịch bản phần cứng khiêm tốn này, tiềm năng tăng tốc đã là 32 lần.
Để hiểu cách tính toán song song vận hành, chúng ta cần nắm rõ các thành phần phần cứng:
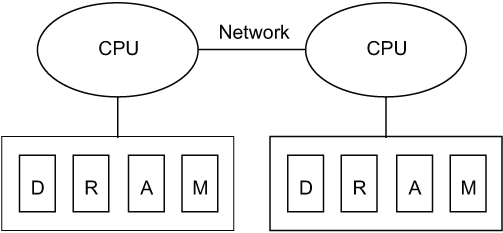
Một trong những hướng tiếp cận đầu tiên và có khả năng mở rộng cao là một hệ thống bộ nhớ phân tán. Mỗi CPU thì sẽ có bộ nhớ riêng (DRAM) và kết nối với CPU khác. Có thể thấy kiến trúc này cho phép ta thêm nhiều node CPU hơn không giới hạn, do các memory của CPU đều độc lập.
Tradeoff của cách tiếp cận này là lập trình viên phía trên có thể phải tự quản lý, phân chia vùng nhớ bên dưới ngay từ đầu.
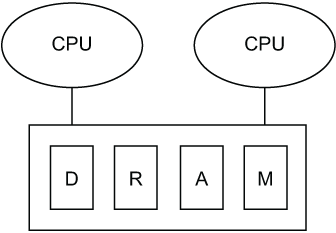
Một hướng tiếp cận khác là kết nối 2 CPU trực tiếp vào 1 vùng nhớ chung. Cách này cho phép nhiều CPU có chung một vùng địa chỉ bộ nhớ, giúp lập trình đơn giản hơn. Hiển nhiên nó cũng đi kèm tradeoff như rủi ro về xung đột bộ nhớ, ví dụ như 2 chương trình trên 2 CPU tranh chấp tài nguyên trên cùng 1 địa chỉ, ảnh hưởng đến độ chính xác hay hiệu năng. Việc đồng bộ các thao tác truy cập giá trị của bộ nhớ giữa các CPU có thể sẽ khá phức tạp và tốn kém.
Như đã nói ở đầu bài, ta không thể đơn giản là tăng tần số xung nhịp (clock frequency) của bộ vi xử lý để đạt được năng suất xử lý (throughput) cao hơn như cách ta đã làm trong quá khứ nữa. Trở ngại lớn nhất trong việc tăng tần số xung nhịp CPU là việc này đòi hỏi nhiều điện năng hơn và sinh ra nhiều nhiệt hơn.
1. Khái niệm Xung nhịp (Clock Frequency) và Chu kỳ (Cycle): Mọi tính toán trong CPU được điều phối bởi một bộ dao động thạch anh. Mỗi “nhịp” (tick) là một cơ hội để các bóng bán dẫn (transistor) chuyển trạng thái (đóng/mở) để xử lý dữ liệu.
2. Công thức Năng lượng tiêu thụ (The Power Wall):
Dù đó là một trung tâm siêu máy tính (HPC) với những giới hạn về hệ thống đường dây điện lắp đặt, hay là chiếc điện thoại di động của ta với dung lượng pin hữu hạn, tất cả các thiết bị ngày nay đều đối mặt với những giới hạn về năng lượng.
Điện năng tiêu thụ của một chip bán dẫn (P) tỷ lệ thuận với điện dung (C), bình phương điện áp (V^2) và tần số xung nhịp (f):
Khi ta tăng tần số (f), ta buộc phải tăng điện áp (V) để duy trì tính ổn định của tín hiệu điện. Vì V được bình phương, lượng nhiệt sinh ra tăng theo hàm mũ. Đến một ngưỡng nhất định, chúng ta không thể tản nhiệt kịp cho chip mà không làm nó nóng chảy. Đây gọi là Bức tường năng lượng (Power Wall).
Kết luận: Vì không thể làm cho một “nhịp” chạy nhanh hơn mãi mãi, kiến trúc sư máy tính buộc phải tìm cách làm được nhiều việc hơn trong cùng một nhịp.
Thay vì tăng tần số xung nhịp, tại sao ta không thực hiện nhiều hơn một hoạt động (operation) trong mỗi chu kỳ (cycle)? Đây chính là ý tưởng cốt lõi đằng sau cơ chế vector hóa trên nhiều dòng bộ vi xử lý hiện nay.
1. Xử lý Vô hướng (Scalar Processing – SISD): Trong kiến trúc truyền thống (Single Instruction, Single Data – SISD), mỗi chỉ thị (Instruction) chỉ tác động lên một cặp dữ liệu duy nhất.
Xử lý Vector (Vector Processing – SIMD): Vectorization dựa trên mô hình SIMD (Single Instruction, Multiple Data) – Một chỉ thị duy nhất điều khiển nhiều luồng dữ liệu cùng lúc.
ADD (Cộng) được phát ra, Vector Unit sẽ kích hoạt nhiều ALU song song để cộng toàn bộ các cặp số đó trong đúng một chu kỳ xung nhịp.Việc viết mã để tận dụng SIMD rất phức tạp vì nó phụ thuộc vào kiến trúc tập lệnh của từng loại CPU (như AVX-512 của Intel hay NEON của ARM).
#pragma omp simd) có thể được chèn vào mã nguồn để ra lệnh cho trình biên dịch: “Tôi xác nhận đoạn mã này an toàn, hãy vector hóa nó”. Nếu không có các chỉ dẫn này, trình biên dịch thường chọn phương án an toàn là chạy tuần tự để tránh sai sót dữ liệu.Nếu Vector tốt như vậy, tại sao chúng ta vẫn cần Scalar và tại sao không chạy mọi thứ song song trên vector?
Sự phụ thuộc dữ liệu (Data Dependency):
Cơ chế Vector chỉ hoạt động khi các phép tính độc lập với nhau.
Cấu trúc dữ liệu không liên tục (Non-contiguous Memory): Để Vector Unit hoạt động hiệu quả, dữ liệu phải nằm sát nhau trong bộ nhớ (Memory) để nạp vào thanh ghi rộng một cách nhanh chóng. Nếu dữ liệu nằm rải rác, CPU mất nhiều thời gian để thu thập (Gather), làm triệt tiêu lợi thế về tốc độ.
Chi phí phần cứng và Độ phức tạp: Mở rộng Vector Unit (ví dụ lên 2048-bit) đòi hỏi một diện tích chip khổng lồ cho các thanh ghi và các đường dẫn dữ liệu. Nó cũng làm cho bộ tập lệnh (ISA) trở nên cực kỳ phức tạp cho các trình biên dịch (Compiler) để tối ưu hóa.
Hầu hết các CPU và GPU hiện đại đều có khả năng vector hóa hoặc các cơ chế hoạt động tương đương. Lượng dữ liệu được xử lý trong một chu kỳ xung nhịp được gọi là độ dài vector (vector length). Độ dài này phụ thuộc trực tiếp vào kích thước vật lý của các đơn vị vector có trên bộ vi xử lý.
Hiện nay, độ dài vector phổ biến nhất là 256-bit. Nếu dữ liệu đã được rời rạc hóa là các số thực dấu phẩy động 64-bit (kiểu double), thì ta có thể thực hiện đồng thời bốn phép toán dấu phẩy động dưới dạng một hoạt động vector đơn nhất (256 / 64 = 4).
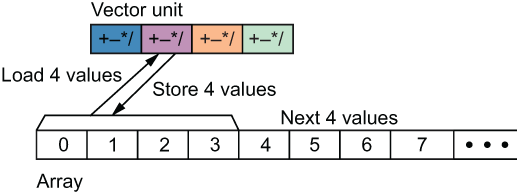
Các đơn vị phần cứng vector sẽ:
Thiết bị tăng tốc (accelerator device) là một thành phần phần cứng rời rạc được thiết kế để thực thi các tác vụ cụ thể với tốc độ cao. Thiết bị tăng tốc phổ biến nhất hiện nay là GPU (Graphics Processing Unit – Đơn vị xử lý đồ họa). Khi được sử dụng cho mục đích tính toán thuần túy thay vì hiển thị hình ảnh, thiết bị này đôi khi được gọi là GPGPU (General-Purpose Graphics Processing Unit – Đơn vị xử lý đồ họa đa mục đích).
GPU chứa rất nhiều lõi xử lý nhỏ, được gọi là các bộ đa xử lý luồng (Streaming Multiprocessors – SMs). Mặc dù cấu trúc của một SM đơn giản hơn so với một lõi CPU, nhưng tổng hợp lại, các SM cung cấp một sức mạnh xử lý khổng lồ. Thông thường, ta sẽ tìm thấy một GPU tích hợp (integrated GPU) có kích thước nhỏ nằm ngay bên trong CPU.
Hầu hết các máy tính hiện đại còn sở hữu một GPU rời (discrete GPU) riêng biệt, kết nối với CPU thông qua bus PCI (Peripheral Component Interface). Việc sử dụng bus này làm phát sinh chi phí kết nối giữa CPU và GPU (communication cost) đối với dữ liệu và các chỉ lệnh. Tuy nhiên, các card đồ họa rời thường mạnh mẽ hơn nhiều so với các đơn vị tích hợp sẵn, do chúng được thiết kế cho một mục đích rõ ràng hơn, và có nhiều không gian phát triển hơn.
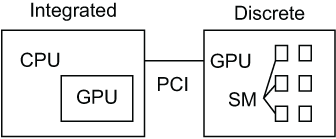
Trong các hệ thống cao cấp, các nhà sản xuất đã phát triển các công nghệ kết nối riêng để giảm thiểu chi phí truyền tải dữ liệu này, ví dụ:
Bây giờ, ta hãy kết hợp tất cả các kiến trúc phần cứng khác nhau đã nêu vào một mô hình thống nhất. Trong mô hình này, hai nút (nodes) mỗi nút sở hữu hai CPU cùng chia sẻ bộ nhớ DRAM.
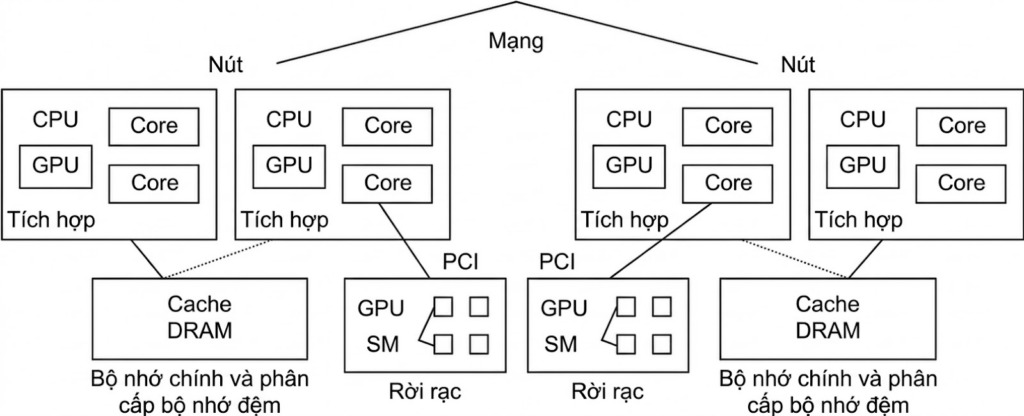
Phần mềm dành cho tính toán song song nhất thiết phải dựa trên cấu trúc phần cứng bên dưới, tuy nhiên nó vẫn là một thực thể tách biệt với phần cứng. Hệ điều hành (OS) đóng vai trò là giao diện trung gian kết nối giữa hai thực thể này.
Ta cần lưu ý rằng các hoạt động song song không tự nhiên phát sinh; thay vào đó, mã nguồn phải chỉ định rõ cách thức song song hóa công việc. Điều này thực hiện thông qua việc:
Trước hết ta nên xác định các thành phần có thể song song hóa, quyết định kỹ thuật tối ưu nhất để vận hành song song. Dưới đây là bốn kỹ thuật phổ biến nhất:
Khi ta chạy một chương trình, Hệ điều hành (OS) tạo ra một Tiến trình. Một tiến trình không chỉ là mã nguồn; nó là một thực thể bao gồm:
Trong các hệ điều hành hiện đại, Tiến trình A không thể đọc hoặc ghi vào bộ nhớ của Tiến trình B. Đây là một tính năng bảo mật và ổn định. Nếu Tiến trình A bị lỗi (crash), nó không làm ảnh hưởng đến dữ liệu của Tiến trình B.
Vấn đề: Nếu ta muốn chia một bài toán lớn (ví dụ: nhân hai ma trận khổng lồ) cho 10 tiến trình cùng làm, làm sao Tiến trình 1 gửi kết quả bán thành phẩm cho Tiến trình 2 khi bộ nhớ của chúng hoàn toàn tách biệt?
Giải pháp: Cần một cơ chế để “copy” dữ liệu từ không gian bộ nhớ này sang không gian bộ nhớ khác. Đó chính là lý do Message Passing (Chuyển tin nhắn) ra đời.
Tại sao không cho các tiến trình dùng chung bộ nhớ? Vì giới hạn vật lý của phần cứng.
Trong kiến trúc phân tán, CPU ở Node A tuyệt đối không có cách nào chạm tới thanh RAM ở Node B về mặt vật lý. Cách duy nhất là đóng gói dữ liệu thành một Tin nhắn (Message) và gửi qua dây dẫn mạng.

Trong mô hình này, ứng dụng của ta sẽ khởi tạo các tiến trình riêng biệt, được gọi là các ranks trong thuật ngữ chuyển tin nhắn. Mỗi tiến trình này có không gian bộ nhớ riêng và đường ống chỉ lệnh (instruction pipeline) riêng biệt.
Khi chạy một ứng dụng song song dùng MPI, ta khởi tạo N bản sao của cùng một chương trình.
Quá trình gửi tin nhắn diễn ra qua hai tầng:
MPI_Send(dữ liệu).Thực tế 1 tiến trình không luôn chạy trên 1 lõi cố định.
Hiện tượng Context Switching (Chuyển đổi ngữ cảnh): Nếu ta có 4 lõi nhưng chạy 8 tiến trình, OS sẽ cho mỗi tiến trình chạy khoảng vài miligiây, sau đó tạm dừng (lưu trạng thái vào RAM), và nạp tiến trình khác vào lõi. Việc này diễn ra liên tục, tạo cảm giác 8 tiến trình chạy song song, nhưng thực tế chúng đang “chia sẻ” thời gian của lõi.
Trong tính toán hiệu năng cao (HPC), người ta thường dùng kỹ thuật Binding (Ràng buộc): Ép chặt Rank 0 vào Core 0, Rank 1 vào Core 1 để tránh lãng phí thời gian chuyển đổi ngữ cảnh của OS.
Mặc dù cả hai đều dùng nhiều thực thể tính toán, chúng khác nhau về mức độ kết nối (Coupling).
| Đặc điểm | Tính toán Song song (MPI) | Tính toán Phân tán (P2P, Web) |
| Mục tiêu | Tối ưu tốc độ hoàn thành 1 tác vụ đơn lẻ. | Tối ưu độ tin cậy và khả năng phục vụ từ xa. |
| Giao tiếp | Tightly-coupled (Kết nối chặt): Các tiến trình phụ thuộc nhau rất lớn, tốc độ mạng cực nhanh (micro-giây). | Loosely-coupled (Kết nối lỏng): Các tiến trình độc lập hơn, có thể nằm cách xa nhau địa lý, chịu được độ trễ mạng cao. |
| Cơ chế | Sử dụng thư viện chuyên dụng như MPI. | Sử dụng các giao thức hệ thống như RPC (Remote Procedure Call) hoặc IPC (Inter-process communication) qua mạng. |
Ví dụ: Trong dự án, máy tính nhận một khối dữ liệu, xử lý trong 1 tiếng, sau đó gửi kết quả về máy chủ. Nếu máy tắt đột ngột, hệ thống vẫn chạy bình thường. Trong MPI, nếu một Rank bị lỗi, thường toàn bộ ứng dụng song song sẽ dừng lại để đảm bảo tính toàn vẹn dữ liệu.
Khi ta chạy một chương trình (process), hệ điều hành cấp cho nó một không gian bộ nhớ riêng biệt (Address Space). Không gian này chứa mã lệnh, dữ liệu và các tài nguyên khác.
Việc khởi tạo một Tiến trình mới rất tốn kém về tài nguyên hệ thống vì hệ điều hành phải cấp phát một vùng nhớ hoàn toàn độc lập. Luồng ra đời để giải quyết vấn đề này. Một luồng là một đơn vị thực thi nhỏ nhất nằm bên trong một tiến trình.
x và luồng B có thể đọc giá trị đó ngay lập tức mà không cần qua các bước chuyển giao dữ liệu phức tạp. Tuy nhiên điều này cũng tạo ra 1 vấn đề mới.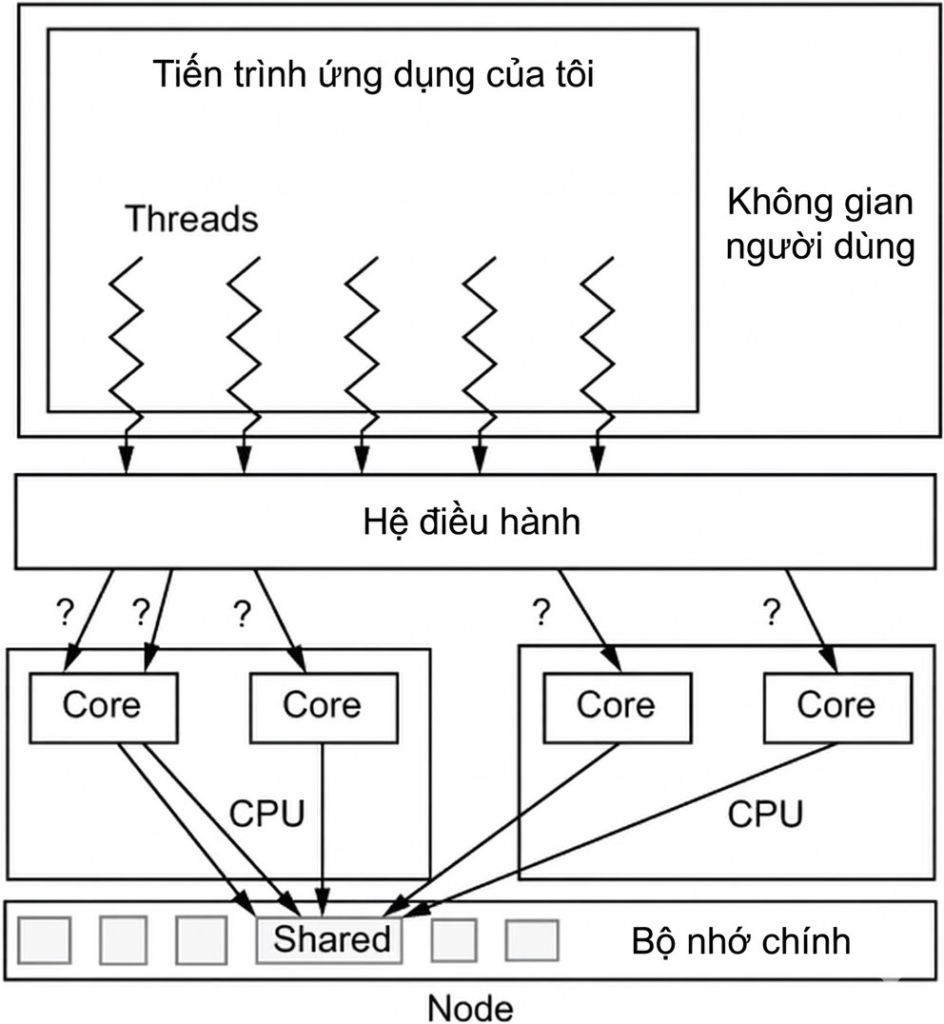
Khi hai luồng cùng truy cập và sửa đổi một vùng nhớ đồng thời, kết quả cuối cùng phụ thuộc vào việc luồng nào chạy nhanh hơn (Race Condition). Đây là lỗi logic cực kỳ khó phát hiện. Để xử lý, thông thường cần tới các cơ chế đồng bộ hóa (như locks hoặc barriers) để đảm bảo tại một thời điểm chỉ một luồng được thay đổi dữ liệu quan trọng.
Xử lý luồng (Stream processing) là một khái niệm về luồng dữ liệu (dataflow), trong đó một luồng dữ liệu được xử lý bởi một bộ vi xử lý chuyên dụng có cấu tạo đơn giản hơn. Kỹ thuật này từ lâu đã được sử dụng trong tính toán nhúng, sau đó được điều chỉnh để kết xuất các tập hợp vật thể hình học lớn cho màn hình máy tính trong một bộ vi xử lý chuyên dụng là GPU.
Các GPU này được thiết kế với một tập hợp rộng các phép toán số học và nhiều bộ đa xử lý luồng (SMs) để xử lý dữ liệu hình học song song. Vậy cụ thể GPU đã làm gì để thực hiện tốt hơn?
Trước hết xem xét ở kiến trúc CPU, một lệnh (instruction) đi vào CPU được chia thành các giai đoạn (Stages):
Các mạch này có thực hiện việc nối đầu mạch. Ta thấy nếu chạy theo tuần tự:
Để tối ưu (Pipelining): Khi lệnh số 1 chuyển sang Mạch B, CPU lập tức đẩy lệnh số 2 vào Mạch A. Mục tiêu là để tất cả các mạch A, B, C, D đều có việc để làm trong mỗi chu kỳ xung nhịp.
Hiện tượng này xảy ra khi một mạch ở phía sau không thể thực hiện việc của mình vì nó thiếu thông tin từ mạch phía trước. Tuy nhiên tại 1 số thời điểm, hiện tượng Stall có thể xảy ra
Giả sử ta có 2 lệnh:
Lệnh 1: X = 5 + 5Lệnh 2: Y = X * 2Tiến trình trong đường ống:
5+5 cho Lệnh 1 | Mạch B giải mã Lệnh 2.
X. Nhưng lúc này Mạch C mới đang tính X, chưa có kết quả cuối cùng.Giả sử có lệnh điều kiện: Nếu (A > B) thì nhảy đến Lệnh X, nếu không thì chạy tiếp Lệnh Y.
Lệnh Y.Nếu (A > B) đi đến giai đoạn Execute (Mạch C), CPU mới biết kết quả là đúng hay sai.Để tối ưu, CPU sử dụng một bộ phận gọi là Branch Predictor (dựa trên lịch sử các lần chạy trước) để “đoán” xem nhánh nào sẽ được chọn và nạp sẵn các lệnh của nhánh đó vào đường ống. Nếu đoán sai, CPU buộc phải hủy toàn bộ các lệnh đã nạp nhầm, xóa sạch đường ống (Pipeline Flush) và bắt đầu lại từ điểm rẽ nhánh đúng.
Ngoài ra CPU cũng thực hiện Out-of-order Execution (OoOE – Thực thi ngoài tuần tự). Trong một chương trình, các lệnh thường có sự phụ thuộc lẫn nhau.
A = Lấy dữ liệu từ RAM (Mất 200 nhịp)B = A + 5 (Phụ thuộc vào A)C = 10 * 2 (Không phụ thuộc vào A hay B) Nếu chạy tuần tự, lệnh số 3 phải đợi lệnh số 1 và 2 hoàn thành, dù nó chẳng liên quan gì. CPU sẽ đứng im chờ dữ liệu từ RAM.Ngược lại, GPU được thiết kế cho Parallelism (Song song hóa), không phải Latency (Độ trễ).
GPU sử dụng cơ chế Hardware Multithreading. Nếu một nhóm nhân (thread) đang chờ dữ liệu từ RAM, GPU ngay lập tức tráo một nhóm nhân khác vào để tính toán. Nó không cố gắng làm một lệnh chạy nhanh hơn, nó chỉ cố gắng làm nhiều lệnh nhất có thể cùng lúc.
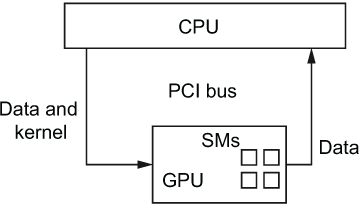
Dữ liệu và hạt nhân tính toán (kernel) được hiển thị là được chuyển giao (offloaded) qua bus PCI sang GPU để tính toán. GPU vẫn còn hạn chế về chức năng so với CPU, nhưng ở những nơi có thể sử dụng các chức năng chuyên dụng này, chúng cung cấp khả năng tính toán phi thường với yêu cầu năng lượng thấp hơn. Các bộ vi xử lý chuyên dụng khác cũng thuộc danh mục này, mặc dù ta sẽ tập trung chủ yếu vào GPU trong các cuộc thảo luận của mình.
Trong quá trình tìm hiểu về tính toán song song, ta sẽ bắt gặp các từ viết tắt như SIMD (một chỉ lệnh, nhiều dữ liệu) và MIMD (nhiều chỉ lệnh, nhiều dữ liệu). Những thuật ngữ này thuộc về các danh mục kiến trúc máy tính do Michael Flynn đề xuất vào năm 1966, được biết đến với tên gọi Phân loại của Flynn (Flynn’s Taxonomy).
Hệ thống phân loại này giúp ta nhìn nhận khả năng mà có thể song song hóa trong các kiến trúc theo những cách khác nhau. Việc phân loại dựa trên việc chia nhỏ các chỉ lệnh (instructions) và dữ liệu (data) thành các hoạt động tuần tự hoặc song song
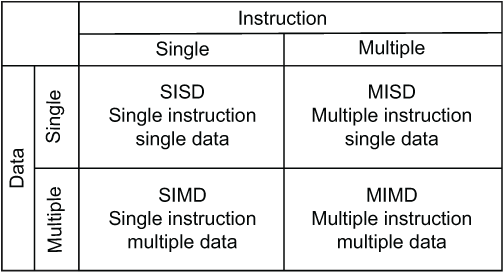
Cần lưu ý rằng mặc dù hệ thống phân loại này rất hữu ích, một số kiến trúc và thuật ngữ toán (algorithms) không khớp hoàn toàn vào một danh mục nhất định. Sự hữu dụng của nó nằm ở việc giúp ta nhận diện các đặc điểm của từng loại, chẳng hạn như danh mục SIMD thường gặp khó khăn với các câu lệnh điều kiện (conditionals). Nguyên nhân là vì mỗi mục dữ liệu có thể muốn thực thi một khối mã khác nhau, nhưng tất cả các luồng lại bắt buộc phải thực thi cùng một chỉ lệnh.
Ở ví dụ trước đó về núi lửa, ta đã xem xét việc song song hóa dữ liệu cho các ô lưới (cells) hoặc điểm ảnh (pixels). Tuy nhiên, song song hóa dữ liệu còn có thể áp dụng cho các hạt (particles) và các đối tượng dữ liệu khác.
Đây là cách tiếp cận phổ biến nhất và thường là đơn giản nhất. Về cơ bản, mỗi tiến trình thực thi cùng một chương trình nhưng vận hành trên một tập con dữ liệu duy nhất, như được minh họa:
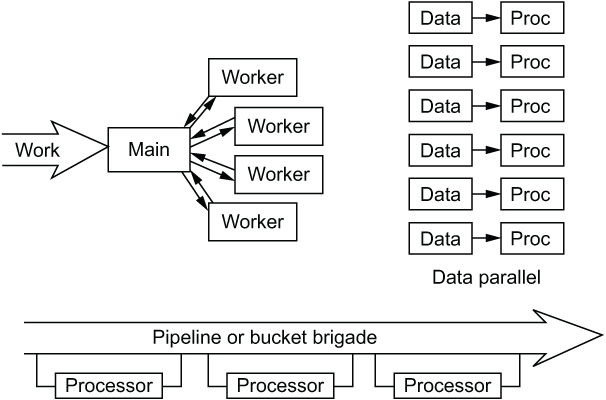
Ưu điểm của song song hóa dữ liệu là khả năng mở rộng tốt khi kích thước vấn đề và số lượng bộ vi xử lý tăng lên.
Một cách tiếp cận khác là song song hóa tác vụ. Các chiến lược này bao gồm:
Ta cũng có thể kết hợp các chiến lược song song khác nhau để khai thác mức độ song song hóa lớn hơn cho ứng dụng.
Khi chúng ta hình dung về “một chiếc máy tính” ngày nay, chúng ta có lẽ sẽ nghĩ đến một thiết bị như máy tính để bàn (PC), máy chơi game cầm tay hoặc điện thoại thông minh. Nhưng đó không phải là những cỗ máy duy nhất mà con người từng sử dụng để tính toán và điện toán.
Để truy vết lịch sử của máy tính, trước tiên chúng ta cần quyết định xem cái gì được coi là máy tính và máy tính khác với những chiếc máy tính bỏ túi hoặc máy tính toán thuần túy như thế nào. Đây là một câu hỏi khó đến ngạc nhiên
Hãy cùng xem xét thêm một số khái niệm thường được đề xuất để định nghĩa máy tính. Từ điển tiếng Anh Oxford, yêu cầu máy tính phải là thiết bị điện tử. Nhưng những cỗ máy tương tự có thể được làm từ các chất nền (vật liệu) khác, chẳng hạn như nước
MONIAC, viết tắt của Monetary National Income Analogue Computer được chế tạo vào năm 1949, MONIAC là một máy tính được sử dụng để mô phỏng dòng tiền chạy qua nền kinh tế và để minh họa các tác động của các can thiệp kinh tế lên một mô hình kinh tế.
Một số người lập luận rằng máy tính phải là kỹ thuật số (digital), trái ngược với tương tự (analog). Một cỗ máy kỹ thuật số là cỗ máy biểu diễn dữ liệu bằng các chữ số, các tập hợp ký hiệu rời rạc như các chữ số nhị phân 0 và 1. Ngược lại, một cỗ máy tương tự có một tập hợp vô hạn, liên tục các trạng thái có thể xảy ra, chẳng hạn như lượng nước trong các bể của MONIAC, khiến MONIAC trở thành một cỗ máy tương tự.
Trong lý thuyết tính toán, chúng ta có Luận thuyết Church (Church’s thesis), một định nghĩa khắt khe hơn về máy tính mà hầu hết các nhà khoa học máy tính hiện đại đều đồng ý. Nó có thể được diễn giải như sau:
Một máy tính là một cỗ máy có thể mô phỏng bất kỳ cỗ máy nào khác, với điều kiện được cung cấp bao nhiêu bộ nhớ tùy ý.
Hiện tại các máy tính rõ ràng tồn tại để có thể thực hiện những việc sau, vì vậy một máy tính theo luận thuyết Church cũng phải có khả năng thực hiện các tác vụ này:
goto).if).
Vào khoảng những năm 40000 TCN,người ta tìm thấy xương Lebombo, một mảnh xương với các khía khắc có thể đã được sử dụng như một chiếc gậy tính. Một vạch đại diện cho một vật thể vật lý, có thể trong thời kì này, nó dùng cho đếm động vật, các mặt hàng thực phẩm hoặc các ngày để tính thời gian cho một cuộc săn bắn nào đó.
Xương Lebombo là một ví dụ về biểu diễn dữ liệu. Nó có thể đã được sử dụng cho một hình thức tính toán đơn giản như cộng thêm một vào tổng mỗi khi một dấu vết mới được tạo ra.
Khoảng những năm 4000 TCN, các thành phố đầu tiên bắt đầu phát triển. Các thành phố đòi hỏi những hành vi/tổ chức ở quy mô lớn hơn, ví dụ như theo dõi việc giao thương và thuế. Vào năm 3000 TCN, văn hóa thành phố Sumer ở Lưỡng Hà (Iraq ngày nay) đã phát triển hệ thống chữ viết đầu tiên, và đến năm 2500 TCN, họ đã sở hữu chiếc máy tính toán đầu tiên: bàn tính (abacus)
Bàn tính đang biểu diễn 070710678
Trong cách sử dụng thông thường, trạng thái của bàn tính biểu diễn số (thập phân, tự nhiên).
Có chín cột, mỗi cột đại diện cho một trong các chữ số trong số này. Mỗi cột được chia thành một hộp dưới chứa năm hạt và một hộp trên chứa hai hạt. Vị trí mặc định của các hạt ở hộp dưới là ở dưới, và vị trí mặc định của các hạt ở hộp trên là ở trên.
Ở trạng thái này, một cột biểu thị chữ số 0. Mỗi hạt được đẩy từ dưới lên trên của hộp dưới có giá trị là 1. Mỗi hạt được đẩy từ trên xuống dưới của hộp trên có giá trị là 5.
Để cộng 1 vào một số trên bàn tính (tức là tăng nó lên), bạn nâng một hạt từ hộp dưới của cột ngoài cùng bên phải. Nếu tất cả năm hạt trong hộp dưới của một cột đã được nâng lên, bạn đẩy tất cả chúng xuống lại và thay thế chúng bằng cách hạ một trong các hạt ở hộp trên trong cùng cột đó. Nếu cả hai hạt trên đều đã hạ xuống, bạn đẩy chúng ngược lên và thay thế chúng bằng cách nâng một hạt từ hộp dưới ở cột bên trái của nó. Việc chuyển dữ liệu từ một cột sang cột bên trái của nó được gọi là phép toán nhớ. (Giống như việc xét chữ số của 1 số từ phải sang trái, thì mỗi hàng đơn vị ta x 10 vậy)
Để cộng hai số, a + b, trước tiên bạn thiết lập bàn tính để biểu diễn các chữ số của a. Sau đó, bạn thực hiện b lần tăng như trên. Trạng thái của bàn tính khi đó biểu diễn kết quả.
Kiểu tính toán này, nơi số thứ nhất được “nạp vào” thiết bị và số thứ hai được “cộng thêm vào” đó, để lại kết quả cuối cùng là trạng thái của hệ thống, được gọi là kiến trúc tích lũy (accumulator architecture), và nó vẫn còn được sử dụng phổ biến ngày nay. Nó “tích lũy” kết quả của một chuỗi các phép tính; ví dụ, chúng ta có thể cộng một danh sách gồm nhiều số bằng cách cộng lần lượt từng số vào trạng thái và xem tổng tích lũy mới nhất sau mỗi lần cộng.
Khoảng năm 100 TCN, xuất hiện cơ chế Antikythera. Nó được tìm thấy vào năm 1901 trong một xác tàu đắm ở Địa Trung Hải; con tàu bị đắm dường như đang trên đường từ Hy Lạp đến La Mã, mang theo cơ chế này để bán hoặc làm vật phẩm cống nạp.
Chạy bằng bánh răng cơ khí, dùng để dự đoán các sự kiện thiên văn, bao gồm vị trí của năm hành tinh, các pha của mặt trăng, thời điểm nhật thực/nguyệt thực và thời gian diễn ra Thế vận hội Olympic. Nó bao gồm 37 bánh răng bằng đồng, và người dùng sẽ quay một tay cầm để mô phỏng diễn biến tương lai của các trạng thái thiên văn. Các kết quả được hiển thị trên các mặt đồng hồ, được tính toán dựa trên tỷ số truyền của các bánh răng cơ khí.
Máy đo quãng đường (Odometers) là những cỗ máy đo khoảng cách tầm xa mà người Hy Lạp và La Mã đã sử dụng để khảo sát và lập bản đồ đế chế của họ.
Loại máy đo quãng đường này hoạt động như sau: chúng phát ra tiếng “cạch” mỗi khi được đẩy đi một khoảng cách nhất định. Chiếc máy đo này được kéo bởi một con ngựa, giống như một cỗ xe. Có một số viên bi kim loại được lưu trữ trong các hốc của một bánh răng gỗ hình tròn. Một trong các bánh xe của xe có gắn một cái chốt sao cho cứ sau mỗi vòng quay, nó lại chạm và làm xoay bánh răng một góc cố định nhỏ. Một cái lỗ có kích thước bằng viên bi nằm dưới một vị trí của bánh răng cho phép một viên bi phía trên nó rơi ra khỏi hốc và rơi vào một hộp thu thập bên dưới. Tổng quãng đường đã đi được ghi lại bằng số lượng viên bi trong hộp đếm vào cuối chuyến đi.
Những cỗ máy này có phải là máy tính không? Rõ ràng có các khái niệm về dữ liệu được sử dụng để đại diện cho các vật thể trong thế giới, cũng như các hình thức tự động hóa và tính toán. Nhưng giống như MONIAC, mỗi cỗ máy chỉ làm được một việc duy nhất: dự đoán nhật thực hoặc đo khoảng cách. Theo luận thuyết Church, ta thấy rằng các cỗ máy này không thể lập trình lại để làm 1 việc khác.

Trong nhiều năm tiếp theo, xuất hiện nhiều “máy móc” với ý tưởng phát triển từ các ý tưởng trên. Ví dụ Codex Madrid của Davinci, dùng để tính toán qua hệ thống bánh răng. Tỷ số truyền giữa mỗi cặp cột là 1:10, vì vậy bánh xe của mỗi cột sẽ quay với tốc độ bằng 1/10 so với cột bên phải của nó. Có 13 bánh xe, mỗi bánh xe đại diện cho các cột của một số thập phân
Máy Phân tích đã được thiết kế như một chiếc máy lập trình được, có mục đích hoàn toàn tổng quát (general-purpose).
Để đạt được tính tổng quát này, Máy Phân tích cung cấp một loạt các phép toán số học và các hoạt động khác dưới dạng các bộ phận máy đơn giản, cùng với một bộ nhớ để lưu trữ dữ liệu và khả năng đọc các chương trình từ thẻ đục lỗ.
Các chương trình này quy định một trình tự các thao tác đọc/ghi bộ nhớ và các phép toán số học, đồng thời cho phép rẽ nhánh tùy thuộc vào trạng thái của phép tính, tức là một câu lệnh if.
Phần lõi của Máy Phân tích chứa nhiều máy đơn giản độc lập, mỗi máy thực hiện một chức năng nhất định, chẳng hạn như cộng các số và kiểm tra xem một số có bằng một số khác hay không.
Máy Phân tích đã giới thiệu khái niệm hiện đại về bộ nhớ máy tính. Mỗi máy có thể giữ một con số khác nhau. Mỗi máy sẽ được gán một mã định danh số hoặc “địa chỉ” (address) để chỉ định chính xác máy nào cần đọc hoặc ghi.
Một chuỗi các chỉ thị (instructions) sẽ được mã hóa dưới dạng nhị phân và đục lỗ trên băng giấy. Mỗi chỉ thị sẽ ra lệnh cho cỗ máy kích hoạt một trong các máy đơn giản. Thông thường, sau mỗi chỉ thị, cỗ máy sẽ đẩy băng giấy đục lỗ theo từng dòng để tải chỉ thị tiếp theo. Tuy nhiên, cỗ máy cũng có khả năng kiểm tra kết quả của máy đơn giản vừa chạy và tùy thuộc vào giá trị đó, nó có thể nhảy đến một dòng khác trên giấy. Điều này mang lại cho các chương trình khả năng thay đổi hành vi để phản hồi lại các kết quả trung gian.
Một chương trình cũng có thể được tạo ra để chạy mãi mãi bằng cách dán phần cuối của băng giấy đục lỗ vào phần đầu của nó, tạo thành một vòng lặp vật lý, như trong máy băng giấy.
Thiết kế của nó chứa đựng tất cả các đặc điểm cơ bản của một máy tính hiện đại: CPU, bộ nhớ, bus, các thanh ghi, bộ điều khiển và đơn vị số học. Nó có thể đọc, ghi và xử lý dữ liệu. Nó có thể làm toán. Không giống như các máy tính thuần túy trước đó, nó có thể nhảy (goto) và rẽ nhánh (if), chuyển đến các chỉ thị khác nhau trong chương trình tùy theo trạng thái tính toán.
Trước khi có máy tính hiện đại, thế giới trải qua một giai đoạn “lai” gọi là Cơ – Điện (Electromechanical). Thay vì dùng bánh răng thuần túy, người ta dùng điện để điều khiển các chuyển động cơ học.
Rơ-le là linh kiện then chốt của thời kỳ này. Bạn có thể hiểu đơn giản nó là một công tắc điện được đóng/ngắt bằng một tín hiệu điện khác, thay vì dùng tay người.
Hiến pháp Hoa Kỳ yêu cầu việc điều tra dân số phải được thực hiện và xử lý sau mỗi 10 năm, và đến năm 1890, dân số đã tăng đến mức việc xử lý các số liệu thống kê bằng con người là không thể. Herman Hollerith đã thiết kế một chiếc máy để tự động hóa việc xử lý dữ liệu và sử dụng nó thành công trong kỳ điều tra dân số năm 1890 để thực hiện phân tích dữ liệu lớn trên thông tin của 62 triệu công dân. Dữ liệu của mỗi công dân được chuyển từ mẫu đơn điều tra viết tay sang một thẻ đục lỗ bởi con người. Mỗi câu hỏi trong cuộc điều tra dân số là dạng trắc nghiệm, và được mã hóa trên thẻ đục lỗ bằng cách đục bỏ một trong số các lựa chọn.
Các xấp thẻ có thể được đọc vào máy, máy sẽ kiểm tra sự hiện diện hay vắng mặt của các đặc điểm nhất định hoặc sự kết hợp của các đặc điểm. Điều này có nghĩa là chiếc máy này có khả năng tương đương với các truy vấn SQL hiện đại, bao gồm SELECT, WHERE, GROUP BY, và ORDER BY.
Thế chiến II là “lò luyện” thúc đẩy máy tính phát triển vượt bậc nhờ nhu cầu giải mã:
Khi rơ-le cơ học lộ khuyết điểm (chậm, hay bị kẹt, phát ra tiếng ồn), Bóng chân không (Vacuum Tubes/Valves) ra đời (1904).
Hãy tưởng tượng nó như một cái bóng đèn nhưng có thêm một “lưới” điều khiển ở giữa.
Hoàn thành năm 1945, ENIAC là máy tính điện tử đa năng bằng bóng chân không.
Máy ảo (Virtual Machine) đầu tiên: Nhóm lập trình viên gồm 6 phụ nữ (như Betty Jean Jennings, Frances Bilas…) đã tạo ra một bước ngoặt: Thay vì rút dây cho mỗi bài toán, họ thiết lập một cấu hình dây cố định cho phép máy đọc các lệnh từ các bảng công tắc.
Lúc này, các công tắc đóng vai trò là “phần mềm” sơ khai, điều khiển lớp “phần cứng” bên dưới. Đây chính là khái niệm máy ảo đầu tiên trong lịch sử.
Được chứng minh lần đầu bởi máy Manchester Baby (1948), đây là kiến trúc mà mọi máy tính và smartphone ngày nay vẫn dùng.
Năm 1947, Bóng bán dẫn (Transistor) ra đời, đánh dấu sự kết thúc của những căn phòng đầy bóng chân không nóng bức.
Sự vượt trội của transistor đến từ bản chất vật lý của trạng thái rắn so với môi trường chân không:
Các “máy tính mini” (minicomputers) chạy bóng bán dẫn của những năm 1960 không sử dụng vi mạch (microchips), mà thay vào đó được chế tạo từ các loại bóng bán dẫn “lớn”, dài khoảng 1 cm.
Các ứng dụng của máy tính bán dẫn trong những năm 1960 bao gồm việc vận hành ARPANET, tiền thân của internet dựa trên TCP/IP ngày nay, và việc Margaret Hamilton lập trình mã đổ bộ lên mặt trăng của tàu Apollo năm 1969 bằng ngôn ngữ hợp ngữ (assembly). Hình ảnh là bản in chương trình hợp ngữ hoàn chỉnh của bà cho tàu Apollo 11
Công việc sau này thực sự là “khoa học tên lửa” (rocket science), và yêu cầu bà phải tạo ra lĩnh vực kỹ thuật phần mềm (software engineering) hiện đại trong khi tìm kiếm các phương pháp để làm cho đoạn mã cực kỳ quan trọng này trở nên chính xác hơn.
Vào năm 1965, Gordon Moore, CEO của Intel, đã đưa ra một quan sát mà từ đó được gọi là Định luật Moore. Định luật này nói rằng tốc độ của máy tính hoặc số lượng bóng bán dẫn trên mỗi đơn vị diện tích sẽ tăng gấp đôi sau mỗi 18 tháng hoặc 2 năm.
Công nghệ IC cho phép các mạch điện dựa trên bóng bán dẫn được thu nhỏ lại, sao cho cùng một hệ thống dây điện từng lấp đầy một tủ rack những năm 1960 giờ đây có thể nằm gọn trên một “chip” silicon kích thước bằng móng tay. Từ góc nhìn kiến trúc, các con chip không có gì quá kỳ lạ, nếu bạn lấy sơ đồ đi dây của một chiếc máy bóng đèn chân không những năm 1940 và thu nhỏ nó lại, bạn sẽ có một con chip.
Nếu nhìn chip qua kính hiển vi, bạn sẽ thấy các mô hình đi dây tương tự như dây điện ở mặt sau của các tủ rack những năm 1940, 1950 hoặc 1960. Chip silicon sau đó được “đóng gói” bên trong một khối nhựa thường có màu đen lớn hơn, với các chân kim loại lớn kết nối các đầu vào và đầu ra tinh vi của chip với thế giới bên ngoài, thường là một bảng mạch in.
Những năm 1980 là thời hoàng kim của kiến trúc máy tính: lần đầu tiên, máy tính điện tử trở nên đủ rẻ và nhỏ để được sản xuất hàng loạt và được những người bình thường mua về sử dụng tại nhà.
Chiếc IBM 5150 PC ra mắt vào năm 1981, dựa trên chip Intel 8088. IBM và các công ty khác đã bán chiếc máy này cũng như các máy PC khác trong suốt những năm 1980 để sử dụng trong các văn phòng kinh doanh.
Khái niệm PC (Personal Computer) là thái cực đối lập với thị trường máy tính gia đình đa dạng và thiên về kiến trúc vì hai lý do.
Để phản ứng lại các hệ điều hành độc quyền đang được cài đặt trên PC và các máy tính lớn hơn, dự án GNU và phong trào Phần mềm Tự do đã được Richard Stallman tạo ra trong thập kỷ này, điều này sau đó đã dẫn đến các hệ thống và triết lý dựa trên Linux mà chúng ta sử dụng ngày nay.
Kiến trúc máy tính bị thống trị bởi kiến trúc tiêu chuẩn của máy tính cá nhân (PC), vốn đã được sử dụng trong tin học văn phòng những năm 1980 nhưng giờ đây được các tập đoàn PC đẩy mạnh khắp nơi, kể cả trong gia đình và trường học. Các hệ điều hành mã nguồn đóng được bán kèm như một phần của gói PC. Trong thời gian này, các trường học đã ngừng dạy khoa học máy tính và tập trung dạy cách sử dụng phần mềm văn phòng thương mại.
Chuyển từ việc coi đối tượng người dùng là lập trình viên và thành viên cộng đồng công nghệ sang coi người dùng là khách hàng và người tiêu dùng các sản phẩm phần mềm, chẳng hạn như trình xử lý văn bản và bảng tính (VD: Word, Excel, …)
Như định luật Moore đã dự đoán một cách đáng tin cậy, tốc độ bộ vi xử lý tăng gấp đôi sau mỗi 18 tháng. World Wide Web chính thức hoạt động tại CERN vào năm 1990 và phát triển phổ biến, dẫn đến cơn sốt đầu tư dot-com vào cuối thập kỷ. Khi có nhiều hacker và cuối cùng là người tiêu dùng tham gia vào web, các thiết kế máy tính máy chủ gắn trên giá đỡ (rack-mounted server) chuyên dụng đã trở nên phổ biến, bắt đầu với Compaq ProLiant vào năm 1993. Giống như Manchester Baby và các máy tính mini những năm 1960, chúng được thiết kế để xếp chồng trong các đơn vị giá đỡ 19 inch, nhưng hoạt động liên tục với độ tin cậy cao. -> xuất hiện định nghĩa về server
Kiến trúc PC gồm các linh kiện hàng hóa kết hợp với hệ điều hành vẫn tiếp tục duy trì trong suốt những năm 2000. Định luật Moore, và hệ quả là việc lắp ráp hoặc mua một chiếc máy tính mới có tốc độ gấp đôi sau mỗi vài năm, vẫn tiếp diễn. Các máy móc sử dụng cùng một thiết kế máy tính PC cơ bản, với các giao diện và thành phần khác nhau được nâng cấp về tốc độ. Tốc độ internet cũng tăng lên, cho phép truyền phát video cũng như chuyển văn bản và hình ảnh.
Trong những năm 1990 và 2000, giả định rằng tốc độ xung nhịp của các bộ vi xử lý sẽ tăng gấp đôi sau mỗi vài năm, và thực tế là như vậy. Định luật Moore trở thành một lời tiên tri tự ứng nghiệm khi các nhà sản xuất chip ở Thung lũng Silicon sử dụng nó như một mục tiêu cần đạt được.
Tuy nhiên, tất cả đã sụp đổ vào những năm 2010. Công nghệ sản xuất bóng bán dẫn thực sự vẫn tiếp tục tăng gấp đôi số lượng bóng bán dẫn trên mỗi đơn vị diện tích, nhưng tốc độ xung nhịp đã đạt mức tối đa vào năm 2010, ở khoảng 3.5 GHz.
Đột nhiên, các bộ vi xử lý không còn nhanh hơn nữa. Điều này là do các định luật vật lý cơ bản xung quanh tốc độ tính toán và nhiệt lượng. Trong thời kỳ định luật Moore, nhiệt độ của các bộ vi xử lý cũng tăng lên cùng với tốc độ; cần có các quạt lớn hơn, mạnh hơn và các hệ thống làm mát khác như làm mát bằng chất lỏng. Các bóng bán dẫn nhỏ đi, nhưng các cánh quạt lại to ra. Nếu xu hướng này tiếp tục qua những năm 2010, giờ đây chúng ta sẽ có những bộ vi xử lý nóng hơn cả bề mặt mặt trời.
Một khái niệm liên quan chặt chẽ là mức tiêu thụ điện năng. Khi các con chip tỏa nhiều nhiệt hơn, chúng tiêu thụ nhiều điện hơn, và thập kỷ này cũng chứng kiến sự khởi đầu của một nỗ lực hướng tới tính toán năng lượng thấp, di động hơn, đặc biệt là dưới dạng điện thoại thông minh.
Trong khi hai thập kỷ trước đó chứng kiến kiến trúc máy tính trì trệ như một lĩnh vực nghiên cứu, chỉ dựa vào những tiến bộ trong công nghệ chế tạo để tạo ra các lợi ích định kỳ, thì giờ đây lĩnh vực này lại mở rộng trở lại cho những ý tưởng hoàn toàn mới.
Chúng ta không thể làm máy tính nhanh hơn thông qua dạng “tốc độ” của định luật Moore, nhưng chúng ta vẫn có thể nhồi nhét ngày càng nhiều bóng bán dẫn lên chip với dạng “mật độ” của nó. Giờ đây, chúng ta có thể xem xét việc làm cho mọi thứ trở nên song song (parallel), thực hiện nhiều thao tác cùng một lúc thay vì từng cái một.
Trong khi vẫn còn nhiều kiến trúc song song cần được khám phá, những năm 2010 đã chứng kiến ba loại kiến trúc song song chính thành công trong thế giới thực.
Xu hướng cho thấy rõ các tài nguyên nghiên cứu đổ vào để tạo ra các sản phẩm nhỏ nhất, dùng ít năng lượng nhất, hiệu quả hơn (như điện thoại thông minh, tivi thông minh, tủ lạnh thông minh, máy giặt thông minh, ….) , hoặc ngược hẳn lại, là tạo ra những thứ mạnh nhất, to nhất (các hệ thống datacenter, server khổng lồ), và hiếm có đầu tư cho vùng ở giữa.
Khái niệm tính toán hiện đại đã được Church định nghĩa. Các máy điện tử thương mại của những năm 1950, bắt đầu với UNIVAC, qua các máy tính mini những năm 1960 và vi mạch những năm 1970 cho đến ngày nay dường như có thể được nhận diện rõ ràng là máy tính. Nhưng liệu có bất cứ thứ gì trước đó nên được công nhận là “chiếc máy tính đầu tiên”?
Có lẽ con người đã tính toán từ năm 40.000 TCN với bàn tính, xương, đá và các con số trong đầu. Tất cả những thứ trên về mặt lý thuyết đều là máy tính Church vì chúng có thể mô phỏng bất kỳ cỗ máy nào nếu được lập trình theo một cách nhất định. Vì vậy, có lẽ chúng ta đã luôn có máy tính — và Church chỉ là người đầu tiên nhận ra chúng.
Tham khảo: