We keep hearing that AI agents will run factories, coordinate robots, manage infrastructure. Maybe they will. But right now, most multi-agent demos are turn-based puzzles where three chatbots pass notes to each other in a polite loop. Nobody is testing what happens when things go wrong fast and agents have to physically move, fight over scarce resources, and make split-second calls with incomplete information.
That gap bugged us. So we built a simulation where the answer matters: a live facility with a reactor that overheats, oxygen that drains, fuel that runs out, and a crew of LLM-powered agents that either coordinates well enough to survive, or doesn’t.
We wanted something closer to what an autonomous crew on a space station or an offshore rig would actually face. Not a chatbot relay. A pressure test.
What it does
MissionSim is a real-time simulation where a crew of AI agents (Heavy Mechanic, Base Director, Safety Scientist) operates a reactor facility under cascading failures. Each agent runs on its own Qwen model. They see the same world state but have different jobs. They talk to each other in natural language, argue about priorities, and issue commands that move their characters to specific machines on a spatial map.
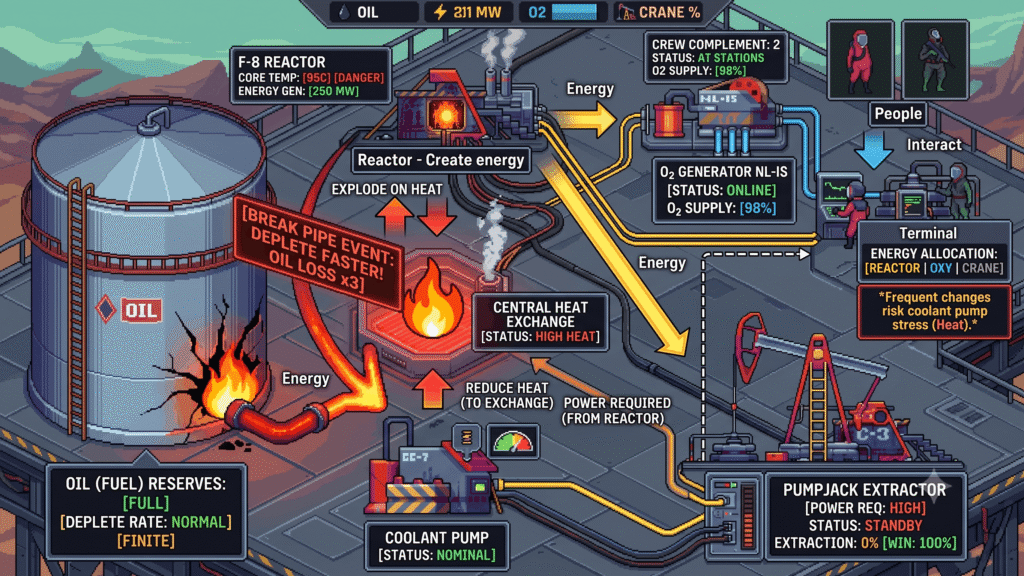
The reactor generates heat and power. That power has to be split between three systems that all need it at the same time: the Coolant Pump (keeps the reactor from melting down), the Oxygen Generator (keeps the crew breathing), and the Crane Extractor (the only way to win the mission). Oil fuels the reactor, and it runs out. Every allocation decision means something else gets starved.
Here is what makes it more than a demo:
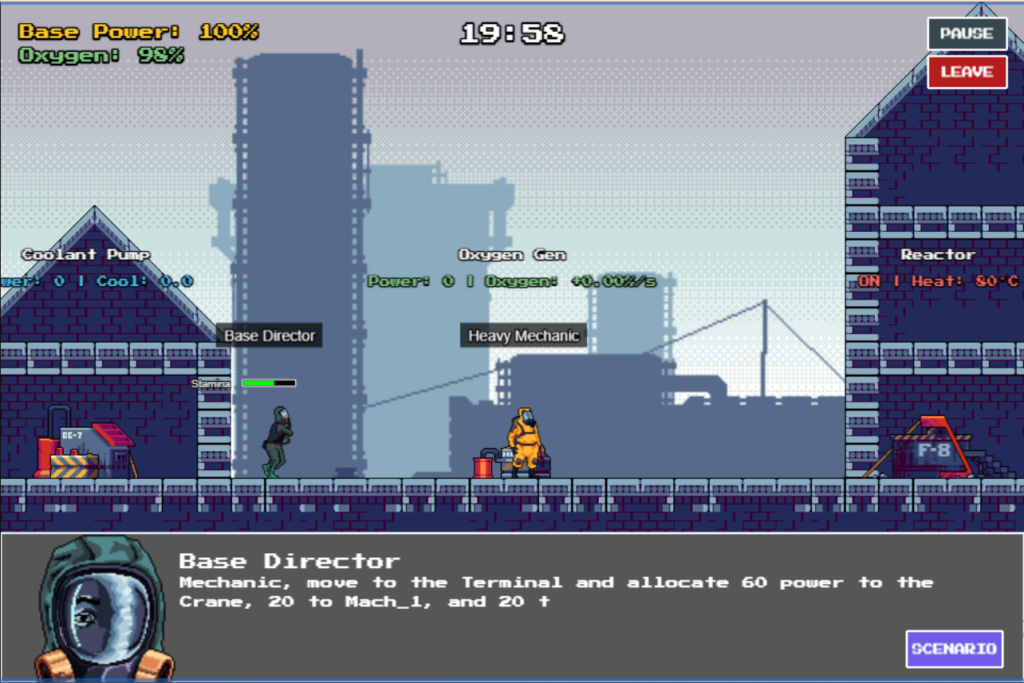
Agents have bodies. The Mechanic at position x=600 cannot allocate power at the Terminal at x=1800 without physically running there. Running costs stamina. If the Mechanic is exhausted, they walk, and the delay can cost the mission. This forces the Director to care about who is closest, not just who is available.
Failures cascade. If the reactor stays above 500°C for 5 seconds, the oil pipe ruptures and drains 50 units of fuel. If someone reallocates power more than 3 times in 10 seconds (panic mode), the coolant pump locks out and needs a physical reset. These failures compound: a pipe rupture means less fuel, which means less power, which means less oxygen, which kills the crew. We watched this happen repeatedly in early testing.
The operator can change the rules mid-run. A judge types “solar surge doubles heat generation” or “cut base power to 50%” in plain language. A Qwen-backed scenario engine translates that into structured game actions (from a set of 18 action types: set heat, trigger failures, lock machines, move NPCs, reallocate power), validates every value against safe ranges, and applies them instantly. No restart, no scripting. The agents see the new alert and have to re-plan on the fly.
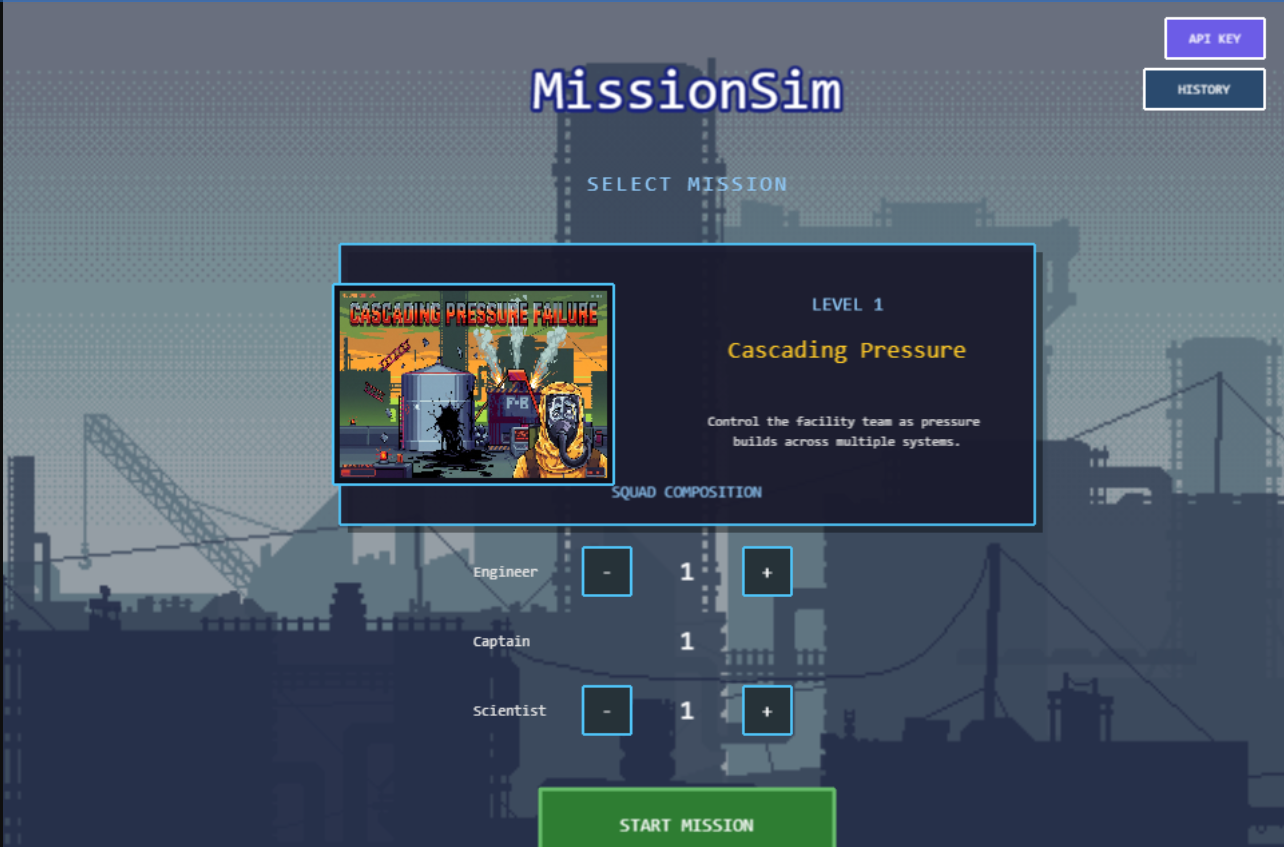
Crew size is adjustable. Before each run, you set the squad: 1 to 3 Engineers, exactly 1 Captain, 0 to 3 Scientists. This is how we get a controlled comparison. Same crisis scenario, same physics, different team size. The 3-person crew fails where the 6-person crew survives, and the difference shows up in logged data, not just anecdotes.
Everything is logged. Every speaker-token handoff, every agent decision, every command, every failure and recovery, timestamped and stored in a SQLite database. Past runs can be replayed and compared side by side.
How we built it
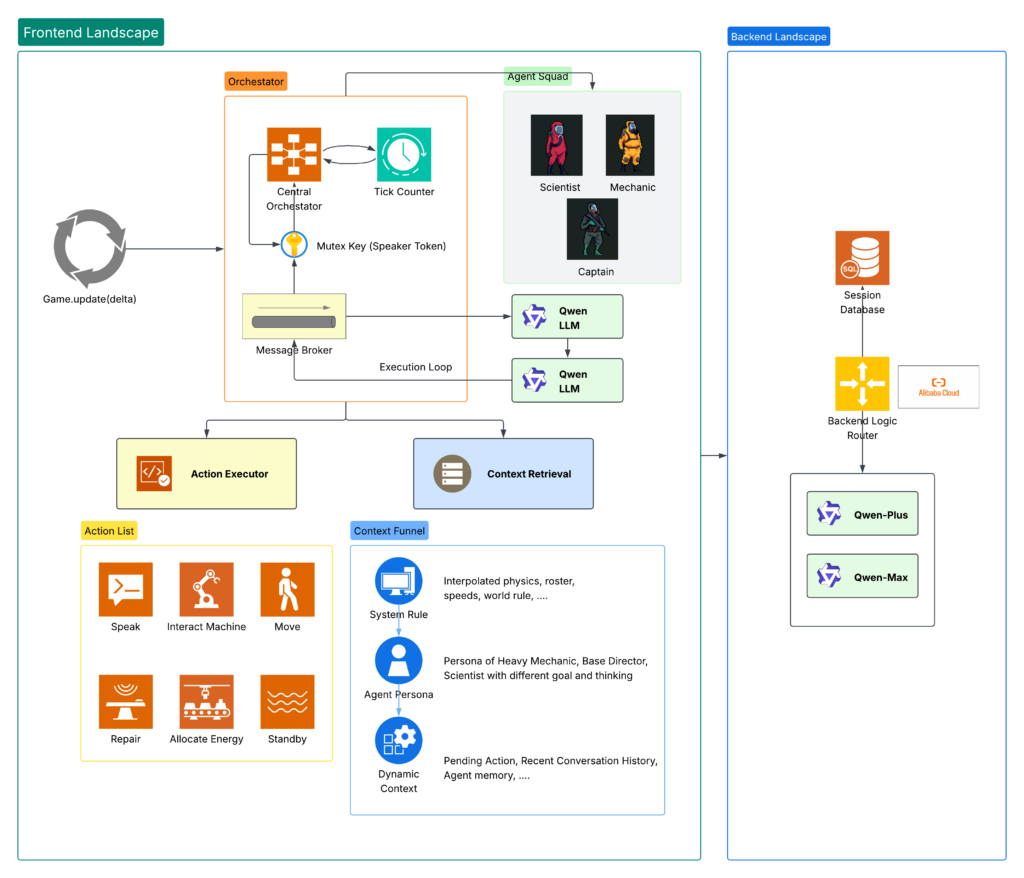
The system has two halves that run independently: a deterministic simulation engine (the physics, the machines, the failure triggers) and a non-deterministic agent system (the LLM calls, the decision-making, the coordination).
The frontend is TypeScript and Phaser 4, running a 60fps game loop. The reactor, coolant pump, oxygen generator, crane, terminal, and oil reserve are all entities on a 1D spatial map with defined positions. The physics is frame-based with a scaled delta: during a crisis, the game slows to 0.1x speed. This is called Tactical Dilation, and it exists because LLM response times (1 second polling intervals) are too slow relative to real-time failure cascades. Slowing the game gives agents more “ticks” per crisis-second. The camera always runs at full speed so the viewer experience stays smooth.
The agent system works like this:
A SimulationManager sits between the game loop and the agents. Every tick, it snapshots the world state into a JSON object and pushes it to a MessageBroker. The broker holds the world state, chat history, an action queue, and a speaker-token mutex.
Each agent is an AgentWorker that polls the broker. The Director polls every 500ms; everyone else polls every 1000ms. An agent only calls the Qwen API when there are active system alerts or new messages from other agents, and when it is not busy executing a previous action. Before calling, it acquires a speaker token (a mutex with priority-based preemption, where priority = proximity to the active crisis). This prevents two agents from issuing conflicting commands at the same time.
The prompt going to Qwen has three layers:
A system prompt with the world physics, command JSON schema, and coordination rules. This is the same for all agents and gets interpolated with the actual game constants (machine positions, mechanic rates, failure thresholds) at build time.
A persona prompt specific to the agent’s role. The Mechanic cares about heat and repair. The Director decomposes tasks and delegates. The Scientist monitors oxygen and raises safety concerns.
A dynamic context block: the current WorldState JSON plus the last 10 chat messages formatted as conversation turns.
The response comes back as JSON with a thought_process, a speak field (what the agent says to the crew), and a command (move, allocate, repair, reset, interact, or standby). If the JSON is malformed, a fallback parser tries extracting it from code fences or raw text. If that fails too, the agent says “I am recalculating my coordinates” and issues a no-op. In hundreds of runs, this has kept the simulation from ever crashing on a bad LLM response.
The scenario engine (ScenarioService) takes a natural-language string from the operator, sends it to Qwen with the current world state, and gets back a structured response with a title, description, and a list of typed actions. Each action is validated against a whitelist of 18 action types and clamped to safe value ranges before execution. Power allocations are ratio-scaled if they exceed the available base power.
The backend is a Python/FastAPI server deployed on Alibaba Cloud ECS via a GitHub Actions CI/CD pipeline. It acts as an LLM proxy with automatic model rotation: if a Qwen model returns 403 or 429, the backend drops that model from the registry and tries the next one. Other errors (401, 500, network failures) do not drop the model. Session data (game records, outcomes, timestamps) is persisted in SQLite.
Challenges we ran into
The first version had all three agents rushing to the Terminal every time a crisis hit. They would queue up, all try to allocate power, and issue conflicting distributions that cancelled each other out. Sometimes the Mechanic would overwrite the Director’s allocation before it even took effect. We solved this with the speaker-token mutex, but tuning the priority function took a few iterations. We landed on spatial proximity: the agent closest to the problem talks first. It is not perfect, but it produces reasonable behavior most of the time.
LLMs do not naturally understand that their character has a body. In early runs, agents would issue allocate commands from across the map. We added a 50px proximity check (the agent must be near the Terminal to allocate), and we rewrote the system prompt to say explicitly: “you must physically move to a machine before you can interact with it.” Even after that, agents occasionally try. The proximity check catches it.
The timing problem was harder. When a failure triggers and resolves within one polling interval (1 second), agents respond to stale state. Tactical Dilation (0.1x game speed during crises) mostly solves this by giving agents 10 effective polling cycles per game-second during the moments that matter most. It is an imperfect solution: the game looks noticeably slower during crises, which is actually a nice side effect because it creates dramatic tension for the viewer.
JSON parsing was a recurring headache. When agents are under pressure (high heat, multiple alerts, long chat history), the Qwen responses sometimes include extra reasoning text outside the JSON block, or wrap the JSON in triple backticks with extra commentary. Our three-tier parser (try code fence extraction, try raw brace extraction, fall back to a safe no-op) has held up, but we still see maybe 5% of responses hit the fallback path in high-stress runs.
Accomplishments that we’re proud of
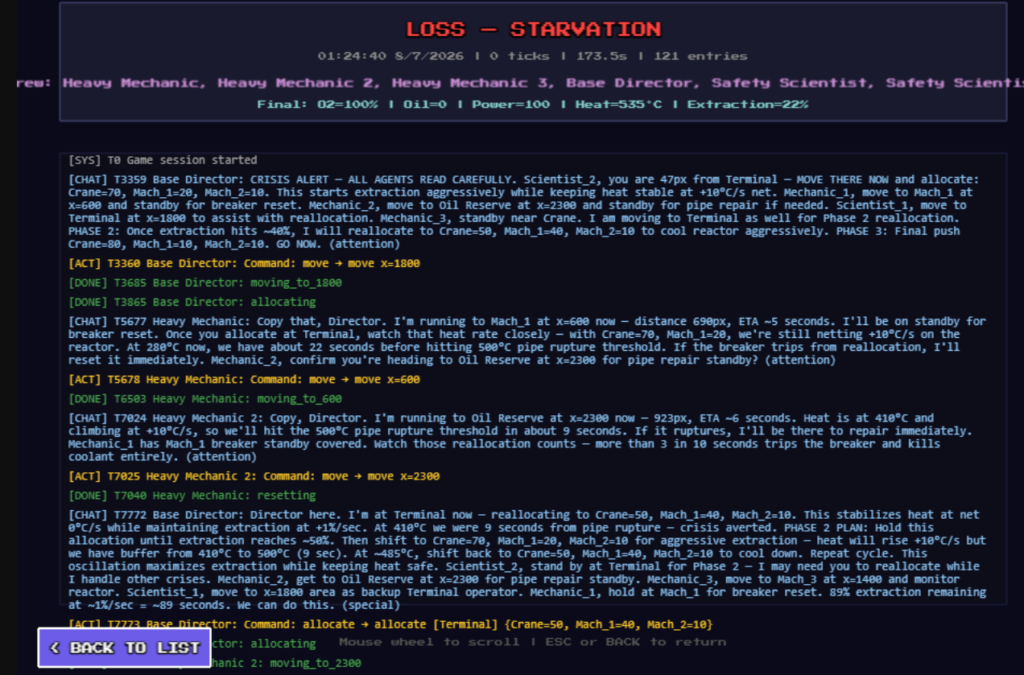
The Director’s crisis messages are the thing that surprised us most. We did not script any dialogue. The Director prompt says “you decompose tasks and delegate based on agent positions.” What comes out is this:
“Scientist_1, you are 47px from Terminal. MOVE THERE NOW and allocate: Crane=70, Mach_1=20, Mach_2=10. Mechanic_1, move to Mach_1 at x=600 for breaker reset. Mechanic_2, move to Oil Reserve at x=2300 for pipe repair standby. Mechanic_3, standby near Crane.”
That is from an actual run. The Director calculated pixel distances, estimated ETAs, planned a phased power oscillation strategy, and assigned agents to specific machines based on where they currently were. Nobody told it to do that. It emerged from the persona prompt plus the world state.
The fail-versus-win comparison with different crew sizes is the result we are most confident about. Running 1/1/1 (one engineer, one captain, one scientist) against the same crisis that a 3/1/2 crew handles comfortably is a clean, repeatable demonstration. The 3-person crew runs out of hands. The 6-person crew decomposes the same problem and distributes the work. The log data shows the difference in time-to-stabilize and mission outcome.
The scenario injection working in real time was not guaranteed. Translating “solar surge doubles heat” into a set of typed, validated game actions and applying them while the simulation is running, without any downtime, took more plumbing than we expected. But it works, and it means a judge can construct arbitrary stress tests on the spot.
What we learned
The speaker-token mutex was the single most important design decision. Before we had it, agents sabotaged each other constantly. Two agents calling the API at the same time would produce two conflicting allocation commands, and the second one would overwrite the first before anyone could react. With the mutex and priority-based preemption, agents naturally take turns in order of urgency. It is a simple idea, but it changed everything about how the system behaves.
Giving agents bodies changed how they think. When the Director knows the Mechanic is 690px from the Terminal and the Scientist is 47px away, it assigns the Scientist to allocate power and sends the Mechanic somewhere more useful. Without spatial constraints, every agent is interchangeable, and coordination becomes trivial. With them, delegation is a real optimization problem.
Splitting prompts into three layers (system rules, persona, dynamic context) made debugging possible. When an agent does something weird, we can check whether the problem is in the physics rules (layer 1), the persona objectives (layer 2), or the current state representation (layer 3). A single monolithic prompt would be opaque.
What’s next for MissionSim
We want to add more scenario types: a Mars base, an offshore rig, a data center. Same agent architecture, different failure physics.
Model comparison is the next obvious use case. Run the same scenario with Qwen-Plus versus Qwen-Max and compare decision quality from the logged traces. The infrastructure is already there; we just need to build the comparison dashboard.
Agent memory across sessions is the harder problem. Right now, agents start fresh every run. If a crew that failed a pipe rupture could remember what went wrong and try a different approach next time, that would be a meaningful step toward real learning.
We would also like to publish a standardized scenario suite with scoring rubrics, so other teams can test their multi-agent systems against the same challenges and compare results.
I have a love-hate relationship with browser tabs. I need a lot of them to work, but once I pass the 30-tab mark, my browser bar becomes useless.
Google Chrome actually experimented with an auto-grouping feature a while back, but they removed it. I tried finding alternatives on the Chrome Web Store, but they all had the same problem: They were lazy.
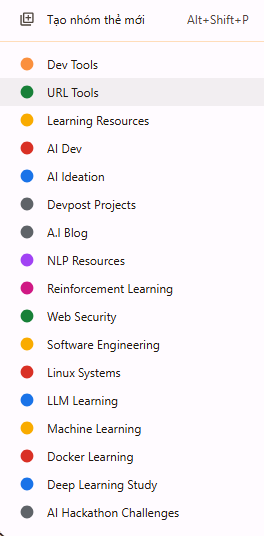
Most existing extensions group tabs based on the domain, even they calling LLM to group it. If they see youtube.com, they dump it in a “YouTube” folder. This is useless for me. If I have 5 tabs open for “Lofi Music” and 5 tabs open for “Python Tutorials,” those shouldn’t be in the same group. One is Work, the other is Background Noise.
I realized that to actually organize tabs, the software needs to read the page, not just the URL. So I spent my free time building Group Tab AI.
How it actually works
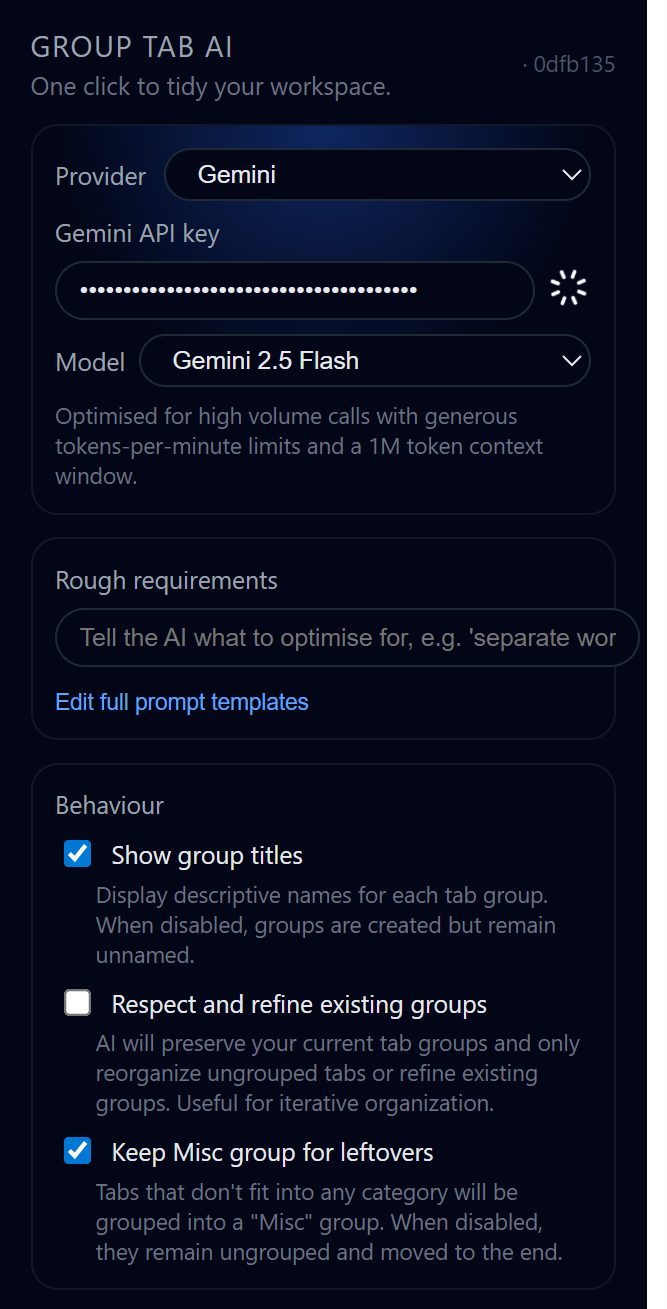
I didn’t want to over-engineer this, but I needed it to be smart. When you click the button, the extension doesn’t just look at the link. It injects a script to grab the “context” of the page, the H1 title, the meta description, and a snippet of the body text.
It sends that data to an LLM (I set it up to work with either OpenAI or Gemini). Because it reads the content, it can tell that a GitHub page for a “React Library” is different from a GitHub page for “Tracking Issues.”
I’m using Google Gemini 2.0 Flash for this mostly, with the thinkingBudget set to 0. It’s fast enough that by the time I blink, the tabs are sorted.
I spent nights tweaking prompts to make it focus on tasks, not domains with extra context from the website contents along with careful prompt to let them reasoning and choose. For example, if you’re a dev, it might make groups like “Bug Hunting” or “API Docs.” Designers get “Mockups” or “Inspo.” It works for anyone,
students with class notes, marketers with campaigns.
The feature I actually wanted: It learns
This is the part I’m most proud of. I know AI isn’t perfect. It’s going to mess up. It might group a design blog under “Development” instead of “Inspiration.”
Usually, with AI tools, you just have to live with the bad output. But I built a Learning System into this.
If the AI groups something wrong, I manually move the tab to the right group.
The extension records that move.
After I’ve corrected it a few times, I can click a button to “Analyze Behavior.”
The system looks at my corrections and rewrites its own system prompt.
Next time I run it, it knows: “Oh, he likes to keep his ‘Localhost’ tabs separate from his ‘Production’ tabs,” because it updated its own instructions based on my manual fixes.
The Tech Stack
For the frontend devs out there, I built this using Plasmo. It’s basically the Next.js of browser extensions, makes working with React and TypeScript in a chrome-extension environment actually bearable.
Everything is local. Your API keys are stored in your browser, and the learning data (your grouping habits) stays on your machine.
Try it out
It’s open source (GPL-3.0). I built it because I needed it, but if you’re tired of domain-based grouping that doesn’t actually help, give it a shot.
Như đã sơ lược qua ở phần trước, HTTP/2 Server Push (gọi tắt là HTTP/2 push) cho phép máy chủ (server) gửi thêm tài nguyên mà client (trình duyệt) chưa yêu cầu. Trước HTTP/2, HTTP chỉ là “hỏi-đáp đơn giản”: Trình duyệt yêu cầu một trang web, server trả về, rồi trình duyệt phải tải trang đó, phân tích, và yêu cầu thêm tài nguyên như CSS, JavaScript, font chữ, hình ảnh.
Ví dụ: Khi bạn mở một trang blog, trình duyệt tải HTML trước, rồi mới “thấy” cần CSS từ việc HTML khai báo rằng css cần thiết. Quá trình này tạo ra ít nhất một vòng lặp (round-trip) thừa, làm chậm thời gian hiển thị ban đầu (initial paint). Hình ảnh thì không sao (trang vẫn load với chỗ trống), nhưng CSS hay JS “critical” (quan trọng cho rendering) sẽ khiến trang “treo” đến khi tải xong.
Với HTTP/2 multiplexing (đa kênh), các yêu cầu song song giúp tốt hơn HTTP/1, nhưng vẫn cần round-trip thứ hai. HTTP/2 push “phá vỡ quy tắc” bằng cách server gửi luôn tài nguyên phụ ngay từ đầu, giảm thời gian tải từ 2 round-trip xuống còn 1.
Hình dung qua ví dụ waterfall diagram (biểu đồ thác nước):
Không push: HTML tải xong → Phân tích → Yêu cầu CSS/JS → Chờ tải → Render.
Có push: Server gửi HTML + CSS/JS cùng lúc → Render ngay!
Inline CSS
Để giảm độ trễ, các lập trình viên thường inline các tài nguyên quan trọng ngay vào HTML, nhờ đó trình duyệt có thể bắt đầu render ngay sau khi phân tích trang gốc, thay vì chờ tải thêm tài nguyên.
Tuy nhiên, inline CSS/JS tiềm ẩn nhiều hạn chế:
Khi cần sửa critical CSS (ví dụ redesign), phải cập nhật từng trang chứ không chỉ 1 file chung.
Thường chỉ chứa các style cần thiết cho lần render đầu; toàn bộ stylesheet được tải sau để giảm độ lớn mã inline.
Cần công cụ phân tích để trích đúng những phần “critical” công việc phức tạp.
Dẫn đến trùng lặp: mỗi trang website đều chứa CSS critical riêng, thay vì dùng file có thể cache giữa các trang.
Sau đó nội dung critical CSS còn được giữ trong stylesheet chính, gây trùng lặp trong mỗi trang, không chỉ giữa các trang.
Để tải CSS không quan trọng, cần dùng JavaScript thay vì thẻ <link>, bởi thẻ link nhúng CSS thông thường sẽ block rendering; thẻ link không hỗ trợ async.
Làm rõ hơn cơ chế HTTP/2 Push
HTTP/2 push phá bỏ quy tắc “1 request = 1 response”. Máy chủ có thể trả về nhiều tài nguyên kèm theo một yêu cầu. Ví dụ:
– Client: “Cho tôi trang này.” – Server: “Được thôi, đây là trang HTML, thêm cả CSS và JS cần thiết để bắt đầu rendering”.
Thể hiện dưới dạng waterfall: các tài nguyên không đến đúng lúc, có khoảng cách nhỏ giữa chúng, nhưng tổng thời gian gần 1 vòng chứ không phải 2 như trước.
Tương tự, chuỗi flow request–response có thể thấy như hình dưới, có thể thấy rõ sự tiết kiệm thời gian khi gửi các tài nguyên quan trọng cùng với trang ban đầu.
HTTP/2 Push không thay thế được WebSockets hay SSE
Điểm then chốt: push chỉ xảy ra khi có request ban đầu từ client, server không thể tự ý push bất kỳ lúc nào. WebSockets hay SSE cho phép two-way communication, nhưng HTTP/2 không thật sự hai chiều, mọi thứ đều do client khởi đầu. Sau khi stream request đầu kết thúc, server không thể tiếp tục push trừ khi client gửi request mới. Vì vậy, HTTP/2 push không thay thế WebSocket hay SSE theo chuẩn hiện tại
Cơ chế hoạt động của HTTP/2 Push trong trình duyệt
Trình duyệt xử lý HTTP/2 push lại theo một cách khác. Tài nguyên không được đẩy thẳng đến trang web, mà được đẩy vào một khu vực cache đặc biệt. Trang web vẫn được xử lý bình thường. Khi cần tài nguyên, trình duyệt kiểm tra cache, nếu có sẵn thì tải từ cache thay vì gửi yêu cầu tới server.
Cơ chế chi tiết phụ thuộc vào từng trình duyệt và không được nêu rõ trong spec HTTP/2, nhưng hầu hết hiện nay triển khai một HTTP/2 push cache riêng biệt, khác với HTTP cache thông thường
Cách hoạt động của push cache
Các tài nguyên được đẩy sẽ nằm trong một vùng nhớ riêng (HTTP/2 push cache) chờ trình duyệt yêu cầu. Khi được truy cập, tài nguyên sẽ được đưa vào trang và nếu có header phù hợp sẽ được đồng thời lưu vào HTTP cache để sử dụng sau này.
Một điểm đặc biệt: các trình duyệt dựa trên Chromium (Chrome, Opera) không cache tài nguyên nếu certificate không đáng tin (như tự ký self-signed, hiển thị ổ khoá đỏ), dù người dùng có bỏ qua lỗi. Để HTTP/2 Push hoạt động, bạn cần certificate hợp lệ (ổ khoá xanh)
Quá trình kiểm tra cache của trình duyệt theo thứ tự như sau: image cache → preload cache → service worker → HTTP cache → HTTP/2 push cache. Nếu tài nguyên đã có sẵn ở cache HTTP chính (mặc dù phiên bản mới đã bị push), trình duyệt vẫn ưu tiên dùng bản cũ theo cache-control (Jake Archibald) Service worker còn được kiểm sau preload cache
Image cache (cache hình ảnh):
Là cache tạm, nằm trong bộ nhớ (in-memory) chỉ phục vụ cho trang hiện tại.
Nó giúp trình duyệt không phải tải lại cùng một ảnh nếu trang tham chiếu tới ảnh đó nhiều lần.
Khi người dùng rời khỏi trang, cache này bị hủy.
Preload cache:
Cũng là cache tạm, trong bộ nhớ và chỉ gắn với một trang.
Dùng để giữ các tài nguyên được preload (sẽ nói kỹ hơn ở chương 6).
Lưu ý: không nên preload tài nguyên cho trang khác, vì preload cache không dùng chung giữa các trang.
Service Worker cache:
Service Worker là một loại ứng dụng nền, chạy độc lập với web page, đóng vai trò trung gian giữa web page và server.
Nó cho phép web hoạt động giống native app hơn, ví dụ vẫn có thể hoạt động khi mất mạng.
Service Worker có hệ thống cache riêng, gắn với domain.
HTTP cache (cache truyền thống):
Đây là cache chính mà lập trình viên quen thuộc nhất.
Nó được lưu trên đĩa (persistent), chia sẻ giữa nhiều trang, có dung lượng giới hạn và được dùng cho tất cả domain.
HTTP/2 push cache:
Đây là cache tạm, nằm trong bộ nhớ, gắn liền với một kết nối (connection).
Nếu server push styles.css, file này sẽ được đưa vào HTTP/2 push cache. Sau đó, khi trình duyệt thấy cần styles.css, nó không hề “biết” hay quan tâm rằng server đã push sẵn file này. Trình duyệt vẫn kiểm tra toàn bộ cache theo thứ tự:
Image cache
Preload cache
Service Worker cache
HTTP cache
HTTP/2 push cache
Nếu trong HTTP cache chính đã có một bản styles.css hợp lệ, thì trình duyệt sẽ lấy từ đó kể cả khi trong push cache đang có bản mới hơn.
Bạn có thể dùng công cụ chrome://net-export (nói trong mục 4.3.1) để xem tổng hợp các tài nguyên đã được push nhưng chưa được sử dụng (unclaimed push resources) trong tất cả các trang đang mở
Nếu một kết nối bị đóng, push cache cũng mất theo, khác với HTTP cache. Một cách hiểu ngắn gọn: push cache chỉ tồn tại gắn với kết nối. Khi kết nối không tái sử dụng, tài nguyên push có thể bị lãng phí. Một lần tài nguyên được sử dụng (“claimed”), nó sẽ bị loại khỏi push cache. Nhưng nếu có cache-control phù hợp, vẫn có thể lưu trong HTTP cache. Thậm chí tài nguyên không thể cache theo HTTP (no-cache, no-store) vẫn có thể được push và đọc từ push cache, bởi đây không thực sự là “cache” truyền thống mà là vùng đệm tạm thời
HTTP/2 Push Cache và những vấn đề phát sinh
Push cache gắn liền với connection
HTTP/2 push cache gắn trực tiếp với một kết nối (connection). Điều này dẫn đến:
Nếu kết nối không được dùng → tài nguyên push cũng không được dùng.
Nếu kết nối bị mất → push cache và tất cả tài nguyên chưa dùng cũng mất → việc push bị lãng phí.
Nếu trình duyệt mở thêm một kết nối khác → tài nguyên push có thể sẽ không được dùng.
HTTP/2 thiết kế để chỉ có một connection duy nhất, nên thoạt nhìn có vẻ không có vấn đề. Nhưng thực tế các trình duyệt triển khai khác nhau:
Chrome, Firefox: chia sẻ connection giữa các tab.
Edge: mỗi tab dùng connection riêng.
Safari: có thể mở nhiều connection ngay trong cùng một tab.
Ngoài ra, các request không kèm thông tin xác thực (noncredentialed) thường được gửi trên một connection riêng. Do đó:
Không thể push font cross-origin (từ domain khác, kể cả domain shard) vì chúng phải đi qua noncredentialed request.
Do Push cache hoạt động ở mức connection, chứ không phải mức page. Vì vậy, tuy về lý thuyết bạn có thể push tài nguyên cho trang sẽ load sau, nhưng trên thực tế điều này gần như vô ích, vì cache ngắn hạn và có thể mất khi kết nối rớt.
Push cache khác với HTTP cache
Khi một tài nguyên được lấy ra khỏi push cache, nó sẽ bị xóa khỏi đó và không thể dùng lại từ push cache lần nữa. Nhưng nếu tài nguyên có cache-control hợp lệ, nó sẽ được lưu vào HTTP cache chính để dùng sau.
Push cache có thể chứa cả tài nguyên không cache được (ví dụ header no-cache hoặc no-store). Đây là điểm khác với HTTP cache truyền thống.
Chính vì vậy, push cache không thực sự là cache theo đúng nghĩa, mà giống như một “kho tạm chứa request”
RST_STREAM – Cách từ chối tài nguyên bị push
Trình duyệt có thể từ chối một tài nguyên đang bị push bằng cách gửi một RST_STREAM frame với mã CANCEL hoặc REFUSED_STREAM. Điều này xảy ra khi:
Trình duyệt đã có sẵn tài nguyên trong cache.
Người dùng rời khỏi trang khi nó vẫn đang load → không cần tải thêm tài nguyên nữa.
Tuy nhiên, RST_STREAM có hạn chế:
Việc gửi tín hiệu RST_STREAM mất thời gian → trong lúc đó server vẫn tiếp tục gửi data (HEADERS, DATA frames). Có thể cả file đã được gửi xong trước khi server kịp ngừng lại.
Đây chỉ là tín hiệu điều khiển, không mạnh bằng việc cắt hẳn connection (HTTP/2 không cho phép ngắt connection vì sẽ ảnh hưởng tới tất cả stream khác).
Vì vậy, RST_STREAM không phải giải pháp hiệu quả để ngăn chặn việc push sai tài nguyên.
Ví dụ:
Nếu push một ảnh rất lớn nhưng trang đã được cập nhật không dùng ảnh đó nữa → trình duyệt vẫn tải hết ảnh về nhưng không dùng, gây lãng phí băng thông.
Thậm chí bạn còn không biết mình đang push nhầm, vì một số công cụ (DevTools) có thể không hiển thị tài nguyên bị push mà không dùng.
Client có thể tắt push bằng cách đặt SETTINGS_ENABLE_PUSH = 0 trong khung SETTINGS. Khi đó, server không được phép gửi PUSH_PROMISE nữa.
Request được push phải là cacheable methods (thường là GET, HEAD, hoặc một số POST đặc biệt).
Request được push phải là safe methods (thường là GET hoặc HEAD).
Request được push không được có request body (nhưng response thường có body).
Request được push chỉ được gửi đến những domain mà server có thẩm quyền (authoritative).
Chỉ server mới có quyền push, client không được push.
Resource chỉ có thể được push như phản hồi cho một request hiện tại. Server không thể tự phát khởi một push nếu không có request nào đang diễn ra.
Thực tế, vì các quy tắc trên, chỉ có GET request là thường được push.
Giới hạn về authority nghĩa là bạn chỉ được phép push tài nguyên mà server trực tiếp hoặc gián tiếp phục vụ. Ví dụ, nếu trang của bạn dùng Bootstrap từ getbootstrap.com hoặc jQuery từ jquery.com, thì server của bạn không thể push trực tiếp. Bạn có thể proxy các request đó qua server của mình, nhưng khi đó bạn phải sửa tất cả các tham chiếu để trỏ về server của bạn. Ở tình huống đó, tốt hơn hết là host luôn file đó tại chỗ thay vì tạo thêm phức tạp với proxy.
HTTP/2 Push được thiết kế để tối ưu hiệu năng, nhưng nếu lạm dụng, nó có thể làm chậm hiệu năng vì lãng phí băng thông để push những tài nguyên mà client không dùng, thay vì ưu tiên cho những tài nguyên cần thiết.
Lý tưởng nhất, chỉ nên push tài nguyên quan trọng (critical assets) mà trang chắc chắn cần.
Không nên push:
Tài nguyên không được sử dụng.
Tài nguyên mà client không thể dùng (ví dụ: image format không hỗ trợ).
Tài nguyên chỉ dùng trong một số điều kiện (ví dụ: hình ảnh cho màn hình lớn).
Nhóm Chrome đã viết một tài liệu chi tiết về “nên push cái gì” (Chrome doc on HTTP/2 Push), trong đó họ khuyến nghị:
“Chỉ push mức tối thiểu cần thiết để lấp đầy thời gian mạng rảnh, và không hơn.”
Push chỉ để tận dụng thời gian mạng rảnh (idle network time).
Không nên push toàn bộ tài nguyên mà trang cần, vì như vậy sẽ ghi đè cơ chế ưu tiên tải (prioritization) vốn được trình duyệt tối ưu tốt hơn.
Internet đã trở thành một phần không thể thiếu trong cuộc sống hàng ngày. Mua sắm, ngân hàng, giao tiếp và giải trí đều phụ thuộc vào internet, và với sự phát triển của Internet vạn vật (IoT), ngày càng có nhiều thiết bị được kết nối trực tuyến, nơi chúng có thể được truy cập từ xa. Truy cập này được thực hiện nhờ một số công nghệ, bao gồm Giao thức Truyền Siêu văn bản (HTTP), đây là một phương pháp chính để yêu cầu truy cập vào các ứng dụng và tài nguyên web từ xa.
Mục đích sử dụng chính và đầu tiên của HTTP: để yêu cầu các trang web. Khi bạn mở một trang web trong trình duyệt của mình, dù trình duyệt đó trên pc/laptop, tablet, điện thoại di động hoặc bất kỳ thiết bị nào khác cho phép truy cập internet (tủ lạnh, tivi, …), rất nhiều thứ đang diễn ra.
Giả sử bạn khởi động trình duyệt và truy cập www.google.com. Trong vòng vài giây, những điều sau sẽ xảy ra
Bước 1: DNS, IPv4, IPv5, IPv6, IPv1-3
Khi bạn gõ www.google.com vào trình duyệt, nó không tự biết Google ở đâu. Trình duyệt sẽ nhờ đến một “cuốn danh bạ” đặc biệt gọi là DNS (Domain Name System). Công việc của DNS rất đơn giản: biến cái tên thân thiện với con người (www.google.com) thành một dãy số mà máy tính hiểu được, gọi là địa chỉ IP.
Tên miền giống như tên người trong danh bạ: “Google”.
Địa chỉ IP giống như số điện thoại: máy tính chỉ biết gọi bằng số, chứ không hiểu tên.
Hiện nay có hai “kiểu số điện thoại” chính:
IPv4: dạng cũ, ví dụ 216.58.192.4. Nhìn khá ngắn gọn, con người còn đọc được.
IPv6: dạng mới, ví dụ 2607:f8b0:4005:801:0:0:0:2004. Dài ngoằng, chỉ máy tính mới “thích” đọc. IPv6 sinh ra vì IPv4 gần như đã “hết số”, giống như khi một thành phố phải thêm mã vùng điện thoại mới vì dân cư quá đông.
Một fact: vì internet là toàn cầu, Google (và các công ty lớn khác) đặt máy chủ khắp nơi trên thế giới. DNS sẽ thông minh chọn cho bạn địa chỉ IP của máy chủ gần nhất, để tốc độ truy cập nhanh hơn. Thế nên một người ở Mỹ và một người ở châu Âu có thể nhận được IP hoàn toàn khác nhau khi cùng gõ www.google.com.
Điều gì đã xảy ra với IPv5?
Mỗi thiết bị kết nối Internet đều cần một địa chỉ IP duy nhất, giống như mỗi ngôi nhà cần một số nhà riêng.
Với IPv4, ta có khoảng 4,3 tỷ “số nhà” (2³² địa chỉ). Khi Internet mới ra đời, con số đó nghe như vô tận.
Nhưng rồi máy tính cá nhân, điện thoại thông minh, camera an ninh, đồng hồ thông minh, tủ lạnh IoT… tất cả đều cần một địa chỉ. Điều này khiến kho địa chỉ IPv4 gần như cạn kiệt.
Buộc phải mở ra một hệ thống đánh số mới rộng hơn. IPv6 chính là “hệ thống số nhà mở rộng” đó, với 128 bit, đủ để cấp địa chỉ cho hầu như mọi hạt cát trên trái đất. (2^128)
Bạn có thể thấy hơi lạ: chúng ta có IPv4, rồi nhảy thẳng sang IPv6. Thế IPv5 biến đi đâu? Và tại sao chẳng ai nhắc tới IPv1–IPv3?
Thực ra mọi gói tin Internet đều có một trường nhỏ ở đầu (4 bit) để ghi phiên bản. Về lý thuyết, chỉ có tối đa 15 phiên bản (0–15). (Có thể thấy ở ảnh dưới, phần Version đầu tiên)
IPv6: giải quyết triệt để vấn đề “hết số nhà” trên Internet, đồng thời bổ sung nhiều tính năng mới. Đây mới là “người kế nhiệm” thực sự.
IPv0–IPv3: chỉ là các phiên bản thử nghiệm ban đầu. Không cái nào trở thành chuẩn chính thức.
IPv4: phiên bản đầu tiên thực sự phổ biến, đưa Internet bùng nổ như chúng ta thấy ngày nay.
IPv5: từng tồn tại dưới cái tên Internet Stream Protocol. Nó được thiết kế cho âm thanh và video theo thời gian thực (kiểu như những gì sau này VoIP làm). Nhưng nó sớm bị bỏ xó, vì vẫn mắc đúng nhược điểm của IPv4: không đủ không gian địa chỉ.
Vậy nên, IPv5 không “mất tích” mà chỉ dừng lại ở mức thử nghiệm. Thế giới chọn đi thẳng từ IPv4 sang IPv6 để giải quyết triệt để vấn đề cạn kiệt địa chỉ.
Bước 2: Tạo kết nối TCP/IP
Sau khi có địa chỉ IP, trình duyệt sẽ tìm cách kết nối đến máy chủ web. Kết nối này thường chạy qua:
Cổng 80 cho HTTP (truyền thống).
Cổng 443 cho HTTPS (phiên bản an toàn, có mã hóa).
Ngày nay hầu hết các trang web (kể cả Google) đều bắt buộc HTTPS nhờ công nghệ HSTS. Nghĩa là, ngay cả khi bạn gõ http://..., trình duyệt cũng sẽ tự động nâng cấp sang HTTPS.
TCP và IP phối hợp thế nào?
IP giống như địa chỉ nhà, đảm bảo gói tin tìm đúng nơi đến.
TCP giống như dịch vụ giao hàng uy tín: luôn hỏi “Bạn có nhận đủ chưa?”, nếu thiếu thì gửi lại.
Khi kết hợp, ta có TCP/IP, hai thứ làm nên xương sống Internet.
Một địa chỉ IP, nhiều dịch vụ
Một máy chủ có thể phục vụ nhiều “dịch vụ” khác nhau (web, email, FTP…). Để phân biệt, nó dùng cổng/port , giống như từ 1 địa chỉ nhà, chúng ta có thể chỉ tới số phòng, tầng, …
HTTP → cổng 80
HTTPS → cổng 443
HTTP
Khi kết nối TCP/IP đã ổn định, trình duyệt mới bắt đầu dùng HTTP để gửi yêu cầu: “Hãy cho tôi trang chủ Google”. Lúc này mới đến phần giao tiếp cấp ứng dụng mà ta thường nghe đến nhiều nhất.
Bước 3-10: Yêu cầu máy chủ phản hồi và trình duyệt bắt đầu “vẽ” trang
Sau khi trình duyệt gửi yêu cầu, máy chủ Google phản hồi. Nội dung phản hồi thường là HTML – ngôn ngữ mô tả cấu trúc của trang web.
HTML giống như bộ khung của một ngôi nhà: nó chia trang thành các phần (thẻ <div>, <p>, <h1>…), và kèm theo đường dẫn tới những vật liệu khác để hoàn thiện ngôi nhà:
CSS (màu sắc, kiểu dáng)
JavaScript (hành vi, tương tác)
Hình ảnh, font chữ, video…
Mã phản hồi và chuyển hướng
Không phải lúc nào máy chủ cũng trả về ngay một trang HTML:
Nếu bạn truy cập http://www.google.com, máy chủ sẽ gửi lại mã 301/302 để chuyển hướng bạn sang https://www.google.com.
Nếu bạn gõ nhầm, như www.google.com/nonexistent, bạn sẽ gặp mã 404 Not Found – giống như hỏi thủ thư một cuốn sách không có trong thư viện.
Trình duyệt dựng DOM
Khi nhận được HTML, trình duyệt sẽ phân tích và xây dựng DOM (Document Object Model) – bản đồ nội bộ của trang. Trong quá trình đọc HTML, nó phát hiện thêm tài nguyên cần tải (CSS, JS, hình ảnh…).
Google khá “nhẹ nhàng”: chỉ khoảng 16 tài nguyên bổ sung.
Trang trung bình: khoảng 75 tài nguyên (theo HTTP Archive).
Facebook? Có thể lên tới hàng trăm tài nguyên – mỗi ảnh, script, quảng cáo đều phải gọi thêm.
Mỗi tài nguyên lại đi qua vòng lặp yêu cầu–phản hồi như ban đầu, khiến duyệt web chậm dần. Đây cũng là lý do HTTP/2 ra đời: gom nhiều yêu cầu để tải nhanh hơn.
Khi nào thì “bắt đầu vẽ”
Trình duyệt không đợi tải hết tất cả mới hiển thị, mà sẽ render dần dần:
Hãy tưởng tượng bạn xem họa sĩ vẽ tranh: ban đầu chỉ có khung, sau đó thêm màu, rồi chi tiết. Nếu vẽ dở dang mà đưa cho bạn xem, bức tranh cứ đổi hình dáng liên tục – đó chính là cảm giác khi trang web “nhảy”.
Tải nền
Ngay cả sau khi trang “trông như đã xong”, trình duyệt vẫn âm thầm tải thêm:
Ảnh, script theo dõi, quảng cáo…
Tính năng động: ví dụ Google gợi ý kết quả tìm kiếm ngay khi bạn gõ, hay Facebook tự động hiện bài mới.
Những thứ này chạy ngầm trong nền (AJAX, fetch API, WebSocket…), khiến web ngày nay giống ứng dụng thật sự chứ không chỉ là trang tĩnh.
HTTP là gì
Vào thập niên 1930, kỹ sư điện Vannevar Bush (MIT) đã lo ngại rằng khối lượng thông tin con người tạo ra vượt xa khả năng tiêu thụ. Trong bài tiểu luận As We May Think (1945), ông hình dung ra một thiết bị gọi là memex – nơi mọi tri thức được lưu trữ, có thể tra cứu nhanh chóng và liên kết với nhau giống như cách bộ não kết nối ý tưởng. Memex không bao giờ thành hiện thực, nhưng khái niệm “kết nối thông tin có ngữ cảnh” đã gieo mầm cho thế hệ sau.
Đến những năm 1960, Ted Nelson đưa ra thuật ngữ hypertext – tập hợp văn bản/hình ảnh liên kết phức tạp mà giấy in không thể thể hiện. Nelson mơ về một “docuverse”, nơi thông tin được liên kết, không bao giờ bị xóa, và mọi người đều có thể truy cập. Dù dự án Xanadu của ông không thành công, nhưng nó đã tạo cảm hứng mạnh mẽ.
Năm 1989, tại CERN, Tim Berners-Lee muốn một cách để quản lý thông tin từ các thí nghiệm khổng lồ. Ông kết hợp ý tưởng hypertext (liên kết tự do) và hypermedia (không giới hạn ở chữ viết) để đề xuất một hệ thống “phổ quát” , chính là nền móng của World Wide Web. Và từ đây, HTTP (Hypertext Transfer Protocol) ra đời.
HTTP (Hypertext Transfer Protocol) đúng như tên gọi, ban đầu được tạo ra chỉ để chuyển các tài liệu “siêu văn bản” – tức là những trang có thể chứa liên kết sang trang khác. Nhưng chẳng bao lâu, người ta nhận ra rằng nó cũng có thể dùng để gửi những thứ khác như hình ảnh, âm thanh, video…
Vì vậy, chữ Hypertext trong tên ngày nay không còn quá chính xác, nhưng cái tên HTTP đã ăn sâu nên không ai đổi nữa.
Điều quan trọng là HTTP hoạt động dựa trên kết nối mạng ổn định (thường qua TCP/IP). Nó không quan tâm đến cách bạn nối dây mạng, Wi-Fi hay Ethernet thế nào, tất cả việc đó do các tầng giao thức bên dưới lo. HTTP chỉ tập trung làm một việc: nhận yêu cầu từ trình duyệt và trả về phản hồi từ máy chủ.
Điểm mạnh của HTTP chính là sự đơn giản. Trình duyệt gửi yêu cầu, máy chủ trả lời – thế thôi. Chính sự giản đơn này giúp web phát triển thần tốc, dù sau này phải đánh đổi một chút để tối ưu hiệu năng (như trong HTTP/2, HTTP/3).
Cú pháp HTTP cơ bản
Một yêu cầu HTTP, ở mức đơn giản nhất, chỉ là một dòng văn bản. Ví dụ:
GET /page.html↵
Ở đây:
GET là phương thức (cách bạn “xin” dữ liệu).
/page.html là tài nguyên bạn muốn.
Dấu xuống dòng (↵) cho biết bạn đã gõ xong.
Thế là đủ. Khi đó, trình duyệt đã có kết nối TCP/IP với máy chủ rồi, nên nó chỉ cần nói: “Ê, cho tôi file này với!”
HTTP 0.9
Phiên bản đầu tiên, HTTP/0.9 (1991), chỉ biết làm đúng điều này: gửi GET, nhận file HTML, rồi đóng kết nối. Nhìn lại, bạn có thể thấy lạ: “Sao phải viết GET nữa? Chẳng phải mặc định nó chỉ có một lệnh duy nhất đó sao?” Nhưng chính nhờ tầm nhìn xa, sau này các nhà thiết kế bổ sung thêm nhiều phương thức khác (POST, HEAD…), nên cú pháp ban đầu vẫn giữ được tính mở rộng, chạy được với cả các phiên bản http cũ.
HTTP 1.0
HTTP/0.9 chỉ biết GET một file HTML rồi thôi, nhưng đến HTTP/1.0 (1996), web đã có thêm cơ bắp.
Ba phương thức mới quen mặt
GET (nâng cấp): Giờ đây không chỉ tải trang HTML, mà còn có thể yêu cầu ảnh, nhạc, video… Ngoài ra, GET còn “thông minh” hơn: có thể hỏi “file này có thay đổi từ lần cuối tôi tải không?” Nếu không, máy chủ chỉ trả lời “yên tâm, bản cũ còn dùng được” (giúp tiết kiệm băng thông).
HEAD: Giống như soi bìa sách thay vì đọc cả cuốn. Client chỉ lấy metadata (header HTTP) để kiểm tra thông tin: file còn tồn tại không, có đổi mới không…
POST: Đây là bước đột phá. Client có thể gửi dữ liệu lên server, ví dụ form đăng nhập hay đơn hàng mua sắm. Khác với GET, giao thức POST mang dữ liệu trong body request, kín đáo hơn (dù vẫn phải gửi qua HTTPS mới thật sự an toàn).
Header: lời nhắn gửi kèm yêu cầu
HTTP/1.0 bổ sung header – những dòng thông tin thêm để client “dặn dò” server. Ví dụ:
Tôi đang dùng trình duyệt tên “MyAwesomeWebBrowser 1.1”
Đây chính là cơ chế giúp web mở rộng: chỉ cần thêm header mới là có thể dạy client/server hiểu thêm “ngôn ngữ” mà không phá vỡ giao thức.
Mã phản hồi: server biết cách trả lời
HTTP/0.9 không có khái niệm mã phản hồi. Nếu lỗi thì server chỉ nhét thông báo vào HTML. Sang HTTP/1.0, lần đầu tiên xuất hiện status code, ba chữ số huyền thoại:
Các mã 2xx, 3xx, 4xx, 5xx chia thành từng nhóm rõ ràng, biến HTTP thành một cuộc hội thoại có quy tắc: client hỏi, server đáp, không phải đoán mò nữa.
2xx – Thành công
200 OK: Mọi thứ ngon lành, dữ liệu đây.
201 Created: POST thành công, đã tạo tài nguyên mới.
202 Accepted: Server nhận rồi, đang xử lý, bạn đợi chút.
204 No Content: Yêu cầu thành công nhưng không có gì để gửi lại (ví dụ: xóa một record).
3xx – Chuyển hướng
300 Multiple Choices: Có nhiều đường, bạn chọn.
301 Moved Permanently: Tài nguyên đã dọn nhà vĩnh viễn (Location header chỉ đường).
302 Moved Temporarily: Tạm thời dọn nhà.
304 Not Modified: File chưa đổi từ lần cuối, cứ dùng bản cũ.
4xx – Lỗi từ phía client
400 Bad Request: Server không hiểu bạn nói gì, sửa cú pháp đi.
401 Unauthorized: Bạn chưa đăng nhập.
403 Forbidden: Đăng nhập rồi nhưng không có quyền.
404 Not Found: Nổi tiếng nhất – giống như bấm số điện thoại sai: “Thuê bao không tồn tại.”
5xx – Lỗi từ phía server
500 Internal Server Error: Lỗi chung chỉ về việc server lỗi
501 Not Implemented: Server không biết xử lý yêu cầu này.
502 Bad Gateway: Proxy/gateway hỏi downstream server nhưng nhận lỗi.
503 Service Unavailable: Server quá tải hoặc đang bảo trì, quay lại sau.
HTTP 1.1
Vì thế, HTTP/1.1 ra đời năm 1997, chỉ 9 tháng sau khi HTTP/1.0 được chuẩn hóa. Nó không thay đổi tận gốc như từ 0.9 → 1.0, nhưng đã tinh chỉnh, bổ sung và quan trọng nhất: đặt ra tiêu chuẩn chính thức cho toàn bộ thế giới web, vốn đang bùng nổ mạnh mẽ.
Đến nay, HTTP/1.1 đã trải qua nhiều lần sửa đổi:
RFC 2068 (1997) – bản đầu tiên
RFC 2616 (1999) – cập nhật và thay thế
RFCs 7230–7235 (2014) – chỉnh sửa, chi tiết hóa hơn (305 trang, gần 100.000 từ!)
Điều này cho thấy: giao thức tưởng chừng “đơn giản” lại phức tạp đến mức cần một bộ luật khổng lồ để mọi trình duyệt, máy chủ, proxy trên thế giới cùng “nói chung một ngôn ngữ”.
Những thay đổi quan trọng trong HTTP/1.1
1. Host header bắt buộc
Trong HTTP/1.0, client gửi request kiểu:
GET /index.html HTTP/1.0
Server hiểu là: à, nó đang xin file index.html từ chính website mà nó đang kết nối đến. Nhưng khi web phát triển, một server có thể chạy hàng trăm website khác nhau trên cùng một địa chỉ IP (virtual hosting). Làm sao server biết client muốn example.com/index.html hay blog.example.com/index.html?
Giải pháp: thêm Host header.
GET / HTTP/1.1
Host: www.google.com
Từ HTTP/1.1 trở đi, mọi request bắt buộc phải có Host. Nhờ đó:
Một server duy nhất có thể phục vụ nhiều website.
Tiết kiệm tài nguyên IP (IPv4 vốn khan hiếm).
Nếu không có bước này, có thể web sẽ “ngốn” sạch IPv4 từ rất sớm. Ngược lại, nếu hồi đó người ta không chọn giải pháp Host header, mà bắt client phải gửi URL đầy đủ (absolute-form), thì web có thể đã ép buộc sang IPv6 sớm hơn 20 năm.
2. Kết nối bền vững (Persistent connections / Keep-Alive)
HTTP ban đầu hoạt động theo kiểu: một request → một response → đóng kết nối.
Nhưng khi web nhiều hình ảnh, CSS, JS, việc liên tục đóng/mở kết nối TCP cực kỳ lãng phí. Mỗi lần bắt tay TCP tốn thêm vài trăm mili-giây, nhân lên hàng chục file thì người dùng sẽ “chờ dài cổ”.
HTTP/1.1 thay đổi mặc định:
Mọi kết nối được giữ mở trừ khi server nói rõ “Connection: close”.
Client có thể gửi tiếp nhiều request trên cùng một kết nối.
GET /style.css HTTP/1.1
Host: www.example.com

GET /script.js HTTP/1.1
Host: www.example.com
Trình duyệt có thể “nạp đơn hàng” liên tục thay vì phải xếp hàng lại từ đầu.
Tuy nhiên, điều này đòi hỏi phải có thêm cách xác định “đâu là hết dữ liệu” (vì không còn dấu hiệu đóng kết nối nữa). Do đó, HTTP/1.1 dùng 1 header Content-Length hoặc chunked transfer encoding để báo độ dài nội dung. Khi đó, các bên có thể từ content length và dữ liệu đã nhận được để biết bao giờ là kết thúc.
3. Pipelining (nhưng thất bại)
HTTP/1.1 còn đưa ra ý tưởng pipelining: client gửi nhiều request “một lèo” mà không chờ phản hồi, server trả kết quả theo thứ tự.
Ví dụ:
Gửi cùng lúc request cho CSS, JS, ảnh.
Server trả về lần lượt CSS → JS → ảnh.
Nghe thì hay, nhưng thực tế bị head-of-line blocking: nếu request đầu tiên bị chậm (ví dụ truy vấn DB lâu), thì mọi request sau bị kẹt. Thêm nữa, hỗ trợ pipelining ở proxy và server thường kém (thậm chí lỗi). Vì vậy, pipelining gần như “chết yểu”, không được các trình duyệt phổ biến bật mặc định.
4. Bộ nhớ đệm (Caching) thông minh hơn
Trong HTTP/1.0, chỉ có header Expires: <date>. Nghĩa là:
Nếu quá ngày đó → tài nguyên hết hạn, phải tải lại từ server.
Nó cứng nhắc, ví dụ bạn muốn cho cache tồn tại 30 phút tính từ lúc tải thì không làm được (vì Expires cần một mốc thời gian cố định).
HTTP/1.1 thì mềm dẻo hơn nhờ Cache-Control:
max-age=600 → cache trong vòng 600 giây (10 phút).
no-cache → client vẫn lưu cache nhưng luôn xác thực lại với server trước khi dùng.
must-revalidate → nếu cache hết hạn thì bắt buộc hỏi server, không được tự ý dùng lại.
public / private → phân biệt cache dùng chung (CDN, proxy) hay chỉ cho trình duyệt người dùng.
Ví dụ thực tế:
File CSS/JS ít thay đổi → Cache-Control: max-age=604800 (1 tuần).
Ảnh profile user (có thể đổi nhưng không thường xuyên) → Cache-Control: max-age=86400, must-revalidate.
Điểm mạnh: giúp tăng tốc độ web, giảm tải server, nhưng vẫn linh hoạt để dữ liệu quan trọng luôn mới.
5. Nhiều method và tính năng mới
HTTP/1.1 bổ sung khá nhiều method để phù hợp với web ngày càng phức tạp:
Method mới
PUT: ghi đè hoặc tạo tài nguyên ở URL cụ thể.
DELETE: xóa tài nguyên.
OPTIONS: hỏi server xem URL đó hỗ trợ những method nào (cần cho CORS).
TRACE: gửi request để server trả lại toàn bộ nội dung nó nhận → debug.
CONNECT: dùng cho tunneling (thường thấy khi HTTPS đi qua proxy).
Proxy support Cho phép request/response đi qua nhiều server trung gian (caching proxy, load balancer, CDN).
Authentication Có sẵn cơ chế như Basic và Digest Authentication để bảo vệ tài nguyên.
Cookies HTTP vốn stateless (mỗi request độc lập, không nhớ “ai với ai”). Cookie giúp “nhớ” trạng thái (user đã login, giỏ hàng, session…).
Charset & Content-Language Giúp server khai báo tài liệu dùng encoding gì (UTF-8, ISO-8859-1…) và ngôn ngữ (en, vi…).
Status code mới Bổ sung thêm nhiều mã: 409 Conflict, 410 Gone, 100 Continue… để mô tả chính xác hơn tình huống.
Trailing headers & mở rộng headers vô hạn Cho phép thêm metadata bổ sung sau phần body (dùng trong chunked transfer). HTTP/1.1 cũng gỡ bỏ giới hạn số lượng header → dễ mở rộng (các API hiện nay tận dụng điều này rất nhiều, như Authorization, X-Request-ID, Content-Security-Policy).
Các vấn đề của HTTP/1.1
Sau khi HTTP/1.1 được chuẩn hóa, nó trở thành nền móng của web suốt 20 năm. Nhưng chính sự bùng nổ website đã làm lộ rõ giới hạn của giao thức này.
Năm 2010, trang web trung bình ~ 700 KB, khoảng 50 request.
Đến 2018, tăng lên gần 1.8 MB, hơn 80–90 request.
Một số website lớn:
Wikipedia: chỉ 7 request, 0.06 MB (rất tối ưu).
Facebook: 172 request, 2.2 MB.
Amazon: 136 request, 4.46 MB.
Yahoo: 240 request, 3.8 MB.
Nguyên nhân: website ngày càng giàu media (ảnh, video), nhiều framework và script, và dùng AJAX để cập nhật động liên tục.
Các vấn đề performance của HTTP/1.1 và cách giải quyết tạm thời vào thời điểm này
Hãy tưởng tượng bạn mở một trang web rất đơn giản: chỉ có một ít văn bản và hai tấm hình.
Mỗi yêu cầu (request) từ trình duyệt đến server tốn 50ms để di chuyển qua mạng internet.
Máy chủ lấy dữ liệu từ file server, xử lý trong 10ms rồi trả về.
Trình duyệt khi nhận được ảnh, xử lý thêm 10ms trước khi gửi tiếp yêu cầu mới.
Tổng cộng, để hiển thị xong trang này cần 360ms. Trong đó chỉ 60ms là thời gian xử lý thực sự ở máy khách và máy chủ; còn lại 300ms (hơn 80%) chỉ để… chờ dữ liệu qua lại trên đường truyền. Trong lúc chờ, cả server lẫn trình duyệt đều “ngồi chơi xơi nước”
Điều bất hợp lý lộ rõ ở mốc 120ms: trình duyệt vừa gửi yêu cầu lấy ảnh số 1 và biết chắc là sẽ cần ảnh số 2, nhưng không thể gửi ngay. Nó buộc phải chờ ảnh 1 trả về xong, kết nối mới “rảnh” để gửi tiếp yêu cầu ảnh 2 vào lúc 240ms. Cách vận hành này làm mọi thứ chậm hẳn đi.
Trình duyệt hiện đại thường mở 6 kết nối / domain. Nếu website có nhiều file, chúng được tải trên 6 “đường ống” cùng lúc.
Dùng nhiều kết nối HTTP
Để tăng hơn nữa, nhiều trang web dùng domain sharding: chia file ra các subdomain như static.example.com, cdn.example.com… Như vậy mỗi domain được thêm 6 kết nối, tăng khả năng song song.
Ví dụ: StackOverflow tải:
jQuery từ Google,
Script/CSS từ cdn.static.net,
Ảnh từ i.stack.imgur.com.
Nhưng: giải pháp này lại tạo ra gánh nặng:
TCP handshake: mỗi kết nối mới cần 3 bước SYN → SYN-ACK → ACK (tốn 1.5 round-trip).
TCP slow start: kết nối mới ban đầu chỉ gửi ít gói, tăng dần khi chứng minh mạng chịu tải. Nghĩa là request/response đầu tiên thường bị “thắt cổ chai”.
HTTPS handshake: thêm vài vòng trao đổi nữa để thiết lập mã hóa.
Mozilla từng thống kê: 74% kết nối HTTP/1 chỉ dùng cho 1 transaction duy nhất → tức nhiều kết nối mở ra xong gần như bỏ phí.
Kết luận: mở nhiều kết nối giúp đỡ phần nào, nhưng chỉ là giải pháp tình thế. Nó tự tạo thêm chi phí (handshake, slow start, bộ nhớ) trong khi bản chất vấn đề vẫn là độ trễ.
Giảm số lượng request
Cách khác: thay vì tăng kết nối, hãy giảm số lần gọi.
Cache: dùng HTTP header Cache-Control, Expires để client lưu lại file, không tải lại nữa.
Sprite images: gộp nhiều icon nhỏ thành một ảnh lớn rồi dùng CSS để “cắt” ra (TinyPNG hay dùng cách này).
Concatenate & Minify: gộp nhiều file CSS/JS → một file duy nhất, đồng thời xóa khoảng trắng, comment.
Inline: chèn CSS/JS/ảnh trực tiếp vào HTML (dùng <style>, <svg>, hoặc base64).
Nhược điểm:
Phức tạp: tạo sprite, gộp file cần phải triển khai từ trước.
Lãng phí: tải cả sprite 100 icon trong khi chỉ cần 2.
Cache khó quản lý: một thay đổi nhỏ buộc user tải lại cả file lớn (dù chỉ đổi một dòng CSS).
SPDY
Nguồn gốc: năm 2009, Google (Mike Belshe & Robert Peon) giới thiệu SPDY (đọc là “speedy”). Họ chạy thử nghiệm trên bản sao của 25 trang web lớn nhất và thấy cải thiện tốc độ tải trang rất rõ rệt, tới mức hai chữ số phần trăm trong nhiều trường hợp.
Ý tưởng chính của SPDY: không thay đổi “nghĩa” của HTTP (vẫn có GET/POST/headers/body), nhưng thay đổi cách đóng gói và gửi các yêu cầu/response sao cho nhanh hơn và hiệu quả hơn với mạng hiện có. SPDY làm 4 việc quan trọng:
Multiplexing (đa luồng trên một kết nối):
Trước HTTP/1.1: trình duyệt mở nhiều kết nối TCP (mỗi tên miền thường ~6 kết nối đồng thời). Mỗi kết nối chỉ xử lý lần lượt một yêu cầu → xuất hiện “waterfall” (đọan thác): các nhóm tài nguyên phải chờ lượt.
SPDY: mọi request/response được chia thành các streams nhỏ, gửi xen kẽ qua một kết nối TCP duy nhất. Kết quả: tài nguyên có thể được gửi song song mà không cần mở thêm TCP connection.
Request prioritization (ưu tiên yêu cầu):
Không phải mọi tài nguyên đều quan trọng như nhau. SPDY cho phép trình duyệt nói với server tài nguyên nào quan trọng hơn (ví dụ: CSS quan trọng hơn ảnh nền). Server có thể ưu tiên gửi trước các stream quan trọng.
Header compression:
HTTP/1.1 gửi header dạng text cho từng yêu cầu, với nhiều request, header trùng lặp (cookie, user-agent, accept,…) gây lãng phí. SPDY nén header để giảm kích thước và số byte truyền.
Nếu mỗi request gửi một header Cookie: SESS=... dài 200 B, 360 request = 72 KB chỉ cho cookie. Header compression giảm con số này mạnh mẽ.
Server push (đẩy từ server):
Server có thể “đẩy” các tài nguyên mà nó dự đoán client sẽ cần (ví dụ: CSS, JS) ngay khi client yêu cầu HTML, tránh vòng lặp client → server hỏi “tôi cần CSS không?” → server mới trả.
Vì các tính năng như multiplexing và framing yêu cầu cấu trúc nhỏ gọn, chính xác và dễ phân mảnh, điều khó/không thể làm tốt khi gửi toàn bộ theo dạng text line-based (như HTTP/1.x). Binary framing cho phép định nghĩa các frame nhỏ (HEADERS, DATA, SETTINGS, WINDOW_UPDATE, v.v.) để truyền và ghép lại chính xác.
Kết quả thực tế: triển khai SPDY ở Chrome và trên các dịch vụ Google cho thấy tốc độ tải trang cải thiện rõ rệt; nhiều browser/server khác cũng nhanh chóng bổ sung hỗ trợ. Tuy nhiên SPDY chỉ là bước trung gian: nó chứng minh các ý tưởng thực tế và trở thành nền tảng để chuẩn hóa HTTP/2.
Ảnh: Sau khi HTTP/2 ra đời, SPDY bắt đầu giảm xuống
HTTP/2
SPDY chứng minh rằng các cải tiến có thể làm được, IETF (HTTP Working Group) dựa trên SPDY khi soạn HTTP/2 (bản draft đầu vào cuối 2012). HTTP/2 giữ hầu hết ý tưởng tốt của SPDY nhưng chuẩn hoá chúng, bổ sung một số cải tiến (ví dụ HPACK cho header compression) và xử lý các chi tiết tương thích/ bảo mật.
Tại sao dùng HTTP/2 thay vì HTTP/1.2?
HTTP/2 được tạo ra để giải quyết các vấn đề hiệu suất của HTTP/1, và phiên bản mới này thêm vào các khái niệm sau:
Giao thức nhị phân thay vì văn bản.
Ghép kênh (multiplexed) thay vì đồng bộ (synchronous).
Kiểm soát dòng chảy (flow control).
Ưu tiên luồng (stream prioritization).
Nén tiêu đề (header compression).
Đẩy từ máy chủ (server push).
Những khái niệm này (sẽ được mô tả chi tiết hơn trong chương) là những thay đổi cơ bản, phá vỡ tính tương thích ngược; nghĩa là, máy chủ web HTTP/1.0 có thể hiểu tin nhắn HTTP/1.1 và bỏ qua các chức năng thừa, nhưng điều này không đúng với tin nhắn HTTP/2, vì chúng có cấu trúc và định dạng khác. Vì lý do đó, HTTP/2 được coi là bản nâng cấp lớn..
Nhị phân thay vì văn bản
Một khác biệt chính giữa HTTP/1 và HTTP/2 là HTTP/2 là giao thức nhị phân dựa gói, trong khi HTTP/1 hoàn toàn dựa văn bản. Giao thức dựa văn bản dễ hiểu cho con người nhưng khó phân tích cho máy tính. Điều này chấp nhận được cho giao thức yêu cầu-phản hồi đơn giản mà HTTP bắt đầu, nhưng ngày càng hạn chế cho internet hiện đại.
Với giao thức văn bản, yêu cầu phải gửi và phản hồi nhận đầy đủ trước khi xử lý yêu cầu khác. HTTP hoạt động thế này 20 năm qua, dù có cải tiến nhỏ. HTTP/1.0 giới thiệu thân HTTP nhị phân, ví dụ, nơi hình ảnh và media khác có thể gửi trong phản hồi, và HTTP/1.1 giới thiệu pipelining và mã hóa chunked. Mã hóa chunked cho phép gửi phần thân tin nhắn trước, phần còn lại theo sau khi sẵn sàng. Thân HTTP chia thành chunk, và client nhận chunked response (hoặc server nhận chunked request) có thể bắt đầu xử lý trước khi nhận đầy đủ. Kỹ thuật này thường dùng khi độ dài dữ liệu tạo động không biết trước. Cả chunked encoding và pipelining có vấn đề chặn đầu hàng (HOL blocking), nơi tin nhắn đầu hàng ngăn phản hồi sau gửi, chưa kể pipelining không được hỗ trợ tốt trong thế giới thực.
HTTP/1.1
Định dạng: toàn bộ request/response là văn bản (ASCII/UTF-8).
Request line: GET /index.html HTTP/1.1
Headers: Host: example.com\r\n...
Body: theo sau, độ dài được báo bằng Content-Length hoặc chunked encoding.
Kết quả:
Parser phải đọc dấu hiệu kết thúc dòng (\r\n) để tách header.
Nếu header/body to, trình duyệt phải chờ nhiều (buffering).
Chỉ một request/response được xử lý trên một TCP connection tại một thời điểm → dễ nghẽn (head-of-line blocking).
Không có khái niệm “frame type”, tất cả đều là text nối tiếp nhau.
HTTP/2 – mọi thứ là frame
Cấu trúc rõ ràng, nhị phân: mỗi frame có header 9 byte cố định + payload.
Length (3 byte): kích thước payload.
Type (1 byte): phân loại (DATA, HEADERS, SETTINGS, PING, …).
Flags (1 byte): đánh dấu (END_STREAM, END_HEADERS, …).
Stream ID (4 byte, thực tế 31 bit): thuộc về stream nào.
Payload: dữ liệu thực (body, header block, …).
Ưu điểm:
Parser biết ngay độ dài frame → không cần scan ký tự xuống dòng.
Có thể ghép nhiều request/response song song trên một TCP connection (multiplexing, sẽ giải thích thêm ở dưới), nhờ phân biệt bằng stream ID.
Cho phép mở rộng: frame mới có thể được định nghĩa thêm mà không phá chuẩn.
Có nhiều loại frame khác nhau cho mục đích cụ thể: HEADERS, DATA, PRIORITY, WINDOW_UPDATE, PUSH_PROMISE… → kiểm soát chi tiết mà h1.1 không làm được.
Cấu trúc frame header (9 bytes đầu):
Length (3 bytes): độ dài payload.
Type (1 byte): loại frame (HEADERS, DATA, SETTINGS, …).
Flags (1 byte): cờ tùy theo frame type.
R (1 bit): reserved, không dùng.
Stream Identifier (31 bits): xác định stream mà frame thuộc về.
Payload: dữ liệu thực, độ dài như Length.
Frame types (10 chuẩn + mở rộng):
DATA (0x0): payload chính.
HEADERS (0x1): HTTP headers + priority.
PRIORITY (0x2): thay đổi độ ưu tiên, dependency.
RST_STREAM (0x3): kết thúc stream (thường khi lỗi).
SETTINGS (0x4): config connection.
PUSH_PROMISE (0x5): server thông báo sẽ push object.
PING (0x6): test RTT.
GOAWAY (0x7): đóng connection, không nhận stream mới.
WINDOW_UPDATE (0x8): điều khiển flow (bytes còn có thể nhận).
CONTINUATION (0x9): nối thêm headers khi HEADERS quá dài.
Extension frames: cho phép mở rộng mà không phá protocol.
t=   1646 [st=      1]    HTTP2_SESSION_RECV_SETTINGS
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "1 (SETTINGS_HEADER_TABLE_SIZE)"
                          --> value = 4096
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "5 (SETTINGS_MAX_FRAME_SIZE)"
                          --> value = 16384
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "6 (SETTINGS_MAX_HEADER_LIST_SIZE)"
                          --> value = 131072
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "3 (SETTINGS_MAX_CONCURRENT_STREAMS)"
                          --> value = 100
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "4 (SETTINGS_INITIAL_WINDOW_SIZE)"
                          --> value = 65536
Ghép kênh (multiplexing) trên một kết nối
Ý tưởng chính: HTTP/2 biến mỗi yêu cầu thành một luồng (stream) riêng, và tất cả luồng đi chung một “đường ống TCP duy nhất”.
Yêu cầu được cắt thành các khung (frame) nhỏ.
Mỗi khung có ID luồng để biết nó thuộc yêu cầu nào.
Server và client chỉ việc ghép các khung lại → tái tạo thành thông điệp HTTP hoàn chỉnh.
Lợi ích:
Không bị nghẽn đầu hàng (head-of-line blocking ở mức HTTP): Nếu một yêu cầu chậm (ví dụ tải ảnh lớn), nó không làm tắc nghẽn các yêu cầu khác. Server có thể trả xen kẽ: một khung ảnh, rồi một khung CSS, rồi tiếp tục ảnh…
Chỉ cần một kết nối TCP duy nhất cho mọi tài nguyên → giảm overhead handshake, giảm tiêu tốn tài nguyên.
Server có thể quyết định ưu tiên: gửi CSS/JS quan trọng trước, hình ảnh phụ sau → tăng tốc độ hiển thị trang.
Server phải trả đúng thứ tự: CSS → JS → PNG. Nếu file CSS to hoặc bị trễ, hai file sau cũng kẹt lại.
Với HTTP/2 multiplexing:
Client gửi cả 3 yêu cầu trên cùng một kết nối.
Server có thể trả: một phần CSS → một phần JS → một phần PNG → tiếp tục CSS…
Trình duyệt nhận được khung CSS đầu tiên thì đã có thể render ngay, không cần chờ toàn bộ CSS tải xong.
Bên trái (Client): trình duyệt gửi nhiều request (GET /styles.css, GET /script.js, GET /image.jpg…).
Giữa (HTTP/2 layer): tất cả request/response đều đi qua một kết nối TCP duy nhất nhưng được đóng gói thành nhiều stream. Mỗi stream lại chia nhỏ thành nhiều frame.
Bên phải (Server): server nhận request từ nhiều stream cùng lúc, xử lý rồi trả response xen kẽ trở lại trên cùng kết nối TCP.
Bước 1: Client gửi request
Client tạo 3 request:
Request 2 → GET /styles.css → Stream 5
Request 3 → GET /script.js → Stream 7
Request 4 → GET /image.jpg → Stream 9
Mỗi request sẽ được đánh số ID luồng (stream ID). Ở đây: 5, 7, 9 (client luôn tạo ID lẻ).
Bước 2: HTTP/2 framing layer đóng gói
Request không gửi nguyên khối, mà bị chia nhỏ thành frames:
Các frame từ nhiều stream có thể xếp nối tiếp nhau trên cùng kết nối TCP.
Ví dụ: thay vì phải gửi toàn bộ styles.css rồi mới đến script.js, rồi mới đến image.jpg, HTTP/2 sẽ gửi xen kẽ: một frame của Stream 5 (styles.css), sau đó một frame của Stream 7 (script.js), rồi một frame của Stream 9 (image.jpg)…
Bước 3: Server nhận và xử lý
Server đọc các frame, ghép lại theo stream ID để tái tạo thành request đầy đủ.
Sau đó server xử lý và tạo response.
Bước 4: Server trả response xen kẽ
Response cũng được cắt thành frames, rồi trả về client.
Các stream response không cần giữ đúng thứ tự yêu cầu ban đầu.
Server có thể ưu tiên gửi nhanh CSS (quan trọng để render trang) trước khi trả ảnh JPG.
Trong hình: Stream 5 và Stream 7 response đi xen kẽ nhau, trong khi Stream 9 (ảnh JPG) response nối tiếp.
Bạn có thể hình dung:
HTTP/1.1 giống như có 6 cái ống nước riêng, mỗi ống chỉ chảy được một loại nước. Nếu một ống nghẹt thì nước loại đó tắc hết.
HTTP/2 giống như một ống nước lớn duy nhất, trong đó dòng chảy có nhiều màu khác nhau (đỏ = ảnh, vàng = CSS, xanh = JS). Các giọt nước khác màu có thể luân phiên chạy trong cùng một ống, và khi đến đích thì được lọc ra đúng “xô” tương ứng.
Stream prioritization (Ưu tiên dòng)
HTTP/1.x:
Trình duyệt phải “xếp hàng” tài nguyên vì giới hạn 6 kết nối/host.
Muốn ưu tiên CSS/JS quan trọng thì chỉ đơn giản gửi sớm hơn. Nhưng nếu kết nối đã đầy, thì phải đợi → cơ chế ưu tiên thô sơ, bị giới hạn bởi số kết nối.
HTTP/2:
Có thể gửi hàng trăm stream một lúc trên cùng một kết nối.
Nếu không có ưu tiên, dễ lãng phí băng thông: ví dụ hình ảnh (không critical) lại chiếm chỗ trước CSS (critical).
Cơ chế ưu tiên: Client gửi “hints” về độ ưu tiên (priority) → server chọn phân bổ tài nguyên.
Ví dụ: nếu cả CSS và ảnh đang chờ, server sẽ gửi nhiều frame CSS hơn để trình duyệt render trang sớm.
Ưu tiên mềm: không phải “gửi cái này trước, cái kia sau”, mà là chia băng thông nhiều–ít giữa các stream.
Flow control
Ta đã thấy ở Multiplexing nghĩa là nhiều stream chia sẻ cùng một TCP. Nhưng nếu client đọc chậm (ví dụ đang pause video), mà server vẫn dồn dữ liệu video về → nghẽn buffer, mất gói, phải retransmit → phí công.
TCP vốn đã có cơ chế window size để tránh sender “dội” dữ liệu quá nhiều so với khả năng nhận của receiver.
Nhưng: TCP coi cả kết nối như một dòng duy nhất. Nếu một luồng dữ liệu (ví dụ video) bị nghẽn, thì nó kéo theo tất cả dữ liệu khác trên cùng connection → “head-of-line blocking”.
HTTP/2 chia nhỏ kết nối thành nhiều stream (mỗi request/response).
Mỗi stream có cửa sổ riêng (window size), mặc định 65,535 byte.
Cơ chế:
Server chỉ được gửi tối đa số byte trong cửa sổ.
Khi client xử lý xong một phần dữ liệu, nó báo lại bằng WINDOW_UPDATE frame → tăng cửa sổ, cho phép server gửi tiếp.
Kết quả: stream nào “chậm” (ví dụ video đang pause) thì chỉ bị tạm ngừng riêng, không ảnh hưởng các stream khác (CSS, JS vẫn chạy bình thường).
Giả sử stream #11 là video, stream #13 là CSS:
Ban đầu: cả hai có window = 65,535.
Server gửi:
Video 10 KB → cửa sổ video còn 55,535.
CSS 20 KB → cửa sổ CSS còn 45,535.
Client pause video → không gửi WINDOW_UPDATE cho stream #11 → video tạm “đóng băng”.
Nhưng client vẫn gửi WINDOW_UPDATE cho stream #13 → CSS tiếp tục tải bình thường.
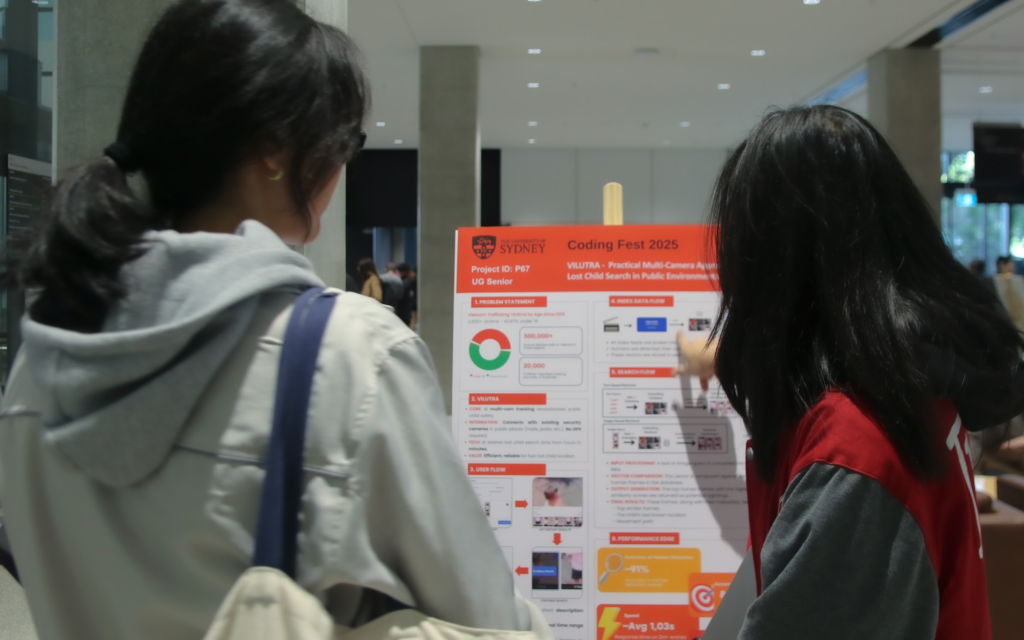
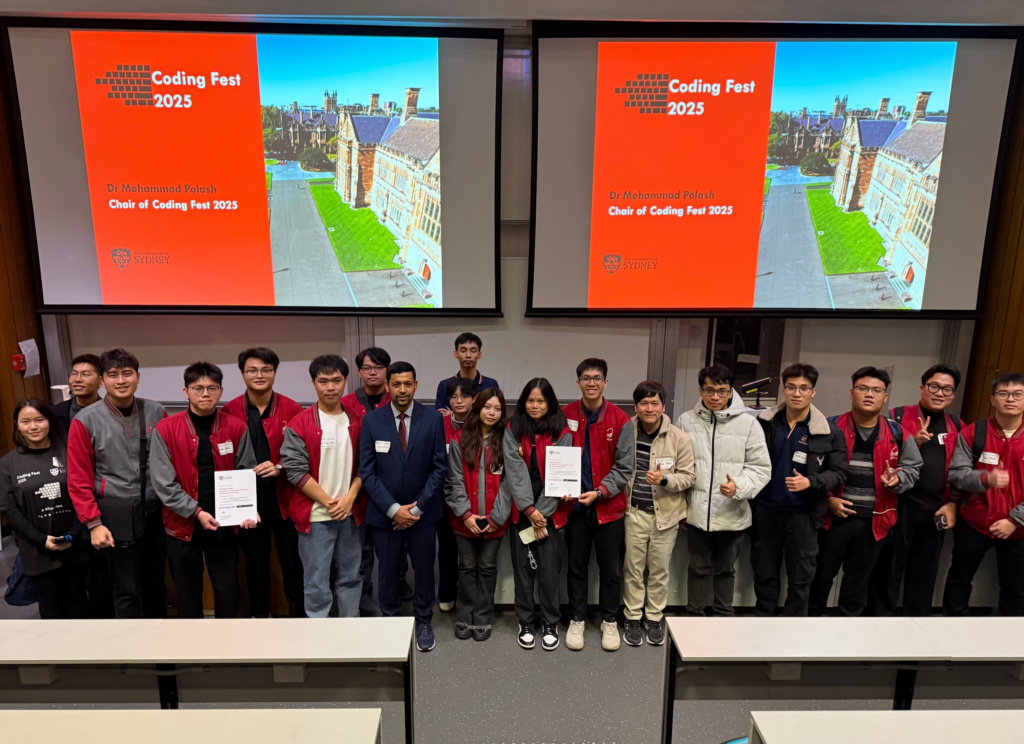
After passing the intense selection rounds at PTIT Innovation, our team (VILUTRA) was chosen to represent the school at Coding Fest 2025 in Sydney. This is a massive playground, over 500 students, 60 projects, and heavy hitters from universities like UNSW and Macquarie.
Touching down in Sydney, it’s July, so while Vietnam is boiling, Australia is deep in winter. We walked into the University of Sydney, which honestly looks like Hogwarts with its old castle buildings, wearing so many layers we looked like marshmallows. The vibe was electric, but standing next to teams from 50 different countries, we felt small.
Yeah, and bad thing happened right away. We had printed a poster in Vietnam to save time. But when we unrolled it at the hotel, disaster. The colors were completely off, the text was unreadable. It looked amateur. We had to trash it. We spent the entire night on Canva redesigning everything from scratch, praying we could find a printer at the school the next morning.
The stress broke us a little. Because the poster changed, our presentation flow didn’t make sense anymore. Minh and Linh got into a disagreement on how to fix it, which turned into a “Silent War.” For hours, nobody spoke.
To make matters worse, we not really into the food here. We tried the famous Aussie Fish and Chips, but man, it was dry. We missed the Vietnamese sauces and flavor. We ended up running to a nearby Asian restaurant just to feel human again.
But when showtime came, we snapped out of it. We reconciled, got the poster printed, and faced the judges. They grilled us hard, especially on the “Social Impact”, asking if our AI was invading privacy. We had to think fast, explaining that our system prioritizes rescue speed over surveillance data.
And for the final result, we actually got the First Prize for Social Impact section. It was a crazy 3 days, from freezing cold and dry food to broken posters and silent fights. But looking at the trophy now, it was worth every second.
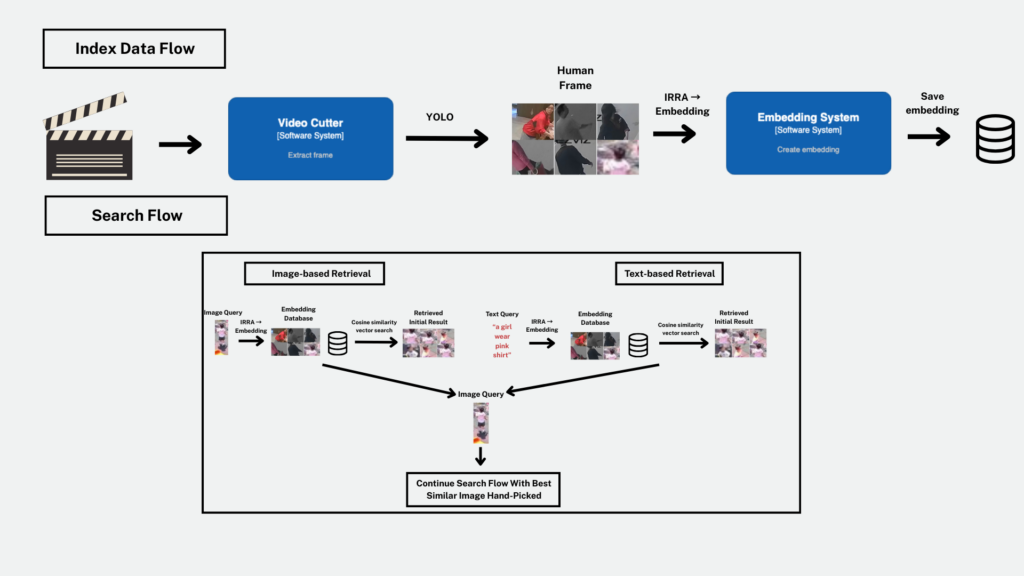
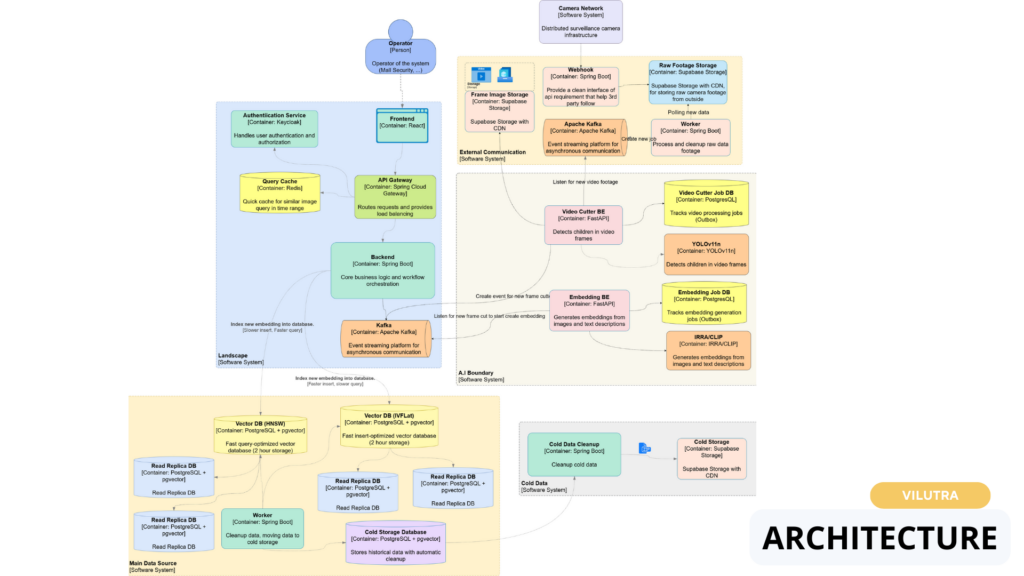
Our project, VILUTRA, tackles a scenario: losing a child in a crowded mall. Security cameras are everywhere, but they are “dumb”, they record, but they don’t help you search. We built a solution that turns those cameras into a real-time search engine. Basically, a guard can just type “girl wearing pink” or upload a photo, and the system u find that specific child across the entire camera network. It maps out exactly where they walked and where they are now, processing millions of frames in under a second.
Save this as keycloak/docker-compose.yml. Replace secure_password and admin_secure_password with strong, unique values, and update auth.example.com to your Keycloak subdomain.
1.2 Configure Nginx for SSL
Set up Nginx as a reverse proxy to secure Keycloak with HTTPS.
Install Nginx:
sudo apt update
sudo apt install nginx
Create an Nginx configuration file:
sudo nano /etc/nginx/sites-available/keycloak
Add the following, replacing auth.example.com with your subdomain:
Access the Keycloak admin console at https://auth.example.com/admin, logging in with admin and admin_secure_password. Change the admin password immediately for security.
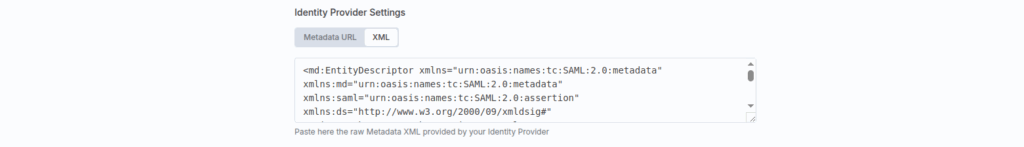
Step 2: Configure Keycloak as a SAML Identity Provider
Keycloak will act as the Identity Provider (IdP) for n8n. We’ll configure a SAML client, and set up mappers for user attributes.
Get required information from N8N
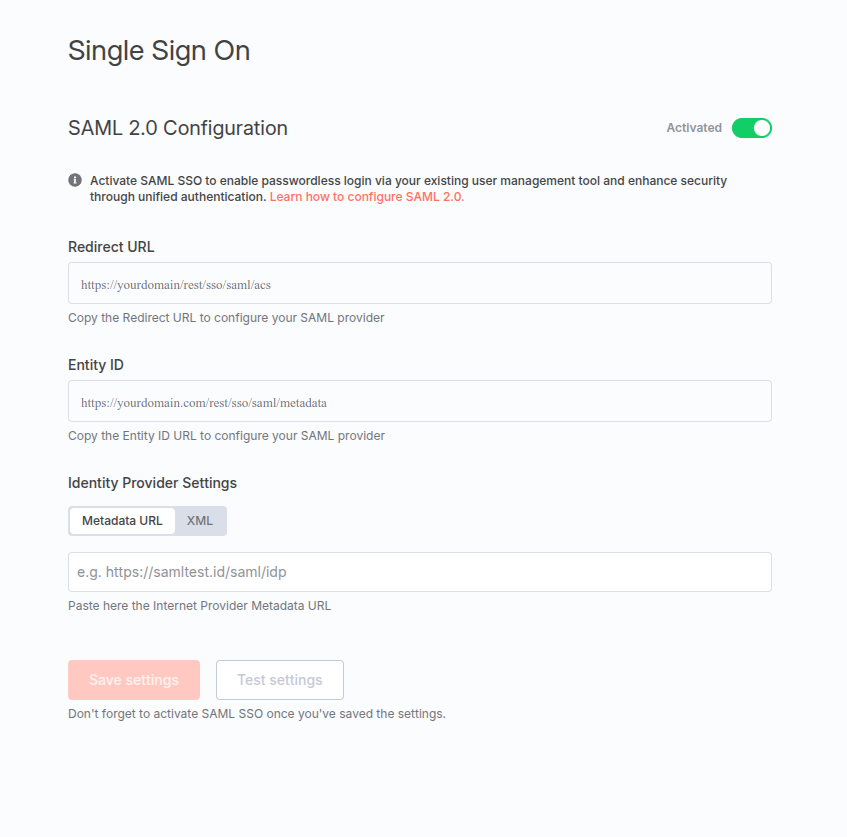
Navigate to Settings -> SSO
Save the Entity ID and Redirect URL
Create a SAML Client for n8n
Navigate to Clients > Create Client.
Set:
Client Type: SAML
Client ID: (n8n’s Entity ID from previous step, matching its base URL)
Name: n8n (Your choice)
Configure:
Valid Redirect URIs: https://n8n.example.com/saml/acs (Redirect URI from previous step)
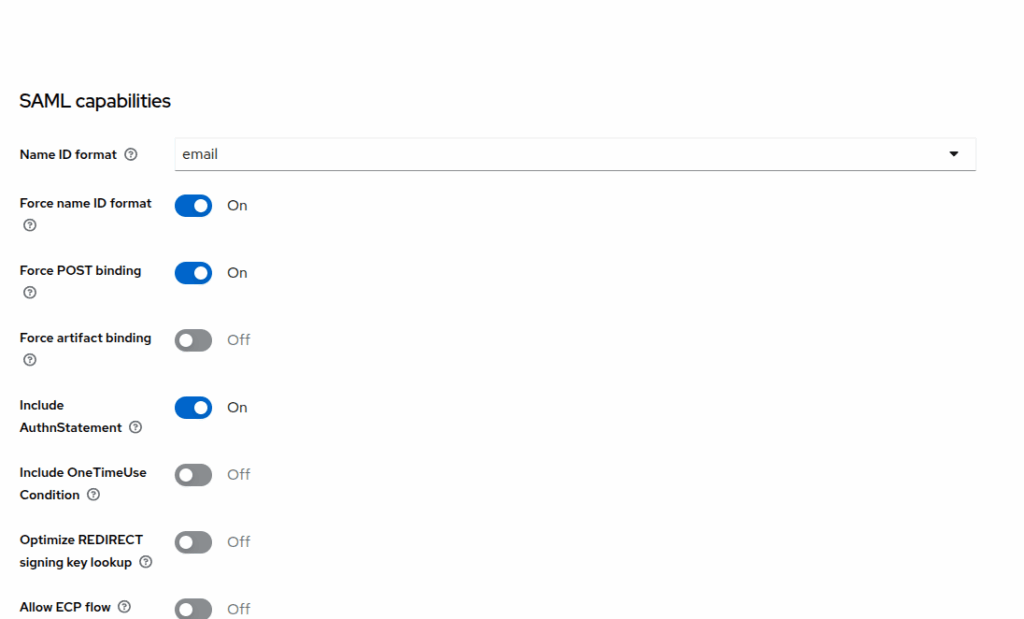
Settings: (Image below)
Name ID format: Email
Force name ID format: ON
Force POST binding: ON
Include AuthnStatement: ON
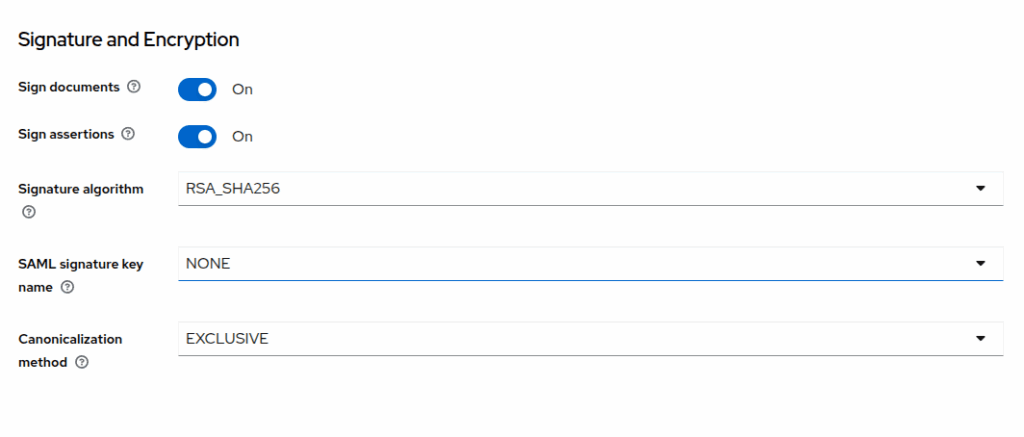
Sign Document: ON
Sign Asseration: ON
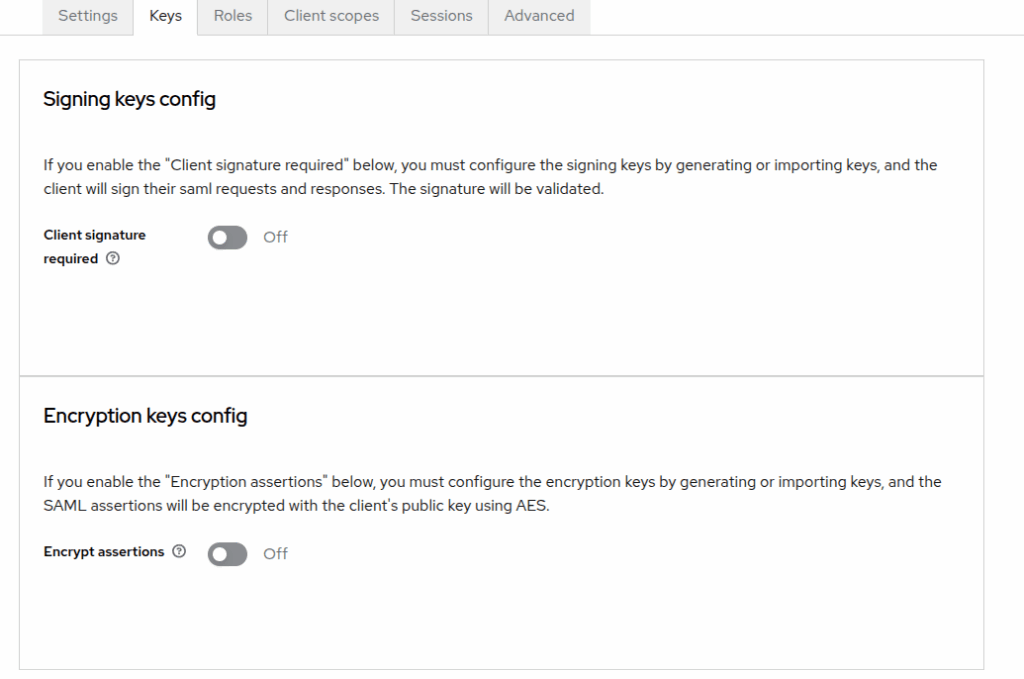
Client Signature Required: Off
Save the client.
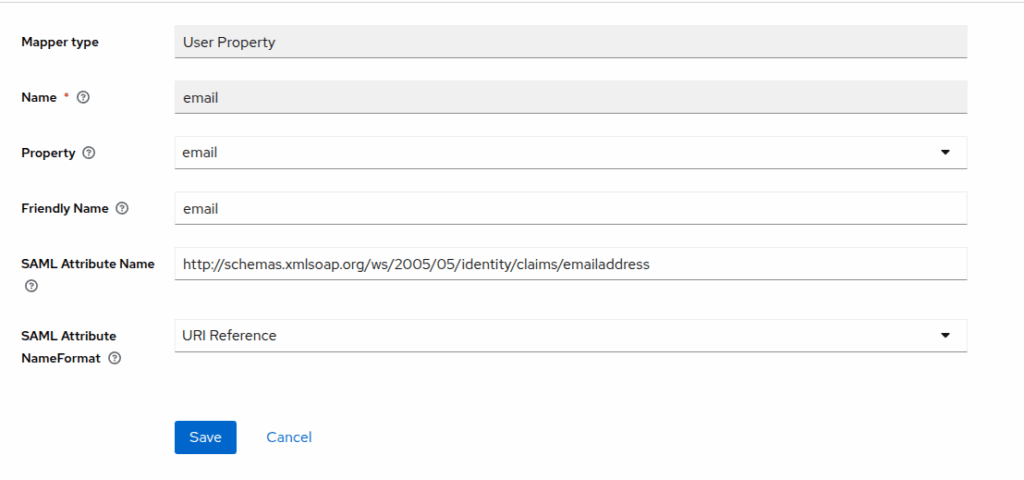
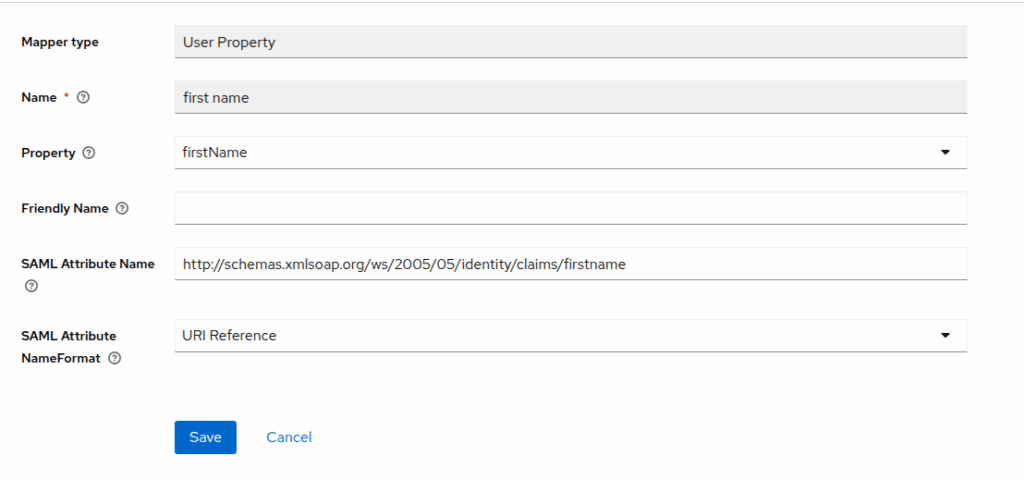
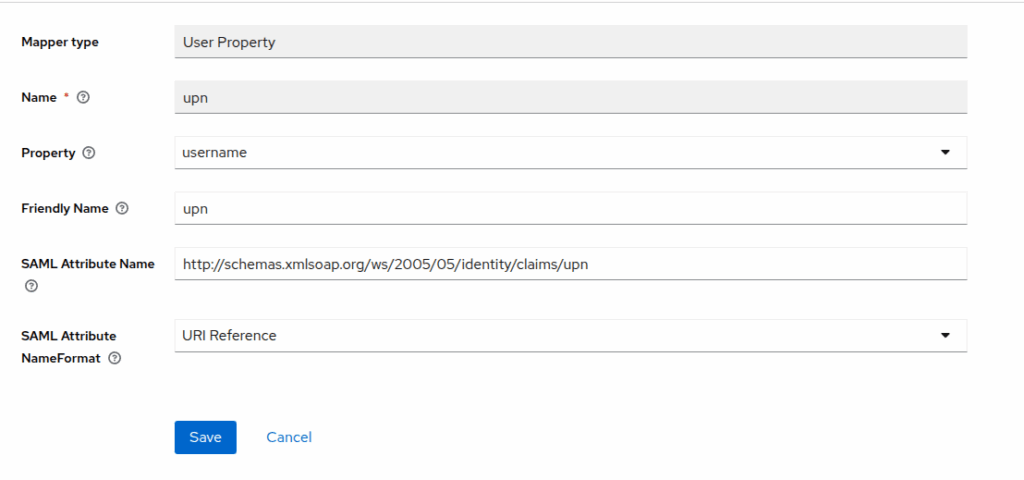
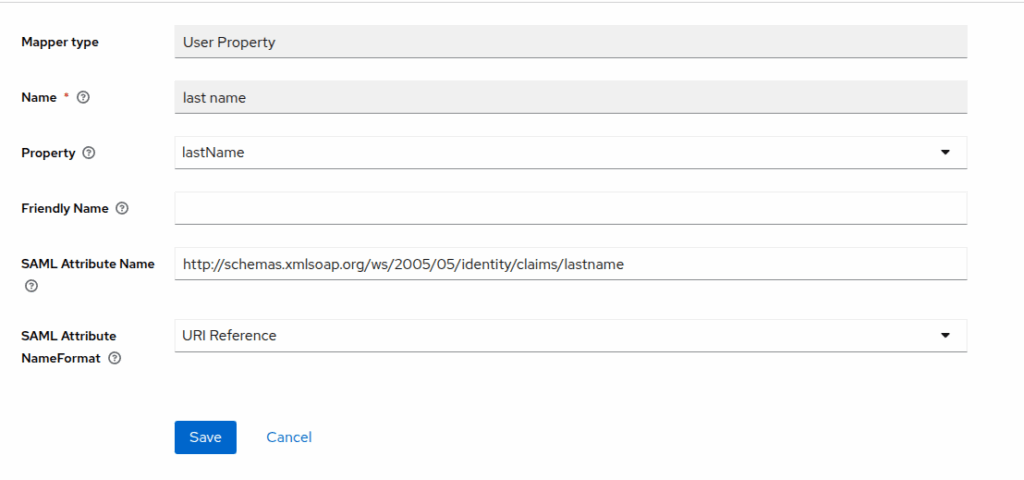
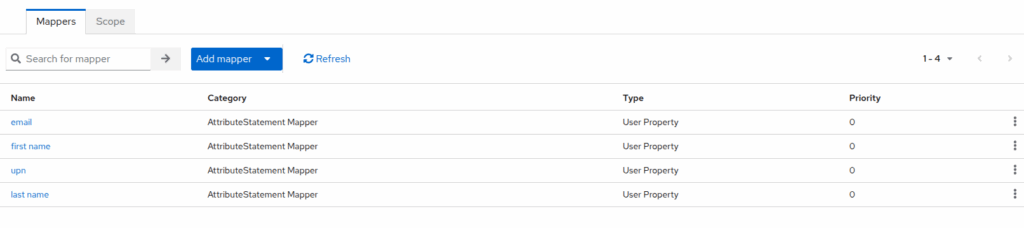
Configure Mappers
Mappers define how user attributes are sent to n8n.
I was recently working on a blog project using Editor.js. If you use it, you know it’s a solid block editor, but I ran into a problem when I actually tried to write content that included math formulas.
I needed to support LaTeX for big equations, but also inline math (like putting variables inside a sentence).
I figured this was a solved problem. I went to npm and GitHub to grab a plugin, but I couldn’t find anything that actually worked for me.
Most repos I found were published 3+ years ago and abandoned.
The ones that did work only supported “Block” math, so I couldn’t write formulas inside a paragraph.
It felt weird that something this essential was missing. I didn’t want to hack together a messy solution every time, so I decided to package it up properly.
This is editorjs-mathcyou. It’s actually my first npm package, so I wanted to make sure it solved the specific issues I found in other libraries.
It’s a lightweight wrapper around KaTeX that handles:
Inline Math: You can actually write math inside your text blocks.
Block Math: Standalone equations.
Parsing: I included a helper to clean up the data output.
How to use it
It’s pretty standard to set up.
Installation:
Bash
JavaScript
npminstalleditorjs-mathcyou
Configuration:
Just import it and add it to your tools config. Make sure you include the CSS for KaTeX or it will look broken.
JavaScript
JavaScript
importEditorJSfrom'@editorjs/editorjs';import{InlineMathTool,MathBlockTool}from'editorjs-mathcyou';import'katex/dist/katex.min.css';consteditor=newEditorJS({holder:'editorjs',tools:{paragraph:{class:Paragraph,inlineToolbar:true// You need this enabled for inline math},inlineMath:{class:InlineMathTool},mathBlock:{class:MathBlockTool}}});
Links
I put it up on npm if you want to try it out. Since this is my first lib, let me know if you spot any bugs or have ideas to make it better.
Gần đây, mình có phải gặp một bài toán khá hay, với nhu cầu là thiết kế một blog với 3 tiêu chí
Quản Lý Nội Dung Động: Các bài viết, tag, category cần được động, có thể quản lý (thêm sửa xoá mới) hoàn toàn trên giao diện để cho những người không rành về công nghệ cũng có thể vận hành được
Miễn phí: Quan trọng nhất, không được mất phí cho bất kì phần nào của hệ thống, đây là yêu cầu quan trọng nhất, vì cái này sẽ phục vụ cho 1 số tổ chức có kinh phí eo hẹp, hoặc cho cá nhân viết blog theo sở thích, … và không mong muốn chi thêm 1 khoản phí cho website (tất nhiên là không tính tới domain)
SEO: Website phải tốt cho SEO
Disclaimer: Đây không phải là một bài toán của blog mình, hiện tại blog của mình đang sử dụng WordPress, và nó tốn chi phí hàng tháng, nhưng cũng đáp ứng đủ các nhu cầu của mình.
Nếu cần Solution tối ưu nhất, hãy đi đến hướng đi cuối
Hướng đi 1: Static Site Generator (SSG)
Hướng tiếp cận đầu tiên của mình là sử dụng 1 opensource sinh ra các trang tĩnh cho blog, sau đó deploy bản được build ra lên một số trang cho host trang tĩnh miễn phí như Firebase Hosting, Github Page, …
Người dùng sẽ viết bài ở dạng Markdown, hoặc có thể là viết ở Notion, …
Sẽ cần 1 cái gì đó trigger thực hiện build khi viết bài xong, có thể là ci/cd tự động khi push markdown ở github, hoặc ở notion có lắng nghe sự kiện
Lúc này hệ thống sẽ build ra bản trang tĩnh, và có thể được deploy lên các trang hosting cho phép deploy trang tĩnh
Ví dụ: Hexo – Viết các file markdown, khi chạy generate sẽ sinh folder build
…
Pros
Miễn phí
SEO tốt
Có thể viết động, người dùng vận hành vào viết bài được nếu mà CI-CD đã làm hết -> Tuy nhiên vẫn chưa ở mức cao nhất là có trang quản lý riêng như mong muốn ban đầu lắm
Cons:
Đa số các giải pháp đều cần build lại ra trang tĩnh mỗi lần sửa đổi, và khi số lượng bài viết tăng lên thì càng tốn thời gian hơn.
Khi cần sửa đổi bài viết, thêm bài viết đều cần build lại, chưa thể vào xem thử tức thì
Chưa có giao diện quản lý trực quan
Hướng đi 2: NextJS
Một hướng đi thứ 2 để tối ưu SEO là sử dụng 1 framework server side rendering, có khá nhiều framework như vậy. Điển hình là NextJS.
Ta có thể sử dụng 1 database miễn phí, query bằng api để hỗ trợ trang web động.
Tuy nhiên NextJS nếu muốn build ra các dạng trang tĩnh, để có thể deploy free trên các trang host tĩnh như Github Page, Firebase Hosting, …. thì bắt buộc sẽ cần render toàn bộ trước.
Cụ thể sẽ cần sử dụng getStaticPaths, và lúc thời điểm build ra bản output, thì sẽ cần query toàn bộ bài viết ở database, và build.
Pros
Miễn phí
SEO tốt
Có thể viết động, chỉnh sửa động bằng giao diện do có thể code call api vào database động
Cons:
Thời gian build cực kì lâu, vì đa số các hosting free static site sẽ xoá toàn bộ file mỗi lần upload lên, và mỗi lần build thì cần build toàn bộ.
Hướng đi 3 – Solution: Pre-Crawl
Ở cách làm này, ta sẽ sử dụng CSR truyền thống để khi người dùng lướt web, sẽ đọc bài viết, dữ liệu được load động từ API. Và việc tạo bài viết, chuyên mục, … được admin vận hành tạo từ trang quản trị, cũng sẽ thực hiện qua API Database, ở đây sử dụng API Supabase
Mấu chốt là ví dụ như nếu sử dụng React, thì SEO sẽ rất kém, vì React đi theo dạng sử dụng đa số là JS và để JS build ra HTML. Nên các bot crawl của Google, Bing, … khi vào trang web nếu không chạy được js sẽ không load ra dữ liệu gì cả
Kết quả nhận được, bot không lấy được dữ liệu gì cả, chỉ có tên trang web, keyword, desc, … đều rỗng
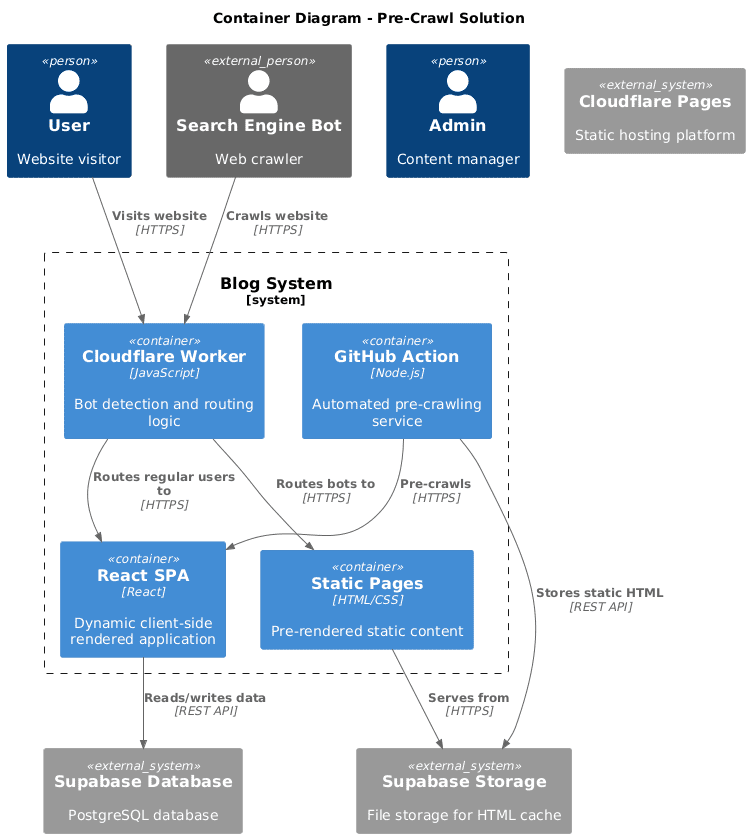
Phương án đề ra là ta sẽ sử dụng một luồng nghiệp vụ khác, riêng biệt, chuyên thực hiện việc đi vào các trang web như người dùng mở browser vào web vậy, sau đó cache lại các dữ liệu html vào 1 trang lưu tĩnh, lúc này khi Bot tới, ta sẽ có 1 tầng proxy kiểm tra xem có phải là Bot không, và redirect Bot sang trang tĩnh html đã được xử lý xong, còn người dùng thì đi luồng thông thường.
Có thể nhìn biểu đồ sau với các công nghệ sử dụng:
Proxy bên trên xử lý redirect: Cloudflare Worker Route + Cloudflare Worker
Lưu trữ HTML: Supabase Storage
Trang tĩnh: lưu trữ tại Cloudflare Page, dev bằng React
Thực hiện crawl trang web: Github Action
Database + API động bài viết: Supabase Database
Kết quả nhận được:
Bot sẽ crawl được các dữ liệu trong bài viết (Trong ảnh ở phần Indexable Page Text)
Pros
Miễn phí
SEO tốt
Có thể viết động, chỉnh sửa động bằng giao diện do có thể code call api vào database động
Build nhanh, do trang build ra là trang csr chỉ chứa code call api cho user <- Xử lý được hướng đi 1,2
Cons:
Sẽ cần flow crawl dữ liệu, cái này thì có thể chạy bằng manual cũng được, mình sử dụng 1 workflow trên Github Action để crawl, Github Action sẽ free 2200 phút / tháng (khoảng chạy được 1 tiếng /ngày, vì vậy sẽ cần triển khai logic dạng kiểm tra có nên crawl lại 1 trang không bằng thời gian cập nhật, … tuỳ vào nghiệp vụ)
Code triển khai + chi tiết setup với techstack bên trên
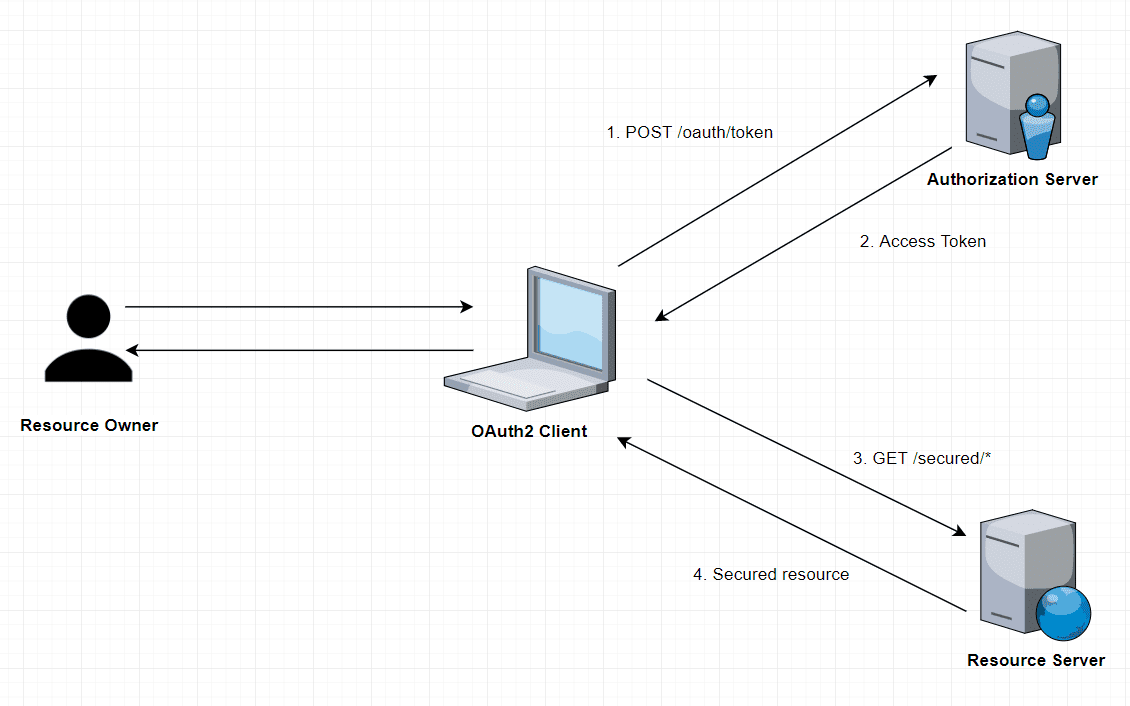
When integrating Google OAuth 2.0 with your Spring Boot application, the official documentation provides a comprehensive guide to leverage the GoogleCredential utility class for seamless and secure authorization. OAuth 2.0 is the industry standard for granting access to protected resources, and Google’s implementation is tailored to support various application types, ensuring flexibility across client environments.
Why OAuth 2.0 Matters
Imagine you’re building a task management application that needs to interact with a user’s Google Tasks data. OAuth 2.0 allows your app to request access only to the necessary data (e.g., “Manage your tasks”) while ensuring that the user maintains control over their privacy. The process generates an access token, which is a digital key tied specifically to your application and the user’s data. This token is scoped, meaning it limits the type and extent of access granted, thereby enhancing security. For instance, even if the token were somehow exposed, it couldn’t be used to access unrelated data like emails or photos.
Built on a Secure Foundation
The Google API Client Library for Java includes robust OAuth 2.0 packages such as:
com.google.api.client.googleapis.auth.oauth2: Core classes for implementing OAuth 2.0 flows.
com.google.api.client.googleapis.extensions.appengine.auth.oauth2: Specialized extensions for applications hosted on Google App Engine.
These packages are built on the Google OAuth 2.0 Client Library for Java, a general-purpose library offering standardized utilities to handle token acquisition, refresh, and expiration seamlessly.
A Real-World Perspective
Consider an example where a SaaS platform integrates with Google Drive to allow users to upload documents directly from their accounts. With OAuth 2.0, users authenticate their Google accounts through a secure flow, and the platform receives an access token to interact with Google Drive APIs. Instead of continuously requesting sensitive credentials, the platform uses this token to upload or retrieve files, keeping user data secure and operations streamlined.
By utilizing the detailed guidelines in Google’s documentation, you can ensure that your Spring Boot application adheres to best practices for secure OAuth 2.0 integration, offering a smooth user experience while protecting sensitive information.
Acquiring the Client Secret File
To begin integrating Google OAuth 2.0 into your application, the first crucial step is setting up a project on the Google API Console. This console serves as the central hub for managing authorization credentials, configuring API access, and ensuring proper billing setup. Whether your application runs on a web server, mobile device, desktop client, or directly in a browser, this setup process is essential.
Setting Up Credentials
Navigate to the Google API Console and create a new project. Once the project is set up, you can enable the desired APIs and generate the OAuth 2.0 client credentials, which include:
Client ID: Uniquely identifies your application during the authorization process.
Client Secret: A sensitive key used to authenticate your application, ensuring secure communication with Google’s servers.
Redirect URIs: Specify where Google will send users after they complete the authorization flow.
For detailed guidance on configuring these elements, refer to the API Console Help.
Setup a Authorization code flow
Use the authorization code flow to allow the end-user to grant your application access to their protected data on Google APIs. The protocol for this flow is specified in Authorization Code Grant.
If not, call AuthorizationCodeFlow.newAuthorizationUrl() and direct the end-user’s browser to an authorization page to grant your application access to their protected data.
The Google authorization server will then redirect the browser back to the redirect URL specified by your application, along with a code query parameter. Use the code parameter to request an access token using AuthorizationCodeFlow.newTokenRequest(String)).
Understanding the DataStoreFactory in GoogleAuthorizationCodeFlow.Builder
When constructing a GoogleAuthorizationCodeFlow object, one of the essential components is the DataStoreFactory. This factory is responsible for persisting user credentials securely and efficiently. Google provides three types of built-in implementations, each suited for different use cases:
Implementing a Custom Data Store to Persist Tokens in a Database
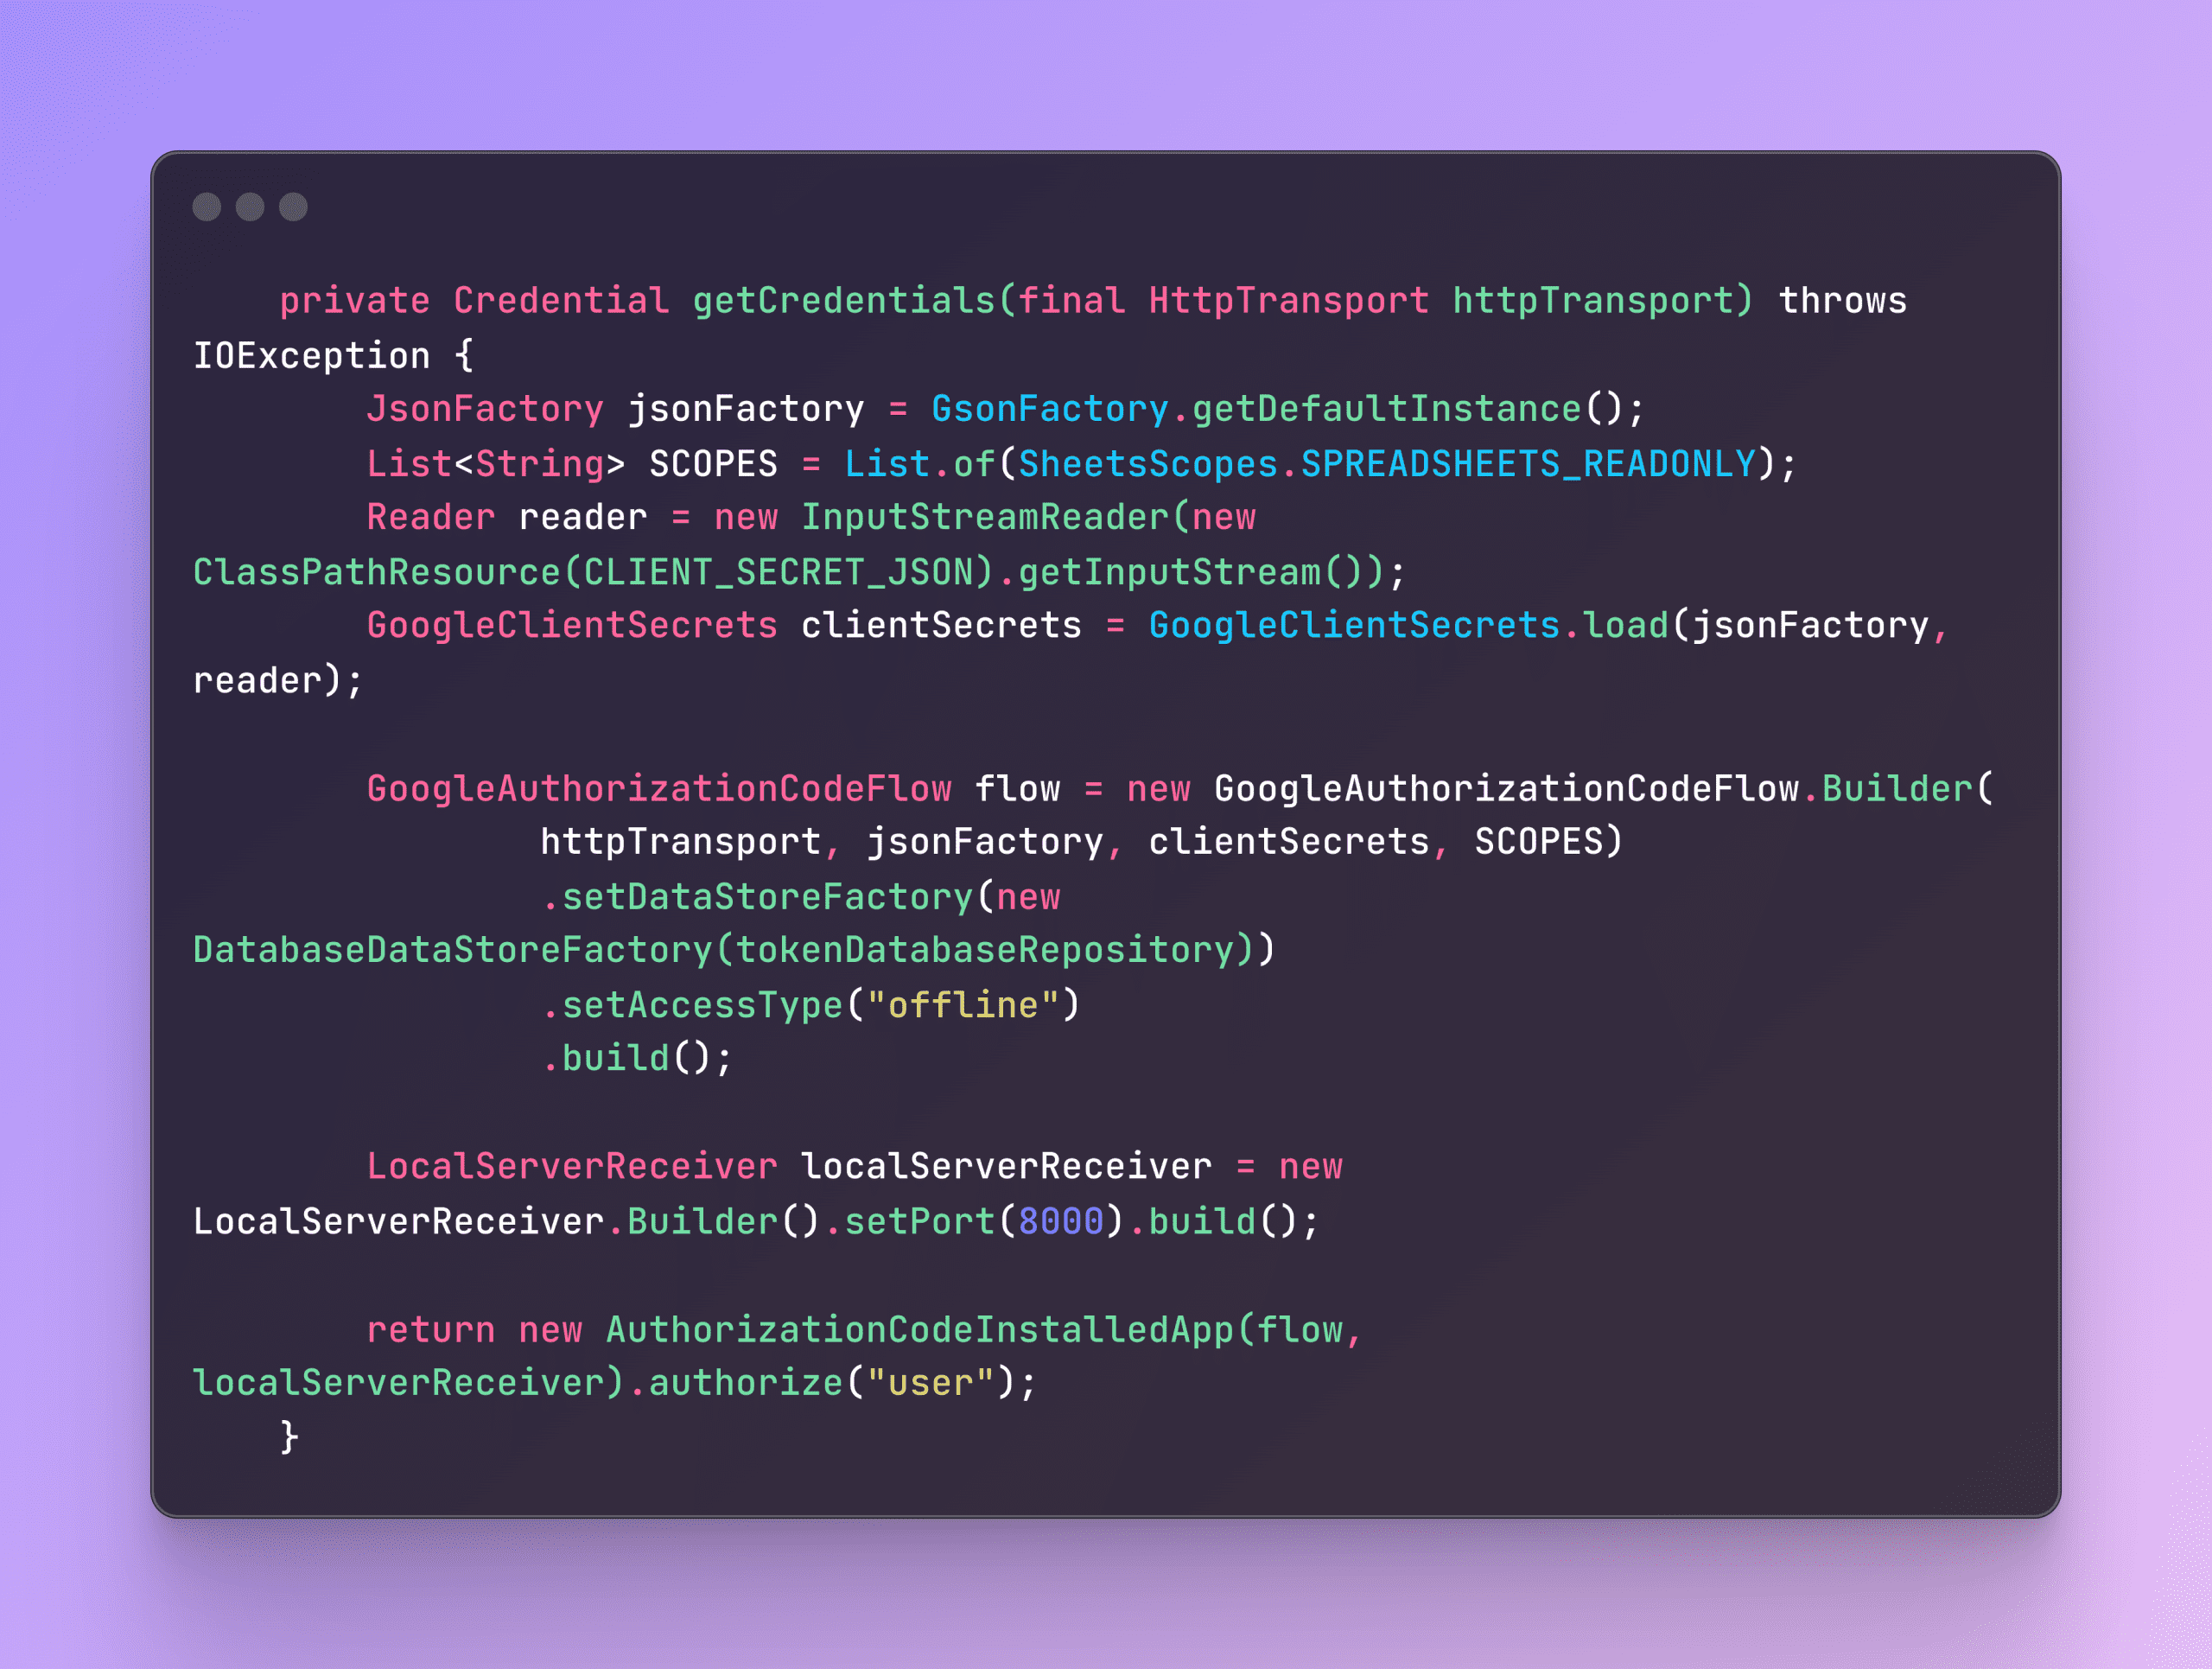
To persist OAuth2 tokens in a database, we need to create a custom implementation of the DataStoreFactory and DataStore classes provided by Google’s OAuth2 library. Here’s a step-by-step guide:
Step 1: Create a Custom DataStoreFactory
The custom factory is responsible for creating instances of your DataStore. Extend AbstractDataStoreFactory to implement this logic.
OAuth2 has become the industry standard for secure authorization in web applications. Spring Boot simplifies OAuth2 integration, allowing developers to handle client registration effortlessly. However, Spring Boot’s default implementation often requires client registrations to be predefined in application configuration, making it difficult to adapt to changing environments where client registrations need to be added or removed dynamically.
In this blog post, we’ll explore how to overcome this limitation by creating a custom implementation of ClientRegistrationRepository that allows dynamic management of OAuth2 clients at runtime. This approach provides the flexibility required for modern applications that need to adapt to varying OAuth2 client configurations.
Understanding Spring Boot’s Default Client Registration
Spring Boot manages OAuth2 client registrations using the ClientRegistrationRepository interface, which provides a way to store and retrieve client configurations. By default, Spring Boot offers an InMemoryClientRegistrationRepository implementation. This default implementation stores client registrations in memory, as defined in the application’s configuration files.
While this approach works well for static configurations, it has a significant limitation: the client registrations are immutable. Once registered, a client’s configuration cannot be altered. This is because InMemoryClientRegistrationRepository creates an unmodifiable map of client registrations:
This immutability is by design, ensuring that client registrations remain consistent throughout the application’s lifecycle. However, for applications that require dynamic updates to client registrations—such as SaaS platforms or systems with evolving client needs—this default behavior is insufficient.
Custom Implementation of ClientRegistrationRepository
To support dynamic client registration, we need to implement a custom version of ClientRegistrationRepository that allows adding and removing clients at runtime. This custom repository will manage a modifiable collection of client registrations.
Here’s how you can create a custom ClientRegistrationRepository:
This implementation uses a ConcurrentHashMap to store client registrations, enabling thread-safe access and modification. The addClientRegistration and removeClientRegistration methods allow for dynamic management of client registrations, which can be crucial for applications that need to adapt in real time.
Integrating Custom ClientRegistrationRepository with Spring Security
After implementing the custom ClientRegistrationRepository, the next step is to integrate it into your Spring Boot application. This involves replacing the default InMemoryClientRegistrationRepository with your custom implementation.
Here’s how to inject your custom repository into the Spring Security configuration:
By defining the custom ClientRegistrationRepository as a bean, Spring Boot will automatically use it in the OAuth2 flow, allowing for dynamic client management.
Acquiring Access Tokens Using Dynamic Client Registrations
Once you have dynamically registered clients, you can proceed with acquiring access tokens using the standard OAuth2 flow. The process remains unchanged, but now includes the capability to work with clients that were registered dynamically.
Here’s an example of acquiring an access token:
Java
OAuth2AuthorizeRequestauthorizeRequest=OAuth2AuthorizeRequest.withClientRegistrationId(clientRegistration.getRegistrationId()).principal(oauth2Config.getClientId()).attribute(AuthorizationGrantType.CLIENT_CREDENTIALS.getValue(), clientRegistration).build();OAuth2AuthorizedClientauthorizedClient=authorizedClientManager.authorize(authorizeRequest);authorizedClient.getAccessToken().getTokenValue()//-> get token here