#chemistry #simulation #gameplay #games
Cuối năm 2022, ba nhà nghiên cứu Yaniv Leviathan, Matan Kalman và Yossi Matias tại Google Research ở Israel đăng lên arXiv bài báo Fast Inference from Transformers via Speculative Decoding. Họ tuyên bố tìm được cách giúp LLM trả lời nhanh gấp đôi hoặc gấp ba với claim rằng output của phương pháp này không thay đổi so với thông thường, giữ nguyên chính xác phân phối xác suất ban đầu.
Đầu năm 2023, một nhóm khác tại DeepMind do Charlie Chen dẫn đầu công bố bài báo Accelerating Large Language Model Decoding with Speculative Sampling với thuật toán cốt lõi của họ gần như giống hệt. Tuy nhiên nhóm tác giả ghi chú rõ rằng công trình được thực hiện độc lập và cùng thời điểm với nhóm Leviathan.

Khi ta gõ câu hỏi vào ChatGPT hay Claude, model không đọc từng chữ cái hay từng từ. Nó đọc token, là những mảnh văn bản có kích thước không đều nhau.
Ví dụ, câu tiếng Anh:
"The capital of France is Paris."
Sau khi qua tokenizer (một bộ chia chữ thành token), có thể trở thành:
["The", " capital", " of", " France", " is", " Paris", "."]
Mỗi token được gán một ID số duy nhất đại diện cho mảnh văn bản đó. Ví dụ " Paris" có ID 12437 và "." có ID 13
Với tiếng Việt, tokenizer có thể hoạt động khác một chút
"Hôm nay trời rất đẹp"
→ ["Hôm", " nay", " tr", "ời", " rất", " đẹp"]
Một từ tiếng Việt có dấu có thể bị chia thành 2-3 token. Đây là lý do model xử lý tiếng Việt thường tốn thêm token hơn tiếng Anh cho cùng một nội dung.
Khi model nhận một chuỗi token, nó sẽ chạy chuỗi này qua hàng chục lớp (layers) mạng neural tính toán nối tiếp nhau. Quá trình này được gọi là forward pass.
Input: "Hôm nay trời rất"

Forward pass qua 32 layer của model...

Output: bảng điểm cho ~100.000 token trong vocabulary
  "đẹp"    45%
  "nóng"   25%
  "lạnh"   20%
  "xanh"    3%
  ...       7%
Bảng điểm này được gọi là probability distribution (phân phối xác suất). Nó cho biết model đánh giá token nào có khả năng đứng tiếp theo cao nhất cùng với tỷ lệ phần trăm tương ứng.
Tổng tất cả xác suất luôn bằng 100%. Thay vì khẳng định một đáp án đúng, model chỉ đưa ra khả năng phần trăm cho từng trường hợp, như 45% cho từ “đẹp”, 25% cho từ “nóng”, hoặc 20% cho từ “lạnh”.
Sau khi có bảng xác suất, cần một quy tắc chọn token nào sẽ được dùng.
Greedy: chọn token có xác suất cao nhất.
"đẹp" 45%  ← luôn chọn cái này
"nóng" 25%
"lạnh" 20%
Với cùng một input, phương pháp greedy luôn cho ra output giống hệt nhau. Đây là cách tiếp cận deterministic và dễ dự đoán.
Sampling: chọn ngẫu nhiên theo tỷ lệ xác suất.
45% trường hợp → chọn "đẹp"
25% trường hợp → chọn "nóng"
20% trường hợp → chọn "lạnh"
Việc này giống như tung một con xúc xắc 100 mặt với 45 mặt ghi “đẹp”, 25 mặt “nóng” và 20 mặt “lạnh”. Mỗi lần tung sẽ cho ra kết quả khác nhau nhưng vẫn bám sát tỷ lệ tổng thể.
Sampling được dùng khi muốn output đa dạng, để cùng một câu hỏi mỗi lần trả lời hơi khác nhau. Nhiều chatbot dùng sampling (hoặc sampling với temperature thấp) để câu trả lời bớt máy móc.
Sự phân biệt này quan trọng vì speculative decoding phải bảo đảm output cuối cùng khớp hoàn toàn với target model, bất kể model dùng greedy hay sampling. Việc này khá đơn giản với greedy nhưng lại đòi hỏi một thuật toán phức tạp hơn nhiều đối với sampling, chi tiết sẽ được nói rõ ở phần tiếp.
Cách làm ban đầu của các LLM Model là autoregressive, hay sinh token tuần tự, nghĩa là token phía sau luôn phụ thuộc vào token phía trước.
Ví dụ sinh 3 token:
Lần 1:
  Input:  "The capital of France is"
  Model chạy forward pass...
  Output: " Paris"

Lần 2:
  Input:  "The capital of France is Paris"
  Model chạy forward pass...
  Output: "."

Lần 3:
  Input:  "The capital of France is Paris."
  Model chạy forward pass...
  Output: <END>
Bởi vì rõ ràng theo một cách suy nghĩ đơn giản, các từ tiếp theo ta muốn nghĩ ra nên có sự phụ thuộc vào từ trước đó.
Sự phụ thuộc này tạo ra một chuỗi tuần tự bắt buộc:
Token 1 → cần biết token 1 để tính token 2
Token 2 → cần biết token 2 để tính token 3
Token 3 → cần biết token 3 để tính token 4
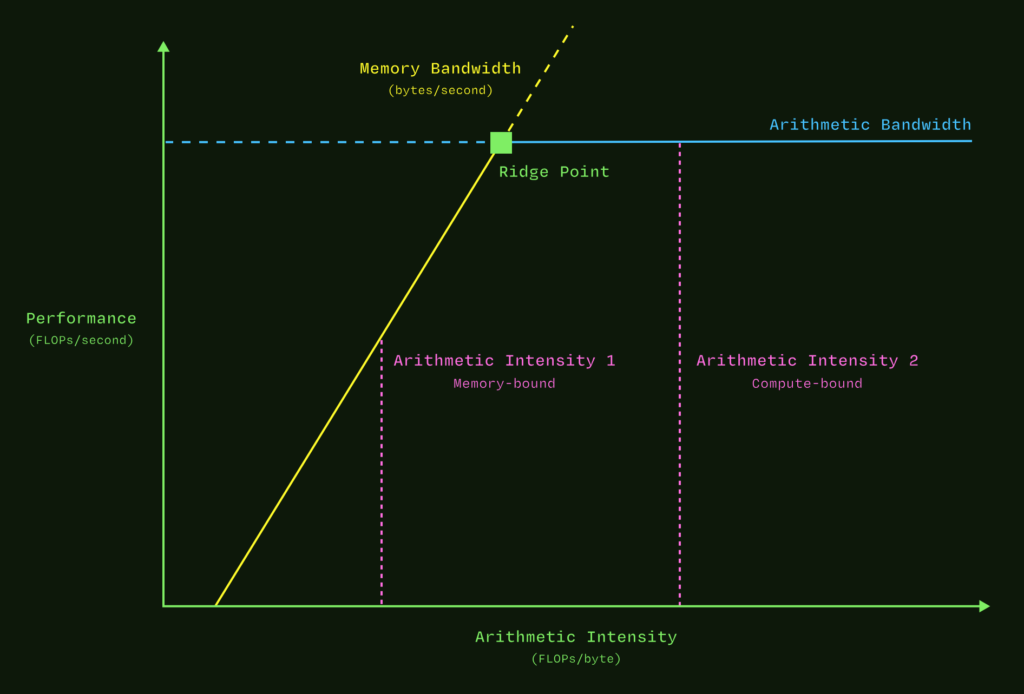
...Một model có 70B tham số (parameters) đồng nghĩa với việc hệ thống phải đọc 70 tỷ con số trọng số từ bộ nhớ GPU mỗi lần chạy.
Để sinh một token mới, GPU phải:
GPU hiện đại như H100 có sức mạnh tính toán khổng lồ, lên tới hàng trăm nghìn tỷ phép tính mỗi giây. Phần lớn khả năng này bị lãng phí khi hệ thống chỉ xử lý một token. Sau khi đọc xong 70 tỷ trọng số, GPU chỉ áp dụng chúng cho một vị trí rồi bỏ qua, sau đó lại phải đọc lại ngần ấy trọng số cho vị trí tiếp theo.
Giống như ta mở quyển từ điển 70 tỷ trang, đọc hết, chỉ để tra một từ. Rồi đóng sách, mở lại, đọc hết 70 tỷ trang, tra một từ nữa.
Quá trình này được gọi là trạng thái memory-bound, nơi tốc độ hệ thống bị giới hạn bởi tốc độ đọc bộ nhớ thay vì tốc độ tính toán. GPU lúc này rơi vào trạng thái “đói việc” vì khả năng tính toán dư thừa nhưng dữ liệu không được nạp đủ nhanh.
Đây chính là kẽ hở mà speculative decoding khai thác.
Mỗi token đi qua một layer của Transformer sẽ tạo ra một vector số chứa khoảng 4.096 hoặc 8.192 giá trị. Có thể hiểu đơn giản dãy số này mô phỏng mức độ hiểu của model về toàn bộ bối cảnh tại thời điểm này. Có thể đọc thêm bài sau:
Token "is" đi qua:
  Layer 1  → hidden state h¹  (4096 số)
  Layer 2  → hidden state h²  (4096 số)
  ...
  Layer 32 → hidden state h³² (4096 số)
Mỗi layer tinh chỉnh hidden state, thêm vào nó sự hiểu biết sâu hơn. Có thể là layer đầu có thể nắm cú pháp, layer giữa hiểu ngữ nghĩa, layer cuối tổng hợp toàn bộ. Hidden state cuối cùng là h³² sẽ đi qua lớp chuyển đổi LM head để biến vector 4096 số thành bảng xác suất cho khoảng 100.000 token:
h³² (4096 số)
     ↓
  LM head
     ↓
Bảng xác suất cho mọi token tiếp theo
  " Paris"   80%
  " Lyon"     5%
  " located"  3%
  ...
Đến đây, chúng ta đã biết nguyên nhân LLM sinh token chậm là do hệ thống phải chạy model lớn cho từng token một, trong khi GPU lại đang lãng phí phần lớn sức mạnh tính toán.
Speculative decoding được xây dựng dựa trên một nhận xét đơn giản nhưng cực kỳ hiệu quả:
Rất nhiều token tiếp theo thực ra rất dễ đoán, ví dụ như dấu chấm, dấu phẩy, dấu ngoặc, xuống dòng, cú pháp JSON, các cụm từ thông dụng, hoặc phần lặp lại từ prompt. Model lớn không cần phải vất vả tính toán cho từng token hiển nhiên như vậy.
Từ đó ta có một hệ thống sơ khai speculative decoding bao gồm hai thành phần:
Draft model (drafter): Model nhỏ hơn nhiều, ví dụ loại 1B parameters. Nó nhanh hơn dù chất lượng kém hơn. Nhiệm vụ của nó chỉ là đề xuất các token dự tuyển (candidate) và hoàn toàn không có quyền quyết định output cuối cùng.
Target model (model lớn): Đây là model ta thật sự muốn dùng, ví dụ loại 70B parameters. Nó cho ra chất lượng cao nhưng chậm. Điểm mấu chốt là output cuối cùng gửi cho người dùng bắt buộc phải giống hệt output của model này.
Ta hãy thử đi qua lại ví dụ ban đầu
Prompt: "The capital of France is"
Giả sử target model (70B) sẽ sinh ra: " Paris" "." <END>
Bước 1: Drafter đề xuất 4 candidate
Draft model nhỏ (1B) chạy autoregressive, nghĩa là nó cũng phải sinh từng token một giống như target:
Draft pass 1: "The capital of France is"          → " Paris"
Draft pass 2: "The capital of France is Paris"     → "."
Draft pass 3: "The capital of France is Paris."    → " It"
Draft pass 4: "The capital of France is Paris. It" → " is"
Dù có 4 draft pass, thời gian xử lý sẽ nhanh hơn vì model nhỏ.
Những token này mới chỉ là các candidate nội bộ và chưa token nào được gửi cho người dùng.
Candidate: [" Paris", ".", " It", " is"]
Bước 2: Target kiểm tra cả 4 candidate trong MỘT pass
Target model sẽ nhận toàn bộ chuỗi candidate:
Input: ["The", " capital", " of", " France", " is",
        " Paris", ".", " It", " is"]
                  └── 4 candidate ──┘
Sau đó, target chạy một forward pass duy nhất trên toàn bộ input để tính xác suất cho từng vị trí:
Lúc này ta có thể chạy song song, với việc giả định rằng: nếu model sẽ sinh ra cả đoạn như vậy thì token tiếp theo sẽ là gì
Sau "The capital of France is"              → target chọn " Paris"
Sau "The capital of France is Paris"        → target chọn "."
Sau "The capital of France is Paris."       → target chọn <END>
Sau "The capital of France is Paris. It"    → target chọn khác
Bước 3: So sánh từ trái sang phải
Vị trí  Draft       Target       Kết quả
  1     " Paris"    " Paris"     ✓ Accept
  2     "."         "."          ✓ Accept
  3     " It"       <END>        ✗ Reject (dùng <END> từ target)
  4     " is"       —            ✗ Discard (không kiểm tra)
Tại vị trí số 3, draft đề xuất ” It” nhưng target lại yêu cầu <END>. Vì draft sai nên hệ thống sẽ bỏ ” It” và sử dụng <END> từ target. Token thứ 4 là ” is” cũng bị loại bỏ do nó được tính toán dựa trên ” It”, mà ” It” thì đã bị loại.
Kết quả vòng này:
Output: " Paris" "." <END>
Kết quả này hoàn toàn khớp với output mà target tự sinh ra. Giả sử với tốc độ là
Một target pass (70B): ~20 ms Một draft pass (1B): ~0.5 ms
Về mặt thời gian:
Cách thường:  3 target pass = 3 × 20 = 60 ms
Speculative:  4 draft pass + 1 target verify
              = 2 + 22 = 24 ms

Speedup: 60 / 24 ≈ 2.5×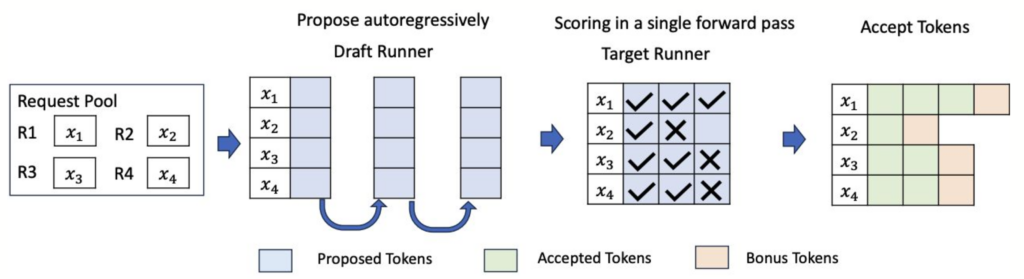
Chúng ta đã thống nhất rằng việc sinh token phải tuần tự vì token sau phụ thuộc vào token trước. Vậy target làm cách nào để kiểm tra 4 vị trí song song?
Sự khác biệt nằm ở hai khái niệm: sinh (generate) và chấm điểm (score/verify).
Khi sinh: Token tương lai chưa tồn tại. Model bắt buộc phải đoán token đầu tiên, sau đó mới có dữ liệu để đoán token thứ hai. Tính tuần tự này là thực tế và không thể phá vỡ.
Khi chấm điểm: Drafter đã cung cấp sẵn cả 4 candidate. Target không cần phải tìm kiếm chúng nữa. Việc của nó chỉ là tính xem nếu đây là token tiếp theo thì xác suất sẽ là bao nhiêu.
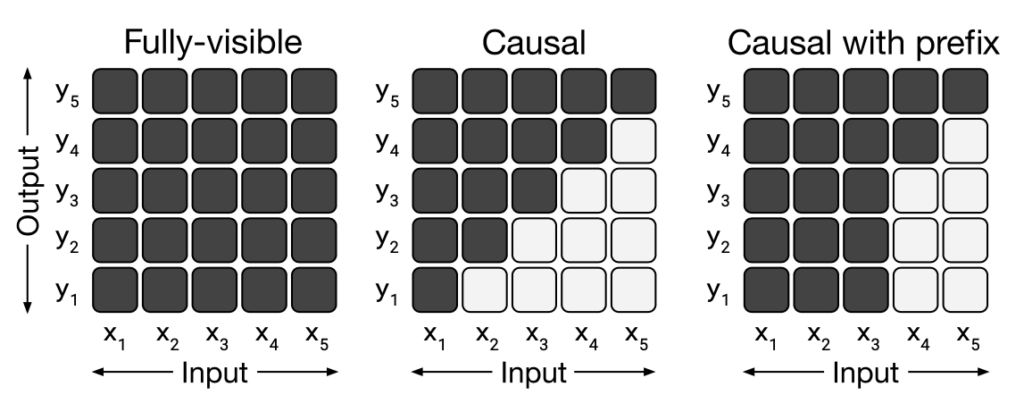
Mạng Transformer có một cơ chế mang tên causal mask. Trong cùng một forward pass, cơ chế này hoạt động như sau:
Vị trí " Paris" chỉ thấy: prefix (prefix ở đây là cả câu trước đó - The capital ....)
Vị trí "."      chỉ thấy: prefix + " Paris"
Vị trí " It"    chỉ thấy: prefix + " Paris" + "."
Vị trí " is"    chỉ thấy: prefix + " Paris" + "." + " It"
Mỗi vị trí chỉ có thể nhìn được các vị trí trước nó mà không thể nhìn các vị trí sau. Nhờ cơ chế này, kết quả tính toán tại mỗi vị trí hoàn toàn trùng khớp với việc chạy riêng lẻ từng vị trí một.
Hơn nữa, do toàn bộ input đã có giá trị cụ thể từ các candidate có sẵn, GPU có thể tính toán tất cả các vị trí song song trong cùng một phép nhân ma trận lớn.
Đây chính xác là loại phép tính mà Transformer thực hiện khi xử lý prompt ban đầu trong giai đoạn gọi là prefill. Quá trình verification ở đây gần giống một đoạn prefill ngắn với 4 token thay vì hàng trăm token.
Thêm vào đó, do GPU đang trong trạng thái memory-bound khi giải mã một token, việc đọc 70 tỷ trọng số để xử lý 4 token không tốn kém hơn bao nhiêu so với việc xử lý 1 token. Trọng số đằng nào cũng đã được đọc lên, GPU chỉ việc dùng luôn cho cả 4 vị trí.
Chi phí verify 4 candidate ≈ chi phí sinh 1 token
(Dù không chính xác tuyệt đối nhưng cùng chung một bậc chi phí)
Dù vậy, cần lưu ý là nếu ” It” bị từ chối tại vị trí thứ 3, kết quả tại vị trí thứ 4 cũng sẽ tự động bị bỏ. Nguyên nhân là do vị trí 4 được tính toán với điều kiện ” It” tồn tại. Một khi ” It” đã bị loại bỏ, bối cảnh thực tế (prefix) đã thay đổi hoàn toàn.
Câu trả lời là không. Draft model 1B đúng là sẽ kém hơn target 70B và các đề xuất candidate của nó hoàn toàn có thể sai lệch. Tuy nhiên, output của draft không bao giờ được gửi thẳng cho người dùng.
Hãy tưởng tượng drafter là một thực tập sinh phụ trách viết bản nháp, còn target là tổng biên tập có quyền ký duyệt. Thực tập sinh có thể mắc lỗi, nhưng điều đó không thành vấn đề vì mọi văn bản đều phải qua tay tổng biên tập kiểm tra trước khi xuất bản.
Quy tắc áp dụng rất đơn giản:
Nếu draft token = token target chọn:
    dùng draft token (vì nó bằng target token)

Nếu draft token ≠ token target chọn:
    bỏ draft token
    dùng target token thay thế
Dù trong trường hợp nào đi nữa, token được hệ thống chốt (commit) luôn luôn giống hệt token mà target chọn.
Ví dụ draft đề xuất chuỗi candidate sau:
"Lyon" "is" "beautiful"
Khi target tiến hành kiểm tra vị trí đầu tiên:
Draft:  "Lyon"
Target: "Paris"
→ Reject "Lyon"
→ Discard "is" và "beautiful"
→ Output "Paris" từ target
Vòng lặp tiếp theo sẽ bắt đầu lại từ "...is Paris" để draft thử lại lần nữa.
Kết quả lúc này vẫn hoàn toàn giống với output của target. Tuy nhiên, vòng chạy vừa rồi không hề mang lại tốc độ nào, thậm chí nó còn chậm hơn so với mức baseline do hệ thống phải tốn thêm thời gian chạy draft.
Speculative = 2ms (draft) + 22ms (verify) = 24 ms
Baseline    = 20 ms (khi chỉ chạy 1 target pass)

→ Chậm hơn 4ms
Qua đó có thể thấy chất lượng của draft chỉ ảnh hưởng đến tốc độ, chứ không làm suy giảm chất lượng đầu ra:
Draft tốt  → chất lượng bằng target, tốc độ nhanh
Draft kém  → chất lượng bằng target, ít nhanh hơn hoặc thậm chí chậm hơn baseline
Từ “kém hơn” không đồng nghĩa với việc model nhỏ đoán sai mọi token. Khi phần tiền tố (prefix) đã rõ ràng, rất nhiều token thực tế cực kỳ dễ đoán trước:
Dấu chấm kết thúc một câu hoàn chỉnh
Dấu phẩy nối trong danh sách
Dấu ngoặc đóng nối tiếp sau ngoặc mở
Ký tự xuống dòng sau mỗi đoạn văn
Các thành phần cú pháp JSON như dấu hai chấm, ngoặc vuông, ngoặc nhọn
Các thành phần cú pháp code như dấu chấm phẩy, từ khóa return, dấu ngoặc nhọn đóng
Các cụm từ liên kết thông dụng như "in order to", "for example"
Những đoạn văn bản lặp lại từ prompt trong tác vụ chỉnh sửa code hoặc viết lại câu
Model lớn thực sự chỉ cần thiết để giải quyết những vị trí khó, ví dụ như:
Lựa chọn đáp án trong các bài toán reasoning logic
Thực hiện các phép tính toán học
Chốt tên riêng, số liệu cụ thể hay hành động chính xác
Quyết định cấu trúc câu ở những vị trí còn mơ hồ
Drafter không cần phải thông minh ngang ngửa target. Nhiệm vụ của nó chỉ là đoán trúng trùng khớp với target đủ thường xuyên. Khi tỷ lệ trúng đủ cao, lượng target pass tiết kiệm được sẽ bù đắp dư dả cho lượng chi phí dùng để chạy draft.
Phần trước đã giải thích trường hợp greedy, nơi target luôn chọn token có xác suất cao nhất nên việc so sánh rất đơn giản. Tuy nhiên, nhiều ứng dụng LLM thực tế lại dùng sampling. Đây là lúc speculative decoding thực sự bộc lộ sự phức tạp.
Với phương pháp greedy, target chỉ có một token đúng duy nhất là token có xác suất cao nhất:
Target:  60% Paris, 30% London, 10% Rome
Greedy → luôn chọn Paris
Việc so sánh lúc này vô cùng dễ dàng:
Draft Paris  → accept
Draft London → reject, thay bằng Paris
Thế nhưng với sampling, target không khẳng định “đáp án là Paris”. Target yêu cầu một tỷ lệ phân bổ:
60% trường hợp phải ra Paris
30% trường hợp phải ra London
10% trường hợp phải ra Rome
Lúc này, cả Paris, London và Rome đều là những output hợp lệ. Hệ thống không có token “sai”, nó chỉ có tỷ lệ.
Vấn đề nảy sinh là draft model thường có phân phối khác với target:
              Target p     Draft q
Paris           60%          50%
London          30%          40%
Rome            10%          10%
Nếu ta lấy thẳng output của draft, phân phối sẽ là 50/40/10, hoàn toàn sai lệch so với phân phối mục tiêu 60/30/10 của target.
Ngược lại, nếu ta chỉ accept khi draft khớp với lựa chọn ưu tiên nhất của target (Paris), những lần draft đề xuất London sẽ luôn bị reject. Output cuối cùng sẽ biến thành 100% Paris. Như vậy, ta vô tình biến sampling thành greedy.
Bởi vậy, chúng bản cần một phương pháp cho phép tái sử dụng token từ draft mà vẫn giữ nguyên được phân phối của target.
Thay vì phân tích một lần chạy đơn lẻ, bạn hãy thử tưởng tượng ta chạy hệ thống 1.000 lần với cùng một prefix để xem output tạo ra tỷ lệ gì.
Dựa trên phân phối q, draft sẽ đề xuất:
Paris:  ~500 lần  (vì q(Paris) = 50%)
London: ~400 lần  (vì q(London) = 40%)
Rome:   ~100 lần  (vì q(Rome) = 10%)
Trong khi đó, target muốn output cuối cùng bám sát phân phối p:
Paris:  ~600 lần  (vì p(Paris) = 60%)
London: ~300 lần  (vì p(London) = 30%)
Rome:   ~100 lần  (vì p(Rome) = 10%)
Hãy làm một phép so sánh trực tiếp:
Paris:
  Draft có 500, target cần 600
  → Draft THIẾU Paris → accept toàn bộ 500

London:
  Draft có 400, target chỉ cần 300
  → Draft THỪA 100 London → chỉ accept 300 trong số 400

Rome:
  Draft có 100, target cần 100
  → Vừa đủ → accept toàn bộ 100
Tỷ lệ accept cụ thể cho từng token được tính như sau:
Paris:  accept 500/500 = 100%
        tính: p/q = 60%/50% = 1.20 → min(1, 1.20) = 1 ✓

London: accept 300/400 = 75%
        tính: p/q = 30%/40% = 0.75 → min(1, 0.75) = 0.75 ✓

Rome:   accept 100/100 = 100%
        tính: p/q = 10%/10% = 1.00 → min(1, 1.00) = 1 ✓
Công thức tổng quát:
accept_probability(token) = min(1, p(token) / q(token))Ý nghĩa trực tiếp của công thức này là:
Sau bước accept, chúng ta có:
Paris:  500 (accept hết)
London: 300 (accept 300/400, reject 100)
Rome:   100 (accept hết)

Tổng accept: 900
Tổng reject: 100
Trong khi đó target cần:
Paris: 600 → còn thiếu 100
London: 300 → đã đủ
Rome: 100 → đã đủ
Như vậy, 100 trường hợp bị reject bắt buộc phải được dùng để bổ sung chính xác phần còn thiếu. Trong ví dụ này, toàn bộ chúng phải là Paris.
Nhiều người sẽ thắc mắc tại sao không reject rồi lấy mẫu (sample) lại từ target? Thử hình dung nếu 100 trường hợp reject lại được lấy mẫu từ target theo tỷ lệ 60/30/10, chúng ta sẽ có:
Thêm: Paris 60, London 30, Rome 10
Kết quả sẽ là:
Paris:  500 + 60 = 560  (cần 600 → sai)
London: 300 + 30 = 330  (cần 300 → sai)
Rome:   100 + 10 = 110  (cần 100 → sai)
Quá trình này sai lệch hoàn toàn vì London và Rome đã đủ số lượng (quota) nhưng hệ thống lại tự động bổ sung thêm.
Do đó, quá trình sửa lỗi (correction) phải được lấy từ phần target còn thiếu, hay còn gọi là residual distribution:
residual(token) = max(0, p(token) - q(token))

Paris:  max(0, 0.60 - 0.50) = 0.10
London: max(0, 0.30 - 0.40) = 0    ← đã đủ
Rome:   max(0, 0.10 - 0.10) = 0    ← đã đủ
Sau khi chuẩn hóa residual, tỷ lệ Paris sẽ là 100%. Mọi lượt reject đều được tự động sửa thành Paris.
Kết quả cuối cùng:
Paris:  500 + 100 = 600  ✓
London: 300              ✓
Rome: 100 ✓Thuật toán tổng thể sẽ diễn ra như sau:
1. Draft tạo distribution q
2. Sample candidate x từ q
3. Target tạo distribution p
4. Tính: accept_prob = min(1, p(x)/q(x))
5. Sinh random u trong khoảng [0,1]
6. Nếu u ≤ accept_prob:
       output x
   Nếu u > accept_prob:
       sample correction từ normalize(max(0, p-q))
       output correction
Với cách thiết kế này, dù đi qua nhánh accept hay reject thì output cuối cùng vẫn luôn giữ đúng phân phối p.
Giả sử draft sinh ra chuỗi 4 token:
D1, D2, D3, D4
Kèm theo phân phối draft tại từng vị trí:
q1, q2, q3, q4
Sau một lượt kiểm tra (pass), target trả về phân phối:
p1, p2, p3, p4
Quá trình kiểm tra sẽ tiến hành từ trái sang phải:
min(1, p1(D1)/q1(D1)). Nếu hệ thống đồng ý accept, ta chuyển sang xét vị trí 2.Ý tưởng phác thảo rồi kiểm duyệt (draft-then-verify) dành riêng cho phương pháp greedy đã từng xuất hiện trước đây. Một trong những công trình tiêu biểu là Blockwise Parallel Decoding của nhóm tác giả Stern, Shazeer, Uszkoreit tại hội nghị NeurIPS 2018.
Cách xử lý với greedy khá cơ bản:
Draft = target argmax → accept
Khác → reject
Tuy nhiên, điểm mới mẻ trong những bài báo năm 2022-2023 không chỉ nằm ở việc vận dụng model nhỏ để đề xuất token. Điểm đột phá thực sự chính là:
Chúng ta có thể tận dụng lại mẫu sinh ra từ model nhỏ, loại bỏ khi sai và bổ sung đúng mức tỷ lệ (probability) còn thiếu. Bằng cách đó, toàn bộ output vẫn giữ nguyên tính chuẩn xác so với phân phối của model lớn, kể cả khi dùng phương pháp lấy mẫu ngẫu nhiên (stochastic sampling).
Phiên bản speculative decoding nguyên bản hoạt động tốt nhưng vẫn tồn tại nhiều giới hạn. Từ năm 2023 đến giữa năm 2026, hàng chục biến thể đã ra đời để khắc phục từng điểm yếu cụ thể.
Đây là vấn đề lớn nhất và nhóm biến thể giải quyết vấn đề này cũng đóng vai trò quan trọng nhất hiện tại, tiêu biểu là EAGLE.
Trong speculative decoding nguyên bản, draft model là một LLM nhỏ hoàn toàn độc lập. Việc nó phải tự đọc và hiểu lại toàn bộ bối cảnh thông qua các layer riêng gây lãng phí lớn về thời gian và bộ nhớ.
Vấn đề là target model đã chạy rồi. Nó đã xử lý prefix qua 32 layer và tạo ra các hidden state chứa đầy đủ thông tin context. Vậy tại sao drafter không tận dụng luôn nguồn thông tin đó thay vì phải tính toán lại từ đầu?
Đó chính là ý tưởng cốt lõi của EAGLE (Efficient Adaptive Generation via Leveraged hidden-state Estimation).
Hãy quay lại khái niệm hidden state ở Phần I. Khi target xử lý token "I" qua 32 layer, nó tạo ra một hidden state chuẩn xác h_I dưới dạng vector 4096 số chứa toàn bộ thông tin bối cảnh.
Target dùng h_I để dự đoán token tiếp theo:
h_I
 ↓
LM head
 ↓
" love" (80%), " am" (7%), " think" (5%), ...
 ↓
Chọn " love"
Thông thường, để biết token đứng ngay sau " love", target bắt buộc phải chạy " love" qua toàn bộ 32 layer:
embedding(" love") + KV cache("I")
        ↓
32 Transformer layers
        ↓
h_love (exact hidden state)
        ↓
LM head
        ↓
" coffee" (65%), " tea" (15%), ...
Bước này rất tốn kém, mất khoảng 20ms cho mỗi token.
EAGLE thay thế bước này bằng cách sử dụng:
h_I (exact hidden state target đã tạo)
+
embedding(" love") (token vừa được chọn)
        ↓
MỘT draft decoder layer nhỏ
        ↓
ĥ_love (bản ước lượng hidden state)
        ↓
Chính LM head của target
        ↓
candidate " coffee"
EAGLE tạo ra một vector ẩn gần đúng (ĥ_love), sau đó dùng chính LM head của target để biến vector đó thành xác suất dự đoán token.
Ký hiệu ĥ dùng để chỉ bản ước lượng. EAGLE đoán hidden state mà target có khả năng sẽ tạo ra, dù độ chính xác không đạt mức 100%.
Từ điểm xuất phát h_I, target có thể chọn ra nhiều token khác nhau:
"I love" (nếu chọn " love")
"I am"   (nếu chọn " am")
"I think" (nếu chọn " think")
Phần văn bản nối tiếp (continuation) trong tương lai phụ thuộc hoàn toàn vào việc token nào thực sự được chọn. Nếu chỉ cung cấp h_I cho EAGLE mà giấu đi token được chọn, hệ thống sẽ không biết phải rẽ theo nhánh nào.
h_I:              chứa thông tin "context trước token mới"
embedding(" love"): cho biết "token nào vừa thực sự được chọn"
EAGLE kết hợp cả hai yếu tố này để ước lượng hidden state tiếp theo một cách chuẩn xác hơn.
Sau bước đầu tiên để có được ĥ_love và candidate " coffee", EAGLE tiếp tục quy trình:
ĥ_love + embedding(" coffee")
        ↓
EAGLE decoder
        ↓
ĥ_coffee
        ↓
LM head
        ↓
candidate "."
Và tiếp tục với:
ĥ_coffee + embedding(".")
        ↓
EAGLE decoder
        ↓
ĥ_dot
        ↓
LM head
        ↓
candidate tiếp theo
EAGLE vẫn giữ bản chất autoregressive nên cần nhiều draft pass. Điểm khác biệt là mỗi pass chỉ chạy qua một draft layer nhỏ thay vì toàn bộ 32 target layer.
EAGLE pass 1 → ĥ_love   → " coffee"   (~0.3ms)
EAGLE pass 2 → ĥ_coffee → "."         (~0.3ms)
EAGLE pass 3 → ĥ_dot    → next        (~0.3ms)
ĥ_love chỉ là một bản ước lượng nên nó có thể khác với h_love thực tế.
Nếu sự khác biệt nằm trong phạm vi cho phép:
LM_head(h_love)  → " coffee"
LM_head(ĥ_love)  → " coffee"
→ Candidate đúng
Nếu sự khác biệt quá lớn:
LM_head(h_love)  → " coffee"
LM_head(ĥ_love)  → " tea"
→ Candidate sai → target verify bắt lỗi → reject " tea", dùng " coffee"
Giống như mọi biến thể speculative decoding khác, mọi lỗi sai đều sẽ bị bắt lại.
EAGLE nguyên bản đặt ra yêu cầu khá khắt khe:
draft output ĥ phải gần với exact target feature h
Cách làm này được gọi là feature regression vì nó ép drafter phải tạo ra một vector giống hệt target.
EAGLE-3 nhận ra rằng mục tiêu thực sự không phải là việc tái tạo chính xác hidden state. Mục tiêu duy nhất là:
LM head(draft state) → dự đoán đúng target token
Draft state không bị bắt buộc phải giống hệt exact target feature. Nó chỉ cần tạo ra đúng xác suất token khi đi qua LM head là đủ.
EAGLE-3 còn bổ sung một cải tiến khác. Thay vì chỉ sử dụng top-layer feature, nó thu thập hidden state từ nhiều layer khác nhau (low, mid, high) rồi kết hợp (fuse) lại:
low-layer feature   l
mid-layer feature   m
high-layer feature  h
        ↓ concatenate
FC projection
        ↓
fused feature g
Mỗi layer chứa một loại thông tin khác nhau. Ví dụ layer đầu nắm bắt cú pháp, layer giữa xử lý ngữ nghĩa và layer cuối có nhiệm vụ tổng hợp. EAGLE-3 tận dụng toàn bộ lượng thông tin này.
Dù mỗi pass của EAGLE-3 rất rẻ, việc sinh ra 7 draft token vẫn đòi hỏi 7 pass tuần tự:
pass 1 → D1
pass 2 → D2
...
pass 7 → D7
Để khắc phục, một hướng đi mới đã xuất hiện: tạo ra toàn bộ draft token trong một pass duy nhất thông qua parallel drafting.
Quay lại nhận xét ở Phần 2 cơ chế attention không ép buộc quá trình sinh text (generation) phải diễn ra tuần tự. Thứ thực sự tạo ra tính tuần tự bắt buộc là vòng lặp phản hồi (feedback loop):
model output → sample token → token embedding mới → model chạy tiếp
Parallel drafter loại bỏ hoàn toàn vòng lặp đó. Thay vì chờ đợi kết quả token D1 rồi mới bắt đầu tính D2, hệ thống đặt các biến tạm (placeholder) vào vị trí của D2:
Position 1: [anchor embedding, target context]  ← dữ liệu đã biết
Position 2: [MASK embedding, learned hidden]     ← biến tạm
Position 3: [MASK embedding, learned hidden]     ← biến tạm
Position 4: [MASK embedding, learned hidden]     ← biến tạm
Vector MASK embedding không phải là token tương lai thật mà chỉ là một dạng đại diện được drafter học hỏi trong quá trình huấn luyện.
Cả 4 vị trí này sẽ đi qua drafter cùng một lúc:
4 input positions
        ↓
Lightweight draft layers xử lý trong một forward pass
        ↓
4 output states
        ↓
LM head
        ↓
[D1, D2, D3, D4]
Dĩ nhiên, sự đánh đổi ở đây là D2 không thể biết D1 thực sự được chọn là gì vì D1 chưa được lấy mẫu (sample) khi D2 đang được tính. Token càng nằm xa anchor thì khả năng đoán sai càng cao.
Nhờ thiết kế này, mọi draft layer đều có thể truy cập thẳng vào target context chứ không chỉ riêng layer đầu tiên.
Các biến thể vừa nhắc tới (như EAGLE hay P-EAGLE) đều đòi hỏi phải huấn luyện drafter, hoặc ít nhất cũng cần một model nhỏ đi kèm như phiên bản gốc. Vậy nếu chúng ta không muốn huấn luyện thêm bất cứ thứ gì thì sao?
Phương pháp Prompt Lookup Decoding (PLD) hoặc n-gram matching ra đời nhằm tìm kiếm các đoạn văn bản (continuation) đã từng xuất hiện trong prompt ban đầu hoặc các output trước đó.
Lấy ví dụ, giả sử prompt chứa đoạn mã cũ sau:
function calculateTotal(items) {
    let total = 0;
    for (const item of items) {
        total += item.price;
    }
    return total;
}
Khi yêu cầu output sửa lại đoạn function này để thêm tính thuế (tax), hệ thống sẽ chủ động dò tìm phần token trùng lặp giữa output đang sinh và phần prompt. Sau đó, nó tự động đề xuất phần tiếp theo bởi vì thông thường output sẽ sao chép phần lớn nội dung code cũ.
prefix matching trong prompt/output history
        ↓
candidate continuation
        ↓
target verify
Hệ thống hoàn toàn không dùng neural drafter. Nhờ đó, máy chủ không tốn tài nguyên huấn luyện, không gánh thêm GPU weights và không tốn bộ nhớ.
Cách làm này tỏ ra đặc biệt hiệu quả trong các tác vụ như chỉnh sửa code, tóm tắt nội dung hay viết lại câu, nơi phần output chủ yếu dựa trên input.
Tuy nhiên, nó lại khá yếu trong các đoạn chat mở (open-ended) vì câu trả lời thường không liên quan nhiều đến input ban đầu
Thay vì phải gánh thêm một model nhỏ bên ngoài, một hướng tiếp cận khác là dùng chính target model nhưng chạy với số lượng layer ít hơn.
Với phương pháp LayerSkip, hệ thống dùng model 32 layer nhưng chỉ chạy draft bằng 8 layer đầu tiên:
Draft:
  Layer 1 → ... → Layer 8 → LM head → draft token

Verify:
  Lấy Hidden state từ layer 8 của draft tokens
  → Layer 9 → ... → Layer 32 → LM head → target prediction
Tuy nhiên, bản chất các hidden state ở layer 8 vốn không được thiết kế để chạy thẳng qua LM head. Vì vậy, LayerSkip phải thay đổi lại cả công thức huấn luyện:
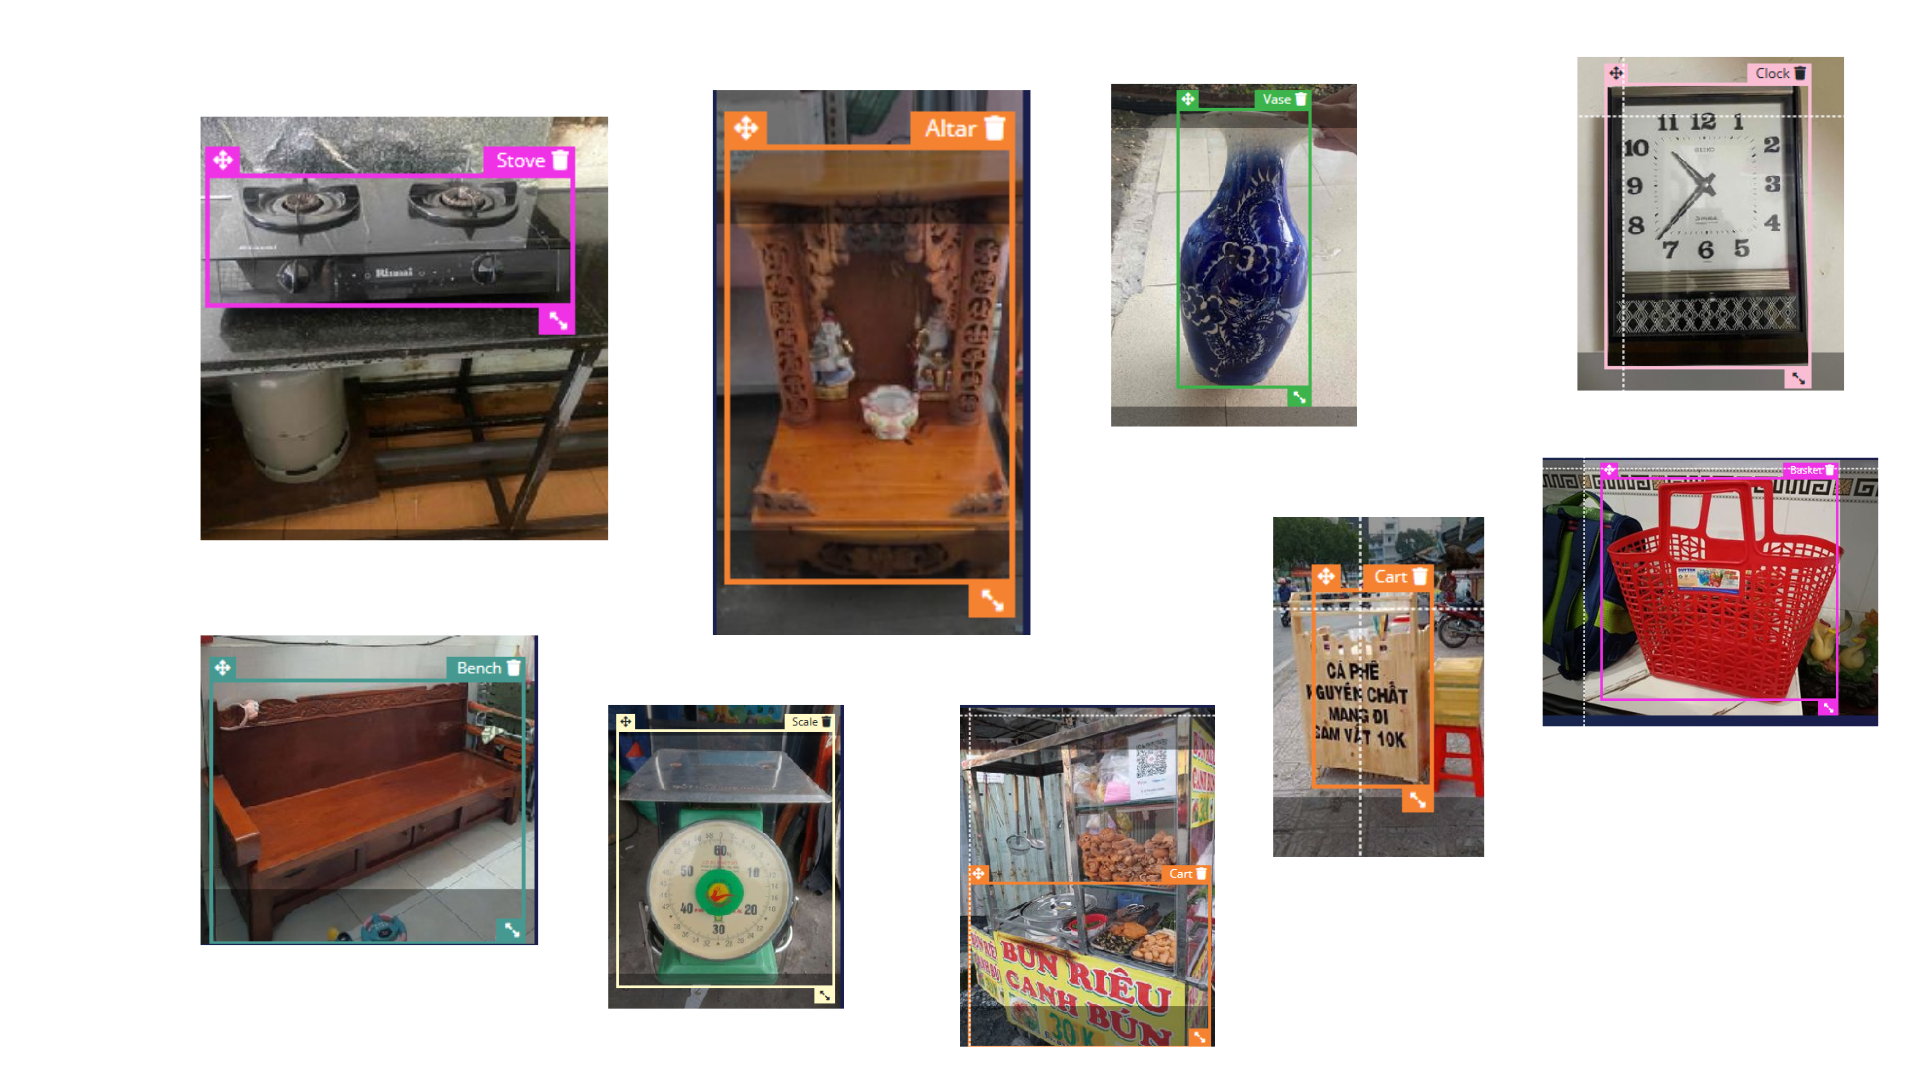
Virulen (VietLens) is a PWA English-learning app that lets learners in Vietnam point their camera at real-world objects and instantly see their English word, Vietnamese meaning, pronunciation, and example sentences.
Instead of memorizing words from Western textbooks, learners build a collection of cards from the everyday objects around them – plastic stools, rice cookers, street food, school furniture – the real Vietnam.
Novelty:
Label Tool Build Around Edge Impulse: https://github.com/quochung-cyou/label-tool-edgeimpulse
cái chõ xôi (sticky rice steamer)ghế nhựa (red plastic stool)quán cóc (street stall)mâm cơm (family meal tray)The result is a visual and cultural mismatch: “Chair” in the book is a Western dining chair; “chair” in real life is a plastic stool or bamboo bench. Students memorize the word, but it doesn’t connect to their reality.
Virulen / VietLens targets this exact gap: Offline-first, locally trained object recognition + English learning, optimized for low-end Android devices in Vietnam.

The large diagram below is the end‑to‑end pipeline that produces the on‑device model used in Virulen.
To make it easier to understand, we break it into four stages.

This block corresponds to the left side of the diagram.
This stage answers: “What images from the web might show the Vietnam objects we care about?”

This block is the middle bottom of the diagram.
This stage answers: “Which of those images are actually useful for our Vietnam‑focused dataset?”

This block is the bottom‑right.
This stage answers: “How do we turn raw images into high‑quality labeled training data?”

This block is the top pipeline and the central Edge Impulse logo.
public/edge-impulse/ and loaded in the app by lib/edge-impulse-browser.ts.ScanCamera uses this model to run real‑time detection directly in the browser.lib/edge-impulse-browser.ts lazy-loads:
/edge-impulse/edge-impulse-standalone.js/edge-impulse/run-impulse.jsScanCamera (components/scan-camera.tsx):
getUserMedia video.lib/ei-image.ts).lib/card-dictionary.ts → findCardByLabel).localStorage (lib/storage.ts).app/globals.css, shadcn-style components in components/ui).components/detection-overlay.tsx, components/capture-card-animation.tsx).components/floating-dock.tsx).lib/edge-impulse-browser.ts) to detect objects in real time.lib/card-dictionary.json → lib/card-dictionary.ts).lib/card-types.ts, lib/word-data.ts):
components/week-progress.tsx)app/page.tsx, lib/storage.ts).app/cards/page.tsx, components/beautiful-card-collection.tsx).app/manifest.ts, app/layout.tsx + SwRegister) with:
start_url: "/virulen/"display: "standalone"public/edge-impulse/.public/edge-impulse)vosk-browser (script loaded in app/layout.tsx for browser speech recognition)localStorage for cards, favorites, and statsframer-motion, CSS animations# in the repo root pnpm install # or npm install
pnpm dev
# or
npm run dev
By default this runs on http://localhost:3000. Open it on a device with a camera (you can also use your laptop camera).
Note: In dev, base paths may differ from production (
next.config.mjsusesbasePath: "/virulen"andassetPrefix: "/virulen/"for static export).
This project is configured for static export:
pnpm build
# then
pnpm start   # Next.js standalone server
Or, if you run next export in your deployment pipeline, ensure you respect:
basePath: "/virulen"assetPrefix: "/virulen/"public/edge-impulse/.app/
page.tsx – Home dashboard (stats, daily mission, quick actions, recent scans).scan/page.tsx – Scan screen (integrates ScanCamera, current detections, “catch” animation).cards/ – Card list and detail pages.manifest.ts – PWA manifest.layout.tsx – Root layout, fonts, PWA & speech scripts.components/
scan-camera.tsx – Core camera + Edge Impulse pipeline.detection-overlay.tsx – Renders bounding boxes.beautiful-card-collection.tsx, word-card-item.tsx, word-card-modal.tsx – Collection UI.floating-dock.tsx, stats-card.tsx, week-progress.tsx – Navigation and dashboard UI.audio-recorder.tsx – Voice features (for pronunciation practice and missions).lib/
edge-impulse-browser.ts – Loads and instantiates the Edge Impulse classifier.ei-image.ts – Packs camera frames into features for the model.card-dictionary.json – Dictionary of all supported words and metadata.card-dictionary.ts / card-types.ts – Card models and helper functions.storage.ts – Local storage for cards, favorites, and user stats.asset-path.ts – Base path helper for static assets.public/edge-impulse/
edge-impulse-standalone.js, run-impulse.js, model assets).card-dictionary.json with more rural artifacts, foods, and tools.điếu cày, nón lá, bánh xèo).vosk-browser fully for offline pronunciation practice and voice-based quizzes.Approach to 64-class semantic segmentation on the GOOSE dataset. Final test score: 63.8 % composite mIoU on the ICRA 2026 Field Robotics Workshop Challenge.
The GOOSE (German Outdoor and Offroad Dataset) and its extension GOOSE-Ex contain images from three robotic platforms in unstructured outdoor environments. The task is pixel-level classification into 64 classes. Some classes are common (car, road, sky). Others are narrow (tree_root, barrel, kick_scooter). A few barely exist in the data.
Two model architectures, three augmentation strategies, test-time augmentation, and a greedy rule-learning ensemble are included. The repo contains training scripts, logs, and visualizations.
GOOSE dataset splits below:
| Split | Images | Labels | Camera |
|---|---|---|---|
| goose_2d_train | ~24,000 | yes | windshield_vis |
| goose_2d_val | ~556 | yes | windshield_vis |
| gooseEx_2d_train | ~4,500 | yes | camera_left |
| gooseEx_2d_val | ~192 | yes | camera_left |
| Test set | ~361 | no | both |
Labels are grayscale PNGs where pixel value = class ID (0..63). Class 0 is undefined and counts toward metrics. No ignore index.
Class imbalance is the top challenge. forest alone covers 20.7 % of all pixels. sky, asphalt, and low_grass together add another 36 %. Meanwhile pipe has roughly 1,852 pixels across the entire training set. barrel has 1,199. Several classes are so rare that models never learn them.

Patches for the worst-performing classes (kick_scooter, barrier_tape, pipe, tree_root, motorcycle) are shown below. Most are tiny, occluded, or poorly lit.

Model 1: UPerHead with FlashInternImage-L (DCNv4 backbone)
FlashInternImage-L uses deformable convolutions v4. The UPerHead decoder fuses pyramid pooling with FPN-style features. An auxiliary FCN head on stage 3 provides extra gradient flow.
Model 2: Mask2Former with the same backbone
Mask2Former uses a transformer decoder with 200 queries and a pixel decoder based on multi-scale deformable attention. Initialized from ADE20K weights (mask2former_flash_internimage_l_640_160k_ade20k_ss.pth) with manual handling of the 150 → 64 class mismatch. Training was slower per iteration (~2.1s vs ~0.9s) and stopped at ~47,000 iterations. Learning rate: 5e-5.
Standard MMSeg pipeline: random resize between 0.5x and 2.0x, random crop to 2048×1024, horizontal flip, photometric distortion, ImageNet normalization.
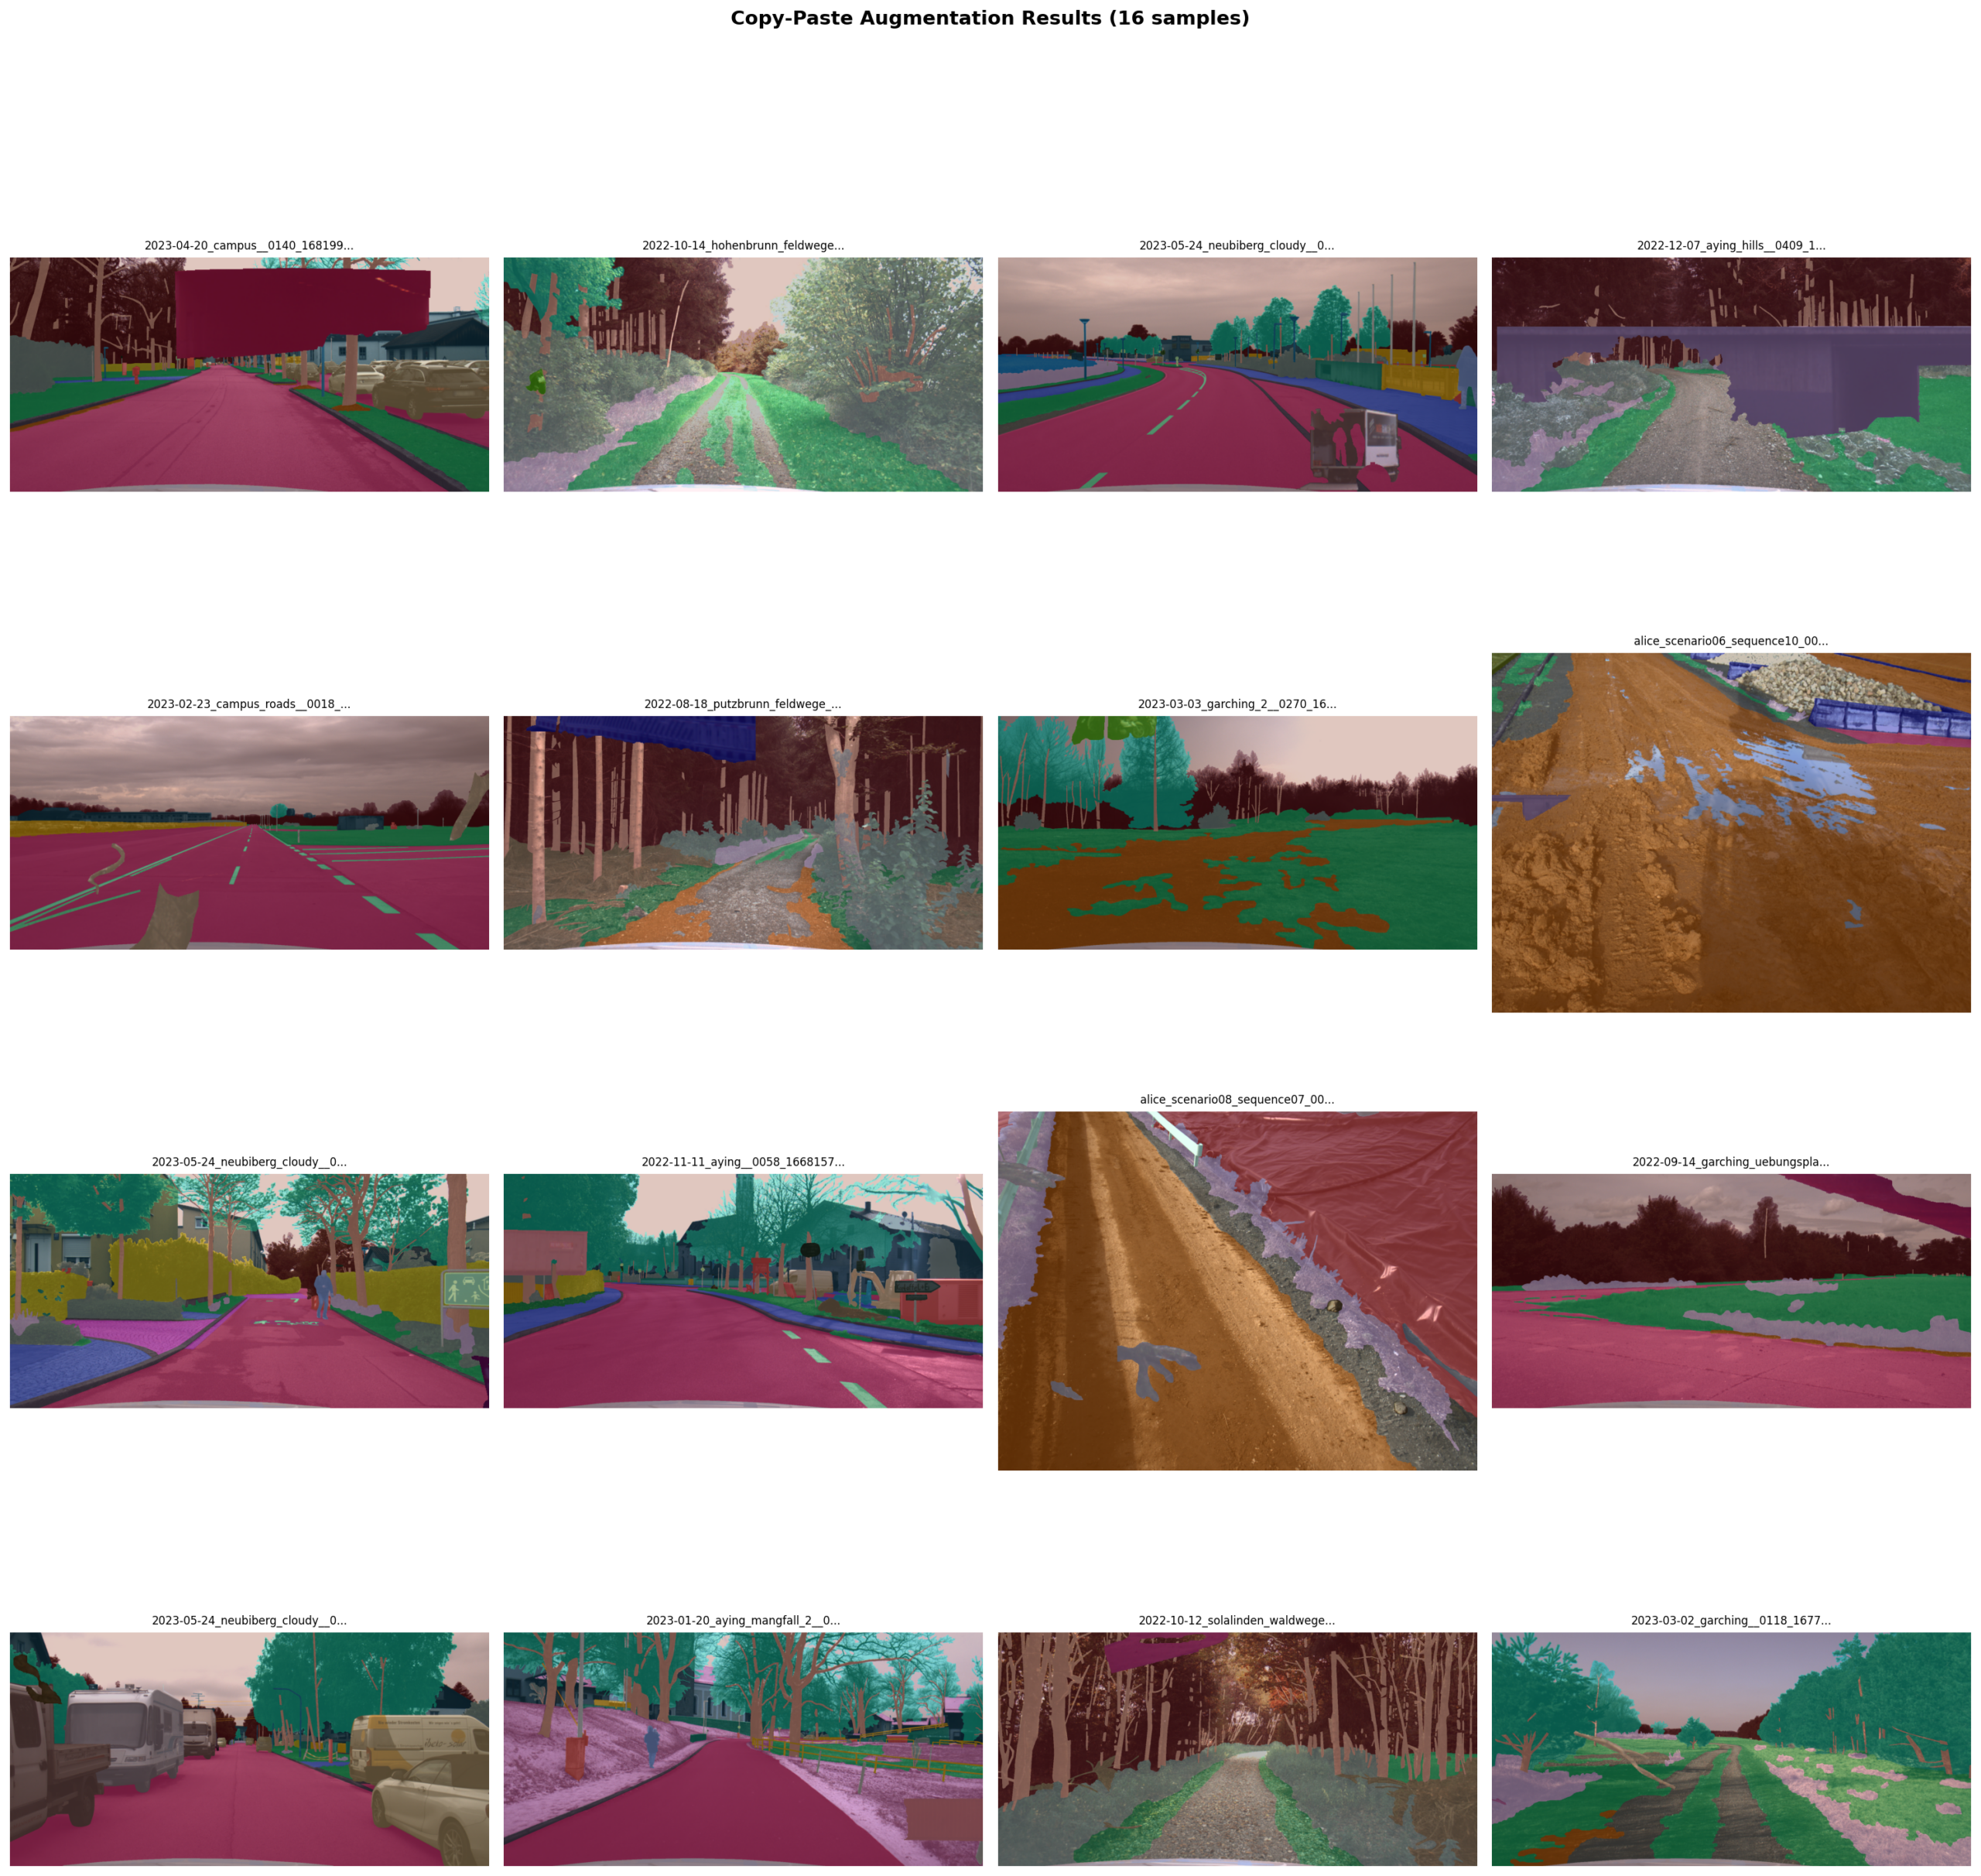
Copy-Paste: Instances of 17 rare classes extracted and pasted onto random target images with scaling from 0.2x to 4x. Two target images per source instance.

Class weighting: Both models used ENet-style weights: 1 / log(1.02 + frequency), normalized and scaled to 64.
Multi-scale inference at [0.75, 1.0, 1.25, 1.5] with horizontal flipping.
Model 1 (UPerHead) outperformed Model 2 on validation: 51.71 % vs 46.85 % mIoU. M2 still won specific classes. street_light, for instance: M1 got 13.1 % IoU while M2 got 46.8 %.
Tuned rule ensemble: A 3D histogram H[m1_pred, m2_pred, ground_truth] built over the full validation set. For every pixel group where M1 predicts class i and M2 predicts class c, the question is whether overriding M1 with M2 improves mIoU. An atom is accepted only if:
The greedy search accepted 18 atoms across 10 rules. Examples:
building and M1 says obstacle or pole, trust M2curb and M1 says fence, gravel, or low_grass, trust M2street_light and M1 says forest or pole, trust M2M1 alone: 44.21 % mIoU on the tuning split. Tuned ensemble: 47.94 %. A +3.72 % gain from 18 pixel-level rules.
Training ran on a single A100. M1 peaked around 58 GB memory. M2 was lighter at ~48 GB but slower.

M1 converged to higher mIoU and stayed there. M2’s loss looked reasonable but validation metrics plateaued lower. Mask2Former likely needs more data, longer training, or a better initialization than the ADE20K transfer. The transformer decoder also consumes many iterations.
| Approach | aAcc | mIoU | mAcc |
|---|---|---|---|
| UPerHead (M1) | 87.19 % | 51.71 % | 61.41 % |
| Mask2Former (M2) | 84.52 % | 46.85 % | 60.23 % |
| Tuned ensemble | 87.19 % | 51.79 % | 61.41 % |

The tuned ensemble edges out M1 by 0.08 % on validation. The real win is per-class. Some classes improved significantly.
Top 30 classes by M1 IoU below. M1 dominates frequent classes like sky, asphalt, and forest. M2 is competitive on street_light, rider, and bicycle.

The scatter plot below shows log frequency against IoU for both models. Rare classes cluster near zero. sky sits alone at the top right. barrel is an outlier with high IoU despite low frequency because it has a consistent visual signature (yellow cylinders).

16 diverse classes spanning the frequency spectrum. M1 covers more area overall, but M2 bulges on street_light and bicycle.

Most points sit below the diagonal, meaning recall is the bottleneck. The model finds the class when it is present, but misses many pixels. sky and barrel are the exceptions — high precision, high recall, easy classes.

Row-normalized confusion for the top 20 frequent classes. Dark diagonals = good recall. Off-diagonal heat shows misclassification patterns.
Common misclassifications: tree_crown → forest, high_grass → low_grass, wall → building. The model struggles with fine-grained vegetation boundaries and architectural edges.
M1 and M2 agree on 86.77 % of pixels. When they disagree, M1 wins 96 % of the time. The 4 % where M2 wins is where the ensemble gains come from.

Highest disagreement rates are on wall, rock, rider, and moss. These are ambiguous classes with fuzzy boundaries.

The waterfall chart below shows each accepted atom’s contribution to mIoU. Most atoms give small gains. A few give large gains — notably the debris → soil rule and the fence → curb rule.

Per-class IoU changes from the tuned rules. Biggest winners: curb (+55.3 %), debris (+23.5 %), street_light (+20.2 %). Some classes drop slightly, but the guard rails prevent any single class from dropping severely.

Image, ground truth, M1, M2. M2 is visibly noisier on vegetation and road boundaries.


No ground truth for the test set: image → M1 → M2 → tuned ensemble. The tuned rules shift predictions: building edges get cleaner, curb appears where M1 predicted fence, street_light appears where M1 predicted pole.


The numbers above are from local validation. The official challenge test set evaluation is below. Composite mIoU: 63.80 %.
| ID | Class | mIoU (%) |
|---|---|---|
| 0 | undefined | 25.56 |
| 1 | traffic_cone | 0.00 |
| 2 | snow | 67.67 |
| 3 | cobble | 87.26 |
| 4 | obstacle | 53.99 |
| 5 | leaves | 19.74 |
| 6 | street_light | 49.20 |
| 7 | bikeway | 0.00 |
| 8 | ego_vehicle | 91.97 |
| 9 | pedestrian_crossing | 0.00 |
| 10 | road_block | 71.51 |
| 11 | road_marking | 72.07 |
| 12 | car | 93.73 |
| 13 | bicycle | 70.06 |
| 14 | person | 86.77 |
| 15 | bus | 87.79 |
| 16 | forest | 70.40 |
| 17 | bush | 38.97 |
| 18 | moss | 1.27 |
| 19 | traffic_light | 70.61 |
| 20 | motorcycle | 42.61 |
| 21 | sidewalk | 66.88 |
| 22 | curb | 63.23 |
| 23 | asphalt | 92.28 |
| 24 | gravel | 31.68 |
| 25 | boom_barrier | 35.35 |
| 26 | rail_track | 78.25 |
| 27 | tree_crown | 53.52 |
| 28 | tree_trunk | 65.07 |
| 29 | debris | 25.62 |
| 30 | crops | 77.21 |
| 31 | soil | 61.59 |
| 32 | rider | 44.85 |
| 33 | animal | 30.41 |
| 34 | truck | 51.78 |
| 35 | on_rails | 84.62 |
| 36 | caravan | 80.90 |
| 37 | trailer | 27.69 |
| 38 | building | 85.81 |
| 39 | wall | 54.83 |
| 40 | rock | 20.05 |
| 41 | fence | 84.46 |
| 42 | guard_rail | 62.40 |
| 43 | bridge | 7.62 |
| 44 | tunnel | 0.00 |
| 45 | pole | 50.44 |
| 46 | traffic_sign | 70.61 |
| 47 | misc_sign | 70.84 |
| 48 | barrier_tape | 27.02 |
| 49 | kick_scooter | 1.44 |
| 50 | low_grass | 73.01 |
| 51 | high_grass | 59.68 |
| 52 | scenery_vegetation | 33.35 |
| 53 | sky | 97.54 |
| 54 | water | 51.23 |
| 55 | wire | 31.55 |
| 56 | outlier | 0.00 |
| 57 | heavy_machinery | 48.78 |
| 58 | container | 59.42 |
| 59 | hedge | 48.98 |
| 60 | barrel | 92.30 |
| 61 | pipe | 0.00 |
| 62 | tree_root | 0.00 |
| 63 | military_vehicle | 0.00 |
| Category | mIoU (%) |
|---|---|
| Animal | 30.41 |
| Construction | 78.37 |
| Human | 86.67 |
| Object | 40.42 |
| Road | 69.99 |
| Sign | 72.07 |
| Sky | 97.54 |
| Terrain | 89.14 |
| Vegetation | 93.39 |
| Vehicle | 86.77 |
| Water | 51.23 |
The test gap between validation and test is notable. Some classes improved (cobble, road_block, trailer), others collapsed (leaves, moss, rock). The test set likely has different scene distributions or lighting conditions. The 0 % classes remained 0 %. traffic_cone and pipe probably need external data or synthetic injection to improve.
| File | What it does |
|---|---|
train_segment_py.py | Train UPerHead model. Full MMSeg config in Python. |
train_mask2former_l.py | Train Mask2Former. Handles ADE20K pretrained weights with class mismatch. |
generate_submission.py | Inference + submission packaging for UPerHead. |
generate_submission_mask2former.py | Inference + submission packaging for Mask2Former. |
ensemble_submission_tuned.py | Apply tuned_rules.py to test predictions. |
tune_ensemble_v2.py | Greedy rule optimizer. Builds 3D histogram, selects atoms. |
copypaste_augmentation.py | Copy-Paste augmentation for rare classes. |
copypaste_config.py | Config for Copy-Paste. |
Steps to go from a fresh machine to running training or inference.
| Component | Minimum | Recommended |
|---|---|---|
| GPU | NVIDIA A100 80 GB | A100 80 GB or H100 |
| GPU memory (train) | ~58 GB (UPerHead), ~48 GB (Mask2Former) | 80 GB |
| Host RAM | 64 GB | 128 GB |
| Disk space | 400 GB free | 500 GB+ |
| CUDA capability | >= 8.0 (Ampere) | >= 8.0 |
Training ran on a single A100. The scripts are single-GPU. For inference only, a smaller GPU may work with reduced batch size or TTA disabled.
build-essential, git, wgetCheck CUDA and NVCC:
nvidia-smi
nvcc --version
Create the conda environment:
conda create -n dcnv4 python=3.10 -y
conda activate dcnv4
Install core deep-learning stack:
conda install pytorch torchvision pytorch-cuda=11.7 -c pytorch -c nvidia -y
Install OpenMMLab dependencies:
pip install -U openmim
mim install mmcv-full==1.5.0
mim install mmsegmentation==0.27.0
pip install timm==0.6.11 mmdet==2.28.1
Install remaining Python packages used by the scripts:
pip install opencv-python Pillow tqdm matplotlib scipy numpy pandas
The DCNv4 backbone requires a custom CUDA operator. It must be compiled from source: (The DCNv4 version in this repo is modified for compatibility with the current environment – A100 and newer cuda/python versions)
cd DCNv4/DCNv4_op
pip install -e .
If this fails, typical causes are:
CUDA_HOME not set: export CUDA_HOME=/usr/local/cudaVerify the build:
python -c "import DCNv4.ext; print('OK')"
The GOOSE and GOOSE-Ex datasets are downloaded automatically by the preparation script. They need ~192 GB of disk space.
python prepare_combined_dataset.py
This creates the expected data/ tree:
data/
  goose_2d_train/
  goose_2d_val/
  gooseEx_2d_train/
  gooseEx_2d_val/
  goose_2d_train_copypaste/   # created by copypaste_augmentation.py
  goose_label_mapping.csv
Pretrained backbones are downloaded automatically on first run from HuggingFace:
flash_intern_image_l_22kto1k_384.pthmask2former_flash_internimage_l_640_160k_ade20k_ss.pthTo skip training and run inference only, download the best fine-tuned checkpoints and place them under checkpoints/goose_seg_dcnv4/ and checkpoints/goose_mask2former_l/.
The conda environment is dcnv4. Python 3.10, PyTorch, MMCV, MMSegmentation.
Train UPerHead:
conda run -n dcnv4 python train_segment_py.py > training.log 2>&1 &
Train Mask2Former:
conda run -n dcnv4 python train_mask2former_l.py > training_maskformer.log 2>&1 &
Generate validation predictions and submission:
conda run -n dcnv4 python generate_submission.py
conda run -n dcnv4 python generate_submission_mask2former.py
Tune the ensemble:
conda run -n dcnv4 python tune_ensemble_v2.py
conda run -n dcnv4 python ensemble_submission_tuned.py
Regenerate all README visuals:
conda run -n dcnv4 python generate_readme_visuals.py
conda run -n dcnv4 python generate_confusion_heatmap.py
conda run -n dcnv4 python generate_disagreement_chart.py
conda run -n dcnv4 python generate_pr_scatter.py
conda run -n dcnv4 python generate_test_side_by_sides.py
Worked:
Didn’t work:
traffic_cone, pipe, tree_root, military_vehicle, kick_scooter) scored exactly 0.0 on test.Not tried:
Khi chúng ta hình dung về “một chiếc máy tính” ngày nay, chúng ta có lẽ sẽ nghĩ đến một thiết bị như máy tính để bàn (PC), máy chơi game cầm tay hoặc điện thoại thông minh. Nhưng đó không phải là những cỗ máy duy nhất mà con người từng sử dụng để tính toán và điện toán.
Để truy vết lịch sử của máy tính, trước tiên chúng ta cần quyết định xem cái gì được coi là máy tính và máy tính khác với những chiếc máy tính bỏ túi hoặc máy tính toán thuần túy như thế nào. Đây là một câu hỏi khó đến ngạc nhiên
Hãy cùng xem xét thêm một số khái niệm thường được đề xuất để định nghĩa máy tính. Từ điển tiếng Anh Oxford, yêu cầu máy tính phải là thiết bị điện tử. Nhưng những cỗ máy tương tự có thể được làm từ các chất nền (vật liệu) khác, chẳng hạn như nước
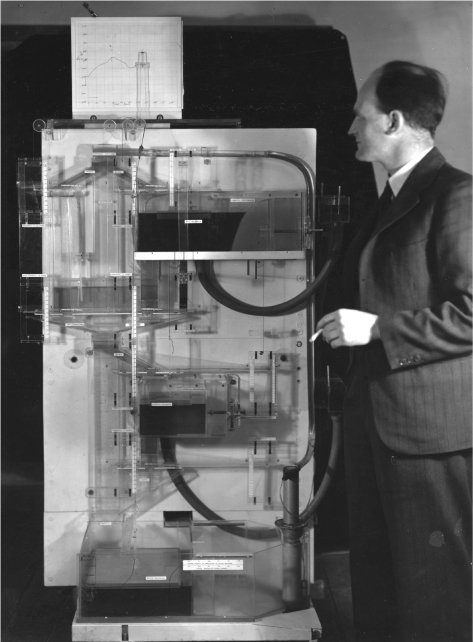
MONIAC, viết tắt của Monetary National Income Analogue Computer được chế tạo vào năm 1949, MONIAC là một máy tính được sử dụng để mô phỏng dòng tiền chạy qua nền kinh tế và để minh họa các tác động của các can thiệp kinh tế lên một mô hình kinh tế.
Một số người lập luận rằng máy tính phải là kỹ thuật số (digital), trái ngược với tương tự (analog). Một cỗ máy kỹ thuật số là cỗ máy biểu diễn dữ liệu bằng các chữ số, các tập hợp ký hiệu rời rạc như các chữ số nhị phân 0 và 1. Ngược lại, một cỗ máy tương tự có một tập hợp vô hạn, liên tục các trạng thái có thể xảy ra, chẳng hạn như lượng nước trong các bể của MONIAC, khiến MONIAC trở thành một cỗ máy tương tự.
Trong lý thuyết tính toán, chúng ta có Luận thuyết Church (Church’s thesis), một định nghĩa khắt khe hơn về máy tính mà hầu hết các nhà khoa học máy tính hiện đại đều đồng ý. Nó có thể được diễn giải như sau:
Một máy tính là một cỗ máy có thể mô phỏng bất kỳ cỗ máy nào khác, với điều kiện được cung cấp bao nhiêu bộ nhớ tùy ý.
Hiện tại các máy tính rõ ràng tồn tại để có thể thực hiện những việc sau, vì vậy một máy tính theo luận thuyết Church cũng phải có khả năng thực hiện các tác vụ này:
goto).if).
Vào khoảng những năm 40000 TCN,người ta tìm thấy xương Lebombo, một mảnh xương với các khía khắc có thể đã được sử dụng như một chiếc gậy tính. Một vạch đại diện cho một vật thể vật lý, có thể trong thời kì này, nó dùng cho đếm động vật, các mặt hàng thực phẩm hoặc các ngày để tính thời gian cho một cuộc săn bắn nào đó.
Xương Lebombo là một ví dụ về biểu diễn dữ liệu. Nó có thể đã được sử dụng cho một hình thức tính toán đơn giản như cộng thêm một vào tổng mỗi khi một dấu vết mới được tạo ra.
Khoảng những năm 4000 TCN, các thành phố đầu tiên bắt đầu phát triển. Các thành phố đòi hỏi những hành vi/tổ chức ở quy mô lớn hơn, ví dụ như theo dõi việc giao thương và thuế. Vào năm 3000 TCN, văn hóa thành phố Sumer ở Lưỡng Hà (Iraq ngày nay) đã phát triển hệ thống chữ viết đầu tiên, và đến năm 2500 TCN, họ đã sở hữu chiếc máy tính toán đầu tiên: bàn tính (abacus)
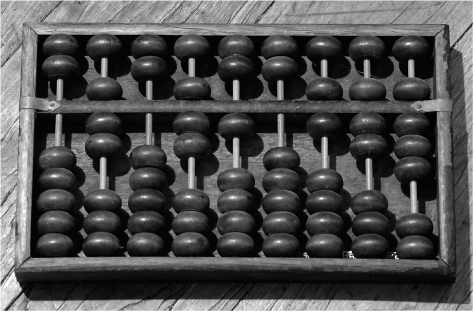
Bàn tính đang biểu diễn 070710678
Trong cách sử dụng thông thường, trạng thái của bàn tính biểu diễn số (thập phân, tự nhiên).
Có chín cột, mỗi cột đại diện cho một trong các chữ số trong số này. Mỗi cột được chia thành một hộp dưới chứa năm hạt và một hộp trên chứa hai hạt. Vị trí mặc định của các hạt ở hộp dưới là ở dưới, và vị trí mặc định của các hạt ở hộp trên là ở trên.
Ở trạng thái này, một cột biểu thị chữ số 0. Mỗi hạt được đẩy từ dưới lên trên của hộp dưới có giá trị là 1. Mỗi hạt được đẩy từ trên xuống dưới của hộp trên có giá trị là 5.
Để cộng 1 vào một số trên bàn tính (tức là tăng nó lên), bạn nâng một hạt từ hộp dưới của cột ngoài cùng bên phải. Nếu tất cả năm hạt trong hộp dưới của một cột đã được nâng lên, bạn đẩy tất cả chúng xuống lại và thay thế chúng bằng cách hạ một trong các hạt ở hộp trên trong cùng cột đó. Nếu cả hai hạt trên đều đã hạ xuống, bạn đẩy chúng ngược lên và thay thế chúng bằng cách nâng một hạt từ hộp dưới ở cột bên trái của nó. Việc chuyển dữ liệu từ một cột sang cột bên trái của nó được gọi là phép toán nhớ. (Giống như việc xét chữ số của 1 số từ phải sang trái, thì mỗi hàng đơn vị ta x 10 vậy)
Để cộng hai số, a + b, trước tiên bạn thiết lập bàn tính để biểu diễn các chữ số của a. Sau đó, bạn thực hiện b lần tăng như trên. Trạng thái của bàn tính khi đó biểu diễn kết quả.
Kiểu tính toán này, nơi số thứ nhất được “nạp vào” thiết bị và số thứ hai được “cộng thêm vào” đó, để lại kết quả cuối cùng là trạng thái của hệ thống, được gọi là kiến trúc tích lũy (accumulator architecture), và nó vẫn còn được sử dụng phổ biến ngày nay. Nó “tích lũy” kết quả của một chuỗi các phép tính; ví dụ, chúng ta có thể cộng một danh sách gồm nhiều số bằng cách cộng lần lượt từng số vào trạng thái và xem tổng tích lũy mới nhất sau mỗi lần cộng.
Khoảng năm 100 TCN, xuất hiện cơ chế Antikythera. Nó được tìm thấy vào năm 1901 trong một xác tàu đắm ở Địa Trung Hải; con tàu bị đắm dường như đang trên đường từ Hy Lạp đến La Mã, mang theo cơ chế này để bán hoặc làm vật phẩm cống nạp.
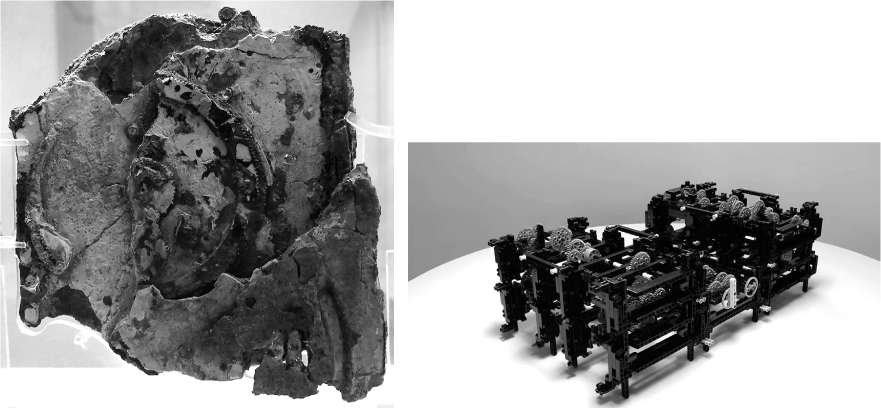
Chạy bằng bánh răng cơ khí, dùng để dự đoán các sự kiện thiên văn, bao gồm vị trí của năm hành tinh, các pha của mặt trăng, thời điểm nhật thực/nguyệt thực và thời gian diễn ra Thế vận hội Olympic. Nó bao gồm 37 bánh răng bằng đồng, và người dùng sẽ quay một tay cầm để mô phỏng diễn biến tương lai của các trạng thái thiên văn. Các kết quả được hiển thị trên các mặt đồng hồ, được tính toán dựa trên tỷ số truyền của các bánh răng cơ khí.
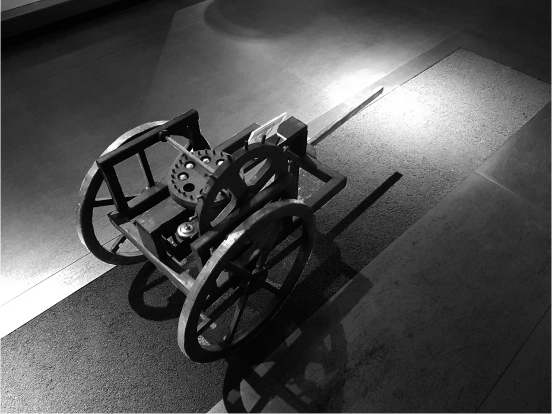
Máy đo quãng đường (Odometers) là những cỗ máy đo khoảng cách tầm xa mà người Hy Lạp và La Mã đã sử dụng để khảo sát và lập bản đồ đế chế của họ.
Loại máy đo quãng đường này hoạt động như sau: chúng phát ra tiếng “cạch” mỗi khi được đẩy đi một khoảng cách nhất định. Chiếc máy đo này được kéo bởi một con ngựa, giống như một cỗ xe. Có một số viên bi kim loại được lưu trữ trong các hốc của một bánh răng gỗ hình tròn. Một trong các bánh xe của xe có gắn một cái chốt sao cho cứ sau mỗi vòng quay, nó lại chạm và làm xoay bánh răng một góc cố định nhỏ. Một cái lỗ có kích thước bằng viên bi nằm dưới một vị trí của bánh răng cho phép một viên bi phía trên nó rơi ra khỏi hốc và rơi vào một hộp thu thập bên dưới. Tổng quãng đường đã đi được ghi lại bằng số lượng viên bi trong hộp đếm vào cuối chuyến đi.
Những cỗ máy này có phải là máy tính không? Rõ ràng có các khái niệm về dữ liệu được sử dụng để đại diện cho các vật thể trong thế giới, cũng như các hình thức tự động hóa và tính toán. Nhưng giống như MONIAC, mỗi cỗ máy chỉ làm được một việc duy nhất: dự đoán nhật thực hoặc đo khoảng cách. Theo luận thuyết Church, ta thấy rằng các cỗ máy này không thể lập trình lại để làm 1 việc khác.

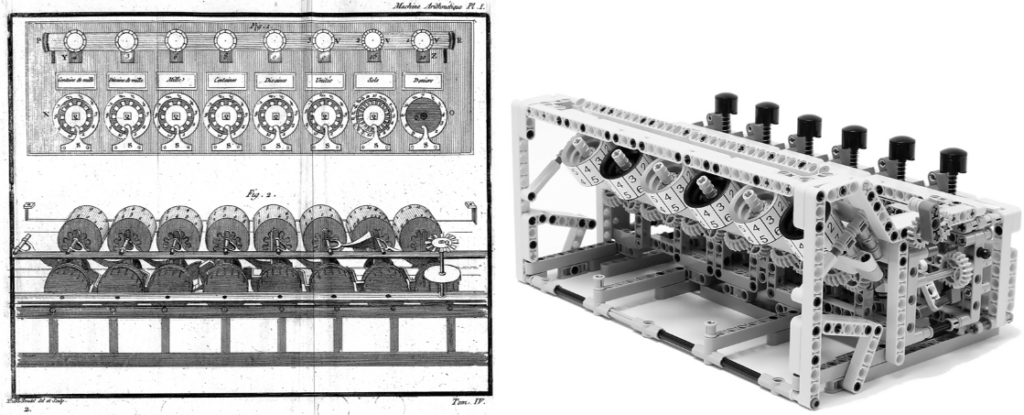
Trong nhiều năm tiếp theo, xuất hiện nhiều “máy móc” với ý tưởng phát triển từ các ý tưởng trên. Ví dụ Codex Madrid của Davinci, dùng để tính toán qua hệ thống bánh răng. Tỷ số truyền giữa mỗi cặp cột là 1:10, vì vậy bánh xe của mỗi cột sẽ quay với tốc độ bằng 1/10 so với cột bên phải của nó. Có 13 bánh xe, mỗi bánh xe đại diện cho các cột của một số thập phân
Máy Phân tích đã được thiết kế như một chiếc máy lập trình được, có mục đích hoàn toàn tổng quát (general-purpose).
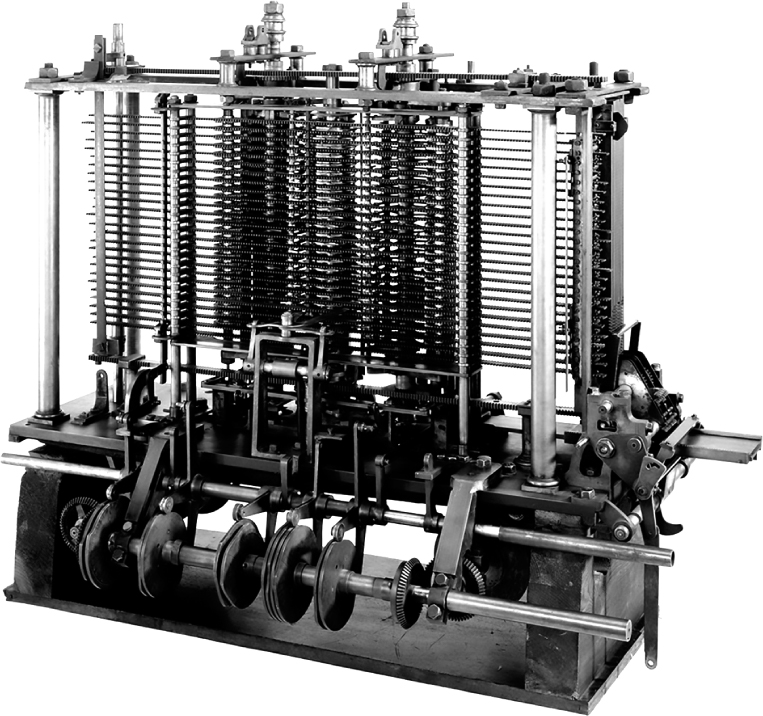
Để đạt được tính tổng quát này, Máy Phân tích cung cấp một loạt các phép toán số học và các hoạt động khác dưới dạng các bộ phận máy đơn giản, cùng với một bộ nhớ để lưu trữ dữ liệu và khả năng đọc các chương trình từ thẻ đục lỗ.
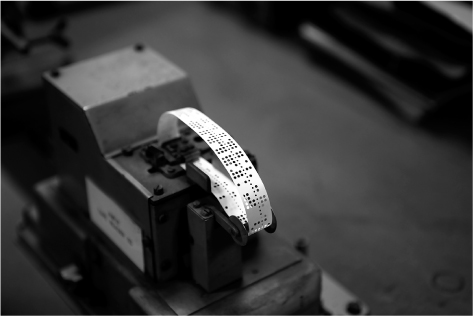
Các chương trình này quy định một trình tự các thao tác đọc/ghi bộ nhớ và các phép toán số học, đồng thời cho phép rẽ nhánh tùy thuộc vào trạng thái của phép tính, tức là một câu lệnh if.
Phần lõi của Máy Phân tích chứa nhiều máy đơn giản độc lập, mỗi máy thực hiện một chức năng nhất định, chẳng hạn như cộng các số và kiểm tra xem một số có bằng một số khác hay không.
Máy Phân tích đã giới thiệu khái niệm hiện đại về bộ nhớ máy tính. Mỗi máy có thể giữ một con số khác nhau. Mỗi máy sẽ được gán một mã định danh số hoặc “địa chỉ” (address) để chỉ định chính xác máy nào cần đọc hoặc ghi.
Một chuỗi các chỉ thị (instructions) sẽ được mã hóa dưới dạng nhị phân và đục lỗ trên băng giấy. Mỗi chỉ thị sẽ ra lệnh cho cỗ máy kích hoạt một trong các máy đơn giản. Thông thường, sau mỗi chỉ thị, cỗ máy sẽ đẩy băng giấy đục lỗ theo từng dòng để tải chỉ thị tiếp theo. Tuy nhiên, cỗ máy cũng có khả năng kiểm tra kết quả của máy đơn giản vừa chạy và tùy thuộc vào giá trị đó, nó có thể nhảy đến một dòng khác trên giấy. Điều này mang lại cho các chương trình khả năng thay đổi hành vi để phản hồi lại các kết quả trung gian.
Một chương trình cũng có thể được tạo ra để chạy mãi mãi bằng cách dán phần cuối của băng giấy đục lỗ vào phần đầu của nó, tạo thành một vòng lặp vật lý, như trong máy băng giấy.
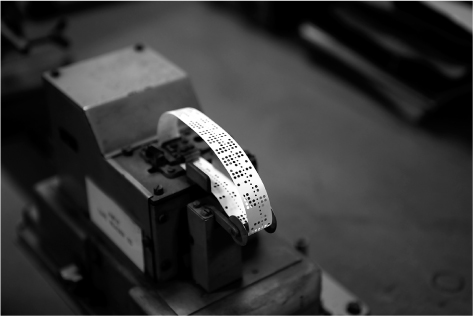
Thiết kế của nó chứa đựng tất cả các đặc điểm cơ bản của một máy tính hiện đại: CPU, bộ nhớ, bus, các thanh ghi, bộ điều khiển và đơn vị số học. Nó có thể đọc, ghi và xử lý dữ liệu. Nó có thể làm toán. Không giống như các máy tính thuần túy trước đó, nó có thể nhảy (goto) và rẽ nhánh (if), chuyển đến các chỉ thị khác nhau trong chương trình tùy theo trạng thái tính toán.
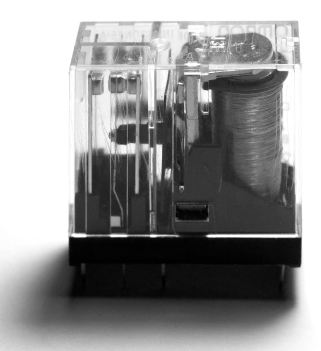
Trước khi có máy tính hiện đại, thế giới trải qua một giai đoạn “lai” gọi là Cơ – Điện (Electromechanical). Thay vì dùng bánh răng thuần túy, người ta dùng điện để điều khiển các chuyển động cơ học.
Rơ-le là linh kiện then chốt của thời kỳ này. Bạn có thể hiểu đơn giản nó là một công tắc điện được đóng/ngắt bằng một tín hiệu điện khác, thay vì dùng tay người.
Hiến pháp Hoa Kỳ yêu cầu việc điều tra dân số phải được thực hiện và xử lý sau mỗi 10 năm, và đến năm 1890, dân số đã tăng đến mức việc xử lý các số liệu thống kê bằng con người là không thể. Herman Hollerith đã thiết kế một chiếc máy để tự động hóa việc xử lý dữ liệu và sử dụng nó thành công trong kỳ điều tra dân số năm 1890 để thực hiện phân tích dữ liệu lớn trên thông tin của 62 triệu công dân. Dữ liệu của mỗi công dân được chuyển từ mẫu đơn điều tra viết tay sang một thẻ đục lỗ bởi con người. Mỗi câu hỏi trong cuộc điều tra dân số là dạng trắc nghiệm, và được mã hóa trên thẻ đục lỗ bằng cách đục bỏ một trong số các lựa chọn.
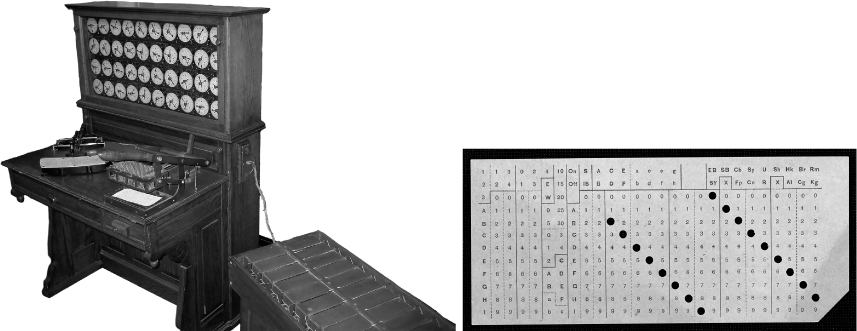
Các xấp thẻ có thể được đọc vào máy, máy sẽ kiểm tra sự hiện diện hay vắng mặt của các đặc điểm nhất định hoặc sự kết hợp của các đặc điểm. Điều này có nghĩa là chiếc máy này có khả năng tương đương với các truy vấn SQL hiện đại, bao gồm SELECT, WHERE, GROUP BY, và ORDER BY.
Thế chiến II là “lò luyện” thúc đẩy máy tính phát triển vượt bậc nhờ nhu cầu giải mã:
Khi rơ-le cơ học lộ khuyết điểm (chậm, hay bị kẹt, phát ra tiếng ồn), Bóng chân không (Vacuum Tubes/Valves) ra đời (1904).
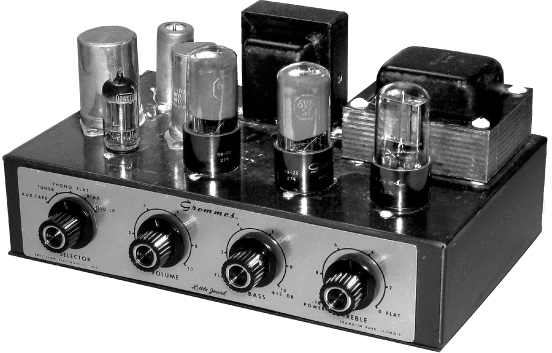
Hãy tưởng tượng nó như một cái bóng đèn nhưng có thêm một “lưới” điều khiển ở giữa.
Hoàn thành năm 1945, ENIAC là máy tính điện tử đa năng bằng bóng chân không.
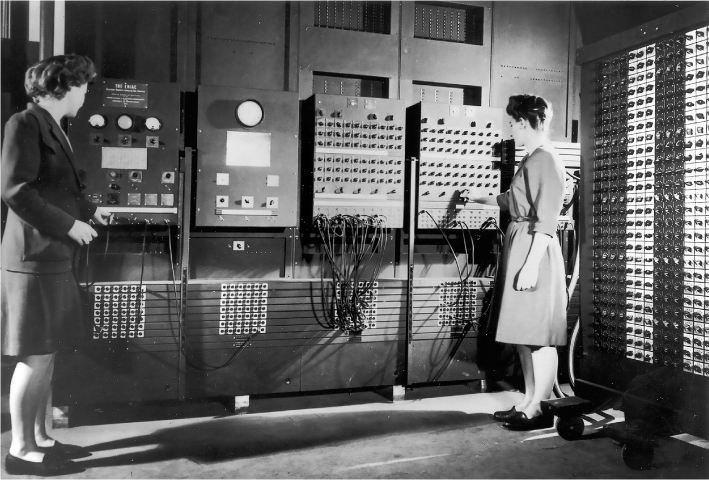
Máy ảo (Virtual Machine) đầu tiên: Nhóm lập trình viên gồm 6 phụ nữ (như Betty Jean Jennings, Frances Bilas…) đã tạo ra một bước ngoặt: Thay vì rút dây cho mỗi bài toán, họ thiết lập một cấu hình dây cố định cho phép máy đọc các lệnh từ các bảng công tắc.
Lúc này, các công tắc đóng vai trò là “phần mềm” sơ khai, điều khiển lớp “phần cứng” bên dưới. Đây chính là khái niệm máy ảo đầu tiên trong lịch sử.
Được chứng minh lần đầu bởi máy Manchester Baby (1948), đây là kiến trúc mà mọi máy tính và smartphone ngày nay vẫn dùng.
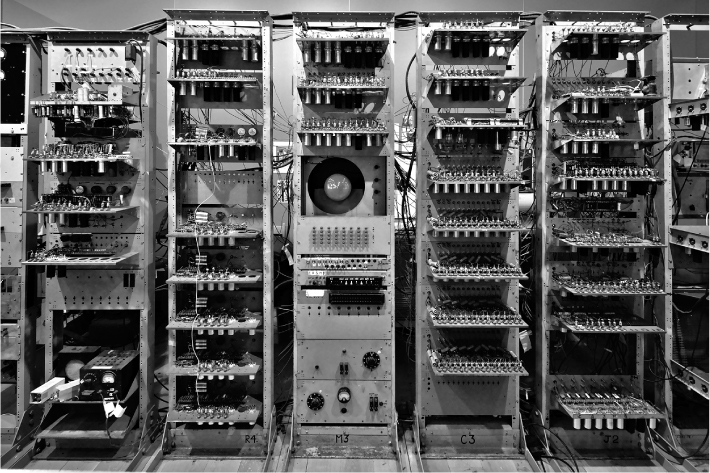
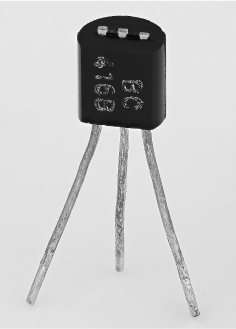
Năm 1947, Bóng bán dẫn (Transistor) ra đời, đánh dấu sự kết thúc của những căn phòng đầy bóng chân không nóng bức.
Sự vượt trội của transistor đến từ bản chất vật lý của trạng thái rắn so với môi trường chân không:
Các “máy tính mini” (minicomputers) chạy bóng bán dẫn của những năm 1960 không sử dụng vi mạch (microchips), mà thay vào đó được chế tạo từ các loại bóng bán dẫn “lớn”, dài khoảng 1 cm.
Các ứng dụng của máy tính bán dẫn trong những năm 1960 bao gồm việc vận hành ARPANET, tiền thân của internet dựa trên TCP/IP ngày nay, và việc Margaret Hamilton lập trình mã đổ bộ lên mặt trăng của tàu Apollo năm 1969 bằng ngôn ngữ hợp ngữ (assembly). Hình ảnh là bản in chương trình hợp ngữ hoàn chỉnh của bà cho tàu Apollo 11
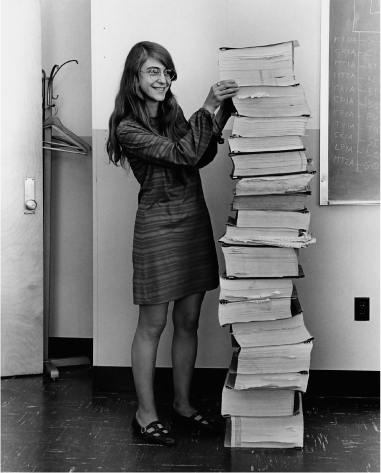
Công việc sau này thực sự là “khoa học tên lửa” (rocket science), và yêu cầu bà phải tạo ra lĩnh vực kỹ thuật phần mềm (software engineering) hiện đại trong khi tìm kiếm các phương pháp để làm cho đoạn mã cực kỳ quan trọng này trở nên chính xác hơn.
Vào năm 1965, Gordon Moore, CEO của Intel, đã đưa ra một quan sát mà từ đó được gọi là Định luật Moore. Định luật này nói rằng tốc độ của máy tính hoặc số lượng bóng bán dẫn trên mỗi đơn vị diện tích sẽ tăng gấp đôi sau mỗi 18 tháng hoặc 2 năm.
Công nghệ IC cho phép các mạch điện dựa trên bóng bán dẫn được thu nhỏ lại, sao cho cùng một hệ thống dây điện từng lấp đầy một tủ rack những năm 1960 giờ đây có thể nằm gọn trên một “chip” silicon kích thước bằng móng tay. Từ góc nhìn kiến trúc, các con chip không có gì quá kỳ lạ, nếu bạn lấy sơ đồ đi dây của một chiếc máy bóng đèn chân không những năm 1940 và thu nhỏ nó lại, bạn sẽ có một con chip.
Nếu nhìn chip qua kính hiển vi, bạn sẽ thấy các mô hình đi dây tương tự như dây điện ở mặt sau của các tủ rack những năm 1940, 1950 hoặc 1960. Chip silicon sau đó được “đóng gói” bên trong một khối nhựa thường có màu đen lớn hơn, với các chân kim loại lớn kết nối các đầu vào và đầu ra tinh vi của chip với thế giới bên ngoài, thường là một bảng mạch in.
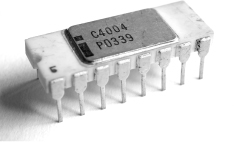
Những năm 1980 là thời hoàng kim của kiến trúc máy tính: lần đầu tiên, máy tính điện tử trở nên đủ rẻ và nhỏ để được sản xuất hàng loạt và được những người bình thường mua về sử dụng tại nhà.
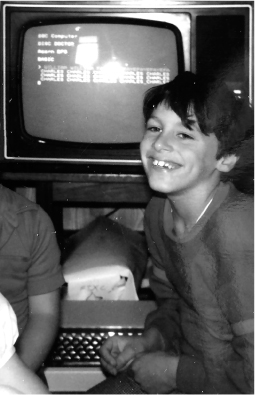
Chiếc IBM 5150 PC ra mắt vào năm 1981, dựa trên chip Intel 8088. IBM và các công ty khác đã bán chiếc máy này cũng như các máy PC khác trong suốt những năm 1980 để sử dụng trong các văn phòng kinh doanh.
Khái niệm PC (Personal Computer) là thái cực đối lập với thị trường máy tính gia đình đa dạng và thiên về kiến trúc vì hai lý do.
Để phản ứng lại các hệ điều hành độc quyền đang được cài đặt trên PC và các máy tính lớn hơn, dự án GNU và phong trào Phần mềm Tự do đã được Richard Stallman tạo ra trong thập kỷ này, điều này sau đó đã dẫn đến các hệ thống và triết lý dựa trên Linux mà chúng ta sử dụng ngày nay.
Kiến trúc máy tính bị thống trị bởi kiến trúc tiêu chuẩn của máy tính cá nhân (PC), vốn đã được sử dụng trong tin học văn phòng những năm 1980 nhưng giờ đây được các tập đoàn PC đẩy mạnh khắp nơi, kể cả trong gia đình và trường học. Các hệ điều hành mã nguồn đóng được bán kèm như một phần của gói PC. Trong thời gian này, các trường học đã ngừng dạy khoa học máy tính và tập trung dạy cách sử dụng phần mềm văn phòng thương mại.
Chuyển từ việc coi đối tượng người dùng là lập trình viên và thành viên cộng đồng công nghệ sang coi người dùng là khách hàng và người tiêu dùng các sản phẩm phần mềm, chẳng hạn như trình xử lý văn bản và bảng tính (VD: Word, Excel, …)
Như định luật Moore đã dự đoán một cách đáng tin cậy, tốc độ bộ vi xử lý tăng gấp đôi sau mỗi 18 tháng. World Wide Web chính thức hoạt động tại CERN vào năm 1990 và phát triển phổ biến, dẫn đến cơn sốt đầu tư dot-com vào cuối thập kỷ. Khi có nhiều hacker và cuối cùng là người tiêu dùng tham gia vào web, các thiết kế máy tính máy chủ gắn trên giá đỡ (rack-mounted server) chuyên dụng đã trở nên phổ biến, bắt đầu với Compaq ProLiant vào năm 1993. Giống như Manchester Baby và các máy tính mini những năm 1960, chúng được thiết kế để xếp chồng trong các đơn vị giá đỡ 19 inch, nhưng hoạt động liên tục với độ tin cậy cao. -> xuất hiện định nghĩa về server
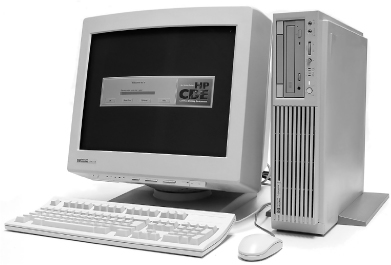
Kiến trúc PC gồm các linh kiện hàng hóa kết hợp với hệ điều hành vẫn tiếp tục duy trì trong suốt những năm 2000. Định luật Moore, và hệ quả là việc lắp ráp hoặc mua một chiếc máy tính mới có tốc độ gấp đôi sau mỗi vài năm, vẫn tiếp diễn. Các máy móc sử dụng cùng một thiết kế máy tính PC cơ bản, với các giao diện và thành phần khác nhau được nâng cấp về tốc độ. Tốc độ internet cũng tăng lên, cho phép truyền phát video cũng như chuyển văn bản và hình ảnh.
Trong những năm 1990 và 2000, giả định rằng tốc độ xung nhịp của các bộ vi xử lý sẽ tăng gấp đôi sau mỗi vài năm, và thực tế là như vậy. Định luật Moore trở thành một lời tiên tri tự ứng nghiệm khi các nhà sản xuất chip ở Thung lũng Silicon sử dụng nó như một mục tiêu cần đạt được.
Tuy nhiên, tất cả đã sụp đổ vào những năm 2010. Công nghệ sản xuất bóng bán dẫn thực sự vẫn tiếp tục tăng gấp đôi số lượng bóng bán dẫn trên mỗi đơn vị diện tích, nhưng tốc độ xung nhịp đã đạt mức tối đa vào năm 2010, ở khoảng 3.5 GHz.
Đột nhiên, các bộ vi xử lý không còn nhanh hơn nữa. Điều này là do các định luật vật lý cơ bản xung quanh tốc độ tính toán và nhiệt lượng. Trong thời kỳ định luật Moore, nhiệt độ của các bộ vi xử lý cũng tăng lên cùng với tốc độ; cần có các quạt lớn hơn, mạnh hơn và các hệ thống làm mát khác như làm mát bằng chất lỏng. Các bóng bán dẫn nhỏ đi, nhưng các cánh quạt lại to ra. Nếu xu hướng này tiếp tục qua những năm 2010, giờ đây chúng ta sẽ có những bộ vi xử lý nóng hơn cả bề mặt mặt trời.
Một khái niệm liên quan chặt chẽ là mức tiêu thụ điện năng. Khi các con chip tỏa nhiều nhiệt hơn, chúng tiêu thụ nhiều điện hơn, và thập kỷ này cũng chứng kiến sự khởi đầu của một nỗ lực hướng tới tính toán năng lượng thấp, di động hơn, đặc biệt là dưới dạng điện thoại thông minh.
Trong khi hai thập kỷ trước đó chứng kiến kiến trúc máy tính trì trệ như một lĩnh vực nghiên cứu, chỉ dựa vào những tiến bộ trong công nghệ chế tạo để tạo ra các lợi ích định kỳ, thì giờ đây lĩnh vực này lại mở rộng trở lại cho những ý tưởng hoàn toàn mới.
Chúng ta không thể làm máy tính nhanh hơn thông qua dạng “tốc độ” của định luật Moore, nhưng chúng ta vẫn có thể nhồi nhét ngày càng nhiều bóng bán dẫn lên chip với dạng “mật độ” của nó. Giờ đây, chúng ta có thể xem xét việc làm cho mọi thứ trở nên song song (parallel), thực hiện nhiều thao tác cùng một lúc thay vì từng cái một.
Trong khi vẫn còn nhiều kiến trúc song song cần được khám phá, những năm 2010 đã chứng kiến ba loại kiến trúc song song chính thành công trong thế giới thực.
Xu hướng cho thấy rõ các tài nguyên nghiên cứu đổ vào để tạo ra các sản phẩm nhỏ nhất, dùng ít năng lượng nhất, hiệu quả hơn (như điện thoại thông minh, tivi thông minh, tủ lạnh thông minh, máy giặt thông minh, ….) , hoặc ngược hẳn lại, là tạo ra những thứ mạnh nhất, to nhất (các hệ thống datacenter, server khổng lồ), và hiếm có đầu tư cho vùng ở giữa.
Khái niệm tính toán hiện đại đã được Church định nghĩa. Các máy điện tử thương mại của những năm 1950, bắt đầu với UNIVAC, qua các máy tính mini những năm 1960 và vi mạch những năm 1970 cho đến ngày nay dường như có thể được nhận diện rõ ràng là máy tính. Nhưng liệu có bất cứ thứ gì trước đó nên được công nhận là “chiếc máy tính đầu tiên”?
Có lẽ con người đã tính toán từ năm 40.000 TCN với bàn tính, xương, đá và các con số trong đầu. Tất cả những thứ trên về mặt lý thuyết đều là máy tính Church vì chúng có thể mô phỏng bất kỳ cỗ máy nào nếu được lập trình theo một cách nhất định. Vì vậy, có lẽ chúng ta đã luôn có máy tính — và Church chỉ là người đầu tiên nhận ra chúng.
Tham khảo:
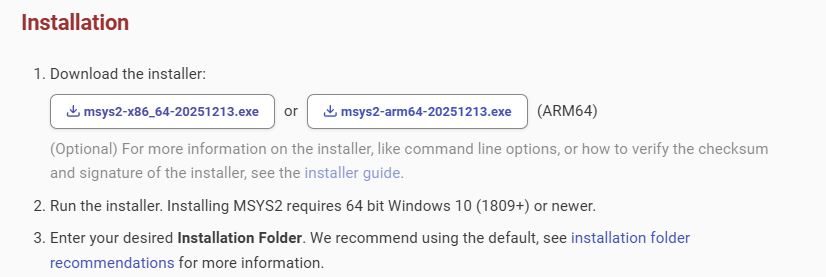

This Installation Folder is important, please remember of it
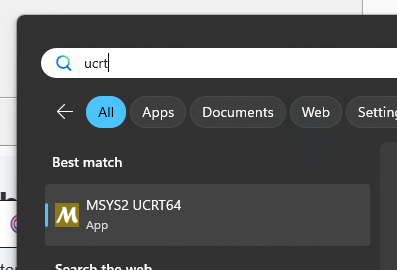
Search for it in your Start menu.
Run the update command:
pacman -SyuInstall GnuCOBOL:
pacman -S mingw-w64-ucrt-x86_64-gnucobol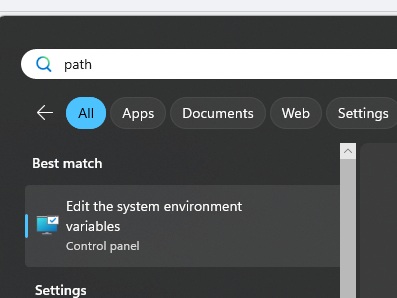
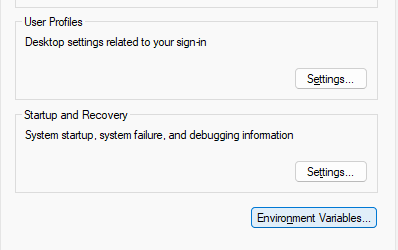
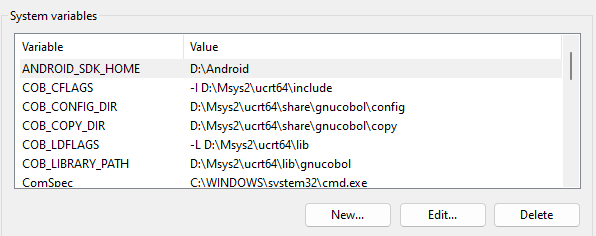
COB_CONFIG_DIR: C:\msys64\ucrt64\share\gnucobol\configCOB_COPY_DIR: C:\msys64\ucrt64\share\gnucobol\copyCOB_LIBRARY_PATH: C:\msys64\ucrt64\lib\gnucobol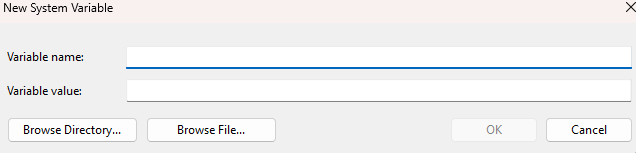
Now you can run your cobol program
| Goal | Command | Result |
| Quick Test | cobc -x -j file.cbl | Runs immediately; no permanent .exe kept. |
| Build App | cobc -x file.cbl | Creates file.exe to run anytime. |
| Build for Python | cobc -m file.cbl | Creates a .dll library for Python to call. |
| Check Errors | cobc -f syntax-only file.cbl | Only checks for code errors without building. |

: fatal error: libcob.h: No such file or directory
10 | #include <libcob.h>
| ^~~~~~~~~~
compilation terminated.
The error fatal error: libcob.h: No such file or directory means the COBOL compiler (cobc) found your code, but the C compiler (which GnuCOBOL uses under the hood) can’t find the necessary “header files” to finish building the program.
Adding these to Environment Variables like previous step
| Variable Name | Variable Value |
COB_CFLAGS | -I D:\Msys2\ucrt64\include |
COB_LDFLAGS | -L D:\Msys2\ucrt64\lib |
-I (Include): Points to the folder containing libcob.h.-L (Library): Points to the folder containing the actual library files (.lib or .a).Or a quick command if you not want add it:
cobc -x -j TEST-PROGRAM.cbl -I D:\Msys2\ucrt64\include -L D:\Msys2\ucrt64\libnanosleep64 could not be located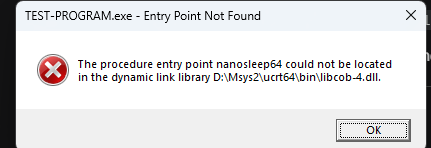
If you got (nanosleep64 could not be located) may indicate: your system is confused between two different versions of the C compiler.
The nanosleep64 error is a classic sign that a program compiled with one Windows runtime (like UCRT) is trying to link with an incompatible version of a library.
You could run this command
where gccIf the output show more than one directory path, it may appear your computer have 2 installed GCC place
To solve this:
You need to tell Windows that the D: drive tools are the priority.
C:\Msys2\ucrt64\bin in the list. (the path you added in installation step)the other bin directory in where gcc command).Close your current Command Prompt and open a new one for the change to take effect.
Alternative Way:
cobc -x -j TEST-PROGRAM.cbl -conf="D:\Msys2\ucrt64\share\gnucobol\config\default.conf"Như đã sơ lược qua ở phần trước, HTTP/2 Server Push (gọi tắt là HTTP/2 push) cho phép máy chủ (server) gửi thêm tài nguyên mà client (trình duyệt) chưa yêu cầu. Trước HTTP/2, HTTP chỉ là “hỏi-đáp đơn giản”: Trình duyệt yêu cầu một trang web, server trả về, rồi trình duyệt phải tải trang đó, phân tích, và yêu cầu thêm tài nguyên như CSS, JavaScript, font chữ, hình ảnh.
Ví dụ: Khi bạn mở một trang blog, trình duyệt tải HTML trước, rồi mới “thấy” cần CSS từ việc HTML khai báo rằng css cần thiết. Quá trình này tạo ra ít nhất một vòng lặp (round-trip) thừa, làm chậm thời gian hiển thị ban đầu (initial paint). Hình ảnh thì không sao (trang vẫn load với chỗ trống), nhưng CSS hay JS “critical” (quan trọng cho rendering) sẽ khiến trang “treo” đến khi tải xong.

Với HTTP/2 multiplexing (đa kênh), các yêu cầu song song giúp tốt hơn HTTP/1, nhưng vẫn cần round-trip thứ hai. HTTP/2 push “phá vỡ quy tắc” bằng cách server gửi luôn tài nguyên phụ ngay từ đầu, giảm thời gian tải từ 2 round-trip xuống còn 1.
Hình dung qua ví dụ waterfall diagram (biểu đồ thác nước):


Để giảm độ trễ, các lập trình viên thường inline các tài nguyên quan trọng ngay vào HTML, nhờ đó trình duyệt có thể bắt đầu render ngay sau khi phân tích trang gốc, thay vì chờ tải thêm tài nguyên.
Tuy nhiên, inline CSS/JS tiềm ẩn nhiều hạn chế:
<link>, bởi thẻ link nhúng CSS thông thường sẽ block rendering; thẻ link không hỗ trợ async.HTTP/2 push phá bỏ quy tắc “1 request = 1 response”. Máy chủ có thể trả về nhiều tài nguyên kèm theo một yêu cầu. Ví dụ:
– Client: “Cho tôi trang này.”
– Server: “Được thôi, đây là trang HTML, thêm cả CSS và JS cần thiết để bắt đầu rendering”.

Thể hiện dưới dạng waterfall: các tài nguyên không đến đúng lúc, có khoảng cách nhỏ giữa chúng, nhưng tổng thời gian gần 1 vòng chứ không phải 2 như trước.

Tương tự, chuỗi flow request–response có thể thấy như hình dưới, có thể thấy rõ sự tiết kiệm thời gian khi gửi các tài nguyên quan trọng cùng với trang ban đầu.

Điểm then chốt: push chỉ xảy ra khi có request ban đầu từ client, server không thể tự ý push bất kỳ lúc nào. WebSockets hay SSE cho phép two-way communication, nhưng HTTP/2 không thật sự hai chiều, mọi thứ đều do client khởi đầu. Sau khi stream request đầu kết thúc, server không thể tiếp tục push trừ khi client gửi request mới. Vì vậy, HTTP/2 push không thay thế WebSocket hay SSE theo chuẩn hiện tại
Trình duyệt xử lý HTTP/2 push lại theo một cách khác. Tài nguyên không được đẩy thẳng đến trang web, mà được đẩy vào một khu vực cache đặc biệt. Trang web vẫn được xử lý bình thường. Khi cần tài nguyên, trình duyệt kiểm tra cache, nếu có sẵn thì tải từ cache thay vì gửi yêu cầu tới server.
Cơ chế chi tiết phụ thuộc vào từng trình duyệt và không được nêu rõ trong spec HTTP/2, nhưng hầu hết hiện nay triển khai một HTTP/2 push cache riêng biệt, khác với HTTP cache thông thường
Các tài nguyên được đẩy sẽ nằm trong một vùng nhớ riêng (HTTP/2 push cache) chờ trình duyệt yêu cầu. Khi được truy cập, tài nguyên sẽ được đưa vào trang và nếu có header phù hợp sẽ được đồng thời lưu vào HTTP cache để sử dụng sau này.
Một điểm đặc biệt: các trình duyệt dựa trên Chromium (Chrome, Opera) không cache tài nguyên nếu certificate không đáng tin (như tự ký self-signed, hiển thị ổ khoá đỏ), dù người dùng có bỏ qua lỗi. Để HTTP/2 Push hoạt động, bạn cần certificate hợp lệ (ổ khoá xanh)
Quá trình kiểm tra cache của trình duyệt theo thứ tự như sau: image cache → preload cache → service worker → HTTP cache → HTTP/2 push cache. Nếu tài nguyên đã có sẵn ở cache HTTP chính (mặc dù phiên bản mới đã bị push), trình duyệt vẫn ưu tiên dùng bản cũ theo cache-control (Jake Archibald) Service worker còn được kiểm sau preload cache

Image cache (cache hình ảnh):
Preload cache:
Service Worker cache:
HTTP cache (cache truyền thống):
HTTP/2 push cache:
Nếu server push styles.css, file này sẽ được đưa vào HTTP/2 push cache.
Sau đó, khi trình duyệt thấy cần styles.css, nó không hề “biết” hay quan tâm rằng server đã push sẵn file này. Trình duyệt vẫn kiểm tra toàn bộ cache theo thứ tự:
Nếu trong HTTP cache chính đã có một bản styles.css hợp lệ, thì trình duyệt sẽ lấy từ đó kể cả khi trong push cache đang có bản mới hơn.
Bạn có thể dùng công cụ chrome://net-export (nói trong mục 4.3.1) để xem tổng hợp các tài nguyên đã được push nhưng chưa được sử dụng (unclaimed push resources) trong tất cả các trang đang mở

Nếu một kết nối bị đóng, push cache cũng mất theo, khác với HTTP cache. Một cách hiểu ngắn gọn: push cache chỉ tồn tại gắn với kết nối. Khi kết nối không tái sử dụng, tài nguyên push có thể bị lãng phí. Một lần tài nguyên được sử dụng (“claimed”), nó sẽ bị loại khỏi push cache. Nhưng nếu có cache-control phù hợp, vẫn có thể lưu trong HTTP cache. Thậm chí tài nguyên không thể cache theo HTTP (no-cache, no-store) vẫn có thể được push và đọc từ push cache, bởi đây không thực sự là “cache” truyền thống mà là vùng đệm tạm thời
HTTP/2 push cache gắn trực tiếp với một kết nối (connection). Điều này dẫn đến:
HTTP/2 thiết kế để chỉ có một connection duy nhất, nên thoạt nhìn có vẻ không có vấn đề. Nhưng thực tế các trình duyệt triển khai khác nhau:
Ngoài ra, các request không kèm thông tin xác thực (noncredentialed) thường được gửi trên một connection riêng. Do đó:
Do Push cache hoạt động ở mức connection, chứ không phải mức page. Vì vậy, tuy về lý thuyết bạn có thể push tài nguyên cho trang sẽ load sau, nhưng trên thực tế điều này gần như vô ích, vì cache ngắn hạn và có thể mất khi kết nối rớt.
no-cache hoặc no-store). Đây là điểm khác với HTTP cache truyền thống.Trình duyệt có thể từ chối một tài nguyên đang bị push bằng cách gửi một RST_STREAM frame với mã CANCEL hoặc REFUSED_STREAM. Điều này xảy ra khi:
Tuy nhiên, RST_STREAM có hạn chế:
Ví dụ:
Đặc tả HTTP/2 đưa ra một số quy tắc cơ bản về push: RFC7540 – Push Resources
GET, HEAD, hoặc một số POST đặc biệt).GET hoặc HEAD).Thực tế, vì các quy tắc trên, chỉ có GET request là thường được push.
Giới hạn về authority nghĩa là bạn chỉ được phép push tài nguyên mà server trực tiếp hoặc gián tiếp phục vụ. Ví dụ, nếu trang của bạn dùng Bootstrap từ getbootstrap.com hoặc jQuery từ jquery.com, thì server của bạn không thể push trực tiếp. Bạn có thể proxy các request đó qua server của mình, nhưng khi đó bạn phải sửa tất cả các tham chiếu để trỏ về server của bạn. Ở tình huống đó, tốt hơn hết là host luôn file đó tại chỗ thay vì tạo thêm phức tạp với proxy.
HTTP/2 Push được thiết kế để tối ưu hiệu năng, nhưng nếu lạm dụng, nó có thể làm chậm hiệu năng vì lãng phí băng thông để push những tài nguyên mà client không dùng, thay vì ưu tiên cho những tài nguyên cần thiết.
Nhóm Chrome đã viết một tài liệu chi tiết về “nên push cái gì” (Chrome doc on HTTP/2 Push), trong đó họ khuyến nghị:
“Chỉ push mức tối thiểu cần thiết để lấp đầy thời gian mạng rảnh, và không hơn.”
Các nghiên cứu khác cũng khẳng định nên áp dụng chiến lược bảo thủ khi dùng push. (PerfPlanet – HTTP/2 Push the details)
Tóm lại: Thà push thiếu còn hơn push thừa.
Một câu hỏi thực tiễn: ai sẽ quyết định nên push cái gì?
Một ví dụ: Jetty (Eclipse Jetty), một Java Servlet Engine, chọn cách tự động push. (Jetty HTTP/2 Push Config)
Referer).Cách này giúp giảm độ phức tạp khi cấu hình, nhưng bạn sẽ phụ thuộc vào thuật toán của Jetty, vốn có thể không phù hợp với mọi website.
Do đó, việc quyết định push cái gì không đơn giản:
Internet đã trở thành một phần không thể thiếu trong cuộc sống hàng ngày. Mua sắm, ngân hàng, giao tiếp và giải trí đều phụ thuộc vào internet, và với sự phát triển của Internet vạn vật (IoT), ngày càng có nhiều thiết bị được kết nối trực tuyến, nơi chúng có thể được truy cập từ xa. Truy cập này được thực hiện nhờ một số công nghệ, bao gồm Giao thức Truyền Siêu văn bản (HTTP), đây là một phương pháp chính để yêu cầu truy cập vào các ứng dụng và tài nguyên web từ xa.
Mục đích sử dụng chính và đầu tiên của HTTP: để yêu cầu các trang web. Khi bạn mở một trang web trong trình duyệt của mình, dù trình duyệt đó trên pc/laptop, tablet, điện thoại di động hoặc bất kỳ thiết bị nào khác cho phép truy cập internet (tủ lạnh, tivi, …), rất nhiều thứ đang diễn ra.
Giả sử bạn khởi động trình duyệt và truy cập www.google.com. Trong vòng vài giây, những điều sau sẽ xảy ra

Khi bạn gõ www.google.com vào trình duyệt, nó không tự biết Google ở đâu. Trình duyệt sẽ nhờ đến một “cuốn danh bạ” đặc biệt gọi là DNS (Domain Name System). Công việc của DNS rất đơn giản: biến cái tên thân thiện với con người (www.google.com) thành một dãy số mà máy tính hiểu được, gọi là địa chỉ IP.
Hiện nay có hai “kiểu số điện thoại” chính:
216.58.192.4. Nhìn khá ngắn gọn, con người còn đọc được.2607:f8b0:4005:801:0:0:0:2004. Dài ngoằng, chỉ máy tính mới “thích” đọc. IPv6 sinh ra vì IPv4 gần như đã “hết số”, giống như khi một thành phố phải thêm mã vùng điện thoại mới vì dân cư quá đông.Một fact: vì internet là toàn cầu, Google (và các công ty lớn khác) đặt máy chủ khắp nơi trên thế giới. DNS sẽ thông minh chọn cho bạn địa chỉ IP của máy chủ gần nhất, để tốc độ truy cập nhanh hơn. Thế nên một người ở Mỹ và một người ở châu Âu có thể nhận được IP hoàn toàn khác nhau khi cùng gõ www.google.com.
Mỗi thiết bị kết nối Internet đều cần một địa chỉ IP duy nhất, giống như mỗi ngôi nhà cần một số nhà riêng.
Buộc phải mở ra một hệ thống đánh số mới rộng hơn. IPv6 chính là “hệ thống số nhà mở rộng” đó, với 128 bit, đủ để cấp địa chỉ cho hầu như mọi hạt cát trên trái đất. (2^128)
Bạn có thể thấy hơi lạ: chúng ta có IPv4, rồi nhảy thẳng sang IPv6. Thế IPv5 biến đi đâu? Và tại sao chẳng ai nhắc tới IPv1–IPv3?
Thực ra mọi gói tin Internet đều có một trường nhỏ ở đầu (4 bit) để ghi phiên bản. Về lý thuyết, chỉ có tối đa 15 phiên bản (0–15). (Có thể thấy ở ảnh dưới, phần Version đầu tiên)

Vậy nên, IPv5 không “mất tích” mà chỉ dừng lại ở mức thử nghiệm. Thế giới chọn đi thẳng từ IPv4 sang IPv6 để giải quyết triệt để vấn đề cạn kiệt địa chỉ.
Sau khi có địa chỉ IP, trình duyệt sẽ tìm cách kết nối đến máy chủ web. Kết nối này thường chạy qua:
Ngày nay hầu hết các trang web (kể cả Google) đều bắt buộc HTTPS nhờ công nghệ HSTS. Nghĩa là, ngay cả khi bạn gõ http://..., trình duyệt cũng sẽ tự động nâng cấp sang HTTPS.
Khi kết hợp, ta có TCP/IP, hai thứ làm nên xương sống Internet.
Một máy chủ có thể phục vụ nhiều “dịch vụ” khác nhau (web, email, FTP…). Để phân biệt, nó dùng cổng/port , giống như từ 1 địa chỉ nhà, chúng ta có thể chỉ tới số phòng, tầng, …
Khi kết nối TCP/IP đã ổn định, trình duyệt mới bắt đầu dùng HTTP để gửi yêu cầu: “Hãy cho tôi trang chủ Google”. Lúc này mới đến phần giao tiếp cấp ứng dụng mà ta thường nghe đến nhiều nhất.
Sau khi trình duyệt gửi yêu cầu, máy chủ Google phản hồi. Nội dung phản hồi thường là HTML – ngôn ngữ mô tả cấu trúc của trang web.
HTML giống như bộ khung của một ngôi nhà: nó chia trang thành các phần (thẻ <div>, <p>, <h1>…), và kèm theo đường dẫn tới những vật liệu khác để hoàn thiện ngôi nhà:
Không phải lúc nào máy chủ cũng trả về ngay một trang HTML:
http://www.google.com, máy chủ sẽ gửi lại mã 301/302 để chuyển hướng bạn sang https://www.google.com.www.google.com/nonexistent, bạn sẽ gặp mã 404 Not Found – giống như hỏi thủ thư một cuốn sách không có trong thư viện.Khi nhận được HTML, trình duyệt sẽ phân tích và xây dựng DOM (Document Object Model) – bản đồ nội bộ của trang. Trong quá trình đọc HTML, nó phát hiện thêm tài nguyên cần tải (CSS, JS, hình ảnh…).
Mỗi tài nguyên lại đi qua vòng lặp yêu cầu–phản hồi như ban đầu, khiến duyệt web chậm dần. Đây cũng là lý do HTTP/2 ra đời: gom nhiều yêu cầu để tải nhanh hơn.
Trình duyệt không đợi tải hết tất cả mới hiển thị, mà sẽ render dần dần:
Hãy tưởng tượng bạn xem họa sĩ vẽ tranh: ban đầu chỉ có khung, sau đó thêm màu, rồi chi tiết. Nếu vẽ dở dang mà đưa cho bạn xem, bức tranh cứ đổi hình dáng liên tục – đó chính là cảm giác khi trang web “nhảy”.
Ngay cả sau khi trang “trông như đã xong”, trình duyệt vẫn âm thầm tải thêm:
Những thứ này chạy ngầm trong nền (AJAX, fetch API, WebSocket…), khiến web ngày nay giống ứng dụng thật sự chứ không chỉ là trang tĩnh.
Vào thập niên 1930, kỹ sư điện Vannevar Bush (MIT) đã lo ngại rằng khối lượng thông tin con người tạo ra vượt xa khả năng tiêu thụ. Trong bài tiểu luận As We May Think (1945), ông hình dung ra một thiết bị gọi là memex – nơi mọi tri thức được lưu trữ, có thể tra cứu nhanh chóng và liên kết với nhau giống như cách bộ não kết nối ý tưởng. Memex không bao giờ thành hiện thực, nhưng khái niệm “kết nối thông tin có ngữ cảnh” đã gieo mầm cho thế hệ sau.

Đến những năm 1960, Ted Nelson đưa ra thuật ngữ hypertext – tập hợp văn bản/hình ảnh liên kết phức tạp mà giấy in không thể thể hiện. Nelson mơ về một “docuverse”, nơi thông tin được liên kết, không bao giờ bị xóa, và mọi người đều có thể truy cập. Dù dự án Xanadu của ông không thành công, nhưng nó đã tạo cảm hứng mạnh mẽ.

Năm 1989, tại CERN, Tim Berners-Lee muốn một cách để quản lý thông tin từ các thí nghiệm khổng lồ. Ông kết hợp ý tưởng hypertext (liên kết tự do) và hypermedia (không giới hạn ở chữ viết) để đề xuất một hệ thống “phổ quát” , chính là nền móng của World Wide Web. Và từ đây, HTTP (Hypertext Transfer Protocol) ra đời.
HTTP (Hypertext Transfer Protocol) đúng như tên gọi, ban đầu được tạo ra chỉ để chuyển các tài liệu “siêu văn bản” – tức là những trang có thể chứa liên kết sang trang khác. Nhưng chẳng bao lâu, người ta nhận ra rằng nó cũng có thể dùng để gửi những thứ khác như hình ảnh, âm thanh, video…
Vì vậy, chữ Hypertext trong tên ngày nay không còn quá chính xác, nhưng cái tên HTTP đã ăn sâu nên không ai đổi nữa.
Điều quan trọng là HTTP hoạt động dựa trên kết nối mạng ổn định (thường qua TCP/IP). Nó không quan tâm đến cách bạn nối dây mạng, Wi-Fi hay Ethernet thế nào, tất cả việc đó do các tầng giao thức bên dưới lo. HTTP chỉ tập trung làm một việc: nhận yêu cầu từ trình duyệt và trả về phản hồi từ máy chủ.
Điểm mạnh của HTTP chính là sự đơn giản. Trình duyệt gửi yêu cầu, máy chủ trả lời – thế thôi. Chính sự giản đơn này giúp web phát triển thần tốc, dù sau này phải đánh đổi một chút để tối ưu hiệu năng (như trong HTTP/2, HTTP/3).

Một yêu cầu HTTP, ở mức đơn giản nhất, chỉ là một dòng văn bản. Ví dụ:
GET /page.html↵Ở đây:
↵) cho biết bạn đã gõ xong.Thế là đủ. Khi đó, trình duyệt đã có kết nối TCP/IP với máy chủ rồi, nên nó chỉ cần nói: “Ê, cho tôi file này với!”
Phiên bản đầu tiên, HTTP/0.9 (1991), chỉ biết làm đúng điều này: gửi GET, nhận file HTML, rồi đóng kết nối. Nhìn lại, bạn có thể thấy lạ: “Sao phải viết GET nữa? Chẳng phải mặc định nó chỉ có một lệnh duy nhất đó sao?” Nhưng chính nhờ tầm nhìn xa, sau này các nhà thiết kế bổ sung thêm nhiều phương thức khác (POST, HEAD…), nên cú pháp ban đầu vẫn giữ được tính mở rộng, chạy được với cả các phiên bản http cũ.
HTTP/0.9 chỉ biết GET một file HTML rồi thôi, nhưng đến HTTP/1.0 (1996), web đã có thêm cơ bắp.
HTTP/1.0 bổ sung header – những dòng thông tin thêm để client “dặn dò” server. Ví dụ:
GET /page.html HTTP/1.0
Accept: text/html,application/xhtml+xml
Accept-Encoding: gzip, deflate
User-Agent: MyAwesomeWebBrowser 1.1
Đọc ngắn gọn thì header nói:
Đây chính là cơ chế giúp web mở rộng: chỉ cần thêm header mới là có thể dạy client/server hiểu thêm “ngôn ngữ” mà không phá vỡ giao thức.
HTTP/0.9 không có khái niệm mã phản hồi. Nếu lỗi thì server chỉ nhét thông báo vào HTML. Sang HTTP/1.0, lần đầu tiên xuất hiện status code, ba chữ số huyền thoại:
Các mã 2xx, 3xx, 4xx, 5xx chia thành từng nhóm rõ ràng, biến HTTP thành một cuộc hội thoại có quy tắc: client hỏi, server đáp, không phải đoán mò nữa.
Vì thế, HTTP/1.1 ra đời năm 1997, chỉ 9 tháng sau khi HTTP/1.0 được chuẩn hóa. Nó không thay đổi tận gốc như từ 0.9 → 1.0, nhưng đã tinh chỉnh, bổ sung và quan trọng nhất: đặt ra tiêu chuẩn chính thức cho toàn bộ thế giới web, vốn đang bùng nổ mạnh mẽ.
Đến nay, HTTP/1.1 đã trải qua nhiều lần sửa đổi:
Điều này cho thấy: giao thức tưởng chừng “đơn giản” lại phức tạp đến mức cần một bộ luật khổng lồ để mọi trình duyệt, máy chủ, proxy trên thế giới cùng “nói chung một ngôn ngữ”.
Trong HTTP/1.0, client gửi request kiểu:
GET /index.html HTTP/1.0
Server hiểu là: à, nó đang xin file index.html từ chính website mà nó đang kết nối đến. Nhưng khi web phát triển, một server có thể chạy hàng trăm website khác nhau trên cùng một địa chỉ IP (virtual hosting). Làm sao server biết client muốn example.com/index.html hay blog.example.com/index.html?
Giải pháp: thêm Host header.
GET / HTTP/1.1
Host: www.google.com
Từ HTTP/1.1 trở đi, mọi request bắt buộc phải có Host. Nhờ đó:
Nếu không có bước này, có thể web sẽ “ngốn” sạch IPv4 từ rất sớm. Ngược lại, nếu hồi đó người ta không chọn giải pháp Host header, mà bắt client phải gửi URL đầy đủ (absolute-form), thì web có thể đã ép buộc sang IPv6 sớm hơn 20 năm.
HTTP ban đầu hoạt động theo kiểu: một request → một response → đóng kết nối.
Nhưng khi web nhiều hình ảnh, CSS, JS, việc liên tục đóng/mở kết nối TCP cực kỳ lãng phí. Mỗi lần bắt tay TCP tốn thêm vài trăm mili-giây, nhân lên hàng chục file thì người dùng sẽ “chờ dài cổ”.
HTTP/1.1 thay đổi mặc định:
GET /style.css HTTP/1.1
Host: www.example.com

GET /script.js HTTP/1.1
Host: www.example.com
Trình duyệt có thể “nạp đơn hàng” liên tục thay vì phải xếp hàng lại từ đầu.
Tuy nhiên, điều này đòi hỏi phải có thêm cách xác định “đâu là hết dữ liệu” (vì không còn dấu hiệu đóng kết nối nữa). Do đó, HTTP/1.1 dùng 1 header Content-Length hoặc chunked transfer encoding để báo độ dài nội dung. Khi đó, các bên có thể từ content length và dữ liệu đã nhận được để biết bao giờ là kết thúc.

HTTP/1.1 còn đưa ra ý tưởng pipelining: client gửi nhiều request “một lèo” mà không chờ phản hồi, server trả kết quả theo thứ tự.
Ví dụ:
Nghe thì hay, nhưng thực tế bị head-of-line blocking: nếu request đầu tiên bị chậm (ví dụ truy vấn DB lâu), thì mọi request sau bị kẹt. Thêm nữa, hỗ trợ pipelining ở proxy và server thường kém (thậm chí lỗi). Vì vậy, pipelining gần như “chết yểu”, không được các trình duyệt phổ biến bật mặc định.
Trong HTTP/1.0, chỉ có header Expires: <date>. Nghĩa là:
Expires cần một mốc thời gian cố định).HTTP/1.1 thì mềm dẻo hơn nhờ Cache-Control:
max-age=600 → cache trong vòng 600 giây (10 phút).no-cache → client vẫn lưu cache nhưng luôn xác thực lại với server trước khi dùng.must-revalidate → nếu cache hết hạn thì bắt buộc hỏi server, không được tự ý dùng lại.public / private → phân biệt cache dùng chung (CDN, proxy) hay chỉ cho trình duyệt người dùng.Ví dụ thực tế:
Cache-Control: max-age=604800 (1 tuần).Cache-Control: no-cache, must-revalidate.Cache-Control: max-age=86400, must-revalidate.Điểm mạnh: giúp tăng tốc độ web, giảm tải server, nhưng vẫn linh hoạt để dữ liệu quan trọng luôn mới.
HTTP/1.1 bổ sung khá nhiều method để phù hợp với web ngày càng phức tạp:
PUT: ghi đè hoặc tạo tài nguyên ở URL cụ thể.DELETE: xóa tài nguyên.OPTIONS: hỏi server xem URL đó hỗ trợ những method nào (cần cho CORS).TRACE: gửi request để server trả lại toàn bộ nội dung nó nhận → debug.CONNECT: dùng cho tunneling (thường thấy khi HTTPS đi qua proxy).409 Conflict, 410 Gone, 100 Continue… để mô tả chính xác hơn tình huống.Authorization, X-Request-ID, Content-Security-Policy).Sau khi HTTP/1.1 được chuẩn hóa, nó trở thành nền móng của web suốt 20 năm. Nhưng chính sự bùng nổ website đã làm lộ rõ giới hạn của giao thức này.

Theo thống kê từ HTTP Archive:
Nguyên nhân: website ngày càng giàu media (ảnh, video), nhiều framework và script, và dùng AJAX để cập nhật động liên tục.
Hãy tưởng tượng bạn mở một trang web rất đơn giản: chỉ có một ít văn bản và hai tấm hình.

Tổng cộng, để hiển thị xong trang này cần 360ms. Trong đó chỉ 60ms là thời gian xử lý thực sự ở máy khách và máy chủ; còn lại 300ms (hơn 80%) chỉ để… chờ dữ liệu qua lại trên đường truyền. Trong lúc chờ, cả server lẫn trình duyệt đều “ngồi chơi xơi nước”
Điều bất hợp lý lộ rõ ở mốc 120ms: trình duyệt vừa gửi yêu cầu lấy ảnh số 1 và biết chắc là sẽ cần ảnh số 2, nhưng không thể gửi ngay. Nó buộc phải chờ ảnh 1 trả về xong, kết nối mới “rảnh” để gửi tiếp yêu cầu ảnh 2 vào lúc 240ms. Cách vận hành này làm mọi thứ chậm hẳn đi.
Trình duyệt hiện đại thường mở 6 kết nối / domain. Nếu website có nhiều file, chúng được tải trên 6 “đường ống” cùng lúc.
Để tăng hơn nữa, nhiều trang web dùng domain sharding: chia file ra các subdomain như static.example.com, cdn.example.com… Như vậy mỗi domain được thêm 6 kết nối, tăng khả năng song song.
Ví dụ: StackOverflow tải:
cdn.static.net,i.stack.imgur.com.
Nhưng: giải pháp này lại tạo ra gánh nặng:

Mozilla từng thống kê: 74% kết nối HTTP/1 chỉ dùng cho 1 transaction duy nhất → tức nhiều kết nối mở ra xong gần như bỏ phí.
Kết luận: mở nhiều kết nối giúp đỡ phần nào, nhưng chỉ là giải pháp tình thế. Nó tự tạo thêm chi phí (handshake, slow start, bộ nhớ) trong khi bản chất vấn đề vẫn là độ trễ.
Cách khác: thay vì tăng kết nối, hãy giảm số lần gọi.
Cache-Control, Expires để client lưu lại file, không tải lại nữa.
<style>, <svg>, hoặc base64).Nhược điểm:
Nguồn gốc: năm 2009, Google (Mike Belshe & Robert Peon) giới thiệu SPDY (đọc là “speedy”). Họ chạy thử nghiệm trên bản sao của 25 trang web lớn nhất và thấy cải thiện tốc độ tải trang rất rõ rệt, tới mức hai chữ số phần trăm trong nhiều trường hợp.
Ý tưởng chính của SPDY: không thay đổi “nghĩa” của HTTP (vẫn có GET/POST/headers/body), nhưng thay đổi cách đóng gói và gửi các yêu cầu/response sao cho nhanh hơn và hiệu quả hơn với mạng hiện có. SPDY làm 4 việc quan trọng:
Cookie: SESS=... dài 200 B, 360 request = 72 KB chỉ cho cookie. Header compression giảm con số này mạnh mẽ.Vì các tính năng như multiplexing và framing yêu cầu cấu trúc nhỏ gọn, chính xác và dễ phân mảnh, điều khó/không thể làm tốt khi gửi toàn bộ theo dạng text line-based (như HTTP/1.x). Binary framing cho phép định nghĩa các frame nhỏ (HEADERS, DATA, SETTINGS, WINDOW_UPDATE, v.v.) để truyền và ghép lại chính xác.
Kết quả thực tế: triển khai SPDY ở Chrome và trên các dịch vụ Google cho thấy tốc độ tải trang cải thiện rõ rệt; nhiều browser/server khác cũng nhanh chóng bổ sung hỗ trợ. Tuy nhiên SPDY chỉ là bước trung gian: nó chứng minh các ý tưởng thực tế và trở thành nền tảng để chuẩn hóa HTTP/2.

Ảnh: Sau khi HTTP/2 ra đời, SPDY bắt đầu giảm xuống
SPDY chứng minh rằng các cải tiến có thể làm được, IETF (HTTP Working Group) dựa trên SPDY khi soạn HTTP/2 (bản draft đầu vào cuối 2012). HTTP/2 giữ hầu hết ý tưởng tốt của SPDY nhưng chuẩn hoá chúng, bổ sung một số cải tiến (ví dụ HPACK cho header compression) và xử lý các chi tiết tương thích/ bảo mật.
HTTP/2 được tạo ra để giải quyết các vấn đề hiệu suất của HTTP/1, và phiên bản mới này thêm vào các khái niệm sau:
Những khái niệm này (sẽ được mô tả chi tiết hơn trong chương) là những thay đổi cơ bản, phá vỡ tính tương thích ngược; nghĩa là, máy chủ web HTTP/1.0 có thể hiểu tin nhắn HTTP/1.1 và bỏ qua các chức năng thừa, nhưng điều này không đúng với tin nhắn HTTP/2, vì chúng có cấu trúc và định dạng khác. Vì lý do đó, HTTP/2 được coi là bản nâng cấp lớn..
Một khác biệt chính giữa HTTP/1 và HTTP/2 là HTTP/2 là giao thức nhị phân dựa gói, trong khi HTTP/1 hoàn toàn dựa văn bản. Giao thức dựa văn bản dễ hiểu cho con người nhưng khó phân tích cho máy tính. Điều này chấp nhận được cho giao thức yêu cầu-phản hồi đơn giản mà HTTP bắt đầu, nhưng ngày càng hạn chế cho internet hiện đại.
Với giao thức văn bản, yêu cầu phải gửi và phản hồi nhận đầy đủ trước khi xử lý yêu cầu khác. HTTP hoạt động thế này 20 năm qua, dù có cải tiến nhỏ. HTTP/1.0 giới thiệu thân HTTP nhị phân, ví dụ, nơi hình ảnh và media khác có thể gửi trong phản hồi, và HTTP/1.1 giới thiệu pipelining và mã hóa chunked. Mã hóa chunked cho phép gửi phần thân tin nhắn trước, phần còn lại theo sau khi sẵn sàng. Thân HTTP chia thành chunk, và client nhận chunked response (hoặc server nhận chunked request) có thể bắt đầu xử lý trước khi nhận đầy đủ. Kỹ thuật này thường dùng khi độ dài dữ liệu tạo động không biết trước. Cả chunked encoding và pipelining có vấn đề chặn đầu hàng (HOL blocking), nơi tin nhắn đầu hàng ngăn phản hồi sau gửi, chưa kể pipelining không được hỗ trợ tốt trong thế giới thực.
GET /index.html HTTP/1.1Host: example.com\r\n...Content-Length hoặc chunked encoding.\r\n) để tách header.HEADERS, DATA, PRIORITY, WINDOW_UPDATE, PUSH_PROMISE… → kiểm soát chi tiết mà h1.1 không làm được.
Cấu trúc frame header (9 bytes đầu):
Length.Frame types (10 chuẩn + mở rộng):
DATA (0x0): payload chính.HEADERS (0x1): HTTP headers + priority.PRIORITY (0x2): thay đổi độ ưu tiên, dependency.RST_STREAM (0x3): kết thúc stream (thường khi lỗi).SETTINGS (0x4): config connection.PUSH_PROMISE (0x5): server thông báo sẽ push object.PING (0x6): test RTT.GOAWAY (0x7): đóng connection, không nhận stream mới.WINDOW_UPDATE (0x8): điều khiển flow (bytes còn có thể nhận).CONTINUATION (0x9): nối thêm headers khi HEADERS quá dài.
t=   1646 [st=      1]    HTTP2_SESSION_RECV_SETTINGS
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "1 (SETTINGS_HEADER_TABLE_SIZE)"
                          --> value = 4096
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "5 (SETTINGS_MAX_FRAME_SIZE)"
                          --> value = 16384
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "6 (SETTINGS_MAX_HEADER_LIST_SIZE)"
                          --> value = 131072
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "3 (SETTINGS_MAX_CONCURRENT_STREAMS)"
                          --> value = 100
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "4 (SETTINGS_INITIAL_WINDOW_SIZE)"
--> value = 65536Ý tưởng chính:
HTTP/2 biến mỗi yêu cầu thành một luồng (stream) riêng, và tất cả luồng đi chung một “đường ống TCP duy nhất”.
Lợi ích:
Ví dụ:
Cần tải 3 tài nguyên: styles.css, main.js, logo.png.


Mỗi request sẽ được đánh số ID luồng (stream ID). Ở đây: 5, 7, 9 (client luôn tạo ID lẻ).

Ví dụ: thay vì phải gửi toàn bộ styles.css rồi mới đến script.js, rồi mới đến image.jpg, HTTP/2 sẽ gửi xen kẽ: một frame của Stream 5 (styles.css), sau đó một frame của Stream 7 (script.js), rồi một frame của Stream 9 (image.jpg)…
Bạn có thể hình dung:

HTTP/1.x:
HTTP/2:
Ta đã thấy ở Multiplexing nghĩa là nhiều stream chia sẻ cùng một TCP. Nhưng nếu client đọc chậm (ví dụ đang pause video), mà server vẫn dồn dữ liệu video về → nghẽn buffer, mất gói, phải retransmit → phí công.
TCP vốn đã có cơ chế window size để tránh sender “dội” dữ liệu quá nhiều so với khả năng nhận của receiver.
Nhưng: TCP coi cả kết nối như một dòng duy nhất. Nếu một luồng dữ liệu (ví dụ video) bị nghẽn, thì nó kéo theo tất cả dữ liệu khác trên cùng connection → “head-of-line blocking”.
WINDOW_UPDATE frame → tăng cửa sổ, cho phép server gửi tiếp.Giả sử stream #11 là video, stream #13 là CSS:
WINDOW_UPDATE cho stream #11 → video tạm “đóng băng”.WINDOW_UPDATE cho stream #13 → CSS tiếp tục tải bình thường.Lợi ích
Vấn đề trong HTTP/1:
Cookie (to, nặng).User-Agent, Host, Accept, Accept-Encoding…Vấn đề: headers lớn, lặp nhiều (cookie, user-agent, accept, …). Một trang ~140 request, mỗi request ~460 bytes → ~63 KB headers, phần lớn lặp.
Cách làm:
:method: GET).:method: GET có thể là entry số 2 trong bảng. Thay vì gửi "GET" cả chữ, client chỉ gửi số 2.host: example.com có thể được lưu ở entry #62 → request sau chỉ cần gửi 62 thay vì nguyên chuỗi.Ví dụ:
:authority: www.akamai.com, :method: GET, ... → thêm vào bảng.:path → chỉ cần gửi index + giá trị mới.Cơ chế: server gửi PUSH_PROMISE frame gắn vào một stream hiện có.
Stream ID trong PUSH_PROMISE = stream gốc (ví dụ: /index.html).Mục tiêu: đặt tài nguyên vào cache trước khi client yêu cầu.
Rủi ro: push sai (tài nguyên đã cache rồi, hoặc client không cần) → lãng phí băng thông.
After passing the intense selection rounds at PTIT Innovation, our team (VILUTRA) was chosen to represent the school at Coding Fest 2025 in Sydney. This is a massive playground, over 500 students, 60 projects, and heavy hitters from universities like UNSW and Macquarie.
Touching down in Sydney, it’s July, so while Vietnam is boiling, Australia is deep in winter. We walked into the University of Sydney, which honestly looks like Hogwarts with its old castle buildings, wearing so many layers we looked like marshmallows. The vibe was electric, but standing next to teams from 50 different countries, we felt small.
Yeah, and bad thing happened right away. We had printed a poster in Vietnam to save time. But when we unrolled it at the hotel, disaster. The colors were completely off, the text was unreadable. It looked amateur. We had to trash it. We spent the entire night on Canva redesigning everything from scratch, praying we could find a printer at the school the next morning.

The stress broke us a little. Because the poster changed, our presentation flow didn’t make sense anymore. Minh and Linh got into a disagreement on how to fix it, which turned into a “Silent War.” For hours, nobody spoke.
To make matters worse, we not really into the food here. We tried the famous Aussie Fish and Chips, but man, it was dry. We missed the Vietnamese sauces and flavor. We ended up running to a nearby Asian restaurant just to feel human again.
But when showtime came, we snapped out of it. We reconciled, got the poster printed, and faced the judges. They grilled us hard, especially on the “Social Impact”, asking if our AI was invading privacy. We had to think fast, explaining that our system prioritizes rescue speed over surveillance data.
And for the final result, we actually got the First Prize for Social Impact section. It was a crazy 3 days, from freezing cold and dry food to broken posters and silent fights. But looking at the trophy now, it was worth every second.
Our project, VILUTRA, tackles a scenario: losing a child in a crowded mall. Security cameras are everywhere, but they are “dumb”, they record, but they don’t help you search. We built a solution that turns those cameras into a real-time search engine. Basically, a guard can just type “girl wearing pink” or upload a photo, and the system u find that specific child across the entire camera network. It maps out exactly where they walked and where they are now, processing millions of frames in under a second.
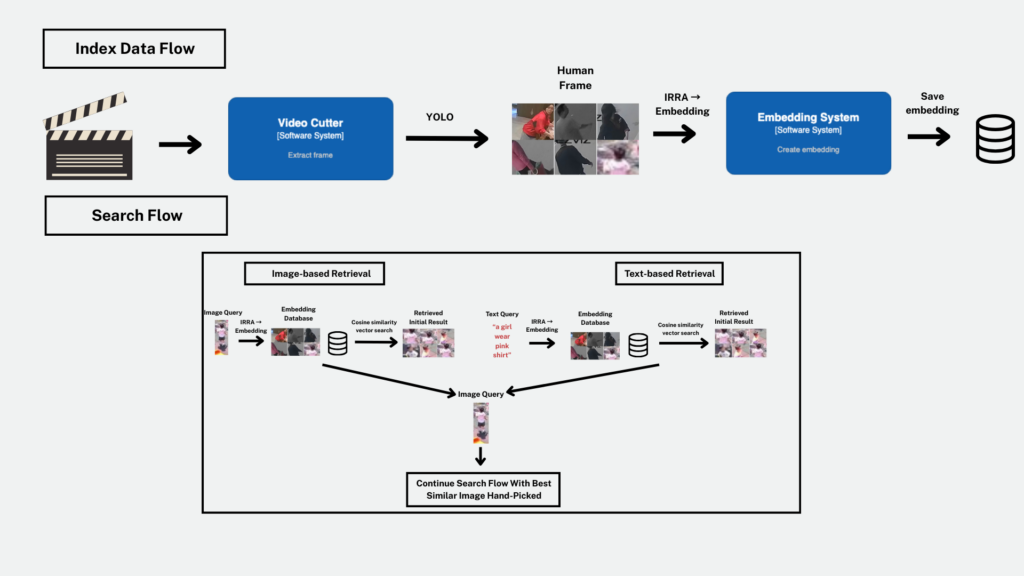
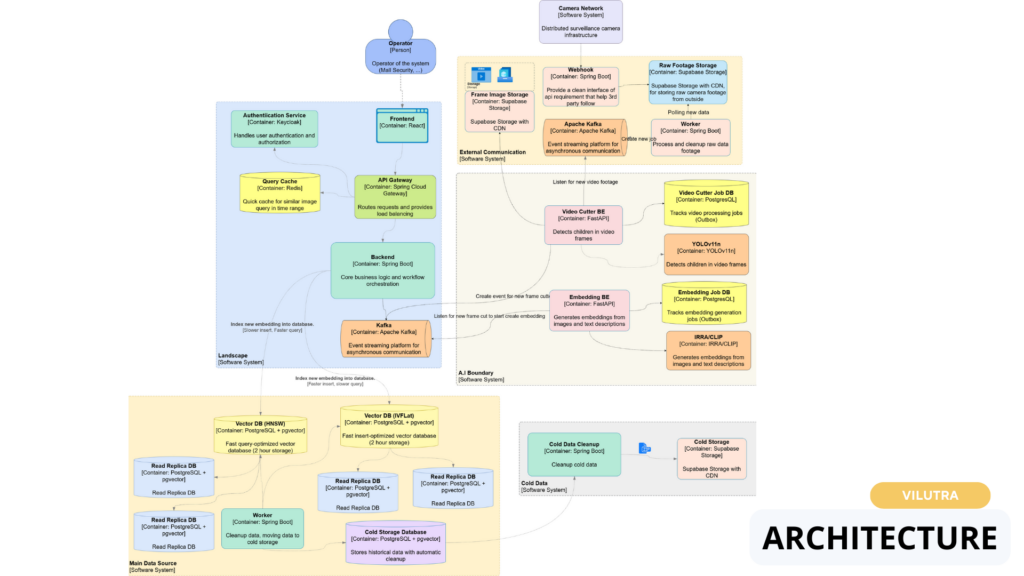
Khi huấn luyện một bộ phân loại bằng học có giám sát (supervised learning), mỗi mẫu dữ liệu đều có một nhãn (label) được gán thủ công, mô tả lớp mà mẫu đó thuộc về. Tập hợp tất cả các mẫu dữ liệu dùng để học, cùng với nhãn của chúng, được gọi là tập huấn luyện (training set).
Chúng ta sẽ lần lượt trình bày từng mẫu trong tập huấn luyện cho bộ phân loại. Với mỗi mẫu, hệ thống nhận các đặc trưng (features) của mẫu và dự đoán lớp của nó.
Nếu dự đoán đúng (tức là khớp với nhãn đã gán), chúng ta chuyển sang mẫu tiếp theo. Nếu dự đoán sai, chúng ta cung cấp đầu ra của bộ phân loại và nhãn đúng trở lại cho nó.

Như ảnh trên, ta có thể thấy, trong quá trình huấn luyện, chúng ta sẽ cần điều chỉnh các tham số (parameter) của bộ phân loại để tăng khả năng dự đoán đúng nhãn. Điều này dẫn đến một bài toán tối ưu hóa (optimization problem), nơi mục tiêu là giảm thiểu sai số hoặc tối đa hóa xác suất xảy ra của dữ liệu. Một kỹ thuật phổ biến để giải bài toán này là phương pháp giảm gradient (gradient descent).
Ta có một hàm số [latex]f[/latex] nhận đầu vào là một vector các số thực và trả về một số thực duy nhất. Một ví dụ đơn giản là hàm tính tổng bình phương các phần tử trong vector:
from scratch.linear_algebra import Vector, dot

def sum_of_squares(v: Vector) -> float:
    """Tính tổng bình phương các phần tử trong vector v"""
    return dot(v, v)
Mục tiêu là tìm vector [latex]v[/latex] sao cho hàm [latex]f(v)[/latex] đạt giá trị lớn nhất (tối đa hóa) hoặc nhỏ nhất (tối thiểu hóa). Gradient (vector của các đạo hàm riêng [latex]\nabla f[/latex]) cho biết hướng làm hàm số tăng nhanh nhất. Ý tưởng của phương pháp giảm gradient là:

Trong hình trên thể hiện một hàm hai biến [latex]f(x, y) = x^2 + y^2[/latex], có dạng hình paraboloid lồi hướng lên, với điểm thấp nhất nằm tại gốc tọa độ [latex](0, 0, 0)[/latex].
Các mũi tên tam giác đỏ thể hiện các bước di chuyển của thuật toán. Tại mỗi bước, gradient được tính và điểm hiện tại được cập nhật theo hướng:
[latex]v_{\text{new}} = v_{\text{old}} – \eta \nabla f(v_{\text{old}})[/latex]
trong đó [latex]\eta[/latex] là tốc độ học (learning rate).
Nếu hàm [latex]f[/latex] chỉ có một biến, đạo hàm tại điểm [latex]x[/latex] đo lường sự thay đổi của [latex]f(x)[/latex] khi [latex]x[/latex] thay đổi một lượng rất nhỏ.
[latex]
\frac{f(x + h) – f(x)}{h}
[/latex]
Đây gọi là thương số sai phân.

Đường cong màu xám là đồ thị của hàm [latex]f(x)[/latex].
Hai điểm được đánh dấu:
Tam giác màu xanh dương thể hiện:
[latex]
\frac{f(x+h) – f(x)}{h}
[/latex]
→ chính là ước lượng đạo hàm tại [latex]x[/latex].
Khi hàm [latex]f[/latex] có nhiều biến, ta tính đạo hàm riêng (partial derivative) cho từng biến, giữ các biến khác cố định:
def partial_difference_quotient(f: Callable[[Vector], float], v: Vector, i: int, h: float) -> float:
    """Tính thương số sai phân riêng thứ i của hàm f tại vector v"""
    w = [v_j + (h if j == i else 0) for j, v_j in enumerate(v)]
    return (f(w) - f(v)) / h

def estimate_gradient(f: Callable[[Vector], float], v: Vector, h: float = 0.0001):
    return [partial_difference_quotient(f, v, i, h) for i in range(len(v))]
Lưu ý: Việc ước lượng gradient bằng thương số sai phân tốn nhiều tài nguyên tính toán, đặc biệt với vector có kích thước lớn. Trong thực tế, người ta thường tính gradient trực tiếp bằng toán học để tối ưu hiệu suất.
Rõ ràng rằng hàm tổng bình phương (sum of squares) đạt giá trị nhỏ nhất khi đầu vào là một vector toàn số không. Tuy nhiên, giả sử chúng ta chưa biết điều này, chúng ta có thể sử dụng gradient để tìm giá trị tối thiểu trong không gian các vector ba chiều. Bắt đầu từ một điểm ngẫu nhiên, ta thực hiện các bước nhỏ theo hướng ngược với gradient cho đến khi gradient đạt giá trị rất nhỏ.
from scratch.linear_algebra import distance, add, scalar_multiply

def gradient_step(v: Vector, gradient: Vector, step_size: float) -> Vector:
    """Di chuyển một khoảng `step_size` theo hướng `gradient` từ điểm `v`"""
    assert len(v) == len(gradient)
    step = scalar_multiply(step_size, gradient)
    return add(v, step)

def sum_of_squares_gradient(v: Vector) -> Vector:
    """Tính gradient của hàm tổng bình phương"""
    return [2 * v_i for v_i in v]

# Chọn điểm bắt đầu ngẫu nhiên
v = [random.uniform(-10, 10) for i in range(3)]

for epoch in range(1000):
    grad = sum_of_squares_gradient(v)    # Tính gradient tại v
    v = gradient_step(v, grad, -0.01)    # Bước ngược hướng gradient
    print(epoch, v)

assert distance(v, [0, 0, 0]) < 0.001    # v gần với [0, 0, 0]
Nếu thực thi đoạn code trên, vector v sẽ tiến gần đến [0, 0, 0]. Số lượng epoch càng lớn, kết quả càng chính xác.
Chúng ta bắt đầu với một hệ thống có các tham số được khởi tạo ngẫu nhiên. Sau đó, chúng ta huấn luyện nó bằng dữ liệu trong tập huấn luyện. Khi hệ thống được triển khai ra thế giới thực, nó sẽ đối mặt với dữ liệu thực tế (deployment data, release data, hoặc user data).
Chúng ta muốn biết hệ thống sẽ hoạt động tốt như thế nào trên dữ liệu thực tế trước khi triển khai. Không cần độ chính xác hoàn hảo, nhưng thường chúng ta mong hệ thống đạt hoặc vượt một ngưỡng chất lượng nhất định. Làm sao để ước lượng chất lượng dự đoán của hệ thống trước khi triển khai?
Hệ thống cần hoạt động tốt trên tập huấn luyện, nhưng nếu chỉ đánh giá độ chính xác dựa trên dữ liệu này, chúng ta thường bị đánh lừa.
Giả sử chúng ta dùng bộ phân loại có giám sát để xử lý ảnh chó. Với mỗi ảnh, hệ thống sẽ gán nhãn xác định giống chó. Mục tiêu là triển khai hệ thống trực tuyến để người dùng có thể kéo ảnh chó của họ vào trình duyệt và nhận về giống chó hoặc nhãn “giống hỗn hợp (mixed breed)”.
Để huấn luyện, chúng ta thu thập 1.000 ảnh chó thuần chủng, mỗi ảnh được chuyên gia gắn nhãn. Chúng ta cho hệ thống xem cả 1.000 ảnh, lặp đi lặp lại qua nhiều epoch (lần lặp), thường xáo trộn thứ tự ảnh mỗi lần lặp để tránh trình tự lặp lại. Nếu hệ thống được thiết kế tốt, nó sẽ dần đạt kết quả chính xác hơn, ví dụ đạt 99% trong việc xác định giống chó trên tập huấn luyện.
Tuy nhiên, điều này không có nghĩa hệ thống sẽ đạt 99% chính xác khi triển khai trực tuyến. Vấn đề là hệ thống có thể đã khai thác các mối quan hệ đặc biệt trong tập huấn luyện, nhưng không đúng với dữ liệu nói chung.

Ví dụ, giả sử các ảnh chó Poodle trong tập huấn luyện đều có một cục bông ở đuôi, trong khi các giống khác thì không. Hệ thống nhận ra điều này và chỉ cần tìm cục bông để phân loại Poodle, thay vì xem xét các đặc trưng như kích thước chân, hình dạng mũi, v.v. Quy tắc này giúp phân loại đúng 100% ảnh Poodle trong tập huấn luyện, nhưng không phải cách chúng ta mong muốn. Hệ thống được cho là đã “học cách gian lận” (cheating)

Một ví dụ khác: Giả sử tất cả ảnh chó Yorkshire Terrier (Yorkie) trong tập huấn luyện đều được chụp khi chó ngồi trên ghế sofa, và không ảnh nào của giống khác có sofa. Hệ thống có thể học rằng nếu có sofa trong ảnh, đó là Yorkie. Quy tắc này hoạt động hoàn hảo trên tập huấn luyện.

Khi triển khai, nếu ai đó gửi ảnh một chú chó Great Dane đứng trước trang trí lễ hội với những quả bóng trắng hoặc một chú Husky nằm trên sofa, hệ thống có thể nhầm quả bóng trắng ở đuôi Great Dane là cục bông và gọi đó là Poodle, hoặc thấy sofa và gọi Husky là Yorkie.
Đây không chỉ là vấn đề lý thuyết. Một ví dụ nổi tiếng từ những năm 1960 (Muehlhauser 2011) kể về một hệ thống học máy nhận diện xe tăng trong ảnh cây cối. Hệ thống được cho là nhận diện xe tăng hoàn hảo, nhưng sau đó phát hiện rằng ảnh có xe tăng được chụp vào ngày nắng, còn ảnh không xe tăng chụp vào ngày âm u. Hệ thống chỉ phân biệt trời sáng và tối, không liên quan gì đến xe tăng.
Đây là lý do tại sao chỉ nhìn vào hiệu suất trên tập huấn luyện không đủ để dự đoán hiệu suất thực tế. Hệ thống có thể học các đặc điểm kỳ lạ (idiosyncrasies) trong tập huấn luyện và sử dụng chúng làm quy tắc, nhưng thất bại với dữ liệu mới không có những đặc điểm đó. Hiện tượng này được gọi là quá khớp (overfitting), hay thường gọi là “gian lận” (cheating)
Cách tốt nhất để xác định hiệu suất của hệ thống trên dữ liệu mới, chưa từng thấy là thử nghiệm nó trên dữ liệu kiểm thử (test data hoặc test set). Dữ liệu kiểm thử sẽ không được cho vào trong quá trình huấn luyện, vì vậy từ góc nhìn của hệ thống, chúng sẽ là các dữ liệu mới hoàn toàn.
Dữ liệu kiểm thử phải đại diện cho dữ liệu thực tế mà hệ thống sẽ gặp khi triển khai. Quy trình thông thường là huấn luyện hệ thống trên tập huấn luyện cho đến khi đạt hiệu suất tốt nhất có thể, sau đó đánh giá trên tập kiểm thử để dự đoán hiệu suất thực tế.
Nếu hiệu suất trên tập kiểm thử không đủ tốt, chúng ta cần cải thiện hệ thống, thường bằng cách thu thập thêm dữ liệu và huấn luyện lại. Thêm dữ liệu cũng giúp đa dạng hóa tập huấn luyện, ví dụ, tìm chó không phải Poodle có cục bông ở đuôi hoặc chó không phải Yorkie trên sofa, buộc hệ thống tìm cách phân loại khác để tránh quá khớp.

Do đó, chúng ta tách dữ liệu kiểm thử khỏi tập huấn luyện ngay từ đầu và chỉ sử dụng nó một lần sau khi huấn luyện hoàn tất. Nếu hệ thống không đạt yêu cầu trên tập kiểm thử, chúng ta phải bắt đầu lại với hệ thống mới được khởi tạo ngẫu nhiên, huấn luyện với dữ liệu mới hoặc lâu hơn, rồi đánh giá lại trên tập kiểm thử.
Thông thường, chúng ta tạo tập kiểm thử bằng cách chia tập dữ liệu gốc thành hai phần: tập huấn luyện (khoảng 75%) và tập kiểm thử (25%). Việc chọn mẫu thường ngẫu nhiên, nhưng có thể dùng thuật toán phức tạp hơn để đảm bảo mỗi tập đại diện tốt cho dữ liệu gốc.
Trong quy trình trên, chúng ta huấn luyện hệ thống, sau đó dừng lại và đánh giá trên tập kiểm thử. Nếu hiệu suất không đủ, chúng ta bắt đầu lại. Cách này hiệu quả nhưng chậm.
Trong thực tế, chúng ta thường muốn ước lượng hiệu suất hệ thống trong quá trình huấn luyện để dừng lại khi đạt mục tiêu. Vì vậy, chúng ta chia dữ liệu gốc thành ba tập: tập huấn luyện (training set), tập xác thực (validation set), và tập kiểm thử (test set), thường theo tỷ lệ 60% – 20% – 20%

Quy trình mới là: huấn luyện qua một epoch trên tập huấn luyện, sau đó đánh giá hiệu suất trên tập xác thực. Việc này được lặp lại sau mỗi epoch, gây rò rỉ dữ liệu, nhưng tập xác thực chỉ dùng để ước lượng không chính thức. Hiệu suất trên tập xác thực giúp chúng ta theo dõi quá trình học của hệ thống. Khi thấy hiệu suất đủ tốt, chúng ta dùng tập kiểm thử một lần để đánh giá chính xác.
Tập xác thực cũng hữu ích khi tìm kiếm siêu tham số (hyperparameters) – các biến được cài đặt trước để kiểm soát hoạt động của hệ thống, như mức độ cập nhật tham số sau lỗi hoặc độ phức tạp của bộ phân loại. Với mỗi bộ siêu tham số, chúng ta huấn luyện trên tập huấn luyện và đánh giá trên tập xác thực. Kết quả từ tập xác thực giúp quyết định khi nào dừng huấn luyện. Khi hiệu suất đạt yêu cầu, chúng ta dùng tập kiểm thử để đánh giá cuối cùng.
Quy trình này là một vòng lặp: chọn siêu tham số, huấn luyện, đánh giá trên tập xác thực, lặp lại với bộ siêu tham số mới, và cuối cùng chọn hệ thống tốt nhất để kiểm tra trên tập kiểm thử.

Vì tập xác thực đã ảnh hưởng đến việc chọn siêu tham số. Dù bộ phân loại không học trực tiếp từ tập xác thực, dữ liệu này đã “rò rỉ” vào quá trình chọn bộ phân loại tốt nhất. Để đánh giá chính xác trên dữ liệu hoàn toàn mới, không có cách nào khác ngoài việc dùng tập kiểm thử vào cuối cùng.
Trong phần trước, chúng ta đã dành gần một nửa dữ liệu huấn luyện để làm tập xác thực và kiểm tra. Điều này không thành vấn đề khi chúng ta có lượng dữ liệu đủ lớn để chia. Nhưng nếu tập dữ liệu của chúng ta nhỏ và không thể thu thập thêm dữ liệu thì sao?
Nếu chúng ta chấp nhận một ước lượng về hiệu suất của hệ thống thay vì một phép đo đáng tin cậy, chúng ta không cần phải để dành một tập kiểm tra riêng. Thực tế, chúng ta có thể huấn luyện trên toàn bộ dữ liệu đầu vào và vẫn dự đoán được hiệu suất trên dữ liệu mới.
Kỹ thuật thực hiện công việc này được gọi là xác thực chéo (cross-validation) hoặc xác thực luân phiên (rotation validation).
Ý tưởng cốt lõi là chạy một vòng lặp lặp đi lặp lại việc huấn luyện hệ thống từ đầu và sau đó kiểm tra nó. Mỗi lần lặp, chúng ta chia toàn bộ dữ liệu đầu vào thành một tập huấn luyện tạm thời và một tập xác thực tạm thời. Điều quan trọng là các tập này được tạo khác nhau trong mỗi lần lặp. Điều này cho phép chúng ta sử dụng toàn bộ dữ liệu để huấn luyện (mặc dù không phải tất cả cùng một lúc, như sẽ thấy sau).
Chúng ta bắt đầu bằng cách xây dựng một bộ phân loại mới. Dữ liệu đầu vào được chia thành tập huấn luyện tạm thời và tập xác thực tạm thời. Chúng ta huấn luyện hệ thống trên tập huấn luyện tạm thời và đánh giá nó bằng tập kiểm tra tạm thời, từ đó thu được điểm số về hiệu suất của bộ phân loại. Sau đó, chúng ta lặp lại vòng lặp, nhưng lần này chia dữ liệu thành các tập huấn luyện và kiểm tra tạm thời khác. Khi đã hoàn thành tất cả các lần lặp, trung bình của các điểm số này là ước lượng hiệu suất tổng thể của bộ phân loại.

Nhờ xác thực chéo, chúng ta có thể huấn luyện trên toàn bộ dữ liệu (mặc dù không phải tất cả trong mỗi lần lặp) và vẫn có được một phép đo khách quan về chất lượng hệ thống từ tập kiểm tra riêng. Thuật toán này không gặp vấn đề rò rỉ dữ liệu (data leakage) vì mỗi lần lặp, chúng ta tạo một bộ phân loại mới, và tập kiểm tra tạm thời cho bộ phân loại đó chứa dữ liệu hoàn toàn mới, chưa từng được sử dụng bởi bộ phân loại cụ thể đó, do đó việc sử dụng nó để đánh giá hiệu suất là công bằng. Tuy nhiên, nhược điểm của kỹ thuật này là ước lượng cuối cùng về độ chính xác của hệ thống không đáng tin cậy bằng khi sử dụng tập kiểm tra riêng.
Có nhiều thuật toán khác nhau để xây dựng các tập huấn luyện và xác thực tạm thời. Có thể điểm qua 1 số phương pháp phổ biến:
Phương pháp phổ biến nhất để xây dựng các tập dữ liệu tạm thời cho xác thực chéo được gọi là xác thực chéo k-fold. Ở đây, chữ “k” không phải là chữ cái đầu của một từ, mà đại diện cho một số nguyên (ví dụ, chúng ta có thể thực hiện “xác thực chéo 2-fold” hoặc “xác thực chéo 5-fold”). Thông thường, giá trị của k là số lần chúng ta muốn lặp lại vòng lặp.
Thuật toán bắt đầu trước khi vòng lặp xác thực chéo diễn ra. Chúng ta lấy dữ liệu huấn luyện và chia nó thành một loạt các nhóm có kích thước bằng nhau. Mỗi mẫu dữ liệu được đặt vào đúng một nhóm, và tất cả các nhóm có kích thước giống nhau (trừ một nhóm nhỏ hơn ở cuối nếu không thể chia đều dữ liệu).
Để hình dung, hãy tưởng tượng bạn viết tất cả các mẫu trong tập huấn luyện lên một tờ giấy dài, sau đó gấp tờ giấy đó thành một số phần bằng nhau. Mỗi lần gấp tạo ra một nếp, và phần vật liệu giữa các nếp được gọi là một fold.

Hãy sử dụng năm fold này để xem vòng lặp diễn ra như thế nào. Lần đầu tiên qua vòng lặp, chúng ta coi các mẫu trong Fold 2 đến Fold 5 là tập huấn luyện tạm thời, và các mẫu trong Fold 1 là tập kiểm tra tạm thời. Nghĩa là, chúng ta huấn luyện bộ phân loại với các mẫu trong Fold 2 đến Fold 5, sau đó đánh giá nó với các mẫu trong Fold 1.


Lần tiếp theo qua vòng lặp, bắt đầu với một bộ phân loại mới được khởi tạo với các số ngẫu nhiên, chúng ta sử dụng các mẫu trong Fold 1, 3, 4, và 5 làm tập huấn luyện tạm thời, và các mẫu trong Fold 2 làm tập kiểm tra tạm thời. Chúng ta huấn luyện và kiểm tra như thường lệ với hai tập này, và tiếp tục với các fold còn lại.