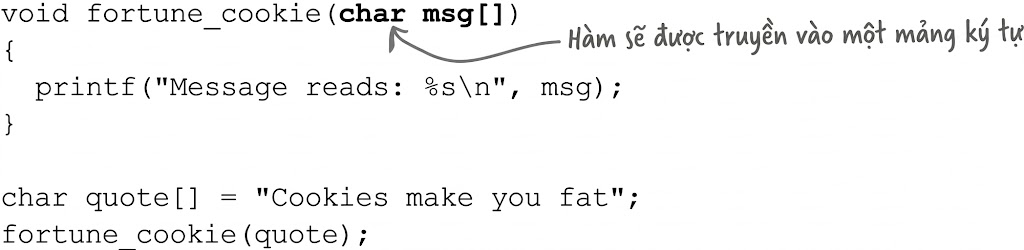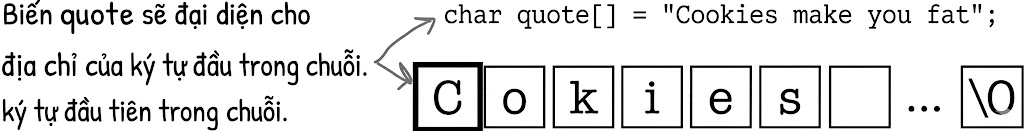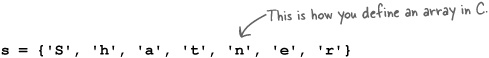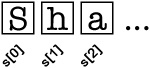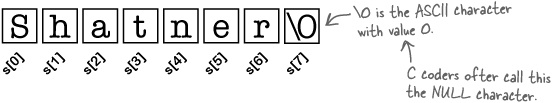Trước khi bắt đầu, bạn cần xác nhận phần cứng và hệ điều hành đáp ứng các tiêu chuẩn sau:
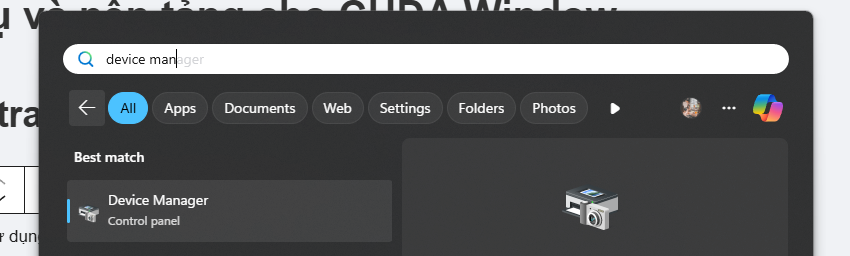
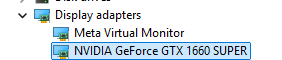
GPU: Phải sử dụng GPU NVIDIA hỗ trợ CUDA. Kiểm tra bằng cách mở Device Manager -> Display adapters.
Display Adapter cho thấy đang sử dụng GPU NVIDIA
Hệ điều hành: Windows 10 hoặc Windows 11 (phiên bản 64-bit).
Driver: NVIDIA Driver phải ở phiên bản mới nhất để hỗ trợ các tập lệnh CUDA hiện đại.
2. Cài đặt Môi trường Phát triển (Visual Studio & VS Code)
Cài đặt Visual Studio
Truy cập trang chủ Microsoft và tải Visual Studio (https://visualstudio.microsoft.com/downloads/)
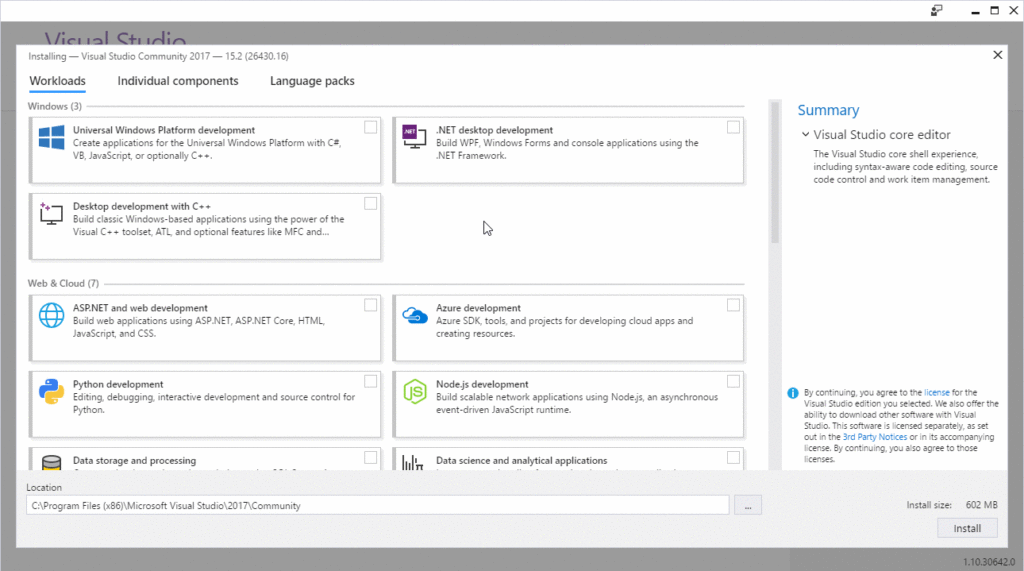
Trong quá trình cài đặt, tại tab Workloads, bạn bắt buộc phải tích chọn mục Desktop development with C++.
Nếu thiếu thành phần này, trình biên dịch nvcc của CUDA sẽ không tìm thấy cl.exe và không thể build project.
3. Lựa chọn phiên bản CUDA Toolkit (Local vs. Network)
Khi truy cập trang tải NVIDIA CUDA Downloads, bạn sẽ phải chọn giữa hai loại bộ cài đặt:
Loại Installer
Đặc điểm
Network Installer
Dung lượng tải về ban đầu rất nhỏ. Quá trình cài đặt sẽ tải các thành phần cần thiết từ server của NVIDIA.
Local Installer
Dung lượng lớn (thường > 2GB). Chứa toàn bộ các thành phần cần thiết để cài đặt offline.
Quy trình cài đặt CUDA Toolkit
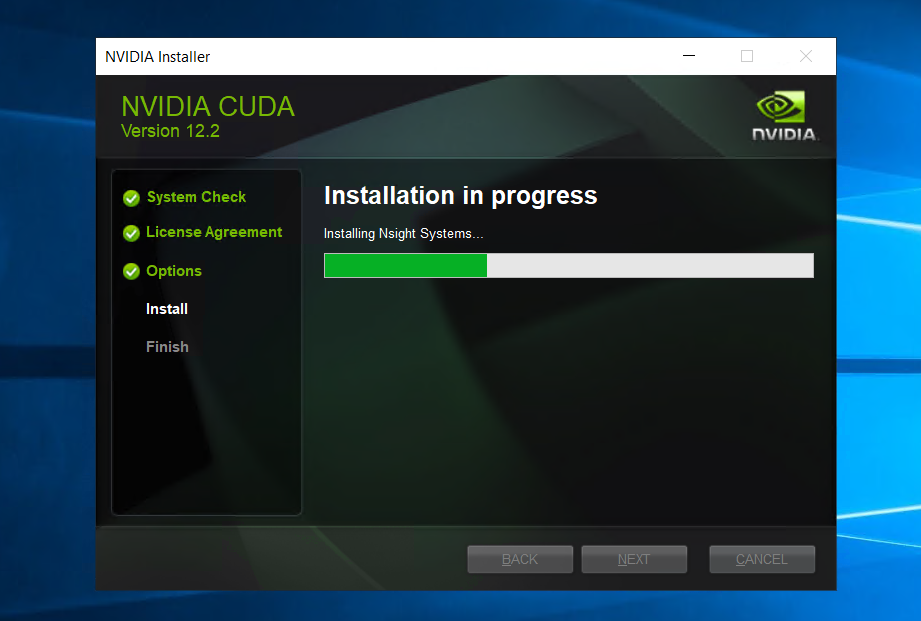
Khi khởi chạy tệp tin cài đặt (ví dụ: cuda_13.2.0_windows.exe), trình cài đặt sẽ giải nén vào một thư mục tạm thời. Sau đó, giao diện chính sẽ xuất hiện:
Kiểm tra tính tương thích: Trình cài đặt sẽ quét hệ thống để đảm bảo GPU và phiên bản Windows được hỗ trợ.
Lựa chọn chế độ cài đặt (Options):
Express (Recommended): Cài đặt toàn bộ các thành phần mặc định, bao gồm Driver, Toolkit, và Visual Studio Integration.
Custom (Advanced): Cho phép chọn cụ thể các thành phần.
Visual Studio Integration: Nếu thấy thông báo về Visual Studio, hãy đảm bảo rằng Visual Studio đã được đóng hoàn toàn. CUDA sẽ tự động cài đặt các template dự án và công cụ build vào Visual Studio.
Hoàn tất: Sau khi cài đặt xong, trình cài đặt sẽ liệt kê các thành phần đã được thêm vào hệ thống.
Xác minh cài đặt (Verification)
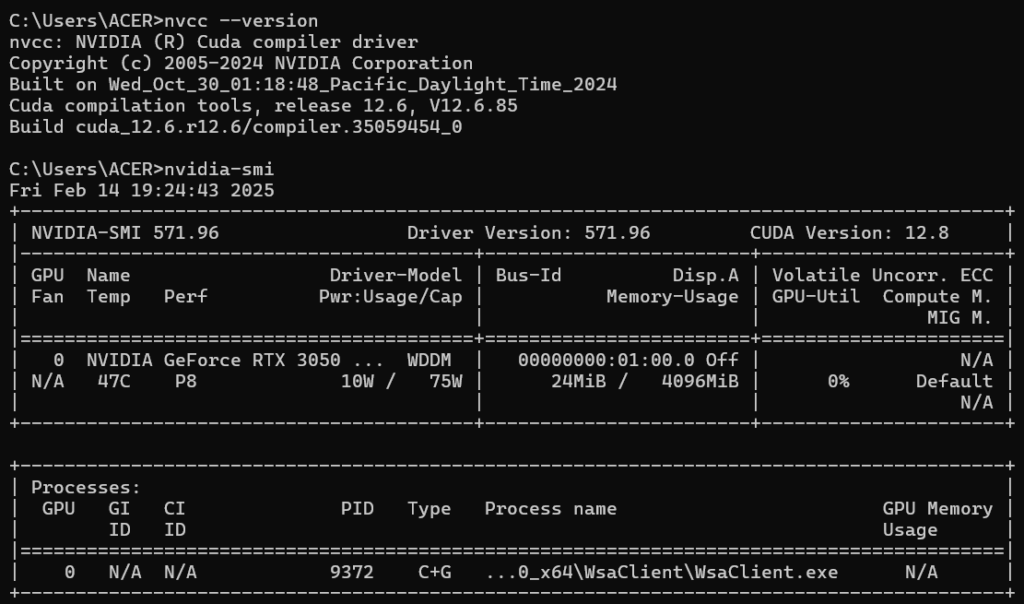
Việc cài đặt thành công trên giao diện không đồng nghĩa với việc các biến môi trường đã được nhận diện chính xác. Bạn cần thực hiện kiểm tra qua Command Prompt (cmd) hoặc PowerShell.
Kiểm tra trình biên dịch (nvcc)
Mở terminal và gõ lệnh:
Bash
nvcc --version
Nếu hệ thống trả về thông tin phiên bản (ví dụ: Cuda compilation tools, release 13.2, V13.2.xx), nghĩa là trình biên dịch CUDA đã sẵn sàng. Nếu nhận lỗi “command not found”, bạn cần kiểm tra lại biến môi trường PATH.
Kiểm tra phần cứng và Driver (nvidia-smi)
Gõ lệnh:
Bash
nvidia-smi
Lệnh này sẽ hiển thị bảng thông số GPU hiện tại, bao gồm:
Tên GPU (ví dụ: RTX 4070).
Phiên bản Driver hiện tại.
CUDA Version: Đây là phiên bản CUDA tối đa mà Driver hiện tại hỗ trợ (không nhất thiết phải trùng với phiên bản Toolkit bạn vừa cài, nhưng phải lớn hơn hoặc bằng).
Để lập trình CUDA, bạn không nên tạo dự án C++ thông thường mà nên sử dụng Template có sẵn của NVIDIA để các thiết lập về thư viện (Library) và đường dẫn (Include Path) được tự động cấu hình.
Các bước thực hiện:
Mở Visual Studio.
Chọn Create a new project.
Trong ô tìm kiếm, gõ từ khóa “CUDA”.
Chọn Template có tên CUDA [Phiên bản] Runtime (Ví dụ: CUDA 13.2 Runtime). Nhấn Next.
Đặt tên dự án và nhấn Create.
Giải thích về Template:
CUDA Runtime: Đây là mẫu dự án đã được tích hợp sẵn các “Build Customizations”. Nó cho phép Visual Studio hiểu các tệp tin có đuôi .cu là tệp mã nguồn CUDA và cần dùng trình biên dịch nvcc thay vì trình biên dịch C++ tiêu chuẩn.
Nếu bạn không thấy Template này, nghĩa là bước cài đặt CUDA Toolkit trước đó chưa tích hợp thành công vào Visual Studio. Bạn cần chạy lại bộ cài CUDA
Viết mã thử nghiệm “Hello World” từ GPU
Khi dự án được tạo, mặc định sẽ có một tệp kernel.cu. Bạn hãy xóa nội dung cũ và thay bằng đoạn mã dưới đây để kiểm tra khả năng thực thi song song:
C
#include"cuda_runtime.h"#include"device_launch_parameters.h"#include<stdio.h>// Kernel chạy trên GPU__global__ voidhelloFromGPU(){printf("Hello World từ GPU! Block: %d, Thread: %d\n",blockIdx.x,threadIdx.x);}intmain(){printf("Hello World từ CPU!\n");// Chạy Kernel với 2 Block, mỗi Block có 5 Thread (tổng cộng 10 luồng song song) helloFromGPU<<<2,5>>>();// Chờ GPU hoàn thành công việc trước khi kết thúc chương trình CPUcudaError_t err =cudaDeviceSynchronize();if(err != cudaSuccess){printf("Lỗi CUDA: %s\n",cudaGetErrorString(err));return1;}return0;}
Biên dịch và Chạy (Build & Run)
Chọn cấu hình: Trên thanh công cụ, đảm bảo bạn đang chọn x64 (CUDA hiện tại không còn hỗ trợ x86/32-bit).
Build: Nhấn Ctrl + Shift + B để biên dịch.
Run: Nhấn Ctrl + F5 để chạy không debug.
Kết quả mong đợi: Màn hình console sẽ hiển thị dòng “Hello World từ CPU!” trước, sau đó là 10 dòng “Hello World từ GPU!” với các chỉ số Block và Thread khác nhau.
Xử lý lỗi “cudaSetDevice failed!”
Nếu bạn chạy chương trình và nhận được thông báo lỗi:
cudaSetDevice failed! Do you have a CUDA-capable GPU installed?addWithCuda failed!...exited with code 1 (0x1).
Đây là dấu hiệu cho thấy CUDA Runtime không thể khởi tạo hoặc giao tiếp với GPU. Nguyên nhân thường nằm ở một trong ba trường hợp sau:
Trường hợp 1: Driver NVIDIA quá cũ (Lỗi phổ biến nhất)
Bộ cài CUDA Toolkit thường đi kèm với một bản Driver nhất định. Tuy nhiên, nếu bạn cài bản CUDA Toolkit mới (ví dụ 12.x hoặc 13.x) nhưng Driver trên máy vẫn là bản cũ từ nhiều năm trước, GPU sẽ không hiểu được các tập lệnh mới. (Điều này có thể kiểm tra ở đoạn thử nghiệm lệnh nvidia-smi và nvcc ở bước trước)
Cách khắc phục: Truy cập NVIDIA Driver Downloads. Chọn đúng dòng Card đồ họa của bạn và tải bản Game Ready Driver hoặc Studio Driver mới nhất. Cài đặt và khởi động lại máy.
Trường hợp 2: Lệch phiên bản giữa CUDA Toolkit và Driver
Mỗi phiên bản CUDA Toolkit yêu cầu một phiên bản Driver tối thiểu (Minimum Driver Version).
Ví dụ: CUDA 12.x yêu cầu Driver phiên bản 525.60.13 trở lên trên Windows.
Nếu bạn sử dụng Toolkit phiên bản cao hơn mức Driver hỗ trợ, hàm cudaSetDevice sẽ trả về mã lỗi.
Trường hợp 3: Thiết bị không hỗ trợ CUDA
Dù hiếm gặp trên các dòng máy tính mới, nhưng nếu bạn sử dụng GPU onboard (Intel/AMD) hoặc các dòng GPU NVIDIA quá cũ (kiến trúc Tesla đời đầu), phần cứng sẽ không có nhân CUDA để thực thi.
CUDA là một nền tảng tính toán song song và mô hình lập trình do NVIDIA phát triển. Nền tảng này cho phép gia tăng đáng kể hiệu suất tính toán bằng cách khai thác sức mạnh của bộ xử lý đồ họa (GPU). CUDA cho phép dev viết chương trình tăng tốc các ứng dụng tiêu tốn nhiều tài nguyên tính toán bằng cách sử dụng các ngôn ngữ lập trình phổ biến như C, C++, và Fortran
Ngôn ngữ CUDA C mở rộng ngôn ngữ lập trình ANSI C phổ biến với một lượng tối thiểu các cú pháp mới và các hàm thư viện. Như tên gọi của nó, CUDA C được xây dựng trên nền tảng CUDA của NVIDIA. Hiện nay, CUDA là framework phổ biến nhất cho tính toán song song khối lượng lớn, được sử dụng rộng rãi trong ngành tính toán hiệu năng cao (HPC) với các công cụ thiết yếu như trình biên dịch, trình gỡ lỗi và trình phân tích hiệu năng có sẵn trên các hệ điều hành phổ biến nhất.
Cấu trúc của một chương trình CUDA C phản ánh sự cùng tồn tại của một máy chủ (host) chính là CPU và một hoặc nhiều thiết bị (devices) chính là các GPU trong máy tính. Mỗi tệp mã nguồn CUDA C có thể chứa hỗn hợp cả mã cho máy chủ (host code) và mã cho thiết bị (device code).
Theo mặc định, bất kỳ chương trình C truyền thống nào cũng là một chương trình CUDA chỉ chứa mã máy chủ.
Ta có thể thêm mã thiết bị vào bất kỳ tệp nguồn nào. Mã thiết bị được đánh dấu rõ ràng bằng các từ khóa CUDA C đặc biệt.
Mã thiết bị bao gồm các hàm, hay còn gọi là các kernel, mã của chúng được thực thi theo cách thức song song dữ liệu.
Như hình trên ta thấy quá trình bắt đầu với mã máy chủ (mã tuần tự trên CPU).
Khi một hàm kernel được gọi, một số lượng lớn các luồng (threads) sẽ được kích hoạt (launched) trên một thiết bị để thực thi kernel đó.
Tất cả các luồng được kích hoạt bởi một lần gọi kernel được gọi chung là một lưới (grid). Những luồng này là phương tiện thực thi song song chính trong nền tảng CUDA.
Khi tất cả các luồng của một lưới đã hoàn thành việc thực thi, lưới đó sẽ kết thúc và việc thực thi tiếp tục trên máy chủ cho đến khi một lưới khác được kích hoạt.
Đây là một mô hình đơn giản hóa, trong đó việc thực thi của CPU và GPU không chồng chéo lên nhau. Nhiều ứng dụng tính toán không đồng nhất thực tế sẽ quản lý việc thực thi chồng chéo giữa CPU và GPU để tận dụng tối đa sức mạnh của cả hai.
Một kernel cộng vectơ (vector addition)
Bản CPU
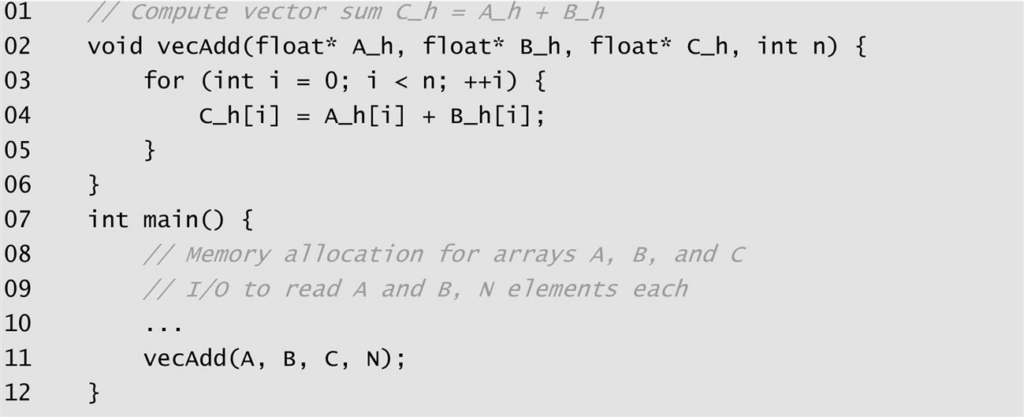
Ta sử dụng phép cộng vectơ để minh họa cấu trúc chương trình CUDA C. Cộng vectơ là phép tính song song dữ liệu đơn giản nhất có thể – tương đương với chương trình “Hello World” của lập trình tuần tự. Trước khi xem mã kernel, ta hãy xem xét hàm cộng vectơ truyền thống (chạy trên CPU).
Mục tiêu: Cho hai vector A, B có kích thước n phần tử. Ta cần tính tổng từng phần tử của hai vector và cho kết quả ở vector C, với C[i] = A[i] + B[i] cho mọi 0 ≤ i < n.
Hình trên cho thấy một chương trình C đơn giản gồm hàm main và hàm cộng vectơ vecAdd.
Quy ước đặt tên: Trong tất cả các ví dụ, khi cần phân biệt giữa dữ liệu của máy chủ và thiết bị, ta sẽ thêm hậu tố _h (CPU) cho các biến dùng bởi máy chủ và _d cho các biến dùng bởi thiết bị (GPU).
Như đã thảo luận ở phần 2, các tham số số của hàm vecAdd – A, B và C là các con trỏ.
Tại đây ở phần comment // Memory allocation for arrays A, B, and C thì ta sẽ khởi tạo các mảng phần tử A, B, C. Sau đó, khi truyền tham số vào vecAdd, ta đang truyền 1 con trỏ với cú pháp float *A_h
Ôn tập: Một mảng trong chương trình C có thể được truy cập thông qua một con trỏ trỏ đến phần tử thứ 0 của nó. Ví dụ, câu lệnh P=&(A[0]) làm cho P trỏ đến phần tử thứ 0 của mảng A. Lúc này P[i] tương đương với A[i]. Thực tế, chính tên mảng A cũng là một con trỏ trỏ đến phần tử thứ 0 của nó. (Có thể xem lại bài 2)
Trong hình, việc truyền tên mảng A vào hàm vecAdd làm cho tham số đầu tiên A_h của hàm trỏ đến phần tử thứ 0 của A. Kết quả là A_h[i] trong thân hàm có thể truy cập vào A[i] của hàm main.
Hàm vecAdd trong hình sử dụng một vòng lặp for để duyệt qua các phần tử của vectơ. Ở lần lặp thứ i, phần tử đầu ra C_h[i] nhận giá trị tổng của A_h[i] và B_h[i]. Tham số độ dài vectơ n được dùng để điều khiển vòng lặp.
Bản CPU
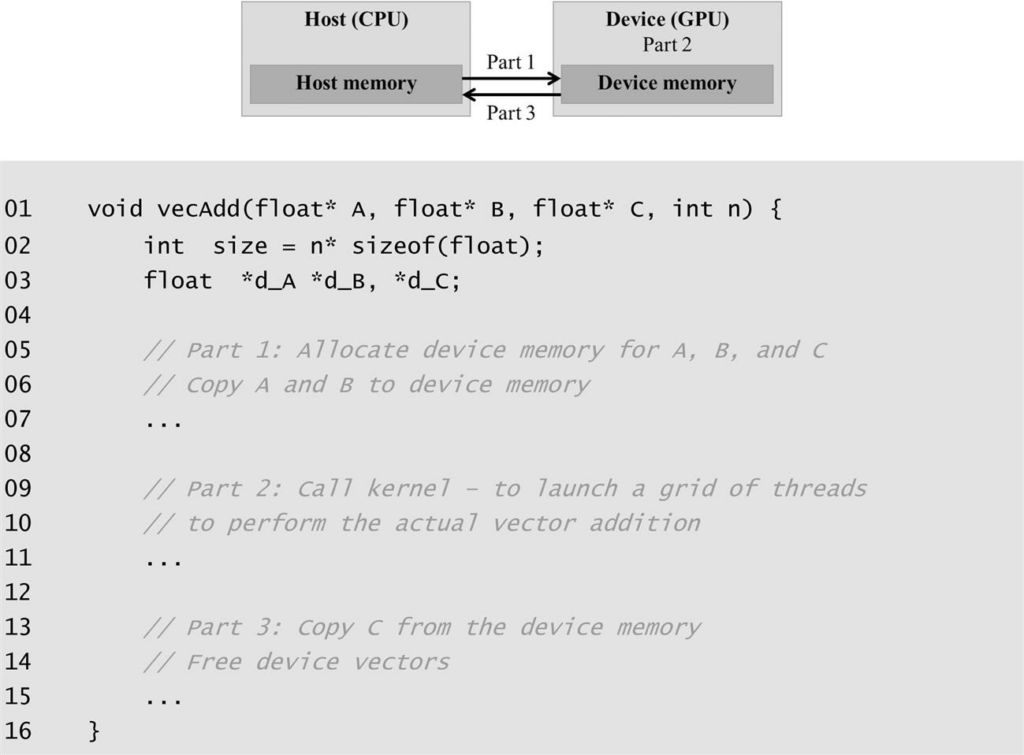
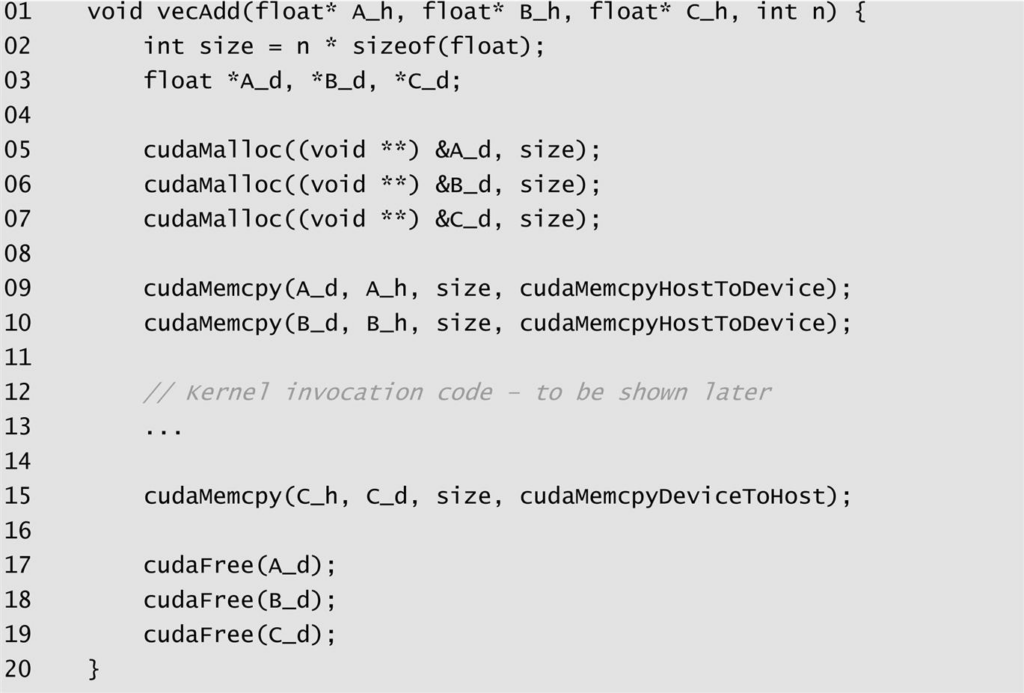
Giờ ta hãy xem cách để thực thi cộng vectơ song song, cụ thể ta sẽ sửa đổi hàm vecAdd và chuyển các tính toán của nó sang một thiết bị. Cấu trúc của hàm vecAdd đã sửa đổi được trình bày trong ảnh dưới
Phần 1: Cấp phát không gian trong bộ nhớ thiết bị (GPU) để chứa các bản sao của các vectơ A, B và C, sau đó sao chép vectơ A và B từ bộ nhớ máy chủ sang bộ nhớ thiết bị.
Phần 2: Gọi kernel cộng vectơ thực sự để kích hoạt một lưới các luồng trên thiết bị.
Phần 3: Sao chép vectơ tổng C từ bộ nhớ thiết bị về bộ nhớ máy chủ và giải phóng bộ nhớ của ba mảng này trên thiết bị.
Bộ nhớ toàn cục của thiết bị và truyền dữ liệu
Trong các hệ thống CUDA hiện nay, các thiết bị (GPU) thường là các bảng mạch phần cứng đi kèm với bộ nhớ truy cập ngẫu nhiên động (DRAM) riêng biệt (hay còn gọi là VRAM của GPU), được gọi là bộ nhớ toàn cục của thiết bị (device global memory), hoặc gọi ngắn gọn là bộ nhớ toàn cục.
Ví dụ: NVIDIA Volta V100 đi kèm với 16GB hoặc 32GB bộ nhớ toàn cục.
Việc gọi đây là bộ nhớ “toàn cục” nhằm phân biệt nó với các loại bộ nhớ thiết bị khác mà lập trình viên cũng có thể truy cập được
Đối với kernel cộng vectơ, trước khi gọi kernel, thực tế ta thực hiện các bước sau
Cấp phát không gian trong bộ nhớ toàn cục của thiết bị (GPU).
Truyền dữ liệu từ bộ nhớ máy chủ (CPU) sang không gian đã cấp phát đó.
Tương tự, sau khi thiết bị thực thi xong, ta cần:
Giải phóng không gian bộ nhớ toàn cục đã cấp phát khi không còn cần thiết.
Truyền dữ liệu kết quả từ bộ nhớ toàn cục của thiết bị trở lại bộ nhớ máy chủ
Khi ta nói Host CPU sẽ có bộ nhớ riêng, thông thường trong một hệ thống máy tính, đó chính là Ram. Và các thiết bị (Device) GPU cũng sẽ có bộ nhớ riêng, hay thường được gọi là thông số VRAM của GPU. Thông thường thì GPU không thể sử dụng các biến trên bộ nhớ CPU (Ram) để làm việc (trừ 1 số ngoại lệ sẽ được thảo luận sau), vì vậy như ảnh sơ đồ một luồng cơ bản ban đầu, ta thường cần khởi tạo các biến tại máy chủ CPU trước, rồi copy dữ liệu sang GPU các dữ liệu cần dùng trong tính toán tại GPU, rồi sau khi tính toán xong, ta sẽ copy lại.
Hệ thống CUDA cung cấp các hàm API để thực hiện các hoạt động này thay cho lập trình viên. Thuật ngữ “truyền dữ liệu từ máy chủ sang thiết bị” sẽ được hiểu là sao chép dữ liệu từ bộ nhớ máy chủ (RAM của CPU) sang bộ nhớ toàn cục của thiết bị (VRAM của GPU).
Quản lý bộ nhớ: cudaMalloc và cudaFree
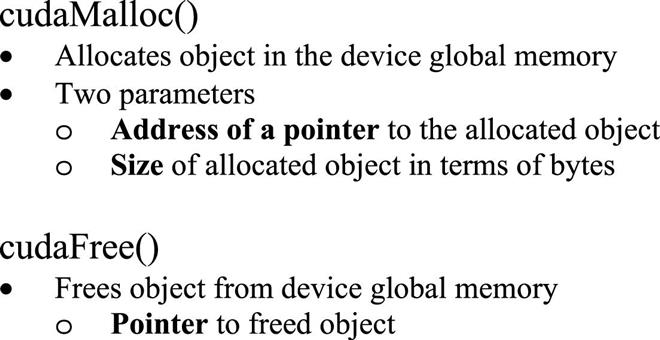
Hình trên giới thiệu hai hàm API dùng để cấp phát và giải phóng bộ nhớ toàn cục của thiết bị.
cudaMalloc(): Có thể được gọi từ mã máy chủ để cấp phát một vùng bộ nhớ toàn cục cho một đối tượng. Hàm này có sự tương đồng rất lớn với hàm malloc của thư viện C tiêu chuẩn.
Tham số thứ nhất: Là địa chỉ của một biến con trỏ. Biến con trỏ này sẽ được thiết lập để trỏ đến đối tượng vừa được cấp phát. Địa chỉ của biến con trỏ phải được ép kiểu thành (void **) vì hàm này mong đợi một con trỏ vạn năng (generic pointer). Điều này cho phép cudaMalloc ghi địa chỉ của vùng nhớ vừa cấp phát vào biến con trỏ của ta bất kể kiểu dữ liệu của nó là gì.
Tham số thứ hai: Xác định kích thước dữ liệu cần cấp phát, tính bằng số byte.
cudaFree(): Giải phóng không gian lưu trữ khỏi bộ nhớ toàn cục. Nó chỉ cần giá trị của con trỏ (địa chỉ vùng nhớ cần giải phóng) làm đối số, do đó không cần truyền địa chỉ của con trỏ như cudaMalloc.
Ví dụ minh họa:
C
float*A_d;int size = n *sizeof(float);cudaMalloc((void**)&A_d, size);// ... thực hiện tính toán ...cudaFree(A_d);
Trong ví dụ này, ta dùng hậu tố _d cho con trỏ A_d để chỉ rõ nó trỏ đến một đối tượng trong bộ nhớ thiết bị. Khi cudaMalloc trả về, A_d sẽ chứa địa chỉ vùng nhớ trên GPU dành cho vectơ A. Lưu ý rằng khi tính toán size, ta phải chuyển đổi từ số lượng phần tử sang số byte (ví dụ: n phần tử kiểu float sẽ chiếm n lần 4 byte).
Các địa chỉ trong A_d, B_d, và C_d trỏ đến các vị trí trong bộ nhớ toàn cục của thiết bị. Ta không được phép giải mã (dereference) các con trỏ này trong mã máy chủ (CPU). Việc truy cập trực tiếp nội dung con trỏ thiết bị từ CPU sẽ gây ra lỗi thực thi hoặc ngoại lệ hệ thống.
Truyền dữ liệu: cudaMemcpy
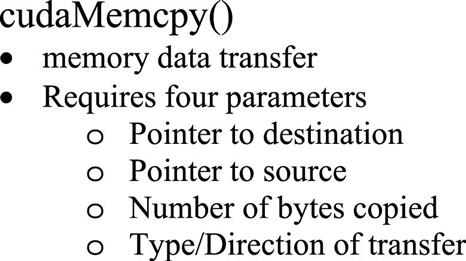
Sau khi đã cấp phát không gian trên thiết bị, ta cần chuyển dữ liệu vào đó. Hàm API thực hiện việc này là cudaMemcpy.
Hình trên mô tả hàm cudaMemcpy với bốn tham số:
Đích (Destination): Con trỏ tới vị trí đích của đối tượng dữ liệu cần sao chép.
Nguồn (Source): Con trỏ tới vị trí nguồn của dữ liệu.
Kích thước (Size): Số byte cần sao chép.
Loại truyền dẫn (Kind/Direction): Xác định các loại bộ nhớ liên quan:
cudaMemcpyHostToDevice: Từ máy chủ sang thiết bị.
cudaMemcpyDeviceToHost: Từ thiết bị về máy chủ.
cudaMemcpyDeviceToDevice: Giữa hai vị trí trong bộ nhớ thiết bị.
cudaMemcpyHostToHost: Giữa hai vị trí trong bộ nhớ máy chủ.
Áp dụng vào ví dụ vecAdd: Ta thực hiện sao chép các vectơ A và B sang thiết bị trước khi tính toán, và sao chép kết quả C về máy chủ sau khi hoàn tất:
C
cudaMemcpy(A_d, A_h, size, cudaMemcpyHostToDevice);cudaMemcpy(B_d, B_h, size, cudaMemcpyHostToDevice);// ... (Gọi kernel thực hiện cộng vectơ ở đây) ...cudaMemcpy(C_h, C_d, size, cudaMemcpyDeviceToHost);
Tổng quan, chương trình hiện tại của ta có thể được thấy như sau, chỉ còn thiếu 1 phần gọi kernel để thực hiện việc tính toán.
Các hàm kernel và phân luồng
Trong CUDA C, một kernel là một hàm sẽ được thực thi song song bởi nhiều luồng trên thiết bị. Ta định nghĩa một kernel bằng cách thêm từ khóa khai báo hàm __global__ vào trước định nghĩa hàm.
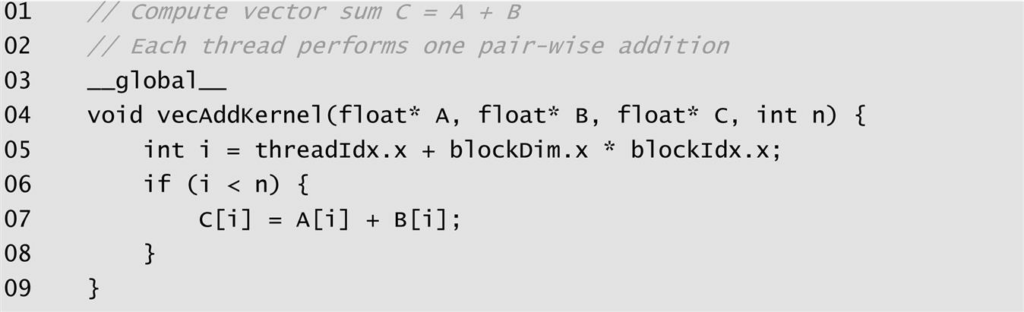
Khi ta gọi một hàm __global__, nó sẽ được thực thi trên thiết bị. Một điểm đặc biệt là các hàm __global__ phải trả về kiểu void. Ta hãy xem xét ví dụ về kernel cộng vectơ trong hình sau:
Hàm vecAddKernel trong hình trông rất giống với vòng lặp trong hàm vecAdd ở ví dụ CPU, nhưng có hai điểm khác biệt quan trọng:
Từ khóa __global__ thông báo cho trình biên dịch rằng đây là một kernel.
Vòng lặp for đã biến mất.
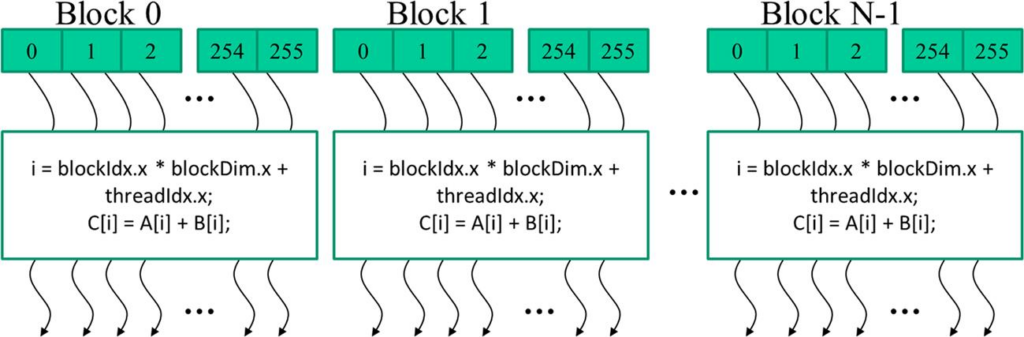
Tại sao vòng lặp lại biến mất? Đó là vì khi kernel này được kích hoạt, một lưới các luồng sẽ được tạo ra. Ta cấu trúc chương trình sao cho mỗi luồng trong lưới sẽ thực hiện một lần lặp của vòng lặp ban đầu. Để làm được điều này, mỗi luồng cần biết nó phải xử lý phần tử nào của các vectơ A, B và C.
Biến tích hợp và định danh luồng (Thread Identification)
CUDA C cung cấp các biến tích hợp sẵn (built-in variables) để giúp các luồng xác định danh tính của mình. Một trong những biến quan trọng nhất là threadIdx. Trong ví dụ đơn giản này, ta sử dụng threadIdx.x để lấy chỉ số của luồng trong một khối (block).
Câu lệnh sau trong kernel:
int i = threadIdx.x;
cho phép mỗi luồng tự gán cho mình một giá trị i khác nhau dựa trên chỉ số của nó. Nếu ta kích hoạt n luồng, thì luồng thứ 0 sẽ có i=0, luồng thứ 1 sẽ có i=1, và cứ tiếp tục cho đến luồng thứ n-1. Nhờ đó, mỗi luồng sẽ thực hiện phép cộng trên một cặp phần tử khác nhau của các vectơ:
if (i < n) C_d[i] = A_d[i] + B_d[i];
Câu lệnh if (i < n) là một biện pháp bảo vệ, Nó đảm bảo rằng nếu số lượng luồng được kích hoạt lớn hơn độ dài vectơ n, các luồng “thừa” sẽ không truy cập vào vùng nhớ ngoài phạm vi của mảng.
SPMD (Single Program, Multiple Data)
Mô hình thực thi này được gọi là SPMD (Một chương trình, nhiều dữ liệu). Tất cả các luồng đều thực thi cùng một mã nguồn (hàm kernel), nhưng mỗi luồng hoạt động trên một phần dữ liệu khác nhau dựa trên định danh của nó. Đây là cách CUDA khai thác tính song song dữ liệu trên quy mô lớn.
Gọi hàm kernel
Khi ta gọi một kernel từ mã máy chủ, ta cần cung cấp các tham số cấu hình thực thi. Các tham số này xác định số lượng luồng trong lưới sẽ được kích hoạt để thực thi kernel đó.
CUDA C sử dụng cú pháp ngoặc nhọn ba lớp <<< ... >>> để bao quanh các thông số này. Cú pháp tổng quát như sau:
Ở đây, ta đang yêu cầu hệ thống kích hoạt 1 khối duy nhất chứa n luồng.
Tham số thứ nhất (1) xác định số lượng khối trong lưới.
Tham số thứ hai (n) xác định số lượng luồng trong mỗi khối.
Khi lệnh gọi này được thực thi, môi trường chạy CUDA (runtime) sẽ tạo ra một lưới gồm n luồng trên thiết bị. Mỗi luồng sẽ thực thi mã của vecAddKernel với một giá trị threadIdx.x duy nhất từ 0 đến n-1.
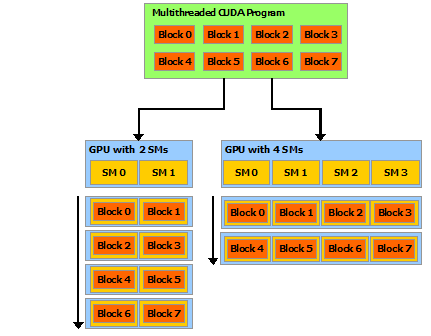
Ta sẽ thảo luận sau cách sử dụng nhiều khối để xử lý các tập dữ liệu cực lớn vượt quá giới hạn số lượng luồng của một khối đơn lẻ.
Biên dịch (Compilation)
Quy trình biên dịch một chương trình CUDA C khác với chương trình C thông thường vì nó chứa cả mã chạy trên CPU (host) và mã chạy trên GPU (device).
Trình biên dịch NVCC: NVIDIA cung cấp một trình biên dịch tên là nvcc. Nó sẽ phân tách mã máy chủ và mã thiết bị trong tệp nguồn (thường có phần mở rộng là .cu).
Xử lý mã máy chủ: Mã máy chủ là mã C/C++ tiêu chuẩn, nó sẽ được gửi đến trình biên dịch C/C++ thông thường của hệ thống (như gcc trên Linux hoặc cl.exe trên Windows) để biên dịch và liên kết.
Xử lý mã thiết bị: Mã thiết bị (các hàm kernel và các hàm bổ trợ) sẽ được nvcc biên dịch thành một dạng trung gian gọi là PTX (Parallel Thread Execution), hoặc trực tiếp thành mã máy nhị phân cho một kiến trúc GPU cụ thể.
Hợp nhất: Cuối cùng, nvcc sẽ chèn các lệnh cần thiết để nạp mã thiết bị vào GPU và kích hoạt kernel vào trong mã máy chủ, tạo ra một tệp thực thi duy nhất.
Khi ta chạy tệp thực thi này, phần mã máy chủ sẽ bắt đầu chạy trên CPU. Khi gặp lệnh gọi kernel, hệ thống sẽ sử dụng mã thiết bị đã được đóng gói sẵn để kích hoạt các luồng trên GPU.
Ta đã làm quen với những khái niệm nền tảng nhất của lập trình song song trên nền tảng CUDA. Dưới đây là những điểm quan trọng mà ta cần ghi nhớ để làm tiền đề cho các kỹ thuật tối ưu hóa phức tạp hơn:
Song song hóa dữ liệu (Data Parallelism): Đây là chìa khóa để đạt được hiệu suất cao. Khi một công việc lớn có thể chia nhỏ thành các phần độc lập (như xử lý từng điểm ảnh hoặc từng phần tử vectơ), ta có thể tận dụng hàng nghìn lõi xử lý của GPU để thực thi chúng cùng lúc.
Mô hình Máy chủ – Thiết bị (Host – Device): Một chương trình CUDA luôn có sự phân chia vai trò rõ rệt. CPU (Host) đóng vai trò điều khiển, quản lý luồng công việc, trong khi GPU (Device) đóng vai trò là bộ tăng tốc, thực thi các tác vụ tính toán nặng.
Quản lý bộ nhớ: Ta đã học cách sử dụng các hàm API của CUDA để quản lý vòng đời của dữ liệu trên GPU:
cudaMalloc: Cấp phát không gian trên thiết bị.
cudaMemcpy: Chuyển dữ liệu qua lại giữa RAM máy chủ và VRAM thiết bị.
cudaFree: Giải phóng tài nguyên sau khi sử dụng.
Kernel và Luồng (Threads): Kernel là hàm chạy trên GPU. Khi kích hoạt một kernel, ta không chỉ gọi một hàm đơn thuần mà là đang kích hoạt cả một lưới (grid) gồm rất nhiều luồng. Mỗi luồng sử dụng các biến như threadIdx để biết mình cần xử lý phần dữ liệu nào.
Mô hình SPMD: CUDA sử dụng mô hình “Một chương trình, nhiều dữ liệu”, giúp đơn giản hóa việc lập trình song song bằng cách viết một đoạn mã duy nhất nhưng cho phép hàng triệu luồng thực thi nó trên các vùng dữ liệu khác nhau.
Khi chúng ta hình dung về “một chiếc máy tính” ngày nay, chúng ta có lẽ sẽ nghĩ đến một thiết bị như máy tính để bàn (PC), máy chơi game cầm tay hoặc điện thoại thông minh. Nhưng đó không phải là những cỗ máy duy nhất mà con người từng sử dụng để tính toán và điện toán.
Để truy vết lịch sử của máy tính, trước tiên chúng ta cần quyết định xem cái gì được coi là máy tính và máy tính khác với những chiếc máy tính bỏ túi hoặc máy tính toán thuần túy như thế nào. Đây là một câu hỏi khó đến ngạc nhiên
Máy tính phải là thiết bị điện tử?
Hãy cùng xem xét thêm một số khái niệm thường được đề xuất để định nghĩa máy tính. Từ điển tiếng Anh Oxford, yêu cầu máy tính phải là thiết bị điện tử. Nhưng những cỗ máy tương tự có thể được làm từ các chất nền (vật liệu) khác, chẳng hạn như nước
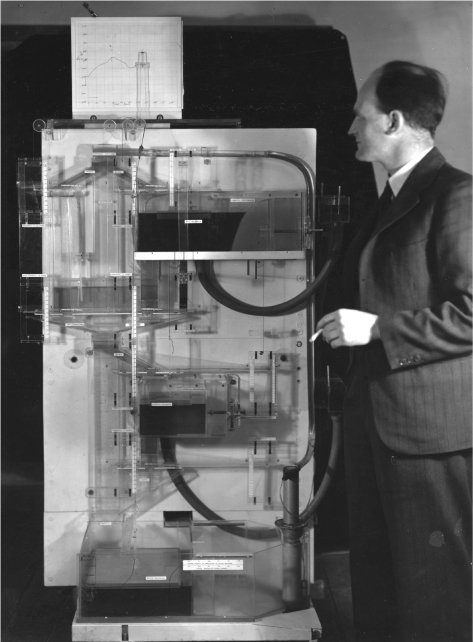
MONIAC, viết tắt của Monetary National Income Analogue Computer được chế tạo vào năm 1949, MONIAC là một máy tính được sử dụng để mô phỏng dòng tiền chạy qua nền kinh tế và để minh họa các tác động của các can thiệp kinh tế lên một mô hình kinh tế.
Một số người lập luận rằng máy tính phải là kỹ thuật số (digital), trái ngược với tương tự (analog). Một cỗ máy kỹ thuật số là cỗ máy biểu diễn dữ liệu bằng các chữ số, các tập hợp ký hiệu rời rạc như các chữ số nhị phân 0 và 1. Ngược lại, một cỗ máy tương tự có một tập hợp vô hạn, liên tục các trạng thái có thể xảy ra, chẳng hạn như lượng nước trong các bể của MONIAC, khiến MONIAC trở thành một cỗ máy tương tự.
Trong lý thuyết tính toán, chúng ta có Luận thuyết Church (Church’s thesis), một định nghĩa khắt khe hơn về máy tính mà hầu hết các nhà khoa học máy tính hiện đại đều đồng ý. Nó có thể được diễn giải như sau:
Một máy tính là một cỗ máy có thể mô phỏng bất kỳ cỗ máy nào khác, với điều kiện được cung cấp bao nhiêu bộ nhớ tùy ý.
Hiện tại các máy tính rõ ràng tồn tại để có thể thực hiện những việc sau, vì vậy một máy tính theo luận thuyết Church cũng phải có khả năng thực hiện các tác vụ này:
Đọc, ghi và xử lý dữ liệu.
Đọc, ghi và thực thi chương trình.
Cộng (và do đó thực hiện các phép tính số học).
Nhảy (lệnh goto).
Rẽ nhánh (lệnh if).
Trước cuộc cách mạng công nghiệp
Vào khoảng những năm 40000 TCN,người ta tìm thấy xương Lebombo, một mảnh xương với các khía khắc có thể đã được sử dụng như một chiếc gậy tính. Một vạch đại diện cho một vật thể vật lý, có thể trong thời kì này, nó dùng cho đếm động vật, các mặt hàng thực phẩm hoặc các ngày để tính thời gian cho một cuộc săn bắn nào đó.
Xương Lebombo là một ví dụ về biểu diễn dữ liệu. Nó có thể đã được sử dụng cho một hình thức tính toán đơn giản như cộng thêm một vào tổng mỗi khi một dấu vết mới được tạo ra.
Khoảng những năm 4000 TCN, các thành phố đầu tiên bắt đầu phát triển. Các thành phố đòi hỏi những hành vi/tổ chức ở quy mô lớn hơn, ví dụ như theo dõi việc giao thương và thuế. Vào năm 3000 TCN, văn hóa thành phố Sumer ở Lưỡng Hà (Iraq ngày nay) đã phát triển hệ thống chữ viết đầu tiên, và đến năm 2500 TCN, họ đã sở hữu chiếc máy tính toán đầu tiên: bàn tính (abacus)
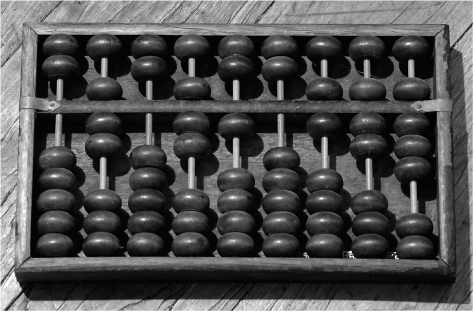
Bàn tính đang biểu diễn 070710678
Trong cách sử dụng thông thường, trạng thái của bàn tính biểu diễn số (thập phân, tự nhiên).
Có chín cột, mỗi cột đại diện cho một trong các chữ số trong số này. Mỗi cột được chia thành một hộp dưới chứa năm hạt và một hộp trên chứa hai hạt. Vị trí mặc định của các hạt ở hộp dưới là ở dưới, và vị trí mặc định của các hạt ở hộp trên là ở trên.
Ở trạng thái này, một cột biểu thị chữ số 0. Mỗi hạt được đẩy từ dưới lên trên của hộp dưới có giá trị là 1. Mỗi hạt được đẩy từ trên xuống dưới của hộp trên có giá trị là 5.
Cột 1: 0
Cột 2: 1 nút xuống ở trên (+5) , 2 nút dưới đẩy lên (+2 ) = 7
…
Để cộng 1 vào một số trên bàn tính (tức là tăng nó lên), bạn nâng một hạt từ hộp dưới của cột ngoài cùng bên phải. Nếu tất cả năm hạt trong hộp dưới của một cột đã được nâng lên, bạn đẩy tất cả chúng xuống lại và thay thế chúng bằng cách hạ một trong các hạt ở hộp trên trong cùng cột đó. Nếu cả hai hạt trên đều đã hạ xuống, bạn đẩy chúng ngược lên và thay thế chúng bằng cách nâng một hạt từ hộp dưới ở cột bên trái của nó. Việc chuyển dữ liệu từ một cột sang cột bên trái của nó được gọi là phép toán nhớ. (Giống như việc xét chữ số của 1 số từ phải sang trái, thì mỗi hàng đơn vị ta x 10 vậy)
Để cộng hai số, a + b, trước tiên bạn thiết lập bàn tính để biểu diễn các chữ số của a. Sau đó, bạn thực hiện b lần tăng như trên. Trạng thái của bàn tính khi đó biểu diễn kết quả.
Kiểu tính toán này, nơi số thứ nhất được “nạp vào” thiết bị và số thứ hai được “cộng thêm vào” đó, để lại kết quả cuối cùng là trạng thái của hệ thống, được gọi là kiến trúc tích lũy (accumulator architecture), và nó vẫn còn được sử dụng phổ biến ngày nay. Nó “tích lũy” kết quả của một chuỗi các phép tính; ví dụ, chúng ta có thể cộng một danh sách gồm nhiều số bằng cách cộng lần lượt từng số vào trạng thái và xem tổng tích lũy mới nhất sau mỗi lần cộng.
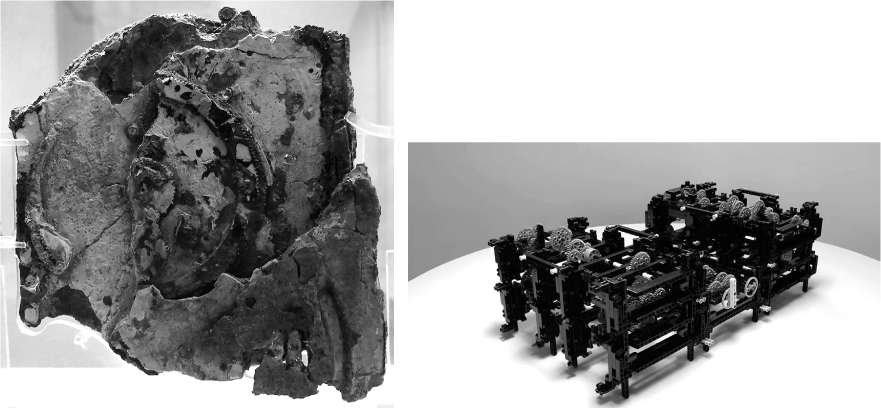
Khoảng năm 100 TCN, xuất hiện cơ chế Antikythera. Nó được tìm thấy vào năm 1901 trong một xác tàu đắm ở Địa Trung Hải; con tàu bị đắm dường như đang trên đường từ Hy Lạp đến La Mã, mang theo cơ chế này để bán hoặc làm vật phẩm cống nạp.
Chạy bằng bánh răng cơ khí, dùng để dự đoán các sự kiện thiên văn, bao gồm vị trí của năm hành tinh, các pha của mặt trăng, thời điểm nhật thực/nguyệt thực và thời gian diễn ra Thế vận hội Olympic. Nó bao gồm 37 bánh răng bằng đồng, và người dùng sẽ quay một tay cầm để mô phỏng diễn biến tương lai của các trạng thái thiên văn. Các kết quả được hiển thị trên các mặt đồng hồ, được tính toán dựa trên tỷ số truyền của các bánh răng cơ khí.
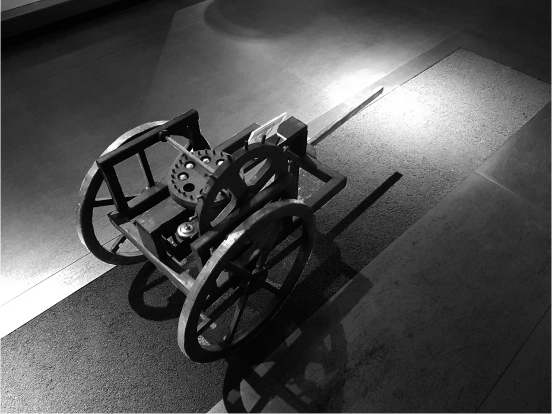
Máy đo quãng đường (Odometers) là những cỗ máy đo khoảng cách tầm xa mà người Hy Lạp và La Mã đã sử dụng để khảo sát và lập bản đồ đế chế của họ.
Loại máy đo quãng đường này hoạt động như sau: chúng phát ra tiếng “cạch” mỗi khi được đẩy đi một khoảng cách nhất định. Chiếc máy đo này được kéo bởi một con ngựa, giống như một cỗ xe. Có một số viên bi kim loại được lưu trữ trong các hốc của một bánh răng gỗ hình tròn. Một trong các bánh xe của xe có gắn một cái chốt sao cho cứ sau mỗi vòng quay, nó lại chạm và làm xoay bánh răng một góc cố định nhỏ. Một cái lỗ có kích thước bằng viên bi nằm dưới một vị trí của bánh răng cho phép một viên bi phía trên nó rơi ra khỏi hốc và rơi vào một hộp thu thập bên dưới. Tổng quãng đường đã đi được ghi lại bằng số lượng viên bi trong hộp đếm vào cuối chuyến đi.
Những cỗ máy này có phải là máy tính không? Rõ ràng có các khái niệm về dữ liệu được sử dụng để đại diện cho các vật thể trong thế giới, cũng như các hình thức tự động hóa và tính toán. Nhưng giống như MONIAC, mỗi cỗ máy chỉ làm được một việc duy nhất: dự đoán nhật thực hoặc đo khoảng cách. Theo luận thuyết Church, ta thấy rằng các cỗ máy này không thể lập trình lại để làm 1 việc khác.
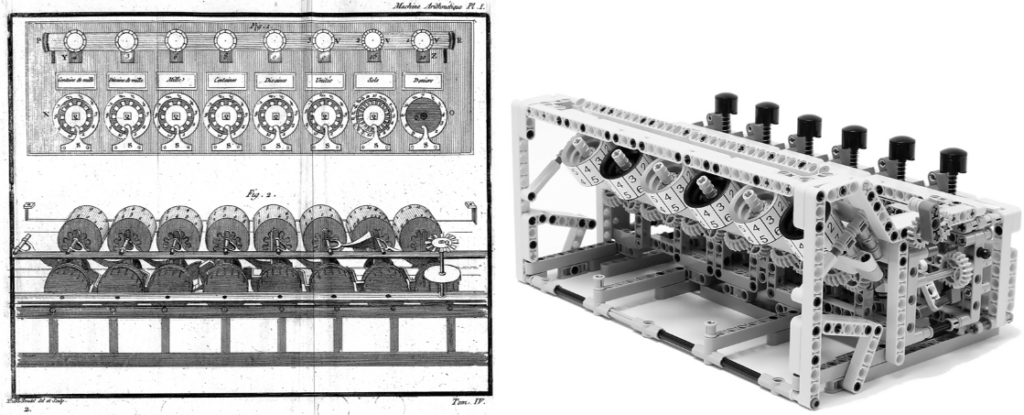
Trong nhiều năm tiếp theo, xuất hiện nhiều “máy móc” với ý tưởng phát triển từ các ý tưởng trên. Ví dụ Codex Madrid của Davinci, dùng để tính toán qua hệ thống bánh răng. Tỷ số truyền giữa mỗi cặp cột là 1:10, vì vậy bánh xe của mỗi cột sẽ quay với tốc độ bằng 1/10 so với cột bên phải của nó. Có 13 bánh xe, mỗi bánh xe đại diện cho các cột của một số thập phân
Cách mạng công nghiệp
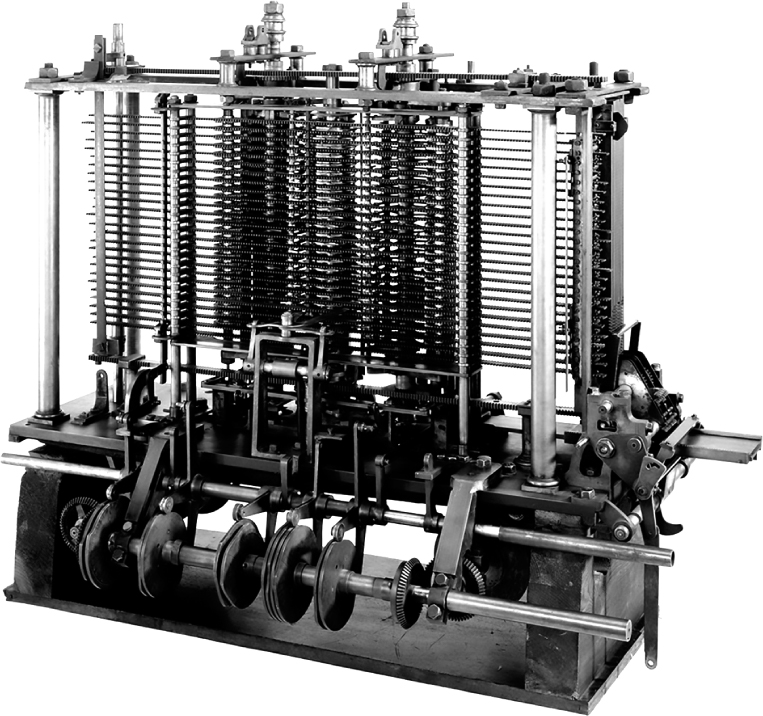
Máy Phân tích đã được thiết kế như một chiếc máy lập trình được, có mục đích hoàn toàn tổng quát (general-purpose).
Để đạt được tính tổng quát này, Máy Phân tích cung cấp một loạt các phép toán số học và các hoạt động khác dưới dạng các bộ phận máy đơn giản, cùng với một bộ nhớ để lưu trữ dữ liệu và khả năng đọc các chương trình từ thẻ đục lỗ.
Các chương trình này quy định một trình tự các thao tác đọc/ghi bộ nhớ và các phép toán số học, đồng thời cho phép rẽ nhánh tùy thuộc vào trạng thái của phép tính, tức là một câu lệnh if.
Cấu trúc bộ nhớ và lệnh (Core and Memory)
Phần lõi của Máy Phân tích chứa nhiều máy đơn giản độc lập, mỗi máy thực hiện một chức năng nhất định, chẳng hạn như cộng các số và kiểm tra xem một số có bằng một số khác hay không.
Máy Phân tích đã giới thiệu khái niệm hiện đại về bộ nhớ máy tính. Mỗi máy có thể giữ một con số khác nhau. Mỗi máy sẽ được gán một mã định danh số hoặc “địa chỉ” (address) để chỉ định chính xác máy nào cần đọc hoặc ghi.
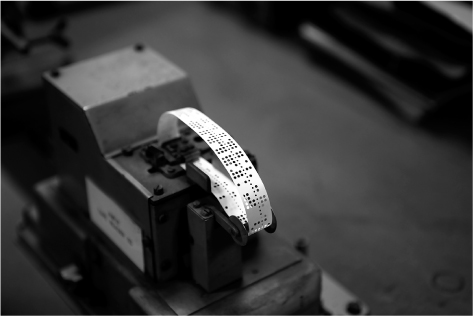
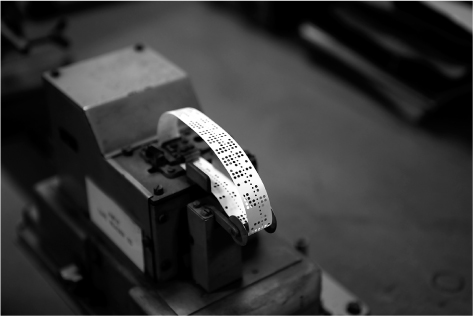
Một chuỗi các chỉ thị (instructions) sẽ được mã hóa dưới dạng nhị phân và đục lỗ trên băng giấy. Mỗi chỉ thị sẽ ra lệnh cho cỗ máy kích hoạt một trong các máy đơn giản. Thông thường, sau mỗi chỉ thị, cỗ máy sẽ đẩy băng giấy đục lỗ theo từng dòng để tải chỉ thị tiếp theo. Tuy nhiên, cỗ máy cũng có khả năng kiểm tra kết quả của máy đơn giản vừa chạy và tùy thuộc vào giá trị đó, nó có thể nhảy đến một dòng khác trên giấy. Điều này mang lại cho các chương trình khả năng thay đổi hành vi để phản hồi lại các kết quả trung gian.
Một chương trình cũng có thể được tạo ra để chạy mãi mãi bằng cách dán phần cuối của băng giấy đục lỗ vào phần đầu của nó, tạo thành một vòng lặp vật lý, như trong máy băng giấy.
Máy Phân tích có phải là máy tính Church?
Thiết kế của nó chứa đựng tất cả các đặc điểm cơ bản của một máy tính hiện đại: CPU, bộ nhớ, bus, các thanh ghi, bộ điều khiển và đơn vị số học. Nó có thể đọc, ghi và xử lý dữ liệu. Nó có thể làm toán. Không giống như các máy tính thuần túy trước đó, nó có thể nhảy (goto) và rẽ nhánh (if), chuyển đến các chỉ thị khác nhau trong chương trình tùy theo trạng thái tính toán.
Cơ – Điện
Trước khi có máy tính hiện đại, thế giới trải qua một giai đoạn “lai” gọi là Cơ – Điện (Electromechanical). Thay vì dùng bánh răng thuần túy, người ta dùng điện để điều khiển các chuyển động cơ học.
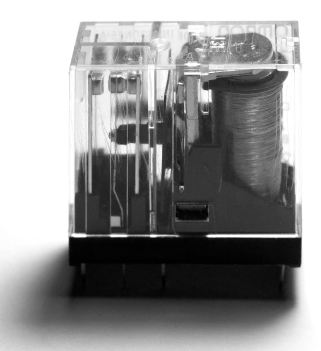
Rơ-le là linh kiện then chốt của thời kỳ này. Bạn có thể hiểu đơn giản nó là một công tắc điện được đóng/ngắt bằng một tín hiệu điện khác, thay vì dùng tay người.
Cấu tạo và hoạt động: Nó gồm một cuộn dây đồng (solenoid) quấn quanh một lõi sắt. Khi có dòng điện chạy qua cuộn dây, nó tạo ra từ trường biến lõi sắt thành nam châm điện. Lực từ này sẽ hút một thanh sắt (gọi là phần ứng – armature) di chuyển vật lý để chạm vào tiếp điểm, giúp đóng hoặc ngắt một mạch điện thứ hai.
Tại sao nó quan trọng? Chỉ cần một dòng điện nhỏ, yếu có thể điều khiển một mạch điện khác mang năng lượng khổng lồ (như khởi động động cơ xe tải).
Tính logic: Nếu kết hợp nhiều rơ-le, ta có thể tạo ra các phép tính logic (VÍ DỤ: “Nếu rơ-le A đóng VÀ rơ-le B đóng thì đèn mới sáng”). Đây chính là nền tảng của tư duy máy tính.
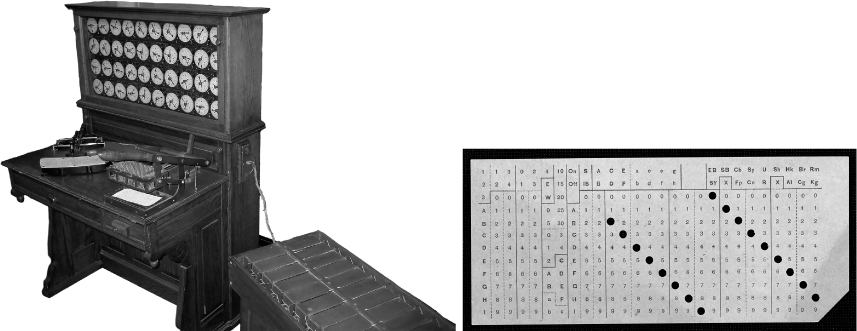
Hiến pháp Hoa Kỳ yêu cầu việc điều tra dân số phải được thực hiện và xử lý sau mỗi 10 năm, và đến năm 1890, dân số đã tăng đến mức việc xử lý các số liệu thống kê bằng con người là không thể. Herman Hollerith đã thiết kế một chiếc máy để tự động hóa việc xử lý dữ liệu và sử dụng nó thành công trong kỳ điều tra dân số năm 1890 để thực hiện phân tích dữ liệu lớn trên thông tin của 62 triệu công dân. Dữ liệu của mỗi công dân được chuyển từ mẫu đơn điều tra viết tay sang một thẻ đục lỗ bởi con người. Mỗi câu hỏi trong cuộc điều tra dân số là dạng trắc nghiệm, và được mã hóa trên thẻ đục lỗ bằng cách đục bỏ một trong số các lựa chọn.
Các xấp thẻ có thể được đọc vào máy, máy sẽ kiểm tra sự hiện diện hay vắng mặt của các đặc điểm nhất định hoặc sự kết hợp của các đặc điểm. Điều này có nghĩa là chiếc máy này có khả năng tương đương với các truy vấn SQL hiện đại, bao gồm SELECT, WHERE, GROUP BY, và ORDER BY.
Cuộc chiến mật mã (Thế chiến II)
Thế chiến II là “lò luyện” thúc đẩy máy tính phát triển vượt bậc nhờ nhu cầu giải mã:
Máy Enigma (Đức): Một hệ thống các bánh xe xoay (rotors) làm thay đổi chữ cái theo quy luật điện học cực kỳ phức tạp. VD: tự động chuyển bất kì số nào thêm 3 đơn vị chẳng hạn, vậy nên mật báo truyền tin là “123” sẽ bị chuyển thành “456”, một đoạn văn bản sẽ bị mã hóa thành một dạng khác không dịch được
Máy Bomba (Ba Lan) và Bombe (Anh): Các cỗ máy cơ-điện dùng để “quét” hàng triệu khả năng của Enigma. Alan Turing (Anh) đã cải tiến máy này để bẻ khóa mật mã hải quân Đức, giúp phe Đồng minh xoay chuyển cục diện.
Zuse Z3 (Đức): Cỗ máy của Konrad Zuse (1941) sử dụng tới 2.000 rơ-le. Đây được coi là máy tính lập trình được đầu tiên, dù nó chạy rất chậm (10 lệnh/giây).
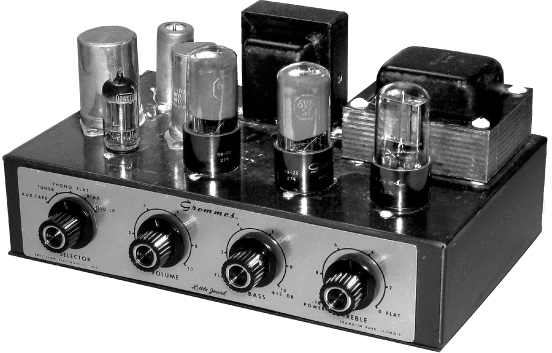
Khi rơ-le cơ học lộ khuyết điểm (chậm, hay bị kẹt, phát ra tiếng ồn), Bóng chân không (Vacuum Tubes/Valves) ra đời (1904).
Hãy tưởng tượng nó như một cái bóng đèn nhưng có thêm một “lưới” điều khiển ở giữa.
Cơ chế: Khi sợi đốt nóng lên, các electron bị đẩy ra khỏi cực âm (cathode) và bay qua chân không để đến cực dương (anode), tạo thành dòng điện.
Tác dụng: Bằng cách thay đổi điện áp ở lưới điều khiển, ta có thể cho phép dòng điện đi qua hoặc chặn lại.
Ưu điểm vượt trội: Vì không có bộ phận chuyển động cơ học (không có thanh sắt nào phải nhảy lên xuống như rơ-le), bóng chân không có thể đóng ngắt hàng triệu lần mỗi giây. Điều này giúp máy tính chuyển từ tốc độ “rùa bò” của rơ-le sang tốc độ điện tử cực nhanh.
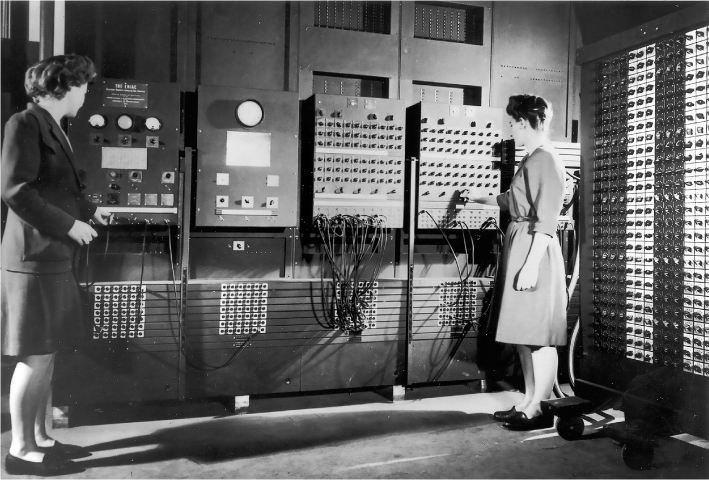
Hoàn thành năm 1945, ENIAC là máy tính điện tử đa năng bằng bóng chân không.
Lập trình bằng tay: Để “lập trình”, các nữ toán viên phải trực tiếp cắm các dây cáp vào bảng điều khiển
Máy ảo (Virtual Machine) đầu tiên: Nhóm lập trình viên gồm 6 phụ nữ (như Betty Jean Jennings, Frances Bilas…) đã tạo ra một bước ngoặt: Thay vì rút dây cho mỗi bài toán, họ thiết lập một cấu hình dây cố định cho phép máy đọc các lệnh từ các bảng công tắc.
Lúc này, các công tắc đóng vai trò là “phần mềm” sơ khai, điều khiển lớp “phần cứng” bên dưới. Đây chính là khái niệm máy ảo đầu tiên trong lịch sử.
Kiến trúc von Neumann
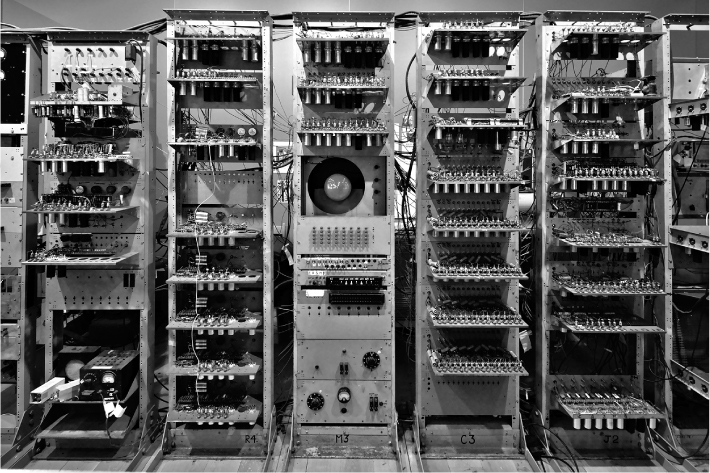
Được chứng minh lần đầu bởi máy Manchester Baby (1948), đây là kiến trúc mà mọi máy tính và smartphone ngày nay vẫn dùng.
Nguyên lý Stored-program: Cả chương trình và dữ liệu đều được lưu trữ chung trong cùng một bộ nhớ.
Phát kiến:
1. Tốc độ: Thay đổi chương trình chỉ đơn giản là nạp một dãy số mới vào bộ nhớ, không cần động vào phần cứng.
2. Tự sửa đổi (Self-modifying code): Vì chương trình cũng chỉ là dữ liệu trong bộ nhớ, máy tính có thể tự viết ra các lệnh mới hoặc tự thay đổi mã nguồn của chính nó khi đang chạy. Đây là nền tảng tối thượng cho trí tuệ nhân tạo và các hệ điều hành phức tạp.
Định luật Moore và máy tính hiện đại
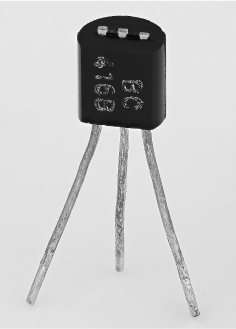
Năm 1947, Bóng bán dẫn (Transistor) ra đời, đánh dấu sự kết thúc của những căn phòng đầy bóng chân không nóng bức.
Sự vượt trội của transistor đến từ bản chất vật lý của trạng thái rắn so với môi trường chân không:
Không cần năng lượng kích hoạt: Bóng chân không cần dòng điện để nung nóng sợi đốt liên tục (giống bóng đèn dây tóc), gây lãng phí năng lượng cực lớn dưới dạng nhiệt. Transistor hoạt động bằng điện trường, không cần nung nóng, tiêu thụ năng lượng ít hơn hàng nghìn lần.
Kích thước và khả năng tích hợp: Vì hoạt động trong chất rắn, transistor có thể được thu nhỏ xuống mức nanomet. Bóng chân không cần khoảng không gian vật lý đủ lớn để các electron bay qua và vỏ thủy tinh để duy trì chân không, nên không thể thu nhỏ.
Độ bền vật lý: Bóng chân không có sợi đốt sẽ bị “cháy” sau một thời gian sử dụng và vỏ thủy tinh dễ vỡ. Transistor là một khối chất rắn đồng nhất, không có bộ phận tiêu hao hay chuyển động, nên tuổi thọ gần như vĩnh cửu trong điều kiện bình thường.
Tốc độ chuyển mạch (Switching Speed): Việc điều khiển dòng điện bằng điện trường trong chất bán dẫn nhanh hơn rất nhiều so với việc điều khiển dòng electron bay trong chân không.
Những năm 1960 và các Bóng bán dẫn lớn (The 1960s and Big Transistors)
Các “máy tính mini” (minicomputers) chạy bóng bán dẫn của những năm 1960 không sử dụng vi mạch (microchips), mà thay vào đó được chế tạo từ các loại bóng bán dẫn “lớn”, dài khoảng 1 cm.
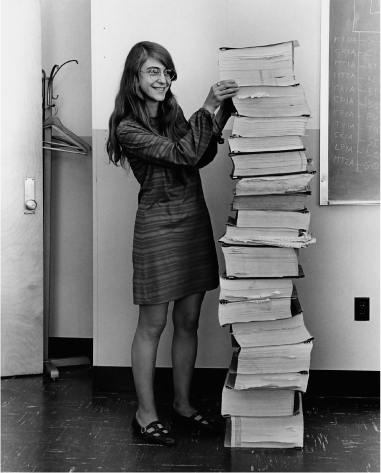
Các ứng dụng của máy tính bán dẫn trong những năm 1960 bao gồm việc vận hành ARPANET, tiền thân của internet dựa trên TCP/IP ngày nay, và việc Margaret Hamilton lập trình mã đổ bộ lên mặt trăng của tàu Apollo năm 1969 bằng ngôn ngữ hợp ngữ (assembly). Hình ảnh là bản in chương trình hợp ngữ hoàn chỉnh của bà cho tàu Apollo 11
Công việc sau này thực sự là “khoa học tên lửa” (rocket science), và yêu cầu bà phải tạo ra lĩnh vực kỹ thuật phần mềm (software engineering) hiện đại trong khi tìm kiếm các phương pháp để làm cho đoạn mã cực kỳ quan trọng này trở nên chính xác hơn.
Vào năm 1965, Gordon Moore, CEO của Intel, đã đưa ra một quan sát mà từ đó được gọi là Định luật Moore. Định luật này nói rằng tốc độ của máy tính hoặc số lượng bóng bán dẫn trên mỗi đơn vị diện tích sẽ tăng gấp đôi sau mỗi 18 tháng hoặc 2 năm.
1970 và IC
Công nghệ IC cho phép các mạch điện dựa trên bóng bán dẫn được thu nhỏ lại, sao cho cùng một hệ thống dây điện từng lấp đầy một tủ rack những năm 1960 giờ đây có thể nằm gọn trên một “chip” silicon kích thước bằng móng tay. Từ góc nhìn kiến trúc, các con chip không có gì quá kỳ lạ, nếu bạn lấy sơ đồ đi dây của một chiếc máy bóng đèn chân không những năm 1940 và thu nhỏ nó lại, bạn sẽ có một con chip.
Nếu nhìn chip qua kính hiển vi, bạn sẽ thấy các mô hình đi dây tương tự như dây điện ở mặt sau của các tủ rack những năm 1940, 1950 hoặc 1960. Chip silicon sau đó được “đóng gói” bên trong một khối nhựa thường có màu đen lớn hơn, với các chân kim loại lớn kết nối các đầu vào và đầu ra tinh vi của chip với thế giới bên ngoài, thường là một bảng mạch in.
1980
Những năm 1980 là thời hoàng kim của kiến trúc máy tính: lần đầu tiên, máy tính điện tử trở nên đủ rẻ và nhỏ để được sản xuất hàng loạt và được những người bình thường mua về sử dụng tại nhà.
Chiếc IBM 5150 PC ra mắt vào năm 1981, dựa trên chip Intel 8088. IBM và các công ty khác đã bán chiếc máy này cũng như các máy PC khác trong suốt những năm 1980 để sử dụng trong các văn phòng kinh doanh.
Khái niệm PC (Personal Computer) là thái cực đối lập với thị trường máy tính gia đình đa dạng và thiên về kiến trúc vì hai lý do.
Thứ nhất, nó thực thi một kiến trúc chuẩn hóa trên các thành phần máy tính để nhiều nhà sản xuất có thể sản xuất chúng tương thích với nhau.
Thứ hai, nó bao bọc tất cả phần cứng dưới một hệ điều hành nghiêm ngặt, kiểm soát mọi quyền truy cập vào phần cứng thông qua một giao diện tiêu chuẩn. IBM có thể sử dụng ảnh hưởng thị trường của mình để áp đặt các tiêu chuẩn lên linh kiện, nhờ đó họ có thể mua chúng từ những nhà cung cấp rẻ nhất và kiếm tiền bằng cách đóng dấu thương hiệu của mình lên những chiếc PC đã lắp ráp.
Để phản ứng lại các hệ điều hành độc quyền đang được cài đặt trên PC và các máy tính lớn hơn, dự án GNU và phong trào Phần mềm Tự do đã được Richard Stallman tạo ra trong thập kỷ này, điều này sau đó đã dẫn đến các hệ thống và triết lý dựa trên Linux mà chúng ta sử dụng ngày nay.
1990
Kiến trúc máy tính bị thống trị bởi kiến trúc tiêu chuẩn của máy tính cá nhân (PC), vốn đã được sử dụng trong tin học văn phòng những năm 1980 nhưng giờ đây được các tập đoàn PC đẩy mạnh khắp nơi, kể cả trong gia đình và trường học. Các hệ điều hành mã nguồn đóng được bán kèm như một phần của gói PC. Trong thời gian này, các trường học đã ngừng dạy khoa học máy tính và tập trung dạy cách sử dụng phần mềm văn phòng thương mại.
Chuyển từ việc coi đối tượng người dùng là lập trình viên và thành viên cộng đồng công nghệ sang coi người dùng là khách hàng và người tiêu dùng các sản phẩm phần mềm, chẳng hạn như trình xử lý văn bản và bảng tính (VD: Word, Excel, …)
Như định luật Moore đã dự đoán một cách đáng tin cậy, tốc độ bộ vi xử lý tăng gấp đôi sau mỗi 18 tháng. World Wide Web chính thức hoạt động tại CERN vào năm 1990 và phát triển phổ biến, dẫn đến cơn sốt đầu tư dot-com vào cuối thập kỷ. Khi có nhiều hacker và cuối cùng là người tiêu dùng tham gia vào web, các thiết kế máy tính máy chủ gắn trên giá đỡ (rack-mounted server) chuyên dụng đã trở nên phổ biến, bắt đầu với Compaq ProLiant vào năm 1993. Giống như Manchester Baby và các máy tính mini những năm 1960, chúng được thiết kế để xếp chồng trong các đơn vị giá đỡ 19 inch, nhưng hoạt động liên tục với độ tin cậy cao. -> xuất hiện định nghĩa về server
Những năm 2000, 2010 và Sự kết thúc của Định luật Moore
Kiến trúc PC gồm các linh kiện hàng hóa kết hợp với hệ điều hành vẫn tiếp tục duy trì trong suốt những năm 2000. Định luật Moore, và hệ quả là việc lắp ráp hoặc mua một chiếc máy tính mới có tốc độ gấp đôi sau mỗi vài năm, vẫn tiếp diễn. Các máy móc sử dụng cùng một thiết kế máy tính PC cơ bản, với các giao diện và thành phần khác nhau được nâng cấp về tốc độ. Tốc độ internet cũng tăng lên, cho phép truyền phát video cũng như chuyển văn bản và hình ảnh.
Trong những năm 1990 và 2000, giả định rằng tốc độ xung nhịp của các bộ vi xử lý sẽ tăng gấp đôi sau mỗi vài năm, và thực tế là như vậy. Định luật Moore trở thành một lời tiên tri tự ứng nghiệm khi các nhà sản xuất chip ở Thung lũng Silicon sử dụng nó như một mục tiêu cần đạt được.
Tuy nhiên, tất cả đã sụp đổ vào những năm 2010. Công nghệ sản xuất bóng bán dẫn thực sự vẫn tiếp tục tăng gấp đôi số lượng bóng bán dẫn trên mỗi đơn vị diện tích, nhưng tốc độ xung nhịp đã đạt mức tối đa vào năm 2010, ở khoảng 3.5 GHz.
Đột nhiên, các bộ vi xử lý không còn nhanh hơn nữa. Điều này là do các định luật vật lý cơ bản xung quanh tốc độ tính toán và nhiệt lượng. Trong thời kỳ định luật Moore, nhiệt độ của các bộ vi xử lý cũng tăng lên cùng với tốc độ; cần có các quạt lớn hơn, mạnh hơn và các hệ thống làm mát khác như làm mát bằng chất lỏng. Các bóng bán dẫn nhỏ đi, nhưng các cánh quạt lại to ra. Nếu xu hướng này tiếp tục qua những năm 2010, giờ đây chúng ta sẽ có những bộ vi xử lý nóng hơn cả bề mặt mặt trời.
Một khái niệm liên quan chặt chẽ là mức tiêu thụ điện năng. Khi các con chip tỏa nhiều nhiệt hơn, chúng tiêu thụ nhiều điện hơn, và thập kỷ này cũng chứng kiến sự khởi đầu của một nỗ lực hướng tới tính toán năng lượng thấp, di động hơn, đặc biệt là dưới dạng điện thoại thông minh.
Trong khi hai thập kỷ trước đó chứng kiến kiến trúc máy tính trì trệ như một lĩnh vực nghiên cứu, chỉ dựa vào những tiến bộ trong công nghệ chế tạo để tạo ra các lợi ích định kỳ, thì giờ đây lĩnh vực này lại mở rộng trở lại cho những ý tưởng hoàn toàn mới.
Chúng ta không thể làm máy tính nhanh hơn thông qua dạng “tốc độ” của định luật Moore, nhưng chúng ta vẫn có thể nhồi nhét ngày càng nhiều bóng bán dẫn lên chip với dạng “mật độ” của nó. Giờ đây, chúng ta có thể xem xét việc làm cho mọi thứ trở nên song song (parallel), thực hiện nhiều thao tác cùng một lúc thay vì từng cái một.
Trong khi vẫn còn nhiều kiến trúc song song cần được khám phá, những năm 2010 đã chứng kiến ba loại kiến trúc song song chính thành công trong thế giới thực.
Đa nhân (Multicore): Đây là các con chip được sản xuất để chứa nhiều bản sao của một thiết kế CPU. Thập kỷ này bắt đầu với các hệ thống lõi kép (duo-core) và tiến triển qua lõi tứ (quad), tám (eight) và thậm chí nhiều lõi hơn.
Điện toán cụm (Cluster computing): Một dạng song song hóa trong đó nhiều máy đơn nhân hoặc đa nhân thông thường được liên kết yếu với nhau. Công việc tính toán được chia thành nhiều phần độc lập có thể gán cho mỗi máy. Phương pháp này đặc biệt hữu ích cho các tác vụ “dữ liệu lớn” theo mô hình map-reduce.
Xử lý đồ họa (GPU): Sự phát triển của các card đồ họa (đơn vị xử lý đồ họa – GPU) thành các thiết bị tính toán song song đa năng. Khái niệm này hiện đang liên tục phát triển thành nhiều kiến trúc mới lạ, chẳng hạn như các chip được quảng cáo phục vụ cho A.I (NPU/TPU) gần đây được tìm thấy trên điện thoại di động.
2020, Cloud/IoT
Internet Vạn vật (IoT): Các thiết bị ngày càng nhỏ và rẻ sẽ được nhúng vào ngày càng nhiều vật thể trong thế giới thực. Từ “thành phố thông minh” giám sát giao thông đến “nhà máy thông minh” theo dõi từng món hàng. Tủ lạnh của bạn sẽ tự nhận biết khi nào sắp hết pho mát và tự động đặt hàng ở siêu thị.
Điện toán Đám mây (Cloud Computing): Ngược lại với xu hướng trên, các thiết bị IoT năng lượng thấp sẽ không tính toán nhiều mà chủ yếu để thu thập dữ liệu. Dữ liệu này sau đó sẽ được xử lý ở quy mô khổng lồ trong các trung tâm tính toán chuyên dụng: những tòa nhà có kích thước bằng kho hàng chứa đầy năng lượng tính toán.
Xu hướng cho thấy rõ các tài nguyên nghiên cứu đổ vào để tạo ra các sản phẩm nhỏ nhất, dùng ít năng lượng nhất, hiệu quả hơn (như điện thoại thông minh, tivi thông minh, tủ lạnh thông minh, máy giặt thông minh, ….) , hoặc ngược hẳn lại, là tạo ra những thứ mạnh nhất, to nhất (các hệ thống datacenter, server khổng lồ), và hiếm có đầu tư cho vùng ở giữa.
Khái niệm tính toán hiện đại đã được Church định nghĩa. Các máy điện tử thương mại của những năm 1950, bắt đầu với UNIVAC, qua các máy tính mini những năm 1960 và vi mạch những năm 1970 cho đến ngày nay dường như có thể được nhận diện rõ ràng là máy tính. Nhưng liệu có bất cứ thứ gì trước đó nên được công nhận là “chiếc máy tính đầu tiên”?
Manchester Baby là một máy tính Church nếu chấp nhận rằng nó có thể được cấp bộ nhớ vô hạn, dù cách làm không rõ ràng.
ENIAC có tiềm năng là máy tính Church nếu được lập trình theo cách máy ảo (VM), nhưng nó vẫn là kiến trúc Harvard.
Zuse Z3, Colossus, hay Máy Phân tích của Babbage đều có thể đạt được trạng thái này về mặt lý thuyết.
IBM đã thực hiện phân tích dữ liệu lớn từ những năm 1890, nhưng phân tích dữ liệu không phải là tính toán Church tổng quát trừ khi bạn tìm ra cách biến mọi vấn đề thành một truy vấn SQL.
Có lẽ con người đã tính toán từ năm 40.000 TCN với bàn tính, xương, đá và các con số trong đầu. Tất cả những thứ trên về mặt lý thuyết đều là máy tính Church vì chúng có thể mô phỏng bất kỳ cỗ máy nào nếu được lập trình theo một cách nhất định. Vì vậy, có lẽ chúng ta đã luôn có máy tính — và Church chỉ là người đầu tiên nhận ra chúng.
Tham khảo:
Computer Architecture (Charles Fox)
Kiến trúc máy tính (Wikipedia)
Parallel and High Performance Computing (Yuliana Zamora, Robert Robey)
Ngôn ngữ C mang lại nhiều quyền kiểm soát hơn đối với cách chương trình sử dụng bộ nhớ của máy tính.
Mã C bao gồm các con trỏ
Con trỏ là một trong những thứ cơ bản nhất cần hiểu trong ngôn ngữ lập trình C. Vậy con trỏ là gì? Một con trỏ chỉ đơn giản là địa chỉ của một mẩu dữ liệu trong bộ nhớ.
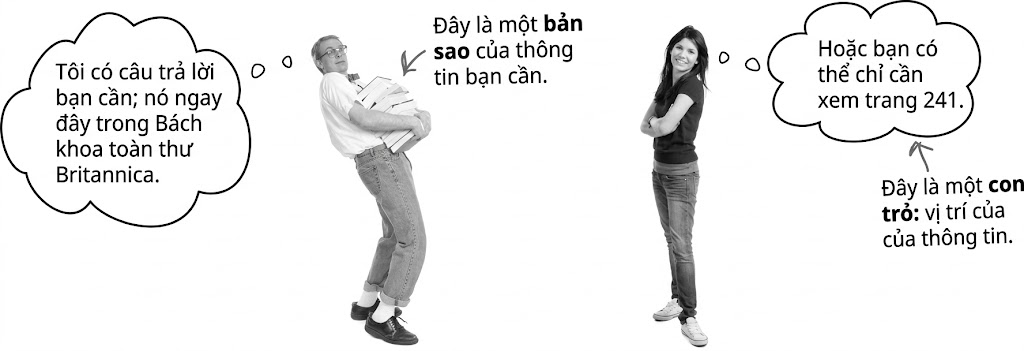
1 – Thay vì truyền đi toàn bộ một bản sao của dữ liệu, bạn chỉ cần truyền một con trỏ.
Hãy tưởng tượng bạn có một cuốn bách khoa toàn thư dày 10.000 trang. Một người bạn muốn mượn nó để tra cứu.
Không dùng con trỏ (Truyền bản sao): Bạn phải đi photocopy toàn bộ 10.000 trang đó và đưa cho bạn của bạn. Quá trình này tốn cực kỳ nhiều thời gian, công sức và tốn thêm một không gian khổng lồ để chứa bộ copy đó.
Dùng con trỏ: Bạn chỉ cần viết số giá sách (địa chỉ) lên một tờ giấy note nhỏ xíu và đưa cho người bạn: “Nó ở ngăn số 3, kệ số 5 nhé”. Nhanh, gọn, lẹ.
Trong C, nếu bạn có một cục dữ liệu rất lớn (như một struct chứa hàng ngàn thông tin), việc copy nó mỗi lần gọi hàm sẽ làm chậm chương trình của bạn.
C
#include<stdio.h>// Một cục dữ liệu khổng lồ (Giống như cuốn sách 10.000 trang)struct DuLieuKhongLo {int mang[10000];};// CÁCH 1: KHÔNG DÙNG CON TRỎ (Truyền bản sao - Chậm, tốn bộ nhớ)// Máy tính phải copy toàn bộ 10.000 phần tử vào một biến 'ban_sao' mớivoidXuLyBanSao(struct DuLieuKhongLo ban_sao){printf("Đang xử lý bản sao...\n");}// CÁCH 2: DÙNG CON TRỎ (Truyền địa chỉ - Nhanh, nhẹ)// Máy tính chỉ cần truyền 1 địa chỉ duy nhất (như tờ giấy note)voidXuLyConTro(struct DuLieuKhongLo *dia_chi_du_lieu){printf("Đang xử lý trực tiếp từ địa chỉ...\n");}intmain(){struct DuLieuKhongLo du_lieu_cua_toi;// Gọi hàm cách 2 sẽ chạy nhanh hơn rất nhiều!XuLyConTro(&du_lieu_cua_toi);return0;}
2 – Bạn có thể muốn hai đoạn mã cùng hoạt động trên cùng một mẩu dữ liệu thay vì trên một bản sao tách biệt.
Không dùng con trỏ (Làm việc trên bản sao): Bạn tải một file Word báo cáo về máy tính và gửi qua email cho sếp. Sếp sửa lỗi chính tả trên file của sếp. Sửa xong, file trên máy bạn không hề thay đổi vì sếp đang sửa trên bản copy của sếp.
Dùng con trỏ: Bạn tạo một link Google Docs và gửi cho sếp (link này chính là con trỏ). Cả bạn và sếp đều đang nhìn vào và chỉnh sửa trên cùng một tài liệu duy nhất. Sếp gõ chữ nào, bạn thấy chữ đó.
Con trỏ giúp bạn làm cả hai việc này: tránh việc tạo bản sao và chia sẻ dữ liệu.
Bộ nhớ
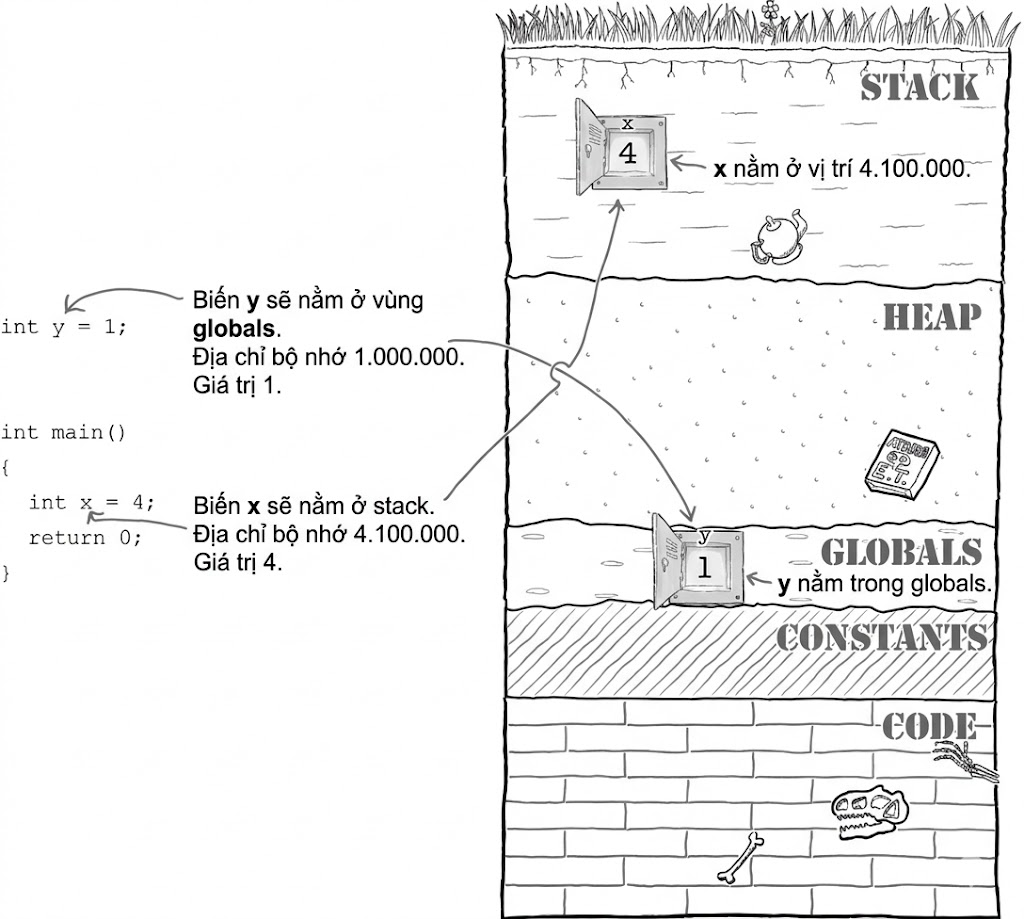
Mỗi khi bạn khai báo một biến, máy tính sẽ tạo ra không gian cho nó ở một nơi nào đó trong bộ nhớ. Nếu bạn khai báo một biến bên trong một hàm như main(), máy tính sẽ lưu trữ nó trong một khu vực của bộ nhớ được gọi là stack (ngăn xếp). Nếu một biến được khai báo bên ngoài bất kỳ hàm nào, nó sẽ được lưu trữ trong phần globals (toàn cục) của bộ nhớ.
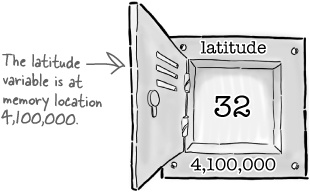
Máy tính có thể cấp phát, giả sử, vị trí bộ nhớ số 4.100.000 trong ngăn xếp (stack) cho biến x. Nếu bạn gán số 4 cho biến đó, máy tính sẽ lưu số 4 tại vị trí 4.100.000.
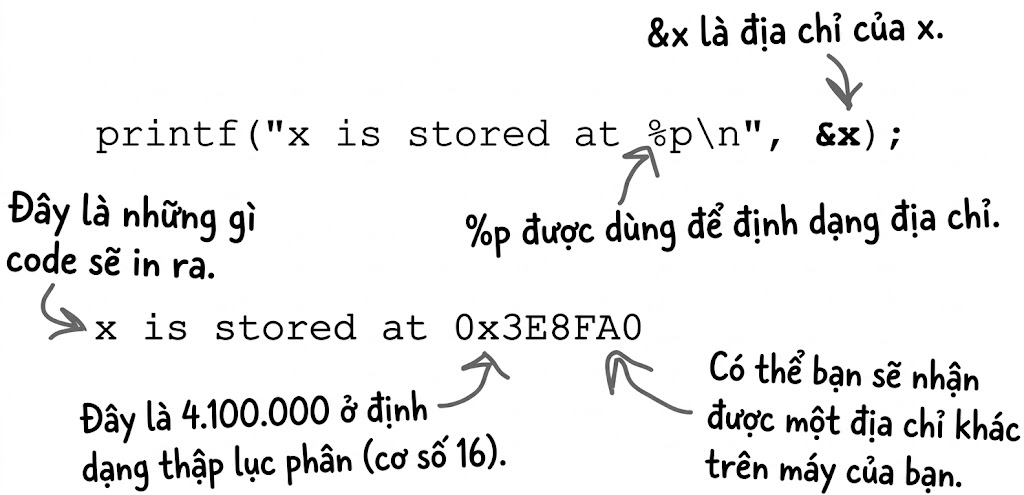
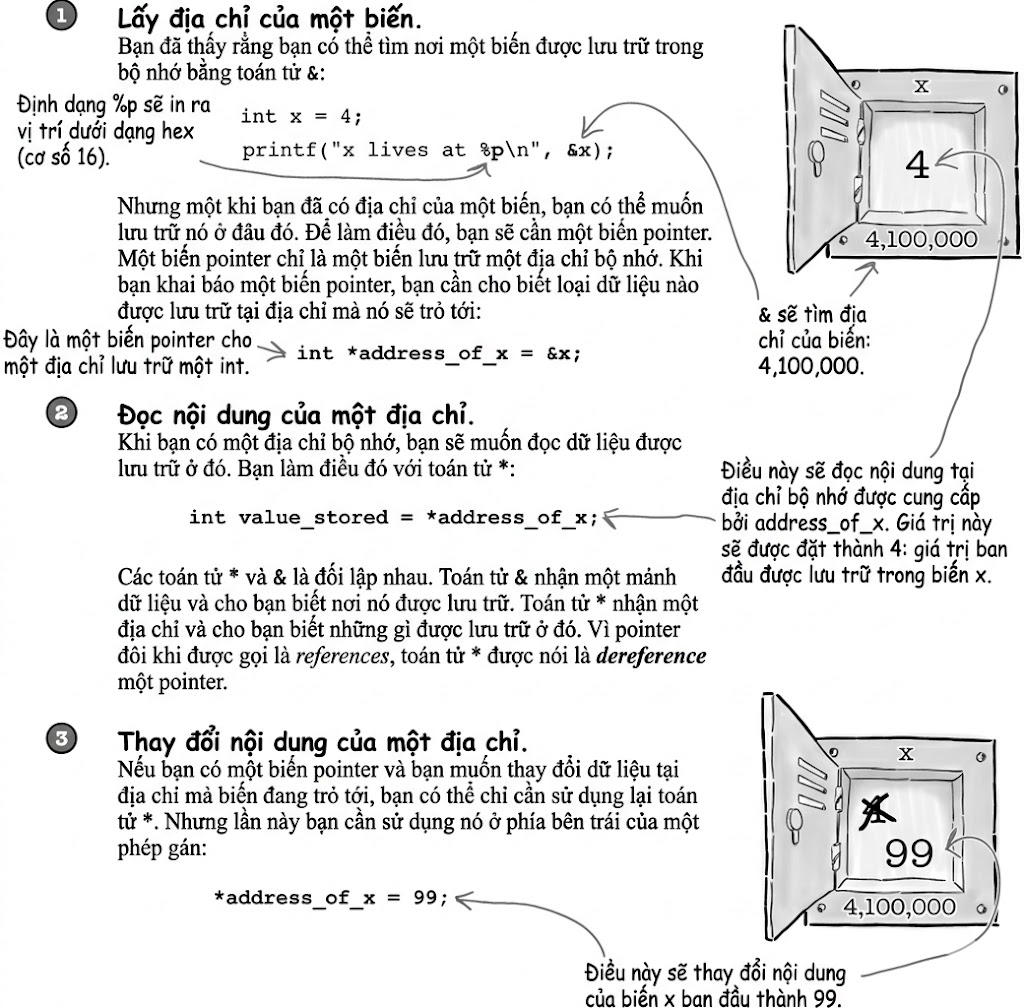
Nếu bạn muốn tìm ra địa chỉ bộ nhớ của biến, bạn có thể sử dụng toán tử &:
Địa chỉ của biến cho bạn biết nơi để tìm thấy biến đó trong bộ nhớ. Đó là lý do tại sao một địa chỉ cũng được gọi là một con trỏ, bởi vì nó trỏ tới biến đó trong bộ nhớ.
Vấn đề khi truyền tham số bằng giá trị
Hãy tưởng tượng bạn đang viết một trò chơi trong đó người chơi phải tìm đường di chuyển xung quanh…
Trò chơi sẽ cần kiểm soát rất nhiều thứ, như điểm số, mạng sống và vị trí hiện tại của người chơi. Bạn sẽ không muốn viết trò chơi thành một khối mã nguồn khổng lồ; thay vào đó, bạn sẽ tạo ra nhiều hàm nhỏ hơn, mỗi hàm sẽ thực hiện một việc gì đó hữu ích trong trò chơi:
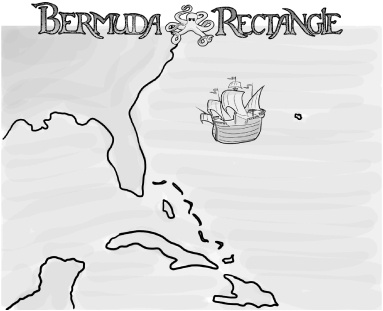
Tất cả những điều này thì có liên quan gì đến con trỏ? Hãy bắt đầu viết mã mà không cần lo lắng chút nào về con trỏ cả. Bạn cứ việc sử dụng các biến như bạn vẫn thường làm. Một phần chính của trò chơi sẽ là điều hướng con tàu của bạn xung quanh Hình chữ nhật Bermuda, vì vậy hãy đi sâu hơn vào việc mã nguồn sẽ cần làm gì trong một trong các hàm điều hướng.
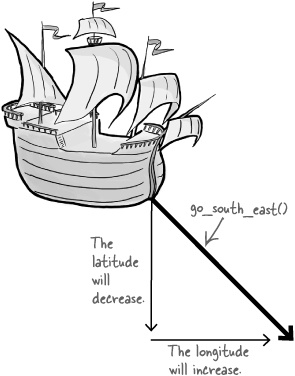
Trò chơi sẽ theo dõi vị trí của người chơi bằng cách sử dụng vĩ độ (latitudes) và kinh độ (longitudes). Vĩ độ là khoảng cách người chơi ở về phía Bắc hay Nam, còn kinh độ là vị trí của họ ở phía Đông hay Tây. Nếu một người chơi muốn đi về phía Đông Nam, điều đó có nghĩa là vĩ độ của họ sẽ giảm xuống, và kinh độ của họ sẽ tăng lên:
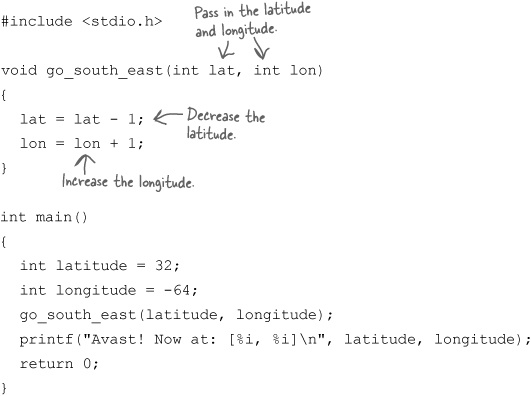
Vì vậy, bạn có thể viết một hàm go_south_east() nhận các đối số cho vĩ độ và kinh độ, sau đó nó sẽ tăng và giảm (các giá trị này):
Chương trình bắt đầu đặt một con tàu ở vị trí [32, –64], vì vậy nếu nó đi về hướng Đông Nam, vị trí mới của con tàu sẽ là [31, –63].
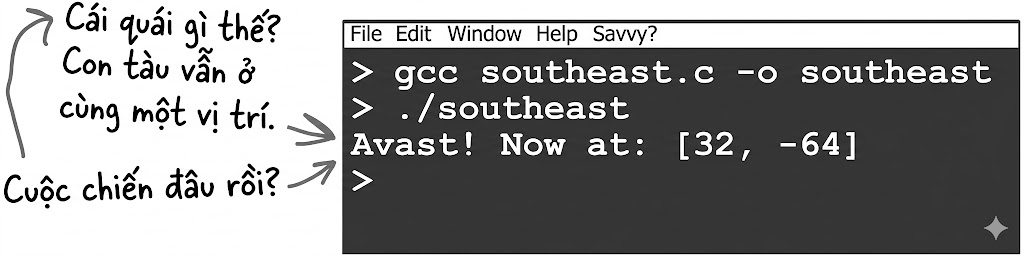
Mã nguồn đáng lẽ phải di chuyển con tàu về phía Đông Nam từ [32, –64] đến vị trí mới tại [31, –63]. Nhưng nếu bạn biên dịch và chạy chương trình, điều này sẽ xảy ra:
Vị trí của con tàu vẫn giữ nguyên chính xác như trước.
C truyền các đối số dưới dạng giá trị
Đoạn mã đã bị lỗi do cách mà ngôn ngữ C gọi hàm.
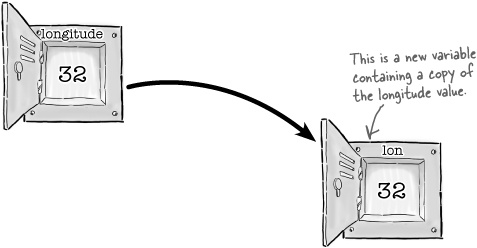
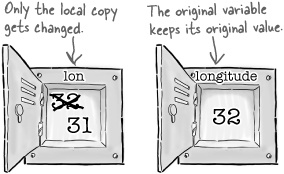
Ban đầu, hàm main() có một biến cục bộ tên là longitude chứa giá trị 32.
Khi máy tính gọi hàm go_south_east(), nó sao chép giá trị của biến longitude sang đối số lon. Đây thực chất chỉ là một phép gán từ biến longitude sang biến lon. Khi bạn gọi một hàm, bạn không truyền bản thân biến đó làm đối số, mà chỉ truyền giá trị của nó.
Khi hàm go_south_east() thay đổi giá trị của lon, hàm này chỉ đang thay đổi bản sao cục bộ của chính nó. Điều đó có nghĩa là khi máy tính quay trở lại hàm main(), biến longitude vẫn giữ giá trị ban đầu của nó là 32.
Nhưng nếu đó là cách C gọi hàm, thì làm sao bạn có thể viết được một hàm có khả năng cập nhật một biến?
Sẽ rất dễ dàng nếu bạn sử dụng con trỏ…
Hãy thử truyền một con trỏ trỏ tới biến
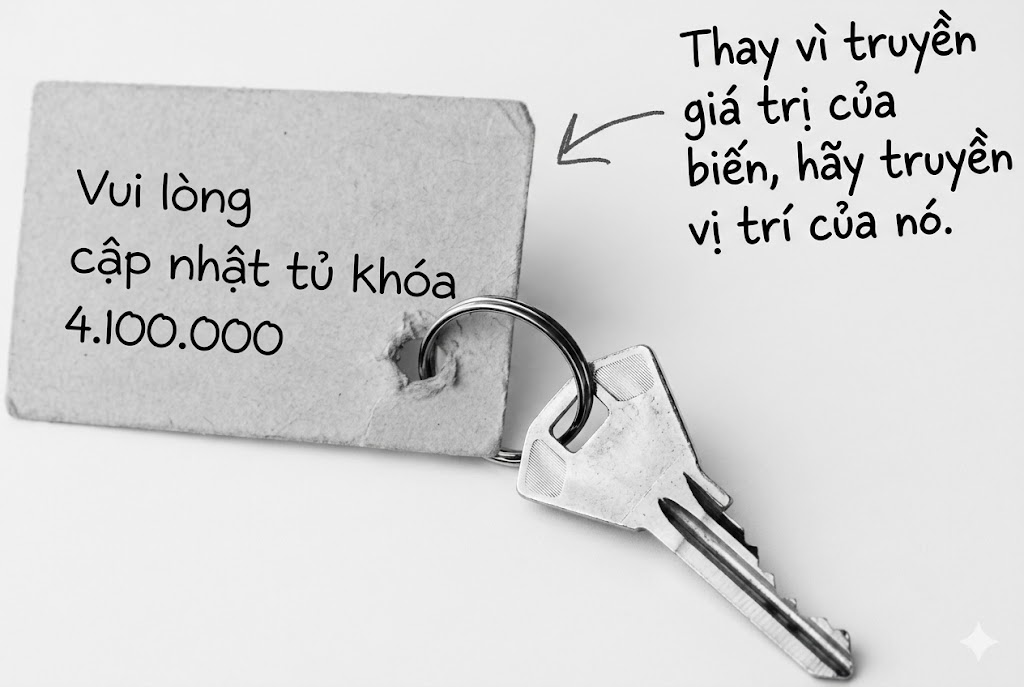
Thay vì truyền giá trị của các biến vĩ độ và kinh độ, điều gì sẽ xảy ra nếu bạn truyền địa chỉ của chúng? Nếu biến kinh độ (longitude) nằm trong bộ nhớ ngăn xếp (stack) tại vị trí 4.100.000, điều gì sẽ xảy ra nếu bạn truyền số vị trí 4.100.000 làm tham số cho hàm go_south_east()?
Nếu hàm go_south_east() được báo cho biết rằng giá trị vĩ độ (latitude) nằm ở vị trí 4.100.000, thì nó sẽ không chỉ có thể tìm thấy giá trị vĩ độ hiện tại, mà còn có thể thay đổi nội dung của biến vĩ độ gốc. Tất cả những gì hàm cần làm là đọc và cập nhật nội dung của vị trí bộ nhớ 4.100.000.
Bởi vì hàm go_south_east() đang cập nhật trực tiếp biến vĩ độ gốc, máy tính sẽ có thể in ra vị trí đã được cập nhật khi nó quay trở lại hàm main().
Hỏi: Tôi đã in vị trí của biến trên máy của mình và nó không phải là 4.100.000. Tôi có làm gì sai không?
Đáp: Bạn không làm gì sai cả. Vị trí bộ nhớ mà chương trình của bạn sử dụng cho các biến sẽ khác nhau từ máy này sang máy khác.
Hỏi: Tại sao các biến cục bộ được lưu trữ trong ngăn xếp (stack) và các biến toàn cục (globals) được lưu trữ ở một nơi khác?
Đáp: Các biến cục bộ và toàn cục được sử dụng theo những cách khác nhau. Bạn sẽ luôn chỉ có một bản sao duy nhất của một biến toàn cục, nhưng nếu bạn viết một hàm tự gọi chính nó (đệ quy), bạn có thể nhận được rất nhiều phiên bản của cùng một biến cục bộ.
Con trỏ giúp việc chia sẻ bộ nhớ dễ dàng hơn
Đây là một trong những lý do chính để sử dụng con trỏ, nhằm cho phép các hàm chia sẻ bộ nhớ. Dữ liệu được tạo ra bởi một hàm có thể được sửa đổi bởi một hàm khác, miễn là nó biết nơi để tìm thấy dữ liệu đó trong bộ nhớ.
Những điểm chính
Các biến được cấp phát không gian lưu trữ trong bộ nhớ.
Các biến cục bộ tồn tại trong ngăn xếp / stack.
Các biến toàn cục tồn tại trong khu vực toàn cục / globals.
Con trỏ chỉ là các biến lưu trữ các địa chỉ bộ nhớ.
Toán tử & tìm địa chỉ của một biến.)
Toán tử * có thể đọc nội dung của một địa chỉ bộ nhớ.
Toán tử * cũng có thể thiết lập / thay đổi nội dung của một địa chỉ bộ nhớ.
Hỏi: Các con trỏ (pointers) có phải là địa chỉ vật lý thực sự trên chip RAM không?
Đáp: Không hoàn toàn. Con trỏ lưu trữ địa chỉ ảo (virtual address) thuộc không gian địa chỉ (address space) của một tiến trình (process). Đối với tiến trình đó, đây là địa chỉ “thực”, nhưng nó không trỏ trực tiếp đến vị trí vật lý trên chip RAM.
Hỏi: “Không gian địa chỉ ảo” có nghĩa là gì?
Đáp: Hệ điều hành (OS) cung cấp cho mỗi tiến trình một lớp trừu tượng (abstraction layer). Tiến trình nhìn thấy bộ nhớ như một dải ô nhớ tuyến tính, liên tục, đánh số từ 0 đến N. Điều này giúp lập trình viên không phải quản lý việc tranh chấp bộ nhớ với các tiến trình khác đang chạy song song. VD: Discord và Zalo đều cùng chạy trên máy bạn, 2 tiến trình không cần lo về việc Discord cũng muốn lưu biến “tên người dùng” ở ô nhớ 1000, Zalo cũng muốn lưu “danh bạ” ở ô nhớ 1000. Thực tế hệ điều hành sẽ cấp phát cho tiến trình 1 mã khác, ví dụ Hà Nội và Bắc Ninh có 1 số tên đường giống nhau, còn bên dưới trên đường đó nhà số 1 đường Quang Trung ở Bắc Ninh không phải nhà số 1 đường Quang Trung ở Hà Nội. Việc quản lý đó là nội bộ trong tiến trình
Hỏi: Tại sao bộ nhớ thực tế lại không giống như vậy?
Đáp: Bộ nhớ vật lý (RAM) được quản lý theo các đơn vị gọi là khung trang (page frames). Một dữ liệu mà bạn thấy là “liên tục” trong bộ nhớ ảo có thể bị chia nhỏ và nằm rải rác ở nhiều vị trí khác nhau trên RAM vật lý. Việc tách biệt này cho phép Hệ điều hành thực hiện các kỹ thuật: Paging (Phân trang): Di chuyển các phần bộ nhớ ít dùng từ RAM xuống ổ cứng (Swap/Pagefile) để giải phóng không gian. Memory Protection (Bảo vệ bộ nhớ): Ngăn chặn tiến trình này truy cập trái phép vào dữ liệu của tiến trình khác. Relocation (Tái định vị): Di chuyển dữ liệu trong RAM mà không làm thay đổi giá trị của con trỏ trong chương trình.
Cơ chế nào chuyển đổi từ “địa chỉ ảo” trong con trỏ sang “địa chỉ vật lý”?
Đó là nhiệm vụ của MMU (Memory Management Unit) – một thành phần phần cứng trong CPU – kết hợp với Page Tables (Bảng trang) do Hệ điều hành quản lý. Mỗi khi bạn truy xuất một con trỏ, MMU sẽ tra cứu bảng này để tìm ra địa chỉ vật lý tương ứng trên RAM.
Cấu trúc vật lý của RAM phức tạp như thế nào?
Ở cấp độ phần cứng, RAM được tổ chức thành các Channels (Kênh), Ranks, và Banks. Dữ liệu được truy xuất thông qua các tín hiệu điện dựa trên địa chỉ dòng (Row) và cột (Column). Ngoài ra, các kiến trúc hiện đại như NUMA (Non-Uniform Memory Access) còn khiến tốc độ truy cập bộ nhớ khác nhau tùy thuộc vào khoảng cách vật lý giữa CPU và các thanh RAM.
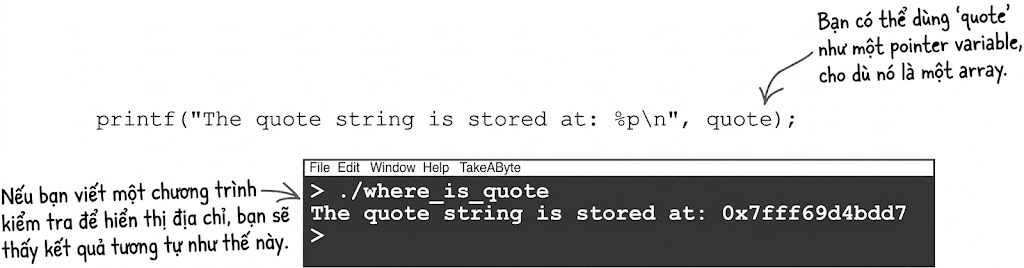
Hỏi: Tại sao tôi phải in các con trỏ ra bằng cách sử dụng chuỗi định dạng %p?
Đáp: Bạn không bắt buộc phải sử dụng chuỗi %p. Trên hầu hết các cỗ máy hiện đại, bạn có thể sử dụng %li (long integer), mặc dù trình biên dịch có thể đưa ra cho bạn một cảnh báo nếu bạn làm vậy.
Hỏi: Tại sao định dạng %p lại hiển thị địa chỉ bộ nhớ ở định dạng hex (thập lục phân)?
Đáp: Đó là cách các kỹ sư thường dùng để nhắc tới các địa chỉ bộ nhớ.
Truyền String vào hàm
Bạn đã biết cách truyền các giá trị đơn giản làm đối số (arguments) cho hàm, nhưng chuyện gì sẽ xảy ra nếu bạn muốn gửi một thứ gì đó phức tạp hơn vào hàm, chẳng hạn như một chuỗi (string)?
Chuỗi trong C thực chất là các mảng ký tự (arrays of characters). Điều đó có nghĩa là nếu bạn muốn truyền một chuỗi vào hàm, bạn có thể làm như thế này:
Đối số msg được định nghĩa giống như một mảng, nhưng vì bạn sẽ không biết trước chuỗi đó dài bao nhiêu, nên đối số msg không bao gồm độ dài cụ thể. Điều này trông có vẻ đơn giản và dễ hiểu, nhưng có một điều hơi kỳ lạ đang diễn ra…
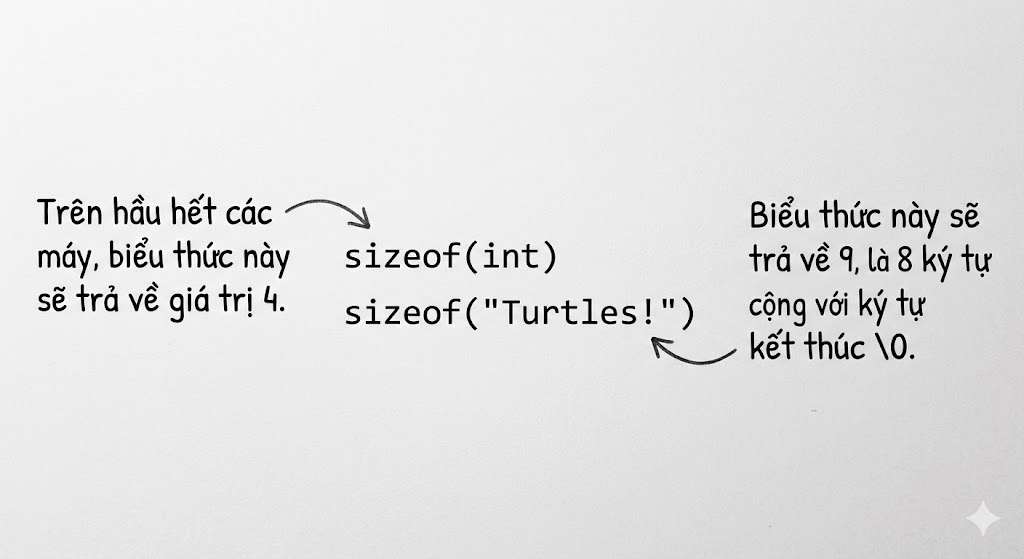
C có một toán tử (operator) gọi là sizeof, nó có thể cho bạn biết một thứ gì đó chiếm bao nhiêu byte không gian trong bộ nhớ. Bạn có thể gọi toán tử này kèm với một kiểu dữ liệu (data type) hoặc với một đoạn dữ liệu cụ thể:
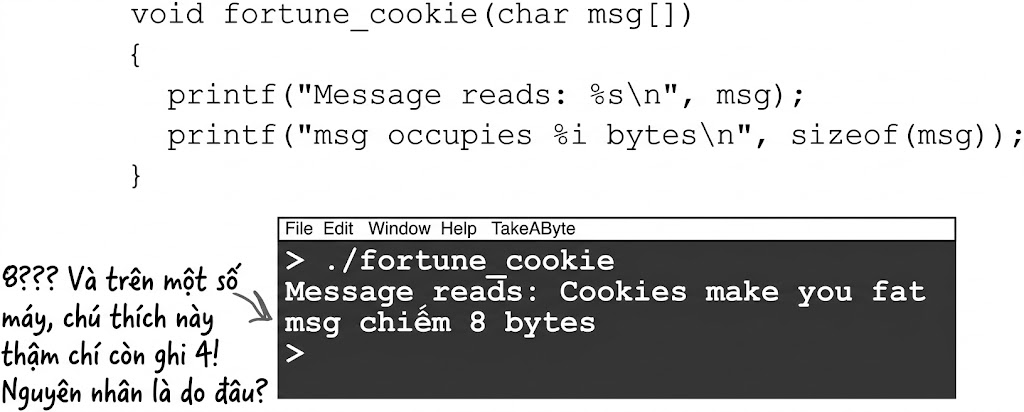
Nhưng một điều kỳ lạ sẽ xảy ra nếu bạn nhìn vào độ dài của chuỗi mà bạn đã truyền vào hàm:
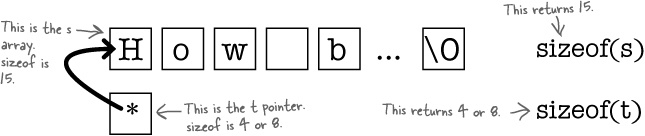
Thay vì hiển thị toàn bộ chiều dài thực tế của chuỗi, đoạn mã chỉ trả về 4 hoặc 8 byte. Chuyện gì đã xảy ra vậy? Tại sao nó lại nghĩ rằng chuỗi chúng ta truyền vào lại ngắn hơn?
Theo bạn, tại sao sizeof(msg) lại ngắn hơn chiều dài của toàn bộ chuỗi? msg thực chất là gì? Tại sao nó lại trả về các kích thước khác nhau trên các máy tính khác nhau?
Biến mảng (Array variables) giống như con trỏ (pointers)
Khi bạn tạo một mảng, biến mảng đó có thể được sử dụng như một con trỏ trỏ đến vị trí bắt đầu của mảng trong bộ nhớ. Khi C nhìn thấy một dòng mã trong một hàm như thế này:
Máy tính sẽ dành riêng một không gian trên ngăn xếp (stack) cho từng ký tự trong chuỗi, cộng thêm ký tự kết thúc \0. Nhưng nó cũng sẽ liên kết địa chỉ của ký tự đầu tiên với biến quote. Mỗi khi biến quote được sử dụng trong mã, máy tính sẽ thay thế nó bằng địa chỉ của ký tự đầu tiên trong chuỗi. Trên thực tế, biến mảng hoạt động y hệt như một con trỏ:
…vậy hóa ra hàm của chúng ta đã được truyền một con trỏ
Đó chính là lý do tại sao điều kỳ lạ kia lại xảy ra trong đoạn mã fortune_cookie(). Mặc dù trông có vẻ như bạn đang truyền một chuỗi (string) vào hàm fortune_cookie(), nhưng thực tế bạn chỉ đang truyền một con trỏ trỏ đến chuỗi đó mà thôi:
Và đó cũng là lý do tại sao toán tử sizeof lại trả về một kết quả kỳ quặc. Nó chỉ đang trả về kích thước của một con trỏ trỏ đến một chuỗi. Trên các hệ điều hành 32-bit, một con trỏ chiếm 4 byte bộ nhớ, và trên các hệ điều hành 64-bit, một con trỏ chiếm 8 byte.
Hỏi:sizeof có phải là một hàm (function) không?
Đáp: Không, nó là một toán tử (operator).
Hỏi: Sự khác biệt là gì?
Đáp: Một toán tử được trình biên dịch (compiler) biên dịch thành một chuỗi các chỉ thị. Nhưng nếu đoạn mã gọi một hàm, nó phải nhảy đến một phần mã riêng biệt khác. Nó không phải là một hàm vì: Cú pháp: Đối với các biểu thức (expressions), sizeof không bắt buộc phải có dấu ngoặc đơn (ví dụ: sizeof x là hợp lệ). Hàm luôn yêu cầu dấu ngoặc đơn để truyền đối số. Xử lý: Hàm được thực thi bởi CPU khi chương trình đang chạy. sizeof chủ yếu được xử lý bởi trình biên dịch trong quá trình chuyển đổi mã nguồn thành mã máy.
Hỏi: Vậy sizeof được tính toán khi chương trình được biên dịch à?
Đáp: Đúng vậy. Trình biên dịch có thể xác định kích thước không gian lưu trữ ngay tại thời điểm biên dịch (compile time).
Khi bạn viết:
C
int a =10;size_t s =sizeof(a);
Trình biên dịch sẽ thấy a là kiểu int. Nếu trên hệ thống đó int chiếm 4 bytes, trình biên dịch sẽ chuyển mã nguồn trên tương đương với việc bạn viết:
C
int a =10;size_t s =4; // Con số 4 được ghi thẳng vào mã máy
Tại thời điểm biên dịch (Compile-time)
Trong hầu hết các trường hợp, sizeof được tính toán hoàn toàn tại thời điểm biên dịch.
Trình biên dịch kiểm tra kiểu dữ liệu (static type) của toán hạng (operand).
Dựa trên bảng ký hiệu (symbol table) và quy tắc căn chỉnh bộ nhớ (memory alignment) của kiến trúc mục tiêu (ví dụ: x86 hoặc ARM), trình biên dịch xác định số lượng byte mà kiểu dữ liệu đó chiếm dụng.
Trình biên dịch sau đó thay thế toàn bộ biểu thức sizeof(...) bằng một hằng số (constant literal) trong mã máy.
Hệ quả: Không có lệnh gọi hàm (function call), không có việc nhảy địa chỉ bộ nhớ, và không tiêu tốn tài nguyên CPU khi chương trình đang chạy để tính toán giá trị này.
Tại thời điểm thực thi (Runtime) – Ngoại lệ
Có một trường hợp duy nhất sizeof được tính toán khi chương trình đang chạy: Mảng có kích thước thay đổi (Variable Length Array – VLA) trong tiêu chuẩn C99. Khi bạn khai báo int arr[n] với n là một biến, trình biên dịch không thể biết n bằng bao nhiêu cho đến khi chương trình chạy. Lúc này, sizeof(arr) sẽ tạo ra mã máy để tính toán kích thước dựa trên giá trị hiện tại của n.
Hỏi: Tại sao con trỏ lại có kích thước khác nhau trên các máy tính khác nhau?
Đáp: Trên hệ điều hành 32-bit, một địa chỉ bộ nhớ được lưu trữ dưới dạng một số 32-bit. Đó là lý do tại sao nó được gọi là hệ thống 32-bit. 32 bit == 4 byte. Đó cũng là lý do tại sao hệ thống 64-bit lại sử dụng 8 byte để lưu trữ một địa chỉ.
Hỏi: Nếu tôi tạo một biến con trỏ, biến con trỏ đó có nằm trong bộ nhớ không?
Đáp: Có. Biến con trỏ thực chất chỉ là một biến dùng để lưu trữ một con số.
Hỏi: Vậy tôi có thể tìm địa chỉ của một biến con trỏ không?
Đáp: Có — bằng cách sử dụng toán tử &.
Hỏi: Tôi có thể chuyển đổi một con trỏ thành một con số thông thường không?
Đáp: Trên hầu hết các hệ thống là có. Các trình biên dịch C thường làm cho kiểu dữ liệu long có cùng kích thước với một địa chỉ bộ nhớ. Vì vậy, nếu p là một con trỏ và bạn muốn lưu nó vào một biến long tên là a, bạn có thể gõ a = (long)p.
Nhưng biến mảng không hoàn toàn là con trỏ
Mặc dù bạn có thể sử dụng một biến mảng như một con trỏ, nhưng vẫn có một vài điểm khác biệt. Để thấy sự khác biệt này, hãy suy nghĩ về đoạn mã sau:
C
char s[]="How big is it?";char*t = s;
sizeof(một mảng) là… kích thước của một mảng.
Bạn đã thấy rằng sizeof(một con trỏ) trả về giá trị 4 hoặc 8, bởi vì đó là kích thước của con trỏ trên các hệ thống 32-bit và 64-bit. Nhưng nếu bạn gọi sizeof trên một biến mảng, C đủ thông minh để hiểu rằng điều bạn muốn biết là mảng đó lớn cỡ nào trong bộ nhớ.
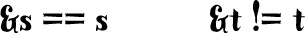
Địa chỉ của mảng… chính là địa chỉ của mảng.
Một biến con trỏ chỉ là một biến lưu trữ một địa chỉ bộ nhớ. Nhưng còn biến mảng thì sao? Nếu bạn sử dụng toán tử & trên một biến mảng, kết quả bằng chính biến mảng đó.
Nếu một lập trình viên viết &s, điều đó có nghĩa là “Địa chỉ của mảng s là gì?”. Địa chỉ của mảng s chỉ đơn giản là… s. Nhưng nếu ai đó viết &t, điều đó có nghĩa là “Địa chỉ của biến t là gì?”.
Một biến mảng không thể trỏ đi nơi khác.
Khi bạn tạo một biến con trỏ, máy tính sẽ cấp phát 4 hoặc 8 byte không gian để lưu trữ nó. Nhưng chuyện gì sẽ xảy ra nếu bạn tạo một mảng? Máy tính sẽ cấp phát không gian để lưu trữ mảng, nhưng nó sẽ không cấp phát bất kỳ bộ nhớ nào để lưu trữ bản thân cái “biến” mảng đó. Trình biên dịch chỉ đơn giản là gắn địa chỉ của phần tử bắt đầu của mảng vào đó.
Nhưng bởi vì các biến mảng không có không gian lưu trữ được cấp phát, điều đó có nghĩa là bạn không thể bắt chúng trỏ vào bất cứ thứ gì khác.
Tại sao mảng thực sự bắt đầu từ 0
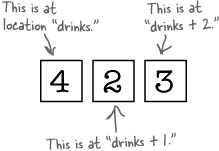
Một biến mảng có thể được sử dụng như một con trỏ trỏ đến phần tử đầu tiên trong một mảng. Điều đó có nghĩa là bạn có thể đọc phần tử đầu tiên của mảng bằng cách sử dụng ký pháp ngoặc vuông hoặc sử dụng toán tử * như thế này:
Nhưng vì một địa chỉ bộ nhớ chỉ là một con số, điều đó có nghĩa là bạn có thể thực hiện phép toán con trỏ (pointer arithmetic) và thực sự cộng thêm các giá trị vào một giá trị con trỏ để tìm địa chỉ tiếp theo. Vì vậy, bạn có thể sử dụng ngoặc vuông để đọc phần tử có chỉ số 2, hoặc bạn chỉ cần cộng 2 vào địa chỉ của phần tử đầu tiên:
Nói chung, hai biểu thức drinks[i] và *(drinks + i) là hoàn toàn tương đương nhau. Đó là lý do tại sao các mảng bắt đầu bằng chỉ số 0. Chỉ số (index) thực chất chỉ là con số được cộng vào con trỏ để tìm vị trí của phần tử đó.
Hỏi: Khi nào C điều chỉnh các tính toán của phép toán con trỏ?
Đáp: Nó xảy ra khi trình biên dịch đang tạo ra tệp thực thi (executable). Nó xem xét kiểu dữ liệu của biến và sau đó nhân các dấu cộng và trừ với kích thước của biến cơ sở. Nếu trình biên dịch thấy rằng bạn đang làm việc với một mảng int và bạn đang cộng 2, trình biên dịch sẽ nhân số đó với 4 (chiều dài của một int) và cộng thêm 8.
Hỏi: C có sử dụng toán tử sizeof khi nó đang điều chỉnh phép toán con trỏ không?
Đáp: Về hiệu quả là có. Toán tử sizeof cũng được giải quyết tại thời điểm biên dịch, và cả sizeof lẫn các phép toán con trỏ sẽ sử dụng cùng các kích thước cho các kiểu dữ liệu khác nhau.
Tại sao con trỏ có kiểu dữ liệu
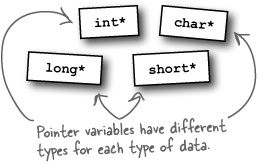
Nếu con trỏ chỉ đơn thuần là các địa chỉ, vậy thì tại sao các biến con trỏ lại cần có kiểu dữ liệu (như int*, char*,…)? Tại sao bạn không thể lưu trữ tất cả các con trỏ vào một loại biến con trỏ chung duy nhất nào đó?
Lý do là vì phép toán con trỏ (pointer arithmetic) rất “láu cá”.
Nếu bạn cộng 1 vào một con trỏ kiểu char, con trỏ đó sẽ trỏ đến ngay địa chỉ bộ nhớ tiếp theo. Nhưng đó là bởi vì một ký tự (char) chỉ chiếm đúng 1 byte bộ nhớ.
Vậy chuyện gì xảy ra nếu bạn có một con trỏ kiểu int? Các số nguyên (int) thường chiếm 4 byte dung lượng, vì vậy nếu bạn cộng 1 vào một con trỏ kiểu int, mã nguồn sau khi biên dịch thực chất sẽ cộng 4 vào địa chỉ bộ nhớ đó.
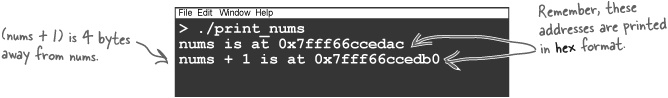
C
int nums[]={1,2,3};printf("nums đang ở địa chỉ %p\n", nums);printf("nums + 1 đang ở địa chỉ %p\n", nums +1);
Nếu bạn chạy đoạn mã này, hai địa chỉ bộ nhớ sẽ cách nhau nhiều hơn một byte. Do đó, các kiểu con trỏ tồn tại để trình biên dịch biết cần phải điều chỉnh bao nhiêu khi thực hiện phép toán con trỏ.
Sử dụng con trỏ để nhập dữ liệu
Cách yêu cầu người dùng nhập một chuỗi ký tự từ bàn phím bằng hàm scanf():
C
char name[40];printf("Nhập tên bạn: ");scanf("%39s", name); // scanf sẽ đọc 39 kí tự cộng thêm string terminator
Hàm scanf() hoạt động như thế nào? Nó nhận vào một con trỏ kiểu char (char*), và trong trường hợp này, bạn đang truyền vào một biến mảng. Đến lúc này, chắc bạn đã lờ mờ hiểu tại sao nó lại nhận một con trỏ rồi chứ? Đó là vì hàm scanf() sẽ cập nhật nội dung của mảng đó. Những hàm cần cập nhật giá trị của một biến thì không cần giá trị của biến đó — chúng cần địa chỉ của nó.
Nhập số bằng scanf() (Entering numbers with scanf())
Vậy làm thế nào để nhập dữ liệu vào một trường số? Bạn thực hiện bằng cách truyền một con trỏ đến một biến số.
C
int age;printf("Nhập tuổi của bạn: ");scanf("%i",&age);
Bởi vì bạn truyền địa chỉ của biến số vào hàm, scanf() có thể cập nhật nội dung của biến đó. Và để giúp bạn, bạn có thể truyền một chuỗi định dạng (format string) chứa các mã định dạng tương tự như loại bạn dùng trong hàm printf(). Bạn thậm chí có thể dùng scanf() để nhập nhiều thông tin cùng lúc:
C
int lanh_su, vi_do;scanf("%i %i",&lanh_su,&vi_do);
Có một… vấn đề nho nhỏ với hàm scanf(). Từ nãy đến giờ, tất cả các đoạn mã bạn viết đều rất cẩn thận đặt giới hạn cho số lượng ký tự mà scanf() sẽ đọc vào:
scanf("%39s", name);
Tại sao lại phải làm vậy? Suy cho cùng, scanf() dùng chung kiểu chuỗi định dạng như printf(), mà khi chúng ta in một chuỗi bằng printf(), ta chỉ dùng %s thôi mà.
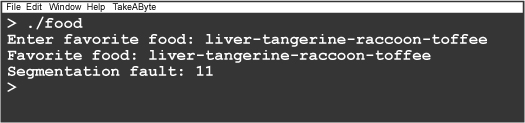
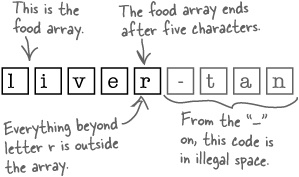
À, nếu bạn chỉ dùng %s trong scanf(), rắc rối sẽ nảy sinh nếu ai đó cao hứng gõ quá nhiều:
Chương trình sẽ bị crash (sập). Lý do là vì scanf() ghi dữ liệu vượt xa khỏi phạm vi bộ nhớ được cấp phát cho mảng food.
scanf() có thể gây ra lỗi tràn bộ đệm (scanf() can cause buffer overflows)
Nếu bạn quên giới hạn độ dài của chuỗi khi đọc bằng scanf(), bất kỳ người dùng nào cũng có thể nhập vào lượng dữ liệu lớn hơn nhiều so với không gian lưu trữ của chương trình. Phần dữ liệu thừa đó sẽ bị ghi đè vào những vùng bộ nhớ vốn không được máy tính cấp phát cho mục đích đó.
Nếu may mắn, dữ liệu đó chỉ đơn giản là được lưu trữ ở đó và không gây ra chuyện gì. Nhưng rất có khả năng lỗi tràn bộ đệm (buffer overflow) sẽ gây ra các lỗi nghiêm trọng (bugs). Nó có thể được gọi là segmentation fault hoặc abort trap, nhưng dù thông báo lỗi hiện ra là gì, kết quả cuối cùng vẫn là chương trình của bạn bị “ngỏm”.
fgets() là một sự thay thế cho scanf()
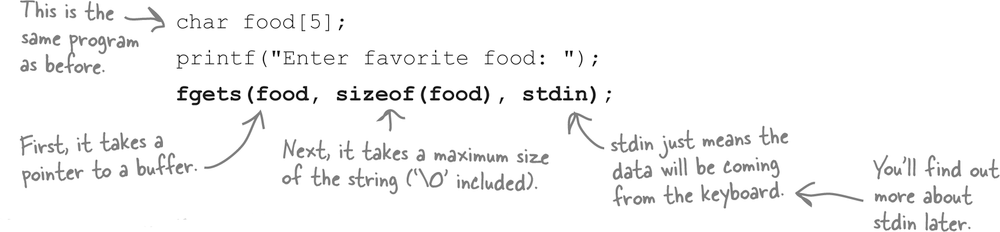
Có một hàm khác mà bạn có thể sử dụng để nhập dữ liệu văn bản: fgets(). Giống như hàm scanf(), nó nhận một con trỏ kiểu char, nhưng không giốngscanf(), hàm fgets() bắt buộc phải được cung cấp độ dài tối đa:
Điều đó có nghĩa là bạn không thể “vô tình” quên thiết lập độ dài khi gọi fgets(); nó nằm ngay trong chữ ký hàm như một đối số bắt buộc. Ngoài ra, hãy lưu ý rằng kích thước bộ đệm của fgets()đã bao gồm cả ký tự kết thúc \0. Vì vậy, bạn không cần phải trừ đi 1 đơn vị độ dài như khi làm với scanf().
Sử dụng sizeof với fgets()
Đoạn mã trên thiết lập độ dài tối đa bằng toán tử sizeof.
sizeof trả về lượng không gian bị chiếm dụng bởi một biến.
Trong đoạn mã trên, food là một biến mảng, vì vậy sizeof trả về kích thước của mảng đó (là 5).
Nếu food chỉ là một biến con trỏ đơn thuần, toán tử sizeof sẽ chỉ trả về kích thước của một con trỏ (thường là 4 hoặc 8 byte tùy hệ điều hành).
Nếu bạn biết chắc mình đang truyền một biến mảng vào hàm fgets(), thì việc dùng sizeof là ổn. Nếu bạn chỉ truyền một con trỏ đơn giản, bạn nên nhập trực tiếp kích thước mà bạn muốn:
C
fgets(con_tro_chuoi,20, stdin);
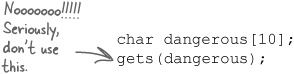
Hàm fgets() thực chất bắt nguồn từ một hàm cũ hơn gọi là gets().
Mặc dù fgets() được xem là hàm an toàn hơn scanf(), sự thật là hàm gets() cũ còn nguy hiểm khủng khiếp hơn cả hai hàm kia cộng lại. Lý do ư? Hàm gets()hoàn toàn không có giới hạn nào cả:
Tiêu chí
scanf()
fgets()
Giới hạn
Có thể giới hạn dữ liệu, miễn là bạn nhớ thêm kích thước vào chuỗi định dạng.
Có giới hạn bắt buộc. Không gì có thể lọt qua được nó.
Nhiều trường
Có! Cho phép nhập nhiều trường dữ liệu có cấu trúc (ví dụ: ngày/tháng/năm).
fgets() chỉ cho phép nhập một chuỗi duy nhất vào bộ đệm.
Khoảng trắng
%s sẽ dừng lại ngay khi gặp dấu cách. Nhập “Pizza Bò” chỉ lấy được “Pizza”.
fgets() có thể đọc toàn bộ chuỗi bao gồm cả khoảng trắng.
stdin: Bạn có để ý đối số thứ ba của fgets là stdin không? Nó viết tắt của “standard input”, nghĩa là lấy dữ liệu từ bàn phím.
Ký tự \n: Một điểm cực kỳ quan trọng là fgets() thường đọc luôn cả ký tự xuống dòng (khi bạn nhấn Enter) vào trong chuỗi. Điều này khác với scanf().
Hằng chuỗi không bao giờ có thể cập nhật được
Một biến trỏ đến một hằng chuỗi (string literal) không thể được dùng để thay đổi nội dung của chính chuỗi đó:
char *cards = "JQK";(Biến cards trỏ đến một hằng chuỗi – KHÔNG THỂ THAY ĐỔI)
Nhưng nếu bạn tạo một mảng (array) từ một hằng chuỗi, khi đó bạn có thể sửa đổi nó:
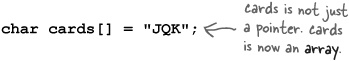
char cards[] = "JQK";(Đây là một mảng chứa bản sao của chuỗi – CÓ THỂ THAY ĐỔI)
Tất cả đều nằm ở cách mà ngôn ngữ C sử dụng bộ nhớ…
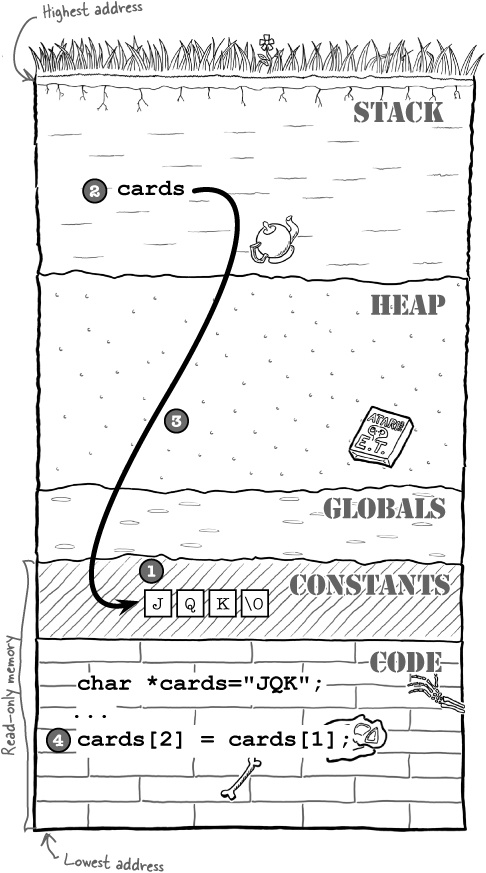
Trong bộ nhớ: char *cards = "JQK" Để hiểu tại sao dòng mã này lại gây ra lỗi bộ nhớ, chúng ta cần đào sâu vào bộ nhớ của máy tính và xem chính xác máy tính sẽ làm gì.
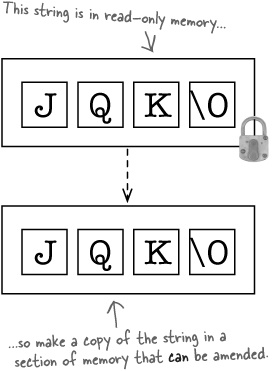
Máy tính nạp hằng chuỗi: Khi máy tính nạp chương trình vào bộ nhớ, nó đặt tất cả các giá trị hằng số — như hằng chuỗi "JQK" — vào khối bộ nhớ hằng số (constant memory block). Phần bộ nhớ này là chỉ đọc (read-only).
Chương trình tạo biến cards trên ngăn xếp (stack): Ngăn xếp là phần bộ nhớ mà máy tính sử dụng cho các biến cục bộ: các biến nằm bên trong hàm. Biến cards sẽ nằm ở đây.
Biến cards được gán địa chỉ của "JQK": Biến cards sẽ chứa địa chỉ của hằng chuỗi "JQK". Các hằng chuỗi thường được lưu trữ trong bộ nhớ chỉ đọc để ngăn chặn bất kỳ ai thay đổi chúng.
Máy tính cố gắng thay đổi chuỗi: Khi chương trình cố gắng thay đổi nội dung của chuỗi mà biến cards đang trỏ tới, nó không thể thực hiện được; chuỗi đó là chỉ đọc.
String literal (Hằng chuỗi): Là một chuỗi ký tự được viết trực tiếp trong mã nguồn nằm trong dấu ngoặc kép (ví dụ: "JQK"). Trong C, các hằng chuỗi này được lưu ở một vùng nhớ đặc biệt dành riêng cho dữ liệu không đổi.
Segmentation Fault (Lỗi phân đoạn): Thường là kết quả của việc cố gắng ghi dữ liệu vào vùng nhớ “chỉ đọc”, đây chính là lỗi mà đoạn code trên gặp phải.
Nếu bạn định thay đổi một chuỗi, hãy tạo một bản sao
Sự thật là nếu bạn muốn thay đổi nội dung của một chuỗi, bạn cần phải thao tác trên một bản sao. Nếu bạn tạo ra một bản sao của chuỗi đó trong một vùng nhớ không phải là “chỉ đọc”, sẽ chẳng có vấn đề gì xảy ra khi bạn cố gắng thay đổi các ký tự bên trong nó.
Nhưng làm thế nào để tạo một bản sao?
Có lẽ bạn chưa thấy rõ tại sao điều này lại thay đổi được mọi thứ. Tất cả các chuỗi đều là mảng. Nhưng trong đoạn mã cũ, cards chỉ là một con trỏ. Trong đoạn mã mới, nó là một mảng. Nếu bạn khai báo một mảng tên là cards và sau đó gán cho nó một hằng chuỗi, mảng cards sẽ là một bản sao hoàn toàn mới. Biến đó không chỉ đơn thuần là trỏ vào hằng chuỗi nữa.
Sự thật là nếu bạn muốn thay đổi nội dung của một chuỗi, bạn cần phải thao tác trên một bản sao. Nếu bạn tạo ra một bản sao của chuỗi đó trong một vùng nhớ không phải là “chỉ đọc”, sẽ chẳng có vấn đề gì xảy ra khi bạn cố gắng thay đổi các ký tự bên trong nó.
Nhưng làm thế nào để tạo một bản sao? Ồ, đơn giản thôi, chỉ cần tạo chuỗi đó dưới dạng một mảng mới.
Có lẽ bạn chưa thấy rõ tại sao điều này lại thay đổi được mọi thứ. Tất cả các chuỗi đều là mảng. Nhưng trong đoạn mã cũ, cards chỉ là một con trỏ. Trong đoạn mã mới, nó là một mảng. Nếu bạn khai báo một mảng tên là cards và sau đó gán cho nó một hằng chuỗi, mảng cards sẽ là một bản sao hoàn toàn mới. Biến đó không chỉ đơn thuần là trỏ vào hằng chuỗi nữa. Nó là một mảng mới toanh chứa một bản sao “tươi rói” của hằng chuỗi đó.
Để thấy điều này hoạt động như thế nào trong thực tế, bạn cần nhìn vào những gì xảy ra trong bộ nhớ.
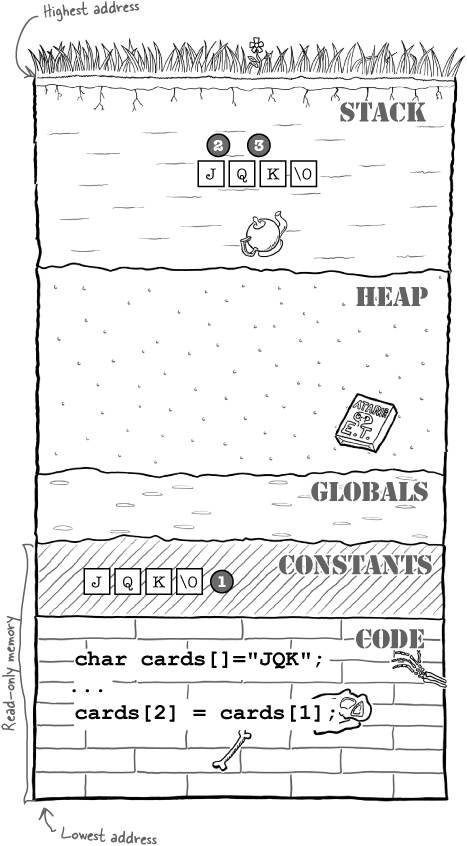
Trong bộ nhớ: char cards[] = "JQK"
Máy tính nạp hằng chuỗi: Như trước đó, khi máy tính nạp chương trình vào bộ nhớ, nó lưu trữ các giá trị hằng số — như chuỗi "JQK" — vào bộ nhớ chỉ đọc (read-only memory).
Chương trình tạo một mảng mới trên ngăn xếp (stack): Vì chúng ta đang khai báo một mảng, chương trình sẽ tạo ra một mảng đủ lớn để chứa chuỗi "JQK" — tương đương với kích thước của 4 ký tự (bao gồm cả ký tự kết thúc \0).
Chương trình khởi tạo mảng: Bên cạnh việc cấp phát không gian, chương trình cũng sẽ sao chép nội dung của hằng chuỗi "JQK" vào bộ nhớ ngăn xếp (stack).
Vì vậy, sự khác biệt là: Đoạn mã gốc sử dụng một con trỏ để trỏ đến một hằng chuỗi chỉ đọc. Nhưng nếu bạn khởi tạo một mảng bằng một hằng chuỗi, bạn sẽ có một bản sao của các ký tự đó, và bạn có thể thay đổi chúng tùy thích.
Một cách để tránh vấn đề này trong tương lai là đừng bao giờ viết mã gán một con trỏ char đơn thuần cho một giá trị hằng chuỗi như:
char *s = "Some string";
Thực ra không có gì sai khi gán một con trỏ cho một hằng chuỗi — vấn đề chỉ xảy ra khi bạn cố gắng sửa đổi hằng chuỗi đó. Thay vào đó, nếu bạn muốn gán một con trỏ cho một hằng số, hãy luôn đảm bảo bạn sử dụng từ khóa const:
const char *s = "some string";
Bằng cách đó, nếu trình biên dịch thấy đoạn mã nào cố gắng sửa đổi chuỗi, nó sẽ báo lỗi biên dịch ngay lập tức:
s[0] = 'S';monte.c:7: error: assignment of read-only location
Stack (Ngăn xếp): Là vùng nhớ dành cho các biến cục bộ. Vùng nhớ này có thể đọc và ghi thoải mái, đó là lý do tại sao khi copy chuỗi sang đây, bạn có thể sửa đổi được.
const keyword: Đây là một “lời hứa” với trình biên dịch rằng: “Tôi sẽ không thay đổi giá trị này”. Nếu bạn vi phạm, trình biên dịch sẽ nhắc nhở bạn ngay thay vì để chương trình bị sụp đổ (crash) khi đang chạy.
Hỏi: Tại sao trình biên dịch không báo luôn là tôi không được phép thay đổi chuỗi đó?
Đáp: Bởi vì chúng ta khai báo cards là một con trỏ char * đơn thuần, trình biên dịch không thể biết chắc chắn rằng biến đó sẽ luôn trỏ vào một hằng chuỗi trong suốt quá trình chạy.
Hỏi: Tại sao các hằng chuỗi lại được lưu trong bộ nhớ chỉ đọc?
Đáp: Vì chúng được thiết kế để làm hằng số. Nếu bạn viết một hàm để in chữ “Hello World”, bạn chắc chắn không muốn một phần khác của chương trình vô tình sửa nó thành “Goodbye World” đâu đúng không?
Hỏi: Có phải mọi hệ điều hành đều thực thi quy tắc “chỉ đọc” này không?
Đáp: Đại đa số là có. Một số phiên bản của gcc trên Cygwin thực tế cho phép bạn sửa đổi hằng chuỗi mà không phàn nàn gì. Nhưng hãy nhớ: làm vậy luôn luôn là sai.
Hỏi: const thực sự có nghĩa là gì? Nó có làm cho chuỗi trở thành “chỉ đọc” không?
Đáp: Bản thân các hằng chuỗi đã là chỉ đọc rồi. Từ khóa const là để trình biên dịch sẽ “la làng” lên nếu bạn cố tình dùng biến đó để sửa đổi mảng/chuỗi, giúp bạn phát hiện lỗi sớm ngay khi viết code.
Bộ nhớ ghi nhớ (Memory Memorizer)
Ngăn xếp (Stack): Đây là vùng nhớ dành cho biến cục bộ. Mỗi khi bạn gọi một hàm, các biến cục bộ của hàm đó được tạo ra trên stack. Nó giống như một chồng đĩa: biến được thêm vào khi vào hàm và lấy ra khi thoát hàm. Điều kỳ lạ là stack thực sự hoạt động “ngược”: nó bắt đầu từ đỉnh bộ nhớ và phát triển dần xuống dưới.
Heap: Đây là vùng nhớ dành cho bộ nhớ động: những dữ liệu được tạo ra khi chương trình đang chạy và tồn tại trong thời gian dài.
Biến toàn cục (Globals): Là biến nằm ngoài tất cả các hàm và mọi hàm đều nhìn thấy. Chúng được tạo ra ngay khi chương trình bắt đầu chạy và bạn có thể cập nhật chúng thoải mái.
Hằng số (Constants): Cũng được tạo ra khi chương trình bắt đầu, nhưng được lưu ở vùng nhớ chỉ đọc. Đây là nơi chứa các hằng chuỗi.
Mã lệnh (Code): Cuối cùng là phân đoạn mã. Nhiều hệ điều hành đặt mã lệnh ở địa chỉ thấp nhất. Đây là nơi chứa mã máy thực sự sau khi biên dịch và nó cũng là chỉ đọc.
C là một ngôn ngữ cho các chương trình “nhỏ và nhanh”. Nó là một ngôn ngữ “bậc thấp” và thấp hơn đa số ngôn ngữ khác, điều này có nghĩa là, chúng ta có thể viết code “gần với” máy tính hơn rất nhiều các ngôn ngữ bậc cao.
Cách C hoạt động
Máy tính thì chỉ hiểu được chỉ một và duy nhất 1 ngôn ngữ: ngôn ngữ máy tính (machine code), hay thực tế là 1 chuỗi số 1 và 0. Để ngôn ngữ C có thể được chuyển thành machine code, ta cần có 1 compiler
Đây là một chương trình C cơ bản, hay (source code) – code nguồn, source code thì chứa các ngôn ngữ C mà con người vẫn có thể hiểu được
Với sợ trợ giúp của trình biên dịch (compiler), compiler sẽ kiểm tra các lỗi của code, và nếu mọi thứ ổn, nó sẽ biên dịch
và cuối cùng trình biên dịch thường sẽ tạo ra 1 file mới, hay thường được gọi là executable (file có thể chạy được). File này chứa ngôn ngữ máy (machine code), 1 chuỗi các số 1 và 0 mà máy tính thực sự có thể hiểu và chạy được. Đây là file chương trình mà chúng ta có thể chạy
C được sử dụng khi tốc độ, không gian, khả năng portable (mang sang một máy khác) được ưu tiên. Thực tế, nhiều hệ điều hành đều được viết bằng C, nhiều ngôn ngữ khác cũng được viết bằng C, nhiều game cũng được viết bằng C.
Thông thường có 3 chuẩn C hiện tại, ANSI C có từ cuối những nam 1980, khá nhiều thứ đã được sửa đổi theo chuẩn C99 (1999). Nhiều tính năng mới cũng được thêm vào chuẩn hiện tại, C11 (2011), có thể sau đó sẽ có nhiều phiên bản khác chưa được đề cập trong bài viết, nhưng nhìn chung các nhà thiết kế luôn cố gắng mang lại nhiều tính năng, lợi ích mới từ các bản C mới nhưng vẫn đảm bảo vẫn có những quy tắc/chuẩn chung để phục vụ các chương trình cũ có thể chạy tốt.
Một chương trình C thường trông như thế nào?
Để tạo ra 1 chương trình hoàn chỉnh, bạn cần viết code vào 1 file mã nguồn C (source code C). File C thì bạn viết bằng gì cũng được, kể cả notepad, text editor, visual studio code, … , file name thường kết thúc bằng .c
Đây là hình minh họa cho 1 chương trình C, hiển nhiên đây chỉ là 1 mẫu, không bắt buộc bạn phải tuân theo mẫu này, tuy nhiên nhìn chung trong ngành mọi người thường hay follow 1 chuẩn để tất cả mọi người cùng hiểu
Phần 1 đầu thường bắt đầu bằng comment, thường là thông tin về chứng chỉ, người tạo ra file code, mục đích, …
Phần 2 thường là các phần include, C thì là 1 ngôn ngữ rất rất bé, và thường thì khá khó để nó có thể tạo 1 chương trình thực tiễn nào nếu không có sự bổ trợ của thư viện ngoài. Hay là, nếu không có thư viện ngoài bổ sung, và chỉ có những tính năng cơ bản của C, ta khó có thể làm được 1 chương trình gì cả. Bạn cần khai báo với compiler (trình phiên dịch) về code ngoài/thư viện ngoài ta muốn sử dụng, ở đây stdio.h phục vụ như 1 thư viện giúp ta đọc/viết vào terminal
Phần cuối là các hàm. Tất cả code C đều thường chạy trong các hàm, trong đó có 1 hàm được gọi là main(), đây là điểm khởi đầu của chương trình
Máy tính sẽ bắt đầu chạy từ hàm main(). Nếu chương trình không có hàm main() thì không thể chạy được. Hàm main() có phần trả về thường là kiểu int. Phần này dùng để chỉ báo cho máy tính, nếu số được trả về trong main là 0, máy tính coi chương trình chạy thành công, và có vấn đề nếu số trả về là bất kì số nào khác 0.
Chạy chương trình
Cho một chương trình mẫu như sau:
Như đã đề cập, C là một ngôn ngữ biên dịch (compiled language). Điều này có nghĩa là máy tính sẽ không dịch mã code của bạn một cách trực tiếp ngay khi chạy. Thay vào đó, bạn cần phải chuyển đổi, hay nói cách khác là biên dịch (compile), đoạn code nguồn mà con người có thể đọc hiểu (source code) thành ngôn ngữ máy (machine code) để máy tính có thể xử lý.
Để biên dịch code, bạn cần một chương trình gọi là compiler (trình biên dịch). Một trong những trình biên dịch C phổ biến nhất là GNU Compiler Collection, hay thường gọi tắt là gcc. gcc có sẵn trên rất nhiều hệ điều hành và nó có thể biên dịch nhiều ngôn ngữ khác chứ không chỉ riêng C.
Dưới đây là cách bạn có thể biên dịch và chạy chương trình bằng gcc trên cửa sổ dòng lệnh (terminal/command prompt):
gcc cards.c -o cards
Câu lệnh này yêu cầu gcc lấy file mã nguồn cards.c của bạn và biên dịch nó thành một file chạy được có tên là cards (hoặc cards.exe nếu bạn đang dùng Windows).
Bạn có thể gộp chung bước biên dịch và chạy mã trên hầu hết các máy bằng thủ thuật sau (dành cho Mac/Linux):
gcc cards.c -o cards && ./cards
Lệnh này sẽ chỉ chạy chương trình mới nếu nó được biên dịch thành công. Nếu có lỗi xảy ra trong quá trình biên dịch, nó sẽ bỏ qua việc chạy chương trình và chỉ hiển thị lỗi lên màn hình để bạn sửa.
Q:
Tại sao trên Linux hay Mac, ta lại cần có ./ ở trước tên chương trình khi chạy?
A:
Trong các hệ điều hành dạng Unix, chương trình thường chỉ được chạy nếu bạn chỉ chính xác thư mục nơi mà chương trình nằm ở đó, hoặc chương trình có trong danh sách biến môi trường PATH
Sơ qua về mảng và chuỗi
Nếu bạn biết đến C sau khi đã làm việc qua với một ngôn ngữ bậc cao, chắc hẳn bạn sẽ đặt câu hỏi là, trong chương trình trên, khi ta hỏi tên của lá bài, chúng ta đang sử dụng 1 mảng các kí tự, và có vẻ nó khác với cách bạn lưu trữ chuỗi trên các ngôn ngữ khác (string), còn nếu bạn chưa hiểu các khái niệm này thì cũng không sao, ta sẽ đi từ qua từng khái niệm.
Thực tế thì, ngôn ngữ C không hỗ trợ kiểu dữ liệu chuỗi (string) một cách trực tiếp từ trong lõi. (Dù vậy, vẫn có các thư viện mở rộng của C cung cấp chuỗi cho bạn).
Bởi vì C là ngôn ngữ “bậc thấp” hơn so với đa số các ngôn ngữ khác, nên thay vì dùng chuỗi, nó thường sử dụng một thứ tương tự: một mảng các ký tự đơn lẻ (an array of single characters).
Nếu bạn đã từng lập trình ở các ngôn ngữ khác, hẳn bạn đã gặp khái niệm “mảng” (array). Mảng đơn giản là một danh sách các phần tử được gán chung một cái tên. Ví dụ, card_name chỉ là tên một biến mà bạn dùng để gọi danh sách các ký tự được người dùng nhập vào từ bàn phím. Nếu bạn định nghĩa card_name là một mảng gồm 2 ký tự, bạn có thể gọi ký tự đầu tiên là card_name[0] và ký tự thứ hai là card_name[1].
Vậy khi C nhìn thấy một chuỗi như thế này: s = "Shatner"
Nó sẽ đọc chuỗi đó giống như một mảng chứa các ký tự riêng biệt: ['S', 'h', 'a', 't', 'n', 'e', 'r'].
Mỗi kí tự (char/character) trong chuỗi này chỉ như 1 phần tử của 1 mảng, vì vậy ta có thể trỏ tới 1 kí tự độc lập bất kì sử dụng index như, s[0] = ‘S’, s[1] = ‘h’
Chuyện gì xảy ra khi C muốn in chuỗi này ra màn hình? Ở nhiều ngôn ngữ khác, máy tính theo dõi rất sát sao kích thước của một mảng, nó luôn biết 1 mảng có bao nhiêu kí tự, vì vậy giả sử khi ta cần in ra 1 chuỗi nào đó, nó chỉ cần tìm vị trí đầu của chuỗi đó, nhảy một số bước (theo số lượng kí tự nó đã biết) để đến vị trí cuối, và in toàn bộ ra.
Nhưng vì C là ngôn ngữ bậc thấp, nó không phải lúc nào cũng biết chính xác độ dài của mảng là bao nhiêu. Để giải quyết vấn đề này, C thêm một ký tự báo hiệu (sentinel character) vào cuối mỗi chuỗi. Ký tự này có giá trị là \0 (còn gọi là null terminator).
Bất cứ khi nào máy tính cần đọc nội dung của một chuỗi, nó sẽ đi qua từng phần tử của mảng ký tự, cho đến khi nó đụng phải \0.
Điều đó có nghĩa là chữ "Shatner" thực chất được lưu trong bộ nhớ máy tính dưới dạng: ['S', 'h', 'a', 't', 'n', 'e', 'r', '\0'].
s = "Shatner"
Đó là lý do tại sao khi khai báo biến lưu 2 ký tự, ta lại phải khai báo kích thước là 3: char card_name[3]; Ký tự thứ ba chính là không gian dự phòng dành cho ký tự báo hiệu \0.
H: Tại sao các ký tự lại được đánh số từ 0? Sao không phải là 1?
Đ: Chỉ số (index) thực chất là một khoảng cách (offset): nó là thước đo xem ký tự đó nằm cách ký tự đầu tiên bao xa.
H: Tại sao lại thế?
Đ: Máy tính sẽ lưu trữ các ký tự trong các byte bộ nhớ liên tiếp nhau. Nó có thể sử dụng chỉ số này để tính toán ra vị trí của ký tự. Nếu nó biết rằng c[0] đang nằm ở vị trí bộ nhớ 1.000.000, thì nó có thể tính toán rất nhanh rằng c[96] nằm ở vị trí 1.000.000 + 96.
H: Tại sao nó cần một ký tự báo hiệu (sentinel character)? Chẳng lẽ nó không biết chuỗi dài bao nhiêu sao?
Đ: Thường thì nó không biết đâu. C không giỏi lắm trong việc theo dõi xem các mảng có độ dài bao nhiêu, và chuỗi thì bản chất cũng chỉ là một mảng mà thôi.
H: Nó không biết mảng dài bao nhiêu ?
Đ: Đúng vậy. Đôi khi trình biên dịch (compiler) có thể tìm ra độ dài của một mảng bằng cách phân tích code, nhưng thường thì C dựa dẫm vào bạn trong việc theo dõi các mảng của mình.
H: Dùng nháy đơn hay nháy kép thì có quan trọng không?
Đ: Có chứ. Nháy đơn (' ') được dùng cho các ký tự đơn lẻ, nhưng nháy kép (" ") thì luôn được dùng cho chuỗi.
H: Vậy tôi nên định nghĩa chuỗi của mình bằng dấu nháy kép (" ") hay khai báo rõ ràng nó là một mảng các ký tự? Đ: Thông thường bạn sẽ định nghĩa chuỗi bằng dấu nháy kép. Chúng được gọi là chuỗi ký tự (string literals), và gõ chúng thì dễ dàng hơn nhiều.
H: Có sự khác biệt nào giữa chuỗi ký tự (string literals) và mảng ký tự (character arrays) không?
Đ: Chỉ có một điểm thôi: chuỗi ký tự là các hằng số (constant).
H: Điều đó có nghĩa là gì?
Đ: Có nghĩa là bạn không thể thay đổi từng ký tự đơn lẻ một khi chúng đã được tạo ra.
H: Chuyện gì sẽ xảy ra nếu tôi cố tình thử thay đổi?
Đ: Điều này phụ thuộc vào trình biên dịch, nhưng gcc thường sẽ hiển thị lỗi bus error.
H: Lỗi bus error? Lỗi bus error là cái gì vậy?
Đ: C sẽ lưu trữ các chuỗi ký tự (string literals) trong bộ nhớ theo một cách khác. Lỗi bus error chỉ đơn giản có nghĩa là chương trình của bạn không thể cập nhật (chỉnh sửa) phần bộ nhớ đó
Các phép toán nhẹ nhàng và Cấu trúc điều khiển
Trong C, một dấu bằng (=) được dùng để gán giá trị (assignment). Nhưng hai dấu bằng (==) lại được dùng để kiểm tra sự bằng nhau (testing equality).
Tăng/giảm biến một khoảng nhất định: x += 5; hoặc x -= 2;
Tăng/giảm biến đi 1 đơn vị: x++; hoặc x--;
Hai loại câu lệnh chính
Làm một việc gì đó (Do something): Hầu hết các lệnh trong C đều là các hành động định nghĩa biến, đọc dữ liệu, in ra màn hình.
Bạn có thể nhóm nhiều câu lệnh lại với nhau bằng dấu ngoặc nhọn { } để tạo thành một khối lệnh (block statements).
Chỉ làm điều gì đó NẾU điều kiện là đúng (Do something only if): Đây là các câu lệnh điều khiển, tiêu biểu là if.
C
if(x ==2){puts("Hãy làm gì đó!");}
Để viết một chương trình đếm bài (như trong trò Blackjack), bạn cần kiểm tra xem một lá bài có nằm trong khoảng từ 3 đến 6 hay không. Nghĩa là bạn phải kiểm tra nhiều điều kiện cùng lúc. C cung cấp các toán tử logic (boolean operators) để làm việc này:
&& (AND – VÀ): Chỉ trả về đúng (true) khi cả hai điều kiện đều đúng. (Ví dụ: val >= 3 && val <= 6)
|| (OR – HOẶC): Trả về đúng (true) nếu một trong hai điều kiện đúng.
! (NOT – PHỦ ĐỊNH): Lật ngược giá trị của điều kiện. (Đang đúng thành sai, đang sai thành đúng).
Lưu ý: Trong C không có khái niệm true hay false một cách nguyên thủy. C quy ước: số 0 nghĩa là Sai (false), và bất kỳ số nào khác 0 đều được coi là Đúng (true).
Gemini đã nói
Dưới đây là phần tiếp nối được viết dựa trên đoạn tiếng Anh bạn cung cấp, giữ nguyên văn phong gần gũi, dễ hiểu và mang tính hướng dẫn từng bước của bạn:
Nhưng làm thế nào để bạn chạy được chương trình?
Như đã đề cập, C là một ngôn ngữ biên dịch (compiled language). Điều này có nghĩa là máy tính sẽ không dịch mã code của bạn một cách trực tiếp ngay khi chạy. Thay vào đó, bạn cần phải chuyển đổi, hay nói cách khác là biên dịch (compile), đoạn code nguồn mà con người có thể đọc hiểu (source code) thành ngôn ngữ máy (machine code) để máy tính có thể xử lý.
Để biên dịch code, bạn cần một chương trình gọi là compiler (trình biên dịch). Một trong những trình biên dịch C phổ biến nhất là GNU Compiler Collection, hay thường gọi tắt là gcc. gcc có sẵn trên rất nhiều hệ điều hành và nó có thể biên dịch nhiều ngôn ngữ khác chứ không chỉ riêng C. Điều tuyệt vời nhất? Nó hoàn toàn miễn phí.
Dưới đây là cách bạn có thể biên dịch và chạy chương trình bằng gcc trên cửa sổ dòng lệnh (terminal/command prompt):
Bash
gcc cards.c -o cards
Câu lệnh này yêu cầu gcc lấy file mã nguồn cards.c của bạn và biên dịch nó thành một file chạy được có tên là cards (hoặc cards.exe nếu bạn đang dùng Windows).
Mẹo nhỏ (Geek Bits): Bạn có thể gộp chung bước biên dịch và chạy mã trên hầu hết các máy bằng thủ thuật sau (dành cho Mac/Linux):
Bash
gcc cards.c -o cards && ./cards
Lệnh này sẽ chỉ chạy chương trình mới nếu nó được biên dịch thành công. Nếu có lỗi xảy ra trong quá trình biên dịch, nó sẽ bỏ qua việc chạy chương trình và chỉ hiển thị lỗi lên màn hình để bạn sửa.
Hiểu sâu hơn về Chuỗi (Strings) trong C
Thực tế thì, ngôn ngữ C không hỗ trợ kiểu dữ liệu chuỗi (string) một cách trực tiếp từ trong lõi. (Dù vậy, vẫn có các thư viện mở rộng của C cung cấp chuỗi cho bạn).
Bởi vì C là ngôn ngữ “bậc thấp” hơn so với đa số các ngôn ngữ khác, nên thay vì dùng chuỗi, nó thường sử dụng một thứ tương tự: một mảng các ký tự đơn lẻ (an array of single characters).
Nếu bạn đã từng lập trình ở các ngôn ngữ khác, hẳn bạn đã gặp khái niệm “mảng” (array). Mảng đơn giản là một danh sách các phần tử được gán chung một cái tên. Ví dụ, card_name chỉ là tên một biến mà bạn dùng để gọi danh sách các ký tự được người dùng nhập vào từ bàn phím. Nếu bạn định nghĩa card_name là một mảng gồm 2 ký tự, bạn có thể gọi ký tự đầu tiên là card_name[0] và ký tự thứ hai là card_name[1].
Vậy khi C nhìn thấy một chuỗi như thế này: s = "Shatner"
Nó sẽ đọc chuỗi đó giống như một mảng chứa các ký tự riêng biệt: ['S', 'h', 'a', 't', 'n', 'e', 'r'].
Đừng để rơi khỏi điểm kết thúc của chuỗi! Chuyện gì xảy ra khi C muốn in chuỗi này ra màn hình? Ở nhiều ngôn ngữ khác, máy tính theo dõi rất sát sao kích thước của một mảng. Nhưng vì C là ngôn ngữ bậc thấp, nó không phải lúc nào cũng biết chính xác độ dài của mảng là bao nhiêu.
Để giải quyết vấn đề này, C thêm một ký tự báo hiệu (sentinel character) vào cuối mỗi chuỗi. Ký tự này có giá trị là \0 (còn gọi là null terminator).
Bất cứ khi nào máy tính cần đọc nội dung của một chuỗi, nó sẽ đi qua từng phần tử của mảng ký tự, cho đến khi nó đụng phải \0. Điều đó có nghĩa là chữ "Shatner" thực chất được lưu trong bộ nhớ máy tính dưới dạng: ['S', 'h', 'a', 't', 'n', 'e', 'r', '\0'].
Đó là lý do tại sao khi khai báo biến lưu 2 ký tự, ta lại phải khai báo kích thước là 3: char card_name[3]; Ký tự thứ ba chính là không gian dự phòng dành cho ký tự báo hiệu \0.
Không có câu hỏi nào là ngớ ngẩn (Q&A):
H:Tại sao các ký tự trong mảng lại được đánh số từ 0 chứ không phải 1?Đ: Chỉ số (index) thực chất là một “khoảng cách” (offset): nó đo xem ký tự đó nằm cách ký tự đầu tiên bao xa. Ký tự đầu tiên cách chính nó 0 bước, nên nó ở vị trí số 0.
H:Có sự khác biệt nào giữa việc dùng nháy đơn (‘ ‘) và nháy kép (” “) không?Đ: Có. Nháy đơn luôn được dùng cho các ký tự đơn lẻ (ví dụ: 'A'), còn nháy kép luôn được dùng cho chuỗi (ví dụ: "Shatner").
Các phép toán nhẹ nhàng và Cấu trúc điều khiển
Không phải dấu Bằng nào cũng giống nhau Trong C, một dấu bằng (=) được dùng để gán giá trị (assignment). Nhưng hai dấu bằng (==) lại được dùng để kiểm tra sự bằng nhau (testing equality). Hãy nhớ kỹ điều này vì nó là nguyên nhân gây ra vô số lỗi khó chịu cho người mới bắt đầu!
Tăng/giảm biến một khoảng nhất định: x += 5; hoặc x -= 2;
Tăng/giảm biến đi 1 đơn vị: x++; hoặc x--;
Hai loại câu lệnh chính
Làm một việc gì đó (Do something): Hầu hết các lệnh trong C đều là các hành động định nghĩa biến, đọc dữ liệu, in ra màn hình. Bạn có thể nhóm nhiều câu lệnh lại với nhau bằng dấu ngoặc nhọn { } để tạo thành một khối lệnh (block statements).
Chỉ làm điều gì đó NẾU điều kiện là đúng (Do something only if): Đây là các câu lệnh điều khiển, tiêu biểu là if.
C
if (x == 2) {
    puts("Hãy làm gì đó!");
}
Đếm bài? Bằng ngôn ngữ C?
Để viết một chương trình đếm bài (như trong trò Blackjack), bạn cần kiểm tra xem một lá bài có nằm trong khoảng từ 3 đến 6 hay không. Nghĩa là bạn phải kiểm tra nhiều điều kiện cùng lúc. C cung cấp các toán tử logic (boolean operators) để làm việc này:
&& (AND – VÀ): Chỉ trả về đúng (true) khi cả hai điều kiện đều đúng. (Ví dụ: val >= 3 && val <= 6)
|| (OR – HOẶC): Trả về đúng (true) nếu một trong hai điều kiện đúng.
! (NOT – PHỦ ĐỊNH): Lật ngược giá trị của điều kiện. (Đang đúng thành sai, đang sai thành đúng).
Lưu ý: Trong C không có khái niệm true hay false một cách nguyên thủy. C quy ước: số 0 nghĩa là Sai (false), và bất kỳ số nào khác 0 đều được coi là Đúng (true).
Câu lệnh Switch: Cách thay thế nhiều lệnh “if”
Đôi khi bạn cần kiểm tra giá trị của cùng một biến hết lần này đến lần khác. Thay vì viết một danh sách dài dằng dặc các lệnh else if, C cho bạn một giải pháp thanh lịch hơn: câu lệnh switch.
C
switch(card_name[0]){case'K':case'Q':case'J': val =10;break;case'A': val =11;break;default: val =atoi(card_name);}
Khi máy tính chạy đến lệnh switch, nó sẽ tìm một case khớp với giá trị của biến. Khi tìm thấy, nó sẽ chạy TẤT CẢ các dòng code bên dưới nó cho đến khi gặp lệnh break. Nếu bạn quên lệnh break, code sẽ chạy tuột xuống các case bên dưới
Đôi khi làm một lần là chưa đủ… (Vòng lặp)
Nếu bạn muốn chương trình của mình lặp đi lặp lại một hành động thì sao? Hãy dùng vòng lặp (Loops).
Vòng lặp while: Chạy đi chạy lại một đoạn code chừng nào điều kiện của nó vẫn còn đúng.
C
while(count <10){puts("Vẫn đang đếm..."); count++;}
Vòng lặp for: Thực chất là một phiên bản viết gọn gàng hơn của vòng lặp while. Nó gom phần khởi tạo biến, điều kiện chạy, và bước tăng biến vào cùng một dòng, giúp code dễ đọc hơn rất nhiều.
C
for(int i =0; i <10; i++){puts("Vẫn đang đếm...");}
Cách thoát khỏi vòng lặp:
Dùng lệnh break để ngay lập tức phá vỡ và thoát ra khỏi vòng lặp hiện tại.
Dùng lệnh continue để bỏ qua phần còn lại của vòng lặp và quay ngay lên đầu vòng lặp để bắt đầu một chu kỳ lặp mới.
Hàm (Functions)
Cho đến giờ, chúng ta toàn viết code vào trong một hàm gọi là main(). Nhưng bạn hoàn toàn có thể tự tạo hàm của riêng mình.
Mọi hàm trong C thường có 3 phần cơ bản:
Kiểu trả về (Return type): Cho biết hàm này sau khi chạy xong sẽ ném ra kết quả là kiểu dữ liệu gì (ví dụ: int, float,…). Nếu hàm chỉ chạy mà không trả về kết quả gì cả, bạn dùng từ khóa void (nghĩa là “trống rỗng / không quan trọng”).
Tên hàm.
Tham số (Parameters/Arguments): Các biến mà hàm nhận vào để xử lý.
Dưới đây là phần tiếp nối được viết dựa trên đoạn tiếng Anh bạn cung cấp, giữ nguyên văn phong gần gũi, dễ hiểu và mang tính hướng dẫn từng bước của bạn:
Nhưng làm thế nào để bạn chạy được chương trình?
Như đã đề cập, C là một ngôn ngữ biên dịch (compiled language). Điều này có nghĩa là máy tính sẽ không dịch mã code của bạn một cách trực tiếp ngay khi chạy. Thay vào đó, bạn cần phải chuyển đổi, hay nói cách khác là biên dịch (compile), đoạn code nguồn mà con người có thể đọc hiểu (source code) thành ngôn ngữ máy (machine code) để máy tính có thể xử lý.
Để biên dịch code, bạn cần một chương trình gọi là compiler (trình biên dịch). Một trong những trình biên dịch C phổ biến nhất là GNU Compiler Collection, hay thường gọi tắt là gcc. gcc có sẵn trên rất nhiều hệ điều hành và nó có thể biên dịch nhiều ngôn ngữ khác chứ không chỉ riêng C. Điều tuyệt vời nhất? Nó hoàn toàn miễn phí.
Dưới đây là cách bạn có thể biên dịch và chạy chương trình bằng gcc trên cửa sổ dòng lệnh (terminal/command prompt):
Bash
gcc cards.c -o cards
Câu lệnh này yêu cầu gcc lấy file mã nguồn cards.c của bạn và biên dịch nó thành một file chạy được có tên là cards (hoặc cards.exe nếu bạn đang dùng Windows).
Mẹo nhỏ (Geek Bits): Bạn có thể gộp chung bước biên dịch và chạy mã trên hầu hết các máy bằng thủ thuật sau (dành cho Mac/Linux):
Bash
gcc cards.c -o cards && ./cards
Lệnh này sẽ chỉ chạy chương trình mới nếu nó được biên dịch thành công. Nếu có lỗi xảy ra trong quá trình biên dịch, nó sẽ bỏ qua việc chạy chương trình và chỉ hiển thị lỗi lên màn hình để bạn sửa.
Hiểu sâu hơn về Chuỗi (Strings) trong C
Thực tế thì, ngôn ngữ C không hỗ trợ kiểu dữ liệu chuỗi (string) một cách trực tiếp từ trong lõi. (Dù vậy, vẫn có các thư viện mở rộng của C cung cấp chuỗi cho bạn).
Bởi vì C là ngôn ngữ “bậc thấp” hơn so với đa số các ngôn ngữ khác, nên thay vì dùng chuỗi, nó thường sử dụng một thứ tương tự: một mảng các ký tự đơn lẻ (an array of single characters).
Nếu bạn đã từng lập trình ở các ngôn ngữ khác, hẳn bạn đã gặp khái niệm “mảng” (array). Mảng đơn giản là một danh sách các phần tử được gán chung một cái tên. Ví dụ, card_name chỉ là tên một biến mà bạn dùng để gọi danh sách các ký tự được người dùng nhập vào từ bàn phím. Nếu bạn định nghĩa card_name là một mảng gồm 2 ký tự, bạn có thể gọi ký tự đầu tiên là card_name[0] và ký tự thứ hai là card_name[1].
Vậy khi C nhìn thấy một chuỗi như thế này: s = "Shatner"
Nó sẽ đọc chuỗi đó giống như một mảng chứa các ký tự riêng biệt: ['S', 'h', 'a', 't', 'n', 'e', 'r'].
Đừng để rơi khỏi điểm kết thúc của chuỗi! Chuyện gì xảy ra khi C muốn in chuỗi này ra màn hình? Ở nhiều ngôn ngữ khác, máy tính theo dõi rất sát sao kích thước của một mảng. Nhưng vì C là ngôn ngữ bậc thấp, nó không phải lúc nào cũng biết chính xác độ dài của mảng là bao nhiêu.
Để giải quyết vấn đề này, C thêm một ký tự báo hiệu (sentinel character) vào cuối mỗi chuỗi. Ký tự này có giá trị là \0 (còn gọi là null terminator).
Bất cứ khi nào máy tính cần đọc nội dung của một chuỗi, nó sẽ đi qua từng phần tử của mảng ký tự, cho đến khi nó đụng phải \0. Điều đó có nghĩa là chữ "Shatner" thực chất được lưu trong bộ nhớ máy tính dưới dạng: ['S', 'h', 'a', 't', 'n', 'e', 'r', '\0'].
Đó là lý do tại sao khi khai báo biến lưu 2 ký tự, ta lại phải khai báo kích thước là 3: char card_name[3]; Ký tự thứ ba chính là không gian dự phòng dành cho ký tự báo hiệu \0.
Không có câu hỏi nào là ngớ ngẩn (Q&A):
H:Tại sao các ký tự trong mảng lại được đánh số từ 0 chứ không phải 1?Đ: Chỉ số (index) thực chất là một “khoảng cách” (offset): nó đo xem ký tự đó nằm cách ký tự đầu tiên bao xa. Ký tự đầu tiên cách chính nó 0 bước, nên nó ở vị trí số 0.
H:Có sự khác biệt nào giữa việc dùng nháy đơn (‘ ‘) và nháy kép (” “) không?Đ: Có. Nháy đơn luôn được dùng cho các ký tự đơn lẻ (ví dụ: 'A'), còn nháy kép luôn được dùng cho chuỗi (ví dụ: "Shatner").
Các phép toán nhẹ nhàng và Cấu trúc điều khiển
Không phải dấu Bằng nào cũng giống nhau Trong C, một dấu bằng (=) được dùng để gán giá trị (assignment). Nhưng hai dấu bằng (==) lại được dùng để kiểm tra sự bằng nhau (testing equality). Hãy nhớ kỹ điều này vì nó là nguyên nhân gây ra vô số lỗi khó chịu cho người mới bắt đầu!
Tăng/giảm biến một khoảng nhất định: x += 5; hoặc x -= 2;
Tăng/giảm biến đi 1 đơn vị: x++; hoặc x--;
Hai loại câu lệnh chính
Làm một việc gì đó (Do something): Hầu hết các lệnh trong C đều là các hành động định nghĩa biến, đọc dữ liệu, in ra màn hình. Bạn có thể nhóm nhiều câu lệnh lại với nhau bằng dấu ngoặc nhọn { } để tạo thành một khối lệnh (block statements).
Chỉ làm điều gì đó NẾU điều kiện là đúng (Do something only if): Đây là các câu lệnh điều khiển, tiêu biểu là if.
C
if(x ==2){puts("Hãy làm gì đó!");}
Đếm bài? Bằng ngôn ngữ C?
Để viết một chương trình đếm bài (như trong trò Blackjack), bạn cần kiểm tra xem một lá bài có nằm trong khoảng từ 3 đến 6 hay không. Nghĩa là bạn phải kiểm tra nhiều điều kiện cùng lúc. C cung cấp các toán tử logic (boolean operators) để làm việc này:
&& (AND – VÀ): Chỉ trả về đúng (true) khi cả hai điều kiện đều đúng. (Ví dụ: val >= 3 && val <= 6)
|| (OR – HOẶC): Trả về đúng (true) nếu một trong hai điều kiện đúng.
! (NOT – PHỦ ĐỊNH): Lật ngược giá trị của điều kiện. (Đang đúng thành sai, đang sai thành đúng).
Lưu ý: Trong C không có khái niệm true hay false một cách nguyên thủy. C quy ước: số 0 nghĩa là Sai (false), và bất kỳ số nào khác 0 đều được coi là Đúng (true).
Câu lệnh Switch: Cách thay thế nhiều lệnh “if”
Đôi khi bạn cần kiểm tra giá trị của cùng một biến hết lần này đến lần khác. Thay vì viết một danh sách dài dằng dặc các lệnh else if, C cho bạn một giải pháp thanh lịch hơn: câu lệnh switch.
C
switch(card_name[0]){case'K':case'Q':case'J': val =10;break;case'A': val =11;break;default: val =atoi(card_name);}
Khi máy tính chạy đến lệnh switch, nó sẽ tìm một case khớp với giá trị của biến. Khi tìm thấy, nó sẽ chạy TẤT CẢ các dòng code bên dưới nó cho đến khi gặp lệnh break.
H: Tại sao tôi lại dùng lệnh switch thay vì dùng if?
Đ: Nếu bạn đang thực hiện việc kiểm tra nhiều lần trên cùng một biến, bạn có thể sẽ muốn dùng lệnh switch.
H: Ưu điểm của việc dùng lệnh switch là gì?
Đ: Có vài ưu điểm. Đầu tiên: sự rõ ràng. Nhìn vào là thấy rõ cả một khối code đang xử lý chỉ một biến duy nhất. Điều đó không quá rõ ràng nếu bạn chỉ có một dãy các câu lệnh if. Thứ hai, bạn có thể tận dụng logic “rơi tự do” (fall-through) để tái sử dụng các phần code cho các trường hợp (cases) khác nhau.
H: Tôi có thể kiểm tra chuỗi (strings) trong lệnh switch không?
Đ: Không, bạn không thể dùng lệnh switch để kiểm tra một chuỗi các ký tự hay bất kỳ loại mảng (array) nào. Lệnh switch sẽ chỉ kiểm tra một giá trị đơn lẻ mà thôi.
Đôi khi làm một lần là chưa đủ… (Vòng lặp)
Nếu bạn muốn chương trình của mình lặp đi lặp lại một hành động thì sao? Hãy dùng vòng lặp (Loops).
Vòng lặp while: Chạy đi chạy lại một đoạn code chừng nào điều kiện của nó vẫn còn đúng.
C
while(count <10){puts("Vẫn đang đếm..."); count++;}
Bạn có thể dùng vòng lặp while bất cứ lúc nào bạn cần lặp lại một đoạn code, nhưng đa số thời gian các vòng lặp của bạn sẽ có cùng một loại cấu trúc như sau:
Làm một việc gì đó đơn giản trước vòng lặp, ví dụ như cài đặt một biến đếm (counter).
Có một điều kiện kiểm tra đơn giản ngay trên vòng lặp.
Làm một việc gì đó ở cuối vòng lặp, ví dụ như cập nhật biến đếm.
Ví dụ, đây là một vòng lặp while đếm từ 1 đến 10:
Những vòng lặp kiểu này chứa đoạn code chuẩn bị các biến cho vòng lặp, một loại điều kiện nào đó được kiểm tra mỗi khi vòng lặp chạy, và cuối cùng là một đoạn code nào đó ở cuối vòng lặp để cập nhật biến đếm hoặc thứ gì đó tương tự.
Vòng lặp for: Thực chất là một phiên bản viết gọn gàng hơn của vòng lặp while. Nó gom phần khởi tạo biến, điều kiện chạy, và bước tăng biến vào cùng một dòng, giúp code dễ đọc hơn rất nhiều.
Bởi vì khuôn mẫu này quá phổ biến, các nhà thiết kế ra C đã tạo ra vòng lặp for để làm cho nó trở nên súc tích hơn một chút. Đây là cùng một đoạn code đó nhưng được viết bằng vòng lặp for:
Vòng lặp for thực sự được sử dụng rất nhiều trong C, nếu không muốn nói là nhiều hơn, vòng lặp while. Chúng không chỉ làm cho code ngắn hơn một chút, mà còn giúp các lập trình viên C khác dễ đọc hơn, bởi vì toàn bộ phần code điều khiển vòng lặp, những thứ kiểm soát giá trị của biến đếm (counter), giờ đây được gói gọn vào trong câu lệnh for và được đưa ra khỏi phần thân vòng lặp. Mọi vòng lặp for đều cần phải có một thứ gì đó nằm trong phần thân của nó.
Cách thoát khỏi vòng lặp:
Dùng lệnh break để ngay lập tức phá vỡ và thoát ra khỏi vòng lặp hiện tại.
Dùng lệnh continue để bỏ qua phần còn lại của vòng lặp và quay ngay lên đầu vòng lặp để bắt đầu một chu kỳ lặp mới.
Hàm (Functions)
Cho đến giờ, chúng ta toàn viết code vào trong một hàm gọi là main(). Nhưng bạn hoàn toàn có thể tự tạo hàm của riêng mình.
Mọi hàm trong C thường có 3 phần cơ bản:
Kiểu trả về (Return type): Cho biết hàm này sau khi chạy xong sẽ ném ra kết quả là kiểu dữ liệu gì (ví dụ: int, float,…). Nếu hàm chỉ chạy mà không trả về kết quả gì cả, bạn dùng từ khóa void (nghĩa là “trống rỗng / không quan trọng”).
Tên hàm.
Tham số (Parameters/Arguments): Các biến mà hàm nhận vào để xử lý.
: fatal error: libcob.h: No such file or directory
10 | #include <libcob.h>
| ^~~~~~~~~~
compilation terminated.
The error fatal error: libcob.h: No such file or directory means the COBOL compiler (cobc) found your code, but the C compiler (which GnuCOBOL uses under the hood) can’t find the necessary “header files” to finish building the program.
Adding these to Environment Variables like previous step
Variable Name
Variable Value
COB_CFLAGS
-I D:\Msys2\ucrt64\include
COB_LDFLAGS
-L D:\Msys2\ucrt64\lib
-I (Include): Points to the folder containing libcob.h.
-L (Library): Points to the folder containing the actual library files (.lib or .a).
If you got (nanosleep64 could not be located) may indicate: your system is confused between two different versions of the C compiler.
The nanosleep64 error is a classic sign that a program compiled with one Windows runtime (like UCRT) is trying to link with an incompatible version of a library.
You could run this command
where gcc
If the output show more than one directory path, it may appear your computer have 2 installed GCC place
To solve this:
You need to tell Windows that the D: drive tools are the priority.
Search for “Edit the system environment variables” in your Start Menu and open it.
Click Environment Variables.
In the System variables (bottom) list, find the one named Path and click Edit.
Find C:\Msys2\ucrt64\bin in the list. (the path you added in installation step)
Click the “Move Up” button repeatedly until it is at the very top of the list (above the other bin directory in where gcc command).
Click OK on all windows.
Close your current Command Prompt and open a new one for the change to take effect.
I have a love-hate relationship with browser tabs. I need a lot of them to work, but once I pass the 30-tab mark, my browser bar becomes useless.
Google Chrome actually experimented with an auto-grouping feature a while back, but they removed it. I tried finding alternatives on the Chrome Web Store, but they all had the same problem: They were lazy.
Most existing extensions group tabs based on the domain, even they calling LLM to group it. If they see youtube.com, they dump it in a “YouTube” folder. This is useless for me. If I have 5 tabs open for “Lofi Music” and 5 tabs open for “Python Tutorials,” those shouldn’t be in the same group. One is Work, the other is Background Noise.
I realized that to actually organize tabs, the software needs to read the page, not just the URL. So I spent my free time building Group Tab AI.
How it actually works
I didn’t want to over-engineer this, but I needed it to be smart. When you click the button, the extension doesn’t just look at the link. It injects a script to grab the “context” of the page, the H1 title, the meta description, and a snippet of the body text.
It sends that data to an LLM (I set it up to work with either OpenAI or Gemini). Because it reads the content, it can tell that a GitHub page for a “React Library” is different from a GitHub page for “Tracking Issues.”
I’m using Google Gemini 2.0 Flash for this mostly, with the thinkingBudget set to 0. It’s fast enough that by the time I blink, the tabs are sorted.
I spent nights tweaking prompts to make it focus on tasks, not domains with extra context from the website contents along with careful prompt to let them reasoning and choose. For example, if you’re a dev, it might make groups like “Bug Hunting” or “API Docs.” Designers get “Mockups” or “Inspo.” It works for anyone,
students with class notes, marketers with campaigns.
The feature I actually wanted: It learns
This is the part I’m most proud of. I know AI isn’t perfect. It’s going to mess up. It might group a design blog under “Development” instead of “Inspiration.”
Usually, with AI tools, you just have to live with the bad output. But I built a Learning System into this.
If the AI groups something wrong, I manually move the tab to the right group.
The extension records that move.
After I’ve corrected it a few times, I can click a button to “Analyze Behavior.”
The system looks at my corrections and rewrites its own system prompt.
Next time I run it, it knows: “Oh, he likes to keep his ‘Localhost’ tabs separate from his ‘Production’ tabs,” because it updated its own instructions based on my manual fixes.
The Tech Stack
For the frontend devs out there, I built this using Plasmo. It’s basically the Next.js of browser extensions, makes working with React and TypeScript in a chrome-extension environment actually bearable.
Everything is local. Your API keys are stored in your browser, and the learning data (your grouping habits) stays on your machine.
Try it out
It’s open source (GPL-3.0). I built it because I needed it, but if you’re tired of domain-based grouping that doesn’t actually help, give it a shot.
Kaggle’s setup is amazing for quick experiments but not great when you start treating your work like an actual project. You get one main notebook. That’s it.
If you want to use your own .py files, you basically have to zip them up, upload them as a dataset, and then import from that path. It’s clunky and hard to maintain. Change one line of code? You need to re-upload the dataset again.
I saw this frustration all over the web, in Kaggle forums, Stack Overflow threads, even Reddit. Everyone was hacking their way around it, trying things like chained kernels or huge notebooks with thousands of lines of code. Nobody seemed happy with it.
So I went down the rabbit hole. Read a bunch of Medium posts, watched YouTube tutorials, skimmed corporate engineering blogs. I noticed a pattern: real ML pipelines in the wild are automated. They have CI/CD. They deploy cleanly. But for personal Kaggle projects, nobody had built something simple and usable.
That’s when it clicked, I could write a small tool that did the boring part for me. A script that could take my local project, package it up neatly, and push it to Kaggle as a dataset and a runnable notebook automatically.
Building kaggle-auto-deploy
The idea was simple:
Collect all project files.
Upload them as a Kaggle dataset.
Auto-generate a notebook that sets everything up and runs main.py.
Push it, version it, done.
So that’s what I built. A small CLI tool:
python kaggle_deploy.py ./my_project
For example, I used it on a small housing price predictor I’d built.
Behind the scenes, it ties into Git too, so every deployment matches a commit. No more “which version did I upload again?” moments.
git clone https://github.com/yourusername/kaggle-auto-deploy.git
cd kaggle-auto-deploy
Make it Executable (Linux/Mac)
chmod +x kaggle_deployer.py
Optional: Add to PATH (Linux/Mac)
# Add to ~/.bashrc or ~/.zshrc
export PATH="$PATH:/path/to/kaggle_deployer"
Usage
Basic Usage
python kaggle_deployer.py /path/to/your/project
Sample Project
This repository includes a sample project called housing_price_predictor that demonstrates how to structure a multi-file Python project for deployment to Kaggle.
python kaggle_deploy.py ./housing_price_predictor
Project Structure
housing_price_predictor/
├── main.py          # Entry point
├── data_loader.py   # Data loading and preprocessing
├── model.py         # Model training and evaluation
├── utils/
│   └── helpers.py   # Utility functions
├── data/
│   └── housing.csv  # Sample data
└── requirements.txt # Dependencies
Running the Sample Project
# Run locally
cd housing_price_predictor
python main.py

# Deploy to Kaggle
python kaggle_deployer.py ./housing_price_predictor
This entry is part 8 of 8 in the series SWE Học A.I
Word Embedding
Để xây dựng các hệ thống có thể hỗ trợ dịch thuật và sinh văn bản, trước hết chúng ta phải biến đổi văn bản thành một dạng mà máy tính có thể xử lý được. Như thường lệ, mọi thứ cần được chuyển thành con số. Có hai cách phổ biến để làm điều này:
1. Dựa trên ký tự (Character-based)
Trong cách tiếp cận này, ta đánh số tất cả các ký hiệu có thể xuất hiện trong văn bản.
Bảng mã ký tự toàn diện nhất hiện nay là Unicode.
Phiên bản mới nhất, Unicode 13.0.0 (2020), bao phủ 154 ngôn ngữ viết của con người và liệt kê tới 143.859 ký tự khác nhau (Unicode Consortium, 2020).
Mỗi ký hiệu trong bất kỳ hệ thống chữ viết nào đều có thể được gán một số duy nhất, từ 0 đến xấp xỉ 144.000.
Ví dụ, trong chương này, để đơn giản, ta chỉ xét 89 ký tự phổ biến nhất trong tiếng Anh (chữ cái, số, dấu câu, khoảng trắng).
Ví dụ nhỏ:
Văn bản: "AI is cool!"
Với bảng ký tự chỉ gồm 89 ký hiệu, ta có thể ánh xạ:
Câu "AI is cool!" sẽ được biểu diễn thành một dãy số: [0, 8, 26, 8, 45, 26, 12, 22, 22, 19, 75].
2. Dựa trên từ (Word-based)
Trong cách này, ta đánh số tất cả các từ có thể xuất hiện.
Nếu tính tất cả ngôn ngữ trên thế giới, đây là một nhiệm vụ khổng lồ.
Ngay cả với tiếng Anh, không có con số chính xác về tổng số từ.
Các từ điển hiện đại của tiếng Anh thường có khoảng 300.000 mục từ (Dictionary.com, 2020).
Giả sử ta duyệt qua toàn bộ từ điển và gán cho mỗi từ một số duy nhất, bắt đầu từ 0. Danh sách các từ cùng số hiệu của chúng sẽ tạo thành từ vựng (vocabulary).
Câu "I like AI" sẽ được biểu diễn thành [0, 1, 2].
Câu "AI is fun" sẽ là [2, 5, 6].
Với mong muốn cải tiến cách biểu diễn từ thay vì chỉ gán mỗi từ một con số, với mục tiêu là có thể:
So sánh từ (tìm từ có ý nghĩa gần giống nhau).
Kết hợp từ (trung hòa hoặc biến đổi ý nghĩa giữa hai từ).
Thao tác trên không gian vector để tìm ra mối quan hệ ngữ nghĩa tiềm ẩn.
Đây chính là nền tảng để phát triển attention và sau đó là transformer.
Kỹ thuật này gọi là word embedding (hoặc token embedding, khi áp dụng cho token nói chung).
Ví dụ
Giả sử Hôm nay đạo diễn muốn quay cảnh một nhóm động vật đuổi theo nhân vật chính. Văn phòng gửi cho đoàn làm phim một biểu đồ như sau, trục ngang là tốc độ tối đa, trục dọc là cân nặng trung bình của từng loài
Nhưng bản in bị lỗi và khi được đưa tới đoàn làm phim thì không có nhãn trục, chỉ còn các điểm động vật nằm trong không gian 2D. Vì vậy đoàn làm phim không biết trục ngang và trục dọc đang biểu diễn cho việc gì.
Đạo diễn nói:
“Tôi muốn trong cảnh quay sẽ là một con ngựa đuổi theo nhân vật chính. Tôi cảm giác được ngựa sẽ phù hợp. Chúng là sự lựa chọn hoàn hảo, đừng mang gì khác tới đây hết.”
Đoàn làm phim gật đầu, đưa ngựa vào trường quay. Nhưng chỉ vài phút sau, đạo diễn đã đập tay xuống ghế, quát lớn:
“Không được! Ngựa chạy thì nhanh đấy, nhưng trông chúng quá nhạy, cứ bồn chồn như… cáo ấy. Tôi không muốn thứ gì giống cáo. Hãy mang tới cho tôi một loài vẫn mạnh mẽ như ngựa, nhưng phải bớt cái chất ‘cáo’ đi.”
Đoàn làm phim đứng sững. Trời ạ, “ngựa trừ đi cáo” thì là cái gì? Nhưng rồi anh nhớ tới tấm biểu đồ mà văn phòng gửi. Nếu coi mỗi con vật là một mũi tên trong không gian này, thì việc đạo diễn yêu cầu chẳng khác nào một phép toán vector.
Anh lấy mũi tên của ngựa, trừ đi mũi tên của cáo. Kết quả? Một con… lười khổng lồ (giant sloth).
Đoàn làm phim ngập ngừng:
“Thưa đạo diễn, nếu bỏ đi cái tính nhanh nhẹn của cáo khỏi ngựa, chúng ta sẽ có… lười khổng lồ.”
Đạo diễn nhìn rồi hất ly latte xuống đất:
“Không! Lười thì đẹp đấy, nhưng chậm như rùa! Tôi cần thứ gì đó nhanh hơn, phải thật nhanh! Giống như… chim chẳng hạn.”
Anh lại quay vào bảng, lần này cộng thêm vector chim vào kết quả vừa rồi. Và thật bất ngờ, mũi tên mới chỉ thẳng tới… gấu nâu.
Đạo diễn khoanh tay, hất tóc, ánh mắt sáng lên:
“Tuyệt. Cuối cùng cũng đúng ý tôi: mạnh mẽ như ngựa, không lắt nhắt như cáo, lại nhanh như chim chạy. Mang gấu tới đây đi.”
Và thế là cảnh rượt đuổi được quay với một đàn gấu nâu hung hãn. Bộ phim sau này trở thành bom tấn, được ca ngợi hết lời.
Kết luận
Có hai yếu tố then chốt trong câu chuyện này. Yếu tố thứ nhất là các loài vật trên biểu đồ của chúng ta đã được sắp xếp theo một cách hữu ích, dù chúng ta không biết cách đó là gì, hay các trục thể hiện điều gì về dữ liệu.
Điểm then chốt thứ hai là cuối cùng chúng ta không cần nhãn trục. Chúng ta có thể định hướng trên biểu đồ chỉ bằng cách cộng và trừ các mũi tên trỏ tới các phần tử trên biểu đồ. Tức là, chúng ta không cố tìm một “con ngựa chậm hơn.” Thay vào đó, ta thao tác trực tiếp với các con vật trên biểu đồ, và các thuộc tính của chúng đi theo một cách ngầm định. Nếu loại bỏ đi tính nhanh nhẹn của cáo khỏi một con vật lớn như ngựa, ta sẽ thu được một con vật to và chậm.
Điều này liên quan gì đến xử lý ngôn ngữ?
Nhúng từ (Embedding Words)
Để áp dụng những gì vừa thấy cho từ ngữ, ta thay các con vật bằng các từ. Và thay vì chỉ dùng hai trục, ta sẽ đặt các từ vào một không gian có hàng trăm chiều.
Chúng ta thực hiện điều này bằng một thuật toán tự động tìm ra ý nghĩa của mỗi trục trong không gian khi đặt từng từ vào vị trí phù hợp. Thay vì gán cho mỗi từ một số đơn lẻ, thuật toán gán cho mỗi từ cả một danh sách số đó là tọa độ của từ trong một không gian lớn.
Ví dụ: từ “Hưng” biểu diễn là [0, 0.5, 1, 50, 4, …]
Thuật toán này gọi là embedder, và quá trình đó gọi là nhúng từ vào không gian embedding, tạo ra các word embeddings.
Bộ nhúng tự tìm cách xây dựng không gian và xác định tọa độ của mỗi từ sao cho nó nằm gần những từ tương tự. Ví dụ, nếu nó thấy nhiều câu bắt đầu bằng “I just drank some …”, thì danh từ xuất hiện sau cụm đó sẽ được hiểu là một loại đồ uống và được đặt gần các từ chỉ đồ uống khác. Nếu nó thấy nhiều câu như “I just ate a red …”, thì từ tiếp theo được hiểu là thứ có màu đỏ và có thể ăn được, nên được đặt gần những thứ vừa đỏ vừa có thể ăn được.
Tương tự với hàng chục, thậm chí hàng trăm mối quan hệ khác, cả rõ ràng lẫn tinh tế. Bởi vì không gian có rất nhiều chiều và các trục có thể mang ý nghĩa phức tạp tùy ý, một từ có thể thuộc đồng thời nhiều cụm dựa trên những đặc tính dường như không liên quan.
Điểm hay khi huấn luyện một bộ nhúng trong không gian có hàng trăm (hoặc thậm chí hàng nghìn) chiều là nó có thể sử dụng không gian hiệu quả hơn khả năng trực giác của con người, cho phép biểu diễn đồng thời một số lượng lớn các mối quan hệ.
Những phép “số học từ” vừa nêu là minh chứng thú vị cho không gian nhúng, nhưng quan trọng hơn, chúng cho phép ta thực hiện có ý nghĩa các phép toán trên từ như so sánh, phóng to/thu nhỏ, và cộng trừ tất cả đều hữu ích cho các thuật toán được bàn tới trong chương này.
Hình trên trình bày sáu bộ gồm bốn từ liên quan mà chúng ta đưa vào một bộ nhúng tiêu chuẩn. Mức độ tương đồng giữa embedding của hai từ càng lớn thì cặp từ đó càng có điểm cao, nên giao điểm tương ứng càng tối. Đồ thị đối xứng quanh đường chéo từ trên trái xuống dưới phải, vì thứ tự so sánh hai từ không ảnh hưởng kết quả.
Từ hình ta thấy mỗi từ khớp với chính nó mạnh nhất và cũng khớp với những từ liên quan hơn là với những từ không liên quan. Vì ta đặt các từ có liên quan cạnh nhau, đồ thị hiện ra những khối nhỏ thể hiện tương đồng. Tuy nhiên có vài điều thú vị: ví dụ vì sao fish lại khớp hơn mức trung bình với chocolate và coffee, hay vì sao blue lại ghi điểm tốt với caramel? Đây có thể là những hiện tượng phát sinh từ dữ liệu huấn luyện cụ thể mà bộ nhúng dùng.
Các thức uống cà phê và hương vị ghi điểm mạnh với nhau, có lẽ vì người ta thường gọi cà phê kèm các siro hương vị đó. Ngoài ra còn thấy manh mối về mối quan hệ giữa màu sắc và hương vị.
ELMo
Word embeddings là một bước tiến lớn so với việc gán số nguyên cho từ. Nhưng dù mạnh, cách tạo embedding như trên vẫn có một vấn đề: sắc thái ngữ nghĩa (nuance).
Nhiều ngôn ngữ có từ có nhiều nghĩa nhưng viết và phát âm giống nhau. Nếu muốn hiểu đúng nghĩa từ, ta cần phân biệt các nghĩa đó. Một cách là gán cho mỗi nghĩa của một từ một embedding riêng. Ví dụ cupcake chỉ có một nghĩa nên có một embedding; nhưng train có hai nghĩa thực sự khác nhau — một là danh từ (“I rode on a train”) (train là tàu), một là động từ (“I like to train dogs”) (train là huấn luyện), nên cần hai embedding riêng.
Những từ như vậy đặt ra hai thách thức. Thứ nhất, ta phải tạo embedding riêng cho từng nghĩa. Thứ hai, ta phải chọn embedding đúng khi những từ này xuất hiện làm input.
Việc giải quyết hai thách thức này đòi hỏi phải xét ngữ cảnh của mỗi từ. Thuật toán đầu tiên làm việc này ở quy mô lớn gọi là Embeddings from Language Models, hay tên thân mật ELMo (Peters et al. 2018), trùng tên một nhân vật Muppet trong chương trình thiếu nhi Sesame Street. Người ta nói ELMo sinh ra các contextualized word embeddings (embedding phụ thuộc ngữ cảnh).
Attention
Ta đã thấy cách cải thiện chất lượng dịch thuật bằng việc xét đến toàn bộ các từ trong câu. Nhưng khi dịch một từ cụ thể, lại có thể thấy, không phải từ nào trong câu cũng quan trọng, thậm chí nhiều từ còn không liên quan.
Ví dụ: giả sử ta dịch câu: “I saw a big dog eat his dinner.” – Tôi thấy một chú chó lớn đang ăn
Khi dịch từ dog (chó), ta gần như chẳng quan tâm gì đến từ saw. (nhìn thấy)
Nhưng để dịch đúng đại từ sở hữu his, ta cần kết nối nó với cụm big dog (chú chó lớn)
Nếu ta có thể xác định, với mỗi từ trong đầu vào, những từ nào thực sự ảnh hưởng đến việc dịch, thì ta có thể tập trung xử lý chỉ những từ đó, còn bỏ qua phần còn lại. Điều này tiết kiệm rất nhiều bộ nhớ và thời gian tính toán.
Và nếu ta làm điều này theo cách không phụ thuộc vào việc xử lý tuần tự (word-by-word), thì ta còn có thể tính toán song song.
Thuật toán thực hiện ý tưởng đó gọi là attention, hay cụ thể hơn là self-attention (Bahdanau, Cho & Bengio 2016; Sutskever, Vinyals & Le 2014; Cho et al. 2014).
Attention giúp mô hình tập trung tài nguyên vào những phần quan trọng nhất của đầu vào.
QKV – Query, Key, Value
Phiên bản attention hiện đại thường dựa trên một kỹ thuật gọi là query, key, value (QKV).
Ba từ này vốn xuất phát từ lĩnh vực cơ sở dữ liệu (database), nên khi đưa sang ngữ cảnh NLP có vẻ hơi trừu tượng. Vì vậy, ta sẽ dùng một phép ẩn dụ trực quan để giải thích, rồi sau đó kết nối lại với Q–K–V.
Ví dụ: Mua sơn
Giả sử anh cần mua sơn. Người ta chỉ cho anh mô tả: “màu vàng nhạt pha một chút cam đậm.”
Ở thị trấn chỉ có một cửa hàng sơn duy nhất. Người bán hàng mới vào nghề, không rành từng màu. Anh và nhân viên đều hiểu rằng để ra màu mong muốn, anh phải pha trộn nhiều loại sơn có sẵn. Nhưng vấn đề là: chọn loại nào, và mỗi loại bao nhiêu?
Người bán đề nghị:
“Anh hãy so sánh mô tả của mình với tên trên nhãn từng hộp sơn. Hộp nào khớp nhiều thì múc nhiều, khớp ít thì múc ít. Rồi mình trộn tất cả lại.”
Ví dụ: so với mô tả “màu vàng nhạt pha một chút cam đậm.” (“light yellow with a bit of dark orange”)
“Sunny Yellow” (Vàng cam) → khớp nhiều, vừa có vàng và cam.
“Orange Crush” → khá khớp
“Lunch with Teal” cũng lọt vào một chút, chỉ vì trùng từ “with”.
Trong câu chuyện này có 3 thành phần chính:
Yêu cầu (request): “light yellow with a bit of dark orange.”
Mô tả (description): tên trên nhãn mỗi hộp, như “Sunny Yellow”, “Mellow Blue”…
Nội dung (content): bản thân màu sơn trong hộp.
Quy trình: ta so sánh yêu cầu với từng mô tả → mức độ khớp càng cao → càng lấy nhiều nội dung từ hộp đó.
Đây chính là QKV:
Cho một yêu cầu, so sánh nó với mô tả của từng mục, rồi trộn nội dung theo mức độ phù hợp.
Trong ngôn ngữ cơ sở dữ liệu:
Query (Q): yêu cầu tìm kiếm (tương ứng với “request”).
Key (K): khóa định danh, mô tả của từng mục (tương ứng với “description”).
Value (V): giá trị thật sự được lưu trữ (tương ứng với “content”).
Cơ sở dữ liệu so sánh query với key để tính điểm khớp, rồi dùng điểm đó quyết định lấy bao nhiêu phần của value.
➡️ Vậy:
Request ↔ Query (Q)
Description ↔ Key (K)
Content ↔ Value (V)
Self-Attention
Giả sử ta có một câu gồm 5 từ đầu vào. Mỗi từ được biểu diễn bằng một vector (embedding). Ta có ba “hộp” neural network nho nhỏ (thường chỉ là các fully connected layer 1 tầng) để biến đổi vector đó thành:
Q (query)
K (key)
V (value)
Ví dụ: với từ dog (thứ ta cần dịch):
Một mạng (màu đỏ) biến vector “dog” thành Q.
Từ dinner được biến thành K (qua mạng xanh) và V (qua mạng xanh lá).
Ta so sánh Q của dog với K của dinner bằng một hàm tính điểm (scoring function, ký hiệu S trong vòng tròn). Hàm này trả về một số từ 0 → 1:
Khớp nhiều → điểm cao.
Khớp ít → điểm thấp.
Sau đó, ta lấy V của dinner, nhân với điểm này (scaling). Kết quả: giá trị dinner đóng góp nhiều hay ít vào đầu ra của dog tùy mức độ khớp.
Mở rộng ra toàn câu
Trong thực tế, không chỉ so sánh dog ↔ dinner, mà dog được so sánh với tất cả từ trong câu (kể cả chính nó).
Mỗi từ trong câu sẽ đóng góp vào kết quả cuối của dog, với trọng số do điểm khớp quyết định.
Lưu ý:
Ta chỉ có 3 mạng duy nhất (Q, K, V), và áp dụng chúng cho tất cả từ → tiết kiệm tính toán.
Sau khi có điểm khớp, ta áp dụng softmax để chuẩn hóa, tránh số quá to/nhỏ, đồng thời làm nổi bật các khớp mạnh.
Cuối cùng, ta cộng tất cả giá trị V đã được scale lại → ra vector mới của dog.
Lặp quy trình này đồng thời cho mọi từ trong câu
Embedding đóng vai trò gì?
Hàm scoring sẽ coi hai vector giống nhau → điểm cao. Vậy để hoạt động đúng, các từ có ý nghĩa gần nhau phải được nhúng gần nhau trong không gian embedding.
Ví dụ: trong như cách làm onehot encoding, ta gán số cho từ theo thứ tự (keep = 1003, flint = 1004). Nếu dùng số này so sánh thì keep và flint lại cực kỳ giống nhau (sai hoàn toàn).
Với embedding:
keep sẽ gần retain, hold, reserve.
Cách xa hẳn flint, dinosaur.
Nhờ embedding, scoring mới có ý nghĩa.
Q/KV Attention
Trong self-attention, Q, K, V đều sinh ra từ cùng một input.
Nhưng có biến thể khác:
Q đến từ một nguồn khác, còn K và V vẫn từ input gốc.
Giống như ví dụ mua sơn:
Query đến từ khách hàng.
Key & Value đến từ cửa hàng.
Đây gọi là Q/KV attention.
Thường dùng trong mạng encoder–decoder (ví dụ seq2seq):
Q từ encoder.
K, V từ decoder.
Multi-Head Attention
Ý tưởng của attention là xác định những từ nào có sự tương đồng và tạo ra một phép trộn hữu ích từ chúng. Nhưng “giống nhau” có thể được định nghĩa theo rất nhiều tiêu chí khác nhau.
Ví dụ: ta có thể xem các danh từ là giống nhau, hoặc các màu sắc, hoặc các khái niệm không gian như “lên – xuống”, hoặc các khái niệm thời gian như “hôm qua – ngày mai”. Vậy lựa chọn nào là tốt nhất?
Thực ra không có một câu trả lời duy nhất. Trên thực tế, ta thường muốn so sánh các từ theo nhiều tiêu chí cùng lúc.
Khi viết ca từ bài hát, ta có thể muốn đánh giá cao những cặp từ có nghĩa gần giống nhau, có vần cuối giống nhau, có số âm tiết bằng nhau, và thậm chí có nhịp điệu trong trọng âm giống nhau.
Nhưng khi viết về thể thao, ta có thể muốn coi những cầu thủ cùng đội, cùng vị trí là “giống nhau”.
Để chấm điểm các từ theo nhiều tiêu chí, ta chỉ cần chạy nhiều mạng attention độc lập cùng lúc. Mỗi mạng như vậy gọi là một head (một “đầu chú ý”). Mỗi head được khởi tạo độc lập, và ta hy vọng rằng trong quá trình huấn luyện, mỗi head sẽ học được một cách riêng để so sánh các đầu vào, theo những tiêu chí hữu ích và khác biệt so với các head khác. Nếu muốn, ta còn có thể thêm cơ chế để ép các head tập trung vào các khía cạnh khác nhau của đầu vào. Cơ chế này gọi là multi-head attention
Mỗi head là một mạng attention độc lập. Càng nhiều head, thì mô hình càng có khả năng tập trung vào nhiều khía cạnh khác nhau của dữ liệu đầu vào.
Hình trên minh họa một lớp multi-head attention. Như hình vẽ, ta thường kết hợp đầu ra của tất cả các head thành một danh sách, rồi cho qua một lớp fully connected duy nhất. Nhờ vậy, đầu ra của toàn bộ lớp multi-head có cùng kích thước với đầu vào, điều này cho phép ta dễ dàng xếp chồng nhiều lớp multi-head liên tiếp.
Layer Icons (Biểu tượng các lớp Attention)
(a) Self-attention.
(b) Multi-head self-attention.
(c) Q/KV attention.
(d) Multi-head Q/KV attention.
(Multi-head attention được vẽ như một khối 3D nhỏ, gợi ý rằng nó là “một chồng” các mạng attention. Với Q/KV attention, trong biểu tượng kim cương có thêm một vạch nhỏ để chỉ đầu vào Q, còn K và V đi vào từ một phía khác.)
Transformers
Mục tiêu của ta là xây dựng một mô hình dịch máy không dựa vào RNN, mà dựa vào attention networks. Ý tưởng chủ chốt: các lớp attention sẽ học cách biến đổi đầu vào thành bản dịch, dựa trên mối quan hệ giữa các từ.
Cách tiếp cận này lần đầu xuất hiện trong bài báo nổi tiếng “Attention Is All You Need” (Vaswani et al., 2017). Tác giả gọi mô hình này là transformer (cái tên hơi “mập mờ” nhưng giờ đã thành chuẩn trong lĩnh vực). Mô hình transformer hoạt động hiệu quả đến mức đã mở ra một thế hệ mới của các mô hình ngôn ngữ, vừa huấn luyện song song dễ dàng, vừa vượt trội hơn RNN trong nhiều tác vụ khác nhau.
Transformer sử dụng thêm ba ý tưởng nữa:
Skip Connections
Ý tưởng đầu tiên gọi là residual connection hay skip connection (He et al., 2015). Nguồn cảm hứng của nó là giảm lượng công việc mà một lớp mạng sâu phải thực hiện.
Một phép so sánh: Giả sử ta vẽ một bức chân dung bằng sơn acrylic trên một tấm vải. Sau nhiều tuần, bức tranh hoàn thành. Người mẫu xem và nói: “Tôi thích rồi, nhưng tiếc là hôm đó tôi đeo nhẫn sai, lẽ ra phải là cái nhẫn khác. Anh có thể sửa không?”
Cách 1: mời người mẫu quay lại, vẽ lại toàn bộ bức tranh từ đầu. Tốn thời gian và công sức khủng khiếp.
Cách 2: chỉ cần vẽ chồng cái nhẫn mới lên cái cũ. Nhanh gọn hơn nhiều.
Một lớp trong mạng sâu cũng vậy. Nó nhận tensor đầu vào, xử lý, và tạo ra tensor đầu ra. Nhưng nếu chỉ cần thay đổi một phần nhỏ, thì thật lãng phí nếu lớp đó phải xử lý toàn bộ. Giống như việc vẽ lại cả bức tranh chỉ để thay cái nhẫn. Thay vào đó, lớp chỉ cần tính toán phần thay đổi cần thiết, rồi cộng nó với đầu vào ban đầu để ra đầu ra cuối cùng.
Ý tưởng này hoạt động tuyệt vời trong deep learning:
giúp các lớp nhỏ gọn hơn, nhanh hơn,
cải thiện truyền gradient trong backpropagation,
cho phép huấn luyện hiệu quả các mạng có hàng chục hoặc hàng trăm lớp.
Đường nối thêm đưa input đến nút cộng gọi là skip connection (nối tắt), hay residual connection (nối tàn dư, vì nó cộng thêm “phần dư”).
Transformer dùng skip connections không chỉ để tăng hiệu quả, mà còn để theo dõi vị trí của từng phần tử trong đầu vào (sẽ thấy ở phần positional encoding).
Norm-Add
Ý tưởng thứ hai là một rút gọn ký hiệu, thường gọi là norm-add.
Trong transformer, ta thường áp dụng bước chuẩn hóa gọi là layer normalization (layer norm) lên đầu ra của một lớp (Vaswani et al., 2017). Đây là một dạng regularization giống như dropout hay batchnorm, giúp chống overfitting bằng cách giữ cho các giá trị trong mạng không quá lớn hoặc quá nhỏ. Layer norm học cách điều chỉnh giá trị đầu ra của lớp để có dạng gần giống một phân phối chuẩn (mean = 0, std = 1).
Một cách thông dụng: đặt layer norm ngay trước bước cộng của skip connection Vì hai bước này luôn đi kèm nhau, nên người ta gộp chúng thành một khái niệm gọi là norm-add. Biểu tượng norm-add là sự kết hợp của biểu tượng chuẩn hóa và cộng.
Có nhiều biến thể khác (đặt norm trước lớp, hoặc sau bước cộng), nhưng nhìn chung hiệu quả tương đương.
Positional Encoding (Mã hóa vị trí)
Ý tưởng thứ ba giải quyết một vấn đề phát sinh khi ta bỏ RNN ra khỏi hệ thống: ta mất thông tin về vị trí của từng từ trong câu.
Trong RNN, thông tin này có sẵn, vì từ đi vào theo thứ tự và trạng thái ẩn có thể ghi nhớ vị trí. Nhưng với attention, nhiều từ bị trộn lẫn vào nhau, vậy làm sao biết từ nào ở chỗ nào?
Giải pháp: thêm thông tin vị trí của mỗi từ trực tiếp vào vector biểu diễn của từ đó. Cách làm này gọi là positional encoding.
Cách đơn giản: nối thêm vài bit vào cuối mỗi từ để lưu vị trí. Nhưng cách này tốn bộ nhớ và khó xử lý khi câu quá dài (ví dụ câu càng dài hơn thì số bit cần để lưu vị trí càng tốn). (ảnh trái)
Cách tốt hơn: dùng một hàm toán học để biến chỉ số vị trí thành một vector đặc trưng (cùng chiều với embedding). Ví dụ: nếu embedding dài 128, thì mỗi vị trí được ánh xạ thành một vector 128 chiều riêng biệt. (ảnh phải)
Thay vì nối thêm vector này, ta cộng trực tiếp nó vào embedding của từ Cách này gọn gàng hơn, không cần thêm bits đặc biệt. Phương pháp này gọi là positional embedding, vì nó giống embedding từ vựng. Biểu tượng minh họa có dạng sóng sin, vì hàm thường dùng chính là sine wave encoding (Vaswani et al., 2017).
Nghe có vẻ lạ: cộng vị trí vào embedding sẽ thay đổi vector của từ. Vậy liệu thông tin vị trí có bị “hòa tan” mất trong quá trình attention không?
Hóa ra là không:
Hàm positional embedding chỉ tác động lên một vài bit nhất định (Vaswani et al., 2017; Kazemnejad, 2019).
Transformer học được cách phân biệt thông tin nội dung và thông tin vị trí.
Quan trọng hơn: nhờ có skip connections, positional embedding không bao giờ bị mất hoàn toàn. Sau mỗi tầng xử lý, nó lại được cộng thêm vào, luôn đi cùng với từ.
Ghép các mảnh ghép
Giờ thì ta đã có đủ nguyên liệu để dựng nên một transformer. Và để tiện theo dõi, ta vẫn sẽ dùng bài toán dịch từ ngữ ở mức độ từng từ làm ví dụ minh họa xuyên suốt.
Điều cần lưu ý trước tiên: cái tên transformer ngày nay được dùng cho một họ mạng nơ-ron rất rộng, tất cả đều lấy cảm hứng từ kiến trúc trong bài báo gốc Attention Is All You Need (Vaswani et al. 2017). Ở đây, ta sẽ không đi vào từng biến thể, mà chỉ bám vào một “phiên bản chung”, một bộ khung chuẩn.
Cấu trúc tổng thể
Ở bên trái là encoder (mã hóa),
ở giữa có một cây cầu dữ liệu,
và bên phải là decoder (giải mã).
Một câu đầu vào sẽ đi qua encoder, được xử lý và “chưng cất” thành thông tin. Rồi decoder nhận dòng thông tin đó, dần dần tạo ra câu dịch mới.
Nếu bạn đã quen với seq2seq dùng RNN thì bố cục này trông có chút quen: có phần encoder, phần decoder, và thông tin chảy từ trái sang phải. Nhưng điểm khác biệt then chốt: không còn bất kỳ (recurrent cell) nào nữa. Tất cả được thay bằng các lớp attention.
Trong sơ đồ:
E tượng trưng cho một encoder block,
D là một decoder block,
các nét đứt cho thấy nhiều block giống hệt nhau được lặp lại.
Ở đầu vào, cả encoder và decoder đều bắt đầu bằng word embedding (biểu diễn từ thành vector) cộng thêm positional embedding (mã hóa vị trí từ). Ở đầu ra của decoder, ta có một lớp fully connected + softmax để dự đoán từ kế tiếp.
Decoder lại còn có một vòng lặp: mỗi từ mà nó sinh ra sẽ được đưa trở lại vào chính nó, để sinh tiếp từ sau. Đó là cơ chế autoregressive.
Encoder block
Lớp đầu tiên: multi-head self-attention (ví dụ 8 head). Vì đây là self-attention, nên queries, keys, values đều được rút ra từ chính input của block.
Lớp này được bao quanh bởi skip connection + layer norm (norm-add), vừa để giữ số liệu “gọn gàng” (phân phối Gaussian đẹp), vừa để bảo toàn thông tin vị trí.
Lớp kế tiếp: một cặp feed-forward pointwise (thường hiểu như 2 convolution 1×1).
Lớp đầu có activation ReLU, lớp sau thì không.
Chức năng: tinh chỉnh đầu ra từ attention, loại bỏ dư thừa, giữ lại phần cốt lõi.
Như thường lệ, cả cụm này cũng được gói trong skip connection + norm-add.
Tiếp theo là decoder block. Bố cục hơi giống encoder block, nhưng có thêm một bước attention đặc biệt.
Bước đầu tiên: multi-head self-attention (giống encoder).
Input chính là các từ mà decoder đã sinh ra cho đến nay. Nếu mới bắt đầu, thì chỉ có token [START].
Nhờ self-attention, hệ thống học cách xem từ nào liên quan từ nào trong dãy đầu ra tạm thời này.
Vẫn có skip connection + norm-add bao quanh.
Nhưng ở đây có thêm một chi tiết: masking (hình tam giác nhỏ trong sơ đồ).
Bước thứ hai: multi-head Q/KV attention.
Query (Q) đến từ output của self-attention trước đó.
Keys và Values đến từ tất cả các encoder block (nguyên câu nguồn đã được mã hóa).
Nhờ thế, decoder biết cách “nhìn sang” câu gốc để chọn thông tin nào cần dùng khi dịch tiếp.
Bước này cũng được bọc skip connection + norm-add.
Cuối cùng: một cặp convolution 1×1 (giống encoder block).
Ghép lại thành Transformer
Khi ráp mọi mảnh, ta có sơ đồ:
Nhiều encoder block chồng nhau bên trái.
Nhiều decoder block chồng nhau bên phải.
Các lớp convolution 1×1 thường được ký hiệu bằng 2 hộp nhỏ xếp đôi.
Nét đứt = lặp lại nhiều lần.
Vấn đề song song & Masking
Một ưu điểm tuyệt vời của attention là: xử lý song song. Dù ta đưa vào 5 từ hay 500 từ, lớp attention vẫn chạy trong cùng một thời gian. Điều này khác hẳn RNN, vốn phải xử lý tuần tự từng bước.
Nhưng khi huấn luyện mô hình để dự đoán từ kế tiếp, sẽ nảy sinh một vấn đề. Ví dụ câu: “My dog loves taking long walks.”
Nếu ta đưa vào “My dog loves taking long” và muốn dự đoán từ thứ 6 (walks), thì ổn.
Nhưng đồng thời, ta cũng muốn mô hình dự đoán từ thứ 5 (long), dự đoán từ thứ 4 (taking), … tất cả song song.
Vấn đề: khi dự đoán long, mô hình thấy luôn từ long trong input. Quá dễ, và không còn ý nghĩa học.
Cách giải: masking. Trong self-attention của decoder, ta chèn một lớp mặt nạ, để tại mỗi bước dự đoán, mô hình chỉ được nhìn thấy các từ trước đó, không được nhìn “tương lai”.
Khi dự đoán từ thứ 1 → không thấy gì.
Khi dự đoán từ thứ 2 → chỉ thấy “My”.
Khi dự đoán từ thứ 3 → chỉ thấy “My dog”.
… và cứ thế.
Nhờ masking, mô hình vừa chạy song song và không bị “nhìn thấy” dữ liệu. Ta cố tình ẩn bớt dữ liệu đi để mô hình có thể học thêm.
Như đã sơ lược qua ở phần trước, HTTP/2 Server Push (gọi tắt là HTTP/2 push) cho phép máy chủ (server) gửi thêm tài nguyên mà client (trình duyệt) chưa yêu cầu. Trước HTTP/2, HTTP chỉ là “hỏi-đáp đơn giản”: Trình duyệt yêu cầu một trang web, server trả về, rồi trình duyệt phải tải trang đó, phân tích, và yêu cầu thêm tài nguyên như CSS, JavaScript, font chữ, hình ảnh.
Ví dụ: Khi bạn mở một trang blog, trình duyệt tải HTML trước, rồi mới “thấy” cần CSS từ việc HTML khai báo rằng css cần thiết. Quá trình này tạo ra ít nhất một vòng lặp (round-trip) thừa, làm chậm thời gian hiển thị ban đầu (initial paint). Hình ảnh thì không sao (trang vẫn load với chỗ trống), nhưng CSS hay JS “critical” (quan trọng cho rendering) sẽ khiến trang “treo” đến khi tải xong.
Với HTTP/2 multiplexing (đa kênh), các yêu cầu song song giúp tốt hơn HTTP/1, nhưng vẫn cần round-trip thứ hai. HTTP/2 push “phá vỡ quy tắc” bằng cách server gửi luôn tài nguyên phụ ngay từ đầu, giảm thời gian tải từ 2 round-trip xuống còn 1.
Hình dung qua ví dụ waterfall diagram (biểu đồ thác nước):
Không push: HTML tải xong → Phân tích → Yêu cầu CSS/JS → Chờ tải → Render.
Có push: Server gửi HTML + CSS/JS cùng lúc → Render ngay!
Inline CSS
Để giảm độ trễ, các lập trình viên thường inline các tài nguyên quan trọng ngay vào HTML, nhờ đó trình duyệt có thể bắt đầu render ngay sau khi phân tích trang gốc, thay vì chờ tải thêm tài nguyên.
Tuy nhiên, inline CSS/JS tiềm ẩn nhiều hạn chế:
Khi cần sửa critical CSS (ví dụ redesign), phải cập nhật từng trang chứ không chỉ 1 file chung.
Thường chỉ chứa các style cần thiết cho lần render đầu; toàn bộ stylesheet được tải sau để giảm độ lớn mã inline.
Cần công cụ phân tích để trích đúng những phần “critical” công việc phức tạp.
Dẫn đến trùng lặp: mỗi trang website đều chứa CSS critical riêng, thay vì dùng file có thể cache giữa các trang.
Sau đó nội dung critical CSS còn được giữ trong stylesheet chính, gây trùng lặp trong mỗi trang, không chỉ giữa các trang.
Để tải CSS không quan trọng, cần dùng JavaScript thay vì thẻ <link>, bởi thẻ link nhúng CSS thông thường sẽ block rendering; thẻ link không hỗ trợ async.
Làm rõ hơn cơ chế HTTP/2 Push
HTTP/2 push phá bỏ quy tắc “1 request = 1 response”. Máy chủ có thể trả về nhiều tài nguyên kèm theo một yêu cầu. Ví dụ:
– Client: “Cho tôi trang này.” – Server: “Được thôi, đây là trang HTML, thêm cả CSS và JS cần thiết để bắt đầu rendering”.
Thể hiện dưới dạng waterfall: các tài nguyên không đến đúng lúc, có khoảng cách nhỏ giữa chúng, nhưng tổng thời gian gần 1 vòng chứ không phải 2 như trước.
Tương tự, chuỗi flow request–response có thể thấy như hình dưới, có thể thấy rõ sự tiết kiệm thời gian khi gửi các tài nguyên quan trọng cùng với trang ban đầu.
HTTP/2 Push không thay thế được WebSockets hay SSE
Điểm then chốt: push chỉ xảy ra khi có request ban đầu từ client, server không thể tự ý push bất kỳ lúc nào. WebSockets hay SSE cho phép two-way communication, nhưng HTTP/2 không thật sự hai chiều, mọi thứ đều do client khởi đầu. Sau khi stream request đầu kết thúc, server không thể tiếp tục push trừ khi client gửi request mới. Vì vậy, HTTP/2 push không thay thế WebSocket hay SSE theo chuẩn hiện tại
Cơ chế hoạt động của HTTP/2 Push trong trình duyệt
Trình duyệt xử lý HTTP/2 push lại theo một cách khác. Tài nguyên không được đẩy thẳng đến trang web, mà được đẩy vào một khu vực cache đặc biệt. Trang web vẫn được xử lý bình thường. Khi cần tài nguyên, trình duyệt kiểm tra cache, nếu có sẵn thì tải từ cache thay vì gửi yêu cầu tới server.
Cơ chế chi tiết phụ thuộc vào từng trình duyệt và không được nêu rõ trong spec HTTP/2, nhưng hầu hết hiện nay triển khai một HTTP/2 push cache riêng biệt, khác với HTTP cache thông thường
Cách hoạt động của push cache
Các tài nguyên được đẩy sẽ nằm trong một vùng nhớ riêng (HTTP/2 push cache) chờ trình duyệt yêu cầu. Khi được truy cập, tài nguyên sẽ được đưa vào trang và nếu có header phù hợp sẽ được đồng thời lưu vào HTTP cache để sử dụng sau này.
Một điểm đặc biệt: các trình duyệt dựa trên Chromium (Chrome, Opera) không cache tài nguyên nếu certificate không đáng tin (như tự ký self-signed, hiển thị ổ khoá đỏ), dù người dùng có bỏ qua lỗi. Để HTTP/2 Push hoạt động, bạn cần certificate hợp lệ (ổ khoá xanh)
Quá trình kiểm tra cache của trình duyệt theo thứ tự như sau: image cache → preload cache → service worker → HTTP cache → HTTP/2 push cache. Nếu tài nguyên đã có sẵn ở cache HTTP chính (mặc dù phiên bản mới đã bị push), trình duyệt vẫn ưu tiên dùng bản cũ theo cache-control (Jake Archibald) Service worker còn được kiểm sau preload cache
Image cache (cache hình ảnh):
Là cache tạm, nằm trong bộ nhớ (in-memory) chỉ phục vụ cho trang hiện tại.
Nó giúp trình duyệt không phải tải lại cùng một ảnh nếu trang tham chiếu tới ảnh đó nhiều lần.
Khi người dùng rời khỏi trang, cache này bị hủy.
Preload cache:
Cũng là cache tạm, trong bộ nhớ và chỉ gắn với một trang.
Dùng để giữ các tài nguyên được preload (sẽ nói kỹ hơn ở chương 6).
Lưu ý: không nên preload tài nguyên cho trang khác, vì preload cache không dùng chung giữa các trang.
Service Worker cache:
Service Worker là một loại ứng dụng nền, chạy độc lập với web page, đóng vai trò trung gian giữa web page và server.
Nó cho phép web hoạt động giống native app hơn, ví dụ vẫn có thể hoạt động khi mất mạng.
Service Worker có hệ thống cache riêng, gắn với domain.
HTTP cache (cache truyền thống):
Đây là cache chính mà lập trình viên quen thuộc nhất.
Nó được lưu trên đĩa (persistent), chia sẻ giữa nhiều trang, có dung lượng giới hạn và được dùng cho tất cả domain.
HTTP/2 push cache:
Đây là cache tạm, nằm trong bộ nhớ, gắn liền với một kết nối (connection).
Nếu server push styles.css, file này sẽ được đưa vào HTTP/2 push cache. Sau đó, khi trình duyệt thấy cần styles.css, nó không hề “biết” hay quan tâm rằng server đã push sẵn file này. Trình duyệt vẫn kiểm tra toàn bộ cache theo thứ tự:
Image cache
Preload cache
Service Worker cache
HTTP cache
HTTP/2 push cache
Nếu trong HTTP cache chính đã có một bản styles.css hợp lệ, thì trình duyệt sẽ lấy từ đó kể cả khi trong push cache đang có bản mới hơn.
Bạn có thể dùng công cụ chrome://net-export (nói trong mục 4.3.1) để xem tổng hợp các tài nguyên đã được push nhưng chưa được sử dụng (unclaimed push resources) trong tất cả các trang đang mở
Nếu một kết nối bị đóng, push cache cũng mất theo, khác với HTTP cache. Một cách hiểu ngắn gọn: push cache chỉ tồn tại gắn với kết nối. Khi kết nối không tái sử dụng, tài nguyên push có thể bị lãng phí. Một lần tài nguyên được sử dụng (“claimed”), nó sẽ bị loại khỏi push cache. Nhưng nếu có cache-control phù hợp, vẫn có thể lưu trong HTTP cache. Thậm chí tài nguyên không thể cache theo HTTP (no-cache, no-store) vẫn có thể được push và đọc từ push cache, bởi đây không thực sự là “cache” truyền thống mà là vùng đệm tạm thời
HTTP/2 Push Cache và những vấn đề phát sinh
Push cache gắn liền với connection
HTTP/2 push cache gắn trực tiếp với một kết nối (connection). Điều này dẫn đến:
Nếu kết nối không được dùng → tài nguyên push cũng không được dùng.
Nếu kết nối bị mất → push cache và tất cả tài nguyên chưa dùng cũng mất → việc push bị lãng phí.
Nếu trình duyệt mở thêm một kết nối khác → tài nguyên push có thể sẽ không được dùng.
HTTP/2 thiết kế để chỉ có một connection duy nhất, nên thoạt nhìn có vẻ không có vấn đề. Nhưng thực tế các trình duyệt triển khai khác nhau:
Chrome, Firefox: chia sẻ connection giữa các tab.
Edge: mỗi tab dùng connection riêng.
Safari: có thể mở nhiều connection ngay trong cùng một tab.
Ngoài ra, các request không kèm thông tin xác thực (noncredentialed) thường được gửi trên một connection riêng. Do đó:
Không thể push font cross-origin (từ domain khác, kể cả domain shard) vì chúng phải đi qua noncredentialed request.
Do Push cache hoạt động ở mức connection, chứ không phải mức page. Vì vậy, tuy về lý thuyết bạn có thể push tài nguyên cho trang sẽ load sau, nhưng trên thực tế điều này gần như vô ích, vì cache ngắn hạn và có thể mất khi kết nối rớt.
Push cache khác với HTTP cache
Khi một tài nguyên được lấy ra khỏi push cache, nó sẽ bị xóa khỏi đó và không thể dùng lại từ push cache lần nữa. Nhưng nếu tài nguyên có cache-control hợp lệ, nó sẽ được lưu vào HTTP cache chính để dùng sau.
Push cache có thể chứa cả tài nguyên không cache được (ví dụ header no-cache hoặc no-store). Đây là điểm khác với HTTP cache truyền thống.
Chính vì vậy, push cache không thực sự là cache theo đúng nghĩa, mà giống như một “kho tạm chứa request”
RST_STREAM – Cách từ chối tài nguyên bị push
Trình duyệt có thể từ chối một tài nguyên đang bị push bằng cách gửi một RST_STREAM frame với mã CANCEL hoặc REFUSED_STREAM. Điều này xảy ra khi:
Trình duyệt đã có sẵn tài nguyên trong cache.
Người dùng rời khỏi trang khi nó vẫn đang load → không cần tải thêm tài nguyên nữa.
Tuy nhiên, RST_STREAM có hạn chế:
Việc gửi tín hiệu RST_STREAM mất thời gian → trong lúc đó server vẫn tiếp tục gửi data (HEADERS, DATA frames). Có thể cả file đã được gửi xong trước khi server kịp ngừng lại.
Đây chỉ là tín hiệu điều khiển, không mạnh bằng việc cắt hẳn connection (HTTP/2 không cho phép ngắt connection vì sẽ ảnh hưởng tới tất cả stream khác).
Vì vậy, RST_STREAM không phải giải pháp hiệu quả để ngăn chặn việc push sai tài nguyên.
Ví dụ:
Nếu push một ảnh rất lớn nhưng trang đã được cập nhật không dùng ảnh đó nữa → trình duyệt vẫn tải hết ảnh về nhưng không dùng, gây lãng phí băng thông.
Thậm chí bạn còn không biết mình đang push nhầm, vì một số công cụ (DevTools) có thể không hiển thị tài nguyên bị push mà không dùng.
Client có thể tắt push bằng cách đặt SETTINGS_ENABLE_PUSH = 0 trong khung SETTINGS. Khi đó, server không được phép gửi PUSH_PROMISE nữa.
Request được push phải là cacheable methods (thường là GET, HEAD, hoặc một số POST đặc biệt).
Request được push phải là safe methods (thường là GET hoặc HEAD).
Request được push không được có request body (nhưng response thường có body).
Request được push chỉ được gửi đến những domain mà server có thẩm quyền (authoritative).
Chỉ server mới có quyền push, client không được push.
Resource chỉ có thể được push như phản hồi cho một request hiện tại. Server không thể tự phát khởi một push nếu không có request nào đang diễn ra.
Thực tế, vì các quy tắc trên, chỉ có GET request là thường được push.
Giới hạn về authority nghĩa là bạn chỉ được phép push tài nguyên mà server trực tiếp hoặc gián tiếp phục vụ. Ví dụ, nếu trang của bạn dùng Bootstrap từ getbootstrap.com hoặc jQuery từ jquery.com, thì server của bạn không thể push trực tiếp. Bạn có thể proxy các request đó qua server của mình, nhưng khi đó bạn phải sửa tất cả các tham chiếu để trỏ về server của bạn. Ở tình huống đó, tốt hơn hết là host luôn file đó tại chỗ thay vì tạo thêm phức tạp với proxy.
HTTP/2 Push được thiết kế để tối ưu hiệu năng, nhưng nếu lạm dụng, nó có thể làm chậm hiệu năng vì lãng phí băng thông để push những tài nguyên mà client không dùng, thay vì ưu tiên cho những tài nguyên cần thiết.
Lý tưởng nhất, chỉ nên push tài nguyên quan trọng (critical assets) mà trang chắc chắn cần.
Không nên push:
Tài nguyên không được sử dụng.
Tài nguyên mà client không thể dùng (ví dụ: image format không hỗ trợ).
Tài nguyên chỉ dùng trong một số điều kiện (ví dụ: hình ảnh cho màn hình lớn).
Nhóm Chrome đã viết một tài liệu chi tiết về “nên push cái gì” (Chrome doc on HTTP/2 Push), trong đó họ khuyến nghị:
“Chỉ push mức tối thiểu cần thiết để lấp đầy thời gian mạng rảnh, và không hơn.”
Push chỉ để tận dụng thời gian mạng rảnh (idle network time).
Không nên push toàn bộ tài nguyên mà trang cần, vì như vậy sẽ ghi đè cơ chế ưu tiên tải (prioritization) vốn được trình duyệt tối ưu tốt hơn.