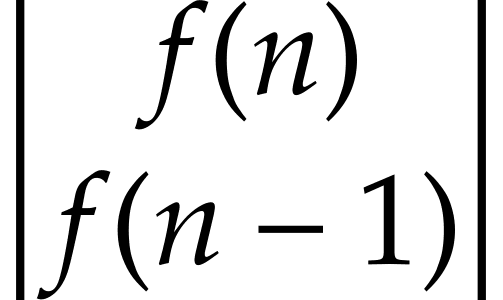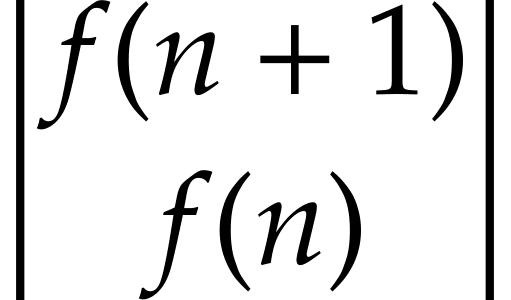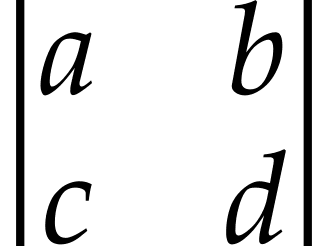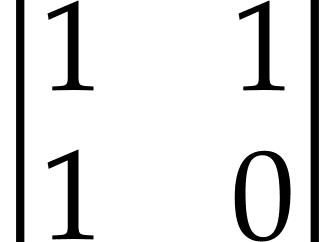Collection và Collections trong Java

COLLECTION & COLLECTIONS

Collection

Collection trong java là một root interface trong hệ thống cấp bậc Collection. Java Collection cung cấp nhiều interface (Set, List, Queue, Deque,…) và các lớp (ArrayList, Vector, LinkedList, PriorityQueue, HashSet, LinkedHashSet, TreeSet,…)

- quochung.cyou PTIT

Collections

Collections trong java là một khuôn khổ cung cấp một kiến trúc để lưu trữ và thao tác tới nhóm các đối tượng. Tất cả các hoạt động mà bạn thực hiện trên một dữ liệu như tìm kiếm, phân loại, chèn, xóa,… có thể được thực hiện bởi Java Collections.

Hệ thống cấp bậc Collection

Gói java.util chứa tất cả các lớp và interface của Collection

NxEiS NhpDt2aCqAp qDQG0p29nHkoqtQieaej5V4WwooYzSmeDjJzkgHwTXDzYqt52o6bvg3rZo0KL4pUT9Dt4kULTdN4X - quochung.cyou PTIT

Các phương thức

Iterable interface chứa dữ liệu thành viên Iterator interface.

Giao tiếp Iterator cung cấp phương tiện để lặp đi lặp lại các thành phần từ đầu đến cuối của một collection.

  • Ngoài ra, ta còn có thể làm việc với Collection thông qua Iterator Interface.
Phương thứcMô tả
public boolean hasNext()Nó trả về true nếu iterator còn phần tử kế tiếp phần tử đang duyệt.
public object next()Nó trả về phần tử hiện tại và di chuyển con trỏ trỏ tới phần tử tiếp theo.
public void remove()Nó loại bỏ phần tử cuối được trả về bởi Iterator. Nó hiếm khi được sử dụng.
  • Một số method của Interface Collection. Các method này sẽ được các Interface con kế thừa lại:
Phương thứcMô tả
boolean add(Object element)Được sử dụng để chèn một phần tử vào collection.
boolean addAll(Collection c)Được sử dụng để chèn các phần tử collection được chỉ định vào collection gọi phương thức này.
boolean remove(Object element)Được sử dụng để xóa phần tử từ collection.
boolean removeAll(Collection c)Được sử dụng để xóa tất cả các phần tử của collection được chỉ định từ collection gọi phương thức này.
boolean retainAll(Collection c)Được sử dụng để xóa tất cả các thành phần từ collection gọi phương thức này ngoại trừ collection được chỉ định.
int size()Trả lại tổng số các phần tử trong collection.
void clear()Loại bỏ tổng số của phần tử khỏi collection.
boolean contains(Object element)Được sử dụng để tìm kiếm phần tử.
boolean containsAll(Collection c)Được sử dụng để tìm kiếm collection được chỉ định trong collection.
Iterator iterator()Trả về một iterator.
Object[] toArray()Chuyển đổi collection thành mảng (array).
boolean isEmpty()Kiểm tra nếu collection trống.
boolean equals(Object element)So sanh 2 collection.
int hashCode()Trả về số hashcode của collection.
  • Collections chỉ chứa static method. Một số method của collections:
Phương thứcMô tả
void sort()sắp xếp collections
min(), max()trả về phần tử nhỏ nhất /lớn nhất trong Collection
int binarySearch()tìm kiếm nhị phân một giá trị
void reverse()đảo ngược collections
void copy()Sao chép tất cả các phần tử từ một danh sách này sang một danh sách khác.
int frequency()Trả về số lượng các phần tử có trong bộ sưu tập được chỉ định bằng đối tượng được chỉ định.
int indexOfSubList()Trả về vị trí bắt đầu của lần xuất hiện đầu tiên của danh sách mục tiêu được chỉ định trong danh sách nguồn quy định, hoặc -1 nếu không tìm thấy đối tượng chỉ định.

CÁC COLLECTION THƯỜNG GẶP

List

List là một interface trong java. Nó chứa các phương thức để chèn và xóa các phần tử dựa trên chỉ số index.

Khai báo của interface List trong Java:

5neMDTW8gs2P6eXH6p091esF7GsoSWfQ2nGklyLNTQa L3zMRzi57gksf3ZP4ZVupWuENZzXYPr8iefiiKvQMO0rtd4fm JwWvNuuIhL4ejupOD20JRZFnWcuP7nfCSwRQO DLMBj7p5 - quochung.cyou PTIT
  • Các method của List thường dùng:
Phương thứcMô tả
void add(int index, Object element)Nó được sử dụng để chèn các phần tử vào list tại chỉ số index.
boolean addAll(int index, Collection c)Nó được sử dụng để chèn tất cả các yếu tố của c vào danh sách tại chỉ số index.
object get(int index)Nó được sử dụng để trả về đối tượng được lưu trữ tại chỉ số index trong list.
object set(int index, Object element)Nó được sử dụng để gán phần tử cho vị trí được chỉ định index trong list.
object remove(int index)Nó được sử dụng để xóa các phần tử tại vị trí có chỉ số index và trả về phần tử đã xóa.
ListIterator listIterator()Nó được sử dụng để trả về một Iterator mà bắt đầu từ phần tử đầu tiên của list.
ListIterator listIterator(int index)Nó được sử dụng để trả về một Iterator mà phần tử bắt đầu từ chỉ số index chỉ định.

ArrayList

Lớp ArrayList trong java là một lớp kế thừa lớp AbstractList và triển khai của List Interface nên nó sẽ có một vài đặc điểm và phương thức tương đồng với List.

ArrayList được sử dụng như một mảng động để lưu trữ các phần tử.

Những đặc điểm của ArrayList:

  • Lớp ArrayList trong java có thể chứa các phần tử trùng lặp.
  • Lớp ArrayList duy trì thứ tự của phần tử được thêm vào.
  • Lớp ArrayList là không đồng bộ (non-synchronized).
  • Lớp ArrayList cho phép truy cập ngẫu nhiên vì nó lưu dữ liệu theo chỉ mục.
  • Lớp ArrayList trong java, thao tác chậm vì cần nhiều sự dịch chuyển nếu bất kỳ phần tử nào bị xoá khỏi danh sách.

Khởi tạo ArrayList:

- quochung.cyou PTIT
  • Các method của ArrayList thường dùng:
Phương thứcMô tả
boolean add(Object o)Nó được sử dụng để nối thêm phần tử được chỉ định vào cuối một danh sách.
void add(int index, Object element)Nó được sử dụng để chèn phần tử element tại vị trí index vào danh sách.
boolean addAll(Collection c)Nó được sử dụng để nối tất cả các phần tử trong collection c vào cuối của danh sách, theo thứ tự chúng được trả về bởi bộ lặp iterator.
boolean addAll(int index, Collection c)Nó được sử dụng để chèn tất cả các phần tử trong collection c vào danh sách, bắt đầu từ vị trí index.
void retainAll(Collection c)Nó được sử dụng để xóa những phần tử không thuộc collection c ra khỏi danh sách.
void removeAll(Collection c)Nó được sử dụng để xóa những phần tử thuộc collection c ra khỏi danh sách.
int indexOf(Object o)Nó được sử dụng để trả về chỉ mục trong danh sách với sự xuất hiện đầu tiên của phần tử được chỉ định, hoặc -1 nếu danh sách không chứa phần tử này.
int lastIndexOf(Object o)Nó được sử dụng để trả về chỉ mục trong danh sách với sự xuất hiện cuối cùng của phần tử được chỉ định, hoặc -1 nếu danh sách không chứa phần tử này.
Object[] toArray()Nó được sử dụng để trả về một mảng chứa tất cả các phần tử trong danh sách này theo đúng thứ tự.
Object[] toArray(Object[] a)Nó được sử dụng để trả về một mảng chứa tất cả các phần tử trong danh sách này theo đúng thứ tự.
Object clone()Nó được sử dụng để trả về một bản sao của ArrayList.
void clear()Nó được sử dụng để xóa tất cả các phần tử từ danh sách này.
void trimToSize()Nó được sử dụng để cắt dung lượng của thể hiện ArrayList này là kích thước danh sách hiện tại.
boolean contains(element)Kết quả trả về là true nếu tìm thấy element trong danh sách, ngược lại trả về false.
  • Như tìm hiểu bên trên, ta thấy ArrayList và Vector gần giống nhau. Tuy nhiên, ta có thể so sánh một vài sự khác biệt như sau:
ArrayListVector
ArrayList là non-synchronized.Vector là synchronized.
ArrayList là nhanh hơn vì nó là non-synchronized.Vector là chậm hơn vì nó là synchronized. Tức là, trong môi trường đa luồng, các thread giữ nó ở trong trạng thái runnable hoặc non-runnable cho đến khi thread hiện tại giải phóng đối tượng đó.
ArrayList được duyệt bởi Iterator.Vector được duyệt bởi Enumeration và Iterator.

Map

Trong java, map được sử dụng để lưu trữ và truy xuất dữ liệu theo cặp key và value. Mỗi cặp key và value được gọi là mục nhập (entry). Map trong java chỉ chứa các giá trị key duy nhất. Map rất hữu ích nếu bạn phải tìm kiếm, cập nhật hoặc xóa các phần tử trên dựa vào các key.

Các phương thức hữu ích của Map interface

Phương thứcMô tả
Object put(Object key, Object value)Nó được sử dụng để chèn một mục nhập trong map hiện tại.
void putAll(Map map)Nó được sử dụng để chèn map chỉ định vào map hiện tại.
Object remove(Object key)Nó được sử dụng để xóa một mục nhập của key được chỉ định.
Object get(Object key)Nó được sử dụng để trả lại giá trị cho khoá được chỉ định.
boolean containsKey(Object key)Nó được sử dụng để tìm kiếm key được chỉ định từ map hiện tại.
Set keySet()Nó được sử dụng để trả đối tượng Set có chứa tất cả các keys.
Set entrySet()Nó được sử dụng để trả lại đối tượng Set có chứa tất cả các keys và values.

Map.Entry Interface

Entry là một interface con của Map. Vì vậy, chúng ta được truy cập nó bằng tên Map.Entry. Nó cung cấp các phương pháp để truy xuất các key và value.

Các phương thức của Map.Entry interface

Phương thứcMô tả
Object getKey()Nó được dùng để lấy key.
Object getValue()Nó được sử dụng để lấy value.

Phân biệt List và ArrayList

l3YItbjXQXR8GyrhYUZxXwrnTHVTIsgLFaOXblTC0rMSBNS ZDBrEcOro1kCT0uB8Q o 6ksM3OguGn1g8L7RlROphHGpAFwi7Ud5sUIWS3zK odQh konRWvb JBKEKJVRZv2QqLs9m - quochung.cyou PTIT
  • List là một interface –  ArrayList là một class thuộc framework Collection
  • List kế thừa từ Collection – ArrayList kế thừa AbstractArrayList và implement List
  • List lưu các phần tử theo thứ tự vị trí, ArrayList như một mảng động có thể thêm xoá phần tử

Sắp xếp trong Java

Sắp xếp bằng cách tạo hàm compare.to sử dụng giao diện Comparable để sắp xếp

XpxUcDwgV3pbMLRG4GxdnGT0YTZLY 7JDFAhyafARqXcz EWyrVgZsqugh 3yZG IrgLtCzVv6RI4pGVxX jmf7x - quochung.cyou PTIT

Sắp xếp bằng cách sử dụng Comparator để sắp xếp tiện dụng hơn

R61xA9a2WnpDW53cJ3RltUzPcccRmmqUEiREl5ixNBz5V0SRZ1kj e9DC FIur0x 8WH8sc0GFT MA DdRJKRIAiswoNQbO3QLVjUjX - quochung.cyou PTIT

[site_reviews_form]
Tìm hiểu về Java cơ bản, Regex và 4 tính chất OOP trong Java

Java cơ bản

Cú pháp cơ bản

Khi nói về một chương trình Java, do đây là một ngôn ngữ được tạo ra với thiên hướng “Hướng đối tượng” rất lớn, nên chương trình Java có thể tóm tắt bằng việc một tập hợp các vật thể – object tương tác với nhau bằng các hàm, thông số, …

  • Object – Vật thể: Chứa thông số và các hàm. VD Object Máy tính có thông số CPU, Ram, dung lượng máy, .. có các hàm tương tác như: lướt web, bật máy, …
  • Class – Lớp: Là một bản gốc chứa các thông số và các hàm mà vật thể được tạo lên
  • Method – Hàm: Là các hàm tương tác với 1 object

Trước nhất, một cấu trúc chương trình cơ bản trong Java sẽ trông như sau:

- quochung.cyou PTIT

Các lưu ý về cú pháp trong Java:

  • Quan trọng viết hoa: Tức là Hello và hello sẽ khác nhau trong Java
  • Tên file: Tên một file thường trùng tên với class trong file đó
  • Hàm Main(): Trong mỗi class luôn cần có method main(), sẽ là thứ đầu tiên được chạy của hàm đó

Nhập xuất

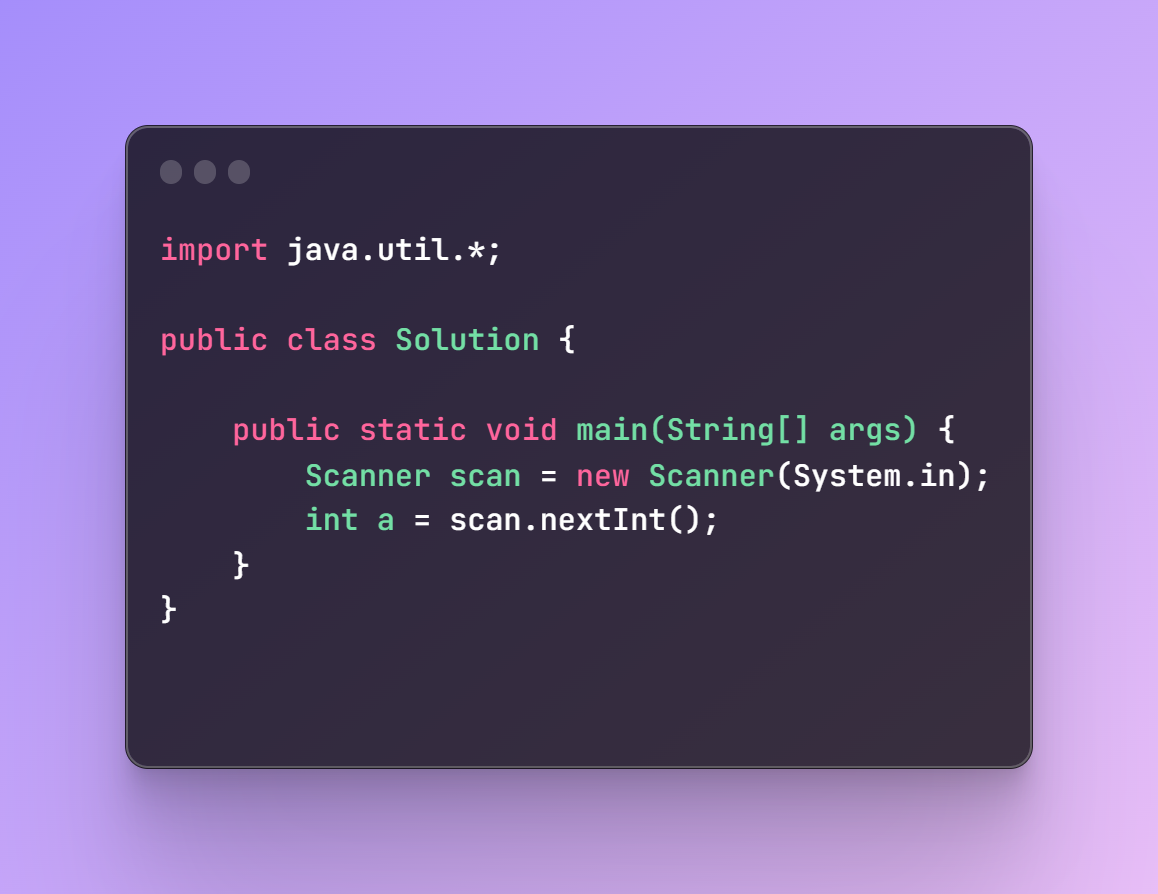
Để nhập vào các dữ liệu từ input phía người dùng trong Java, chúng ta sẽ sử dụng lớp Scanner có sẵn trong Java để nhập vào dữ liệu.

Đầu tiên cần khai báo và import thư viện Scanner

d4ShbqBEYkxwtDP5qg2IiV8EPOjuo7Dp8qOyZPP1YYn3wdFHbznbhQmFESwmsMA1NYU j9OcXiIt5uv5Jv3r93mIhCoPLpnRwpTDWRSH5pA8uLT - quochung.cyou PTIT

Khởi tạo một object Scanner trong chương trình để đảm nhận việc lấy dữ liệu

- quochung.cyou PTIT

Ở đây ta đã lấy dữ liệu cho một biến int – tương tự như C, là một kiểu dữ liệu lưu số nguyên bằng hàm nextInt().

Cú pháp:

(data-type) (variable-name) = scan.next…();

Ta cần thay trong dấu “…” bằng phương thức ta muốn:

Phương thứcMô tả
nextByte()Đọc một số nguyên kiểu byte
nextShort()Đọc một số nguyên kiểu short
nextInt()Đọc một số nguyên kiểu int
nextLong()Đọc một số nguyên kiểu long
nextFloat()Đọc một số kiểu float
nextDouble()Đọc một số kiểu double
next()Đọc một string kết thức trước một ký tự trắng
nextLine()Đọc một line of text (kết thúc bằng phím Enter)

Ví dụ: Nhập một string.

XCwDQMbooym1U2GYI2OLYDPYVMR5z9 Zzof2 7ETeGrsF CBe2CXC2caLa2aqll9VhN2CQXV4BC5v2w4ommFQ2XrHk13pdjBl6qQh7Vtfgot4u9qECfqvdqupmh5HcdEq9YFsjMYbbgSnIdgufpS Q - quochung.cyou PTIT
  • Trong Java cũng gặp tình trạng bị trôi lệnh khi nhập 1 string ngay sau khi nhập 1 số. Cách sử lý là dùng thêm 1 lần nhập scan.nextLine() trước khi nhập string.
1GzSTAKxxTKzrpiG pwya5V5mbPYOtMPk7MImqjauAg C2HZFfTO475AzOdwQ2swl7TJFPoQwAVL2VQWRo6GB7rSQHzzz UkRlx RdhvVCZQO3OVh FaV178nUHwDg7k0QfKYo4qMIS86sNIfcj5Nw - quochung.cyou PTIT

Để in ra dữ liệu trong Java

  • Sử dụng System.out.println();
    • Xuất kết quả ra màn hình đồng thời con trỏ chuột nhảy xuống dòng tiếp theo
  • Sử dụng System.out.print();
    • Xuất kết quả ra màn hình nhưng con trỏ chuột không xuống dòng.
  • Sử dụng System.out.printf();
    • Xuất ra màn hình kết quả đồng thời có thể định dạng được kết quả đó nhờ vào các đối số thích hợp. (đặc tả)
    • Giống trong C và CPP.

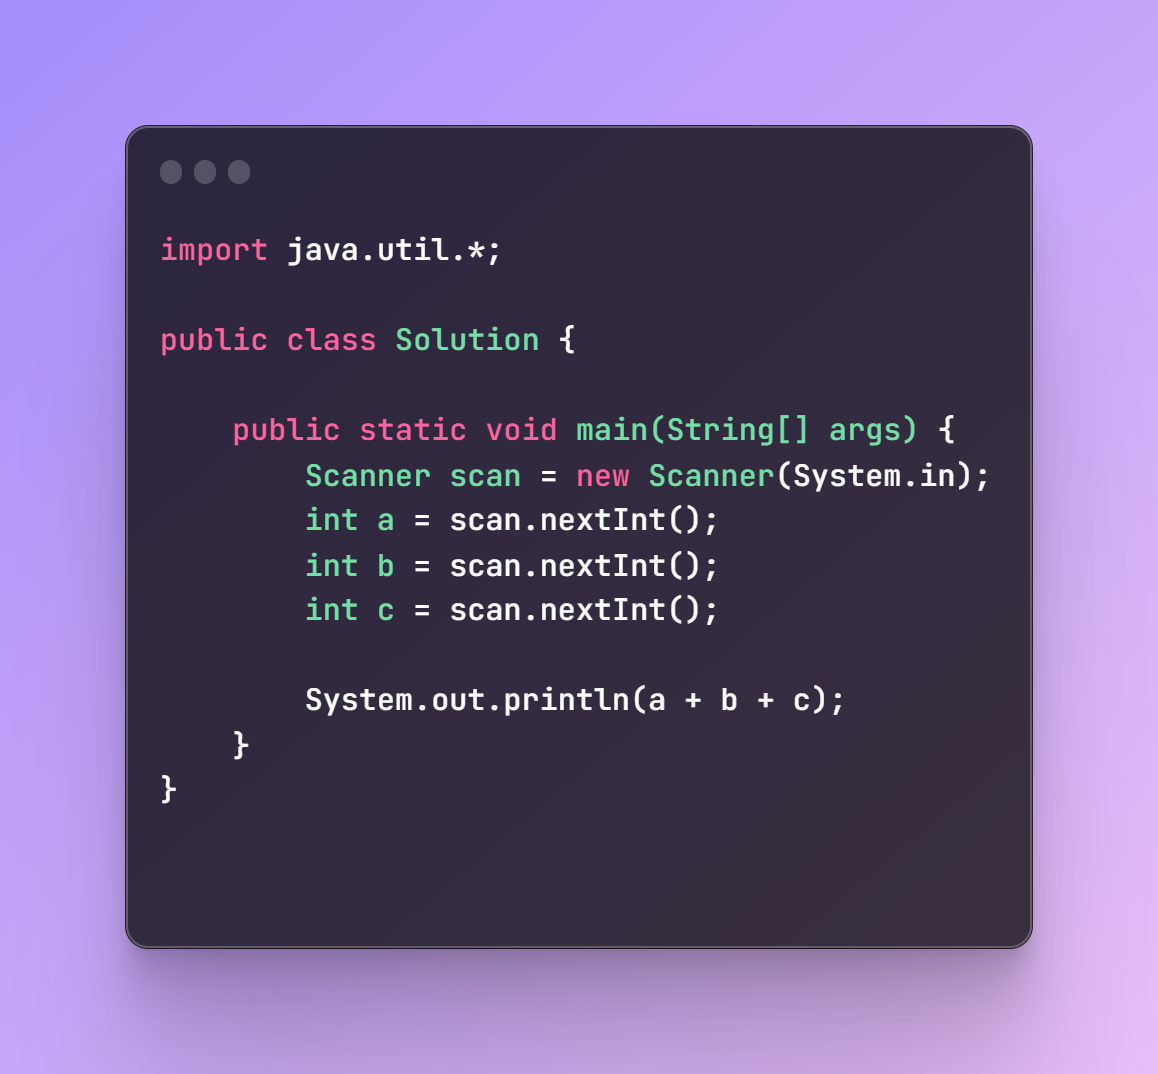
Ví dụ chương trình nhập vào a, b, c và in ra a+b+c

UW0ZOZIkKORmBqllGVt fOb3AnE3bpAyhXJDwG2Gev2ipj6siWvZC0Zzi9bna2xNvJqha62HxIU L7TCK8TtyebiJ moUrRId8bdnb - quochung.cyou PTIT

Biến

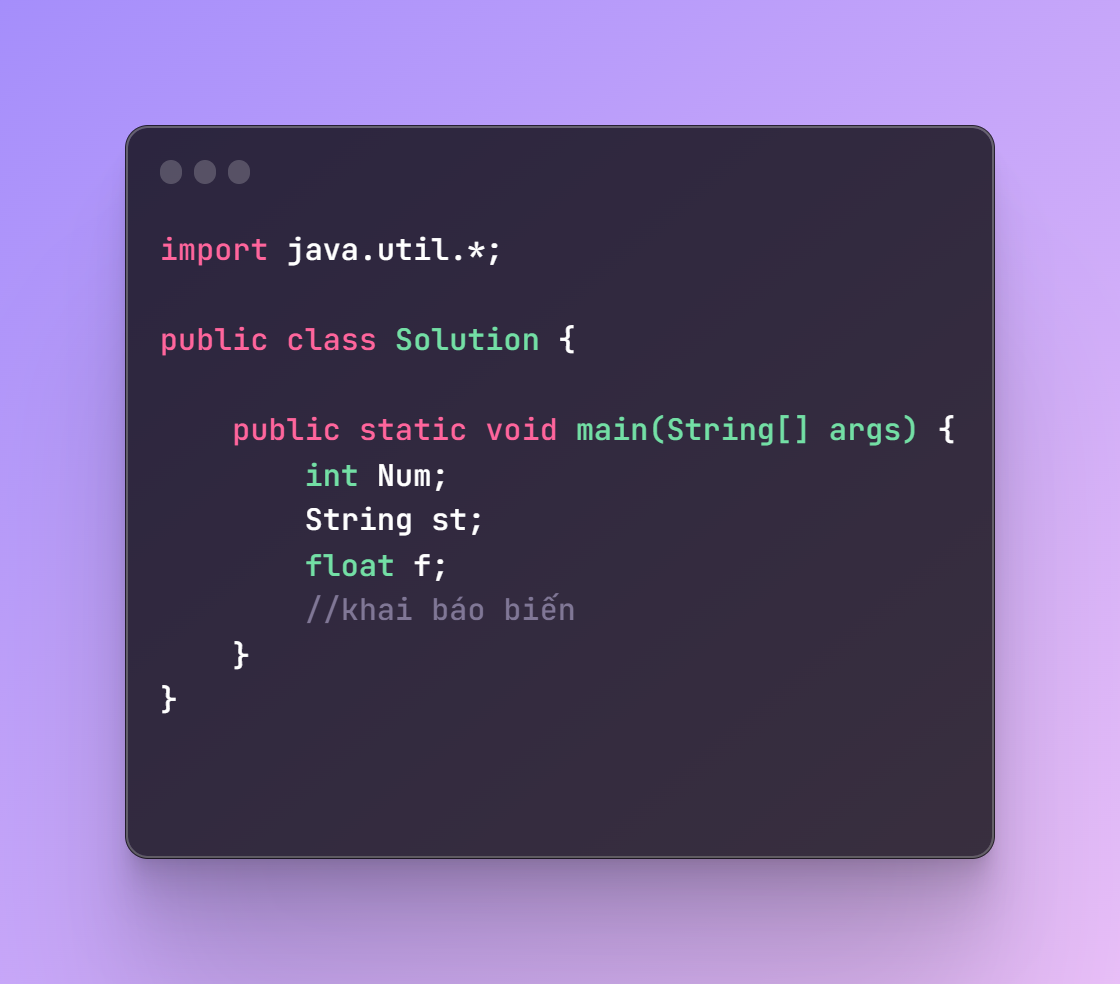
Khai báo: Data-type Variable-name = giá trị;

e Z1l79WxgoZ1Ht XJAIct CYFuolCXxLXyxrT QaDum47UPv7hhg8D3fljVEB 6vFQKxTy6ZxSs7U Jwlag0NceGZb0rMyfe6ULodTkNypUGXcSr - quochung.cyou PTIT

Biến trong Java có 3 loại, mỗi loại nằm ở vị trí riêng:

  • Biến thực thể (instance variable): nằm trong class, không thuộc method nào. Biến này thuộc về các thực thể (instance – object) được tạo ra từ class.
  • Biến tĩnh (static variable): tương tự biến thực thể, nhưng có từ khóa static để đánh dấu biến thuộc về class, không phải object.
  • Biến cục bộ (local variable): được khai báo trong method.
YjEGEubPn91QA A9cn4EIIQ4WtLLgnyXbCYqoWHCyhkzntfx1o8d - quochung.cyou PTIT

Toán tử

Các toán tử trong java tương tự như C++:

  • Toán tử tăng giảm (increment, decrement): a++, ++a, a–, –a
  • Toán tử thuận và đối (position, negation): +a, -a
  • Toán tử số học (arithmetic): a + b, a – b, a * b, a / b (chia nguyên), a % b (chia dư)
  • Toán tử ba ngôi (ternary): a > b ? a : b và có thể lồng nhau như (a > 0) ? “Dương” : (a < 0) ? “Âm” : “Số không”
  • Toán tử gán (assignment): phép gán a = 5 và phép gán kết hợp như a += 5, a -= 3
  • Toán tử quan hệ (relational): So sánh bằng a == 5, khác a != 5, lớn a > 5, bé a < 5, lớn hơn hoặc bằng a >= 5, bé hơn hoặc bằng a <= 5.
  • Toán tử logic (thực hiện trên boolean): phép and a && b, or a || b và not !a
  • Toán tử thao tác bit (bitwise): gồm and 10 & 3, or 10 | 3 và not !10. Các phép bitwise thực hiện trên số nguyên, và kí hiệu chỉ gồm 1 dấu.
  • Toán tử dịch chuyển bit (bit shifting): phép dịch trái x << y (nhân 2^y), dịch phải điền cùng dấu x >> y (chia nguyên 2^y) và dịch phải điền 0 (zero filled – chia nguyên lấy trị tuyệt đối cho 2^y) x >>> y.

Câu lệnh rẽ nhánh if else

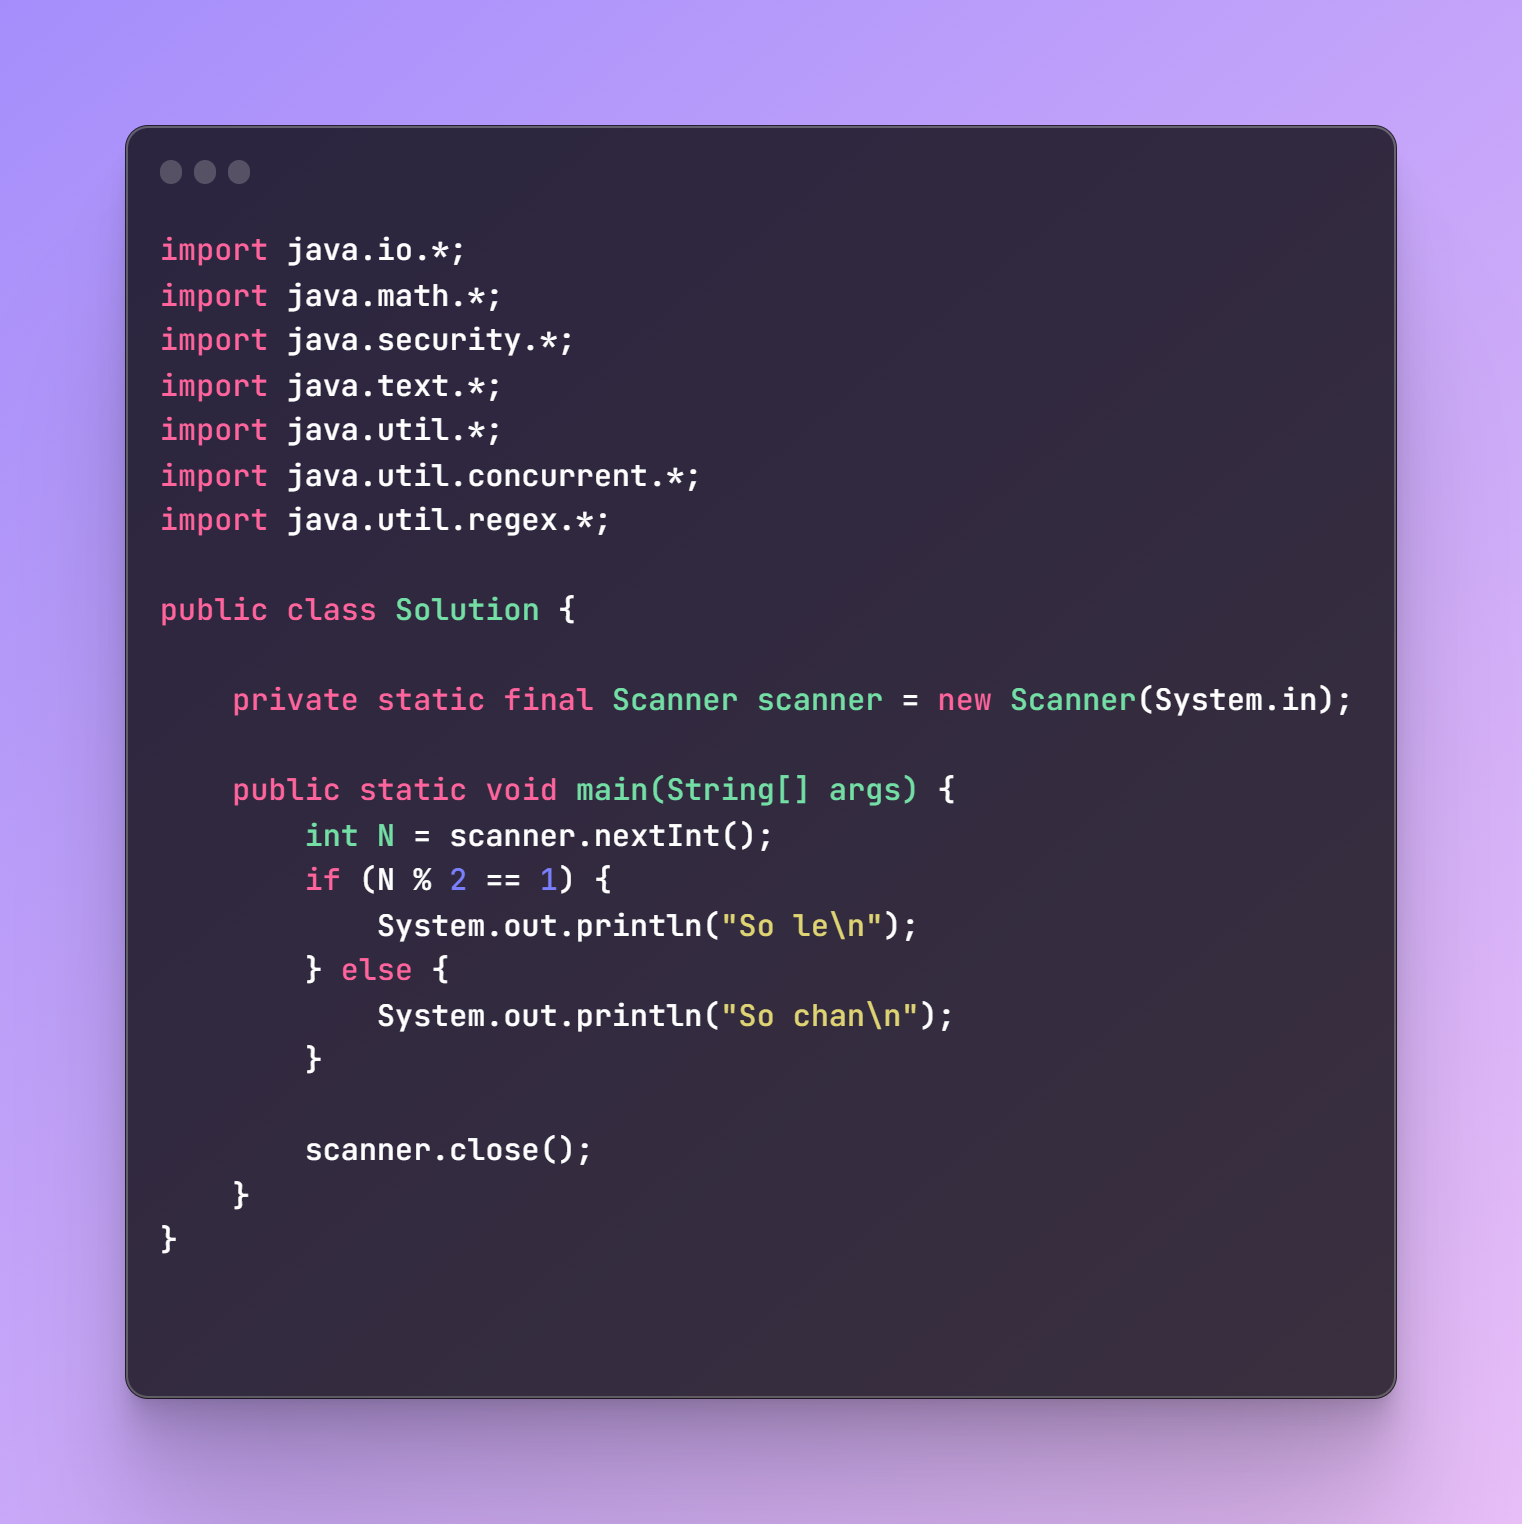
Lệnh if else tương tự như trong C++. Nếu điều kiện trong if đúng thì thực hiện lệnh, nếu không thì đi tiếp hoặc thực hiện lệnh trong else (nếu có).

HUJWDAEwyK4UpA9boMoeir7vLR6Yf9u941YhsWNBrv8 5UTCfI7LSNX9crbSswXFFOKal sKpnfiGYbKkgWULltvOYqEk7oabni4TDC15LQMB blIy9wEI2NMEYSaQRz4XMQ6kVQVDMUyP3Yoj 2nw - quochung.cyou PTIT

Ngoài ra ta có thể thay if else bằng toán tử 3 ngôi hoặc switch-case với cấu trúc giống như C++.

Vòng lặp

While loop

Vòng lặp while kiểm tra điều kiện, nếu đúng thì thực hiện lệnh, sau đó quay lại kiểm tra điều kiện lần nữa,… cho tới khi điều kiện sai thì dừng.

dxUA9zFg6R6824hGZvHTcL0Qm1nkOZfrigNin hiXFI3xLCTZYaIU TQYJZY0Wt KdjlqjiLY2Ne0birdqSrt3AsJvdruZ3QvPLUSeDWnWBgwmTmWqYtuXRQjEZJBiqnG9I9ZFjuVekde5GRBD7hAw - quochung.cyou PTIT

Do while loop

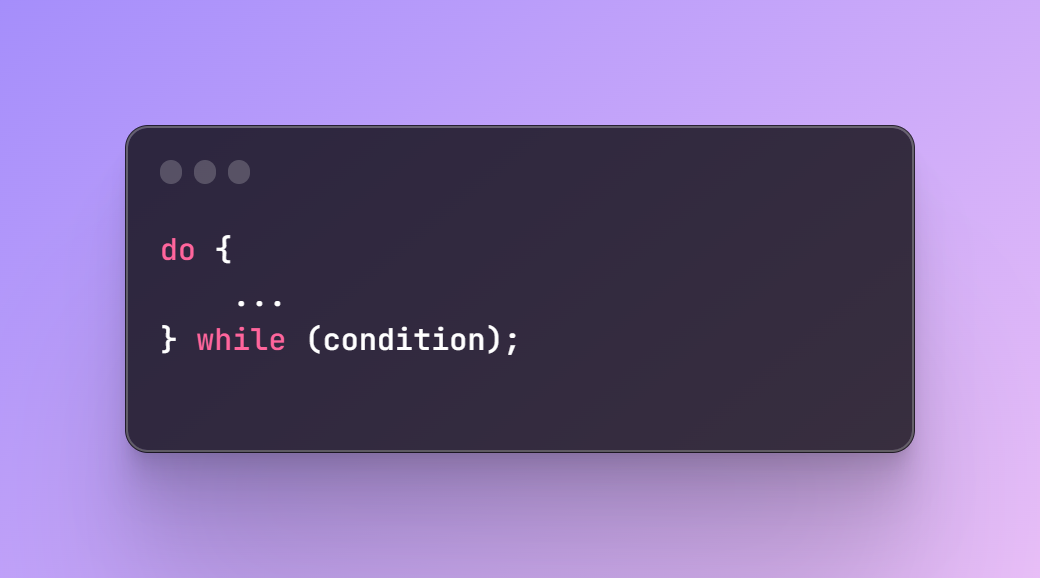
Lặp do while khác với while chút xíu, là do while sẽ thực hiện lệnh trước rồi mới check điều kiện. Do đó, lệnh luôn được thực hiện ít nhất một lần.

9 c6EirvGWa9h8 iJ4LqKO5qtcuU4AmkDvR5NRbJ3d14 z3MmWJOtSg7951clkoYQw 1WUEELH4Sd7cyDA0hG HtYGkiZZWRiS8DAwmoTM1VHnkO0qjP1DgrauCCESZaWJrRiQD8DAXoSXpOBebwWw - quochung.cyou PTIT

Cả hai vòng lặp do while và while cần tránh lặp vô tận.

For loop

bH2cbQGchETxH4LOLtRUbIGTXsFUWQhcyBQ1Fq4yfg8c9 JoEU5rI8HMYCAXloTmYCAYPdw8Txs9i8Mj3pXCa9eckvNub9bJbXiWyvXz - quochung.cyou PTIT

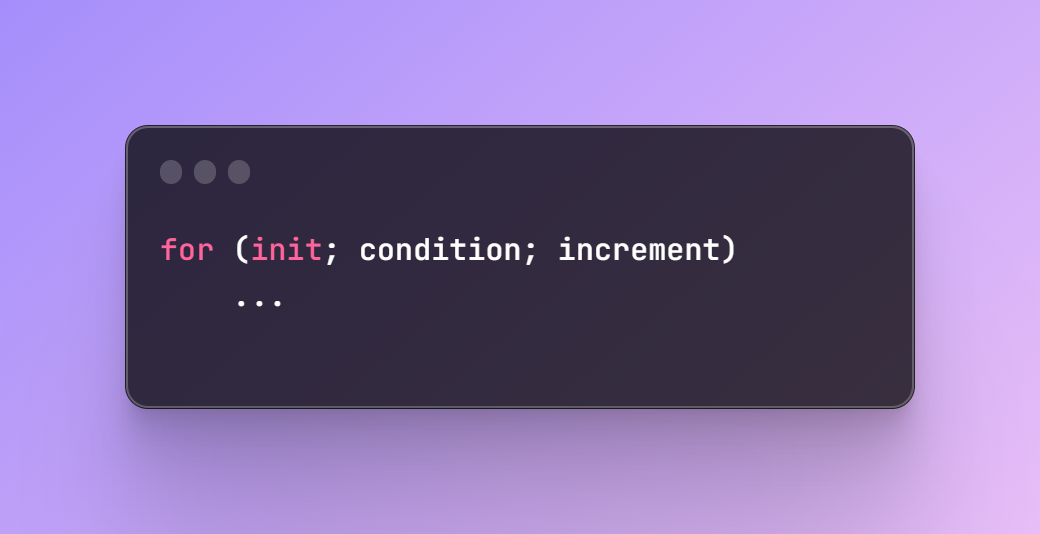
Lệnh lặp for gồm 3 phần trong ngoặc tròn:

  • Phần init dùng khởi tạo biến đếm
  • Phần condition chỉ định điều kiện lặp tiếp
  • Phần increment dùng tăng, giảm biến đếm, để tới lúc nào đó điều kiện trở thành false.

Java có một vòng lặp khác, gọi là for each nhưng vẫn dùng từ khóa for, nhưng theo cú pháp khác.

IETV2P326PUyV73Hv43YV8 8U6OALzC5aoayCf wkxV8TlnadDKpjxjp2qKKDG29LthVb ny1TVXYlgC09N1 Kb 5jv11DDO JXNx0Jl8EIUvFDJE VL5asaydmNQ - quochung.cyou PTIT

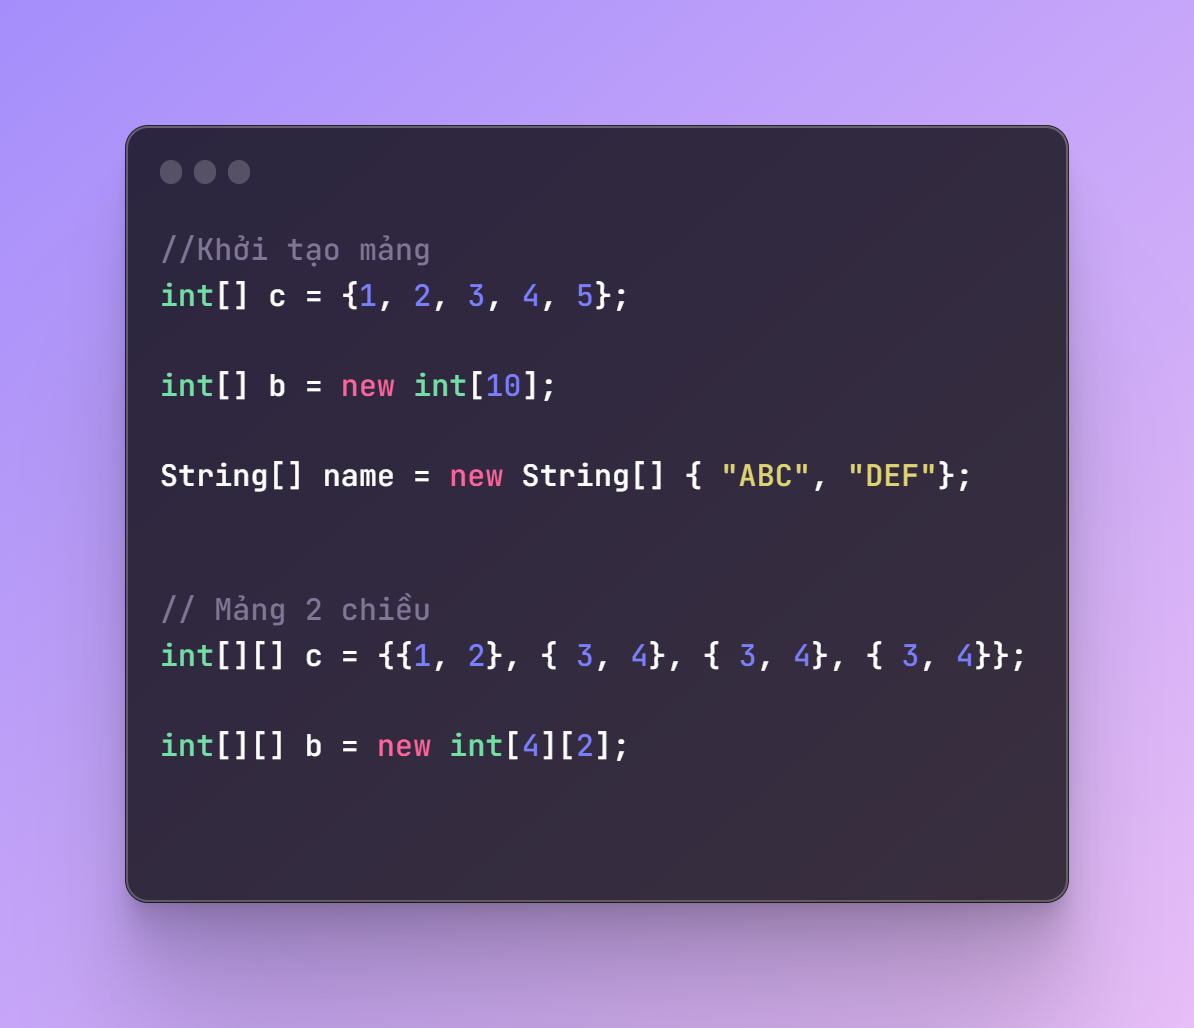
Mảng – Array

Cần import thư viện Array để sử dụng

tv4pBB1oiXBngPY8rXto27fnpBCTtCUWopb6qhWltdDVDf4iPfYW z DppqJ7i7AJ3V4W0Me GNkyrrN0fsTVm 8wsD8wRKjvaL6Vra5g1PR2LKAAR9Y4Jh2P1EBD5w42Zi3y5S85LB5NqEIPvSUDA - quochung.cyou PTIT

Khai báo mảng: Data-type Array-name

Zue1kRbn73F1 qEW4KC7CpS3wVNMotEqQQ1sLdFybIYF9zuJ9u AigBMyehiW8LIdsjF r3AHty EKb8MlxryVrbjSErNaDaJyNnCLaWNhmYiC8h GCBl2VC4kDcu9ukNS4MkKbC5R0MQJ3NnkQHbQ - quochung.cyou PTIT
kdH6lqXxIqP4D3Cq0 1vTyQynO2Gta uU Mnv5xvxSZi9wGPQNNaI6UCrQKgbvNSSUI6m8C8gagdHDUZU6k9zzC - quochung.cyou PTIT
  • Truy cập một phần tử trong mảng: Tên mảng[vị trí] – giống với C++ a[x]
  • Bằng các cú pháp nhập xuất tương tự C++, có thể triển khai sắp xếp, làm việc trên mảng

Wrapper Class

Lớp Wrapper sẽ giúp chúng ta chuyển đổi qua lại giữa một kiểu dữ liệu nguyên thủy sang kiểu dữ liệu đối tượng và ngược lại.

Kiểu nguyên thủyKiểu Wrapper
booleanBoolean
charCharacter
byteByte
shortShort
intInteger
longLong
floatFloat
doubleDouble

int a = 5;

a.ham()

Integer a = 5; a.ham()

  • Chuyển đổi một kiểu nguyên thủy sang kiểu Wrapper của nó người ta gọi là Boxing. Ngược lại, khi bạn chuyển từ một kiểu Wrapper sang kiểu nguyên thủy của nó người ta gọi là Unboxing.
  • Một số cấu trúc khác bên trong ngôn ngữ Java, như ArrayList hay Vector đều chứa đựng các tập hợp kiểu dữ liệu đối tượng thay vì kiểu nguyên thủy, nên việc biết và vận dụng các lớp Wrapper là một bắt buộc.
  • Ngoài ra thì kiểu dữ liệu đối tượng sẽ thích hợp hơn trong việc thực thi đa luồng (multithreading) và đồng bộ hóa (synchronization).
  • Các phương thức với Wrapper class:
    • …Value(): giúp chuyển đổi một giá trị của lớp Wrapper nào đó về kiểu dữ liệu nguyên thủy (unboxing).
    • parse…(“”): Tham số truyền vào cho phương thức là một chuỗi, kết quả nhận được là một giá trị nguyên thủy tương ứng với chuỗi truyền vào.
    • toString(): chuyển đổi từ liểu dữ liệu Wrapper thành string.
OI7t2DwTSt3W0WPWjI9aLjldapVMTUM3HZueXpBCt7dtwKTx lS0k8fcpPqHmZ - quochung.cyou PTIT

String Class

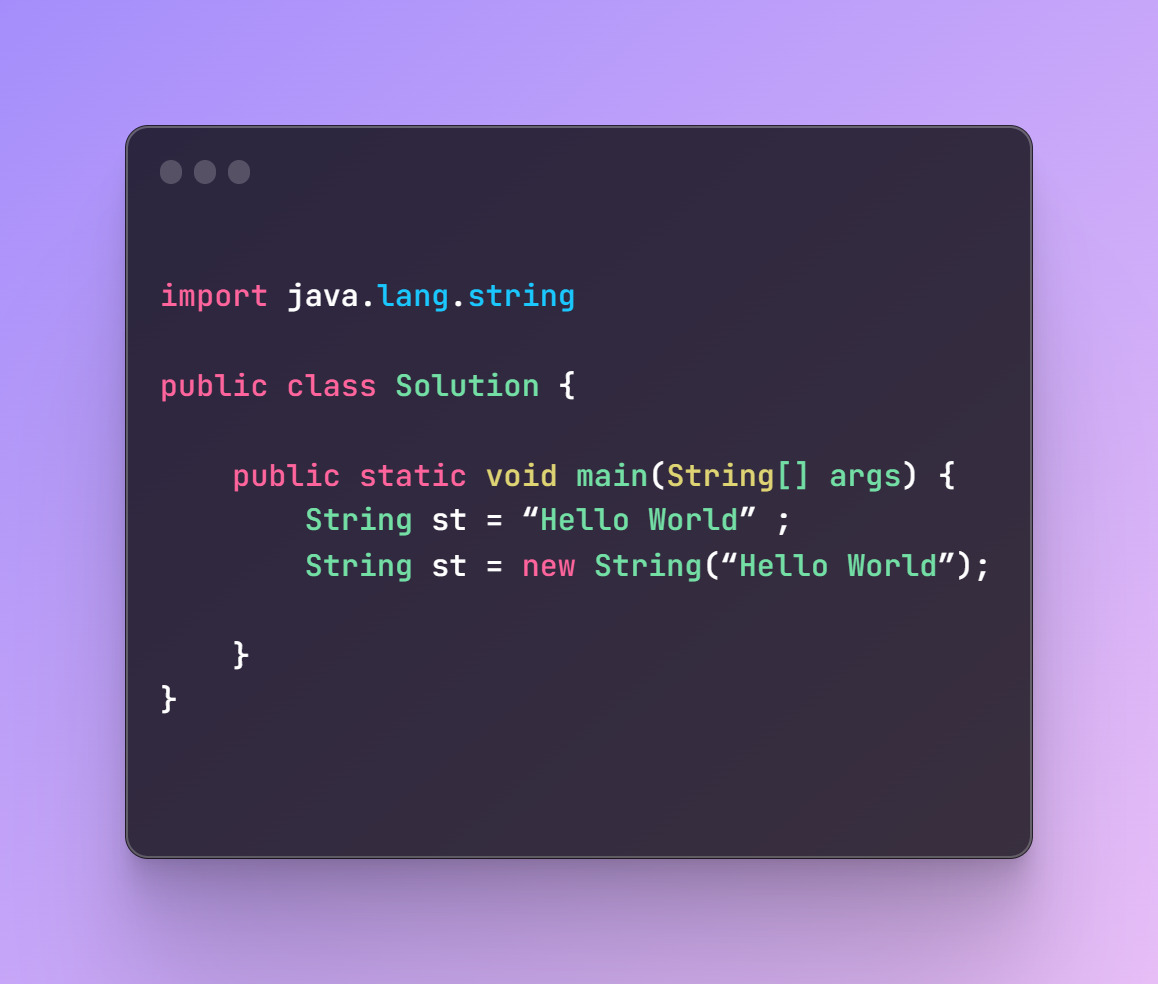
String không phải kiểu dữ liệu nguyên thuỷ, mà một đối tượng của class String.

Cần import thư viện

41xXlAv9jdQqNH4UPKjLjpC9XQ0aHoGybInKQ5oKWWV6zEGTHxhB8ktTEDRWXozX yNaZEF9Cq9m9HNlQ8MY0V2qbQCVTWYSYLgUfZqDmidVgjk fD n8FfYEXnH4k7LhNZKY9bM 3wNq1VdaChCuA - quochung.cyou PTIT
S5XvA0 yH0ITS - quochung.cyou PTIT
  • Class String chứa các hàm có chức năng tương đồng với kiểu dữ liệu chuỗi của các ngôn ngữ khác như C++, Python, có thể kể đến vài hàm chính như:
  • length() : Trả về độ dài chuỗi
  • charAt(i): Kí tự ở vị trí i ; 
  • trim(): Bỏ đi khoảng trắng hai đầu
  • replace(): Thay đổi hết các đoạn chuỗi con thành đoạn chuỗi con mới
  • Và rất nhiều hàm khác được tích hợp sẵn

Math Class

Là lớp chứa các phương thức, hỗ trợ Toán Học trong Java, tương tự C++, có rất nhiều hàm được dùng phổ biến như:

  • Pow : Luỹ thừa
  • Sqrt: Lấy căn
  • Sin, cos, tan: Lượng giác
  • Floor, Ceil: Làm tròn
  • Và nhiều hàm hỗ trợ khác cho các công việc đặc thù.

Regex

Thuật ngữ Regex viết tắt của Regular expression. Nó là một chuỗi ký tự khác nhau diễn tả một mẫu tìm kiếm cụ thể. Nó cũng được gọi là Rational expression.

Nó được dùng để tìm kiếm và thao tác trên chuỗi văn bản. Nói một cách dễ hiểu là bạn có thể tìm một một mẫu dễ dàng và thay thế chúng bằng những mẫu phù hợp với sự giúp đỡ của biểu thức chính quy.

Pattern Class: (Lớp khuôn mẫu)

  • Đây là phiên bản biên dịch của một biểu thức chính quy. Nó được sử dụng để xác định một khuôn mẫu cho các biểu thức chính quy.
  • Lớp này có phương thức Compile(), ta sẽ truyền Xâu cần so khớp vào trong phương thức này, và nó sẽ trả về 1 đối tượng Pattern.
No.Phương thứcMô tả
1static Pattern compile(String regex)biên dịch regex đã cho và trả về thể hiện của Pattern.
2Matcher matcher(CharSequence input)tạo một matcher khớp với đầu vào đã cho với mẫu.
3static boolean matches(String regex, CharSequence input)Nó biên dịch biểu thức chính quy và tìm kiếm các chuỗi con từ chuỗi input phù hợp với mẫu regex.
4String[] split(CharSequence input)chia chuỗi input đã cho thành mảng các kết quả trùng khớp với mẫu đã cho.
5String pattern()trả về mẫu regex.

Matcher Class – Lớp so sánh

  • Lớp Matcher thực thi interface MatchResult. Nó được sử dụng để thực hiện các hoạt động so khớp trên một chuỗi ký tự.
  • Thực hiện chức năng So khớp chính.
  • Ta sẽ có được 1 đối tượng Matcher khi gọi tới phương thức matcher() trên một đối tượng Pattern.
  • Ta truyền Xâu đầu vào – Xâu cần so khớp vào matcher() và xem xem nó có chứa mẫu mong muốn xuất hiện.
No.Phương thứcMô tả
1boolean matches()kiểm tra xem biểu thức chính quy có khớp với mẫu hay không.
2boolean find()tìm biểu thức tiếp theo khớp với mẫu.
3boolean find(int start)tìm biểu thức tiếp theo khớp với mẫu từ số bắt đầu đã cho.
4String group()trả về chuỗi con phù hợp.
5int start()trả về vị trí bắt đầu của chuỗi con phù hợp.
6int end()trả về vị trí kết thúc của chuỗi con phù hợp.
7int groupCount()trả về tổng số các chuỗi con phù hợp.

Cú pháp Regex

No.Biểu thức chính quyMô tả
1.Khớp (match) với bất kỳ ký tự nào
2^regexBiểu thức chính quy phải khớp tại điểm bắt đầu
3regex$Biểu thức chính quy phải khớp ở cuối dòng.
4[abc]Thiết lập định nghĩa, có thể khớp với a hoặc b hoặc c.
5[abc][vz]Thiết lập định nghĩa, có thể khớp với a hoặc b hoặc c theo sau là v hay z.
6[^abc]Khi dấu ^ xuất hiện như là nhân vật đầu tiên trong dấu ngoặc vuông, nó phủ nhận mô hình. Điều này có thể khớp với bất kỳ ký tự nào ngoại trừ a hoặc b hoặc c.
7[a-d1-7]Phạm vi: phù hợp với một chuỗi giữa a và điểm d và con số từ 1 đến 7.
8X |∣ ZTìm X hoặc Z.
9XZTìm X và theo sau là Z.
10$Kiểm tra kết thúc dòng.
11\dSố bất kỳ, viết ngắn gọn cho [0-9]
12\DKý tự không phải là số, viết ngắn gon cho [^0-9]
13\sKý tự khoảng trắng, viết ngắn gọn cho [ \t\n\x0b\r\f]
14\SKý tự không phải khoản trắng, viết ngắn gọn cho [^\s]
15\wKý tự chữ, viết ngắn gọn cho [a-zA-Z_0-9]
16\WKý tự không phải chữ, viết ngắn gọn cho [^\w]
17\S+Một số ký tự không phải khoảng trắng (Một hoặc nhiều)
18\bKý tự thuộc a-z hoặc A-Z hoặc 0-9 hoặc , viết ngắn gọn cho [a-zA-Z0-9].
19*∗Xuất hiện 0 hoặc nhiều lần, viết ngắn gọn cho {0,}
20++Xuất hiện 1 hoặc nhiều lần, viết ngắn gọn cho {1,}
21??Xuất hiện 0 hoặc 1 lần, ? viết ngắn gọn cho {0,1}.
22\{ X \}{X}Xuất hiện X lần, {}
23\{ X, Y \}{X,Y}Xuất hiện trong khoảng X tới Y lần.
24*?∗?* có nghĩa là xuất hiện 0 hoặc nhiều lần, thêm ? phía sau nghĩa là tìm kiếm khớp nhỏ nhất.
K0VqPW12e2Rt V nY aU3YdTYW89WMhlTVdwCHkjoE 3k5JSh9sOsfhfy5e0k1RLSNZYHslcGnz0YyPU6hQ8iH6IZOq8CttsXi8eX5FAohNZi4i2iEtaqq17l3hT Yv QkKzt0PsZBN YPgwez4Qw - quochung.cyou PTIT

Class và Object – Java OOP

Encapsulation (Tính đóng gói)

  • Tính đóng gói trong java là kỹ thuật ẩn giấu thông tin không liên quan và hiện thị ra thông liên quan. Mục đích chính của đóng gói trong java là giảm thiểu mức độ phức tạp phát triển phần mềm. Tức là thiết kế để các thuộc tính và phương thức thuộc về (bên trong) một lớp.
  • Với các access modifier, tính đóng gói sẽ có thể giúp ngăn chặn những lớp bên ngoài truy cập, thay đổi thuộc tính và phương thức của một lớp. Từ đó, giúp cho việc che giấu dữ liệu, để bảo vệ trạng thái bên trong của một đối tượng. Hơn nữa, việc ẩn giấu các biến thì các lớp sẽ không chia sẻ thông tin với nhau được. Điều này làm giảm số lượng khớp nối có thể có trong một ứng dụng.

Ví dụ: Các biến của class đều ở private và chỉ truy cập được qua các phương thức public.

Ce60mqRAo9P9W55lx0wM OxCm8lFECFJrI7eqpQN1FoJiTiw IcJaf2vvVu - quochung.cyou PTIT

Tính kế thừa

Tính kế thừa trong Java là một cơ chế trong đó một đối tượng có được tất cả các thuộc tính và hành vi của một đối tượng cha.

  • Khi bạn kế thừa từ một class có sẵn, bạn có thể tái sử dụng các phương thức và trường của class cha. Hơn nữa, bạn có thể thêm các phương thức và trường mới trong class hiện tại.
  • Sử dụng tính kế thừa, ta có thể thực hiện Method Overriding, từ đó xuất hiện tính Đa hình trong runtime.
  • Phân loại:
    • Đơn kế thừa.
    • Kế thừa nhiều cấp.
    • Kế thừa thứ bậc.
Ảnh
  • Đa kế thừa và Kế thừa hỗn hợp không được hỗ trợ thông qua Class trong Java, nhưng vẫn được hỗ trợ thông qua Interface.

Cú pháp: sử dụng từ khóa extends

p1Jp1YQ59htzcCL1CeeXlpwwBLgmGsYtp9bWkP1vs28ahClg3wL7MArd7HWLVokbJsHV09znbF6IQU KsbABrCVy9b4h1jT4LzfNECaahCiP4hniZaq VYizxxMfvRVmFe wzLNvxfhliURevK H1A - quochung.cyou PTIT
3BMaF24YMVkGVr TjYtwE5HK3krzXMXVCAXOUt UcJ nOKP2gNzK6QITmHCzEseoayATqN f1eM - quochung.cyou PTIT
  • Ngoài ra còn có từ khóa super để tham chiếu trực tiếp đến đối tượng của lớp cha gần nhất.
  • Sử dụng từ khóa super.xxx để gọi đến phương thức xxx của lớp cha gần nhất.
  • Sử dụng super() để gọi trực tiếp constructor (hàm tạo) của lớp cha gần nhất.

Polymorphism (Tính đa hình).

  • Đa hình là ta có thể thực hiện một hành động bằng nhiều cách khác nhau.
  • Có hai kiểu của đa hình trong java, đó là đa hình lúc biên dịch (compile) và đa hình lúc thực thi (runtime). Chúng ta có thể thực hiện đa hình trong java bằng cách method overriding (ghi đè phương thức) và method overloading (nạp chồng phương thức).
  • Ghi đè phương thức: method overriding – ghi đè method ở lớp cha trong lớp con, ta chỉ cần viết code thực thi khác của method đó ở trong lớp con là được.
  • Nạp chồng phương thức : method overloading – Trong một class có thẻ có nhiều method cùng tên nhưng khác nhau tham số truyền vào và dữ liệu trả về, cách hoạt động khác nhau.
zxjvmgNtzKEZWud8u02qY7sfyLPwk3AnZcZ7PiLjFMpgHlhgsklByV0kD5Mm2NvcmK bCsDH2 rlldIq - quochung.cyou PTIT
6joY FctI6mmYgFi YZ53KBJcMsJ 1K5u C132rbLXiX6C463RTxTlYSSx4PwAEzKVVBWxXY7qnWVni LaGnSyHgnZuqWiaCfw5CSeDhIfF6mBS0zCGCc9u3QtpV4h03 56MERfYMTmw YGBAzl4g - quochung.cyou PTIT

Abstract Classes (Lớp trừu tượng).

  • Một phương thức được khai báo là abstract và không có code thực thi thì đó là phương thức trừu tượng, (giống virtual trong C++), được khai báo với từ khóa abstract ở trước.
  • Lớp trừu tượng thường được dùng để kế thừa. Và lớp trừu tượng không thể tạo ra instance.
  • Lớp abstract là lớp có các abstract method (Phương thức trừu tượng) (Có thể có hàm không trừu tượng)
  • Phương thức trừu tượng (abstract method)
    • Một phương thức được khai báo là abstract và không có trình triển khai thì đó là phương thức trừu tượng.
    • Nếu muốn một lớp chứa một phương thức cụ thể nhưng bạn muốn triển khai thực sự phương thức đó để được quyết định bởi các lớp con, thì bạn có thể khai báo phương thức đó trong lớp cha ở dạng abstract.
hms8oMyC9f6CcqbpRKUSJF7aYpy AaqY5JxDHXeCpuEJovaWF zyjcCrGvZg178w1N547DaSYCm2YzS fY8eF no5wgxht10UgMm8T2ZL1hOwd UeMKz - quochung.cyou PTIT

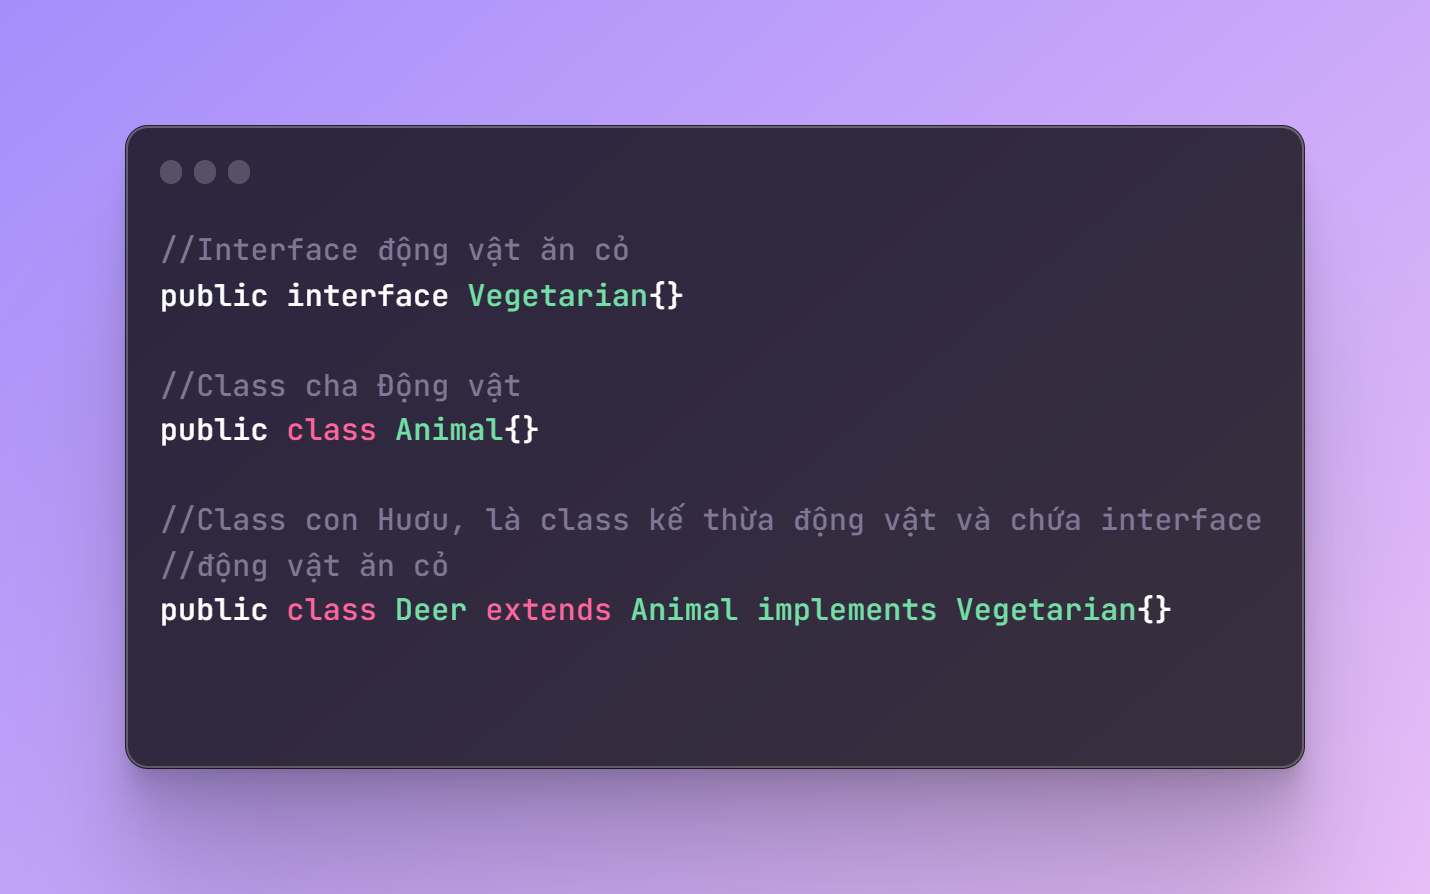
Interface

Là một bản thiết kế của một lớp. Nó chỉ có các phương thức trừu tượng. Interface là một kỹ thuật để thu được tính trừu tượng hoàn toàn và đa kế thừa trong Java. Nó không thể được khởi tạo giống như lớp trừu tượng.

1d27jfdZ26V 6Jf7zJCbe o Iguv7NhQC4p1E92JjyAlmVqisYEAZZecGXV7EW1ab2Y DNGj9CJKNrDvLnsguzhxu8u1Iivq1V2 w3354ZC 7BgZ4fMMTLyapTpJBlPFSIBsaCaPe6i HFhw1gnhJQ - quochung.cyou PTIT

Một interface khác với một class ở một số điểm sau đây:

  • Không thể khởi tạo interface, interface không có Constructor
  • Phương thức interface đều phải là abstract (Khác lớp trừu tượng vẫn có thể có phương thức không trừu tượng)
  • Tất cả trường interface đều là static hoặc final
  • Interface chỉ có thể kế thừa từ interface
uA5WtBBrDCh2LDj OXxLrVnWpP 5BVC9Y4ZM9IxOrEv2P5fVstrgbQe5qt3bQxfIP5hFaCFHPVMM9Fog0ORpdTon8lfVupXMwKYslI3WAKupKPL0Ms k3fcpua2vdCJLOlWIoXQnrnAYfy 9VHCfog - quochung.cyou PTIT

 Modifiers

  • Có hai loại Modifier trong Java, đó là: Access Modifier và Non-access Modifier. 
  • Tương tự OOP trong C++, trong Java có 4 phạm vi truy cập của Access Modifier như sau:
    • private
    • default
    • protected
    • public
Access ModifierTrong lớpTrong packageNgoài package bởi lớp conNgoài package
PrivateYNNN
DefaultYYNN
ProtectedYYYN
PublicYYYY

Lưu ý:

  • Constructor cần để public để có thể thực hiện tính Kế thừa.
  • Nếu không khai báo Access Modifier, thì nó mặc định là default.
  • Protected access modifier được truy cập bên trong package và bên ngoài package nhưng phải kế thừa.
  • Ngoài ra có thêm final dùng để hạn chế người dùng:
    • final variable: không thể thay đổi giá trị (hằng số)
    • final parameter: tương tự final variable
    • final method: không thể ghi đè
    • final class: không thể kế thừa

Recap sự kiện BigGame 2022 – CLB Lập Trình PTIT

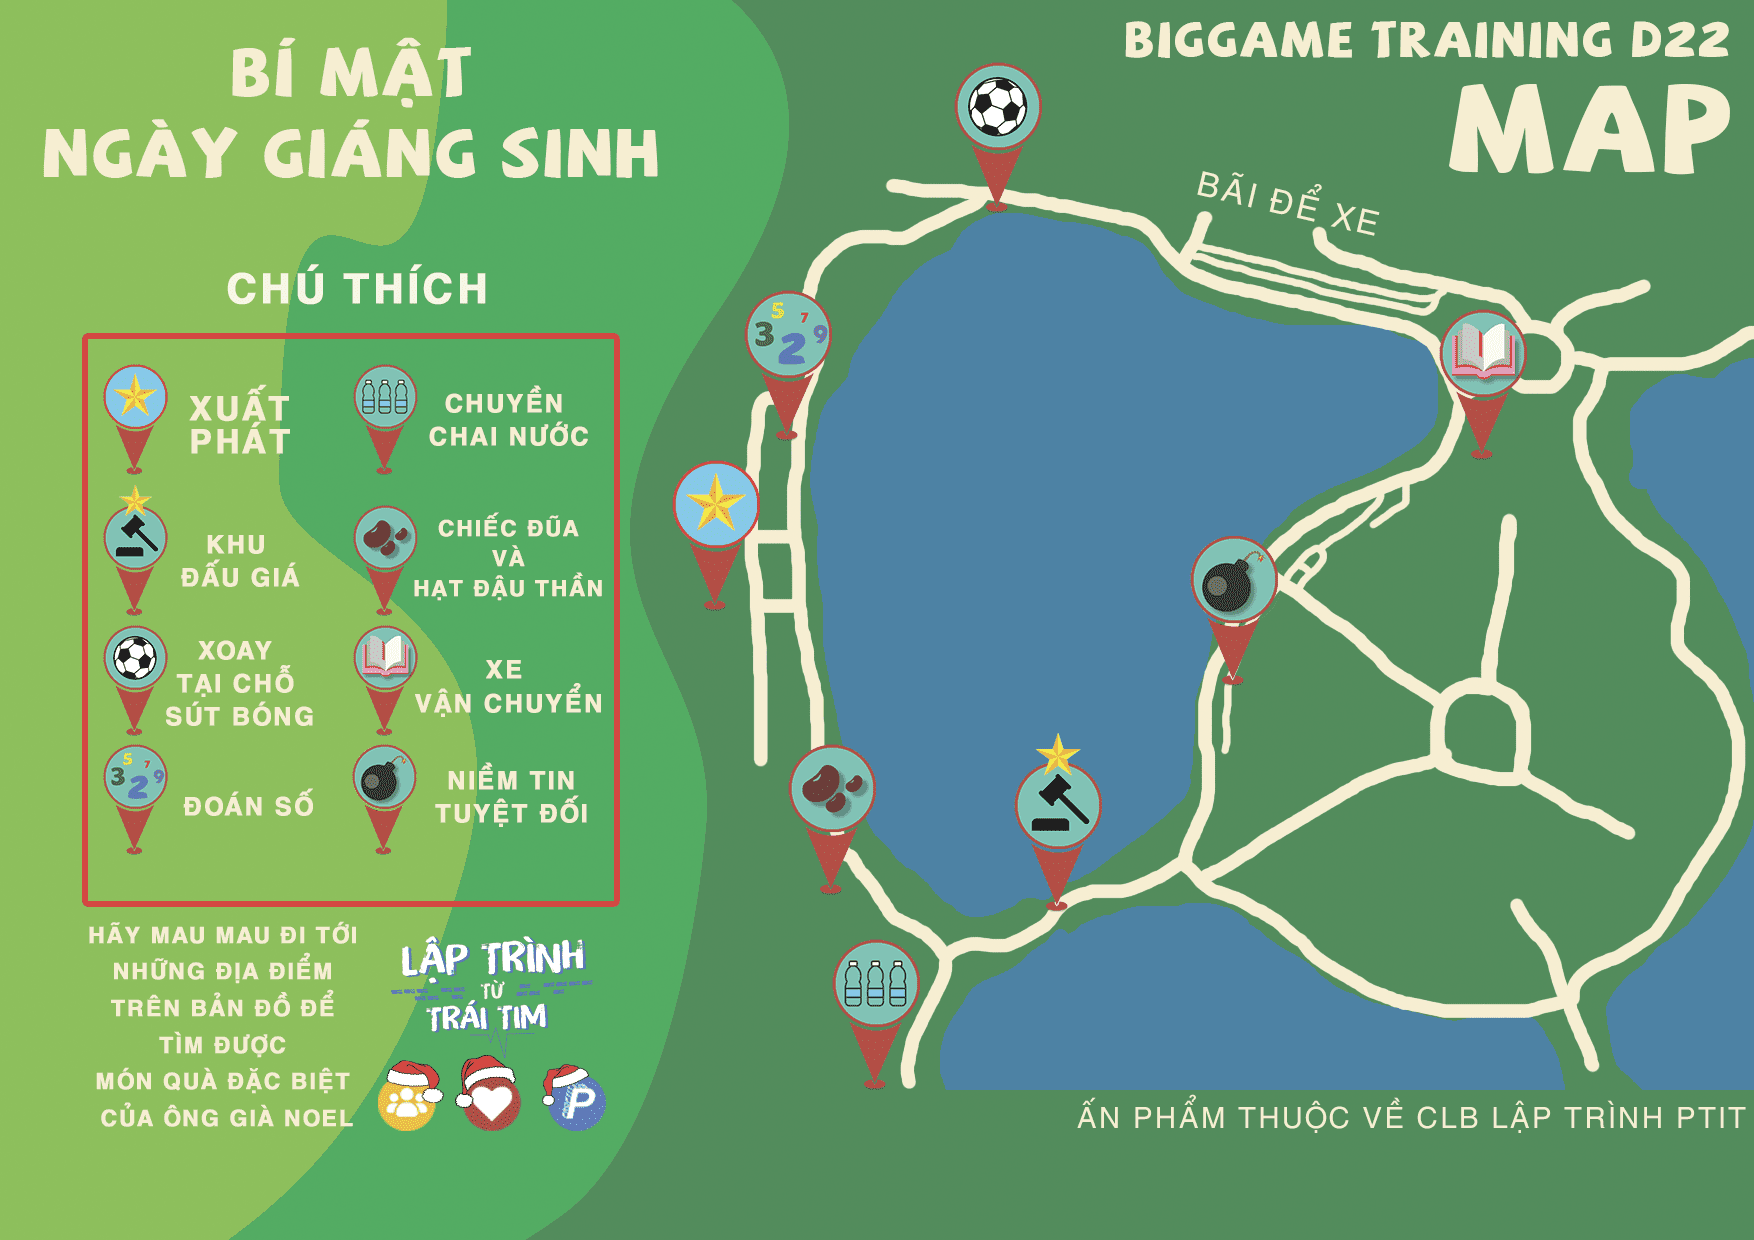
Sự kiện BigGame là một trong những sự kiện lớn của CLB Lập Trình PTIT được tổ chức trong kì Training để chọn thành viên chính thức của khoá mới. Sự kiện BigGame 2022 với chủ đề “Bí mật ngày Giáng Sinh” đã được tổ chức tại Công Viên Yên Sở và diễn ra vô cùng sôi động, kịch tính.

ban do yen so - quochung.cyou PTIT
Bản đồ – Map trò chơi (Công viên Yên Sở)

Vào buổi sáng của buổi BigGame, các bạn D22 đã được phân chia thành 5 team để chơi game trong ngày. Tham gia các trò chơi trên bản đồ sẽ nhận được điểm thưởng, ngoài ra còn có các điểm thường từ các phần quà rải rác trong bản đồ.

20221225 074405 - quochung.cyou PTIT
Tập trung đầu buổi
IMG 4952 - quochung.cyou PTIT
Phân chia team tham gia BigGame
20221225 081503 - quochung.cyou PTIT
MC (Anh Đức – Minh Anh) dẫn truyện và phổ biến quy tắc
20221225 091348 - quochung.cyou PTIT
Trò chơi (Chiếc đũa và Hạt đậu thần)
IMG 5052 - quochung.cyou PTIT
Trò chơi (Niềm tin tuyệt đối)
20221225 084413 - quochung.cyou PTIT
Các team tìm thấy phần quà ngẫu nhiên
20221225 103617 - quochung.cyou PTIT
Buổi đấu giá dùng điểm mua gợi ý về kho báu lớn nhất
20221225 103915 - quochung.cyou PTIT
Buổi đấu giá dùng điểm mua gợi ý về kho báu lớn nhất
20221225 134414 1 - quochung.cyou PTIT
Buổi mua gợi ý bằng hòm quay gacha
20221225 145939 - quochung.cyou PTIT
Văn nghệ của Team 1 Jupiter vào buổi chiều
20221225 151918 - quochung.cyou PTIT
Văn nghệ của Team 4
20221225 154713 - quochung.cyou PTIT
Trao các giải thưởng trong kì Training
IMG 5235 - quochung.cyou PTIT
Buổi BigGame kết thúc và chụp ảnh mọi người

[Game C++] Talking Simulator

Screenshot 1

A talking simulator game written in C++ with SFML Lib.

Main game mechanic is player going around, talking with npc and do question (Discrete Math, Data Structure and Algorithm, Politics, History, …) Answering question will give you point in stats, and your stats with affect the game ending.

Currently the game have up to 9 Ending!

Source repo: https://github.com/quochung-cyou/TalkingSimulator

Project Structure

  • main.cpp : Running the game
  • Game.cpp : Main game loop
  • GameStateBase.cpp, GameStateMachine.cpp: Handle the game state <INTRO (Splash screen) -> STORY -> MENU -> PLAY -> QUIZ -> END>
  • GSQuiz.cpp, Quiz.cpp: Handle the question system
  • MapConnector.cpp: Store player data like stats, last map, current map, map …
  • GSPlay.cpp: Play game state, Gameplay, handle the conversation with npc, render object, interact object
  • DialogSystem.cpp: Handle the dialog chat

Installation

Prerequisites

In order to compile this project you will need to:

  • have SFML installed on your system. If you don’t know how to do it see this link.
  • have CMake installed

Compilation

Detailed explanation here

On Linux with install.sh

  • Go in the repo folder

cd the/repo/location

  • Execute install.sh script

./install.sh

On Windows with CMake GUI and Visual Studio

  • Install the right SFML version or compile it (see this)
  • Run CMake
  • Select the repo location
  • Click on Configure, if you have installed the x64 version of SFML, in the pop up window select x64 in the Optionnal platform for generator drop down
  • Click on Finish
  • Click on Generate

Screenshots


Screenshot 2
Screenshot 3
Screenshot 4
Screenshot 5
Screenshot 6
Screenshot 7

Thuật toán: Tìm hiểu về Quay lui nhánh cận

  1. Lý thuyết 

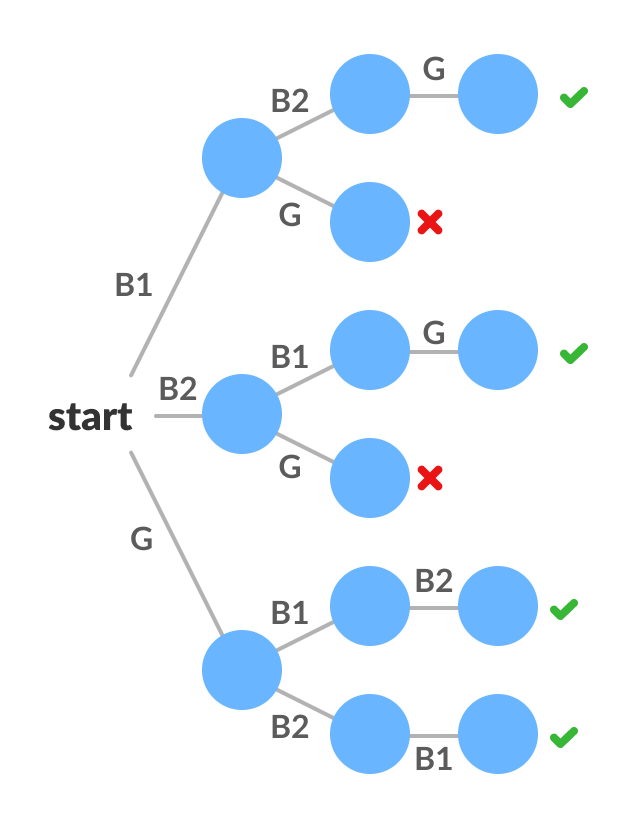
Quay lui là một kĩ thuật thiết kế giải thuật dựa trên đệ quy. Ý tưởng của quay lui là tìm lời giải từng bước, mỗi bước chọn một trong số các lựa chọn khả dĩ và đệ quy.

Tư tưởng

Dùng để giải bài toán liệt kê các cấu hình. Mỗi cấu hình được xây dựng bằng từng phần tử. Mỗi phần tử lại được chọn bằng cách thử tất cả các khả năng.

Các bước trong việc liệt kê cấu hình dạng X[1…n]:

  • Xét tất cả các giá trị X[1] có thể nhận, thử X[1] nhận các giá trị đó. Với mỗi giá trị của X[1] ta sẽ:
  • Xét tất cả giá trị X[2] có thể nhận, lại thử X[2] cho các giá trị đó. Với mỗi giá trị X[2] lại xét khả năng giá trị của X[3]…tiếp tục như vậy cho tới bước:
  • …
  • ….
  • Xét tất cả giá trị X[n] có thể nhận, thử cho X[n] nhận lần lượt giá trị đó.
  • Thông báo cấu hình tìm được.

Bản chất của quay lui là một quá trình tìm kiếm theo chiều sâu

Backtracking Algorithm

Kĩ thuật nhánh cận

Vì thuật toán đệ quy/quay lui thường có độ phức tạp là cấp số mũ nên đa số bài toán sẽ không thể xử lí trong thời gian yêu cầu.

Tuy nhiên khi xét các trường hợp, ta có thể áp dụng kĩ thuật bằng cách loại bỏ sớm các nhánh không thể khả thi từ sớm để giảm bớt rất nhiều độ phức tạp của Code.

VD:

Ta có 10 công việc với thời gian cần làm và lương nhận được khác nhau. Mỗi công việc chỉ làm 1 lần.

Cho một khoảng thời gian có là T, ví dụ khi ta đã tìm được 1 khả năng:

  • Trong 10 tiếng, chọn 4 công việc và kiếm được 600 nghìn

Thì khi xét 1 nhánh khác với 3 công việc, và ta nhận thấy nếu 

  • Thời gian còn lại / (Thời gian dành cho công việc tốt nhất) * Lương công việc cao nhất

Tức là cho dù ta làm công việc tốt nhất cho khoảng thời gian còn lại mà vẫn ít tiền hơn khả năng trên, thì không việc gì cần xét tiếp nhánh đó nữa.

|| Khi bạn đang tắc đường và cố chui vào 1 ngõ rẽ cho nhanh, nhưng bạn nhẩm cho dù đi đường vòng này nhanh nhất vẫn chậm hơn chờ tắc bình thường, thì tốt nhất nên quay đầu lại ngay chứ đừng chui vào ngõ tiếp.

Bài 1:  P135SUMG – SUM5 G – Xâu đặc biệt

https://www.spoj.com/PTIT/problems/P135SUMG/

RiGSu98VtUp07pJVcrBUMkU1Uj47Ht 6UU GqjI8QBq31D 8aSs - quochung.cyou PTIT

Ý tưởng:

  • Tại các vị trí ‘_’ , ta thử tất cả chữ cái có thể thay vào, sau đó tiếp tục di chuyển đến các từ ngữ tiếp theo
  • Cần lưu trữ lại số lượng các phụ âm, nguyên âm, số lượng chữ L hiện tại để dừng lại nếu không thỏa mãn yêu cầu

Độ phức tạp Code: 

  • Do đi qua từng vị trí (n) và tại mỗi vị trí có nhiều nhất 2 nhánh mới tạo ra, nên ~ 2^n
d7UxEWp b1yaW8 P dgr56MMHG8HvFPC2OElB0zyzTjDAAXTYjwfTJQbhQtp Hz0dt8jNSjdLFQYU y1CQoR9THLyI8zoNSAdiO G4t1JYMbGn2QQoBfubnxXgcyNE83nT - quochung.cyou PTIT

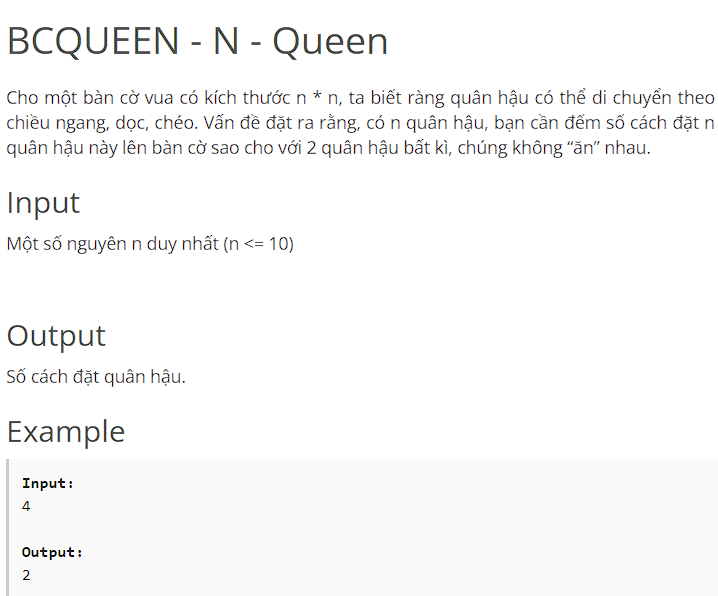
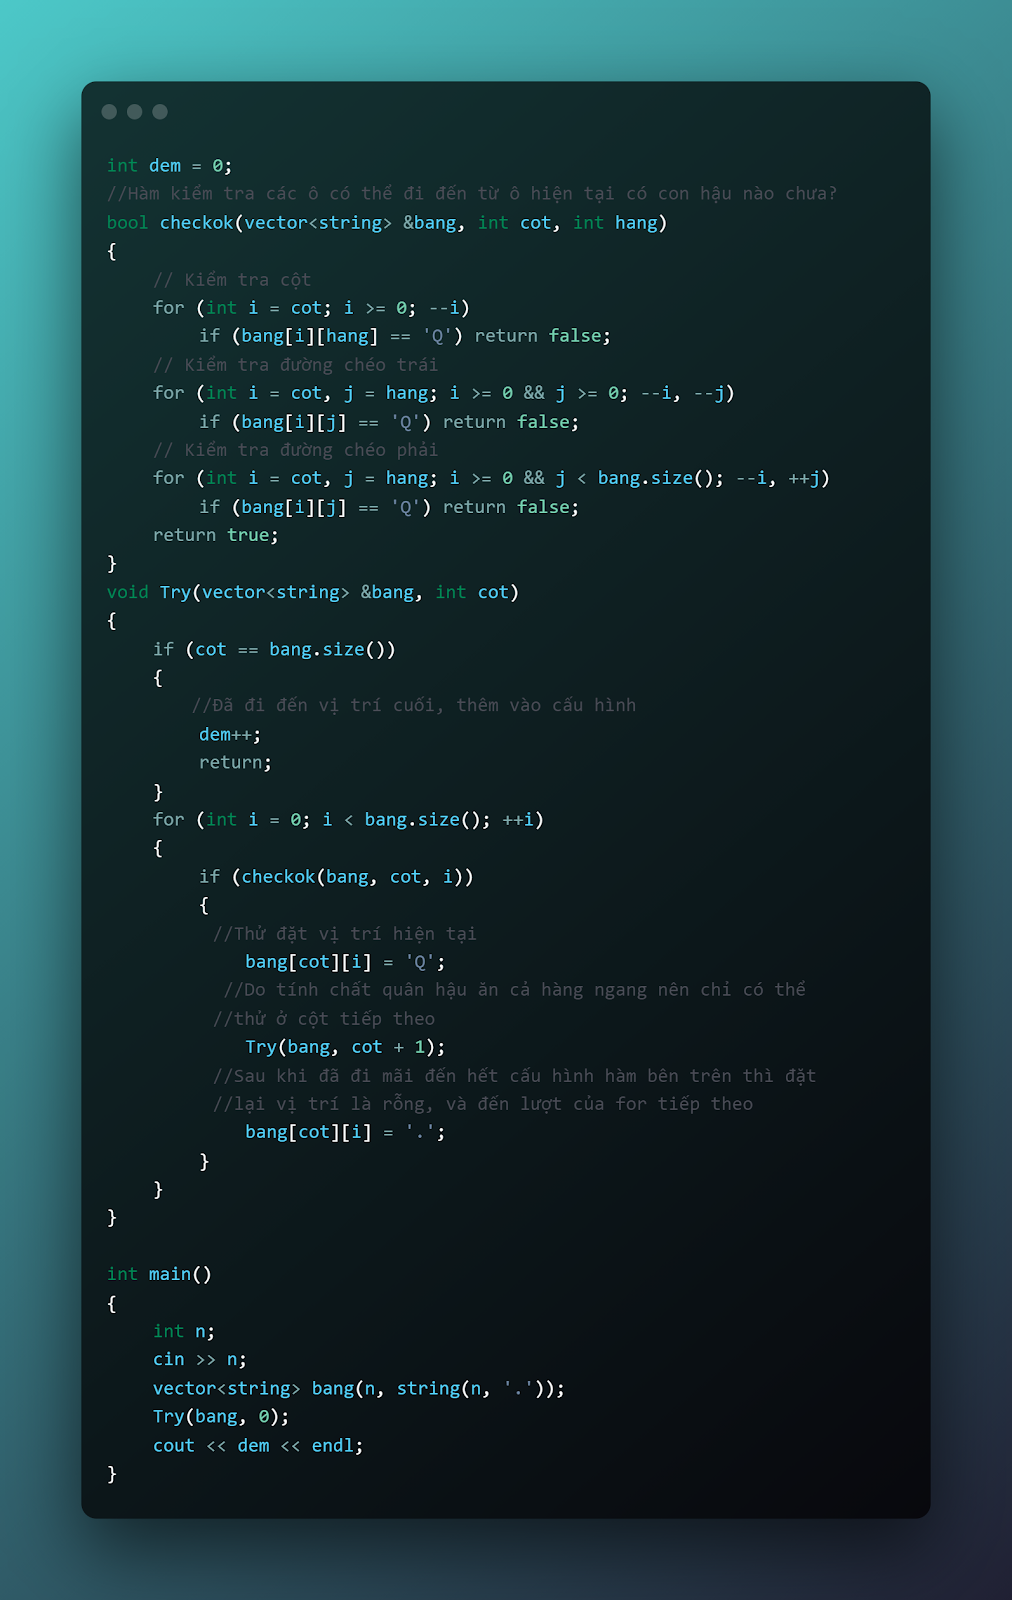
Bài 2:  BCQUEEN – N – Queen

https://www.spoj.com/PTIT/problems/BCQUEEN/

MkdmamvxiEI2wZdvuMFEpwcjb9KuLsQGTdflV8Us2OTz4pK 7wyJ - quochung.cyou PTIT

Ý tưởng:

  • Tại các vị trí bất kì, ta thử đặt quân hậu tại đó, sau đó tiếp tục thử
  • Khi đi đến vị trí cuối cùng (cuối phải) thì dừng lại và đếm cấu hình đã thỏa mãn thêm 1
GitHub - andykdy/N-Queens: Solving N-Queens with genetic algorithm

Độ phức tạp:

  • Tại mỗi hàng cần lặp qua tất cả các cột rồi tại mỗi cột tiếp tục thử
  • Độ phức tạp: n^2
30ZkDBRPXWzBw7HXRyJFYAvFw4aal - quochung.cyou PTIT

Bài 3:  P167PROC – ROUND 7C – Ký tự lặp trong 2 xâu liên tiếp

https://www.spoj.com/PTIT/problems/P167PROC/

Ý tưởng:

  • Do N khá nhỏ, ta sinh hoán vị các cách sắp xếp từ
  • Tại mỗi cấu hình hoán vị, ta thử lặp qua dãy sắp xếp hiện tại và đếm số lần lặp, do input đảm bảo các từ được sắp xếp sẵn nên có thể dùng tìm kiếm nhị phân để tối ưu

Độ phức tạp:

  • Gọi độ dài string là L, số lượng xâu là n
  • Sinh toàn bộ hoán vị :  L !
  • Tại mỗi hoán vị, lặp qua dãy 1 lần : n
  • Tại mỗi phần tử, lặp qua tất cả vị trí và tìm kiểm nhị phân : L log(L)
  • Độ phức tạp tổng : L ! n L log(L)
Pi S8JJ9lR7tmY1rcqzGGg8Q MdDsUoLSkGhn2qam fTQbC5rhcBXXW9 AImMp5hP aqsN0yXD kEN8 NYKk0ua2XQ7bwbziNRFTsvk0d0I4fr1PbhNVR4oLr RGQ7f23kPEsR7GoOSajNAWNAkH9A - quochung.cyou PTIT

Thuật toán: Tìm hiểu về Stack

  1. Lý thuyết 

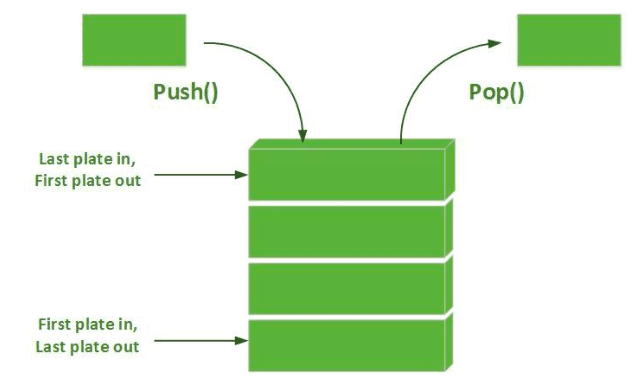
Stack là một danh sách được bổ sung 2 thao tác: thêm một phần tử vào cuối danh sách, và loại bỏ một phần tử ở cuối danh sách. Ví trí cuối của Stack được gọi là đỉnh (top).

Stack và Queue là các cấu trúc dữ liệu được sử dụng để lưu trữ các yếu tố dữ liệu và nó dựa trên một số các ví dụ có thực trong cuộc sống hàng ngày của chúng ta. Ví dụ, Stack là một chồng đĩa CD, nơi bạn có thể lấy ra và đưa vào đĩa CD thông qua đỉnh của ngăn xếp đĩa CD. 

Stack in C++ Example: C++ Stack Program And Algorithm

Chủ yếu Stack có ba hàm cơ bản sau được thực hiện:

  • Push: Thêm một mục(phần tử, thành phần) trong stack. Nếu stack đầy, thì nó được cho là điều kiện Tràn.
  • Pop: Loại bỏ một mục khỏi stack. Các mục được xuất hiện theo thứ tự đảo ngược mà chúng được Push. Nếu stack trống, thì nó được cho là điều kiện trống.
  • Peek hoặc Top: Trả về phần tử trên cùng của stack.
  • isEmpty: Trả về true nếu stack trống, ngược lại là false.

Tất cả các hàm trên của stack đều có độ phức tạp O(1)

BÀI TẬP ỨNG DỤNG : Tìm Min/Max trên đoạn tịnh tiến

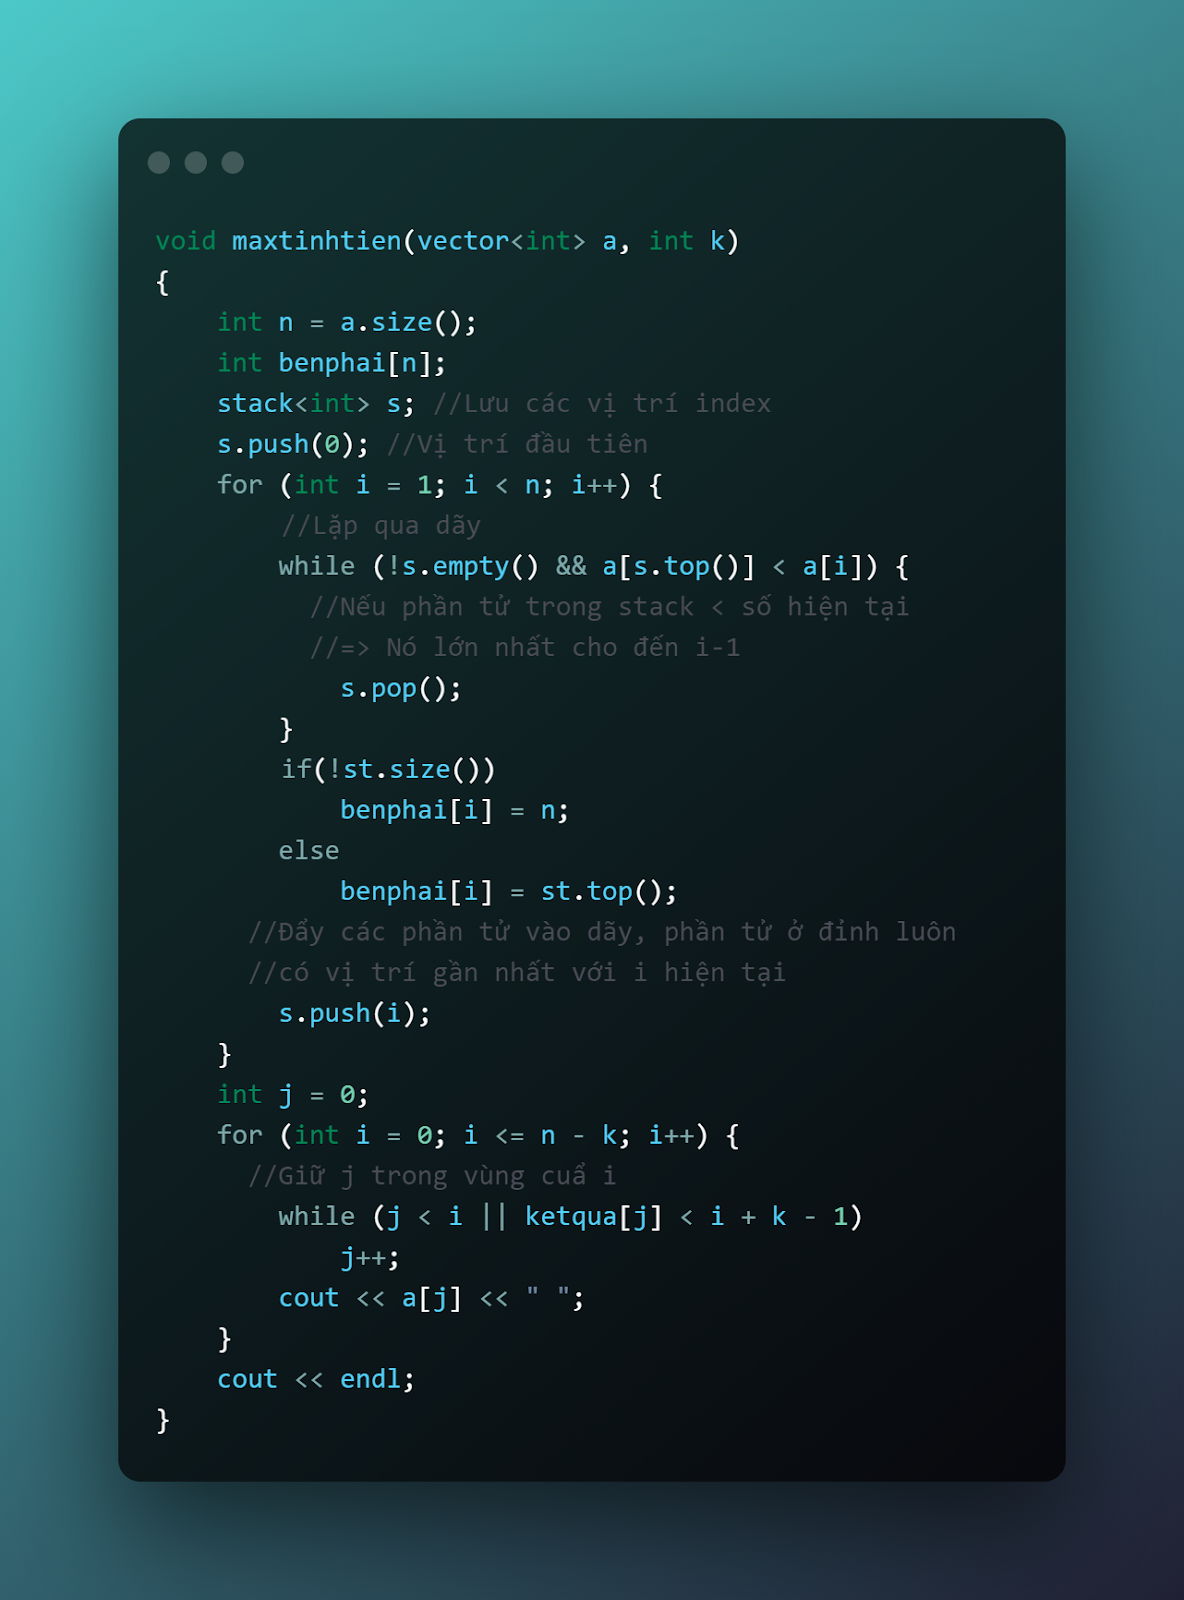
Sơ lược đề bài: Cho một dãy số có n phần tử, in ra max của các đoạn có độ dài k liên tiếp trong dãy

Cách làm thông thường:

Ta lặp từ 1-> n, với mỗi đoạn k, ta lặp qua đoạn k và lấy phần tử min, max.

Độ phức tạp: O(N*k)

Sử dụng stack:

  • Trước hết ta tìm phần tử lớn hơn nó bên phải đầu tiên
  • Đặt 1 biến j và i. Tại mỗi vị trí kiểm tra, ta lặp tìm phần tử lớn nhất bên phải mà vẫn thuộc vùng (i+k-1)
  • Chạy chay: (k = 3). A = (1, 2, 3, 1, 4, 5, 2, 3, 6)
012345678               
123145236
012345678
124458889
23445666X

0: (i+k-1) = 2. Trong vùng vị trí (0-2) có các vị trí phần tử lớn hơn là (1,2,4)  có 1-2 thỏa mãn, lấy vị trí 2 -> 3

1: (i+k-1) = 3. Trong vùng (1-3) phần tử lớn hơn phải là: (2,4,4) , có vị trí 2 thỏa mãn, lấy vị trí 2-> 3

2: (i+k-1) = 4. Trong vùng (2-4), phần tử lớn hơn bên phải lả (4,4,5), có vị trí 4 thỏa mãn, lấy 4 -> 4

…

Kết quả: 3 3 4 5 5 5 6

- quochung.cyou PTIT

Thuật toán: Tìm hiểu về Queue

  1. Lý thuyết 

Queue (Hàng đợi)

Hàng đợi (tiếng anh: Queue) là một cấu trúc dữ liệu dùng để lưu giữ các đối tượng theo cơ chế FIFO (viết tắt từ tiếng Anh: First In First Out), nghĩa là “vào trước ra trước”.

Có thể tưởng tượng queue như một hàng người xếp hàng, ai trên đầu thì vào trước, người tiếp tục xếp vào hàng sẽ vào sau theo thứ tự.

Stacks and Queues in Data Structures: An Overview in 2022

Các hàm có trong Queue:

  • empty() Kiểm tra xem hàng đợi hiện tại có đang rỗng hay không.
  • size() Trả về số lượng phần tử có trong hàng đợi
  • front() Trả về phần tử đầu tiên của hàng đợi.
  • back() Trả về phần tử cuối cùng của hàng đợi.
  • push() Nạp thêm một phần tử vào hàng đợi (từ cuối)
  • pop() Xóa một phần tử ở đầu của hàng đợi.

Tất cả các hàm trên có độ phức tạp O(1)

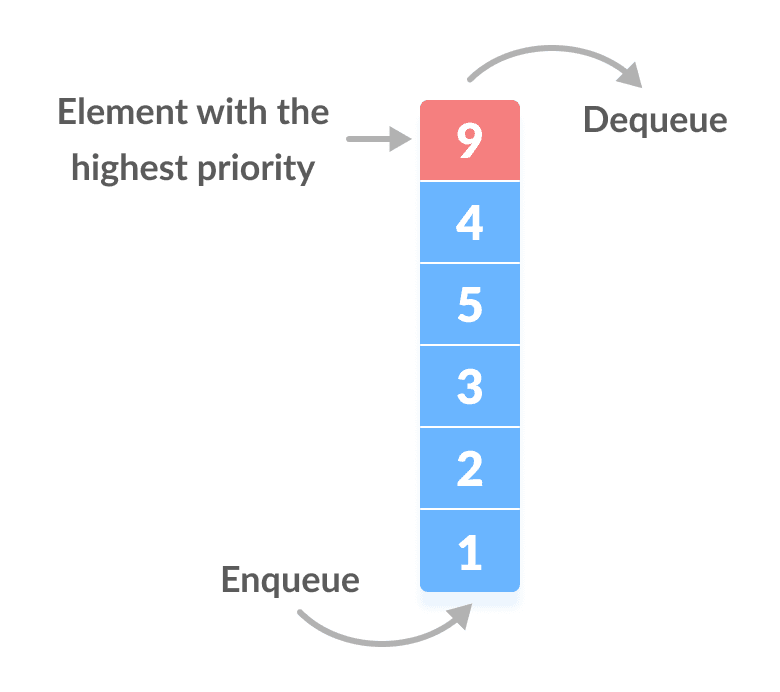
Priority Queue (Hàng đợi ưu tiên)

Priority Queue Data Structure

Đúng như cái tên của nó, hàng đợi ưu tiên là một phiên bản mở rộng của Queue (Hàng đợi) với các thuộc tính sau:

– Mọi phần tử đều được gắn liền với một độ ưu tiên

– Một phần tử có độ ưu tiên cao sẽ được dequeued (xóa khỏi Priority Queue) trước một phần tử có độ ưu tiên thấp

– Nếu hai phần tử có cùng độ ưu tiên, lúc này việc phần tử nào được xử lý trước sẽ phụ thuộc vào thứ tự của chúng ở trong Priority Queue. 

Ví dụ: Phần tử có giá trị cao nhất được coi là phần tử có mức ưu tiên cao nhất. Tuy nhiên, trong các trường hợp khác, chúng ta có thể giả sử phần tử có giá trị thấp nhất là phần tử có mức ưu tiên cao nhất. Trong các trường hợp khác, chúng ta có thể thiết lập các mức ưu tiên tùy ý. 

Sự khác biệt giữa Priority Queue và hàng đợi thông thường: 

Trong một hàng đợi thông thường, quy tắc vào trước ra trước được thực hiện, trong khi đó, trong hàng đợi ưu tiên, các giá trị được lấy dựa trên cơ sở mức độ ưu tiên. Phần tử có mức ưu tiên cao nhất sẽ ra trước.

Có nhiều cách để triển khai Priority Queue, tuy nhiên trong thư viện chuẩn C++, cách thức được dùng là Heap vì Heap cung cấp thời gian trung bình tốt hơn các cách khác.

8Fkv8rgrdNpGAWFgzvCNNCaSvOvgvXVrvea5VD617mr WdvQiCYXSmYaGI66FvT11IEx1gd7LySW5GcjNi6QBzxJntYJknyolnnsMtM - quochung.cyou PTIT

Cách thức hoạt động khi thêm phần tử:

Nếu không có nút,

   Tạo một nút mới.

Mặt khác (một nút đã được tạo)

   Chèn nút mới vào cuối (nút cuối cùng từ trái sang phải.)

Tạo cấu trúc dữ liệu heap cho mảng

Các lệnh của priority_queue trong thư viện STL của C++

empty() Kiểm tra hàng đợi có rỗng không O(1)

size() Trả về kích cỡ của hàng đợi O(1)

top() Trả về phần tử ưu tiên cao nhất của hàng đợi O(1)

push() Thêm một phần tử vào hàng đợi O(logN)

pop() Xóa phần tử ưu tiên cao nhất O(logN)

Với hàng đợi ưu tiên có N phần tử cần thêm vào thì chi phí khởi tạo là O(NlogN)

Deque (Hàng đợi hai đầu)

Hàng đợi hai đầu (deque) là cấu trúc dữ liệu chứa 0 hoặc nhiều phần tử có cùng kiểu dữ liệu và được biểu diễn bằng một hàng có phần tử đầu (front) và phần tử cuối (last). Deque hỗ trợ 4 thao tác như sau:

  • Thêm một phần tử vào cuối deque. (Push back)
  • Thêm một phần tử vào đầu deque. (Push front)
  • Bỏ đi phần tử ở cuối deque, trả về giá trị của phần tử đó. (Pop back)
  • Bỏ đi phần tử ở đầu deque, trả về giá trị của phần tử đó. (Pop front)

Về ứng dụng, ta sẽ bổ sung thêm một số thao tác sau:

  • Lấy giá trị của phần tử cuối mà không xóa nó. (back)
  • Lấy giá trị của phần tử đầu mà không xóa nó. (front)
  • Tìm số lượng phần tử trong deque. (size)
  • Kiểm tra xem deque có rỗng hay không. (empty)

Các thao tác trên đều có độ phức tạp khoảng O(1).

Bài tập ứng dụng

ABD938WfjCN 4mK6tN7vF Y5ZV - quochung.cyou PTIT

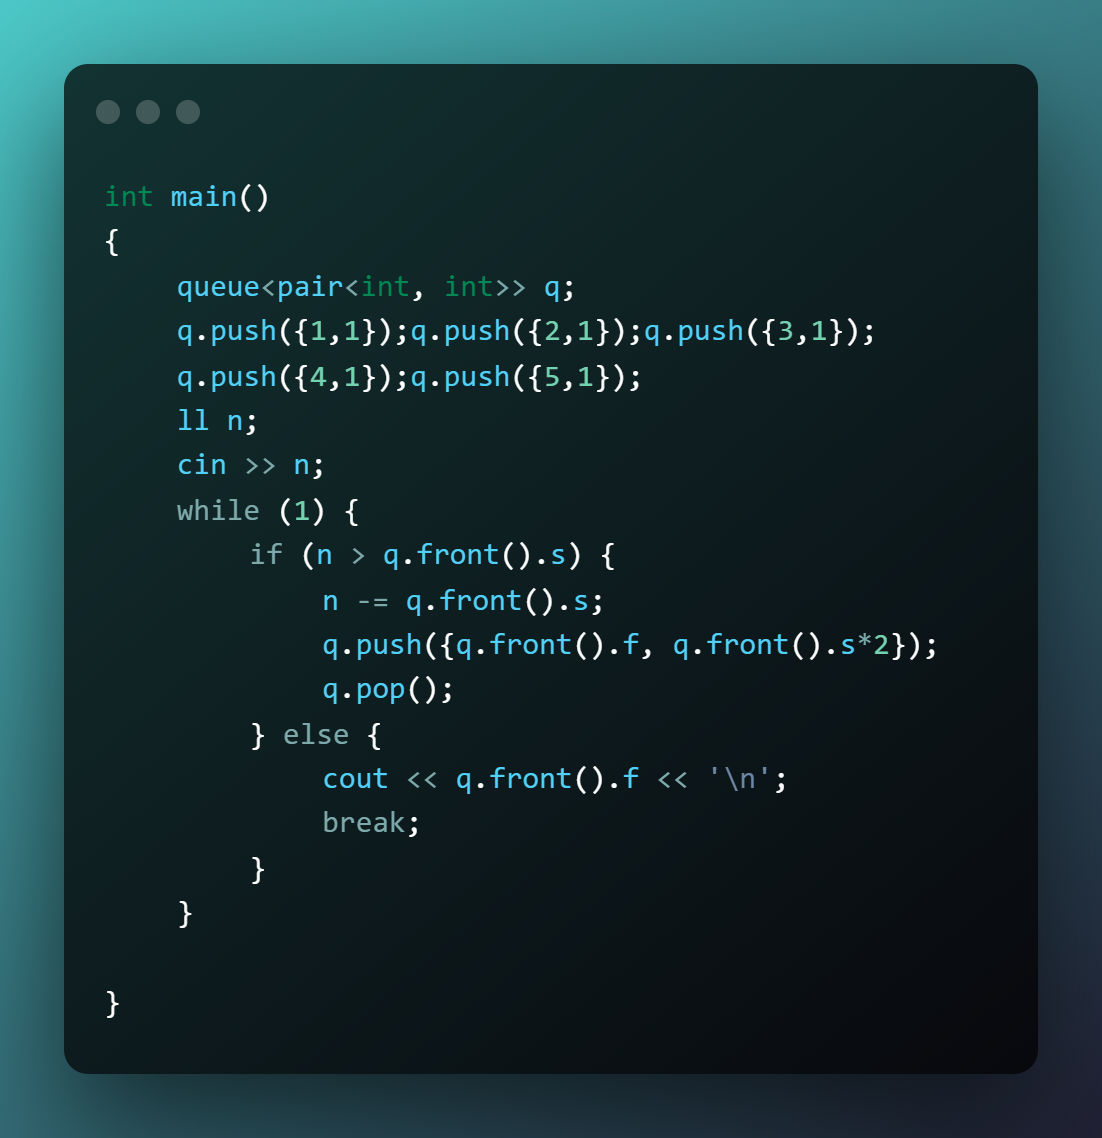
Chỉ đơn giản là sử dụng queue và làm theo yêu cầu của bài

ymfskj8S6oFfBKAISxAKe7COm G3UslAeNft1 dzLOiCWZGziwV q9 FdXCe R6O7CTQa4Ur7iYyyeBAKRVdmGdqfqr4v6TR YCSSJMb Jxq2R9YbcCh0QliSC8trx t KVlGG8SqFT9dbmogewjmg - quochung.cyou PTIT

Làm như cách làm của bài, tuy nhiên thay vì đẩy 2 phần tử của đầu queue xuống, ta sẽ lưu queue dưới dạng số-số lần xuất hiện, nếu như lần chơi hiện tại < số lần xuất hiện hiện tại, vậy thì đầu queue sẽ đang là số đó, bằng không ta đẩy số lần xuất hiện gấp đôi

VD : 1-1 2-1 3-1 4-1 5-1 (số – số lần xuất hiện)

Lượt chơi thứ 6: 1-2 2-2 3-2 4-2 5-2

- quochung.cyou PTIT

Thuật toán: Tìm hiểu về Lí thuyết đồ thị

Các khái niệm cơ bản của đồ thị

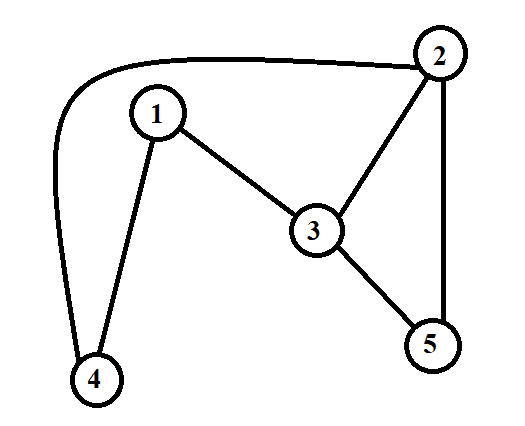
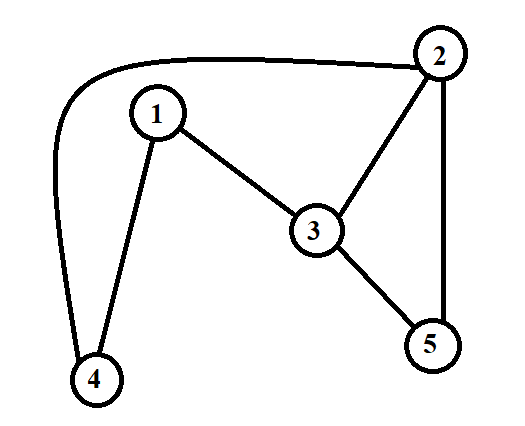
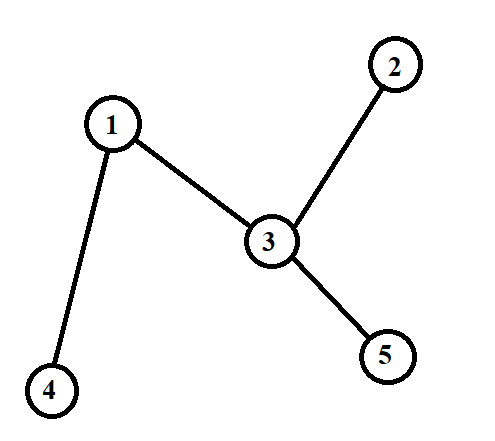
Một đồ thị là một cấu trúc rời rạc gồm tập hợp các đỉnh và các cạnh nối giữa các đỉnh đó. 

Có thể mô tả đồ thị theo cách hình thức như sau:

G=(V,E)

tức là đồ thị G có tập các đỉnh là V, tập các cạnh là E. Có thể hiểu E là tập hợp các cặp (u, v) với u và v là hai đỉnh thuộc V.

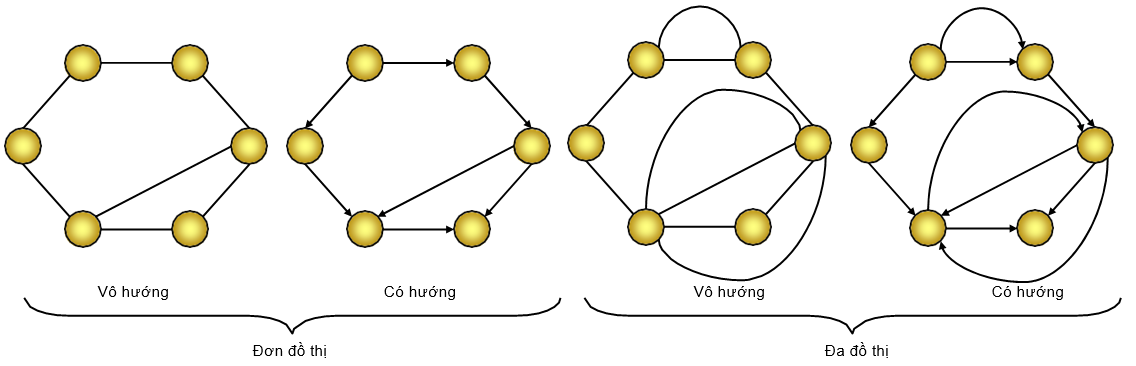
  • G được gọi là đơn đồ thị nếu như giữa hai đỉnh (u, v) của V có nhiều nhất một cạnh trong E nối từ u tới v.
  • G được gọi là đa đồ thị nếu như giữa hai đỉnh (u,v) của V có thể có nhiều hơn 1 cạnh nối trong E nối từ u tới v. Đơn đồ thị là trường hợp đặc biệt của đa đồ thị
  • G được gọi là đồ thị vô hướng nếu các cạnh là cạnh 2 chiều, có thể đi từ u -> v và v -> u trên 1 cạnh
  • G được gọi là đồ thị có hướng nếu các cạnh có định hướng một chiều, ví dụ cạnh (u,v) chỉ có thể đi từ u -> v
https://cdn.ucode.vn/uploads/2247/upload/ikDUaEPJ.png
  • Hai đỉnh trong đồ thị vô hướng được gọi là đỉnh kề nếu giữa chúng có cạnh nối với nhau. Cạnh này được gọi là cạnh liên thuộc
  • Nếu một cạnh nối một đỉnh với chính nó, ta gọi đó là khuyên
  • Bậc là số lượng cạnh liên thuộc của một đỉnh

Graph trong cuộc sống

  • Trong các ứng dụng bản đồ như Google Map. Với các điểm đến là một nút, ta có nhiều bài toán Đường đi ngắn nhất, hay tìm đường để đi từ điểm A -> B

Biểu diễn đồ thị

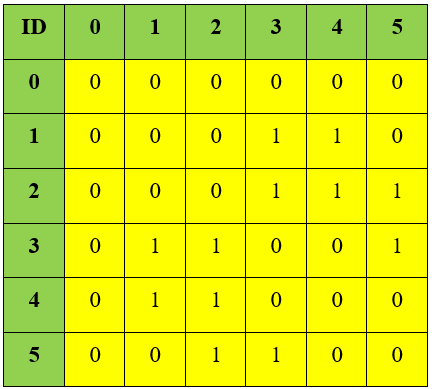
Ma trận kề

https://i.imgur.com/TvhSFTk.png
https://i.imgur.com/iu0lCKv.png

Với mỗi cạnh giữa 2 đỉnh u và v, ta có thể biểu diễn dưới dạng ma trận, với nếu matran[x][y] là số lượng cạnh nối giữa đỉnh x và đỉnh y

Ưu điểm của ma trận kề:

  • Đơn giản, dễ cài đặt.
  • Kiểm tra cạnh giữa 2 đỉnh trong O(1)

Nhược điểm của ma trận kề:

  • Tốn N^2 (số đỉnh) để triển khai bộ nhớ
  • Để tìm tất cả các đỉnh kề của đỉnh x, ta cần duyệt qua toàn bộ hàng/cột của đỉnh x O(n)

Danh sách kề

https://i.imgur.com/ZX0n2Jw.png
https://i.imgur.com/lhFAoTW.png

Ta sẽ có một mảng hoặc vector 2 chiều, và lưu mỗi đỉnh các đỉnh kề của chúng.

Ưu điểm của danh sách kề:

  • Tìm các đỉnh kề của một đỉnh rất nhanh
  • Tiết kiệm không gian lưu trữ

Nhược điểm của danh sách kề: 

  • Kiểm tra 2 đỉnh có kề nhau hay không cần duyệt qua danh sách kề của u hoặc v tốn O(m) thời gian

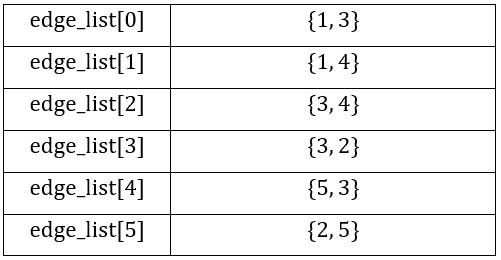
Danh sách cạnh

https://i.imgur.com/1LjUEv1.png
https://i.imgur.com/op5RtSJ.png

Ta lưu lại tất cả các cạnh của đồ thị dưới dạng pair (u,v) chứ không lưu đỉnh

Ưu điểm của danh sách cạnh:

  • Tốn không gian lưu trữ tùy thuộc vào số cạnh
  • Phù hợp trường hợp cần duyệt toàn bộ cạnh thì

Nhược điểm của danh sách cạnh: 

  • Tốn thời gian nếu cần duyệt các đỉnh kề vì cần duyệt qua toàn bộ cạnh và tìm đỉnh cần tìm trong đó

Các thuật toán tìm kiếm trên đồ thị

  • Ta gọi một đường đi từ u->v có độ dài k là tập hợp k đỉnh mà khi đi qua các đỉnh này ta đi được từ u->v
  • Một chu trình là một đường đi sau khi đi xong sẽ về điểm xuất phát. 
  • Đường đi đơn là đường đi mà tập hợp k đỉnh phân biệt
  • Chu trình đơn là chu trình mà tập hợp đỉnh trên chu trình phân biệt
What are BFS and DFS in a binary tree? - Quora

Thuật toán DFS (Tìm kiếm theo chiều sâu)

Tư tưởng thuật toán:

Thuật toán tìm kiếm theo chiều sâu (DFS) là bắt đầu từ

một đỉnh bất kì v nào đó + đánh dấu đỉnh v đã được duyệt,

chọn một đỉnh u bất kỳ kề với v và lấy nó làm đỉnh duyệt

tiếp theo.

DFS Từ điểm bắt đầu u , ta tìm đỉnh đầu tiên trong các đỉnh kề của u, tiếp tục DFS trên đó và lặp lại. Nếu không còn đỉnh để đi nữa, ta sẽ quay trở lại ngã rẽ gần nhất. 

clh1bw33aC0sforrTia06AMcYj6GdrWr BbHxX70v9TA863ptT0HoRGBg5E0Gz7g9VahuQ EZQhwooXi37iIBao3pT800oQMhBZrqGBMTljE - quochung.cyou PTIT

Cài đặt theo đệ quy

ukehMLCbI9Gah q bKUGsAFYsvBUKEwIUCG7nOuKtgBxl84kB3daAR 2wAD9RGEyMqPdsqJADnBgQpQpWnwjZPGhA9Je8ZXjYCU7Tws2dPaPbVp81hp qTW90mYV8Pwaihb3v c8EnswJmvQw BFKA - quochung.cyou PTIT

Cài đặt theo Stack (Không đệ quy)

Thuật toán BFS  (Tìm kiếm theo chiều rộng)

Tư tưởng thuật toán:

  • Dựa trên tư tưởng lập ra một thứ tự duyệt các đỉnh, sao cho các đỉnh gần s hơn sẽ luôn luôn được duyệt xong trước các đỉnh xa s hơn. 
  • Ví dụ, từ đỉnh s ta thăm các đỉnh kề với nó là x1,x2,x3 Khi thăm tới x1​, sẽ phát sinh việc thăm các đỉnh kề với x1a, x1b. Dĩ nhiên các đỉnh này đều xa s hơn so với x2,x3 cho nên chúng sẽ chỉ được thăm sau khi toàn bộ các đỉnh x2,x3  đã được thăm hết.
  • Thuật toán loang (thuật toán vết dầu loang) là một kĩ thuật sử dụng BFS để tìm tất cả các điểm có thể đi tới. Điểm khác biệt giữa Loang so với đa số những bài BFS là ta không phải tìm chi phí nhỏ nhất.
  • Thuật toán loang được dùng khá nhiều trong tin học, điển hình là thuật toán loang trên ma trận được ứng dụng để đếm số thành phần liên thông trên ma trận. 
gEztwUnJpdiq5AHKkQxLewvEq2KFiVVzJxeKQjaqf1pWGnlpZ2AATKFHtkKz - quochung.cyou PTIT

Cài đặt theo Queue

Độ phức tạp tính toán của DFS và BFS

Tùy vào cách cài đặt đồ thị mà ta sẽ thu được các giải thuật với độ phức tạp khác nhau:

  • Nếu đồ thị biểu diễn bằng danh sách kề, cả hai giải thuật BFS/DFS đều có độ phức tạp là O(n + m) ~ O(n) Cách cài đặt này là tốt nhất.
  • Nếu đồ thị biểu diễn bằng ma trận kề, độ phức tạp tính toán sẽ là O(n^2)
  • Nếu đồ thị biểu diễn bằng danh sách cạnh, thao tác duyệt mọi đỉnh kề với đỉnh u sẽ buộc phải duyệt qua toàn bộ danh sách cạnh, dẫn đến độ phức tạp tính toán là O(n*m). Đây là cách cài đặt tệ nhất.

Tính liên thông của đồ thị

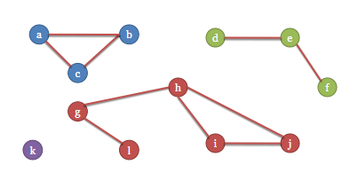
  • Đồ thị vô hướng được coi là liên thông nếu luôn tìm được đường đi giữa hai đỉnh bất kỳ của nó.
  • Trong trường hợp đồ thị G không liên thông, ta có thể phân ra G thành một số đồ thị con liên thông mà chúng đôi một không có đỉnh chung. Mỗi đồ thị con như vậy là một thành phần liên thông của G. Như vậy, đồ thị liên thông khi và chỉ khi số thành phần liên thông của nó là 1.
  • Đối với đồ thị vô hướng, đường đi từ đỉnh u đến đỉnh v cũng giống như đỉnh đường đi từ đỉnh v đến đỉnh u. Chính vì vậy, nếu tồn tại u sao cho u có đường đi đến tất cả các đỉnh còn lại của đồ thị thì ta kết luận được đồ thị là liên thông.
  • Đỉnh khớp (cut vertex/ articulation point): của một đồ thị vô hướng là đỉnh mà nếu xóa đỉnh này khỏi đồ thị và các cạnh nối đến nó thì số thành phần liên thông của đồ thị sẽ tăng thêm hoặc biến đồ thị từ liên thông thành không liên thông
Articulation Points or Cut Vertices in a Graph

Ví dụ: Xóa 0 và 3 thì đồ thị đang có thể đi lại giữa các đỉnh (Đồ thị liên thông) tạo thành 2 thành phần liên thông (1,2) và (4) không đi lại được với nhau

  • Cạnh cầu (bridge): của một đồ thị vô hướng là cạnh mà nếu xóa đi khỏi đồ thị thì số thành phần liên thông của đồ thị sẽ tăng thêm
Bridges in a graph - GeeksforGeeks
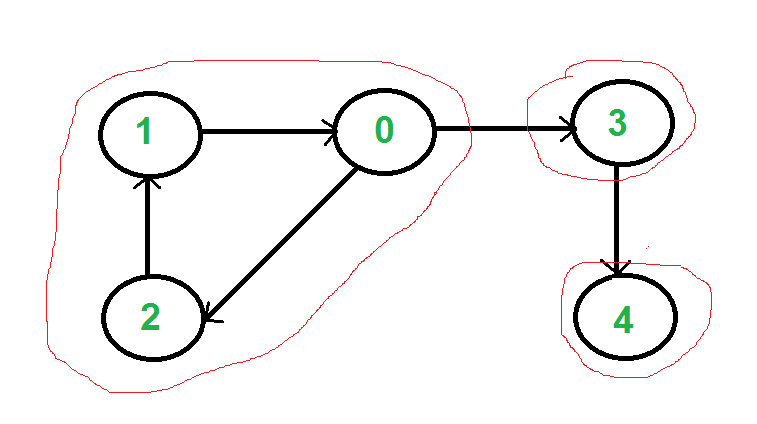
  • Liên thông mạnh (strongly connected): Đồ thị có hướng gọi là liên thông mạnh nếu có đường đi từ a tới b và từ b tới a với mọi cặp đỉnh a và b của đồ thị.
SCC

Giữa 2 đỉnh bất kì trong đồ thị con (0,1,2) và đồ thị con (3,4) đều có cạnh nối với nhau

  • Liên thông yếu (weakly connected): Đồ thị có hướng gọi là liên thông yếu nếu có đường đi giữa 2 đỉnh bất kỳ của đồ thị vô hướng tương ứng với đồ thị đã cho. Tức là hủy bỏ các hướng của các cạnh trong đồ thị.
Đồ thị liên thông – Wikipedia tiếng Việt

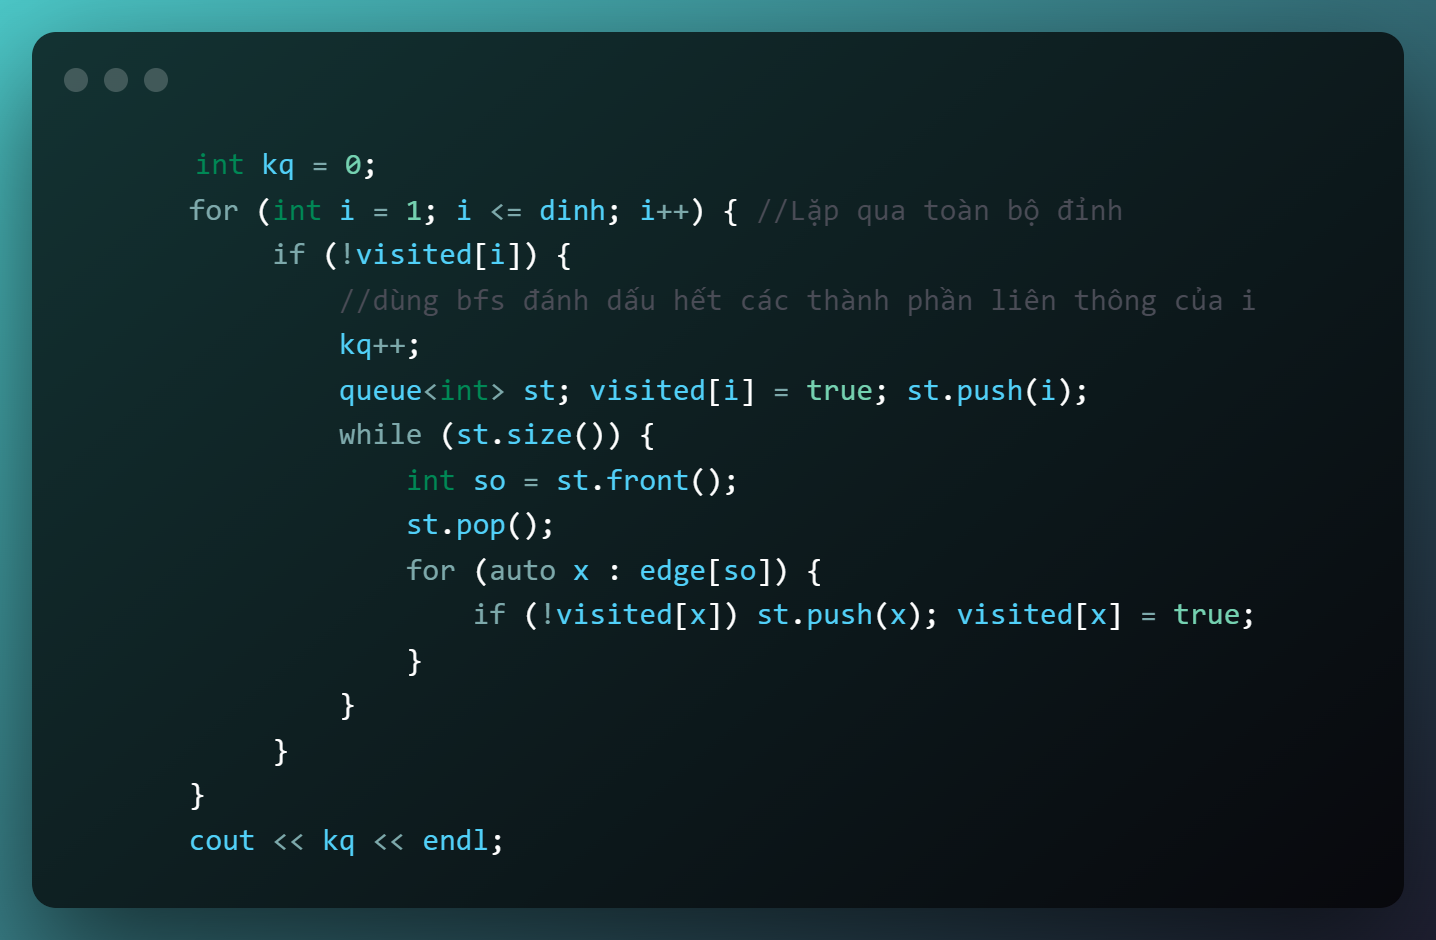
Đếm số thành phần liên thông bằng DFS và BFS

6Ou2LqL vuZJvHO0BCoOCkwKK6ut5J3xIr5k2dnLQ RLV5s3WxDn zgkH10HsZogthEKYW3DiHQ4tBoDE 0LFQ0GG2XwIvQySVgTQoMgVet lH6uSMN7f1NWkMriTlboyfoXagrTkcBJq0levBmbHg - quochung.cyou PTIT
HOij1GBiY20YbZeI5DSQvzujGMzR2hnOoEHz9Oa4 ljlfjY4ybuPXUfKZkuF5yzkE2pjZoYoBobZe83ZjOkC5svAkaxne82kq8Dvb3rDumyasNvN4d2c1KCKj 1gU82Fuycl8W75sGG3KBmMtyhAXw - quochung.cyou PTIT

Thuật toán: Tìm hiểu về chia để trị

Trong khoa học máy tính, chia để trị là một mô hình thiết kế thuật toán quan trọng, hoạt động dựa trên ý tưởng chia vấn đề cần giải quyết thành các vấn đề con cùng dạng với vấn đề đã cho, chỉ khác là cỡ của chúng nhỏ hơn, cứ như vậy lặp lại nhiều lần, cho đến khi bài toán thu được đủ đơn giản để có thể giải quyết trực tiếp. Sau đó, lời giải của các bài toán nhỏ được tổng hợp lại thành lời giải cho bài toán ban đầu.

Một giải thuật chia để trị thường được thiết kế theo 3 bước như sau:

  1. Chia (divide): Chia bài toán ra thành các bài toán nhỏ hơn (subproblems). Về cơ bản thì những bài toán nhỏ này giống với bài toán ban đầu.
  2. Trị (conquer): Giải quyết bài toán con trong trường hợp nó đủ nhỏ, còn không thì tiếp tục tiến hành chia tách nó ra thành những bài toán con nhỏ hơn nữa.
  3. Kết hợp (combine): Kết hợp các kết quả từ bài toán con nhỏ nhất, để ra lời giải cho các bài toán con (subproblems), và cứ thế cuối cùng ra được lời giải cho bài toán ban đầu.
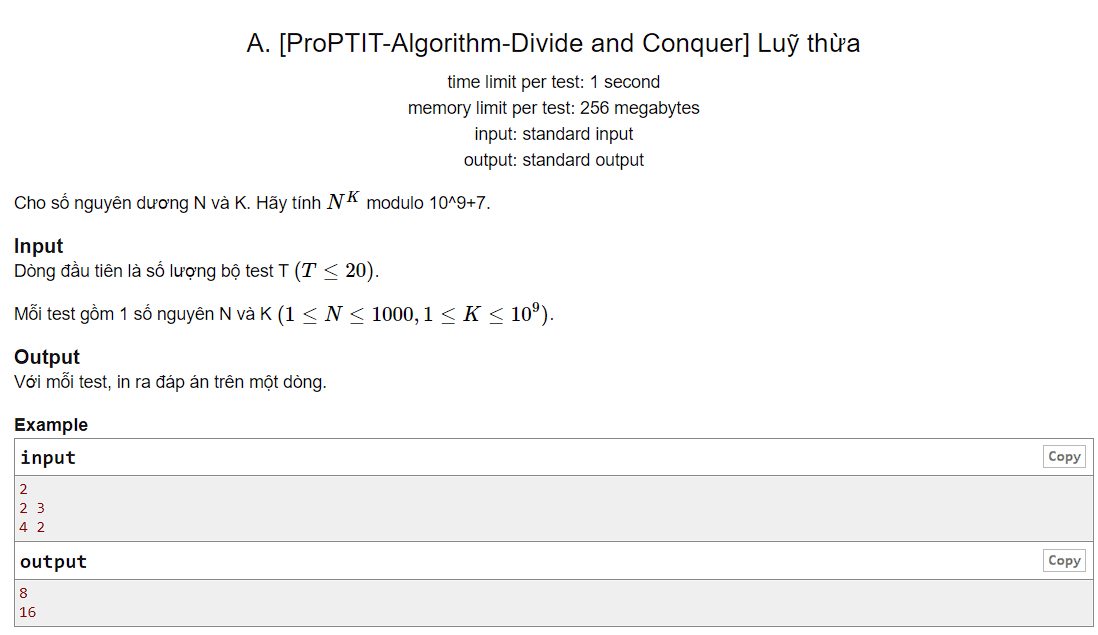
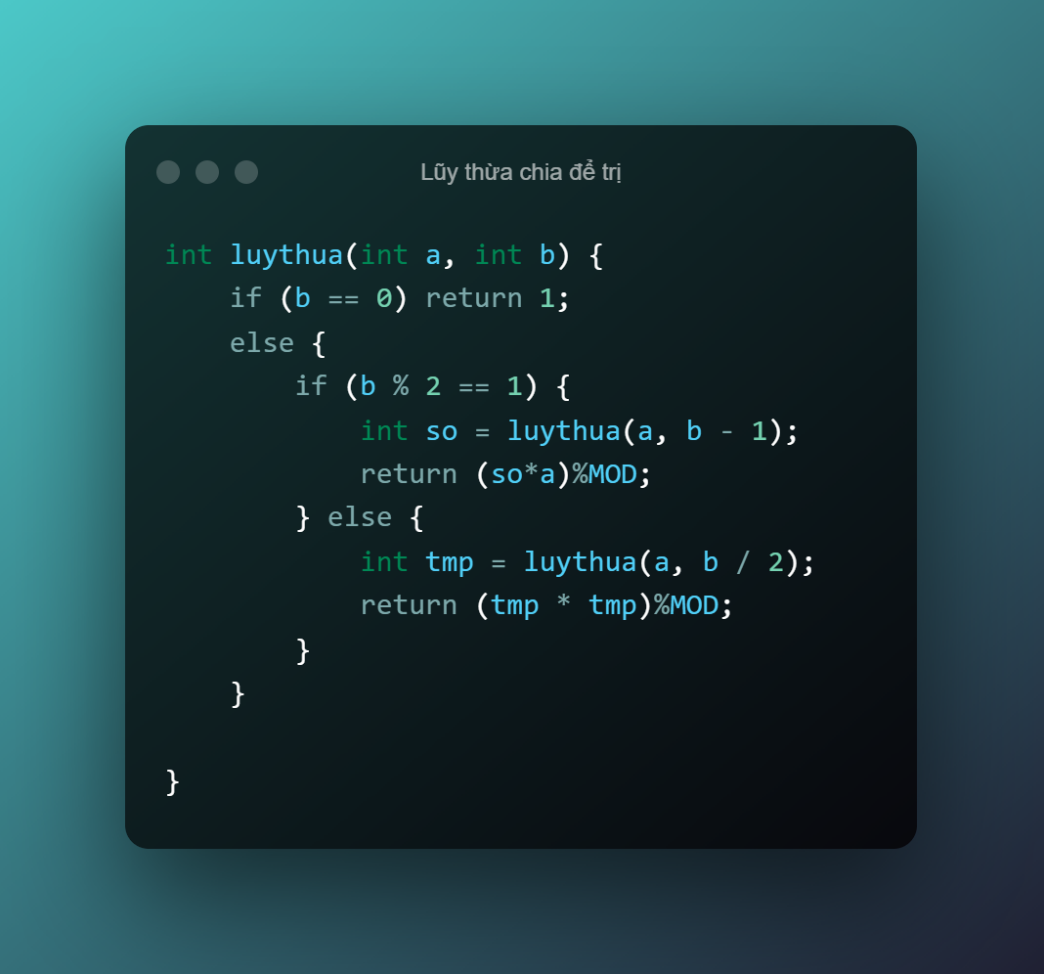
  1. Áp dụng vào bài toán tính lũy thừa
- quochung.cyou PTIT

Cách tính thông thường:

  • Để tính a^b thì  ta lặp từ 1 -> b  rồi nhân dần a lên, độ phức tạp O(n)

VD: 3^5

Tính 1: 3×1 = 3

Tính 2: 3×3 = 9

Tính 3: 9×3 = 27

Tính 4: 27×3=81

Tính 5: 81×3=243

  • Vậy mỗi bước, thực chất ta đang giảm bài toán từ a^b xuống thành a^(b-1) x a và lặp cho đến khi b về 0.

Thay vì đó, ta nhận thấy khi mũ b = 1 thì có thể đưa ra trực tiếp a, hoặc nếu mũ b bằng 0 thì đưa ra trực tiếp 1

  • https://lh3.googleusercontent.com/p56VK1dXqRiTqHokOyC2egoXy0ovboBWl5FhEDYYK6VJWUJwTIXQ2P-8Oem9_xbz6YnDaIf4v5IDPeL6jgzVvqktrLM3ymyjnLtfOgViICtHt-gBbm2-XhhvgCJf0PUkzJ-M0BXi1-15vrrmeA

Đồng thời tránh việc tràn số, ta sẽ mod các phép nhân theo công thức

Như vậy với mỗi lần đệ quy, ta sẽ chia bài toán về bài toán nhỏ hơn là a^(b/2) và tiếp tục như vậy cho đến khi đến điểm neo là b = 1 hoặc b = 0. 

LFPDK90m8Hr5J7 cif3wSXTgMlZrDgMJypWGuJTbEAdp4jyIzDCKPv9qFUFLedAstYOFnkqFVBzBb9L70 JTmMKYl 1T2zFLcs34hGWNlib3MDnqrLt5TkraU zzAhGkWkhGMUv bAEmTn0KMp3KQ - quochung.cyou PTIT

Độ phức tạp: O(logN)

  1. Áp dụng vào bài toán số Fibbonaci thứ N
FRuTfJwsjAGHclBZFJgtKbwMpZ D9kRXZZwW6BAf7rjamxMyygjfkWDjmt1SFdCYYRpIVG1jtFNHCE1mI4T Ow0yvHpR5Yu1bEiUzTPcc4wBcD6K2qImAVBnhfy8Ny3bfyNUNvkZd76XyNmO3NXWEQ - quochung.cyou PTIT

Thông thường, với cách làm lặp/đệ quy và lưu vào mảng trước để thực hiện nhiều truy vấn, với n nhỏ ta hoàn toàn có thể làm điều đó với công thức f(n) = f(n-1) + f(n-2), tuy nhiên với những bài toán nàO(n) sẽ không thực hiện được trong thời gian giới hạn thì cách này sẽ không thể thực hiện được.

Nhận định:

  • Liệu có thể đưa bài toán về dạng tính lũy thừa như ở trên rồi sử dụng chia để trị?
  • Có thể tạo mối liên hệ giữa F(n) bất kì với các số trong dãy Fibbonaci không?

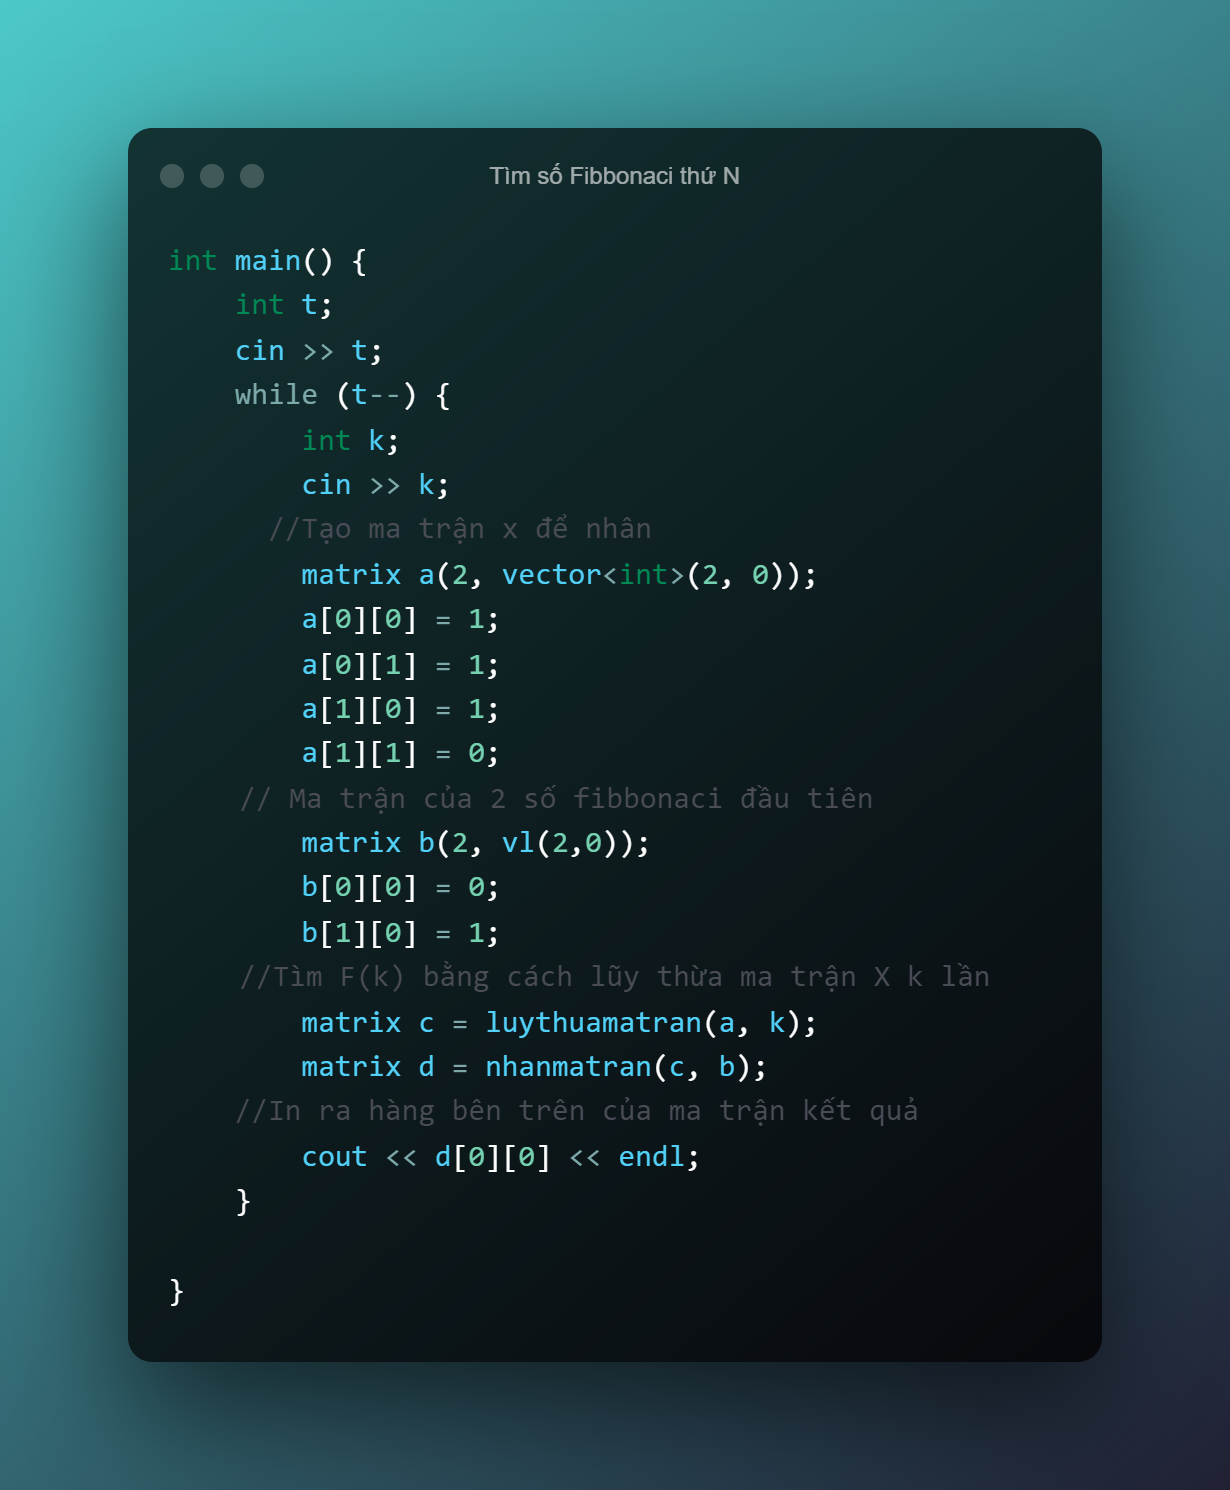
Cách làm theo tư tưởng chia để trị bằng cách áp dụng nhân ma trận:

Với 2 ma trận như sau:

Ma trận A :

image 9 - quochung.cyou PTIT

Ma trận B :

image 10 - quochung.cyou PTIT
  • Liệu có thể tìm thấy một ma trận X để B = X * A

Gọi ma trận cần tìm có dạng

image 6 - quochung.cyou PTIT

Thực hiện nhân hàng trên của ma trận, đồng thời f(n+1) = f(n) + f(n-1) ta có :

  • a x f(n) + b x f(n-1) = f(n+1) 
  • a x f(n) + b x f(n-1) = f(n+1) = f(n) + f(n-1)
  • a = 1, b = 1

Thực hiện nhân hàng dưới của ma trận, ta có:

  • c x f(n) + d x f(n-1) = f(n)
  • c = 1 , d = 0

Vậy ma trận X cần tìm có dạng

image 5 - quochung.cyou PTIT
  • alt text
  • Chứng minh quy nạp với các f(n) khác, ta có thể tìm được f(n) bất kì bằng cách nhân ma trận X với ma trận ban đầu (F(0) = 0, F(1) = 1)
zvfOZq7QCd72Sfx0b5D Y69dMmPkJUNGK9XWlGLLaMAcQZLlUCaR0 B5W8LnkYI8ubymwbQXfVN89rqR1yd4GD3RjcAynaYqrkAKdTBooxlMGKvZvTESUoOFh tHoKyJGmmbmDY3ZOz j40vzepDoA - quochung.cyou PTIT
  • Hàm nhân 2 ma trận
qvOTzIw7n cWpEc2zupn87QmMvsnHB1iFVzgWLvYQxOTx 98Fz - quochung.cyou PTIT
  • Lũy thừa ma trận áp dụng chia để trị
Ba3V Ww5ZxV gRjpPfg 98egI9 Abw7SBErY kEjEkMPcK 5GD4KjzB7YvtMwmY1BfFzGVyiF2DzLchXzdBttuNrP2x0anGb rnyCqRwmLtqlP 78ahKgPVUlXYLhPDpcKJkp06lGQl7nh63z3hcvg - quochung.cyou PTIT

Tìm số Fibbonaci

Thuật toán: Tìm hiểu về Sinh

Mục tiêu

  • + Sinh Nhị Phân
  • + Sinh Tổ Hợp
  • + Sinh Hoán Vị 
  1. Sinh Nhị Phân
image 2 - quochung.cyou PTIT

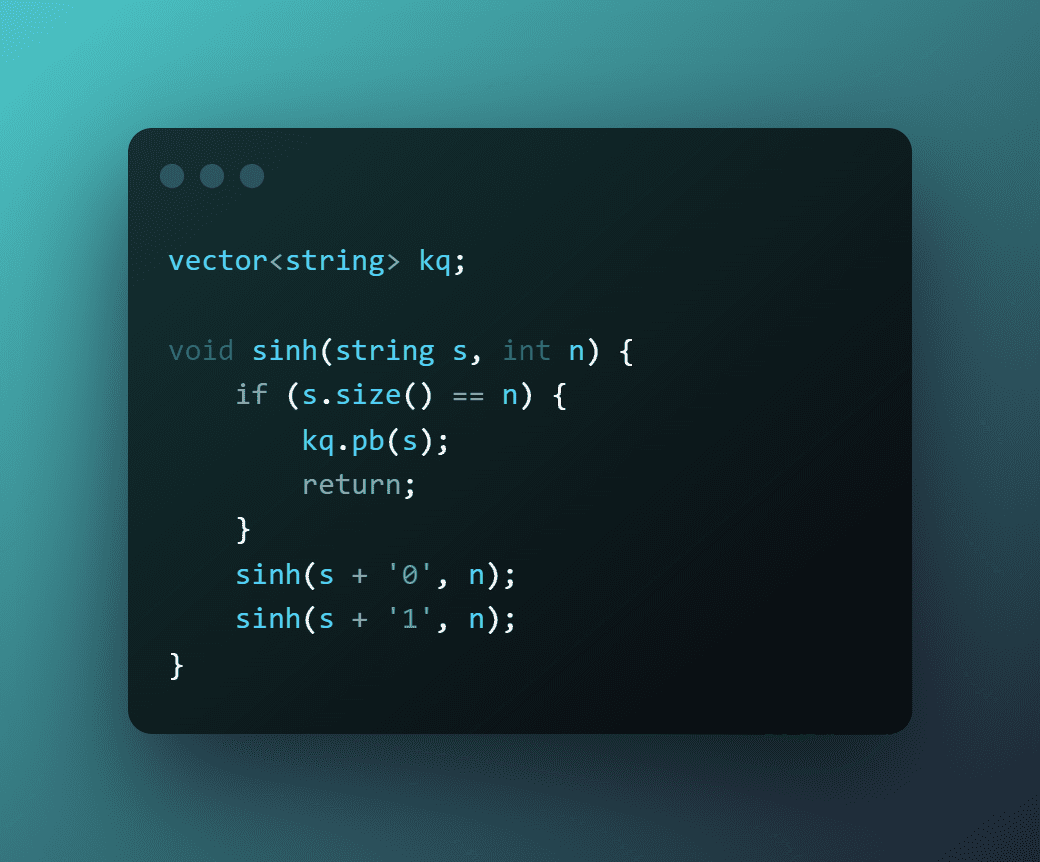
Nguyên lí hoạt động:

Bước 1: Chúng ta bắt đầu sinh với xâu rỗng “”

Bước 2: Tại mỗi lần sinh, ta đệ quy tiếp với xâu được thêm 1 và 0

Bước 3: Khi đạt đủ độ dài thì thêm vào vector toàn cục “kq” 

Do mỗi lần sinh ta có 2 trường hợp và lặp như thế n lần, nên độ khó là O(2^n)

  1. Sinh Tổ Hợp
https://lh4.googleusercontent.com/qqgU2X2q64xCrXGDgRumXLEWo-7qakZLtMUxpPjeNe7zgqAdm0nJCNv0BR-mxP_HjdnTDO2ASd9MpbpNFNRXTGfz7zlBPwo_8LCdp3D4vgnJC3bJlBpJhuRR_t4Zf_B652Kw2wWDmBttSZCJyQ

Nguyên lí hoạt động:

  • Đầu tiên ta thử với index = 1, và số là 1. Sau đó cứ thử tiếp các trường hợp khác
  • Chạy số 1 -> 
  • for (1->n) ra các số bắt đầu từ 1 -> ra các số bắt đầu từ 2,3,…

ra các số bắt đầu từ 2 -> ra các số bắt đầu từ 1,3,…. 

Độ khó: (n^k) Do mỗi lần ta cần đi qua n, và ta lặp tiếp n lần như thế cho đến khi đạt cấu hình k 

image 1 - quochung.cyou PTIT

  1. Sinh Hoán Vị
image - quochung.cyou PTIT

Nguyên lí hoạt động:

  1. Khởi tạo dãy ban đầu là 1..2..3….n
  2. Ta tiếp tục tìm hoán vị tiếp theo và in ra dãy hiện tại

Để tìm hoán vị tiếp theo:

  • Hoán vị sinh ra phải lớn hơn hoán vị hiện tại hơn thế nữa phải là hoán vị vừa đủ lớn hơn hoán hoán vị hiện tại theo nghĩa không thể có một hoán vị nào khác chen giữa chúng khi sắp thứ tự.
  • Vậy kỹ thuật sinh hoán vị kế tiếp từ hoán vị hiện tại được xây dựng như sau 

+ Tìm từ vị trí sát cuối lên đầu, gặp chỉ số đầu tiên thỏa mãn x[i]<x[i+1] .

+ Nếu tìm thấy chỉ số i như trên

+ Trong đoạn cuối giảm dần, tìm phần tử x[k] nhỏ nhất thỏa mãn điều kiện x[k] >x[i].

+ Đảo giá trị x[k] và x[i]. Đảo ngược lại đoạn cuối

+ Nếu không tìm thấy tức là toàn dãy đã sắp xếp giảm dần, đây là cấu hình cuối cùng ( i < 0)

Độ khó: O(n!)