Kiến trúc Microservice nói một cách đơn giản, là việc ta chia nhỏ một hệ thống lớn thành nhiều service nhỏ để xử lý các công việc riêng biệt với nhau. Việc chia nhỏ hệ thống lớn đem đến rất nhiều lợi ích, ví dụ như ta có thể có nhiều team dev làm việc trên nhiều phần khác nhau, giúp tăng hiệu suất. Ta có thể giải quyết các bài toán lớn khi mà quá nhiều request tập trung về 1 server, ….
Tuy nhiên nó cũng đi kèm nhiều vấn đề:
Ví dụ trong thực tế, trong quá trình ship hàng, một quá trình xảy ra như sau
Cửa hàng giao đồ cần chuyển cho shipper
Shipper giao hàng tới cho người nhận
Shipper báo lại cho cửa hàng là hàng đã giao
Các công việc này, nếu coi các chủ thể thành 1 kiến trúc monolith, hay “1 khối” sẽ làm hết mọi việc, thì phía cửa hàng sẽ chuẩn bị hàng, giao hàng, rồi thu tiền hết một mình. Nhưng lúc này, ta sẽ chia chúng thành 2 service “nhỏ hơn”
Service cửa hàng: Chỉ chuẩn bị hàng
Service vận chuyển: Vận chuyển hàng và giao hàng
Khi chỉ 1 khối làm việc một mình, cửa hàng luôn biết là hàng đã giao chưa. Nhưng lúc này khi chia làm 2 service, bên vận chuyển phải báo lại cửa hàng để cửa hàng nắm lại thông tin, lúc này, nếu ví dụ bên vận chuyển đã giao hàng, mà không báo lại cho cửa hàng do quên, do lỗi, .. sẽ dẫn đến sự “bất đồng bộ”, một vấn đề rất thường gặp, hay là đảm bảo tính “Consistency” trong kiến trúc Microservice
Pattern Transactional Outbox
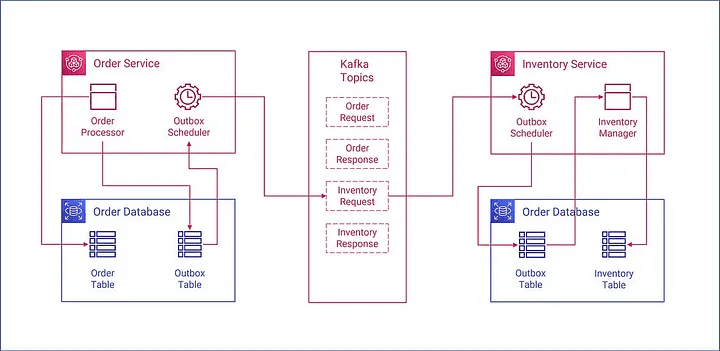
Có nhiều giải pháp cho vấn đề này, một trong số đó là Transactional Outbox, ví dụ hình ảnh và từng bước ở dưới
Một khách hàng đặt một đơn hàng mới
Hệ thống Order Service quản lý đơn hàng cập nhật đơn hàng thành “ĐANG VẬN CHUYỂN” và tạo 1 event “OrderCreated”
Event “OrderCreated” được cho vào message queue: như trong hình ảnh là Kafka
Một hệ thống Outbox Processor khác sẽ liên tục gửi Event yêu cầu cập nhật đến Inventory Service và Notification Service cho đến khi thành công, nếu xảy ra lỗi, nó sẽ thử lại
Các cấu phần
Outbox Entity/Outbox Table: Chứa các Event
Outbox Persistence Mechanism: Một hệ thống bảo đảm event trong outbox table
Outbox Processor: Một tác vụ background chịu trách nghiệm xử lý event khỏi Outbox
Liên tục gọi vào table của table định kỳ xem có event nào mới không
Nếu có, gửi event mới đến các message queue
Xử lý việc thử lại nếu thất bại
Một số câu hỏi
Q: Tại sao khi tạo một order ở phía order-service chẳng hạn, ta không gửi thẳng luôn 1 message đến message broker ở giữa là kafka, … rồi phía payment-service sẽ consume message đó thôi, tại sao cần 1 table outbox?
A: Sẽ có 2 vấn đề khi làm như vậy
1. Ví dụ, nếu order-service chưa cập nhật trạng thái, mà đã send message cho message queue rồi, thì sẽ không đảm bảo tính nhất quán. Message chỉ nên được gửi khi transaction ở local database đã commit, còn nếu bị rollback theo ACID, thì message cũng không được gửi. Tức là message cũng nên nằm trong 1 transaction của Database. Ví dụ nó đã commit xuống database local rồi, nhưng mà crash nên không gửi được message
2. Message thì đã được gửi rồi, nhưng mà transaction ở local chưa run xong, và sau đó nó fail nên roll back lại, nhưng mà message đã gửi rồi
Thì lúc này ta sẽ lưu các event, hay message chuẩn bị gửi đi ở phía local database. Điều này đảm bảo là toàn bộ transaction ở local đã hoàn thành, hoặc đã rollback hết, rồi mới sẽ gửi message đi, bằng việc liên tục gọi về local để gửi message đi
Ưu điểm/Nhược điểm
Ưu điểm:
Dữ liệu được đảm bảo nhất quán
Giảm bớt sự phụ thuộc quá chặt giữa các service
Nhược điểm:
Tăng thêm độ phức tạp do có thêm việc scan bảng outbox, giảm hiệu năng
Tăng thêm tài nguyên lưu trữ bảng outbox, ta lại phải làm thêm cơ chế cleanup event nếu nó grow quá lớn
Có thể xảy ra trường hợp gửi nhiều hơn 1 message, vì vậy message broker hoặc phía nhận cần đảm bảo tính idempotent. (Tức là dù có gửi bao nhiêu request cùng 1 loại thì kết quả không đổi và như request đầu tiên). Ví dụ: lưu lại id message để không xử lý lại nếu đã xử lý rồi
Đóng gói là một trong những tính chất quan trọng của lập trình hướng đối tượng
Đóng gói giúp che dấu thông tin bên trong của một đối tượng, chỉ cho phép các đối tượng khác tương tác thông qua các phương thức được cung cấp
Đóng gói giúp giảm sự phức tạp của chương trình, giúp dễ dàng bảo trì và mở rộng chương trình
Ví dụ, trong một chiếc xe ô tô, ta có rất nhiều cấu phận và thông số. Nó có động cơ, vô lăng, bình xăng, đánh lửa, …
Nhưng ta thường không tương tác trực tiếp được vào chúng, mà thông qua các phương thức như bấm ga, bấm còi, đạp phanh, …
Khi bấm ga, có thể cả một quy trình rất dài đang xảy ra, như động cơ chạy, bình xăng bơm xăng, đánh lửa đốt xăng, …
Nhưng ta không cần quan tâm đến những thứ đó, ta chỉ cần bấm ga, và xe sẽ chạy
Ngoài ra, đóng gói giúp ta đảm bảo việc dữ liệu sẽ được giấu khỏi các đối tượng khác, và chỉ có các phương thức được cung cấp mới có thể tương tác với dữ liệu đó. Giúp đảm bảo tính toàn vẹn của dữ liệu.
Ví dụ:
getter, setter là một ví dụ về đóng gói. Nhờ getter, setter, ta có thể đảm bảo dữ liệu được cập nhật từ đối tượng khác sẽ luôn theo ý của mình, hay dữ liệu được lấy ra từ đối tượng khác sẽ luôn đúng theo ý của mình
Ví dụ trong các thư viện của Java, ta có thể thấy rất nhiều ví dụ về đóng gói. Ví dụ như trong class Scanner, ta có thể thấy rằng các biến được khai báo là private, và ta không thể truy cập trực tiếp vào chúng. Nhưng ta có thể sử dụng các phương thức như nextInt(), nextDouble(), nextLine(), … để lấy dữ liệu từ bàn phím. (Có thể ctrl + click vào các phương thức đó để xem code, sẽ thấy Scanner sử dụng các biến private để lấy dữ liệu từ bàn phím)
Đóng gói xuất hiện ở mọi nơi: Từ cả cái máy tính của bạn chỉ cần 1 nút bật, một game với cả trăm nghìn class chỉ cần 1 lần nhấn Play sẽ bắt đầu chạy, các thư viện Java với vô vàn chức năng đã được đóng gói và cho phép ta sử dụng qua những hàm rất đơn giản.
Trong lập trình phần mềm, yêu cầu của một chương trình thay đổi liên tục đáp ứng nhu cầu của khách hàng. Việc đóng gói và phân tách công việc của những bộ phận khác nhau là cực kì quan trọng, khi đó, ta sẽ cố gắng giới hạn những thay đổi chỉ bên trong 1 bộ phận nhỏ, độc lập nhất có thể và ít ảnh hưởng tới nhiều chỗ khác.
Kế thừa
Kế thừa là một trong những tính chất quan trọng của lập trình hướng đối tượng
Kế thừa giúp ta có thể sử dụng lại các đặc tính của một đối tượng khác, giúp giảm sự lặp lại của code, giúp dễ dàng bảo trì và mở rộng chương trình
Kế thừa giúp ta có thể tạo ra các đối tượng mới từ các đối tượng đã có, và có thể thêm các đặc tính mới vào các đối tượng mới đó
Ta nhận thấy kế thừa, hay sơ đồ cây xuất hiện ở mọi nơi trong cuộc sống. Như một chiếc ô tô có thể gọi là xe bốn bánh, xe bốn bánh có thể coi là phương tiện giao thông, …. Con người có thể coi là động vật. trong sinh học ta có các giống loài, trong vật lý có nhiều loại sóng khác nhau cùng là sóng,có chung tính chất là sóng, …
Ví dụ:
Ví dụ ta có nhiều class cần tạo như Chó, Mèo, Gà, Vịt, … Ta nhận thấy chúng đều có chung 1 đặc điểm là chúng đều là động vật, và có chung 1 số đặc điểm như là có thể ăn, có thể ngủ, có thể chạy, có thể bơi, … Ta có thể tạo ra một class cha là Động vật, và các class trên sẽ kế thừa từ class Động vật. Như vậy, ta có thể sử dụng lại các đặc điểm của class Động vật cho các class con, và có thể thêm các đặc điểm mới vào các class con đó, ví dụ Chó thì có thêm đặc điểm là sủa, Mèo thì có thêm đặc điểm là kêu meo meo, …
Các phương thức, thuộc tính của class cha sẽ được các class con kế thừa, và có thể sử dụng lại. Ngoài ra, các class con có thể thêm các phương thức, thuộc tính mới vào các class con đó. Điều này giúp giảm bớt các code dư thừa, giúp dễ dàng bảo trì và mở rộng chương trình
Có thể ở các class nhỏ hiện tại các bạn chưa thấy kế thừa hữu ích. Tuy nhiên khi bài toán ngày càng lớn lên, đặc biệt thiên về domain chuyên ngành, 1 class sẽ có rất nhiều thuộc tính và phương thức. Ví dụ: một cái bánh bình thường ở tạp hoá, có thể có lên tới 10-15 thuộc tính như màu sắc, hình dạng, giá, hạn sử dụng, ngày sản xuất, thành phần sản phẩm, các chứng chỉ an toàn thực phẩm, mã barcode, hay có các biến như “có thể cho động vật ăn”, … sau đó lại có nhiều loại bánh khác nhau nữa
Class Object
Trong Java, mọi class đều kế thừa từ class Object
Class Object là class cha của tất cả các class khác
Class Object có các phương thức như equals(), toString(), hashCode(), clone(), finalize(), wait(), notify(), notifyAll(), …
Các phương thức này được các class khác kế thừa, và có thể sử dụng lại
Có nhiều phương thức các bạn chưa cần đào sâu. Tuy nhiên tạm thời có thể để ý nó có các phương thức quan trọng như equals, toString, hashCode. Đây là các phương thức thường được dùng.
Đa hình
Đa hình là một trong những tính chất quan trọng của lập trình hướng đối tượng
Đa hình giúp ta có thể sử dụng các đối tượng khác nhau, nhưng có cùng một kiểu dữ liệu, giúp giảm sự lặp lại của code, giúp dễ dàng bảo trì và mở rộng chương trình
Override
Override là một kĩ thuật trong đa hình, giúp ta có thể thay đổi cách thức hoạt động của một phương thức đã có sẵn trong class cha
Override giúp ta có thể sử dụng các đối tượng khác nhau, nhưng có cùng một class cha, và khi gọi các phương thức, ta sẽ thấy mỗi đối tượng sẽ thực hiện theo cách của nó, chứ không phải cách của đối tượng khác
Overload là một kĩ thuật trong đa hình, giúp ta có thể tạo ra nhiều phương thức cùng tên, nhưng khác nhau về tham số truyền vào
Overload giúp ta có thể sử dụng các phương thức khác nhau, nhưng có cùng một tên, và khi gọi các phương thức, ta sẽ thấy mỗi phương thức sẽ thực hiện theo cách của nó, chứ không phải cách của phương thức khác
Cú pháp:
publicclassClassCha {
    publicvoidmethodName(int a) {
        // code
    }

    publicvoidmethodName(int a, int b) {
        // code
    }
}
Dễ thấy overload trong các phương thức của class Math, như Math.max(), Math.min(), Math.abs(), Math.pow(), Math.sqrt(), Math.round(), Math.floor(), Math.ceil(), Math.random(), … Chúng đều có cùng một tên là Math, nhưng khác nhau về tham số truyền vào. Ví dụ nếu truyền vào số nguyên, thì xử lý khác, truyền số thực thì xử lý khác, …
Phân biệt Overload và Override
Overload
Override
Cùng tên, khác tham số
Cùng tên, cùng tham số
Cùng class
Khác class
Overload giúp ta có thể tạo ra nhiều phương thức cùng tên, nhưng khác nhau về tham số truyền vào
Override là một kĩ thuật trong đa hình, giúp ta có thể thay đổi cách thức hoạt động của một phương thức đã có sẵn trong class cha
Overload chạy trong compile time
Override chạy trong run time
Đa hình compile time và runtime
Đa hình compile time là đa hình mà chúng ta có thể thấy được ngay trong quá trình code, ví dụ như overload. Đa hình compile time sẽ được thực hiện trong compile time, tức là khi chúng ta build chương trình, chúng ta sẽ thấy các phương thức được overload sẽ được thực hiện theo cách của nó, chứ không phải cách của phương thức khác
Đa hình runtime là đa hình mà chúng ta không thể thấy được ngay trong quá trình code, ví dụ như override. Đa hình runtime sẽ được thực hiện trong runtime, tức là khi chúng ta chạy chương trình, chúng ta sẽ thấy các phương thức được override sẽ được thực hiện theo cách của nó, chứ không phải cách của phương thức khác
Ví dụ: Khi viết code lúc compile ta đã thấy ngay phương thức nào được gọi, nhưng khi chạy chương trình, ta mới thấy phương thức nào được thực hiện của override
Ví dụ:
Ta có các class Chó, Mèo, Bò. Chúng đều kế thừa từ class Động vật. Ta có thể tạo ra một mảng các đối tượng Động vật, và có thể thêm vào đó các đối tượng Chó, Mèo, Bò. Như vậy, ta có thể sử dụng các đối tượng khác nhau, nhưng có cùng một kiểu dữ liệu, là Động vật.
Chúng có thể có chung 1 hàm là keu(), nhưng khi gọi hàm keu() trên mảng các đối tượng Động vật, ta sẽ thấy mỗi đối tượng sẽ keu() theo cách của nó, chứ không phải cách của đối tượng khác. Như vậy, ta có thể sử dụng các đối tượng khác nhau, nhưng có cùng một kiểu dữ liệu, và khi gọi các phương thức, ta sẽ thấy mỗi đối tượng sẽ thực hiện theo cách của nó, chứ không phải cách của đối tượng khác.
Tạo ra một class ConNguoi, có các thuộc tính là tên, tuổi, giới tính, …
Có các class con là SinhVien, NhanVien, HocSinhCap3 kế thừa từ class ConNguoi
Các class con có thể có thêm các thuộc tính riêng của nó, ví dụ SinhVien có thuộc tính là mã sinh viên, NhanVien có thuộc tính là mã nhân viên, …
Các class con có thể có thêm các phương thức riêng của nó, ví dụ SinhVien có phương thức là học, NhanVien có phương thức là làm việc, …
Có 1 phương thức chung của 3 class con là lamViecBuoiSang(), nhưng mỗi class con sẽ thực hiện theo cách của nó, chứ không phải cách của class con khác. Ví dụ SinhVien sẽ đi học đại học, NhanVien sẽ đi làm, HocSinhCap3 sẽ đi học ở trường cấp 3
This entry is part 1 of 2 in the series Java Memory
Mở đầu: Tại sao cần học quản lý bộ nhớ trong Java
Đã bao giờ bạn gặp phải những câu kiểu “Nháy nút refresh ở màn hình desktop máy tính cho máy chạy nhanh hơn”, hay khởi động lại điện thoại, máy tính, chạy lại ứng dụng, web để dùng mượt hơn chưa?
Nếu có, khả năng cao bạn đã gặp phải việc một ứng dụng đã không quản lý bộ nhớ tốt, điều này khiến cho bộ nhớ ngày càng sử dụng nhiều, và khi đầy thì ứng dụng bị lag. Việc ứng dụng bị lag có thể do nhiều vấn đề như, như mạng chậm, cơ sở dữ liệu, … nhưng việc bộ nhớ bị dùng full thường chiếm một phần khá lớn trong vấn đề này.
Hiểu được cách Java quản lý bộ nhớ là một điều thiết yếu để tối ưu hệ thống.
Kiểu dữ liệu nguyên thuỷ và object
Kiểu dữ liệu nguyên thuỷ trong Java có thể kể đến byte, short, int, long, char, ….
Trong Java, các đối tượng tạo từ các class như Integer, Double, Float, … Hay từ những class mà tự bạn tạo ra, thì chúng ta đang không thực sự lưu giá trị của nó, mà ta đang lưu “địa chỉ” đến giá trị thực sự của nó
Hãy thử đi từ từ lại vấn đề này, khi ta sử dụng các kiểu biến nguyên thuỷ, ví dụ khai báo như sau
byte x = 7
Thì trong Java, bản chất biến x này đang giữ giá trị thực sự, giá trị bit (00000111)
Còn một biến Object, hay biến địa chỉ thì chúng ta như đang lưu một “điều khiển”, một tham chiếu địa chỉ đến giá trị thực sự
Dog myDog = new Dog();
Okay, mong là bạn đã hơi mường tượng được điều gì đó, tiếp theo ta sẽ đến hai khái niệm là Stack và Heap
Trong bộ nhớ Java, ta thường nhắc tới 2 nơi lưu chính đó là Stack và Heap. Toàn bộ Thread trong hệ thống sẽ có các stack khác nhau, tuy nhiên share chung 1 heap
Cơ bản ở reference bên trên, hay cách lưu tham chiếu, thì giá trị thực sẽ luôn nằm ở heap
Các biến nguyên thuỷ trong Java nếu được khai báo dưới dạng local variable (biến nằm trong các hàm, …) sẽ được lưu vào stack, còn các biến lưu dạng toàn cục của 1 class (instance variable) sẽ được lưu vào heap.
Tương tự, các biến tham chiếu (reference) cũng được lưu tương tự, nếu chúng là các local variable, các biến nằm trong 1 hàm main, 1 phương thức, … chúng sẽ được lưu trong stack. (Lưu cái con trỏ trong stack), còn nếu nó là biến toàn cục class (instance variable), nó sẽ nằm trong heap (vì hiện tại, nó đang được lưu trong 1 giá trị object thực sự khác, hay là heap)
Java Pass-by-Value, Call-By-Value
Tiếp theo, ta sẽ đi đến khái niệm pass-by-value, hay call-by-value trong Java. Hiểu đơn giản, khi ta truyền các biến như 1 tham số trong 1 hàm, ta chỉ đang truyền một bản “copy” của đối tượng ban đầu đó.
Ví dụ như đoạn code sau, đoạn code sẽ vẫn in ra 5, giá trị ban đầu của a, vì khi ta truyền vào hàm kia, ta chỉ đang truyền một bản sao của biến a, có giá trị là 5, chứ không thực sự truyền a, nên a ở hàm main sẽ không bị thay đổi.
Tuy nhiên, ta lại sẽ có một vấn đề thường hay mắc lầm khác, Hãy thử xem đoạn code sau:
Đầu tiên ta có một object John, với tuổi là 20, và tên là John
Sau đó ta chạy hàm change, nơi mà ta sẽ cập nhậtbiến tuổi truyền vào thành 90, còn tên của person truyền vào thành Michael
Bạn sẽ nghĩ là, okay, giờ ta đang truyền một bản sao thôi đúng không? Vậy thì tuổi vẫn giữ là 20, còn tên vẫn giữ là John
Nhưng kết quả thật bất ngờ, tuổi thì đúng là không thay đổi 20, nhưng tên thì cập nhật thành Michael. Tại sao lại như vậy?
Ta hãy quay trở lại khái niệm vừa nhắc tới
Khi ta truyền một biến nguyên thuỷ, hay trong trường hợp trên là age, ta đang như tạo một bản sao của một tờ giấy bình thường, tờ giấy đó ghi số là 20, ta đưa cho người khác. Họ sửa chúng thành 90, 100 hay gì đi chăng nữa, thì tờ giấy ban đầu của ta vẫn là 20
Tuy nhiên, khi ta truyền một biến reference (tham chiếu) của Object person, ta đang truyền bản sao của “tham chiếu” của nó. Hay đơn giản là, ta đang tạo ra bản sao của một cái điều khiển, vậy thì cái điều khiển bản sao này khi đưa cho người khác, vẫn sẽ bật tắt được tivi ban đầu của mình.
Escaping References
Ta sẽ đi sang vấn đề. Vậy thì điều này có thể ảnh hưởng điều gì?
Một trong bốn tính chất của OOP, Encapsulation – tính đóng gói, trong đó có thể kể đến việc, ta sẽ cho toàn bộ biến trong class thành private, ẩn chúng với bên ngoài, với class khác. Để thay đổi, hay tương tác với chúng, ta chỉ tương tác qua các phương thức public mà ta cài đặt. (Ví dụ như Getter, Setter)
Tuy nhiên ta đi đến một vấn đề mới. Vì vấn đề truyền tham chiếu, truyền điều khiển thay đổi phần gốc như trên, thì với một ví dụ như trên, ta đang để private Name của Person, tuy nhiên khi gán nó cho một biến ngoài sb bằng getter, rồi thay đổi nó, thì nó cũng thay đổi giá trị được giấu bên trong class gốc.
Điều này phá huỷ việc đóng gói của chúng ta, do ta bằng 1 cách nào đó, đã thay đổi được giá trị private, mà không cần đi qua các phương thức setter hay các phương thức cho phép thay đổi của class.
Kĩ thuật defensive copying
Lúc này, có một solution được biết đến với tên defensive copying
Ta sẽ không muốn lưu một bản tham chiếu đến một cái điều khiển, nơi mà ta có thể thay đổi giá trị đang được ẩn. Mà các phương thức lấy các tham chiếu này ra, ta sẽ tạo hẳn 1 object mới, một bản sao chỉ copy giá trị của biến gốc, chứ không copy điều khiển đến biến gốc.
Như ví dụ trên, ở hàm Getter, ta chỉ trả về một biến String Builder mới, chứa dữ liệu của name, nhưng không có khả năng thay đổi name gốc
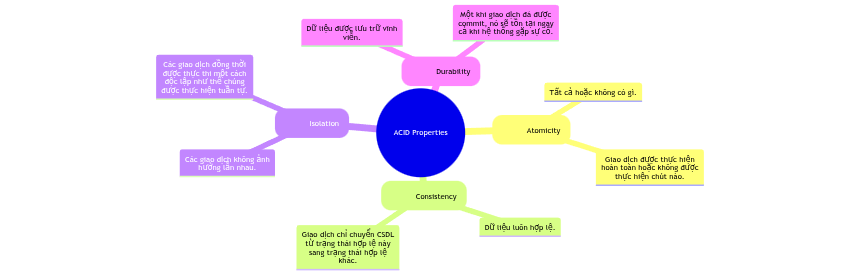
Đầu tiên, ta cần phải hiểu về Transaction trong Database. Một phiên (Transaction) trong database có thể được coi tạo lên bởi 4 tính chất ACID
Một transaction (phiên) thể hiên một nhóm các câu lệnh được chạy trong database, thông thường chứa nhiều lệnh khác nhau.
Hãy tưởng tượng bạn chuyển 1 triệu đồng từ tài khoản A sang tài khoản B. Transaction sẽ bao gồm 2 bước:
Trừ 1 triệu từ tài khoản A
Cộng 1 triệu vào tài khoản B
Nếu bước 1 thành công nhưng bước 2 thất bại (vì lý do nào đó), transaction sẽ rollback (hoàn tác) – tức là hoàn lại 1 triệu vào tài khoản A. Như vậy sẽ không có tiền nào bị “biến mất”.
Các cấp độ isolation trong Database
Read Uncommitted Isolation Level (Cấp độ “đọc chưa hoàn thành”)
Đây là cấp độ khá lỏng lẻo, khi mà ta sẽ đọc các dữ liệu chưa được commit của row. Tức là bất kì lệnh cập nhật ,thêm vào mà chưa thật sự commit vào database cũng sẽ có luôn trong phiên hiện tại của mình. Cấp độ này thường được dùng trong các hệ thống đặt vé, đặt lịch hẹn khi mà các transaction khác đang cố update tình trạng của 1 vé, kể cả khi phiên ngoài đó chưa thực thi xong, nhưng ta cũng sẽ coi như là nó đã được chạy.
Cấp độ này thường k đảm bảo tính toàn vẹn của dữ liệu đọc được, tuy nhiên nếu chúng có thể chấp nhận được thì chúng có thể được dùng để giảm bớt tình trạng deadlock, … (Ví dụ như đọc toàn bộ dân số việt nam, ta có thể chấp nhận sai số khoảng 100-200 người chẳng hạn)
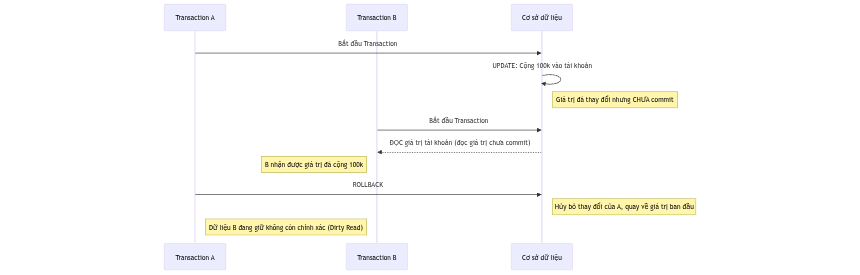
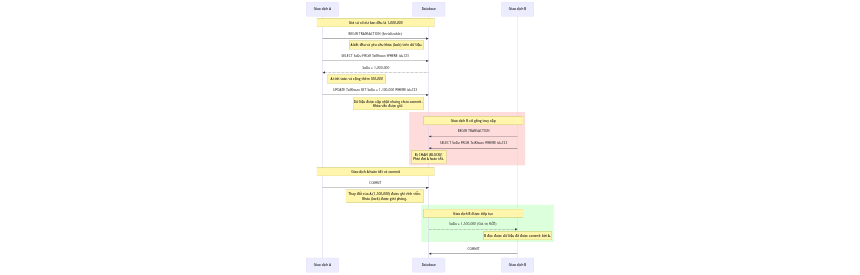
Transaction A bắt đầu và thực hiện một phép UPDATE (cộng 100k vào một tài khoản). Tại thời điểm này, sự thay đổi chỉ tồn tại trong phiên của Transaction A và chưa được xác nhận (commit) vào cơ sở dữ liệu.
Transaction B bắt đầu và đọc dữ liệu từ chính tài khoản đó. Do mức cô lập (isolation level) của cơ sở dữ liệu thấp, Transaction B đã đọc phải dữ liệu “bẩn” (dirty data) – là dữ liệu đã được Transaction A thay đổi nhưng chưa được commit.
Transaction A gặp lỗi hoặc quyết định hủy bỏ, do đó nó thực hiện lệnh ROLLBACK. Mọi thay đổi của Transaction A sẽ bị hủy bỏ, và dữ liệu trong tài khoản quay trở lại giá trị ban đầu như trước khi A bắt đầu.
Kết quả: Transaction B bây giờ đang giữ một giá trị không còn tồn tại trong cơ sở dữ liệu, dẫn đến sự không nhất quán về dữ liệu.
Read Committed Isolation Level (cấp độ “đọc phải hoàn thành”)
Đặc điểm: Chỉ đọc được dữ liệu đã được commit. Đây là mức độ phổ biến nhất.
Transaction A đang cộng 100k vào tài khoản của bạn
Transaction B sẽ không thấy số tiền tăng cho đến khi A commit thành công
Transaction A bắt đầu và thực hiện một phép UPDATE (cộng 100k vào một tài khoản). Tại thời điểm này, sự thay đổi chỉ tồn tại trong phiên của Transaction A và chưa được xác nhận (commit) vào cơ sở dữ liệu.
Transaction B bắt đầu và đọc dữ liệu từ chính tài khoản đó. Do mức cô lập (isolation level) của cơ sở dữ liệu thấp, Transaction B đã đọc phải dữ liệu “bẩn” (dirty data) – là dữ liệu đã được Transaction A thay đổi nhưng chưa được commit.
Transaction A gặp lỗi hoặc quyết định hủy bỏ, do đó nó thực hiện lệnh ROLLBACK. Mọi thay đổi của Transaction A sẽ bị hủy bỏ, và dữ liệu trong tài khoản quay trở lại giá trị ban đầu như trước khi A bắt đầu.
Kết quả: Transaction B bây giờ đang giữ một giá trị không còn tồn tại trong cơ sở dữ liệu, dẫn đến sự không nhất quán về dữ liệu.
Trong Spring: Đây là mức độ mặc định khi bạn dùng @Transactional.
Repeatable Reads Isolation Level (Cấp độ “đọc lại”)
Giả sử, ta có một bảng chứa số tiền lương của nhân viên, và ta có một transaction chứa 2 lệnh như sau
Lệnh 1: Đếm số lượng nhân viên
Lệnh 2: Đếm tổng tiền lương của nhân viên
Lúc này, giả sử một trường hợp mà có một nhân viên mới được thêm vào ngay sau khi Lệnh 1 hoàn thành. Lúc này kết quả của lệnh 2 sẽ bị thay đổi (do có 1 nhân viên mới). Lúc này chúng ta thường sẽ chọn cấp độ Repeatable Read, đó là đảm bảo rằng số lượng row (hàng) nằm trong phiên hiện tại giữ nguyên giá trị cho đến khi hết transaction.
Điều này đảm bảo số lượng row nhân viên phải được đảm bảo từ đầu phiên, nên nhân viên mới kia (1 row mới) không được count vào, và lệnh 2 đảm bảo giá trị vẫn đúng.
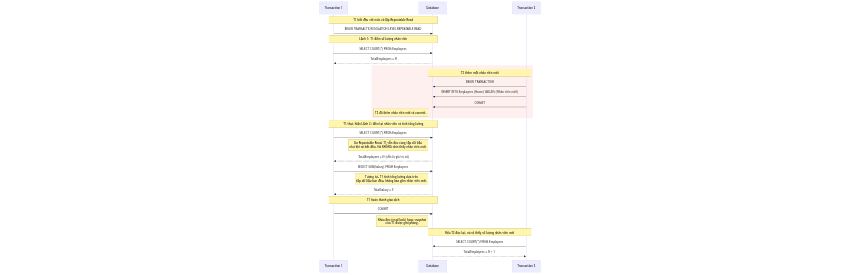
Transaction 1 (T1) bắt đầu với mức cô lập Repeatable Read. Điều này có nghĩa là bất kỳ dữ liệu nào T1 đọc trong quá trình thực hiện sẽ giữ nguyên (nhất quán) trong suốt thời gian của transaction, ngay cả khi các transaction khác (như T2) thực hiện các thay đổi và commit.
Khi T1 thực hiện Lệnh 1 (SELECT COUNT(*) FROM Employees), nó đọc được số lượng nhân viên là 10. Tại thời điểm này, một “snapshot” (ảnh chụp nhanh) của dữ liệu được tạo ra cho T1.
Transaction 2 (T2) chèn thêm một nhân viên mới và commit. Lúc này, về mặt vật lý, cơ sở dữ liệu đã có 11 nhân viên.
Tuy nhiên, khi T1 thực hiện Lệnh 2 (SELECT SUM(Salary) FROM Employees), nhờ cơ chế Repeatable Read, nó vẫn đọc dữ liệu dựa trên “snapshot” ban đầu của nó. Điều này có nghĩa là T1 sẽ không thấy được nhân viên mới mà T2 đã thêm vào. Do đó, tổng lương vẫn là 100,000,000 VND (tương ứng với 10 nhân viên ban đầu), đảm bảo tính nhất quán (không bị non-repeatable read) trong cùng một transaction.
Serializable Isolation Level
Đây là cấp độ mạnh nhất trong isolation
Không một transaction nào khác được quyền đọc hoặc ghi cho đến khi transaction này hoàn thành
Cấp độ này giải quyết đa số vấn đề mà 3 cấp độ kia có, nhưng mà nó thường làm giới hạn, chỉ cho phép 1 query chạy 1 lúc trong hệ thống, tạo thành 1 điểm nghẽn và khó scale hệ thống hơn.
Nghe thì có vẻ Serializable giúp ta thoải mái và đảm bảo dữ liệu đúng, tuy nhiên bản chất, nó ngăn chặn mọi hành động đa luồng trong database vào 1 vùng dữ liệu, và ta chỉ chạy được 1 phiên trên 1 vùng vào 1 thời điểm
Transaction A bắt đầu và đọc dữ liệu. Khi Transaction A thực hiện các thao tác đọc và ghi, cơ sở dữ liệu sẽ áp dụng một khóa độc quyền (exclusive lock) lên các dữ liệu mà A đang truy cập.
Trong khi A đang giữ khóa, Transaction B cố gắng đọc cùng một dữ liệu. Tuy nhiên, do dữ liệu đang bị khóa bởi A ở mức độ Serializable, Transaction B sẽ bị chặn (blocked) và phải đợi cho đến khi A hoàn thành.
Khi Transaction A thực hiện COMMIT, khóa độc quyền được giải phóng.
Lúc này, Transaction B mới có thể tiếp tục và đọc được dữ liệu, đảm bảo rằng nó luôn đọc được dữ liệu ở trạng thái nhất quán và đã được commit cuối cùng.
Khi code các ứng dụng backend bằng Java với Spring Framework, khả năng cao là bạn đã gặp qua một đoạn code sử dụng @Autowired. Tuy nhiên, nếu bạn sử dụng một số phần mềm lint để kiểm tra code, bạn có thể thấy các phần mềm sẽ cảnh báo @Autowired is deprecated (Autowired không được khuyến khích sử dụng nữa, cách làm không tốt)
Nhìn sơ qua thì đây có vẻ là một cách đơn giản và nhanh gọn để thực hiện DI qua Spring. Chỉ cần khai báo các dependency rồi thêm một annotation (@Autowired), các phần liên kết sẽ được Spring xử lí
Tuy nhiên, cách làm phổ biến này lại có thể dẫn đến nhiều vấn đề về sau này. Hãy thử xem qua các thủ pháp DI được sử dụng qua Spring Framework và các ưu nhược điểm của chúng
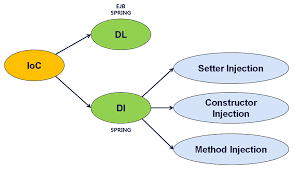
3 cách thực hiện Dependency Injection trong Spring Framework
Field Injection
Field Injection chính là tên gọi của cách inject dependency khi ta khai báo bằng @Autowired
Về cơ bản khi khai báo annotation này trên 1 field, method, constructor. Spring sẽ tự tìm dependency phù hợp và kết nối chúng với nhau.
@Autowired về mặc định không sai, tuy nhiên nếu sử dụng không hợp lí chúng có thể gây ra một số vấn đề về sau.
Ví dụ với một code như sau:
Khai báo một Multiplier trong Calculator nhanh chóng bằng @Autowired sẽ không báo lỗi gì khi compile, về cách hoạt động, khi chạy chương trình, Spring sẽ tự tìm kiếm dependency và kết nối chúng với nhau
Tuy nhiên, vì chúng tự động, nên ta thiếu kiểm soát hơn phần này. Tức là lúc này ta không có cách nào để thêm thủ công dependency nữa cho các hoàn cảnh khác ngoài lúc chạy ứng dụng (VD khi chạy test)
Ví dụ như code trên sẽ không báo lỗi, tuy nhiên khi chạy test thì chúng có thể throw NullPointer
Lí do là ở file test trên thì chúng ta đang không có chỗ nào liên kết với Spring cả, vì vậy Spring sẽ không quản lý các bean mà ta đã tạo (Khai báo @Component ở các class kia) nên chúng sẽ không nối vào nhau được -> Ta sẽ bị null pointer vì Multiplier không được khởi tạo lên
Để xử lý vấn đề này, thì nếu sử dụng 2 thủ pháp DI bên dưới (Constructor Injection và Setter Injection) , ta có thể có nhiều khả năng kiểm soát hơn và thêm dependency một cách thủ công mà không qua Spring, tạo nhiều khả năng hơn cho việc test
Hoặc, ta có thể khai báo @SpringBootTest để Spring quản lý file test này và tự động thực hiện việc gắn các bean mà không cần gắn chay
Setter Injection
Cách làm trên như tên của nó, ta sẽ set một dependency của class lớn hơn ở thời điểm runtime
Cách làm này cho phép ta dễ dàng thay đổi dependency của một class trong runtime, ví dụ như đổi 1 repo khác 1 service nào đó, …
Tuy nhiên, ngoài ưu điểm là sự flexible khi set ở runtime, thì nó cũng đi cùng vài nhược điểm khác
Do được set trong runtime, ta đôi khi có thể gặp phải NullPointer khi dependency chưa được khởi tạo, là null, … (vì lúc này chúng là optional, không bắt buộc với class nữa)
Do nó lỏng lẻo hơn nên lúc này với các method trong class gọi đến dependency, ta không được đảm bảo là dependency đã được set, hoặc ta lại phải thêm code để kiểm tra là có dependency chưa, 1 là thêm code, 2 là dẫn tới nullpointer
Với cách làm như thế này, ta có thể không cần Spring quản lý các bean mà có thể test chay hơn, có nhiều quyền kiểm soát hơn vào việc quản lý các dependency
Constructor Injection
Như tên của thủ pháp, ta sẽ thêm dependency cho 1 class ngay tại thời điểm khởi tạo class cha
Ở file test trên, mình đang sử dụng mock để dựng class multiplier lên theo kèm để gắn vào Calculator qua constructor
Việc này đảm bảo 1 class luôn có đủ dependency để khởi tạo (tuỳ theo cách custom constructor)
Hoặc mình hoàn toàn có thể làm như thế này
(Việc sử dụng mock cho phép nhiều khả năng khác trong test hơn, ví dụ mình có thể kiểm tra xem một hàm trong class đó được gọi bao nhiêu lần, … , chúng được quản lý theo dạng Proxy Design Pattern, mình sẽ nói ở bài viết khác)
Bạn có thể đọc thêm bài viết này về một số khái niệm trong Spring như IoC, Bean, …
Pessimistic locking (Khoá bi quan) là một chiến thuật xử lí có thể tổng quát rằng, giả dụ, bạn có một tập dữ liệu đang bị truy cập đồng thời, người đầu tiên truy cập sẽ khoá tập dữ liệu này lại, độc quyền sửa đổi nó, cho đến khi phiên đó hoàn thành. Điều này đảm bảo dữ liệu sẽ chuẩn xác hơn khoá lạc quan, nhưng cũng có thể tạo ra Deadlock
Ví dụ bài toán
Bạn đang chơi một con game sinh tồn, có một chiếc rương chứa đồ chung mà hai người chơi đều có thể mở, nhưng nếu cả hai cùng mở, người này lấy đồ, người kia lại cho đồ vào, đôi khi dữ liệu sẽ bị loạn
Khoá bi quan sẽ xử lí như sau
Khi người chơi A mở rương, khoá rương lại. Lúc này người chơi khác ấn vào rương sẽ bị thông báo như dạng “rương đang được mở bởi người khác”, và không thể truy cập cho đến khi người chơi A đóng rương.
Deadlock
Deadlock xảy ra khi hai phiên không thể tiến triển được nữa, vì cùng phụ thuộc vào nhau chờ phía bên kia mở khoá, có thể xem hình dưới đây
Ta có một database post chứa các bài viết. Trong đó có 1 bài viết id 1 và title là “Transaction”
Ngoài ra ta có 1 post chứa post_detail, là nội dung bài viết, số lượng like comment, …
Alice đầu tiên truy cập vào bảng post_detail, cập nhật số lượng like comment. Lúc này bảng post_detail thay đổi “người thay đổi cuối” thành Alice. Alice lock bảng post_detail
Lúc này Bob cũng truy cập vào bảng post, đổi tên nó thành thứ khác. Bob lock bảng post
Do bảng post và postdetail liên kết với nhau, lúc này ở phiên của Bob sẽ gọi về post_detail của post id 1 để thay đổi “người thay đổi” thành Bob. Tuy nhiên, nó đang bị khoá bởi Alice, vì vậy phải chờ Alice xong đã
Phía Alice lúc này cũng cập nhật lên bảng post, nhưng nó lại bị khoá bởi Bob, nên cũng phải đợi Bob xong đã
=> Điều này trở thành vòng tuần hoàn vô hạn, cho đến khi hệ quản trị cơ sở dữ liệu có cơ chế phát hiện ra, và huỷ cả 2 phiên.
Deadlock ở mọi nơi: hệ điều hành, trong code đa luồng, ..
Deadlock không chỉ xảy ra trong database, nó có thể xảy ra trong mọi hệ thống. Trong hệ điều hành, trong …., chỉ cần nếu chúng có thể truy cập từ nhiều nguồn cùng lúc
Ví dụ, đa luồng trong Java cũng có thể tạo deadlock khi 2 luồng cùng đợi nhau chứ không ai chạy trước
Cách xử lí
Khi Alice thực hiện khoá post, ta có thể khoá luôn cả post_Detail và các bảng liên quan
Hệ thống của ta cần có cơ chế phát hiện deadlock, ví dụ lock chờ đợi quá lâu, …
Đây là một kĩ thuật xử lí vấn đề khi người dùng cùng làm việc trên một tập dữ liệu, nhưng sẽ không ảnh hưởng đến nhau. Nói cách khác, không có một khoá hay vấn đề gì ngăn cản người dùng cả, chúng ta chỉ kiểm tra lazy xem đang có một phiên nào khác đang sửa tập dữ liệu này không. Nếu có, ta sẽ rollback lại dữ liệu
Bài toán thực tế
Giả sử, bạn đang làm việc trên một bài toán khá đơn giản: một cửa hàng bán đồ điện tử. Nhiệm vụ của bạn là một giao diện admin để có thể lấy toàn bộ sản phẩm, thêm mới, cập nhật vài sản phẩm nào đó, xoá vài sản phẩm đi. Một bài toán CRUD đơn giản.
Lúc này, ta có 2 nhân viên đang trực ca và sử dụng hệ thống – Alice và Bob. Một ngày đẹp trời, Alice mới nhập kho vài chiếc màn máy tính phiên bản mới “Acer 2023”, cô muốn sửa tên “Acer 2022” trong sản phẩm cửa hàng thành “Acer 2023”. Đúng lúc này, Bob cũng đang muốn sửa tên của sản phẩm “Acer 2022” một cách fancy hơn, như là “Acer 2022 144hz”.
Quá trình xảy ra như sau:
Alice mở thông tin của món hàng, mở lên giao diện sửa tên. Bỗng nhiên, máy pha cà phê của cô báo hoàn thành, cô lập tức chạy đi lấy cà phê
Ở phía Bob, anh cũng đang mở thông tin món hàng “Acer 2022”, sửa tên thành “Acer 2022 144hz”, sau đó đi chơi
Alice quay trở lại, cô cũng nhập tên “Acer 2023”, sau đó ấn nút save
Bob đi chơi về và: ủa? sao lại thành tên này rồi?. Anh hỏi Alice thì cô cũng một mực khẳng định là tên hiển thị trong giao diện sửa của cô lúc sửa là “Acer 2022”, chứ chưa phải là “Acer 2022 144hz”
Vậy ai là người sai ở đây?
Là Alice, người ấn save lần cuối
Hay là Bob, người ấn đầu tiên?
Để xử lí vấn đề này, Optimistic locking đưa ra cách giải quyết là: các user cần được cập nhật rằng tập dữ liệu đã thay đổi
Một vài ví dụ có thể bạn từng thấy trong các ứng dụng về Optimistic locking
Bạn đang ở màn hình chọn voucher của shopee, sau khi chọn xong và chuẩn bị thanh toán. Lúc ấn thanh toán, bạn được báo “một vài voucher đã hết/thay đổi, vui lòng xem lại”
Bạn đang xem giá xe ở Grab, thì có thông báo yêu cầu reload lại do giá đã thay đổi
Bạn xem một post ở Facebook, lúc viết comment thì có thông báo “bài viết có thể không tồn tại nữa”
Khi bạn thực hiện commit
Các phase của Optimistic locking
Lưu lại timestamp, thời gian cuối khi mà một phiên bắt đầu
Bắt đầu sửa dữ liệu
Validate kiểm tra lại, kiểm tra xem thời gian lần cuối lưu ở phía client có giống với thời gian ở phía database không
Nếu không có conflict xảy ra, cập nhật mọi dữ liệu. Còn không thì resolve nó, có thể là huỷ phiên hiện tại, hoặc cho phép merge, ….
Áp vào bài toán của chúng ta, ta có flow như sau
Alice thực hiện sửa ở phía local của Alice, ở database lúc này lưu “số phiên bản” của món đồ này là 1
Bob thực hiện sửa, sau đó lưu lại. Database cập nhật phiên bản lúc này đã là “2”
Alice ấn nút lưu, phát hiện phiên bản sai lệch, đưa ra cách xử lí nào đó cho người dùng
Tổng kết
Optimistic locking ngăn các vấn đề conflict dữ liệu xảy ra bằng cách kiểm tra conflict, sau đó tạo ra các cách resolve nó (merge, bỏ phiên, …)
Nó được gọi là Optimistic locking (khoá lạc quan)…. vì chúng ta lạc quan là khả năng conflict khá ít xảy ra
Phù hợp với nhiều món hàng, record và ít nguwofi dùng
Cho phép 1 cách nhiều người dùng làm trên 1 dữ liệu
Tốn ít công sức hơn, không cần khoá, …
Nhưng nếu conflict xảy ra, thường user sẽ phải làm lại phiên hoàn toàn …
Đây có lẽ là cách lưu trữ thường được thấy và dễ tưởng nhất. Trường primary key sẽ đóng vai trò như số thứ tự, giúp phân biệt giữa các row khác nhau, cách lưu trữ bằng số có thể được DB tự gen bằng cách gen sequence.
Khá tiện quản lý, sử dụng trong tầng dữ liệu
Dễ hiểu, dễ đọc, dễ tìm
Điểm trừ của cách làm này là:
Giả sử bạn đang lưu trữ dữ liệu cho 1 tệp khách hàng, được đánh id từ 1-1000, một ngày nào đó, bạn cần migrate data từ các bảng khác, từ những bảng cũ, … (kiểu sát nhập công ty, …) và cũng có tập dữ liệu được đánh số từ 1-100, 500-1000 gì đó. Điều này làm việc sát nhập trở lên khó khăn hơn do key chính để phân biệt các hàng đã bị trùng
Việc đánh số tuần tự cũng có thể tạo các risk về security, … Ví dụ bài viết đang được lưu đơn giản đánh bài viết số 1,2,… Từ đó từ bên ngoài có thể đoán được và truy cập được 1 bài viết bất kì.
Lưu trữ bằng UUID
Lúc này, một cách làm khác đã thường được sử dụng là UUID (Universally unique identifier). Sẽ khó có ai có thể đoán được uuid của 1 bài viết được sinh ra ngẫu nhiên.
UUID được sinh ngẫu nhiên, tỉ lệ trùng lặp là rất thấp
Tránh được việc user tự mở 1 bài viết bất kì
Tuy nhiên nó cũng đi kèm một số nhược điểm quan trọng
UUID dài. Để lưu trữ 1 uuid, thông thường ta cần tới 16 byte. Nó tốn dữ liệu hơn nhiều trong database so với lưu số thông thường. Sau này, khi ta sử dụng các database quan hệ giữa nhiều bảng, việc join các cột foreign keys sẽ ngày càng lớn hơn giữa các primary key
UUID do được sinh random, nên database sẽ khó lòng index một bảng để truy vấn nhanh hơn (VD MySQL sử dụng B+ Tree, cần một trường nào đó đánh theo một dãy giá trị có thể sắp xếp được: số, …).
Một số cách làm khác
ULID (Universally Unique Lexicographically Sortable Identifier). Vẫn là 16 byte, nhưng phần đầu sẽ chứa dữ liệu của timestamp (ngày tháng), và còn lại là ngẫu nhiên. Điều này giúp xử lí việc index database, dễ sắp xếp hơn
TSID (Time-Sorted Unique Identifiers). Cũng giống với ý tưởng của ULID nhưng chỉ tốn 8 byte. Tuy nhiên chúng cũng đi kèm với 1 số tradeoff
Đi sâu vào TSID
Có nhiều cách để triển khai TSID, trong bài này mình sẽ nói về Hypersistence TSID (Thư viện OSS), cho phép tạo 1 TSID 64-bit gồm 2 phần
Vì TSID là một số 64-bit (có thể sắp xếp), ta có thể lưu nó vào database dưới dạng bigint
CREATE TABLE post (
    id bigint NOT NULL,
    title varchar(255),
    PRIMARY KEY (id)
)
Lưu ở phía Entity
@Entity
@Table(name = "post")
public class Post {

    @Id
    private Long id;

    private String title;

}
Tổng kết về TSID
Đa phần giữ được các ưu điểm của UUID như khó đoán ở phía người dùng, tạo sự phân biệt, …
Lưu trữ nhẹ hơn UUID (8 byte vs 16 byte)
Tuy nhiên TSID có thể có tỉ lệ bị sinh ra ngẫu nhiên trùng cao hơn do chỉ có 22bit ngẫu nhiên (xác suất sinh trùng là 0.3%)
Xử lí việc sinh trùng, bạn có thể thêm số lần retry để tự động sinh lại nếu xảy ra collision
Khi nào nên sử dụng TSID
Phần ID có thể expose cho phía client người dùng, ví dụ như id bài viết, video, …. còn các bảng phụ hỗ trợ liên quan có thể cứ dùng dạng số để thuận tiện và tiết kiệm
Các database expose cho người dùng, cần tính đến việc scale lâu dài, và tiết kiệm
Một Package (gói) trong Java là một nhóm các class, interface và các package con tương tự, liên quan đến nhau. Chúng ta có thể coi package giống như là một folder.
Các package trong Java được sử dụng để tránh việc xung đột trong khi đặt tên, để kiểm soát truy cập, giúp bạn tìm kiếm và sử dụng các class, interface… một các dễ dàng hơn.
Phân loại
a. Các package có sẵn trong Java API:
java.lang: Chứa các lớp hỗ trợ ngôn ngữ (ví dụ: lớp được định nghĩa các kiểu dữ liệu nguyên thủy, các phép toán). Package này được import tự động.
java.io: Chứa lớp để hỗ trợ input / output (I/O)
java.util: Chứa các lớp tiện ích thực hiện các cấu trúc dữ liệu như danh sách liên kết, dictionary và hỗ trợ cho các hoạt động date / time.
java.applet: Chứa các lớp để tạo Applet.
java.awt: Chứa các class để triển khai các thành phần cho giao diện người dùng đồ họa (ví dụ như button, menu,…).
java.net: Chứa các lớp để hỗ trợ các thao tác trong mạng (network).
b. Package do người dùng tự định nghĩa
Lợi thế của việc sử dụng Package
Package được sử dụng để phân loại lớp và interface giúp dễ dàng bảo trì.
Package cung cấp bảo vể truy cập
Package khắc phục được việc đặt trùng tên.
Triển khai Package
Nếu tên package là traidat.vietnam.hanoi, khi đó có 3 thư mục là: traidat, vietnam, hanoi. Package traidat chứa subpackage – package con vietnam, sau đó package vietnam lại chứa subpackage là hanoi
Tên package thường được viết thường hết các chữ cái, và ghi rõ nghĩa của các class nằm trong package. VD package “math” chứa các class toán học, …
Để có thể sử dụng các phương thức, … của class TenClass này. Ta có thể gọi
Exception trong Java
Định Nghĩa
Exception (ngoại lệ) là một tình trạng bất thường. Trong java, ngoại lệ là một sự kiện làm gián đoạn luồng bình thường của chương trình. Nó là một đối tượng được ném ra tại runtime.
VD: Một chiếc ô tô đang chạy bình thường trên đường, thì bỗng nhiên dừng lại – chương trình dừng lại (RTE – Run Time Error), lúc này do ô tô hết xăng không chạy được nữa, vậy việc “hết xăng” là một ngoại lệ – sự bất thường bỗng xảy ra trong chương trình
Các loại Exception
Checked Exceptions: Các Exceptions là lớp extends từ lớp Throwable ngoại trừ RuntimeException và Error. Các Checked Exception được kiểm tra tại compile-time (Lúc chương trình được biên dịch)
Unchecked Exception: Các lớp extends từ RuntimeException được gọi là Unchecked Exception, ví dụ: ArithmeticException, NullPointerException, ArrayIndexOutOfBoundsException,… Các Exception này thường xảy ra khi lỗi đó không lường trước được.
Error: Đây là các lỗi không thể cứu chữa được, không thể làm gì khi nó xảy ra được nữa (VD: Hết ram, …)
VD: Khi ta chuẩn bị đi ra ngoài, ta sợ trời có thể mưa nên đã phòng sẵn một cái ô.
Việc trời mưa ta đã lường trước được, nên gọi là Checked Exception, và ta đã khai báo “cái ô” để chuẩn bị trước.
Tuy nhiên có một số vấn đề khác ta không lường được, ví dụ có một vũng nước trên đường, có một cái ô tô chắn không ra khỏi nhà (Các vấn đề phải thực thi chương trình, đi ra ngoài mới có thể gặp)
Checked Exceptions
IOException: Ngoại lệ liên quan đến file input / output
SQLException: Ngoại lệ liên quan đến cú pháp SQL
DataAccessException: Ngoại lệ liên quan đến việc truy cập CSDL
ClassNotFoundException: Bị ném khi JVM không thể tìm thấy một lớp mà nó cần, do lỗi dòng lệnh, sự cố đường dẫn hoặc tệp, class bị thiếu…
InstantiationException: Ngoại lệ khi cố gắng tạo đối tượng của một abstract class hoặc interface
UnChecked Exceptions
NullPointerException: Ngoại lệ bị ném ra khi cố gắng truy cập một đối tượng có biến tham chiếu có giá trị hiện tại là null
ArrayIndexOutOfBound: Ngoại lệ khi cố gắng truy cập một phần tử vượt quá độ dài của mảng
IllegalArgumentException: Ngoại lệ bị ném ra khi một phương thức nhận được một đối số được định dạng khác với phương thức mong đợi.
IllegalStateException: Ngoại lệ bị ném ra khi trạng thái của môi trường không phù hợp với hoạt động cố gắng thực hiện, ví dụ: Sử dụng Scanner đã bị đóng.
NumberFormatException: Ngoại lệ bị ném khi một phương thức chuyển đổi một Chuỗi thành số nhưng không thể chuyển đổi.
ArithmeticException: Lỗi số học, chẳng hạn như chia cho 0.
Xử lí Exception
Khối lệnh try-catch:
Lưu ý: Bạn có thể sử dụng nhiều khối catch với một khối try duy nhất. (Xử lí nhiều lỗi khi thử làm gì đó)
Khối lệnh finally:
Khối lệnh finally trong java được sử dụng để thực thi các lệnh quan trọng như đóng kết nối, đóng cả stream,…
Khối lệnh finally trong java luôn được thực thi cho dù có ngoại lệ xảy ra hay không hoặc gặp lệnh return trong khối try.
Quy tắc:
Đối với mỗi khối try, có thể có không hoặc nhiều khối catch, nhưng chỉ có một khối finally.
Khối finally sẽ không được thực thi nếu chương trình bị thoát (bằng cách gọi System.exit() hoặc xảy ra một lỗi không thể tránh khiến chương trình bị chết).
Custom Exception
Chúng ta có thể khai báo 1 class mới và extends Exception để trở thành 1 ngoại lệ checked
Chúng ta có thể khai báo 1 class mới và extends RuntimeException để trở thành 1 ngoại lệ unchecked
Tính đa hình (Polymorphism) là một trong bốn tính chất cơ bản của OOP. Trong lập trình, thuật ngữ này dùng để ám chỉ đến việc một biến, một hàm hoặc một phương thức có thể tồn tại ở nhiều dạng khác nhau. Đa hình là hiện tượng mà các đối tượng thuộc các class khác nhau có thể biểu diễn cùng một thông điệp theo các cách khác nhau.
Ví dụ:
Một người A có thể là một học sinh, đồng thời là thành viên câu lạc bộ, đồng thời là nhân viên bán thời gian quán café.
Một hành động “làm việc” nếu cho học sinh sẽ là học tập, cho kế toán sẽ là “tính toán”, …
Lập trình viên có thể tận dụng Tính đa hình trong OOP vào những trường hợp sau:
Khi các lớp con cần dùng phương thức của lớp cha để bổ sung cho một phương thức khác.
Khi một lớp cần có nhiều phương thức cùng tên nhưng khác tham số (parameter).
Tính đa hình trong OOP gồm có 2 loại:
Runtime Polymorphism (Đa hình thời gian chạy)
Compile Time Polymorphism (Đa hình thời gian biên dịch)
Theo đó , tính đa hình cho phép một phương thức thực thi những hành vi khác nhau theo hai hướng: sử dụng phương thức ghi đè (method overriding) hoặc phương thức nạp chồng (method overloading).
Đa hình thời gian chạy là trường hợp một đối tượng bị ràng buộc với chức năng của chúng ngay tại thời gian chương trình đang chạy. Đa hình thời gian chạy sử dụng phương thức ghi đè.
Đa hình thời gian biên dịch là trường hợp một đối tượng bị ràng buộc với chức năng của chúng ngay tại thời gian chương trình đang biên dịch. Đa hình thời gian biên dịch sử dụng phương thức nạp chồng.
Phương thức ảo, từ khóa Virtual
Một số tài liệu có viết công dụng của Virtual Function như sau:
“Virtual Function là để khai báo một function ở class cha (base class) mà sau đó các class kế thừa (derived class) có thể override function đó”
Các hàm ảo sẽ cho phép chúng ta tạo một danh sách các con trỏ lớp cơ sở và các phương thức của bất kỳ lớp dẫn xuất nào mà không cần biết loại đối tượng của lớp dẫn xuất.
Khi khai báo hàm ảo với từ khóa virtual nghĩa là hàm này sẽ được gọi theo loại đối tượng được trỏ (hoặc tham chiếu), chứ không phải theo loại của con trỏ (hoặc tham chiếu). Và điều này dẫn đến kết quả khác nhau:
Nếu không khai báo hàm ảo virtual trình biên dịch sẽ gọi hàm tại lớp cở sở base (lớp cha)
Nếu dùng hàm ảo virtual trình biên dịch sẽ gọi hàm tại lớp dẫn xuất derived (lớp kế thừa)
Phương thức thuần ảo, lớp ảo
Hàm thuần ảo (pure virtual function) được sử dụng khi:
Không cần sử dụng hàm này trong lớp cơ sở, chỉ phục vụ cho lớp dẫn xuất
Lớp dẫn xuất bắt buộc phải định nghĩa lại hàm thuần ảo (Nạp chồng)
Ví dụ: Chúng ta có một lớp cơ sở là Shape. Các lớp dẫn xuất của lớp Shape là Triangle, Square và Circle. Chúng ta muốn tính diện tích của các hình này.
Chúng ta có thể tạo ra một hàm thuần ảo có tên là calculateArea() trong lớp Shape. Các lớp Triangle, Square và Circle phải định nghĩa lại hàm calculateArea() với công thức tính diện tích khác nhau cho mỗi hình.
Lớp ảo
Có một vấn đề khi một lớp cơ sở được kế thừa bởi nhiều lớp dẫn xuất. Ví dụ, xét tình huống các lớp kế thừa theo sơ đồ như sau:
Lớp B và Lớp C kế thừa từ lớp A. Chúng trở thành A (B) và A (C). Lúc này, nếu ta lại cho D kế thừa từ B và C, ta vô tình tạo ra tới 2 con đường kế thừa về 1 điểm đích.
D kế thừa thông qua B kế thừa A
D kế thừa thông qua C kế thừa A
Điều này sẽ khiến trình biên dịch mơ hồ và không biết nên đi theo con đường nào và tạo ra lỗi.
Thay vì kế thừa thông thường, ta sẽ định nghĩa B và C là các lớp ảo, việc sử dụng lớp ảo sẽ tiết kiệm không gian và tránh việc trùng lặp kế thừa.
Nếu kế thừa thông thường, khi tạo class D kế thừa đồng thời B và C, ta thực chất tạo ra 2 bản sao class A
Nếu cho class B và class C thành virtual, thì khi tạo class C chúng ta sẽ dùng chung 1 bản class A.