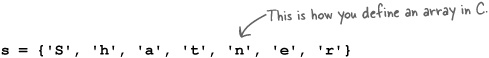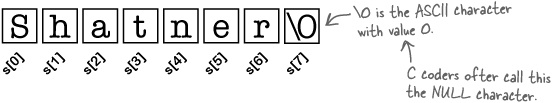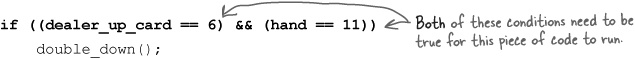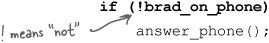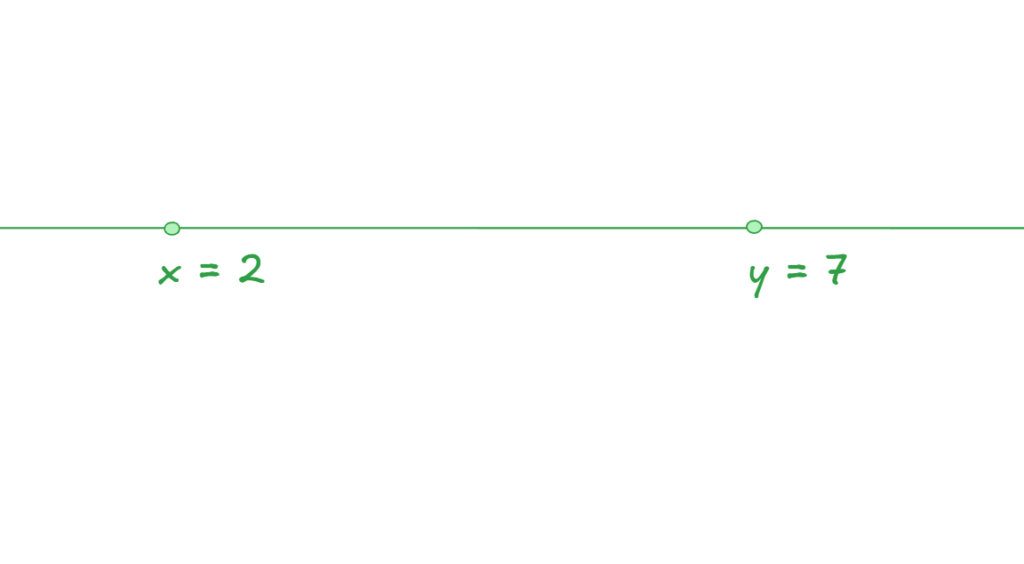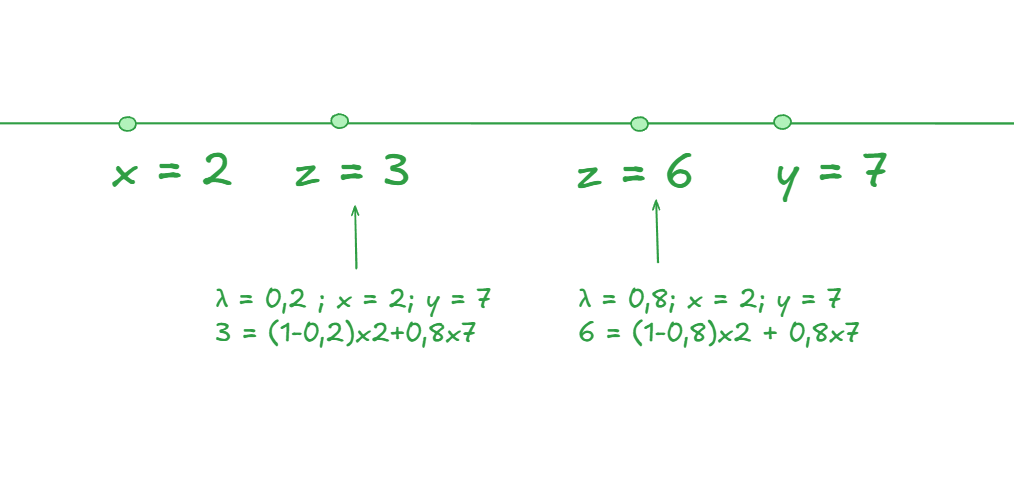Post

[A.I System Programming] B2: Tìm hiểu C Memory/Pointer

Ngôn ngữ C mang lại nhiều quyền kiểm soát hơn đối với cách chương trình sử dụng bộ nhớ của máy tính.

Mã C bao gồm các con trỏ

Con trỏ là một trong những thứ cơ bản nhất cần hiểu trong ngôn ngữ lập trình C. Vậy con trỏ là gì? Một con trỏ chỉ đơn giản là địa chỉ của một mẩu dữ liệu trong bộ nhớ.


1 – Thay vì truyền đi toàn bộ một bản sao của dữ liệu, bạn chỉ cần truyền một con trỏ.
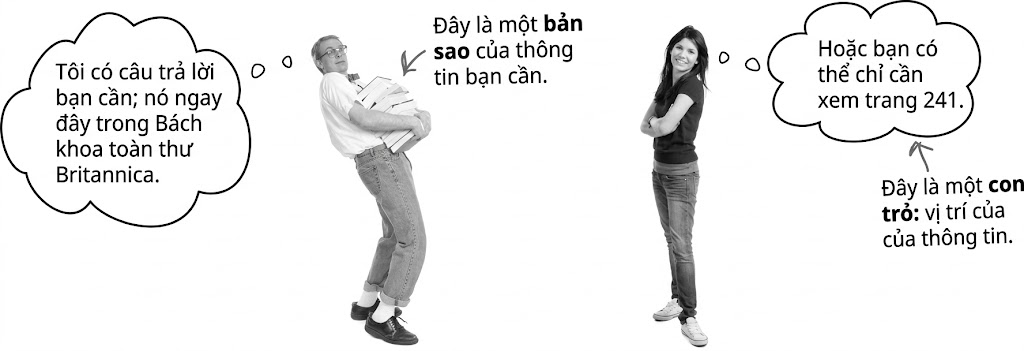
image 23 - quochung.cyou PTIT

Hãy tưởng tượng bạn có một cuốn bách khoa toàn thư dày 10.000 trang. Một người bạn muốn mượn nó để tra cứu.

  • Không dùng con trỏ (Truyền bản sao): Bạn phải đi photocopy toàn bộ 10.000 trang đó và đưa cho bạn của bạn. Quá trình này tốn cực kỳ nhiều thời gian, công sức và tốn thêm một không gian khổng lồ để chứa bộ copy đó.
  • Dùng con trỏ: Bạn chỉ cần viết số giá sách (địa chỉ) lên một tờ giấy note nhỏ xíu và đưa cho người bạn: “Nó ở ngăn số 3, kệ số 5 nhé”. Nhanh, gọn, lẹ.

Trong C, nếu bạn có một cục dữ liệu rất lớn (như một struct chứa hàng ngàn thông tin), việc copy nó mỗi lần gọi hàm sẽ làm chậm chương trình của bạn.

C
#include <stdio.h>

// Một cục dữ liệu khổng lồ (Giống như cuốn sách 10.000 trang)
struct DuLieuKhongLo {
    int mang[10000]; 
};

// CÁCH 1: KHÔNG DÙNG CON TRỎ (Truyền bản sao - Chậm, tốn bộ nhớ)
// Máy tính phải copy toàn bộ 10.000 phần tử vào một biến 'ban_sao' mới
void XuLyBanSao(struct DuLieuKhongLo ban_sao) {
    printf("Đang xử lý bản sao...\n");
}

// CÁCH 2: DÙNG CON TRỎ (Truyền địa chỉ - Nhanh, nhẹ)
// Máy tính chỉ cần truyền 1 địa chỉ duy nhất (như tờ giấy note)
void XuLyConTro(struct DuLieuKhongLo *dia_chi_du_lieu) {
    printf("Đang xử lý trực tiếp từ địa chỉ...\n");
}

int main() {
    struct DuLieuKhongLo du_lieu_cua_toi;
    
    // Gọi hàm cách 2 sẽ chạy nhanh hơn rất nhiều!
    XuLyConTro(&du_lieu_cua_toi); 
    
    return 0;
}

2 – Bạn có thể muốn hai đoạn mã cùng hoạt động trên cùng một mẩu dữ liệu thay vì trên một bản sao tách biệt.

Không dùng con trỏ (Làm việc trên bản sao): Bạn tải một file Word báo cáo về máy tính và gửi qua email cho sếp. Sếp sửa lỗi chính tả trên file của sếp. Sửa xong, file trên máy bạn không hề thay đổi vì sếp đang sửa trên bản copy của sếp.

Dùng con trỏ: Bạn tạo một link Google Docs và gửi cho sếp (link này chính là con trỏ). Cả bạn và sếp đều đang nhìn vào và chỉnh sửa trên cùng một tài liệu duy nhất. Sếp gõ chữ nào, bạn thấy chữ đó.

Con trỏ giúp bạn làm cả hai việc này: tránh việc tạo bản sao và chia sẻ dữ liệu.

Bộ nhớ

Mỗi khi bạn khai báo một biến, máy tính sẽ tạo ra không gian cho nó ở một nơi nào đó trong bộ nhớ. Nếu bạn khai báo một biến bên trong một hàm như main(), máy tính sẽ lưu trữ nó trong một khu vực của bộ nhớ được gọi là stack (ngăn xếp). Nếu một biến được khai báo bên ngoài bất kỳ hàm nào, nó sẽ được lưu trữ trong phần globals (toàn cục) của bộ nhớ.
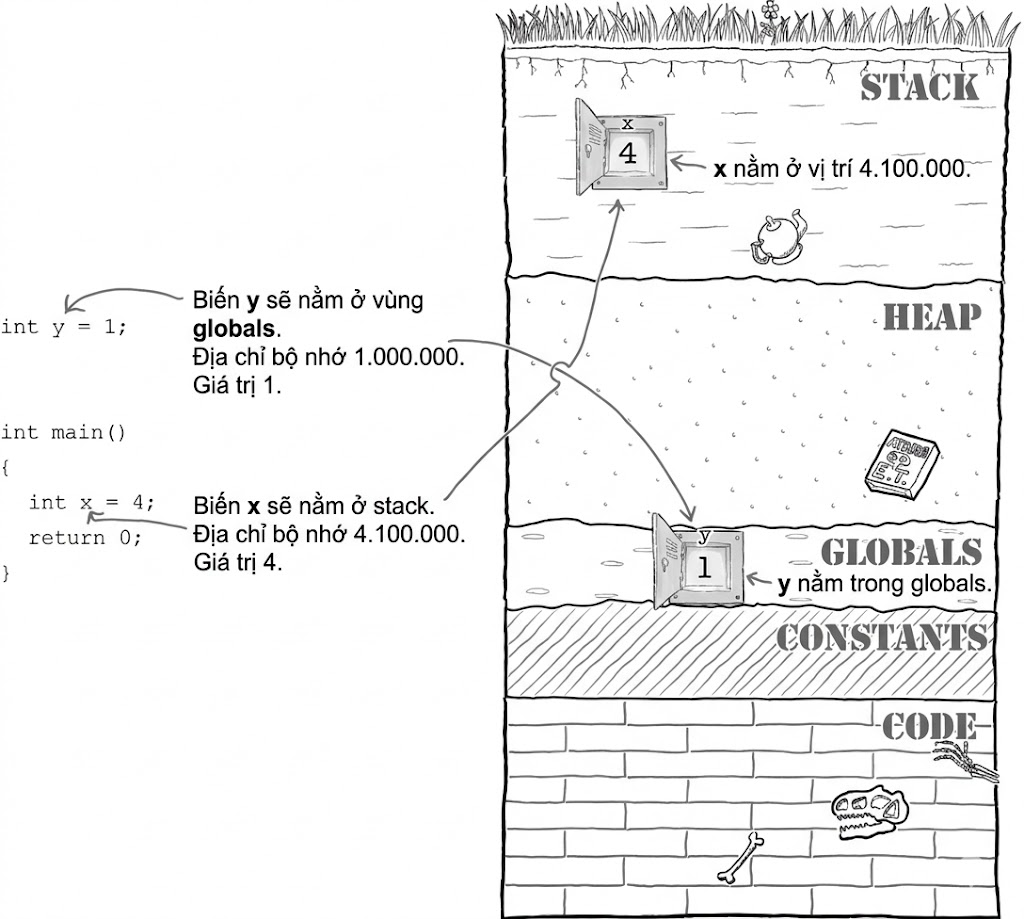
image 25 - quochung.cyou PTIT

Máy tính có thể cấp phát, giả sử, vị trí bộ nhớ số 4.100.000 trong ngăn xếp (stack) cho biến x. Nếu bạn gán số 4 cho biến đó, máy tính sẽ lưu số 4 tại vị trí 4.100.000.

Nếu bạn muốn tìm ra địa chỉ bộ nhớ của biến, bạn có thể sử dụng toán tử &:
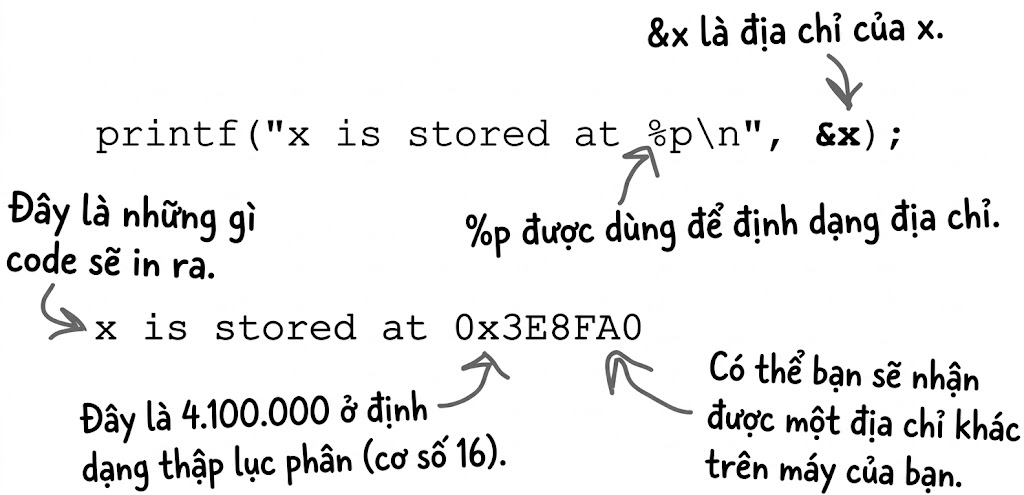
image 26 - quochung.cyou PTIT

Địa chỉ của biến cho bạn biết nơi để tìm thấy biến đó trong bộ nhớ. Đó là lý do tại sao một địa chỉ cũng được gọi là một con trỏ, bởi vì nó trỏ tới biến đó trong bộ nhớ.

Vấn đề khi truyền tham số bằng giá trị

Hãy tưởng tượng bạn đang viết một trò chơi trong đó người chơi phải tìm đường di chuyển xung quanh…
image 27 - quochung.cyou PTIT

Trò chơi sẽ cần kiểm soát rất nhiều thứ, như điểm số, mạng sống và vị trí hiện tại của người chơi. Bạn sẽ không muốn viết trò chơi thành một khối mã nguồn khổng lồ; thay vào đó, bạn sẽ tạo ra nhiều hàm nhỏ hơn, mỗi hàm sẽ thực hiện một việc gì đó hữu ích trong trò chơi:
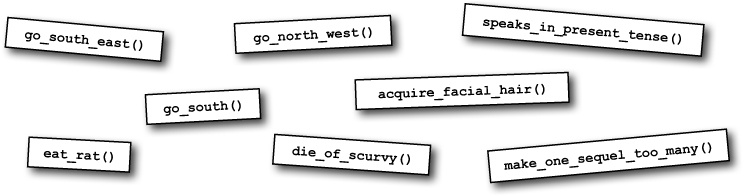
image 28 - quochung.cyou PTIT

Tất cả những điều này thì có liên quan gì đến con trỏ? Hãy bắt đầu viết mã mà không cần lo lắng chút nào về con trỏ cả. Bạn cứ việc sử dụng các biến như bạn vẫn thường làm. Một phần chính của trò chơi sẽ là điều hướng con tàu của bạn xung quanh Hình chữ nhật Bermuda, vì vậy hãy đi sâu hơn vào việc mã nguồn sẽ cần làm gì trong một trong các hàm điều hướng.

Trò chơi sẽ theo dõi vị trí của người chơi bằng cách sử dụng vĩ độ (latitudes) và kinh độ (longitudes). Vĩ độ là khoảng cách người chơi ở về phía Bắc hay Nam, còn kinh độ là vị trí của họ ở phía Đông hay Tây. Nếu một người chơi muốn đi về phía Đông Nam, điều đó có nghĩa là vĩ độ của họ sẽ giảm xuống, và kinh độ của họ sẽ tăng lên:
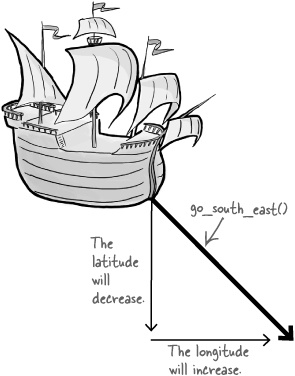
image 29 - quochung.cyou PTIT

Vì vậy, bạn có thể viết một hàm go_south_east() nhận các đối số cho vĩ độ và kinh độ, sau đó nó sẽ tăng và giảm (các giá trị này):

Chương trình bắt đầu đặt một con tàu ở vị trí [32, –64], vì vậy nếu nó đi về hướng Đông Nam, vị trí mới của con tàu sẽ là [31, –63].
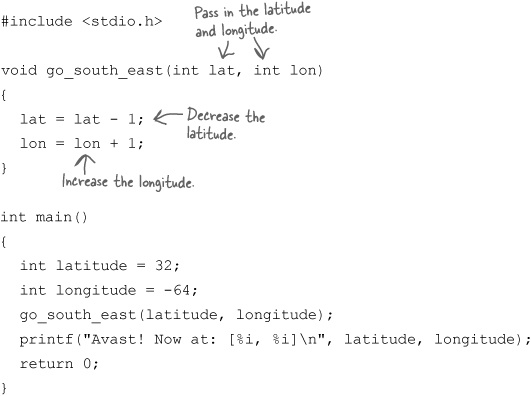
image 30 - quochung.cyou PTIT

Mã nguồn đáng lẽ phải di chuyển con tàu về phía Đông Nam từ [32, –64] đến vị trí mới tại [31, –63]. Nhưng nếu bạn biên dịch và chạy chương trình, điều này sẽ xảy ra:
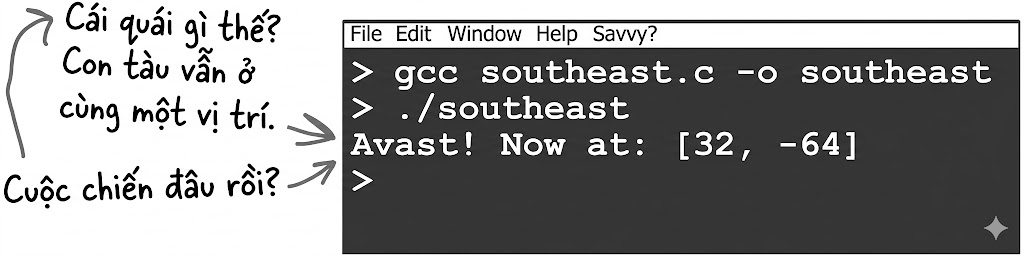
image 33 - quochung.cyou PTIT

Vị trí của con tàu vẫn giữ nguyên chính xác như trước.

C truyền các đối số dưới dạng giá trị

Đoạn mã đã bị lỗi do cách mà ngôn ngữ C gọi hàm.

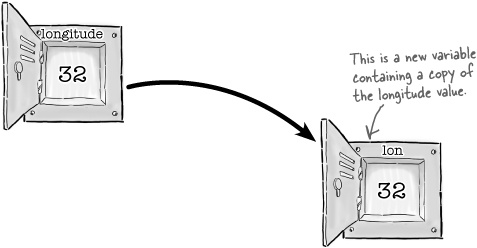
  • Ban đầu, hàm main() có một biến cục bộ tên là longitude chứa giá trị 32.
image 31 - quochung.cyou PTIT
  • Khi máy tính gọi hàm go_south_east(), nó sao chép giá trị của biến longitude sang đối số lon. Đây thực chất chỉ là một phép gán từ biến longitude sang biến lon. Khi bạn gọi một hàm, bạn không truyền bản thân biến đó làm đối số, mà chỉ truyền giá trị của nó.
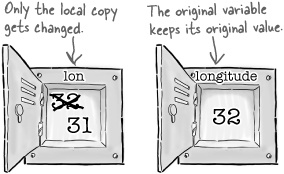
  • Khi hàm go_south_east() thay đổi giá trị của lon, hàm này chỉ đang thay đổi bản sao cục bộ của chính nó. Điều đó có nghĩa là khi máy tính quay trở lại hàm main(), biến longitude vẫn giữ giá trị ban đầu của nó là 32.
image 32 - quochung.cyou PTIT

Nhưng nếu đó là cách C gọi hàm, thì làm sao bạn có thể viết được một hàm có khả năng cập nhật một biến?

Sẽ rất dễ dàng nếu bạn sử dụng con trỏ…

Hãy thử truyền một con trỏ trỏ tới biến

Thay vì truyền giá trị của các biến vĩ độ và kinh độ, điều gì sẽ xảy ra nếu bạn truyền địa chỉ của chúng? Nếu biến kinh độ (longitude) nằm trong bộ nhớ ngăn xếp (stack) tại vị trí 4.100.000, điều gì sẽ xảy ra nếu bạn truyền số vị trí 4.100.000 làm tham số cho hàm go_south_east()?
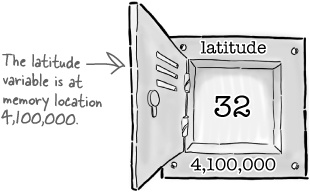
image 34 - quochung.cyou PTIT

Nếu hàm go_south_east() được báo cho biết rằng giá trị vĩ độ (latitude) nằm ở vị trí 4.100.000, thì nó sẽ không chỉ có thể tìm thấy giá trị vĩ độ hiện tại, mà còn có thể thay đổi nội dung của biến vĩ độ gốc. Tất cả những gì hàm cần làm là đọc và cập nhật nội dung của vị trí bộ nhớ 4.100.000.
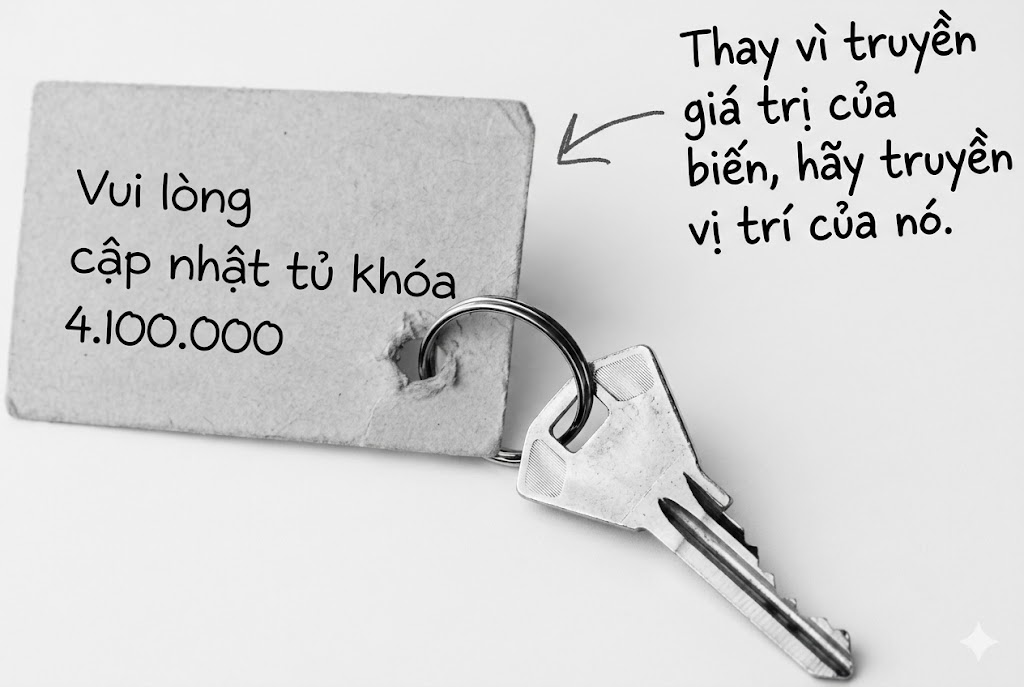
image 35 - quochung.cyou PTIT

Bởi vì hàm go_south_east() đang cập nhật trực tiếp biến vĩ độ gốc, máy tính sẽ có thể in ra vị trí đã được cập nhật khi nó quay trở lại hàm main().

image 36 - quochung.cyou PTIT
Hỏi: Tôi đã in vị trí của biến trên máy của mình và nó không phải là 4.100.000. Tôi có làm gì sai không?Đáp: Bạn không làm gì sai cả. Vị trí bộ nhớ mà chương trình của bạn sử dụng cho các biến sẽ khác nhau từ máy này sang máy khác.
Hỏi: Tại sao các biến cục bộ được lưu trữ trong ngăn xếp (stack) và các biến toàn cục (globals) được lưu trữ ở một nơi khác?Đáp: Các biến cục bộ và toàn cục được sử dụng theo những cách khác nhau. Bạn sẽ luôn chỉ có một bản sao duy nhất của một biến toàn cục, nhưng nếu bạn viết một hàm tự gọi chính nó (đệ quy), bạn có thể nhận được rất nhiều phiên bản của cùng một biến cục bộ.

Con trỏ giúp việc chia sẻ bộ nhớ dễ dàng hơn

Đây là một trong những lý do chính để sử dụng con trỏ, nhằm cho phép các hàm chia sẻ bộ nhớ. Dữ liệu được tạo ra bởi một hàm có thể được sửa đổi bởi một hàm khác, miễn là nó biết nơi để tìm thấy dữ liệu đó trong bộ nhớ.
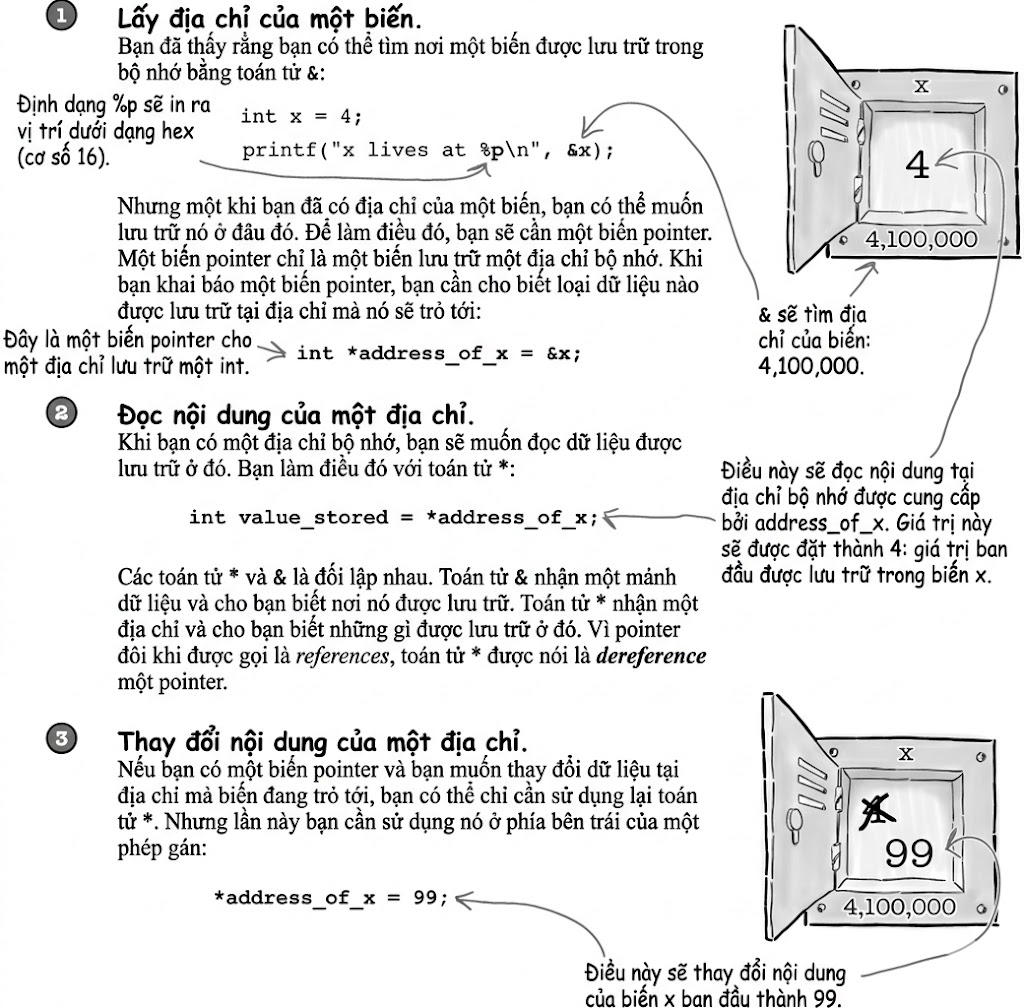
image 37 - quochung.cyou PTIT

Những điểm chính

  • Các biến được cấp phát không gian lưu trữ trong bộ nhớ.
  • Các biến cục bộ tồn tại trong ngăn xếp / stack.
  • Các biến toàn cục tồn tại trong khu vực toàn cục / globals.
  • Con trỏ chỉ là các biến lưu trữ các địa chỉ bộ nhớ.
  • Toán tử & tìm địa chỉ của một biến.)
  • Toán tử * có thể đọc nội dung của một địa chỉ bộ nhớ.
  • Toán tử * cũng có thể thiết lập / thay đổi nội dung của một địa chỉ bộ nhớ.
Hỏi: Các con trỏ (pointers) có phải là địa chỉ vật lý thực sự trên chip RAM không?Đáp: Không hoàn toàn. Con trỏ lưu trữ địa chỉ ảo (virtual address) thuộc không gian địa chỉ (address space) của một tiến trình (process). Đối với tiến trình đó, đây là địa chỉ “thực”, nhưng nó không trỏ trực tiếp đến vị trí vật lý trên chip RAM.
Hỏi: “Không gian địa chỉ ảo” có nghĩa là gì?Đáp: Hệ điều hành (OS) cung cấp cho mỗi tiến trình một lớp trừu tượng (abstraction layer). Tiến trình nhìn thấy bộ nhớ như một dải ô nhớ tuyến tính, liên tục, đánh số từ 0 đến N. Điều này giúp lập trình viên không phải quản lý việc tranh chấp bộ nhớ với các tiến trình khác đang chạy song song.
VD: Discord và Zalo đều cùng chạy trên máy bạn, 2 tiến trình không cần lo về việc Discord cũng muốn lưu biến “tên người dùng” ở ô nhớ 1000, Zalo cũng muốn lưu “danh bạ” ở ô nhớ 1000.
Thực tế hệ điều hành sẽ cấp phát cho tiến trình 1 mã khác, ví dụ Hà Nội và Bắc Ninh có 1 số tên đường giống nhau, còn bên dưới trên đường đó nhà số 1 đường Quang Trung ở Bắc Ninh không phải nhà số 1 đường Quang Trung ở Hà Nội. Việc quản lý đó là nội bộ trong tiến trình
Hỏi: Tại sao bộ nhớ thực tế lại không giống như vậy?Đáp: Bộ nhớ vật lý (RAM) được quản lý theo các đơn vị gọi là khung trang (page frames). Một dữ liệu mà bạn thấy là “liên tục” trong bộ nhớ ảo có thể bị chia nhỏ và nằm rải rác ở nhiều vị trí khác nhau trên RAM vật lý. Việc tách biệt này cho phép Hệ điều hành thực hiện các kỹ thuật:
Paging (Phân trang): Di chuyển các phần bộ nhớ ít dùng từ RAM xuống ổ cứng (Swap/Pagefile) để giải phóng không gian.
Memory Protection (Bảo vệ bộ nhớ): Ngăn chặn tiến trình này truy cập trái phép vào dữ liệu của tiến trình khác.
Relocation (Tái định vị): Di chuyển dữ liệu trong RAM mà không làm thay đổi giá trị của con trỏ trong chương trình.
Cơ chế nào chuyển đổi từ “địa chỉ ảo” trong con trỏ sang “địa chỉ vật lý”?Đó là nhiệm vụ của MMU (Memory Management Unit) – một thành phần phần cứng trong CPU – kết hợp với Page Tables (Bảng trang) do Hệ điều hành quản lý. Mỗi khi bạn truy xuất một con trỏ, MMU sẽ tra cứu bảng này để tìm ra địa chỉ vật lý tương ứng trên RAM.
Cấu trúc vật lý của RAM phức tạp như thế nào?Ở cấp độ phần cứng, RAM được tổ chức thành các Channels (Kênh), Ranks, và Banks. Dữ liệu được truy xuất thông qua các tín hiệu điện dựa trên địa chỉ dòng (Row) và cột (Column). Ngoài ra, các kiến trúc hiện đại như NUMA (Non-Uniform Memory Access) còn khiến tốc độ truy cập bộ nhớ khác nhau tùy thuộc vào khoảng cách vật lý giữa CPU và các thanh RAM.
Hỏi: Tại sao tôi phải in các con trỏ ra bằng cách sử dụng chuỗi định dạng %p?Đáp: Bạn không bắt buộc phải sử dụng chuỗi %p. Trên hầu hết các cỗ máy hiện đại, bạn có thể sử dụng %li (long integer), mặc dù trình biên dịch có thể đưa ra cho bạn một cảnh báo nếu bạn làm vậy.
Hỏi: Tại sao định dạng %p lại hiển thị địa chỉ bộ nhớ ở định dạng hex (thập lục phân)?Đáp: Đó là cách các kỹ sư thường dùng để nhắc tới các địa chỉ bộ nhớ.

Truyền String vào hàm

Bạn đã biết cách truyền các giá trị đơn giản làm đối số (arguments) cho hàm, nhưng chuyện gì sẽ xảy ra nếu bạn muốn gửi một thứ gì đó phức tạp hơn vào hàm, chẳng hạn như một chuỗi (string)?

Chuỗi trong C thực chất là các mảng ký tự (arrays of characters). Điều đó có nghĩa là nếu bạn muốn truyền một chuỗi vào hàm, bạn có thể làm như thế này:
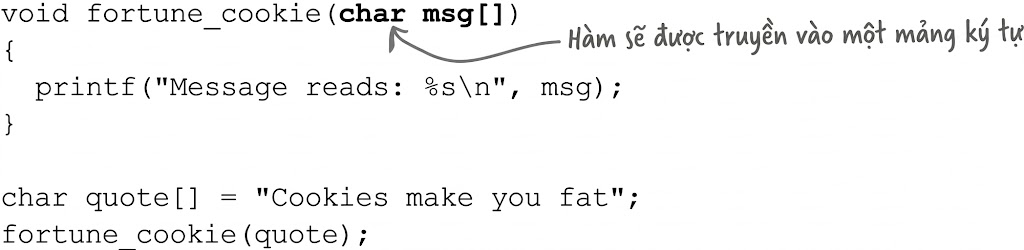
image 38 - quochung.cyou PTIT

Đối số msg được định nghĩa giống như một mảng, nhưng vì bạn sẽ không biết trước chuỗi đó dài bao nhiêu, nên đối số msg không bao gồm độ dài cụ thể. Điều này trông có vẻ đơn giản và dễ hiểu, nhưng có một điều hơi kỳ lạ đang diễn ra…

C có một toán tử (operator) gọi là sizeof, nó có thể cho bạn biết một thứ gì đó chiếm bao nhiêu byte không gian trong bộ nhớ. Bạn có thể gọi toán tử này kèm với một kiểu dữ liệu (data type) hoặc với một đoạn dữ liệu cụ thể:
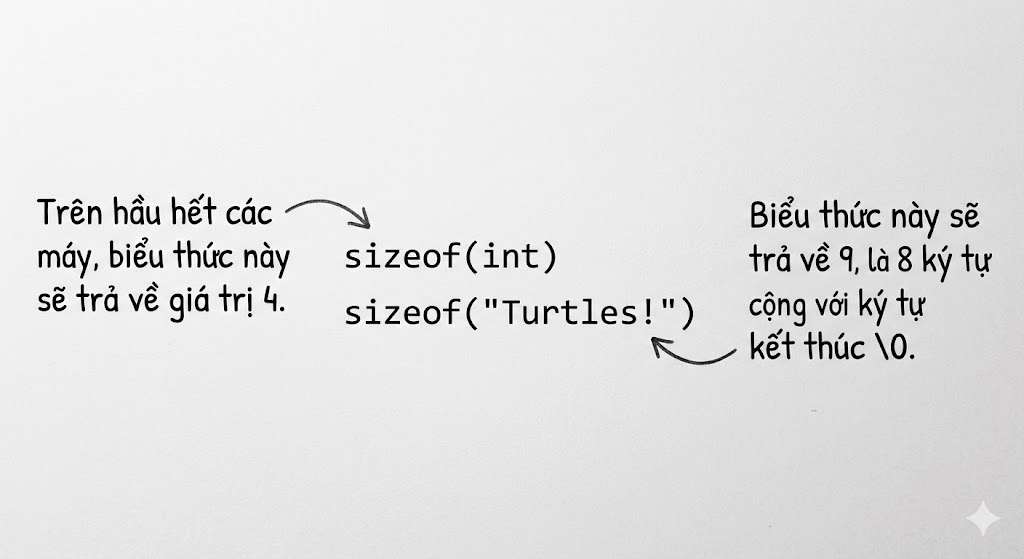
image 39 - quochung.cyou PTIT

Nhưng một điều kỳ lạ sẽ xảy ra nếu bạn nhìn vào độ dài của chuỗi mà bạn đã truyền vào hàm:
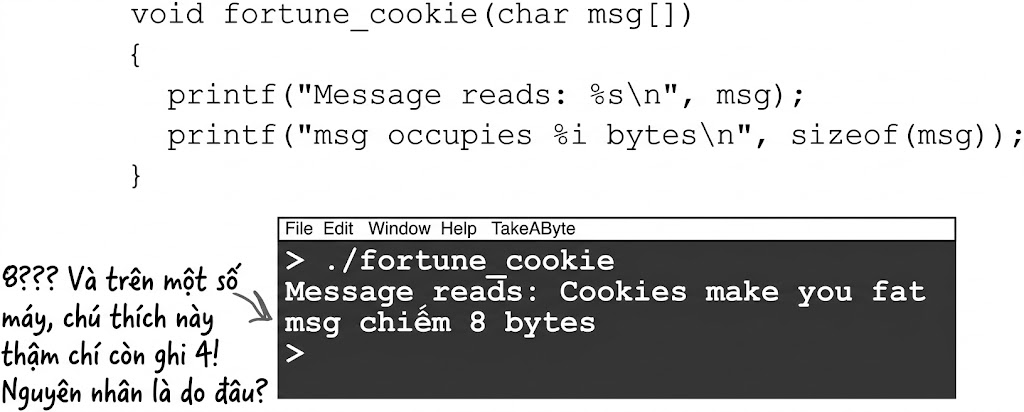
image 40 - quochung.cyou PTIT

Thay vì hiển thị toàn bộ chiều dài thực tế của chuỗi, đoạn mã chỉ trả về 4 hoặc 8 byte. Chuyện gì đã xảy ra vậy? Tại sao nó lại nghĩ rằng chuỗi chúng ta truyền vào lại ngắn hơn?

Theo bạn, tại sao sizeof(msg) lại ngắn hơn chiều dài của toàn bộ chuỗi? msg thực chất là gì? Tại sao nó lại trả về các kích thước khác nhau trên các máy tính khác nhau?

Biến mảng (Array variables) giống như con trỏ (pointers)

Khi bạn tạo một mảng, biến mảng đó có thể được sử dụng như một con trỏ trỏ đến vị trí bắt đầu của mảng trong bộ nhớ. Khi C nhìn thấy một dòng mã trong một hàm như thế này:
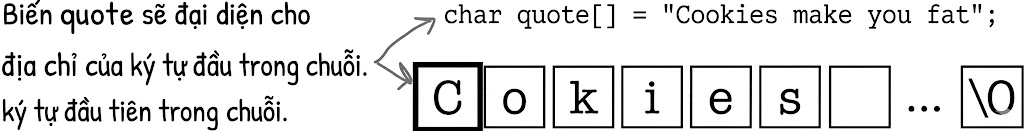
image 41 - quochung.cyou PTIT

Máy tính sẽ dành riêng một không gian trên ngăn xếp (stack) cho từng ký tự trong chuỗi, cộng thêm ký tự kết thúc \0. Nhưng nó cũng sẽ liên kết địa chỉ của ký tự đầu tiên với biến quote. Mỗi khi biến quote được sử dụng trong mã, máy tính sẽ thay thế nó bằng địa chỉ của ký tự đầu tiên trong chuỗi. Trên thực tế, biến mảng hoạt động y hệt như một con trỏ:
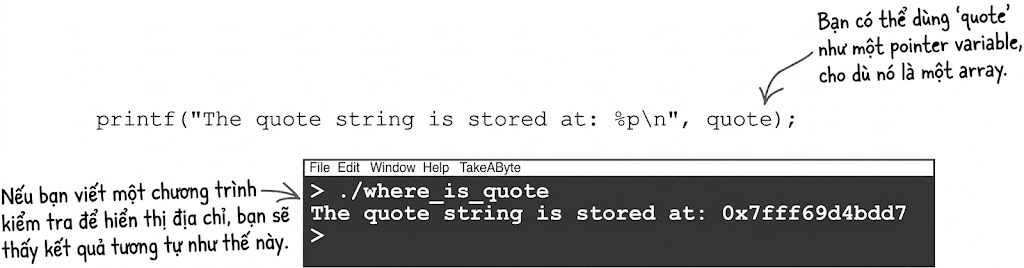
image 42 - quochung.cyou PTIT

…vậy hóa ra hàm của chúng ta đã được truyền một con trỏ

Đó chính là lý do tại sao điều kỳ lạ kia lại xảy ra trong đoạn mã fortune_cookie(). Mặc dù trông có vẻ như bạn đang truyền một chuỗi (string) vào hàm fortune_cookie(), nhưng thực tế bạn chỉ đang truyền một con trỏ trỏ đến chuỗi đó mà thôi:

Và đó cũng là lý do tại sao toán tử sizeof lại trả về một kết quả kỳ quặc. Nó chỉ đang trả về kích thước của một con trỏ trỏ đến một chuỗi. Trên các hệ điều hành 32-bit, một con trỏ chiếm 4 byte bộ nhớ, và trên các hệ điều hành 64-bit, một con trỏ chiếm 8 byte.

Hỏi: sizeof có phải là một hàm (function) không?Đáp: Không, nó là một toán tử (operator).
Hỏi: Sự khác biệt là gì?Đáp: Một toán tử được trình biên dịch (compiler) biên dịch thành một chuỗi các chỉ thị. Nhưng nếu đoạn mã gọi một hàm, nó phải nhảy đến một phần mã riêng biệt khác.
Nó không phải là một hàm vì:
Cú pháp: Đối với các biểu thức (expressions), sizeof không bắt buộc phải có dấu ngoặc đơn (ví dụ: sizeof x là hợp lệ). Hàm luôn yêu cầu dấu ngoặc đơn để truyền đối số.
Xử lý: Hàm được thực thi bởi CPU khi chương trình đang chạy. sizeof chủ yếu được xử lý bởi trình biên dịch trong quá trình chuyển đổi mã nguồn thành mã máy.
Hỏi: Vậy sizeof được tính toán khi chương trình được biên dịch à?Đáp: Đúng vậy. Trình biên dịch có thể xác định kích thước không gian lưu trữ ngay tại thời điểm biên dịch (compile time).

Khi bạn viết:

C
int a = 10;
size_t s = sizeof(a);

Trình biên dịch sẽ thấy a là kiểu int. Nếu trên hệ thống đó int chiếm 4 bytes, trình biên dịch sẽ chuyển mã nguồn trên tương đương với việc bạn viết:

C
int a = 10;
size_t s = 4; // Con số 4 được ghi thẳng vào mã máy

Tại thời điểm biên dịch (Compile-time)

Trong hầu hết các trường hợp, sizeof được tính toán hoàn toàn tại thời điểm biên dịch.

  • Trình biên dịch kiểm tra kiểu dữ liệu (static type) của toán hạng (operand).
  • Dựa trên bảng ký hiệu (symbol table) và quy tắc căn chỉnh bộ nhớ (memory alignment) của kiến trúc mục tiêu (ví dụ: x86 hoặc ARM), trình biên dịch xác định số lượng byte mà kiểu dữ liệu đó chiếm dụng.
  • Trình biên dịch sau đó thay thế toàn bộ biểu thức sizeof(...) bằng một hằng số (constant literal) trong mã máy.

Hệ quả: Không có lệnh gọi hàm (function call), không có việc nhảy địa chỉ bộ nhớ, và không tiêu tốn tài nguyên CPU khi chương trình đang chạy để tính toán giá trị này.

Tại thời điểm thực thi (Runtime) – Ngoại lệ

Có một trường hợp duy nhất sizeof được tính toán khi chương trình đang chạy: Mảng có kích thước thay đổi (Variable Length Array – VLA) trong tiêu chuẩn C99. Khi bạn khai báo int arr[n] với n là một biến, trình biên dịch không thể biết n bằng bao nhiêu cho đến khi chương trình chạy. Lúc này, sizeof(arr) sẽ tạo ra mã máy để tính toán kích thước dựa trên giá trị hiện tại của n.

Hỏi: Tại sao con trỏ lại có kích thước khác nhau trên các máy tính khác nhau? Đáp: Trên hệ điều hành 32-bit, một địa chỉ bộ nhớ được lưu trữ dưới dạng một số 32-bit. Đó là lý do tại sao nó được gọi là hệ thống 32-bit. 32 bit == 4 byte. Đó cũng là lý do tại sao hệ thống 64-bit lại sử dụng 8 byte để lưu trữ một địa chỉ.
Hỏi: Nếu tôi tạo một biến con trỏ, biến con trỏ đó có nằm trong bộ nhớ không?Đáp: Có. Biến con trỏ thực chất chỉ là một biến dùng để lưu trữ một con số.
Hỏi: Vậy tôi có thể tìm địa chỉ của một biến con trỏ không?Đáp: Có — bằng cách sử dụng toán tử &.
Hỏi: Tôi có thể chuyển đổi một con trỏ thành một con số thông thường không?Đáp: Trên hầu hết các hệ thống là có. Các trình biên dịch C thường làm cho kiểu dữ liệu long có cùng kích thước với một địa chỉ bộ nhớ. Vì vậy, nếu p là một con trỏ và bạn muốn lưu nó vào một biến long tên là a, bạn có thể gõ a = (long)p.

Nhưng biến mảng không hoàn toàn là con trỏ

Mặc dù bạn có thể sử dụng một biến mảng như một con trỏ, nhưng vẫn có một vài điểm khác biệt. Để thấy sự khác biệt này, hãy suy nghĩ về đoạn mã sau:

C
char s[] = "How big is it?";
char *t = s;

sizeof(một mảng) là… kích thước của một mảng.

Bạn đã thấy rằng sizeof(một con trỏ) trả về giá trị 4 hoặc 8, bởi vì đó là kích thước của con trỏ trên các hệ thống 32-bit và 64-bit. Nhưng nếu bạn gọi sizeof trên một biến mảng, C đủ thông minh để hiểu rằng điều bạn muốn biết là mảng đó lớn cỡ nào trong bộ nhớ.
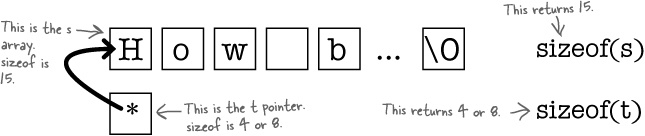
image 43 - quochung.cyou PTIT

Địa chỉ của mảng… chính là địa chỉ của mảng.

Một biến con trỏ chỉ là một biến lưu trữ một địa chỉ bộ nhớ. Nhưng còn biến mảng thì sao? Nếu bạn sử dụng toán tử & trên một biến mảng, kết quả bằng chính biến mảng đó.
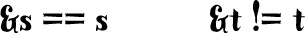
image 44 - quochung.cyou PTIT

Nếu một lập trình viên viết &s, điều đó có nghĩa là “Địa chỉ của mảng s là gì?”. Địa chỉ của mảng s chỉ đơn giản là… s. Nhưng nếu ai đó viết &t, điều đó có nghĩa là “Địa chỉ của biến t là gì?”.

Một biến mảng không thể trỏ đi nơi khác.

Khi bạn tạo một biến con trỏ, máy tính sẽ cấp phát 4 hoặc 8 byte không gian để lưu trữ nó. Nhưng chuyện gì sẽ xảy ra nếu bạn tạo một mảng? Máy tính sẽ cấp phát không gian để lưu trữ mảng, nhưng nó sẽ không cấp phát bất kỳ bộ nhớ nào để lưu trữ bản thân cái “biến” mảng đó. Trình biên dịch chỉ đơn giản là gắn địa chỉ của phần tử bắt đầu của mảng vào đó.

Nhưng bởi vì các biến mảng không có không gian lưu trữ được cấp phát, điều đó có nghĩa là bạn không thể bắt chúng trỏ vào bất cứ thứ gì khác.

image 45 - quochung.cyou PTIT

Tại sao mảng thực sự bắt đầu từ 0

Một biến mảng có thể được sử dụng như một con trỏ trỏ đến phần tử đầu tiên trong một mảng. Điều đó có nghĩa là bạn có thể đọc phần tử đầu tiên của mảng bằng cách sử dụng ký pháp ngoặc vuông hoặc sử dụng toán tử * như thế này:

image 46 - quochung.cyou PTIT

Nhưng vì một địa chỉ bộ nhớ chỉ là một con số, điều đó có nghĩa là bạn có thể thực hiện phép toán con trỏ (pointer arithmetic) và thực sự cộng thêm các giá trị vào một giá trị con trỏ để tìm địa chỉ tiếp theo. Vì vậy, bạn có thể sử dụng ngoặc vuông để đọc phần tử có chỉ số 2, hoặc bạn chỉ cần cộng 2 vào địa chỉ của phần tử đầu tiên:

printf("3rd order: %i drinks\n", 
drinks[2]);
printf("3rd order: %i drinks\n", 
*(drinks + 2));
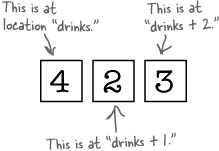
image 47 - quochung.cyou PTIT

Nói chung, hai biểu thức drinks[i] và *(drinks + i) là hoàn toàn tương đương nhau. Đó là lý do tại sao các mảng bắt đầu bằng chỉ số 0. Chỉ số (index) thực chất chỉ là con số được cộng vào con trỏ để tìm vị trí của phần tử đó.

Hỏi: Khi nào C điều chỉnh các tính toán của phép toán con trỏ?Đáp: Nó xảy ra khi trình biên dịch đang tạo ra tệp thực thi (executable). Nó xem xét kiểu dữ liệu của biến và sau đó nhân các dấu cộng và trừ với kích thước của biến cơ sở.
Nếu trình biên dịch thấy rằng bạn đang làm việc với một mảng int và bạn đang cộng 2, trình biên dịch sẽ nhân số đó với 4 (chiều dài của một int) và cộng thêm 8.
Hỏi: C có sử dụng toán tử sizeof khi nó đang điều chỉnh phép toán con trỏ không? Đáp: Về hiệu quả là có. Toán tử sizeof cũng được giải quyết tại thời điểm biên dịch, và cả sizeof lẫn các phép toán con trỏ sẽ sử dụng cùng các kích thước cho các kiểu dữ liệu khác nhau.

Tại sao con trỏ có kiểu dữ liệu

Nếu con trỏ chỉ đơn thuần là các địa chỉ, vậy thì tại sao các biến con trỏ lại cần có kiểu dữ liệu (như int*, char*,…)? Tại sao bạn không thể lưu trữ tất cả các con trỏ vào một loại biến con trỏ chung duy nhất nào đó?

Lý do là vì phép toán con trỏ (pointer arithmetic) rất “láu cá”.

Nếu bạn cộng 1 vào một con trỏ kiểu char, con trỏ đó sẽ trỏ đến ngay địa chỉ bộ nhớ tiếp theo. Nhưng đó là bởi vì một ký tự (char) chỉ chiếm đúng 1 byte bộ nhớ.
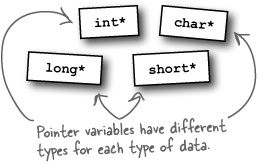
image 48 - quochung.cyou PTIT

Vậy chuyện gì xảy ra nếu bạn có một con trỏ kiểu int? Các số nguyên (int) thường chiếm 4 byte dung lượng, vì vậy nếu bạn cộng 1 vào một con trỏ kiểu int, mã nguồn sau khi biên dịch thực chất sẽ cộng 4 vào địa chỉ bộ nhớ đó.

C
int nums[] = {1, 2, 3};
printf("nums đang ở địa chỉ %p\n", nums);
printf("nums + 1 đang ở địa chỉ %p\n", nums + 1);
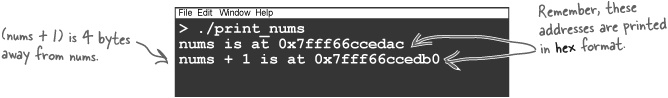
image 49 - quochung.cyou PTIT

Nếu bạn chạy đoạn mã này, hai địa chỉ bộ nhớ sẽ cách nhau nhiều hơn một byte. Do đó, các kiểu con trỏ tồn tại để trình biên dịch biết cần phải điều chỉnh bao nhiêu khi thực hiện phép toán con trỏ.

Sử dụng con trỏ để nhập dữ liệu

Cách yêu cầu người dùng nhập một chuỗi ký tự từ bàn phím bằng hàm scanf():

C
char name[40];
printf("Nhập tên bạn: ");
scanf("%39s", name); // scanf sẽ đọc 39 kí tự cộng thêm string terminator

Hàm scanf() hoạt động như thế nào? Nó nhận vào một con trỏ kiểu char (char*), và trong trường hợp này, bạn đang truyền vào một biến mảng. Đến lúc này, chắc bạn đã lờ mờ hiểu tại sao nó lại nhận một con trỏ rồi chứ? Đó là vì hàm scanf() sẽ cập nhật nội dung của mảng đó. Những hàm cần cập nhật giá trị của một biến thì không cần giá trị của biến đó — chúng cần địa chỉ của nó.

Nhập số bằng scanf() (Entering numbers with scanf())

Vậy làm thế nào để nhập dữ liệu vào một trường số? Bạn thực hiện bằng cách truyền một con trỏ đến một biến số.

C
int age;
printf("Nhập tuổi của bạn: ");
scanf("%i", &age);

Bởi vì bạn truyền địa chỉ của biến số vào hàm, scanf() có thể cập nhật nội dung của biến đó. Và để giúp bạn, bạn có thể truyền một chuỗi định dạng (format string) chứa các mã định dạng tương tự như loại bạn dùng trong hàm printf(). Bạn thậm chí có thể dùng scanf() để nhập nhiều thông tin cùng lúc:

C
int lanh_su, vi_do;
scanf("%i  %i", &lanh_su, &vi_do);

Có một… vấn đề nho nhỏ với hàm scanf(). Từ nãy đến giờ, tất cả các đoạn mã bạn viết đều rất cẩn thận đặt giới hạn cho số lượng ký tự mà scanf() sẽ đọc vào:

  • scanf("%39s", name);

Tại sao lại phải làm vậy? Suy cho cùng, scanf() dùng chung kiểu chuỗi định dạng như printf(), mà khi chúng ta in một chuỗi bằng printf(), ta chỉ dùng %s thôi mà.

À, nếu bạn chỉ dùng %s trong scanf(), rắc rối sẽ nảy sinh nếu ai đó cao hứng gõ quá nhiều:

C
char food[5];
printf("Nhập món ăn yêu thích: ");
scanf("%s", food); // Cực kỳ nguy hiểm!
printf("Món yêu thích là: %s\n", food);
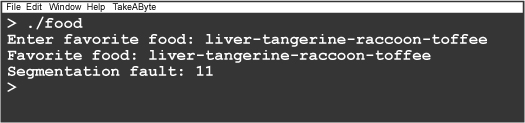
image 50 - quochung.cyou PTIT
image 51 - quochung.cyou PTIT

Chương trình sẽ bị crash (sập). Lý do là vì scanf() ghi dữ liệu vượt xa khỏi phạm vi bộ nhớ được cấp phát cho mảng food.
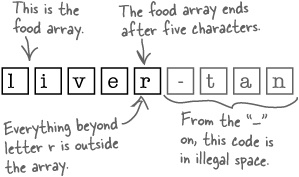
image 52 - quochung.cyou PTIT

scanf() có thể gây ra lỗi tràn bộ đệm (scanf() can cause buffer overflows)

Nếu bạn quên giới hạn độ dài của chuỗi khi đọc bằng scanf(), bất kỳ người dùng nào cũng có thể nhập vào lượng dữ liệu lớn hơn nhiều so với không gian lưu trữ của chương trình. Phần dữ liệu thừa đó sẽ bị ghi đè vào những vùng bộ nhớ vốn không được máy tính cấp phát cho mục đích đó.

Nếu may mắn, dữ liệu đó chỉ đơn giản là được lưu trữ ở đó và không gây ra chuyện gì. Nhưng rất có khả năng lỗi tràn bộ đệm (buffer overflow) sẽ gây ra các lỗi nghiêm trọng (bugs). Nó có thể được gọi là segmentation fault hoặc abort trap, nhưng dù thông báo lỗi hiện ra là gì, kết quả cuối cùng vẫn là chương trình của bạn bị “ngỏm”.

fgets() là một sự thay thế cho scanf()

Có một hàm khác mà bạn có thể sử dụng để nhập dữ liệu văn bản: fgets(). Giống như hàm scanf(), nó nhận một con trỏ kiểu char, nhưng không giống scanf(), hàm fgets() bắt buộc phải được cung cấp độ dài tối đa:

C
char food[5];
printf("Nhập món ăn yêu thích: ");
fgets(food, sizeof(food), stdin);

Điều đó có nghĩa là bạn không thể “vô tình” quên thiết lập độ dài khi gọi fgets(); nó nằm ngay trong chữ ký hàm như một đối số bắt buộc. Ngoài ra, hãy lưu ý rằng kích thước bộ đệm của fgets() đã bao gồm cả ký tự kết thúc \0. Vì vậy, bạn không cần phải trừ đi 1 đơn vị độ dài như khi làm với scanf().
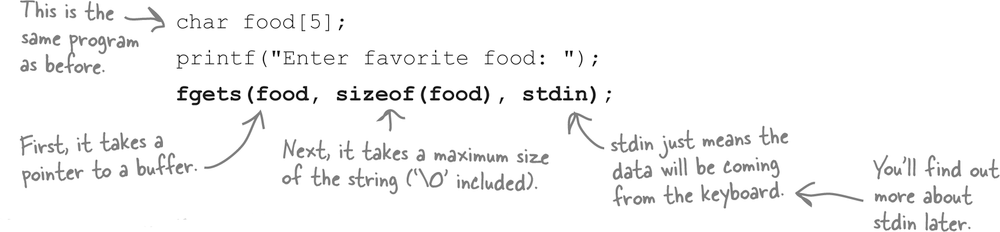
image 53 - quochung.cyou PTIT

Sử dụng sizeof với fgets()

Đoạn mã trên thiết lập độ dài tối đa bằng toán tử sizeof.

sizeof trả về lượng không gian bị chiếm dụng bởi một biến.

  • Trong đoạn mã trên, food là một biến mảng, vì vậy sizeof trả về kích thước của mảng đó (là 5).
  • Nếu food chỉ là một biến con trỏ đơn thuần, toán tử sizeof sẽ chỉ trả về kích thước của một con trỏ (thường là 4 hoặc 8 byte tùy hệ điều hành).

Nếu bạn biết chắc mình đang truyền một biến mảng vào hàm fgets(), thì việc dùng sizeof là ổn. Nếu bạn chỉ truyền một con trỏ đơn giản, bạn nên nhập trực tiếp kích thước mà bạn muốn:

C
fgets(con_tro_chuoi, 20, stdin);

Hàm fgets() thực chất bắt nguồn từ một hàm cũ hơn gọi là gets().

Mặc dù fgets() được xem là hàm an toàn hơn scanf(), sự thật là hàm gets() cũ còn nguy hiểm khủng khiếp hơn cả hai hàm kia cộng lại. Lý do ư? Hàm gets() hoàn toàn không có giới hạn nào cả:
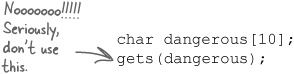
image 54 - quochung.cyou PTIT
Tiêu chíscanf()fgets()
Giới hạnCó thể giới hạn dữ liệu, miễn là bạn nhớ thêm kích thước vào chuỗi định dạng.Có giới hạn bắt buộc. Không gì có thể lọt qua được nó.
Nhiều trườngCó! Cho phép nhập nhiều trường dữ liệu có cấu trúc (ví dụ: ngày/tháng/năm).fgets() chỉ cho phép nhập một chuỗi duy nhất vào bộ đệm.
Khoảng trắng%s sẽ dừng lại ngay khi gặp dấu cách. Nhập “Pizza Bò” chỉ lấy được “Pizza”.fgets() có thể đọc toàn bộ chuỗi bao gồm cả khoảng trắng.
  • stdin: Bạn có để ý đối số thứ ba của fgets là stdin không? Nó viết tắt của “standard input”, nghĩa là lấy dữ liệu từ bàn phím.
  • Ký tự \n: Một điểm cực kỳ quan trọng là fgets() thường đọc luôn cả ký tự xuống dòng (khi bạn nhấn Enter) vào trong chuỗi. Điều này khác với scanf().

Hằng chuỗi không bao giờ có thể cập nhật được

Một biến trỏ đến một hằng chuỗi (string literal) không thể được dùng để thay đổi nội dung của chính chuỗi đó:

char *cards = "JQK"; (Biến cards trỏ đến một hằng chuỗi – KHÔNG THỂ THAY ĐỔI)

Nhưng nếu bạn tạo một mảng (array) từ một hằng chuỗi, khi đó bạn có thể sửa đổi nó:

char cards[] = "JQK"; (Đây là một mảng chứa bản sao của chuỗi – CÓ THỂ THAY ĐỔI)

Tất cả đều nằm ở cách mà ngôn ngữ C sử dụng bộ nhớ…
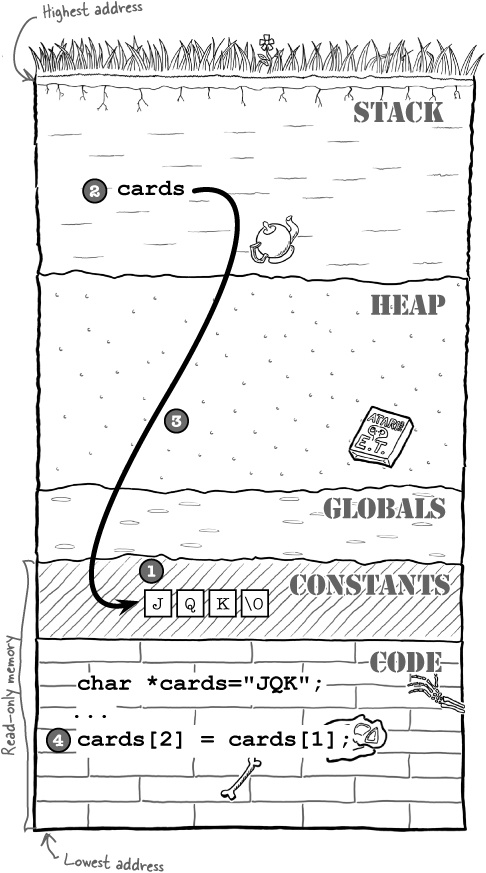
image 55 - quochung.cyou PTIT

Trong bộ nhớ: char *cards = "JQK" Để hiểu tại sao dòng mã này lại gây ra lỗi bộ nhớ, chúng ta cần đào sâu vào bộ nhớ của máy tính và xem chính xác máy tính sẽ làm gì.

  1. Máy tính nạp hằng chuỗi: Khi máy tính nạp chương trình vào bộ nhớ, nó đặt tất cả các giá trị hằng số — như hằng chuỗi "JQK" — vào khối bộ nhớ hằng số (constant memory block). Phần bộ nhớ này là chỉ đọc (read-only).
  2. Chương trình tạo biến cards trên ngăn xếp (stack): Ngăn xếp là phần bộ nhớ mà máy tính sử dụng cho các biến cục bộ: các biến nằm bên trong hàm. Biến cards sẽ nằm ở đây.
  3. Biến cards được gán địa chỉ của "JQK": Biến cards sẽ chứa địa chỉ của hằng chuỗi "JQK". Các hằng chuỗi thường được lưu trữ trong bộ nhớ chỉ đọc để ngăn chặn bất kỳ ai thay đổi chúng.
  4. Máy tính cố gắng thay đổi chuỗi: Khi chương trình cố gắng thay đổi nội dung của chuỗi mà biến cards đang trỏ tới, nó không thể thực hiện được; chuỗi đó là chỉ đọc.

String literal (Hằng chuỗi): Là một chuỗi ký tự được viết trực tiếp trong mã nguồn nằm trong dấu ngoặc kép (ví dụ: "JQK"). Trong C, các hằng chuỗi này được lưu ở một vùng nhớ đặc biệt dành riêng cho dữ liệu không đổi.

Segmentation Fault (Lỗi phân đoạn): Thường là kết quả của việc cố gắng ghi dữ liệu vào vùng nhớ “chỉ đọc”, đây chính là lỗi mà đoạn code trên gặp phải.

Nếu bạn định thay đổi một chuỗi, hãy tạo một bản sao

Sự thật là nếu bạn muốn thay đổi nội dung của một chuỗi, bạn cần phải thao tác trên một bản sao. Nếu bạn tạo ra một bản sao của chuỗi đó trong một vùng nhớ không phải là “chỉ đọc”, sẽ chẳng có vấn đề gì xảy ra khi bạn cố gắng thay đổi các ký tự bên trong nó.

Nhưng làm thế nào để tạo một bản sao?
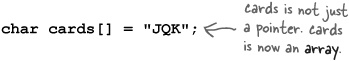
image 56 - quochung.cyou PTIT

Có lẽ bạn chưa thấy rõ tại sao điều này lại thay đổi được mọi thứ. Tất cả các chuỗi đều là mảng. Nhưng trong đoạn mã cũ, cards chỉ là một con trỏ. Trong đoạn mã mới, nó là một mảng. Nếu bạn khai báo một mảng tên là cards và sau đó gán cho nó một hằng chuỗi, mảng cards sẽ là một bản sao hoàn toàn mới. Biến đó không chỉ đơn thuần là trỏ vào hằng chuỗi nữa.

Sự thật là nếu bạn muốn thay đổi nội dung của một chuỗi, bạn cần phải thao tác trên một bản sao. Nếu bạn tạo ra một bản sao của chuỗi đó trong một vùng nhớ không phải là “chỉ đọc”, sẽ chẳng có vấn đề gì xảy ra khi bạn cố gắng thay đổi các ký tự bên trong nó.

Nhưng làm thế nào để tạo một bản sao? Ồ, đơn giản thôi, chỉ cần tạo chuỗi đó dưới dạng một mảng mới.
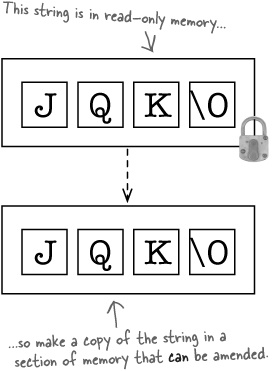
image 57 - quochung.cyou PTIT

Có lẽ bạn chưa thấy rõ tại sao điều này lại thay đổi được mọi thứ. Tất cả các chuỗi đều là mảng. Nhưng trong đoạn mã cũ, cards chỉ là một con trỏ. Trong đoạn mã mới, nó là một mảng. Nếu bạn khai báo một mảng tên là cards và sau đó gán cho nó một hằng chuỗi, mảng cards sẽ là một bản sao hoàn toàn mới. Biến đó không chỉ đơn thuần là trỏ vào hằng chuỗi nữa. Nó là một mảng mới toanh chứa một bản sao “tươi rói” của hằng chuỗi đó.

Để thấy điều này hoạt động như thế nào trong thực tế, bạn cần nhìn vào những gì xảy ra trong bộ nhớ.
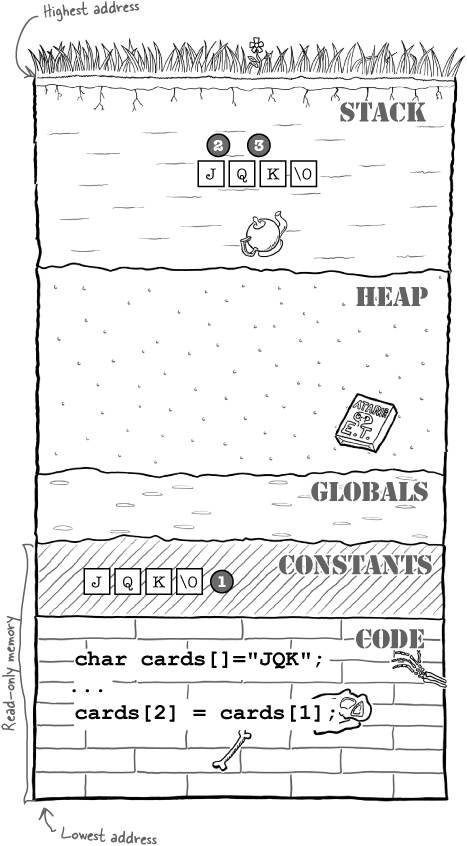
image 58 - quochung.cyou PTIT

Trong bộ nhớ: char cards[] = "JQK"

  1. Máy tính nạp hằng chuỗi: Như trước đó, khi máy tính nạp chương trình vào bộ nhớ, nó lưu trữ các giá trị hằng số — như chuỗi "JQK" — vào bộ nhớ chỉ đọc (read-only memory).
  2. Chương trình tạo một mảng mới trên ngăn xếp (stack): Vì chúng ta đang khai báo một mảng, chương trình sẽ tạo ra một mảng đủ lớn để chứa chuỗi "JQK" — tương đương với kích thước của 4 ký tự (bao gồm cả ký tự kết thúc \0).
  3. Chương trình khởi tạo mảng: Bên cạnh việc cấp phát không gian, chương trình cũng sẽ sao chép nội dung của hằng chuỗi "JQK" vào bộ nhớ ngăn xếp (stack).

Vì vậy, sự khác biệt là: Đoạn mã gốc sử dụng một con trỏ để trỏ đến một hằng chuỗi chỉ đọc. Nhưng nếu bạn khởi tạo một mảng bằng một hằng chuỗi, bạn sẽ có một bản sao của các ký tự đó, và bạn có thể thay đổi chúng tùy thích.

Một cách để tránh vấn đề này trong tương lai là đừng bao giờ viết mã gán một con trỏ char đơn thuần cho một giá trị hằng chuỗi như:

char *s = "Some string";

Thực ra không có gì sai khi gán một con trỏ cho một hằng chuỗi — vấn đề chỉ xảy ra khi bạn cố gắng sửa đổi hằng chuỗi đó. Thay vào đó, nếu bạn muốn gán một con trỏ cho một hằng số, hãy luôn đảm bảo bạn sử dụng từ khóa const:

const char *s = "some string";

Bằng cách đó, nếu trình biên dịch thấy đoạn mã nào cố gắng sửa đổi chuỗi, nó sẽ báo lỗi biên dịch ngay lập tức:

s[0] = 'S'; monte.c:7: error: assignment of read-only location

  • Stack (Ngăn xếp): Là vùng nhớ dành cho các biến cục bộ. Vùng nhớ này có thể đọc và ghi thoải mái, đó là lý do tại sao khi copy chuỗi sang đây, bạn có thể sửa đổi được.
  • const keyword: Đây là một “lời hứa” với trình biên dịch rằng: “Tôi sẽ không thay đổi giá trị này”. Nếu bạn vi phạm, trình biên dịch sẽ nhắc nhở bạn ngay thay vì để chương trình bị sụp đổ (crash) khi đang chạy.
Hỏi: Tại sao trình biên dịch không báo luôn là tôi không được phép thay đổi chuỗi đó?Đáp: Bởi vì chúng ta khai báo cards là một con trỏ char * đơn thuần, trình biên dịch không thể biết chắc chắn rằng biến đó sẽ luôn trỏ vào một hằng chuỗi trong suốt quá trình chạy.
Hỏi: Tại sao các hằng chuỗi lại được lưu trong bộ nhớ chỉ đọc?Đáp: Vì chúng được thiết kế để làm hằng số. Nếu bạn viết một hàm để in chữ “Hello World”, bạn chắc chắn không muốn một phần khác của chương trình vô tình sửa nó thành “Goodbye World” đâu đúng không?
Hỏi: Có phải mọi hệ điều hành đều thực thi quy tắc “chỉ đọc” này không?Đáp: Đại đa số là có. Một số phiên bản của gcc trên Cygwin thực tế cho phép bạn sửa đổi hằng chuỗi mà không phàn nàn gì. Nhưng hãy nhớ: làm vậy luôn luôn là sai.
Hỏi: const thực sự có nghĩa là gì? Nó có làm cho chuỗi trở thành “chỉ đọc” không?Đáp: Bản thân các hằng chuỗi đã là chỉ đọc rồi. Từ khóa const là để trình biên dịch sẽ “la làng” lên nếu bạn cố tình dùng biến đó để sửa đổi mảng/chuỗi, giúp bạn phát hiện lỗi sớm ngay khi viết code.

Bộ nhớ ghi nhớ (Memory Memorizer)

  • Ngăn xếp (Stack): Đây là vùng nhớ dành cho biến cục bộ. Mỗi khi bạn gọi một hàm, các biến cục bộ của hàm đó được tạo ra trên stack. Nó giống như một chồng đĩa: biến được thêm vào khi vào hàm và lấy ra khi thoát hàm. Điều kỳ lạ là stack thực sự hoạt động “ngược”: nó bắt đầu từ đỉnh bộ nhớ và phát triển dần xuống dưới.
  • Heap: Đây là vùng nhớ dành cho bộ nhớ động: những dữ liệu được tạo ra khi chương trình đang chạy và tồn tại trong thời gian dài.
  • Biến toàn cục (Globals): Là biến nằm ngoài tất cả các hàm và mọi hàm đều nhìn thấy. Chúng được tạo ra ngay khi chương trình bắt đầu chạy và bạn có thể cập nhật chúng thoải mái.
  • Hằng số (Constants): Cũng được tạo ra khi chương trình bắt đầu, nhưng được lưu ở vùng nhớ chỉ đọc. Đây là nơi chứa các hằng chuỗi.
  • Mã lệnh (Code): Cuối cùng là phân đoạn mã. Nhiều hệ điều hành đặt mã lệnh ở địa chỉ thấp nhất. Đây là nơi chứa mã máy thực sự sau khi biên dịch và nó cũng là chỉ đọc.

[A.I System Programming] B1: Tìm hiểu lại C Core

Ngôn ngữ C

C là một ngôn ngữ cho các chương trình “nhỏ và nhanh”. Nó là một ngôn ngữ “bậc thấp” và thấp hơn đa số ngôn ngữ khác, điều này có nghĩa là, chúng ta có thể viết code “gần với” máy tính hơn rất nhiều các ngôn ngữ bậc cao.

Cách C hoạt động

Máy tính thì chỉ hiểu được chỉ một và duy nhất 1 ngôn ngữ: ngôn ngữ máy tính (machine code), hay thực tế là 1 chuỗi số 1 và 0. Để ngôn ngữ C có thể được chuyển thành machine code, ta cần có 1 compiler

image - quochung.cyou PTIT

Đây là một chương trình C cơ bản, hay (source code) – code nguồn, source code thì chứa các ngôn ngữ C mà con người vẫn có thể hiểu được

image 1 - quochung.cyou PTIT

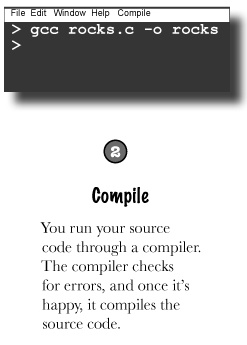
Với sợ trợ giúp của trình biên dịch (compiler), compiler sẽ kiểm tra các lỗi của code, và nếu mọi thứ ổn, nó sẽ biên dịch

image 2 - quochung.cyou PTIT

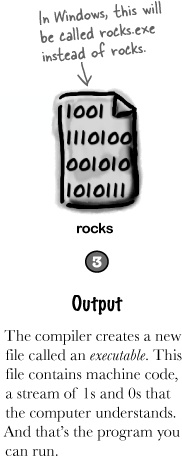
và cuối cùng trình biên dịch thường sẽ tạo ra 1 file mới, hay thường được gọi là executable (file có thể chạy được). File này chứa ngôn ngữ máy (machine code), 1 chuỗi các số 1 và 0 mà máy tính thực sự có thể hiểu và chạy được. Đây là file chương trình mà chúng ta có thể chạy

C được sử dụng khi tốc độ, không gian, khả năng portable (mang sang một máy khác) được ưu tiên. Thực tế, nhiều hệ điều hành đều được viết bằng C, nhiều ngôn ngữ khác cũng được viết bằng C, nhiều game cũng được viết bằng C.

Thông thường có 3 chuẩn C hiện tại, ANSI C có từ cuối những nam 1980, khá nhiều thứ đã được sửa đổi theo chuẩn C99 (1999). Nhiều tính năng mới cũng được thêm vào chuẩn hiện tại, C11 (2011), có thể sau đó sẽ có nhiều phiên bản khác chưa được đề cập trong bài viết, nhưng nhìn chung các nhà thiết kế luôn cố gắng mang lại nhiều tính năng, lợi ích mới từ các bản C mới nhưng vẫn đảm bảo vẫn có những quy tắc/chuẩn chung để phục vụ các chương trình cũ có thể chạy tốt.

Một chương trình C thường trông như thế nào?

Để tạo ra 1 chương trình hoàn chỉnh, bạn cần viết code vào 1 file mã nguồn C (source code C). File C thì bạn viết bằng gì cũng được, kể cả notepad, text editor, visual studio code, … , file name thường kết thúc bằng .c

image 3 - quochung.cyou PTIT

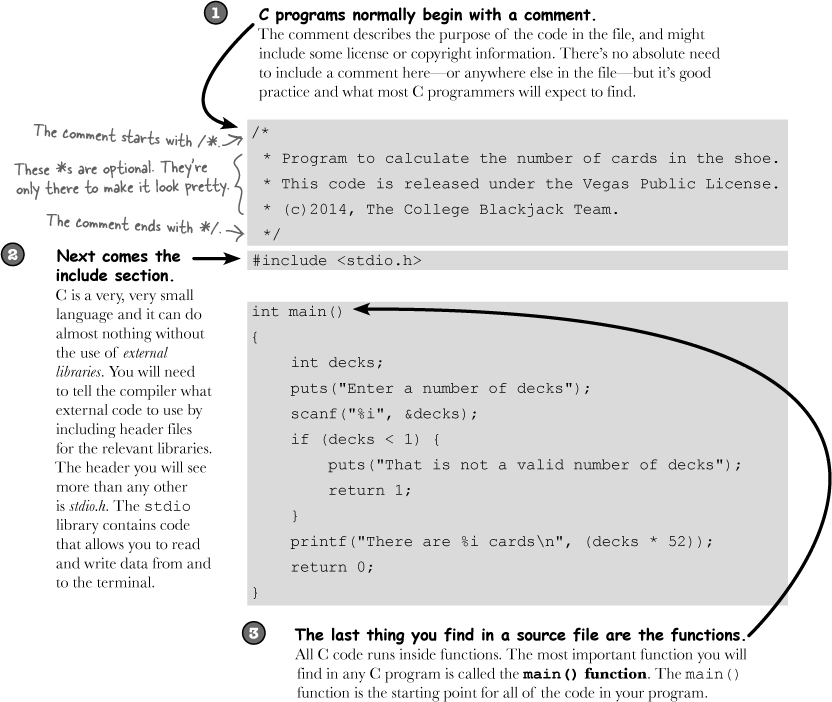
Đây là hình minh họa cho 1 chương trình C, hiển nhiên đây chỉ là 1 mẫu, không bắt buộc bạn phải tuân theo mẫu này, tuy nhiên nhìn chung trong ngành mọi người thường hay follow 1 chuẩn để tất cả mọi người cùng hiểu

  • Phần 1 đầu thường bắt đầu bằng comment, thường là thông tin về chứng chỉ, người tạo ra file code, mục đích, …
  • Phần 2 thường là các phần include, C thì là 1 ngôn ngữ rất rất bé, và thường thì khá khó để nó có thể tạo 1 chương trình thực tiễn nào nếu không có sự bổ trợ của thư viện ngoài. Hay là, nếu không có thư viện ngoài bổ sung, và chỉ có những tính năng cơ bản của C, ta khó có thể làm được 1 chương trình gì cả. Bạn cần khai báo với compiler (trình phiên dịch) về code ngoài/thư viện ngoài ta muốn sử dụng, ở đây stdio.h phục vụ như 1 thư viện giúp ta đọc/viết vào terminal
  • Phần cuối là các hàm. Tất cả code C đều thường chạy trong các hàm, trong đó có 1 hàm được gọi là main(), đây là điểm khởi đầu của chương trình

Máy tính sẽ bắt đầu chạy từ hàm main(). Nếu chương trình không có hàm main() thì không thể chạy được. Hàm main() có phần trả về thường là kiểu int. Phần này dùng để chỉ báo cho máy tính, nếu số được trả về trong main là 0, máy tính coi chương trình chạy thành công, và có vấn đề nếu số trả về là bất kì số nào khác 0.

Chạy chương trình

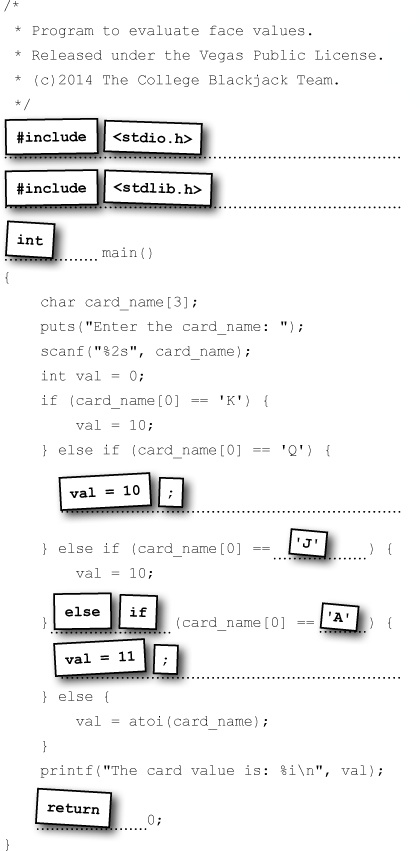
Cho một chương trình mẫu như sau:

image 6 - quochung.cyou PTIT

Như đã đề cập, C là một ngôn ngữ biên dịch (compiled language). Điều này có nghĩa là máy tính sẽ không dịch mã code của bạn một cách trực tiếp ngay khi chạy. Thay vào đó, bạn cần phải chuyển đổi, hay nói cách khác là biên dịch (compile), đoạn code nguồn mà con người có thể đọc hiểu (source code) thành ngôn ngữ máy (machine code) để máy tính có thể xử lý.

Để biên dịch code, bạn cần một chương trình gọi là compiler (trình biên dịch). Một trong những trình biên dịch C phổ biến nhất là GNU Compiler Collection, hay thường gọi tắt là gcc. gcc có sẵn trên rất nhiều hệ điều hành và nó có thể biên dịch nhiều ngôn ngữ khác chứ không chỉ riêng C.

Bạn có thể tham khảo cách cài tại đây: https://quochung.cyou/cach-cai-dat-c-mingw-cho-vs-code-c-20/

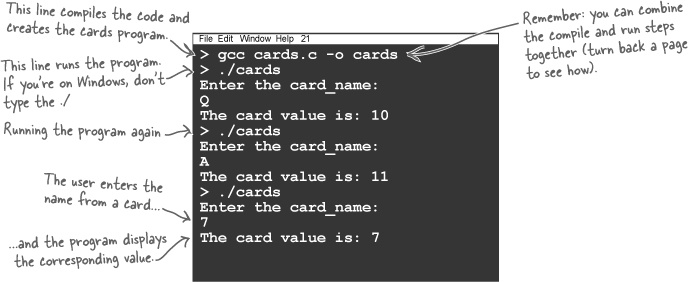
Dưới đây là cách bạn có thể biên dịch và chạy chương trình bằng gcc trên cửa sổ dòng lệnh (terminal/command prompt):

gcc cards.c -o cards
image 4 - quochung.cyou PTIT

Câu lệnh này yêu cầu gcc lấy file mã nguồn cards.c của bạn và biên dịch nó thành một file chạy được có tên là cards (hoặc cards.exe nếu bạn đang dùng Windows).

Bạn có thể gộp chung bước biên dịch và chạy mã trên hầu hết các máy bằng thủ thuật sau (dành cho Mac/Linux):

gcc cards.c -o cards && ./cards

Lệnh này sẽ chỉ chạy chương trình mới nếu nó được biên dịch thành công. Nếu có lỗi xảy ra trong quá trình biên dịch, nó sẽ bỏ qua việc chạy chương trình và chỉ hiển thị lỗi lên màn hình để bạn sửa.

image 5 - quochung.cyou PTIT
Q:Tại sao trên Linux hay Mac, ta lại cần có ./ ở trước tên chương trình khi chạy?
A:Trong các hệ điều hành dạng Unix, chương trình thường chỉ được chạy nếu bạn chỉ chính xác thư mục nơi mà chương trình nằm ở đó, hoặc chương trình có trong danh sách biến môi trường PATH
image 7 - quochung.cyou PTIT

Sơ qua về mảng và chuỗi

Nếu bạn biết đến C sau khi đã làm việc qua với một ngôn ngữ bậc cao, chắc hẳn bạn sẽ đặt câu hỏi là, trong chương trình trên, khi ta hỏi tên của lá bài, chúng ta đang sử dụng 1 mảng các kí tự, và có vẻ nó khác với cách bạn lưu trữ chuỗi trên các ngôn ngữ khác (string), còn nếu bạn chưa hiểu các khái niệm này thì cũng không sao, ta sẽ đi từ qua từng khái niệm.

Thực tế thì, ngôn ngữ C không hỗ trợ kiểu dữ liệu chuỗi (string) một cách trực tiếp từ trong lõi. (Dù vậy, vẫn có các thư viện mở rộng của C cung cấp chuỗi cho bạn).

Bởi vì C là ngôn ngữ “bậc thấp” hơn so với đa số các ngôn ngữ khác, nên thay vì dùng chuỗi, nó thường sử dụng một thứ tương tự: một mảng các ký tự đơn lẻ (an array of single characters).

Nếu bạn đã từng lập trình ở các ngôn ngữ khác, hẳn bạn đã gặp khái niệm “mảng” (array). Mảng đơn giản là một danh sách các phần tử được gán chung một cái tên. Ví dụ, card_name chỉ là tên một biến mà bạn dùng để gọi danh sách các ký tự được người dùng nhập vào từ bàn phím. Nếu bạn định nghĩa card_name là một mảng gồm 2 ký tự, bạn có thể gọi ký tự đầu tiên là card_name[0] và ký tự thứ hai là card_name[1].

Vậy khi C nhìn thấy một chuỗi như thế này: s = "Shatner"

Nó sẽ đọc chuỗi đó giống như một mảng chứa các ký tự riêng biệt: ['S', 'h', 'a', 't', 'n', 'e', 'r'].

image 8 - quochung.cyou PTIT

Mỗi kí tự (char/character) trong chuỗi này chỉ như 1 phần tử của 1 mảng, vì vậy ta có thể trỏ tới 1 kí tự độc lập bất kì sử dụng index như, s[0] = ‘S’, s[1] = ‘h’

image 9 - quochung.cyou PTIT

Chuyện gì xảy ra khi C muốn in chuỗi này ra màn hình? Ở nhiều ngôn ngữ khác, máy tính theo dõi rất sát sao kích thước của một mảng, nó luôn biết 1 mảng có bao nhiêu kí tự, vì vậy giả sử khi ta cần in ra 1 chuỗi nào đó, nó chỉ cần tìm vị trí đầu của chuỗi đó, nhảy một số bước (theo số lượng kí tự nó đã biết) để đến vị trí cuối, và in toàn bộ ra.

Nhưng vì C là ngôn ngữ bậc thấp, nó không phải lúc nào cũng biết chính xác độ dài của mảng là bao nhiêu. Để giải quyết vấn đề này, C thêm một ký tự báo hiệu (sentinel character) vào cuối mỗi chuỗi. Ký tự này có giá trị là \0 (còn gọi là null terminator).

image 10 - quochung.cyou PTIT

Bất cứ khi nào máy tính cần đọc nội dung của một chuỗi, nó sẽ đi qua từng phần tử của mảng ký tự, cho đến khi nó đụng phải \0.

Điều đó có nghĩa là chữ "Shatner" thực chất được lưu trong bộ nhớ máy tính dưới dạng: ['S', 'h', 'a', 't', 'n', 'e', 'r', '\0'].

s = "Shatner"
image 11 - quochung.cyou PTIT

Đó là lý do tại sao khi khai báo biến lưu 2 ký tự, ta lại phải khai báo kích thước là 3: char card_name[3]; Ký tự thứ ba chính là không gian dự phòng dành cho ký tự báo hiệu \0.

H: Tại sao các ký tự lại được đánh số từ 0? Sao không phải là 1?

Đ: Chỉ số (index) thực chất là một khoảng cách (offset): nó là thước đo xem ký tự đó nằm cách ký tự đầu tiên bao xa.

H: Tại sao lại thế?

Đ: Máy tính sẽ lưu trữ các ký tự trong các byte bộ nhớ liên tiếp nhau. Nó có thể sử dụng chỉ số này để tính toán ra vị trí của ký tự. Nếu nó biết rằng c[0] đang nằm ở vị trí bộ nhớ 1.000.000, thì nó có thể tính toán rất nhanh rằng c[96] nằm ở vị trí 1.000.000 + 96.

H: Tại sao nó cần một ký tự báo hiệu (sentinel character)? Chẳng lẽ nó không biết chuỗi dài bao nhiêu sao?

Đ: Thường thì nó không biết đâu. C không giỏi lắm trong việc theo dõi xem các mảng có độ dài bao nhiêu, và chuỗi thì bản chất cũng chỉ là một mảng mà thôi.

H: Nó không biết mảng dài bao nhiêu ?

Đ: Đúng vậy. Đôi khi trình biên dịch (compiler) có thể tìm ra độ dài của một mảng bằng cách phân tích code, nhưng thường thì C dựa dẫm vào bạn trong việc theo dõi các mảng của mình.

H: Dùng nháy đơn hay nháy kép thì có quan trọng không?

Đ: Có chứ. Nháy đơn (' ') được dùng cho các ký tự đơn lẻ, nhưng nháy kép (" ") thì luôn được dùng cho chuỗi.

H: Vậy tôi nên định nghĩa chuỗi của mình bằng dấu nháy kép (" ") hay khai báo rõ ràng nó là một mảng các ký tự? Đ: Thông thường bạn sẽ định nghĩa chuỗi bằng dấu nháy kép. Chúng được gọi là chuỗi ký tự (string literals), và gõ chúng thì dễ dàng hơn nhiều.

H: Có sự khác biệt nào giữa chuỗi ký tự (string literals) và mảng ký tự (character arrays) không?

Đ: Chỉ có một điểm thôi: chuỗi ký tự là các hằng số (constant).

H: Điều đó có nghĩa là gì?

Đ: Có nghĩa là bạn không thể thay đổi từng ký tự đơn lẻ một khi chúng đã được tạo ra.

H: Chuyện gì sẽ xảy ra nếu tôi cố tình thử thay đổi?

Đ: Điều này phụ thuộc vào trình biên dịch, nhưng gcc thường sẽ hiển thị lỗi bus error.

H: Lỗi bus error? Lỗi bus error là cái gì vậy?

Đ: C sẽ lưu trữ các chuỗi ký tự (string literals) trong bộ nhớ theo một cách khác. Lỗi bus error chỉ đơn giản có nghĩa là chương trình của bạn không thể cập nhật (chỉnh sửa) phần bộ nhớ đó

Các phép toán nhẹ nhàng và Cấu trúc điều khiển

Trong C, một dấu bằng (=) được dùng để gán giá trị (assignment). Nhưng hai dấu bằng (==) lại được dùng để kiểm tra sự bằng nhau (testing equality).

  • Tăng/giảm biến một khoảng nhất định: x += 5; hoặc x -= 2;
  • Tăng/giảm biến đi 1 đơn vị: x++; hoặc x--;

Hai loại câu lệnh chính

  1. Làm một việc gì đó (Do something): Hầu hết các lệnh trong C đều là các hành động định nghĩa biến, đọc dữ liệu, in ra màn hình.
image 12 - quochung.cyou PTIT
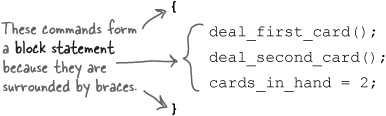
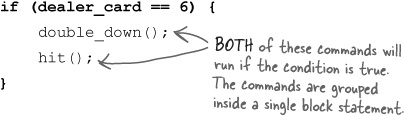
  1. Bạn có thể nhóm nhiều câu lệnh lại với nhau bằng dấu ngoặc nhọn { } để tạo thành một khối lệnh (block statements).
image 13 - quochung.cyou PTIT
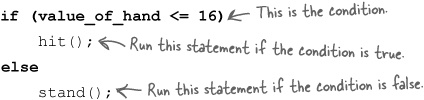
  1. Chỉ làm điều gì đó NẾU điều kiện là đúng (Do something only if): Đây là các câu lệnh điều khiển, tiêu biểu là if.
image 14 - quochung.cyou PTIT
image 15 - quochung.cyou PTIT
C
if (x == 2) {
    puts("Hãy làm gì đó!");
}

Để viết một chương trình đếm bài (như trong trò Blackjack), bạn cần kiểm tra xem một lá bài có nằm trong khoảng từ 3 đến 6 hay không. Nghĩa là bạn phải kiểm tra nhiều điều kiện cùng lúc. C cung cấp các toán tử logic (boolean operators) để làm việc này:

  • && (AND – VÀ): Chỉ trả về đúng (true) khi cả hai điều kiện đều đúng. (Ví dụ: val >= 3 && val <= 6)
image 16 - quochung.cyou PTIT
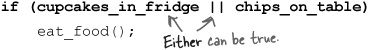
  • || (OR – HOẶC): Trả về đúng (true) nếu một trong hai điều kiện đúng.
image 17 - quochung.cyou PTIT
  • ! (NOT – PHỦ ĐỊNH): Lật ngược giá trị của điều kiện. (Đang đúng thành sai, đang sai thành đúng).
image 18 - quochung.cyou PTIT

Lưu ý: Trong C không có khái niệm true hay false một cách nguyên thủy. C quy ước: số 0 nghĩa là Sai (false), và bất kỳ số nào khác 0 đều được coi là Đúng (true).

Gemini đã nói

Dưới đây là phần tiếp nối được viết dựa trên đoạn tiếng Anh bạn cung cấp, giữ nguyên văn phong gần gũi, dễ hiểu và mang tính hướng dẫn từng bước của bạn:


Nhưng làm thế nào để bạn chạy được chương trình?

Như đã đề cập, C là một ngôn ngữ biên dịch (compiled language). Điều này có nghĩa là máy tính sẽ không dịch mã code của bạn một cách trực tiếp ngay khi chạy. Thay vào đó, bạn cần phải chuyển đổi, hay nói cách khác là biên dịch (compile), đoạn code nguồn mà con người có thể đọc hiểu (source code) thành ngôn ngữ máy (machine code) để máy tính có thể xử lý.

Để biên dịch code, bạn cần một chương trình gọi là compiler (trình biên dịch). Một trong những trình biên dịch C phổ biến nhất là GNU Compiler Collection, hay thường gọi tắt là gcc. gcc có sẵn trên rất nhiều hệ điều hành và nó có thể biên dịch nhiều ngôn ngữ khác chứ không chỉ riêng C. Điều tuyệt vời nhất? Nó hoàn toàn miễn phí.

Dưới đây là cách bạn có thể biên dịch và chạy chương trình bằng gcc trên cửa sổ dòng lệnh (terminal/command prompt):

Bash

gcc cards.c -o cards

Câu lệnh này yêu cầu gcc lấy file mã nguồn cards.c của bạn và biên dịch nó thành một file chạy được có tên là cards (hoặc cards.exe nếu bạn đang dùng Windows).

Mẹo nhỏ (Geek Bits): Bạn có thể gộp chung bước biên dịch và chạy mã trên hầu hết các máy bằng thủ thuật sau (dành cho Mac/Linux):

Bash

gcc cards.c -o cards && ./cards

Lệnh này sẽ chỉ chạy chương trình mới nếu nó được biên dịch thành công. Nếu có lỗi xảy ra trong quá trình biên dịch, nó sẽ bỏ qua việc chạy chương trình và chỉ hiển thị lỗi lên màn hình để bạn sửa.


Hiểu sâu hơn về Chuỗi (Strings) trong C

Thực tế thì, ngôn ngữ C không hỗ trợ kiểu dữ liệu chuỗi (string) một cách trực tiếp từ trong lõi. (Dù vậy, vẫn có các thư viện mở rộng của C cung cấp chuỗi cho bạn).

Bởi vì C là ngôn ngữ “bậc thấp” hơn so với đa số các ngôn ngữ khác, nên thay vì dùng chuỗi, nó thường sử dụng một thứ tương tự: một mảng các ký tự đơn lẻ (an array of single characters).

Nếu bạn đã từng lập trình ở các ngôn ngữ khác, hẳn bạn đã gặp khái niệm “mảng” (array). Mảng đơn giản là một danh sách các phần tử được gán chung một cái tên. Ví dụ, card_name chỉ là tên một biến mà bạn dùng để gọi danh sách các ký tự được người dùng nhập vào từ bàn phím. Nếu bạn định nghĩa card_name là một mảng gồm 2 ký tự, bạn có thể gọi ký tự đầu tiên là card_name[0] và ký tự thứ hai là card_name[1].

Vậy khi C nhìn thấy một chuỗi như thế này: s = "Shatner"

Nó sẽ đọc chuỗi đó giống như một mảng chứa các ký tự riêng biệt: ['S', 'h', 'a', 't', 'n', 'e', 'r'].

Đừng để rơi khỏi điểm kết thúc của chuỗi! Chuyện gì xảy ra khi C muốn in chuỗi này ra màn hình? Ở nhiều ngôn ngữ khác, máy tính theo dõi rất sát sao kích thước của một mảng. Nhưng vì C là ngôn ngữ bậc thấp, nó không phải lúc nào cũng biết chính xác độ dài của mảng là bao nhiêu.

Để giải quyết vấn đề này, C thêm một ký tự báo hiệu (sentinel character) vào cuối mỗi chuỗi. Ký tự này có giá trị là \0 (còn gọi là null terminator).

Bất cứ khi nào máy tính cần đọc nội dung của một chuỗi, nó sẽ đi qua từng phần tử của mảng ký tự, cho đến khi nó đụng phải \0. Điều đó có nghĩa là chữ "Shatner" thực chất được lưu trong bộ nhớ máy tính dưới dạng: ['S', 'h', 'a', 't', 'n', 'e', 'r', '\0'].

Đó là lý do tại sao khi khai báo biến lưu 2 ký tự, ta lại phải khai báo kích thước là 3: char card_name[3]; Ký tự thứ ba chính là không gian dự phòng dành cho ký tự báo hiệu \0.

Không có câu hỏi nào là ngớ ngẩn (Q&A):

  • H: Tại sao các ký tự trong mảng lại được đánh số từ 0 chứ không phải 1? Đ: Chỉ số (index) thực chất là một “khoảng cách” (offset): nó đo xem ký tự đó nằm cách ký tự đầu tiên bao xa. Ký tự đầu tiên cách chính nó 0 bước, nên nó ở vị trí số 0.
  • H: Có sự khác biệt nào giữa việc dùng nháy đơn (‘ ‘) và nháy kép (” “) không? Đ: Có. Nháy đơn luôn được dùng cho các ký tự đơn lẻ (ví dụ: 'A'), còn nháy kép luôn được dùng cho chuỗi (ví dụ: "Shatner").

Các phép toán nhẹ nhàng và Cấu trúc điều khiển

Không phải dấu Bằng nào cũng giống nhau Trong C, một dấu bằng (=) được dùng để gán giá trị (assignment). Nhưng hai dấu bằng (==) lại được dùng để kiểm tra sự bằng nhau (testing equality). Hãy nhớ kỹ điều này vì nó là nguyên nhân gây ra vô số lỗi khó chịu cho người mới bắt đầu!

  • Tăng/giảm biến một khoảng nhất định: x += 5; hoặc x -= 2;
  • Tăng/giảm biến đi 1 đơn vị: x++; hoặc x--;

Hai loại câu lệnh chính

  1. Làm một việc gì đó (Do something): Hầu hết các lệnh trong C đều là các hành động định nghĩa biến, đọc dữ liệu, in ra màn hình. Bạn có thể nhóm nhiều câu lệnh lại với nhau bằng dấu ngoặc nhọn { } để tạo thành một khối lệnh (block statements).
  2. Chỉ làm điều gì đó NẾU điều kiện là đúng (Do something only if): Đây là các câu lệnh điều khiển, tiêu biểu là if.

C

if (x == 2) {
    puts("Hãy làm gì đó!");
}

Đếm bài? Bằng ngôn ngữ C?

Để viết một chương trình đếm bài (như trong trò Blackjack), bạn cần kiểm tra xem một lá bài có nằm trong khoảng từ 3 đến 6 hay không. Nghĩa là bạn phải kiểm tra nhiều điều kiện cùng lúc. C cung cấp các toán tử logic (boolean operators) để làm việc này:

  • && (AND – VÀ): Chỉ trả về đúng (true) khi cả hai điều kiện đều đúng. (Ví dụ: val >= 3 && val <= 6)
  • || (OR – HOẶC): Trả về đúng (true) nếu một trong hai điều kiện đúng.
  • ! (NOT – PHỦ ĐỊNH): Lật ngược giá trị của điều kiện. (Đang đúng thành sai, đang sai thành đúng).

Lưu ý: Trong C không có khái niệm true hay false một cách nguyên thủy. C quy ước: số 0 nghĩa là Sai (false), và bất kỳ số nào khác 0 đều được coi là Đúng (true).


Câu lệnh Switch: Cách thay thế nhiều lệnh “if”

Đôi khi bạn cần kiểm tra giá trị của cùng một biến hết lần này đến lần khác. Thay vì viết một danh sách dài dằng dặc các lệnh else if, C cho bạn một giải pháp thanh lịch hơn: câu lệnh switch.

C
switch(card_name[0]) {
    case 'K':
    case 'Q':
    case 'J':
        val = 10;
        break;
    case 'A':
        val = 11;
        break;
    default:
        val = atoi(card_name);
}

Khi máy tính chạy đến lệnh switch, nó sẽ tìm một case khớp với giá trị của biến. Khi tìm thấy, nó sẽ chạy TẤT CẢ các dòng code bên dưới nó cho đến khi gặp lệnh break. Nếu bạn quên lệnh break, code sẽ chạy tuột xuống các case bên dưới

Đôi khi làm một lần là chưa đủ… (Vòng lặp)

Nếu bạn muốn chương trình của mình lặp đi lặp lại một hành động thì sao? Hãy dùng vòng lặp (Loops).

  • Vòng lặp while: Chạy đi chạy lại một đoạn code chừng nào điều kiện của nó vẫn còn đúng.
C
while (count < 10) {
    puts("Vẫn đang đếm...");
    count++;
}

Vòng lặp for: Thực chất là một phiên bản viết gọn gàng hơn của vòng lặp while. Nó gom phần khởi tạo biến, điều kiện chạy, và bước tăng biến vào cùng một dòng, giúp code dễ đọc hơn rất nhiều.

C
for (int i = 0; i < 10; i++) {
    puts("Vẫn đang đếm...");
}

Cách thoát khỏi vòng lặp:

  • Dùng lệnh break để ngay lập tức phá vỡ và thoát ra khỏi vòng lặp hiện tại.
  • Dùng lệnh continue để bỏ qua phần còn lại của vòng lặp và quay ngay lên đầu vòng lặp để bắt đầu một chu kỳ lặp mới.

Hàm (Functions)

Cho đến giờ, chúng ta toàn viết code vào trong một hàm gọi là main(). Nhưng bạn hoàn toàn có thể tự tạo hàm của riêng mình.

Mọi hàm trong C thường có 3 phần cơ bản:

  1. Kiểu trả về (Return type): Cho biết hàm này sau khi chạy xong sẽ ném ra kết quả là kiểu dữ liệu gì (ví dụ: int, float,…). Nếu hàm chỉ chạy mà không trả về kết quả gì cả, bạn dùng từ khóa void (nghĩa là “trống rỗng / không quan trọng”).
  2. Tên hàm.
  3. Tham số (Parameters/Arguments): Các biến mà hàm nhận vào để xử lý.
C
int tim_so_lon_hon(int a, int b) {
    if (a > b) {
        return a;
    }
    return b;
}

Gemini đã nói

Dưới đây là phần tiếp nối được viết dựa trên đoạn tiếng Anh bạn cung cấp, giữ nguyên văn phong gần gũi, dễ hiểu và mang tính hướng dẫn từng bước của bạn:


Nhưng làm thế nào để bạn chạy được chương trình?

Như đã đề cập, C là một ngôn ngữ biên dịch (compiled language). Điều này có nghĩa là máy tính sẽ không dịch mã code của bạn một cách trực tiếp ngay khi chạy. Thay vào đó, bạn cần phải chuyển đổi, hay nói cách khác là biên dịch (compile), đoạn code nguồn mà con người có thể đọc hiểu (source code) thành ngôn ngữ máy (machine code) để máy tính có thể xử lý.

Để biên dịch code, bạn cần một chương trình gọi là compiler (trình biên dịch). Một trong những trình biên dịch C phổ biến nhất là GNU Compiler Collection, hay thường gọi tắt là gcc. gcc có sẵn trên rất nhiều hệ điều hành và nó có thể biên dịch nhiều ngôn ngữ khác chứ không chỉ riêng C. Điều tuyệt vời nhất? Nó hoàn toàn miễn phí.

Dưới đây là cách bạn có thể biên dịch và chạy chương trình bằng gcc trên cửa sổ dòng lệnh (terminal/command prompt):

Bash

gcc cards.c -o cards

Câu lệnh này yêu cầu gcc lấy file mã nguồn cards.c của bạn và biên dịch nó thành một file chạy được có tên là cards (hoặc cards.exe nếu bạn đang dùng Windows).

Mẹo nhỏ (Geek Bits): Bạn có thể gộp chung bước biên dịch và chạy mã trên hầu hết các máy bằng thủ thuật sau (dành cho Mac/Linux):

Bash

gcc cards.c -o cards && ./cards

Lệnh này sẽ chỉ chạy chương trình mới nếu nó được biên dịch thành công. Nếu có lỗi xảy ra trong quá trình biên dịch, nó sẽ bỏ qua việc chạy chương trình và chỉ hiển thị lỗi lên màn hình để bạn sửa.


Hiểu sâu hơn về Chuỗi (Strings) trong C

Thực tế thì, ngôn ngữ C không hỗ trợ kiểu dữ liệu chuỗi (string) một cách trực tiếp từ trong lõi. (Dù vậy, vẫn có các thư viện mở rộng của C cung cấp chuỗi cho bạn).

Bởi vì C là ngôn ngữ “bậc thấp” hơn so với đa số các ngôn ngữ khác, nên thay vì dùng chuỗi, nó thường sử dụng một thứ tương tự: một mảng các ký tự đơn lẻ (an array of single characters).

Nếu bạn đã từng lập trình ở các ngôn ngữ khác, hẳn bạn đã gặp khái niệm “mảng” (array). Mảng đơn giản là một danh sách các phần tử được gán chung một cái tên. Ví dụ, card_name chỉ là tên một biến mà bạn dùng để gọi danh sách các ký tự được người dùng nhập vào từ bàn phím. Nếu bạn định nghĩa card_name là một mảng gồm 2 ký tự, bạn có thể gọi ký tự đầu tiên là card_name[0] và ký tự thứ hai là card_name[1].

Vậy khi C nhìn thấy một chuỗi như thế này: s = "Shatner"

Nó sẽ đọc chuỗi đó giống như một mảng chứa các ký tự riêng biệt: ['S', 'h', 'a', 't', 'n', 'e', 'r'].

Đừng để rơi khỏi điểm kết thúc của chuỗi! Chuyện gì xảy ra khi C muốn in chuỗi này ra màn hình? Ở nhiều ngôn ngữ khác, máy tính theo dõi rất sát sao kích thước của một mảng. Nhưng vì C là ngôn ngữ bậc thấp, nó không phải lúc nào cũng biết chính xác độ dài của mảng là bao nhiêu.

Để giải quyết vấn đề này, C thêm một ký tự báo hiệu (sentinel character) vào cuối mỗi chuỗi. Ký tự này có giá trị là \0 (còn gọi là null terminator).

Bất cứ khi nào máy tính cần đọc nội dung của một chuỗi, nó sẽ đi qua từng phần tử của mảng ký tự, cho đến khi nó đụng phải \0. Điều đó có nghĩa là chữ "Shatner" thực chất được lưu trong bộ nhớ máy tính dưới dạng: ['S', 'h', 'a', 't', 'n', 'e', 'r', '\0'].

Đó là lý do tại sao khi khai báo biến lưu 2 ký tự, ta lại phải khai báo kích thước là 3: char card_name[3]; Ký tự thứ ba chính là không gian dự phòng dành cho ký tự báo hiệu \0.

Không có câu hỏi nào là ngớ ngẩn (Q&A):

  • H: Tại sao các ký tự trong mảng lại được đánh số từ 0 chứ không phải 1? Đ: Chỉ số (index) thực chất là một “khoảng cách” (offset): nó đo xem ký tự đó nằm cách ký tự đầu tiên bao xa. Ký tự đầu tiên cách chính nó 0 bước, nên nó ở vị trí số 0.
  • H: Có sự khác biệt nào giữa việc dùng nháy đơn (‘ ‘) và nháy kép (” “) không? Đ: Có. Nháy đơn luôn được dùng cho các ký tự đơn lẻ (ví dụ: 'A'), còn nháy kép luôn được dùng cho chuỗi (ví dụ: "Shatner").

Các phép toán nhẹ nhàng và Cấu trúc điều khiển

Không phải dấu Bằng nào cũng giống nhau Trong C, một dấu bằng (=) được dùng để gán giá trị (assignment). Nhưng hai dấu bằng (==) lại được dùng để kiểm tra sự bằng nhau (testing equality). Hãy nhớ kỹ điều này vì nó là nguyên nhân gây ra vô số lỗi khó chịu cho người mới bắt đầu!

  • Tăng/giảm biến một khoảng nhất định: x += 5; hoặc x -= 2;
  • Tăng/giảm biến đi 1 đơn vị: x++; hoặc x--;

Hai loại câu lệnh chính

  1. Làm một việc gì đó (Do something): Hầu hết các lệnh trong C đều là các hành động định nghĩa biến, đọc dữ liệu, in ra màn hình. Bạn có thể nhóm nhiều câu lệnh lại với nhau bằng dấu ngoặc nhọn { } để tạo thành một khối lệnh (block statements).
  2. Chỉ làm điều gì đó NẾU điều kiện là đúng (Do something only if): Đây là các câu lệnh điều khiển, tiêu biểu là if.
C
if (x == 2) {
    puts("Hãy làm gì đó!");
}

Đếm bài? Bằng ngôn ngữ C?

Để viết một chương trình đếm bài (như trong trò Blackjack), bạn cần kiểm tra xem một lá bài có nằm trong khoảng từ 3 đến 6 hay không. Nghĩa là bạn phải kiểm tra nhiều điều kiện cùng lúc. C cung cấp các toán tử logic (boolean operators) để làm việc này:

  • && (AND – VÀ): Chỉ trả về đúng (true) khi cả hai điều kiện đều đúng. (Ví dụ: val >= 3 && val <= 6)
  • || (OR – HOẶC): Trả về đúng (true) nếu một trong hai điều kiện đúng.
  • ! (NOT – PHỦ ĐỊNH): Lật ngược giá trị của điều kiện. (Đang đúng thành sai, đang sai thành đúng).

Lưu ý: Trong C không có khái niệm true hay false một cách nguyên thủy. C quy ước: số 0 nghĩa là Sai (false), và bất kỳ số nào khác 0 đều được coi là Đúng (true).


Câu lệnh Switch: Cách thay thế nhiều lệnh “if”

Đôi khi bạn cần kiểm tra giá trị của cùng một biến hết lần này đến lần khác. Thay vì viết một danh sách dài dằng dặc các lệnh else if, C cho bạn một giải pháp thanh lịch hơn: câu lệnh switch.

C
switch(card_name[0]) {
    case 'K':
    case 'Q':
    case 'J':
        val = 10;
        break;
    case 'A':
        val = 11;
        break;
    default:
        val = atoi(card_name);
}

Khi máy tính chạy đến lệnh switch, nó sẽ tìm một case khớp với giá trị của biến. Khi tìm thấy, nó sẽ chạy TẤT CẢ các dòng code bên dưới nó cho đến khi gặp lệnh break.

H: Tại sao tôi lại dùng lệnh switch thay vì dùng if?

Đ: Nếu bạn đang thực hiện việc kiểm tra nhiều lần trên cùng một biến, bạn có thể sẽ muốn dùng lệnh switch.

H: Ưu điểm của việc dùng lệnh switch là gì?

Đ: Có vài ưu điểm. Đầu tiên: sự rõ ràng. Nhìn vào là thấy rõ cả một khối code đang xử lý chỉ một biến duy nhất. Điều đó không quá rõ ràng nếu bạn chỉ có một dãy các câu lệnh if. Thứ hai, bạn có thể tận dụng logic “rơi tự do” (fall-through) để tái sử dụng các phần code cho các trường hợp (cases) khác nhau.

H: Tôi có thể kiểm tra chuỗi (strings) trong lệnh switch không?

Đ: Không, bạn không thể dùng lệnh switch để kiểm tra một chuỗi các ký tự hay bất kỳ loại mảng (array) nào. Lệnh switch sẽ chỉ kiểm tra một giá trị đơn lẻ mà thôi.


Đôi khi làm một lần là chưa đủ… (Vòng lặp)

Nếu bạn muốn chương trình của mình lặp đi lặp lại một hành động thì sao? Hãy dùng vòng lặp (Loops).

  • Vòng lặp while: Chạy đi chạy lại một đoạn code chừng nào điều kiện của nó vẫn còn đúng.
C
while (count < 10) { 
  puts("Vẫn đang đếm..."); 
  count++; 
}

Bạn có thể dùng vòng lặp while bất cứ lúc nào bạn cần lặp lại một đoạn code, nhưng đa số thời gian các vòng lặp của bạn sẽ có cùng một loại cấu trúc như sau:

  1. Làm một việc gì đó đơn giản trước vòng lặp, ví dụ như cài đặt một biến đếm (counter).
  2. Có một điều kiện kiểm tra đơn giản ngay trên vòng lặp.
  3. Làm một việc gì đó ở cuối vòng lặp, ví dụ như cập nhật biến đếm.

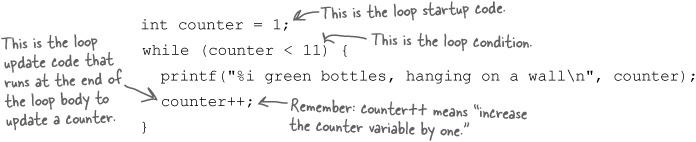
Ví dụ, đây là một vòng lặp while đếm từ 1 đến 10:

image 20 - quochung.cyou PTIT

Những vòng lặp kiểu này chứa đoạn code chuẩn bị các biến cho vòng lặp, một loại điều kiện nào đó được kiểm tra mỗi khi vòng lặp chạy, và cuối cùng là một đoạn code nào đó ở cuối vòng lặp để cập nhật biến đếm hoặc thứ gì đó tương tự.

  • Vòng lặp for: Thực chất là một phiên bản viết gọn gàng hơn của vòng lặp while. Nó gom phần khởi tạo biến, điều kiện chạy, và bước tăng biến vào cùng một dòng, giúp code dễ đọc hơn rất nhiều.

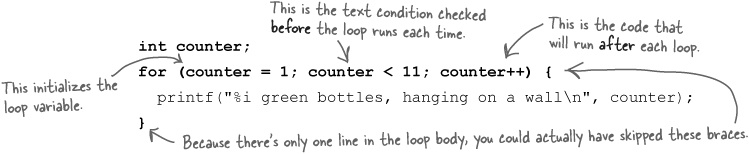
Bởi vì khuôn mẫu này quá phổ biến, các nhà thiết kế ra C đã tạo ra vòng lặp for để làm cho nó trở nên súc tích hơn một chút. Đây là cùng một đoạn code đó nhưng được viết bằng vòng lặp for:

image 21 - quochung.cyou PTIT

Vòng lặp for thực sự được sử dụng rất nhiều trong C, nếu không muốn nói là nhiều hơn, vòng lặp while. Chúng không chỉ làm cho code ngắn hơn một chút, mà còn giúp các lập trình viên C khác dễ đọc hơn, bởi vì toàn bộ phần code điều khiển vòng lặp, những thứ kiểm soát giá trị của biến đếm (counter), giờ đây được gói gọn vào trong câu lệnh for và được đưa ra khỏi phần thân vòng lặp. Mọi vòng lặp for đều cần phải có một thứ gì đó nằm trong phần thân của nó.

Cách thoát khỏi vòng lặp:

  • Dùng lệnh break để ngay lập tức phá vỡ và thoát ra khỏi vòng lặp hiện tại.
  • Dùng lệnh continue để bỏ qua phần còn lại của vòng lặp và quay ngay lên đầu vòng lặp để bắt đầu một chu kỳ lặp mới.

Hàm (Functions)

Cho đến giờ, chúng ta toàn viết code vào trong một hàm gọi là main(). Nhưng bạn hoàn toàn có thể tự tạo hàm của riêng mình.

Mọi hàm trong C thường có 3 phần cơ bản:

  1. Kiểu trả về (Return type): Cho biết hàm này sau khi chạy xong sẽ ném ra kết quả là kiểu dữ liệu gì (ví dụ: int, float,…). Nếu hàm chỉ chạy mà không trả về kết quả gì cả, bạn dùng từ khóa void (nghĩa là “trống rỗng / không quan trọng”).
  2. Tên hàm.
  3. Tham số (Parameters/Arguments): Các biến mà hàm nhận vào để xử lý.
C
int tim_so_lon_hon(int a, int b) {
    if (a > b) {
        return a;
    }
    return b;
}

Tìm hiểu Convex function

Về mặt hình học, một tập hợp được gọi là Convex (Lồi) nếu bạn lấy bất kỳ hai điểm nào nằm trong tập hợp đó, đoạn thẳng nối chúng cũng phải nằm hoàn toàn bên trong tập hợp đó.

Tại sao ta cần định nghĩa này? Bởi vì nó đại diện cho sự “không có lỗ hổng” và “không có điểm lõm”

Trước tiên, hãy thử xem một bài toán nhỏ hơn khác như sau

Cho một số thực [latex]\lambda[/latex] sao cho [latex]0 \le \lambda \le 1[/latex] và hai điểm [latex]x = 2, y = 7[/latex]

image 12 - quochung.cyou PTIT

Khi đó mọi điểm trên đoạn thẳng nối [latex]x[/latex] và [latex]y[/latex] có dạng

[latex]z=(1−λ)x+λy.[/latex]

Nếu [latex]\lambda[/latex] gần 0 hơn, thì nó sẽ ở gần bên x hơn, và ngược lại nếu gần 1 hơn, thì điểm đó sẽ gần y hơn

image 13 - quochung.cyou PTIT

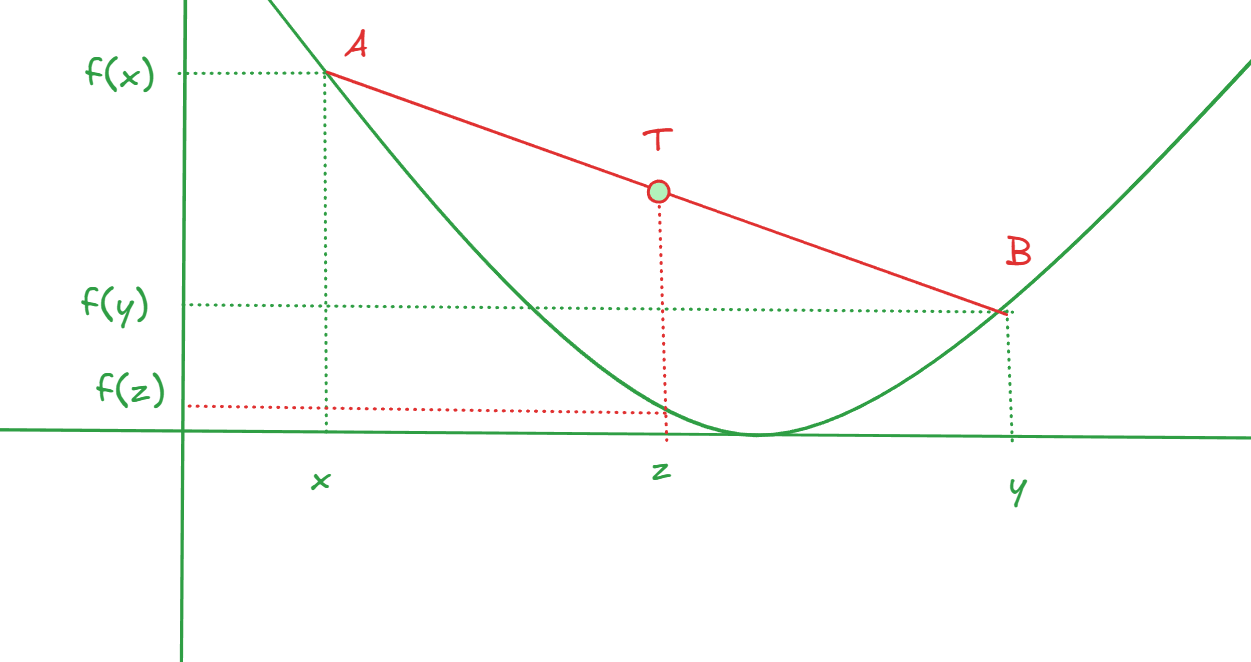
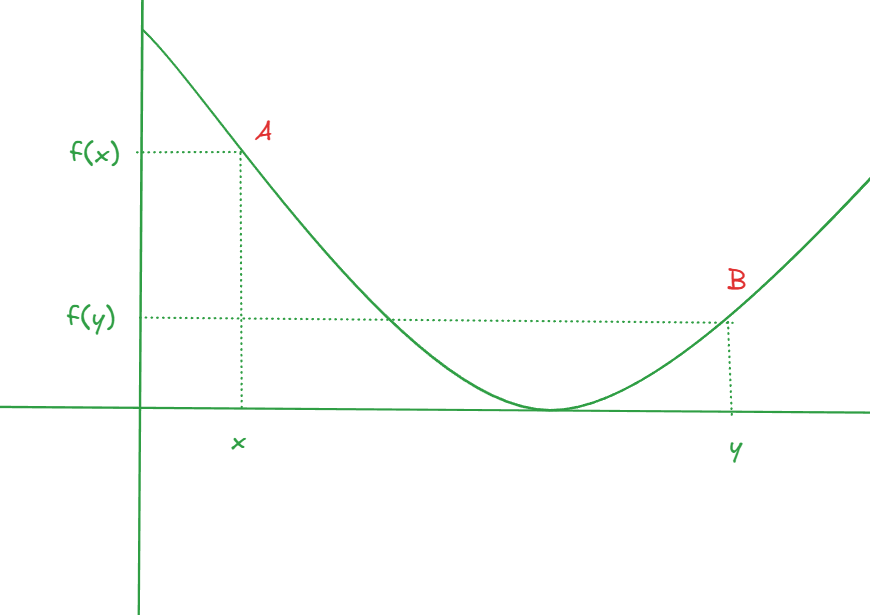
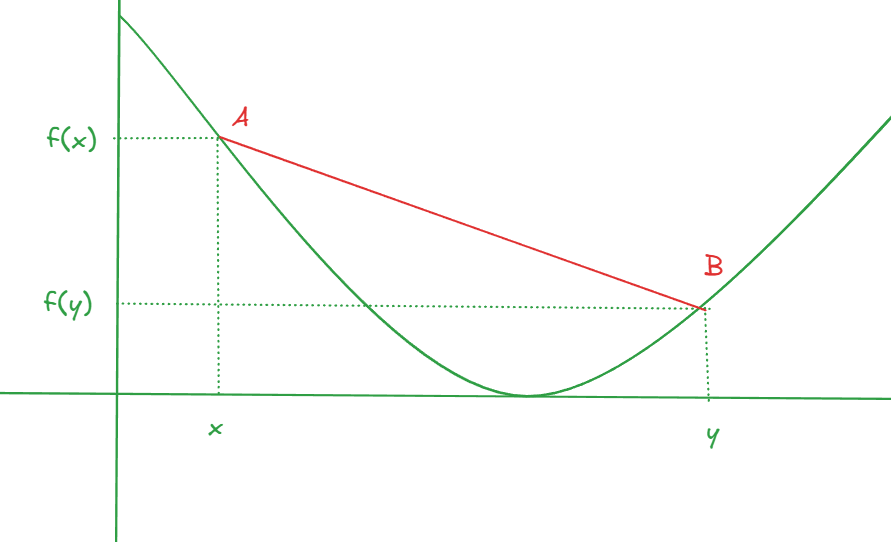
Tiếp theo, cho một hàm số có hình dạng như sau, với hai điểm [latex]x[/latex] và [latex]y[/latex], ta nối và thể hiện vị trí của [latex]f(x)[/latex] và [latex]f(y)[/latex]

image 14 - quochung.cyou PTIT

Đặt hai điểm [latex]A[/latex] và [latex]B[/latex] có toạ độ [latex](x,f(x))[/latex], [latex](y,f(y))[/latex]

image 15 - quochung.cyou PTIT

Lúc này thực hiện nối 2 điểm [latex]A[/latex] và [latex]B[/latex]

image 16 - quochung.cyou PTIT

Như vừa nói qua việc

Khi đó mọi điểm trên đoạn thẳng nối [latex]x[/latex] và [latex]y[/latex] có dạng

[latex]z=(1−λ)x+λy.[/latex]

Ta nhận thấy, lúc này với đoạn thẳng nối từ [latex]A[/latex] tới [latex]B[/latex], từ phần vừa suy ra ở trên, ta có thể biểu diễn độ cao các điểm nằm trên đoạn thẳng này như sau

[latex]z=(1−λ)f(x)+λf(y)[/latex]

Như vậy với [latex]λ=0[/latex], thì độ cao của điểm chính bằng f(x) hay điểm A, và nếu [latex]λ=1[/latex], thì độ cao của điểm chính bằng f(y) hay điểm B, giá trị sẽ giảm dần từ A -> B theo phương trình

image 18 - quochung.cyou PTIT

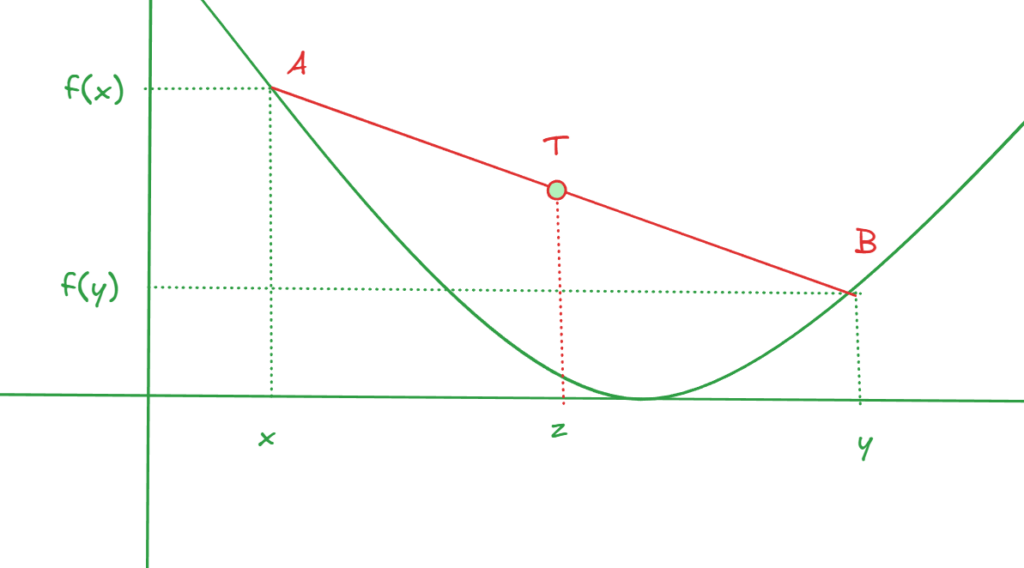
Lúc này lấy một điểm [latex]T[/latex] và số [latex]z[/latex], ta có, z nằm trên đoạn thẳng nối từ [latex]x[/latex] tới [latex]y[/latex], vậy z có thể biểu diễn bằng

[latex]z=(1−λ)x+λy[/latex]

cũng như

image 20 - quochung.cyou PTIT

[latex]f(z)=f((1−λ)x+λy)[/latex]

Ta thấy, độ cao [latex]f(z)[/latex] nằm ở dưới độ cao điểm [latex]T[/latex]

Hay

f(λx+(1−λ)y)<λf(x)+(1−λ)f(y)f(\lambda x + (1 – \lambda)y) < \lambda f(x) + (1 – \lambda)f(y)

Lúc này, ta đến với định nghĩa hàm lồi được phát biểu như sau

Định nghĩa hàm lồi (Convex function)

Một hàm số [latex]f(x)[/latex] được gọi là hàm lồi nếu bạn lấy 2 điểm bất kỳ trên đồ thị, nối chúng lại bằng một đoạn thẳng (dây cung), thì đoạn thẳng đó luôn nằm phía trên hoặc trùng với phần đường cong của đồ thị nằm giữa hai điểm đó.

Công thức toán học (Đại số):

f(λx+(1−λ)y⏟Điểm trên trục hoành)≤λf(x)+(1−λ)f(y)⏟Điểm trên đoạn thẳngf(\underbrace{\lambda x + (1 – \lambda)y}_{\text{Điểm trên trục hoành}}) \le \underbrace{\lambda f(x) + (1 – \lambda)f(y)}_{\text{Điểm trên đoạn thẳng}}

(Với [latex]\lambda[/latex] nằm trong khoảng [latex][0, 1][/latex]).

  • Hình dáng: Giống cái cốc ([latex]\cup[/latex]) hoặc cái bát.
  • Ngược lại: Nếu đoạn thẳng nằm dưới, ta có hàm lõm (concave), hình cái mũ ([latex]\cap[/latex]).

Ý nghĩa

image 23 - quochung.cyou PTIT

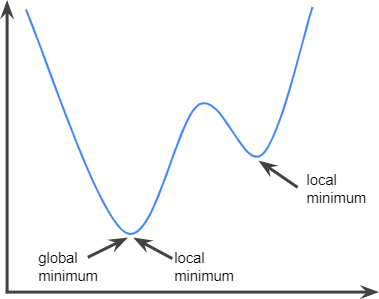
Nếu một đồ thị có 2 cái đáy (2 cực tiểu), thì bắt buộc ở giữa 2 cái đáy đó phải có một cái đỉnh đồi (cực đại) nhô lên ngăn cách chúng. -> Đồ thị sẽ lượn xuống, rồi lượn lên (tạo đỉnh), rồi lại lượn xuống.

Hãy tập trung vào cái đỉnh đồi nằm giữa đó.

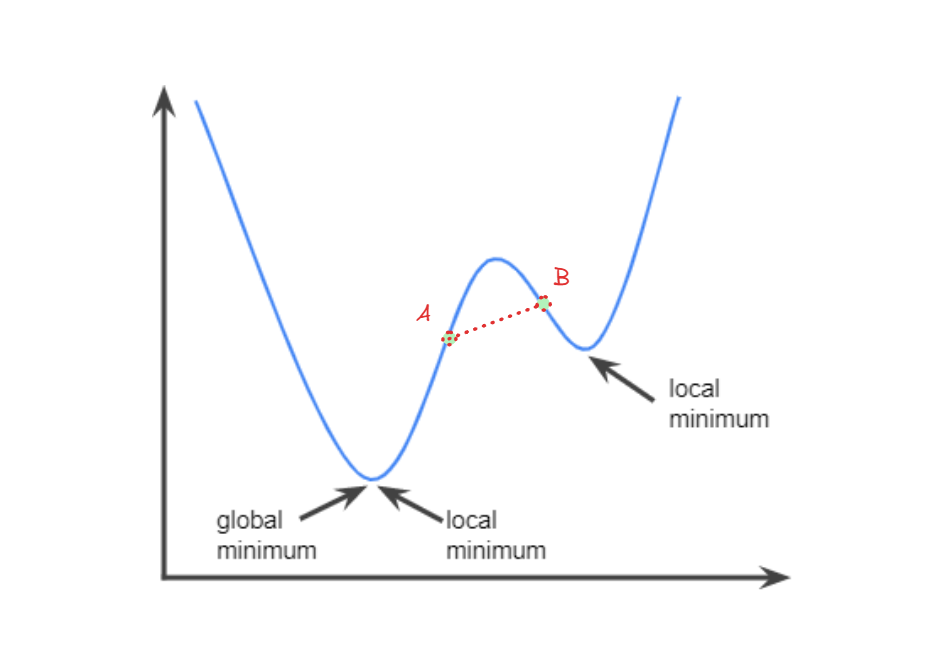
  1. Chọn một điểm [latex]A[/latex] nằm bên sườn trái của ngọn đồi.
  2. Chọn một điểm [latex]B[/latex] nằm bên sườn phải của ngọn đồi.
  3. Nối dây từ [latex]A[/latex] và [latex]B[/latex]
image 24 - quochung.cyou PTIT

Theo thực tế hình vẽ: Vì [latex]A[/latex] và [latex]B[/latex] nằm ở hai bên sườn dốc, còn đỉnh đồi nhô lên ở giữa, nên sợi dây [latex]AB[/latex] sẽ đâm xuyên qua quả đồi. Phần đỉnh đồi sẽ nằm cao hơn sợi dây [latex]AB[/latex]

Theo định nghĩa hàm lồi: Định nghĩa bắt buộc sợi dây [latex]AB[/latex] phải luôn nằm cao hơn hoặc bằng mọi điểm của đồ thị ở giữa [latex]A[/latex] và [latex]B[/latex]

Vì sự tồn tại của một “đỉnh đồi” (ngăn cách 2 cái đáy) vi phạm định nghĩa “sợi dây nằm trên”, nên:

  1. Hàm lồi tuyệt đối không được phép có đỉnh đồi nào (không có cực đại địa phương).
  2. Nếu không có đỉnh đồi nào ngăn cách, thì không thể có 2 cái đáy riêng biệt.
  3. Hệ quả: Nó chỉ có thể đi xuống rồi đi lên duy nhất 1 lần (hình chữ U hoặc V). [latex]\rightarrow[/latex] Chỉ có 1 đáy duy nhất.

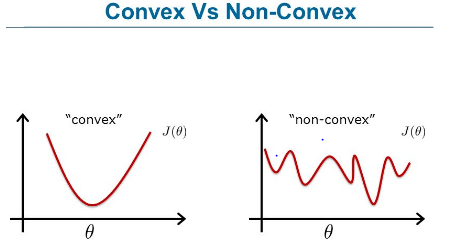
Khi bạn muốn tìm giải pháp tốt nhất (chi phí thấp nhất, lợi nhuận cao nhất, sai số nhỏ nhất), bạn đang đi tìm “đáy” của một đồ thị. Với các hàm bình thường (không lồi), đồ thị giống như một dãy núi nhấp nhô. Bạn có thể leo xuống một thung lũng (cực tiểu địa phương – Local Minimum) và tưởng đó là nơi thấp nhất, nhưng thực ra bên cạnh còn có một cái hực sâu hơn (Global Minimum) mà bạn không thấy vì bị ngọn núi che khuất.

image 22 - quochung.cyou PTIT

Attempt to finetune SLM for solving RCA in 5G network data

Part I: Introduction & The RCA Problem Space

Modern mobile networks are complex systems requiring high reliability. However, despite monitoring, faults like hardware failures or software misconfigurations occur. While detecting a fault is straightforward, the main challenge is Root Cause Analysis (RCA) — finding the root cause of the symptoms to help engineers fix them.

This project replicates the paper (Reasoning Language Models for Root Cause Analysis in 5G Wireless Networks) https://arxiv.org/pdf/2507.21974

The Complexity of 5G O&M

Traditionally, RCA relied on expert-defined logical frameworks or “fault trees”. However, these methods don’t scale well with 5G network complexity. While standard machine learning (Decision Trees, SVMs, Neural Networks) has been used, these models often lack the interpretability and reasoning needed for critical infrastructure.

Defining the Objective: RCA as Probabilistic Inference

We treat RCA as a probabilistic inference task. Formally, the goal is to identify the most probable cause from a set of potential root causes , given:

  • ****: Network engineering parameters.
  • ****: User plane observations.
  • ****: Observed symptoms.

The objective is to solve for:

c^=arg⁡maxc∈Cp(c|U,Yt,st)

This mathematical formulation provides a framework, but modeling these intricate dependencies in real-world data is notoriously difficult. This implementation explores how domain-adapted, reasoning-enhanced Large Language Models (LLMs) can bridge this gap by providing structured, multi-step diagnostic explanations.

The TeleLogs Framework

To benchmark these capabilities, we utilize TeleLogs, a curated dataset of network troubleshooting scenarios with expert-level annotations. TeleLogs simulates a realistic 5G environment where a User Equipment (UE) moves through a region covered by multiple Base Stations (BSs), providing full visibility into network configurations and performance drops.


Part II: Dataset Architecture & Diagnostic Parameters

To perform effective RCA, the model must synthesize three distinct data streams: configuration parameters, time-series observations, and defined symptoms.

Symptom Definition: The 600 Mbps Threshold

In this study, diagnostic scenarios are centered around a specific symptom (st): a significant degradation in downlink throughput where the performance falls below 600 Mbps. This drop serves as the trigger for the analysis, requiring the model to identify if the cause is environmental, a misconfiguration, or a mobility issue.

Network Engineering Parameters (U)

The dataset provides a comprehensive view of the network topology through static configuration parameters. Key parameters used in our analysis include:

ParameterDescription
gNodeB ID / Cell IDUnique identifiers for the base station and cell.
Mechanical/Digital TiltThe vertical angle of the antenna, essential for coverage analysis.
Mechanical/Digital AzimuthThe horizontal direction of the antenna.
Beam ScenarioSpecific beamforming configurations that determine vertical beamwidth.
Height & PCIPhysical height of the antenna and the Physical Cell ID.
Beam ScenarioSpecific beamforming configurations that determine vertical beamwidth.

User Plane Drive Test Data (Yt)

This represents the dynamic interaction between the user and the network. The model analyzes the following time-series indicators:

  • Throughput (DL): The primary indicator of service quality.
  • RSRP & SINR: Measure the signal strength and quality of the serving cell.
  • Neighboring RSRP: Signal strength from the top-k neighbor cells, used to detect interference or handover opportunities.
  • Resource Blocks (PRBs): The amount of radio resources allocated to the user.

The Ground Truth: Root Cause Classes (C1–C8)

The implementation evaluates the model’s ability to classify symptoms into one of eight distinct categories:

  • C1: Excessive downtilt causing weak coverage.
  • C2: Over-shooting coverage (distance > 1 km).
  • C3: Better performance available on a neighboring cell.
  • C4: Interference from non-colocated co-frequency cells.
  • C5: PCI Mod 30 conflict causing reference signal overlap.
  • C6: Performance degradation due to frequent handovers.
  • C7: Misconfigured handover thresholds.
  • C8: Insufficient PRB allocation.

Part III: Baseline Evaluation

Before fine-tuning, I established a performance baseline using Qwen2.5-1.5B-Instruct.

The Benchmarking Protocol

I ran a zero-shot inference on the TeleLogs Phase 1 test dataset, which contains 864 scenarios. The model was prompted using the standard template to analyze user-plane data and site engineering parameters, then choose the most likely root cause from the eight predefined classes.

Initial Findings

The baseline results showed the model was mostly guessing based on simple patterns:

  • Total Accuracy: 10.53% (91/864 correct).
  • The C1 Bias: The model correctly identified C1 (Excessive Downtilt) 42.59% of the time but used it as a “catch-all” for errors. In the top 10 most frequent errors, the model predicted C1 for other classes (C6, C8, C7, C2, C3, C4, and C5) a total of 312 times.
  • Instruction Following: While the model often produced the correct format (the boxed answer), it lacked the underlying logic to connect the RSRP/SINR drops to specific mobility or interference issues.
  • Placeholders: For many classes (C2, C4, C5, C8), the accuracy hovered near 3%, indicating that the base model could not differentiate between various types of signal degradation.
analysis report baseline - quochung.cyou PTIT
- quochung.cyou PTIT

Part IV: Synthetic Data Generation Phase 1 — Reasoning Traces

To improve reasoning, I started the first phase of synthetic data generation. The goal was to create a dataset that demonstrates the Chain-of-Thought (CoT) required for RCA.

The Teacher Model: Qwen3-32B

I utilized Qwen3-32B as the high-reasoning agent. Its significantly larger parameter count and inherent reasoning capabilities allowed it to act as the “expert engineer”. Unlike the 1.5B model, the 32B model can synthesize the relationship between (Engineering Parameters) and (User Observations) more effectively.

CoT Prompting Strategy

I implemented a customized prompting strategy designed to guide the model through a structured diagnostic trajectory. The prompt forced the model to:

  1. Analyze Data: Explicitly list the throughput drops and serving cell changes.
  2. Eliminate Unlikely Causes: Systematically rule out causes—for example, ruling out C2 (distance) if the serving cell is far away.
  3. Validate via Reflection: Check for specific conflicts, such as the PCI Mod 30 check for interference.

Data Acquisition

Through this multi-agent pipeline, I harvested an initial set of 138 samples. Each sample consisted of the original network log paired with a detailed reasoning trace leading to the correct ground-truth answer. This dataset was intended to teach the 1.5B model how to think, rather than just what to predict.


Part V: Experiment 1 The First LoRA Attempt

With 138 high-quality reasoning traces, I initiated the first fine-tuning stage. The goal was to align the Qwen2.5-1.5B-Instruct model with the structured diagnostic patterns found in the synthetic dataset. Following the general recommendations for domain adaptation in the provided LoRA research , I established a baseline configuration to mirror the paper’s parameters where possible.

Configuration and Training Setup

  • LoRA Hyperparameters: r = 32, alpha = 32, dropout = 0.1
  • Learning Rate: 1e-6
  • Epochs: 10.
  • Targeting: Applied LoRA across all linear layers (Query, Key, Value, Projection, and MLP) to maximize the model’s capacity to absorb the new domain knowledge.

The Regression Reality: 8.91% Accuracy

The results were a stark contrast to expectations. Instead of improving upon the baseline, the model’s performance dropped to 8.91% (77/864 correct).

  • Placeholder Issues: A significant issue was the increase in “placeholder” predictions. In the top 10 error categories, 7 were instances where the model outputted a placeholder rather than a valid root cause.
  • Reduced Instruction Following: The model lost some ability to follow basic formatting instructions. Focusing on the reasoning traces caused the model to struggle with the required \boxed{} format.
  • Word Count Increase: The mean word count increased from 245 to 651 words, often containing circular logic without a valid conclusion.

Hypothesis: Sample Sparsity and Overfitting

My hypothesis for this failure was sample sparsity. 138 samples are likely insufficient for a 1.5B model to learn both the complex 5G domain rules and the specific “Elimination-based” or “Contradiction-based” prompting strategies used in the dataset. The model likely overfitted to the specific noise of those 138 examples rather than learning the underlying causal relationships.

analysis report 77 - quochung.cyou PTIT
- quochung.cyou PTIT

Part VI: Experiment 2 Scaling Sample Size

To address the sparsity issue identified in Experiment 1, I moved to scale the training data. If 138 samples caused overfitting, perhaps a larger, more diverse dataset would force the model to generalize the reasoning steps.

The 300-Sample Expansion

I re-ran the synthetic generation pipeline with the Qwen3-32B teacher model to reach 300 samples. I also ensured a more balanced distribution across the 8 root cause classes to prevent the model from defaulting to “C1” as it did in the baseline.

Results: Marginal Recovery (9.61%)

Training the 1.5B model on 300 samples yielded a slight recovery but remained below the zero-shot baseline:

  • Total Accuracy: 9.61% (83/864).
  • Improved Class Recognition: Accuracy for C2 (18.52%) and C3 (19.44%) saw noticeable jumps compared to the near-zero baseline performance.
  • Persistent Failures: The “Placeholder” issue remained rampant. Truth C3 and C6 both saw 28 placeholder errors.
  • Word Count Increase: The mean word count increased to 1318 words, with some responses reaching 12,023 tokens.

Thinking: The Depth vs. Clarity Trade-off

This experiment showed that raw reasoning traces led to verbosity. Without synthesizing these traces, the model produced overly long responses.


Part VII: Synthetic Data Generation Phase 2

Experiment 2 showed that more raw reasoning traces were insufficient. The model mimicked the teacher’s verbosity without learning the logic. To fix this, I updated the synthetic data generation strategy.

The Theoretical Shift: From Traces to Correction

Instead of just saving any correct answer, I implemented a “Reflective Teacher” loop using Qwen3-32B. This approach mirrors the “Aggregator” concept in the paper, designed to synthesize concise, structured explanations.

The Reflection Loop

I introduced a two-tier evaluation for every synthetic sample:

  1. Initial Attempt: The teacher model performs RCA on the raw data.
  2. The “Correction” Prompt: * If Correct: The model is instructed to condense the reasoning into a specific “RCA Reasoning Format” (Data Analysis → Root Cause Analysis → Identification), without give it answer to prevent leakage.
  • If Incorrect: I forced a Self-Reflection phase. The system prompt would tell the model its assumption was wrong and demand it identify exactly where the logic failed (e.g., “I ignored the PCI Mod 30 check”). This reflection was then added back to the prompt to generate a “perfected” reasoning trace.

Reasoning Optimization

This new pipeline produced 300 samples of refined data. The reasoning traces were focused on key steps, such as checking the distance for C2 or the PRB count for C8.


Part VIII: Experiment 3 Training on Error-Correction Traces

With the 300 “reflected” samples, I reset the training. This experiment was the first true test of whether teaching a model how it failed was more effective than just showing it how to succeed.

Training on this densified dataset finally yielded an increase in accuracy:

  • Total Accuracy: 12.04% (104/864). While modest, this officially surpassed the zero-shot baseline (10.53%).
  • Mean Word Count: A massive drop from 1318 to 33.5 words. The model stopped hallucinating long, circular paths and started focusing on the final answer.

Class-Specific Breakthrough: The C1 Dominance

  • C1 Accuracy: 73.15% (79/108). This was a significant improvement.
  • Thinking: By learning the rules for C1, the model became proficient at identifying coverage-related drops.
  • Over-correction: However, the model predicted C1 for almost every other class (e.g., Truth C8 → Pred C1: 85 times).

Analysis: The Learning Capacity Gap

Experiment 3 proved that Data Quality > Data Quantity. However, it also revealed that at a low rank (r=32), the 1.5B model was struggling to hold more than one complex rule at a time. It had “mastered” C1 but was overriding its knowledge of other causes to do so. This set the stage for our exploration into LoRA hyperparameters.

analysis report 104 - quochung.cyou PTIT
- quochung.cyou PTIT

Part IX: Theoretical Intermission LoRA Hyperparameter Optimization

The jump to 12% accuracy in Experiment 3 was a proof-of-concept for my self-reflection dataset, but the heavy “C1 bias” suggested the model’s update capacity was saturated.

Raschka’s Principles & The Alpha Heuristic

  • The Alpha Scaling: A common rule of thumb is setting alpha (the scaling factor) to twice the value of r (the rank), effectively alpha = 2 * r. This ensures the influence of the LoRA weights is balanced against the pre-trained weights.
  • Layer Coverage: To maximize performance, LoRA should be applied across all layers, including projection and MLP layers, not just the Key and Value matrices. This increases the number of trainable parameters, which is vital for domain-specific tasks like 5G RCA where the model must learn entirely new technical correlations.

The Capacity Problem: Rank vs. Knowledge

In a 1.5B model, a rank of 32 only updates a small fraction of parameters. This might not provide enough capacity to store 8 distinct 5G diagnostic rules. If the rank is too small, the model may only capture dominant patterns like C1 (Downtilt) and miss others.


Part X: Experiment 4 Expanding the Rank (r=128)

Armed with the theory that our model lacked the “memory” to differentiate between classes, I pushed the rank significantly higher.

The Setup: Boosting Rank and Alpha

  • LoRA Config: r = 128, a = 64
  • Methodology: I maintained the 300 “reflected” samples from the previous phase but allowed the model more degrees of freedom to store the learned weights.

Accuracy: 16.32%

- quochung.cyou PTIT
analysis report 141 - quochung.cyou PTIT

Expanding the rank improved performance:

  • Total Accuracy: 16.32% (141/864).
  • Diversification: The C1 bias decreased. The model’s recognition of C4 (Neighbor interference) jumped to 29.63%, and C7 (Handover thresholds) reached 21.30%.
  • Word Count Consistency: The mean word count remained stable at 960.63 words, indicating that higher rank did not necessarily mean more rambling, but rather more precise reasoning.

Analysis: Reducing Categorical Confusion

In the error logs, we saw a shift. Instead of predicting C1 for everything, the model began confusing similar signal-based issues. For example, Truth C3 (Neighbor throughput) was often confused with C4 (Neighbor interference). This shows progress — the model now understands the problem involves “Neighboring Cells” but is still fine-tuning the specific logic that distinguishes interference from a handover opportunity.


Part XI: Scaling the Dataset 2000 Samples

Recognizing that the 1.5B model’s improvement was driven by better data and increased rank, I increased the training set size. However, scaling synthetic data requires a strict “Teacher-Student” hierarchy to prevent errors.

The “Major Voting” Strategy

I utilized a Qwen2.5-7B-Instruct model, which had better baseline performance, to act as a secondary filter.

  • The Process: For each question, the 7B model generated multiple reasoning trajectories.
  • The Filter: Only samples where the 7B model reached the correct answer via majority voting were added.
  • The Result: This method produced a dataset of 2000 high-quality reasoning traces.

Response-Only Training (SFT Optimization)

To further improve efficiency and focus, I pivoted to training on responses only.

  • The Goal: By masking the loss for the system and user prompts, the model focuses its entire learning capacity on the reasoning steps and the final \boxed{} identification.
  • Alignment: This technique prevents the model from wasting parameter updates on memorizing the structure of the input logs and engineering tables, ensuring it prioritizes the causal logic instead.

Part XII: Experiment 5 High-Rank Performance (r=256)

The final phase of my implementation involved pushing the LoRA rank to the maximum sustainable level for a 1.5B model while utilizing the massive 2000-sample dataset. This experiment aimed to replicate the “Reasoning LLM” performance gains described in the paper.

Final Configuration

  • LoRA Hyperparameters: Rank 256, Alpha 128.
  • Data Density: 2000 “major-voted” samples from the reflection pipeline.
  • Optimization: AdamW optimizer with a cosine learning rate scheduler, applied to all linear layers as suggested by Raschka’s research.

Final Result: 21.41% Accuracy

This iteration achieved the highest performance:

  • Total Accuracy: 21.41% (185/864 correct).
  • Balanced Learning: The “C1 bias” was significantly mitigated. Accuracy for C7 (Handover Thresholds) reached 37.96%, and C8 (PRB Allocation) surged to 23.15%.
  • PCI Mod 30 Success: The model finally began correctly identifying C6 (PCI Conflict) at a 29.63% rate, proving it had successfully encoded the mathematical relationship between PCI values and reference signal overlap.

Analysis: The Impact of Scale

The jump from 16.32% to 21.41% demonstrates that for a 1.5B model, the combination of dataset density and rank capacity is significant. By providing 2000 examples, the model found common causal themes across different logs, resulting in better generalization rather than rote memorization.

analysis report 185 - quochung.cyou PTIT
- quochung.cyou PTIT

—

radar performance shift - quochung.cyou PTIT
- quochung.cyou PTIT

The easy way install and compile Cobol in Windows

Install Msys2

  • Download and Install MSYS2: Follow the installer on their site.
image - quochung.cyou PTIT
image 1 - quochung.cyou PTIT

This Installation Folder is important, please remember of it

image 3 - quochung.cyou PTIT

Install Cobol Compiler

Search for it in your Start menu.

image 4 - quochung.cyou PTIT

Run the update command:

pacman -Syu

Install GnuCOBOL:

pacman -S mingw-w64-ucrt-x86_64-gnucobol

Add to Path

image 5 - quochung.cyou PTIT
image 6 - quochung.cyou PTIT
image 7 - quochung.cyou PTIT
  • Find “Path” and Edit:
    • Add the installation folder and cobol suffix for it, for example if you install in C:\msys64 as default, you can use C:\msys64\ucrt64\bin
  • Optional (For run compiler in Window Terminal)
    • Use new… button and add new (Variable Name: Variable Value)
      • COB_CONFIG_DIR: C:\msys64\ucrt64\share\gnucobol\config
      • COB_COPY_DIR: C:\msys64\ucrt64\share\gnucobol\copy
      • COB_LIBRARY_PATH: C:\msys64\ucrt64\lib\gnucobol
image 8 - quochung.cyou PTIT

Now you can run your cobol program

GoalCommandResult
Quick Testcobc -x -j file.cblRuns immediately; no permanent .exe kept.
Build Appcobc -x file.cblCreates file.exe to run anytime.
Build for Pythoncobc -m file.cblCreates a .dll library for Python to call.
Check Errorscobc -f syntax-only file.cblOnly checks for code errors without building.
image 11 - quochung.cyou PTIT

Common Error

: fatal error: libcob.h: No such file or directory

   10 | #include <libcob.h>

      |          ^~~~~~~~~~

compilation terminated.

The error fatal error: libcob.h: No such file or directory means the COBOL compiler (cobc) found your code, but the C compiler (which GnuCOBOL uses under the hood) can’t find the necessary “header files” to finish building the program.

Adding these to Environment Variables like previous step

Variable NameVariable Value
COB_CFLAGS-I D:\Msys2\ucrt64\include
COB_LDFLAGS-L D:\Msys2\ucrt64\lib
  • -I (Include): Points to the folder containing libcob.h.
  • -L (Library): Points to the folder containing the actual library files (.lib or .a).

Or a quick command if you not want add it:

cobc -x -j TEST-PROGRAM.cbl -I D:\Msys2\ucrt64\include -L D:\Msys2\ucrt64\lib

nanosleep64 could not be located

image 10 - quochung.cyou PTIT

If you got (nanosleep64 could not be located) may indicate: your system is confused between two different versions of the C compiler.

The nanosleep64 error is a classic sign that a program compiled with one Windows runtime (like UCRT) is trying to link with an incompatible version of a library.

You could run this command

where gcc

If the output show more than one directory path, it may appear your computer have 2 installed GCC place

To solve this:

You need to tell Windows that the D: drive tools are the priority.

  1. Search for “Edit the system environment variables” in your Start Menu and open it.
  2. Click Environment Variables.
  3. In the System variables (bottom) list, find the one named Path and click Edit.
  4. Find C:\Msys2\ucrt64\bin in the list. (the path you added in installation step)
  5. Click the “Move Up” button repeatedly until it is at the very top of the list (above the other bin directory in where gcc command).
  6. Click OK on all windows.

Close your current Command Prompt and open a new one for the change to take effect.

Alternative Way:

cobc -x -j TEST-PROGRAM.cbl -conf="D:\Msys2\ucrt64\share\gnucobol\config\default.conf"

A simple extension that fixes my browser chaos

I have a love-hate relationship with browser tabs. I need a lot of them to work, but once I pass the 30-tab mark, my browser bar becomes useless.

Google Chrome actually experimented with an auto-grouping feature a while back, but they removed it. I tried finding alternatives on the Chrome Web Store, but they all had the same problem: They were lazy.

Most existing extensions group tabs based on the domain, even they calling LLM to group it. If they see youtube.com, they dump it in a “YouTube” folder. This is useless for me. If I have 5 tabs open for “Lofi Music” and 5 tabs open for “Python Tutorials,” those shouldn’t be in the same group. One is Work, the other is Background Noise.

I realized that to actually organize tabs, the software needs to read the page, not just the URL. So I spent my free time building Group Tab AI.

How it actually works

image 8 - quochung.cyou PTIT

I didn’t want to over-engineer this, but I needed it to be smart. When you click the button, the extension doesn’t just look at the link. It injects a script to grab the “context” of the page, the H1 title, the meta description, and a snippet of the body text.

It sends that data to an LLM (I set it up to work with either OpenAI or Gemini). Because it reads the content, it can tell that a GitHub page for a “React Library” is different from a GitHub page for “Tracking Issues.”

I’m using Google Gemini 2.0 Flash for this mostly, with the thinkingBudget set to 0. It’s fast enough that by the time I blink, the tabs are sorted.

I spent nights tweaking prompts to make it focus on tasks, not domains with extra context from the website contents along with careful prompt to let them reasoning and choose. For example, if you’re a dev, it might make groups like “Bug Hunting” or “API Docs.” Designers get “Mockups” or “Inspo.” It works for anyone,

students with class notes, marketers with campaigns.

image 10 - quochung.cyou PTIT

The feature I actually wanted: It learns

This is the part I’m most proud of. I know AI isn’t perfect. It’s going to mess up. It might group a design blog under “Development” instead of “Inspiration.”

Usually, with AI tools, you just have to live with the bad output. But I built a Learning System into this.

  1. If the AI groups something wrong, I manually move the tab to the right group.
  2. The extension records that move.
  3. After I’ve corrected it a few times, I can click a button to “Analyze Behavior.”
  4. The system looks at my corrections and rewrites its own system prompt.

Next time I run it, it knows: “Oh, he likes to keep his ‘Localhost’ tabs separate from his ‘Production’ tabs,” because it updated its own instructions based on my manual fixes.

The Tech Stack

For the frontend devs out there, I built this using Plasmo. It’s basically the Next.js of browser extensions, makes working with React and TypeScript in a chrome-extension environment actually bearable.

Everything is local. Your API keys are stored in your browser, and the learning data (your grouping habits) stays on your machine.

Try it out

It’s open source (GPL-3.0). I built it because I needed it, but if you’re tired of domain-based grouping that doesn’t actually help, give it a shot.

https://github.com/quochung-cyou/group-tab-ai-extension

Releases: https://github.com/quochung-cyou/group-tab-ai-extension/releases/

Kaggle Multi Local Module Project Python

image - quochung.cyou PTIT

Kaggle’s setup is amazing for quick experiments but not great when you start treating your work like an actual project. You get one main notebook. That’s it.

If you want to use your own .py files, you basically have to zip them up, upload them as a dataset, and then import from that path. It’s clunky and hard to maintain. Change one line of code? You need to re-upload the dataset again.

I saw this frustration all over the web, in Kaggle forums, Stack Overflow threads, even Reddit. Everyone was hacking their way around it, trying things like chained kernels or huge notebooks with thousands of lines of code. Nobody seemed happy with it.

So I went down the rabbit hole. Read a bunch of Medium posts, watched YouTube tutorials, skimmed corporate engineering blogs. I noticed a pattern: real ML pipelines in the wild are automated. They have CI/CD. They deploy cleanly. But for personal Kaggle projects, nobody had built something simple and usable.

That’s when it clicked, I could write a small tool that did the boring part for me. A script that could take my local project, package it up neatly, and push it to Kaggle as a dataset and a runnable notebook automatically.

Building kaggle-auto-deploy

The idea was simple:

  • Collect all project files.
  • Upload them as a Kaggle dataset.
  • Auto-generate a notebook that sets everything up and runs main.py.
  • Push it, version it, done.

So that’s what I built. A small CLI tool:

python kaggle_deploy.py ./my_project

For example, I used it on a small housing price predictor I’d built.

Behind the scenes, it ties into Git too, so every deployment matches a commit. No more “which version did I upload again?” moments.

Repository: https://github.com/quochung-cyou/kaggle-auto-deploy

Sample: https://www.kaggle.com/datasets/quochungcyou/housing-price-predictor-files https://www.kaggle.com/code/quochungcyou/multi-local-module-project-python-run-sample

Overview

This solution automatically converts any multi-file Python project into a Kaggle-compatible format by:

  • Analyzing your project structure and dependencies
  • Creating a Kaggle dataset containing all your project files
  • Generating a Kaggle notebook that automatically downloads and runs your project
  • Uploading everything to Kaggle via API

Guide

You can try command below to try deploy the sample housing price predictor project:

python kaggle_deploy.py ./housing_price_predictor
alt text
alt text

If you modify the code and redeploy again, you may need use Check Update option to update the dataset and notebook.

alt text

Prerequisites

  1. Install Kaggle API
pip install kaggle
  1. Configure Kaggle Credentials
    • Option A: API Token File
      • Go to https://www.kaggle.com/account
      • Click “Create New API Token”
      • Download kaggle.json
      • Place it in:
        • Linux/Mac: ~/.kaggle/kaggle.json
        • Windows: C:\Users{username}.kaggle\kaggle.json
    • Option B: Environment Variablesexport KAGGLE_USERNAME=”your-username” export KAGGLE_KEY=”your-api-key”
  2. Set Permissions (Linux/Mac)
chmod 600 ~/.kaggle/kaggle.json

Installation & Setup

  1. Download the Deployer Script
git clone https://github.com/yourusername/kaggle-auto-deploy.git
cd kaggle-auto-deploy
  1. Make it Executable (Linux/Mac)
chmod +x kaggle_deployer.py
  1. Optional: Add to PATH (Linux/Mac)
# Add to ~/.bashrc or ~/.zshrc
export PATH="$PATH:/path/to/kaggle_deployer"

Usage

Basic Usage

python kaggle_deployer.py /path/to/your/project

Sample Project

This repository includes a sample project called housing_price_predictor that demonstrates how to structure a multi-file Python project for deployment to Kaggle.

python kaggle_deploy.py ./housing_price_predictor

Project Structure

housing_price_predictor/
├── main.py          # Entry point
├── data_loader.py   # Data loading and preprocessing
├── model.py         # Model training and evaluation
├── utils/
│   └── helpers.py   # Utility functions
├── data/
│   └── housing.csv  # Sample data
└── requirements.txt # Dependencies

Running the Sample Project

# Run locally
cd housing_price_predictor
python main.py

# Deploy to Kaggle
python kaggle_deployer.py ./housing_price_predictor

[SWE học A.I] Tìm hiểu về Attention và Transformer

Word Embedding

Để xây dựng các hệ thống có thể hỗ trợ dịch thuật và sinh văn bản, trước hết chúng ta phải biến đổi văn bản thành một dạng mà máy tính có thể xử lý được. Như thường lệ, mọi thứ cần được chuyển thành con số. Có hai cách phổ biến để làm điều này:


1. Dựa trên ký tự (Character-based)

Trong cách tiếp cận này, ta đánh số tất cả các ký hiệu có thể xuất hiện trong văn bản.

  • Bảng mã ký tự toàn diện nhất hiện nay là Unicode.
  • Phiên bản mới nhất, Unicode 13.0.0 (2020), bao phủ 154 ngôn ngữ viết của con người và liệt kê tới 143.859 ký tự khác nhau (Unicode Consortium, 2020).
  • Mỗi ký hiệu trong bất kỳ hệ thống chữ viết nào đều có thể được gán một số duy nhất, từ 0 đến xấp xỉ 144.000.

Ví dụ, trong chương này, để đơn giản, ta chỉ xét 89 ký tự phổ biến nhất trong tiếng Anh (chữ cái, số, dấu câu, khoảng trắng).

Ví dụ nhỏ:

  • Văn bản: "AI is cool!"
  • Với bảng ký tự chỉ gồm 89 ký hiệu, ta có thể ánh xạ:
    • "A" → 0, "I" → 8, " " (dấu cách) → 26, "s" → 45, "c" → 12, "o" → 22, "l" → 19, "!" → 75
  • Câu "AI is cool!" sẽ được biểu diễn thành một dãy số: [0, 8, 26, 8, 45, 26, 12, 22, 22, 19, 75].

2. Dựa trên từ (Word-based)

Trong cách này, ta đánh số tất cả các từ có thể xuất hiện.

  • Nếu tính tất cả ngôn ngữ trên thế giới, đây là một nhiệm vụ khổng lồ.
  • Ngay cả với tiếng Anh, không có con số chính xác về tổng số từ.
  • Các từ điển hiện đại của tiếng Anh thường có khoảng 300.000 mục từ (Dictionary.com, 2020).

Giả sử ta duyệt qua toàn bộ từ điển và gán cho mỗi từ một số duy nhất, bắt đầu từ 0. Danh sách các từ cùng số hiệu của chúng sẽ tạo thành từ vựng (vocabulary).

Ví dụ nhỏ:

  • Một từ điển mini gồm:
    • {"I": 0, "like": 1, "AI": 2, "because": 3, "it": 4, "is": 5, "fun": 6}
  • Câu "I like AI" sẽ được biểu diễn thành [0, 1, 2].
  • Câu "AI is fun" sẽ là [2, 5, 6].

Với mong muốn cải tiến cách biểu diễn từ thay vì chỉ gán mỗi từ một con số, với mục tiêu là có thể:

  • So sánh từ (tìm từ có ý nghĩa gần giống nhau).
  • Kết hợp từ (trung hòa hoặc biến đổi ý nghĩa giữa hai từ).
  • Thao tác trên không gian vector để tìm ra mối quan hệ ngữ nghĩa tiềm ẩn.

Đây chính là nền tảng để phát triển attention và sau đó là transformer.

Kỹ thuật này gọi là word embedding (hoặc token embedding, khi áp dụng cho token nói chung).

Ví dụ

Giả sử Hôm nay đạo diễn muốn quay cảnh một nhóm động vật đuổi theo nhân vật chính. Văn phòng gửi cho đoàn làm phim một biểu đồ như sau, trục ngang là tốc độ tối đa, trục dọc là cân nặng trung bình của từng loài

image 26 - quochung.cyou PTIT

Nhưng bản in bị lỗi và khi được đưa tới đoàn làm phim thì không có nhãn trục, chỉ còn các điểm động vật nằm trong không gian 2D. Vì vậy đoàn làm phim không biết trục ngang và trục dọc đang biểu diễn cho việc gì.

Đạo diễn nói:

“Tôi muốn trong cảnh quay sẽ là một con ngựa đuổi theo nhân vật chính. Tôi cảm giác được ngựa sẽ phù hợp. Chúng là sự lựa chọn hoàn hảo, đừng mang gì khác tới đây hết.”

image 27 - quochung.cyou PTIT


Đoàn làm phim gật đầu, đưa ngựa vào trường quay. Nhưng chỉ vài phút sau, đạo diễn đã đập tay xuống ghế, quát lớn:

“Không được! Ngựa chạy thì nhanh đấy, nhưng trông chúng quá nhạy, cứ bồn chồn như… cáo ấy. Tôi không muốn thứ gì giống cáo. Hãy mang tới cho tôi một loài vẫn mạnh mẽ như ngựa, nhưng phải bớt cái chất ‘cáo’ đi.”

Đoàn làm phim đứng sững. Trời ạ, “ngựa trừ đi cáo” thì là cái gì? Nhưng rồi anh nhớ tới tấm biểu đồ mà văn phòng gửi. Nếu coi mỗi con vật là một mũi tên trong không gian này, thì việc đạo diễn yêu cầu chẳng khác nào một phép toán vector.

Anh lấy mũi tên của ngựa, trừ đi mũi tên của cáo. Kết quả? Một con… lười khổng lồ (giant sloth).

image 28 - quochung.cyou PTIT

Đoàn làm phim ngập ngừng:

“Thưa đạo diễn, nếu bỏ đi cái tính nhanh nhẹn của cáo khỏi ngựa, chúng ta sẽ có… lười khổng lồ.”

Đạo diễn nhìn rồi hất ly latte xuống đất:

“Không! Lười thì đẹp đấy, nhưng chậm như rùa! Tôi cần thứ gì đó nhanh hơn, phải thật nhanh! Giống như… chim chẳng hạn.”

Anh lại quay vào bảng, lần này cộng thêm vector chim vào kết quả vừa rồi. Và thật bất ngờ, mũi tên mới chỉ thẳng tới… gấu nâu.

image 29 - quochung.cyou PTIT

Đạo diễn khoanh tay, hất tóc, ánh mắt sáng lên:

“Tuyệt. Cuối cùng cũng đúng ý tôi: mạnh mẽ như ngựa, không lắt nhắt như cáo, lại nhanh như chim chạy. Mang gấu tới đây đi.”

Và thế là cảnh rượt đuổi được quay với một đàn gấu nâu hung hãn. Bộ phim sau này trở thành bom tấn, được ca ngợi hết lời.

Kết luận

Có hai yếu tố then chốt trong câu chuyện này. Yếu tố thứ nhất là các loài vật trên biểu đồ của chúng ta đã được sắp xếp theo một cách hữu ích, dù chúng ta không biết cách đó là gì, hay các trục thể hiện điều gì về dữ liệu.

Điểm then chốt thứ hai là cuối cùng chúng ta không cần nhãn trục. Chúng ta có thể định hướng trên biểu đồ chỉ bằng cách cộng và trừ các mũi tên trỏ tới các phần tử trên biểu đồ. Tức là, chúng ta không cố tìm một “con ngựa chậm hơn.” Thay vào đó, ta thao tác trực tiếp với các con vật trên biểu đồ, và các thuộc tính của chúng đi theo một cách ngầm định. Nếu loại bỏ đi tính nhanh nhẹn của cáo khỏi một con vật lớn như ngựa, ta sẽ thu được một con vật to và chậm.

Điều này liên quan gì đến xử lý ngôn ngữ?

Nhúng từ (Embedding Words)

Để áp dụng những gì vừa thấy cho từ ngữ, ta thay các con vật bằng các từ. Và thay vì chỉ dùng hai trục, ta sẽ đặt các từ vào một không gian có hàng trăm chiều.

Chúng ta thực hiện điều này bằng một thuật toán tự động tìm ra ý nghĩa của mỗi trục trong không gian khi đặt từng từ vào vị trí phù hợp. Thay vì gán cho mỗi từ một số đơn lẻ, thuật toán gán cho mỗi từ cả một danh sách số đó là tọa độ của từ trong một không gian lớn.

Ví dụ: từ “Hưng” biểu diễn là [0, 0.5, 1, 50, 4, …]

image 30 - quochung.cyou PTIT

Thuật toán này gọi là embedder, và quá trình đó gọi là nhúng từ vào không gian embedding, tạo ra các word embeddings.

Bộ nhúng tự tìm cách xây dựng không gian và xác định tọa độ của mỗi từ sao cho nó nằm gần những từ tương tự. Ví dụ, nếu nó thấy nhiều câu bắt đầu bằng “I just drank some …”, thì danh từ xuất hiện sau cụm đó sẽ được hiểu là một loại đồ uống và được đặt gần các từ chỉ đồ uống khác. Nếu nó thấy nhiều câu như “I just ate a red …”, thì từ tiếp theo được hiểu là thứ có màu đỏ và có thể ăn được, nên được đặt gần những thứ vừa đỏ vừa có thể ăn được.

Tương tự với hàng chục, thậm chí hàng trăm mối quan hệ khác, cả rõ ràng lẫn tinh tế. Bởi vì không gian có rất nhiều chiều và các trục có thể mang ý nghĩa phức tạp tùy ý, một từ có thể thuộc đồng thời nhiều cụm dựa trên những đặc tính dường như không liên quan.

Điểm hay khi huấn luyện một bộ nhúng trong không gian có hàng trăm (hoặc thậm chí hàng nghìn) chiều là nó có thể sử dụng không gian hiệu quả hơn khả năng trực giác của con người, cho phép biểu diễn đồng thời một số lượng lớn các mối quan hệ.

Những phép “số học từ” vừa nêu là minh chứng thú vị cho không gian nhúng, nhưng quan trọng hơn, chúng cho phép ta thực hiện có ý nghĩa các phép toán trên từ như so sánh, phóng to/thu nhỏ, và cộng trừ tất cả đều hữu ích cho các thuật toán được bàn tới trong chương này.

image 32 - quochung.cyou PTIT

Hình trên trình bày sáu bộ gồm bốn từ liên quan mà chúng ta đưa vào một bộ nhúng tiêu chuẩn. Mức độ tương đồng giữa embedding của hai từ càng lớn thì cặp từ đó càng có điểm cao, nên giao điểm tương ứng càng tối. Đồ thị đối xứng quanh đường chéo từ trên trái xuống dưới phải, vì thứ tự so sánh hai từ không ảnh hưởng kết quả.

Từ hình ta thấy mỗi từ khớp với chính nó mạnh nhất và cũng khớp với những từ liên quan hơn là với những từ không liên quan. Vì ta đặt các từ có liên quan cạnh nhau, đồ thị hiện ra những khối nhỏ thể hiện tương đồng. Tuy nhiên có vài điều thú vị: ví dụ vì sao fish lại khớp hơn mức trung bình với chocolate và coffee, hay vì sao blue lại ghi điểm tốt với caramel? Đây có thể là những hiện tượng phát sinh từ dữ liệu huấn luyện cụ thể mà bộ nhúng dùng.

Các thức uống cà phê và hương vị ghi điểm mạnh với nhau, có lẽ vì người ta thường gọi cà phê kèm các siro hương vị đó. Ngoài ra còn thấy manh mối về mối quan hệ giữa màu sắc và hương vị.

ELMo

Word embeddings là một bước tiến lớn so với việc gán số nguyên cho từ. Nhưng dù mạnh, cách tạo embedding như trên vẫn có một vấn đề: sắc thái ngữ nghĩa (nuance).

Nhiều ngôn ngữ có từ có nhiều nghĩa nhưng viết và phát âm giống nhau. Nếu muốn hiểu đúng nghĩa từ, ta cần phân biệt các nghĩa đó. Một cách là gán cho mỗi nghĩa của một từ một embedding riêng. Ví dụ cupcake chỉ có một nghĩa nên có một embedding; nhưng train có hai nghĩa thực sự khác nhau — một là danh từ (“I rode on a train”) (train là tàu), một là động từ (“I like to train dogs”) (train là huấn luyện), nên cần hai embedding riêng.

Những từ như vậy đặt ra hai thách thức. Thứ nhất, ta phải tạo embedding riêng cho từng nghĩa. Thứ hai, ta phải chọn embedding đúng khi những từ này xuất hiện làm input.

Việc giải quyết hai thách thức này đòi hỏi phải xét ngữ cảnh của mỗi từ. Thuật toán đầu tiên làm việc này ở quy mô lớn gọi là Embeddings from Language Models, hay tên thân mật ELMo (Peters et al. 2018), trùng tên một nhân vật Muppet trong chương trình thiếu nhi Sesame Street. Người ta nói ELMo sinh ra các contextualized word embeddings (embedding phụ thuộc ngữ cảnh).

Attention

Ta đã thấy cách cải thiện chất lượng dịch thuật bằng việc xét đến toàn bộ các từ trong câu. Nhưng khi dịch một từ cụ thể, lại có thể thấy, không phải từ nào trong câu cũng quan trọng, thậm chí nhiều từ còn không liên quan.

Ví dụ: giả sử ta dịch câu:
“I saw a big dog eat his dinner.” – Tôi thấy một chú chó lớn đang ăn

  • Khi dịch từ dog (chó), ta gần như chẳng quan tâm gì đến từ saw. (nhìn thấy)
  • Nhưng để dịch đúng đại từ sở hữu his, ta cần kết nối nó với cụm big dog (chú chó lớn)
  • Nếu ta có thể xác định, với mỗi từ trong đầu vào, những từ nào thực sự ảnh hưởng đến việc dịch, thì ta có thể tập trung xử lý chỉ những từ đó, còn bỏ qua phần còn lại. Điều này tiết kiệm rất nhiều bộ nhớ và thời gian tính toán.
  • Và nếu ta làm điều này theo cách không phụ thuộc vào việc xử lý tuần tự (word-by-word), thì ta còn có thể tính toán song song.

Thuật toán thực hiện ý tưởng đó gọi là attention, hay cụ thể hơn là self-attention (Bahdanau, Cho & Bengio 2016; Sutskever, Vinyals & Le 2014; Cho et al. 2014).

Attention giúp mô hình tập trung tài nguyên vào những phần quan trọng nhất của đầu vào.

QKV – Query, Key, Value

Phiên bản attention hiện đại thường dựa trên một kỹ thuật gọi là query, key, value (QKV).

Ba từ này vốn xuất phát từ lĩnh vực cơ sở dữ liệu (database), nên khi đưa sang ngữ cảnh NLP có vẻ hơi trừu tượng. Vì vậy, ta sẽ dùng một phép ẩn dụ trực quan để giải thích, rồi sau đó kết nối lại với Q–K–V.

Ví dụ: Mua sơn

Giả sử anh cần mua sơn. Người ta chỉ cho anh mô tả:
“màu vàng nhạt pha một chút cam đậm.”

Ở thị trấn chỉ có một cửa hàng sơn duy nhất. Người bán hàng mới vào nghề, không rành từng màu. Anh và nhân viên đều hiểu rằng để ra màu mong muốn, anh phải pha trộn nhiều loại sơn có sẵn. Nhưng vấn đề là: chọn loại nào, và mỗi loại bao nhiêu?

Người bán đề nghị:

  • “Anh hãy so sánh mô tả của mình với tên trên nhãn từng hộp sơn. Hộp nào khớp nhiều thì múc nhiều, khớp ít thì múc ít. Rồi mình trộn tất cả lại.”

Ví dụ: so với mô tả “màu vàng nhạt pha một chút cam đậm.” (“light yellow with a bit of dark orange”)

  • “Sunny Yellow” (Vàng cam) → khớp nhiều, vừa có vàng và cam.
  • “Orange Crush” → khá khớp
  • “Lunch with Teal” cũng lọt vào một chút, chỉ vì trùng từ “with”.
image 33 - quochung.cyou PTIT

Trong câu chuyện này có 3 thành phần chính:

  1. Yêu cầu (request): “light yellow with a bit of dark orange.”
  2. Mô tả (description): tên trên nhãn mỗi hộp, như “Sunny Yellow”, “Mellow Blue”…
  3. Nội dung (content): bản thân màu sơn trong hộp.

Quy trình: ta so sánh yêu cầu với từng mô tả → mức độ khớp càng cao → càng lấy nhiều nội dung từ hộp đó.

Đây chính là QKV:

  • Cho một yêu cầu, so sánh nó với mô tả của từng mục, rồi trộn nội dung theo mức độ phù hợp.

Trong ngôn ngữ cơ sở dữ liệu:

  • Query (Q): yêu cầu tìm kiếm (tương ứng với “request”).
  • Key (K): khóa định danh, mô tả của từng mục (tương ứng với “description”).
  • Value (V): giá trị thật sự được lưu trữ (tương ứng với “content”).

Cơ sở dữ liệu so sánh query với key để tính điểm khớp, rồi dùng điểm đó quyết định lấy bao nhiêu phần của value.

➡️ Vậy:

  • Request ↔ Query (Q)
  • Description ↔ Key (K)
  • Content ↔ Value (V)

Self-Attention

Giả sử ta có một câu gồm 5 từ đầu vào. Mỗi từ được biểu diễn bằng một vector (embedding). Ta có ba “hộp” neural network nho nhỏ (thường chỉ là các fully connected layer 1 tầng) để biến đổi vector đó thành:

  • Q (query)
  • K (key)
  • V (value)
image 34 - quochung.cyou PTIT

Ví dụ: với từ dog (thứ ta cần dịch):

  • Một mạng (màu đỏ) biến vector “dog” thành Q.
  • Từ dinner được biến thành K (qua mạng xanh) và V (qua mạng xanh lá).

Ta so sánh Q của dog với K của dinner bằng một hàm tính điểm (scoring function, ký hiệu S trong vòng tròn). Hàm này trả về một số từ 0 → 1:

  • Khớp nhiều → điểm cao.
  • Khớp ít → điểm thấp.

Sau đó, ta lấy V của dinner, nhân với điểm này (scaling). Kết quả: giá trị dinner đóng góp nhiều hay ít vào đầu ra của dog tùy mức độ khớp.

Mở rộng ra toàn câu

Trong thực tế, không chỉ so sánh dog ↔ dinner, mà dog được so sánh với tất cả từ trong câu (kể cả chính nó).

Mỗi từ trong câu sẽ đóng góp vào kết quả cuối của dog, với trọng số do điểm khớp quyết định.

image 35 - quochung.cyou PTIT

Lưu ý:

  1. Ta chỉ có 3 mạng duy nhất (Q, K, V), và áp dụng chúng cho tất cả từ → tiết kiệm tính toán.
  2. Sau khi có điểm khớp, ta áp dụng softmax để chuẩn hóa, tránh số quá to/nhỏ, đồng thời làm nổi bật các khớp mạnh.
  3. Cuối cùng, ta cộng tất cả giá trị V đã được scale lại → ra vector mới của dog.
  4. Lặp quy trình này đồng thời cho mọi từ trong câu
image 36 - quochung.cyou PTIT

Embedding đóng vai trò gì?

Hàm scoring sẽ coi hai vector giống nhau → điểm cao. Vậy để hoạt động đúng, các từ có ý nghĩa gần nhau phải được nhúng gần nhau trong không gian embedding.

Ví dụ: trong như cách làm onehot encoding, ta gán số cho từ theo thứ tự (keep = 1003, flint = 1004). Nếu dùng số này so sánh thì keep và flint lại cực kỳ giống nhau (sai hoàn toàn).

Với embedding:

  • keep sẽ gần retain, hold, reserve.
  • Cách xa hẳn flint, dinosaur.

Nhờ embedding, scoring mới có ý nghĩa.

Q/KV Attention

Trong self-attention, Q, K, V đều sinh ra từ cùng một input.

Nhưng có biến thể khác:

  • Q đến từ một nguồn khác, còn K và V vẫn từ input gốc.

Giống như ví dụ mua sơn:

  • Query đến từ khách hàng.
  • Key & Value đến từ cửa hàng.

Đây gọi là Q/KV attention.

  • Thường dùng trong mạng encoder–decoder (ví dụ seq2seq):
    • Q từ encoder.
    • K, V từ decoder.
image 38 - quochung.cyou PTIT

Multi-Head Attention

Ý tưởng của attention là xác định những từ nào có sự tương đồng và tạo ra một phép trộn hữu ích từ chúng. Nhưng “giống nhau” có thể được định nghĩa theo rất nhiều tiêu chí khác nhau.

Ví dụ: ta có thể xem các danh từ là giống nhau, hoặc các màu sắc, hoặc các khái niệm không gian như “lên – xuống”, hoặc các khái niệm thời gian như “hôm qua – ngày mai”. Vậy lựa chọn nào là tốt nhất?

Thực ra không có một câu trả lời duy nhất. Trên thực tế, ta thường muốn so sánh các từ theo nhiều tiêu chí cùng lúc.

  • Khi viết ca từ bài hát, ta có thể muốn đánh giá cao những cặp từ có nghĩa gần giống nhau, có vần cuối giống nhau, có số âm tiết bằng nhau, và thậm chí có nhịp điệu trong trọng âm giống nhau.
  • Nhưng khi viết về thể thao, ta có thể muốn coi những cầu thủ cùng đội, cùng vị trí là “giống nhau”.

Để chấm điểm các từ theo nhiều tiêu chí, ta chỉ cần chạy nhiều mạng attention độc lập cùng lúc. Mỗi mạng như vậy gọi là một head (một “đầu chú ý”). Mỗi head được khởi tạo độc lập, và ta hy vọng rằng trong quá trình huấn luyện, mỗi head sẽ học được một cách riêng để so sánh các đầu vào, theo những tiêu chí hữu ích và khác biệt so với các head khác. Nếu muốn, ta còn có thể thêm cơ chế để ép các head tập trung vào các khía cạnh khác nhau của đầu vào. Cơ chế này gọi là multi-head attention

image 37 - quochung.cyou PTIT

Mỗi head là một mạng attention độc lập. Càng nhiều head, thì mô hình càng có khả năng tập trung vào nhiều khía cạnh khác nhau của dữ liệu đầu vào.

Hình trên minh họa một lớp multi-head attention. Như hình vẽ, ta thường kết hợp đầu ra của tất cả các head thành một danh sách, rồi cho qua một lớp fully connected duy nhất. Nhờ vậy, đầu ra của toàn bộ lớp multi-head có cùng kích thước với đầu vào, điều này cho phép ta dễ dàng xếp chồng nhiều lớp multi-head liên tiếp.

Layer Icons (Biểu tượng các lớp Attention)

  • (a) Self-attention.
  • (b) Multi-head self-attention.
  • (c) Q/KV attention.
  • (d) Multi-head Q/KV attention.
image 39 - quochung.cyou PTIT

(Multi-head attention được vẽ như một khối 3D nhỏ, gợi ý rằng nó là “một chồng” các mạng attention. Với Q/KV attention, trong biểu tượng kim cương có thêm một vạch nhỏ để chỉ đầu vào Q, còn K và V đi vào từ một phía khác.)

Transformers

Mục tiêu của ta là xây dựng một mô hình dịch máy không dựa vào RNN, mà dựa vào attention networks. Ý tưởng chủ chốt: các lớp attention sẽ học cách biến đổi đầu vào thành bản dịch, dựa trên mối quan hệ giữa các từ.

Cách tiếp cận này lần đầu xuất hiện trong bài báo nổi tiếng “Attention Is All You Need” (Vaswani et al., 2017). Tác giả gọi mô hình này là transformer (cái tên hơi “mập mờ” nhưng giờ đã thành chuẩn trong lĩnh vực). Mô hình transformer hoạt động hiệu quả đến mức đã mở ra một thế hệ mới của các mô hình ngôn ngữ, vừa huấn luyện song song dễ dàng, vừa vượt trội hơn RNN trong nhiều tác vụ khác nhau.

Transformer sử dụng thêm ba ý tưởng nữa:

Skip Connections

Ý tưởng đầu tiên gọi là residual connection hay skip connection (He et al., 2015). Nguồn cảm hứng của nó là giảm lượng công việc mà một lớp mạng sâu phải thực hiện.

Một phép so sánh:
Giả sử ta vẽ một bức chân dung bằng sơn acrylic trên một tấm vải. Sau nhiều tuần, bức tranh hoàn thành. Người mẫu xem và nói: “Tôi thích rồi, nhưng tiếc là hôm đó tôi đeo nhẫn sai, lẽ ra phải là cái nhẫn khác. Anh có thể sửa không?”

  • Cách 1: mời người mẫu quay lại, vẽ lại toàn bộ bức tranh từ đầu. Tốn thời gian và công sức khủng khiếp.
  • Cách 2: chỉ cần vẽ chồng cái nhẫn mới lên cái cũ. Nhanh gọn hơn nhiều.

Một lớp trong mạng sâu cũng vậy. Nó nhận tensor đầu vào, xử lý, và tạo ra tensor đầu ra. Nhưng nếu chỉ cần thay đổi một phần nhỏ, thì thật lãng phí nếu lớp đó phải xử lý toàn bộ. Giống như việc vẽ lại cả bức tranh chỉ để thay cái nhẫn. Thay vào đó, lớp chỉ cần tính toán phần thay đổi cần thiết, rồi cộng nó với đầu vào ban đầu để ra đầu ra cuối cùng.

Ý tưởng này hoạt động tuyệt vời trong deep learning:

  • giúp các lớp nhỏ gọn hơn, nhanh hơn,
  • cải thiện truyền gradient trong backpropagation,
  • cho phép huấn luyện hiệu quả các mạng có hàng chục hoặc hàng trăm lớp.
image 40 - quochung.cyou PTIT

Đường nối thêm đưa input đến nút cộng gọi là skip connection (nối tắt), hay residual connection (nối tàn dư, vì nó cộng thêm “phần dư”).

Transformer dùng skip connections không chỉ để tăng hiệu quả, mà còn để theo dõi vị trí của từng phần tử trong đầu vào (sẽ thấy ở phần positional encoding).

Norm-Add

Ý tưởng thứ hai là một rút gọn ký hiệu, thường gọi là norm-add.

Trong transformer, ta thường áp dụng bước chuẩn hóa gọi là layer normalization (layer norm) lên đầu ra của một lớp (Vaswani et al., 2017). Đây là một dạng regularization giống như dropout hay batchnorm, giúp chống overfitting bằng cách giữ cho các giá trị trong mạng không quá lớn hoặc quá nhỏ. Layer norm học cách điều chỉnh giá trị đầu ra của lớp để có dạng gần giống một phân phối chuẩn (mean = 0, std = 1).

Một cách thông dụng: đặt layer norm ngay trước bước cộng của skip connection Vì hai bước này luôn đi kèm nhau, nên người ta gộp chúng thành một khái niệm gọi là norm-add. Biểu tượng norm-add là sự kết hợp của biểu tượng chuẩn hóa và cộng.

image 41 - quochung.cyou PTIT

Có nhiều biến thể khác (đặt norm trước lớp, hoặc sau bước cộng), nhưng nhìn chung hiệu quả tương đương.

Positional Encoding (Mã hóa vị trí)

Ý tưởng thứ ba giải quyết một vấn đề phát sinh khi ta bỏ RNN ra khỏi hệ thống: ta mất thông tin về vị trí của từng từ trong câu.

Trong RNN, thông tin này có sẵn, vì từ đi vào theo thứ tự và trạng thái ẩn có thể ghi nhớ vị trí. Nhưng với attention, nhiều từ bị trộn lẫn vào nhau, vậy làm sao biết từ nào ở chỗ nào?

Giải pháp: thêm thông tin vị trí của mỗi từ trực tiếp vào vector biểu diễn của từ đó. Cách làm này gọi là positional encoding.

  • Cách đơn giản: nối thêm vài bit vào cuối mỗi từ để lưu vị trí. Nhưng cách này tốn bộ nhớ và khó xử lý khi câu quá dài (ví dụ câu càng dài hơn thì số bit cần để lưu vị trí càng tốn). (ảnh trái)
image 42 - quochung.cyou PTIT
  • Cách tốt hơn: dùng một hàm toán học để biến chỉ số vị trí thành một vector đặc trưng (cùng chiều với embedding). Ví dụ: nếu embedding dài 128, thì mỗi vị trí được ánh xạ thành một vector 128 chiều riêng biệt. (ảnh phải)

Thay vì nối thêm vector này, ta cộng trực tiếp nó vào embedding của từ Cách này gọn gàng hơn, không cần thêm bits đặc biệt. Phương pháp này gọi là positional embedding, vì nó giống embedding từ vựng. Biểu tượng minh họa có dạng sóng sin, vì hàm thường dùng chính là sine wave encoding (Vaswani et al., 2017).

Nghe có vẻ lạ: cộng vị trí vào embedding sẽ thay đổi vector của từ. Vậy liệu thông tin vị trí có bị “hòa tan” mất trong quá trình attention không?

Hóa ra là không:

  • Hàm positional embedding chỉ tác động lên một vài bit nhất định (Vaswani et al., 2017; Kazemnejad, 2019).
  • Transformer học được cách phân biệt thông tin nội dung và thông tin vị trí.

Quan trọng hơn: nhờ có skip connections, positional embedding không bao giờ bị mất hoàn toàn. Sau mỗi tầng xử lý, nó lại được cộng thêm vào, luôn đi cùng với từ.

image 43 - quochung.cyou PTIT

Ghép các mảnh ghép

Giờ thì ta đã có đủ nguyên liệu để dựng nên một transformer. Và để tiện theo dõi, ta vẫn sẽ dùng bài toán dịch từ ngữ ở mức độ từng từ làm ví dụ minh họa xuyên suốt.

Điều cần lưu ý trước tiên: cái tên transformer ngày nay được dùng cho một họ mạng nơ-ron rất rộng, tất cả đều lấy cảm hứng từ kiến trúc trong bài báo gốc Attention Is All You Need (Vaswani et al. 2017). Ở đây, ta sẽ không đi vào từng biến thể, mà chỉ bám vào một “phiên bản chung”, một bộ khung chuẩn.

Cấu trúc tổng thể

image 44 - quochung.cyou PTIT
  • Ở bên trái là encoder (mã hóa),
  • ở giữa có một cây cầu dữ liệu,
  • và bên phải là decoder (giải mã).

Một câu đầu vào sẽ đi qua encoder, được xử lý và “chưng cất” thành thông tin. Rồi decoder nhận dòng thông tin đó, dần dần tạo ra câu dịch mới.

Nếu bạn đã quen với seq2seq dùng RNN thì bố cục này trông có chút quen: có phần encoder, phần decoder, và thông tin chảy từ trái sang phải. Nhưng điểm khác biệt then chốt: không còn bất kỳ (recurrent cell) nào nữa. Tất cả được thay bằng các lớp attention.

Trong sơ đồ:

  • E tượng trưng cho một encoder block,
  • D là một decoder block,
  • các nét đứt cho thấy nhiều block giống hệt nhau được lặp lại.

Ở đầu vào, cả encoder và decoder đều bắt đầu bằng word embedding (biểu diễn từ thành vector) cộng thêm positional embedding (mã hóa vị trí từ). Ở đầu ra của decoder, ta có một lớp fully connected + softmax để dự đoán từ kế tiếp.

Decoder lại còn có một vòng lặp: mỗi từ mà nó sinh ra sẽ được đưa trở lại vào chính nó, để sinh tiếp từ sau. Đó là cơ chế autoregressive.

Encoder block

image 45 - quochung.cyou PTIT
  1. Lớp đầu tiên: multi-head self-attention (ví dụ 8 head). Vì đây là self-attention, nên queries, keys, values đều được rút ra từ chính input của block.
    • Lớp này được bao quanh bởi skip connection + layer norm (norm-add), vừa để giữ số liệu “gọn gàng” (phân phối Gaussian đẹp), vừa để bảo toàn thông tin vị trí.
  2. Lớp kế tiếp: một cặp feed-forward pointwise (thường hiểu như 2 convolution 1×1).
    • Lớp đầu có activation ReLU, lớp sau thì không.
    • Chức năng: tinh chỉnh đầu ra từ attention, loại bỏ dư thừa, giữ lại phần cốt lõi.
    • Như thường lệ, cả cụm này cũng được gói trong skip connection + norm-add.

Vậy encoder block = attention → feed-forward → norm-add bao quanh.

Decoder block

Tiếp theo là decoder block. Bố cục hơi giống encoder block, nhưng có thêm một bước attention đặc biệt.

image 46 - quochung.cyou PTIT
  1. Bước đầu tiên: multi-head self-attention (giống encoder).
    • Input chính là các từ mà decoder đã sinh ra cho đến nay. Nếu mới bắt đầu, thì chỉ có token [START].
    • Nhờ self-attention, hệ thống học cách xem từ nào liên quan từ nào trong dãy đầu ra tạm thời này.
    • Vẫn có skip connection + norm-add bao quanh.
    • Nhưng ở đây có thêm một chi tiết: masking (hình tam giác nhỏ trong sơ đồ).
  2. Bước thứ hai: multi-head Q/KV attention.
    • Query (Q) đến từ output của self-attention trước đó.
    • Keys và Values đến từ tất cả các encoder block (nguyên câu nguồn đã được mã hóa).
    • Nhờ thế, decoder biết cách “nhìn sang” câu gốc để chọn thông tin nào cần dùng khi dịch tiếp.
    • Bước này cũng được bọc skip connection + norm-add.
  3. Cuối cùng: một cặp convolution 1×1 (giống encoder block).

Ghép lại thành Transformer

Khi ráp mọi mảnh, ta có sơ đồ:

  • Nhiều encoder block chồng nhau bên trái.
  • Nhiều decoder block chồng nhau bên phải.
  • Các lớp convolution 1×1 thường được ký hiệu bằng 2 hộp nhỏ xếp đôi.
  • Nét đứt = lặp lại nhiều lần.
image 47 - quochung.cyou PTIT

Vấn đề song song & Masking

Một ưu điểm tuyệt vời của attention là: xử lý song song. Dù ta đưa vào 5 từ hay 500 từ, lớp attention vẫn chạy trong cùng một thời gian. Điều này khác hẳn RNN, vốn phải xử lý tuần tự từng bước.

Nhưng khi huấn luyện mô hình để dự đoán từ kế tiếp, sẽ nảy sinh một vấn đề.
Ví dụ câu: “My dog loves taking long walks.”

  • Nếu ta đưa vào “My dog loves taking long” và muốn dự đoán từ thứ 6 (walks), thì ổn.
  • Nhưng đồng thời, ta cũng muốn mô hình dự đoán từ thứ 5 (long), dự đoán từ thứ 4 (taking), … tất cả song song.
  • Vấn đề: khi dự đoán long, mô hình thấy luôn từ long trong input. Quá dễ, và không còn ý nghĩa học.

Cách giải: masking.
Trong self-attention của decoder, ta chèn một lớp mặt nạ, để tại mỗi bước dự đoán, mô hình chỉ được nhìn thấy các từ trước đó, không được nhìn “tương lai”.

  • Khi dự đoán từ thứ 1 → không thấy gì.
  • Khi dự đoán từ thứ 2 → chỉ thấy “My”.
  • Khi dự đoán từ thứ 3 → chỉ thấy “My dog”.
  • … và cứ thế.

Nhờ masking, mô hình vừa chạy song song và không bị “nhìn thấy” dữ liệu. Ta cố tình ẩn bớt dữ liệu đi để mô hình có thể học thêm.

Tham khảo:

  • Deep Learning (Andrew Glassner)

[HTTP/2] Phần 2: Tìm hiểu thêm Server Push

HTTP/2 Server Push

Như đã sơ lược qua ở phần trước, HTTP/2 Server Push (gọi tắt là HTTP/2 push) cho phép máy chủ (server) gửi thêm tài nguyên mà client (trình duyệt) chưa yêu cầu. Trước HTTP/2, HTTP chỉ là “hỏi-đáp đơn giản”: Trình duyệt yêu cầu một trang web, server trả về, rồi trình duyệt phải tải trang đó, phân tích, và yêu cầu thêm tài nguyên như CSS, JavaScript, font chữ, hình ảnh.

Ví dụ: Khi bạn mở một trang blog, trình duyệt tải HTML trước, rồi mới “thấy” cần CSS từ việc HTML khai báo rằng css cần thiết. Quá trình này tạo ra ít nhất một vòng lặp (round-trip) thừa, làm chậm thời gian hiển thị ban đầu (initial paint). Hình ảnh thì không sao (trang vẫn load với chỗ trống), nhưng CSS hay JS “critical” (quan trọng cho rendering) sẽ khiến trang “treo” đến khi tải xong.

image 18 - quochung.cyou PTIT

Với HTTP/2 multiplexing (đa kênh), các yêu cầu song song giúp tốt hơn HTTP/1, nhưng vẫn cần round-trip thứ hai. HTTP/2 push “phá vỡ quy tắc” bằng cách server gửi luôn tài nguyên phụ ngay từ đầu, giảm thời gian tải từ 2 round-trip xuống còn 1.

Hình dung qua ví dụ waterfall diagram (biểu đồ thác nước):

  • Không push: HTML tải xong → Phân tích → Yêu cầu CSS/JS → Chờ tải → Render.
  • Có push: Server gửi HTML + CSS/JS cùng lúc → Render ngay!
image 19 - quochung.cyou PTIT

Inline CSS

image 20 - quochung.cyou PTIT

Để giảm độ trễ, các lập trình viên thường inline các tài nguyên quan trọng ngay vào HTML, nhờ đó trình duyệt có thể bắt đầu render ngay sau khi phân tích trang gốc, thay vì chờ tải thêm tài nguyên.

Tuy nhiên, inline CSS/JS tiềm ẩn nhiều hạn chế:

  • Khi cần sửa critical CSS (ví dụ redesign), phải cập nhật từng trang chứ không chỉ 1 file chung.
  • Thường chỉ chứa các style cần thiết cho lần render đầu; toàn bộ stylesheet được tải sau để giảm độ lớn mã inline.
  • Cần công cụ phân tích để trích đúng những phần “critical” công việc phức tạp.
  • Dẫn đến trùng lặp: mỗi trang website đều chứa CSS critical riêng, thay vì dùng file có thể cache giữa các trang.
  • Sau đó nội dung critical CSS còn được giữ trong stylesheet chính, gây trùng lặp trong mỗi trang, không chỉ giữa các trang.
  • Để tải CSS không quan trọng, cần dùng JavaScript thay vì thẻ <link>, bởi thẻ link nhúng CSS thông thường sẽ block rendering; thẻ link không hỗ trợ async.

Làm rõ hơn cơ chế HTTP/2 Push

HTTP/2 push phá bỏ quy tắc “1 request = 1 response”. Máy chủ có thể trả về nhiều tài nguyên kèm theo một yêu cầu. Ví dụ:

– Client: “Cho tôi trang này.”
– Server: “Được thôi, đây là trang HTML, thêm cả CSS và JS cần thiết để bắt đầu rendering”.

image 21 - quochung.cyou PTIT

Thể hiện dưới dạng waterfall: các tài nguyên không đến đúng lúc, có khoảng cách nhỏ giữa chúng, nhưng tổng thời gian gần 1 vòng chứ không phải 2 như trước.

image 22 - quochung.cyou PTIT

Tương tự, chuỗi flow request–response có thể thấy như hình dưới, có thể thấy rõ sự tiết kiệm thời gian khi gửi các tài nguyên quan trọng cùng với trang ban đầu.

image 23 - quochung.cyou PTIT

HTTP/2 Push không thay thế được WebSockets hay SSE

Điểm then chốt: push chỉ xảy ra khi có request ban đầu từ client, server không thể tự ý push bất kỳ lúc nào. WebSockets hay SSE cho phép two-way communication, nhưng HTTP/2 không thật sự hai chiều, mọi thứ đều do client khởi đầu. Sau khi stream request đầu kết thúc, server không thể tiếp tục push trừ khi client gửi request mới. Vì vậy, HTTP/2 push không thay thế WebSocket hay SSE theo chuẩn hiện tại

Cơ chế hoạt động của HTTP/2 Push trong trình duyệt

Trình duyệt xử lý HTTP/2 push lại theo một cách khác. Tài nguyên không được đẩy thẳng đến trang web, mà được đẩy vào một khu vực cache đặc biệt. Trang web vẫn được xử lý bình thường. Khi cần tài nguyên, trình duyệt kiểm tra cache, nếu có sẵn thì tải từ cache thay vì gửi yêu cầu tới server.

Cơ chế chi tiết phụ thuộc vào từng trình duyệt và không được nêu rõ trong spec HTTP/2, nhưng hầu hết hiện nay triển khai một HTTP/2 push cache riêng biệt, khác với HTTP cache thông thường

Cách hoạt động của push cache

Các tài nguyên được đẩy sẽ nằm trong một vùng nhớ riêng (HTTP/2 push cache) chờ trình duyệt yêu cầu. Khi được truy cập, tài nguyên sẽ được đưa vào trang và nếu có header phù hợp sẽ được đồng thời lưu vào HTTP cache để sử dụng sau này.

Một điểm đặc biệt: các trình duyệt dựa trên Chromium (Chrome, Opera) không cache tài nguyên nếu certificate không đáng tin (như tự ký self-signed, hiển thị ổ khoá đỏ), dù người dùng có bỏ qua lỗi. Để HTTP/2 Push hoạt động, bạn cần certificate hợp lệ (ổ khoá xanh)

Quá trình kiểm tra cache của trình duyệt theo thứ tự như sau: image cache → preload cache → service worker → HTTP cache → HTTP/2 push cache. Nếu tài nguyên đã có sẵn ở cache HTTP chính (mặc dù phiên bản mới đã bị push), trình duyệt vẫn ưu tiên dùng bản cũ theo cache-control (Jake Archibald) Service worker còn được kiểm sau preload cache

image 24 - quochung.cyou PTIT

Image cache (cache hình ảnh):

  • Là cache tạm, nằm trong bộ nhớ (in-memory) chỉ phục vụ cho trang hiện tại.
  • Nó giúp trình duyệt không phải tải lại cùng một ảnh nếu trang tham chiếu tới ảnh đó nhiều lần.
  • Khi người dùng rời khỏi trang, cache này bị hủy.

Preload cache:

  • Cũng là cache tạm, trong bộ nhớ và chỉ gắn với một trang.
  • Dùng để giữ các tài nguyên được preload (sẽ nói kỹ hơn ở chương 6).
  • Lưu ý: không nên preload tài nguyên cho trang khác, vì preload cache không dùng chung giữa các trang.

Service Worker cache:

  • Service Worker là một loại ứng dụng nền, chạy độc lập với web page, đóng vai trò trung gian giữa web page và server.
  • Nó cho phép web hoạt động giống native app hơn, ví dụ vẫn có thể hoạt động khi mất mạng.
  • Service Worker có hệ thống cache riêng, gắn với domain.

HTTP cache (cache truyền thống):

  • Đây là cache chính mà lập trình viên quen thuộc nhất.
  • Nó được lưu trên đĩa (persistent), chia sẻ giữa nhiều trang, có dung lượng giới hạn và được dùng cho tất cả domain.

HTTP/2 push cache:

  • Đây là cache tạm, nằm trong bộ nhớ, gắn liền với một kết nối (connection).

Nếu server push styles.css, file này sẽ được đưa vào HTTP/2 push cache.
Sau đó, khi trình duyệt thấy cần styles.css, nó không hề “biết” hay quan tâm rằng server đã push sẵn file này. Trình duyệt vẫn kiểm tra toàn bộ cache theo thứ tự:

  1. Image cache
  2. Preload cache
  3. Service Worker cache
  4. HTTP cache
  5. HTTP/2 push cache

Nếu trong HTTP cache chính đã có một bản styles.css hợp lệ, thì trình duyệt sẽ lấy từ đó kể cả khi trong push cache đang có bản mới hơn.

Bạn có thể dùng công cụ chrome://net-export (nói trong mục 4.3.1) để xem tổng hợp các tài nguyên đã được push nhưng chưa được sử dụng (unclaimed push resources) trong tất cả các trang đang mở

image 25 - quochung.cyou PTIT

Nếu một kết nối bị đóng, push cache cũng mất theo, khác với HTTP cache. Một cách hiểu ngắn gọn: push cache chỉ tồn tại gắn với kết nối. Khi kết nối không tái sử dụng, tài nguyên push có thể bị lãng phí. Một lần tài nguyên được sử dụng (“claimed”), nó sẽ bị loại khỏi push cache. Nhưng nếu có cache-control phù hợp, vẫn có thể lưu trong HTTP cache. Thậm chí tài nguyên không thể cache theo HTTP (no-cache, no-store) vẫn có thể được push và đọc từ push cache, bởi đây không thực sự là “cache” truyền thống mà là vùng đệm tạm thời

HTTP/2 Push Cache và những vấn đề phát sinh

Push cache gắn liền với connection

HTTP/2 push cache gắn trực tiếp với một kết nối (connection). Điều này dẫn đến:

  • Nếu kết nối không được dùng → tài nguyên push cũng không được dùng.
  • Nếu kết nối bị mất → push cache và tất cả tài nguyên chưa dùng cũng mất → việc push bị lãng phí.
  • Nếu trình duyệt mở thêm một kết nối khác → tài nguyên push có thể sẽ không được dùng.

HTTP/2 thiết kế để chỉ có một connection duy nhất, nên thoạt nhìn có vẻ không có vấn đề. Nhưng thực tế các trình duyệt triển khai khác nhau:

  • Chrome, Firefox: chia sẻ connection giữa các tab.
  • Edge: mỗi tab dùng connection riêng.
  • Safari: có thể mở nhiều connection ngay trong cùng một tab.

Ngoài ra, các request không kèm thông tin xác thực (noncredentialed) thường được gửi trên một connection riêng. Do đó:

  • Không thể push font cross-origin (từ domain khác, kể cả domain shard) vì chúng phải đi qua noncredentialed request.

Do Push cache hoạt động ở mức connection, chứ không phải mức page. Vì vậy, tuy về lý thuyết bạn có thể push tài nguyên cho trang sẽ load sau, nhưng trên thực tế điều này gần như vô ích, vì cache ngắn hạn và có thể mất khi kết nối rớt.

Push cache khác với HTTP cache

  • Khi một tài nguyên được lấy ra khỏi push cache, nó sẽ bị xóa khỏi đó và không thể dùng lại từ push cache lần nữa. Nhưng nếu tài nguyên có cache-control hợp lệ, nó sẽ được lưu vào HTTP cache chính để dùng sau.
  • Push cache có thể chứa cả tài nguyên không cache được (ví dụ header no-cache hoặc no-store). Đây là điểm khác với HTTP cache truyền thống.
  • Chính vì vậy, push cache không thực sự là cache theo đúng nghĩa, mà giống như một “kho tạm chứa request”

RST_STREAM – Cách từ chối tài nguyên bị push

Trình duyệt có thể từ chối một tài nguyên đang bị push bằng cách gửi một RST_STREAM frame với mã CANCEL hoặc REFUSED_STREAM. Điều này xảy ra khi:

  • Trình duyệt đã có sẵn tài nguyên trong cache.
  • Người dùng rời khỏi trang khi nó vẫn đang load → không cần tải thêm tài nguyên nữa.

Tuy nhiên, RST_STREAM có hạn chế:

  • Việc gửi tín hiệu RST_STREAM mất thời gian → trong lúc đó server vẫn tiếp tục gửi data (HEADERS, DATA frames). Có thể cả file đã được gửi xong trước khi server kịp ngừng lại.
  • Đây chỉ là tín hiệu điều khiển, không mạnh bằng việc cắt hẳn connection (HTTP/2 không cho phép ngắt connection vì sẽ ảnh hưởng tới tất cả stream khác).
  • Vì vậy, RST_STREAM không phải giải pháp hiệu quả để ngăn chặn việc push sai tài nguyên.

Ví dụ:

  • Nếu push một ảnh rất lớn nhưng trang đã được cập nhật không dùng ảnh đó nữa → trình duyệt vẫn tải hết ảnh về nhưng không dùng, gây lãng phí băng thông.
  • Thậm chí bạn còn không biết mình đang push nhầm, vì một số công cụ (DevTools) có thể không hiển thị tài nguyên bị push mà không dùng.

Nên đẩy (push) những gì?

Đặc tả HTTP/2 đưa ra một số quy tắc cơ bản về push: RFC7540 – Push Resources

  • Client có thể tắt push bằng cách đặt SETTINGS_ENABLE_PUSH = 0 trong khung SETTINGS. Khi đó, server không được phép gửi PUSH_PROMISE nữa.
  • Request được push phải là cacheable methods (thường là GET, HEAD, hoặc một số POST đặc biệt).
  • Request được push phải là safe methods (thường là GET hoặc HEAD).
  • Request được push không được có request body (nhưng response thường có body).
  • Request được push chỉ được gửi đến những domain mà server có thẩm quyền (authoritative).
  • Chỉ server mới có quyền push, client không được push.
  • Resource chỉ có thể được push như phản hồi cho một request hiện tại. Server không thể tự phát khởi một push nếu không có request nào đang diễn ra.

Thực tế, vì các quy tắc trên, chỉ có GET request là thường được push.

Giới hạn về authority nghĩa là bạn chỉ được phép push tài nguyên mà server trực tiếp hoặc gián tiếp phục vụ. Ví dụ, nếu trang của bạn dùng Bootstrap từ getbootstrap.com hoặc jQuery từ jquery.com, thì server của bạn không thể push trực tiếp. Bạn có thể proxy các request đó qua server của mình, nhưng khi đó bạn phải sửa tất cả các tham chiếu để trỏ về server của bạn. Ở tình huống đó, tốt hơn hết là host luôn file đó tại chỗ thay vì tạo thêm phức tạp với proxy.

HTTP/2 Push được thiết kế để tối ưu hiệu năng, nhưng nếu lạm dụng, nó có thể làm chậm hiệu năng vì lãng phí băng thông để push những tài nguyên mà client không dùng, thay vì ưu tiên cho những tài nguyên cần thiết.

  • Lý tưởng nhất, chỉ nên push tài nguyên quan trọng (critical assets) mà trang chắc chắn cần.
  • Không nên push:
    • Tài nguyên không được sử dụng.
    • Tài nguyên mà client không thể dùng (ví dụ: image format không hỗ trợ).
    • Tài nguyên chỉ dùng trong một số điều kiện (ví dụ: hình ảnh cho màn hình lớn).

Nhóm Chrome đã viết một tài liệu chi tiết về “nên push cái gì” (Chrome doc on HTTP/2 Push), trong đó họ khuyến nghị:

“Chỉ push mức tối thiểu cần thiết để lấp đầy thời gian mạng rảnh, và không hơn.”

  • Push chỉ để tận dụng thời gian mạng rảnh (idle network time).
  • Không nên push toàn bộ tài nguyên mà trang cần, vì như vậy sẽ ghi đè cơ chế ưu tiên tải (prioritization) vốn được trình duyệt tối ưu tốt hơn.

Các nghiên cứu khác cũng khẳng định nên áp dụng chiến lược bảo thủ khi dùng push. (PerfPlanet – HTTP/2 Push the details)

Tóm lại: Thà push thiếu còn hơn push thừa.

  • Nếu thiếu push → tài nguyên vẫn được tải như thường, chỉ là có thể chậm hơn một chút.
  • Nếu thừa push → lãng phí băng thông client, server và mạng → trang có thể chậm hơn.
  • Nhưng lưu ý: push thừa không làm hỏng trang, chỉ kém tối ưu.

Tự động hóa việc push

Một câu hỏi thực tiễn: ai sẽ quyết định nên push cái gì?

  • Nhà phát triển (Dev) phải tự cấu hình (theo từng trang)?
  • Hay nên có cơ chế tự động hóa?

Một ví dụ: Jetty (Eclipse Jetty), một Java Servlet Engine, chọn cách tự động push. (Jetty HTTP/2 Push Config)

  • Jetty theo dõi request và các request tiếp theo (thông qua header Referer).
  • Từ đó, Jetty học và đề xuất danh sách tài nguyên nên push cho những request tương tự trong tương lai.

Cách này giúp giảm độ phức tạp khi cấu hình, nhưng bạn sẽ phụ thuộc vào thuật toán của Jetty, vốn có thể không phù hợp với mọi website.

Do đó, việc quyết định push cái gì không đơn giản:

  • Nếu để tự động hóa hoàn toàn → có thể sai lệch.
  • Nếu để dev kiểm soát thủ công → phức tạp, nhưng có thể tối ưu hơn vì dev hiểu website và user của mình..

[HTTP/2] Phần 1: Tìm hiểu hành trình đi lên HTTP/2

Điều gì xảy ra khi bạn duyệt web?

Internet đã trở thành một phần không thể thiếu trong cuộc sống hàng ngày. Mua sắm, ngân hàng, giao tiếp và giải trí đều phụ thuộc vào internet, và với sự phát triển của Internet vạn vật (IoT), ngày càng có nhiều thiết bị được kết nối trực tuyến, nơi chúng có thể được truy cập từ xa. Truy cập này được thực hiện nhờ một số công nghệ, bao gồm Giao thức Truyền Siêu văn bản (HTTP), đây là một phương pháp chính để yêu cầu truy cập vào các ứng dụng và tài nguyên web từ xa.

Mục đích sử dụng chính và đầu tiên của HTTP: để yêu cầu các trang web. Khi bạn mở một trang web trong trình duyệt của mình, dù trình duyệt đó trên pc/laptop, tablet, điện thoại di động hoặc bất kỳ thiết bị nào khác cho phép truy cập internet (tủ lạnh, tivi, …), rất nhiều thứ đang diễn ra.

Giả sử bạn khởi động trình duyệt và truy cập www.google.com. Trong vòng vài giây, những điều sau sẽ xảy ra

image - quochung.cyou PTIT

Bước 1: DNS, IPv4, IPv5, IPv6, IPv1-3

Khi bạn gõ www.google.com vào trình duyệt, nó không tự biết Google ở đâu. Trình duyệt sẽ nhờ đến một “cuốn danh bạ” đặc biệt gọi là DNS (Domain Name System). Công việc của DNS rất đơn giản: biến cái tên thân thiện với con người (www.google.com) thành một dãy số mà máy tính hiểu được, gọi là địa chỉ IP.

  • Tên miền giống như tên người trong danh bạ: “Google”.
  • Địa chỉ IP giống như số điện thoại: máy tính chỉ biết gọi bằng số, chứ không hiểu tên.

Hiện nay có hai “kiểu số điện thoại” chính:

  • IPv4: dạng cũ, ví dụ 216.58.192.4. Nhìn khá ngắn gọn, con người còn đọc được.
  • IPv6: dạng mới, ví dụ 2607:f8b0:4005:801:0:0:0:2004. Dài ngoằng, chỉ máy tính mới “thích” đọc. IPv6 sinh ra vì IPv4 gần như đã “hết số”, giống như khi một thành phố phải thêm mã vùng điện thoại mới vì dân cư quá đông.

Một fact: vì internet là toàn cầu, Google (và các công ty lớn khác) đặt máy chủ khắp nơi trên thế giới. DNS sẽ thông minh chọn cho bạn địa chỉ IP của máy chủ gần nhất, để tốc độ truy cập nhanh hơn. Thế nên một người ở Mỹ và một người ở châu Âu có thể nhận được IP hoàn toàn khác nhau khi cùng gõ www.google.com.

Điều gì đã xảy ra với IPv5?

Mỗi thiết bị kết nối Internet đều cần một địa chỉ IP duy nhất, giống như mỗi ngôi nhà cần một số nhà riêng.

  • Với IPv4, ta có khoảng 4,3 tỷ “số nhà” (2³² địa chỉ). Khi Internet mới ra đời, con số đó nghe như vô tận.
  • Nhưng rồi máy tính cá nhân, điện thoại thông minh, camera an ninh, đồng hồ thông minh, tủ lạnh IoT… tất cả đều cần một địa chỉ. Điều này khiến kho địa chỉ IPv4 gần như cạn kiệt.

Buộc phải mở ra một hệ thống đánh số mới rộng hơn. IPv6 chính là “hệ thống số nhà mở rộng” đó, với 128 bit, đủ để cấp địa chỉ cho hầu như mọi hạt cát trên trái đất. (2^128)

Bạn có thể thấy hơi lạ: chúng ta có IPv4, rồi nhảy thẳng sang IPv6. Thế IPv5 biến đi đâu? Và tại sao chẳng ai nhắc tới IPv1–IPv3?

Thực ra mọi gói tin Internet đều có một trường nhỏ ở đầu (4 bit) để ghi phiên bản. Về lý thuyết, chỉ có tối đa 15 phiên bản (0–15). (Có thể thấy ở ảnh dưới, phần Version đầu tiên)

image 1 - quochung.cyou PTIT
  • IPv6: giải quyết triệt để vấn đề “hết số nhà” trên Internet, đồng thời bổ sung nhiều tính năng mới. Đây mới là “người kế nhiệm” thực sự.
  • IPv0–IPv3: chỉ là các phiên bản thử nghiệm ban đầu. Không cái nào trở thành chuẩn chính thức.
  • IPv4: phiên bản đầu tiên thực sự phổ biến, đưa Internet bùng nổ như chúng ta thấy ngày nay.
  • IPv5: từng tồn tại dưới cái tên Internet Stream Protocol. Nó được thiết kế cho âm thanh và video theo thời gian thực (kiểu như những gì sau này VoIP làm). Nhưng nó sớm bị bỏ xó, vì vẫn mắc đúng nhược điểm của IPv4: không đủ không gian địa chỉ.

Vậy nên, IPv5 không “mất tích” mà chỉ dừng lại ở mức thử nghiệm. Thế giới chọn đi thẳng từ IPv4 sang IPv6 để giải quyết triệt để vấn đề cạn kiệt địa chỉ.

Bước 2: Tạo kết nối TCP/IP

Sau khi có địa chỉ IP, trình duyệt sẽ tìm cách kết nối đến máy chủ web. Kết nối này thường chạy qua:

  • Cổng 80 cho HTTP (truyền thống).
  • Cổng 443 cho HTTPS (phiên bản an toàn, có mã hóa).

Ngày nay hầu hết các trang web (kể cả Google) đều bắt buộc HTTPS nhờ công nghệ HSTS. Nghĩa là, ngay cả khi bạn gõ http://..., trình duyệt cũng sẽ tự động nâng cấp sang HTTPS.

TCP và IP phối hợp thế nào?

  • IP giống như địa chỉ nhà, đảm bảo gói tin tìm đúng nơi đến.
  • TCP giống như dịch vụ giao hàng uy tín: luôn hỏi “Bạn có nhận đủ chưa?”, nếu thiếu thì gửi lại.

Khi kết hợp, ta có TCP/IP, hai thứ làm nên xương sống Internet.

Một địa chỉ IP, nhiều dịch vụ

Một máy chủ có thể phục vụ nhiều “dịch vụ” khác nhau (web, email, FTP…). Để phân biệt, nó dùng cổng/port , giống như từ 1 địa chỉ nhà, chúng ta có thể chỉ tới số phòng, tầng, …

  • HTTP → cổng 80
  • HTTPS → cổng 443

HTTP

Khi kết nối TCP/IP đã ổn định, trình duyệt mới bắt đầu dùng HTTP để gửi yêu cầu: “Hãy cho tôi trang chủ Google”. Lúc này mới đến phần giao tiếp cấp ứng dụng mà ta thường nghe đến nhiều nhất.

Bước 3-10: Yêu cầu máy chủ phản hồi và trình duyệt bắt đầu “vẽ” trang

Sau khi trình duyệt gửi yêu cầu, máy chủ Google phản hồi. Nội dung phản hồi thường là HTML – ngôn ngữ mô tả cấu trúc của trang web.

HTML giống như bộ khung của một ngôi nhà: nó chia trang thành các phần (thẻ <div>, <p>, <h1>…), và kèm theo đường dẫn tới những vật liệu khác để hoàn thiện ngôi nhà:

  • CSS (màu sắc, kiểu dáng)
  • JavaScript (hành vi, tương tác)
  • Hình ảnh, font chữ, video…

Mã phản hồi và chuyển hướng

Không phải lúc nào máy chủ cũng trả về ngay một trang HTML:

  • Nếu bạn truy cập http://www.google.com, máy chủ sẽ gửi lại mã 301/302 để chuyển hướng bạn sang https://www.google.com.
  • Nếu bạn gõ nhầm, như www.google.com/nonexistent, bạn sẽ gặp mã 404 Not Found – giống như hỏi thủ thư một cuốn sách không có trong thư viện.

Trình duyệt dựng DOM

Khi nhận được HTML, trình duyệt sẽ phân tích và xây dựng DOM (Document Object Model) – bản đồ nội bộ của trang. Trong quá trình đọc HTML, nó phát hiện thêm tài nguyên cần tải (CSS, JS, hình ảnh…).

  • Google khá “nhẹ nhàng”: chỉ khoảng 16 tài nguyên bổ sung.
  • Trang trung bình: khoảng 75 tài nguyên (theo HTTP Archive).
  • Facebook? Có thể lên tới hàng trăm tài nguyên – mỗi ảnh, script, quảng cáo đều phải gọi thêm.

Mỗi tài nguyên lại đi qua vòng lặp yêu cầu–phản hồi như ban đầu, khiến duyệt web chậm dần. Đây cũng là lý do HTTP/2 ra đời: gom nhiều yêu cầu để tải nhanh hơn.


Khi nào thì “bắt đầu vẽ”

Trình duyệt không đợi tải hết tất cả mới hiển thị, mà sẽ render dần dần:

  • Nếu chờ đủ, web sẽ chậm chạp, người dùng nản.
  • Nếu render sớm quá, trang “nhảy loạn” khi CSS/ảnh/JS tải thêm – gây khó chịu.

Hãy tưởng tượng bạn xem họa sĩ vẽ tranh: ban đầu chỉ có khung, sau đó thêm màu, rồi chi tiết. Nếu vẽ dở dang mà đưa cho bạn xem, bức tranh cứ đổi hình dáng liên tục – đó chính là cảm giác khi trang web “nhảy”.


Tải nền

Ngay cả sau khi trang “trông như đã xong”, trình duyệt vẫn âm thầm tải thêm:

  • Ảnh, script theo dõi, quảng cáo…
  • Tính năng động: ví dụ Google gợi ý kết quả tìm kiếm ngay khi bạn gõ, hay Facebook tự động hiện bài mới.

Những thứ này chạy ngầm trong nền (AJAX, fetch API, WebSocket…), khiến web ngày nay giống ứng dụng thật sự chứ không chỉ là trang tĩnh.

HTTP là gì

Vào thập niên 1930, kỹ sư điện Vannevar Bush (MIT) đã lo ngại rằng khối lượng thông tin con người tạo ra vượt xa khả năng tiêu thụ. Trong bài tiểu luận As We May Think (1945), ông hình dung ra một thiết bị gọi là memex – nơi mọi tri thức được lưu trữ, có thể tra cứu nhanh chóng và liên kết với nhau giống như cách bộ não kết nối ý tưởng. Memex không bao giờ thành hiện thực, nhưng khái niệm “kết nối thông tin có ngữ cảnh” đã gieo mầm cho thế hệ sau.

image 3 - quochung.cyou PTIT

Đến những năm 1960, Ted Nelson đưa ra thuật ngữ hypertext – tập hợp văn bản/hình ảnh liên kết phức tạp mà giấy in không thể thể hiện. Nelson mơ về một “docuverse”, nơi thông tin được liên kết, không bao giờ bị xóa, và mọi người đều có thể truy cập. Dù dự án Xanadu của ông không thành công, nhưng nó đã tạo cảm hứng mạnh mẽ.

image 2 - quochung.cyou PTIT

Năm 1989, tại CERN, Tim Berners-Lee muốn một cách để quản lý thông tin từ các thí nghiệm khổng lồ. Ông kết hợp ý tưởng hypertext (liên kết tự do) và hypermedia (không giới hạn ở chữ viết) để đề xuất một hệ thống “phổ quát” , chính là nền móng của World Wide Web. Và từ đây, HTTP (Hypertext Transfer Protocol) ra đời.

HTTP (Hypertext Transfer Protocol) đúng như tên gọi, ban đầu được tạo ra chỉ để chuyển các tài liệu “siêu văn bản” – tức là những trang có thể chứa liên kết sang trang khác. Nhưng chẳng bao lâu, người ta nhận ra rằng nó cũng có thể dùng để gửi những thứ khác như hình ảnh, âm thanh, video…

Vì vậy, chữ Hypertext trong tên ngày nay không còn quá chính xác, nhưng cái tên HTTP đã ăn sâu nên không ai đổi nữa.

Điều quan trọng là HTTP hoạt động dựa trên kết nối mạng ổn định (thường qua TCP/IP). Nó không quan tâm đến cách bạn nối dây mạng, Wi-Fi hay Ethernet thế nào, tất cả việc đó do các tầng giao thức bên dưới lo. HTTP chỉ tập trung làm một việc: nhận yêu cầu từ trình duyệt và trả về phản hồi từ máy chủ.

Điểm mạnh của HTTP chính là sự đơn giản. Trình duyệt gửi yêu cầu, máy chủ trả lời – thế thôi. Chính sự giản đơn này giúp web phát triển thần tốc, dù sau này phải đánh đổi một chút để tối ưu hiệu năng (như trong HTTP/2, HTTP/3).

image 4 - quochung.cyou PTIT

Cú pháp HTTP cơ bản

Một yêu cầu HTTP, ở mức đơn giản nhất, chỉ là một dòng văn bản. Ví dụ:

GET /page.html↵

Ở đây:

  • GET là phương thức (cách bạn “xin” dữ liệu).
  • /page.html là tài nguyên bạn muốn.
  • Dấu xuống dòng (↵) cho biết bạn đã gõ xong.

Thế là đủ. Khi đó, trình duyệt đã có kết nối TCP/IP với máy chủ rồi, nên nó chỉ cần nói: “Ê, cho tôi file này với!”

HTTP 0.9

Phiên bản đầu tiên, HTTP/0.9 (1991), chỉ biết làm đúng điều này: gửi GET, nhận file HTML, rồi đóng kết nối. Nhìn lại, bạn có thể thấy lạ: “Sao phải viết GET nữa? Chẳng phải mặc định nó chỉ có một lệnh duy nhất đó sao?” Nhưng chính nhờ tầm nhìn xa, sau này các nhà thiết kế bổ sung thêm nhiều phương thức khác (POST, HEAD…), nên cú pháp ban đầu vẫn giữ được tính mở rộng, chạy được với cả các phiên bản http cũ.

HTTP 1.0

HTTP/0.9 chỉ biết GET một file HTML rồi thôi, nhưng đến HTTP/1.0 (1996), web đã có thêm cơ bắp.

Ba phương thức mới quen mặt

  • GET (nâng cấp): Giờ đây không chỉ tải trang HTML, mà còn có thể yêu cầu ảnh, nhạc, video… Ngoài ra, GET còn “thông minh” hơn: có thể hỏi “file này có thay đổi từ lần cuối tôi tải không?” Nếu không, máy chủ chỉ trả lời “yên tâm, bản cũ còn dùng được” (giúp tiết kiệm băng thông).
  • HEAD: Giống như soi bìa sách thay vì đọc cả cuốn. Client chỉ lấy metadata (header HTTP) để kiểm tra thông tin: file còn tồn tại không, có đổi mới không…
  • POST: Đây là bước đột phá. Client có thể gửi dữ liệu lên server, ví dụ form đăng nhập hay đơn hàng mua sắm. Khác với GET, giao thức POST mang dữ liệu trong body request, kín đáo hơn (dù vẫn phải gửi qua HTTPS mới thật sự an toàn).

Header: lời nhắn gửi kèm yêu cầu

HTTP/1.0 bổ sung header – những dòng thông tin thêm để client “dặn dò” server. Ví dụ:

GET /page.html HTTP/1.0
Accept: text/html,application/xhtml+xml
Accept-Encoding: gzip, deflate
User-Agent: MyAwesomeWebBrowser 1.1

Đọc ngắn gọn thì header nói:

  • Tôi muốn nội dung HTML.
  • Tôi có thể nhận file nén (gzip, deflate).
  • Tôi đang dùng trình duyệt tên “MyAwesomeWebBrowser 1.1”

Đây chính là cơ chế giúp web mở rộng: chỉ cần thêm header mới là có thể dạy client/server hiểu thêm “ngôn ngữ” mà không phá vỡ giao thức.

Mã phản hồi: server biết cách trả lời

HTTP/0.9 không có khái niệm mã phản hồi. Nếu lỗi thì server chỉ nhét thông báo vào HTML. Sang HTTP/1.0, lần đầu tiên xuất hiện status code, ba chữ số huyền thoại:

Các mã 2xx, 3xx, 4xx, 5xx chia thành từng nhóm rõ ràng, biến HTTP thành một cuộc hội thoại có quy tắc: client hỏi, server đáp, không phải đoán mò nữa.

2xx – Thành công
  • 200 OK: Mọi thứ ngon lành, dữ liệu đây.
  • 201 Created: POST thành công, đã tạo tài nguyên mới.
  • 202 Accepted: Server nhận rồi, đang xử lý, bạn đợi chút.
  • 204 No Content: Yêu cầu thành công nhưng không có gì để gửi lại (ví dụ: xóa một record).
3xx – Chuyển hướng
  • 300 Multiple Choices: Có nhiều đường, bạn chọn.
  • 301 Moved Permanently: Tài nguyên đã dọn nhà vĩnh viễn (Location header chỉ đường).
  • 302 Moved Temporarily: Tạm thời dọn nhà.
  • 304 Not Modified: File chưa đổi từ lần cuối, cứ dùng bản cũ.
4xx – Lỗi từ phía client
  • 400 Bad Request: Server không hiểu bạn nói gì, sửa cú pháp đi.
  • 401 Unauthorized: Bạn chưa đăng nhập.
  • 403 Forbidden: Đăng nhập rồi nhưng không có quyền.
  • 404 Not Found: Nổi tiếng nhất – giống như bấm số điện thoại sai: “Thuê bao không tồn tại.”
5xx – Lỗi từ phía server
  • 500 Internal Server Error: Lỗi chung chỉ về việc server lỗi
  • 501 Not Implemented: Server không biết xử lý yêu cầu này.
  • 502 Bad Gateway: Proxy/gateway hỏi downstream server nhưng nhận lỗi.
  • 503 Service Unavailable: Server quá tải hoặc đang bảo trì, quay lại sau.

HTTP 1.1

Vì thế, HTTP/1.1 ra đời năm 1997, chỉ 9 tháng sau khi HTTP/1.0 được chuẩn hóa. Nó không thay đổi tận gốc như từ 0.9 → 1.0, nhưng đã tinh chỉnh, bổ sung và quan trọng nhất: đặt ra tiêu chuẩn chính thức cho toàn bộ thế giới web, vốn đang bùng nổ mạnh mẽ.

Đến nay, HTTP/1.1 đã trải qua nhiều lần sửa đổi:

  • RFC 2068 (1997) – bản đầu tiên
  • RFC 2616 (1999) – cập nhật và thay thế
  • RFCs 7230–7235 (2014) – chỉnh sửa, chi tiết hóa hơn (305 trang, gần 100.000 từ!)

Điều này cho thấy: giao thức tưởng chừng “đơn giản” lại phức tạp đến mức cần một bộ luật khổng lồ để mọi trình duyệt, máy chủ, proxy trên thế giới cùng “nói chung một ngôn ngữ”.

Những thay đổi quan trọng trong HTTP/1.1

1. Host header bắt buộc

Trong HTTP/1.0, client gửi request kiểu:

GET /index.html HTTP/1.0

Server hiểu là: à, nó đang xin file index.html từ chính website mà nó đang kết nối đến. Nhưng khi web phát triển, một server có thể chạy hàng trăm website khác nhau trên cùng một địa chỉ IP (virtual hosting). Làm sao server biết client muốn example.com/index.html hay blog.example.com/index.html?

Giải pháp: thêm Host header.

GET / HTTP/1.1
Host: www.google.com

Từ HTTP/1.1 trở đi, mọi request bắt buộc phải có Host. Nhờ đó:

  • Một server duy nhất có thể phục vụ nhiều website.
  • Tiết kiệm tài nguyên IP (IPv4 vốn khan hiếm).

Nếu không có bước này, có thể web sẽ “ngốn” sạch IPv4 từ rất sớm. Ngược lại, nếu hồi đó người ta không chọn giải pháp Host header, mà bắt client phải gửi URL đầy đủ (absolute-form), thì web có thể đã ép buộc sang IPv6 sớm hơn 20 năm.

2. Kết nối bền vững (Persistent connections / Keep-Alive)

HTTP ban đầu hoạt động theo kiểu: một request → một response → đóng kết nối.

Nhưng khi web nhiều hình ảnh, CSS, JS, việc liên tục đóng/mở kết nối TCP cực kỳ lãng phí. Mỗi lần bắt tay TCP tốn thêm vài trăm mili-giây, nhân lên hàng chục file thì người dùng sẽ “chờ dài cổ”.

HTTP/1.1 thay đổi mặc định:

  • Mọi kết nối được giữ mở trừ khi server nói rõ “Connection: close”.
  • Client có thể gửi tiếp nhiều request trên cùng một kết nối.
GET /style.css HTTP/1.1
Host: www.example.com

GET /script.js HTTP/1.1
Host: www.example.com

Trình duyệt có thể “nạp đơn hàng” liên tục thay vì phải xếp hàng lại từ đầu.

Tuy nhiên, điều này đòi hỏi phải có thêm cách xác định “đâu là hết dữ liệu” (vì không còn dấu hiệu đóng kết nối nữa). Do đó, HTTP/1.1 dùng 1 header Content-Length hoặc chunked transfer encoding để báo độ dài nội dung. Khi đó, các bên có thể từ content length và dữ liệu đã nhận được để biết bao giờ là kết thúc.

image 5 - quochung.cyou PTIT
3. Pipelining (nhưng thất bại)

HTTP/1.1 còn đưa ra ý tưởng pipelining: client gửi nhiều request “một lèo” mà không chờ phản hồi, server trả kết quả theo thứ tự.

Ví dụ:

  • Gửi cùng lúc request cho CSS, JS, ảnh.
  • Server trả về lần lượt CSS → JS → ảnh.

Nghe thì hay, nhưng thực tế bị head-of-line blocking: nếu request đầu tiên bị chậm (ví dụ truy vấn DB lâu), thì mọi request sau bị kẹt. Thêm nữa, hỗ trợ pipelining ở proxy và server thường kém (thậm chí lỗi). Vì vậy, pipelining gần như “chết yểu”, không được các trình duyệt phổ biến bật mặc định.

4. Bộ nhớ đệm (Caching) thông minh hơn

Trong HTTP/1.0, chỉ có header Expires: <date>. Nghĩa là:

  • Nếu quá ngày đó → tài nguyên hết hạn, phải tải lại từ server.
  • Nó cứng nhắc, ví dụ bạn muốn cho cache tồn tại 30 phút tính từ lúc tải thì không làm được (vì Expires cần một mốc thời gian cố định).

HTTP/1.1 thì mềm dẻo hơn nhờ Cache-Control:

  • max-age=600 → cache trong vòng 600 giây (10 phút).
  • no-cache → client vẫn lưu cache nhưng luôn xác thực lại với server trước khi dùng.
  • must-revalidate → nếu cache hết hạn thì bắt buộc hỏi server, không được tự ý dùng lại.
  • public / private → phân biệt cache dùng chung (CDN, proxy) hay chỉ cho trình duyệt người dùng.

Ví dụ thực tế:

  • File CSS/JS ít thay đổi → Cache-Control: max-age=604800 (1 tuần).
  • API JSON (luôn muốn dữ liệu mới) → Cache-Control: no-cache, must-revalidate.
  • Ảnh profile user (có thể đổi nhưng không thường xuyên) → Cache-Control: max-age=86400, must-revalidate.

Điểm mạnh: giúp tăng tốc độ web, giảm tải server, nhưng vẫn linh hoạt để dữ liệu quan trọng luôn mới.

5. Nhiều method và tính năng mới

HTTP/1.1 bổ sung khá nhiều method để phù hợp với web ngày càng phức tạp:

  • Method mới
    • PUT: ghi đè hoặc tạo tài nguyên ở URL cụ thể.
    • DELETE: xóa tài nguyên.
    • OPTIONS: hỏi server xem URL đó hỗ trợ những method nào (cần cho CORS).
    • TRACE: gửi request để server trả lại toàn bộ nội dung nó nhận → debug.
    • CONNECT: dùng cho tunneling (thường thấy khi HTTPS đi qua proxy).
  • Proxy support
    Cho phép request/response đi qua nhiều server trung gian (caching proxy, load balancer, CDN).
  • Authentication
    Có sẵn cơ chế như Basic và Digest Authentication để bảo vệ tài nguyên.
  • Cookies
    HTTP vốn stateless (mỗi request độc lập, không nhớ “ai với ai”).
    Cookie giúp “nhớ” trạng thái (user đã login, giỏ hàng, session…).
  • Charset & Content-Language
    Giúp server khai báo tài liệu dùng encoding gì (UTF-8, ISO-8859-1…) và ngôn ngữ (en, vi…).
  • Status code mới
    Bổ sung thêm nhiều mã: 409 Conflict, 410 Gone, 100 Continue… để mô tả chính xác hơn tình huống.
  • Trailing headers & mở rộng headers vô hạn
    Cho phép thêm metadata bổ sung sau phần body (dùng trong chunked transfer).
    HTTP/1.1 cũng gỡ bỏ giới hạn số lượng header → dễ mở rộng (các API hiện nay tận dụng điều này rất nhiều, như Authorization, X-Request-ID, Content-Security-Policy).

Các vấn đề của HTTP/1.1

Sau khi HTTP/1.1 được chuẩn hóa, nó trở thành nền móng của web suốt 20 năm. Nhưng chính sự bùng nổ website đã làm lộ rõ giới hạn của giao thức này.

image 8 - quochung.cyou PTIT

Theo thống kê từ HTTP Archive:

  • Năm 2010, trang web trung bình ~ 700 KB, khoảng 50 request.
  • Đến 2018, tăng lên gần 1.8 MB, hơn 80–90 request.
  • Một số website lớn:
    • Wikipedia: chỉ 7 request, 0.06 MB (rất tối ưu).
    • Facebook: 172 request, 2.2 MB.
    • Amazon: 136 request, 4.46 MB.
    • Yahoo: 240 request, 3.8 MB.

Nguyên nhân: website ngày càng giàu media (ảnh, video), nhiều framework và script, và dùng AJAX để cập nhật động liên tục.

Các vấn đề performance của HTTP/1.1 và cách giải quyết tạm thời vào thời điểm này

Hãy tưởng tượng bạn mở một trang web rất đơn giản: chỉ có một ít văn bản và hai tấm hình.

  • Mỗi yêu cầu (request) từ trình duyệt đến server tốn 50ms để di chuyển qua mạng internet.
  • Máy chủ lấy dữ liệu từ file server, xử lý trong 10ms rồi trả về.
  • Trình duyệt khi nhận được ảnh, xử lý thêm 10ms trước khi gửi tiếp yêu cầu mới.
image 7 - quochung.cyou PTIT

Tổng cộng, để hiển thị xong trang này cần 360ms. Trong đó chỉ 60ms là thời gian xử lý thực sự ở máy khách và máy chủ; còn lại 300ms (hơn 80%) chỉ để… chờ dữ liệu qua lại trên đường truyền. Trong lúc chờ, cả server lẫn trình duyệt đều “ngồi chơi xơi nước”

Điều bất hợp lý lộ rõ ở mốc 120ms: trình duyệt vừa gửi yêu cầu lấy ảnh số 1 và biết chắc là sẽ cần ảnh số 2, nhưng không thể gửi ngay. Nó buộc phải chờ ảnh 1 trả về xong, kết nối mới “rảnh” để gửi tiếp yêu cầu ảnh 2 vào lúc 240ms. Cách vận hành này làm mọi thứ chậm hẳn đi.

Trình duyệt hiện đại thường mở 6 kết nối / domain. Nếu website có nhiều file, chúng được tải trên 6 “đường ống” cùng lúc.

Dùng nhiều kết nối HTTP

Để tăng hơn nữa, nhiều trang web dùng domain sharding: chia file ra các subdomain như static.example.com, cdn.example.com… Như vậy mỗi domain được thêm 6 kết nối, tăng khả năng song song.

Ví dụ: StackOverflow tải:

  • jQuery từ Google,
  • Script/CSS từ cdn.static.net,
  • Ảnh từ i.stack.imgur.com.
image 9 - quochung.cyou PTIT

Nhưng: giải pháp này lại tạo ra gánh nặng:

  • TCP handshake: mỗi kết nối mới cần 3 bước SYN → SYN-ACK → ACK (tốn 1.5 round-trip).
  • TCP slow start: kết nối mới ban đầu chỉ gửi ít gói, tăng dần khi chứng minh mạng chịu tải. Nghĩa là request/response đầu tiên thường bị “thắt cổ chai”.
  • HTTPS handshake: thêm vài vòng trao đổi nữa để thiết lập mã hóa.
image 10 - quochung.cyou PTIT

Mozilla từng thống kê: 74% kết nối HTTP/1 chỉ dùng cho 1 transaction duy nhất → tức nhiều kết nối mở ra xong gần như bỏ phí.

Kết luận: mở nhiều kết nối giúp đỡ phần nào, nhưng chỉ là giải pháp tình thế. Nó tự tạo thêm chi phí (handshake, slow start, bộ nhớ) trong khi bản chất vấn đề vẫn là độ trễ.

Giảm số lượng request

Cách khác: thay vì tăng kết nối, hãy giảm số lần gọi.

  • Cache: dùng HTTP header Cache-Control, Expires để client lưu lại file, không tải lại nữa.
  • Sprite images: gộp nhiều icon nhỏ thành một ảnh lớn rồi dùng CSS để “cắt” ra (TinyPNG hay dùng cách này).
image 11 - quochung.cyou PTIT
  • Concatenate & Minify: gộp nhiều file CSS/JS → một file duy nhất, đồng thời xóa khoảng trắng, comment.
  • Inline: chèn CSS/JS/ảnh trực tiếp vào HTML (dùng <style>, <svg>, hoặc base64).

Nhược điểm:

  • Phức tạp: tạo sprite, gộp file cần phải triển khai từ trước.
  • Lãng phí: tải cả sprite 100 icon trong khi chỉ cần 2.
  • Cache khó quản lý: một thay đổi nhỏ buộc user tải lại cả file lớn (dù chỉ đổi một dòng CSS).

SPDY

Nguồn gốc: năm 2009, Google (Mike Belshe & Robert Peon) giới thiệu SPDY (đọc là “speedy”). Họ chạy thử nghiệm trên bản sao của 25 trang web lớn nhất và thấy cải thiện tốc độ tải trang rất rõ rệt, tới mức hai chữ số phần trăm trong nhiều trường hợp.

Ý tưởng chính của SPDY: không thay đổi “nghĩa” của HTTP (vẫn có GET/POST/headers/body), nhưng thay đổi cách đóng gói và gửi các yêu cầu/response sao cho nhanh hơn và hiệu quả hơn với mạng hiện có. SPDY làm 4 việc quan trọng:

  1. Multiplexing (đa luồng trên một kết nối):
    • Trước HTTP/1.1: trình duyệt mở nhiều kết nối TCP (mỗi tên miền thường ~6 kết nối đồng thời). Mỗi kết nối chỉ xử lý lần lượt một yêu cầu → xuất hiện “waterfall” (đọan thác): các nhóm tài nguyên phải chờ lượt.
    • SPDY: mọi request/response được chia thành các streams nhỏ, gửi xen kẽ qua một kết nối TCP duy nhất. Kết quả: tài nguyên có thể được gửi song song mà không cần mở thêm TCP connection.
  2. Request prioritization (ưu tiên yêu cầu):
    • Không phải mọi tài nguyên đều quan trọng như nhau. SPDY cho phép trình duyệt nói với server tài nguyên nào quan trọng hơn (ví dụ: CSS quan trọng hơn ảnh nền). Server có thể ưu tiên gửi trước các stream quan trọng.
  3. Header compression:
    • HTTP/1.1 gửi header dạng text cho từng yêu cầu, với nhiều request, header trùng lặp (cookie, user-agent, accept,…) gây lãng phí. SPDY nén header để giảm kích thước và số byte truyền.
    • Nếu mỗi request gửi một header Cookie: SESS=... dài 200 B, 360 request = 72 KB chỉ cho cookie. Header compression giảm con số này mạnh mẽ.
  4. Server push (đẩy từ server):
    • Server có thể “đẩy” các tài nguyên mà nó dự đoán client sẽ cần (ví dụ: CSS, JS) ngay khi client yêu cầu HTML, tránh vòng lặp client → server hỏi “tôi cần CSS không?” → server mới trả.

Vì các tính năng như multiplexing và framing yêu cầu cấu trúc nhỏ gọn, chính xác và dễ phân mảnh, điều khó/không thể làm tốt khi gửi toàn bộ theo dạng text line-based (như HTTP/1.x). Binary framing cho phép định nghĩa các frame nhỏ (HEADERS, DATA, SETTINGS, WINDOW_UPDATE, v.v.) để truyền và ghép lại chính xác.

Kết quả thực tế: triển khai SPDY ở Chrome và trên các dịch vụ Google cho thấy tốc độ tải trang cải thiện rõ rệt; nhiều browser/server khác cũng nhanh chóng bổ sung hỗ trợ. Tuy nhiên SPDY chỉ là bước trung gian: nó chứng minh các ý tưởng thực tế và trở thành nền tảng để chuẩn hóa HTTP/2.

image 6 - quochung.cyou PTIT

Ảnh: Sau khi HTTP/2 ra đời, SPDY bắt đầu giảm xuống

HTTP/2

SPDY chứng minh rằng các cải tiến có thể làm được, IETF (HTTP Working Group) dựa trên SPDY khi soạn HTTP/2 (bản draft đầu vào cuối 2012). HTTP/2 giữ hầu hết ý tưởng tốt của SPDY nhưng chuẩn hoá chúng, bổ sung một số cải tiến (ví dụ HPACK cho header compression) và xử lý các chi tiết tương thích/ bảo mật.

Tại sao dùng HTTP/2 thay vì HTTP/1.2?

HTTP/2 được tạo ra để giải quyết các vấn đề hiệu suất của HTTP/1, và phiên bản mới này thêm vào các khái niệm sau:

  • Giao thức nhị phân thay vì văn bản.
  • Ghép kênh (multiplexed) thay vì đồng bộ (synchronous).
  • Kiểm soát dòng chảy (flow control).
  • Ưu tiên luồng (stream prioritization).
  • Nén tiêu đề (header compression).
  • Đẩy từ máy chủ (server push).

Những khái niệm này (sẽ được mô tả chi tiết hơn trong chương) là những thay đổi cơ bản, phá vỡ tính tương thích ngược; nghĩa là, máy chủ web HTTP/1.0 có thể hiểu tin nhắn HTTP/1.1 và bỏ qua các chức năng thừa, nhưng điều này không đúng với tin nhắn HTTP/2, vì chúng có cấu trúc và định dạng khác. Vì lý do đó, HTTP/2 được coi là bản nâng cấp lớn..

Nhị phân thay vì văn bản

Một khác biệt chính giữa HTTP/1 và HTTP/2 là HTTP/2 là giao thức nhị phân dựa gói, trong khi HTTP/1 hoàn toàn dựa văn bản. Giao thức dựa văn bản dễ hiểu cho con người nhưng khó phân tích cho máy tính. Điều này chấp nhận được cho giao thức yêu cầu-phản hồi đơn giản mà HTTP bắt đầu, nhưng ngày càng hạn chế cho internet hiện đại.

Với giao thức văn bản, yêu cầu phải gửi và phản hồi nhận đầy đủ trước khi xử lý yêu cầu khác. HTTP hoạt động thế này 20 năm qua, dù có cải tiến nhỏ. HTTP/1.0 giới thiệu thân HTTP nhị phân, ví dụ, nơi hình ảnh và media khác có thể gửi trong phản hồi, và HTTP/1.1 giới thiệu pipelining và mã hóa chunked. Mã hóa chunked cho phép gửi phần thân tin nhắn trước, phần còn lại theo sau khi sẵn sàng. Thân HTTP chia thành chunk, và client nhận chunked response (hoặc server nhận chunked request) có thể bắt đầu xử lý trước khi nhận đầy đủ. Kỹ thuật này thường dùng khi độ dài dữ liệu tạo động không biết trước. Cả chunked encoding và pipelining có vấn đề chặn đầu hàng (HOL blocking), nơi tin nhắn đầu hàng ngăn phản hồi sau gửi, chưa kể pipelining không được hỗ trợ tốt trong thế giới thực.

HTTP/1.1
  • Định dạng: toàn bộ request/response là văn bản (ASCII/UTF-8).
    • Request line: GET /index.html HTTP/1.1
    • Headers: Host: example.com\r\n...
    • Body: theo sau, độ dài được báo bằng Content-Length hoặc chunked encoding.
  • Kết quả:
    • Parser phải đọc dấu hiệu kết thúc dòng (\r\n) để tách header.
    • Nếu header/body to, trình duyệt phải chờ nhiều (buffering).
    • Chỉ một request/response được xử lý trên một TCP connection tại một thời điểm → dễ nghẽn (head-of-line blocking).
    • Không có khái niệm “frame type”, tất cả đều là text nối tiếp nhau.
HTTP/2 – mọi thứ là frame
  • Cấu trúc rõ ràng, nhị phân: mỗi frame có header 9 byte cố định + payload.
    • Length (3 byte): kích thước payload.
    • Type (1 byte): phân loại (DATA, HEADERS, SETTINGS, PING, …).
    • Flags (1 byte): đánh dấu (END_STREAM, END_HEADERS, …).
    • Stream ID (4 byte, thực tế 31 bit): thuộc về stream nào.
    • Payload: dữ liệu thực (body, header block, …).
  • Ưu điểm:
    • Parser biết ngay độ dài frame → không cần scan ký tự xuống dòng.
    • Có thể ghép nhiều request/response song song trên một TCP connection (multiplexing, sẽ giải thích thêm ở dưới), nhờ phân biệt bằng stream ID.
    • Cho phép mở rộng: frame mới có thể được định nghĩa thêm mà không phá chuẩn.
    • Có nhiều loại frame khác nhau cho mục đích cụ thể: HEADERS, DATA, PRIORITY, WINDOW_UPDATE, PUSH_PROMISE… → kiểm soát chi tiết mà h1.1 không làm được.
image 16 - quochung.cyou PTIT

Cấu trúc frame header (9 bytes đầu):

  • Length (3 bytes): độ dài payload.
  • Type (1 byte): loại frame (HEADERS, DATA, SETTINGS, …).
  • Flags (1 byte): cờ tùy theo frame type.
  • R (1 bit): reserved, không dùng.
  • Stream Identifier (31 bits): xác định stream mà frame thuộc về.
  • Payload: dữ liệu thực, độ dài như Length.

Frame types (10 chuẩn + mở rộng):

  • DATA (0x0): payload chính.
  • HEADERS (0x1): HTTP headers + priority.
  • PRIORITY (0x2): thay đổi độ ưu tiên, dependency.
  • RST_STREAM (0x3): kết thúc stream (thường khi lỗi).
  • SETTINGS (0x4): config connection.
  • PUSH_PROMISE (0x5): server thông báo sẽ push object.
  • PING (0x6): test RTT.
  • GOAWAY (0x7): đóng connection, không nhận stream mới.
  • WINDOW_UPDATE (0x8): điều khiển flow (bytes còn có thể nhận).
  • CONTINUATION (0x9): nối thêm headers khi HEADERS quá dài.
  • Extension frames: cho phép mở rộng mà không phá protocol.
image 17 - quochung.cyou PTIT
t=   1646 [st=      1]    HTTP2_SESSION_RECV_SETTINGS
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "1 (SETTINGS_HEADER_TABLE_SIZE)"
                          --> value = 4096
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "5 (SETTINGS_MAX_FRAME_SIZE)"
                          --> value = 16384
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "6 (SETTINGS_MAX_HEADER_LIST_SIZE)"
                          --> value = 131072
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "3 (SETTINGS_MAX_CONCURRENT_STREAMS)"
                          --> value = 100
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "4 (SETTINGS_INITIAL_WINDOW_SIZE)"
                          --> value = 65536

Ghép kênh (multiplexing) trên một kết nối

Ý tưởng chính:
HTTP/2 biến mỗi yêu cầu thành một luồng (stream) riêng, và tất cả luồng đi chung một “đường ống TCP duy nhất”.

  • Yêu cầu được cắt thành các khung (frame) nhỏ.
  • Mỗi khung có ID luồng để biết nó thuộc yêu cầu nào.
  • Server và client chỉ việc ghép các khung lại → tái tạo thành thông điệp HTTP hoàn chỉnh.

Lợi ích:

  • Không bị nghẽn đầu hàng (head-of-line blocking ở mức HTTP): Nếu một yêu cầu chậm (ví dụ tải ảnh lớn), nó không làm tắc nghẽn các yêu cầu khác. Server có thể trả xen kẽ: một khung ảnh, rồi một khung CSS, rồi tiếp tục ảnh…
  • Chỉ cần một kết nối TCP duy nhất cho mọi tài nguyên → giảm overhead handshake, giảm tiêu tốn tài nguyên.
  • Server có thể quyết định ưu tiên: gửi CSS/JS quan trọng trước, hình ảnh phụ sau → tăng tốc độ hiển thị trang.

Ví dụ:
Cần tải 3 tài nguyên: styles.css, main.js, logo.png.

  • Với HTTP/1.1 pipelining:
    • Client gửi cả 3 yêu cầu nối tiếp.
    • Server phải trả đúng thứ tự: CSS → JS → PNG. Nếu file CSS to hoặc bị trễ, hai file sau cũng kẹt lại.
image 12 - quochung.cyou PTIT
  • Với HTTP/2 multiplexing:
    • Client gửi cả 3 yêu cầu trên cùng một kết nối.
    • Server có thể trả: một phần CSS → một phần JS → một phần PNG → tiếp tục CSS…
    • Trình duyệt nhận được khung CSS đầu tiên thì đã có thể render ngay, không cần chờ toàn bộ CSS tải xong.
image 13 - quochung.cyou PTIT
  • Bên trái (Client): trình duyệt gửi nhiều request (GET /styles.css, GET /script.js, GET /image.jpg…).
  • Giữa (HTTP/2 layer): tất cả request/response đều đi qua một kết nối TCP duy nhất nhưng được đóng gói thành nhiều stream. Mỗi stream lại chia nhỏ thành nhiều frame.
  • Bên phải (Server): server nhận request từ nhiều stream cùng lúc, xử lý rồi trả response xen kẽ trở lại trên cùng kết nối TCP.
Bước 1: Client gửi request
  • Client tạo 3 request:
    • Request 2 → GET /styles.css → Stream 5
    • Request 3 → GET /script.js → Stream 7
    • Request 4 → GET /image.jpg → Stream 9

Mỗi request sẽ được đánh số ID luồng (stream ID). Ở đây: 5, 7, 9 (client luôn tạo ID lẻ).

image 15 - quochung.cyou PTIT
Bước 2: HTTP/2 framing layer đóng gói
  • Request không gửi nguyên khối, mà bị chia nhỏ thành frames:
    • Frame chứa headers (ví dụ GET, URL, cookie, header HTTP).
    • Frame chứa body (nếu có).
  • Các frame từ nhiều stream có thể xếp nối tiếp nhau trên cùng kết nối TCP.

Ví dụ: thay vì phải gửi toàn bộ styles.css rồi mới đến script.js, rồi mới đến image.jpg, HTTP/2 sẽ gửi xen kẽ: một frame của Stream 5 (styles.css), sau đó một frame của Stream 7 (script.js), rồi một frame của Stream 9 (image.jpg)…

Bước 3: Server nhận và xử lý
  • Server đọc các frame, ghép lại theo stream ID để tái tạo thành request đầy đủ.
  • Sau đó server xử lý và tạo response.
Bước 4: Server trả response xen kẽ
  • Response cũng được cắt thành frames, rồi trả về client.
  • Các stream response không cần giữ đúng thứ tự yêu cầu ban đầu.
    • Server có thể ưu tiên gửi nhanh CSS (quan trọng để render trang) trước khi trả ảnh JPG.
    • Trong hình: Stream 5 và Stream 7 response đi xen kẽ nhau, trong khi Stream 9 (ảnh JPG) response nối tiếp.

Bạn có thể hình dung:

  • HTTP/1.1 giống như có 6 cái ống nước riêng, mỗi ống chỉ chảy được một loại nước. Nếu một ống nghẹt thì nước loại đó tắc hết.
  • HTTP/2 giống như một ống nước lớn duy nhất, trong đó dòng chảy có nhiều màu khác nhau (đỏ = ảnh, vàng = CSS, xanh = JS). Các giọt nước khác màu có thể luân phiên chạy trong cùng một ống, và khi đến đích thì được lọc ra đúng “xô” tương ứng.
image 14 - quochung.cyou PTIT

Stream prioritization (Ưu tiên dòng)

HTTP/1.x:

  • Trình duyệt phải “xếp hàng” tài nguyên vì giới hạn 6 kết nối/host.
  • Muốn ưu tiên CSS/JS quan trọng thì chỉ đơn giản gửi sớm hơn. Nhưng nếu kết nối đã đầy, thì phải đợi → cơ chế ưu tiên thô sơ, bị giới hạn bởi số kết nối.

HTTP/2:

  • Có thể gửi hàng trăm stream một lúc trên cùng một kết nối.
  • Nếu không có ưu tiên, dễ lãng phí băng thông: ví dụ hình ảnh (không critical) lại chiếm chỗ trước CSS (critical).
  • Cơ chế ưu tiên: Client gửi “hints” về độ ưu tiên (priority) → server chọn phân bổ tài nguyên.
    • Ví dụ: nếu cả CSS và ảnh đang chờ, server sẽ gửi nhiều frame CSS hơn để trình duyệt render trang sớm.
    • Ưu tiên mềm: không phải “gửi cái này trước, cái kia sau”, mà là chia băng thông nhiều–ít giữa các stream.

Flow control

Ta đã thấy ở Multiplexing nghĩa là nhiều stream chia sẻ cùng một TCP. Nhưng nếu client đọc chậm (ví dụ đang pause video), mà server vẫn dồn dữ liệu video về → nghẽn buffer, mất gói, phải retransmit → phí công.

TCP vốn đã có cơ chế window size để tránh sender “dội” dữ liệu quá nhiều so với khả năng nhận của receiver.

Nhưng: TCP coi cả kết nối như một dòng duy nhất. Nếu một luồng dữ liệu (ví dụ video) bị nghẽn, thì nó kéo theo tất cả dữ liệu khác trên cùng connection → “head-of-line blocking”.

  • HTTP/2 chia nhỏ kết nối thành nhiều stream (mỗi request/response).
  • Mỗi stream có cửa sổ riêng (window size), mặc định 65,535 byte.
  • Cơ chế:
    • Server chỉ được gửi tối đa số byte trong cửa sổ.
    • Khi client xử lý xong một phần dữ liệu, nó báo lại bằng WINDOW_UPDATE frame → tăng cửa sổ, cho phép server gửi tiếp.
  • Kết quả: stream nào “chậm” (ví dụ video đang pause) thì chỉ bị tạm ngừng riêng, không ảnh hưởng các stream khác (CSS, JS vẫn chạy bình thường).

Giả sử stream #11 là video, stream #13 là CSS:

  • Ban đầu: cả hai có window = 65,535.
  • Server gửi:
    • Video 10 KB → cửa sổ video còn 55,535.
    • CSS 20 KB → cửa sổ CSS còn 45,535.
  • Client pause video → không gửi WINDOW_UPDATE cho stream #11 → video tạm “đóng băng”.
  • Nhưng client vẫn gửi WINDOW_UPDATE cho stream #13 → CSS tiếp tục tải bình thường.

Lợi ích

  • Tinh chỉnh: quản lý luồng nào cần, luồng nào tạm dừng.
  • Hiệu quả: tránh lãng phí băng thông/memory vào dữ liệu không tiêu thụ.
  • Khả năng phối hợp: đặc biệt quan trọng khi đi qua proxy/CDN với tốc độ khác nhau.

Header compression

Vấn đề trong HTTP/1:

  • Mỗi request lặp lại hàng đống header giống nhau:
    • Cookie (to, nặng).
    • User-Agent, Host, Accept, Accept-Encoding…
  • Với hàng trăm request nhỏ, phần header đôi khi to hơn cả body!
  • HTTP/1 chỉ nén body (gzip, deflate), không nén header.

Vấn đề: headers lớn, lặp nhiều (cookie, user-agent, accept, …). Một trang ~140 request, mỗi request ~460 bytes → ~63 KB headers, phần lớn lặp.

Cách làm:

  • Giữ bảng tĩnh (61 header phổ biến, ví dụ :method: GET).
  • Giữ bảng động (lưu các header đã thấy trong connection).
  • Ví dụ: :method: GET có thể là entry số 2 trong bảng. Thay vì gửi "GET" cả chữ, client chỉ gửi số 2.
  • Tương tự, host: example.com có thể được lưu ở entry #62 → request sau chỉ cần gửi 62 thay vì nguyên chuỗi.
  • Với các header mới/chưa có trong bảng, vẫn phải gửi chuỗi.
  • Nhưng để tiết kiệm, HTTP/2 dùng Huffman coding (biểu diễn ký tự bằng bit ngắn hơn cho ký tự thường gặp, dài hơn cho ký tự hiếm gặp).
  • Nhờ đó, chuỗi literal cũng nhỏ gọn hơn nhiều so với ASCII/UTF-8 thẳng.

Ví dụ:

  • Request 1: gửi :authority: www.akamai.com, :method: GET, ... → thêm vào bảng.
  • Request 2: gần giống, chỉ khác :path → chỉ cần gửi index + giá trị mới.
  • Tiết kiệm ~85% dung lượng.

Đẩy từ máy chủ

Cơ chế: server gửi PUSH_PROMISE frame gắn vào một stream hiện có.

  • Stream ID trong PUSH_PROMISE = stream gốc (ví dụ: /index.html).
  • Headers trong PUSH_PROMISE mô phỏng như client sẽ request file đó.
  • Sau đó server gửi DATA của object.

Mục tiêu: đặt tài nguyên vào cache trước khi client yêu cầu.

Rủi ro: push sai (tài nguyên đã cache rồi, hoặc client không cần) → lãng phí băng thông.