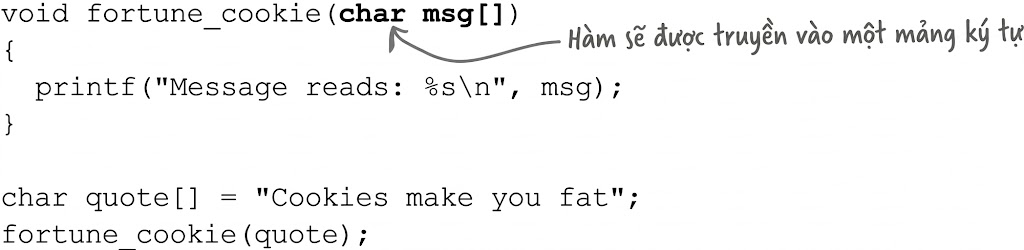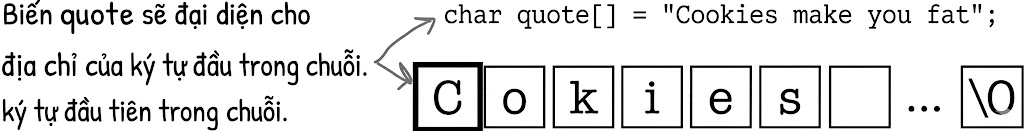Trước khi bắt đầu, bạn cần xác nhận phần cứng và hệ điều hành đáp ứng các tiêu chuẩn sau:
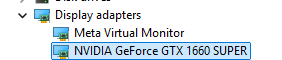
GPU: Phải sử dụng GPU NVIDIA hỗ trợ CUDA. Kiểm tra bằng cách mở Device Manager -> Display adapters.
Display Adapter cho thấy đang sử dụng GPU NVIDIA
Hệ điều hành: Windows 10 hoặc Windows 11 (phiên bản 64-bit).
Driver: NVIDIA Driver phải ở phiên bản mới nhất để hỗ trợ các tập lệnh CUDA hiện đại.
2. Cài đặt Môi trường Phát triển (Visual Studio & VS Code)
Cài đặt Visual Studio
Truy cập trang chủ Microsoft và tải Visual Studio (https://visualstudio.microsoft.com/downloads/)
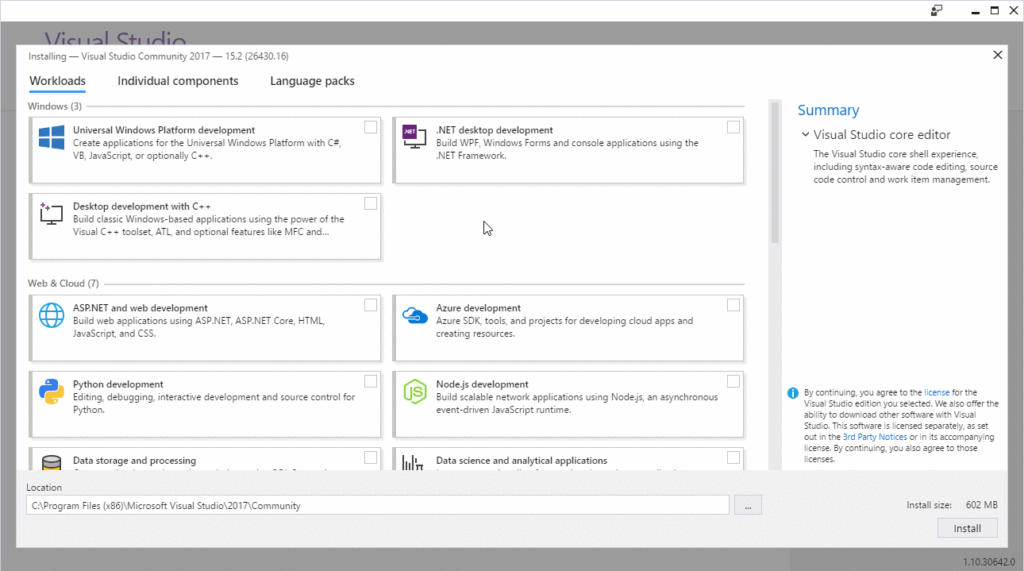
Trong quá trình cài đặt, tại tab Workloads, bạn bắt buộc phải tích chọn mục Desktop development with C++.
Nếu thiếu thành phần này, trình biên dịch nvcc của CUDA sẽ không tìm thấy cl.exe và không thể build project.
3. Lựa chọn phiên bản CUDA Toolkit (Local vs. Network)
Khi truy cập trang tải NVIDIA CUDA Downloads, bạn sẽ phải chọn giữa hai loại bộ cài đặt:
Loại Installer
Đặc điểm
Network Installer
Dung lượng tải về ban đầu rất nhỏ. Quá trình cài đặt sẽ tải các thành phần cần thiết từ server của NVIDIA.
Local Installer
Dung lượng lớn (thường > 2GB). Chứa toàn bộ các thành phần cần thiết để cài đặt offline.
Quy trình cài đặt CUDA Toolkit
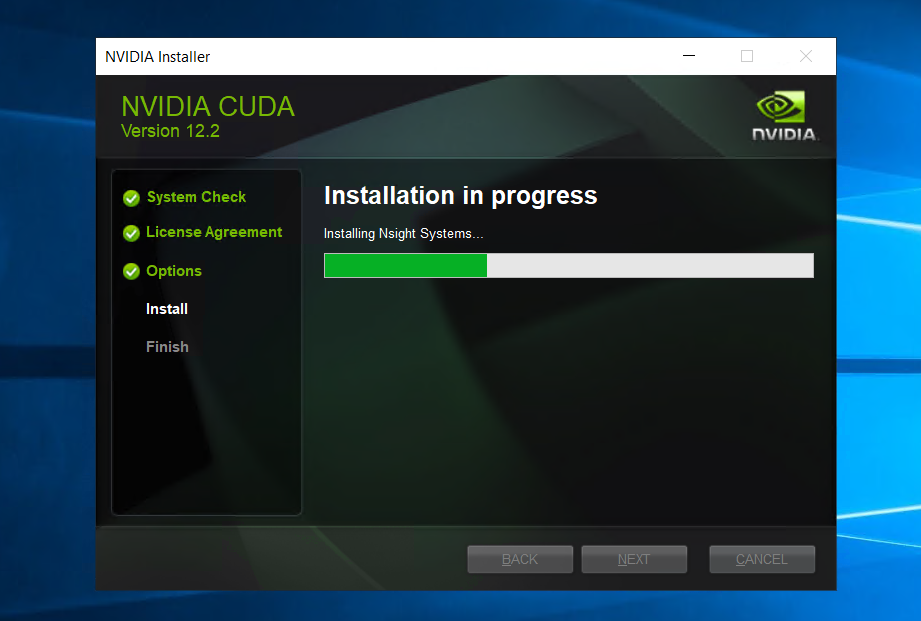
Khi khởi chạy tệp tin cài đặt (ví dụ: cuda_13.2.0_windows.exe), trình cài đặt sẽ giải nén vào một thư mục tạm thời. Sau đó, giao diện chính sẽ xuất hiện:
Kiểm tra tính tương thích: Trình cài đặt sẽ quét hệ thống để đảm bảo GPU và phiên bản Windows được hỗ trợ.
Lựa chọn chế độ cài đặt (Options):
Express (Recommended): Cài đặt toàn bộ các thành phần mặc định, bao gồm Driver, Toolkit, và Visual Studio Integration.
Custom (Advanced): Cho phép chọn cụ thể các thành phần.
Visual Studio Integration: Nếu thấy thông báo về Visual Studio, hãy đảm bảo rằng Visual Studio đã được đóng hoàn toàn. CUDA sẽ tự động cài đặt các template dự án và công cụ build vào Visual Studio.
Hoàn tất: Sau khi cài đặt xong, trình cài đặt sẽ liệt kê các thành phần đã được thêm vào hệ thống.
Xác minh cài đặt (Verification)
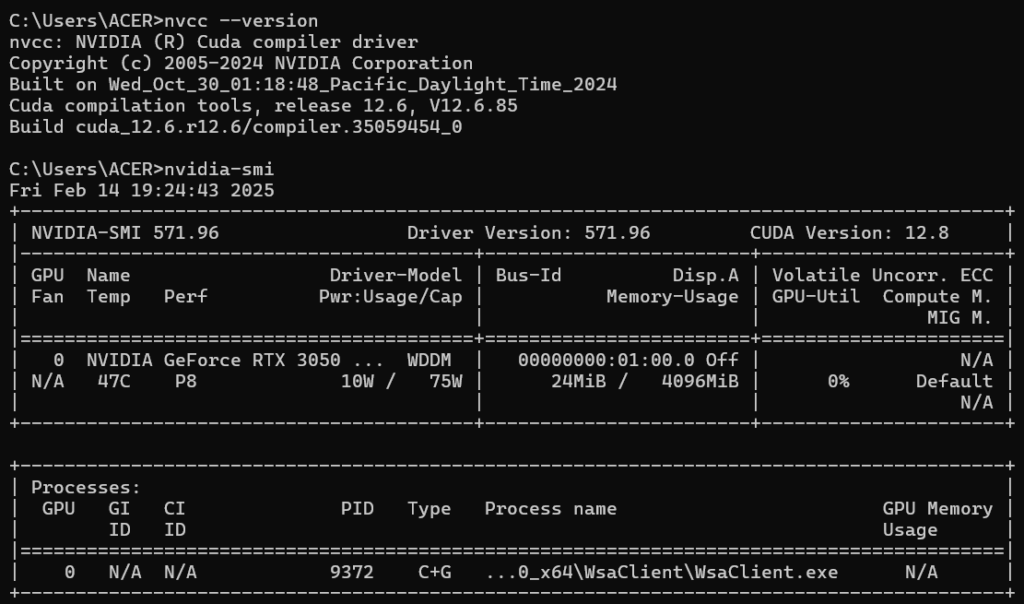
Việc cài đặt thành công trên giao diện không đồng nghĩa với việc các biến môi trường đã được nhận diện chính xác. Bạn cần thực hiện kiểm tra qua Command Prompt (cmd) hoặc PowerShell.
Kiểm tra trình biên dịch (nvcc)
Mở terminal và gõ lệnh:
Bash
nvcc --version
Nếu hệ thống trả về thông tin phiên bản (ví dụ: Cuda compilation tools, release 13.2, V13.2.xx), nghĩa là trình biên dịch CUDA đã sẵn sàng. Nếu nhận lỗi “command not found”, bạn cần kiểm tra lại biến môi trường PATH.
Kiểm tra phần cứng và Driver (nvidia-smi)
Gõ lệnh:
Bash
nvidia-smi
Lệnh này sẽ hiển thị bảng thông số GPU hiện tại, bao gồm:
Tên GPU (ví dụ: RTX 4070).
Phiên bản Driver hiện tại.
CUDA Version: Đây là phiên bản CUDA tối đa mà Driver hiện tại hỗ trợ (không nhất thiết phải trùng với phiên bản Toolkit bạn vừa cài, nhưng phải lớn hơn hoặc bằng).
Để lập trình CUDA, bạn không nên tạo dự án C++ thông thường mà nên sử dụng Template có sẵn của NVIDIA để các thiết lập về thư viện (Library) và đường dẫn (Include Path) được tự động cấu hình.
Các bước thực hiện:
Mở Visual Studio.
Chọn Create a new project.
Trong ô tìm kiếm, gõ từ khóa “CUDA”.
Chọn Template có tên CUDA [Phiên bản] Runtime (Ví dụ: CUDA 13.2 Runtime). Nhấn Next.
Đặt tên dự án và nhấn Create.
Giải thích về Template:
CUDA Runtime: Đây là mẫu dự án đã được tích hợp sẵn các “Build Customizations”. Nó cho phép Visual Studio hiểu các tệp tin có đuôi .cu là tệp mã nguồn CUDA và cần dùng trình biên dịch nvcc thay vì trình biên dịch C++ tiêu chuẩn.
Nếu bạn không thấy Template này, nghĩa là bước cài đặt CUDA Toolkit trước đó chưa tích hợp thành công vào Visual Studio. Bạn cần chạy lại bộ cài CUDA
Viết mã thử nghiệm “Hello World” từ GPU
Khi dự án được tạo, mặc định sẽ có một tệp kernel.cu. Bạn hãy xóa nội dung cũ và thay bằng đoạn mã dưới đây để kiểm tra khả năng thực thi song song:
C
#include"cuda_runtime.h"#include"device_launch_parameters.h"#include<stdio.h>// Kernel chạy trên GPU__global__ voidhelloFromGPU(){printf("Hello World từ GPU! Block: %d, Thread: %d\n",blockIdx.x,threadIdx.x);}intmain(){printf("Hello World từ CPU!\n");// Chạy Kernel với 2 Block, mỗi Block có 5 Thread (tổng cộng 10 luồng song song) helloFromGPU<<<2,5>>>();// Chờ GPU hoàn thành công việc trước khi kết thúc chương trình CPUcudaError_t err =cudaDeviceSynchronize();if(err != cudaSuccess){printf("Lỗi CUDA: %s\n",cudaGetErrorString(err));return1;}return0;}
Biên dịch và Chạy (Build & Run)
Chọn cấu hình: Trên thanh công cụ, đảm bảo bạn đang chọn x64 (CUDA hiện tại không còn hỗ trợ x86/32-bit).
Build: Nhấn Ctrl + Shift + B để biên dịch.
Run: Nhấn Ctrl + F5 để chạy không debug.
Kết quả mong đợi: Màn hình console sẽ hiển thị dòng “Hello World từ CPU!” trước, sau đó là 10 dòng “Hello World từ GPU!” với các chỉ số Block và Thread khác nhau.
Xử lý lỗi “cudaSetDevice failed!”
Nếu bạn chạy chương trình và nhận được thông báo lỗi:
cudaSetDevice failed! Do you have a CUDA-capable GPU installed?addWithCuda failed!...exited with code 1 (0x1).
Đây là dấu hiệu cho thấy CUDA Runtime không thể khởi tạo hoặc giao tiếp với GPU. Nguyên nhân thường nằm ở một trong ba trường hợp sau:
Trường hợp 1: Driver NVIDIA quá cũ (Lỗi phổ biến nhất)
Bộ cài CUDA Toolkit thường đi kèm với một bản Driver nhất định. Tuy nhiên, nếu bạn cài bản CUDA Toolkit mới (ví dụ 12.x hoặc 13.x) nhưng Driver trên máy vẫn là bản cũ từ nhiều năm trước, GPU sẽ không hiểu được các tập lệnh mới. (Điều này có thể kiểm tra ở đoạn thử nghiệm lệnh nvidia-smi và nvcc ở bước trước)
Cách khắc phục: Truy cập NVIDIA Driver Downloads. Chọn đúng dòng Card đồ họa của bạn và tải bản Game Ready Driver hoặc Studio Driver mới nhất. Cài đặt và khởi động lại máy.
Trường hợp 2: Lệch phiên bản giữa CUDA Toolkit và Driver
Mỗi phiên bản CUDA Toolkit yêu cầu một phiên bản Driver tối thiểu (Minimum Driver Version).
Ví dụ: CUDA 12.x yêu cầu Driver phiên bản 525.60.13 trở lên trên Windows.
Nếu bạn sử dụng Toolkit phiên bản cao hơn mức Driver hỗ trợ, hàm cudaSetDevice sẽ trả về mã lỗi.
Trường hợp 3: Thiết bị không hỗ trợ CUDA
Dù hiếm gặp trên các dòng máy tính mới, nhưng nếu bạn sử dụng GPU onboard (Intel/AMD) hoặc các dòng GPU NVIDIA quá cũ (kiến trúc Tesla đời đầu), phần cứng sẽ không có nhân CUDA để thực thi.
CUDA là một nền tảng tính toán song song và mô hình lập trình do NVIDIA phát triển. Nền tảng này cho phép gia tăng đáng kể hiệu suất tính toán bằng cách khai thác sức mạnh của bộ xử lý đồ họa (GPU). CUDA cho phép dev viết chương trình tăng tốc các ứng dụng tiêu tốn nhiều tài nguyên tính toán bằng cách sử dụng các ngôn ngữ lập trình phổ biến như C, C++, và Fortran
Ngôn ngữ CUDA C mở rộng ngôn ngữ lập trình ANSI C phổ biến với một lượng tối thiểu các cú pháp mới và các hàm thư viện. Như tên gọi của nó, CUDA C được xây dựng trên nền tảng CUDA của NVIDIA. Hiện nay, CUDA là framework phổ biến nhất cho tính toán song song khối lượng lớn, được sử dụng rộng rãi trong ngành tính toán hiệu năng cao (HPC) với các công cụ thiết yếu như trình biên dịch, trình gỡ lỗi và trình phân tích hiệu năng có sẵn trên các hệ điều hành phổ biến nhất.
Cấu trúc của một chương trình CUDA C phản ánh sự cùng tồn tại của một máy chủ (host) chính là CPU và một hoặc nhiều thiết bị (devices) chính là các GPU trong máy tính. Mỗi tệp mã nguồn CUDA C có thể chứa hỗn hợp cả mã cho máy chủ (host code) và mã cho thiết bị (device code).
Theo mặc định, bất kỳ chương trình C truyền thống nào cũng là một chương trình CUDA chỉ chứa mã máy chủ.
Ta có thể thêm mã thiết bị vào bất kỳ tệp nguồn nào. Mã thiết bị được đánh dấu rõ ràng bằng các từ khóa CUDA C đặc biệt.
Mã thiết bị bao gồm các hàm, hay còn gọi là các kernel, mã của chúng được thực thi theo cách thức song song dữ liệu.
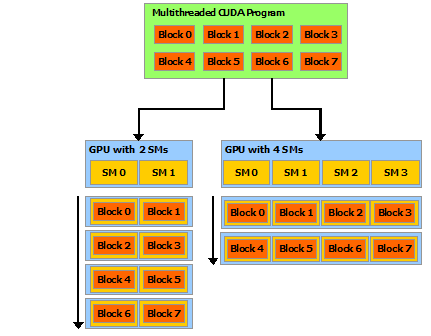
Như hình trên ta thấy quá trình bắt đầu với mã máy chủ (mã tuần tự trên CPU).
Khi một hàm kernel được gọi, một số lượng lớn các luồng (threads) sẽ được kích hoạt (launched) trên một thiết bị để thực thi kernel đó.
Tất cả các luồng được kích hoạt bởi một lần gọi kernel được gọi chung là một lưới (grid). Những luồng này là phương tiện thực thi song song chính trong nền tảng CUDA.
Khi tất cả các luồng của một lưới đã hoàn thành việc thực thi, lưới đó sẽ kết thúc và việc thực thi tiếp tục trên máy chủ cho đến khi một lưới khác được kích hoạt.
Đây là một mô hình đơn giản hóa, trong đó việc thực thi của CPU và GPU không chồng chéo lên nhau. Nhiều ứng dụng tính toán không đồng nhất thực tế sẽ quản lý việc thực thi chồng chéo giữa CPU và GPU để tận dụng tối đa sức mạnh của cả hai.
Một kernel cộng vectơ (vector addition)
Bản CPU
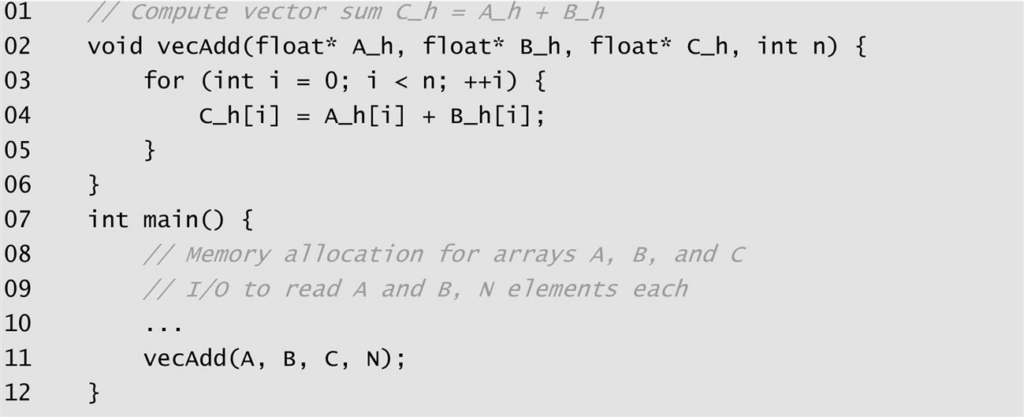
Ta sử dụng phép cộng vectơ để minh họa cấu trúc chương trình CUDA C. Cộng vectơ là phép tính song song dữ liệu đơn giản nhất có thể – tương đương với chương trình “Hello World” của lập trình tuần tự. Trước khi xem mã kernel, ta hãy xem xét hàm cộng vectơ truyền thống (chạy trên CPU).
Mục tiêu: Cho hai vector A, B có kích thước n phần tử. Ta cần tính tổng từng phần tử của hai vector và cho kết quả ở vector C, với C[i] = A[i] + B[i] cho mọi 0 ≤ i < n.
Hình trên cho thấy một chương trình C đơn giản gồm hàm main và hàm cộng vectơ vecAdd.
Quy ước đặt tên: Trong tất cả các ví dụ, khi cần phân biệt giữa dữ liệu của máy chủ và thiết bị, ta sẽ thêm hậu tố _h (CPU) cho các biến dùng bởi máy chủ và _d cho các biến dùng bởi thiết bị (GPU).
Như đã thảo luận ở phần 2, các tham số số của hàm vecAdd – A, B và C là các con trỏ.
Tại đây ở phần comment // Memory allocation for arrays A, B, and C thì ta sẽ khởi tạo các mảng phần tử A, B, C. Sau đó, khi truyền tham số vào vecAdd, ta đang truyền 1 con trỏ với cú pháp float *A_h
Ôn tập: Một mảng trong chương trình C có thể được truy cập thông qua một con trỏ trỏ đến phần tử thứ 0 của nó. Ví dụ, câu lệnh P=&(A[0]) làm cho P trỏ đến phần tử thứ 0 của mảng A. Lúc này P[i] tương đương với A[i]. Thực tế, chính tên mảng A cũng là một con trỏ trỏ đến phần tử thứ 0 của nó. (Có thể xem lại bài 2)
Trong hình, việc truyền tên mảng A vào hàm vecAdd làm cho tham số đầu tiên A_h của hàm trỏ đến phần tử thứ 0 của A. Kết quả là A_h[i] trong thân hàm có thể truy cập vào A[i] của hàm main.
Hàm vecAdd trong hình sử dụng một vòng lặp for để duyệt qua các phần tử của vectơ. Ở lần lặp thứ i, phần tử đầu ra C_h[i] nhận giá trị tổng của A_h[i] và B_h[i]. Tham số độ dài vectơ n được dùng để điều khiển vòng lặp.
Bản CPU
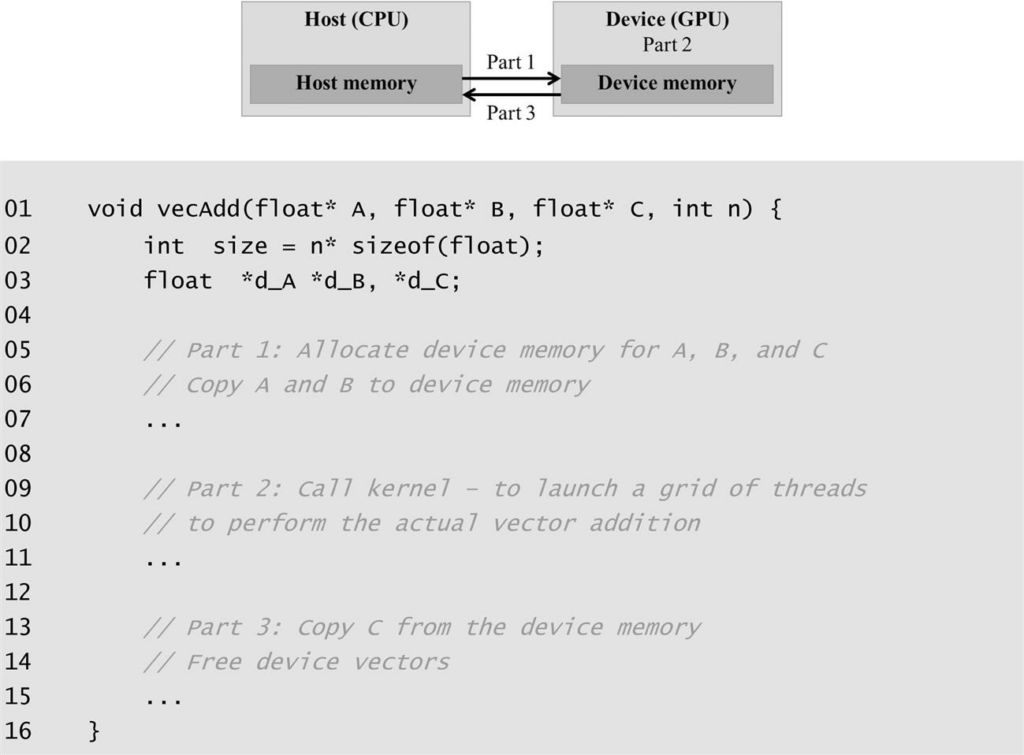
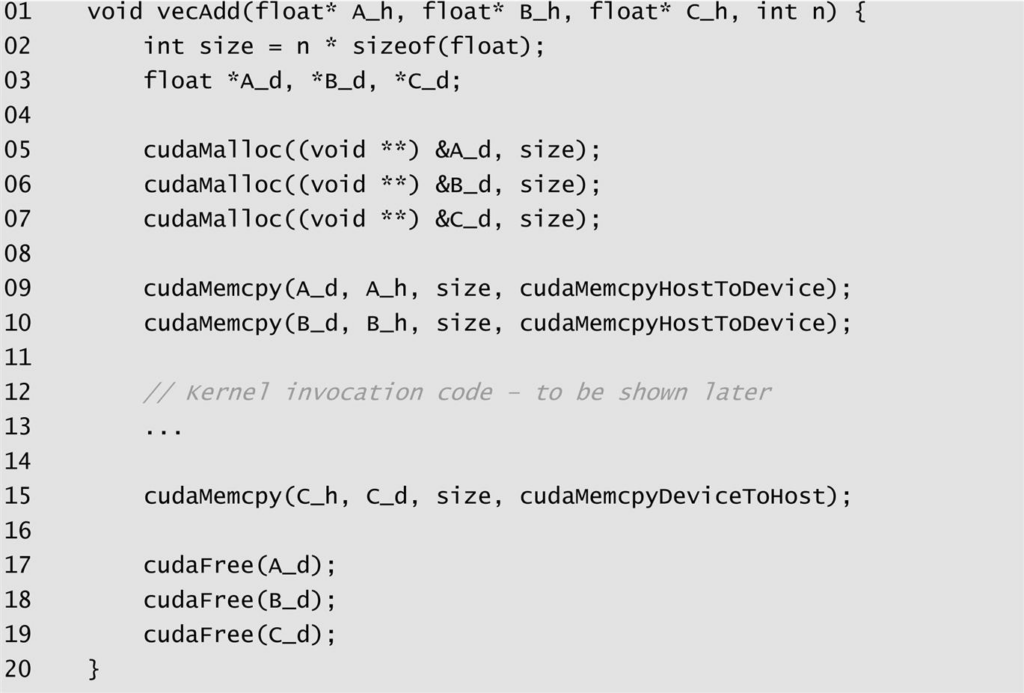
Giờ ta hãy xem cách để thực thi cộng vectơ song song, cụ thể ta sẽ sửa đổi hàm vecAdd và chuyển các tính toán của nó sang một thiết bị. Cấu trúc của hàm vecAdd đã sửa đổi được trình bày trong ảnh dưới
Phần 1: Cấp phát không gian trong bộ nhớ thiết bị (GPU) để chứa các bản sao của các vectơ A, B và C, sau đó sao chép vectơ A và B từ bộ nhớ máy chủ sang bộ nhớ thiết bị.
Phần 2: Gọi kernel cộng vectơ thực sự để kích hoạt một lưới các luồng trên thiết bị.
Phần 3: Sao chép vectơ tổng C từ bộ nhớ thiết bị về bộ nhớ máy chủ và giải phóng bộ nhớ của ba mảng này trên thiết bị.
Bộ nhớ toàn cục của thiết bị và truyền dữ liệu
Trong các hệ thống CUDA hiện nay, các thiết bị (GPU) thường là các bảng mạch phần cứng đi kèm với bộ nhớ truy cập ngẫu nhiên động (DRAM) riêng biệt (hay còn gọi là VRAM của GPU), được gọi là bộ nhớ toàn cục của thiết bị (device global memory), hoặc gọi ngắn gọn là bộ nhớ toàn cục.
Ví dụ: NVIDIA Volta V100 đi kèm với 16GB hoặc 32GB bộ nhớ toàn cục.
Việc gọi đây là bộ nhớ “toàn cục” nhằm phân biệt nó với các loại bộ nhớ thiết bị khác mà lập trình viên cũng có thể truy cập được
Đối với kernel cộng vectơ, trước khi gọi kernel, thực tế ta thực hiện các bước sau
Cấp phát không gian trong bộ nhớ toàn cục của thiết bị (GPU).
Truyền dữ liệu từ bộ nhớ máy chủ (CPU) sang không gian đã cấp phát đó.
Tương tự, sau khi thiết bị thực thi xong, ta cần:
Giải phóng không gian bộ nhớ toàn cục đã cấp phát khi không còn cần thiết.
Truyền dữ liệu kết quả từ bộ nhớ toàn cục của thiết bị trở lại bộ nhớ máy chủ
Khi ta nói Host CPU sẽ có bộ nhớ riêng, thông thường trong một hệ thống máy tính, đó chính là Ram. Và các thiết bị (Device) GPU cũng sẽ có bộ nhớ riêng, hay thường được gọi là thông số VRAM của GPU. Thông thường thì GPU không thể sử dụng các biến trên bộ nhớ CPU (Ram) để làm việc (trừ 1 số ngoại lệ sẽ được thảo luận sau), vì vậy như ảnh sơ đồ một luồng cơ bản ban đầu, ta thường cần khởi tạo các biến tại máy chủ CPU trước, rồi copy dữ liệu sang GPU các dữ liệu cần dùng trong tính toán tại GPU, rồi sau khi tính toán xong, ta sẽ copy lại.
Hệ thống CUDA cung cấp các hàm API để thực hiện các hoạt động này thay cho lập trình viên. Thuật ngữ “truyền dữ liệu từ máy chủ sang thiết bị” sẽ được hiểu là sao chép dữ liệu từ bộ nhớ máy chủ (RAM của CPU) sang bộ nhớ toàn cục của thiết bị (VRAM của GPU).
Quản lý bộ nhớ: cudaMalloc và cudaFree
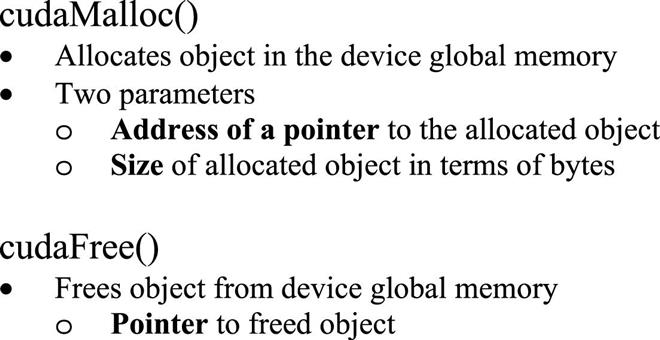
Hình trên giới thiệu hai hàm API dùng để cấp phát và giải phóng bộ nhớ toàn cục của thiết bị.
cudaMalloc(): Có thể được gọi từ mã máy chủ để cấp phát một vùng bộ nhớ toàn cục cho một đối tượng. Hàm này có sự tương đồng rất lớn với hàm malloc của thư viện C tiêu chuẩn.
Tham số thứ nhất: Là địa chỉ của một biến con trỏ. Biến con trỏ này sẽ được thiết lập để trỏ đến đối tượng vừa được cấp phát. Địa chỉ của biến con trỏ phải được ép kiểu thành (void **) vì hàm này mong đợi một con trỏ vạn năng (generic pointer). Điều này cho phép cudaMalloc ghi địa chỉ của vùng nhớ vừa cấp phát vào biến con trỏ của ta bất kể kiểu dữ liệu của nó là gì.
Tham số thứ hai: Xác định kích thước dữ liệu cần cấp phát, tính bằng số byte.
cudaFree(): Giải phóng không gian lưu trữ khỏi bộ nhớ toàn cục. Nó chỉ cần giá trị của con trỏ (địa chỉ vùng nhớ cần giải phóng) làm đối số, do đó không cần truyền địa chỉ của con trỏ như cudaMalloc.
Ví dụ minh họa:
C
float*A_d;int size = n *sizeof(float);cudaMalloc((void**)&A_d, size);// ... thực hiện tính toán ...cudaFree(A_d);
Trong ví dụ này, ta dùng hậu tố _d cho con trỏ A_d để chỉ rõ nó trỏ đến một đối tượng trong bộ nhớ thiết bị. Khi cudaMalloc trả về, A_d sẽ chứa địa chỉ vùng nhớ trên GPU dành cho vectơ A. Lưu ý rằng khi tính toán size, ta phải chuyển đổi từ số lượng phần tử sang số byte (ví dụ: n phần tử kiểu float sẽ chiếm n lần 4 byte).
Các địa chỉ trong A_d, B_d, và C_d trỏ đến các vị trí trong bộ nhớ toàn cục của thiết bị. Ta không được phép giải mã (dereference) các con trỏ này trong mã máy chủ (CPU). Việc truy cập trực tiếp nội dung con trỏ thiết bị từ CPU sẽ gây ra lỗi thực thi hoặc ngoại lệ hệ thống.
Truyền dữ liệu: cudaMemcpy
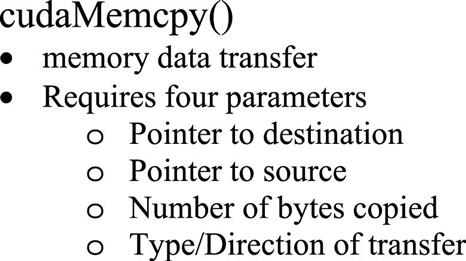
Sau khi đã cấp phát không gian trên thiết bị, ta cần chuyển dữ liệu vào đó. Hàm API thực hiện việc này là cudaMemcpy.
Hình trên mô tả hàm cudaMemcpy với bốn tham số:
Đích (Destination): Con trỏ tới vị trí đích của đối tượng dữ liệu cần sao chép.
Nguồn (Source): Con trỏ tới vị trí nguồn của dữ liệu.
Kích thước (Size): Số byte cần sao chép.
Loại truyền dẫn (Kind/Direction): Xác định các loại bộ nhớ liên quan:
cudaMemcpyHostToDevice: Từ máy chủ sang thiết bị.
cudaMemcpyDeviceToHost: Từ thiết bị về máy chủ.
cudaMemcpyDeviceToDevice: Giữa hai vị trí trong bộ nhớ thiết bị.
cudaMemcpyHostToHost: Giữa hai vị trí trong bộ nhớ máy chủ.
Áp dụng vào ví dụ vecAdd: Ta thực hiện sao chép các vectơ A và B sang thiết bị trước khi tính toán, và sao chép kết quả C về máy chủ sau khi hoàn tất:
C
cudaMemcpy(A_d, A_h, size, cudaMemcpyHostToDevice);cudaMemcpy(B_d, B_h, size, cudaMemcpyHostToDevice);// ... (Gọi kernel thực hiện cộng vectơ ở đây) ...cudaMemcpy(C_h, C_d, size, cudaMemcpyDeviceToHost);
Tổng quan, chương trình hiện tại của ta có thể được thấy như sau, chỉ còn thiếu 1 phần gọi kernel để thực hiện việc tính toán.
Các hàm kernel và phân luồng
Trong CUDA C, một kernel là một hàm sẽ được thực thi song song bởi nhiều luồng trên thiết bị. Ta định nghĩa một kernel bằng cách thêm từ khóa khai báo hàm __global__ vào trước định nghĩa hàm.
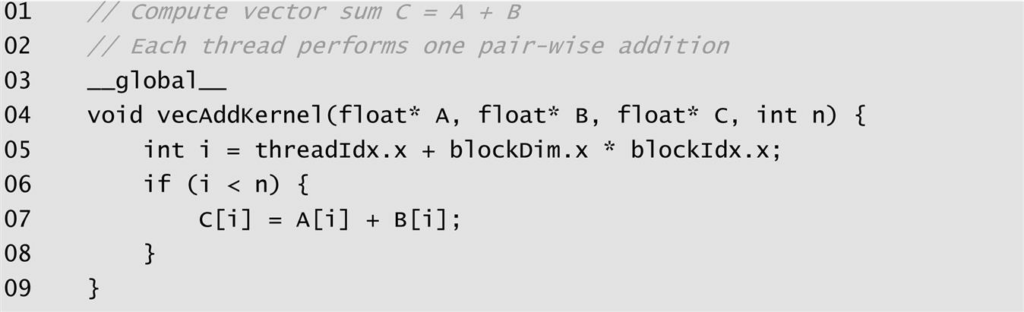
Khi ta gọi một hàm __global__, nó sẽ được thực thi trên thiết bị. Một điểm đặc biệt là các hàm __global__ phải trả về kiểu void. Ta hãy xem xét ví dụ về kernel cộng vectơ trong hình sau:
Hàm vecAddKernel trong hình trông rất giống với vòng lặp trong hàm vecAdd ở ví dụ CPU, nhưng có hai điểm khác biệt quan trọng:
Từ khóa __global__ thông báo cho trình biên dịch rằng đây là một kernel.
Vòng lặp for đã biến mất.
Tại sao vòng lặp lại biến mất? Đó là vì khi kernel này được kích hoạt, một lưới các luồng sẽ được tạo ra. Ta cấu trúc chương trình sao cho mỗi luồng trong lưới sẽ thực hiện một lần lặp của vòng lặp ban đầu. Để làm được điều này, mỗi luồng cần biết nó phải xử lý phần tử nào của các vectơ A, B và C.
Biến tích hợp và định danh luồng (Thread Identification)
CUDA C cung cấp các biến tích hợp sẵn (built-in variables) để giúp các luồng xác định danh tính của mình. Một trong những biến quan trọng nhất là threadIdx. Trong ví dụ đơn giản này, ta sử dụng threadIdx.x để lấy chỉ số của luồng trong một khối (block).
Câu lệnh sau trong kernel:
int i = threadIdx.x;
cho phép mỗi luồng tự gán cho mình một giá trị i khác nhau dựa trên chỉ số của nó. Nếu ta kích hoạt n luồng, thì luồng thứ 0 sẽ có i=0, luồng thứ 1 sẽ có i=1, và cứ tiếp tục cho đến luồng thứ n-1. Nhờ đó, mỗi luồng sẽ thực hiện phép cộng trên một cặp phần tử khác nhau của các vectơ:
if (i < n) C_d[i] = A_d[i] + B_d[i];
Câu lệnh if (i < n) là một biện pháp bảo vệ, Nó đảm bảo rằng nếu số lượng luồng được kích hoạt lớn hơn độ dài vectơ n, các luồng “thừa” sẽ không truy cập vào vùng nhớ ngoài phạm vi của mảng.
SPMD (Single Program, Multiple Data)
Mô hình thực thi này được gọi là SPMD (Một chương trình, nhiều dữ liệu). Tất cả các luồng đều thực thi cùng một mã nguồn (hàm kernel), nhưng mỗi luồng hoạt động trên một phần dữ liệu khác nhau dựa trên định danh của nó. Đây là cách CUDA khai thác tính song song dữ liệu trên quy mô lớn.
Gọi hàm kernel
Khi ta gọi một kernel từ mã máy chủ, ta cần cung cấp các tham số cấu hình thực thi. Các tham số này xác định số lượng luồng trong lưới sẽ được kích hoạt để thực thi kernel đó.
CUDA C sử dụng cú pháp ngoặc nhọn ba lớp <<< ... >>> để bao quanh các thông số này. Cú pháp tổng quát như sau:
Ở đây, ta đang yêu cầu hệ thống kích hoạt 1 khối duy nhất chứa n luồng.
Tham số thứ nhất (1) xác định số lượng khối trong lưới.
Tham số thứ hai (n) xác định số lượng luồng trong mỗi khối.
Khi lệnh gọi này được thực thi, môi trường chạy CUDA (runtime) sẽ tạo ra một lưới gồm n luồng trên thiết bị. Mỗi luồng sẽ thực thi mã của vecAddKernel với một giá trị threadIdx.x duy nhất từ 0 đến n-1.
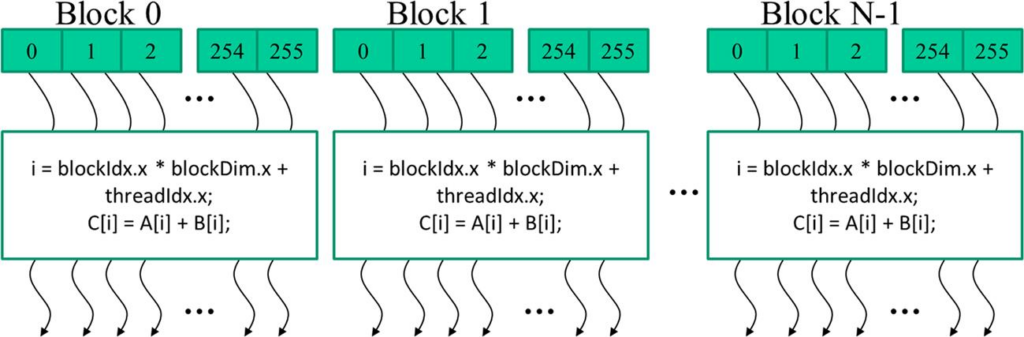
Ta sẽ thảo luận sau cách sử dụng nhiều khối để xử lý các tập dữ liệu cực lớn vượt quá giới hạn số lượng luồng của một khối đơn lẻ.
Biên dịch (Compilation)
Quy trình biên dịch một chương trình CUDA C khác với chương trình C thông thường vì nó chứa cả mã chạy trên CPU (host) và mã chạy trên GPU (device).
Trình biên dịch NVCC: NVIDIA cung cấp một trình biên dịch tên là nvcc. Nó sẽ phân tách mã máy chủ và mã thiết bị trong tệp nguồn (thường có phần mở rộng là .cu).
Xử lý mã máy chủ: Mã máy chủ là mã C/C++ tiêu chuẩn, nó sẽ được gửi đến trình biên dịch C/C++ thông thường của hệ thống (như gcc trên Linux hoặc cl.exe trên Windows) để biên dịch và liên kết.
Xử lý mã thiết bị: Mã thiết bị (các hàm kernel và các hàm bổ trợ) sẽ được nvcc biên dịch thành một dạng trung gian gọi là PTX (Parallel Thread Execution), hoặc trực tiếp thành mã máy nhị phân cho một kiến trúc GPU cụ thể.
Hợp nhất: Cuối cùng, nvcc sẽ chèn các lệnh cần thiết để nạp mã thiết bị vào GPU và kích hoạt kernel vào trong mã máy chủ, tạo ra một tệp thực thi duy nhất.
Khi ta chạy tệp thực thi này, phần mã máy chủ sẽ bắt đầu chạy trên CPU. Khi gặp lệnh gọi kernel, hệ thống sẽ sử dụng mã thiết bị đã được đóng gói sẵn để kích hoạt các luồng trên GPU.
Ta đã làm quen với những khái niệm nền tảng nhất của lập trình song song trên nền tảng CUDA. Dưới đây là những điểm quan trọng mà ta cần ghi nhớ để làm tiền đề cho các kỹ thuật tối ưu hóa phức tạp hơn:
Song song hóa dữ liệu (Data Parallelism): Đây là chìa khóa để đạt được hiệu suất cao. Khi một công việc lớn có thể chia nhỏ thành các phần độc lập (như xử lý từng điểm ảnh hoặc từng phần tử vectơ), ta có thể tận dụng hàng nghìn lõi xử lý của GPU để thực thi chúng cùng lúc.
Mô hình Máy chủ – Thiết bị (Host – Device): Một chương trình CUDA luôn có sự phân chia vai trò rõ rệt. CPU (Host) đóng vai trò điều khiển, quản lý luồng công việc, trong khi GPU (Device) đóng vai trò là bộ tăng tốc, thực thi các tác vụ tính toán nặng.
Quản lý bộ nhớ: Ta đã học cách sử dụng các hàm API của CUDA để quản lý vòng đời của dữ liệu trên GPU:
cudaMalloc: Cấp phát không gian trên thiết bị.
cudaMemcpy: Chuyển dữ liệu qua lại giữa RAM máy chủ và VRAM thiết bị.
cudaFree: Giải phóng tài nguyên sau khi sử dụng.
Kernel và Luồng (Threads): Kernel là hàm chạy trên GPU. Khi kích hoạt một kernel, ta không chỉ gọi một hàm đơn thuần mà là đang kích hoạt cả một lưới (grid) gồm rất nhiều luồng. Mỗi luồng sử dụng các biến như threadIdx để biết mình cần xử lý phần dữ liệu nào.
Mô hình SPMD: CUDA sử dụng mô hình “Một chương trình, nhiều dữ liệu”, giúp đơn giản hóa việc lập trình song song bằng cách viết một đoạn mã duy nhất nhưng cho phép hàng triệu luồng thực thi nó trên các vùng dữ liệu khác nhau.
Ngôn ngữ C mang lại nhiều quyền kiểm soát hơn đối với cách chương trình sử dụng bộ nhớ của máy tính.
Mã C bao gồm các con trỏ
Con trỏ là một trong những thứ cơ bản nhất cần hiểu trong ngôn ngữ lập trình C. Vậy con trỏ là gì? Một con trỏ chỉ đơn giản là địa chỉ của một mẩu dữ liệu trong bộ nhớ.
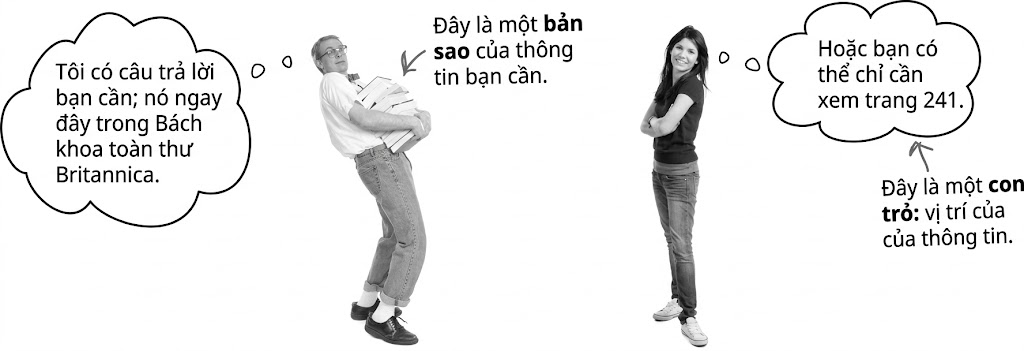
1 – Thay vì truyền đi toàn bộ một bản sao của dữ liệu, bạn chỉ cần truyền một con trỏ.
Hãy tưởng tượng bạn có một cuốn bách khoa toàn thư dày 10.000 trang. Một người bạn muốn mượn nó để tra cứu.
Không dùng con trỏ (Truyền bản sao): Bạn phải đi photocopy toàn bộ 10.000 trang đó và đưa cho bạn của bạn. Quá trình này tốn cực kỳ nhiều thời gian, công sức và tốn thêm một không gian khổng lồ để chứa bộ copy đó.
Dùng con trỏ: Bạn chỉ cần viết số giá sách (địa chỉ) lên một tờ giấy note nhỏ xíu và đưa cho người bạn: “Nó ở ngăn số 3, kệ số 5 nhé”. Nhanh, gọn, lẹ.
Trong C, nếu bạn có một cục dữ liệu rất lớn (như một struct chứa hàng ngàn thông tin), việc copy nó mỗi lần gọi hàm sẽ làm chậm chương trình của bạn.
C
#include<stdio.h>// Một cục dữ liệu khổng lồ (Giống như cuốn sách 10.000 trang)struct DuLieuKhongLo {int mang[10000];};// CÁCH 1: KHÔNG DÙNG CON TRỎ (Truyền bản sao - Chậm, tốn bộ nhớ)// Máy tính phải copy toàn bộ 10.000 phần tử vào một biến 'ban_sao' mớivoidXuLyBanSao(struct DuLieuKhongLo ban_sao){printf("Đang xử lý bản sao...\n");}// CÁCH 2: DÙNG CON TRỎ (Truyền địa chỉ - Nhanh, nhẹ)// Máy tính chỉ cần truyền 1 địa chỉ duy nhất (như tờ giấy note)voidXuLyConTro(struct DuLieuKhongLo *dia_chi_du_lieu){printf("Đang xử lý trực tiếp từ địa chỉ...\n");}intmain(){struct DuLieuKhongLo du_lieu_cua_toi;// Gọi hàm cách 2 sẽ chạy nhanh hơn rất nhiều!XuLyConTro(&du_lieu_cua_toi);return0;}
2 – Bạn có thể muốn hai đoạn mã cùng hoạt động trên cùng một mẩu dữ liệu thay vì trên một bản sao tách biệt.
Không dùng con trỏ (Làm việc trên bản sao): Bạn tải một file Word báo cáo về máy tính và gửi qua email cho sếp. Sếp sửa lỗi chính tả trên file của sếp. Sửa xong, file trên máy bạn không hề thay đổi vì sếp đang sửa trên bản copy của sếp.
Dùng con trỏ: Bạn tạo một link Google Docs và gửi cho sếp (link này chính là con trỏ). Cả bạn và sếp đều đang nhìn vào và chỉnh sửa trên cùng một tài liệu duy nhất. Sếp gõ chữ nào, bạn thấy chữ đó.
Con trỏ giúp bạn làm cả hai việc này: tránh việc tạo bản sao và chia sẻ dữ liệu.
Bộ nhớ
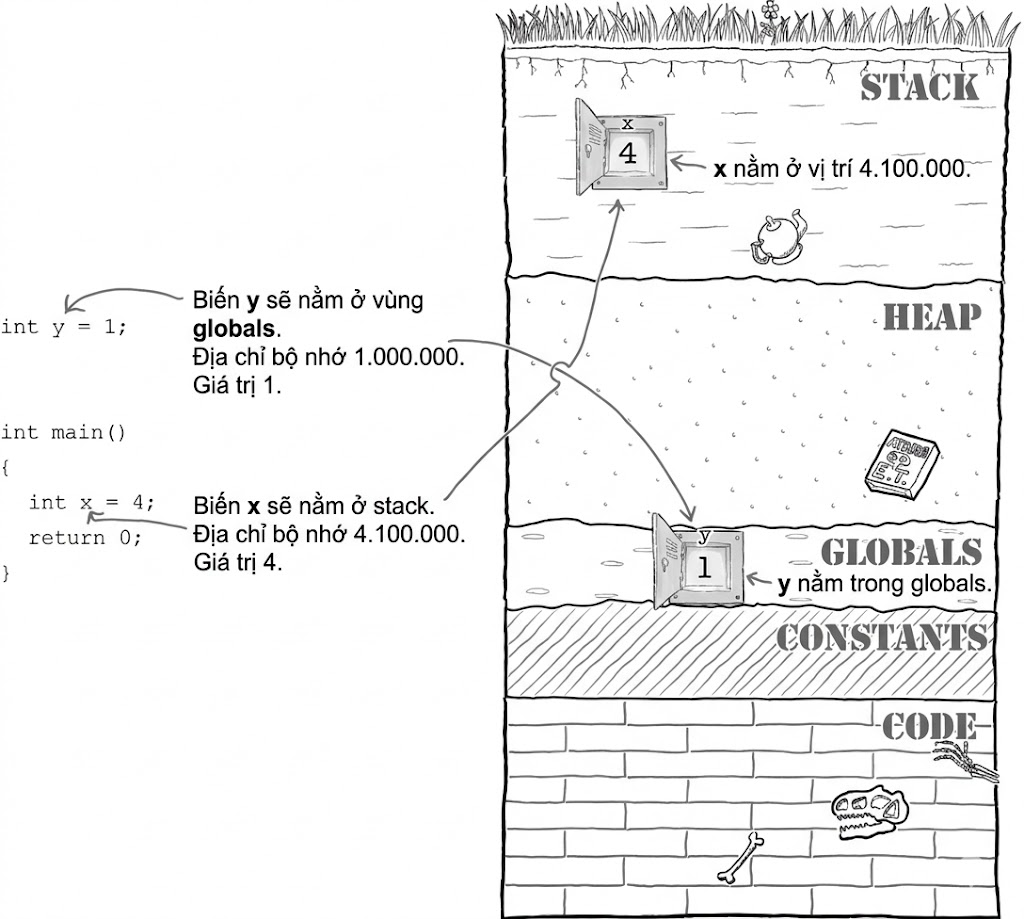
Mỗi khi bạn khai báo một biến, máy tính sẽ tạo ra không gian cho nó ở một nơi nào đó trong bộ nhớ. Nếu bạn khai báo một biến bên trong một hàm như main(), máy tính sẽ lưu trữ nó trong một khu vực của bộ nhớ được gọi là stack (ngăn xếp). Nếu một biến được khai báo bên ngoài bất kỳ hàm nào, nó sẽ được lưu trữ trong phần globals (toàn cục) của bộ nhớ.
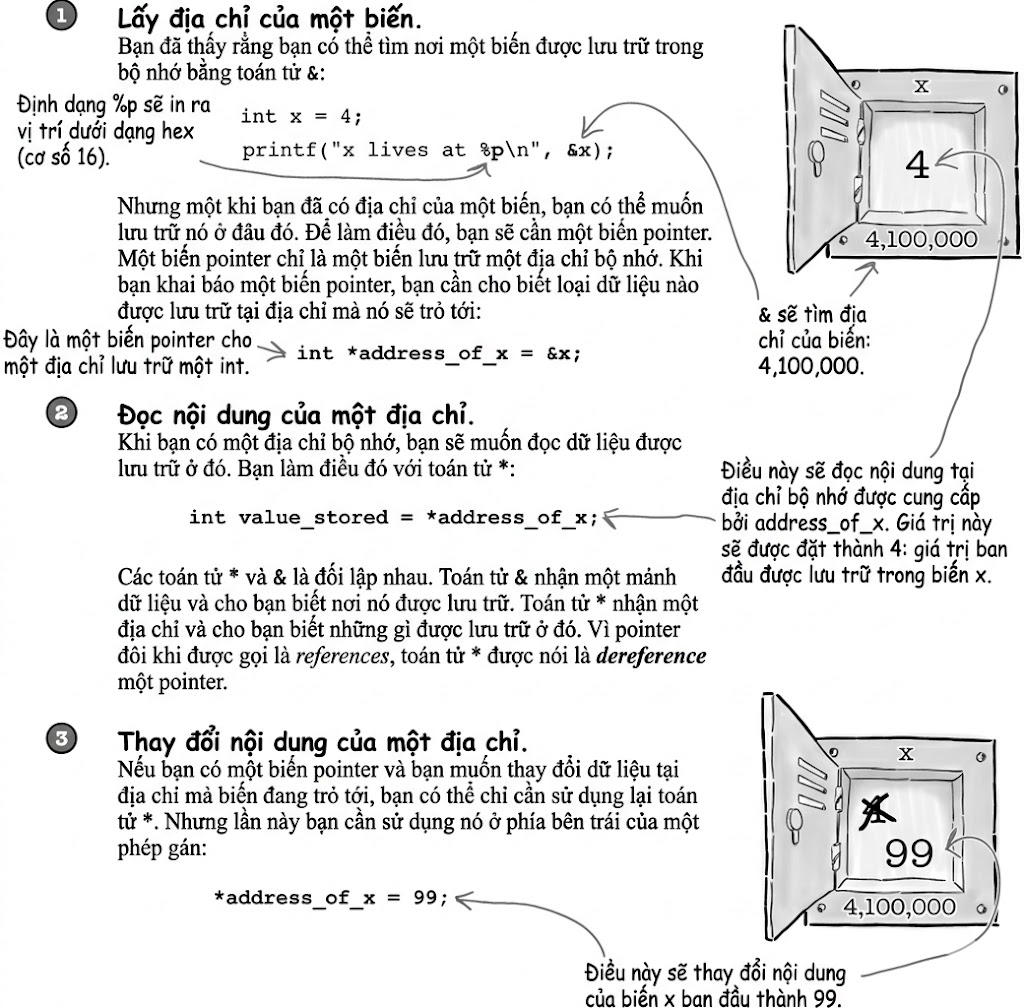
Máy tính có thể cấp phát, giả sử, vị trí bộ nhớ số 4.100.000 trong ngăn xếp (stack) cho biến x. Nếu bạn gán số 4 cho biến đó, máy tính sẽ lưu số 4 tại vị trí 4.100.000.
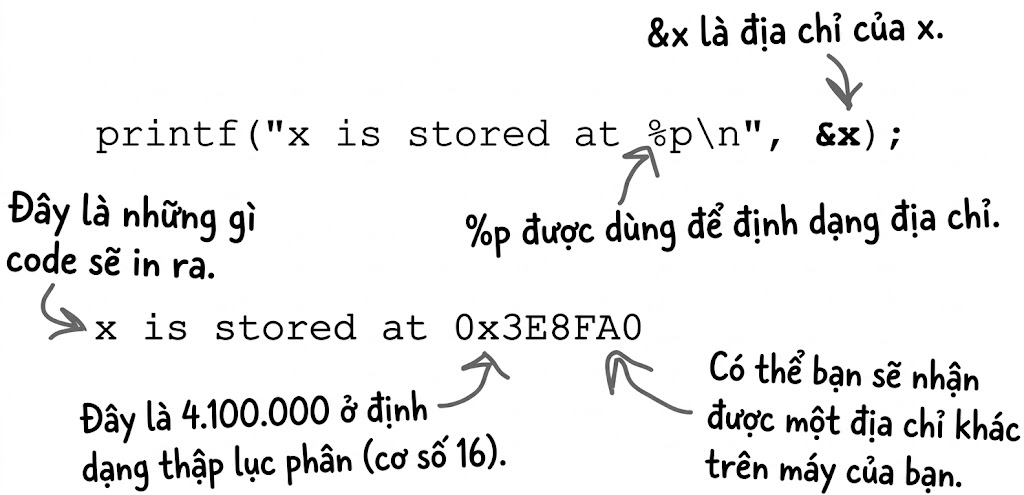
Nếu bạn muốn tìm ra địa chỉ bộ nhớ của biến, bạn có thể sử dụng toán tử &:
Địa chỉ của biến cho bạn biết nơi để tìm thấy biến đó trong bộ nhớ. Đó là lý do tại sao một địa chỉ cũng được gọi là một con trỏ, bởi vì nó trỏ tới biến đó trong bộ nhớ.
Vấn đề khi truyền tham số bằng giá trị
Hãy tưởng tượng bạn đang viết một trò chơi trong đó người chơi phải tìm đường di chuyển xung quanh…
Trò chơi sẽ cần kiểm soát rất nhiều thứ, như điểm số, mạng sống và vị trí hiện tại của người chơi. Bạn sẽ không muốn viết trò chơi thành một khối mã nguồn khổng lồ; thay vào đó, bạn sẽ tạo ra nhiều hàm nhỏ hơn, mỗi hàm sẽ thực hiện một việc gì đó hữu ích trong trò chơi:
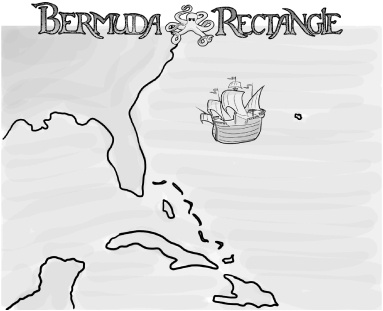
Tất cả những điều này thì có liên quan gì đến con trỏ? Hãy bắt đầu viết mã mà không cần lo lắng chút nào về con trỏ cả. Bạn cứ việc sử dụng các biến như bạn vẫn thường làm. Một phần chính của trò chơi sẽ là điều hướng con tàu của bạn xung quanh Hình chữ nhật Bermuda, vì vậy hãy đi sâu hơn vào việc mã nguồn sẽ cần làm gì trong một trong các hàm điều hướng.
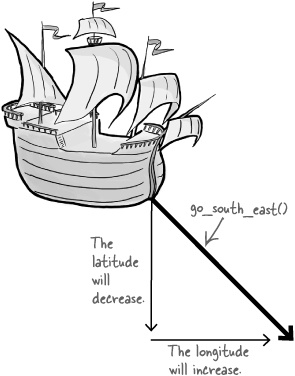
Trò chơi sẽ theo dõi vị trí của người chơi bằng cách sử dụng vĩ độ (latitudes) và kinh độ (longitudes). Vĩ độ là khoảng cách người chơi ở về phía Bắc hay Nam, còn kinh độ là vị trí của họ ở phía Đông hay Tây. Nếu một người chơi muốn đi về phía Đông Nam, điều đó có nghĩa là vĩ độ của họ sẽ giảm xuống, và kinh độ của họ sẽ tăng lên:
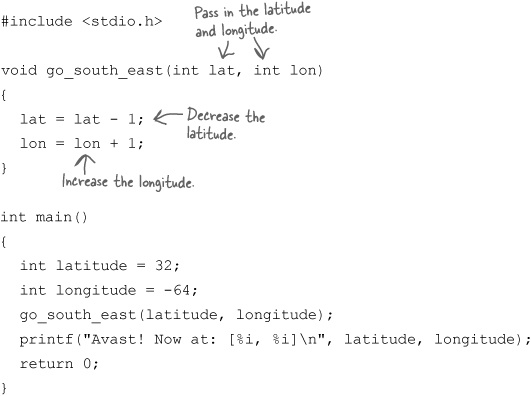
Vì vậy, bạn có thể viết một hàm go_south_east() nhận các đối số cho vĩ độ và kinh độ, sau đó nó sẽ tăng và giảm (các giá trị này):
Chương trình bắt đầu đặt một con tàu ở vị trí [32, –64], vì vậy nếu nó đi về hướng Đông Nam, vị trí mới của con tàu sẽ là [31, –63].
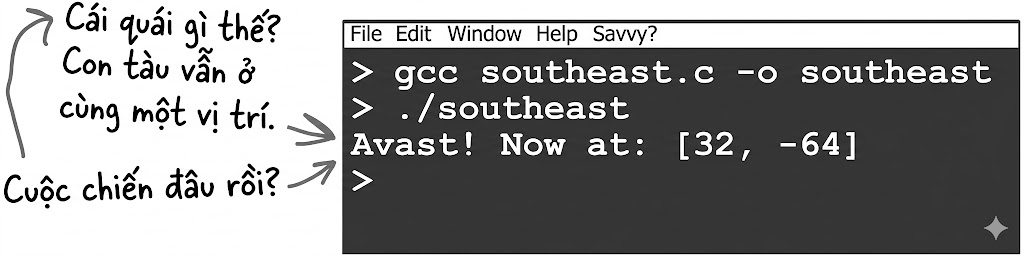
Mã nguồn đáng lẽ phải di chuyển con tàu về phía Đông Nam từ [32, –64] đến vị trí mới tại [31, –63]. Nhưng nếu bạn biên dịch và chạy chương trình, điều này sẽ xảy ra:
Vị trí của con tàu vẫn giữ nguyên chính xác như trước.
C truyền các đối số dưới dạng giá trị
Đoạn mã đã bị lỗi do cách mà ngôn ngữ C gọi hàm.
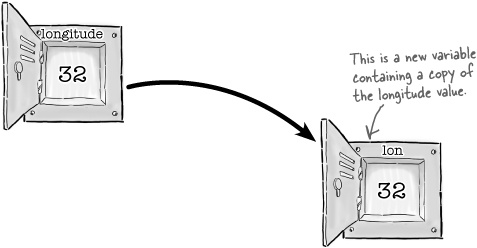
Ban đầu, hàm main() có một biến cục bộ tên là longitude chứa giá trị 32.
Khi máy tính gọi hàm go_south_east(), nó sao chép giá trị của biến longitude sang đối số lon. Đây thực chất chỉ là một phép gán từ biến longitude sang biến lon. Khi bạn gọi một hàm, bạn không truyền bản thân biến đó làm đối số, mà chỉ truyền giá trị của nó.
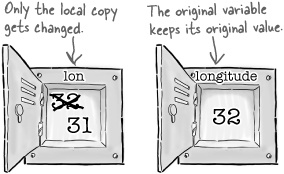
Khi hàm go_south_east() thay đổi giá trị của lon, hàm này chỉ đang thay đổi bản sao cục bộ của chính nó. Điều đó có nghĩa là khi máy tính quay trở lại hàm main(), biến longitude vẫn giữ giá trị ban đầu của nó là 32.
Nhưng nếu đó là cách C gọi hàm, thì làm sao bạn có thể viết được một hàm có khả năng cập nhật một biến?
Sẽ rất dễ dàng nếu bạn sử dụng con trỏ…
Hãy thử truyền một con trỏ trỏ tới biến
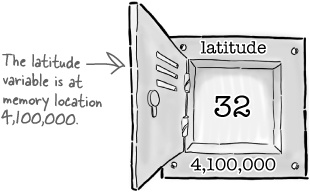
Thay vì truyền giá trị của các biến vĩ độ và kinh độ, điều gì sẽ xảy ra nếu bạn truyền địa chỉ của chúng? Nếu biến kinh độ (longitude) nằm trong bộ nhớ ngăn xếp (stack) tại vị trí 4.100.000, điều gì sẽ xảy ra nếu bạn truyền số vị trí 4.100.000 làm tham số cho hàm go_south_east()?
Nếu hàm go_south_east() được báo cho biết rằng giá trị vĩ độ (latitude) nằm ở vị trí 4.100.000, thì nó sẽ không chỉ có thể tìm thấy giá trị vĩ độ hiện tại, mà còn có thể thay đổi nội dung của biến vĩ độ gốc. Tất cả những gì hàm cần làm là đọc và cập nhật nội dung của vị trí bộ nhớ 4.100.000.
Bởi vì hàm go_south_east() đang cập nhật trực tiếp biến vĩ độ gốc, máy tính sẽ có thể in ra vị trí đã được cập nhật khi nó quay trở lại hàm main().
Hỏi: Tôi đã in vị trí của biến trên máy của mình và nó không phải là 4.100.000. Tôi có làm gì sai không?
Đáp: Bạn không làm gì sai cả. Vị trí bộ nhớ mà chương trình của bạn sử dụng cho các biến sẽ khác nhau từ máy này sang máy khác.
Hỏi: Tại sao các biến cục bộ được lưu trữ trong ngăn xếp (stack) và các biến toàn cục (globals) được lưu trữ ở một nơi khác?
Đáp: Các biến cục bộ và toàn cục được sử dụng theo những cách khác nhau. Bạn sẽ luôn chỉ có một bản sao duy nhất của một biến toàn cục, nhưng nếu bạn viết một hàm tự gọi chính nó (đệ quy), bạn có thể nhận được rất nhiều phiên bản của cùng một biến cục bộ.
Con trỏ giúp việc chia sẻ bộ nhớ dễ dàng hơn
Đây là một trong những lý do chính để sử dụng con trỏ, nhằm cho phép các hàm chia sẻ bộ nhớ. Dữ liệu được tạo ra bởi một hàm có thể được sửa đổi bởi một hàm khác, miễn là nó biết nơi để tìm thấy dữ liệu đó trong bộ nhớ.
Những điểm chính
Các biến được cấp phát không gian lưu trữ trong bộ nhớ.
Các biến cục bộ tồn tại trong ngăn xếp / stack.
Các biến toàn cục tồn tại trong khu vực toàn cục / globals.
Con trỏ chỉ là các biến lưu trữ các địa chỉ bộ nhớ.
Toán tử & tìm địa chỉ của một biến.)
Toán tử * có thể đọc nội dung của một địa chỉ bộ nhớ.
Toán tử * cũng có thể thiết lập / thay đổi nội dung của một địa chỉ bộ nhớ.
Hỏi: Các con trỏ (pointers) có phải là địa chỉ vật lý thực sự trên chip RAM không?
Đáp: Không hoàn toàn. Con trỏ lưu trữ địa chỉ ảo (virtual address) thuộc không gian địa chỉ (address space) của một tiến trình (process). Đối với tiến trình đó, đây là địa chỉ “thực”, nhưng nó không trỏ trực tiếp đến vị trí vật lý trên chip RAM.
Hỏi: “Không gian địa chỉ ảo” có nghĩa là gì?
Đáp: Hệ điều hành (OS) cung cấp cho mỗi tiến trình một lớp trừu tượng (abstraction layer). Tiến trình nhìn thấy bộ nhớ như một dải ô nhớ tuyến tính, liên tục, đánh số từ 0 đến N. Điều này giúp lập trình viên không phải quản lý việc tranh chấp bộ nhớ với các tiến trình khác đang chạy song song. VD: Discord và Zalo đều cùng chạy trên máy bạn, 2 tiến trình không cần lo về việc Discord cũng muốn lưu biến “tên người dùng” ở ô nhớ 1000, Zalo cũng muốn lưu “danh bạ” ở ô nhớ 1000. Thực tế hệ điều hành sẽ cấp phát cho tiến trình 1 mã khác, ví dụ Hà Nội và Bắc Ninh có 1 số tên đường giống nhau, còn bên dưới trên đường đó nhà số 1 đường Quang Trung ở Bắc Ninh không phải nhà số 1 đường Quang Trung ở Hà Nội. Việc quản lý đó là nội bộ trong tiến trình
Hỏi: Tại sao bộ nhớ thực tế lại không giống như vậy?
Đáp: Bộ nhớ vật lý (RAM) được quản lý theo các đơn vị gọi là khung trang (page frames). Một dữ liệu mà bạn thấy là “liên tục” trong bộ nhớ ảo có thể bị chia nhỏ và nằm rải rác ở nhiều vị trí khác nhau trên RAM vật lý. Việc tách biệt này cho phép Hệ điều hành thực hiện các kỹ thuật: Paging (Phân trang): Di chuyển các phần bộ nhớ ít dùng từ RAM xuống ổ cứng (Swap/Pagefile) để giải phóng không gian. Memory Protection (Bảo vệ bộ nhớ): Ngăn chặn tiến trình này truy cập trái phép vào dữ liệu của tiến trình khác. Relocation (Tái định vị): Di chuyển dữ liệu trong RAM mà không làm thay đổi giá trị của con trỏ trong chương trình.
Cơ chế nào chuyển đổi từ “địa chỉ ảo” trong con trỏ sang “địa chỉ vật lý”?
Đó là nhiệm vụ của MMU (Memory Management Unit) – một thành phần phần cứng trong CPU – kết hợp với Page Tables (Bảng trang) do Hệ điều hành quản lý. Mỗi khi bạn truy xuất một con trỏ, MMU sẽ tra cứu bảng này để tìm ra địa chỉ vật lý tương ứng trên RAM.
Cấu trúc vật lý của RAM phức tạp như thế nào?
Ở cấp độ phần cứng, RAM được tổ chức thành các Channels (Kênh), Ranks, và Banks. Dữ liệu được truy xuất thông qua các tín hiệu điện dựa trên địa chỉ dòng (Row) và cột (Column). Ngoài ra, các kiến trúc hiện đại như NUMA (Non-Uniform Memory Access) còn khiến tốc độ truy cập bộ nhớ khác nhau tùy thuộc vào khoảng cách vật lý giữa CPU và các thanh RAM.
Hỏi: Tại sao tôi phải in các con trỏ ra bằng cách sử dụng chuỗi định dạng %p?
Đáp: Bạn không bắt buộc phải sử dụng chuỗi %p. Trên hầu hết các cỗ máy hiện đại, bạn có thể sử dụng %li (long integer), mặc dù trình biên dịch có thể đưa ra cho bạn một cảnh báo nếu bạn làm vậy.
Hỏi: Tại sao định dạng %p lại hiển thị địa chỉ bộ nhớ ở định dạng hex (thập lục phân)?
Đáp: Đó là cách các kỹ sư thường dùng để nhắc tới các địa chỉ bộ nhớ.
Truyền String vào hàm
Bạn đã biết cách truyền các giá trị đơn giản làm đối số (arguments) cho hàm, nhưng chuyện gì sẽ xảy ra nếu bạn muốn gửi một thứ gì đó phức tạp hơn vào hàm, chẳng hạn như một chuỗi (string)?
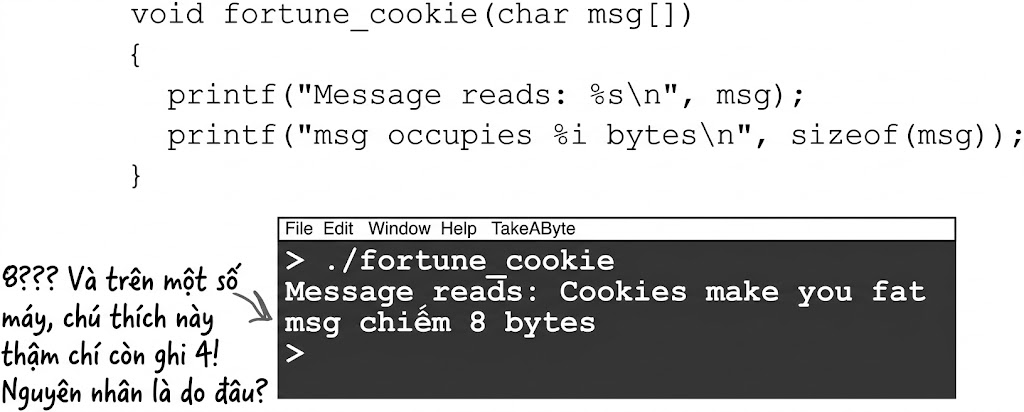
Chuỗi trong C thực chất là các mảng ký tự (arrays of characters). Điều đó có nghĩa là nếu bạn muốn truyền một chuỗi vào hàm, bạn có thể làm như thế này:
Đối số msg được định nghĩa giống như một mảng, nhưng vì bạn sẽ không biết trước chuỗi đó dài bao nhiêu, nên đối số msg không bao gồm độ dài cụ thể. Điều này trông có vẻ đơn giản và dễ hiểu, nhưng có một điều hơi kỳ lạ đang diễn ra…
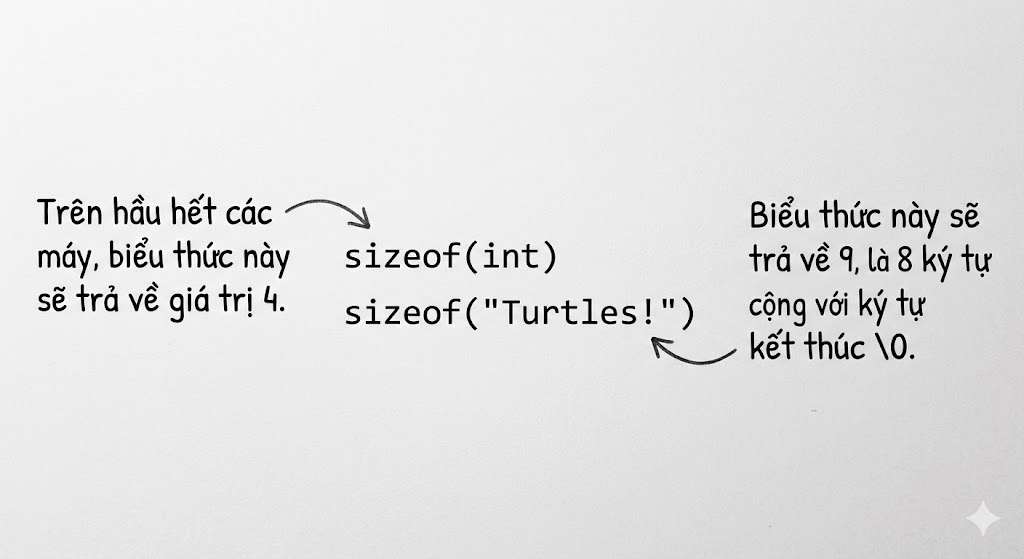
C có một toán tử (operator) gọi là sizeof, nó có thể cho bạn biết một thứ gì đó chiếm bao nhiêu byte không gian trong bộ nhớ. Bạn có thể gọi toán tử này kèm với một kiểu dữ liệu (data type) hoặc với một đoạn dữ liệu cụ thể:
Nhưng một điều kỳ lạ sẽ xảy ra nếu bạn nhìn vào độ dài của chuỗi mà bạn đã truyền vào hàm:
Thay vì hiển thị toàn bộ chiều dài thực tế của chuỗi, đoạn mã chỉ trả về 4 hoặc 8 byte. Chuyện gì đã xảy ra vậy? Tại sao nó lại nghĩ rằng chuỗi chúng ta truyền vào lại ngắn hơn?
Theo bạn, tại sao sizeof(msg) lại ngắn hơn chiều dài của toàn bộ chuỗi? msg thực chất là gì? Tại sao nó lại trả về các kích thước khác nhau trên các máy tính khác nhau?
Biến mảng (Array variables) giống như con trỏ (pointers)
Khi bạn tạo một mảng, biến mảng đó có thể được sử dụng như một con trỏ trỏ đến vị trí bắt đầu của mảng trong bộ nhớ. Khi C nhìn thấy một dòng mã trong một hàm như thế này:
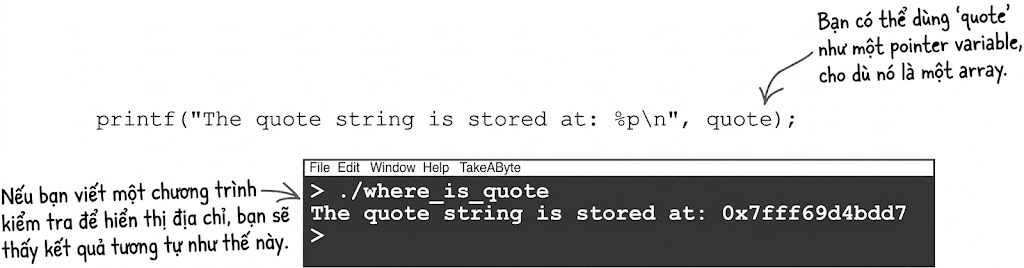
Máy tính sẽ dành riêng một không gian trên ngăn xếp (stack) cho từng ký tự trong chuỗi, cộng thêm ký tự kết thúc \0. Nhưng nó cũng sẽ liên kết địa chỉ của ký tự đầu tiên với biến quote. Mỗi khi biến quote được sử dụng trong mã, máy tính sẽ thay thế nó bằng địa chỉ của ký tự đầu tiên trong chuỗi. Trên thực tế, biến mảng hoạt động y hệt như một con trỏ:
…vậy hóa ra hàm của chúng ta đã được truyền một con trỏ
Đó chính là lý do tại sao điều kỳ lạ kia lại xảy ra trong đoạn mã fortune_cookie(). Mặc dù trông có vẻ như bạn đang truyền một chuỗi (string) vào hàm fortune_cookie(), nhưng thực tế bạn chỉ đang truyền một con trỏ trỏ đến chuỗi đó mà thôi:
Và đó cũng là lý do tại sao toán tử sizeof lại trả về một kết quả kỳ quặc. Nó chỉ đang trả về kích thước của một con trỏ trỏ đến một chuỗi. Trên các hệ điều hành 32-bit, một con trỏ chiếm 4 byte bộ nhớ, và trên các hệ điều hành 64-bit, một con trỏ chiếm 8 byte.
Hỏi:sizeof có phải là một hàm (function) không?
Đáp: Không, nó là một toán tử (operator).
Hỏi: Sự khác biệt là gì?
Đáp: Một toán tử được trình biên dịch (compiler) biên dịch thành một chuỗi các chỉ thị. Nhưng nếu đoạn mã gọi một hàm, nó phải nhảy đến một phần mã riêng biệt khác. Nó không phải là một hàm vì: Cú pháp: Đối với các biểu thức (expressions), sizeof không bắt buộc phải có dấu ngoặc đơn (ví dụ: sizeof x là hợp lệ). Hàm luôn yêu cầu dấu ngoặc đơn để truyền đối số. Xử lý: Hàm được thực thi bởi CPU khi chương trình đang chạy. sizeof chủ yếu được xử lý bởi trình biên dịch trong quá trình chuyển đổi mã nguồn thành mã máy.
Hỏi: Vậy sizeof được tính toán khi chương trình được biên dịch à?
Đáp: Đúng vậy. Trình biên dịch có thể xác định kích thước không gian lưu trữ ngay tại thời điểm biên dịch (compile time).
Khi bạn viết:
C
int a =10;size_t s =sizeof(a);
Trình biên dịch sẽ thấy a là kiểu int. Nếu trên hệ thống đó int chiếm 4 bytes, trình biên dịch sẽ chuyển mã nguồn trên tương đương với việc bạn viết:
C
int a =10;size_t s =4; // Con số 4 được ghi thẳng vào mã máy
Tại thời điểm biên dịch (Compile-time)
Trong hầu hết các trường hợp, sizeof được tính toán hoàn toàn tại thời điểm biên dịch.
Trình biên dịch kiểm tra kiểu dữ liệu (static type) của toán hạng (operand).
Dựa trên bảng ký hiệu (symbol table) và quy tắc căn chỉnh bộ nhớ (memory alignment) của kiến trúc mục tiêu (ví dụ: x86 hoặc ARM), trình biên dịch xác định số lượng byte mà kiểu dữ liệu đó chiếm dụng.
Trình biên dịch sau đó thay thế toàn bộ biểu thức sizeof(...) bằng một hằng số (constant literal) trong mã máy.
Hệ quả: Không có lệnh gọi hàm (function call), không có việc nhảy địa chỉ bộ nhớ, và không tiêu tốn tài nguyên CPU khi chương trình đang chạy để tính toán giá trị này.
Tại thời điểm thực thi (Runtime) – Ngoại lệ
Có một trường hợp duy nhất sizeof được tính toán khi chương trình đang chạy: Mảng có kích thước thay đổi (Variable Length Array – VLA) trong tiêu chuẩn C99. Khi bạn khai báo int arr[n] với n là một biến, trình biên dịch không thể biết n bằng bao nhiêu cho đến khi chương trình chạy. Lúc này, sizeof(arr) sẽ tạo ra mã máy để tính toán kích thước dựa trên giá trị hiện tại của n.
Hỏi: Tại sao con trỏ lại có kích thước khác nhau trên các máy tính khác nhau?
Đáp: Trên hệ điều hành 32-bit, một địa chỉ bộ nhớ được lưu trữ dưới dạng một số 32-bit. Đó là lý do tại sao nó được gọi là hệ thống 32-bit. 32 bit == 4 byte. Đó cũng là lý do tại sao hệ thống 64-bit lại sử dụng 8 byte để lưu trữ một địa chỉ.
Hỏi: Nếu tôi tạo một biến con trỏ, biến con trỏ đó có nằm trong bộ nhớ không?
Đáp: Có. Biến con trỏ thực chất chỉ là một biến dùng để lưu trữ một con số.
Hỏi: Vậy tôi có thể tìm địa chỉ của một biến con trỏ không?
Đáp: Có — bằng cách sử dụng toán tử &.
Hỏi: Tôi có thể chuyển đổi một con trỏ thành một con số thông thường không?
Đáp: Trên hầu hết các hệ thống là có. Các trình biên dịch C thường làm cho kiểu dữ liệu long có cùng kích thước với một địa chỉ bộ nhớ. Vì vậy, nếu p là một con trỏ và bạn muốn lưu nó vào một biến long tên là a, bạn có thể gõ a = (long)p.
Nhưng biến mảng không hoàn toàn là con trỏ
Mặc dù bạn có thể sử dụng một biến mảng như một con trỏ, nhưng vẫn có một vài điểm khác biệt. Để thấy sự khác biệt này, hãy suy nghĩ về đoạn mã sau:
C
char s[]="How big is it?";char*t = s;
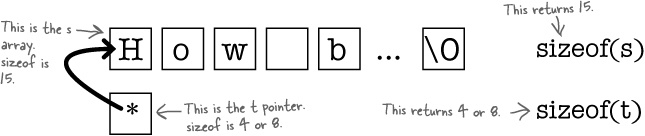
sizeof(một mảng) là… kích thước của một mảng.
Bạn đã thấy rằng sizeof(một con trỏ) trả về giá trị 4 hoặc 8, bởi vì đó là kích thước của con trỏ trên các hệ thống 32-bit và 64-bit. Nhưng nếu bạn gọi sizeof trên một biến mảng, C đủ thông minh để hiểu rằng điều bạn muốn biết là mảng đó lớn cỡ nào trong bộ nhớ.
Địa chỉ của mảng… chính là địa chỉ của mảng.
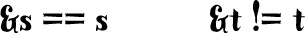
Một biến con trỏ chỉ là một biến lưu trữ một địa chỉ bộ nhớ. Nhưng còn biến mảng thì sao? Nếu bạn sử dụng toán tử & trên một biến mảng, kết quả bằng chính biến mảng đó.
Nếu một lập trình viên viết &s, điều đó có nghĩa là “Địa chỉ của mảng s là gì?”. Địa chỉ của mảng s chỉ đơn giản là… s. Nhưng nếu ai đó viết &t, điều đó có nghĩa là “Địa chỉ của biến t là gì?”.
Một biến mảng không thể trỏ đi nơi khác.
Khi bạn tạo một biến con trỏ, máy tính sẽ cấp phát 4 hoặc 8 byte không gian để lưu trữ nó. Nhưng chuyện gì sẽ xảy ra nếu bạn tạo một mảng? Máy tính sẽ cấp phát không gian để lưu trữ mảng, nhưng nó sẽ không cấp phát bất kỳ bộ nhớ nào để lưu trữ bản thân cái “biến” mảng đó. Trình biên dịch chỉ đơn giản là gắn địa chỉ của phần tử bắt đầu của mảng vào đó.
Nhưng bởi vì các biến mảng không có không gian lưu trữ được cấp phát, điều đó có nghĩa là bạn không thể bắt chúng trỏ vào bất cứ thứ gì khác.
Tại sao mảng thực sự bắt đầu từ 0
Một biến mảng có thể được sử dụng như một con trỏ trỏ đến phần tử đầu tiên trong một mảng. Điều đó có nghĩa là bạn có thể đọc phần tử đầu tiên của mảng bằng cách sử dụng ký pháp ngoặc vuông hoặc sử dụng toán tử * như thế này:
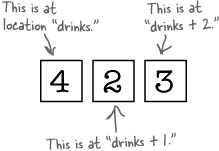
Nhưng vì một địa chỉ bộ nhớ chỉ là một con số, điều đó có nghĩa là bạn có thể thực hiện phép toán con trỏ (pointer arithmetic) và thực sự cộng thêm các giá trị vào một giá trị con trỏ để tìm địa chỉ tiếp theo. Vì vậy, bạn có thể sử dụng ngoặc vuông để đọc phần tử có chỉ số 2, hoặc bạn chỉ cần cộng 2 vào địa chỉ của phần tử đầu tiên:
Nói chung, hai biểu thức drinks[i] và *(drinks + i) là hoàn toàn tương đương nhau. Đó là lý do tại sao các mảng bắt đầu bằng chỉ số 0. Chỉ số (index) thực chất chỉ là con số được cộng vào con trỏ để tìm vị trí của phần tử đó.
Hỏi: Khi nào C điều chỉnh các tính toán của phép toán con trỏ?
Đáp: Nó xảy ra khi trình biên dịch đang tạo ra tệp thực thi (executable). Nó xem xét kiểu dữ liệu của biến và sau đó nhân các dấu cộng và trừ với kích thước của biến cơ sở. Nếu trình biên dịch thấy rằng bạn đang làm việc với một mảng int và bạn đang cộng 2, trình biên dịch sẽ nhân số đó với 4 (chiều dài của một int) và cộng thêm 8.
Hỏi: C có sử dụng toán tử sizeof khi nó đang điều chỉnh phép toán con trỏ không?
Đáp: Về hiệu quả là có. Toán tử sizeof cũng được giải quyết tại thời điểm biên dịch, và cả sizeof lẫn các phép toán con trỏ sẽ sử dụng cùng các kích thước cho các kiểu dữ liệu khác nhau.
Tại sao con trỏ có kiểu dữ liệu
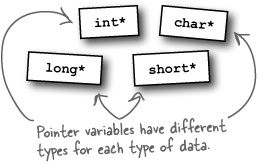
Nếu con trỏ chỉ đơn thuần là các địa chỉ, vậy thì tại sao các biến con trỏ lại cần có kiểu dữ liệu (như int*, char*,…)? Tại sao bạn không thể lưu trữ tất cả các con trỏ vào một loại biến con trỏ chung duy nhất nào đó?
Lý do là vì phép toán con trỏ (pointer arithmetic) rất “láu cá”.
Nếu bạn cộng 1 vào một con trỏ kiểu char, con trỏ đó sẽ trỏ đến ngay địa chỉ bộ nhớ tiếp theo. Nhưng đó là bởi vì một ký tự (char) chỉ chiếm đúng 1 byte bộ nhớ.
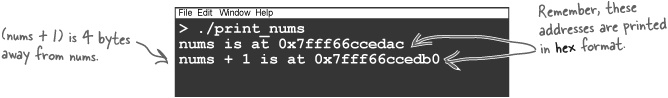
Vậy chuyện gì xảy ra nếu bạn có một con trỏ kiểu int? Các số nguyên (int) thường chiếm 4 byte dung lượng, vì vậy nếu bạn cộng 1 vào một con trỏ kiểu int, mã nguồn sau khi biên dịch thực chất sẽ cộng 4 vào địa chỉ bộ nhớ đó.
C
int nums[]={1,2,3};printf("nums đang ở địa chỉ %p\n", nums);printf("nums + 1 đang ở địa chỉ %p\n", nums +1);
Nếu bạn chạy đoạn mã này, hai địa chỉ bộ nhớ sẽ cách nhau nhiều hơn một byte. Do đó, các kiểu con trỏ tồn tại để trình biên dịch biết cần phải điều chỉnh bao nhiêu khi thực hiện phép toán con trỏ.
Sử dụng con trỏ để nhập dữ liệu
Cách yêu cầu người dùng nhập một chuỗi ký tự từ bàn phím bằng hàm scanf():
C
char name[40];printf("Nhập tên bạn: ");scanf("%39s", name); // scanf sẽ đọc 39 kí tự cộng thêm string terminator
Hàm scanf() hoạt động như thế nào? Nó nhận vào một con trỏ kiểu char (char*), và trong trường hợp này, bạn đang truyền vào một biến mảng. Đến lúc này, chắc bạn đã lờ mờ hiểu tại sao nó lại nhận một con trỏ rồi chứ? Đó là vì hàm scanf() sẽ cập nhật nội dung của mảng đó. Những hàm cần cập nhật giá trị của một biến thì không cần giá trị của biến đó — chúng cần địa chỉ của nó.
Nhập số bằng scanf() (Entering numbers with scanf())
Vậy làm thế nào để nhập dữ liệu vào một trường số? Bạn thực hiện bằng cách truyền một con trỏ đến một biến số.
C
int age;printf("Nhập tuổi của bạn: ");scanf("%i",&age);
Bởi vì bạn truyền địa chỉ của biến số vào hàm, scanf() có thể cập nhật nội dung của biến đó. Và để giúp bạn, bạn có thể truyền một chuỗi định dạng (format string) chứa các mã định dạng tương tự như loại bạn dùng trong hàm printf(). Bạn thậm chí có thể dùng scanf() để nhập nhiều thông tin cùng lúc:
C
int lanh_su, vi_do;scanf("%i %i",&lanh_su,&vi_do);
Có một… vấn đề nho nhỏ với hàm scanf(). Từ nãy đến giờ, tất cả các đoạn mã bạn viết đều rất cẩn thận đặt giới hạn cho số lượng ký tự mà scanf() sẽ đọc vào:
scanf("%39s", name);
Tại sao lại phải làm vậy? Suy cho cùng, scanf() dùng chung kiểu chuỗi định dạng như printf(), mà khi chúng ta in một chuỗi bằng printf(), ta chỉ dùng %s thôi mà.
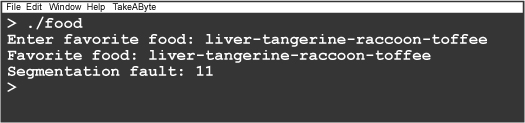
À, nếu bạn chỉ dùng %s trong scanf(), rắc rối sẽ nảy sinh nếu ai đó cao hứng gõ quá nhiều:
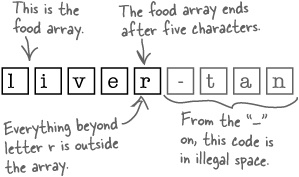
Chương trình sẽ bị crash (sập). Lý do là vì scanf() ghi dữ liệu vượt xa khỏi phạm vi bộ nhớ được cấp phát cho mảng food.
scanf() có thể gây ra lỗi tràn bộ đệm (scanf() can cause buffer overflows)
Nếu bạn quên giới hạn độ dài của chuỗi khi đọc bằng scanf(), bất kỳ người dùng nào cũng có thể nhập vào lượng dữ liệu lớn hơn nhiều so với không gian lưu trữ của chương trình. Phần dữ liệu thừa đó sẽ bị ghi đè vào những vùng bộ nhớ vốn không được máy tính cấp phát cho mục đích đó.
Nếu may mắn, dữ liệu đó chỉ đơn giản là được lưu trữ ở đó và không gây ra chuyện gì. Nhưng rất có khả năng lỗi tràn bộ đệm (buffer overflow) sẽ gây ra các lỗi nghiêm trọng (bugs). Nó có thể được gọi là segmentation fault hoặc abort trap, nhưng dù thông báo lỗi hiện ra là gì, kết quả cuối cùng vẫn là chương trình của bạn bị “ngỏm”.
fgets() là một sự thay thế cho scanf()
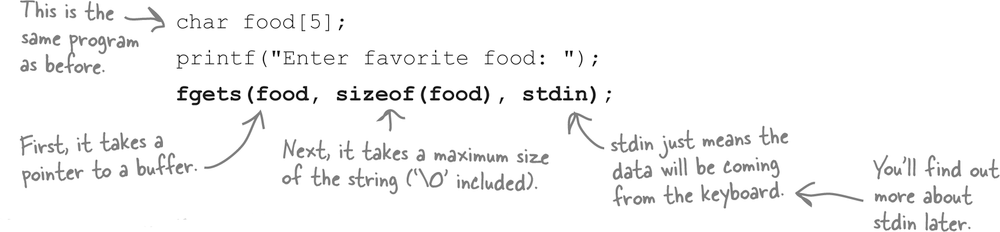
Có một hàm khác mà bạn có thể sử dụng để nhập dữ liệu văn bản: fgets(). Giống như hàm scanf(), nó nhận một con trỏ kiểu char, nhưng không giốngscanf(), hàm fgets() bắt buộc phải được cung cấp độ dài tối đa:
Điều đó có nghĩa là bạn không thể “vô tình” quên thiết lập độ dài khi gọi fgets(); nó nằm ngay trong chữ ký hàm như một đối số bắt buộc. Ngoài ra, hãy lưu ý rằng kích thước bộ đệm của fgets()đã bao gồm cả ký tự kết thúc \0. Vì vậy, bạn không cần phải trừ đi 1 đơn vị độ dài như khi làm với scanf().
Sử dụng sizeof với fgets()
Đoạn mã trên thiết lập độ dài tối đa bằng toán tử sizeof.
sizeof trả về lượng không gian bị chiếm dụng bởi một biến.
Trong đoạn mã trên, food là một biến mảng, vì vậy sizeof trả về kích thước của mảng đó (là 5).
Nếu food chỉ là một biến con trỏ đơn thuần, toán tử sizeof sẽ chỉ trả về kích thước của một con trỏ (thường là 4 hoặc 8 byte tùy hệ điều hành).
Nếu bạn biết chắc mình đang truyền một biến mảng vào hàm fgets(), thì việc dùng sizeof là ổn. Nếu bạn chỉ truyền một con trỏ đơn giản, bạn nên nhập trực tiếp kích thước mà bạn muốn:
C
fgets(con_tro_chuoi,20, stdin);
Hàm fgets() thực chất bắt nguồn từ một hàm cũ hơn gọi là gets().
Mặc dù fgets() được xem là hàm an toàn hơn scanf(), sự thật là hàm gets() cũ còn nguy hiểm khủng khiếp hơn cả hai hàm kia cộng lại. Lý do ư? Hàm gets()hoàn toàn không có giới hạn nào cả:
Tiêu chí
scanf()
fgets()
Giới hạn
Có thể giới hạn dữ liệu, miễn là bạn nhớ thêm kích thước vào chuỗi định dạng.
Có giới hạn bắt buộc. Không gì có thể lọt qua được nó.
Nhiều trường
Có! Cho phép nhập nhiều trường dữ liệu có cấu trúc (ví dụ: ngày/tháng/năm).
fgets() chỉ cho phép nhập một chuỗi duy nhất vào bộ đệm.
Khoảng trắng
%s sẽ dừng lại ngay khi gặp dấu cách. Nhập “Pizza Bò” chỉ lấy được “Pizza”.
fgets() có thể đọc toàn bộ chuỗi bao gồm cả khoảng trắng.
stdin: Bạn có để ý đối số thứ ba của fgets là stdin không? Nó viết tắt của “standard input”, nghĩa là lấy dữ liệu từ bàn phím.
Ký tự \n: Một điểm cực kỳ quan trọng là fgets() thường đọc luôn cả ký tự xuống dòng (khi bạn nhấn Enter) vào trong chuỗi. Điều này khác với scanf().
Hằng chuỗi không bao giờ có thể cập nhật được
Một biến trỏ đến một hằng chuỗi (string literal) không thể được dùng để thay đổi nội dung của chính chuỗi đó:
char *cards = "JQK";(Biến cards trỏ đến một hằng chuỗi – KHÔNG THỂ THAY ĐỔI)
Nhưng nếu bạn tạo một mảng (array) từ một hằng chuỗi, khi đó bạn có thể sửa đổi nó:
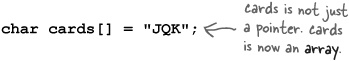
char cards[] = "JQK";(Đây là một mảng chứa bản sao của chuỗi – CÓ THỂ THAY ĐỔI)
Tất cả đều nằm ở cách mà ngôn ngữ C sử dụng bộ nhớ…
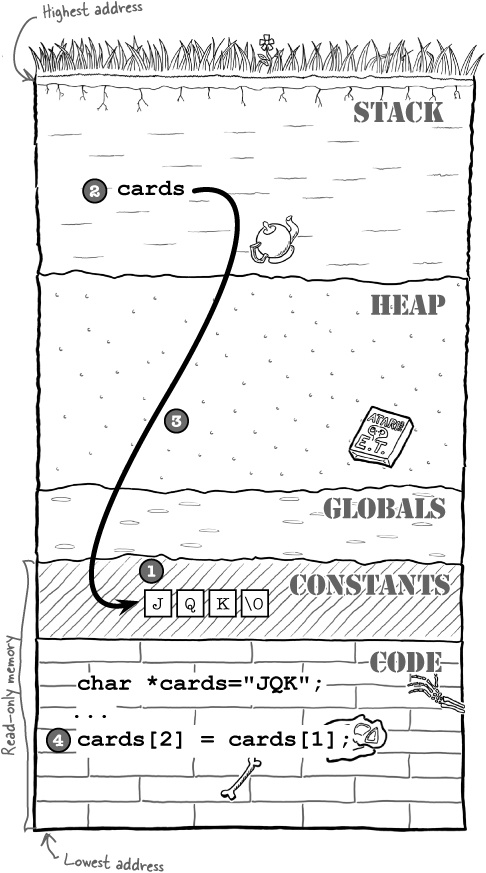
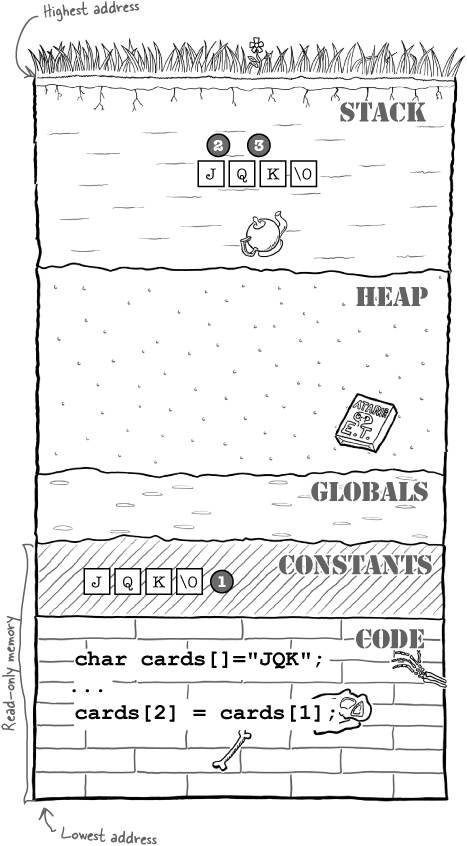
Trong bộ nhớ: char *cards = "JQK" Để hiểu tại sao dòng mã này lại gây ra lỗi bộ nhớ, chúng ta cần đào sâu vào bộ nhớ của máy tính và xem chính xác máy tính sẽ làm gì.
Máy tính nạp hằng chuỗi: Khi máy tính nạp chương trình vào bộ nhớ, nó đặt tất cả các giá trị hằng số — như hằng chuỗi "JQK" — vào khối bộ nhớ hằng số (constant memory block). Phần bộ nhớ này là chỉ đọc (read-only).
Chương trình tạo biến cards trên ngăn xếp (stack): Ngăn xếp là phần bộ nhớ mà máy tính sử dụng cho các biến cục bộ: các biến nằm bên trong hàm. Biến cards sẽ nằm ở đây.
Biến cards được gán địa chỉ của "JQK": Biến cards sẽ chứa địa chỉ của hằng chuỗi "JQK". Các hằng chuỗi thường được lưu trữ trong bộ nhớ chỉ đọc để ngăn chặn bất kỳ ai thay đổi chúng.
Máy tính cố gắng thay đổi chuỗi: Khi chương trình cố gắng thay đổi nội dung của chuỗi mà biến cards đang trỏ tới, nó không thể thực hiện được; chuỗi đó là chỉ đọc.
String literal (Hằng chuỗi): Là một chuỗi ký tự được viết trực tiếp trong mã nguồn nằm trong dấu ngoặc kép (ví dụ: "JQK"). Trong C, các hằng chuỗi này được lưu ở một vùng nhớ đặc biệt dành riêng cho dữ liệu không đổi.
Segmentation Fault (Lỗi phân đoạn): Thường là kết quả của việc cố gắng ghi dữ liệu vào vùng nhớ “chỉ đọc”, đây chính là lỗi mà đoạn code trên gặp phải.
Nếu bạn định thay đổi một chuỗi, hãy tạo một bản sao
Sự thật là nếu bạn muốn thay đổi nội dung của một chuỗi, bạn cần phải thao tác trên một bản sao. Nếu bạn tạo ra một bản sao của chuỗi đó trong một vùng nhớ không phải là “chỉ đọc”, sẽ chẳng có vấn đề gì xảy ra khi bạn cố gắng thay đổi các ký tự bên trong nó.
Nhưng làm thế nào để tạo một bản sao?
Có lẽ bạn chưa thấy rõ tại sao điều này lại thay đổi được mọi thứ. Tất cả các chuỗi đều là mảng. Nhưng trong đoạn mã cũ, cards chỉ là một con trỏ. Trong đoạn mã mới, nó là một mảng. Nếu bạn khai báo một mảng tên là cards và sau đó gán cho nó một hằng chuỗi, mảng cards sẽ là một bản sao hoàn toàn mới. Biến đó không chỉ đơn thuần là trỏ vào hằng chuỗi nữa.
Sự thật là nếu bạn muốn thay đổi nội dung của một chuỗi, bạn cần phải thao tác trên một bản sao. Nếu bạn tạo ra một bản sao của chuỗi đó trong một vùng nhớ không phải là “chỉ đọc”, sẽ chẳng có vấn đề gì xảy ra khi bạn cố gắng thay đổi các ký tự bên trong nó.
Nhưng làm thế nào để tạo một bản sao? Ồ, đơn giản thôi, chỉ cần tạo chuỗi đó dưới dạng một mảng mới.
Có lẽ bạn chưa thấy rõ tại sao điều này lại thay đổi được mọi thứ. Tất cả các chuỗi đều là mảng. Nhưng trong đoạn mã cũ, cards chỉ là một con trỏ. Trong đoạn mã mới, nó là một mảng. Nếu bạn khai báo một mảng tên là cards và sau đó gán cho nó một hằng chuỗi, mảng cards sẽ là một bản sao hoàn toàn mới. Biến đó không chỉ đơn thuần là trỏ vào hằng chuỗi nữa. Nó là một mảng mới toanh chứa một bản sao “tươi rói” của hằng chuỗi đó.
Để thấy điều này hoạt động như thế nào trong thực tế, bạn cần nhìn vào những gì xảy ra trong bộ nhớ.
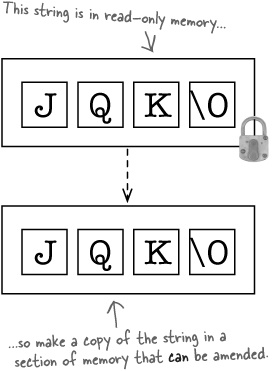
Trong bộ nhớ: char cards[] = "JQK"
Máy tính nạp hằng chuỗi: Như trước đó, khi máy tính nạp chương trình vào bộ nhớ, nó lưu trữ các giá trị hằng số — như chuỗi "JQK" — vào bộ nhớ chỉ đọc (read-only memory).
Chương trình tạo một mảng mới trên ngăn xếp (stack): Vì chúng ta đang khai báo một mảng, chương trình sẽ tạo ra một mảng đủ lớn để chứa chuỗi "JQK" — tương đương với kích thước của 4 ký tự (bao gồm cả ký tự kết thúc \0).
Chương trình khởi tạo mảng: Bên cạnh việc cấp phát không gian, chương trình cũng sẽ sao chép nội dung của hằng chuỗi "JQK" vào bộ nhớ ngăn xếp (stack).
Vì vậy, sự khác biệt là: Đoạn mã gốc sử dụng một con trỏ để trỏ đến một hằng chuỗi chỉ đọc. Nhưng nếu bạn khởi tạo một mảng bằng một hằng chuỗi, bạn sẽ có một bản sao của các ký tự đó, và bạn có thể thay đổi chúng tùy thích.
Một cách để tránh vấn đề này trong tương lai là đừng bao giờ viết mã gán một con trỏ char đơn thuần cho một giá trị hằng chuỗi như:
char *s = "Some string";
Thực ra không có gì sai khi gán một con trỏ cho một hằng chuỗi — vấn đề chỉ xảy ra khi bạn cố gắng sửa đổi hằng chuỗi đó. Thay vào đó, nếu bạn muốn gán một con trỏ cho một hằng số, hãy luôn đảm bảo bạn sử dụng từ khóa const:
const char *s = "some string";
Bằng cách đó, nếu trình biên dịch thấy đoạn mã nào cố gắng sửa đổi chuỗi, nó sẽ báo lỗi biên dịch ngay lập tức:
s[0] = 'S';monte.c:7: error: assignment of read-only location
Stack (Ngăn xếp): Là vùng nhớ dành cho các biến cục bộ. Vùng nhớ này có thể đọc và ghi thoải mái, đó là lý do tại sao khi copy chuỗi sang đây, bạn có thể sửa đổi được.
const keyword: Đây là một “lời hứa” với trình biên dịch rằng: “Tôi sẽ không thay đổi giá trị này”. Nếu bạn vi phạm, trình biên dịch sẽ nhắc nhở bạn ngay thay vì để chương trình bị sụp đổ (crash) khi đang chạy.
Hỏi: Tại sao trình biên dịch không báo luôn là tôi không được phép thay đổi chuỗi đó?
Đáp: Bởi vì chúng ta khai báo cards là một con trỏ char * đơn thuần, trình biên dịch không thể biết chắc chắn rằng biến đó sẽ luôn trỏ vào một hằng chuỗi trong suốt quá trình chạy.
Hỏi: Tại sao các hằng chuỗi lại được lưu trong bộ nhớ chỉ đọc?
Đáp: Vì chúng được thiết kế để làm hằng số. Nếu bạn viết một hàm để in chữ “Hello World”, bạn chắc chắn không muốn một phần khác của chương trình vô tình sửa nó thành “Goodbye World” đâu đúng không?
Hỏi: Có phải mọi hệ điều hành đều thực thi quy tắc “chỉ đọc” này không?
Đáp: Đại đa số là có. Một số phiên bản của gcc trên Cygwin thực tế cho phép bạn sửa đổi hằng chuỗi mà không phàn nàn gì. Nhưng hãy nhớ: làm vậy luôn luôn là sai.
Hỏi: const thực sự có nghĩa là gì? Nó có làm cho chuỗi trở thành “chỉ đọc” không?
Đáp: Bản thân các hằng chuỗi đã là chỉ đọc rồi. Từ khóa const là để trình biên dịch sẽ “la làng” lên nếu bạn cố tình dùng biến đó để sửa đổi mảng/chuỗi, giúp bạn phát hiện lỗi sớm ngay khi viết code.
Bộ nhớ ghi nhớ (Memory Memorizer)
Ngăn xếp (Stack): Đây là vùng nhớ dành cho biến cục bộ. Mỗi khi bạn gọi một hàm, các biến cục bộ của hàm đó được tạo ra trên stack. Nó giống như một chồng đĩa: biến được thêm vào khi vào hàm và lấy ra khi thoát hàm. Điều kỳ lạ là stack thực sự hoạt động “ngược”: nó bắt đầu từ đỉnh bộ nhớ và phát triển dần xuống dưới.
Heap: Đây là vùng nhớ dành cho bộ nhớ động: những dữ liệu được tạo ra khi chương trình đang chạy và tồn tại trong thời gian dài.
Biến toàn cục (Globals): Là biến nằm ngoài tất cả các hàm và mọi hàm đều nhìn thấy. Chúng được tạo ra ngay khi chương trình bắt đầu chạy và bạn có thể cập nhật chúng thoải mái.
Hằng số (Constants): Cũng được tạo ra khi chương trình bắt đầu, nhưng được lưu ở vùng nhớ chỉ đọc. Đây là nơi chứa các hằng chuỗi.
Mã lệnh (Code): Cuối cùng là phân đoạn mã. Nhiều hệ điều hành đặt mã lệnh ở địa chỉ thấp nhất. Đây là nơi chứa mã máy thực sự sau khi biên dịch và nó cũng là chỉ đọc.
Modern mobile networks are complex systems requiring high reliability. However, despite monitoring, faults like hardware failures or software misconfigurations occur. While detecting a fault is straightforward, the main challenge is Root Cause Analysis (RCA) — finding the root cause of the symptoms to help engineers fix them.
This project replicates the paper (Reasoning Language Models for Root Cause Analysis in 5G Wireless Networks) https://arxiv.org/pdf/2507.21974
The Complexity of 5G O&M
Traditionally, RCA relied on expert-defined logical frameworks or “fault trees”. However, these methods don’t scale well with 5G network complexity. While standard machine learning (Decision Trees, SVMs, Neural Networks) has been used, these models often lack the interpretability and reasoning needed for critical infrastructure.
Defining the Objective: RCA as Probabilistic Inference
We treat RCA as a probabilistic inference task. Formally, the goal is to identify the most probable cause from a set of potential root causes , given:
****: Network engineering parameters.
****: User plane observations.
****: Observed symptoms.
The objective is to solve for:
This mathematical formulation provides a framework, but modeling these intricate dependencies in real-world data is notoriously difficult. This implementation explores how domain-adapted, reasoning-enhanced Large Language Models (LLMs) can bridge this gap by providing structured, multi-step diagnostic explanations.
The TeleLogs Framework
To benchmark these capabilities, we utilize TeleLogs, a curated dataset of network troubleshooting scenarios with expert-level annotations. TeleLogs simulates a realistic 5G environment where a User Equipment (UE) moves through a region covered by multiple Base Stations (BSs), providing full visibility into network configurations and performance drops.
Part II: Dataset Architecture & Diagnostic Parameters
To perform effective RCA, the model must synthesize three distinct data streams: configuration parameters, time-series observations, and defined symptoms.
Symptom Definition: The 600 Mbps Threshold
In this study, diagnostic scenarios are centered around a specific symptom (): a significant degradation in downlink throughput where the performance falls below 600 Mbps. This drop serves as the trigger for the analysis, requiring the model to identify if the cause is environmental, a misconfiguration, or a mobility issue.
Network Engineering Parameters (U)
The dataset provides a comprehensive view of the network topology through static configuration parameters. Key parameters used in our analysis include:
Parameter
Description
gNodeB ID / Cell ID
Unique identifiers for the base station and cell.
Mechanical/Digital Tilt
The vertical angle of the antenna, essential for coverage analysis.
Mechanical/Digital Azimuth
The horizontal direction of the antenna.
Beam Scenario
Specific beamforming configurations that determine vertical beamwidth.
Height & PCI
Physical height of the antenna and the Physical Cell ID.
Beam Scenario
Specific beamforming configurations that determine vertical beamwidth.
User Plane Drive Test Data (Yt)
This represents the dynamic interaction between the user and the network. The model analyzes the following time-series indicators:
Throughput (DL): The primary indicator of service quality.
RSRP & SINR: Measure the signal strength and quality of the serving cell.
Neighboring RSRP: Signal strength from the top-k neighbor cells, used to detect interference or handover opportunities.
Resource Blocks (PRBs): The amount of radio resources allocated to the user.
The Ground Truth: Root Cause Classes (C1–C8)
The implementation evaluates the model’s ability to classify symptoms into one of eight distinct categories:
C1: Excessive downtilt causing weak coverage.
C2: Over-shooting coverage (distance > 1 km).
C3: Better performance available on a neighboring cell.
C4: Interference from non-colocated co-frequency cells.
C5: PCI Mod 30 conflict causing reference signal overlap.
C6: Performance degradation due to frequent handovers.
C7: Misconfigured handover thresholds.
C8: Insufficient PRB allocation.
Part III: Baseline Evaluation
Before fine-tuning, I established a performance baseline using Qwen2.5-1.5B-Instruct.
The Benchmarking Protocol
I ran a zero-shot inference on the TeleLogs Phase 1 test dataset, which contains 864 scenarios. The model was prompted using the standard template to analyze user-plane data and site engineering parameters, then choose the most likely root cause from the eight predefined classes.
Initial Findings
The baseline results showed the model was mostly guessing based on simple patterns:
Total Accuracy: 10.53% (91/864 correct).
The C1 Bias: The model correctly identified C1 (Excessive Downtilt) 42.59% of the time but used it as a “catch-all” for errors. In the top 10 most frequent errors, the model predicted C1 for other classes (C6, C8, C7, C2, C3, C4, and C5) a total of 312 times.
Instruction Following: While the model often produced the correct format (the boxed answer), it lacked the underlying logic to connect the RSRP/SINR drops to specific mobility or interference issues.
Placeholders: For many classes (C2, C4, C5, C8), the accuracy hovered near 3%, indicating that the base model could not differentiate between various types of signal degradation.
Part IV: Synthetic Data Generation Phase 1 — Reasoning Traces
To improve reasoning, I started the first phase of synthetic data generation. The goal was to create a dataset that demonstrates the Chain-of-Thought (CoT) required for RCA.
The Teacher Model: Qwen3-32B
I utilized Qwen3-32B as the high-reasoning agent. Its significantly larger parameter count and inherent reasoning capabilities allowed it to act as the “expert engineer”. Unlike the 1.5B model, the 32B model can synthesize the relationship between (Engineering Parameters) and (User Observations) more effectively.
CoT Prompting Strategy
I implemented a customized prompting strategy designed to guide the model through a structured diagnostic trajectory. The prompt forced the model to:
Analyze Data: Explicitly list the throughput drops and serving cell changes.
Eliminate Unlikely Causes: Systematically rule out causes—for example, ruling out C2 (distance) if the serving cell is far away.
Validate via Reflection: Check for specific conflicts, such as the PCI Mod 30 check for interference.
Data Acquisition
Through this multi-agent pipeline, I harvested an initial set of 138 samples. Each sample consisted of the original network log paired with a detailed reasoning trace leading to the correct ground-truth answer. This dataset was intended to teach the 1.5B model how to think, rather than just what to predict.
Part V: Experiment 1 The First LoRA Attempt
With 138 high-quality reasoning traces, I initiated the first fine-tuning stage. The goal was to align the Qwen2.5-1.5B-Instruct model with the structured diagnostic patterns found in the synthetic dataset. Following the general recommendations for domain adaptation in the provided LoRA research , I established a baseline configuration to mirror the paper’s parameters where possible.
Targeting: Applied LoRA across all linear layers (Query, Key, Value, Projection, and MLP) to maximize the model’s capacity to absorb the new domain knowledge.
The Regression Reality: 8.91% Accuracy
The results were a stark contrast to expectations. Instead of improving upon the baseline, the model’s performance dropped to 8.91% (77/864 correct).
Placeholder Issues: A significant issue was the increase in “placeholder” predictions. In the top 10 error categories, 7 were instances where the model outputted a placeholder rather than a valid root cause.
Reduced Instruction Following: The model lost some ability to follow basic formatting instructions. Focusing on the reasoning traces caused the model to struggle with the required \boxed{} format.
Word Count Increase: The mean word count increased from 245 to 651 words, often containing circular logic without a valid conclusion.
Hypothesis: Sample Sparsity and Overfitting
My hypothesis for this failure was sample sparsity. 138 samples are likely insufficient for a 1.5B model to learn both the complex 5G domain rules and the specific “Elimination-based” or “Contradiction-based” prompting strategies used in the dataset. The model likely overfitted to the specific noise of those 138 examples rather than learning the underlying causal relationships.
Part VI: Experiment 2 Scaling Sample Size
To address the sparsity issue identified in Experiment 1, I moved to scale the training data. If 138 samples caused overfitting, perhaps a larger, more diverse dataset would force the model to generalize the reasoning steps.
The 300-Sample Expansion
I re-ran the synthetic generation pipeline with the Qwen3-32B teacher model to reach 300 samples. I also ensured a more balanced distribution across the 8 root cause classes to prevent the model from defaulting to “C1” as it did in the baseline.
Results: Marginal Recovery (9.61%)
Training the 1.5B model on 300 samples yielded a slight recovery but remained below the zero-shot baseline:
Total Accuracy:9.61% (83/864).
Improved Class Recognition: Accuracy for C2 (18.52%) and C3 (19.44%) saw noticeable jumps compared to the near-zero baseline performance.
Persistent Failures: The “Placeholder” issue remained rampant. Truth C3 and C6 both saw 28 placeholder errors.
Word Count Increase: The mean word count increased to 1318 words, with some responses reaching 12,023 tokens.
Thinking: The Depth vs. Clarity Trade-off
This experiment showed that raw reasoning traces led to verbosity. Without synthesizing these traces, the model produced overly long responses.
Part VII: Synthetic Data Generation Phase 2
Experiment 2 showed that more raw reasoning traces were insufficient. The model mimicked the teacher’s verbosity without learning the logic. To fix this, I updated the synthetic data generation strategy.
The Theoretical Shift: From Traces to Correction
Instead of just saving any correct answer, I implemented a “Reflective Teacher” loop using Qwen3-32B. This approach mirrors the “Aggregator” concept in the paper, designed to synthesize concise, structured explanations.
The Reflection Loop
I introduced a two-tier evaluation for every synthetic sample:
Initial Attempt: The teacher model performs RCA on the raw data.
The “Correction” Prompt: * If Correct: The model is instructed to condense the reasoning into a specific “RCA Reasoning Format” (Data Analysis → Root Cause Analysis → Identification), without give it answer to prevent leakage.
If Incorrect: I forced a Self-Reflection phase. The system prompt would tell the model its assumption was wrong and demand it identify exactly where the logic failed (e.g., “I ignored the PCI Mod 30 check”). This reflection was then added back to the prompt to generate a “perfected” reasoning trace.
Reasoning Optimization
This new pipeline produced 300 samples of refined data. The reasoning traces were focused on key steps, such as checking the distance for C2 or the PRB count for C8.
Part VIII: Experiment 3 Training on Error-Correction Traces
With the 300 “reflected” samples, I reset the training. This experiment was the first true test of whether teaching a model how it failed was more effective than just showing it how to succeed.
Training on this densified dataset finally yielded an increase in accuracy:
Total Accuracy:12.04% (104/864). While modest, this officially surpassed the zero-shot baseline (10.53%).
Mean Word Count: A massive drop from 1318 to 33.5 words. The model stopped hallucinating long, circular paths and started focusing on the final answer.
Class-Specific Breakthrough: The C1 Dominance
C1 Accuracy:73.15% (79/108). This was a significant improvement.
Thinking: By learning the rules for C1, the model became proficient at identifying coverage-related drops.
Over-correction: However, the model predicted C1 for almost every other class (e.g., Truth C8 → Pred C1: 85 times).
Analysis: The Learning Capacity Gap
Experiment 3 proved that Data Quality > Data Quantity. However, it also revealed that at a low rank (r=32), the 1.5B model was struggling to hold more than one complex rule at a time. It had “mastered” C1 but was overriding its knowledge of other causes to do so. This set the stage for our exploration into LoRA hyperparameters.
Part IX: Theoretical Intermission LoRA Hyperparameter Optimization
The jump to 12% accuracy in Experiment 3 was a proof-of-concept for my self-reflection dataset, but the heavy “C1 bias” suggested the model’s update capacity was saturated.
Raschka’s Principles & The Alpha Heuristic
The Alpha Scaling: A common rule of thumb is setting alpha (the scaling factor) to twice the value of r (the rank), effectively alpha = 2 * r. This ensures the influence of the LoRA weights is balanced against the pre-trained weights.
Layer Coverage: To maximize performance, LoRA should be applied across all layers, including projection and MLP layers, not just the Key and Value matrices. This increases the number of trainable parameters, which is vital for domain-specific tasks like 5G RCA where the model must learn entirely new technical correlations.
The Capacity Problem: Rank vs. Knowledge
In a 1.5B model, a rank of 32 only updates a small fraction of parameters. This might not provide enough capacity to store 8 distinct 5G diagnostic rules. If the rank is too small, the model may only capture dominant patterns like C1 (Downtilt) and miss others.
Part X: Experiment 4 Expanding the Rank (r=128)
Armed with the theory that our model lacked the “memory” to differentiate between classes, I pushed the rank significantly higher.
The Setup: Boosting Rank and Alpha
LoRA Config: r = 128, a = 64
Methodology: I maintained the 300 “reflected” samples from the previous phase but allowed the model more degrees of freedom to store the learned weights.
Accuracy: 16.32%
Expanding the rank improved performance:
Total Accuracy:16.32% (141/864).
Diversification: The C1 bias decreased. The model’s recognition of C4 (Neighbor interference) jumped to 29.63%, and C7 (Handover thresholds) reached 21.30%.
Word Count Consistency: The mean word count remained stable at 960.63 words, indicating that higher rank did not necessarily mean more rambling, but rather more precise reasoning.
Analysis: Reducing Categorical Confusion
In the error logs, we saw a shift. Instead of predicting C1 for everything, the model began confusing similar signal-based issues. For example, Truth C3 (Neighbor throughput) was often confused with C4 (Neighbor interference). This shows progress — the model now understands the problem involves “Neighboring Cells” but is still fine-tuning the specific logic that distinguishes interference from a handover opportunity.
Part XI: Scaling the Dataset 2000 Samples
Recognizing that the 1.5B model’s improvement was driven by better data and increased rank, I increased the training set size. However, scaling synthetic data requires a strict “Teacher-Student” hierarchy to prevent errors.
The “Major Voting” Strategy
I utilized a Qwen2.5-7B-Instruct model, which had better baseline performance, to act as a secondary filter.
The Process: For each question, the 7B model generated multiple reasoning trajectories.
The Filter: Only samples where the 7B model reached the correct answer via majority voting were added.
The Result: This method produced a dataset of 2000 high-quality reasoning traces.
Response-Only Training (SFT Optimization)
To further improve efficiency and focus, I pivoted to training on responses only.
The Goal: By masking the loss for the system and user prompts, the model focuses its entire learning capacity on the reasoning steps and the final \boxed{} identification.
Alignment: This technique prevents the model from wasting parameter updates on memorizing the structure of the input logs and engineering tables, ensuring it prioritizes the causal logic instead.
Part XII: Experiment 5 High-Rank Performance (r=256)
The final phase of my implementation involved pushing the LoRA rank to the maximum sustainable level for a 1.5B model while utilizing the massive 2000-sample dataset. This experiment aimed to replicate the “Reasoning LLM” performance gains described in the paper.
Final Configuration
LoRA Hyperparameters: Rank 256, Alpha 128.
Data Density: 2000 “major-voted” samples from the reflection pipeline.
Optimization: AdamW optimizer with a cosine learning rate scheduler, applied to all linear layers as suggested by Raschka’s research.
Final Result: 21.41% Accuracy
This iteration achieved the highest performance:
Total Accuracy: 21.41% (185/864 correct).
Balanced Learning: The “C1 bias” was significantly mitigated. Accuracy for C7 (Handover Thresholds) reached 37.96%, and C8 (PRB Allocation) surged to 23.15%.
PCI Mod 30 Success: The model finally began correctly identifying C6 (PCI Conflict) at a 29.63% rate, proving it had successfully encoded the mathematical relationship between PCI values and reference signal overlap.
Analysis: The Impact of Scale
The jump from 16.32% to 21.41% demonstrates that for a 1.5B model, the combination of dataset density and rank capacity is significant. By providing 2000 examples, the model found common causal themes across different logs, resulting in better generalization rather than rote memorization.
: fatal error: libcob.h: No such file or directory
10 | #include <libcob.h>
| ^~~~~~~~~~
compilation terminated.
The error fatal error: libcob.h: No such file or directory means the COBOL compiler (cobc) found your code, but the C compiler (which GnuCOBOL uses under the hood) can’t find the necessary “header files” to finish building the program.
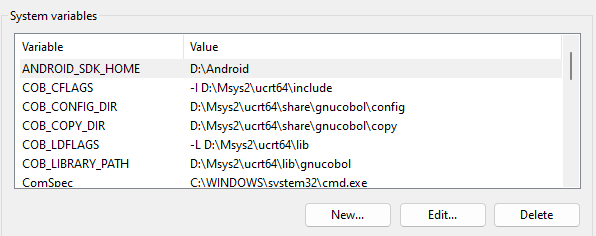
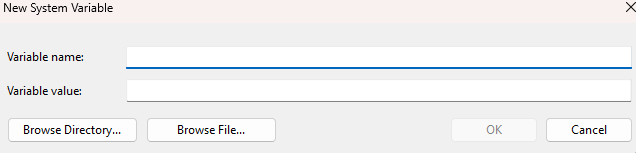
Adding these to Environment Variables like previous step
Variable Name
Variable Value
COB_CFLAGS
-I D:\Msys2\ucrt64\include
COB_LDFLAGS
-L D:\Msys2\ucrt64\lib
-I (Include): Points to the folder containing libcob.h.
-L (Library): Points to the folder containing the actual library files (.lib or .a).
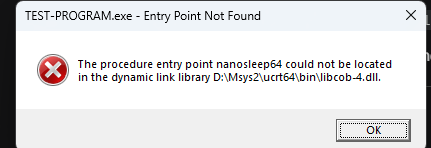
If you got (nanosleep64 could not be located) may indicate: your system is confused between two different versions of the C compiler.
The nanosleep64 error is a classic sign that a program compiled with one Windows runtime (like UCRT) is trying to link with an incompatible version of a library.
You could run this command
where gcc
If the output show more than one directory path, it may appear your computer have 2 installed GCC place
To solve this:
You need to tell Windows that the D: drive tools are the priority.
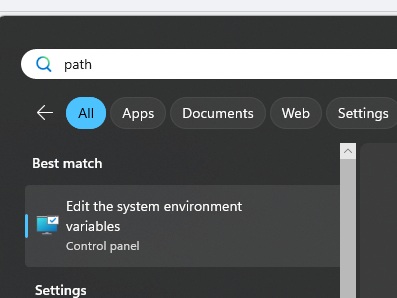
Search for “Edit the system environment variables” in your Start Menu and open it.
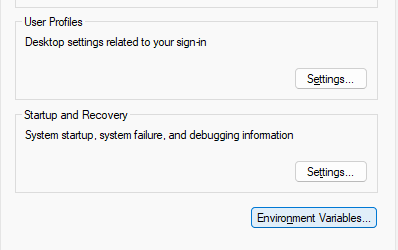
Click Environment Variables.
In the System variables (bottom) list, find the one named Path and click Edit.
Find C:\Msys2\ucrt64\bin in the list. (the path you added in installation step)
Click the “Move Up” button repeatedly until it is at the very top of the list (above the other bin directory in where gcc command).
Click OK on all windows.
Close your current Command Prompt and open a new one for the change to take effect.
I have a love-hate relationship with browser tabs. I need a lot of them to work, but once I pass the 30-tab mark, my browser bar becomes useless.
Google Chrome actually experimented with an auto-grouping feature a while back, but they removed it. I tried finding alternatives on the Chrome Web Store, but they all had the same problem: They were lazy.
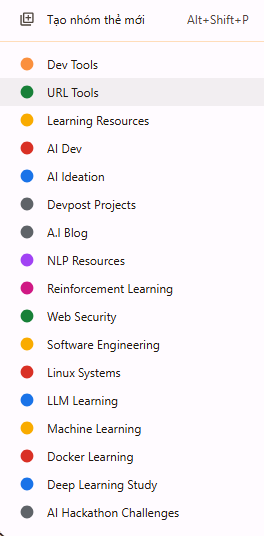
Most existing extensions group tabs based on the domain, even they calling LLM to group it. If they see youtube.com, they dump it in a “YouTube” folder. This is useless for me. If I have 5 tabs open for “Lofi Music” and 5 tabs open for “Python Tutorials,” those shouldn’t be in the same group. One is Work, the other is Background Noise.
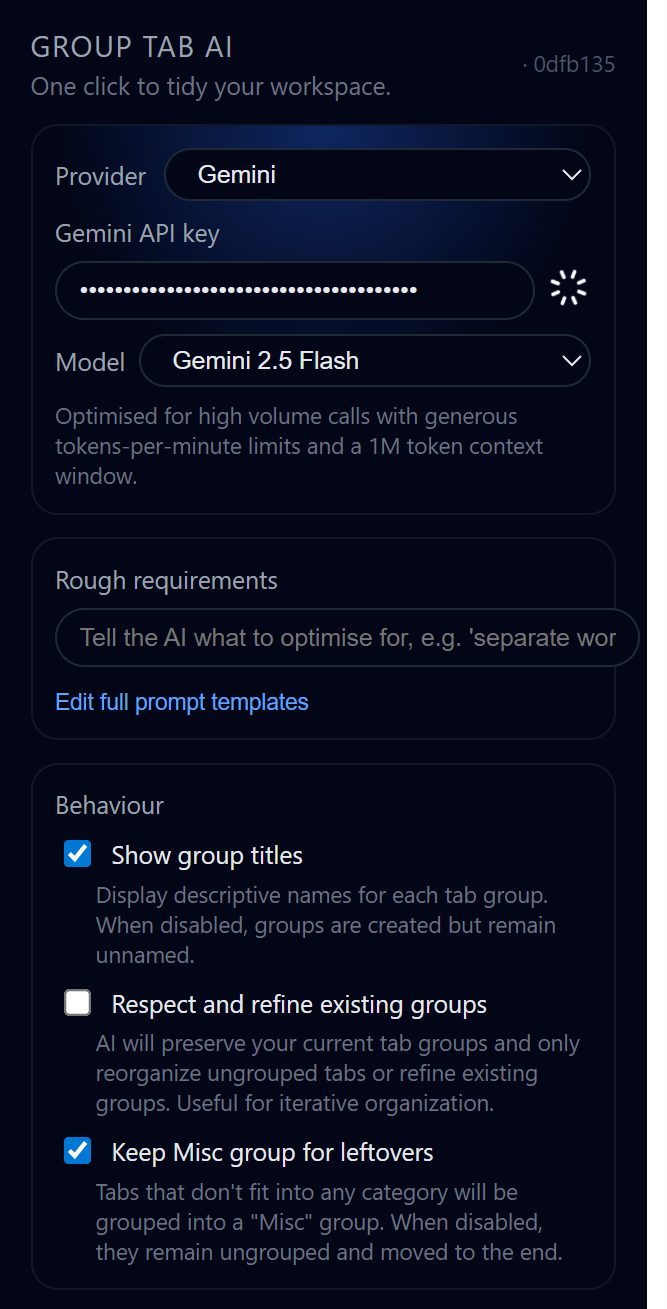
I realized that to actually organize tabs, the software needs to read the page, not just the URL. So I spent my free time building Group Tab AI.
How it actually works
I didn’t want to over-engineer this, but I needed it to be smart. When you click the button, the extension doesn’t just look at the link. It injects a script to grab the “context” of the page, the H1 title, the meta description, and a snippet of the body text.
It sends that data to an LLM (I set it up to work with either OpenAI or Gemini). Because it reads the content, it can tell that a GitHub page for a “React Library” is different from a GitHub page for “Tracking Issues.”
I’m using Google Gemini 2.0 Flash for this mostly, with the thinkingBudget set to 0. It’s fast enough that by the time I blink, the tabs are sorted.
I spent nights tweaking prompts to make it focus on tasks, not domains with extra context from the website contents along with careful prompt to let them reasoning and choose. For example, if you’re a dev, it might make groups like “Bug Hunting” or “API Docs.” Designers get “Mockups” or “Inspo.” It works for anyone,
students with class notes, marketers with campaigns.
The feature I actually wanted: It learns
This is the part I’m most proud of. I know AI isn’t perfect. It’s going to mess up. It might group a design blog under “Development” instead of “Inspiration.”
Usually, with AI tools, you just have to live with the bad output. But I built a Learning System into this.
If the AI groups something wrong, I manually move the tab to the right group.
The extension records that move.
After I’ve corrected it a few times, I can click a button to “Analyze Behavior.”
The system looks at my corrections and rewrites its own system prompt.
Next time I run it, it knows: “Oh, he likes to keep his ‘Localhost’ tabs separate from his ‘Production’ tabs,” because it updated its own instructions based on my manual fixes.
The Tech Stack
For the frontend devs out there, I built this using Plasmo. It’s basically the Next.js of browser extensions, makes working with React and TypeScript in a chrome-extension environment actually bearable.
Everything is local. Your API keys are stored in your browser, and the learning data (your grouping habits) stays on your machine.
Try it out
It’s open source (GPL-3.0). I built it because I needed it, but if you’re tired of domain-based grouping that doesn’t actually help, give it a shot.
Kaggle’s setup is amazing for quick experiments but not great when you start treating your work like an actual project. You get one main notebook. That’s it.
If you want to use your own .py files, you basically have to zip them up, upload them as a dataset, and then import from that path. It’s clunky and hard to maintain. Change one line of code? You need to re-upload the dataset again.
I saw this frustration all over the web, in Kaggle forums, Stack Overflow threads, even Reddit. Everyone was hacking their way around it, trying things like chained kernels or huge notebooks with thousands of lines of code. Nobody seemed happy with it.
So I went down the rabbit hole. Read a bunch of Medium posts, watched YouTube tutorials, skimmed corporate engineering blogs. I noticed a pattern: real ML pipelines in the wild are automated. They have CI/CD. They deploy cleanly. But for personal Kaggle projects, nobody had built something simple and usable.
That’s when it clicked, I could write a small tool that did the boring part for me. A script that could take my local project, package it up neatly, and push it to Kaggle as a dataset and a runnable notebook automatically.
Building kaggle-auto-deploy
The idea was simple:
Collect all project files.
Upload them as a Kaggle dataset.
Auto-generate a notebook that sets everything up and runs main.py.
Push it, version it, done.
So that’s what I built. A small CLI tool:
python kaggle_deploy.py ./my_project
For example, I used it on a small housing price predictor I’d built.
Behind the scenes, it ties into Git too, so every deployment matches a commit. No more “which version did I upload again?” moments.
git clone https://github.com/yourusername/kaggle-auto-deploy.git
cd kaggle-auto-deploy
Make it Executable (Linux/Mac)
chmod +x kaggle_deployer.py
Optional: Add to PATH (Linux/Mac)
# Add to ~/.bashrc or ~/.zshrc
export PATH="$PATH:/path/to/kaggle_deployer"
Usage
Basic Usage
python kaggle_deployer.py /path/to/your/project
Sample Project
This repository includes a sample project called housing_price_predictor that demonstrates how to structure a multi-file Python project for deployment to Kaggle.
python kaggle_deploy.py ./housing_price_predictor
Project Structure
housing_price_predictor/
├── main.py          # Entry point
├── data_loader.py   # Data loading and preprocessing
├── model.py         # Model training and evaluation
├── utils/
│   └── helpers.py   # Utility functions
├── data/
│   └── housing.csv  # Sample data
└── requirements.txt # Dependencies
Running the Sample Project
# Run locally
cd housing_price_predictor
python main.py

# Deploy to Kaggle
python kaggle_deployer.py ./housing_price_predictor
Như đã sơ lược qua ở phần trước, HTTP/2 Server Push (gọi tắt là HTTP/2 push) cho phép máy chủ (server) gửi thêm tài nguyên mà client (trình duyệt) chưa yêu cầu. Trước HTTP/2, HTTP chỉ là “hỏi-đáp đơn giản”: Trình duyệt yêu cầu một trang web, server trả về, rồi trình duyệt phải tải trang đó, phân tích, và yêu cầu thêm tài nguyên như CSS, JavaScript, font chữ, hình ảnh.
Ví dụ: Khi bạn mở một trang blog, trình duyệt tải HTML trước, rồi mới “thấy” cần CSS từ việc HTML khai báo rằng css cần thiết. Quá trình này tạo ra ít nhất một vòng lặp (round-trip) thừa, làm chậm thời gian hiển thị ban đầu (initial paint). Hình ảnh thì không sao (trang vẫn load với chỗ trống), nhưng CSS hay JS “critical” (quan trọng cho rendering) sẽ khiến trang “treo” đến khi tải xong.
Với HTTP/2 multiplexing (đa kênh), các yêu cầu song song giúp tốt hơn HTTP/1, nhưng vẫn cần round-trip thứ hai. HTTP/2 push “phá vỡ quy tắc” bằng cách server gửi luôn tài nguyên phụ ngay từ đầu, giảm thời gian tải từ 2 round-trip xuống còn 1.
Hình dung qua ví dụ waterfall diagram (biểu đồ thác nước):
Không push: HTML tải xong → Phân tích → Yêu cầu CSS/JS → Chờ tải → Render.
Có push: Server gửi HTML + CSS/JS cùng lúc → Render ngay!
Inline CSS
Để giảm độ trễ, các lập trình viên thường inline các tài nguyên quan trọng ngay vào HTML, nhờ đó trình duyệt có thể bắt đầu render ngay sau khi phân tích trang gốc, thay vì chờ tải thêm tài nguyên.
Tuy nhiên, inline CSS/JS tiềm ẩn nhiều hạn chế:
Khi cần sửa critical CSS (ví dụ redesign), phải cập nhật từng trang chứ không chỉ 1 file chung.
Thường chỉ chứa các style cần thiết cho lần render đầu; toàn bộ stylesheet được tải sau để giảm độ lớn mã inline.
Cần công cụ phân tích để trích đúng những phần “critical” công việc phức tạp.
Dẫn đến trùng lặp: mỗi trang website đều chứa CSS critical riêng, thay vì dùng file có thể cache giữa các trang.
Sau đó nội dung critical CSS còn được giữ trong stylesheet chính, gây trùng lặp trong mỗi trang, không chỉ giữa các trang.
Để tải CSS không quan trọng, cần dùng JavaScript thay vì thẻ <link>, bởi thẻ link nhúng CSS thông thường sẽ block rendering; thẻ link không hỗ trợ async.
Làm rõ hơn cơ chế HTTP/2 Push
HTTP/2 push phá bỏ quy tắc “1 request = 1 response”. Máy chủ có thể trả về nhiều tài nguyên kèm theo một yêu cầu. Ví dụ:
– Client: “Cho tôi trang này.” – Server: “Được thôi, đây là trang HTML, thêm cả CSS và JS cần thiết để bắt đầu rendering”.
Thể hiện dưới dạng waterfall: các tài nguyên không đến đúng lúc, có khoảng cách nhỏ giữa chúng, nhưng tổng thời gian gần 1 vòng chứ không phải 2 như trước.
Tương tự, chuỗi flow request–response có thể thấy như hình dưới, có thể thấy rõ sự tiết kiệm thời gian khi gửi các tài nguyên quan trọng cùng với trang ban đầu.
HTTP/2 Push không thay thế được WebSockets hay SSE
Điểm then chốt: push chỉ xảy ra khi có request ban đầu từ client, server không thể tự ý push bất kỳ lúc nào. WebSockets hay SSE cho phép two-way communication, nhưng HTTP/2 không thật sự hai chiều, mọi thứ đều do client khởi đầu. Sau khi stream request đầu kết thúc, server không thể tiếp tục push trừ khi client gửi request mới. Vì vậy, HTTP/2 push không thay thế WebSocket hay SSE theo chuẩn hiện tại
Cơ chế hoạt động của HTTP/2 Push trong trình duyệt
Trình duyệt xử lý HTTP/2 push lại theo một cách khác. Tài nguyên không được đẩy thẳng đến trang web, mà được đẩy vào một khu vực cache đặc biệt. Trang web vẫn được xử lý bình thường. Khi cần tài nguyên, trình duyệt kiểm tra cache, nếu có sẵn thì tải từ cache thay vì gửi yêu cầu tới server.
Cơ chế chi tiết phụ thuộc vào từng trình duyệt và không được nêu rõ trong spec HTTP/2, nhưng hầu hết hiện nay triển khai một HTTP/2 push cache riêng biệt, khác với HTTP cache thông thường
Cách hoạt động của push cache
Các tài nguyên được đẩy sẽ nằm trong một vùng nhớ riêng (HTTP/2 push cache) chờ trình duyệt yêu cầu. Khi được truy cập, tài nguyên sẽ được đưa vào trang và nếu có header phù hợp sẽ được đồng thời lưu vào HTTP cache để sử dụng sau này.
Một điểm đặc biệt: các trình duyệt dựa trên Chromium (Chrome, Opera) không cache tài nguyên nếu certificate không đáng tin (như tự ký self-signed, hiển thị ổ khoá đỏ), dù người dùng có bỏ qua lỗi. Để HTTP/2 Push hoạt động, bạn cần certificate hợp lệ (ổ khoá xanh)
Quá trình kiểm tra cache của trình duyệt theo thứ tự như sau: image cache → preload cache → service worker → HTTP cache → HTTP/2 push cache. Nếu tài nguyên đã có sẵn ở cache HTTP chính (mặc dù phiên bản mới đã bị push), trình duyệt vẫn ưu tiên dùng bản cũ theo cache-control (Jake Archibald) Service worker còn được kiểm sau preload cache
Image cache (cache hình ảnh):
Là cache tạm, nằm trong bộ nhớ (in-memory) chỉ phục vụ cho trang hiện tại.
Nó giúp trình duyệt không phải tải lại cùng một ảnh nếu trang tham chiếu tới ảnh đó nhiều lần.
Khi người dùng rời khỏi trang, cache này bị hủy.
Preload cache:
Cũng là cache tạm, trong bộ nhớ và chỉ gắn với một trang.
Dùng để giữ các tài nguyên được preload (sẽ nói kỹ hơn ở chương 6).
Lưu ý: không nên preload tài nguyên cho trang khác, vì preload cache không dùng chung giữa các trang.
Service Worker cache:
Service Worker là một loại ứng dụng nền, chạy độc lập với web page, đóng vai trò trung gian giữa web page và server.
Nó cho phép web hoạt động giống native app hơn, ví dụ vẫn có thể hoạt động khi mất mạng.
Service Worker có hệ thống cache riêng, gắn với domain.
HTTP cache (cache truyền thống):
Đây là cache chính mà lập trình viên quen thuộc nhất.
Nó được lưu trên đĩa (persistent), chia sẻ giữa nhiều trang, có dung lượng giới hạn và được dùng cho tất cả domain.
HTTP/2 push cache:
Đây là cache tạm, nằm trong bộ nhớ, gắn liền với một kết nối (connection).
Nếu server push styles.css, file này sẽ được đưa vào HTTP/2 push cache. Sau đó, khi trình duyệt thấy cần styles.css, nó không hề “biết” hay quan tâm rằng server đã push sẵn file này. Trình duyệt vẫn kiểm tra toàn bộ cache theo thứ tự:
Image cache
Preload cache
Service Worker cache
HTTP cache
HTTP/2 push cache
Nếu trong HTTP cache chính đã có một bản styles.css hợp lệ, thì trình duyệt sẽ lấy từ đó kể cả khi trong push cache đang có bản mới hơn.
Bạn có thể dùng công cụ chrome://net-export (nói trong mục 4.3.1) để xem tổng hợp các tài nguyên đã được push nhưng chưa được sử dụng (unclaimed push resources) trong tất cả các trang đang mở
Nếu một kết nối bị đóng, push cache cũng mất theo, khác với HTTP cache. Một cách hiểu ngắn gọn: push cache chỉ tồn tại gắn với kết nối. Khi kết nối không tái sử dụng, tài nguyên push có thể bị lãng phí. Một lần tài nguyên được sử dụng (“claimed”), nó sẽ bị loại khỏi push cache. Nhưng nếu có cache-control phù hợp, vẫn có thể lưu trong HTTP cache. Thậm chí tài nguyên không thể cache theo HTTP (no-cache, no-store) vẫn có thể được push và đọc từ push cache, bởi đây không thực sự là “cache” truyền thống mà là vùng đệm tạm thời
HTTP/2 Push Cache và những vấn đề phát sinh
Push cache gắn liền với connection
HTTP/2 push cache gắn trực tiếp với một kết nối (connection). Điều này dẫn đến:
Nếu kết nối không được dùng → tài nguyên push cũng không được dùng.
Nếu kết nối bị mất → push cache và tất cả tài nguyên chưa dùng cũng mất → việc push bị lãng phí.
Nếu trình duyệt mở thêm một kết nối khác → tài nguyên push có thể sẽ không được dùng.
HTTP/2 thiết kế để chỉ có một connection duy nhất, nên thoạt nhìn có vẻ không có vấn đề. Nhưng thực tế các trình duyệt triển khai khác nhau:
Chrome, Firefox: chia sẻ connection giữa các tab.
Edge: mỗi tab dùng connection riêng.
Safari: có thể mở nhiều connection ngay trong cùng một tab.
Ngoài ra, các request không kèm thông tin xác thực (noncredentialed) thường được gửi trên một connection riêng. Do đó:
Không thể push font cross-origin (từ domain khác, kể cả domain shard) vì chúng phải đi qua noncredentialed request.
Do Push cache hoạt động ở mức connection, chứ không phải mức page. Vì vậy, tuy về lý thuyết bạn có thể push tài nguyên cho trang sẽ load sau, nhưng trên thực tế điều này gần như vô ích, vì cache ngắn hạn và có thể mất khi kết nối rớt.
Push cache khác với HTTP cache
Khi một tài nguyên được lấy ra khỏi push cache, nó sẽ bị xóa khỏi đó và không thể dùng lại từ push cache lần nữa. Nhưng nếu tài nguyên có cache-control hợp lệ, nó sẽ được lưu vào HTTP cache chính để dùng sau.
Push cache có thể chứa cả tài nguyên không cache được (ví dụ header no-cache hoặc no-store). Đây là điểm khác với HTTP cache truyền thống.
Chính vì vậy, push cache không thực sự là cache theo đúng nghĩa, mà giống như một “kho tạm chứa request”
RST_STREAM – Cách từ chối tài nguyên bị push
Trình duyệt có thể từ chối một tài nguyên đang bị push bằng cách gửi một RST_STREAM frame với mã CANCEL hoặc REFUSED_STREAM. Điều này xảy ra khi:
Trình duyệt đã có sẵn tài nguyên trong cache.
Người dùng rời khỏi trang khi nó vẫn đang load → không cần tải thêm tài nguyên nữa.
Tuy nhiên, RST_STREAM có hạn chế:
Việc gửi tín hiệu RST_STREAM mất thời gian → trong lúc đó server vẫn tiếp tục gửi data (HEADERS, DATA frames). Có thể cả file đã được gửi xong trước khi server kịp ngừng lại.
Đây chỉ là tín hiệu điều khiển, không mạnh bằng việc cắt hẳn connection (HTTP/2 không cho phép ngắt connection vì sẽ ảnh hưởng tới tất cả stream khác).
Vì vậy, RST_STREAM không phải giải pháp hiệu quả để ngăn chặn việc push sai tài nguyên.
Ví dụ:
Nếu push một ảnh rất lớn nhưng trang đã được cập nhật không dùng ảnh đó nữa → trình duyệt vẫn tải hết ảnh về nhưng không dùng, gây lãng phí băng thông.
Thậm chí bạn còn không biết mình đang push nhầm, vì một số công cụ (DevTools) có thể không hiển thị tài nguyên bị push mà không dùng.
Client có thể tắt push bằng cách đặt SETTINGS_ENABLE_PUSH = 0 trong khung SETTINGS. Khi đó, server không được phép gửi PUSH_PROMISE nữa.
Request được push phải là cacheable methods (thường là GET, HEAD, hoặc một số POST đặc biệt).
Request được push phải là safe methods (thường là GET hoặc HEAD).
Request được push không được có request body (nhưng response thường có body).
Request được push chỉ được gửi đến những domain mà server có thẩm quyền (authoritative).
Chỉ server mới có quyền push, client không được push.
Resource chỉ có thể được push như phản hồi cho một request hiện tại. Server không thể tự phát khởi một push nếu không có request nào đang diễn ra.
Thực tế, vì các quy tắc trên, chỉ có GET request là thường được push.
Giới hạn về authority nghĩa là bạn chỉ được phép push tài nguyên mà server trực tiếp hoặc gián tiếp phục vụ. Ví dụ, nếu trang của bạn dùng Bootstrap từ getbootstrap.com hoặc jQuery từ jquery.com, thì server của bạn không thể push trực tiếp. Bạn có thể proxy các request đó qua server của mình, nhưng khi đó bạn phải sửa tất cả các tham chiếu để trỏ về server của bạn. Ở tình huống đó, tốt hơn hết là host luôn file đó tại chỗ thay vì tạo thêm phức tạp với proxy.
HTTP/2 Push được thiết kế để tối ưu hiệu năng, nhưng nếu lạm dụng, nó có thể làm chậm hiệu năng vì lãng phí băng thông để push những tài nguyên mà client không dùng, thay vì ưu tiên cho những tài nguyên cần thiết.
Lý tưởng nhất, chỉ nên push tài nguyên quan trọng (critical assets) mà trang chắc chắn cần.
Không nên push:
Tài nguyên không được sử dụng.
Tài nguyên mà client không thể dùng (ví dụ: image format không hỗ trợ).
Tài nguyên chỉ dùng trong một số điều kiện (ví dụ: hình ảnh cho màn hình lớn).
Nhóm Chrome đã viết một tài liệu chi tiết về “nên push cái gì” (Chrome doc on HTTP/2 Push), trong đó họ khuyến nghị:
“Chỉ push mức tối thiểu cần thiết để lấp đầy thời gian mạng rảnh, và không hơn.”
Push chỉ để tận dụng thời gian mạng rảnh (idle network time).
Không nên push toàn bộ tài nguyên mà trang cần, vì như vậy sẽ ghi đè cơ chế ưu tiên tải (prioritization) vốn được trình duyệt tối ưu tốt hơn.
Internet đã trở thành một phần không thể thiếu trong cuộc sống hàng ngày. Mua sắm, ngân hàng, giao tiếp và giải trí đều phụ thuộc vào internet, và với sự phát triển của Internet vạn vật (IoT), ngày càng có nhiều thiết bị được kết nối trực tuyến, nơi chúng có thể được truy cập từ xa. Truy cập này được thực hiện nhờ một số công nghệ, bao gồm Giao thức Truyền Siêu văn bản (HTTP), đây là một phương pháp chính để yêu cầu truy cập vào các ứng dụng và tài nguyên web từ xa.
Mục đích sử dụng chính và đầu tiên của HTTP: để yêu cầu các trang web. Khi bạn mở một trang web trong trình duyệt của mình, dù trình duyệt đó trên pc/laptop, tablet, điện thoại di động hoặc bất kỳ thiết bị nào khác cho phép truy cập internet (tủ lạnh, tivi, …), rất nhiều thứ đang diễn ra.
Giả sử bạn khởi động trình duyệt và truy cập www.google.com. Trong vòng vài giây, những điều sau sẽ xảy ra
Bước 1: DNS, IPv4, IPv5, IPv6, IPv1-3
Khi bạn gõ www.google.com vào trình duyệt, nó không tự biết Google ở đâu. Trình duyệt sẽ nhờ đến một “cuốn danh bạ” đặc biệt gọi là DNS (Domain Name System). Công việc của DNS rất đơn giản: biến cái tên thân thiện với con người (www.google.com) thành một dãy số mà máy tính hiểu được, gọi là địa chỉ IP.
Tên miền giống như tên người trong danh bạ: “Google”.
Địa chỉ IP giống như số điện thoại: máy tính chỉ biết gọi bằng số, chứ không hiểu tên.
Hiện nay có hai “kiểu số điện thoại” chính:
IPv4: dạng cũ, ví dụ 216.58.192.4. Nhìn khá ngắn gọn, con người còn đọc được.
IPv6: dạng mới, ví dụ 2607:f8b0:4005:801:0:0:0:2004. Dài ngoằng, chỉ máy tính mới “thích” đọc. IPv6 sinh ra vì IPv4 gần như đã “hết số”, giống như khi một thành phố phải thêm mã vùng điện thoại mới vì dân cư quá đông.
Một fact: vì internet là toàn cầu, Google (và các công ty lớn khác) đặt máy chủ khắp nơi trên thế giới. DNS sẽ thông minh chọn cho bạn địa chỉ IP của máy chủ gần nhất, để tốc độ truy cập nhanh hơn. Thế nên một người ở Mỹ và một người ở châu Âu có thể nhận được IP hoàn toàn khác nhau khi cùng gõ www.google.com.
Điều gì đã xảy ra với IPv5?
Mỗi thiết bị kết nối Internet đều cần một địa chỉ IP duy nhất, giống như mỗi ngôi nhà cần một số nhà riêng.
Với IPv4, ta có khoảng 4,3 tỷ “số nhà” (2³² địa chỉ). Khi Internet mới ra đời, con số đó nghe như vô tận.
Nhưng rồi máy tính cá nhân, điện thoại thông minh, camera an ninh, đồng hồ thông minh, tủ lạnh IoT… tất cả đều cần một địa chỉ. Điều này khiến kho địa chỉ IPv4 gần như cạn kiệt.
Buộc phải mở ra một hệ thống đánh số mới rộng hơn. IPv6 chính là “hệ thống số nhà mở rộng” đó, với 128 bit, đủ để cấp địa chỉ cho hầu như mọi hạt cát trên trái đất. (2^128)
Bạn có thể thấy hơi lạ: chúng ta có IPv4, rồi nhảy thẳng sang IPv6. Thế IPv5 biến đi đâu? Và tại sao chẳng ai nhắc tới IPv1–IPv3?
Thực ra mọi gói tin Internet đều có một trường nhỏ ở đầu (4 bit) để ghi phiên bản. Về lý thuyết, chỉ có tối đa 15 phiên bản (0–15). (Có thể thấy ở ảnh dưới, phần Version đầu tiên)
IPv6: giải quyết triệt để vấn đề “hết số nhà” trên Internet, đồng thời bổ sung nhiều tính năng mới. Đây mới là “người kế nhiệm” thực sự.
IPv0–IPv3: chỉ là các phiên bản thử nghiệm ban đầu. Không cái nào trở thành chuẩn chính thức.
IPv4: phiên bản đầu tiên thực sự phổ biến, đưa Internet bùng nổ như chúng ta thấy ngày nay.
IPv5: từng tồn tại dưới cái tên Internet Stream Protocol. Nó được thiết kế cho âm thanh và video theo thời gian thực (kiểu như những gì sau này VoIP làm). Nhưng nó sớm bị bỏ xó, vì vẫn mắc đúng nhược điểm của IPv4: không đủ không gian địa chỉ.
Vậy nên, IPv5 không “mất tích” mà chỉ dừng lại ở mức thử nghiệm. Thế giới chọn đi thẳng từ IPv4 sang IPv6 để giải quyết triệt để vấn đề cạn kiệt địa chỉ.
Bước 2: Tạo kết nối TCP/IP
Sau khi có địa chỉ IP, trình duyệt sẽ tìm cách kết nối đến máy chủ web. Kết nối này thường chạy qua:
Cổng 80 cho HTTP (truyền thống).
Cổng 443 cho HTTPS (phiên bản an toàn, có mã hóa).
Ngày nay hầu hết các trang web (kể cả Google) đều bắt buộc HTTPS nhờ công nghệ HSTS. Nghĩa là, ngay cả khi bạn gõ http://..., trình duyệt cũng sẽ tự động nâng cấp sang HTTPS.
TCP và IP phối hợp thế nào?
IP giống như địa chỉ nhà, đảm bảo gói tin tìm đúng nơi đến.
TCP giống như dịch vụ giao hàng uy tín: luôn hỏi “Bạn có nhận đủ chưa?”, nếu thiếu thì gửi lại.
Khi kết hợp, ta có TCP/IP, hai thứ làm nên xương sống Internet.
Một địa chỉ IP, nhiều dịch vụ
Một máy chủ có thể phục vụ nhiều “dịch vụ” khác nhau (web, email, FTP…). Để phân biệt, nó dùng cổng/port , giống như từ 1 địa chỉ nhà, chúng ta có thể chỉ tới số phòng, tầng, …
HTTP → cổng 80
HTTPS → cổng 443
HTTP
Khi kết nối TCP/IP đã ổn định, trình duyệt mới bắt đầu dùng HTTP để gửi yêu cầu: “Hãy cho tôi trang chủ Google”. Lúc này mới đến phần giao tiếp cấp ứng dụng mà ta thường nghe đến nhiều nhất.
Bước 3-10: Yêu cầu máy chủ phản hồi và trình duyệt bắt đầu “vẽ” trang
Sau khi trình duyệt gửi yêu cầu, máy chủ Google phản hồi. Nội dung phản hồi thường là HTML – ngôn ngữ mô tả cấu trúc của trang web.
HTML giống như bộ khung của một ngôi nhà: nó chia trang thành các phần (thẻ <div>, <p>, <h1>…), và kèm theo đường dẫn tới những vật liệu khác để hoàn thiện ngôi nhà:
CSS (màu sắc, kiểu dáng)
JavaScript (hành vi, tương tác)
Hình ảnh, font chữ, video…
Mã phản hồi và chuyển hướng
Không phải lúc nào máy chủ cũng trả về ngay một trang HTML:
Nếu bạn truy cập http://www.google.com, máy chủ sẽ gửi lại mã 301/302 để chuyển hướng bạn sang https://www.google.com.
Nếu bạn gõ nhầm, như www.google.com/nonexistent, bạn sẽ gặp mã 404 Not Found – giống như hỏi thủ thư một cuốn sách không có trong thư viện.
Trình duyệt dựng DOM
Khi nhận được HTML, trình duyệt sẽ phân tích và xây dựng DOM (Document Object Model) – bản đồ nội bộ của trang. Trong quá trình đọc HTML, nó phát hiện thêm tài nguyên cần tải (CSS, JS, hình ảnh…).
Google khá “nhẹ nhàng”: chỉ khoảng 16 tài nguyên bổ sung.
Trang trung bình: khoảng 75 tài nguyên (theo HTTP Archive).
Facebook? Có thể lên tới hàng trăm tài nguyên – mỗi ảnh, script, quảng cáo đều phải gọi thêm.
Mỗi tài nguyên lại đi qua vòng lặp yêu cầu–phản hồi như ban đầu, khiến duyệt web chậm dần. Đây cũng là lý do HTTP/2 ra đời: gom nhiều yêu cầu để tải nhanh hơn.
Khi nào thì “bắt đầu vẽ”
Trình duyệt không đợi tải hết tất cả mới hiển thị, mà sẽ render dần dần:
Hãy tưởng tượng bạn xem họa sĩ vẽ tranh: ban đầu chỉ có khung, sau đó thêm màu, rồi chi tiết. Nếu vẽ dở dang mà đưa cho bạn xem, bức tranh cứ đổi hình dáng liên tục – đó chính là cảm giác khi trang web “nhảy”.
Tải nền
Ngay cả sau khi trang “trông như đã xong”, trình duyệt vẫn âm thầm tải thêm:
Ảnh, script theo dõi, quảng cáo…
Tính năng động: ví dụ Google gợi ý kết quả tìm kiếm ngay khi bạn gõ, hay Facebook tự động hiện bài mới.
Những thứ này chạy ngầm trong nền (AJAX, fetch API, WebSocket…), khiến web ngày nay giống ứng dụng thật sự chứ không chỉ là trang tĩnh.
HTTP là gì
Vào thập niên 1930, kỹ sư điện Vannevar Bush (MIT) đã lo ngại rằng khối lượng thông tin con người tạo ra vượt xa khả năng tiêu thụ. Trong bài tiểu luận As We May Think (1945), ông hình dung ra một thiết bị gọi là memex – nơi mọi tri thức được lưu trữ, có thể tra cứu nhanh chóng và liên kết với nhau giống như cách bộ não kết nối ý tưởng. Memex không bao giờ thành hiện thực, nhưng khái niệm “kết nối thông tin có ngữ cảnh” đã gieo mầm cho thế hệ sau.
Đến những năm 1960, Ted Nelson đưa ra thuật ngữ hypertext – tập hợp văn bản/hình ảnh liên kết phức tạp mà giấy in không thể thể hiện. Nelson mơ về một “docuverse”, nơi thông tin được liên kết, không bao giờ bị xóa, và mọi người đều có thể truy cập. Dù dự án Xanadu của ông không thành công, nhưng nó đã tạo cảm hứng mạnh mẽ.
Năm 1989, tại CERN, Tim Berners-Lee muốn một cách để quản lý thông tin từ các thí nghiệm khổng lồ. Ông kết hợp ý tưởng hypertext (liên kết tự do) và hypermedia (không giới hạn ở chữ viết) để đề xuất một hệ thống “phổ quát” , chính là nền móng của World Wide Web. Và từ đây, HTTP (Hypertext Transfer Protocol) ra đời.
HTTP (Hypertext Transfer Protocol) đúng như tên gọi, ban đầu được tạo ra chỉ để chuyển các tài liệu “siêu văn bản” – tức là những trang có thể chứa liên kết sang trang khác. Nhưng chẳng bao lâu, người ta nhận ra rằng nó cũng có thể dùng để gửi những thứ khác như hình ảnh, âm thanh, video…
Vì vậy, chữ Hypertext trong tên ngày nay không còn quá chính xác, nhưng cái tên HTTP đã ăn sâu nên không ai đổi nữa.
Điều quan trọng là HTTP hoạt động dựa trên kết nối mạng ổn định (thường qua TCP/IP). Nó không quan tâm đến cách bạn nối dây mạng, Wi-Fi hay Ethernet thế nào, tất cả việc đó do các tầng giao thức bên dưới lo. HTTP chỉ tập trung làm một việc: nhận yêu cầu từ trình duyệt và trả về phản hồi từ máy chủ.
Điểm mạnh của HTTP chính là sự đơn giản. Trình duyệt gửi yêu cầu, máy chủ trả lời – thế thôi. Chính sự giản đơn này giúp web phát triển thần tốc, dù sau này phải đánh đổi một chút để tối ưu hiệu năng (như trong HTTP/2, HTTP/3).
Cú pháp HTTP cơ bản
Một yêu cầu HTTP, ở mức đơn giản nhất, chỉ là một dòng văn bản. Ví dụ:
GET /page.html↵
Ở đây:
GET là phương thức (cách bạn “xin” dữ liệu).
/page.html là tài nguyên bạn muốn.
Dấu xuống dòng (↵) cho biết bạn đã gõ xong.
Thế là đủ. Khi đó, trình duyệt đã có kết nối TCP/IP với máy chủ rồi, nên nó chỉ cần nói: “Ê, cho tôi file này với!”
HTTP 0.9
Phiên bản đầu tiên, HTTP/0.9 (1991), chỉ biết làm đúng điều này: gửi GET, nhận file HTML, rồi đóng kết nối. Nhìn lại, bạn có thể thấy lạ: “Sao phải viết GET nữa? Chẳng phải mặc định nó chỉ có một lệnh duy nhất đó sao?” Nhưng chính nhờ tầm nhìn xa, sau này các nhà thiết kế bổ sung thêm nhiều phương thức khác (POST, HEAD…), nên cú pháp ban đầu vẫn giữ được tính mở rộng, chạy được với cả các phiên bản http cũ.
HTTP 1.0
HTTP/0.9 chỉ biết GET một file HTML rồi thôi, nhưng đến HTTP/1.0 (1996), web đã có thêm cơ bắp.
Ba phương thức mới quen mặt
GET (nâng cấp): Giờ đây không chỉ tải trang HTML, mà còn có thể yêu cầu ảnh, nhạc, video… Ngoài ra, GET còn “thông minh” hơn: có thể hỏi “file này có thay đổi từ lần cuối tôi tải không?” Nếu không, máy chủ chỉ trả lời “yên tâm, bản cũ còn dùng được” (giúp tiết kiệm băng thông).
HEAD: Giống như soi bìa sách thay vì đọc cả cuốn. Client chỉ lấy metadata (header HTTP) để kiểm tra thông tin: file còn tồn tại không, có đổi mới không…
POST: Đây là bước đột phá. Client có thể gửi dữ liệu lên server, ví dụ form đăng nhập hay đơn hàng mua sắm. Khác với GET, giao thức POST mang dữ liệu trong body request, kín đáo hơn (dù vẫn phải gửi qua HTTPS mới thật sự an toàn).
Header: lời nhắn gửi kèm yêu cầu
HTTP/1.0 bổ sung header – những dòng thông tin thêm để client “dặn dò” server. Ví dụ:
Tôi đang dùng trình duyệt tên “MyAwesomeWebBrowser 1.1”
Đây chính là cơ chế giúp web mở rộng: chỉ cần thêm header mới là có thể dạy client/server hiểu thêm “ngôn ngữ” mà không phá vỡ giao thức.
Mã phản hồi: server biết cách trả lời
HTTP/0.9 không có khái niệm mã phản hồi. Nếu lỗi thì server chỉ nhét thông báo vào HTML. Sang HTTP/1.0, lần đầu tiên xuất hiện status code, ba chữ số huyền thoại:
Các mã 2xx, 3xx, 4xx, 5xx chia thành từng nhóm rõ ràng, biến HTTP thành một cuộc hội thoại có quy tắc: client hỏi, server đáp, không phải đoán mò nữa.
2xx – Thành công
200 OK: Mọi thứ ngon lành, dữ liệu đây.
201 Created: POST thành công, đã tạo tài nguyên mới.
202 Accepted: Server nhận rồi, đang xử lý, bạn đợi chút.
204 No Content: Yêu cầu thành công nhưng không có gì để gửi lại (ví dụ: xóa một record).
3xx – Chuyển hướng
300 Multiple Choices: Có nhiều đường, bạn chọn.
301 Moved Permanently: Tài nguyên đã dọn nhà vĩnh viễn (Location header chỉ đường).
302 Moved Temporarily: Tạm thời dọn nhà.
304 Not Modified: File chưa đổi từ lần cuối, cứ dùng bản cũ.
4xx – Lỗi từ phía client
400 Bad Request: Server không hiểu bạn nói gì, sửa cú pháp đi.
401 Unauthorized: Bạn chưa đăng nhập.
403 Forbidden: Đăng nhập rồi nhưng không có quyền.
404 Not Found: Nổi tiếng nhất – giống như bấm số điện thoại sai: “Thuê bao không tồn tại.”
5xx – Lỗi từ phía server
500 Internal Server Error: Lỗi chung chỉ về việc server lỗi
501 Not Implemented: Server không biết xử lý yêu cầu này.
502 Bad Gateway: Proxy/gateway hỏi downstream server nhưng nhận lỗi.
503 Service Unavailable: Server quá tải hoặc đang bảo trì, quay lại sau.
HTTP 1.1
Vì thế, HTTP/1.1 ra đời năm 1997, chỉ 9 tháng sau khi HTTP/1.0 được chuẩn hóa. Nó không thay đổi tận gốc như từ 0.9 → 1.0, nhưng đã tinh chỉnh, bổ sung và quan trọng nhất: đặt ra tiêu chuẩn chính thức cho toàn bộ thế giới web, vốn đang bùng nổ mạnh mẽ.
Đến nay, HTTP/1.1 đã trải qua nhiều lần sửa đổi:
RFC 2068 (1997) – bản đầu tiên
RFC 2616 (1999) – cập nhật và thay thế
RFCs 7230–7235 (2014) – chỉnh sửa, chi tiết hóa hơn (305 trang, gần 100.000 từ!)
Điều này cho thấy: giao thức tưởng chừng “đơn giản” lại phức tạp đến mức cần một bộ luật khổng lồ để mọi trình duyệt, máy chủ, proxy trên thế giới cùng “nói chung một ngôn ngữ”.
Những thay đổi quan trọng trong HTTP/1.1
1. Host header bắt buộc
Trong HTTP/1.0, client gửi request kiểu:
GET /index.html HTTP/1.0
Server hiểu là: à, nó đang xin file index.html từ chính website mà nó đang kết nối đến. Nhưng khi web phát triển, một server có thể chạy hàng trăm website khác nhau trên cùng một địa chỉ IP (virtual hosting). Làm sao server biết client muốn example.com/index.html hay blog.example.com/index.html?
Giải pháp: thêm Host header.
GET / HTTP/1.1
Host: www.google.com
Từ HTTP/1.1 trở đi, mọi request bắt buộc phải có Host. Nhờ đó:
Một server duy nhất có thể phục vụ nhiều website.
Tiết kiệm tài nguyên IP (IPv4 vốn khan hiếm).
Nếu không có bước này, có thể web sẽ “ngốn” sạch IPv4 từ rất sớm. Ngược lại, nếu hồi đó người ta không chọn giải pháp Host header, mà bắt client phải gửi URL đầy đủ (absolute-form), thì web có thể đã ép buộc sang IPv6 sớm hơn 20 năm.
2. Kết nối bền vững (Persistent connections / Keep-Alive)
HTTP ban đầu hoạt động theo kiểu: một request → một response → đóng kết nối.
Nhưng khi web nhiều hình ảnh, CSS, JS, việc liên tục đóng/mở kết nối TCP cực kỳ lãng phí. Mỗi lần bắt tay TCP tốn thêm vài trăm mili-giây, nhân lên hàng chục file thì người dùng sẽ “chờ dài cổ”.
HTTP/1.1 thay đổi mặc định:
Mọi kết nối được giữ mở trừ khi server nói rõ “Connection: close”.
Client có thể gửi tiếp nhiều request trên cùng một kết nối.
GET /style.css HTTP/1.1
Host: www.example.com

GET /script.js HTTP/1.1
Host: www.example.com
Trình duyệt có thể “nạp đơn hàng” liên tục thay vì phải xếp hàng lại từ đầu.
Tuy nhiên, điều này đòi hỏi phải có thêm cách xác định “đâu là hết dữ liệu” (vì không còn dấu hiệu đóng kết nối nữa). Do đó, HTTP/1.1 dùng 1 header Content-Length hoặc chunked transfer encoding để báo độ dài nội dung. Khi đó, các bên có thể từ content length và dữ liệu đã nhận được để biết bao giờ là kết thúc.
3. Pipelining (nhưng thất bại)
HTTP/1.1 còn đưa ra ý tưởng pipelining: client gửi nhiều request “một lèo” mà không chờ phản hồi, server trả kết quả theo thứ tự.
Ví dụ:
Gửi cùng lúc request cho CSS, JS, ảnh.
Server trả về lần lượt CSS → JS → ảnh.
Nghe thì hay, nhưng thực tế bị head-of-line blocking: nếu request đầu tiên bị chậm (ví dụ truy vấn DB lâu), thì mọi request sau bị kẹt. Thêm nữa, hỗ trợ pipelining ở proxy và server thường kém (thậm chí lỗi). Vì vậy, pipelining gần như “chết yểu”, không được các trình duyệt phổ biến bật mặc định.
4. Bộ nhớ đệm (Caching) thông minh hơn
Trong HTTP/1.0, chỉ có header Expires: <date>. Nghĩa là:
Nếu quá ngày đó → tài nguyên hết hạn, phải tải lại từ server.
Nó cứng nhắc, ví dụ bạn muốn cho cache tồn tại 30 phút tính từ lúc tải thì không làm được (vì Expires cần một mốc thời gian cố định).
HTTP/1.1 thì mềm dẻo hơn nhờ Cache-Control:
max-age=600 → cache trong vòng 600 giây (10 phút).
no-cache → client vẫn lưu cache nhưng luôn xác thực lại với server trước khi dùng.
must-revalidate → nếu cache hết hạn thì bắt buộc hỏi server, không được tự ý dùng lại.
public / private → phân biệt cache dùng chung (CDN, proxy) hay chỉ cho trình duyệt người dùng.
Ví dụ thực tế:
File CSS/JS ít thay đổi → Cache-Control: max-age=604800 (1 tuần).
Ảnh profile user (có thể đổi nhưng không thường xuyên) → Cache-Control: max-age=86400, must-revalidate.
Điểm mạnh: giúp tăng tốc độ web, giảm tải server, nhưng vẫn linh hoạt để dữ liệu quan trọng luôn mới.
5. Nhiều method và tính năng mới
HTTP/1.1 bổ sung khá nhiều method để phù hợp với web ngày càng phức tạp:
Method mới
PUT: ghi đè hoặc tạo tài nguyên ở URL cụ thể.
DELETE: xóa tài nguyên.
OPTIONS: hỏi server xem URL đó hỗ trợ những method nào (cần cho CORS).
TRACE: gửi request để server trả lại toàn bộ nội dung nó nhận → debug.
CONNECT: dùng cho tunneling (thường thấy khi HTTPS đi qua proxy).
Proxy support Cho phép request/response đi qua nhiều server trung gian (caching proxy, load balancer, CDN).
Authentication Có sẵn cơ chế như Basic và Digest Authentication để bảo vệ tài nguyên.
Cookies HTTP vốn stateless (mỗi request độc lập, không nhớ “ai với ai”). Cookie giúp “nhớ” trạng thái (user đã login, giỏ hàng, session…).
Charset & Content-Language Giúp server khai báo tài liệu dùng encoding gì (UTF-8, ISO-8859-1…) và ngôn ngữ (en, vi…).
Status code mới Bổ sung thêm nhiều mã: 409 Conflict, 410 Gone, 100 Continue… để mô tả chính xác hơn tình huống.
Trailing headers & mở rộng headers vô hạn Cho phép thêm metadata bổ sung sau phần body (dùng trong chunked transfer). HTTP/1.1 cũng gỡ bỏ giới hạn số lượng header → dễ mở rộng (các API hiện nay tận dụng điều này rất nhiều, như Authorization, X-Request-ID, Content-Security-Policy).
Các vấn đề của HTTP/1.1
Sau khi HTTP/1.1 được chuẩn hóa, nó trở thành nền móng của web suốt 20 năm. Nhưng chính sự bùng nổ website đã làm lộ rõ giới hạn của giao thức này.
Năm 2010, trang web trung bình ~ 700 KB, khoảng 50 request.
Đến 2018, tăng lên gần 1.8 MB, hơn 80–90 request.
Một số website lớn:
Wikipedia: chỉ 7 request, 0.06 MB (rất tối ưu).
Facebook: 172 request, 2.2 MB.
Amazon: 136 request, 4.46 MB.
Yahoo: 240 request, 3.8 MB.
Nguyên nhân: website ngày càng giàu media (ảnh, video), nhiều framework và script, và dùng AJAX để cập nhật động liên tục.
Các vấn đề performance của HTTP/1.1 và cách giải quyết tạm thời vào thời điểm này
Hãy tưởng tượng bạn mở một trang web rất đơn giản: chỉ có một ít văn bản và hai tấm hình.
Mỗi yêu cầu (request) từ trình duyệt đến server tốn 50ms để di chuyển qua mạng internet.
Máy chủ lấy dữ liệu từ file server, xử lý trong 10ms rồi trả về.
Trình duyệt khi nhận được ảnh, xử lý thêm 10ms trước khi gửi tiếp yêu cầu mới.
Tổng cộng, để hiển thị xong trang này cần 360ms. Trong đó chỉ 60ms là thời gian xử lý thực sự ở máy khách và máy chủ; còn lại 300ms (hơn 80%) chỉ để… chờ dữ liệu qua lại trên đường truyền. Trong lúc chờ, cả server lẫn trình duyệt đều “ngồi chơi xơi nước”
Điều bất hợp lý lộ rõ ở mốc 120ms: trình duyệt vừa gửi yêu cầu lấy ảnh số 1 và biết chắc là sẽ cần ảnh số 2, nhưng không thể gửi ngay. Nó buộc phải chờ ảnh 1 trả về xong, kết nối mới “rảnh” để gửi tiếp yêu cầu ảnh 2 vào lúc 240ms. Cách vận hành này làm mọi thứ chậm hẳn đi.
Trình duyệt hiện đại thường mở 6 kết nối / domain. Nếu website có nhiều file, chúng được tải trên 6 “đường ống” cùng lúc.
Dùng nhiều kết nối HTTP
Để tăng hơn nữa, nhiều trang web dùng domain sharding: chia file ra các subdomain như static.example.com, cdn.example.com… Như vậy mỗi domain được thêm 6 kết nối, tăng khả năng song song.
Ví dụ: StackOverflow tải:
jQuery từ Google,
Script/CSS từ cdn.static.net,
Ảnh từ i.stack.imgur.com.
Nhưng: giải pháp này lại tạo ra gánh nặng:
TCP handshake: mỗi kết nối mới cần 3 bước SYN → SYN-ACK → ACK (tốn 1.5 round-trip).
TCP slow start: kết nối mới ban đầu chỉ gửi ít gói, tăng dần khi chứng minh mạng chịu tải. Nghĩa là request/response đầu tiên thường bị “thắt cổ chai”.
HTTPS handshake: thêm vài vòng trao đổi nữa để thiết lập mã hóa.
Mozilla từng thống kê: 74% kết nối HTTP/1 chỉ dùng cho 1 transaction duy nhất → tức nhiều kết nối mở ra xong gần như bỏ phí.
Kết luận: mở nhiều kết nối giúp đỡ phần nào, nhưng chỉ là giải pháp tình thế. Nó tự tạo thêm chi phí (handshake, slow start, bộ nhớ) trong khi bản chất vấn đề vẫn là độ trễ.
Giảm số lượng request
Cách khác: thay vì tăng kết nối, hãy giảm số lần gọi.
Cache: dùng HTTP header Cache-Control, Expires để client lưu lại file, không tải lại nữa.
Sprite images: gộp nhiều icon nhỏ thành một ảnh lớn rồi dùng CSS để “cắt” ra (TinyPNG hay dùng cách này).
Concatenate & Minify: gộp nhiều file CSS/JS → một file duy nhất, đồng thời xóa khoảng trắng, comment.
Inline: chèn CSS/JS/ảnh trực tiếp vào HTML (dùng <style>, <svg>, hoặc base64).
Nhược điểm:
Phức tạp: tạo sprite, gộp file cần phải triển khai từ trước.
Lãng phí: tải cả sprite 100 icon trong khi chỉ cần 2.
Cache khó quản lý: một thay đổi nhỏ buộc user tải lại cả file lớn (dù chỉ đổi một dòng CSS).
SPDY
Nguồn gốc: năm 2009, Google (Mike Belshe & Robert Peon) giới thiệu SPDY (đọc là “speedy”). Họ chạy thử nghiệm trên bản sao của 25 trang web lớn nhất và thấy cải thiện tốc độ tải trang rất rõ rệt, tới mức hai chữ số phần trăm trong nhiều trường hợp.
Ý tưởng chính của SPDY: không thay đổi “nghĩa” của HTTP (vẫn có GET/POST/headers/body), nhưng thay đổi cách đóng gói và gửi các yêu cầu/response sao cho nhanh hơn và hiệu quả hơn với mạng hiện có. SPDY làm 4 việc quan trọng:
Multiplexing (đa luồng trên một kết nối):
Trước HTTP/1.1: trình duyệt mở nhiều kết nối TCP (mỗi tên miền thường ~6 kết nối đồng thời). Mỗi kết nối chỉ xử lý lần lượt một yêu cầu → xuất hiện “waterfall” (đọan thác): các nhóm tài nguyên phải chờ lượt.
SPDY: mọi request/response được chia thành các streams nhỏ, gửi xen kẽ qua một kết nối TCP duy nhất. Kết quả: tài nguyên có thể được gửi song song mà không cần mở thêm TCP connection.
Request prioritization (ưu tiên yêu cầu):
Không phải mọi tài nguyên đều quan trọng như nhau. SPDY cho phép trình duyệt nói với server tài nguyên nào quan trọng hơn (ví dụ: CSS quan trọng hơn ảnh nền). Server có thể ưu tiên gửi trước các stream quan trọng.
Header compression:
HTTP/1.1 gửi header dạng text cho từng yêu cầu, với nhiều request, header trùng lặp (cookie, user-agent, accept,…) gây lãng phí. SPDY nén header để giảm kích thước và số byte truyền.
Nếu mỗi request gửi một header Cookie: SESS=... dài 200 B, 360 request = 72 KB chỉ cho cookie. Header compression giảm con số này mạnh mẽ.
Server push (đẩy từ server):
Server có thể “đẩy” các tài nguyên mà nó dự đoán client sẽ cần (ví dụ: CSS, JS) ngay khi client yêu cầu HTML, tránh vòng lặp client → server hỏi “tôi cần CSS không?” → server mới trả.
Vì các tính năng như multiplexing và framing yêu cầu cấu trúc nhỏ gọn, chính xác và dễ phân mảnh, điều khó/không thể làm tốt khi gửi toàn bộ theo dạng text line-based (như HTTP/1.x). Binary framing cho phép định nghĩa các frame nhỏ (HEADERS, DATA, SETTINGS, WINDOW_UPDATE, v.v.) để truyền và ghép lại chính xác.
Kết quả thực tế: triển khai SPDY ở Chrome và trên các dịch vụ Google cho thấy tốc độ tải trang cải thiện rõ rệt; nhiều browser/server khác cũng nhanh chóng bổ sung hỗ trợ. Tuy nhiên SPDY chỉ là bước trung gian: nó chứng minh các ý tưởng thực tế và trở thành nền tảng để chuẩn hóa HTTP/2.
Ảnh: Sau khi HTTP/2 ra đời, SPDY bắt đầu giảm xuống
HTTP/2
SPDY chứng minh rằng các cải tiến có thể làm được, IETF (HTTP Working Group) dựa trên SPDY khi soạn HTTP/2 (bản draft đầu vào cuối 2012). HTTP/2 giữ hầu hết ý tưởng tốt của SPDY nhưng chuẩn hoá chúng, bổ sung một số cải tiến (ví dụ HPACK cho header compression) và xử lý các chi tiết tương thích/ bảo mật.
Tại sao dùng HTTP/2 thay vì HTTP/1.2?
HTTP/2 được tạo ra để giải quyết các vấn đề hiệu suất của HTTP/1, và phiên bản mới này thêm vào các khái niệm sau:
Giao thức nhị phân thay vì văn bản.
Ghép kênh (multiplexed) thay vì đồng bộ (synchronous).
Kiểm soát dòng chảy (flow control).
Ưu tiên luồng (stream prioritization).
Nén tiêu đề (header compression).
Đẩy từ máy chủ (server push).
Những khái niệm này (sẽ được mô tả chi tiết hơn trong chương) là những thay đổi cơ bản, phá vỡ tính tương thích ngược; nghĩa là, máy chủ web HTTP/1.0 có thể hiểu tin nhắn HTTP/1.1 và bỏ qua các chức năng thừa, nhưng điều này không đúng với tin nhắn HTTP/2, vì chúng có cấu trúc và định dạng khác. Vì lý do đó, HTTP/2 được coi là bản nâng cấp lớn..
Nhị phân thay vì văn bản
Một khác biệt chính giữa HTTP/1 và HTTP/2 là HTTP/2 là giao thức nhị phân dựa gói, trong khi HTTP/1 hoàn toàn dựa văn bản. Giao thức dựa văn bản dễ hiểu cho con người nhưng khó phân tích cho máy tính. Điều này chấp nhận được cho giao thức yêu cầu-phản hồi đơn giản mà HTTP bắt đầu, nhưng ngày càng hạn chế cho internet hiện đại.
Với giao thức văn bản, yêu cầu phải gửi và phản hồi nhận đầy đủ trước khi xử lý yêu cầu khác. HTTP hoạt động thế này 20 năm qua, dù có cải tiến nhỏ. HTTP/1.0 giới thiệu thân HTTP nhị phân, ví dụ, nơi hình ảnh và media khác có thể gửi trong phản hồi, và HTTP/1.1 giới thiệu pipelining và mã hóa chunked. Mã hóa chunked cho phép gửi phần thân tin nhắn trước, phần còn lại theo sau khi sẵn sàng. Thân HTTP chia thành chunk, và client nhận chunked response (hoặc server nhận chunked request) có thể bắt đầu xử lý trước khi nhận đầy đủ. Kỹ thuật này thường dùng khi độ dài dữ liệu tạo động không biết trước. Cả chunked encoding và pipelining có vấn đề chặn đầu hàng (HOL blocking), nơi tin nhắn đầu hàng ngăn phản hồi sau gửi, chưa kể pipelining không được hỗ trợ tốt trong thế giới thực.
HTTP/1.1
Định dạng: toàn bộ request/response là văn bản (ASCII/UTF-8).
Request line: GET /index.html HTTP/1.1
Headers: Host: example.com\r\n...
Body: theo sau, độ dài được báo bằng Content-Length hoặc chunked encoding.
Kết quả:
Parser phải đọc dấu hiệu kết thúc dòng (\r\n) để tách header.
Nếu header/body to, trình duyệt phải chờ nhiều (buffering).
Chỉ một request/response được xử lý trên một TCP connection tại một thời điểm → dễ nghẽn (head-of-line blocking).
Không có khái niệm “frame type”, tất cả đều là text nối tiếp nhau.
HTTP/2 – mọi thứ là frame
Cấu trúc rõ ràng, nhị phân: mỗi frame có header 9 byte cố định + payload.
Length (3 byte): kích thước payload.
Type (1 byte): phân loại (DATA, HEADERS, SETTINGS, PING, …).
Flags (1 byte): đánh dấu (END_STREAM, END_HEADERS, …).
Stream ID (4 byte, thực tế 31 bit): thuộc về stream nào.
Payload: dữ liệu thực (body, header block, …).
Ưu điểm:
Parser biết ngay độ dài frame → không cần scan ký tự xuống dòng.
Có thể ghép nhiều request/response song song trên một TCP connection (multiplexing, sẽ giải thích thêm ở dưới), nhờ phân biệt bằng stream ID.
Cho phép mở rộng: frame mới có thể được định nghĩa thêm mà không phá chuẩn.
Có nhiều loại frame khác nhau cho mục đích cụ thể: HEADERS, DATA, PRIORITY, WINDOW_UPDATE, PUSH_PROMISE… → kiểm soát chi tiết mà h1.1 không làm được.
Cấu trúc frame header (9 bytes đầu):
Length (3 bytes): độ dài payload.
Type (1 byte): loại frame (HEADERS, DATA, SETTINGS, …).
Flags (1 byte): cờ tùy theo frame type.
R (1 bit): reserved, không dùng.
Stream Identifier (31 bits): xác định stream mà frame thuộc về.
Payload: dữ liệu thực, độ dài như Length.
Frame types (10 chuẩn + mở rộng):
DATA (0x0): payload chính.
HEADERS (0x1): HTTP headers + priority.
PRIORITY (0x2): thay đổi độ ưu tiên, dependency.
RST_STREAM (0x3): kết thúc stream (thường khi lỗi).
SETTINGS (0x4): config connection.
PUSH_PROMISE (0x5): server thông báo sẽ push object.
PING (0x6): test RTT.
GOAWAY (0x7): đóng connection, không nhận stream mới.
WINDOW_UPDATE (0x8): điều khiển flow (bytes còn có thể nhận).
CONTINUATION (0x9): nối thêm headers khi HEADERS quá dài.
Extension frames: cho phép mở rộng mà không phá protocol.
t=   1646 [st=      1]    HTTP2_SESSION_RECV_SETTINGS
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "1 (SETTINGS_HEADER_TABLE_SIZE)"
                          --> value = 4096
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "5 (SETTINGS_MAX_FRAME_SIZE)"
                          --> value = 16384
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "6 (SETTINGS_MAX_HEADER_LIST_SIZE)"
                          --> value = 131072
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "3 (SETTINGS_MAX_CONCURRENT_STREAMS)"
                          --> value = 100
t=   1647 [st=      2]    HTTP2_SESSION_RECV_SETTING
                          --> id = "4 (SETTINGS_INITIAL_WINDOW_SIZE)"
                          --> value = 65536
Ghép kênh (multiplexing) trên một kết nối
Ý tưởng chính: HTTP/2 biến mỗi yêu cầu thành một luồng (stream) riêng, và tất cả luồng đi chung một “đường ống TCP duy nhất”.
Yêu cầu được cắt thành các khung (frame) nhỏ.
Mỗi khung có ID luồng để biết nó thuộc yêu cầu nào.
Server và client chỉ việc ghép các khung lại → tái tạo thành thông điệp HTTP hoàn chỉnh.
Lợi ích:
Không bị nghẽn đầu hàng (head-of-line blocking ở mức HTTP): Nếu một yêu cầu chậm (ví dụ tải ảnh lớn), nó không làm tắc nghẽn các yêu cầu khác. Server có thể trả xen kẽ: một khung ảnh, rồi một khung CSS, rồi tiếp tục ảnh…
Chỉ cần một kết nối TCP duy nhất cho mọi tài nguyên → giảm overhead handshake, giảm tiêu tốn tài nguyên.
Server có thể quyết định ưu tiên: gửi CSS/JS quan trọng trước, hình ảnh phụ sau → tăng tốc độ hiển thị trang.
Server phải trả đúng thứ tự: CSS → JS → PNG. Nếu file CSS to hoặc bị trễ, hai file sau cũng kẹt lại.
Với HTTP/2 multiplexing:
Client gửi cả 3 yêu cầu trên cùng một kết nối.
Server có thể trả: một phần CSS → một phần JS → một phần PNG → tiếp tục CSS…
Trình duyệt nhận được khung CSS đầu tiên thì đã có thể render ngay, không cần chờ toàn bộ CSS tải xong.
Bên trái (Client): trình duyệt gửi nhiều request (GET /styles.css, GET /script.js, GET /image.jpg…).
Giữa (HTTP/2 layer): tất cả request/response đều đi qua một kết nối TCP duy nhất nhưng được đóng gói thành nhiều stream. Mỗi stream lại chia nhỏ thành nhiều frame.
Bên phải (Server): server nhận request từ nhiều stream cùng lúc, xử lý rồi trả response xen kẽ trở lại trên cùng kết nối TCP.
Bước 1: Client gửi request
Client tạo 3 request:
Request 2 → GET /styles.css → Stream 5
Request 3 → GET /script.js → Stream 7
Request 4 → GET /image.jpg → Stream 9
Mỗi request sẽ được đánh số ID luồng (stream ID). Ở đây: 5, 7, 9 (client luôn tạo ID lẻ).
Bước 2: HTTP/2 framing layer đóng gói
Request không gửi nguyên khối, mà bị chia nhỏ thành frames:
Các frame từ nhiều stream có thể xếp nối tiếp nhau trên cùng kết nối TCP.
Ví dụ: thay vì phải gửi toàn bộ styles.css rồi mới đến script.js, rồi mới đến image.jpg, HTTP/2 sẽ gửi xen kẽ: một frame của Stream 5 (styles.css), sau đó một frame của Stream 7 (script.js), rồi một frame của Stream 9 (image.jpg)…
Bước 3: Server nhận và xử lý
Server đọc các frame, ghép lại theo stream ID để tái tạo thành request đầy đủ.
Sau đó server xử lý và tạo response.
Bước 4: Server trả response xen kẽ
Response cũng được cắt thành frames, rồi trả về client.
Các stream response không cần giữ đúng thứ tự yêu cầu ban đầu.
Server có thể ưu tiên gửi nhanh CSS (quan trọng để render trang) trước khi trả ảnh JPG.
Trong hình: Stream 5 và Stream 7 response đi xen kẽ nhau, trong khi Stream 9 (ảnh JPG) response nối tiếp.
Bạn có thể hình dung:
HTTP/1.1 giống như có 6 cái ống nước riêng, mỗi ống chỉ chảy được một loại nước. Nếu một ống nghẹt thì nước loại đó tắc hết.
HTTP/2 giống như một ống nước lớn duy nhất, trong đó dòng chảy có nhiều màu khác nhau (đỏ = ảnh, vàng = CSS, xanh = JS). Các giọt nước khác màu có thể luân phiên chạy trong cùng một ống, và khi đến đích thì được lọc ra đúng “xô” tương ứng.
Stream prioritization (Ưu tiên dòng)
HTTP/1.x:
Trình duyệt phải “xếp hàng” tài nguyên vì giới hạn 6 kết nối/host.
Muốn ưu tiên CSS/JS quan trọng thì chỉ đơn giản gửi sớm hơn. Nhưng nếu kết nối đã đầy, thì phải đợi → cơ chế ưu tiên thô sơ, bị giới hạn bởi số kết nối.
HTTP/2:
Có thể gửi hàng trăm stream một lúc trên cùng một kết nối.
Nếu không có ưu tiên, dễ lãng phí băng thông: ví dụ hình ảnh (không critical) lại chiếm chỗ trước CSS (critical).
Cơ chế ưu tiên: Client gửi “hints” về độ ưu tiên (priority) → server chọn phân bổ tài nguyên.
Ví dụ: nếu cả CSS và ảnh đang chờ, server sẽ gửi nhiều frame CSS hơn để trình duyệt render trang sớm.
Ưu tiên mềm: không phải “gửi cái này trước, cái kia sau”, mà là chia băng thông nhiều–ít giữa các stream.
Flow control
Ta đã thấy ở Multiplexing nghĩa là nhiều stream chia sẻ cùng một TCP. Nhưng nếu client đọc chậm (ví dụ đang pause video), mà server vẫn dồn dữ liệu video về → nghẽn buffer, mất gói, phải retransmit → phí công.
TCP vốn đã có cơ chế window size để tránh sender “dội” dữ liệu quá nhiều so với khả năng nhận của receiver.
Nhưng: TCP coi cả kết nối như một dòng duy nhất. Nếu một luồng dữ liệu (ví dụ video) bị nghẽn, thì nó kéo theo tất cả dữ liệu khác trên cùng connection → “head-of-line blocking”.
HTTP/2 chia nhỏ kết nối thành nhiều stream (mỗi request/response).
Mỗi stream có cửa sổ riêng (window size), mặc định 65,535 byte.
Cơ chế:
Server chỉ được gửi tối đa số byte trong cửa sổ.
Khi client xử lý xong một phần dữ liệu, nó báo lại bằng WINDOW_UPDATE frame → tăng cửa sổ, cho phép server gửi tiếp.
Kết quả: stream nào “chậm” (ví dụ video đang pause) thì chỉ bị tạm ngừng riêng, không ảnh hưởng các stream khác (CSS, JS vẫn chạy bình thường).
Giả sử stream #11 là video, stream #13 là CSS:
Ban đầu: cả hai có window = 65,535.
Server gửi:
Video 10 KB → cửa sổ video còn 55,535.
CSS 20 KB → cửa sổ CSS còn 45,535.
Client pause video → không gửi WINDOW_UPDATE cho stream #11 → video tạm “đóng băng”.
Nhưng client vẫn gửi WINDOW_UPDATE cho stream #13 → CSS tiếp tục tải bình thường.
This entry is part 7 of 8 in the series SWE Học A.I
Huấn luyện (Train)
Khi huấn luyện một bộ phân loại bằng học có giám sát (supervised learning), mỗi mẫu dữ liệu đều có một nhãn (label) được gán thủ công, mô tả lớp mà mẫu đó thuộc về. Tập hợp tất cả các mẫu dữ liệu dùng để học, cùng với nhãn của chúng, được gọi là tập huấn luyện (training set).
Chúng ta sẽ lần lượt trình bày từng mẫu trong tập huấn luyện cho bộ phân loại. Với mỗi mẫu, hệ thống nhận các đặc trưng (features) của mẫu và dự đoán lớp của nó.
Nếu dự đoán đúng (tức là khớp với nhãn đã gán), chúng ta chuyển sang mẫu tiếp theo. Nếu dự đoán sai, chúng ta cung cấp đầu ra của bộ phân loại và nhãn đúng trở lại cho nó.
Như ảnh trên, ta có thể thấy, trong quá trình huấn luyện, chúng ta sẽ cần điều chỉnh các tham số (parameter) của bộ phân loại để tăng khả năng dự đoán đúng nhãn. Điều này dẫn đến một bài toán tối ưu hóa (optimization problem), nơi mục tiêu là giảm thiểu sai số hoặc tối đa hóa xác suất xảy ra của dữ liệu. Một kỹ thuật phổ biến để giải bài toán này là phương pháp giảm gradient (gradient descent).
Gradient descent
Ta có một hàm số [latex]f[/latex] nhận đầu vào là một vector các số thực và trả về một số thực duy nhất. Một ví dụ đơn giản là hàm tính tổng bình phương các phần tử trong vector:
Python
from scratch.linear_algebra import Vector, dotdefsum_of_squares(v: Vector)->float:"""Tính tổng bình phương các phần tử trong vector v"""returndot(v, v)
Mục tiêu là tìm vector [latex]v[/latex] sao cho hàm [latex]f(v)[/latex] đạt giá trị lớn nhất (tối đa hóa) hoặc nhỏ nhất (tối thiểu hóa). Gradient (vector của các đạo hàm riêng [latex]\nabla f[/latex]) cho biết hướng làm hàm số tăng nhanh nhất. Ý tưởng của phương pháp giảm gradient là:
Chọn một điểm xuất phát ngẫu nhiên.
Tính gradient tại điểm đó.
Di chuyển một bước nhỏ theo hướng gradient (để tối đa hóa) hoặc ngược hướng (để tối thiểu hóa).
Lặp lại quá trình với điểm mới.
Trong hình trên thể hiện một hàm hai biến [latex]f(x, y) = x^2 + y^2[/latex], có dạng hình paraboloid lồi hướng lên, với điểm thấp nhất nằm tại gốc tọa độ [latex](0, 0, 0)[/latex].
Các mũi tên tam giác đỏ thể hiện các bước di chuyển của thuật toán. Tại mỗi bước, gradient được tính và điểm hiện tại được cập nhật theo hướng:
trong đó [latex]\eta[/latex] là tốc độ học (learning rate).
Ước lượng gradient
Nếu hàm [latex]f[/latex] chỉ có một biến, đạo hàm tại điểm [latex]x[/latex] đo lường sự thay đổi của [latex]f(x)[/latex] khi [latex]x[/latex] thay đổi một lượng rất nhỏ.
[latex]
\frac{f(x + h) – f(x)}{h}
[/latex]
Đây gọi là thương số sai phân.
[latex]h[/latex]: là một bước nhỏ (ví dụ: 0.001).
[latex]f(x+h)[/latex]: là giá trị hàm khi đi thêm một chút từ [latex]x[/latex].
[latex]f(x+h) – f(x)[/latex]: là phần thay đổi.
Chia cho [latex]h[/latex] để biết “mỗi bước nhỏ thay đổi bao nhiêu” → chính là độ dốc (gradient)
Đường cong màu xám là đồ thị của hàm [latex]f(x)[/latex].
Hai điểm được đánh dấu:
[latex](x, f(x))[/latex] – điểm gốc.
[latex](x + h, f(x + h))[/latex] – điểm gần đó.
Tam giác màu xanh dương thể hiện:
Đáy tam giác là [latex]h[/latex]
Chiều cao là [latex]f(x+h) – f(x)[/latex]
Độ dốc của đoạn thẳng là:
[latex]
\frac{f(x+h) – f(x)}{h}
[/latex]
→ chính là ước lượng đạo hàm tại [latex]x[/latex].
Khi hàm [latex]f[/latex] có nhiều biến, ta tính đạo hàm riêng (partial derivative) cho từng biến, giữ các biến khác cố định:
Python
defpartial_difference_quotient(f: Callable[[Vector],float],v: Vector,i:int,h:float)->float:"""Tính thương số sai phân riêng thứ i của hàm f tại vector v""" w =[v_j +(h if j == i else0)for j, v_j inenumerate(v)]return(f(w)-f(v))/ hdefestimate_gradient(f: Callable[[Vector],float],v: Vector,h:float=0.0001):return[partial_difference_quotient(f, v, i, h)for i inrange(len(v))]
Lưu ý: Việc ước lượng gradient bằng thương số sai phân tốn nhiều tài nguyên tính toán, đặc biệt với vector có kích thước lớn. Trong thực tế, người ta thường tính gradient trực tiếp bằng toán học để tối ưu hiệu suất.
Sử dụng Gradient để Tối Ưu Hóa Hàm Số
Rõ ràng rằng hàm tổng bình phương (sum of squares) đạt giá trị nhỏ nhất khi đầu vào là một vector toàn số không. Tuy nhiên, giả sử chúng ta chưa biết điều này, chúng ta có thể sử dụng gradient để tìm giá trị tối thiểu trong không gian các vector ba chiều. Bắt đầu từ một điểm ngẫu nhiên, ta thực hiện các bước nhỏ theo hướng ngược với gradient cho đến khi gradient đạt giá trị rất nhỏ.
Python
from scratch.linear_algebra import distance, add, scalar_multiplydefgradient_step(v: Vector,gradient: Vector,step_size:float)-> Vector:"""Di chuyển một khoảng `step_size` theo hướng `gradient` từ điểm `v`"""assertlen(v)==len(gradient) step =scalar_multiply(step_size, gradient)returnadd(v, step)defsum_of_squares_gradient(v: Vector)-> Vector:"""Tính gradient của hàm tổng bình phương"""return[2* v_i for v_i in v]# Chọn điểm bắt đầu ngẫu nhiênv =[random.uniform(-10,10)for i inrange(3)]for epoch inrange(1000): grad =sum_of_squares_gradient(v)# Tính gradient tại v v =gradient_step(v, grad,-0.01)# Bước ngược hướng gradientprint(epoch, v)assertdistance(v,[0,0,0])<0.001# v gần với [0, 0, 0]
Nếu thực thi đoạn code trên, vector v sẽ tiến gần đến [0, 0, 0]. Số lượng epoch càng lớn, kết quả càng chính xác.
Kiểm Thử (Test)
Chúng ta bắt đầu với một hệ thống có các tham số được khởi tạo ngẫu nhiên. Sau đó, chúng ta huấn luyện nó bằng dữ liệu trong tập huấn luyện. Khi hệ thống được triển khai ra thế giới thực, nó sẽ đối mặt với dữ liệu thực tế (deployment data, release data, hoặc user data).
Chúng ta muốn biết hệ thống sẽ hoạt động tốt như thế nào trên dữ liệu thực tế trước khi triển khai. Không cần độ chính xác hoàn hảo, nhưng thường chúng ta mong hệ thống đạt hoặc vượt một ngưỡng chất lượng nhất định. Làm sao để ước lượng chất lượng dự đoán của hệ thống trước khi triển khai?
Hệ thống cần hoạt động tốt trên tập huấn luyện, nhưng nếu chỉ đánh giá độ chính xác dựa trên dữ liệu này, chúng ta thường bị đánh lừa.
Giả sử chúng ta dùng bộ phân loại có giám sát để xử lý ảnh chó. Với mỗi ảnh, hệ thống sẽ gán nhãn xác định giống chó. Mục tiêu là triển khai hệ thống trực tuyến để người dùng có thể kéo ảnh chó của họ vào trình duyệt và nhận về giống chó hoặc nhãn “giống hỗn hợp (mixed breed)”.
Để huấn luyện, chúng ta thu thập 1.000 ảnh chó thuần chủng, mỗi ảnh được chuyên gia gắn nhãn. Chúng ta cho hệ thống xem cả 1.000 ảnh, lặp đi lặp lại qua nhiều epoch (lần lặp), thường xáo trộn thứ tự ảnh mỗi lần lặp để tránh trình tự lặp lại. Nếu hệ thống được thiết kế tốt, nó sẽ dần đạt kết quả chính xác hơn, ví dụ đạt 99% trong việc xác định giống chó trên tập huấn luyện.
Tuy nhiên, điều này không có nghĩa hệ thống sẽ đạt 99% chính xác khi triển khai trực tuyến. Vấn đề là hệ thống có thể đã khai thác các mối quan hệ đặc biệt trong tập huấn luyện, nhưng không đúng với dữ liệu nói chung.
Ví dụ, giả sử các ảnh chó Poodle trong tập huấn luyện đều có một cục bông ở đuôi, trong khi các giống khác thì không. Hệ thống nhận ra điều này và chỉ cần tìm cục bông để phân loại Poodle, thay vì xem xét các đặc trưng như kích thước chân, hình dạng mũi, v.v. Quy tắc này giúp phân loại đúng 100% ảnh Poodle trong tập huấn luyện, nhưng không phải cách chúng ta mong muốn. Hệ thống được cho là đã “học cách gian lận” (cheating)
Một ví dụ khác: Giả sử tất cả ảnh chó Yorkshire Terrier (Yorkie) trong tập huấn luyện đều được chụp khi chó ngồi trên ghế sofa, và không ảnh nào của giống khác có sofa. Hệ thống có thể học rằng nếu có sofa trong ảnh, đó là Yorkie. Quy tắc này hoạt động hoàn hảo trên tập huấn luyện.
Khi triển khai, nếu ai đó gửi ảnh một chú chó Great Dane đứng trước trang trí lễ hội với những quả bóng trắng hoặc một chú Husky nằm trên sofa, hệ thống có thể nhầm quả bóng trắng ở đuôi Great Dane là cục bông và gọi đó là Poodle, hoặc thấy sofa và gọi Husky là Yorkie.
Đây không chỉ là vấn đề lý thuyết. Một ví dụ nổi tiếng từ những năm 1960 (Muehlhauser 2011) kể về một hệ thống học máy nhận diện xe tăng trong ảnh cây cối. Hệ thống được cho là nhận diện xe tăng hoàn hảo, nhưng sau đó phát hiện rằng ảnh có xe tăng được chụp vào ngày nắng, còn ảnh không xe tăng chụp vào ngày âm u. Hệ thống chỉ phân biệt trời sáng và tối, không liên quan gì đến xe tăng.
Đây là lý do tại sao chỉ nhìn vào hiệu suất trên tập huấn luyện không đủ để dự đoán hiệu suất thực tế. Hệ thống có thể học các đặc điểm kỳ lạ (idiosyncrasies) trong tập huấn luyện và sử dụng chúng làm quy tắc, nhưng thất bại với dữ liệu mới không có những đặc điểm đó. Hiện tượng này được gọi là quá khớp (overfitting), hay thường gọi là “gian lận” (cheating)
Dữ liệu kiểm thử (Test Data)
Cách tốt nhất để xác định hiệu suất của hệ thống trên dữ liệu mới, chưa từng thấy là thử nghiệm nó trên dữ liệu kiểm thử (test data hoặc test set). Dữ liệu kiểm thử sẽ không được cho vào trong quá trình huấn luyện, vì vậy từ góc nhìn của hệ thống, chúng sẽ là các dữ liệu mới hoàn toàn.
Dữ liệu kiểm thử phải đại diện cho dữ liệu thực tế mà hệ thống sẽ gặp khi triển khai. Quy trình thông thường là huấn luyện hệ thống trên tập huấn luyện cho đến khi đạt hiệu suất tốt nhất có thể, sau đó đánh giá trên tập kiểm thử để dự đoán hiệu suất thực tế.
Nếu hiệu suất trên tập kiểm thử không đủ tốt, chúng ta cần cải thiện hệ thống, thường bằng cách thu thập thêm dữ liệu và huấn luyện lại. Thêm dữ liệu cũng giúp đa dạng hóa tập huấn luyện, ví dụ, tìm chó không phải Poodle có cục bông ở đuôi hoặc chó không phải Yorkie trên sofa, buộc hệ thống tìm cách phân loại khác để tránh quá khớp.
Do đó, chúng ta tách dữ liệu kiểm thử khỏi tập huấn luyện ngay từ đầu và chỉ sử dụng nó một lần sau khi huấn luyện hoàn tất. Nếu hệ thống không đạt yêu cầu trên tập kiểm thử, chúng ta phải bắt đầu lại với hệ thống mới được khởi tạo ngẫu nhiên, huấn luyện với dữ liệu mới hoặc lâu hơn, rồi đánh giá lại trên tập kiểm thử.
Thông thường, chúng ta tạo tập kiểm thử bằng cách chia tập dữ liệu gốc thành hai phần: tập huấn luyện (khoảng 75%) và tập kiểm thử (25%). Việc chọn mẫu thường ngẫu nhiên, nhưng có thể dùng thuật toán phức tạp hơn để đảm bảo mỗi tập đại diện tốt cho dữ liệu gốc.
Dữ Liệu Xác Thực (Validation Data)
Trong quy trình trên, chúng ta huấn luyện hệ thống, sau đó dừng lại và đánh giá trên tập kiểm thử. Nếu hiệu suất không đủ, chúng ta bắt đầu lại. Cách này hiệu quả nhưng chậm.
Trong thực tế, chúng ta thường muốn ước lượng hiệu suất hệ thống trong quá trình huấn luyện để dừng lại khi đạt mục tiêu. Vì vậy, chúng ta chia dữ liệu gốc thành ba tập: tập huấn luyện (training set), tập xác thực (validation set), và tập kiểm thử (test set), thường theo tỷ lệ 60% – 20% – 20%
Quy trình mới là: huấn luyện qua một epoch trên tập huấn luyện, sau đó đánh giá hiệu suất trên tập xác thực. Việc này được lặp lại sau mỗi epoch, gây rò rỉ dữ liệu, nhưng tập xác thực chỉ dùng để ước lượng không chính thức. Hiệu suất trên tập xác thực giúp chúng ta theo dõi quá trình học của hệ thống. Khi thấy hiệu suất đủ tốt, chúng ta dùng tập kiểm thử một lần để đánh giá chính xác.
Tập xác thực cũng hữu ích khi tìm kiếm siêu tham số (hyperparameters) – các biến được cài đặt trước để kiểm soát hoạt động của hệ thống, như mức độ cập nhật tham số sau lỗi hoặc độ phức tạp của bộ phân loại. Với mỗi bộ siêu tham số, chúng ta huấn luyện trên tập huấn luyện và đánh giá trên tập xác thực. Kết quả từ tập xác thực giúp quyết định khi nào dừng huấn luyện. Khi hiệu suất đạt yêu cầu, chúng ta dùng tập kiểm thử để đánh giá cuối cùng.
Quy trình này là một vòng lặp: chọn siêu tham số, huấn luyện, đánh giá trên tập xác thực, lặp lại với bộ siêu tham số mới, và cuối cùng chọn hệ thống tốt nhất để kiểm tra trên tập kiểm thử.
Vì tập xác thực đã ảnh hưởng đến việc chọn siêu tham số. Dù bộ phân loại không học trực tiếp từ tập xác thực, dữ liệu này đã “rò rỉ” vào quá trình chọn bộ phân loại tốt nhất. Để đánh giá chính xác trên dữ liệu hoàn toàn mới, không có cách nào khác ngoài việc dùng tập kiểm thử vào cuối cùng.
Xác Thực Chéo (Cross-Validation)
Trong phần trước, chúng ta đã dành gần một nửa dữ liệu huấn luyện để làm tập xác thực và kiểm tra. Điều này không thành vấn đề khi chúng ta có lượng dữ liệu đủ lớn để chia. Nhưng nếu tập dữ liệu của chúng ta nhỏ và không thể thu thập thêm dữ liệu thì sao?
Nếu chúng ta chấp nhận một ước lượng về hiệu suất của hệ thống thay vì một phép đo đáng tin cậy, chúng ta không cần phải để dành một tập kiểm tra riêng. Thực tế, chúng ta có thể huấn luyện trên toàn bộ dữ liệu đầu vào và vẫn dự đoán được hiệu suất trên dữ liệu mới.
Kỹ thuật thực hiện công việc này được gọi là xác thực chéo (cross-validation) hoặc xác thực luân phiên (rotation validation).
Ý tưởng cốt lõi là chạy một vòng lặp lặp đi lặp lại việc huấn luyện hệ thống từ đầu và sau đó kiểm tra nó. Mỗi lần lặp, chúng ta chia toàn bộ dữ liệu đầu vào thành một tập huấn luyện tạm thời và một tập xác thực tạm thời. Điều quan trọng là các tập này được tạo khác nhau trong mỗi lần lặp. Điều này cho phép chúng ta sử dụng toàn bộ dữ liệu để huấn luyện (mặc dù không phải tất cả cùng một lúc, như sẽ thấy sau).
Chúng ta bắt đầu bằng cách xây dựng một bộ phân loại mới. Dữ liệu đầu vào được chia thành tập huấn luyện tạm thời và tập xác thực tạm thời. Chúng ta huấn luyện hệ thống trên tập huấn luyện tạm thời và đánh giá nó bằng tập kiểm tra tạm thời, từ đó thu được điểm số về hiệu suất của bộ phân loại. Sau đó, chúng ta lặp lại vòng lặp, nhưng lần này chia dữ liệu thành các tập huấn luyện và kiểm tra tạm thời khác. Khi đã hoàn thành tất cả các lần lặp, trung bình của các điểm số này là ước lượng hiệu suất tổng thể của bộ phân loại.
Nhờ xác thực chéo, chúng ta có thể huấn luyện trên toàn bộ dữ liệu (mặc dù không phải tất cả trong mỗi lần lặp) và vẫn có được một phép đo khách quan về chất lượng hệ thống từ tập kiểm tra riêng. Thuật toán này không gặp vấn đề rò rỉ dữ liệu (data leakage) vì mỗi lần lặp, chúng ta tạo một bộ phân loại mới, và tập kiểm tra tạm thời cho bộ phân loại đó chứa dữ liệu hoàn toàn mới, chưa từng được sử dụng bởi bộ phân loại cụ thể đó, do đó việc sử dụng nó để đánh giá hiệu suất là công bằng. Tuy nhiên, nhược điểm của kỹ thuật này là ước lượng cuối cùng về độ chính xác của hệ thống không đáng tin cậy bằng khi sử dụng tập kiểm tra riêng.
Có nhiều thuật toán khác nhau để xây dựng các tập huấn luyện và xác thực tạm thời. Có thể điểm qua 1 số phương pháp phổ biến:
Xác Thực Chéo K-Fold
Phương pháp phổ biến nhất để xây dựng các tập dữ liệu tạm thời cho xác thực chéo được gọi là xác thực chéo k-fold. Ở đây, chữ “k” không phải là chữ cái đầu của một từ, mà đại diện cho một số nguyên (ví dụ, chúng ta có thể thực hiện “xác thực chéo 2-fold” hoặc “xác thực chéo 5-fold”). Thông thường, giá trị của k là số lần chúng ta muốn lặp lại vòng lặp.
Thuật toán bắt đầu trước khi vòng lặp xác thực chéo diễn ra. Chúng ta lấy dữ liệu huấn luyện và chia nó thành một loạt các nhóm có kích thước bằng nhau. Mỗi mẫu dữ liệu được đặt vào đúng một nhóm, và tất cả các nhóm có kích thước giống nhau (trừ một nhóm nhỏ hơn ở cuối nếu không thể chia đều dữ liệu).
Để hình dung, hãy tưởng tượng bạn viết tất cả các mẫu trong tập huấn luyện lên một tờ giấy dài, sau đó gấp tờ giấy đó thành một số phần bằng nhau. Mỗi lần gấp tạo ra một nếp, và phần vật liệu giữa các nếp được gọi là một fold.
Hãy sử dụng năm fold này để xem vòng lặp diễn ra như thế nào. Lần đầu tiên qua vòng lặp, chúng ta coi các mẫu trong Fold 2 đến Fold 5 là tập huấn luyện tạm thời, và các mẫu trong Fold 1 là tập kiểm tra tạm thời. Nghĩa là, chúng ta huấn luyện bộ phân loại với các mẫu trong Fold 2 đến Fold 5, sau đó đánh giá nó với các mẫu trong Fold 1.
Lần tiếp theo qua vòng lặp, bắt đầu với một bộ phân loại mới được khởi tạo với các số ngẫu nhiên, chúng ta sử dụng các mẫu trong Fold 1, 3, 4, và 5 làm tập huấn luyện tạm thời, và các mẫu trong Fold 2 làm tập kiểm tra tạm thời. Chúng ta huấn luyện và kiểm tra như thường lệ với hai tập này, và tiếp tục với các fold còn lại.