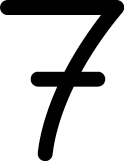
[SWE học A.I] Phần 2: Một số khái niệm toán học

This entry is part 2 of 8 in the series SWE Học A.I

Tổng hợp (Summations)

Tổng hợp (summation) được biểu diễn bằng ký hiệu sigma [latex]\sum[/latex] và được dùng để cộng các phần tử lại với nhau.

Ví dụ, nếu ta muốn lặp qua các số từ 1 đến 5, nhân mỗi số với 2, rồi cộng tổng lại, cách biểu diễn bằng tổng hợp sẽ như sau:

[latex]\sum_{i=1}^{5} 2i[/latex]

Tổng hợp [latex]\sum[/latex] có nghĩa là “cộng một loạt các phần tử lại với nhau”, sử dụng chỉ số i và giá trị tối đa n để biểu thị mỗi lần lặp.

Lũy thừa (Exponents)

Lũy thừa (exponentiation) là phép nhân một số với chính nó một số lần nhất định. Ví dụ, khi ta nâng 2 lên lũy thừa 3 (biểu diễn là [latex]2^3[/latex]), điều đó có nghĩa là nhân ba số 2 với nhau:

[latex]2^3 = 2 \cdot 2 \cdot 2 = 8[/latex]

  • Cơ số (base): Là giá trị được nâng lên lũy thừa (trong ví dụ trên là 2).
  • Số mũ (exponent): Là số lần cơ số được nhân với chính nó (trong ví dụ trên là 3).

Các thuộc tính của lũy thừa

1. Quy tắc nhân (Product Rule)

Khi nhân hai lũy thừa có cùng cơ số, ta cộng các số mũ lại. Ví dụ:

[latex]2^2 \cdot 2^3 = 2^{2+3} = 2^5 = 32[/latex]

Giải thích:

  • [latex]2^2 = 4[/latex], [latex]2^3 = 8[/latex].
  • [latex]4 \cdot 8 = 32[/latex], hoặc trực tiếp: [latex]2^5 = 32[/latex].
  • Quy tắc này chỉ áp dụng khi các lũy thừa có cùng cơ số.

2. Quy tắc chia (Quotient Rule)

Khi chia hai lũy thừa có cùng cơ số, ta trừ số mũ. Ví dụ:

[latex]\frac{x^5}{x^2} = x^{5-2} = x^3[/latex]

Giải thích:

  • Khi chia, các thừa số giống nhau ở tử số và mẫu số triệt tiêu, để lại [latex]x^3[/latex].

3. Lũy thừa âm (Negative Exponents)

Lũy thừa âm biểu thị nghịch đảo của lũy thừa dương. Ví dụ:

[latex]x^{-3} = \frac{1}{x^3}[/latex]

Ví dụ:

  • [latex]\frac{x^5}{x^7} = x^{5-7} = x^{-2} = \frac{1}{x^2}[/latex].
  • Quy tắc nhân vẫn áp dụng cho lũy thừa âm: [latex]x^5 \cdot x^{-3} = x^{5+(-3)} = x^2[/latex].

4. Lũy thừa bằng 0

Bất kỳ số nào (khác 0) nâng lên lũy thừa 0 đều bằng 1:

[latex]x^0 = 1[/latex]

Giải thích:

  • Xét [latex]\frac{x^3}{x^3} = x^{3-3} = x^0[/latex]. Vì một số chia cho chính nó bằng 1, nên [latex]x^0 = 1[/latex].
  • Thuộc tính này đảm bảo tính nhất quán trong các quy tắc lũy thừa.

5. Lũy thừa của lũy thừa (Power Rule)

Khi một lũy thừa được nâng lên một lũy thừa khác, ta nhân các số mũ:

[latex]x^3 = x^{2 \cdot 3} = x^6[/latex]

Giải thích:

  • [latex]x^3 = x^2 \cdot x^2 \cdot x^2 = x^6[/latex].

6. Lũy thừa phân số (Fractional Exponents)

Lũy thừa phân số biểu thị căn (root). Ví dụ:

  • Căn bậc hai: [latex]\sqrt{4} = 4^{\frac{1}{2}} = 2[/latex], vì [latex]2 \cdot 2 = 4[/latex].
  • Căn bậc ba: [latex]\sqrt[3]{8} = 8^{\frac{1}{3}} = 2[/latex], vì [latex]2 \cdot 2 \cdot 2 = 8[/latex].

Ví dụ:

  • [latex]8^{\frac{2}{3}}[/latex] nghĩa là lấy căn bậc ba của 8, rồi bình phương:
    • [latex]\sqrt[3]{8} = 2[/latex].
    • [latex]2^2 = 4[/latex].
    • Do đó, [latex]8^{\frac{2}{3}} = 4[/latex].

Lũy thừa vô tỷ: Lũy thừa với số mũ vô tỷ, như [latex]2^\pi[/latex], có thể được tính xấp xỉ bằng cách sử dụng số hữu tỷ gần đúng. Ví dụ:

[latex]2^\pi \approx 2^{3.1415926535} \approx 8.824977827[/latex]2

Logarit (Logarithms)

Logarit (logarithm) là một hàm toán học tìm số mũ của một cơ số cụ thể để đạt được một số nhất định. Ví dụ, câu hỏi “2 mũ bao nhiêu bằng 8?” được biểu diễn là:

[latex]2^x = 8[/latex]

Câu trả lời là [latex]x = 3[/latex], vì [latex]2^3 = 8[/latex]. Cách biểu diễn bằng logarit là:

[latex]\log_2(8) = 3[/latex]

  • Trong Python, nếu không chỉ định cơ số, hàm log() sử dụng cơ số là số Euler [latex]e \approx 2.718[/latex], phổ biến trong khoa học dữ liệu (data science).
  • Trong các lĩnh vực như đo lường động đất, cơ số mặc định thường là 10.

Giải thích:

  • Cơ số (base) là 2.
  • Logarit tìm số mũ (3) để [latex]2^3 = 8[/latex].
Toán tửThuộc tính lũy thừaThuộc tính logarit
Nhân[latex]x^a \cdot x^b = x^{a+b}[/latex][latex]\log_b (xy) = \log_b x + \log_b y[/latex]
Chia[latex]\frac{x^a}{x^b} = x^{a-b}[/latex][latex]\log_b \left(\frac{x}{y}\right) = \log_b x – \log_b y[/latex]
Lũy thừa[latex]x^a \cdot x^b = x^{a \cdot b}[/latex][latex]\log_b (x^a) = a \log_b x[/latex]
Lũy thừa 0[latex]x^0 = 1[/latex]Không xác định
Nghịch đảo[latex]x^{-a} = \frac{1}{x^a}[/latex][latex]\log_b \left(\frac{1}{x}\right) = -\log_b x[/latex]


Số Euler và Logarit Tự nhiên

Số Euler, ký hiệu [latex]e[/latex], là một hằng số toán học với giá trị xấp xỉ 2.71828, có vai trò quan trọng trong giải tích và các lĩnh vực liên quan.

Tính chất đặc biệt của số Euler nằm ở chỗ đạo hàm của hàm mũ [latex]e^x[/latex] chính là chính nó, giúp đơn giản hóa các phép tính trong các bài toán liên quan đến hàm mũ và logarit.

Xác suất thống kê

Bằng cách nghiên cứu và phân tích dữ liệu đầu vào, chúng ta có thể lựa chọn các thuật toán học máy phù hợp nhất. Những ý tưởng và công cụ hỗ trợ phân tích này thường được tập hợp dưới khái niệm xác suất thống kê. Các khái niệm và ngôn ngữ xác suất thống kê thống kê xuất hiện khắp nơi trong lĩnh vực học máy, từ các bài báo học thuật, chú thích trong mã nguồn, đến tài liệu của các thư viện phần mềm.

Sự ngẫu nhiên (Randomness)

Số ngẫu nhiên đóng vai trò quan trọng trong nhiều thuật toán học máy. Chúng được sử dụng để khởi tạo hệ thống, điều khiển các bước trong quá trình học, và đôi khi còn ảnh hưởng đến kết quả đầu ra.

Việc chọn số ngẫu nhiên đúng cách là yếu tố quyết định: nó có thể tạo ra sự khác biệt giữa một hệ thống học được từ dữ liệu và cho ra kết quả hữu ích, với một hệ thống không học được gì.

Thay vì chọn các số một cách tùy tiện, chúng ta sử dụng nhiều công cụ để kiểm soát loại số cần dùng và cách chọn chúng.

Thông thường, chúng ta chọn một số ngẫu nhiên trong khoảng giới hạn bởi giá trị tối thiểu và tối đa, như khi ai đó yêu cầu bạn “chọn một số từ 1 đến 10”. Trong ví dụ này, lựa chọn của chúng ta bị giới hạn trong một tập hợp hữu hạn các số nguyên từ 1 đến 10. Tuy nhiên, trong thực tế, chúng ta thường làm việc với số thực, có thể nằm giữa các số nguyên. Trong khoảng từ 1 đến 10, có 10 số nguyên, nhưng số lượng số thực là vô hạn.

Khi nói về các tập hợp số, dù ngẫu nhiên hay không, chúng ta thường đề cập đến giá trị trung bình của chúng. Đây là cách đơn giản để mô tả đặc trưng của tập hợp. Có ba cách phổ biến để tính giá trị trung bình, và chúng thường được sử dụng, nên chúng ta sẽ làm rõ tại đây. Hãy lấy ví dụ một danh sách gồm năm số: 1, 3, 4, 4, 13.

  • Trung bình cộng (mean) là giá trị mà chúng ta thường hiểu là “trung bình” trong ngôn ngữ hàng ngày. Nó được tính bằng cách cộng tất cả các phần tử trong danh sách và chia cho số lượng phần tử. Trong ví dụ, tổng các phần tử là 1 + 3 + 4 + 4 + 13 = 25. Có năm phần tử, nên trung bình cộng là 25 / 5 = 5.
  • Mốt (mode) là giá trị xuất hiện nhiều nhất trong danh sách. Trong ví dụ, số 4 xuất hiện hai lần, trong khi các số khác chỉ xuất hiện một lần, nên 4 là mốt. Nếu không có giá trị nào xuất hiện nhiều hơn các giá trị khác, danh sách được coi là không có mốt.
  • Trung vị (median) là giá trị nằm ở giữa khi danh sách được sắp xếp từ nhỏ đến lớn. Trong danh sách đã sắp xếp của chúng ta (1, 3, 4, 4, 13), số 4 nằm ở giữa, nên 4 là trung vị. Nếu danh sách có số phần tử chẵn, trung vị là trung bình cộng của hai phần tử ở giữa. Ví dụ, với danh sách 1, 3, 4, 8, trung vị là (3 + 4) / 2 = 3,5.

Biến ngẫu nhiên và phân phối xác suất (Random Variables and Probability Distributions)

Giả sử bạn là một nhiếp ảnh gia được giao nhiệm vụ chụp ảnh cho một bài báo về bãi xe phế liệu, tập trung vào các xe tải và ô tô hỏng.

Bạn đến một bãi xe chứa nhiều phương tiện hỏng hóc. Sau khi trò chuyện với chủ bãi, bạn đồng ý trả tiền để cô ấy mang từng chiếc xe đến cho bạn chụp ảnh. Để thêm phần thú vị, cô ấy sử dụng một bánh xe quay cũ trong văn phòng, với mỗi khe trên bánh xe đại diện cho một chiếc xe trong bãi, được đánh số từ 1.
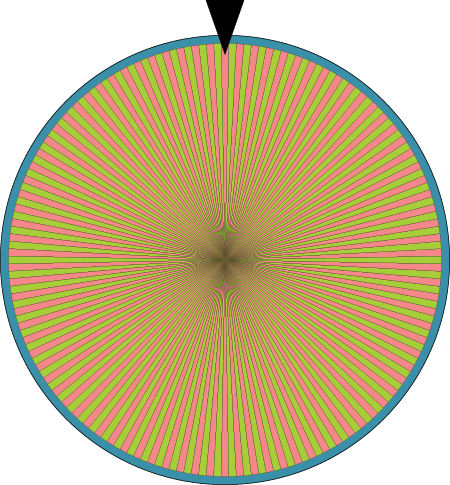
image 19 - quochung.cyou PTIT

Mỗi lần bạn trả tiền, cô ấy quay bánh xe. Khi bánh xe dừng, cô ấy ghi lại số ở vị trí trên cùng, lái xe kéo đến và mang chiếc xe tương ứng đến cho bạn. Bạn chụp ảnh, sau đó cô ấy đưa xe trở lại bãi. Nếu muốn chụp chiếc xe khác, bạn trả tiền, cô ấy quay bánh xe, và quy trình lặp lại.

Giả sử bài báo yêu cầu bạn chụp ảnh năm loại xe khác nhau: sedan, bán tải (pickup), minivan, SUV, và wagon. Với mỗi loại xe, bạn muốn biết xác suất nhận được loại xe đó khi bánh xe quay. Để tính toán, bạn đi kiểm tra từng chiếc xe trong bãi và phân loại chúng vào năm nhóm này. Kết quả được thể hiện như sau:
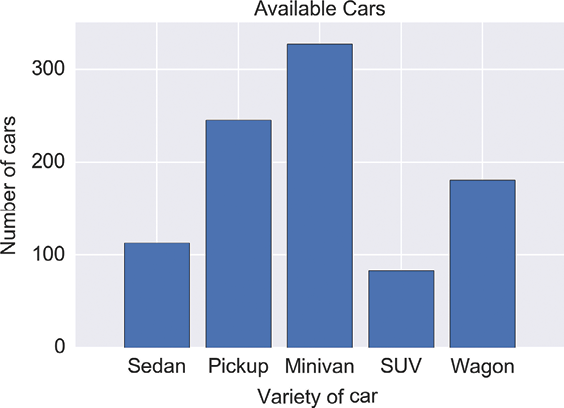
image 20 - quochung.cyou PTIT

Trong gần 950 chiếc xe, minivan chiếm số lượng lớn nhất, tiếp theo là xe bán tải, wagon, sedan, và SUV. Vì mỗi chiếc xe có cơ hội được chọn như nhau, khi quay bánh xe, khả năng cao nhất bạn sẽ nhận được một chiếc minivan.

Nhưng cụ thể, khả năng nhận được minivan cao hơn bao nhiêu?

Để xác định xác suất nhận được từng loại xe, chúng ta chia số lượng xe của mỗi loại cho tổng số xe.

Xác định số lượng từng loại xe
Ví dụ:

  • Minivan: 320 chiếc
  • Pickup: 210 chiếc
  • Wagon: 180 chiếc
  • Sedan: 130 chiếc
  • SUV: 110 chiếc
  • Tổng cộng: 950 chiếc

Tính xác suất bằng cách chia số lượng mỗi loại xe cho tổng số xe

  • Minivan: 320 / 950 ≈ 0.337
  • Pickup: 210 / 950 ≈ 0.221
  • Wagon: 180 / 950 ≈ 0.189
  • Sedan: 130 / 950 ≈ 0.137
  • SUV: 110 / 950 ≈ 0.116

Chuyển sang phần trăm bằng cách nhân với 100

  • Minivan: 0.337 × 100 = 33.7%
  • Pickup: 22.1%
  • Wagon: 18.9%
  • Sedan: 13.7%

Kết quả này cho biết xác suất nhận được từng loại xe, như được minh họa dưới đây:
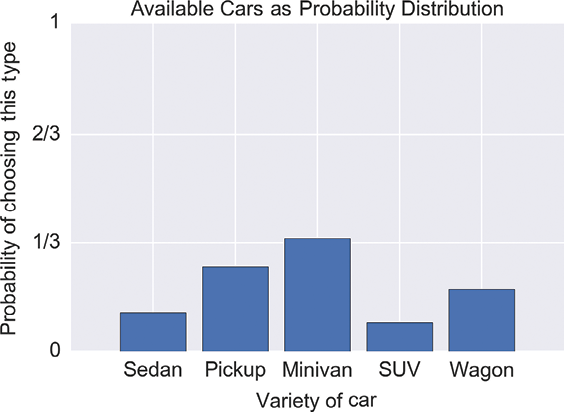
image 21 - quochung.cyou PTIT

Tổng các xác suất của năm loại xe bằng 1,0, thể hiện quy tắc cơ bản của xác suất: các giá trị phải nằm trong khoảng từ 0 đến 1 và tổng bằng 1.

Dựa trên phân phối xác suất này, chúng ta có thể hình dung một bánh xe quay đơn giản hơn, như sau:
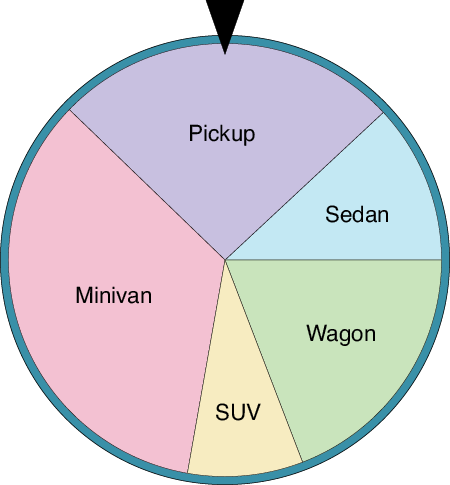
image 22 - quochung.cyou PTIT

Xác suất để con trỏ dừng ở một vùng nhất định tỷ lệ với phần chu vi của vùng đó, được vẽ theo tỷ lệ giống như trong phân phối xác suất.

Thông thường, khi tạo số ngẫu nhiên trên máy tính, chúng ta không sử dụng bánh xe quay mà dựa vào phần mềm để mô phỏng quá trình này. Chẳng hạn, chúng ta có thể cung cấp cho một hàm thư viện danh sách các giá trị, như độ cao của các cột trong phân phối xác suất, và yêu cầu trả về một giá trị. Chúng ta kỳ vọng sẽ nhận được minivan khoảng 34% thời gian, xe bán tải khoảng 26% thời gian, v.v.

Biến ngẫu nhiên

Việc chọn một giá trị ngẫu nhiên từ danh sách các lựa chọn, mỗi lựa chọn có xác suất riêng, đòi hỏi một quy trình cụ thể. Để tiện lợi, chúng ta gói gọn quá trình này vào một khái niệm gọi là biến ngẫu nhiên. (random variable)

Quá trình chọn một giá trị từ phân phối được gọi là rút một giá trị từ biến ngẫu nhiên.

Hàm khối xác suất

Chúng ta đã gọi biểu đồ xác suất là phân phối xác suất, nhưng nó cũng có thể được xem như một hàm. Khi gọi hàm này, nó trả về một loại xe với xác suất tương ứng. Khi chỉ có một số lượng hữu hạn giá trị trả về, như năm loại xe trong ví dụ, chúng ta gọi đó là hàm khối xác suất (probability mass function – pmf) hoặc phân phối xác suất rời rạc. Các thuật ngữ này nhấn mạnh rằng chỉ có một số lượng cố định các kết quả có thể xảy ra.

Chúng ta cũng có thể tạo ra các phân phối xác suất liên tục, thường được sử dụng khi khởi tạo các giá trị trong mạng nơ-ron.

Hãy lấy ví dụ: giả sử bạn muốn biết lượng dầu còn lại trong mỗi chiếc xe mà chủ bãi mang đến. Lượng dầu là một biến liên tục, vì nó có thể là bất kỳ số thực nào.

Biểu đồ phân phối xác suất liên tục cho phép chúng ta tính xác suất nhận được một giá trị trong một khoảng nhất định bằng cách tính diện tích dưới đường cong trong khoảng đó. Chẳng hạn, để tìm xác suất nhận được một chiếc xe có 0,45 đơn vị dầu, chúng ta không chỉ nhìn vào giá trị tại 0,45 mà xem xét một khoảng nhỏ, ví dụ từ 0,44 đến 0,46, và tính diện tích dưới đường cong trong khoảng này. Điều này có nghĩa là đường cong có thể có giá trị lớn hơn 1, miễn là tổng diện tích dưới toàn bộ đường cong bằng 1.

image 23 - quochung.cyou PTIT

Phân phối như thế này được gọi là phân phối xác suất liên tục (continuous probability distribution – cpd) hoặc hàm mật độ xác suất (probability density function – pdf). Đôi khi, thuật ngữ “hàm mật độ xác suất” được sử dụng một cách không chính thức cho cả phân phối rời rạc, nhưng ngữ cảnh thường giúp làm rõ ý nghĩa.

Hiệp phương sai và Tương quan (Covariance and Correlation)

Đôi khi các biến số có thể liên quan với nhau theo những cách thú vị. Hãy tưởng tượng một biến cho chúng ta biết nhiệt độ bên ngoài, và biến kia cho biết khả năng có tuyết rơi. Khi nhiệt độ rất cao, khả năng có tuyết gần như bằng không – việc biết được giá trị của một biến sẽ tiết lộ thông tin quý giá về biến kia. Trong trường hợp này, mối quan hệ mang tính âm tính: khi nhiệt độ tăng cao, khả năng có tuyết giảm xuống, và ngược lại.

Mặt khác, biến thứ hai có thể cho chúng ta biết số lượng người bơi dự kiến tại hồ địa phương. Mối liên hệ giữa nhiệt độ và số người bơi mang tính dương tính, bởi vì trong những ngày ấm áp hơn, chúng ta sẽ thấy nhiều người bơi hơn, và ngược lại.

Khả năng phát hiện những mối quan hệ này và đo lường sức mạnh của chúng có giá trị thực tiễn to lớn. Giả sử chúng ta đang lên kế hoạch huấn luyện một thuật toán để trích xuất thông tin từ tập dữ liệu. Nếu phát hiện ra hai giá trị trong dữ liệu có mối liên hệ chặt chẽ (như nhiệt độ và khả năng có tuyết), chúng ta có thể loại bỏ một trong hai biến đó khỏi dữ liệu vì nó thừa thãi. Điều này không chỉ cải thiện tốc độ huấn luyện mà còn có thể nâng cao chất lượng kết quả.

Trong phần này, chúng ta sẽ khám phá một phép đo gọi là hiệp phương sai (covariance), được các nhà toán học phát triển để xác định sức mạnh của những mối quan hệ này. Chúng ta cũng sẽ tìm hiểu một biến thể gọi là tương quan (correlation), thường hữu ích hơn vì nó không phụ thuộc vào quy mô của các con số liên quan.

Hiệp phương sai

Hãy tưởng tượng chúng ta có hai biến và nhận thấy một mô hình số học cụ thể liên quan đến chúng. Khi giá trị của một biến tăng, biến kia tăng theo một bội số cố định của lượng đó, và điều tương tự xảy ra khi một trong hai biến giảm.

Ví dụ cụ thể: giả sử biến A tăng 3 đơn vị, và biến B tăng 6 đơn vị. Sau đó, B tăng 4 đơn vị, và A tăng 2 đơn vị. Tiếp theo, A giảm 4 đơn vị, và B giảm 8 đơn vị. Trong mọi trường hợp, B tăng hoặc giảm gấp đôi lượng mà A tăng hoặc giảm, vì vậy bội số cố định của chúng ta là 2.

Khi chúng ta quan sát thấy mối quan hệ như vậy (với bất kỳ bội số nào, không chỉ riêng số 2), chúng ta nói rằng hai biến này đồng biến (covary). Chúng ta đo lường sức mạnh của mối liên hệ giữa hai biến, hay tính nhất quán mà chúng đồng biến, bằng một con số gọi là hiệp phương sai. Nếu phát hiện ra rằng khi một giá trị tăng hoặc giảm, giá trị kia cũng làm điều tương tự theo một lượng có thể dự đoán được, thì hiệp phương sai là một số dương, và chúng ta nói rằng hai biến đang thể hiện hiệp phương sai dương.

Cách cổ điển để thảo luận về hiệp phương sai là vẽ các điểm trong không gian 2D
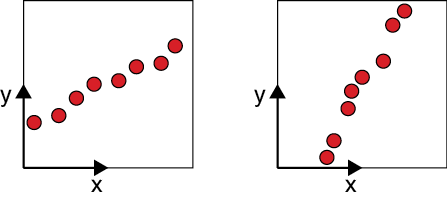
image 25 - quochung.cyou PTIT

Ở đây chúng ta thấy hai tập hợp điểm đồng biến khác nhau. Mỗi điểm có tọa độ x và y, nhưng chúng chỉ là đại diện cho bất kỳ hai biến nào chúng ta muốn so sánh. Sự thay đổi của y theo dõi sự thay đổi của x càng nhất quán, hiệp phương sai càng mạnh.

Nếu một giá trị giảm bất cứ khi nào giá trị kia tăng, chúng ta nói các biến có hiệp phương sai âm.
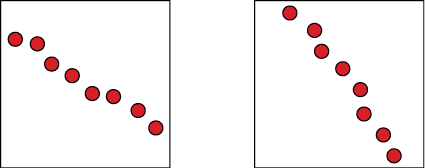
image 26 - quochung.cyou PTIT

Nếu hai biến không có chuyển động khớp nhau một cách nhất quán như vậy, thì hiệp phương sai bằng không.
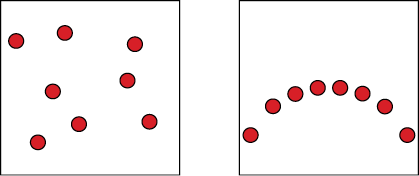
image 27 - quochung.cyou PTIT

Khái niệm hiệp phương sai của chúng ta chỉ nắm bắt được mối quan hệ giữa các biến khi sự thay đổi của chúng là bội số của nhau. Hình trên cho thấy rằng có thể có một mô hình rõ ràng trong dữ liệu (ở đây các chấm tạo thành một phần của hình tròn), nhưng hiệp phương sai vẫn bằng không vì các mối quan hệ rất không nhất quán.

Tương quan

Hiệp phương sai là một khái niệm hữu ích, nhưng nó có một vấn đề. Do cách nó được định nghĩa về mặt toán học, nó không tính đến mối quan hệ giữa các đơn vị của hai biến, điều này khiến chúng ta khó so sánh sức mạnh của các hiệp phương sai khác nhau.

Ví dụ, giả sử chúng ta đo một tá biến mô tả một cây đàn guitar: độ dày của gỗ, chiều dài của cần đàn, thời gian một nốt nhạc cộng hưởng, lực căng trên dây đàn, v.v. Chúng ta có thể tìm thấy hiệp phương sai giữa các cặp phép đo khác nhau, nhưng không thể so sánh một cách có ý nghĩa lượng hiệp phương sai để tìm ra cặp nào có mối quan hệ mạnh nhất và yếu nhất. Ngay cả thang đo cũng quan trọng: nếu chúng ta tìm hiệp phương sai cho một cặp phép đo bằng centimet và hiệp phương sai cho một cặp phép đo khác bằng inch, chúng ta không thể so sánh những giá trị đó để nói cặp nào đồng biến mạnh hơn.

Dấu của hiệp phương sai là tất cả những gì chúng ta học được: giá trị dương có nghĩa là mối quan hệ dương, giá trị âm có nghĩa là mối quan hệ âm, và số không có nghĩa là không có mối quan hệ. Chỉ có dấu là một vấn đề, bởi vì chúng ta thực sự muốn so sánh các tập hợp biến khác nhau.

Sau đó, chúng ta có thể tìm ra thông tin hữu ích như biến nào có tương quan dương và âm mạnh nhất và yếu nhất. Chúng ta có thể sử dụng thông tin đó để cắt giảm kích thước tập dữ liệu của mình, ví dụ, bằng cách loại bỏ một trong các phép đo trong một hoặc nhiều cặp có liên quan chặt chẽ.

Để có được một phép đo cho phép chúng ta thực hiện những so sánh này, chúng ta có thể tính toán một con số hơi khác gọi là hệ số tương quan (correlation coefficient), hay đơn giản là tương quan. Giá trị này bắt đầu với hiệp phương sai nhưng bao gồm một bước tính toán bổ sung. Kết quả là một con số không phụ thuộc vào các đơn vị được chọn cho các biến. Chúng ta có thể nghĩ về tương quan như một phiên bản được chia tỷ lệ của hiệp phương sai, luôn cho chúng ta một giá trị giữa −1 và 1. Giá trị +1 cho chúng ta biết chúng ta có tương quan dương hoàn hảo, trong khi giá trị −1 cho chúng ta biết chúng ta có tương quan âm hoàn hảo.

Tương quan dương hoàn hảo dễ nhận biết: tất cả các chấm nằm dọc theo một đường thẳng di chuyển theo hướng đông bắc-tây nam.
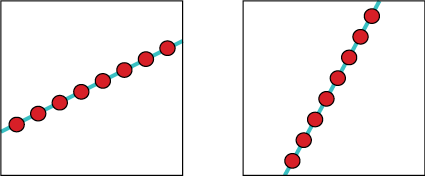
image 28 - quochung.cyou PTIT

Loại mối quan hệ nào giữa các điểm mang lại cho chúng ta tương quan dương, nhưng ở đâu đó trong khoảng từ 0 đến 1? Đó là khi giá trị y tiếp tục tăng với x, nhưng tỷ lệ sẽ không cố định. Chúng ta có thể không dự đoán được nó thay đổi bao nhiều, nhưng chúng ta biết rằng sự tăng của x gây ra sự tăng của y, và sự giảm của x gây ra sự giảm của y.
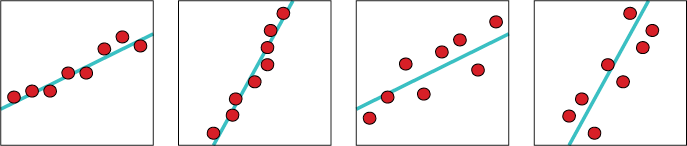
image 29 - quochung.cyou PTIT

Hình trên cho thấy biểu đồ chấm cho một số giá trị dương của tương quan giữa 0 và 1. Các chấm càng gần với việc rơi trên một đường thẳng, giá trị tương quan càng gần với 1. Chúng ta nói rằng nếu giá trị gần số không thì tương quan yếu (hoặc thấp), nếu nó khoảng 0.5 thì trung bình, và nếu nó gần 1 thì mạnh (hoặc cao).

Bây giờ hãy xem xét giá trị tương quan bằng không. Tương quan bằng không có nghĩa là không có mối quan hệ giữa sự thay đổi của một biến và sự thay đổi của biến kia. Chúng ta không thể dự đoán điều gì sẽ xảy ra. Nhớ lại rằng tương quan chỉ là một phiên bản được chia tỷ lệ của hiệp phương sai, vì vậy khi hiệp phương sai bằng không, tương quan cũng vậy.
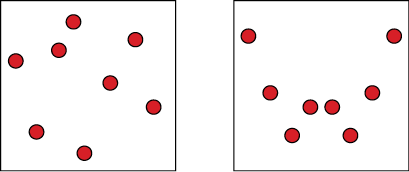
image 30 - quochung.cyou PTIT

Tương quan âm giống như tương quan dương, chỉ khác là các biến di chuyển theo hướng ngược nhau: khi x tăng, y giảm. Giống như với tương quan dương, nếu giá trị gần số không thì tương quan yếu (hoặc thấp), nếu nó khoảng −0.5 thì trung bình, và nếu nó gần −1 thì mạnh (hoặc cao).
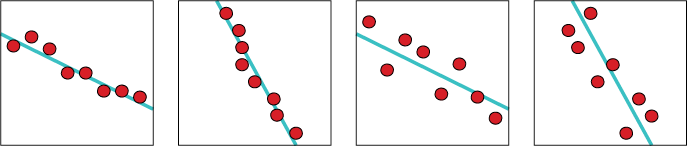
image 31 - quochung.cyou PTIT

Khi hai biến có tương quan dương hoặc âm hoàn hảo (tức là giá trị +1 và −1), chúng ta nói rằng các biến được tương quan tuyến tính, bởi vì (như chúng ta đã thấy) các điểm nằm trên một đường thẳng. Các biến được mô tả bởi bất kỳ giá trị nào khác của tương quan được cho là tương quan phi tuyến tính.

Đạo hàm (Derivative)

Một trong những khía cạnh quan trọng nhất của một đường cong là đạo hàm của nó. Đạo hàm cung cấp thông tin về hình dạng của đường cong tại bất kỳ điểm nào trên đó. Trong phần này, chúng ta sẽ xem xét các ý tưởng cốt lõi dẫn đến khái niệm đạo hàm.

Cực đại và cực tiểu (Maximums and Minimums)

Trong học máy, một nhiệm vụ quan trọng là giảm thiểu sai số của hệ thống. Nói rộng ra, ta muốn tìm cực đại (điểm cao nhất) hoặc cực tiểu (điểm thấp nhất) của đường cong trên toàn bộ chiều dài của nó. Nếu đây là điểm cao nhất hoặc thấp nhất của cả đường cong, ta gọi chúng là cực đại toàn cục (global maximum) và cực tiểu toàn cục (global minimum).
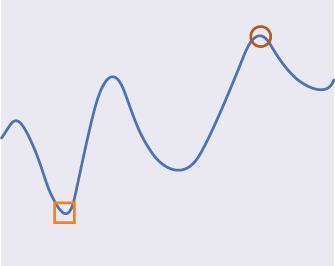
image 33 - quochung.cyou PTIT

Để đơn giản hóa, ta tập trung vào vùng lân cận của một điểm. Hãy tưởng tượng ta đứng tại một điểm trên đường cong và bước sang trái. Nếu con đường dốc lên, ta đi tiếp cho đến khi nó dốc xuống, rồi dừng lại. Nếu con đường dốc xuống, ta dừng khi nó bắt đầu dốc lên. Ta làm tương tự khi bước sang phải. Kết quả, ta có ba điểm: điểm xuất phát, điểm dừng bên trái, và điểm dừng bên phải.
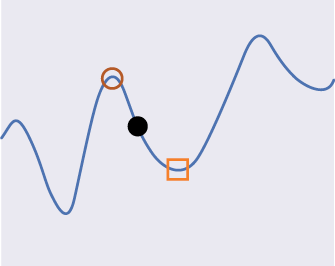
image 34 - quochung.cyou PTIT

Để hiểu sâu hơn về đạo hàm, ta cần làm quen với đường tiếp tuyến. Hãy hình dung đường cong như một con đường uốn lượn. Tại mỗi điểm, ta có thể vẽ một đường thẳng. Đường tiếp tuyến này cho biết con đường đang dốc lên, dốc xuống, hay nằm ngang tại điểm đó.
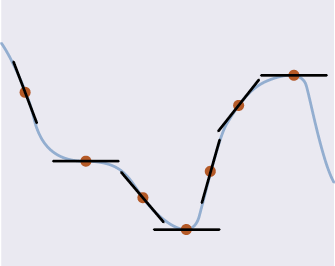
image 35 - quochung.cyou PTIT

Điều kỳ diệu là tại các điểm cực đại hoặc cực tiểu cục bộ, đường tiếp tuyến luôn nằm ngang, với độ dốc bằng 0. Vì vậy, để tìm cực đại và cực tiểu, ta chỉ cần tìm những điểm mà đường tiếp tuyến nằm ngang.
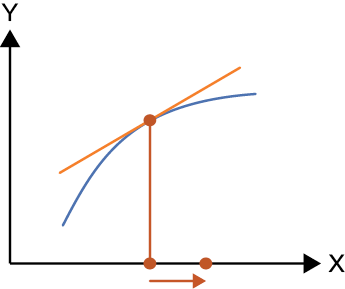
image 39 - quochung.cyou PTIT

Để vẽ đường tiếp tuyến, ta chọn một điểm, bước một khoảng nhỏ sang trái và phải trên đường cong, đánh dấu hai điểm, rồi nối chúng bằng một đường thẳng. Khi kéo hai điểm này lại gần điểm ban đầu, đường thẳng sẽ trở thành đường tiếp tuyến. Độ dốc của đường này chính là đạo hàm.
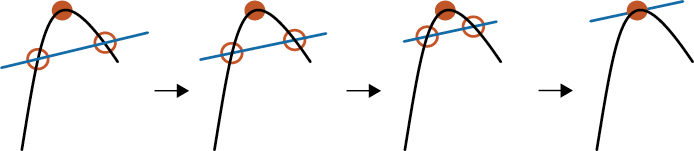
image 36 - quochung.cyou PTIT

Đạo hàm không chỉ là một khái niệm toán học trừu tượng, mà còn là công cụ cốt lõi trong học máy. Khi ta muốn giảm sai số, ta sử dụng đạo hàm để xác định hướng di chuyển trên đường cong.

Nếu đạo hàm dương, ta di chuyển ngược hướng để tìm cực tiểu.
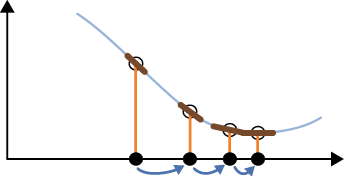
image 38 - quochung.cyou PTIT

Nếu đạo hàm âm, ta di chuyển theo hướng dương.
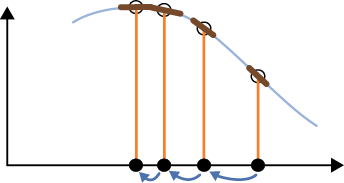
image 37 - quochung.cyou PTIT

Bằng cách lặp lại quá trình này, ta tiến gần đến điểm có đạo hàm bằng 0 – nơi cực đại hoặc cực tiểu cục bộ nằm

Đạo hàm riêng (Partial Derivatives)

Thay vì tính độ dốc trên một hàm một chiều, đạo hàm riêng tính độ dốc theo từng biến, giả sử các biến còn lại được giữ không đổi.

Hãy xem xét hàm [latex]f(x, y) = 2x^3 + 3y^3[/latex]. Đạo hàm riêng theo [latex]x[/latex] và [latex]y[/latex] lần lượt là:

[latex]\frac{\partial f}{\partial x} = 6x^2[/latex]

[latex]\frac{\partial f}{\partial y} = 9y^2[/latex]

Khi làm việc với các hàm đa biến, khái niệm gradient (gradient vector) trở nên quan trọng. Gradient là một vectơ bao gồm tất cả các đạo hàm riêng theo từng biến, chỉ ra hướng và độ lớn của sự thay đổi nhanh nhất của hàm. Với hàm [latex]f(x, y)[/latex], gradient được biểu diễn là:

[latex]\nabla f = \left( \frac{\partial f}{\partial x}, \frac{\partial f}{\partial y} \right)[/latex]

Trong trường hợp [latex]f(x, y) = 2x^3 + 3y^3[/latex], gradient tại một điểm [latex](x, y)[/latex] là:

[latex]\nabla f = (6x^2, 9y^2)[/latex]

Ví dụ, tại điểm [latex](1, 2)[/latex]:

  • [latex]\frac{\partial f}{\partial x} = 6 \cdot 1^2 = 6[/latex]
  • [latex]\frac{\partial f}{\partial y} = 9 \cdot 2^2 = 36[/latex]
  • Gradient: [latex]\nabla f = (6, 36)[/latex]

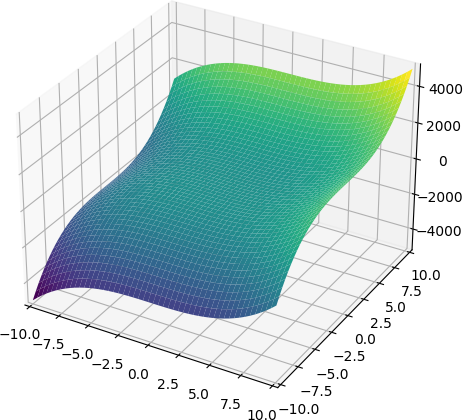
Gradient không chỉ cho biết độ dốc theo từng hướng mà còn chỉ ra hướng tăng trưởng nhanh nhất của hàm. Điều này rất quan trọng trong các thuật toán tối ưu hóa như gradient descent, nơi gradient được sử dụng để cập nhật các tham số nhằm giảm thiểu hàm mất mát.
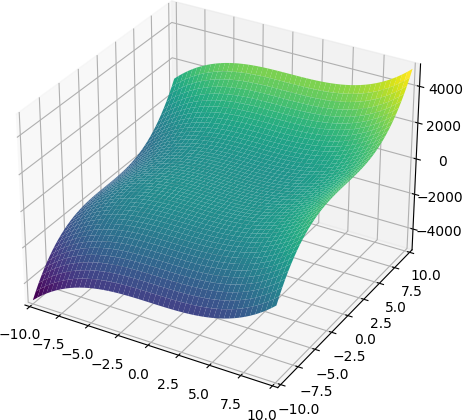
image 1 - quochung.cyou PTIT

Đây là một bề mặt cong với các giá trị [latex]z = f(x, y)[/latex] thay đổi theo [latex]x[/latex] và [latex]y[/latex]. Một số điểm đáng chú ý:

  • Trục [latex]x[/latex] và [latex]y[/latex] đại diện cho các biến đầu vào, trong khi trục [latex]z[/latex] thể hiện giá trị của hàm.
  • Màu sắc thay đổi (từ xanh đậm đến vàng) cho thấy sự thay đổi của giá trị [latex]z[/latex], với các vùng màu vàng thường là đỉnh hoặc đáy của bề mặt.
  • Độ dốc của bề mặt tại một điểm (ví dụ tại [latex](x, y) = (1, 2)[/latex]) có thể được biểu diễn bằng gradient, với thành phần [latex]6[/latex] theo [latex]x[/latex] và [latex]36[/latex] theo [latex]y[/latex].

Quy tắc Chuỗi (Chain Rule).

Giả sử bạn có hai hàm số sau:

  • Hàm thứ nhất: [latex]y = x^2 + 1[/latex]
  • Hàm thứ hai: [latex]z = y^3 – 2[/latex]

Lưu ý rằng hai hàm này có mối liên kết, vì biến [latex]y[/latex] là đầu ra của hàm thứ nhất nhưng lại là đầu vào của hàm thứ hai. Do đó, chúng ta có thể thay hàm [latex]y[/latex] vào hàm [latex]z[/latex] như sau:

[latex]z = (x^2 + 1)^3 – 2[/latex]

Vậy đạo hàm của [latex]z[/latex] theo [latex]x[/latex] là gì? Chúng ta đã có biểu thức thay thế biểu diễn [latex]z[/latex] theo [latex]x[/latex]

Kết quả: [latex]6x(x^2 + 1)^2[/latex]

Vậy đạo hàm của [latex]z[/latex] theo [latex]x[/latex] là:

[latex]\frac{dz}{dx} = 6x(x^2 + 1)^2[/latex]

Tuy nhiên, hãy thử một cách tiếp cận khác. Nếu chúng ta tính riêng đạo hàm của hàm [latex]y[/latex] và hàm [latex]z[/latex], sau đó nhân chúng với nhau, điều này cũng tạo ra đạo hàm của [latex]z[/latex] theo [latex]x[/latex]! Hãy thử làm:

  • Đạo hàm của [latex]y = x^2 + 1[/latex] theo [latex]x[/latex]: [latex]\frac{dy}{dx} = 2x[/latex]
  • Đạo hàm của [latex]z = y^3 – 2[/latex] theo [latex]y[/latex]: [latex]\frac{dz}{dy} = 3y^2[/latex]
  • Theo quy tắc chuỗi: [latex]\frac{dz}{dx} = \frac{dz}{dy} \cdot \frac{dy}{dx} = 3y^2 \cdot 2x = 6xy^2[/latex]

Biểu thức [latex]6xy^2[/latex] trông có vẻ khác với [latex]6x(x^2 + 1)^2[/latex], nhưng đó chỉ vì chúng ta chưa thay hàm [latex]y = x^2 + 1[/latex] vào. Hãy thay [latex]y[/latex] để biểu diễn toàn bộ đạo hàm theo [latex]x[/latex]:

[latex]6xy^2 = 6x(x^2 + 1)^2[/latex]

Kết quả này trùng khớp với đạo hàm đã tính trước đó!

Đây chính là quy tắc chuỗi, quy tắc này phát biểu rằng: với một hàm [latex]y[/latex] (có biến đầu vào là [latex]x[/latex]) được đưa vào một hàm khác [latex]z[/latex] (có biến đầu vào là [latex]y[/latex]), chúng ta có thể tìm đạo hàm của [latex]z[/latex] theo [latex]x[/latex] bằng cách nhân hai đạo hàm tương ứng:

[latex]\frac{dz}{dx} = \frac{dz}{dy} \cdot \frac{dy}{dx}[/latex]

Reference:

  • Essential Math for Data Science (Thomas Nield)
  • Deep Learning (Andrew Glassner)
[SWE học A.I] Phần 1: Sơ lược tiếp cận các mô hình A.I

This entry is part 1 of 8 in the series SWE Học A.I

Học máy (Machine Learning) là gì?

Học máy, nói một cách đơn giản, là một tập hợp những kỹ thuật mà máy tính dùng để “học” từ dữ liệu. Dữ liệu ở đây có thể là bất cứ thứ gì được biểu diễn bằng số. Có thể là giá cổ phiếu biến động qua từng ngày, khối lượng của các hành tinh, chiều cao của mọi người đến hội chợ, hay thậm chí là âm thanh khi bạn nói “Alo” vào điện thoại, những bức ảnh chụp hoa lá, mèo con, hay cả nội dung một bài báo, một cuốn tiểu thuyết. Thậm chí, sở thích nghe nhạc, xem phim, hay hành vi của bạn – như việc bạn hay đi dạo công viên hay thích ăn phở vào cuối tuần – cũng có thể được mã hóa thành số và trở thành dữ liệu.

Mục tiêu của học máy là tìm ra những thông tin “có ý nghĩa” từ đống dữ liệu đó. Nhưng “có ý nghĩa” là thế nào? Tùy bạn thôi! Có khi là tìm ra quy luật ẩn trong dữ liệu, như đoán xem bạn sẽ thích bộ phim nào dựa trên những phim bạn đã xem và chấm điểm. Hoặc là nhận diện chữ viết tay trên một mẩu giấy, hay chỉ cần vài nốt nhạc là biết ngay bài hát đó là gì. Tóm lại, học máy giúp máy tính “hiểu” và dự đoán dựa trên dữ liệu, giống như cách bạn nhận ra một người bạn cũ qua vài đặc điểm quen thuộc.

Giả sử chúng ta có một bảng dữ liệu ghi lại thông tin về thói quen xem phim của một nhóm người:

Người dùngPhim đã xemThể loại yêu thíchĐiểm chấm trung bình
AInception, Interstellar, TenetKhoa học viễn tưởng9.0
BThe Notebook, Titanic, La La LandLãng mạn, Tình cảm8.5
CThe Dark Knight, Joker, LoganHành động, Tâm lý9.2
DCoco, Encanto, Inside OutHoạt hình, Gia đình8.8
EInception, The Matrix, Blade RunnerKhoa học viễn tưởng9.1

Từ bảng dữ liệu trên, ta có thể “nhìn thấy” một số điều thú vị. Ví dụ, người dùng A và E có điểm chấm khá cao và cùng yêu thích thể loại khoa học viễn tưởng. Từ đó, một hệ thống học máy có thể đề xuất cho người dùng A những bộ phim như The Matrix hoặc Blade Runner – vốn đã được người dùng E yêu thích. Hay ngược lại, với người dùng mới có hành vi tương tự A, hệ thống có thể dự đoán họ sẽ thích Interstellar chẳng hạn.

Chính từ những mẫu dữ liệu tưởng chừng đơn giản như thế này, học máy có thể học được mối liên hệ giữa “sở thích” và “nội dung”, để từ đó đưa ra những đề xuất, dự đoán, hay thậm chí là tự động phân loại, nhận diện xu hướng mà con người khó nhìn thấy bằng mắt thường.

Hệ chuyên gia (Expert System)

Ngày xưa, khi học sâu (deep learning) chưa có được sự chú ý nhiều như bây giờ, người ta hay dùng hệ chuyên gia để dạy máy tính học từ dữ liệu.

Hệ chuyên gia là gì? Nó giống như một chương trình máy tính được thiết kế để bắt chước cách suy nghĩ của các chuyên gia con người – như bác sĩ, kỹ sư, hay thậm chí là nhạc sĩ. Ý tưởng là bạn quan sát một chuyên gia làm việc, xem họ làm gì, làm như thế nào, đôi khi còn yêu cầu họ kể lại quy trình suy nghĩ của mình. Từ đó, bạn tạo ra một bộ quy tắc để máy tính làm theo. Hy vọng là máy tính sẽ “bắt chước” được công việc của chuyên gia chỉ bằng cách tuân theo những quy tắc đó.

Ví dụ thực tế: Nhận diện số 7

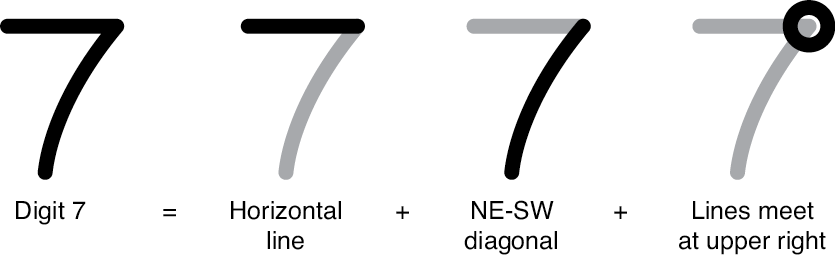
Giả sử chúng ta muốn dạy máy tính nhận diện số 7 viết tay. Sau khi hỏi han, quan sát nhiều người, bạn có thể nghĩ ra ba quy tắc nhỏ để nhận diện số 7:

  • một, số 7 thường có một đường ngang ở gần đỉnh;
  • hai, nó có một đường chéo từ đông bắc xuống tây nam;
  • và ba, hai đường đó gặp nhau ở góc trên bên phải.
image 12 - quochung.cyou PTIT

Nhưng đời không như mơ! Một ngày, bạn gặp một số 7 kỳ lạ.

image 13 - quochung.cyou PTIT

Số 7 này có thêm một đường ngang cắt qua đường chéo ở giữa.

Bộ quy tắc ban đầu của chúng ta không nhận ra đây là số 7, vì chúng ta chưa nghĩ tới trường hợp đặc biệt này. Thế là phải thêm một quy tắc mới. Nhưng rồi lại có số 7 khác, với kiểu viết khác, và bạn lại phải thêm quy tắc nữa. Cứ thế, việc tạo ra một bộ quy tắc đầy đủ cho một vấn đề phức tạp trở thành một nhiệm vụ bất khả thi. Bạn phải đào bới những suy luận mà ngay cả chuyên gia cũng không nhận ra, biến chúng thành hàng tá quy tắc, rồi chỉnh sửa, gỡ lỗi, bổ sung cho những trường hợp bị bỏ sót.

Quá nhiều quy tắc

Tìm ra bộ quy tắc hoàn chỉnh không phải chuyện dễ. Chuyên gia con người thường làm việc theo trực giác, và những ngoại lệ hay trường hợp đặc biệt thì vô vàn.

Bạn thử tưởng tượng mà xem: làm sao viết được bộ quy tắc để máy tính bắt chước cách một bác sĩ X-quang đọc phim MRI để xác định một vết mờ là lành tính hay không? Hay cách một nhân viên điều khiển không lưu xử lý hàng loạt chuyến bay trong giờ cao điểm? Hoặc cách ai đó lái xe an toàn trong cơn bão lớn?

Đã vậy, công nghệ, luật lệ, hay thói quen xã hội còn thay đổi liên tục, khiến bạn phải luôn cập nhật, sửa chữa bộ quy tắc rối như tơ vò này.

Hệ chuyên gia có thể hoạt động tốt trong một số trường hợp, nhưng để áp dụng rộng rãi thì quá khó. Với những trường hợp như này, “học sâu” (deep learning) có thể thể hiện được năng lực của nó. Với đủ dữ liệu huấn luyện, các thuật toán học sâu tự tìm ra quy tắc mà không cần chúng ta phải chỉ từng bước.

Bạn không cần nói với máy tính rằng số 2 trông thế nào, hay số 7 ra sao – nó tự học từ dữ liệu. Nó có thể xác định vết mờ trên MRI là lành tính hay không, đánh giá một bức ảnh chụp từ điện thoại có phơi sáng đúng không, hay xác minh một đoạn văn có phải do một nhân vật lịch sử viết hay không.

Học có giám sát (Supervised Learning)

Nói một cách đơn giản, học máy (machine learning) là xây dựng các thuật toán để tìm ra mối quan hệ trong dữ liệu.

Học có giám sát là một phần của học máy, tập trung vào việc tìm mối liên hệ giữa các đặc điểm đã được đo lường sẵn. Chẳng hạn, trong chương này, mình sẽ nói về một bài toán thực tế: tìm mối liên hệ giữa các đặc điểm của một ngôi nhà (như số phòng, diện tích, hay khoảng cách đến trường học) và giá trị của ngôi nhà.

Giả sử ta muốn tạo một hệ thống, gọi là bộ phân loại hình ảnh, để nhận ra đồ vật chính trong ảnh. Mình sẽ đưa máy một bộ sưu tập ảnh, mỗi ảnh đi kèm một nhãn – như ảnh con hổ có nhãn “hổ”, ảnh con mèo có nhãn “mèo”, và chúng ta kì vọng khi thấy một hình ảnh con hổ khác chưa có trong bộ sưu tập, hệ thống có thể biết được nó là hổ hay mèo.

Hoặc, nếu mình có một cuốn sổ ghi lại các công thức nấu ăn và chấm điểm xem mình thích món nào, thì công thức là dữ liệu đầu vào, còn điểm số là nhãn. Sau khi được huấn luyện với cả tá dữ liệu như thế, máy có thể nhìn một công thức mới và đoán món này có ngon theo khẩu vị của mình không.

Máy Tính “Nghĩ” Như Thế Nào?

Thực chất, máy tính không hiểu món ăn ngon dở ra sao, cũng chẳng biết con hổ trông thế nào ngoài đời. Nó chỉ nhìn vào dữ liệu bạn đưa, tìm các mẫu (patterns) trong đó, và học cách khớp dữ liệu với nhãn. Khi bạn đưa vào một bức ảnh hay công thức mới, máy sẽ dùng những “quy tắc” nó học được để chọn nhãn phù hợp nhất. Nếu máy đoán đúng đủ nhiều lần, mình gọi là nó đã được huấn luyện tốt.

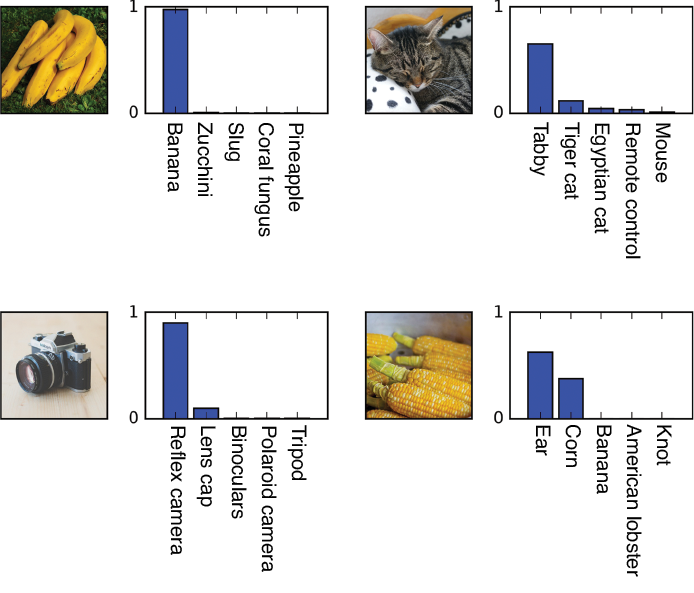
image 14 - quochung.cyou PTIT

Nhìn vào ảnh trên, nơi một bộ phân loại hình ảnh đã được huấn luyện thử phân tích bốn bức ảnh lấy từ trên mạng. Máy chưa từng thấy những bức ảnh này bao giờ. Với mỗi bức, nó đưa ra xác suất cho 1.000 nhãn mà nó biết. Chẳng hạn, bức ảnh ở góc trên bên trái là một chùm chuối. Lý tưởng thì máy sẽ trả về nhãn “chùm chuối”, nhưng vì nó không được huấn luyện với nhãn này, nó chỉ chọn được nhãn gần nhất là “chuối”. Giống như khi bạn chỉ biết từ “mèo” và không biết từ “mèo tam thể”, bạn sẽ gọi con mèo tam thể là “mèo” thôi.

Cách Dữ Liệu Được Sắp Xếp

Mỗi đặc điểm cần được đo lường chính xác và biểu diễn bằng số. Số phòng hay diện tích thì dễ, vì chúng đã là số. Nhưng nếu bạn có thông tin kiểu như mô tả bằng ngôn ngữ tự nhiên về khu phố từ TripAdvisor, việc chuyển chúng thành số sẽ phức tạp hơn nhiều. Chuyển đổi đúng cách là yếu tố quyết định xem bạn có tìm ra được mối quan hệ hay không. Với khái niệm mơ hồ như “giá trị ngôi nhà”, mình thường chọn một con số cụ thể, như giá bán.

Khi đã có các đặc điểm dưới dạng số, mình cần tổ chức chúng sao cho dễ xử lý. Cách phổ biến là biểu diễn mỗi ngôi nhà bằng một hàng số (gọi là một “quan sát”), rồi xếp các hàng này thành từng lô (batch) dữ liệu.

Mỗi hàng là một tập hợp các đặc điểm (features), như số phòng, diện tích, hay khoảng cách đến trường. Quá trình chuyển các đặc điểm thực tế (như “nhà gạch đỏ”) thành số được gọi là kỹ thuật đặc trưng (feature engineering).

Giả sử chúng ta đang thu thập dữ liệu để dự đoán giá bán của các ngôi nhà. Dưới đây là một bảng thể hiện dữ liệu đã được xử lý thành dạng số:

ID nhàSố phòng ngủDiện tích (m²)Khoảng cách đến trường (km)Loại tườngCó sân vườnĐiểm đánh giá khu phốGiá bán (triệu VND)
131200.51 (gạch đỏ)1 (có)8.23.200
22801.20 (xi măng)0 (không)7.12.400
341500.31 (gạch đỏ)1 (có)8.94.100
41602.00 (xi măng)0 (không)6.51.800

Ở đây, các thông tin dạng mô tả như “loại tường” (gạch đỏ hay xi măng), hay “có sân vườn” (có/không) đã được chuyển thành số – một bước quan trọng trong feature engineering.

Từ bảng dữ liệu trên, ta có thể thấy: những ngôi nhà có diện tích lớn hơn, gần trường học hơn, và nằm trong khu phố có điểm đánh giá cao thường có giá bán cao hơn. Điều này cho thấy tầm quan trọng của việc chuyển đổi và biểu diễn đúng các đặc điểm thành dạng số: chỉ khi dữ liệu được tổ chức một cách chính xác, mô hình học máy mới có thể nhận ra các mối liên hệ như vậy để đưa ra dự đoán hợp lý.

Học không giám sát (Unsupervised Learning)

Ta đã đi qua việc giúp máy tính học được từ những dữ liệu đã được đánh nhãn (label) rõ ràng, dễ sử dụng. Tuy nhiên nếu bạn có một đống dữ liệu mà chẳng có nhãn hay gợi ý gì – giống như một mớ đồ vật lộn xộn, không biết thuộc về đâu. Lúc này, chúng ta có thể dùng học không giám sát. (Unsupervised Learning)

Các thuật toán này sẽ tự mày mò, tìm ra mối liên hệ giữa các mẩu dữ liệu mà chẳng cần ai chỉ bảo “cái này là gì, cái kia là gì”.

Ví dụ:

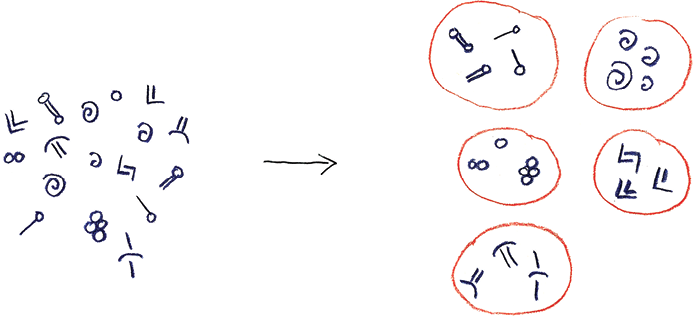
Khi đang đào móng cho một ngôi nhà mới thì phát hiện cả đống bình gốm cổ, mỗi cái có hoa văn khác nhau. Mình gọi bạn khảo cổ đến, nhưng cô ấy chẳng nhận ra hoa văn nào cả (dữ liệu không có nhãn). Có cái trông giống nhau, có cái lại khác biệt hoàn toàn.

Để sắp xếp đống lộn xộn này, cô ấy đã tiếp cận bằng một cách khác, dù không nhận ra hay biết về bất kì kí hiệu nào trên các món đồ cổ, nên cô không biết những món đồ này tới từ thời đại nào, quý giá hay không. Tuy nhiên, nhìn vào những kí hiệu, trang trí, ta thấy chúng có vẻ giống nhau?, và xuất phát từ 1 phong cách nào đó. Lúc này, nhà khảo cổ chia các phần có vẻ giống nhau thành từng cụm, từng nhóm.

image 15 - quochung.cyou PTIT

Kĩ thuật này đưa các dữ liệu thành các nhóm liên quan (cụm), nên ta gọi quá trình này là phân cụm (clustering), hay gọi thuật toán này là thuật toán phân cụm (clustering algorithm)

Ngoài ra, học không giám sát còn giúp làm đẹp dữ liệu, như xóa nhiễu trên ảnh chụp bằng điện thoại, hay nén dữ liệu để tiết kiệm không gian mà vẫn giữ được chất lượng – giống như cách file MP3 lưu âm thanh hay JPG lưu ảnh vậy.

  • Ảnh chụp từ điện thoại thường có nhiễu (noise) do ánh sáng yếu, cảm biến kém, chuyển động, v.v. Học không giám sát có thể tự học cách tách tín hiệu gốc (hình ảnh thật) khỏi nhiễu mà không cần dữ liệu “sạch” để so sánh. Thông thường bài toán này hoạt động nhờ máy chỉ giữ lại thông tin phổ biến, đặc trưng, không thay đổi, còn phần ngẫu nhiên (nhiễu) sẽ bị mất đi.
  • Giống như file MP3 hay JPG: giữ phần quan trọng (tai người/ mắt người cảm nhận được). Loại bỏ phần dư thừa (âm thanh ngoài khả năng nghe, màu sắc không phân biệt được…).

Học tăng cường (Reinforcement Learning)

Hãy tưởng tượng bạn đang chơi một trò chơi phức tạp, như cờ vua hay sáng tác một bản nhạc. Bạn đứng trước một tình huống: nước đi tiếp theo nên là gì, hay nốt nhạc tiếp theo nên chọn ra sao? Chẳng có một đáp án nào hoàn toàn “đúng” cả. Nhưng bạn có thể cảm nhận rằng một lựa chọn thì “tốt hơn” cái kia. (thử một nốt nhạc khác và khi nghe lại thấy bài nhạc có vẻ hay hơn)

Vậy làm sao để máy tính tự tìm ra cách tốt nhất? Chúng ta để nó thử nghiệm, sai lầm, và học hỏi.

Học tăng cường là khi bạn không đưa ra một hướng dẫn chi tiết kiểu “làm thế này, thế kia”. Thay vào đó, bạn chỉ cần đánh giá những gì máy tính thử nghiệm. Máy tính sẽ dựa vào những đánh giá đó để tìm ra cách hành động tốt nhất, từng bước một, hướng tới kết quả mà chúng ta mong muốn.

Ví dụ:

Nhiệm vụ của chúng ta là quyết định xem thang máy nên “đậu” ở đâu khi không có người gọi, và khi ai đó bấm nút gọi thang, chiếc thang nào sẽ được điều động. Mục tiêu? Làm sao để thời gian chờ trung bình của mọi người là ngắn nhất.

image 16 - quochung.cyou PTIT

Vấn đề là, làm sao biết được cách sắp xếp thang máy tốt nhất? Chuyện này phụ thuộc hoàn toàn vào thói quen của mọi người trong tòa nhà.

Buổi sáng, có lẽ mọi người đổ xô đến làm việc, nên thang máy nên chờ sẵn ở tầng một để đón khách. Nhưng đến giờ ăn trưa, mọi người lại muốn ra ngoài, vậy thì thang máy nên “canh” ở các tầng trên, sẵn sàng đưa mọi người xuống tầng trệt. À, mà nếu trời mưa thì sao? Có khi mọi người lại muốn lên căng-tin ở tầng cao nhất để ăn trưa. Mỗi ngày, mỗi giờ, tình hình cứ thay đổi liên tục. Vậy thì làm sao tìm được một “chiến lược” hoàn hảo?

Thực chất, chẳng có một chiến lược nào hoàn hảo cả.

Học tăng cường là một giải pháp với ý tưởng: máy tính sẽ tự nghĩ ra một kế hoạch, hoặc thử thay đổi một chút từ kế hoạch hiện tại, rồi kiểm tra xem nó hoạt động tốt thế nào.

Ví dụ

Hãy tưởng tượng bạn có một robot giao hàng trong một siêu thị nhỏ. Nhiệm vụ của robot là giao một đơn hàng từ kho hàng (điểm xuất phát) đến quầy thanh toán (điểm đích). Siêu thị có 3 con đường để đi:

Đường C: Qua khu đồ đông lạnh, trung bình về cả độ dài và đông người.

Đường A: Qua khu rau củ, ngắn nhưng đông khách, dễ bị chậm.

Đường B: Qua khu đồ khô, đường dài hơn nhưng ít người.

Robot sẽ thử đi từng đường, nhận phản hồi là thời gian đi mất bao lâu, và học để chọn đường nhanh nhất qua nhiều lần thử.

Giả lập dữ liệu (thực tế, robot không biết trước):

  • Đường A: 30 giây (ngắn nhưng đông, dễ chậm).
  • Đường B: 50 giây (dài hơn, ít người).
  • Đường C: 40 giây (trung bình).

Phản hồi (thưởng): Robot được điểm dựa trên thời gian:

  • Điểm = 100 – thời gian (giây). Nghĩa là đi càng nhanh, điểm càng cao.
    • Đường A: 100 – 30 = 70 điểm.
    • Đường B: 100 – 50 = 50 điểm.
    • Đường C: 100 – 40 = 60 điểm.

Mỗi lần, robot chọn một đường, đo thời gian, tính điểm, và ghi nhớ để cải thiện.

Lần thử 1:

  • Robot chọn ngẫu nhiên: Đường A.
  • Thời gian: 30 giây.
  • Điểm: 100 – 30 = 70 điểm.

Lần thử 2:

  • Robot chọn: Đường B.
  • Thời gian: 50 giây.
  • Điểm: 100 – 50 = 50 điểm.

Lần thử 3:

  • Robot chọn: Đường C.
  • Thời gian: 40 giây.
  • Điểm: 100 – 40 = 60 điểm.

Lần thử 4:

  • Robot quay lại thử Đường A (để kiểm tra lại).
  • Thời gian: 30 giây.
  • Điểm: 70 điểm.

Lần thử 5:

  • Robot thử Đường C lần nữa (vì nó từng cho 60 điểm, khá ổn).
  • Thời gian: 40 giây.
  • Điểm: 60 điểm.

Bây giờ, giả sử vào giờ cao điểm (buổi trưa), khu rau củ (Đường A) trở nên rất đông, làm thời gian tăng lên. Dữ liệu mới:

  • Đường A: 60 giây (đông khách) → Điểm: 100 – 60 = 40 điểm.
  • Đường B: 50 giây (vẫn ít người) → Điểm: 100 – 50 = 50 điểm.
  • Đường C: 40 giây (trung bình) → Điểm: 100 – 40 = 60 điểm.

Robot tiếp tục thử:

Lần thử 6:

  • Robot chọn Đường A (vì trước đó nó tốt nhất).
  • Thời gian: 60 giây (do đông khách).
  • Điểm: 100 – 60 = 40 điểm.

Lần thử 7:

  • Robot chọn Đường C.
  • Thời gian: 40 giây.
  • Điểm: 60 điểm.

Lần thử 8:

  • Robot chọn Đường B.
  • Thời gian: 50 giây.
  • Điểm: 50 điểm.

Kết quả sau 8 lần thử

  • Robot nhận ra: Vào giờ cao điểm, Đường C là lựa chọn tốt nhất (60 điểm, 40 giây).
  • Robot sẽ ưu tiên Đường C vào giờ trưa, nhưng vẫn thử các đường khác để cập nhật nếu tình hình thay đổi (ví dụ: khu đồ khô bỗng dưng đông vào giờ khác).
  • Ta đã có 1 hệ thống biết nên sử dụng đường nào theo tham số thời gian, thông minh hơn là chỉ luôn sử dụng 1 bộ quy tắc

Áp dụng vào ví dụ thang máy

Giờ quay lại ví dụ thang máy trong tòa nhà. Giả sử có 3 thang máy và ta phải quyết định thang nào đi đến tầng được gọi (ví dụ: tầng 5).

  • Hành động: Gửi thang máy A, B, hoặc C đến tầng 5.
  • Phản hồi: Đo thời gian chờ của khách (thang nào đến nhanh thì được “thưởng” điểm cao).
  • Học hỏi: Máy tính thử gửi từng thang, đo thời gian chờ, và ghi nhớ thang nào nhanh nhất.
  • Qua nhiều lần thử, máy tính sẽ biết: “Nếu khách gọi ở tầng 5, gửi thang B vì nó gần nhất, chờ chỉ 10 giây, tốt hơn thang A (20 giây) hay thang C (15 giây).”

Học sâu (Deep Learning)

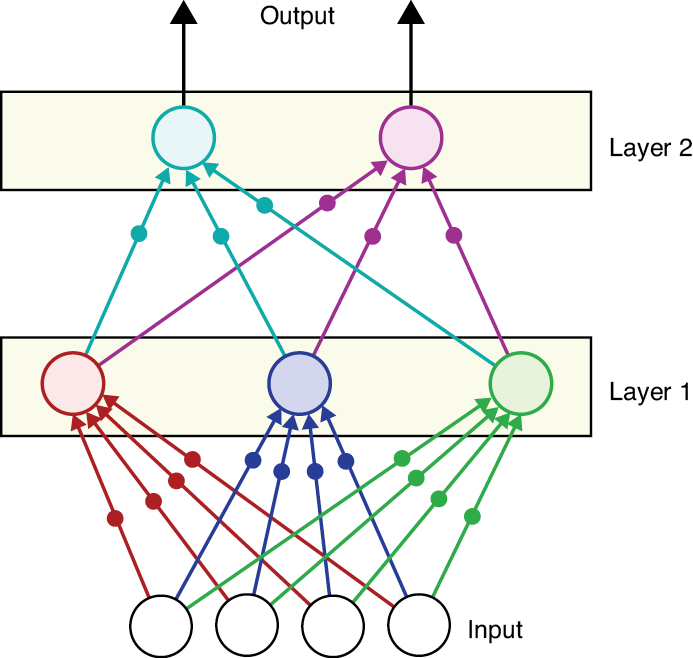
Thuật ngữ “học sâu” chỉ các thuật toán học máy sử dụng nhiều tầng tính toán, hay còn gọi là các tầng.

Khi một hệ thống học sâu gắn tên cho một khuôn mặt trong ảnh, nó không biết khuôn mặt là gì, con người là gì, hay thậm chí con người có tồn tại hay không. Máy tính chỉ đo lường các điểm ảnh và, dựa trên các mẫu học được từ dữ liệu huấn luyện, đưa ra nhãn phù hợp nhất.

image 18 - quochung.cyou PTIT

Dần dần, qua hàng ngàn lần thử, mạng học được cách tạo ra kết quả chính xác. Nếu làm tốt, mạng sẽ đưa ra câu trả lời đúng cho hầu hết dữ liệu huấn luyện, sẵn sàng để trở thành một trợ thủ đắc lực – như nhận diện hình ảnh trên mạng xã hội hay dự đoán giá cổ phiếu.

Ví dụ

Dạy máy đoán táo hay cam
Giả sử bạn muốn máy phân biệt táo và cam dựa trên hai đặc điểm:

  1. Kích thước: Táo thì nhỏ hơn, còn cam thì có kích thước lớn hơn. Đặt nhỏ thì là 1, lớn thì là 2
  2. Màu sắc: Táo thì có sắc đỏ, cam thì có màu cam. Đặt đỏ là 1, cam là 2.

Vậy giả sử nếu ai đó bảo ta rằng họ có 1 quả, và kích thước đâu đó là 1.2, và màu sắc thì khá là đỏ (khoảng 1.2, và không có nhiều ánh cam), vậy ta có thể đoán, có vẻ nó là quả táo

Tập dữ liệu giả (4 ví dụ bạn đưa cho máy):

  • Ví dụ 1: Kích thước 1, màu 1 → Táo.
  • Ví dụ 2: Kích thước 2, màu 2 → Cam.
  • Ví dụ 3: Kích thước 1, màu 1 → Táo.
  • Ví dụ 4: Kích thước 2, màu 2 → Cam.

Lúc này, ta có thể cho máy khởi tạo 1 phương trình đơn giản như:

Kết quả = (Kích thước × số A) + (Màu sắc × số B) – Số A và Số B là các tham số

Bước 1: Thử với ví dụ 1 (Táo: kích thước 1, màu 1)

  • Công thức: (1 × 0.5) + (1 × 0.3) = 0.8
  • Máy đoán: “Gần 1, chắc là táo!” (Đúng, nhưng chưa chắc chắn lắm).

Bước 2: Kiểm tra lỗi

  • Kết quả đúng phải là 1 (Táo), nhưng máy cho 0.8. Sai lệch là 0.2.
  • Máy nghĩ: “Mình đoán gần đúng, nhưng cần sửa công thức một chút.”

Bước 3: Điều chỉnh công thức

  • Máy tăng số A và B lên một chút, ví dụ: A = 0.6, B = 0.4.
  • Thử lại ví dụ 1: (1 × 0.6) + (1 × 0.4) = 1.0 (Đúng là táo!).

Bước 4: Thử với ví dụ 2 (Cam: kích thước 2, màu 2)

  • Công thức mới: (2 × 0.6) + (2 × 0.4) = 1.2 + 0.8 = 2.0
  • Máy đoán: “Gần 2, chắc là cam!” (Đúng).

Bước 5: Lặp lại với các ví dụ khác

  • Máy tiếp tục thử với ví dụ 3, 4, mỗi lần đoán sai thì điều chỉnh số A và B một chút. Qua vài chục lần, máy tìm được số A và B hoàn hảo (ví dụ: A = 0.7, B = 0.5) để đoán đúng hầu hết các trường hợp.

Kết quả sau khi học
Sau khi “học” cả 4 ví dụ, máy có công thức tốt:

  • Táo (kích thước 1, màu 1): (1 × 0.7) + (1 × 0.5) = 1.2 → Đoán “Táo”.
  • Cam (kích thước 2, màu 2): (2 × 0.7) + (2 × 0.5) = 1.4 + 1.0 = 2.4 → Đoán “Cam”.

Bây giờ, nếu bạn đưa một quả mới (kích thước 1.5, màu 1.5), máy tính:
(1.5 × 0.7) + (1.5 × 0.5) = 1.05 + 0.75 = 1.8 → Đoán “Cam” (vì gần 2 hơn).

Học sâu trong thực tế khác gì với ví dụ này?

Trong học sâu, máy không chỉ dùng 2 đặc điểm (kích thước, màu) mà có thể dùng hàng ngàn đặc điểm (như mọi chi tiết trên một bức ảnh). Công thức cũng phức tạp hơn, với nhiều tầng (layers), mỗi tầng có nhiều “hộp tính toán” (nơ-ron). Nhưng ý tưởng vẫn giống:

  • Đưa thông tin vào.
  • Máy đoán, kiểm tra lỗi, sửa công thức (trọng số).
  • Lặp lại nhiều lần cho đến khi đoán đúng.

Reference:

  • Deep Learning (Andrew Glassner)
  • Deep Learning from Scratch (Seth Weidman)

Tìm hiểu lí do cần database, datalake, data warehouse?

Mở đầu

Trong thời đại số ngày nay, dữ liệu hiện hữu ở khắp mọi nơi và đóng vai trò cực kỳ quan trọng trong cuộc sống cũng như công việc của chúng ta. Từ việc chúng ta lướt Facebook, Tiktok hàng ngày, đặt vé xem phim online, cho đến cách các công ty lớn vận hành chuỗi cung ứng phức tạp, mọi thứ đều không ngừng tạo ra và tiêu thụ dữ liệu.

Ví dụ:

  • Facebook biết chúng ta khi lướt trên bảng tin, sẽ dừng lại tại bài viết nào lâu, bài viết nào thu hút sự chú ý, chủ đề nào chúng ta thường xem, bạn bè nào chúng ta thường hay tương tác
  • Các app đặt vé xem phim có dữ liệu về phim nào nhiều người xem, bộ phim thể loại nào thì thường được giới tính, độ tuổi nào quan tâm, ….
image - quochung.cyou PTIT

Nhưng bạn có bao giờ dừng lại và tự hỏi, với một khối lượng dữ liệu khổng lồ và đa dạng như vậy – từ những con số khô khan trong bảng tính Excel, các giao dịch ngân hàng, đến hình ảnh, video, bài đăng mạng xã hội, hay những dòng log hệ thống dày đặc – làm thế nào để chúng ta có thể lưu trữ, quản lý và quan trọng nhất là khai thác chúng một cách hiệu quả?

Trong mọi tổ chức, thông thường sẽ xuất hiện hai nhu cầu cốt lõi:

  • Xử lý các hoạt động diễn ra hàng ngày
  • Phân tích chiến lược dựa trên dữ liệu đã tích luỹ

OLTP và OLAP

OLTP (Online Transaction Processing) – Xử lý giao dịch trực tuyến

Hãy tưởng tượng bạn đang thực hiện một giao dịch trực tuyến: đặt một chiếc vé máy bay trên website hãng hàng không, chuyển tiền qua ứng dụng ngân hàng, hay đơn giản là mua một món hàng trên sàn thương mại điện tử.

Tất cả những hành động này đòi hỏi hệ thống phải xử lý ngay lập tức, đảm bảo tính chính xác tuyệt đối (tiền phải được chuyển đúng tài khoản, vé phải được xác nhận và không bị bán trùng) và diễn ra nhanh chóng, không làm bạn phải chờ đợi. Đó chính là bản chất của OLTP – Xử lý giao dịch trực tuyến.

OLTP tập trung vào việc xử lý một khối lượng lớn các giao dịch nhỏ, riêng lẻ diễn ra liên tục trong thời gian thực. Các ví dụ đời thường của hệ thống OLTP có ở khắp nơi quanh ta: máy tính tiền ở siêu thị (quét mã sản phẩm, trừ số lượng tồn kho, tính tiền), máy ATM rút tiền, hệ thống đặt phòng khách sạn, hay việc bạn cập nhật thông tin cá nhân trên một trang web

image 1 - quochung.cyou PTIT

Đặc điểm quan trọng nhất của các hệ thống OLTP là ưu tiên tốc độ xử lý cực nhanh (thường tính bằng mili giây) và tính nhất quán của dữ liệu. Chắc chắn khách hàng sẽ không muốn tiền của mình bị “bốc hơi” hay thông tin đơn hàng bị sai lệch.

Hệ thống OLTP được thiết kế để đảm bảo điều đó. Chúng thường làm việc với dữ liệu hiện tại (trạng thái mới nhất của thông tin) và thực hiện các truy vấn tương đối đơn giản và lặp đi lặp lại, như tìm kiếm thông tin một bản ghi cụ thể (point query), thêm mới, cập nhật hoặc xóa dữ liệu dựa trên hành động của người dùng.

OLAP (Online Analytical Processing) – Xử lý phân tích trực tuyến

Tuy nhiên, từ góc nhìn của một nhà quản lý doanh nghiệp. Thay vì xử lý từng giao dịch nhỏ lẻ, bạn lại có những câu hỏi lớn hơn, mang tính chiến lược:

  • “Trong quý vừa qua, dòng sản phẩm nào mang lại lợi nhuận cao nhất?”
  • “Xu hướng mua sắm của nhóm khách hàng ở độ tuổi 25-35 là gì?”
  • “Chiến dịch marketing giảm giá 10% vừa rồi có thực sự hiệu quả trong việc thu hút khách hàng mới không?”
image 2 - quochung.cyou PTIT

Để trả lời những câu hỏi này, không thể chỉ nhìn vào một vài giao dịch đơn lẻ. Chúng ta cần phải xem xét một khối lượng dữ liệu lịch sử khổng lồ, tổng hợp thông tin từ nhiều nguồn, và phân tích chúng từ nhiều góc độ khác nhau (ví dụ: theo thời gian, theo khu vực địa lý, theo dòng sản phẩm, theo kênh bán hàng…). Đây chính là lúc OLAP – Xử lý phân tích trực tuyến phát huy vai trò

Các hệ thống OLAP được thiết kế để hỗ trợ việc phân tích dữ liệu phức tạp, giúp khám phá các xu hướng, mẫu hình ẩn giấu và cung cấp những hiểu biết sâu sắc (insights) để hỗ trợ việc ra quyết định kinh doanh (một phần quan trọng của Business Intelligence – BI). Ví dụ về các tác vụ OLAP bao gồm: phân tích doanh thu theo vùng miền qua các năm , dự báo nhu cầu thị trường cho sản phẩm mới, phân khúc khách hàng dựa trên hành vi mua sắm, hay đánh giá hiệu quả hoạt động của các phòng ban.

image 3 - quochung.cyou PTIT

Khác với OLTP, các truy vấn OLAP thường rất phức tạp, đòi hỏi quét qua hàng triệu, thậm chí hàng tỷ bản ghi để tính toán các chỉ số tổng hợp (như tổng, trung bình, đếm, tỷ lệ phần trăm). Do đó, thời gian phản hồi của các truy vấn OLAP có thể lâu hơn đáng kể, từ vài giây, vài phút đến hàng giờ, tùy thuộc vào độ phức tạp và khối lượng dữ liệu. Chúng làm việc chủ yếu với dữ liệu lịch sử được tích lũy qua thời gian.

Tại sao cần phân biệt OLTP và OLAP? Mâu thuẫn thúc đẩy sự tách biệt

Bạn có thể thắc mắc: tại sao không dùng chung một hệ thống cho cả hai việc? Câu trả lời nằm ở sự mâu thuẫn cơ bản trong nhu cầu và đặc tính của OLTP và OLAP.

Hãy hình dung thế này: Hệ thống OLTP giống như một quầy giao dịch ngân hàng luôn bận rộn, cần xử lý nhanh chóng yêu cầu nạp/rút tiền của từng khách hàng. Trong khi đó, hệ thống OLAP giống như một phòng họp lớn nơi các nhà phân tích đang xem xét sổ sách kế toán của cả năm, thực hiện những phép tính toán phức tạp để lập kế hoạch chiến lược.

Nếu cố gắng thực hiện cả hai việc trong cùng một “căn phòng” (tức là trên cùng một cơ sở dữ liệu), sẽ dẫn dàng xảy ra việc các truy vấn phân tích OLAP nặng nề, đòi hỏi nhiều tài nguyên (CPU, bộ nhớ, đọc/ghi đĩa) sẽ làm chậm hoặc thậm chí “tắc nghẽn” các giao dịch OLTP đang diễn ra.

Thử tưởng tượng giao dịch mua hàng online của bạn bị treo chỉ vì bộ phận phân tích đang chạy một báo cáo doanh thu khổng lồ trên cùng hệ thống. Điều này rõ ràng là không thể chấp nhận được đối với các hoạt động kinh doanh cốt lõi, vốn đòi hỏi sự ổn định và tốc độ

image 4 - quochung.cyou PTIT

Database, Data Warehouse, Data Lake

Database (Cơ sở dữ liệu) truyền thống

Database truyền thống, đặc biệt là cơ sở dữ liệu quan hệ (Relational Database), đóng vai trò như cuốn sổ cái điện tử, là nền tảng lưu trữ dữ liệu cho hầu hết các ứng dụng mà chúng ta tương tác hàng ngày, từ mạng xã hội, ứng dụng ngân hàng đến các website thương mại điện tử. Chúng được thiết kế và tối ưu chủ yếu cho các tác vụ OLTP – xử lý giao dịch trực tuyến.

image 5 - quochung.cyou PTIT

Đặc điểm chính của Database truyền thống:

  • Loại dữ liệu: Chúng chủ yếu làm việc với dữ liệu có cấu trúc (structured data). Đây là loại dữ liệu được tổ chức một cách gọn gàng, ngăn nắp trong các bảng (tables), với các hàng (rows) và cột (columns) được định nghĩa rõ ràng, tương tự như cách bạn tổ chức dữ liệu trong một file Excel. Ví dụ: bảng Users có các cột UserID, UserName, Email, Password; bảng Orders có OrderID, UserID, OrderDate, TotalAmount.  
  • Schema (Lược đồ/Cấu trúc): Database truyền thống sử dụng cơ chế Schema-on-Write. Điều này có nghĩa là bạn phải định nghĩa chi tiết cấu trúc của các bảng (tên cột, kiểu dữ liệu của cột là gì – số, chữ, ngày tháng…) trước khi bạn có thể lưu trữ bất kỳ dữ liệu nào vào đó. Giống như bạn phải kẻ sẵn các cột trong sổ kế toán trước khi ghi chép các khoản thu chi vậy. Lược đồ này thường khá cứng nhắc (rigid) và việc thay đổi nó có thể phức tạp, nhưng chính sự cứng nhắc này lại giúp đảm bảo tính nhất quán và toàn vẹn của dữ liệu.  
  • Mục đích chính: Mục tiêu hàng đầu là phục vụ các hoạt động đọc, ghi, cập nhật, xóa (CRUD – Create, Read, Update, Delete) dữ liệu một cách nhanh chóng và đáng tin cậy, hỗ trợ trực tiếp cho các giao dịch OLTP của ứng dụng. Chúng cần đảm bảo mỗi giao dịch diễn ra thành công hoặc thất bại hoàn toàn (tính nguyên tử – Atomicity) và dữ liệu luôn ở trạng thái hợp lệ.  
  • Người dùng: Người dùng trực tiếp chính của các database này thường là các Kỹ sư Backend (Backend Engineers). Họ là những người xây dựng và bảo trì các ứng dụng, viết code để tương tác (đọc/ghi) với database. Người dùng cuối như chúng ta chỉ tương tác gián tiếp với database thông qua giao diện của ứng dụng web hoặc mobile.  
  • Ví dụ: Cơ sở dữ liệu lưu trữ thông tin tài khoản người dùng và bài viết của một diễn đàn trực tuyến, cơ sở dữ liệu quản lý thông tin sản phẩm, đơn hàng và khách hàng của một cửa hàng online, hay cơ sở dữ liệu chứa thông tin chuyến bay, lịch trình và đặt chỗ của một hãng hàng không.

Data Warehouse (Kho dữ liệu)

Khi một doanh nghiệp phát triển, họ thường có rất nhiều hệ thống hoạt động (OLTP) khác nhau: hệ thống quản lý bán hàng (POS), hệ thống quản lý quan hệ khách hàng (CRM), hệ thống quản lý kho (Inventory), hệ thống quản lý nhân sự (HR)…

Mỗi hệ thống lại có cơ sở dữ liệu riêng, dẫn đến tình trạng dữ liệu bị phân mảnh và cô lập (data silos). Việc tổng hợp dữ liệu từ tất cả các nguồn này để có một cái nhìn toàn cảnh về tình hình kinh doanh trở nên vô cùng khó khăn. Thêm vào đó, như chúng ta đã thảo luận, việc chạy các truy vấn phân tích phức tạp (OLAP) trực tiếp trên các hệ thống OLTP đang hoạt động sẽ gây ảnh hưởng nghiêm trọng đến hiệu năng.

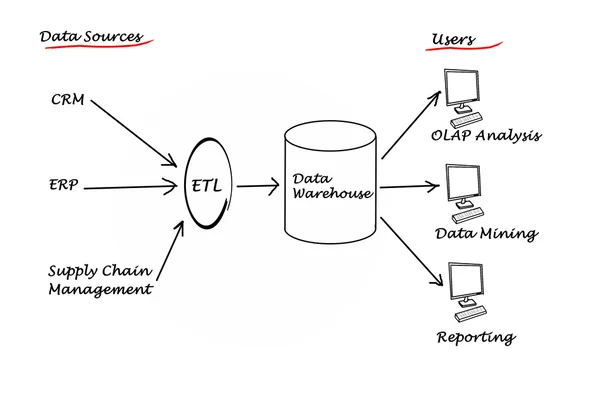
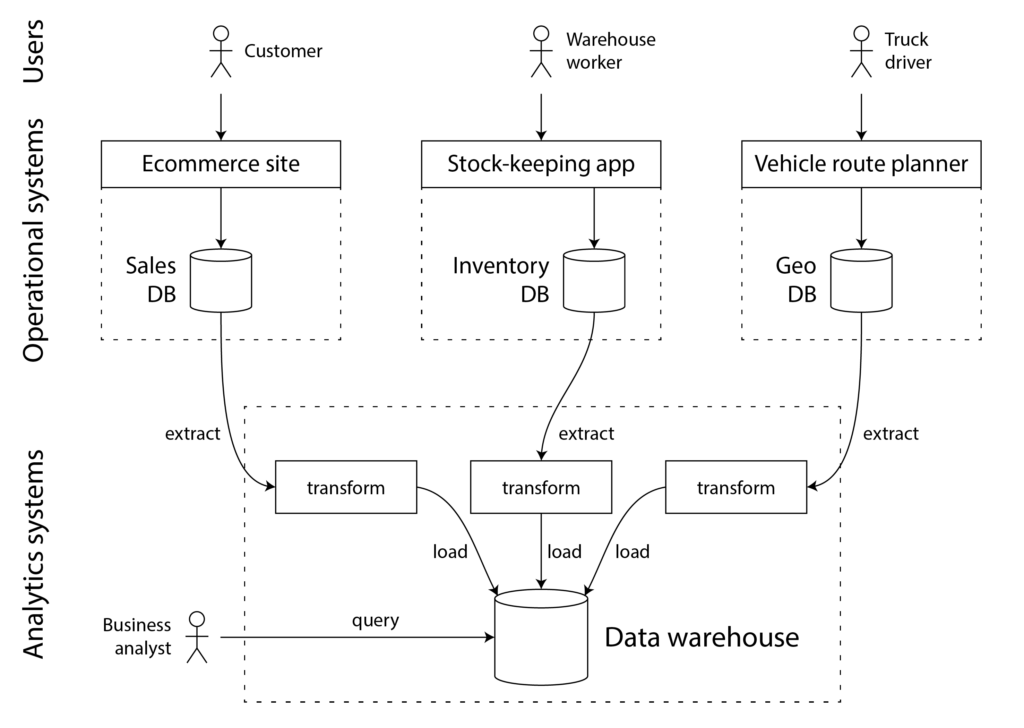
Để giải quyết những thách thức này, khái niệm Data Warehouse (Kho dữ liệu) đã ra đời vào cuối những năm 1980, đầu 1990. Bạn có thể hình dung Data Warehouse như một thư viện trung tâm khổng lồ, được xây dựng riêng biệt với các hệ thống hoạt động hàng ngày. Nó không trực tiếp phục vụ các giao dịch tức thời, mà nhiệm vụ chính là thu thập, tích hợp và lưu trữ dữ liệu từ nhiều nguồn OLTP khác nhau trong toàn doanh nghiệp, sau đó tối ưu hóa dữ liệu đó cho mục đích phân tích (OLAP) và Business Intelligence (BI)

image 7 - quochung.cyou PTIT

Quá trình “nhập sách” vào thư viện – ETL/ELT:

Làm thế nào để dữ liệu từ các hệ thống nguồn khác nhau có thể được chuyển vào Data Warehouse một cách thống nhất? Đó là nhờ một quy trình quan trọng gọi là ETL (Extract – Transform – Load).  

  1. Extract (Trích xuất): Dữ liệu được lấy ra (trích xuất) từ các hệ thống nguồn khác nhau (database OLTP, file log, thậm chí cả dữ liệu từ các dịch vụ bên ngoài như Google Analytics hay hệ thống CRM của đối tác).  
  2. Transform (Biến đổi): Đây là bước quan trọng nhất. Dữ liệu thô được trích xuất thường không đồng nhất (ví dụ: ngày tháng có định dạng khác nhau, tên khách hàng viết hoa/thường lẫn lộn, đơn vị tiền tệ khác nhau…). Ở bước này, dữ liệu sẽ được làm sạch (loại bỏ lỗi, dữ liệu trùng lặp), chuẩn hóa (đưa về cùng một định dạng, đơn vị đo lường), tích hợp (kết hợp dữ liệu từ nhiều nguồn, ví dụ: liên kết thông tin khách hàng từ CRM với lịch sử mua hàng từ hệ thống bán lẻ), và biến đổi thành một cấu trúc (schema) phù hợp cho việc phân tích.  
  3. Load (Tải): Sau khi đã được “tút tát” sạch đẹp và đúng chuẩn, dữ liệu sẽ được tải vào Data Warehouse
image 8 - quochung.cyou PTIT

Đôi khi, thứ tự có thể thay đổi một chút thành ELT (Extract – Load – Transform), tức là dữ liệu được tải vào Data Warehouse trước rồi mới thực hiện biến đổi tại đó. Cách tiếp cận này thường phổ biến hơn với các nền tảng dữ liệu hiện đại có khả năng xử lý mạnh mẽ.

Đặc điểm chính của Data Warehouse:

  • Loại dữ liệu: Chủ yếu lưu trữ dữ liệu có cấu trúc hoặc bán cấu trúc đã được xử lý, làm sạch và tích hợp từ nhiều nguồn khác nhau. Dữ liệu ở đây không còn ở dạng thô như lúc ban đầu.  
  • Schema (Lược đồ/Cấu trúc): Vẫn sử dụng Schema-on-Write hoặc schema được định nghĩa trước, tương tự database truyền thống. Tuy nhiên, schema trong Data Warehouse thường được thiết kế theo mô hình hướng chủ đề (subject-oriented), tập trung vào các lĩnh vực kinh doanh cốt lõi như Bán hàng (Sales), Tiếp thị (Marketing), Tài chính (Finance), Nhân sự (HR)… thay vì theo cấu trúc của từng ứng dụng nguồn. Các mô hình phổ biến là Star Schema và Snowflake Schema, giúp tối ưu cho các truy vấn phân tích.  
  • Mục đích chính: Phục vụ các hoạt động phân tích dữ liệu lịch sử, tạo báo cáo quản trị (BI reports), khám phá insight kinh doanh và hỗ trợ ra quyết định chiến lược (OLAP). Nó giúp trả lời các câu hỏi “Tại sao?” và “Điều gì sẽ xảy ra?”.  
  • Người dùng: Người dùng chính là các Chuyên viên phân tích nghiệp vụ/kinh doanh (Business Analysts) , các nhà quản lý, lãnh đạo doanh nghiệp – những người cần các báo cáo tổng hợp, dashboard trực quan và những phân tích sâu sắc về tình hình hoạt động của công ty.  
  • Tính chất dữ liệu:
    • Tích hợp (Integrated): Dữ liệu từ nhiều nguồn được hợp nhất và chuẩn hóa, tạo ra một bức tranh toàn cảnh.  
    • Bất biến (Non-volatile): Dữ liệu trong Data Warehouse một khi đã được ghi vào thì rất hiếm khi bị cập nhật hay xóa đi. Thay vào đó, các dữ liệu mới (ví dụ: doanh số của ngày hôm qua) sẽ được nạp thêm vào. Điều này giúp lưu giữ lịch sử thay đổi của dữ liệu theo thời gian.  
    • Gắn nhãn thời gian (Time-variant): Dữ liệu luôn được gắn với một yếu tố thời gian (ngày, tuần, tháng, quý, năm), cho phép các nhà phân tích xem xét và so sánh dữ liệu qua các khoảng thời gian khác nhau, từ đó nhận diện xu hướng và mẫu hình phát triển.  
    • Thường là Read-only: Các nhà phân tích chủ yếu thực hiện các truy vấn đọc dữ liệu chứ không sửa đổi dữ liệu gốc trong kho.

Việc xây dựng Data Warehouse được xem là nỗ lực quan trọng đầu tiên của các doanh nghiệp nhằm phá vỡ các “ốc đảo dữ liệu” (data silos) và tạo ra một “nguồn sự thật duy nhất” (single source of truth) cho việc báo cáo và phân tích. Trước khi có Data Warehouse, việc tạo ra một báo cáo tổng hợp đáng tin cậy, ví dụ như kết hợp dữ liệu bán hàng từ hệ thống POS với dữ liệu chi phí marketing từ phòng Marketing và dữ liệu tồn kho từ bộ phận Logistics, là một công việc cực kỳ thủ công, tốn thời gian và dễ sai sót. Quy trình ETL tự động hóa việc tích hợp và làm sạch này, cung cấp cho các nhà phân tích một bộ dữ liệu tập trung, nhất quán và đáng tin cậy để họ có thể đặt ra những câu hỏi phức tạp hơn về hoạt động kinh doanh.  

Data Lake (Hồ dữ liệu)

image 9 - quochung.cyou PTIT

Data Warehouse đã giải quyết rất tốt bài toán tích hợp dữ liệu cho mục đích BI và báo cáo. Tuy nhiên, cùng với sự bùng nổ của Big Data và sự trỗi dậy của Khoa học dữ liệu (Data Science) và Học máy (Machine Learning – ML), Data Warehouse bắt đầu bộc lộ những hạn chế:

  1. Kém linh hoạt: Cấu trúc dữ liệu (schema) phải được định nghĩa trước (Schema-on-Write) khiến việc thêm nguồn dữ liệu mới hoặc thay đổi cấu trúc trở nên tốn thời gian và công sức.  
  2. Khó xử lý dữ liệu phi cấu trúc: Data Warehouse được thiết kế chủ yếu cho dữ liệu có cấu trúc hoặc bán cấu trúc. Việc lưu trữ và phân tích các loại dữ liệu phi cấu trúc như văn bản (email, bài đăng mạng xã hội, đánh giá sản phẩm), hình ảnh, video, âm thanh, dữ liệu cảm biến (IoT)… là rất khó khăn hoặc không hiệu quả.  
  3. Chi phí lưu trữ cao: Việc lưu trữ một khối lượng dữ liệu khổng lồ, đặc biệt là dữ liệu lịch sử trong nhiều năm, trên các hệ thống Data Warehouse truyền thống có thể rất tốn kém.  
  4. Mất mát thông tin tiềm năng: Quá trình Transform trong ETL có thể làm mất đi một số chi tiết hoặc sắc thái trong dữ liệu gốc, mà những chi tiết này lại có thể hữu ích cho các mô hình Machine Learning hoặc các phân tích khám phá sâu hơn.

Để khắc phục những hạn chế này và đáp ứng nhu cầu mới của thời đại Big Data, khái niệm Data Lake (Hồ dữ liệu) đã xuất hiện.

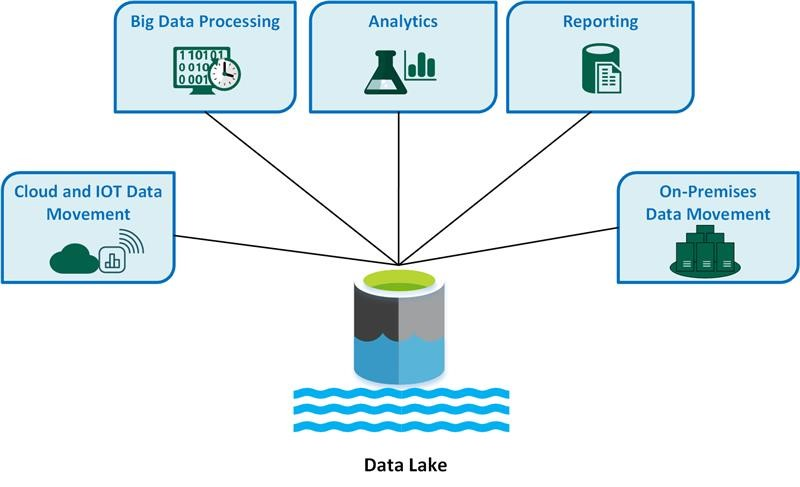
Tương tự, Data Lake là một kho lưu trữ tập trung, có khả năng chứa mọi loại dữ liệu – từ dữ liệu có cấu trúc trong các bảng, dữ liệu bán cấu trúc như file JSON, XML, đến dữ liệu phi cấu trúc như text, ảnh, video – ở định dạng gốc (raw format) của chúng. Nó được thiết kế để xử lý khối lượng dữ liệu cực lớn (terabytes đến petabytes và hơn thế nữa) với chi phí lưu trữ thấp (thường tận dụng các dịch vụ lưu trữ đối tượng trên đám mây như Amazon S3, Google Cloud Storage).

Đặc điểm chính của Data Lake:

  • Loại dữ liệu: Chấp nhận tất cả các loại dữ liệu: structured, semi-structured, và unstructured. Đây là điểm khác biệt lớn nhất so với Database và Data Warehouse.  
  • Schema (Lược đồ/Cấu trúc): Sử dụng cơ chế Schema-on-Read. Nghĩa là dữ liệu được đổ vào hồ mà không cần định nghĩa cấu trúc trước. Cấu trúc (schema) chỉ được áp dụng hoặc suy ra khi dữ liệu được đọc ra để phục vụ một mục đích phân tích cụ thể. Điều này mang lại sự linh hoạt tối đa, cho phép lưu trữ dữ liệu mới một cách nhanh chóng mà không cần lo lắng về việc phải thiết kế schema trước.  
  • Mục đích chính:
    • Lưu trữ tập trung mọi loại dữ liệu của tổ chức với chi phí thấp và khả năng mở rộng cao.  
    • Cung cấp “nguyên liệu thô” cho các hoạt động Khoa học dữ liệu (Data Science) và Học máy (Machine Learning), đặc biệt là huấn luyện các mô hình phức tạp đòi hỏi dữ liệu gốc, chưa qua xử lý nhiều.  
    • Phục vụ các tác vụ phân tích khám phá (exploratory analysis), nơi các nhà khoa học dữ liệu muốn tự do tìm tòi, khám phá dữ liệu mà không bị giới hạn bởi một cấu trúc định sẵn.
    • Xử lý Big Data và các luồng dữ liệu thời gian thực (streaming data).  
  • Người dùng: Người dùng chính của Data Lake là các Nhà khoa học dữ liệu (Data Scientists) và Kỹ sư dữ liệu (Data Engineers). Họ là những người cần truy cập vào dữ liệu gốc, đa dạng và có các công cụ để xử lý, phân tích dữ liệu này (ví dụ: Python với thư viện Pandas, Scikit-learn; R; Apache Spark…). Các Business Analysts cũng có thể sử dụng dữ liệu từ Data Lake, nhưng thường là sau khi dữ liệu đã được xử lý và đưa vào một lớp có cấu trúc hơn (ví dụ: thông qua Data Lakehouse hoặc các công cụ truy vấn SQL-on-Lake).  
  • Lợi ích:
    • Linh hoạt (Flexibility): Có thể lưu trữ mọi loại dữ liệu mà không cần định nghĩa schema trước.
    • Chi phí thấp (Low Cost): Tận dụng các giải pháp lưu trữ rẻ tiền, đặc biệt là trên cloud.  
    • Khả năng mở rộng (Scalability): Dễ dàng mở rộng dung lượng lưu trữ khi dữ liệu tăng lên.  
    • Hỗ trợ đa dạng công cụ: Có thể sử dụng nhiều loại công cụ và framework phân tích khác nhau trên cùng một dữ liệu.  
  • Thách thức – Nguy cơ “Đầm lầy dữ liệu” (Data Swamp): Chính sự linh hoạt của Data Lake cũng là con dao hai lưỡi. Nếu không có quy trình quản lý, kiểm soát chất lượng và tài liệu hóa (metadata management) tốt, Data Lake rất dễ biến thành một “đầm lầy dữ liệu” – một nơi chứa đầy dữ liệu không rõ nguồn gốc, chất lượng kém, trùng lặp, khó hiểu và không thể sử dụng được. Việc quản trị (governance) trong Data Lake là một thách thức lớn.  

Sự ra đời của Data Lake đã thực sự trở thành yếu tố then chốt thúc đẩy sự phát triển mạnh mẽ của Khoa học dữ liệu và Học máy trong môi trường doanh nghiệp. Các mô hình ML phức tạp thường “thích” dữ liệu thô, nơi chúng có thể tự mình khám phá các đặc trưng (features) và mẫu hình mà con người có thể bỏ qua hoặc loại bỏ trong quá trình Transform của ETL vào Data Warehouse. Data Lake cung cấp chính xác nguồn “nguyên liệu” đa dạng, khổng lồ và linh hoạt đó, cho phép các Data Scientist tự do thử nghiệm, xây dựng và huấn luyện các mô hình dự đoán, phân loại, gợi ý… mà không bị giới hạn bởi cấu trúc cứng nhắc của Data Warehouse truyền thống.

So sánh nhanh: Data Lake, Database, Data Warehouse

Đặc điểmDatabase (Cơ sở dữ liệu)Data Warehouse (Kho dữ liệu)Data Lake (Hồ dữ liệu)
Mục đích chínhXử lý giao dịch trực tuyến (OLTP), hoạt động hàng ngàyPhân tích kinh doanh (BI), báo cáo quản trị, hỗ trợ ra quyết định (OLAP) Lưu trữ mọi loại dữ liệu thô, Khoa học dữ liệu, Học máy, phân tích khám phá, Big Data
Loại dữ liệuChủ yếu có cấu trúc (Structured) Có cấu trúc, bán cấu trúc (Đã được xử lý, tích hợp) Mọi loại: Có cấu trúc, bán cấu trúc, phi cấu trúc (Structured, Semi-structured, Unstructured)
Cấu trúc dữ liệu (Schema)Schema-on-Write (Định nghĩa trước, cứng nhắc) Schema-on-Write (Định nghĩa trước, hướng chủ đề) Schema-on-Read (Linh hoạt, áp dụng khi đọc)
Cách xử lý dữ liệuTối ưu cho đọc/ghi/cập nhật/xóa nhanh các bản ghi nhỏTối ưu cho các truy vấn phức tạp, quét lượng lớn dữ liệu lịch sử (ETL/ELT trước khi tải) Lưu trữ dữ liệu thô, xử lý linh hoạt khi cần (Thường là ELT)
Người dùng chínhKỹ sư Backend, Ứng dụng Chuyên viên phân tích (Business Analysts), Nhà quản lý Nhà khoa học dữ liệu (Data Scientists), Kỹ sư dữ liệu (Data Engineers)
Tốc độ truy vấnRất nhanh (cho giao dịch nhỏ) Nhanh (cho truy vấn phân tích đã tối ưu) Có thể chậm hơn (tùy công cụ và tối ưu hóa, ưu tiên lưu trữ rẻ)
Tính linh hoạtThấp Trung bình (Khó thay đổi schema) Cao
Chi phí lưu trữTùy thuộc vào quy mô, có thể cao Thường cao Thấp (Thiết kế cho lưu trữ rẻ)
Ví dụ điển hìnhQuản lý tài khoản người dùng, đơn hàng online Phân tích doanh thu theo quý, báo cáo hiệu quả marketing Huấn luyện mô hình gợi ý sản phẩm, phân tích sentiment từ mạng xã hội, xử lý dữ liệu IoT

Ai/Vai trò nào làm việc với các hệ thống thông tin này?

Để những dữ liệu phức tạp này có thể được xây dựng, vận hành trơn tru và thực sự mang lại giá trị cho tổ chức, không thể thiếu vai trò của những con người với các kỹ năng chuyên môn khác nhau. Sự phát triển của các kiến trúc dữ liệu cũng kéo theo sự chuyên môn hóa ngày càng cao của các vị trí công việc trong lĩnh vực này.

  • Backend Engineer (Kỹ sư Backend / Lập trình viên Backend): Đây là những người thường làm việc trực tiếp nhất với các Database truyền thống (OLTP). Nhiệm vụ chính của họ là xây dựng và duy trì phần “hậu trường” (backend) của các ứng dụng web hoặc mobile – chính là những ứng dụng tạo ra và tiêu thụ dữ liệu hàng ngày. Họ viết code để ứng dụng có thể đọc, ghi, cập nhật và xóa dữ liệu trong database một cách chính xác, hiệu quả và an toàn, đảm bảo các giao dịch OLTP diễn ra suôn sẻ.  
  • Business Analyst (Chuyên viên phân tích nghiệp vụ / kinh doanh – BA): BA là những người dùng của Data Warehouse. Họ là cầu nối giữa bộ phận kinh doanh và kỹ thuật. Sử dụng dữ liệu đã được làm sạch và tích hợp trong Data Warehouse, BA thực hiện các phân tích, tạo ra các báo cáo trực quan (dashboards), khám phá các xu hướng kinh doanh và cung cấp những insight giá trị giúp ban lãnh đạo đưa ra các quyết định sáng suốt hơn (hoạt động Business Intelligence – BI). Họ cần hiểu rõ về nghiệp vụ kinh doanh và có kỹ năng sử dụng các công cụ BI như Tableau, Power BI cũng như SQL để truy vấn dữ liệu.  
  • Data Scientist (Nhà khoa học dữ liệu): Đây là những “nhà thám hiểm” của thế giới dữ liệu, thường làm việc nhiều nhất với Data Lake (nhưng cũng có thể khai thác cả Data Warehouse). Công việc của họ không chỉ dừng lại ở việc phân tích dữ liệu quá khứ mà còn đi sâu vào việc khám phá dữ liệu thô, áp dụng các thuật toán thống kê và Machine Learning (Học máy) để xây dựng các mô hình dự đoán, phân loại, phát hiện bất thường, hoặc tìm ra những insight hoàn toàn mới lạ mà con người khó nhận biết. Họ cũng có thể tạo ra các tính năng sản phẩm dựa trên dữ liệu, ví dụ như hệ thống gợi ý sản phẩm “người mua X cũng mua Y” trên các trang thương mại điện tử. Họ cần nền tảng vững chắc về toán, thống kê, lập trình (thường là Python hoặc R) và kiến thức về các thuật toán ML.  
  • Data Engineer (Kỹ sư dữ liệu): Có thể nói Data Engineer là những người “thợ xây” chính của toàn bộ hạ tầng dữ liệu. Vai trò của họ cực kỳ quan trọng, đảm bảo “dòng chảy” dữ liệu được thông suốt và hiệu quả. Họ chịu trách nhiệm thiết kế, xây dựng, kiểm thử và bảo trì các “đường ống” ( dữ liệu (data pipelines), bao gồm cả việc triển khai quy trình ETL/ELT để di chuyển và biến đổi dữ liệu từ các hệ thống nguồn (OLTP) vào Data Warehouse hoặc Data Lake. Họ đảm bảo dữ liệu luôn sẵn sàng, đáng tin cậy và có thể truy cập được cho các Data Analyst và Data Scientist sử dụng. Kỹ năng cần thiết bao gồm lập trình, hiểu biết về các hệ thống database, data warehouse, data lake, các công cụ ETL và các nền tảng Big Data.  
  • Analytics Engineer (Kỹ sư phân tích): Đây là một vai trò tương đối mới nhưng đang ngày càng trở nên quan trọng, đặc biệt trong bối cảnh của Modern Data Stack (Ngăn xếp dữ liệu hiện đại). Analytics Engineer hoạt động ở lớp trung gian, nối liền khoảng cách giữa Data Engineer và Data Analyst/Scientist. Trong khi Data Engineer tập trung vào việc xây dựng hạ tầng và đưa dữ liệu thô vào Lake/Warehouse, Analytics Engineer lại tập trung vào việc biến đổi (transform) dữ liệu thô đó thành những bộ dữ liệu (data models) sạch sẽ, có cấu trúc tốt, dễ hiểu, đáng tin cậy và được tối ưu hóa cho mục đích phân tích và báo cáo BI. Họ thường là những người rất giỏi SQL, thành thạo các công cụ mô hình hóa dữ liệu như dbt (data build tool), và có hiểu biết tốt về nhu cầu phân tích của nghiệp vụ.  

Một số xu hướng mới

  • Data Lakehouse: Như mình đã nhắc đến ở phần so sánh, Data Lakehouse là một kiến trúc lai đầy hứa hẹn, đang thu hút nhiều sự chú ý. Mục tiêu của nó là kết hợp những ưu điểm tốt nhất của cả Data Warehouse và Data Lake vào một nền tảng duy nhất. Cụ thể, nó cố gắng mang lại sự linh hoạt và chi phí thấp của Data Lake (lưu trữ mọi loại dữ liệu trên bộ nhớ rẻ tiền như object storage) cùng với các tính năng quản lý dữ liệu mạnh mẽ của Data Warehouse như cấu trúc dữ liệu (schema enforcement), đảm bảo tính toàn vẹn giao dịch (ACID transactions), quản trị dữ liệu (data governance) và hiệu năng truy vấn SQL cao. Bằng cách này, Data Lakehouse hướng tới việc đơn giản hóa kiến trúc dữ liệu tổng thể, giảm thiểu việc sao chép dữ liệu giữa Lake và Warehouse, và cho phép nhiều loại workload khác nhau (từ BI, SQL analytics đến Data Science, ML) cùng hoạt động hiệu quả trên một bản sao dữ liệu duy nhất.  
  • DataOps: Lấy cảm hứng từ thành công của DevOps trong lĩnh vực phát triển phần mềm, DataOps ra đời với mục tiêu áp dụng các nguyên tắc tương tự vào toàn bộ vòng đời của dữ liệu, từ khâu thu thập, xử lý, đến phân tích và cung cấp insight. DataOps nhấn mạnh vào Tự động hóa (Automation) các quy trình dữ liệu (như kiểm thử, triển khai pipeline), Giám sát (Monitoring) liên tục chất lượng và hiệu năng dữ liệu, và thúc đẩy Hợp tác (Collaboration) chặt chẽ giữa các nhóm liên quan (Data Engineers, Analysts, Scientists, nghiệp vụ). Mục tiêu cuối cùng của DataOps là tăng tốc độ đưa dữ liệu và insight đến người dùng, cải thiện chất lượng và độ tin cậy của dữ liệu, đồng thời giảm thiểu lỗi và các công việc thủ công lặp đi lặp lại.  
  • Reverse ETL: Nếu như ETL/ELT truyền thống tập trung vào việc đưa dữ liệu VÀO Data Warehouse hoặc Data Lake để phân tích, thì Reverse ETL lại làm điều ngược lại. Nó lấy những dữ liệu đã được xử lý, làm giàu, hoặc những insight giá trị (ví dụ: điểm số khách hàng tiềm năng, phân khúc khách hàng, dự đoán churn rate) từ chính Data Warehouse/Lakehouse và đẩy chúng TRỞ LẠI các hệ thống hoạt động hàng ngày mà các bộ phận nghiệp vụ thường xuyên sử dụng, như hệ thống CRM (Quản lý quan hệ khách hàng), công cụ Marketing Automation, nền tảng quảng cáo, hay công cụ hỗ trợ khách hàng. Việc này giúp “kích hoạt” dữ liệu phân tích, biến insight thành hành động cụ thể một cách nhanh chóng và tự động, giúp các nhóm Sales, Marketing, Customer Success… có thể cá nhân hóa tương tác, tối ưu chiến dịch và cải thiện trải nghiệm khách hàng dựa trên dữ liệu cập nhật nhất.  
  • Data Products & Data Mesh: Đây là một xu hướng mang tính chiến lược và tổ chức hơn là chỉ về công nghệ. Nó đề xuất một cách tiếp cận mới trong việc quản lý và chia sẻ dữ liệu trong các tổ chức lớn, đặc biệt là những nơi có nhiều bộ phận nghiệp vụ (domains) khác nhau. Thay vì tập trung tất cả dữ liệu và đội ngũ data vào một nhóm trung tâm (thường dẫn đến tắc nghẽn), kiến trúc Data Mesh đề xuất phân tán quyền sở hữu và trách nhiệm quản lý dữ liệu về cho chính các nhóm nghiệp vụ (domain teams) – những người hiểu rõ nhất về dữ liệu của mình. Mỗi domain team sẽ chịu trách nhiệm biến dữ liệu của họ thành các “Sản phẩm dữ liệu” (Data Products). Một Data Product không chỉ là dữ liệu thô, mà là một đơn vị logic hoàn chỉnh, bao gồm dữ liệu đã được làm sạch, mô hình hóa, có tài liệu rõ ràng, đáng tin cậy, dễ khám phá, dễ truy cập (thông qua các cổng ra – output ports được định nghĩa tốt) và có chủ sở hữu chịu trách nhiệm về chất lượng. Cách tiếp cận này nhằm mục đích tăng cường khả năng mở rộng, tính linh hoạt, chất lượng dữ liệu và giúp dữ liệu thực sự trở thành tài sản được quản lý tốt như các sản phẩm phần mềm khác trong tổ chức.  

Để tổng kết lại một cách ngắn gọn nhất, bạn có thể nhớ:

  • Database (Cơ sở dữ liệu): Lựa chọn hàng đầu cho các hoạt động hàng ngày, cần xử lý giao dịch nhanh chóng, đáng tin cậy với dữ liệu có cấu trúc. Nó là trái tim của các ứng dụng OLTP.
  • Data Warehouse (Kho dữ liệu): Ngôi nhà lý tưởng cho việc phân tích kinh doanh (BI), tạo báo cáo quản trị, khám phá insight từ dữ liệu lịch sử đã được tích hợp và làm sạch, chủ yếu là dữ liệu có cấu trúc. Nó là trung tâm của các hệ thống OLAP.
  • Data Lake (Hồ dữ liệu): Giải pháp tối ưu khi bạn cần lưu trữ mọi loại dữ liệu (bao gồm cả phi cấu trúc) ở dạng thô, với chi phí thấp và quy mô lớn, phục vụ cho các nhu cầu phân tích nâng cao, Khoa học dữ liệu và Học máy.

Triển khai Cursor Pagination trong Java Spring JPA/Hibernate

Từ bài viết trước

Cursor Pagination

Kĩ thuật: keyset pagination and seek method

Ở một số trang web, bạn sẽ thấy, bạn không thể đi đến thẳng trang cuối, hoặc nhảy đến 1 trang bất kì, mà thông thường sẽ có nút để sang trang kế và trang phía trước. Như vậy ta có thể assume rằng:

Người dùng sẽ chỉ mở trang 10 sau khi mở trang 9.Vậy, ta chỉ cần nhớ vị trí cuối cùng của bài viết ở trang 9 là ở id bao nhiêu, rồi dùng WHERE để truy vấn từ điểm đó, chứ không cần bỏ dần để đi đến điểm đó nữa

SELECT * FROM my_table WHERE id > 21 ORDER BY id LIMIT 5
image 17 - quochung.cyou PTIT
Tối ưu truy vấn Pagination (phân trang) sử dụng Spring Boot (Java) 38

Ví dụ: Sort theo thời gian

SELECT *
FROM my_table
WHERE (update_date = '2017-12-21' AND id > 21) 
    OR update_date > '2017-12-21'
ORDER BY update_date,id LIMIT 5

Cơ bản là ta sẽ chỉ lấy các bài viết có cùng thời gian đăng như bài viết cuối và id > , hoặc thời gian lớn hơn bài viết cuối

image 18 - quochung.cyou PTIT

Để hình dung rõ hơn, hãy thử nhìn vào bảng sau:

IDName
1An
2Nam
3Quan
4Tien
5Hoang
6Nguyen
7Duc
8Thanh
9Hai
10Minh

Ta mong muốn nhận được dữ liệu ở Page 1 như sau

IDName
1An
2Nam
3Quan
4Tien
5Hoang

Ta sẽ có câu query để lấy page 2 dạng như sau

Lấy page 1: SELECT * FROM users ORDER BY ID LIMIT 5
SELECT * FROM users WHERE ID > '5' ORDER BY ID LIMIT 5

Ta có thể thêm HAL bằng Spring HateOAS để response trả về ở dạng như sau, giúp ta lấy dữ liệu dễ dàng hơn

{
    “cursor”: {
        “previous_page”: null,
        “next_page”: "next___5"
    }
}
{
    “cursor”: {
        “previous_page”: "prev___5" ,
        “next_page”: "next___10"
    }
}
  • Cursor sẽ như một con trỏ chỉ tới một record nào đó trong dữ liệu, và khi ta truyền cursor đó vào, backend cần biết ta đang muốn lấy trang tiếp theo hay trang trước từ vị trí con trỏ đó
  • Có nhiều cách để làm điều này, ví dụ thêm prefix dạng như prev___, hay next___ như ví dụ trên
  • Hoặc đơn giản hơn, ta sẽ truyền thêm một biến chỉ ra là đó là next hay prev

Null Cursor

  • Lúc này, từ phía backend, ta có thể sử dụng count hoặc tương tự để kiểm tra xem có trang ở trước đó hay ở sau đó không, rồi trả response ra là null để thể hiện rằng không còn trang nào khác để đi tới ở hướng đó.

Next Cursor

  • Có thể bạn đã nắm được về cách để đi tới trang tiếp theo với cursor pagination.
  • Ví dụ, ta có một danh sách id tăng dần, thì từ trang có id [1,2,3,4,5], ta sẽ where id > 5 để tới trang tiếp theo
SELECT * FROM entries WHERE (myCol > 5) ORDER BY myCol ASC LIMIT 2; -> 6,7
SELECT * FROM entries WHERE (myCol > 7) ORDER BY myCol ASC LIMIT 2; -> 8,9
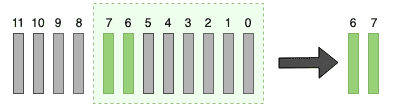
image 9 - quochung.cyou PTIT
image 10 - quochung.cyou PTIT
  • Với một danh sách id giảm dần, ví dụ trang là [10,9,8,7,6] thì ta sẽ where id < 6 để tới trang tiếp theo.
SELECT * FROM entries WHERE (myCol < 5) ORDER BY myCol DESC LIMIT 2; -> 4,3
SELECT * FROM entries WHERE (myCol < 3) ORDER BY myCol DESC LIMIT 2; -> 2,1
image 11 - quochung.cyou PTIT
image 12 - quochung.cyou PTIT

Previous Cursor

  • Tuy nhiên, việc đi tới trang trước đó trở lên khó khăn hơn. Bởi vì dữ liệu sẽ được trả ra từ phía trái đầu
  • Ví dụ, ta đang ở trang id [8,9] , và ta thực hiện truy vấn lấy trang trước đó, 2 phần tử
SELECT * FROM entries WHERE (myCol < 8) ORDER BY myCol ASC LIMIT 2;
image 13 - quochung.cyou PTIT
  • Kết quả sẽ trả về 0,1. Bởi vì nó đang đọc từ trái sang, và khi limit sẽ lấy từ đầu trái chứ không lấy 6,7

Cách giải quyết lấy previous cursor

  • Cách để giải quyết vấn đề này, ta sẽ đảo ngược chiều order by, và sau đó khi limit để lấy đúng vùng dữ liệu xong, ta sẽ đảo một lần nữa về chiều đúng
SELECT pagination.* FROM(SELECT * FROM entries WHERE (myCol < 8) ORDER BY myCol DESC LIMIT 2) AS pagination ORDER BY myCol ASC;
image 14 - quochung.cyou PTIT
  • Các bước vừa xảy ra
  • 1. Đầu tiên, select các row có id < 8 và order by desc. ta có 7,6,…,1,0
  • Sau đó limit 2 để lấy 7,6
  • Rồi order by asc lần nữa để lấy thành 6,7 . Là thứ tự ASC như ban đầu ta muốn

Time Complexity

  • Next Page Travesal: O(log(N) + L) , ta mấy log(N) để tìm tới điểm bất kì vì nó thực hiện như binary search và ta đã index database. Và L là Limit là số ta phải lặp đến để lấy vùng đầu tiên đã chọn
  • Previous Page Traversal: O(log(N) + 2L), sở dĩ là 2L vì ta đã phải đảo chiều 1 lần.
  • Thông thường limit được đặt ở 5-20 cho 1 trang, vì vậy có thể coi L là constant và không đáng kể

Triển khai trong code

image 15 - quochung.cyou PTIT
  • Ta có một class thực hiện việc lấy cursor trước hoặc sau. Sử dụng để decode một giá trị cursor base64 hoặc encode 1 giá trị
  • Ví dụ ta đang cursor pagination theo column 35, ta sẽ có hàm getEncodeCursor để tạo ra giá trị mã hoá cursor
  • Hàm getDecodedCursor sẽ chuyển giá trị mã hoá đó thành số để dùng paging
image 16 - quochung.cyou PTIT
  • Đây là class thực hiện việc paging và nhảy trang. Có thể thấy logic sẽ kiểm tra xem ta đang lấy trang trước hay trang sau, sau đó sort cho phù hợp.
image 17 - quochung.cyou PTIT
image 18 - quochung.cyou PTIT
  • Class xử lý việc trả về. Tại đây ta sẽ lấy ra element tại đầu list và cuối list của trang hiện tại, rồi tìm thử xem phía trước đó còn trang nào không, hay sau đó còn trang nào hay không

Tham khảo:

[BlockChain] P2: Chainlink, một giải pháp khắc phục “oracle problem”, ví dụ thực tế

This entry is part 2 of 2 in the series Blockchain

Chainlink là gì?

image 4 - quochung.cyou PTIT
Chainlink là một dự án mã nguồn mở, được phát triển bởi SmartContract, nhằm giải quyết vấn đề "oracle problem" trong blockchain. Chainlink cung cấp một cách để kết nối các hợp đồng thông minh với các nguồn dữ liệu bên ngoài mà không cần tin tưởng vào bất kỳ bên thứ ba nào.

Ví dụ thực tế

Có thể xem ví dụ thực tế về blockchain qua bảng tính ở bài viết trước trong series. Tại bài này, ta sẽ nói về vấn đề mà Chainlink tập trung giải quyết

  • Chainlink giải quyết một hạn chế cơ bản của blockchain: mặc dù blockchain giúp ta tạo ra một bảng tính an toàn, bảo mật, stable vì phi tập trung, nhưng nó không thể tự mình truy cập hoặc xác minh dữ liệu thế giới thực.

Ví dụ:

  • Bạn có thể sử dụng bảng tính để lưu các lần chấm công của nhân viên, nhưng chính bảng tính không thể xác minh xem những dữ liệu nhập vào đó có đúng hay không; bạn cần một hệ thống bảng chấm công bên ngoài để thực sự theo dõi những giờ này. Vì vậy, để bảng tính có ích, nó cần dữ liệu chỉ nhập chính xác từ một nguồn hệ thống bên ngoài nà, và ta sẽ cần một cây cầu trung gian giữa dữ liệu ngoài và hệ thống blockchain bảo mật bên trong.

Đó chính là những gì Chainlink cung cấp cho blockchain. Nó hoạt động như một mạng lưới oracle phi tập trung. Oracle giống như những sứ giả lấy thông tin từ các nguồn bên ngoài và đưa nó vào blockchain một cách an toàn, và có thể tin tưởng được.

image 8 - quochung.cyou PTIT

Chainlink đảm bảo rằng dữ liệu từ thế giới bên ngoài đến được với hợp đồng thông minh của blockchain một cách an toàn và đáng tin cậy. Vì vậy, nếu hợp đồng thông minh của bạn phụ thuộc vào thông tin thế giới thực,ví dụ như dữ liệu thời tiết, giá cả chứng khoán hiện tại, …, các oracle của Chainlink cung cấp một cách đáng tin cậy để lấy thông tin đó lên blockchain.

Hợp đồng thông minh sau đó có thể thực thi dựa trên dữ liệu thời gian thực được cung cấp, cho dù là chuyển tiền khi đáp ứng được những điều kiện nhất định, hay xác nhận xảy ra một sự kiện. Chainlink đảm bảo thông tin này chính xác và quy trình là phi tập trung, nên không có thực thể đơn lẻ nào có thể thao túng dữ liệu—cũng giống như không có một người đơn lẻ nào có thể bí mật thay đổi giờ làm việc đã theo dõi của mọi người trong bảng tính chia sẻ của chúng ta mà không bị người khác phát hiện.

Ngoài ra còn một số vấn đề khác sẽ thảo luận ở dưới.


Vấn đề “oracle problem”

image 5 - quochung.cyou PTIT
- Trong blockchain, hợp đồng thông minh không thể truy cập trực tiếp vào dữ liệu từ bên ngoài mà cần thông qua một bên thứ ba, gọi là "oracle". Tuy nhiên, việc tin tưởng vào một bên thứ ba có thể gây ra rủi ro cho hợp đồng thông minh. Đó chính là vấn đề "oracle problem".
- Sự bảo mật của blockchain được bảo vệ nhờ nhiều các "xác thực" trên nhiều máy khác nhau, phi tập trung. Tuy nhiên, khi dữ liệu từ bên ngoài được đưa vào, nó có thể bị "tấn công" từ bên ngoài, gây ra rủi ro cho hợp đồng thông minh.

Centralized Oracle Problem

image 6 - quochung.cyou PTIT

Cơ chế oracle blockchain sử dụng một node tập trung để cung cấp dữ liệu cho hợp đồng thông minh điều này cũng tạo ra 1 SPOF (Single Point of Failure), tức là, nếu điểm này bị quá tải, sập, hay có vấn đề thì toàn hệ thống bị chết. Điều này vô tình làm mất đi mục đích của ứng dụng blockchain phi tập trung, khi mà ta không tập trung dữ liệu, hay xử lý vào 1 chỗ. Nếu oracle duy nhất không hoạt động, thì hợp đồng thông minh sẽ không thể tiếp cận với dữ liệu cần thiết để thực thi hoặc sẽ thực hiện không chính xác dựa trên dữ liệu cũ.

Thậm chí tồi tệ hơn, nếu oracle duy nhất bị lỗi, thì dữ liệu được gửi lên chuỗi có thể hoàn toàn sai lệch và dẫn đến hợp đồng thông minh thực hiện những kết quả hoàn toàn sai. Điều này thường được gọi là vấn đề “garbage in, garbage out” nơi mà đầu vào xấu dẫn đến đầu ra xấu. Bên cạnh đó, vì giao dịch blockchain được tự động hóa và không thể thay đổi, một kết quả hợp đồng thông minh dựa trên dữ liệu sai lạc không thể được đảo ngược, có nghĩa là tiền của người dùng có thể bị mất vĩnh viễn.

image 7 - quochung.cyou PTIT

Việc thực sự vượt qua vấn đề oracle đòi hỏi phải có oracle phi tập trung để ngăn chặn việc lỗi, hỏng dữ liệu, hay node hoạt động không chính xác hay ngừng hoạt động. Mạng Lưới Oracle Phi Tập Trung, hoặc gọi tắt là DON (Decentralized Oracle Network), kết hợp nhiều nút oracle độc lập và nhiều nguồn dữ liệu đáng tin cậy để thiết lập sự phi tập trung từ đầu đến cuối

[BlockChain] P1: Tìm hiểu cơ bản về Blockchain, ví dụ thực tiễn

This entry is part 1 of 2 in the series Blockchain

1. Blockchain là gì?

Blockchain là một hệ thống lưu trữ dữ liệu phân tán, mà mỗi block dữ liệu được liên kết với nhau thông qua mã hóa. Mỗi block chứa thông tin về giao dịch, và thông tin về block trước đó. Dữ liệu có sự nhất quán theo trình tự thời gian vì bạn không thể xóa hoặc sửa chuỗi mà không có sự đồng thuận từ mạng lưới. Vì thế, bạn có thể sử dụng công nghệ Blockchain để tạo ra một sổ cái không thể biến đổi hay chỉnh sửa để theo dõi các đơn hàng, khoản thanh toán, tài khoản và những giao dịch khác. Hệ thống chuỗi khối có những cơ chế tích hợp để ngăn chặn các mục nhập giao dịch trái phép và tạo sự nhất quán trong chế độ xem chung của các giao dịch này.

image - quochung.cyou PTIT

Một số đặc điểm của Blockchain:

  • Phân tán: Dữ liệu được lưu trữ trên nhiều máy chủ khác nhau.
  • An toàn: Dữ liệu được mã hóa và không thể thay đổi.
  • Độc lập: Không cần sự can thiệp của bên thứ ba.
  • Bảo mật: Dữ liệu được phân quyền và mã hóa.
  • Trong suốt: Mọi giao dịch đều được lưu trữ và công khai.
  • Tiết kiệm: Giảm chi phí vận hành và tăng hiệu quả.
  • Dễ dàng sử dụng: Không cần kiến thức chuyên sâu về công nghệ.
  • Tính khả chuyển: Dễ dàng mở rộng và phát triển.
  • Tính nhất quán: Mọi giao dịch đều được xác nhận và chứng thực.
  • Tính đồng thuận: Mọi giao dịch đều được thông qua một quy trình đồng thuận.

Ví dụ thực tế

image 2 - quochung.cyou PTIT

Làm việc trên SpreadSheet

  • Trong một công ty, mọi nhân viên đều có quyền truy cập vào một bảng tính chung, và có thể thêm, sửa, xóa dữ liệu trên bảng tính đó.
  • Mỗi thay đổi trên bảng tính sẽ được lưu trữ và công khai cho tất cả mọi người xem. Khi muốn thay đổi dữ liệu, mọi người phải thông qua một quy trình xác nhận. Quy trình này có thể là sự đồng thuận của tất cả mọi người, hoặc là sự xác nhận của một số người quản lý.
  • Sau khi quy trình xác nhận được hoàn tất, dữ liệu mới sẽ được cập nhật lên bảng tính chung, và mọi người có thể xem lại lịch sử thay đổi của dữ liệu.
istockphoto 1366116758 612x612 1 - quochung.cyou PTIT
African American Office Employee Auditor Using Spreadsheet

=> Không khó để nhận ra rằng, bảng tính chung này chính là một ví dụ về Blockchain. Mỗi block dữ liệu tương ứng với một dòng dữ liệu trên bảng tính, và mỗi thay đổi trên bảng tính tương ứng với một giao dịch trên Blockchain.
– Không ai có thể thay đổi dữ liệu cũ, mà chỉ có thể thêm dữ liệu mới. Mỗi giao dịch đều được lưu trữ và công khai, và mọi người đều có thể xem lại lịch sử thay đổi của dữ liệu. Việc xác nhận giao dịch cũng tương tự như quy trình xác nhận trên bảng tính chung.

Tóm lược

Blockchain giống như spreadsheet được chia sẻ này. Nó được phân tán trên nhiều máy tính (nút) trên khắp thế giới. Mỗi khi một giao dịch xảy ra, nó được thêm vào một ‘khối’, tương tự như một hàng mới trong bảng tính của chúng ta. Nếu đa số các nút đồng ý rằng giao dịch là hợp lệ, khối sẽ được niêm phong mật mã và thêm vào chuỗi các giao dịch đã được xác nhận trước đó. Do đó, có cái tên “blockchain”.

Bản chất phân quyền của blockchain khiến nó khó bị chỉnh sửa dữ liệu lịch sử. Nó cũng rất minh bạch, bất kỳ ai tham gia vào mạng lưới đều có thể xem toàn bộ blockchain. Hơn nữa, dữ liệu được bảo vệ bằng các nguyên tắc mật mã, làm cho nó trở nên không thể tấn công hay thay đổi

JPA là gì? Phân biệt và làm rõ Hibernate, Spring Data JPA, JDBC, ORM

Sơ lược định nghĩa JPA

image 12 - quochung.cyou PTIT
  • JPA, hay còn được gọi là Java Persistence API. Sau này được đổi tên thành Jakarta Persistence API
  • JPA giải quyết các vấn đề trong quản lý quan hệ giữa các thực thể, giúp chúng ta map những object Java (POJO – Plain Old Java OBject) thành những bảng trong database, đây là persistence frameworks được sử dụng nhiều nhất trong Java
  • Để hiểu sâu thêm, hãy đi thêm vào 1 số định nghĩa liên quan

Persistence là gì?

image 13 - quochung.cyou PTIT
  • Java Persistence API, Java là tên ngôn ngữ, API ám chỉ rằng đây là một framework cung cấp các api, các logic mà ta dễ dàng sử dụng lại giúp tăng tốc độ phát triển ứng dụng
  • Vậy Persistence là gì?
  • Hầu hết toàn bộ các ứng dụng yêu cầu ta cần có persistent data (dữ liệu lâu dài). Persistence là một trong những concept nền tảng trong công nghệ phần mềm. Gần như toàn bộ hệ thống thông tin đều cần lưu trữ những dữ liệu nào đó cho hệ thống. Object persistence nghĩa là các thực thể có thể “sống lâu” hơn các chương trình, có thể lưu trữ trong các nơi quản lý dữ liệu và có thể khởi tạo lại trong chương trình vào thời điểm nào đó.
  • Ví dụ đơn giản, trong một web mua bán thương mại điện tử chẳng hạn, dữ liệu trong hệ thống thường là các thông tin về sản phẩm, giá bán, nơi bán, … những dữ liệu này luôn được lưu trữ, kể cả web có thể là bị đóng vài phút, nâng cấp lên, … những dữ liệu này luôn “sống lâu” hơn các chương trình code
  • Khi nói về persistence trong Java, ta thường nói về việc map và lưu trữ các thực thể trong database bằng SQL

Làm việc với cơ sở dữ liệu quan hệ bằng Java qua SQL

  • Khi làm việc với các database trong ứng dụng Java, hiểu đơn giản thì ta sẽ ra 1 câu lệnh SQL vào database bằng cách nào đó với Java chứ ta không cần viết chay truy vấn vào thẳng cơ sở dữ liệu nữa.
  • Ban đầu, ta có JDBC (Java Database Connectivity API) hỗ trợ việc ra các câu lệnh SQL vào một cơ sở dữ liệu. Ta sẽ thực hiện câu lệnh truy vấn, nhận được dữ liệu trả về, sau đó xào nấu nó, …
  • Tuy nhiên các công việc này nhìn chung khá gần theo hướng dữ liệu, data, chứ không có quá nhiều về phần mềm Java. Chúng ta thường muốn có cách nào đó để lấy dữ liệu nhanh từ database, và không phải làm các công việc lặp lại này.
  • Các câu lệnh truy vấn đa phần thường dễ bị lặp lại. Giả sử bạn có 1 hệ thống quản lý sinh viên, môn học, lớp học, giáo viên, … Như thông thường, ta phải viết câu lệnh sql để lấy toàn bộ sinh viên, lấy thông tin 1 sinh viên theo tên, theo tuổi, thêm 1 sinh viên, xoá 1 sinh viên, …. mọi thứ thủ công. Rồi làm y vậy với các đối tượng giáo viên, lớp học, …. Nhìn chung các task này lặp đi lặp lại và tốn thời gian, công sức, chưa tính đến nhiều vấn đề bảo mật, viết sai bug khi viết sql chay như vậy.
  • Hiển nhiên, 1 số thời điểm ta vẫn cần viết sql để custom theo ý mình cho các vấn đề hiệu năng, tuỳ biến, …. nhưng nếu có cách nào đó để giảm thiểu các công việc làm việc với database hơn.
image 14 - quochung.cyou PTIT

ORM

image 15 - quochung.cyou PTIT
  • Ngắn gọn thì, object relational mapping (ORM) là một cách để tự động, đóng gói để map qua lại giữa các dữ liệu database và các class trong Java. Tức là một cái ở giữa để chuyển hoá giữa 1 table lưu thông tin SinhVien với 1 class SinhVien trong java chẳng hạn.

JPA, Hibernate, Spring Data là gì

JPA là gì

  • Lúc này JPA như đã định nghĩa cơ bản bên trên, JPA sẽ là một bản vẽ, định nghĩa ta phải làm gì để lưu trữ và làm việc với object như 1 ORM bên trên, bao gồm việc lấy dữ liệu object từ 1 database, rồi biến nó thành 1 object được tạo ra từ 1 class Java chẳng hạn.
  • Hibernate sẽ là một tầng bên trên, triển khai từ JPA, định nghĩa logic code thực sự là sẽ triển khai như thế nào.
image 16 - quochung.cyou PTIT
  • Có thể ví dụ đơn giản. JPA sẽ chứa rất nhiều hàm là để làm việc thì ta sẽ cần có các hàm lấy dữ liệu theo trường nào đó, tìm dữ liệu theo trường nào đó (select + filter sql), xoá 1 row trong database, …

Hibernate là gì

  • Hibernate là 1 JPA Provider, tức là một Provider, một cái triển khai “JPA”
  • Hibernate sẽ implement interface đó, và là cái có code logic triển khai các hàm trên, tự động sinh ra các câu lệnh sql theo nhu cầu. Tức là ta chỉ cần gọi hàm getAllByName() gì đó, hibernate sẽ tự sinh truy vấn sql, chạy xuống JDBC rồi database để làm việc, ta không cần tự viết sql query đó nữa. Ngoài ra, sau khi lấy dữ liệu xong, nó sẽ tự map dữ liệu database thành các object Java luôn để làm việc.
image 17 - quochung.cyou PTIT
  • Ngoài ra Hibernate còn có nhiều chức năng như đảm bảo phiên trong database, session, ….

Spring Data JPA

image 19 - quochung.cyou PTIT
  • Spring Data JPA là 1 tầng bên trên nữa triển khai Hibernate, có những chức năng cùng framework Spring, cho phép mở ra nhiều khả năng hơn nữa như từ việc đặt tên hàm có thể tạo được các query phức tạp, …
  • Chính xác thì Spring Data JPA có thể chạy với các “JPA Provider” khác nhau, tức là một số khác nào triển khai lại JPA có thể dùng với Spring Data JPA
image 18 - quochung.cyou PTIT

Tổng kết

JPA định nghĩa các phần sau

  • Một phương tiện chỉ định việc ánh xạ, map giữa các dữ liệu persistent trong database và thông tin của nó với các class trong Java. JPA sử dụng rất nhiều Java annotations để làm việc này, ngoài ra ta có thể viết nó trong file XML (thêm minh hoạ bên dưới)
  • API để thực hiện các thao tác CRUD cơ bản với các class java và có thể gọi xuống database để làm việc tương tự. (CRUD – Create/Tạo, Read/Đọc, Update/Cập nhật, Delete/Xoá)
  • Thực hiện các thao tác transaction, có thể lấy dữ liệu theo association (ví dụ 1 sinh viên có nhiều môn học, có thể hiểu việc đó và khi lấy 1 sinh viên sẽ lấy luôn các môn học), thêm 1 số tính năng tối ưu khác, các chiến lược cache, …

Hibernate triển khai JPA và làm các công việc sau

  • Hiệu suất – Giảm thiểu nhiều công việc lặp đi lặp lại để query dữ liệu, giúp ta có thêm thời gian tập trung vào code logic bên trên hơn
  • Bảo trì – Do tự động mapping (ORM) của hibernate, giúp giảm thiểu số lượng code, giúp hệ thống dễ hiểu hơn, dễ bảo trì hơn.
  • Hiệu năng – Nhìn chung thì việc tự viết sql trong các case đặc biệt giúp ta dễ control và có performance mong muốn hơn, tuy nhiên trong một số tác vụ thường thấy, hibernate giúp hiệu năng tốt hơn, tự động, hỗ trợ các cơ chế caching ở tầng ứng dụng
  • Độc lập – Hibernate có thể làm việc với Postgres, MySQL …. mà không phụ thuộc vào 1 nền tảng hay sql của nền tảng đó

[Java Memory 2] Cách Garbage Collector Java giải phóng bộ nhớ (Stop The World, Reference Counting, Sweep, ..)

This entry is part 2 of 2 in the series Java Memory

Trở thành “mồi” của GC (Garbage Collector)

  • Ta đã biết, khi một đối tượng không còn tác dụng nữa, thì chúng sẽ bị GC dọn đi để tiết kiệm bộ nhớ, nhưng thế nào là “hết tác dụng” ?
  • Có thể tóm gọn bằng một câu cơ bản “Object tại heap sẽ không còn hữu dụng nếu chúng mất kết nối tới stack”
  • Object mất kết nối tới stack khi không còn một con trỏ nào chỉ tới chúng nữa cả, hãy xem thử đoạn code sau:
Object o = new Object();
System.out.println(o);
o = null; 
  • Ở dòng đầu tiên, ta tạo một đối tượng o, o lúc này thực chất đang chỉ tới giá trị thực sự của đối tượng ta vừa tạo ra trong heap
  • Khi in thử đối tượng này ra, ta có output theo mẫu sau
java.lang.Object@4617c264
  • Tiếp theo, ta cập nhật o thành null. Lúc này, đối tượng nằm ở heap không còn cái gì trỏ đến nó nữa, và không gì có thể truy cập lại nó nữa, và lúc này nó trở thành mồi của GC

Vấn đề không đơn giản

  • Ví dụ trên khá đơn giản do chỉ có 1 object, vấn đề sẽ phức tạp hơn khi ta tiếp cận với nhiều object liên kết với nhau 1 lúc
image 31 - quochung.cyou PTIT
  • Giả sử với 6 dòng lệnh sau, ta sẽ đi qua từng dòng một
image 32 - quochung.cyou PTIT
  • Sau 4 dòng đầu tiên, stack và heap của chúng ta có dạng như sau. Tại stack là các biến giữ con trỏ tới các giá trị thực trong heap.
image 33 - quochung.cyou PTIT

  • Sau dòng thứ 5, ta có hình như sau. Ta thấy, dù sau khi đã cập nhật p1 thành null với mong muốn GC sẽ dọn object này, nhưng thực tế, ta thấy ta vẫn có thể truy cập vào p1 bằng person.get(1) qua list persons, tức là ta vẫn có cách reach đến điểm này
image 34 - quochung.cyou PTIT

  • Chỉ sau khi set cả list thành null, ta mới mất hoàn toàn liên hệ với p1
  • => Không khó để đánh giá các phần tử nào sẽ được Garbage Collector dọn khi bạn đã hiểu về quan hệ bên trên. Dễ dàng thấy, sau 6 bước, p1 mất hoàn toàn liên hệ với stack và sẽ được dọn
  • Tuy nhiên, đó là ta nhìn thủ công, còn để garbage collector biết cái nào còn kết nối với stack sẽ tốn một lượng thời gian, và nó sẽ làm chậm hệ thống lại (chi tiết ở bên dưới). Có nhiều cách để làm điều này, và ta sẽ thảo luận ở bên dưới

Đánh dấu đệ quy

  • Ta sẽ thử đánh dấu các object còn live và object nào có thể bị dọn bởi GC. Dễ dàng, ta thêm 1 bit để dánh dấu xem chúng có còn kết nối với stack hay không. Khi tạo, ta sẽ để bit là 0, và khi ở giai đoạn đánh dấu, object là 0 sẽ bị xoá đi, còn nếu vẫn còn sử dụng, ta sẽ cập nhật nó thành 1
  • Tuy nhiên, heap và stack thay đổi liên tục. Cách đánh dấu được triển khai tuỳ thuộc vào phiên bản Java và GC bạn sử dụng, tuy nhiên, ta sẽ thử xem cách hệ thống đánh từ stack, hãy thử xem ví dụ sau
image 35 - quochung.cyou PTIT
  • Đầu tiên toàn bộ phần tử sẽ được để là 0
image 36 - quochung.cyou PTIT
  • Sau đó, toàn bộ các phần tử có kết nối trực tiếp tới stack được đánh thành 1
image 37 - quochung.cyou PTIT
  • Tuy nhiên, do p1 vẫn có thể truy cập từ danh sách persons, và hơn nữa, ta không thể cứ dọn những gì vẫn còn kết nối. Vì vậy ta cần một cách duyệt đơn giản, với điểm khởi đầu từ các điểm đang = 1, sau đó đi đến mọi quan hệ của nó và đánh chúng thành 1, rồi tiếp tục đệ quy.
  • Các thuật toán đánh dấu đóng vai trò quan trọng trong giai đoạn đánh dấu, đầu tiên thử đi qua cách stop-the-world

Kĩ thuật Stop-The-World – Dừng thế giới

image 38 - quochung.cyou PTIT
  • Với cách đánh dấu trên, ta nhận thấy. Nếu một phần tử được tạo trong quãng đánh dấu, nó sẽ không còn đúng nữa.
  • Vì vây, có một solution đơn giản là ta sẽ dừng mọi luồng khác và chỉ chạy luồng đánh dấu của cả chương trình, điều này sẽ rất ảnh hưởng đến hiệu năng. Ta sẽ thử xem các thuật toán tiếp theo.

Kĩ thuật Reference counting – Đếm liên hệ

image 39 - quochung.cyou PTIT

  • Một cách triển khai khác là đếm số lần một object được trỏ đến. Mỗi object sẽ chứa số lần object được trỏ như một thông số mà nó nắm giữ. Như vậy, GC chỉ việc quét qua và xoá mọi object có 0 lần bị nắm giữ. Cách này sẽ không cần stop-the-world như cách đánh số đệ quy nữa, vì khi object được tạo ra giữa chừng lúc đánh số lần trỏ thì nó vẫn đều là 1 rồi.
  • Tuy nhiên, nó có một điểm yếu là sẽ tạo ra island of isolation, hay các vùng, một tập các object tự trỏ nhau nhưng mà thực tế không có kết nối tới stack
image 40 - quochung.cyou PTIT

Giải phóng bộ nhớ

  • Cách thức làm sao để đánh dấu các object sẽ bị xoá sẽ được quyết định khác nhau bởi phiên bản Java và các kiểu GC khác nhau.
  • Giả sử ta đã đánh dấu được hết các object sẽ có thể bị xoá, tuy nhiên việc xoá chúng đi cũng không phải một quá trình đơn giản
  • Việc xoá object được gọi là sweeping by garbage collector, trong bài viết sẽ mention 3 cách thức sweeping khác nhau
    • Normal sweeping
    • Sweeping with compacting
    • Sweeping with copying

Normal sweeping

image 41 - quochung.cyou PTIT
  • Hình ảnh trên thể hiện các khối bộ nhớ trong ram, các vùng có dấu X là các object đã được đánh dấu và chuẩn bị bị xoá
image 42 - quochung.cyou PTIT
  • Sau khi xoá đi, vùng nhớ của ta có dạng như sau, dễ thấy, điều này dẫn tới một triệu chứng có tên Fragmentation

Fragmentation trong Java Garbage Collector

image 43 - quochung.cyou PTIT
  • Lúc này, vì các vùng trống nằm ở giữa các vùng bị chiếm dụng, nên ta chỉ có thể thêm các bộ nhớ nhỏ hơn hoặc bằng vùng vào các vùng trống. Điều này sẽ dẫn tới 1 vài vấn đề khi ta muốn cấp phát một bộ nhớ lớn hơn
image 44 - quochung.cyou PTIT
  • Giả dụ với trường hợp cấp phát một vùng nhớ lớn hơn các khe trống như ảnh trên, khi cấp phát vào, ta chỉ có thể xếp như sau:
image 45 - quochung.cyou PTIT
  • Dù tổng thể bộ nhớ còn trống ta vẫn đủ để xếp vùng nhớ, nhưng thực tế thì ta không có một vùng nhớ liên tiếp nào chứa đủ vùng nhớ mới này. Và việc này sẽ throw ra 1 runtime exception là OutOfMemoryError.

Ưu nhược điểm của Normal sweeping

  • Normal Sweeping là một kĩ thuật giải phóng vùng nhớ ngây thơ, khá tiện dụng và đơn giản. Tuy nhiên sẽ dẫn tới các vùng nhớ bị phân mảnh. Quá trình này phù hợp khi ta có nhiều bộ nhớ, và ta chỉ cần nhanh chóng dọn bộ nhớ đi. Khi mà lượng vùng nhớ còn trống nhỏ hơn, ta sẽ prefer các kĩ thuật khác

Sweeping with compacting

  • Sweeping with compacting là một quá trình 2 bước. Đầu tiên, chúng vẫn giải phóng bộ nhớ, nhưng sau đó ta sẽ thực hiện thêm 1 bước gọi là compacting (thu gọn), ta sẽ dời toàn bộ vùng nhớ về phía đầu để đảm bảo không có bất kì khoảng trống nào ở giữa
image 46 - quochung.cyou PTIT

Ưu nhược điểm Sweeping with compacting

  • Cách làm này giúp bộ nhớ không còn bị phân mảnh như thông thường, tuy nhiên việc di chuyển các vùng nhớ về đầu là một quá trình tốn kém, vì gần như với lượng vùng nhớ nhỏ và trải dài nhiều, ta sẽ phải copy và di chuyển khá nhiều trên vùng nhớ.

Sweeping with copying

image 50 - quochung.cyou PTIT
  • Ở cách làm này, ta sẽ cần 2 vùng nhớ khác nhau. Ta sẽ không trực tiếp xoá các vùng nhớ bị đánh dấu là xoá đi, mà ta sẽ copy các vùng nhớ k bị xoá vào vùng nhớ mới
image 51 - quochung.cyou PTIT
  • Sau đó mới thực hiện xoá toàn bộ vùng nhớ ở vùng nhớ cũ
image 52 - quochung.cyou PTIT

Ưu nhược điểm của Sweeping with copying

  • Dữ liệu không bị phân mảnh
  • Về hiệu năng thì nhanh hơn compacting, do không phải thực hiện nhiều công đoạn tính toán khi di chuyển, mà chỉ copy nhanh chóng sang vùng mới đang trống hoàn toàn (ở compacting ta ví dụ di chuyển vùng 30-50 sang vùng 0-10, đầu tiên ta phải di 30-40, sau đó lại di vùng 10-20 đi, …. và khó khăn hơn nhiều)
  • Tuy nhiên cần nhiều bộ nhớ hơn vào cùng 1 thời điểm, cần lượng bộ nhớ trữ còn lại đủ nhiều để di chuyển.

Chung kết ACM/ICPC PTIT 2023

Vào ngày 24/09/2022, Học viện Công nghệ Bưu Chính Viễn Thông đã tổ chức kỳ thi chung kết ICPC PTIT 2022. Sự kiện này đã thu hút 41 đội xuất sắc từ hơn 180 đội tham gia (không tính miền Nam). Kỳ thi đã diễn ra tại sảnh A2 của Học viện. Trong kỳ thi năm 2023, có sự tham gia đáng kể của các sinh viên khoá D22 và E22 (năm nhất). Đây là năm thứ hai mình tham gia cuộc thi này, và từ kinh nghiệm năm ngoái, mình đã có một số kinh nghiệm nhất định :v

image 18 - quochung.cyou PTIT

Đội của chúng mình, có tên là “ProPTIT. Ba bà đi bán lợn con”, gồm ba thành viên: Nguyễn Quốc Hưng (E2105), Nguyễn Mai Phương (D21CN01) và Lê Trí Tâm (D21). Sau khi đứng top 20 trong gần cả cuộc thi, chúng mình đã lội ngược dòng vào 15 phút cuối để giải lên 5 bài và giành được top 4 chung cuộc.

Đề thi năm 2023 có nhiều thay đổi so với 2022, nhìn chung các bài năm nay có nhiều đổi mới, tập trung vào giải thuật nhiều hơn, độ khó cũng khó hơn hẳn năm ngoái. Chắc đây cũng là một phần lí do số sinh viên năm nhất vào chung kết khá ít, chỉ có khoảng 1-2 bài cơ bản và còn lại là các bài với các thuật toán kinh điển như Quy hoạch động, dijkstra, greedy.

Một vài hình ảnh đáng chú ý trong kì thi

Thầy Cường và thầy Sơn tại vòng loại kì thi
Đội hình CLB Lập Trình PTIT checkin vòng loại
image 21 - quochung.cyou PTIT
khu vực thi 2023 tại hội trường a2
image 23 - quochung.cyou PTIT
image 24 - quochung.cyou PTIT

Tìm hiểu Consistent hashing (Ánh xạ nhất quán) – Xử lí dữ liệu phân tán

image 60 - quochung.cyou PTIT
  • Consistent hashing (Ánh xạ nhất quán) thường được sử dụng trong các hệ thống phân tán.
  • Trước tiên, để giải thích một số term, thuật ngữ mà các bạn còn có thể confuse, chúng ta sẽ đi từng phần một

Hệ thống phân tán

image 61 - quochung.cyou PTIT
  • Hiểu đơn giản, tưởng tượng việc bạn truy cập đến server như vào 1 cửa hàng mua đồ vậy. Nếu một ngày bình thường, bạn gọi món, đồ ăn đến rất nhanh, đơn giản, phục vụ tốt. Nhưng vào giờ cao điểm, khi chỉ có 1 phục vụ quán, quá nhiều người gọi làm phục vụ quán không đỡ kịp, cửa hàng quá tải và ai cũng có đồ ăn rất chậm.
  • => Để xử lí có nhiều cách, nhưng dễ dàng nhất, chỉ cần tuyển thêm nhiều phục vụ hơn thôi? Quy chiếu về server, ta chỉ cần có nhiều server con khác nhau, và chia nhỏ các yêu cầu của khách hàng đến các server một cách đồng đều, hay chia nhỏ các database, …. Lúc đó, ta có hệ thống phân tán.

Ánh xạ là gì? Tại sao cần ánh xạ (hashing) ?

  • Lúc này ta có một bài toán cần giải quyết, làm sao để chia các yêu cầu của khách hàng vào các server khác nhau, sao cho nó đồng đều? Không được có server làm quá nhiều việc, server làm quá ít việc, ta mong muốn có mọi server đều xử lí đều nhất có thể.
  • Một cách làm phổ biến và dễ hiểu là Round-robin, hay ánh xạ theo phần dư
ServerIndex = hash_function(key) % N
  • Tức là ta sẽ đánh số các request theo thứ tự bằng cách chia dư. Ví dụ ta có 5 server, thì chia dư số thứ tự cho 5
image 62 - quochung.cyou PTIT
  • Ánh xạ chia dư cho 4 server như vậy thì request thứ 1 và 5 sẽ vào ô 1, sau đó là request 0,2 , rồi request 7,6 , …
  • Nghe thì có vẻ rất lí tưởng, request sẽ được chia đều cho các server. Nhưng đó là trường hợp số lượng server không đổi trong “thế giới lí tưởng”. Cuộc sống thực tế thì không đẹp như vậy, chúng ta dễ dàng gặp phải trường hợp sếp bỗng muốn đang từ 4 server, scale lên 15 server. Hay 4 server giảm xuống còn 2 server. Hay 10 server một ngày bỗng chết, mất điện server 1,5,6.
image 63 - quochung.cyou PTIT
  • Lúc này ta cần bê tập dữ liệu từ server sai số thứ tự, rồi đánh số lại theo số lượng server mới. Lúc này rất dễ xảy ra trường hợp server thì bị quá tải, server thì lại rảnh không.
  • Đánh giá vấn đề: Việc chuyển dữ liệu từ những server hỏng, hoặc chuyển ra server mới khi scaleup/down là thiết yếu. Nhưng ta cần một phương pháp để số lượng phần tử cần di chuyển ít nhất có thể

Consistent hashing (Ánh xạ nhất quán)

Định nghĩa

“Consistent hashing is a special kind of hashing technique such that when a hash table is resized, only n/m keys need to be remapped on average where n is the number of keys and m is the number of slots. In contrast, in most traditional hash tables, a change in the number of array slots causes nearly all keys to be remapped because the mapping between the keys and the slots is defined by a modular operation.”

Ánh xạ nhất quán là một kĩ thuật ánh xạ để khi mà bảng ánh xạ thay đổi số lượng, chỉ có n/m từ khoá sẽ cần phải đánh số lại trung bình. Với n là số lượng dữ liệu (trong ví dụ trên là request), và m là số slot (ví dụ trên là server). Điều này tốt hơn ánh xạ chia dư khi mà gần như toàn bộ dữ liệu phải đánh lại hết vì tất cả số dư thường sẽ thay đổi khi m thay đổi.

Một số từ khoá

image 64 - quochung.cyou PTIT
  • Gọi f() là hàm băm, phương trình sẽ cho ra một mã gì đó khi ta truyền vào 1 giá trị. Mỗi phương trình thì luôn có vùng giá trị đầu ra (hash space) nhất định. Ví dụ: chia dư cho m thì vùng giá trị là từ 0 -> m-1. hay SHA-1 thì là từ 0 -> 2^160-1. Ta sẽ có (hash ring) vòng băm tương ứng

Các bước

  • Tiến hành hash các server của chúng ta thành một số nguyên trong hash ring được định nghĩa trước. Khoảng số này tuỳ vào người thiết kế hệ thống tự cân nhắc số lượng server tối đa mà hệ thống sẽ lên.
  • Sau khi có danh sách mapping giữa các node, ta sẽ tiến hành mapping key của data tới các node bằng cách
    • hash giá trị của key thành một số nguyên
    • Di chuyển nó liên tục trong vòng tròn số nguyên (hash ring) đã được tạo theo kim đồng hồ cho tới khi nó quay lại hash key của node đầu tiên nó gặp (đi 1 vòng). Ghi dữ liệu
  • Để dễ hình dung hơn, hãy xem hình ảnh sau
image 66 - quochung.cyou PTIT
  • Để quyết định request nào sẽ được phân bổ vào node nào. Thì ví dụ request có mã là 1000, nó sẽ cứ đi trên vòng tròn bảng giá trị trên và tìm node đầu tiên có mã lớn hơn 1000. nếu nó là lớn nhất rồi thì nó sẽ vòng lại node đầu tiên.
  • Ngoài ra, ví dụ trên hình ảnh trên, ta chỉ có node 1-5, nhưng ta sẽ tạo các “virtual node”, hay node ảo để băm cái vòng của chúng ta nhỏ hơn nữa, và các khoảng của node ảo sẽ quy định nó vào node thật sự nào.
  • Bằng một cách nói nào đó, mỗi server sẽ xử lí một “cung” trên đường tròn

Consistent hashing xử lí vấn đề scale như thế nào

  • Ta sẽ quay lại vấn đề, khi một node nào đó bị sập. Thì consistent hashing sẽ giải quyết bài toán đó như thế nào?
  • Solution nghe ra lại rất đơn giản, lúc này thì các khoảng vòng cung sẽ được kéo rộng ra, các request sẽ tự đi tìm đến vị trí note tiếp theo
image 67 - quochung.cyou PTIT
  • Rõ ràng, ta thấy lúc này chỉ những request ở vòng cung phía trước sẽ cần thay đổi mapping lại. Còn theo cách chia modulo, thì do số dư thường sẽ thay đổi gần như toàn bộ các số, ta sẽ phải di chuyển rất nhiều keys (Request)

Triển khai thuật toán

  • Cùng nhìn lại, chúng ta cần những gì để triển khai thuật toán này?
    • Ta cần một mảng ánh xạ quy đổi ra các node trên hash ring (vòng giá trị)
    • Một map để phân bổ request nào vào node nào
  • Như vạy, để phân bổ request vào các node, ta cần một cơ chế dạng
    • Một cách tìm kiếm nhanh node đầu tiên có giá trị lớn hơn mã của request hiện tại. Do mã của node được trải phẳng trên một khoảng tịnh tiến, dễ dàng, ta có thể triển khai tìm kiếm nhị phân để tìm node đầu tiên có mã lớn hơn bằng mã của request (Lower_bound)
    • Từ mã của node, tìm ra node thực sự để điều hướng
  • Thay đổi khi hash ring thay đổi
    • Để xác định những request nào cần di chuyển, có cách khá đơn giản là ta sẽ lặp và kiểm tra toàn bộ request, sau đó xác định cái nào bị sai để chuyển nó sang node tiếp theo trên vòng. Nhưng cách này rõ ràng là cách “naive method”.
    • Để có thể triển khai với thời gian tối ưu hơn, ta có thể sử dụng một cấu trúc dữ liệu để xác định “khoảng ảnh hưởng”, nơi mà các key cần remap lại
    • Một lần nữa, ta có thể triển khai tìm kiếm nhị phân, bằng cách từ node bị xoá đi, ta dùng mã đó và quay ngược lại, sau đó tìm ra các điểm bị sai và cập nhật chúng cho đến khi đến 1 mã node hash khác.

Các câu hỏi thêm

  • Q: Khi nào nên sử dụng kỹ thuật consistent hashing này ?
  • A: Thông thường, ta sẽ sử dụng nó cho các hệ thống phân tán, nơi mà request thực sự đủ nhiều, và ta có nhiều server cần scaling và cần áp dụng để phân bổ request một cách đều. Amazon Dynamo cũng triển khai kĩ thuật này. Tuy nhiên, với các hệ thống nhỏ hơn, có thể dùng cách ánh xạ chia dư truyền thống, vì việc sử dụng hashing khó hơn cũng đi kèm độ phức tạp của hệ thống tăng lên và khó bảo trì.

  • Q: Tại sao lại gọi là consistent trong consistent hashing (nhất quán)
  • A: Vì khi có sự thay đổi về lượng server, ta không cần hashing lại toàn bộ các key

Tham khảo: