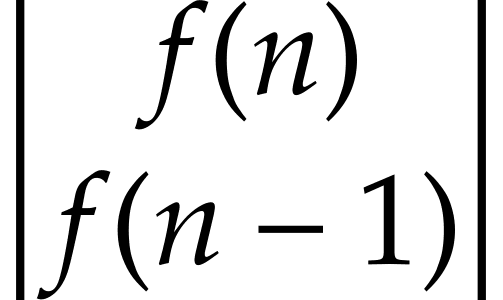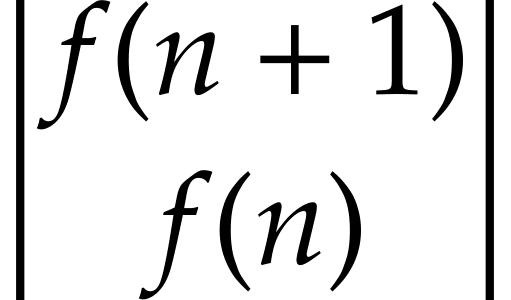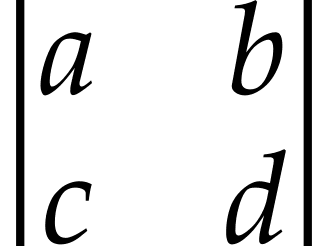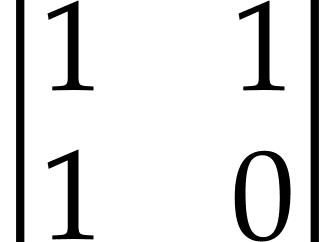Tìm hiểu về Segment Tree

Bài viết là bản dịch của: https://www.hackerearth.com/practice/notes/segment-tree-and-lazy-propagation/

Có rất nhiều bài toán yêu cầu thực hiện các truy vấn trên các đoạn, dãy số, các tập giá trị. Có thể kể đến như: “Tính tổng tất cả phần tử trong mảng từ vị trí l đến r“, hoặc “tìm phần tử bé nhất trong mảng từ vị trí l đến r“. Các bài toán như vậy có thể dễ dàng xử lí bằng các CTDL mạnh, trong đó có Segment Tree (Cây phân đoạn).

Segment Tree là gì ?

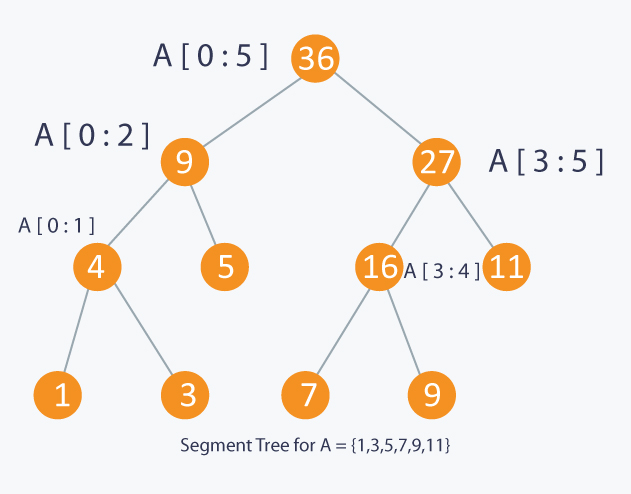
Segment Tree (Cây Phân Đoạn) là một cây nhị phân được dùng để lưu các phân đoạn, khoảng. Với mỗi nút của cây sẽ thể hiện một khoảng.

Ví dụ xét một mảng A có N phần tử và một Cây phân đoạn T:

  • Gốc của cây T sẽ biểu diễn cả mảng A[0:N-1]
  • Mỗi lá của cây T sẽ biểu diễn 1 phần tử nhỏ A[i] với 0 <= i < N
  • Mỗi nút khoảng của cây T biển diễn một khoảng tập hợp nhiều phần tử nhỏ A[i:j] với O <= i < j < N

Gốc của cây T biểu diễn cả mảng A[0:N-1]. Sau đó ta sẽ chia khoảng này thành 2 phần và nó sẽ là 2 nút con của gốc biểu diễn A[0:(N-1)/2] và A[(N-1)/2 + 1:(N-1)]. Các bước tiếp theo ta tiếp tục chia đôi khoảng này và tạo thành 2 nút con của nút đó và lặp lại.

Chiều cao của cây sẽ là Log(2,N) Có N lá biểu diễn N phần tử của mảng. Và số lượng nút là N – 1. Do đó tổng số lượng nút là 2*N – 1.

Sau khi đã xây dựng xong cây phân đoạn thì chúng ta không thể thay đổi cấu trúc của nó nữa. Cấu trúc của cây sẽ là cấu trúc tĩnh. Ta có thể cập nhật giá trị ở các nút nhưng không thể thay đổi cấu trúc của nó. Các thao tác trên Segment Tree thường được sử dụng bằng đệ quy, và có tính thuần đệ quy. Do có tính đệ quy tự nhiên, Segment Tree rất dễ cài đặt. Segment Tree cho ta hai thao tác chính

  • Cập nhật (Update): Thao tác này sẽ cập nhật một phần tử hoặc một khoảng trên mảng
  • Truy vấn (Query): Thao tác này sẽ lấy dữ liệu một khoảng hoặc một phần tử trên cây

Cài đặt

Vì Segment Tree là một cây nhị phân, ta có thể sử dụng một mảng tuyến tính một chiều để biểu diễn Segment Tree. Trong đa số các bài toán cần sử dụng Segment Tree, ta cần phải nghĩ “Làm sao để lưu nó trong một Segment Tree” ?

Ví dụ: Ta cần tìm tổng của toàn bộ phần tử trong mảng từ vị trí l đến r, thì với mỗi nút, ta sẽ lưu tổng của các con của chúng. Nếu ta cần tìm phần tử nhỏ nhất trong mảng từ vị trí l đến r, thì với mỗi nút (trừ nút lá), ta sẽ lưu phần tử nhỏ nhất của nút con của chúng.

Khi ta đã biết cần lưu cái gì trong một Segment Tree, ta có thể bắt đầu cài đặt cây bằng phương pháp đệ quy (từ dưới lên). Ta sẽ đi từ những nút lá và đi về gốc và cập nhật các thay đổi trên đường từ lá đến gốc. Lá sẽ chỉ biểu diễn một phần tử nhỏ. Ở mỗi bước ta sẽ ghép hai nút con thành một nút cha biểu diễn một khoảng. Việc ghép các nút con sẽ khác nhau ở các bài toán khác nhau. Và phần tử gốc sẽ biểu diễn cả mảng.

Để cập nhật (update),  ta đơn giản chỉ cần tìm nút lá chứa phần tử đó để cập nhật. Điều này có thể dễ dàng thực hiện bằng cách chọn đi sang trái hoặc phải tùy theo các nút chứa khoảng có chứa phần tử con đó không. Khi ta đã tìm nút lá , ta sẽ cập nhật lại theo cách từ dưới lên từ lá đó lên ngọn.

Để thực hiện truy vấn trên Segment Tree từ l đến r. Ta sẽ đệ quy từ gốc và kiểm tra xem có một khoảng nào hoàn toàn thuộc từ l đến r không. Nếu có một nút chứa đúng khoảng l – r, ta sẽ trả về giá trị nút đó. Ví dụ một mảng có 7 phần tử.

uSy PSP7fafZ5dPnwBm14ZXAhUtaFEvIVIzIOpR Vul5UUAQnZIgke0tkS1kxc4GirCs78ZzmsjzNzkkWurRyBcWWCOoxjudjRLjabOFoJHV TFQHwOA5OI2mOsNr55hM6xN5EqXcaZ0lTBP6XGMhudbLiK9XT4hTk4DYrejPO1Zsh5Kne0wrE0PgQkUrD5SX3 qRjmOgw - quochung.cyou PTIT
SeBNX kxK3OicJLrTBjxLOWu5eziF7LJkpfNQvGW23p 8WJl4Xc 1hdjdE8v6WYHubGFYZTSJ9itA1TrkDWvSutU OeEAOUZhE6 FnDFRghS n8oMT oW4dA1kthdRoffos1OFLutSf0s1zShgw7oFP0uR6kpDFiS - quochung.cyou PTIT

Sẽ dễ hiểu hơn với một vài ví dụ. Cho một mảng A có N phần tử và vài truy vấn. Có 2 kiểu truy vấn sau:

  • Update (Cập nhật): Tăng một phần tử ở vị trí idx một giá trị val
  • Query (Truy vấn): Lấy tổng từ L đến R sao cho 0 <= l <= r < N

Thuật toán ngây thơ:

Đây là một cách tiếp cận đơn giản nhất. Với truy vấn lấy tổng, ta sẽ chạy một vòng lặp từ l đến r để lấy tổng với độ phức tạp O(N). A[idx] += val sẽ cập nhật giá trị một phần tử với độ phức tạp O(1). Thuật toán này khá tốt nếu các thao tác cập nhật có nhiều và có rất rất ít thao tác lấy tổng.

Thuật toán ngây thơ 2:

Ở hướng này ta sẽ tính và lưu trước một mảng cộng dồn. Với mỗi truy vấn lấy tổng ta chỉ cần trả về (sum[r] – sum[l-1]) với độ phức tạp O(1). Nhưng để cập nhật, ta sẽ cần sửa lại giá trị của cả mảng cộng dồn với độ phức tạp O(N). Thuật toán này sẽ tốt nếu số lượng truy vấn có nhiều và có rất rất ít thao tác cập nhật.

Sử dụng Segment Tree:

Giờ hãy xem ta sẽ sử dụng Segment Tree như thế nào cho bài toán này. Như chúng ta đã biết mỗi nút sẽ biểu diễn một khoảng hoặc một đoạn. Ở bài toán này ta cần tìm tổng của toàn bộ phần tử trong một khoảng cho trước. Vậy ở mỗi nút ta sẽ cần lưu tổng của toàn bộ phần tử trong khoảng và được biểu diễn trong một nút. Để làm điều này, ta sẽ xây dựng một cây phân đoạn sử dụng đệ quy (từ dưới lên) như giải thích bên trên. Mỗi nút lá sẽ có một phần tử duy nhất. Tất cả nút khoảng sẽ là tổng của các nút con của chúng.

XGeX io80mcwedtHGFk46ENf HMu9NwmkBVouWRHismCbAzb2GROfhjpP5nrLcP210cx9E4cSfhxlP 1LXwKhG9Ep4PO2ENvKI0xehbH4 WnVjfA0D fGN5rs b4Tyt3IAwumAeWQ3kkSY1K9wMnTSzOZALlEf0WPSzJpZqd8o1G5WJEiRhkmMODF1ny1w6M8jfluuvkow - quochung.cyou PTIT

Như code bên trên ta sẽ đi từ nút gốc và đệ quy để xây dựng các nút con trái phải cho đến khi gặp phải nút lá Từ nút lá ta sẽ đệ quy ngược về gốc và cập nhật các nút trên đường đi. Biến node thể hiện nút ta đang làm việc. Vì cây phân đoạn là một cây nhị phân, 2*node biểu diễn nút ở bên trái và 2*node + 1 biểu diễn nút phải. start và end thể hiện khoảng l và r biểu diễn bằng nút. Độ phức tạp để xây dựng là O(N).
6qLc0H7dupoZf5isIPyc4jmTiDQpWj0a6rCIw4wTFHNnU XQHRPyCbM0rJfVRDAmbercwCTYipyZGLWTyRDBGRjGpHGmAnOoKPQDOeP78iHJg jey52i Sq 9yc fTxVM7DyMg9RDXNynPNjqOPNmuHjo8uH6imMw HOM5gM45UY2XP C7atdiv8u7O1FvWAAgbBVZeebA - quochung.cyou PTIT

Để cập nhật một phần tử, ta cần vào khoảng mà phần tử đang bên trong và đệ quy tiếp tục sang trái hoặc phải

BEwEwMklqIHfTNrQ QYYz 2rpSBVcIbbnvDjMatLeMg3d tnBUgj58iyq0 TLiIrrfo6sBcYUAor0vf5XPU91103hM9Ia zayaiC aIqhZT00V03zorprYY HySjcK - quochung.cyou PTIT

.Độ phức tạp của thao tác cập nhật sẽ là O(logN).

Để truy vấn trên một khoảng, ta cần đảm bảo 3 điều kiện:

  • Khoảng biểu diễn bởi nút nằm hoàn toàn trong khoảng cần tìm
  • Khoảng biểu diễn bởi nút nằm ngoài trong khoảng cần tìm
  • Khoảng biểu diễn bởi nút nằm một phần bên trong và một phần bên ngoài khoảng cần tìm

Trong trường hợp khoảng của nút nằm ngoài khoảng cần tìm, ta chỉ cần return 0. Nếu khoảng đó nằm hoàn toàn trong khoảng cần tìm, ta chi cần trả về giá trị của nút là tổng của toàn bộ phần tử trong khoảng được biểu diễn bởi bởi nút. Và nếu khoảng được biểu diễn bởi nút nằm một phần trong khoảng cần tìm, ta trả về tổng của nút con trái và nút con phải.

=> Độ phức tạp của truy vấn là O(logN)

wAu44uwDKd92Yx Ao6eM26R1F38XXQJKutGjACZFkP5lg7tDuXFoEeovKrzPeg0595g zPoaBy41aUSIemcDP0dXsg8CMkaDd7RYQfG9XPYRfruGyk05m31VNM ydcskH9lRZBAEfClIEWRyYVwiGOV - quochung.cyou PTIT

Cập nhật một khoảng (Lazy Propagation – Lan truyền lười biếng):

Đôi khi bài toán đặt bạn cần cập nhật một khoảng từ l đến r, thay vì chỉ cập nhật một phần tử. Một phương pháp là cập nhật toàn bộ phần tử từng cái một bằng một vòng lặp, điều này sẽ tốn O(NlogN) thời gian.

Để tránh gọi quá nhiều lần hàm cập nhật, ta có thể sửa đổi lại cách cập nhật một khoảng.

ldznz2TPSJTokrkHe4iYAQO8rhYb210WqFE T4NapL1cKgvKcBYJzf0uD2s1iagBGYEGjEJ63JUMfduFkOB3EpJ0i8xnzqeYXNy7pUcKDqovmQYLZjkBMtjjV4hIX4tmiUjVPEwS RPV2sRB0kjHs8pY5Z WjDvhPwCqKIWmT5qhRWtKH MnEpr7ioAun20VJKr56uvwWQ - quochung.cyou PTIT

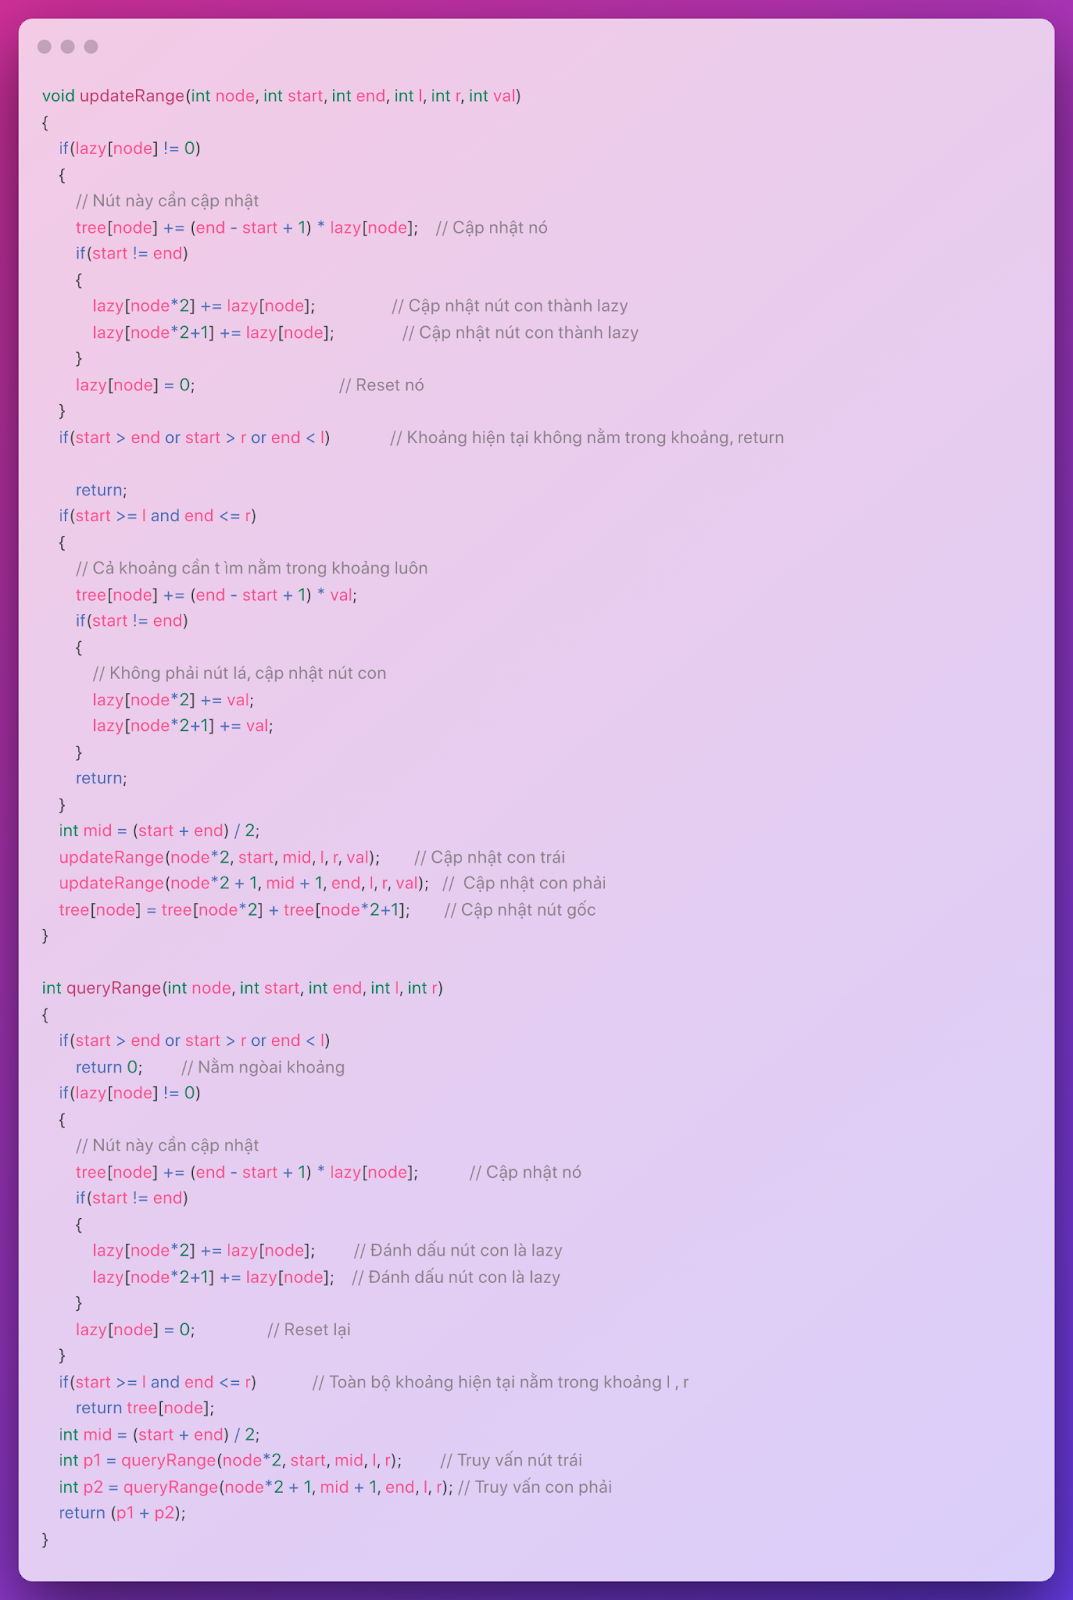
Hãy chỉ làm việc gì đó khi nó cần thiết. Khi cập nhật một khoảng, ta sẽ cập nhật nút và đánh giá các nút con của nó là nó cần cập nhật, và chỉ cập nhật khi cần. Để làm điều này ta cần một mảng lazy[] cùng cỡ với Segment Tree. Mặc địch mọi phần tử của mảng lazy[] đều là 0 thể hiện không có nút nào cần cập nhật. Nếu có một phần tử khác không, lazy[k] là phần tử cần cập nhật, và ta cần cập nhật nút k trong cây nhị phân trước khi làm bất kì truy vấn nào.

Ta cần bảo đảm 3 điều sau:

  • Nếu nút hiện tại cần cập nhật, ta cần cập nhật trước nút con nào đó
  • Nếu khoảng hiện tại của nút hiện tại nằm hoàn toàn trong khoảng cần cập nhật, thì cập nhật luôn và cập nhật lazy[] cho các nút con
  • Nếu khoảng của nút hiện tại chồng lấn với khoảng cần tìm, cập nhật nút như cách cập nhật phía trước.

Vì ta đã cập nhật hàm update để trì hoãn việc cập nhật giá trị, chúng ta cần thay đổi cả hàm truy vấn. Điều duy nhất cần thay đổi là nếu có các thao tác cập nhật nào còn chưa thực hiện, ta cần kiểm tra và cập nhật chúng trước.
KNWGkx8lFRKlGR8A9fpxE Ey fWss05XZuSHpg7kz2wNDR1eYSTju7rHqBRf27 L7kkLsP4zMK959J2D - quochung.cyou PTIT

Chung kết ACM/ICPC PTIT 2022

Vừa qua 09/10/2022 Học viện Công nghệ Bưu Chính Viễn Thông đã tổ chức kì thi chung kết ICPC PTIT 2022 với 33 đội (chưa kể miền Nam) tại sảnh A2 của Học Viện. Kì thi 2022 có sự góp mặt phần lớn của khoá sinh viên D21, E21 (Năm nhất), tuy rằng kết quả chung cuộc bị chênh lệch phần lớn bởi thời gian sub bài chứ không có nhiều khác biệt giữa các team top giữa, nhưng kì thi vẫn đã diễn ra vô cùng hấp dẫn và kịch tích

image - quochung.cyou PTIT
Banner ICPC PTIT 2022

Đội của mình “ProPTIT. GGWP” Gồm mình Nguyễn Quốc Hưng E2105, Nguyễn Mai Phương (D21CN01), Nguyễn Đăng Minh (E2101) đã cố gắng giành thứ hạng #8 với 6 bài, khá tiếc là cây toán của team – Mai Phương đã đưa 2 teammate vào hai bài khó nhất đề bằng câu “hai bài này có vẻ làm được này”, mà bỏ qua 1 câu toán khá vừa tầm đúng ra nên làm.

Một vài hình ảnh đáng chú ý trong kì thi

image 1 - quochung.cyou PTIT
Thầy Từ Minh Phương phát biểu khai mạc
image 2 - quochung.cyou PTIT
Ban tổ chức ICPC PTIT 2022
image 3 - quochung.cyou PTIT
Đội 812 – Đội vô địch cũng là team First Solve bài đầu tiên
308852668 519902050142483 6200032404820115480 n - quochung.cyou PTIT
Khu vực thi – Sảnh A2
310474281 519902076809147 5619913051196432147 n - quochung.cyou PTIT
Khu vực thi – Sảnh A2
311190978 519910133475008 26272425141169940 n - quochung.cyou PTIT
Các thầy cô ban tổ chức
image 6 - quochung.cyou PTIT
Lễ trao giải ICPC PTIT 2022 – Đội vô địch 812

Lễ trao giải cuộc thi: https://portal.ptit.edu.vn/le-trao-giai-cuoc-thi-lap-trinh-theo-chuan-quoc-te-icpc-icpc-ptit-2022/

Sắc màu ICPC PTIT 2022: https://www.facebook.com/media/set/?set=a.518458426953512&type=3

Thuật toán: Tìm hiểu về Quay lui nhánh cận

  1. Lý thuyết 

Quay lui là một kĩ thuật thiết kế giải thuật dựa trên đệ quy. Ý tưởng của quay lui là tìm lời giải từng bước, mỗi bước chọn một trong số các lựa chọn khả dĩ và đệ quy.

Tư tưởng

Dùng để giải bài toán liệt kê các cấu hình. Mỗi cấu hình được xây dựng bằng từng phần tử. Mỗi phần tử lại được chọn bằng cách thử tất cả các khả năng.

Các bước trong việc liệt kê cấu hình dạng X[1…n]:

  • Xét tất cả các giá trị X[1] có thể nhận, thử X[1] nhận các giá trị đó. Với mỗi giá trị của X[1] ta sẽ:
  • Xét tất cả giá trị X[2] có thể nhận, lại thử X[2] cho các giá trị đó. Với mỗi giá trị X[2] lại xét khả năng giá trị của X[3]…tiếp tục như vậy cho tới bước:
  • …
  • ….
  • Xét tất cả giá trị X[n] có thể nhận, thử cho X[n] nhận lần lượt giá trị đó.
  • Thông báo cấu hình tìm được.

Bản chất của quay lui là một quá trình tìm kiếm theo chiều sâu

Backtracking Algorithm

Kĩ thuật nhánh cận

Vì thuật toán đệ quy/quay lui thường có độ phức tạp là cấp số mũ nên đa số bài toán sẽ không thể xử lí trong thời gian yêu cầu.

Tuy nhiên khi xét các trường hợp, ta có thể áp dụng kĩ thuật bằng cách loại bỏ sớm các nhánh không thể khả thi từ sớm để giảm bớt rất nhiều độ phức tạp của Code.

VD:

Ta có 10 công việc với thời gian cần làm và lương nhận được khác nhau. Mỗi công việc chỉ làm 1 lần.

Cho một khoảng thời gian có là T, ví dụ khi ta đã tìm được 1 khả năng:

  • Trong 10 tiếng, chọn 4 công việc và kiếm được 600 nghìn

Thì khi xét 1 nhánh khác với 3 công việc, và ta nhận thấy nếu 

  • Thời gian còn lại / (Thời gian dành cho công việc tốt nhất) * Lương công việc cao nhất

Tức là cho dù ta làm công việc tốt nhất cho khoảng thời gian còn lại mà vẫn ít tiền hơn khả năng trên, thì không việc gì cần xét tiếp nhánh đó nữa.

|| Khi bạn đang tắc đường và cố chui vào 1 ngõ rẽ cho nhanh, nhưng bạn nhẩm cho dù đi đường vòng này nhanh nhất vẫn chậm hơn chờ tắc bình thường, thì tốt nhất nên quay đầu lại ngay chứ đừng chui vào ngõ tiếp.

Bài 1:  P135SUMG – SUM5 G – Xâu đặc biệt

https://www.spoj.com/PTIT/problems/P135SUMG/

RiGSu98VtUp07pJVcrBUMkU1Uj47Ht 6UU GqjI8QBq31D 8aSs - quochung.cyou PTIT

Ý tưởng:

  • Tại các vị trí ‘_’ , ta thử tất cả chữ cái có thể thay vào, sau đó tiếp tục di chuyển đến các từ ngữ tiếp theo
  • Cần lưu trữ lại số lượng các phụ âm, nguyên âm, số lượng chữ L hiện tại để dừng lại nếu không thỏa mãn yêu cầu

Độ phức tạp Code: 

  • Do đi qua từng vị trí (n) và tại mỗi vị trí có nhiều nhất 2 nhánh mới tạo ra, nên ~ 2^n
d7UxEWp b1yaW8 P dgr56MMHG8HvFPC2OElB0zyzTjDAAXTYjwfTJQbhQtp Hz0dt8jNSjdLFQYU y1CQoR9THLyI8zoNSAdiO G4t1JYMbGn2QQoBfubnxXgcyNE83nT - quochung.cyou PTIT

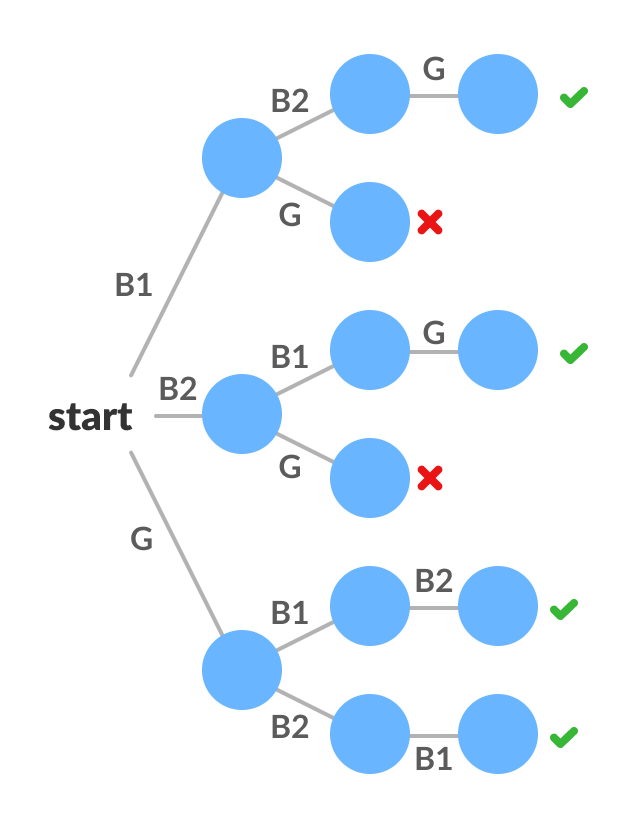
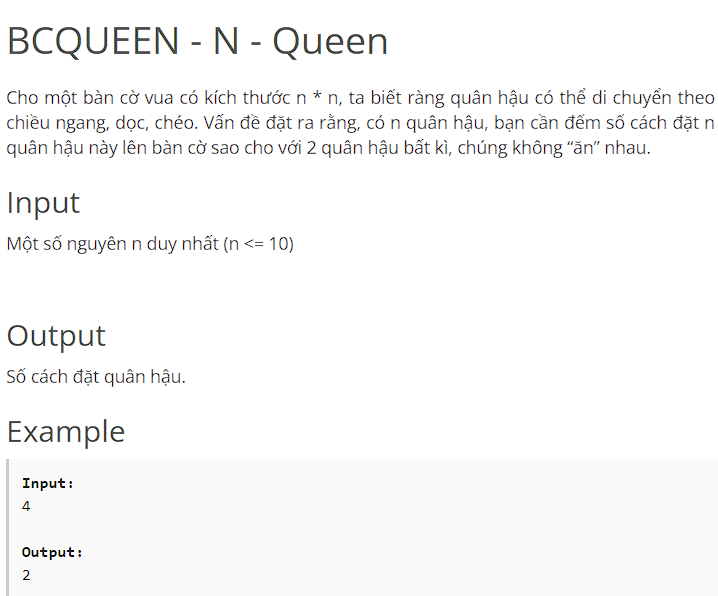
Bài 2:  BCQUEEN – N – Queen

https://www.spoj.com/PTIT/problems/BCQUEEN/

MkdmamvxiEI2wZdvuMFEpwcjb9KuLsQGTdflV8Us2OTz4pK 7wyJ - quochung.cyou PTIT

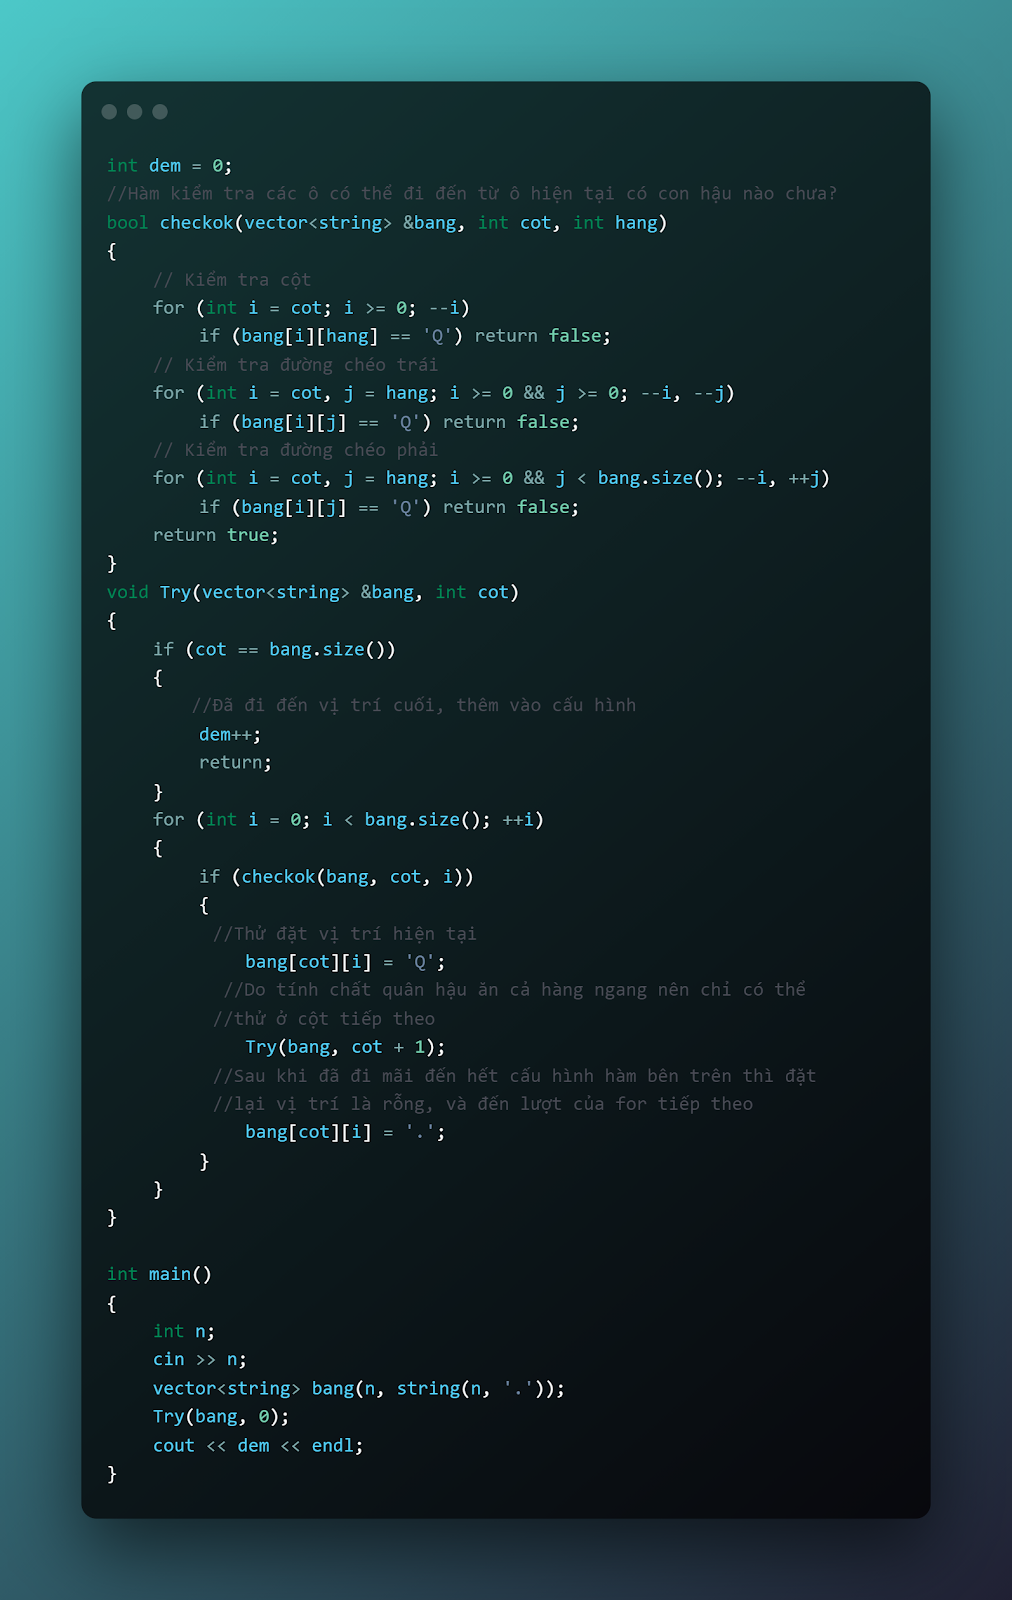
Ý tưởng:

  • Tại các vị trí bất kì, ta thử đặt quân hậu tại đó, sau đó tiếp tục thử
  • Khi đi đến vị trí cuối cùng (cuối phải) thì dừng lại và đếm cấu hình đã thỏa mãn thêm 1
GitHub - andykdy/N-Queens: Solving N-Queens with genetic algorithm

Độ phức tạp:

  • Tại mỗi hàng cần lặp qua tất cả các cột rồi tại mỗi cột tiếp tục thử
  • Độ phức tạp: n^2
30ZkDBRPXWzBw7HXRyJFYAvFw4aal - quochung.cyou PTIT

Bài 3:  P167PROC – ROUND 7C – Ký tự lặp trong 2 xâu liên tiếp

https://www.spoj.com/PTIT/problems/P167PROC/

Ý tưởng:

  • Do N khá nhỏ, ta sinh hoán vị các cách sắp xếp từ
  • Tại mỗi cấu hình hoán vị, ta thử lặp qua dãy sắp xếp hiện tại và đếm số lần lặp, do input đảm bảo các từ được sắp xếp sẵn nên có thể dùng tìm kiếm nhị phân để tối ưu

Độ phức tạp:

  • Gọi độ dài string là L, số lượng xâu là n
  • Sinh toàn bộ hoán vị :  L !
  • Tại mỗi hoán vị, lặp qua dãy 1 lần : n
  • Tại mỗi phần tử, lặp qua tất cả vị trí và tìm kiểm nhị phân : L log(L)
  • Độ phức tạp tổng : L ! n L log(L)
Pi S8JJ9lR7tmY1rcqzGGg8Q MdDsUoLSkGhn2qam fTQbC5rhcBXXW9 AImMp5hP aqsN0yXD kEN8 NYKk0ua2XQ7bwbziNRFTsvk0d0I4fr1PbhNVR4oLr RGQ7f23kPEsR7GoOSajNAWNAkH9A - quochung.cyou PTIT

Thuật toán: Tìm hiểu về Stack

  1. Lý thuyết 

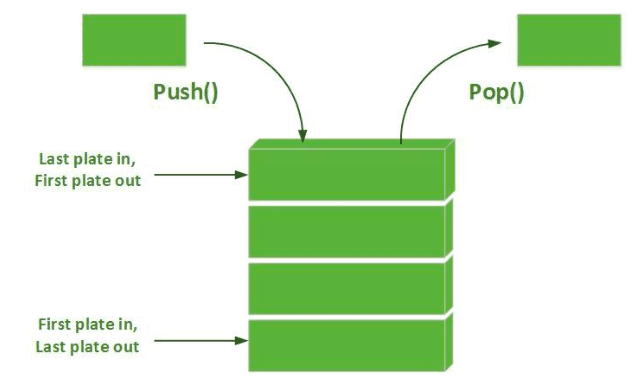
Stack là một danh sách được bổ sung 2 thao tác: thêm một phần tử vào cuối danh sách, và loại bỏ một phần tử ở cuối danh sách. Ví trí cuối của Stack được gọi là đỉnh (top).

Stack và Queue là các cấu trúc dữ liệu được sử dụng để lưu trữ các yếu tố dữ liệu và nó dựa trên một số các ví dụ có thực trong cuộc sống hàng ngày của chúng ta. Ví dụ, Stack là một chồng đĩa CD, nơi bạn có thể lấy ra và đưa vào đĩa CD thông qua đỉnh của ngăn xếp đĩa CD. 

Stack in C++ Example: C++ Stack Program And Algorithm

Chủ yếu Stack có ba hàm cơ bản sau được thực hiện:

  • Push: Thêm một mục(phần tử, thành phần) trong stack. Nếu stack đầy, thì nó được cho là điều kiện Tràn.
  • Pop: Loại bỏ một mục khỏi stack. Các mục được xuất hiện theo thứ tự đảo ngược mà chúng được Push. Nếu stack trống, thì nó được cho là điều kiện trống.
  • Peek hoặc Top: Trả về phần tử trên cùng của stack.
  • isEmpty: Trả về true nếu stack trống, ngược lại là false.

Tất cả các hàm trên của stack đều có độ phức tạp O(1)

BÀI TẬP ỨNG DỤNG : Tìm Min/Max trên đoạn tịnh tiến

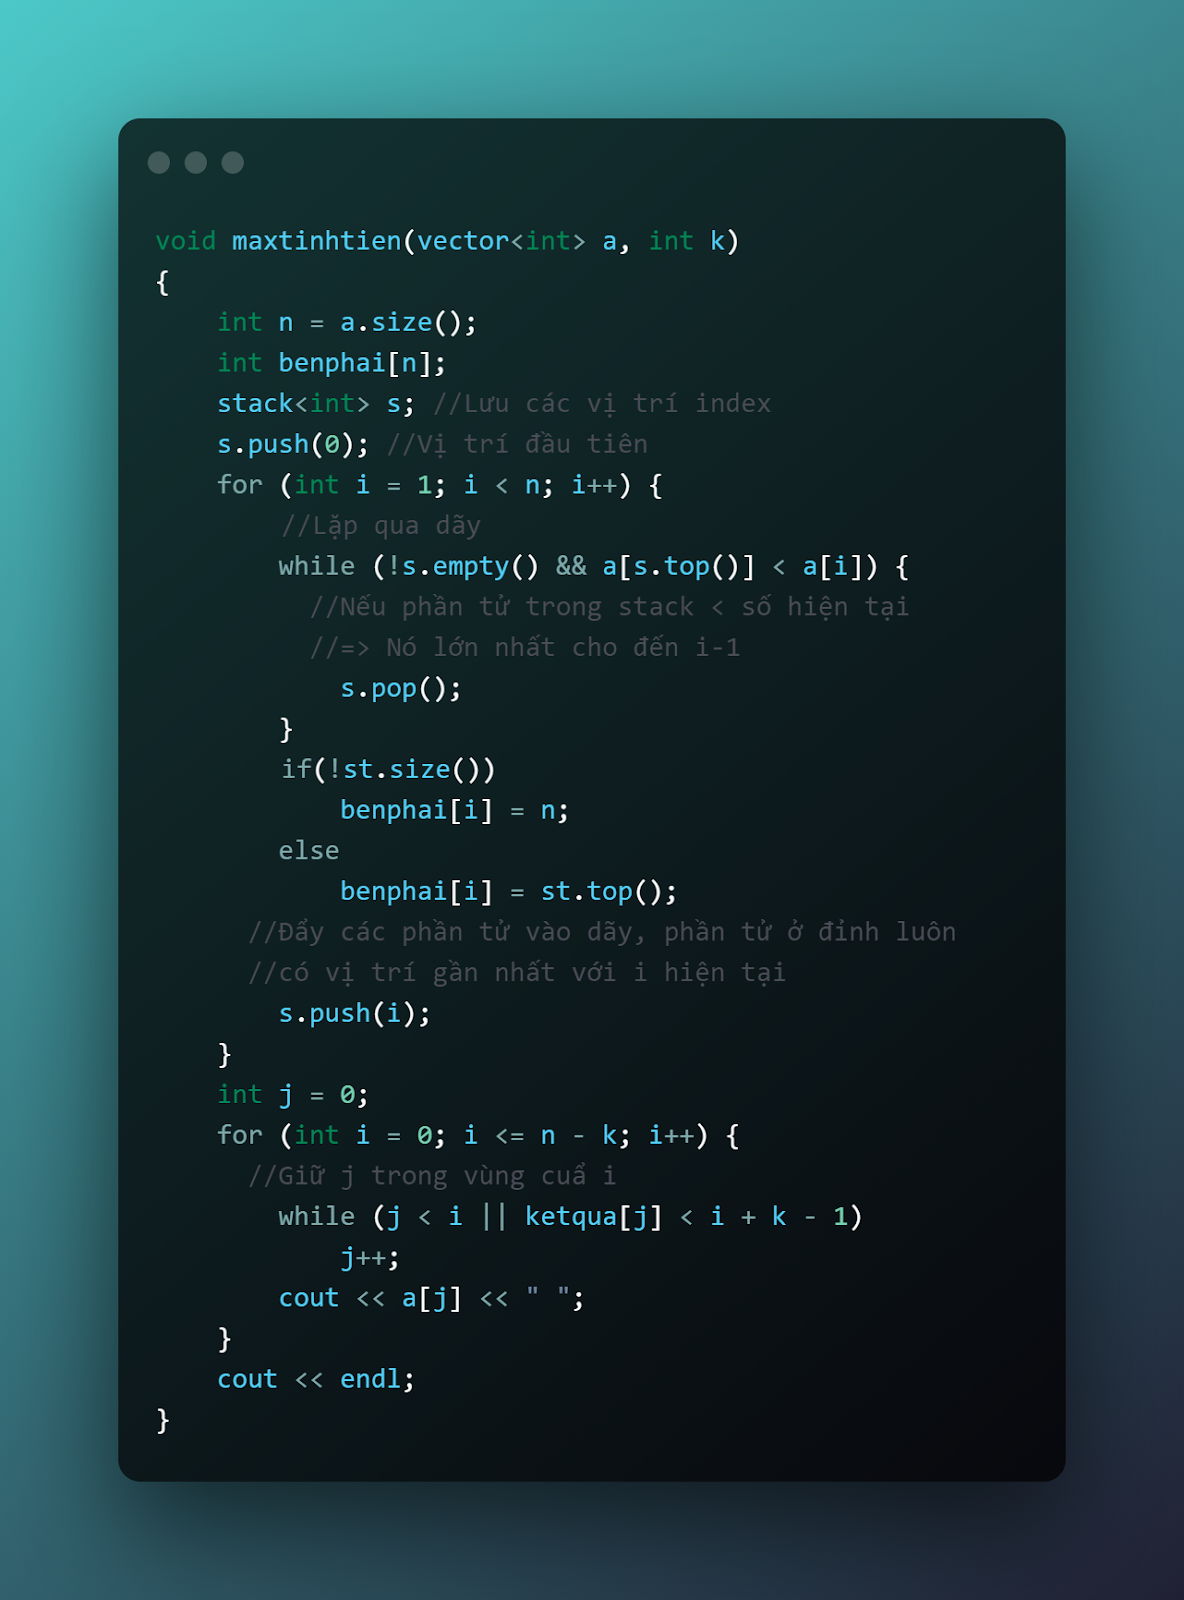
Sơ lược đề bài: Cho một dãy số có n phần tử, in ra max của các đoạn có độ dài k liên tiếp trong dãy

Cách làm thông thường:

Ta lặp từ 1-> n, với mỗi đoạn k, ta lặp qua đoạn k và lấy phần tử min, max.

Độ phức tạp: O(N*k)

Sử dụng stack:

  • Trước hết ta tìm phần tử lớn hơn nó bên phải đầu tiên
  • Đặt 1 biến j và i. Tại mỗi vị trí kiểm tra, ta lặp tìm phần tử lớn nhất bên phải mà vẫn thuộc vùng (i+k-1)
  • Chạy chay: (k = 3). A = (1, 2, 3, 1, 4, 5, 2, 3, 6)
012345678               
123145236
012345678
124458889
23445666X

0: (i+k-1) = 2. Trong vùng vị trí (0-2) có các vị trí phần tử lớn hơn là (1,2,4)  có 1-2 thỏa mãn, lấy vị trí 2 -> 3

1: (i+k-1) = 3. Trong vùng (1-3) phần tử lớn hơn phải là: (2,4,4) , có vị trí 2 thỏa mãn, lấy vị trí 2-> 3

2: (i+k-1) = 4. Trong vùng (2-4), phần tử lớn hơn bên phải lả (4,4,5), có vị trí 4 thỏa mãn, lấy 4 -> 4

…

Kết quả: 3 3 4 5 5 5 6

- quochung.cyou PTIT

Thuật toán: Tìm hiểu về Queue

  1. Lý thuyết 

Queue (Hàng đợi)

Hàng đợi (tiếng anh: Queue) là một cấu trúc dữ liệu dùng để lưu giữ các đối tượng theo cơ chế FIFO (viết tắt từ tiếng Anh: First In First Out), nghĩa là “vào trước ra trước”.

Có thể tưởng tượng queue như một hàng người xếp hàng, ai trên đầu thì vào trước, người tiếp tục xếp vào hàng sẽ vào sau theo thứ tự.

Stacks and Queues in Data Structures: An Overview in 2022

Các hàm có trong Queue:

  • empty() Kiểm tra xem hàng đợi hiện tại có đang rỗng hay không.
  • size() Trả về số lượng phần tử có trong hàng đợi
  • front() Trả về phần tử đầu tiên của hàng đợi.
  • back() Trả về phần tử cuối cùng của hàng đợi.
  • push() Nạp thêm một phần tử vào hàng đợi (từ cuối)
  • pop() Xóa một phần tử ở đầu của hàng đợi.

Tất cả các hàm trên có độ phức tạp O(1)

Priority Queue (Hàng đợi ưu tiên)

Priority Queue Data Structure

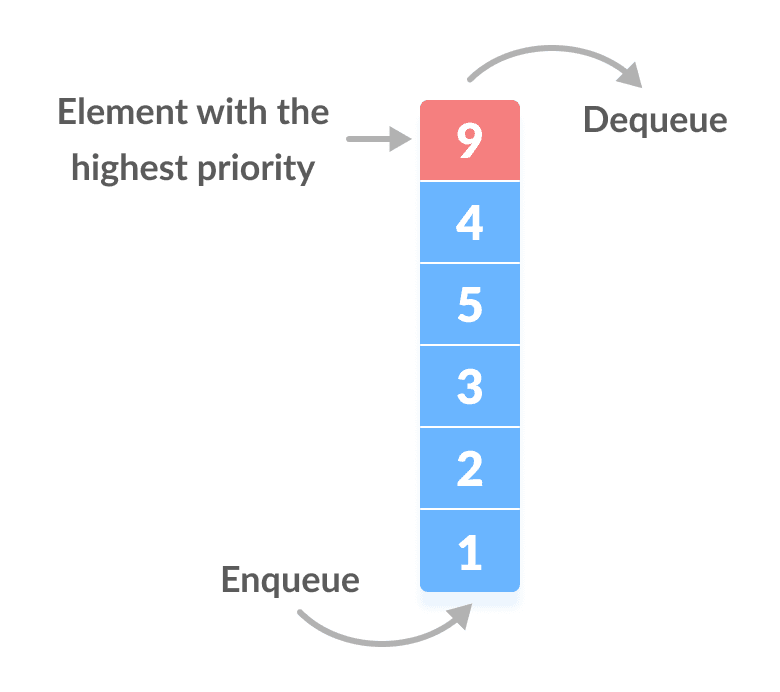
Đúng như cái tên của nó, hàng đợi ưu tiên là một phiên bản mở rộng của Queue (Hàng đợi) với các thuộc tính sau:

– Mọi phần tử đều được gắn liền với một độ ưu tiên

– Một phần tử có độ ưu tiên cao sẽ được dequeued (xóa khỏi Priority Queue) trước một phần tử có độ ưu tiên thấp

– Nếu hai phần tử có cùng độ ưu tiên, lúc này việc phần tử nào được xử lý trước sẽ phụ thuộc vào thứ tự của chúng ở trong Priority Queue. 

Ví dụ: Phần tử có giá trị cao nhất được coi là phần tử có mức ưu tiên cao nhất. Tuy nhiên, trong các trường hợp khác, chúng ta có thể giả sử phần tử có giá trị thấp nhất là phần tử có mức ưu tiên cao nhất. Trong các trường hợp khác, chúng ta có thể thiết lập các mức ưu tiên tùy ý. 

Sự khác biệt giữa Priority Queue và hàng đợi thông thường: 

Trong một hàng đợi thông thường, quy tắc vào trước ra trước được thực hiện, trong khi đó, trong hàng đợi ưu tiên, các giá trị được lấy dựa trên cơ sở mức độ ưu tiên. Phần tử có mức ưu tiên cao nhất sẽ ra trước.
Có nhiều cách để triển khai Priority Queue, tuy nhiên trong thư viện chuẩn C++, cách thức được dùng là Heap vì Heap cung cấp thời gian trung bình tốt hơn các cách khác.

8Fkv8rgrdNpGAWFgzvCNNCaSvOvgvXVrvea5VD617mr WdvQiCYXSmYaGI66FvT11IEx1gd7LySW5GcjNi6QBzxJntYJknyolnnsMtM - quochung.cyou PTIT

Cách thức hoạt động khi thêm phần tử:

Nếu không có nút,

   Tạo một nút mới.

Mặt khác (một nút đã được tạo)

   Chèn nút mới vào cuối (nút cuối cùng từ trái sang phải.)

Tạo cấu trúc dữ liệu heap cho mảng

Các lệnh của priority_queue trong thư viện STL của C++

empty() Kiểm tra hàng đợi có rỗng không O(1)

size() Trả về kích cỡ của hàng đợi O(1)

top() Trả về phần tử ưu tiên cao nhất của hàng đợi O(1)

push() Thêm một phần tử vào hàng đợi O(logN)

pop() Xóa phần tử ưu tiên cao nhất O(logN)

Với hàng đợi ưu tiên có N phần tử cần thêm vào thì chi phí khởi tạo là O(NlogN)

Deque (Hàng đợi hai đầu)

Hàng đợi hai đầu (deque) là cấu trúc dữ liệu chứa 0 hoặc nhiều phần tử có cùng kiểu dữ liệu và được biểu diễn bằng một hàng có phần tử đầu (front) và phần tử cuối (last). Deque hỗ trợ 4 thao tác như sau:

  • Thêm một phần tử vào cuối deque. (Push back)
  • Thêm một phần tử vào đầu deque. (Push front)
  • Bỏ đi phần tử ở cuối deque, trả về giá trị của phần tử đó. (Pop back)
  • Bỏ đi phần tử ở đầu deque, trả về giá trị của phần tử đó. (Pop front)

Về ứng dụng, ta sẽ bổ sung thêm một số thao tác sau:

  • Lấy giá trị của phần tử cuối mà không xóa nó. (back)
  • Lấy giá trị của phần tử đầu mà không xóa nó. (front)
  • Tìm số lượng phần tử trong deque. (size)
  • Kiểm tra xem deque có rỗng hay không. (empty)

Các thao tác trên đều có độ phức tạp khoảng O(1).

Bài tập ứng dụng

ABD938WfjCN 4mK6tN7vF Y5ZV - quochung.cyou PTIT

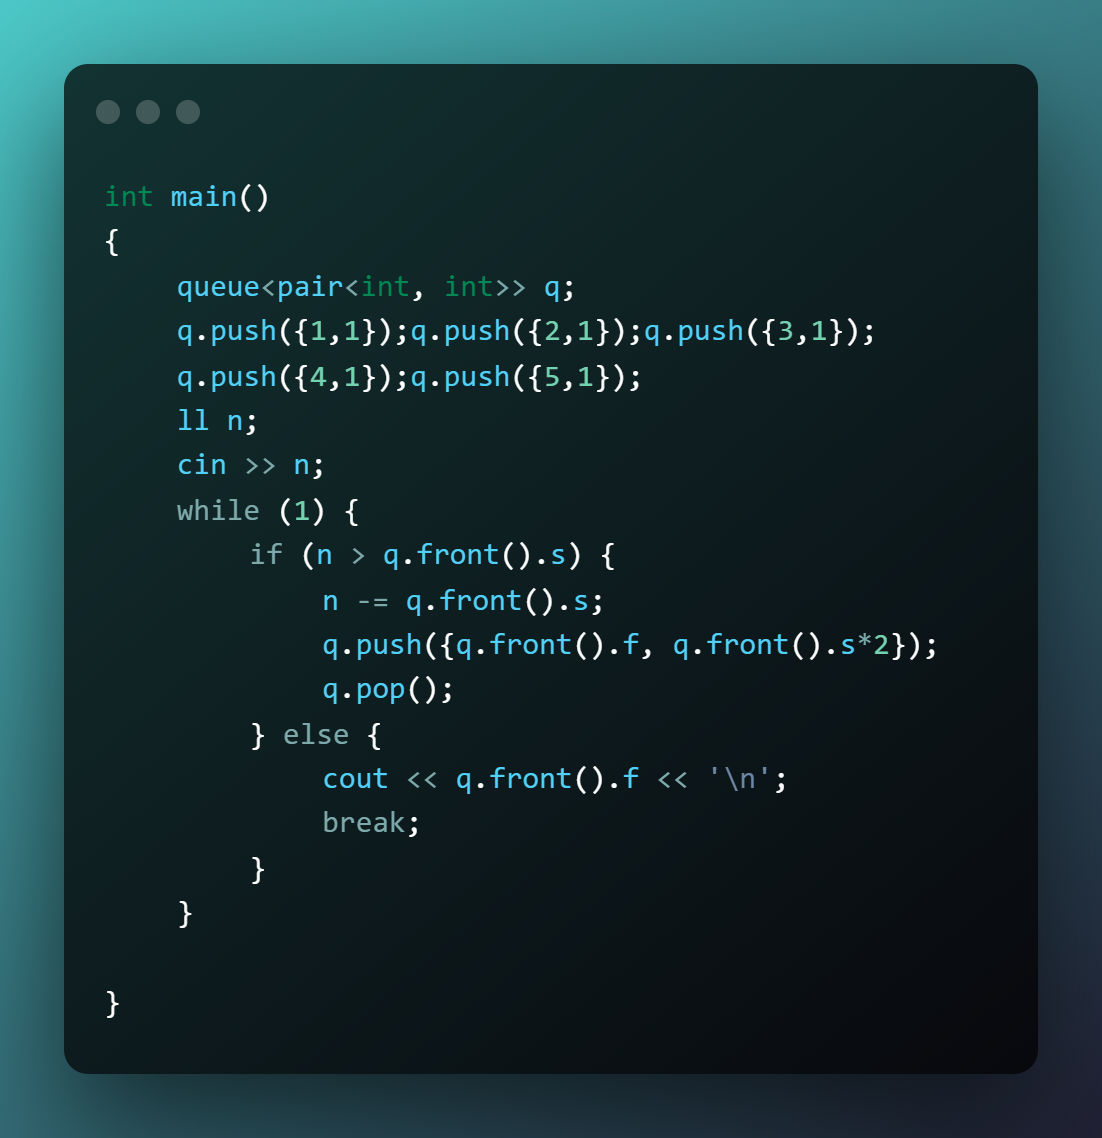
Chỉ đơn giản là sử dụng queue và làm theo yêu cầu của bài

ymfskj8S6oFfBKAISxAKe7COm G3UslAeNft1 dzLOiCWZGziwV q9 FdXCe R6O7CTQa4Ur7iYyyeBAKRVdmGdqfqr4v6TR YCSSJMb Jxq2R9YbcCh0QliSC8trx t KVlGG8SqFT9dbmogewjmg - quochung.cyou PTIT

Làm như cách làm của bài, tuy nhiên thay vì đẩy 2 phần tử của đầu queue xuống, ta sẽ lưu queue dưới dạng số-số lần xuất hiện, nếu như lần chơi hiện tại < số lần xuất hiện hiện tại, vậy thì đầu queue sẽ đang là số đó, bằng không ta đẩy số lần xuất hiện gấp đôi

VD : 1-1 2-1 3-1 4-1 5-1 (số – số lần xuất hiện)

Lượt chơi thứ 6: 1-2 2-2 3-2 4-2 5-2

- quochung.cyou PTIT

Thuật toán: Tìm hiểu về Lí thuyết đồ thị

Các khái niệm cơ bản của đồ thị

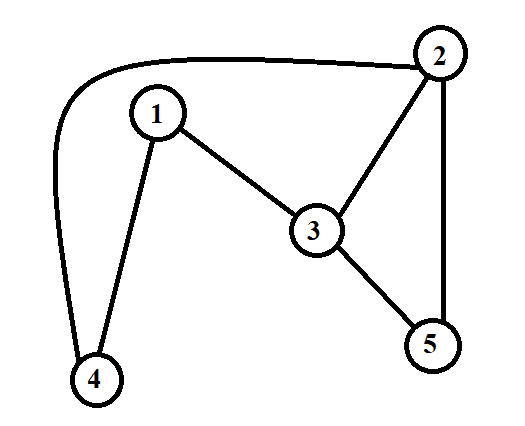
Một đồ thị là một cấu trúc rời rạc gồm tập hợp các đỉnh và các cạnh nối giữa các đỉnh đó. 

Có thể mô tả đồ thị theo cách hình thức như sau:

G=(V,E)

tức là đồ thị G có tập các đỉnh là V, tập các cạnh là E. Có thể hiểu E là tập hợp các cặp (u, v) với u và v là hai đỉnh thuộc V.

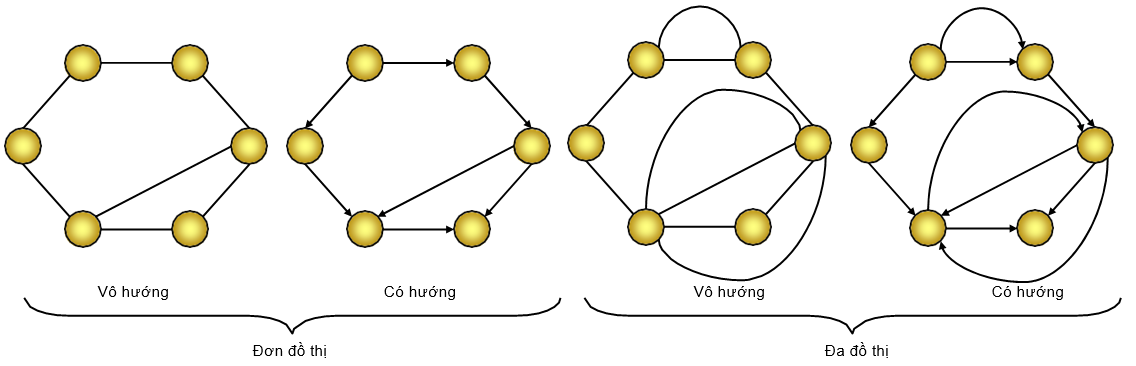
  • G được gọi là đơn đồ thị nếu như giữa hai đỉnh (u, v) của V có nhiều nhất một cạnh trong E nối từ u tới v.
  • G được gọi là đa đồ thị nếu như giữa hai đỉnh (u,v) của V có thể có nhiều hơn 1 cạnh nối trong E nối từ u tới v. Đơn đồ thị là trường hợp đặc biệt của đa đồ thị
  • G được gọi là đồ thị vô hướng nếu các cạnh là cạnh 2 chiều, có thể đi từ u -> v và v -> u trên 1 cạnh
  • G được gọi là đồ thị có hướng nếu các cạnh có định hướng một chiều, ví dụ cạnh (u,v) chỉ có thể đi từ u -> v
https://cdn.ucode.vn/uploads/2247/upload/ikDUaEPJ.png
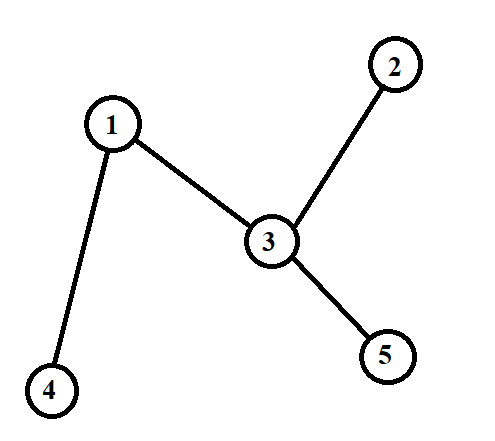
  • Hai đỉnh trong đồ thị vô hướng được gọi là đỉnh kề nếu giữa chúng có cạnh nối với nhau. Cạnh này được gọi là cạnh liên thuộc
  • Nếu một cạnh nối một đỉnh với chính nó, ta gọi đó là khuyên
  • Bậc là số lượng cạnh liên thuộc của một đỉnh

Graph trong cuộc sống

  • Trong các ứng dụng bản đồ như Google Map. Với các điểm đến là một nút, ta có nhiều bài toán Đường đi ngắn nhất, hay tìm đường để đi từ điểm A -> B

Biểu diễn đồ thị

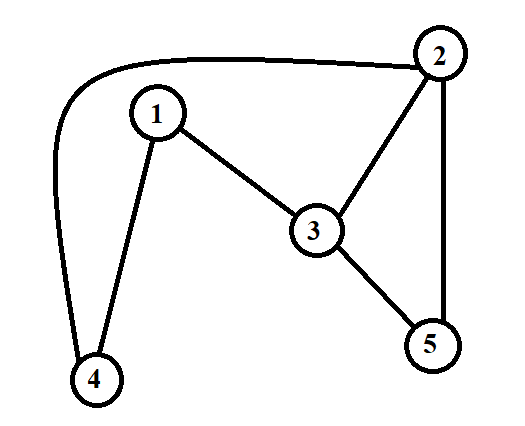
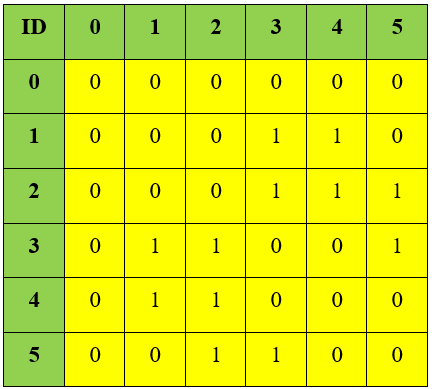
Ma trận kề

https://i.imgur.com/TvhSFTk.png
https://i.imgur.com/iu0lCKv.png

Với mỗi cạnh giữa 2 đỉnh u và v, ta có thể biểu diễn dưới dạng ma trận, với nếu matran[x][y] là số lượng cạnh nối giữa đỉnh x và đỉnh y

Ưu điểm của ma trận kề:

  • Đơn giản, dễ cài đặt.
  • Kiểm tra cạnh giữa 2 đỉnh trong O(1)

Nhược điểm của ma trận kề:

  • Tốn N^2 (số đỉnh) để triển khai bộ nhớ
  • Để tìm tất cả các đỉnh kề của đỉnh x, ta cần duyệt qua toàn bộ hàng/cột của đỉnh x O(n)

Danh sách kề

https://i.imgur.com/ZX0n2Jw.png
https://i.imgur.com/lhFAoTW.png

Ta sẽ có một mảng hoặc vector 2 chiều, và lưu mỗi đỉnh các đỉnh kề của chúng.

Ưu điểm của danh sách kề:

  • Tìm các đỉnh kề của một đỉnh rất nhanh
  • Tiết kiệm không gian lưu trữ

Nhược điểm của danh sách kề: 

  • Kiểm tra 2 đỉnh có kề nhau hay không cần duyệt qua danh sách kề của u hoặc v tốn O(m) thời gian

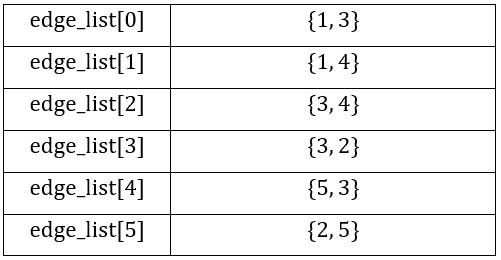
Danh sách cạnh

https://i.imgur.com/1LjUEv1.png
https://i.imgur.com/op5RtSJ.png

Ta lưu lại tất cả các cạnh của đồ thị dưới dạng pair (u,v) chứ không lưu đỉnh

Ưu điểm của danh sách cạnh:

  • Tốn không gian lưu trữ tùy thuộc vào số cạnh
  • Phù hợp trường hợp cần duyệt toàn bộ cạnh thì

Nhược điểm của danh sách cạnh: 

  • Tốn thời gian nếu cần duyệt các đỉnh kề vì cần duyệt qua toàn bộ cạnh và tìm đỉnh cần tìm trong đó

Các thuật toán tìm kiếm trên đồ thị

  • Ta gọi một đường đi từ u->v có độ dài k là tập hợp k đỉnh mà khi đi qua các đỉnh này ta đi được từ u->v
  • Một chu trình là một đường đi sau khi đi xong sẽ về điểm xuất phát. 
  • Đường đi đơn là đường đi mà tập hợp k đỉnh phân biệt
  • Chu trình đơn là chu trình mà tập hợp đỉnh trên chu trình phân biệt
What are BFS and DFS in a binary tree? - Quora

Thuật toán DFS (Tìm kiếm theo chiều sâu)

Tư tưởng thuật toán:

Thuật toán tìm kiếm theo chiều sâu (DFS) là bắt đầu từ

một đỉnh bất kì v nào đó + đánh dấu đỉnh v đã được duyệt,

chọn một đỉnh u bất kỳ kề với v và lấy nó làm đỉnh duyệt

tiếp theo.

DFS Từ điểm bắt đầu u , ta tìm đỉnh đầu tiên trong các đỉnh kề của u, tiếp tục DFS trên đó và lặp lại. Nếu không còn đỉnh để đi nữa, ta sẽ quay trở lại ngã rẽ gần nhất. 

clh1bw33aC0sforrTia06AMcYj6GdrWr BbHxX70v9TA863ptT0HoRGBg5E0Gz7g9VahuQ EZQhwooXi37iIBao3pT800oQMhBZrqGBMTljE - quochung.cyou PTIT

Cài đặt theo đệ quy

ukehMLCbI9Gah q bKUGsAFYsvBUKEwIUCG7nOuKtgBxl84kB3daAR 2wAD9RGEyMqPdsqJADnBgQpQpWnwjZPGhA9Je8ZXjYCU7Tws2dPaPbVp81hp qTW90mYV8Pwaihb3v c8EnswJmvQw BFKA - quochung.cyou PTIT

Cài đặt theo Stack (Không đệ quy)

Thuật toán BFS  (Tìm kiếm theo chiều rộng)

Tư tưởng thuật toán:

  • Dựa trên tư tưởng lập ra một thứ tự duyệt các đỉnh, sao cho các đỉnh gần s hơn sẽ luôn luôn được duyệt xong trước các đỉnh xa s hơn. 
  • Ví dụ, từ đỉnh s ta thăm các đỉnh kề với nó là x1,x2,x3 Khi thăm tới x1​, sẽ phát sinh việc thăm các đỉnh kề với x1a, x1b. Dĩ nhiên các đỉnh này đều xa s hơn so với x2,x3 cho nên chúng sẽ chỉ được thăm sau khi toàn bộ các đỉnh x2,x3  đã được thăm hết.
  • Thuật toán loang (thuật toán vết dầu loang) là một kĩ thuật sử dụng BFS để tìm tất cả các điểm có thể đi tới. Điểm khác biệt giữa Loang so với đa số những bài BFS là ta không phải tìm chi phí nhỏ nhất.
  • Thuật toán loang được dùng khá nhiều trong tin học, điển hình là thuật toán loang trên ma trận được ứng dụng để đếm số thành phần liên thông trên ma trận. 
gEztwUnJpdiq5AHKkQxLewvEq2KFiVVzJxeKQjaqf1pWGnlpZ2AATKFHtkKz - quochung.cyou PTIT

Cài đặt theo Queue

Độ phức tạp tính toán của DFS và BFS

Tùy vào cách cài đặt đồ thị mà ta sẽ thu được các giải thuật với độ phức tạp khác nhau:

  • Nếu đồ thị biểu diễn bằng danh sách kề, cả hai giải thuật BFS/DFS đều có độ phức tạp là O(n + m) ~ O(n) Cách cài đặt này là tốt nhất.
  • Nếu đồ thị biểu diễn bằng ma trận kề, độ phức tạp tính toán sẽ là O(n^2)
  • Nếu đồ thị biểu diễn bằng danh sách cạnh, thao tác duyệt mọi đỉnh kề với đỉnh u sẽ buộc phải duyệt qua toàn bộ danh sách cạnh, dẫn đến độ phức tạp tính toán là O(n*m). Đây là cách cài đặt tệ nhất.

Tính liên thông của đồ thị

  • Đồ thị vô hướng được coi là liên thông nếu luôn tìm được đường đi giữa hai đỉnh bất kỳ của nó.
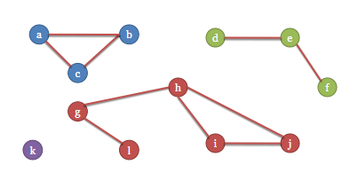
  • Trong trường hợp đồ thị G không liên thông, ta có thể phân ra G thành một số đồ thị con liên thông mà chúng đôi một không có đỉnh chung. Mỗi đồ thị con như vậy là một thành phần liên thông của G. Như vậy, đồ thị liên thông khi và chỉ khi số thành phần liên thông của nó là 1.
  • Đối với đồ thị vô hướng, đường đi từ đỉnh u đến đỉnh v cũng giống như đỉnh đường đi từ đỉnh v đến đỉnh u. Chính vì vậy, nếu tồn tại u sao cho u có đường đi đến tất cả các đỉnh còn lại của đồ thị thì ta kết luận được đồ thị là liên thông.
  • Đỉnh khớp (cut vertex/ articulation point): của một đồ thị vô hướng là đỉnh mà nếu xóa đỉnh này khỏi đồ thị và các cạnh nối đến nó thì số thành phần liên thông của đồ thị sẽ tăng thêm hoặc biến đồ thị từ liên thông thành không liên thông
Articulation Points or Cut Vertices in a Graph

Ví dụ: Xóa 0 và 3 thì đồ thị đang có thể đi lại giữa các đỉnh (Đồ thị liên thông) tạo thành 2 thành phần liên thông (1,2) và (4) không đi lại được với nhau

  • Cạnh cầu (bridge): của một đồ thị vô hướng là cạnh mà nếu xóa đi khỏi đồ thị thì số thành phần liên thông của đồ thị sẽ tăng thêm
Bridges in a graph - GeeksforGeeks
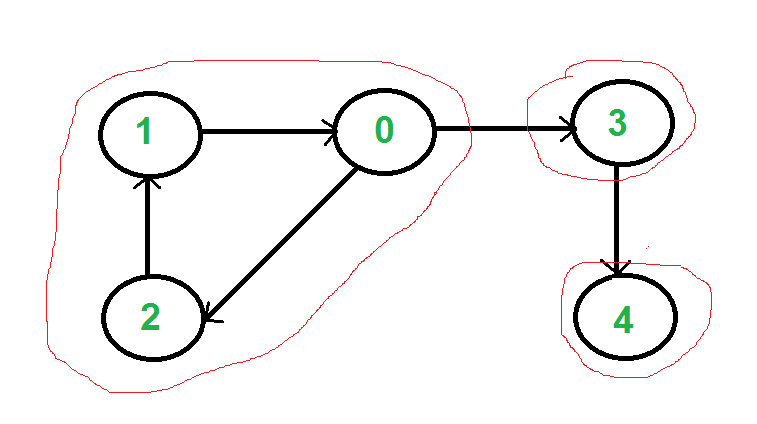
  • Liên thông mạnh (strongly connected): Đồ thị có hướng gọi là liên thông mạnh nếu có đường đi từ a tới b và từ b tới a với mọi cặp đỉnh a và b của đồ thị.
SCC

Giữa 2 đỉnh bất kì trong đồ thị con (0,1,2) và đồ thị con (3,4) đều có cạnh nối với nhau

  • Liên thông yếu (weakly connected): Đồ thị có hướng gọi là liên thông yếu nếu có đường đi giữa 2 đỉnh bất kỳ của đồ thị vô hướng tương ứng với đồ thị đã cho. Tức là hủy bỏ các hướng của các cạnh trong đồ thị.
Đồ thị liên thông – Wikipedia tiếng Việt

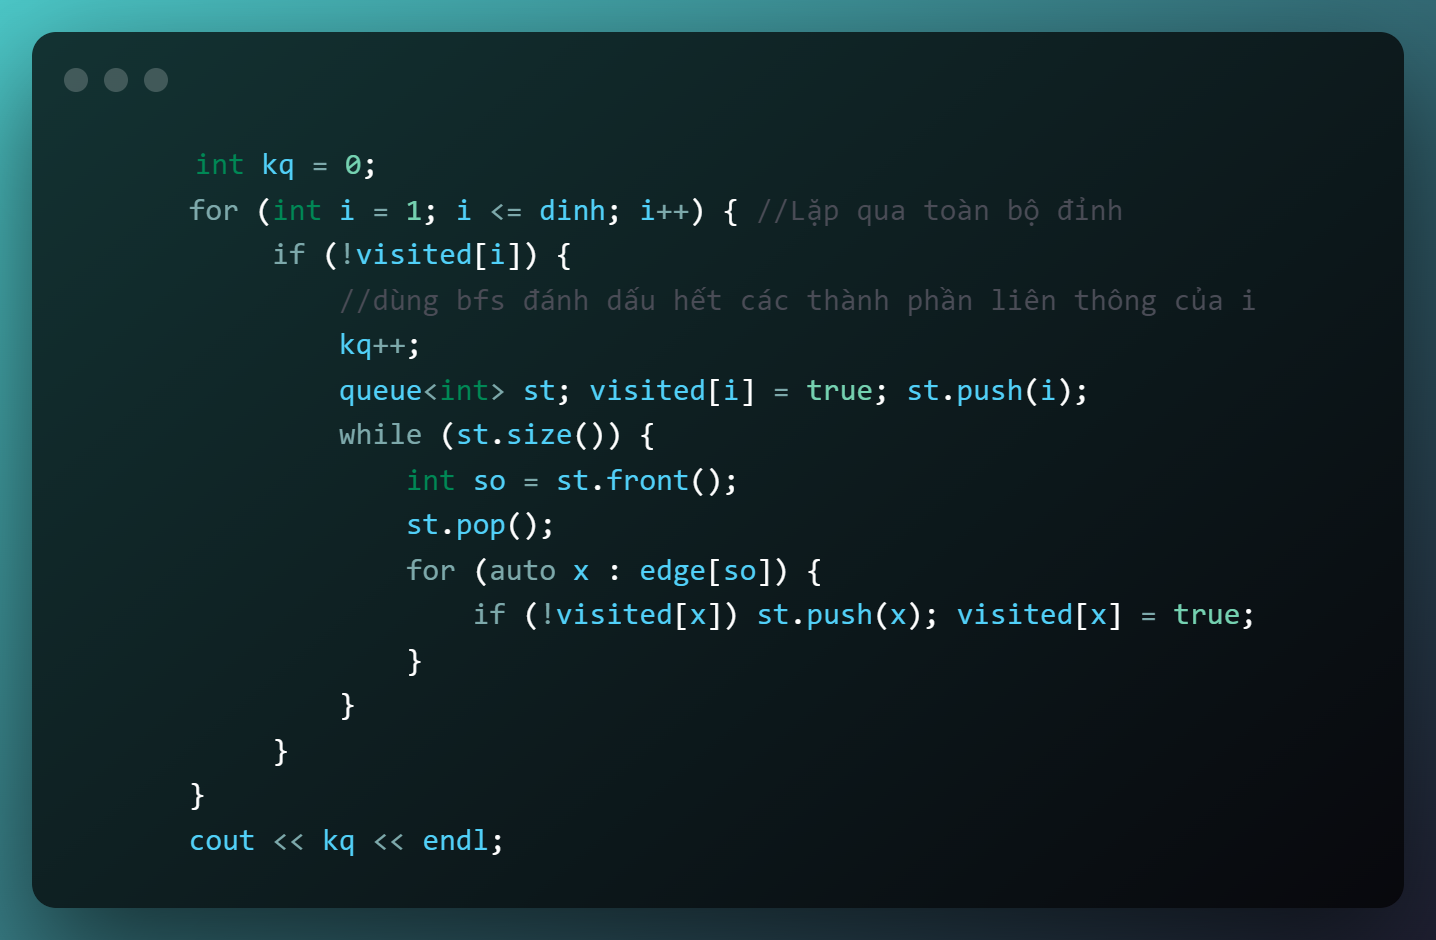
Đếm số thành phần liên thông bằng DFS và BFS

6Ou2LqL vuZJvHO0BCoOCkwKK6ut5J3xIr5k2dnLQ RLV5s3WxDn zgkH10HsZogthEKYW3DiHQ4tBoDE 0LFQ0GG2XwIvQySVgTQoMgVet lH6uSMN7f1NWkMriTlboyfoXagrTkcBJq0levBmbHg - quochung.cyou PTIT
HOij1GBiY20YbZeI5DSQvzujGMzR2hnOoEHz9Oa4 ljlfjY4ybuPXUfKZkuF5yzkE2pjZoYoBobZe83ZjOkC5svAkaxne82kq8Dvb3rDumyasNvN4d2c1KCKj 1gU82Fuycl8W75sGG3KBmMtyhAXw - quochung.cyou PTIT

Thuật toán: Tìm hiểu về chia để trị

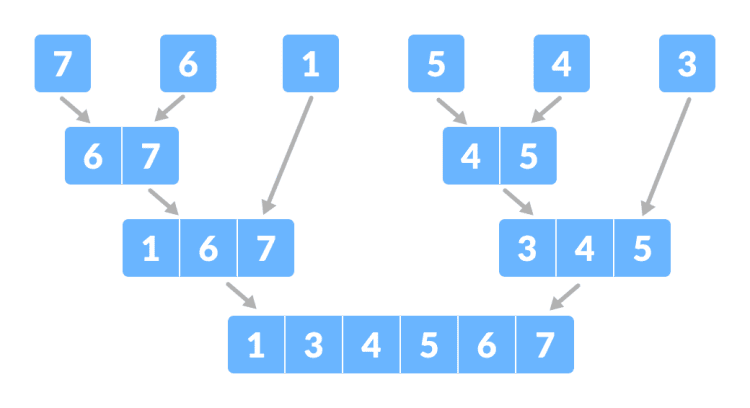
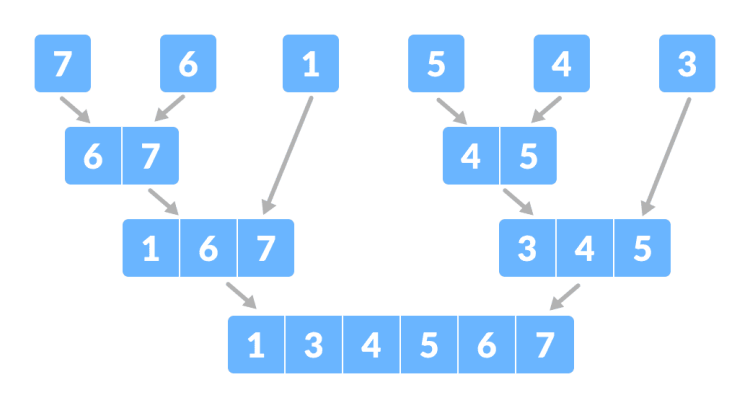
Trong khoa học máy tính, chia để trị là một mô hình thiết kế thuật toán quan trọng, hoạt động dựa trên ý tưởng chia vấn đề cần giải quyết thành các vấn đề con cùng dạng với vấn đề đã cho, chỉ khác là cỡ của chúng nhỏ hơn, cứ như vậy lặp lại nhiều lần, cho đến khi bài toán thu được đủ đơn giản để có thể giải quyết trực tiếp. Sau đó, lời giải của các bài toán nhỏ được tổng hợp lại thành lời giải cho bài toán ban đầu.

Một giải thuật chia để trị thường được thiết kế theo 3 bước như sau:

  1. Chia (divide): Chia bài toán ra thành các bài toán nhỏ hơn (subproblems). Về cơ bản thì những bài toán nhỏ này giống với bài toán ban đầu.
  2. Trị (conquer): Giải quyết bài toán con trong trường hợp nó đủ nhỏ, còn không thì tiếp tục tiến hành chia tách nó ra thành những bài toán con nhỏ hơn nữa.
  3. Kết hợp (combine): Kết hợp các kết quả từ bài toán con nhỏ nhất, để ra lời giải cho các bài toán con (subproblems), và cứ thế cuối cùng ra được lời giải cho bài toán ban đầu.
  1. Áp dụng vào bài toán tính lũy thừa
- quochung.cyou PTIT

Cách tính thông thường:

  • Để tính a^b thì  ta lặp từ 1 -> b  rồi nhân dần a lên, độ phức tạp O(n)

VD: 3^5

Tính 1: 3×1 = 3

Tính 2: 3×3 = 9

Tính 3: 9×3 = 27

Tính 4: 27×3=81

Tính 5: 81×3=243

  • Vậy mỗi bước, thực chất ta đang giảm bài toán từ a^b xuống thành a^(b-1) x a và lặp cho đến khi b về 0.

Thay vì đó, ta nhận thấy khi mũ b = 1 thì có thể đưa ra trực tiếp a, hoặc nếu mũ b bằng 0 thì đưa ra trực tiếp 1

  • https://lh3.googleusercontent.com/p56VK1dXqRiTqHokOyC2egoXy0ovboBWl5FhEDYYK6VJWUJwTIXQ2P-8Oem9_xbz6YnDaIf4v5IDPeL6jgzVvqktrLM3ymyjnLtfOgViICtHt-gBbm2-XhhvgCJf0PUkzJ-M0BXi1-15vrrmeA

Đồng thời tránh việc tràn số, ta sẽ mod các phép nhân theo công thức

Như vậy với mỗi lần đệ quy, ta sẽ chia bài toán về bài toán nhỏ hơn là a^(b/2) và tiếp tục như vậy cho đến khi đến điểm neo là b = 1 hoặc b = 0. 

LFPDK90m8Hr5J7 cif3wSXTgMlZrDgMJypWGuJTbEAdp4jyIzDCKPv9qFUFLedAstYOFnkqFVBzBb9L70 JTmMKYl 1T2zFLcs34hGWNlib3MDnqrLt5TkraU zzAhGkWkhGMUv bAEmTn0KMp3KQ - quochung.cyou PTIT

Độ phức tạp: O(logN)

  1. Áp dụng vào bài toán số Fibbonaci thứ N
FRuTfJwsjAGHclBZFJgtKbwMpZ D9kRXZZwW6BAf7rjamxMyygjfkWDjmt1SFdCYYRpIVG1jtFNHCE1mI4T Ow0yvHpR5Yu1bEiUzTPcc4wBcD6K2qImAVBnhfy8Ny3bfyNUNvkZd76XyNmO3NXWEQ - quochung.cyou PTIT

Thông thường, với cách làm lặp/đệ quy và lưu vào mảng trước để thực hiện nhiều truy vấn, với n nhỏ ta hoàn toàn có thể làm điều đó với công thức f(n) = f(n-1) + f(n-2), tuy nhiên với những bài toán nàO(n) sẽ không thực hiện được trong thời gian giới hạn thì cách này sẽ không thể thực hiện được.

Nhận định:

  • Liệu có thể đưa bài toán về dạng tính lũy thừa như ở trên rồi sử dụng chia để trị?
  • Có thể tạo mối liên hệ giữa F(n) bất kì với các số trong dãy Fibbonaci không?

Cách làm theo tư tưởng chia để trị bằng cách áp dụng nhân ma trận:

Với 2 ma trận như sau:

Ma trận A :

image 9 - quochung.cyou PTIT

Ma trận B :

image 10 - quochung.cyou PTIT
  • Liệu có thể tìm thấy một ma trận X để B = X * A

Gọi ma trận cần tìm có dạng

image 6 - quochung.cyou PTIT

Thực hiện nhân hàng trên của ma trận, đồng thời f(n+1) = f(n) + f(n-1) ta có :

  • a x f(n) + b x f(n-1) = f(n+1) 
  • a x f(n) + b x f(n-1) = f(n+1) = f(n) + f(n-1)
  • a = 1, b = 1

Thực hiện nhân hàng dưới của ma trận, ta có:

  • c x f(n) + d x f(n-1) = f(n)
  • c = 1 , d = 0

Vậy ma trận X cần tìm có dạng

image 5 - quochung.cyou PTIT
  • alt text
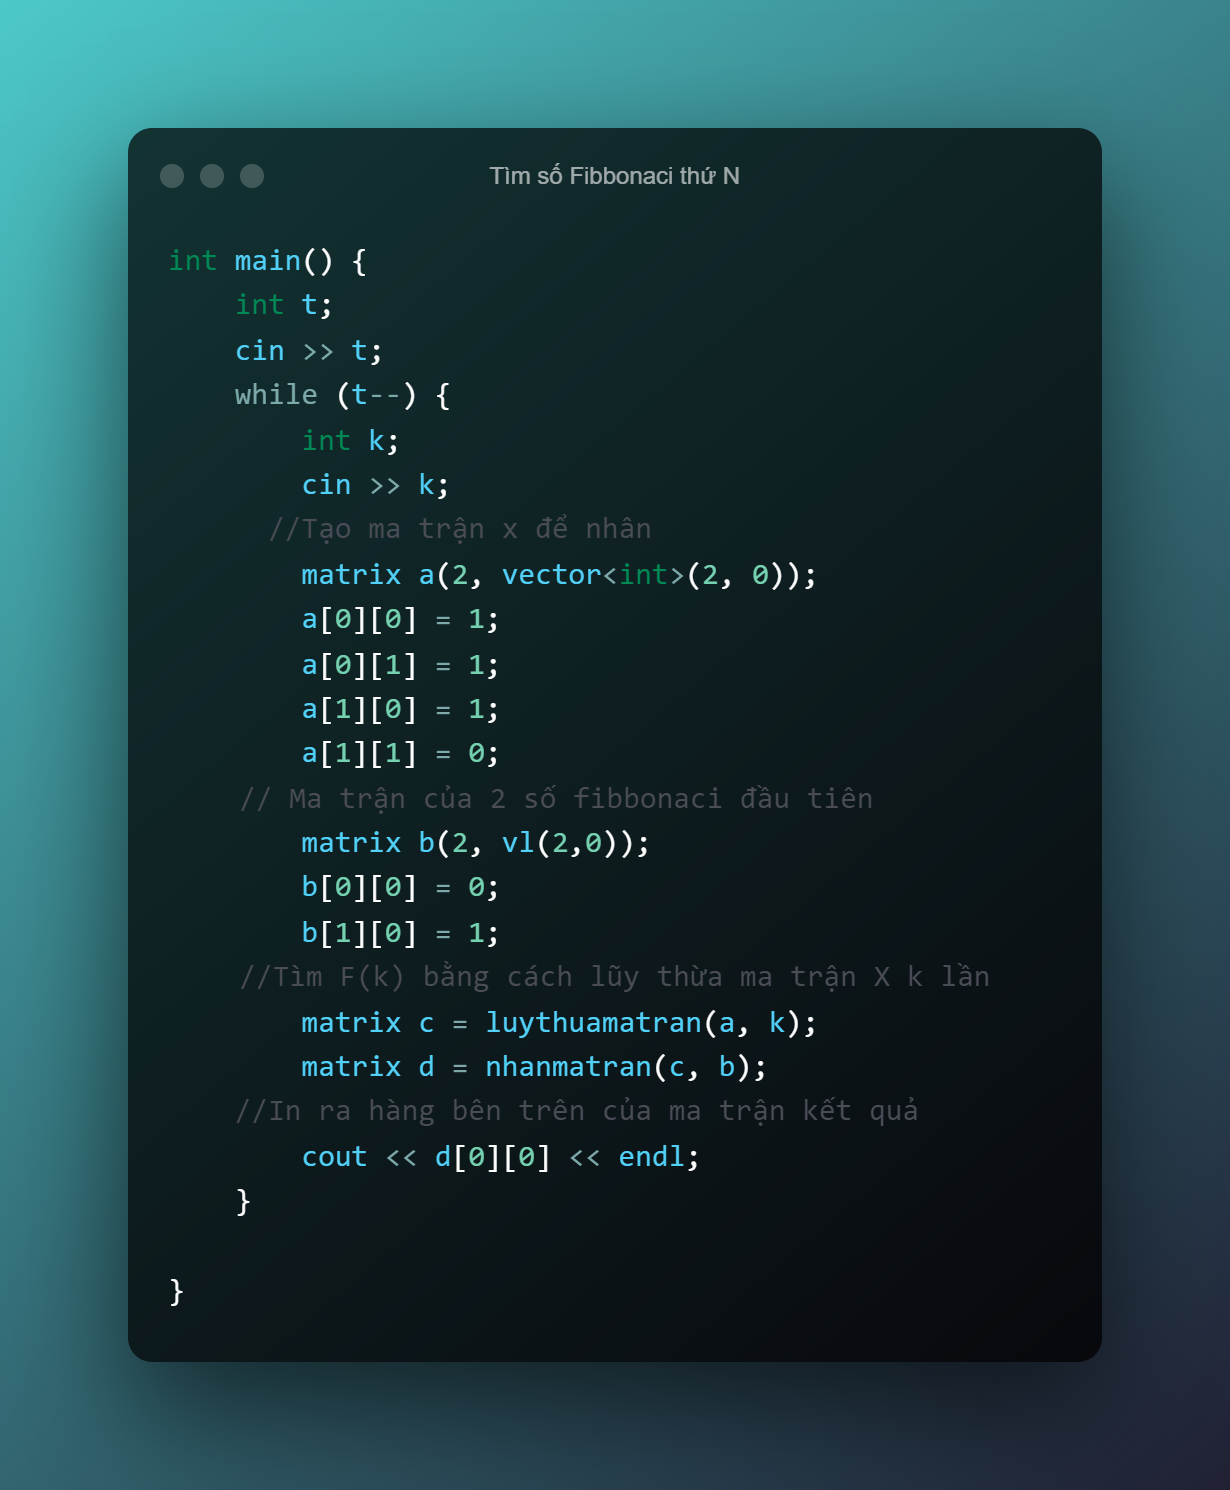
  • Chứng minh quy nạp với các f(n) khác, ta có thể tìm được f(n) bất kì bằng cách nhân ma trận X với ma trận ban đầu (F(0) = 0, F(1) = 1)
zvfOZq7QCd72Sfx0b5D Y69dMmPkJUNGK9XWlGLLaMAcQZLlUCaR0 B5W8LnkYI8ubymwbQXfVN89rqR1yd4GD3RjcAynaYqrkAKdTBooxlMGKvZvTESUoOFh tHoKyJGmmbmDY3ZOz j40vzepDoA - quochung.cyou PTIT
  • Hàm nhân 2 ma trận
qvOTzIw7n cWpEc2zupn87QmMvsnHB1iFVzgWLvYQxOTx 98Fz - quochung.cyou PTIT
  • Lũy thừa ma trận áp dụng chia để trị
Ba3V Ww5ZxV gRjpPfg 98egI9 Abw7SBErY kEjEkMPcK 5GD4KjzB7YvtMwmY1BfFzGVyiF2DzLchXzdBttuNrP2x0anGb rnyCqRwmLtqlP 78ahKgPVUlXYLhPDpcKJkp06lGQl7nh63z3hcvg - quochung.cyou PTIT

Tìm số Fibbonaci

Thuật toán: Tìm hiểu về Sinh

Mục tiêu

  • + Sinh Nhị Phân
  • + Sinh Tổ Hợp
  • + Sinh Hoán Vị 
  1. Sinh Nhị Phân
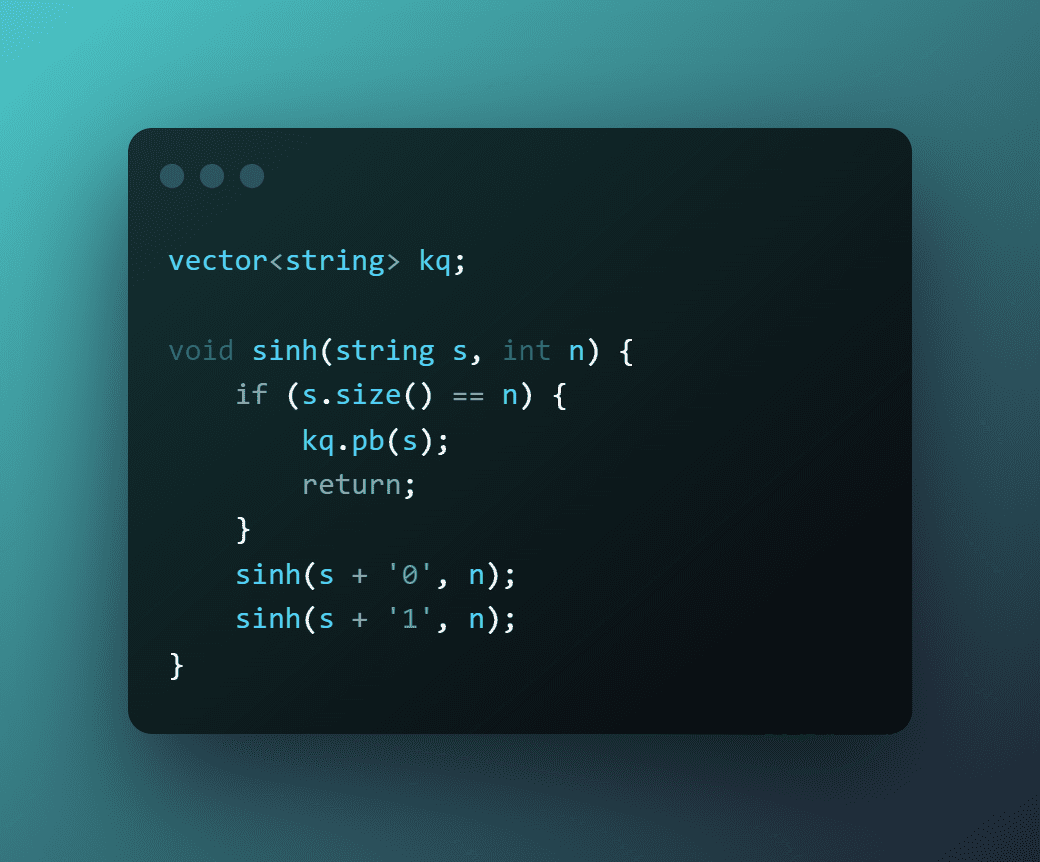
image 2 - quochung.cyou PTIT

Nguyên lí hoạt động:

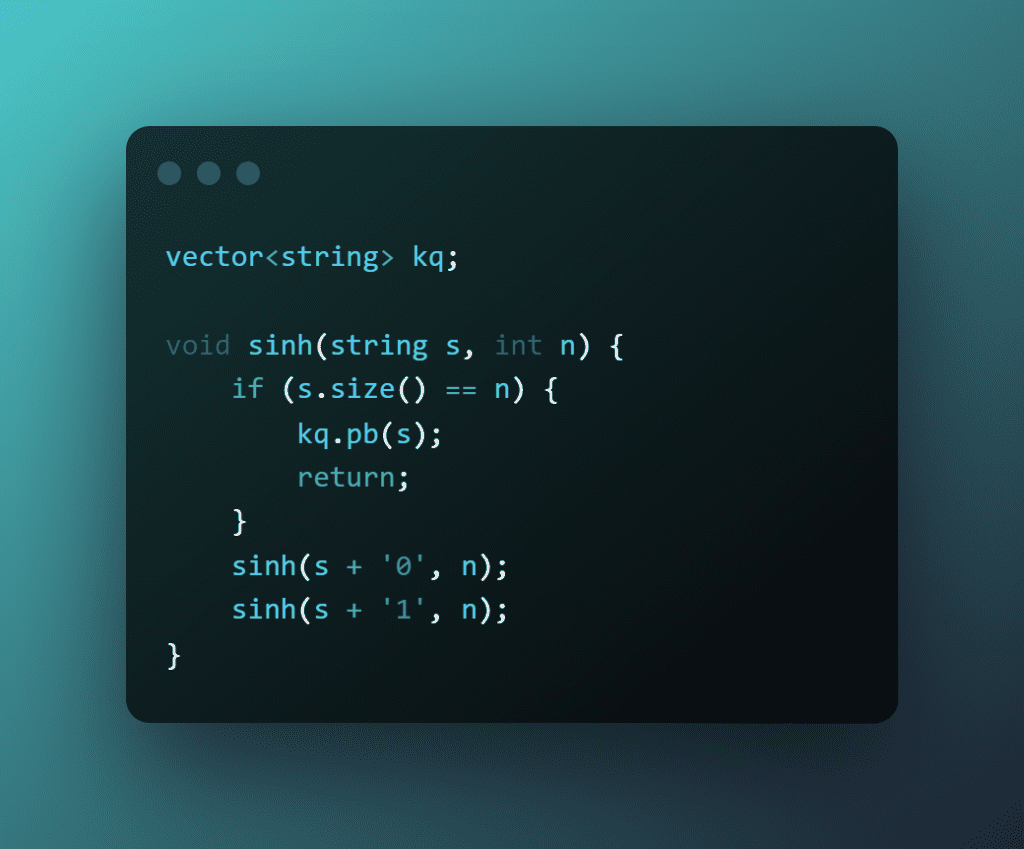
Bước 1: Chúng ta bắt đầu sinh với xâu rỗng “”

Bước 2: Tại mỗi lần sinh, ta đệ quy tiếp với xâu được thêm 1 và 0

Bước 3: Khi đạt đủ độ dài thì thêm vào vector toàn cục “kq” 

Do mỗi lần sinh ta có 2 trường hợp và lặp như thế n lần, nên độ khó là O(2^n)

  1. Sinh Tổ Hợp
https://lh4.googleusercontent.com/qqgU2X2q64xCrXGDgRumXLEWo-7qakZLtMUxpPjeNe7zgqAdm0nJCNv0BR-mxP_HjdnTDO2ASd9MpbpNFNRXTGfz7zlBPwo_8LCdp3D4vgnJC3bJlBpJhuRR_t4Zf_B652Kw2wWDmBttSZCJyQ

Nguyên lí hoạt động:

  • Đầu tiên ta thử với index = 1, và số là 1. Sau đó cứ thử tiếp các trường hợp khác
  • Chạy số 1 -> 
  • for (1->n) ra các số bắt đầu từ 1 -> ra các số bắt đầu từ 2,3,…

ra các số bắt đầu từ 2 -> ra các số bắt đầu từ 1,3,…. 

Độ khó: (n^k) Do mỗi lần ta cần đi qua n, và ta lặp tiếp n lần như thế cho đến khi đạt cấu hình k 

image 1 - quochung.cyou PTIT

  1. Sinh Hoán Vị
image - quochung.cyou PTIT

Nguyên lí hoạt động:

  1. Khởi tạo dãy ban đầu là 1..2..3….n
  2. Ta tiếp tục tìm hoán vị tiếp theo và in ra dãy hiện tại

Để tìm hoán vị tiếp theo:

  • Hoán vị sinh ra phải lớn hơn hoán vị hiện tại hơn thế nữa phải là hoán vị vừa đủ lớn hơn hoán hoán vị hiện tại theo nghĩa không thể có một hoán vị nào khác chen giữa chúng khi sắp thứ tự.
  • Vậy kỹ thuật sinh hoán vị kế tiếp từ hoán vị hiện tại được xây dựng như sau 

+ Tìm từ vị trí sát cuối lên đầu, gặp chỉ số đầu tiên thỏa mãn x[i]<x[i+1] .

+ Nếu tìm thấy chỉ số i như trên

+ Trong đoạn cuối giảm dần, tìm phần tử x[k] nhỏ nhất thỏa mãn điều kiện x[k] >x[i].

+ Đảo giá trị x[k] và x[i]. Đảo ngược lại đoạn cuối

+ Nếu không tìm thấy tức là toàn dãy đã sắp xếp giảm dần, đây là cấu hình cuối cùng ( i < 0)

Độ khó: O(n!)

Thuật toán: Tìm hiểu về Quick Sort and Binary Search

Mục tiêu

  • Khái quát chung về chia để trị.
  • Nguyên lý hoạt động của quick sort.
  • Phần tử pivot là gì? có ảnh hưởng thế nào đến độ phức tạp của thuật toán?
  • Tại sao độ phức tạp của quick sort lại là O(nlog(n)) và tệ nhất là O(n^2).
  • Binary Search hoạt động? tại sao phải so sánh với phần tử chính giữa tập dữ liệu mà k phải lệnh trái hay lệnh phải?
  • Độ phức tạp của BS?
  • Giải thích code 2 bài : Số bé thứ K, Help sudo trên Codeforces

Khái quát chung về chia để trị

Chia để trị là 1 phương pháp áp dụng cho các bài toán có thể giải quyết bằng cách chia nhỏ ra thành các bài toán con từ việc giải quyết các bài toán con này. Sau đó lời giải của các bài toán nhỏ được tổng hợp lại thành lời giải cho bài toán ban đầu.

Thuật toán chia để trị là gì? | Học lập trình JavaScript

Nguyên lí hoạt động của thuật toán Quick Sort

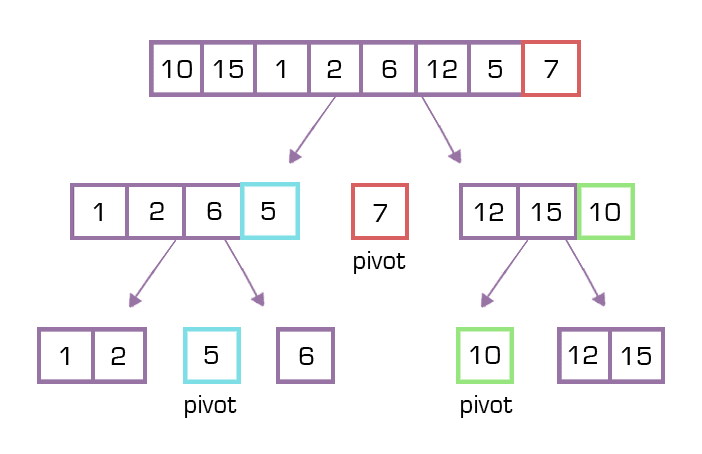
QuickSort hay Sắp xếp nhanh là thuật toán xây dựng dựa trên tư tưởng “Chia để trị” nhắc đến bên trên. 

Đầu tiên ta chọn một phần tử chốt, sau đó so sánh từng phần tử của danh sách với phần tử chốt này để tạo ra 2 phần:

  • Nhỏ hơn phần tử chốt
  • Lớn hơn phần tử chốt

Cứ tiếp tục chia như vậy cho đến khi ta chia ra các dãy con có độ dài bằng 1

Thuật toán QuickSort - Giới thiệu chi tiết và code ví dụ trên nhiều ngôn  ngữ lập trình » Cafedev.vn

Phần tử Pivot là gì? Liên hệ với độ khó thuật toán ? Tại sao độ khó trung bình là O(NlogN) và tệ nhất là O(n^2)

Phần tử chốt (Pivot) được nhắc đến bên trên là phần tử ta sẽ chọn theo từng lần chia để để tạo các danh sách con nhỏ hơn/ lớn hơn phần tử chốt.

Thông thường, ta có 3 cách chọn sau :

  • Chọn phần tử đứng đầu hoặc đứng cuối làm phần tử chốt.
  • Chọn phần tử đứng giữa danh sách làm phần tử chốt.
  • Chọn trung bình trong 3 phần tử đứng đầu, đứng giữa và đứng cuối làm chốt
  • Chọn phần tử ngẫu nhiên làm phần tử chốt 

Bằng việc chọn phần tử chốt, ta sẽ chia dần dãy ra thành các danh sách con nhỏ hơn/ lớn hơn phần tử chốt.

Trong trường hợp tốt: Ta chọn được phần tử chốt mà chia được dãy thành 2 phần bằng nhau hoặc tương đương, vì vậy ta chỉ cần log(2, N) để chia dãy. Và vì mỗi lần ta lại duyệt qua cả dãy, nên độ khó thuật toán là O(NlogN) (Nxlog(2,N))

Trong trường hợp xấu : Ta chọn phải những phần tử chốt lớn nhất hoặc bé nhất dãy, lúc này danh sách con chia ra thì 1 bên chỉ có 1 phần tử, bên còn lại có n-1 phần tử, và nếu cứ như vậy ta cần chia N lần mới xong. Nên độ khó lúc này là O(n^2)

Vậy có thể thống kê độ khó thuật toán QuickSort như sau :

  • Tốt nhất : O(NlogN)
  • Trung bình : O(NlogN)
  • Tệ nhất : O(N^2)

Thuật toán tìm kiếm nhị phân

Hãy tưởng tượng bạn đang cần tìm tên Nguyễn Quốc Hưng trong một cuốn danh bạ điện thoại dày cộp không có mục lục.

Lật từng trang để tìm lúc này tìm có vẻ thật bất khả thi, trong trường hợp xấu nhất, nếu tên Nguyễn Quốc Hưng ở cuối và ta lật từ đầu, vậy ta phải lật hết N trang của cuốn sách O(N)

33,730 Large Book Stock Photos, Pictures & Royalty-Free Images - iStock

Liệu có cách nào nhanh hơn không ?

Thực ra trong thực tế, ta đã luôn vô thức làm cách nhanh hơn. Bạn có thể chỉ cần chọn 1 trang ở giữa, bên trong là tên Ngọc Tâm, T > H, lúc này bạn biết hiện tại là ở vùng chữ T, và Hưng (H) không thể xuất hiện ở những trang phía sau nữa được, và ta chỉ cần tìm ngược lại phía trước. Lật 1 trang sách thấy tên của Hoàng Dương (D), ta biết H không thể ở phía trước D, vì vậy ta chỉ cần tìm tiếp trong phần tiếp theo của chữ D.

How to implement Binary Search in Swift? | by Zafer Şevik | Medium

Hình ảnh minh họa:

Ta cần tìm kiếm số 6

chỉ-mục-giữa = (cuối + đầu)/ 2

Bước 1 : Chọn phần tử ở giữa (số 4), 4 < 6, vậy số 6 chỉ có thể ở vùng bên trái số 4 (những số lớn hơn số 4)

Bước 2 : Chọn phần tử ở giữa ở vùng còn lại lúc này (số 7) , 7 > 6, vậy 6 phải ở bên phải

Lúc này vùng thỏa mãn chỉ còn 1 phần tử, và đó là 6

Do cần chia 2 lần lặp lại, vậy ta chỉ cần chia log(2,N) lần để tìm ra số cần tìm, vậy độ khó của thuật toán tìm kiếm nhị phân là O(logN)

Giải thích Code 2 bài Số bé thứ k, Help Sudo

  1. Số bé thứ K

Cho 1 dãy số nguyên. Bạn hãy tìm phần tử ở vị trí thứ k sau khi sắp xếp tăng dần.

Input : 

9 3

9 5 2 8 51 4 46 98 100

Output : 5

Ý tưởng : 

Sắp xếp lại dãy theo chiều tăng dần, sau đó gọi ra Mang[k-1] để lấy vị trí thứ k

Độ khó thuật toán : O(NlogN – Trung bình)

g ZnWavgMM1YVO8YgCac2M9lAyqg - quochung.cyou PTIT
  1. Help Sudo

Sudo là 1 cậu bé rất thích chơi trốn tìm. Cậu thường rủ bạn bè chơi trên khu phố nơi có 1 hàng cây gồm n cái cây được cắt tỉa để chiều cao tăng dần. Sudo lại rất thích số x nên khi chơi cậu sẽ chốn ở cây có độ cao là x. Tuy nhiên hàng cây rất dài và Sudo đang rất khó khăn để tìm cây có chiều cao là x. Bạn hãy giúp Sudo nhé.

(Tìm xem có x tồn tại trong mảng không)

Input : 

5 16

2 4 7 9 16

Output : YES

Ý tưởng : Dùng lí thuyết tìm kiếm nhị phân để tìm xem có tồn tại số hay không

Độ khó thuật toán : O(logN)

1PxT8ou9wMrD047eh5v ASkWuOZSuiCbBNPD7AjR 2p2yf tk8K3p3YMdxxBSjydHMrRLPNG ldF0r0HfLsCYTFm69 yPR2gm8iWR80ePvhz 2EfBPcM ma7jFjSqXruYU6lPrW6AtZIyeOOQ - quochung.cyou PTIT