JPA là gì? Phân biệt và làm rõ Hibernate, Spring Data JPA, JDBC, ORM

Sơ lược định nghĩa JPA

image 12 - quochung.cyou PTIT
  • JPA, hay còn được gọi là Java Persistence API. Sau này được đổi tên thành Jakarta Persistence API
  • JPA giải quyết các vấn đề trong quản lý quan hệ giữa các thực thể, giúp chúng ta map những object Java (POJO – Plain Old Java OBject) thành những bảng trong database, đây là persistence frameworks được sử dụng nhiều nhất trong Java
  • Để hiểu sâu thêm, hãy đi thêm vào 1 số định nghĩa liên quan

Persistence là gì?

image 13 - quochung.cyou PTIT
  • Java Persistence API, Java là tên ngôn ngữ, API ám chỉ rằng đây là một framework cung cấp các api, các logic mà ta dễ dàng sử dụng lại giúp tăng tốc độ phát triển ứng dụng
  • Vậy Persistence là gì?
  • Hầu hết toàn bộ các ứng dụng yêu cầu ta cần có persistent data (dữ liệu lâu dài). Persistence là một trong những concept nền tảng trong công nghệ phần mềm. Gần như toàn bộ hệ thống thông tin đều cần lưu trữ những dữ liệu nào đó cho hệ thống. Object persistence nghĩa là các thực thể có thể “sống lâu” hơn các chương trình, có thể lưu trữ trong các nơi quản lý dữ liệu và có thể khởi tạo lại trong chương trình vào thời điểm nào đó.
  • Ví dụ đơn giản, trong một web mua bán thương mại điện tử chẳng hạn, dữ liệu trong hệ thống thường là các thông tin về sản phẩm, giá bán, nơi bán, … những dữ liệu này luôn được lưu trữ, kể cả web có thể là bị đóng vài phút, nâng cấp lên, … những dữ liệu này luôn “sống lâu” hơn các chương trình code
  • Khi nói về persistence trong Java, ta thường nói về việc map và lưu trữ các thực thể trong database bằng SQL

Làm việc với cơ sở dữ liệu quan hệ bằng Java qua SQL

  • Khi làm việc với các database trong ứng dụng Java, hiểu đơn giản thì ta sẽ ra 1 câu lệnh SQL vào database bằng cách nào đó với Java chứ ta không cần viết chay truy vấn vào thẳng cơ sở dữ liệu nữa.
  • Ban đầu, ta có JDBC (Java Database Connectivity API) hỗ trợ việc ra các câu lệnh SQL vào một cơ sở dữ liệu. Ta sẽ thực hiện câu lệnh truy vấn, nhận được dữ liệu trả về, sau đó xào nấu nó, …
  • Tuy nhiên các công việc này nhìn chung khá gần theo hướng dữ liệu, data, chứ không có quá nhiều về phần mềm Java. Chúng ta thường muốn có cách nào đó để lấy dữ liệu nhanh từ database, và không phải làm các công việc lặp lại này.
  • Các câu lệnh truy vấn đa phần thường dễ bị lặp lại. Giả sử bạn có 1 hệ thống quản lý sinh viên, môn học, lớp học, giáo viên, … Như thông thường, ta phải viết câu lệnh sql để lấy toàn bộ sinh viên, lấy thông tin 1 sinh viên theo tên, theo tuổi, thêm 1 sinh viên, xoá 1 sinh viên, …. mọi thứ thủ công. Rồi làm y vậy với các đối tượng giáo viên, lớp học, …. Nhìn chung các task này lặp đi lặp lại và tốn thời gian, công sức, chưa tính đến nhiều vấn đề bảo mật, viết sai bug khi viết sql chay như vậy.
  • Hiển nhiên, 1 số thời điểm ta vẫn cần viết sql để custom theo ý mình cho các vấn đề hiệu năng, tuỳ biến, …. nhưng nếu có cách nào đó để giảm thiểu các công việc làm việc với database hơn.
image 14 - quochung.cyou PTIT

ORM

image 15 - quochung.cyou PTIT
  • Ngắn gọn thì, object relational mapping (ORM) là một cách để tự động, đóng gói để map qua lại giữa các dữ liệu database và các class trong Java. Tức là một cái ở giữa để chuyển hoá giữa 1 table lưu thông tin SinhVien với 1 class SinhVien trong java chẳng hạn.

JPA, Hibernate, Spring Data là gì

JPA là gì

  • Lúc này JPA như đã định nghĩa cơ bản bên trên, JPA sẽ là một bản vẽ, định nghĩa ta phải làm gì để lưu trữ và làm việc với object như 1 ORM bên trên, bao gồm việc lấy dữ liệu object từ 1 database, rồi biến nó thành 1 object được tạo ra từ 1 class Java chẳng hạn.
  • Hibernate sẽ là một tầng bên trên, triển khai từ JPA, định nghĩa logic code thực sự là sẽ triển khai như thế nào.
image 16 - quochung.cyou PTIT
  • Có thể ví dụ đơn giản. JPA sẽ chứa rất nhiều hàm là để làm việc thì ta sẽ cần có các hàm lấy dữ liệu theo trường nào đó, tìm dữ liệu theo trường nào đó (select + filter sql), xoá 1 row trong database, …

Hibernate là gì

  • Hibernate là 1 JPA Provider, tức là một Provider, một cái triển khai “JPA”
  • Hibernate sẽ implement interface đó, và là cái có code logic triển khai các hàm trên, tự động sinh ra các câu lệnh sql theo nhu cầu. Tức là ta chỉ cần gọi hàm getAllByName() gì đó, hibernate sẽ tự sinh truy vấn sql, chạy xuống JDBC rồi database để làm việc, ta không cần tự viết sql query đó nữa. Ngoài ra, sau khi lấy dữ liệu xong, nó sẽ tự map dữ liệu database thành các object Java luôn để làm việc.
image 17 - quochung.cyou PTIT
  • Ngoài ra Hibernate còn có nhiều chức năng như đảm bảo phiên trong database, session, ….

Spring Data JPA

image 19 - quochung.cyou PTIT
  • Spring Data JPA là 1 tầng bên trên nữa triển khai Hibernate, có những chức năng cùng framework Spring, cho phép mở ra nhiều khả năng hơn nữa như từ việc đặt tên hàm có thể tạo được các query phức tạp, …
  • Chính xác thì Spring Data JPA có thể chạy với các “JPA Provider” khác nhau, tức là một số khác nào triển khai lại JPA có thể dùng với Spring Data JPA
image 18 - quochung.cyou PTIT

Tổng kết

JPA định nghĩa các phần sau

  • Một phương tiện chỉ định việc ánh xạ, map giữa các dữ liệu persistent trong database và thông tin của nó với các class trong Java. JPA sử dụng rất nhiều Java annotations để làm việc này, ngoài ra ta có thể viết nó trong file XML (thêm minh hoạ bên dưới)
  • API để thực hiện các thao tác CRUD cơ bản với các class java và có thể gọi xuống database để làm việc tương tự. (CRUD – Create/Tạo, Read/Đọc, Update/Cập nhật, Delete/Xoá)
  • Thực hiện các thao tác transaction, có thể lấy dữ liệu theo association (ví dụ 1 sinh viên có nhiều môn học, có thể hiểu việc đó và khi lấy 1 sinh viên sẽ lấy luôn các môn học), thêm 1 số tính năng tối ưu khác, các chiến lược cache, …

Hibernate triển khai JPA và làm các công việc sau

  • Hiệu suất – Giảm thiểu nhiều công việc lặp đi lặp lại để query dữ liệu, giúp ta có thêm thời gian tập trung vào code logic bên trên hơn
  • Bảo trì – Do tự động mapping (ORM) của hibernate, giúp giảm thiểu số lượng code, giúp hệ thống dễ hiểu hơn, dễ bảo trì hơn.
  • Hiệu năng – Nhìn chung thì việc tự viết sql trong các case đặc biệt giúp ta dễ control và có performance mong muốn hơn, tuy nhiên trong một số tác vụ thường thấy, hibernate giúp hiệu năng tốt hơn, tự động, hỗ trợ các cơ chế caching ở tầng ứng dụng
  • Độc lập – Hibernate có thể làm việc với Postgres, MySQL …. mà không phụ thuộc vào 1 nền tảng hay sql của nền tảng đó

[Java Memory 2] Cách Garbage Collector Java giải phóng bộ nhớ (Stop The World, Reference Counting, Sweep, ..)

This entry is part 2 of 2 in the series Java Memory

Trở thành “mồi” của GC (Garbage Collector)

  • Ta đã biết, khi một đối tượng không còn tác dụng nữa, thì chúng sẽ bị GC dọn đi để tiết kiệm bộ nhớ, nhưng thế nào là “hết tác dụng” ?
  • Có thể tóm gọn bằng một câu cơ bản “Object tại heap sẽ không còn hữu dụng nếu chúng mất kết nối tới stack”
  • Object mất kết nối tới stack khi không còn một con trỏ nào chỉ tới chúng nữa cả, hãy xem thử đoạn code sau:
Object o = new Object();
System.out.println(o);
o = null; 
  • Ở dòng đầu tiên, ta tạo một đối tượng o, o lúc này thực chất đang chỉ tới giá trị thực sự của đối tượng ta vừa tạo ra trong heap
  • Khi in thử đối tượng này ra, ta có output theo mẫu sau
java.lang.Object@4617c264
  • Tiếp theo, ta cập nhật o thành null. Lúc này, đối tượng nằm ở heap không còn cái gì trỏ đến nó nữa, và không gì có thể truy cập lại nó nữa, và lúc này nó trở thành mồi của GC

Vấn đề không đơn giản

  • Ví dụ trên khá đơn giản do chỉ có 1 object, vấn đề sẽ phức tạp hơn khi ta tiếp cận với nhiều object liên kết với nhau 1 lúc
image 31 - quochung.cyou PTIT
  • Giả sử với 6 dòng lệnh sau, ta sẽ đi qua từng dòng một
image 32 - quochung.cyou PTIT
  • Sau 4 dòng đầu tiên, stack và heap của chúng ta có dạng như sau. Tại stack là các biến giữ con trỏ tới các giá trị thực trong heap.
image 33 - quochung.cyou PTIT

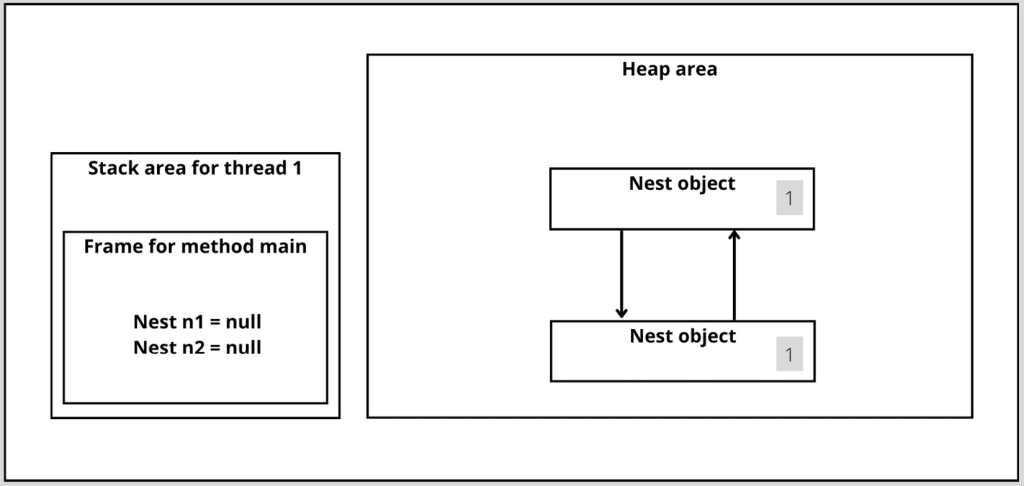
  • Sau dòng thứ 5, ta có hình như sau. Ta thấy, dù sau khi đã cập nhật p1 thành null với mong muốn GC sẽ dọn object này, nhưng thực tế, ta thấy ta vẫn có thể truy cập vào p1 bằng person.get(1) qua list persons, tức là ta vẫn có cách reach đến điểm này
image 34 - quochung.cyou PTIT

  • Chỉ sau khi set cả list thành null, ta mới mất hoàn toàn liên hệ với p1
  • => Không khó để đánh giá các phần tử nào sẽ được Garbage Collector dọn khi bạn đã hiểu về quan hệ bên trên. Dễ dàng thấy, sau 6 bước, p1 mất hoàn toàn liên hệ với stack và sẽ được dọn
  • Tuy nhiên, đó là ta nhìn thủ công, còn để garbage collector biết cái nào còn kết nối với stack sẽ tốn một lượng thời gian, và nó sẽ làm chậm hệ thống lại (chi tiết ở bên dưới). Có nhiều cách để làm điều này, và ta sẽ thảo luận ở bên dưới

Đánh dấu đệ quy

  • Ta sẽ thử đánh dấu các object còn live và object nào có thể bị dọn bởi GC. Dễ dàng, ta thêm 1 bit để dánh dấu xem chúng có còn kết nối với stack hay không. Khi tạo, ta sẽ để bit là 0, và khi ở giai đoạn đánh dấu, object là 0 sẽ bị xoá đi, còn nếu vẫn còn sử dụng, ta sẽ cập nhật nó thành 1
  • Tuy nhiên, heap và stack thay đổi liên tục. Cách đánh dấu được triển khai tuỳ thuộc vào phiên bản Java và GC bạn sử dụng, tuy nhiên, ta sẽ thử xem cách hệ thống đánh từ stack, hãy thử xem ví dụ sau
image 35 - quochung.cyou PTIT
  • Đầu tiên toàn bộ phần tử sẽ được để là 0
image 36 - quochung.cyou PTIT
  • Sau đó, toàn bộ các phần tử có kết nối trực tiếp tới stack được đánh thành 1
image 37 - quochung.cyou PTIT
  • Tuy nhiên, do p1 vẫn có thể truy cập từ danh sách persons, và hơn nữa, ta không thể cứ dọn những gì vẫn còn kết nối. Vì vậy ta cần một cách duyệt đơn giản, với điểm khởi đầu từ các điểm đang = 1, sau đó đi đến mọi quan hệ của nó và đánh chúng thành 1, rồi tiếp tục đệ quy.
  • Các thuật toán đánh dấu đóng vai trò quan trọng trong giai đoạn đánh dấu, đầu tiên thử đi qua cách stop-the-world

Kĩ thuật Stop-The-World – Dừng thế giới

image 38 - quochung.cyou PTIT
  • Với cách đánh dấu trên, ta nhận thấy. Nếu một phần tử được tạo trong quãng đánh dấu, nó sẽ không còn đúng nữa.
  • Vì vây, có một solution đơn giản là ta sẽ dừng mọi luồng khác và chỉ chạy luồng đánh dấu của cả chương trình, điều này sẽ rất ảnh hưởng đến hiệu năng. Ta sẽ thử xem các thuật toán tiếp theo.

Kĩ thuật Reference counting – Đếm liên hệ

image 39 - quochung.cyou PTIT

  • Một cách triển khai khác là đếm số lần một object được trỏ đến. Mỗi object sẽ chứa số lần object được trỏ như một thông số mà nó nắm giữ. Như vậy, GC chỉ việc quét qua và xoá mọi object có 0 lần bị nắm giữ. Cách này sẽ không cần stop-the-world như cách đánh số đệ quy nữa, vì khi object được tạo ra giữa chừng lúc đánh số lần trỏ thì nó vẫn đều là 1 rồi.
  • Tuy nhiên, nó có một điểm yếu là sẽ tạo ra island of isolation, hay các vùng, một tập các object tự trỏ nhau nhưng mà thực tế không có kết nối tới stack
image 40 - quochung.cyou PTIT

Giải phóng bộ nhớ

  • Cách thức làm sao để đánh dấu các object sẽ bị xoá sẽ được quyết định khác nhau bởi phiên bản Java và các kiểu GC khác nhau.
  • Giả sử ta đã đánh dấu được hết các object sẽ có thể bị xoá, tuy nhiên việc xoá chúng đi cũng không phải một quá trình đơn giản
  • Việc xoá object được gọi là sweeping by garbage collector, trong bài viết sẽ mention 3 cách thức sweeping khác nhau
    • Normal sweeping
    • Sweeping with compacting
    • Sweeping with copying

Normal sweeping

image 41 - quochung.cyou PTIT
  • Hình ảnh trên thể hiện các khối bộ nhớ trong ram, các vùng có dấu X là các object đã được đánh dấu và chuẩn bị bị xoá
image 42 - quochung.cyou PTIT
  • Sau khi xoá đi, vùng nhớ của ta có dạng như sau, dễ thấy, điều này dẫn tới một triệu chứng có tên Fragmentation

Fragmentation trong Java Garbage Collector

image 43 - quochung.cyou PTIT
  • Lúc này, vì các vùng trống nằm ở giữa các vùng bị chiếm dụng, nên ta chỉ có thể thêm các bộ nhớ nhỏ hơn hoặc bằng vùng vào các vùng trống. Điều này sẽ dẫn tới 1 vài vấn đề khi ta muốn cấp phát một bộ nhớ lớn hơn
image 44 - quochung.cyou PTIT
  • Giả dụ với trường hợp cấp phát một vùng nhớ lớn hơn các khe trống như ảnh trên, khi cấp phát vào, ta chỉ có thể xếp như sau:
image 45 - quochung.cyou PTIT
  • Dù tổng thể bộ nhớ còn trống ta vẫn đủ để xếp vùng nhớ, nhưng thực tế thì ta không có một vùng nhớ liên tiếp nào chứa đủ vùng nhớ mới này. Và việc này sẽ throw ra 1 runtime exception là OutOfMemoryError.

Ưu nhược điểm của Normal sweeping

  • Normal Sweeping là một kĩ thuật giải phóng vùng nhớ ngây thơ, khá tiện dụng và đơn giản. Tuy nhiên sẽ dẫn tới các vùng nhớ bị phân mảnh. Quá trình này phù hợp khi ta có nhiều bộ nhớ, và ta chỉ cần nhanh chóng dọn bộ nhớ đi. Khi mà lượng vùng nhớ còn trống nhỏ hơn, ta sẽ prefer các kĩ thuật khác

Sweeping with compacting

  • Sweeping with compacting là một quá trình 2 bước. Đầu tiên, chúng vẫn giải phóng bộ nhớ, nhưng sau đó ta sẽ thực hiện thêm 1 bước gọi là compacting (thu gọn), ta sẽ dời toàn bộ vùng nhớ về phía đầu để đảm bảo không có bất kì khoảng trống nào ở giữa
image 46 - quochung.cyou PTIT

Ưu nhược điểm Sweeping with compacting

  • Cách làm này giúp bộ nhớ không còn bị phân mảnh như thông thường, tuy nhiên việc di chuyển các vùng nhớ về đầu là một quá trình tốn kém, vì gần như với lượng vùng nhớ nhỏ và trải dài nhiều, ta sẽ phải copy và di chuyển khá nhiều trên vùng nhớ.

Sweeping with copying

image 50 - quochung.cyou PTIT
  • Ở cách làm này, ta sẽ cần 2 vùng nhớ khác nhau. Ta sẽ không trực tiếp xoá các vùng nhớ bị đánh dấu là xoá đi, mà ta sẽ copy các vùng nhớ k bị xoá vào vùng nhớ mới
image 51 - quochung.cyou PTIT
  • Sau đó mới thực hiện xoá toàn bộ vùng nhớ ở vùng nhớ cũ
image 52 - quochung.cyou PTIT

Ưu nhược điểm của Sweeping with copying

  • Dữ liệu không bị phân mảnh
  • Về hiệu năng thì nhanh hơn compacting, do không phải thực hiện nhiều công đoạn tính toán khi di chuyển, mà chỉ copy nhanh chóng sang vùng mới đang trống hoàn toàn (ở compacting ta ví dụ di chuyển vùng 30-50 sang vùng 0-10, đầu tiên ta phải di 30-40, sau đó lại di vùng 10-20 đi, …. và khó khăn hơn nhiều)
  • Tuy nhiên cần nhiều bộ nhớ hơn vào cùng 1 thời điểm, cần lượng bộ nhớ trữ còn lại đủ nhiều để di chuyển.

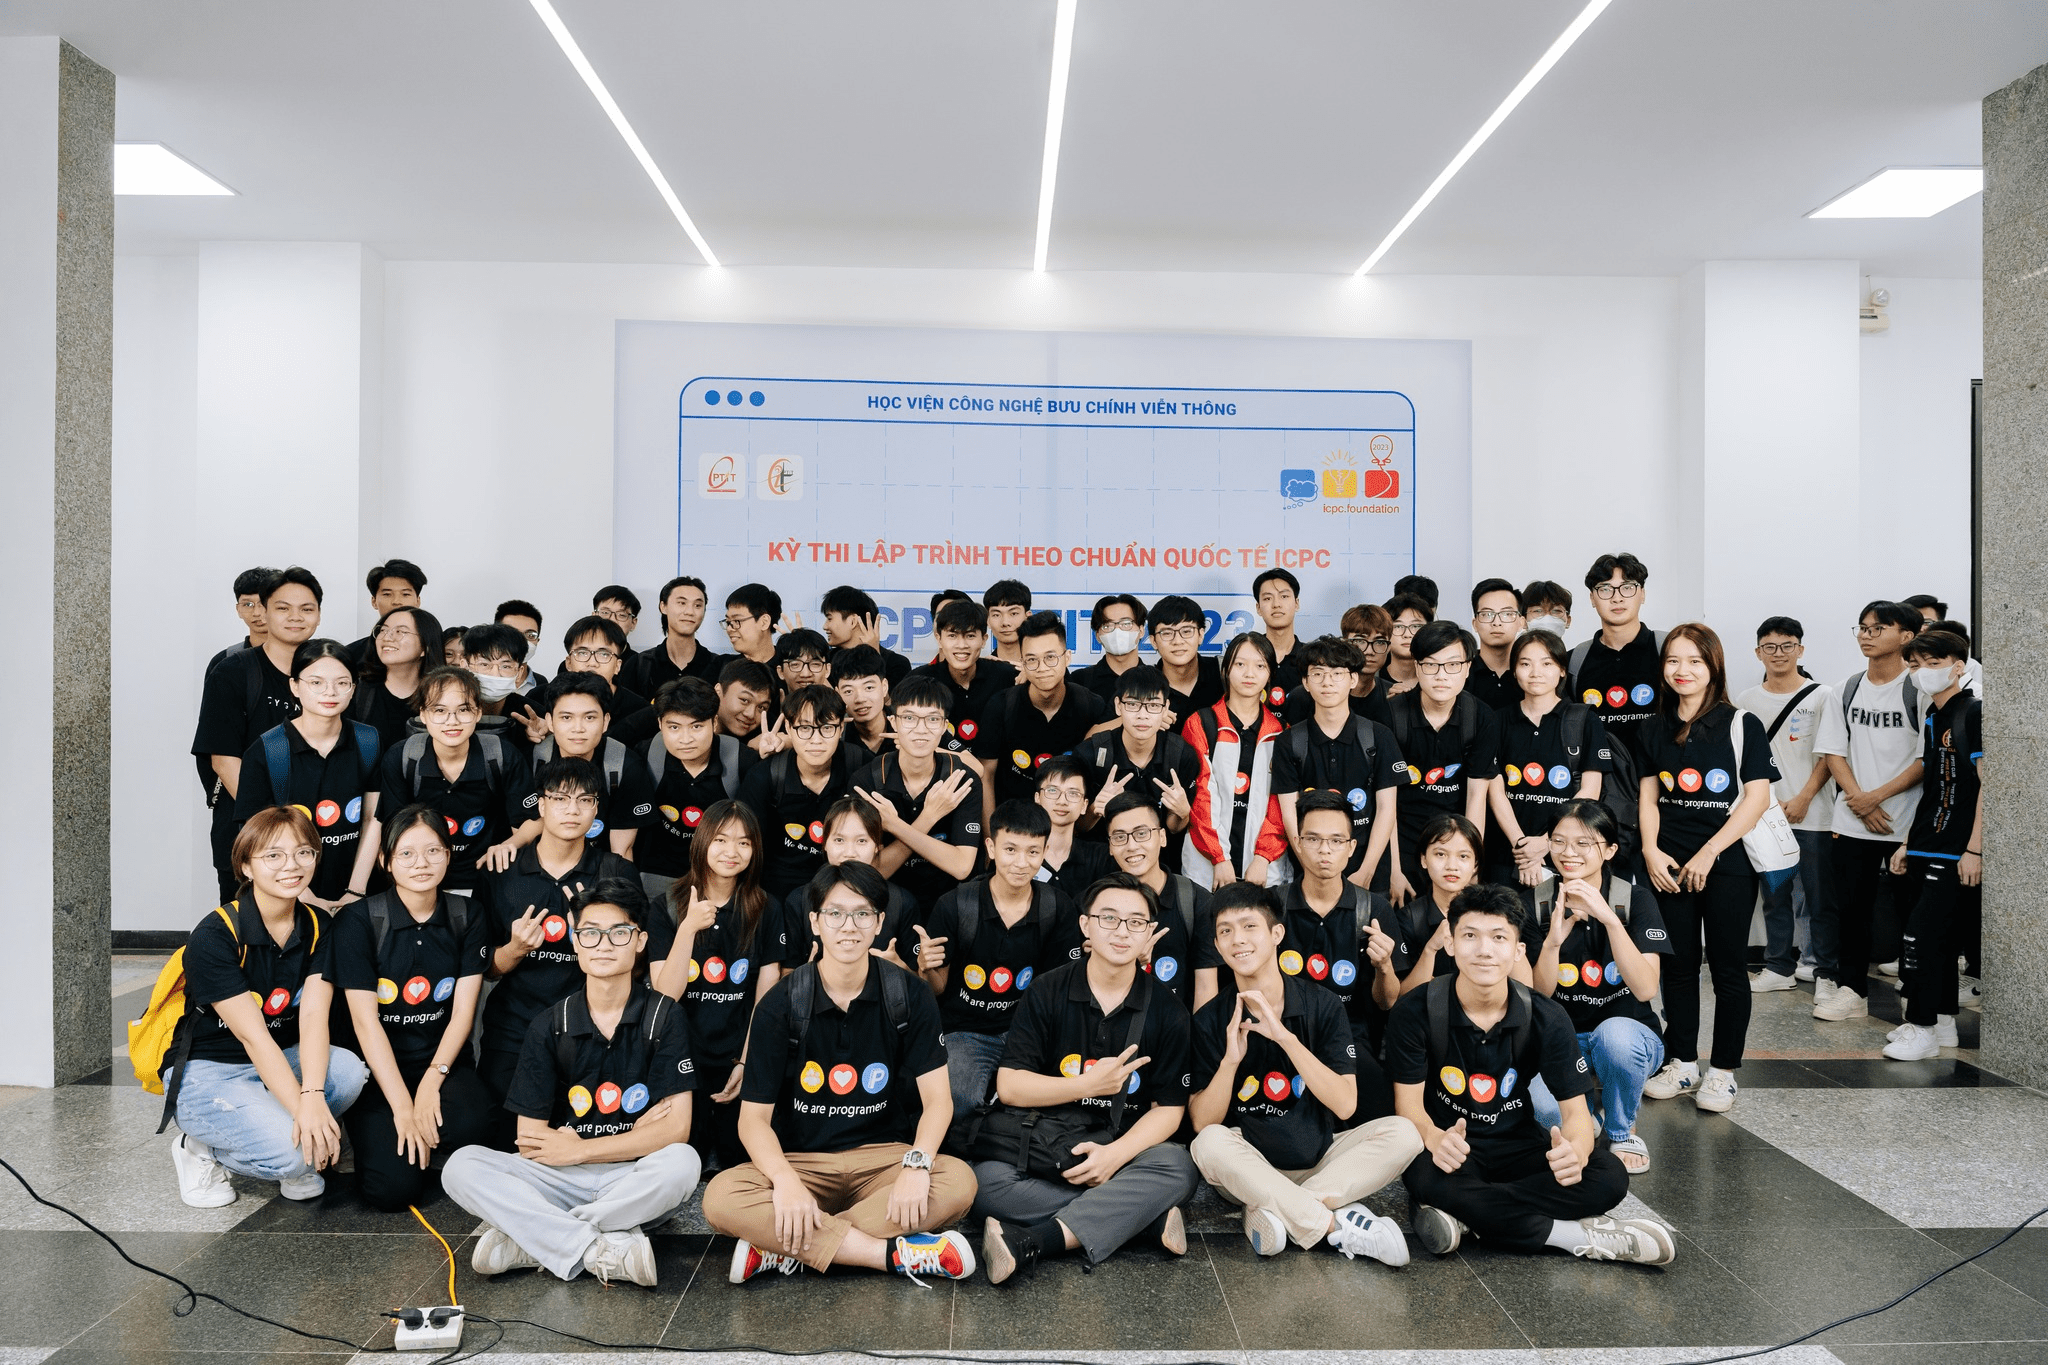
Chung kết ACM/ICPC PTIT 2023

Vào ngày 24/09/2022, Học viện Công nghệ Bưu Chính Viễn Thông đã tổ chức kỳ thi chung kết ICPC PTIT 2022. Sự kiện này đã thu hút 41 đội xuất sắc từ hơn 180 đội tham gia (không tính miền Nam). Kỳ thi đã diễn ra tại sảnh A2 của Học viện. Trong kỳ thi năm 2023, có sự tham gia đáng kể của các sinh viên khoá D22 và E22 (năm nhất). Đây là năm thứ hai mình tham gia cuộc thi này, và từ kinh nghiệm năm ngoái, mình đã có một số kinh nghiệm nhất định :v

image 18 - quochung.cyou PTIT

Đội của chúng mình, có tên là “ProPTIT. Ba bà đi bán lợn con”, gồm ba thành viên: Nguyễn Quốc Hưng (E2105), Nguyễn Mai Phương (D21CN01) và Lê Trí Tâm (D21). Sau khi đứng top 20 trong gần cả cuộc thi, chúng mình đã lội ngược dòng vào 15 phút cuối để giải lên 5 bài và giành được top 4 chung cuộc.

Đề thi năm 2023 có nhiều thay đổi so với 2022, nhìn chung các bài năm nay có nhiều đổi mới, tập trung vào giải thuật nhiều hơn, độ khó cũng khó hơn hẳn năm ngoái. Chắc đây cũng là một phần lí do số sinh viên năm nhất vào chung kết khá ít, chỉ có khoảng 1-2 bài cơ bản và còn lại là các bài với các thuật toán kinh điển như Quy hoạch động, dijkstra, greedy.

Một vài hình ảnh đáng chú ý trong kì thi

Thầy Cường và thầy Sơn tại vòng loại kì thi
Đội hình CLB Lập Trình PTIT checkin vòng loại
image 21 - quochung.cyou PTIT
khu vực thi 2023 tại hội trường a2
image 23 - quochung.cyou PTIT
image 24 - quochung.cyou PTIT

Sự ra đời của Java, các thuật ngữ JVM, JDK, JRE

Giới thiêu về Java

Ngôn ngữ lập trình Java được thiết kế để trở thành một ngôn ngữ không phụ thuộc vào nền tảng (machine-independent). Java có thể chạy trên bất kỳ nền tảng nào miễn là có máy ảo Java (Java Virtual Machine – JVM). Máy ảo Java là một chương trình có thể chạy trên nhiều nền tảng khác nhau mà không cần phải biên dịch lại. Máy ảo Java có thể chạy trên các máy tính, điện thoại, máy tính bảng, máy chủ, … Máy ảo Java có thể được cài đặt trên các hệ điều hành khác nhau như Windows, Linux, Mac OS, …

Java vừa đủ mạnh với nhiều thư viện, tính năng, bảo đảm các sự chặt chẽ, nhưng cũng đồng thời chạy rất nhanh. Java có thể được sử dụng để phát triển các ứng dụng desktop, web, mobile, game, … Java cũng là một trong những ngôn ngữ lập trình được sử dụng nhiều nhất hiện nay.

image 10 - quochung.cyou PTIT

Java Virtual Machine (JVM)

Không như C/C++ khi mà code được biên dịch thì sẽ tạo thành các mã lệnh được làm cho riêng các vi xử lý khác nhau. Code java đầu tiên được biên dịch thành một dạng tổng quát – bytecode, là ngôn ngữ cho JVM chạy. Sau đó JVM mới chạy thành các ngôn ngữ máy cho nền tảng đó.

image 6 - quochung.cyou PTIT

Trình tự hoạt động:

image 7 - quochung.cyou PTIT

JRE – Java Runtime Environment

  • The Java Runtime Environment (JRE) provides the libraries, the Java Virtual Machine, and other components to run applets and applications written in the Java programming language. In addition, two key deployment technologies are part of the JRE: Java Plug-in, which enables applets to run in popular browsers; and Java Web Start, which deploys standalone applications over a network. It is also the foundation for the technologies in the Java 2 Platform, Enterprise Edition (J2EE) for enterprise software development and deployment. The JRE does not contain tools and utilities such as compilers or debuggers for developing applets and applications.
  • JRE – đúng như tên của nó (môi trường chạy java) chứa các thư viện, chứa cả JVM ở bên trong, và một số thành phần khác để chạy được các phần mềm Java. Hiểu đơn giản, nếu bạn có 1 file jar, 1 chương trình java, chỉ cần có JRE là bạn có thể chạy chúng.
image 12 - quochung.cyou PTIT

JDK – Java Development Kit

  • JDK (Java Development Kit) – Bộ công cụ lập trình Java
  • Hiểu đơn giản thì JDK chứa JRE và thêm một số công cụ khác để hỗ trợ cho việc lập trình, compile các file code .java sang file .class (đọc thêm bên dưới)
image 11 - quochung.cyou PTIT

Cấu trúc chương trình Java

image 8 - quochung.cyou PTIT
  • Trong file source code, chứa “class” (lớp)
  • Mỗi “class” chứa nhiều “method” (hàm) khác nhau.
  • Mỗi “method” chứa nhiều “statements” (dòng lệnh) khác nhau.

Ví dụ 1 file class:

``` 

public class HelloWorld {
    public static void main(String[] args) {
        System.out.println("Hello World!");
    }
}

```
  • Khi một dự án Java chạy, JVM sẽ tìm class bạn để là class đầu tiên khởi chạy, rồi sau đó tìm đến method main để chạy.
public static void main(String[] args) {
   // đây là hàm đầu tiên được chạy
}

image 9 - quochung.cyou PTIT

Tham khảo:

Tìm hiểu Consistent hashing (Ánh xạ nhất quán) – Xử lí dữ liệu phân tán

image 60 - quochung.cyou PTIT
  • Consistent hashing (Ánh xạ nhất quán) thường được sử dụng trong các hệ thống phân tán.
  • Trước tiên, để giải thích một số term, thuật ngữ mà các bạn còn có thể confuse, chúng ta sẽ đi từng phần một

Hệ thống phân tán

image 61 - quochung.cyou PTIT
  • Hiểu đơn giản, tưởng tượng việc bạn truy cập đến server như vào 1 cửa hàng mua đồ vậy. Nếu một ngày bình thường, bạn gọi món, đồ ăn đến rất nhanh, đơn giản, phục vụ tốt. Nhưng vào giờ cao điểm, khi chỉ có 1 phục vụ quán, quá nhiều người gọi làm phục vụ quán không đỡ kịp, cửa hàng quá tải và ai cũng có đồ ăn rất chậm.
  • => Để xử lí có nhiều cách, nhưng dễ dàng nhất, chỉ cần tuyển thêm nhiều phục vụ hơn thôi? Quy chiếu về server, ta chỉ cần có nhiều server con khác nhau, và chia nhỏ các yêu cầu của khách hàng đến các server một cách đồng đều, hay chia nhỏ các database, …. Lúc đó, ta có hệ thống phân tán.

Ánh xạ là gì? Tại sao cần ánh xạ (hashing) ?

  • Lúc này ta có một bài toán cần giải quyết, làm sao để chia các yêu cầu của khách hàng vào các server khác nhau, sao cho nó đồng đều? Không được có server làm quá nhiều việc, server làm quá ít việc, ta mong muốn có mọi server đều xử lí đều nhất có thể.
  • Một cách làm phổ biến và dễ hiểu là Round-robin, hay ánh xạ theo phần dư
ServerIndex = hash_function(key) % N
  • Tức là ta sẽ đánh số các request theo thứ tự bằng cách chia dư. Ví dụ ta có 5 server, thì chia dư số thứ tự cho 5
image 62 - quochung.cyou PTIT
  • Ánh xạ chia dư cho 4 server như vậy thì request thứ 1 và 5 sẽ vào ô 1, sau đó là request 0,2 , rồi request 7,6 , …
  • Nghe thì có vẻ rất lí tưởng, request sẽ được chia đều cho các server. Nhưng đó là trường hợp số lượng server không đổi trong “thế giới lí tưởng”. Cuộc sống thực tế thì không đẹp như vậy, chúng ta dễ dàng gặp phải trường hợp sếp bỗng muốn đang từ 4 server, scale lên 15 server. Hay 4 server giảm xuống còn 2 server. Hay 10 server một ngày bỗng chết, mất điện server 1,5,6.
image 63 - quochung.cyou PTIT
  • Lúc này ta cần bê tập dữ liệu từ server sai số thứ tự, rồi đánh số lại theo số lượng server mới. Lúc này rất dễ xảy ra trường hợp server thì bị quá tải, server thì lại rảnh không.
  • Đánh giá vấn đề: Việc chuyển dữ liệu từ những server hỏng, hoặc chuyển ra server mới khi scaleup/down là thiết yếu. Nhưng ta cần một phương pháp để số lượng phần tử cần di chuyển ít nhất có thể

Consistent hashing (Ánh xạ nhất quán)

Định nghĩa

“Consistent hashing is a special kind of hashing technique such that when a hash table is resized, only n/m keys need to be remapped on average where n is the number of keys and m is the number of slots. In contrast, in most traditional hash tables, a change in the number of array slots causes nearly all keys to be remapped because the mapping between the keys and the slots is defined by a modular operation.”

Ánh xạ nhất quán là một kĩ thuật ánh xạ để khi mà bảng ánh xạ thay đổi số lượng, chỉ có n/m từ khoá sẽ cần phải đánh số lại trung bình. Với n là số lượng dữ liệu (trong ví dụ trên là request), và m là số slot (ví dụ trên là server). Điều này tốt hơn ánh xạ chia dư khi mà gần như toàn bộ dữ liệu phải đánh lại hết vì tất cả số dư thường sẽ thay đổi khi m thay đổi.

Một số từ khoá

image 64 - quochung.cyou PTIT
  • Gọi f() là hàm băm, phương trình sẽ cho ra một mã gì đó khi ta truyền vào 1 giá trị. Mỗi phương trình thì luôn có vùng giá trị đầu ra (hash space) nhất định. Ví dụ: chia dư cho m thì vùng giá trị là từ 0 -> m-1. hay SHA-1 thì là từ 0 -> 2^160-1. Ta sẽ có (hash ring) vòng băm tương ứng

Các bước

  • Tiến hành hash các server của chúng ta thành một số nguyên trong hash ring được định nghĩa trước. Khoảng số này tuỳ vào người thiết kế hệ thống tự cân nhắc số lượng server tối đa mà hệ thống sẽ lên.
  • Sau khi có danh sách mapping giữa các node, ta sẽ tiến hành mapping key của data tới các node bằng cách
    • hash giá trị của key thành một số nguyên
    • Di chuyển nó liên tục trong vòng tròn số nguyên (hash ring) đã được tạo theo kim đồng hồ cho tới khi nó quay lại hash key của node đầu tiên nó gặp (đi 1 vòng). Ghi dữ liệu
  • Để dễ hình dung hơn, hãy xem hình ảnh sau
image 66 - quochung.cyou PTIT
  • Để quyết định request nào sẽ được phân bổ vào node nào. Thì ví dụ request có mã là 1000, nó sẽ cứ đi trên vòng tròn bảng giá trị trên và tìm node đầu tiên có mã lớn hơn 1000. nếu nó là lớn nhất rồi thì nó sẽ vòng lại node đầu tiên.
  • Ngoài ra, ví dụ trên hình ảnh trên, ta chỉ có node 1-5, nhưng ta sẽ tạo các “virtual node”, hay node ảo để băm cái vòng của chúng ta nhỏ hơn nữa, và các khoảng của node ảo sẽ quy định nó vào node thật sự nào.
  • Bằng một cách nói nào đó, mỗi server sẽ xử lí một “cung” trên đường tròn

Consistent hashing xử lí vấn đề scale như thế nào

  • Ta sẽ quay lại vấn đề, khi một node nào đó bị sập. Thì consistent hashing sẽ giải quyết bài toán đó như thế nào?
  • Solution nghe ra lại rất đơn giản, lúc này thì các khoảng vòng cung sẽ được kéo rộng ra, các request sẽ tự đi tìm đến vị trí note tiếp theo
image 67 - quochung.cyou PTIT
  • Rõ ràng, ta thấy lúc này chỉ những request ở vòng cung phía trước sẽ cần thay đổi mapping lại. Còn theo cách chia modulo, thì do số dư thường sẽ thay đổi gần như toàn bộ các số, ta sẽ phải di chuyển rất nhiều keys (Request)

Triển khai thuật toán

  • Cùng nhìn lại, chúng ta cần những gì để triển khai thuật toán này?
    • Ta cần một mảng ánh xạ quy đổi ra các node trên hash ring (vòng giá trị)
    • Một map để phân bổ request nào vào node nào
  • Như vạy, để phân bổ request vào các node, ta cần một cơ chế dạng
    • Một cách tìm kiếm nhanh node đầu tiên có giá trị lớn hơn mã của request hiện tại. Do mã của node được trải phẳng trên một khoảng tịnh tiến, dễ dàng, ta có thể triển khai tìm kiếm nhị phân để tìm node đầu tiên có mã lớn hơn bằng mã của request (Lower_bound)
    • Từ mã của node, tìm ra node thực sự để điều hướng
  • Thay đổi khi hash ring thay đổi
    • Để xác định những request nào cần di chuyển, có cách khá đơn giản là ta sẽ lặp và kiểm tra toàn bộ request, sau đó xác định cái nào bị sai để chuyển nó sang node tiếp theo trên vòng. Nhưng cách này rõ ràng là cách “naive method”.
    • Để có thể triển khai với thời gian tối ưu hơn, ta có thể sử dụng một cấu trúc dữ liệu để xác định “khoảng ảnh hưởng”, nơi mà các key cần remap lại
    • Một lần nữa, ta có thể triển khai tìm kiếm nhị phân, bằng cách từ node bị xoá đi, ta dùng mã đó và quay ngược lại, sau đó tìm ra các điểm bị sai và cập nhật chúng cho đến khi đến 1 mã node hash khác.

Các câu hỏi thêm

  • Q: Khi nào nên sử dụng kỹ thuật consistent hashing này ?
  • A: Thông thường, ta sẽ sử dụng nó cho các hệ thống phân tán, nơi mà request thực sự đủ nhiều, và ta có nhiều server cần scaling và cần áp dụng để phân bổ request một cách đều. Amazon Dynamo cũng triển khai kĩ thuật này. Tuy nhiên, với các hệ thống nhỏ hơn, có thể dùng cách ánh xạ chia dư truyền thống, vì việc sử dụng hashing khó hơn cũng đi kèm độ phức tạp của hệ thống tăng lên và khó bảo trì.

  • Q: Tại sao lại gọi là consistent trong consistent hashing (nhất quán)
  • A: Vì khi có sự thay đổi về lượng server, ta không cần hashing lại toàn bộ các key

Tham khảo:

Chung kết ACM/ICPC PTIT 2022

Vừa qua 09/10/2022 Học viện Công nghệ Bưu Chính Viễn Thông đã tổ chức kì thi chung kết ICPC PTIT 2022 với 33 đội (chưa kể miền Nam) tại sảnh A2 của Học Viện. Kì thi 2022 có sự góp mặt phần lớn của khoá sinh viên D21, E21 (Năm nhất), tuy rằng kết quả chung cuộc bị chênh lệch phần lớn bởi thời gian sub bài chứ không có nhiều khác biệt giữa các team top giữa, nhưng kì thi vẫn đã diễn ra vô cùng hấp dẫn và kịch tích

image - quochung.cyou PTIT
Banner ICPC PTIT 2022

Đội của mình “ProPTIT. GGWP” Gồm mình Nguyễn Quốc Hưng E2105, Nguyễn Mai Phương (D21CN01), Nguyễn Đăng Minh (E2101) đã cố gắng giành thứ hạng #8 với 6 bài, khá tiếc là cây toán của team – Mai Phương đã đưa 2 teammate vào hai bài khó nhất đề bằng câu “hai bài này có vẻ làm được này”, mà bỏ qua 1 câu toán khá vừa tầm đúng ra nên làm.

Một vài hình ảnh đáng chú ý trong kì thi

image 1 - quochung.cyou PTIT
Thầy Từ Minh Phương phát biểu khai mạc
image 2 - quochung.cyou PTIT
Ban tổ chức ICPC PTIT 2022
image 3 - quochung.cyou PTIT
Đội 812 – Đội vô địch cũng là team First Solve bài đầu tiên
308852668 519902050142483 6200032404820115480 n - quochung.cyou PTIT
Khu vực thi – Sảnh A2
310474281 519902076809147 5619913051196432147 n - quochung.cyou PTIT
Khu vực thi – Sảnh A2
311190978 519910133475008 26272425141169940 n - quochung.cyou PTIT
Các thầy cô ban tổ chức
image 6 - quochung.cyou PTIT
Lễ trao giải ICPC PTIT 2022 – Đội vô địch 812

Lễ trao giải cuộc thi: https://portal.ptit.edu.vn/le-trao-giai-cuoc-thi-lap-trinh-theo-chuan-quoc-te-icpc-icpc-ptit-2022/

Sắc màu ICPC PTIT 2022: https://www.facebook.com/media/set/?set=a.518458426953512&type=3