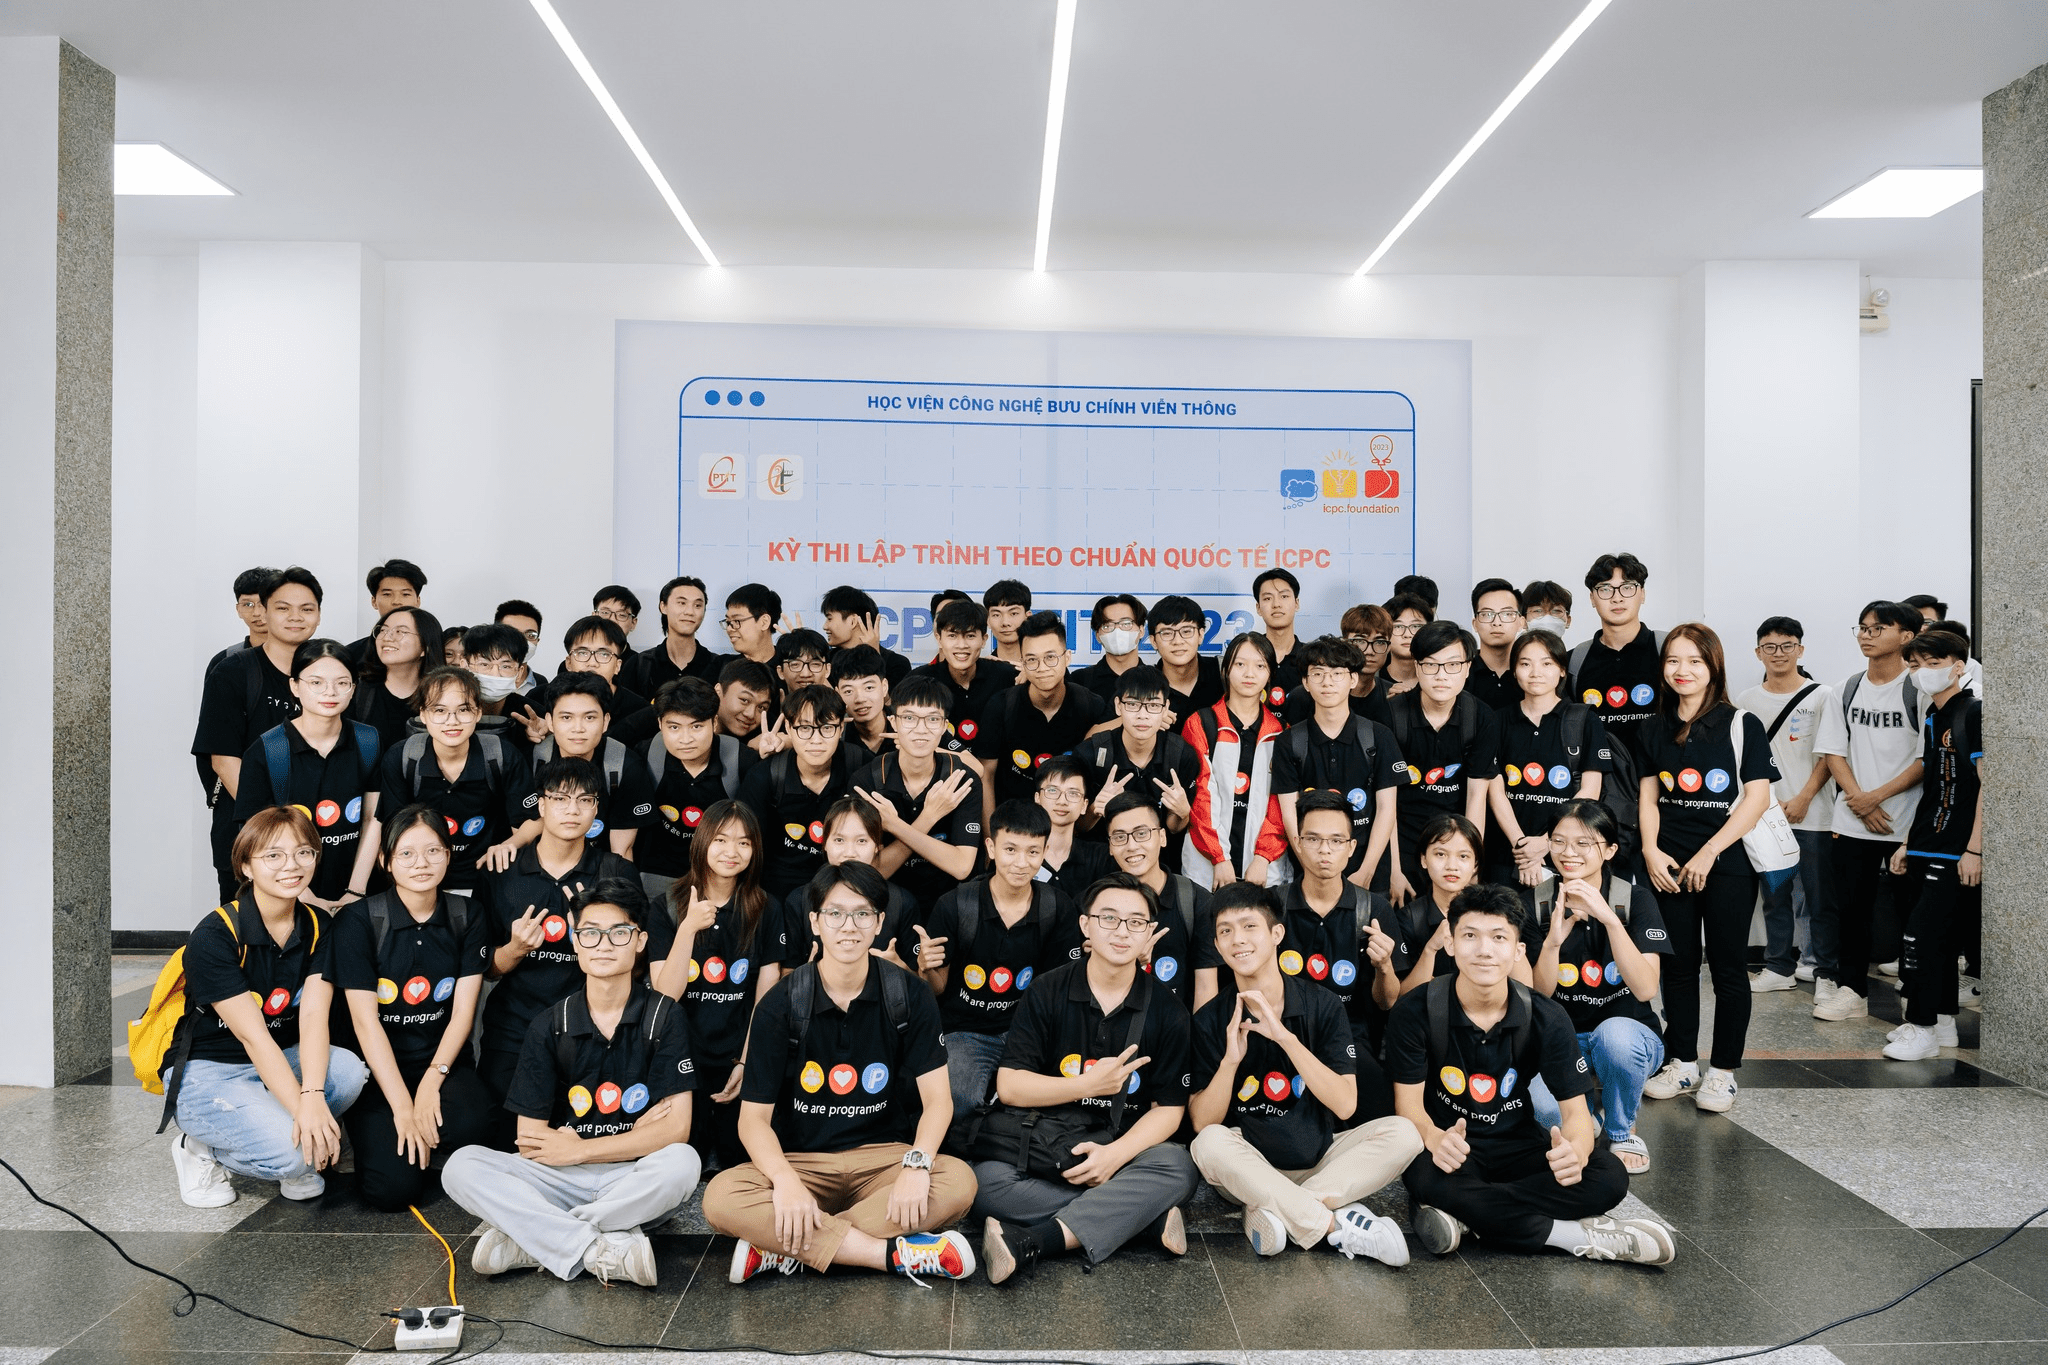
Vào ngày 24/09/2022, Học viện Công nghệ Bưu Chính Viễn Thông đã tổ chức kỳ thi chung kết ICPC PTIT 2022. Sự kiện này đã thu hút 41 đội xuất sắc từ hơn 180 đội tham gia (không tính miền Nam). Kỳ thi đã diễn ra tại sảnh A2 của Học viện. Trong kỳ thi năm 2023, có sự tham gia đáng kể của các sinh viên khoá D22 và E22 (năm nhất). Đây là năm thứ hai mình tham gia cuộc thi này, và từ kinh nghiệm năm ngoái, mình đã có một số kinh nghiệm nhất định :v
Đội của chúng mình, có tên là “ProPTIT. Ba bà đi bán lợn con”, gồm ba thành viên: Nguyễn Quốc Hưng (E2105), Nguyễn Mai Phương (D21CN01) và Lê Trí Tâm (D21). Sau khi đứng top 20 trong gần cả cuộc thi, chúng mình đã lội ngược dòng vào 15 phút cuối để giải lên 5 bài và giành được top 4 chung cuộc.
Đề thi năm 2023 có nhiều thay đổi so với 2022, nhìn chung các bài năm nay có nhiều đổi mới, tập trung vào giải thuật nhiều hơn, độ khó cũng khó hơn hẳn năm ngoái. Chắc đây cũng là một phần lí do số sinh viên năm nhất vào chung kết khá ít, chỉ có khoảng 1-2 bài cơ bản và còn lại là các bài với các thuật toán kinh điển như Quy hoạch động, dijkstra, greedy.
Phân trang đơn giản là ta sẽ chia một tập dữ liệu lớn và truyền cho user thành từng phần nhỏ hơn. Hãy tưởng tượng, bạn đang thiết kế một hệ thống backend cho phía frontend của một trang tin tức, phía FE muốn một lệnh API để có lấy dữ liệu các bài viết từ database của bạn.
Bài toán sẽ khá đơn giản nếu bạn chỉ có 10-20 bài viết, bạn chỉ cần làm theo cách truyền thống, lấy dữ liệu từ database từ backend, gửi một file json chứa dữ liệu cho FE, mọi thứ nghe có vẻ đơn giản.
Tuy nhiên khi tập dữ liệu của ta ngày càng lớn, ví dụ, lúc này 1 Model bài viết có rất nhiều trường (ảnh đại diện, chuyên mục, thời gian đăng, ….), và ta có hàng 1000-10000 bài viết, việc trả 1 lần tập dữ liệu lớn như thế sẽ làm chậm ở 2 chỗ:
Lấy toàn bộ dữ liệu từ database tốn thời gian
Truyền 1 lần dữ liệu lớn như vậy sẽ rất nặng, tốn tiền mạng thật sự của user (tải 1 file lớn mỗi lần), và lúc tải 1 file lớn như thế cũng rất chậm, tốn thời gian, gây khó chịu người dùng
Tổng kết 1
Khi đó, ta có thể sử dụng đến phân trang, và mỗi lần người dùng chỉ có thể xem 1 trang, ta chỉ gửi khoảng 10-15 bài viết 1 lần thôi, khi người dùng sang trang khác ta sẽ gửi tập dữ liệu khác, khá đơn giản.
Triển khai phân trang bằng Spring Boot
Triển khai Model
Triển khai Repository
Để có thể truy cập các JPA Entity trên từ database, ta sẽ tạo 1 PostRepository
JPARepository đã kế thừa sẵn một interface là PagingAndSortingRepository của Spring hỗ trợ việc phân trang và sắp xếp. Dù là một interface, không có implemention, nhưng khi chương trình khởi chạy, Spring sẽ tự động generate các code implemention thật cho chúng ta, thực thi các thao tác với database, và chúng ta chỉ cần define các method có sẵn thôi.
Phân trang
Do Spring đã làm đa số các phần code, giờ ta chỉ cần triển khai thêm 2 việc
Tạo một PostPageRequest class, implement từ Pageable interface của Spring
Truyền tham số cần tìm cho PostPageRequest
Khi implement interface Pageable, ta sẽ phải triển khai một số hàm. Lúc này class PostPageRequest sẽ như một object “trang” , kiểu trang 5 thì là một object Trang, trang 6 là một object khác. Từ object trang đó ta có thể lấy trang tiếp theo, trang phía trước, các bài viết trong trang,….
offset và limit
Bạn có thể thấy trong code trên có các tham số offset và limit. Hai tham số trong sql có ý nghĩa như sau
offset x : Lùi x kết quả từ dãy kết quả trả ra
limit y: Từ danh sách kết quả trả ra, lấy y kết quả đầu tiên.
Ví dụ: ta có các bài viết đánh số từ 1-100. offset 5 thì ta sẽ có danh sách là 6-100. limit tiếp 10 thì ta có danh sách 6-16…
Nếu bạn đã hiểu định nghĩa offset và limit, hãy thử đọc lại code bên trên, bạn sẽ dễ dàng hiểu được các method lấy trang tiếp theo, lấy trang trước, …. đang làm gì.
Tổng kết 2
Như vậy, ta đã triển khai được phân trang bằng Spring Boot, tuy nhiên liệu như vậy đã tối ưu cho trang web của bạn chưa?
Tối ưu limit và offset trong MySQL
Offset
Query Duration (ms)
0
1
50
1
1000
13
10000
150
25000
500
50000
930
100000
1750
Những biểu đồ và bảng
Ta có thể thấy, bằng việc dùng offset để lùi kết quả đi một đoạn, rồi lấy limit để lấy lượng bài ở trang đó nghe có vẻ rất đơn giản, dễ hiểu. Nhưng thực tế trong MySQL chúng được thực hiện như sau:
…the rows are first sorted according to the <order by clause> and then limited by dropping the number of rows specified in the <result offset clause> from the beginning…
…các dòng đầu tiên được sắp xếp (ví dụ theo id, thời gian đăng bài…) sau đó xóa x hàng đầu tiên được yêu cầu khi sử dụng offset
Nếu bạn nghĩ kĩ, câu lệnh offset chỉ nhận đúng 1 tham số: lượng dòng bị bỏ qua cho đến tập kết quả muốn nhận.
Cách duy nhất hệ thống database có thể làm điều này là lấy toàn bộ dữ liệu cần tìm, sau đó ném đi x hàng đầu bạn đã đặt ra yêu cầu. Khi offset đủ lớn, lượng công việc cho database sẽ rất nhiều và thời gian để truy vấn sẽ tăng khó kiểm soát.
Khi sử dụng offset, ta mở trang đầu tiên, trang thứ 2, thời gian mất chỉ 1ms (1 phần nghìn giây), gần như không có vấn đề gì.
Trang thứ 10000, 150ms, vẫn chưa nhận ra điều gì quá lo ngại
100000 1750ms, 1,75 giây.
Ta có thể thấy, nếu người dùng mở 1 trang càng xa, hiệu suất của trang sẽ càng giảm, việc một user mở trang thứ 10000 có thể gây vấn đề hiệu năng hơn nhiều cho database hơn 100 người dùng khác mở trang 1
Hướng khắc phục
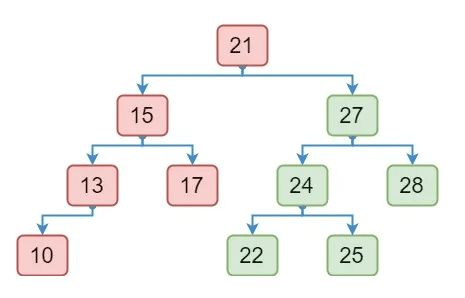
Trước hết, ta cần tìm hiểu xem những hệ quản trị cơ sở dữ liệu đang làm gì để sắp xếp dữ liệu của chúng ta. Ta sẽ assume hệ cơ sở dữ liệu đang sử dụng một B-Tree để index database (một bản nâng cấp của cây nhị phân cân bằng).
Nếu bạn chưa từng nghe đến cụm từ trên, bạn có thể tìm hiểu ở link sau:
Lúc này database của chúng ta lưu dữ liệu theo dạng như sau:
Khi ta sử dụng offset 0, limit 5 để lấy 5 bài viết đầu tiên chẳng hạn, database sẽ chạy các kết quả sau
SELECT * FROM my_table ORDER BY id LIMIT 5
Tuy nhiên, với offset, sau khi offset 5 và limit 5, ta có
Như vậy, ta phải đi qua 5 cái đầu trước, bỏ dần nó, rồi sau đó mới limit 5 cái sau. Khá là tốn thời gian
Vấn đề: Database không biết điểm khởi đầu của trang tiếp theo ở đâu, vì vậy nó cứ phải bỏ dần các hàng phía trước cho đến khi đến được vị trí chỉ định
=> Khắc phục: Ta nhớ xem vị trí lần cuối là ở đâu ?
Kĩ thuật: keyset pagination and seek method
Ở một số trang web, bạn sẽ thấy, bạn không thể đi đến thẳng trang cuối, hoặc nhảy đến 1 trang bất kì, mà thông thường sẽ có nút để sang trang kế và trang phía trước. Như vậy ta có thể assume rằng:
Người dùng sẽ chỉ mở trang 10 sau khi mở trang 9.
Vậy, ta chỉ cần nhớ vị trí cuối cùng của bài viết ở trang 9 là ở id bao nhiêu, rồi dùng WHERE để truy vấn từ điểm đó, chứ không cần bỏ dần để đi đến điểm đó nữa
SELECT * FROM my_table WHERE id > 21 ORDER BY id LIMIT 5
Ví dụ: Sort theo thời gian
SELECT *
FROM my_table
WHERE (update_date = '2017-12-21' AND id > 21)
    OR update_date > '2017-12-21'
ORDER BY update_date,id LIMIT 5
Cơ bản là ta sẽ chỉ lấy các bài viết có cùng thời gian đăng như bài viết cuối và id > , hoặc thời gian lớn hơn bài viết cuối
Tổng kết
Phương pháp keyset pagination and seek giúp tối ưu việc phân trang cho các bài toán lớn hơn rất nhiều (Tham khảo biểu đồ trên)
Trước tiên để tìm hiểu về cấu trúc Serverless, trước hết ta hãy xem thử các cấu trúc truyền thống thường được sử dụng, và một số từ khoá và định nghĩa của chúng.
Ví dụ với một cấu trúc như trên, toàn bộ ứng dụng của chúng ta sẽ được chứa chung trong 1 khối lớn, và cùng tương tác vào 1 database. Để dễ hiểu hơn, mình sẽ ví dụ chúng như sau:
Một cửa hàng bán trà sữa bán 4 loại trà sữa:
Trà sữa dâu
Trà sữa ô long
Trà sữa bạc hà
Trà sữa socola
Tất cả trà sữa này sẽ được nhân viên pha bằng cùng 1 chiếc máy, cái máy này có thể pha được cả 4 loại trà sữa trên, rất đa năng tiện dụng. Ngoài ra, để có thể pha trà sữa bằng máy, ta cần nhiên liệu pha trà sữa, các nhiên liệu cho 4 loại trà sữa thì khác nhau, và được để chung trong 1 thùng nhiên liệu.
Máy pha trà sữa – Code/Server xử lí Logic tính toán, ..
Thùng nhiên liệu – Database, cơ sở dữ liệu tổng
Nhiên liệu – Các dữ liệu
Vậy ta có thể thấy, với một lượng người dùng chưa lớn, xây dựng cấu trúc đưa toàn bộ các logic vào 1 server như trên có thể khả thi, tuy nhiên, khi người dùng ngày càng tăng lên, việc làm trà sữa nào cùng phải dùng chung 1 cái máy, và việc lấy nhiên liệu nào cũng phải lấy từ 1 thùng nhiên liệu lớn sẽ khiến cho 1 khối chung quá tải, một trong những cách tối ưu cho vấn đề này là chia nhỏ các công việc nhỏ ra.
Tối ưu: Chia nhỏ các vấn đề
Lúc này, ta sẽ chia nhỏ các vấn đề thành 4 luồng như sau, vẫn tại cùng 1 địa điểm, 1 server cửa hàng đó, ta chia cấu trúc thành:
Máy pha trà sữa 1, chỉ pha trà sữa dâu. Cùng 1 thùng nhiên liệu chỉ cho trà sữa dâu
Máy pha trà sữa 2, chỉ pha trà sữa ô long. Cùng 1 thùng nhiên liệu chỉ cho trà sữa ô long
Máy pha trà sữa 3, chỉ pha trà sữa bạc hà. Cùng 1 thùng nhiên liệu chỉ cho trà sữa bạc hà
Máy pha trà sữa 4, chỉ pha trà sữa socola. Cùng 1 thùng nhiên liệu chỉ cho trà sữa socola
Lúc này, với các khách order các trà sữa khác nhau, nhân viên có thể đến các máy pha và thùng nhiên liệu khác nhau, chia tách thành các luồng nên sẽ giảm tải hơn một chút. Tuy nhiên, lại có một số vấn đề như sau:
Các luồng sẽ không giống nhau. Ví dụ trà sữa dâu thường được gọi nhiều hơn trà sữa socola, nên đúng ra cái máy, hay tài nguyên server (cpu, ram,…) nên được phân bố nhiều hơn cho trà sữa socola
Nếu một máy trà sữa bị lỗi, ví dụ hãy tưởng tượng về code, dù lúc này đã chia nhỏ nhiều function ra, nhưng nếu hỏng cái gì thì thường ta phải khởi động lại cả server chung, đồng nghĩa các function khác đang chạy tốt cũng phải khởi động lại.
Lúc này, ta sẽ thử nói về một số từ khoá trong triển khai cấu trúc để xử lí vấn đề trên
Lại tưởng tượng về cửa hàng bán trà sữa, hãy coi cả cửa hàng như một cái máy chủ, một cái máy tính để có thể chạy các code (các máy pha trà sữa). Chúng ta có thể mua một mặt bằng để đặt cửa hàng (mua đứt). Tương tự, ta có thể mua các server về nhà chúng ta, về công ty để tự triển khai, tự lắp đặt.
Triển khai 1: Tự cài đặt server
Một server thì nhìn chung có cấu trúc tương tự như một máy tính, laptop bình thường. Tuy nhiên được thiết kế để chịu tải tốt hơn, chạy 24/7, chịu đựng các điều kiện như nhiệt độ, thời tiết, bụi, … tốt hơn, và một số đặc tính khác nữa.
Việc tự mua một server về triển khai thường được các công ty lớn sử dụng, tuy nhiên lúc này ta sẽ phải lo các vấn đề như nhiệt độ, cần bật máy làm mát, điều hoà, quạt,… để server mát mẻ 24/7. Hay phải lo các vấn đề như điện để tải server, tránh các trường hợp mất điện thì server cũng hỏng, ….
Nó giống với việc bạn mua mặt bằng để làm cửa hàng trà sữa, sau khi mua xong thì không thể mở rộng đất ra nếu muốn mở rộng cửa hàng được, phải tự lo các vấn đề như vệ sinh mặt bằng, điện nước, …. Điều này không phù hợp nếu ta chỉ cần một dịch vụ nhỏ, hoặc muốn mở rộng lớn ra hơn sau này.
Tối ưu: Đưa các dịch vụ lên các nền tảng riêng
Triển khai 2: infrastructure as a service (IaaS) – Cơ sở hạ tầng như một dịch vụ
Như tên của nó, cơ sở hạ tầng như một dịch vụ. Tức là ta sẽ thuê luôn một mặt bằng cho cửa hàng trà sữa, một cái máy chủ về để sử dụng. Các đơn vị cho thuê thường là các công ty lớn như nước ngoài có Amazon, Microsoft, Google. Trong nước thì có Viettel Cloud, … Các nhà cho thuê, đơn vị này sẽ bảo đảm vấn đề điện duy trì server ổn định, băng thông mạng cho server tốc độ cao, ….
Ngoài ra nếu server các bạn bị tấn công, ddos, các đơn vị này cũng sẽ có thể chuyển bạn sang một server, cụm network mạng khác để tránh, …
Nhìn chung việc cho thuê hay mua dịch vụ này đã giảm tải bớt rất nhiều sự đau đầu cho bạn. Lúc này bạn như có một cái máy tính ảo có thể truy cập từ xa, và đặt các code của mình lên đây để chạy.
Tối ưu: Các dịch vụ tự co giãn theo nhu cầu, tiết kiệm chi phí
Triển khai 3: Container as a Service (CaaS) – Một khối container như dịch vụ
Để giải thích việc này thì khá trừu tượng, nhưng lúc này bạn sẽ được cung cấp dịch vụ như các container. Các container này thì gọn nhẹ hơn, tốn ít tài nguyên, tiền bạc để thuê, và có thể co giãn được (tức là có thể tự tăng ram, cpu khi nhu cầu nâng cao)
Bạn tưởng tượng thì nếu bạn chia nhỏ các phần của ứng dụng của mình đủ nhỏ, để chúng có thể triển khai độc lập trên 1 container nhỏ, lúc này các hệ thống container có thể tạo ra rất nhiều bản container của phần ứng dụng đó của bạn, tự nâng cấu hình khi nhu cầu sử dụng tăng cao, hoặc tự triển khai một container khác chạy thay thế nếu container hiện tại bị sập, …
Triển khai 4: Function as a Service (FaaS) – Một hàm, chức năng như một dịch vụ
Với triết lý lập trình hàm (Function do only one thing), khi làm việc với kiến trúc Functions as a service, chỉ nên để function làm một việc duy nhất
Điểm mạnh nhất của FaaS là nó độc lập các function, nếu function chỉ thực thi một nhiệm vụ duy nhất. FaaS sẽ làm rất tốt công việc của nó được giao. Tuy nhiên, nếu gọi các function lồng nhau, rất dễ xảy ra vấn đề về performance.
Tức là lúc này bạn có thể chia các máy bán trà sữa này làm một tác vụ duy nhất như 1 hàm, trong đó có cả thùng nhiên liệu là database nhỏ của riêng loại trà sữa đó thôi. Lúc này các máy bán trà sữa này được đặt tại nhiều điểm khác nhau, (bạn chỉ đang thuê cái máy – một function như một dịch vụ). Do kết nối internet hạ tầng đủ nhanh, chúng vẫn có thể chấp nhận được với cửa hàng trà sữa của bạn. Và nếu 1 máy hỏng thì các máy khác vẫn không làm sao cả.
Các FaaS cũng có thể có các tính năng kế thừa như CaaS, tức là tự tạo một điểm khác nếu quá tải, tự tạo ra nhiều điểm vẫn là cùng 1 máy bán trà sữa và chia nhỏ luồng hơn nữa để xử lý tốt hơn, hay tự khởi động một điểm khác khi chỗ hiện tại bị sập, …
Một số từ khoá
Auto-scaling: Các máy chủ nhỏ này sẽ tự động co giãn ssd, ram, cpu, …. để phù hợp với nhu cầu, ví dụ máy pha trà sữa này nhiều khách order thì tự tăng tài nguyên lên, còn nếu ít khách thì tự giảm xuống
Event-driven: Các máy pha trà sữa nếu không ai gọi thì tự tắt đi, và chỉ bật lên (cold-start), sẽ bật lên (đủ nhanh tuỳ theo độ nặng của code bạn) khi có khách gọi (một event – sự kiện)
pay-per-execution: Một số chỗ sẽ thu phí bạn thuê theo số lần gọi dịch vụ chứ không phải thời gian thuê. ví dụ máy bán trà sữa dâu khá ế, 1 tháng có đúng 4 khách gọi 4 thời điểm khác nhau, bạn không cần bật máy cả tháng, mà chỉ tính tiền thuê 4 lần đó thôi
pay-as-use: Một số chỗ thu phí theo thời gian, tuy nhiên nhỏ lẻ hơn. Kiểu theo tiếng, theo ngày, … khi đó nếu bạn chỉ cần dùng 1 thời gian ngắn rồi tắt đi thì sẽ tiết kiệm chi phí hơn nhiều
Tóm lại về serverless
Hi vọng qua ví dụ trà sữa trên bạn sẽ có một cái nhìn tổng quan hoặc cơ bản về serverless.
Serverless – Không có server, không có nghĩa là sẽ không có cái server máy chủ nào chạy code cả. Mà cơ bản bạn sẽ không cần sở hữu một cái máy chủ, tự bảo quản và vận hành nó, mà có thể thuê các đơn vị khác đảm bảo dịch vụ và ổn định hơn để thực thi các tác vụ của mình.
Như lúc này cửa hàng trà sữa có thể đưa 4 máy pha trà sữa, 4 đoạn code độc lập này lên 4 điểm khác nhau. Lúc này ví dụ 1 điểm code bị bug, có vấn đề thì các nơi khác vẫn hoạt động bình thường.
Ngoài ra các điểm này có thể tự co giãn – (tham khảo thêm ở phần từ khoá bên trên) để phục vụ tốt hơn nếu có nhu cầu nhiều hơn ở một luồng nào đó.
Ưu điểm của serverless
Tiết kiệm chi phí, không cần thuê/mua cả mặt bằng – cả 1 server để chứa mấy cái máy pha, mà chỉ cần thuê cái máy pha là được
Giảm bớt nỗi lo quản lý mặt bằng – server như điện, tiền mạng, ….
Nhược điểm của serverless hay FaaS
Test và debug khó hơn, do nó chỉ bật khi mình cần, hơn nữa bạn không nhìn được rõ chúng đang chạy như thế nào như code trên máy mình, vì lúc này toàn bộ code đang ở một điểm khác.
Vấn đề bảo mật, lúc này bạn đang để database và code ở một đơn vị khác cho thuê. Nhìn chung thì chắc chắn việc bảo mật không thể bằng tự mình quản lí được.
Không phù hợp cho các tác vụ chạy liên tục 24/7. Do điểm tốt của serverless là tiết kiệm tiền, tự tắt đi khi mà không cần sử dụng. Nhưng nếu bạn cần dùng liên tục thì nên thuê CaaS hoặc IaaS
Giảm hiệu năng. Do các máy pha chỉ bật khi ta cần đến, nên sẽ tốn thêm thời gian bật lên. Bạn cần chia nhỏ function nhất có thể để chúng độc lập, và bật đủ nhanh để không ảnh hưởng người dùng
Sau khi trải nghiệm nhiều dịch vụ VPS có location ở gần Việt Nam, mình thấy đa số giá cả khá đắt, không phù hợp với budget sinh viên của mình lắm. Sau một thời gian tìm hiểu, và xem đánh giá tại https://www.vpsbenchmarks.com/, mình có tìm thấy một bên mới có giá cả khá oke với location Hongkong là Hosthatch
Giá cả phải chăng cho chất lượng
Hosthatch có cả server Sing, Tokyo ngoài HongKong.
Với mức giá khá phải chăng, khoảng 270-280k cho gói NVME 12G ram, 4 Core và 50GB NVMe (Không phải ssd nhé). Với mức giá này ở một số bên tại Việt Nam như Ftech, Vietnix chỉ có khoảng 2G ram, 1 core với cấu hình tương tự.
VPS hiếm hoi có location ở Hong Kong
Như bạn đã biết location Hong Kong rất gần Việt Nam. Do vậy không có gì ngạc nhiên khi website lưu trữ ở vị trí này có tốc độ truy cập từ Việt Nam rất tốt. Thậm chí không kém gì với location trong nước.
Một lợi thế khác của Location Hong Kong:
Tính ổn định cao khi đứt cáp xảy ra.
Khi sử dụng dịch vụ hosting của các nhà cung cấp nước ngoài, bạn luôn lo lắng về đứt cáp xảy ra phải không?
Location Hong Kong thường ít bị ảnh hưởng bởi sự cố đứt cáp. Location Nhật Bản, Singapore thường bị ảnh hưởng nhiều hơn.
Setup sử dụng, cài đặt VNC Server để điều khiển như Remote Desktop
Hosthatch cung cấp một trang điều khiển dạng như trên
Có vài option hdh sẵn để lựa chọn, đa số là các bản phổ biến như Ubuntu, Debian, ….
Hosthatch sẽ cung cấp root password, sau đó bạn có thể ssh vào vps theo lệnh
ssh root + @ + ipaddress
Thông thường mình sẽ cài luôn vnc lên vps để tiện điều khiển, nếu muốn một giao diện để sử dụng VPS cho dễ, các bạn có thể làm theo các bước sau sau khi ssh
Lúc này bạn sẽ được hỏi đặt mật khẩu, bạn tạo mật khẩu nữa là xongật
Output
You will require a password to access your desktops.

Password:
Verify:
Mật khẩu chỉ được dài 6-8 kí tự, nếu bạn nhập dài hơn nó sẽ tự động cắt ngắn
Output
Would you like to enter a view-only password (y/n)? n
xauth:  file /home/sammy/.Xauthority does not exist

New 'X' desktop is your_hostname:1

Creating default startup script /home/sammy/.vnc/xstartup
Starting applications specified in /home/sammy/.vnc/xstartup
Log file is /home/sammy/.vnc/your_hostname:1.log
Vừa qua 09/10/2022 Học viện Công nghệ Bưu Chính Viễn Thông đã tổ chức kì thi chung kết ICPC PTIT 2022 với 33 đội (chưa kể miền Nam) tại sảnh A2 của Học Viện. Kì thi 2022 có sự góp mặt phần lớn của khoá sinh viên D21, E21 (Năm nhất), tuy rằng kết quả chung cuộc bị chênh lệch phần lớn bởi thời gian sub bài chứ không có nhiều khác biệt giữa các team top giữa, nhưng kì thi vẫn đã diễn ra vô cùng hấp dẫn và kịch tích
Banner ICPC PTIT 2022
Đội của mình “ProPTIT. GGWP” Gồm mình Nguyễn Quốc Hưng E2105, Nguyễn Mai Phương (D21CN01), Nguyễn Đăng Minh (E2101) đã cố gắng giành thứ hạng #8 với 6 bài, khá tiếc là cây toán của team – Mai Phương đã đưa 2 teammate vào hai bài khó nhất đề bằng câu “hai bài này có vẻ làm được này”, mà bỏ qua 1 câu toán khá vừa tầm đúng ra nên làm.
Một vài hình ảnh đáng chú ý trong kì thi
Thầy Từ Minh Phương phát biểu khai mạcBan tổ chức ICPC PTIT 2022Đội 812 – Đội vô địch cũng là team First Solve bài đầu tiênKhu vực thi – Sảnh A2Khu vực thi – Sảnh A2Các thầy cô ban tổ chứcLễ trao giải ICPC PTIT 2022 – Đội vô địch 812
Lễ trao giải cuộc thi: https://portal.ptit.edu.vn/le-trao-giai-cuoc-thi-lap-trinh-theo-chuan-quoc-te-icpc-icpc-ptit-2022/
Sắc màu ICPC PTIT 2022: https://www.facebook.com/media/set/?set=a.518458426953512&type=3