Save Google OAuth2 token in database with Spring Boot

Following this official document from Google: https://developers.google.com/api-client-library/java/google-api-java-client/oauth2

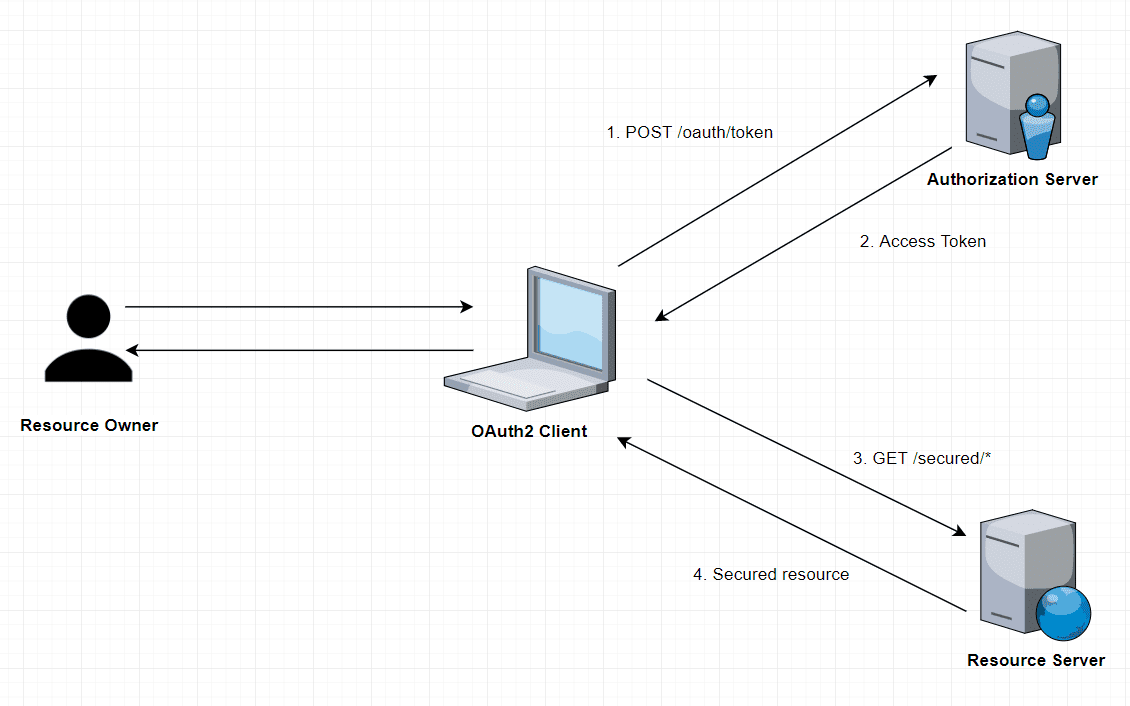
When integrating Google OAuth 2.0 with your Spring Boot application, the official documentation provides a comprehensive guide to leverage the GoogleCredential utility class for seamless and secure authorization. OAuth 2.0 is the industry standard for granting access to protected resources, and Google’s implementation is tailored to support various application types, ensuring flexibility across client environments.

Why OAuth 2.0 Matters

Imagine you’re building a task management application that needs to interact with a user’s Google Tasks data. OAuth 2.0 allows your app to request access only to the necessary data (e.g., “Manage your tasks”) while ensuring that the user maintains control over their privacy. The process generates an access token, which is a digital key tied specifically to your application and the user’s data. This token is scoped, meaning it limits the type and extent of access granted, thereby enhancing security. For instance, even if the token were somehow exposed, it couldn’t be used to access unrelated data like emails or photos.

Built on a Secure Foundation

The Google API Client Library for Java includes robust OAuth 2.0 packages such as:

  • com.google.api.client.googleapis.auth.oauth2: Core classes for implementing OAuth 2.0 flows.
  • com.google.api.client.googleapis.extensions.appengine.auth.oauth2: Specialized extensions for applications hosted on Google App Engine.

These packages are built on the Google OAuth 2.0 Client Library for Java, a general-purpose library offering standardized utilities to handle token acquisition, refresh, and expiration seamlessly.

A Real-World Perspective

Consider an example where a SaaS platform integrates with Google Drive to allow users to upload documents directly from their accounts. With OAuth 2.0, users authenticate their Google accounts through a secure flow, and the platform receives an access token to interact with Google Drive APIs. Instead of continuously requesting sensitive credentials, the platform uses this token to upload or retrieve files, keeping user data secure and operations streamlined.

By utilizing the detailed guidelines in Google’s documentation, you can ensure that your Spring Boot application adheres to best practices for secure OAuth 2.0 integration, offering a smooth user experience while protecting sensitive information.

Acquiring the Client Secret File

To begin integrating Google OAuth 2.0 into your application, the first crucial step is setting up a project on the Google API Console. This console serves as the central hub for managing authorization credentials, configuring API access, and ensuring proper billing setup. Whether your application runs on a web server, mobile device, desktop client, or directly in a browser, this setup process is essential.

Setting Up Credentials

Navigate to the Google API Console and create a new project. Once the project is set up, you can enable the desired APIs and generate the OAuth 2.0 client credentials, which include:

  • Client ID: Uniquely identifies your application during the authorization process.
  • Client Secret: A sensitive key used to authenticate your application, ensuring secure communication with Google’s servers.
  • Redirect URIs: Specify where Google will send users after they complete the authorization flow.

For detailed guidance on configuring these elements, refer to the API Console Help.

Setup a Authorization code flow

Use the authorization code flow to allow the end-user to grant your application access to their protected data on Google APIs. The protocol for this flow is specified in Authorization Code Grant.

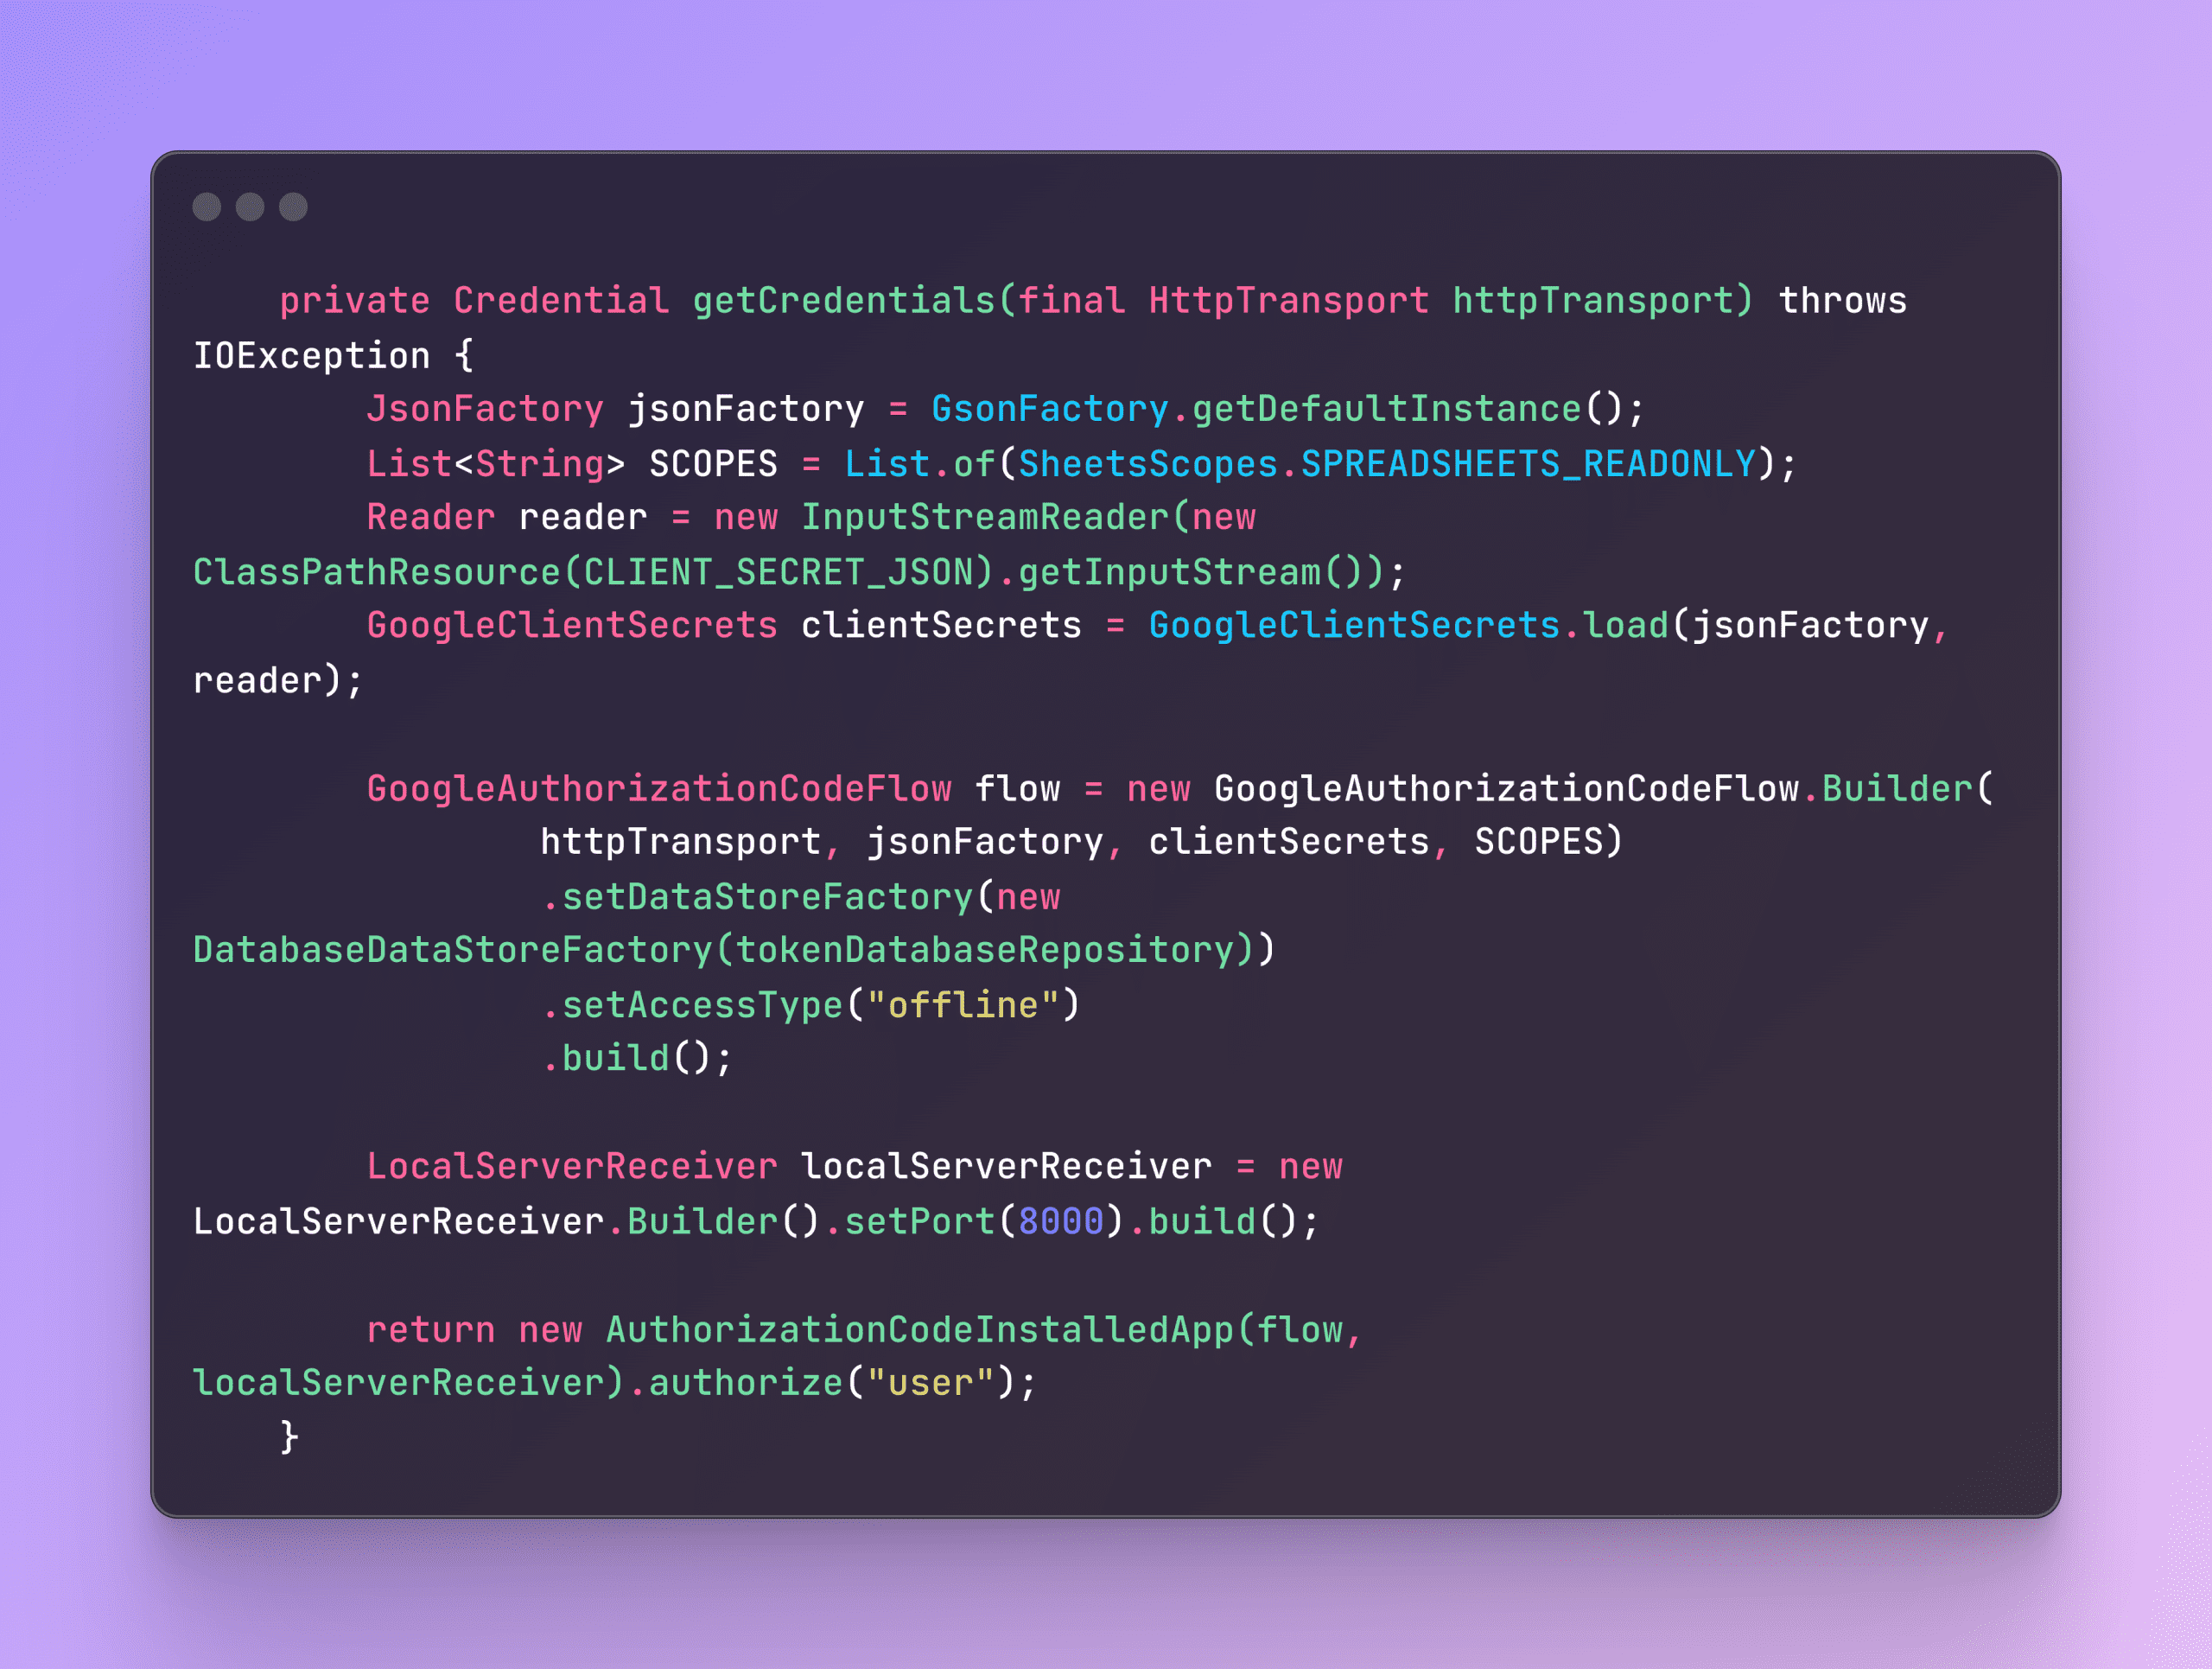
This flow is implemented using GoogleAuthorizationCodeFlow. The steps are:

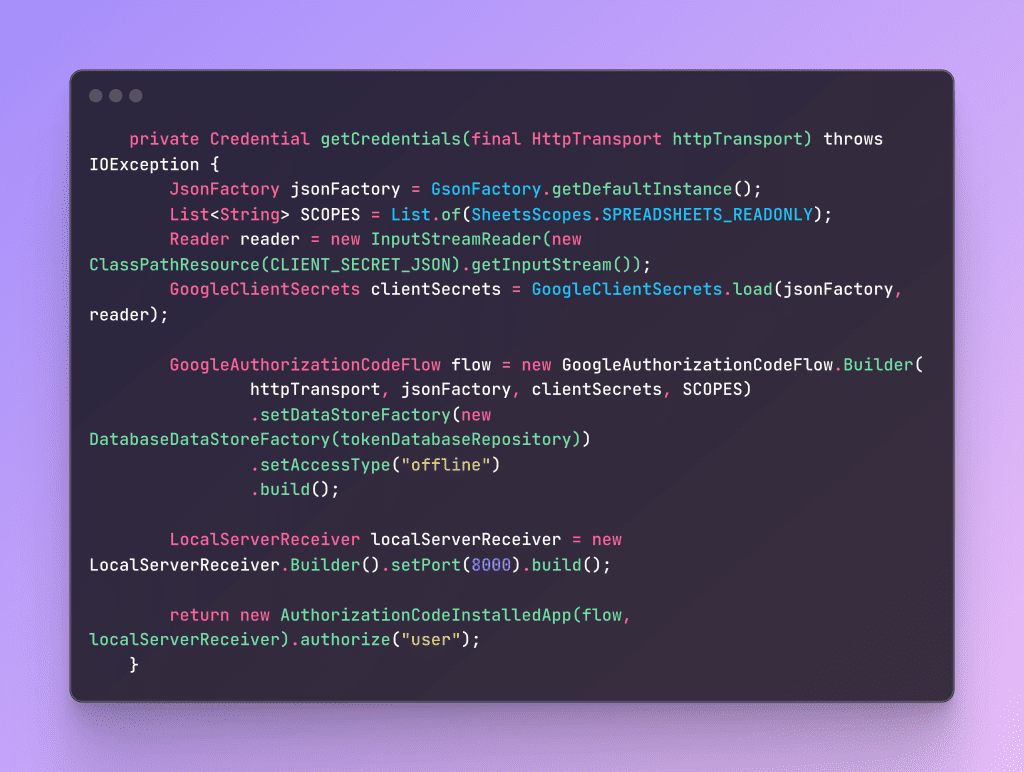
Code implementation is like this

image - quochung.cyou PTIT

Understanding the DataStoreFactory in GoogleAuthorizationCodeFlow.Builder

When constructing a GoogleAuthorizationCodeFlow object, one of the essential components is the DataStoreFactory. This factory is responsible for persisting user credentials securely and efficiently. Google provides three types of built-in implementations, each suited for different use cases:

Implementing a Custom Data Store to Persist Tokens in a Database

To persist OAuth2 tokens in a database, we need to create a custom implementation of the DataStoreFactory and DataStore classes provided by Google’s OAuth2 library. Here’s a step-by-step guide:


Step 1: Create a Custom DataStoreFactory

The custom factory is responsible for creating instances of your DataStore. Extend AbstractDataStoreFactory to implement this logic.

Java
import com.google.api.client.util.store.AbstractDataStoreFactory;
import com.google.api.client.util.store.DataStore;

import java.io.IOException;
import java.io.Serializable;

public class DatabaseDataStoreFactory extends AbstractDataStoreFactory {

    private TokenDatabaseRepository tokenDatabaseRepository;

    public DatabaseDataStoreFactory(TokenDatabaseRepository tokenDatabaseRepository) {
        this.tokenDatabaseRepository = tokenDatabaseRepository;
    }

    @Override
    protected <V extends Serializable> DataStore<V> createDataStore(String id) throws IOException {
        return new DatabaseDataStore<>(this, id, tokenDatabaseRepository);
    }
}

Step 2: Implement the Custom DataStore

This class handles token persistence logic. Extend AbstractDataStore and implement the required methods like set(), get(), delete(), etc.

Java
import com.google.api.client.util.store.AbstractDataStore;
import com.google.api.client.util.store.DataStore;
import com.google.api.client.util.store.DataStoreFactory;

import java.io.IOException;
import java.io.Serializable;
import java.util.Collection;
import java.util.Set;

public class DatabaseDataStore<V extends Serializable> extends AbstractDataStore<V> {

    private final TokenDatabaseRepository<V> tokenDatabaseRepository;

    protected DatabaseDataStore(DataStoreFactory dataStoreFactory, String id, TokenDatabaseRepository<V> tokenDatabaseRepository) {
        super(dataStoreFactory, id);
        this.tokenDatabaseRepository = tokenDatabaseRepository;
    }

    @Override
    public int size() throws IOException {
        return tokenDatabaseRepository.size();
    }

    @Override
    public boolean isEmpty() throws IOException {
        return tokenDatabaseRepository.isEmpty();
    }

    @Override
    public boolean containsKey(String key) {
        return tokenDatabaseRepository.containsKey(key);
    }

    @Override
    public boolean containsValue(V value) {
        return tokenDatabaseRepository.containsValue(value);
    }

    @Override
    public Set<String> keySet() throws IOException {
        return tokenDatabaseRepository.keySet();
    }

    @Override
    public Collection<V> values() throws IOException {
        return tokenDatabaseRepository.values();
    }

    @Override
    public V get(String key) throws IOException {
        return tokenDatabaseRepository.get(key);
    }

    @Override
    public DataStore<V> set(String key, V value) throws IOException {
        tokenDatabaseRepository.set(key, value);
        return this;
    }

    @Override
    public DataStore<V> clear() {
        tokenDatabaseRepository.clear();
        return this;
    }

    @Override
    public DataStore<V> delete(String key) throws IOException {
        tokenDatabaseRepository.delete(key);
        return this;
    }
}

Step 3: Create the TokenRepository Interface

Leverage Spring Data JPA to handle database interactions.

Java
public interface TokenDatabaseRepository<V> {
    int size();

    boolean isEmpty();

    boolean containsKey(String key);

    boolean containsValue(V value);

    Set<String> keySet();

    Collection<V> values();

    V get(String key);

    TokenDatabaseRepository<V> set(String key, V value);

    TokenDatabaseRepository<V> clear();

    void delete(String key);


}
Java
@Repository
@RequiredArgsConstructor
public class TokenDatabaseRepositoryImpl implements TokenDatabaseRepository<StoredCredential> {

    private final TokenRepositorySql tokenRepositorySql;
    private final GoogleAuthItemMapper googleAuthItemMapper;

    @Override
    public int size() {
        return (int) tokenRepositorySql.count();
    }

    @Override
    public boolean isEmpty() {
        return tokenRepositorySql.count() == 0;
    }

    @Override
    public boolean containsKey(String key) {
        return tokenRepositorySql.existsByKey(key);
    }

    @Override
    public boolean containsValue(StoredCredential value) {
        var googleAuthItem = googleAuthItemMapper.from(value);
        return tokenRepositorySql.existsByAccessTokenAndRefreshToken(googleAuthItem.getAccessToken(), googleAuthItem.getRefreshToken());
    }

    @Override
    public Set<String> keySet() {
        return tokenRepositorySql.findAll().stream()
                .map(GoogleAuthItem::getKey)
                .collect(Collectors.toSet());
    }

    @Override
    public Collection<StoredCredential> values() {
        return tokenRepositorySql.findAll().stream()
                .map(googleAuthItemMapper::to)
                .collect(Collectors.toList());
    }

    @Override
    public StoredCredential get(String key) {
        Optional<GoogleAuthItem> optionalGoogleAuthItem = tokenRepositorySql.findById(key);
        return optionalGoogleAuthItem.map(googleAuthItemMapper::to).orElse(null);
    }

    @Override
    @Transactional
    public TokenDatabaseRepository<StoredCredential> set(String key, StoredCredential value) {
        var googleAuthItem = googleAuthItemMapper.from(value);
        googleAuthItem.setKey(key);
        tokenRepositorySql.save(googleAuthItem);
        return this;
    }

    @Override
    @Transactional
    public TokenDatabaseRepository<StoredCredential> clear() {
        tokenRepositorySql.deleteAll();
        return this;
    }

    @Override
    public void delete(String key) {
        tokenRepositorySql.deleteByKey(key);
    }
}
Java
public interface TokenRepositorySql extends JpaRepository<GoogleAuthItem, String> {

    boolean existsByKey(String key);

    boolean existsByAccessTokenAndRefreshToken(String accessToken, String refreshToken);

    void deleteByKey(String key);

}
Dynamic OAuth2 Client for Spring Boot

Introduction

OAuth2 has become the industry standard for secure authorization in web applications. Spring Boot simplifies OAuth2 integration, allowing developers to handle client registration effortlessly. However, Spring Boot’s default implementation often requires client registrations to be predefined in application configuration, making it difficult to adapt to changing environments where client registrations need to be added or removed dynamically.

In this blog post, we’ll explore how to overcome this limitation by creating a custom implementation of ClientRegistrationRepository that allows dynamic management of OAuth2 clients at runtime. This approach provides the flexibility required for modern applications that need to adapt to varying OAuth2 client configurations.

Understanding Spring Boot’s Default Client Registration

Spring Boot manages OAuth2 client registrations using the ClientRegistrationRepository interface, which provides a way to store and retrieve client configurations. By default, Spring Boot offers an InMemoryClientRegistrationRepository implementation. This default implementation stores client registrations in memory, as defined in the application’s configuration files.

While this approach works well for static configurations, it has a significant limitation: the client registrations are immutable. Once registered, a client’s configuration cannot be altered. This is because InMemoryClientRegistrationRepository creates an unmodifiable map of client registrations:

Java
	public InMemoryClientRegistrationRepository(List < ClientRegistration > registrations) {
	    this(createRegistrationsMap(registrations));
	}

	private static Map < String, ClientRegistration > createRegistrationsMap(List < ClientRegistration > registrations) {
	    Assert.notEmpty(registrations, "registrations cannot be empty");
	    return toUnmodifiableConcurrentMap(registrations);
	}

	private static Map < String, ClientRegistration > toUnmodifiableConcurrentMap(List < ClientRegistration > registrations) {
	    ConcurrentHashMap < String, ClientRegistration > result = new ConcurrentHashMap < > ();
	    for (ClientRegistration registration: registrations) {
	        Assert.state(!result.containsKey(registration.getRegistrationId()),
	            () - > String.format("Duplicate key %s", registration.getRegistrationId()));
	        result.put(registration.getRegistrationId(), registration);
	    }
	    return Collections.unmodifiableMap(result);
	}

This immutability is by design, ensuring that client registrations remain consistent throughout the application’s lifecycle. However, for applications that require dynamic updates to client registrations—such as SaaS platforms or systems with evolving client needs—this default behavior is insufficient.

Custom Implementation of ClientRegistrationRepository

To support dynamic client registration, we need to implement a custom version of ClientRegistrationRepository that allows adding and removing clients at runtime. This custom repository will manage a modifiable collection of client registrations.

Here’s how you can create a custom ClientRegistrationRepository:

Java
public class DynamicClientRegistrationRepository implements ClientRegistrationRepository {
    private final ConcurrentHashMap < String, ClientRegistration > clientRegistrations = new ConcurrentHashMap < > ();

    public void addClientRegistration(String registrationId, ClientRegistration registration) {
        clientRegistrations.put(registrationId, registration);
    }

    @Override
    public ClientRegistration findByRegistrationId(String registrationId) {
        return clientRegistrations.get(registrationId);
    }
}

This implementation uses a ConcurrentHashMap to store client registrations, enabling thread-safe access and modification. The addClientRegistration and removeClientRegistration methods allow for dynamic management of client registrations, which can be crucial for applications that need to adapt in real time.

Java
clientRegistrationRepository.addClientRegistration(clientRegistration.getRegistrationId(), clientRegistration);

Integrating Custom ClientRegistrationRepository with Spring Security

After implementing the custom ClientRegistrationRepository, the next step is to integrate it into your Spring Boot application. This involves replacing the default InMemoryClientRegistrationRepository with your custom implementation.

Here’s how to inject your custom repository into the Spring Security configuration:

Java
        OAuth2AuthorizedClientProvider authorizedClientProvider = OAuth2AuthorizedClientProviderBuilder.builder()
            .clientCredentials()
            .build();
        clientRegistrationRepository = new DynamicClientRegistrationRepository();
        clientService = new InMemoryOAuth2AuthorizedClientService(clientRegistrationRepository);
        var clientManager = new AuthorizedClientServiceOAuth2AuthorizedClientManager(
            clientRegistrationRepository, clientService);
        clientManager.setAuthorizedClientProvider(authorizedClientProvider);

By defining the custom ClientRegistrationRepository as a bean, Spring Boot will automatically use it in the OAuth2 flow, allowing for dynamic client management.

Acquiring Access Tokens Using Dynamic Client Registrations

Once you have dynamically registered clients, you can proceed with acquiring access tokens using the standard OAuth2 flow. The process remains unchanged, but now includes the capability to work with clients that were registered dynamically.

Here’s an example of acquiring an access token:

Java
        OAuth2AuthorizeRequest authorizeRequest = OAuth2AuthorizeRequest.withClientRegistrationId(clientRegistration.getRegistrationId())
            .principal(oauth2Config.getClientId())
            .attribute(AuthorizationGrantType.CLIENT_CREDENTIALS.getValue(), clientRegistration)
            .build();
        OAuth2AuthorizedClient authorizedClient = authorizedClientManager.authorize(authorizeRequest);
        authorizedClient.getAccessToken().getTokenValue() //-> get token here

JPA là gì? Phân biệt và làm rõ Hibernate, Spring Data JPA, JDBC, ORM

Sơ lược định nghĩa JPA

image 12 - quochung.cyou PTIT
  • JPA, hay còn được gọi là Java Persistence API. Sau này được đổi tên thành Jakarta Persistence API
  • JPA giải quyết các vấn đề trong quản lý quan hệ giữa các thực thể, giúp chúng ta map những object Java (POJO – Plain Old Java OBject) thành những bảng trong database, đây là persistence frameworks được sử dụng nhiều nhất trong Java
  • Để hiểu sâu thêm, hãy đi thêm vào 1 số định nghĩa liên quan

Persistence là gì?

image 13 - quochung.cyou PTIT
  • Java Persistence API, Java là tên ngôn ngữ, API ám chỉ rằng đây là một framework cung cấp các api, các logic mà ta dễ dàng sử dụng lại giúp tăng tốc độ phát triển ứng dụng
  • Vậy Persistence là gì?
  • Hầu hết toàn bộ các ứng dụng yêu cầu ta cần có persistent data (dữ liệu lâu dài). Persistence là một trong những concept nền tảng trong công nghệ phần mềm. Gần như toàn bộ hệ thống thông tin đều cần lưu trữ những dữ liệu nào đó cho hệ thống. Object persistence nghĩa là các thực thể có thể “sống lâu” hơn các chương trình, có thể lưu trữ trong các nơi quản lý dữ liệu và có thể khởi tạo lại trong chương trình vào thời điểm nào đó.
  • Ví dụ đơn giản, trong một web mua bán thương mại điện tử chẳng hạn, dữ liệu trong hệ thống thường là các thông tin về sản phẩm, giá bán, nơi bán, … những dữ liệu này luôn được lưu trữ, kể cả web có thể là bị đóng vài phút, nâng cấp lên, … những dữ liệu này luôn “sống lâu” hơn các chương trình code
  • Khi nói về persistence trong Java, ta thường nói về việc map và lưu trữ các thực thể trong database bằng SQL

Làm việc với cơ sở dữ liệu quan hệ bằng Java qua SQL

  • Khi làm việc với các database trong ứng dụng Java, hiểu đơn giản thì ta sẽ ra 1 câu lệnh SQL vào database bằng cách nào đó với Java chứ ta không cần viết chay truy vấn vào thẳng cơ sở dữ liệu nữa.
  • Ban đầu, ta có JDBC (Java Database Connectivity API) hỗ trợ việc ra các câu lệnh SQL vào một cơ sở dữ liệu. Ta sẽ thực hiện câu lệnh truy vấn, nhận được dữ liệu trả về, sau đó xào nấu nó, …
  • Tuy nhiên các công việc này nhìn chung khá gần theo hướng dữ liệu, data, chứ không có quá nhiều về phần mềm Java. Chúng ta thường muốn có cách nào đó để lấy dữ liệu nhanh từ database, và không phải làm các công việc lặp lại này.
  • Các câu lệnh truy vấn đa phần thường dễ bị lặp lại. Giả sử bạn có 1 hệ thống quản lý sinh viên, môn học, lớp học, giáo viên, … Như thông thường, ta phải viết câu lệnh sql để lấy toàn bộ sinh viên, lấy thông tin 1 sinh viên theo tên, theo tuổi, thêm 1 sinh viên, xoá 1 sinh viên, …. mọi thứ thủ công. Rồi làm y vậy với các đối tượng giáo viên, lớp học, …. Nhìn chung các task này lặp đi lặp lại và tốn thời gian, công sức, chưa tính đến nhiều vấn đề bảo mật, viết sai bug khi viết sql chay như vậy.
  • Hiển nhiên, 1 số thời điểm ta vẫn cần viết sql để custom theo ý mình cho các vấn đề hiệu năng, tuỳ biến, …. nhưng nếu có cách nào đó để giảm thiểu các công việc làm việc với database hơn.
image 14 - quochung.cyou PTIT

ORM

image 15 - quochung.cyou PTIT
  • Ngắn gọn thì, object relational mapping (ORM) là một cách để tự động, đóng gói để map qua lại giữa các dữ liệu database và các class trong Java. Tức là một cái ở giữa để chuyển hoá giữa 1 table lưu thông tin SinhVien với 1 class SinhVien trong java chẳng hạn.

JPA, Hibernate, Spring Data là gì

JPA là gì

  • Lúc này JPA như đã định nghĩa cơ bản bên trên, JPA sẽ là một bản vẽ, định nghĩa ta phải làm gì để lưu trữ và làm việc với object như 1 ORM bên trên, bao gồm việc lấy dữ liệu object từ 1 database, rồi biến nó thành 1 object được tạo ra từ 1 class Java chẳng hạn.
  • Hibernate sẽ là một tầng bên trên, triển khai từ JPA, định nghĩa logic code thực sự là sẽ triển khai như thế nào.
image 16 - quochung.cyou PTIT
  • Có thể ví dụ đơn giản. JPA sẽ chứa rất nhiều hàm là để làm việc thì ta sẽ cần có các hàm lấy dữ liệu theo trường nào đó, tìm dữ liệu theo trường nào đó (select + filter sql), xoá 1 row trong database, …

Hibernate là gì

  • Hibernate là 1 JPA Provider, tức là một Provider, một cái triển khai “JPA”
  • Hibernate sẽ implement interface đó, và là cái có code logic triển khai các hàm trên, tự động sinh ra các câu lệnh sql theo nhu cầu. Tức là ta chỉ cần gọi hàm getAllByName() gì đó, hibernate sẽ tự sinh truy vấn sql, chạy xuống JDBC rồi database để làm việc, ta không cần tự viết sql query đó nữa. Ngoài ra, sau khi lấy dữ liệu xong, nó sẽ tự map dữ liệu database thành các object Java luôn để làm việc.
image 17 - quochung.cyou PTIT
  • Ngoài ra Hibernate còn có nhiều chức năng như đảm bảo phiên trong database, session, ….

Spring Data JPA

image 19 - quochung.cyou PTIT
  • Spring Data JPA là 1 tầng bên trên nữa triển khai Hibernate, có những chức năng cùng framework Spring, cho phép mở ra nhiều khả năng hơn nữa như từ việc đặt tên hàm có thể tạo được các query phức tạp, …
  • Chính xác thì Spring Data JPA có thể chạy với các “JPA Provider” khác nhau, tức là một số khác nào triển khai lại JPA có thể dùng với Spring Data JPA
image 18 - quochung.cyou PTIT

Tổng kết

JPA định nghĩa các phần sau

  • Một phương tiện chỉ định việc ánh xạ, map giữa các dữ liệu persistent trong database và thông tin của nó với các class trong Java. JPA sử dụng rất nhiều Java annotations để làm việc này, ngoài ra ta có thể viết nó trong file XML (thêm minh hoạ bên dưới)
  • API để thực hiện các thao tác CRUD cơ bản với các class java và có thể gọi xuống database để làm việc tương tự. (CRUD – Create/Tạo, Read/Đọc, Update/Cập nhật, Delete/Xoá)
  • Thực hiện các thao tác transaction, có thể lấy dữ liệu theo association (ví dụ 1 sinh viên có nhiều môn học, có thể hiểu việc đó và khi lấy 1 sinh viên sẽ lấy luôn các môn học), thêm 1 số tính năng tối ưu khác, các chiến lược cache, …

Hibernate triển khai JPA và làm các công việc sau

  • Hiệu suất – Giảm thiểu nhiều công việc lặp đi lặp lại để query dữ liệu, giúp ta có thêm thời gian tập trung vào code logic bên trên hơn
  • Bảo trì – Do tự động mapping (ORM) của hibernate, giúp giảm thiểu số lượng code, giúp hệ thống dễ hiểu hơn, dễ bảo trì hơn.
  • Hiệu năng – Nhìn chung thì việc tự viết sql trong các case đặc biệt giúp ta dễ control và có performance mong muốn hơn, tuy nhiên trong một số tác vụ thường thấy, hibernate giúp hiệu năng tốt hơn, tự động, hỗ trợ các cơ chế caching ở tầng ứng dụng
  • Độc lập – Hibernate có thể làm việc với Postgres, MySQL …. mà không phụ thuộc vào 1 nền tảng hay sql của nền tảng đó

Spring IOC, Dependency Injection, @Component và @Bean

Mở đầu

  • Java là một trong những ngôn ngữ lập trình phổ biến nhất hiện nay. Java cung cấp khả năng xây dựng các ứng dụng từ đơn giản đến những ứng dụng hoạt động chặt chẽ, đủ khả năng cho các dự án lớn tầm thương mại (enterprise). Nhờ sự ra đời từ rất sớm, Java có rất nhiều thư viện, tài liệu, code, … và nhiều tài nguyên khác. Từ Java, có thể xây dựng các ứng dụng web, mobile, desktop, các phần mềm cho các lĩnh vực như iOT, …
  • Trong bài hôm nay, mình sẽ chỉ tập trung vào mảng web của Java. Trong đó có thể kể tới Spring Framework, đây là một hệ sinh thái toàn diện với rất nhiều giải pháp trong phát triển ứng dụng Java, giúp lập trình viên giảm bớt rất nhiều thời gian để xây dựng phần mềm.
  • Trong bài viết này, ta sẽ đi qua 3 mục có thể nói là core của Spring bao gồm: Spring IOC (Inversion of Control), Dependency Injection (DI), cũng như khái niệm về Bean, Component, … trong Spring

Spring IOC (Inversion Of Control)

image 5 - quochung.cyou PTIT
  • Đây có thể nói là các phần cốt lõi của cả Spring Framework. Để nói về tác dụng của nó, hãy thử xem qua bài toán sau:
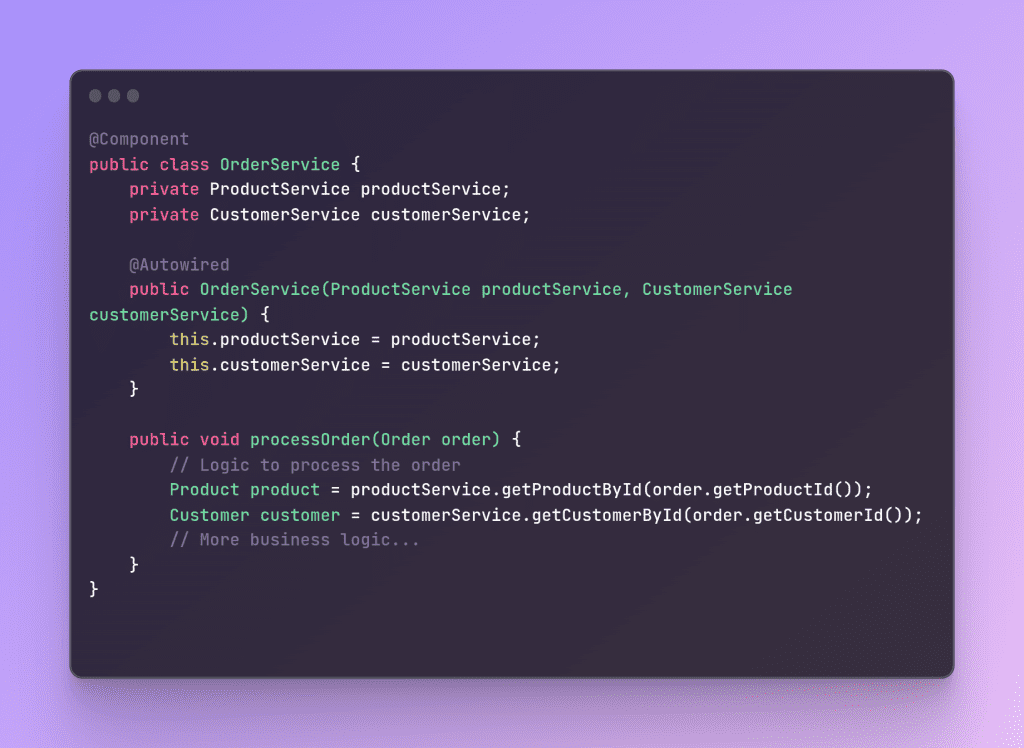
  • Ta có một class trong Java, chuyên xử lý các đơn hàng mới của một cửa hàng. Lúc này, một đơn hàng sẽ chứa 2 thông tin là id của người dùng (vd KH11), và id của sản phẩm (vd MAYGIAT), ta sẽ cần từ 2 id này, gọi sang 2 class khác là ProductService (quản lý sản phẩm), và CustomerService (quản lý khách hàng), để từ mã id lấy ra thông tin của khách hàng, sản phẩm rồi sau đó xử lý sâu hơn (Tạo ra đơn hàng cần thông tin địa chỉ khách hàng, rồi thì giá sản phẩm, …)
  • Với code thông thường, ta cần làm như sau:
image 6 - quochung.cyou PTIT
  • Lúc này, ta cần phải tạo các đối tượng của class con là ProductService và CustomerService một cách thủ công, để quản lý vòng đời của chúng (ví dụ khi nào tạo, khi nào tắt ta bị phụ thuộc vào class OrderService).
  • Rồi thì, ProductService là một class dạng stateless (các object ProductService khác nhau thường không có gì khác cả, tức là ta cần 1 object là được). Lúc này, ta có thể triển khai sử dụng design pattern Singleton (1 class chỉ tạo ra 1 object duy nhất), nhưng ta cũng phải triển khai thủ công
  • Rõ ràng, ta thấy vấn đề mệt nhất của việc làm thủ công là “Control – Khả năng điều khiển, quản lý”, ở ví dụ trên, ta đang đưa hết việc quản lý cho OrderService về tạo các object cho class phụ thuộc, ví dụ một class khác cần ProductService thì sao? Ta có thể lại phải new 1 object mới, lúc này ta bị thừa object. Hoặc class đó lại phải tạo ra 1 object con là OrderService, rồi dùng class con của OrderService
image 7 - quochung.cyou PTIT
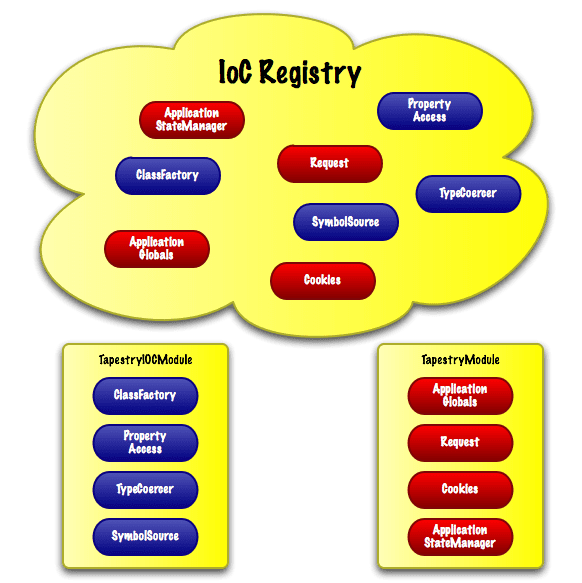
  • IOC (Inversion of Control) , lúc này các framework IoC hay các IOC Container sẽ là nơi chứa mọi quản lý, control của các object. Nó quyết định vòng đời của các object ta cần dùng, khi nào thì tạo, khi nào thì xoá, ghép cái nào với cái nào
  • Tưởng tượng nếu làm thủ công, ta sẽ cần 1 class dạng IOCContainer, rồi trong IOCContainer, ta tạo ra hết mọi object cần có. Rồi ở OrderService, ta sẽ gọi IoCContainer.getProductService() chẳng hạn, ở chỗ khác cần cái gì cũng gọi như vậy, lúc này ta dễ dàng quản lý các object này hơn

  • Lúc này Spring IOC xuất hiện, ta sẽ khai báo các class cần được quản lý bởi Spring IoC là Bean (sẽ nói thêm ở dưới). Khi nào cần dùng tới class nào, ta chỉ việc sử dụng Dependency Injection để gắn chúng lại với nhau.
image 8 - quochung.cyou PTIT

Dependency Injection

  • Bạn có thể tham khảo bài viết sau

Component và Bean trong Spring

image 9 - quochung.cyou PTIT

Component

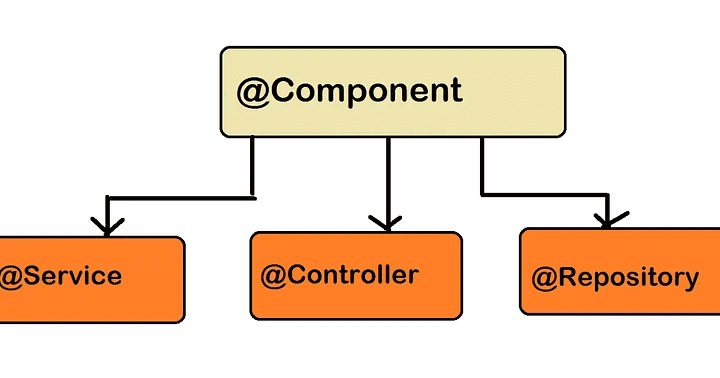
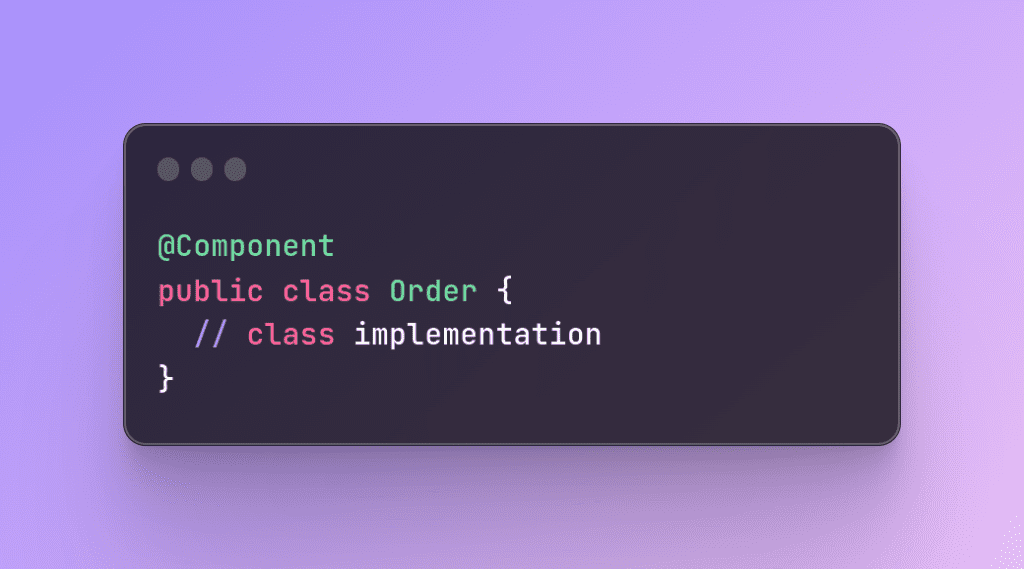
  • Trong Spring, @Component là một annotation để đánh dấu cho Spring biết class nào là một Component (cấu phần) hay Bean mà Spring sẽ quản lý. Các annotation @Service, @Controller, @Repository cũng hoạt động tương tự.
image 10 - quochung.cyou PTIT
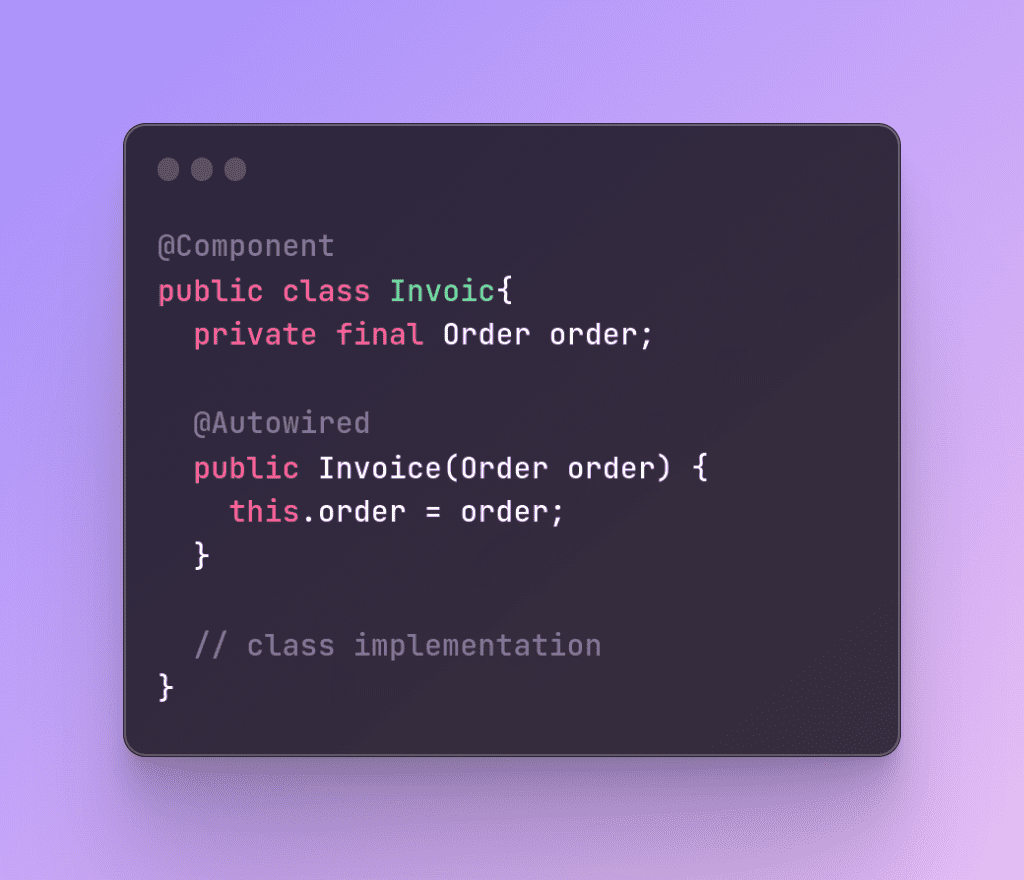
  • Và khi khai báo cả 2 class là Component, ta có thể kết nối chúng qua Dependency Injection (bạn có thể tham khảo thêm bên trên)
image 11 - quochung.cyou PTIT
  • Spring lúc này sẽ tự động ghép nối 2 class trên vào thời điểm được chạy lên.

Bean

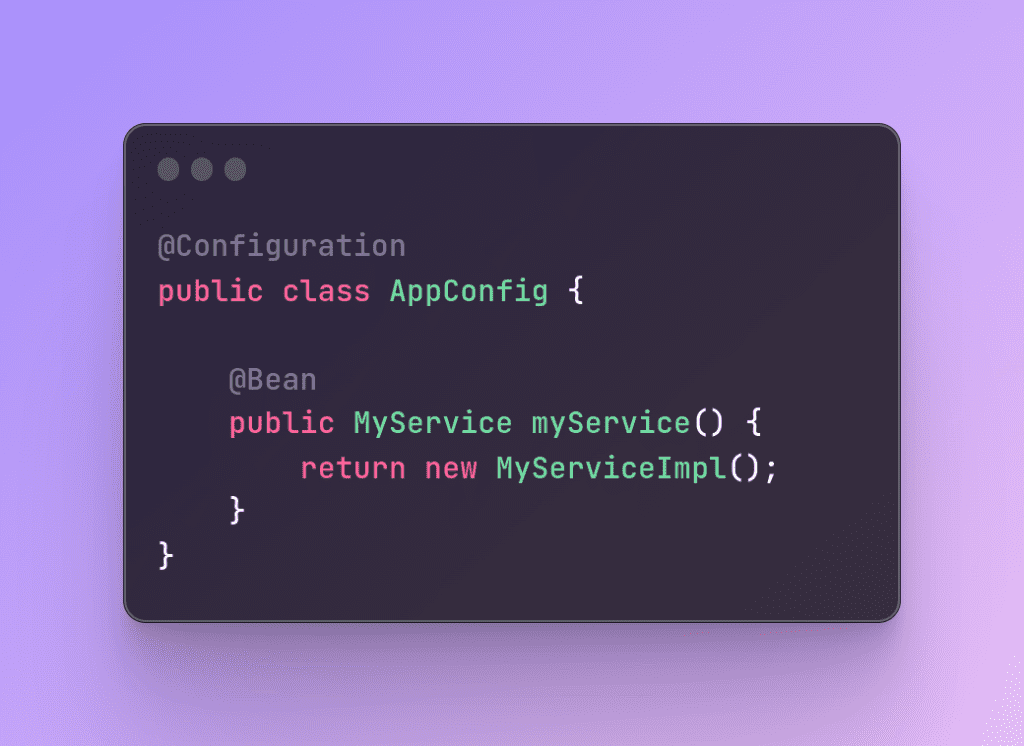
  • Bean trong Spring là annotation để định nghĩa 1 bean. Thường chúng được dùng cho các class utils (hỗ trợ ngoài), hoặc class ở bên thứ 3, mà không nằm trong luồng logic core.
image 12 - quochung.cyou PTIT
  • @Bean cần được khai báo trong 1 class có annotation @Configuration. Ta có thể khai báo nhiều bean khác nhau.
image 13 - quochung.cyou PTIT
  • Ví dụ ta có thể tạo 1 bean BCryptPasswordENcoder để mã hoá mật khẩu, sau đó có thể sử dụng chúng trong class UserService. Spring tự biết ghép chúng lại với nhau’

Câu hỏi thêm

  • Ngoài các khái niệm cơ bản như vậy, ta biết rằng mặc định các bean khi khởi tạo sẽ là singleton, ta có thể chỉnh nó thành các kiểu khác, ví dụ sẽ là tồn tại nhiều bean khác nhau của 1 class, … bằng cách đặt scope cho chúng. Tham khảo thêm tại: https://docs.spring.io/spring-framework/reference/core/beans/factory-scopes.html
  • Như nói từ đầu, do Spring IOC đã quản lý các bean, nên ta cũng có thể sử dụng AOP, như kiểu khi một bean được tạo ra, ta sẽ chạy gì đó, khi bị huỷ thì log gì đó chẳng hạn (https://docs.spring.io/spring-framework/reference/core/beans/factory-nature.html)
  • Lúc nào thì dùng Component, lúc nào thì dùng Bean? Điều này tuỳ vào dự án của bạn, thường thì annotation @Bean sẽ dùng cho các class của bên thứ 3, không nằm chính trong luồng usecase, hay context của dự án và @Component thì ngược lại

3 cách thực hiện Dependency Injection (DI) và vấn đề với @Autowired trong Spring

Lời mở đầu

Khi code các ứng dụng backend bằng Java với Spring Framework, khả năng cao là bạn đã gặp qua một đoạn code sử dụng @Autowired. Tuy nhiên, nếu bạn sử dụng một số phần mềm lint để kiểm tra code, bạn có thể thấy các phần mềm sẽ cảnh báo @Autowired is deprecated (Autowired không được khuyến khích sử dụng nữa, cách làm không tốt)

image - quochung.cyou PTIT
  • Nhìn sơ qua thì đây có vẻ là một cách đơn giản và nhanh gọn để thực hiện DI qua Spring. Chỉ cần khai báo các dependency rồi thêm một annotation (@Autowired), các phần liên kết sẽ được Spring xử lí
  • Tuy nhiên, cách làm phổ biến này lại có thể dẫn đến nhiều vấn đề về sau này. Hãy thử xem qua các thủ pháp DI được sử dụng qua Spring Framework và các ưu nhược điểm của chúng

3 cách thực hiện Dependency Injection trong Spring Framework

Field Injection

  • Field Injection chính là tên gọi của cách inject dependency khi ta khai báo bằng @Autowired
  • Về cơ bản khi khai báo annotation này trên 1 field, method, constructor. Spring sẽ tự tìm dependency phù hợp và kết nối chúng với nhau.
  • @Autowired về mặc định không sai, tuy nhiên nếu sử dụng không hợp lí chúng có thể gây ra một số vấn đề về sau.
  • Ví dụ với một code như sau:
image 1 - quochung.cyou PTIT
  • Khai báo một Multiplier trong Calculator nhanh chóng bằng @Autowired sẽ không báo lỗi gì khi compile, về cách hoạt động, khi chạy chương trình, Spring sẽ tự tìm kiếm dependency và kết nối chúng với nhau
  • Tuy nhiên, vì chúng tự động, nên ta thiếu kiểm soát hơn phần này. Tức là lúc này ta không có cách nào để thêm thủ công dependency nữa cho các hoàn cảnh khác ngoài lúc chạy ứng dụng (VD khi chạy test)
image 2 - quochung.cyou PTIT
  • Ví dụ như code trên sẽ không báo lỗi, tuy nhiên khi chạy test thì chúng có thể throw NullPointer
  • Lí do là ở file test trên thì chúng ta đang không có chỗ nào liên kết với Spring cả, vì vậy Spring sẽ không quản lý các bean mà ta đã tạo (Khai báo @Component ở các class kia) nên chúng sẽ không nối vào nhau được -> Ta sẽ bị null pointer vì Multiplier không được khởi tạo lên
  • Để xử lý vấn đề này, thì nếu sử dụng 2 thủ pháp DI bên dưới (Constructor Injection và Setter Injection) , ta có thể có nhiều khả năng kiểm soát hơn và thêm dependency một cách thủ công mà không qua Spring, tạo nhiều khả năng hơn cho việc test
  • Hoặc, ta có thể khai báo @SpringBootTest để Spring quản lý file test này và tự động thực hiện việc gắn các bean mà không cần gắn chay
image 20 - quochung.cyou PTIT

Setter Injection

image 3 - quochung.cyou PTIT
  • Cách làm trên như tên của nó, ta sẽ set một dependency của class lớn hơn ở thời điểm runtime
  • Cách làm này cho phép ta dễ dàng thay đổi dependency của một class trong runtime, ví dụ như đổi 1 repo khác 1 service nào đó, …
  • Tuy nhiên, ngoài ưu điểm là sự flexible khi set ở runtime, thì nó cũng đi cùng vài nhược điểm khác
  • Do được set trong runtime, ta đôi khi có thể gặp phải NullPointer khi dependency chưa được khởi tạo, là null, … (vì lúc này chúng là optional, không bắt buộc với class nữa)
  • Do nó lỏng lẻo hơn nên lúc này với các method trong class gọi đến dependency, ta không được đảm bảo là dependency đã được set, hoặc ta lại phải thêm code để kiểm tra là có dependency chưa, 1 là thêm code, 2 là dẫn tới nullpointer
image 21 - quochung.cyou PTIT
  • Với cách làm như thế này, ta có thể không cần Spring quản lý các bean mà có thể test chay hơn, có nhiều quyền kiểm soát hơn vào việc quản lý các dependency

Constructor Injection

image 4 - quochung.cyou PTIT
  • Như tên của thủ pháp, ta sẽ thêm dependency cho 1 class ngay tại thời điểm khởi tạo class cha
  • Ở file test trên, mình đang sử dụng mock để dựng class multiplier lên theo kèm để gắn vào Calculator qua constructor
  • Việc này đảm bảo 1 class luôn có đủ dependency để khởi tạo (tuỳ theo cách custom constructor)
  • Hoặc mình hoàn toàn có thể làm như thế này
image 22 - quochung.cyou PTIT
  • (Việc sử dụng mock cho phép nhiều khả năng khác trong test hơn, ví dụ mình có thể kiểm tra xem một hàm trong class đó được gọi bao nhiêu lần, … , chúng được quản lý theo dạng Proxy Design Pattern, mình sẽ nói ở bài viết khác)

Bạn có thể đọc thêm bài viết này về một số khái niệm trong Spring như IoC, Bean, …

Tham khảo:

Tối ưu truy vấn Pagination (phân trang) sử dụng Spring Boot (Java)

image 4 - quochung.cyou PTIT

Phân trang là gì, tại sao cần phân trang

Phân trang đơn giản là ta sẽ chia một tập dữ liệu lớn và truyền cho user thành từng phần nhỏ hơn. Hãy tưởng tượng, bạn đang thiết kế một hệ thống backend cho phía frontend của một trang tin tức, phía FE muốn một lệnh API để có lấy dữ liệu các bài viết từ database của bạn.

image 5 - quochung.cyou PTIT

Bài toán sẽ khá đơn giản nếu bạn chỉ có 10-20 bài viết, bạn chỉ cần làm theo cách truyền thống, lấy dữ liệu từ database từ backend, gửi một file json chứa dữ liệu cho FE, mọi thứ nghe có vẻ đơn giản.

Tuy nhiên khi tập dữ liệu của ta ngày càng lớn, ví dụ, lúc này 1 Model bài viết có rất nhiều trường (ảnh đại diện, chuyên mục, thời gian đăng, ….), và ta có hàng 1000-10000 bài viết, việc trả 1 lần tập dữ liệu lớn như thế sẽ làm chậm ở 2 chỗ:

  • Lấy toàn bộ dữ liệu từ database tốn thời gian
  • Truyền 1 lần dữ liệu lớn như vậy sẽ rất nặng, tốn tiền mạng thật sự của user (tải 1 file lớn mỗi lần), và lúc tải 1 file lớn như thế cũng rất chậm, tốn thời gian, gây khó chịu người dùng

Tổng kết 1

Khi đó, ta có thể sử dụng đến phân trang, và mỗi lần người dùng chỉ có thể xem 1 trang, ta chỉ gửi khoảng 10-15 bài viết 1 lần thôi, khi người dùng sang trang khác ta sẽ gửi tập dữ liệu khác, khá đơn giản.

Triển khai phân trang bằng Spring Boot

Triển khai Model

image 6 - quochung.cyou PTIT

Triển khai Repository

Để có thể truy cập các JPA Entity trên từ database, ta sẽ tạo 1 PostRepository

image 7 - quochung.cyou PTIT

JPARepository đã kế thừa sẵn một interface là PagingAndSortingRepository của Spring hỗ trợ việc phân trang và sắp xếp. Dù là một interface, không có implemention, nhưng khi chương trình khởi chạy, Spring sẽ tự động generate các code implemention thật cho chúng ta, thực thi các thao tác với database, và chúng ta chỉ cần define các method có sẵn thôi.

Phân trang

Do Spring đã làm đa số các phần code, giờ ta chỉ cần triển khai thêm 2 việc

  • Tạo một PostPageRequest class, implement từ Pageable interface của Spring
  • Truyền tham số cần tìm cho PostPageRequest
image 9 - quochung.cyou PTIT

Khi implement interface Pageable, ta sẽ phải triển khai một số hàm. Lúc này class PostPageRequest sẽ như một object “trang” , kiểu trang 5 thì là một object Trang, trang 6 là một object khác. Từ object trang đó ta có thể lấy trang tiếp theo, trang phía trước, các bài viết trong trang,….

offset và limit

Bạn có thể thấy trong code trên có các tham số offset và limit. Hai tham số trong sql có ý nghĩa như sau

  • offset x : Lùi x kết quả từ dãy kết quả trả ra
  • limit y: Từ danh sách kết quả trả ra, lấy y kết quả đầu tiên.
  • Ví dụ: ta có các bài viết đánh số từ 1-100. offset 5 thì ta sẽ có danh sách là 6-100. limit tiếp 10 thì ta có danh sách 6-16…

Nếu bạn đã hiểu định nghĩa offset và limit, hãy thử đọc lại code bên trên, bạn sẽ dễ dàng hiểu được các method lấy trang tiếp theo, lấy trang trước, …. đang làm gì.

image 10 - quochung.cyou PTIT

Tổng kết 2

Như vậy, ta đã triển khai được phân trang bằng Spring Boot, tuy nhiên liệu như vậy đã tối ưu cho trang web của bạn chưa?

Tối ưu limit và offset trong MySQL

image 11 - quochung.cyou PTIT
image 12 - quochung.cyou PTIT
OffsetQuery Duration (ms)
01
501
100013
10000150
25000500
50000930
1000001750

Những biểu đồ và bảng

Ta có thể thấy, bằng việc dùng offset để lùi kết quả đi một đoạn, rồi lấy limit để lấy lượng bài ở trang đó nghe có vẻ rất đơn giản, dễ hiểu. Nhưng thực tế trong MySQL chúng được thực hiện như sau:

…the rows are first sorted according to the <order by clause> and then limited by dropping the number of rows specified in the <result offset clause> from the beginning…

…các dòng đầu tiên được sắp xếp (ví dụ theo id, thời gian đăng bài…) sau đó xóa x hàng đầu tiên được yêu cầu khi sử dụng offset
image 13 - quochung.cyou PTIT

Nếu bạn nghĩ kĩ, câu lệnh offset chỉ nhận đúng 1 tham số: lượng dòng bị bỏ qua cho đến tập kết quả muốn nhận.

Cách duy nhất hệ thống database có thể làm điều này là lấy toàn bộ dữ liệu cần tìm, sau đó ném đi x hàng đầu bạn đã đặt ra yêu cầu. Khi offset đủ lớn, lượng công việc cho database sẽ rất nhiều và thời gian để truy vấn sẽ tăng khó kiểm soát.

Khi sử dụng offset, ta mở trang đầu tiên, trang thứ 2, thời gian mất chỉ 1ms (1 phần nghìn giây), gần như không có vấn đề gì.

Trang thứ 10000, 150ms, vẫn chưa nhận ra điều gì quá lo ngại

100000 1750ms, 1,75 giây.

Ta có thể thấy, nếu người dùng mở 1 trang càng xa, hiệu suất của trang sẽ càng giảm, việc một user mở trang thứ 10000 có thể gây vấn đề hiệu năng hơn nhiều cho database hơn 100 người dùng khác mở trang 1

Hướng khắc phục

Trước hết, ta cần tìm hiểu xem những hệ quản trị cơ sở dữ liệu đang làm gì để sắp xếp dữ liệu của chúng ta. Ta sẽ assume hệ cơ sở dữ liệu đang sử dụng một B-Tree để index database (một bản nâng cấp của cây nhị phân cân bằng).

Nếu bạn chưa từng nghe đến cụm từ trên, bạn có thể tìm hiểu ở link sau:

Lúc này database của chúng ta lưu dữ liệu theo dạng như sau:

image 14 - quochung.cyou PTIT

Khi ta sử dụng offset 0, limit 5 để lấy 5 bài viết đầu tiên chẳng hạn, database sẽ chạy các kết quả sau

SELECT * FROM my_table ORDER BY id LIMIT 5
image 15 - quochung.cyou PTIT

Tuy nhiên, với offset, sau khi offset 5 và limit 5, ta có

image 16 - quochung.cyou PTIT

Như vậy, ta phải đi qua 5 cái đầu trước, bỏ dần nó, rồi sau đó mới limit 5 cái sau. Khá là tốn thời gian

Vấn đề: Database không biết điểm khởi đầu của trang tiếp theo ở đâu, vì vậy nó cứ phải bỏ dần các hàng phía trước cho đến khi đến được vị trí chỉ định

=> Khắc phục: Ta nhớ xem vị trí lần cuối là ở đâu ?

Kĩ thuật: keyset pagination and seek method

Ở một số trang web, bạn sẽ thấy, bạn không thể đi đến thẳng trang cuối, hoặc nhảy đến 1 trang bất kì, mà thông thường sẽ có nút để sang trang kế và trang phía trước. Như vậy ta có thể assume rằng:

Người dùng sẽ chỉ mở trang 10 sau khi mở trang 9.

Vậy, ta chỉ cần nhớ vị trí cuối cùng của bài viết ở trang 9 là ở id bao nhiêu, rồi dùng WHERE để truy vấn từ điểm đó, chứ không cần bỏ dần để đi đến điểm đó nữa
SELECT * FROM my_table WHERE id > 21 ORDER BY id LIMIT 5
image 17 - quochung.cyou PTIT

Ví dụ: Sort theo thời gian

SELECT *
FROM my_table
WHERE (update_date = '2017-12-21' AND id > 21) 
    OR update_date > '2017-12-21'
ORDER BY update_date,id LIMIT 5

Cơ bản là ta sẽ chỉ lấy các bài viết có cùng thời gian đăng như bài viết cuối và id > , hoặc thời gian lớn hơn bài viết cuối

image 18 - quochung.cyou PTIT

Tổng kết

  • Phương pháp keyset pagination and seek giúp tối ưu việc phân trang cho các bài toán lớn hơn rất nhiều (Tham khảo biểu đồ trên)
  • Triển khai trong Java (JPA/Hibernate)

Tuy nhiên, phương pháp này sẽ có thêm các vấn đề sau

  • Ta cần thay đổi lại code của hệ thống để triển khai phương pháp này, cần phải nhớ hàng cuối cùng hiện tại, làm code phức tạp hơn, khó quản lí hơn
  • Cần phải index database theo id, pubdate, ….
  • Các hàng tìm kiếm cần được sắp xếp, không được null
  • Không thể đi trực tiếp đến trang 500,1000,… được, mà chỉ có thể sang trang kế tiếp do ta cần nhớ điểm cuối từ trang phía trước

Có thể tham khảo thêm Spring HateOAS hỗ trợ thêm vấn đề này

Các nguồn tham khảo: