Comparison of Open-Source Status Page Solutions

In this blog post, we will delve into a detailed comparison of several open-source projects used to create status pages. Status pages are essential for keeping users informed about the operational status and incidents of various services. We will analyze the pros and cons of each solution, focusing on aspects such as community support, feature set, and maintainability. The open-source projects we will compare include CState, Kener, Cachet, Statping, and OneUpTime.

Pros And Cons

CState (Static Page)

Repository: CState on GitHub

image 4 - quochung.cyou PTIT

Pros:

  • Still maintained.
  • Large community support.
  • Supports categories and services, following the feature-service model.
  • Allows status updates by creating an incident.

Cons:

  • Static site, not dynamic. Changes like adding services require a site rebuild.
  • No API for remote updates.
  • No automated health checks.
  • No scheduling calendar for maintenance.

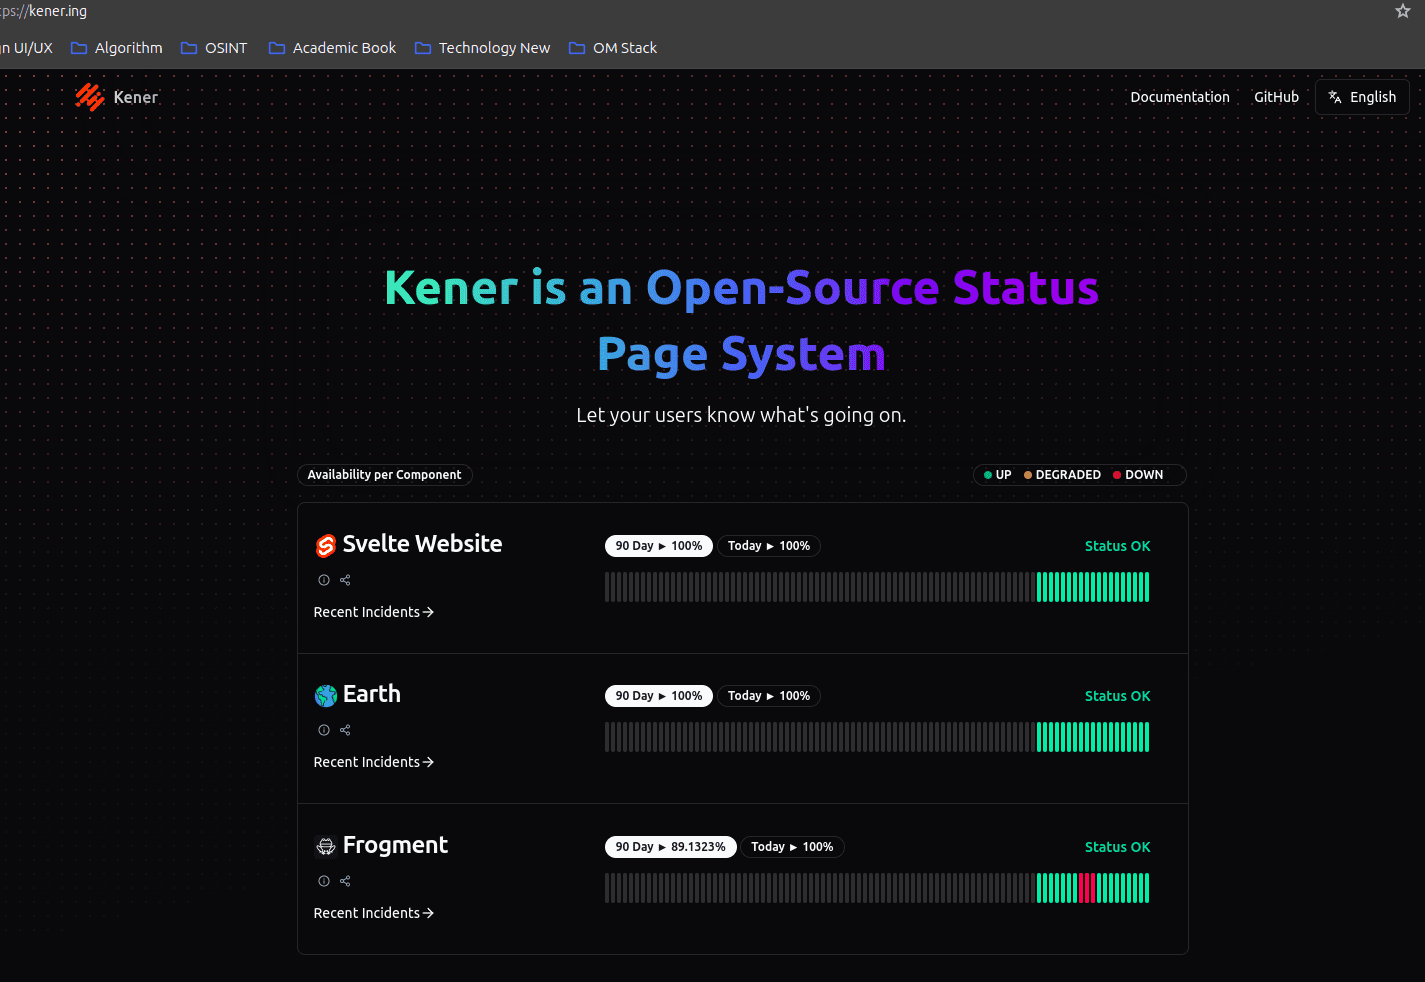
Kener (JavaScript)

image 9 - quochung.cyou PTIT

Repository: Kener on GitHub

Pros:

  • Still maintained.
  • Large community support.
  • API support for status updates and health check automation.
  • Supports cron jobs for automatic API health checks.
  • Allows creating incidents which override the API status updates.

Cons:

  • Supports categorizing multiple services but does not synchronize category status with services. (For ex: when a service go down, the whole category will not see any affect, currently it feel like just a category for “minimize and grouping”, not really have any function for category)

Cachet

image 7 - quochung.cyou PTIT

Repository: Cachet on GitHub

Pros:

  • Active Maintenance: Frequently updated and well-maintained.
  • Community Support: Large community support.
  • API Support: Comprehensive API for status updates and management.
  • Component-Based: Allows for detailed component and group management.

Cons:

  • Group Limitations: Services can only be linked to one group, which might limit flexibility.
  • PHP-Based: Requires a PHP environment, which may not be ideal for all users.

Statping

image 10 - quochung.cyou PTIT

Repository: Statping on GitHub

Pros:

  • API Support: API for status updates and multi-platform support, including mobile apps.
  • Management Dashboard: Includes a comprehensive dashboard for managing services.
  • Automated Monitoring: Supports automated health checks with response time metrics.

Cons:

  • Maintenance: Less frequently maintained, which could pose risks for long-term use.
  • Group Limitations: Similar to Cachet, services can only be linked to one group.

Additional Insights:

  • Platform Compatibility: Compatible with multiple platforms, enhancing flexibility.
  • User Experience: Intuitive dashboard and easy-to-navigate interface.

OneUpTime

image 8 - quochung.cyou PTIT

Repository: OneUpTime on GitHub

Pros:

  • Active Maintenance: Frequently updated and maintained.
  • Comprehensive Features: Includes a management dashboard, automated health checks, and scheduling for maintenance.
  • Incident Management: Allows manual incident creation and supports announcements and alerts.

Cons:

  • Complexity: Complex system with many services, which might be overwhelming for some users.
  • Integration: Requires careful integration with existing authentication systems.

Conclusion

FeatureCStateKenerCachetStatpingOneUpTime
LanguageStatic Page, HTMLJavaScriptPHPGoJavaScript
MaintainabilityMaintainedMaintainedMaintainedPoorly maintainedMaintained
Grouping ServicesSupportedSupported (need tweaks)Single Group per ServiceSingle Group per ServiceSupported
Manual Incident UpdatesSupported (static config)SupportedSupportedSupportedSupported
Automated Health ChecksNot SupportedSupportedSupportedSupportedSupported
Maintenance SchedulingNot SupportedSupportedSupportedSupportedSupported
Operational Management DashboardNot SupportedNot SupportedSupportedSupportedSupported
API for Operations and Incident ManagementNot SupportedSupportedSupportedSupportedSupported

Summary

  • CState: A good choice if you prefer a simple, static site. It is fast and easy to host but lacks dynamic updates and automated health checks.
  • Kener: Suitable for those needing dynamic updates and automated health checks, with a high level of customization possible through JavaScript. However, it requires additional coding for full functionality.
  • Cachet: A well-rounded option with a user-friendly interface and comprehensive API support. It is best suited for environments where PHP is already in use.
  • Statping: Provides a comprehensive feature set with automated monitoring and a management dashboard. However, it is less frequently maintained, which could be a concern for long-term reliability.
  • OneUpTime: Offers the most features, including health checks, scheduling, and a management dashboard. It is highly scalable and suitable for enterprise-level applications but is complex and requires careful integration.

By evaluating these options based on your specific requirements and technical capabilities, you can select the most suitable open-source project for your status page needs.

Camunda 7 | Get history data of form in user task

Introduction to Camunda 7

image 2 - quochung.cyou PTIT

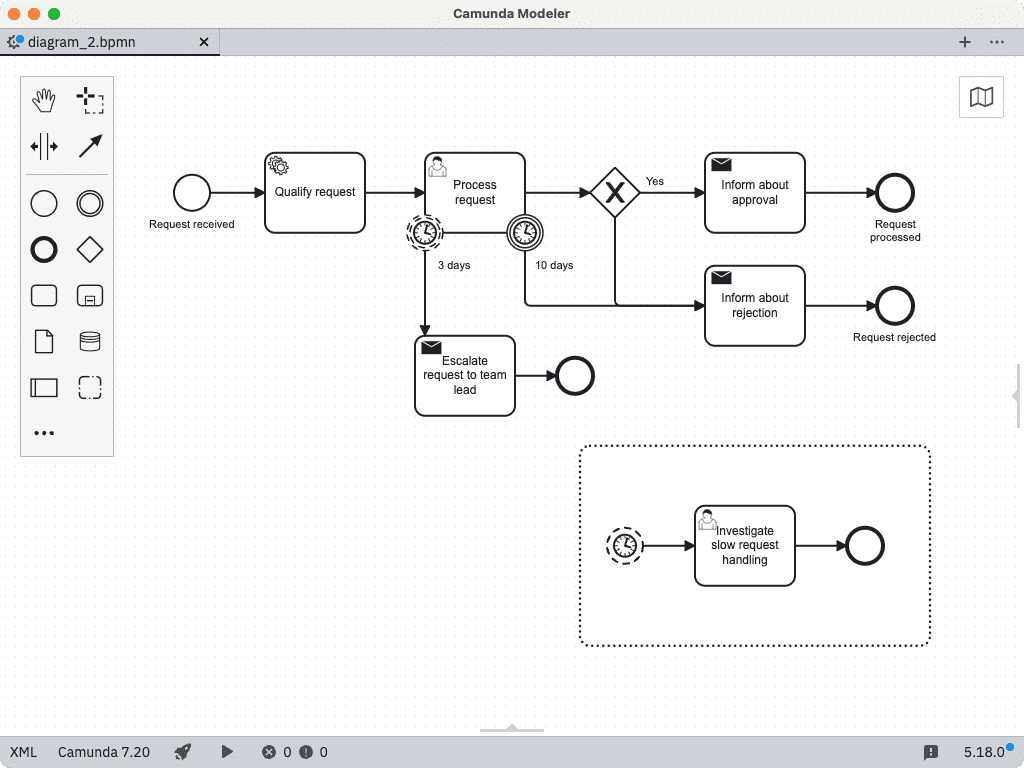
Camunda 7 is a powerful, open-source platform designed for workflow and process automation. It offers a comprehensive suite of tools for managing business processes, including capabilities for modeling, automating, and optimizing workflows. One of the key features of Camunda is its ability to track and retrieve historical data, such as process variables and form data, from completed process instances. However, retrieving form data from completed instances can be tricky as Camunda 7 does not provide an out-of-the-box API for this purpose.

Retrieving Historical Data

When working with Camunda, it’s often necessary to access historical data from completed process instances. This data can include process variables and form data, which provide insights into the execution and outcomes of the process. Retrieving this data is essential for reporting, auditing, and analysis purposes.

In this solution:

  1. The BPMN model instance is retrieved using the repositoryService.
  2. The task is fetched from the BPMN model using the task definition key.
  3. If the task is found, the form key is retrieved from the task attributes.
  4. The deployment ID is obtained from the process definition query.
  5. The form resource is retrieved using the GetDeploymentResourceCmd.
  6. The form data is read into a map and set into the result DTO as a JSON string.

Accessing Historical Form Data

By default, Camunda 7 does not provide an out-of-the-box API to retrieve form data from completed process instances. To work around this limitation, you can use a custom approach to fetch the form data stored as process variables.

Here’s a workaround to retrieve form data:

image 3 - quochung.cyou PTIT

Integration Testing Camunda 7 | No startFormHandler defined in process

Introduction to Camunda

image - quochung.cyou PTIT

Camunda is a popular open-source platform for workflow and process automation. It enables developers to model, automate, and optimize business processes. Camunda integrates well with Java applications, offering robust capabilities for managing complex workflows and business rules.

Understanding the Error

When performing integration testing in Camunda, you might encounter the following error:

org.camunda.bpm.engine.exception.NullValueException: No startFormHandler defined in process 'SalesOrderProcess_v2:1:cee4056f-a1d8-11eb-9f61-6683657f7a30': startFormHandler is null

This error occurs because the start event of the process expects a form handler to be defined, but none is provided. The startFormHandler is responsible for managing the form associated with the start event. When it is not defined, Camunda throws a NullValueException. This problem likely cause because of, usually camunda will have BpmnParser class that when reading the XML bpmn file, it will construct the event handler. But in your test, you not inject it

Solution: Mocking the Start Event Handler

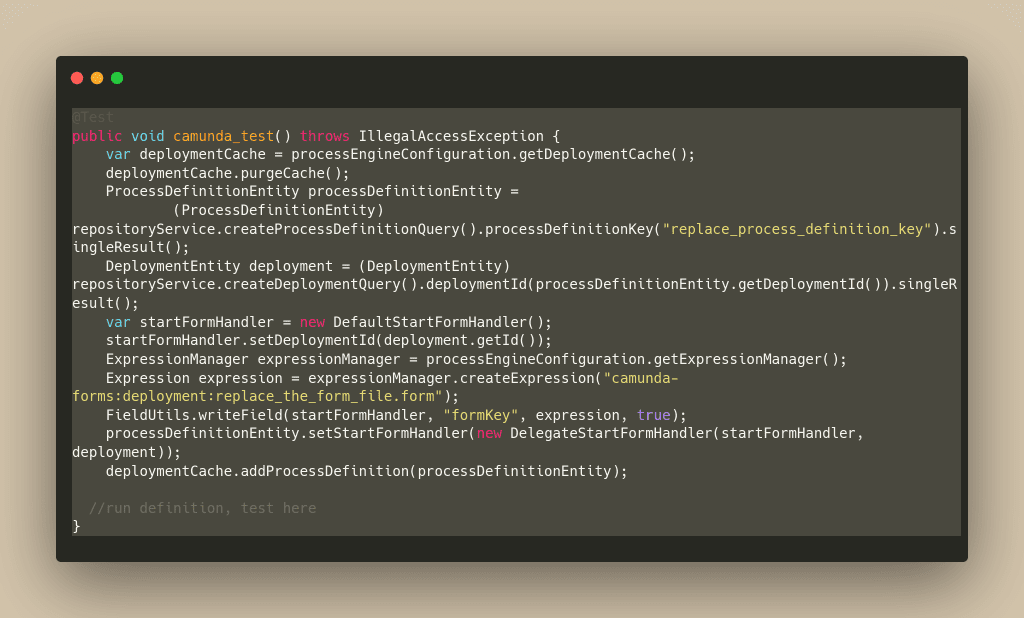
To resolve this issue, you can mock the start event handler in your integration tests. The following example demonstrates how to set up a mock start event handler to bypass the error and proceed with the testing.

Truncate table to make sure it clean state before test

      - ACT_HI_ACTINST
      - ACT_HI_DETAIL
      - ACT_HI_PROCINST
      - ACT_HI_TASKINST
      - ACT_RU_EXECUTION
      - ACT_RU_IDENTITYLINK
      - ACT_RU_TASK
      - ACT_RU_VARIABLE
      - ACT_RE_PROCDEF
      - ACT_RE_DEPLOYMENT
      - ACT_ID_USER
      - ACT_ID_GROUP
      - ACT_ID_MEMBERSHIP
      - ACT_ID_INFO
      - ACT_ID_TENANT
      - ACT_ID_TENANT_MEMBER
      - ACT_GE_BYTEARRAY

In this solution:

  1. The deployment cache is purged to ensure a clean state.
  2. The process definition is retrieved based on the process definition key.
  3. The deployment entity associated with the process definition is obtained.
  4. A DefaultStartFormHandler is created and associated with the deployment.
  5. The form key is set using the ExpressionManager.
  6. The DelegateStartFormHandler is assigned to the process definition.
  7. The process definition is added back to the deployment cache.
image 1 - quochung.cyou PTIT

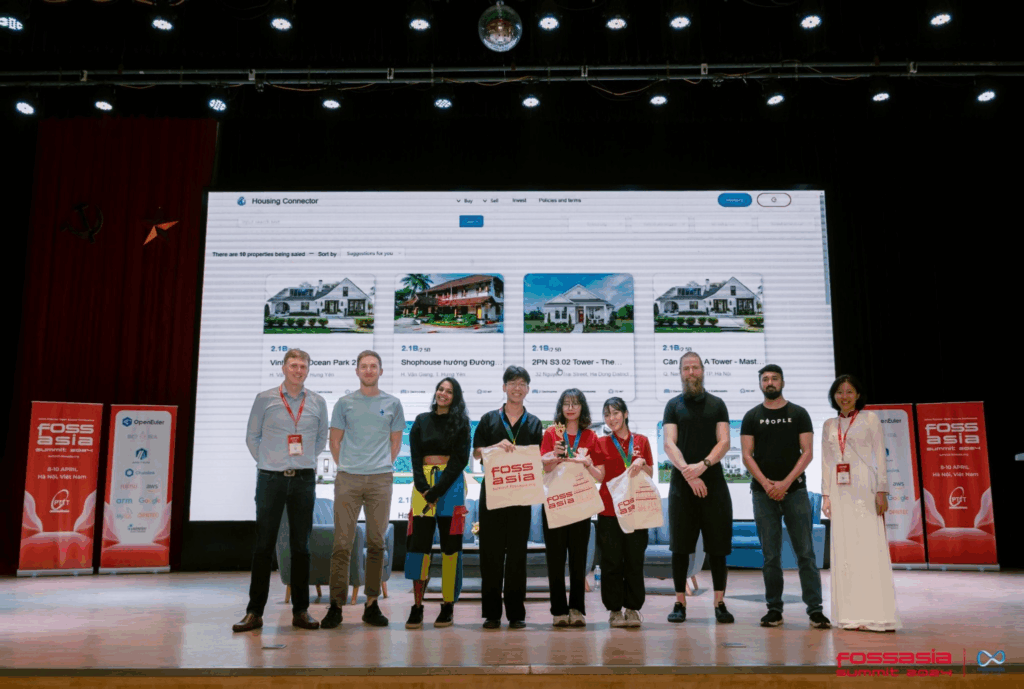
FOSSASIA 2024 Hackathon: Housing Connector

image 1 - quochung.cyou PTIT

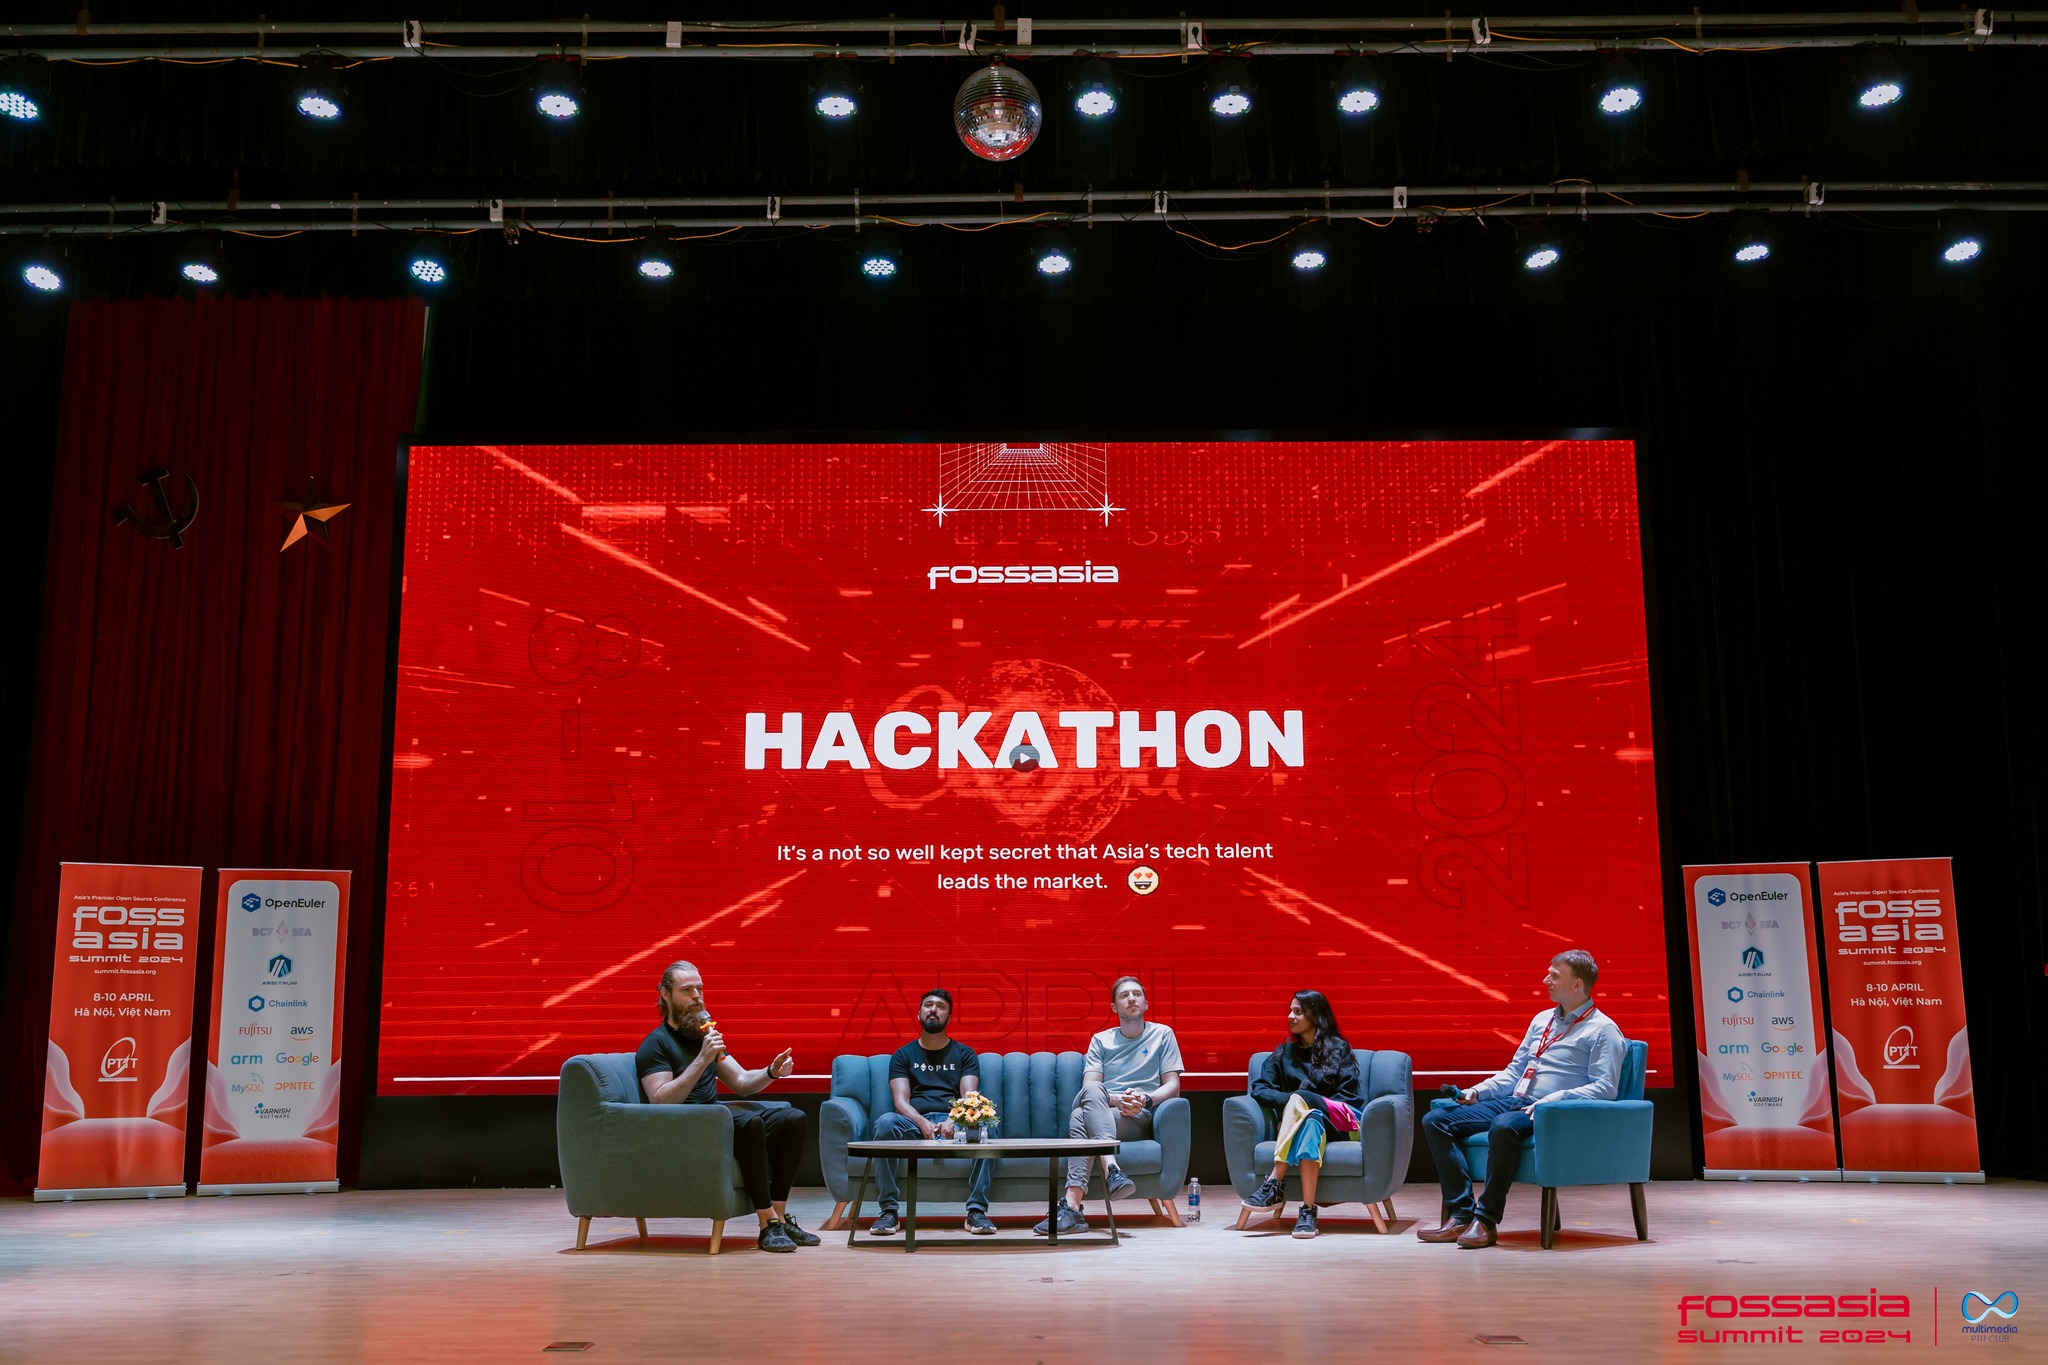
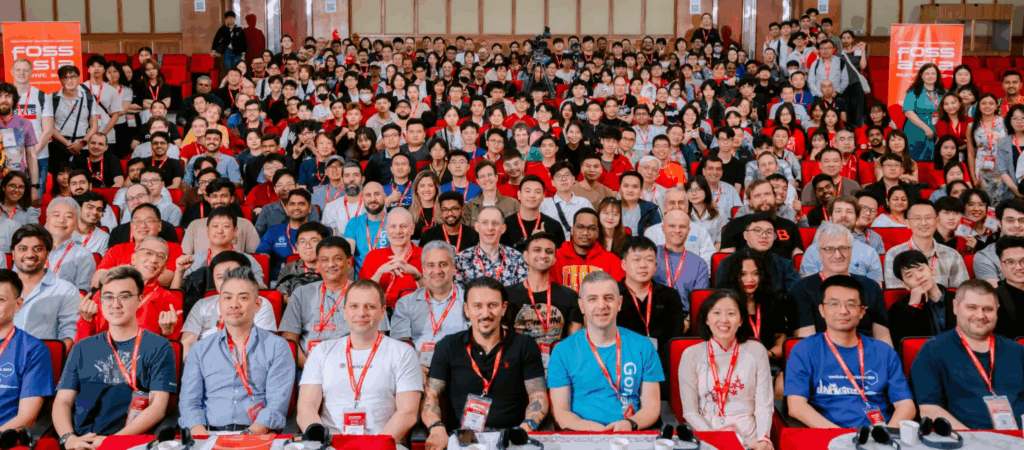
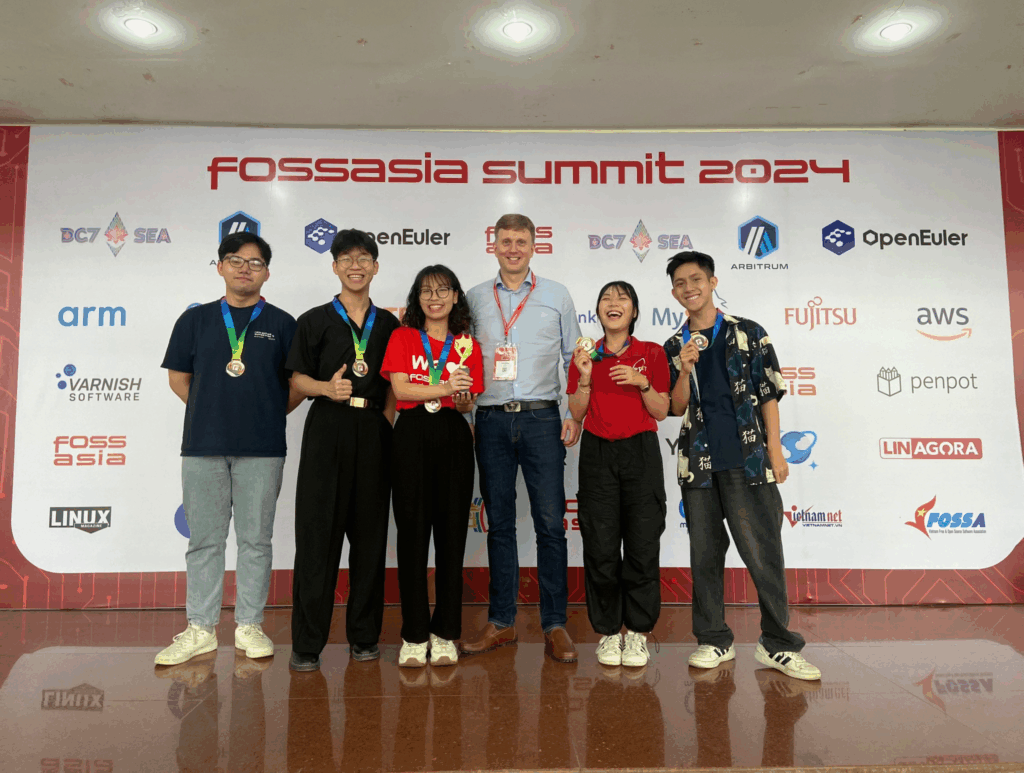
The atmosphere at the FOSSASIA Summit 2024 was absolutely electric. Hosted at PTIT, it’s a massive gathering with over 5,000 people from 50 countries, 200+ speakers from giants like Google, Huawei, and Oracle,…. Amid all that, there’s this Web3-focused hackathon, sponsored by Chainlink and Devfolio, challenging devs to build real-world blockchain solutions in just 48 hours.

image - quochung.cyou PTIT

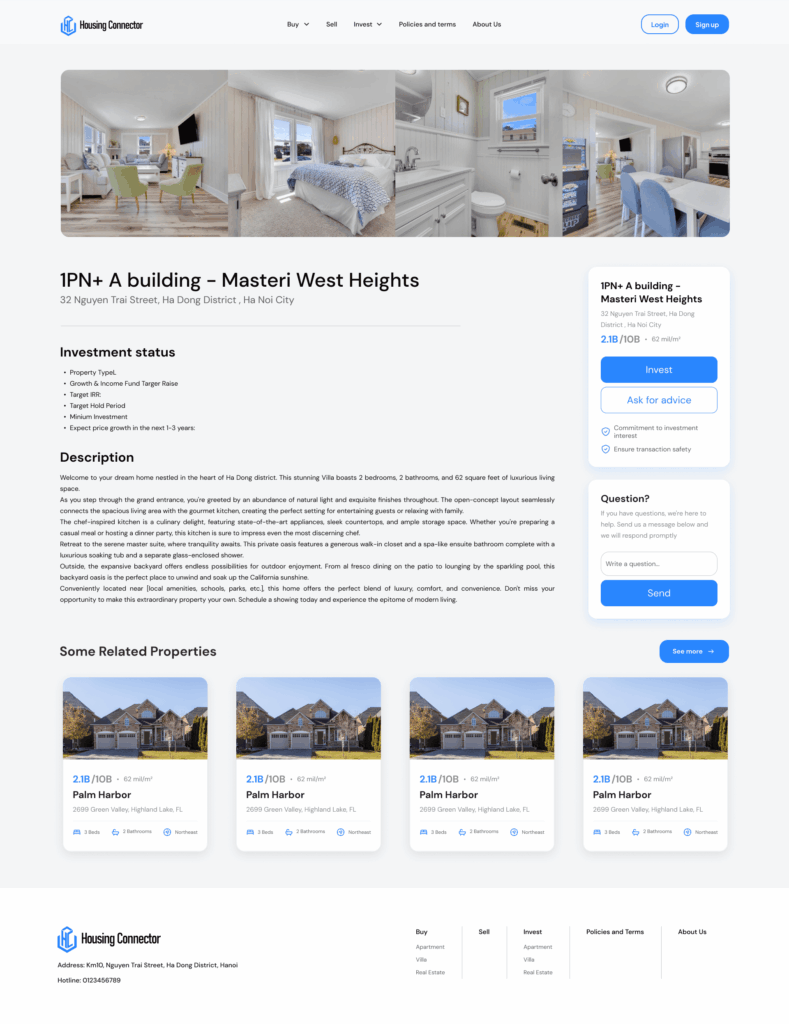
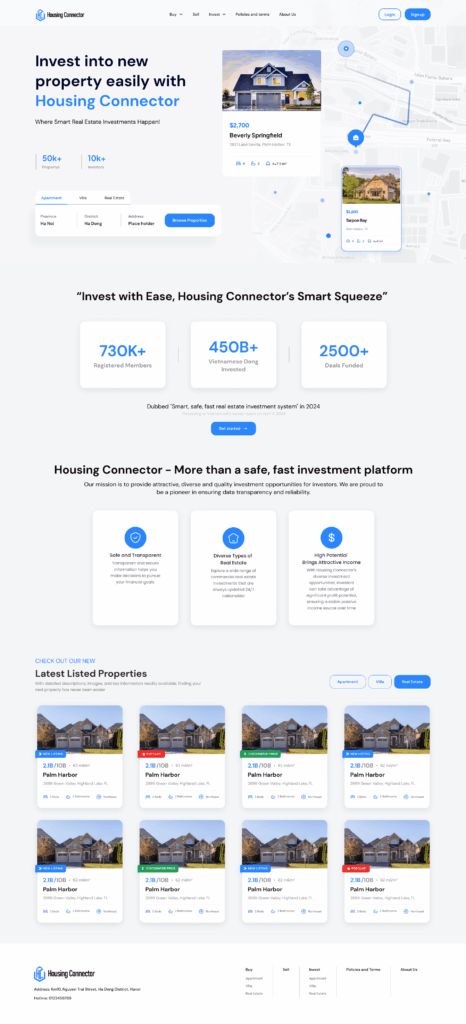
The idea came from what I see at work. Vietnam’s real estate is growing fast, the market’s supposed to double in size soon, with more young people in their 20s and 30s wanting in. But buying property? It’s expensive, and if you team up with friends or family, contracts get messy with arguments and risks. A lot of folks are shopping online now like 70% or something but trust is low. So, we made Housing Connector: a platform where small investors can pool money for properties, connect with agents, and use blockchain to keep everything clear and safe.

image 5 - quochung.cyou PTIT
image 4 - quochung.cyou PTIT

Basically, it works like this: Investors check out listings with details on location, costs, potential returns. They chip in what they can, sign smart contracts through Chainlink so no one’s getting screwed. When the property sells, money gets split automatically, minus a small fee, that’s how the app makes money. Agents get leads and data to sell better, and as more join, it pulls in more investors and properties. It’s a loop that could grow quick. We used React for the front end, Solidity for contracts, and stuff like Ethereum and Web3.js. Nothing fancy, just enough for a basic demo.

image 6 - quochung.cyou PTIT
image 7 - quochung.cyou PTIT

We submitted right at the deadline: a POC where you could “buy” a apartment in Hanoi with pooled funds. Out of over 1,000 people and 43 teams, they picked us as winners!

image 3 - quochung.cyou PTIT
image 2 - quochung.cyou PTIT

Honestly, it taught me a lot about teamwork under pressure. We’re proud of the prototype, even if it’s rough – built in two days, after all. Maybe we’ll keep working on it, add more features like AI for price predictions. Shoutout to FOSSASIA for the event!!!

Tìm hiểu về session fixation – Vấn đề bảo mật trong authentication bằng cookie

Session cookies

  • Cách đơn giản nhất để triển khai authentication theo dạng token, và cũng là cách được triển khai rất phổ biến trong các website, là sử dụng cookie. Một luồng đơn giản bao gồm: Sau khi người dùng xác thực danh tính bằng tài khoản, mật khẩu, …, hệ thống sẽ trả về 1 header Set-Cookie ở response, yêu cầu trình duyệt sẽ lưu 1 token ngẫu nhiên trong bộ nhớ cookie. Các kết nối tiếp theo vào trang web sẽ có đính kèm header Cookie chứa token. Hệ thống sẽ kiểm tra xem có người dùng nào gắn với token này không.
image 41 - quochung.cyou PTIT

Ví dụ thực tế về session cookie

  • Bạn đến phòng gửi đồ, gửi đồ của mình gồm ví tiền, đồ cá nhân, …
  • Phòng gửi đồ cất đồ, và cho bạn 1 thẻ id là ID_NGUOI_DUNG_1, họ sẽ nhớ là với cái id này thì được lấy đống đồ kia
  • Lần sau bạn tới với id trên, phòng gửi đồ sẽ cho bạn quyền được sử dụng đồ theo id này. Hiển nhiên id sẽ được sinh 1 cách ngẫu nhiên và bảo mật để khó lòng đoán được trong thực tế.

Session Fixation

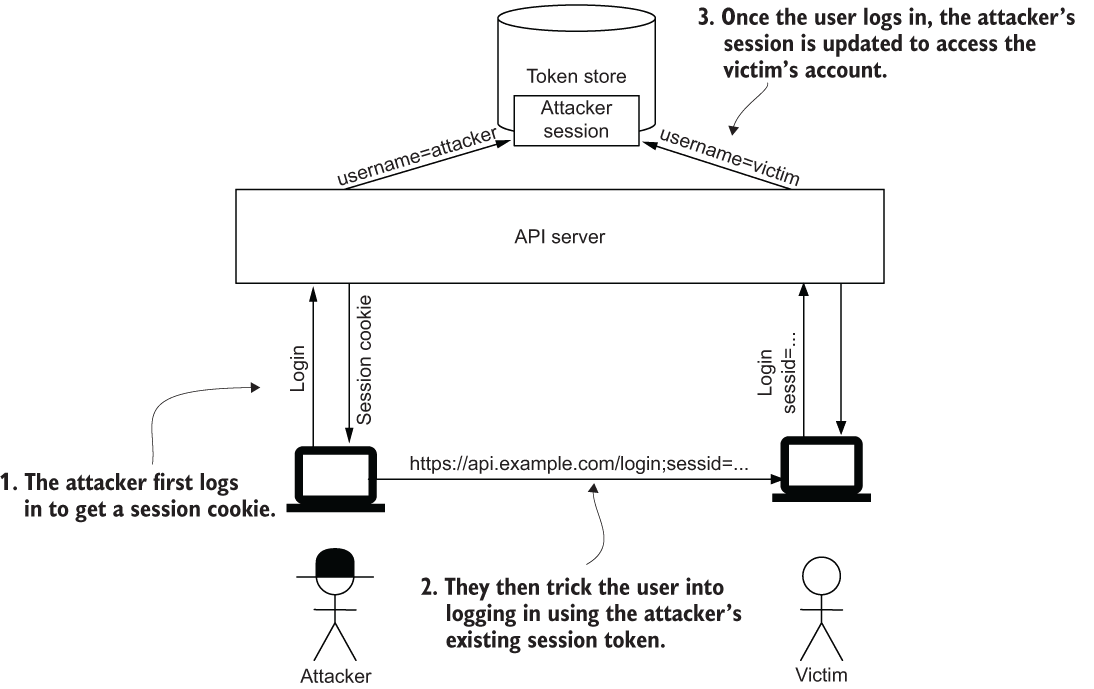
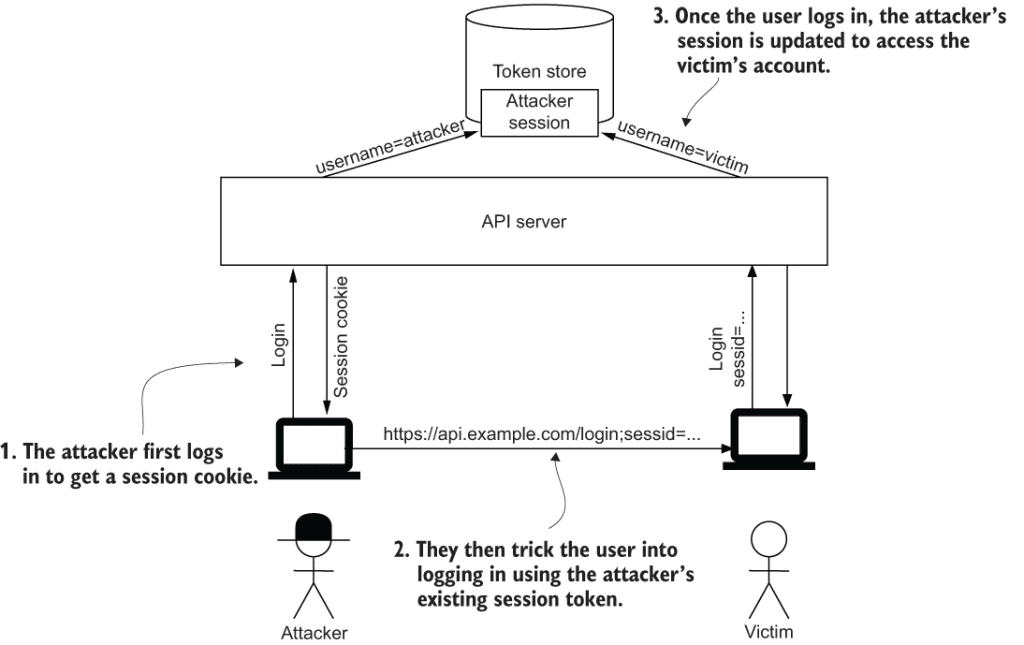
Case kẻ tấn công có thể sử dụng như ví dụ trên:

  • Hacker đầu tiên đến phòng gửi đồ, xưng danh và được cho thẻ ID là ID_NGUOI_DUNG_1
  • Hacker bằng cách nào đó khiến người dùng cầm thẻ ID đó đi gửi đồ, phòng gửi đồ sẽ cất các đồ vào ID_NGUOI_DUNG_1
  • Lúc này hacker dùng id kia đi lấy được đồ của người dùng.

Về việc làm sao để khiến người dùng cầm thẻ id đi gửi đồ thì có rất nhiều cách, có thể kể tới:

  • Hacker gửi cho bạn 1 đường link kèm id bên trong, người dùng khi click vào, hệ thống yêu cầu đăng nhập. Sau khi người dùng đăng nhập bằng tài khoản mật khẩu của mình, hệ thống lại gán id của hacker vào các thông tin có thể truy cập của người dùng
  • Tấn công theo subdomain. Ví dụ ta có trang web example.com và hacker.example.com. Hacker có quyền kiểm soát ở subdomain, khi người dùng vào hacker.example.com, người dùng đã nhận được id được sinh ra của hacker, và khi đăng nhập ở example.com thì id đó sẽ được gán với thông tin của người dùng

  • Giả sử đây là một đoạn code triển khai cookie token và có thể bị dính Session Fixation
image 42 - quochung.cyou PTIT
image 43 - quochung.cyou PTIT
  • Để giải quyết vấn đề trên code trên. Rất đơn giản, ta cần đảm bảo khi người dùng đăng nhập, các session cũ phải bị huỷ đi và đảm bảo thông tin người dùng chỉ có thể gắn với 1 id được tạo mới, và hacker không đoán được.

Luồng như ví dụ thực tế:

  • Khi người dùng cầm id của hacker đến phòng gửi đồ để tạo id mới
  • phòng gửi đồ kiểm tra và thấy id này đã được tạo ra từ trước.
  • Phòng gửi đồ huỷ id cũ đi nếu đã tồn tại
  • Tạo id mới
image 44 - quochung.cyou PTIT

Các cách solution khác được suggest:

  • Solution: Utilize SSL / TLS session identifier: Các giao thức mã hoá SSL/TLS cũng sinh ra các session identifier để định danh. Ta có thể sử dụng luôn phần này vì nó đã được làm bảo mật mạnh. Tuy nhiên một số trình duyệt sẽ không hỗ trợ cách trên
  • Accept only server-generated SIDs: Các SID (session id) chỉ nên được sinh ra bởi server để hạn chế khả năng hacker tạo sid
  • Logout function: Ta có thể có các chức năng đăng xuất, rời trình duyệt, … khi đó sẽ huỷ luôn id để đảm bảo không có request nào khác được gửi vào
  • Verify that additional information is consistent throughout session: Thông thường thì khi người dùng sử dụng, họ chỉ sử dụng 1 địa chỉ ip, hoặc 1 địa chỉ mac, … tuỳ vào usecase. Ta có thể kiểm tra giữa các request có thông tin nào bị thay đổi không để tăng thêm khả năng bảo mật
  • Do not accept session identifiers from GET / POST variables: Không nên để SID vào trong các biến ở request, điều này khiến hacker dễ dàng tạo các url chứa sid độc để tấn công hơn.

Tham khảo:

[Phần 2] Session Token và JWT Token, Refresh Token, khi nào quyết định sử dụng, ưu và nhược điểm

This entry is part 2 of 2 in the series API Security

Bearer Token

image 19 - quochung.cyou PTIT
  • Lúc này, ta đã đang thực hiện giao tiếp với server qua token, có một câu hỏi đặt ra là, làm sao để gửi token đó cho phía server?
  • Hiển nhiên, ta có thể làm điều ở ở body của request, ở param, … hoặc ở cookie. Tuy nhiên, có một cách thông dụng và được sử dụng hầu hết hiện nay để chuyển 1 token không qua cookie đó là sử dụng dạng “Bearer” https://tools.ietf.org/html/rfc6750
  • Bearer lúc đầu được tạo ra nhằm phục vụ cho OAuth2 (sẽ nói thêm sau)
  • Để gửi 1 token qua api, ta chỉ cần để nó ở header Authorization
Authorization: Bearer QDAmQ9TStkDCpVK5A9kFowtYn2k
  • Việc sử dụng giao tiếp qua Authorization cũng cho phép ta sử dụng header WWW-Authenticate để giúp đầu api “thân thiện” với http hơn
  • WWW-Authenticate có thể theo kèm một tham số là “realm”, bạn có thể hiểu trường này như một trường nhằm định dang đầu api hiện tại. VD nếu realm = admin, thì client sẽ hiểu đầu api này cần token dành cho admin, nếu realm = users thì là các đầu api open cho user
  • Ngoài ra, ta cũng có thể thêm các thông báo về việc token hết hạn, sai, …
HTTP/1.1 401 Unauthorized
WWW-Authenticate: Bearer realm="users", error="invalid_token",
        error_description="Token has expired"
  • Phần này giúp phía client có thể biết là token đã hết hạn và yêu cầu tạo token mới
image 20 - quochung.cyou PTIT
  • Để lưu token ở phía client mà không cần sử dụng cookie, ta có thể sử dụng các bộ nhớ có sẵn của trình duyệt như
    • sessionStorage: Các thực thể có thể được lưu tại đây, bộ nhớ chỉ là tạm thời và bị xoá khi tab bị đóng
    • localStorage: Dữ liệu được lưu kể cả khi trình duyệt đóng và chỉ xoá nếu ta yêu cầu
  • Nghe sessionStorage giống với cookie, tuy nhiên sessionStorage sẽ không share giữa các tab với nhau. Tức là cookie sẽ share giữa các tab, nhưng chỉ chung 1 domain (tức là phân biệt bằng tên miền). Còn sessionStorage chỉ lưu trạng thái ở tab hiện tại

JWT Token

  • Ta đã đi qua cách authentication bằng sử dụng basic authentication, rồi đến token được lưu ở cookie hoặc local/session storage. Tuy nhiên các cách thức này đều yêu cầu token cũng phải được lưu ở phía server.
  • Tức là mỗi truy vấn vào server, ta lại phải gọi vào database, với hàng triệu, hàng tỉ token ngày càng tăng lên để kiểm tra xem token có tồn tại chưa, có hết hạn chưa, … Chưa kể đến ta còn phải giải mã token ra nếu ta mã hoá nó trong database (thường là có)
  • Việc này tạo thành một bài toán lớn và ngày càng khó giải khi số lượng user tăng cao
image 21 - quochung.cyou PTIT
  • Lúc này, có một giải pháp khác đã được tạo ra, đó là JWT (Json Web Token)
  • Định nghĩa: JWT hay JSON Web Token là một format thông dụng cho các token ở dạng “self-contained” (chỉ lưu ở client). JWT thường bao gồm các claims (các khẳng định rằng user này có gì, có kia) và các quyền của user. VD, JWT sẽ chứa là user có quyền được vào trang a, trang b, ….
  • JWT ngoài ra được mã hoá crypto để bảo vệ khỏi các vấn đề bảo mật liên quan

Lưu JWT ở phía Client

  • Bạn sẽ có câu hỏi: Làm sao để một token chỉ có thể lưu ở client mà không ở server, vậy thì làm sao ta biết là token nào là thoả mãn, chưa bị người khác sửa, thêm quyền kiểu admin vào và cầm token đó đi request server?
image 22 - quochung.cyou PTIT
  • Một trong các cách được đề ra có thể xem qua ảnh sau. Tức là khi phía server sinh ra 1 token thoả mãn, ta sẽ thêm 1 key (HMAC) vào đuôi của token.
  • Hmac được sinh ra từ claims và 1 đoạn key, điều này giúp kiểm tra nếu đoạn claims đã bị sửa đổi thì phần HMAC sẽ không trùng khớp nữa.
  • Điều này đảm bảo là người khác khi sửa gì đó thì sẽ không thoả mãn nữa do ta có phần đuôi tag để kiểm tra xem. (Server sẽ thử giải mã phần key xem có đúng với ban đầu không, key này chỉ server biết)
  • Cấu trúc JWT có 3 phần
    • Header: Chứa các thông tin về kiểu token này dùng mã hoá dạng gì, …
    • Claims: Phần chứa thông tin ta muốn để trong token, ví dụ quyền của user
    • HMAC Tag: Phần mã hoá đảm bảo tính toàn vẹn của token
image 22 - quochung.cyou PTIT
  • JWT trở lên ngày càng phổ biến ở những năm gần đây do JSON Web Tokens đã được tiêu chuẩn hoá vào 2015. (Trước đây ta gọi những token stateless bên trên là JSON Token). JWT là một chuẩn với chức năng tương tự như ý tưởng JSON Tokens ban đầu, nhưng có một số chức năng thêm:
    • Một quy định chung cho phần header chứa các thông tin kèm cho JWT, ví dụ như thuật toán mã hoá, …
    • Một số chuẩn chung về phần claims, là trường nào lưu gì, …
    • Nhiều thuật toán khác nhau để mã hoá và xác thực.
  • Tuy rằng JWT chỉ là một quy chuẩn định nghĩa tại https://tools.ietf.org/html/rfc7519, nó được xây dựng từ một tập hợp nhiều quy chuẩn được gọi là JSON Object Signing and Encryption (JOSE). JOSE chứa nhiều tiêu chuẩn sau:
  • Một token JWT cơ bản trông như sau:
image 20 - quochung.cyou PTIT
  • Sự linh hoạt của JWT cũng là điểm yếu lớn nhất của nó, nhiều cuộc tấn công đã xảy ra nhờ vào sự linh hoạt này. JOSE là một tập các phần thiết kế cho phép lập trình viên chọn từ nhiều thuật toán khác nhau, và không phải sự kết hợp nào cũng đem lại tính bảo mật tốt.
  • VD: Vào năm 2015, (http://mng.bz/awKz) Tim McClean đã tìm ra một lỗ hổng trong rất nhiều thư viện JWT về việc ở phần header, ta có thể sửa nó thành thuật toán khác, và thậm chỉ sửa nó thành “none”. Điều này vô tình bảo các thư viện JWT ở phía backend khi kiểm tra token đã không dùng thuật toán nào để kiểm tra mã hoá, và các phần claims bị sửa trái phép không bị phát hiện. (Hay còn được biết đến là JWT None Attack)

Paseto

image 21 - quochung.cyou PTIT
  • Các lỗi trong các quy chuẩn dẫn tới sự phát triển của các công cụ thay thế với hi vọng vẫn chứa các tính năng tương tự nhưng sẽ sửa một số vấn đề của bộ cũ.
  • Một ví dụ là Paseto, cung cấp các trình mã hoá đối xứng, khoá public, … hỗ trợ xử lý các vấn đề của Jose và các chuẩn JWT chung.
  • Điểm chung ngắn gọn giữa Paseto và Jose là thay vì cho phép lập trình viên mix giữa nhiều cấu phần khác nhau trong bộ Jose, Paseto chứa một bộ fix cứng chung về thuật toán (AESS, RSA, Ed25519, …), giúp giảm thiểu các vấn đề bảo mật xảy ra.

Một số chuẩn chung trong claims của JWT

Thông thường, phần claims sẽ có các mục sau:

issIssuerChỉ ra là ai đã tạo ra token này, thường là url của trang đã sinh token.
audAudienceChỉ ra token này dành cho ai, có thể là id của user, …
iatIssued-AtThời điểm token được tạo ra
nbfNot-BeforeToken bị cấm nếu dùng trước thời gian này. VD đặt là 2/1 mà dùng vào 1/1 thì không được
expExpiryThời điểm token hết hạn
subSubjectĐịnh danh chủ đề của token, thường là username, id hay gì đó
jtiJWT IDID không bị trùng của token, dùng để tra cứu sau này nếu cần

JWT trong Database, xoá token

image 23 - quochung.cyou PTIT
  • Các token stateless, chỉ cần ở client side là một cách hay để giảm bớt state khỏi database. Điều này giúp ta scale các api mà không cần nâng cấp nhiều phần cứng database hay phải triển khai nhiều việc hơn.
  • Tuy nhiên, việc lưu trữ token ở database lại cho phép ta có một quyền năng lớn, đó là có thể revoke, hay quyết định 1 token có hợp lệ hay không, bằng cách chỉ cần xoá nó khỏi database. Hiển nhiên, việc lưu ở database đi kèm rất nhiều vấn đề về scale, có thể là ta cần nhiều database token cho nhiều service nhỏ khác nhau, nếu ta tập trung nó lại, nó có thể là 1 điểm SPOF (Single Point of Failure), 1 điểm nghẽn trong toàn luồng và chỉ cần nó chết, toàn hệ thống sẽ ngỏm do không có khả năng authentication

  • Có một số cách để xử lý vấn đề này. Ta có thể lưu database, tuy nhiên không lưu toàn bộ token mà chỉ cần 1 id unique nào đó mà có thể link với 1 token, khi huỷ hợp lệ 1 token, ta chỉ cần huỷ id đó, khi token đó được gửi bởi client, ta sẽ giải mã ra id và kiểm tra. Điều này giúp ta giảm bớt phần nào đó về database
  • Một cách khác là, ta có thể chỉ lưu các token bị huỷ hợp lệ, hay danh sách đen. Khi token được gửi lên ,ta xem nó có trong danh sách đen hay không, thì sẽ từ chối token đó. Các token mà đã hết hạn sử dụng rồi có thể clean up dần đi, giúp database danh sách đen nhỏ
  • Một cách khác là thay vì block 1 token, ta có thể chỉ chặn 1 số chức năng ở 1 tập hợp tk. Ví dụ, ta thường có chức năng đăng xuất ở mọi thiết bị khác khi ta đổi mật khẩu, để làm điều này, ta có thể thêm vào database toàn bộ token của người dùng trước ngày nào đó đều bị xoá, điều này giúp giảm không gian cần cho database, nhưng đi kèm query phức tạp hơn.

Tham khảo:

  • API Security in Action
  • Modern API Architecture

Còn tiếp

[Phần 2] Sự phát triển của các mô hình hệ thống Backend (N-layered, DDD, Hexagon, Onion, Clean Architecture)

2005 — Hexagon (Ports and Adapters) (Khối lập phương – Cổng và bộ chuyển đổi)

  • Trước đó, các tầng của chúng ta chỉ đi từ trên xuống theo thứ tự. Với việc sử dụng dependency inversion, mọi thứ đều đã thay đổi
  • Đây như là một thế giới mới cho các kỹ sư phần mềm. Ta có thể kiểm soát được hướng của sự phụ thuộc theo cách ta muốn. Lúc này, business logic sẽ không gọi xuống tầng data access nữa. Để đọc thêm về dependency inversion, bạn có thể tham khảo bài sau:
1*B2f9ycR5sN6thAhCe0vfiA - quochung.cyou PTIT
1*1Hyocpa6Xpy mXqYeb zqw - quochung.cyou PTIT
1 PRLCk7qPIL PHT mNXw2cQ - quochung.cyou PTIT
  • Thay vì những layer hình chữ nhật như ban đầu, lúc này, ông đã vẽ một hình lục phương, trông có vẻ khá phức tạp hơn một cấu trúc đa tầng ban đầu, tuy nhiên nó lại khá đơn giản
  • Điều gì đã xảy ra trong hình minh hoạ trên? Như ta thấy, lúc này Domain đã là thành phần ở giữa và là trung tâm của toàn bộ hệ thống, nó không còn phụ thuộc vào bất kì thứ gì khác nữa
  • Để thể hiện việc tầng Domain đã là trung tâm, tầng Business Logic/Domain được đặt tên là Core
  • Các module khác được chia thành 2 phần. Lúc này, với 1 class thực hiện các công việc, ví dụ Repository làm việc với dữ liệu thì không chỉ còn là 1 class concrete mặc định nữa, mà được chia làm đôi thành phần ảo (interface) và phần triển khai thật sự (code logic class). Các phần interface định nghĩa các phương thức mà class logic cần triển khai được đặt tên là ports (cổng)
  • Các phần triển khai code thực tế nằm trong các module bên ngoài, và được gọi là adapters
  • Rõ ràng, ta thấy các logic Domain/Core của hệ thống giờ không còn phụ thuộc vào ai cả, vì nó là những chức năng mà hệ thống bắt buộc phải có, mọi module khác đều chỉ là gắn thêm vào, và phải triển khai các cổng (các interface) mà phần core đã định nghĩa sẵn.
image 3 - quochung.cyou PTIT

Ví dụ về port, adapter và core của hexagon architecture

  • Ta có, ví dụ như một chiếc laptop. Các cổng của nó là gì? Ta có cổng hdmi, cổng tai nghe 3.5, cổng sạc, cổng type c, cổng usb, ….
  • Rõ ràng, khi muốn thêm gì đó cho chiếc laptop, ví dụ ta muốn cắm thêm 1 tài nguyên lưu trữ dữ liệu vào, ta phải dùng 1 chiếc usb, hoặc 1 thẻ nhớ, và chúng phải có khuôn mẫu, đúng với quy chuẩn mà cái laptop đã quy định ra -> tôi có cổng usb như này, nếu muốn cắm gì vào thì phải theo khuôn như thế. Giống như việc, trong core đã có các interface, ta chỉ làm việc với các hàm của interface, module bên ngoài triển khai logic phải triển khai đúng theo bản khuôn mẫu, các hàm đó.
  • Ví dụ, nếu không dùng interface, nhà sản xuất usb lại tự tạo ra các đầu cắm khác nhau, giờ chẳng lẽ máy tính là một high-level module (một phần quan trọng hơn), lúc sản xuất lại phải theo cái đầu cắm của usb? Điều này không hợp lý
image 1 - quochung.cyou PTIT

Các ưu điểm rõ ràng

  • Lúc này các module bên ngoài cắm vào thường độc lập với nhau, và chúng dễ thay thế hơn. Ta đã định nghĩa trước ta cần gì trong core, giờ bên ngoài chỉ triển khai logic lại từ các yêu cầu đó. Nếu ta thay đổi cách gọi lấy dữ liệu từ việc gọi vào database sang đọc ghi trong file excel, ta chỉ thay đổi ở module, và vẫn là hàm getAll() mà core đã quy định. Tương tự với giao diện, cũng là module ngoài, cũng phải làm như vậy.
  • => Các module độc lập, dễ thay thế hơn, và phải tuân thủ các quy tắc của core logic
image 2 - quochung.cyou PTIT

2008 — Onion – Kiến trúc củ hành

image 4 - quochung.cyou PTIT
1 lRxsDk6eaUy9O4 RaVuJ1g - quochung.cyou PTIT
  • Nhìn chung, Onion Architecture vẫn khá tương đồng với Hexagon Architecture, tuy nhiên ở Hexagon, ta có 1 khối ở giữa và ta mong muốn các module chỉ như các thiết bị ngoài cắm vào ổ đó và tách biệt lẫn nhau. Còn ở Onion Architecture, ta có những tầng như những chiếc vòng, và tầng ở vòng bên ngoài phụ thuộc vào tầng bên dưới
image 6 - quochung.cyou PTIT
  • Theo 1 cách nhìn nào đó, Onion Architecture có một hướng phụ thuộc khá thẳng như N-Layered, nhưng thực tế ta vẫn áp dụng đảo sự phụ thuộc để cho phép tầng Domain hay Business là tầng dưới cùng của hệ thống
image 8 - quochung.cyou PTIT
  • Có một vài điểm thể hiện sự khác biệt ở đây. Là thay vì có 1 core quá lớn và mọi module đều phụ thuộc vào nó đôi khi có thể gây ra một số nhược điểm. Tức là 1 sự thay đổi trong core có thể khiến nhiều module khác nhau phải sửa đổi
  • Thay vì vậy, ta có một số tầng khác, ví dụ như ở ảnh trên là Application, sẽ wrap lại tầng Domain, Domain sẽ chứa những code mà có ít sự thay đổi, và Application có thể chứa nhiều logic và thường xuyên thay đổi nhiều hơn sẽ nằm ở bên trên.
  • Có thể cảm giác nó như tính đóng gói của OOP, khi mà những phần bên trong sẽ được wrap lại ở các tầng bên ngoài chứa nhiều logic hơn, và khi phần bên trong hoàn thiện sẽ chứa ít sự thay đổi hơn

2012 — Clean Architecture

image 9 - quochung.cyou PTIT
image 10 - quochung.cyou PTIT
image 11 - quochung.cyou PTIT
  • Nhìn chung, ta nhận thấy ta vẫn có 1 tầng chứa những phần về logic của Domain/Business, nay được đặt tên là Entities nằm trên cùng, và ta có các tầng khác thuộc module ngoài như Infra (Thường là data access của database), presentation (giao diện) phụ thuộc dần vào trong.
  • Thực tế, bạn có thể thấy Hexagon, Onion hay Clean Architecture có một cách định hướng khá giống nhau, ở Clean Architecture, Uncle Bob đã thêm 1 số layer bên ngoài như thư viện thứ 3, dll, …

Tổng kết

  • Nhìn chung, các kiến trúc về sau như Hexagon, Onion, Clean Architecture đều là các cách tiếp cận áp dụng các thủ pháp như Dependency Inversion, … nhằm tập trung vào phần core, domain, … và các module bên ngoài phải được xây dựng dựa theo hệ thống chính, chứ hệ thống chính không đi theo module bên ngoài
  • Việc triển khai các cấu trúc phức tạp hơn cho phép ta mở rộng dễ hơn về sau khi logic ở core ngày càng tăng lên, tuy nhiên, không có cấu trúc nào là hoàn toàn hoàn hảo và được xây dựng ở các thời điểm khác nhau cho mục đích khác nhau.
  • Do sự phát triển của microservice, các hệ thống còn được chia nhỏ ra nhiều service nhỏ hơn nữa, khi logic ở mỗi service không quá nhiều, ta dễ dàng có thể triển khai 1 cấu trúc 3 tầng thay vì các cấu trúc quá phức tạp và phải đi qua nhiều tầng để giúp tăng tốc độ triển khai dự án.

[Phần 1] Session Token và JWT Token, Refresh Token, khi nào quyết định sử dụng, ưu và nhược điểm

This entry is part 1 of 2 in the series API Security

Lời đầu

  • Trước khi đi vào Session Token hay JWT Token, hay có thể tóm gọn là authentication qua token, ta sẽ đi qua về 1 cách khác để authentication qua các giao thức API, và sau đó sẽ nói về ưu nhược điểm giữa chúng

Http Basic Authentication

  • Luồng chạy của HTTP “Basic” Authentication như sau:
image 14 - quochung.cyou PTIT
  • Khi người dùng truy cập và không có thông tin đăng nhập, hệ thống sẽ trả về 401 (Unauthorized) và thông tin đi kèm là cách để có thể author qua header WWW-Authenticate với thông tin (Ví dụ trên ảnh là yêu cầu Authen qua Basic)
  • Khi ta truy cập với Header Authorization + Basic + chuỗi mã, lúc này hệ thống sẽ kiểm tra và cho phép có quyền hay không.
 Authorization: Basic dGVzdDoxMjPCow==
  • Ví dụ như mã trên, đoạn mã sau Basic cơ bản là một đoạn String được mã hoá ở dạng base64, bạn có thể decode nó qua các trang base64, ví dụ
image 15 - quochung.cyou PTIT
  • Ví như với mã trên, khi decode, ta nhận được đoạn mã test:123£, đây là format của Basic Authen, với đầy đủ là username:password, thì ở đây test là username, và password là 123£

Ưu điểm

  • Sử dụng đơn giản, luồng không phức tạp, triển khai nhanh
  • Phù hợp cho authentication trong nội bộ, cho các ứng dụng trên môi trường kiểm thử (non-prod)

Nhược điểm

  • Toàn bộ request đều sẽ phải gửi username và password, điều này nhìn chung tăng khả năng xảy ra lộ mật khẩu.
  • Do lần nào cũng gửi mật khẩu, nên nếu bạn mã hoá nó, việc này là một công đoạn khá tốn tài nguyên. Những thuật toán hashing, mã hoá mật khẩu hiện đại có thể tốn tới 100ms (0,1s) để giải mã mật khẩu rồi kiểm tra có đúng không. Điều này hao tốn CPU cho hệ thống
  • Một số vấn đề khác về UX (giao diện mặc định đăng nhập xấu), vấn đề bảo mật về việc lưu password ở client để gửi đi authen, ….

Token Authentication trong API

Khái niệm

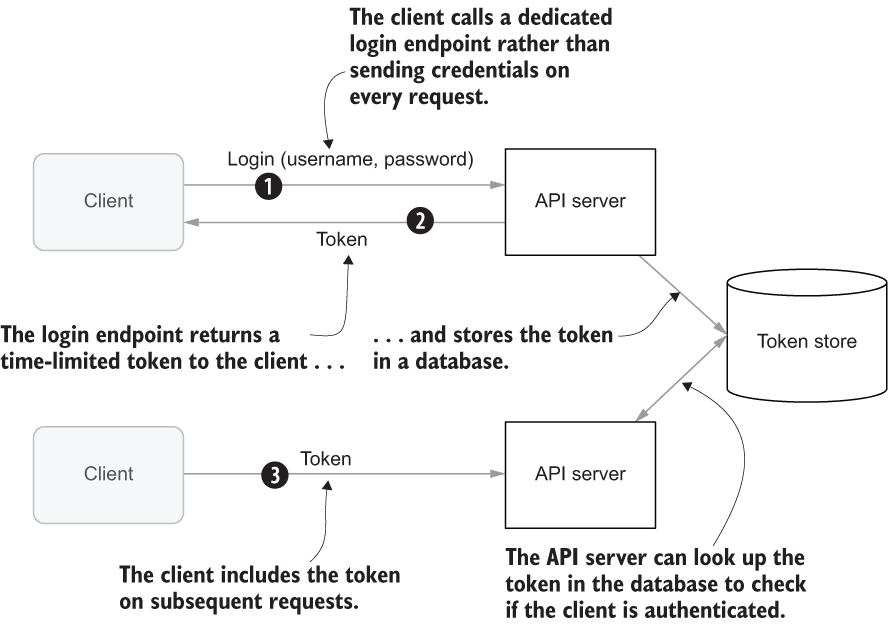
  • Hiểu đơn giản, thông thường thì authentication bằng token sẽ hoạt động như sau: Tài khoản, mật khẩu, … thông tin user chỉ cần nộp 1 lần, người dùng sau đó sẽ được cấp 1 token, 1 đoạn mã có thời hạn sử dụng. Người dùng sau đó có thể dùng token này để authentication cho đến khi đoạn token hết hạn sử dụng
  • Ví dụ về token authentication trong thực tế, điều này giống như bạn đi một khu vui chơi. Bạn đã đặt vé từ trước, và để xác minh bạn đã đặt vé chưa, bạn phải xuất trình căn cước công dân, ảnh thẻ, hộ chiếu, …. Thay vì vậy, khu vui chơi sau khi nhận căn cước công dân ở cửa vào, sẽ cấp cho bạn 1 phiếu vé có thời hạn 1 ngày hay gì đó, sau đó bạn dùng phiếu vé này để đi chơi trong khu vui chơi trong thời gian của vé.

Cách tiếp cận 1: Lưu trữ token trong database

image 16 - quochung.cyou PTIT
  • Người dùng lần đầu sẽ gửi thông tin của mình cho server, server sẽ từ đó sinh ra 1 token và lưu nó vào database
  • Lần sau người dùng sẽ chỉ cần gửi token, và sau đó server kiểm tra token có trong database không, còn hạn sử dụng không, … rồi cho phép người dùng

Việc này khắc phục các điểm:

  • Đầu tiên, token thường không chứa thông tin mật khẩu, tài khoản, … nữa nên ít lo bị lộ thông tin cá nhân của người dùng hơn.
  • Giảm bớt các nhược điểm của Basic Authen là phải mã hoá, giải mã mật khẩu, ….
  • Nếu có vấn đề bảo mật xảy ra, token được cài đặt là có thời hạn, và hơn nữa ta đã lưu ở trong database, ví dụ, bạn bị mất token vào tay người khác, thì thiệt hại cũng được giảm thiểu. Hoặc ta có thể trực tiếp ngăn chặn bằng cách xoá token đó đi trong database.

Session Cookie

  • Cách triển khai đơn giản nhất của hướng tiếp cận trên, và cũng khá phổ biến là sử dụng cookie. Sau khi người dùng đăng nhập bằng thông tin, phía server sẽ trả về 1 header Set-Cookie trong response để yêu cầu trình duyệt người dùng lưu 1 chuỗi token ngẫu nhiên trong bộ nhớ cookie của trình duyệt
  • Các request vào trang đó sẽ sử dụng token như 1 header Cookie (do cookie được tạo ra để lưu trữ những thông tin của người dùng trong 1 site)
image 18 - quochung.cyou PTIT

Ưu điểm

  • Cookie có nhiều cơ chế về bảo mật có sẵn, ví dụ như cookie chỉ gắn liền với từng tên miền, nên nó luôn đảm bảo không có chuyện ta gửi sang trang khác đoạn cookie chứa thông tin nhạy cảm
  • Cookie có thể được đánh dấu là Secure, điều này giúp đảm bảo khi gửi kết nối tới trang nào thì cookie chỉ được gửi nếu kết nối đó là Https và đã được mã hoá.

Nhược điểm

  • Trong thiết kế API theo hướng RestAPI đó là kết nối giữa client người dùng và server nên là stateless http://quochung.cyou/kien-truc-stateful-va-stateless-la-gi/. Đó là server sẽ không lưu trạng thái nào của người dùng giữa các request khác nhau.
  • Cookies phá vỡ nguyên tắc này vì server lúc này lưu trạng thái của cookie với các client khác nhau. Vào thời điểm đầu khi session cookie được sử dụng, chúng thường là nơi lưu trữ tạm thời 1 số trạng thái của người dùng, ví dụ như 1 giỏ hàng, 1 danh sách sản phẩm đã được chọn mà người dùng chưa thanh toán. (Kiểu khi người dùng chọn rồi, nó không lưu trực tiếp vào database) mà chỉ lưu vào cookie, điều này dễ gây ra một số lỗi bất thường cho website.
Cookie attributeÝ nghĩa
SecureCookie chỉ có thể gửi qua kết nối https
HttpOnlyKhông thể đọc trực tiếp bằng javascript
SameSiteChỉ gửi cho cùng trang
Một số attribute của cookie về bảo mật

Spring IOC, Dependency Injection, @Component và @Bean

Mở đầu

  • Java là một trong những ngôn ngữ lập trình phổ biến nhất hiện nay. Java cung cấp khả năng xây dựng các ứng dụng từ đơn giản đến những ứng dụng hoạt động chặt chẽ, đủ khả năng cho các dự án lớn tầm thương mại (enterprise). Nhờ sự ra đời từ rất sớm, Java có rất nhiều thư viện, tài liệu, code, … và nhiều tài nguyên khác. Từ Java, có thể xây dựng các ứng dụng web, mobile, desktop, các phần mềm cho các lĩnh vực như iOT, …
  • Trong bài hôm nay, mình sẽ chỉ tập trung vào mảng web của Java. Trong đó có thể kể tới Spring Framework, đây là một hệ sinh thái toàn diện với rất nhiều giải pháp trong phát triển ứng dụng Java, giúp lập trình viên giảm bớt rất nhiều thời gian để xây dựng phần mềm.
  • Trong bài viết này, ta sẽ đi qua 3 mục có thể nói là core của Spring bao gồm: Spring IOC (Inversion of Control), Dependency Injection (DI), cũng như khái niệm về Bean, Component, … trong Spring

Spring IOC (Inversion Of Control)

image 5 - quochung.cyou PTIT
  • Đây có thể nói là các phần cốt lõi của cả Spring Framework. Để nói về tác dụng của nó, hãy thử xem qua bài toán sau:
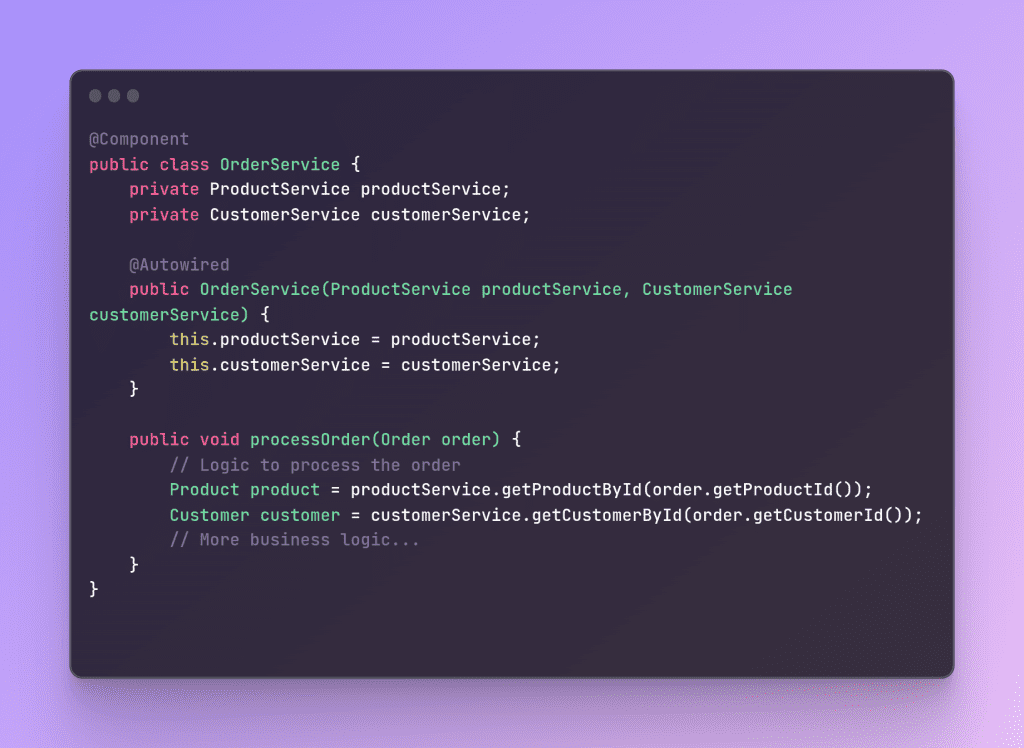
  • Ta có một class trong Java, chuyên xử lý các đơn hàng mới của một cửa hàng. Lúc này, một đơn hàng sẽ chứa 2 thông tin là id của người dùng (vd KH11), và id của sản phẩm (vd MAYGIAT), ta sẽ cần từ 2 id này, gọi sang 2 class khác là ProductService (quản lý sản phẩm), và CustomerService (quản lý khách hàng), để từ mã id lấy ra thông tin của khách hàng, sản phẩm rồi sau đó xử lý sâu hơn (Tạo ra đơn hàng cần thông tin địa chỉ khách hàng, rồi thì giá sản phẩm, …)
  • Với code thông thường, ta cần làm như sau:
image 6 - quochung.cyou PTIT
  • Lúc này, ta cần phải tạo các đối tượng của class con là ProductService và CustomerService một cách thủ công, để quản lý vòng đời của chúng (ví dụ khi nào tạo, khi nào tắt ta bị phụ thuộc vào class OrderService).
  • Rồi thì, ProductService là một class dạng stateless (các object ProductService khác nhau thường không có gì khác cả, tức là ta cần 1 object là được). Lúc này, ta có thể triển khai sử dụng design pattern Singleton (1 class chỉ tạo ra 1 object duy nhất), nhưng ta cũng phải triển khai thủ công
  • Rõ ràng, ta thấy vấn đề mệt nhất của việc làm thủ công là “Control – Khả năng điều khiển, quản lý”, ở ví dụ trên, ta đang đưa hết việc quản lý cho OrderService về tạo các object cho class phụ thuộc, ví dụ một class khác cần ProductService thì sao? Ta có thể lại phải new 1 object mới, lúc này ta bị thừa object. Hoặc class đó lại phải tạo ra 1 object con là OrderService, rồi dùng class con của OrderService
image 7 - quochung.cyou PTIT
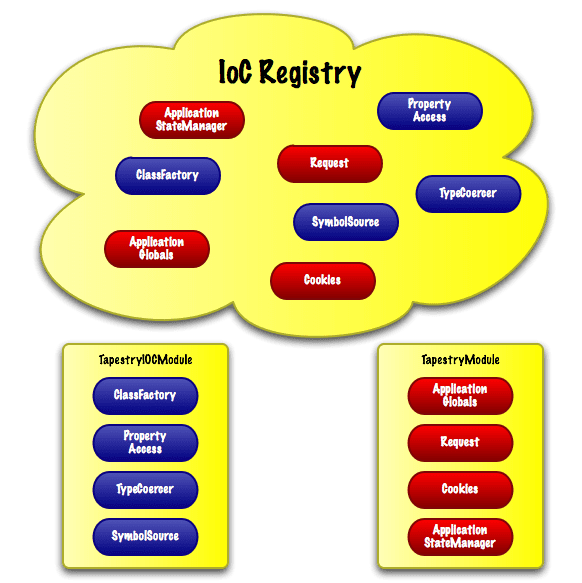
  • IOC (Inversion of Control) , lúc này các framework IoC hay các IOC Container sẽ là nơi chứa mọi quản lý, control của các object. Nó quyết định vòng đời của các object ta cần dùng, khi nào thì tạo, khi nào thì xoá, ghép cái nào với cái nào
  • Tưởng tượng nếu làm thủ công, ta sẽ cần 1 class dạng IOCContainer, rồi trong IOCContainer, ta tạo ra hết mọi object cần có. Rồi ở OrderService, ta sẽ gọi IoCContainer.getProductService() chẳng hạn, ở chỗ khác cần cái gì cũng gọi như vậy, lúc này ta dễ dàng quản lý các object này hơn

  • Lúc này Spring IOC xuất hiện, ta sẽ khai báo các class cần được quản lý bởi Spring IoC là Bean (sẽ nói thêm ở dưới). Khi nào cần dùng tới class nào, ta chỉ việc sử dụng Dependency Injection để gắn chúng lại với nhau.
image 8 - quochung.cyou PTIT

Dependency Injection

  • Bạn có thể tham khảo bài viết sau

Component và Bean trong Spring

image 9 - quochung.cyou PTIT

Component

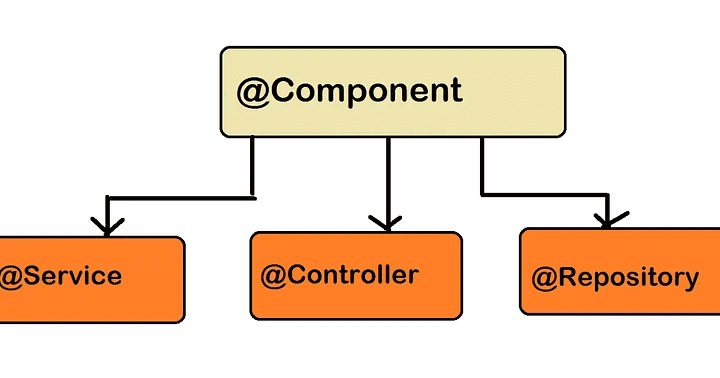
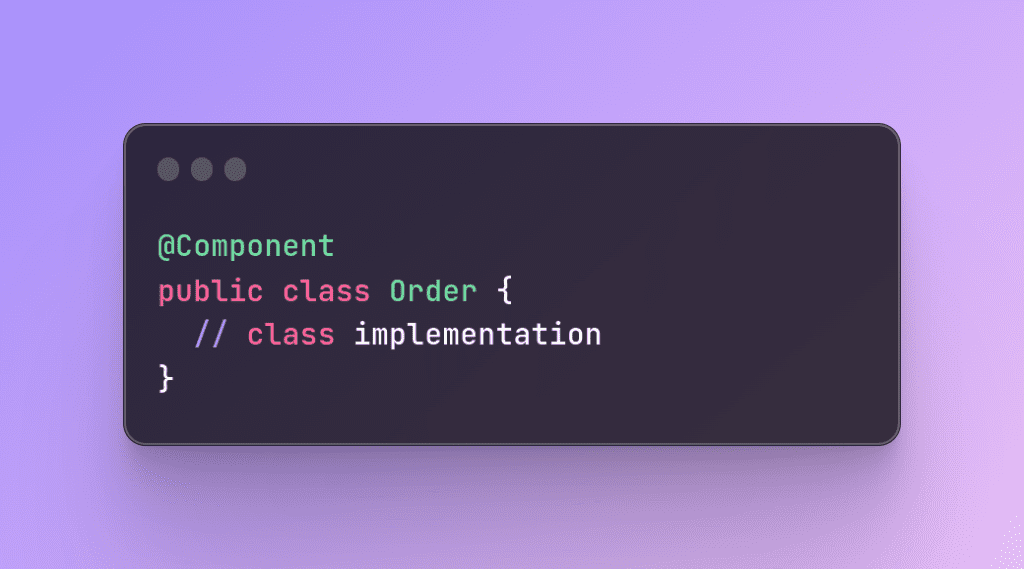
  • Trong Spring, @Component là một annotation để đánh dấu cho Spring biết class nào là một Component (cấu phần) hay Bean mà Spring sẽ quản lý. Các annotation @Service, @Controller, @Repository cũng hoạt động tương tự.
image 10 - quochung.cyou PTIT
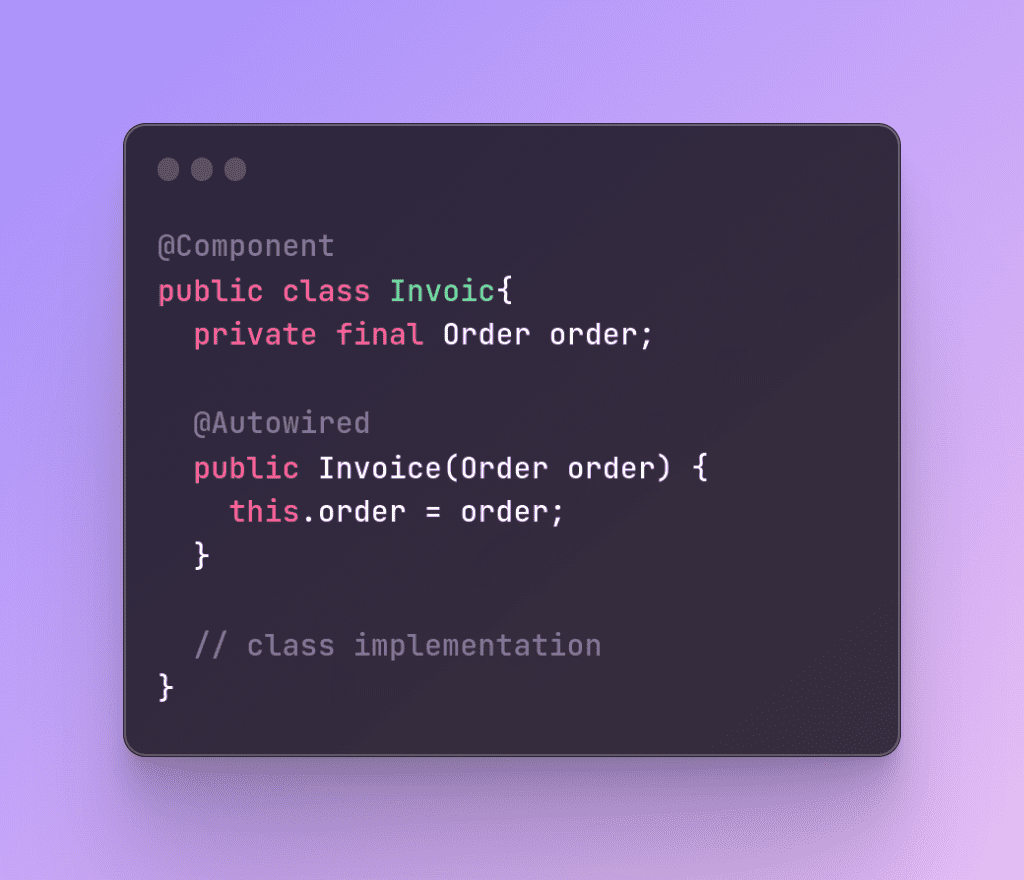
  • Và khi khai báo cả 2 class là Component, ta có thể kết nối chúng qua Dependency Injection (bạn có thể tham khảo thêm bên trên)
image 11 - quochung.cyou PTIT
  • Spring lúc này sẽ tự động ghép nối 2 class trên vào thời điểm được chạy lên.

Bean

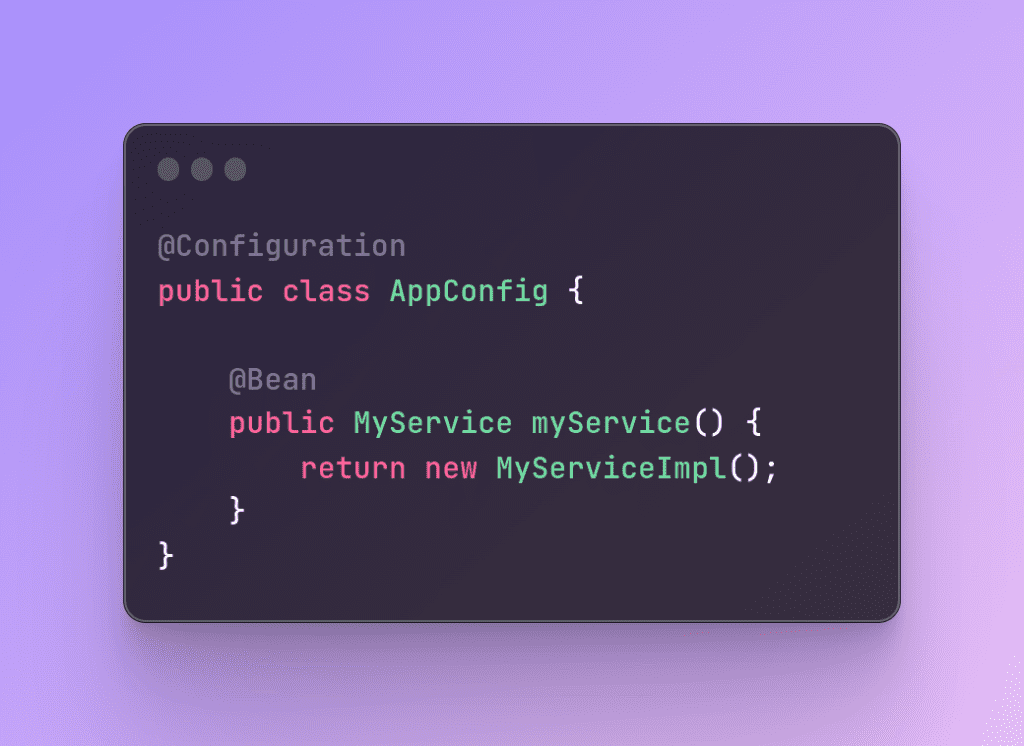
  • Bean trong Spring là annotation để định nghĩa 1 bean. Thường chúng được dùng cho các class utils (hỗ trợ ngoài), hoặc class ở bên thứ 3, mà không nằm trong luồng logic core.
image 12 - quochung.cyou PTIT
  • @Bean cần được khai báo trong 1 class có annotation @Configuration. Ta có thể khai báo nhiều bean khác nhau.
image 13 - quochung.cyou PTIT
  • Ví dụ ta có thể tạo 1 bean BCryptPasswordENcoder để mã hoá mật khẩu, sau đó có thể sử dụng chúng trong class UserService. Spring tự biết ghép chúng lại với nhau’

Câu hỏi thêm

  • Ngoài các khái niệm cơ bản như vậy, ta biết rằng mặc định các bean khi khởi tạo sẽ là singleton, ta có thể chỉnh nó thành các kiểu khác, ví dụ sẽ là tồn tại nhiều bean khác nhau của 1 class, … bằng cách đặt scope cho chúng. Tham khảo thêm tại: https://docs.spring.io/spring-framework/reference/core/beans/factory-scopes.html
  • Như nói từ đầu, do Spring IOC đã quản lý các bean, nên ta cũng có thể sử dụng AOP, như kiểu khi một bean được tạo ra, ta sẽ chạy gì đó, khi bị huỷ thì log gì đó chẳng hạn (https://docs.spring.io/spring-framework/reference/core/beans/factory-nature.html)
  • Lúc nào thì dùng Component, lúc nào thì dùng Bean? Điều này tuỳ vào dự án của bạn, thường thì annotation @Bean sẽ dùng cho các class của bên thứ 3, không nằm chính trong luồng usecase, hay context của dự án và @Component thì ngược lại

Transactional Outbox Pattern trong thiết kế Microservices

Kiến trúc Microservice và vấn đề Consistency

  • Kiến trúc Microservice nói một cách đơn giản, là việc ta chia nhỏ một hệ thống lớn thành nhiều service nhỏ để xử lý các công việc riêng biệt với nhau. Việc chia nhỏ hệ thống lớn đem đến rất nhiều lợi ích, ví dụ như ta có thể có nhiều team dev làm việc trên nhiều phần khác nhau, giúp tăng hiệu suất. Ta có thể giải quyết các bài toán lớn khi mà quá nhiều request tập trung về 1 server, ….
  • Tuy nhiên nó cũng đi kèm nhiều vấn đề:

  • Ví dụ trong thực tế, trong quá trình ship hàng, một quá trình xảy ra như sau
    • Cửa hàng giao đồ cần chuyển cho shipper
    • Shipper giao hàng tới cho người nhận
    • Shipper báo lại cho cửa hàng là hàng đã giao
image - quochung.cyou PTIT
  • Các công việc này, nếu coi các chủ thể thành 1 kiến trúc monolith, hay “1 khối” sẽ làm hết mọi việc, thì phía cửa hàng sẽ chuẩn bị hàng, giao hàng, rồi thu tiền hết một mình. Nhưng lúc này, ta sẽ chia chúng thành 2 service “nhỏ hơn”
    • Service cửa hàng: Chỉ chuẩn bị hàng
    • Service vận chuyển: Vận chuyển hàng và giao hàng
  • Khi chỉ 1 khối làm việc một mình, cửa hàng luôn biết là hàng đã giao chưa. Nhưng lúc này khi chia làm 2 service, bên vận chuyển phải báo lại cửa hàng để cửa hàng nắm lại thông tin, lúc này, nếu ví dụ bên vận chuyển đã giao hàng, mà không báo lại cho cửa hàng do quên, do lỗi, .. sẽ dẫn đến sự “bất đồng bộ”, một vấn đề rất thường gặp, hay là đảm bảo tính “Consistency” trong kiến trúc Microservice

Pattern Transactional Outbox

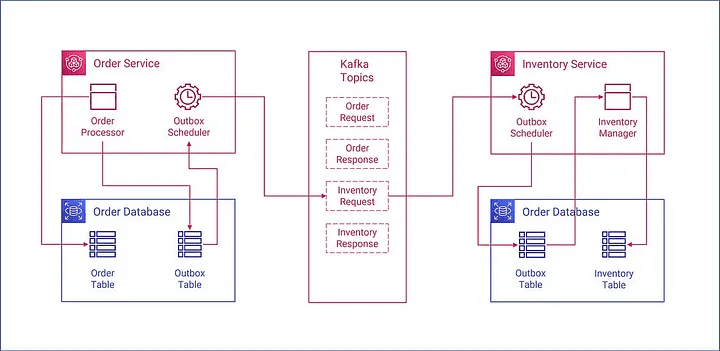
  • Có nhiều giải pháp cho vấn đề này, một trong số đó là Transactional Outbox, ví dụ hình ảnh và từng bước ở dưới
image 1 - quochung.cyou PTIT
  • Một khách hàng đặt một đơn hàng mới
  • Hệ thống Order Service quản lý đơn hàng cập nhật đơn hàng thành “ĐANG VẬN CHUYỂN” và tạo 1 event “OrderCreated”
  • Event “OrderCreated” được cho vào message queue: như trong hình ảnh là Kafka
  • Một hệ thống Outbox Processor khác sẽ liên tục gửi Event yêu cầu cập nhật đến Inventory Service và Notification Service cho đến khi thành công, nếu xảy ra lỗi, nó sẽ thử lại

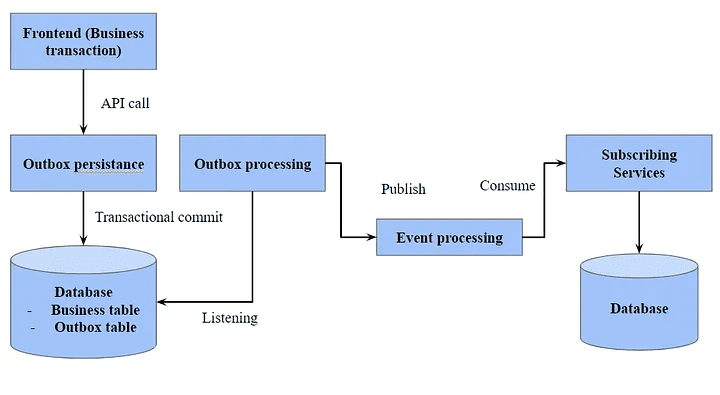
Các cấu phần

  • Outbox Entity/Outbox Table: Chứa các Event
  • Outbox Persistence Mechanism: Một hệ thống bảo đảm event trong outbox table
  • Outbox Processor: Một tác vụ background chịu trách nghiệm xử lý event khỏi Outbox
    • Liên tục gọi vào table của table định kỳ xem có event nào mới không
    • Nếu có, gửi event mới đến các message queue
    • Xử lý việc thử lại nếu thất bại
image 2 - quochung.cyou PTIT

Một số câu hỏi

  • Q: Tại sao khi tạo một order ở phía order-service chẳng hạn, ta không gửi thẳng luôn 1 message đến message broker ở giữa là kafka, … rồi phía payment-service sẽ consume message đó thôi, tại sao cần 1 table outbox?
  • A: Sẽ có 2 vấn đề khi làm như vậy
    • 1. Ví dụ, nếu order-service chưa cập nhật trạng thái, mà đã send message cho message queue rồi, thì sẽ không đảm bảo tính nhất quán. Message chỉ nên được gửi khi transaction ở local database đã commit, còn nếu bị rollback theo ACID, thì message cũng không được gửi. Tức là message cũng nên nằm trong 1 transaction của Database. Ví dụ nó đã commit xuống database local rồi, nhưng mà crash nên không gửi được message
    • 2. Message thì đã được gửi rồi, nhưng mà transaction ở local chưa run xong, và sau đó nó fail nên roll back lại, nhưng mà message đã gửi rồi
  • Thì lúc này ta sẽ lưu các event, hay message chuẩn bị gửi đi ở phía local database. Điều này đảm bảo là toàn bộ transaction ở local đã hoàn thành, hoặc đã rollback hết, rồi mới sẽ gửi message đi, bằng việc liên tục gọi về local để gửi message đi
image 3 - quochung.cyou PTIT

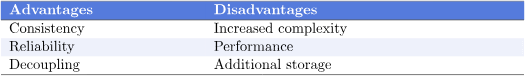
Ưu điểm/Nhược điểm

image 4 - quochung.cyou PTIT
  • Ưu điểm:
  • Dữ liệu được đảm bảo nhất quán
  • Giảm bớt sự phụ thuộc quá chặt giữa các service
  • Nhược điểm:
  • Tăng thêm độ phức tạp do có thêm việc scan bảng outbox, giảm hiệu năng
  • Tăng thêm tài nguyên lưu trữ bảng outbox, ta lại phải làm thêm cơ chế cleanup event nếu nó grow quá lớn
  • Có thể xảy ra trường hợp gửi nhiều hơn 1 message, vì vậy message broker hoặc phía nhận cần đảm bảo tính idempotent. (Tức là dù có gửi bao nhiêu request cùng 1 loại thì kết quả không đổi và như request đầu tiên). Ví dụ: lưu lại id message để không xử lý lại nếu đã xử lý rồi