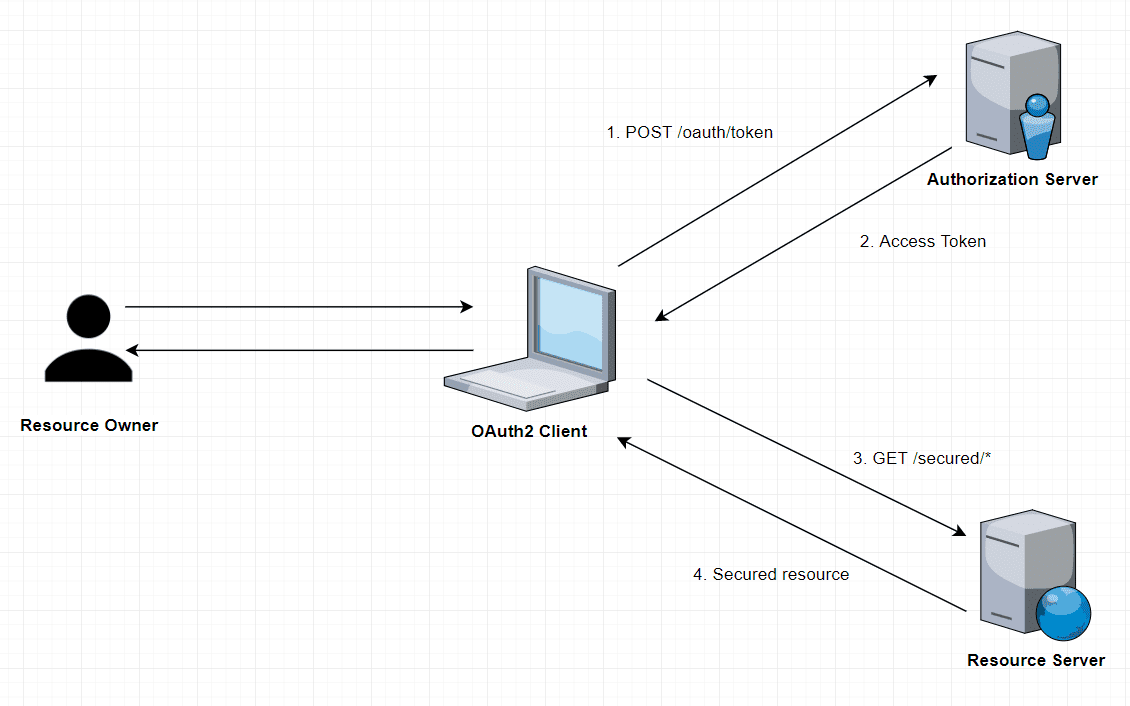
Save Google OAuth2 token in database with Spring Boot

Following this official document from Google: https://developers.google.com/api-client-library/java/google-api-java-client/oauth2

When integrating Google OAuth 2.0 with your Spring Boot application, the official documentation provides a comprehensive guide to leverage the GoogleCredential utility class for seamless and secure authorization. OAuth 2.0 is the industry standard for granting access to protected resources, and Google’s implementation is tailored to support various application types, ensuring flexibility across client environments.

Why OAuth 2.0 Matters

Imagine you’re building a task management application that needs to interact with a user’s Google Tasks data. OAuth 2.0 allows your app to request access only to the necessary data (e.g., “Manage your tasks”) while ensuring that the user maintains control over their privacy. The process generates an access token, which is a digital key tied specifically to your application and the user’s data. This token is scoped, meaning it limits the type and extent of access granted, thereby enhancing security. For instance, even if the token were somehow exposed, it couldn’t be used to access unrelated data like emails or photos.

Built on a Secure Foundation

The Google API Client Library for Java includes robust OAuth 2.0 packages such as:

  • com.google.api.client.googleapis.auth.oauth2: Core classes for implementing OAuth 2.0 flows.
  • com.google.api.client.googleapis.extensions.appengine.auth.oauth2: Specialized extensions for applications hosted on Google App Engine.

These packages are built on the Google OAuth 2.0 Client Library for Java, a general-purpose library offering standardized utilities to handle token acquisition, refresh, and expiration seamlessly.

A Real-World Perspective

Consider an example where a SaaS platform integrates with Google Drive to allow users to upload documents directly from their accounts. With OAuth 2.0, users authenticate their Google accounts through a secure flow, and the platform receives an access token to interact with Google Drive APIs. Instead of continuously requesting sensitive credentials, the platform uses this token to upload or retrieve files, keeping user data secure and operations streamlined.

By utilizing the detailed guidelines in Google’s documentation, you can ensure that your Spring Boot application adheres to best practices for secure OAuth 2.0 integration, offering a smooth user experience while protecting sensitive information.

Acquiring the Client Secret File

To begin integrating Google OAuth 2.0 into your application, the first crucial step is setting up a project on the Google API Console. This console serves as the central hub for managing authorization credentials, configuring API access, and ensuring proper billing setup. Whether your application runs on a web server, mobile device, desktop client, or directly in a browser, this setup process is essential.

Setting Up Credentials

Navigate to the Google API Console and create a new project. Once the project is set up, you can enable the desired APIs and generate the OAuth 2.0 client credentials, which include:

  • Client ID: Uniquely identifies your application during the authorization process.
  • Client Secret: A sensitive key used to authenticate your application, ensuring secure communication with Google’s servers.
  • Redirect URIs: Specify where Google will send users after they complete the authorization flow.

For detailed guidance on configuring these elements, refer to the API Console Help.

Setup a Authorization code flow

Use the authorization code flow to allow the end-user to grant your application access to their protected data on Google APIs. The protocol for this flow is specified in Authorization Code Grant.

This flow is implemented using GoogleAuthorizationCodeFlow. The steps are:

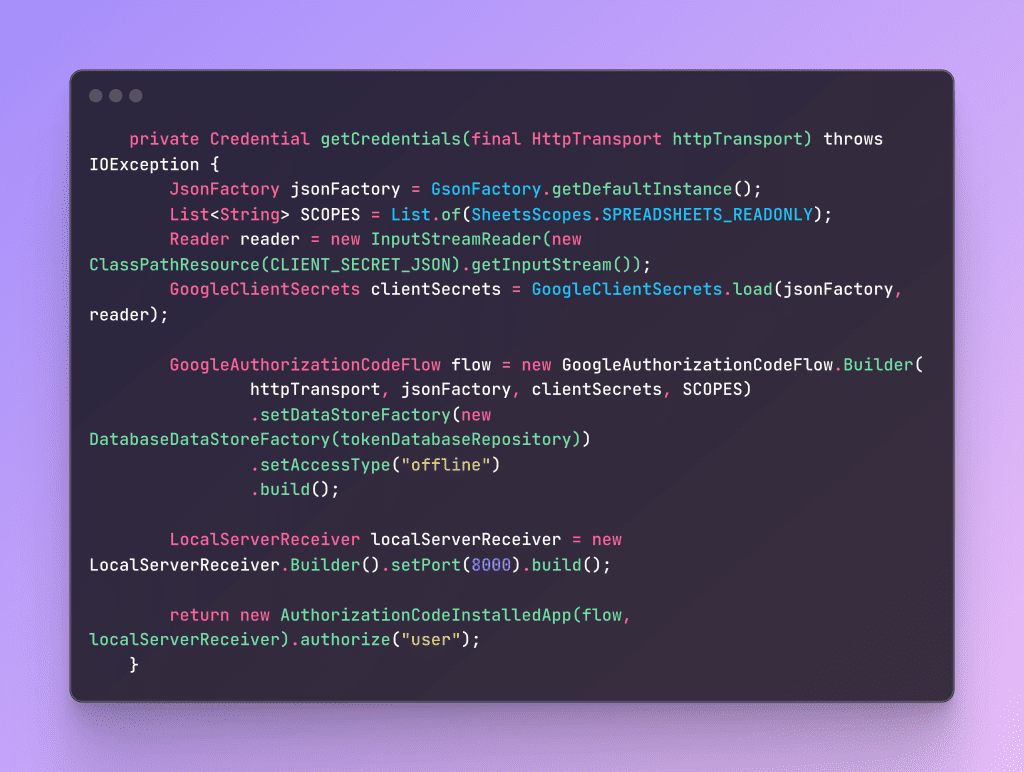
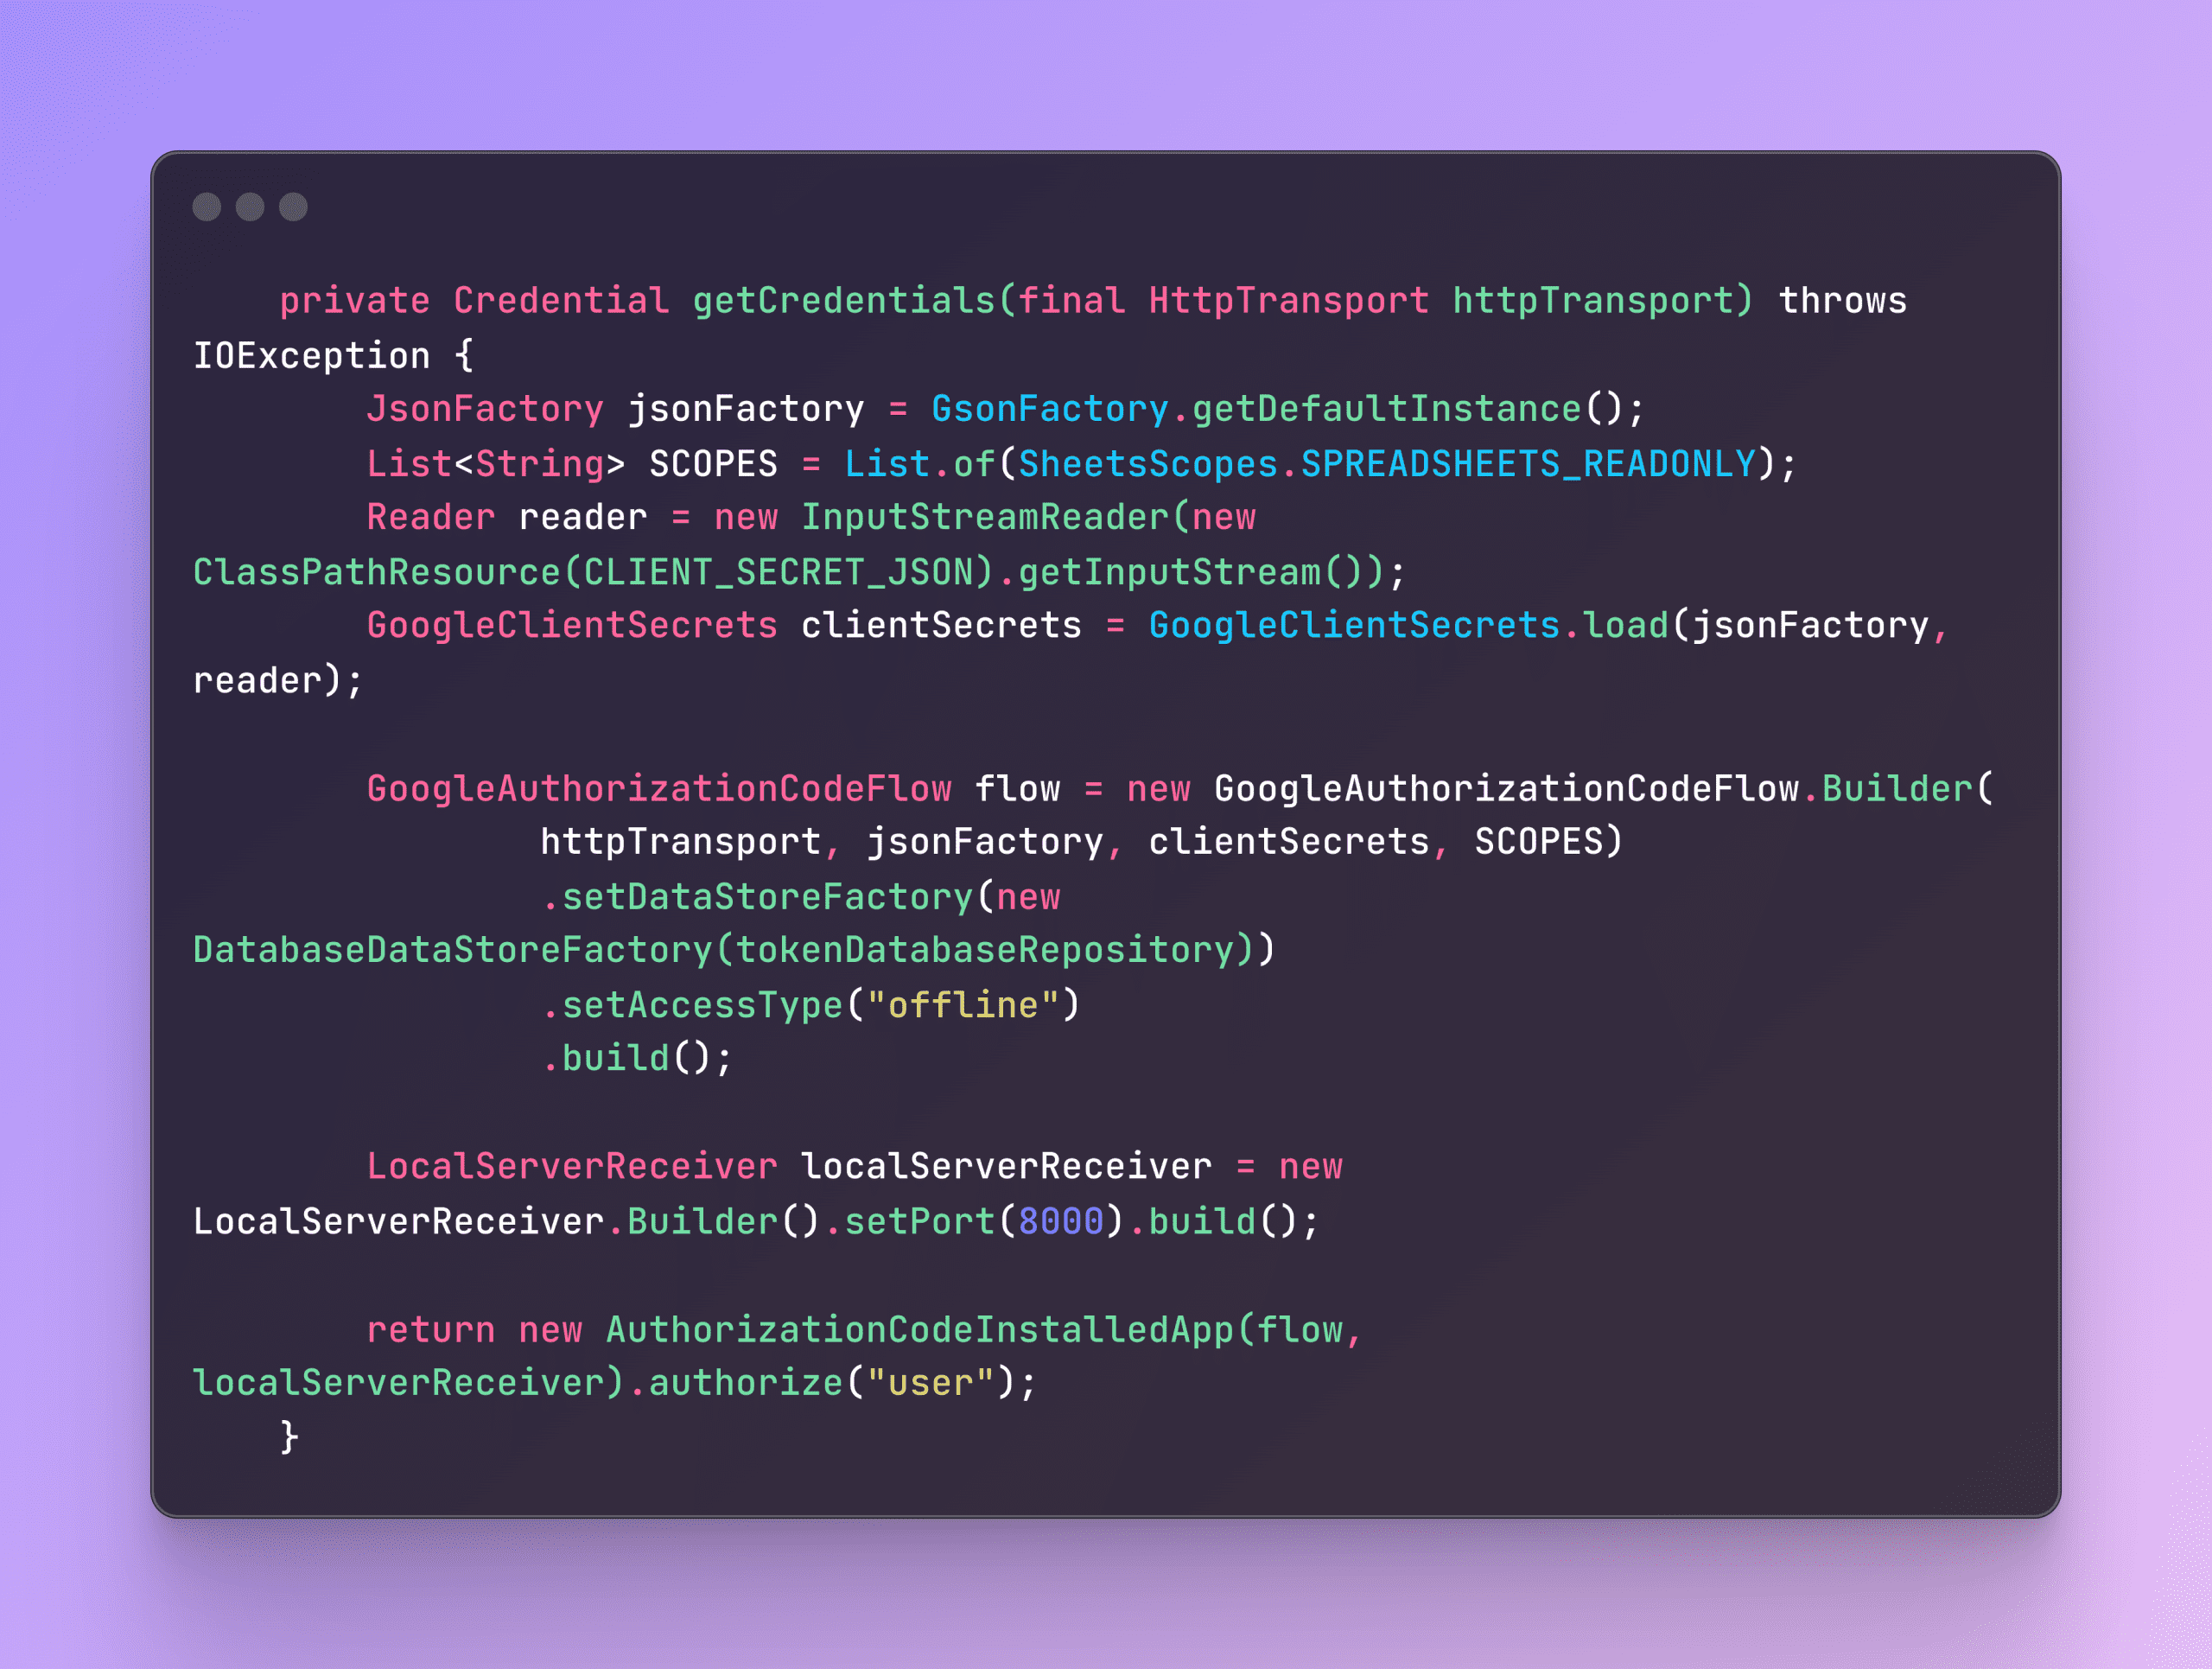
Code implementation is like this

image - quochung.cyou PTIT

Understanding the DataStoreFactory in GoogleAuthorizationCodeFlow.Builder

When constructing a GoogleAuthorizationCodeFlow object, one of the essential components is the DataStoreFactory. This factory is responsible for persisting user credentials securely and efficiently. Google provides three types of built-in implementations, each suited for different use cases:

Implementing a Custom Data Store to Persist Tokens in a Database

To persist OAuth2 tokens in a database, we need to create a custom implementation of the DataStoreFactory and DataStore classes provided by Google’s OAuth2 library. Here’s a step-by-step guide:


Step 1: Create a Custom DataStoreFactory

The custom factory is responsible for creating instances of your DataStore. Extend AbstractDataStoreFactory to implement this logic.

Java
import com.google.api.client.util.store.AbstractDataStoreFactory;
import com.google.api.client.util.store.DataStore;

import java.io.IOException;
import java.io.Serializable;

public class DatabaseDataStoreFactory extends AbstractDataStoreFactory {

    private TokenDatabaseRepository tokenDatabaseRepository;

    public DatabaseDataStoreFactory(TokenDatabaseRepository tokenDatabaseRepository) {
        this.tokenDatabaseRepository = tokenDatabaseRepository;
    }

    @Override
    protected <V extends Serializable> DataStore<V> createDataStore(String id) throws IOException {
        return new DatabaseDataStore<>(this, id, tokenDatabaseRepository);
    }
}

Step 2: Implement the Custom DataStore

This class handles token persistence logic. Extend AbstractDataStore and implement the required methods like set(), get(), delete(), etc.

Java
import com.google.api.client.util.store.AbstractDataStore;
import com.google.api.client.util.store.DataStore;
import com.google.api.client.util.store.DataStoreFactory;

import java.io.IOException;
import java.io.Serializable;
import java.util.Collection;
import java.util.Set;

public class DatabaseDataStore<V extends Serializable> extends AbstractDataStore<V> {

    private final TokenDatabaseRepository<V> tokenDatabaseRepository;

    protected DatabaseDataStore(DataStoreFactory dataStoreFactory, String id, TokenDatabaseRepository<V> tokenDatabaseRepository) {
        super(dataStoreFactory, id);
        this.tokenDatabaseRepository = tokenDatabaseRepository;
    }

    @Override
    public int size() throws IOException {
        return tokenDatabaseRepository.size();
    }

    @Override
    public boolean isEmpty() throws IOException {
        return tokenDatabaseRepository.isEmpty();
    }

    @Override
    public boolean containsKey(String key) {
        return tokenDatabaseRepository.containsKey(key);
    }

    @Override
    public boolean containsValue(V value) {
        return tokenDatabaseRepository.containsValue(value);
    }

    @Override
    public Set<String> keySet() throws IOException {
        return tokenDatabaseRepository.keySet();
    }

    @Override
    public Collection<V> values() throws IOException {
        return tokenDatabaseRepository.values();
    }

    @Override
    public V get(String key) throws IOException {
        return tokenDatabaseRepository.get(key);
    }

    @Override
    public DataStore<V> set(String key, V value) throws IOException {
        tokenDatabaseRepository.set(key, value);
        return this;
    }

    @Override
    public DataStore<V> clear() {
        tokenDatabaseRepository.clear();
        return this;
    }

    @Override
    public DataStore<V> delete(String key) throws IOException {
        tokenDatabaseRepository.delete(key);
        return this;
    }
}

Step 3: Create the TokenRepository Interface

Leverage Spring Data JPA to handle database interactions.

Java
public interface TokenDatabaseRepository<V> {
    int size();

    boolean isEmpty();

    boolean containsKey(String key);

    boolean containsValue(V value);

    Set<String> keySet();

    Collection<V> values();

    V get(String key);

    TokenDatabaseRepository<V> set(String key, V value);

    TokenDatabaseRepository<V> clear();

    void delete(String key);


}
Java
@Repository
@RequiredArgsConstructor
public class TokenDatabaseRepositoryImpl implements TokenDatabaseRepository<StoredCredential> {

    private final TokenRepositorySql tokenRepositorySql;
    private final GoogleAuthItemMapper googleAuthItemMapper;

    @Override
    public int size() {
        return (int) tokenRepositorySql.count();
    }

    @Override
    public boolean isEmpty() {
        return tokenRepositorySql.count() == 0;
    }

    @Override
    public boolean containsKey(String key) {
        return tokenRepositorySql.existsByKey(key);
    }

    @Override
    public boolean containsValue(StoredCredential value) {
        var googleAuthItem = googleAuthItemMapper.from(value);
        return tokenRepositorySql.existsByAccessTokenAndRefreshToken(googleAuthItem.getAccessToken(), googleAuthItem.getRefreshToken());
    }

    @Override
    public Set<String> keySet() {
        return tokenRepositorySql.findAll().stream()
                .map(GoogleAuthItem::getKey)
                .collect(Collectors.toSet());
    }

    @Override
    public Collection<StoredCredential> values() {
        return tokenRepositorySql.findAll().stream()
                .map(googleAuthItemMapper::to)
                .collect(Collectors.toList());
    }

    @Override
    public StoredCredential get(String key) {
        Optional<GoogleAuthItem> optionalGoogleAuthItem = tokenRepositorySql.findById(key);
        return optionalGoogleAuthItem.map(googleAuthItemMapper::to).orElse(null);
    }

    @Override
    @Transactional
    public TokenDatabaseRepository<StoredCredential> set(String key, StoredCredential value) {
        var googleAuthItem = googleAuthItemMapper.from(value);
        googleAuthItem.setKey(key);
        tokenRepositorySql.save(googleAuthItem);
        return this;
    }

    @Override
    @Transactional
    public TokenDatabaseRepository<StoredCredential> clear() {
        tokenRepositorySql.deleteAll();
        return this;
    }

    @Override
    public void delete(String key) {
        tokenRepositorySql.deleteByKey(key);
    }
}
Java
public interface TokenRepositorySql extends JpaRepository<GoogleAuthItem, String> {

    boolean existsByKey(String key);

    boolean existsByAccessTokenAndRefreshToken(String accessToken, String refreshToken);

    void deleteByKey(String key);

}
Dynamic OAuth2 Client for Spring Boot

Introduction

OAuth2 has become the industry standard for secure authorization in web applications. Spring Boot simplifies OAuth2 integration, allowing developers to handle client registration effortlessly. However, Spring Boot’s default implementation often requires client registrations to be predefined in application configuration, making it difficult to adapt to changing environments where client registrations need to be added or removed dynamically.

In this blog post, we’ll explore how to overcome this limitation by creating a custom implementation of ClientRegistrationRepository that allows dynamic management of OAuth2 clients at runtime. This approach provides the flexibility required for modern applications that need to adapt to varying OAuth2 client configurations.

Understanding Spring Boot’s Default Client Registration

Spring Boot manages OAuth2 client registrations using the ClientRegistrationRepository interface, which provides a way to store and retrieve client configurations. By default, Spring Boot offers an InMemoryClientRegistrationRepository implementation. This default implementation stores client registrations in memory, as defined in the application’s configuration files.

While this approach works well for static configurations, it has a significant limitation: the client registrations are immutable. Once registered, a client’s configuration cannot be altered. This is because InMemoryClientRegistrationRepository creates an unmodifiable map of client registrations:

Java
	public InMemoryClientRegistrationRepository(List < ClientRegistration > registrations) {
	    this(createRegistrationsMap(registrations));
	}

	private static Map < String, ClientRegistration > createRegistrationsMap(List < ClientRegistration > registrations) {
	    Assert.notEmpty(registrations, "registrations cannot be empty");
	    return toUnmodifiableConcurrentMap(registrations);
	}
	private static Map < String, ClientRegistration > toUnmodifiableConcurrentMap(List < ClientRegistration > registrations) {
	    ConcurrentHashMap < String, ClientRegistration > result = new ConcurrentHashMap < > ();
	    for (ClientRegistration registration: registrations) {
	        Assert.state(!result.containsKey(registration.getRegistrationId()),
	            () - > String.format("Duplicate key %s", registration.getRegistrationId()));
	        result.put(registration.getRegistrationId(), registration);
	    }
	    return Collections.unmodifiableMap(result);
	}
This immutability is by design, ensuring that client registrations remain consistent throughout the application’s lifecycle. However, for applications that require dynamic updates to client registrations—such as SaaS platforms or systems with evolving client needs—this default behavior is insufficient.

Custom Implementation of ClientRegistrationRepository

To support dynamic client registration, we need to implement a custom version of ClientRegistrationRepository that allows adding and removing clients at runtime. This custom repository will manage a modifiable collection of client registrations.

Here’s how you can create a custom ClientRegistrationRepository:

Java
public class DynamicClientRegistrationRepository implements ClientRegistrationRepository {
    private final ConcurrentHashMap < String, ClientRegistration > clientRegistrations = new ConcurrentHashMap < > ();

    public void addClientRegistration(String registrationId, ClientRegistration registration) {
        clientRegistrations.put(registrationId, registration);
    }
    @Override
    public ClientRegistration findByRegistrationId(String registrationId) {
        return clientRegistrations.get(registrationId);
    }
}

This implementation uses a ConcurrentHashMap to store client registrations, enabling thread-safe access and modification. The addClientRegistration and removeClientRegistration methods allow for dynamic management of client registrations, which can be crucial for applications that need to adapt in real time.

Java
clientRegistrationRepository.addClientRegistration(clientRegistration.getRegistrationId(), clientRegistration);

Integrating Custom ClientRegistrationRepository with Spring Security

After implementing the custom ClientRegistrationRepository, the next step is to integrate it into your Spring Boot application. This involves replacing the default InMemoryClientRegistrationRepository with your custom implementation.

Here’s how to inject your custom repository into the Spring Security configuration:

Java
        OAuth2AuthorizedClientProvider authorizedClientProvider = OAuth2AuthorizedClientProviderBuilder.builder()
            .clientCredentials()
            .build();
        clientRegistrationRepository = new DynamicClientRegistrationRepository();
        clientService = new InMemoryOAuth2AuthorizedClientService(clientRegistrationRepository);
        var clientManager = new AuthorizedClientServiceOAuth2AuthorizedClientManager(
            clientRegistrationRepository, clientService);
        clientManager.setAuthorizedClientProvider(authorizedClientProvider);

By defining the custom ClientRegistrationRepository as a bean, Spring Boot will automatically use it in the OAuth2 flow, allowing for dynamic client management.

Acquiring Access Tokens Using Dynamic Client Registrations

Once you have dynamically registered clients, you can proceed with acquiring access tokens using the standard OAuth2 flow. The process remains unchanged, but now includes the capability to work with clients that were registered dynamically.

Here’s an example of acquiring an access token:

Java
        OAuth2AuthorizeRequest authorizeRequest = OAuth2AuthorizeRequest.withClientRegistrationId(clientRegistration.getRegistrationId())
            .principal(oauth2Config.getClientId())
            .attribute(AuthorizationGrantType.CLIENT_CREDENTIALS.getValue(), clientRegistration)
            .build();
        OAuth2AuthorizedClient authorizedClient = authorizedClientManager.authorize(authorizeRequest);
        authorizedClient.getAccessToken().getTokenValue() //-> get token here

Register a custom function in Camunda 7 with Spring Boot

Introduction to Camunda 7

image 2 - quochung.cyou PTIT

Camunda 7 is a powerful, open-source platform designed for workflow and process automation. It offers a comprehensive suite of tools for managing business processes, including capabilities for modeling, automating, and optimizing workflows.

Before Camunda BPM 7.18

In both approaches, you need to register your method via the function mapper. If you want to call a method from a bean using an expression like ${myBean.method()}, the process happens automatically without any additional code. However, if you prefer to use the method in the format ${runner:method()} or ${method()}, here’s how you can do it.

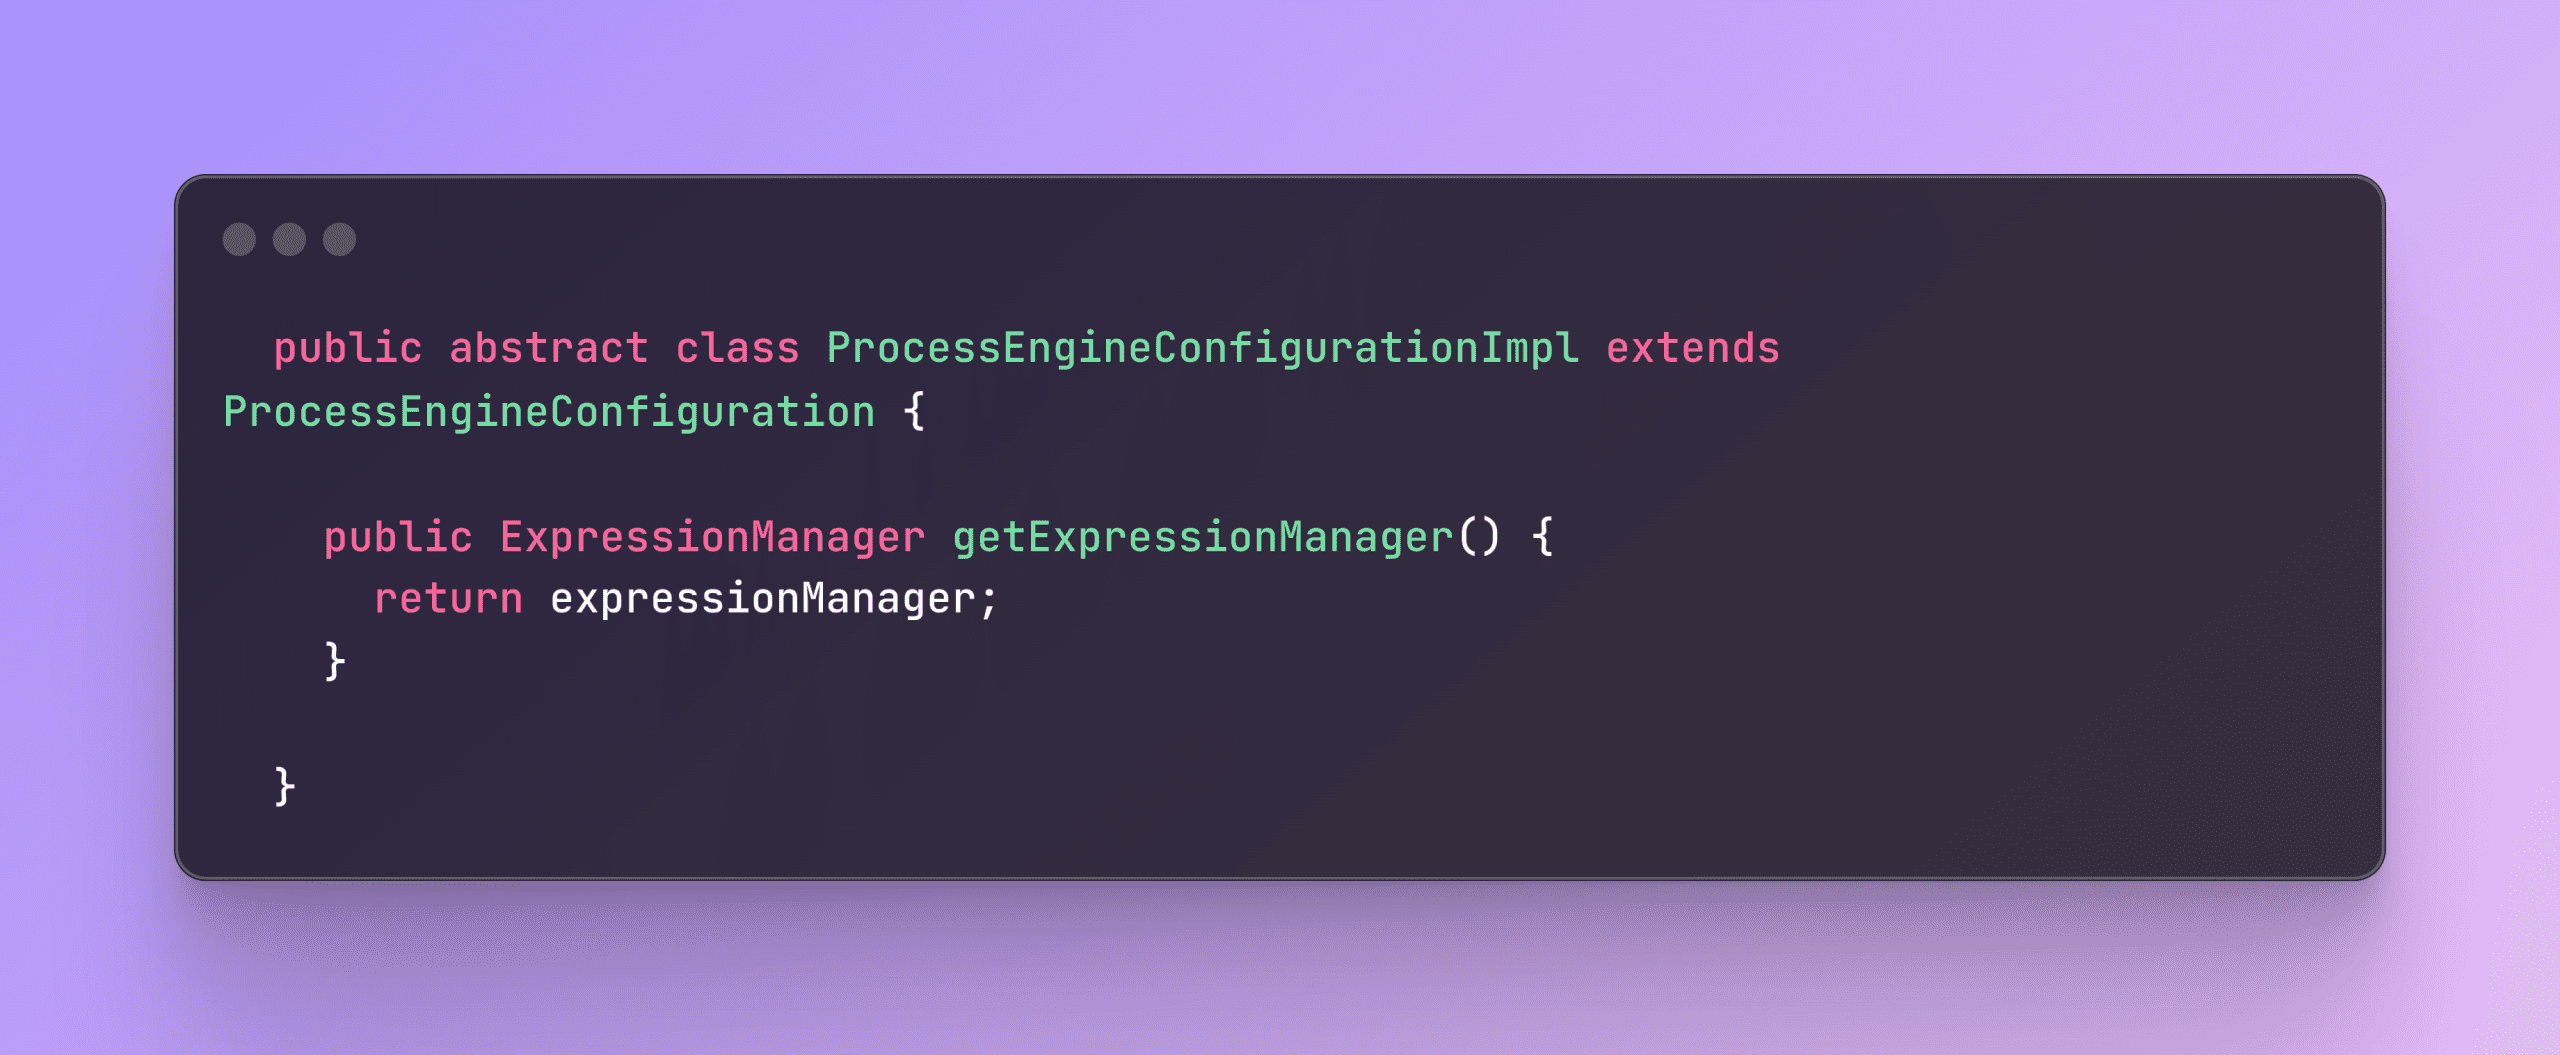
In the ProcessEngineConfigurationImpl class provided by Camunda, you’ll find the ExpressionManager. This class exposes all the necessary methods for you to use.

image 11 - quochung.cyou PTIT
image 12 - quochung.cyou PTIT

To register a new function mapper, you need to create a class that implements the FunctionMapper interface. Here’s a sample implementation to get you started.

image 13 - quochung.cyou PTIT

Now, you can create a process engine plugin to initialize the function mapper when Camunda’s process engine starts configuring.

image 14 - quochung.cyou PTIT

Now you can use ${jsonPath(a, b) in workflow

After Camunda BPM 7.18

After Camunda 7.18, the addFunctionMapper function was removed. You might need an alternative workaround, and this link might be helpful for you.

https://forum.camunda.io/t/how-do-i-add-functionmappers-to-expressionmanager-in-7-18/40466/2

Camunda 7 | Get history data of form in user task

Introduction to Camunda 7

image 2 - quochung.cyou PTIT

Camunda 7 is a powerful, open-source platform designed for workflow and process automation. It offers a comprehensive suite of tools for managing business processes, including capabilities for modeling, automating, and optimizing workflows. One of the key features of Camunda is its ability to track and retrieve historical data, such as process variables and form data, from completed process instances. However, retrieving form data from completed instances can be tricky as Camunda 7 does not provide an out-of-the-box API for this purpose.

Retrieving Historical Data

When working with Camunda, it’s often necessary to access historical data from completed process instances. This data can include process variables and form data, which provide insights into the execution and outcomes of the process. Retrieving this data is essential for reporting, auditing, and analysis purposes.

In this solution:

  1. The BPMN model instance is retrieved using the repositoryService.
  2. The task is fetched from the BPMN model using the task definition key.
  3. If the task is found, the form key is retrieved from the task attributes.
  4. The deployment ID is obtained from the process definition query.
  5. The form resource is retrieved using the GetDeploymentResourceCmd.
  6. The form data is read into a map and set into the result DTO as a JSON string.

Accessing Historical Form Data

By default, Camunda 7 does not provide an out-of-the-box API to retrieve form data from completed process instances. To work around this limitation, you can use a custom approach to fetch the form data stored as process variables.

Here’s a workaround to retrieve form data:

image 3 - quochung.cyou PTIT

[LibGDX | Java 2D Game] Phần 1: Cài đặt môi trường

Lời mở đầu

image 19 - quochung.cyou PTIT

Xin chào mọi người! Trước khi bắt tay vào việc phát triển game 2D với LibGDX, hãy dành một chút thời gian để hiểu rõ hơn về ‘bộ công cụ’ mà chúng ta sẽ sử dụng.

LibGDX là một framework mạnh mẽ cho phép lập trình viên tạo game đa nền tảng, từ desktop cho tới mobile và web, mà không cần thay đổi đoạn code nguồn. Thông qua ngôn ngữ Java – một ngôn ngữ lập trình rất phổ biến vì tính linh hoạt, mạnh mẽ và khá dễ tiếp cận, được giảng dạy tại nhiều trường đại học trên thế giới.

Video

Chào mọi người! Video này là phần đầu tiên trong series hướng dẫn sử dụng LibGDX để phát triển game 2D sử dụng Java. Ở tập này, mình sẽ dẫn dắt các bạn qua quá trình cài đặt môi trường phát triển game, bao gồm cách thiết lập LibGDX và các công cụ cần thiết để bắt đầu tạo ra những tựa game đầu tiên của mình. Ngoài ra là một chút khái niệm về cách render tile của game 2D và game loop

Các tài nguyên sử dụng trong video:

Triển khai Cursor Pagination trong Java Spring JPA/Hibernate

Từ bài viết trước

Cursor Pagination

Kĩ thuật: keyset pagination and seek method

Ở một số trang web, bạn sẽ thấy, bạn không thể đi đến thẳng trang cuối, hoặc nhảy đến 1 trang bất kì, mà thông thường sẽ có nút để sang trang kế và trang phía trước. Như vậy ta có thể assume rằng:

Người dùng sẽ chỉ mở trang 10 sau khi mở trang 9.Vậy, ta chỉ cần nhớ vị trí cuối cùng của bài viết ở trang 9 là ở id bao nhiêu, rồi dùng WHERE để truy vấn từ điểm đó, chứ không cần bỏ dần để đi đến điểm đó nữa

SELECT * FROM my_table WHERE id > 21 ORDER BY id LIMIT 5
image 17 - quochung.cyou PTIT
Tối ưu truy vấn Pagination (phân trang) sử dụng Spring Boot (Java) 38

Ví dụ: Sort theo thời gian

SELECT *
FROM my_table
WHERE (update_date = '2017-12-21' AND id > 21) 
    OR update_date > '2017-12-21'
ORDER BY update_date,id LIMIT 5

Cơ bản là ta sẽ chỉ lấy các bài viết có cùng thời gian đăng như bài viết cuối và id > , hoặc thời gian lớn hơn bài viết cuối

image 18 - quochung.cyou PTIT

Để hình dung rõ hơn, hãy thử nhìn vào bảng sau:

IDName
1An
2Nam
3Quan
4Tien
5Hoang
6Nguyen
7Duc
8Thanh
9Hai
10Minh

Ta mong muốn nhận được dữ liệu ở Page 1 như sau

IDName
1An
2Nam
3Quan
4Tien
5Hoang

Ta sẽ có câu query để lấy page 2 dạng như sau

Lấy page 1: SELECT * FROM users ORDER BY ID LIMIT 5
SELECT * FROM users WHERE ID > '5' ORDER BY ID LIMIT 5

Ta có thể thêm HAL bằng Spring HateOAS để response trả về ở dạng như sau, giúp ta lấy dữ liệu dễ dàng hơn

{
    “cursor”: {
        “previous_page”: null,
        “next_page”: "next___5"
    }
}
{
    “cursor”: {
        “previous_page”: "prev___5" ,
        “next_page”: "next___10"
    }
}
  • Cursor sẽ như một con trỏ chỉ tới một record nào đó trong dữ liệu, và khi ta truyền cursor đó vào, backend cần biết ta đang muốn lấy trang tiếp theo hay trang trước từ vị trí con trỏ đó
  • Có nhiều cách để làm điều này, ví dụ thêm prefix dạng như prev___, hay next___ như ví dụ trên
  • Hoặc đơn giản hơn, ta sẽ truyền thêm một biến chỉ ra là đó là next hay prev

Null Cursor

  • Lúc này, từ phía backend, ta có thể sử dụng count hoặc tương tự để kiểm tra xem có trang ở trước đó hay ở sau đó không, rồi trả response ra là null để thể hiện rằng không còn trang nào khác để đi tới ở hướng đó.

Next Cursor

  • Có thể bạn đã nắm được về cách để đi tới trang tiếp theo với cursor pagination.
  • Ví dụ, ta có một danh sách id tăng dần, thì từ trang có id [1,2,3,4,5], ta sẽ where id > 5 để tới trang tiếp theo
SELECT * FROM entries WHERE (myCol > 5) ORDER BY myCol ASC LIMIT 2; -> 6,7
SELECT * FROM entries WHERE (myCol > 7) ORDER BY myCol ASC LIMIT 2; -> 8,9
image 9 - quochung.cyou PTIT
image 10 - quochung.cyou PTIT
  • Với một danh sách id giảm dần, ví dụ trang là [10,9,8,7,6] thì ta sẽ where id < 6 để tới trang tiếp theo.
SELECT * FROM entries WHERE (myCol < 5) ORDER BY myCol DESC LIMIT 2; -> 4,3
SELECT * FROM entries WHERE (myCol < 3) ORDER BY myCol DESC LIMIT 2; -> 2,1
image 11 - quochung.cyou PTIT
image 12 - quochung.cyou PTIT

Previous Cursor

  • Tuy nhiên, việc đi tới trang trước đó trở lên khó khăn hơn. Bởi vì dữ liệu sẽ được trả ra từ phía trái đầu
  • Ví dụ, ta đang ở trang id [8,9] , và ta thực hiện truy vấn lấy trang trước đó, 2 phần tử
SELECT * FROM entries WHERE (myCol < 8) ORDER BY myCol ASC LIMIT 2;
image 13 - quochung.cyou PTIT
  • Kết quả sẽ trả về 0,1. Bởi vì nó đang đọc từ trái sang, và khi limit sẽ lấy từ đầu trái chứ không lấy 6,7

Cách giải quyết lấy previous cursor

  • Cách để giải quyết vấn đề này, ta sẽ đảo ngược chiều order by, và sau đó khi limit để lấy đúng vùng dữ liệu xong, ta sẽ đảo một lần nữa về chiều đúng
SELECT pagination.* FROM(SELECT * FROM entries WHERE (myCol < 8) ORDER BY myCol DESC LIMIT 2) AS pagination ORDER BY myCol ASC;
image 14 - quochung.cyou PTIT
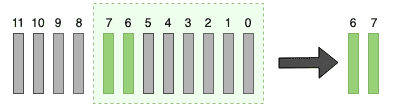
  • Các bước vừa xảy ra
  • 1. Đầu tiên, select các row có id < 8 và order by desc. ta có 7,6,…,1,0
  • Sau đó limit 2 để lấy 7,6
  • Rồi order by asc lần nữa để lấy thành 6,7 . Là thứ tự ASC như ban đầu ta muốn

Time Complexity

  • Next Page Travesal: O(log(N) + L) , ta mấy log(N) để tìm tới điểm bất kì vì nó thực hiện như binary search và ta đã index database. Và L là Limit là số ta phải lặp đến để lấy vùng đầu tiên đã chọn
  • Previous Page Traversal: O(log(N) + 2L), sở dĩ là 2L vì ta đã phải đảo chiều 1 lần.
  • Thông thường limit được đặt ở 5-20 cho 1 trang, vì vậy có thể coi L là constant và không đáng kể

Triển khai trong code

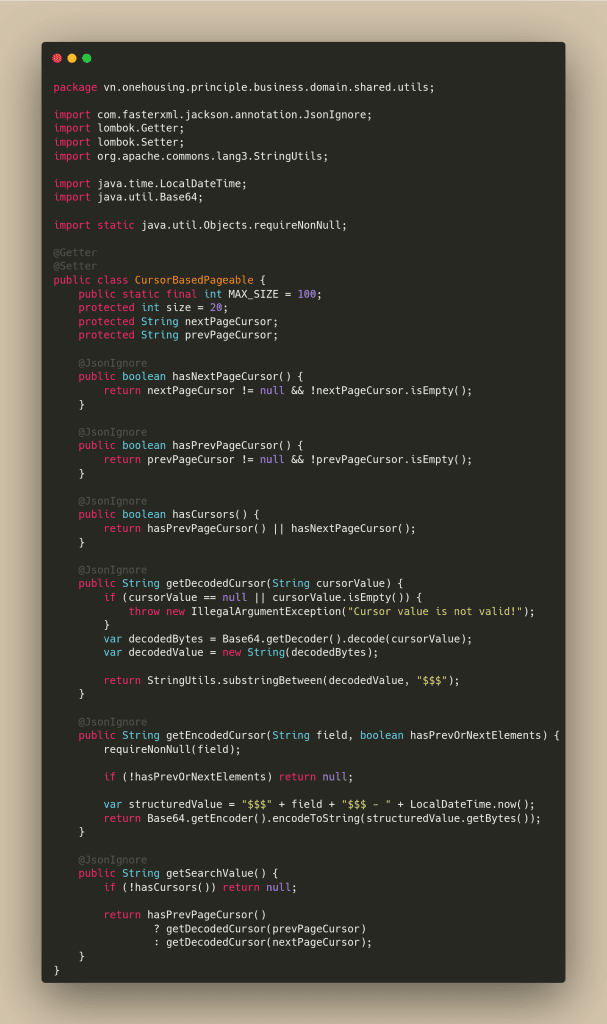
image 15 - quochung.cyou PTIT
  • Ta có một class thực hiện việc lấy cursor trước hoặc sau. Sử dụng để decode một giá trị cursor base64 hoặc encode 1 giá trị
  • Ví dụ ta đang cursor pagination theo column 35, ta sẽ có hàm getEncodeCursor để tạo ra giá trị mã hoá cursor
  • Hàm getDecodedCursor sẽ chuyển giá trị mã hoá đó thành số để dùng paging
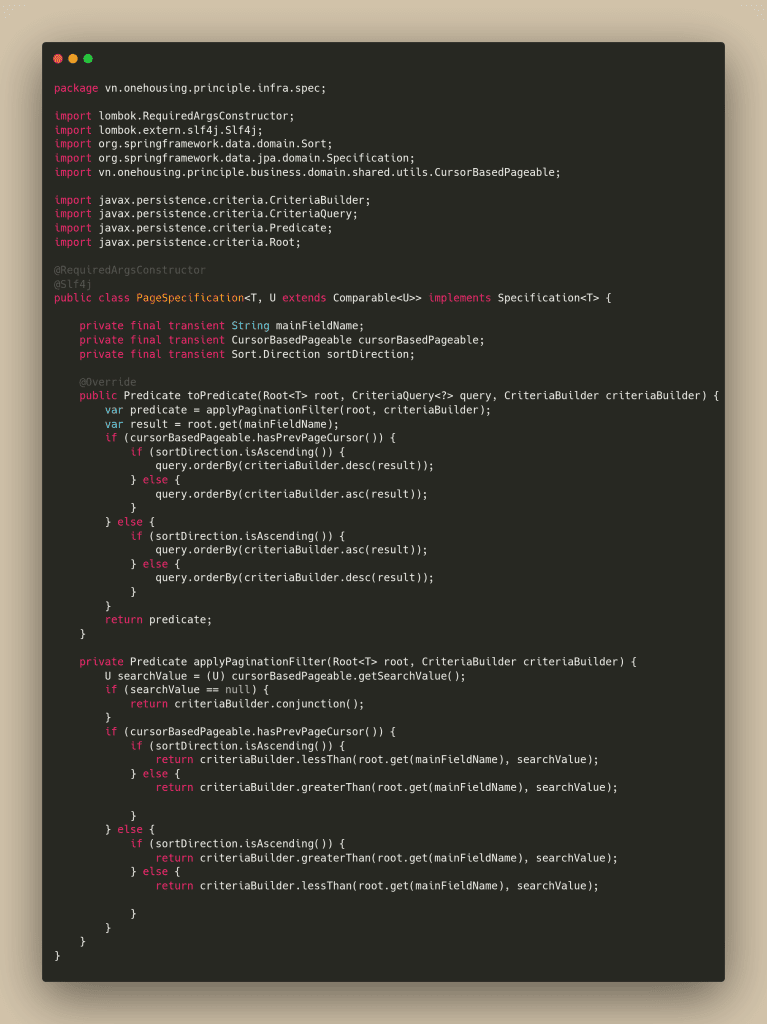
image 16 - quochung.cyou PTIT
  • Đây là class thực hiện việc paging và nhảy trang. Có thể thấy logic sẽ kiểm tra xem ta đang lấy trang trước hay trang sau, sau đó sort cho phù hợp.
image 17 - quochung.cyou PTIT
image 18 - quochung.cyou PTIT
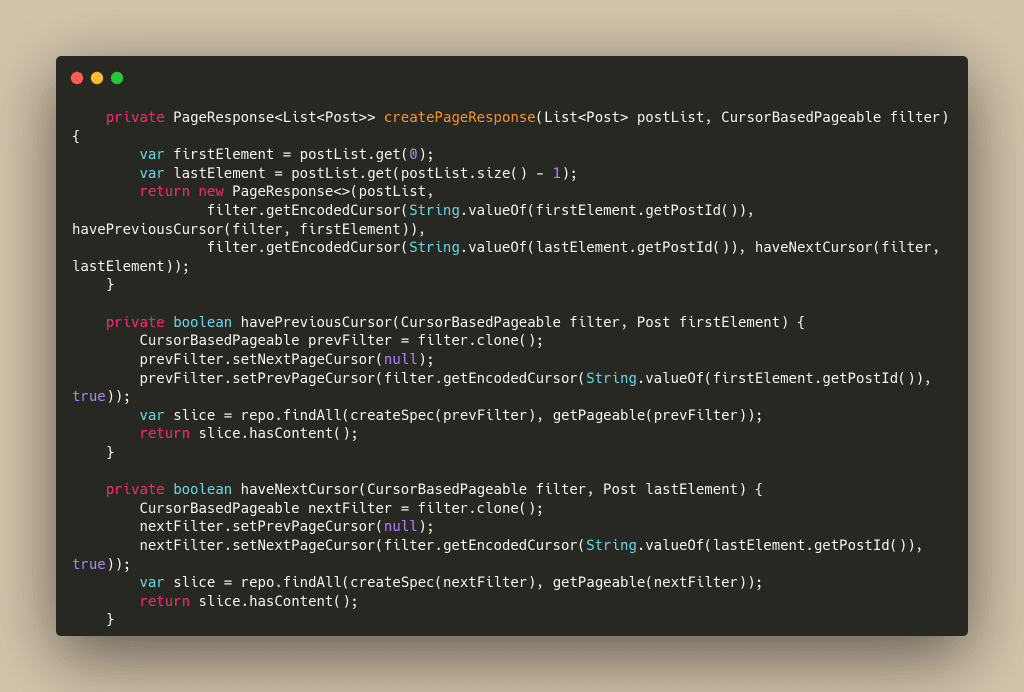
  • Class xử lý việc trả về. Tại đây ta sẽ lấy ra element tại đầu list và cuối list của trang hiện tại, rồi tìm thử xem phía trước đó còn trang nào không, hay sau đó còn trang nào hay không

Tham khảo:

[Java Core] B8: File, sơ lược về test trong Java

This entry is part 8 of 8 in the series Java Core

1. Xử lý File trong Java

Đọc và ghi file trong java là các hoạt động nhập/xuất dữ liệu (nhập dữ liệu từ bàn phím, đọc dữ liệu từ file, ghi dữ liệu lên màn hình, ghi ra file, ghi ra đĩa, ghi ra máy in…) đều được gọi là luồng (stream).

1.1 Một số class thường sử dụng

  • File: Là thực thể dẫn tới file, hoặc thư mục, cho các hàm để làm việc với File
  • FileInputStream/FileOutputStream: Đọc ghi file binary
  • FileReader/FileWriter: Đọc ghi file văn bản
  • BufferedReader/BufferedWriter: Đọc ghi file có Buffer
image - quochung.cyou PTIT
  • Hiểu đơn giản hiện tại thì, tất cả dữ liệu sẽ đều là các Input/OutputStream, là cấu phần byte, để đọc ghi dữ liệu
  • Thì ở tầng đầu tiên, các class như FileInputStream, FileOutputStream sẽ chỉ có các phương thức write các bytes.
  • Các tầng trên thực chất là wrap lại các cách viết, đọc byte này thành các phương thức dạng readInt, writeInt từ các class DataInputStream, DataOutputStream, …

1.2 Về Character Stream và Byte Stream

  • ByteStream của Java có thể thực hiện các thao tác vào ra mỗi 8-bit bytes (2^8 - 256) - ASCII
  • Còn luồng Character Stream, hay sử dụng các FileReader FileWriter thì đọc ghi 16-bit unicode, hỗ trợ được các ngôn ngữ đặc thù hơn (có dấu, gần thì tiếng Việt, các ngôn ngữ khác trên thế giới) do 16-bit unicode cho phép biểu diễn nhiều từ ngữ hơn
  • Thực chất thì cả 2 luồng này đều là wrap trên FileInputStream/FileOutputStream (cấu phần đọc byte thấp nhất ta nói ở trên), tuy nhiên FileReader/FileWriter sẽ đọc 2 bytes một lần
image 1 - quochung.cyou PTIT

1.4 BufferReader/Writer

  • Với BufferReader thì thực tế ta sẽ cung cấp một bộ đệm ở giữa ở Ram, giúp truy cập nhanh hơn. Hiểu đơn giản kiểu: Ví dụ trên mạng có một bài báo, bạn mỗi khi muốn đọc thì cần lên mạng, tải trang đó rồi đọc. Nhưng nếu lưu nó về máy thì khi truy cập sẽ nhanh hơn
image 3 - quochung.cyou PTIT

Câu hỏi: Buffer tốt thế sao không lúc nào cũng dùng ?

  • Tuỳ vào bài toán, thông thường thì BufferReader tốt cho mọi trường hợp vì việc sử dụng các bộ nhớ truy cập nhanh (cache, ram) để lưu tạm thời một vùng nhỏ bộ nhớ (rồi từ từ đẩy vào thêm, rồi lại đẩy ra) để đọc ghi là một practice chuẩn, thường được sử dụng trong nhiều lĩnh vực (buffer trong , database cache, front end cache, server cache, quy hoạch động chuẩn bị trước data …)
  • tuy nhiên việc vùng nhỏ đó là bao nhiêu cho chuẩn, lúc nào đẩy ra đẩy vào thì là 1 câu chuyện khác. -> Invalidation Cache, các chiến lược để nạp page trong hệ điều hành, …

1.5 Đường dẫn tương đối và tuyệt đối

1.5.1 Đường dẫn (Path) là gì?

Hầu hết các hệ thống tập tin được sử dụng ngày hôm nay lưu trữ các tập tin trong một cây (hoặc cấu trúc phân cấp). Ở đầu cây là một (hoặc nhiều hơn) các nút gốc. Dưới nút gốc, có các tệp và thư mục (thư mục trong Microsoft Windows). Mỗi thư mục có thể chứa các tệp tin và các thư mục con, do đó có thể chứa các tệp và thư mục con, v.v … có khả năng lưu trữ một chiều sâu gần như vô hạn.

image 4 - quochung.cyou PTIT

1.5.2 Đường dẫn tương đối/tuyệt đối

Một đường dẫn tuyệt đối luôn chứa các phần tử gốc và danh sách thư mục đầy đủ cần thiết để định vị tệp tin. Ví dụ, D:/file.txt là một đường dẫn tuyệt đối. Tất cả thông tin cần thiết để định vị tệp tin được chứa trong chuỗi đường dẫn.

Một đường dẫn tương đối cần phải được kết hợp với một đường dẫn khác để truy cập một tập tin. Ví dụ là đây là đường dẫn tới file xuất phát từ file dự án

image 5 - quochung.cyou PTIT
  • Ví dụ như ảnh trên, ta có đường dẫn tuyệt đối được trích từ ổ D, rồi vào thư mục Eclipse, …
  • Đường dẫn tương đối thì chỉ là từ thư mục dự án equinox/…/file

1.5.3 Ý nghĩa

  • Đường dẫn tuyệt đối thì ví dụ khi mang file sang nơi khác để chạy thì có thể sẽ không chạy được, vì có thể do máy người khác dùng một cách sắp thư mục khác (window vs linux), hoặc code thì dùng ổ D:/ mà máy người dùng không có ổ này, …
  • Đường dẫn tương đối sẽ được ưa dùng hơn, tức là ta sẽ lưu file nằm gọn trong cùng thư mục dự án, và khi đóng gói thì các thao tác chỉ nằm trong khu vực của dự án

2. Unit Test

2.1. Giới thiệu

Unit Test là một loại kiểm thử phần mềm trong đó các đơn vị hay thành phần riêng lẻ của phần mềm được kiểm thử.

Một Unit là một thành phần PM nhỏ nhất mà ta có thể kiểm tra được như các hàm (Function), thủ tục (Procedure), lớp (Class), hoặc các phương thức (Method).

Ở bài này cơ bản thì, ta sẽ viết các test cho các hàm/lớp trong Java, bằng cách kiểm tra với các input đầu vào định sẵn thì output có ra đúng với ta viết test hay không

  • Ví dụ, ta có phương thức tính tổng 2 số, thì ta dự đoán là khi truyền vào 10,20 thì kết quả phải là 30. Input là 10,20 – Output là 30, và ta kiểm tra 30 với kết quả thực tế khi chạy hàm
  • Việc kiểm tra sẽ được xử lý qua các test case, ta sẽ viết các test trước. Khi muốn kiểm tra tính năng, ta không phải ngồi thử bằng tay mà có thể chỉ cần ấn chạy test tự động

2.2 Cài đặt các thư viện để test trong Java

2.3 Assertions, viết Unit Test

Assertions là một thư viện cung cấp một số api phương thức hỗ trợ việc kiểm thử

image 6 - quochung.cyou PTIT

Ví dụ ảnh trên, ta có 1 hàm tính tổng. Ta viết ra 1 test để thử các input đầu vào để kiểm tra xem expectedSum là kết quả đúng với actualSum là kết quả trả ra của code có đúng không

-> Tưởng tượng như các test input output của codeforce để kiểm tra tính đúng đắn của code

image 7 - quochung.cyou PTIT

Chúng ta cùng bắt đầu viết thử 1 Unit Test cho đoạn code sau đây bằng thư viện JUnit:

Ví dụ ta có lớp Circle với phương thức sau:

public class Circle {

    public static double calculateArea(double radius) {
        return Math.PI * radius * radius;
    }
}

Sau đó, ta tạo lớp CalculatorTest trong đường dẫn src/main/test. Trong đó ta sử dụng annotation @Test để định nghĩa cho 1 test.

public class CircleTest {

    @Test
    public void testCalculateArea() {
        //...
    }
}

2.4 Một số quy tắc viết Test

Đối với JUnit, ta có một số quy tắc đặt tên sao cho chuẩn như sau:

  • Ta phải có từ “Test” ở cuối tên class, ví dụ: LoginControllerTest, StudentControllerTest,… -> Nhận biết file nào là test (Maven sẽ tự động thêm các lớp này vào Test scope)
  • Đặt tên các test rõ ràng, ta có thể theo cấu trúc sau: Given[ExplainYourInput]When[WhatIsDone]Then[ExpectedResult] ví dụ:
@Test
public void GivenNullUsernameWhenCreateStudentThenShouldThrowException()

public void Test_01_Khi_Nhap_Vao_So_Am_Thi_Thong_Bao_Sai()

public void Test_02_Khi_Nhap_Vao_So_Duong_Thi_Thong_Bao_Dung()
  • Tức là khi cho gì đó (Given) vào thời điểm nào đó (Create) thì nên làm gì (Then)
  • Ví dụ: Test cho 1 hàm nhập đầu vào gì đó, nếu người dùng nhập số âm thì chương trình nên trả ra là hãy nhập lại. File test sẽ kiểm tra có thật là chương trình bắt nhập lại hay không -> Yêu cầu làm thử bài toán trên
  • Ngoài ra, các test cần có tính độc lập. Tức là các test có thể thực hiện theo thứ tự ngẫu nhiên, và một test không nên phụ thuộc vào một test khác.
  • Ví dụ không nên có chuyện cần chạy test 1 rồi test 6 chạy mới pass

2.5 Chạy thử hàng loạt test và Test Coverage

image 8 - quochung.cyou PTIT
  • Chuột phải vào project, ví dụ như ảnh trên ta có các lựa chọn Run All Test là chạy toàn bộ test trong thư mục test của dự án

2.5.1 Test Coverage là gì

  • Test coverage (độ bao phủ kiểm thử) là một phép đo để đánh giá mức độ mà mã nguồn của chương trình đã được kiểm tra thông qua việc chạy các ca kiểm thử. Nó đo lường tỷ lệ phần trăm của mã nguồn được thực thi bởi các ca kiểm thử.
  • Ví dụ, test của ta đã đi hết 90/100 dòng của code thực tế. Tức là đã có 90 dòng đã được chạy trong quá trình test, và kết quả có vẻ đang đúng với expected trong test, ta gọi đó là Line Coverage (bao phủ theo số lượng dòng)
  • Ngoài ra còn có bao phủ theo số lượng class được chạy, số lượng hàm được chạy

=> Test Coverage là một chỉ số thể hiện tương đối dự án có đang ở trạng thái được test kiểm tra kĩ hay không. (nếu mà test viết chuẩn) Ví dụ, với những dự án được test coverage rất cao, khoảng 80-90%, thì dù sau này ta có sửa code, refactor, clean code hay gì đi nữa, ta có thể đảm bảo là khi chạy lại các test ta đã viết, ta sẽ biết chỗ nào có thể đang bị hỏng, chưa đúng để sửa lại

  • Mục tiêu của việc đạt test coverage là tăng độ tin cậy của chương trình bằng cách đảm bảo rằng các phần quan trọng của mã nguồn đã được kiểm tra. Tuy nhiên, test coverage không đảm bảo rằng tất cả các lỗi đều được phát hiện, và nó cũng không thể đo lường chất lượng của các ca kiểm thử.
image 9 - quochung.cyou PTIT
  • Như ảnh trên, ở More Run/Debug ta có thể có lựa chọn run thử toàn bộ test để đo coverage hiện tại của dự án
image 10 - quochung.cyou PTIT
  • Ta có hình ảnh Inteliji thể hiện bao nhiêu class đã được chạy qua, bao nhiêu method, bao nhiêu line đã được cover. Tuỳ vào cách đánh giá của công ty, hệ số, ... thì ta sẽ gộp thành 1 coverage tổng thể
image 11 - quochung.cyou PTIT
  • Đây được gọi là kim tự tháp test (testing pyramid), ở bên dưới là các test sẽ nhỏ, độc lập hơn, chạy nhanh hơn. Thường các test này khó móc nối với nhau (kiểu khó thử được 1 luồng là ấn nút giao diện rồi kiểm tra), nên để test ở đây, ta mặc định là mọi thứ đã móc nối chuẩn, rồi viết test sao cho từng module, cấu phần đều chuẩn
  • Ở các level cao hơn, test sẽ được móc nối giữa nhiều cấu phần (database, giao diện, nhiều service ngoài, …) sẽ yêu cầu thời gian chạy lâu hơn

[Java Core] B7: Exception trong Java

This entry is part 7 of 8 in the series Java Core

1. Làm quen với Exception: Checked và Unchecked Exception, Error

1.1 Lời mở đầu

  • Trong cuộc sống, không phải lúc nào mọi việc cũng diễn ra suôn sẻ, không phải lúc nào mọi thứ cũng theo đúng kế hoạch. Đôi khi, có những tình huống không mong muốn xảy ra, và chúng ta cần phải xử lý chúng.
image - quochung.cyou PTIT
  • Khi một ứng dụng ngày càng lớn lên, chắc chắn ta không thể đảm bảo ứng dụng luôn hoạt động như cách ta muốn 100% mọi lúc được. Đến lúc nào đó, sẽ có lỗi xảy ra.

Ví dụ:

  • Khi một ứng dụng cần đọc một file từ ổ cứng, nhưng file đó không tồn tại.
  • Khi ứng dụng cần quyền chụp ảnh từ camera, nhưng người dùng không cho phép.
  • Khi ứng dụng kết nối tới một server, nhưng server đang bị mất điện và không kết nối được.

Khi đó, hệ thống cần có những cách xử lý riêng cho người dùng biết vấn đề đang xảy ra, và có những cách xử lý riêng cho hệ thống có thể tiếp tục hoạt động mà không bị ảnh hưởng quá nhiều.

Ví dụ:

  • Khi file không tồn tại, ứng dụng cần thông báo cho người dùng biết rằng file không tồn tại và yêu cầu người dùng chọn file khác, hoặc kiểm tra lại đường dẫn file.
  • Khi người dùng không cho phép ứng dụng chụp ảnh, ứng dụng cần thông báo cho người dùng biết rằng không thể chụp ảnh và yêu cầu người dùng cấp quyền.
  • Khi server bị mất điện, ứng dụng cần thông báo cho người dùng biết rằng không thể kết nối tới server và yêu cầu người dùng thử lại sau, hoặc kiểm tra xem đường truyền wifi, 3G, 4G có vấn đề gì không.

1.2 Exception là gì?

  • Exception dịch ra tiếng Việt có nghĩa là ngoại lệ. Exception là một sự kiện xảy ra trong quá trình thực thi chương trình, làm ảnh hưởng đến luồng thực thi của chương trình.

1.3 Checked và Unchecked Exception

1.3.1 Checked Exception

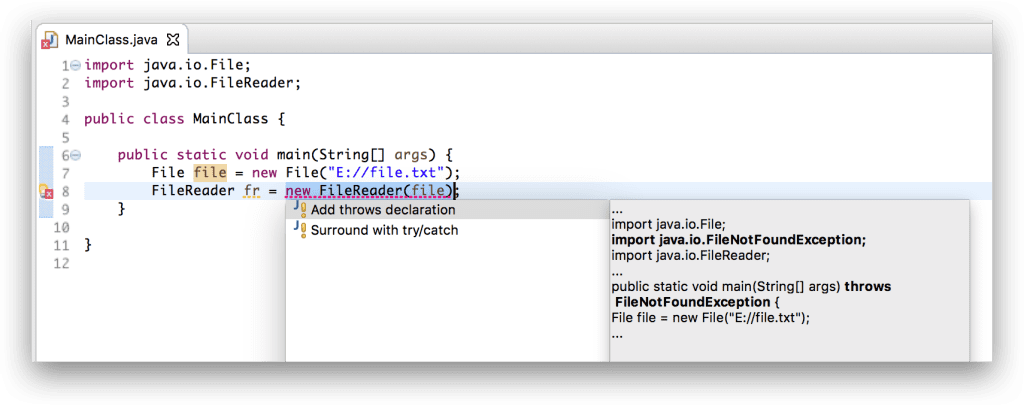
image 1 - quochung.cyou PTIT
  • Ảnh ví dụ: Khi ta thử đọc 1 file, IDE ngay lập tức thông báo có thể xảy ra FileNotFoundException (Ngoại lệ file không tồn tại) và yêu cầu ta phải xử lý nó.
  • Checked Exception thường là những lỗi phổ biến mà chúng ta có thể dự đoán được sẽ xảy ra cho một thao tác nào đó.
  • Ví dụ, khi đi dã ngoại, để phòng ngừa việc có mưa, ta mang theo áo mưa. Việc trời mưa là một ngoại lệ mà ta đã dự đoán trước và lên trước kế hoạch để xử lý nó.

1.3.2 Unchecked Exception

  • Đây là những Exception không được kiểm tra tại thời điểm biên dịch (compile time). Tức là chúng ta không nhận được thông báo lỗi từ trình biên dịch khi mà nó phát hiện ra rằng chúng ta chưa xử lý nó.
  • Đây là các exception khá nguy hiểm, khi mà chúng ta không thể dự đoán được chúng sẽ xảy ra khi nào. Bởi vì Exception này xảy ra khi ứng dụng đang thực thi, nên nó còn có thể gọi là Runtime Exception.
  • Ví dụ, khi một ứng dụng chia một số cho 0, nó sẽ ném ra một ngoại lệ ArithmeticException (Ngoại lệ toán học).
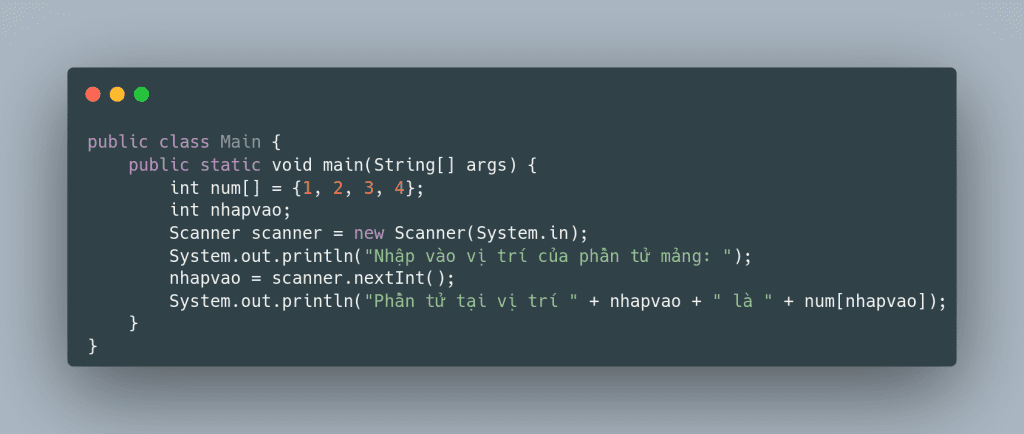
image 2 - quochung.cyou PTIT
  • Trong đoạn code trên, nếu ta nhập vào 1 số không tồn tại trong mảng, nó sẽ bị một Exception ArrayIndexOutOfBoundsException (Ngoại lệ vượt quá giới hạn của mảng)., đây là một ví dụ về Unchecked Exception. Vì ta không thể biết được trước khi chạy chương trình, nó sẽ xảy ra khi nào.

1.4 Error

  • Error là một dạng ngoại lệ mà chúng ta không thể xử lý được. Error thường xảy ra khi mà hệ thống gặp phải những vấn đề nghiêm trọng, không thể khắc phục được.
  • Ví dụ, khi một ứng dụng chạy hết bộ nhớ, nó sẽ ném ra một ngoại lệ OutOfMemoryError (Lỗi hết bộ nhớ). Đây là một ví dụ về Error. Đây là một ngoại lệ ta không thể xử lý được, và nó thường xảy ra khi mà hệ thống gặp phải những vấn đề nghiêm trọng, không thể khắc phục được.

2. Bắt Exception với try-catch

Bài tập

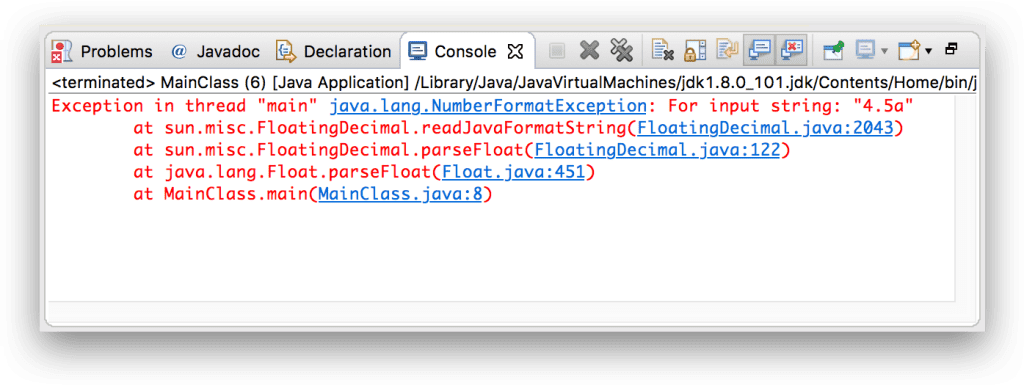
  • Hãy viết chương trình nhập vào 1 String, và sử dụng Integer.parseInt để chuyển đổi String đó sang kiểu int. Thử nếu nhập vào 1 chuỗi không phải là số, xem chương trình sẽ báo lỗi như thế nào.
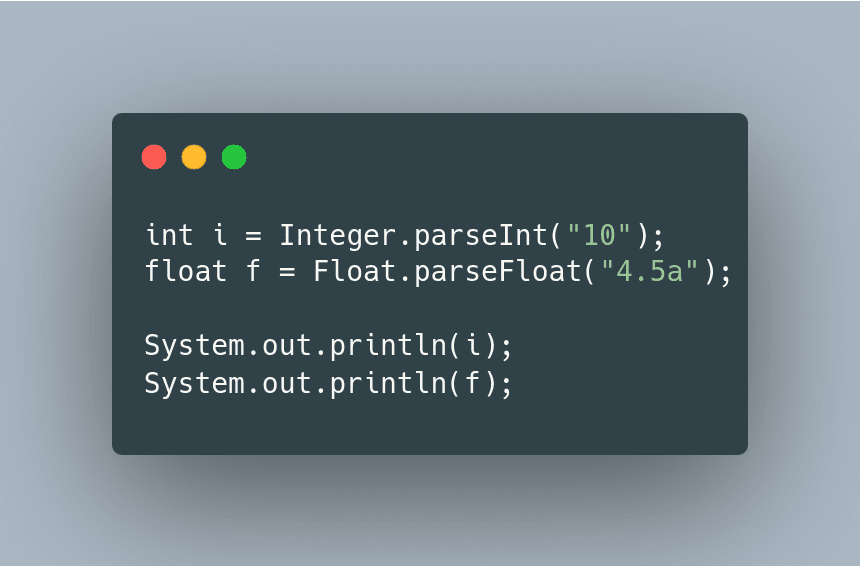
image 3 - quochung.cyou PTIT
  • Khi chạy chương trình trên, ta sẽ nhận được một ngoại lệ NumberFormatException (Ngoại lệ không đúng định dạng số). Đây là một ví dụ về Unchecked Exception. Vì lúc compile, ta không nhận lỗi nào báo trước cả, do IDE không biết trước được String truyền vào khi chạy chương trình
image 5 - quochung.cyou PTIT

2.1 Cách bắt Exception

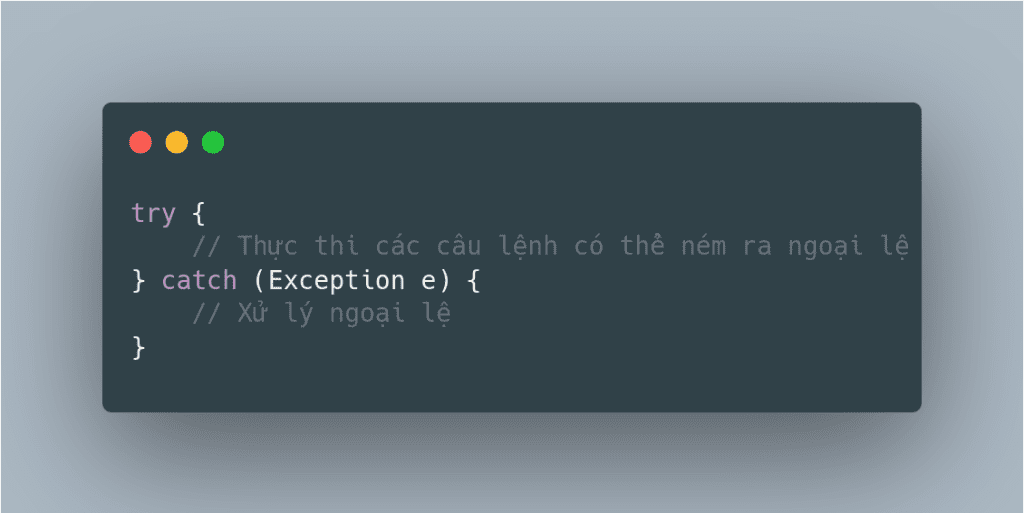
  • Để bắt Exception, ta sử dụng cấu trúc try-catch. Cấu trúc try-catch sẽ giúp chúng ta bắt ngoại lệ, và xử lý nó một cách an toàn.
  • Cấu trúc try-catch có dạng như sau:
image 6 - quochung.cyou PTIT
  • Trong đó:
    • try: Là một khối lệnh, chứa các câu lệnh có thể ném ra ngoại lệ.
    • catch: Là một khối lệnh, chứa các câu lệnh xử lý ngoại lệ. Trong đó, Exception e là một biến, chứa thông tin về ngoại lệ xảy ra.

2.2 Ví dụ

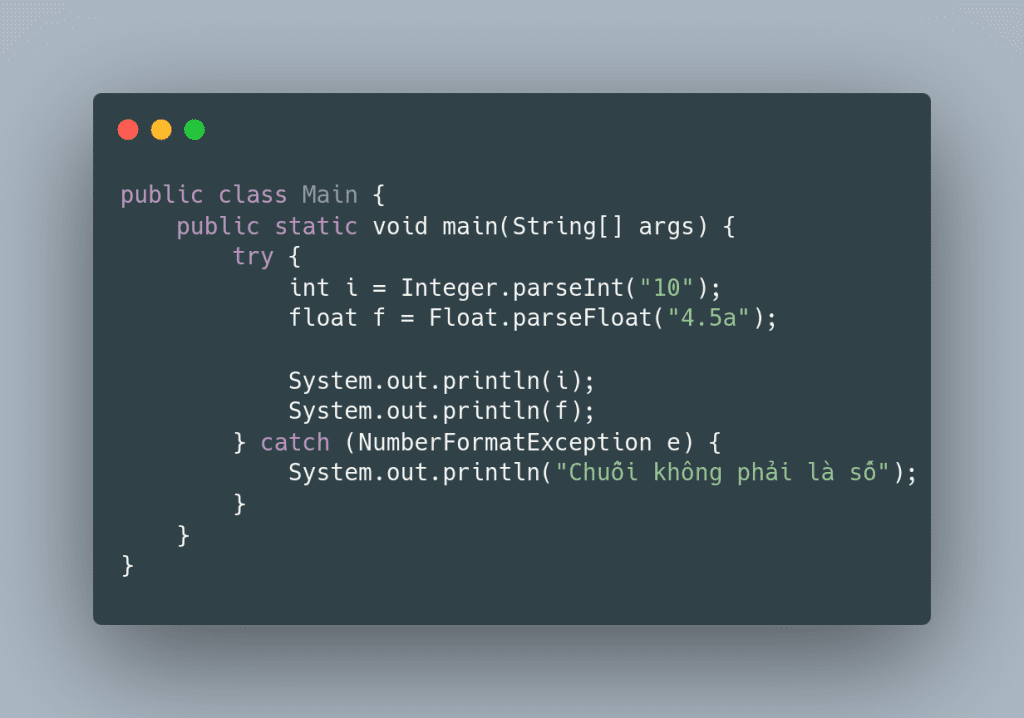
  • Ví dụ, ta sẽ sử dụng cấu trúc try-catch để bắt ngoại lệ NumberFormatException khi chuyển đổi một chuỗi không phải là số sang kiểu int.
image 7 - quochung.cyou PTIT
  • Khi chạy chương trình trên, ta sẽ nhận được thông báo “Chuỗi không phải là số” khi chuyển đổi chuỗi “4.5a” sang kiểu float.

2.3 catch nhiều Exception

  • Ta cũng có thể bắt nhiều ngoại lệ trong cùng một cấu trúc try-catch, bằng cách sử dụng nhiều khối catch.

Bài tập

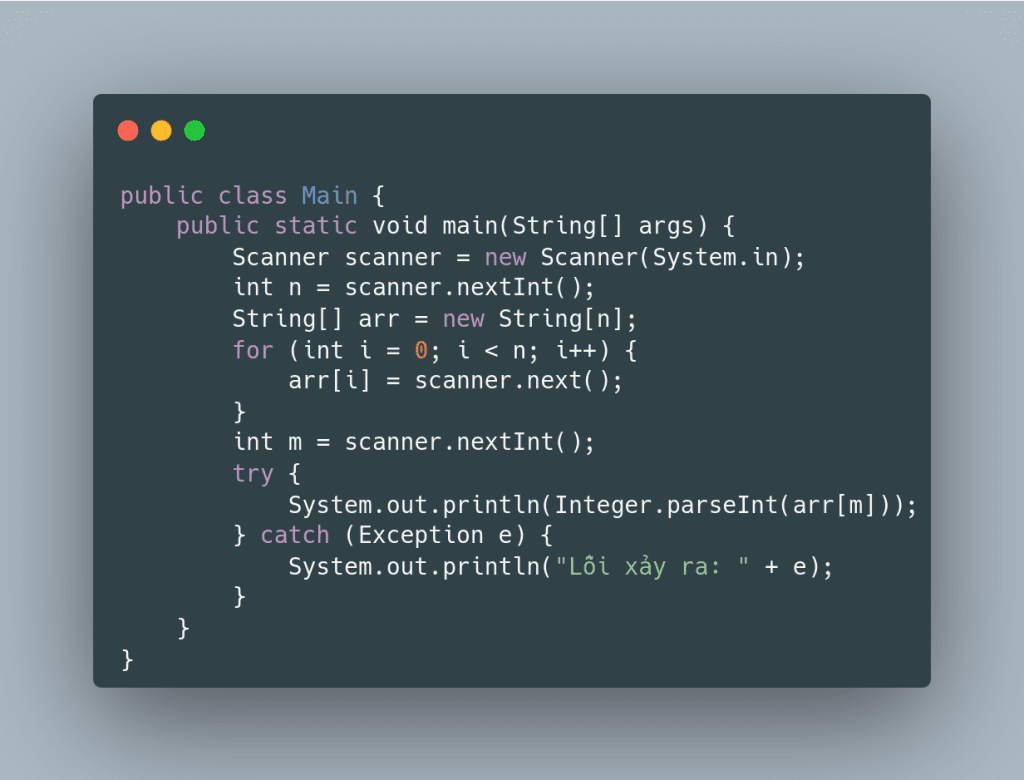
  • Hãy viết chương trình nhập vào số n, sau đó nhập vào n string. Sau đó nhập vào 1 số m, và in ra string thứ m. Nếu truy cập ngoài mảng, hãy in ra thông báo “Truy cập ngoài mảng”, còn nếu không in ra số được chuyển đổi từ string đó sang kiểu int, nếu không thể chuyển đổi được, hãy in ra thông báo “Chuỗi không phải là số”.\
image 8 - quochung.cyou PTIT
  • Như ví dụ trên, ta thấy ta có thể catch nhiều Exception trong cùng một cấu trúc try-catch.

2.4 Catch Exception cha

  • Ta cũng có thể bắt Exception cha của một Exception con. Ví dụ, ta có thể bắt Exception cha của NumberFormatException là Exception.

Bài tập

  • Tương tự bài tập trên, nhưng chỉ dùng 1 catch, và có bất kì lỗi gì xảy ra ta đều in ra “Lỗi xảy ra + tên lỗi”.
image 9 - quochung.cyou PTIT
  • Như ví dụ trên, ta thấy ta có thể bắt Exception cha của NumberFormatException là Exception.

3. Sử dụng finally

3.1 finally là gì?

  • finally là một khối lệnh, chứa các câu lệnh sẽ được thực thi sau khi khối lệnh try-catch kết thúc.
  • finally sẽ được thực thi sau khi khối lệnh try-catch kết thúc, bất kể có ngoại lệ xảy ra hay không.

3.2 Ví dụ

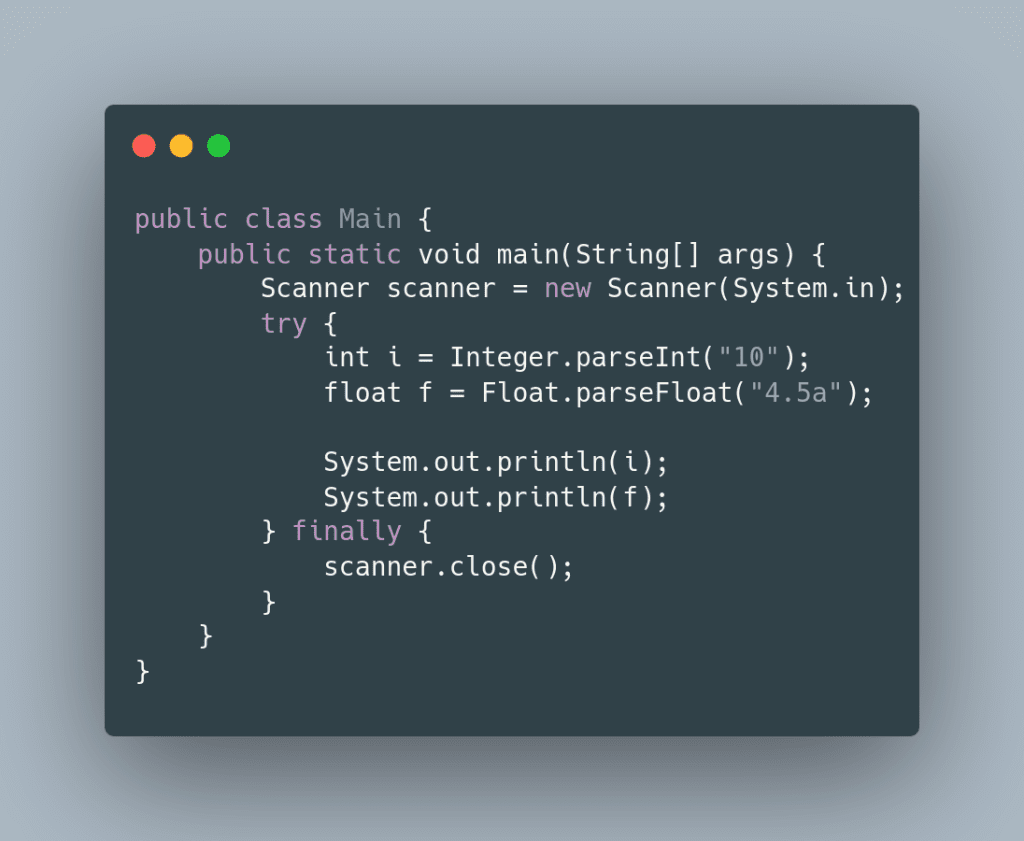
  • Ví dụ, ta sẽ sử dụng finally để đóng Scanner sau khi sử dụng xong.
image 10 - quochung.cyou PTIT
  • Trong đoạn code trên, ta sẽ đóng Scanner sau khi sử dụng xong, bất kể có ngoại lệ xảy ra hay không.

Tác dụng

  • finally thường được sử dụng để giải phóng tài nguyên, như đóng file, đóng kết nối, đóng Scanner, … Đây là một practice nên làm đó là giải phóng tài nguyên sau khi sử dụng xong, tránh lãng phí tài nguyên.

3.3 Một số câu hỏi

3.3.1 Tại sao không sử dụng Exception là xong mà cần catch Exception cụ thể, có nhiều class Exception con

  • Khi sử dụng Exception là xong, ta sẽ bắt được tất cả các Exception, nhưng đôi khi ta cần xử lý một cách cụ thể cho từng Exception. Vì khi có lỗi xảy ra, cứ chỉ báo là đã có lỗi xảy ra thì thứ nhất người dùng rất khó chịu, ta khi sửa lỗi cũng không biết lỗi xảy ra là gì, ở đâu. Thứ hai, ta cũng không thể xử lý lỗi một cách cụ thể.
  • Việc catch đúng Exception cụ thể sẽ giúp ta xử lý lỗi một cách cụ thể. Ví dụ: Nếu lỗi là chia cho 0, ta báo cho người dùng rằng họ nhập sai để họ biết sai ở đâu và sửa lại, còn nếu lỗi là không tìm thấy file, ta báo cho người dùng biết rằng file không tồn tại để họ biết cần phải tạo file mới. Hoặc nếu là các lỗi người dùng không hiểu được, ta cần báo các lỗi cụ thể, có định danh rõ ràng để lập trình viên có thể biết và sửa lỗi
  • Ví dụ, trong window đôi lúc ta bị màn hình xanh, ta có các mã lỗi kiểu như 0x0000000A, 0x0000000B, … những mã lỗi này không phục vụ cho người dùng hiểu, nhưng người dùng có thể dùng nó để báo cáo, và lập trình viên có thể dùng nó để sửa lỗi.

3.3.2 Có thể Try không có Catch không?

  • Có thể, nhưng ta cần có một khối finally để giải phóng tài nguyên.
  • Ví dụ, ta có thể sử dụng try-finally để giải phóng tài nguyên, mà không cần catch Exception.
image 11 - quochung.cyou PTIT

4. Cây phân cấp Exception

  • Trong Java, Exception được phân cấp theo một cấu trúc cây, với Throwable là gốc của cây, Error và Exception là 2 nhánh con của Throwable.
image 12 - quochung.cyou PTIT
  • Interface Iterable nhằm ám chỉ những class bên dưới kế thừa có tính “có thể ném ra được”
  • Lí do tại sao cần 1 cây Exception sẽ được giải thích bên dưới, mục câu hỏi tại sao không catch mọi exception

4.1 Throw, tung ra ngoại lệ

  • Đến hiện tại, ta đã biết các Exception có sẵn trong Java, và cách bắt nó bằng cấu trúc try-catch.
  • Ta nhận thấy, các Exception đều triển khai từ Throwable, và có thể tung ra (throw) một Exception bằng cách sử dụng từ khóa throw.

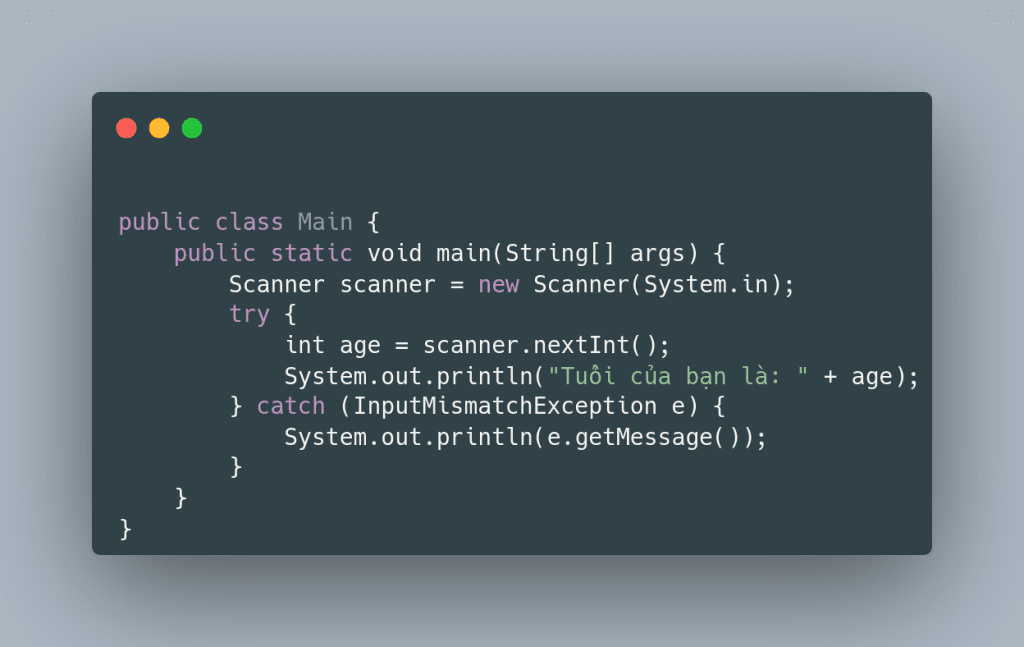
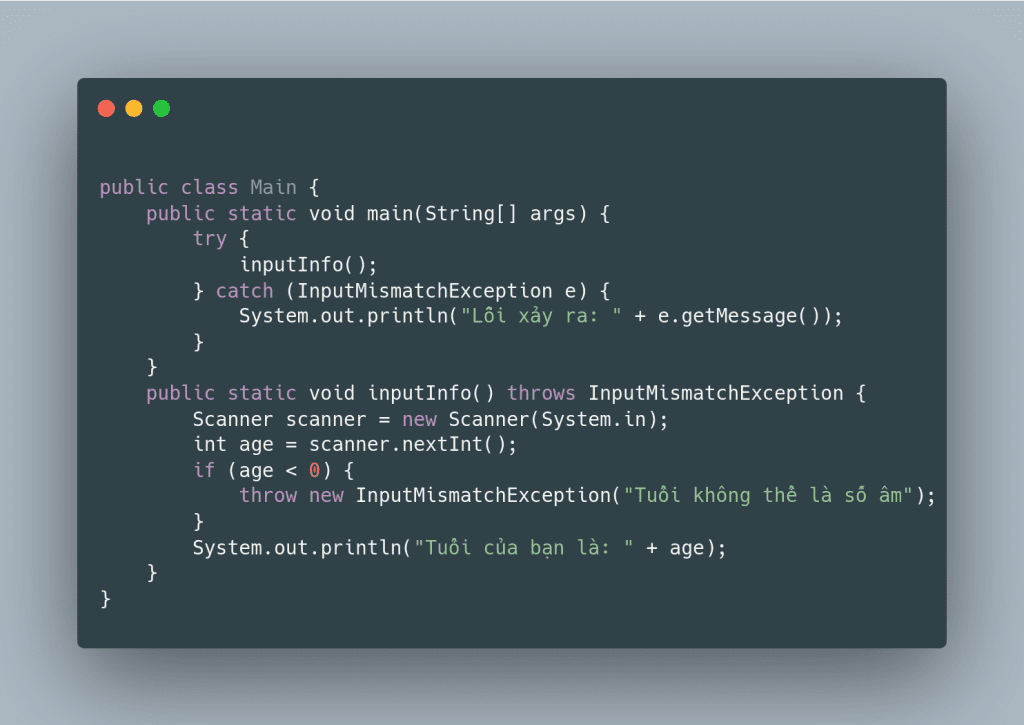
Ví dụ: Ta cần nhập vào một số là tuổi của người dùng, ta sử dụng nextInt của Scanner để nhập vào, nhưng nếu người dùng nhập vào một chuỗi không phải là số, ta sẽ tung ra một Exception InputMismatchException (Ngoại lệ nhập không đúng).

image 13 - quochung.cyou PTIT
image 15 - quochung.cyou PTIT
  • Tuy nhiên, người dùng vẫn có thể nhập vào 1 số âm, lúc này ta có thể thêm các điều kiện của riêng mình và throw ra Exception nếu muốn
image 16 - quochung.cyou PTIT

4.2 Throws

  • throws là một từ khóa, dùng để khai báo một phương thức có thể ném ra một ngoại lệ.
  • Ví dụ: Ta chia 1 hàm riêng để nhập vào thông tin nhân viên, nếu nhập sai ta sẽ trả ra 1 số Exception như InputMismatchException, NumberFormatException, …. Tuy nhiên ta muốn nơi gọi đến hàm này tự xử lý ngoại lệ, ta có thể sử dụng throws để khai báo phương thức có thể ném ra ngoại lệ.
image 17 - quochung.cyou PTIT
  • Như code trên, ở hàm inputInfo ta sử dụng throws để khai báo phương thức có thể ném ra ngoại lệ. Lúc này ở nơi gọi đến hàm inputInfo sẽ bị yêu cầu xử lý ngoại lệ InputMismatchException mà ta đã khai báo.
image 19 - quochung.cyou PTIT
  • Như ảnh trên, ta thấy ở bên phải là luồng gọi hàm, và bên trái là luồng Exception được quay ngược lên trên để tìm nơi xử lý nó.

4.3 Tạo ra Exception của riêng mình

  • Đôi khi, ta cần tạo ra Exception của riêng mình, để phục vụ cho mục đích của riêng mình.
  • Tên Throwable có nghĩa là “có thể ném ra”, nghĩa là các Exception bên dưới của chúng ta có thể sử dụng các từ khoá throws, throw để ném ra.
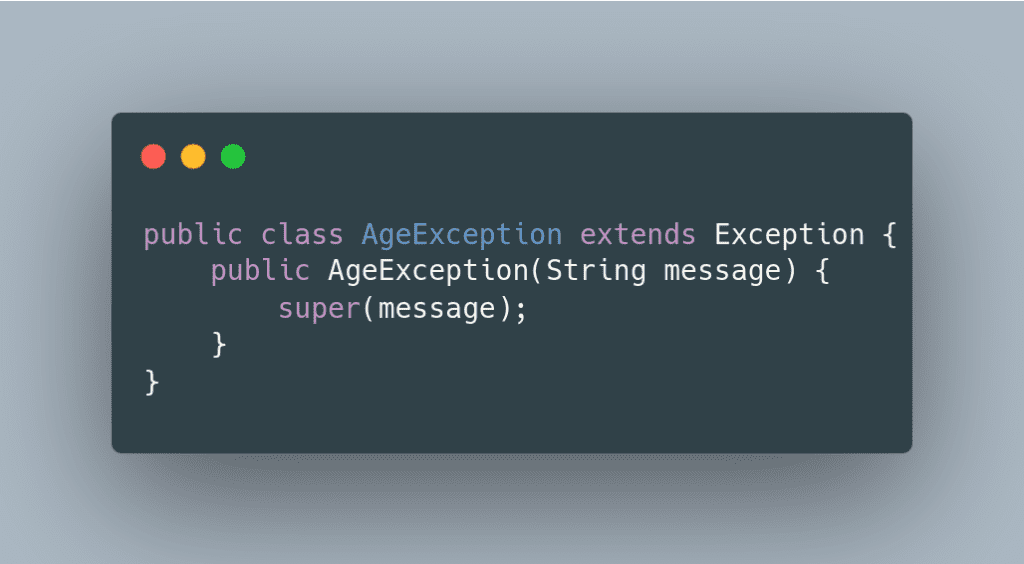
  • Để tạo ra Exception của riêng mình, ta cần tạo ra một class kế thừa từ Exception hoặc RuntimeException. Để tạo 1 Checked Exception, ta kế thừa từ Exception, còn để tạo 1 Unchecked Exception, ta kế thừa từ RuntimeException.
  • Ví dụ, ta cần tạo ra 1 Exception AgeException (Ngoại lệ tuổi), nếu tuổi nhập vào nhỏ hơn 0, ta sẽ ném ra Exception này.
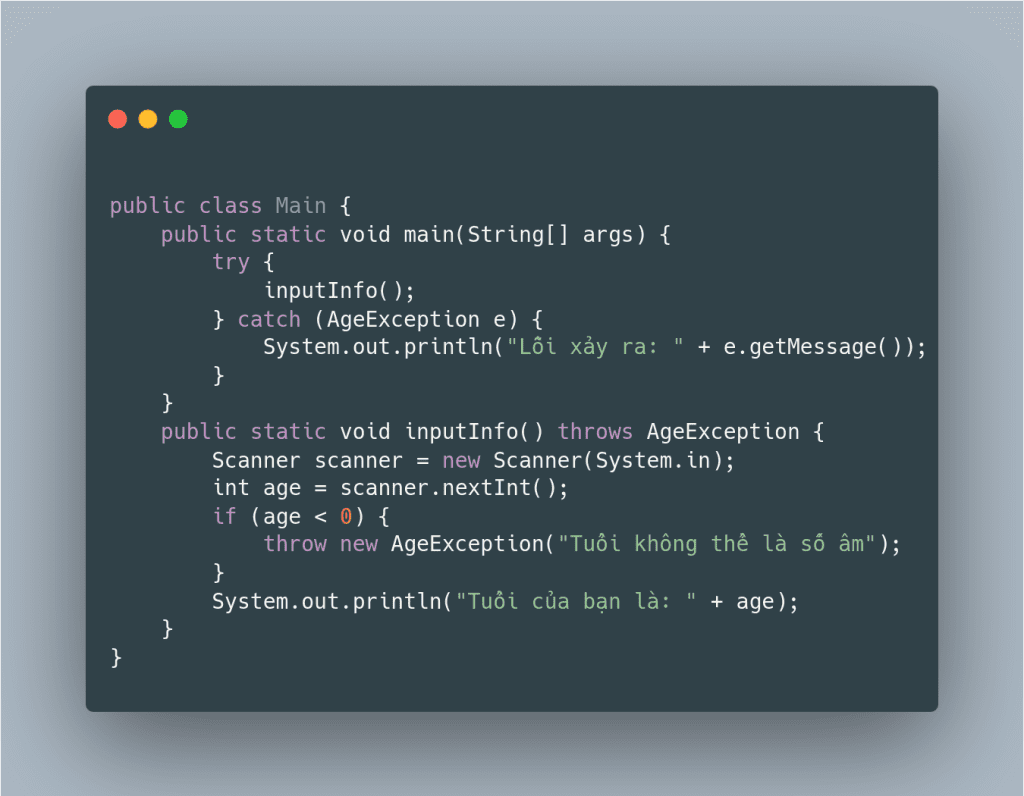
image 20 - quochung.cyou PTIT
  • Ví dụ, ta sẽ sử dụng AgeException để ném ra Exception khi tuổi nhập vào nhỏ hơn 0.
image 21 - quochung.cyou PTIT
  • Như code trên, ta sử dụng AgeException để ném ra Exception khi tuổi nhập vào nhỏ hơn 0.

[Java Core] B6: Design Pattern Iterator. Iterable và Collection trong Java

This entry is part 6 of 8 in the series Java Core

Buổi 6: Một số trúc dữ liệu thường thấy trong Java

  • Cấu trúc dữ liệu là gì, sử dụng khi nào
  • Interface Iterable, Collection -> List, Set, Queue
  • Interface Map, SortedMap -> HashMap, TreeMap
  • Sử dụng một số hàm của cấu trúc dữ liệu như sort

Cấu trúc dữ liệu là gì, sử dụng khi nào

Cấu trúc dữ liệu là một cách tổ chức dữ liệu trong máy tính để có thể lưu trữ và xử lý dữ liệu một cách hiệu quả. Cấu trúc dữ liệu là một phần quan trọng trong việc thiết kế các chương trình và các thuật toán.

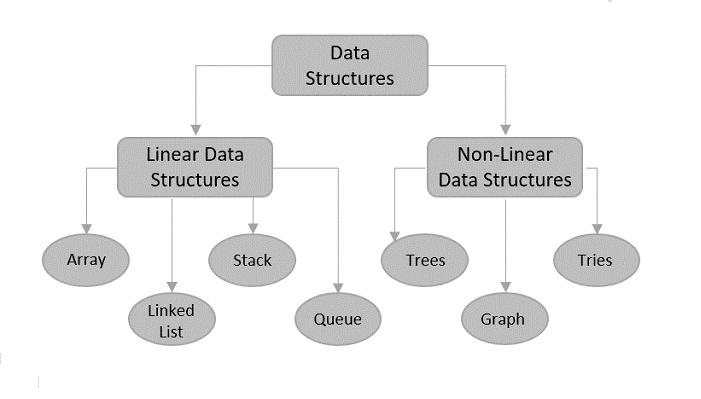
image 60 - quochung.cyou PTIT
  • Thông thường, sẽ có 2 kiểu cấu trúc dữ liệu chính là Linear Data Structure và Non-Linear Data Structure hay cấu trúc dữ liệu tuyến tính và cấu trúc dữ liệu phi tuyến tính.
  • Cấu trúc dữ liệu tuyến tính là các cấu trúc dữ liệu mà các phần tử dữ liệu được sắp xếp theo một thứ tự nhất định. Các cấu trúc dữ liệu tuyến tính thường được sử dụng để lưu trữ dữ liệu đơn giản như danh sách, mảng, hàng đợi, stack, …
  • Cấu trúc dữ liệu phi tuyến tính là các cấu trúc dữ liệu mà các phần tử dữ liệu được sắp xếp theo một thứ tự không nhất định. Các cấu trúc dữ liệu phi tuyến tính thường được sử dụng để lưu trữ dữ liệu phức tạp như cây, đồ thị, …
image 62 - quochung.cyou PTIT

=> Câu hỏi: Với các cấu trúc dữ liệu phức tạp như vậy, làm sao để ta có thể lưu trữ, và duyệt qua các phần tử của chúng?

  • Nghe như một công việc đơn giản với các cấu trúc dữ liệu tuyến tính như list. Ta chỉ cần duyệt qua toàn bộ phần tử khi duyệt. Nhưng làm sao để ta duyệt thứ tự một cấu trúc dữ liệu phức tạp, ví dụ như cây ? Có thể, ta cần nó duyệt theo DFS, hoặc BFS, hoặc duyệt theo thứ tự trước, sau, hoặc duyệt ngẫu nhiên, …
image 63 - quochung.cyou PTIT

Interface Iterable, Collection -> List, Set, Queue

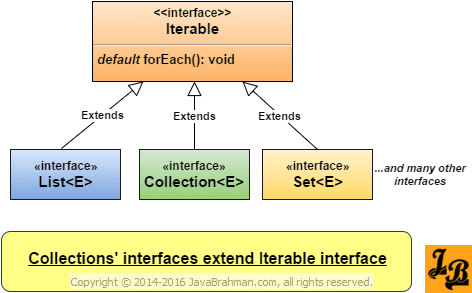
  • Interface Iterable là một interface trong Java, nó có một phương thức là iterator() trả về một đối tượng Iterator để duyệt qua các phần tử của một Collection.  
image 64 - quochung.cyou PTIT
image 65 - quochung.cyou PTIT

Ví dụ:

image 66 - quochung.cyou PTIT


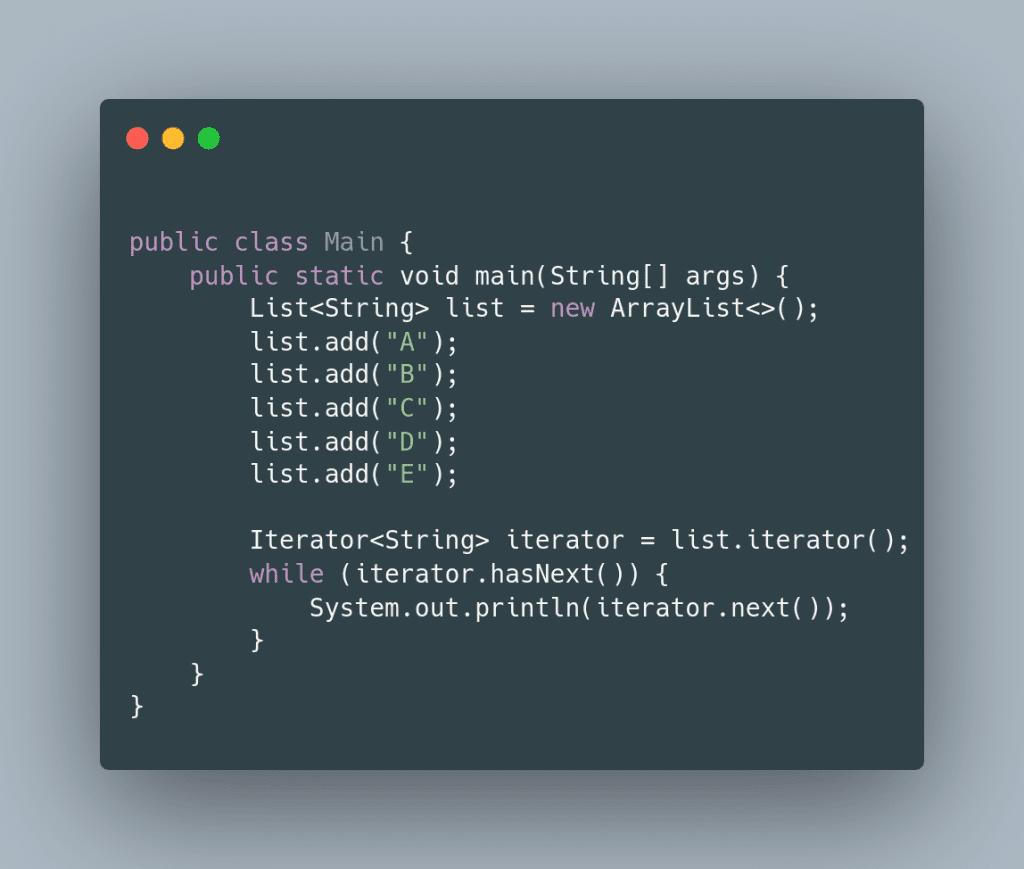
  • Như trong ví dụ trên, ta có thể thấy, ta có thể duyệt qua các phần tử của một Collection bằng cách sử dụng Iterator.
  • Ta lấy ra iterator của object list, thuộc class ArrayList. Do interface List đã define hàm iterator, nên class ArrayList phải implement hàm iterator này, và tự triển khai logic cách để duyệt qua bản thân như thế nào.
  • Các class khác như LinkedList, Vector, … cũng phải implement hàm iterator này, và tự triển khai logic cách để duyệt qua bản thân như thế nào.
  • Điều này cho phép khi duyệt qua các Map, Set, … ta không cần phải quan tâm đến cách duyệt của chúng, mà chỉ cần gọi hàm iterator() của chúng, và duyệt qua các phần tử của chúng.
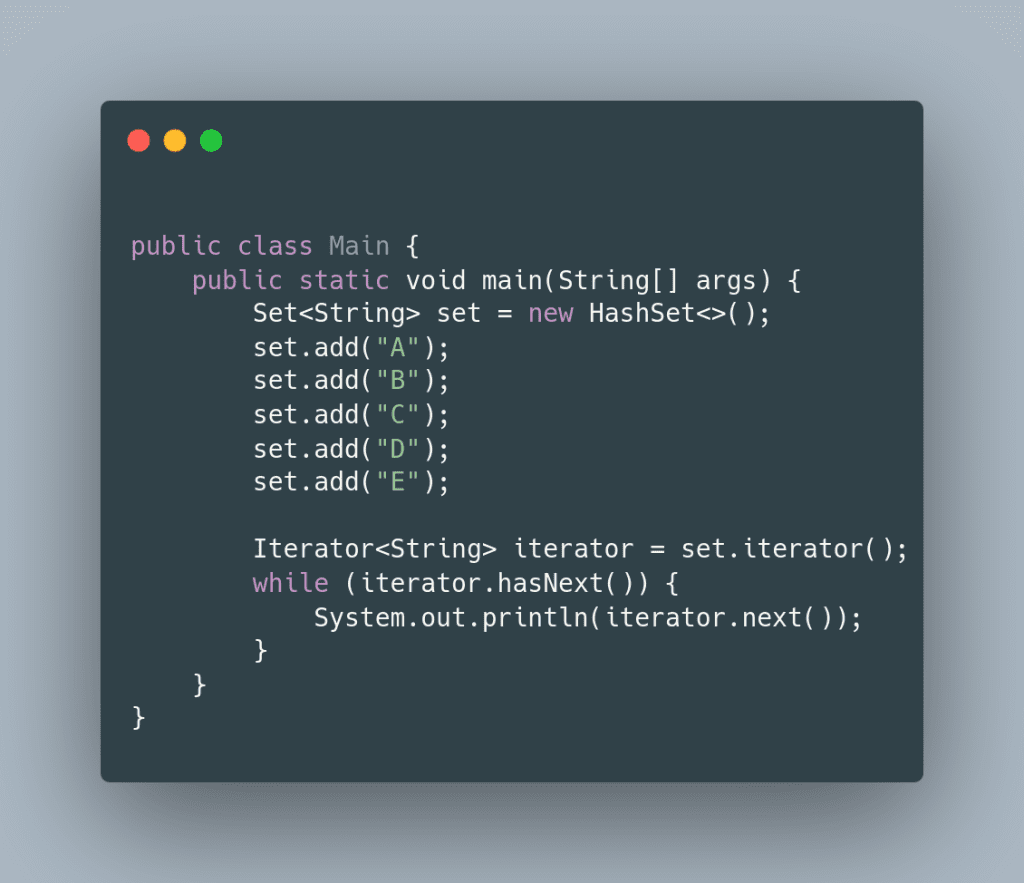
  • Ví dụ về việc duyệt qua các phần tử của một Set:
image 67 - quochung.cyou PTIT
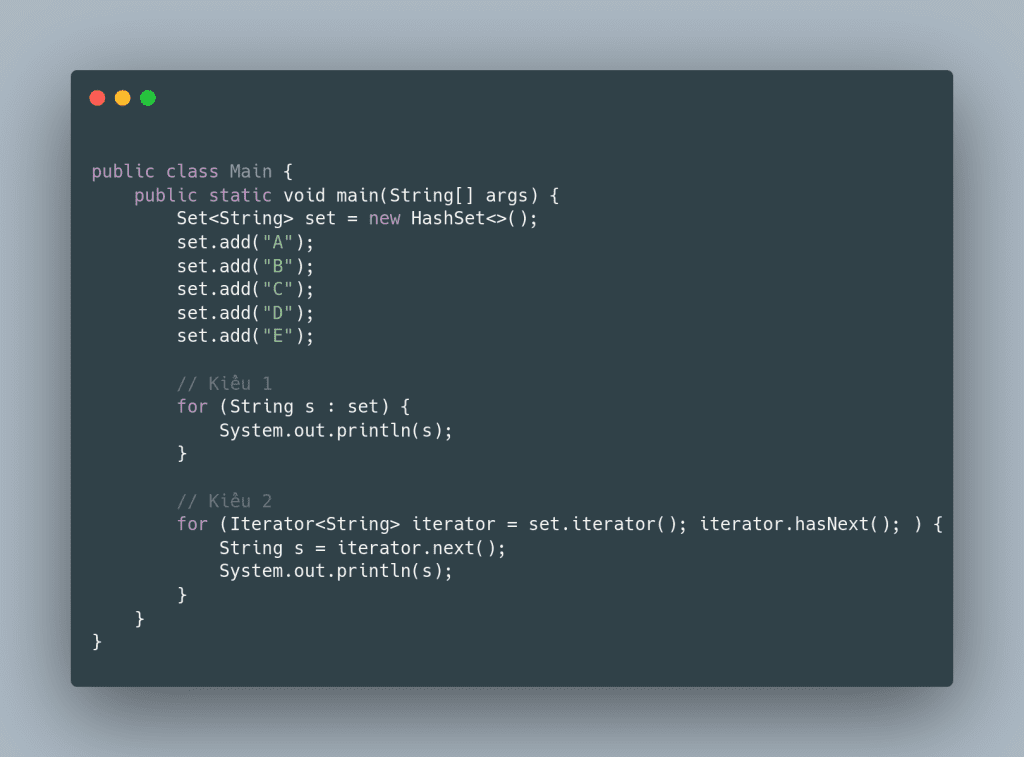
  • Hoặc là có thể duyệt bằng for-each, có 2 kiểu như sau:
image 68 - quochung.cyou PTIT

Định nghĩa một số cấu trúc dữ liệu trong Java

Set

  • Set: là một cấu trúc dữ liệu mà nó không chứa các phần tử trùng lặp. Các phần tử trong Set được sắp xếp theo thứ tự tùy vào cách implement của từng class. Các class implement Set có thể là HashSet, LinkedHashSet, TreeSet, …
    • HashSet: là một class implement Set, nó sử dụng một HashMap để lưu trữ các phần tử. Do đó, các phần tử trong HashSet sẽ không được sắp xếp theo thứ tự
    • LinkedHashSet: là một class implement Set, nó sử dụng một LinkedHashMap để lưu trữ các phần tử. Do đó, các phần tử trong LinkedHashSet sẽ được sắp xếp theo thứ tự.
    • TreeSet: là một class implement Set, nó sử dụng một TreeMap để lưu trữ các phần tử. Do đó, các phần tử trong TreeSet sẽ được sắp xếp theo thứ tự.

Độ phức tạp:

HashSetLinkedHashSetTreeSet
Cách thức làm việcHashSet sử dụng HashMap nội bộ để lưu trữ phần tử.LinkedHashSet sử dụng LinkedHashMap nội bộ để lưu trữ phần tử.TreeSet sử dụng TreeMap nội bộ để lưu trữ phần tử.
Thứ tự của các phần tửKhông duy trì thứ tự của các phần tử.Duy trì thứ tự chèn của các phần tử.Duy trì thứ tự theo bộ so sánh (hoặc tăng dần tự nhiên).
Hiệu suấtTốt hơn so với LinkedHashSet và TreeSet.Nằm giữa HashSet và TreeSet, hiệu suất gần như tương tự HashSet.Thấp hơn HashSet và LinkedHashSet do phải sắp xếp.
Thao tác thêm, xóa, truy xuấtO(1) cho chèn, loại bỏ, và truy xuất.O(1) cho chèn, loại bỏ, và truy xuất.O(log(n)) cho chèn, loại bỏ, và truy xuất.
So sánh các phần tửSử dụng equals() và hashCode() để so sánh và loại bỏ phần tử trùng lặp.Sử dụng equals() và hashCode() để so sánh và loại bỏ phần tử trùng lặp.Sử dụng compare() hoặc compareTo() để so sánh và loại bỏ phần tử trùng lặp. Không sử dụng equals() và hashCode().
Phần tử NullCho phép tối đa một phần tử null.Cho phép tối đa một phần tử null.Không cho phép phần tử null, nếu thử chèn sẽ ném NullPointerException.
Sử dụng bộ nhớĐòi hỏi ít bộ nhớ hơn so với LinkedHashSet và TreeSet.Yêu cầu bộ nhớ nhiều hơn HashSet do duy trì LinkedList cùng với HashMap.Yêu cầu bộ nhớ nhiều hơn HashSet do duy trì bộ so sánh và TreeMap.
Khi nào sử dụng?Muốn danh sách không chứa phần tử trùng và không cần duy trì thứ tự.Muốn danh sách không chứa phần tử trùng và muốn duy trì thứ tự chèn.Muốn danh sách không chứa phần tử trùng và muốn sắp xếp các phần tử.

Tóm gọn:

  • HashSet: không duy trì thứ tự, tốc độ nhanh
  • LinkedHashSet: duy trì thứ tự theo thứ tự chèn, tốc độ giữa
  • TreeSet: duy trì thứ tự theo bộ so sánh, tốc độ chậm hơn

Map

  • Là cấu trúc dữ liệu theo kiểu key-value, trong đó key là duy nhất, và value có thể trùng nhau. Các class implement Map có thể là HashMap, LinkedHashMap, TreeMap, …

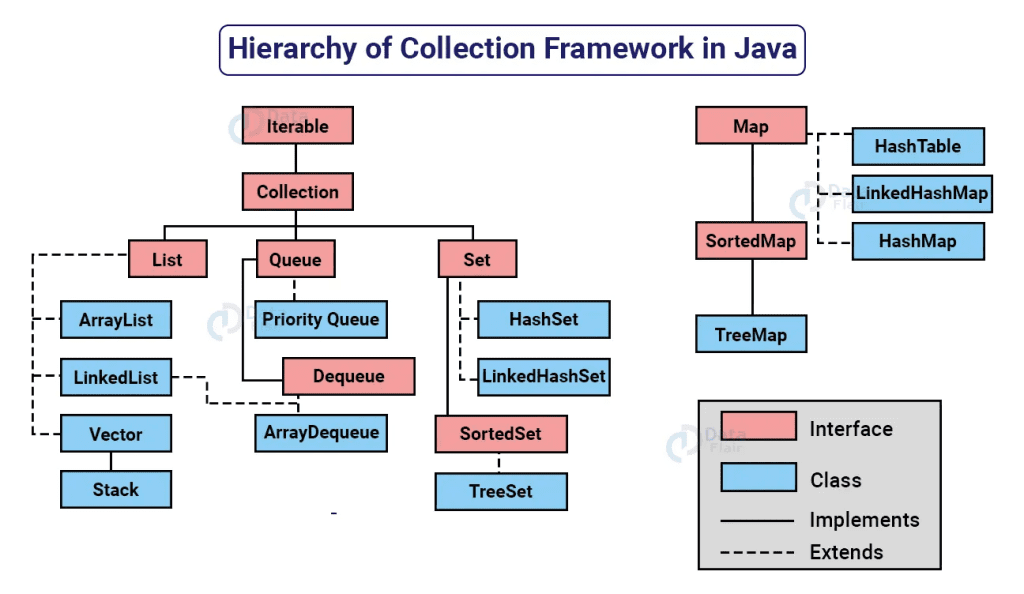
Sơ đồ kế thừa của các cấu trúc dữ liệu trong Java

image 69 - quochung.cyou PTIT
  • Theo hình trên, ta có 3 interface chủ đạo gồm List, Queue, Set sẽ kế thừa từ interface Collection. Từ interface Collection, chúng sẽ có các hàm chung như add, remove, contains, … và các hàm khác.
  • Lúc này, ở các class implement List, Queue, Set, chúng sẽ phải implement các hàm này, và tự triển khai logic cách để add, remove, contains, … như thế nào. Ngoài ra là triển khai các hàm từ interface Iterable, để có thể duyệt qua các phần tử của chúng, và các hàm từ riêng các interface List, Queue, Set, để có thể thực hiện các thao tác riêng của chúng.
  • Map thì là một trường phái khác, do chúng không kế thừa từ interface Collection, vì Map nhận vào 2 value. Do đó, để sử dụng được các hàm Collection trong Map, ta có thể lấy ra keySet, valueSet, entrySet của Map, và sử dụng các hàm Collection trên chúng.
image 70 - quochung.cyou PTIT

Về Comparable và Comparator, cách sử dụng trong các cấu trúc dữ liệu để sắp xếp

  • Trong Java, có 2 cách để sắp xếp các phần tử của một cấu trúc dữ liệu, đó là sử dụng Comparable và Comparator.
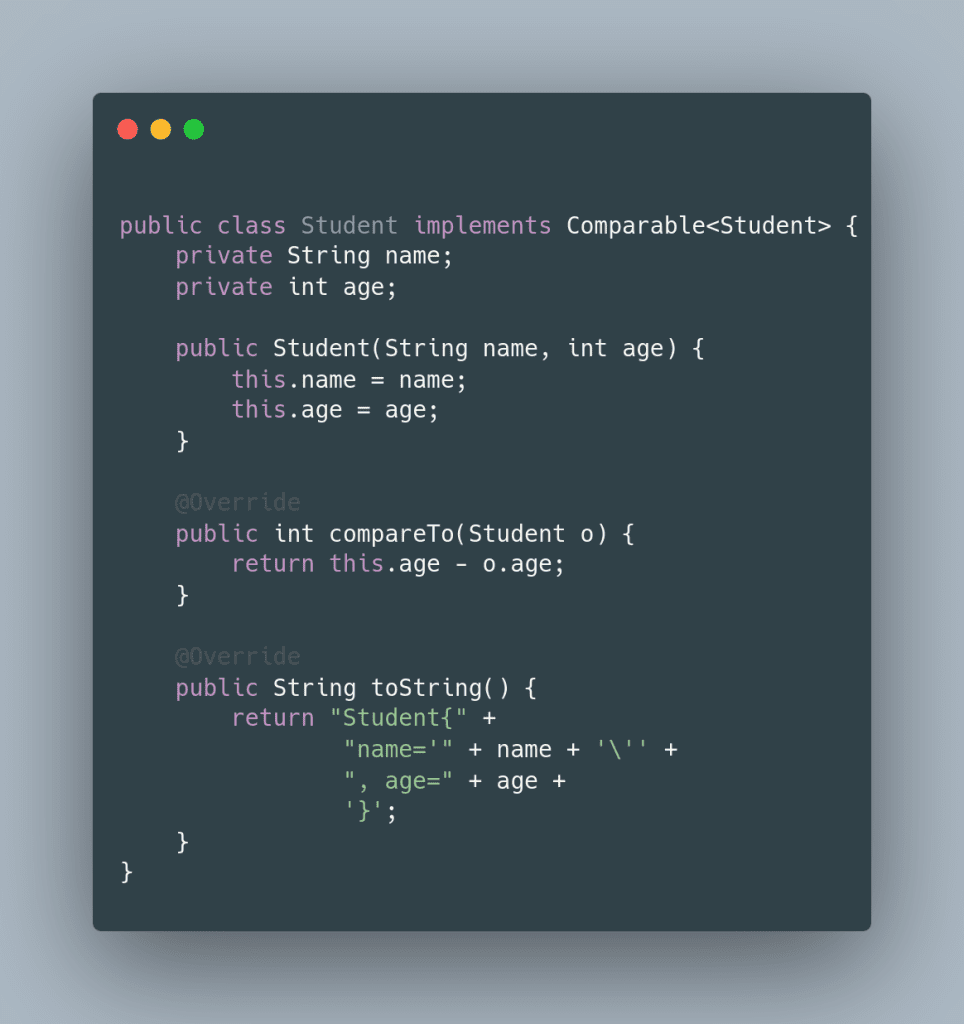
  • Comparable là một interface, nó có một hàm là compareTo(), và nó được implement bởi các class muốn sắp xếp các phần tử của chúng. Hàm compareTo() sẽ trả về một số nguyên, và nó sẽ được sử dụng để so sánh 2 phần tử của cấu trúc dữ liệu đó. Nếu trả về số âm, thì phần tử đầu tiên sẽ được đặt trước phần tử thứ hai, nếu trả về số dương, thì phần tử thứ hai sẽ được đặt trước phần tử đầu tiên, nếu trả về 0, thì 2 phần tử sẽ được đặt ngang hàng với nhau.

Code ví dụ:

image 71 - quochung.cyou PTIT
  • Như code trên, class Student implement interface Comparable, và phải triển khai cách để so sánh giữa 2 Student với nhau
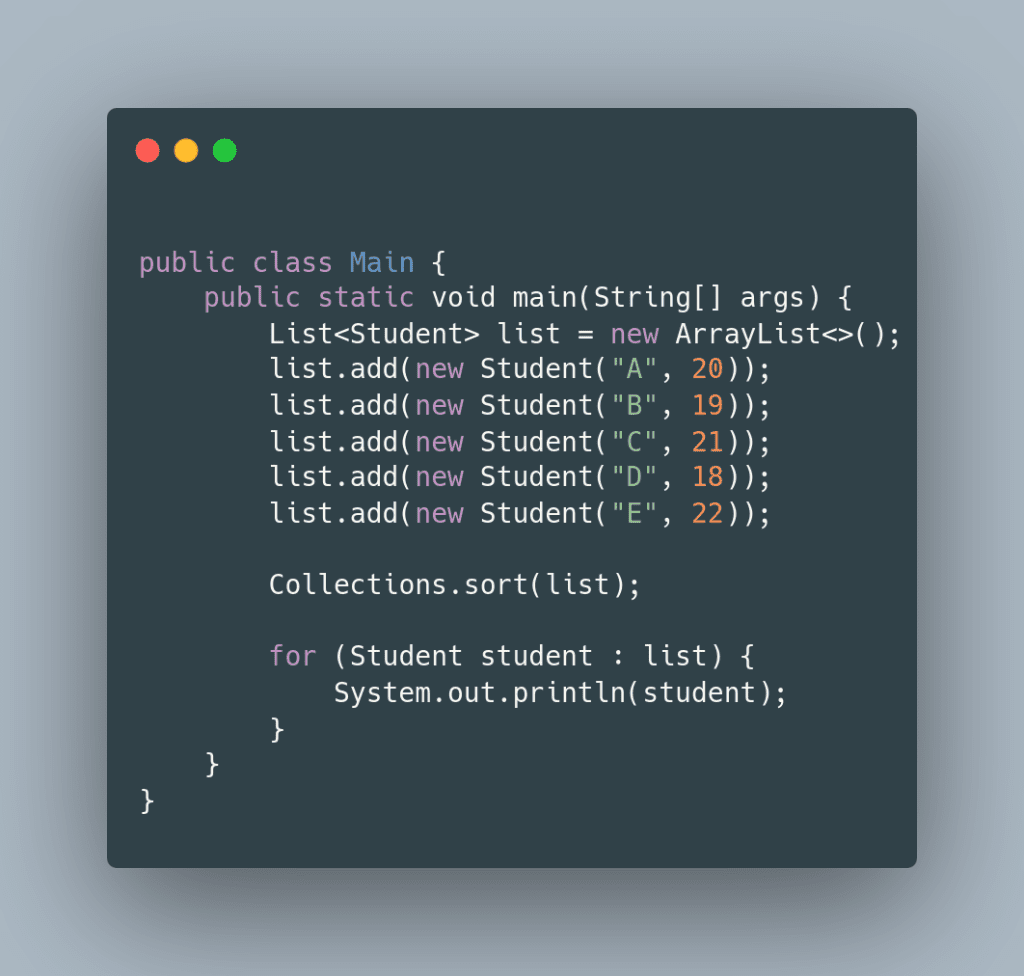
  • Để sử dụng so sánh, ta có thể sử dụng hàm sort() của class Collections để sắp xếp các phần tử của một List:
image 72 - quochung.cyou PTIT
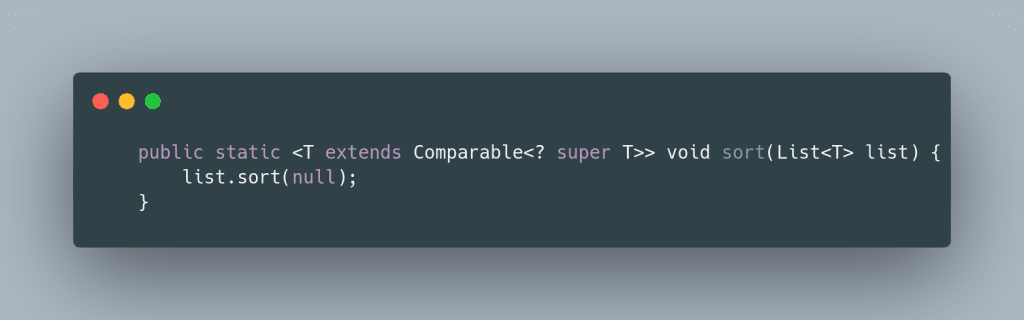
  • Code thực tế trong Collection, có thể Ctrl+Click vào để xem
image 73 - quochung.cyou PTIT
  • Như code trên, ta có thể thấy, hàm sort của Collections sẽ nhận vào một List, và List này phải chứa T là một class implement Comparable, và hàm sort sẽ sử dụng hàm compareTo của T để so sánh các phần tử của List với nhau.
  • Comparator là một interface, nó có một hàm là compare(), và nó được implement bởi các class muốn sắp xếp các phần tử của chúng. Hàm compare() sẽ trả về một số nguyên, và nó sẽ được sử dụng để so sánh 2 phần tử của cấu trúc dữ liệu đó. Nếu trả về số âm, thì phần tử đầu tiên sẽ được đặt trước phần tử thứ hai, nếu trả về số dương, thì phần tử thứ hai sẽ được đặt trước phần tử đầu tiên, nếu trả về 0, thì 2 phần tử sẽ được đặt ngang hàng với nhau.

Code ví dụ:

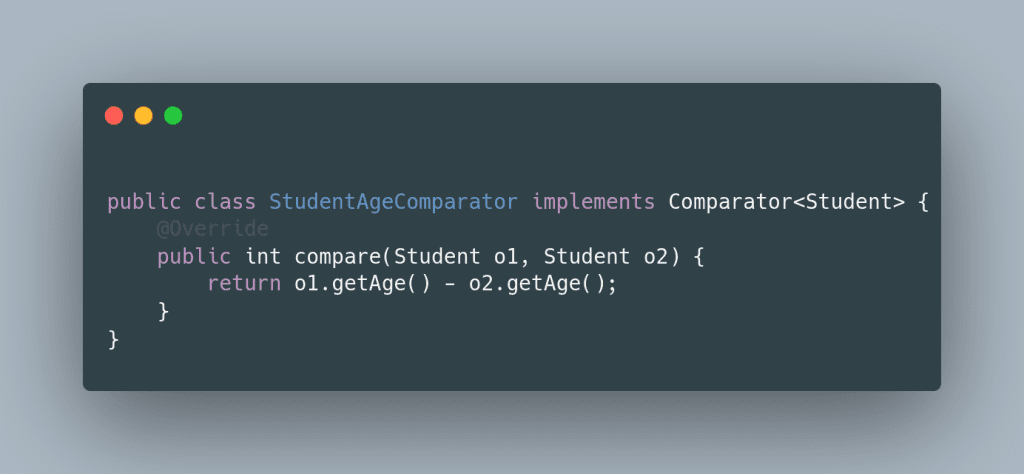
image 74 - quochung.cyou PTIT
image 75 - quochung.cyou PTIT
  • Như code trên, class StudentAgeComparator implement interface Comparator, và phải triển khai cách để so sánh giữa 2 Student với nhau
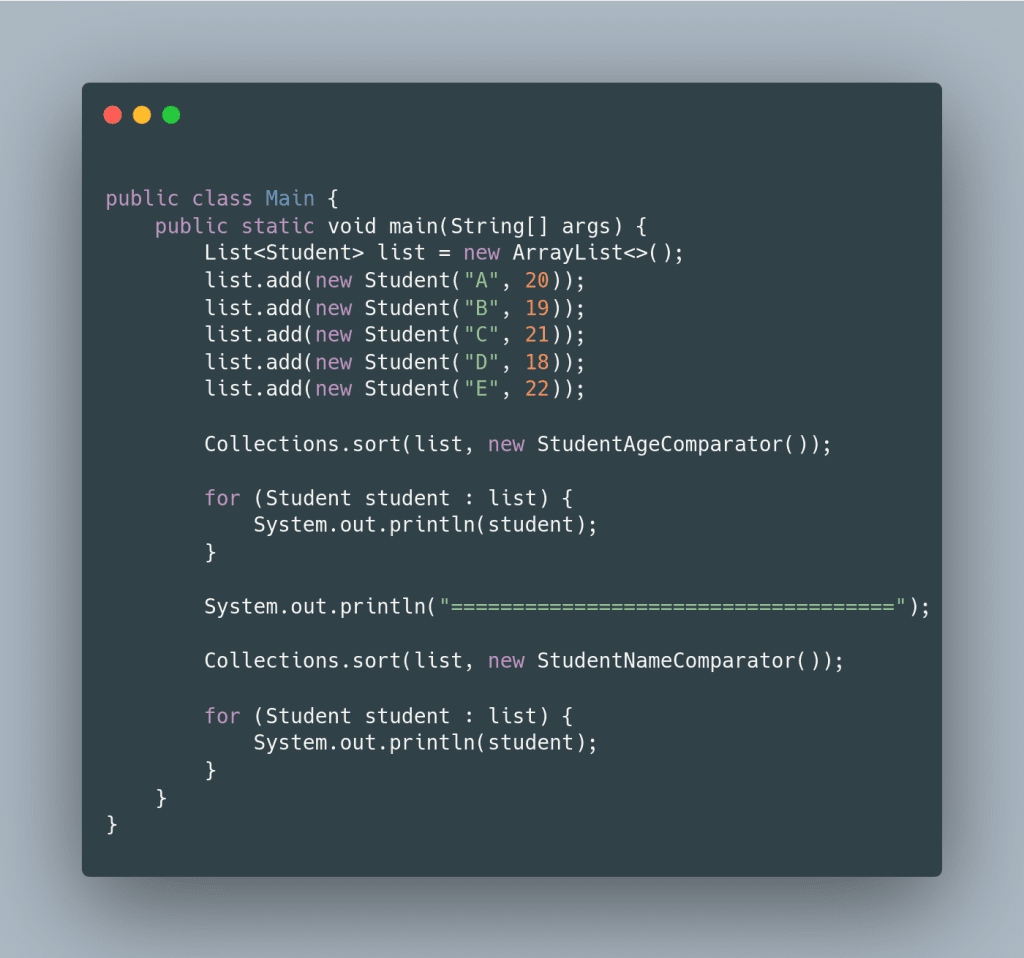
  • Để sử dụng so sánh, ta có thể sử dụng hàm sort() của class Collections để sắp xếp các phần tử của một List:
image 76 - quochung.cyou PTIT
  • Code thực tế trong Collection, có thể Ctrl+Click vào để xem
image 77 - quochung.cyou PTIT
  • Như code trên, ta có thể thấy, hàm sort của Collections sẽ nhận vào một List, và 1 Comparator, và hàm sort sẽ sử dụng hàm compare của Comparator để so sánh các phần tử của List với nhau.
  • So sánh Comparable và Comparator
ComparableComparator
Comparable là một interface, nó có một hàm là compareTo(), và nó được implement bởi các class muốn sắp xếp các phần tử của chúng.Comparator là một interface, nó có một hàm là compare(), và nó được implement bởi các class muốn sắp xếp các phần tử của chúng.
Comparable bắt buộc triển khai trong class mà ta muốn sort class đó, và chỉ chỉ khai được một cách duy nhất.Comparator không bắt buộc triển khai trong class mà ta muốn sort class đó, và có thể khai báo nhiều Comparator khác nhau, tuỳ vào mục đích sử dụng.
  • Ví dụ về việc sử dụng nhiều loại Comparator khác nhau:
image 78 - quochung.cyou PTIT
image 79 - quochung.cyou PTIT
  • Như code trên, ta có thể thấy, ta có thể sử dụng nhiều Comparator khác nhau, để sắp xếp các phần tử của List theo nhiều cách khác nhau.

[Java Core] B5: Tính chất trừu tượng, Interface và Abstract Class trong Java

This entry is part 5 of 8 in the series Java Core

Buổi 5: Interface và trừu tượng

  • Interface là gì?
  • Interface và Abstract class
  • Tính trừu tượng
  • Khi nào dùng interface, khi nào dùng abstract class?
  • Bài tập về interface và trừu tượng

Interface là gì?

  • Interface là một khái niệm trừu tượng, nó chỉ ra những gì mà một đối tượng có thể làm, nhưng không nói ra làm thế nào để đối tượng đó làm được điều đó.

Ví dụ cú pháp khai báo interface:

image 48 - quochung.cyou PTIT
  • Trong ví dụ trên, interface Animal chỉ ra rằng một Animal có thể làm được 2 việc là ăn và di chuyển, nhưng không nói ra làm thế nào để ăn và di chuyển.
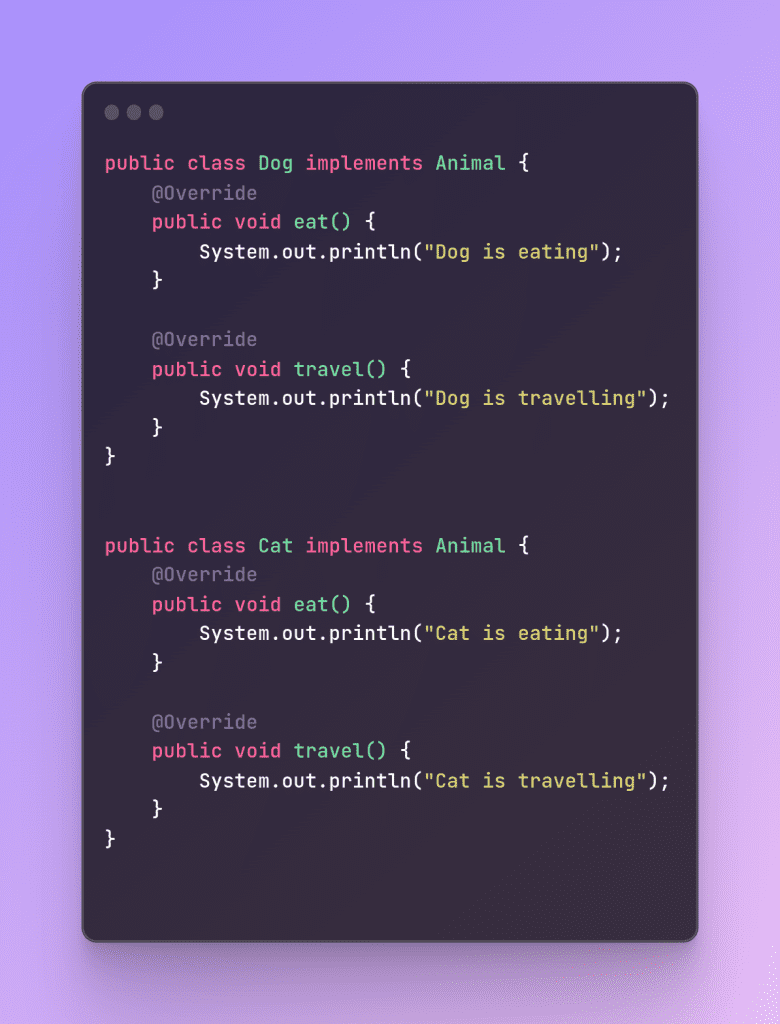
  • Lúc này, ví dụ ta có 1 class Dog và Cat thì ta có thể implement interface Animal vào 2 class này như sau:
image 50 - quochung.cyou PTIT
  • Lúc này, ta có thể khởi tạo 2 đối tượng Dog và Cat và gọi các phương thức eat() và travel() mà không cần quan tâm đến cách thức của 2 phương thức này.
image 51 - quochung.cyou PTIT
  • Kết quả khi chạy chương trình:

Dog is eating

Dog is travelling

Cat is eating

Cat is travelling

Take away | Tổng hợp

  • Như vậy, interface có thể nhìn nhận như 1 bản hợp đồng, tôi quy định trước, tôi chỉ định nghĩa là, các class implement interface này phải làm được những gì tôi quy định.
  • Như vậy, khi bên khác implement interface này, bên đó phải làm theo những gì mà interface quy định, nếu không làm theo, bên đó sẽ bị lỗi compile.
  • Còn nếu bên nào sử dụng interface, ta có thể khởi tạo đối tượng của class implement interface đó, và gọi các phương thức, và biết chắc phương thức tồn tại và có thể gọi được ở class đó, vì class đó đã implement interface đó.

Abstract class

  • Abstract Class – Lớp trừu tượng, là 1 lớp trong Java, nhưng có thể chứa cả các phương thức trừu tượng (abstract method) và các phương thức thường (non-abstract method).
  • Abstract Class không thể khởi tạo đối tượng, nhưng có thể khai báo biến kiểu Abstract Class, và khởi tạo đối tượng của class con của Abstract Class.

Ví dụ:

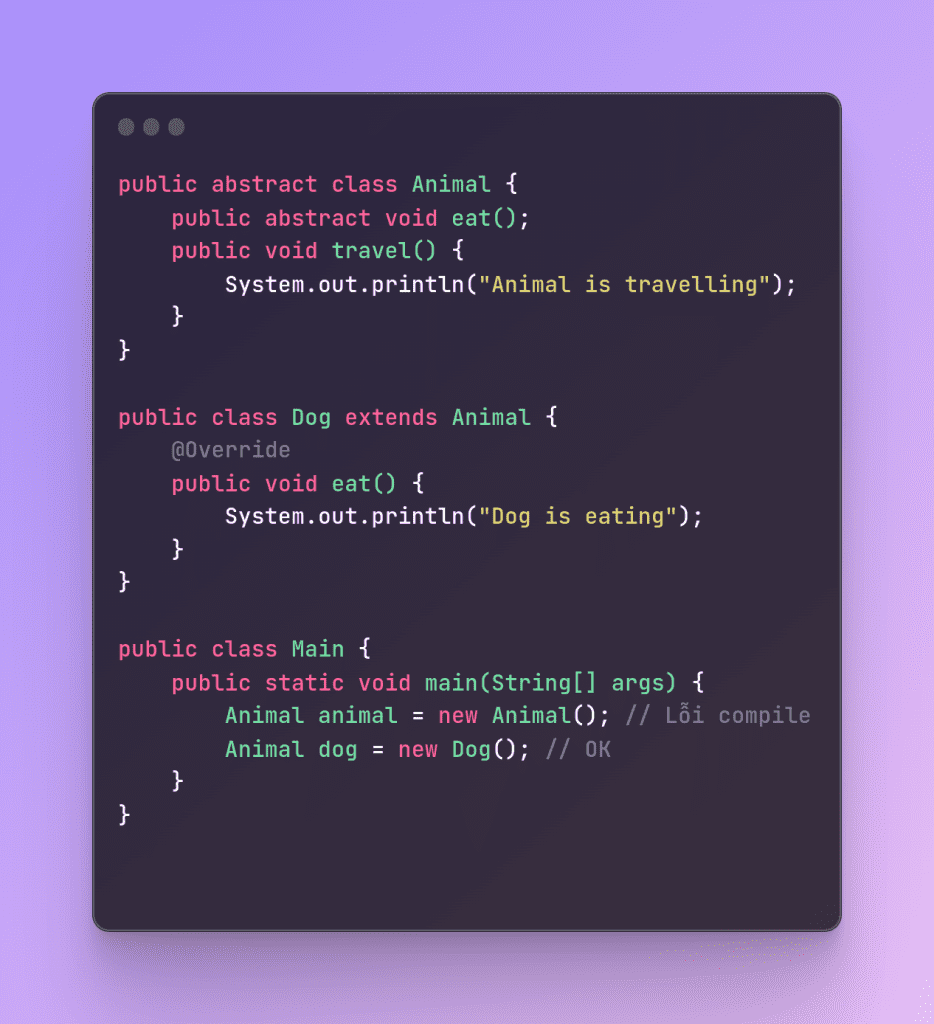
image 52 - quochung.cyou PTIT
  • Kết quả khi chạy chương trình:

Dog is eating

Animal is travelling

Cat is eating

Animal is travelling

Take away | Tổng hợp

  • Như vậy, Abstract Class nhìn chung giống Class, nhưng mà có thể tạo thêm phương thức trừu tượng, các class kế thừa từ Abstract Class này phải implement các phương thức trừu tượng này, nếu không sẽ bị lỗi compile.
  • Các phương thức trừu tượng này, có thể hiểu là các phương thức mà Abstract Class này quy định, các class kế thừa từ Abstract Class này phải có, và phải implement các phương thức này.
  • Các phương thức thường (non-abstract method) thì không cần implement, vì các class kế thừa từ Abstract Class này đã có sẵn các phương thức này.
  • Abstract Class thì không thể khởi tạo đối tượng, nhưng có thể khai báo biến kiểu Abstract Class, và khởi tạo đối tượng của class con của Abstract Class.

Ví dụ

image 53 - quochung.cyou PTIT
  • Lí do, vì abstract class hay interface chứa những hàm trừu tượng, những hàm chỉ định nghĩa, chưa có logic và giao việc triển khai logic cho các nơi ghi đè nó, nên không thể khởi tạo đối tượng từ abstract class hay interface được. (Vì nó chưa có logic, chưa có gì để chạy cả)

So sánh Interface và Abstract Class

InterfaceAbstract Class
Interface chỉ có thể chứa các phương thức trừu tượngAbstract Class có thể chứa cả các phương thức trừu tượng và các phương thức thường
Interface không thể khởi tạo đối tượngAbstract Class không thể khởi tạo đối tượng
Biến trong interface mặc định là public static finalBiến trong abstract class không có mặc định gì cả
Interface không có constructorAbstract Class có constructor
Interface không có gì để ghi đèAbstract Class có thể có các phương thức để ghi đè
Interface có thể kế thừa nhiều interface khácAbstract Class chỉ có thể kế thừa 1 abstract class khác
Các class implement interface có thể implement nhiều interface khácCác class kế thừa từ abstract class chỉ có thể kế thừa 1 abstract class khác
  • Note: Sau này interface có thể có các phương thức thường, nhưng mà vẫn không thể khởi tạo đối tượng từ interface được.
  • Về biến trong interface, mặc định là public static final, nên khi khai báo biến trong interface, không cần khai báo public static final nữa. Tức là các biến trong interface là tồn tại duy nhất, không đổi được, ở dạng static.
  • Về biến trong abstract class, không có mặc định gì cả, nên có thể tạo các “biến thường”, tức là mỗi object tạo ra bởi 1 class chứa giá trị khác nhau.

Special Question: Diamond Problem

  • Diamond Problem là gì?
  • Diamond Problem là một vấn đề xảy ra khi đa kế thừa, tức là nếu 1 class kế thừa từ 2 nơi có trùng thứ gì đó, thì nó làm sao biết nên dùng cái nào ???
  • Mặc định thì, Java không cho phép kế thừa từ 2 class, nhưng nếu kế thừa từ 2 interface thì được. (Vì interface chỉ chứa các phương thức trừu tượng, không có gì để ghi đè)
  • Ví dụ:
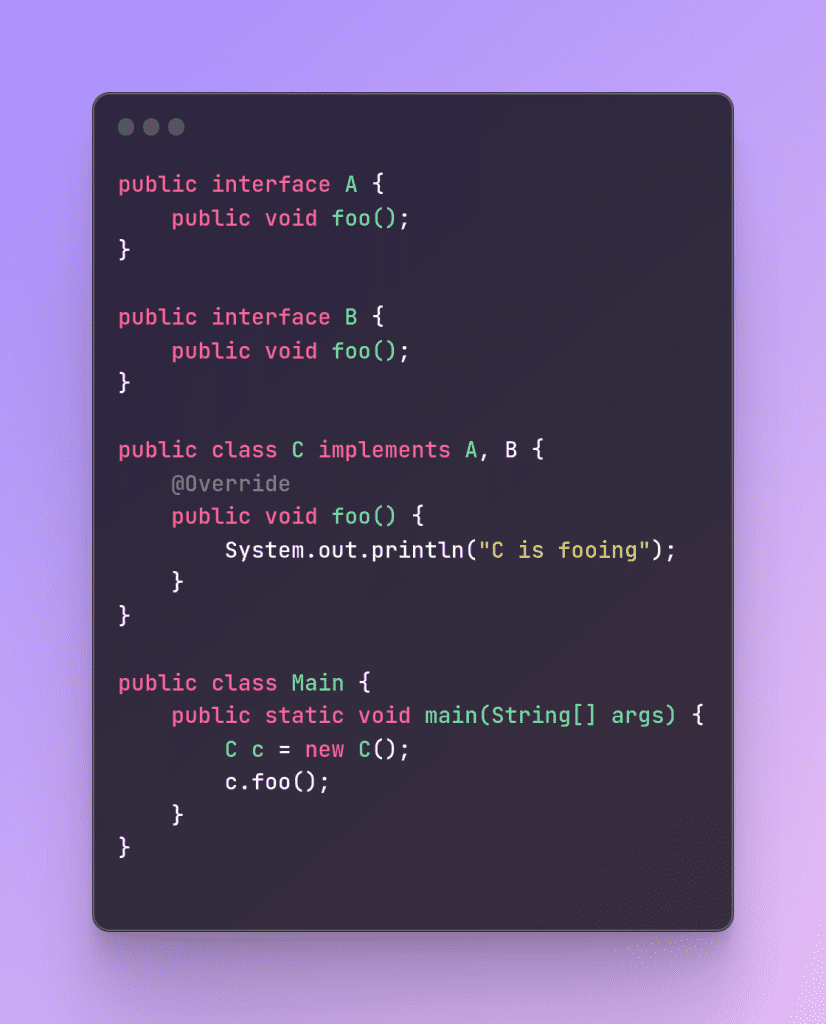
image 55 - quochung.cyou PTIT

Khi nào dùng interface, khi nào dùng abstract class?

  • Khi nào dùng interface, khi nào dùng abstract class?
  • Câu trả lời đơn giản: Khi nào cần thì dùng, tuỳ vào mục đích của mình
  • Nhưng mà, để hiểu rõ hơn, ta cùng xem ví dụ sau:
image 56 - quochung.cyou PTIT
  • Như vậy, ta có thể thấy, khi dùng interface, ta phải implement lại cả phương thức travel(), trong khi khi dùng abstract class, ta không cần implement lại phương thức travel().
  • Tuy nhiên, interface lại cho phép ta kế thừa nhiều interface khác, trong khi abstract class thì không.

Tổng kết

  • Có thể thấy, abstract class cho phép ta có các khả năng trừu tượng, và có thể chứa các logic có sẵn ta muốn dùng cho nhiều class con. Lúc này ta có thể cân nhắc sử dụng abstract class
  • Thay vì điều đó, interface thường được dùng để chỉ behavior - tính cách, cách xử sự của 1 đối tượng. Tức là 1 cái ô tô thì có thể xử lý các interface là ChayXe, ChayDongCo, ChayDien, ChayDau… Như vậy, interface thường được dùng để chỉ ra tính chất của 1 đối tượng, còn logic thì để class implement interface đó tự triển khai.
image 47 - quochung.cyou PTIT
  • Với abstract class, ta dùng cho những case ta có logic tập trung, có thể reuse ở class con. Vừa có khả năng trừu tượng mà các class con sẽ có đặc tính riêng. Tuy nhiên nếu class đó quá lớn, ví dụ class PhuongTien có đủ thứ hàm như ChayXe, ChayDongCo, ChayDien, ChayDau… , thì ví dụ XeDap kế thừa lại có các hàm chạy động cơ, chạy điện => Như thế bị thừa, không cần thiết, làm confuse cho người đọc code => Ta nên tách ra thành interface.
  • Với interface, ta dùng cho những case ta chỉ cần chỉ ra tính chất của 1 đối tượng, còn logic thì để class implement interface đó tự triển khai.

Tính trừu tượng

  • Tính trừu tượng là gì?
  • Tính trừu tượng là một khái niệm trong lập trình hướng đối tượng, nó cho phép ta chỉ ra những gì mà một đối tượng có thể làm, nhưng không nói ra làm thế nào để đối tượng đó làm được điều đó.
  • Tức là, khi ta dùng xe máy, ta chỉ biết là nó có thể chạy, có thể dừng, có thể bật đèn, có thể bật còi, nhưng ta không cần biết làm thế nào để nó chạy, dừng, bật đèn, bật còi.
  • Tính trừu tượng là một khái niệm quan trọng trong lập trình hướng đối tượng, nó cho phép ta tách biệt được phần logic của đối tượng và phần giao tiếp với đối tượng. Ta chỉ quan tâm đến phần giao tiếp với đối tượng, còn phần logic của đối tượng thì ta không cần quan tâm. Điều này giúp ta có thể dễ dàng thay đổi phần logic của đối tượng mà không ảnh hưởng đến phần giao tiếp với đối tượng.

Tại sao cần sử dụng interface

  • Giả sử, ta có 1 interface là “Athlete” – Vận động viên với 2 hàm là play() – là chơi thể thao nào đó
image 45 - quochung.cyou PTIT
image 46 - quochung.cyou PTIT
  • Giả sử, ta có 1 class Team – 1 đội chơi, sẽ có thể thêm vận động viên vào, ta nhận thấy, nếu có thể, ta luôn lên sử dụng interface thay vì khai báo thẳng 1 class cụ thể, vì khi đó, ta có thể thêm bất cứ vận động viên nào vào đội chơi, miễn là vận động viên đó implement interface Athlete.
image 57 - quochung.cyou PTIT
  • Như code trên, bất kì vận động viên nào implement interface Athlete đều có thể thêm vào đội chơi, và có thể chơi được. Điều này giúp code dễ mở rộng, flexible hơn, sau này ta có thể thêm bất cứ vận động viên nào vào đội chơi, miễn là vận động viên đó implement interface Athlete.

Đây cũng được biết là quy tắc prefer interface over class hay prefer composition over inheritance

Interface làm đúng sự phụ thuộc của module level cao

  • Giả sử, ta có class DienThoai, khi này khi ta muốn sạc điện thoại, ta sẽ gọi 1 class bên trong DienThoai là sạc điện bằng củ sạc Samsung
image 58 - quochung.cyou PTIT
  • Ta thấy, với thiết kế hiện tại, ta sẽ truyền tham số là cường độ vào củ sạc Samsung để class đó thực hiện sạc.
  • Tuy nhiên, bất kì sự thay đổi nào ở class CuSac vào phương thức sac có thể yêu cầu class điện thoại truyền thêm tham số, hay phải dùng tên hàm khác, …
  • Điều này là không đúng, điện thoại rõ ràng là module cấp cao hơn, và nên có quyền quyết định dùng củ sạc nào, chứ không phải củ sạc quyết định điện thoại phải làm gì để dùng.
  • Vì vậy, ta nên tạo ra 1 interface là CuSac để điện thoại có thể sạc, và class CuSacSamSung implement interface CuSac này.
image 59 - quochung.cyou PTIT
  • Lúc này, sự phụ thuộc đã thay đổi. Giờ DienThoai chỉ sử dụng interface củ sạc, ví dụ như Iphone quy định là tôi dùng cổng lightning, máy Samsung bảo tôi dùng cổng sạc USB-C vậy. Các nhà sản xuất củ sạc phải đi theo họ.
  • Thì ở đây, DienThoai dùng interface để định nghĩa là tôi sẽ muốn sạc như thế nào. Còn củ sạc thì implement interface đó, và tự triển khai logic riêng của mình, nhưng phải tuân thủ theo hợp đồng interface mà DienThoai sử dụng