JPA là gì? Phân biệt và làm rõ Hibernate, Spring Data JPA, JDBC, ORM

Sơ lược định nghĩa JPA

image 12 - quochung.cyou PTIT
  • JPA, hay còn được gọi là Java Persistence API. Sau này được đổi tên thành Jakarta Persistence API
  • JPA giải quyết các vấn đề trong quản lý quan hệ giữa các thực thể, giúp chúng ta map những object Java (POJO – Plain Old Java OBject) thành những bảng trong database, đây là persistence frameworks được sử dụng nhiều nhất trong Java
  • Để hiểu sâu thêm, hãy đi thêm vào 1 số định nghĩa liên quan

Persistence là gì?

image 13 - quochung.cyou PTIT
  • Java Persistence API, Java là tên ngôn ngữ, API ám chỉ rằng đây là một framework cung cấp các api, các logic mà ta dễ dàng sử dụng lại giúp tăng tốc độ phát triển ứng dụng
  • Vậy Persistence là gì?
  • Hầu hết toàn bộ các ứng dụng yêu cầu ta cần có persistent data (dữ liệu lâu dài). Persistence là một trong những concept nền tảng trong công nghệ phần mềm. Gần như toàn bộ hệ thống thông tin đều cần lưu trữ những dữ liệu nào đó cho hệ thống. Object persistence nghĩa là các thực thể có thể “sống lâu” hơn các chương trình, có thể lưu trữ trong các nơi quản lý dữ liệu và có thể khởi tạo lại trong chương trình vào thời điểm nào đó.
  • Ví dụ đơn giản, trong một web mua bán thương mại điện tử chẳng hạn, dữ liệu trong hệ thống thường là các thông tin về sản phẩm, giá bán, nơi bán, … những dữ liệu này luôn được lưu trữ, kể cả web có thể là bị đóng vài phút, nâng cấp lên, … những dữ liệu này luôn “sống lâu” hơn các chương trình code
  • Khi nói về persistence trong Java, ta thường nói về việc map và lưu trữ các thực thể trong database bằng SQL

Làm việc với cơ sở dữ liệu quan hệ bằng Java qua SQL

  • Khi làm việc với các database trong ứng dụng Java, hiểu đơn giản thì ta sẽ ra 1 câu lệnh SQL vào database bằng cách nào đó với Java chứ ta không cần viết chay truy vấn vào thẳng cơ sở dữ liệu nữa.
  • Ban đầu, ta có JDBC (Java Database Connectivity API) hỗ trợ việc ra các câu lệnh SQL vào một cơ sở dữ liệu. Ta sẽ thực hiện câu lệnh truy vấn, nhận được dữ liệu trả về, sau đó xào nấu nó, …
  • Tuy nhiên các công việc này nhìn chung khá gần theo hướng dữ liệu, data, chứ không có quá nhiều về phần mềm Java. Chúng ta thường muốn có cách nào đó để lấy dữ liệu nhanh từ database, và không phải làm các công việc lặp lại này.
  • Các câu lệnh truy vấn đa phần thường dễ bị lặp lại. Giả sử bạn có 1 hệ thống quản lý sinh viên, môn học, lớp học, giáo viên, … Như thông thường, ta phải viết câu lệnh sql để lấy toàn bộ sinh viên, lấy thông tin 1 sinh viên theo tên, theo tuổi, thêm 1 sinh viên, xoá 1 sinh viên, …. mọi thứ thủ công. Rồi làm y vậy với các đối tượng giáo viên, lớp học, …. Nhìn chung các task này lặp đi lặp lại và tốn thời gian, công sức, chưa tính đến nhiều vấn đề bảo mật, viết sai bug khi viết sql chay như vậy.
  • Hiển nhiên, 1 số thời điểm ta vẫn cần viết sql để custom theo ý mình cho các vấn đề hiệu năng, tuỳ biến, …. nhưng nếu có cách nào đó để giảm thiểu các công việc làm việc với database hơn.
image 14 - quochung.cyou PTIT

ORM

image 15 - quochung.cyou PTIT
  • Ngắn gọn thì, object relational mapping (ORM) là một cách để tự động, đóng gói để map qua lại giữa các dữ liệu database và các class trong Java. Tức là một cái ở giữa để chuyển hoá giữa 1 table lưu thông tin SinhVien với 1 class SinhVien trong java chẳng hạn.

JPA, Hibernate, Spring Data là gì

JPA là gì

  • Lúc này JPA như đã định nghĩa cơ bản bên trên, JPA sẽ là một bản vẽ, định nghĩa ta phải làm gì để lưu trữ và làm việc với object như 1 ORM bên trên, bao gồm việc lấy dữ liệu object từ 1 database, rồi biến nó thành 1 object được tạo ra từ 1 class Java chẳng hạn.
  • Hibernate sẽ là một tầng bên trên, triển khai từ JPA, định nghĩa logic code thực sự là sẽ triển khai như thế nào.
image 16 - quochung.cyou PTIT
  • Có thể ví dụ đơn giản. JPA sẽ chứa rất nhiều hàm là để làm việc thì ta sẽ cần có các hàm lấy dữ liệu theo trường nào đó, tìm dữ liệu theo trường nào đó (select + filter sql), xoá 1 row trong database, …

Hibernate là gì

  • Hibernate là 1 JPA Provider, tức là một Provider, một cái triển khai “JPA”
  • Hibernate sẽ implement interface đó, và là cái có code logic triển khai các hàm trên, tự động sinh ra các câu lệnh sql theo nhu cầu. Tức là ta chỉ cần gọi hàm getAllByName() gì đó, hibernate sẽ tự sinh truy vấn sql, chạy xuống JDBC rồi database để làm việc, ta không cần tự viết sql query đó nữa. Ngoài ra, sau khi lấy dữ liệu xong, nó sẽ tự map dữ liệu database thành các object Java luôn để làm việc.
image 17 - quochung.cyou PTIT
  • Ngoài ra Hibernate còn có nhiều chức năng như đảm bảo phiên trong database, session, ….

Spring Data JPA

image 19 - quochung.cyou PTIT
  • Spring Data JPA là 1 tầng bên trên nữa triển khai Hibernate, có những chức năng cùng framework Spring, cho phép mở ra nhiều khả năng hơn nữa như từ việc đặt tên hàm có thể tạo được các query phức tạp, …
  • Chính xác thì Spring Data JPA có thể chạy với các “JPA Provider” khác nhau, tức là một số khác nào triển khai lại JPA có thể dùng với Spring Data JPA
image 18 - quochung.cyou PTIT

Tổng kết

JPA định nghĩa các phần sau

  • Một phương tiện chỉ định việc ánh xạ, map giữa các dữ liệu persistent trong database và thông tin của nó với các class trong Java. JPA sử dụng rất nhiều Java annotations để làm việc này, ngoài ra ta có thể viết nó trong file XML (thêm minh hoạ bên dưới)
  • API để thực hiện các thao tác CRUD cơ bản với các class java và có thể gọi xuống database để làm việc tương tự. (CRUD – Create/Tạo, Read/Đọc, Update/Cập nhật, Delete/Xoá)
  • Thực hiện các thao tác transaction, có thể lấy dữ liệu theo association (ví dụ 1 sinh viên có nhiều môn học, có thể hiểu việc đó và khi lấy 1 sinh viên sẽ lấy luôn các môn học), thêm 1 số tính năng tối ưu khác, các chiến lược cache, …

Hibernate triển khai JPA và làm các công việc sau

  • Hiệu suất – Giảm thiểu nhiều công việc lặp đi lặp lại để query dữ liệu, giúp ta có thêm thời gian tập trung vào code logic bên trên hơn
  • Bảo trì – Do tự động mapping (ORM) của hibernate, giúp giảm thiểu số lượng code, giúp hệ thống dễ hiểu hơn, dễ bảo trì hơn.
  • Hiệu năng – Nhìn chung thì việc tự viết sql trong các case đặc biệt giúp ta dễ control và có performance mong muốn hơn, tuy nhiên trong một số tác vụ thường thấy, hibernate giúp hiệu năng tốt hơn, tự động, hỗ trợ các cơ chế caching ở tầng ứng dụng
  • Độc lập – Hibernate có thể làm việc với Postgres, MySQL …. mà không phụ thuộc vào 1 nền tảng hay sql của nền tảng đó
Kiến trúc Stateful và Stateless là gì?

image 45 - quochung.cyou PTIT

Lời mở đầu

  • Trong khoa học máy tính, “state” nghĩa là một trạng thái của hệ thống, của một thành phần hoặc ứng dụng của chúng ta tại một điểm thời gian
  • Ví dụ: Bạn đang mua hàng trong amazon.com, ta có thể coi việc bạn “đang đăng nhập” là một trạng thái, “đang có hàng trong giỏ” là một trạng thái, ….
  • Trạng thái biểu diễn dữ liệu đang được lưu trữ, và giúp chúng ta kiểm soát hiện trạng hiện tại của ứng dụng.

Kiến trúc Stateful

  • Tưởng tượng bạn đến một cửa hàng pizza để ăn. Hiện tại quán chỉ có 1 phục vụ bàn, phục vụ bàn sẽ lấy các note từ bàn của bạn, bạn order gì, hay là những món bạn trước đây từng ăn, bạn có dị ứng gì không, …
image 46 - quochung.cyou PTIT
  • Tất cả những thông tin trên sẽ được phục vụ bàn ghi lại về một “state” hay trạng thái của khách hàng. Chỉ có phục vụ bàn có những thông tin này, nếu bạn dạo này thích ăn món gì đó khác hơn, hoặc bị dị ứng gì đó mới, bạn cần cập nhật đúng với phục vụ này để thay đổi. Nhưng mà cả quán chỉ có 1 phục vụ nên bạn không lo nhầm người.
  • Tưởng tượng rằng, quán ăn có đông khách hơn, và phục vụ phải phục vụ rất nhiều khach. Quán cần nhiều phục vụ hơn, tuy nhiên lúc này, nếu bạn muốn đổi khẩu vị hay món khác, thì nếu bạn chọn người phục vụ khác sẽ không được.
image 47 - quochung.cyou PTIT
  • Những nhân viên phục vụ khác thì chẳng có thông tin gì về state của bạn cả. Họ không thể đổi đơn hàng của bạn, hay đọc chúng. Nếu một nhà hàng hoạt động theo kiểu như vậy, tức là chỉ 1 phục vụ có thông tin của bạn, sẽ được gọi là cấu trúc stateful
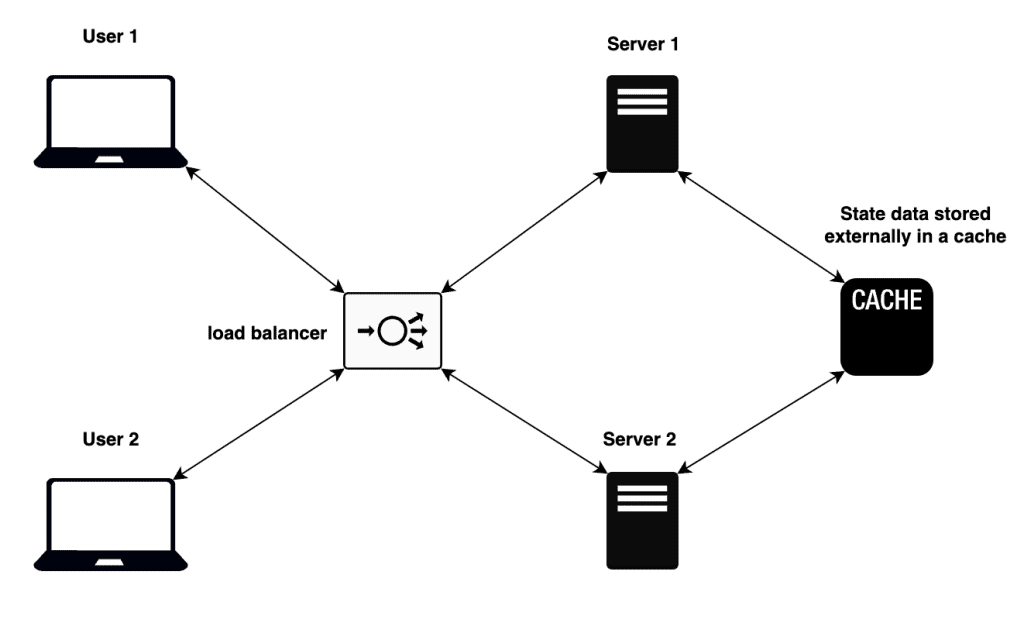
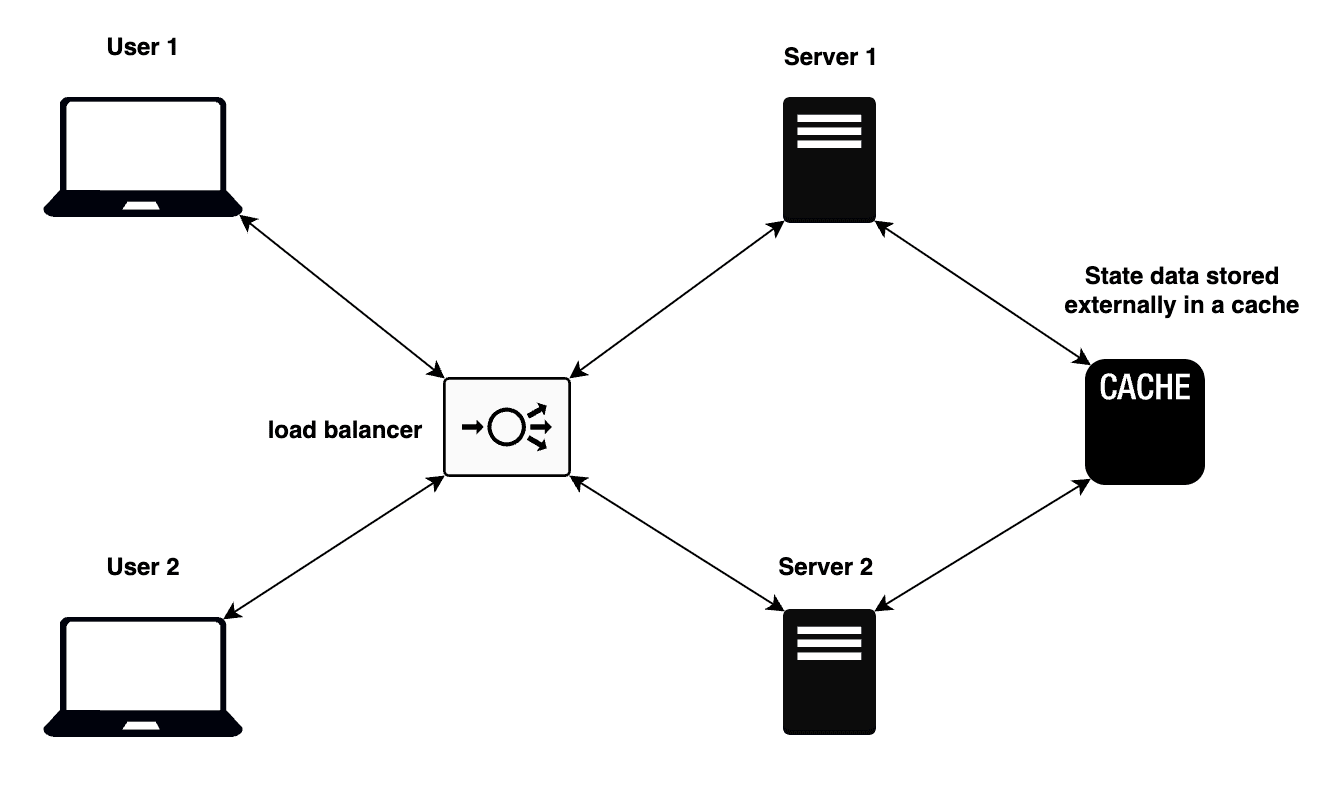
  • Tưởng tượng về dạng server, một hệ thống stateful sẽ chỉ có 1 server duy nhất ghi nhớ dữ liệu của người dùng. Toàn bộ các request, làm việc sau này của 1 khách hàng sẽ chỉ được điều hướng vào người đó qua các trình load balancer (cân bằng tải) với 1 sticky session. Một server sẽ luôn biết client của mình là ai.
image 48 - quochung.cyou PTIT

  • Sticky session (phiên được ghim) là một cài đặt cho phép cân bằng tải (load balancer) điều hướng các request của người dùng đến riêng 1 server duy nhất trong quá trình 1 phiên của họ. (1 phiên có thể kết thúc khi người dùng tắt browser, tắt máy, sau 1 ngày, …)
  • Điều này đi ngược lại với cách cân bằn gtari truyền thống, khi mà request của bạn được phân bổ đến các server khác nhau bằng round-robin hoặc các cách phân bổ khác. (kiểu phân bổ dần 1->2->3->4 rồi lại quay về 1 theo thứ tự request, hoặc phân bổ random, …)
  • Cách làm trên nghe có vẻ khá ổn với các hệ thống nhỏ. Tuy nhiên, thế giới chúng ta không lý tưởng. Giả sử, nếu 1 server bị chết, bị dồn quá tải, … thì toàn bộ thông tin của người dùng với server đó sẽ mất hết, điều này hoàn toàn không ổn chút nào.
  • Hơn nữa, việc phân bổ dữ liệu như vậy cũng không tốt trong nhiều trường hợp. Ví dụ, có một số client gửi rất nhiều request, khiến cho 1 server bị quá tải, trong khi vài server khác lại chỉ có vài request nhỏ, khiến việc cân bằng chung không ổn.

Kiến trúc Stateless

  • Kiến trúc stateless, dịch thuần tiếng anh là (không có state). Không hẳn là không có state, mà lúc này các server – hay vị phục vụ bàn sẽ không trực tiếp nhớ xem là khách hàng order gì, thông tin như nào, mà thay vì đó, họ sẽ dùng một phần mềm gì đó, một điện thoại, một tờ giấy chung để ghi thông tin khách hàng. Khi đó, nếu phục vụ khác đến, họ chỉ cần đọc tờ giấy lưu trữ chung để xem khách hàng muốn gì.
image 49 - quochung.cyou PTIT
  • Bằng việc lưu các trạng thái của khách hàng ở một hệ thống chung nào đó, có thể truy cập bởi mọi phục vụ/server, server nào cũng có thể phục vụ chung 1 khách hàng.
  • Nhìn về khoa học máy tính, lúc này ta có thể phân bổ request của người dùng đến server bất kì, việc dữ liệu của người dùng có thể lưu ở 1 database nào đó khác biệt, có thể truy cập bằng mọi server.
  • Việc cân bằng tải cũng tốt hơn, vì lúc này ta có thể chọn các server sđang ít khách phục vụ, hoặc đánh theo tuần tự, …
image 50 - quochung.cyou PTIT

Tổng kết

  • Nhìn chung, stateless mang lại tính mở rộng lâu dài và ổn định tốt hơn stateful
  • Stateless/stateful không chỉ là cách thiết kế server, cân bằng tải như ví dụ trên. Mà có thể áp dụng vào các design pattern, các hàm trong code, ….

Tham khảo:

Dependency Inversion là gì, biến N-Layered thành DDD

N-Layered

Bất kì mô hình hệ thống nào đều nhắm đến giúp code của bạn được tổ chức tốt hơn, đẹp hơn. Khi mà nhu cầu của người dùng ngày càng cao, độ phức tạp của hệ thống càng gia tăng, mô hình hệ thống của bạn cũng cần phải bắt kịp chúng. Với một số dự án nhỏ, có thể bạn chỉ cần thêm thẳng code vào controller, tuy nhiên, ở các hệ thống lớn hơn bạn sẽ cần một số cách tiếp cận hợp lí hơn.

Đa số hệ thống chỉ cần cấu trúc N-Layered (N tầng) với 3 tầng cơ bản:

  • User Interface (UI) — chịu trách nhiệm tương tác với người dùng (giao diện)
  • Business logic layer (BLL)— Xử lí các logic chính của hệ thống
  • Data Access layer (DAL) — Là tầng giao tiếp với dữ liệu như database, …
1 pd5bfxtxV9AK0 QlIOK6Vw - quochung.cyou PTIT

VỚi một hệ thống như vậy, đa số vấn đề của bạn sẽ giải quyết theo 1 chiều thông thường. Các tầng sẽ phụ thuộc trực tiếp vào nhau, sau đó gọi dần xuống tầng bên dưới.

image 9 - quochung.cyou PTIT

Ví dụ một luồng:

  • User click vào 1 nút trên tầng UI của website. Tầng UI sau đó gọi 1 API vào Bussiness Logic, bussiness logic gọi xuống Data Access để lấy dữ liệu bài viết ở database, sau đó ở bussiness logic sẽ xử lí dữ liệu đó (format, thêm thắt ngày tháng, ….), rồi cuối cùng trả về tầng trên cùng UI.

Tuy rằng kiến trúc N-Layered giúp ta xử lí đa số vấn đề, giúp code gọn hơn, clean hơn, tổ chức các chức năng liên quan thành nhiều layer khác nhau, dễ cài đặt, nhưng chúng cũng có một số vấn đề:

  • Khi hệ thống lớn dần, thường các logic sẽ được xử lí ở tầng Data Access (database), chứ không phải ở Business Logic. Điều này khiến lập trình viên thường tập trung vào tầng db hơn là tầng logic chính.
  • Tầng Data Access dần làm mọi việc, khó để thay đổi, vì các tầng trên đều nhảy vào nó.
  • Các tầng liên kết với nhau chặt chẽ, và vài thay đổi ở tầng Data Access sẽ làm hỏng các phần khác.

Ví dụ: Sau khi code nhiều ngày đêm, bạn gửi sản phẩm là một trang đọc báo cho khách hàng. Trang đọc báo này có cơ chế như sau:

  • Tầng UI: Hiển thị một bài viết
  • Business Logic: Gọi xuống database lấy dữ liệu các bài viết
  • Data Access: Làm việc với database, lấy các dữ liệu bài viết ra từ một database MySQL chẳng hạn.

Tầng Business Logic chứa các hàm:

  • layBaiViet() -> dataAccess.layBaiVietDb()

Tầng Data Access sẽ chứa hàm bên trên, nơi Business gọi xuống, và thực hiện các tác vụ, vì lúc này các model, object đang nằm ở tầng Data, chứ không ở tầng Business:

  • layBaiVietDb() -> locBaiViet() -> suaNgayThang() -> ….

Do các model, entity ta làm việc với db đều chứa hết ở tầng này, nên ta cần xử lí các hàm ở tầng Data Access. Và kể cả có chuyển các hàm này lên tầng bên trên, thì nhìn chung các Model đều vẫn chứa ở Data Access. Chỉ cần mình thay đổi ví dụ Model ở Data Access một hàm mới, bên trên đều phải thay đổi.

Tưởng tượng lúc này, một ngày đẹp trời, khách hàng của bạn muốn chuyển DB sang MongoDB chẳng hạn, hoặc chuyển sang abcxyz gì đó. Lúc này bạn lại phải sửa hết code ở tầng Data Access cho hợp DB mới, và việc sửa ở đây cũng dẫn đến sửa các tầng bên trên

DDD – Domain Driven Design

Mô hình trên cho rằng, ta nên tập trung vào phần Business, hay còn gọi là Domain là phần core, cốt lõi của hệ thống hơn, thay vì Data Access. Data Access chỉ nên tập trung vào lấy dữ liệu, cập nhật dữ liệu, …. , còn xử lí logic nên nằm ở Domain. Tuy nhiên, với cấu trúc như thông thường khi mà chiều phụ thuộc, gọi xuống đang đi từ trên xuống dưới, ta buộc phải dồn logic xuống dưới cùng. Lúc này, ta có một kĩ thuật mới (Dependency Inversion – Đảo chiều sự phụ thuộc) , đây cũng là chữ cái “D” trong S.O.L.I.D

image 10 - quochung.cyou PTIT

Điều gì đã thay đổi ? Ta vẫn giữ những cấu trúc tầng, cho phép code được tổ chức, chia thành các khối, giữ nguyên các điểm tốt của N-Layered, tuy nhiên với một vài cải tiến:

  • Business Logic/Domain sẽ là phần lõi, ở giữa của hệ thống, được dùng ở các phần khác
  • Business Logic giờ mới là phần khó thay đổi. Điều này có thể chấp nhận, bạn hãy tưởng tượng, có thể hệ thống bạn sẽ đổi database khác, đổi cách lấy dữ liệu, hay giao diện khác, còn logic trung tâm của hệ thống (ví dụ hệ thống ngân hàng thì logic trung tâm là xử lí tiền, …) thì không thể đổi được (trừ khi công ty sập)
  • Mỗi thay đổi của tầng Business/Domain sẽ cần đổi ở tầng khác, điều này cũng đúng hơn với tự nhiên, khi mà concept cốt lõi là logic của ứng dụng, mục tiêu của ứng dụng thay đổi thì mới thay đổi các tầng ocn kia.

Nhưng làm sao để có thể đảo chiều sự phụ thuộc?

Trước tiên, hãy xem cách triển khai thông thường của N-Layered

image 11 - quochung.cyou PTIT
  • OrderService là một module xử lí các order (đơn hàng) cho hệ thống shop của bạn. Nhưng chúng chưa có dữ liệu, vì vậy chúng cần gọi xuống SqlOrderRepository là một module lấy dữ liệu từ database. Như vậy, OrderService phụ thuộc vào SqlOrderRepository
image 12 - quochung.cyou PTIT
  • Thông thường, người ta sẽ viết OrderService phụ thuộc vào một IOrderRepository (interface), để giúp việc thay thế dễ dàng hơn (phụ thuộc 1 interface ảo, chứ không phải 1 class)
  • Lúc này ta chỉ cần di chuyển interface trên về business
image 13 - quochung.cyou PTIT
  • Lúc này, ta sẽ quy định các method của repository, các hàm như kiểu getOrderByName (lấy dữ liệu từ tên), update, create, …. OrderService phụ thuộc trực tiếp vào repository này (Vẫn ở tầng Business)
  • Lúc này tầng Data Access, các class xử lí dữ liệu thực sự sẽ implement lại repository từ tầng Business, implement lại các hàm trên, nơi viết logic thực sự.
  • Lúc này, tầng Data Access đang phụ thuộc ngược vào tầng Bussiness
  • Rõ ràng, OrderService không cần quan tâm Data Access có thể là database nào nữa, nó có thể là class MySQL, Môngo,…. , chỉ cần biết chúng phải implement interface Repository có ở Business, và việc xử lí logic thì data access xử lí sao thì business không cần quan tâm.
  • Việc gắn các class ở dataaccess vào business có thể thông qua các IoC Container (Ví dụ như Spring IoC – Inversion of Control)
image 14 - quochung.cyou PTIT

  • Cách làm trên được gọi là Dependency Inversion (đảo ngược sự phụ thuộc) khi mà sự phụ thuộc, nơi xử lí được đảo ngược lại.

Tham khảo: