A simple extension that fixes my browser chaos

I have a love-hate relationship with browser tabs. I need a lot of them to work, but once I pass the 30-tab mark, my browser bar becomes useless.

Google Chrome actually experimented with an auto-grouping feature a while back, but they removed it. I tried finding alternatives on the Chrome Web Store, but they all had the same problem: They were lazy.

Most existing extensions group tabs based on the domain, even they calling LLM to group it. If they see youtube.com, they dump it in a “YouTube” folder. This is useless for me. If I have 5 tabs open for “Lofi Music” and 5 tabs open for “Python Tutorials,” those shouldn’t be in the same group. One is Work, the other is Background Noise.

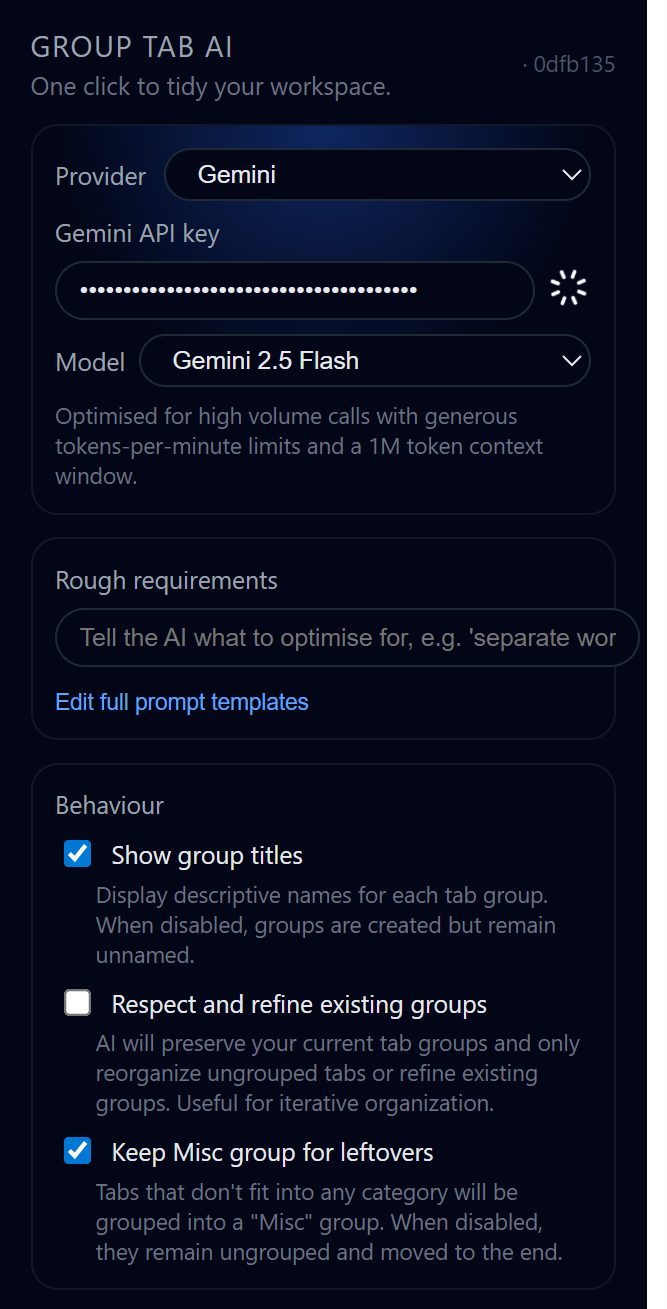
I realized that to actually organize tabs, the software needs to read the page, not just the URL. So I spent my free time building Group Tab AI.

How it actually works

image 8 - quochung.cyou PTIT

I didn’t want to over-engineer this, but I needed it to be smart. When you click the button, the extension doesn’t just look at the link. It injects a script to grab the “context” of the page, the H1 title, the meta description, and a snippet of the body text.

It sends that data to an LLM (I set it up to work with either OpenAI or Gemini). Because it reads the content, it can tell that a GitHub page for a “React Library” is different from a GitHub page for “Tracking Issues.”

I’m using Google Gemini 2.0 Flash for this mostly, with the thinkingBudget set to 0. It’s fast enough that by the time I blink, the tabs are sorted.

I spent nights tweaking prompts to make it focus on tasks, not domains with extra context from the website contents along with careful prompt to let them reasoning and choose. For example, if you’re a dev, it might make groups like “Bug Hunting” or “API Docs.” Designers get “Mockups” or “Inspo.” It works for anyone,

students with class notes, marketers with campaigns.
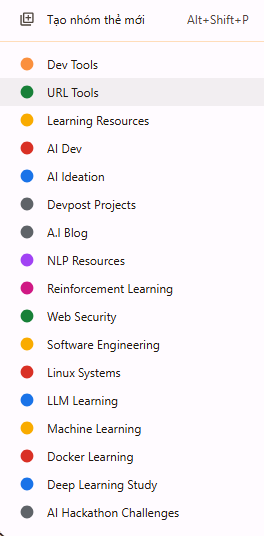
image 10 - quochung.cyou PTIT

The feature I actually wanted: It learns

This is the part I’m most proud of. I know AI isn’t perfect. It’s going to mess up. It might group a design blog under “Development” instead of “Inspiration.”

Usually, with AI tools, you just have to live with the bad output. But I built a Learning System into this.

  1. If the AI groups something wrong, I manually move the tab to the right group.
  2. The extension records that move.
  3. After I’ve corrected it a few times, I can click a button to “Analyze Behavior.”
  4. The system looks at my corrections and rewrites its own system prompt.

Next time I run it, it knows: “Oh, he likes to keep his ‘Localhost’ tabs separate from his ‘Production’ tabs,” because it updated its own instructions based on my manual fixes.

The Tech Stack

For the frontend devs out there, I built this using Plasmo. It’s basically the Next.js of browser extensions, makes working with React and TypeScript in a chrome-extension environment actually bearable.

Everything is local. Your API keys are stored in your browser, and the learning data (your grouping habits) stays on your machine.

Try it out

It’s open source (GPL-3.0). I built it because I needed it, but if you’re tired of domain-based grouping that doesn’t actually help, give it a shot.

https://github.com/quochung-cyou/group-tab-ai-extension

Releases: https://github.com/quochung-cyou/group-tab-ai-extension/releases/
Kaggle Multi Local Module Project Python

image - quochung.cyou PTIT

Kaggle’s setup is amazing for quick experiments but not great when you start treating your work like an actual project. You get one main notebook. That’s it.

If you want to use your own .py files, you basically have to zip them up, upload them as a dataset, and then import from that path. It’s clunky and hard to maintain. Change one line of code? You need to re-upload the dataset again.

I saw this frustration all over the web, in Kaggle forums, Stack Overflow threads, even Reddit. Everyone was hacking their way around it, trying things like chained kernels or huge notebooks with thousands of lines of code. Nobody seemed happy with it.

So I went down the rabbit hole. Read a bunch of Medium posts, watched YouTube tutorials, skimmed corporate engineering blogs. I noticed a pattern: real ML pipelines in the wild are automated. They have CI/CD. They deploy cleanly. But for personal Kaggle projects, nobody had built something simple and usable.

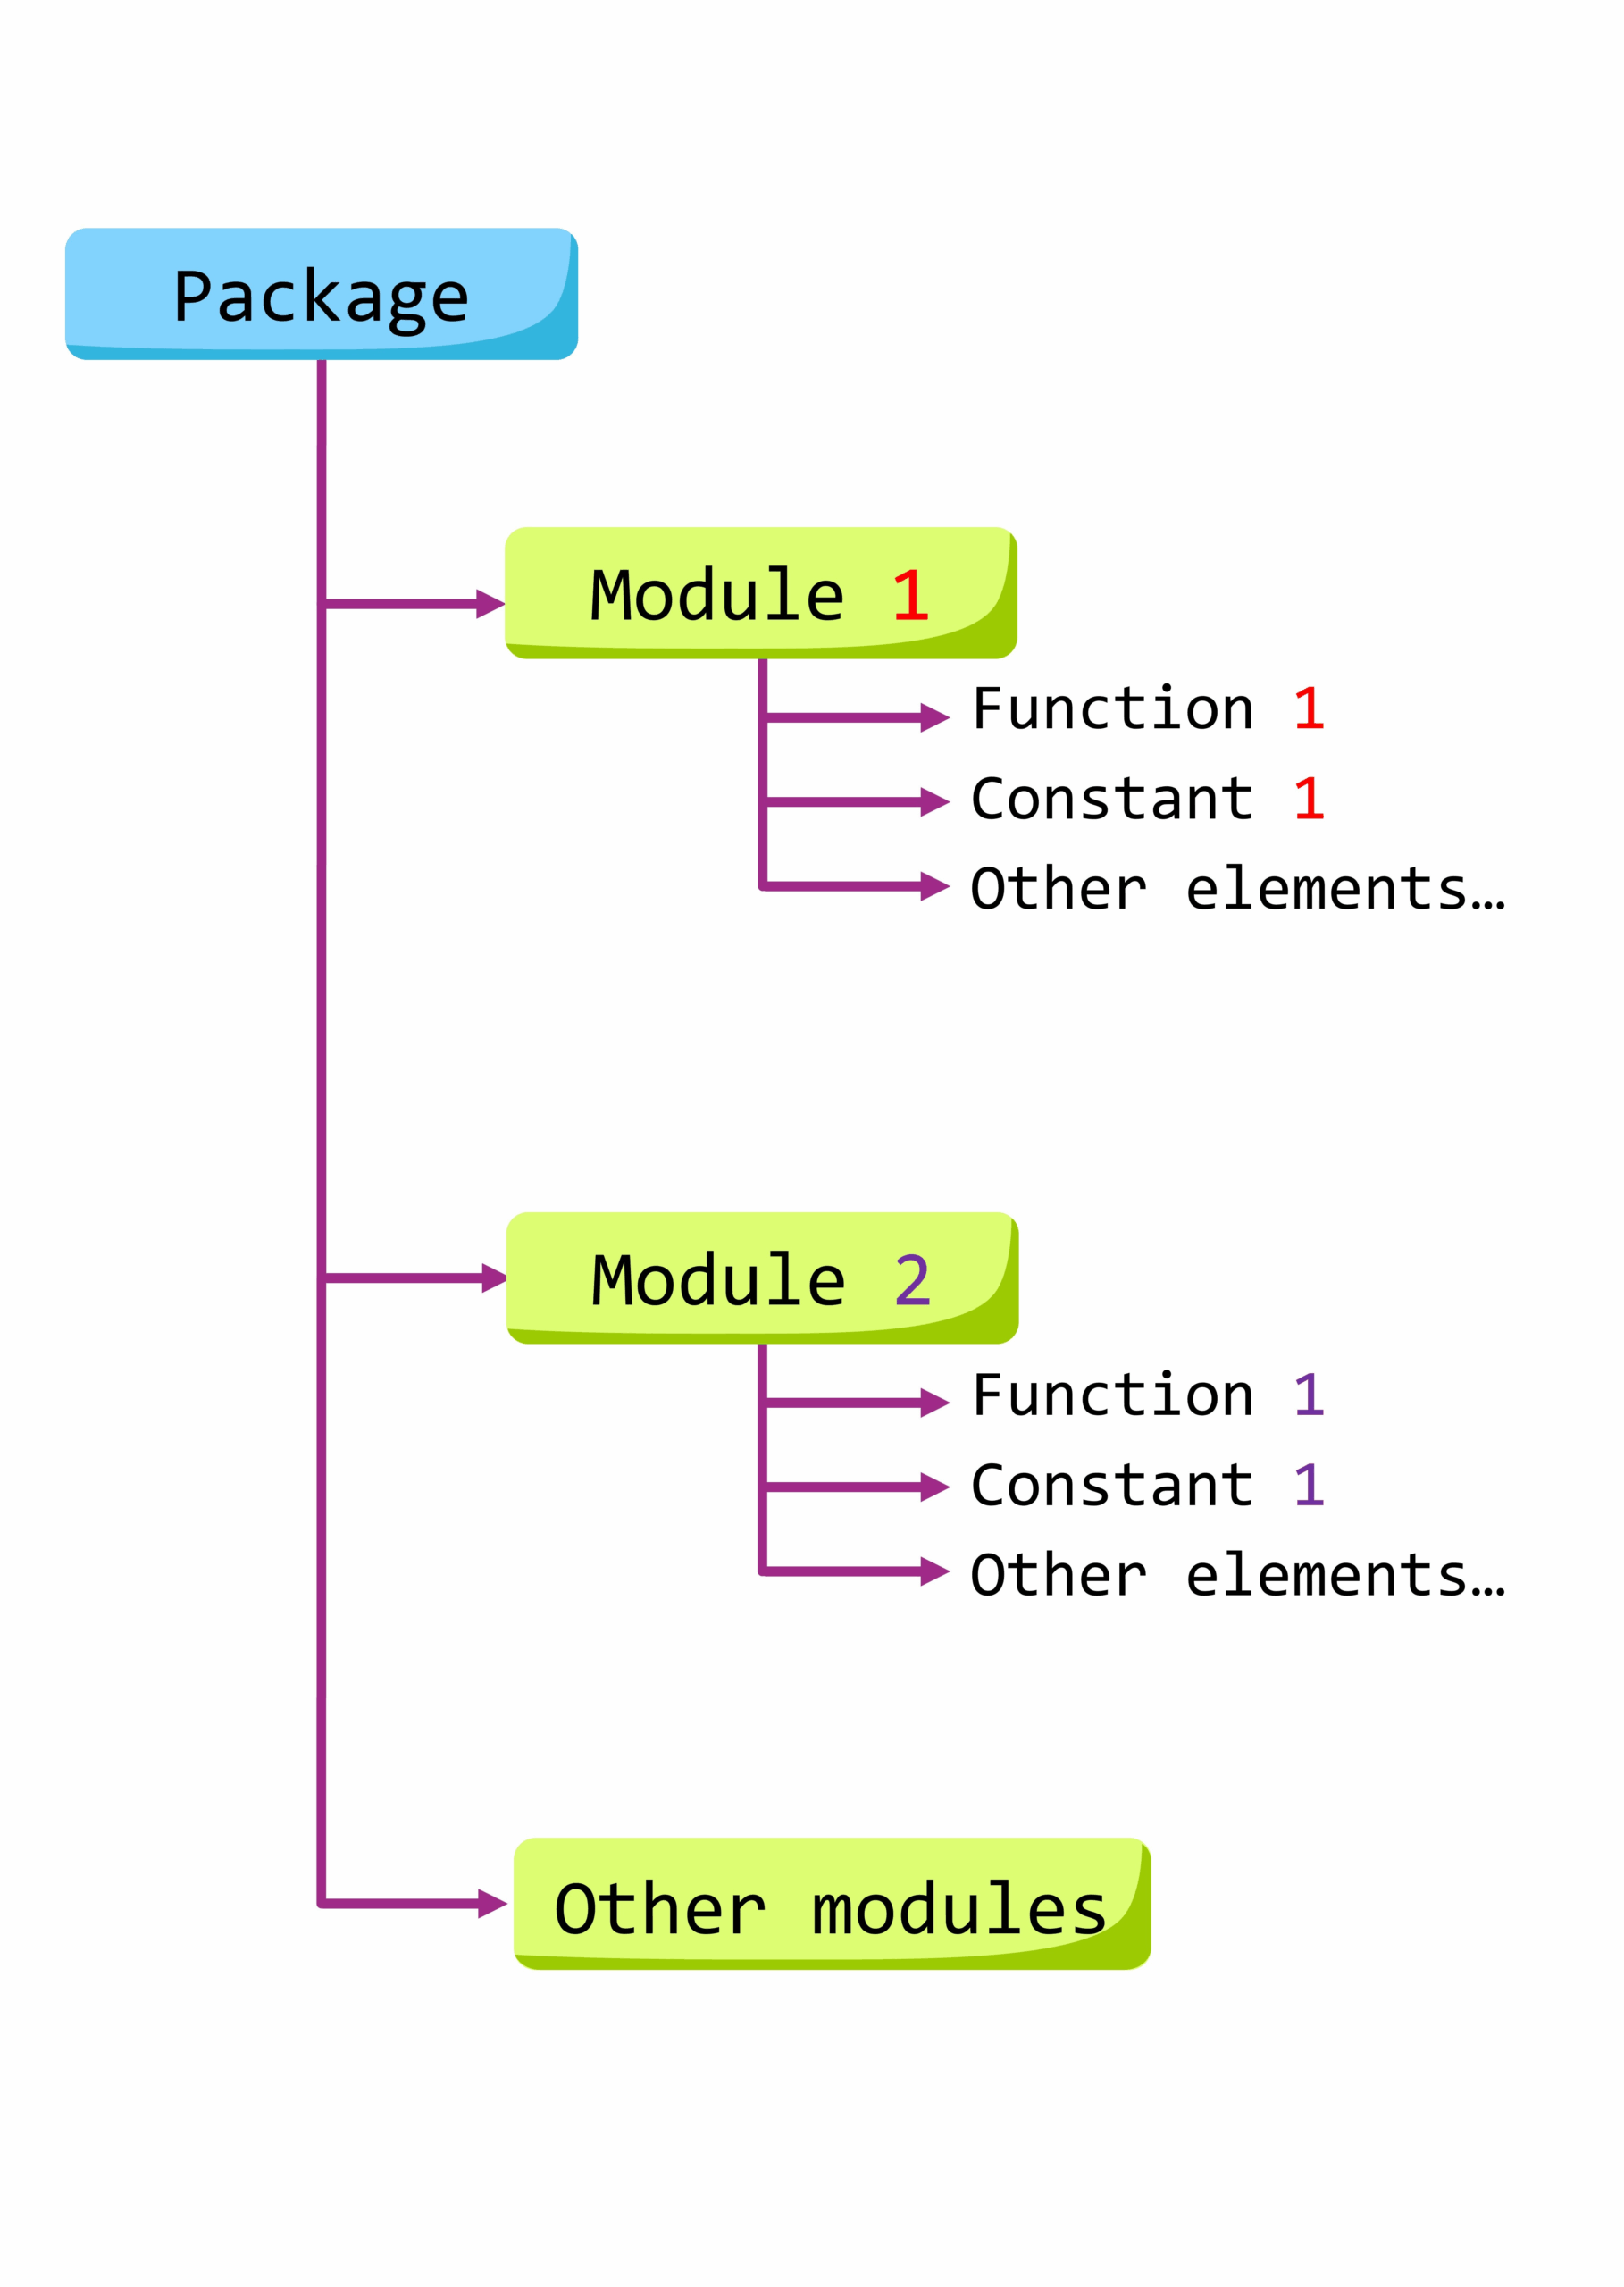
That’s when it clicked, I could write a small tool that did the boring part for me. A script that could take my local project, package it up neatly, and push it to Kaggle as a dataset and a runnable notebook automatically.

Building kaggle-auto-deploy

The idea was simple:

  • Collect all project files.
  • Upload them as a Kaggle dataset.
  • Auto-generate a notebook that sets everything up and runs main.py.
  • Push it, version it, done.

So that’s what I built. A small CLI tool:

python kaggle_deploy.py ./my_project

For example, I used it on a small housing price predictor I’d built.

Behind the scenes, it ties into Git too, so every deployment matches a commit. No more “which version did I upload again?” moments.

Repository: https://github.com/quochung-cyou/kaggle-auto-deploy

Sample: https://www.kaggle.com/datasets/quochungcyou/housing-price-predictor-files https://www.kaggle.com/code/quochungcyou/multi-local-module-project-python-run-sample

Overview

This solution automatically converts any multi-file Python project into a Kaggle-compatible format by:

  • Analyzing your project structure and dependencies
  • Creating a Kaggle dataset containing all your project files
  • Generating a Kaggle notebook that automatically downloads and runs your project
  • Uploading everything to Kaggle via API

Guide

You can try command below to try deploy the sample housing price predictor project:

python kaggle_deploy.py ./housing_price_predictor
alt text
alt text

If you modify the code and redeploy again, you may need use Check Update option to update the dataset and notebook.

alt text

Prerequisites

  1. Install Kaggle API
pip install kaggle
  1. Configure Kaggle Credentials
    • Option A: API Token File
      • Go to https://www.kaggle.com/account
      • Click “Create New API Token”
      • Download kaggle.json
      • Place it in:
        • Linux/Mac: ~/.kaggle/kaggle.json
        • Windows: C:\Users{username}.kaggle\kaggle.json
    • Option B: Environment Variablesexport KAGGLE_USERNAME=”your-username” export KAGGLE_KEY=”your-api-key”
  2. Set Permissions (Linux/Mac)
chmod 600 ~/.kaggle/kaggle.json

Installation & Setup

  1. Download the Deployer Script
git clone https://github.com/yourusername/kaggle-auto-deploy.git
cd kaggle-auto-deploy
  1. Make it Executable (Linux/Mac)
chmod +x kaggle_deployer.py
  1. Optional: Add to PATH (Linux/Mac)
# Add to ~/.bashrc or ~/.zshrc
export PATH="$PATH:/path/to/kaggle_deployer"

Usage

Basic Usage

python kaggle_deployer.py /path/to/your/project

Sample Project

This repository includes a sample project called housing_price_predictor that demonstrates how to structure a multi-file Python project for deployment to Kaggle.

python kaggle_deploy.py ./housing_price_predictor

Project Structure

housing_price_predictor/
├── main.py          # Entry point
├── data_loader.py   # Data loading and preprocessing
├── model.py         # Model training and evaluation
├── utils/
│   └── helpers.py   # Utility functions
├── data/
│   └── housing.csv  # Sample data
└── requirements.txt # Dependencies

Running the Sample Project

# Run locally
cd housing_price_predictor
python main.py

# Deploy to Kaggle
python kaggle_deployer.py ./housing_price_predictor

Register a custom function in Camunda 7 with Spring Boot

Introduction to Camunda 7

image 2 - quochung.cyou PTIT

Camunda 7 is a powerful, open-source platform designed for workflow and process automation. It offers a comprehensive suite of tools for managing business processes, including capabilities for modeling, automating, and optimizing workflows.

Before Camunda BPM 7.18

In both approaches, you need to register your method via the function mapper. If you want to call a method from a bean using an expression like ${myBean.method()}, the process happens automatically without any additional code. However, if you prefer to use the method in the format ${runner:method()} or ${method()}, here’s how you can do it.

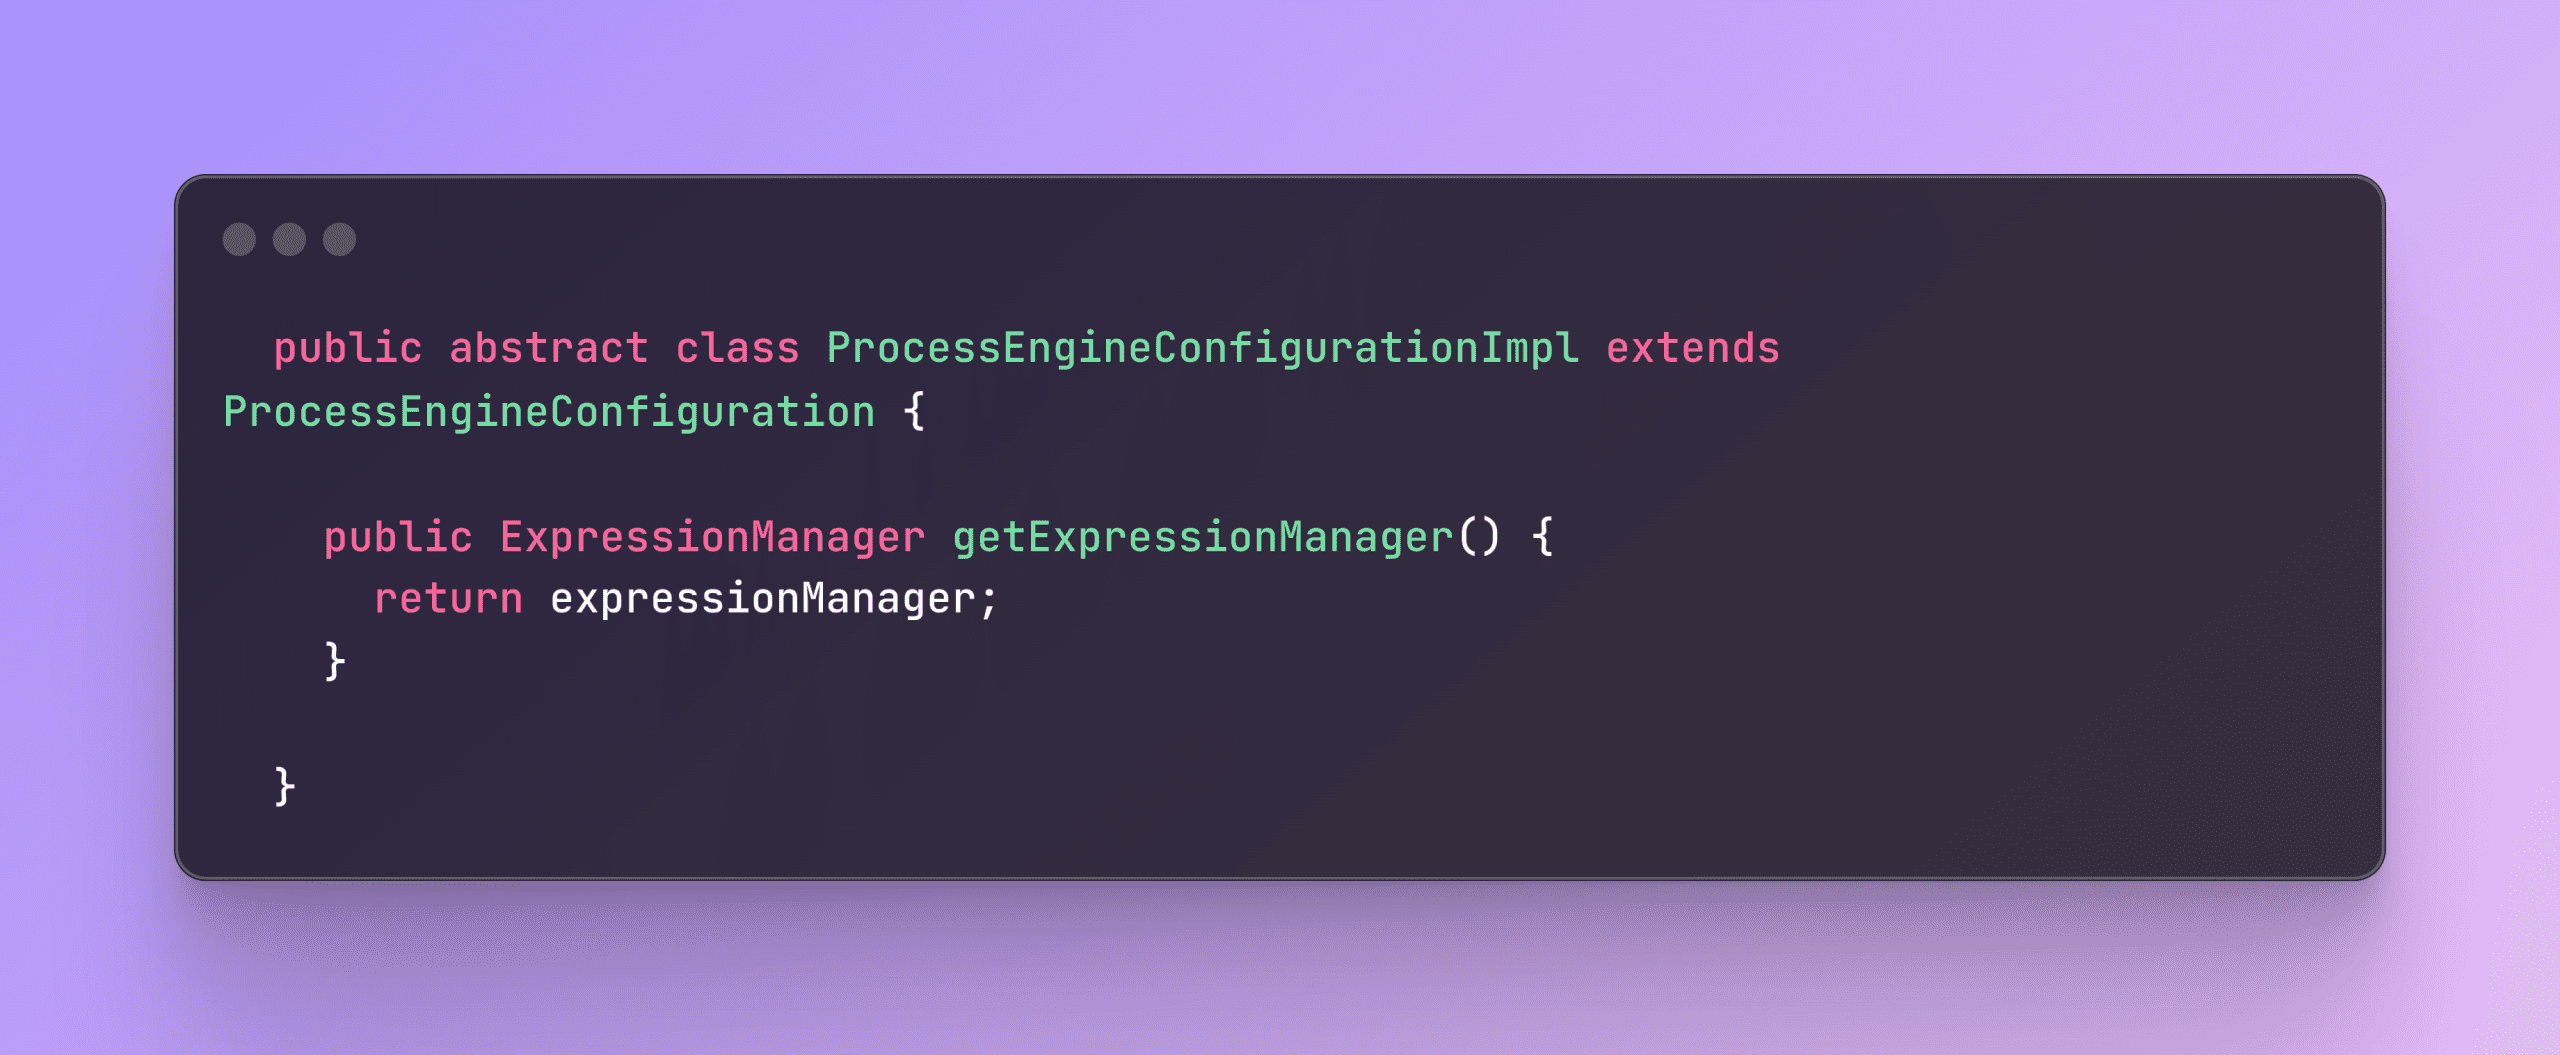
In the ProcessEngineConfigurationImpl class provided by Camunda, you’ll find the ExpressionManager. This class exposes all the necessary methods for you to use.

image 11 - quochung.cyou PTIT
image 12 - quochung.cyou PTIT

To register a new function mapper, you need to create a class that implements the FunctionMapper interface. Here’s a sample implementation to get you started.

image 13 - quochung.cyou PTIT

Now, you can create a process engine plugin to initialize the function mapper when Camunda’s process engine starts configuring.

image 14 - quochung.cyou PTIT

Now you can use ${jsonPath(a, b) in workflow

After Camunda BPM 7.18

After Camunda 7.18, the addFunctionMapper function was removed. You might need an alternative workaround, and this link might be helpful for you.

https://forum.camunda.io/t/how-do-i-add-functionmappers-to-expressionmanager-in-7-18/40466/2

Camunda 7 | Get history data of form in user task

Introduction to Camunda 7

image 2 - quochung.cyou PTIT

Camunda 7 is a powerful, open-source platform designed for workflow and process automation. It offers a comprehensive suite of tools for managing business processes, including capabilities for modeling, automating, and optimizing workflows. One of the key features of Camunda is its ability to track and retrieve historical data, such as process variables and form data, from completed process instances. However, retrieving form data from completed instances can be tricky as Camunda 7 does not provide an out-of-the-box API for this purpose.

Retrieving Historical Data

When working with Camunda, it’s often necessary to access historical data from completed process instances. This data can include process variables and form data, which provide insights into the execution and outcomes of the process. Retrieving this data is essential for reporting, auditing, and analysis purposes.

In this solution:

  1. The BPMN model instance is retrieved using the repositoryService.
  2. The task is fetched from the BPMN model using the task definition key.
  3. If the task is found, the form key is retrieved from the task attributes.
  4. The deployment ID is obtained from the process definition query.
  5. The form resource is retrieved using the GetDeploymentResourceCmd.
  6. The form data is read into a map and set into the result DTO as a JSON string.

Accessing Historical Form Data

By default, Camunda 7 does not provide an out-of-the-box API to retrieve form data from completed process instances. To work around this limitation, you can use a custom approach to fetch the form data stored as process variables.

Here’s a workaround to retrieve form data:

image 3 - quochung.cyou PTIT

Integration Testing Camunda 7 | No startFormHandler defined in process

Introduction to Camunda

image - quochung.cyou PTIT

Camunda is a popular open-source platform for workflow and process automation. It enables developers to model, automate, and optimize business processes. Camunda integrates well with Java applications, offering robust capabilities for managing complex workflows and business rules.

Understanding the Error

When performing integration testing in Camunda, you might encounter the following error:

org.camunda.bpm.engine.exception.NullValueException: No startFormHandler defined in process 'SalesOrderProcess_v2:1:cee4056f-a1d8-11eb-9f61-6683657f7a30': startFormHandler is null

This error occurs because the start event of the process expects a form handler to be defined, but none is provided. The startFormHandler is responsible for managing the form associated with the start event. When it is not defined, Camunda throws a NullValueException. This problem likely cause because of, usually camunda will have BpmnParser class that when reading the XML bpmn file, it will construct the event handler. But in your test, you not inject it

Solution: Mocking the Start Event Handler

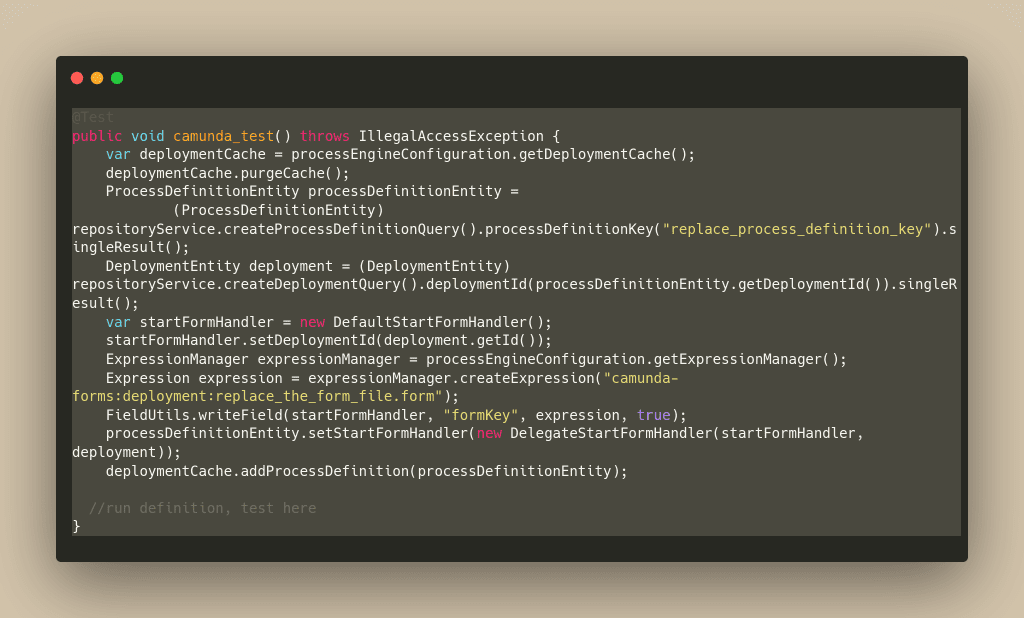
To resolve this issue, you can mock the start event handler in your integration tests. The following example demonstrates how to set up a mock start event handler to bypass the error and proceed with the testing.

Truncate table to make sure it clean state before test

      - ACT_HI_ACTINST
      - ACT_HI_DETAIL
      - ACT_HI_PROCINST
      - ACT_HI_TASKINST
      - ACT_RU_EXECUTION
      - ACT_RU_IDENTITYLINK
      - ACT_RU_TASK
      - ACT_RU_VARIABLE
      - ACT_RE_PROCDEF
      - ACT_RE_DEPLOYMENT
      - ACT_ID_USER
      - ACT_ID_GROUP
      - ACT_ID_MEMBERSHIP
      - ACT_ID_INFO
      - ACT_ID_TENANT
      - ACT_ID_TENANT_MEMBER
      - ACT_GE_BYTEARRAY

In this solution:

  1. The deployment cache is purged to ensure a clean state.
  2. The process definition is retrieved based on the process definition key.
  3. The deployment entity associated with the process definition is obtained.
  4. A DefaultStartFormHandler is created and associated with the deployment.
  5. The form key is set using the ExpressionManager.
  6. The DelegateStartFormHandler is assigned to the process definition.
  7. The process definition is added back to the deployment cache.
image 1 - quochung.cyou PTIT

[LibGDX | Java 2D Game] Phần 1: Cài đặt môi trường

Lời mở đầu

image 19 - quochung.cyou PTIT

Xin chào mọi người! Trước khi bắt tay vào việc phát triển game 2D với LibGDX, hãy dành một chút thời gian để hiểu rõ hơn về ‘bộ công cụ’ mà chúng ta sẽ sử dụng.

LibGDX là một framework mạnh mẽ cho phép lập trình viên tạo game đa nền tảng, từ desktop cho tới mobile và web, mà không cần thay đổi đoạn code nguồn. Thông qua ngôn ngữ Java – một ngôn ngữ lập trình rất phổ biến vì tính linh hoạt, mạnh mẽ và khá dễ tiếp cận, được giảng dạy tại nhiều trường đại học trên thế giới.

Video

Chào mọi người! Video này là phần đầu tiên trong series hướng dẫn sử dụng LibGDX để phát triển game 2D sử dụng Java. Ở tập này, mình sẽ dẫn dắt các bạn qua quá trình cài đặt môi trường phát triển game, bao gồm cách thiết lập LibGDX và các công cụ cần thiết để bắt đầu tạo ra những tựa game đầu tiên của mình. Ngoài ra là một chút khái niệm về cách render tile của game 2D và game loop

Các tài nguyên sử dụng trong video:

Triển khai Cursor Pagination trong Java Spring JPA/Hibernate

Từ bài viết trước

Cursor Pagination

Kĩ thuật: keyset pagination and seek method

Ở một số trang web, bạn sẽ thấy, bạn không thể đi đến thẳng trang cuối, hoặc nhảy đến 1 trang bất kì, mà thông thường sẽ có nút để sang trang kế và trang phía trước. Như vậy ta có thể assume rằng:

Người dùng sẽ chỉ mở trang 10 sau khi mở trang 9.Vậy, ta chỉ cần nhớ vị trí cuối cùng của bài viết ở trang 9 là ở id bao nhiêu, rồi dùng WHERE để truy vấn từ điểm đó, chứ không cần bỏ dần để đi đến điểm đó nữa

SELECT * FROM my_table WHERE id > 21 ORDER BY id LIMIT 5
image 17 - quochung.cyou PTIT
Tối ưu truy vấn Pagination (phân trang) sử dụng Spring Boot (Java) 38

Ví dụ: Sort theo thời gian

SELECT *
FROM my_table
WHERE (update_date = '2017-12-21' AND id > 21) 
    OR update_date > '2017-12-21'
ORDER BY update_date,id LIMIT 5

Cơ bản là ta sẽ chỉ lấy các bài viết có cùng thời gian đăng như bài viết cuối và id > , hoặc thời gian lớn hơn bài viết cuối

image 18 - quochung.cyou PTIT

Để hình dung rõ hơn, hãy thử nhìn vào bảng sau:

IDName
1An
2Nam
3Quan
4Tien
5Hoang
6Nguyen
7Duc
8Thanh
9Hai
10Minh

Ta mong muốn nhận được dữ liệu ở Page 1 như sau

IDName
1An
2Nam
3Quan
4Tien
5Hoang

Ta sẽ có câu query để lấy page 2 dạng như sau

Lấy page 1: SELECT * FROM users ORDER BY ID LIMIT 5
SELECT * FROM users WHERE ID > '5' ORDER BY ID LIMIT 5

Ta có thể thêm HAL bằng Spring HateOAS để response trả về ở dạng như sau, giúp ta lấy dữ liệu dễ dàng hơn

{
    “cursor”: {
        “previous_page”: null,
        “next_page”: "next___5"
    }
}
{
    “cursor”: {
        “previous_page”: "prev___5" ,
        “next_page”: "next___10"
    }
}
  • Cursor sẽ như một con trỏ chỉ tới một record nào đó trong dữ liệu, và khi ta truyền cursor đó vào, backend cần biết ta đang muốn lấy trang tiếp theo hay trang trước từ vị trí con trỏ đó
  • Có nhiều cách để làm điều này, ví dụ thêm prefix dạng như prev___, hay next___ như ví dụ trên
  • Hoặc đơn giản hơn, ta sẽ truyền thêm một biến chỉ ra là đó là next hay prev

Null Cursor

  • Lúc này, từ phía backend, ta có thể sử dụng count hoặc tương tự để kiểm tra xem có trang ở trước đó hay ở sau đó không, rồi trả response ra là null để thể hiện rằng không còn trang nào khác để đi tới ở hướng đó.

Next Cursor

  • Có thể bạn đã nắm được về cách để đi tới trang tiếp theo với cursor pagination.
  • Ví dụ, ta có một danh sách id tăng dần, thì từ trang có id [1,2,3,4,5], ta sẽ where id > 5 để tới trang tiếp theo
SELECT * FROM entries WHERE (myCol > 5) ORDER BY myCol ASC LIMIT 2; -> 6,7
SELECT * FROM entries WHERE (myCol > 7) ORDER BY myCol ASC LIMIT 2; -> 8,9
image 9 - quochung.cyou PTIT
image 10 - quochung.cyou PTIT
  • Với một danh sách id giảm dần, ví dụ trang là [10,9,8,7,6] thì ta sẽ where id < 6 để tới trang tiếp theo.
SELECT * FROM entries WHERE (myCol < 5) ORDER BY myCol DESC LIMIT 2; -> 4,3
SELECT * FROM entries WHERE (myCol < 3) ORDER BY myCol DESC LIMIT 2; -> 2,1
image 11 - quochung.cyou PTIT
image 12 - quochung.cyou PTIT

Previous Cursor

  • Tuy nhiên, việc đi tới trang trước đó trở lên khó khăn hơn. Bởi vì dữ liệu sẽ được trả ra từ phía trái đầu
  • Ví dụ, ta đang ở trang id [8,9] , và ta thực hiện truy vấn lấy trang trước đó, 2 phần tử
SELECT * FROM entries WHERE (myCol < 8) ORDER BY myCol ASC LIMIT 2;
image 13 - quochung.cyou PTIT
  • Kết quả sẽ trả về 0,1. Bởi vì nó đang đọc từ trái sang, và khi limit sẽ lấy từ đầu trái chứ không lấy 6,7

Cách giải quyết lấy previous cursor

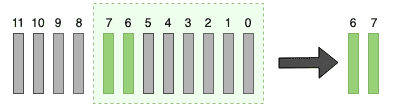
  • Cách để giải quyết vấn đề này, ta sẽ đảo ngược chiều order by, và sau đó khi limit để lấy đúng vùng dữ liệu xong, ta sẽ đảo một lần nữa về chiều đúng
SELECT pagination.* FROM(SELECT * FROM entries WHERE (myCol < 8) ORDER BY myCol DESC LIMIT 2) AS pagination ORDER BY myCol ASC;
image 14 - quochung.cyou PTIT
  • Các bước vừa xảy ra
  • 1. Đầu tiên, select các row có id < 8 và order by desc. ta có 7,6,…,1,0
  • Sau đó limit 2 để lấy 7,6
  • Rồi order by asc lần nữa để lấy thành 6,7 . Là thứ tự ASC như ban đầu ta muốn

Time Complexity

  • Next Page Travesal: O(log(N) + L) , ta mấy log(N) để tìm tới điểm bất kì vì nó thực hiện như binary search và ta đã index database. Và L là Limit là số ta phải lặp đến để lấy vùng đầu tiên đã chọn
  • Previous Page Traversal: O(log(N) + 2L), sở dĩ là 2L vì ta đã phải đảo chiều 1 lần.
  • Thông thường limit được đặt ở 5-20 cho 1 trang, vì vậy có thể coi L là constant và không đáng kể

Triển khai trong code

image 15 - quochung.cyou PTIT
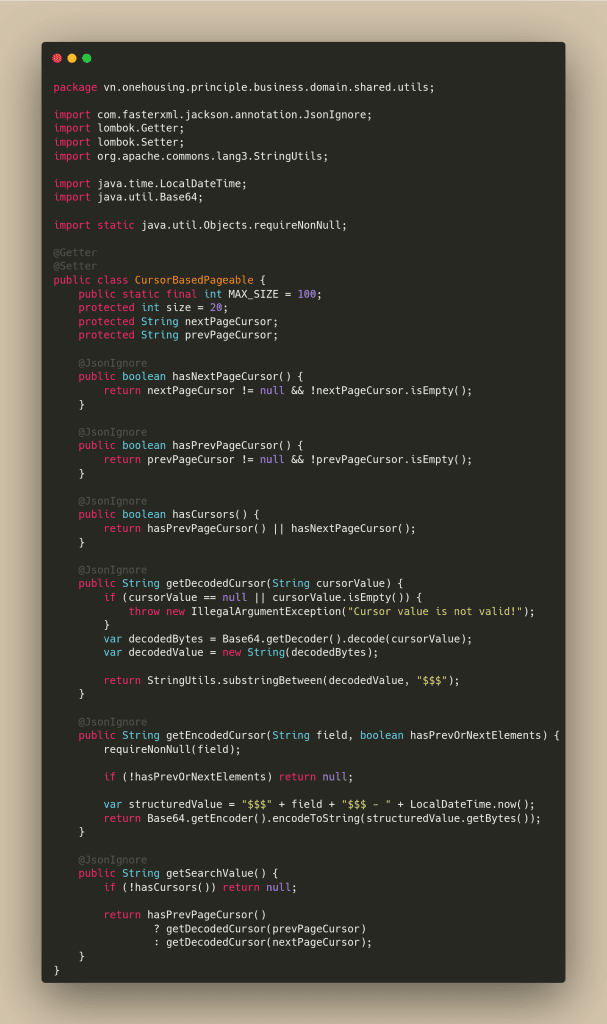
  • Ta có một class thực hiện việc lấy cursor trước hoặc sau. Sử dụng để decode một giá trị cursor base64 hoặc encode 1 giá trị
  • Ví dụ ta đang cursor pagination theo column 35, ta sẽ có hàm getEncodeCursor để tạo ra giá trị mã hoá cursor
  • Hàm getDecodedCursor sẽ chuyển giá trị mã hoá đó thành số để dùng paging
image 16 - quochung.cyou PTIT
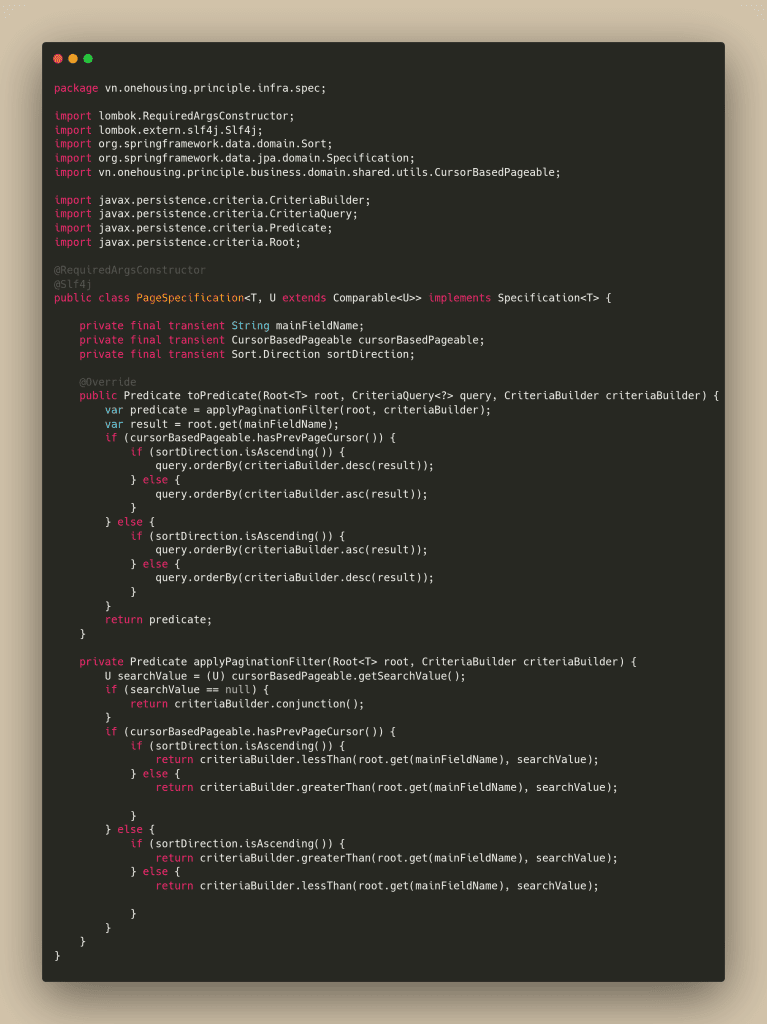
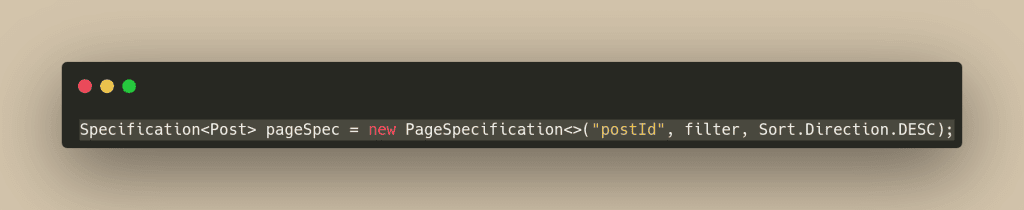
  • Đây là class thực hiện việc paging và nhảy trang. Có thể thấy logic sẽ kiểm tra xem ta đang lấy trang trước hay trang sau, sau đó sort cho phù hợp.
image 17 - quochung.cyou PTIT
image 18 - quochung.cyou PTIT
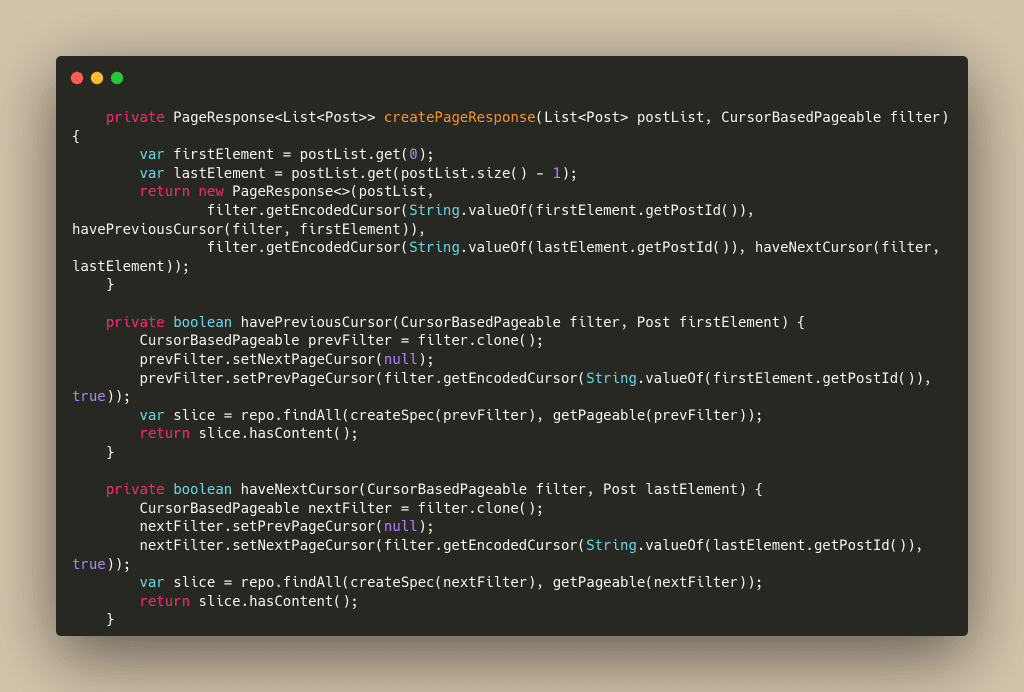
  • Class xử lý việc trả về. Tại đây ta sẽ lấy ra element tại đầu list và cuối list của trang hiện tại, rồi tìm thử xem phía trước đó còn trang nào không, hay sau đó còn trang nào hay không

Tham khảo:

[Java Core] B8: File, sơ lược về test trong Java

This entry is part 8 of 8 in the series Java Core

1. Xử lý File trong Java

Đọc và ghi file trong java là các hoạt động nhập/xuất dữ liệu (nhập dữ liệu từ bàn phím, đọc dữ liệu từ file, ghi dữ liệu lên màn hình, ghi ra file, ghi ra đĩa, ghi ra máy in…) đều được gọi là luồng (stream).

1.1 Một số class thường sử dụng

  • File: Là thực thể dẫn tới file, hoặc thư mục, cho các hàm để làm việc với File
  • FileInputStream/FileOutputStream: Đọc ghi file binary
  • FileReader/FileWriter: Đọc ghi file văn bản
  • BufferedReader/BufferedWriter: Đọc ghi file có Buffer
image - quochung.cyou PTIT
  • Hiểu đơn giản hiện tại thì, tất cả dữ liệu sẽ đều là các Input/OutputStream, là cấu phần byte, để đọc ghi dữ liệu
  • Thì ở tầng đầu tiên, các class như FileInputStream, FileOutputStream sẽ chỉ có các phương thức write các bytes.
  • Các tầng trên thực chất là wrap lại các cách viết, đọc byte này thành các phương thức dạng readInt, writeInt từ các class DataInputStream, DataOutputStream, …

1.2 Về Character Stream và Byte Stream

  • ByteStream của Java có thể thực hiện các thao tác vào ra mỗi 8-bit bytes (2^8 - 256) - ASCII
  • Còn luồng Character Stream, hay sử dụng các FileReader FileWriter thì đọc ghi 16-bit unicode, hỗ trợ được các ngôn ngữ đặc thù hơn (có dấu, gần thì tiếng Việt, các ngôn ngữ khác trên thế giới) do 16-bit unicode cho phép biểu diễn nhiều từ ngữ hơn
  • Thực chất thì cả 2 luồng này đều là wrap trên FileInputStream/FileOutputStream (cấu phần đọc byte thấp nhất ta nói ở trên), tuy nhiên FileReader/FileWriter sẽ đọc 2 bytes một lần
image 1 - quochung.cyou PTIT

1.4 BufferReader/Writer

  • Với BufferReader thì thực tế ta sẽ cung cấp một bộ đệm ở giữa ở Ram, giúp truy cập nhanh hơn. Hiểu đơn giản kiểu: Ví dụ trên mạng có một bài báo, bạn mỗi khi muốn đọc thì cần lên mạng, tải trang đó rồi đọc. Nhưng nếu lưu nó về máy thì khi truy cập sẽ nhanh hơn
image 3 - quochung.cyou PTIT

Câu hỏi: Buffer tốt thế sao không lúc nào cũng dùng ?

  • Tuỳ vào bài toán, thông thường thì BufferReader tốt cho mọi trường hợp vì việc sử dụng các bộ nhớ truy cập nhanh (cache, ram) để lưu tạm thời một vùng nhỏ bộ nhớ (rồi từ từ đẩy vào thêm, rồi lại đẩy ra) để đọc ghi là một practice chuẩn, thường được sử dụng trong nhiều lĩnh vực (buffer trong , database cache, front end cache, server cache, quy hoạch động chuẩn bị trước data …)
  • tuy nhiên việc vùng nhỏ đó là bao nhiêu cho chuẩn, lúc nào đẩy ra đẩy vào thì là 1 câu chuyện khác. -> Invalidation Cache, các chiến lược để nạp page trong hệ điều hành, …

1.5 Đường dẫn tương đối và tuyệt đối

1.5.1 Đường dẫn (Path) là gì?

Hầu hết các hệ thống tập tin được sử dụng ngày hôm nay lưu trữ các tập tin trong một cây (hoặc cấu trúc phân cấp). Ở đầu cây là một (hoặc nhiều hơn) các nút gốc. Dưới nút gốc, có các tệp và thư mục (thư mục trong Microsoft Windows). Mỗi thư mục có thể chứa các tệp tin và các thư mục con, do đó có thể chứa các tệp và thư mục con, v.v … có khả năng lưu trữ một chiều sâu gần như vô hạn.

image 4 - quochung.cyou PTIT

1.5.2 Đường dẫn tương đối/tuyệt đối

Một đường dẫn tuyệt đối luôn chứa các phần tử gốc và danh sách thư mục đầy đủ cần thiết để định vị tệp tin. Ví dụ, D:/file.txt là một đường dẫn tuyệt đối. Tất cả thông tin cần thiết để định vị tệp tin được chứa trong chuỗi đường dẫn.

Một đường dẫn tương đối cần phải được kết hợp với một đường dẫn khác để truy cập một tập tin. Ví dụ là đây là đường dẫn tới file xuất phát từ file dự án

image 5 - quochung.cyou PTIT
  • Ví dụ như ảnh trên, ta có đường dẫn tuyệt đối được trích từ ổ D, rồi vào thư mục Eclipse, …
  • Đường dẫn tương đối thì chỉ là từ thư mục dự án equinox/…/file

1.5.3 Ý nghĩa

  • Đường dẫn tuyệt đối thì ví dụ khi mang file sang nơi khác để chạy thì có thể sẽ không chạy được, vì có thể do máy người khác dùng một cách sắp thư mục khác (window vs linux), hoặc code thì dùng ổ D:/ mà máy người dùng không có ổ này, …
  • Đường dẫn tương đối sẽ được ưa dùng hơn, tức là ta sẽ lưu file nằm gọn trong cùng thư mục dự án, và khi đóng gói thì các thao tác chỉ nằm trong khu vực của dự án

2. Unit Test

2.1. Giới thiệu

Unit Test là một loại kiểm thử phần mềm trong đó các đơn vị hay thành phần riêng lẻ của phần mềm được kiểm thử.

Một Unit là một thành phần PM nhỏ nhất mà ta có thể kiểm tra được như các hàm (Function), thủ tục (Procedure), lớp (Class), hoặc các phương thức (Method).

Ở bài này cơ bản thì, ta sẽ viết các test cho các hàm/lớp trong Java, bằng cách kiểm tra với các input đầu vào định sẵn thì output có ra đúng với ta viết test hay không

  • Ví dụ, ta có phương thức tính tổng 2 số, thì ta dự đoán là khi truyền vào 10,20 thì kết quả phải là 30. Input là 10,20 – Output là 30, và ta kiểm tra 30 với kết quả thực tế khi chạy hàm
  • Việc kiểm tra sẽ được xử lý qua các test case, ta sẽ viết các test trước. Khi muốn kiểm tra tính năng, ta không phải ngồi thử bằng tay mà có thể chỉ cần ấn chạy test tự động

2.2 Cài đặt các thư viện để test trong Java

2.3 Assertions, viết Unit Test

Assertions là một thư viện cung cấp một số api phương thức hỗ trợ việc kiểm thử

image 6 - quochung.cyou PTIT

Ví dụ ảnh trên, ta có 1 hàm tính tổng. Ta viết ra 1 test để thử các input đầu vào để kiểm tra xem expectedSum là kết quả đúng với actualSum là kết quả trả ra của code có đúng không

-> Tưởng tượng như các test input output của codeforce để kiểm tra tính đúng đắn của code

image 7 - quochung.cyou PTIT

Chúng ta cùng bắt đầu viết thử 1 Unit Test cho đoạn code sau đây bằng thư viện JUnit:

Ví dụ ta có lớp Circle với phương thức sau:

public class Circle {

    public static double calculateArea(double radius) {
        return Math.PI * radius * radius;
    }
}

Sau đó, ta tạo lớp CalculatorTest trong đường dẫn src/main/test. Trong đó ta sử dụng annotation @Test để định nghĩa cho 1 test.

public class CircleTest {

    @Test
    public void testCalculateArea() {
        //...
    }
}

2.4 Một số quy tắc viết Test

Đối với JUnit, ta có một số quy tắc đặt tên sao cho chuẩn như sau:

  • Ta phải có từ “Test” ở cuối tên class, ví dụ: LoginControllerTest, StudentControllerTest,… -> Nhận biết file nào là test (Maven sẽ tự động thêm các lớp này vào Test scope)
  • Đặt tên các test rõ ràng, ta có thể theo cấu trúc sau: Given[ExplainYourInput]When[WhatIsDone]Then[ExpectedResult] ví dụ:
@Test
public void GivenNullUsernameWhenCreateStudentThenShouldThrowException()

public void Test_01_Khi_Nhap_Vao_So_Am_Thi_Thong_Bao_Sai()

public void Test_02_Khi_Nhap_Vao_So_Duong_Thi_Thong_Bao_Dung()
  • Tức là khi cho gì đó (Given) vào thời điểm nào đó (Create) thì nên làm gì (Then)
  • Ví dụ: Test cho 1 hàm nhập đầu vào gì đó, nếu người dùng nhập số âm thì chương trình nên trả ra là hãy nhập lại. File test sẽ kiểm tra có thật là chương trình bắt nhập lại hay không -> Yêu cầu làm thử bài toán trên
  • Ngoài ra, các test cần có tính độc lập. Tức là các test có thể thực hiện theo thứ tự ngẫu nhiên, và một test không nên phụ thuộc vào một test khác.
  • Ví dụ không nên có chuyện cần chạy test 1 rồi test 6 chạy mới pass

2.5 Chạy thử hàng loạt test và Test Coverage

image 8 - quochung.cyou PTIT
  • Chuột phải vào project, ví dụ như ảnh trên ta có các lựa chọn Run All Test là chạy toàn bộ test trong thư mục test của dự án

2.5.1 Test Coverage là gì

  • Test coverage (độ bao phủ kiểm thử) là một phép đo để đánh giá mức độ mà mã nguồn của chương trình đã được kiểm tra thông qua việc chạy các ca kiểm thử. Nó đo lường tỷ lệ phần trăm của mã nguồn được thực thi bởi các ca kiểm thử.
  • Ví dụ, test của ta đã đi hết 90/100 dòng của code thực tế. Tức là đã có 90 dòng đã được chạy trong quá trình test, và kết quả có vẻ đang đúng với expected trong test, ta gọi đó là Line Coverage (bao phủ theo số lượng dòng)
  • Ngoài ra còn có bao phủ theo số lượng class được chạy, số lượng hàm được chạy

=> Test Coverage là một chỉ số thể hiện tương đối dự án có đang ở trạng thái được test kiểm tra kĩ hay không. (nếu mà test viết chuẩn) Ví dụ, với những dự án được test coverage rất cao, khoảng 80-90%, thì dù sau này ta có sửa code, refactor, clean code hay gì đi nữa, ta có thể đảm bảo là khi chạy lại các test ta đã viết, ta sẽ biết chỗ nào có thể đang bị hỏng, chưa đúng để sửa lại

  • Mục tiêu của việc đạt test coverage là tăng độ tin cậy của chương trình bằng cách đảm bảo rằng các phần quan trọng của mã nguồn đã được kiểm tra. Tuy nhiên, test coverage không đảm bảo rằng tất cả các lỗi đều được phát hiện, và nó cũng không thể đo lường chất lượng của các ca kiểm thử.
image 9 - quochung.cyou PTIT
  • Như ảnh trên, ở More Run/Debug ta có thể có lựa chọn run thử toàn bộ test để đo coverage hiện tại của dự án
image 10 - quochung.cyou PTIT
  • Ta có hình ảnh Inteliji thể hiện bao nhiêu class đã được chạy qua, bao nhiêu method, bao nhiêu line đã được cover. Tuỳ vào cách đánh giá của công ty, hệ số, ... thì ta sẽ gộp thành 1 coverage tổng thể
image 11 - quochung.cyou PTIT
  • Đây được gọi là kim tự tháp test (testing pyramid), ở bên dưới là các test sẽ nhỏ, độc lập hơn, chạy nhanh hơn. Thường các test này khó móc nối với nhau (kiểu khó thử được 1 luồng là ấn nút giao diện rồi kiểm tra), nên để test ở đây, ta mặc định là mọi thứ đã móc nối chuẩn, rồi viết test sao cho từng module, cấu phần đều chuẩn
  • Ở các level cao hơn, test sẽ được móc nối giữa nhiều cấu phần (database, giao diện, nhiều service ngoài, …) sẽ yêu cầu thời gian chạy lâu hơn

[Java Core] B7: Exception trong Java

This entry is part 7 of 8 in the series Java Core

1. Làm quen với Exception: Checked và Unchecked Exception, Error

1.1 Lời mở đầu

  • Trong cuộc sống, không phải lúc nào mọi việc cũng diễn ra suôn sẻ, không phải lúc nào mọi thứ cũng theo đúng kế hoạch. Đôi khi, có những tình huống không mong muốn xảy ra, và chúng ta cần phải xử lý chúng.
image - quochung.cyou PTIT
  • Khi một ứng dụng ngày càng lớn lên, chắc chắn ta không thể đảm bảo ứng dụng luôn hoạt động như cách ta muốn 100% mọi lúc được. Đến lúc nào đó, sẽ có lỗi xảy ra.

Ví dụ:

  • Khi một ứng dụng cần đọc một file từ ổ cứng, nhưng file đó không tồn tại.
  • Khi ứng dụng cần quyền chụp ảnh từ camera, nhưng người dùng không cho phép.
  • Khi ứng dụng kết nối tới một server, nhưng server đang bị mất điện và không kết nối được.

Khi đó, hệ thống cần có những cách xử lý riêng cho người dùng biết vấn đề đang xảy ra, và có những cách xử lý riêng cho hệ thống có thể tiếp tục hoạt động mà không bị ảnh hưởng quá nhiều.

Ví dụ:

  • Khi file không tồn tại, ứng dụng cần thông báo cho người dùng biết rằng file không tồn tại và yêu cầu người dùng chọn file khác, hoặc kiểm tra lại đường dẫn file.
  • Khi người dùng không cho phép ứng dụng chụp ảnh, ứng dụng cần thông báo cho người dùng biết rằng không thể chụp ảnh và yêu cầu người dùng cấp quyền.
  • Khi server bị mất điện, ứng dụng cần thông báo cho người dùng biết rằng không thể kết nối tới server và yêu cầu người dùng thử lại sau, hoặc kiểm tra xem đường truyền wifi, 3G, 4G có vấn đề gì không.

1.2 Exception là gì?

  • Exception dịch ra tiếng Việt có nghĩa là ngoại lệ. Exception là một sự kiện xảy ra trong quá trình thực thi chương trình, làm ảnh hưởng đến luồng thực thi của chương trình.

1.3 Checked và Unchecked Exception

1.3.1 Checked Exception

image 1 - quochung.cyou PTIT
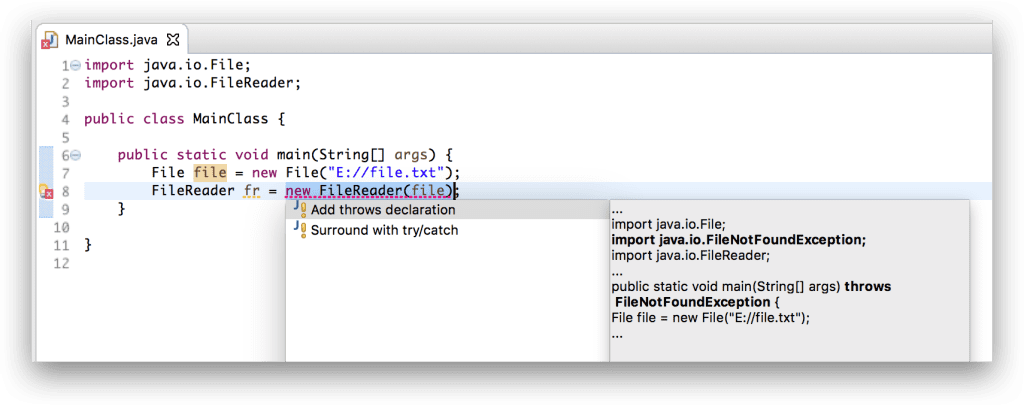
  • Ảnh ví dụ: Khi ta thử đọc 1 file, IDE ngay lập tức thông báo có thể xảy ra FileNotFoundException (Ngoại lệ file không tồn tại) và yêu cầu ta phải xử lý nó.
  • Checked Exception thường là những lỗi phổ biến mà chúng ta có thể dự đoán được sẽ xảy ra cho một thao tác nào đó.
  • Ví dụ, khi đi dã ngoại, để phòng ngừa việc có mưa, ta mang theo áo mưa. Việc trời mưa là một ngoại lệ mà ta đã dự đoán trước và lên trước kế hoạch để xử lý nó.

1.3.2 Unchecked Exception

  • Đây là những Exception không được kiểm tra tại thời điểm biên dịch (compile time). Tức là chúng ta không nhận được thông báo lỗi từ trình biên dịch khi mà nó phát hiện ra rằng chúng ta chưa xử lý nó.
  • Đây là các exception khá nguy hiểm, khi mà chúng ta không thể dự đoán được chúng sẽ xảy ra khi nào. Bởi vì Exception này xảy ra khi ứng dụng đang thực thi, nên nó còn có thể gọi là Runtime Exception.
  • Ví dụ, khi một ứng dụng chia một số cho 0, nó sẽ ném ra một ngoại lệ ArithmeticException (Ngoại lệ toán học).
image 2 - quochung.cyou PTIT
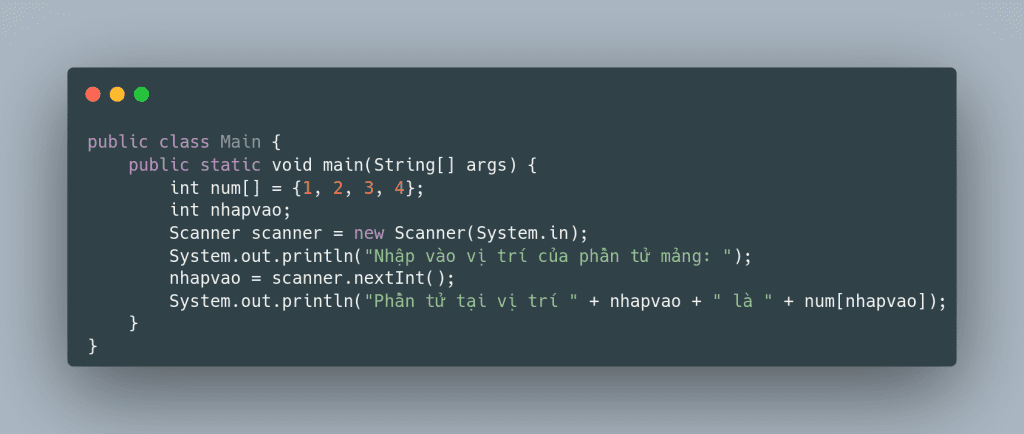
  • Trong đoạn code trên, nếu ta nhập vào 1 số không tồn tại trong mảng, nó sẽ bị một Exception ArrayIndexOutOfBoundsException (Ngoại lệ vượt quá giới hạn của mảng)., đây là một ví dụ về Unchecked Exception. Vì ta không thể biết được trước khi chạy chương trình, nó sẽ xảy ra khi nào.

1.4 Error

  • Error là một dạng ngoại lệ mà chúng ta không thể xử lý được. Error thường xảy ra khi mà hệ thống gặp phải những vấn đề nghiêm trọng, không thể khắc phục được.
  • Ví dụ, khi một ứng dụng chạy hết bộ nhớ, nó sẽ ném ra một ngoại lệ OutOfMemoryError (Lỗi hết bộ nhớ). Đây là một ví dụ về Error. Đây là một ngoại lệ ta không thể xử lý được, và nó thường xảy ra khi mà hệ thống gặp phải những vấn đề nghiêm trọng, không thể khắc phục được.

2. Bắt Exception với try-catch

Bài tập

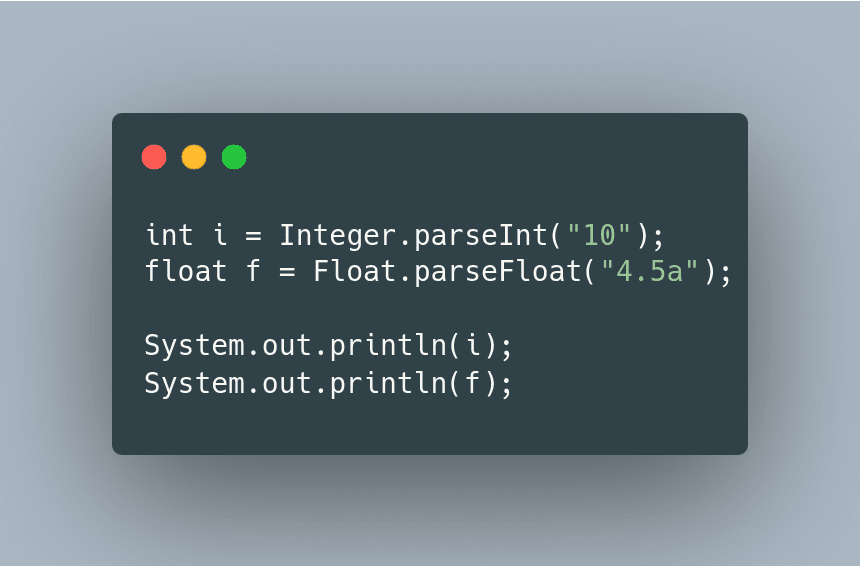
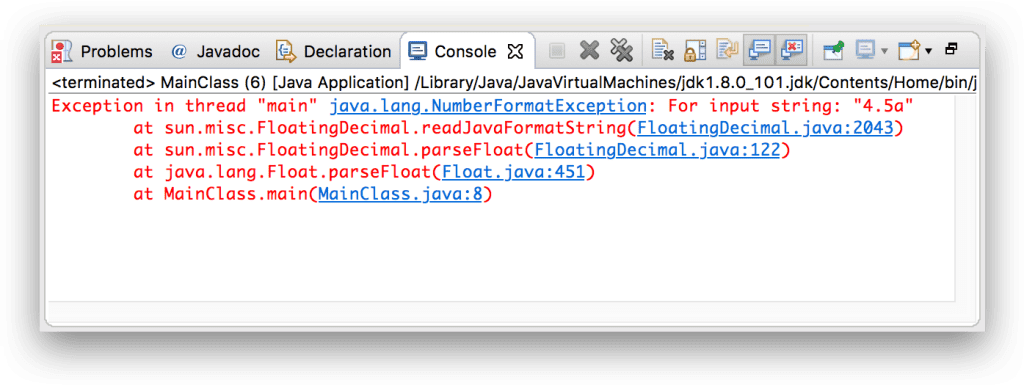
  • Hãy viết chương trình nhập vào 1 String, và sử dụng Integer.parseInt để chuyển đổi String đó sang kiểu int. Thử nếu nhập vào 1 chuỗi không phải là số, xem chương trình sẽ báo lỗi như thế nào.
image 3 - quochung.cyou PTIT
  • Khi chạy chương trình trên, ta sẽ nhận được một ngoại lệ NumberFormatException (Ngoại lệ không đúng định dạng số). Đây là một ví dụ về Unchecked Exception. Vì lúc compile, ta không nhận lỗi nào báo trước cả, do IDE không biết trước được String truyền vào khi chạy chương trình
image 5 - quochung.cyou PTIT

2.1 Cách bắt Exception

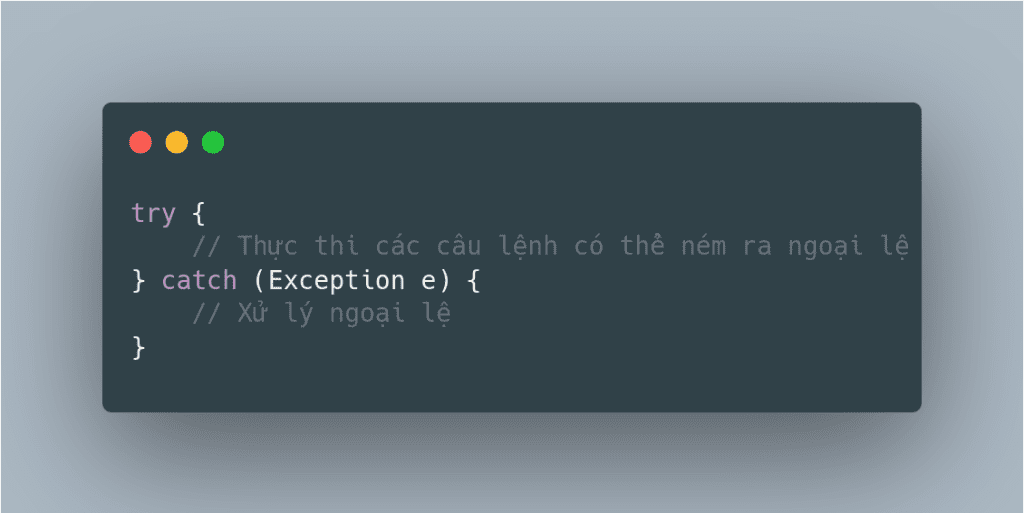
  • Để bắt Exception, ta sử dụng cấu trúc try-catch. Cấu trúc try-catch sẽ giúp chúng ta bắt ngoại lệ, và xử lý nó một cách an toàn.
  • Cấu trúc try-catch có dạng như sau:
image 6 - quochung.cyou PTIT
  • Trong đó:
    • try: Là một khối lệnh, chứa các câu lệnh có thể ném ra ngoại lệ.
    • catch: Là một khối lệnh, chứa các câu lệnh xử lý ngoại lệ. Trong đó, Exception e là một biến, chứa thông tin về ngoại lệ xảy ra.

2.2 Ví dụ

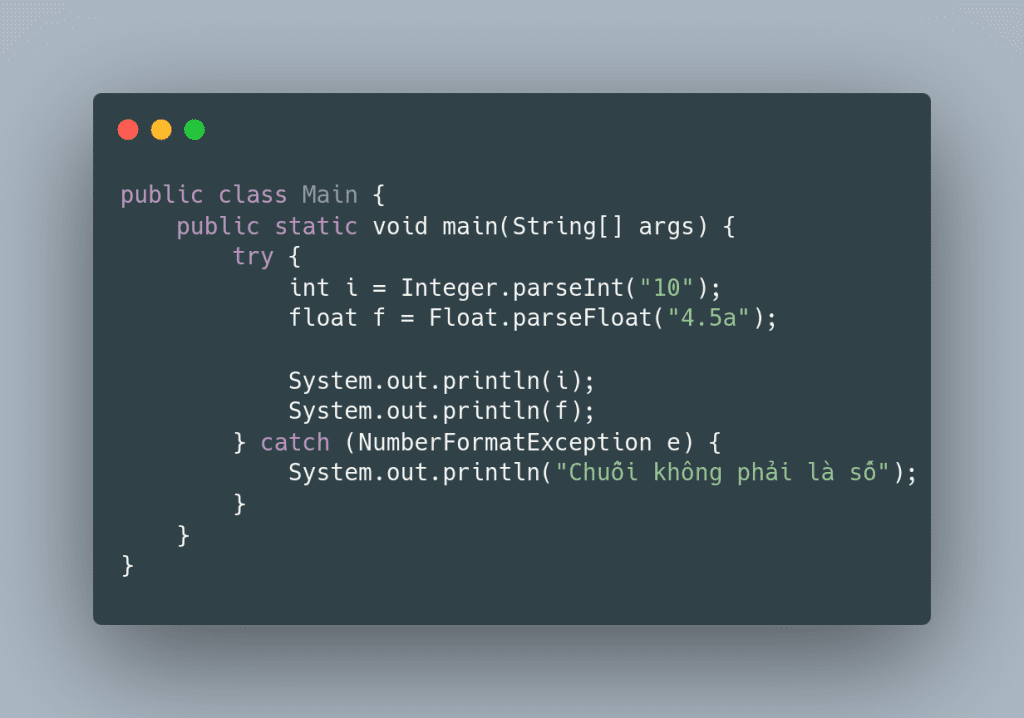
  • Ví dụ, ta sẽ sử dụng cấu trúc try-catch để bắt ngoại lệ NumberFormatException khi chuyển đổi một chuỗi không phải là số sang kiểu int.
image 7 - quochung.cyou PTIT
  • Khi chạy chương trình trên, ta sẽ nhận được thông báo “Chuỗi không phải là số” khi chuyển đổi chuỗi “4.5a” sang kiểu float.

2.3 catch nhiều Exception

  • Ta cũng có thể bắt nhiều ngoại lệ trong cùng một cấu trúc try-catch, bằng cách sử dụng nhiều khối catch.

Bài tập

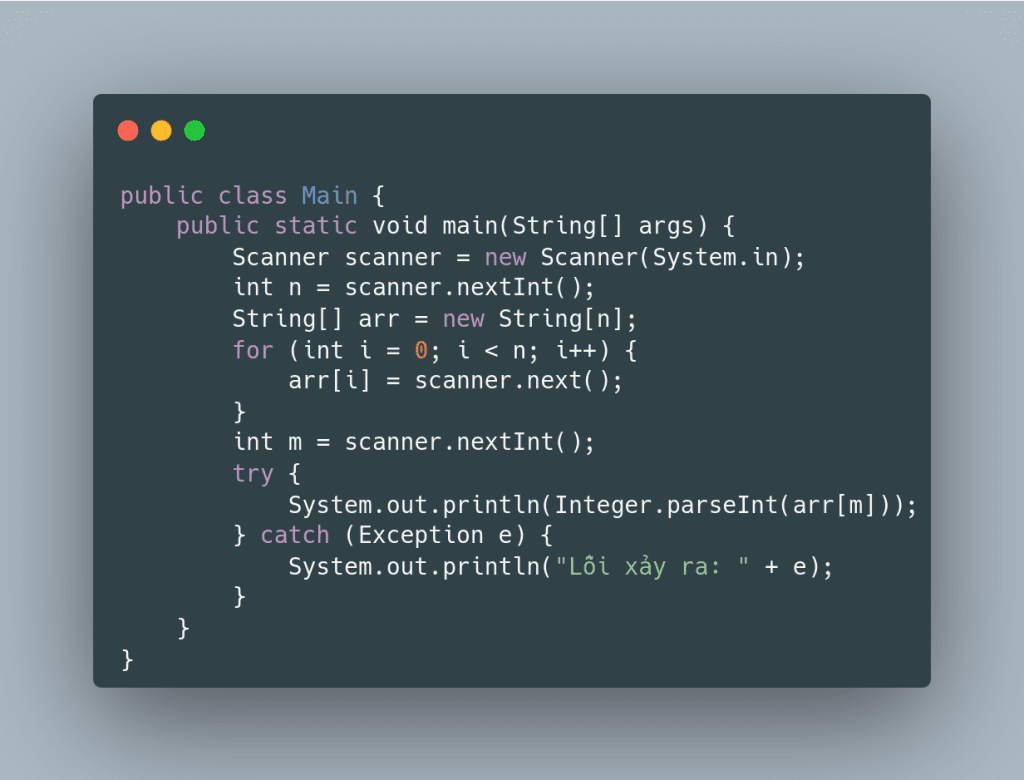
  • Hãy viết chương trình nhập vào số n, sau đó nhập vào n string. Sau đó nhập vào 1 số m, và in ra string thứ m. Nếu truy cập ngoài mảng, hãy in ra thông báo “Truy cập ngoài mảng”, còn nếu không in ra số được chuyển đổi từ string đó sang kiểu int, nếu không thể chuyển đổi được, hãy in ra thông báo “Chuỗi không phải là số”.\
image 8 - quochung.cyou PTIT
  • Như ví dụ trên, ta thấy ta có thể catch nhiều Exception trong cùng một cấu trúc try-catch.

2.4 Catch Exception cha

  • Ta cũng có thể bắt Exception cha của một Exception con. Ví dụ, ta có thể bắt Exception cha của NumberFormatException là Exception.

Bài tập

  • Tương tự bài tập trên, nhưng chỉ dùng 1 catch, và có bất kì lỗi gì xảy ra ta đều in ra “Lỗi xảy ra + tên lỗi”.
image 9 - quochung.cyou PTIT
  • Như ví dụ trên, ta thấy ta có thể bắt Exception cha của NumberFormatException là Exception.

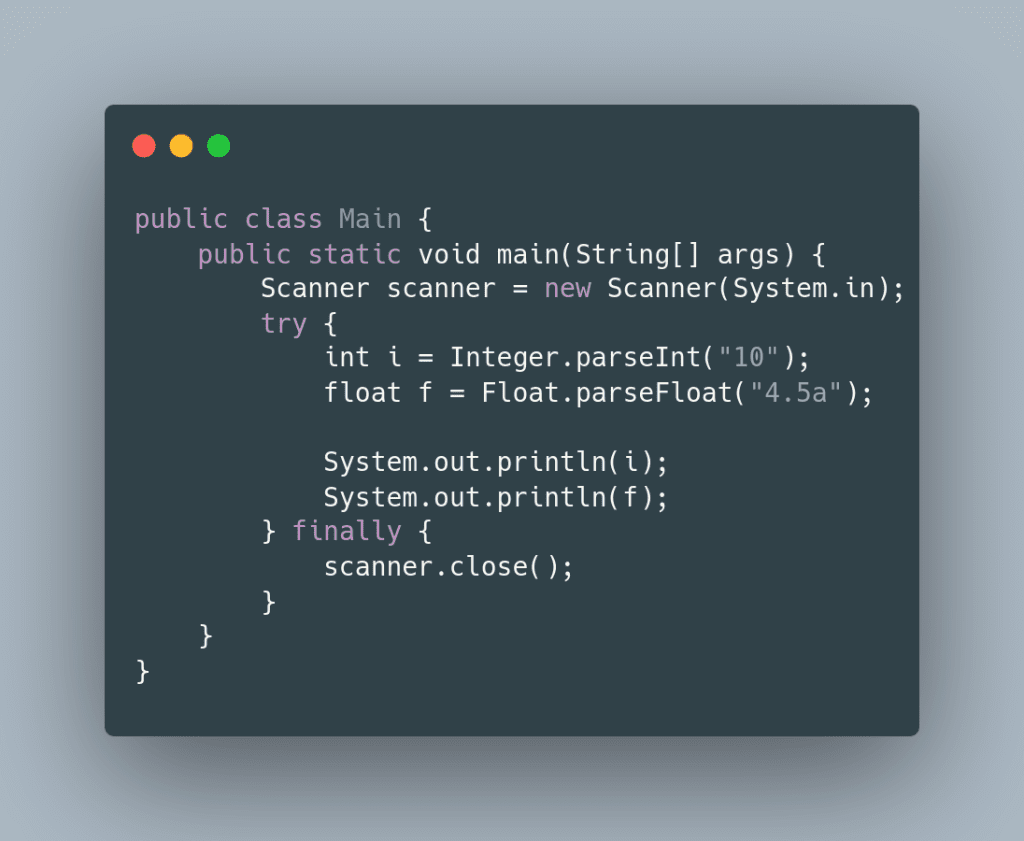
3. Sử dụng finally

3.1 finally là gì?

  • finally là một khối lệnh, chứa các câu lệnh sẽ được thực thi sau khi khối lệnh try-catch kết thúc.
  • finally sẽ được thực thi sau khi khối lệnh try-catch kết thúc, bất kể có ngoại lệ xảy ra hay không.

3.2 Ví dụ

  • Ví dụ, ta sẽ sử dụng finally để đóng Scanner sau khi sử dụng xong.
image 10 - quochung.cyou PTIT
  • Trong đoạn code trên, ta sẽ đóng Scanner sau khi sử dụng xong, bất kể có ngoại lệ xảy ra hay không.

Tác dụng

  • finally thường được sử dụng để giải phóng tài nguyên, như đóng file, đóng kết nối, đóng Scanner, … Đây là một practice nên làm đó là giải phóng tài nguyên sau khi sử dụng xong, tránh lãng phí tài nguyên.

3.3 Một số câu hỏi

3.3.1 Tại sao không sử dụng Exception là xong mà cần catch Exception cụ thể, có nhiều class Exception con

  • Khi sử dụng Exception là xong, ta sẽ bắt được tất cả các Exception, nhưng đôi khi ta cần xử lý một cách cụ thể cho từng Exception. Vì khi có lỗi xảy ra, cứ chỉ báo là đã có lỗi xảy ra thì thứ nhất người dùng rất khó chịu, ta khi sửa lỗi cũng không biết lỗi xảy ra là gì, ở đâu. Thứ hai, ta cũng không thể xử lý lỗi một cách cụ thể.
  • Việc catch đúng Exception cụ thể sẽ giúp ta xử lý lỗi một cách cụ thể. Ví dụ: Nếu lỗi là chia cho 0, ta báo cho người dùng rằng họ nhập sai để họ biết sai ở đâu và sửa lại, còn nếu lỗi là không tìm thấy file, ta báo cho người dùng biết rằng file không tồn tại để họ biết cần phải tạo file mới. Hoặc nếu là các lỗi người dùng không hiểu được, ta cần báo các lỗi cụ thể, có định danh rõ ràng để lập trình viên có thể biết và sửa lỗi
  • Ví dụ, trong window đôi lúc ta bị màn hình xanh, ta có các mã lỗi kiểu như 0x0000000A, 0x0000000B, … những mã lỗi này không phục vụ cho người dùng hiểu, nhưng người dùng có thể dùng nó để báo cáo, và lập trình viên có thể dùng nó để sửa lỗi.

3.3.2 Có thể Try không có Catch không?

  • Có thể, nhưng ta cần có một khối finally để giải phóng tài nguyên.
  • Ví dụ, ta có thể sử dụng try-finally để giải phóng tài nguyên, mà không cần catch Exception.
image 11 - quochung.cyou PTIT

4. Cây phân cấp Exception

  • Trong Java, Exception được phân cấp theo một cấu trúc cây, với Throwable là gốc của cây, Error và Exception là 2 nhánh con của Throwable.
image 12 - quochung.cyou PTIT
  • Interface Iterable nhằm ám chỉ những class bên dưới kế thừa có tính “có thể ném ra được”
  • Lí do tại sao cần 1 cây Exception sẽ được giải thích bên dưới, mục câu hỏi tại sao không catch mọi exception

4.1 Throw, tung ra ngoại lệ

  • Đến hiện tại, ta đã biết các Exception có sẵn trong Java, và cách bắt nó bằng cấu trúc try-catch.
  • Ta nhận thấy, các Exception đều triển khai từ Throwable, và có thể tung ra (throw) một Exception bằng cách sử dụng từ khóa throw.

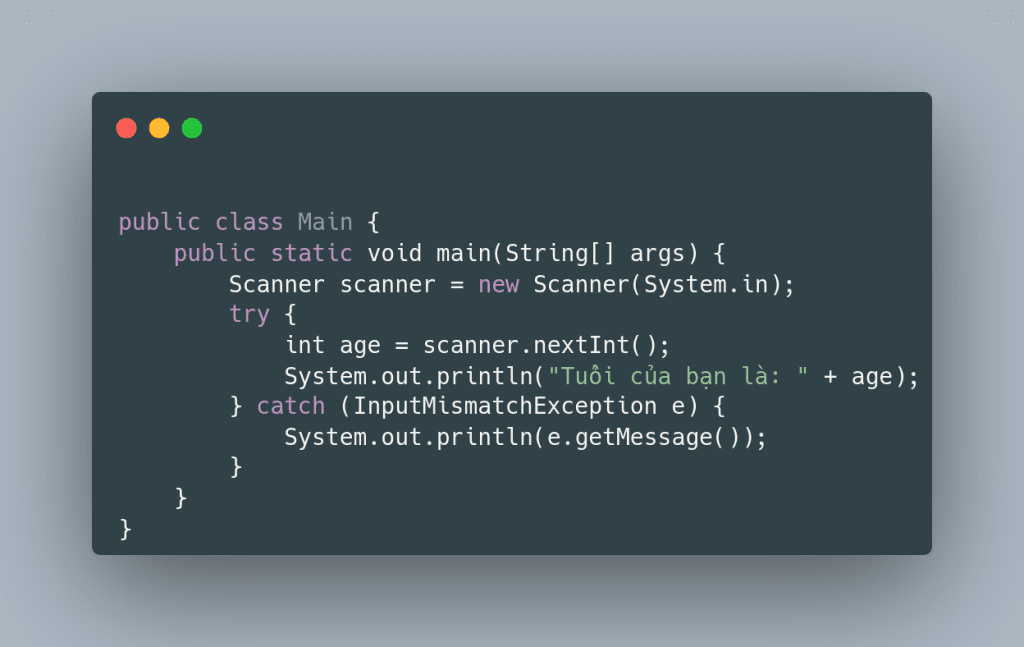
Ví dụ: Ta cần nhập vào một số là tuổi của người dùng, ta sử dụng nextInt của Scanner để nhập vào, nhưng nếu người dùng nhập vào một chuỗi không phải là số, ta sẽ tung ra một Exception InputMismatchException (Ngoại lệ nhập không đúng).

image 13 - quochung.cyou PTIT
image 15 - quochung.cyou PTIT
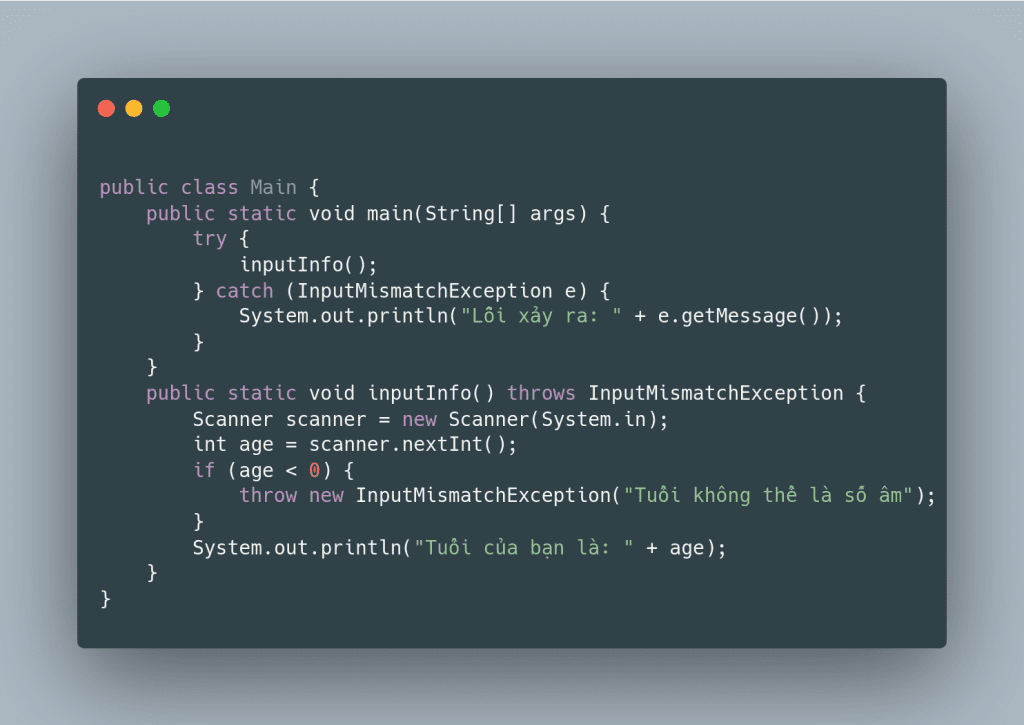
  • Tuy nhiên, người dùng vẫn có thể nhập vào 1 số âm, lúc này ta có thể thêm các điều kiện của riêng mình và throw ra Exception nếu muốn
image 16 - quochung.cyou PTIT

4.2 Throws

  • throws là một từ khóa, dùng để khai báo một phương thức có thể ném ra một ngoại lệ.
  • Ví dụ: Ta chia 1 hàm riêng để nhập vào thông tin nhân viên, nếu nhập sai ta sẽ trả ra 1 số Exception như InputMismatchException, NumberFormatException, …. Tuy nhiên ta muốn nơi gọi đến hàm này tự xử lý ngoại lệ, ta có thể sử dụng throws để khai báo phương thức có thể ném ra ngoại lệ.
image 17 - quochung.cyou PTIT
  • Như code trên, ở hàm inputInfo ta sử dụng throws để khai báo phương thức có thể ném ra ngoại lệ. Lúc này ở nơi gọi đến hàm inputInfo sẽ bị yêu cầu xử lý ngoại lệ InputMismatchException mà ta đã khai báo.
image 19 - quochung.cyou PTIT
  • Như ảnh trên, ta thấy ở bên phải là luồng gọi hàm, và bên trái là luồng Exception được quay ngược lên trên để tìm nơi xử lý nó.

4.3 Tạo ra Exception của riêng mình

  • Đôi khi, ta cần tạo ra Exception của riêng mình, để phục vụ cho mục đích của riêng mình.
  • Tên Throwable có nghĩa là “có thể ném ra”, nghĩa là các Exception bên dưới của chúng ta có thể sử dụng các từ khoá throws, throw để ném ra.
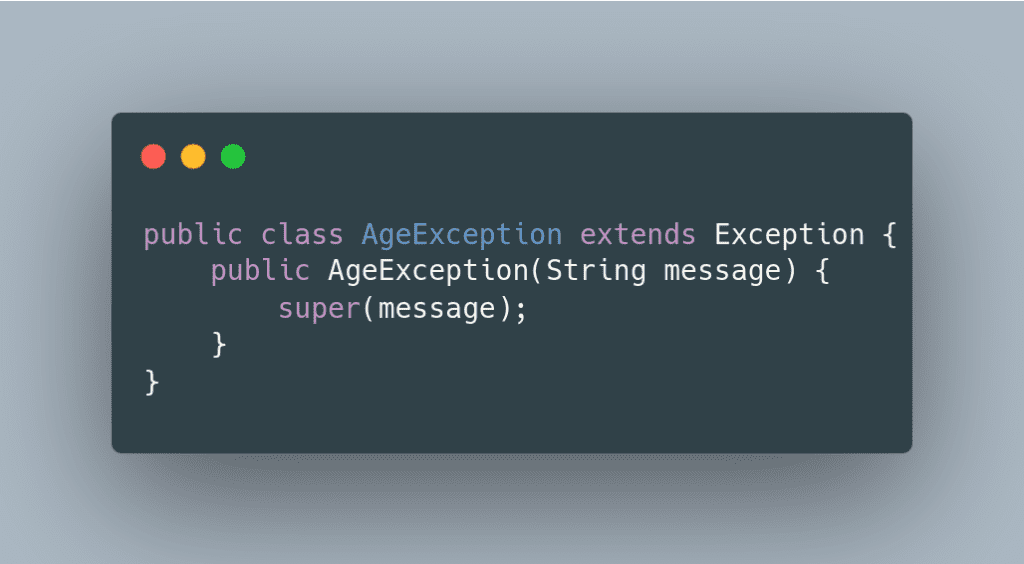
  • Để tạo ra Exception của riêng mình, ta cần tạo ra một class kế thừa từ Exception hoặc RuntimeException. Để tạo 1 Checked Exception, ta kế thừa từ Exception, còn để tạo 1 Unchecked Exception, ta kế thừa từ RuntimeException.
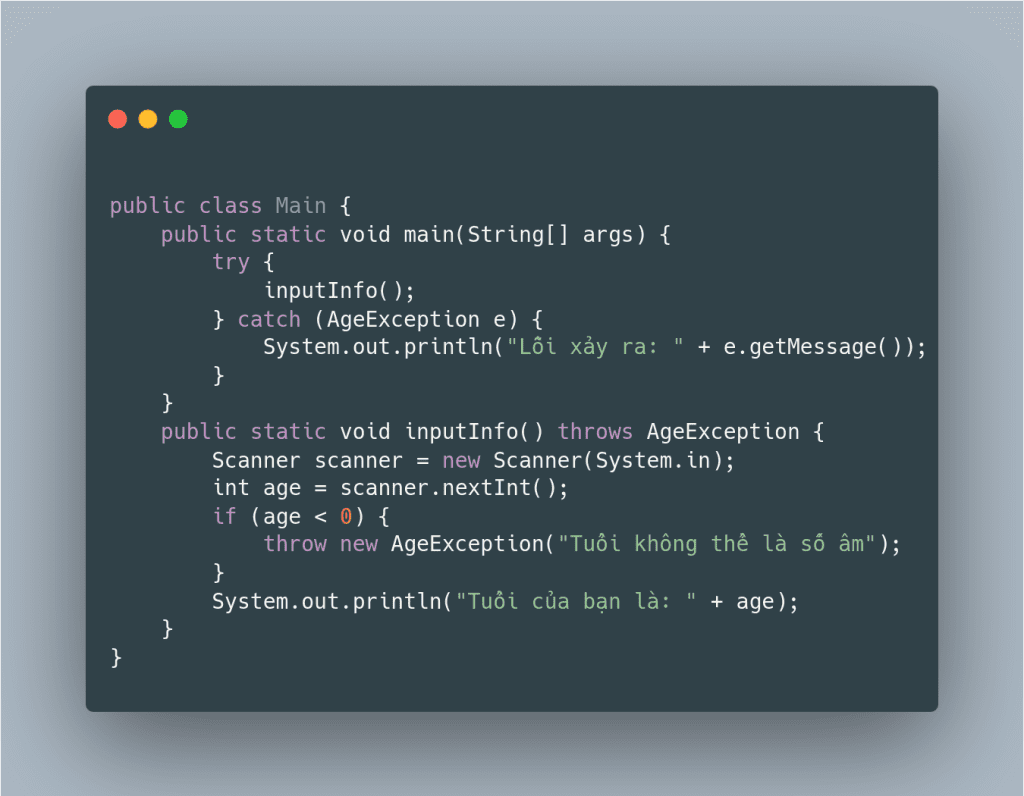
  • Ví dụ, ta cần tạo ra 1 Exception AgeException (Ngoại lệ tuổi), nếu tuổi nhập vào nhỏ hơn 0, ta sẽ ném ra Exception này.
image 20 - quochung.cyou PTIT
  • Ví dụ, ta sẽ sử dụng AgeException để ném ra Exception khi tuổi nhập vào nhỏ hơn 0.
image 21 - quochung.cyou PTIT
  • Như code trên, ta sử dụng AgeException để ném ra Exception khi tuổi nhập vào nhỏ hơn 0.

[Java Core] B6: Design Pattern Iterator. Iterable và Collection trong Java

This entry is part 6 of 8 in the series Java Core

Buổi 6: Một số trúc dữ liệu thường thấy trong Java

  • Cấu trúc dữ liệu là gì, sử dụng khi nào
  • Interface Iterable, Collection -> List, Set, Queue
  • Interface Map, SortedMap -> HashMap, TreeMap
  • Sử dụng một số hàm của cấu trúc dữ liệu như sort

Cấu trúc dữ liệu là gì, sử dụng khi nào

Cấu trúc dữ liệu là một cách tổ chức dữ liệu trong máy tính để có thể lưu trữ và xử lý dữ liệu một cách hiệu quả. Cấu trúc dữ liệu là một phần quan trọng trong việc thiết kế các chương trình và các thuật toán.

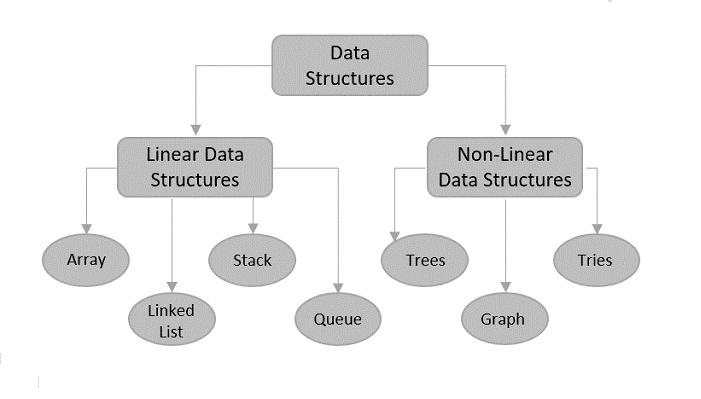
image 60 - quochung.cyou PTIT
  • Thông thường, sẽ có 2 kiểu cấu trúc dữ liệu chính là Linear Data Structure và Non-Linear Data Structure hay cấu trúc dữ liệu tuyến tính và cấu trúc dữ liệu phi tuyến tính.
  • Cấu trúc dữ liệu tuyến tính là các cấu trúc dữ liệu mà các phần tử dữ liệu được sắp xếp theo một thứ tự nhất định. Các cấu trúc dữ liệu tuyến tính thường được sử dụng để lưu trữ dữ liệu đơn giản như danh sách, mảng, hàng đợi, stack, …
  • Cấu trúc dữ liệu phi tuyến tính là các cấu trúc dữ liệu mà các phần tử dữ liệu được sắp xếp theo một thứ tự không nhất định. Các cấu trúc dữ liệu phi tuyến tính thường được sử dụng để lưu trữ dữ liệu phức tạp như cây, đồ thị, …
image 62 - quochung.cyou PTIT

=> Câu hỏi: Với các cấu trúc dữ liệu phức tạp như vậy, làm sao để ta có thể lưu trữ, và duyệt qua các phần tử của chúng?

  • Nghe như một công việc đơn giản với các cấu trúc dữ liệu tuyến tính như list. Ta chỉ cần duyệt qua toàn bộ phần tử khi duyệt. Nhưng làm sao để ta duyệt thứ tự một cấu trúc dữ liệu phức tạp, ví dụ như cây ? Có thể, ta cần nó duyệt theo DFS, hoặc BFS, hoặc duyệt theo thứ tự trước, sau, hoặc duyệt ngẫu nhiên, …
image 63 - quochung.cyou PTIT

Interface Iterable, Collection -> List, Set, Queue

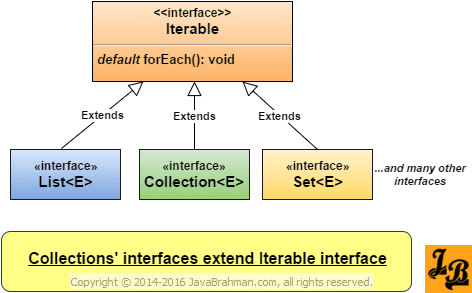
  • Interface Iterable là một interface trong Java, nó có một phương thức là iterator() trả về một đối tượng Iterator để duyệt qua các phần tử của một Collection.  
image 64 - quochung.cyou PTIT
image 65 - quochung.cyou PTIT

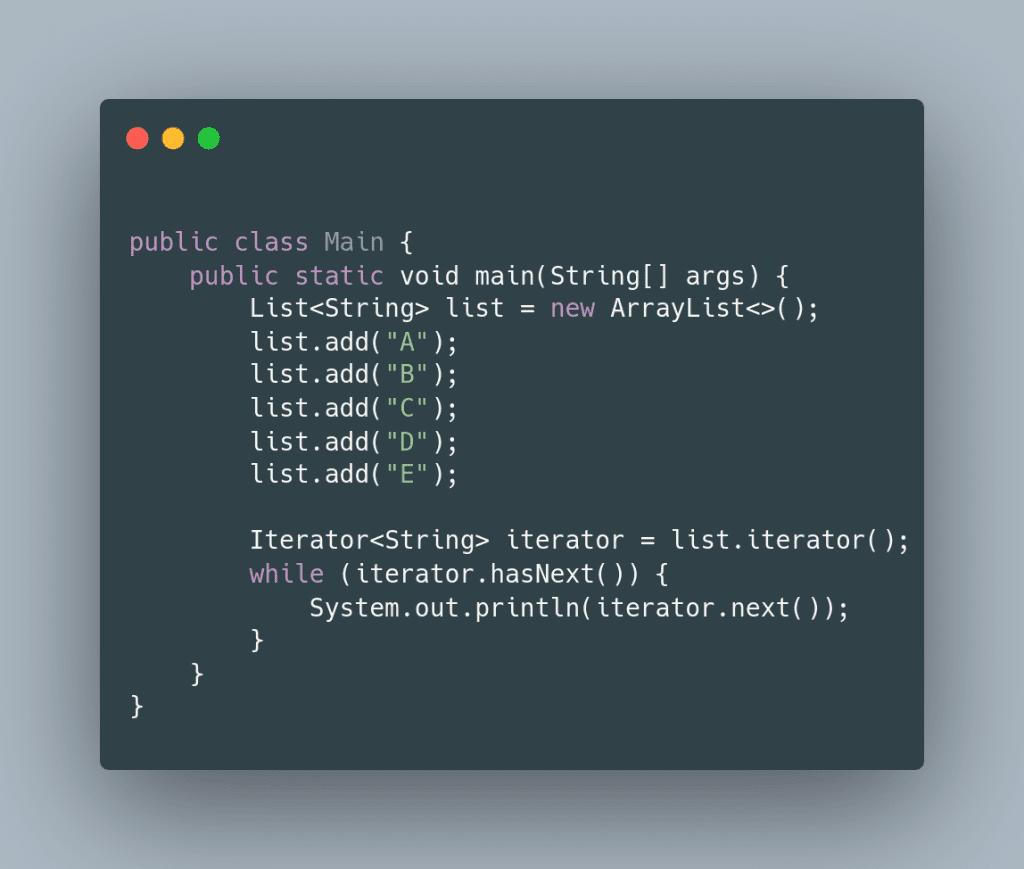
Ví dụ:

image 66 - quochung.cyou PTIT


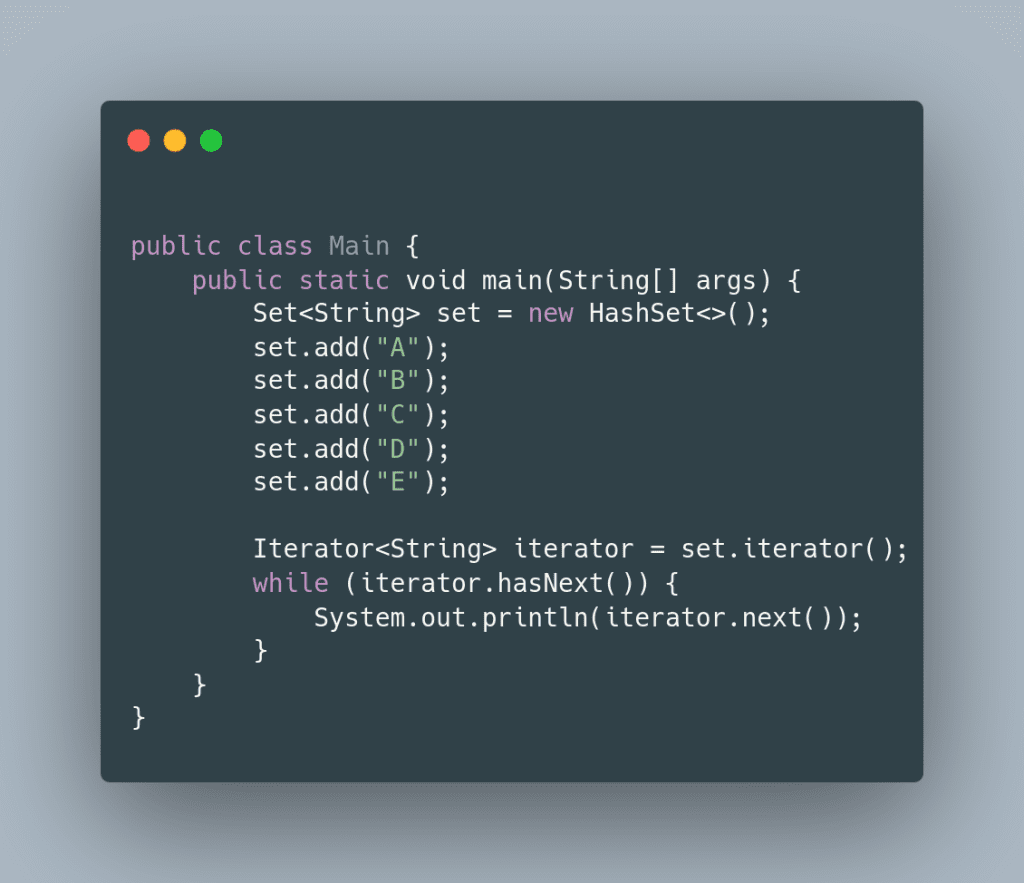
  • Như trong ví dụ trên, ta có thể thấy, ta có thể duyệt qua các phần tử của một Collection bằng cách sử dụng Iterator.
  • Ta lấy ra iterator của object list, thuộc class ArrayList. Do interface List đã define hàm iterator, nên class ArrayList phải implement hàm iterator này, và tự triển khai logic cách để duyệt qua bản thân như thế nào.
  • Các class khác như LinkedList, Vector, … cũng phải implement hàm iterator này, và tự triển khai logic cách để duyệt qua bản thân như thế nào.
  • Điều này cho phép khi duyệt qua các Map, Set, … ta không cần phải quan tâm đến cách duyệt của chúng, mà chỉ cần gọi hàm iterator() của chúng, và duyệt qua các phần tử của chúng.
  • Ví dụ về việc duyệt qua các phần tử của một Set:
image 67 - quochung.cyou PTIT
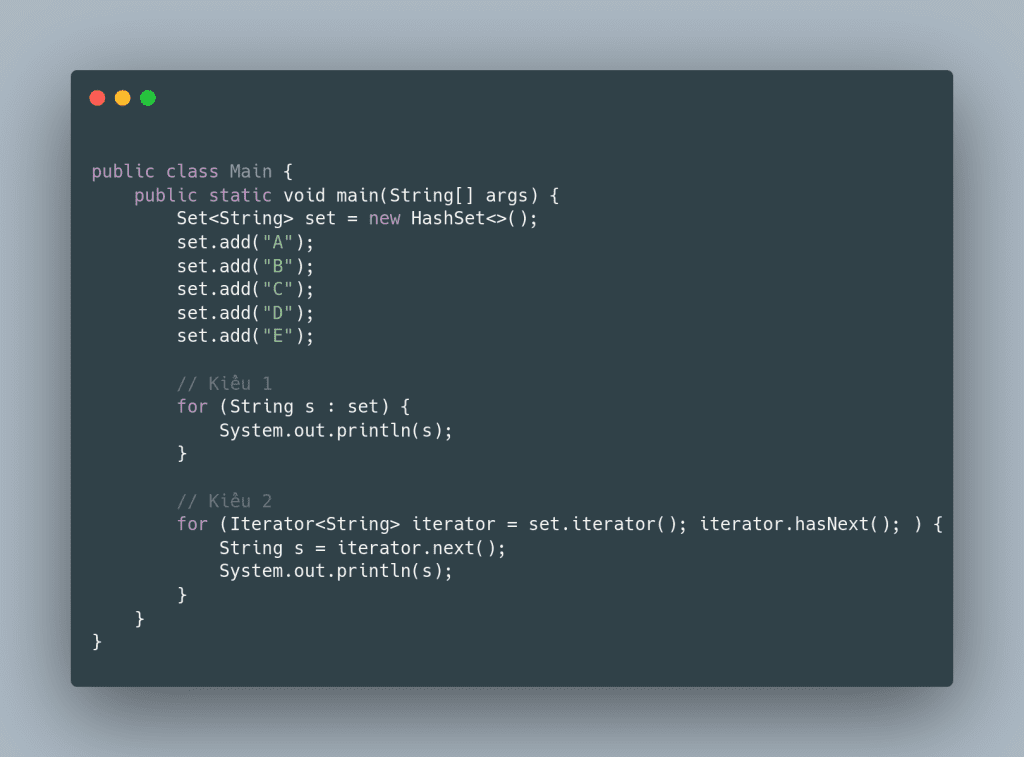
  • Hoặc là có thể duyệt bằng for-each, có 2 kiểu như sau:
image 68 - quochung.cyou PTIT

Định nghĩa một số cấu trúc dữ liệu trong Java

Set

  • Set: là một cấu trúc dữ liệu mà nó không chứa các phần tử trùng lặp. Các phần tử trong Set được sắp xếp theo thứ tự tùy vào cách implement của từng class. Các class implement Set có thể là HashSet, LinkedHashSet, TreeSet, …
    • HashSet: là một class implement Set, nó sử dụng một HashMap để lưu trữ các phần tử. Do đó, các phần tử trong HashSet sẽ không được sắp xếp theo thứ tự
    • LinkedHashSet: là một class implement Set, nó sử dụng một LinkedHashMap để lưu trữ các phần tử. Do đó, các phần tử trong LinkedHashSet sẽ được sắp xếp theo thứ tự.
    • TreeSet: là một class implement Set, nó sử dụng một TreeMap để lưu trữ các phần tử. Do đó, các phần tử trong TreeSet sẽ được sắp xếp theo thứ tự.

Độ phức tạp:

HashSetLinkedHashSetTreeSet
Cách thức làm việcHashSet sử dụng HashMap nội bộ để lưu trữ phần tử.LinkedHashSet sử dụng LinkedHashMap nội bộ để lưu trữ phần tử.TreeSet sử dụng TreeMap nội bộ để lưu trữ phần tử.
Thứ tự của các phần tửKhông duy trì thứ tự của các phần tử.Duy trì thứ tự chèn của các phần tử.Duy trì thứ tự theo bộ so sánh (hoặc tăng dần tự nhiên).
Hiệu suấtTốt hơn so với LinkedHashSet và TreeSet.Nằm giữa HashSet và TreeSet, hiệu suất gần như tương tự HashSet.Thấp hơn HashSet và LinkedHashSet do phải sắp xếp.
Thao tác thêm, xóa, truy xuấtO(1) cho chèn, loại bỏ, và truy xuất.O(1) cho chèn, loại bỏ, và truy xuất.O(log(n)) cho chèn, loại bỏ, và truy xuất.
So sánh các phần tửSử dụng equals() và hashCode() để so sánh và loại bỏ phần tử trùng lặp.Sử dụng equals() và hashCode() để so sánh và loại bỏ phần tử trùng lặp.Sử dụng compare() hoặc compareTo() để so sánh và loại bỏ phần tử trùng lặp. Không sử dụng equals() và hashCode().
Phần tử NullCho phép tối đa một phần tử null.Cho phép tối đa một phần tử null.Không cho phép phần tử null, nếu thử chèn sẽ ném NullPointerException.
Sử dụng bộ nhớĐòi hỏi ít bộ nhớ hơn so với LinkedHashSet và TreeSet.Yêu cầu bộ nhớ nhiều hơn HashSet do duy trì LinkedList cùng với HashMap.Yêu cầu bộ nhớ nhiều hơn HashSet do duy trì bộ so sánh và TreeMap.
Khi nào sử dụng?Muốn danh sách không chứa phần tử trùng và không cần duy trì thứ tự.Muốn danh sách không chứa phần tử trùng và muốn duy trì thứ tự chèn.Muốn danh sách không chứa phần tử trùng và muốn sắp xếp các phần tử.

Tóm gọn:

  • HashSet: không duy trì thứ tự, tốc độ nhanh
  • LinkedHashSet: duy trì thứ tự theo thứ tự chèn, tốc độ giữa
  • TreeSet: duy trì thứ tự theo bộ so sánh, tốc độ chậm hơn

Map

  • Là cấu trúc dữ liệu theo kiểu key-value, trong đó key là duy nhất, và value có thể trùng nhau. Các class implement Map có thể là HashMap, LinkedHashMap, TreeMap, …

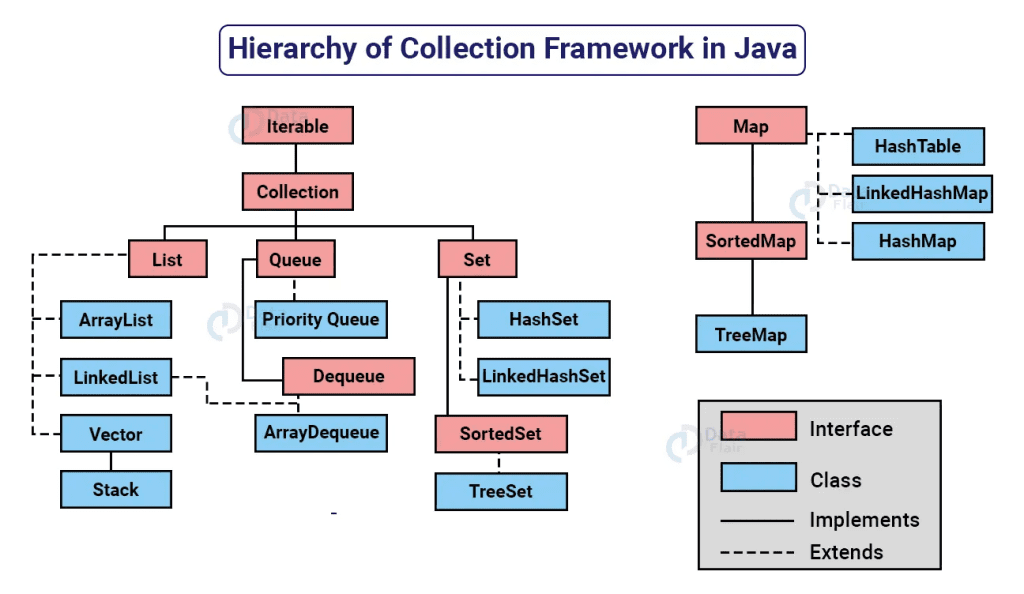
Sơ đồ kế thừa của các cấu trúc dữ liệu trong Java

image 69 - quochung.cyou PTIT
  • Theo hình trên, ta có 3 interface chủ đạo gồm List, Queue, Set sẽ kế thừa từ interface Collection. Từ interface Collection, chúng sẽ có các hàm chung như add, remove, contains, … và các hàm khác.
  • Lúc này, ở các class implement List, Queue, Set, chúng sẽ phải implement các hàm này, và tự triển khai logic cách để add, remove, contains, … như thế nào. Ngoài ra là triển khai các hàm từ interface Iterable, để có thể duyệt qua các phần tử của chúng, và các hàm từ riêng các interface List, Queue, Set, để có thể thực hiện các thao tác riêng của chúng.
  • Map thì là một trường phái khác, do chúng không kế thừa từ interface Collection, vì Map nhận vào 2 value. Do đó, để sử dụng được các hàm Collection trong Map, ta có thể lấy ra keySet, valueSet, entrySet của Map, và sử dụng các hàm Collection trên chúng.
image 70 - quochung.cyou PTIT

Về Comparable và Comparator, cách sử dụng trong các cấu trúc dữ liệu để sắp xếp

  • Trong Java, có 2 cách để sắp xếp các phần tử của một cấu trúc dữ liệu, đó là sử dụng Comparable và Comparator.
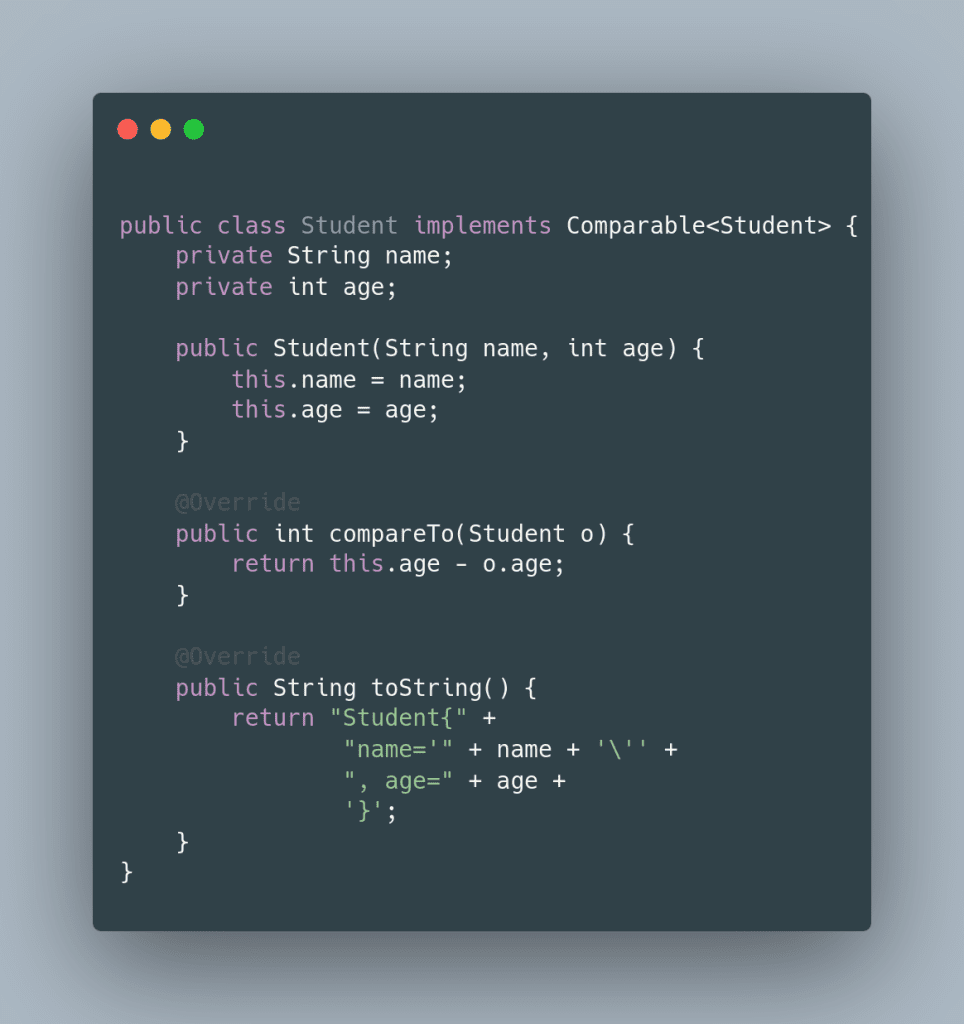
  • Comparable là một interface, nó có một hàm là compareTo(), và nó được implement bởi các class muốn sắp xếp các phần tử của chúng. Hàm compareTo() sẽ trả về một số nguyên, và nó sẽ được sử dụng để so sánh 2 phần tử của cấu trúc dữ liệu đó. Nếu trả về số âm, thì phần tử đầu tiên sẽ được đặt trước phần tử thứ hai, nếu trả về số dương, thì phần tử thứ hai sẽ được đặt trước phần tử đầu tiên, nếu trả về 0, thì 2 phần tử sẽ được đặt ngang hàng với nhau.

Code ví dụ:

image 71 - quochung.cyou PTIT
  • Như code trên, class Student implement interface Comparable, và phải triển khai cách để so sánh giữa 2 Student với nhau
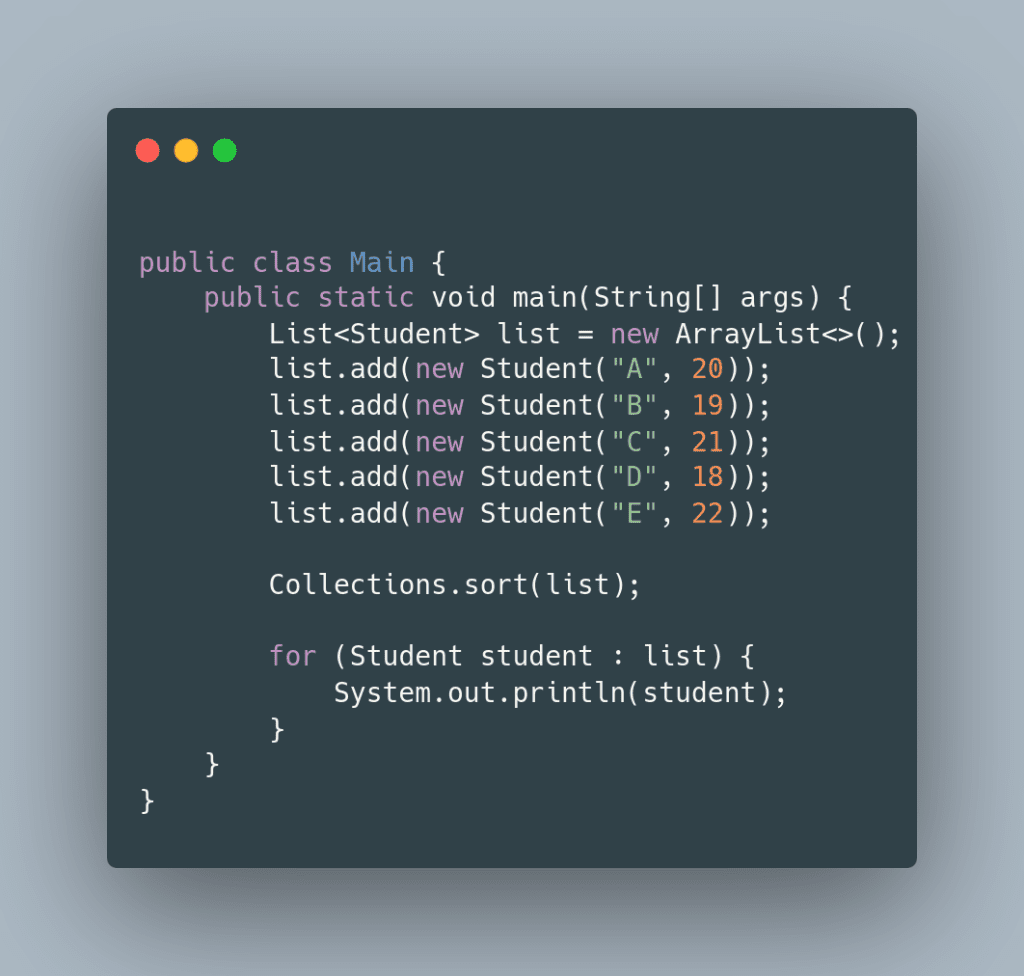
  • Để sử dụng so sánh, ta có thể sử dụng hàm sort() của class Collections để sắp xếp các phần tử của một List:
image 72 - quochung.cyou PTIT
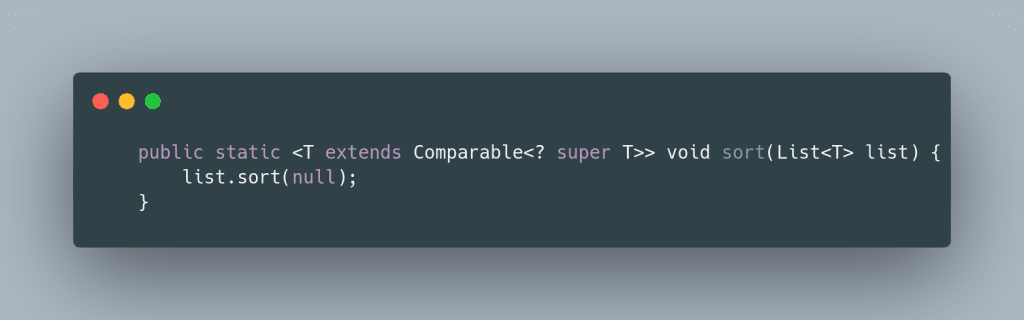
  • Code thực tế trong Collection, có thể Ctrl+Click vào để xem
image 73 - quochung.cyou PTIT
  • Như code trên, ta có thể thấy, hàm sort của Collections sẽ nhận vào một List, và List này phải chứa T là một class implement Comparable, và hàm sort sẽ sử dụng hàm compareTo của T để so sánh các phần tử của List với nhau.
  • Comparator là một interface, nó có một hàm là compare(), và nó được implement bởi các class muốn sắp xếp các phần tử của chúng. Hàm compare() sẽ trả về một số nguyên, và nó sẽ được sử dụng để so sánh 2 phần tử của cấu trúc dữ liệu đó. Nếu trả về số âm, thì phần tử đầu tiên sẽ được đặt trước phần tử thứ hai, nếu trả về số dương, thì phần tử thứ hai sẽ được đặt trước phần tử đầu tiên, nếu trả về 0, thì 2 phần tử sẽ được đặt ngang hàng với nhau.

Code ví dụ:

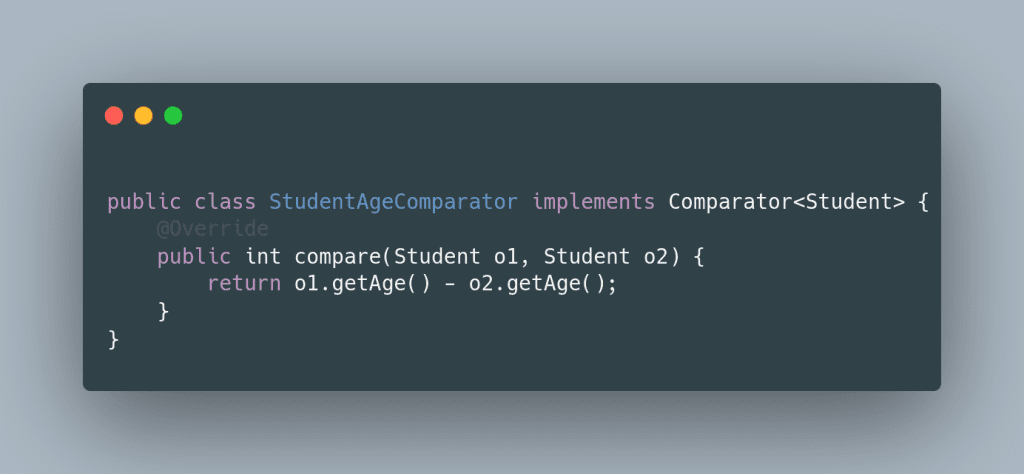
image 74 - quochung.cyou PTIT
image 75 - quochung.cyou PTIT
  • Như code trên, class StudentAgeComparator implement interface Comparator, và phải triển khai cách để so sánh giữa 2 Student với nhau
  • Để sử dụng so sánh, ta có thể sử dụng hàm sort() của class Collections để sắp xếp các phần tử của một List:
image 76 - quochung.cyou PTIT
  • Code thực tế trong Collection, có thể Ctrl+Click vào để xem
image 77 - quochung.cyou PTIT
  • Như code trên, ta có thể thấy, hàm sort của Collections sẽ nhận vào một List, và 1 Comparator, và hàm sort sẽ sử dụng hàm compare của Comparator để so sánh các phần tử của List với nhau.
  • So sánh Comparable và Comparator
ComparableComparator
Comparable là một interface, nó có một hàm là compareTo(), và nó được implement bởi các class muốn sắp xếp các phần tử của chúng.Comparator là một interface, nó có một hàm là compare(), và nó được implement bởi các class muốn sắp xếp các phần tử của chúng.
Comparable bắt buộc triển khai trong class mà ta muốn sort class đó, và chỉ chỉ khai được một cách duy nhất.Comparator không bắt buộc triển khai trong class mà ta muốn sort class đó, và có thể khai báo nhiều Comparator khác nhau, tuỳ vào mục đích sử dụng.
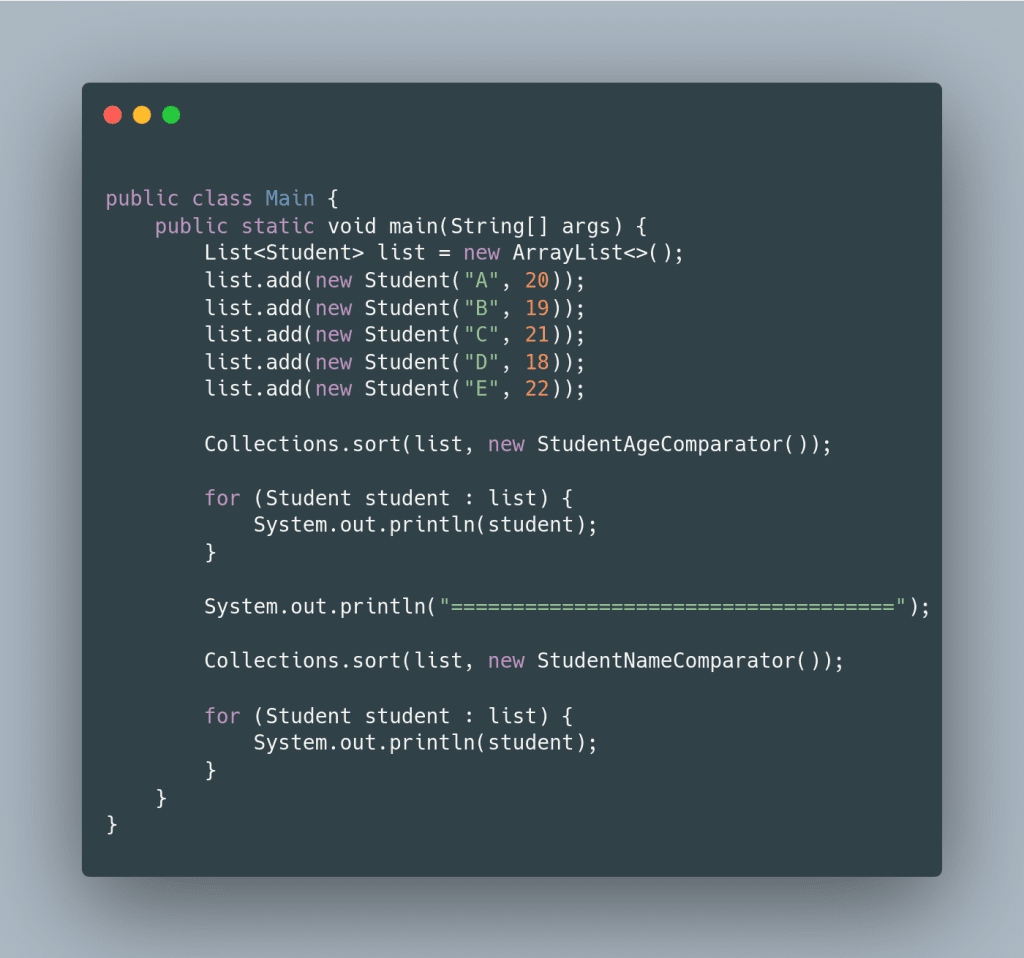
  • Ví dụ về việc sử dụng nhiều loại Comparator khác nhau:
image 78 - quochung.cyou PTIT
image 79 - quochung.cyou PTIT
  • Như code trên, ta có thể thấy, ta có thể sử dụng nhiều Comparator khác nhau, để sắp xếp các phần tử của List theo nhiều cách khác nhau.