Khi nào dùng interface, khi nào dùng abstract class?
Bài tập về interface và trừu tượng
Interface là gì?
Interface là một khái niệm trừu tượng, nó chỉ ra những gì mà một đối tượng có thể làm, nhưng không nói ra làm thế nào để đối tượng đó làm được điều đó.
Ví dụ cú pháp khai báo interface:
Trong ví dụ trên, interface Animal chỉ ra rằng một Animal có thể làm được 2 việc là ăn và di chuyển, nhưng không nói ra làm thế nào để ăn và di chuyển.
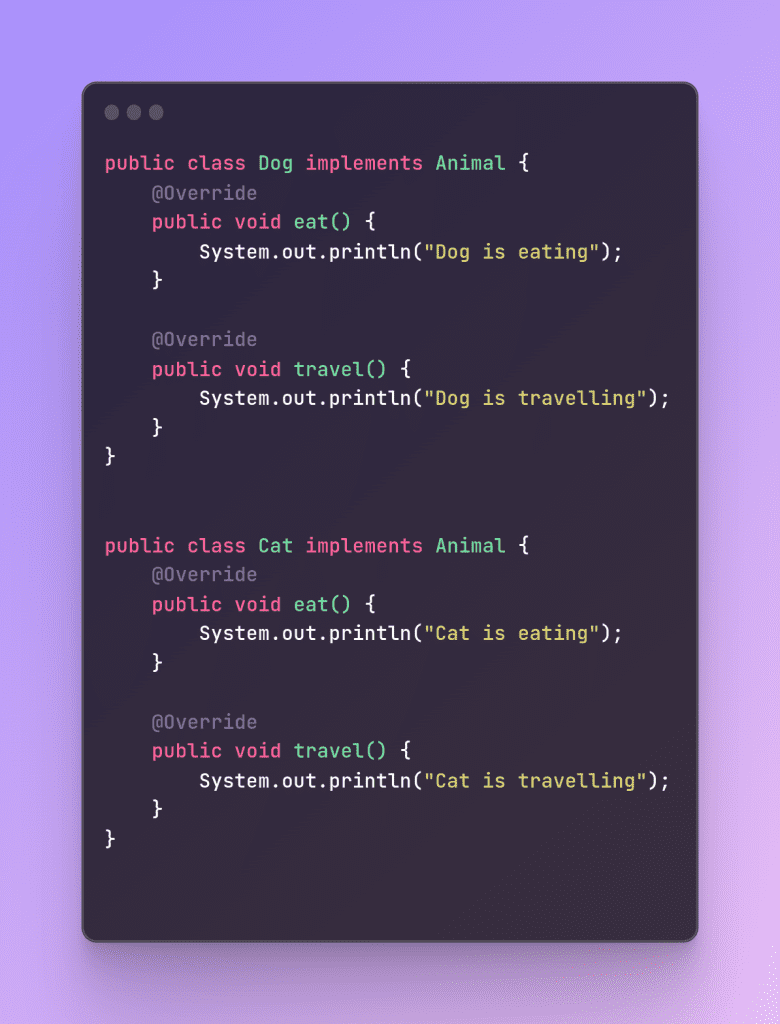
Lúc này, ví dụ ta có 1 class Dog và Cat thì ta có thể implement interface Animal vào 2 class này như sau:
Lúc này, ta có thể khởi tạo 2 đối tượng Dog và Cat và gọi các phương thức eat() và travel() mà không cần quan tâm đến cách thức của 2 phương thức này.
Kết quả khi chạy chương trình:
Dog is eating

Dog is travelling

Cat is eating

Cat is travelling
Take away | Tổng hợp
Như vậy, interface có thể nhìn nhận như 1 bản hợp đồng, tôi quy định trước, tôi chỉ định nghĩa là, các class implement interface này phải làm được những gì tôi quy định.
Như vậy, khi bên khác implement interface này, bên đó phải làm theo những gì mà interface quy định, nếu không làm theo, bên đó sẽ bị lỗi compile.
Còn nếu bên nào sử dụng interface, ta có thể khởi tạo đối tượng của class implement interface đó, và gọi các phương thức, và biết chắc phương thức tồn tại và có thể gọi được ở class đó, vì class đó đã implement interface đó.
Abstract class
Abstract Class – Lớp trừu tượng, là 1 lớp trong Java, nhưng có thể chứa cả các phương thức trừu tượng (abstract method) và các phương thức thường (non-abstract method).
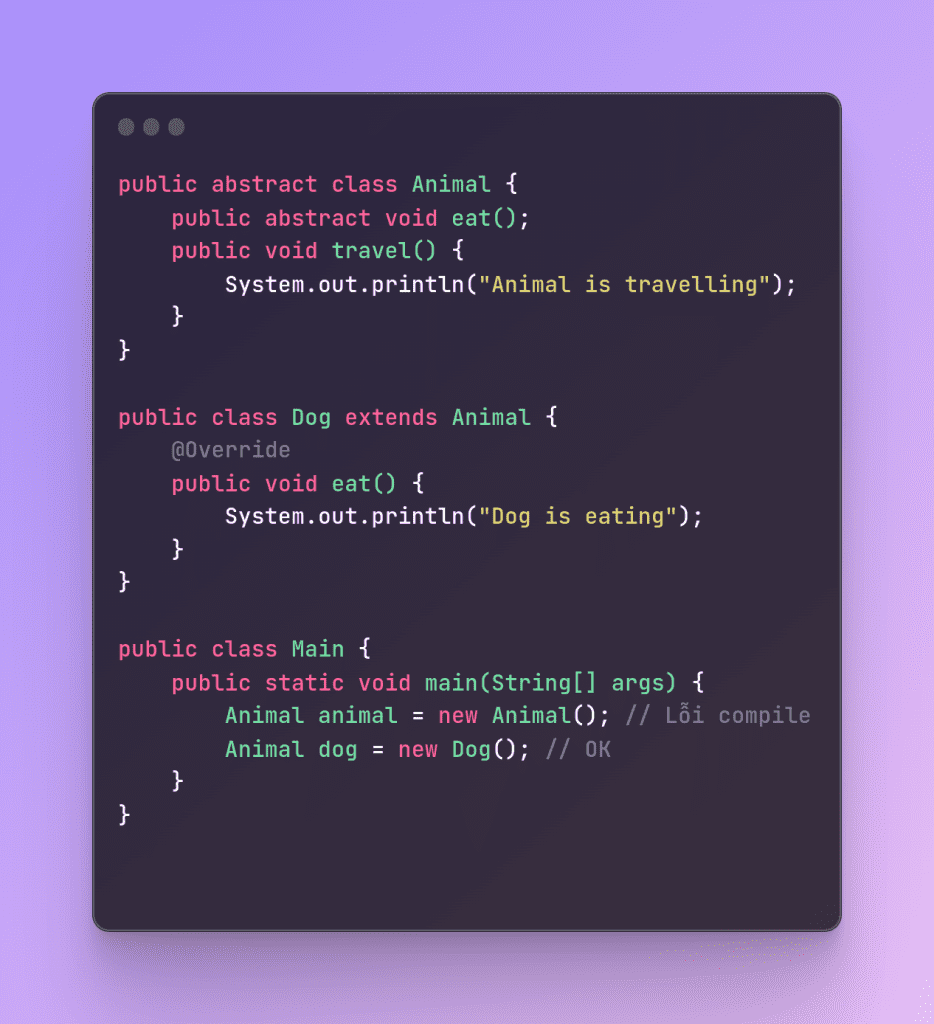
Abstract Class không thể khởi tạo đối tượng, nhưng có thể khai báo biến kiểu Abstract Class, và khởi tạo đối tượng của class con của Abstract Class.
Ví dụ:
Kết quả khi chạy chương trình:
Dog is eating

Animal is travelling

Cat is eating

Animal is travelling
Take away | Tổng hợp
Như vậy, Abstract Class nhìn chung giống Class, nhưng mà có thể tạo thêm phương thức trừu tượng, các class kế thừa từ Abstract Class này phải implement các phương thức trừu tượng này, nếu không sẽ bị lỗi compile.
Các phương thức trừu tượng này, có thể hiểu là các phương thức mà Abstract Class này quy định, các class kế thừa từ Abstract Class này phải có, và phải implement các phương thức này.
Các phương thức thường (non-abstract method) thì không cần implement, vì các class kế thừa từ Abstract Class này đã có sẵn các phương thức này.
Abstract Class thì không thể khởi tạo đối tượng, nhưng có thể khai báo biến kiểu Abstract Class, và khởi tạo đối tượng của class con của Abstract Class.
Ví dụ
Lí do, vì abstract class hay interface chứa những hàm trừu tượng, những hàm chỉ định nghĩa, chưa có logic và giao việc triển khai logic cho các nơi ghi đè nó, nên không thể khởi tạo đối tượng từ abstract class hay interface được. (Vì nó chưa có logic, chưa có gì để chạy cả)
So sánh Interface và Abstract Class
Interface
Abstract Class
Interface chỉ có thể chứa các phương thức trừu tượng
Abstract Class có thể chứa cả các phương thức trừu tượng và các phương thức thường
Interface không thể khởi tạo đối tượng
Abstract Class không thể khởi tạo đối tượng
Biến trong interface mặc định là public static final
Biến trong abstract class không có mặc định gì cả
Interface không có constructor
Abstract Class có constructor
Interface không có gì để ghi đè
Abstract Class có thể có các phương thức để ghi đè
Interface có thể kế thừa nhiều interface khác
Abstract Class chỉ có thể kế thừa 1 abstract class khác
Các class implement interface có thể implement nhiều interface khác
Các class kế thừa từ abstract class chỉ có thể kế thừa 1 abstract class khác
Note: Sau này interface có thể có các phương thức thường, nhưng mà vẫn không thể khởi tạo đối tượng từ interface được.
Về biến trong interface, mặc định là public static final, nên khi khai báo biến trong interface, không cần khai báo public static final nữa. Tức là các biến trong interface là tồn tại duy nhất, không đổi được, ở dạng static.
Về biến trong abstract class, không có mặc định gì cả, nên có thể tạo các “biến thường”, tức là mỗi object tạo ra bởi 1 class chứa giá trị khác nhau.
Special Question: Diamond Problem
Diamond Problem là gì?
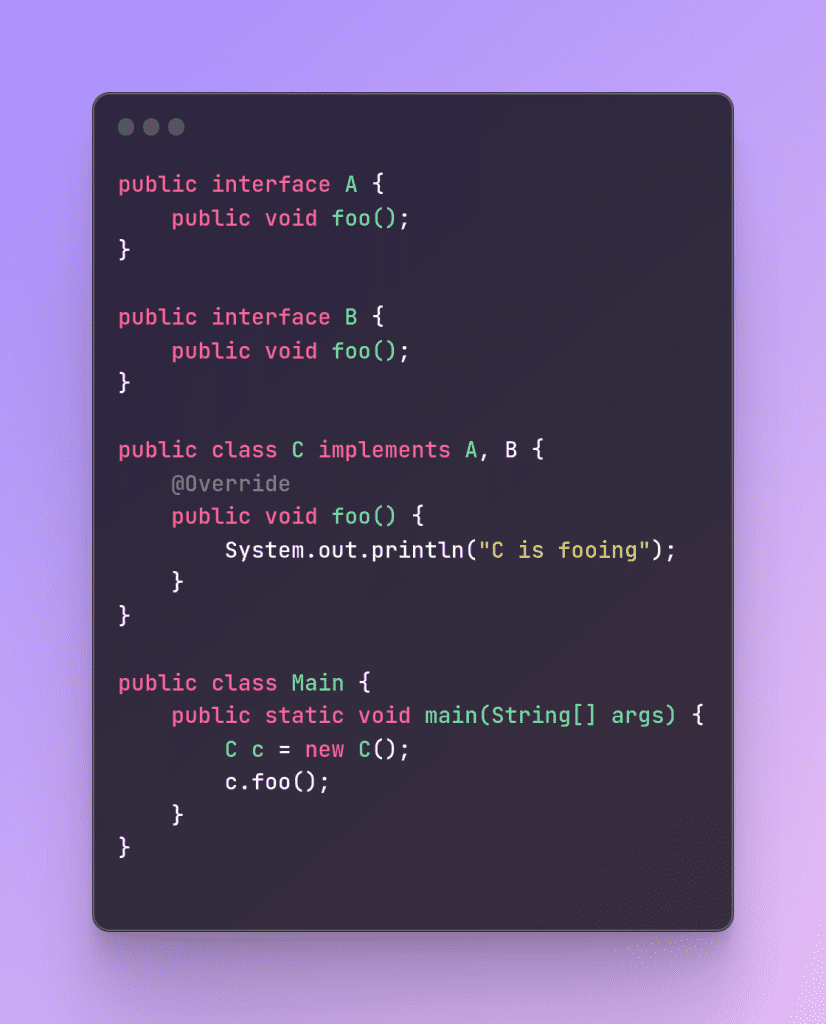
Diamond Problem là một vấn đề xảy ra khi đa kế thừa, tức là nếu 1 class kế thừa từ 2 nơi có trùng thứ gì đó, thì nó làm sao biết nên dùng cái nào ???
Mặc định thì, Java không cho phép kế thừa từ 2 class, nhưng nếu kế thừa từ 2 interface thì được. (Vì interface chỉ chứa các phương thức trừu tượng, không có gì để ghi đè)
Ví dụ:
Khi nào dùng interface, khi nào dùng abstract class?
Khi nào dùng interface, khi nào dùng abstract class?
Câu trả lời đơn giản: Khi nào cần thì dùng, tuỳ vào mục đích của mình
Nhưng mà, để hiểu rõ hơn, ta cùng xem ví dụ sau:
Như vậy, ta có thể thấy, khi dùng interface, ta phải implement lại cả phương thức travel(), trong khi khi dùng abstract class, ta không cần implement lại phương thức travel().
Tuy nhiên, interface lại cho phép ta kế thừa nhiều interface khác, trong khi abstract class thì không.
Tổng kết
Có thể thấy, abstract class cho phép ta có các khả năng trừu tượng, và có thể chứa các logic có sẵn ta muốn dùng cho nhiều class con. Lúc này ta có thể cân nhắc sử dụng abstract class
Thay vì điều đó, interface thường được dùng để chỉ behavior - tính cách, cách xử sự của 1 đối tượng. Tức là 1 cái ô tô thì có thể xử lý các interface là ChayXe, ChayDongCo, ChayDien, ChayDau… Như vậy, interface thường được dùng để chỉ ra tính chất của 1 đối tượng, còn logic thì để class implement interface đó tự triển khai.
Với abstract class, ta dùng cho những case ta có logic tập trung, có thể reuse ở class con. Vừa có khả năng trừu tượng mà các class con sẽ có đặc tính riêng. Tuy nhiên nếu class đó quá lớn, ví dụ class PhuongTien có đủ thứ hàm như ChayXe, ChayDongCo, ChayDien, ChayDau… , thì ví dụ XeDap kế thừa lại có các hàm chạy động cơ, chạy điện => Như thế bị thừa, không cần thiết, làm confuse cho người đọc code => Ta nên tách ra thành interface.
Với interface, ta dùng cho những case ta chỉ cần chỉ ra tính chất của 1 đối tượng, còn logic thì để class implement interface đó tự triển khai.
Tính trừu tượng
Tính trừu tượng là gì?
Tính trừu tượng là một khái niệm trong lập trình hướng đối tượng, nó cho phép ta chỉ ra những gì mà một đối tượng có thể làm, nhưng không nói ra làm thế nào để đối tượng đó làm được điều đó.
Tức là, khi ta dùng xe máy, ta chỉ biết là nó có thể chạy, có thể dừng, có thể bật đèn, có thể bật còi, nhưng ta không cần biết làm thế nào để nó chạy, dừng, bật đèn, bật còi.
Tính trừu tượng là một khái niệm quan trọng trong lập trình hướng đối tượng, nó cho phép ta tách biệt được phần logic của đối tượng và phần giao tiếp với đối tượng. Ta chỉ quan tâm đến phần giao tiếp với đối tượng, còn phần logic của đối tượng thì ta không cần quan tâm. Điều này giúp ta có thể dễ dàng thay đổi phần logic của đối tượng mà không ảnh hưởng đến phần giao tiếp với đối tượng.
Tại sao cần sử dụng interface
Giả sử, ta có 1 interface là “Athlete” – Vận động viên với 2 hàm là play() – là chơi thể thao nào đó
Giả sử, ta có 1 class Team – 1 đội chơi, sẽ có thể thêm vận động viên vào, ta nhận thấy, nếu có thể, ta luôn lên sử dụng interface thay vì khai báo thẳng 1 class cụ thể, vì khi đó, ta có thể thêm bất cứ vận động viên nào vào đội chơi, miễn là vận động viên đó implement interface Athlete.
Như code trên, bất kì vận động viên nào implement interface Athlete đều có thể thêm vào đội chơi, và có thể chơi được. Điều này giúp code dễ mở rộng, flexible hơn, sau này ta có thể thêm bất cứ vận động viên nào vào đội chơi, miễn là vận động viên đó implement interface Athlete.
Đây cũng được biết là quy tắc prefer interface over class hay prefer composition over inheritance
Interface làm đúng sự phụ thuộc của module level cao
Giả sử, ta có class DienThoai, khi này khi ta muốn sạc điện thoại, ta sẽ gọi 1 class bên trong DienThoai là sạc điện bằng củ sạc Samsung
Ta thấy, với thiết kế hiện tại, ta sẽ truyền tham số là cường độ vào củ sạc Samsung để class đó thực hiện sạc.
Tuy nhiên, bất kì sự thay đổi nào ở class CuSac vào phương thức sac có thể yêu cầu class điện thoại truyền thêm tham số, hay phải dùng tên hàm khác, …
Điều này là không đúng, điện thoại rõ ràng là module cấp cao hơn, và nên có quyền quyết định dùng củ sạc nào, chứ không phải củ sạc quyết định điện thoại phải làm gì để dùng.
Vì vậy, ta nên tạo ra 1 interface là CuSac để điện thoại có thể sạc, và class CuSacSamSung implement interface CuSac này.
Lúc này, sự phụ thuộc đã thay đổi. Giờ DienThoai chỉ sử dụng interface củ sạc, ví dụ như Iphone quy định là tôi dùng cổng lightning, máy Samsung bảo tôi dùng cổng sạc USB-C vậy. Các nhà sản xuất củ sạc phải đi theo họ.
Thì ở đây, DienThoai dùng interface để định nghĩa là tôi sẽ muốn sạc như thế nào. Còn củ sạc thì implement interface đó, và tự triển khai logic riêng của mình, nhưng phải tuân thủ theo hợp đồng interface mà DienThoai sử dụng
Lúc này, ta đã đang thực hiện giao tiếp với server qua token, có một câu hỏi đặt ra là, làm sao để gửi token đó cho phía server?
Hiển nhiên, ta có thể làm điều ở ở body của request, ở param, … hoặc ở cookie. Tuy nhiên, có một cách thông dụng và được sử dụng hầu hết hiện nay để chuyển 1 token không qua cookie đó là sử dụng dạng “Bearer” https://tools.ietf.org/html/rfc6750
Bearer lúc đầu được tạo ra nhằm phục vụ cho OAuth2 (sẽ nói thêm sau)
Để gửi 1 token qua api, ta chỉ cần để nó ở header Authorization
Authorization: Bearer QDAmQ9TStkDCpVK5A9kFowtYn2k
Việc sử dụng giao tiếp qua Authorization cũng cho phép ta sử dụng header WWW-Authenticate để giúp đầu api “thân thiện” với http hơn
WWW-Authenticate có thể theo kèm một tham số là “realm”, bạn có thể hiểu trường này như một trường nhằm định dang đầu api hiện tại. VD nếu realm = admin, thì client sẽ hiểu đầu api này cần token dành cho admin, nếu realm = users thì là các đầu api open cho user
Ngoài ra, ta cũng có thể thêm các thông báo về việc token hết hạn, sai, …
HTTP/1.1 401 Unauthorized
WWW-Authenticate: Bearer realm="users", error="invalid_token",
        error_description="Token has expired"
Phần này giúp phía client có thể biết là token đã hết hạn và yêu cầu tạo token mới
Để lưu token ở phía client mà không cần sử dụng cookie, ta có thể sử dụng các bộ nhớ có sẵn của trình duyệt như
sessionStorage: Các thực thể có thể được lưu tại đây, bộ nhớ chỉ là tạm thời và bị xoá khi tab bị đóng
localStorage: Dữ liệu được lưu kể cả khi trình duyệt đóng và chỉ xoá nếu ta yêu cầu
Nghe sessionStorage giống với cookie, tuy nhiên sessionStorage sẽ không share giữa các tab với nhau. Tức là cookie sẽ share giữa các tab, nhưng chỉ chung 1 domain (tức là phân biệt bằng tên miền). Còn sessionStorage chỉ lưu trạng thái ở tab hiện tại
JWT Token
Ta đã đi qua cách authentication bằng sử dụng basic authentication, rồi đến token được lưu ở cookie hoặc local/session storage. Tuy nhiên các cách thức này đều yêu cầu token cũng phải được lưu ở phía server.
Tức là mỗi truy vấn vào server, ta lại phải gọi vào database, với hàng triệu, hàng tỉ token ngày càng tăng lên để kiểm tra xem token có tồn tại chưa, có hết hạn chưa, … Chưa kể đến ta còn phải giải mã token ra nếu ta mã hoá nó trong database (thường là có)
Việc này tạo thành một bài toán lớn và ngày càng khó giải khi số lượng user tăng cao
Lúc này, có một giải pháp khác đã được tạo ra, đó là JWT (Json Web Token)
Định nghĩa: JWT hay JSON Web Token là một format thông dụng cho các token ở dạng “self-contained” (chỉ lưu ở client). JWT thường bao gồm các claims (các khẳng định rằng user này có gì, có kia) và các quyền của user. VD, JWT sẽ chứa là user có quyền được vào trang a, trang b, ….
JWT ngoài ra được mã hoá crypto để bảo vệ khỏi các vấn đề bảo mật liên quan
Lưu JWT ở phía Client
Bạn sẽ có câu hỏi: Làm sao để một token chỉ có thể lưu ở client mà không ở server, vậy thì làm sao ta biết là token nào là thoả mãn, chưa bị người khác sửa, thêm quyền kiểu admin vào và cầm token đó đi request server?
Một trong các cách được đề ra có thể xem qua ảnh sau. Tức là khi phía server sinh ra 1 token thoả mãn, ta sẽ thêm 1 key (HMAC) vào đuôi của token.
Hmac được sinh ra từ claims và 1 đoạn key, điều này giúp kiểm tra nếu đoạn claims đã bị sửa đổi thì phần HMAC sẽ không trùng khớp nữa.
Điều này đảm bảo là người khác khi sửa gì đó thì sẽ không thoả mãn nữa do ta có phần đuôi tag để kiểm tra xem. (Server sẽ thử giải mã phần key xem có đúng với ban đầu không, key này chỉ server biết)
Cấu trúc JWT có 3 phần
Header: Chứa các thông tin về kiểu token này dùng mã hoá dạng gì, …
Claims: Phần chứa thông tin ta muốn để trong token, ví dụ quyền của user
HMAC Tag: Phần mã hoá đảm bảo tính toàn vẹn của token
JWT trở lên ngày càng phổ biến ở những năm gần đây do JSON Web Tokens đã được tiêu chuẩn hoá vào 2015. (Trước đây ta gọi những token stateless bên trên là JSON Token). JWT là một chuẩn với chức năng tương tự như ý tưởng JSON Tokens ban đầu, nhưng có một số chức năng thêm:
Một quy định chung cho phần header chứa các thông tin kèm cho JWT, ví dụ như thuật toán mã hoá, …
Một số chuẩn chung về phần claims, là trường nào lưu gì, …
Nhiều thuật toán khác nhau để mã hoá và xác thực.
Tuy rằng JWT chỉ là một quy chuẩn định nghĩa tại https://tools.ietf.org/html/rfc7519, nó được xây dựng từ một tập hợp nhiều quy chuẩn được gọi là JSON Object Signing and Encryption (JOSE). JOSE chứa nhiều tiêu chuẩn sau:
JSON Web Signing (JWS, https://tools.ietf.org/html/rfc7515) định nghĩa cách các JSON Object được xác minh bằng HMAC hoặc các dạng chữ ký số khác
Sự linh hoạt của JWT cũng là điểm yếu lớn nhất của nó, nhiều cuộc tấn công đã xảy ra nhờ vào sự linh hoạt này. JOSE là một tập các phần thiết kế cho phép lập trình viên chọn từ nhiều thuật toán khác nhau, và không phải sự kết hợp nào cũng đem lại tính bảo mật tốt.
VD: Vào năm 2015, (http://mng.bz/awKz) Tim McClean đã tìm ra một lỗ hổng trong rất nhiều thư viện JWT về việc ở phần header, ta có thể sửa nó thành thuật toán khác, và thậm chỉ sửa nó thành “none”. Điều này vô tình bảo các thư viện JWT ở phía backend khi kiểm tra token đã không dùng thuật toán nào để kiểm tra mã hoá, và các phần claims bị sửa trái phép không bị phát hiện. (Hay còn được biết đến là JWT None Attack)
Paseto
Các lỗi trong các quy chuẩn dẫn tới sự phát triển của các công cụ thay thế với hi vọng vẫn chứa các tính năng tương tự nhưng sẽ sửa một số vấn đề của bộ cũ.
Một ví dụ là Paseto, cung cấp các trình mã hoá đối xứng, khoá public, … hỗ trợ xử lý các vấn đề của Jose và các chuẩn JWT chung.
Điểm chung ngắn gọn giữa Paseto và Jose là thay vì cho phép lập trình viên mix giữa nhiều cấu phần khác nhau trong bộ Jose, Paseto chứa một bộ fix cứng chung về thuật toán (AESS, RSA, Ed25519, …), giúp giảm thiểu các vấn đề bảo mật xảy ra.
Một số chuẩn chung trong claims của JWT
Thông thường, phần claims sẽ có các mục sau:
iss
Issuer
Chỉ ra là ai đã tạo ra token này, thường là url của trang đã sinh token.
aud
Audience
Chỉ ra token này dành cho ai, có thể là id của user, …
iat
Issued-At
Thời điểm token được tạo ra
nbf
Not-Before
Token bị cấm nếu dùng trước thời gian này. VD đặt là 2/1 mà dùng vào 1/1 thì không được
exp
Expiry
Thời điểm token hết hạn
sub
Subject
Định danh chủ đề của token, thường là username, id hay gì đó
jti
JWT ID
ID không bị trùng của token, dùng để tra cứu sau này nếu cần
JWT trong Database, xoá token
Các token stateless, chỉ cần ở client side là một cách hay để giảm bớt state khỏi database. Điều này giúp ta scale các api mà không cần nâng cấp nhiều phần cứng database hay phải triển khai nhiều việc hơn.
Tuy nhiên, việc lưu trữ token ở database lại cho phép ta có một quyền năng lớn, đó là có thể revoke, hay quyết định 1 token có hợp lệ hay không, bằng cách chỉ cần xoá nó khỏi database. Hiển nhiên, việc lưu ở database đi kèm rất nhiều vấn đề về scale, có thể là ta cần nhiều database token cho nhiều service nhỏ khác nhau, nếu ta tập trung nó lại, nó có thể là 1 điểm SPOF (Single Point of Failure), 1 điểm nghẽn trong toàn luồng và chỉ cần nó chết, toàn hệ thống sẽ ngỏm do không có khả năng authentication
Có một số cách để xử lý vấn đề này. Ta có thể lưu database, tuy nhiên không lưu toàn bộ token mà chỉ cần 1 id unique nào đó mà có thể link với 1 token, khi huỷ hợp lệ 1 token, ta chỉ cần huỷ id đó, khi token đó được gửi bởi client, ta sẽ giải mã ra id và kiểm tra. Điều này giúp ta giảm bớt phần nào đó về database
Một cách khác là, ta có thể chỉ lưu các token bị huỷ hợp lệ, hay danh sách đen. Khi token được gửi lên ,ta xem nó có trong danh sách đen hay không, thì sẽ từ chối token đó. Các token mà đã hết hạn sử dụng rồi có thể clean up dần đi, giúp database danh sách đen nhỏ
Một cách khác là thay vì block 1 token, ta có thể chỉ chặn 1 số chức năng ở 1 tập hợp tk. Ví dụ, ta thường có chức năng đăng xuất ở mọi thiết bị khác khi ta đổi mật khẩu, để làm điều này, ta có thể thêm vào database toàn bộ token của người dùng trước ngày nào đó đều bị xoá, điều này giúp giảm không gian cần cho database, nhưng đi kèm query phức tạp hơn.
JPA, hay còn được gọi là Java Persistence API. Sau này được đổi tên thành Jakarta Persistence API
JPA giải quyết các vấn đề trong quản lý quan hệ giữa các thực thể, giúp chúng ta map những object Java (POJO – Plain Old Java OBject) thành những bảng trong database, đây là persistence frameworks được sử dụng nhiều nhất trong Java
Để hiểu sâu thêm, hãy đi thêm vào 1 số định nghĩa liên quan
Persistence là gì?
Java Persistence API, Java là tên ngôn ngữ, API ám chỉ rằng đây là một framework cung cấp các api, các logic mà ta dễ dàng sử dụng lại giúp tăng tốc độ phát triển ứng dụng
Vậy Persistence là gì?
Hầu hết toàn bộ các ứng dụng yêu cầu ta cần có persistent data (dữ liệu lâu dài). Persistence là một trong những concept nền tảng trong công nghệ phần mềm. Gần như toàn bộ hệ thống thông tin đều cần lưu trữ những dữ liệu nào đó cho hệ thống. Object persistence nghĩa là các thực thể có thể “sống lâu” hơn các chương trình, có thể lưu trữ trong các nơi quản lý dữ liệu và có thể khởi tạo lại trong chương trình vào thời điểm nào đó.
Ví dụ đơn giản, trong một web mua bán thương mại điện tử chẳng hạn, dữ liệu trong hệ thống thường là các thông tin về sản phẩm, giá bán, nơi bán, … những dữ liệu này luôn được lưu trữ, kể cả web có thể là bị đóng vài phút, nâng cấp lên, … những dữ liệu này luôn “sống lâu” hơn các chương trình code
Khi nói về persistence trong Java, ta thường nói về việc map và lưu trữ các thực thể trong database bằng SQL
Làm việc với cơ sở dữ liệu quan hệ bằng Java qua SQL
Khi làm việc với các database trong ứng dụng Java, hiểu đơn giản thì ta sẽ ra 1 câu lệnh SQL vào database bằng cách nào đó với Java chứ ta không cần viết chay truy vấn vào thẳng cơ sở dữ liệu nữa.
Ban đầu, ta có JDBC (Java Database Connectivity API) hỗ trợ việc ra các câu lệnh SQL vào một cơ sở dữ liệu. Ta sẽ thực hiện câu lệnh truy vấn, nhận được dữ liệu trả về, sau đó xào nấu nó, …
Tuy nhiên các công việc này nhìn chung khá gần theo hướng dữ liệu, data, chứ không có quá nhiều về phần mềm Java. Chúng ta thường muốn có cách nào đó để lấy dữ liệu nhanh từ database, và không phải làm các công việc lặp lại này.
Các câu lệnh truy vấn đa phần thường dễ bị lặp lại. Giả sử bạn có 1 hệ thống quản lý sinh viên, môn học, lớp học, giáo viên, … Như thông thường, ta phải viết câu lệnh sql để lấy toàn bộ sinh viên, lấy thông tin 1 sinh viên theo tên, theo tuổi, thêm 1 sinh viên, xoá 1 sinh viên, …. mọi thứ thủ công. Rồi làm y vậy với các đối tượng giáo viên, lớp học, …. Nhìn chung các task này lặp đi lặp lại và tốn thời gian, công sức, chưa tính đến nhiều vấn đề bảo mật, viết sai bug khi viết sql chay như vậy.
Hiển nhiên, 1 số thời điểm ta vẫn cần viết sql để custom theo ý mình cho các vấn đề hiệu năng, tuỳ biến, …. nhưng nếu có cách nào đó để giảm thiểu các công việc làm việc với database hơn.
ORM
Ngắn gọn thì, object relational mapping (ORM) là một cách để tự động, đóng gói để map qua lại giữa các dữ liệu database và các class trong Java. Tức là một cái ở giữa để chuyển hoá giữa 1 table lưu thông tin SinhVien với 1 class SinhVien trong java chẳng hạn.
JPA, Hibernate, Spring Data là gì
JPA là gì
Lúc này JPA như đã định nghĩa cơ bản bên trên, JPA sẽ là một bản vẽ, định nghĩa ta phải làm gì để lưu trữ và làm việc với object như 1 ORM bên trên, bao gồm việc lấy dữ liệu object từ 1 database, rồi biến nó thành 1 object được tạo ra từ 1 class Java chẳng hạn.
Hibernate sẽ là một tầng bên trên, triển khai từ JPA, định nghĩa logic code thực sự là sẽ triển khai như thế nào.
Có thể ví dụ đơn giản. JPA sẽ chứa rất nhiều hàm là để làm việc thì ta sẽ cần có các hàm lấy dữ liệu theo trường nào đó, tìm dữ liệu theo trường nào đó (select + filter sql), xoá 1 row trong database, …
Hibernate là gì
Hibernate là 1 JPA Provider, tức là một Provider, một cái triển khai “JPA”
Hibernate sẽ implement interface đó, và là cái có code logic triển khai các hàm trên, tự động sinh ra các câu lệnh sql theo nhu cầu. Tức là ta chỉ cần gọi hàm getAllByName() gì đó, hibernate sẽ tự sinh truy vấn sql, chạy xuống JDBC rồi database để làm việc, ta không cần tự viết sql query đó nữa. Ngoài ra, sau khi lấy dữ liệu xong, nó sẽ tự map dữ liệu database thành các object Java luôn để làm việc.
Ngoài ra Hibernate còn có nhiều chức năng như đảm bảo phiên trong database, session, ….
Spring Data JPA là 1 tầng bên trên nữa triển khai Hibernate, có những chức năng cùng framework Spring, cho phép mở ra nhiều khả năng hơn nữa như từ việc đặt tên hàm có thể tạo được các query phức tạp, …
Chính xác thì Spring Data JPA có thể chạy với các “JPA Provider” khác nhau, tức là một số khác nào triển khai lại JPA có thể dùng với Spring Data JPA
Tổng kết
JPA định nghĩa các phần sau
Một phương tiện chỉ định việc ánh xạ, map giữa các dữ liệu persistent trong database và thông tin của nó với các class trong Java. JPA sử dụng rất nhiều Java annotations để làm việc này, ngoài ra ta có thể viết nó trong file XML (thêm minh hoạ bên dưới)
API để thực hiện các thao tác CRUD cơ bản với các class java và có thể gọi xuống database để làm việc tương tự. (CRUD – Create/Tạo, Read/Đọc, Update/Cập nhật, Delete/Xoá)
Thực hiện các thao tác transaction, có thể lấy dữ liệu theo association (ví dụ 1 sinh viên có nhiều môn học, có thể hiểu việc đó và khi lấy 1 sinh viên sẽ lấy luôn các môn học), thêm 1 số tính năng tối ưu khác, các chiến lược cache, …
Hibernate triển khai JPA và làm các công việc sau
Hiệu suất – Giảm thiểu nhiều công việc lặp đi lặp lại để query dữ liệu, giúp ta có thêm thời gian tập trung vào code logic bên trên hơn
Bảo trì – Do tự động mapping (ORM) của hibernate, giúp giảm thiểu số lượng code, giúp hệ thống dễ hiểu hơn, dễ bảo trì hơn.
Hiệu năng – Nhìn chung thì việc tự viết sql trong các case đặc biệt giúp ta dễ control và có performance mong muốn hơn, tuy nhiên trong một số tác vụ thường thấy, hibernate giúp hiệu năng tốt hơn, tự động, hỗ trợ các cơ chế caching ở tầng ứng dụng
Độc lập – Hibernate có thể làm việc với Postgres, MySQL …. mà không phụ thuộc vào 1 nền tảng hay sql của nền tảng đó
2005 — Hexagon (Ports and Adapters) (Khối lập phương – Cổng và bộ chuyển đổi)
Trước đó, các tầng của chúng ta chỉ đi từ trên xuống theo thứ tự. Với việc sử dụng dependency inversion, mọi thứ đều đã thay đổi
Đây như là một thế giới mới cho các kỹ sư phần mềm. Ta có thể kiểm soát được hướng của sự phụ thuộc theo cách ta muốn. Lúc này, business logic sẽ không gọi xuống tầng data access nữa. Để đọc thêm về dependency inversion, bạn có thể tham khảo bài sau:
Thay vì những layer hình chữ nhật như ban đầu, lúc này, ông đã vẽ một hình lục phương, trông có vẻ khá phức tạp hơn một cấu trúc đa tầng ban đầu, tuy nhiên nó lại khá đơn giản
Điều gì đã xảy ra trong hình minh hoạ trên? Như ta thấy, lúc này Domain đã là thành phần ở giữa và là trung tâm của toàn bộ hệ thống, nó không còn phụ thuộc vào bất kì thứ gì khác nữa
Để thể hiện việc tầng Domain đã là trung tâm, tầng Business Logic/Domain được đặt tên là Core
Các module khác được chia thành 2 phần. Lúc này, với 1 class thực hiện các công việc, ví dụ Repository làm việc với dữ liệu thì không chỉ còn là 1 class concrete mặc định nữa, mà được chia làm đôi thành phần ảo (interface) và phần triển khai thật sự (code logic class). Các phần interface định nghĩa các phương thức mà class logic cần triển khai được đặt tên là ports (cổng)
Các phần triển khai code thực tế nằm trong các module bên ngoài, và được gọi là adapters
Rõ ràng, ta thấy các logic Domain/Core của hệ thống giờ không còn phụ thuộc vào ai cả, vì nó là những chức năng mà hệ thống bắt buộc phải có, mọi module khác đều chỉ là gắn thêm vào, và phải triển khai các cổng (các interface) mà phần core đã định nghĩa sẵn.
Ví dụ về port, adapter và core của hexagon architecture
Ta có, ví dụ như một chiếc laptop. Các cổng của nó là gì? Ta có cổng hdmi, cổng tai nghe 3.5, cổng sạc, cổng type c, cổng usb, ….
Rõ ràng, khi muốn thêm gì đó cho chiếc laptop, ví dụ ta muốn cắm thêm 1 tài nguyên lưu trữ dữ liệu vào, ta phải dùng 1 chiếc usb, hoặc 1 thẻ nhớ, và chúng phải có khuôn mẫu, đúng với quy chuẩn mà cái laptop đã quy định ra -> tôi có cổng usb như này, nếu muốn cắm gì vào thì phải theo khuôn như thế. Giống như việc, trong core đã có các interface, ta chỉ làm việc với các hàm của interface, module bên ngoài triển khai logic phải triển khai đúng theo bản khuôn mẫu, các hàm đó.
Ví dụ, nếu không dùng interface, nhà sản xuất usb lại tự tạo ra các đầu cắm khác nhau, giờ chẳng lẽ máy tính là một high-level module (một phần quan trọng hơn), lúc sản xuất lại phải theo cái đầu cắm của usb? Điều này không hợp lý
Các ưu điểm rõ ràng
Lúc này các module bên ngoài cắm vào thường độc lập với nhau, và chúng dễ thay thế hơn. Ta đã định nghĩa trước ta cần gì trong core, giờ bên ngoài chỉ triển khai logic lại từ các yêu cầu đó. Nếu ta thay đổi cách gọi lấy dữ liệu từ việc gọi vào database sang đọc ghi trong file excel, ta chỉ thay đổi ở module, và vẫn là hàm getAll() mà core đã quy định. Tương tự với giao diện, cũng là module ngoài, cũng phải làm như vậy.
=> Các module độc lập, dễ thay thế hơn, và phải tuân thủ các quy tắc của core logic
2008 — Onion – Kiến trúc củ hành
Nhìn chung, Onion Architecture vẫn khá tương đồng với Hexagon Architecture, tuy nhiên ở Hexagon, ta có 1 khối ở giữa và ta mong muốn các module chỉ như các thiết bị ngoài cắm vào ổ đó và tách biệt lẫn nhau. Còn ở Onion Architecture, ta có những tầng như những chiếc vòng, và tầng ở vòng bên ngoài phụ thuộc vào tầng bên dưới
Theo 1 cách nhìn nào đó, Onion Architecture có một hướng phụ thuộc khá thẳng như N-Layered, nhưng thực tế ta vẫn áp dụng đảo sự phụ thuộc để cho phép tầng Domain hay Business là tầng dưới cùng của hệ thống
Có một vài điểm thể hiện sự khác biệt ở đây. Là thay vì có 1 core quá lớn và mọi module đều phụ thuộc vào nó đôi khi có thể gây ra một số nhược điểm. Tức là 1 sự thay đổi trong core có thể khiến nhiều module khác nhau phải sửa đổi
Thay vì vậy, ta có một số tầng khác, ví dụ như ở ảnh trên là Application, sẽ wrap lại tầng Domain, Domain sẽ chứa những code mà có ít sự thay đổi, và Application có thể chứa nhiều logic và thường xuyên thay đổi nhiều hơn sẽ nằm ở bên trên.
Có thể cảm giác nó như tính đóng gói của OOP, khi mà những phần bên trong sẽ được wrap lại ở các tầng bên ngoài chứa nhiều logic hơn, và khi phần bên trong hoàn thiện sẽ chứa ít sự thay đổi hơn
2012 — Clean Architecture
Nhìn chung, ta nhận thấy ta vẫn có 1 tầng chứa những phần về logic của Domain/Business, nay được đặt tên là Entities nằm trên cùng, và ta có các tầng khác thuộc module ngoài như Infra (Thường là data access của database), presentation (giao diện) phụ thuộc dần vào trong.
Thực tế, bạn có thể thấy Hexagon, Onion hay Clean Architecture có một cách định hướng khá giống nhau, ở Clean Architecture, Uncle Bob đã thêm 1 số layer bên ngoài như thư viện thứ 3, dll, …
Tổng kết
Nhìn chung, các kiến trúc về sau như Hexagon, Onion, Clean Architecture đều là các cách tiếp cận áp dụng các thủ pháp như Dependency Inversion, … nhằm tập trung vào phần core, domain, … và các module bên ngoài phải được xây dựng dựa theo hệ thống chính, chứ hệ thống chính không đi theo module bên ngoài
Việc triển khai các cấu trúc phức tạp hơn cho phép ta mở rộng dễ hơn về sau khi logic ở core ngày càng tăng lên, tuy nhiên, không có cấu trúc nào là hoàn toàn hoàn hảo và được xây dựng ở các thời điểm khác nhau cho mục đích khác nhau.
Do sự phát triển của microservice, các hệ thống còn được chia nhỏ ra nhiều service nhỏ hơn nữa, khi logic ở mỗi service không quá nhiều, ta dễ dàng có thể triển khai 1 cấu trúc 3 tầng thay vì các cấu trúc quá phức tạp và phải đi qua nhiều tầng để giúp tăng tốc độ triển khai dự án.
This entry is part 1 of 2 in the series API Security
Lời đầu
Trước khi đi vào Session Token hay JWT Token, hay có thể tóm gọn là authentication qua token, ta sẽ đi qua về 1 cách khác để authentication qua các giao thức API, và sau đó sẽ nói về ưu nhược điểm giữa chúng
Http Basic Authentication
Luồng chạy của HTTP “Basic” Authentication như sau:
Khi người dùng truy cập và không có thông tin đăng nhập, hệ thống sẽ trả về 401 (Unauthorized) và thông tin đi kèm là cách để có thể author qua header WWW-Authenticate với thông tin (Ví dụ trên ảnh là yêu cầu Authen qua Basic)
Khi ta truy cập với Header Authorization + Basic + chuỗi mã, lúc này hệ thống sẽ kiểm tra và cho phép có quyền hay không.
Authorization: Basic dGVzdDoxMjPCow==
Ví dụ như mã trên, đoạn mã sau Basic cơ bản là một đoạn String được mã hoá ở dạng base64, bạn có thể decode nó qua các trang base64, ví dụ
Ví như với mã trên, khi decode, ta nhận được đoạn mã test:123£, đây là format của Basic Authen, với đầy đủ là username:password, thì ở đây test là username, và password là 123£
Ưu điểm
Sử dụng đơn giản, luồng không phức tạp, triển khai nhanh
Phù hợp cho authentication trong nội bộ, cho các ứng dụng trên môi trường kiểm thử (non-prod)
Nhược điểm
Toàn bộ request đều sẽ phải gửi username và password, điều này nhìn chung tăng khả năng xảy ra lộ mật khẩu.
Do lần nào cũng gửi mật khẩu, nên nếu bạn mã hoá nó, việc này là một công đoạn khá tốn tài nguyên. Những thuật toán hashing, mã hoá mật khẩu hiện đại có thể tốn tới 100ms (0,1s) để giải mã mật khẩu rồi kiểm tra có đúng không. Điều này hao tốn CPU cho hệ thống
Một số vấn đề khác về UX (giao diện mặc định đăng nhập xấu), vấn đề bảo mật về việc lưu password ở client để gửi đi authen, ….
Token Authentication trong API
Khái niệm
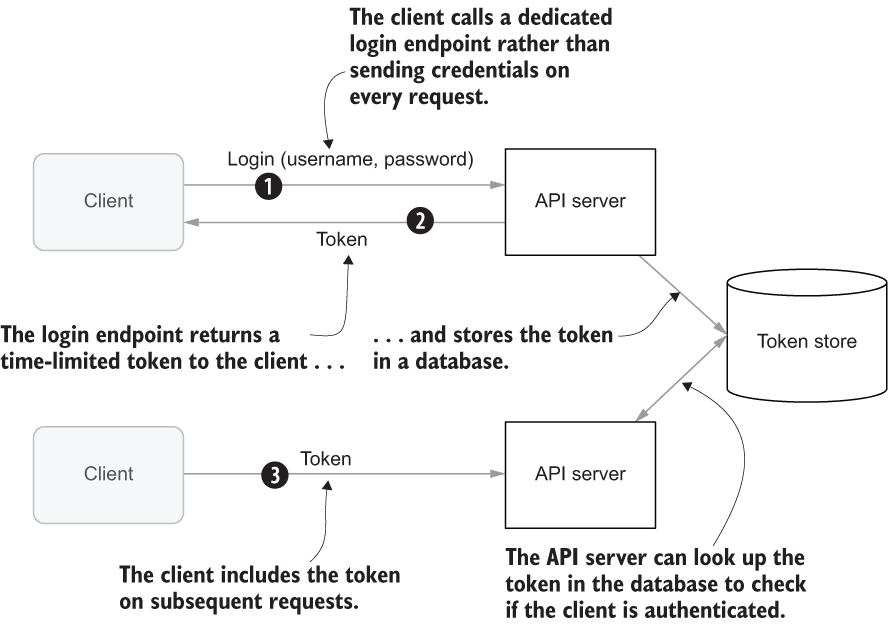
Hiểu đơn giản, thông thường thì authentication bằng token sẽ hoạt động như sau: Tài khoản, mật khẩu, … thông tin user chỉ cần nộp 1 lần, người dùng sau đó sẽ được cấp 1 token, 1 đoạn mã có thời hạn sử dụng. Người dùng sau đó có thể dùng token này để authentication cho đến khi đoạn token hết hạn sử dụng
Ví dụ về token authentication trong thực tế, điều này giống như bạn đi một khu vui chơi. Bạn đã đặt vé từ trước, và để xác minh bạn đã đặt vé chưa, bạn phải xuất trình căn cước công dân, ảnh thẻ, hộ chiếu, …. Thay vì vậy, khu vui chơi sau khi nhận căn cước công dân ở cửa vào, sẽ cấp cho bạn 1 phiếu vé có thời hạn 1 ngày hay gì đó, sau đó bạn dùng phiếu vé này để đi chơi trong khu vui chơi trong thời gian của vé.
Cách tiếp cận 1: Lưu trữ token trong database
Người dùng lần đầu sẽ gửi thông tin của mình cho server, server sẽ từ đó sinh ra 1 token và lưu nó vào database
Lần sau người dùng sẽ chỉ cần gửi token, và sau đó server kiểm tra token có trong database không, còn hạn sử dụng không, … rồi cho phép người dùng
Việc này khắc phục các điểm:
Đầu tiên, token thường không chứa thông tin mật khẩu, tài khoản, … nữa nên ít lo bị lộ thông tin cá nhân của người dùng hơn.
Giảm bớt các nhược điểm của Basic Authen là phải mã hoá, giải mã mật khẩu, ….
Nếu có vấn đề bảo mật xảy ra, token được cài đặt là có thời hạn, và hơn nữa ta đã lưu ở trong database, ví dụ, bạn bị mất token vào tay người khác, thì thiệt hại cũng được giảm thiểu. Hoặc ta có thể trực tiếp ngăn chặn bằng cách xoá token đó đi trong database.
Session Cookie
Cách triển khai đơn giản nhất của hướng tiếp cận trên, và cũng khá phổ biến là sử dụng cookie. Sau khi người dùng đăng nhập bằng thông tin, phía server sẽ trả về 1 header Set-Cookie trong response để yêu cầu trình duyệt người dùng lưu 1 chuỗi token ngẫu nhiên trong bộ nhớ cookie của trình duyệt
Các request vào trang đó sẽ sử dụng token như 1 header Cookie (do cookie được tạo ra để lưu trữ những thông tin của người dùng trong 1 site)
Ưu điểm
Cookie có nhiều cơ chế về bảo mật có sẵn, ví dụ như cookie chỉ gắn liền với từng tên miền, nên nó luôn đảm bảo không có chuyện ta gửi sang trang khác đoạn cookie chứa thông tin nhạy cảm
Cookie có thể được đánh dấu là Secure, điều này giúp đảm bảo khi gửi kết nối tới trang nào thì cookie chỉ được gửi nếu kết nối đó là Https và đã được mã hoá.
Nhược điểm
Trong thiết kế API theo hướng RestAPI đó là kết nối giữa client người dùng và server nên là stateless http://quochung.cyou/kien-truc-stateful-va-stateless-la-gi/. Đó là server sẽ không lưu trạng thái nào của người dùng giữa các request khác nhau.
Cookies phá vỡ nguyên tắc này vì server lúc này lưu trạng thái của cookie với các client khác nhau. Vào thời điểm đầu khi session cookie được sử dụng, chúng thường là nơi lưu trữ tạm thời 1 số trạng thái của người dùng, ví dụ như 1 giỏ hàng, 1 danh sách sản phẩm đã được chọn mà người dùng chưa thanh toán. (Kiểu khi người dùng chọn rồi, nó không lưu trực tiếp vào database) mà chỉ lưu vào cookie, điều này dễ gây ra một số lỗi bất thường cho website.
Java là một trong những ngôn ngữ lập trình phổ biến nhất hiện nay. Java cung cấp khả năng xây dựng các ứng dụng từ đơn giản đến những ứng dụng hoạt động chặt chẽ, đủ khả năng cho các dự án lớn tầm thương mại (enterprise). Nhờ sự ra đời từ rất sớm, Java có rất nhiều thư viện, tài liệu, code, … và nhiều tài nguyên khác. Từ Java, có thể xây dựng các ứng dụng web, mobile, desktop, các phần mềm cho các lĩnh vực như iOT, …
Trong bài hôm nay, mình sẽ chỉ tập trung vào mảng web của Java. Trong đó có thể kể tới Spring Framework, đây là một hệ sinh thái toàn diện với rất nhiều giải pháp trong phát triển ứng dụng Java, giúp lập trình viên giảm bớt rất nhiều thời gian để xây dựng phần mềm.
Trong bài viết này, ta sẽ đi qua 3 mục có thể nói là core của Spring bao gồm: Spring IOC (Inversion of Control), Dependency Injection (DI), cũng như khái niệm về Bean, Component, … trong Spring
Spring IOC (Inversion Of Control)
Đây có thể nói là các phần cốt lõi của cả Spring Framework. Để nói về tác dụng của nó, hãy thử xem qua bài toán sau:
Ta có một class trong Java, chuyên xử lý các đơn hàng mới của một cửa hàng. Lúc này, một đơn hàng sẽ chứa 2 thông tin là id của người dùng (vd KH11), và id của sản phẩm (vd MAYGIAT), ta sẽ cần từ 2 id này, gọi sang 2 class khác là ProductService (quản lý sản phẩm), và CustomerService (quản lý khách hàng), để từ mã id lấy ra thông tin của khách hàng, sản phẩm rồi sau đó xử lý sâu hơn (Tạo ra đơn hàng cần thông tin địa chỉ khách hàng, rồi thì giá sản phẩm, …)
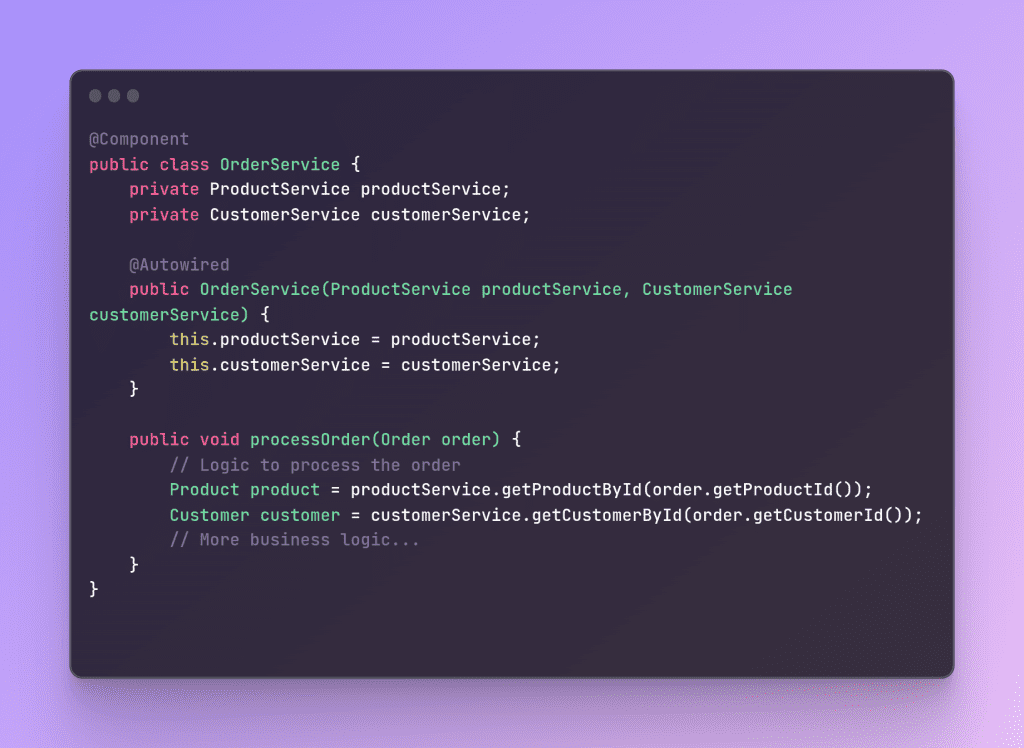
Với code thông thường, ta cần làm như sau:
Lúc này, ta cần phải tạo các đối tượng của class con là ProductService và CustomerService một cách thủ công, để quản lý vòng đời của chúng (ví dụ khi nào tạo, khi nào tắt ta bị phụ thuộc vào class OrderService).
Rồi thì, ProductService là một class dạng stateless (các object ProductService khác nhau thường không có gì khác cả, tức là ta cần 1 object là được). Lúc này, ta có thể triển khai sử dụng design pattern Singleton (1 class chỉ tạo ra 1 object duy nhất), nhưng ta cũng phải triển khai thủ công
Rõ ràng, ta thấy vấn đề mệt nhất của việc làm thủ công là “Control – Khả năng điều khiển, quản lý”, ở ví dụ trên, ta đang đưa hết việc quản lý cho OrderService về tạo các object cho class phụ thuộc, ví dụ một class khác cần ProductService thì sao? Ta có thể lại phải new 1 object mới, lúc này ta bị thừa object. Hoặc class đó lại phải tạo ra 1 object con là OrderService, rồi dùng class con của OrderService
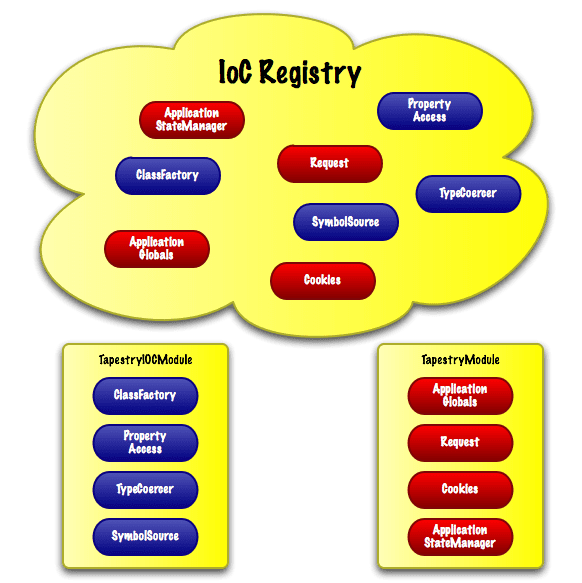
IOC (Inversion of Control) , lúc này các framework IoC hay các IOC Container sẽ là nơi chứa mọi quản lý, control của các object. Nó quyết định vòng đời của các object ta cần dùng, khi nào thì tạo, khi nào thì xoá, ghép cái nào với cái nào
Tưởng tượng nếu làm thủ công, ta sẽ cần 1 class dạng IOCContainer, rồi trong IOCContainer, ta tạo ra hết mọi object cần có. Rồi ở OrderService, ta sẽ gọi IoCContainer.getProductService() chẳng hạn, ở chỗ khác cần cái gì cũng gọi như vậy, lúc này ta dễ dàng quản lý các object này hơn
Lúc này Spring IOC xuất hiện, ta sẽ khai báo các class cần được quản lý bởi Spring IoC là Bean (sẽ nói thêm ở dưới). Khi nào cần dùng tới class nào, ta chỉ việc sử dụng DependencyInjection để gắn chúng lại với nhau.
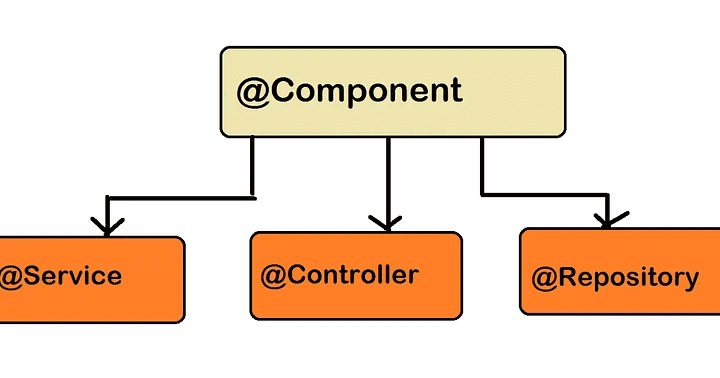
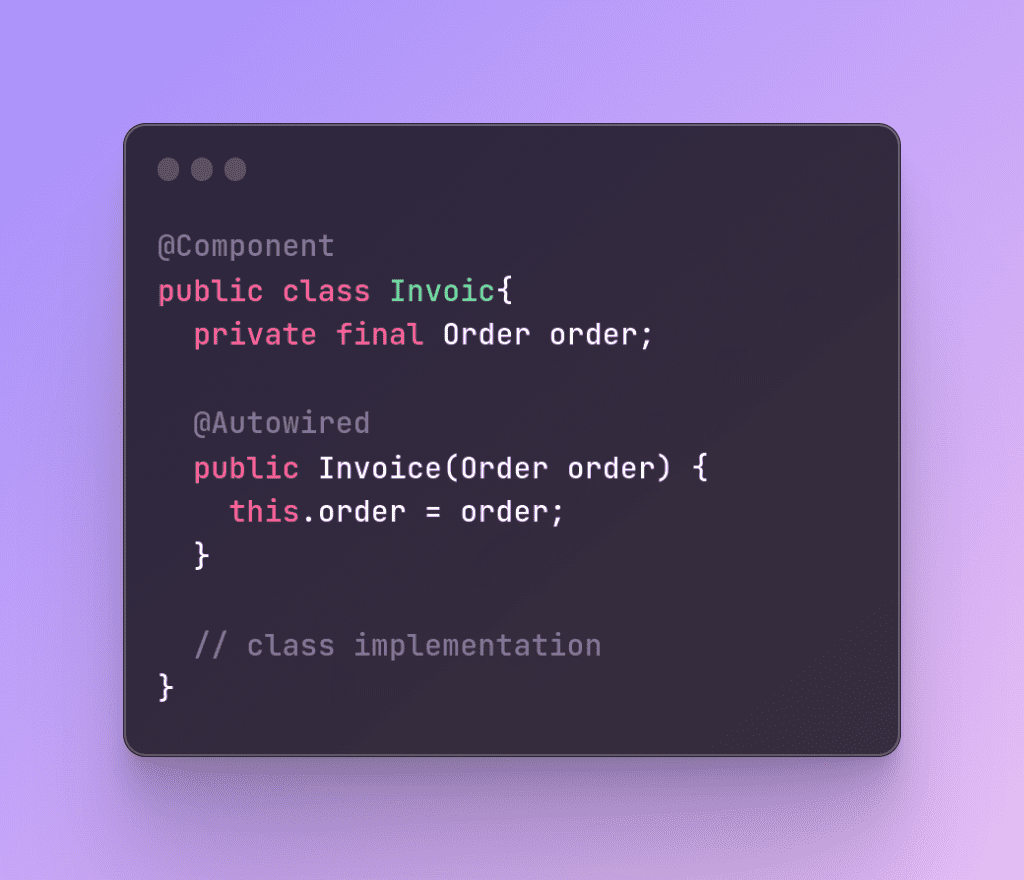
Trong Spring, @Component là một annotation để đánh dấu cho Spring biết class nào là một Component (cấu phần) hay Bean mà Spring sẽ quản lý. Các annotation @Service, @Controller, @Repository cũng hoạt động tương tự.
Và khi khai báo cả 2 class là Component, ta có thể kết nối chúng qua Dependency Injection (bạn có thể tham khảo thêm bên trên)
Spring lúc này sẽ tự động ghép nối 2 class trên vào thời điểm được chạy lên.
Bean
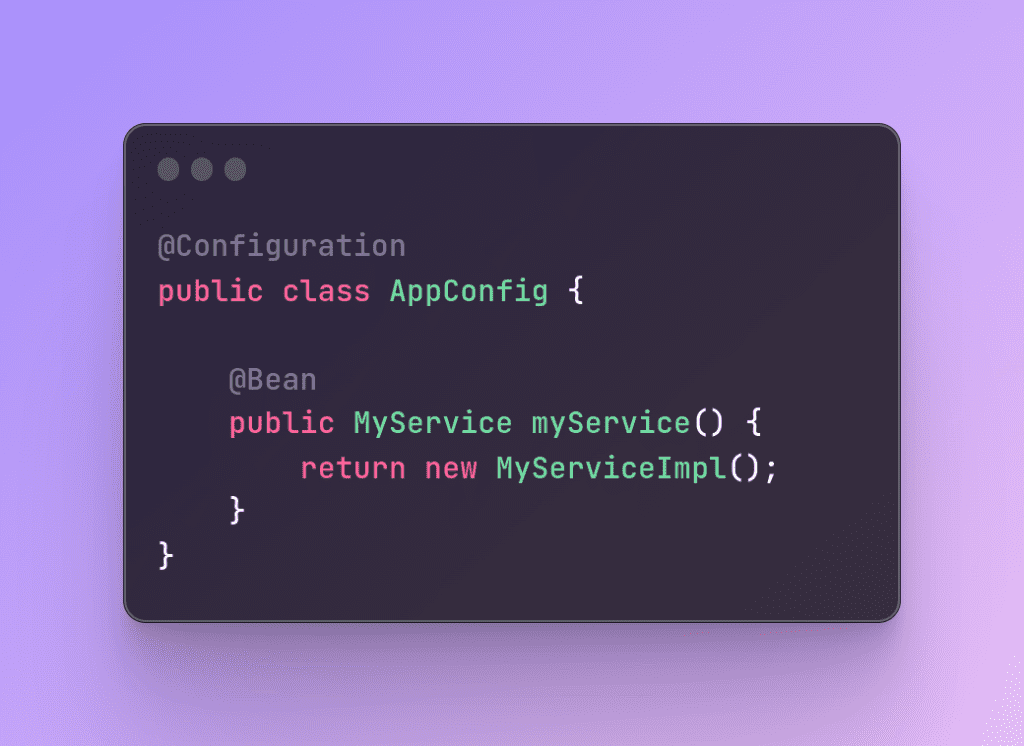
Bean trong Spring là annotation để định nghĩa 1 bean. Thường chúng được dùng cho các class utils (hỗ trợ ngoài), hoặc class ở bên thứ 3, mà không nằm trong luồng logic core.
@Bean cần được khai báo trong 1 class có annotation @Configuration. Ta có thể khai báo nhiều bean khác nhau.
Ví dụ ta có thể tạo 1 bean BCryptPasswordENcoder để mã hoá mật khẩu, sau đó có thể sử dụng chúng trong class UserService. Spring tự biết ghép chúng lại với nhau’
Câu hỏi thêm
Ngoài các khái niệm cơ bản như vậy, ta biết rằng mặc định các bean khi khởi tạo sẽ là singleton, ta có thể chỉnh nó thành các kiểu khác, ví dụ sẽ là tồn tại nhiều bean khác nhau của 1 class, … bằng cách đặt scope cho chúng. Tham khảo thêm tại: https://docs.spring.io/spring-framework/reference/core/beans/factory-scopes.html
Lúc nào thì dùng Component, lúc nào thì dùng Bean? Điều này tuỳ vào dự án của bạn, thường thì annotation @Bean sẽ dùng cho các class của bên thứ 3, không nằm chính trong luồng usecase, hay context của dự án và @Component thì ngược lại
Ta đã biết, khi một đối tượng không còn tác dụng nữa, thì chúng sẽ bị GC dọn đi để tiết kiệm bộ nhớ, nhưng thế nào là “hết tác dụng” ?
Có thể tóm gọn bằng một câu cơ bản “Object tại heap sẽ không còn hữu dụng nếu chúng mất kết nối tới stack”
Object mất kết nối tới stack khi không còn một con trỏ nào chỉ tới chúng nữa cả, hãy xem thử đoạn code sau:
Object o = new Object();
System.out.println(o);
o = null;
Ở dòng đầu tiên, ta tạo một đối tượng o, o lúc này thực chất đang chỉ tới giá trị thực sự của đối tượng ta vừa tạo ra trong heap
Khi in thử đối tượng này ra, ta có output theo mẫu sau
java.lang.Object@4617c264
Tiếp theo, ta cập nhật o thành null. Lúc này, đối tượng nằm ở heap không còn cái gì trỏ đến nó nữa, và không gì có thể truy cập lại nó nữa, và lúc này nó trở thành mồi của GC
Vấn đề không đơn giản
Ví dụ trên khá đơn giản do chỉ có 1 object, vấn đề sẽ phức tạp hơn khi ta tiếp cận với nhiều object liên kết với nhau 1 lúc
Giả sử với 6 dòng lệnh sau, ta sẽ đi qua từng dòng một
Sau 4 dòng đầu tiên, stack và heap của chúng ta có dạng như sau. Tại stack là các biến giữ con trỏ tới các giá trị thực trong heap.
Sau dòng thứ 5, ta có hình như sau. Ta thấy, dù sau khi đã cập nhật p1 thành null với mong muốn GC sẽ dọn object này, nhưng thực tế, ta thấy ta vẫn có thể truy cập vào p1 bằng person.get(1) qua list persons, tức là ta vẫn có cách reach đến điểm này
Chỉ sau khi set cả list thành null, ta mới mất hoàn toàn liên hệ với p1
=> Không khó để đánh giá các phần tử nào sẽ được Garbage Collector dọn khi bạn đã hiểu về quan hệ bên trên. Dễ dàng thấy, sau 6 bước, p1 mất hoàn toàn liên hệ với stack và sẽ được dọn
Tuy nhiên, đó là ta nhìn thủ công, còn để garbage collector biết cái nào còn kết nối với stack sẽ tốn một lượng thời gian, và nó sẽ làm chậm hệ thống lại (chi tiết ở bên dưới). Có nhiều cách để làm điều này, và ta sẽ thảo luận ở bên dưới
Đánh dấu đệ quy
Ta sẽ thử đánh dấu các object còn live và object nào có thể bị dọn bởi GC. Dễ dàng, ta thêm 1 bit để dánh dấu xem chúng có còn kết nối với stack hay không. Khi tạo, ta sẽ để bit là 0, và khi ở giai đoạn đánh dấu, object là 0 sẽ bị xoá đi, còn nếu vẫn còn sử dụng, ta sẽ cập nhật nó thành 1
Tuy nhiên, heap và stack thay đổi liên tục. Cách đánh dấu được triển khai tuỳ thuộc vào phiên bản Java và GC bạn sử dụng, tuy nhiên, ta sẽ thử xem cách hệ thống đánh từ stack, hãy thử xem ví dụ sau
Đầu tiên toàn bộ phần tử sẽ được để là 0
Sau đó, toàn bộ các phần tử có kết nối trực tiếp tới stack được đánh thành 1
Tuy nhiên, do p1 vẫn có thể truy cập từ danh sách persons, và hơn nữa, ta không thể cứ dọn những gì vẫn còn kết nối. Vì vậy ta cần một cách duyệt đơn giản, với điểm khởi đầu từ các điểm đang = 1, sau đó đi đến mọi quan hệ của nó và đánh chúng thành 1, rồi tiếp tục đệ quy.
Các thuật toán đánh dấu đóng vai trò quan trọng trong giai đoạn đánh dấu, đầu tiên thử đi qua cách stop-the-world
Kĩ thuật Stop-The-World – Dừng thế giới
Với cách đánh dấu trên, ta nhận thấy. Nếu một phần tử được tạo trong quãng đánh dấu, nó sẽ không còn đúng nữa.
Vì vây, có một solution đơn giản là ta sẽ dừng mọi luồng khác và chỉ chạy luồng đánh dấu của cả chương trình, điều này sẽ rất ảnh hưởng đến hiệu năng. Ta sẽ thử xem các thuật toán tiếp theo.
Kĩ thuật Reference counting – Đếm liên hệ
Một cách triển khai khác là đếm số lần một object được trỏ đến. Mỗi object sẽ chứa số lần object được trỏ như một thông số mà nó nắm giữ. Như vậy, GC chỉ việc quét qua và xoá mọi object có 0 lần bị nắm giữ. Cách này sẽ không cần stop-the-world như cách đánh số đệ quy nữa, vì khi object được tạo ra giữa chừng lúc đánh số lần trỏ thì nó vẫn đều là 1 rồi.
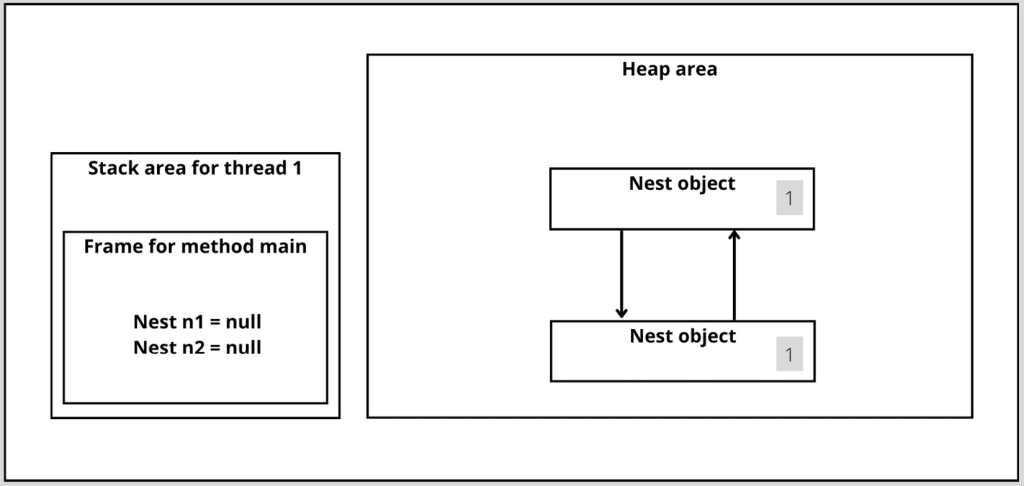
Tuy nhiên, nó có một điểm yếu là sẽ tạo ra island of isolation, hay các vùng, một tập các object tự trỏ nhau nhưng mà thực tế không có kết nối tới stack
Giải phóng bộ nhớ
Cách thức làm sao để đánh dấu các object sẽ bị xoá sẽ được quyết định khác nhau bởi phiên bản Java và các kiểu GC khác nhau.
Giả sử ta đã đánh dấu được hết các object sẽ có thể bị xoá, tuy nhiên việc xoá chúng đi cũng không phải một quá trình đơn giản
Việc xoá object được gọi là sweeping by garbage collector, trong bài viết sẽ mention 3 cách thức sweeping khác nhau
Normal sweeping
Sweeping with compacting
Sweeping with copying
Normal sweeping
Hình ảnh trên thể hiện các khối bộ nhớ trong ram, các vùng có dấu X là các object đã được đánh dấu và chuẩn bị bị xoá
Sau khi xoá đi, vùng nhớ của ta có dạng như sau, dễ thấy, điều này dẫn tới một triệu chứng có tên Fragmentation
Fragmentation trong Java Garbage Collector
Lúc này, vì các vùng trống nằm ở giữa các vùng bị chiếm dụng, nên ta chỉ có thể thêm các bộ nhớ nhỏ hơn hoặc bằng vùng vào các vùng trống. Điều này sẽ dẫn tới 1 vài vấn đề khi ta muốn cấp phát một bộ nhớ lớn hơn
Giả dụ với trường hợp cấp phát một vùng nhớ lớn hơn các khe trống như ảnh trên, khi cấp phát vào, ta chỉ có thể xếp như sau:
Dù tổng thể bộ nhớ còn trống ta vẫn đủ để xếp vùng nhớ, nhưng thực tế thì ta không có một vùng nhớ liên tiếp nào chứa đủ vùng nhớ mới này. Và việc này sẽ throw ra 1 runtime exception là OutOfMemoryError.
Ưu nhược điểm của Normal sweeping
Normal Sweeping là một kĩ thuật giải phóng vùng nhớ ngây thơ, khá tiện dụng và đơn giản. Tuy nhiên sẽ dẫn tới các vùng nhớ bị phân mảnh. Quá trình này phù hợp khi ta có nhiều bộ nhớ, và ta chỉ cần nhanh chóng dọn bộ nhớ đi. Khi mà lượng vùng nhớ còn trống nhỏ hơn, ta sẽ prefer các kĩ thuật khác
Sweeping with compacting
Sweeping with compacting là một quá trình 2 bước. Đầu tiên, chúng vẫn giải phóng bộ nhớ, nhưng sau đó ta sẽ thực hiện thêm 1 bước gọi là compacting (thu gọn), ta sẽ dời toàn bộ vùng nhớ về phía đầu để đảm bảo không có bất kì khoảng trống nào ở giữa
Ưu nhược điểm Sweeping with compacting
Cách làm này giúp bộ nhớ không còn bị phân mảnh như thông thường, tuy nhiên việc di chuyển các vùng nhớ về đầu là một quá trình tốn kém, vì gần như với lượng vùng nhớ nhỏ và trải dài nhiều, ta sẽ phải copy và di chuyển khá nhiều trên vùng nhớ.
Sweeping with copying
Ở cách làm này, ta sẽ cần 2 vùng nhớ khác nhau. Ta sẽ không trực tiếp xoá các vùng nhớ bị đánh dấu là xoá đi, mà ta sẽ copy các vùng nhớ k bị xoá vào vùng nhớ mới
Sau đó mới thực hiện xoá toàn bộ vùng nhớ ở vùng nhớ cũ
Ưu nhược điểm của Sweeping with copying
Dữ liệu không bị phân mảnh
Về hiệu năng thì nhanh hơn compacting, do không phải thực hiện nhiều công đoạn tính toán khi di chuyển, mà chỉ copy nhanh chóng sang vùng mới đang trống hoàn toàn (ở compacting ta ví dụ di chuyển vùng 30-50 sang vùng 0-10, đầu tiên ta phải di 30-40, sau đó lại di vùng 10-20 đi, …. và khó khăn hơn nhiều)
Tuy nhiên cần nhiều bộ nhớ hơn vào cùng 1 thời điểm, cần lượng bộ nhớ trữ còn lại đủ nhiều để di chuyển.
Đóng gói là một trong những tính chất quan trọng của lập trình hướng đối tượng
Đóng gói giúp che dấu thông tin bên trong của một đối tượng, chỉ cho phép các đối tượng khác tương tác thông qua các phương thức được cung cấp
Đóng gói giúp giảm sự phức tạp của chương trình, giúp dễ dàng bảo trì và mở rộng chương trình
Ví dụ, trong một chiếc xe ô tô, ta có rất nhiều cấu phận và thông số. Nó có động cơ, vô lăng, bình xăng, đánh lửa, …
Nhưng ta thường không tương tác trực tiếp được vào chúng, mà thông qua các phương thức như bấm ga, bấm còi, đạp phanh, …
Khi bấm ga, có thể cả một quy trình rất dài đang xảy ra, như động cơ chạy, bình xăng bơm xăng, đánh lửa đốt xăng, …
Nhưng ta không cần quan tâm đến những thứ đó, ta chỉ cần bấm ga, và xe sẽ chạy
Ngoài ra, đóng gói giúp ta đảm bảo việc dữ liệu sẽ được giấu khỏi các đối tượng khác, và chỉ có các phương thức được cung cấp mới có thể tương tác với dữ liệu đó. Giúp đảm bảo tính toàn vẹn của dữ liệu.
Ví dụ:
getter, setter là một ví dụ về đóng gói. Nhờ getter, setter, ta có thể đảm bảo dữ liệu được cập nhật từ đối tượng khác sẽ luôn theo ý của mình, hay dữ liệu được lấy ra từ đối tượng khác sẽ luôn đúng theo ý của mình
Ví dụ trong các thư viện của Java, ta có thể thấy rất nhiều ví dụ về đóng gói. Ví dụ như trong class Scanner, ta có thể thấy rằng các biến được khai báo là private, và ta không thể truy cập trực tiếp vào chúng. Nhưng ta có thể sử dụng các phương thức như nextInt(), nextDouble(), nextLine(), … để lấy dữ liệu từ bàn phím. (Có thể ctrl + click vào các phương thức đó để xem code, sẽ thấy Scanner sử dụng các biến private để lấy dữ liệu từ bàn phím)
Đóng gói xuất hiện ở mọi nơi: Từ cả cái máy tính của bạn chỉ cần 1 nút bật, một game với cả trăm nghìn class chỉ cần 1 lần nhấn Play sẽ bắt đầu chạy, các thư viện Java với vô vàn chức năng đã được đóng gói và cho phép ta sử dụng qua những hàm rất đơn giản.
Trong lập trình phần mềm, yêu cầu của một chương trình thay đổi liên tục đáp ứng nhu cầu của khách hàng. Việc đóng gói và phân tách công việc của những bộ phận khác nhau là cực kì quan trọng, khi đó, ta sẽ cố gắng giới hạn những thay đổi chỉ bên trong 1 bộ phận nhỏ, độc lập nhất có thể và ít ảnh hưởng tới nhiều chỗ khác.
Kế thừa
Kế thừa là một trong những tính chất quan trọng của lập trình hướng đối tượng
Kế thừa giúp ta có thể sử dụng lại các đặc tính của một đối tượng khác, giúp giảm sự lặp lại của code, giúp dễ dàng bảo trì và mở rộng chương trình
Kế thừa giúp ta có thể tạo ra các đối tượng mới từ các đối tượng đã có, và có thể thêm các đặc tính mới vào các đối tượng mới đó
Ta nhận thấy kế thừa, hay sơ đồ cây xuất hiện ở mọi nơi trong cuộc sống. Như một chiếc ô tô có thể gọi là xe bốn bánh, xe bốn bánh có thể coi là phương tiện giao thông, …. Con người có thể coi là động vật. trong sinh học ta có các giống loài, trong vật lý có nhiều loại sóng khác nhau cùng là sóng,có chung tính chất là sóng, …
Ví dụ:
Ví dụ ta có nhiều class cần tạo như Chó, Mèo, Gà, Vịt, … Ta nhận thấy chúng đều có chung 1 đặc điểm là chúng đều là động vật, và có chung 1 số đặc điểm như là có thể ăn, có thể ngủ, có thể chạy, có thể bơi, … Ta có thể tạo ra một class cha là Động vật, và các class trên sẽ kế thừa từ class Động vật. Như vậy, ta có thể sử dụng lại các đặc điểm của class Động vật cho các class con, và có thể thêm các đặc điểm mới vào các class con đó, ví dụ Chó thì có thêm đặc điểm là sủa, Mèo thì có thêm đặc điểm là kêu meo meo, …
Các phương thức, thuộc tính của class cha sẽ được các class con kế thừa, và có thể sử dụng lại. Ngoài ra, các class con có thể thêm các phương thức, thuộc tính mới vào các class con đó. Điều này giúp giảm bớt các code dư thừa, giúp dễ dàng bảo trì và mở rộng chương trình
Có thể ở các class nhỏ hiện tại các bạn chưa thấy kế thừa hữu ích. Tuy nhiên khi bài toán ngày càng lớn lên, đặc biệt thiên về domain chuyên ngành, 1 class sẽ có rất nhiều thuộc tính và phương thức. Ví dụ: một cái bánh bình thường ở tạp hoá, có thể có lên tới 10-15 thuộc tính như màu sắc, hình dạng, giá, hạn sử dụng, ngày sản xuất, thành phần sản phẩm, các chứng chỉ an toàn thực phẩm, mã barcode, hay có các biến như “có thể cho động vật ăn”, … sau đó lại có nhiều loại bánh khác nhau nữa
Class Object
Trong Java, mọi class đều kế thừa từ class Object
Class Object là class cha của tất cả các class khác
Class Object có các phương thức như equals(), toString(), hashCode(), clone(), finalize(), wait(), notify(), notifyAll(), …
Các phương thức này được các class khác kế thừa, và có thể sử dụng lại
Có nhiều phương thức các bạn chưa cần đào sâu. Tuy nhiên tạm thời có thể để ý nó có các phương thức quan trọng như equals, toString, hashCode. Đây là các phương thức thường được dùng.
Đa hình
Đa hình là một trong những tính chất quan trọng của lập trình hướng đối tượng
Đa hình giúp ta có thể sử dụng các đối tượng khác nhau, nhưng có cùng một kiểu dữ liệu, giúp giảm sự lặp lại của code, giúp dễ dàng bảo trì và mở rộng chương trình
Override
Override là một kĩ thuật trong đa hình, giúp ta có thể thay đổi cách thức hoạt động của một phương thức đã có sẵn trong class cha
Override giúp ta có thể sử dụng các đối tượng khác nhau, nhưng có cùng một class cha, và khi gọi các phương thức, ta sẽ thấy mỗi đối tượng sẽ thực hiện theo cách của nó, chứ không phải cách của đối tượng khác
Overload là một kĩ thuật trong đa hình, giúp ta có thể tạo ra nhiều phương thức cùng tên, nhưng khác nhau về tham số truyền vào
Overload giúp ta có thể sử dụng các phương thức khác nhau, nhưng có cùng một tên, và khi gọi các phương thức, ta sẽ thấy mỗi phương thức sẽ thực hiện theo cách của nó, chứ không phải cách của phương thức khác
Cú pháp:
publicclassClassCha {
    publicvoidmethodName(int a) {
        // code
    }

    publicvoidmethodName(int a, int b) {
        // code
    }
}
Dễ thấy overload trong các phương thức của class Math, như Math.max(), Math.min(), Math.abs(), Math.pow(), Math.sqrt(), Math.round(), Math.floor(), Math.ceil(), Math.random(), … Chúng đều có cùng một tên là Math, nhưng khác nhau về tham số truyền vào. Ví dụ nếu truyền vào số nguyên, thì xử lý khác, truyền số thực thì xử lý khác, …
Phân biệt Overload và Override
Overload
Override
Cùng tên, khác tham số
Cùng tên, cùng tham số
Cùng class
Khác class
Overload giúp ta có thể tạo ra nhiều phương thức cùng tên, nhưng khác nhau về tham số truyền vào
Override là một kĩ thuật trong đa hình, giúp ta có thể thay đổi cách thức hoạt động của một phương thức đã có sẵn trong class cha
Overload chạy trong compile time
Override chạy trong run time
Đa hình compile time và runtime
Đa hình compile time là đa hình mà chúng ta có thể thấy được ngay trong quá trình code, ví dụ như overload. Đa hình compile time sẽ được thực hiện trong compile time, tức là khi chúng ta build chương trình, chúng ta sẽ thấy các phương thức được overload sẽ được thực hiện theo cách của nó, chứ không phải cách của phương thức khác
Đa hình runtime là đa hình mà chúng ta không thể thấy được ngay trong quá trình code, ví dụ như override. Đa hình runtime sẽ được thực hiện trong runtime, tức là khi chúng ta chạy chương trình, chúng ta sẽ thấy các phương thức được override sẽ được thực hiện theo cách của nó, chứ không phải cách của phương thức khác
Ví dụ: Khi viết code lúc compile ta đã thấy ngay phương thức nào được gọi, nhưng khi chạy chương trình, ta mới thấy phương thức nào được thực hiện của override
Ví dụ:
Ta có các class Chó, Mèo, Bò. Chúng đều kế thừa từ class Động vật. Ta có thể tạo ra một mảng các đối tượng Động vật, và có thể thêm vào đó các đối tượng Chó, Mèo, Bò. Như vậy, ta có thể sử dụng các đối tượng khác nhau, nhưng có cùng một kiểu dữ liệu, là Động vật.
Chúng có thể có chung 1 hàm là keu(), nhưng khi gọi hàm keu() trên mảng các đối tượng Động vật, ta sẽ thấy mỗi đối tượng sẽ keu() theo cách của nó, chứ không phải cách của đối tượng khác. Như vậy, ta có thể sử dụng các đối tượng khác nhau, nhưng có cùng một kiểu dữ liệu, và khi gọi các phương thức, ta sẽ thấy mỗi đối tượng sẽ thực hiện theo cách của nó, chứ không phải cách của đối tượng khác.
Tạo ra một class ConNguoi, có các thuộc tính là tên, tuổi, giới tính, …
Có các class con là SinhVien, NhanVien, HocSinhCap3 kế thừa từ class ConNguoi
Các class con có thể có thêm các thuộc tính riêng của nó, ví dụ SinhVien có thuộc tính là mã sinh viên, NhanVien có thuộc tính là mã nhân viên, …
Các class con có thể có thêm các phương thức riêng của nó, ví dụ SinhVien có phương thức là học, NhanVien có phương thức là làm việc, …
Có 1 phương thức chung của 3 class con là lamViecBuoiSang(), nhưng mỗi class con sẽ thực hiện theo cách của nó, chứ không phải cách của class con khác. Ví dụ SinhVien sẽ đi học đại học, NhanVien sẽ đi làm, HocSinhCap3 sẽ đi học ở trường cấp 3
Cách Java lưu trữ dữ liệu (Kiểu dữ liệu nguyên thuỷ, Object, Wrapper class, Auto-boxing, Auto-unboxing)
Constructor, Super, This
Pass by value
Garbage Collector
I. Cách Java lưu trữ dữ liệu (Kiểu dữ liệu nguyên thuỷ, Object, Wrapper class, Auto-boxing, Auto-unboxing)
1. Kiểu dữ liệu nguyên thuỷ (Primitive data type)
Trong Java, có 8 kiểu dữ liệu nguyên thuỷ (Primitive data type): byte, short, int, long, float, double, boolean, char.
Kiểu dữ liệu nguyên thuỷ là các kiểu dữ liệu mà không phải là đối tượng, không có các phương thức, thuộc tính, … như các đối tượng.
Tức là, bạn không thấy các phương thức toString(), equals(), hashCode(), … trong các kiểu dữ liệu nguyên thuỷ.
inta=1;

// a không có hàm hay biến như các object// a.toString() không tồn tại// a.equals() không tồn tại// a.(gì đó) không tồn tại
Ví dụ, khi khai báo 1 biến int a = 1;, thì Java sẽ cấp phát 1 vùng nhớ có kích thước 4 byte để lưu giá trị 1 vào biến a. Thực chất trong bộ nhớ nó được lưu theo binary là 00000000 00000000 00000000 00000001. (1 byte = 8 bit)
Do có các 32 bit, nên int có thể lưu giá trị từ -2^31 đến 2^31 – 1. (1 bit để lưu dấu)
Tương tự, các kiểu dữ liệu khác cũng được lưu theo binary, và có kích thước khác nhau.
2. Object
2.1 Object là gì?
Trong Java, mọi thứ đều là đối tượng (Object). Vậy nên các kiểu dữ liệu nguyên thuỷ cũng là đối tượng.
Hiện tại các em chưa học về kế thừa, nhưng cứ tạm hiểu, khi ta nói về 1 tập đối tượng, ví dụ: Xe Ô Tô, hay class Car, có các thuộc tính, phương thức gì đó. Xe máy, hay class Motorbike, cũng có các thuộc tính, phương thức gì đó. Vậy thì Xe Ô Tô và Xe Máy đều là đối tượng, và chúng có các thuộc tính, phương thức giống nhau.
Vậy ta gọi tập đối tượng có cả xe máy và xe ô tô, không chứa các phương thức đặc thù như chạy, dừng, … là gì? Đó là tập đối tượng Xe, hay class Vehicle. Vậy nên, Xe Ô Tô và Xe Máy đều là Xe, hay Vehicle. Tập hợp Vehicle có thể nằm trong tập hợp to hơn là Phương Tiện Giao Thông, hay class Transportation.
Trong Java cũng như vậy, mọi class các em tạo ra mặc định đều thuộc 1 tập hợp chung là Object. Và class này luôn cung cấp cho mọi object tạo ra từ các class khác các phương thức, thuộc tính như toString(), equals(), hashCode(), … như đã nói ở trên.
2.2 Object được lưu thế nào trong Java
Hiểu đơn giản, giá trị cách lưu object thực sự rất phức tạp, điều đó đều do Java quản lý, và ta không cần quan tâm. Ta chỉ cần biết, khi tạo ra 1 object, ta chỉ lưu 1 địa chỉ tới object đó. Và từ địa chỉ này, ta có thể ra lệnh từ xa để lấy các thuộc tính, phương thức của object đó.
Vậy nên, khi ta gán 1 object cho 1 biến, thực chất ta đang gán 1 địa chỉ tới object đó cho biến đó.
Studentobj=newStudent();

// obj là 1 địa chỉ tới object Student
Vậy nên ta không thể so sánh 2 object với nhau bằng toán tử ==, mà phải dùng phương thức equals().
Wrapper class là các class được tạo ra để bao bọc các kiểu dữ liệu nguyên thuỷ. Ví dụ: Integer, Float, Double, Boolean, Character, …
Wrapper class cung cấp các phương thức để thao tác với các kiểu dữ liệu nguyên thuỷ. Ví dụ: Integer.parseInt(), Integer.toString(), Integer.valueOf(), …
Primitive data type
Wrapper class
byte
Byte
short
Short
int
Integer
long
Long
float
Float
double
Double
boolean
Boolean
char
Character
Các kiểu dữ liệu lưu dạng object này tuân theo cách Java lưu trữ object, tức là không lưu trực tiếp object, mà chỉ lưu địa chỉ tới object đó.
Ưu điểm
Nhược điểm
Có thể sử dụng các phương thức của object
Tốn bộ nhớ hơn
Ví dụ, ở Java ta có thể chuyển String thành số, từ các số hay từ 1 object bất kì sang String rất nhanh bằng toString(), ngoài ra khi nó là Object, ta có thể sử dụng các kĩ thuật OOP như kế thừa, đa hình, … (sẽ nói ở các buổi sau).
inta=1;

// a không có hàm hay biến như các object// a.toString() không tồn tạiIntegerb=1;

// b có hàm toString()// b.toString() tồn tại
2.4 Auto-boxing và Auto-unboxing
Auto-boxing là quá trình chuyển đổi từ kiểu dữ liệu nguyên thuỷ sang kiểu dữ liệu lưu dạng object.
Auto-unboxing là quá trình chuyển đổi từ kiểu dữ liệu lưu dạng object sang kiểu dữ liệu nguyên thuỷ.
Autoboxing và Auto-unboxing giúp cho việc sử dụng các kiểu dữ liệu nguyên thuỷ và object trở nên dễ dàng hơn. Ví dụ, khi ta muốn sử dụng HashMap, thì ta không thể sử dụng kiểu dữ liệu nguyên thuỷ là int, mà phải sử dụng Integer.
Tuy nhiên, trong nhiều trường hợp nên hạn chế dùng các kiểu Object do chúng tốn bộ nhớ
for (Integeri=0; i < 1000000; i++) {

  // ...

}

// Tốn bộ nhớ hơn// Vì i là object, nên phải tạo ra 1 object mới mỗi lần tăng i// Còn nếu dùng int, thì chỉ cần tạo ra 1 biến int i, và tăng i mỗi lần
3. Các phương thức khởi tạo (Constructor) trong Java
Constructor là một phương thức đặc biệt, nó được gọi khi ta khởi tạo một đối tượng. Constructor có tên giống với tên class, và không có kiểu trả về.
Constructor được sử dụng để khởi tạo các giá trị ban đầu cho đối tượng. Ví dụ như ta có một class Student, trong đó có các thuộc tính name, age, address, math, literature, english. Ta có thể tạo một constructor như sau:
Constructor có thể có hoặc không có tham số. Nếu không có tham số, thì constructor đó được gọi là constructor mặc định. Nếu có tham số, thì constructor đó được gọi là constructor có tham số.
Constructor có thể có nhiều tham số, và các tham số đó có thể là bất kỳ kiểu dữ liệu nào.
Constructor có thể có nhiều hơn một, và các constructor đó có thể có số lượng tham số khác nhau.
Constructor có thể gọi constructor khác của cùng một class bằng từ khóa this(). Ví dụ:
Trong quá trình thực thi chương trình, Java sẽ liên tục tìm các Object không được tham chiếu tới Heap Memory (mang giá trị null hoặc một vài trường hợp khác). Sau đó Garbage Collector sẽ tự động giải phóng bộ nhớ cho các ô nhớ chứa tham chiếu đó.
Điều này kiến lập trình viên không cần phải giải phóng bộ nhớ thủ công như C/C++. Thay vào đó, để giải phóng bộ nhớ, lập trình viên chỉ cần loại bỏ tham chiếu của Object.
5. Cách Java truyền tham số | Pass-by-value
Cách Java truyền tham số
5.1. Pass-by-value
Trong Java, khi ta truyền tham số vào một hàm, thì tham số đó sẽ được copy ra một vùng nhớ khác, và hàm sẽ thao tác với tham số ở vùng nhớ mới này.
Vậy nên, khi ta thay đổi giá trị của tham số trong hàm, thì giá trị của tham số bên ngoài hàm không bị thay đổi.
5.2. Tại sao pass-by-value mà String lại thay đổi được?
Ta hãy quay trở lại khái niệm vừa nhắc tới Khi ta truyền một biến nguyên thuỷ, hay trong trường hợp trên là age, ta đang như tạo một bản sao của một tờ giấy bình thường, tờ giấy đó ghi số là 20, ta đưa cho người khác. Họ sửa chúng thành 90, 100 hay gì đi chăng nữa, thì tờ giấy ban đầu của ta vẫn là 20
Tuy nhiên, khi ta truyền một biến reference (tham chiếu) của Object person, ta đang truyền bản sao của “tham chiếu” của nó. Hay đơn giản là, ta đang tạo ra bản sao của một cái điều khiển, vậy thì cái điều khiển bản sao này khi đưa cho người khác, vẫn sẽ bật tắt được tivi ban đầu của mình.
Class và Object (Lớp và Đối tượng) là hai trong những khái niệm quan trọng nhất của ngôn ngữ lập trình hướng đối tượng (OOP).
Sự khác biệt chính giữa một Class và một Object trong Java là:
Class là một mô hình chi tiết để bạn sử dụng tạo ra các Object. Class định nghĩa tất cả các thuộc tính và các phương thức cần thiết của một Object.
Mỗi Object phải thuộc một Class nào đó. Và một Object là một thể hiện của Class. Tất cả các Object thuộc về cùng một Class có cùng các thuộc tính và các phương thức.
Syntac :
ClassAobj=newClassA();
Vậy thực chất Java đã làm những gì?
Khi ta sử dụng new Example(), Java sẽ dành ra một số lượng vừa đủ ô nhớ trong bộ nhớ để lưu trữ các giá trị của một đối tượng Example và sau đó khởi tạo đối tượng đó.
Sau khi khởi tạo, Java sẽ lấy địa chỉ của vùng nhớ đó, gán vào cho “biến” obj. Biến obj được định nghĩa là kiểu Example, hay tức là nếu ta truy cập vào địa chỉ mà biến obj lưu thì vùng nhớ đó sẽ là vùng nhớ của một đối tượng Example.
Điều cần nói
Hiểu đơn giản, một object trong Java thực chất như 1 cái điều khiển, đang được cài đặt cho 1 cái tivi thực chất ở trong đó. Khi ta bấm nút trên điều khiển, thực chất ta đang gửi tín hiệu đến tivi, và tivi sẽ thực hiện hành động tương ứng. Vậy nên, khi ta gọi hàm obj.printInfo(), thực chất ta đang gửi tín hiệu đến đối tượng obj, và đối tượng obj sẽ thực hiện hành động tương ứng.
Lúc này, cứ tạm nhớ nó chỉ là cái điều khiển, chứ không phải cái tivi thật sự, sâu hơn ta sẽ tìm hiểu tiếp ở dưới. (Phần equal và hashcode)
Từ khóa this
Từ khoá this trong Java được sử dụng để tham chiếu đến đối tượng hiện tại. Từ khoá this có thể được sử dụng để tham chiếu bất kỳ biến nào của đối tượng hiện tại.
Trong ví dụ trên, ta có một class Person, trong đó có thuộc tính name. Ta muốn gán giá trị cho thuộc tính name, ta sẽ tạo một hàm khởi tạo, và trong hàm khởi tạo đó, ta sẽ gán giá trị cho thuộc tính name. Vì tên của tham số trùng với tên của thuộc tính, nên ta sẽ dùng từ khóa this để tham chiếu đến thuộc tính name.
Từ khóa this cũng có thể được sử dụng để tham chiếu đến các phương thức của đối tượng hiện tại.
Access modifier là một từ khóa trong Java, nó được dùng để chỉ định quyền truy cập của một thuộc tính hoặc một phương thức. Có 4 loại access modifier trong Java, đó là public, private, protected, default.
Bài này chỉ cần nói default, private, public
Public
Khi ta dùng từ khóa public với một thuộc tính hoặc một phương thức, thì thuộc tính hoặc phương thức đó có thể được truy cập từ bên ngoài class.
Khi ta dùng từ khóa protected với một thuộc tính hoặc một phương thức, thì thuộc tính hoặc phương thức đó chỉ có thể được truy cập từ bên trong class, hoặc từ bên trong các class con của class đó.
Khi ta không dùng từ khóa nào với một thuộc tính hoặc một phương thức, thì thuộc tính hoặc phương thức đó chỉ có thể được truy cập từ bên trong class, hoặc từ bên trong các class cùng package với class đó.
Khi ta dùng access modifier, ta có thể kiểm soát được quyền truy cập của các thuộc tính và phương thức. Ví dụ, ta có một class Person, trong đó có thuộc tính name. Ta muốn thuộc tính name này chỉ có thể được truy cập từ bên trong class Person, và không thể được truy cập từ bên ngoài class Person. Vì vậy, ta sẽ dùng từ khóa private với thuộc tính name.
publicclassPerson {
  private String name;
}
Điều cần nói
Trong thực tế, ví dụ như 1 cái ô tô, bên trong có rất nhiều cấu kiện tinh vi. Khi ta khởi động xe, các cấu kiện hoạt động với nhau, ta không biết chúng làm gì, làm như nào, chỉ biết là khi bật xe, thì xe chạy.
Các cấu kiện đó là những thứ “private”, chỉ bên trong một class “Oto” với nhau mới biết, bên ngoài không biết. Điều này giúp cho việc sử dụng xe dễ dàng hơn, thứ bên ngoài không cần biết quá nhiều về xe bên trong.
Getter và Setter
Getter
Getter là một hàm dùng để lấy giá trị của một thuộc tính. Ví dụ, ta có một class Person, trong đó có thuộc tính name. Để lấy giá trị của thuộc tính name, ta sẽ tạo một hàm getName().
Setter là một hàm dùng để gán giá trị cho một thuộc tính. Ví dụ, ta có một class Person, trong đó có thuộc tính name. Để gán giá trị cho thuộc tính name, ta sẽ tạo một hàm setName().
Khi ta dùng Getter và Setter, ta có thể kiểm soát được quyền truy cập của các thuộc tính. Ví dụ, ta có một class Person, trong đó có thuộc tính name. Ta muốn thuộc tính name này chỉ có thể được truy cập từ bên trong class Person, và không thể được truy cập từ bên ngoài class Person. Vì vậy, ta sẽ dùng từ khóa private với thuộc tính name, và tạo một hàm getName() và setName() để lấy và gán giá trị cho thuộc tính name.
Hiểu đơn giản hơn, khi để tất cả thuộc tính private và chỉ getter setter public, vô hình chung ta sẽ dẫn mọi truy cập vào 1 class chỉ còn 1 con đường, đó là getter và setter
Điều này giúp ta có được “quyền kiểm soát”, “control” ở 1 class đó, ta có thể kiểm soát được các giá trị được gán vào thuộc tính, và các giá trị được lấy ra từ thuộc tính.
Ví dụ, ta có một class là “NhaHang”, nó có một phương thức lấy số điện thoại, tuy nhiên ta muốn khi lấy số điện thoại, ta sẽ chuẩn hoá lại giá trị đó, ví dụ như thêm dấu +84 vào đầu, hoặc thêm dấu – vào giữa, hoặc thêm dấu cách vào giữa, hoặc thêm dấu ngoặc vào đầu cuối, … Vậy nên, ta sẽ tạo một hàm getter, và trong hàm getter đó, ta sẽ chuẩn hoá lại giá trị trước khi trả về.
class NhaHang {
  private String soDienThoai;

  String getSoDienThoai() {
    // Chuẩn hoá lại số điện thoạireturn soDienThoai;
  }

  void setSoDienThoai(String soDienThoai) {
    this.soDienThoai = soDienThoai;
  }
}
Như này, ta đảm bảo số điện thoại được lấy ra dùng cho class khác luôn là số điện thoại chuẩn hoá, không cần phải chuẩn hoá lại nữa. Vì cách duy nhất để lấy số điện thoại ra là dùng hàm getter, và hàm getter đã chuẩn hoá rồi.
Tương tự với setter, giả sử ta có một class ConNguoi với thuộc tính chiều cao. Chiều cao thì không thể âm được, vậy nên ta sẽ tạo một hàm setter, trong đó ta sẽ kiểm tra giá trị trước khi gán vào thuộc tính.
class ConNguoi {
  private int chieuCao;

  void setChieuCao(int chieuCao) {
    if (chieuCao < 0) {
      this.chieuCao = 0;
    } else {
      this.chieuCao = chieuCao;
    }
  }
}
Điều này đảm bảo tính toàn vẹn của dữ liệu, giúp cho mọi thứ chính xác và chặt chẽ
Ngoài ra, nó cũng giúp tăng tính bảo mật, không lộ quá nhiều thông tin bên trong class ra bên ngoài, mà mọi thứ chỉ có thể truy cập, sử dụng qua các phương thức ta đã định nghĩa sẵn. (Tính chất này còn được gọi là encapsulation, đóng gói trong OOP)
Từ khoá Static
Static là gì
Static là một từ khóa trong Java, nó có thể được dùng với biến, hàm, class. Static có nghĩa là tĩnh, tức là nó chỉ tồn tại ở một vị trí duy nhất, tồn tại ngay cả khi chưa tạo ra đối tượng. Vì vậy, khi ta dùng static với biến, hàm, class, ta có thể gọi chúng mà không cần tạo ra đối tượng.
Ví dụ, trong các thư viện Java, ta thường thấy các hàm, biến, class static. Vì vậy, ta có thể gọi chúng mà không cần tạo ra đối tượng.
Math.sqrt(2);
Từ khoá static với biến
Khi ta dùng static với biến, thì biến đó sẽ được tạo ra ngay cả khi chưa tạo ra đối tượng. Vì vậy, ta có thể gọi biến đó mà không cần tạo ra đối tượng. Biến static này là tồn tại duy nhất, tức là nó chỉ có một giá trị duy nhất, và nó sẽ được sử dụng chung cho tất cả các đối tượng.
class Person {
  static int count=0;

  Person() {
    count++;
  }
}
Hàm main static
Hàm main() là một hàm static, nó được gọi khi chương trình bắt đầu chạy. Ví dụ:
public classHelloWorld {
  public staticvoidmain(String[] args) {
    System.out.println("Hello World");
  }
}
Lí do hàm main là static
Như ta biết, để gọi 1 hàm từ 1 đối tượng, ta phải tạo ra 1 đối tượng đó trước.
Vậy nếu hàm main không phải là static, thì ta phải tạo ra 1 đối tượng của class HelloWorld trước, rồi gọi hàm main từ đối tượng đó.
Vì vậy, hàm main static thường xuất hiện ở class khởi nguồn. Như vậy, Java có thể gọi thẳng hàm main luôn mà không cần khởi tạo class trước đó.
Lí do hàm static chỉ có thể gọi hàm static khác
Tuy nhiên, 1 hàm static chỉ có thể gọi các hàm static khác, và chỉ có thể truy cập các biến static khác. Lí do là vì, khi ta gọi hàm static, ta không cần tạo ra 1 đối tượng, vậy nên ta không thể truy cập các biến không phải static của đối tượng đó được. Và vì ta không tạo ra 1 đối tượng, nên ta không thể gọi các hàm không phải static của đối tượng đó được.
Cứ tưởng tượng đơn giản, các hàm, biến, class static luôn chỉ tồn tại độc nhất, tồn tại ngay cả khi chưa tạo ra đối tượng. Vì vậy, các hàm, biến, class static luôn có thể được gọi mà không cần tạo ra đối tượng. Nếu mà 1 hàm static gọi 1 hàm không static, thì lỡ đâu hàm không static đó lại cần phải truy cập đến các biến không static, thì làm sao mà truy cập được, vì chưa tạo ra đối tượng mà.
Về equal và hashcode, ==
Trong Java, có 2 cách để so sánh 2 đối tượng với nhau, đó là so sánh bằng toán tử == và so sánh bằng hàm equal(). Tuy nhiên, 2 cách này lại có 2 cách hoạt động khác nhau.
Khi ta so sánh 2 đối tượng bằng toán tử ==, ta đang so sánh 2 địa chỉ của 2 đối tượng đó. Nếu 2 đối tượng đó có cùng địa chỉ, thì toán tử == sẽ trả về true, ngược lại thì trả về false.
Khi ta so sánh 2 đối tượng bằng hàm equal(), ta đang so sánh 2 nội dung của 2 đối tượng đó. Nếu 2 đối tượng đó có cùng nội dung, thì hàm equal() sẽ trả về true, ngược lại thì trả về false.
equal() dùng để so sánh nội dung của 2 đối tượng. (Lưu ý: toán tử == sẽ là so sánh giá trị của 2 biến đó, hay chính xác hơn là so sánh địa chỉ, chứ không phải so sánh nội dung)
hashcode() dùng để xác định vị trí của đối tượng đó trong một bảng băm (cấu trúc dữ liệu mà đa số sẽ sử dụng)
Vì như đã dạy ở trên, ta khi tạo 1 biến, thì thực chất nó chỉ là 1 tham chiếu
Vì vậy, các String có cùng 1 giá trị, dùng == để so sánh sẽ trả về false, vì chúng có các tham chiếu khác nhau
– Ta có thể thấy, khi gán 1 String khác, nếu không dùng new gán vào string cũ, chúng sẽ bằng nhau vì chúng cùng tham chiếu vào 1 địa chỉ
int a=5;
int b=5;

Integer a1=5;
Integer b1=5;

Integer a2=100;
Integer b2=100;

Integer a3=500;
Integer b3=500;


System.out.println(a == b); // true
System.out.println(a1 == b1); // true vì đây là tham chiếu, nhưng mà Java có cơ chế cache Integer từ -128 đến 127, nên khi gán 2 số từ -128 đến 127, chúng sẽ cùng tham chiếu đến 1 địa chỉ, nên == sẽ trả về true
System.out.println(a2 == b2); // true vì đây là tham chiếu, nhưng mà Java có cơ chế cache Integer từ -128 đến 127, nên khi gán 2 số từ -128 đến 127, chúng sẽ cùng tham chiếu đến 1 địa chỉ, nên == sẽ trả về true
System.out.println(a3 == b3); // false
System.out.println(a3.equal(b3)); // true vì đây là so sánh nội dung, không phải so sánh tham chiếu
String và String Builder trong Java
String là một class trong Java, nó được sử dụng để lưu trữ một chuỗi các ký tự. Một đối tượng String được tạo ra bằng cách sử dụng từ khóa new và có thể được khởi tạo bằng một chuỗi ký tự hoặc một đối tượng String khác.
Lí do là vì, khi ta tạo biến String mới, ta chỉ đang tạo 1 tham chiếu đến vùng nhớ của String đó.
String là một dạng immutable, tức là nó không thể thay đổi được. Vì vậy, khi ta thay đổi giá trị của String, ta đang tạo ra một String mới, và tham chiếu đến nó.
String str="Hello";

str = "World";
Để nhập vào String từ bàn phím, ta sử dụng hàm nextLine() của Scanner
String Builder là một class trong Java, nó được sử dụng để lưu trữ một chuỗi các ký tự. Một đối tượng String Builder được tạo ra bằng cách sử dụng từ khóa new và có thể được khởi tạo bằng một chuỗi ký tự hoặc một đối tượng String khác.
String Builder là một dạng mutable, tức là nó có thể thay đổi được. Vì vậy, khi ta thay đổi giá trị của String Builder, ta không tạo ra một String Builder mới, mà chỉ thay đổi giá trị của String Builder đó.
Để nhập vào String Builder từ bàn phím, ta sử dụng hàm nextLine() của Scanner như String
Vậy StringBuilder khác String ở chỗ nào
Stringstr="Hello";

str = str + " World";
Khi ta thực hiện phép cộng chuỗi, ta đang tạo ra một String mới, và tham chiếu đến nó. Vậy nên khi ta thực hiện phép cộng chuỗi nhiều lần, ta sẽ tạo ra rất nhiều String mới, và tham chiếu đến chúng. Điều này sẽ làm tốn rất nhiều bộ nhớ, và làm chậm chương trình.
Vì vậy, khi ta cần thay đổi giá trị của chuỗi nhiều lần, ta nên sử dụng StringBuilder, để tránh tạo ra quá nhiều String mới.
Bảng so sánh
String
StringBuilder
String là immutable
StringBuilder là mutable
Khi thay đổi ít lần, String tốn ít bộ nhớ hơn
Khi thay đổi ít lần, StringBuilder không được hết khả năng và tốn bộ nhớ nhiều hơn (lí do bên dưới)
Khi thay đổi nhiều lần, String tốn nhiều bộ nhớ hơn và thời gian hơn
Khi thay đổi nhiều lần, StringBuilder tốn ít bộ nhớ hơn và thời gian hơn
inttotal=50000;
Strings="";
for (inti=0; i < total; i++) { s += String.valueOf(i); }
// 4828msStringBuildersb=newStringBuilder();
for (inti=0; i < total; i++) { sb.append(String.valueOf(i)); }
// 4ms
Lí do StringBuilder có thể động như vậy vì nó sử dụng cơ chế mảng động, tức là khi khai báo 1 String độ dài 10, thực chất Java dành ra nhiều ô nhớ hơn để khi thêm độ dài mới vào tốc độ sẽ nhanh hơn (do không phải di chuyển toàn bộ vùng nhớ sang phần khác). Trong khi đó, String thực chất là một mảng tĩnh, khi khai báo 1 String độ dài 10, Java chỉ dành ra đúng 10 ô nhớ, khi thêm độ dài mới vào, Java sẽ phải di chuyển toàn bộ vùng nhớ sang phần khác, điều này sẽ làm chậm tốc độ xử lí.
Tuy nhiên, do dùng ô nhớ ít hơn, String tốn ít bộ nhớ hơn StringBuilder. Vì vậy, khi ta cần thay đổi giá trị của chuỗi ít lần, ta nên sử dụng String, để tránh tốn bộ nhớ.
Kĩ thuật mảng động: Nhân đôi mảng
Hiểu đơn giản, mảng luôn được khởi tạo số lượng phần từ nhiều hơn thực tế, để khi thêm phần tử vào mảng, ta không cần phải di chuyển toàn bộ mảng sang phần khác.
Điều này thực chất đang hi sinh bộ nhớ nhiều hơn để có hiệu quả thời gian tốt hơn trong đa số trường hợp.
7. Inner class
Inner class là gì
Inner class là một class được khai báo bên trong một class khác. Inner class có thể được khai báo là static hoặc non-static. Inner class có thể truy cập tất cả các biến và phương thức của class bên ngoài nó.
Inner class static là một class được khai báo bên trong một class khác, và được khai báo là static. Inner class static có thể truy cập tất cả các biến và phương thức của class bên ngoài nó.
Inner class non-static là một class được khai báo bên trong một class khác, và không được khai báo là static. Inner class non-static có thể truy cập tất cả các biến và phương thức của class bên ngoài nó.
Inner class có thể được dùng để tạo ra một class chỉ được sử dụng bởi một class khác. Ví dụ, ta có một class Person, trong đó có một class Address. Class Address này chỉ được sử dụng bởi class Person, nên ta có thể tạo ra một inner class Address.
từ việc import Scanner, import ArrayList, import String, … có thể import bất kì class nào trong Java, và sử dụng nó trong class của mình.
import java.util.Scanner;

classPerson {
  String name;
  int age;

  voidinput() {
    Scannersc=newScanner(System.in);
    name = sc.nextLine();
    age = sc.nextInt();
  }
}
Tuy nhiên, có thể tự tạo ra các class của riêng mình, và sử dụng nó trong class của mình. Ví dụ có các Class như QuanLySinhVien, SinhVien, MonHoc, … thì có thể tạo ra các file QuanLySinhVien.java, SinhVien.java, MonHoc.java, … và sử dụng chúng trong class của mình.
import java.util.Scanner;

classSinhVien {
  String name;
  int age;

  voidinput() {
    Scannersc=newScanner(System.in);
    name = sc.nextLine();
    age = sc.nextInt();
  }
}


classQuanLySinhVien {
  SinhVien[] danhSachSinhVien;

  voidinput() {
    Scannersc=newScanner(System.in);
    intn= sc.nextInt();
    danhSachSinhVien = newSinhVien[n];
    for (inti=0; i < n; i++) {
      danhSachSinhVien[i] = newSinhVien();
      danhSachSinhVien[i].input();
    }
  }
}
Lưu ý, trong 1 file thì chỉ có thể có 1 class public, và tên của class đó phải trùng với tên của file. Ví dụ, trong file QuanLySinhVien.java, ta chỉ có thể có 1 class public, và tên của class đó phải là QuanLySinhVien.
// QuanLySinhVien.java
public classQuanLySinhVien {
  ...
}