[A.I System Programming] B4: Motivation của GPU

This entry is part 4 of 6 in the series A.I System Programming

Như đã thấy ở Phần 3, lịch sử máy tính đã chứng kiến một bước ngoặt vào những năm 2010: Sự sụp đổ của Định luật Moore về mặt tốc độ. Khi xung nhịp chạm ngưỡng 3.5 GHz và bài toán nhiệt năng trở thành ‘bức tường’ ngăn cản sự phát triển theo chiều dọc, thế giới công nghệ buộc phải chuyển mình sang chiều ngang.

Khi tốc độ đơn nhân không còn tăng, tính toán song song (Parallel Computing) không còn là một lựa chọn xa xỉ, mà là con đường duy nhất để duy trì đà tăng trưởng của công nghệ.
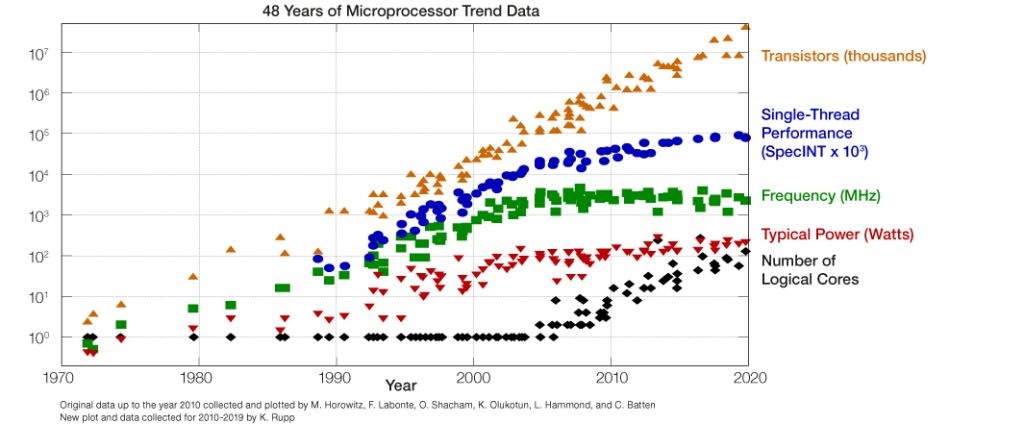
image 82 - quochung.cyou PTIT

Tính toán song song

Tính toán song song là việc thực thi nhiều thao tác tại một thời điểm duy nhất. Như đã thấy từ biểu đồ trên, Single Thread Performance (Hiệu năng đơn nhân), Frequency (Xung nhịp) của CPU đã không còn tăng đáng kể từ sau những năm 2010, thậm chí là giảm xuống/giữ nguyên để đạt được mục tiêu tiết kiệm điện hơn, nhiệt năng giảm đi. Sự thay đổi lớn nhất từ 2010 là số lượng nhân (Logical Core)

Tuy nhiên, việc các hệ thống máy tính được trang bị nhiều core hơn, mở ra khả nưang cho phép thực thi nhiều thao tác tại 1 thời điểm duy nhất, nhưng việc này không diễn ra tự động. Tức là từ góc nhìn của 1 lập trình viên, không phải cứ đưa chương trình vào các phần cứng nhiều nhân là chương trình sẽ chạy nhanh hơn, mà điều này còn cần chính lập trình viên đó hiểu và sửa đổi chương trình để có thể tận dụng khả năng của phần cứng.

  1. Nhìn chung đầu tiên, ta cần xác định liệu ứng dụng có tiềm năng/có khả năng tận dụng từ tính toán song song không?
  2. Tiềm năng song song, hay tính đồng thời (concurrency), có nghĩa là ta có thể xác nhận rằng việc thực hiện các thao tác theo bất kỳ thứ tự nào là an toàn khi các tài nguyên hệ thống trở nên sẵn dụng.

Và, với tính toán song song, có một yêu cầu bổ sung: các thao tác này phải xảy ra cùng một lúc. Để điều này thực hiện được, ta cũng phải tận dụng đúng cách các tài nguyên để thực thi các thao tác này một cách đồng thời.

Nghe có vẻ khá hàn lâm, ta có thể đi qua 1 ví dụ thực tế

Ví dụ thực tế
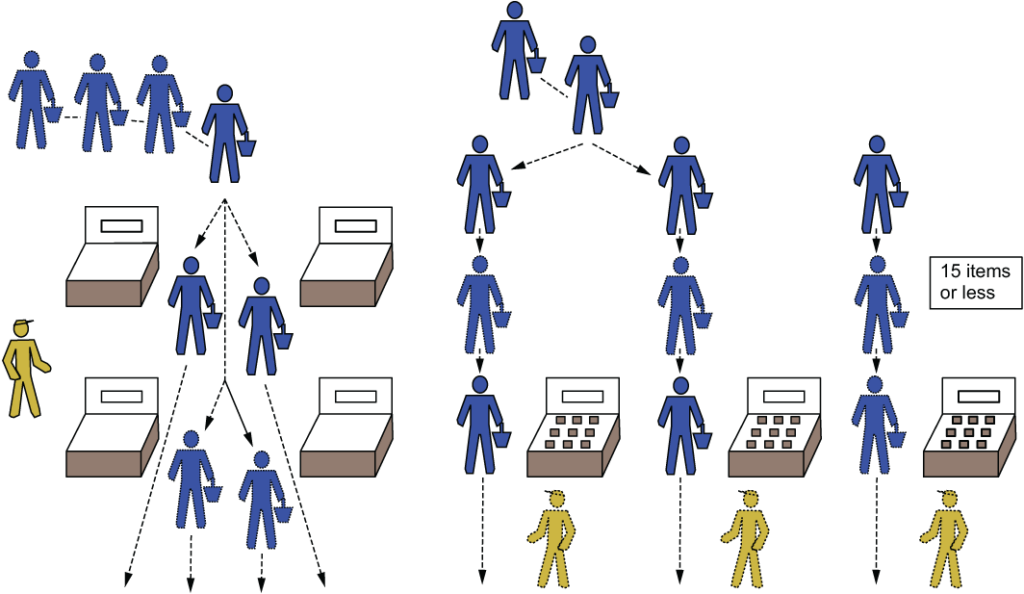
image 83 - quochung.cyou PTIT

Có thể thấy vô số ví dụ về xử lý song song ngay trong cuộc sống hàng ngày. Ví dụ là một hàng thanh toán tại siêu thị, mục tiêu là giúp khách hàng thanh toán nhanh chóng những món đồ họ muốn mua.

Việc này có thể được thực hiện bằng cách thuê nhiều thu ngân để xử lý (thanh toán) cho khách hàng từng người một. Trong trường hợp này, những thu ngân lành nghề có thể thực hiện quy trình thanh toán nhanh hơn để khách hàng rời đi sớm hơn.

Một chiến lược khác là sử dụng nhiều trạm tự thanh toán và cho phép khách hàng tự thực hiện quy trình. Chiến lược này đòi hỏi ít nguồn lực con người hơn từ siêu thị và có thể mở thêm nhiều làn để xử lý khách hàng. Quầy tự thanh toán thì có thể sẽ xử lý chậm hơn quầy thu ngân do khách hàng không quen với việc này, tuy nhiên tổng thể thì nhiều khách hàng hơn có thể thanh toán nhanh chóng nhờ tính song song được tăng cường, dẫn đến các hàng đợi ngắn hơn.

Chúng ta giải quyết các vấn đề tính toán bằng cách phát triển các thuật toán (algorithms): một tập hợp các bước để đạt được kết quả mong muốn.

  • Trong phép ẩn dụ về siêu thị, quy trình thanh toán chính là thuật toán.
  • Trong trường hợp này, nó bao gồm việc:
    • B1: dỡ đồ khỏi giỏ
    • B2: quét mã các món đồ để lấy giá
    • B3: thanh toán tiền.
  • Thuật toán này là tuần tự (sequential/serial); nó phải tuân theo đúng thứ tự này. Rõ ràng ta không thể vừa bảo khách hàng hãy thanh toán tiền, nếu ta chưa dỡ đồ ra để quét mã kiểm tra giá.

Nếu có hàng trăm khách hàng cần thực hiện nhiệm vụ này, thuật toán thanh toán cho nhiều khách hàng sẽ chứa đựng một tính song song có thể tận dụng được. Về mặt lý thuyết, không có sự phụ thuộc nào giữa bất kỳ hai khách hàng nào đang thực hiện quy trình thanh toán. Bằng cách sử dụng nhiều làn thanh toán hoặc các trạm tự thanh toán, các siêu thị đã bộc lộ tính song song (expose parallelism), từ đó tăng tốc độ khách hàng mua hàng và rời khỏi cửa hàng. Mỗi lựa chọn trong cách chúng ta triển khai tính song song này đều dẫn đến các chi phí và lợi ích khác nhau.

Định nghĩa: Tính toán song song (Parallel computing) là việc thực hành xác định và bộc lộ tính song song trong các thuật toán, thể hiện điều này trong phần mềm của chúng ta, và hiểu rõ các chi phí, lợi ích cũng như những giới hạn của cách triển khai đã chọn.

Tính năng phần cứng

Vì có rất nhiều tính năng phần cứng song song khác nhau, điều này đặt ra những thách thức mới cho lập trình viên. Một trong số đó là siêu phân luồng (hyperthreading), được giới thiệu bởi Intel. Việc có hai hàng đợi lệnh xen kẽ công việc vào các đơn vị logic phần cứng cho phép một lõi vật lý hiển thị như hai lõi đối với hệ điều hành (OS).

Bộ xử lý vector (Vector processors) là một tính năng phần cứng khác bắt đầu xuất hiện trong các bộ vi xử lý phổ thông vào khoảng năm 2000. Chúng thực thi nhiều lệnh cùng một lúc. Độ rộng tính bằng bit của bộ xử lý vector (còn gọi là đơn vị vector – vector unit) xác định số lượng lệnh thực thi đồng thời. Ví dụ, một đơn vị vector rộng 256-bit có thể thực thi bốn lệnh 64-bit (số thực dấu phẩy động độ chính xác kép – doubles) hoặc tám lệnh 32-bit (độ chính xác đơn – single-precision) cùng một lúc.

Có thể tạm bỏ qua cách mà các công nghệ này hoạt động, từ một phép tính, ta thử xem xét một CPU 16 lõi có siêu phân luồng và một đơn vị vector rộng 256-bit. Một chương trình tuần tự (serial) chỉ sử dụng một lõi duy nhất và không sử dụng vector hóa sẽ chỉ tận dụng được 0,8% khả năng xử lý lý thuyết của bộ vi xử lý này!

16 cores × 2 hyperthreads × (256 bit-wide vector unit)/(64-bit double) = 128-way parallelism
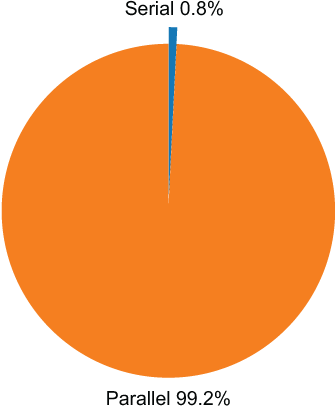
image 84 - quochung.cyou PTIT

Hiệu quả năng lượng: Làm được nhiều hơn với ít tài nguyên hơn

Một trong những lĩnh vực tác động mới của tính toán song song là hiệu quả năng lượng. Trên các thiết bị cầm tay, tính song song giúp ứng dụng chạy nhanh hơn, cho phép thiết bị quay lại chế độ ngủ (sleep mode) sớm hơn. Nó cũng cho phép sử dụng các bộ vi xử lý chậm hơn nhưng có tính song song cao hơn, vốn tiêu thụ ít điện năng hơn.

Công thức ước tính mức tiêu thụ năng lượng của ứng dụng:

P=(N Bộ xử lý)×(R Watt/Bộ xử lý)×(T giờ)P = (N \text{ Bộ xử lý}) \times (R \text{ Watt/Bộ xử lý}) \times (T \text{ giờ})

Trong đó: P là năng lượng tiêu thụ, N là số bộ xử lý, R là công suất thiết kế nhiệt (TDP), và T là thời gian chạy.

Ví dụ:

  • Dùng CPU: 20 bộ xử lý Xeon (120W) chạy trong 24 giờ tiêu tốn 57,60 kWh.
  • Dùng GPU: 4 GPU NVIDIA V100 (300W) chạy trong 24 giờ tiêu tốn 28,80 kWh. Dù thời gian chạy bằng nhau, phiên bản dùng GPU chỉ tiêu tốn một nửa chi phí năng lượng.

Các định luật cơ bản của tính toán song song

Trong tính toán tuần tự, mọi thao tác đều nhanh lên khi tần số xung nhịp tăng. Ngược lại, với tính toán song song, chúng ta phải sửa đổi ứng dụng để khai thác phần cứng.

Định luật Amdahl

Định luật Amdahl (đề xuất bởi Gene Amdahl năm 1967) mô tả sự tăng tốc của một vấn đề có kích thước cố định khi số lượng bộ xử lý tăng lên:

Speedup(N)=1S+PN\text{Speedup}(N) = \frac{1}{S + \frac{P}{N}}

Trong đó: P là phần mã có thể song song hóa, S là phần mã tuần tự (S + P = 1), và N là số lượng bộ xử lý.

Ví dụ một biểu đồ trục hoành là số lượng nhân và trục tung là tốc độ tăng lên. Trong mong muốn, khi ta đi từ 1 nhân lên 32 nhân, ta có thể tăng tốc độ lên đúng 32 lần. Tuy nhiên nếu chỉ cần với 10% mã không thể song song hoá, tức là có 90% mã song song hoá được thôi, thì speedup cũng đã chỉ còn là khoảng ~8 ở 32 nhân (so với 32 lần tăng tốc)
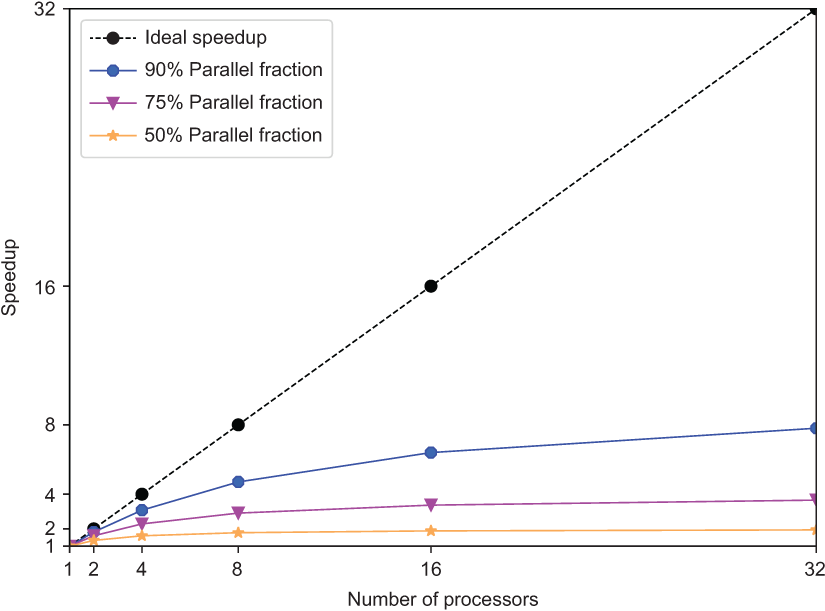
image 85 - quochung.cyou PTIT

Hãy tưởng tượng một quy trình làm giày gồm:

  • Thiết kế mẫu (Tuần tự): 10 giờ (Chỉ có 1 nhà thiết kế chính có thể quyết định kiểu dáng).
  • Gia công và đóng gói (Song song): 90 giờ.

Áp dụng công thức: P = 0.9 (90%), S = 0.1 (10%).

  • Với 2 bộ xử lý (N=2): Speedup = 1.82 lần.
  • Với 10 bộ xử lý (N=10): Speedup = 5.26 lần.
  • Với vô hạn bộ xử lý: Speedup = 10 lần.

Dù có trang bị hệ thống máy móc khổng lồ (tăng N lên cực lớn), ta cũng không bao giờ tăng tốc quy trình sản xuất lên quá 10 lần. 10 giờ thiết kế ban đầu là “vùng bất khả xâm phạm”.

Định luật Gustafson-Barsis

Gustafson và Barsis (1988) chỉ ra rằng: trong thực tế, khi có thêm nhiều bộ xử lý, chúng ta thường tăng kích thước vấn đề lên. Nếu kích thước vấn đề tăng tỷ lệ thuận với số lượng bộ xử lý, sự tăng tốc được tính bằng:

SpeedUp(N)=N−S×(N−1)\text{SpeedUp}(N) = N – S \times (N – 1)

Kết quả là một vấn đề lớn hơn có thể được giải quyết trong cùng một khoảng thời gian bằng cách sử dụng nhiều bộ xử lý hơn. Kịch bản này được gọi là mở rộng yếu (weak scaling).
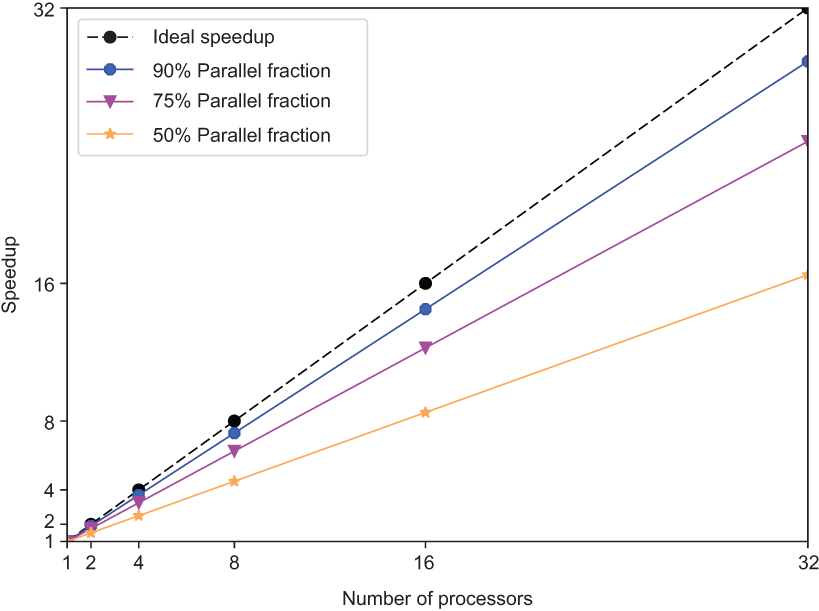
image 86 - quochung.cyou PTIT

Định nghĩa: Weak scaling đại diện cho thời gian tìm ra lời giải so với số lượng bộ xử lý cho một kích thước vấn đề cố định trên mỗi bộ xử lý.

Giả sử ta có 1 giờ để dọn dẹp và ta có một số lượng nhân công tùy ý.

  • Phần tuần tự (S): Lập kế hoạch phân công công việc (mất 5 phút). Dù có bao nhiêu người, vẫn phải mất 5 phút này để nói cho mọi người biết phải làm gì.
  • Phần song song (P): Việc lau chùi thực tế.

Phân tích:

  1. Với 1 người: Trong 1 giờ, ta dành 5 phút lập kế hoạch và 55 phút còn lại để lau xong 1 căn phòng.
  2. Với 10 người: vẫn dành 5 phút lập kế hoạch. Nhưng trong 55 phút còn lại, 10 người này có thể lau sạch 10 căn phòng.

Kết luận: Ta không làm sạch 1 căn phòng nhanh gấp 10 lần (vì vẫn vướng 5 phút họp), nhưng ta đã giải quyết được một khối lượng công việc lớn gấp nhiều lần trong cùng một quỹ thời gian 1 giờ.

So sánh Mở rộng Mạnh (Strong Scaling) và Mở rộng Yếu (Weak Scaling)
  • Mở rộng mạnh (Strong scaling): Giữ nguyên tổng kích thước bài toán và chia nhỏ nó ra cho nhiều bộ xử lý hơn. Mục tiêu chính là giảm thời gian tính toán.
  • Mở rộng yếu (Weak scaling): Giữ nguyên kích thước bài toán trên mỗi bộ xử lý (mật độ không đổi), dẫn đến tổng kích thước bài toán tăng lên khi thêm bộ xử lý. Điều này giúp tận dụng thêm bộ nhớ của các bộ xử lý mới để giải quyết vấn đề lớn hơn.
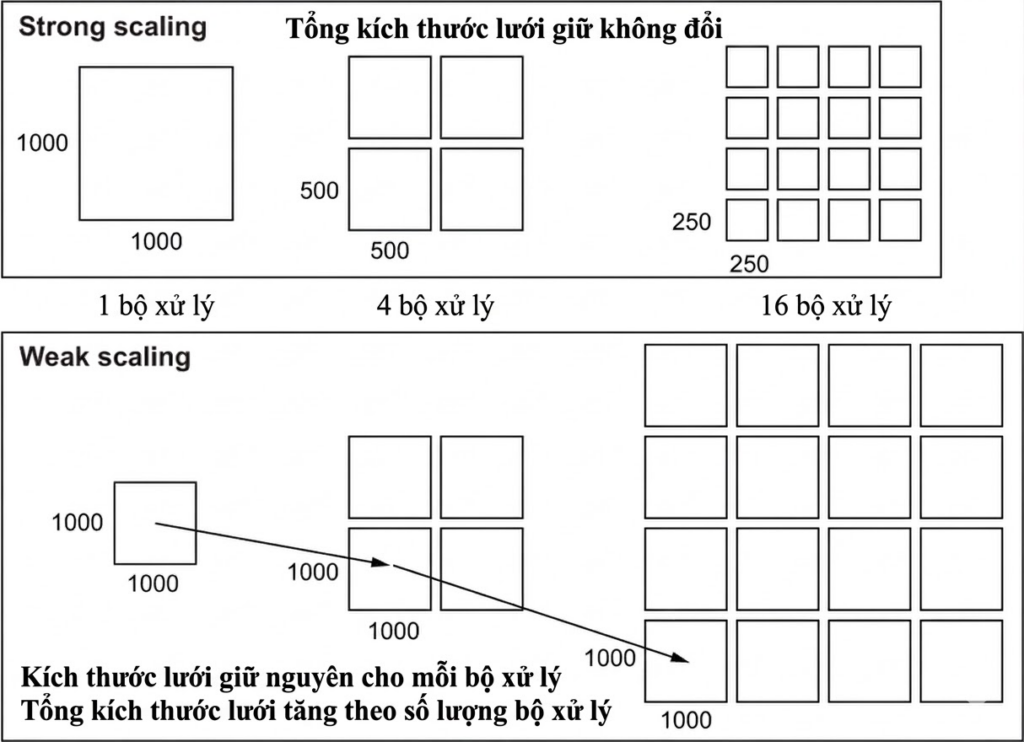
image 87 - quochung.cyou PTIT

Trong thực tế, cả hai đều quan trọng vì chúng giải quyết các kịch bản khác nhau. Thuật ngữ khả năng mở rộng (scalability) thường được dùng để chỉ việc liệu có thể thêm tính song song vào phần cứng hoặc phần mềm hay không, và liệu có giới hạn tổng thể cho sự cải thiện đó hay không.

Khả năng mở rộng bộ nhớ (Memory Scaling)

Mặc dù đa số mọi người quan tâm vào thời gian chạy, nhưng khả năng mở rộng bộ nhớ thường quan trọng hơn.

Giả sử ta vận hành một hệ thống siêu thị gồm 4 chi nhánh (tương đương 4 bộ xử lý – Proc). Để hệ thống hoạt động, mỗi chi nhánh cần quản lý hai loại dữ liệu sau:

  • Loại 1: Danh sách giá sản phẩm (Bảng giá chung)
    • Mọi chi nhánh đều phải bán cùng một mức giá. Khi khách hàng quét mã vạch, máy tính tại chi nhánh đó phải biết giá ngay lập tức mà không cần hỏi chi nhánh khác.
    • Cách lưu trữ: Ta phải chép một bản danh sách giá đầy đủ vào máy tính của tất cả 4 chi nhánh.
    • Đặc điểm: Nếu danh sách giá tăng lên (từ 1.000 mặt hàng lên 1.000.000 mặt hàng), thì máy tính tại mỗi chi nhánh đều phải tăng dung lượng lưu trữ tương ứng để chứa hết đống dữ liệu đó.
  • Loại 2: Danh sách khách hàng thân thiết
    • Hệ thống có 4.000 khách hàng. Để giảm tải, ta chia ra: chi nhánh A giữ thông tin 1.000 người đầu tiên, chi nhánh B giữ 1.000 người tiếp theo, tương tự cho C và D.
    • Cách lưu trữ: Dữ liệu được chia nhỏ và phân chia cho các chi nhánh.
    • Đặc điểm: Nếu số lượng khách hàng tăng lên 16.000 người, ta chỉ cần mở thêm 12 chi nhánh nữa (tổng 16 chi nhánh). Lúc này, mỗi máy tính chi nhánh vẫn chỉ phải quản lý đúng 1.000 khách hàng như cũ.

Từ ví dụ trên, ta chuyển dịch sang các thuật ngữ chuyên môn trong hình ảnh:

  • Mảng sao chép (Replicated Array – R) – Tương ứng với “Bảng giá chung”
    • Định nghĩa: Là tập dữ liệu mà mỗi bộ xử lý (Proc) bắt buộc phải giữ một bản sao toàn phần.
    • Tại sao phải thế? Trong tính toán song song, có những dữ liệu mà mọi bộ xử lý đều cần truy cập liên tục (ví dụ: hằng số vật lý, bản đồ địa hình, bảng tra cứu). Việc sao chép giúp Proc lấy dữ liệu ngay lập tức từ bộ nhớ cục bộ (Local Memory), không phải chờ đợi truyền tin qua mạng giữa các Proc khác, giúp tăng tốc độ xử lý.
  • Mảng phân tán (Distributed Array – D) – Tương ứng với “Danh sách khách hàng”
    • Định nghĩa: Là tập dữ liệu khổng lồ được chia nhỏ. Mỗi Proc chỉ giữ một phần (segment).
    • Tại sao phải thế? Để xử lý các bài toán cực lớn (Big Data) mà một máy đơn lẻ không bao giờ chứa nổi. Ta tận dụng tổng dung lượng RAM của nhiều máy cộng lại.
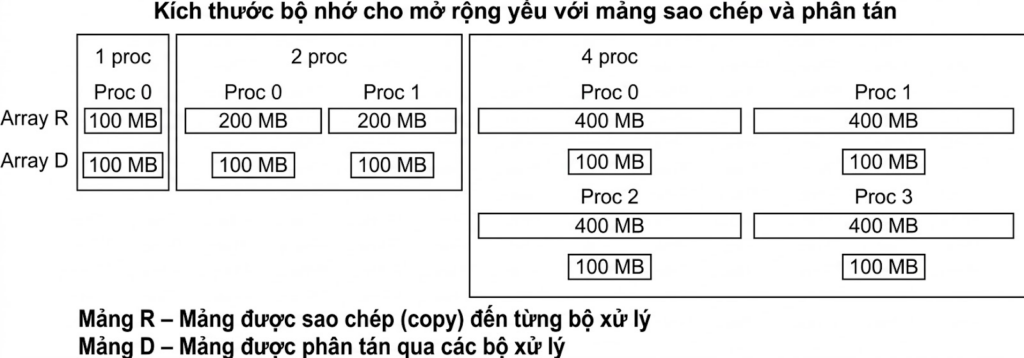
image 88 - quochung.cyou PTIT

Hãy nhìn lại thông số trong hình:

  1. Ở 1 Proc: Ta có mảng R (100MB) và mảng D (100MB). Tổng cộng tốn 200MB RAM.
  2. Ở 4 Proc (Quy mô bài toán tăng gấp 4):
    • Mảng D được chia cho 4 máy, nên mỗi máy vẫn chỉ gánh 100MB (Tổng 400MB). Đây là tin tốt.
    • Vấn đề nằm ở mảng R: Vì tính chất sao chép, khi tổng dữ liệu R tăng lên 400MB, thì từng máy một đều phải gánh đủ 400MB.
    • Kết quả: Một máy bây giờ phải chứa 400MB (R) + 100MB (D) = 500MB.

Mảng D (Phân tán): Khi quy mô bài toán tăng gấp 4 (từ 100 MB lên 400 MB tổng cộng) và số Proc tăng lên 4, lượng dữ liệu mảng D mà mỗi Proc phải xử lý vẫn giữ nguyên là 100 MB. Đây là trạng thái mở rộng lý tưởng.

Mảng R (Sao chép): Vì tính chất phải sao chép toàn bộ, khi kích thước bài toán tăng lên 400 MB, mọi Proc đều phải chứa đủ 400 MB.

Nếu máy chỉ có 450MB RAM, thì coi như bây giờ ta vẫn luôn có một giới hạn trên cho việc tăng số lượng process là các dữ liệu bắt buộc phải copy tại mọi máy. Dù ta có mua thêm 100 hay 1000 máy nữa cũng vô dụng, vì mỗi cái máy đơn lẻ đó đều không đủ RAM để chứa mảng R đang phình to.

  • Thời gian chạy (Runtime): Nếu thuật toán dở, ta thêm máy thì nó chạy nhanh hơn hoặc chậm đi một chút, nhưng nó vẫn chạy được.
  • Bộ nhớ (Memory): Nếu thiết kế mảng sao chép (R) quá nhiều, khi bài toán lớn đến một mức nhất định, nó sẽ không thể chạy được vì vượt ngưỡng RAM vật lý của từng nút xử lý.

Tính toán song song hoạt động như thế nào?

Tính toán song song đòi hỏi sự kết hợp giữa hiểu biết về phần cứng, phần mềm và tính song song để phát triển ứng dụng. Với một số khái niệm như (CPU/Process/Thread/…) nếu bạn chưa biết, phần này sẽ được đề cập sơ lược qua ở các phần sau khi đi sâu hơn.

Ta thấy rằng giữa mã nguồn và phần cứng, ứng dụng phải đi qua các lớp bổ sung, bao gồm trình biên dịch (compiler) và hệ điều hành (OS).
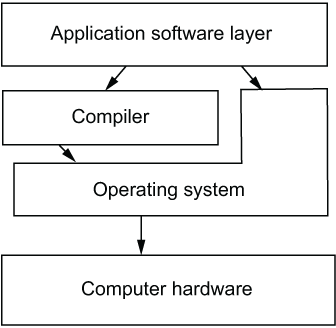
image 89 - quochung.cyou PTIT

Chúng ta phân loại các phương pháp tiếp cận song song có thể thực hiện thành:

  1. Song song hóa dựa trên tiến trình (Process-based): Mỗi tiến trình có không gian bộ nhớ riêng.
  2. Song song hóa dựa trên luồng (Thread-based): Các luồng chia sẻ chung bộ nhớ.
  3. Vector hóa (Vectorization): Thực hiện một lệnh trên nhiều dữ liệu.
  4. Xử lý dòng (Stream processing): Thường gắn liền với GPU.

Chúng ta sẽ sử dụng phương pháp song song hóa dữ liệu (data parallel) trên một lưới không gian hai chiều (2D). Ví dụ minh họa là hình ảnh 2D của núi lửa Krakatau

Để hiểu tại sao chúng ta cần những khái niệm này, hãy đi từ bài toán thực tế: Dự báo sóng thần sau khi núi lửa Krakatau phun trào.
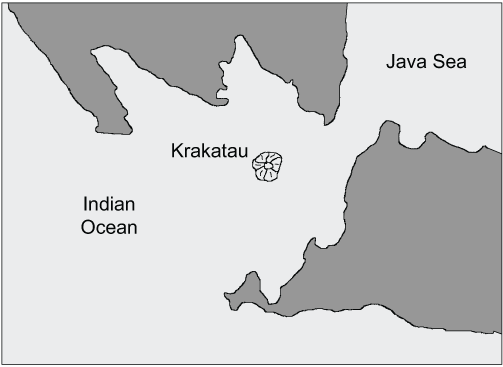
image 90 - quochung.cyou PTIT
Bước 1: Rời rạc hóa vấn đề thành các ô hoặc phần tử nhỏ hơn

Trước khi tính toán chi tiết, ta phải chia nhỏ miền vấn đề thành các mảnh nhỏ, quá trình này gọi là rời rạc hóa (discretization). Trong xử lý ảnh, đây chính là các pixel. Trong mô phỏng, chúng được gọi là các ô (cells) hoặc phần tử (elements).
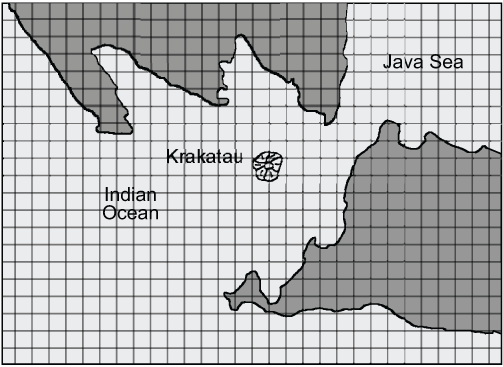
image 91 - quochung.cyou PTIT

Nước biển là một khối liền mạch. Nhưng máy tính chỉ có thể lưu trữ dữ liệu dưới dạng các con số riêng biệt trong bộ nhớ (RAM).

  • Việc cần làm: Ta đặt một lưới (grid) lên bản đồ vùng biển Krakatau. Mỗi ô vuông (ô đơn vị) sẽ đại diện cho một vị trí.
  • Dữ liệu lưu trữ: Tại mỗi ô, ta lưu một con số cụ thể như: Độ cao mực nước hiện tại.
    • Ô gần núi lửa: 10 mét (đang có sóng lớn).
    • Ô xa núi lửa: 0 mét (nước đang lặng).
Bước 2: Xác định hạt nhân tính toán (kernel) hoặc thao tác trên mỗi phần tử

Hãy tưởng tượng tại giây thứ 1, ô A có sóng cao 10m, ô B bên cạnh có sóng cao 0m.

  • Câu hỏi: Ở giây thứ 2, chuyện gì xảy ra với ô B?
  • Thực tế: Nước từ ô A sẽ tràn sang ô B. Độ cao nước ở ô B sẽ tăng lên.

Nếu ta chỉ tính toán “cô lập” (chỉ nhìn vào ô B mà không nhìn xung quanh), máy tính sẽ thấy ô B đang là 0m và mãi mãi là 0m. Nó không hề biết có một con sóng cực lớn ngay bên cạnh sắp ập đến.

Để biết tương lai của một vị trí (ô trung tâm), ta bắt buộc phải xem xét tình trạng của các vị trí xung quanh (lân cận). Đây chính là sự tương tác vật lý.

Các phép tính trên dữ liệu rời rạc này thường ở dạng toán tử khuôn mẫu (stencil operation). Nó được gọi như vậy vì nó liên quan đến một mẫu các ô lân cận để tính toán giá trị mới cho ô trung tâm.
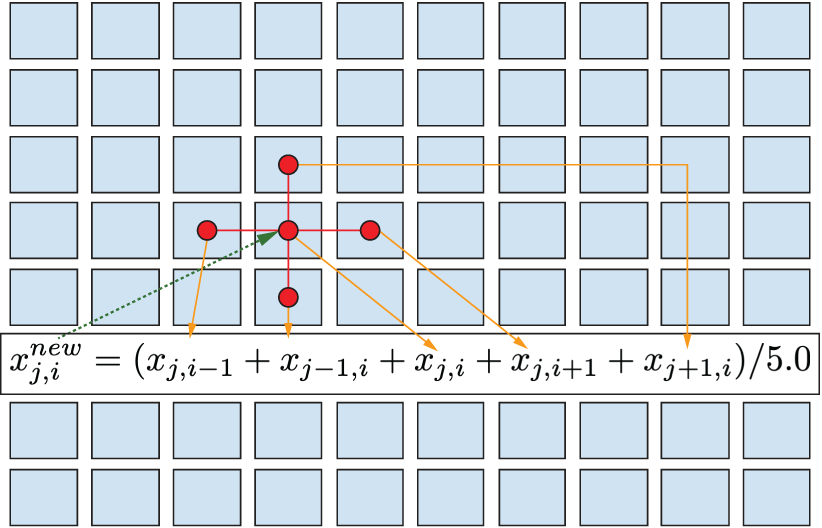
image 92 - quochung.cyou PTIT

Mô phỏng sự thay đổi (Wave Propagation): Trong bài toán Krakatau, việc dùng Stencil giúp máy tính tính toán sự lan truyền. Sóng từ ô này truyền sang ô kia qua từng bước thời gian.

  • Bước 1: Tính toán dựa trên lân cận.
  • Bước 2: Cập nhật giá trị mới.
  • Bước 3: Lặp lại (Sóng sẽ di chuyển dần trên màn hình).
Bước 3: Vector hóa để xử lý nhiều đơn vị dữ liệu cùng lúc

Chúng ta bắt đầu giới thiệu tính song song bằng cách nhìn vào Vector hóa (Vectorization). Một số bộ vi xử lý có khả năng thao tác trên nhiều mảnh dữ liệu cùng một lúc; khả năng này được gọi là các thao tác vector.
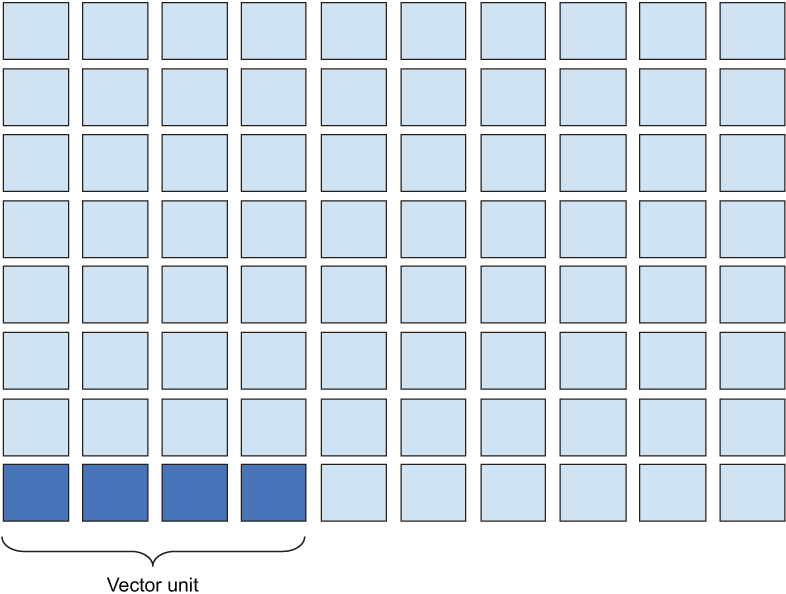
image 93 - quochung.cyou PTIT
Bước 4: Luồng (Threads) để triển khai nhiều lộ trình tính toán

Vì hầu hết các CPU ngày nay có ít nhất 4 lõi xử lý, chúng ta sử dụng đa luồng (threading) để vận hành các lõi đồng thời trên bốn hàng cùng một lúc.
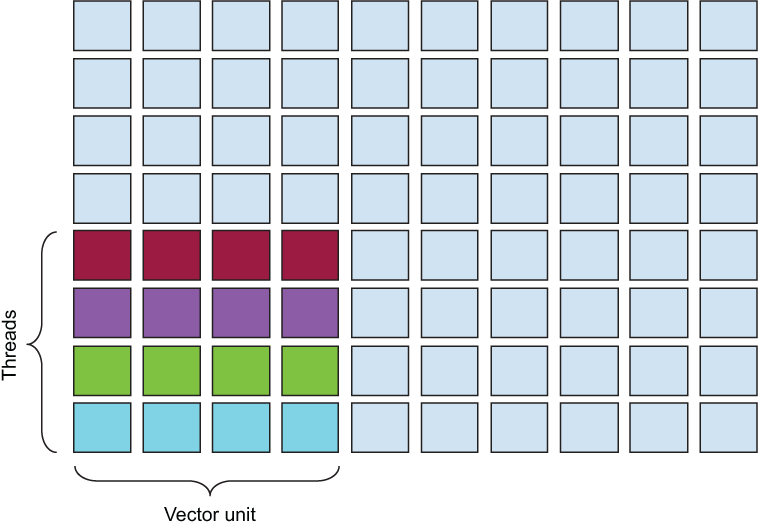
image 94 - quochung.cyou PTIT
Bước 5: Tiến trình (Processes) để trải rộng tính toán sang các không gian bộ nhớ riêng biệt

Chúng ta có thể chia nhỏ công việc hơn nữa giữa các bộ vi xử lý trên hai máy tính để bàn, thường được gọi là các nút (nodes) trong xử lý song song. Khi công việc được chia tách giữa các nút, không gian bộ nhớ cho mỗi nút là riêng biệt và độc lập.
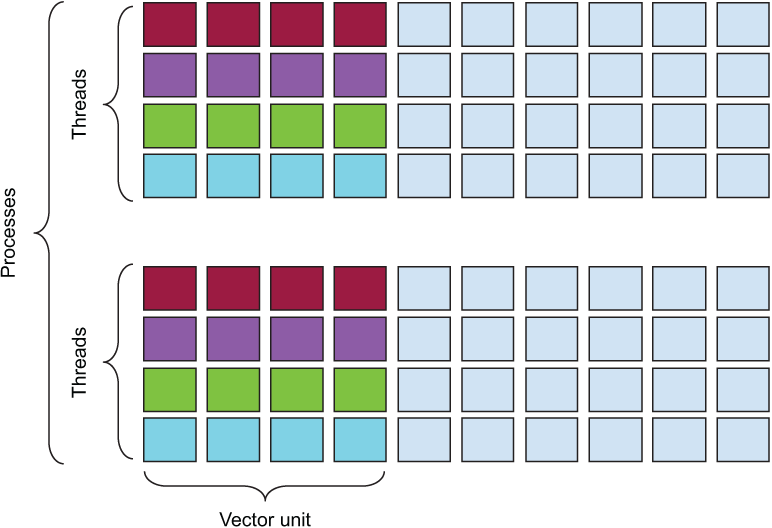
image 95 - quochung.cyou PTIT

Ngay cả với kịch bản phần cứng khiêm tốn này, tiềm năng tăng tốc đã là 32 lần.

Mô hình phần cứng cho các hệ thống song song

Để hiểu cách tính toán song song vận hành, chúng ta cần nắm rõ các thành phần phần cứng:

  • DRAM (Dynamic Random Access Memory): Bộ nhớ lưu trữ thông tin/dữ liệu.
  • Lõi tính toán (Core): Thực hiện các phép tính số học và logic.
  • Bộ xử lý (Processor/CPU): Được trang bị nhiều lõi.
  • Thiết bị tăng tốc (Accelerator): Thường là GPU, với hàng nghìn lõi và không gian bộ nhớ riêng.
  • Nút tính toán (Compute Node): Sự kết hợp của CPU, DRAM và thiết bị tăng tốc (ví dụ: một thùng máy đơn lẻ).
  • Mạng kết nối (Interconnect): Liên kết các nút với nhau.

Kiến trúc bộ nhớ phân tán (Distributed memory): Cross Node
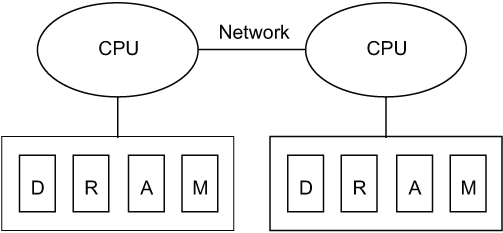
image 96 - quochung.cyou PTIT

Một trong những hướng tiếp cận đầu tiên và có khả năng mở rộng cao là một hệ thống bộ nhớ phân tán. Mỗi CPU thì sẽ có bộ nhớ riêng (DRAM) và kết nối với CPU khác. Có thể thấy kiến trúc này cho phép ta thêm nhiều node CPU hơn không giới hạn, do các memory của CPU đều độc lập.

Tradeoff của cách tiếp cận này là lập trình viên phía trên có thể phải tự quản lý, phân chia vùng nhớ bên dưới ngay từ đầu.

Kiến trúc bộ nhớ chia sẻ (Shared memory): On Node
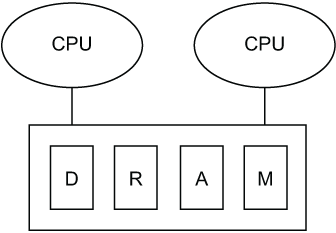
01_16

Một hướng tiếp cận khác là kết nối 2 CPU trực tiếp vào 1 vùng nhớ chung. Cách này cho phép nhiều CPU có chung một vùng địa chỉ bộ nhớ, giúp lập trình đơn giản hơn. Hiển nhiên nó cũng đi kèm tradeoff như rủi ro về xung đột bộ nhớ, ví dụ như 2 chương trình trên 2 CPU tranh chấp tài nguyên trên cùng 1 địa chỉ, ảnh hưởng đến độ chính xác hay hiệu năng. Việc đồng bộ các thao tác truy cập giá trị của bộ nhớ giữa các CPU có thể sẽ khá phức tạp và tốn kém.

Vector units: Nhiều thao tác trong cùng một instruction

Như đã nói ở đầu bài, ta không thể đơn giản là tăng tần số xung nhịp (clock frequency) của bộ vi xử lý để đạt được năng suất xử lý (throughput) cao hơn như cách ta đã làm trong quá khứ nữa. Trở ngại lớn nhất trong việc tăng tần số xung nhịp CPU là việc này đòi hỏi nhiều điện năng hơn và sinh ra nhiều nhiệt hơn.

1. Khái niệm Xung nhịp (Clock Frequency) và Chu kỳ (Cycle): Mọi tính toán trong CPU được điều phối bởi một bộ dao động thạch anh. Mỗi “nhịp” (tick) là một cơ hội để các bóng bán dẫn (transistor) chuyển trạng thái (đóng/mở) để xử lý dữ liệu.

  • Vấn đề: Để tăng xung nhịp (ví dụ từ 2GHz lên 5GHz), các electron phải di chuyển nhanh hơn và các transistor phải đóng mở nhanh hơn.

2. Công thức Năng lượng tiêu thụ (The Power Wall):

Dù đó là một trung tâm siêu máy tính (HPC) với những giới hạn về hệ thống đường dây điện lắp đặt, hay là chiếc điện thoại di động của ta với dung lượng pin hữu hạn, tất cả các thiết bị ngày nay đều đối mặt với những giới hạn về năng lượng.

Điện năng tiêu thụ của một chip bán dẫn (P) tỷ lệ thuận với điện dung (C), bình phương điện áp (V^2) và tần số xung nhịp (f):

P≈C⋅V2⋅fP \approx C \cdot V^2 \cdot f

Khi ta tăng tần số (f), ta buộc phải tăng điện áp (V) để duy trì tính ổn định của tín hiệu điện. Vì V được bình phương, lượng nhiệt sinh ra tăng theo hàm mũ. Đến một ngưỡng nhất định, chúng ta không thể tản nhiệt kịp cho chip mà không làm nó nóng chảy. Đây gọi là Bức tường năng lượng (Power Wall).

Kết luận: Vì không thể làm cho một “nhịp” chạy nhanh hơn mãi mãi, kiến trúc sư máy tính buộc phải tìm cách làm được nhiều việc hơn trong cùng một nhịp.

Thay vì tăng tần số xung nhịp, tại sao ta không thực hiện nhiều hơn một hoạt động (operation) trong mỗi chu kỳ (cycle)? Đây chính là ý tưởng cốt lõi đằng sau cơ chế vector hóa trên nhiều dòng bộ vi xử lý hiện nay.

1. Xử lý Vô hướng (Scalar Processing – SISD): Trong kiến trúc truyền thống (Single Instruction, Single Data – SISD), mỗi chỉ thị (Instruction) chỉ tác động lên một cặp dữ liệu duy nhất.

  • Cơ chế: Nếu ta muốn cộng 8 cặp số, CPU phải thực hiện 8 lần: Lấy lệnh cộng -> Lấy dữ liệu A1, B1 -> Cộng -> Lưu kết quả -> Lặp lại 8 lần.
  • Chi phí: Mỗi lần thực hiện, CPU tốn năng lượng để “giải mã chỉ thị” (Instruction Decoding) và điều phối dòng dữ liệu. Với 8 phép cộng, ta tốn 8 lần chi phí giải mã.

Xử lý Vector (Vector Processing – SIMD): Vectorization dựa trên mô hình SIMD (Single Instruction, Multiple Data) – Một chỉ thị duy nhất điều khiển nhiều luồng dữ liệu cùng lúc.

  • Cấu tạo phần cứng: Thay vì một bộ logic toán học (ALU – Arithmetic Logic Unit) hẹp, CPU trang bị các Vector Units có các thanh ghi (Registers) rất rộng (128-bit, 256-bit hoặc 512-bit).
  • Cơ chế thực thi: Thay vì nạp một số 32-bit vào thanh ghi, CPU nạp một “mảng” gồm nhiều số 32-bit vào thanh ghi rộng này. Khi lệnh ADD (Cộng) được phát ra, Vector Unit sẽ kích hoạt nhiều ALU song song để cộng toàn bộ các cặp số đó trong đúng một chu kỳ xung nhịp.

Việc viết mã để tận dụng SIMD rất phức tạp vì nó phụ thuộc vào kiến trúc tập lệnh của từng loại CPU (như AVX-512 của Intel hay NEON của ARM).

  • Compiler Analysis: Trình biên dịch tự động phân tích các vòng lặp (loop) và cố gắng chuyển chúng thành lệnh Vector.
  • Pragmas/Directives: Là các chỉ dẫn (ví dụ: #pragma omp simd) có thể được chèn vào mã nguồn để ra lệnh cho trình biên dịch: “Tôi xác nhận đoạn mã này an toàn, hãy vector hóa nó”. Nếu không có các chỉ dẫn này, trình biên dịch thường chọn phương án an toàn là chạy tuần tự để tránh sai sót dữ liệu.

Nếu Vector tốt như vậy, tại sao chúng ta vẫn cần Scalar và tại sao không chạy mọi thứ song song trên vector?

Sự phụ thuộc dữ liệu (Data Dependency):

Cơ chế Vector chỉ hoạt động khi các phép tính độc lập với nhau.

  • Nếu ta tính: A = B + C và D = A + E. Ta không thể dùng Vector để tính A và D cùng lúc vì giá trị của D phụ thuộc vào kết quả của A.

Cấu trúc dữ liệu không liên tục (Non-contiguous Memory): Để Vector Unit hoạt động hiệu quả, dữ liệu phải nằm sát nhau trong bộ nhớ (Memory) để nạp vào thanh ghi rộng một cách nhanh chóng. Nếu dữ liệu nằm rải rác, CPU mất nhiều thời gian để thu thập (Gather), làm triệt tiêu lợi thế về tốc độ.

Chi phí phần cứng và Độ phức tạp: Mở rộng Vector Unit (ví dụ lên 2048-bit) đòi hỏi một diện tích chip khổng lồ cho các thanh ghi và các đường dẫn dữ liệu. Nó cũng làm cho bộ tập lệnh (ISA) trở nên cực kỳ phức tạp cho các trình biên dịch (Compiler) để tối ưu hóa.

Hầu hết các CPU và GPU hiện đại đều có khả năng vector hóa hoặc các cơ chế hoạt động tương đương. Lượng dữ liệu được xử lý trong một chu kỳ xung nhịp được gọi là độ dài vector (vector length). Độ dài này phụ thuộc trực tiếp vào kích thước vật lý của các đơn vị vector có trên bộ vi xử lý.

Hiện nay, độ dài vector phổ biến nhất là 256-bit. Nếu dữ liệu đã được rời rạc hóa là các số thực dấu phẩy động 64-bit (kiểu double), thì ta có thể thực hiện đồng thời bốn phép toán dấu phẩy động dưới dạng một hoạt động vector đơn nhất (256 / 64 = 4).
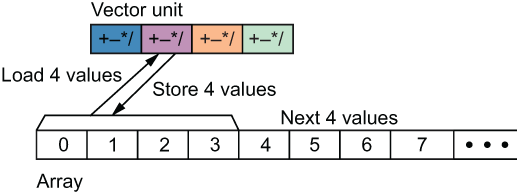
image 97 - quochung.cyou PTIT

Các đơn vị phần cứng vector sẽ:

  1. Nạp (load) một khối dữ liệu vào cùng một lúc.
  2. Thực hiện đồng thời một hoạt động duy nhất trên toàn bộ khối dữ liệu đó.
  3. Sau đó lưu trữ (store) kết quả cuối cùng.
Thiết bị tăng tốc: Bộ vi xử lý bổ sung chuyên dụng

Thiết bị tăng tốc (accelerator device) là một thành phần phần cứng rời rạc được thiết kế để thực thi các tác vụ cụ thể với tốc độ cao. Thiết bị tăng tốc phổ biến nhất hiện nay là GPU (Graphics Processing Unit – Đơn vị xử lý đồ họa). Khi được sử dụng cho mục đích tính toán thuần túy thay vì hiển thị hình ảnh, thiết bị này đôi khi được gọi là GPGPU (General-Purpose Graphics Processing Unit – Đơn vị xử lý đồ họa đa mục đích).

Cấu tạo và hiệu năng của GPU

GPU chứa rất nhiều lõi xử lý nhỏ, được gọi là các bộ đa xử lý luồng (Streaming Multiprocessors – SMs). Mặc dù cấu trúc của một SM đơn giản hơn so với một lõi CPU, nhưng tổng hợp lại, các SM cung cấp một sức mạnh xử lý khổng lồ. Thông thường, ta sẽ tìm thấy một GPU tích hợp (integrated GPU) có kích thước nhỏ nằm ngay bên trong CPU.

GPU rời và chi phí kết nối

Hầu hết các máy tính hiện đại còn sở hữu một GPU rời (discrete GPU) riêng biệt, kết nối với CPU thông qua bus PCI (Peripheral Component Interface). Việc sử dụng bus này làm phát sinh chi phí kết nối giữa CPU và GPU (communication cost) đối với dữ liệu và các chỉ lệnh. Tuy nhiên, các card đồ họa rời thường mạnh mẽ hơn nhiều so với các đơn vị tích hợp sẵn, do chúng được thiết kế cho một mục đích rõ ràng hơn, và có nhiều không gian phát triển hơn.
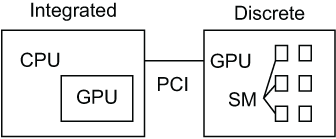
image 98 - quochung.cyou PTIT

Trong các hệ thống cao cấp, các nhà sản xuất đã phát triển các công nghệ kết nối riêng để giảm thiểu chi phí truyền tải dữ liệu này, ví dụ:

  • NVIDIA sử dụng công nghệ NVLink.
  • AMD Radeon sử dụng công nghệ Infinity Fabric.

Bây giờ, ta hãy kết hợp tất cả các kiến trúc phần cứng khác nhau đã nêu vào một mô hình thống nhất. Trong mô hình này, hai nút (nodes) mỗi nút sở hữu hai CPU cùng chia sẻ bộ nhớ DRAM.
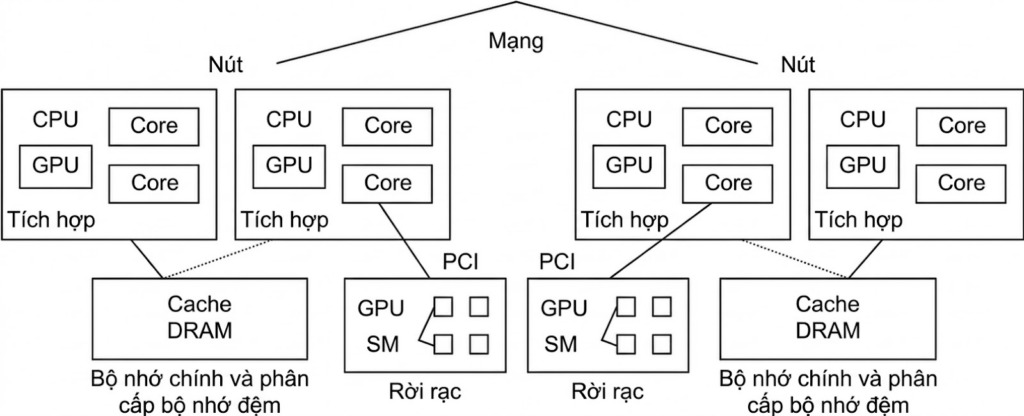
image 99 - quochung.cyou PTIT
Đặc điểm của mô hình
  • Mỗi CPU là một bộ vi xử lý đa nhân (dual-core) tích hợp sẵn GPU.
  • Một GPU rời được kết nối thông qua bus PCI vào một trong các CPU.
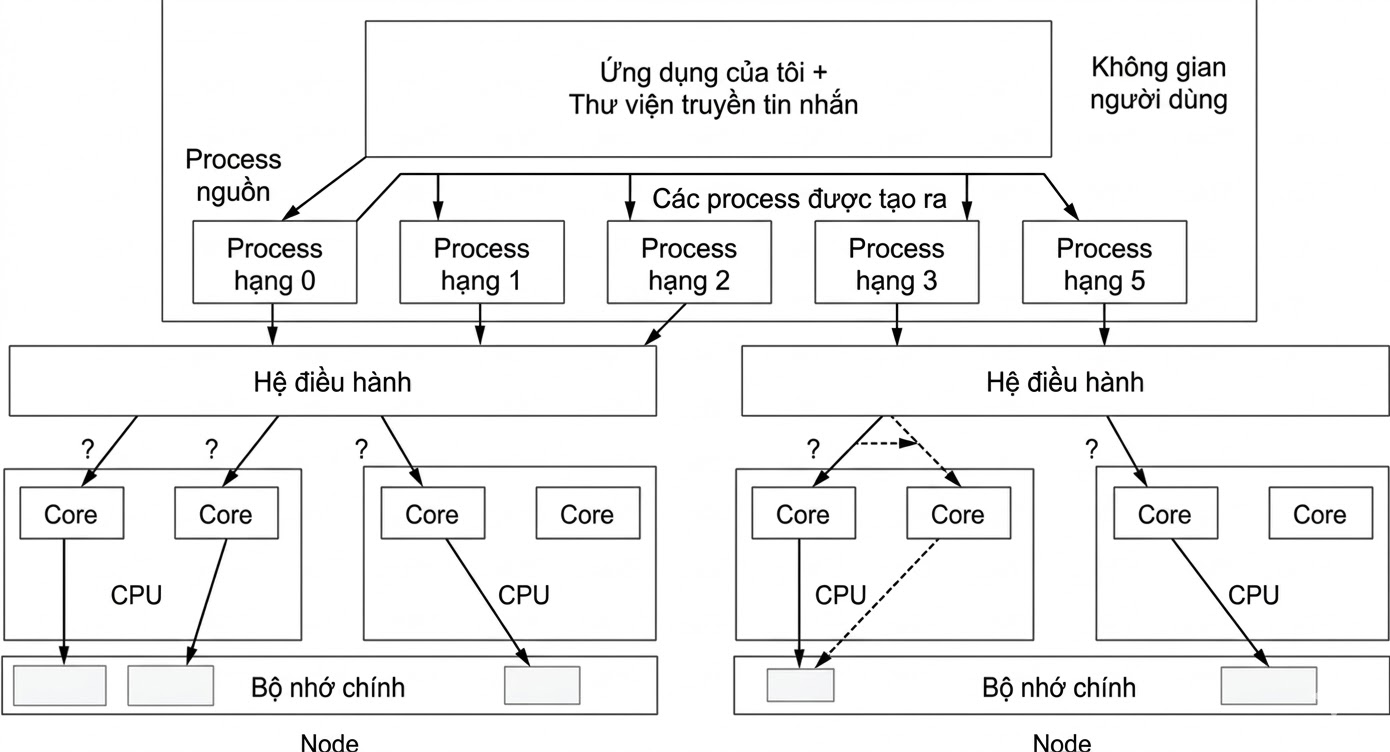
  • Mặc dù các CPU dùng chung bộ nhớ chính, nhưng chúng thường nằm trong các vùng Truy cập bộ nhớ không đồng nhất (Non-Uniform Memory Access – NUMA) khác nhau. Điều này có nghĩa là việc một CPU truy cập vào bộ nhớ của CPU thứ hai sẽ tiêu tốn nhiều tài nguyên (đắt đỏ) hơn so với việc truy cập vào bộ nhớ cục bộ của chính nó.

Tầng hệ điều hành

Phần mềm dành cho tính toán song song nhất thiết phải dựa trên cấu trúc phần cứng bên dưới, tuy nhiên nó vẫn là một thực thể tách biệt với phần cứng. Hệ điều hành (OS) đóng vai trò là giao diện trung gian kết nối giữa hai thực thể này.

Ta cần lưu ý rằng các hoạt động song song không tự nhiên phát sinh; thay vào đó, mã nguồn phải chỉ định rõ cách thức song song hóa công việc. Điều này thực hiện thông qua việc:

  • Khởi tạo các tiến trình (processes) hoặc các luồng (threads).
  • Chuyển giao (offloading) dữ liệu, công việc và chỉ lệnh sang một thiết bị tính toán chuyên dụng.
  • Thực hiện thao tác trên các khối dữ liệu cùng một lúc.

Trước hết ta nên xác định các thành phần có thể song song hóa, quyết định kỹ thuật tối ưu nhất để vận hành song song. Dưới đây là bốn kỹ thuật phổ biến nhất:

  • Song song hóa dựa trên tiến trình (Process-based parallelization): Chuyển tin nhắn (Message passing).
  • Song song hóa dựa trên luồng (Thread-based parallelization): Chia sẻ dữ liệu qua bộ nhớ.
  • Vector hóa (Vectorization): Thực hiện nhiều thao tác với một chỉ lệnh duy nhất. <- Đã được nêu qua ở trên
  • Xử lý luồng (Stream processing): Thông qua các bộ vi xử lý chuyên dụng.

Song song hóa dựa trên tiến trình: Cơ chế chuyển tin nhắn (Message Passing)

Đơn vị thực thi: Tiến trình (Process)

Khi ta chạy một chương trình, Hệ điều hành (OS) tạo ra một Tiến trình. Một tiến trình không chỉ là mã nguồn; nó là một thực thể bao gồm:

  • Address Space (Không gian địa chỉ): Một dải bộ nhớ RAM mà OS cấp riêng cho tiến trình đó.
  • Registers & Program Counter: Các thanh ghi vật lý trên CPU lưu trữ trạng thái hiện tại của lệnh đang chạy.
  • Instruction Pipeline: Luồng các lệnh mã máy đang chờ được CPU xử lý.
Cơ chế cô lập bộ nhớ (Memory Isolation)

Trong các hệ điều hành hiện đại, Tiến trình A không thể đọc hoặc ghi vào bộ nhớ của Tiến trình B. Đây là một tính năng bảo mật và ổn định. Nếu Tiến trình A bị lỗi (crash), nó không làm ảnh hưởng đến dữ liệu của Tiến trình B.

Vấn đề: Nếu ta muốn chia một bài toán lớn (ví dụ: nhân hai ma trận khổng lồ) cho 10 tiến trình cùng làm, làm sao Tiến trình 1 gửi kết quả bán thành phẩm cho Tiến trình 2 khi bộ nhớ của chúng hoàn toàn tách biệt?

Giải pháp: Cần một cơ chế để “copy” dữ liệu từ không gian bộ nhớ này sang không gian bộ nhớ khác. Đó chính là lý do Message Passing (Chuyển tin nhắn) ra đời.

Tại sao không cho các tiến trình dùng chung bộ nhớ? Vì giới hạn vật lý của phần cứng.

  • Shared Memory (Bộ nhớ dùng chung): Nhiều nhân CPU cùng cắm vào một thanh RAM. Giới hạn là số lượng khe cắm RAM và băng thông đường truyền trên bo mạch chủ.
  • Distributed Memory (Bộ nhớ phân tán): Đây là kiến trúc của các siêu máy tính hoặc cụm máy chủ (Cluster). Mỗi “Nút” (Node) là một máy tính hoàn chỉnh có CPU và RAM riêng. Các nút này nối với nhau qua mạng (Ethernet hoặc InfiniBand).

Trong kiến trúc phân tán, CPU ở Node A tuyệt đối không có cách nào chạm tới thanh RAM ở Node B về mặt vật lý. Cách duy nhất là đóng gói dữ liệu thành một Tin nhắn (Message) và gửi qua dây dẫn mạng.

image 100 - quochung.cyou PTIT
Khái niệm Ranks và Không gian bộ nhớ

Trong mô hình này, ứng dụng của ta sẽ khởi tạo các tiến trình riêng biệt, được gọi là các ranks trong thuật ngữ chuyển tin nhắn. Mỗi tiến trình này có không gian bộ nhớ riêng và đường ống chỉ lệnh (instruction pipeline) riêng biệt.

Khi chạy một ứng dụng song song dùng MPI, ta khởi tạo N bản sao của cùng một chương trình.

  • Để phân biệt chúng, MPI gán cho mỗi bản sao một con số định danh duy nhất, gọi là Rank, bắt đầu từ 0, 1, 2, …, N-1.
  • Dựa vào Rank, lập trình viên viết logic: “Nếu tôi là Rank 0, tôi sẽ điều phối; nếu tôi là Rank 1, tôi sẽ tính toán phần dữ liệu này”.
Không gian Người dùng (User Space) vs. Nhân (Kernel Space)

Quá trình gửi tin nhắn diễn ra qua hai tầng:

  1. User Space: Nơi mã ứng dụng của ta chạy. Ta gọi hàm MPI_Send(dữ liệu).
  2. Kernel Space: Nhân của hệ điều hành quản lý phần cứng (Card mạng).
  3. Cơ chế: Dữ liệu được copy từ User Space xuống Kernel Space, sau đó Kernel đẩy dữ liệu qua Driver card mạng để sang máy khác.
Phân biệt Tiến trình (Phần mềm) và Lõi/Core (Phần cứng)

Thực tế 1 tiến trình không luôn chạy trên 1 lõi cố định.

  • Core (Lõi): Là một mạch điện vật lý thực hiện tính toán.
  • Scheduler (Trình điều phối của OS): Là một thuật toán trong nhân OS. Nó quyết định tiến trình nào được sử dụng lõi nào tại thời điểm nào.

Hiện tượng Context Switching (Chuyển đổi ngữ cảnh): Nếu ta có 4 lõi nhưng chạy 8 tiến trình, OS sẽ cho mỗi tiến trình chạy khoảng vài miligiây, sau đó tạm dừng (lưu trạng thái vào RAM), và nạp tiến trình khác vào lõi. Việc này diễn ra liên tục, tạo cảm giác 8 tiến trình chạy song song, nhưng thực tế chúng đang “chia sẻ” thời gian của lõi.
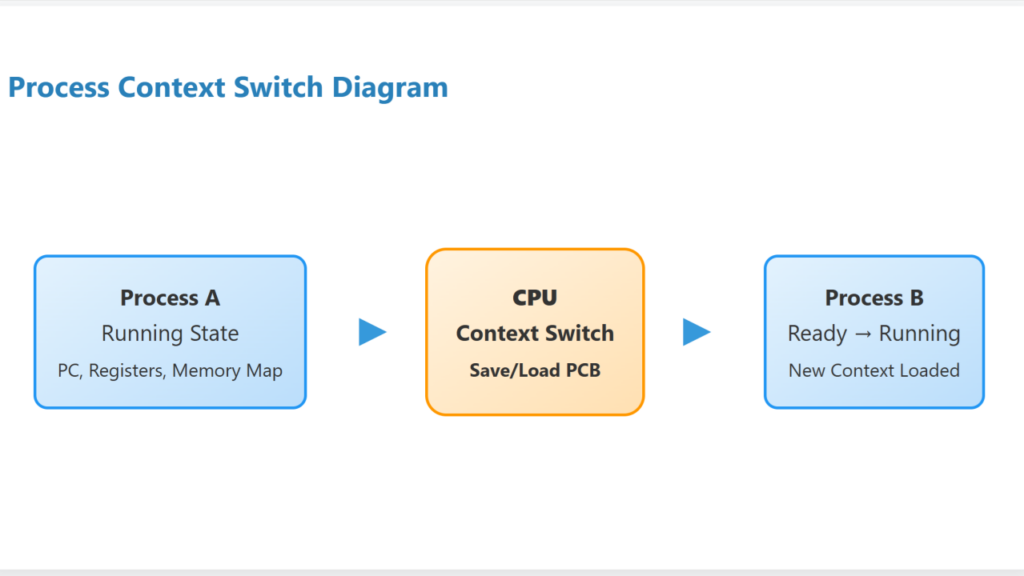
image 101 - quochung.cyou PTIT

Trong tính toán hiệu năng cao (HPC), người ta thường dùng kỹ thuật Binding (Ràng buộc): Ép chặt Rank 0 vào Core 0, Rank 1 vào Core 1 để tránh lãng phí thời gian chuyển đổi ngữ cảnh của OS.

Tính toán Phân tán (Distributed Computing) vs. Tính toán Song song (Parallel Computing)

Mặc dù cả hai đều dùng nhiều thực thể tính toán, chúng khác nhau về mức độ kết nối (Coupling).

Đặc điểmTính toán Song song (MPI)Tính toán Phân tán (P2P, Web)
Mục tiêuTối ưu tốc độ hoàn thành 1 tác vụ đơn lẻ.Tối ưu độ tin cậy và khả năng phục vụ từ xa.
Giao tiếpTightly-coupled (Kết nối chặt): Các tiến trình phụ thuộc nhau rất lớn, tốc độ mạng cực nhanh (micro-giây).Loosely-coupled (Kết nối lỏng): Các tiến trình độc lập hơn, có thể nằm cách xa nhau địa lý, chịu được độ trễ mạng cao.
Cơ chếSử dụng thư viện chuyên dụng như MPI.Sử dụng các giao thức hệ thống như RPC (Remote Procedure Call) hoặc IPC (Inter-process communication) qua mạng.

Ví dụ: Trong dự án, máy tính nhận một khối dữ liệu, xử lý trong 1 tiếng, sau đó gửi kết quả về máy chủ. Nếu máy tắt đột ngột, hệ thống vẫn chạy bình thường. Trong MPI, nếu một Rank bị lỗi, thường toàn bộ ứng dụng song song sẽ dừng lại để đảm bảo tính toàn vẹn dữ liệu.

Song song hóa dựa trên luồng: Chia sẻ dữ liệu qua bộ nhớ

Khi ta chạy một chương trình (process), hệ điều hành cấp cho nó một không gian bộ nhớ riêng biệt (Address Space). Không gian này chứa mã lệnh, dữ liệu và các tài nguyên khác.

Việc khởi tạo một Tiến trình mới rất tốn kém về tài nguyên hệ thống vì hệ điều hành phải cấp phát một vùng nhớ hoàn toàn độc lập. Luồng ra đời để giải quyết vấn đề này. Một luồng là một đơn vị thực thi nhỏ nhất nằm bên trong một tiến trình.

  • Con trỏ chỉ lệnh (Instruction Pointer – IP): Đây là một thanh ghi trong CPU lưu trữ địa chỉ của lệnh tiếp theo sẽ được thực thi. Trong một tiến trình đơn luồng, chỉ có một IP. Để thực hiện song song, ta khởi tạo nhiều IP chạy đồng thời trên các nhân CPU khác nhau, mỗi IP đại diện cho một luồng.
  • Cơ chế chia sẻ bộ nhớ: Vì tất cả các luồng thuộc cùng một tiến trình, chúng nhìn thấy chung một không gian địa chỉ. Điều này có nghĩa là luồng A có thể ghi một giá trị vào biến x và luồng B có thể đọc giá trị đó ngay lập tức mà không cần qua các bước chuyển giao dữ liệu phức tạp. Tuy nhiên điều này cũng tạo ra 1 vấn đề mới.
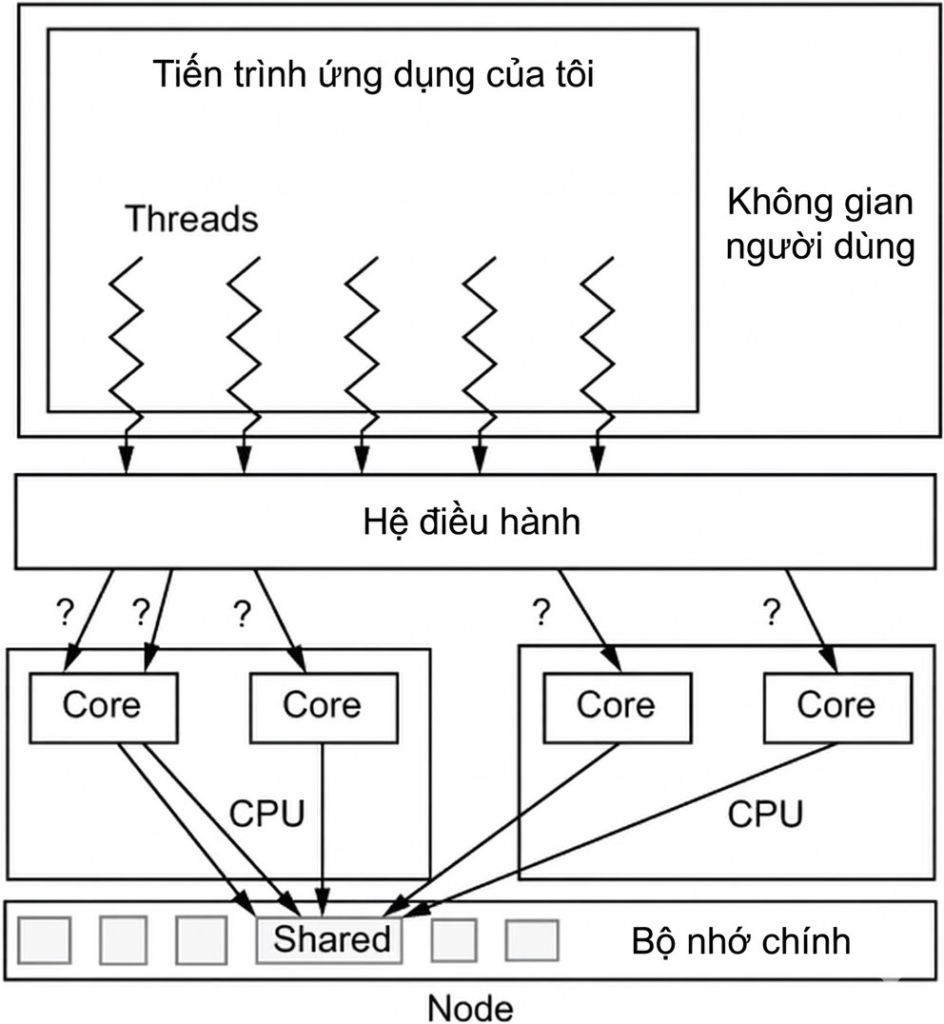
image 102 - quochung.cyou PTIT

Khi hai luồng cùng truy cập và sửa đổi một vùng nhớ đồng thời, kết quả cuối cùng phụ thuộc vào việc luồng nào chạy nhanh hơn (Race Condition). Đây là lỗi logic cực kỳ khó phát hiện. Để xử lý, thông thường cần tới các cơ chế đồng bộ hóa (như locks hoặc barriers) để đảm bảo tại một thời điểm chỉ một luồng được thay đổi dữ liệu quan trọng.

Xử lý luồng thông qua bộ vi xử lý chuyên dụng (GPU)

Xử lý luồng (Stream processing) là một khái niệm về luồng dữ liệu (dataflow), trong đó một luồng dữ liệu được xử lý bởi một bộ vi xử lý chuyên dụng có cấu tạo đơn giản hơn. Kỹ thuật này từ lâu đã được sử dụng trong tính toán nhúng, sau đó được điều chỉnh để kết xuất các tập hợp vật thể hình học lớn cho màn hình máy tính trong một bộ vi xử lý chuyên dụng là GPU.

Từ xử lý đồ họa đến GPGPU

Các GPU này được thiết kế với một tập hợp rộng các phép toán số học và nhiều bộ đa xử lý luồng (SMs) để xử lý dữ liệu hình học song song. Vậy cụ thể GPU đã làm gì để thực hiện tốt hơn?

Đường ống lệnh (Instruction Pipeline)

Trước hết xem xét ở kiến trúc CPU, một lệnh (instruction) đi vào CPU được chia thành các giai đoạn (Stages):

  1. Fetch (Lấy lệnh): Lấy lệnh từ bộ nhớ.
  2. Decode (Giải mã): Hiểu lệnh đó yêu cầu làm gì.
  3. Execute (Thực thi): ALU thực hiện phép toán.
  4. Write-back (Ghi kết quả): Lưu kết quả vào thanh ghi.

Các mạch này có thực hiện việc nối đầu mạch. Ta thấy nếu chạy theo tuần tự:

  • Chu kỳ 1: Mạch A chạy. Mạch B, C, D đứng im (Idle).
  • Chu kỳ 2: Mạch B chạy. Mạch A, C, D đứng im.
  • … Cứ thế, tại một thời điểm chỉ có 25% phần cứng CPU hoạt động.

Để tối ưu (Pipelining): Khi lệnh số 1 chuyển sang Mạch B, CPU lập tức đẩy lệnh số 2 vào Mạch A. Mục tiêu là để tất cả các mạch A, B, C, D đều có việc để làm trong mỗi chu kỳ xung nhịp.

Hiện tượng này xảy ra khi một mạch ở phía sau không thể thực hiện việc của mình vì nó thiếu thông tin từ mạch phía trước. Tuy nhiên tại 1 số thời điểm, hiện tượng Stall có thể xảy ra

Giả sử ta có 2 lệnh:

  1. Lệnh 1: X = 5 + 5
  2. Lệnh 2: Y = X * 2

Tiến trình trong đường ống:

  • Chu kỳ 1: Mạch A lấy Lệnh 1.
  • Chu kỳ 2: Mạch B giải mã Lệnh 1 | Mạch A lấy Lệnh 2.
  • Chu kỳ 3: Mạch C tính 5+5 cho Lệnh 1 | Mạch B giải mã Lệnh 2.
    • Vấn đề: Mạch B giải mã Lệnh 2 và thấy nó cần giá trị X. Nhưng lúc này Mạch C mới đang tính X, chưa có kết quả cuối cùng.
  • Chu kỳ 4: Mạch B (giải mã Lệnh 2) buộc phải phát tín hiệu “Dừng”. Mạch A cũng phải dừng theo vì không có chỗ để đẩy lệnh mới vào.
    • Kết quả: Mạch C và D vẫn chạy nốt Lệnh 1, nhưng Mạch A và B bị Trống (Stall). CPU tốn một chu kỳ xung nhịp mà không tạo ra kết quả hữu ích nào

Giả sử có lệnh điều kiện: Nếu (A > B) thì nhảy đến Lệnh X, nếu không thì chạy tiếp Lệnh Y.

  • Tại giai đoạn Fetch (Mạch A), CPU nạp lệnh tiếp theo theo thứ tự mặc định là Lệnh Y.
  • Nhưng phải đợi 2 chu kỳ sau, khi lệnh Nếu (A > B) đi đến giai đoạn Execute (Mạch C), CPU mới biết kết quả là đúng hay sai.

Để tối ưu, CPU sử dụng một bộ phận gọi là Branch Predictor (dựa trên lịch sử các lần chạy trước) để “đoán” xem nhánh nào sẽ được chọn và nạp sẵn các lệnh của nhánh đó vào đường ống. Nếu đoán sai, CPU buộc phải hủy toàn bộ các lệnh đã nạp nhầm, xóa sạch đường ống (Pipeline Flush) và bắt đầu lại từ điểm rẽ nhánh đúng.

Ngoài ra CPU cũng thực hiện Out-of-order Execution (OoOE – Thực thi ngoài tuần tự). Trong một chương trình, các lệnh thường có sự phụ thuộc lẫn nhau.

  • Xét 2 lệnh:
    1. A = Lấy dữ liệu từ RAM (Mất 200 nhịp)
    2. B = A + 5 (Phụ thuộc vào A)
    3. C = 10 * 2 (Không phụ thuộc vào A hay B) Nếu chạy tuần tự, lệnh số 3 phải đợi lệnh số 1 và 2 hoàn thành, dù nó chẳng liên quan gì. CPU sẽ đứng im chờ dữ liệu từ RAM.
  • Cơ chế OoOE: CPU có một bộ đệm gọi là Instruction Window thực hiện quét các lệnh sắp tới, phân tích xem lệnh nào đã có đủ dữ liệu đầu vào. Trong ví dụ trên, CPU thấy lệnh số 3 đã sẵn sàng, nó sẽ đẩy lệnh 3 lên thực thi trước trong khi lệnh 1 vẫn đang chờ RAM. Sau khi có kết quả, nó sẽ sắp xếp lại (Reorder Buffer) để đảm bảo kết quả cuối cùng đúng như thứ tự.

Ngược lại, GPU được thiết kế cho Parallelism (Song song hóa), không phải Latency (Độ trễ).

GPU sử dụng cơ chế Hardware Multithreading. Nếu một nhóm nhân (thread) đang chờ dữ liệu từ RAM, GPU ngay lập tức tráo một nhóm nhân khác vào để tính toán. Nó không cố gắng làm một lệnh chạy nhanh hơn, nó chỉ cố gắng làm nhiều lệnh nhất có thể cùng lúc.

  • Kiến trúc CPU: Dành 1 phần diện tích chip cho ALU tính toán, phần còn lại dành cho Control Logic (Branch Prediction, OoOE) và Cache
  • Kiến trúc GPU: Loại bỏ hầu hết Branch Prediction và OoOE. Thay vào đó, GPU dùng diện tích đó để tập trung cho các nhân tính toán ALU
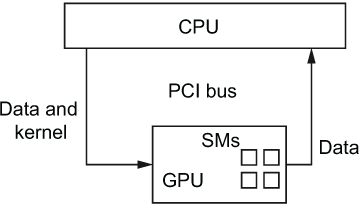
image 103 - quochung.cyou PTIT

Dữ liệu và hạt nhân tính toán (kernel) được hiển thị là được chuyển giao (offloaded) qua bus PCI sang GPU để tính toán. GPU vẫn còn hạn chế về chức năng so với CPU, nhưng ở những nơi có thể sử dụng các chức năng chuyên dụng này, chúng cung cấp khả năng tính toán phi thường với yêu cầu năng lượng thấp hơn. Các bộ vi xử lý chuyên dụng khác cũng thuộc danh mục này, mặc dù ta sẽ tập trung chủ yếu vào GPU trong các cuộc thảo luận của mình.

Phân loại các cách tiếp cận song song

Trong quá trình tìm hiểu về tính toán song song, ta sẽ bắt gặp các từ viết tắt như SIMD (một chỉ lệnh, nhiều dữ liệu) và MIMD (nhiều chỉ lệnh, nhiều dữ liệu). Những thuật ngữ này thuộc về các danh mục kiến trúc máy tính do Michael Flynn đề xuất vào năm 1966, được biết đến với tên gọi Phân loại của Flynn (Flynn’s Taxonomy).

Hệ thống phân loại này giúp ta nhìn nhận khả năng mà có thể song song hóa trong các kiến trúc theo những cách khác nhau. Việc phân loại dựa trên việc chia nhỏ các chỉ lệnh (instructions) và dữ liệu (data) thành các hoạt động tuần tự hoặc song song
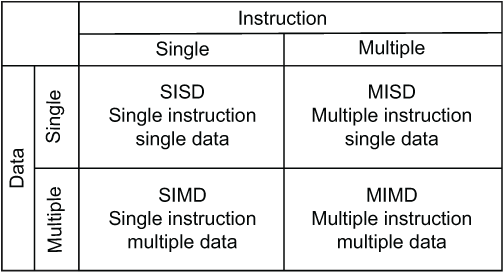
image 104 - quochung.cyou PTIT
  • SISD (Single Instruction, Single Data): Kiến trúc tuần tự truyền thống, một chỉ lệnh xử lý một dữ liệu.
  • MISD (Multiple Instruction, Single Data): Trường hợp có nhiều chuỗi chỉ lệnh cùng xử lý một luồng dữ liệu duy nhất. Đây không phải là một kiến trúc phổ biến; ví dụ điển hình nhất là việc tính toán dư thừa (redundant computation) trên cùng một dữ liệu. Phương pháp này được sử dụng trong các hệ thống đòi hỏi khả năng chịu lỗi cực cao như bộ điều khiển tàu vũ trụ. Do tàu vũ trụ hoạt động trong môi trường bức xạ cao, chúng thường chạy hai bản sao của mỗi phép tính và so sánh kết quả đầu ra của cả hai.
  • SIMD (Single Instruction, Multiple Data): Vector hóa là ví dụ điển hình, trong đó cùng một chỉ lệnh được thực hiện trên nhiều dữ liệu khác nhau. Một biến thể của SIMD là SIMT (Single Instruction, Multi-Thread – Một chỉ lệnh, nhiều luồng), thường được dùng để mô tả các nhóm làm việc (work groups) của GPU.
  • MIMD (Multiple Instruction, Multiple Data): Danh mục cuối cùng có tính song song ở cả chỉ lệnh và dữ liệu. Danh mục này mô tả các kiến trúc song song đa lõi, chiếm đa số trong các hệ thống song song quy mô lớn hiện nay.

Cần lưu ý rằng mặc dù hệ thống phân loại này rất hữu ích, một số kiến trúc và thuật ngữ toán (algorithms) không khớp hoàn toàn vào một danh mục nhất định. Sự hữu dụng của nó nằm ở việc giúp ta nhận diện các đặc điểm của từng loại, chẳng hạn như danh mục SIMD thường gặp khó khăn với các câu lệnh điều kiện (conditionals). Nguyên nhân là vì mỗi mục dữ liệu có thể muốn thực thi một khối mã khác nhau, nhưng tất cả các luồng lại bắt buộc phải thực thi cùng một chỉ lệnh.

Các chiến lược song song

Ở ví dụ trước đó về núi lửa, ta đã xem xét việc song song hóa dữ liệu cho các ô lưới (cells) hoặc điểm ảnh (pixels). Tuy nhiên, song song hóa dữ liệu còn có thể áp dụng cho các hạt (particles) và các đối tượng dữ liệu khác.

Song song hóa dữ liệu (Data Parallelism)

Đây là cách tiếp cận phổ biến nhất và thường là đơn giản nhất. Về cơ bản, mỗi tiến trình thực thi cùng một chương trình nhưng vận hành trên một tập con dữ liệu duy nhất, như được minh họa:
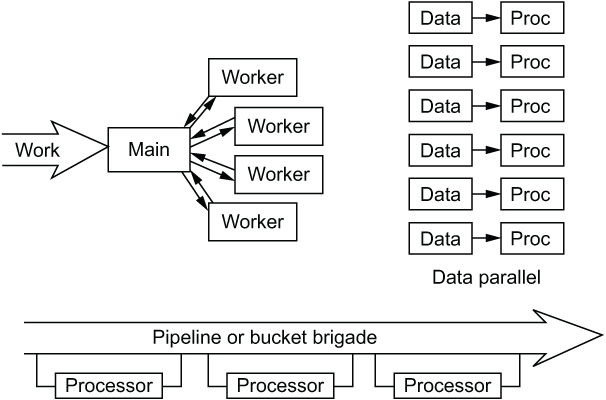
image 105 - quochung.cyou PTIT

Ưu điểm của song song hóa dữ liệu là khả năng mở rộng tốt khi kích thước vấn đề và số lượng bộ vi xử lý tăng lên.

Song song hóa tác vụ (Task Parallelism)

Một cách tiếp cận khác là song song hóa tác vụ. Các chiến lược này bao gồm:

  • Điều khiển chính – Main-worker): Một bộ vi xử lý đóng vai trò điều phối, lập lịch và phân phối các tác vụ cho tất cả các bộ vi xử lý worker. Mỗi worker sẽ kiểm tra mục công việc tiếp theo ngay khi nó trả lại kết quả của tác vụ đã hoàn thành trước đó.
  • Đường ống (Pipeline): Chiến lược này được sử dụng trong các bộ vi xử lý siêu cấp (superscalar processors), nơi các phép tính địa chỉ và số nguyên được thực hiện bằng một đơn vị logic riêng biệt thay vì dùng bộ xử lý số thực dấu phẩy động, cho phép các phép tính này được thực hiện song song.
  • Tiếp sức/Dây chuyền (Bucket-brigade): Sử dụng mỗi bộ vi xử lý để vận hành và biến đổi dữ liệu trong một chuỗi các hoạt động liên tiếp.

Ta cũng có thể kết hợp các chiến lược song song khác nhau để khai thác mức độ song song hóa lớn hơn cho ứng dụng.

[A.I System Programming] B3: Lịch sử của máy tính

This entry is part 3 of 6 in the series A.I System Programming

Máy tính là gì?

Khi chúng ta hình dung về “một chiếc máy tính” ngày nay, chúng ta có lẽ sẽ nghĩ đến một thiết bị như máy tính để bàn (PC), máy chơi game cầm tay hoặc điện thoại thông minh. Nhưng đó không phải là những cỗ máy duy nhất mà con người từng sử dụng để tính toán và điện toán.

Để truy vết lịch sử của máy tính, trước tiên chúng ta cần quyết định xem cái gì được coi là máy tính và máy tính khác với những chiếc máy tính bỏ túi hoặc máy tính toán thuần túy như thế nào. Đây là một câu hỏi khó đến ngạc nhiên

Máy tính phải là thiết bị điện tử?

Hãy cùng xem xét thêm một số khái niệm thường được đề xuất để định nghĩa máy tính. Từ điển tiếng Anh Oxford, yêu cầu máy tính phải là thiết bị điện tử. Nhưng những cỗ máy tương tự có thể được làm từ các chất nền (vật liệu) khác, chẳng hạn như nước

image 59 - quochung.cyou PTIT

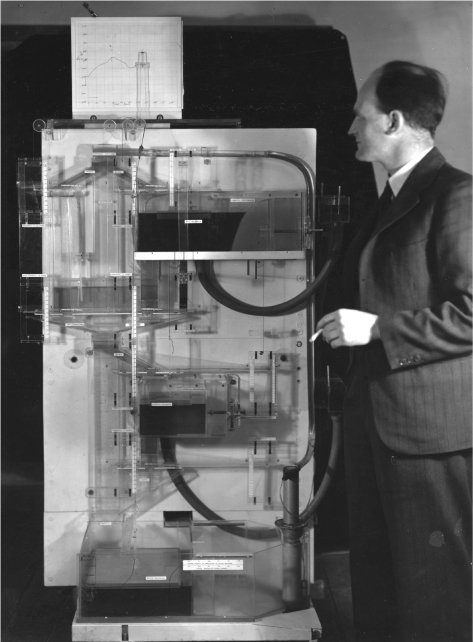
MONIAC, viết tắt của Monetary National Income Analogue Computer được chế tạo vào năm 1949, MONIAC là một máy tính được sử dụng để mô phỏng dòng tiền chạy qua nền kinh tế và để minh họa các tác động của các can thiệp kinh tế lên một mô hình kinh tế.

Một số người lập luận rằng máy tính phải là kỹ thuật số (digital), trái ngược với tương tự (analog). Một cỗ máy kỹ thuật số là cỗ máy biểu diễn dữ liệu bằng các chữ số, các tập hợp ký hiệu rời rạc như các chữ số nhị phân 0 và 1. Ngược lại, một cỗ máy tương tự có một tập hợp vô hạn, liên tục các trạng thái có thể xảy ra, chẳng hạn như lượng nước trong các bể của MONIAC, khiến MONIAC trở thành một cỗ máy tương tự.

Trong lý thuyết tính toán, chúng ta có Luận thuyết Church (Church’s thesis), một định nghĩa khắt khe hơn về máy tính mà hầu hết các nhà khoa học máy tính hiện đại đều đồng ý. Nó có thể được diễn giải như sau:

Một máy tính là một cỗ máy có thể mô phỏng bất kỳ cỗ máy nào khác, với điều kiện được cung cấp bao nhiêu bộ nhớ tùy ý.

Hiện tại các máy tính rõ ràng tồn tại để có thể thực hiện những việc sau, vì vậy một máy tính theo luận thuyết Church cũng phải có khả năng thực hiện các tác vụ này:

  • Đọc, ghi và xử lý dữ liệu.
  • Đọc, ghi và thực thi chương trình.
  • Cộng (và do đó thực hiện các phép tính số học).
  • Nhảy (lệnh goto).
  • Rẽ nhánh (lệnh if).

Trước cuộc cách mạng công nghiệp

image 60 - quochung.cyou PTIT

Vào khoảng những năm 40000 TCN,người ta tìm thấy xương Lebombo, một mảnh xương với các khía khắc có thể đã được sử dụng như một chiếc gậy tính. Một vạch đại diện cho một vật thể vật lý, có thể trong thời kì này, nó dùng cho đếm động vật, các mặt hàng thực phẩm hoặc các ngày để tính thời gian cho một cuộc săn bắn nào đó.

Xương Lebombo là một ví dụ về biểu diễn dữ liệu. Nó có thể đã được sử dụng cho một hình thức tính toán đơn giản như cộng thêm một vào tổng mỗi khi một dấu vết mới được tạo ra.

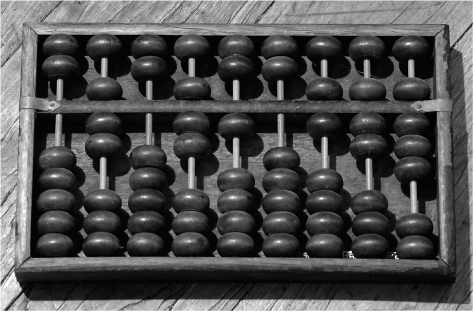
Khoảng những năm 4000 TCN, các thành phố đầu tiên bắt đầu phát triển. Các thành phố đòi hỏi những hành vi/tổ chức ở quy mô lớn hơn, ví dụ như theo dõi việc giao thương và thuế. Vào năm 3000 TCN, văn hóa thành phố Sumer ở Lưỡng Hà (Iraq ngày nay) đã phát triển hệ thống chữ viết đầu tiên, và đến năm 2500 TCN, họ đã sở hữu chiếc máy tính toán đầu tiên: bàn tính (abacus)

image 61 - quochung.cyou PTIT

Bàn tính đang biểu diễn 070710678

Trong cách sử dụng thông thường, trạng thái của bàn tính biểu diễn số (thập phân, tự nhiên).

Có chín cột, mỗi cột đại diện cho một trong các chữ số trong số này. Mỗi cột được chia thành một hộp dưới chứa năm hạt và một hộp trên chứa hai hạt. Vị trí mặc định của các hạt ở hộp dưới là ở dưới, và vị trí mặc định của các hạt ở hộp trên là ở trên.

Ở trạng thái này, một cột biểu thị chữ số 0. Mỗi hạt được đẩy từ dưới lên trên của hộp dưới có giá trị là 1. Mỗi hạt được đẩy từ trên xuống dưới của hộp trên có giá trị là 5.

  • Cột 1: 0
  • Cột 2: 1 nút xuống ở trên (+5) , 2 nút dưới đẩy lên (+2 ) = 7
  • …

Để cộng 1 vào một số trên bàn tính (tức là tăng nó lên), bạn nâng một hạt từ hộp dưới của cột ngoài cùng bên phải. Nếu tất cả năm hạt trong hộp dưới của một cột đã được nâng lên, bạn đẩy tất cả chúng xuống lại và thay thế chúng bằng cách hạ một trong các hạt ở hộp trên trong cùng cột đó. Nếu cả hai hạt trên đều đã hạ xuống, bạn đẩy chúng ngược lên và thay thế chúng bằng cách nâng một hạt từ hộp dưới ở cột bên trái của nó. Việc chuyển dữ liệu từ một cột sang cột bên trái của nó được gọi là phép toán nhớ. (Giống như việc xét chữ số của 1 số từ phải sang trái, thì mỗi hàng đơn vị ta x 10 vậy)

Để cộng hai số, a + b, trước tiên bạn thiết lập bàn tính để biểu diễn các chữ số của a. Sau đó, bạn thực hiện b lần tăng như trên. Trạng thái của bàn tính khi đó biểu diễn kết quả.

Kiểu tính toán này, nơi số thứ nhất được “nạp vào” thiết bị và số thứ hai được “cộng thêm vào” đó, để lại kết quả cuối cùng là trạng thái của hệ thống, được gọi là kiến trúc tích lũy (accumulator architecture), và nó vẫn còn được sử dụng phổ biến ngày nay. Nó “tích lũy” kết quả của một chuỗi các phép tính; ví dụ, chúng ta có thể cộng một danh sách gồm nhiều số bằng cách cộng lần lượt từng số vào trạng thái và xem tổng tích lũy mới nhất sau mỗi lần cộng.

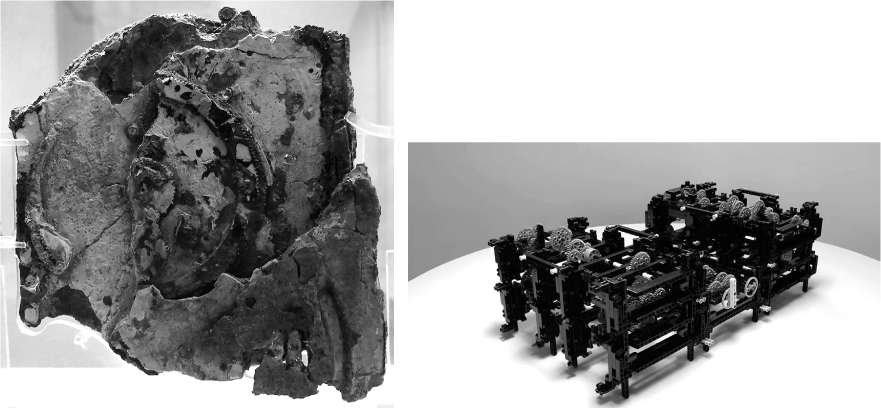
Khoảng năm 100 TCN, xuất hiện cơ chế Antikythera. Nó được tìm thấy vào năm 1901 trong một xác tàu đắm ở Địa Trung Hải; con tàu bị đắm dường như đang trên đường từ Hy Lạp đến La Mã, mang theo cơ chế này để bán hoặc làm vật phẩm cống nạp.

image 62 - quochung.cyou PTIT

Chạy bằng bánh răng cơ khí, dùng để dự đoán các sự kiện thiên văn, bao gồm vị trí của năm hành tinh, các pha của mặt trăng, thời điểm nhật thực/nguyệt thực và thời gian diễn ra Thế vận hội Olympic. Nó bao gồm 37 bánh răng bằng đồng, và người dùng sẽ quay một tay cầm để mô phỏng diễn biến tương lai của các trạng thái thiên văn. Các kết quả được hiển thị trên các mặt đồng hồ, được tính toán dựa trên tỷ số truyền của các bánh răng cơ khí.

image 63 - quochung.cyou PTIT

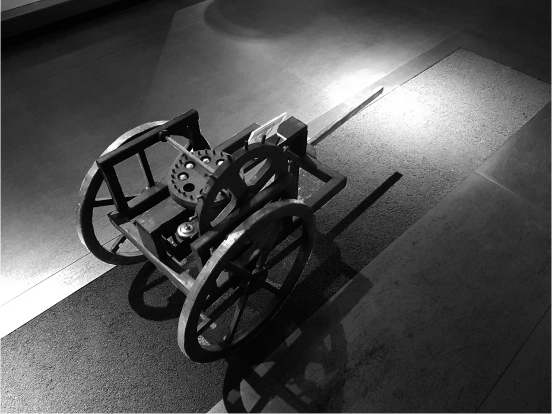
Máy đo quãng đường (Odometers) là những cỗ máy đo khoảng cách tầm xa mà người Hy Lạp và La Mã đã sử dụng để khảo sát và lập bản đồ đế chế của họ.

Loại máy đo quãng đường này hoạt động như sau: chúng phát ra tiếng “cạch” mỗi khi được đẩy đi một khoảng cách nhất định. Chiếc máy đo này được kéo bởi một con ngựa, giống như một cỗ xe. Có một số viên bi kim loại được lưu trữ trong các hốc của một bánh răng gỗ hình tròn. Một trong các bánh xe của xe có gắn một cái chốt sao cho cứ sau mỗi vòng quay, nó lại chạm và làm xoay bánh răng một góc cố định nhỏ. Một cái lỗ có kích thước bằng viên bi nằm dưới một vị trí của bánh răng cho phép một viên bi phía trên nó rơi ra khỏi hốc và rơi vào một hộp thu thập bên dưới. Tổng quãng đường đã đi được ghi lại bằng số lượng viên bi trong hộp đếm vào cuối chuyến đi.

Những cỗ máy này có phải là máy tính không? Rõ ràng có các khái niệm về dữ liệu được sử dụng để đại diện cho các vật thể trong thế giới, cũng như các hình thức tự động hóa và tính toán. Nhưng giống như MONIAC, mỗi cỗ máy chỉ làm được một việc duy nhất: dự đoán nhật thực hoặc đo khoảng cách. Theo luận thuyết Church, ta thấy rằng các cỗ máy này không thể lập trình lại để làm 1 việc khác.

image 64 - quochung.cyou PTIT

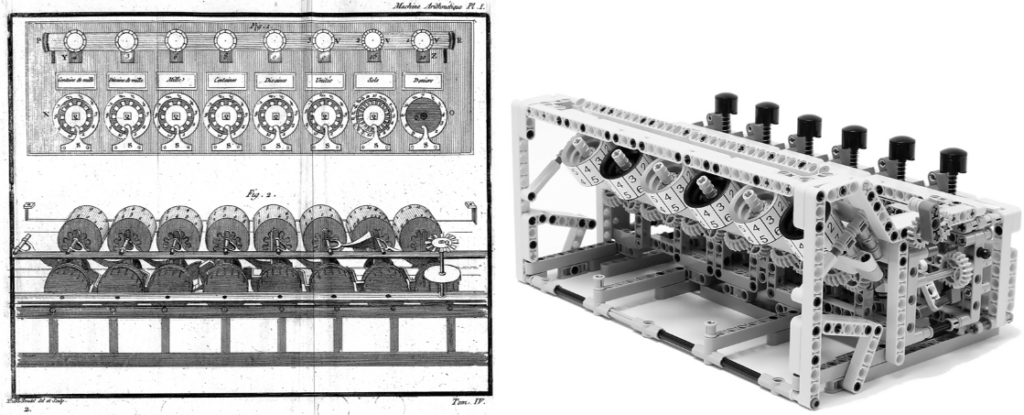
Trong nhiều năm tiếp theo, xuất hiện nhiều “máy móc” với ý tưởng phát triển từ các ý tưởng trên. Ví dụ Codex Madrid của Davinci, dùng để tính toán qua hệ thống bánh răng. Tỷ số truyền giữa mỗi cặp cột là 1:10, vì vậy bánh xe của mỗi cột sẽ quay với tốc độ bằng 1/10 so với cột bên phải của nó. Có 13 bánh xe, mỗi bánh xe đại diện cho các cột của một số thập phân

image 65 - quochung.cyou PTIT

Cách mạng công nghiệp

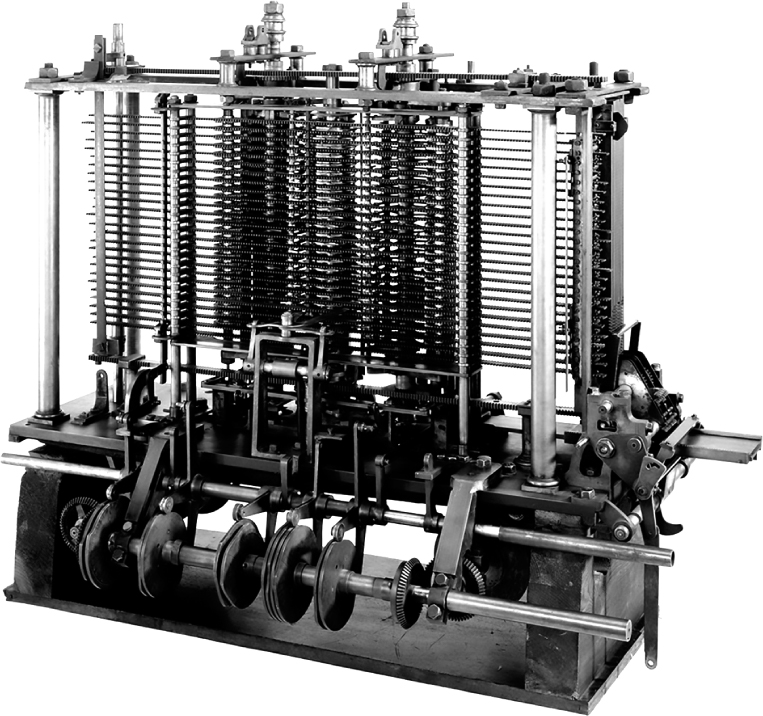
Máy Phân tích đã được thiết kế như một chiếc máy lập trình được, có mục đích hoàn toàn tổng quát (general-purpose).

image 67 - quochung.cyou PTIT

Để đạt được tính tổng quát này, Máy Phân tích cung cấp một loạt các phép toán số học và các hoạt động khác dưới dạng các bộ phận máy đơn giản, cùng với một bộ nhớ để lưu trữ dữ liệu và khả năng đọc các chương trình từ thẻ đục lỗ.

image 69 - quochung.cyou PTIT

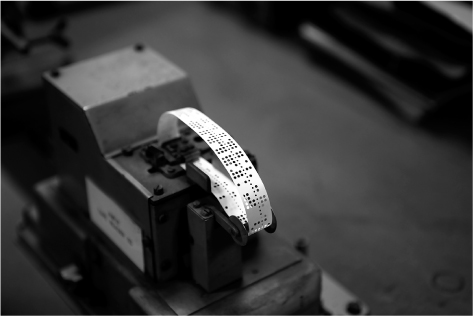
Các chương trình này quy định một trình tự các thao tác đọc/ghi bộ nhớ và các phép toán số học, đồng thời cho phép rẽ nhánh tùy thuộc vào trạng thái của phép tính, tức là một câu lệnh if.

Cấu trúc bộ nhớ và lệnh (Core and Memory)

Phần lõi của Máy Phân tích chứa nhiều máy đơn giản độc lập, mỗi máy thực hiện một chức năng nhất định, chẳng hạn như cộng các số và kiểm tra xem một số có bằng một số khác hay không.

Máy Phân tích đã giới thiệu khái niệm hiện đại về bộ nhớ máy tính. Mỗi máy có thể giữ một con số khác nhau. Mỗi máy sẽ được gán một mã định danh số hoặc “địa chỉ” (address) để chỉ định chính xác máy nào cần đọc hoặc ghi.

Một chuỗi các chỉ thị (instructions) sẽ được mã hóa dưới dạng nhị phân và đục lỗ trên băng giấy. Mỗi chỉ thị sẽ ra lệnh cho cỗ máy kích hoạt một trong các máy đơn giản. Thông thường, sau mỗi chỉ thị, cỗ máy sẽ đẩy băng giấy đục lỗ theo từng dòng để tải chỉ thị tiếp theo. Tuy nhiên, cỗ máy cũng có khả năng kiểm tra kết quả của máy đơn giản vừa chạy và tùy thuộc vào giá trị đó, nó có thể nhảy đến một dòng khác trên giấy. Điều này mang lại cho các chương trình khả năng thay đổi hành vi để phản hồi lại các kết quả trung gian.

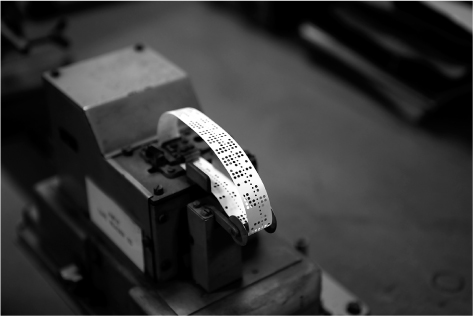
Một chương trình cũng có thể được tạo ra để chạy mãi mãi bằng cách dán phần cuối của băng giấy đục lỗ vào phần đầu của nó, tạo thành một vòng lặp vật lý, như trong máy băng giấy.

image 70 - quochung.cyou PTIT

Máy Phân tích có phải là máy tính Church?

Thiết kế của nó chứa đựng tất cả các đặc điểm cơ bản của một máy tính hiện đại: CPU, bộ nhớ, bus, các thanh ghi, bộ điều khiển và đơn vị số học. Nó có thể đọc, ghi và xử lý dữ liệu. Nó có thể làm toán. Không giống như các máy tính thuần túy trước đó, nó có thể nhảy (goto) và rẽ nhánh (if), chuyển đến các chỉ thị khác nhau trong chương trình tùy theo trạng thái tính toán.

Cơ – Điện

Trước khi có máy tính hiện đại, thế giới trải qua một giai đoạn “lai” gọi là Cơ – Điện (Electromechanical). Thay vì dùng bánh răng thuần túy, người ta dùng điện để điều khiển các chuyển động cơ học.

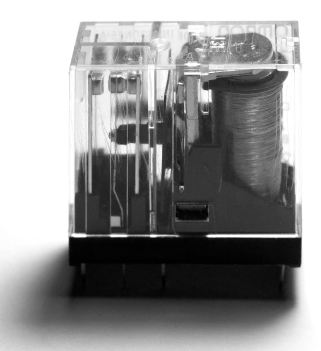
Rơ-le là linh kiện then chốt của thời kỳ này. Bạn có thể hiểu đơn giản nó là một công tắc điện được đóng/ngắt bằng một tín hiệu điện khác, thay vì dùng tay người.

  • Cấu tạo và hoạt động: Nó gồm một cuộn dây đồng (solenoid) quấn quanh một lõi sắt. Khi có dòng điện chạy qua cuộn dây, nó tạo ra từ trường biến lõi sắt thành nam châm điện. Lực từ này sẽ hút một thanh sắt (gọi là phần ứng – armature) di chuyển vật lý để chạm vào tiếp điểm, giúp đóng hoặc ngắt một mạch điện thứ hai.
  • Tại sao nó quan trọng? Chỉ cần một dòng điện nhỏ, yếu có thể điều khiển một mạch điện khác mang năng lượng khổng lồ (như khởi động động cơ xe tải).
    • Tính logic: Nếu kết hợp nhiều rơ-le, ta có thể tạo ra các phép tính logic (VÍ DỤ: “Nếu rơ-le A đóng VÀ rơ-le B đóng thì đèn mới sáng”). Đây chính là nền tảng của tư duy máy tính.
image 72 - quochung.cyou PTIT

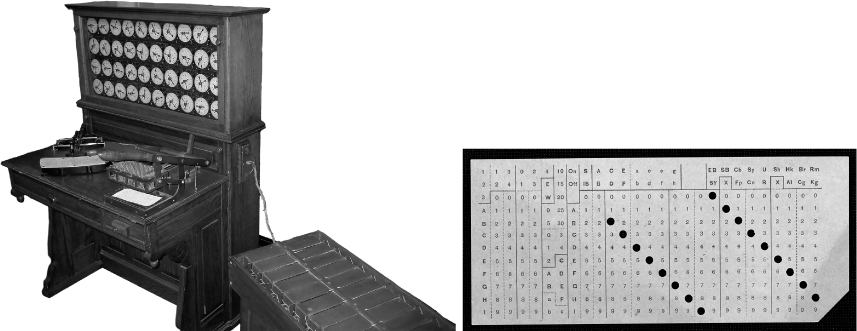
Hiến pháp Hoa Kỳ yêu cầu việc điều tra dân số phải được thực hiện và xử lý sau mỗi 10 năm, và đến năm 1890, dân số đã tăng đến mức việc xử lý các số liệu thống kê bằng con người là không thể. Herman Hollerith đã thiết kế một chiếc máy để tự động hóa việc xử lý dữ liệu và sử dụng nó thành công trong kỳ điều tra dân số năm 1890 để thực hiện phân tích dữ liệu lớn trên thông tin của 62 triệu công dân. Dữ liệu của mỗi công dân được chuyển từ mẫu đơn điều tra viết tay sang một thẻ đục lỗ bởi con người. Mỗi câu hỏi trong cuộc điều tra dân số là dạng trắc nghiệm, và được mã hóa trên thẻ đục lỗ bằng cách đục bỏ một trong số các lựa chọn.

image 71 - quochung.cyou PTIT

Các xấp thẻ có thể được đọc vào máy, máy sẽ kiểm tra sự hiện diện hay vắng mặt của các đặc điểm nhất định hoặc sự kết hợp của các đặc điểm. Điều này có nghĩa là chiếc máy này có khả năng tương đương với các truy vấn SQL hiện đại, bao gồm SELECT, WHERE, GROUP BY, và ORDER BY.

Cuộc chiến mật mã (Thế chiến II)

Thế chiến II là “lò luyện” thúc đẩy máy tính phát triển vượt bậc nhờ nhu cầu giải mã:

  • Máy Enigma (Đức): Một hệ thống các bánh xe xoay (rotors) làm thay đổi chữ cái theo quy luật điện học cực kỳ phức tạp. VD: tự động chuyển bất kì số nào thêm 3 đơn vị chẳng hạn, vậy nên mật báo truyền tin là “123” sẽ bị chuyển thành “456”, một đoạn văn bản sẽ bị mã hóa thành một dạng khác không dịch được
  • Máy Bomba (Ba Lan) và Bombe (Anh): Các cỗ máy cơ-điện dùng để “quét” hàng triệu khả năng của Enigma. Alan Turing (Anh) đã cải tiến máy này để bẻ khóa mật mã hải quân Đức, giúp phe Đồng minh xoay chuyển cục diện.
  • Zuse Z3 (Đức): Cỗ máy của Konrad Zuse (1941) sử dụng tới 2.000 rơ-le. Đây được coi là máy tính lập trình được đầu tiên, dù nó chạy rất chậm (10 lệnh/giây).

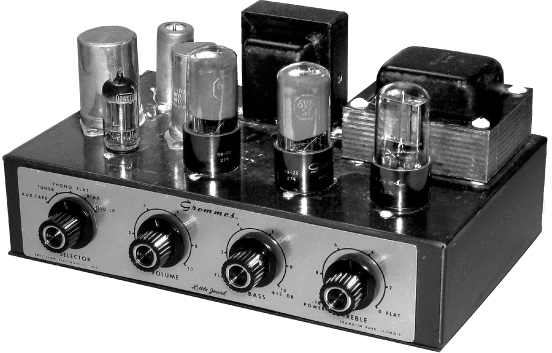
Khi rơ-le cơ học lộ khuyết điểm (chậm, hay bị kẹt, phát ra tiếng ồn), Bóng chân không (Vacuum Tubes/Valves) ra đời (1904).

image 73 - quochung.cyou PTIT

Hãy tưởng tượng nó như một cái bóng đèn nhưng có thêm một “lưới” điều khiển ở giữa.

  • Cơ chế: Khi sợi đốt nóng lên, các electron bị đẩy ra khỏi cực âm (cathode) và bay qua chân không để đến cực dương (anode), tạo thành dòng điện.
  • Tác dụng: Bằng cách thay đổi điện áp ở lưới điều khiển, ta có thể cho phép dòng điện đi qua hoặc chặn lại.
  • Ưu điểm vượt trội: Vì không có bộ phận chuyển động cơ học (không có thanh sắt nào phải nhảy lên xuống như rơ-le), bóng chân không có thể đóng ngắt hàng triệu lần mỗi giây. Điều này giúp máy tính chuyển từ tốc độ “rùa bò” của rơ-le sang tốc độ điện tử cực nhanh.

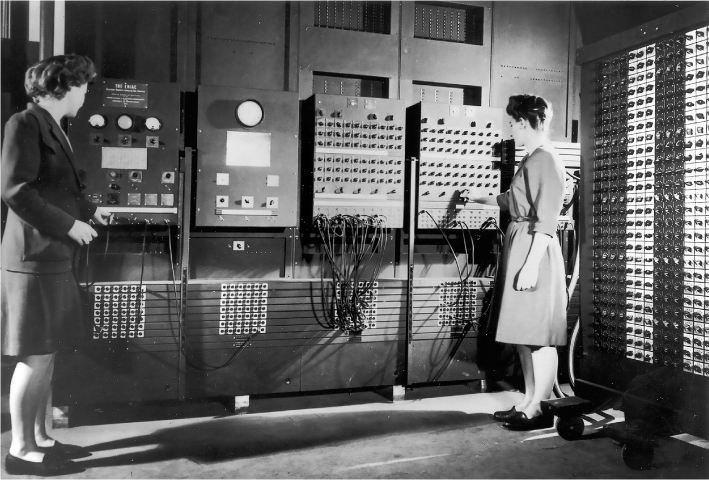
Hoàn thành năm 1945, ENIAC là máy tính điện tử đa năng bằng bóng chân không.

image 74 - quochung.cyou PTIT
  • Lập trình bằng tay: Để “lập trình”, các nữ toán viên phải trực tiếp cắm các dây cáp vào bảng điều khiển

Máy ảo (Virtual Machine) đầu tiên: Nhóm lập trình viên gồm 6 phụ nữ (như Betty Jean Jennings, Frances Bilas…) đã tạo ra một bước ngoặt: Thay vì rút dây cho mỗi bài toán, họ thiết lập một cấu hình dây cố định cho phép máy đọc các lệnh từ các bảng công tắc.

Lúc này, các công tắc đóng vai trò là “phần mềm” sơ khai, điều khiển lớp “phần cứng” bên dưới. Đây chính là khái niệm máy ảo đầu tiên trong lịch sử.

Kiến trúc von Neumann

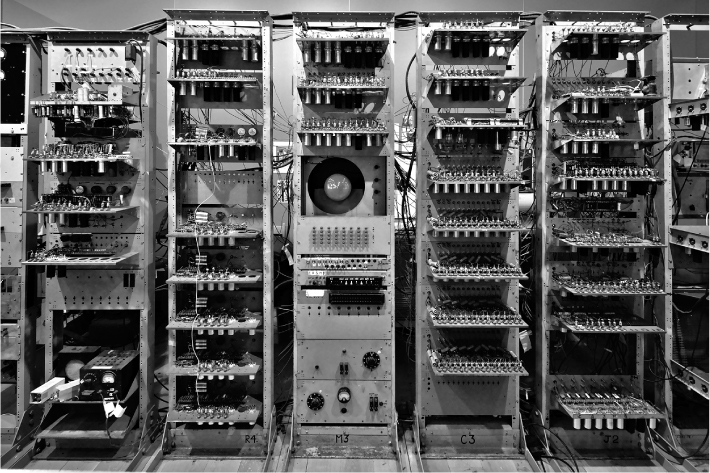
Được chứng minh lần đầu bởi máy Manchester Baby (1948), đây là kiến trúc mà mọi máy tính và smartphone ngày nay vẫn dùng.

image 75 - quochung.cyou PTIT
  • Nguyên lý Stored-program: Cả chương trình và dữ liệu đều được lưu trữ chung trong cùng một bộ nhớ.
  • Phát kiến:
    • 1. Tốc độ: Thay đổi chương trình chỉ đơn giản là nạp một dãy số mới vào bộ nhớ, không cần động vào phần cứng.
    • 2. Tự sửa đổi (Self-modifying code): Vì chương trình cũng chỉ là dữ liệu trong bộ nhớ, máy tính có thể tự viết ra các lệnh mới hoặc tự thay đổi mã nguồn của chính nó khi đang chạy. Đây là nền tảng tối thượng cho trí tuệ nhân tạo và các hệ điều hành phức tạp.

Định luật Moore và máy tính hiện đại

Năm 1947, Bóng bán dẫn (Transistor) ra đời, đánh dấu sự kết thúc của những căn phòng đầy bóng chân không nóng bức.

Sự vượt trội của transistor đến từ bản chất vật lý của trạng thái rắn so với môi trường chân không:

  • Không cần năng lượng kích hoạt: Bóng chân không cần dòng điện để nung nóng sợi đốt liên tục (giống bóng đèn dây tóc), gây lãng phí năng lượng cực lớn dưới dạng nhiệt. Transistor hoạt động bằng điện trường, không cần nung nóng, tiêu thụ năng lượng ít hơn hàng nghìn lần.
  • Kích thước và khả năng tích hợp: Vì hoạt động trong chất rắn, transistor có thể được thu nhỏ xuống mức nanomet. Bóng chân không cần khoảng không gian vật lý đủ lớn để các electron bay qua và vỏ thủy tinh để duy trì chân không, nên không thể thu nhỏ.
  • Độ bền vật lý: Bóng chân không có sợi đốt sẽ bị “cháy” sau một thời gian sử dụng và vỏ thủy tinh dễ vỡ. Transistor là một khối chất rắn đồng nhất, không có bộ phận tiêu hao hay chuyển động, nên tuổi thọ gần như vĩnh cửu trong điều kiện bình thường.
  • Tốc độ chuyển mạch (Switching Speed): Việc điều khiển dòng điện bằng điện trường trong chất bán dẫn nhanh hơn rất nhiều so với việc điều khiển dòng electron bay trong chân không.

Những năm 1960 và các Bóng bán dẫn lớn (The 1960s and Big Transistors)

Các “máy tính mini” (minicomputers) chạy bóng bán dẫn của những năm 1960 không sử dụng vi mạch (microchips), mà thay vào đó được chế tạo từ các loại bóng bán dẫn “lớn”, dài khoảng 1 cm.

image 77 - quochung.cyou PTIT

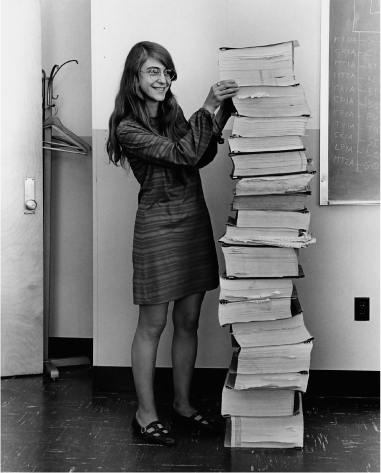
Các ứng dụng của máy tính bán dẫn trong những năm 1960 bao gồm việc vận hành ARPANET, tiền thân của internet dựa trên TCP/IP ngày nay, và việc Margaret Hamilton lập trình mã đổ bộ lên mặt trăng của tàu Apollo năm 1969 bằng ngôn ngữ hợp ngữ (assembly). Hình ảnh là bản in chương trình hợp ngữ hoàn chỉnh của bà cho tàu Apollo 11

image 78 - quochung.cyou PTIT

Công việc sau này thực sự là “khoa học tên lửa” (rocket science), và yêu cầu bà phải tạo ra lĩnh vực kỹ thuật phần mềm (software engineering) hiện đại trong khi tìm kiếm các phương pháp để làm cho đoạn mã cực kỳ quan trọng này trở nên chính xác hơn.

Vào năm 1965, Gordon Moore, CEO của Intel, đã đưa ra một quan sát mà từ đó được gọi là Định luật Moore. Định luật này nói rằng tốc độ của máy tính hoặc số lượng bóng bán dẫn trên mỗi đơn vị diện tích sẽ tăng gấp đôi sau mỗi 18 tháng hoặc 2 năm.

1970 và IC

Công nghệ IC cho phép các mạch điện dựa trên bóng bán dẫn được thu nhỏ lại, sao cho cùng một hệ thống dây điện từng lấp đầy một tủ rack những năm 1960 giờ đây có thể nằm gọn trên một “chip” silicon kích thước bằng móng tay. Từ góc nhìn kiến trúc, các con chip không có gì quá kỳ lạ, nếu bạn lấy sơ đồ đi dây của một chiếc máy bóng đèn chân không những năm 1940 và thu nhỏ nó lại, bạn sẽ có một con chip.

Nếu nhìn chip qua kính hiển vi, bạn sẽ thấy các mô hình đi dây tương tự như dây điện ở mặt sau của các tủ rack những năm 1940, 1950 hoặc 1960. Chip silicon sau đó được “đóng gói” bên trong một khối nhựa thường có màu đen lớn hơn, với các chân kim loại lớn kết nối các đầu vào và đầu ra tinh vi của chip với thế giới bên ngoài, thường là một bảng mạch in.

image 76 - quochung.cyou PTIT

1980

Những năm 1980 là thời hoàng kim của kiến trúc máy tính: lần đầu tiên, máy tính điện tử trở nên đủ rẻ và nhỏ để được sản xuất hàng loạt và được những người bình thường mua về sử dụng tại nhà.

image 79 - quochung.cyou PTIT

Chiếc IBM 5150 PC ra mắt vào năm 1981, dựa trên chip Intel 8088. IBM và các công ty khác đã bán chiếc máy này cũng như các máy PC khác trong suốt những năm 1980 để sử dụng trong các văn phòng kinh doanh.

Khái niệm PC (Personal Computer) là thái cực đối lập với thị trường máy tính gia đình đa dạng và thiên về kiến trúc vì hai lý do.

  • Thứ nhất, nó thực thi một kiến trúc chuẩn hóa trên các thành phần máy tính để nhiều nhà sản xuất có thể sản xuất chúng tương thích với nhau.
  • Thứ hai, nó bao bọc tất cả phần cứng dưới một hệ điều hành nghiêm ngặt, kiểm soát mọi quyền truy cập vào phần cứng thông qua một giao diện tiêu chuẩn. IBM có thể sử dụng ảnh hưởng thị trường của mình để áp đặt các tiêu chuẩn lên linh kiện, nhờ đó họ có thể mua chúng từ những nhà cung cấp rẻ nhất và kiếm tiền bằng cách đóng dấu thương hiệu của mình lên những chiếc PC đã lắp ráp.

Để phản ứng lại các hệ điều hành độc quyền đang được cài đặt trên PC và các máy tính lớn hơn, dự án GNU và phong trào Phần mềm Tự do đã được Richard Stallman tạo ra trong thập kỷ này, điều này sau đó đã dẫn đến các hệ thống và triết lý dựa trên Linux mà chúng ta sử dụng ngày nay.

1990

Kiến trúc máy tính bị thống trị bởi kiến trúc tiêu chuẩn của máy tính cá nhân (PC), vốn đã được sử dụng trong tin học văn phòng những năm 1980 nhưng giờ đây được các tập đoàn PC đẩy mạnh khắp nơi, kể cả trong gia đình và trường học. Các hệ điều hành mã nguồn đóng được bán kèm như một phần của gói PC. Trong thời gian này, các trường học đã ngừng dạy khoa học máy tính và tập trung dạy cách sử dụng phần mềm văn phòng thương mại.

Chuyển từ việc coi đối tượng người dùng là lập trình viên và thành viên cộng đồng công nghệ sang coi người dùng là khách hàng và người tiêu dùng các sản phẩm phần mềm, chẳng hạn như trình xử lý văn bản và bảng tính (VD: Word, Excel, …)

Như định luật Moore đã dự đoán một cách đáng tin cậy, tốc độ bộ vi xử lý tăng gấp đôi sau mỗi 18 tháng. World Wide Web chính thức hoạt động tại CERN vào năm 1990 và phát triển phổ biến, dẫn đến cơn sốt đầu tư dot-com vào cuối thập kỷ. Khi có nhiều hacker và cuối cùng là người tiêu dùng tham gia vào web, các thiết kế máy tính máy chủ gắn trên giá đỡ (rack-mounted server) chuyên dụng đã trở nên phổ biến, bắt đầu với Compaq ProLiant vào năm 1993. Giống như Manchester Baby và các máy tính mini những năm 1960, chúng được thiết kế để xếp chồng trong các đơn vị giá đỡ 19 inch, nhưng hoạt động liên tục với độ tin cậy cao. -> xuất hiện định nghĩa về server

image 80 - quochung.cyou PTIT

Những năm 2000, 2010 và Sự kết thúc của Định luật Moore

Kiến trúc PC gồm các linh kiện hàng hóa kết hợp với hệ điều hành vẫn tiếp tục duy trì trong suốt những năm 2000. Định luật Moore, và hệ quả là việc lắp ráp hoặc mua một chiếc máy tính mới có tốc độ gấp đôi sau mỗi vài năm, vẫn tiếp diễn. Các máy móc sử dụng cùng một thiết kế máy tính PC cơ bản, với các giao diện và thành phần khác nhau được nâng cấp về tốc độ. Tốc độ internet cũng tăng lên, cho phép truyền phát video cũng như chuyển văn bản và hình ảnh.

Trong những năm 1990 và 2000, giả định rằng tốc độ xung nhịp của các bộ vi xử lý sẽ tăng gấp đôi sau mỗi vài năm, và thực tế là như vậy. Định luật Moore trở thành một lời tiên tri tự ứng nghiệm khi các nhà sản xuất chip ở Thung lũng Silicon sử dụng nó như một mục tiêu cần đạt được.

Tuy nhiên, tất cả đã sụp đổ vào những năm 2010. Công nghệ sản xuất bóng bán dẫn thực sự vẫn tiếp tục tăng gấp đôi số lượng bóng bán dẫn trên mỗi đơn vị diện tích, nhưng tốc độ xung nhịp đã đạt mức tối đa vào năm 2010, ở khoảng 3.5 GHz.

Đột nhiên, các bộ vi xử lý không còn nhanh hơn nữa. Điều này là do các định luật vật lý cơ bản xung quanh tốc độ tính toán và nhiệt lượng. Trong thời kỳ định luật Moore, nhiệt độ của các bộ vi xử lý cũng tăng lên cùng với tốc độ; cần có các quạt lớn hơn, mạnh hơn và các hệ thống làm mát khác như làm mát bằng chất lỏng. Các bóng bán dẫn nhỏ đi, nhưng các cánh quạt lại to ra. Nếu xu hướng này tiếp tục qua những năm 2010, giờ đây chúng ta sẽ có những bộ vi xử lý nóng hơn cả bề mặt mặt trời.

Một khái niệm liên quan chặt chẽ là mức tiêu thụ điện năng. Khi các con chip tỏa nhiều nhiệt hơn, chúng tiêu thụ nhiều điện hơn, và thập kỷ này cũng chứng kiến sự khởi đầu của một nỗ lực hướng tới tính toán năng lượng thấp, di động hơn, đặc biệt là dưới dạng điện thoại thông minh.

Trong khi hai thập kỷ trước đó chứng kiến kiến trúc máy tính trì trệ như một lĩnh vực nghiên cứu, chỉ dựa vào những tiến bộ trong công nghệ chế tạo để tạo ra các lợi ích định kỳ, thì giờ đây lĩnh vực này lại mở rộng trở lại cho những ý tưởng hoàn toàn mới.

Chúng ta không thể làm máy tính nhanh hơn thông qua dạng “tốc độ” của định luật Moore, nhưng chúng ta vẫn có thể nhồi nhét ngày càng nhiều bóng bán dẫn lên chip với dạng “mật độ” của nó. Giờ đây, chúng ta có thể xem xét việc làm cho mọi thứ trở nên song song (parallel), thực hiện nhiều thao tác cùng một lúc thay vì từng cái một.

Trong khi vẫn còn nhiều kiến trúc song song cần được khám phá, những năm 2010 đã chứng kiến ba loại kiến trúc song song chính thành công trong thế giới thực.

  1. Đa nhân (Multicore): Đây là các con chip được sản xuất để chứa nhiều bản sao của một thiết kế CPU. Thập kỷ này bắt đầu với các hệ thống lõi kép (duo-core) và tiến triển qua lõi tứ (quad), tám (eight) và thậm chí nhiều lõi hơn.
  2. Điện toán cụm (Cluster computing): Một dạng song song hóa trong đó nhiều máy đơn nhân hoặc đa nhân thông thường được liên kết yếu với nhau. Công việc tính toán được chia thành nhiều phần độc lập có thể gán cho mỗi máy. Phương pháp này đặc biệt hữu ích cho các tác vụ “dữ liệu lớn” theo mô hình map-reduce.
  3. Xử lý đồ họa (GPU): Sự phát triển của các card đồ họa (đơn vị xử lý đồ họa – GPU) thành các thiết bị tính toán song song đa năng. Khái niệm này hiện đang liên tục phát triển thành nhiều kiến trúc mới lạ, chẳng hạn như các chip được quảng cáo phục vụ cho A.I (NPU/TPU) gần đây được tìm thấy trên điện thoại di động.

2020, Cloud/IoT

  • Internet Vạn vật (IoT): Các thiết bị ngày càng nhỏ và rẻ sẽ được nhúng vào ngày càng nhiều vật thể trong thế giới thực. Từ “thành phố thông minh” giám sát giao thông đến “nhà máy thông minh” theo dõi từng món hàng. Tủ lạnh của bạn sẽ tự nhận biết khi nào sắp hết pho mát và tự động đặt hàng ở siêu thị.
  • Điện toán Đám mây (Cloud Computing): Ngược lại với xu hướng trên, các thiết bị IoT năng lượng thấp sẽ không tính toán nhiều mà chủ yếu để thu thập dữ liệu. Dữ liệu này sau đó sẽ được xử lý ở quy mô khổng lồ trong các trung tâm tính toán chuyên dụng: những tòa nhà có kích thước bằng kho hàng chứa đầy năng lượng tính toán.

Xu hướng cho thấy rõ các tài nguyên nghiên cứu đổ vào để tạo ra các sản phẩm nhỏ nhất, dùng ít năng lượng nhất, hiệu quả hơn (như điện thoại thông minh, tivi thông minh, tủ lạnh thông minh, máy giặt thông minh, ….) , hoặc ngược hẳn lại, là tạo ra những thứ mạnh nhất, to nhất (các hệ thống datacenter, server khổng lồ), và hiếm có đầu tư cho vùng ở giữa.

Khái niệm tính toán hiện đại đã được Church định nghĩa. Các máy điện tử thương mại của những năm 1950, bắt đầu với UNIVAC, qua các máy tính mini những năm 1960 và vi mạch những năm 1970 cho đến ngày nay dường như có thể được nhận diện rõ ràng là máy tính. Nhưng liệu có bất cứ thứ gì trước đó nên được công nhận là “chiếc máy tính đầu tiên”?

  • Manchester Baby là một máy tính Church nếu chấp nhận rằng nó có thể được cấp bộ nhớ vô hạn, dù cách làm không rõ ràng.
  • ENIAC có tiềm năng là máy tính Church nếu được lập trình theo cách máy ảo (VM), nhưng nó vẫn là kiến trúc Harvard.
  • Zuse Z3, Colossus, hay Máy Phân tích của Babbage đều có thể đạt được trạng thái này về mặt lý thuyết.
  • IBM đã thực hiện phân tích dữ liệu lớn từ những năm 1890, nhưng phân tích dữ liệu không phải là tính toán Church tổng quát trừ khi bạn tìm ra cách biến mọi vấn đề thành một truy vấn SQL.

Có lẽ con người đã tính toán từ năm 40.000 TCN với bàn tính, xương, đá và các con số trong đầu. Tất cả những thứ trên về mặt lý thuyết đều là máy tính Church vì chúng có thể mô phỏng bất kỳ cỗ máy nào nếu được lập trình theo một cách nhất định. Vì vậy, có lẽ chúng ta đã luôn có máy tính — và Church chỉ là người đầu tiên nhận ra chúng.

Tham khảo:

  • Computer Architecture (Charles Fox)
  • Kiến trúc máy tính (Wikipedia)
  • Parallel and High Performance Computing (Yuliana Zamora, Robert Robey)

The easy way install and compile Cobol in Windows

Install Msys2

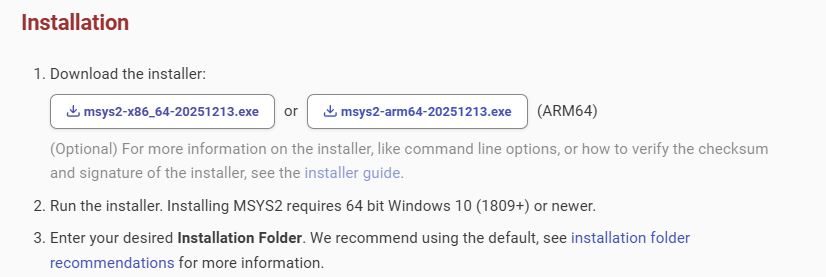
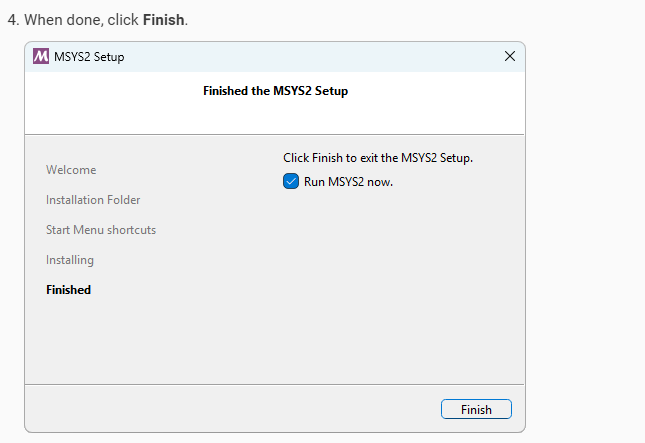
  • Download and Install MSYS2: Follow the installer on their site.
image - quochung.cyou PTIT
image 1 - quochung.cyou PTIT

This Installation Folder is important, please remember of it

image 3 - quochung.cyou PTIT

Install Cobol Compiler

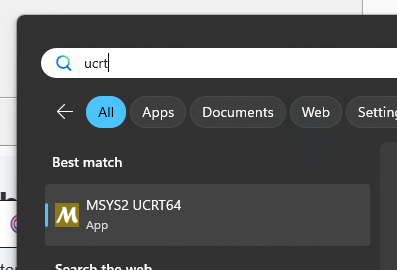
Search for it in your Start menu.

image 4 - quochung.cyou PTIT

Run the update command:

pacman -Syu

Install GnuCOBOL:

pacman -S mingw-w64-ucrt-x86_64-gnucobol

Add to Path

image 5 - quochung.cyou PTIT
image 6 - quochung.cyou PTIT
image 7 - quochung.cyou PTIT
  • Find “Path” and Edit:
    • Add the installation folder and cobol suffix for it, for example if you install in C:\msys64 as default, you can use C:\msys64\ucrt64\bin
  • Optional (For run compiler in Window Terminal)
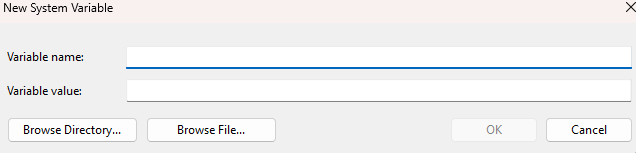
    • Use new… button and add new (Variable Name: Variable Value)
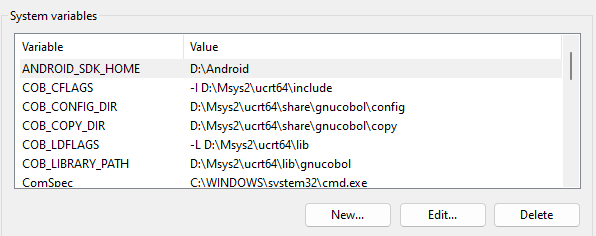
      • COB_CONFIG_DIR: C:\msys64\ucrt64\share\gnucobol\config
      • COB_COPY_DIR: C:\msys64\ucrt64\share\gnucobol\copy
      • COB_LIBRARY_PATH: C:\msys64\ucrt64\lib\gnucobol
image 8 - quochung.cyou PTIT

Now you can run your cobol program

GoalCommandResult
Quick Testcobc -x -j file.cblRuns immediately; no permanent .exe kept.
Build Appcobc -x file.cblCreates file.exe to run anytime.
Build for Pythoncobc -m file.cblCreates a .dll library for Python to call.
Check Errorscobc -f syntax-only file.cblOnly checks for code errors without building.
image 11 - quochung.cyou PTIT

Common Error

: fatal error: libcob.h: No such file or directory

   10 | #include <libcob.h>

      |          ^~~~~~~~~~

compilation terminated.

The error fatal error: libcob.h: No such file or directory means the COBOL compiler (cobc) found your code, but the C compiler (which GnuCOBOL uses under the hood) can’t find the necessary “header files” to finish building the program.

Adding these to Environment Variables like previous step

Variable NameVariable Value
COB_CFLAGS-I D:\Msys2\ucrt64\include
COB_LDFLAGS-L D:\Msys2\ucrt64\lib
  • -I (Include): Points to the folder containing libcob.h.
  • -L (Library): Points to the folder containing the actual library files (.lib or .a).

Or a quick command if you not want add it:

cobc -x -j TEST-PROGRAM.cbl -I D:\Msys2\ucrt64\include -L D:\Msys2\ucrt64\lib

nanosleep64 could not be located

image 10 - quochung.cyou PTIT

If you got (nanosleep64 could not be located) may indicate: your system is confused between two different versions of the C compiler.

The nanosleep64 error is a classic sign that a program compiled with one Windows runtime (like UCRT) is trying to link with an incompatible version of a library.

You could run this command

where gcc

If the output show more than one directory path, it may appear your computer have 2 installed GCC place

To solve this:

You need to tell Windows that the D: drive tools are the priority.

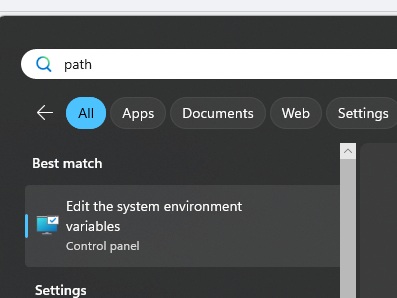
  1. Search for “Edit the system environment variables” in your Start Menu and open it.
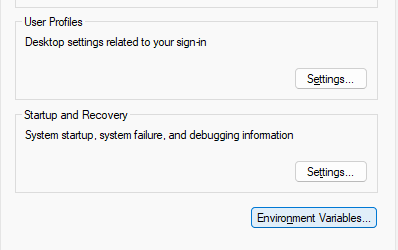
  2. Click Environment Variables.
  3. In the System variables (bottom) list, find the one named Path and click Edit.
  4. Find C:\Msys2\ucrt64\bin in the list. (the path you added in installation step)
  5. Click the “Move Up” button repeatedly until it is at the very top of the list (above the other bin directory in where gcc command).
  6. Click OK on all windows.

Close your current Command Prompt and open a new one for the change to take effect.

Alternative Way:

cobc -x -j TEST-PROGRAM.cbl -conf="D:\Msys2\ucrt64\share\gnucobol\config\default.conf"

Tìm hiểu Consistent hashing (Ánh xạ nhất quán) – Xử lí dữ liệu phân tán

image 60 - quochung.cyou PTIT
  • Consistent hashing (Ánh xạ nhất quán) thường được sử dụng trong các hệ thống phân tán.
  • Trước tiên, để giải thích một số term, thuật ngữ mà các bạn còn có thể confuse, chúng ta sẽ đi từng phần một

Hệ thống phân tán

image 61 - quochung.cyou PTIT
  • Hiểu đơn giản, tưởng tượng việc bạn truy cập đến server như vào 1 cửa hàng mua đồ vậy. Nếu một ngày bình thường, bạn gọi món, đồ ăn đến rất nhanh, đơn giản, phục vụ tốt. Nhưng vào giờ cao điểm, khi chỉ có 1 phục vụ quán, quá nhiều người gọi làm phục vụ quán không đỡ kịp, cửa hàng quá tải và ai cũng có đồ ăn rất chậm.
  • => Để xử lí có nhiều cách, nhưng dễ dàng nhất, chỉ cần tuyển thêm nhiều phục vụ hơn thôi? Quy chiếu về server, ta chỉ cần có nhiều server con khác nhau, và chia nhỏ các yêu cầu của khách hàng đến các server một cách đồng đều, hay chia nhỏ các database, …. Lúc đó, ta có hệ thống phân tán.

Ánh xạ là gì? Tại sao cần ánh xạ (hashing) ?

  • Lúc này ta có một bài toán cần giải quyết, làm sao để chia các yêu cầu của khách hàng vào các server khác nhau, sao cho nó đồng đều? Không được có server làm quá nhiều việc, server làm quá ít việc, ta mong muốn có mọi server đều xử lí đều nhất có thể.
  • Một cách làm phổ biến và dễ hiểu là Round-robin, hay ánh xạ theo phần dư
ServerIndex = hash_function(key) % N
  • Tức là ta sẽ đánh số các request theo thứ tự bằng cách chia dư. Ví dụ ta có 5 server, thì chia dư số thứ tự cho 5
image 62 - quochung.cyou PTIT
  • Ánh xạ chia dư cho 4 server như vậy thì request thứ 1 và 5 sẽ vào ô 1, sau đó là request 0,2 , rồi request 7,6 , …
  • Nghe thì có vẻ rất lí tưởng, request sẽ được chia đều cho các server. Nhưng đó là trường hợp số lượng server không đổi trong “thế giới lí tưởng”. Cuộc sống thực tế thì không đẹp như vậy, chúng ta dễ dàng gặp phải trường hợp sếp bỗng muốn đang từ 4 server, scale lên 15 server. Hay 4 server giảm xuống còn 2 server. Hay 10 server một ngày bỗng chết, mất điện server 1,5,6.
image 63 - quochung.cyou PTIT
  • Lúc này ta cần bê tập dữ liệu từ server sai số thứ tự, rồi đánh số lại theo số lượng server mới. Lúc này rất dễ xảy ra trường hợp server thì bị quá tải, server thì lại rảnh không.
  • Đánh giá vấn đề: Việc chuyển dữ liệu từ những server hỏng, hoặc chuyển ra server mới khi scaleup/down là thiết yếu. Nhưng ta cần một phương pháp để số lượng phần tử cần di chuyển ít nhất có thể

Consistent hashing (Ánh xạ nhất quán)

Định nghĩa

“Consistent hashing is a special kind of hashing technique such that when a hash table is resized, only n/m keys need to be remapped on average where n is the number of keys and m is the number of slots. In contrast, in most traditional hash tables, a change in the number of array slots causes nearly all keys to be remapped because the mapping between the keys and the slots is defined by a modular operation.”

Ánh xạ nhất quán là một kĩ thuật ánh xạ để khi mà bảng ánh xạ thay đổi số lượng, chỉ có n/m từ khoá sẽ cần phải đánh số lại trung bình. Với n là số lượng dữ liệu (trong ví dụ trên là request), và m là số slot (ví dụ trên là server). Điều này tốt hơn ánh xạ chia dư khi mà gần như toàn bộ dữ liệu phải đánh lại hết vì tất cả số dư thường sẽ thay đổi khi m thay đổi.

Một số từ khoá

image 64 - quochung.cyou PTIT
  • Gọi f() là hàm băm, phương trình sẽ cho ra một mã gì đó khi ta truyền vào 1 giá trị. Mỗi phương trình thì luôn có vùng giá trị đầu ra (hash space) nhất định. Ví dụ: chia dư cho m thì vùng giá trị là từ 0 -> m-1. hay SHA-1 thì là từ 0 -> 2^160-1. Ta sẽ có (hash ring) vòng băm tương ứng

Các bước

  • Tiến hành hash các server của chúng ta thành một số nguyên trong hash ring được định nghĩa trước. Khoảng số này tuỳ vào người thiết kế hệ thống tự cân nhắc số lượng server tối đa mà hệ thống sẽ lên.
  • Sau khi có danh sách mapping giữa các node, ta sẽ tiến hành mapping key của data tới các node bằng cách
    • hash giá trị của key thành một số nguyên
    • Di chuyển nó liên tục trong vòng tròn số nguyên (hash ring) đã được tạo theo kim đồng hồ cho tới khi nó quay lại hash key của node đầu tiên nó gặp (đi 1 vòng). Ghi dữ liệu
  • Để dễ hình dung hơn, hãy xem hình ảnh sau
image 66 - quochung.cyou PTIT
  • Để quyết định request nào sẽ được phân bổ vào node nào. Thì ví dụ request có mã là 1000, nó sẽ cứ đi trên vòng tròn bảng giá trị trên và tìm node đầu tiên có mã lớn hơn 1000. nếu nó là lớn nhất rồi thì nó sẽ vòng lại node đầu tiên.
  • Ngoài ra, ví dụ trên hình ảnh trên, ta chỉ có node 1-5, nhưng ta sẽ tạo các “virtual node”, hay node ảo để băm cái vòng của chúng ta nhỏ hơn nữa, và các khoảng của node ảo sẽ quy định nó vào node thật sự nào.
  • Bằng một cách nói nào đó, mỗi server sẽ xử lí một “cung” trên đường tròn

Consistent hashing xử lí vấn đề scale như thế nào

  • Ta sẽ quay lại vấn đề, khi một node nào đó bị sập. Thì consistent hashing sẽ giải quyết bài toán đó như thế nào?
  • Solution nghe ra lại rất đơn giản, lúc này thì các khoảng vòng cung sẽ được kéo rộng ra, các request sẽ tự đi tìm đến vị trí note tiếp theo
image 67 - quochung.cyou PTIT
  • Rõ ràng, ta thấy lúc này chỉ những request ở vòng cung phía trước sẽ cần thay đổi mapping lại. Còn theo cách chia modulo, thì do số dư thường sẽ thay đổi gần như toàn bộ các số, ta sẽ phải di chuyển rất nhiều keys (Request)

Triển khai thuật toán

  • Cùng nhìn lại, chúng ta cần những gì để triển khai thuật toán này?
    • Ta cần một mảng ánh xạ quy đổi ra các node trên hash ring (vòng giá trị)
    • Một map để phân bổ request nào vào node nào
  • Như vạy, để phân bổ request vào các node, ta cần một cơ chế dạng
    • Một cách tìm kiếm nhanh node đầu tiên có giá trị lớn hơn mã của request hiện tại. Do mã của node được trải phẳng trên một khoảng tịnh tiến, dễ dàng, ta có thể triển khai tìm kiếm nhị phân để tìm node đầu tiên có mã lớn hơn bằng mã của request (Lower_bound)
    • Từ mã của node, tìm ra node thực sự để điều hướng
  • Thay đổi khi hash ring thay đổi
    • Để xác định những request nào cần di chuyển, có cách khá đơn giản là ta sẽ lặp và kiểm tra toàn bộ request, sau đó xác định cái nào bị sai để chuyển nó sang node tiếp theo trên vòng. Nhưng cách này rõ ràng là cách “naive method”.
    • Để có thể triển khai với thời gian tối ưu hơn, ta có thể sử dụng một cấu trúc dữ liệu để xác định “khoảng ảnh hưởng”, nơi mà các key cần remap lại
    • Một lần nữa, ta có thể triển khai tìm kiếm nhị phân, bằng cách từ node bị xoá đi, ta dùng mã đó và quay ngược lại, sau đó tìm ra các điểm bị sai và cập nhật chúng cho đến khi đến 1 mã node hash khác.

Các câu hỏi thêm

  • Q: Khi nào nên sử dụng kỹ thuật consistent hashing này ?
  • A: Thông thường, ta sẽ sử dụng nó cho các hệ thống phân tán, nơi mà request thực sự đủ nhiều, và ta có nhiều server cần scaling và cần áp dụng để phân bổ request một cách đều. Amazon Dynamo cũng triển khai kĩ thuật này. Tuy nhiên, với các hệ thống nhỏ hơn, có thể dùng cách ánh xạ chia dư truyền thống, vì việc sử dụng hashing khó hơn cũng đi kèm độ phức tạp của hệ thống tăng lên và khó bảo trì.

  • Q: Tại sao lại gọi là consistent trong consistent hashing (nhất quán)
  • A: Vì khi có sự thay đổi về lượng server, ta không cần hashing lại toàn bộ các key

Tham khảo:

Kiến trúc Stateful và Stateless là gì?

image 45 - quochung.cyou PTIT

Lời mở đầu

  • Trong khoa học máy tính, “state” nghĩa là một trạng thái của hệ thống, của một thành phần hoặc ứng dụng của chúng ta tại một điểm thời gian
  • Ví dụ: Bạn đang mua hàng trong amazon.com, ta có thể coi việc bạn “đang đăng nhập” là một trạng thái, “đang có hàng trong giỏ” là một trạng thái, ….
  • Trạng thái biểu diễn dữ liệu đang được lưu trữ, và giúp chúng ta kiểm soát hiện trạng hiện tại của ứng dụng.
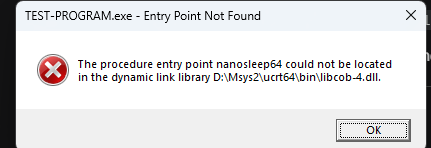
Kiến trúc Stateful

  • Tưởng tượng bạn đến một cửa hàng pizza để ăn. Hiện tại quán chỉ có 1 phục vụ bàn, phục vụ bàn sẽ lấy các note từ bàn của bạn, bạn order gì, hay là những món bạn trước đây từng ăn, bạn có dị ứng gì không, …
image 46 - quochung.cyou PTIT
  • Tất cả những thông tin trên sẽ được phục vụ bàn ghi lại về một “state” hay trạng thái của khách hàng. Chỉ có phục vụ bàn có những thông tin này, nếu bạn dạo này thích ăn món gì đó khác hơn, hoặc bị dị ứng gì đó mới, bạn cần cập nhật đúng với phục vụ này để thay đổi. Nhưng mà cả quán chỉ có 1 phục vụ nên bạn không lo nhầm người.
  • Tưởng tượng rằng, quán ăn có đông khách hơn, và phục vụ phải phục vụ rất nhiều khach. Quán cần nhiều phục vụ hơn, tuy nhiên lúc này, nếu bạn muốn đổi khẩu vị hay món khác, thì nếu bạn chọn người phục vụ khác sẽ không được.
image 47 - quochung.cyou PTIT
  • Những nhân viên phục vụ khác thì chẳng có thông tin gì về state của bạn cả. Họ không thể đổi đơn hàng của bạn, hay đọc chúng. Nếu một nhà hàng hoạt động theo kiểu như vậy, tức là chỉ 1 phục vụ có thông tin của bạn, sẽ được gọi là cấu trúc stateful
  • Tưởng tượng về dạng server, một hệ thống stateful sẽ chỉ có 1 server duy nhất ghi nhớ dữ liệu của người dùng. Toàn bộ các request, làm việc sau này của 1 khách hàng sẽ chỉ được điều hướng vào người đó qua các trình load balancer (cân bằng tải) với 1 sticky session. Một server sẽ luôn biết client của mình là ai.
image 48 - quochung.cyou PTIT

  • Sticky session (phiên được ghim) là một cài đặt cho phép cân bằng tải (load balancer) điều hướng các request của người dùng đến riêng 1 server duy nhất trong quá trình 1 phiên của họ. (1 phiên có thể kết thúc khi người dùng tắt browser, tắt máy, sau 1 ngày, …)
  • Điều này đi ngược lại với cách cân bằn gtari truyền thống, khi mà request của bạn được phân bổ đến các server khác nhau bằng round-robin hoặc các cách phân bổ khác. (kiểu phân bổ dần 1->2->3->4 rồi lại quay về 1 theo thứ tự request, hoặc phân bổ random, …)
  • Cách làm trên nghe có vẻ khá ổn với các hệ thống nhỏ. Tuy nhiên, thế giới chúng ta không lý tưởng. Giả sử, nếu 1 server bị chết, bị dồn quá tải, … thì toàn bộ thông tin của người dùng với server đó sẽ mất hết, điều này hoàn toàn không ổn chút nào.
  • Hơn nữa, việc phân bổ dữ liệu như vậy cũng không tốt trong nhiều trường hợp. Ví dụ, có một số client gửi rất nhiều request, khiến cho 1 server bị quá tải, trong khi vài server khác lại chỉ có vài request nhỏ, khiến việc cân bằng chung không ổn.

Kiến trúc Stateless

  • Kiến trúc stateless, dịch thuần tiếng anh là (không có state). Không hẳn là không có state, mà lúc này các server – hay vị phục vụ bàn sẽ không trực tiếp nhớ xem là khách hàng order gì, thông tin như nào, mà thay vì đó, họ sẽ dùng một phần mềm gì đó, một điện thoại, một tờ giấy chung để ghi thông tin khách hàng. Khi đó, nếu phục vụ khác đến, họ chỉ cần đọc tờ giấy lưu trữ chung để xem khách hàng muốn gì.
image 49 - quochung.cyou PTIT
  • Bằng việc lưu các trạng thái của khách hàng ở một hệ thống chung nào đó, có thể truy cập bởi mọi phục vụ/server, server nào cũng có thể phục vụ chung 1 khách hàng.
  • Nhìn về khoa học máy tính, lúc này ta có thể phân bổ request của người dùng đến server bất kì, việc dữ liệu của người dùng có thể lưu ở 1 database nào đó khác biệt, có thể truy cập bằng mọi server.
  • Việc cân bằng tải cũng tốt hơn, vì lúc này ta có thể chọn các server sđang ít khách phục vụ, hoặc đánh theo tuần tự, …
image 50 - quochung.cyou PTIT

Tổng kết

  • Nhìn chung, stateless mang lại tính mở rộng lâu dài và ổn định tốt hơn stateful
  • Stateless/stateful không chỉ là cách thiết kế server, cân bằng tải như ví dụ trên. Mà có thể áp dụng vào các design pattern, các hàm trong code, ….

Tham khảo:

Tìm hiểu về Serverless dễ hiểu bằng trà sữa

1 kvYDcS71SZXcyP yeqQMww - quochung.cyou PTIT

Serverless là gì, IaaS, CaaS, FaaS là gì, ..

Trước tiên để tìm hiểu về cấu trúc Serverless, trước hết ta hãy xem thử các cấu trúc truyền thống thường được sử dụng, và một số từ khoá và định nghĩa của chúng.

Mô tả cấu trúc Monolithic truyền thống

Ví dụ với một cấu trúc như trên, toàn bộ ứng dụng của chúng ta sẽ được chứa chung trong 1 khối lớn, và cùng tương tác vào 1 database. Để dễ hiểu hơn, mình sẽ ví dụ chúng như sau:

Một cửa hàng bán trà sữa bán 4 loại trà sữa:

  • Trà sữa dâu
  • Trà sữa ô long
  • Trà sữa bạc hà
  • Trà sữa socola

Tất cả trà sữa này sẽ được nhân viên pha bằng cùng 1 chiếc máy, cái máy này có thể pha được cả 4 loại trà sữa trên, rất đa năng tiện dụng. Ngoài ra, để có thể pha trà sữa bằng máy, ta cần nhiên liệu pha trà sữa, các nhiên liệu cho 4 loại trà sữa thì khác nhau, và được để chung trong 1 thùng nhiên liệu.

  • Máy pha trà sữa – Code/Server xử lí Logic tính toán, ..
  • Thùng nhiên liệu – Database, cơ sở dữ liệu tổng
  • Nhiên liệu – Các dữ liệu

Vậy ta có thể thấy, với một lượng người dùng chưa lớn, xây dựng cấu trúc đưa toàn bộ các logic vào 1 server như trên có thể khả thi, tuy nhiên, khi người dùng ngày càng tăng lên, việc làm trà sữa nào cùng phải dùng chung 1 cái máy, và việc lấy nhiên liệu nào cũng phải lấy từ 1 thùng nhiên liệu lớn sẽ khiến cho 1 khối chung quá tải, một trong những cách tối ưu cho vấn đề này là chia nhỏ các công việc nhỏ ra.

Tối ưu: Chia nhỏ các vấn đề

Lúc này, ta sẽ chia nhỏ các vấn đề thành 4 luồng như sau, vẫn tại cùng 1 địa điểm, 1 server cửa hàng đó, ta chia cấu trúc thành:

  • Máy pha trà sữa 1, chỉ pha trà sữa dâu. Cùng 1 thùng nhiên liệu chỉ cho trà sữa dâu
  • Máy pha trà sữa 2, chỉ pha trà sữa ô long. Cùng 1 thùng nhiên liệu chỉ cho trà sữa ô long
  • Máy pha trà sữa 3, chỉ pha trà sữa bạc hà. Cùng 1 thùng nhiên liệu chỉ cho trà sữa bạc hà
  • Máy pha trà sữa 4, chỉ pha trà sữa socola. Cùng 1 thùng nhiên liệu chỉ cho trà sữa socola

Lúc này, với các khách order các trà sữa khác nhau, nhân viên có thể đến các máy pha và thùng nhiên liệu khác nhau, chia tách thành các luồng nên sẽ giảm tải hơn một chút. Tuy nhiên, lại có một số vấn đề như sau:

  • Các luồng sẽ không giống nhau. Ví dụ trà sữa dâu thường được gọi nhiều hơn trà sữa socola, nên đúng ra cái máy, hay tài nguyên server (cpu, ram,…) nên được phân bố nhiều hơn cho trà sữa socola
  • Nếu một máy trà sữa bị lỗi, ví dụ hãy tưởng tượng về code, dù lúc này đã chia nhỏ nhiều function ra, nhưng nếu hỏng cái gì thì thường ta phải khởi động lại cả server chung, đồng nghĩa các function khác đang chạy tốt cũng phải khởi động lại.

Lúc này, ta sẽ thử nói về một số từ khoá trong triển khai cấu trúc để xử lí vấn đề trên

image 1 - quochung.cyou PTIT

Lại tưởng tượng về cửa hàng bán trà sữa, hãy coi cả cửa hàng như một cái máy chủ, một cái máy tính để có thể chạy các code (các máy pha trà sữa). Chúng ta có thể mua một mặt bằng để đặt cửa hàng (mua đứt). Tương tự, ta có thể mua các server về nhà chúng ta, về công ty để tự triển khai, tự lắp đặt.

image 8 - quochung.cyou PTIT

Triển khai 1: Tự cài đặt server

Một server thì nhìn chung có cấu trúc tương tự như một máy tính, laptop bình thường. Tuy nhiên được thiết kế để chịu tải tốt hơn, chạy 24/7, chịu đựng các điều kiện như nhiệt độ, thời tiết, bụi, … tốt hơn, và một số đặc tính khác nữa.

image 2 - quochung.cyou PTIT

Việc tự mua một server về triển khai thường được các công ty lớn sử dụng, tuy nhiên lúc này ta sẽ phải lo các vấn đề như nhiệt độ, cần bật máy làm mát, điều hoà, quạt,… để server mát mẻ 24/7. Hay phải lo các vấn đề như điện để tải server, tránh các trường hợp mất điện thì server cũng hỏng, ….

Nó giống với việc bạn mua mặt bằng để làm cửa hàng trà sữa, sau khi mua xong thì không thể mở rộng đất ra nếu muốn mở rộng cửa hàng được, phải tự lo các vấn đề như vệ sinh mặt bằng, điện nước, …. Điều này không phù hợp nếu ta chỉ cần một dịch vụ nhỏ, hoặc muốn mở rộng lớn ra hơn sau này.

Tối ưu: Đưa các dịch vụ lên các nền tảng riêng

Triển khai 2: infrastructure as a service (IaaS) – Cơ sở hạ tầng như một dịch vụ

image 3 - quochung.cyou PTIT

Như tên của nó, cơ sở hạ tầng như một dịch vụ. Tức là ta sẽ thuê luôn một mặt bằng cho cửa hàng trà sữa, một cái máy chủ về để sử dụng. Các đơn vị cho thuê thường là các công ty lớn như nước ngoài có Amazon, Microsoft, Google. Trong nước thì có Viettel Cloud, … Các nhà cho thuê, đơn vị này sẽ bảo đảm vấn đề điện duy trì server ổn định, băng thông mạng cho server tốc độ cao, ….

Ngoài ra nếu server các bạn bị tấn công, ddos, các đơn vị này cũng sẽ có thể chuyển bạn sang một server, cụm network mạng khác để tránh, …

Nhìn chung việc cho thuê hay mua dịch vụ này đã giảm tải bớt rất nhiều sự đau đầu cho bạn. Lúc này bạn như có một cái máy tính ảo có thể truy cập từ xa, và đặt các code của mình lên đây để chạy.

Tối ưu: Các dịch vụ tự co giãn theo nhu cầu, tiết kiệm chi phí

Triển khai 3: Container as a Service (CaaS) – Một khối container như dịch vụ

image 7 - quochung.cyou PTIT

Để giải thích việc này thì khá trừu tượng, nhưng lúc này bạn sẽ được cung cấp dịch vụ như các container. Các container này thì gọn nhẹ hơn, tốn ít tài nguyên, tiền bạc để thuê, và có thể co giãn được (tức là có thể tự tăng ram, cpu khi nhu cầu nâng cao)

Bạn tưởng tượng thì nếu bạn chia nhỏ các phần của ứng dụng của mình đủ nhỏ, để chúng có thể triển khai độc lập trên 1 container nhỏ, lúc này các hệ thống container có thể tạo ra rất nhiều bản container của phần ứng dụng đó của bạn, tự nâng cấu hình khi nhu cầu sử dụng tăng cao, hoặc tự triển khai một container khác chạy thay thế nếu container hiện tại bị sập, …

image 4 - quochung.cyou PTIT

Triển khai 4: Function as a Service (FaaS) – Một hàm, chức năng như một dịch vụ

Với triết lý lập trình hàm (Function do only one thing), khi làm việc với kiến trúc Functions as a service, chỉ nên để function làm một việc duy nhất

Điểm mạnh nhất của FaaS là nó độc lập các function, nếu function chỉ thực thi một nhiệm vụ duy nhất. FaaS sẽ làm rất tốt công việc của nó được giao. Tuy nhiên, nếu gọi các function lồng nhau, rất dễ xảy ra vấn đề về performance.

Tức là lúc này bạn có thể chia các máy bán trà sữa này làm một tác vụ duy nhất như 1 hàm, trong đó có cả thùng nhiên liệu là database nhỏ của riêng loại trà sữa đó thôi. Lúc này các máy bán trà sữa này được đặt tại nhiều điểm khác nhau, (bạn chỉ đang thuê cái máy – một function như một dịch vụ). Do kết nối internet hạ tầng đủ nhanh, chúng vẫn có thể chấp nhận được với cửa hàng trà sữa của bạn. Và nếu 1 máy hỏng thì các máy khác vẫn không làm sao cả.

Các FaaS cũng có thể có các tính năng kế thừa như CaaS, tức là tự tạo một điểm khác nếu quá tải, tự tạo ra nhiều điểm vẫn là cùng 1 máy bán trà sữa và chia nhỏ luồng hơn nữa để xử lý tốt hơn, hay tự khởi động một điểm khác khi chỗ hiện tại bị sập, …

image 5 - quochung.cyou PTIT

Một số từ khoá

Auto-scaling: Các máy chủ nhỏ này sẽ tự động co giãn ssd, ram, cpu, …. để phù hợp với nhu cầu, ví dụ máy pha trà sữa này nhiều khách order thì tự tăng tài nguyên lên, còn nếu ít khách thì tự giảm xuống

Event-driven: Các máy pha trà sữa nếu không ai gọi thì tự tắt đi, và chỉ bật lên (cold-start), sẽ bật lên (đủ nhanh tuỳ theo độ nặng của code bạn) khi có khách gọi (một event – sự kiện)

pay-per-execution: Một số chỗ sẽ thu phí bạn thuê theo số lần gọi dịch vụ chứ không phải thời gian thuê. ví dụ máy bán trà sữa dâu khá ế, 1 tháng có đúng 4 khách gọi 4 thời điểm khác nhau, bạn không cần bật máy cả tháng, mà chỉ tính tiền thuê 4 lần đó thôi

pay-as-use: Một số chỗ thu phí theo thời gian, tuy nhiên nhỏ lẻ hơn. Kiểu theo tiếng, theo ngày, … khi đó nếu bạn chỉ cần dùng 1 thời gian ngắn rồi tắt đi thì sẽ tiết kiệm chi phí hơn nhiều

Tóm lại về serverless

image 6 - quochung.cyou PTIT

Hi vọng qua ví dụ trà sữa trên bạn sẽ có một cái nhìn tổng quan hoặc cơ bản về serverless.

Serverless – Không có server, không có nghĩa là sẽ không có cái server máy chủ nào chạy code cả. Mà cơ bản bạn sẽ không cần sở hữu một cái máy chủ, tự bảo quản và vận hành nó, mà có thể thuê các đơn vị khác đảm bảo dịch vụ và ổn định hơn để thực thi các tác vụ của mình.

Như lúc này cửa hàng trà sữa có thể đưa 4 máy pha trà sữa, 4 đoạn code độc lập này lên 4 điểm khác nhau. Lúc này ví dụ 1 điểm code bị bug, có vấn đề thì các nơi khác vẫn hoạt động bình thường.

Ngoài ra các điểm này có thể tự co giãn – (tham khảo thêm ở phần từ khoá bên trên) để phục vụ tốt hơn nếu có nhu cầu nhiều hơn ở một luồng nào đó.

image 9 - quochung.cyou PTIT

Ưu điểm của serverless

  • Tiết kiệm chi phí, không cần thuê/mua cả mặt bằng – cả 1 server để chứa mấy cái máy pha, mà chỉ cần thuê cái máy pha là được
  • Giảm bớt nỗi lo quản lý mặt bằng – server như điện, tiền mạng, ….

Nhược điểm của serverless hay FaaS

  • Test và debug khó hơn, do nó chỉ bật khi mình cần, hơn nữa bạn không nhìn được rõ chúng đang chạy như thế nào như code trên máy mình, vì lúc này toàn bộ code đang ở một điểm khác.
  • Vấn đề bảo mật, lúc này bạn đang để database và code ở một đơn vị khác cho thuê. Nhìn chung thì chắc chắn việc bảo mật không thể bằng tự mình quản lí được.
  • Không phù hợp cho các tác vụ chạy liên tục 24/7. Do điểm tốt của serverless là tiết kiệm tiền, tự tắt đi khi mà không cần sử dụng. Nhưng nếu bạn cần dùng liên tục thì nên thuê CaaS hoặc IaaS
  • Giảm hiệu năng. Do các máy pha chỉ bật khi ta cần đến, nên sẽ tốn thêm thời gian bật lên. Bạn cần chia nhỏ function nhất có thể để chúng độc lập, và bật đủ nhanh để không ảnh hưởng người dùng

Cài đặt WSL2 Ubuntu trên Window ít lỗi không cần Microsoft Store

WSL là gì

tich hop nhan linux tren windows 10 1 - quochung.cyou PTIT

WSL (Windows Subsystem for Linux) là một tính năng có trên Windows x64 (từ Windows 10, bản 1607 và trên Windows Server 2019), nó cho phép chạy hệ điều hành Linux (GNU/Linux) trên Windows. Với WSL bạn có thể chạy các lệnh, các ứng dụng trực tiếp từ dòng lệnh Windows mà không phải bận tâm về việc tạo / quản lý máy ảo như trước đây. Cụ thể, một số lưu ý mà Microsoft liệt kê có thể làm với WSL:

  • Chọn sử dụng distro Linux từ Microsoft Store: Hiện giờ đang có các Distro Linux rất gọn nhẹ trên Store sử dụng được ngày như Ubuntu, Debian …
  • Chạy được từ dòng lệnh các lệnh linux như ls, grep, sed … hoặc bất kỳ chương trình nhị phân 64 bit (ELF-64) nào của Linux
  • Chạy được các công cụ như: vim, emacs …; các ngôn ngữ lập trình như NodeJS, JavaScript, C/C++, C# …, các dịch vụ như MySQL, Apache, lighthttpd …
  • Có thể thực hiện cài đặt các gói từ trình quản lý gói của Distro đó (như lệnh apt trên Ubuntu)
  • Từ Windows có thể chạy các ứng dụng Linux (dòng lệnh)
  • Từ Linux có thể gọi ứng dụng của Windows

Một số phần cần dựa vào WSL để chạy trên Win

  • Docker
  • Terminal (Konsole)
  • ZSH / Fish
  • VSCode
  • Git
  • PHP
  • Node.js
  • Golang

Cài đặt WSL2 Ubuntu không cần sử dụng Microsoft Store, tránh một số lỗi như Window tắt Update, …

Đầu tiên, bật Powershell lên, có thể dùng Window + S để tìm powershell

image - quochung.cyou PTIT


# Tải về Ubuntu 20.04, copy lệnh dưới vào powershell
Invoke-WebRequest -Uri https://aka.ms/wslubuntu2004 -OutFile Ubuntu.appx -UseBasicParsing

# Cài đặt file vừa tải xong, copy lệnh dưới vào powershell
Add-AppxPackage .\Ubuntu.appx

Sau khi thấy đã cài đặt hoàn tất, Window + S và tìm ubuntu để chạy các phần setup cơ bản

Sau khi hoàn thiện, bật powershell lần nữa và chạy thử lệnh sau để kiểm tra ubuntu đã lên chưa

wsl --list --verbose

//Sẽ in ra dạng
  NAME                   STATE           VERSION
  Ubuntu-20.04           Running         1
maxresdefault 1 - quochung.cyou PTIT

Nếu đã hiển thị như trên, gõ lệnh sau để sang WSL2

wsl --set-version Ubuntu-20.04 2

Review VPS tại Hosthatch.com, VPS chất lượng tốt giá rẻ gần Việt Nam

Link trải nghiệm

Sau khi trải nghiệm nhiều dịch vụ VPS có location ở gần Việt Nam, mình thấy đa số giá cả khá đắt, không phù hợp với budget sinh viên của mình lắm. Sau một thời gian tìm hiểu, và xem đánh giá tại https://www.vpsbenchmarks.com/, mình có tìm thấy một bên mới có giá cả khá oke với location Hongkong là Hosthatch

image 5 - quochung.cyou PTIT

Giá cả phải chăng cho chất lượng

Hosthatch có cả server Sing, Tokyo ngoài HongKong.

image 8 - quochung.cyou PTIT

Với mức giá khá phải chăng, khoảng 270-280k cho gói NVME 12G ram, 4 Core và 50GB NVMe (Không phải ssd nhé). Với mức giá này ở một số bên tại Việt Nam như Ftech, Vietnix chỉ có khoảng 2G ram, 1 core với cấu hình tương tự.
VPS hiếm hoi có location ở Hong Kong

Như bạn đã biết location Hong Kong rất gần Việt Nam. Do vậy không có gì ngạc nhiên khi website lưu trữ ở vị trí này có tốc độ truy cập từ Việt Nam rất tốt. Thậm chí không kém gì với location trong nước.

Một lợi thế khác của Location Hong Kong: 

Tính ổn định cao khi đứt cáp xảy ra.

Khi sử dụng dịch vụ hosting của các nhà cung cấp nước ngoài, bạn luôn lo lắng về đứt cáp xảy ra phải không?

Location Hong Kong thường ít bị ảnh hưởng bởi sự cố đứt cáp. Location Nhật Bản, Singapore thường bị ảnh hưởng nhiều hơn. 

image 6 - quochung.cyou PTIT

​Setup sử dụng, cài đặt VNC Server để điều khiển như Remote Desktop

hosthatch console - quochung.cyou PTIT
Hosthatch cung cấp một trang điều khiển dạng như trên

Có vài option hdh sẵn để lựa chọn, đa số là các bản phổ biến như Ubuntu, Debian, ….

Hosthatch sẽ cung cấp root password, sau đó bạn có thể ssh vào vps theo lệnh

ssh root + @ + ipaddress

Thông thường mình sẽ cài luôn vnc lên vps để tiện điều khiển, nếu muốn một giao diện để sử dụng VPS cho dễ, các bạn có thể làm theo các bước sau sau khi ssh

Cài đặt Desktop và VNC Server

Desktop: xfce4

sudo apt update 
sudo apt install xfce4 xfce4-goodies
sudo apt install tightvncserver
vncserver

Lúc này bạn sẽ được hỏi đặt mật khẩu, bạn tạo mật khẩu nữa là xongật

Output
You will require a password to access your desktops.

Password:
Verify:

Mật khẩu chỉ được dài 6-8 kí tự, nếu bạn nhập dài hơn nó sẽ tự động cắt ngắn

Output
Would you like to enter a view-only password (y/n)? n
xauth:  file /home/sammy/.Xauthority does not exist

New 'X' desktop is your_hostname:1

Creating default startup script /home/sammy/.vnc/xstartup
Starting applications specified in /home/sammy/.vnc/xstartup
Log file is /home/sammy/.vnc/your_hostname:1.log

Sau khi xong sẽ có thông báo dạng như sau

Bây giờ bạn có thể dùng một số phần mềm như https://www.realvnc.com/en/connect/download/viewer/ để kết nối với IP:5901 và sử dụng

xfce vnc - quochung.cyou PTIT

Đánh giá chung

Ưu điểm

  • Giá cả phải chăng, rẻ so với thị trường. Cấu hình cũng khá mạnh tương xứng
  • Có nhiều server gần Việt Nam như Hongkong, Sing với đường truyền tốt
  • Cài đặt nhanh, dễ dùng, ít downtime

Nhược điểm

  • Ít được biết đến, lúc mới mua xong mình loay hoay mãi mới cài được các thứ. Trong khi ở bên khác thì cài đặt và làm tiện nhanh hơn
  • Customer Support khá vô dụng, nhắn kĩ thuật có khi 1 tuần mới rep. Và theo nhiều review thì nếu nhắn quá gắt có thể bị khoá tài khoản luôn

Khắc phục Arch Manjaro KDE bị giật lag, đơ màn hình và tác vụ

Sơ lược về Linux

Ten reasons why we should use Linux - Open Source For You

Mô hình Linux hệ điều hành có thể được tìm thấy trong mọi thứ, từ điện thoại thông minh đến ô tô, siêu máy tính đến thiết bị gia dụng, máy tính gia đình cho đến máy chủ doanh nghiệp. Kể từ giữa những năm 1990, Linux đã phát triển thành cơ sở người dùng toàn cầu. Nó cũng cung cấp phần lớn Internet, 500 siêu máy tính hàng đầu và thị trường chứng khoán thế giới. Ngoài việc là nền tảng được lựa chọn để chạy PC, máy chủ và hệ thống nhúng trên toàn thế giới, Linux còn là một trong những hệ điều hành đáng tin cậy, an toàn và không lo lắng nhất có thể truy cập được. Giống như Windows, iOS và Mac OS, Linux là một hệ điều hành. Trên thực tế, một trong những nền tảng phổ biến nhất thế giới, Android, được hỗ trợ trên hệ điều hành Linux. Linux có nhiều loại để đáp ứng mọi nhu cầu của người dùng. Bạn sẽ tìm thấy một “biến thể” của Linux phù hợp với nhu cầu của mình, cho dù bạn là người dùng mới bắt đầu hay người dùng thành thạo. Các phiên bản như vậy được gọi là bản phân phối (hoặc “bản phân phối”). Hầu hết mọi bản phân phối Linux đều có thể được tải xuống miễn phí, ghi vào đĩa (hoặc cài đặt trên ổ đĩa flash USB) và sử dụng trên bao nhiêu máy tùy thích. Chúng tôi sẽ nói về Manjaro Linux trong bài đăng này.

Manjaro Linux là gì

Manjaro - Wikipedia

Manjaro thân thiện với người dùng, mã nguồn mở hệ điều hành. Manjaro lý tưởng cho cả người mới và người dùng máy tính có kinh nghiệm, cung cấp tất cả các lợi ích của phần mềm tiên tiến kết hợp với việc nhấn mạnh vào việc bắt đầu nhanh chóng, các công cụ tự động ít cần tương tác thủ công và hỗ trợ dễ dàng khi cần thiết. Ngược lại với các hệ điều hành độc quyền, bạn có toàn quyền kiểm soát phần cứng của mình. Do đó, Manjaro là một hệ điều hành mạnh mẽ, tuyệt vời để sử dụng tại nhà, tại doanh nghiệp và trong các môi trường phát triển. Nhiều chương trình Windows phổ biến có thể được chạy qua Steam bằng phần mềm tương thích như Wine, PlayonLinux hoặc Proton. Các mẫu được cung cấp ở đây không có nghĩa là đầy đủ! Manjaro là sự thỏa hiệp lý tưởng cho những người tìm kiếm hiệu suất cao, khả năng kiểm soát hoàn toàn và phần mềm tiên tiến đồng thời duy trì một mức độ ổn định phần mềm nhất định.

Sửa lỗi giật lag

1. Ananicy

https://aur.archlinux.org/packages/ananicy-cpp

Anacity là một daemon sẽ điều chỉnh độ ưu tiên của các tác vụ để đem lại cảm giác mượt mà hơn cho các tác vụ mà người dùng thường dùng.

2. Tăng độ phản hồi của hệ thống khi ở ram hết

Trên các máy Linux truyền thống, khi hệ thống bắt đầu sử dụng hết ram của máy tính, khả năng phản hồi của toàn bộ hệ thống sẽ bị giảm dần và sẽ đến mức gần như đơ cứng và không thể sử dụng được. Lúc này các trình diệt OOM (OOM-Killer) sẽ xuất hiện và tự động đóng các ứng dụng cho đến khi giải phóng một bộ nhớ đủ lớn để hệ thống bình thường trở lại.

Một số trình OOM-Killer:

  • systemd-oomd — Provided by systemd as systemd-oomd.service that uses cgroups-v2 and pressure stall information (PSI) to monitor and take action on processes before an OOM occurs in kernel space.
https://github.com/systemd/systemd, systemd-oomd(8) || systemd
  • earlyoom — Simple userspace OOM-killer implementation written in C.
https://github.com/rfjakob/earlyoom || earlyoom
  • oomd — OOM-killer implementation based on PSI, requires Linux kernel version 4.20+. Configuration is in JSON and is quite complex. Confirmed to work in Facebook’s production environment.
https://github.com/facebookincubator/oomd || oomdAUR
  • nohang — Sophisticated OOM handler written in Python, with optional PSI support, more configurable than earlyoom.
https://github.com/hakavlad/nohang || nohang-gitAUR
  • low-memory-monitor — GNOME developer’s effort that aims to provides better communication to userspace applications to indicate the low memory state, besides that it could be configured to trigger the kernel OOM-killer. Based on PSI, requires Linux 5.2+.
https://gitlab.freedesktop.org/hadess/low-memory-monitor/ || low-memory-monitor-gitAUR
  • uresourced — A small daemon that enables cgroup based resource protection for the active graphical user session.
https://gitlab.freedesktop.org/benzea/uresourced || uresourcedAUR

3. Sử dụng bộ nhớ swap

Swap hay còn được gọi là RAM ảo được sử dụng để hỗ trợ lưu trữ dữ liệu khi bộ nhớ vật lý (RAM) đã đầy. Đôi khi SWAP cũng được dùng song song để tăng dung lượng bộ nhớ đệm. SWAP thường dùng trên các hệ điều hành Linux, Ubuntu hoặc CentOS. 

Trường hợp đầy RAM, Swap sẽ được hệ thống dùng làm bộ nhớ thay thế. Tuy nhiên, tốc độ của nó chậm hơn rất nhiều so với ổ cứng vật lý.

Swap là gì? Tổng quan về swap - CloudCraft

Một trong những trường hợp quan trọng cần đến Swap là khi RAM đầy. Theo đó, Swap sẽ hạn chế các sự cố liên quan đến vấn đề bảo mật thông tin, nhất là trong hệ thống điều hành Linux.Có thể hiểu một cách đơn giản là: bạn không bao giờ có thể lường trước được dung lượng bộ nhớ cho tất cả chương trình trên hệ điều hành. Vì vậy, khi sự cố xảy ra (đầy RAM), Swap sẽ làm nhiệm vụ duy trì tất cả các hoạt động bình thường dù tốc độ có phần chậm hơn thay vì dừng cả hệ thống khiến thông tin dễ bị rò rỉ.

Swap rất cần thiết trong các hệ điều hành phổ biến hiện nay. Tuy nhiên khi nào bạn cần đến nó?

  • Khi dùng một phần mềm yêu cầu hệ thống có hỗ trợ bộ nhớ Swap trong phần cài đặt (ví dụ: Oracle).Khi muốn hoạt động của hệ thống ổn định hơn, đặc biệt quan trọng đối với các hệ thống không có nhiều dung lượng RAM.Nếu bạn đang dùng Ubuntu, hệ điều hành này sẽ yêu cầu Swap cho chế độ ngủ đông.

Để kiểm tra bạn đang có bộ nhớ swap nào hoạt động không

$ swapon --show 

Tạo một partition mới để làm swap

Bạn có thể dùng GParted hoặc một số trình partition để tạo một partition mới. Bộ nhớ của partition sẽ là dung lượng ram của swap, thông thường bạn có thể dùng 4G-10G.

sudo mkswap /dev/sda3
//Chuyển partition /dev/sda3 thành partition sử dụng cho swap 

sudo swapon /dev/sda3
//Bật swap cho /dev/sda3

sudo bash -c "echo UUID=$(lsblk -no UUID /dev/sda3) none swap defaults 0 0 >> /etc/fstab"
//Bật swap tự động khi hệ thống lên

Sửa lỗi âm thanh chất lượng cao (High Fidelity A2DP) loa Bluetooth trên Ubuntu, Debian, …

TH1: Có thể chuyển sang chế độ HiFi A2DP, nhưng không nghe thấy nhạc

  • Bạn mở file manager bằng quyền root, (chuột phải open as root)
  • Tìm đến /home/tên người dùng/.config/pulse (Nếu không có .config thì tìm bật “Show Hidden File” lên)
  • Xóa folder trên, sau đó ra ngoài gõ pulseaudio -k để khởi động lại daemon

TH2: Khi chuyển sang chế độ HiFi A2DP thì bị lỗi (Failed to change profile to a2dp_sink)

TH3: Khi chuyển sang chế độ HiFi A2DP thì bị lỗi khác

  • Cài đặt blueman sudo apt-get install blueman
  • Mở file ở /etc/bluetooth/main.conf và thêm Disable=headset
  • Khởi động lại daemon bluetooth sudo service bluetooth restart