Ta đã biết, khi một đối tượng không còn tác dụng nữa, thì chúng sẽ bị GC dọn đi để tiết kiệm bộ nhớ, nhưng thế nào là “hết tác dụng” ?
Có thể tóm gọn bằng một câu cơ bản “Object tại heap sẽ không còn hữu dụng nếu chúng mất kết nối tới stack”
Object mất kết nối tới stack khi không còn một con trỏ nào chỉ tới chúng nữa cả, hãy xem thử đoạn code sau:
Object o = new Object();
System.out.println(o);
o = null;
Ở dòng đầu tiên, ta tạo một đối tượng o, o lúc này thực chất đang chỉ tới giá trị thực sự của đối tượng ta vừa tạo ra trong heap
Khi in thử đối tượng này ra, ta có output theo mẫu sau
java.lang.Object@4617c264
Tiếp theo, ta cập nhật o thành null. Lúc này, đối tượng nằm ở heap không còn cái gì trỏ đến nó nữa, và không gì có thể truy cập lại nó nữa, và lúc này nó trở thành mồi của GC
Vấn đề không đơn giản
Ví dụ trên khá đơn giản do chỉ có 1 object, vấn đề sẽ phức tạp hơn khi ta tiếp cận với nhiều object liên kết với nhau 1 lúc
Giả sử với 6 dòng lệnh sau, ta sẽ đi qua từng dòng một
Sau 4 dòng đầu tiên, stack và heap của chúng ta có dạng như sau. Tại stack là các biến giữ con trỏ tới các giá trị thực trong heap.
Sau dòng thứ 5, ta có hình như sau. Ta thấy, dù sau khi đã cập nhật p1 thành null với mong muốn GC sẽ dọn object này, nhưng thực tế, ta thấy ta vẫn có thể truy cập vào p1 bằng person.get(1) qua list persons, tức là ta vẫn có cách reach đến điểm này
Chỉ sau khi set cả list thành null, ta mới mất hoàn toàn liên hệ với p1
=> Không khó để đánh giá các phần tử nào sẽ được Garbage Collector dọn khi bạn đã hiểu về quan hệ bên trên. Dễ dàng thấy, sau 6 bước, p1 mất hoàn toàn liên hệ với stack và sẽ được dọn
Tuy nhiên, đó là ta nhìn thủ công, còn để garbage collector biết cái nào còn kết nối với stack sẽ tốn một lượng thời gian, và nó sẽ làm chậm hệ thống lại (chi tiết ở bên dưới). Có nhiều cách để làm điều này, và ta sẽ thảo luận ở bên dưới
Đánh dấu đệ quy
Ta sẽ thử đánh dấu các object còn live và object nào có thể bị dọn bởi GC. Dễ dàng, ta thêm 1 bit để dánh dấu xem chúng có còn kết nối với stack hay không. Khi tạo, ta sẽ để bit là 0, và khi ở giai đoạn đánh dấu, object là 0 sẽ bị xoá đi, còn nếu vẫn còn sử dụng, ta sẽ cập nhật nó thành 1
Tuy nhiên, heap và stack thay đổi liên tục. Cách đánh dấu được triển khai tuỳ thuộc vào phiên bản Java và GC bạn sử dụng, tuy nhiên, ta sẽ thử xem cách hệ thống đánh từ stack, hãy thử xem ví dụ sau
Đầu tiên toàn bộ phần tử sẽ được để là 0
Sau đó, toàn bộ các phần tử có kết nối trực tiếp tới stack được đánh thành 1
Tuy nhiên, do p1 vẫn có thể truy cập từ danh sách persons, và hơn nữa, ta không thể cứ dọn những gì vẫn còn kết nối. Vì vậy ta cần một cách duyệt đơn giản, với điểm khởi đầu từ các điểm đang = 1, sau đó đi đến mọi quan hệ của nó và đánh chúng thành 1, rồi tiếp tục đệ quy.
Các thuật toán đánh dấu đóng vai trò quan trọng trong giai đoạn đánh dấu, đầu tiên thử đi qua cách stop-the-world
Kĩ thuật Stop-The-World – Dừng thế giới
Với cách đánh dấu trên, ta nhận thấy. Nếu một phần tử được tạo trong quãng đánh dấu, nó sẽ không còn đúng nữa.
Vì vây, có một solution đơn giản là ta sẽ dừng mọi luồng khác và chỉ chạy luồng đánh dấu của cả chương trình, điều này sẽ rất ảnh hưởng đến hiệu năng. Ta sẽ thử xem các thuật toán tiếp theo.
Kĩ thuật Reference counting – Đếm liên hệ
Một cách triển khai khác là đếm số lần một object được trỏ đến. Mỗi object sẽ chứa số lần object được trỏ như một thông số mà nó nắm giữ. Như vậy, GC chỉ việc quét qua và xoá mọi object có 0 lần bị nắm giữ. Cách này sẽ không cần stop-the-world như cách đánh số đệ quy nữa, vì khi object được tạo ra giữa chừng lúc đánh số lần trỏ thì nó vẫn đều là 1 rồi.
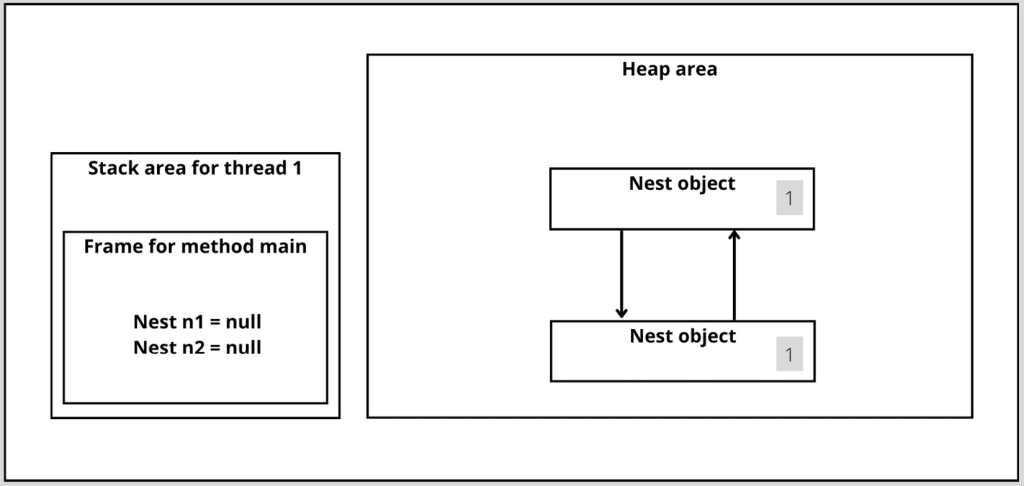
Tuy nhiên, nó có một điểm yếu là sẽ tạo ra island of isolation, hay các vùng, một tập các object tự trỏ nhau nhưng mà thực tế không có kết nối tới stack
Giải phóng bộ nhớ
Cách thức làm sao để đánh dấu các object sẽ bị xoá sẽ được quyết định khác nhau bởi phiên bản Java và các kiểu GC khác nhau.
Giả sử ta đã đánh dấu được hết các object sẽ có thể bị xoá, tuy nhiên việc xoá chúng đi cũng không phải một quá trình đơn giản
Việc xoá object được gọi là sweeping by garbage collector, trong bài viết sẽ mention 3 cách thức sweeping khác nhau
Normal sweeping
Sweeping with compacting
Sweeping with copying
Normal sweeping
Hình ảnh trên thể hiện các khối bộ nhớ trong ram, các vùng có dấu X là các object đã được đánh dấu và chuẩn bị bị xoá
Sau khi xoá đi, vùng nhớ của ta có dạng như sau, dễ thấy, điều này dẫn tới một triệu chứng có tên Fragmentation
Fragmentation trong Java Garbage Collector
Lúc này, vì các vùng trống nằm ở giữa các vùng bị chiếm dụng, nên ta chỉ có thể thêm các bộ nhớ nhỏ hơn hoặc bằng vùng vào các vùng trống. Điều này sẽ dẫn tới 1 vài vấn đề khi ta muốn cấp phát một bộ nhớ lớn hơn
Giả dụ với trường hợp cấp phát một vùng nhớ lớn hơn các khe trống như ảnh trên, khi cấp phát vào, ta chỉ có thể xếp như sau:
Dù tổng thể bộ nhớ còn trống ta vẫn đủ để xếp vùng nhớ, nhưng thực tế thì ta không có một vùng nhớ liên tiếp nào chứa đủ vùng nhớ mới này. Và việc này sẽ throw ra 1 runtime exception là OutOfMemoryError.
Ưu nhược điểm của Normal sweeping
Normal Sweeping là một kĩ thuật giải phóng vùng nhớ ngây thơ, khá tiện dụng và đơn giản. Tuy nhiên sẽ dẫn tới các vùng nhớ bị phân mảnh. Quá trình này phù hợp khi ta có nhiều bộ nhớ, và ta chỉ cần nhanh chóng dọn bộ nhớ đi. Khi mà lượng vùng nhớ còn trống nhỏ hơn, ta sẽ prefer các kĩ thuật khác
Sweeping with compacting
Sweeping with compacting là một quá trình 2 bước. Đầu tiên, chúng vẫn giải phóng bộ nhớ, nhưng sau đó ta sẽ thực hiện thêm 1 bước gọi là compacting (thu gọn), ta sẽ dời toàn bộ vùng nhớ về phía đầu để đảm bảo không có bất kì khoảng trống nào ở giữa
Ưu nhược điểm Sweeping with compacting
Cách làm này giúp bộ nhớ không còn bị phân mảnh như thông thường, tuy nhiên việc di chuyển các vùng nhớ về đầu là một quá trình tốn kém, vì gần như với lượng vùng nhớ nhỏ và trải dài nhiều, ta sẽ phải copy và di chuyển khá nhiều trên vùng nhớ.
Sweeping with copying
Ở cách làm này, ta sẽ cần 2 vùng nhớ khác nhau. Ta sẽ không trực tiếp xoá các vùng nhớ bị đánh dấu là xoá đi, mà ta sẽ copy các vùng nhớ k bị xoá vào vùng nhớ mới
Sau đó mới thực hiện xoá toàn bộ vùng nhớ ở vùng nhớ cũ
Ưu nhược điểm của Sweeping with copying
Dữ liệu không bị phân mảnh
Về hiệu năng thì nhanh hơn compacting, do không phải thực hiện nhiều công đoạn tính toán khi di chuyển, mà chỉ copy nhanh chóng sang vùng mới đang trống hoàn toàn (ở compacting ta ví dụ di chuyển vùng 30-50 sang vùng 0-10, đầu tiên ta phải di 30-40, sau đó lại di vùng 10-20 đi, …. và khó khăn hơn nhiều)
Tuy nhiên cần nhiều bộ nhớ hơn vào cùng 1 thời điểm, cần lượng bộ nhớ trữ còn lại đủ nhiều để di chuyển.
Consistent hashing (Ánh xạ nhất quán) thường được sử dụng trong các hệ thống phân tán.
Trước tiên, để giải thích một số term, thuật ngữ mà các bạn còn có thể confuse, chúng ta sẽ đi từng phần một
Hệ thống phân tán
Hiểu đơn giản, tưởng tượng việc bạn truy cập đến server như vào 1 cửa hàng mua đồ vậy. Nếu một ngày bình thường, bạn gọi món, đồ ăn đến rất nhanh, đơn giản, phục vụ tốt. Nhưng vào giờ cao điểm, khi chỉ có 1 phục vụ quán, quá nhiều người gọi làm phục vụ quán không đỡ kịp, cửa hàng quá tải và ai cũng có đồ ăn rất chậm.
=> Để xử lí có nhiều cách, nhưng dễ dàng nhất, chỉ cần tuyển thêm nhiều phục vụ hơn thôi? Quy chiếu về server, ta chỉ cần có nhiều server con khác nhau, và chia nhỏ các yêu cầu của khách hàng đến các server một cách đồng đều, hay chia nhỏ các database, …. Lúc đó, ta có hệ thống phân tán.
Ánh xạ là gì? Tại sao cần ánh xạ (hashing) ?
Lúc này ta có một bài toán cần giải quyết, làm sao để chia các yêu cầu của khách hàng vào các server khác nhau, sao cho nó đồng đều? Không được có server làm quá nhiều việc, server làm quá ít việc, ta mong muốn có mọi server đều xử lí đều nhất có thể.
Một cách làm phổ biến và dễ hiểu là Round-robin, hay ánh xạ theo phần dư
ServerIndex = hash_function(key) % N
Tức là ta sẽ đánh số các request theo thứ tự bằng cách chia dư. Ví dụ ta có 5 server, thì chia dư số thứ tự cho 5
Ánh xạ chia dư cho 4 server như vậy thì request thứ 1 và 5 sẽ vào ô 1, sau đó là request 0,2 , rồi request 7,6 , …
Nghe thì có vẻ rất lí tưởng, request sẽ được chia đều cho các server. Nhưng đó là trường hợp số lượng server không đổi trong “thế giới lí tưởng”. Cuộc sống thực tế thì không đẹp như vậy, chúng ta dễ dàng gặp phải trường hợp sếp bỗng muốn đang từ 4 server, scale lên 15 server. Hay 4 server giảm xuống còn 2 server. Hay 10 server một ngày bỗng chết, mất điện server 1,5,6.
Lúc này ta cần bê tập dữ liệu từ server sai số thứ tự, rồi đánh số lại theo số lượng server mới. Lúc này rất dễ xảy ra trường hợp server thì bị quá tải, server thì lại rảnh không.
Đánh giá vấn đề: Việc chuyển dữ liệu từ những server hỏng, hoặc chuyển ra server mới khi scaleup/down là thiết yếu. Nhưng ta cần một phương pháp để số lượng phần tử cần di chuyển ít nhất có thể
Consistent hashing (Ánh xạ nhất quán)
Định nghĩa
“Consistent hashing is a special kind of hashing technique such that when a hash table is resized, only n/m keys need to be remapped on average where n is the number of keys and m is the number of slots. In contrast, in most traditional hash tables, a change in the number of array slots causes nearly all keys to be remapped because the mapping between the keys and the slots is defined by a modular operation.”
Ánh xạ nhất quán là một kĩ thuật ánh xạ để khi mà bảng ánh xạ thay đổi số lượng, chỉ có n/m từ khoá sẽ cần phải đánh số lại trung bình. Với n là số lượng dữ liệu (trong ví dụ trên là request), và m là số slot (ví dụ trên là server). Điều này tốt hơn ánh xạ chia dư khi mà gần như toàn bộ dữ liệu phải đánh lại hết vì tất cả số dư thường sẽ thay đổi khi m thay đổi.
Một số từ khoá
Gọi f() là hàm băm, phương trình sẽ cho ra một mã gì đó khi ta truyền vào 1 giá trị. Mỗi phương trình thì luôn có vùng giá trị đầu ra (hash space) nhất định. Ví dụ: chia dư cho m thì vùng giá trị là từ 0 -> m-1. hay SHA-1 thì là từ 0 -> 2^160-1. Ta sẽ có (hash ring) vòng băm tương ứng
Các bước
Tiến hành hash các server của chúng ta thành một số nguyên trong hash ring được định nghĩa trước. Khoảng số này tuỳ vào người thiết kế hệ thống tự cân nhắc số lượng server tối đa mà hệ thống sẽ lên.
Sau khi có danh sách mapping giữa các node, ta sẽ tiến hành mapping key của data tới các node bằng cách
hash giá trị của key thành một số nguyên
Di chuyển nó liên tục trong vòng tròn số nguyên (hash ring) đã được tạo theo kim đồng hồ cho tới khi nó quay lại hash key của node đầu tiên nó gặp (đi 1 vòng). Ghi dữ liệu
Để dễ hình dung hơn, hãy xem hình ảnh sau
Để quyết định request nào sẽ được phân bổ vào node nào. Thì ví dụ request có mã là 1000, nó sẽ cứ đi trên vòng tròn bảng giá trị trên và tìm node đầu tiên có mã lớn hơn 1000. nếu nó là lớn nhất rồi thì nó sẽ vòng lại node đầu tiên.
Ngoài ra, ví dụ trên hình ảnh trên, ta chỉ có node 1-5, nhưng ta sẽ tạo các “virtual node”, hay node ảo để băm cái vòng của chúng ta nhỏ hơn nữa, và các khoảng của node ảo sẽ quy định nó vào node thật sự nào.
Bằng một cách nói nào đó, mỗi server sẽ xử lí một “cung” trên đường tròn
Consistent hashing xử lí vấn đề scale như thế nào
Ta sẽ quay lại vấn đề, khi một node nào đó bị sập. Thì consistent hashing sẽ giải quyết bài toán đó như thế nào?
Solution nghe ra lại rất đơn giản, lúc này thì các khoảng vòng cung sẽ được kéo rộng ra, các request sẽ tự đi tìm đến vị trí note tiếp theo
Rõ ràng, ta thấy lúc này chỉ những request ở vòng cung phía trước sẽ cần thay đổi mapping lại. Còn theo cách chia modulo, thì do số dư thường sẽ thay đổi gần như toàn bộ các số, ta sẽ phải di chuyển rất nhiều keys (Request)
Triển khai thuật toán
Cùng nhìn lại, chúng ta cần những gì để triển khai thuật toán này?
Ta cần một mảng ánh xạ quy đổi ra các node trên hash ring (vòng giá trị)
Một map để phân bổ request nào vào node nào
Như vạy, để phân bổ request vào các node, ta cần một cơ chế dạng
Một cách tìm kiếm nhanh node đầu tiên có giá trị lớn hơn mã của request hiện tại. Do mã của node được trải phẳng trên một khoảng tịnh tiến, dễ dàng, ta có thể triển khai tìm kiếm nhị phân để tìm node đầu tiên có mã lớn hơn bằng mã của request (Lower_bound)
Từ mã của node, tìm ra node thực sự để điều hướng
Thay đổi khi hash ring thay đổi
Để xác định những request nào cần di chuyển, có cách khá đơn giản là ta sẽ lặp và kiểm tra toàn bộ request, sau đó xác định cái nào bị sai để chuyển nó sang node tiếp theo trên vòng. Nhưng cách này rõ ràng là cách “naive method”.
Để có thể triển khai với thời gian tối ưu hơn, ta có thể sử dụng một cấu trúc dữ liệu để xác định “khoảng ảnh hưởng”, nơi mà các key cần remap lại
Một lần nữa, ta có thể triển khai tìm kiếm nhị phân, bằng cách từ node bị xoá đi, ta dùng mã đó và quay ngược lại, sau đó tìm ra các điểm bị sai và cập nhật chúng cho đến khi đến 1 mã node hash khác.
Các câu hỏi thêm
Q: Khi nào nên sử dụng kỹ thuật consistent hashing này ?
A: Thông thường, ta sẽ sử dụng nó cho các hệ thống phân tán, nơi mà request thực sự đủ nhiều, và ta có nhiều server cần scaling và cần áp dụng để phân bổ request một cách đều. Amazon Dynamo cũng triển khai kĩ thuật này. Tuy nhiên, với các hệ thống nhỏ hơn, có thể dùng cách ánh xạ chia dư truyền thống, vì việc sử dụng hashing khó hơn cũng đi kèm độ phức tạp của hệ thống tăng lên và khó bảo trì.
Q: Tại sao lại gọi là consistent trong consistent hashing (nhất quán)
A: Vì khi có sự thay đổi về lượng server, ta không cần hashing lại toàn bộ các key
In computer science, ACID (atomicity, consistency, isolation, durability) is a set of properties of database transactions intended to guarantee data validity despite errors, power failures, and other mishaps.[1] In the context of databases, a sequence of database operations that satisfies the ACID properties (which can be perceived as a single logical operation on the data) is called a transaction. For example, a transfer of funds from one bank account to another, even involving multiple changes such as debiting one account and crediting another, is a single transaction.
Bản dịch
Trong khoa học máy tính, thuật ngữ ACID gồm bốn yếu tố mà database transaction (phiên cơ sở dữ liệu) được xây dựng để đảm bảo dữ liệu sẽ luôn chuẩn xác, cho dù có xảy ra lỗi, vấn đề điện, …. Trong database, một dãy các câu lệnh database mà thoả mãn các tính chất ACID được gọi là một transaction (phiên). Ví dụ đơn giản, việc bạn chuyển tiền từ ngân hàng A sang ngân hàng B, chúng chứa rất nhiều sự thay đổi, như giảm tiền ở ví A, tăng tiền ở ví B, tạo thêm lịch sử, …. là một phine
Định nghĩa một Transaction
Một transaction (phiên) thể hiên một nhóm các câu lệnh được chạy trong database, thông thường chứa nhiều lệnh khác nhau
Ví dụ việc chuyển tiền trong ngân hàng gồm 4 câu lệnh từ tài khoản Alice sang tài khoản Bob
ACID là gì
ACID, là viết tắt của 4 chữ cái đầu trong (Atomicity, Consistency, Isolation, Durability) là 4 tính chất của một transaction, nhằm đảm bảo dữ liệu luôn chuẩn xác, đúng điều kiện cho dù server sập, mất điện, ..
Atomic – Tính đồng bộ
Đảm bảo rằng toàn bộ câu lệnh trong một phiên luôn phải đồng bộ trạng thái. Tức là, 1 là toàn bộ đều được chạy thành công, thay đổi xảy ra, hoặc là toàn bộ đều phải bị chặn, chứ không lọt cái gì riêng lẻ cả
Consistent – Tính nhất quán
Đảm bảo rằng một phiên chỉ có thể chuyển một database từ một trạng thái đang đúng (valid) sang một trạng thái valid (đúng) khác, ngăn chặn các dữ liệu bị lỗi, …
Các kiểu dữ liệu, kiểm tra, trigger, …. các điều kiện đều phải đảm bảo pass trước khi phiên chạy
Isolation – Tính cách ly
Quy định việc khi nào và bằng cách nào mà một thay đổi từ một phiên có thể hiển thị cho phần khác. Serializable và Snapshot Isolation là 2 level trong sự chặt chẽ này (Đọc thêm: …)
Có thể đạt được Isolation bằng pessimistic or optimistic locking.
Đảm bảo rằng kết quả của phiên luôn được chắc chắn lưu trong hệ thống. Sự thay đổi phải được giữ cho dù hệ thống sập, mất điện, ….
Chúng có thể được lưu như 1 transaction log, … và khi hệ thống khởi động lại, ta có thể chạy lại mọi thay đối giữa chừng để đảm bảo dữ liệu ổn định
Các ưu điểm của ACID Transaction
Dữ liệu sạch
Đảm bảo rằng dữ liệu luôn chuẩn, không bị mất mát. Tránh các cập nhật bị mất, dirty read, stale read (thảo luận bên dưới). Đảm bảo các tiêu chuẩn về dữ liệu cho phần code. Điều này là tuyệt đối cần thiết cho các hệ thống ngân hàng, tiền bạc, … vì mọi dữ liệu sai sót đều ảnh hưởng trực tiếp đến công ty. Xử lí các vấn đề sai sót ở ngay tầng database bằng sự nhất quán, chuẩn chỉnh được tạo ra bởi phiên ACID là một cách khá đơn giản.
Xử lí đồng bộ đồng thời (Concurrency)
Truy cập đồng thời xảy ra thường xuyên trong các hệ thống lớn. Ví dụ như một cái rương vật phẩm chung trong game, một số tiền chung trong tài khoản ngân hàng (tưởng tượng bạn nhận tiền và chuyển tiền cùng lúc), bảng xếp hạng trong game, ….
Tính chất Isolation – cách ly của ACID giúp các lập trình viên trong điều này
Database sẽ đảm bảo transaction với một ” serializable isolation”, lập trình viên có thể xử lí transaction một cách “tuần tự” như queue vậy, dù thực tế chúng xảy ra đồng thời.
Tại sao lại cần React? Viết bằng Javascript thuần không ổn sao?
Mọi thứ xuất hiện đều có lí do của nó. Thời kỳ đầu tiên của lập trình web, đa số chúng ta chỉ có các web tĩnh, có thể là các trang đọc báo, trang tài liệu wiki, …. Các dữ liệu trên trang thường không thay đổi. Điều này kéo dài một thời gian, tuy nhiên chúng ta ngày càng mong muốn nhiều hơn, chúng ta muốn những website “động”, những website mạng xã hội mà bài viết được cập nhật mỗi lần tải trang, những trang web mà có thể nhận/gửi tin nhắn mới, những trang web có các video mới như Youtube, …
Trước khi React sinh ra
Hãy tưởng tượng một bài toán thực tế. Ta có một cái nút “đăng nhập”, khi người dùng nhấn nút, yêu cầu của bài toán cần có 4 trạng thái như sau:
Nút trước khi bị ấn hiển thị màu xanh dương, ghi là “Nhấn để đăng nhập”
Nút khi bị ấn hiển thị màu xanh dương nhưng đen đi một xíu do đang bị ấn, hiển thị chữ “đang đăng nhập”
Sau khi đăng nhập hoàn thành, nút chuyển sang màu xanh lá, hiển thị “đăng nhập thành công”
Sau khi đăng nhập thất bại, nút chuyển sang màu đỏ, hiển thị “đăng nhập thất bại”
Chúng ta tưởng tượng, code xử lí đăng nhập sẽ trong file javascript, còn cái nút thì ở file html. Như vậy, để cập nhật trạng thái màu, chữ của nút, ta thường phải làm các bước sau:
Lấy DOM của nút, tức là trong file xử lí code cần cho ngôn ngữ lập trình biết là ta muốn thay đổi cái nút nào. thường ta sẽ sử dụng các cú pháp như document.getElementById (Lấy một dom bằng định danh ID), hoặc document.querySelector (Lấy bằng query), ….
Thêm một event listener là khi nhấn nút sẽ chạy hàm nào đó, chạy logic gì đó cho nút
Viết code xử lí hàm thay đổi nút
Xoá listener, reset mọi thứ về ban đầu khi tải lại trang -> nút về trạng thái chưa ấn
Oke, hãy thử làm bài toán này, đầu tiên hãy tạo nút chúng ta cần ở HTML
Tiếp theo trong Javascript, ta tìm nút trên để thêm hàm xử lí khi nhấn cho nó
const dangnhapbutton = document.getElementById("dangnhapbutton"); //lấy nút theo id
dangnhapbutton .addEventListener("click", () => { //thêm event khi ấn
  // xử lí khi ấn ở đây
});
Oke, giờ giả sử, khi ấn nút, thì nó cần hiện là “Đang đăng nhập”, ta sửa code dạng như sau
const dangnhapbutton = document.getElementById("dangnhapbutton"); //lấy nút theo id
dangnhapbutton .addEventListener("click", () => { //thêm event khi ấn
  dangnhapbutton.textContent = "Đang đăng nhập"; //hiển thị đang đăng nhập
});
Giờ thì khi ấn nút, nút từ “đăng nhập” sẽ được chuyển thành “đang đăng nhập”. Tuy nhiên chúng ta cần nó hiển thị đăng nhập thành công, hoặc đăng nhập thất bại, hoặc sau 1 lúc thì nó lại chuyển về “đăng nhập”. Giờ làm sao nhỉ? Ta cần một cách nào đó để biết là nút đang ở trạng thái nào phía hiển thị, sau đó tuỳ nó đang ở trạng thái gì thì sẽ chuyển sang trạng thái mới.
Ví dụ ta thử làm Khi ấn 1 lần, chuyển đăng nhập -> đang đăng nhập. ấn tiếp thì chuyển lại về đăng nhập
<button type="button" id="dangnhapbutton" data-dangnhap="false">Đăng nhập</button> //ta cần một attribute data-dangnhap để lưu trạng thái phía hiển thị
const dangnhapbutton = document.getElementById("dangnhapbutton"); //lấy nút theo id
dangnhapbutton .addEventListener("click", () => { //thêm event khi ấn
  const trangthai = dangnhapbutton .getAttribute("data-dangnhap") === "true"; //lấy trạng thái phía frontend xem là đăngn hập chưa
  dangnhapbutton .setAttribute("data-dangnhap", !trangthai ); //đảo ngược trạng thái
  dangnhapbutton .textContent = trangthai  ? "Đang đăng nhập" : "Đăng nhập"; //tuỳ trạng thái là 0 hay 1 thì cập nhật trạng thái mới
});
Vấn đề cơ bản như 1 nút chỉ tắt bật như vậy. Nhưng ta phải lưu cùng lúc 1 attribute thông số gì đó ở phía html, rồi lại lưu 1 biến ở phía code để xử lí. Giả sử ta có 4 trạng thái, 10 trạng thái gì đó, ta sẽ phải lưu 10 cái ở phía html, rồi lấy ra 10 cái ở javascript rồi if else logic xử lí…
Điều này rõ ràng rất khó scale mở rộng hệ thống hơn. Sẽ ra sao nếu web của ta có rất nhiều nút? Ta sẽ có 1 đống code thừa trùng lặp, ta phải code rất nhiều cho một tác vụ tưởng chừng đơn giản, …
Liệu có cách nào để chúng liên kết với nhau, để ta có thể xử lí qua lại dễ dàng hơn không nhỉ?
Thời điểm này, việc tạo ra một cách thuận tiện, dễ mở rộng cho frontend là một thử thách với các công ty. Đây là tiền đề cho sự ra đời cho một số cái tên nổi tiếng, mà chắc bạn đã từng nghe qua như: Backbone, KnockoutJS, AngularJS, and jQuery.
Hãy cùng xem những giải pháp trên có gì khác với React, các cách tiếp cận khác nhau của từng giải pháp
Java được biết đến là ngôn ngữ lập trình bậc cao, hướng đối tượng và giúp bảo mật mạnh mẽ, và còn được định nghĩa là một Platform. Java được phát triển bởi Sun Microsystems, do James Gosling khởi xướng và ra mắt năm 1995. Java vẫn được sử dụng rất nhiều trong các dự án công nghệ mới. Tên ban đầu của Java là OAK, sau đó được Sun Microsystem đổi tên vào năm 1995 và tập trung phát triển các sản phẩm theo trend www (world wide web). Năm 2009, Java được mua lại bởi Oracle.
Các nguyên tắc thiết kế hướng đối tượng – SOLID
SOLID nghĩa là gì
Nguyên tắc SOLID là một phương pháp tiếp cận hướng đối tượng trong thiết kế cấu trúc phần mềm được sử dụng trong Java. Robert C. Martin là người đã đưa ra ý tưởng này (còn được biết đến với tên Uncle Bob). Năm nguyên tắc này đã làm thay đổi toàn bộ lĩnh vực lập trình hướng đối tượng, cũng như cách các phần mềm được viết ra. Nguyên tắc SOLID cũng đảm bảo rằng phần mềm có tính chất mô-đun (dễ tái sử dụng và dùng trong nhiều vị trí), dễ hiểu, dễ gỡ lỗi và dễ refactor (tái cấu trúc, cập nhật).
S: Single responsibility principle – Nguyên tắc một chức năng
O: Open-closed principle – Nguyên tắc đóng và mở
L: Liskov substitution principle – Nguyên tắc thay thế
I: Interface segregation principle – Nguyên tắc chia nhỏ
D: Dependency inversion principle – Nguyên tắc đảo ngược phụ thuộc
Lí do nên áp dụng các nguyên tắc SOLID
Clean: Nguyên tắc SOLID giúp code clean, dễ nhìn hơn và chuẩn hoá format của code để nhiều người hiểu hơn.
Dễ bảo trì: Code dễ bảo trì, sửa lỗi hơn.
Tính co giãn: Dễ dàng refactor, tái cấu trúc lại code. Dễ dàng phát triển các tính năng mới sau này
Tối ưu: Giảm bớt các code dư thừa.
Kiểm nghiệm: Viết unit test dễ hơn
Dễ đọc: Giúp code đọc dễ hiểu hơn
Độc lập: Code hoạt động độc lập, ít phụ thuộc các phần khác, giảm thiểu lỗi
Tái sử dụng: Code được chia nhỏ và độc lập như các module, dễ dàng sử dụng lại.
SOLID trong Java
Nguyên tắc 1: Single responsibility principle – Nguyên tắc một chức năng
Nguyên tắc này được phát biểu như sau:
Một class chỉ nên giữ 1 trách nhiệm duy nhất, chỉ có thể sửa đổi class với 1 lý do duy nhất.
A class should have one and only one reason to change, meaning that a class should have only one job.
Theo nguyên lí này, mỗi class chỉ nên có một vai trò duy nhất. Tức là bạn có thể để 1 class có rất nhiều chức năng, làm đủ thứ, với nhiều method khác nhau. Tuy nhiên việc nhét toàn bộ chức năng vào 1 class khiến code khó bảo trì, khó hiểu hơn, và xử lí một phần nhỏ của cả một class chứa rất nhiều chức năng này có thể làm lỗi toàn bộ các chức năng khác.
Hãy thử xem một class sau:
Việc cho toàn bộ các phương thức gộp vào 1 class NguoiChoi như này đã vi phạm quy tắc, thực hiện rất nhiều thay đổi chỉ trong 1 class như lấy dữ liệu từ database, chuyển sang json để trả về, di chuyển nhân vật, …. Sau này khi nâng cấp thêm chức năng, class này ngày càng phình to ra. Khiến cho việc bảo trì, nâng cấp, test, …. trở lên khó khăn hơn sau này.
Thay vì vậy, ta có thể chuyển thành như sau
Lúc này mỗi class sẽ độc lập hơn và các luồng hoạt động cũng sẽ rõ ràng hơn, khi có lỗi xảy ra hay cần nâng cấp chức năng, bạn có thể dễ dàng sửa đổi vào các class trong 1 luồng chứ không phải thay đổi hay thêm mọi thứ vào 1 class và khiến chúng phình to hơn nữa.
Tuy số lượng class nhiều hơn những việc sửa chữa sẽ đơn giản hơn, dễ dàng tái sử dụng hơn, class ngắn hơn nên cũng ít bug hơn.
Một số ví dụ về nguyên tắc SRP cần xem xét có thể cần được tách riêng bao gồm: Persistence, Validation, Notification, Error Handling, Logging, Class Instantiation, Formatting, Parsing, Mapping, …
Nguyên tắc 2: Open-closed principle – Nguyên tắc đóng và mở
Nguyên tắc này được phát biểu như sau:
Có thể thoải mái mở rộng 1 class, nhưng không được sửa đổi bên trong class đó.
Objects or entities should be open for extension, but closed for modification.
Nghe qua thấy nguyên lý có sự mâu thuẫn do thường chúng ta thấy rằng dễ mở rộng là phải dễ thay đổi, đằng nay dễ mở rộng nhưng không cho thay đổi. Thực sự theo nguyên lý này, chúng ta không được thay đổi hiện trạng của các lớp có sẵn, nếu muốn thêm tính năng mới, thì hãy mở rộng class cũ bằng cách kế thừa để xây dựng class mới. Làm như vậy sẽ tránh được các tình huống làm hỏng tính ổn định của chương trình đang có.
Theo nguyên tắc này, sau khi thiết kế một class với một số chức năng nhất định, cần đảm bảo các chức năng này hoạt động trơn tru trong tương lai, tránh sửa đổi thêm sau này. Như vậy, class luôn “đóng – closed” cho các sửa đổi vào các chức năng đã được thiết kế trước, nhưng lại phải “mở – open” để mở rộng tính năng hơn, để mở thì có 1 số cách phổ biến như:
Tạo ra một class kế thừa
Viết lại chức năng hàm đó từ class cha
Nâng cấp chức năng/hàm của class cha ở class con
Lấy ví dụ như sau:
Với cách thiết kế như trên, khi ta có các class con kế thừa từ class cha NguoiChoi, và cần kiểm tra xem class con có hệ là gì, hay ví dụ ta cần tạo thêm nhiều class con khác tương tự, ta lại phải thêm nhiều if else vào class gốc. Thay vào đó, ta nên thiết kế như sau:
Lúc này, khi cần nâng cấp thêm nhiều hệ mới cho hệ thống, ta chỉ cần tạo các class con và sử dụng chức năng của class chính, không cần thực hiện trực tiếp vào class chính nữa.
Lợi ích của nguyên lý này là đôi khi chúng ta cần sử dụng các class từ các nguồn thư viện thứ 3, hoặc từ chính các thư viện có sẵn trong Java. Chúng ta có thể dễ dàng extend và tạo các class con mới kế thừa từ class cha để phục vụ cho một mục đích, chức năng mới của dự án, mà không cần quá lo lắng về class cha sẽ bị lỗi do ta đã không sửa đổi chúng.
Tuy nhiên, việc kế thừa class cha có thể dẫn tới việc chức năng các class con lại quá khác nhau và không có chung ý nghĩa, nên chú ý vào ý nghĩa của các chức năng, tránh tạo ra quá nhiều class dẫn xuất. Mặc dù những sửa đổi nhỏ trong class thường không ảnh hưởng, chúng ta cũng cần phải test cẩn thận. Và đó là lý do chính tại sao chúng ta cần phải viết test case cho các chức năng, để có thể nhận thấy hành vi không mong muốn xảy ra trong code.
Lúc này, ta có thể sử dụng interface như các bản thiết kế cha để có thể làm các chức năng mở rộng sau này, việc sử dụng interface cũng giúp code đạt thêm tính “Loose coupling” – “liên kết lỏng” hơn và tránh sự phụ thuộc quá chặt chẽ vào các class.
Nguyên tắc 3: Liskov substitution principle – Nguyên tắc thay thế
Barbara Liskov đã đưa ra nguyên tắc Liskov Substitution Principle (LSP) này. Nguyên tắc này cho rằng: trong kế thừa, các class con, class kế thừa phải luôn có thể thay thế được class cha. Tức là, nếu class A kế thừa từ class B, thì mình luôn có thể sử dụng class A thay cho class B mà các chức năng không bị thay đổi.
Lấy ví dụ về hình vuông và hình chữ nhật
Như trong toán học được dạy ở các cấp dưới, ta hay được nghe là “hình vuông cũng là hình chữ nhật”, Nhìn ví dụ trên ta thấy mọi tính toán đều rất hợp lý. Do hình vuông có 2 cạnh bằng nhau, mỗi khi set độ dài 1 cạnh thì ta set luôn độ dài của cạnh còn lại bằng cách viết đè phương thức set chiều cao và set chiều rộng.
Tuy nhiên, class HinhVuong sau khi kế thừa class HinhChuNhat đã làm thay đổi các đặc tính vốn có của HinhChuNhat, dẫn đến vi phạm LSP. Thử với một ví dụ như sau
Rõ ràng, lúc này ta khai báo một object class HinhChuNhat theo HinhVuong, set chiều cao và chiều rộng, nhưng do ta đã ghi đè hàm set chiều cao chiều rộng nên chiều cao chiều rộng bị cập nhật thành 10, và tính diện tích ra là 10×10 = 100, rõ ràng không đúng vì hình chữ nhật đúng ra diện tích là 5×10 = 50, hay có thể nói là: Class HinhVuong không thể dùng thay thế cho class HinhChuNhat
Những vi phạm về nguyên lý LSP
Các lớp dẫn xuất có các phương thức ghi đè phương thức của lớp cha nhưng với chức năng hoàn toàn khác.
Các lớp dẫn xuất có phương thức ghi đè phương thức của lớp cha là một phương thức rỗng.
Các phương thức bắt buộc kế thừa từ lớp cha ở lớp dẫn xuất nhưng không được sử dụng.
Phát sinh ngoại lệ trong phương thức của lớp dẫn xuất.
Đây là nguyên lý… dễ bị vi phạm nhất, nguyên nhân chủ yếu là do sự thiếu kinh nghiệm khi thiết kế class. Thuông thường, design các class dựa theo đời thật: hình vuông là hình chữ nhật, file nào cũng là file. Tuy nhiên, không thể bê nguyên văn mối quan hệ này vào code. Hãy nhớ 1 điều:
Trong thực tế, A là B (hình vuông là hình chữ nhật) không có nghĩa là class A nên kế thừa class B. Chỉ cho class A kế thừa class B khi class A thay thế được cho class B.
Nguyên lý này ẩn giấu trong hầu hết mọi đoạn code, giúp cho code linh hoạt và ổn định mà ta không hề hay biết. Ví dụ như trong Java, ta có thể chạy hàm foreach với List, ArrayList, LinkedList bởi vì chúng cùng kế thừa interface Iterable. Các class List, ArrayList, … đã được thiết kế đúng LSP, chúng có thể thay thế cho Iterable mà không làm hỏng tính đúng đắn của chương trình.
Theo đó, để sửa vấn đề hình vuông – hình chữ nhật trên, ta nên để chúng cùng kế thừa một class Shape như sau
Lúc này việc set các chiều cao và chiều rộng thì chỉ class con mới có, và không vi phạm nguyên tắc LSP.
Việc thiết kế áp dụng theo nguyên tắc LSP giúp chúng ta giảm bớt quá lạm dụng việc kế thừa trong class. Ý nghĩa của các chức năng không được thay đổi để có thể sử dụng ở nhiều phạm vi khác nhau hơn.
Nguyên tắc 4: Interface segregation principle – Nguyên tắc chia nhỏ
Nguyên tắc này được phát biểu như sau:
Thay vì dùng 1 interface lớn, ta nên tách thành nhiều interface nhỏ, với nhiều mục đích cụ thể.
Many client-specific interfaces are better than one general-purpose interface.
Theo nguyên tắc ISP, một class con khi implement các interface thì không nên bị bắt buộc implement các phương thức mà mình không sử dụng bao giờ. Theo cách hiểu trên, nguyên tắc này sẽ ưu tiên việc chia nhỏ các interface ra thành các phương thức sử dụng cho các mục đích đặc thù hơn, tránh sử dụng cả một interface lớn.
Hay nói một cách khác, khi ta implement một interface trong 1 class, mà có 1 vài phương thức mình cứ phải kế thừa dù cũng không cần thiết không phải một cách hay. Ngắn gọn là: Không một client nào nên bị bắt buộc phải kế thừa một phương thức nào đó mà nó không dùng
Hãy tưởng tượng chúng ta có 1 interface lớn, khoảng 100 methods. Việc implements sẽ khá cực khổ, ngoài ra còn có thể dư thừa vì 1 class không cần dùng hết 100 method. Khi tách interface ra thành nhiều interface nhỏ, gồm các method liên quan tới nhau, việc implement và quản lý sẽ dễ hơn.
Như vậy, việc class Bike implement interface Vehicle khiến class Bike phải viết lại cả hàm openDoor() mở cửa, dù xe đạp thì không có cửa, và thường thì ta sẽ phải để nó rỗng. Như vậy khiến code bị dư thừa và nếu mở rộng ra thì các class con ngày càng bị phình to, khó bảo trì hơn
Việc áp dụng nguyên tắc trên giúp code dễ đọc và dễ quản lí bảo trì hơn. Giảm bớt code dư thừa và chỉ phải viết các phương thức cần thiết.
Nguyên tắc 5: Dependency inversion principle – Nguyên tắc đảo ngược phụ thuộc
Lấy ví dụ:
Như ta thấy, các thiết bị như tai nghe dùng cổng 3.5mm, điện thoại Android dùng dây sạc TypeC, điện thoại IOS dùng dây sạc Lightning, cổng cắm của Camera cũng khác, …
Vậy khi ta làm dây sạc, dây kết nối cho các máy này. Ta có chọn trước là nó sẽ dùng cho thiết bị nào không? Rõ ràng là không, các dây sạc này (các module cấp thấp) không quy định là nó dùng cho module cấp cao nào, mà chính các thiết bị như máy ảnh, điện thoại, tai nghe mới quy định nó dùng module cấp thấp nào.
Nguyên tắc này được phát biểu như sau:
Các module cấp cao không nên phụ thuộc vào các modules cấp thấp. Cả 2 nên phụ thuộc vào abstraction.
Interface (abstraction) không nên phụ thuộc vào chi tiết, mà ngược lại. ( Các class giao tiếp với nhau thông qua interface, không phải thông qua implementation.)
High-level modules should not depend on low-level modules. Both should depend on abstractions.
Abstractions should not depend upon details. Details should depend upon abstractions.
Ví dụ, ta đang thiết kế một hệ thống thanh toán bằng ngân hàng như sau:
Ví dụ lúc này, ta cần thêm phương thức thanh toán bằng tiền mặt, cần có thêm một số tham số thì sao?
Ta thấy lúc này ta lại phải sửa đổi ở module cấp cao (highlevel module) là CuaHang, thêm if else để xử lí phương thức mới, mà sau này, nếu thêm các phương thức mới nữa, ta lại cứ phải thêm rất nhiều if else vào cái class lớn này.
Nó đã vi phạm 2 nguyên tắc là nguyên tắc (Nguyên tắc đảo ngược phụ thuộc) vì một class level cao hơn lại khai báo các chi tiết của class level bé hơn, hơn nữa lại còn sai về (Nguyên tắc một chức năng) vì đã khai báo nhiều chức năng hơn trong class lớn. Đúng ra class lớn chỉ nên thực hiện thanh toán thôi, còn cụ thể thanh toán thế nào thì phải là class khác.
Áp dụng nguyên tắc Dependency inversion principle – Nguyên tắc đảo ngược phụ thuộc
Lúc này các module cấp cao high-level là CuaHang đã có một interface ở giữa là PhuongThucThanhToan với các chức năng của các lớp cấp thấp (low-level module) như ThanhToanTienMat, ThanhToanNganHang. Ta đã đảo ngược sự phụ thuộc.
Như vậy, khi ta muốn thêm các lớp thanh toán khác như PayPal, Thẻ tín dụng, ví điện tử,…. Ta chỉ cần viết thêm các class con khác kế thừa từ interface PhuongThucThanhToan, chứ không cần động gì vào các code cũ này nữa.
Tính đa hình (Polymorphism) là một trong bốn tính chất cơ bản của OOP. Trong lập trình, thuật ngữ này dùng để ám chỉ đến việc một biến, một hàm hoặc một phương thức có thể tồn tại ở nhiều dạng khác nhau. Đa hình là hiện tượng mà các đối tượng thuộc các class khác nhau có thể biểu diễn cùng một thông điệp theo các cách khác nhau.
Ví dụ:
Một người A có thể là một học sinh, đồng thời là thành viên câu lạc bộ, đồng thời là nhân viên bán thời gian quán café.
Một hành động “làm việc” nếu cho học sinh sẽ là học tập, cho kế toán sẽ là “tính toán”, …
Lập trình viên có thể tận dụng Tính đa hình trong OOP vào những trường hợp sau:
Khi các lớp con cần dùng phương thức của lớp cha để bổ sung cho một phương thức khác.
Khi một lớp cần có nhiều phương thức cùng tên nhưng khác tham số (parameter).
Tính đa hình trong OOP gồm có 2 loại:
Runtime Polymorphism (Đa hình thời gian chạy)
Compile Time Polymorphism (Đa hình thời gian biên dịch)
Theo đó , tính đa hình cho phép một phương thức thực thi những hành vi khác nhau theo hai hướng: sử dụng phương thức ghi đè (method overriding) hoặc phương thức nạp chồng (method overloading).
Đa hình thời gian chạy là trường hợp một đối tượng bị ràng buộc với chức năng của chúng ngay tại thời gian chương trình đang chạy. Đa hình thời gian chạy sử dụng phương thức ghi đè.
Đa hình thời gian biên dịch là trường hợp một đối tượng bị ràng buộc với chức năng của chúng ngay tại thời gian chương trình đang biên dịch. Đa hình thời gian biên dịch sử dụng phương thức nạp chồng.
Phương thức ảo, từ khóa Virtual
Một số tài liệu có viết công dụng của Virtual Function như sau:
“Virtual Function là để khai báo một function ở class cha (base class) mà sau đó các class kế thừa (derived class) có thể override function đó”
Các hàm ảo sẽ cho phép chúng ta tạo một danh sách các con trỏ lớp cơ sở và các phương thức của bất kỳ lớp dẫn xuất nào mà không cần biết loại đối tượng của lớp dẫn xuất.
Khi khai báo hàm ảo với từ khóa virtual nghĩa là hàm này sẽ được gọi theo loại đối tượng được trỏ (hoặc tham chiếu), chứ không phải theo loại của con trỏ (hoặc tham chiếu). Và điều này dẫn đến kết quả khác nhau:
Nếu không khai báo hàm ảo virtual trình biên dịch sẽ gọi hàm tại lớp cở sở base (lớp cha)
Nếu dùng hàm ảo virtual trình biên dịch sẽ gọi hàm tại lớp dẫn xuất derived (lớp kế thừa)
Phương thức thuần ảo, lớp ảo
Hàm thuần ảo (pure virtual function) được sử dụng khi:
Không cần sử dụng hàm này trong lớp cơ sở, chỉ phục vụ cho lớp dẫn xuất
Lớp dẫn xuất bắt buộc phải định nghĩa lại hàm thuần ảo (Nạp chồng)
Ví dụ: Chúng ta có một lớp cơ sở là Shape. Các lớp dẫn xuất của lớp Shape là Triangle, Square và Circle. Chúng ta muốn tính diện tích của các hình này.
Chúng ta có thể tạo ra một hàm thuần ảo có tên là calculateArea() trong lớp Shape. Các lớp Triangle, Square và Circle phải định nghĩa lại hàm calculateArea() với công thức tính diện tích khác nhau cho mỗi hình.
Lớp ảo
Có một vấn đề khi một lớp cơ sở được kế thừa bởi nhiều lớp dẫn xuất. Ví dụ, xét tình huống các lớp kế thừa theo sơ đồ như sau:
Lớp B và Lớp C kế thừa từ lớp A. Chúng trở thành A (B) và A (C). Lúc này, nếu ta lại cho D kế thừa từ B và C, ta vô tình tạo ra tới 2 con đường kế thừa về 1 điểm đích.
D kế thừa thông qua B kế thừa A
D kế thừa thông qua C kế thừa A
Điều này sẽ khiến trình biên dịch mơ hồ và không biết nên đi theo con đường nào và tạo ra lỗi.
Thay vì kế thừa thông thường, ta sẽ định nghĩa B và C là các lớp ảo, việc sử dụng lớp ảo sẽ tiết kiệm không gian và tránh việc trùng lặp kế thừa.
Nếu kế thừa thông thường, khi tạo class D kế thừa đồng thời B và C, ta thực chất tạo ra 2 bản sao class A
Nếu cho class B và class C thành virtual, thì khi tạo class C chúng ta sẽ dùng chung 1 bản class A.
Tính kế thừa (Inheritance) là một trong bốn tính chất cơ bản của Lập trình hướng đối tượng (OOP).
Kế thừa có thể được định nghĩa là quá trình mà một lớp (class) có được các thuộc tính của một lớp khác. Các thuộc tính đó có thể là một phương thức (method) hoặc một trường (field) nào đó. Có nghĩa là nếu lớp A kế thừa lớp B thì lớp A sẽ có những thuộc tính và phương thức của lớp B.
Lớp được thừa hưởng những thuộc tính và phương thức từ lớp khác được gọi là dẫn xuất (Derived Class) hay lớp Con (Subclass) và các lớp bị lớp khác kế thừa được gọi là lớp cơ sở (Base Class) hoặc lớp cha (Parent Class).
Cú pháp kế thừa
Đơn kế thừa, đa kế thừa
Đơn kế thừa
Đơn kế thừa (single inheritance) là một class con kế thừa duy nhất từ một class cha. Ví dụ như class sinh viên chỉ kế thừa duy nhất từ class con người.
Khai báo:
Tính chất dẫn xuất trong đơn kế thừa
Lớp dẫn xuất
Lớp dẫn xuất
Lớp dẫn xuất
Lớp cơ sở
Public
Private
Protected
Private
Không kế thừa
Không kế thừa
Không kế thừa
Protected
Protected
Private
Protected
Public
Public
Private
Protected
public: Nếu kế thừa ở dạng này, sau khi kế thừa, tất cả các thành viên dạng public lớp cha sẽ public ở lớp con, dạng protected ở lớp cha vẫn sẽ là protected ở lớp con.
protected: Nếu dùng protected thì sau khi kế thừa, tất cả các thành viên dạng public lớp cha sẽ trở thành protected tại lớp con.
private: Trường hợp ta sử dụng private, thì sau khi kế thừa, tất cả các thành viên dạng public và protected ở lớp cha sẽ thành private tại lớp con.
Đa kế thừa
Đa kế thừa (multiple inheritance) nghĩa là thay vì một class dẫn xuất kế thừa từ một class cơ sở, class dẫn xuất này có thể có kế thừa từ nhiều class cơ sở khác nhau. Ví dụ như con cái thì sẽ kế thừa đặc điểm từ cả bố và mẹ của chúng.
Khai báo:
Khi thừa kế từ nhiều class cơ sở, bạn thấy sẽ có một vấn đề phát sinh chính là khi lớp cơ sở có phương thức trùng tên, khi gọi phương thức sẽ xảy ra sự mơ hồ. Sự mơ hồ nghĩa là trình biên dịch không biết bạn đang gọi phương thức từ class dẫn xuất nào. Để giải quyết vấn đề này, ta có thể sử dụng toán tử phạm vi :: để chỉ rõ phương thức ở class nào. Ví dụ:
Function Overloading & Operator Overloading
Ngôn ngữ C++ cho phép xác định nhiều hơn một định nghĩa cho một tên hàm hoặc một toán tử trong cùng phạm vi, được gọi tương ứng là Nạp chồng hàm và Nạp chồng toán tử.
Một khai báo nạp chồng là một khai báo mà đã được khai báo cùng tên như một khai báo được khai báo trước đó trong cùng phạm vi, ngoại trừ rằng: cả hai khai báo có các tham số khác nhau và định nghĩa khác nhau
Nạp chồng hàm
Kỹ thuật này cho phép sử dụng cùng một tên gọi cho các hàm “giống nhau” (có cùng mục đích). Nhưng khác nhau về kiểu dữ liệu tham số hoặc số lượng tham số.
Ví dụ: Nạp chồng hàm cho phép ta khai báo và định nghĩa các hàm sau với cùng một tên gọi.
Nạp chồng toán tử
.Nạp chồng toán tử (overload operator) là bạn định nghĩa lại toán tử đã có trên kiểu dữ liệu người dùng tự định nghĩa để dể dàng thể hiện các câu lệnh trong chương trình.
Ví dụ như bạn định nghĩa phép cộng cho kiểu dữ liệu phân số thì sẽ thực hiện cộng hai phân số rồi trả về một phân số mới. So với việc thực hiện gọi hàm, việc overload toán tử sẽ làm cho câu lệnh ngắn gọn, dễ hiểu hơn.
Cú pháp:
=> Như đã giới thiệu, bản chất việc dùng toán tử là lời gọi hàm, do đó chúng ta overload toán tử cũng giống overload hàm, vậy chúng ta sẽ overload hàm nào? Chúng ta sẽ overload hàm có tên là operator @, với @ là toán tử cần overload (+, -, *, /…), kiểu trả về của hàm chính là lớp đó.
Nạp chồng toán tử 2 ngôi:
Function Overriding
Trong kế thừa, khi lớp con khai báo phương thức có tên trùng với phương thức ở lớp cha thì phương thức của lớp cha sẽ bị thay thế bởi phương thức ở lớp con.
Hàm Friend
Hàm bạn của một lớp không phải là hàm thành viên nên nó không phụ thuộc vào lớp và có thể định nghĩa ở trong hoặc ngoài lớp.
Hàm bạn có thể truy cập trực tiếp các thành viên private và một lớp có thể có nhiều hàm bạn.
Cú pháp khai báo hàm bạn đơn giản là thêm từ khóa friend trước hàm bình thường ta vẫn sử dụng.