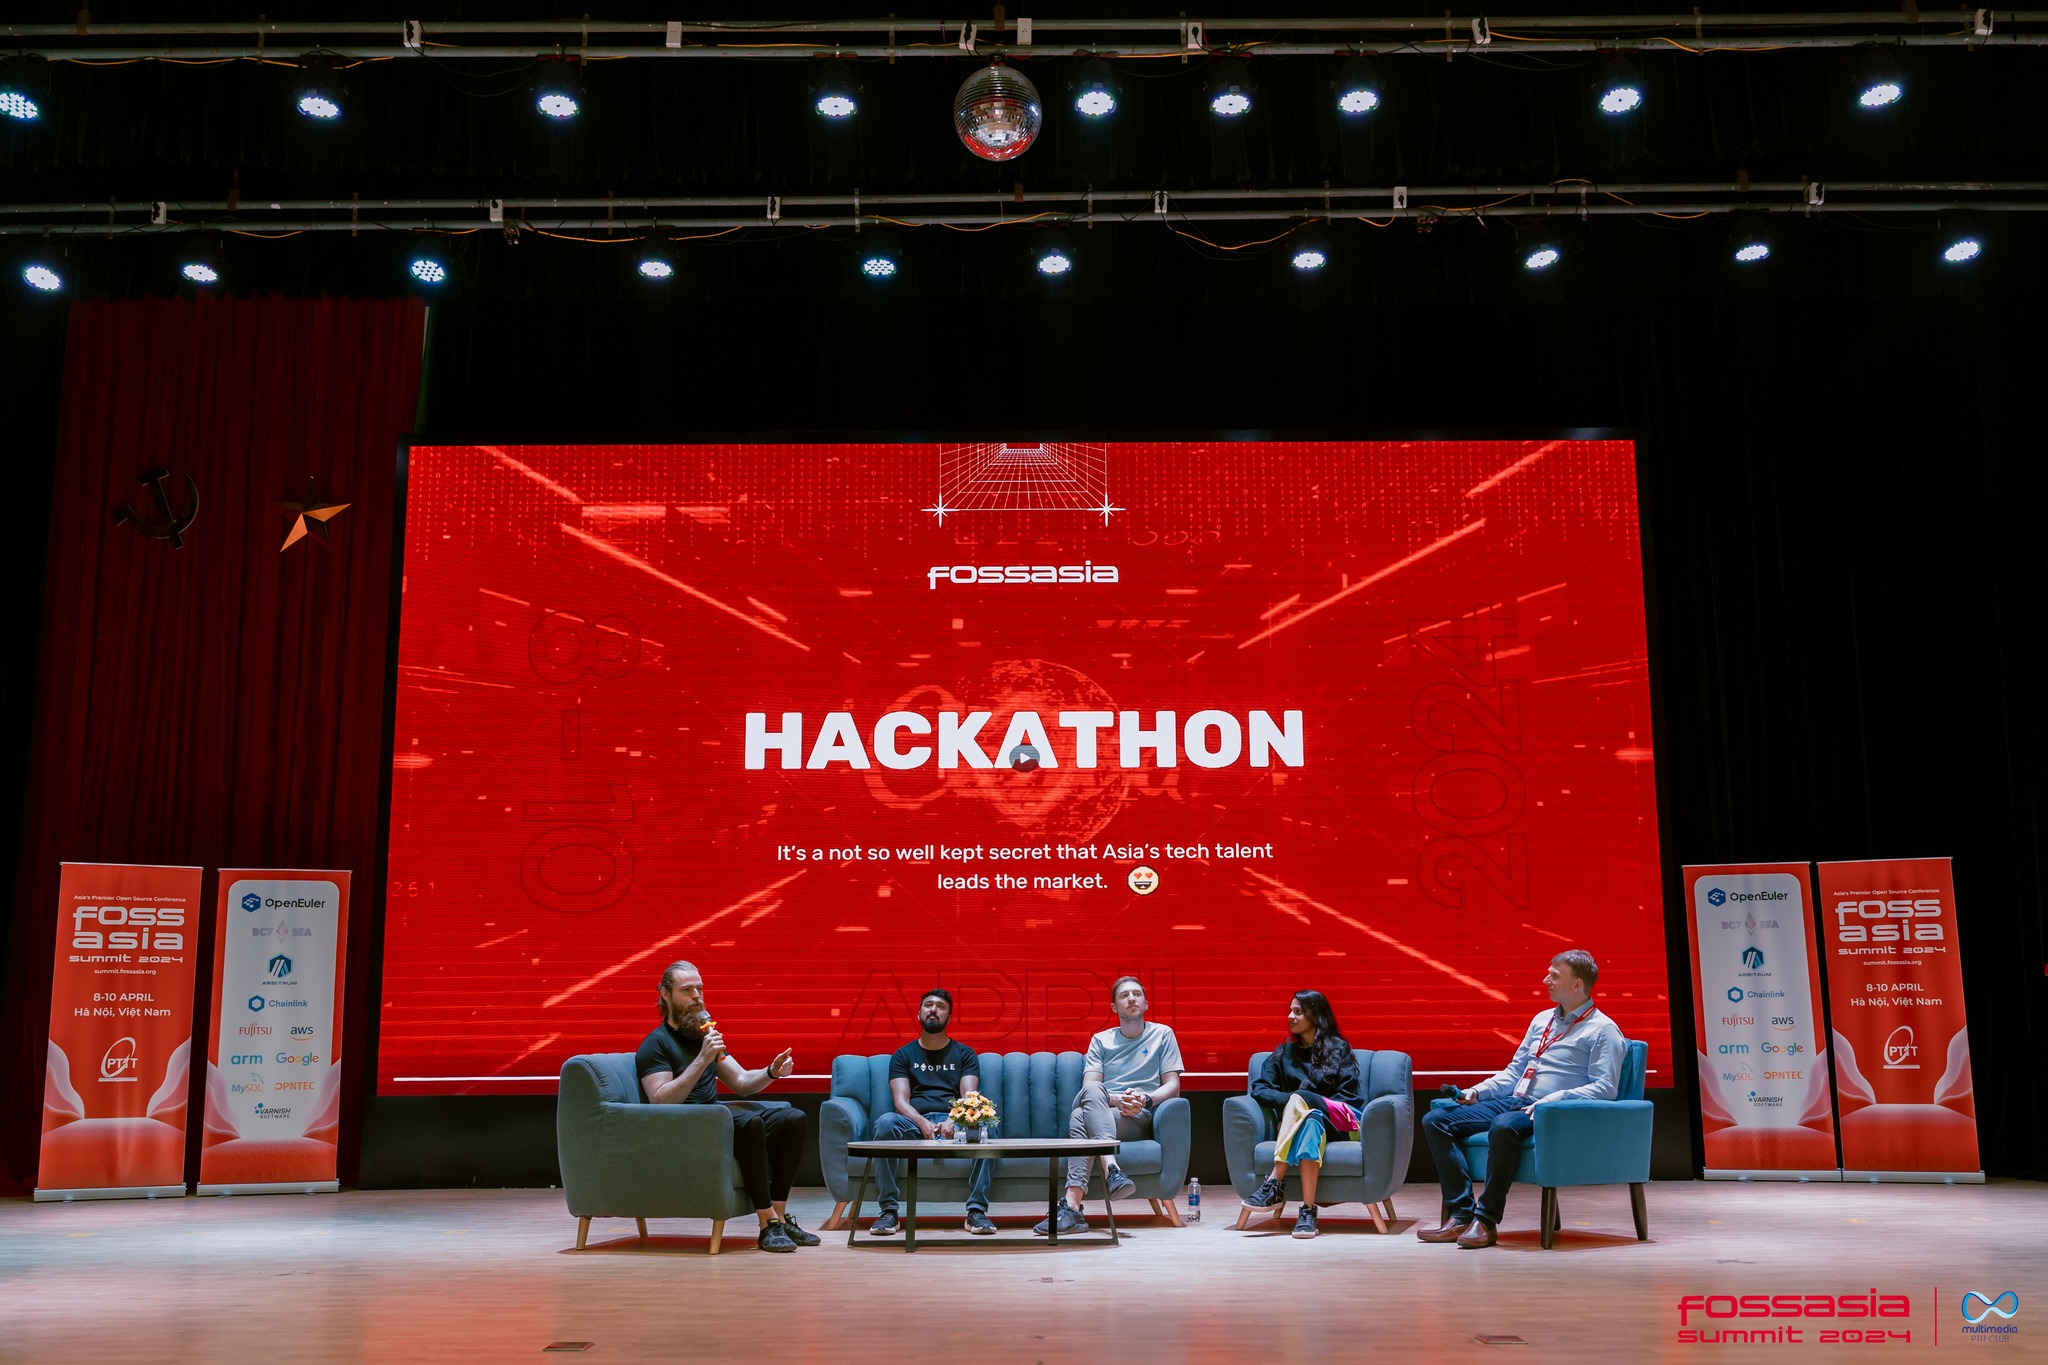
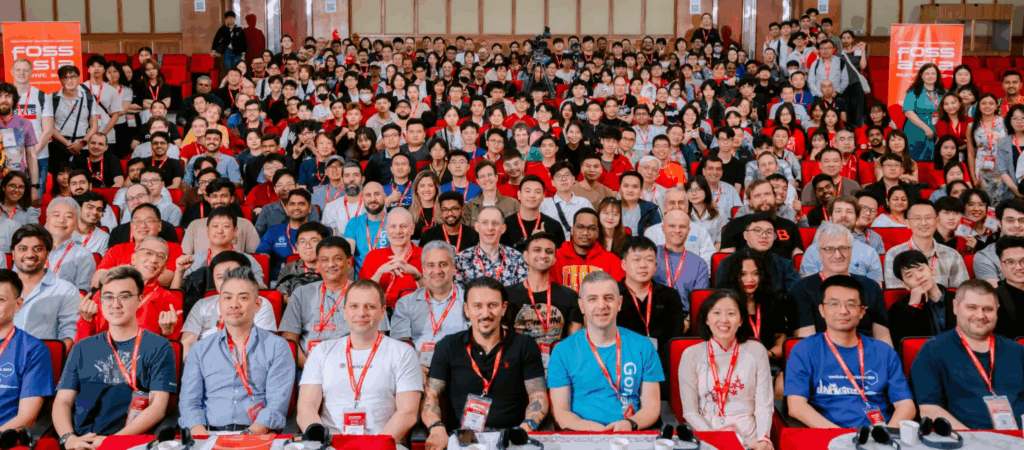
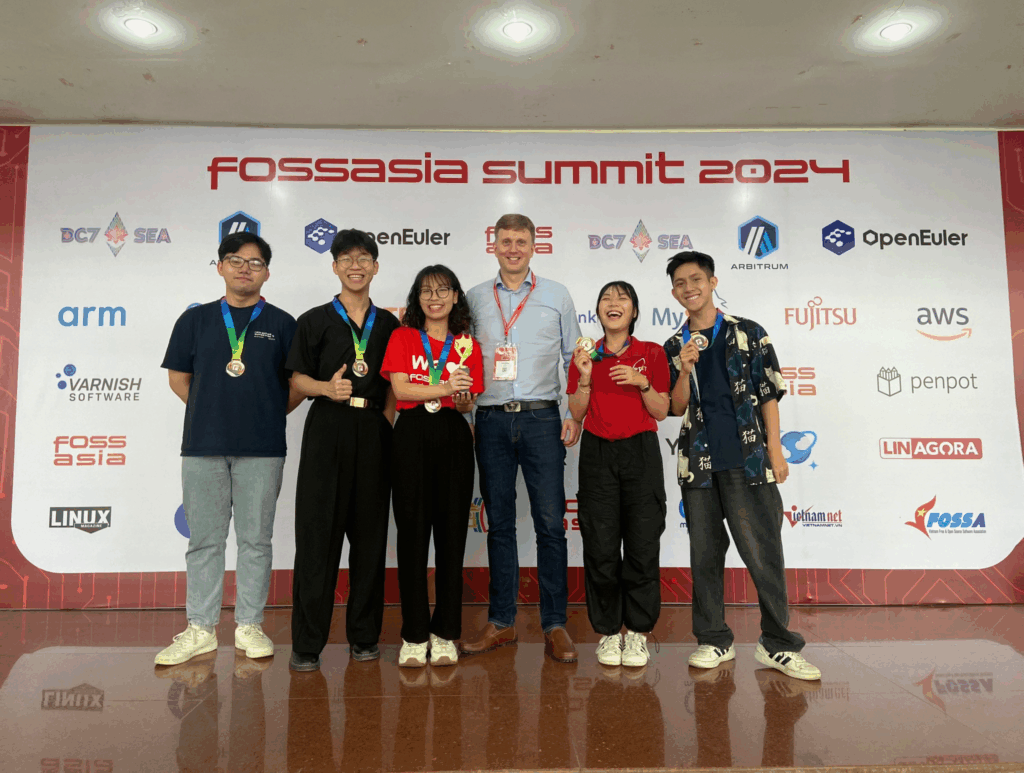
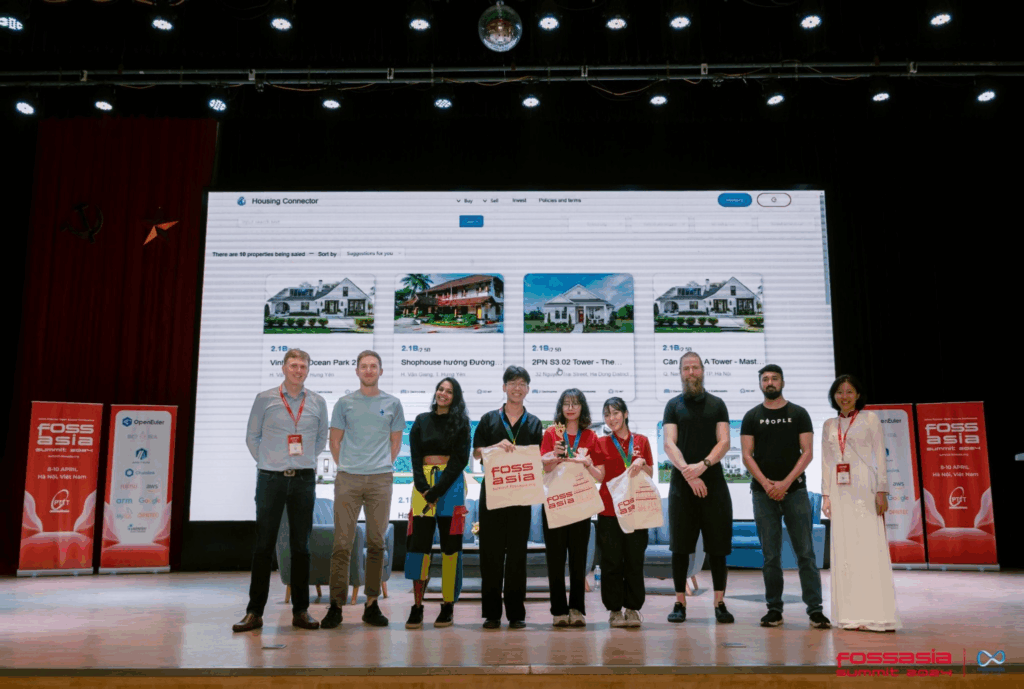
The atmosphere at the FOSSASIA Summit 2024 was absolutely electric. Hosted at PTIT, it’s a massive gathering with over 5,000 people from 50 countries, 200+ speakers from giants like Google, Huawei, and Oracle,…. Amid all that, there’s this Web3-focused hackathon, sponsored by Chainlink and Devfolio, challenging devs to build real-world blockchain solutions in just 48 hours.
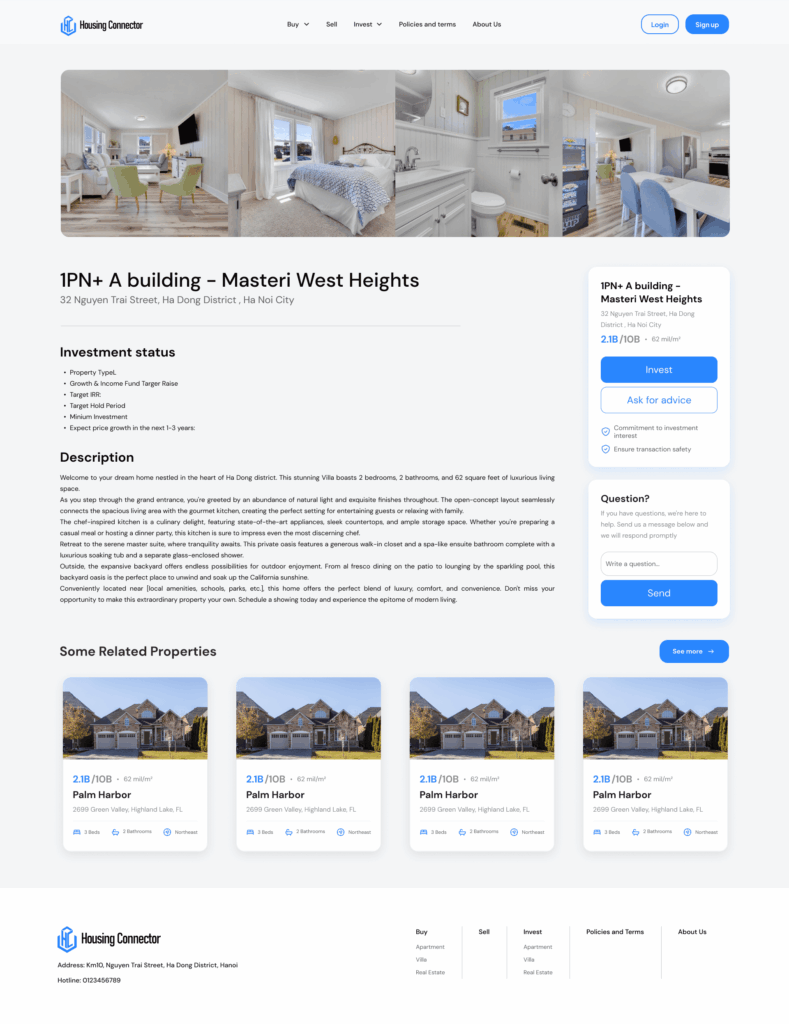
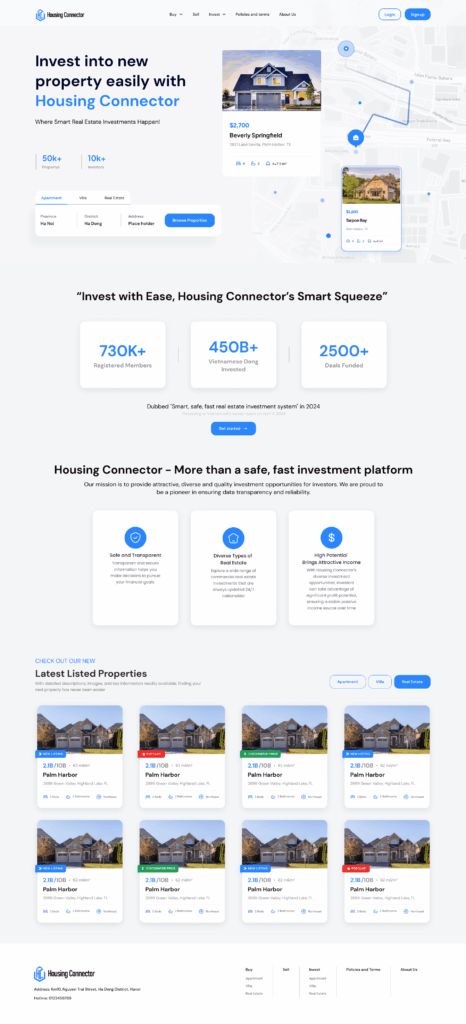
The idea came from what I see at work. Vietnam’s real estate is growing fast, the market’s supposed to double in size soon, with more young people in their 20s and 30s wanting in. But buying property? It’s expensive, and if you team up with friends or family, contracts get messy with arguments and risks. A lot of folks are shopping online now like 70% or something but trust is low. So, we made Housing Connector: a platform where small investors can pool money for properties, connect with agents, and use blockchain to keep everything clear and safe.
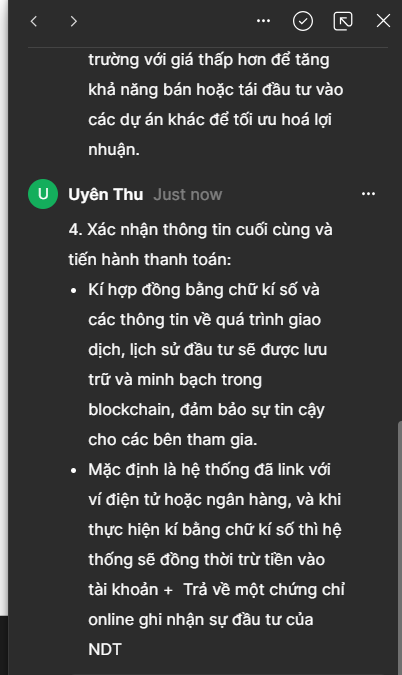
Basically, it works like this: Investors check out listings with details on location, costs, potential returns. They chip in what they can, sign smart contracts through Chainlink so no one’s getting screwed. When the property sells, money gets split automatically, minus a small fee, that’s how the app makes money. Agents get leads and data to sell better, and as more join, it pulls in more investors and properties. It’s a loop that could grow quick. We used React for the front end, Solidity for contracts, and stuff like Ethereum and Web3.js. Nothing fancy, just enough for a basic demo.
We submitted right at the deadline: a POC where you could “buy” a apartment in Hanoi with pooled funds. Out of over 1,000 people and 43 teams, they picked us as winners!
Honestly, it taught me a lot about teamwork under pressure. We’re proud of the prototype, even if it’s rough – built in two days, after all. Maybe we’ll keep working on it, add more features like AI for price predictions. Shoutout to FOSSASIA for the event!!!
Xin chào mọi người! Trước khi bắt tay vào việc phát triển game 2D với LibGDX, hãy dành một chút thời gian để hiểu rõ hơn về ‘bộ công cụ’ mà chúng ta sẽ sử dụng.
LibGDX là một framework mạnh mẽ cho phép lập trình viên tạo game đa nền tảng, từ desktop cho tới mobile và web, mà không cần thay đổi đoạn code nguồn. Thông qua ngôn ngữ Java – một ngôn ngữ lập trình rất phổ biến vì tính linh hoạt, mạnh mẽ và khá dễ tiếp cận, được giảng dạy tại nhiều trường đại học trên thế giới.
Video
Chào mọi người! Video này là phần đầu tiên trong series hướng dẫn sử dụng LibGDX để phát triển game 2D sử dụng Java. Ở tập này, mình sẽ dẫn dắt các bạn qua quá trình cài đặt môi trường phát triển game, bao gồm cách thiết lập LibGDX và các công cụ cần thiết để bắt đầu tạo ra những tựa game đầu tiên của mình. Ngoài ra là một chút khái niệm về cách render tile của game 2D và game loop
Ở một số trang web, bạn sẽ thấy, bạn không thể đi đến thẳng trang cuối, hoặc nhảy đến 1 trang bất kì, mà thông thường sẽ có nút để sang trang kế và trang phía trước. Như vậy ta có thể assume rằng:
Người dùng sẽ chỉ mở trang 10 sau khi mở trang 9.Vậy, ta chỉ cần nhớ vị trí cuối cùng của bài viết ở trang 9 là ở id bao nhiêu, rồi dùng WHERE để truy vấn từ điểm đó, chứ không cần bỏ dần để đi đến điểm đó nữa
SELECT * FROM my_table WHERE id > 21 ORDER BY id LIMIT 5
Tối ưu truy vấn Pagination (phân trang) sử dụng Spring Boot (Java) 38
Ví dụ: Sort theo thời gian
SELECT *
FROM my_table
WHERE (update_date = '2017-12-21' AND id > 21)
    OR update_date > '2017-12-21'
ORDER BY update_date,id LIMIT 5
Cơ bản là ta sẽ chỉ lấy các bài viết có cùng thời gian đăng như bài viết cuối và id > , hoặc thời gian lớn hơn bài viết cuối
Để hình dung rõ hơn, hãy thử nhìn vào bảng sau:
ID
Name
1
An
2
Nam
3
Quan
4
Tien
5
Hoang
6
Nguyen
7
Duc
8
Thanh
9
Hai
10
Minh
Ta mong muốn nhận được dữ liệu ở Page 1 như sau
ID
Name
1
An
2
Nam
3
Quan
4
Tien
5
Hoang
Ta sẽ có câu query để lấy page 2 dạng như sau
Lấy page 1: SELECT * FROM users ORDER BY ID LIMIT 5
SELECT * FROM users WHERE ID > '5' ORDER BY ID LIMIT 5
Ta có thể thêm HAL bằng Spring HateOAS để response trả về ở dạng như sau, giúp ta lấy dữ liệu dễ dàng hơn
Cursor sẽ như một con trỏ chỉ tới một record nào đó trong dữ liệu, và khi ta truyền cursor đó vào, backend cần biết ta đang muốn lấy trang tiếp theo hay trang trước từ vị trí con trỏ đó
Có nhiều cách để làm điều này, ví dụ thêm prefix dạng như prev___, hay next___ như ví dụ trên
Hoặc đơn giản hơn, ta sẽ truyền thêm một biến chỉ ra là đó là next hay prev
Null Cursor
Lúc này, từ phía backend, ta có thể sử dụng count hoặc tương tự để kiểm tra xem có trang ở trước đó hay ở sau đó không, rồi trả response ra là null để thể hiện rằng không còn trang nào khác để đi tới ở hướng đó.
Next Cursor
Có thể bạn đã nắm được về cách để đi tới trang tiếp theo với cursor pagination.
Ví dụ, ta có một danh sách id tăng dần, thì từ trang có id [1,2,3,4,5], ta sẽ where id > 5 để tới trang tiếp theo
SELECT * FROM entries WHERE (myCol > 5) ORDER BY myCol ASC LIMIT 2; -> 6,7
SELECT * FROM entries WHERE (myCol > 7) ORDER BY myCol ASC LIMIT 2; -> 8,9
Với một danh sách id giảm dần, ví dụ trang là [10,9,8,7,6] thì ta sẽ where id < 6 để tới trang tiếp theo.
SELECT * FROM entries WHERE (myCol < 5) ORDER BY myCol DESC LIMIT 2; -> 4,3
SELECT * FROM entries WHERE (myCol < 3) ORDER BY myCol DESC LIMIT 2; -> 2,1
Previous Cursor
Tuy nhiên, việc đi tới trang trước đó trở lên khó khăn hơn. Bởi vì dữ liệu sẽ được trả ra từ phía trái đầu
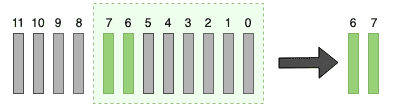
Ví dụ, ta đang ở trang id [8,9] , và ta thực hiện truy vấn lấy trang trước đó, 2 phần tử
SELECT * FROM entries WHERE (myCol < 8) ORDER BY myCol ASC LIMIT 2;
Kết quả sẽ trả về 0,1. Bởi vì nó đang đọc từ trái sang, và khi limit sẽ lấy từ đầu trái chứ không lấy 6,7
Cách giải quyết lấy previous cursor
Cách để giải quyết vấn đề này, ta sẽ đảo ngược chiều order by, và sau đó khi limit để lấy đúng vùng dữ liệu xong, ta sẽ đảo một lần nữa về chiều đúng
SELECT pagination.* FROM(SELECT * FROM entries WHERE (myCol < 8) ORDER BY myCol DESC LIMIT 2) AS pagination ORDER BY myCol ASC;
Các bước vừa xảy ra
1. Đầu tiên, select các row có id < 8 và order by desc. ta có 7,6,…,1,0
Sau đó limit 2 để lấy 7,6
Rồi order by asc lần nữa để lấy thành 6,7 . Là thứ tự ASC như ban đầu ta muốn
Time Complexity
Next Page Travesal: O(log(N) + L) , ta mấy log(N) để tìm tới điểm bất kì vì nó thực hiện như binary search và ta đã index database. Và L là Limit là số ta phải lặp đến để lấy vùng đầu tiên đã chọn
Previous Page Traversal: O(log(N) + 2L), sở dĩ là 2L vì ta đã phải đảo chiều 1 lần.
Thông thường limit được đặt ở 5-20 cho 1 trang, vì vậy có thể coi L là constant và không đáng kể
Triển khai trong code
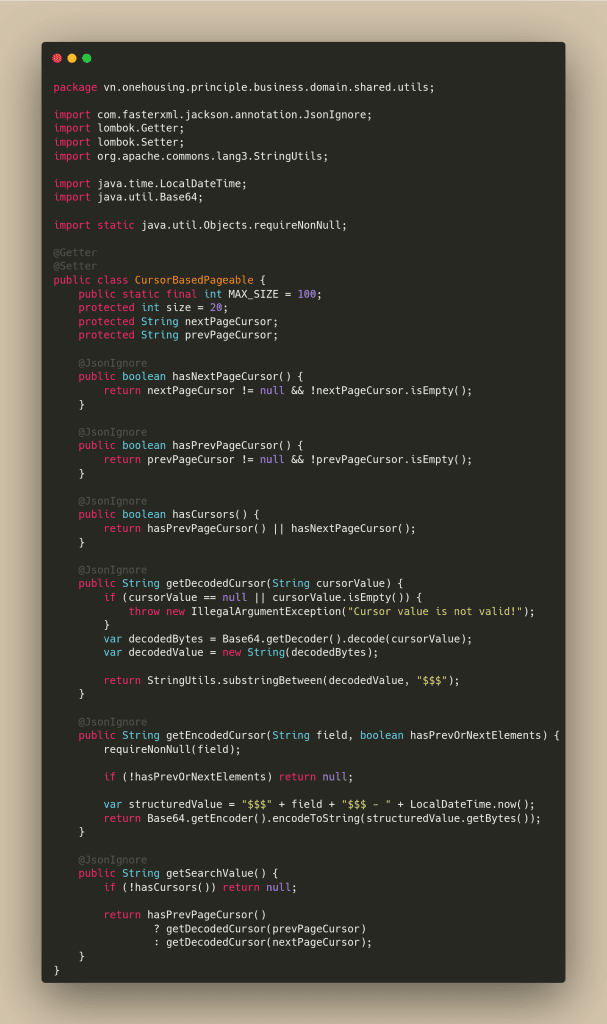
Ta có một class thực hiện việc lấy cursor trước hoặc sau. Sử dụng để decode một giá trị cursor base64 hoặc encode 1 giá trị
Ví dụ ta đang cursor pagination theo column 35, ta sẽ có hàm getEncodeCursor để tạo ra giá trị mã hoá cursor
Hàm getDecodedCursor sẽ chuyển giá trị mã hoá đó thành số để dùng paging
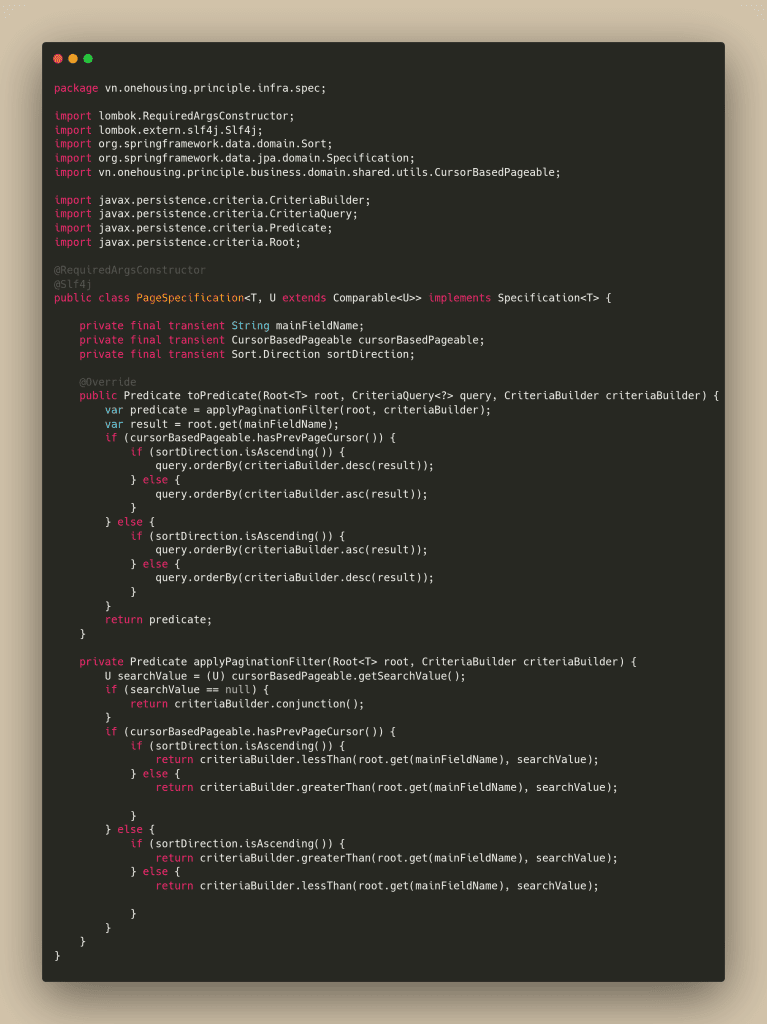
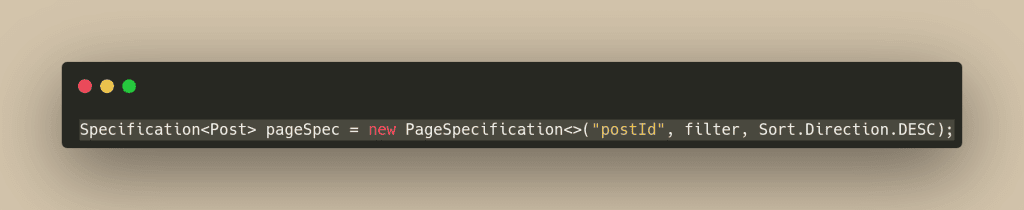
Đây là class thực hiện việc paging và nhảy trang. Có thể thấy logic sẽ kiểm tra xem ta đang lấy trang trước hay trang sau, sau đó sort cho phù hợp.
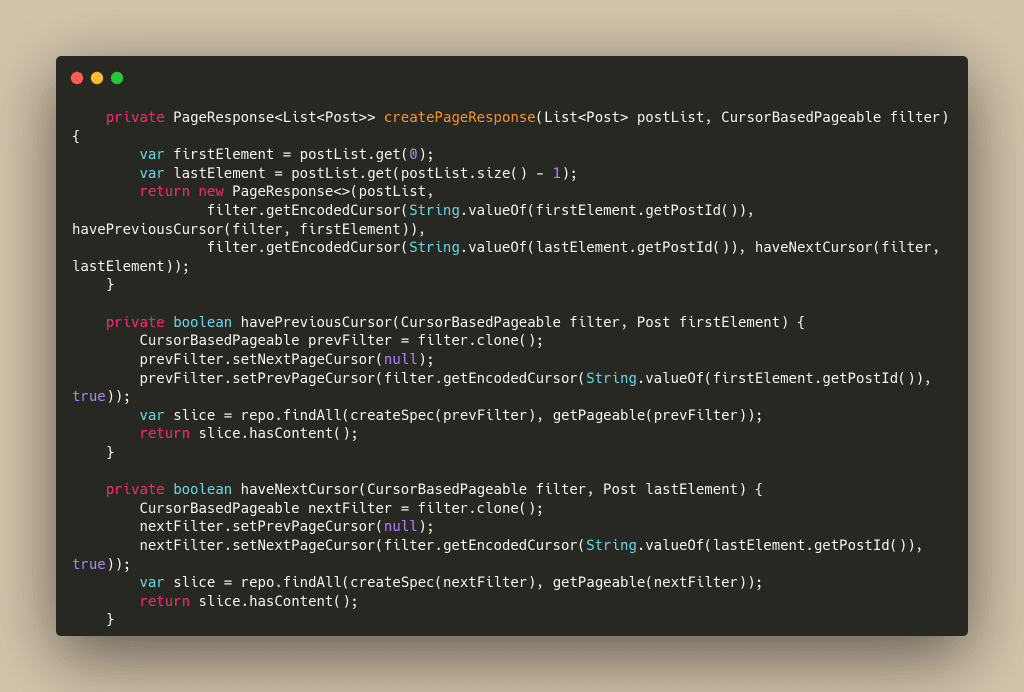
Class xử lý việc trả về. Tại đây ta sẽ lấy ra element tại đầu list và cuối list của trang hiện tại, rồi tìm thử xem phía trước đó còn trang nào không, hay sau đó còn trang nào hay không
This entry is part 2 of 2 in the series Blockchain
Chainlink là gì?
Chainlink là một dự án mã nguồn mở, được phát triển bởi SmartContract, nhằm giải quyết vấn đề "oracle problem" trong blockchain. Chainlink cung cấp một cách để kết nối các hợp đồng thông minh với các nguồn dữ liệu bên ngoài mà không cần tin tưởng vào bất kỳ bên thứ ba nào.
Ví dụ thực tế
Có thể xem ví dụ thực tế về blockchain qua bảng tính ở bài viết trước trong series. Tại bài này, ta sẽ nói về vấn đề mà Chainlink tập trung giải quyết
Chainlink giải quyết một hạn chế cơ bản của blockchain: mặc dù blockchain giúp ta tạo ra một bảng tính an toàn, bảo mật, stable vì phi tập trung, nhưng nó không thể tự mình truy cập hoặc xác minh dữ liệu thế giới thực.
Ví dụ:
Bạn có thể sử dụng bảng tính để lưu các lần chấm công của nhân viên, nhưng chính bảng tính không thể xác minh xem những dữ liệu nhập vào đó có đúng hay không; bạn cần một hệ thống bảng chấm công bên ngoài để thực sự theo dõi những giờ này. Vì vậy, để bảng tính có ích, nó cần dữ liệu chỉ nhập chính xác từ một nguồn hệ thống bên ngoài nà, và ta sẽ cần một cây cầu trung gian giữa dữ liệu ngoài và hệ thống blockchain bảo mật bên trong.
Đó chính là những gì Chainlink cung cấp cho blockchain. Nó hoạt động như một mạng lưới oracle phi tập trung. Oracle giống như những sứ giả lấy thông tin từ các nguồn bên ngoài và đưa nó vào blockchain một cách an toàn, và có thể tin tưởng được.
Chainlink đảm bảo rằng dữ liệu từ thế giới bên ngoài đến được với hợp đồng thông minh của blockchain một cách an toàn và đáng tin cậy. Vì vậy, nếu hợp đồng thông minh của bạn phụ thuộc vào thông tin thế giới thực,ví dụ như dữ liệu thời tiết, giá cả chứng khoán hiện tại, …, các oracle của Chainlink cung cấp một cách đáng tin cậy để lấy thông tin đó lên blockchain.
Hợp đồng thông minh sau đó có thể thực thi dựa trên dữ liệu thời gian thực được cung cấp, cho dù là chuyển tiền khi đáp ứng được những điều kiện nhất định, hay xác nhận xảy ra một sự kiện. Chainlink đảm bảo thông tin này chính xác và quy trình là phi tập trung, nên không có thực thể đơn lẻ nào có thể thao túng dữ liệu—cũng giống như không có một người đơn lẻ nào có thể bí mật thay đổi giờ làm việc đã theo dõi của mọi người trong bảng tính chia sẻ của chúng ta mà không bị người khác phát hiện.
Ngoài ra còn một số vấn đề khác sẽ thảo luận ở dưới.
Vấn đề “oracle problem”
- Trong blockchain, hợp đồng thông minh không thể truy cập trực tiếp vào dữ liệu từ bên ngoài mà cần thông qua một bên thứ ba, gọi là "oracle". Tuy nhiên, việc tin tưởng vào một bên thứ ba có thể gây ra rủi ro cho hợp đồng thông minh. Đó chính là vấn đề "oracle problem".
- Sự bảo mật của blockchain được bảo vệ nhờ nhiều các "xác thực" trên nhiều máy khác nhau, phi tập trung. Tuy nhiên, khi dữ liệu từ bên ngoài được đưa vào, nó có thể bị "tấn công" từ bên ngoài, gây ra rủi ro cho hợp đồng thông minh.
Centralized Oracle Problem
Cơ chế oracle blockchain sử dụng một node tập trung để cung cấp dữ liệu cho hợp đồng thông minh điều này cũng tạo ra 1 SPOF (Single Point of Failure), tức là, nếu điểm này bị quá tải, sập, hay có vấn đề thì toàn hệ thống bị chết. Điều này vô tình làm mất đi mục đích của ứng dụng blockchain phi tập trung, khi mà ta không tập trung dữ liệu, hay xử lý vào 1 chỗ. Nếu oracle duy nhất không hoạt động, thì hợp đồng thông minh sẽ không thể tiếp cận với dữ liệu cần thiết để thực thi hoặc sẽ thực hiện không chính xác dựa trên dữ liệu cũ.
Thậm chí tồi tệ hơn, nếu oracle duy nhất bị lỗi, thì dữ liệu được gửi lên chuỗi có thể hoàn toàn sai lệch và dẫn đến hợp đồng thông minh thực hiện những kết quả hoàn toàn sai. Điều này thường được gọi là vấn đề “garbage in, garbage out” nơi mà đầu vào xấu dẫn đến đầu ra xấu. Bên cạnh đó, vì giao dịch blockchain được tự động hóa và không thể thay đổi, một kết quả hợp đồng thông minh dựa trên dữ liệu sai lạc không thể được đảo ngược, có nghĩa là tiền của người dùng có thể bị mất vĩnh viễn.
Việc thực sự vượt qua vấn đề oracle đòi hỏi phải có oracle phi tập trung để ngăn chặn việc lỗi, hỏng dữ liệu, hay node hoạt động không chính xác hay ngừng hoạt động. Mạng Lưới Oracle Phi Tập Trung, hoặc gọi tắt là DON (Decentralized Oracle Network), kết hợp nhiều nút oracle độc lập và nhiều nguồn dữ liệu đáng tin cậy để thiết lập sự phi tập trung từ đầu đến cuối
This entry is part 1 of 2 in the series Blockchain
1. Blockchain là gì?
Blockchain là một hệ thống lưu trữ dữ liệu phân tán, mà mỗi block dữ liệu được liên kết với nhau thông qua mã hóa. Mỗi block chứa thông tin về giao dịch, và thông tin về block trước đó. Dữ liệu có sự nhất quán theo trình tự thời gian vì bạn không thể xóa hoặc sửa chuỗi mà không có sự đồng thuận từ mạng lưới. Vì thế, bạn có thể sử dụng công nghệ Blockchain để tạo ra một sổ cái không thể biến đổi hay chỉnh sửa để theo dõi các đơn hàng, khoản thanh toán, tài khoản và những giao dịch khác. Hệ thống chuỗi khối có những cơ chế tích hợp để ngăn chặn các mục nhập giao dịch trái phép và tạo sự nhất quán trong chế độ xem chung của các giao dịch này.
Một số đặc điểm của Blockchain:
Phân tán: Dữ liệu được lưu trữ trên nhiều máy chủ khác nhau.
An toàn: Dữ liệu được mã hóa và không thể thay đổi.
Độc lập: Không cần sự can thiệp của bên thứ ba.
Bảo mật: Dữ liệu được phân quyền và mã hóa.
Trong suốt: Mọi giao dịch đều được lưu trữ và công khai.
Tiết kiệm: Giảm chi phí vận hành và tăng hiệu quả.
Dễ dàng sử dụng: Không cần kiến thức chuyên sâu về công nghệ.
Tính khả chuyển: Dễ dàng mở rộng và phát triển.
Tính nhất quán: Mọi giao dịch đều được xác nhận và chứng thực.
Tính đồng thuận: Mọi giao dịch đều được thông qua một quy trình đồng thuận.
Ví dụ thực tế
Làm việc trên SpreadSheet
Trong một công ty, mọi nhân viên đều có quyền truy cập vào một bảng tính chung, và có thể thêm, sửa, xóa dữ liệu trên bảng tính đó.
Mỗi thay đổi trên bảng tính sẽ được lưu trữ và công khai cho tất cả mọi người xem. Khi muốn thay đổi dữ liệu, mọi người phải thông qua một quy trình xác nhận. Quy trình này có thể là sự đồng thuận của tất cả mọi người, hoặc là sự xác nhận của một số người quản lý.
Sau khi quy trình xác nhận được hoàn tất, dữ liệu mới sẽ được cập nhật lên bảng tính chung, và mọi người có thể xem lại lịch sử thay đổi của dữ liệu.
African American Office Employee Auditor Using Spreadsheet
=> Không khó để nhận ra rằng, bảng tính chung này chính là một ví dụ về Blockchain. Mỗi block dữ liệu tương ứng với một dòng dữ liệu trên bảng tính, và mỗi thay đổi trên bảng tính tương ứng với một giao dịch trên Blockchain. – Không ai có thể thay đổi dữ liệu cũ, mà chỉ có thể thêm dữ liệu mới. Mỗi giao dịch đều được lưu trữ và công khai, và mọi người đều có thể xem lại lịch sử thay đổi của dữ liệu. Việc xác nhận giao dịch cũng tương tự như quy trình xác nhận trên bảng tính chung.
Tóm lược
Blockchain giống như spreadsheet được chia sẻ này. Nó được phân tán trên nhiều máy tính (nút) trên khắp thế giới. Mỗi khi một giao dịch xảy ra, nó được thêm vào một ‘khối’, tương tự như một hàng mới trong bảng tính của chúng ta. Nếu đa số các nút đồng ý rằng giao dịch là hợp lệ, khối sẽ được niêm phong mật mã và thêm vào chuỗi các giao dịch đã được xác nhận trước đó. Do đó, có cái tên “blockchain”.
Bản chất phân quyền của blockchain khiến nó khó bị chỉnh sửa dữ liệu lịch sử. Nó cũng rất minh bạch, bất kỳ ai tham gia vào mạng lưới đều có thể xem toàn bộ blockchain. Hơn nữa, dữ liệu được bảo vệ bằng các nguyên tắc mật mã, làm cho nó trở nên không thể tấn công hay thay đổi
1. Làm quen với Exception: Checked và Unchecked Exception, Error
1.1 Lời mở đầu
Trong cuộc sống, không phải lúc nào mọi việc cũng diễn ra suôn sẻ, không phải lúc nào mọi thứ cũng theo đúng kế hoạch. Đôi khi, có những tình huống không mong muốn xảy ra, và chúng ta cần phải xử lý chúng.
Khi một ứng dụng ngày càng lớn lên, chắc chắn ta không thể đảm bảo ứng dụng luôn hoạt động như cách ta muốn 100% mọi lúc được. Đến lúc nào đó, sẽ có lỗi xảy ra.
Ví dụ:
Khi một ứng dụng cần đọc một file từ ổ cứng, nhưng file đó không tồn tại.
Khi ứng dụng cần quyền chụp ảnh từ camera, nhưng người dùng không cho phép.
Khi ứng dụng kết nối tới một server, nhưng server đang bị mất điện và không kết nối được.
Khi đó, hệ thống cần có những cách xử lý riêng cho người dùng biết vấn đề đang xảy ra, và có những cách xử lý riêng cho hệ thống có thể tiếp tục hoạt động mà không bị ảnh hưởng quá nhiều.
Ví dụ:
Khi file không tồn tại, ứng dụng cần thông báo cho người dùng biết rằng file không tồn tại và yêu cầu người dùng chọn file khác, hoặc kiểm tra lại đường dẫn file.
Khi người dùng không cho phép ứng dụng chụp ảnh, ứng dụng cần thông báo cho người dùng biết rằng không thể chụp ảnh và yêu cầu người dùng cấp quyền.
Khi server bị mất điện, ứng dụng cần thông báo cho người dùng biết rằng không thể kết nối tới server và yêu cầu người dùng thử lại sau, hoặc kiểm tra xem đường truyền wifi, 3G, 4G có vấn đề gì không.
1.2 Exception là gì?
Exception dịch ra tiếng Việt có nghĩa là ngoại lệ. Exception là một sự kiện xảy ra trong quá trình thực thi chương trình, làm ảnh hưởng đến luồng thực thi của chương trình.
1.3 Checked và Unchecked Exception
1.3.1 Checked Exception
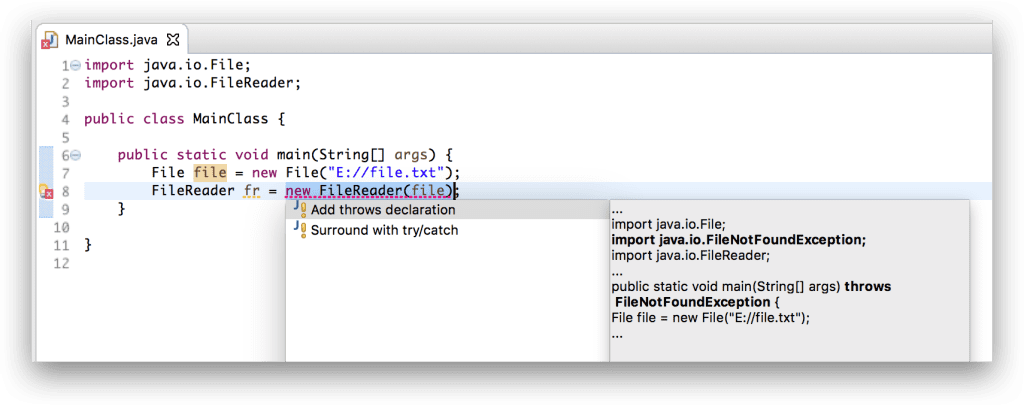
Ảnh ví dụ: Khi ta thử đọc 1 file, IDE ngay lập tức thông báo có thể xảy ra FileNotFoundException (Ngoại lệ file không tồn tại) và yêu cầu ta phải xử lý nó.
Checked Exception thường là những lỗi phổ biến mà chúng ta có thể dự đoán được sẽ xảy ra cho một thao tác nào đó.
Ví dụ, khi đi dã ngoại, để phòng ngừa việc có mưa, ta mang theo áo mưa. Việc trời mưa là một ngoại lệ mà ta đã dự đoán trước và lên trước kế hoạch để xử lý nó.
1.3.2 Unchecked Exception
Đây là những Exception không được kiểm tra tại thời điểm biên dịch (compile time). Tức là chúng ta không nhận được thông báo lỗi từ trình biên dịch khi mà nó phát hiện ra rằng chúng ta chưa xử lý nó.
Đây là các exception khá nguy hiểm, khi mà chúng ta không thể dự đoán được chúng sẽ xảy ra khi nào. Bởi vì Exception này xảy ra khi ứng dụng đang thực thi, nên nó còn có thể gọi là Runtime Exception.
Ví dụ, khi một ứng dụng chia một số cho 0, nó sẽ ném ra một ngoại lệ ArithmeticException (Ngoại lệ toán học).
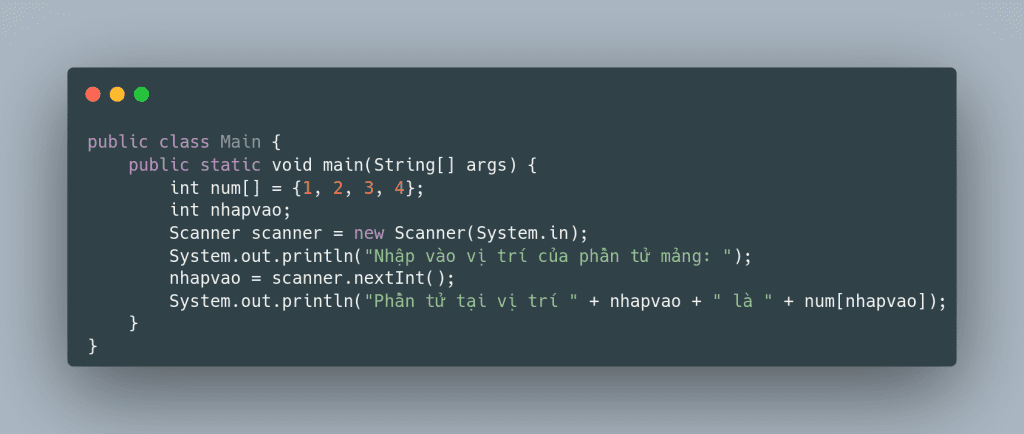
Trong đoạn code trên, nếu ta nhập vào 1 số không tồn tại trong mảng, nó sẽ bị một Exception ArrayIndexOutOfBoundsException (Ngoại lệ vượt quá giới hạn của mảng)., đây là một ví dụ về Unchecked Exception. Vì ta không thể biết được trước khi chạy chương trình, nó sẽ xảy ra khi nào.
1.4 Error
Error là một dạng ngoại lệ mà chúng ta không thể xử lý được. Error thường xảy ra khi mà hệ thống gặp phải những vấn đề nghiêm trọng, không thể khắc phục được.
Ví dụ, khi một ứng dụng chạy hết bộ nhớ, nó sẽ ném ra một ngoại lệ OutOfMemoryError (Lỗi hết bộ nhớ). Đây là một ví dụ về Error. Đây là một ngoại lệ ta không thể xử lý được, và nó thường xảy ra khi mà hệ thống gặp phải những vấn đề nghiêm trọng, không thể khắc phục được.
2. Bắt Exception với try-catch
Bài tập
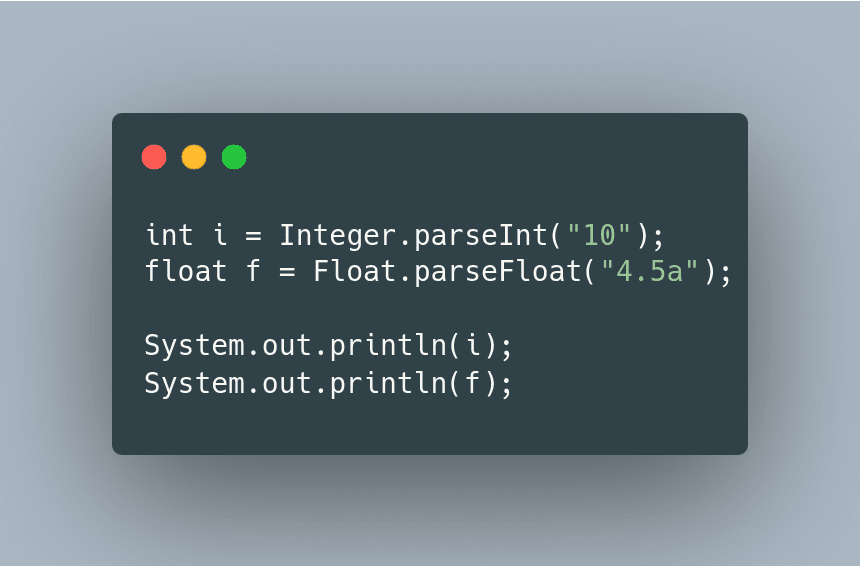
Hãy viết chương trình nhập vào 1 String, và sử dụng Integer.parseInt để chuyển đổi String đó sang kiểu int. Thử nếu nhập vào 1 chuỗi không phải là số, xem chương trình sẽ báo lỗi như thế nào.
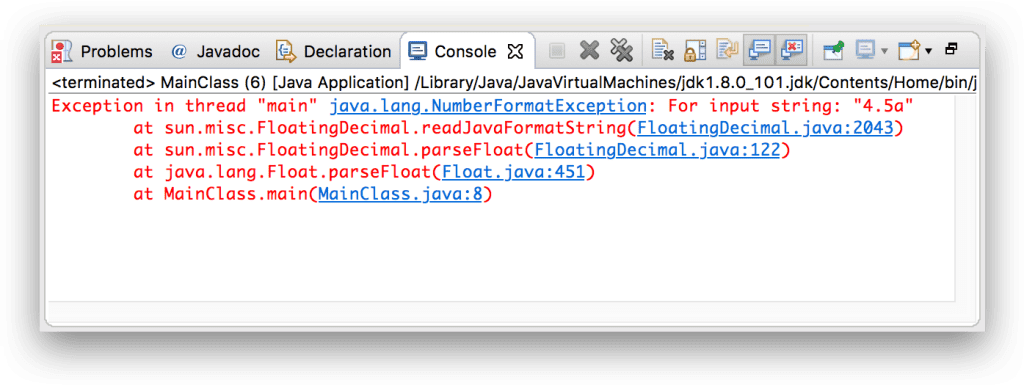
Khi chạy chương trình trên, ta sẽ nhận được một ngoại lệ NumberFormatException (Ngoại lệ không đúng định dạng số). Đây là một ví dụ về Unchecked Exception. Vì lúc compile, ta không nhận lỗi nào báo trước cả, do IDE không biết trước được String truyền vào khi chạy chương trình
2.1 Cách bắt Exception
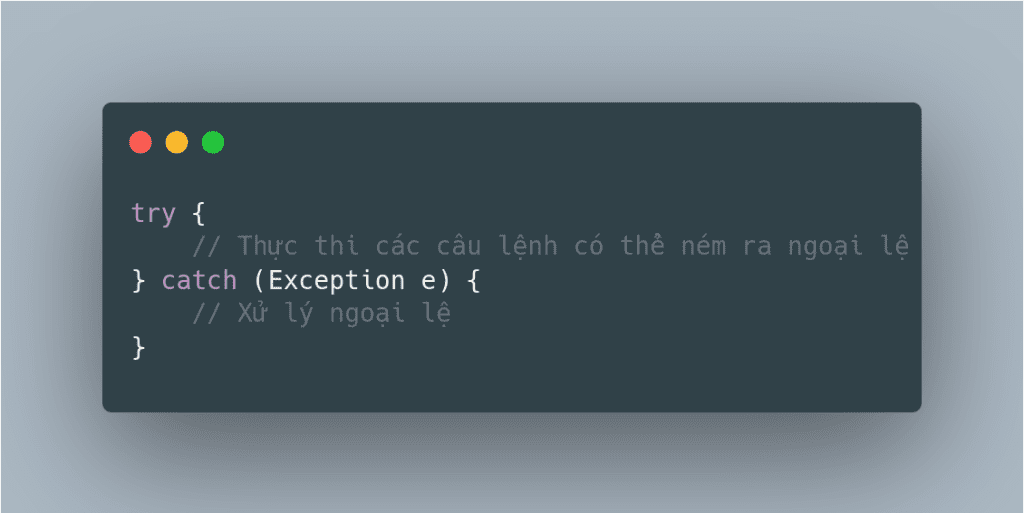
Để bắt Exception, ta sử dụng cấu trúc try-catch. Cấu trúc try-catch sẽ giúp chúng ta bắt ngoại lệ, và xử lý nó một cách an toàn.
Cấu trúc try-catch có dạng như sau:
Trong đó:
try: Là một khối lệnh, chứa các câu lệnh có thể ném ra ngoại lệ.
catch: Là một khối lệnh, chứa các câu lệnh xử lý ngoại lệ. Trong đó, Exception e là một biến, chứa thông tin về ngoại lệ xảy ra.
2.2 Ví dụ
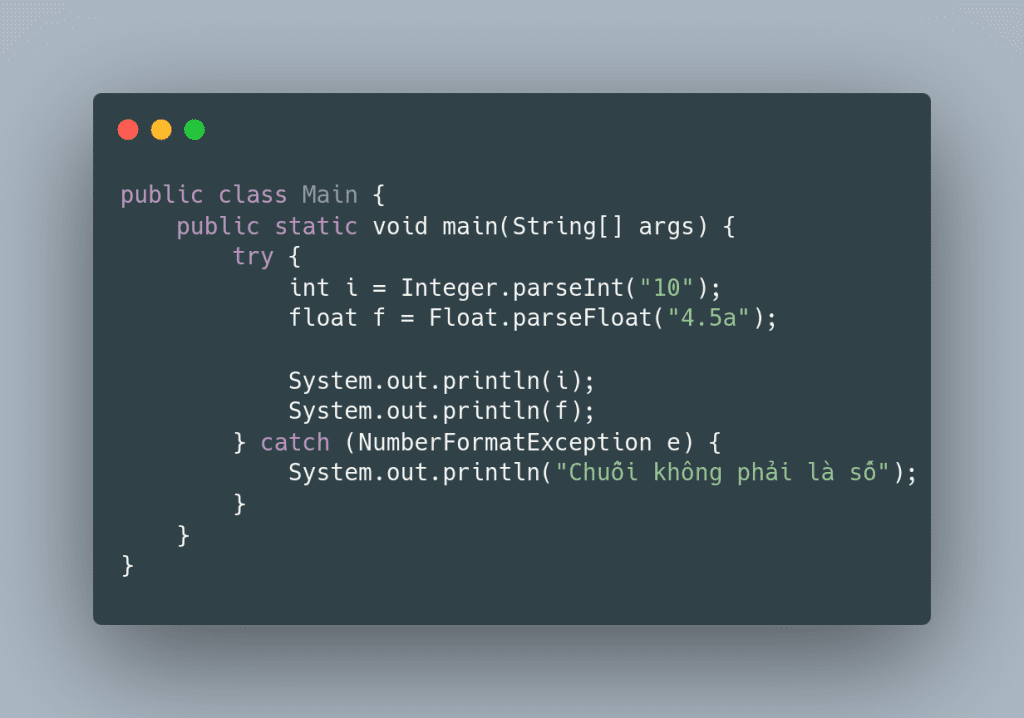
Ví dụ, ta sẽ sử dụng cấu trúc try-catch để bắt ngoại lệ NumberFormatException khi chuyển đổi một chuỗi không phải là số sang kiểu int.
Khi chạy chương trình trên, ta sẽ nhận được thông báo “Chuỗi không phải là số” khi chuyển đổi chuỗi “4.5a” sang kiểu float.
2.3 catch nhiều Exception
Ta cũng có thể bắt nhiều ngoại lệ trong cùng một cấu trúc try-catch, bằng cách sử dụng nhiều khối catch.
Bài tập
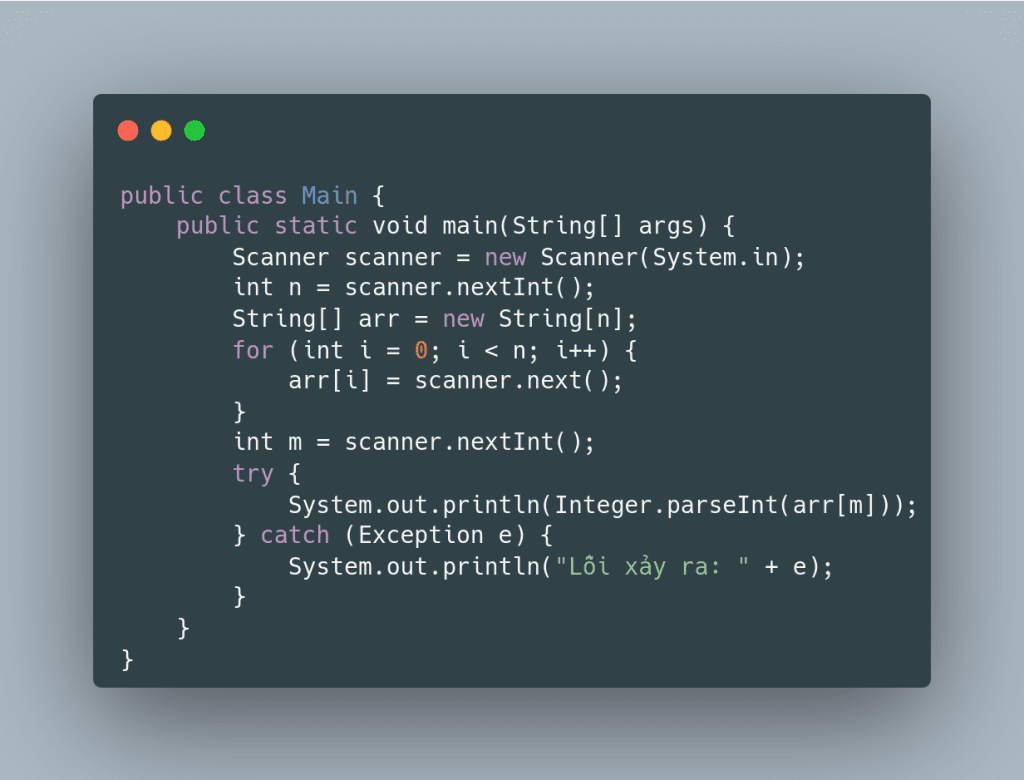
Hãy viết chương trình nhập vào số n, sau đó nhập vào n string. Sau đó nhập vào 1 số m, và in ra string thứ m. Nếu truy cập ngoài mảng, hãy in ra thông báo “Truy cập ngoài mảng”, còn nếu không in ra số được chuyển đổi từ string đó sang kiểu int, nếu không thể chuyển đổi được, hãy in ra thông báo “Chuỗi không phải là số”.\
Như ví dụ trên, ta thấy ta có thể catch nhiều Exception trong cùng một cấu trúc try-catch.
2.4 Catch Exception cha
Ta cũng có thể bắt Exception cha của một Exception con. Ví dụ, ta có thể bắt Exception cha của NumberFormatException là Exception.
Bài tập
Tương tự bài tập trên, nhưng chỉ dùng 1 catch, và có bất kì lỗi gì xảy ra ta đều in ra “Lỗi xảy ra + tên lỗi”.
Như ví dụ trên, ta thấy ta có thể bắt Exception cha của NumberFormatException là Exception.
3. Sử dụng finally
3.1 finally là gì?
finally là một khối lệnh, chứa các câu lệnh sẽ được thực thi sau khi khối lệnh try-catch kết thúc.
finally sẽ được thực thi sau khi khối lệnh try-catch kết thúc, bất kể có ngoại lệ xảy ra hay không.
3.2 Ví dụ
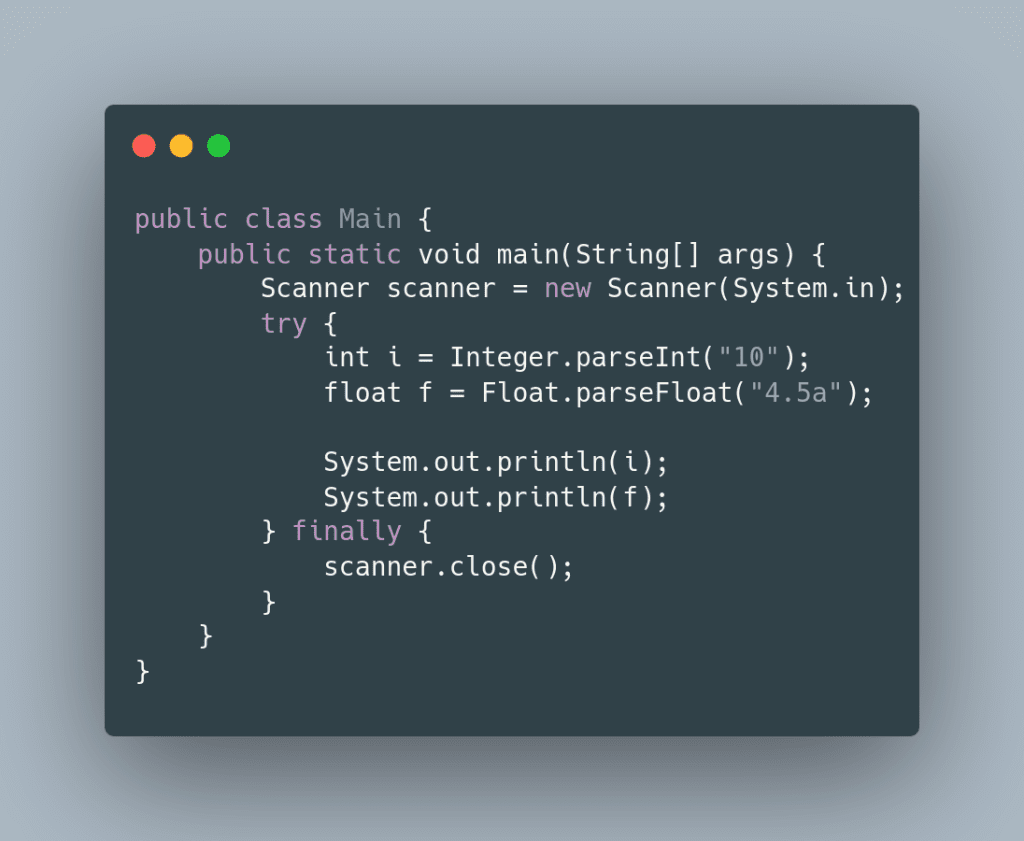
Ví dụ, ta sẽ sử dụng finally để đóng Scanner sau khi sử dụng xong.
Trong đoạn code trên, ta sẽ đóng Scanner sau khi sử dụng xong, bất kể có ngoại lệ xảy ra hay không.
Tác dụng
finally thường được sử dụng để giải phóng tài nguyên, như đóng file, đóng kết nối, đóng Scanner, … Đây là một practice nên làm đó là giải phóng tài nguyên sau khi sử dụng xong, tránh lãng phí tài nguyên.
3.3 Một số câu hỏi
3.3.1 Tại sao không sử dụng Exception là xong mà cần catch Exception cụ thể, có nhiều class Exception con
Khi sử dụng Exception là xong, ta sẽ bắt được tất cả các Exception, nhưng đôi khi ta cần xử lý một cách cụ thể cho từng Exception. Vì khi có lỗi xảy ra, cứ chỉ báo là đã có lỗi xảy ra thì thứ nhất người dùng rất khó chịu, ta khi sửa lỗi cũng không biết lỗi xảy ra là gì, ở đâu. Thứ hai, ta cũng không thể xử lý lỗi một cách cụ thể.
Việc catch đúng Exception cụ thể sẽ giúp ta xử lý lỗi một cách cụ thể. Ví dụ: Nếu lỗi là chia cho 0, ta báo cho người dùng rằng họ nhập sai để họ biết sai ở đâu và sửa lại, còn nếu lỗi là không tìm thấy file, ta báo cho người dùng biết rằng file không tồn tại để họ biết cần phải tạo file mới. Hoặc nếu là các lỗi người dùng không hiểu được, ta cần báo các lỗi cụ thể, có định danh rõ ràng để lập trình viên có thể biết và sửa lỗi
Ví dụ, trong window đôi lúc ta bị màn hình xanh, ta có các mã lỗi kiểu như 0x0000000A, 0x0000000B, … những mã lỗi này không phục vụ cho người dùng hiểu, nhưng người dùng có thể dùng nó để báo cáo, và lập trình viên có thể dùng nó để sửa lỗi.
3.3.2 Có thể Try không có Catch không?
Có thể, nhưng ta cần có một khối finally để giải phóng tài nguyên.
Ví dụ, ta có thể sử dụng try-finally để giải phóng tài nguyên, mà không cần catch Exception.
4. Cây phân cấp Exception
Trong Java, Exception được phân cấp theo một cấu trúc cây, với Throwable là gốc của cây, Error và Exception là 2 nhánh con của Throwable.
Interface Iterable nhằm ám chỉ những class bên dưới kế thừa có tính “có thể ném ra được”
Lí do tại sao cần 1 cây Exception sẽ được giải thích bên dưới, mục câu hỏi tại sao không catch mọi exception
4.1 Throw, tung ra ngoại lệ
Đến hiện tại, ta đã biết các Exception có sẵn trong Java, và cách bắt nó bằng cấu trúc try-catch.
Ta nhận thấy, các Exception đều triển khai từ Throwable, và có thể tung ra (throw) một Exception bằng cách sử dụng từ khóa throw.
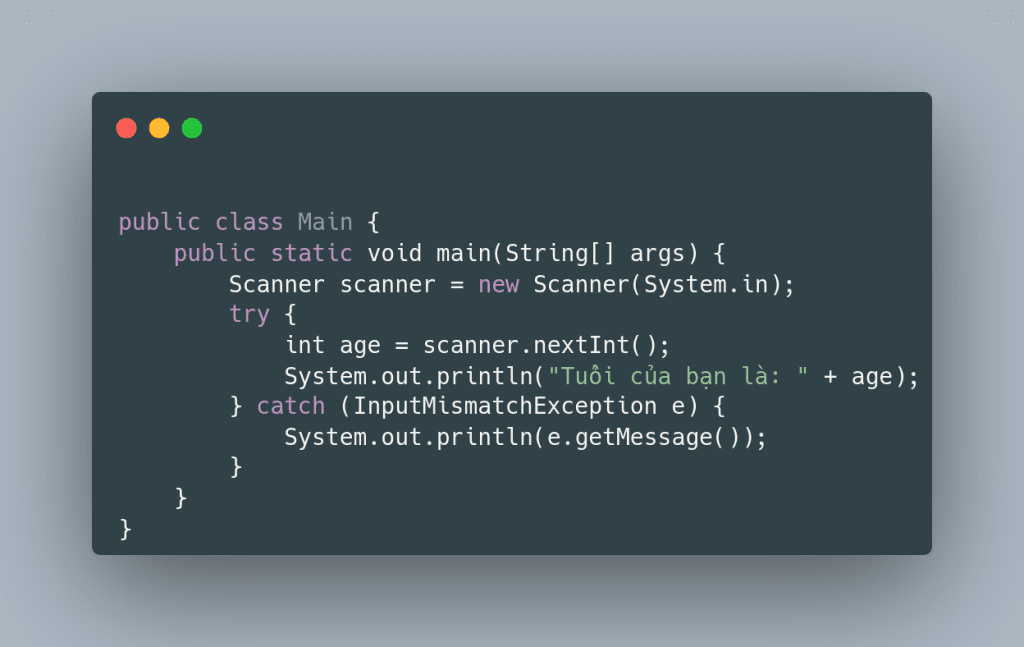
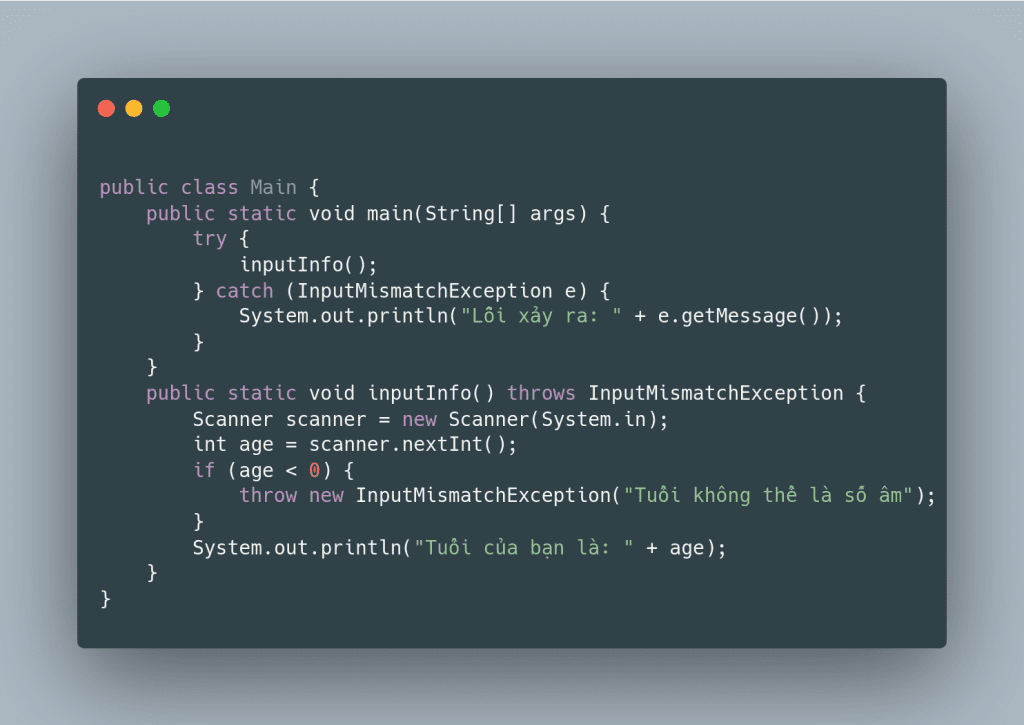
Ví dụ: Ta cần nhập vào một số là tuổi của người dùng, ta sử dụng nextInt của Scanner để nhập vào, nhưng nếu người dùng nhập vào một chuỗi không phải là số, ta sẽ tung ra một Exception InputMismatchException (Ngoại lệ nhập không đúng).
Tuy nhiên, người dùng vẫn có thể nhập vào 1 số âm, lúc này ta có thể thêm các điều kiện của riêng mình và throw ra Exception nếu muốn
4.2 Throws
throws là một từ khóa, dùng để khai báo một phương thức có thể ném ra một ngoại lệ.
Ví dụ: Ta chia 1 hàm riêng để nhập vào thông tin nhân viên, nếu nhập sai ta sẽ trả ra 1 số Exception như InputMismatchException, NumberFormatException, …. Tuy nhiên ta muốn nơi gọi đến hàm này tự xử lý ngoại lệ, ta có thể sử dụng throws để khai báo phương thức có thể ném ra ngoại lệ.
Như code trên, ở hàm inputInfo ta sử dụng throws để khai báo phương thức có thể ném ra ngoại lệ. Lúc này ở nơi gọi đến hàm inputInfo sẽ bị yêu cầu xử lý ngoại lệ InputMismatchException mà ta đã khai báo.
Như ảnh trên, ta thấy ở bên phải là luồng gọi hàm, và bên trái là luồng Exception được quay ngược lên trên để tìm nơi xử lý nó.
4.3 Tạo ra Exception của riêng mình
Đôi khi, ta cần tạo ra Exception của riêng mình, để phục vụ cho mục đích của riêng mình.
Tên Throwable có nghĩa là “có thể ném ra”, nghĩa là các Exception bên dưới của chúng ta có thể sử dụng các từ khoá throws, throw để ném ra.
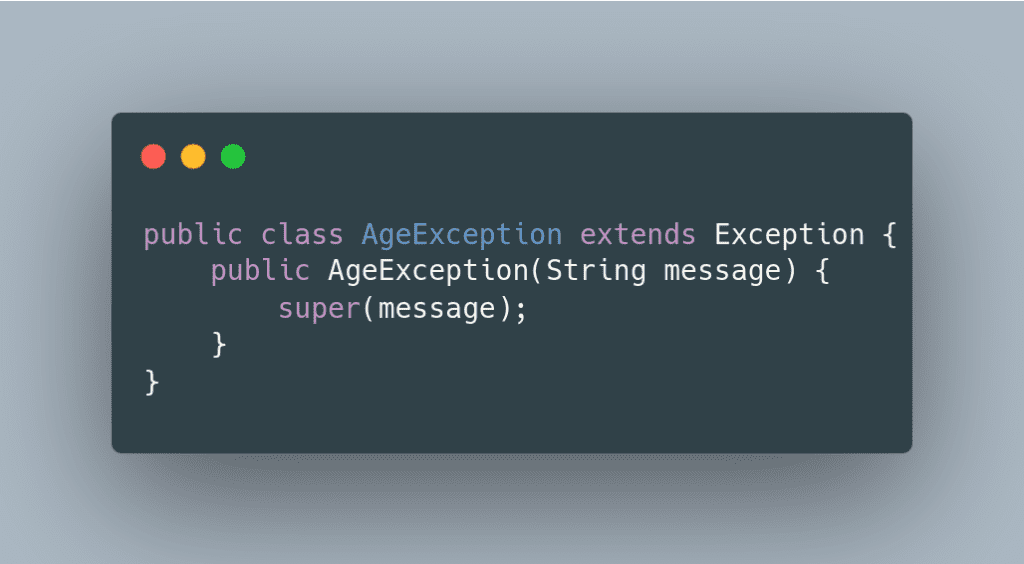
Để tạo ra Exception của riêng mình, ta cần tạo ra một class kế thừa từ Exception hoặc RuntimeException. Để tạo 1 Checked Exception, ta kế thừa từ Exception, còn để tạo 1 Unchecked Exception, ta kế thừa từ RuntimeException.
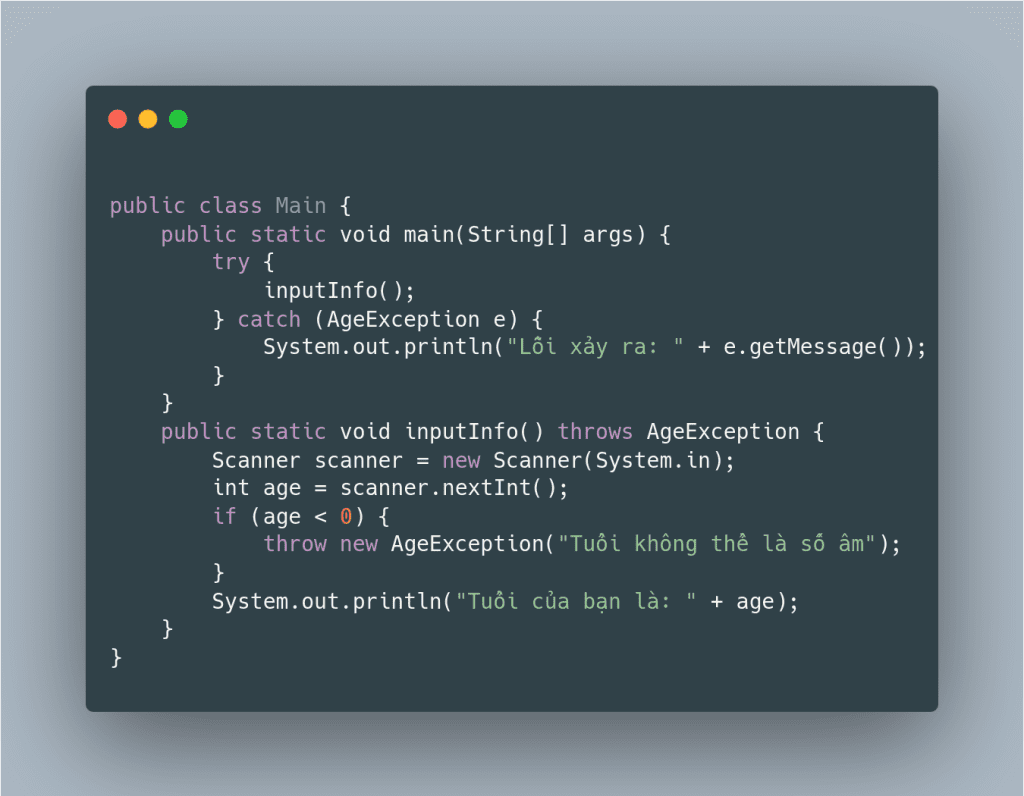
Ví dụ, ta cần tạo ra 1 Exception AgeException (Ngoại lệ tuổi), nếu tuổi nhập vào nhỏ hơn 0, ta sẽ ném ra Exception này.
Ví dụ, ta sẽ sử dụng AgeException để ném ra Exception khi tuổi nhập vào nhỏ hơn 0.
Như code trên, ta sử dụng AgeException để ném ra Exception khi tuổi nhập vào nhỏ hơn 0.
Cấu trúc dữ liệu là một cách tổ chức dữ liệu trong máy tính để có thể lưu trữ và xử lý dữ liệu một cách hiệu quả. Cấu trúc dữ liệu là một phần quan trọng trong việc thiết kế các chương trình và các thuật toán.
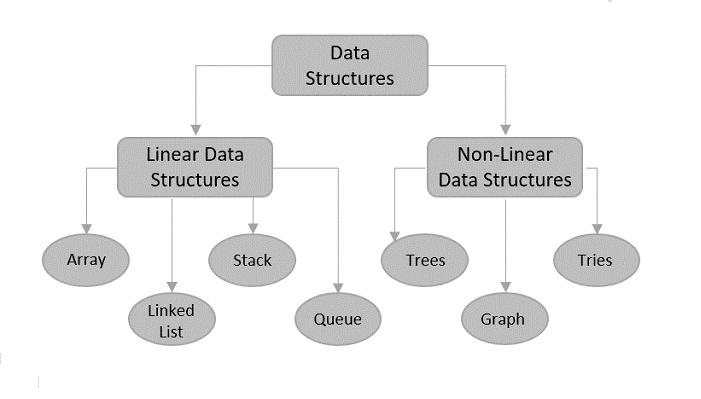
Thông thường, sẽ có 2 kiểu cấu trúc dữ liệu chính là Linear Data Structure và Non-Linear Data Structure hay cấu trúc dữ liệu tuyến tính và cấu trúc dữ liệu phi tuyến tính.
Cấu trúc dữ liệu tuyến tính là các cấu trúc dữ liệu mà các phần tử dữ liệu được sắp xếp theo một thứ tự nhất định. Các cấu trúc dữ liệu tuyến tính thường được sử dụng để lưu trữ dữ liệu đơn giản như danh sách, mảng, hàng đợi, stack, …
Cấu trúc dữ liệu phi tuyến tính là các cấu trúc dữ liệu mà các phần tử dữ liệu được sắp xếp theo một thứ tự không nhất định. Các cấu trúc dữ liệu phi tuyến tính thường được sử dụng để lưu trữ dữ liệu phức tạp như cây, đồ thị, …
=> Câu hỏi: Với các cấu trúc dữ liệu phức tạp như vậy, làm sao để ta có thể lưu trữ, và duyệt qua các phần tử của chúng?
Nghe như một công việc đơn giản với các cấu trúc dữ liệu tuyến tính như list. Ta chỉ cần duyệt qua toàn bộ phần tử khi duyệt. Nhưng làm sao để ta duyệt thứ tự một cấu trúc dữ liệu phức tạp, ví dụ như cây ? Có thể, ta cần nó duyệt theo DFS, hoặc BFS, hoặc duyệt theo thứ tự trước, sau, hoặc duyệt ngẫu nhiên, …
Interface Iterable là một interface trong Java, nó có một phương thức là iterator() trả về một đối tượng Iterator để duyệt qua các phần tử của một Collection.
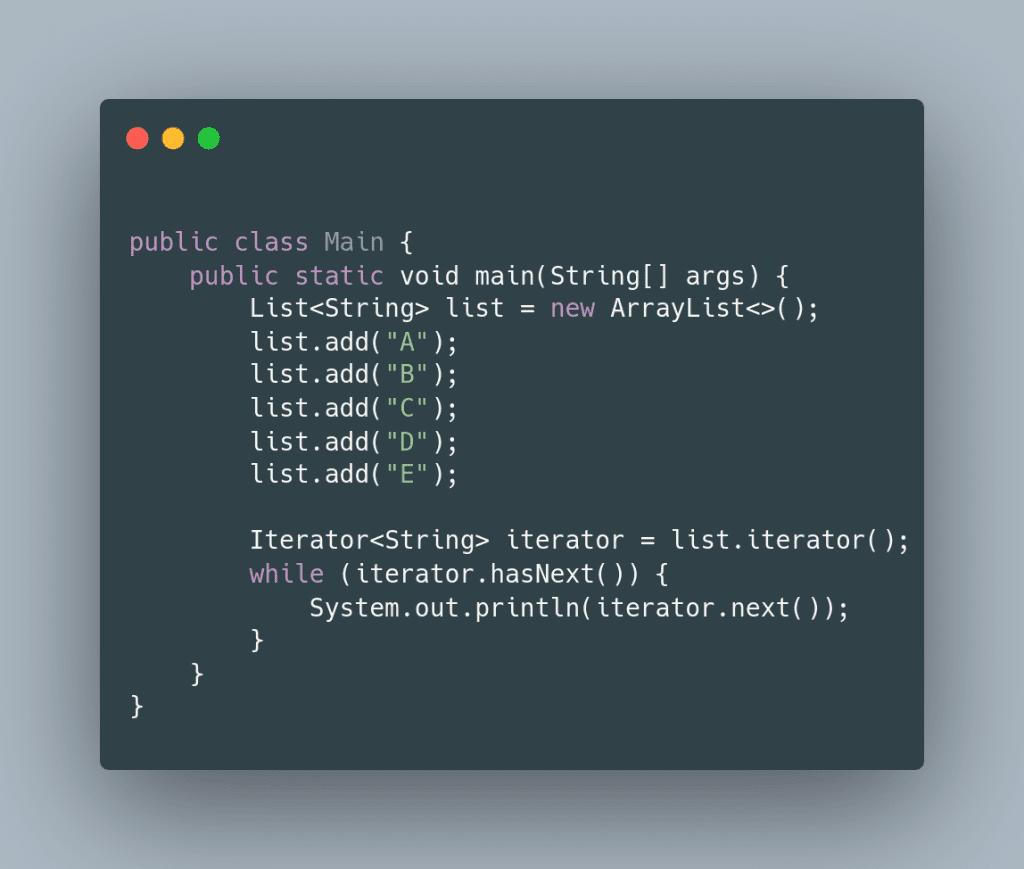
Ví dụ:
Như trong ví dụ trên, ta có thể thấy, ta có thể duyệt qua các phần tử của một Collection bằng cách sử dụng Iterator.
Ta lấy ra iterator của object list, thuộc class ArrayList. Do interface List đã define hàm iterator, nên class ArrayList phải implement hàm iterator này, và tự triển khai logic cách để duyệt qua bản thân như thế nào.
Các class khác như LinkedList, Vector, … cũng phải implement hàm iterator này, và tự triển khai logic cách để duyệt qua bản thân như thế nào.
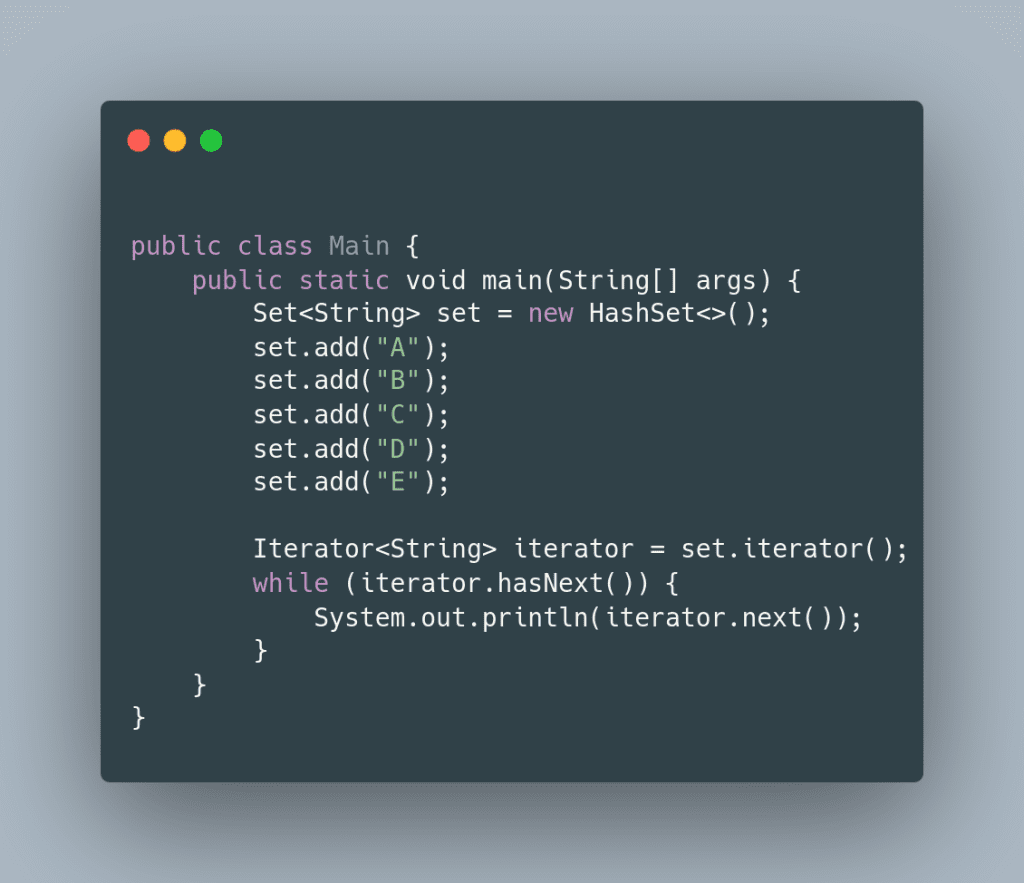
Điều này cho phép khi duyệt qua các Map, Set, … ta không cần phải quan tâm đến cách duyệt của chúng, mà chỉ cần gọi hàm iterator() của chúng, và duyệt qua các phần tử của chúng.
Ví dụ về việc duyệt qua các phần tử của một Set:
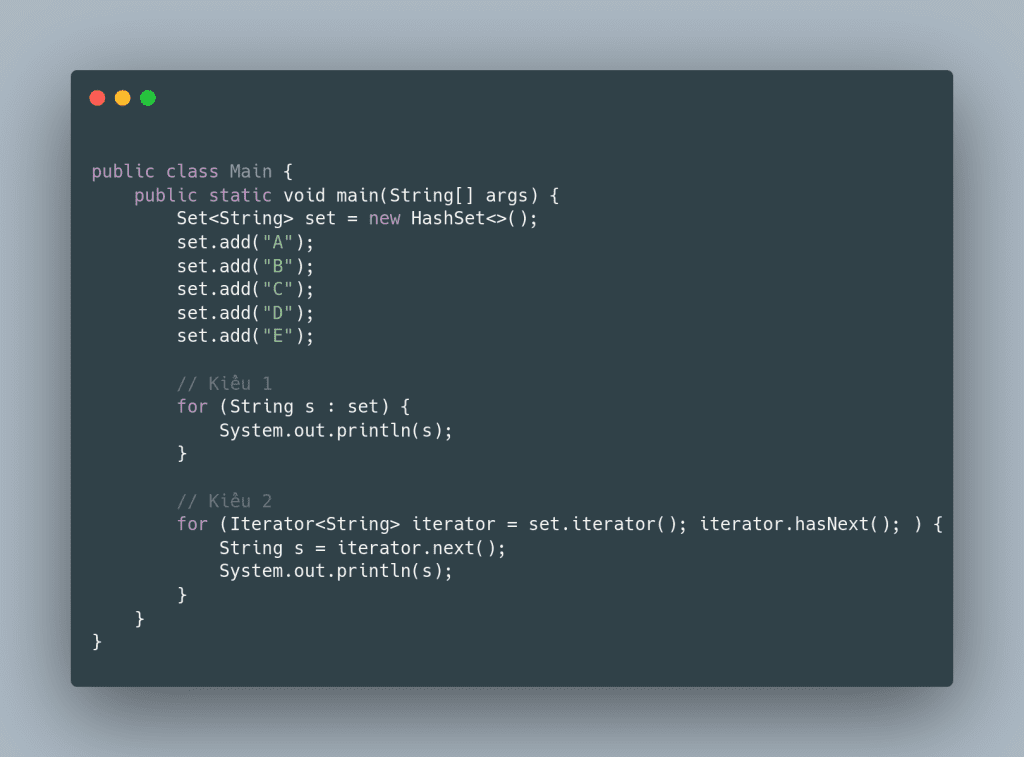
Hoặc là có thể duyệt bằng for-each, có 2 kiểu như sau:
Định nghĩa một số cấu trúc dữ liệu trong Java
Set
Set: là một cấu trúc dữ liệu mà nó không chứa các phần tử trùng lặp. Các phần tử trong Set được sắp xếp theo thứ tự tùy vào cách implement của từng class. Các class implement Set có thể là HashSet, LinkedHashSet, TreeSet, …
HashSet: là một class implement Set, nó sử dụng một HashMap để lưu trữ các phần tử. Do đó, các phần tử trong HashSet sẽ không được sắp xếp theo thứ tự
LinkedHashSet: là một class implement Set, nó sử dụng một LinkedHashMap để lưu trữ các phần tử. Do đó, các phần tử trong LinkedHashSet sẽ được sắp xếp theo thứ tự.
TreeSet: là một class implement Set, nó sử dụng một TreeMap để lưu trữ các phần tử. Do đó, các phần tử trong TreeSet sẽ được sắp xếp theo thứ tự.
Độ phức tạp:
HashSet
LinkedHashSet
TreeSet
Cách thức làm việc
HashSet sử dụng HashMap nội bộ để lưu trữ phần tử.
LinkedHashSet sử dụng LinkedHashMap nội bộ để lưu trữ phần tử.
TreeSet sử dụng TreeMap nội bộ để lưu trữ phần tử.
Thứ tự của các phần tử
Không duy trì thứ tự của các phần tử.
Duy trì thứ tự chèn của các phần tử.
Duy trì thứ tự theo bộ so sánh (hoặc tăng dần tự nhiên).
Hiệu suất
Tốt hơn so với LinkedHashSet và TreeSet.
Nằm giữa HashSet và TreeSet, hiệu suất gần như tương tự HashSet.
Thấp hơn HashSet và LinkedHashSet do phải sắp xếp.
Thao tác thêm, xóa, truy xuất
O(1) cho chèn, loại bỏ, và truy xuất.
O(1) cho chèn, loại bỏ, và truy xuất.
O(log(n)) cho chèn, loại bỏ, và truy xuất.
So sánh các phần tử
Sử dụng equals() và hashCode() để so sánh và loại bỏ phần tử trùng lặp.
Sử dụng equals() và hashCode() để so sánh và loại bỏ phần tử trùng lặp.
Sử dụng compare() hoặc compareTo() để so sánh và loại bỏ phần tử trùng lặp. Không sử dụng equals() và hashCode().
Phần tử Null
Cho phép tối đa một phần tử null.
Cho phép tối đa một phần tử null.
Không cho phép phần tử null, nếu thử chèn sẽ ném NullPointerException.
Sử dụng bộ nhớ
Đòi hỏi ít bộ nhớ hơn so với LinkedHashSet và TreeSet.
Yêu cầu bộ nhớ nhiều hơn HashSet do duy trì LinkedList cùng với HashMap.
Yêu cầu bộ nhớ nhiều hơn HashSet do duy trì bộ so sánh và TreeMap.
Khi nào sử dụng?
Muốn danh sách không chứa phần tử trùng và không cần duy trì thứ tự.
Muốn danh sách không chứa phần tử trùng và muốn duy trì thứ tự chèn.
Muốn danh sách không chứa phần tử trùng và muốn sắp xếp các phần tử.
Tóm gọn:
HashSet: không duy trì thứ tự, tốc độ nhanh
LinkedHashSet: duy trì thứ tự theo thứ tự chèn, tốc độ giữa
TreeSet: duy trì thứ tự theo bộ so sánh, tốc độ chậm hơn
Map
Là cấu trúc dữ liệu theo kiểu key-value, trong đó key là duy nhất, và value có thể trùng nhau. Các class implement Map có thể là HashMap, LinkedHashMap, TreeMap, …
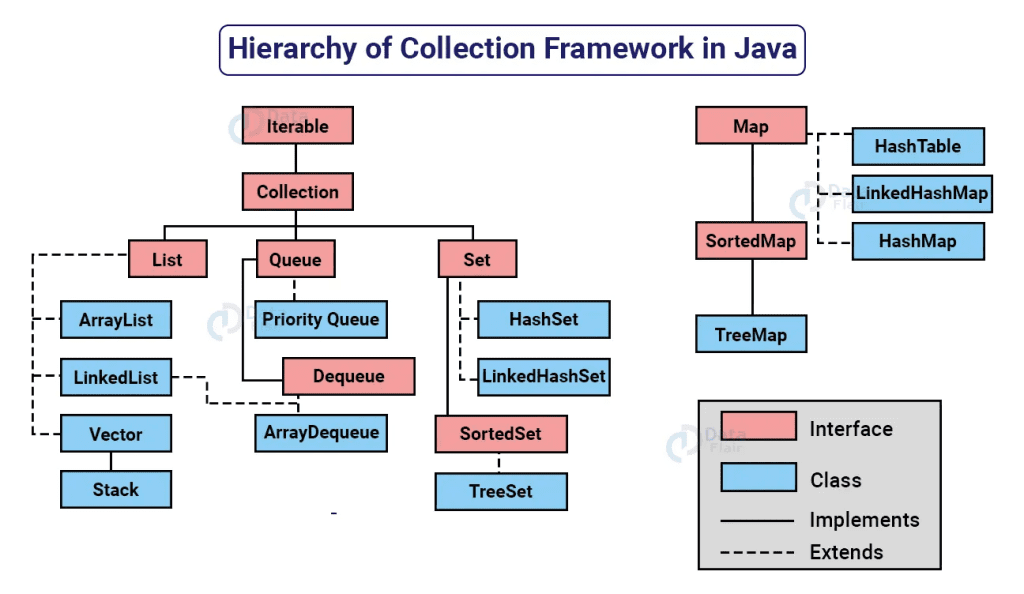
Sơ đồ kế thừa của các cấu trúc dữ liệu trong Java
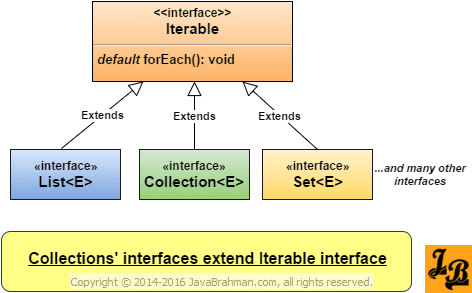
Theo hình trên, ta có 3 interface chủ đạo gồm List, Queue, Set sẽ kế thừa từ interface Collection. Từ interface Collection, chúng sẽ có các hàm chung như add, remove, contains, … và các hàm khác.
Lúc này, ở các class implement List, Queue, Set, chúng sẽ phải implement các hàm này, và tự triển khai logic cách để add, remove, contains, … như thế nào. Ngoài ra là triển khai các hàm từ interface Iterable, để có thể duyệt qua các phần tử của chúng, và các hàm từ riêng các interface List, Queue, Set, để có thể thực hiện các thao tác riêng của chúng.
Map thì là một trường phái khác, do chúng không kế thừa từ interface Collection, vì Map nhận vào 2 value. Do đó, để sử dụng được các hàm Collection trong Map, ta có thể lấy ra keySet, valueSet, entrySet của Map, và sử dụng các hàm Collection trên chúng.
Về Comparable và Comparator, cách sử dụng trong các cấu trúc dữ liệu để sắp xếp
Trong Java, có 2 cách để sắp xếp các phần tử của một cấu trúc dữ liệu, đó là sử dụng Comparable và Comparator.
Comparable là một interface, nó có một hàm là compareTo(), và nó được implement bởi các class muốn sắp xếp các phần tử của chúng. Hàm compareTo() sẽ trả về một số nguyên, và nó sẽ được sử dụng để so sánh 2 phần tử của cấu trúc dữ liệu đó. Nếu trả về số âm, thì phần tử đầu tiên sẽ được đặt trước phần tử thứ hai, nếu trả về số dương, thì phần tử thứ hai sẽ được đặt trước phần tử đầu tiên, nếu trả về 0, thì 2 phần tử sẽ được đặt ngang hàng với nhau.
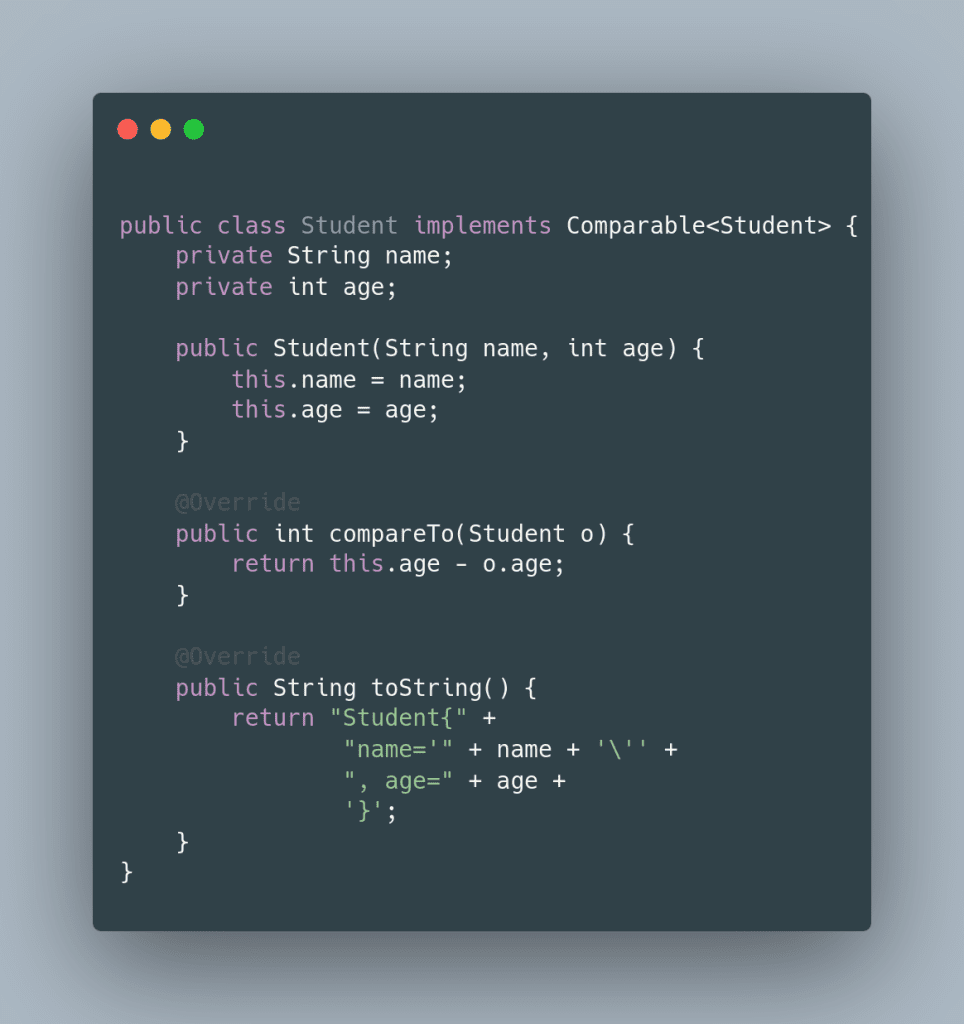
Code ví dụ:
Như code trên, class Student implement interface Comparable, và phải triển khai cách để so sánh giữa 2 Student với nhau
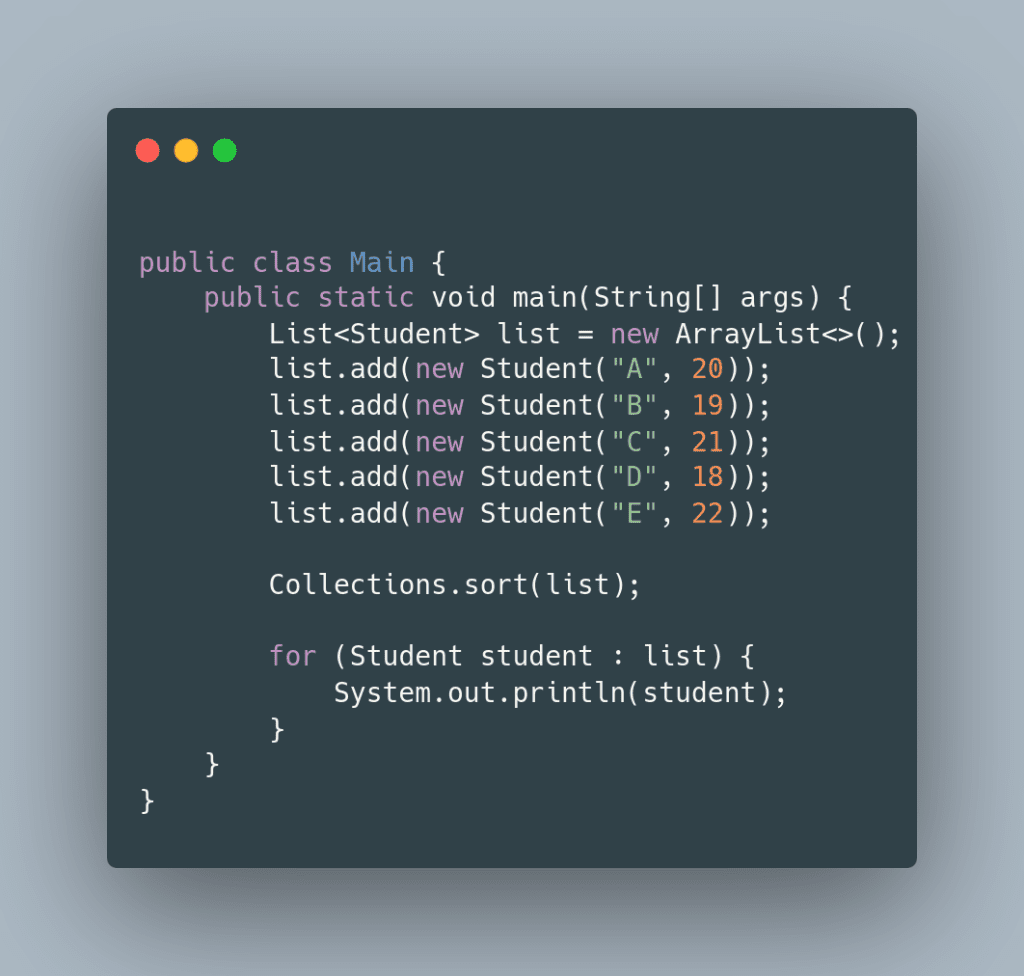
Để sử dụng so sánh, ta có thể sử dụng hàm sort() của class Collections để sắp xếp các phần tử của một List:
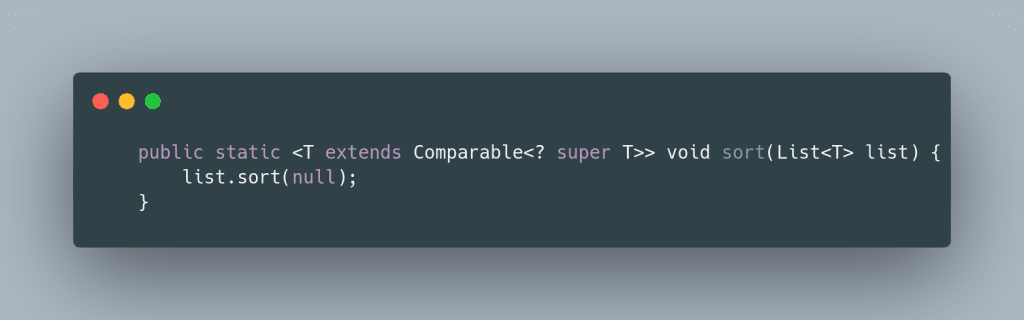
Code thực tế trong Collection, có thể Ctrl+Click vào để xem
Như code trên, ta có thể thấy, hàm sort của Collections sẽ nhận vào một List, và List này phải chứa T là một class implement Comparable, và hàm sort sẽ sử dụng hàm compareTo của T để so sánh các phần tử của List với nhau.
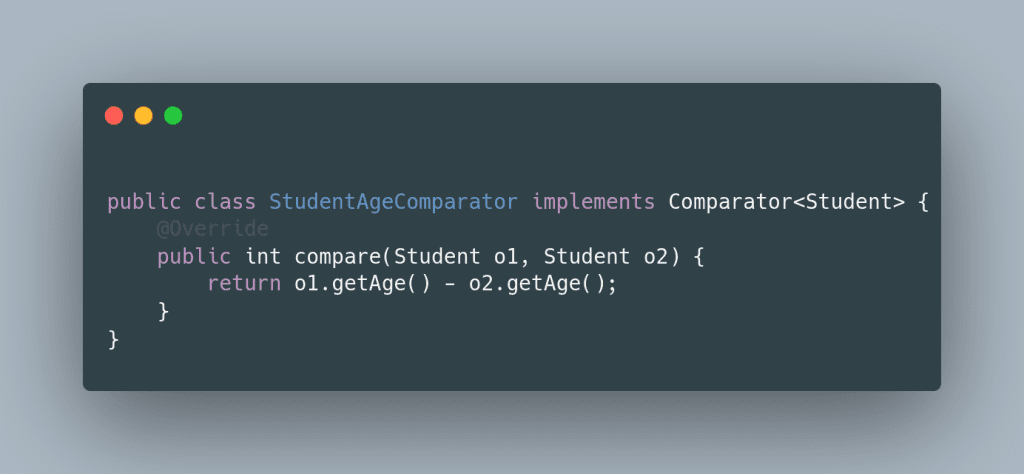
Comparator là một interface, nó có một hàm là compare(), và nó được implement bởi các class muốn sắp xếp các phần tử của chúng. Hàm compare() sẽ trả về một số nguyên, và nó sẽ được sử dụng để so sánh 2 phần tử của cấu trúc dữ liệu đó. Nếu trả về số âm, thì phần tử đầu tiên sẽ được đặt trước phần tử thứ hai, nếu trả về số dương, thì phần tử thứ hai sẽ được đặt trước phần tử đầu tiên, nếu trả về 0, thì 2 phần tử sẽ được đặt ngang hàng với nhau.
Code ví dụ:
Như code trên, class StudentAgeComparator implement interface Comparator, và phải triển khai cách để so sánh giữa 2 Student với nhau
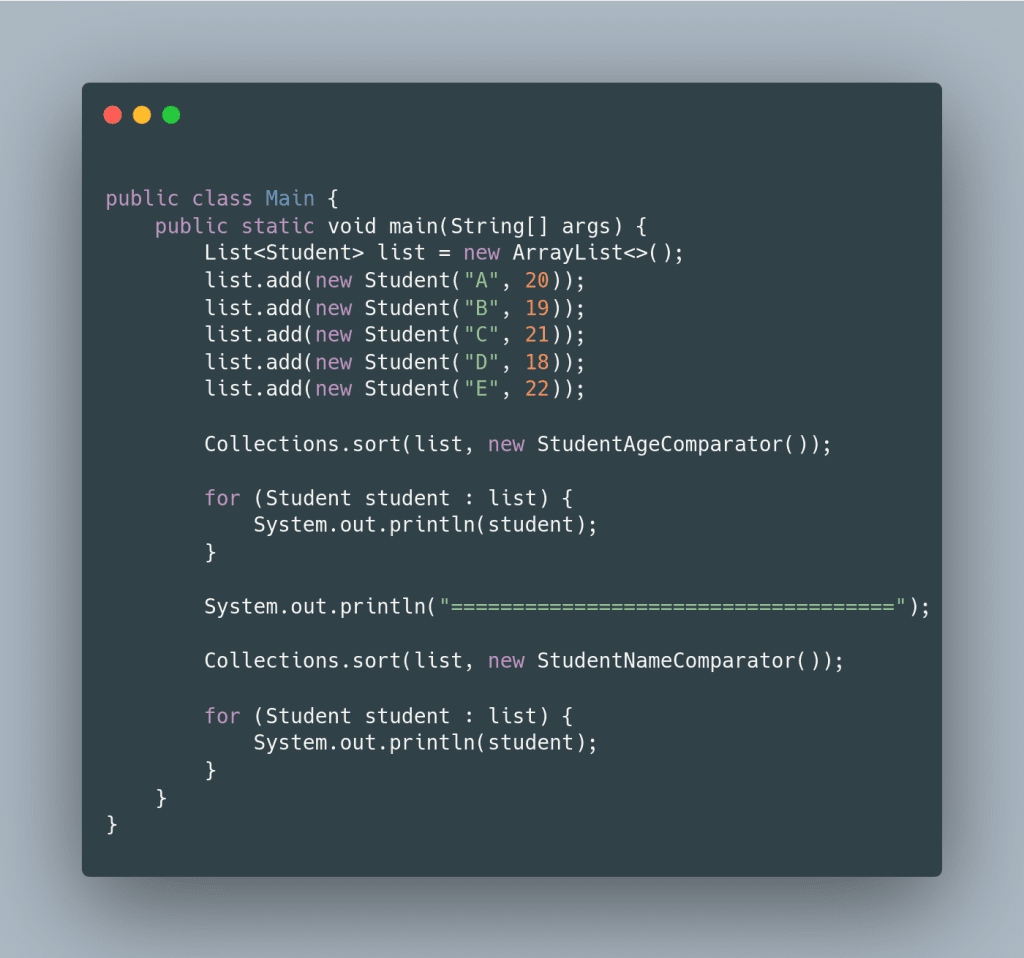
Để sử dụng so sánh, ta có thể sử dụng hàm sort() của class Collections để sắp xếp các phần tử của một List:
Code thực tế trong Collection, có thể Ctrl+Click vào để xem
Như code trên, ta có thể thấy, hàm sort của Collections sẽ nhận vào một List, và 1 Comparator, và hàm sort sẽ sử dụng hàm compare của Comparator để so sánh các phần tử của List với nhau.
So sánh Comparable và Comparator
Comparable
Comparator
Comparable là một interface, nó có một hàm là compareTo(), và nó được implement bởi các class muốn sắp xếp các phần tử của chúng.
Comparator là một interface, nó có một hàm là compare(), và nó được implement bởi các class muốn sắp xếp các phần tử của chúng.
Comparable bắt buộc triển khai trong class mà ta muốn sort class đó, và chỉ chỉ khai được một cách duy nhất.
Comparator không bắt buộc triển khai trong class mà ta muốn sort class đó, và có thể khai báo nhiều Comparator khác nhau, tuỳ vào mục đích sử dụng.
Ví dụ về việc sử dụng nhiều loại Comparator khác nhau:
Như code trên, ta có thể thấy, ta có thể sử dụng nhiều Comparator khác nhau, để sắp xếp các phần tử của List theo nhiều cách khác nhau.
Khi nào dùng interface, khi nào dùng abstract class?
Bài tập về interface và trừu tượng
Interface là gì?
Interface là một khái niệm trừu tượng, nó chỉ ra những gì mà một đối tượng có thể làm, nhưng không nói ra làm thế nào để đối tượng đó làm được điều đó.
Ví dụ cú pháp khai báo interface:
Trong ví dụ trên, interface Animal chỉ ra rằng một Animal có thể làm được 2 việc là ăn và di chuyển, nhưng không nói ra làm thế nào để ăn và di chuyển.
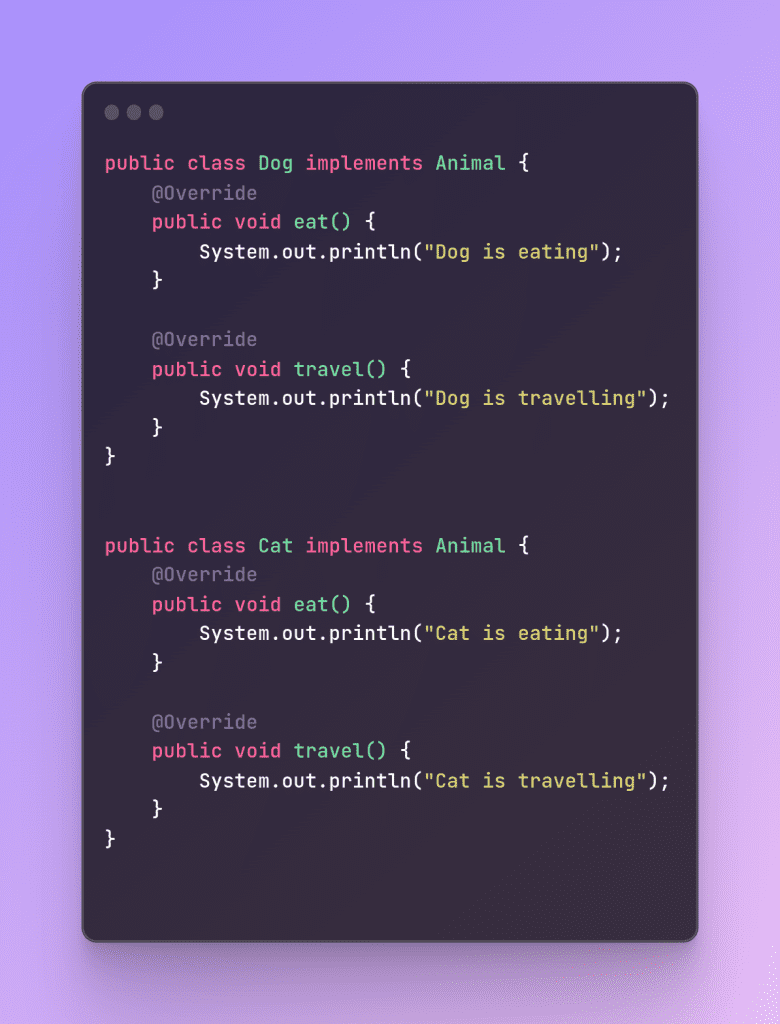
Lúc này, ví dụ ta có 1 class Dog và Cat thì ta có thể implement interface Animal vào 2 class này như sau:
Lúc này, ta có thể khởi tạo 2 đối tượng Dog và Cat và gọi các phương thức eat() và travel() mà không cần quan tâm đến cách thức của 2 phương thức này.
Kết quả khi chạy chương trình:
Dog is eating

Dog is travelling

Cat is eating

Cat is travelling
Take away | Tổng hợp
Như vậy, interface có thể nhìn nhận như 1 bản hợp đồng, tôi quy định trước, tôi chỉ định nghĩa là, các class implement interface này phải làm được những gì tôi quy định.
Như vậy, khi bên khác implement interface này, bên đó phải làm theo những gì mà interface quy định, nếu không làm theo, bên đó sẽ bị lỗi compile.
Còn nếu bên nào sử dụng interface, ta có thể khởi tạo đối tượng của class implement interface đó, và gọi các phương thức, và biết chắc phương thức tồn tại và có thể gọi được ở class đó, vì class đó đã implement interface đó.
Abstract class
Abstract Class – Lớp trừu tượng, là 1 lớp trong Java, nhưng có thể chứa cả các phương thức trừu tượng (abstract method) và các phương thức thường (non-abstract method).
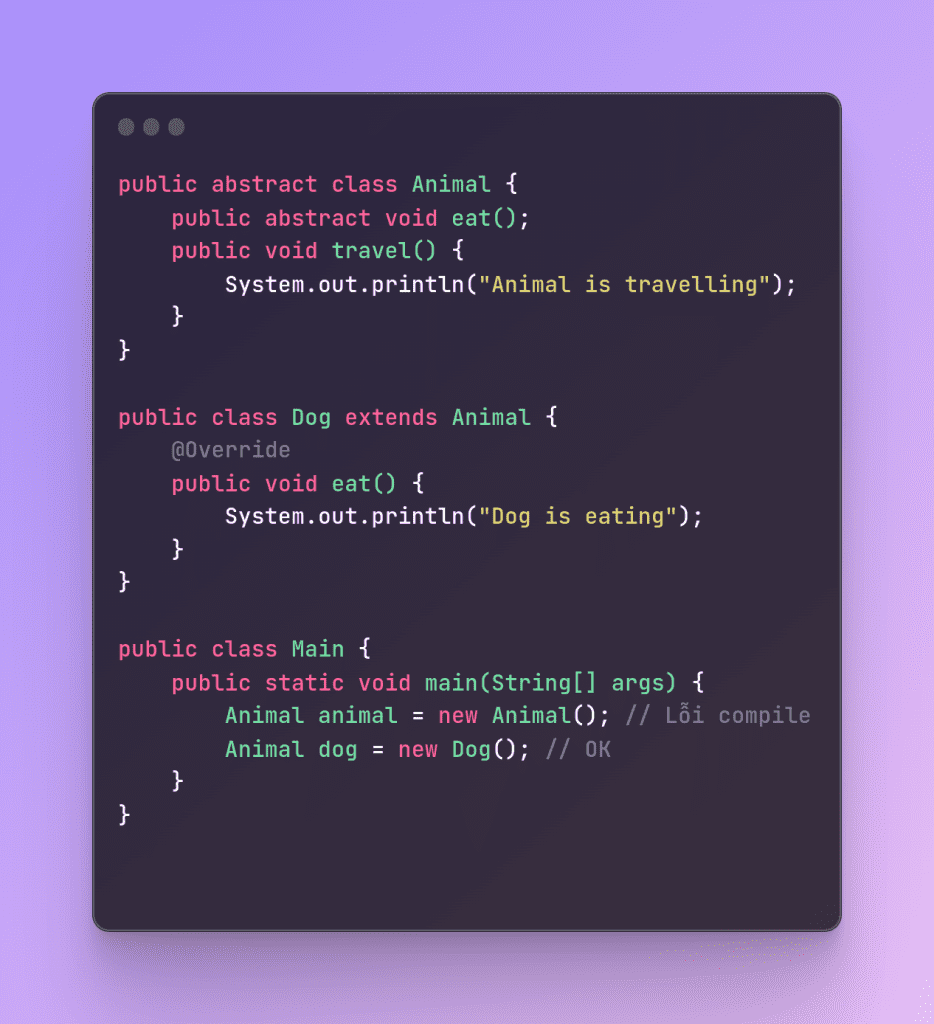
Abstract Class không thể khởi tạo đối tượng, nhưng có thể khai báo biến kiểu Abstract Class, và khởi tạo đối tượng của class con của Abstract Class.
Ví dụ:
Kết quả khi chạy chương trình:
Dog is eating

Animal is travelling

Cat is eating

Animal is travelling
Take away | Tổng hợp
Như vậy, Abstract Class nhìn chung giống Class, nhưng mà có thể tạo thêm phương thức trừu tượng, các class kế thừa từ Abstract Class này phải implement các phương thức trừu tượng này, nếu không sẽ bị lỗi compile.
Các phương thức trừu tượng này, có thể hiểu là các phương thức mà Abstract Class này quy định, các class kế thừa từ Abstract Class này phải có, và phải implement các phương thức này.
Các phương thức thường (non-abstract method) thì không cần implement, vì các class kế thừa từ Abstract Class này đã có sẵn các phương thức này.
Abstract Class thì không thể khởi tạo đối tượng, nhưng có thể khai báo biến kiểu Abstract Class, và khởi tạo đối tượng của class con của Abstract Class.
Ví dụ
Lí do, vì abstract class hay interface chứa những hàm trừu tượng, những hàm chỉ định nghĩa, chưa có logic và giao việc triển khai logic cho các nơi ghi đè nó, nên không thể khởi tạo đối tượng từ abstract class hay interface được. (Vì nó chưa có logic, chưa có gì để chạy cả)
So sánh Interface và Abstract Class
Interface
Abstract Class
Interface chỉ có thể chứa các phương thức trừu tượng
Abstract Class có thể chứa cả các phương thức trừu tượng và các phương thức thường
Interface không thể khởi tạo đối tượng
Abstract Class không thể khởi tạo đối tượng
Biến trong interface mặc định là public static final
Biến trong abstract class không có mặc định gì cả
Interface không có constructor
Abstract Class có constructor
Interface không có gì để ghi đè
Abstract Class có thể có các phương thức để ghi đè
Interface có thể kế thừa nhiều interface khác
Abstract Class chỉ có thể kế thừa 1 abstract class khác
Các class implement interface có thể implement nhiều interface khác
Các class kế thừa từ abstract class chỉ có thể kế thừa 1 abstract class khác
Note: Sau này interface có thể có các phương thức thường, nhưng mà vẫn không thể khởi tạo đối tượng từ interface được.
Về biến trong interface, mặc định là public static final, nên khi khai báo biến trong interface, không cần khai báo public static final nữa. Tức là các biến trong interface là tồn tại duy nhất, không đổi được, ở dạng static.
Về biến trong abstract class, không có mặc định gì cả, nên có thể tạo các “biến thường”, tức là mỗi object tạo ra bởi 1 class chứa giá trị khác nhau.
Special Question: Diamond Problem
Diamond Problem là gì?
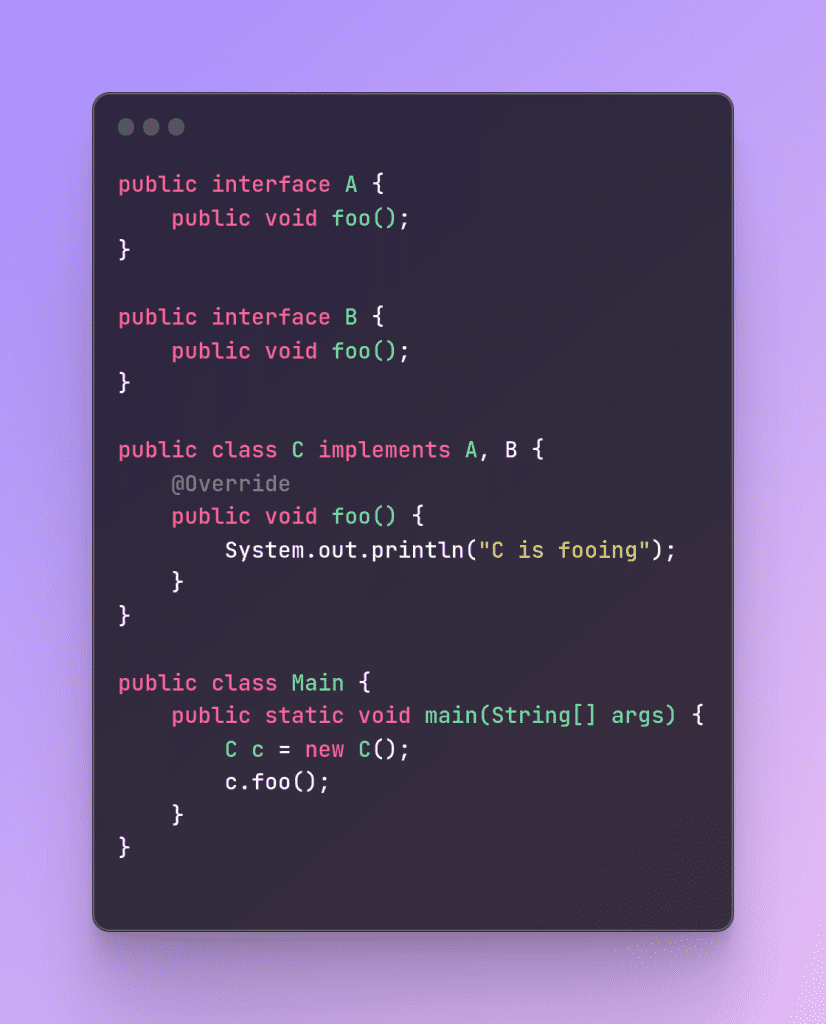
Diamond Problem là một vấn đề xảy ra khi đa kế thừa, tức là nếu 1 class kế thừa từ 2 nơi có trùng thứ gì đó, thì nó làm sao biết nên dùng cái nào ???
Mặc định thì, Java không cho phép kế thừa từ 2 class, nhưng nếu kế thừa từ 2 interface thì được. (Vì interface chỉ chứa các phương thức trừu tượng, không có gì để ghi đè)
Ví dụ:
Khi nào dùng interface, khi nào dùng abstract class?
Khi nào dùng interface, khi nào dùng abstract class?
Câu trả lời đơn giản: Khi nào cần thì dùng, tuỳ vào mục đích của mình
Nhưng mà, để hiểu rõ hơn, ta cùng xem ví dụ sau:
Như vậy, ta có thể thấy, khi dùng interface, ta phải implement lại cả phương thức travel(), trong khi khi dùng abstract class, ta không cần implement lại phương thức travel().
Tuy nhiên, interface lại cho phép ta kế thừa nhiều interface khác, trong khi abstract class thì không.
Tổng kết
Có thể thấy, abstract class cho phép ta có các khả năng trừu tượng, và có thể chứa các logic có sẵn ta muốn dùng cho nhiều class con. Lúc này ta có thể cân nhắc sử dụng abstract class
Thay vì điều đó, interface thường được dùng để chỉ behavior - tính cách, cách xử sự của 1 đối tượng. Tức là 1 cái ô tô thì có thể xử lý các interface là ChayXe, ChayDongCo, ChayDien, ChayDau… Như vậy, interface thường được dùng để chỉ ra tính chất của 1 đối tượng, còn logic thì để class implement interface đó tự triển khai.
Với abstract class, ta dùng cho những case ta có logic tập trung, có thể reuse ở class con. Vừa có khả năng trừu tượng mà các class con sẽ có đặc tính riêng. Tuy nhiên nếu class đó quá lớn, ví dụ class PhuongTien có đủ thứ hàm như ChayXe, ChayDongCo, ChayDien, ChayDau… , thì ví dụ XeDap kế thừa lại có các hàm chạy động cơ, chạy điện => Như thế bị thừa, không cần thiết, làm confuse cho người đọc code => Ta nên tách ra thành interface.
Với interface, ta dùng cho những case ta chỉ cần chỉ ra tính chất của 1 đối tượng, còn logic thì để class implement interface đó tự triển khai.
Tính trừu tượng
Tính trừu tượng là gì?
Tính trừu tượng là một khái niệm trong lập trình hướng đối tượng, nó cho phép ta chỉ ra những gì mà một đối tượng có thể làm, nhưng không nói ra làm thế nào để đối tượng đó làm được điều đó.
Tức là, khi ta dùng xe máy, ta chỉ biết là nó có thể chạy, có thể dừng, có thể bật đèn, có thể bật còi, nhưng ta không cần biết làm thế nào để nó chạy, dừng, bật đèn, bật còi.
Tính trừu tượng là một khái niệm quan trọng trong lập trình hướng đối tượng, nó cho phép ta tách biệt được phần logic của đối tượng và phần giao tiếp với đối tượng. Ta chỉ quan tâm đến phần giao tiếp với đối tượng, còn phần logic của đối tượng thì ta không cần quan tâm. Điều này giúp ta có thể dễ dàng thay đổi phần logic của đối tượng mà không ảnh hưởng đến phần giao tiếp với đối tượng.
Tại sao cần sử dụng interface
Giả sử, ta có 1 interface là “Athlete” – Vận động viên với 2 hàm là play() – là chơi thể thao nào đó
Giả sử, ta có 1 class Team – 1 đội chơi, sẽ có thể thêm vận động viên vào, ta nhận thấy, nếu có thể, ta luôn lên sử dụng interface thay vì khai báo thẳng 1 class cụ thể, vì khi đó, ta có thể thêm bất cứ vận động viên nào vào đội chơi, miễn là vận động viên đó implement interface Athlete.
Như code trên, bất kì vận động viên nào implement interface Athlete đều có thể thêm vào đội chơi, và có thể chơi được. Điều này giúp code dễ mở rộng, flexible hơn, sau này ta có thể thêm bất cứ vận động viên nào vào đội chơi, miễn là vận động viên đó implement interface Athlete.
Đây cũng được biết là quy tắc prefer interface over class hay prefer composition over inheritance
Interface làm đúng sự phụ thuộc của module level cao
Giả sử, ta có class DienThoai, khi này khi ta muốn sạc điện thoại, ta sẽ gọi 1 class bên trong DienThoai là sạc điện bằng củ sạc Samsung
Ta thấy, với thiết kế hiện tại, ta sẽ truyền tham số là cường độ vào củ sạc Samsung để class đó thực hiện sạc.
Tuy nhiên, bất kì sự thay đổi nào ở class CuSac vào phương thức sac có thể yêu cầu class điện thoại truyền thêm tham số, hay phải dùng tên hàm khác, …
Điều này là không đúng, điện thoại rõ ràng là module cấp cao hơn, và nên có quyền quyết định dùng củ sạc nào, chứ không phải củ sạc quyết định điện thoại phải làm gì để dùng.
Vì vậy, ta nên tạo ra 1 interface là CuSac để điện thoại có thể sạc, và class CuSacSamSung implement interface CuSac này.
Lúc này, sự phụ thuộc đã thay đổi. Giờ DienThoai chỉ sử dụng interface củ sạc, ví dụ như Iphone quy định là tôi dùng cổng lightning, máy Samsung bảo tôi dùng cổng sạc USB-C vậy. Các nhà sản xuất củ sạc phải đi theo họ.
Thì ở đây, DienThoai dùng interface để định nghĩa là tôi sẽ muốn sạc như thế nào. Còn củ sạc thì implement interface đó, và tự triển khai logic riêng của mình, nhưng phải tuân thủ theo hợp đồng interface mà DienThoai sử dụng
Chuẩn hoá database (Database normalization) là một cách thức cấu trúc các dữ liệu trong một cơ sở dữ liệu quan hệ theo một dạng chuẩn. Đơn giản thì, ta sẽ kết nối các thông tin giữa các bảng khác nhau bằng 1 key hay 1 id gì đó định danh 1 hàng.
Việc chuẩn hoá database giúp đảm bảo dữ liệu sẽ “chuẩn hơn”, giảm bớt các khả năng xảy ra một số hiện tượng dưới đây:
Một số vấn đề mà chuẩn hoá database giải quyết
Insertion anomaly (Khi thêm dữ liệu): Xảy ra khi một dữ liệu được thêm vào bảng nhưng không theo cấu trúc của bảng. Ví dụ, ta có một cột trong bảng người dùng là address, chứa địa chỉ người dùng. Tuy nhiên do không có ràng buộc gì cả, thì có thể có những người dùng địa chỉ là “xã, tỉnh, quốc gia”, có người lại là “số nhà, xã, tỉnh, quốc gia”, do dữ liệu ở 1 cột chỉ là 1 dạng text.
Update anomaly (Khi cập nhật) xảy ra khi dữ liệu không được cập nhật ở mọi vị trí. Ví dụ, ta có 2 bảng là thông tin sinh viên và thông tin công dân. Cả 2 đều chỉ về 1 đối tượng, tuy nhiên do có 2 cột địa chỉ ở cả 2, thì khi cập nhật 1 cái, có thể địa chỉ của cái còn lại cũng nên được đồng bộ.
Deletion anomaly (Khi xoá): Do dữ liệu “địa chỉ” nếu nằm ở nhiều bảng khác nhau dù chung mục đích, khiến nếu muốn xoá một dữ liệu đi cần xoá ở nhiều vị trí hơn.
Ví dụ về chuẩn hoá Database
Giả sử ta có bảng sau để chứa các Assistant Principal, sẽ dạy các học sinh nào, lớp nào
Ta thấy, ta đang lưu danh sách học sinh theo kiểu cách nhau bằng dấu phẩy, và tương tự với student id.
Có một số vấn đề có thể nhận thấy. Việc lưu như vậy khiến ta phải scale chiều dài dữ liệu cột Students theo số lượng sinh viên, và ví dụ, ta scale nó là một dung lượng nào đó là 10000 kí tự chẳng hạn, mà nhiều dòng lại không dùng tới 10000 kí tự => điều này vô hình chung làm dữ liệu của hàng bị phình to, chỗ nhiều chỗ ít, mà lại tốn tài nguyên để scale toàn bộ hàng có dữ liệu là 10000.
Ở mức chuẩn hoá 1NF, ta có thể tách bảng thành như sau
Ta vẫn lưu được các dữ liệu cần thiết, và trong 1 ô đảm bảo không có lưu như vậy nữa
Tuy nhiên, ta nhận thấy, có nhiều hàng có dữ liệu trùng nhau, vd như Jack White, hay id của các Assistant Principal
Với ở dạng này, ta nhận thấy, nếu bảng có thêm nhiều trường hơn, to hơn nữa. Thì ta sẽ có rất nhiều hàng trùng dữ liệu thừa thãi, kiểu đều chung Class, Class ID, Assistant Principal Id, …. rất nhiều trường khác, chỉ khác nhau đúng trường Student Name và Student ID
Lúc này, ta sang mức chuẩn hoá 2NF. Ta sẽ nhìn chung vẫn như cách 1NF là có nhiều hàng tách ra để hiển thị dữ liệu. Tuy nhiên, ta chỉ nhớ chúng theo ID, rồi sau đó từ ID đó ta có thể lấy dữ liệu ở bảng riêng biệt dành riêng cho việc lưu trữ Student => Mà không gộp nó vào 1 chỗ nữa
Lúc này dữ liệu trùng và bị lặp chỉ có cột id, và nó nhẹ hơn nhiều
Ở mức chuẩn hoá 3NF tiếp theo, ta đưa mọi dữ liệu về riêng bảng của nó. VD ta có bảng riêng chỉ lưu class, bảng riêng chỉ lưu student, …
Ưu điểm chuẩn hoá
Chuẩn hoá database nhìn chung giúp ta giảm bớt sự trùng lặp dữ liệu, dữ liệu dư thừa, bằng việc sử dụng nhiều bảng riêng biệt để lưu các dữ liệu cần thiết. Giúp dữ liệu gọn nhẹ, dễ nhìn hơn.
Chuẩn hoá cũng giúp ta giảm thiểu việc có các ô dữ liệu trống (null), vì ví dụ: Nếu ta có 1 bảng chỉ là ConNguoi, có cả cột lương thưởng (cho người đi làm), và tiền đóng học (cho sinh viên). Vậy sinh viên thì không có lương thưởng, còn người đi làm không có ô tiền đóng học. Ta có thể tách riêng bảng ra cho mục đích đó.
Đảo chuẩn hoá Database và case study của Instagram
Nhược điểm của chuẩn hoá
Vì lúc này dữ liệu bị phân tán ra, ta thường phải viết các câu query phức tạp hơn, gộp nhiều bảng vào với nhau để thao tác dữ liệu, việc này tăng độ phức tạp của hệ thống, cũng như giảm tốc độ vì phải đọc nhiều bảng khác nhau.
Ví dụ với dữ liệu trên, để lấy danh sách sinh viên, hoặc số lượng sinh viên 1 Assistant Principal quản lý, ta chỉ cần 1 cột trong bảng, rồi select 1 row là được
Còn nếu tách riêng ra, ta phải join cả bảng Student vào, rồi select filter theo assistant id, và để đếm số lượng thì phải dùng count
Việc này được gọi là đảo chuẩn hoá database, nó có thể làm dữ liệu bị dư thừa và tạo ra nhiều vấn đề mà chuẩn hoá giải quyết, nhưng bù lại giúp cải thiện hiệu năng hệ thống
Ví dụ của Instagram về chuẩn hoá database
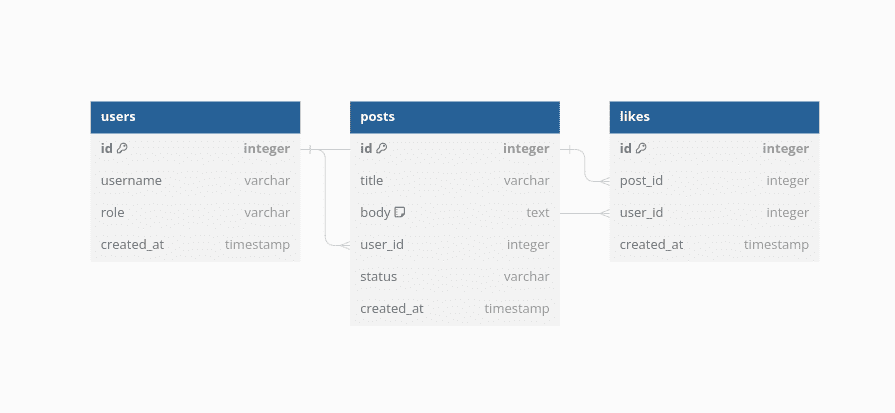
Ta có bảng users là thông tin người dùng. 1 bảng posts là các bài viết của người dùng, và bảng likes là chứa thông tin về các lượt like của 1 bài viết, gồm ai là người like bài viết đó.
Lúc này, để lấy tổng số like của bài viết, ta thường phải gọi lệnh vào bảng likes dạng
SELECT
    posts.id AS post_id,
    posts.title AS post_title,
    COUNT(likes.id) AS total_likes
FROM
    posts
LEFT JOIN
    likes ON posts.id = likes.post_id
WHERE
    posts.id = 1
GROUP BY
    posts.id, posts.title;
cơ bản thì nó cần join vào bảng likes, rồi tìm các likes thuộc id bài viết và đếm. Điều này nhìn chung nếu 1 bài viết có 1 triệu likes, thì ta phải đếm 1 triệu hàng, và có hàng tá bài viết như thế, và rất nhiều người cùng vào like, xem bài viết, mỗi khi cần hiển thị tổng số like, ta phải chạy lại lệnh kia, thứ mà rất tốn thời gian.
Lúc này ta có thể áp dụng đảo chuẩn hoá, bằng việc đơn giản là sẽ thêm 1 cột total_likes để lưu trữ tổng lượng like của bài viết, ta vẫn cần bảng likes để khi người ta mở xem ai là người likes thì nó sẽ lưu trữ thông tin.
Hiển nhiên, việc này sẽ khiến việc quản lý và code sẽ phức tạp hơn để vừa có cơ chế chuẩn hoá, mà lại đảo chuẩn hoá 1 thuộc tính, nhưng nó giúp cho query database nhanh hơn rất nhiều.
Lúc này, ta đã đang thực hiện giao tiếp với server qua token, có một câu hỏi đặt ra là, làm sao để gửi token đó cho phía server?
Hiển nhiên, ta có thể làm điều ở ở body của request, ở param, … hoặc ở cookie. Tuy nhiên, có một cách thông dụng và được sử dụng hầu hết hiện nay để chuyển 1 token không qua cookie đó là sử dụng dạng “Bearer” https://tools.ietf.org/html/rfc6750
Bearer lúc đầu được tạo ra nhằm phục vụ cho OAuth2 (sẽ nói thêm sau)
Để gửi 1 token qua api, ta chỉ cần để nó ở header Authorization
Authorization: Bearer QDAmQ9TStkDCpVK5A9kFowtYn2k
Việc sử dụng giao tiếp qua Authorization cũng cho phép ta sử dụng header WWW-Authenticate để giúp đầu api “thân thiện” với http hơn
WWW-Authenticate có thể theo kèm một tham số là “realm”, bạn có thể hiểu trường này như một trường nhằm định dang đầu api hiện tại. VD nếu realm = admin, thì client sẽ hiểu đầu api này cần token dành cho admin, nếu realm = users thì là các đầu api open cho user
Ngoài ra, ta cũng có thể thêm các thông báo về việc token hết hạn, sai, …
HTTP/1.1 401 Unauthorized
WWW-Authenticate: Bearer realm="users", error="invalid_token",
        error_description="Token has expired"
Phần này giúp phía client có thể biết là token đã hết hạn và yêu cầu tạo token mới
Để lưu token ở phía client mà không cần sử dụng cookie, ta có thể sử dụng các bộ nhớ có sẵn của trình duyệt như
sessionStorage: Các thực thể có thể được lưu tại đây, bộ nhớ chỉ là tạm thời và bị xoá khi tab bị đóng
localStorage: Dữ liệu được lưu kể cả khi trình duyệt đóng và chỉ xoá nếu ta yêu cầu
Nghe sessionStorage giống với cookie, tuy nhiên sessionStorage sẽ không share giữa các tab với nhau. Tức là cookie sẽ share giữa các tab, nhưng chỉ chung 1 domain (tức là phân biệt bằng tên miền). Còn sessionStorage chỉ lưu trạng thái ở tab hiện tại
JWT Token
Ta đã đi qua cách authentication bằng sử dụng basic authentication, rồi đến token được lưu ở cookie hoặc local/session storage. Tuy nhiên các cách thức này đều yêu cầu token cũng phải được lưu ở phía server.
Tức là mỗi truy vấn vào server, ta lại phải gọi vào database, với hàng triệu, hàng tỉ token ngày càng tăng lên để kiểm tra xem token có tồn tại chưa, có hết hạn chưa, … Chưa kể đến ta còn phải giải mã token ra nếu ta mã hoá nó trong database (thường là có)
Việc này tạo thành một bài toán lớn và ngày càng khó giải khi số lượng user tăng cao
Lúc này, có một giải pháp khác đã được tạo ra, đó là JWT (Json Web Token)
Định nghĩa: JWT hay JSON Web Token là một format thông dụng cho các token ở dạng “self-contained” (chỉ lưu ở client). JWT thường bao gồm các claims (các khẳng định rằng user này có gì, có kia) và các quyền của user. VD, JWT sẽ chứa là user có quyền được vào trang a, trang b, ….
JWT ngoài ra được mã hoá crypto để bảo vệ khỏi các vấn đề bảo mật liên quan
Lưu JWT ở phía Client
Bạn sẽ có câu hỏi: Làm sao để một token chỉ có thể lưu ở client mà không ở server, vậy thì làm sao ta biết là token nào là thoả mãn, chưa bị người khác sửa, thêm quyền kiểu admin vào và cầm token đó đi request server?
Một trong các cách được đề ra có thể xem qua ảnh sau. Tức là khi phía server sinh ra 1 token thoả mãn, ta sẽ thêm 1 key (HMAC) vào đuôi của token.
Hmac được sinh ra từ claims và 1 đoạn key, điều này giúp kiểm tra nếu đoạn claims đã bị sửa đổi thì phần HMAC sẽ không trùng khớp nữa.
Điều này đảm bảo là người khác khi sửa gì đó thì sẽ không thoả mãn nữa do ta có phần đuôi tag để kiểm tra xem. (Server sẽ thử giải mã phần key xem có đúng với ban đầu không, key này chỉ server biết)
Cấu trúc JWT có 3 phần
Header: Chứa các thông tin về kiểu token này dùng mã hoá dạng gì, …
Claims: Phần chứa thông tin ta muốn để trong token, ví dụ quyền của user
HMAC Tag: Phần mã hoá đảm bảo tính toàn vẹn của token
JWT trở lên ngày càng phổ biến ở những năm gần đây do JSON Web Tokens đã được tiêu chuẩn hoá vào 2015. (Trước đây ta gọi những token stateless bên trên là JSON Token). JWT là một chuẩn với chức năng tương tự như ý tưởng JSON Tokens ban đầu, nhưng có một số chức năng thêm:
Một quy định chung cho phần header chứa các thông tin kèm cho JWT, ví dụ như thuật toán mã hoá, …
Một số chuẩn chung về phần claims, là trường nào lưu gì, …
Nhiều thuật toán khác nhau để mã hoá và xác thực.
Tuy rằng JWT chỉ là một quy chuẩn định nghĩa tại https://tools.ietf.org/html/rfc7519, nó được xây dựng từ một tập hợp nhiều quy chuẩn được gọi là JSON Object Signing and Encryption (JOSE). JOSE chứa nhiều tiêu chuẩn sau:
JSON Web Signing (JWS, https://tools.ietf.org/html/rfc7515) định nghĩa cách các JSON Object được xác minh bằng HMAC hoặc các dạng chữ ký số khác
Sự linh hoạt của JWT cũng là điểm yếu lớn nhất của nó, nhiều cuộc tấn công đã xảy ra nhờ vào sự linh hoạt này. JOSE là một tập các phần thiết kế cho phép lập trình viên chọn từ nhiều thuật toán khác nhau, và không phải sự kết hợp nào cũng đem lại tính bảo mật tốt.
VD: Vào năm 2015, (http://mng.bz/awKz) Tim McClean đã tìm ra một lỗ hổng trong rất nhiều thư viện JWT về việc ở phần header, ta có thể sửa nó thành thuật toán khác, và thậm chỉ sửa nó thành “none”. Điều này vô tình bảo các thư viện JWT ở phía backend khi kiểm tra token đã không dùng thuật toán nào để kiểm tra mã hoá, và các phần claims bị sửa trái phép không bị phát hiện. (Hay còn được biết đến là JWT None Attack)
Paseto
Các lỗi trong các quy chuẩn dẫn tới sự phát triển của các công cụ thay thế với hi vọng vẫn chứa các tính năng tương tự nhưng sẽ sửa một số vấn đề của bộ cũ.
Một ví dụ là Paseto, cung cấp các trình mã hoá đối xứng, khoá public, … hỗ trợ xử lý các vấn đề của Jose và các chuẩn JWT chung.
Điểm chung ngắn gọn giữa Paseto và Jose là thay vì cho phép lập trình viên mix giữa nhiều cấu phần khác nhau trong bộ Jose, Paseto chứa một bộ fix cứng chung về thuật toán (AESS, RSA, Ed25519, …), giúp giảm thiểu các vấn đề bảo mật xảy ra.
Một số chuẩn chung trong claims của JWT
Thông thường, phần claims sẽ có các mục sau:
iss
Issuer
Chỉ ra là ai đã tạo ra token này, thường là url của trang đã sinh token.
aud
Audience
Chỉ ra token này dành cho ai, có thể là id của user, …
iat
Issued-At
Thời điểm token được tạo ra
nbf
Not-Before
Token bị cấm nếu dùng trước thời gian này. VD đặt là 2/1 mà dùng vào 1/1 thì không được
exp
Expiry
Thời điểm token hết hạn
sub
Subject
Định danh chủ đề của token, thường là username, id hay gì đó
jti
JWT ID
ID không bị trùng của token, dùng để tra cứu sau này nếu cần
JWT trong Database, xoá token
Các token stateless, chỉ cần ở client side là một cách hay để giảm bớt state khỏi database. Điều này giúp ta scale các api mà không cần nâng cấp nhiều phần cứng database hay phải triển khai nhiều việc hơn.
Tuy nhiên, việc lưu trữ token ở database lại cho phép ta có một quyền năng lớn, đó là có thể revoke, hay quyết định 1 token có hợp lệ hay không, bằng cách chỉ cần xoá nó khỏi database. Hiển nhiên, việc lưu ở database đi kèm rất nhiều vấn đề về scale, có thể là ta cần nhiều database token cho nhiều service nhỏ khác nhau, nếu ta tập trung nó lại, nó có thể là 1 điểm SPOF (Single Point of Failure), 1 điểm nghẽn trong toàn luồng và chỉ cần nó chết, toàn hệ thống sẽ ngỏm do không có khả năng authentication
Có một số cách để xử lý vấn đề này. Ta có thể lưu database, tuy nhiên không lưu toàn bộ token mà chỉ cần 1 id unique nào đó mà có thể link với 1 token, khi huỷ hợp lệ 1 token, ta chỉ cần huỷ id đó, khi token đó được gửi bởi client, ta sẽ giải mã ra id và kiểm tra. Điều này giúp ta giảm bớt phần nào đó về database
Một cách khác là, ta có thể chỉ lưu các token bị huỷ hợp lệ, hay danh sách đen. Khi token được gửi lên ,ta xem nó có trong danh sách đen hay không, thì sẽ từ chối token đó. Các token mà đã hết hạn sử dụng rồi có thể clean up dần đi, giúp database danh sách đen nhỏ
Một cách khác là thay vì block 1 token, ta có thể chỉ chặn 1 số chức năng ở 1 tập hợp tk. Ví dụ, ta thường có chức năng đăng xuất ở mọi thiết bị khác khi ta đổi mật khẩu, để làm điều này, ta có thể thêm vào database toàn bộ token của người dùng trước ngày nào đó đều bị xoá, điều này giúp giảm không gian cần cho database, nhưng đi kèm query phức tạp hơn.