[Phần 2] Session Token và JWT Token, Refresh Token, khi nào quyết định sử dụng, ưu và nhược điểm

This entry is part 2 of 2 in the series API Security

Bearer Token

image 19 - quochung.cyou PTIT
  • Lúc này, ta đã đang thực hiện giao tiếp với server qua token, có một câu hỏi đặt ra là, làm sao để gửi token đó cho phía server?
  • Hiển nhiên, ta có thể làm điều ở ở body của request, ở param, … hoặc ở cookie. Tuy nhiên, có một cách thông dụng và được sử dụng hầu hết hiện nay để chuyển 1 token không qua cookie đó là sử dụng dạng “Bearer” https://tools.ietf.org/html/rfc6750
  • Bearer lúc đầu được tạo ra nhằm phục vụ cho OAuth2 (sẽ nói thêm sau)
  • Để gửi 1 token qua api, ta chỉ cần để nó ở header Authorization
Authorization: Bearer QDAmQ9TStkDCpVK5A9kFowtYn2k
  • Việc sử dụng giao tiếp qua Authorization cũng cho phép ta sử dụng header WWW-Authenticate để giúp đầu api “thân thiện” với http hơn
  • WWW-Authenticate có thể theo kèm một tham số là “realm”, bạn có thể hiểu trường này như một trường nhằm định dang đầu api hiện tại. VD nếu realm = admin, thì client sẽ hiểu đầu api này cần token dành cho admin, nếu realm = users thì là các đầu api open cho user
  • Ngoài ra, ta cũng có thể thêm các thông báo về việc token hết hạn, sai, …
HTTP/1.1 401 Unauthorized
WWW-Authenticate: Bearer realm="users", error="invalid_token",
        error_description="Token has expired"
  • Phần này giúp phía client có thể biết là token đã hết hạn và yêu cầu tạo token mới
image 20 - quochung.cyou PTIT
  • Để lưu token ở phía client mà không cần sử dụng cookie, ta có thể sử dụng các bộ nhớ có sẵn của trình duyệt như
    • sessionStorage: Các thực thể có thể được lưu tại đây, bộ nhớ chỉ là tạm thời và bị xoá khi tab bị đóng
    • localStorage: Dữ liệu được lưu kể cả khi trình duyệt đóng và chỉ xoá nếu ta yêu cầu
  • Nghe sessionStorage giống với cookie, tuy nhiên sessionStorage sẽ không share giữa các tab với nhau. Tức là cookie sẽ share giữa các tab, nhưng chỉ chung 1 domain (tức là phân biệt bằng tên miền). Còn sessionStorage chỉ lưu trạng thái ở tab hiện tại

JWT Token

  • Ta đã đi qua cách authentication bằng sử dụng basic authentication, rồi đến token được lưu ở cookie hoặc local/session storage. Tuy nhiên các cách thức này đều yêu cầu token cũng phải được lưu ở phía server.
  • Tức là mỗi truy vấn vào server, ta lại phải gọi vào database, với hàng triệu, hàng tỉ token ngày càng tăng lên để kiểm tra xem token có tồn tại chưa, có hết hạn chưa, … Chưa kể đến ta còn phải giải mã token ra nếu ta mã hoá nó trong database (thường là có)
  • Việc này tạo thành một bài toán lớn và ngày càng khó giải khi số lượng user tăng cao
image 21 - quochung.cyou PTIT
  • Lúc này, có một giải pháp khác đã được tạo ra, đó là JWT (Json Web Token)
  • Định nghĩa: JWT hay JSON Web Token là một format thông dụng cho các token ở dạng “self-contained” (chỉ lưu ở client). JWT thường bao gồm các claims (các khẳng định rằng user này có gì, có kia) và các quyền của user. VD, JWT sẽ chứa là user có quyền được vào trang a, trang b, ….
  • JWT ngoài ra được mã hoá crypto để bảo vệ khỏi các vấn đề bảo mật liên quan

Lưu JWT ở phía Client

  • Bạn sẽ có câu hỏi: Làm sao để một token chỉ có thể lưu ở client mà không ở server, vậy thì làm sao ta biết là token nào là thoả mãn, chưa bị người khác sửa, thêm quyền kiểu admin vào và cầm token đó đi request server?
image 22 - quochung.cyou PTIT
  • Một trong các cách được đề ra có thể xem qua ảnh sau. Tức là khi phía server sinh ra 1 token thoả mãn, ta sẽ thêm 1 key (HMAC) vào đuôi của token.
  • Hmac được sinh ra từ claims và 1 đoạn key, điều này giúp kiểm tra nếu đoạn claims đã bị sửa đổi thì phần HMAC sẽ không trùng khớp nữa.
  • Điều này đảm bảo là người khác khi sửa gì đó thì sẽ không thoả mãn nữa do ta có phần đuôi tag để kiểm tra xem. (Server sẽ thử giải mã phần key xem có đúng với ban đầu không, key này chỉ server biết)
  • Cấu trúc JWT có 3 phần
    • Header: Chứa các thông tin về kiểu token này dùng mã hoá dạng gì, …
    • Claims: Phần chứa thông tin ta muốn để trong token, ví dụ quyền của user
    • HMAC Tag: Phần mã hoá đảm bảo tính toàn vẹn của token
image 22 - quochung.cyou PTIT
  • JWT trở lên ngày càng phổ biến ở những năm gần đây do JSON Web Tokens đã được tiêu chuẩn hoá vào 2015. (Trước đây ta gọi những token stateless bên trên là JSON Token). JWT là một chuẩn với chức năng tương tự như ý tưởng JSON Tokens ban đầu, nhưng có một số chức năng thêm:
    • Một quy định chung cho phần header chứa các thông tin kèm cho JWT, ví dụ như thuật toán mã hoá, …
    • Một số chuẩn chung về phần claims, là trường nào lưu gì, …
    • Nhiều thuật toán khác nhau để mã hoá và xác thực.
  • Tuy rằng JWT chỉ là một quy chuẩn định nghĩa tại https://tools.ietf.org/html/rfc7519, nó được xây dựng từ một tập hợp nhiều quy chuẩn được gọi là JSON Object Signing and Encryption (JOSE). JOSE chứa nhiều tiêu chuẩn sau:
  • Một token JWT cơ bản trông như sau:
image 20 - quochung.cyou PTIT
  • Sự linh hoạt của JWT cũng là điểm yếu lớn nhất của nó, nhiều cuộc tấn công đã xảy ra nhờ vào sự linh hoạt này. JOSE là một tập các phần thiết kế cho phép lập trình viên chọn từ nhiều thuật toán khác nhau, và không phải sự kết hợp nào cũng đem lại tính bảo mật tốt.
  • VD: Vào năm 2015, (http://mng.bz/awKz) Tim McClean đã tìm ra một lỗ hổng trong rất nhiều thư viện JWT về việc ở phần header, ta có thể sửa nó thành thuật toán khác, và thậm chỉ sửa nó thành “none”. Điều này vô tình bảo các thư viện JWT ở phía backend khi kiểm tra token đã không dùng thuật toán nào để kiểm tra mã hoá, và các phần claims bị sửa trái phép không bị phát hiện. (Hay còn được biết đến là JWT None Attack)

Paseto

image 21 - quochung.cyou PTIT
  • Các lỗi trong các quy chuẩn dẫn tới sự phát triển của các công cụ thay thế với hi vọng vẫn chứa các tính năng tương tự nhưng sẽ sửa một số vấn đề của bộ cũ.
  • Một ví dụ là Paseto, cung cấp các trình mã hoá đối xứng, khoá public, … hỗ trợ xử lý các vấn đề của Jose và các chuẩn JWT chung.
  • Điểm chung ngắn gọn giữa Paseto và Jose là thay vì cho phép lập trình viên mix giữa nhiều cấu phần khác nhau trong bộ Jose, Paseto chứa một bộ fix cứng chung về thuật toán (AESS, RSA, Ed25519, …), giúp giảm thiểu các vấn đề bảo mật xảy ra.

Một số chuẩn chung trong claims của JWT

Thông thường, phần claims sẽ có các mục sau:

issIssuerChỉ ra là ai đã tạo ra token này, thường là url của trang đã sinh token.
audAudienceChỉ ra token này dành cho ai, có thể là id của user, …
iatIssued-AtThời điểm token được tạo ra
nbfNot-BeforeToken bị cấm nếu dùng trước thời gian này. VD đặt là 2/1 mà dùng vào 1/1 thì không được
expExpiryThời điểm token hết hạn
subSubjectĐịnh danh chủ đề của token, thường là username, id hay gì đó
jtiJWT IDID không bị trùng của token, dùng để tra cứu sau này nếu cần

JWT trong Database, xoá token

image 23 - quochung.cyou PTIT
  • Các token stateless, chỉ cần ở client side là một cách hay để giảm bớt state khỏi database. Điều này giúp ta scale các api mà không cần nâng cấp nhiều phần cứng database hay phải triển khai nhiều việc hơn.
  • Tuy nhiên, việc lưu trữ token ở database lại cho phép ta có một quyền năng lớn, đó là có thể revoke, hay quyết định 1 token có hợp lệ hay không, bằng cách chỉ cần xoá nó khỏi database. Hiển nhiên, việc lưu ở database đi kèm rất nhiều vấn đề về scale, có thể là ta cần nhiều database token cho nhiều service nhỏ khác nhau, nếu ta tập trung nó lại, nó có thể là 1 điểm SPOF (Single Point of Failure), 1 điểm nghẽn trong toàn luồng và chỉ cần nó chết, toàn hệ thống sẽ ngỏm do không có khả năng authentication

  • Có một số cách để xử lý vấn đề này. Ta có thể lưu database, tuy nhiên không lưu toàn bộ token mà chỉ cần 1 id unique nào đó mà có thể link với 1 token, khi huỷ hợp lệ 1 token, ta chỉ cần huỷ id đó, khi token đó được gửi bởi client, ta sẽ giải mã ra id và kiểm tra. Điều này giúp ta giảm bớt phần nào đó về database
  • Một cách khác là, ta có thể chỉ lưu các token bị huỷ hợp lệ, hay danh sách đen. Khi token được gửi lên ,ta xem nó có trong danh sách đen hay không, thì sẽ từ chối token đó. Các token mà đã hết hạn sử dụng rồi có thể clean up dần đi, giúp database danh sách đen nhỏ
  • Một cách khác là thay vì block 1 token, ta có thể chỉ chặn 1 số chức năng ở 1 tập hợp tk. Ví dụ, ta thường có chức năng đăng xuất ở mọi thiết bị khác khi ta đổi mật khẩu, để làm điều này, ta có thể thêm vào database toàn bộ token của người dùng trước ngày nào đó đều bị xoá, điều này giúp giảm không gian cần cho database, nhưng đi kèm query phức tạp hơn.

Tham khảo:

  • API Security in Action
  • Modern API Architecture

Còn tiếp

[Phần 2] Sự phát triển của các mô hình hệ thống Backend (N-layered, DDD, Hexagon, Onion, Clean Architecture)

2005 — Hexagon (Ports and Adapters) (Khối lập phương – Cổng và bộ chuyển đổi)

  • Trước đó, các tầng của chúng ta chỉ đi từ trên xuống theo thứ tự. Với việc sử dụng dependency inversion, mọi thứ đều đã thay đổi
  • Đây như là một thế giới mới cho các kỹ sư phần mềm. Ta có thể kiểm soát được hướng của sự phụ thuộc theo cách ta muốn. Lúc này, business logic sẽ không gọi xuống tầng data access nữa. Để đọc thêm về dependency inversion, bạn có thể tham khảo bài sau:
1*B2f9ycR5sN6thAhCe0vfiA - quochung.cyou PTIT
1*1Hyocpa6Xpy mXqYeb zqw - quochung.cyou PTIT
1 PRLCk7qPIL PHT mNXw2cQ - quochung.cyou PTIT
  • Thay vì những layer hình chữ nhật như ban đầu, lúc này, ông đã vẽ một hình lục phương, trông có vẻ khá phức tạp hơn một cấu trúc đa tầng ban đầu, tuy nhiên nó lại khá đơn giản
  • Điều gì đã xảy ra trong hình minh hoạ trên? Như ta thấy, lúc này Domain đã là thành phần ở giữa và là trung tâm của toàn bộ hệ thống, nó không còn phụ thuộc vào bất kì thứ gì khác nữa
  • Để thể hiện việc tầng Domain đã là trung tâm, tầng Business Logic/Domain được đặt tên là Core
  • Các module khác được chia thành 2 phần. Lúc này, với 1 class thực hiện các công việc, ví dụ Repository làm việc với dữ liệu thì không chỉ còn là 1 class concrete mặc định nữa, mà được chia làm đôi thành phần ảo (interface) và phần triển khai thật sự (code logic class). Các phần interface định nghĩa các phương thức mà class logic cần triển khai được đặt tên là ports (cổng)
  • Các phần triển khai code thực tế nằm trong các module bên ngoài, và được gọi là adapters
  • Rõ ràng, ta thấy các logic Domain/Core của hệ thống giờ không còn phụ thuộc vào ai cả, vì nó là những chức năng mà hệ thống bắt buộc phải có, mọi module khác đều chỉ là gắn thêm vào, và phải triển khai các cổng (các interface) mà phần core đã định nghĩa sẵn.
image 3 - quochung.cyou PTIT

Ví dụ về port, adapter và core của hexagon architecture

  • Ta có, ví dụ như một chiếc laptop. Các cổng của nó là gì? Ta có cổng hdmi, cổng tai nghe 3.5, cổng sạc, cổng type c, cổng usb, ….
  • Rõ ràng, khi muốn thêm gì đó cho chiếc laptop, ví dụ ta muốn cắm thêm 1 tài nguyên lưu trữ dữ liệu vào, ta phải dùng 1 chiếc usb, hoặc 1 thẻ nhớ, và chúng phải có khuôn mẫu, đúng với quy chuẩn mà cái laptop đã quy định ra -> tôi có cổng usb như này, nếu muốn cắm gì vào thì phải theo khuôn như thế. Giống như việc, trong core đã có các interface, ta chỉ làm việc với các hàm của interface, module bên ngoài triển khai logic phải triển khai đúng theo bản khuôn mẫu, các hàm đó.
  • Ví dụ, nếu không dùng interface, nhà sản xuất usb lại tự tạo ra các đầu cắm khác nhau, giờ chẳng lẽ máy tính là một high-level module (một phần quan trọng hơn), lúc sản xuất lại phải theo cái đầu cắm của usb? Điều này không hợp lý
image 1 - quochung.cyou PTIT

Các ưu điểm rõ ràng

  • Lúc này các module bên ngoài cắm vào thường độc lập với nhau, và chúng dễ thay thế hơn. Ta đã định nghĩa trước ta cần gì trong core, giờ bên ngoài chỉ triển khai logic lại từ các yêu cầu đó. Nếu ta thay đổi cách gọi lấy dữ liệu từ việc gọi vào database sang đọc ghi trong file excel, ta chỉ thay đổi ở module, và vẫn là hàm getAll() mà core đã quy định. Tương tự với giao diện, cũng là module ngoài, cũng phải làm như vậy.
  • => Các module độc lập, dễ thay thế hơn, và phải tuân thủ các quy tắc của core logic
image 2 - quochung.cyou PTIT

2008 — Onion – Kiến trúc củ hành

image 4 - quochung.cyou PTIT
1 lRxsDk6eaUy9O4 RaVuJ1g - quochung.cyou PTIT
  • Nhìn chung, Onion Architecture vẫn khá tương đồng với Hexagon Architecture, tuy nhiên ở Hexagon, ta có 1 khối ở giữa và ta mong muốn các module chỉ như các thiết bị ngoài cắm vào ổ đó và tách biệt lẫn nhau. Còn ở Onion Architecture, ta có những tầng như những chiếc vòng, và tầng ở vòng bên ngoài phụ thuộc vào tầng bên dưới
image 6 - quochung.cyou PTIT
  • Theo 1 cách nhìn nào đó, Onion Architecture có một hướng phụ thuộc khá thẳng như N-Layered, nhưng thực tế ta vẫn áp dụng đảo sự phụ thuộc để cho phép tầng Domain hay Business là tầng dưới cùng của hệ thống
image 8 - quochung.cyou PTIT
  • Có một vài điểm thể hiện sự khác biệt ở đây. Là thay vì có 1 core quá lớn và mọi module đều phụ thuộc vào nó đôi khi có thể gây ra một số nhược điểm. Tức là 1 sự thay đổi trong core có thể khiến nhiều module khác nhau phải sửa đổi
  • Thay vì vậy, ta có một số tầng khác, ví dụ như ở ảnh trên là Application, sẽ wrap lại tầng Domain, Domain sẽ chứa những code mà có ít sự thay đổi, và Application có thể chứa nhiều logic và thường xuyên thay đổi nhiều hơn sẽ nằm ở bên trên.
  • Có thể cảm giác nó như tính đóng gói của OOP, khi mà những phần bên trong sẽ được wrap lại ở các tầng bên ngoài chứa nhiều logic hơn, và khi phần bên trong hoàn thiện sẽ chứa ít sự thay đổi hơn

2012 — Clean Architecture

image 9 - quochung.cyou PTIT
image 10 - quochung.cyou PTIT
image 11 - quochung.cyou PTIT
  • Nhìn chung, ta nhận thấy ta vẫn có 1 tầng chứa những phần về logic của Domain/Business, nay được đặt tên là Entities nằm trên cùng, và ta có các tầng khác thuộc module ngoài như Infra (Thường là data access của database), presentation (giao diện) phụ thuộc dần vào trong.
  • Thực tế, bạn có thể thấy Hexagon, Onion hay Clean Architecture có một cách định hướng khá giống nhau, ở Clean Architecture, Uncle Bob đã thêm 1 số layer bên ngoài như thư viện thứ 3, dll, …

Tổng kết

  • Nhìn chung, các kiến trúc về sau như Hexagon, Onion, Clean Architecture đều là các cách tiếp cận áp dụng các thủ pháp như Dependency Inversion, … nhằm tập trung vào phần core, domain, … và các module bên ngoài phải được xây dựng dựa theo hệ thống chính, chứ hệ thống chính không đi theo module bên ngoài
  • Việc triển khai các cấu trúc phức tạp hơn cho phép ta mở rộng dễ hơn về sau khi logic ở core ngày càng tăng lên, tuy nhiên, không có cấu trúc nào là hoàn toàn hoàn hảo và được xây dựng ở các thời điểm khác nhau cho mục đích khác nhau.
  • Do sự phát triển của microservice, các hệ thống còn được chia nhỏ ra nhiều service nhỏ hơn nữa, khi logic ở mỗi service không quá nhiều, ta dễ dàng có thể triển khai 1 cấu trúc 3 tầng thay vì các cấu trúc quá phức tạp và phải đi qua nhiều tầng để giúp tăng tốc độ triển khai dự án.

[Phần 1] Session Token và JWT Token, Refresh Token, khi nào quyết định sử dụng, ưu và nhược điểm

This entry is part 1 of 2 in the series API Security

Lời đầu

  • Trước khi đi vào Session Token hay JWT Token, hay có thể tóm gọn là authentication qua token, ta sẽ đi qua về 1 cách khác để authentication qua các giao thức API, và sau đó sẽ nói về ưu nhược điểm giữa chúng

Http Basic Authentication

  • Luồng chạy của HTTP “Basic” Authentication như sau:
image 14 - quochung.cyou PTIT
  • Khi người dùng truy cập và không có thông tin đăng nhập, hệ thống sẽ trả về 401 (Unauthorized) và thông tin đi kèm là cách để có thể author qua header WWW-Authenticate với thông tin (Ví dụ trên ảnh là yêu cầu Authen qua Basic)
  • Khi ta truy cập với Header Authorization + Basic + chuỗi mã, lúc này hệ thống sẽ kiểm tra và cho phép có quyền hay không.
 Authorization: Basic dGVzdDoxMjPCow==
  • Ví dụ như mã trên, đoạn mã sau Basic cơ bản là một đoạn String được mã hoá ở dạng base64, bạn có thể decode nó qua các trang base64, ví dụ
image 15 - quochung.cyou PTIT
  • Ví như với mã trên, khi decode, ta nhận được đoạn mã test:123£, đây là format của Basic Authen, với đầy đủ là username:password, thì ở đây test là username, và password là 123£

Ưu điểm

  • Sử dụng đơn giản, luồng không phức tạp, triển khai nhanh
  • Phù hợp cho authentication trong nội bộ, cho các ứng dụng trên môi trường kiểm thử (non-prod)

Nhược điểm

  • Toàn bộ request đều sẽ phải gửi username và password, điều này nhìn chung tăng khả năng xảy ra lộ mật khẩu.
  • Do lần nào cũng gửi mật khẩu, nên nếu bạn mã hoá nó, việc này là một công đoạn khá tốn tài nguyên. Những thuật toán hashing, mã hoá mật khẩu hiện đại có thể tốn tới 100ms (0,1s) để giải mã mật khẩu rồi kiểm tra có đúng không. Điều này hao tốn CPU cho hệ thống
  • Một số vấn đề khác về UX (giao diện mặc định đăng nhập xấu), vấn đề bảo mật về việc lưu password ở client để gửi đi authen, ….

Token Authentication trong API

Khái niệm

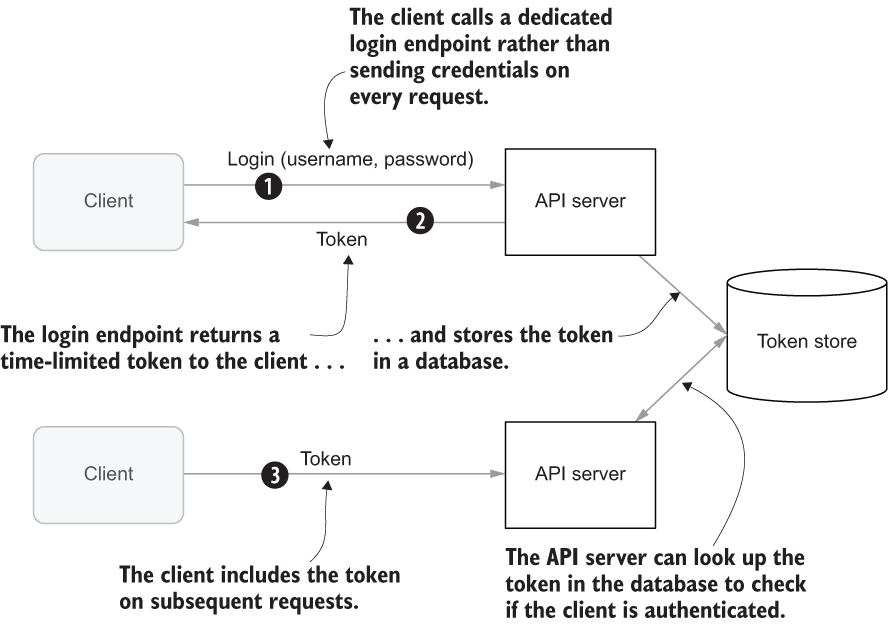
  • Hiểu đơn giản, thông thường thì authentication bằng token sẽ hoạt động như sau: Tài khoản, mật khẩu, … thông tin user chỉ cần nộp 1 lần, người dùng sau đó sẽ được cấp 1 token, 1 đoạn mã có thời hạn sử dụng. Người dùng sau đó có thể dùng token này để authentication cho đến khi đoạn token hết hạn sử dụng
  • Ví dụ về token authentication trong thực tế, điều này giống như bạn đi một khu vui chơi. Bạn đã đặt vé từ trước, và để xác minh bạn đã đặt vé chưa, bạn phải xuất trình căn cước công dân, ảnh thẻ, hộ chiếu, …. Thay vì vậy, khu vui chơi sau khi nhận căn cước công dân ở cửa vào, sẽ cấp cho bạn 1 phiếu vé có thời hạn 1 ngày hay gì đó, sau đó bạn dùng phiếu vé này để đi chơi trong khu vui chơi trong thời gian của vé.

Cách tiếp cận 1: Lưu trữ token trong database

image 16 - quochung.cyou PTIT
  • Người dùng lần đầu sẽ gửi thông tin của mình cho server, server sẽ từ đó sinh ra 1 token và lưu nó vào database
  • Lần sau người dùng sẽ chỉ cần gửi token, và sau đó server kiểm tra token có trong database không, còn hạn sử dụng không, … rồi cho phép người dùng

Việc này khắc phục các điểm:

  • Đầu tiên, token thường không chứa thông tin mật khẩu, tài khoản, … nữa nên ít lo bị lộ thông tin cá nhân của người dùng hơn.
  • Giảm bớt các nhược điểm của Basic Authen là phải mã hoá, giải mã mật khẩu, ….
  • Nếu có vấn đề bảo mật xảy ra, token được cài đặt là có thời hạn, và hơn nữa ta đã lưu ở trong database, ví dụ, bạn bị mất token vào tay người khác, thì thiệt hại cũng được giảm thiểu. Hoặc ta có thể trực tiếp ngăn chặn bằng cách xoá token đó đi trong database.

Session Cookie

  • Cách triển khai đơn giản nhất của hướng tiếp cận trên, và cũng khá phổ biến là sử dụng cookie. Sau khi người dùng đăng nhập bằng thông tin, phía server sẽ trả về 1 header Set-Cookie trong response để yêu cầu trình duyệt người dùng lưu 1 chuỗi token ngẫu nhiên trong bộ nhớ cookie của trình duyệt
  • Các request vào trang đó sẽ sử dụng token như 1 header Cookie (do cookie được tạo ra để lưu trữ những thông tin của người dùng trong 1 site)
image 18 - quochung.cyou PTIT

Ưu điểm

  • Cookie có nhiều cơ chế về bảo mật có sẵn, ví dụ như cookie chỉ gắn liền với từng tên miền, nên nó luôn đảm bảo không có chuyện ta gửi sang trang khác đoạn cookie chứa thông tin nhạy cảm
  • Cookie có thể được đánh dấu là Secure, điều này giúp đảm bảo khi gửi kết nối tới trang nào thì cookie chỉ được gửi nếu kết nối đó là Https và đã được mã hoá.

Nhược điểm

  • Trong thiết kế API theo hướng RestAPI đó là kết nối giữa client người dùng và server nên là stateless http://quochung.cyou/kien-truc-stateful-va-stateless-la-gi/. Đó là server sẽ không lưu trạng thái nào của người dùng giữa các request khác nhau.
  • Cookies phá vỡ nguyên tắc này vì server lúc này lưu trạng thái của cookie với các client khác nhau. Vào thời điểm đầu khi session cookie được sử dụng, chúng thường là nơi lưu trữ tạm thời 1 số trạng thái của người dùng, ví dụ như 1 giỏ hàng, 1 danh sách sản phẩm đã được chọn mà người dùng chưa thanh toán. (Kiểu khi người dùng chọn rồi, nó không lưu trực tiếp vào database) mà chỉ lưu vào cookie, điều này dễ gây ra một số lỗi bất thường cho website.
Cookie attributeÝ nghĩa
SecureCookie chỉ có thể gửi qua kết nối https
HttpOnlyKhông thể đọc trực tiếp bằng javascript
SameSiteChỉ gửi cho cùng trang
Một số attribute của cookie về bảo mật

[Java Memory 1] Escaping References trong Java, Call-by-value và sử dụng Defensive copying. Biến trong Java lưu thế nào

This entry is part 1 of 2 in the series Java Memory

Mở đầu: Tại sao cần học quản lý bộ nhớ trong Java

  • Đã bao giờ bạn gặp phải những câu kiểu “Nháy nút refresh ở màn hình desktop máy tính cho máy chạy nhanh hơn”, hay khởi động lại điện thoại, máy tính, chạy lại ứng dụng, web để dùng mượt hơn chưa?
  • Nếu có, khả năng cao bạn đã gặp phải việc một ứng dụng đã không quản lý bộ nhớ tốt, điều này khiến cho bộ nhớ ngày càng sử dụng nhiều, và khi đầy thì ứng dụng bị lag. Việc ứng dụng bị lag có thể do nhiều vấn đề như, như mạng chậm, cơ sở dữ liệu, … nhưng việc bộ nhớ bị dùng full thường chiếm một phần khá lớn trong vấn đề này.
  • Hiểu được cách Java quản lý bộ nhớ là một điều thiết yếu để tối ưu hệ thống.

Kiểu dữ liệu nguyên thuỷ và object

  • Kiểu dữ liệu nguyên thuỷ trong Java có thể kể đến byte, short, int, long, char, ….
  • Trong Java, các đối tượng tạo từ các class như Integer, Double, Float, … Hay từ những class mà tự bạn tạo ra, thì chúng ta đang không thực sự lưu giá trị của nó, mà ta đang lưu “địa chỉ” đến giá trị thực sự của nó
image 33 - quochung.cyou PTIT
  • Hãy thử đi từ từ lại vấn đề này, khi ta sử dụng các kiểu biến nguyên thuỷ, ví dụ khai báo như sau
byte x = 7
image 34 - quochung.cyou PTIT
  • Thì trong Java, bản chất biến x này đang giữ giá trị thực sự, giá trị bit (00000111)
  • Còn một biến Object, hay biến địa chỉ thì chúng ta như đang lưu một “điều khiển”, một tham chiếu địa chỉ đến giá trị thực sự
Dog myDog = new Dog();
image 35 - quochung.cyou PTIT
image 36 - quochung.cyou PTIT
  • Okay, mong là bạn đã hơi mường tượng được điều gì đó, tiếp theo ta sẽ đến hai khái niệm là Stack và Heap
image 37 - quochung.cyou PTIT
  • Trong bộ nhớ Java, ta thường nhắc tới 2 nơi lưu chính đó là Stack và Heap. Toàn bộ Thread trong hệ thống sẽ có các stack khác nhau, tuy nhiên share chung 1 heap
  • Cơ bản ở reference bên trên, hay cách lưu tham chiếu, thì giá trị thực sẽ luôn nằm ở heap
  • Các biến nguyên thuỷ trong Java nếu được khai báo dưới dạng local variable (biến nằm trong các hàm, …) sẽ được lưu vào stack, còn các biến lưu dạng toàn cục của 1 class (instance variable) sẽ được lưu vào heap.
  • Tương tự, các biến tham chiếu (reference) cũng được lưu tương tự, nếu chúng là các local variable, các biến nằm trong 1 hàm main, 1 phương thức, … chúng sẽ được lưu trong stack. (Lưu cái con trỏ trong stack), còn nếu nó là biến toàn cục class (instance variable), nó sẽ nằm trong heap (vì hiện tại, nó đang được lưu trong 1 giá trị object thực sự khác, hay là heap)
image 38 - quochung.cyou PTIT

Java Pass-by-Value, Call-By-Value

  • Tiếp theo, ta sẽ đi đến khái niệm pass-by-value, hay call-by-value trong Java. Hiểu đơn giản, khi ta truyền các biến như 1 tham số trong 1 hàm, ta chỉ đang truyền một bản “copy” của đối tượng ban đầu đó.
image 39 - quochung.cyou PTIT
  • Ví dụ như đoạn code sau, đoạn code sẽ vẫn in ra 5, giá trị ban đầu của a, vì khi ta truyền vào hàm kia, ta chỉ đang truyền một bản sao của biến a, có giá trị là 5, chứ không thực sự truyền a, nên a ở hàm main sẽ không bị thay đổi.
  • Tuy nhiên, ta lại sẽ có một vấn đề thường hay mắc lầm khác, Hãy thử xem đoạn code sau:
image 41 - quochung.cyou PTIT

  • Đầu tiên ta có một object John, với tuổi là 20, và tên là John
  • Sau đó ta chạy hàm change, nơi mà ta sẽ cập nhậtbiến tuổi truyền vào thành 90, còn tên của person truyền vào thành Michael
  • Bạn sẽ nghĩ là, okay, giờ ta đang truyền một bản sao thôi đúng không? Vậy thì tuổi vẫn giữ là 20, còn tên vẫn giữ là John
  • Nhưng kết quả thật bất ngờ, tuổi thì đúng là không thay đổi 20, nhưng tên thì cập nhật thành Michael. Tại sao lại như vậy?
image 42 - quochung.cyou PTIT
  • Ta hãy quay trở lại khái niệm vừa nhắc tới
  • Khi ta truyền một biến nguyên thuỷ, hay trong trường hợp trên là age, ta đang như tạo một bản sao của một tờ giấy bình thường, tờ giấy đó ghi số là 20, ta đưa cho người khác. Họ sửa chúng thành 90, 100 hay gì đi chăng nữa, thì tờ giấy ban đầu của ta vẫn là 20
  • Tuy nhiên, khi ta truyền một biến reference (tham chiếu) của Object person, ta đang truyền bản sao của “tham chiếu” của nó. Hay đơn giản là, ta đang tạo ra bản sao của một cái điều khiển, vậy thì cái điều khiển bản sao này khi đưa cho người khác, vẫn sẽ bật tắt được tivi ban đầu của mình.
image 43 - quochung.cyou PTIT

Escaping References

  • Ta sẽ đi sang vấn đề. Vậy thì điều này có thể ảnh hưởng điều gì?
  • Một trong bốn tính chất của OOP, Encapsulation – tính đóng gói, trong đó có thể kể đến việc, ta sẽ cho toàn bộ biến trong class thành private, ẩn chúng với bên ngoài, với class khác. Để thay đổi, hay tương tác với chúng, ta chỉ tương tác qua các phương thức public mà ta cài đặt. (Ví dụ như Getter, Setter)
  • Bạn có thể đọc thêm bài này để hiểu thêm: http://quochung.cyou/tai-sao-can-viet-getter-setter-cho-cac-class/
image 44 - quochung.cyou PTIT
  • Tuy nhiên ta đi đến một vấn đề mới. Vì vấn đề truyền tham chiếu, truyền điều khiển thay đổi phần gốc như trên, thì với một ví dụ như trên, ta đang để private Name của Person, tuy nhiên khi gán nó cho một biến ngoài sb bằng getter, rồi thay đổi nó, thì nó cũng thay đổi giá trị được giấu bên trong class gốc.
  • Điều này phá huỷ việc đóng gói của chúng ta, do ta bằng 1 cách nào đó, đã thay đổi được giá trị private, mà không cần đi qua các phương thức setter hay các phương thức cho phép thay đổi của class.
image 45 - quochung.cyou PTIT

Kĩ thuật defensive copying

  • Lúc này, có một solution được biết đến với tên defensive copying
  • Ta sẽ không muốn lưu một bản tham chiếu đến một cái điều khiển, nơi mà ta có thể thay đổi giá trị đang được ẩn. Mà các phương thức lấy các tham chiếu này ra, ta sẽ tạo hẳn 1 object mới, một bản sao chỉ copy giá trị của biến gốc, chứ không copy điều khiển đến biến gốc.
image 46 - quochung.cyou PTIT
  • Như ví dụ trên, ở hàm Getter, ta chỉ trả về một biến String Builder mới, chứa dữ liệu của name, nhưng không có khả năng thay đổi name gốc
image 47 - quochung.cyou PTIT
  • Vấn đề đã được giải quyết !

Sự ra đời của Java, các thuật ngữ JVM, JDK, JRE

Giới thiêu về Java

Ngôn ngữ lập trình Java được thiết kế để trở thành một ngôn ngữ không phụ thuộc vào nền tảng (machine-independent). Java có thể chạy trên bất kỳ nền tảng nào miễn là có máy ảo Java (Java Virtual Machine – JVM). Máy ảo Java là một chương trình có thể chạy trên nhiều nền tảng khác nhau mà không cần phải biên dịch lại. Máy ảo Java có thể chạy trên các máy tính, điện thoại, máy tính bảng, máy chủ, … Máy ảo Java có thể được cài đặt trên các hệ điều hành khác nhau như Windows, Linux, Mac OS, …

Java vừa đủ mạnh với nhiều thư viện, tính năng, bảo đảm các sự chặt chẽ, nhưng cũng đồng thời chạy rất nhanh. Java có thể được sử dụng để phát triển các ứng dụng desktop, web, mobile, game, … Java cũng là một trong những ngôn ngữ lập trình được sử dụng nhiều nhất hiện nay.

image 10 - quochung.cyou PTIT

Java Virtual Machine (JVM)

Không như C/C++ khi mà code được biên dịch thì sẽ tạo thành các mã lệnh được làm cho riêng các vi xử lý khác nhau. Code java đầu tiên được biên dịch thành một dạng tổng quát – bytecode, là ngôn ngữ cho JVM chạy. Sau đó JVM mới chạy thành các ngôn ngữ máy cho nền tảng đó.

image 6 - quochung.cyou PTIT

Trình tự hoạt động:

image 7 - quochung.cyou PTIT

JRE – Java Runtime Environment

  • The Java Runtime Environment (JRE) provides the libraries, the Java Virtual Machine, and other components to run applets and applications written in the Java programming language. In addition, two key deployment technologies are part of the JRE: Java Plug-in, which enables applets to run in popular browsers; and Java Web Start, which deploys standalone applications over a network. It is also the foundation for the technologies in the Java 2 Platform, Enterprise Edition (J2EE) for enterprise software development and deployment. The JRE does not contain tools and utilities such as compilers or debuggers for developing applets and applications.
  • JRE – đúng như tên của nó (môi trường chạy java) chứa các thư viện, chứa cả JVM ở bên trong, và một số thành phần khác để chạy được các phần mềm Java. Hiểu đơn giản, nếu bạn có 1 file jar, 1 chương trình java, chỉ cần có JRE là bạn có thể chạy chúng.
image 12 - quochung.cyou PTIT

JDK – Java Development Kit

  • JDK (Java Development Kit) – Bộ công cụ lập trình Java
  • Hiểu đơn giản thì JDK chứa JRE và thêm một số công cụ khác để hỗ trợ cho việc lập trình, compile các file code .java sang file .class (đọc thêm bên dưới)
image 11 - quochung.cyou PTIT

Cấu trúc chương trình Java

image 8 - quochung.cyou PTIT
  • Trong file source code, chứa “class” (lớp)
  • Mỗi “class” chứa nhiều “method” (hàm) khác nhau.
  • Mỗi “method” chứa nhiều “statements” (dòng lệnh) khác nhau.

Ví dụ 1 file class:

``` 

public class HelloWorld {
    public static void main(String[] args) {
        System.out.println("Hello World!");
    }
}

```
  • Khi một dự án Java chạy, JVM sẽ tìm class bạn để là class đầu tiên khởi chạy, rồi sau đó tìm đến method main để chạy.
public static void main(String[] args) {
   // đây là hàm đầu tiên được chạy
}

image 9 - quochung.cyou PTIT

Tham khảo:

[Phần 1] Sự phát triển của các mô hình hệ thống Backend (N-layered, DDD, Hexagon, Onion, Clean Architecture)

Chương 1: Nơi mọi thứ bắt đầu

Vào những ngày đầu tiên thuở sơ khai, chưa có một “mô hình hệ thống” hay “architecture” nào tồn tại cả. Giang hồ lúc này mạnh ai nấy làm, bạn chỉ cần biết GoF Pattern thì có thể tự xưng bá một phương, là một “architect”, một lập trình viên dày dặn trong nghề.

Thời gian thắm thoắt thoi đưa, từ những cái máy tính to bằng cả cái phòng, từ những chiếc ổ cứng dày cộp chỉ chứa vài MB, công nghệ ngày càng phát triển, máy tính dần thu gọn hơn, ngày càng mạnh mẽ hơn, tiếp cận đến nhiều người hơn. Lúc này, yêu cầu của người dùng ngày càng tăng chóng mặt, khiến cho độ phức tạp của các phần mềm gia tăng.

Thứ đầu tiên những cao thủ trong ngành tạo ra là (Tách UI ra khỏi các logic bussiness), từ hình thái này, các mô hình MVC đầu tiên đã được ra đời:

image - quochung.cyou PTIT

Hiểu một cách đơn giản, hãy nghĩ đến ứng dụng Facebook và website Facebook. Liệu các câu lệnh như: lấy dữ liệu các bài viết người dùng mới nhất, lấy dữ liệu của 1 trang profile có khác biệt về mặt logic khi ở trên điện thoại hay trên web? Câu trả lời là không, điểm duy nhất khác biệt chỉ là UI hay View (phần hiển thị với người dùng)

Việc tách biệt UI ra khỏi Logic giúp ứng dụng modun hoá hơn, ta có thể dùng chung 1 logic, và khi cần hiển thị trên 1 sản phẩm khác: web, điện thoại, màn hình tivi, màn hình ô tô, … , ta chỉ cần nối phần UI của thiết bị đó với các logic đã chìa ra là được.

Nghe có vẻ như vấn đề đã được giảm bớt 1 chút. Nhưng chưa phải là tất cả, lúc này View có thể chỉ là vài tấm ảnh, một cái nút, Controller sẽ là người ở giữa trung chuyển các câu lệnh, và phần lớn logic bị dồn xuống Model, nơi thường xuyên phải lưu dữ liệu vào database, file, … hay nhìn chung là trực tiếp vào các “đối tượng” của chúng ta.

Chương 2: 2002 – N-Layered (Cấu trúc xếp chồng N tầng)

Một mô hình “lí tưởng” không tồn tại, cũng như mọi thứ, chúng đều là thành quả của nhiều lần thử nghiệm, và được rút kinh nghiệm rất nhiều lần.

Một lập trình viên đã tiên phong trong việc tạo ra một mô hình hệ thống, góp phần ảnh hưởng lớn đến rất nhiều thế hệ lập trình viên sau này tên là Martin Fowler.

image 1 - quochung.cyou PTIT

Ông đã cho ra đời cuốn “Patterns of Enterprise Application Architecture” (Cách thực hiện một mô hình ứng dụng phục vụ cho doanh nghiệp), nơi mà ông đã nói về cấu trúc N-Layered

1 pd5bfxtxV9AK0 QlIOK6Vw - quochung.cyou PTIT

Ý tưởng khá đơn giản, ta sẽ phân loại và nhóm các phần code liên quan đến nhau lại thành “1 tầng”, khi đó ta sẽ có nhiều tầng xếp chồng lên nhau.

Tuy nhiên, Fowler cũng biết việc không nhất quán sẽ xảy ra nếu cứ mỗi ông lập trình viên lại xếp các tầng một cách vô tổ chức, ông đã thêm một số “quy tắc” nhỏ góp phần đồng bộ:

  • Bạn có thể đặt tên một layer – tầng là gì cũng được
  • Bạn có thể có bao nhiêu layer tuỳ thích
  • Bạn có thể thêm một layer ở giữa các layer thường có
  • Bạn có thể có nhiều thành phần trong 1 layer
  • Quan trọng là: cần có một hệ thống cấp bậc rõ ràng giữa các layer, chúng nên gọi đến nhau theo từng cấp một.
1 0Kq2jEHDWcfdeorqKPdYFQ - quochung.cyou PTIT

Điều này đã giúp các ứng dụng giảm bớt các code trùng lặp, và cũng làm cho code có một cấu trúc rõ ràng.

Thông thường đa số ứng dụng chỉ cần 3 tầng là đã có thể phục vụ các nhu cầu cơ bản

image 4 - quochung.cyou PTIT
  • User Interface (UI) — chịu trách nhiệm tương tác với người dùng (giao diện)
  • Business logic layer (BLL)— Xử lí các logic chính của hệ thống
  • Data Access layer (DAL) — Là tầng giao tiếp với dữ liệu như database, …
image 5 - quochung.cyou PTIT
  • Bạn có thể thấy trong các video hướng dẫn làm các dự án backend bằng Spring Boot, người ta thường có một 1 tầng Service (Bussiness), sau đó mới gọi xuống tầng Repository (Data Access), nơi mà giao tiếp trực tiếp với database.
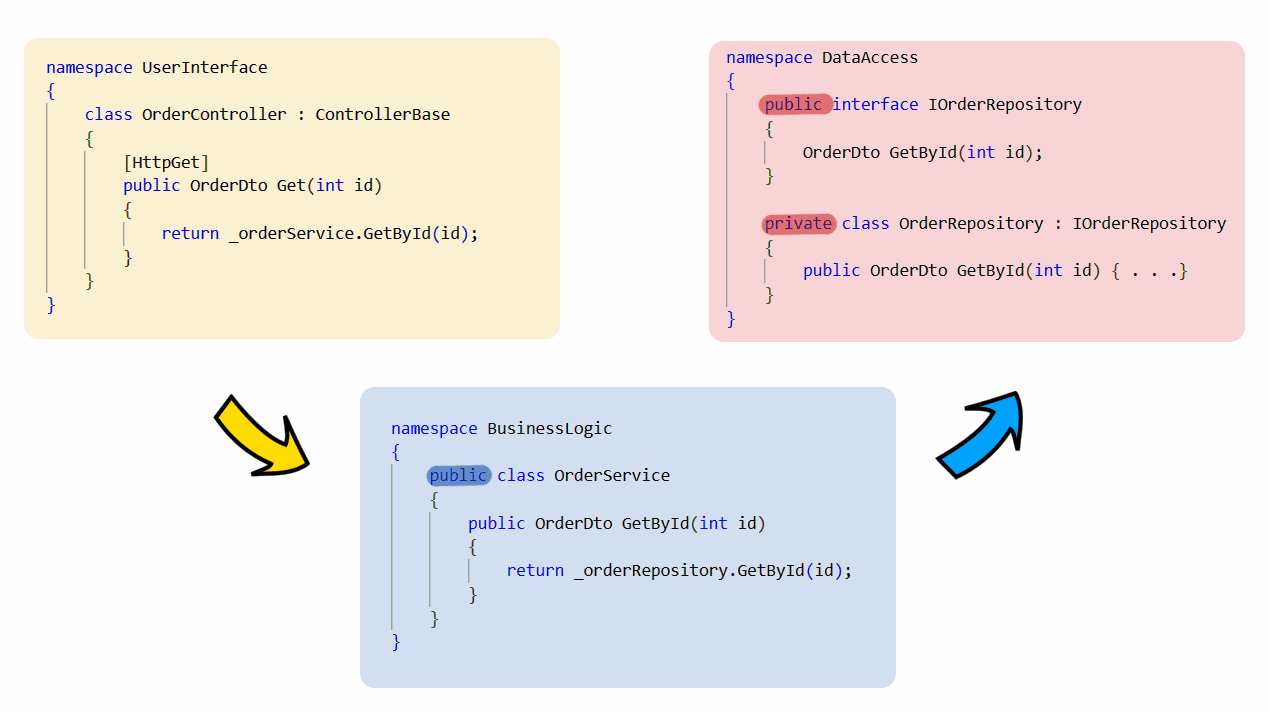
  • Các tầng sẽ gọi đến nhau qua các interface, ví dụ: có một interface là OrderRepository phục vụ lấy dữ liệu từ db. Lúc này, tầng bussiness chỉ cần quan tâm sẽ thực hiện các giao thức lấy dữ liệu của interface này, còn logic thực sự ở tầng data access sẽ được ta viết từ các class implement interface trên.
  • => Ví dụ: ta có 1 interface OrderRepository. ta có 2 class khác implement interface trên là OrderRepositoryImplMongo, OrderRepositoryImplMySQL. Do cả 2 cùng implement orderrepo, nên từ bussiness ta có thể dễ dàng lắp một class khác cho 1 database khác, thuận tiện cho việc xử lí. (Bạn có thể đọc thêm Dependency Injection)
image 6 - quochung.cyou PTIT

Chương 3: 2003 – Domain Driven Design (DDD)

Tưởng chừng N-Layered đã có thể xử lí được các vấn đề hiện tại, tên tuổi của Fowler sẽ được ghi tên vào sử sách. Nhưng vào năm 2003, một anh tài trong giang hồ, một lập trình 46 tuổi đến từ Boston, Eric Evans đã công bố một cuốn sách “Domain-Driven Design: Tackling Complexity in the Heart of Software” (Domain Driven Design: Xử lí sự phức tạp cốt lõi của phần mềm). Cuốn sách đã khiến 1 anh chàng Martin nào đó trên thế giới phải cất poster và khóc.

image 7 - quochung.cyou PTIT

Nhìn chung thì Evans vẫn đồng ý với đa số các ý tưởng của N-Layered, đó là sự kế thừa của hệ thống chỉ nên đi theo 1 hướng (các tầng gọi nhau lần lượt từ trên xuống dưới).

Tuy nhiên ông cho rằng, cũng không tệ lắm nếu một module bậc thấp (tầng bên dưới) có thể gọi lên module bậc cao ở tầng cao hơn. Miễn là nó không phá vỡ hướng đi kế thừa của hệ thống (dependency direction). Điều này có thể làm được bằng callback, hoặc một số design pattern như observer, ….

Ông cũng cho rằng, các Controller thường bị lắp quá nhiều logic, nên ông đã chuyển chúng sang 1 layer khác tên là Application. Ông cũng cho rằng tầng Bussiness logic nên được chú trọng nhiều hơn là tầng database (data access). Nhưng nhìn chung cấu trúc cũng không thay đổi nhiều lắm.

image 8 - quochung.cyou PTIT

Ở cấu trúc của ông, một hệ thống được quy định như sau:

  • Presentation Layer — tầng “trình bày”, tương tác với bên ngoài.
  • Application Layer — Nhận và điều phối các yêu cầu, sau đó chuyển qua tầng Domain.
  • Domain Layer — Chứa các chức năng chính của hệ thống.
  • Infrastructure Layer — Xử lí dữ liệu (tương tự tầng data access)

Bạn có thể thấy ông đã đổi tên một số tầng tưởng chừng như có chung mục đích, nhưng chúng có nguyên do của nó. User Interface thường có ý nghĩa là bạn có một user người dùng nào đó, nhưng không phải lúc nào cũng vậy. Đôi khi ta có một GUI (Graphical User Interface – Giao diện người dùng) cho users, nhưng cũng có thể là 1 CLI (Command Line Interface – Giao diện cmd) cho lập trình viên, hay có thể là API (Application Programming Interface) cho các ứng dụng khác gọi vào. Tầng Presentation thì sẽ “Generic” , chung chung hơn, bao quát hơn.

Business logic thì nghe có vẻ hơi trừu tượng cho đội lập trình viên, vì chúng ta thường không thiên về mảng kinh tế, vì vậy ông đã tạo ra 1 tên mới “Domain – miền”

Ở tầng dưới cùng, đôi lúc, ta không chỉ lưu dữ liệu vào ram, vào database hay đâu đó. Mà có thể ta muốn nó sẽ gọi đến chỗ khác, kiểu gửi 1 email, 1 tin nhắn zalo, … nên chúng được gộp chung thành tầng Infrastructure (Hạ tầng).

Nhìn chung là thế, một số sự thay đổi tên, thêm 1 layer mới, có một số phần khác đã được thêm vào tầng Domain. Và đó là DDD – Domain Driven Design.


Tham khảo:

Vấn đề khi sử dụng số hoặc UUID cho Primary Key trong database

Lưu trữ dạng số

image 23 - quochung.cyou PTIT

Đây có lẽ là cách lưu trữ thường được thấy và dễ tưởng nhất. Trường primary key sẽ đóng vai trò như số thứ tự, giúp phân biệt giữa các row khác nhau, cách lưu trữ bằng số có thể được DB tự gen bằng cách gen sequence.

  • Khá tiện quản lý, sử dụng trong tầng dữ liệu
  • Dễ hiểu, dễ đọc, dễ tìm

Điểm trừ của cách làm này là:

  • Giả sử bạn đang lưu trữ dữ liệu cho 1 tệp khách hàng, được đánh id từ 1-1000, một ngày nào đó, bạn cần migrate data từ các bảng khác, từ những bảng cũ, … (kiểu sát nhập công ty, …) và cũng có tập dữ liệu được đánh số từ 1-100, 500-1000 gì đó. Điều này làm việc sát nhập trở lên khó khăn hơn do key chính để phân biệt các hàng đã bị trùng
  • Việc đánh số tuần tự cũng có thể tạo các risk về security, … Ví dụ bài viết đang được lưu đơn giản đánh bài viết số 1,2,… Từ đó từ bên ngoài có thể đoán được và truy cập được 1 bài viết bất kì.

Lưu trữ bằng UUID

image 24 - quochung.cyou PTIT

Lúc này, một cách làm khác đã thường được sử dụng là UUID (Universally unique identifier). Sẽ khó có ai có thể đoán được uuid của 1 bài viết được sinh ra ngẫu nhiên.

  • UUID được sinh ngẫu nhiên, tỉ lệ trùng lặp là rất thấp
  • Tránh được việc user tự mở 1 bài viết bất kì
image 25 - quochung.cyou PTIT

Tuy nhiên nó cũng đi kèm một số nhược điểm quan trọng

  • UUID dài. Để lưu trữ 1 uuid, thông thường ta cần tới 16 byte. Nó tốn dữ liệu hơn nhiều trong database so với lưu số thông thường. Sau này, khi ta sử dụng các database quan hệ giữa nhiều bảng, việc join các cột foreign keys sẽ ngày càng lớn hơn giữa các primary key
  • UUID do được sinh random, nên database sẽ khó lòng index một bảng để truy vấn nhanh hơn (VD MySQL sử dụng B+ Tree, cần một trường nào đó đánh theo một dãy giá trị có thể sắp xếp được: số, …).

Một số cách làm khác

  • ULID (Universally Unique Lexicographically Sortable Identifier). Vẫn là 16 byte, nhưng phần đầu sẽ chứa dữ liệu của timestamp (ngày tháng), và còn lại là ngẫu nhiên. Điều này giúp xử lí việc index database, dễ sắp xếp hơn
  • TSID (Time-Sorted Unique Identifiers). Cũng giống với ý tưởng của ULID nhưng chỉ tốn 8 byte. Tuy nhiên chúng cũng đi kèm với 1 số tradeoff

Đi sâu vào TSID

Có nhiều cách để triển khai TSID, trong bài này mình sẽ nói về Hypersistence TSID (Thư viện OSS), cho phép tạo 1 TSID 64-bit gồm 2 phần

  • 42-bit là dữ liệu thời gian
  • 22 bit là dữ liệu random

Thêm vào maven

<dependency>
    <groupId>io.hypersistence</groupId>
    <artifactId>hypersistence-tsid</artifactId>
    <version>${hypersistence-tsid.version}</version>
</dependency>

Tạo 1 object TSID

TSID tsid = TSID.fast();

`Từ TSID, ta có thể extract ra được thời gian

image 26 - quochung.cyou PTIT
image 27 - quochung.cyou PTIT
image 28 - quochung.cyou PTIT

Sử dụng vào database

Vì TSID là một số 64-bit (có thể sắp xếp), ta có thể lưu nó vào database dưới dạng bigint

CREATE TABLE post (
    id bigint NOT NULL,
    title varchar(255),
    PRIMARY KEY (id)
)

Lưu ở phía Entity

@Entity
@Table(name = "post")
public class Post {
 
    @Id
    private Long id;
 
    private String title;
     
}

Tổng kết về TSID

  • Đa phần giữ được các ưu điểm của UUID như khó đoán ở phía người dùng, tạo sự phân biệt, …
  • Lưu trữ nhẹ hơn UUID (8 byte vs 16 byte)
  • Tuy nhiên TSID có thể có tỉ lệ bị sinh ra ngẫu nhiên trùng cao hơn do chỉ có 22bit ngẫu nhiên (xác suất sinh trùng là 0.3%)

Xử lí việc sinh trùng, bạn có thể thêm số lần retry để tự động sinh lại nếu xảy ra collision

image 29 - quochung.cyou PTIT

Khi nào nên sử dụng TSID

  • Phần ID có thể expose cho phía client người dùng, ví dụ như id bài viết, video, …. còn các bảng phụ hỗ trợ liên quan có thể cứ dùng dạng số để thuận tiện và tiết kiệm
  • Các database expose cho người dùng, cần tính đến việc scale lâu dài, và tiết kiệm

Tham khảo:

Sử dụng Keyset Pagination – Seek bằng  Blaze Persistence

Nếu bạn chưa nghe về khái niệm này, có thể đọc ở đây http://quochung.cyou/toi-uu-truy-van-pagination-phan-trang-su-dung-spring-boot-java/

 Blaze Persistence

Tuy nhiên bạn có thể sử dụng  Blaze Persistence để làm điều đó và có thể hoạt động plug-n-play với JPA luôn.

Tạo một CriteriaBuilderFactory

image 15 - quochung.cyou PTIT

Lấy tập dữ liệu Top-N trên cùng

image 16 - quochung.cyou PTIT

Để lấy trang đầu tiên, ta sử dụng một query Top-N như sau.

  • Bạn có thể tùy chỉnh orderByAsc để căn theo sort by tập dữ liệu cần có
  • pageSize quy định số lượng số phần tử cần lấy
  • withKeysetExtraction sẽ yêu cầu Blaze Persistence để lưu các thông số để có thể lấy dữ liệu cho query N phần tử tiếp theo
image 17 - quochung.cyou PTIT
  • PagedList implement từ List có sẵn của Java, với một số hàm để bạn có thể extract dữ liệu
image 18 - quochung.cyou PTIT

Output:

image 19 - quochung.cyou PTIT

Lấy trang tiếp theo

image 20 - quochung.cyou PTIT

  • Page tiếp theo sẽ sử dụng keysetPage ta đã có trước đó, để có thể thực hiện skip lượng row cần thiết để lấy tập dữ liệu tiếp theo

Thử nghiệm kết quả

image 22 - quochung.cyou PTIT
  • Sử dụng cách tương tự để nhảy sang các trang kế tiếp

Tham khảo:

Tối ưu truy vấn Pagination (phân trang) sử dụng Spring Boot (Java)

image 4 - quochung.cyou PTIT

Phân trang là gì, tại sao cần phân trang

Phân trang đơn giản là ta sẽ chia một tập dữ liệu lớn và truyền cho user thành từng phần nhỏ hơn. Hãy tưởng tượng, bạn đang thiết kế một hệ thống backend cho phía frontend của một trang tin tức, phía FE muốn một lệnh API để có lấy dữ liệu các bài viết từ database của bạn.

image 5 - quochung.cyou PTIT

Bài toán sẽ khá đơn giản nếu bạn chỉ có 10-20 bài viết, bạn chỉ cần làm theo cách truyền thống, lấy dữ liệu từ database từ backend, gửi một file json chứa dữ liệu cho FE, mọi thứ nghe có vẻ đơn giản.

Tuy nhiên khi tập dữ liệu của ta ngày càng lớn, ví dụ, lúc này 1 Model bài viết có rất nhiều trường (ảnh đại diện, chuyên mục, thời gian đăng, ….), và ta có hàng 1000-10000 bài viết, việc trả 1 lần tập dữ liệu lớn như thế sẽ làm chậm ở 2 chỗ:

  • Lấy toàn bộ dữ liệu từ database tốn thời gian
  • Truyền 1 lần dữ liệu lớn như vậy sẽ rất nặng, tốn tiền mạng thật sự của user (tải 1 file lớn mỗi lần), và lúc tải 1 file lớn như thế cũng rất chậm, tốn thời gian, gây khó chịu người dùng

Tổng kết 1

Khi đó, ta có thể sử dụng đến phân trang, và mỗi lần người dùng chỉ có thể xem 1 trang, ta chỉ gửi khoảng 10-15 bài viết 1 lần thôi, khi người dùng sang trang khác ta sẽ gửi tập dữ liệu khác, khá đơn giản.

Triển khai phân trang bằng Spring Boot

Triển khai Model

image 6 - quochung.cyou PTIT

Triển khai Repository

Để có thể truy cập các JPA Entity trên từ database, ta sẽ tạo 1 PostRepository

image 7 - quochung.cyou PTIT

JPARepository đã kế thừa sẵn một interface là PagingAndSortingRepository của Spring hỗ trợ việc phân trang và sắp xếp. Dù là một interface, không có implemention, nhưng khi chương trình khởi chạy, Spring sẽ tự động generate các code implemention thật cho chúng ta, thực thi các thao tác với database, và chúng ta chỉ cần define các method có sẵn thôi.

Phân trang

Do Spring đã làm đa số các phần code, giờ ta chỉ cần triển khai thêm 2 việc

  • Tạo một PostPageRequest class, implement từ Pageable interface của Spring
  • Truyền tham số cần tìm cho PostPageRequest
image 9 - quochung.cyou PTIT

Khi implement interface Pageable, ta sẽ phải triển khai một số hàm. Lúc này class PostPageRequest sẽ như một object “trang” , kiểu trang 5 thì là một object Trang, trang 6 là một object khác. Từ object trang đó ta có thể lấy trang tiếp theo, trang phía trước, các bài viết trong trang,….

offset và limit

Bạn có thể thấy trong code trên có các tham số offset và limit. Hai tham số trong sql có ý nghĩa như sau

  • offset x : Lùi x kết quả từ dãy kết quả trả ra
  • limit y: Từ danh sách kết quả trả ra, lấy y kết quả đầu tiên.
  • Ví dụ: ta có các bài viết đánh số từ 1-100. offset 5 thì ta sẽ có danh sách là 6-100. limit tiếp 10 thì ta có danh sách 6-16…

Nếu bạn đã hiểu định nghĩa offset và limit, hãy thử đọc lại code bên trên, bạn sẽ dễ dàng hiểu được các method lấy trang tiếp theo, lấy trang trước, …. đang làm gì.

image 10 - quochung.cyou PTIT

Tổng kết 2

Như vậy, ta đã triển khai được phân trang bằng Spring Boot, tuy nhiên liệu như vậy đã tối ưu cho trang web của bạn chưa?

Tối ưu limit và offset trong MySQL

image 11 - quochung.cyou PTIT
image 12 - quochung.cyou PTIT
OffsetQuery Duration (ms)
01
501
100013
10000150
25000500
50000930
1000001750

Những biểu đồ và bảng

Ta có thể thấy, bằng việc dùng offset để lùi kết quả đi một đoạn, rồi lấy limit để lấy lượng bài ở trang đó nghe có vẻ rất đơn giản, dễ hiểu. Nhưng thực tế trong MySQL chúng được thực hiện như sau:

…the rows are first sorted according to the <order by clause> and then limited by dropping the number of rows specified in the <result offset clause> from the beginning…

…các dòng đầu tiên được sắp xếp (ví dụ theo id, thời gian đăng bài…) sau đó xóa x hàng đầu tiên được yêu cầu khi sử dụng offset
image 13 - quochung.cyou PTIT

Nếu bạn nghĩ kĩ, câu lệnh offset chỉ nhận đúng 1 tham số: lượng dòng bị bỏ qua cho đến tập kết quả muốn nhận.

Cách duy nhất hệ thống database có thể làm điều này là lấy toàn bộ dữ liệu cần tìm, sau đó ném đi x hàng đầu bạn đã đặt ra yêu cầu. Khi offset đủ lớn, lượng công việc cho database sẽ rất nhiều và thời gian để truy vấn sẽ tăng khó kiểm soát.

Khi sử dụng offset, ta mở trang đầu tiên, trang thứ 2, thời gian mất chỉ 1ms (1 phần nghìn giây), gần như không có vấn đề gì.

Trang thứ 10000, 150ms, vẫn chưa nhận ra điều gì quá lo ngại

100000 1750ms, 1,75 giây.

Ta có thể thấy, nếu người dùng mở 1 trang càng xa, hiệu suất của trang sẽ càng giảm, việc một user mở trang thứ 10000 có thể gây vấn đề hiệu năng hơn nhiều cho database hơn 100 người dùng khác mở trang 1

Hướng khắc phục

Trước hết, ta cần tìm hiểu xem những hệ quản trị cơ sở dữ liệu đang làm gì để sắp xếp dữ liệu của chúng ta. Ta sẽ assume hệ cơ sở dữ liệu đang sử dụng một B-Tree để index database (một bản nâng cấp của cây nhị phân cân bằng).

Nếu bạn chưa từng nghe đến cụm từ trên, bạn có thể tìm hiểu ở link sau:

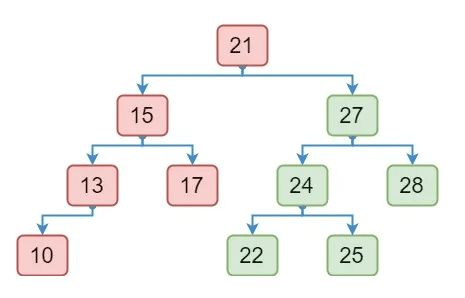
Lúc này database của chúng ta lưu dữ liệu theo dạng như sau:

image 14 - quochung.cyou PTIT

Khi ta sử dụng offset 0, limit 5 để lấy 5 bài viết đầu tiên chẳng hạn, database sẽ chạy các kết quả sau

SELECT * FROM my_table ORDER BY id LIMIT 5
image 15 - quochung.cyou PTIT

Tuy nhiên, với offset, sau khi offset 5 và limit 5, ta có

image 16 - quochung.cyou PTIT

Như vậy, ta phải đi qua 5 cái đầu trước, bỏ dần nó, rồi sau đó mới limit 5 cái sau. Khá là tốn thời gian

Vấn đề: Database không biết điểm khởi đầu của trang tiếp theo ở đâu, vì vậy nó cứ phải bỏ dần các hàng phía trước cho đến khi đến được vị trí chỉ định

=> Khắc phục: Ta nhớ xem vị trí lần cuối là ở đâu ?

Kĩ thuật: keyset pagination and seek method

Ở một số trang web, bạn sẽ thấy, bạn không thể đi đến thẳng trang cuối, hoặc nhảy đến 1 trang bất kì, mà thông thường sẽ có nút để sang trang kế và trang phía trước. Như vậy ta có thể assume rằng:

Người dùng sẽ chỉ mở trang 10 sau khi mở trang 9.

Vậy, ta chỉ cần nhớ vị trí cuối cùng của bài viết ở trang 9 là ở id bao nhiêu, rồi dùng WHERE để truy vấn từ điểm đó, chứ không cần bỏ dần để đi đến điểm đó nữa
SELECT * FROM my_table WHERE id > 21 ORDER BY id LIMIT 5
image 17 - quochung.cyou PTIT

Ví dụ: Sort theo thời gian

SELECT *
FROM my_table
WHERE (update_date = '2017-12-21' AND id > 21) 
    OR update_date > '2017-12-21'
ORDER BY update_date,id LIMIT 5

Cơ bản là ta sẽ chỉ lấy các bài viết có cùng thời gian đăng như bài viết cuối và id > , hoặc thời gian lớn hơn bài viết cuối

image 18 - quochung.cyou PTIT

Tổng kết

  • Phương pháp keyset pagination and seek giúp tối ưu việc phân trang cho các bài toán lớn hơn rất nhiều (Tham khảo biểu đồ trên)
  • Triển khai trong Java (JPA/Hibernate)

Tuy nhiên, phương pháp này sẽ có thêm các vấn đề sau

  • Ta cần thay đổi lại code của hệ thống để triển khai phương pháp này, cần phải nhớ hàng cuối cùng hiện tại, làm code phức tạp hơn, khó quản lí hơn
  • Cần phải index database theo id, pubdate, ….
  • Các hàng tìm kiếm cần được sắp xếp, không được null
  • Không thể đi trực tiếp đến trang 500,1000,… được, mà chỉ có thể sang trang kế tiếp do ta cần nhớ điểm cuối từ trang phía trước

Có thể tham khảo thêm Spring HateOAS hỗ trợ thêm vấn đề này

Các nguồn tham khảo: