Kaggle’s setup is amazing for quick experiments but not great when you start treating your work like an actual project. You get one main notebook. That’s it.
If you want to use your own .py files, you basically have to zip them up, upload them as a dataset, and then import from that path. It’s clunky and hard to maintain. Change one line of code? You need to re-upload the dataset again.
I saw this frustration all over the web, in Kaggle forums, Stack Overflow threads, even Reddit. Everyone was hacking their way around it, trying things like chained kernels or huge notebooks with thousands of lines of code. Nobody seemed happy with it.
So I went down the rabbit hole. Read a bunch of Medium posts, watched YouTube tutorials, skimmed corporate engineering blogs. I noticed a pattern: real ML pipelines in the wild are automated. They have CI/CD. They deploy cleanly. But for personal Kaggle projects, nobody had built something simple and usable.
That’s when it clicked, I could write a small tool that did the boring part for me. A script that could take my local project, package it up neatly, and push it to Kaggle as a dataset and a runnable notebook automatically.
Building kaggle-auto-deploy
The idea was simple:
Collect all project files.
Upload them as a Kaggle dataset.
Auto-generate a notebook that sets everything up and runs main.py.
Push it, version it, done.
So that’s what I built. A small CLI tool:
python kaggle_deploy.py ./my_project
For example, I used it on a small housing price predictor I’d built.
Behind the scenes, it ties into Git too, so every deployment matches a commit. No more “which version did I upload again?” moments.
git clone https://github.com/yourusername/kaggle-auto-deploy.git
cd kaggle-auto-deploy
Make it Executable (Linux/Mac)
chmod +x kaggle_deployer.py
Optional: Add to PATH (Linux/Mac)
# Add to ~/.bashrc or ~/.zshrc
export PATH="$PATH:/path/to/kaggle_deployer"
Usage
Basic Usage
python kaggle_deployer.py /path/to/your/project
Sample Project
This repository includes a sample project called housing_price_predictor that demonstrates how to structure a multi-file Python project for deployment to Kaggle.
python kaggle_deploy.py ./housing_price_predictor
Project Structure
housing_price_predictor/
├── main.py          # Entry point
├── data_loader.py   # Data loading and preprocessing
├── model.py         # Model training and evaluation
├── utils/
│   └── helpers.py   # Utility functions
├── data/
│   └── housing.csv  # Sample data
└── requirements.txt # Dependencies
Running the Sample Project
# Run locally
cd housing_price_predictor
python main.py

# Deploy to Kaggle
python kaggle_deployer.py ./housing_price_predictor
Save this as keycloak/docker-compose.yml. Replace secure_password and admin_secure_password with strong, unique values, and update auth.example.com to your Keycloak subdomain.
1.2 Configure Nginx for SSL
Set up Nginx as a reverse proxy to secure Keycloak with HTTPS.
Install Nginx:
sudo apt update
sudo apt install nginx
Create an Nginx configuration file:
sudo nano /etc/nginx/sites-available/keycloak
Add the following, replacing auth.example.com with your subdomain:
Access the Keycloak admin console at https://auth.example.com/admin, logging in with admin and admin_secure_password. Change the admin password immediately for security.
Step 2: Configure Keycloak as a SAML Identity Provider
Keycloak will act as the Identity Provider (IdP) for n8n. We’ll configure a SAML client, and set up mappers for user attributes.
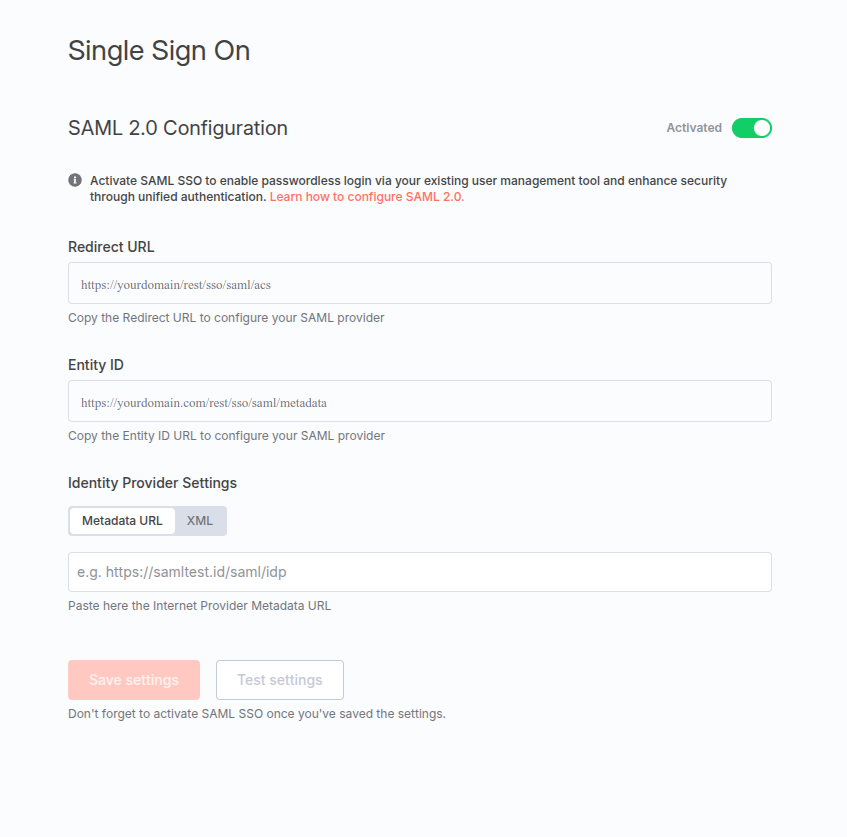
Get required information from N8N
Navigate to Settings -> SSO
Save the Entity ID and Redirect URL
Create a SAML Client for n8n
Navigate to Clients > Create Client.
Set:
Client Type: SAML
Client ID: (n8n’s Entity ID from previous step, matching its base URL)
Name: n8n (Your choice)
Configure:
Valid Redirect URIs: https://n8n.example.com/saml/acs (Redirect URI from previous step)
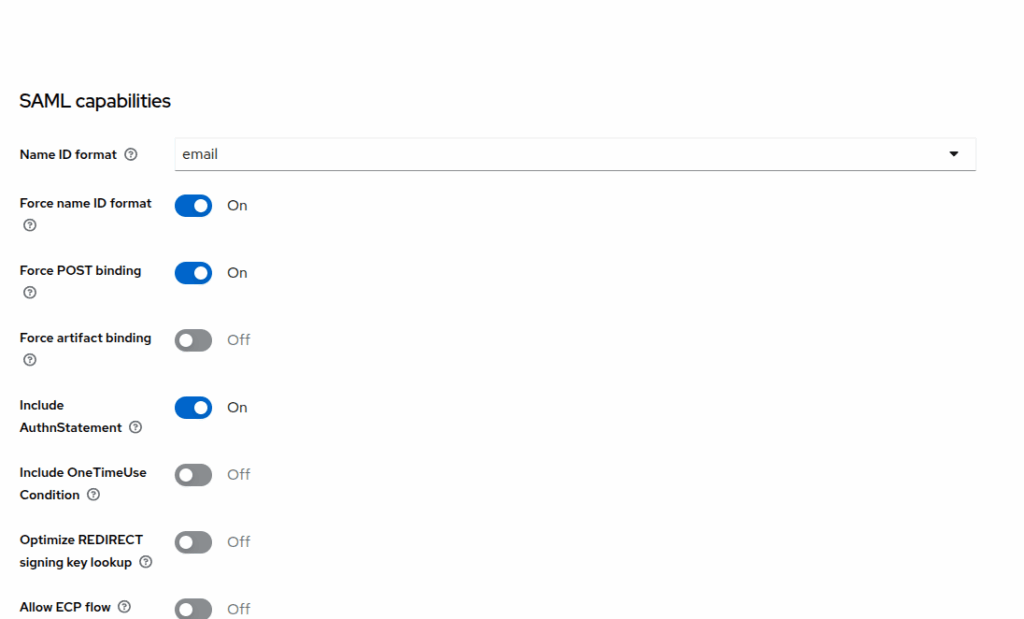
Settings: (Image below)
Name ID format: Email
Force name ID format: ON
Force POST binding: ON
Include AuthnStatement: ON
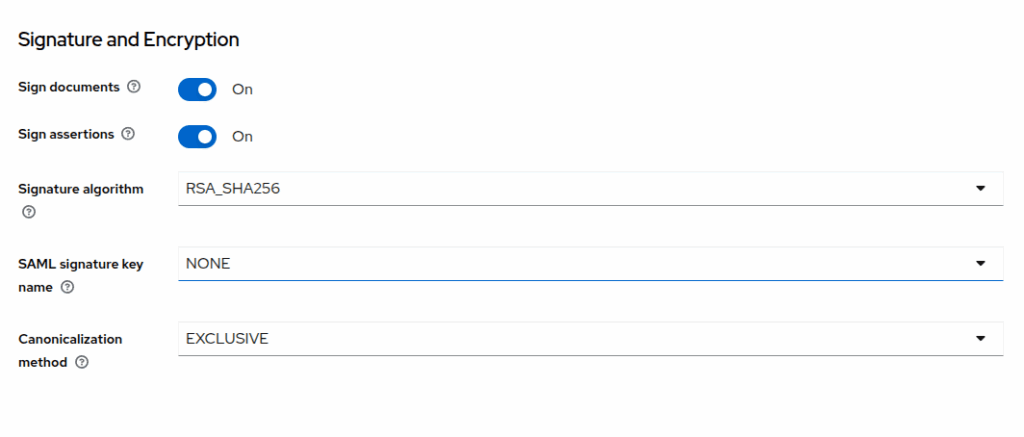
Sign Document: ON
Sign Asseration: ON
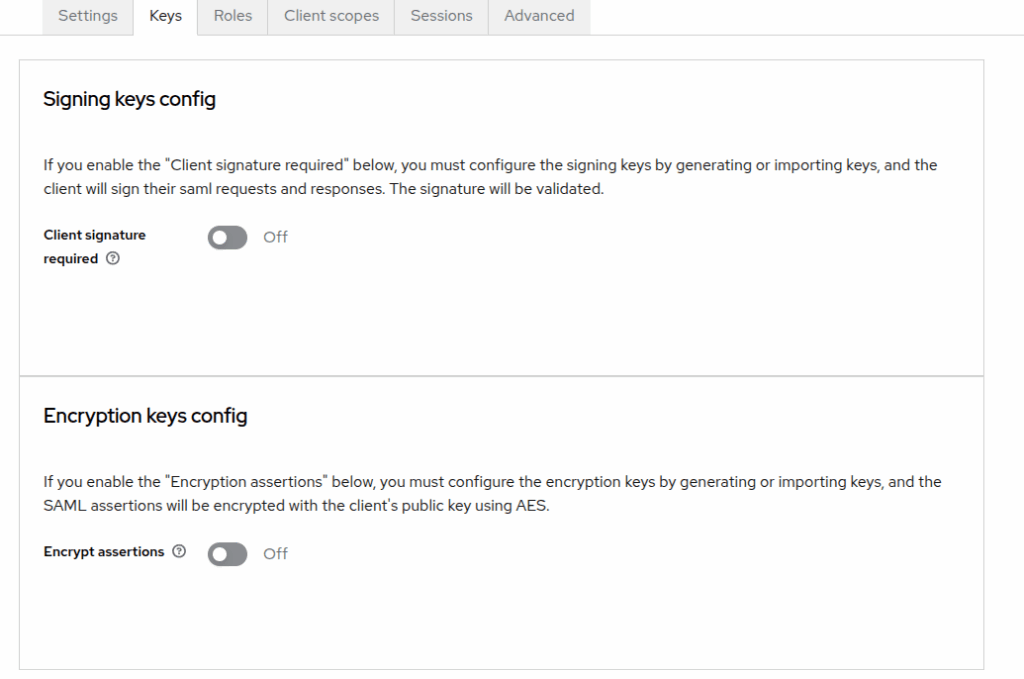
Client Signature Required: Off
Save the client.
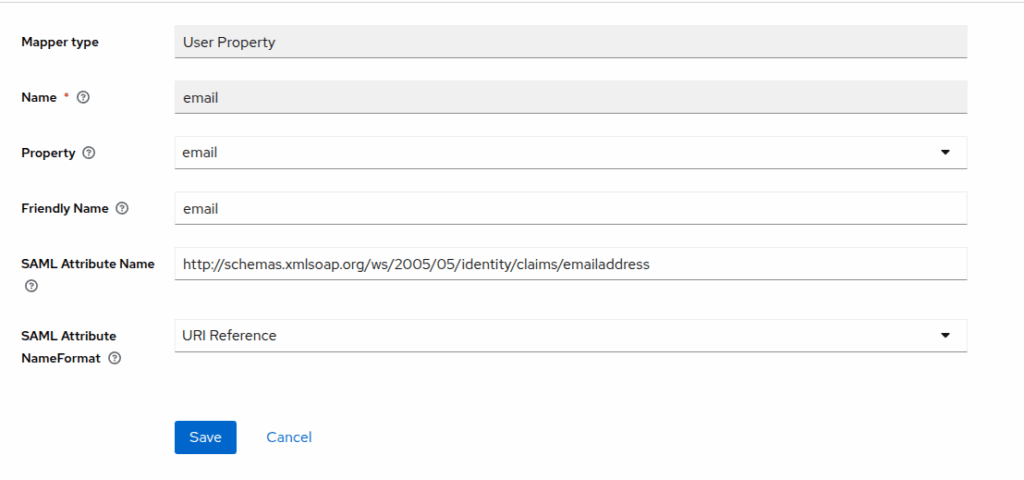
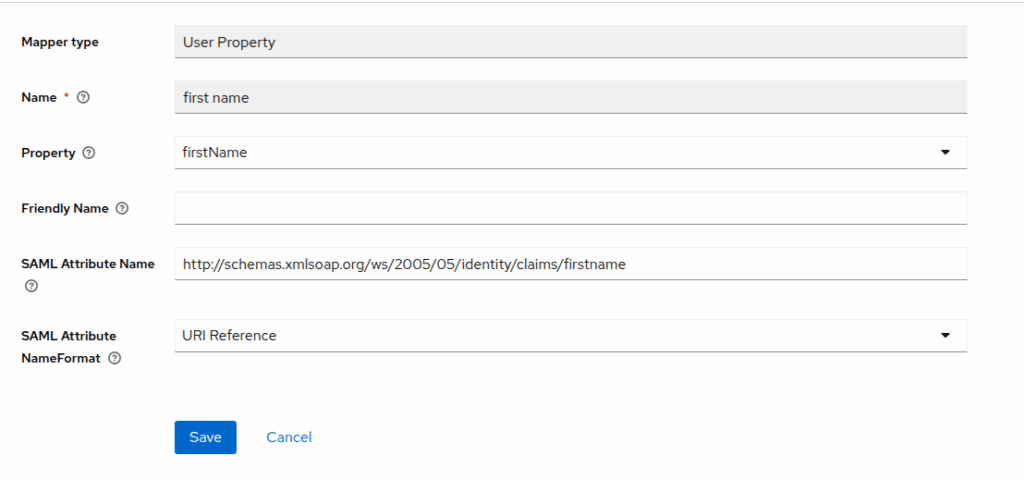
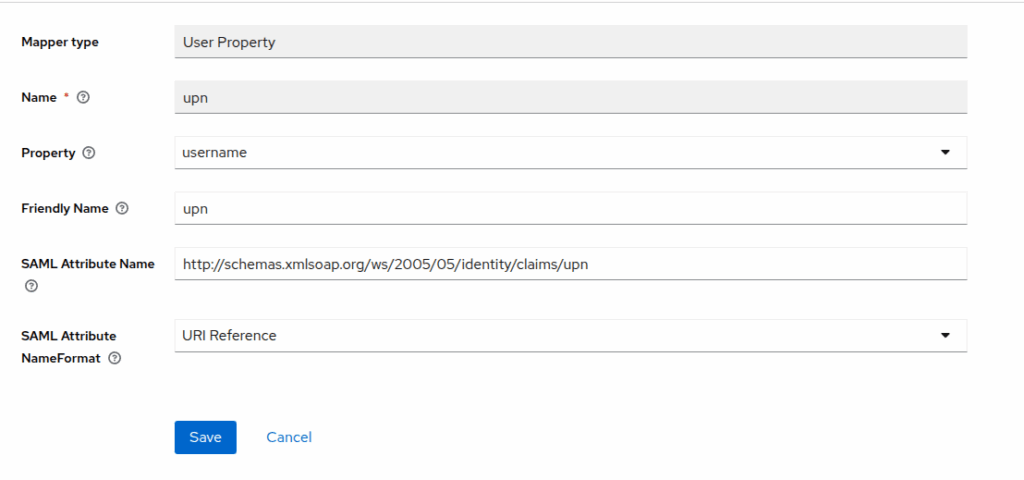
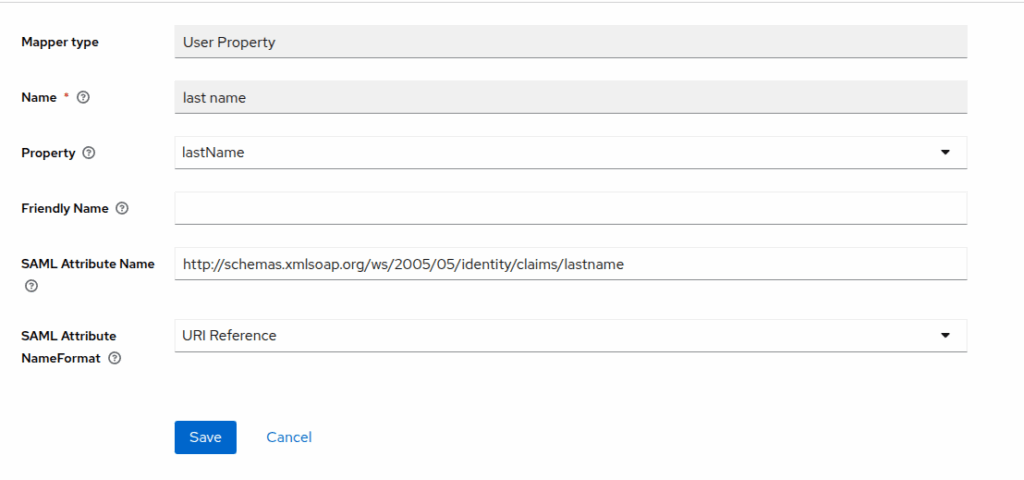
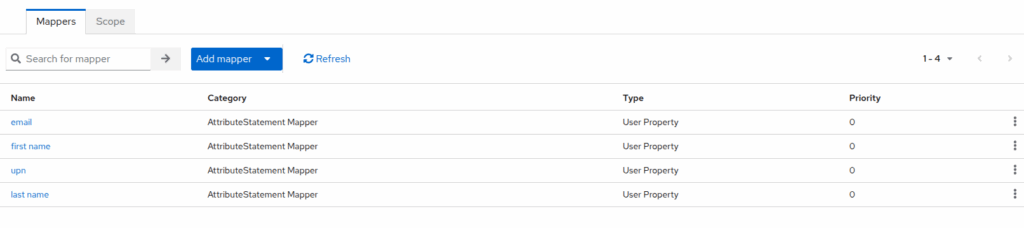
Configure Mappers
Mappers define how user attributes are sent to n8n.
Trong thời đại số ngày nay, dữ liệu hiện hữu ở khắp mọi nơi và đóng vai trò cực kỳ quan trọng trong cuộc sống cũng như công việc của chúng ta. Từ việc chúng ta lướt Facebook, Tiktok hàng ngày, đặt vé xem phim online, cho đến cách các công ty lớn vận hành chuỗi cung ứng phức tạp, mọi thứ đều không ngừng tạo ra và tiêu thụ dữ liệu.
Ví dụ:
Facebook biết chúng ta khi lướt trên bảng tin, sẽ dừng lại tại bài viết nào lâu, bài viết nào thu hút sự chú ý, chủ đề nào chúng ta thường xem, bạn bè nào chúng ta thường hay tương tác
Các app đặt vé xem phim có dữ liệu về phim nào nhiều người xem, bộ phim thể loại nào thì thường được giới tính, độ tuổi nào quan tâm, ….
Nhưng bạn có bao giờ dừng lại và tự hỏi, với một khối lượng dữ liệu khổng lồ và đa dạng như vậy – từ những con số khô khan trong bảng tính Excel, các giao dịch ngân hàng, đến hình ảnh, video, bài đăng mạng xã hội, hay những dòng log hệ thống dày đặc – làm thế nào để chúng ta có thể lưu trữ, quản lý và quan trọng nhất là khai thác chúng một cách hiệu quả?
Trong mọi tổ chức, thông thường sẽ xuất hiện hai nhu cầu cốt lõi:
Xử lý các hoạt động diễn ra hàng ngày
Phân tích chiến lược dựa trên dữ liệu đã tích luỹ
OLTP và OLAP
OLTP (Online Transaction Processing) – Xử lý giao dịch trực tuyến
Hãy tưởng tượng bạn đang thực hiện một giao dịch trực tuyến: đặt một chiếc vé máy bay trên website hãng hàng không, chuyển tiền qua ứng dụng ngân hàng, hay đơn giản là mua một món hàng trên sàn thương mại điện tử.
Tất cả những hành động này đòi hỏi hệ thống phải xử lý ngay lập tức, đảm bảo tính chính xác tuyệt đối (tiền phải được chuyển đúng tài khoản, vé phải được xác nhận và không bị bán trùng) và diễn ra nhanh chóng, không làm bạn phải chờ đợi. Đó chính là bản chất của OLTP – Xử lý giao dịch trực tuyến.
OLTP tập trung vào việc xử lý một khối lượng lớn các giao dịch nhỏ, riêng lẻ diễn ra liên tục trong thời gian thực. Các ví dụ đời thường của hệ thống OLTP có ở khắp nơi quanh ta: máy tính tiền ở siêu thị (quét mã sản phẩm, trừ số lượng tồn kho, tính tiền), máy ATM rút tiền, hệ thống đặt phòng khách sạn, hay việc bạn cập nhật thông tin cá nhân trên một trang web
Đặc điểm quan trọng nhất của các hệ thống OLTP là ưu tiên tốc độ xử lý cực nhanh (thường tính bằng mili giây) và tính nhất quán của dữ liệu. Chắc chắn khách hàng sẽ không muốn tiền của mình bị “bốc hơi” hay thông tin đơn hàng bị sai lệch.
Hệ thống OLTP được thiết kế để đảm bảo điều đó. Chúng thường làm việc với dữ liệu hiện tại (trạng thái mới nhất của thông tin) và thực hiện các truy vấn tương đối đơn giản và lặp đi lặp lại, như tìm kiếm thông tin một bản ghi cụ thể (point query), thêm mới, cập nhật hoặc xóa dữ liệu dựa trên hành động của người dùng.
OLAP (Online Analytical Processing) – Xử lý phân tích trực tuyến
Tuy nhiên, từ góc nhìn của một nhà quản lý doanh nghiệp. Thay vì xử lý từng giao dịch nhỏ lẻ, bạn lại có những câu hỏi lớn hơn, mang tính chiến lược:
“Trong quý vừa qua, dòng sản phẩm nào mang lại lợi nhuận cao nhất?”
“Xu hướng mua sắm của nhóm khách hàng ở độ tuổi 25-35 là gì?”
“Chiến dịch marketing giảm giá 10% vừa rồi có thực sự hiệu quả trong việc thu hút khách hàng mới không?”
Để trả lời những câu hỏi này, không thể chỉ nhìn vào một vài giao dịch đơn lẻ. Chúng ta cần phải xem xét một khối lượng dữ liệu lịch sử khổng lồ, tổng hợp thông tin từ nhiều nguồn, và phân tích chúng từ nhiều góc độ khác nhau (ví dụ: theo thời gian, theo khu vực địa lý, theo dòng sản phẩm, theo kênh bán hàng…). Đây chính là lúc OLAP – Xử lý phân tích trực tuyến phát huy vai trò
Các hệ thống OLAP được thiết kế để hỗ trợ việc phân tích dữ liệu phức tạp, giúp khám phá các xu hướng, mẫu hình ẩn giấu và cung cấp những hiểu biết sâu sắc (insights) để hỗ trợ việc ra quyết định kinh doanh (một phần quan trọng của Business Intelligence – BI). Ví dụ về các tác vụ OLAP bao gồm: phân tích doanh thu theo vùng miền qua các năm , dự báo nhu cầu thị trường cho sản phẩm mới, phân khúc khách hàng dựa trên hành vi mua sắm, hay đánh giá hiệu quả hoạt động của các phòng ban.
Khác với OLTP, các truy vấn OLAP thường rất phức tạp, đòi hỏi quét qua hàng triệu, thậm chí hàng tỷ bản ghi để tính toán các chỉ số tổng hợp (như tổng, trung bình, đếm, tỷ lệ phần trăm). Do đó, thời gian phản hồi của các truy vấn OLAP có thể lâu hơn đáng kể, từ vài giây, vài phút đến hàng giờ, tùy thuộc vào độ phức tạp và khối lượng dữ liệu. Chúng làm việc chủ yếu với dữ liệu lịch sử được tích lũy qua thời gian.
Tại sao cần phân biệt OLTP và OLAP? Mâu thuẫn thúc đẩy sự tách biệt
Bạn có thể thắc mắc: tại sao không dùng chung một hệ thống cho cả hai việc? Câu trả lời nằm ở sự mâu thuẫn cơ bản trong nhu cầu và đặc tính của OLTP và OLAP.
Hãy hình dung thế này: Hệ thống OLTP giống như một quầy giao dịch ngân hàng luôn bận rộn, cần xử lý nhanh chóng yêu cầu nạp/rút tiền của từng khách hàng. Trong khi đó, hệ thống OLAP giống như một phòng họp lớn nơi các nhà phân tích đang xem xét sổ sách kế toán của cả năm, thực hiện những phép tính toán phức tạp để lập kế hoạch chiến lược.
Nếu cố gắng thực hiện cả hai việc trong cùng một “căn phòng” (tức là trên cùng một cơ sở dữ liệu), sẽ dẫn dàng xảy ra việc các truy vấn phân tích OLAP nặng nề, đòi hỏi nhiều tài nguyên (CPU, bộ nhớ, đọc/ghi đĩa) sẽ làm chậm hoặc thậm chí “tắc nghẽn” các giao dịch OLTP đang diễn ra.
Thử tưởng tượng giao dịch mua hàng online của bạn bị treo chỉ vì bộ phận phân tích đang chạy một báo cáo doanh thu khổng lồ trên cùng hệ thống. Điều này rõ ràng là không thể chấp nhận được đối với các hoạt động kinh doanh cốt lõi, vốn đòi hỏi sự ổn định và tốc độ
Database, Data Warehouse, Data Lake
Database (Cơ sở dữ liệu) truyền thống
Database truyền thống, đặc biệt là cơ sở dữ liệu quan hệ (Relational Database), đóng vai trò như cuốn sổ cái điện tử, là nền tảng lưu trữ dữ liệu cho hầu hết các ứng dụng mà chúng ta tương tác hàng ngày, từ mạng xã hội, ứng dụng ngân hàng đến các website thương mại điện tử. Chúng được thiết kế và tối ưu chủ yếu cho các tác vụ OLTP – xử lý giao dịch trực tuyến.
Đặc điểm chính của Database truyền thống:
Loại dữ liệu: Chúng chủ yếu làm việc với dữ liệu có cấu trúc (structured data). Đây là loại dữ liệu được tổ chức một cách gọn gàng, ngăn nắp trong các bảng (tables), với các hàng (rows) và cột (columns) được định nghĩa rõ ràng, tương tự như cách bạn tổ chức dữ liệu trong một file Excel. Ví dụ: bảng Users có các cột UserID, UserName, Email, Password; bảng Orders có OrderID, UserID, OrderDate, TotalAmount.
Schema (Lược đồ/Cấu trúc): Database truyền thống sử dụng cơ chế Schema-on-Write. Điều này có nghĩa là bạn phải định nghĩa chi tiết cấu trúc của các bảng (tên cột, kiểu dữ liệu của cột là gì – số, chữ, ngày tháng…) trước khi bạn có thể lưu trữ bất kỳ dữ liệu nào vào đó. Giống như bạn phải kẻ sẵn các cột trong sổ kế toán trước khi ghi chép các khoản thu chi vậy. Lược đồ này thường khá cứng nhắc (rigid) và việc thay đổi nó có thể phức tạp, nhưng chính sự cứng nhắc này lại giúp đảm bảo tính nhất quán và toàn vẹn của dữ liệu.
Mục đích chính: Mục tiêu hàng đầu là phục vụ các hoạt động đọc, ghi, cập nhật, xóa (CRUD – Create, Read, Update, Delete) dữ liệu một cách nhanh chóng và đáng tin cậy, hỗ trợ trực tiếp cho các giao dịch OLTP của ứng dụng. Chúng cần đảm bảo mỗi giao dịch diễn ra thành công hoặc thất bại hoàn toàn (tính nguyên tử – Atomicity) và dữ liệu luôn ở trạng thái hợp lệ.
Người dùng: Người dùng trực tiếp chính của các database này thường là các Kỹ sư Backend (Backend Engineers). Họ là những người xây dựng và bảo trì các ứng dụng, viết code để tương tác (đọc/ghi) với database. Người dùng cuối như chúng ta chỉ tương tác gián tiếp với database thông qua giao diện của ứng dụng web hoặc mobile.
Ví dụ: Cơ sở dữ liệu lưu trữ thông tin tài khoản người dùng và bài viết của một diễn đàn trực tuyến, cơ sở dữ liệu quản lý thông tin sản phẩm, đơn hàng và khách hàng của một cửa hàng online, hay cơ sở dữ liệu chứa thông tin chuyến bay, lịch trình và đặt chỗ của một hãng hàng không.
Data Warehouse (Kho dữ liệu)
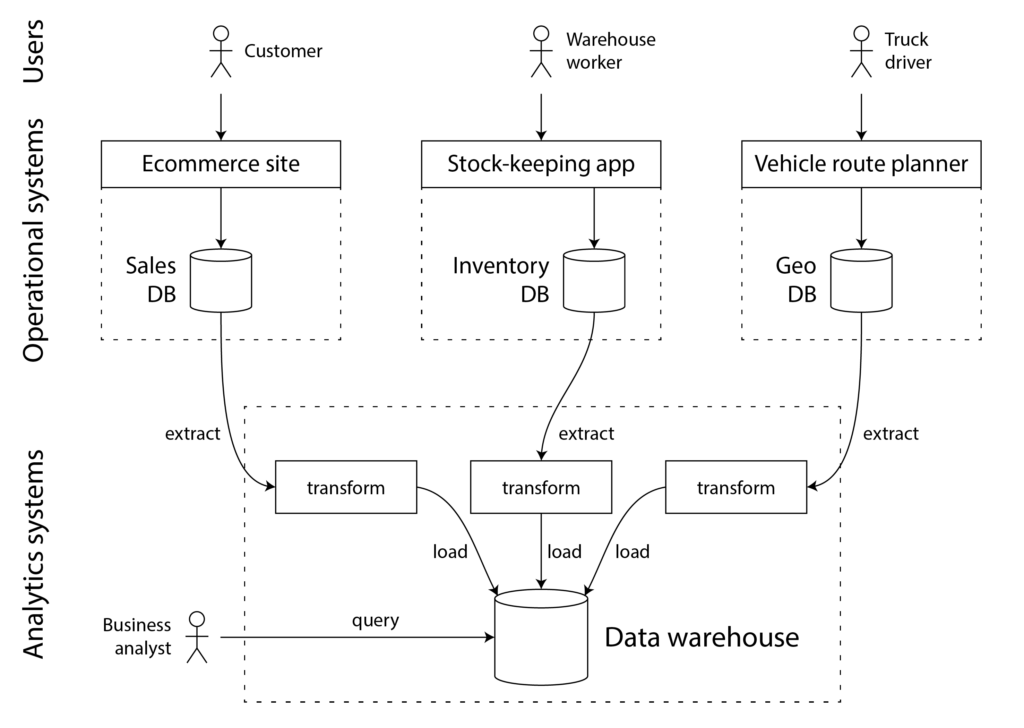
Khi một doanh nghiệp phát triển, họ thường có rất nhiều hệ thống hoạt động (OLTP) khác nhau: hệ thống quản lý bán hàng (POS), hệ thống quản lý quan hệ khách hàng (CRM), hệ thống quản lý kho (Inventory), hệ thống quản lý nhân sự (HR)…
Mỗi hệ thống lại có cơ sở dữ liệu riêng, dẫn đến tình trạng dữ liệu bị phân mảnh và cô lập (data silos). Việc tổng hợp dữ liệu từ tất cả các nguồn này để có một cái nhìn toàn cảnh về tình hình kinh doanh trở nên vô cùng khó khăn. Thêm vào đó, như chúng ta đã thảo luận, việc chạy các truy vấn phân tích phức tạp (OLAP) trực tiếp trên các hệ thống OLTP đang hoạt động sẽ gây ảnh hưởng nghiêm trọng đến hiệu năng.
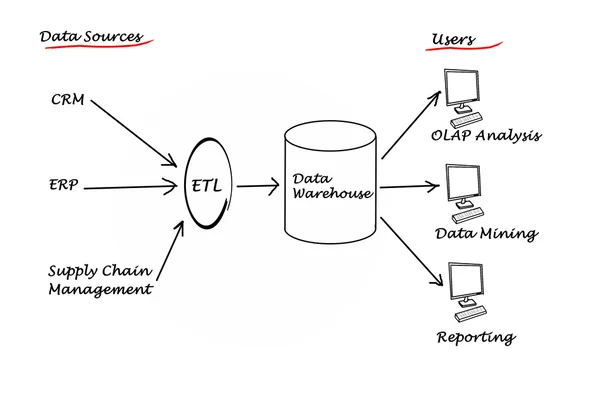
Để giải quyết những thách thức này, khái niệm Data Warehouse (Kho dữ liệu) đã ra đời vào cuối những năm 1980, đầu 1990. Bạn có thể hình dung Data Warehouse như một thư viện trung tâm khổng lồ, được xây dựng riêng biệt với các hệ thống hoạt động hàng ngày. Nó không trực tiếp phục vụ các giao dịch tức thời, mà nhiệm vụ chính là thu thập, tích hợp và lưu trữ dữ liệu từ nhiều nguồn OLTP khác nhau trong toàn doanh nghiệp, sau đó tối ưu hóa dữ liệu đó cho mục đích phân tích (OLAP) và Business Intelligence (BI)
Quá trình “nhập sách” vào thư viện – ETL/ELT:
Làm thế nào để dữ liệu từ các hệ thống nguồn khác nhau có thể được chuyển vào Data Warehouse một cách thống nhất? Đó là nhờ một quy trình quan trọng gọi là ETL (Extract – Transform – Load).
Extract (Trích xuất): Dữ liệu được lấy ra (trích xuất) từ các hệ thống nguồn khác nhau (database OLTP, file log, thậm chí cả dữ liệu từ các dịch vụ bên ngoài như Google Analytics hay hệ thống CRM của đối tác).
Transform (Biến đổi): Đây là bước quan trọng nhất. Dữ liệu thô được trích xuất thường không đồng nhất (ví dụ: ngày tháng có định dạng khác nhau, tên khách hàng viết hoa/thường lẫn lộn, đơn vị tiền tệ khác nhau…). Ở bước này, dữ liệu sẽ được làm sạch (loại bỏ lỗi, dữ liệu trùng lặp), chuẩn hóa (đưa về cùng một định dạng, đơn vị đo lường), tích hợp (kết hợp dữ liệu từ nhiều nguồn, ví dụ: liên kết thông tin khách hàng từ CRM với lịch sử mua hàng từ hệ thống bán lẻ), và biến đổi thành một cấu trúc (schema) phù hợp cho việc phân tích.
Load (Tải): Sau khi đã được “tút tát” sạch đẹp và đúng chuẩn, dữ liệu sẽ được tải vào Data Warehouse
Đôi khi, thứ tự có thể thay đổi một chút thành ELT (Extract – Load – Transform), tức là dữ liệu được tải vào Data Warehouse trước rồi mới thực hiện biến đổi tại đó. Cách tiếp cận này thường phổ biến hơn với các nền tảng dữ liệu hiện đại có khả năng xử lý mạnh mẽ.
Đặc điểm chính của Data Warehouse:
Loại dữ liệu: Chủ yếu lưu trữ dữ liệu có cấu trúc hoặc bán cấu trúc đã được xử lý, làm sạch và tích hợp từ nhiều nguồn khác nhau. Dữ liệu ở đây không còn ở dạng thô như lúc ban đầu.
Schema (Lược đồ/Cấu trúc): Vẫn sử dụng Schema-on-Write hoặc schema được định nghĩa trước, tương tự database truyền thống. Tuy nhiên, schema trong Data Warehouse thường được thiết kế theo mô hình hướng chủ đề (subject-oriented), tập trung vào các lĩnh vực kinh doanh cốt lõi như Bán hàng (Sales), Tiếp thị (Marketing), Tài chính (Finance), Nhân sự (HR)… thay vì theo cấu trúc của từng ứng dụng nguồn. Các mô hình phổ biến là Star Schema và Snowflake Schema, giúp tối ưu cho các truy vấn phân tích.
Mục đích chính: Phục vụ các hoạt động phân tích dữ liệu lịch sử, tạo báo cáo quản trị (BI reports), khám phá insight kinh doanh và hỗ trợ ra quyết định chiến lược (OLAP). Nó giúp trả lời các câu hỏi “Tại sao?” và “Điều gì sẽ xảy ra?”.
Người dùng: Người dùng chính là các Chuyên viên phân tích nghiệp vụ/kinh doanh (Business Analysts) , các nhà quản lý, lãnh đạo doanh nghiệp – những người cần các báo cáo tổng hợp, dashboard trực quan và những phân tích sâu sắc về tình hình hoạt động của công ty.
Tính chất dữ liệu:
Tích hợp (Integrated): Dữ liệu từ nhiều nguồn được hợp nhất và chuẩn hóa, tạo ra một bức tranh toàn cảnh.
Bất biến (Non-volatile): Dữ liệu trong Data Warehouse một khi đã được ghi vào thì rất hiếm khi bị cập nhật hay xóa đi. Thay vào đó, các dữ liệu mới (ví dụ: doanh số của ngày hôm qua) sẽ được nạp thêm vào. Điều này giúp lưu giữ lịch sử thay đổi của dữ liệu theo thời gian.
Gắn nhãn thời gian (Time-variant): Dữ liệu luôn được gắn với một yếu tố thời gian (ngày, tuần, tháng, quý, năm), cho phép các nhà phân tích xem xét và so sánh dữ liệu qua các khoảng thời gian khác nhau, từ đó nhận diện xu hướng và mẫu hình phát triển.
Thường là Read-only: Các nhà phân tích chủ yếu thực hiện các truy vấn đọc dữ liệu chứ không sửa đổi dữ liệu gốc trong kho.
Việc xây dựng Data Warehouse được xem là nỗ lực quan trọng đầu tiên của các doanh nghiệp nhằm phá vỡ các “ốc đảo dữ liệu” (data silos) và tạo ra một “nguồn sự thật duy nhất” (single source of truth) cho việc báo cáo và phân tích. Trước khi có Data Warehouse, việc tạo ra một báo cáo tổng hợp đáng tin cậy, ví dụ như kết hợp dữ liệu bán hàng từ hệ thống POS với dữ liệu chi phí marketing từ phòng Marketing và dữ liệu tồn kho từ bộ phận Logistics, là một công việc cực kỳ thủ công, tốn thời gian và dễ sai sót. Quy trình ETL tự động hóa việc tích hợp và làm sạch này, cung cấp cho các nhà phân tích một bộ dữ liệu tập trung, nhất quán và đáng tin cậy để họ có thể đặt ra những câu hỏi phức tạp hơn về hoạt động kinh doanh.
Data Lake (Hồ dữ liệu)
Data Warehouse đã giải quyết rất tốt bài toán tích hợp dữ liệu cho mục đích BI và báo cáo. Tuy nhiên, cùng với sự bùng nổ của Big Data và sự trỗi dậy của Khoa học dữ liệu (Data Science) và Học máy (Machine Learning – ML), Data Warehouse bắt đầu bộc lộ những hạn chế:
Kém linh hoạt: Cấu trúc dữ liệu (schema) phải được định nghĩa trước (Schema-on-Write) khiến việc thêm nguồn dữ liệu mới hoặc thay đổi cấu trúc trở nên tốn thời gian và công sức.
Khó xử lý dữ liệu phi cấu trúc: Data Warehouse được thiết kế chủ yếu cho dữ liệu có cấu trúc hoặc bán cấu trúc. Việc lưu trữ và phân tích các loại dữ liệu phi cấu trúc như văn bản (email, bài đăng mạng xã hội, đánh giá sản phẩm), hình ảnh, video, âm thanh, dữ liệu cảm biến (IoT)… là rất khó khăn hoặc không hiệu quả.
Chi phí lưu trữ cao: Việc lưu trữ một khối lượng dữ liệu khổng lồ, đặc biệt là dữ liệu lịch sử trong nhiều năm, trên các hệ thống Data Warehouse truyền thống có thể rất tốn kém.
Mất mát thông tin tiềm năng: Quá trình Transform trong ETL có thể làm mất đi một số chi tiết hoặc sắc thái trong dữ liệu gốc, mà những chi tiết này lại có thể hữu ích cho các mô hình Machine Learning hoặc các phân tích khám phá sâu hơn.
Để khắc phục những hạn chế này và đáp ứng nhu cầu mới của thời đại Big Data, khái niệm Data Lake (Hồ dữ liệu) đã xuất hiện.
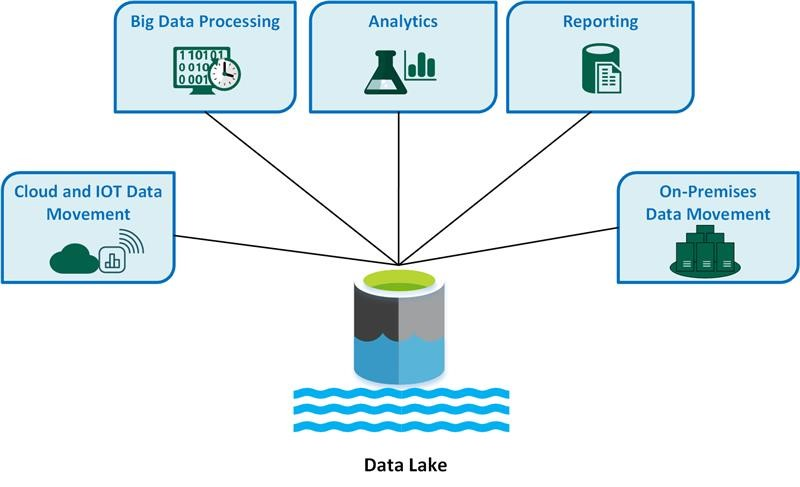
Tương tự, Data Lake là một kho lưu trữ tập trung, có khả năng chứa mọi loại dữ liệu – từ dữ liệu có cấu trúc trong các bảng, dữ liệu bán cấu trúc như file JSON, XML, đến dữ liệu phi cấu trúc như text, ảnh, video – ở định dạng gốc (raw format) của chúng. Nó được thiết kế để xử lý khối lượng dữ liệu cực lớn (terabytes đến petabytes và hơn thế nữa) với chi phí lưu trữ thấp (thường tận dụng các dịch vụ lưu trữ đối tượng trên đám mây như Amazon S3, Google Cloud Storage).
Đặc điểm chính của Data Lake:
Loại dữ liệu: Chấp nhận tất cả các loại dữ liệu: structured, semi-structured, và unstructured. Đây là điểm khác biệt lớn nhất so với Database và Data Warehouse.
Schema (Lược đồ/Cấu trúc): Sử dụng cơ chế Schema-on-Read. Nghĩa là dữ liệu được đổ vào hồ mà không cần định nghĩa cấu trúc trước. Cấu trúc (schema) chỉ được áp dụng hoặc suy ra khi dữ liệu được đọc ra để phục vụ một mục đích phân tích cụ thể. Điều này mang lại sự linh hoạt tối đa, cho phép lưu trữ dữ liệu mới một cách nhanh chóng mà không cần lo lắng về việc phải thiết kế schema trước.
Mục đích chính:
Lưu trữ tập trung mọi loại dữ liệu của tổ chức với chi phí thấp và khả năng mở rộng cao.
Cung cấp “nguyên liệu thô” cho các hoạt động Khoa học dữ liệu (Data Science) và Học máy (Machine Learning), đặc biệt là huấn luyện các mô hình phức tạp đòi hỏi dữ liệu gốc, chưa qua xử lý nhiều.
Phục vụ các tác vụ phân tích khám phá (exploratory analysis), nơi các nhà khoa học dữ liệu muốn tự do tìm tòi, khám phá dữ liệu mà không bị giới hạn bởi một cấu trúc định sẵn.
Xử lý Big Data và các luồng dữ liệu thời gian thực (streaming data).
Người dùng: Người dùng chính của Data Lake là các Nhà khoa học dữ liệu (Data Scientists) và Kỹ sư dữ liệu (Data Engineers). Họ là những người cần truy cập vào dữ liệu gốc, đa dạng và có các công cụ để xử lý, phân tích dữ liệu này (ví dụ: Python với thư viện Pandas, Scikit-learn; R; Apache Spark…). Các Business Analysts cũng có thể sử dụng dữ liệu từ Data Lake, nhưng thường là sau khi dữ liệu đã được xử lý và đưa vào một lớp có cấu trúc hơn (ví dụ: thông qua Data Lakehouse hoặc các công cụ truy vấn SQL-on-Lake).
Lợi ích:
Linh hoạt (Flexibility): Có thể lưu trữ mọi loại dữ liệu mà không cần định nghĩa schema trước.
Chi phí thấp (Low Cost): Tận dụng các giải pháp lưu trữ rẻ tiền, đặc biệt là trên cloud.
Khả năng mở rộng (Scalability): Dễ dàng mở rộng dung lượng lưu trữ khi dữ liệu tăng lên.
Hỗ trợ đa dạng công cụ: Có thể sử dụng nhiều loại công cụ và framework phân tích khác nhau trên cùng một dữ liệu.
Thách thức – Nguy cơ “Đầm lầy dữ liệu” (Data Swamp): Chính sự linh hoạt của Data Lake cũng là con dao hai lưỡi. Nếu không có quy trình quản lý, kiểm soát chất lượng và tài liệu hóa (metadata management) tốt, Data Lake rất dễ biến thành một “đầm lầy dữ liệu” – một nơi chứa đầy dữ liệu không rõ nguồn gốc, chất lượng kém, trùng lặp, khó hiểu và không thể sử dụng được. Việc quản trị (governance) trong Data Lake là một thách thức lớn.
Sự ra đời của Data Lake đã thực sự trở thành yếu tố then chốt thúc đẩy sự phát triển mạnh mẽ của Khoa học dữ liệu và Học máy trong môi trường doanh nghiệp. Các mô hình ML phức tạp thường “thích” dữ liệu thô, nơi chúng có thể tự mình khám phá các đặc trưng (features) và mẫu hình mà con người có thể bỏ qua hoặc loại bỏ trong quá trình Transform của ETL vào Data Warehouse. Data Lake cung cấp chính xác nguồn “nguyên liệu” đa dạng, khổng lồ và linh hoạt đó, cho phép các Data Scientist tự do thử nghiệm, xây dựng và huấn luyện các mô hình dự đoán, phân loại, gợi ý… mà không bị giới hạn bởi cấu trúc cứng nhắc của Data Warehouse truyền thống.
So sánh nhanh: Data Lake, Database, Data Warehouse
Đặc điểm
Database (Cơ sở dữ liệu)
Data Warehouse (Kho dữ liệu)
Data Lake (Hồ dữ liệu)
Mục đích chính
Xử lý giao dịch trực tuyến (OLTP), hoạt động hàng ngày
Phân tích kinh doanh (BI), báo cáo quản trị, hỗ trợ ra quyết định (OLAP)
Lưu trữ mọi loại dữ liệu thô, Khoa học dữ liệu, Học máy, phân tích khám phá, Big Data
Loại dữ liệu
Chủ yếu có cấu trúc (Structured)
Có cấu trúc, bán cấu trúc (Đã được xử lý, tích hợp)
Tối ưu cho đọc/ghi/cập nhật/xóa nhanh các bản ghi nhỏ
Tối ưu cho các truy vấn phức tạp, quét lượng lớn dữ liệu lịch sử (ETL/ELT trước khi tải)
Lưu trữ dữ liệu thô, xử lý linh hoạt khi cần (Thường là ELT)
Người dùng chính
Kỹ sư Backend, Ứng dụng
Chuyên viên phân tích (Business Analysts), Nhà quản lý
Nhà khoa học dữ liệu (Data Scientists), Kỹ sư dữ liệu (Data Engineers)
Tốc độ truy vấn
Rất nhanh (cho giao dịch nhỏ)
Nhanh (cho truy vấn phân tích đã tối ưu)
Có thể chậm hơn (tùy công cụ và tối ưu hóa, ưu tiên lưu trữ rẻ)
Tính linh hoạt
Thấp
Trung bình (Khó thay đổi schema)
Cao
Chi phí lưu trữ
Tùy thuộc vào quy mô, có thể cao
Thường cao
Thấp (Thiết kế cho lưu trữ rẻ)
Ví dụ điển hình
Quản lý tài khoản người dùng, đơn hàng online
Phân tích doanh thu theo quý, báo cáo hiệu quả marketing
Huấn luyện mô hình gợi ý sản phẩm, phân tích sentiment từ mạng xã hội, xử lý dữ liệu IoT
Ai/Vai trò nào làm việc với các hệ thống thông tin này?
Để những dữ liệu phức tạp này có thể được xây dựng, vận hành trơn tru và thực sự mang lại giá trị cho tổ chức, không thể thiếu vai trò của những con người với các kỹ năng chuyên môn khác nhau. Sự phát triển của các kiến trúc dữ liệu cũng kéo theo sự chuyên môn hóa ngày càng cao của các vị trí công việc trong lĩnh vực này.
Backend Engineer (Kỹ sư Backend / Lập trình viên Backend): Đây là những người thường làm việc trực tiếp nhất với các Database truyền thống (OLTP). Nhiệm vụ chính của họ là xây dựng và duy trì phần “hậu trường” (backend) của các ứng dụng web hoặc mobile – chính là những ứng dụng tạo ra và tiêu thụ dữ liệu hàng ngày. Họ viết code để ứng dụng có thể đọc, ghi, cập nhật và xóa dữ liệu trong database một cách chính xác, hiệu quả và an toàn, đảm bảo các giao dịch OLTP diễn ra suôn sẻ.
Business Analyst (Chuyên viên phân tích nghiệp vụ / kinh doanh – BA): BA là những người dùng của Data Warehouse. Họ là cầu nối giữa bộ phận kinh doanh và kỹ thuật. Sử dụng dữ liệu đã được làm sạch và tích hợp trong Data Warehouse, BA thực hiện các phân tích, tạo ra các báo cáo trực quan (dashboards), khám phá các xu hướng kinh doanh và cung cấp những insight giá trị giúp ban lãnh đạo đưa ra các quyết định sáng suốt hơn (hoạt động Business Intelligence – BI). Họ cần hiểu rõ về nghiệp vụ kinh doanh và có kỹ năng sử dụng các công cụ BI như Tableau, Power BI cũng như SQL để truy vấn dữ liệu.
Data Scientist (Nhà khoa học dữ liệu): Đây là những “nhà thám hiểm” của thế giới dữ liệu, thường làm việc nhiều nhất với Data Lake (nhưng cũng có thể khai thác cả Data Warehouse). Công việc của họ không chỉ dừng lại ở việc phân tích dữ liệu quá khứ mà còn đi sâu vào việc khám phá dữ liệu thô, áp dụng các thuật toán thống kê và Machine Learning (Học máy) để xây dựng các mô hình dự đoán, phân loại, phát hiện bất thường, hoặc tìm ra những insight hoàn toàn mới lạ mà con người khó nhận biết. Họ cũng có thể tạo ra các tính năng sản phẩm dựa trên dữ liệu, ví dụ như hệ thống gợi ý sản phẩm “người mua X cũng mua Y” trên các trang thương mại điện tử. Họ cần nền tảng vững chắc về toán, thống kê, lập trình (thường là Python hoặc R) và kiến thức về các thuật toán ML.
Data Engineer (Kỹ sư dữ liệu): Có thể nói Data Engineer là những người “thợ xây” chính của toàn bộ hạ tầng dữ liệu. Vai trò của họ cực kỳ quan trọng, đảm bảo “dòng chảy” dữ liệu được thông suốt và hiệu quả. Họ chịu trách nhiệm thiết kế, xây dựng, kiểm thử và bảo trì các “đường ống” ( dữ liệu (data pipelines), bao gồm cả việc triển khai quy trình ETL/ELT để di chuyển và biến đổi dữ liệu từ các hệ thống nguồn (OLTP) vào Data Warehouse hoặc Data Lake. Họ đảm bảo dữ liệu luôn sẵn sàng, đáng tin cậy và có thể truy cập được cho các Data Analyst và Data Scientist sử dụng. Kỹ năng cần thiết bao gồm lập trình, hiểu biết về các hệ thống database, data warehouse, data lake, các công cụ ETL và các nền tảng Big Data.
Analytics Engineer (Kỹ sư phân tích): Đây là một vai trò tương đối mới nhưng đang ngày càng trở nên quan trọng, đặc biệt trong bối cảnh của Modern Data Stack (Ngăn xếp dữ liệu hiện đại). Analytics Engineer hoạt động ở lớp trung gian, nối liền khoảng cách giữa Data Engineer và Data Analyst/Scientist. Trong khi Data Engineer tập trung vào việc xây dựng hạ tầng và đưa dữ liệu thô vào Lake/Warehouse, Analytics Engineer lại tập trung vào việc biến đổi (transform) dữ liệu thô đó thành những bộ dữ liệu (data models) sạch sẽ, có cấu trúc tốt, dễ hiểu, đáng tin cậy và được tối ưu hóa cho mục đích phân tích và báo cáo BI. Họ thường là những người rất giỏi SQL, thành thạo các công cụ mô hình hóa dữ liệu như dbt (data build tool), và có hiểu biết tốt về nhu cầu phân tích của nghiệp vụ.
Một số xu hướng mới
Data Lakehouse: Như mình đã nhắc đến ở phần so sánh, Data Lakehouse là một kiến trúc lai đầy hứa hẹn, đang thu hút nhiều sự chú ý. Mục tiêu của nó là kết hợp những ưu điểm tốt nhất của cả Data Warehouse và Data Lake vào một nền tảng duy nhất. Cụ thể, nó cố gắng mang lại sự linh hoạt và chi phí thấp của Data Lake (lưu trữ mọi loại dữ liệu trên bộ nhớ rẻ tiền như object storage) cùng với các tính năng quản lý dữ liệu mạnh mẽ của Data Warehouse như cấu trúc dữ liệu (schema enforcement), đảm bảo tính toàn vẹn giao dịch (ACID transactions), quản trị dữ liệu (data governance) và hiệu năng truy vấn SQL cao. Bằng cách này, Data Lakehouse hướng tới việc đơn giản hóa kiến trúc dữ liệu tổng thể, giảm thiểu việc sao chép dữ liệu giữa Lake và Warehouse, và cho phép nhiều loại workload khác nhau (từ BI, SQL analytics đến Data Science, ML) cùng hoạt động hiệu quả trên một bản sao dữ liệu duy nhất.
DataOps: Lấy cảm hứng từ thành công của DevOps trong lĩnh vực phát triển phần mềm, DataOps ra đời với mục tiêu áp dụng các nguyên tắc tương tự vào toàn bộ vòng đời của dữ liệu, từ khâu thu thập, xử lý, đến phân tích và cung cấp insight. DataOps nhấn mạnh vào Tự động hóa (Automation) các quy trình dữ liệu (như kiểm thử, triển khai pipeline), Giám sát (Monitoring) liên tục chất lượng và hiệu năng dữ liệu, và thúc đẩy Hợp tác (Collaboration) chặt chẽ giữa các nhóm liên quan (Data Engineers, Analysts, Scientists, nghiệp vụ). Mục tiêu cuối cùng của DataOps là tăng tốc độ đưa dữ liệu và insight đến người dùng, cải thiện chất lượng và độ tin cậy của dữ liệu, đồng thời giảm thiểu lỗi và các công việc thủ công lặp đi lặp lại.
Reverse ETL: Nếu như ETL/ELT truyền thống tập trung vào việc đưa dữ liệu VÀO Data Warehouse hoặc Data Lake để phân tích, thì Reverse ETL lại làm điều ngược lại. Nó lấy những dữ liệu đã được xử lý, làm giàu, hoặc những insight giá trị (ví dụ: điểm số khách hàng tiềm năng, phân khúc khách hàng, dự đoán churn rate) từ chính Data Warehouse/Lakehouse và đẩy chúng TRỞ LẠI các hệ thống hoạt động hàng ngày mà các bộ phận nghiệp vụ thường xuyên sử dụng, như hệ thống CRM (Quản lý quan hệ khách hàng), công cụ Marketing Automation, nền tảng quảng cáo, hay công cụ hỗ trợ khách hàng. Việc này giúp “kích hoạt” dữ liệu phân tích, biến insight thành hành động cụ thể một cách nhanh chóng và tự động, giúp các nhóm Sales, Marketing, Customer Success… có thể cá nhân hóa tương tác, tối ưu chiến dịch và cải thiện trải nghiệm khách hàng dựa trên dữ liệu cập nhật nhất.
Data Products & Data Mesh: Đây là một xu hướng mang tính chiến lược và tổ chức hơn là chỉ về công nghệ. Nó đề xuất một cách tiếp cận mới trong việc quản lý và chia sẻ dữ liệu trong các tổ chức lớn, đặc biệt là những nơi có nhiều bộ phận nghiệp vụ (domains) khác nhau. Thay vì tập trung tất cả dữ liệu và đội ngũ data vào một nhóm trung tâm (thường dẫn đến tắc nghẽn), kiến trúc Data Mesh đề xuất phân tán quyền sở hữu và trách nhiệm quản lý dữ liệu về cho chính các nhóm nghiệp vụ (domain teams) – những người hiểu rõ nhất về dữ liệu của mình. Mỗi domain team sẽ chịu trách nhiệm biến dữ liệu của họ thành các “Sản phẩm dữ liệu” (Data Products). Một Data Product không chỉ là dữ liệu thô, mà là một đơn vị logic hoàn chỉnh, bao gồm dữ liệu đã được làm sạch, mô hình hóa, có tài liệu rõ ràng, đáng tin cậy, dễ khám phá, dễ truy cập (thông qua các cổng ra – output ports được định nghĩa tốt) và có chủ sở hữu chịu trách nhiệm về chất lượng. Cách tiếp cận này nhằm mục đích tăng cường khả năng mở rộng, tính linh hoạt, chất lượng dữ liệu và giúp dữ liệu thực sự trở thành tài sản được quản lý tốt như các sản phẩm phần mềm khác trong tổ chức.
Để tổng kết lại một cách ngắn gọn nhất, bạn có thể nhớ:
Database (Cơ sở dữ liệu): Lựa chọn hàng đầu cho các hoạt động hàng ngày, cần xử lý giao dịch nhanh chóng, đáng tin cậy với dữ liệu có cấu trúc. Nó là trái tim của các ứng dụng OLTP.
Data Warehouse (Kho dữ liệu): Ngôi nhà lý tưởng cho việc phân tích kinh doanh (BI), tạo báo cáo quản trị, khám phá insight từ dữ liệu lịch sử đã được tích hợp và làm sạch, chủ yếu là dữ liệu có cấu trúc. Nó là trung tâm của các hệ thống OLAP.
Data Lake (Hồ dữ liệu): Giải pháp tối ưu khi bạn cần lưu trữ mọi loại dữ liệu (bao gồm cả phi cấu trúc) ở dạng thô, với chi phí thấp và quy mô lớn, phục vụ cho các nhu cầu phân tích nâng cao, Khoa học dữ liệu và Học máy.
When integrating Google OAuth 2.0 with your Spring Boot application, the official documentation provides a comprehensive guide to leverage the GoogleCredential utility class for seamless and secure authorization. OAuth 2.0 is the industry standard for granting access to protected resources, and Google’s implementation is tailored to support various application types, ensuring flexibility across client environments.
Why OAuth 2.0 Matters
Imagine you’re building a task management application that needs to interact with a user’s Google Tasks data. OAuth 2.0 allows your app to request access only to the necessary data (e.g., “Manage your tasks”) while ensuring that the user maintains control over their privacy. The process generates an access token, which is a digital key tied specifically to your application and the user’s data. This token is scoped, meaning it limits the type and extent of access granted, thereby enhancing security. For instance, even if the token were somehow exposed, it couldn’t be used to access unrelated data like emails or photos.
Built on a Secure Foundation
The Google API Client Library for Java includes robust OAuth 2.0 packages such as:
com.google.api.client.googleapis.auth.oauth2: Core classes for implementing OAuth 2.0 flows.
com.google.api.client.googleapis.extensions.appengine.auth.oauth2: Specialized extensions for applications hosted on Google App Engine.
These packages are built on the Google OAuth 2.0 Client Library for Java, a general-purpose library offering standardized utilities to handle token acquisition, refresh, and expiration seamlessly.
A Real-World Perspective
Consider an example where a SaaS platform integrates with Google Drive to allow users to upload documents directly from their accounts. With OAuth 2.0, users authenticate their Google accounts through a secure flow, and the platform receives an access token to interact with Google Drive APIs. Instead of continuously requesting sensitive credentials, the platform uses this token to upload or retrieve files, keeping user data secure and operations streamlined.
By utilizing the detailed guidelines in Google’s documentation, you can ensure that your Spring Boot application adheres to best practices for secure OAuth 2.0 integration, offering a smooth user experience while protecting sensitive information.
Acquiring the Client Secret File
To begin integrating Google OAuth 2.0 into your application, the first crucial step is setting up a project on the Google API Console. This console serves as the central hub for managing authorization credentials, configuring API access, and ensuring proper billing setup. Whether your application runs on a web server, mobile device, desktop client, or directly in a browser, this setup process is essential.
Setting Up Credentials
Navigate to the Google API Console and create a new project. Once the project is set up, you can enable the desired APIs and generate the OAuth 2.0 client credentials, which include:
Client ID: Uniquely identifies your application during the authorization process.
Client Secret: A sensitive key used to authenticate your application, ensuring secure communication with Google’s servers.
Redirect URIs: Specify where Google will send users after they complete the authorization flow.
For detailed guidance on configuring these elements, refer to the API Console Help.
Setup a Authorization code flow
Use the authorization code flow to allow the end-user to grant your application access to their protected data on Google APIs. The protocol for this flow is specified in Authorization Code Grant.
If not, call AuthorizationCodeFlow.newAuthorizationUrl() and direct the end-user’s browser to an authorization page to grant your application access to their protected data.
The Google authorization server will then redirect the browser back to the redirect URL specified by your application, along with a code query parameter. Use the code parameter to request an access token using AuthorizationCodeFlow.newTokenRequest(String)).
Understanding the DataStoreFactory in GoogleAuthorizationCodeFlow.Builder
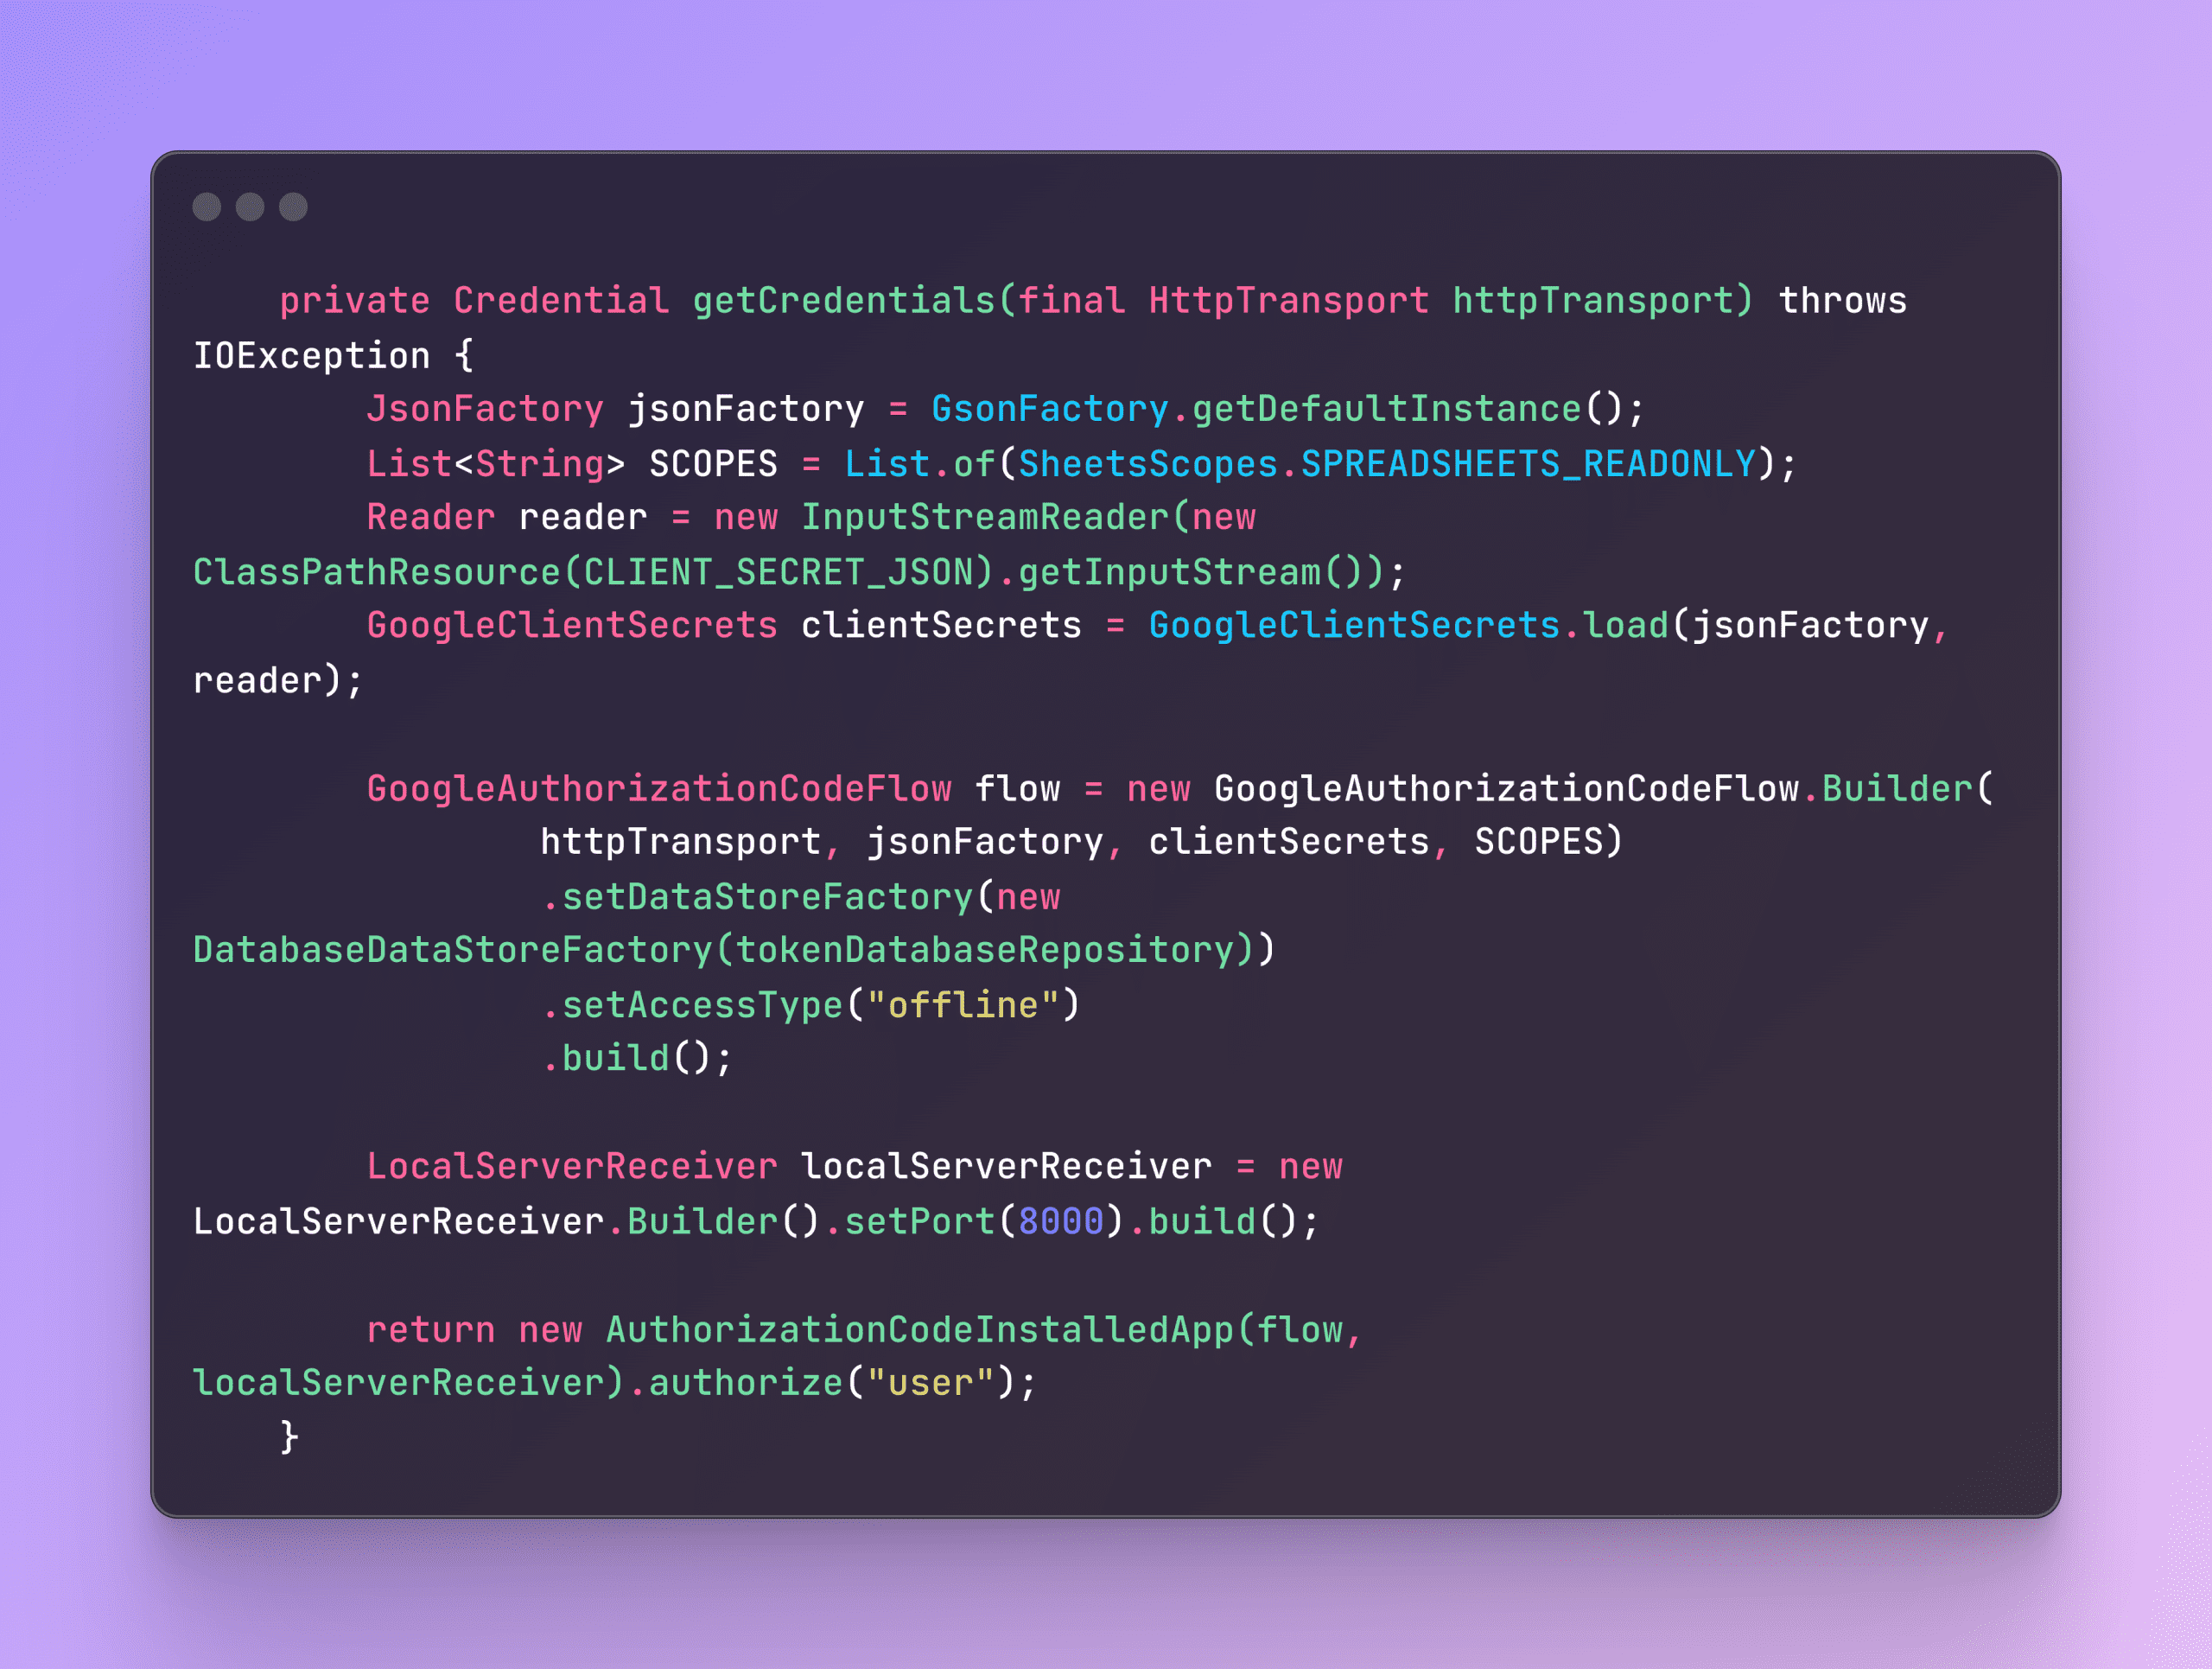
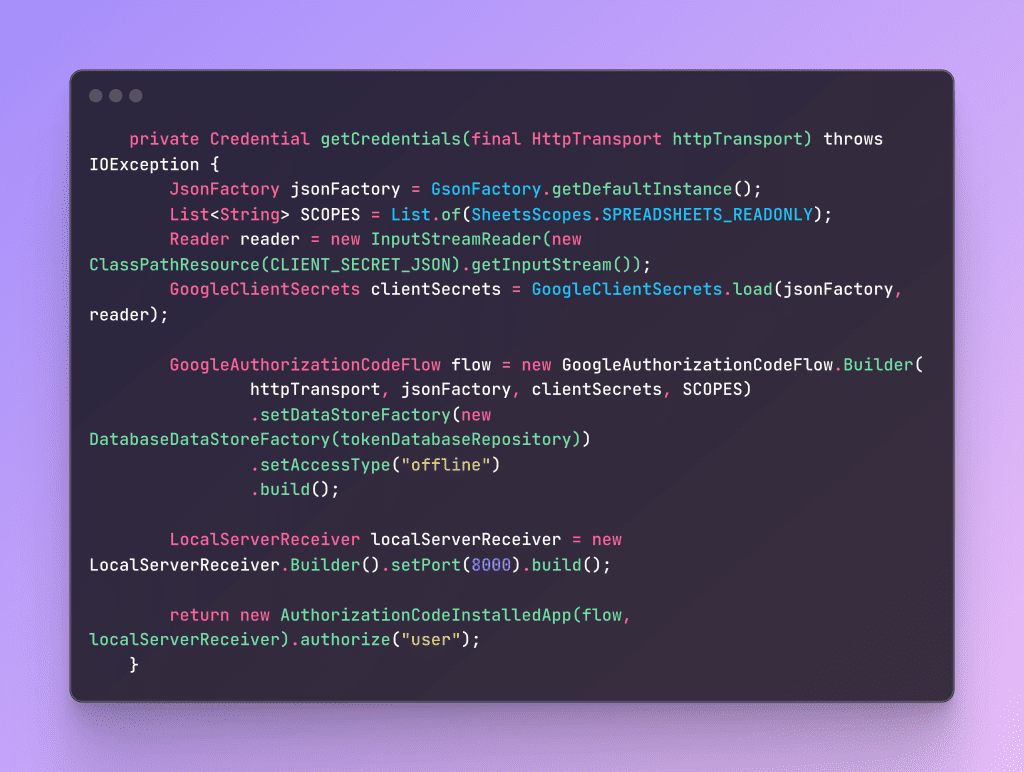
When constructing a GoogleAuthorizationCodeFlow object, one of the essential components is the DataStoreFactory. This factory is responsible for persisting user credentials securely and efficiently. Google provides three types of built-in implementations, each suited for different use cases:
Implementing a Custom Data Store to Persist Tokens in a Database
To persist OAuth2 tokens in a database, we need to create a custom implementation of the DataStoreFactory and DataStore classes provided by Google’s OAuth2 library. Here’s a step-by-step guide:
Step 1: Create a Custom DataStoreFactory
The custom factory is responsible for creating instances of your DataStore. Extend AbstractDataStoreFactory to implement this logic.
How to Retrieve a Google User ID Using OAuth2 Playground
With OAuth2 Playground, you can securely interact with Google APIs without needing to build the OAuth2 authentication flow from scratch. Here’s a straightforward guide to help you retrieve the Google user ID in just a few steps:
Step 1: Access the Google OAuth2 Playground
Start by visiting the Google OAuth2 Playground. This is a helpful tool for developers who want to explore how Google’s OAuth2 system works and test API calls quickly.
Step 2: Select the People API v1 Scope
To retrieve a user’s ID, you’ll need to access the People API. In the OAuth2 Playground, under Step 1, select the appropriate API scope:
Click on “Select & Authorize APIs.”
Look for People API v1 and check it.
This API will allow you to access basic user information, including the Google ID.
Step 3: Authorize API Access
Once you’ve selected the API scope, click Authorize APIs. You’ll be redirected to a Google login page, where you’ll log in and grant the necessary permissions. This allows the OAuth2 Playground to act on behalf of the user and retrieve data from the People API.
Step 4: Exchange Authorization Code for Tokens
After authorization, you’ll receive an authorization code in the Playground. In Step 2, click Exchange authorization code for tokens. This will provide you with an access token, which you’ll use to make authorized API requests.
Now that you have the access token, it’s time to make a request to the People API to get the user’s Google ID. Use the following CURL command in your terminal or directly in the OAuth2 Playground’s built-in HTTP request tool:
Replace YOUR_ACCESS_TOKEN with the token you obtained in the previous step. This request will return a JSON object with the user’s profile data, including their Google ID.
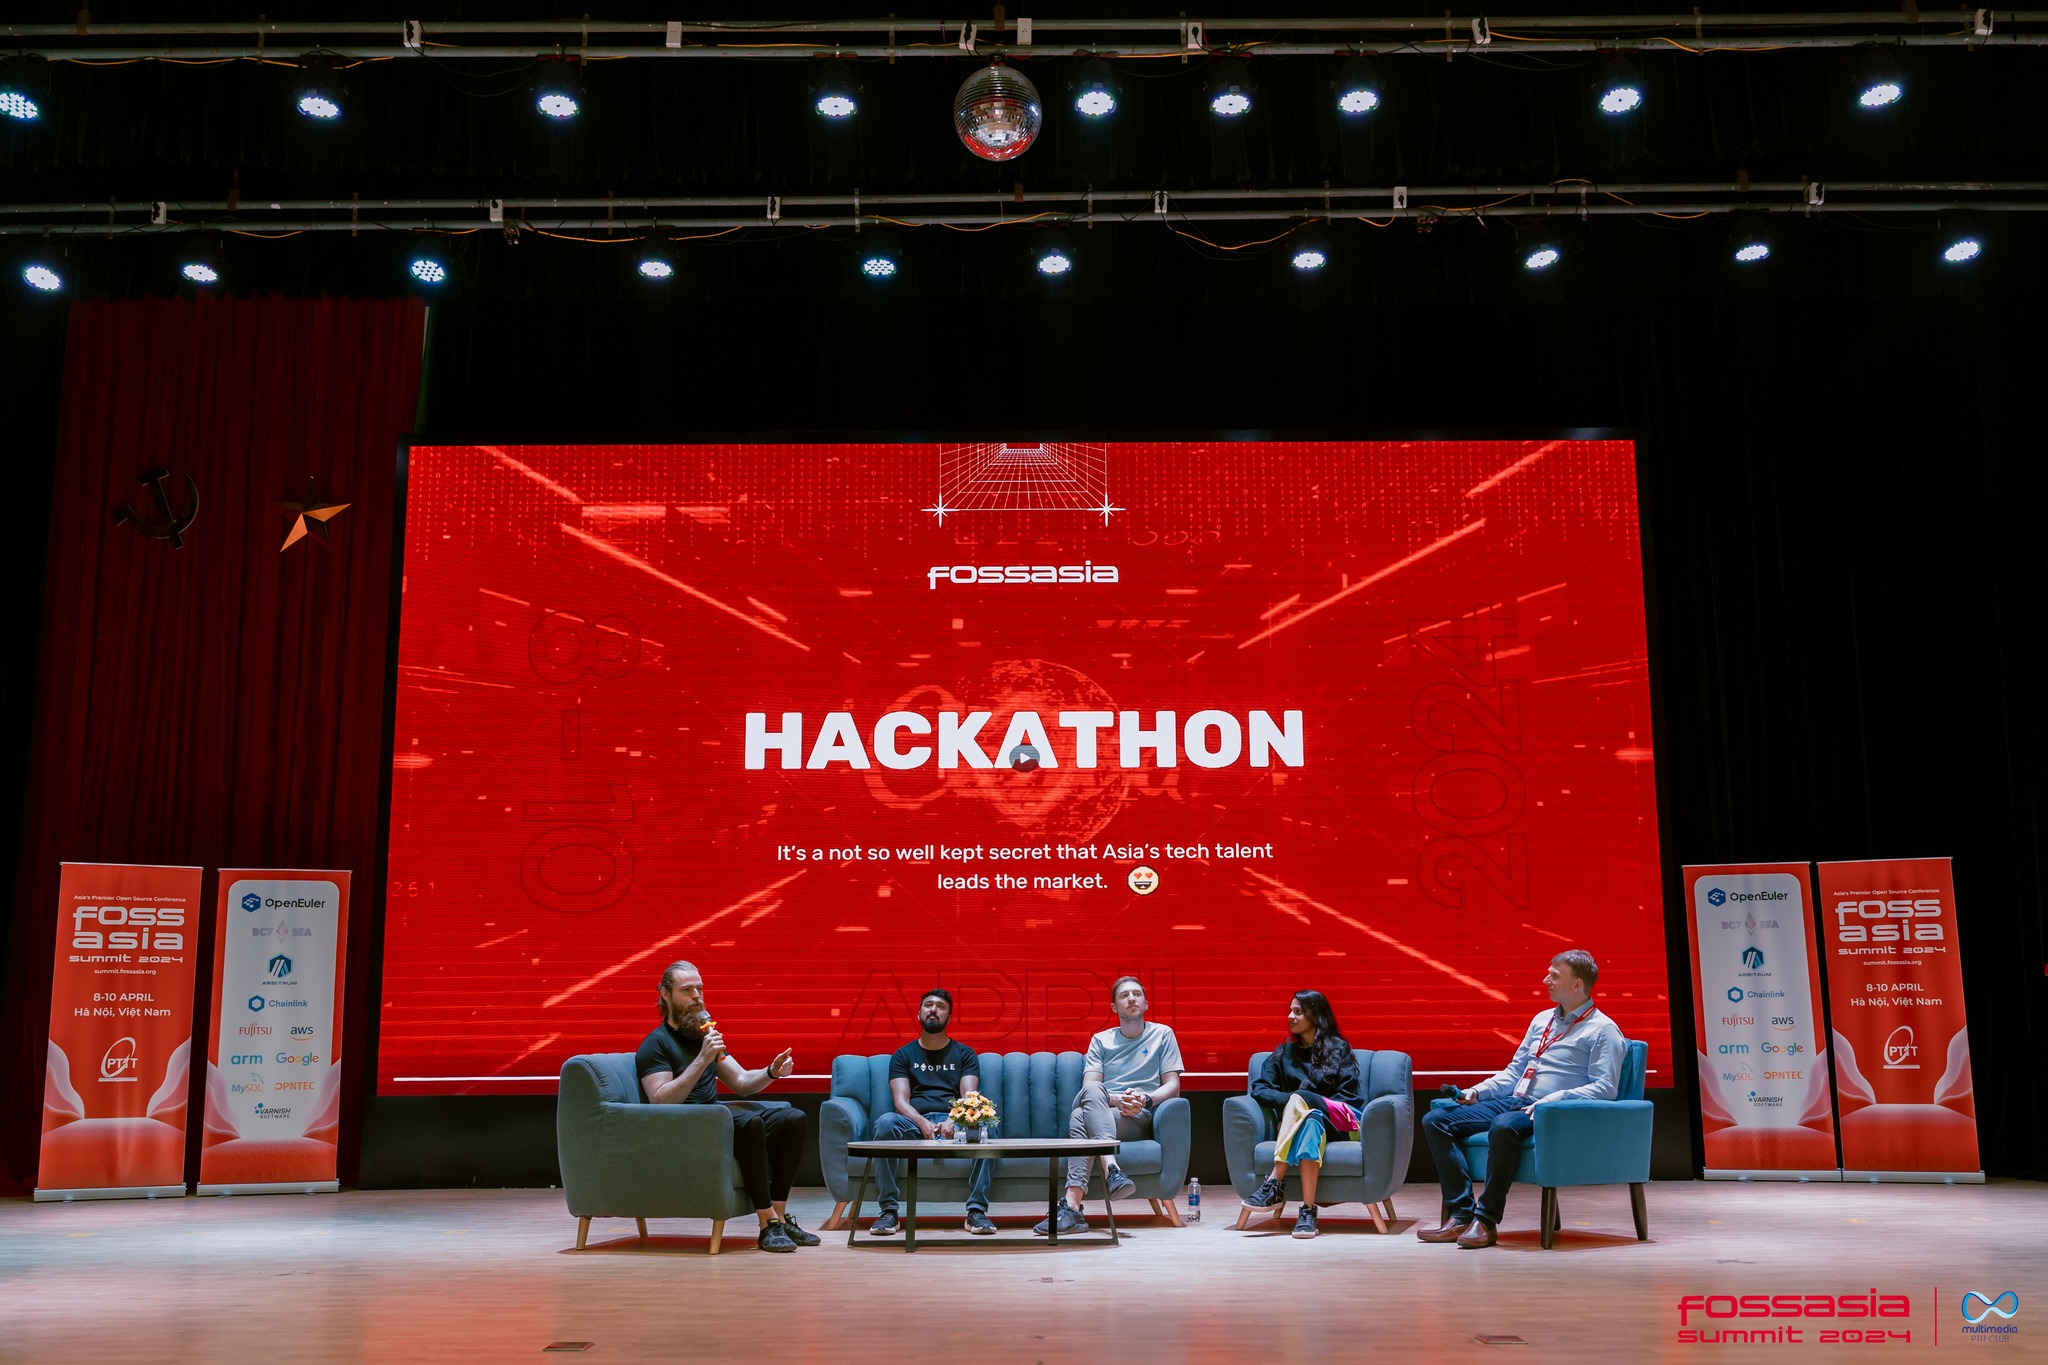
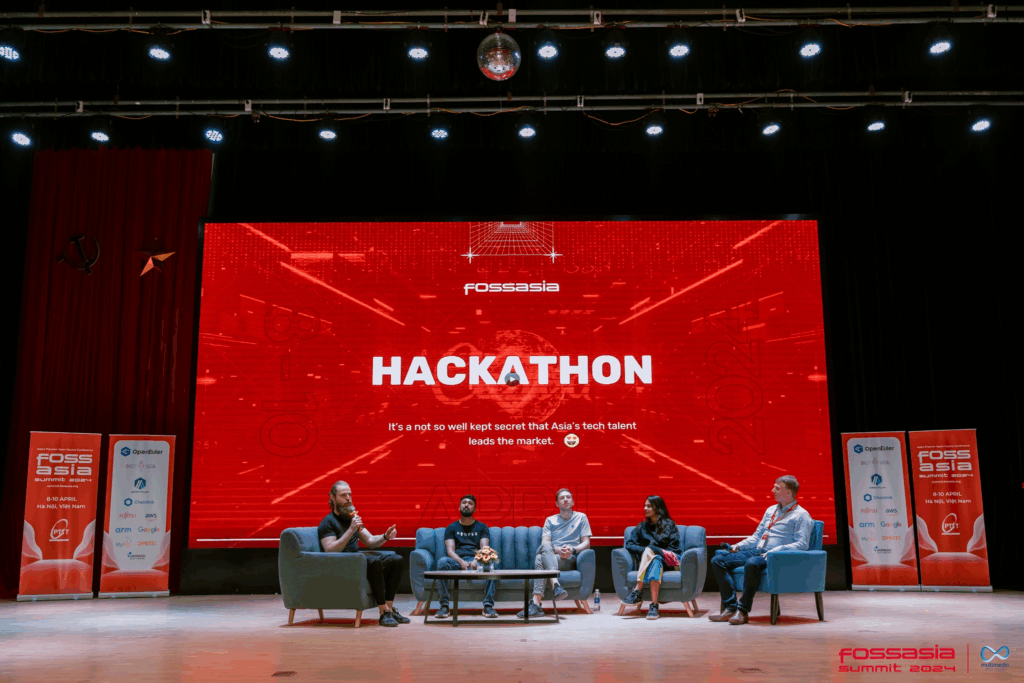
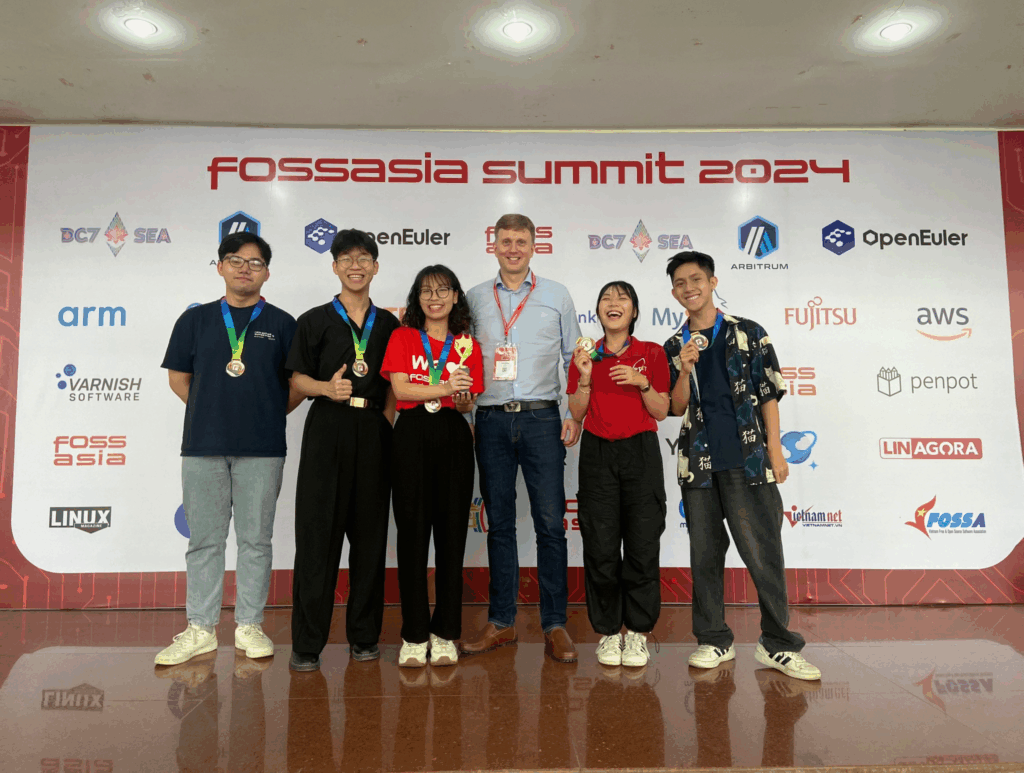
The atmosphere at the FOSSASIA Summit 2024 was absolutely electric. Hosted at PTIT, it’s a massive gathering with over 5,000 people from 50 countries, 200+ speakers from giants like Google, Huawei, and Oracle,…. Amid all that, there’s this Web3-focused hackathon, sponsored by Chainlink and Devfolio, challenging devs to build real-world blockchain solutions in just 48 hours.
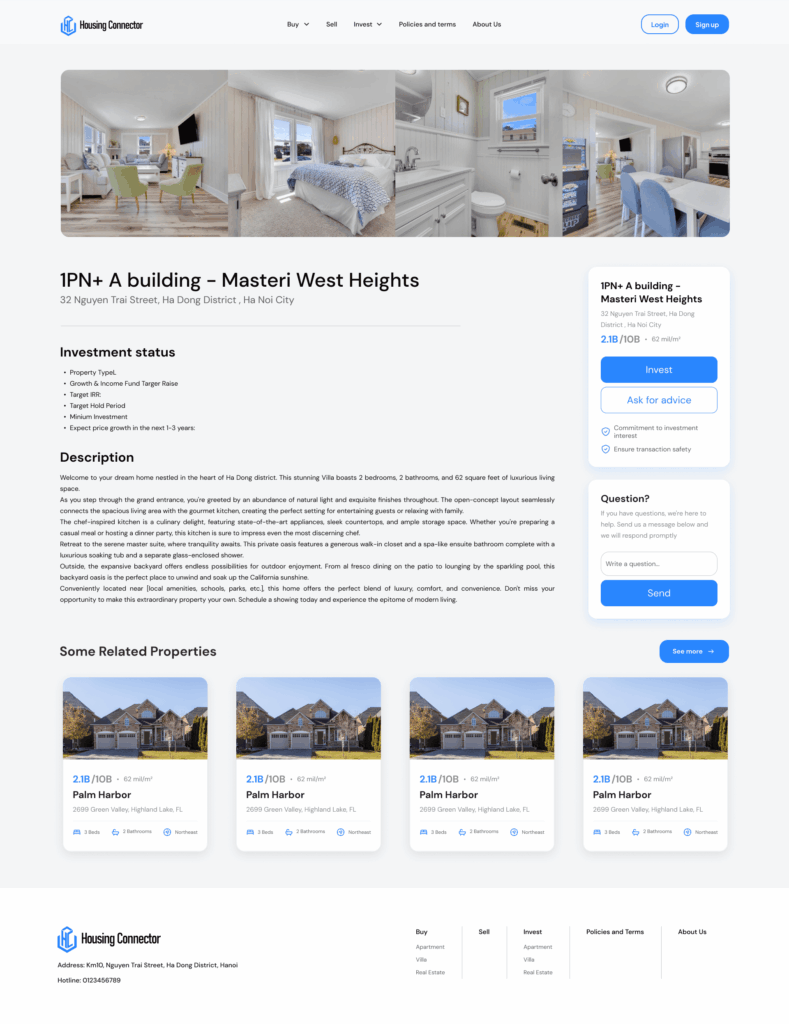
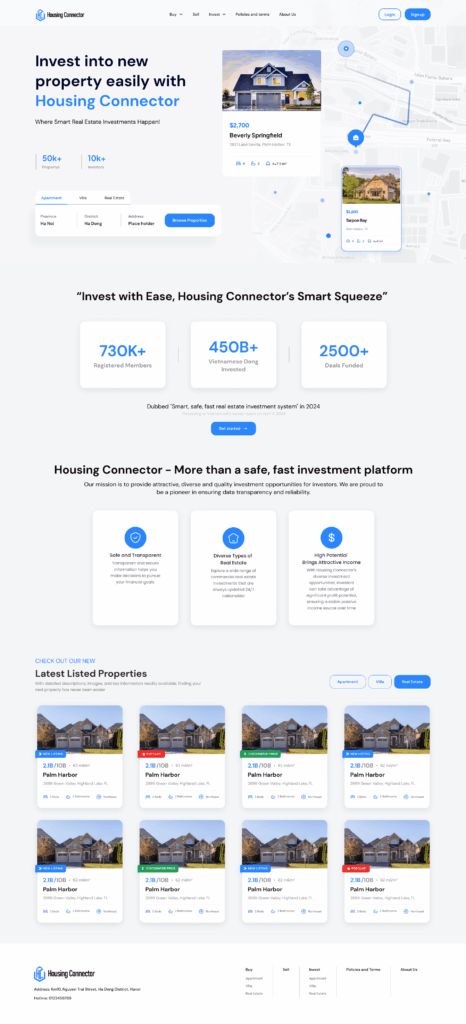
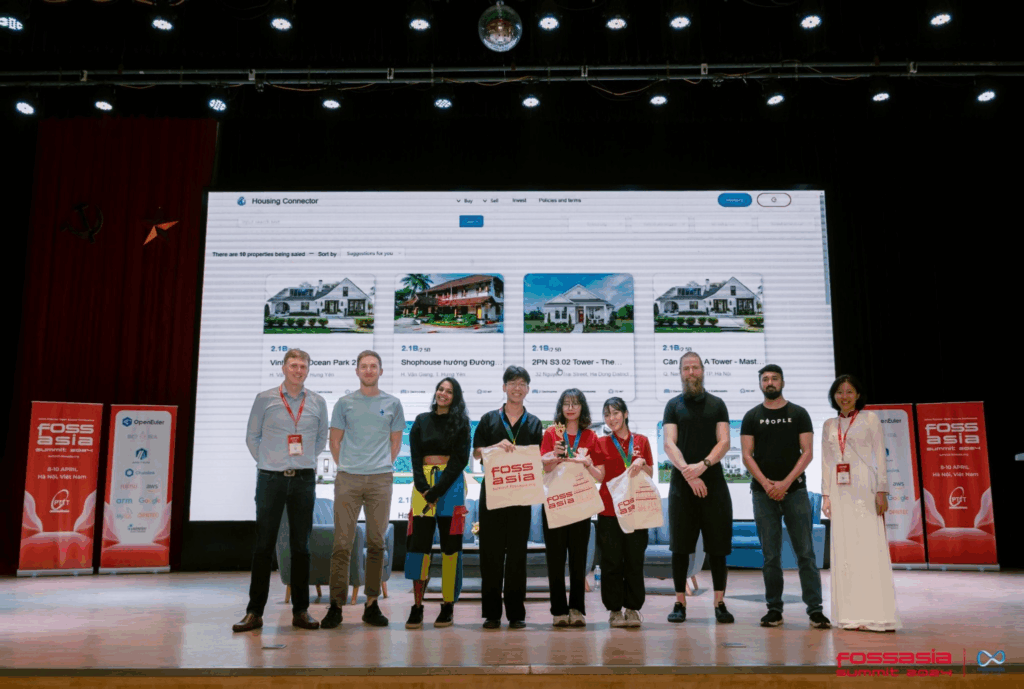
The idea came from what I see at work. Vietnam’s real estate is growing fast, the market’s supposed to double in size soon, with more young people in their 20s and 30s wanting in. But buying property? It’s expensive, and if you team up with friends or family, contracts get messy with arguments and risks. A lot of folks are shopping online now like 70% or something but trust is low. So, we made Housing Connector: a platform where small investors can pool money for properties, connect with agents, and use blockchain to keep everything clear and safe.
Basically, it works like this: Investors check out listings with details on location, costs, potential returns. They chip in what they can, sign smart contracts through Chainlink so no one’s getting screwed. When the property sells, money gets split automatically, minus a small fee, that’s how the app makes money. Agents get leads and data to sell better, and as more join, it pulls in more investors and properties. It’s a loop that could grow quick. We used React for the front end, Solidity for contracts, and stuff like Ethereum and Web3.js. Nothing fancy, just enough for a basic demo.
We submitted right at the deadline: a POC where you could “buy” a apartment in Hanoi with pooled funds. Out of over 1,000 people and 43 teams, they picked us as winners!
Honestly, it taught me a lot about teamwork under pressure. We’re proud of the prototype, even if it’s rough – built in two days, after all. Maybe we’ll keep working on it, add more features like AI for price predictions. Shoutout to FOSSASIA for the event!!!
This entry is part 2 of 2 in the series Blockchain
Chainlink là gì?
Chainlink là một dự án mã nguồn mở, được phát triển bởi SmartContract, nhằm giải quyết vấn đề "oracle problem" trong blockchain. Chainlink cung cấp một cách để kết nối các hợp đồng thông minh với các nguồn dữ liệu bên ngoài mà không cần tin tưởng vào bất kỳ bên thứ ba nào.
Ví dụ thực tế
Có thể xem ví dụ thực tế về blockchain qua bảng tính ở bài viết trước trong series. Tại bài này, ta sẽ nói về vấn đề mà Chainlink tập trung giải quyết
Chainlink giải quyết một hạn chế cơ bản của blockchain: mặc dù blockchain giúp ta tạo ra một bảng tính an toàn, bảo mật, stable vì phi tập trung, nhưng nó không thể tự mình truy cập hoặc xác minh dữ liệu thế giới thực.
Ví dụ:
Bạn có thể sử dụng bảng tính để lưu các lần chấm công của nhân viên, nhưng chính bảng tính không thể xác minh xem những dữ liệu nhập vào đó có đúng hay không; bạn cần một hệ thống bảng chấm công bên ngoài để thực sự theo dõi những giờ này. Vì vậy, để bảng tính có ích, nó cần dữ liệu chỉ nhập chính xác từ một nguồn hệ thống bên ngoài nà, và ta sẽ cần một cây cầu trung gian giữa dữ liệu ngoài và hệ thống blockchain bảo mật bên trong.
Đó chính là những gì Chainlink cung cấp cho blockchain. Nó hoạt động như một mạng lưới oracle phi tập trung. Oracle giống như những sứ giả lấy thông tin từ các nguồn bên ngoài và đưa nó vào blockchain một cách an toàn, và có thể tin tưởng được.
Chainlink đảm bảo rằng dữ liệu từ thế giới bên ngoài đến được với hợp đồng thông minh của blockchain một cách an toàn và đáng tin cậy. Vì vậy, nếu hợp đồng thông minh của bạn phụ thuộc vào thông tin thế giới thực,ví dụ như dữ liệu thời tiết, giá cả chứng khoán hiện tại, …, các oracle của Chainlink cung cấp một cách đáng tin cậy để lấy thông tin đó lên blockchain.
Hợp đồng thông minh sau đó có thể thực thi dựa trên dữ liệu thời gian thực được cung cấp, cho dù là chuyển tiền khi đáp ứng được những điều kiện nhất định, hay xác nhận xảy ra một sự kiện. Chainlink đảm bảo thông tin này chính xác và quy trình là phi tập trung, nên không có thực thể đơn lẻ nào có thể thao túng dữ liệu—cũng giống như không có một người đơn lẻ nào có thể bí mật thay đổi giờ làm việc đã theo dõi của mọi người trong bảng tính chia sẻ của chúng ta mà không bị người khác phát hiện.
Ngoài ra còn một số vấn đề khác sẽ thảo luận ở dưới.
Vấn đề “oracle problem”
- Trong blockchain, hợp đồng thông minh không thể truy cập trực tiếp vào dữ liệu từ bên ngoài mà cần thông qua một bên thứ ba, gọi là "oracle". Tuy nhiên, việc tin tưởng vào một bên thứ ba có thể gây ra rủi ro cho hợp đồng thông minh. Đó chính là vấn đề "oracle problem".
- Sự bảo mật của blockchain được bảo vệ nhờ nhiều các "xác thực" trên nhiều máy khác nhau, phi tập trung. Tuy nhiên, khi dữ liệu từ bên ngoài được đưa vào, nó có thể bị "tấn công" từ bên ngoài, gây ra rủi ro cho hợp đồng thông minh.
Centralized Oracle Problem
Cơ chế oracle blockchain sử dụng một node tập trung để cung cấp dữ liệu cho hợp đồng thông minh điều này cũng tạo ra 1 SPOF (Single Point of Failure), tức là, nếu điểm này bị quá tải, sập, hay có vấn đề thì toàn hệ thống bị chết. Điều này vô tình làm mất đi mục đích của ứng dụng blockchain phi tập trung, khi mà ta không tập trung dữ liệu, hay xử lý vào 1 chỗ. Nếu oracle duy nhất không hoạt động, thì hợp đồng thông minh sẽ không thể tiếp cận với dữ liệu cần thiết để thực thi hoặc sẽ thực hiện không chính xác dựa trên dữ liệu cũ.
Thậm chí tồi tệ hơn, nếu oracle duy nhất bị lỗi, thì dữ liệu được gửi lên chuỗi có thể hoàn toàn sai lệch và dẫn đến hợp đồng thông minh thực hiện những kết quả hoàn toàn sai. Điều này thường được gọi là vấn đề “garbage in, garbage out” nơi mà đầu vào xấu dẫn đến đầu ra xấu. Bên cạnh đó, vì giao dịch blockchain được tự động hóa và không thể thay đổi, một kết quả hợp đồng thông minh dựa trên dữ liệu sai lạc không thể được đảo ngược, có nghĩa là tiền của người dùng có thể bị mất vĩnh viễn.
Việc thực sự vượt qua vấn đề oracle đòi hỏi phải có oracle phi tập trung để ngăn chặn việc lỗi, hỏng dữ liệu, hay node hoạt động không chính xác hay ngừng hoạt động. Mạng Lưới Oracle Phi Tập Trung, hoặc gọi tắt là DON (Decentralized Oracle Network), kết hợp nhiều nút oracle độc lập và nhiều nguồn dữ liệu đáng tin cậy để thiết lập sự phi tập trung từ đầu đến cuối
This entry is part 1 of 2 in the series Blockchain
1. Blockchain là gì?
Blockchain là một hệ thống lưu trữ dữ liệu phân tán, mà mỗi block dữ liệu được liên kết với nhau thông qua mã hóa. Mỗi block chứa thông tin về giao dịch, và thông tin về block trước đó. Dữ liệu có sự nhất quán theo trình tự thời gian vì bạn không thể xóa hoặc sửa chuỗi mà không có sự đồng thuận từ mạng lưới. Vì thế, bạn có thể sử dụng công nghệ Blockchain để tạo ra một sổ cái không thể biến đổi hay chỉnh sửa để theo dõi các đơn hàng, khoản thanh toán, tài khoản và những giao dịch khác. Hệ thống chuỗi khối có những cơ chế tích hợp để ngăn chặn các mục nhập giao dịch trái phép và tạo sự nhất quán trong chế độ xem chung của các giao dịch này.
Một số đặc điểm của Blockchain:
Phân tán: Dữ liệu được lưu trữ trên nhiều máy chủ khác nhau.
An toàn: Dữ liệu được mã hóa và không thể thay đổi.
Độc lập: Không cần sự can thiệp của bên thứ ba.
Bảo mật: Dữ liệu được phân quyền và mã hóa.
Trong suốt: Mọi giao dịch đều được lưu trữ và công khai.
Tiết kiệm: Giảm chi phí vận hành và tăng hiệu quả.
Dễ dàng sử dụng: Không cần kiến thức chuyên sâu về công nghệ.
Tính khả chuyển: Dễ dàng mở rộng và phát triển.
Tính nhất quán: Mọi giao dịch đều được xác nhận và chứng thực.
Tính đồng thuận: Mọi giao dịch đều được thông qua một quy trình đồng thuận.
Ví dụ thực tế
Làm việc trên SpreadSheet
Trong một công ty, mọi nhân viên đều có quyền truy cập vào một bảng tính chung, và có thể thêm, sửa, xóa dữ liệu trên bảng tính đó.
Mỗi thay đổi trên bảng tính sẽ được lưu trữ và công khai cho tất cả mọi người xem. Khi muốn thay đổi dữ liệu, mọi người phải thông qua một quy trình xác nhận. Quy trình này có thể là sự đồng thuận của tất cả mọi người, hoặc là sự xác nhận của một số người quản lý.
Sau khi quy trình xác nhận được hoàn tất, dữ liệu mới sẽ được cập nhật lên bảng tính chung, và mọi người có thể xem lại lịch sử thay đổi của dữ liệu.
African American Office Employee Auditor Using Spreadsheet
=> Không khó để nhận ra rằng, bảng tính chung này chính là một ví dụ về Blockchain. Mỗi block dữ liệu tương ứng với một dòng dữ liệu trên bảng tính, và mỗi thay đổi trên bảng tính tương ứng với một giao dịch trên Blockchain. – Không ai có thể thay đổi dữ liệu cũ, mà chỉ có thể thêm dữ liệu mới. Mỗi giao dịch đều được lưu trữ và công khai, và mọi người đều có thể xem lại lịch sử thay đổi của dữ liệu. Việc xác nhận giao dịch cũng tương tự như quy trình xác nhận trên bảng tính chung.
Tóm lược
Blockchain giống như spreadsheet được chia sẻ này. Nó được phân tán trên nhiều máy tính (nút) trên khắp thế giới. Mỗi khi một giao dịch xảy ra, nó được thêm vào một ‘khối’, tương tự như một hàng mới trong bảng tính của chúng ta. Nếu đa số các nút đồng ý rằng giao dịch là hợp lệ, khối sẽ được niêm phong mật mã và thêm vào chuỗi các giao dịch đã được xác nhận trước đó. Do đó, có cái tên “blockchain”.
Bản chất phân quyền của blockchain khiến nó khó bị chỉnh sửa dữ liệu lịch sử. Nó cũng rất minh bạch, bất kỳ ai tham gia vào mạng lưới đều có thể xem toàn bộ blockchain. Hơn nữa, dữ liệu được bảo vệ bằng các nguyên tắc mật mã, làm cho nó trở nên không thể tấn công hay thay đổi
This entry is part 1 of 2 in the series API Security
Lời đầu
Trước khi đi vào Session Token hay JWT Token, hay có thể tóm gọn là authentication qua token, ta sẽ đi qua về 1 cách khác để authentication qua các giao thức API, và sau đó sẽ nói về ưu nhược điểm giữa chúng
Http Basic Authentication
Luồng chạy của HTTP “Basic” Authentication như sau:
Khi người dùng truy cập và không có thông tin đăng nhập, hệ thống sẽ trả về 401 (Unauthorized) và thông tin đi kèm là cách để có thể author qua header WWW-Authenticate với thông tin (Ví dụ trên ảnh là yêu cầu Authen qua Basic)
Khi ta truy cập với Header Authorization + Basic + chuỗi mã, lúc này hệ thống sẽ kiểm tra và cho phép có quyền hay không.
Authorization: Basic dGVzdDoxMjPCow==
Ví dụ như mã trên, đoạn mã sau Basic cơ bản là một đoạn String được mã hoá ở dạng base64, bạn có thể decode nó qua các trang base64, ví dụ
Ví như với mã trên, khi decode, ta nhận được đoạn mã test:123£, đây là format của Basic Authen, với đầy đủ là username:password, thì ở đây test là username, và password là 123£
Ưu điểm
Sử dụng đơn giản, luồng không phức tạp, triển khai nhanh
Phù hợp cho authentication trong nội bộ, cho các ứng dụng trên môi trường kiểm thử (non-prod)
Nhược điểm
Toàn bộ request đều sẽ phải gửi username và password, điều này nhìn chung tăng khả năng xảy ra lộ mật khẩu.
Do lần nào cũng gửi mật khẩu, nên nếu bạn mã hoá nó, việc này là một công đoạn khá tốn tài nguyên. Những thuật toán hashing, mã hoá mật khẩu hiện đại có thể tốn tới 100ms (0,1s) để giải mã mật khẩu rồi kiểm tra có đúng không. Điều này hao tốn CPU cho hệ thống
Một số vấn đề khác về UX (giao diện mặc định đăng nhập xấu), vấn đề bảo mật về việc lưu password ở client để gửi đi authen, ….
Token Authentication trong API
Khái niệm
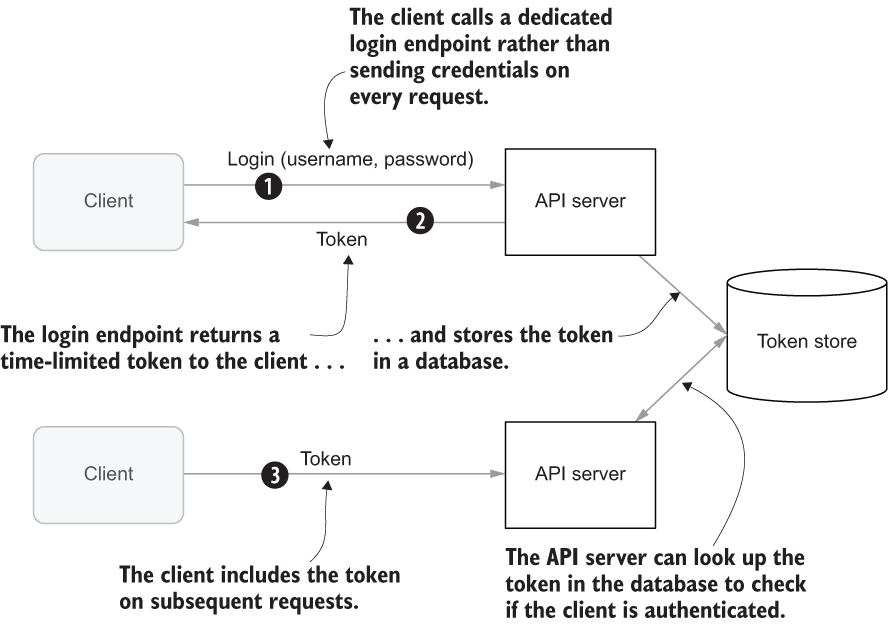
Hiểu đơn giản, thông thường thì authentication bằng token sẽ hoạt động như sau: Tài khoản, mật khẩu, … thông tin user chỉ cần nộp 1 lần, người dùng sau đó sẽ được cấp 1 token, 1 đoạn mã có thời hạn sử dụng. Người dùng sau đó có thể dùng token này để authentication cho đến khi đoạn token hết hạn sử dụng
Ví dụ về token authentication trong thực tế, điều này giống như bạn đi một khu vui chơi. Bạn đã đặt vé từ trước, và để xác minh bạn đã đặt vé chưa, bạn phải xuất trình căn cước công dân, ảnh thẻ, hộ chiếu, …. Thay vì vậy, khu vui chơi sau khi nhận căn cước công dân ở cửa vào, sẽ cấp cho bạn 1 phiếu vé có thời hạn 1 ngày hay gì đó, sau đó bạn dùng phiếu vé này để đi chơi trong khu vui chơi trong thời gian của vé.
Cách tiếp cận 1: Lưu trữ token trong database
Người dùng lần đầu sẽ gửi thông tin của mình cho server, server sẽ từ đó sinh ra 1 token và lưu nó vào database
Lần sau người dùng sẽ chỉ cần gửi token, và sau đó server kiểm tra token có trong database không, còn hạn sử dụng không, … rồi cho phép người dùng
Việc này khắc phục các điểm:
Đầu tiên, token thường không chứa thông tin mật khẩu, tài khoản, … nữa nên ít lo bị lộ thông tin cá nhân của người dùng hơn.
Giảm bớt các nhược điểm của Basic Authen là phải mã hoá, giải mã mật khẩu, ….
Nếu có vấn đề bảo mật xảy ra, token được cài đặt là có thời hạn, và hơn nữa ta đã lưu ở trong database, ví dụ, bạn bị mất token vào tay người khác, thì thiệt hại cũng được giảm thiểu. Hoặc ta có thể trực tiếp ngăn chặn bằng cách xoá token đó đi trong database.
Session Cookie
Cách triển khai đơn giản nhất của hướng tiếp cận trên, và cũng khá phổ biến là sử dụng cookie. Sau khi người dùng đăng nhập bằng thông tin, phía server sẽ trả về 1 header Set-Cookie trong response để yêu cầu trình duyệt người dùng lưu 1 chuỗi token ngẫu nhiên trong bộ nhớ cookie của trình duyệt
Các request vào trang đó sẽ sử dụng token như 1 header Cookie (do cookie được tạo ra để lưu trữ những thông tin của người dùng trong 1 site)
Ưu điểm
Cookie có nhiều cơ chế về bảo mật có sẵn, ví dụ như cookie chỉ gắn liền với từng tên miền, nên nó luôn đảm bảo không có chuyện ta gửi sang trang khác đoạn cookie chứa thông tin nhạy cảm
Cookie có thể được đánh dấu là Secure, điều này giúp đảm bảo khi gửi kết nối tới trang nào thì cookie chỉ được gửi nếu kết nối đó là Https và đã được mã hoá.
Nhược điểm
Trong thiết kế API theo hướng RestAPI đó là kết nối giữa client người dùng và server nên là stateless http://quochung.cyou/kien-truc-stateful-va-stateless-la-gi/. Đó là server sẽ không lưu trạng thái nào của người dùng giữa các request khác nhau.
Cookies phá vỡ nguyên tắc này vì server lúc này lưu trạng thái của cookie với các client khác nhau. Vào thời điểm đầu khi session cookie được sử dụng, chúng thường là nơi lưu trữ tạm thời 1 số trạng thái của người dùng, ví dụ như 1 giỏ hàng, 1 danh sách sản phẩm đã được chọn mà người dùng chưa thanh toán. (Kiểu khi người dùng chọn rồi, nó không lưu trực tiếp vào database) mà chỉ lưu vào cookie, điều này dễ gây ra một số lỗi bất thường cho website.
Kiến trúc Microservice nói một cách đơn giản, là việc ta chia nhỏ một hệ thống lớn thành nhiều service nhỏ để xử lý các công việc riêng biệt với nhau. Việc chia nhỏ hệ thống lớn đem đến rất nhiều lợi ích, ví dụ như ta có thể có nhiều team dev làm việc trên nhiều phần khác nhau, giúp tăng hiệu suất. Ta có thể giải quyết các bài toán lớn khi mà quá nhiều request tập trung về 1 server, ….
Tuy nhiên nó cũng đi kèm nhiều vấn đề:
Ví dụ trong thực tế, trong quá trình ship hàng, một quá trình xảy ra như sau
Cửa hàng giao đồ cần chuyển cho shipper
Shipper giao hàng tới cho người nhận
Shipper báo lại cho cửa hàng là hàng đã giao
Các công việc này, nếu coi các chủ thể thành 1 kiến trúc monolith, hay “1 khối” sẽ làm hết mọi việc, thì phía cửa hàng sẽ chuẩn bị hàng, giao hàng, rồi thu tiền hết một mình. Nhưng lúc này, ta sẽ chia chúng thành 2 service “nhỏ hơn”
Service cửa hàng: Chỉ chuẩn bị hàng
Service vận chuyển: Vận chuyển hàng và giao hàng
Khi chỉ 1 khối làm việc một mình, cửa hàng luôn biết là hàng đã giao chưa. Nhưng lúc này khi chia làm 2 service, bên vận chuyển phải báo lại cửa hàng để cửa hàng nắm lại thông tin, lúc này, nếu ví dụ bên vận chuyển đã giao hàng, mà không báo lại cho cửa hàng do quên, do lỗi, .. sẽ dẫn đến sự “bất đồng bộ”, một vấn đề rất thường gặp, hay là đảm bảo tính “Consistency” trong kiến trúc Microservice
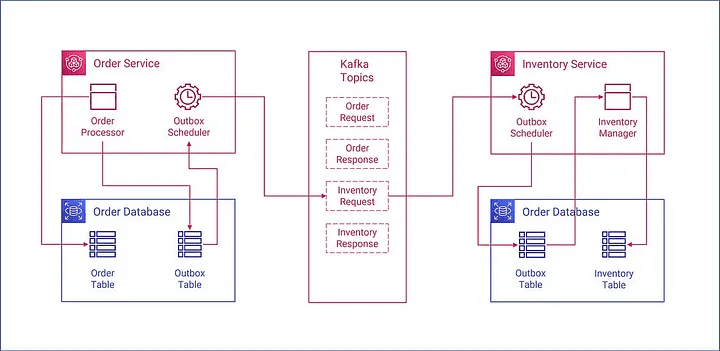
Pattern Transactional Outbox
Có nhiều giải pháp cho vấn đề này, một trong số đó là Transactional Outbox, ví dụ hình ảnh và từng bước ở dưới
Một khách hàng đặt một đơn hàng mới
Hệ thống Order Service quản lý đơn hàng cập nhật đơn hàng thành “ĐANG VẬN CHUYỂN” và tạo 1 event “OrderCreated”
Event “OrderCreated” được cho vào message queue: như trong hình ảnh là Kafka
Một hệ thống Outbox Processor khác sẽ liên tục gửi Event yêu cầu cập nhật đến Inventory Service và Notification Service cho đến khi thành công, nếu xảy ra lỗi, nó sẽ thử lại
Các cấu phần
Outbox Entity/Outbox Table: Chứa các Event
Outbox Persistence Mechanism: Một hệ thống bảo đảm event trong outbox table
Outbox Processor: Một tác vụ background chịu trách nghiệm xử lý event khỏi Outbox
Liên tục gọi vào table của table định kỳ xem có event nào mới không
Nếu có, gửi event mới đến các message queue
Xử lý việc thử lại nếu thất bại
Một số câu hỏi
Q: Tại sao khi tạo một order ở phía order-service chẳng hạn, ta không gửi thẳng luôn 1 message đến message broker ở giữa là kafka, … rồi phía payment-service sẽ consume message đó thôi, tại sao cần 1 table outbox?
A: Sẽ có 2 vấn đề khi làm như vậy
1. Ví dụ, nếu order-service chưa cập nhật trạng thái, mà đã send message cho message queue rồi, thì sẽ không đảm bảo tính nhất quán. Message chỉ nên được gửi khi transaction ở local database đã commit, còn nếu bị rollback theo ACID, thì message cũng không được gửi. Tức là message cũng nên nằm trong 1 transaction của Database. Ví dụ nó đã commit xuống database local rồi, nhưng mà crash nên không gửi được message
2. Message thì đã được gửi rồi, nhưng mà transaction ở local chưa run xong, và sau đó nó fail nên roll back lại, nhưng mà message đã gửi rồi
Thì lúc này ta sẽ lưu các event, hay message chuẩn bị gửi đi ở phía local database. Điều này đảm bảo là toàn bộ transaction ở local đã hoàn thành, hoặc đã rollback hết, rồi mới sẽ gửi message đi, bằng việc liên tục gọi về local để gửi message đi
Ưu điểm/Nhược điểm
Ưu điểm:
Dữ liệu được đảm bảo nhất quán
Giảm bớt sự phụ thuộc quá chặt giữa các service
Nhược điểm:
Tăng thêm độ phức tạp do có thêm việc scan bảng outbox, giảm hiệu năng
Tăng thêm tài nguyên lưu trữ bảng outbox, ta lại phải làm thêm cơ chế cleanup event nếu nó grow quá lớn
Có thể xảy ra trường hợp gửi nhiều hơn 1 message, vì vậy message broker hoặc phía nhận cần đảm bảo tính idempotent. (Tức là dù có gửi bao nhiêu request cùng 1 loại thì kết quả không đổi và như request đầu tiên). Ví dụ: lưu lại id message để không xử lý lại nếu đã xử lý rồi