[Phần 2] Sự phát triển của các mô hình hệ thống Backend (N-layered, DDD, Hexagon, Onion, Clean Architecture)

2005 — Hexagon (Ports and Adapters) (Khối lập phương – Cổng và bộ chuyển đổi)

  • Trước đó, các tầng của chúng ta chỉ đi từ trên xuống theo thứ tự. Với việc sử dụng dependency inversion, mọi thứ đều đã thay đổi
  • Đây như là một thế giới mới cho các kỹ sư phần mềm. Ta có thể kiểm soát được hướng của sự phụ thuộc theo cách ta muốn. Lúc này, business logic sẽ không gọi xuống tầng data access nữa. Để đọc thêm về dependency inversion, bạn có thể tham khảo bài sau:
1*B2f9ycR5sN6thAhCe0vfiA - quochung.cyou PTIT
1*1Hyocpa6Xpy mXqYeb zqw - quochung.cyou PTIT
1 PRLCk7qPIL PHT mNXw2cQ - quochung.cyou PTIT
  • Thay vì những layer hình chữ nhật như ban đầu, lúc này, ông đã vẽ một hình lục phương, trông có vẻ khá phức tạp hơn một cấu trúc đa tầng ban đầu, tuy nhiên nó lại khá đơn giản
  • Điều gì đã xảy ra trong hình minh hoạ trên? Như ta thấy, lúc này Domain đã là thành phần ở giữa và là trung tâm của toàn bộ hệ thống, nó không còn phụ thuộc vào bất kì thứ gì khác nữa
  • Để thể hiện việc tầng Domain đã là trung tâm, tầng Business Logic/Domain được đặt tên là Core
  • Các module khác được chia thành 2 phần. Lúc này, với 1 class thực hiện các công việc, ví dụ Repository làm việc với dữ liệu thì không chỉ còn là 1 class concrete mặc định nữa, mà được chia làm đôi thành phần ảo (interface) và phần triển khai thật sự (code logic class). Các phần interface định nghĩa các phương thức mà class logic cần triển khai được đặt tên là ports (cổng)
  • Các phần triển khai code thực tế nằm trong các module bên ngoài, và được gọi là adapters
  • Rõ ràng, ta thấy các logic Domain/Core của hệ thống giờ không còn phụ thuộc vào ai cả, vì nó là những chức năng mà hệ thống bắt buộc phải có, mọi module khác đều chỉ là gắn thêm vào, và phải triển khai các cổng (các interface) mà phần core đã định nghĩa sẵn.
image 3 - quochung.cyou PTIT

Ví dụ về port, adapter và core của hexagon architecture

  • Ta có, ví dụ như một chiếc laptop. Các cổng của nó là gì? Ta có cổng hdmi, cổng tai nghe 3.5, cổng sạc, cổng type c, cổng usb, ….
  • Rõ ràng, khi muốn thêm gì đó cho chiếc laptop, ví dụ ta muốn cắm thêm 1 tài nguyên lưu trữ dữ liệu vào, ta phải dùng 1 chiếc usb, hoặc 1 thẻ nhớ, và chúng phải có khuôn mẫu, đúng với quy chuẩn mà cái laptop đã quy định ra -> tôi có cổng usb như này, nếu muốn cắm gì vào thì phải theo khuôn như thế. Giống như việc, trong core đã có các interface, ta chỉ làm việc với các hàm của interface, module bên ngoài triển khai logic phải triển khai đúng theo bản khuôn mẫu, các hàm đó.
  • Ví dụ, nếu không dùng interface, nhà sản xuất usb lại tự tạo ra các đầu cắm khác nhau, giờ chẳng lẽ máy tính là một high-level module (một phần quan trọng hơn), lúc sản xuất lại phải theo cái đầu cắm của usb? Điều này không hợp lý
image 1 - quochung.cyou PTIT

Các ưu điểm rõ ràng

  • Lúc này các module bên ngoài cắm vào thường độc lập với nhau, và chúng dễ thay thế hơn. Ta đã định nghĩa trước ta cần gì trong core, giờ bên ngoài chỉ triển khai logic lại từ các yêu cầu đó. Nếu ta thay đổi cách gọi lấy dữ liệu từ việc gọi vào database sang đọc ghi trong file excel, ta chỉ thay đổi ở module, và vẫn là hàm getAll() mà core đã quy định. Tương tự với giao diện, cũng là module ngoài, cũng phải làm như vậy.
  • => Các module độc lập, dễ thay thế hơn, và phải tuân thủ các quy tắc của core logic
image 2 - quochung.cyou PTIT

2008 — Onion – Kiến trúc củ hành

image 4 - quochung.cyou PTIT
1 lRxsDk6eaUy9O4 RaVuJ1g - quochung.cyou PTIT
  • Nhìn chung, Onion Architecture vẫn khá tương đồng với Hexagon Architecture, tuy nhiên ở Hexagon, ta có 1 khối ở giữa và ta mong muốn các module chỉ như các thiết bị ngoài cắm vào ổ đó và tách biệt lẫn nhau. Còn ở Onion Architecture, ta có những tầng như những chiếc vòng, và tầng ở vòng bên ngoài phụ thuộc vào tầng bên dưới
image 6 - quochung.cyou PTIT
  • Theo 1 cách nhìn nào đó, Onion Architecture có một hướng phụ thuộc khá thẳng như N-Layered, nhưng thực tế ta vẫn áp dụng đảo sự phụ thuộc để cho phép tầng Domain hay Business là tầng dưới cùng của hệ thống
image 8 - quochung.cyou PTIT
  • Có một vài điểm thể hiện sự khác biệt ở đây. Là thay vì có 1 core quá lớn và mọi module đều phụ thuộc vào nó đôi khi có thể gây ra một số nhược điểm. Tức là 1 sự thay đổi trong core có thể khiến nhiều module khác nhau phải sửa đổi
  • Thay vì vậy, ta có một số tầng khác, ví dụ như ở ảnh trên là Application, sẽ wrap lại tầng Domain, Domain sẽ chứa những code mà có ít sự thay đổi, và Application có thể chứa nhiều logic và thường xuyên thay đổi nhiều hơn sẽ nằm ở bên trên.
  • Có thể cảm giác nó như tính đóng gói của OOP, khi mà những phần bên trong sẽ được wrap lại ở các tầng bên ngoài chứa nhiều logic hơn, và khi phần bên trong hoàn thiện sẽ chứa ít sự thay đổi hơn

2012 — Clean Architecture

image 9 - quochung.cyou PTIT
image 10 - quochung.cyou PTIT
image 11 - quochung.cyou PTIT
  • Nhìn chung, ta nhận thấy ta vẫn có 1 tầng chứa những phần về logic của Domain/Business, nay được đặt tên là Entities nằm trên cùng, và ta có các tầng khác thuộc module ngoài như Infra (Thường là data access của database), presentation (giao diện) phụ thuộc dần vào trong.
  • Thực tế, bạn có thể thấy Hexagon, Onion hay Clean Architecture có một cách định hướng khá giống nhau, ở Clean Architecture, Uncle Bob đã thêm 1 số layer bên ngoài như thư viện thứ 3, dll, …

Tổng kết

  • Nhìn chung, các kiến trúc về sau như Hexagon, Onion, Clean Architecture đều là các cách tiếp cận áp dụng các thủ pháp như Dependency Inversion, … nhằm tập trung vào phần core, domain, … và các module bên ngoài phải được xây dựng dựa theo hệ thống chính, chứ hệ thống chính không đi theo module bên ngoài
  • Việc triển khai các cấu trúc phức tạp hơn cho phép ta mở rộng dễ hơn về sau khi logic ở core ngày càng tăng lên, tuy nhiên, không có cấu trúc nào là hoàn toàn hoàn hảo và được xây dựng ở các thời điểm khác nhau cho mục đích khác nhau.
  • Do sự phát triển của microservice, các hệ thống còn được chia nhỏ ra nhiều service nhỏ hơn nữa, khi logic ở mỗi service không quá nhiều, ta dễ dàng có thể triển khai 1 cấu trúc 3 tầng thay vì các cấu trúc quá phức tạp và phải đi qua nhiều tầng để giúp tăng tốc độ triển khai dự án.
Các cấp độ Isolation trong Database dễ hiểu

Sơ lược về Database

Về term “database”, bạn có thể đọc bài viết sau:

https://quochung.cyou/tim-hieu-li-do-can-database-datalake-data-warehouse/

Transaction trong Database

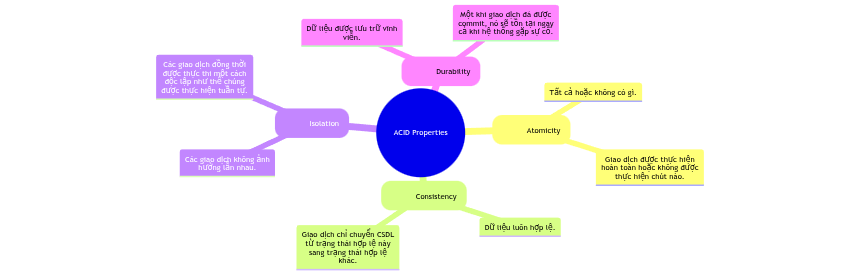
ACID:

  • Đầu tiên, ta cần phải hiểu về Transaction trong Database. Một phiên (Transaction) trong database có thể được coi tạo lên bởi 4 tính chất ACID
  • Một transaction (phiên) thể hiên một nhóm các câu lệnh được chạy trong database, thông thường chứa nhiều lệnh khác nhau.
image 48 - quochung.cyou PTIT

Hãy tưởng tượng bạn chuyển 1 triệu đồng từ tài khoản A sang tài khoản B. Transaction sẽ bao gồm 2 bước:

  1. Trừ 1 triệu từ tài khoản A
  2. Cộng 1 triệu vào tài khoản B

Nếu bước 1 thành công nhưng bước 2 thất bại (vì lý do nào đó), transaction sẽ rollback (hoàn tác) – tức là hoàn lại 1 triệu vào tài khoản A. Như vậy sẽ không có tiền nào bị “biến mất”.

Các cấp độ isolation trong Database

Read Uncommitted Isolation Level (Cấp độ “đọc chưa hoàn thành”)

  • Đây là cấp độ khá lỏng lẻo, khi mà ta sẽ đọc các dữ liệu chưa được commit của row. Tức là bất kì lệnh cập nhật ,thêm vào mà chưa thật sự commit vào database cũng sẽ có luôn trong phiên hiện tại của mình. Cấp độ này thường được dùng trong các hệ thống đặt vé, đặt lịch hẹn khi mà các transaction khác đang cố update tình trạng của 1 vé, kể cả khi phiên ngoài đó chưa thực thi xong, nhưng ta cũng sẽ coi như là nó đã được chạy.
  • Cấp độ này thường k đảm bảo tính toàn vẹn của dữ liệu đọc được, tuy nhiên nếu chúng có thể chấp nhận được thì chúng có thể được dùng để giảm bớt tình trạng deadlock, … (Ví dụ như đọc toàn bộ dân số việt nam, ta có thể chấp nhận sai số khoảng 100-200 người chẳng hạn)
image 53 - quochung.cyou PTIT
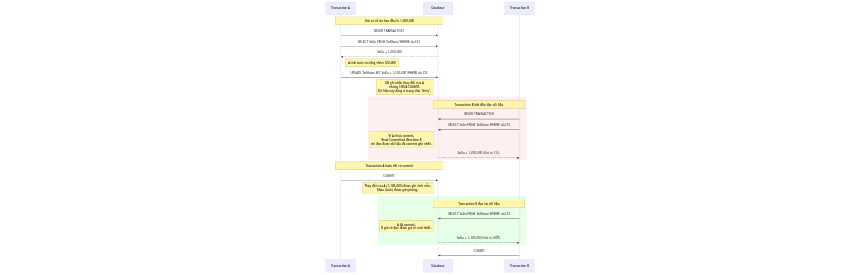
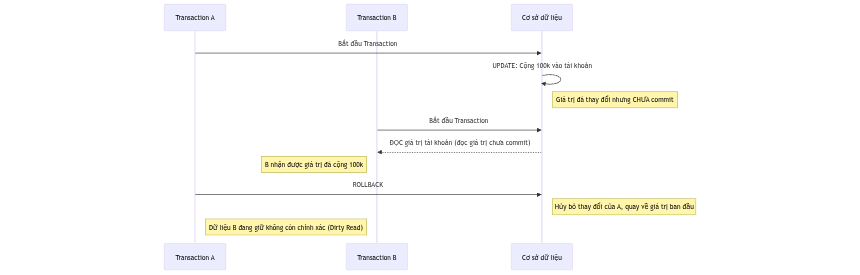
  1. Transaction A bắt đầu và thực hiện một phép UPDATE (cộng 100k vào một tài khoản). Tại thời điểm này, sự thay đổi chỉ tồn tại trong phiên của Transaction A và chưa được xác nhận (commit) vào cơ sở dữ liệu.
  2. Transaction B bắt đầu và đọc dữ liệu từ chính tài khoản đó. Do mức cô lập (isolation level) của cơ sở dữ liệu thấp, Transaction B đã đọc phải dữ liệu “bẩn” (dirty data) – là dữ liệu đã được Transaction A thay đổi nhưng chưa được commit.
  3. Transaction A gặp lỗi hoặc quyết định hủy bỏ, do đó nó thực hiện lệnh ROLLBACK. Mọi thay đổi của Transaction A sẽ bị hủy bỏ, và dữ liệu trong tài khoản quay trở lại giá trị ban đầu như trước khi A bắt đầu.
  4. Kết quả: Transaction B bây giờ đang giữ một giá trị không còn tồn tại trong cơ sở dữ liệu, dẫn đến sự không nhất quán về dữ liệu.

Read Committed Isolation Level (cấp độ “đọc phải hoàn thành”)

Đặc điểm: Chỉ đọc được dữ liệu đã được commit. Đây là mức độ phổ biến nhất.

  • Transaction A đang cộng 100k vào tài khoản của bạn
  • Transaction B sẽ không thấy số tiền tăng cho đến khi A commit thành công
  • Nếu A rollback, B không hề biết có giao dịch A

Ưu điểm: An toàn, tránh đọc dữ liệu “bẩn” (dirty read).

image 50 - quochung.cyou PTIT
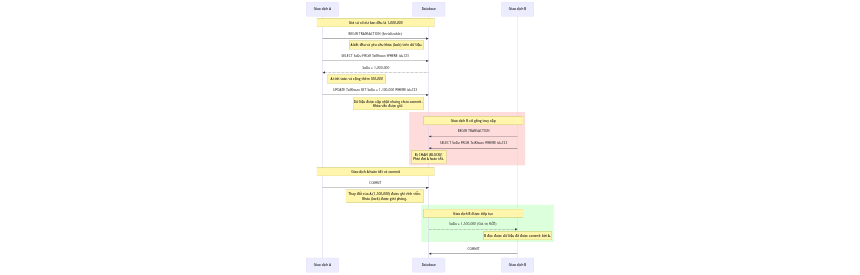
  1. Transaction A bắt đầu và thực hiện một phép UPDATE (cộng 100k vào một tài khoản). Tại thời điểm này, sự thay đổi chỉ tồn tại trong phiên của Transaction A và chưa được xác nhận (commit) vào cơ sở dữ liệu.
  2. Transaction B bắt đầu và đọc dữ liệu từ chính tài khoản đó. Do mức cô lập (isolation level) của cơ sở dữ liệu thấp, Transaction B đã đọc phải dữ liệu “bẩn” (dirty data) – là dữ liệu đã được Transaction A thay đổi nhưng chưa được commit.
  3. Transaction A gặp lỗi hoặc quyết định hủy bỏ, do đó nó thực hiện lệnh ROLLBACK. Mọi thay đổi của Transaction A sẽ bị hủy bỏ, và dữ liệu trong tài khoản quay trở lại giá trị ban đầu như trước khi A bắt đầu.
  4. Kết quả: Transaction B bây giờ đang giữ một giá trị không còn tồn tại trong cơ sở dữ liệu, dẫn đến sự không nhất quán về dữ liệu.

Trong Spring: Đây là mức độ mặc định khi bạn dùng @Transactional.

Repeatable Reads Isolation Level (Cấp độ “đọc lại”)

  • Giả sử, ta có một bảng chứa số tiền lương của nhân viên, và ta có một transaction chứa 2 lệnh như sau
  • Lệnh 1: Đếm số lượng nhân viên
  • Lệnh 2: Đếm tổng tiền lương của nhân viên

Lúc này, giả sử một trường hợp mà có một nhân viên mới được thêm vào ngay sau khi Lệnh 1 hoàn thành. Lúc này kết quả của lệnh 2 sẽ bị thay đổi (do có 1 nhân viên mới). Lúc này chúng ta thường sẽ chọn cấp độ Repeatable Read, đó là đảm bảo rằng số lượng row (hàng) nằm trong phiên hiện tại giữ nguyên giá trị cho đến khi hết transaction.

  • Điều này đảm bảo số lượng row nhân viên phải được đảm bảo từ đầu phiên, nên nhân viên mới kia (1 row mới) không được count vào, và lệnh 2 đảm bảo giá trị vẫn đúng.
image 51 - quochung.cyou PTIT
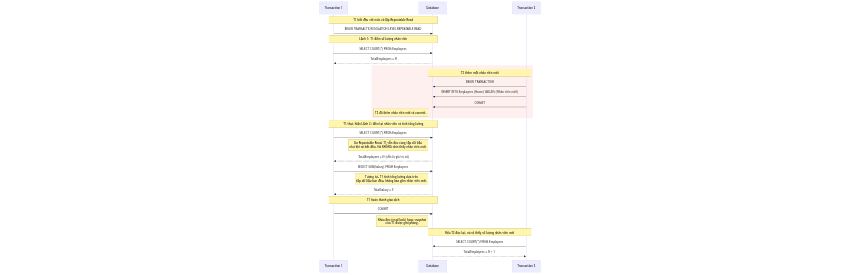
  • Transaction 1 (T1) bắt đầu với mức cô lập Repeatable Read. Điều này có nghĩa là bất kỳ dữ liệu nào T1 đọc trong quá trình thực hiện sẽ giữ nguyên (nhất quán) trong suốt thời gian của transaction, ngay cả khi các transaction khác (như T2) thực hiện các thay đổi và commit.
  • Khi T1 thực hiện Lệnh 1 (SELECT COUNT(*) FROM Employees), nó đọc được số lượng nhân viên là 10. Tại thời điểm này, một “snapshot” (ảnh chụp nhanh) của dữ liệu được tạo ra cho T1.
  • Transaction 2 (T2) chèn thêm một nhân viên mới và commit. Lúc này, về mặt vật lý, cơ sở dữ liệu đã có 11 nhân viên.
  • Tuy nhiên, khi T1 thực hiện Lệnh 2 (SELECT SUM(Salary) FROM Employees), nhờ cơ chế Repeatable Read, nó vẫn đọc dữ liệu dựa trên “snapshot” ban đầu của nó. Điều này có nghĩa là T1 sẽ không thấy được nhân viên mới mà T2 đã thêm vào. Do đó, tổng lương vẫn là 100,000,000 VND (tương ứng với 10 nhân viên ban đầu), đảm bảo tính nhất quán (không bị non-repeatable read) trong cùng một transaction.

Serializable Isolation Level

  • Đây là cấp độ mạnh nhất trong isolation
  • Không một transaction nào khác được quyền đọc hoặc ghi cho đến khi transaction này hoàn thành
  • Cấp độ này giải quyết đa số vấn đề mà 3 cấp độ kia có, nhưng mà nó thường làm giới hạn, chỉ cho phép 1 query chạy 1 lúc trong hệ thống, tạo thành 1 điểm nghẽn và khó scale hệ thống hơn.

Nghe thì có vẻ Serializable giúp ta thoải mái và đảm bảo dữ liệu đúng, tuy nhiên bản chất, nó ngăn chặn mọi hành động đa luồng trong database vào 1 vùng dữ liệu, và ta chỉ chạy được 1 phiên trên 1 vùng vào 1 thời điểm

image 52 - quochung.cyou PTIT
  • Transaction A bắt đầu và đọc dữ liệu. Khi Transaction A thực hiện các thao tác đọc và ghi, cơ sở dữ liệu sẽ áp dụng một khóa độc quyền (exclusive lock) lên các dữ liệu mà A đang truy cập.
  • Trong khi A đang giữ khóa, Transaction B cố gắng đọc cùng một dữ liệu. Tuy nhiên, do dữ liệu đang bị khóa bởi A ở mức độ Serializable, Transaction B sẽ bị chặn (blocked) và phải đợi cho đến khi A hoàn thành.
  • Khi Transaction A thực hiện COMMIT, khóa độc quyền được giải phóng.
  • Lúc này, Transaction B mới có thể tiếp tục và đọc được dữ liệu, đảm bảo rằng nó luôn đọc được dữ liệu ở trạng thái nhất quán và đã được commit cuối cùng.

Tham khảo:

Sự ra đời của Java, các thuật ngữ JVM, JDK, JRE

Giới thiêu về Java

Ngôn ngữ lập trình Java được thiết kế để trở thành một ngôn ngữ không phụ thuộc vào nền tảng (machine-independent). Java có thể chạy trên bất kỳ nền tảng nào miễn là có máy ảo Java (Java Virtual Machine – JVM). Máy ảo Java là một chương trình có thể chạy trên nhiều nền tảng khác nhau mà không cần phải biên dịch lại. Máy ảo Java có thể chạy trên các máy tính, điện thoại, máy tính bảng, máy chủ, … Máy ảo Java có thể được cài đặt trên các hệ điều hành khác nhau như Windows, Linux, Mac OS, …

Java vừa đủ mạnh với nhiều thư viện, tính năng, bảo đảm các sự chặt chẽ, nhưng cũng đồng thời chạy rất nhanh. Java có thể được sử dụng để phát triển các ứng dụng desktop, web, mobile, game, … Java cũng là một trong những ngôn ngữ lập trình được sử dụng nhiều nhất hiện nay.

image 10 - quochung.cyou PTIT

Java Virtual Machine (JVM)

Không như C/C++ khi mà code được biên dịch thì sẽ tạo thành các mã lệnh được làm cho riêng các vi xử lý khác nhau. Code java đầu tiên được biên dịch thành một dạng tổng quát – bytecode, là ngôn ngữ cho JVM chạy. Sau đó JVM mới chạy thành các ngôn ngữ máy cho nền tảng đó.

image 6 - quochung.cyou PTIT

Trình tự hoạt động:

image 7 - quochung.cyou PTIT

JRE – Java Runtime Environment

  • The Java Runtime Environment (JRE) provides the libraries, the Java Virtual Machine, and other components to run applets and applications written in the Java programming language. In addition, two key deployment technologies are part of the JRE: Java Plug-in, which enables applets to run in popular browsers; and Java Web Start, which deploys standalone applications over a network. It is also the foundation for the technologies in the Java 2 Platform, Enterprise Edition (J2EE) for enterprise software development and deployment. The JRE does not contain tools and utilities such as compilers or debuggers for developing applets and applications.
  • JRE – đúng như tên của nó (môi trường chạy java) chứa các thư viện, chứa cả JVM ở bên trong, và một số thành phần khác để chạy được các phần mềm Java. Hiểu đơn giản, nếu bạn có 1 file jar, 1 chương trình java, chỉ cần có JRE là bạn có thể chạy chúng.
image 12 - quochung.cyou PTIT

JDK – Java Development Kit

  • JDK (Java Development Kit) – Bộ công cụ lập trình Java
  • Hiểu đơn giản thì JDK chứa JRE và thêm một số công cụ khác để hỗ trợ cho việc lập trình, compile các file code .java sang file .class (đọc thêm bên dưới)
image 11 - quochung.cyou PTIT

Cấu trúc chương trình Java

image 8 - quochung.cyou PTIT
  • Trong file source code, chứa “class” (lớp)
  • Mỗi “class” chứa nhiều “method” (hàm) khác nhau.
  • Mỗi “method” chứa nhiều “statements” (dòng lệnh) khác nhau.

Ví dụ 1 file class:

``` 

public class HelloWorld {
    public static void main(String[] args) {
        System.out.println("Hello World!");
    }
}

```
  • Khi một dự án Java chạy, JVM sẽ tìm class bạn để là class đầu tiên khởi chạy, rồi sau đó tìm đến method main để chạy.
public static void main(String[] args) {
   // đây là hàm đầu tiên được chạy
}

image 9 - quochung.cyou PTIT

Tham khảo:

[Phần 1] Sự phát triển của các mô hình hệ thống Backend (N-layered, DDD, Hexagon, Onion, Clean Architecture)

Chương 1: Nơi mọi thứ bắt đầu

Vào những ngày đầu tiên thuở sơ khai, chưa có một “mô hình hệ thống” hay “architecture” nào tồn tại cả. Giang hồ lúc này mạnh ai nấy làm, bạn chỉ cần biết GoF Pattern thì có thể tự xưng bá một phương, là một “architect”, một lập trình viên dày dặn trong nghề.

Thời gian thắm thoắt thoi đưa, từ những cái máy tính to bằng cả cái phòng, từ những chiếc ổ cứng dày cộp chỉ chứa vài MB, công nghệ ngày càng phát triển, máy tính dần thu gọn hơn, ngày càng mạnh mẽ hơn, tiếp cận đến nhiều người hơn. Lúc này, yêu cầu của người dùng ngày càng tăng chóng mặt, khiến cho độ phức tạp của các phần mềm gia tăng.

Thứ đầu tiên những cao thủ trong ngành tạo ra là (Tách UI ra khỏi các logic bussiness), từ hình thái này, các mô hình MVC đầu tiên đã được ra đời:

image - quochung.cyou PTIT

Hiểu một cách đơn giản, hãy nghĩ đến ứng dụng Facebook và website Facebook. Liệu các câu lệnh như: lấy dữ liệu các bài viết người dùng mới nhất, lấy dữ liệu của 1 trang profile có khác biệt về mặt logic khi ở trên điện thoại hay trên web? Câu trả lời là không, điểm duy nhất khác biệt chỉ là UI hay View (phần hiển thị với người dùng)

Việc tách biệt UI ra khỏi Logic giúp ứng dụng modun hoá hơn, ta có thể dùng chung 1 logic, và khi cần hiển thị trên 1 sản phẩm khác: web, điện thoại, màn hình tivi, màn hình ô tô, … , ta chỉ cần nối phần UI của thiết bị đó với các logic đã chìa ra là được.

Nghe có vẻ như vấn đề đã được giảm bớt 1 chút. Nhưng chưa phải là tất cả, lúc này View có thể chỉ là vài tấm ảnh, một cái nút, Controller sẽ là người ở giữa trung chuyển các câu lệnh, và phần lớn logic bị dồn xuống Model, nơi thường xuyên phải lưu dữ liệu vào database, file, … hay nhìn chung là trực tiếp vào các “đối tượng” của chúng ta.

Chương 2: 2002 – N-Layered (Cấu trúc xếp chồng N tầng)

Một mô hình “lí tưởng” không tồn tại, cũng như mọi thứ, chúng đều là thành quả của nhiều lần thử nghiệm, và được rút kinh nghiệm rất nhiều lần.

Một lập trình viên đã tiên phong trong việc tạo ra một mô hình hệ thống, góp phần ảnh hưởng lớn đến rất nhiều thế hệ lập trình viên sau này tên là Martin Fowler.

image 1 - quochung.cyou PTIT

Ông đã cho ra đời cuốn “Patterns of Enterprise Application Architecture” (Cách thực hiện một mô hình ứng dụng phục vụ cho doanh nghiệp), nơi mà ông đã nói về cấu trúc N-Layered

1 pd5bfxtxV9AK0 QlIOK6Vw - quochung.cyou PTIT

Ý tưởng khá đơn giản, ta sẽ phân loại và nhóm các phần code liên quan đến nhau lại thành “1 tầng”, khi đó ta sẽ có nhiều tầng xếp chồng lên nhau.

Tuy nhiên, Fowler cũng biết việc không nhất quán sẽ xảy ra nếu cứ mỗi ông lập trình viên lại xếp các tầng một cách vô tổ chức, ông đã thêm một số “quy tắc” nhỏ góp phần đồng bộ:

  • Bạn có thể đặt tên một layer – tầng là gì cũng được
  • Bạn có thể có bao nhiêu layer tuỳ thích
  • Bạn có thể thêm một layer ở giữa các layer thường có
  • Bạn có thể có nhiều thành phần trong 1 layer
  • Quan trọng là: cần có một hệ thống cấp bậc rõ ràng giữa các layer, chúng nên gọi đến nhau theo từng cấp một.
1 0Kq2jEHDWcfdeorqKPdYFQ - quochung.cyou PTIT

Điều này đã giúp các ứng dụng giảm bớt các code trùng lặp, và cũng làm cho code có một cấu trúc rõ ràng.

Thông thường đa số ứng dụng chỉ cần 3 tầng là đã có thể phục vụ các nhu cầu cơ bản

image 4 - quochung.cyou PTIT
  • User Interface (UI) — chịu trách nhiệm tương tác với người dùng (giao diện)
  • Business logic layer (BLL)— Xử lí các logic chính của hệ thống
  • Data Access layer (DAL) — Là tầng giao tiếp với dữ liệu như database, …
image 5 - quochung.cyou PTIT
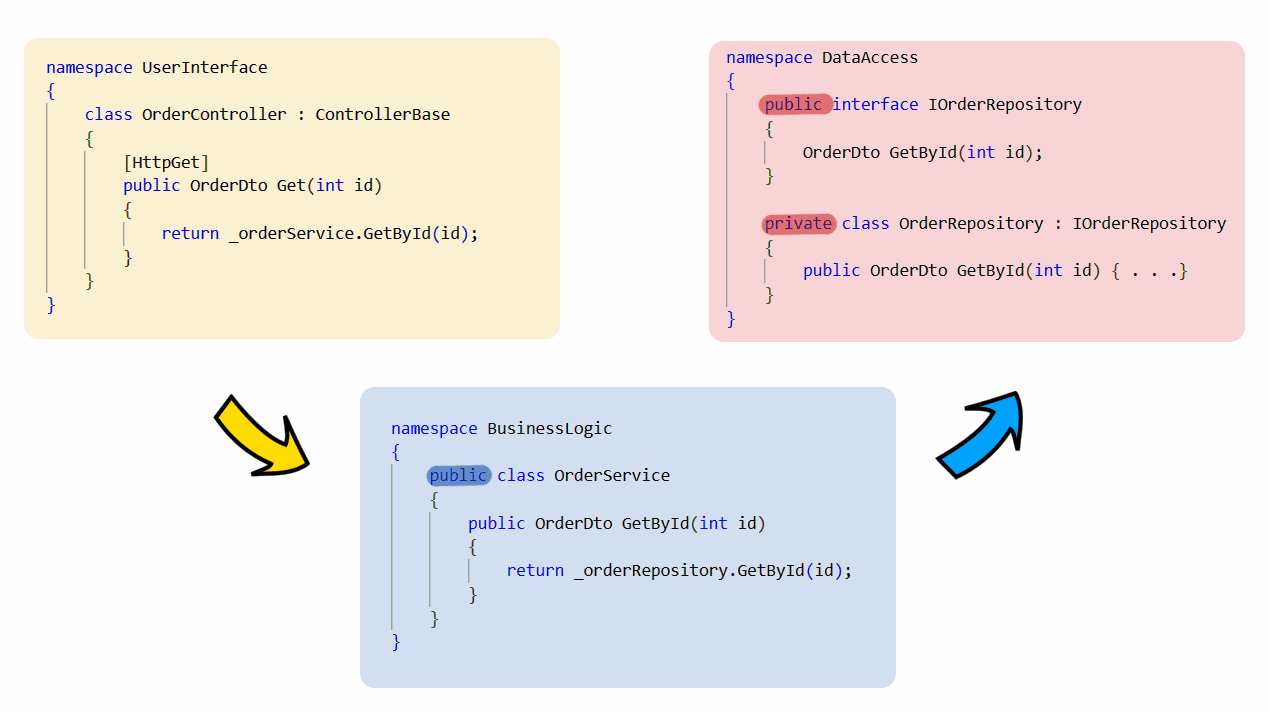
  • Bạn có thể thấy trong các video hướng dẫn làm các dự án backend bằng Spring Boot, người ta thường có một 1 tầng Service (Bussiness), sau đó mới gọi xuống tầng Repository (Data Access), nơi mà giao tiếp trực tiếp với database.
  • Các tầng sẽ gọi đến nhau qua các interface, ví dụ: có một interface là OrderRepository phục vụ lấy dữ liệu từ db. Lúc này, tầng bussiness chỉ cần quan tâm sẽ thực hiện các giao thức lấy dữ liệu của interface này, còn logic thực sự ở tầng data access sẽ được ta viết từ các class implement interface trên.
  • => Ví dụ: ta có 1 interface OrderRepository. ta có 2 class khác implement interface trên là OrderRepositoryImplMongo, OrderRepositoryImplMySQL. Do cả 2 cùng implement orderrepo, nên từ bussiness ta có thể dễ dàng lắp một class khác cho 1 database khác, thuận tiện cho việc xử lí. (Bạn có thể đọc thêm Dependency Injection)
image 6 - quochung.cyou PTIT

Chương 3: 2003 – Domain Driven Design (DDD)

Tưởng chừng N-Layered đã có thể xử lí được các vấn đề hiện tại, tên tuổi của Fowler sẽ được ghi tên vào sử sách. Nhưng vào năm 2003, một anh tài trong giang hồ, một lập trình 46 tuổi đến từ Boston, Eric Evans đã công bố một cuốn sách “Domain-Driven Design: Tackling Complexity in the Heart of Software” (Domain Driven Design: Xử lí sự phức tạp cốt lõi của phần mềm). Cuốn sách đã khiến 1 anh chàng Martin nào đó trên thế giới phải cất poster và khóc.

image 7 - quochung.cyou PTIT

Nhìn chung thì Evans vẫn đồng ý với đa số các ý tưởng của N-Layered, đó là sự kế thừa của hệ thống chỉ nên đi theo 1 hướng (các tầng gọi nhau lần lượt từ trên xuống dưới).

Tuy nhiên ông cho rằng, cũng không tệ lắm nếu một module bậc thấp (tầng bên dưới) có thể gọi lên module bậc cao ở tầng cao hơn. Miễn là nó không phá vỡ hướng đi kế thừa của hệ thống (dependency direction). Điều này có thể làm được bằng callback, hoặc một số design pattern như observer, ….

Ông cũng cho rằng, các Controller thường bị lắp quá nhiều logic, nên ông đã chuyển chúng sang 1 layer khác tên là Application. Ông cũng cho rằng tầng Bussiness logic nên được chú trọng nhiều hơn là tầng database (data access). Nhưng nhìn chung cấu trúc cũng không thay đổi nhiều lắm.

image 8 - quochung.cyou PTIT

Ở cấu trúc của ông, một hệ thống được quy định như sau:

  • Presentation Layer — tầng “trình bày”, tương tác với bên ngoài.
  • Application Layer — Nhận và điều phối các yêu cầu, sau đó chuyển qua tầng Domain.
  • Domain Layer — Chứa các chức năng chính của hệ thống.
  • Infrastructure Layer — Xử lí dữ liệu (tương tự tầng data access)

Bạn có thể thấy ông đã đổi tên một số tầng tưởng chừng như có chung mục đích, nhưng chúng có nguyên do của nó. User Interface thường có ý nghĩa là bạn có một user người dùng nào đó, nhưng không phải lúc nào cũng vậy. Đôi khi ta có một GUI (Graphical User Interface – Giao diện người dùng) cho users, nhưng cũng có thể là 1 CLI (Command Line Interface – Giao diện cmd) cho lập trình viên, hay có thể là API (Application Programming Interface) cho các ứng dụng khác gọi vào. Tầng Presentation thì sẽ “Generic” , chung chung hơn, bao quát hơn.

Business logic thì nghe có vẻ hơi trừu tượng cho đội lập trình viên, vì chúng ta thường không thiên về mảng kinh tế, vì vậy ông đã tạo ra 1 tên mới “Domain – miền”

Ở tầng dưới cùng, đôi lúc, ta không chỉ lưu dữ liệu vào ram, vào database hay đâu đó. Mà có thể ta muốn nó sẽ gọi đến chỗ khác, kiểu gửi 1 email, 1 tin nhắn zalo, … nên chúng được gộp chung thành tầng Infrastructure (Hạ tầng).

Nhìn chung là thế, một số sự thay đổi tên, thêm 1 layer mới, có một số phần khác đã được thêm vào tầng Domain. Và đó là DDD – Domain Driven Design.


Tham khảo:

Tại sao cần viết getter, setter cho các Class?

Getter, Setter là gì

Getter, Setter là các method để lấy dữ liệu và cập nhật dữ liệu cho các trường của 1 class

image - quochung.cyou PTIT

Như ví dụ trên, thay vì viết

Account taiKhoan;
taiKhoan.ID = 10;
//Thay vì viết như trên để cập nhật dữ liệu cho một object Account có ID thành 10, ta sẽ viết rằng

taiKhoan.setID(10);

Tại sao cần phải tạo ra getter, setter như vậy?

Để ngắn hơn chăng? Để đơn giản hơn? Cũng không phải, cách viết hàm trong một số trường hợp còn làm code dài hơn và khó đọc hơn là set thẳng trực tiếp, lí do thực sự là, việc này áp dụng tính chất đóng gói (encapsulation) của OOP.

image 1 - quochung.cyou PTIT

Tính đóng gói (Encapsulation) từ Getter, Setter

Khi sử dụng getter, setter, ta sẽ để access cho các biến trong class thành private, và để cho các phương thức get, set là public. Lúc này, để có thể truy cập hay cập nhật dữ liệu của các biến của 1 object, ta chỉ còn 1 con đường duy nhất thông qua getter setter

Điều này giúp cho ta có thể thêm một lớp validation (xác thực) dữ liệu khi tác động đến dữ liệu của 1 object. Ví dụ, một con mèo không thể có chiều cao là 0 được, một đồ vật phải luôn có trọng lượng,….

image 2 - quochung.cyou PTIT
image 3 - quochung.cyou PTIT

Do lúc này, cách duy nhất để thay đổi chiều cao của con mèo chỉ có thể qua setHeight, ta luôn đảm bảo dữ liệu của chúng ta được xác minh.

Tổng kết

  • Việc sử dụng getter, setter và sử dụng access modifier (private) cho các biến và public cho getter/setter giúp ta đóng gói class, chỉ để lại duy nhất 1 con đường để truy cập/cập nhật
  • Khi chỉ còn 1 con đường, lập trình viên có thể thêm 1 lớp xác thực để tránh dữ liệu bị cập nhật xấu, sai.

Tham khảo: Head First Java 3rd Edition