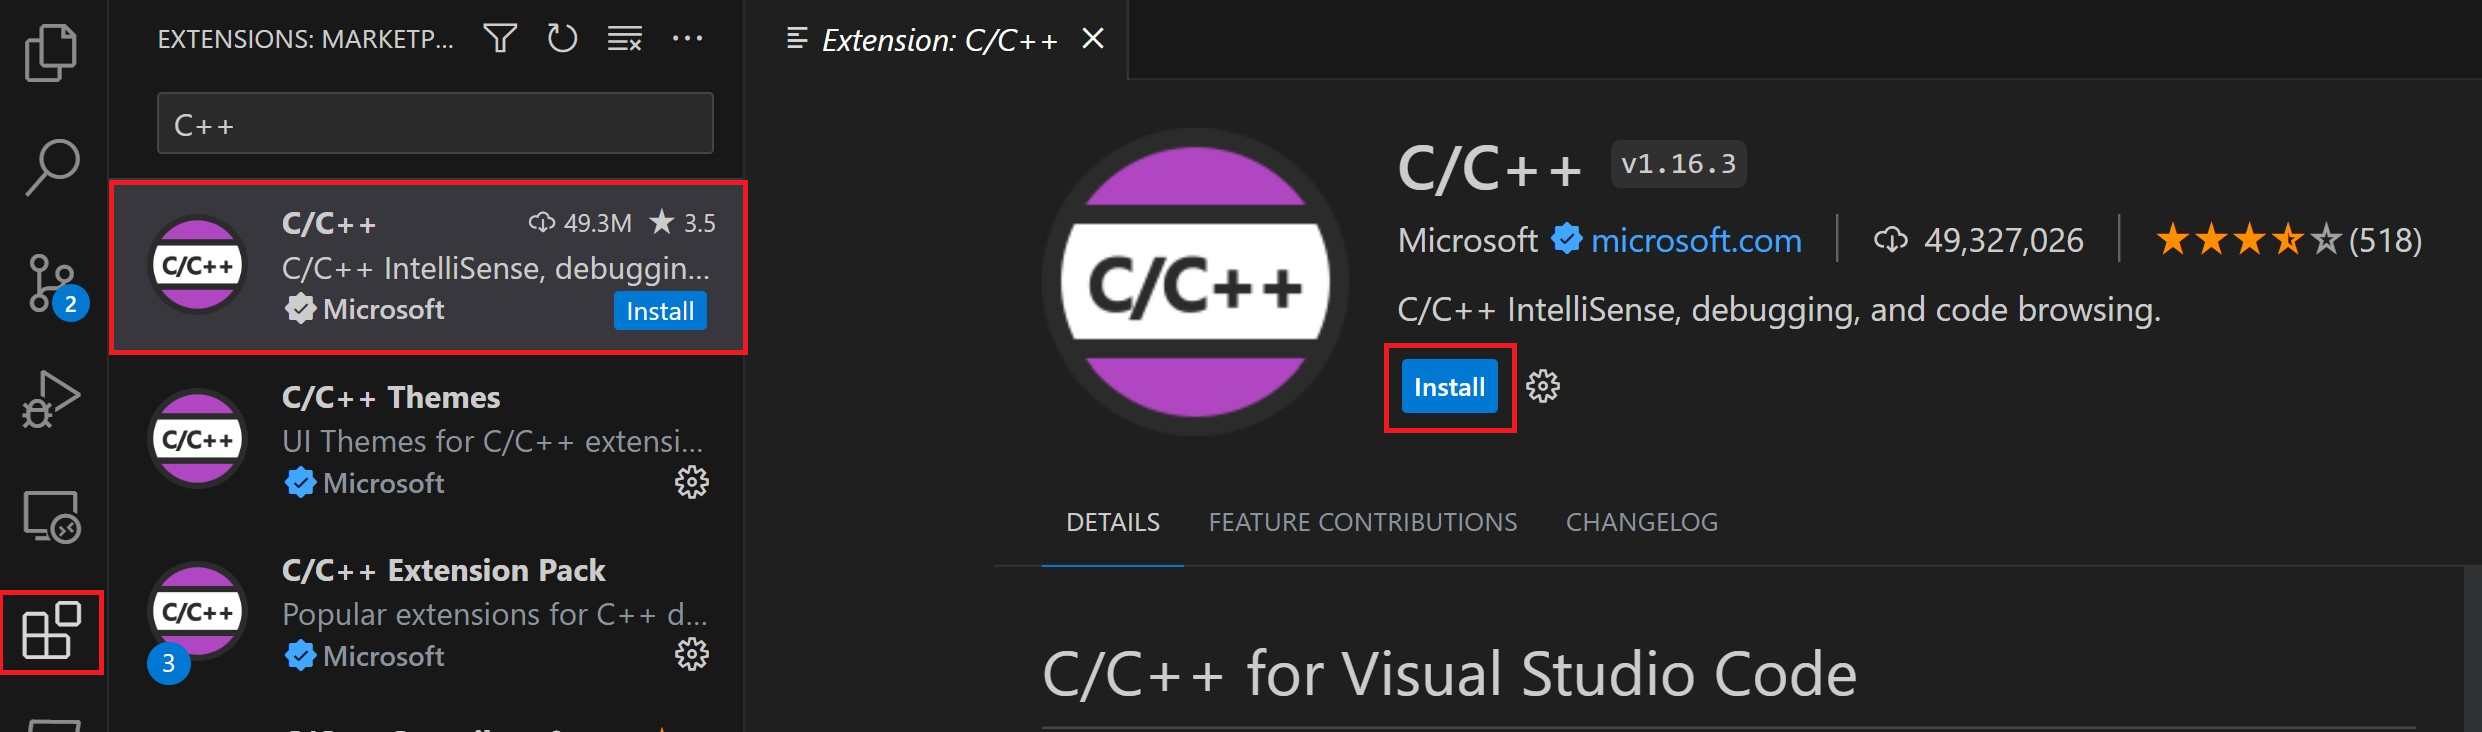
Đây là một plugin hỗ trợ tạo 1 class Java đơn giản (POJO – Plain Old Java Object) từ JSON. Khi cài đặt, chỉ cần chuột phải vào 1 package, New -> Generate POJOS from JSON, và chọn tên class
Jump to Line
Cho phép bạn nhảy đến bất kì dòng code nào khi đang ở chế độ debug. Hiểu đơn giản, bạn có thể nhảy để chạy luôn một đoạn code mà không cần chạy các code trước đó
SonarLint
Một plugin cực kì mạnh giúp bạn tìm và sửa bug, ngoài ra nó cũng có thể detect các vấn đề bảo mật, các đoạn code không clean, … khi bạn đang viết
SonarLint hỗ trợ nhiều ngôn ngữ giúp lập trình viên viết code clean hơn và nhanh hơn
JPA Buddy
Một bộ công cụ giúp bạn làm việc với JPA dễ dàng hơn, có giao diện và khả năng sinh code để làm việc với các thư viện nổi tiếng như HIbernate, Mapstruct, Lombok, …
Maven Helper
Giúp bạn kiểm tra và tìm các dependency có vấn đề với nhau trong maven.
GenerateAllSetter
Giúp bạn nhanh chóng sinh hàm setter nhanh với giá mặc định
CodeGlance
Giúp bạn có một cái nhìn tổng quan về file code hiện tại, dễ dàng di chuyển đến các mục code bạn đang cần tìm
Đây có lẽ là cách lưu trữ thường được thấy và dễ tưởng nhất. Trường primary key sẽ đóng vai trò như số thứ tự, giúp phân biệt giữa các row khác nhau, cách lưu trữ bằng số có thể được DB tự gen bằng cách gen sequence.
Khá tiện quản lý, sử dụng trong tầng dữ liệu
Dễ hiểu, dễ đọc, dễ tìm
Điểm trừ của cách làm này là:
Giả sử bạn đang lưu trữ dữ liệu cho 1 tệp khách hàng, được đánh id từ 1-1000, một ngày nào đó, bạn cần migrate data từ các bảng khác, từ những bảng cũ, … (kiểu sát nhập công ty, …) và cũng có tập dữ liệu được đánh số từ 1-100, 500-1000 gì đó. Điều này làm việc sát nhập trở lên khó khăn hơn do key chính để phân biệt các hàng đã bị trùng
Việc đánh số tuần tự cũng có thể tạo các risk về security, … Ví dụ bài viết đang được lưu đơn giản đánh bài viết số 1,2,… Từ đó từ bên ngoài có thể đoán được và truy cập được 1 bài viết bất kì.
Lưu trữ bằng UUID
Lúc này, một cách làm khác đã thường được sử dụng là UUID (Universally unique identifier). Sẽ khó có ai có thể đoán được uuid của 1 bài viết được sinh ra ngẫu nhiên.
UUID được sinh ngẫu nhiên, tỉ lệ trùng lặp là rất thấp
Tránh được việc user tự mở 1 bài viết bất kì
Tuy nhiên nó cũng đi kèm một số nhược điểm quan trọng
UUID dài. Để lưu trữ 1 uuid, thông thường ta cần tới 16 byte. Nó tốn dữ liệu hơn nhiều trong database so với lưu số thông thường. Sau này, khi ta sử dụng các database quan hệ giữa nhiều bảng, việc join các cột foreign keys sẽ ngày càng lớn hơn giữa các primary key
UUID do được sinh random, nên database sẽ khó lòng index một bảng để truy vấn nhanh hơn (VD MySQL sử dụng B+ Tree, cần một trường nào đó đánh theo một dãy giá trị có thể sắp xếp được: số, …).
Một số cách làm khác
ULID (Universally Unique Lexicographically Sortable Identifier). Vẫn là 16 byte, nhưng phần đầu sẽ chứa dữ liệu của timestamp (ngày tháng), và còn lại là ngẫu nhiên. Điều này giúp xử lí việc index database, dễ sắp xếp hơn
TSID (Time-Sorted Unique Identifiers). Cũng giống với ý tưởng của ULID nhưng chỉ tốn 8 byte. Tuy nhiên chúng cũng đi kèm với 1 số tradeoff
Đi sâu vào TSID
Có nhiều cách để triển khai TSID, trong bài này mình sẽ nói về Hypersistence TSID (Thư viện OSS), cho phép tạo 1 TSID 64-bit gồm 2 phần
Vì TSID là một số 64-bit (có thể sắp xếp), ta có thể lưu nó vào database dưới dạng bigint
CREATE TABLE post (
    id bigint NOT NULL,
    title varchar(255),
    PRIMARY KEY (id)
)
Lưu ở phía Entity
@Entity
@Table(name = "post")
public class Post {

    @Id
    private Long id;

    private String title;

}
Tổng kết về TSID
Đa phần giữ được các ưu điểm của UUID như khó đoán ở phía người dùng, tạo sự phân biệt, …
Lưu trữ nhẹ hơn UUID (8 byte vs 16 byte)
Tuy nhiên TSID có thể có tỉ lệ bị sinh ra ngẫu nhiên trùng cao hơn do chỉ có 22bit ngẫu nhiên (xác suất sinh trùng là 0.3%)
Xử lí việc sinh trùng, bạn có thể thêm số lần retry để tự động sinh lại nếu xảy ra collision
Khi nào nên sử dụng TSID
Phần ID có thể expose cho phía client người dùng, ví dụ như id bài viết, video, …. còn các bảng phụ hỗ trợ liên quan có thể cứ dùng dạng số để thuận tiện và tiết kiệm
Các database expose cho người dùng, cần tính đến việc scale lâu dài, và tiết kiệm
Getter, Setter là các method để lấy dữ liệu và cập nhật dữ liệu cho các trường của 1 class
Như ví dụ trên, thay vì viết
Account taiKhoan;
taiKhoan.ID = 10;
//Thay vì viết như trên để cập nhật dữ liệu cho một object Account có ID thành 10, ta sẽ viết rằng

taiKhoan.setID(10);
Tại sao cần phải tạo ra getter, setter như vậy?
Để ngắn hơn chăng? Để đơn giản hơn? Cũng không phải, cách viết hàm trong một số trường hợp còn làm code dài hơn và khó đọc hơn là set thẳng trực tiếp, lí do thực sự là, việc này áp dụng tính chất đóng gói (encapsulation) của OOP.
Tính đóng gói (Encapsulation) từ Getter, Setter
Khi sử dụng getter, setter, ta sẽ để access cho các biến trong class thành private, và để cho các phương thức get, set là public. Lúc này, để có thể truy cập hay cập nhật dữ liệu của các biến của 1 object, ta chỉ còn 1 con đường duy nhất thông qua getter setter
Điều này giúp cho ta có thể thêm một lớp validation (xác thực) dữ liệu khi tác động đến dữ liệu của 1 object. Ví dụ, một con mèo không thể có chiều cao là 0 được, một đồ vật phải luôn có trọng lượng,….
Do lúc này, cách duy nhất để thay đổi chiều cao của con mèo chỉ có thể qua setHeight, ta luôn đảm bảo dữ liệu của chúng ta được xác minh.
Tổng kết
Việc sử dụng getter, setter và sử dụng access modifier (private) cho các biến và public cho getter/setter giúp ta đóng gói class, chỉ để lại duy nhất 1 con đường để truy cập/cập nhật
Khi chỉ còn 1 con đường, lập trình viên có thể thêm 1 lớp xác thực để tránh dữ liệu bị cập nhật xấu, sai.