3 cách thực hiện Dependency Injection (DI) và vấn đề với @Autowired trong Spring

Lời mở đầu

Khi code các ứng dụng backend bằng Java với Spring Framework, khả năng cao là bạn đã gặp qua một đoạn code sử dụng @Autowired. Tuy nhiên, nếu bạn sử dụng một số phần mềm lint để kiểm tra code, bạn có thể thấy các phần mềm sẽ cảnh báo @Autowired is deprecated (Autowired không được khuyến khích sử dụng nữa, cách làm không tốt)

image - quochung.cyou PTIT
  • Nhìn sơ qua thì đây có vẻ là một cách đơn giản và nhanh gọn để thực hiện DI qua Spring. Chỉ cần khai báo các dependency rồi thêm một annotation (@Autowired), các phần liên kết sẽ được Spring xử lí
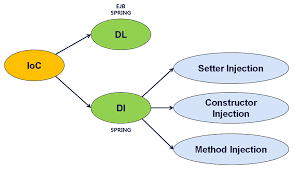
  • Tuy nhiên, cách làm phổ biến này lại có thể dẫn đến nhiều vấn đề về sau này. Hãy thử xem qua các thủ pháp DI được sử dụng qua Spring Framework và các ưu nhược điểm của chúng

3 cách thực hiện Dependency Injection trong Spring Framework

Field Injection

  • Field Injection chính là tên gọi của cách inject dependency khi ta khai báo bằng @Autowired
  • Về cơ bản khi khai báo annotation này trên 1 field, method, constructor. Spring sẽ tự tìm dependency phù hợp và kết nối chúng với nhau.
  • @Autowired về mặc định không sai, tuy nhiên nếu sử dụng không hợp lí chúng có thể gây ra một số vấn đề về sau.
  • Ví dụ với một code như sau:
image 1 - quochung.cyou PTIT
  • Khai báo một Multiplier trong Calculator nhanh chóng bằng @Autowired sẽ không báo lỗi gì khi compile, về cách hoạt động, khi chạy chương trình, Spring sẽ tự tìm kiếm dependency và kết nối chúng với nhau
  • Tuy nhiên, vì chúng tự động, nên ta thiếu kiểm soát hơn phần này. Tức là lúc này ta không có cách nào để thêm thủ công dependency nữa cho các hoàn cảnh khác ngoài lúc chạy ứng dụng (VD khi chạy test)
image 2 - quochung.cyou PTIT
  • Ví dụ như code trên sẽ không báo lỗi, tuy nhiên khi chạy test thì chúng có thể throw NullPointer
  • Lí do là ở file test trên thì chúng ta đang không có chỗ nào liên kết với Spring cả, vì vậy Spring sẽ không quản lý các bean mà ta đã tạo (Khai báo @Component ở các class kia) nên chúng sẽ không nối vào nhau được -> Ta sẽ bị null pointer vì Multiplier không được khởi tạo lên
  • Để xử lý vấn đề này, thì nếu sử dụng 2 thủ pháp DI bên dưới (Constructor Injection và Setter Injection) , ta có thể có nhiều khả năng kiểm soát hơn và thêm dependency một cách thủ công mà không qua Spring, tạo nhiều khả năng hơn cho việc test
  • Hoặc, ta có thể khai báo @SpringBootTest để Spring quản lý file test này và tự động thực hiện việc gắn các bean mà không cần gắn chay
image 20 - quochung.cyou PTIT

Setter Injection

image 3 - quochung.cyou PTIT
  • Cách làm trên như tên của nó, ta sẽ set một dependency của class lớn hơn ở thời điểm runtime
  • Cách làm này cho phép ta dễ dàng thay đổi dependency của một class trong runtime, ví dụ như đổi 1 repo khác 1 service nào đó, …
  • Tuy nhiên, ngoài ưu điểm là sự flexible khi set ở runtime, thì nó cũng đi cùng vài nhược điểm khác
  • Do được set trong runtime, ta đôi khi có thể gặp phải NullPointer khi dependency chưa được khởi tạo, là null, … (vì lúc này chúng là optional, không bắt buộc với class nữa)
  • Do nó lỏng lẻo hơn nên lúc này với các method trong class gọi đến dependency, ta không được đảm bảo là dependency đã được set, hoặc ta lại phải thêm code để kiểm tra là có dependency chưa, 1 là thêm code, 2 là dẫn tới nullpointer
image 21 - quochung.cyou PTIT
  • Với cách làm như thế này, ta có thể không cần Spring quản lý các bean mà có thể test chay hơn, có nhiều quyền kiểm soát hơn vào việc quản lý các dependency

Constructor Injection

image 4 - quochung.cyou PTIT
  • Như tên của thủ pháp, ta sẽ thêm dependency cho 1 class ngay tại thời điểm khởi tạo class cha
  • Ở file test trên, mình đang sử dụng mock để dựng class multiplier lên theo kèm để gắn vào Calculator qua constructor
  • Việc này đảm bảo 1 class luôn có đủ dependency để khởi tạo (tuỳ theo cách custom constructor)
  • Hoặc mình hoàn toàn có thể làm như thế này
image 22 - quochung.cyou PTIT
  • (Việc sử dụng mock cho phép nhiều khả năng khác trong test hơn, ví dụ mình có thể kiểm tra xem một hàm trong class đó được gọi bao nhiêu lần, … , chúng được quản lý theo dạng Proxy Design Pattern, mình sẽ nói ở bài viết khác)

Bạn có thể đọc thêm bài viết này về một số khái niệm trong Spring như IoC, Bean, …

Tham khảo:

Vấn đề khi sử dụng số hoặc UUID cho Primary Key trong database

Lưu trữ dạng số

image 23 - quochung.cyou PTIT

Đây có lẽ là cách lưu trữ thường được thấy và dễ tưởng nhất. Trường primary key sẽ đóng vai trò như số thứ tự, giúp phân biệt giữa các row khác nhau, cách lưu trữ bằng số có thể được DB tự gen bằng cách gen sequence.

  • Khá tiện quản lý, sử dụng trong tầng dữ liệu
  • Dễ hiểu, dễ đọc, dễ tìm

Điểm trừ của cách làm này là:

  • Giả sử bạn đang lưu trữ dữ liệu cho 1 tệp khách hàng, được đánh id từ 1-1000, một ngày nào đó, bạn cần migrate data từ các bảng khác, từ những bảng cũ, … (kiểu sát nhập công ty, …) và cũng có tập dữ liệu được đánh số từ 1-100, 500-1000 gì đó. Điều này làm việc sát nhập trở lên khó khăn hơn do key chính để phân biệt các hàng đã bị trùng
  • Việc đánh số tuần tự cũng có thể tạo các risk về security, … Ví dụ bài viết đang được lưu đơn giản đánh bài viết số 1,2,… Từ đó từ bên ngoài có thể đoán được và truy cập được 1 bài viết bất kì.

Lưu trữ bằng UUID

image 24 - quochung.cyou PTIT

Lúc này, một cách làm khác đã thường được sử dụng là UUID (Universally unique identifier). Sẽ khó có ai có thể đoán được uuid của 1 bài viết được sinh ra ngẫu nhiên.

  • UUID được sinh ngẫu nhiên, tỉ lệ trùng lặp là rất thấp
  • Tránh được việc user tự mở 1 bài viết bất kì
image 25 - quochung.cyou PTIT

Tuy nhiên nó cũng đi kèm một số nhược điểm quan trọng

  • UUID dài. Để lưu trữ 1 uuid, thông thường ta cần tới 16 byte. Nó tốn dữ liệu hơn nhiều trong database so với lưu số thông thường. Sau này, khi ta sử dụng các database quan hệ giữa nhiều bảng, việc join các cột foreign keys sẽ ngày càng lớn hơn giữa các primary key
  • UUID do được sinh random, nên database sẽ khó lòng index một bảng để truy vấn nhanh hơn (VD MySQL sử dụng B+ Tree, cần một trường nào đó đánh theo một dãy giá trị có thể sắp xếp được: số, …).

Một số cách làm khác

  • ULID (Universally Unique Lexicographically Sortable Identifier). Vẫn là 16 byte, nhưng phần đầu sẽ chứa dữ liệu của timestamp (ngày tháng), và còn lại là ngẫu nhiên. Điều này giúp xử lí việc index database, dễ sắp xếp hơn
  • TSID (Time-Sorted Unique Identifiers). Cũng giống với ý tưởng của ULID nhưng chỉ tốn 8 byte. Tuy nhiên chúng cũng đi kèm với 1 số tradeoff

Đi sâu vào TSID

Có nhiều cách để triển khai TSID, trong bài này mình sẽ nói về Hypersistence TSID (Thư viện OSS), cho phép tạo 1 TSID 64-bit gồm 2 phần

  • 42-bit là dữ liệu thời gian
  • 22 bit là dữ liệu random

Thêm vào maven

<dependency>
    <groupId>io.hypersistence</groupId>
    <artifactId>hypersistence-tsid</artifactId>
    <version>${hypersistence-tsid.version}</version>
</dependency>

Tạo 1 object TSID

TSID tsid = TSID.fast();

`Từ TSID, ta có thể extract ra được thời gian

image 26 - quochung.cyou PTIT
image 27 - quochung.cyou PTIT
image 28 - quochung.cyou PTIT

Sử dụng vào database

Vì TSID là một số 64-bit (có thể sắp xếp), ta có thể lưu nó vào database dưới dạng bigint

CREATE TABLE post (
    id bigint NOT NULL,
    title varchar(255),
    PRIMARY KEY (id)
)

Lưu ở phía Entity

@Entity
@Table(name = "post")
public class Post {
 
    @Id
    private Long id;
 
    private String title;
     
}

Tổng kết về TSID

  • Đa phần giữ được các ưu điểm của UUID như khó đoán ở phía người dùng, tạo sự phân biệt, …
  • Lưu trữ nhẹ hơn UUID (8 byte vs 16 byte)
  • Tuy nhiên TSID có thể có tỉ lệ bị sinh ra ngẫu nhiên trùng cao hơn do chỉ có 22bit ngẫu nhiên (xác suất sinh trùng là 0.3%)

Xử lí việc sinh trùng, bạn có thể thêm số lần retry để tự động sinh lại nếu xảy ra collision

image 29 - quochung.cyou PTIT

Khi nào nên sử dụng TSID

  • Phần ID có thể expose cho phía client người dùng, ví dụ như id bài viết, video, …. còn các bảng phụ hỗ trợ liên quan có thể cứ dùng dạng số để thuận tiện và tiết kiệm
  • Các database expose cho người dùng, cần tính đến việc scale lâu dài, và tiết kiệm

Tham khảo:

Tối ưu truy vấn Pagination (phân trang) sử dụng Spring Boot (Java)

image 4 - quochung.cyou PTIT

Phân trang là gì, tại sao cần phân trang

Phân trang đơn giản là ta sẽ chia một tập dữ liệu lớn và truyền cho user thành từng phần nhỏ hơn. Hãy tưởng tượng, bạn đang thiết kế một hệ thống backend cho phía frontend của một trang tin tức, phía FE muốn một lệnh API để có lấy dữ liệu các bài viết từ database của bạn.

image 5 - quochung.cyou PTIT

Bài toán sẽ khá đơn giản nếu bạn chỉ có 10-20 bài viết, bạn chỉ cần làm theo cách truyền thống, lấy dữ liệu từ database từ backend, gửi một file json chứa dữ liệu cho FE, mọi thứ nghe có vẻ đơn giản.

Tuy nhiên khi tập dữ liệu của ta ngày càng lớn, ví dụ, lúc này 1 Model bài viết có rất nhiều trường (ảnh đại diện, chuyên mục, thời gian đăng, ….), và ta có hàng 1000-10000 bài viết, việc trả 1 lần tập dữ liệu lớn như thế sẽ làm chậm ở 2 chỗ:

  • Lấy toàn bộ dữ liệu từ database tốn thời gian
  • Truyền 1 lần dữ liệu lớn như vậy sẽ rất nặng, tốn tiền mạng thật sự của user (tải 1 file lớn mỗi lần), và lúc tải 1 file lớn như thế cũng rất chậm, tốn thời gian, gây khó chịu người dùng

Tổng kết 1

Khi đó, ta có thể sử dụng đến phân trang, và mỗi lần người dùng chỉ có thể xem 1 trang, ta chỉ gửi khoảng 10-15 bài viết 1 lần thôi, khi người dùng sang trang khác ta sẽ gửi tập dữ liệu khác, khá đơn giản.

Triển khai phân trang bằng Spring Boot

Triển khai Model

image 6 - quochung.cyou PTIT

Triển khai Repository

Để có thể truy cập các JPA Entity trên từ database, ta sẽ tạo 1 PostRepository

image 7 - quochung.cyou PTIT

JPARepository đã kế thừa sẵn một interface là PagingAndSortingRepository của Spring hỗ trợ việc phân trang và sắp xếp. Dù là một interface, không có implemention, nhưng khi chương trình khởi chạy, Spring sẽ tự động generate các code implemention thật cho chúng ta, thực thi các thao tác với database, và chúng ta chỉ cần define các method có sẵn thôi.

Phân trang

Do Spring đã làm đa số các phần code, giờ ta chỉ cần triển khai thêm 2 việc

  • Tạo một PostPageRequest class, implement từ Pageable interface của Spring
  • Truyền tham số cần tìm cho PostPageRequest
image 9 - quochung.cyou PTIT

Khi implement interface Pageable, ta sẽ phải triển khai một số hàm. Lúc này class PostPageRequest sẽ như một object “trang” , kiểu trang 5 thì là một object Trang, trang 6 là một object khác. Từ object trang đó ta có thể lấy trang tiếp theo, trang phía trước, các bài viết trong trang,….

offset và limit

Bạn có thể thấy trong code trên có các tham số offset và limit. Hai tham số trong sql có ý nghĩa như sau

  • offset x : Lùi x kết quả từ dãy kết quả trả ra
  • limit y: Từ danh sách kết quả trả ra, lấy y kết quả đầu tiên.
  • Ví dụ: ta có các bài viết đánh số từ 1-100. offset 5 thì ta sẽ có danh sách là 6-100. limit tiếp 10 thì ta có danh sách 6-16…

Nếu bạn đã hiểu định nghĩa offset và limit, hãy thử đọc lại code bên trên, bạn sẽ dễ dàng hiểu được các method lấy trang tiếp theo, lấy trang trước, …. đang làm gì.

image 10 - quochung.cyou PTIT

Tổng kết 2

Như vậy, ta đã triển khai được phân trang bằng Spring Boot, tuy nhiên liệu như vậy đã tối ưu cho trang web của bạn chưa?

Tối ưu limit và offset trong MySQL

image 11 - quochung.cyou PTIT
image 12 - quochung.cyou PTIT
OffsetQuery Duration (ms)
01
501
100013
10000150
25000500
50000930
1000001750

Những biểu đồ và bảng

Ta có thể thấy, bằng việc dùng offset để lùi kết quả đi một đoạn, rồi lấy limit để lấy lượng bài ở trang đó nghe có vẻ rất đơn giản, dễ hiểu. Nhưng thực tế trong MySQL chúng được thực hiện như sau:

…the rows are first sorted according to the <order by clause> and then limited by dropping the number of rows specified in the <result offset clause> from the beginning…

…các dòng đầu tiên được sắp xếp (ví dụ theo id, thời gian đăng bài…) sau đó xóa x hàng đầu tiên được yêu cầu khi sử dụng offset
image 13 - quochung.cyou PTIT

Nếu bạn nghĩ kĩ, câu lệnh offset chỉ nhận đúng 1 tham số: lượng dòng bị bỏ qua cho đến tập kết quả muốn nhận.

Cách duy nhất hệ thống database có thể làm điều này là lấy toàn bộ dữ liệu cần tìm, sau đó ném đi x hàng đầu bạn đã đặt ra yêu cầu. Khi offset đủ lớn, lượng công việc cho database sẽ rất nhiều và thời gian để truy vấn sẽ tăng khó kiểm soát.

Khi sử dụng offset, ta mở trang đầu tiên, trang thứ 2, thời gian mất chỉ 1ms (1 phần nghìn giây), gần như không có vấn đề gì.

Trang thứ 10000, 150ms, vẫn chưa nhận ra điều gì quá lo ngại

100000 1750ms, 1,75 giây.

Ta có thể thấy, nếu người dùng mở 1 trang càng xa, hiệu suất của trang sẽ càng giảm, việc một user mở trang thứ 10000 có thể gây vấn đề hiệu năng hơn nhiều cho database hơn 100 người dùng khác mở trang 1

Hướng khắc phục

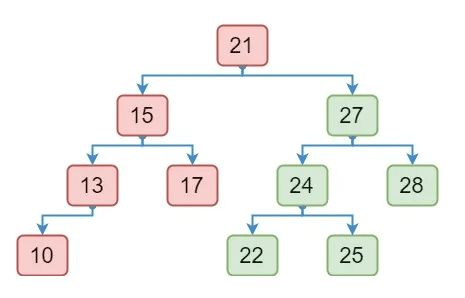
Trước hết, ta cần tìm hiểu xem những hệ quản trị cơ sở dữ liệu đang làm gì để sắp xếp dữ liệu của chúng ta. Ta sẽ assume hệ cơ sở dữ liệu đang sử dụng một B-Tree để index database (một bản nâng cấp của cây nhị phân cân bằng).

Nếu bạn chưa từng nghe đến cụm từ trên, bạn có thể tìm hiểu ở link sau:

Lúc này database của chúng ta lưu dữ liệu theo dạng như sau:

image 14 - quochung.cyou PTIT

Khi ta sử dụng offset 0, limit 5 để lấy 5 bài viết đầu tiên chẳng hạn, database sẽ chạy các kết quả sau

SELECT * FROM my_table ORDER BY id LIMIT 5
image 15 - quochung.cyou PTIT

Tuy nhiên, với offset, sau khi offset 5 và limit 5, ta có

image 16 - quochung.cyou PTIT

Như vậy, ta phải đi qua 5 cái đầu trước, bỏ dần nó, rồi sau đó mới limit 5 cái sau. Khá là tốn thời gian

Vấn đề: Database không biết điểm khởi đầu của trang tiếp theo ở đâu, vì vậy nó cứ phải bỏ dần các hàng phía trước cho đến khi đến được vị trí chỉ định

=> Khắc phục: Ta nhớ xem vị trí lần cuối là ở đâu ?

Kĩ thuật: keyset pagination and seek method

Ở một số trang web, bạn sẽ thấy, bạn không thể đi đến thẳng trang cuối, hoặc nhảy đến 1 trang bất kì, mà thông thường sẽ có nút để sang trang kế và trang phía trước. Như vậy ta có thể assume rằng:

Người dùng sẽ chỉ mở trang 10 sau khi mở trang 9.

Vậy, ta chỉ cần nhớ vị trí cuối cùng của bài viết ở trang 9 là ở id bao nhiêu, rồi dùng WHERE để truy vấn từ điểm đó, chứ không cần bỏ dần để đi đến điểm đó nữa
SELECT * FROM my_table WHERE id > 21 ORDER BY id LIMIT 5
image 17 - quochung.cyou PTIT

Ví dụ: Sort theo thời gian

SELECT *
FROM my_table
WHERE (update_date = '2017-12-21' AND id > 21) 
    OR update_date > '2017-12-21'
ORDER BY update_date,id LIMIT 5

Cơ bản là ta sẽ chỉ lấy các bài viết có cùng thời gian đăng như bài viết cuối và id > , hoặc thời gian lớn hơn bài viết cuối

image 18 - quochung.cyou PTIT

Tổng kết

  • Phương pháp keyset pagination and seek giúp tối ưu việc phân trang cho các bài toán lớn hơn rất nhiều (Tham khảo biểu đồ trên)
  • Triển khai trong Java (JPA/Hibernate)

Tuy nhiên, phương pháp này sẽ có thêm các vấn đề sau

  • Ta cần thay đổi lại code của hệ thống để triển khai phương pháp này, cần phải nhớ hàng cuối cùng hiện tại, làm code phức tạp hơn, khó quản lí hơn
  • Cần phải index database theo id, pubdate, ….
  • Các hàng tìm kiếm cần được sắp xếp, không được null
  • Không thể đi trực tiếp đến trang 500,1000,… được, mà chỉ có thể sang trang kế tiếp do ta cần nhớ điểm cuối từ trang phía trước

Có thể tham khảo thêm Spring HateOAS hỗ trợ thêm vấn đề này

Các nguồn tham khảo: