Same-origin policy (SOP) và Cross-Origin Re-source Sharing (CORS)

Same Origin Policy (SOP)

image 23 - quochung.cyou PTIT
  • Đôi khi, khi thực hiện các lệnh trong Javascript, bạn có thể gặp một lỗi như thế này
  • “Access to fetch at xxx from origin null has been blocked by CORS policy: Response to preflight request doesn’t pass access control check: No ‘Access-Control-Allow-Origin’ header is present on the requested resource. If an opaque response serves your needs, set the request’s mode to ‘no-cors’ to fetch the resource with CORS disabled.
image 22 - quochung.cyou PTIT
  • Mặc định thì, trình duyệt chỉ cho phép JavaScript gửi các HTTP request về phía server ở “cùng một nguồn – same origin” với chỗ mà script được load. Điều này được quy định bởi same-origin policy (SOP) – quy tắc 1 nguồn, đây là một tảng đá quan trọng trong bảo mật ứng dụng web.
  • Nguồn của 1 trang web là tổng hợp bởi protocol, địa chỉ máy chủ, cổng của url. Nếu không có cổng thì cổng mặc định sẽ được dùng (http thì là 80, https là 443). Ví dụ: url https://www.google.com/search có protocol là https, địa chỉ máy chủ là www.google.com và cổng port là 443. Hai url được gọi là cùng nguồn (same origin) nếu protocol, host và port đều giống nhau
  • Điều này giúp web được bảo mật hơn, vì các dữ liệu đều đảm bảo chỉ đến từ nguồn ta đang truy cập.

Vấn đề giả định

  • Thông thường, bất kì request nào của chúng ta đều chứa các cookie. Ở các website hiện đại, các cookie này thường chứa các thông tin bảo mật, ví dụ như thông tin tài khoản mật khẩu, … Ví dụ bạn vào 1 website nào đó, sau khi đăng nhập và lần sau vào lại trang bạn không cần đăng nhập nữa, vì trình duyệt đã nhớ thông tin đó ở đâu đó để không cần nhập lại nữa. (Điều này sẽ phức tạp hơn, nhưng sẽ không đi sâu ở đây).
  • Điều này dẫn đến 1 việc, khi bạn vào trang https://hacker.com chẳng hạn, trang này sẽ tự động gửi 1 request khác sang https://nganhang.com, request này lại đang chứa hết cookie, hay các thông tin của bạn. Và hacker.com có thể đọc trộm được thông tin của bạn khi request trả về.
  • ĐIều này có thể được sửa chữa bằng Same Origin Policy bên trên, hoặc SameSite=Strict trong cookie, bắt buộc 1 request khi gửi sang 1 server khác, thì chỉ đang chạy trên web đó. (tức là ở nganhang.com mới được gửi request gì chứa thông tin sang nganhang.com) để bảo mật
  • Tuy nhiên, giả sử bạn đang làm 1 hệ thống thông tin thời tiết ở web thoitiet.com, và bạn muốn bạn bè mình ở các trang như baochi.com, quochung.com có thể gọi tới lấy thông tin thì lại không được. Điều đó dẫn ta tới CORS

Cross-Origin Re-source Sharing (CORS)

image 24 - quochung.cyou PTIT
  • Tuy nhiên, trang web chúng ta ngày càng mở rộng, ta không chỉ xuất dữ liệu từ 1 trang tĩnh duy nhất nữa. Có thể ta muốn gọi api để lấy dữ liệu từ một trang báo gì đó để hiển thị trên trang của mình, ta cần lấy dữ liệu về số ca mắc covid 19 từ đâu đó, ta cần lấy thông tin thời tiết, … Lúc này ta sẽ đi đến lí thuyết CORS.
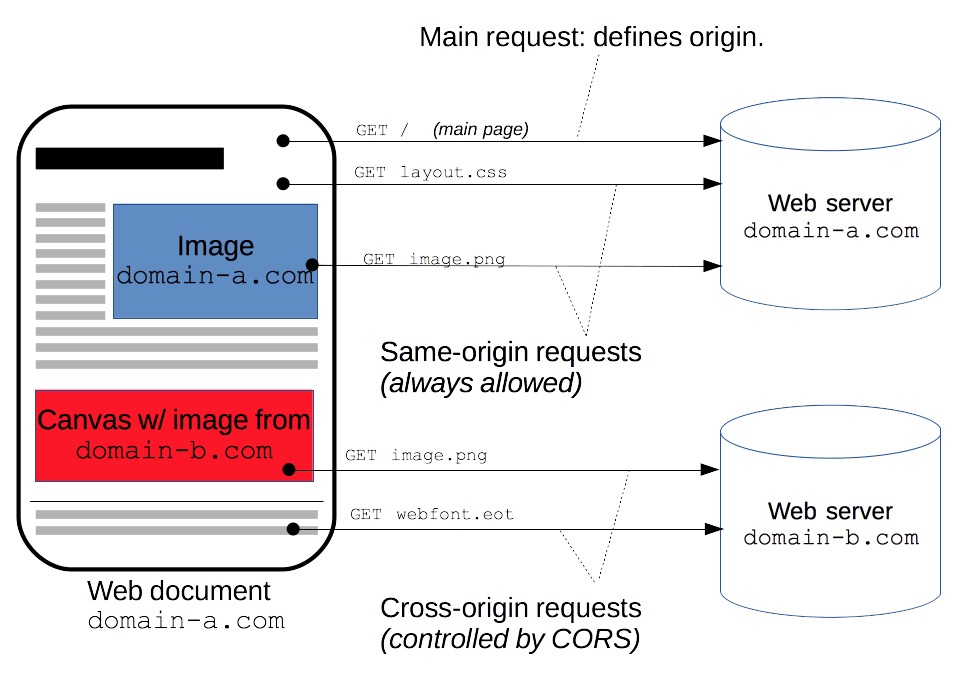
image 16 - quochung.cyou PTIT

Preflight requests

  • Hiểu đơn giản, CORS là một số quy định ta có thể cài đặt ở phía nhận dữ liệu, để thông báo là: tôi cho phép ông A, ông B lấy dữ liệu, vì ông này web nhà tôi, còn các ông C, D, E thì không
  • Lúc này, phía client sẽ gửi trước một “preflight request” để xem, liệu mình có quyền được truy cập dữ liệu hay không.
  • Định nghĩa: Preflight request là một request sẽ xảy ra do “bình thường” thì trình duyệt sẽ chặn các requets vi phạm SOP. Lúc này trình duyệt sẽ thực hiện 1 request OPTIONS tới server để xem request có được cho phép hay không. Server có thể deny hoặc allow request với một số limit về headers và method (ví dụ như method nào được dùng, header phải thế nào, …)
image 15 - quochung.cyou PTIT
  • Phía Server sẽ phản hồi bằng cách gửi về 1 request với header chứa thông tin rằng các thông số cross-origin như nào thì sẽ được chấp nhận. Nếu như request ban đầu không match với các điều kiện từ phía server, hoặc server không phản hồi 1 CORS header nào, trình duyệt sẽ chặn và k gửi request.

CORS Header

CORS headerResponseDescription
Access-Control-Allow-OriginBothChỉ ra origin, hay nguồn nào được phép gửi request, để * để cho phép mọi nguồn
Access-Control-Allow-HeadersPreflightCho phép các header nào được chấp thuận ở request thật, để * để cho phép mọi header
Access-Control-Allow-MethodsPreflightHTTP method nào được chấp thuận, để * để cho phép mọi method
Access-Control-Allow-CredentialsBoth Chỉ ra trình duyệt có được chứa thông tin tài khoản trong request không, thông tin có thể là basic authentication, browser cookie, hoặc chứng chỉ TLS phía client. Nếu là “true” thì các header khác không được để *
Access-Control-Max-AgePreflightChỉ ra lượng thời gian (tính bằng giây) để trình duyệt cache phản hồi cors. Thường trình duyệt sẽ lưu khoảng 24 tiếng, chrome là 10 phút. Phần này chỉ áp dụng cho header và http method cho phép.
  • Both tức là header này có thể tồn tại ở các phản hồi từ server khi nhận request thực sự (actual) và cả request preflight. còn nếu là actual tức là header chỉ tồn tại ở phản hồi từ server khi nhận actual request (request thật), preflight nghĩa là header chỉ tồn tại ở phản hồi từ server khi nhận preflight request.

Tham khảo:
3 cách thực hiện Dependency Injection (DI) và vấn đề với @Autowired trong Spring

Lời mở đầu

Khi code các ứng dụng backend bằng Java với Spring Framework, khả năng cao là bạn đã gặp qua một đoạn code sử dụng @Autowired. Tuy nhiên, nếu bạn sử dụng một số phần mềm lint để kiểm tra code, bạn có thể thấy các phần mềm sẽ cảnh báo @Autowired is deprecated (Autowired không được khuyến khích sử dụng nữa, cách làm không tốt)

image - quochung.cyou PTIT
  • Nhìn sơ qua thì đây có vẻ là một cách đơn giản và nhanh gọn để thực hiện DI qua Spring. Chỉ cần khai báo các dependency rồi thêm một annotation (@Autowired), các phần liên kết sẽ được Spring xử lí
  • Tuy nhiên, cách làm phổ biến này lại có thể dẫn đến nhiều vấn đề về sau này. Hãy thử xem qua các thủ pháp DI được sử dụng qua Spring Framework và các ưu nhược điểm của chúng

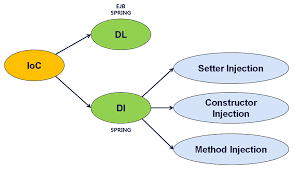
3 cách thực hiện Dependency Injection trong Spring Framework

Field Injection

  • Field Injection chính là tên gọi của cách inject dependency khi ta khai báo bằng @Autowired
  • Về cơ bản khi khai báo annotation này trên 1 field, method, constructor. Spring sẽ tự tìm dependency phù hợp và kết nối chúng với nhau.
  • @Autowired về mặc định không sai, tuy nhiên nếu sử dụng không hợp lí chúng có thể gây ra một số vấn đề về sau.
  • Ví dụ với một code như sau:
image 1 - quochung.cyou PTIT
  • Khai báo một Multiplier trong Calculator nhanh chóng bằng @Autowired sẽ không báo lỗi gì khi compile, về cách hoạt động, khi chạy chương trình, Spring sẽ tự tìm kiếm dependency và kết nối chúng với nhau
  • Tuy nhiên, vì chúng tự động, nên ta thiếu kiểm soát hơn phần này. Tức là lúc này ta không có cách nào để thêm thủ công dependency nữa cho các hoàn cảnh khác ngoài lúc chạy ứng dụng (VD khi chạy test)
image 2 - quochung.cyou PTIT
  • Ví dụ như code trên sẽ không báo lỗi, tuy nhiên khi chạy test thì chúng có thể throw NullPointer
  • Lí do là ở file test trên thì chúng ta đang không có chỗ nào liên kết với Spring cả, vì vậy Spring sẽ không quản lý các bean mà ta đã tạo (Khai báo @Component ở các class kia) nên chúng sẽ không nối vào nhau được -> Ta sẽ bị null pointer vì Multiplier không được khởi tạo lên
  • Để xử lý vấn đề này, thì nếu sử dụng 2 thủ pháp DI bên dưới (Constructor Injection và Setter Injection) , ta có thể có nhiều khả năng kiểm soát hơn và thêm dependency một cách thủ công mà không qua Spring, tạo nhiều khả năng hơn cho việc test
  • Hoặc, ta có thể khai báo @SpringBootTest để Spring quản lý file test này và tự động thực hiện việc gắn các bean mà không cần gắn chay
image 20 - quochung.cyou PTIT

Setter Injection

image 3 - quochung.cyou PTIT
  • Cách làm trên như tên của nó, ta sẽ set một dependency của class lớn hơn ở thời điểm runtime
  • Cách làm này cho phép ta dễ dàng thay đổi dependency của một class trong runtime, ví dụ như đổi 1 repo khác 1 service nào đó, …
  • Tuy nhiên, ngoài ưu điểm là sự flexible khi set ở runtime, thì nó cũng đi cùng vài nhược điểm khác
  • Do được set trong runtime, ta đôi khi có thể gặp phải NullPointer khi dependency chưa được khởi tạo, là null, … (vì lúc này chúng là optional, không bắt buộc với class nữa)
  • Do nó lỏng lẻo hơn nên lúc này với các method trong class gọi đến dependency, ta không được đảm bảo là dependency đã được set, hoặc ta lại phải thêm code để kiểm tra là có dependency chưa, 1 là thêm code, 2 là dẫn tới nullpointer
image 21 - quochung.cyou PTIT
  • Với cách làm như thế này, ta có thể không cần Spring quản lý các bean mà có thể test chay hơn, có nhiều quyền kiểm soát hơn vào việc quản lý các dependency

Constructor Injection

image 4 - quochung.cyou PTIT
  • Như tên của thủ pháp, ta sẽ thêm dependency cho 1 class ngay tại thời điểm khởi tạo class cha
  • Ở file test trên, mình đang sử dụng mock để dựng class multiplier lên theo kèm để gắn vào Calculator qua constructor
  • Việc này đảm bảo 1 class luôn có đủ dependency để khởi tạo (tuỳ theo cách custom constructor)
  • Hoặc mình hoàn toàn có thể làm như thế này
image 22 - quochung.cyou PTIT
  • (Việc sử dụng mock cho phép nhiều khả năng khác trong test hơn, ví dụ mình có thể kiểm tra xem một hàm trong class đó được gọi bao nhiêu lần, … , chúng được quản lý theo dạng Proxy Design Pattern, mình sẽ nói ở bài viết khác)

Bạn có thể đọc thêm bài viết này về một số khái niệm trong Spring như IoC, Bean, …

Tham khảo:

[Phần 1] Sự phát triển của các mô hình hệ thống Backend (N-layered, DDD, Hexagon, Onion, Clean Architecture)

Chương 1: Nơi mọi thứ bắt đầu

Vào những ngày đầu tiên thuở sơ khai, chưa có một “mô hình hệ thống” hay “architecture” nào tồn tại cả. Giang hồ lúc này mạnh ai nấy làm, bạn chỉ cần biết GoF Pattern thì có thể tự xưng bá một phương, là một “architect”, một lập trình viên dày dặn trong nghề.

Thời gian thắm thoắt thoi đưa, từ những cái máy tính to bằng cả cái phòng, từ những chiếc ổ cứng dày cộp chỉ chứa vài MB, công nghệ ngày càng phát triển, máy tính dần thu gọn hơn, ngày càng mạnh mẽ hơn, tiếp cận đến nhiều người hơn. Lúc này, yêu cầu của người dùng ngày càng tăng chóng mặt, khiến cho độ phức tạp của các phần mềm gia tăng.

Thứ đầu tiên những cao thủ trong ngành tạo ra là (Tách UI ra khỏi các logic bussiness), từ hình thái này, các mô hình MVC đầu tiên đã được ra đời:

image - quochung.cyou PTIT

Hiểu một cách đơn giản, hãy nghĩ đến ứng dụng Facebook và website Facebook. Liệu các câu lệnh như: lấy dữ liệu các bài viết người dùng mới nhất, lấy dữ liệu của 1 trang profile có khác biệt về mặt logic khi ở trên điện thoại hay trên web? Câu trả lời là không, điểm duy nhất khác biệt chỉ là UI hay View (phần hiển thị với người dùng)

Việc tách biệt UI ra khỏi Logic giúp ứng dụng modun hoá hơn, ta có thể dùng chung 1 logic, và khi cần hiển thị trên 1 sản phẩm khác: web, điện thoại, màn hình tivi, màn hình ô tô, … , ta chỉ cần nối phần UI của thiết bị đó với các logic đã chìa ra là được.

Nghe có vẻ như vấn đề đã được giảm bớt 1 chút. Nhưng chưa phải là tất cả, lúc này View có thể chỉ là vài tấm ảnh, một cái nút, Controller sẽ là người ở giữa trung chuyển các câu lệnh, và phần lớn logic bị dồn xuống Model, nơi thường xuyên phải lưu dữ liệu vào database, file, … hay nhìn chung là trực tiếp vào các “đối tượng” của chúng ta.

Chương 2: 2002 – N-Layered (Cấu trúc xếp chồng N tầng)

Một mô hình “lí tưởng” không tồn tại, cũng như mọi thứ, chúng đều là thành quả của nhiều lần thử nghiệm, và được rút kinh nghiệm rất nhiều lần.

Một lập trình viên đã tiên phong trong việc tạo ra một mô hình hệ thống, góp phần ảnh hưởng lớn đến rất nhiều thế hệ lập trình viên sau này tên là Martin Fowler.

image 1 - quochung.cyou PTIT

Ông đã cho ra đời cuốn “Patterns of Enterprise Application Architecture” (Cách thực hiện một mô hình ứng dụng phục vụ cho doanh nghiệp), nơi mà ông đã nói về cấu trúc N-Layered

1 pd5bfxtxV9AK0 QlIOK6Vw - quochung.cyou PTIT

Ý tưởng khá đơn giản, ta sẽ phân loại và nhóm các phần code liên quan đến nhau lại thành “1 tầng”, khi đó ta sẽ có nhiều tầng xếp chồng lên nhau.

Tuy nhiên, Fowler cũng biết việc không nhất quán sẽ xảy ra nếu cứ mỗi ông lập trình viên lại xếp các tầng một cách vô tổ chức, ông đã thêm một số “quy tắc” nhỏ góp phần đồng bộ:

  • Bạn có thể đặt tên một layer – tầng là gì cũng được
  • Bạn có thể có bao nhiêu layer tuỳ thích
  • Bạn có thể thêm một layer ở giữa các layer thường có
  • Bạn có thể có nhiều thành phần trong 1 layer
  • Quan trọng là: cần có một hệ thống cấp bậc rõ ràng giữa các layer, chúng nên gọi đến nhau theo từng cấp một.
1 0Kq2jEHDWcfdeorqKPdYFQ - quochung.cyou PTIT

Điều này đã giúp các ứng dụng giảm bớt các code trùng lặp, và cũng làm cho code có một cấu trúc rõ ràng.

Thông thường đa số ứng dụng chỉ cần 3 tầng là đã có thể phục vụ các nhu cầu cơ bản

image 4 - quochung.cyou PTIT
  • User Interface (UI) — chịu trách nhiệm tương tác với người dùng (giao diện)
  • Business logic layer (BLL)— Xử lí các logic chính của hệ thống
  • Data Access layer (DAL) — Là tầng giao tiếp với dữ liệu như database, …
image 5 - quochung.cyou PTIT
  • Bạn có thể thấy trong các video hướng dẫn làm các dự án backend bằng Spring Boot, người ta thường có một 1 tầng Service (Bussiness), sau đó mới gọi xuống tầng Repository (Data Access), nơi mà giao tiếp trực tiếp với database.
  • Các tầng sẽ gọi đến nhau qua các interface, ví dụ: có một interface là OrderRepository phục vụ lấy dữ liệu từ db. Lúc này, tầng bussiness chỉ cần quan tâm sẽ thực hiện các giao thức lấy dữ liệu của interface này, còn logic thực sự ở tầng data access sẽ được ta viết từ các class implement interface trên.
  • => Ví dụ: ta có 1 interface OrderRepository. ta có 2 class khác implement interface trên là OrderRepositoryImplMongo, OrderRepositoryImplMySQL. Do cả 2 cùng implement orderrepo, nên từ bussiness ta có thể dễ dàng lắp một class khác cho 1 database khác, thuận tiện cho việc xử lí. (Bạn có thể đọc thêm Dependency Injection)
image 6 - quochung.cyou PTIT

Chương 3: 2003 – Domain Driven Design (DDD)

Tưởng chừng N-Layered đã có thể xử lí được các vấn đề hiện tại, tên tuổi của Fowler sẽ được ghi tên vào sử sách. Nhưng vào năm 2003, một anh tài trong giang hồ, một lập trình 46 tuổi đến từ Boston, Eric Evans đã công bố một cuốn sách “Domain-Driven Design: Tackling Complexity in the Heart of Software” (Domain Driven Design: Xử lí sự phức tạp cốt lõi của phần mềm). Cuốn sách đã khiến 1 anh chàng Martin nào đó trên thế giới phải cất poster và khóc.

image 7 - quochung.cyou PTIT

Nhìn chung thì Evans vẫn đồng ý với đa số các ý tưởng của N-Layered, đó là sự kế thừa của hệ thống chỉ nên đi theo 1 hướng (các tầng gọi nhau lần lượt từ trên xuống dưới).

Tuy nhiên ông cho rằng, cũng không tệ lắm nếu một module bậc thấp (tầng bên dưới) có thể gọi lên module bậc cao ở tầng cao hơn. Miễn là nó không phá vỡ hướng đi kế thừa của hệ thống (dependency direction). Điều này có thể làm được bằng callback, hoặc một số design pattern như observer, ….

Ông cũng cho rằng, các Controller thường bị lắp quá nhiều logic, nên ông đã chuyển chúng sang 1 layer khác tên là Application. Ông cũng cho rằng tầng Bussiness logic nên được chú trọng nhiều hơn là tầng database (data access). Nhưng nhìn chung cấu trúc cũng không thay đổi nhiều lắm.

image 8 - quochung.cyou PTIT

Ở cấu trúc của ông, một hệ thống được quy định như sau:

  • Presentation Layer — tầng “trình bày”, tương tác với bên ngoài.
  • Application Layer — Nhận và điều phối các yêu cầu, sau đó chuyển qua tầng Domain.
  • Domain Layer — Chứa các chức năng chính của hệ thống.
  • Infrastructure Layer — Xử lí dữ liệu (tương tự tầng data access)

Bạn có thể thấy ông đã đổi tên một số tầng tưởng chừng như có chung mục đích, nhưng chúng có nguyên do của nó. User Interface thường có ý nghĩa là bạn có một user người dùng nào đó, nhưng không phải lúc nào cũng vậy. Đôi khi ta có một GUI (Graphical User Interface – Giao diện người dùng) cho users, nhưng cũng có thể là 1 CLI (Command Line Interface – Giao diện cmd) cho lập trình viên, hay có thể là API (Application Programming Interface) cho các ứng dụng khác gọi vào. Tầng Presentation thì sẽ “Generic” , chung chung hơn, bao quát hơn.

Business logic thì nghe có vẻ hơi trừu tượng cho đội lập trình viên, vì chúng ta thường không thiên về mảng kinh tế, vì vậy ông đã tạo ra 1 tên mới “Domain – miền”

Ở tầng dưới cùng, đôi lúc, ta không chỉ lưu dữ liệu vào ram, vào database hay đâu đó. Mà có thể ta muốn nó sẽ gọi đến chỗ khác, kiểu gửi 1 email, 1 tin nhắn zalo, … nên chúng được gộp chung thành tầng Infrastructure (Hạ tầng).

Nhìn chung là thế, một số sự thay đổi tên, thêm 1 layer mới, có một số phần khác đã được thêm vào tầng Domain. Và đó là DDD – Domain Driven Design.


Tham khảo:

Kiến trúc Stateful và Stateless là gì?

image 45 - quochung.cyou PTIT

Lời mở đầu

  • Trong khoa học máy tính, “state” nghĩa là một trạng thái của hệ thống, của một thành phần hoặc ứng dụng của chúng ta tại một điểm thời gian
  • Ví dụ: Bạn đang mua hàng trong amazon.com, ta có thể coi việc bạn “đang đăng nhập” là một trạng thái, “đang có hàng trong giỏ” là một trạng thái, ….
  • Trạng thái biểu diễn dữ liệu đang được lưu trữ, và giúp chúng ta kiểm soát hiện trạng hiện tại của ứng dụng.

Kiến trúc Stateful

  • Tưởng tượng bạn đến một cửa hàng pizza để ăn. Hiện tại quán chỉ có 1 phục vụ bàn, phục vụ bàn sẽ lấy các note từ bàn của bạn, bạn order gì, hay là những món bạn trước đây từng ăn, bạn có dị ứng gì không, …
image 46 - quochung.cyou PTIT
  • Tất cả những thông tin trên sẽ được phục vụ bàn ghi lại về một “state” hay trạng thái của khách hàng. Chỉ có phục vụ bàn có những thông tin này, nếu bạn dạo này thích ăn món gì đó khác hơn, hoặc bị dị ứng gì đó mới, bạn cần cập nhật đúng với phục vụ này để thay đổi. Nhưng mà cả quán chỉ có 1 phục vụ nên bạn không lo nhầm người.
  • Tưởng tượng rằng, quán ăn có đông khách hơn, và phục vụ phải phục vụ rất nhiều khach. Quán cần nhiều phục vụ hơn, tuy nhiên lúc này, nếu bạn muốn đổi khẩu vị hay món khác, thì nếu bạn chọn người phục vụ khác sẽ không được.
image 47 - quochung.cyou PTIT
  • Những nhân viên phục vụ khác thì chẳng có thông tin gì về state của bạn cả. Họ không thể đổi đơn hàng của bạn, hay đọc chúng. Nếu một nhà hàng hoạt động theo kiểu như vậy, tức là chỉ 1 phục vụ có thông tin của bạn, sẽ được gọi là cấu trúc stateful
  • Tưởng tượng về dạng server, một hệ thống stateful sẽ chỉ có 1 server duy nhất ghi nhớ dữ liệu của người dùng. Toàn bộ các request, làm việc sau này của 1 khách hàng sẽ chỉ được điều hướng vào người đó qua các trình load balancer (cân bằng tải) với 1 sticky session. Một server sẽ luôn biết client của mình là ai.
image 48 - quochung.cyou PTIT

  • Sticky session (phiên được ghim) là một cài đặt cho phép cân bằng tải (load balancer) điều hướng các request của người dùng đến riêng 1 server duy nhất trong quá trình 1 phiên của họ. (1 phiên có thể kết thúc khi người dùng tắt browser, tắt máy, sau 1 ngày, …)
  • Điều này đi ngược lại với cách cân bằn gtari truyền thống, khi mà request của bạn được phân bổ đến các server khác nhau bằng round-robin hoặc các cách phân bổ khác. (kiểu phân bổ dần 1->2->3->4 rồi lại quay về 1 theo thứ tự request, hoặc phân bổ random, …)
  • Cách làm trên nghe có vẻ khá ổn với các hệ thống nhỏ. Tuy nhiên, thế giới chúng ta không lý tưởng. Giả sử, nếu 1 server bị chết, bị dồn quá tải, … thì toàn bộ thông tin của người dùng với server đó sẽ mất hết, điều này hoàn toàn không ổn chút nào.
  • Hơn nữa, việc phân bổ dữ liệu như vậy cũng không tốt trong nhiều trường hợp. Ví dụ, có một số client gửi rất nhiều request, khiến cho 1 server bị quá tải, trong khi vài server khác lại chỉ có vài request nhỏ, khiến việc cân bằng chung không ổn.

Kiến trúc Stateless

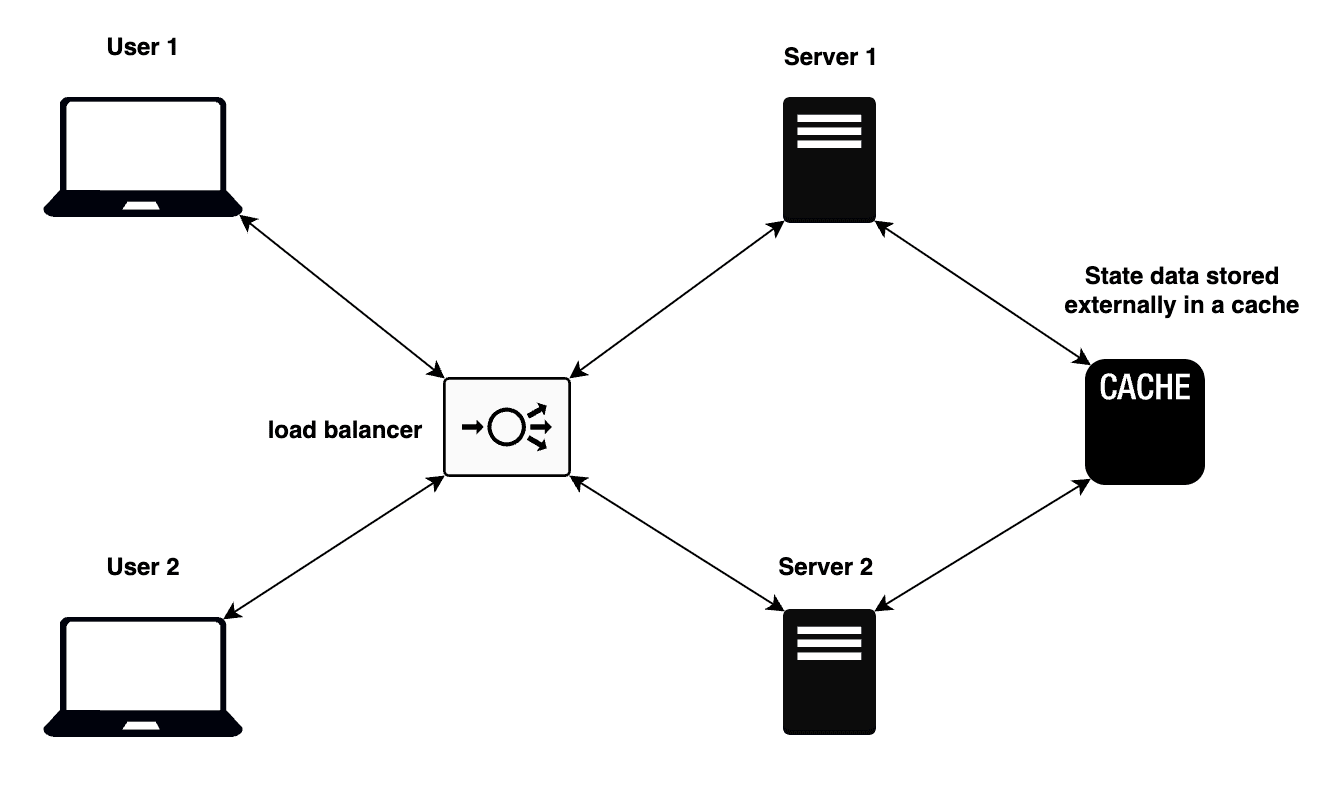
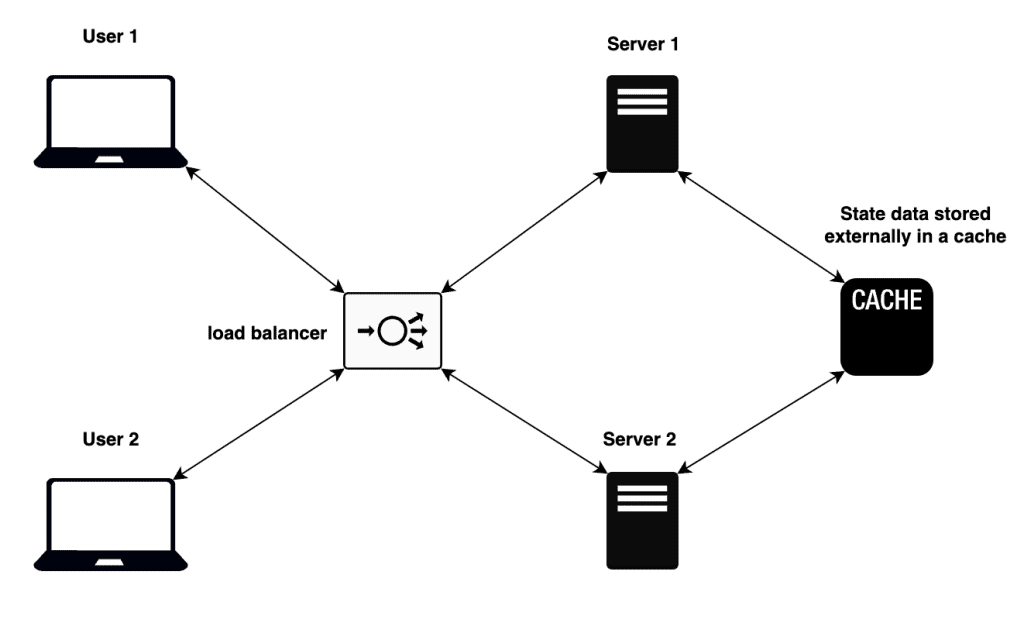
  • Kiến trúc stateless, dịch thuần tiếng anh là (không có state). Không hẳn là không có state, mà lúc này các server – hay vị phục vụ bàn sẽ không trực tiếp nhớ xem là khách hàng order gì, thông tin như nào, mà thay vì đó, họ sẽ dùng một phần mềm gì đó, một điện thoại, một tờ giấy chung để ghi thông tin khách hàng. Khi đó, nếu phục vụ khác đến, họ chỉ cần đọc tờ giấy lưu trữ chung để xem khách hàng muốn gì.
image 49 - quochung.cyou PTIT
  • Bằng việc lưu các trạng thái của khách hàng ở một hệ thống chung nào đó, có thể truy cập bởi mọi phục vụ/server, server nào cũng có thể phục vụ chung 1 khách hàng.
  • Nhìn về khoa học máy tính, lúc này ta có thể phân bổ request của người dùng đến server bất kì, việc dữ liệu của người dùng có thể lưu ở 1 database nào đó khác biệt, có thể truy cập bằng mọi server.
  • Việc cân bằng tải cũng tốt hơn, vì lúc này ta có thể chọn các server sđang ít khách phục vụ, hoặc đánh theo tuần tự, …
image 50 - quochung.cyou PTIT

Tổng kết

  • Nhìn chung, stateless mang lại tính mở rộng lâu dài và ổn định tốt hơn stateful
  • Stateless/stateful không chỉ là cách thiết kế server, cân bằng tải như ví dụ trên. Mà có thể áp dụng vào các design pattern, các hàm trong code, ….

Tham khảo:
[Tìm hiểu React – Phần 1] Tại sao React ra đời

image 32 - quochung.cyou PTIT

Tại sao lại cần React? Viết bằng Javascript thuần không ổn sao?

Mọi thứ xuất hiện đều có lí do của nó. Thời kỳ đầu tiên của lập trình web, đa số chúng ta chỉ có các web tĩnh, có thể là các trang đọc báo, trang tài liệu wiki, …. Các dữ liệu trên trang thường không thay đổi. Điều này kéo dài một thời gian, tuy nhiên chúng ta ngày càng mong muốn nhiều hơn, chúng ta muốn những website “động”, những website mạng xã hội mà bài viết được cập nhật mỗi lần tải trang, những trang web mà có thể nhận/gửi tin nhắn mới, những trang web có các video mới như Youtube, …

Trước khi React sinh ra

  • Hãy tưởng tượng một bài toán thực tế. Ta có một cái nút “đăng nhập”, khi người dùng nhấn nút, yêu cầu của bài toán cần có 4 trạng thái như sau:
    • Nút trước khi bị ấn hiển thị màu xanh dương, ghi là “Nhấn để đăng nhập”
    • Nút khi bị ấn hiển thị màu xanh dương nhưng đen đi một xíu do đang bị ấn, hiển thị chữ “đang đăng nhập”
    • Sau khi đăng nhập hoàn thành, nút chuyển sang màu xanh lá, hiển thị “đăng nhập thành công”
    • Sau khi đăng nhập thất bại, nút chuyển sang màu đỏ, hiển thị “đăng nhập thất bại”
image 33 - quochung.cyou PTIT
  • Chúng ta tưởng tượng, code xử lí đăng nhập sẽ trong file javascript, còn cái nút thì ở file html. Như vậy, để cập nhật trạng thái màu, chữ của nút, ta thường phải làm các bước sau:
    • Lấy DOM của nút, tức là trong file xử lí code cần cho ngôn ngữ lập trình biết là ta muốn thay đổi cái nút nào. thường ta sẽ sử dụng các cú pháp như document.getElementById (Lấy một dom bằng định danh ID), hoặc document.querySelector (Lấy bằng query), ….
    • Thêm một event listener là khi nhấn nút sẽ chạy hàm nào đó, chạy logic gì đó cho nút
    • Viết code xử lí hàm thay đổi nút
    • Xoá listener, reset mọi thứ về ban đầu khi tải lại trang -> nút về trạng thái chưa ấn

Oke, hãy thử làm bài toán này, đầu tiên hãy tạo nút chúng ta cần ở HTML

<button type="button" id="dangnhapbutton">Đăng nhập</button>

Tiếp theo trong Javascript, ta tìm nút trên để thêm hàm xử lí khi nhấn cho nó

const dangnhapbutton = document.getElementById("dangnhapbutton"); //lấy nút theo id
dangnhapbutton .addEventListener("click", () => { //thêm event khi ấn 
  // xử lí khi ấn ở đây
});

Oke, giờ giả sử, khi ấn nút, thì nó cần hiện là “Đang đăng nhập”, ta sửa code dạng như sau

const dangnhapbutton = document.getElementById("dangnhapbutton"); //lấy nút theo id
dangnhapbutton .addEventListener("click", () => { //thêm event khi ấn 
  dangnhapbutton.textContent = "Đang đăng nhập"; //hiển thị đang đăng nhập
});
  • Giờ thì khi ấn nút, nút từ “đăng nhập” sẽ được chuyển thành “đang đăng nhập”. Tuy nhiên chúng ta cần nó hiển thị đăng nhập thành công, hoặc đăng nhập thất bại, hoặc sau 1 lúc thì nó lại chuyển về “đăng nhập”. Giờ làm sao nhỉ? Ta cần một cách nào đó để biết là nút đang ở trạng thái nào phía hiển thị, sau đó tuỳ nó đang ở trạng thái gì thì sẽ chuyển sang trạng thái mới.
  • Ví dụ ta thử làm Khi ấn 1 lần, chuyển đăng nhập -> đang đăng nhập. ấn tiếp thì chuyển lại về đăng nhập
<button type="button" id="dangnhapbutton" data-dangnhap="false">Đăng nhập</button> //ta cần một attribute data-dangnhap để lưu trạng thái phía hiển thị
const dangnhapbutton = document.getElementById("dangnhapbutton"); //lấy nút theo id
dangnhapbutton .addEventListener("click", () => { //thêm event khi ấn 
  const trangthai = dangnhapbutton .getAttribute("data-dangnhap") === "true"; //lấy trạng thái phía frontend xem là đăngn hập chưa
  dangnhapbutton .setAttribute("data-dangnhap", !trangthai ); //đảo ngược trạng thái
  dangnhapbutton .textContent = trangthai  ? "Đang đăng nhập" : "Đăng nhập"; //tuỳ trạng thái là 0 hay 1 thì cập nhật trạng thái mới 
});
  • Vấn đề cơ bản như 1 nút chỉ tắt bật như vậy. Nhưng ta phải lưu cùng lúc 1 attribute thông số gì đó ở phía html, rồi lại lưu 1 biến ở phía code để xử lí. Giả sử ta có 4 trạng thái, 10 trạng thái gì đó, ta sẽ phải lưu 10 cái ở phía html, rồi lấy ra 10 cái ở javascript rồi if else logic xử lí…
  • Điều này rõ ràng rất khó scale mở rộng hệ thống hơn. Sẽ ra sao nếu web của ta có rất nhiều nút? Ta sẽ có 1 đống code thừa trùng lặp, ta phải code rất nhiều cho một tác vụ tưởng chừng đơn giản, …
  • Liệu có cách nào để chúng liên kết với nhau, để ta có thể xử lí qua lại dễ dàng hơn không nhỉ?

Thời điểm này, việc tạo ra một cách thuận tiện, dễ mở rộng cho frontend là một thử thách với các công ty. Đây là tiền đề cho sự ra đời cho một số cái tên nổi tiếng, mà chắc bạn đã từng nghe qua như: Backbone, KnockoutJS, AngularJS, and jQuery.

Hãy cùng xem những giải pháp trên có gì khác với React, các cách tiếp cận khác nhau của từng giải pháp

Đọc tiếp phần 2:

Vấn đề khi sử dụng số hoặc UUID cho Primary Key trong database

Lưu trữ dạng số

image 23 - quochung.cyou PTIT

Đây có lẽ là cách lưu trữ thường được thấy và dễ tưởng nhất. Trường primary key sẽ đóng vai trò như số thứ tự, giúp phân biệt giữa các row khác nhau, cách lưu trữ bằng số có thể được DB tự gen bằng cách gen sequence.

  • Khá tiện quản lý, sử dụng trong tầng dữ liệu
  • Dễ hiểu, dễ đọc, dễ tìm

Điểm trừ của cách làm này là:

  • Giả sử bạn đang lưu trữ dữ liệu cho 1 tệp khách hàng, được đánh id từ 1-1000, một ngày nào đó, bạn cần migrate data từ các bảng khác, từ những bảng cũ, … (kiểu sát nhập công ty, …) và cũng có tập dữ liệu được đánh số từ 1-100, 500-1000 gì đó. Điều này làm việc sát nhập trở lên khó khăn hơn do key chính để phân biệt các hàng đã bị trùng
  • Việc đánh số tuần tự cũng có thể tạo các risk về security, … Ví dụ bài viết đang được lưu đơn giản đánh bài viết số 1,2,… Từ đó từ bên ngoài có thể đoán được và truy cập được 1 bài viết bất kì.

Lưu trữ bằng UUID

image 24 - quochung.cyou PTIT

Lúc này, một cách làm khác đã thường được sử dụng là UUID (Universally unique identifier). Sẽ khó có ai có thể đoán được uuid của 1 bài viết được sinh ra ngẫu nhiên.

  • UUID được sinh ngẫu nhiên, tỉ lệ trùng lặp là rất thấp
  • Tránh được việc user tự mở 1 bài viết bất kì
image 25 - quochung.cyou PTIT

Tuy nhiên nó cũng đi kèm một số nhược điểm quan trọng

  • UUID dài. Để lưu trữ 1 uuid, thông thường ta cần tới 16 byte. Nó tốn dữ liệu hơn nhiều trong database so với lưu số thông thường. Sau này, khi ta sử dụng các database quan hệ giữa nhiều bảng, việc join các cột foreign keys sẽ ngày càng lớn hơn giữa các primary key
  • UUID do được sinh random, nên database sẽ khó lòng index một bảng để truy vấn nhanh hơn (VD MySQL sử dụng B+ Tree, cần một trường nào đó đánh theo một dãy giá trị có thể sắp xếp được: số, …).

Một số cách làm khác

  • ULID (Universally Unique Lexicographically Sortable Identifier). Vẫn là 16 byte, nhưng phần đầu sẽ chứa dữ liệu của timestamp (ngày tháng), và còn lại là ngẫu nhiên. Điều này giúp xử lí việc index database, dễ sắp xếp hơn
  • TSID (Time-Sorted Unique Identifiers). Cũng giống với ý tưởng của ULID nhưng chỉ tốn 8 byte. Tuy nhiên chúng cũng đi kèm với 1 số tradeoff

Đi sâu vào TSID

Có nhiều cách để triển khai TSID, trong bài này mình sẽ nói về Hypersistence TSID (Thư viện OSS), cho phép tạo 1 TSID 64-bit gồm 2 phần

  • 42-bit là dữ liệu thời gian
  • 22 bit là dữ liệu random

Thêm vào maven

<dependency>
    <groupId>io.hypersistence</groupId>
    <artifactId>hypersistence-tsid</artifactId>
    <version>${hypersistence-tsid.version}</version>
</dependency>

Tạo 1 object TSID

TSID tsid = TSID.fast();

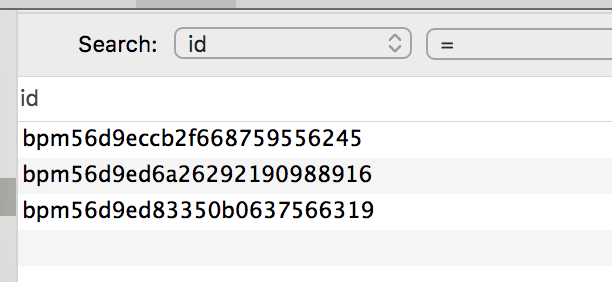
`Từ TSID, ta có thể extract ra được thời gian

image 26 - quochung.cyou PTIT
image 27 - quochung.cyou PTIT
image 28 - quochung.cyou PTIT

Sử dụng vào database

Vì TSID là một số 64-bit (có thể sắp xếp), ta có thể lưu nó vào database dưới dạng bigint

CREATE TABLE post (
    id bigint NOT NULL,
    title varchar(255),
    PRIMARY KEY (id)
)

Lưu ở phía Entity

@Entity
@Table(name = "post")
public class Post {
 
    @Id
    private Long id;
 
    private String title;
     
}

Tổng kết về TSID

  • Đa phần giữ được các ưu điểm của UUID như khó đoán ở phía người dùng, tạo sự phân biệt, …
  • Lưu trữ nhẹ hơn UUID (8 byte vs 16 byte)
  • Tuy nhiên TSID có thể có tỉ lệ bị sinh ra ngẫu nhiên trùng cao hơn do chỉ có 22bit ngẫu nhiên (xác suất sinh trùng là 0.3%)

Xử lí việc sinh trùng, bạn có thể thêm số lần retry để tự động sinh lại nếu xảy ra collision

image 29 - quochung.cyou PTIT

Khi nào nên sử dụng TSID

  • Phần ID có thể expose cho phía client người dùng, ví dụ như id bài viết, video, …. còn các bảng phụ hỗ trợ liên quan có thể cứ dùng dạng số để thuận tiện và tiết kiệm
  • Các database expose cho người dùng, cần tính đến việc scale lâu dài, và tiết kiệm

Tham khảo:

Sử dụng Keyset Pagination – Seek bằng  Blaze Persistence

Nếu bạn chưa nghe về khái niệm này, có thể đọc ở đây http://quochung.cyou/toi-uu-truy-van-pagination-phan-trang-su-dung-spring-boot-java/

 Blaze Persistence

Tuy nhiên bạn có thể sử dụng  Blaze Persistence để làm điều đó và có thể hoạt động plug-n-play với JPA luôn.

Tạo một CriteriaBuilderFactory

image 15 - quochung.cyou PTIT

Lấy tập dữ liệu Top-N trên cùng

image 16 - quochung.cyou PTIT

Để lấy trang đầu tiên, ta sử dụng một query Top-N như sau.

  • Bạn có thể tùy chỉnh orderByAsc để căn theo sort by tập dữ liệu cần có
  • pageSize quy định số lượng số phần tử cần lấy
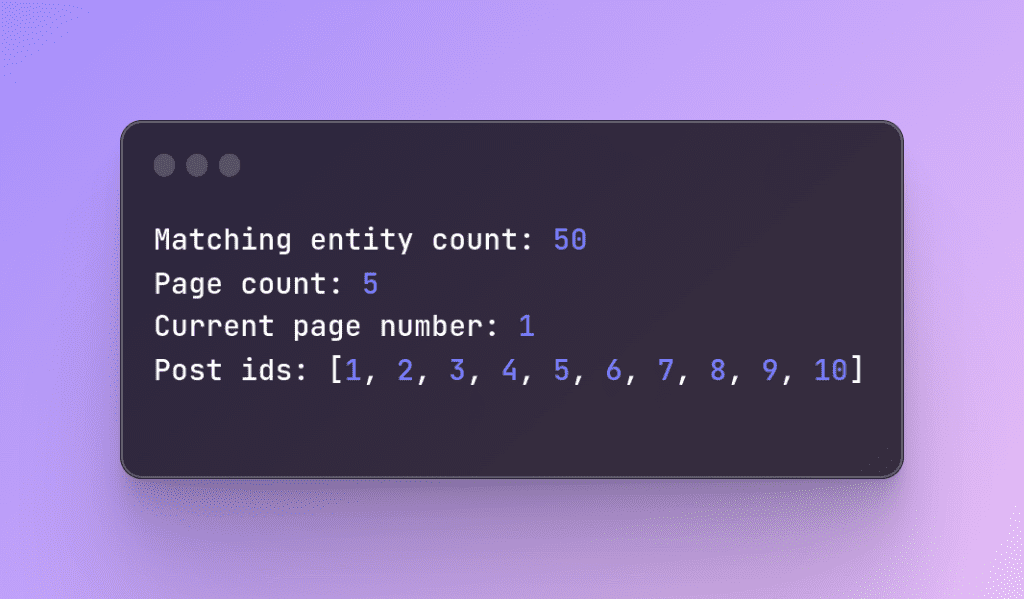
  • withKeysetExtraction sẽ yêu cầu Blaze Persistence để lưu các thông số để có thể lấy dữ liệu cho query N phần tử tiếp theo
image 17 - quochung.cyou PTIT
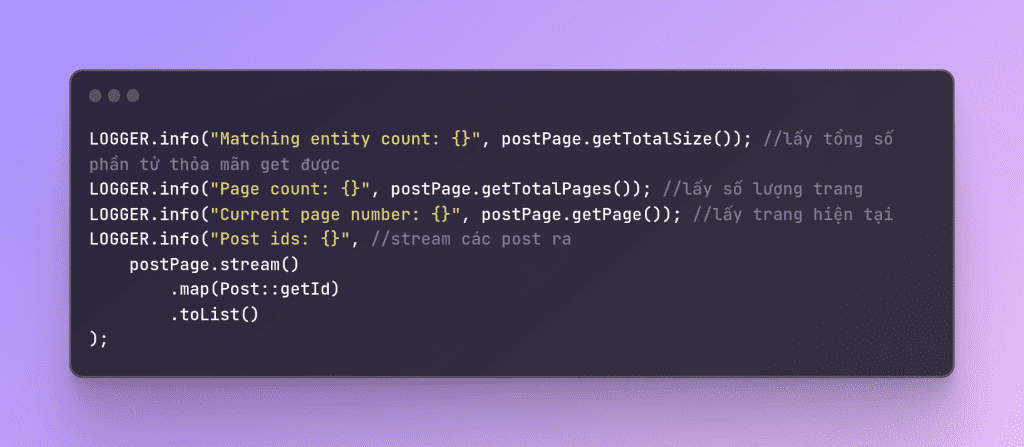
  • PagedList implement từ List có sẵn của Java, với một số hàm để bạn có thể extract dữ liệu
image 18 - quochung.cyou PTIT

Output:

image 19 - quochung.cyou PTIT

Lấy trang tiếp theo

image 20 - quochung.cyou PTIT

  • Page tiếp theo sẽ sử dụng keysetPage ta đã có trước đó, để có thể thực hiện skip lượng row cần thiết để lấy tập dữ liệu tiếp theo

Thử nghiệm kết quả

image 22 - quochung.cyou PTIT
  • Sử dụng cách tương tự để nhảy sang các trang kế tiếp

Tham khảo:

Dependency Inversion là gì, biến N-Layered thành DDD

N-Layered

Bất kì mô hình hệ thống nào đều nhắm đến giúp code của bạn được tổ chức tốt hơn, đẹp hơn. Khi mà nhu cầu của người dùng ngày càng cao, độ phức tạp của hệ thống càng gia tăng, mô hình hệ thống của bạn cũng cần phải bắt kịp chúng. Với một số dự án nhỏ, có thể bạn chỉ cần thêm thẳng code vào controller, tuy nhiên, ở các hệ thống lớn hơn bạn sẽ cần một số cách tiếp cận hợp lí hơn.

Đa số hệ thống chỉ cần cấu trúc N-Layered (N tầng) với 3 tầng cơ bản:

  • User Interface (UI) — chịu trách nhiệm tương tác với người dùng (giao diện)
  • Business logic layer (BLL)— Xử lí các logic chính của hệ thống
  • Data Access layer (DAL) — Là tầng giao tiếp với dữ liệu như database, …
1 pd5bfxtxV9AK0 QlIOK6Vw - quochung.cyou PTIT

VỚi một hệ thống như vậy, đa số vấn đề của bạn sẽ giải quyết theo 1 chiều thông thường. Các tầng sẽ phụ thuộc trực tiếp vào nhau, sau đó gọi dần xuống tầng bên dưới.

image 9 - quochung.cyou PTIT

Ví dụ một luồng:

  • User click vào 1 nút trên tầng UI của website. Tầng UI sau đó gọi 1 API vào Bussiness Logic, bussiness logic gọi xuống Data Access để lấy dữ liệu bài viết ở database, sau đó ở bussiness logic sẽ xử lí dữ liệu đó (format, thêm thắt ngày tháng, ….), rồi cuối cùng trả về tầng trên cùng UI.

Tuy rằng kiến trúc N-Layered giúp ta xử lí đa số vấn đề, giúp code gọn hơn, clean hơn, tổ chức các chức năng liên quan thành nhiều layer khác nhau, dễ cài đặt, nhưng chúng cũng có một số vấn đề:

  • Khi hệ thống lớn dần, thường các logic sẽ được xử lí ở tầng Data Access (database), chứ không phải ở Business Logic. Điều này khiến lập trình viên thường tập trung vào tầng db hơn là tầng logic chính.
  • Tầng Data Access dần làm mọi việc, khó để thay đổi, vì các tầng trên đều nhảy vào nó.
  • Các tầng liên kết với nhau chặt chẽ, và vài thay đổi ở tầng Data Access sẽ làm hỏng các phần khác.

Ví dụ: Sau khi code nhiều ngày đêm, bạn gửi sản phẩm là một trang đọc báo cho khách hàng. Trang đọc báo này có cơ chế như sau:

  • Tầng UI: Hiển thị một bài viết
  • Business Logic: Gọi xuống database lấy dữ liệu các bài viết
  • Data Access: Làm việc với database, lấy các dữ liệu bài viết ra từ một database MySQL chẳng hạn.

Tầng Business Logic chứa các hàm:

  • layBaiViet() -> dataAccess.layBaiVietDb()

Tầng Data Access sẽ chứa hàm bên trên, nơi Business gọi xuống, và thực hiện các tác vụ, vì lúc này các model, object đang nằm ở tầng Data, chứ không ở tầng Business:

  • layBaiVietDb() -> locBaiViet() -> suaNgayThang() -> ….

Do các model, entity ta làm việc với db đều chứa hết ở tầng này, nên ta cần xử lí các hàm ở tầng Data Access. Và kể cả có chuyển các hàm này lên tầng bên trên, thì nhìn chung các Model đều vẫn chứa ở Data Access. Chỉ cần mình thay đổi ví dụ Model ở Data Access một hàm mới, bên trên đều phải thay đổi.

Tưởng tượng lúc này, một ngày đẹp trời, khách hàng của bạn muốn chuyển DB sang MongoDB chẳng hạn, hoặc chuyển sang abcxyz gì đó. Lúc này bạn lại phải sửa hết code ở tầng Data Access cho hợp DB mới, và việc sửa ở đây cũng dẫn đến sửa các tầng bên trên

DDD – Domain Driven Design

Mô hình trên cho rằng, ta nên tập trung vào phần Business, hay còn gọi là Domain là phần core, cốt lõi của hệ thống hơn, thay vì Data Access. Data Access chỉ nên tập trung vào lấy dữ liệu, cập nhật dữ liệu, …. , còn xử lí logic nên nằm ở Domain. Tuy nhiên, với cấu trúc như thông thường khi mà chiều phụ thuộc, gọi xuống đang đi từ trên xuống dưới, ta buộc phải dồn logic xuống dưới cùng. Lúc này, ta có một kĩ thuật mới (Dependency Inversion – Đảo chiều sự phụ thuộc) , đây cũng là chữ cái “D” trong S.O.L.I.D

image 10 - quochung.cyou PTIT

Điều gì đã thay đổi ? Ta vẫn giữ những cấu trúc tầng, cho phép code được tổ chức, chia thành các khối, giữ nguyên các điểm tốt của N-Layered, tuy nhiên với một vài cải tiến:

  • Business Logic/Domain sẽ là phần lõi, ở giữa của hệ thống, được dùng ở các phần khác
  • Business Logic giờ mới là phần khó thay đổi. Điều này có thể chấp nhận, bạn hãy tưởng tượng, có thể hệ thống bạn sẽ đổi database khác, đổi cách lấy dữ liệu, hay giao diện khác, còn logic trung tâm của hệ thống (ví dụ hệ thống ngân hàng thì logic trung tâm là xử lí tiền, …) thì không thể đổi được (trừ khi công ty sập)
  • Mỗi thay đổi của tầng Business/Domain sẽ cần đổi ở tầng khác, điều này cũng đúng hơn với tự nhiên, khi mà concept cốt lõi là logic của ứng dụng, mục tiêu của ứng dụng thay đổi thì mới thay đổi các tầng ocn kia.

Nhưng làm sao để có thể đảo chiều sự phụ thuộc?

Trước tiên, hãy xem cách triển khai thông thường của N-Layered

image 11 - quochung.cyou PTIT
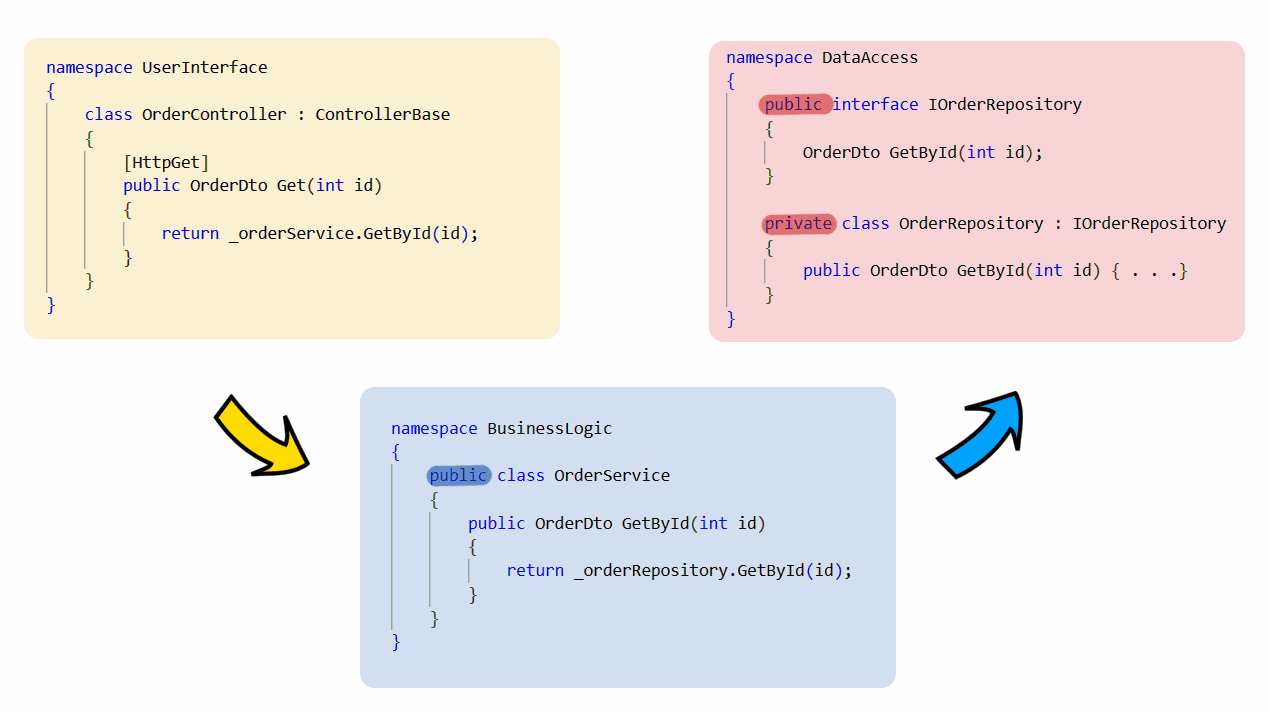
  • OrderService là một module xử lí các order (đơn hàng) cho hệ thống shop của bạn. Nhưng chúng chưa có dữ liệu, vì vậy chúng cần gọi xuống SqlOrderRepository là một module lấy dữ liệu từ database. Như vậy, OrderService phụ thuộc vào SqlOrderRepository
image 12 - quochung.cyou PTIT
  • Thông thường, người ta sẽ viết OrderService phụ thuộc vào một IOrderRepository (interface), để giúp việc thay thế dễ dàng hơn (phụ thuộc 1 interface ảo, chứ không phải 1 class)
  • Lúc này ta chỉ cần di chuyển interface trên về business
image 13 - quochung.cyou PTIT
  • Lúc này, ta sẽ quy định các method của repository, các hàm như kiểu getOrderByName (lấy dữ liệu từ tên), update, create, …. OrderService phụ thuộc trực tiếp vào repository này (Vẫn ở tầng Business)
  • Lúc này tầng Data Access, các class xử lí dữ liệu thực sự sẽ implement lại repository từ tầng Business, implement lại các hàm trên, nơi viết logic thực sự.
  • Lúc này, tầng Data Access đang phụ thuộc ngược vào tầng Bussiness
  • Rõ ràng, OrderService không cần quan tâm Data Access có thể là database nào nữa, nó có thể là class MySQL, Môngo,…. , chỉ cần biết chúng phải implement interface Repository có ở Business, và việc xử lí logic thì data access xử lí sao thì business không cần quan tâm.
  • Việc gắn các class ở dataaccess vào business có thể thông qua các IoC Container (Ví dụ như Spring IoC – Inversion of Control)
image 14 - quochung.cyou PTIT

  • Cách làm trên được gọi là Dependency Inversion (đảo ngược sự phụ thuộc) khi mà sự phụ thuộc, nơi xử lí được đảo ngược lại.

Tham khảo:

Tối ưu truy vấn Pagination (phân trang) sử dụng Spring Boot (Java)

image 4 - quochung.cyou PTIT

Phân trang là gì, tại sao cần phân trang

Phân trang đơn giản là ta sẽ chia một tập dữ liệu lớn và truyền cho user thành từng phần nhỏ hơn. Hãy tưởng tượng, bạn đang thiết kế một hệ thống backend cho phía frontend của một trang tin tức, phía FE muốn một lệnh API để có lấy dữ liệu các bài viết từ database của bạn.

image 5 - quochung.cyou PTIT

Bài toán sẽ khá đơn giản nếu bạn chỉ có 10-20 bài viết, bạn chỉ cần làm theo cách truyền thống, lấy dữ liệu từ database từ backend, gửi một file json chứa dữ liệu cho FE, mọi thứ nghe có vẻ đơn giản.

Tuy nhiên khi tập dữ liệu của ta ngày càng lớn, ví dụ, lúc này 1 Model bài viết có rất nhiều trường (ảnh đại diện, chuyên mục, thời gian đăng, ….), và ta có hàng 1000-10000 bài viết, việc trả 1 lần tập dữ liệu lớn như thế sẽ làm chậm ở 2 chỗ:

  • Lấy toàn bộ dữ liệu từ database tốn thời gian
  • Truyền 1 lần dữ liệu lớn như vậy sẽ rất nặng, tốn tiền mạng thật sự của user (tải 1 file lớn mỗi lần), và lúc tải 1 file lớn như thế cũng rất chậm, tốn thời gian, gây khó chịu người dùng

Tổng kết 1

Khi đó, ta có thể sử dụng đến phân trang, và mỗi lần người dùng chỉ có thể xem 1 trang, ta chỉ gửi khoảng 10-15 bài viết 1 lần thôi, khi người dùng sang trang khác ta sẽ gửi tập dữ liệu khác, khá đơn giản.

Triển khai phân trang bằng Spring Boot

Triển khai Model

image 6 - quochung.cyou PTIT

Triển khai Repository

Để có thể truy cập các JPA Entity trên từ database, ta sẽ tạo 1 PostRepository

image 7 - quochung.cyou PTIT

JPARepository đã kế thừa sẵn một interface là PagingAndSortingRepository của Spring hỗ trợ việc phân trang và sắp xếp. Dù là một interface, không có implemention, nhưng khi chương trình khởi chạy, Spring sẽ tự động generate các code implemention thật cho chúng ta, thực thi các thao tác với database, và chúng ta chỉ cần define các method có sẵn thôi.

Phân trang

Do Spring đã làm đa số các phần code, giờ ta chỉ cần triển khai thêm 2 việc

  • Tạo một PostPageRequest class, implement từ Pageable interface của Spring
  • Truyền tham số cần tìm cho PostPageRequest
image 9 - quochung.cyou PTIT

Khi implement interface Pageable, ta sẽ phải triển khai một số hàm. Lúc này class PostPageRequest sẽ như một object “trang” , kiểu trang 5 thì là một object Trang, trang 6 là một object khác. Từ object trang đó ta có thể lấy trang tiếp theo, trang phía trước, các bài viết trong trang,….

offset và limit

Bạn có thể thấy trong code trên có các tham số offset và limit. Hai tham số trong sql có ý nghĩa như sau

  • offset x : Lùi x kết quả từ dãy kết quả trả ra
  • limit y: Từ danh sách kết quả trả ra, lấy y kết quả đầu tiên.
  • Ví dụ: ta có các bài viết đánh số từ 1-100. offset 5 thì ta sẽ có danh sách là 6-100. limit tiếp 10 thì ta có danh sách 6-16…

Nếu bạn đã hiểu định nghĩa offset và limit, hãy thử đọc lại code bên trên, bạn sẽ dễ dàng hiểu được các method lấy trang tiếp theo, lấy trang trước, …. đang làm gì.

image 10 - quochung.cyou PTIT

Tổng kết 2

Như vậy, ta đã triển khai được phân trang bằng Spring Boot, tuy nhiên liệu như vậy đã tối ưu cho trang web của bạn chưa?

Tối ưu limit và offset trong MySQL

image 11 - quochung.cyou PTIT
image 12 - quochung.cyou PTIT
OffsetQuery Duration (ms)
01
501
100013
10000150
25000500
50000930
1000001750

Những biểu đồ và bảng

Ta có thể thấy, bằng việc dùng offset để lùi kết quả đi một đoạn, rồi lấy limit để lấy lượng bài ở trang đó nghe có vẻ rất đơn giản, dễ hiểu. Nhưng thực tế trong MySQL chúng được thực hiện như sau:

…the rows are first sorted according to the <order by clause> and then limited by dropping the number of rows specified in the <result offset clause> from the beginning…

…các dòng đầu tiên được sắp xếp (ví dụ theo id, thời gian đăng bài…) sau đó xóa x hàng đầu tiên được yêu cầu khi sử dụng offset
image 13 - quochung.cyou PTIT

Nếu bạn nghĩ kĩ, câu lệnh offset chỉ nhận đúng 1 tham số: lượng dòng bị bỏ qua cho đến tập kết quả muốn nhận.

Cách duy nhất hệ thống database có thể làm điều này là lấy toàn bộ dữ liệu cần tìm, sau đó ném đi x hàng đầu bạn đã đặt ra yêu cầu. Khi offset đủ lớn, lượng công việc cho database sẽ rất nhiều và thời gian để truy vấn sẽ tăng khó kiểm soát.

Khi sử dụng offset, ta mở trang đầu tiên, trang thứ 2, thời gian mất chỉ 1ms (1 phần nghìn giây), gần như không có vấn đề gì.

Trang thứ 10000, 150ms, vẫn chưa nhận ra điều gì quá lo ngại

100000 1750ms, 1,75 giây.

Ta có thể thấy, nếu người dùng mở 1 trang càng xa, hiệu suất của trang sẽ càng giảm, việc một user mở trang thứ 10000 có thể gây vấn đề hiệu năng hơn nhiều cho database hơn 100 người dùng khác mở trang 1

Hướng khắc phục

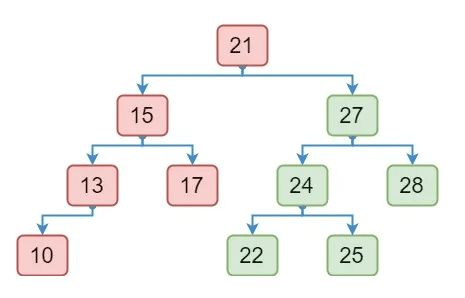
Trước hết, ta cần tìm hiểu xem những hệ quản trị cơ sở dữ liệu đang làm gì để sắp xếp dữ liệu của chúng ta. Ta sẽ assume hệ cơ sở dữ liệu đang sử dụng một B-Tree để index database (một bản nâng cấp của cây nhị phân cân bằng).

Nếu bạn chưa từng nghe đến cụm từ trên, bạn có thể tìm hiểu ở link sau:

Lúc này database của chúng ta lưu dữ liệu theo dạng như sau:

image 14 - quochung.cyou PTIT

Khi ta sử dụng offset 0, limit 5 để lấy 5 bài viết đầu tiên chẳng hạn, database sẽ chạy các kết quả sau

SELECT * FROM my_table ORDER BY id LIMIT 5
image 15 - quochung.cyou PTIT

Tuy nhiên, với offset, sau khi offset 5 và limit 5, ta có

image 16 - quochung.cyou PTIT

Như vậy, ta phải đi qua 5 cái đầu trước, bỏ dần nó, rồi sau đó mới limit 5 cái sau. Khá là tốn thời gian

Vấn đề: Database không biết điểm khởi đầu của trang tiếp theo ở đâu, vì vậy nó cứ phải bỏ dần các hàng phía trước cho đến khi đến được vị trí chỉ định

=> Khắc phục: Ta nhớ xem vị trí lần cuối là ở đâu ?

Kĩ thuật: keyset pagination and seek method

Ở một số trang web, bạn sẽ thấy, bạn không thể đi đến thẳng trang cuối, hoặc nhảy đến 1 trang bất kì, mà thông thường sẽ có nút để sang trang kế và trang phía trước. Như vậy ta có thể assume rằng:

Người dùng sẽ chỉ mở trang 10 sau khi mở trang 9.

Vậy, ta chỉ cần nhớ vị trí cuối cùng của bài viết ở trang 9 là ở id bao nhiêu, rồi dùng WHERE để truy vấn từ điểm đó, chứ không cần bỏ dần để đi đến điểm đó nữa
SELECT * FROM my_table WHERE id > 21 ORDER BY id LIMIT 5
image 17 - quochung.cyou PTIT

Ví dụ: Sort theo thời gian

SELECT *
FROM my_table
WHERE (update_date = '2017-12-21' AND id > 21) 
    OR update_date > '2017-12-21'
ORDER BY update_date,id LIMIT 5

Cơ bản là ta sẽ chỉ lấy các bài viết có cùng thời gian đăng như bài viết cuối và id > , hoặc thời gian lớn hơn bài viết cuối

image 18 - quochung.cyou PTIT

Tổng kết

  • Phương pháp keyset pagination and seek giúp tối ưu việc phân trang cho các bài toán lớn hơn rất nhiều (Tham khảo biểu đồ trên)
  • Triển khai trong Java (JPA/Hibernate)

Tuy nhiên, phương pháp này sẽ có thêm các vấn đề sau

  • Ta cần thay đổi lại code của hệ thống để triển khai phương pháp này, cần phải nhớ hàng cuối cùng hiện tại, làm code phức tạp hơn, khó quản lí hơn
  • Cần phải index database theo id, pubdate, ….
  • Các hàng tìm kiếm cần được sắp xếp, không được null
  • Không thể đi trực tiếp đến trang 500,1000,… được, mà chỉ có thể sang trang kế tiếp do ta cần nhớ điểm cuối từ trang phía trước

Có thể tham khảo thêm Spring HateOAS hỗ trợ thêm vấn đề này

Các nguồn tham khảo:

[Web] CyouTodo

CyouTodo

Demo: https://todo.quochung.cyou

Source: https://github.com/quochung-cyou/CyouTodo
Author

  • quochungcyou

Project Structure

├── index.html - Trang hiển thị task
├── README.md
├── login.html - Trang đăng nhập đawng kí
├── dashboard.html - Trang dashboard
├── LICENSE - Giấy phép sử dụng
├── asset
│   ├── css
│   │   ├── index.css - CSS chung cho index/dashboard
│   │   ├── login.css - CSS cho login
│   │   ├── lightdarkmode.css - CSS cho phần bật sáng tối
│   │   ├── preload.css - CSS cho phần loader
|   ├── js
│   │   ├── index.js - JS chung cho index
│   │   ├── login.js - JS cho login
│   │   ├── lightdarkmode.js - JS cho phần bật sáng tối
│   │   ├── dashboard.js - JS cho phần dashboard
|   ├── img Lưu ảnh của project

Sequence Diagram

diagram - quochung.cyou PTIT

Description

  • Web bài tập lớn Team Web ProPTIT D21
  • Đề tài: CyouTodo – Ứng dụng quản lý công việc cá nhân
  • Phần chính là FrontEnd

Demo image

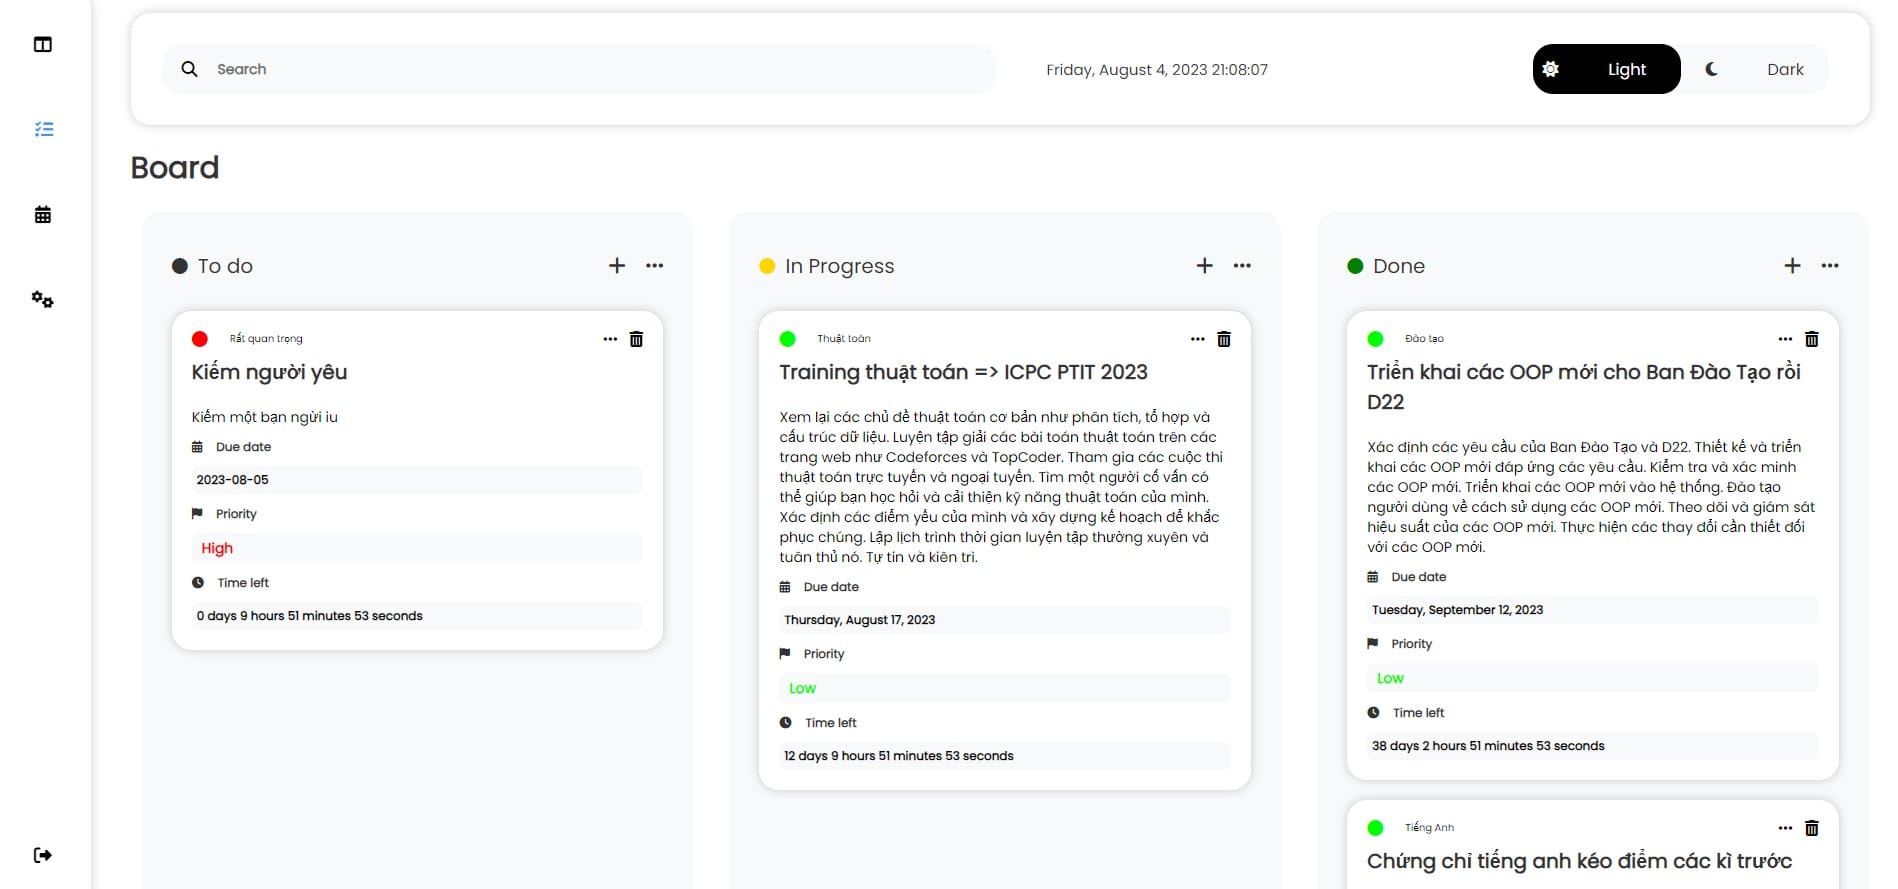
cyoutodo1 - quochung.cyou PTIT
cyoutodo2 - quochung.cyou PTIT
cyoutodo3 - quochung.cyou PTIT

Feature

  • [x] Đăng nhập/Đăng ký
  • [x] Thêm/Xoá/Sửa công việc
  • [x] Light/Dark mode
  • [x] Đếm ngược thời gian công việc
  • [x] Hiển thị thời gian còn lại, mức độ quan trọng
  • [x] Thống kê công việc, lịch
  • [ ] Cài đặt tài khoản

Prerequisites and Setup

  • JavaScript
  • JQuery
  • HTML/CSS (Pure CSS)
  • Firebase for hosting/realtime database
  • ApexChart (JS) – Just for demo

License Information

  • This software is licensed under MIT License.
  • Read More on the license.

Giúp đỡ tôi bằng cách chia sẻ hoặc tặng sao

stars - quochung.cyou PTIT

Thông tin liên hệ

Nếu có bất kỳ nội dung nào liên quan còn thiếu,hãy tạo issues cho nó, tôi sẽ theo dõi và cải thiện。

MIT License

Copyright (c) 2023 QuocHung

Permission is hereby granted, free of charge, to any person obtaining a copy
of this software and associated documentation files (the "Software"), to deal
in the Software without restriction, including without limitation the rights
to use, copy, modify, merge, publish, distribute, sublicense, and/or sell
copies of the Software, and to permit persons to whom the Software is
furnished to do so, subject to the following conditions:

The above copyright notice and this permission notice shall be included in all
copies or substantial portions of the Software.

THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR
IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,
FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE
AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER
LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,
OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE
SOFTWARE.