Xin chào mọi người! Trước khi bắt tay vào việc phát triển game 2D với LibGDX, hãy dành một chút thời gian để hiểu rõ hơn về ‘bộ công cụ’ mà chúng ta sẽ sử dụng.
LibGDX là một framework mạnh mẽ cho phép lập trình viên tạo game đa nền tảng, từ desktop cho tới mobile và web, mà không cần thay đổi đoạn code nguồn. Thông qua ngôn ngữ Java – một ngôn ngữ lập trình rất phổ biến vì tính linh hoạt, mạnh mẽ và khá dễ tiếp cận, được giảng dạy tại nhiều trường đại học trên thế giới.
Video
Chào mọi người! Video này là phần đầu tiên trong series hướng dẫn sử dụng LibGDX để phát triển game 2D sử dụng Java. Ở tập này, mình sẽ dẫn dắt các bạn qua quá trình cài đặt môi trường phát triển game, bao gồm cách thiết lập LibGDX và các công cụ cần thiết để bắt đầu tạo ra những tựa game đầu tiên của mình. Ngoài ra là một chút khái niệm về cách render tile của game 2D và game loop
Ở một số trang web, bạn sẽ thấy, bạn không thể đi đến thẳng trang cuối, hoặc nhảy đến 1 trang bất kì, mà thông thường sẽ có nút để sang trang kế và trang phía trước. Như vậy ta có thể assume rằng:
Người dùng sẽ chỉ mở trang 10 sau khi mở trang 9.Vậy, ta chỉ cần nhớ vị trí cuối cùng của bài viết ở trang 9 là ở id bao nhiêu, rồi dùng WHERE để truy vấn từ điểm đó, chứ không cần bỏ dần để đi đến điểm đó nữa
SELECT * FROM my_table WHERE id > 21 ORDER BY id LIMIT 5
Tối ưu truy vấn Pagination (phân trang) sử dụng Spring Boot (Java) 38
Ví dụ: Sort theo thời gian
SELECT *
FROM my_table
WHERE (update_date = '2017-12-21' AND id > 21)
    OR update_date > '2017-12-21'
ORDER BY update_date,id LIMIT 5
Cơ bản là ta sẽ chỉ lấy các bài viết có cùng thời gian đăng như bài viết cuối và id > , hoặc thời gian lớn hơn bài viết cuối
Để hình dung rõ hơn, hãy thử nhìn vào bảng sau:
ID
Name
1
An
2
Nam
3
Quan
4
Tien
5
Hoang
6
Nguyen
7
Duc
8
Thanh
9
Hai
10
Minh
Ta mong muốn nhận được dữ liệu ở Page 1 như sau
ID
Name
1
An
2
Nam
3
Quan
4
Tien
5
Hoang
Ta sẽ có câu query để lấy page 2 dạng như sau
Lấy page 1: SELECT * FROM users ORDER BY ID LIMIT 5
SELECT * FROM users WHERE ID > '5' ORDER BY ID LIMIT 5
Ta có thể thêm HAL bằng Spring HateOAS để response trả về ở dạng như sau, giúp ta lấy dữ liệu dễ dàng hơn
Cursor sẽ như một con trỏ chỉ tới một record nào đó trong dữ liệu, và khi ta truyền cursor đó vào, backend cần biết ta đang muốn lấy trang tiếp theo hay trang trước từ vị trí con trỏ đó
Có nhiều cách để làm điều này, ví dụ thêm prefix dạng như prev___, hay next___ như ví dụ trên
Hoặc đơn giản hơn, ta sẽ truyền thêm một biến chỉ ra là đó là next hay prev
Null Cursor
Lúc này, từ phía backend, ta có thể sử dụng count hoặc tương tự để kiểm tra xem có trang ở trước đó hay ở sau đó không, rồi trả response ra là null để thể hiện rằng không còn trang nào khác để đi tới ở hướng đó.
Next Cursor
Có thể bạn đã nắm được về cách để đi tới trang tiếp theo với cursor pagination.
Ví dụ, ta có một danh sách id tăng dần, thì từ trang có id [1,2,3,4,5], ta sẽ where id > 5 để tới trang tiếp theo
SELECT * FROM entries WHERE (myCol > 5) ORDER BY myCol ASC LIMIT 2; -> 6,7
SELECT * FROM entries WHERE (myCol > 7) ORDER BY myCol ASC LIMIT 2; -> 8,9
Với một danh sách id giảm dần, ví dụ trang là [10,9,8,7,6] thì ta sẽ where id < 6 để tới trang tiếp theo.
SELECT * FROM entries WHERE (myCol < 5) ORDER BY myCol DESC LIMIT 2; -> 4,3
SELECT * FROM entries WHERE (myCol < 3) ORDER BY myCol DESC LIMIT 2; -> 2,1
Previous Cursor
Tuy nhiên, việc đi tới trang trước đó trở lên khó khăn hơn. Bởi vì dữ liệu sẽ được trả ra từ phía trái đầu
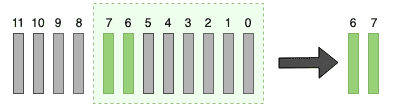
Ví dụ, ta đang ở trang id [8,9] , và ta thực hiện truy vấn lấy trang trước đó, 2 phần tử
SELECT * FROM entries WHERE (myCol < 8) ORDER BY myCol ASC LIMIT 2;
Kết quả sẽ trả về 0,1. Bởi vì nó đang đọc từ trái sang, và khi limit sẽ lấy từ đầu trái chứ không lấy 6,7
Cách giải quyết lấy previous cursor
Cách để giải quyết vấn đề này, ta sẽ đảo ngược chiều order by, và sau đó khi limit để lấy đúng vùng dữ liệu xong, ta sẽ đảo một lần nữa về chiều đúng
SELECT pagination.* FROM(SELECT * FROM entries WHERE (myCol < 8) ORDER BY myCol DESC LIMIT 2) AS pagination ORDER BY myCol ASC;
Các bước vừa xảy ra
1. Đầu tiên, select các row có id < 8 và order by desc. ta có 7,6,…,1,0
Sau đó limit 2 để lấy 7,6
Rồi order by asc lần nữa để lấy thành 6,7 . Là thứ tự ASC như ban đầu ta muốn
Time Complexity
Next Page Travesal: O(log(N) + L) , ta mấy log(N) để tìm tới điểm bất kì vì nó thực hiện như binary search và ta đã index database. Và L là Limit là số ta phải lặp đến để lấy vùng đầu tiên đã chọn
Previous Page Traversal: O(log(N) + 2L), sở dĩ là 2L vì ta đã phải đảo chiều 1 lần.
Thông thường limit được đặt ở 5-20 cho 1 trang, vì vậy có thể coi L là constant và không đáng kể
Triển khai trong code
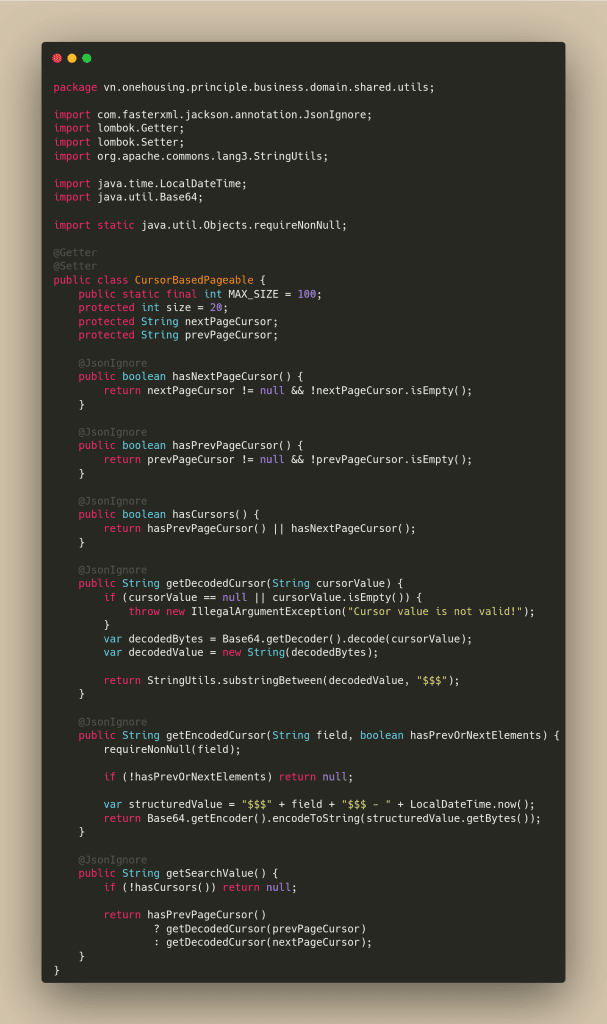
Ta có một class thực hiện việc lấy cursor trước hoặc sau. Sử dụng để decode một giá trị cursor base64 hoặc encode 1 giá trị
Ví dụ ta đang cursor pagination theo column 35, ta sẽ có hàm getEncodeCursor để tạo ra giá trị mã hoá cursor
Hàm getDecodedCursor sẽ chuyển giá trị mã hoá đó thành số để dùng paging
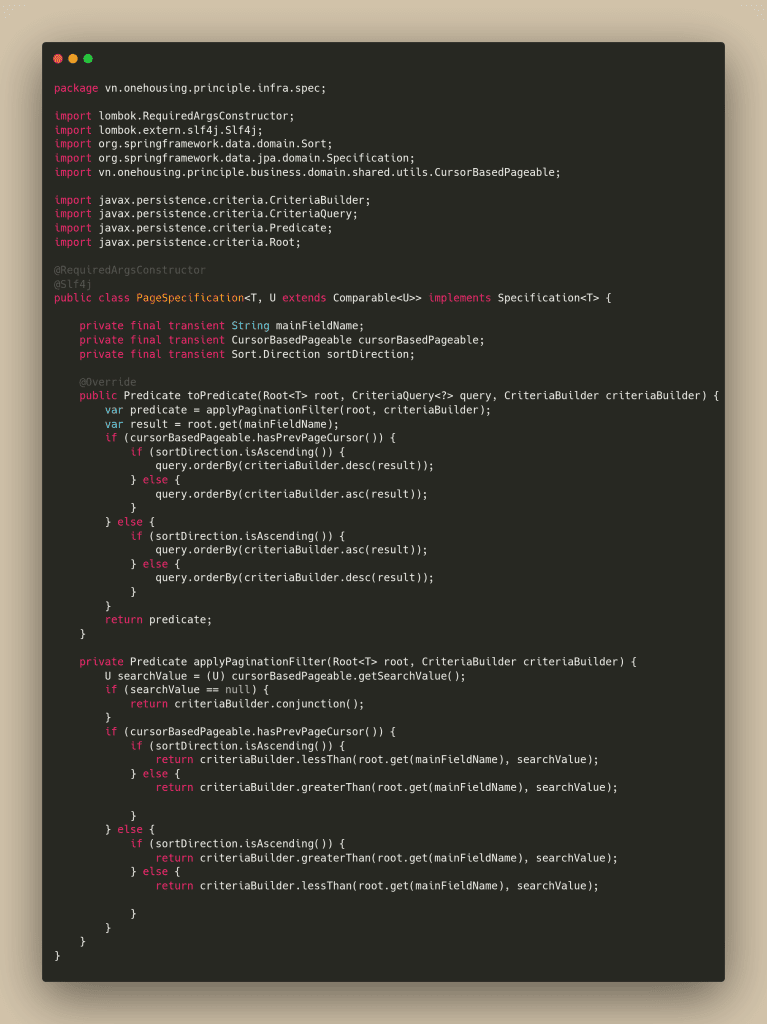
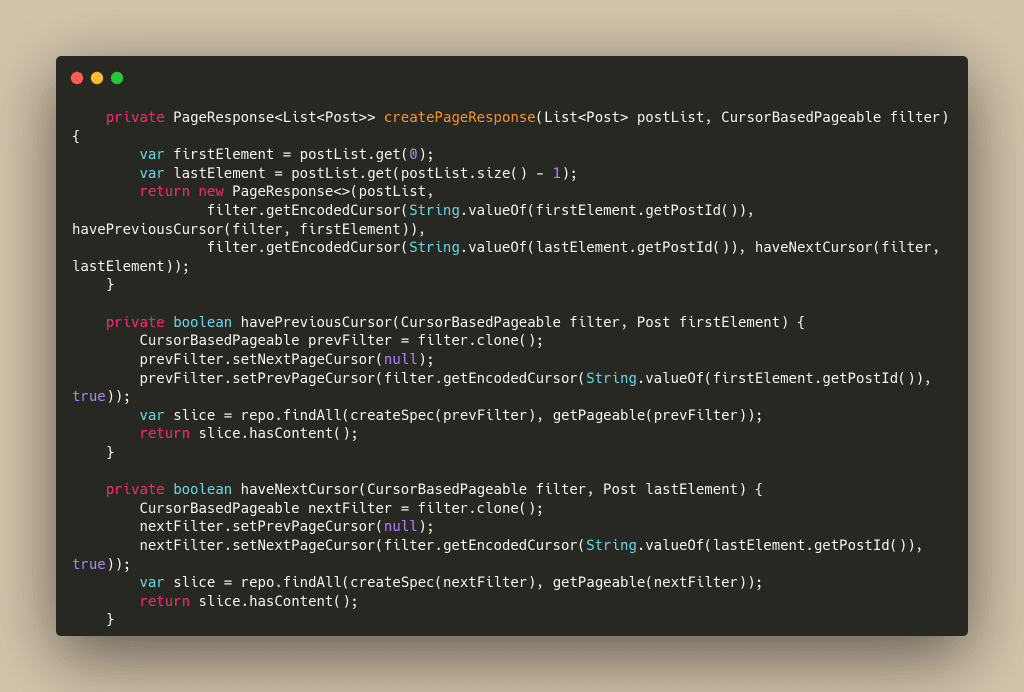
Đây là class thực hiện việc paging và nhảy trang. Có thể thấy logic sẽ kiểm tra xem ta đang lấy trang trước hay trang sau, sau đó sort cho phù hợp.
Class xử lý việc trả về. Tại đây ta sẽ lấy ra element tại đầu list và cuối list của trang hiện tại, rồi tìm thử xem phía trước đó còn trang nào không, hay sau đó còn trang nào hay không
This entry is part 1 of 2 in the series Blockchain
1. Blockchain là gì?
Blockchain là một hệ thống lưu trữ dữ liệu phân tán, mà mỗi block dữ liệu được liên kết với nhau thông qua mã hóa. Mỗi block chứa thông tin về giao dịch, và thông tin về block trước đó. Dữ liệu có sự nhất quán theo trình tự thời gian vì bạn không thể xóa hoặc sửa chuỗi mà không có sự đồng thuận từ mạng lưới. Vì thế, bạn có thể sử dụng công nghệ Blockchain để tạo ra một sổ cái không thể biến đổi hay chỉnh sửa để theo dõi các đơn hàng, khoản thanh toán, tài khoản và những giao dịch khác. Hệ thống chuỗi khối có những cơ chế tích hợp để ngăn chặn các mục nhập giao dịch trái phép và tạo sự nhất quán trong chế độ xem chung của các giao dịch này.
Một số đặc điểm của Blockchain:
Phân tán: Dữ liệu được lưu trữ trên nhiều máy chủ khác nhau.
An toàn: Dữ liệu được mã hóa và không thể thay đổi.
Độc lập: Không cần sự can thiệp của bên thứ ba.
Bảo mật: Dữ liệu được phân quyền và mã hóa.
Trong suốt: Mọi giao dịch đều được lưu trữ và công khai.
Tiết kiệm: Giảm chi phí vận hành và tăng hiệu quả.
Dễ dàng sử dụng: Không cần kiến thức chuyên sâu về công nghệ.
Tính khả chuyển: Dễ dàng mở rộng và phát triển.
Tính nhất quán: Mọi giao dịch đều được xác nhận và chứng thực.
Tính đồng thuận: Mọi giao dịch đều được thông qua một quy trình đồng thuận.
Ví dụ thực tế
Làm việc trên SpreadSheet
Trong một công ty, mọi nhân viên đều có quyền truy cập vào một bảng tính chung, và có thể thêm, sửa, xóa dữ liệu trên bảng tính đó.
Mỗi thay đổi trên bảng tính sẽ được lưu trữ và công khai cho tất cả mọi người xem. Khi muốn thay đổi dữ liệu, mọi người phải thông qua một quy trình xác nhận. Quy trình này có thể là sự đồng thuận của tất cả mọi người, hoặc là sự xác nhận của một số người quản lý.
Sau khi quy trình xác nhận được hoàn tất, dữ liệu mới sẽ được cập nhật lên bảng tính chung, và mọi người có thể xem lại lịch sử thay đổi của dữ liệu.
African American Office Employee Auditor Using Spreadsheet
=> Không khó để nhận ra rằng, bảng tính chung này chính là một ví dụ về Blockchain. Mỗi block dữ liệu tương ứng với một dòng dữ liệu trên bảng tính, và mỗi thay đổi trên bảng tính tương ứng với một giao dịch trên Blockchain. – Không ai có thể thay đổi dữ liệu cũ, mà chỉ có thể thêm dữ liệu mới. Mỗi giao dịch đều được lưu trữ và công khai, và mọi người đều có thể xem lại lịch sử thay đổi của dữ liệu. Việc xác nhận giao dịch cũng tương tự như quy trình xác nhận trên bảng tính chung.
Tóm lược
Blockchain giống như spreadsheet được chia sẻ này. Nó được phân tán trên nhiều máy tính (nút) trên khắp thế giới. Mỗi khi một giao dịch xảy ra, nó được thêm vào một ‘khối’, tương tự như một hàng mới trong bảng tính của chúng ta. Nếu đa số các nút đồng ý rằng giao dịch là hợp lệ, khối sẽ được niêm phong mật mã và thêm vào chuỗi các giao dịch đã được xác nhận trước đó. Do đó, có cái tên “blockchain”.
Bản chất phân quyền của blockchain khiến nó khó bị chỉnh sửa dữ liệu lịch sử. Nó cũng rất minh bạch, bất kỳ ai tham gia vào mạng lưới đều có thể xem toàn bộ blockchain. Hơn nữa, dữ liệu được bảo vệ bằng các nguyên tắc mật mã, làm cho nó trở nên không thể tấn công hay thay đổi
Chuẩn hoá database (Database normalization) là một cách thức cấu trúc các dữ liệu trong một cơ sở dữ liệu quan hệ theo một dạng chuẩn. Đơn giản thì, ta sẽ kết nối các thông tin giữa các bảng khác nhau bằng 1 key hay 1 id gì đó định danh 1 hàng.
Việc chuẩn hoá database giúp đảm bảo dữ liệu sẽ “chuẩn hơn”, giảm bớt các khả năng xảy ra một số hiện tượng dưới đây:
Một số vấn đề mà chuẩn hoá database giải quyết
Insertion anomaly (Khi thêm dữ liệu): Xảy ra khi một dữ liệu được thêm vào bảng nhưng không theo cấu trúc của bảng. Ví dụ, ta có một cột trong bảng người dùng là address, chứa địa chỉ người dùng. Tuy nhiên do không có ràng buộc gì cả, thì có thể có những người dùng địa chỉ là “xã, tỉnh, quốc gia”, có người lại là “số nhà, xã, tỉnh, quốc gia”, do dữ liệu ở 1 cột chỉ là 1 dạng text.
Update anomaly (Khi cập nhật) xảy ra khi dữ liệu không được cập nhật ở mọi vị trí. Ví dụ, ta có 2 bảng là thông tin sinh viên và thông tin công dân. Cả 2 đều chỉ về 1 đối tượng, tuy nhiên do có 2 cột địa chỉ ở cả 2, thì khi cập nhật 1 cái, có thể địa chỉ của cái còn lại cũng nên được đồng bộ.
Deletion anomaly (Khi xoá): Do dữ liệu “địa chỉ” nếu nằm ở nhiều bảng khác nhau dù chung mục đích, khiến nếu muốn xoá một dữ liệu đi cần xoá ở nhiều vị trí hơn.
Ví dụ về chuẩn hoá Database
Giả sử ta có bảng sau để chứa các Assistant Principal, sẽ dạy các học sinh nào, lớp nào
Ta thấy, ta đang lưu danh sách học sinh theo kiểu cách nhau bằng dấu phẩy, và tương tự với student id.
Có một số vấn đề có thể nhận thấy. Việc lưu như vậy khiến ta phải scale chiều dài dữ liệu cột Students theo số lượng sinh viên, và ví dụ, ta scale nó là một dung lượng nào đó là 10000 kí tự chẳng hạn, mà nhiều dòng lại không dùng tới 10000 kí tự => điều này vô hình chung làm dữ liệu của hàng bị phình to, chỗ nhiều chỗ ít, mà lại tốn tài nguyên để scale toàn bộ hàng có dữ liệu là 10000.
Ở mức chuẩn hoá 1NF, ta có thể tách bảng thành như sau
Ta vẫn lưu được các dữ liệu cần thiết, và trong 1 ô đảm bảo không có lưu như vậy nữa
Tuy nhiên, ta nhận thấy, có nhiều hàng có dữ liệu trùng nhau, vd như Jack White, hay id của các Assistant Principal
Với ở dạng này, ta nhận thấy, nếu bảng có thêm nhiều trường hơn, to hơn nữa. Thì ta sẽ có rất nhiều hàng trùng dữ liệu thừa thãi, kiểu đều chung Class, Class ID, Assistant Principal Id, …. rất nhiều trường khác, chỉ khác nhau đúng trường Student Name và Student ID
Lúc này, ta sang mức chuẩn hoá 2NF. Ta sẽ nhìn chung vẫn như cách 1NF là có nhiều hàng tách ra để hiển thị dữ liệu. Tuy nhiên, ta chỉ nhớ chúng theo ID, rồi sau đó từ ID đó ta có thể lấy dữ liệu ở bảng riêng biệt dành riêng cho việc lưu trữ Student => Mà không gộp nó vào 1 chỗ nữa
Lúc này dữ liệu trùng và bị lặp chỉ có cột id, và nó nhẹ hơn nhiều
Ở mức chuẩn hoá 3NF tiếp theo, ta đưa mọi dữ liệu về riêng bảng của nó. VD ta có bảng riêng chỉ lưu class, bảng riêng chỉ lưu student, …
Ưu điểm chuẩn hoá
Chuẩn hoá database nhìn chung giúp ta giảm bớt sự trùng lặp dữ liệu, dữ liệu dư thừa, bằng việc sử dụng nhiều bảng riêng biệt để lưu các dữ liệu cần thiết. Giúp dữ liệu gọn nhẹ, dễ nhìn hơn.
Chuẩn hoá cũng giúp ta giảm thiểu việc có các ô dữ liệu trống (null), vì ví dụ: Nếu ta có 1 bảng chỉ là ConNguoi, có cả cột lương thưởng (cho người đi làm), và tiền đóng học (cho sinh viên). Vậy sinh viên thì không có lương thưởng, còn người đi làm không có ô tiền đóng học. Ta có thể tách riêng bảng ra cho mục đích đó.
Đảo chuẩn hoá Database và case study của Instagram
Nhược điểm của chuẩn hoá
Vì lúc này dữ liệu bị phân tán ra, ta thường phải viết các câu query phức tạp hơn, gộp nhiều bảng vào với nhau để thao tác dữ liệu, việc này tăng độ phức tạp của hệ thống, cũng như giảm tốc độ vì phải đọc nhiều bảng khác nhau.
Ví dụ với dữ liệu trên, để lấy danh sách sinh viên, hoặc số lượng sinh viên 1 Assistant Principal quản lý, ta chỉ cần 1 cột trong bảng, rồi select 1 row là được
Còn nếu tách riêng ra, ta phải join cả bảng Student vào, rồi select filter theo assistant id, và để đếm số lượng thì phải dùng count
Việc này được gọi là đảo chuẩn hoá database, nó có thể làm dữ liệu bị dư thừa và tạo ra nhiều vấn đề mà chuẩn hoá giải quyết, nhưng bù lại giúp cải thiện hiệu năng hệ thống
Ví dụ của Instagram về chuẩn hoá database
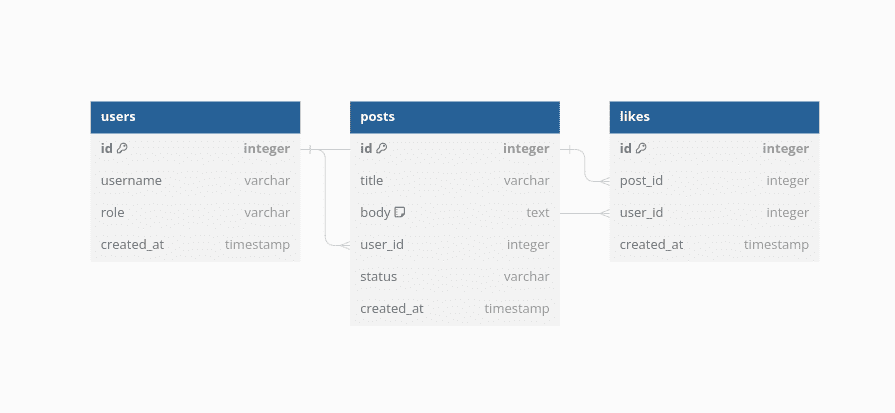
Ta có bảng users là thông tin người dùng. 1 bảng posts là các bài viết của người dùng, và bảng likes là chứa thông tin về các lượt like của 1 bài viết, gồm ai là người like bài viết đó.
Lúc này, để lấy tổng số like của bài viết, ta thường phải gọi lệnh vào bảng likes dạng
SELECT
    posts.id AS post_id,
    posts.title AS post_title,
    COUNT(likes.id) AS total_likes
FROM
    posts
LEFT JOIN
    likes ON posts.id = likes.post_id
WHERE
    posts.id = 1
GROUP BY
    posts.id, posts.title;
cơ bản thì nó cần join vào bảng likes, rồi tìm các likes thuộc id bài viết và đếm. Điều này nhìn chung nếu 1 bài viết có 1 triệu likes, thì ta phải đếm 1 triệu hàng, và có hàng tá bài viết như thế, và rất nhiều người cùng vào like, xem bài viết, mỗi khi cần hiển thị tổng số like, ta phải chạy lại lệnh kia, thứ mà rất tốn thời gian.
Lúc này ta có thể áp dụng đảo chuẩn hoá, bằng việc đơn giản là sẽ thêm 1 cột total_likes để lưu trữ tổng lượng like của bài viết, ta vẫn cần bảng likes để khi người ta mở xem ai là người likes thì nó sẽ lưu trữ thông tin.
Hiển nhiên, việc này sẽ khiến việc quản lý và code sẽ phức tạp hơn để vừa có cơ chế chuẩn hoá, mà lại đảo chuẩn hoá 1 thuộc tính, nhưng nó giúp cho query database nhanh hơn rất nhiều.
Lúc này, ta đã đang thực hiện giao tiếp với server qua token, có một câu hỏi đặt ra là, làm sao để gửi token đó cho phía server?
Hiển nhiên, ta có thể làm điều ở ở body của request, ở param, … hoặc ở cookie. Tuy nhiên, có một cách thông dụng và được sử dụng hầu hết hiện nay để chuyển 1 token không qua cookie đó là sử dụng dạng “Bearer” https://tools.ietf.org/html/rfc6750
Bearer lúc đầu được tạo ra nhằm phục vụ cho OAuth2 (sẽ nói thêm sau)
Để gửi 1 token qua api, ta chỉ cần để nó ở header Authorization
Authorization: Bearer QDAmQ9TStkDCpVK5A9kFowtYn2k
Việc sử dụng giao tiếp qua Authorization cũng cho phép ta sử dụng header WWW-Authenticate để giúp đầu api “thân thiện” với http hơn
WWW-Authenticate có thể theo kèm một tham số là “realm”, bạn có thể hiểu trường này như một trường nhằm định dang đầu api hiện tại. VD nếu realm = admin, thì client sẽ hiểu đầu api này cần token dành cho admin, nếu realm = users thì là các đầu api open cho user
Ngoài ra, ta cũng có thể thêm các thông báo về việc token hết hạn, sai, …
HTTP/1.1 401 Unauthorized
WWW-Authenticate: Bearer realm="users", error="invalid_token",
        error_description="Token has expired"
Phần này giúp phía client có thể biết là token đã hết hạn và yêu cầu tạo token mới
Để lưu token ở phía client mà không cần sử dụng cookie, ta có thể sử dụng các bộ nhớ có sẵn của trình duyệt như
sessionStorage: Các thực thể có thể được lưu tại đây, bộ nhớ chỉ là tạm thời và bị xoá khi tab bị đóng
localStorage: Dữ liệu được lưu kể cả khi trình duyệt đóng và chỉ xoá nếu ta yêu cầu
Nghe sessionStorage giống với cookie, tuy nhiên sessionStorage sẽ không share giữa các tab với nhau. Tức là cookie sẽ share giữa các tab, nhưng chỉ chung 1 domain (tức là phân biệt bằng tên miền). Còn sessionStorage chỉ lưu trạng thái ở tab hiện tại
JWT Token
Ta đã đi qua cách authentication bằng sử dụng basic authentication, rồi đến token được lưu ở cookie hoặc local/session storage. Tuy nhiên các cách thức này đều yêu cầu token cũng phải được lưu ở phía server.
Tức là mỗi truy vấn vào server, ta lại phải gọi vào database, với hàng triệu, hàng tỉ token ngày càng tăng lên để kiểm tra xem token có tồn tại chưa, có hết hạn chưa, … Chưa kể đến ta còn phải giải mã token ra nếu ta mã hoá nó trong database (thường là có)
Việc này tạo thành một bài toán lớn và ngày càng khó giải khi số lượng user tăng cao
Lúc này, có một giải pháp khác đã được tạo ra, đó là JWT (Json Web Token)
Định nghĩa: JWT hay JSON Web Token là một format thông dụng cho các token ở dạng “self-contained” (chỉ lưu ở client). JWT thường bao gồm các claims (các khẳng định rằng user này có gì, có kia) và các quyền của user. VD, JWT sẽ chứa là user có quyền được vào trang a, trang b, ….
JWT ngoài ra được mã hoá crypto để bảo vệ khỏi các vấn đề bảo mật liên quan
Lưu JWT ở phía Client
Bạn sẽ có câu hỏi: Làm sao để một token chỉ có thể lưu ở client mà không ở server, vậy thì làm sao ta biết là token nào là thoả mãn, chưa bị người khác sửa, thêm quyền kiểu admin vào và cầm token đó đi request server?
Một trong các cách được đề ra có thể xem qua ảnh sau. Tức là khi phía server sinh ra 1 token thoả mãn, ta sẽ thêm 1 key (HMAC) vào đuôi của token.
Hmac được sinh ra từ claims và 1 đoạn key, điều này giúp kiểm tra nếu đoạn claims đã bị sửa đổi thì phần HMAC sẽ không trùng khớp nữa.
Điều này đảm bảo là người khác khi sửa gì đó thì sẽ không thoả mãn nữa do ta có phần đuôi tag để kiểm tra xem. (Server sẽ thử giải mã phần key xem có đúng với ban đầu không, key này chỉ server biết)
Cấu trúc JWT có 3 phần
Header: Chứa các thông tin về kiểu token này dùng mã hoá dạng gì, …
Claims: Phần chứa thông tin ta muốn để trong token, ví dụ quyền của user
HMAC Tag: Phần mã hoá đảm bảo tính toàn vẹn của token
JWT trở lên ngày càng phổ biến ở những năm gần đây do JSON Web Tokens đã được tiêu chuẩn hoá vào 2015. (Trước đây ta gọi những token stateless bên trên là JSON Token). JWT là một chuẩn với chức năng tương tự như ý tưởng JSON Tokens ban đầu, nhưng có một số chức năng thêm:
Một quy định chung cho phần header chứa các thông tin kèm cho JWT, ví dụ như thuật toán mã hoá, …
Một số chuẩn chung về phần claims, là trường nào lưu gì, …
Nhiều thuật toán khác nhau để mã hoá và xác thực.
Tuy rằng JWT chỉ là một quy chuẩn định nghĩa tại https://tools.ietf.org/html/rfc7519, nó được xây dựng từ một tập hợp nhiều quy chuẩn được gọi là JSON Object Signing and Encryption (JOSE). JOSE chứa nhiều tiêu chuẩn sau:
JSON Web Signing (JWS, https://tools.ietf.org/html/rfc7515) định nghĩa cách các JSON Object được xác minh bằng HMAC hoặc các dạng chữ ký số khác
Sự linh hoạt của JWT cũng là điểm yếu lớn nhất của nó, nhiều cuộc tấn công đã xảy ra nhờ vào sự linh hoạt này. JOSE là một tập các phần thiết kế cho phép lập trình viên chọn từ nhiều thuật toán khác nhau, và không phải sự kết hợp nào cũng đem lại tính bảo mật tốt.
VD: Vào năm 2015, (http://mng.bz/awKz) Tim McClean đã tìm ra một lỗ hổng trong rất nhiều thư viện JWT về việc ở phần header, ta có thể sửa nó thành thuật toán khác, và thậm chỉ sửa nó thành “none”. Điều này vô tình bảo các thư viện JWT ở phía backend khi kiểm tra token đã không dùng thuật toán nào để kiểm tra mã hoá, và các phần claims bị sửa trái phép không bị phát hiện. (Hay còn được biết đến là JWT None Attack)
Paseto
Các lỗi trong các quy chuẩn dẫn tới sự phát triển của các công cụ thay thế với hi vọng vẫn chứa các tính năng tương tự nhưng sẽ sửa một số vấn đề của bộ cũ.
Một ví dụ là Paseto, cung cấp các trình mã hoá đối xứng, khoá public, … hỗ trợ xử lý các vấn đề của Jose và các chuẩn JWT chung.
Điểm chung ngắn gọn giữa Paseto và Jose là thay vì cho phép lập trình viên mix giữa nhiều cấu phần khác nhau trong bộ Jose, Paseto chứa một bộ fix cứng chung về thuật toán (AESS, RSA, Ed25519, …), giúp giảm thiểu các vấn đề bảo mật xảy ra.
Một số chuẩn chung trong claims của JWT
Thông thường, phần claims sẽ có các mục sau:
iss
Issuer
Chỉ ra là ai đã tạo ra token này, thường là url của trang đã sinh token.
aud
Audience
Chỉ ra token này dành cho ai, có thể là id của user, …
iat
Issued-At
Thời điểm token được tạo ra
nbf
Not-Before
Token bị cấm nếu dùng trước thời gian này. VD đặt là 2/1 mà dùng vào 1/1 thì không được
exp
Expiry
Thời điểm token hết hạn
sub
Subject
Định danh chủ đề của token, thường là username, id hay gì đó
jti
JWT ID
ID không bị trùng của token, dùng để tra cứu sau này nếu cần
JWT trong Database, xoá token
Các token stateless, chỉ cần ở client side là một cách hay để giảm bớt state khỏi database. Điều này giúp ta scale các api mà không cần nâng cấp nhiều phần cứng database hay phải triển khai nhiều việc hơn.
Tuy nhiên, việc lưu trữ token ở database lại cho phép ta có một quyền năng lớn, đó là có thể revoke, hay quyết định 1 token có hợp lệ hay không, bằng cách chỉ cần xoá nó khỏi database. Hiển nhiên, việc lưu ở database đi kèm rất nhiều vấn đề về scale, có thể là ta cần nhiều database token cho nhiều service nhỏ khác nhau, nếu ta tập trung nó lại, nó có thể là 1 điểm SPOF (Single Point of Failure), 1 điểm nghẽn trong toàn luồng và chỉ cần nó chết, toàn hệ thống sẽ ngỏm do không có khả năng authentication
Có một số cách để xử lý vấn đề này. Ta có thể lưu database, tuy nhiên không lưu toàn bộ token mà chỉ cần 1 id unique nào đó mà có thể link với 1 token, khi huỷ hợp lệ 1 token, ta chỉ cần huỷ id đó, khi token đó được gửi bởi client, ta sẽ giải mã ra id và kiểm tra. Điều này giúp ta giảm bớt phần nào đó về database
Một cách khác là, ta có thể chỉ lưu các token bị huỷ hợp lệ, hay danh sách đen. Khi token được gửi lên ,ta xem nó có trong danh sách đen hay không, thì sẽ từ chối token đó. Các token mà đã hết hạn sử dụng rồi có thể clean up dần đi, giúp database danh sách đen nhỏ
Một cách khác là thay vì block 1 token, ta có thể chỉ chặn 1 số chức năng ở 1 tập hợp tk. Ví dụ, ta thường có chức năng đăng xuất ở mọi thiết bị khác khi ta đổi mật khẩu, để làm điều này, ta có thể thêm vào database toàn bộ token của người dùng trước ngày nào đó đều bị xoá, điều này giúp giảm không gian cần cho database, nhưng đi kèm query phức tạp hơn.
JPA, hay còn được gọi là Java Persistence API. Sau này được đổi tên thành Jakarta Persistence API
JPA giải quyết các vấn đề trong quản lý quan hệ giữa các thực thể, giúp chúng ta map những object Java (POJO – Plain Old Java OBject) thành những bảng trong database, đây là persistence frameworks được sử dụng nhiều nhất trong Java
Để hiểu sâu thêm, hãy đi thêm vào 1 số định nghĩa liên quan
Persistence là gì?
Java Persistence API, Java là tên ngôn ngữ, API ám chỉ rằng đây là một framework cung cấp các api, các logic mà ta dễ dàng sử dụng lại giúp tăng tốc độ phát triển ứng dụng
Vậy Persistence là gì?
Hầu hết toàn bộ các ứng dụng yêu cầu ta cần có persistent data (dữ liệu lâu dài). Persistence là một trong những concept nền tảng trong công nghệ phần mềm. Gần như toàn bộ hệ thống thông tin đều cần lưu trữ những dữ liệu nào đó cho hệ thống. Object persistence nghĩa là các thực thể có thể “sống lâu” hơn các chương trình, có thể lưu trữ trong các nơi quản lý dữ liệu và có thể khởi tạo lại trong chương trình vào thời điểm nào đó.
Ví dụ đơn giản, trong một web mua bán thương mại điện tử chẳng hạn, dữ liệu trong hệ thống thường là các thông tin về sản phẩm, giá bán, nơi bán, … những dữ liệu này luôn được lưu trữ, kể cả web có thể là bị đóng vài phút, nâng cấp lên, … những dữ liệu này luôn “sống lâu” hơn các chương trình code
Khi nói về persistence trong Java, ta thường nói về việc map và lưu trữ các thực thể trong database bằng SQL
Làm việc với cơ sở dữ liệu quan hệ bằng Java qua SQL
Khi làm việc với các database trong ứng dụng Java, hiểu đơn giản thì ta sẽ ra 1 câu lệnh SQL vào database bằng cách nào đó với Java chứ ta không cần viết chay truy vấn vào thẳng cơ sở dữ liệu nữa.
Ban đầu, ta có JDBC (Java Database Connectivity API) hỗ trợ việc ra các câu lệnh SQL vào một cơ sở dữ liệu. Ta sẽ thực hiện câu lệnh truy vấn, nhận được dữ liệu trả về, sau đó xào nấu nó, …
Tuy nhiên các công việc này nhìn chung khá gần theo hướng dữ liệu, data, chứ không có quá nhiều về phần mềm Java. Chúng ta thường muốn có cách nào đó để lấy dữ liệu nhanh từ database, và không phải làm các công việc lặp lại này.
Các câu lệnh truy vấn đa phần thường dễ bị lặp lại. Giả sử bạn có 1 hệ thống quản lý sinh viên, môn học, lớp học, giáo viên, … Như thông thường, ta phải viết câu lệnh sql để lấy toàn bộ sinh viên, lấy thông tin 1 sinh viên theo tên, theo tuổi, thêm 1 sinh viên, xoá 1 sinh viên, …. mọi thứ thủ công. Rồi làm y vậy với các đối tượng giáo viên, lớp học, …. Nhìn chung các task này lặp đi lặp lại và tốn thời gian, công sức, chưa tính đến nhiều vấn đề bảo mật, viết sai bug khi viết sql chay như vậy.
Hiển nhiên, 1 số thời điểm ta vẫn cần viết sql để custom theo ý mình cho các vấn đề hiệu năng, tuỳ biến, …. nhưng nếu có cách nào đó để giảm thiểu các công việc làm việc với database hơn.
ORM
Ngắn gọn thì, object relational mapping (ORM) là một cách để tự động, đóng gói để map qua lại giữa các dữ liệu database và các class trong Java. Tức là một cái ở giữa để chuyển hoá giữa 1 table lưu thông tin SinhVien với 1 class SinhVien trong java chẳng hạn.
JPA, Hibernate, Spring Data là gì
JPA là gì
Lúc này JPA như đã định nghĩa cơ bản bên trên, JPA sẽ là một bản vẽ, định nghĩa ta phải làm gì để lưu trữ và làm việc với object như 1 ORM bên trên, bao gồm việc lấy dữ liệu object từ 1 database, rồi biến nó thành 1 object được tạo ra từ 1 class Java chẳng hạn.
Hibernate sẽ là một tầng bên trên, triển khai từ JPA, định nghĩa logic code thực sự là sẽ triển khai như thế nào.
Có thể ví dụ đơn giản. JPA sẽ chứa rất nhiều hàm là để làm việc thì ta sẽ cần có các hàm lấy dữ liệu theo trường nào đó, tìm dữ liệu theo trường nào đó (select + filter sql), xoá 1 row trong database, …
Hibernate là gì
Hibernate là 1 JPA Provider, tức là một Provider, một cái triển khai “JPA”
Hibernate sẽ implement interface đó, và là cái có code logic triển khai các hàm trên, tự động sinh ra các câu lệnh sql theo nhu cầu. Tức là ta chỉ cần gọi hàm getAllByName() gì đó, hibernate sẽ tự sinh truy vấn sql, chạy xuống JDBC rồi database để làm việc, ta không cần tự viết sql query đó nữa. Ngoài ra, sau khi lấy dữ liệu xong, nó sẽ tự map dữ liệu database thành các object Java luôn để làm việc.
Ngoài ra Hibernate còn có nhiều chức năng như đảm bảo phiên trong database, session, ….
Spring Data JPA là 1 tầng bên trên nữa triển khai Hibernate, có những chức năng cùng framework Spring, cho phép mở ra nhiều khả năng hơn nữa như từ việc đặt tên hàm có thể tạo được các query phức tạp, …
Chính xác thì Spring Data JPA có thể chạy với các “JPA Provider” khác nhau, tức là một số khác nào triển khai lại JPA có thể dùng với Spring Data JPA
Tổng kết
JPA định nghĩa các phần sau
Một phương tiện chỉ định việc ánh xạ, map giữa các dữ liệu persistent trong database và thông tin của nó với các class trong Java. JPA sử dụng rất nhiều Java annotations để làm việc này, ngoài ra ta có thể viết nó trong file XML (thêm minh hoạ bên dưới)
API để thực hiện các thao tác CRUD cơ bản với các class java và có thể gọi xuống database để làm việc tương tự. (CRUD – Create/Tạo, Read/Đọc, Update/Cập nhật, Delete/Xoá)
Thực hiện các thao tác transaction, có thể lấy dữ liệu theo association (ví dụ 1 sinh viên có nhiều môn học, có thể hiểu việc đó và khi lấy 1 sinh viên sẽ lấy luôn các môn học), thêm 1 số tính năng tối ưu khác, các chiến lược cache, …
Hibernate triển khai JPA và làm các công việc sau
Hiệu suất – Giảm thiểu nhiều công việc lặp đi lặp lại để query dữ liệu, giúp ta có thêm thời gian tập trung vào code logic bên trên hơn
Bảo trì – Do tự động mapping (ORM) của hibernate, giúp giảm thiểu số lượng code, giúp hệ thống dễ hiểu hơn, dễ bảo trì hơn.
Hiệu năng – Nhìn chung thì việc tự viết sql trong các case đặc biệt giúp ta dễ control và có performance mong muốn hơn, tuy nhiên trong một số tác vụ thường thấy, hibernate giúp hiệu năng tốt hơn, tự động, hỗ trợ các cơ chế caching ở tầng ứng dụng
Độc lập – Hibernate có thể làm việc với Postgres, MySQL …. mà không phụ thuộc vào 1 nền tảng hay sql của nền tảng đó
2005 — Hexagon (Ports and Adapters) (Khối lập phương – Cổng và bộ chuyển đổi)
Trước đó, các tầng của chúng ta chỉ đi từ trên xuống theo thứ tự. Với việc sử dụng dependency inversion, mọi thứ đều đã thay đổi
Đây như là một thế giới mới cho các kỹ sư phần mềm. Ta có thể kiểm soát được hướng của sự phụ thuộc theo cách ta muốn. Lúc này, business logic sẽ không gọi xuống tầng data access nữa. Để đọc thêm về dependency inversion, bạn có thể tham khảo bài sau:
Thay vì những layer hình chữ nhật như ban đầu, lúc này, ông đã vẽ một hình lục phương, trông có vẻ khá phức tạp hơn một cấu trúc đa tầng ban đầu, tuy nhiên nó lại khá đơn giản
Điều gì đã xảy ra trong hình minh hoạ trên? Như ta thấy, lúc này Domain đã là thành phần ở giữa và là trung tâm của toàn bộ hệ thống, nó không còn phụ thuộc vào bất kì thứ gì khác nữa
Để thể hiện việc tầng Domain đã là trung tâm, tầng Business Logic/Domain được đặt tên là Core
Các module khác được chia thành 2 phần. Lúc này, với 1 class thực hiện các công việc, ví dụ Repository làm việc với dữ liệu thì không chỉ còn là 1 class concrete mặc định nữa, mà được chia làm đôi thành phần ảo (interface) và phần triển khai thật sự (code logic class). Các phần interface định nghĩa các phương thức mà class logic cần triển khai được đặt tên là ports (cổng)
Các phần triển khai code thực tế nằm trong các module bên ngoài, và được gọi là adapters
Rõ ràng, ta thấy các logic Domain/Core của hệ thống giờ không còn phụ thuộc vào ai cả, vì nó là những chức năng mà hệ thống bắt buộc phải có, mọi module khác đều chỉ là gắn thêm vào, và phải triển khai các cổng (các interface) mà phần core đã định nghĩa sẵn.
Ví dụ về port, adapter và core của hexagon architecture
Ta có, ví dụ như một chiếc laptop. Các cổng của nó là gì? Ta có cổng hdmi, cổng tai nghe 3.5, cổng sạc, cổng type c, cổng usb, ….
Rõ ràng, khi muốn thêm gì đó cho chiếc laptop, ví dụ ta muốn cắm thêm 1 tài nguyên lưu trữ dữ liệu vào, ta phải dùng 1 chiếc usb, hoặc 1 thẻ nhớ, và chúng phải có khuôn mẫu, đúng với quy chuẩn mà cái laptop đã quy định ra -> tôi có cổng usb như này, nếu muốn cắm gì vào thì phải theo khuôn như thế. Giống như việc, trong core đã có các interface, ta chỉ làm việc với các hàm của interface, module bên ngoài triển khai logic phải triển khai đúng theo bản khuôn mẫu, các hàm đó.
Ví dụ, nếu không dùng interface, nhà sản xuất usb lại tự tạo ra các đầu cắm khác nhau, giờ chẳng lẽ máy tính là một high-level module (một phần quan trọng hơn), lúc sản xuất lại phải theo cái đầu cắm của usb? Điều này không hợp lý
Các ưu điểm rõ ràng
Lúc này các module bên ngoài cắm vào thường độc lập với nhau, và chúng dễ thay thế hơn. Ta đã định nghĩa trước ta cần gì trong core, giờ bên ngoài chỉ triển khai logic lại từ các yêu cầu đó. Nếu ta thay đổi cách gọi lấy dữ liệu từ việc gọi vào database sang đọc ghi trong file excel, ta chỉ thay đổi ở module, và vẫn là hàm getAll() mà core đã quy định. Tương tự với giao diện, cũng là module ngoài, cũng phải làm như vậy.
=> Các module độc lập, dễ thay thế hơn, và phải tuân thủ các quy tắc của core logic
2008 — Onion – Kiến trúc củ hành
Nhìn chung, Onion Architecture vẫn khá tương đồng với Hexagon Architecture, tuy nhiên ở Hexagon, ta có 1 khối ở giữa và ta mong muốn các module chỉ như các thiết bị ngoài cắm vào ổ đó và tách biệt lẫn nhau. Còn ở Onion Architecture, ta có những tầng như những chiếc vòng, và tầng ở vòng bên ngoài phụ thuộc vào tầng bên dưới
Theo 1 cách nhìn nào đó, Onion Architecture có một hướng phụ thuộc khá thẳng như N-Layered, nhưng thực tế ta vẫn áp dụng đảo sự phụ thuộc để cho phép tầng Domain hay Business là tầng dưới cùng của hệ thống
Có một vài điểm thể hiện sự khác biệt ở đây. Là thay vì có 1 core quá lớn và mọi module đều phụ thuộc vào nó đôi khi có thể gây ra một số nhược điểm. Tức là 1 sự thay đổi trong core có thể khiến nhiều module khác nhau phải sửa đổi
Thay vì vậy, ta có một số tầng khác, ví dụ như ở ảnh trên là Application, sẽ wrap lại tầng Domain, Domain sẽ chứa những code mà có ít sự thay đổi, và Application có thể chứa nhiều logic và thường xuyên thay đổi nhiều hơn sẽ nằm ở bên trên.
Có thể cảm giác nó như tính đóng gói của OOP, khi mà những phần bên trong sẽ được wrap lại ở các tầng bên ngoài chứa nhiều logic hơn, và khi phần bên trong hoàn thiện sẽ chứa ít sự thay đổi hơn
2012 — Clean Architecture
Nhìn chung, ta nhận thấy ta vẫn có 1 tầng chứa những phần về logic của Domain/Business, nay được đặt tên là Entities nằm trên cùng, và ta có các tầng khác thuộc module ngoài như Infra (Thường là data access của database), presentation (giao diện) phụ thuộc dần vào trong.
Thực tế, bạn có thể thấy Hexagon, Onion hay Clean Architecture có một cách định hướng khá giống nhau, ở Clean Architecture, Uncle Bob đã thêm 1 số layer bên ngoài như thư viện thứ 3, dll, …
Tổng kết
Nhìn chung, các kiến trúc về sau như Hexagon, Onion, Clean Architecture đều là các cách tiếp cận áp dụng các thủ pháp như Dependency Inversion, … nhằm tập trung vào phần core, domain, … và các module bên ngoài phải được xây dựng dựa theo hệ thống chính, chứ hệ thống chính không đi theo module bên ngoài
Việc triển khai các cấu trúc phức tạp hơn cho phép ta mở rộng dễ hơn về sau khi logic ở core ngày càng tăng lên, tuy nhiên, không có cấu trúc nào là hoàn toàn hoàn hảo và được xây dựng ở các thời điểm khác nhau cho mục đích khác nhau.
Do sự phát triển của microservice, các hệ thống còn được chia nhỏ ra nhiều service nhỏ hơn nữa, khi logic ở mỗi service không quá nhiều, ta dễ dàng có thể triển khai 1 cấu trúc 3 tầng thay vì các cấu trúc quá phức tạp và phải đi qua nhiều tầng để giúp tăng tốc độ triển khai dự án.
This entry is part 1 of 2 in the series API Security
Lời đầu
Trước khi đi vào Session Token hay JWT Token, hay có thể tóm gọn là authentication qua token, ta sẽ đi qua về 1 cách khác để authentication qua các giao thức API, và sau đó sẽ nói về ưu nhược điểm giữa chúng
Http Basic Authentication
Luồng chạy của HTTP “Basic” Authentication như sau:
Khi người dùng truy cập và không có thông tin đăng nhập, hệ thống sẽ trả về 401 (Unauthorized) và thông tin đi kèm là cách để có thể author qua header WWW-Authenticate với thông tin (Ví dụ trên ảnh là yêu cầu Authen qua Basic)
Khi ta truy cập với Header Authorization + Basic + chuỗi mã, lúc này hệ thống sẽ kiểm tra và cho phép có quyền hay không.
Authorization: Basic dGVzdDoxMjPCow==
Ví dụ như mã trên, đoạn mã sau Basic cơ bản là một đoạn String được mã hoá ở dạng base64, bạn có thể decode nó qua các trang base64, ví dụ
Ví như với mã trên, khi decode, ta nhận được đoạn mã test:123£, đây là format của Basic Authen, với đầy đủ là username:password, thì ở đây test là username, và password là 123£
Ưu điểm
Sử dụng đơn giản, luồng không phức tạp, triển khai nhanh
Phù hợp cho authentication trong nội bộ, cho các ứng dụng trên môi trường kiểm thử (non-prod)
Nhược điểm
Toàn bộ request đều sẽ phải gửi username và password, điều này nhìn chung tăng khả năng xảy ra lộ mật khẩu.
Do lần nào cũng gửi mật khẩu, nên nếu bạn mã hoá nó, việc này là một công đoạn khá tốn tài nguyên. Những thuật toán hashing, mã hoá mật khẩu hiện đại có thể tốn tới 100ms (0,1s) để giải mã mật khẩu rồi kiểm tra có đúng không. Điều này hao tốn CPU cho hệ thống
Một số vấn đề khác về UX (giao diện mặc định đăng nhập xấu), vấn đề bảo mật về việc lưu password ở client để gửi đi authen, ….
Token Authentication trong API
Khái niệm
Hiểu đơn giản, thông thường thì authentication bằng token sẽ hoạt động như sau: Tài khoản, mật khẩu, … thông tin user chỉ cần nộp 1 lần, người dùng sau đó sẽ được cấp 1 token, 1 đoạn mã có thời hạn sử dụng. Người dùng sau đó có thể dùng token này để authentication cho đến khi đoạn token hết hạn sử dụng
Ví dụ về token authentication trong thực tế, điều này giống như bạn đi một khu vui chơi. Bạn đã đặt vé từ trước, và để xác minh bạn đã đặt vé chưa, bạn phải xuất trình căn cước công dân, ảnh thẻ, hộ chiếu, …. Thay vì vậy, khu vui chơi sau khi nhận căn cước công dân ở cửa vào, sẽ cấp cho bạn 1 phiếu vé có thời hạn 1 ngày hay gì đó, sau đó bạn dùng phiếu vé này để đi chơi trong khu vui chơi trong thời gian của vé.
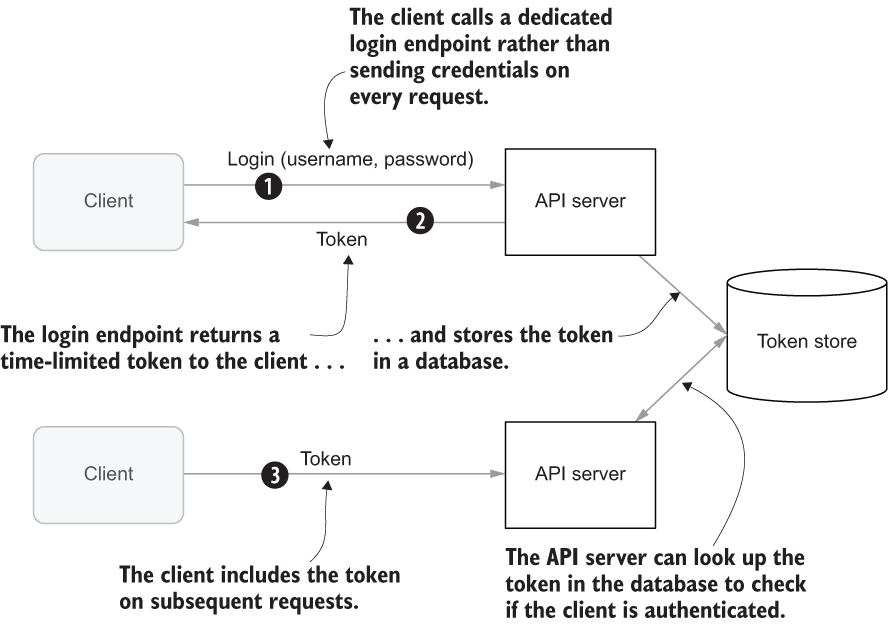
Cách tiếp cận 1: Lưu trữ token trong database
Người dùng lần đầu sẽ gửi thông tin của mình cho server, server sẽ từ đó sinh ra 1 token và lưu nó vào database
Lần sau người dùng sẽ chỉ cần gửi token, và sau đó server kiểm tra token có trong database không, còn hạn sử dụng không, … rồi cho phép người dùng
Việc này khắc phục các điểm:
Đầu tiên, token thường không chứa thông tin mật khẩu, tài khoản, … nữa nên ít lo bị lộ thông tin cá nhân của người dùng hơn.
Giảm bớt các nhược điểm của Basic Authen là phải mã hoá, giải mã mật khẩu, ….
Nếu có vấn đề bảo mật xảy ra, token được cài đặt là có thời hạn, và hơn nữa ta đã lưu ở trong database, ví dụ, bạn bị mất token vào tay người khác, thì thiệt hại cũng được giảm thiểu. Hoặc ta có thể trực tiếp ngăn chặn bằng cách xoá token đó đi trong database.
Session Cookie
Cách triển khai đơn giản nhất của hướng tiếp cận trên, và cũng khá phổ biến là sử dụng cookie. Sau khi người dùng đăng nhập bằng thông tin, phía server sẽ trả về 1 header Set-Cookie trong response để yêu cầu trình duyệt người dùng lưu 1 chuỗi token ngẫu nhiên trong bộ nhớ cookie của trình duyệt
Các request vào trang đó sẽ sử dụng token như 1 header Cookie (do cookie được tạo ra để lưu trữ những thông tin của người dùng trong 1 site)
Ưu điểm
Cookie có nhiều cơ chế về bảo mật có sẵn, ví dụ như cookie chỉ gắn liền với từng tên miền, nên nó luôn đảm bảo không có chuyện ta gửi sang trang khác đoạn cookie chứa thông tin nhạy cảm
Cookie có thể được đánh dấu là Secure, điều này giúp đảm bảo khi gửi kết nối tới trang nào thì cookie chỉ được gửi nếu kết nối đó là Https và đã được mã hoá.
Nhược điểm
Trong thiết kế API theo hướng RestAPI đó là kết nối giữa client người dùng và server nên là stateless http://quochung.cyou/kien-truc-stateful-va-stateless-la-gi/. Đó là server sẽ không lưu trạng thái nào của người dùng giữa các request khác nhau.
Cookies phá vỡ nguyên tắc này vì server lúc này lưu trạng thái của cookie với các client khác nhau. Vào thời điểm đầu khi session cookie được sử dụng, chúng thường là nơi lưu trữ tạm thời 1 số trạng thái của người dùng, ví dụ như 1 giỏ hàng, 1 danh sách sản phẩm đã được chọn mà người dùng chưa thanh toán. (Kiểu khi người dùng chọn rồi, nó không lưu trực tiếp vào database) mà chỉ lưu vào cookie, điều này dễ gây ra một số lỗi bất thường cho website.
Java là một trong những ngôn ngữ lập trình phổ biến nhất hiện nay. Java cung cấp khả năng xây dựng các ứng dụng từ đơn giản đến những ứng dụng hoạt động chặt chẽ, đủ khả năng cho các dự án lớn tầm thương mại (enterprise). Nhờ sự ra đời từ rất sớm, Java có rất nhiều thư viện, tài liệu, code, … và nhiều tài nguyên khác. Từ Java, có thể xây dựng các ứng dụng web, mobile, desktop, các phần mềm cho các lĩnh vực như iOT, …
Trong bài hôm nay, mình sẽ chỉ tập trung vào mảng web của Java. Trong đó có thể kể tới Spring Framework, đây là một hệ sinh thái toàn diện với rất nhiều giải pháp trong phát triển ứng dụng Java, giúp lập trình viên giảm bớt rất nhiều thời gian để xây dựng phần mềm.
Trong bài viết này, ta sẽ đi qua 3 mục có thể nói là core của Spring bao gồm: Spring IOC (Inversion of Control), Dependency Injection (DI), cũng như khái niệm về Bean, Component, … trong Spring
Spring IOC (Inversion Of Control)
Đây có thể nói là các phần cốt lõi của cả Spring Framework. Để nói về tác dụng của nó, hãy thử xem qua bài toán sau:
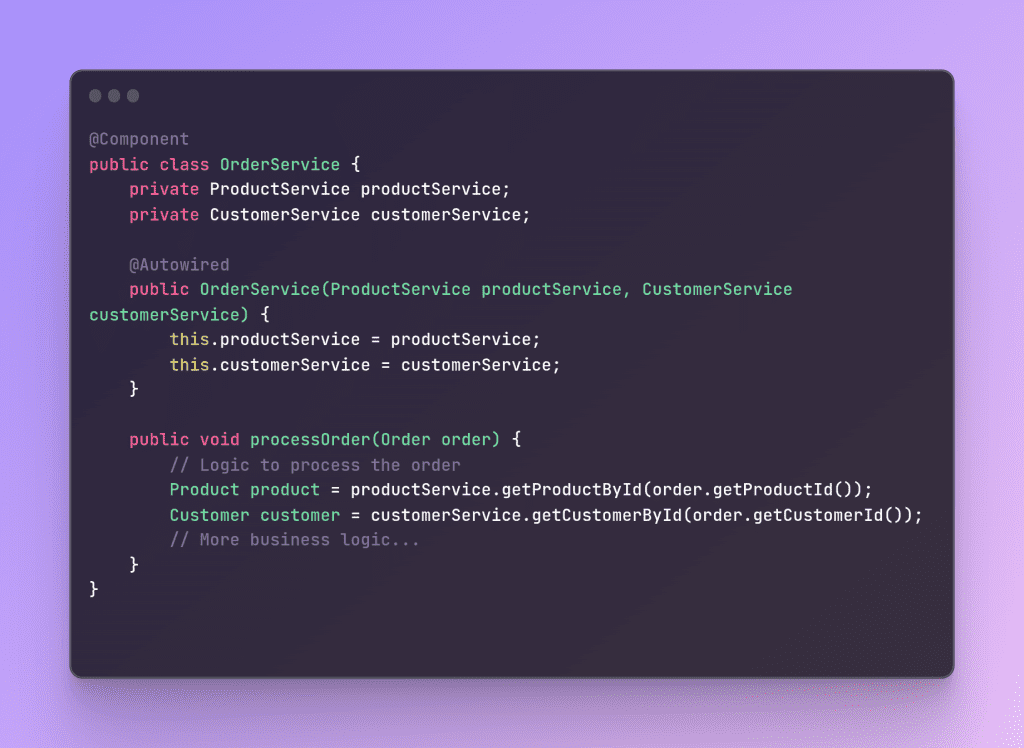
Ta có một class trong Java, chuyên xử lý các đơn hàng mới của một cửa hàng. Lúc này, một đơn hàng sẽ chứa 2 thông tin là id của người dùng (vd KH11), và id của sản phẩm (vd MAYGIAT), ta sẽ cần từ 2 id này, gọi sang 2 class khác là ProductService (quản lý sản phẩm), và CustomerService (quản lý khách hàng), để từ mã id lấy ra thông tin của khách hàng, sản phẩm rồi sau đó xử lý sâu hơn (Tạo ra đơn hàng cần thông tin địa chỉ khách hàng, rồi thì giá sản phẩm, …)
Với code thông thường, ta cần làm như sau:
Lúc này, ta cần phải tạo các đối tượng của class con là ProductService và CustomerService một cách thủ công, để quản lý vòng đời của chúng (ví dụ khi nào tạo, khi nào tắt ta bị phụ thuộc vào class OrderService).
Rồi thì, ProductService là một class dạng stateless (các object ProductService khác nhau thường không có gì khác cả, tức là ta cần 1 object là được). Lúc này, ta có thể triển khai sử dụng design pattern Singleton (1 class chỉ tạo ra 1 object duy nhất), nhưng ta cũng phải triển khai thủ công
Rõ ràng, ta thấy vấn đề mệt nhất của việc làm thủ công là “Control – Khả năng điều khiển, quản lý”, ở ví dụ trên, ta đang đưa hết việc quản lý cho OrderService về tạo các object cho class phụ thuộc, ví dụ một class khác cần ProductService thì sao? Ta có thể lại phải new 1 object mới, lúc này ta bị thừa object. Hoặc class đó lại phải tạo ra 1 object con là OrderService, rồi dùng class con của OrderService
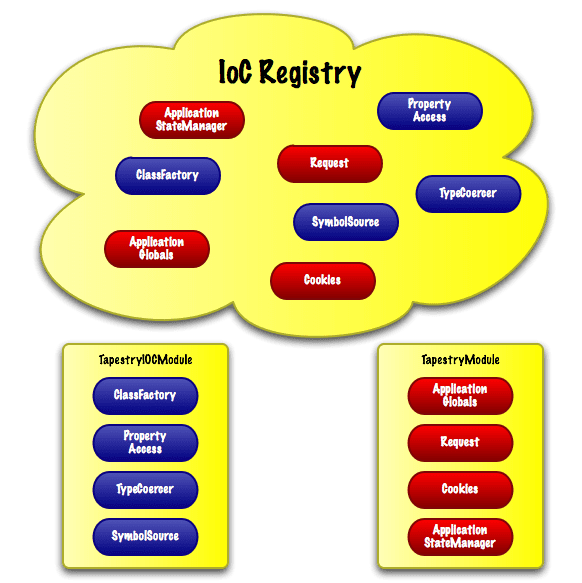
IOC (Inversion of Control) , lúc này các framework IoC hay các IOC Container sẽ là nơi chứa mọi quản lý, control của các object. Nó quyết định vòng đời của các object ta cần dùng, khi nào thì tạo, khi nào thì xoá, ghép cái nào với cái nào
Tưởng tượng nếu làm thủ công, ta sẽ cần 1 class dạng IOCContainer, rồi trong IOCContainer, ta tạo ra hết mọi object cần có. Rồi ở OrderService, ta sẽ gọi IoCContainer.getProductService() chẳng hạn, ở chỗ khác cần cái gì cũng gọi như vậy, lúc này ta dễ dàng quản lý các object này hơn
Lúc này Spring IOC xuất hiện, ta sẽ khai báo các class cần được quản lý bởi Spring IoC là Bean (sẽ nói thêm ở dưới). Khi nào cần dùng tới class nào, ta chỉ việc sử dụng DependencyInjection để gắn chúng lại với nhau.
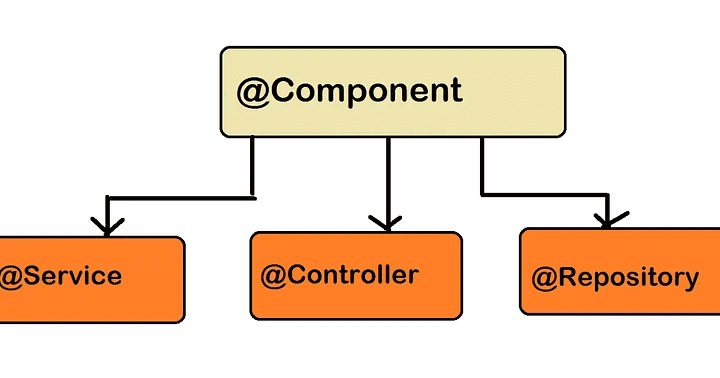
Trong Spring, @Component là một annotation để đánh dấu cho Spring biết class nào là một Component (cấu phần) hay Bean mà Spring sẽ quản lý. Các annotation @Service, @Controller, @Repository cũng hoạt động tương tự.
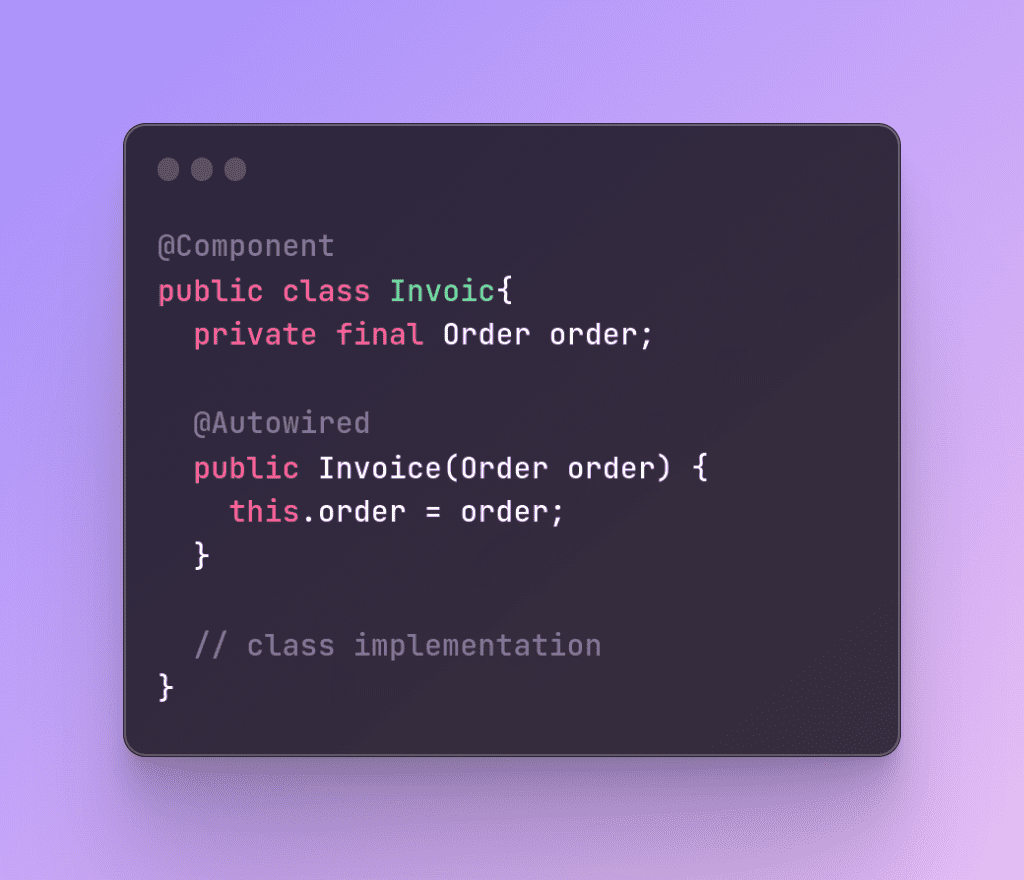
Và khi khai báo cả 2 class là Component, ta có thể kết nối chúng qua Dependency Injection (bạn có thể tham khảo thêm bên trên)
Spring lúc này sẽ tự động ghép nối 2 class trên vào thời điểm được chạy lên.
Bean
Bean trong Spring là annotation để định nghĩa 1 bean. Thường chúng được dùng cho các class utils (hỗ trợ ngoài), hoặc class ở bên thứ 3, mà không nằm trong luồng logic core.
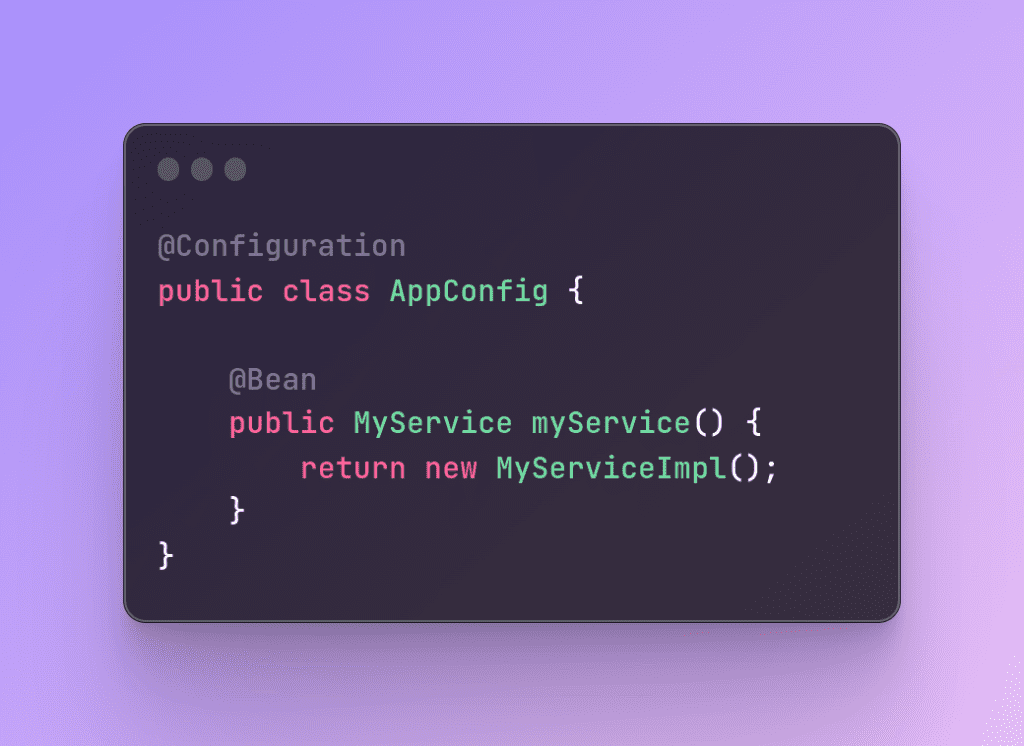
@Bean cần được khai báo trong 1 class có annotation @Configuration. Ta có thể khai báo nhiều bean khác nhau.
Ví dụ ta có thể tạo 1 bean BCryptPasswordENcoder để mã hoá mật khẩu, sau đó có thể sử dụng chúng trong class UserService. Spring tự biết ghép chúng lại với nhau’
Câu hỏi thêm
Ngoài các khái niệm cơ bản như vậy, ta biết rằng mặc định các bean khi khởi tạo sẽ là singleton, ta có thể chỉnh nó thành các kiểu khác, ví dụ sẽ là tồn tại nhiều bean khác nhau của 1 class, … bằng cách đặt scope cho chúng. Tham khảo thêm tại: https://docs.spring.io/spring-framework/reference/core/beans/factory-scopes.html
Lúc nào thì dùng Component, lúc nào thì dùng Bean? Điều này tuỳ vào dự án của bạn, thường thì annotation @Bean sẽ dùng cho các class của bên thứ 3, không nằm chính trong luồng usecase, hay context của dự án và @Component thì ngược lại
Kiến trúc Microservice nói một cách đơn giản, là việc ta chia nhỏ một hệ thống lớn thành nhiều service nhỏ để xử lý các công việc riêng biệt với nhau. Việc chia nhỏ hệ thống lớn đem đến rất nhiều lợi ích, ví dụ như ta có thể có nhiều team dev làm việc trên nhiều phần khác nhau, giúp tăng hiệu suất. Ta có thể giải quyết các bài toán lớn khi mà quá nhiều request tập trung về 1 server, ….
Tuy nhiên nó cũng đi kèm nhiều vấn đề:
Ví dụ trong thực tế, trong quá trình ship hàng, một quá trình xảy ra như sau
Cửa hàng giao đồ cần chuyển cho shipper
Shipper giao hàng tới cho người nhận
Shipper báo lại cho cửa hàng là hàng đã giao
Các công việc này, nếu coi các chủ thể thành 1 kiến trúc monolith, hay “1 khối” sẽ làm hết mọi việc, thì phía cửa hàng sẽ chuẩn bị hàng, giao hàng, rồi thu tiền hết một mình. Nhưng lúc này, ta sẽ chia chúng thành 2 service “nhỏ hơn”
Service cửa hàng: Chỉ chuẩn bị hàng
Service vận chuyển: Vận chuyển hàng và giao hàng
Khi chỉ 1 khối làm việc một mình, cửa hàng luôn biết là hàng đã giao chưa. Nhưng lúc này khi chia làm 2 service, bên vận chuyển phải báo lại cửa hàng để cửa hàng nắm lại thông tin, lúc này, nếu ví dụ bên vận chuyển đã giao hàng, mà không báo lại cho cửa hàng do quên, do lỗi, .. sẽ dẫn đến sự “bất đồng bộ”, một vấn đề rất thường gặp, hay là đảm bảo tính “Consistency” trong kiến trúc Microservice
Pattern Transactional Outbox
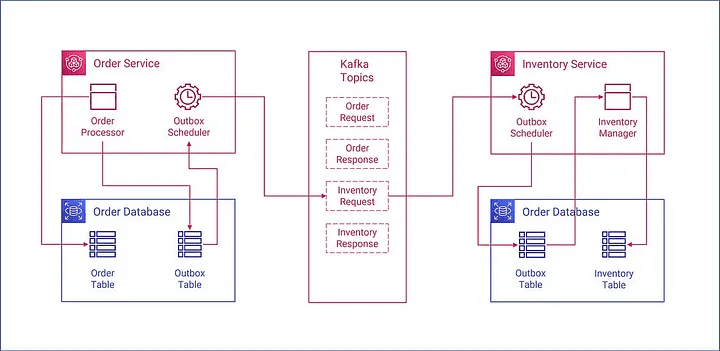
Có nhiều giải pháp cho vấn đề này, một trong số đó là Transactional Outbox, ví dụ hình ảnh và từng bước ở dưới
Một khách hàng đặt một đơn hàng mới
Hệ thống Order Service quản lý đơn hàng cập nhật đơn hàng thành “ĐANG VẬN CHUYỂN” và tạo 1 event “OrderCreated”
Event “OrderCreated” được cho vào message queue: như trong hình ảnh là Kafka
Một hệ thống Outbox Processor khác sẽ liên tục gửi Event yêu cầu cập nhật đến Inventory Service và Notification Service cho đến khi thành công, nếu xảy ra lỗi, nó sẽ thử lại
Các cấu phần
Outbox Entity/Outbox Table: Chứa các Event
Outbox Persistence Mechanism: Một hệ thống bảo đảm event trong outbox table
Outbox Processor: Một tác vụ background chịu trách nghiệm xử lý event khỏi Outbox
Liên tục gọi vào table của table định kỳ xem có event nào mới không
Nếu có, gửi event mới đến các message queue
Xử lý việc thử lại nếu thất bại
Một số câu hỏi
Q: Tại sao khi tạo một order ở phía order-service chẳng hạn, ta không gửi thẳng luôn 1 message đến message broker ở giữa là kafka, … rồi phía payment-service sẽ consume message đó thôi, tại sao cần 1 table outbox?
A: Sẽ có 2 vấn đề khi làm như vậy
1. Ví dụ, nếu order-service chưa cập nhật trạng thái, mà đã send message cho message queue rồi, thì sẽ không đảm bảo tính nhất quán. Message chỉ nên được gửi khi transaction ở local database đã commit, còn nếu bị rollback theo ACID, thì message cũng không được gửi. Tức là message cũng nên nằm trong 1 transaction của Database. Ví dụ nó đã commit xuống database local rồi, nhưng mà crash nên không gửi được message
2. Message thì đã được gửi rồi, nhưng mà transaction ở local chưa run xong, và sau đó nó fail nên roll back lại, nhưng mà message đã gửi rồi
Thì lúc này ta sẽ lưu các event, hay message chuẩn bị gửi đi ở phía local database. Điều này đảm bảo là toàn bộ transaction ở local đã hoàn thành, hoặc đã rollback hết, rồi mới sẽ gửi message đi, bằng việc liên tục gọi về local để gửi message đi
Ưu điểm/Nhược điểm
Ưu điểm:
Dữ liệu được đảm bảo nhất quán
Giảm bớt sự phụ thuộc quá chặt giữa các service
Nhược điểm:
Tăng thêm độ phức tạp do có thêm việc scan bảng outbox, giảm hiệu năng
Tăng thêm tài nguyên lưu trữ bảng outbox, ta lại phải làm thêm cơ chế cleanup event nếu nó grow quá lớn
Có thể xảy ra trường hợp gửi nhiều hơn 1 message, vì vậy message broker hoặc phía nhận cần đảm bảo tính idempotent. (Tức là dù có gửi bao nhiêu request cùng 1 loại thì kết quả không đổi và như request đầu tiên). Ví dụ: lưu lại id message để không xử lý lại nếu đã xử lý rồi