[Java Core] B1: Tại sao nên học Java, syntax cơ bản

This entry is part 1 of 8 in the series Java Core

Giới thiêu về Java

Ngôn ngữ lập trình Java được thiết kế để trở thành một ngôn ngữ không phụ thuộc vào nền tảng (machine-independent). Java có thể chạy trên bất kỳ nền tảng nào miễn là có máy ảo Java (Java Virtual Machine – JVM). Máy ảo Java là một chương trình có thể chạy trên nhiều nền tảng khác nhau mà không cần phải biên dịch lại. Máy ảo Java có thể chạy trên các máy tính, điện thoại, máy tính bảng, máy chủ, … Máy ảo Java có thể được cài đặt trên các hệ điều hành khác nhau như Windows, Linux, Mac OS, …

Java vừa đủ mạnh với nhiều thư viện, tính năng, bảo đảm các sự chặt chẽ, nhưng cũng đồng thời chạy rất nhanh. Java có thể được sử dụng để phát triển các ứng dụng desktop, web, mobile, game, … Java cũng là một trong những ngôn ngữ lập trình được sử dụng nhiều nhất hiện nay.

Điều cần nói

  • Q: Tại sao Java ra đời, tại sao cần hướng đối tượng chứ không code hết vào 1 file
  • A: Trước khi Java ra đời, các ngôn ngữ lập trình khác như C/C++ đã ra đời. Tuy nhiên, các ngôn ngữ này có một số hạn chế như sau:
    • Các ngôn ngữ này không thể chạy trên nhiều nền tảng khác nhau, mà phải biên dịch lại cho từng nền tảng khác nhau. Ví dụ như C++ trên Windows và C++ trên Linux là 2 ngôn ngữ khác nhau, nên phải biên dịch lại.
    • Các ngôn ngữ này không có khái niệm về hướng đối tượng, nên không thể phát triển các ứng dụng lớn, phức tạp.
    • Cơ chế hướng đối tượng của Java giúp chương trình trở thành các đối tượng làm việc với nhau, giúp cho việc phát triển các ứng dụng lớn, phức tạp trở nên dễ dàng hơn. (Sẽ nói sâu hơn vào phần sau)

Ba thành phần nền tảng Java không thể thiếu và cách chúng hoạt động cùng nhau trong các ứng dụng Java của bạn. Cụ thể:

  • JDK (Java Development Kit – Bộ công cụ phát triển Java)
  • JRE (Java Runtime Environment – Môi trường thực thi Java)
  • JVM (Java Virtual Machine – Máy ảo Java)
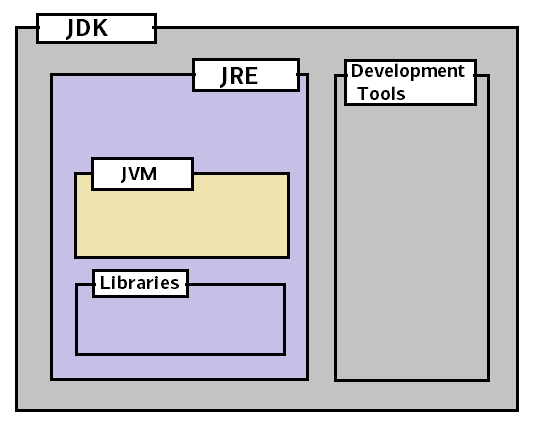
JDK JRE JVM - quochung.cyou PTIT

Cách Java thực hiện một đoạn code như sau:

  • Với các file code ví dụ là Party.java, nó sẽ được biên dịch bởi trình biên dịch javac trong JDK để tạo ra file Party.class chứa các bytecode.
  • Các file .class và các thư viện cần có cho Java sẽ được tổng hợp bởi JRE
  • Từ các đoạn mã máy trên, JRE sẽ đưa cho JVM để thực thi, và chạy một “máy ảo” độc lập để thực thi chương trình của chúng ta.

Điều đó nghĩa là, chương trình chúng ta đang chạy “tách biệt” với hệ thống (chạy trong JVM). Vậy nên với Java ta chỉ cần viết một lần, biên dịch một lần và nó có thể chạy ở mọi nền tảng mà JVM hỗ trợ. Khả năng đó được lý giải vì khác với các ngôn ngữ như C hay C++, Java được thiết kế theo nhiều lớp khác nhau để tách biệt giữa chương trình Java và hệ thống.

Java Virtual Machine (JVM)

Không như C/C++ khi mà code được biên dịch thì sẽ tạo thành các mã lệnh được làm cho riêng các vi xử lý khác nhau. Code java đầu tiên được biên dịch thành một dạng tổng quát – bytecode, là ngôn ngữ cho JVM chạy. Sau đó JVM mới chạy thành các ngôn ngữ máy cho nền tảng đó.

image 3 - quochung.cyou PTIT

Trình tự hoạt động:

  • Bạn tạo ra một đoạn code (source) với đuôi .java
  • javac compiler biến nó thành 1 file .class
  • File .class sẽ được đọc bởi JVM, và chuyển thành bytecode để chạy trên các nền tảng khác nhau.
image 2 - quochung.cyou PTIT

Điều cần nói

  • Tóm lại, Java sẽ không compile code ra thẳng mã máy, mà sẽ compile ra dạng .class đặc biệt, gọi là bytecode. Sau đó, JVM sẽ đọc bytecode này, và chuyển nó thành mã máy để chạy trên nền tảng đó.

Ưu điểm:

  • Khả năng độc lập với nền tảng, chỉ cần có JVM là được. Người dùng cuối, thiết bị cuối không cần cài cả bộ mingw như C++, họ chỉ cần JVM (là một phần nhỏ trong bộ JDK để lập trình), tức là bộ chỉ dùng để chạy thôi, và bộ thư viện này có sẵn trên hầu hết các thiết bị hiện nay.
  • Do chạy trên máy ảo, nên có tính bảo mật cao hơn, do mỗi chương trình là một máy ảo khác nhau

Nhược điểm:

  • Chậm hơn C++, vì phải chạy trên máy ảo. Code không được ra thẳng mã máy để chạy cho nhanh, và phải qua 1 tầng nữa để JVM biên dịch thành mã máy. Ví dụ: các thiết bị Android theo cơ chế này nên chúng thường mở ứng dụng chậm hơn IOS, và dùng tài nguyên nhiều hơn. Tuy nhiên những lần mở sau thì nhanh hơn, vì JVM đã biên dịch thành mã máy rồi, nên chỉ cần chạy mã máy thôi.
  • Có thể nói sâu hơn nếu muốn: JVM ngày xưa thì chỉ có cơ chế JIT (Just In Time – vừa đúng lúc), tức là khi nào cần mở ứng dụng thì nó mới biên dịch .class thành mã máy, khi biên dịch nó sẽ tự động tối ưu code, tối giản file, … để lần sau nhanh hơn. Sau này nó có thêm cơ chế AOT (Ahead Of Time – trước thời gian), tức là khi cài đặt ứng dụng, nó sẽ biên dịch luôn thành mã máy, để lần sau mở ứng dụng sẽ nhanh hơn. Tuy nhiên, cơ chế này sẽ làm tăng dung lượng file cài đặt, và cũng làm tăng thời gian cài đặt.

Cấu trúc chương trình Java

  • Trong file source code, chứa “class” (lớp)
  • Mỗi “class” chứa nhiều “method” (hàm) khác nhau.
  • Mỗi “method” chứa nhiều “statements” (dòng lệnh) khác nhau.

Ví dụ 1 file class:

image 1 - quochung.cyou PTIT
``` 

public class HelloWorld {
    public static void main(String[] args) {
        System.out.println("Hello World!");
    }
}

```
  • Khi một dự án Java chạy, JVM sẽ tìm class bạn để là class đầu tiên khởi chạy, rồi sau đó tìm đến method main để chạy.
image - quochung.cyou PTIT
public static void main(String[] args) {
   // đây là hàm đầu tiên được chạy
}

2. Bắt đầu với Java

2.0 Sắp xếp các element trong 1 chương trình Java

ElementMô tảBắt buộc cóĐể ở đâu
Packagepackage abc;KhôngĐầu file
Importimport abc;KhôngSau package
khai báo classpublic class abc {Sau import
khai báo biếnint a;KhôngBất cứ đâu
khai báo hàmpublic void abc() {KhôngBất cứ đâu

Package là gì:

  • Tưởng tượng package như cây thư mục thôi, nó giúp chúng ta phân loại các file code của chúng ta, để dễ quản lý hơn. Ví dụ như chúng ta có 1 project lớn, có 1000 file code, thì chúng ta sẽ phân chúng thành các package nhỏ, ví dụ như package com.company.project1com.company.project2, … để dễ quản lý hơn.
JVM
  • Giả dụ ta có cấu trúc thư mục như sau

anhclb
└── anhfirstmeet
    ├── 2020
    │   ├── QuocHung.png
    │   └── PMA.png
    └── 2021
    │   ├── QuocHung.png
    │   └── PMA.png

  • Thì chỉ cần nhìn vào đây, có 2 file ảnh QuocHung, nhưng người ta biết ngay là 2 file ảnh khác nhau, vì nó nằm trong 2 thư mục khác nhau. Tương tự, package cũng giúp chúng ta phân loại các file code của chúng ta, để dễ quản lý hơn.
  • Ví dụ package thư mục chuyên chứa các class xử lí tác vụ (như java.util), các thư mục chuyên chứa code xử lí thuật toán (như algorithm trong C++)

2.1. Nhập, xuất

Ví dụ đơn giản về nhật xuất trong Java:

import java.util.Scanner;

publicclassSayHelloExample {
    publicstaticvoidmain(String[] args) {
        Scannerscanner=newScanner(System.in);

        System.out.print("Enter your name: ");
        Stringname= scanner.nextLine();

        System.out.println("Hello " + name + "!");
    }
}

Để bắt đầu ta sẽ đến với các hàm xuất:

  • System.in.println() để in ra và xuống dòng
  • System.in.print() để in nội dung thông thường

Với việc nhập ta sẽ cần khai báo một đối tượng Scanner thuộc package java.util. Sau đó, ta có thể sử dụng các hàm .next().nextInt(),… để lấy dữ liệu theo dạng token hoặc .nextLine() để lấy cả dòng.

Bài tập

  • Cho số bộ test, mỗi bộ test nhập vào 2 số a, b. In ra a/b làm tròn đến 2 dấu phẩy thập phân theo format như sau:
  • Bo test 0001: 1/2 = 0.50
  • Bo test 0002: 1/3 = 0.33
  • Yêu cầu sử dụng printf

Điều cần nói

  • Một chương trình nhập xuất cơ bản như trên cho ta mường tượng về sự hướng đối tượng chặt chẽ của Java
  • Ví dụ trong C++, để nhập ta có cin, để xuất có cout, trong Python để xuất có printf, trong C cũng là printf, sao Java lại phải dài tận System.out.printf như vậy ?
  • Đó là vì trong Java, mọi thứ đều là đối tượng, nên để xuất ra màn hình, ta phải gọi đến hàm printf của đối tượng System.out. Đây là một trong những điểm khác biệt giữa Java và các ngôn ngữ khác. Điều này thể hiện sự tường minh tuyệt đối
  • Ví dụ trong C++ hay Python như trên, cái gì đang in ra ? Hàm in ra được gọi từ hư không, chẳng có gì khởi nguồn cả, còn Java thì không, ta phải gọi đến hàm printf của đối tượng System.out, nó là một đối tượng thực sự, nó có một hàm printf, và ta gọi đến hàm printf của nó. Điều này thể hiện sự tường minh tuyệt đối của Java, mọi thứ đều là đối tượng, không có gì hư không cả.
  • Rõ ràng, chương trình bắt đầu với đối tượng là class Example, sau đó nó tự động chạy hàm main và đang giao tiếp với các đối tượng khác, ở đây là Scanner để nhập vào, và System.out để xuất ra. Điều này thể hiện sự hướng đối tượng chặt chẽ của Java, mọi thứ đều là đối tượng, và chúng đang nói chuyện, giao tiếp với nhau.

2.2. Khai báo biến, câu lệnh rẽ nhánh, vòng lặp

2.2.1. Biến

  • Biến trong Java chia làm 3 loại
    • Local Variables
    • Instance Variables
    • Static Variables
  • Ngoài ra biến trong Java còn dùng để chứa 2 kiểu dữ liệu primitives và references
  • Local Variable là biến được khai báo trong một phương thức, constructor hoặc một khối lệnh. Biến này chỉ có giá trị trong phương thức, constructor hoặc khối lệnh đó. Khi phương thức, constructor hoặc khối lệnh kết thúc, biến này sẽ bị hủy. (Ví dụ trong hàm main ở trên, biến name là một local variable, và chỉ dùng được trong hàm main đó)
  • Instance Variable là biến được khai báo trong một class, nhưng bên ngoài các phương thức, constructor hoặc khối lệnh. Biến này có thể được truy cập bởi bất kỳ phương thức, constructor hoặc khối lệnh nào của class đó.

Ví dụ:

publicclassExample {
    public String name; // instance variablepublicvoidsayHello() {
        Stringmessage="Hello " + name; // local variable
        System.out.println(message);
    }
}

  • Static Variable là biến được khai báo trong một class, nhưng bên ngoài các phương thức, constructor hoặc khối lệnh. Biến này có thể được truy cập bởi bất kỳ phương thức, constructor hoặc khối lệnh nào của class đó. Tuy nhiên, biến này chỉ có một bản thể duy nhất, không phải mỗi đối tượng sẽ có một bản thể riêng.

Ví dụ:

publicclassExample {
    publicstaticintcount=0; // static variablepublicExample() {
        count++;
    }
}

  • Như trên, nếu không có static thì mỗi class example tạo ra nhiều object con thì count là khác nhau, còn hiện tại, count là độc nhất, gắn chặt với class Example, không phải với object con của nó.

2.2.2. Câu lệnh rẽ nhánh

  • Nhìn chung, câu lệnh rẽ nhánh trong Java cũng giống với C và C++
if (condition1) {
    //do something
} elseif (condition2) {
    
} else {
    
}

Câu hỏi

  • Q: Có dùng được kiểu while(1) trong Java như C++ không?
  • A: Không, trong Java thì boolean và integer là 2 kiểu dữ liệu khác nhau, không thể dùng chung được. Trong Java, để tạo vòng lặp vô hạn, ta sẽ dùng while(true) thay cho while(1).
  • Lí do cho điều này là vì trong C++, 0 là false, 1 là true, 2 cũng là true, nói chung số dương là true. Điều này làm rối loạn cho người mới lập trình, không đủ tường minh, nên trong Java, boolean và integer là 2 kiểu dữ liệu khác nhau, không thể dùng chung được.

Câu hỏi

  • Q: Liệu viết nhiều class có phải viết hàm main hết cho chúng không
  • A: Không, chỉ cần viết một class có hàm main là được. Các class khác có thể không có hàm main, hoặc có hàm main nhưng không được gọi đến. Class chính có hàm main sẽ khởi động lên ,rồi gọi vào các class khác.
  • Một comment bắt đầu bằng hai dấu gạch //
// đây là comment

2.2.3. Vòng lặp

Nhìn chung, vòng lặp trong Java cũng giống với C và C++

  • Câu lệnh lặp for
for (int i = 0; i < 10; i++) {
    // thực hiện câu lệnh này 10 lần
}
  • Câu lệnh lặp while
while (true) {
    // thực hiện câu lệnh này mãi mãi
}
  • Câu lệnh lặp do-while
do {
    // thực hiện câu lệnh này ít nhất 1 lần
} while (true);

Lệnh lặp for gồm 3 phần trong ngoặc tròn:

  • Phần init dùng khởi tạo biến đếm
  • Phần condition chỉ định điều kiện lặp tiếp
  • Phần increment dùng tăng, giảm biến đếm, để tới lúc nào đó điều kiện trở thành false.

Java có một vòng lặp khác, gọi là foreach nhưng vẫn dùng từ khóa for, nhưng theo cú pháp khác.

int[] a = { 1, 2, 3 };
for (int e: a)

Các kiểu dữ liệu nguyên thủy

Kiểu dữ liệuKích thướcGiá trị tối thiểuGiá trị tối đaMô tả
byte1 byte-128127Lưu trữ các số nguyên có dấu
short2 bytes-32,76832,767Lưu trữ các số nguyên có dấu
int4 bytes-2,147,483,6482,147,483,647Lưu trữ các số nguyên có dấu
long8 bytes-9,223,372,036,854,775,8089,223,372,036,854,775,807Lưu trữ các số nguyên có dấu
float4 bytes1.40129846432481707e-453.40282346638528860e+38Lưu trữ các số thực
double8 bytes4.94065645841246544e-324d1.79769313486231570e+308dLưu trữ các số thực
boolean1 bittruefalseLưu trữ các giá trị logic
char2 bytes‘\u0000’ (or 0)‘\uffff’ (or 65,535 inclusive)Lưu trữ các ký tự/ chữ cái Unicode

Mảng trong Java

  • Mảng trong Java là một tập hợp các phần tử có cùng kiểu dữ liệu. Mảng trong Java có thể chứa các kiểu dữ liệu nguyên thủy như int, float, double, char, … hoặc các đối tượng như String, … Mảng trong Java có độ dài cố định, nghĩa là khi khai báo mảng, ta phải xác định được số lượng phần tử của mảng đó. Mảng trong Java có thể là mảng một chiều, mảng hai chiều, mảng ba chiều, … Mảng trong Java có thể được khai báo như sau:
// Khai báo mảng một chiềuint[] a = newint[10];

int[] b = {1, 2, 3, 4, 5};

// Khai báo mảng hai chiềuint[][] c = newint[10][10];

int[][] d = {{1, 2, 3}, {4, 5, 6}, {7, 8, 9}};

Điều cần nói

  • Một lần nữa ta thấy được sự chặt chẽ của Java. Ở đây, như ta nhớ, để khai báo 1 biến ta phải theo syntax sau:
  • <kiểu dữ liệu> <tên biến> = <giá trị>;
  • Vậy ở đây, int[], double[] coi cả cục này là kiểu dữ liệu “mảng” (array), và a, b là tên biến, và new int[10] là giá trị của biến đó. Vậy, ta có thể hiểu là a, b là 2 biến kiểu mảng, và giá trị của nó là 2 mảng có 10 phần tử, và các phần tử đó có kiểu int.
  • Điều này khác với C++, vì kiểu dữ liệu là kiểu dữ liệu, chứ không có chuyện trong kiểu dữ liệu lại có cả số lượng phần tử như c++

Trong C++ trông nó như sau:

int a[10];

Các phương thức so sánh

Phương thứcMô tả
<Nhỏ hơn
<=Nhỏ hơn hoặc bằng
>Lớn hơn
>=Lớn hơn hoặc bằng
==Bằng
!=Không bằng
&&
||Hoặc
!Phủ định
? :Toán tử 3 ngôi

Ôn lại cuối buổi

3. Tại sao Java lại ra đời, tại sao cần hướng đối tượng chứ không code hết vào 1 file

  • A: Trước khi Java ra đời, các ngôn ngữ lập trình khác như C/C++ đã ra đời. Tuy nhiên, các ngôn ngữ này có một số hạn chế như sau:
    • Các ngôn ngữ này không thể chạy trên nhiều nền tảng khác nhau, mà phải biên dịch lại cho từng nền tảng khác nhau. Ví dụ như C++ trên Windows và C++ trên Linux là 2 ngôn ngữ khác nhau, nên phải biên dịch lại.
    • Các ngôn ngữ này không có khái niệm về hướng đối tượng, nên không thể phát triển các ứng dụng lớn, phức tạp.
    • Cơ chế hướng đối tượng của Java giúp chương trình trở thành các đối tượng làm việc với nhau, giúp cho việc phát triển các ứng dụng lớn, phức tạp trở nên dễ dàng hơn. (Sẽ nói sâu hơn vào phần sau)
  • Ví dụ: thay vì code hết code vào 1 file HopThu, chuyên làm mọi việc xử lí email, … ta chia làm 3 class GuiThu, NhanThu, ThungRacThu, làm chỉ nhiệm vụ như tên của nó
  • Khi có lỗi xảy ra, ví dụ gửi thư, ta chỉ cần sửa class GuiThu, không cần sửa cả class NhanThu, ThungRacThu, … như vậy sẽ dễ dàng hơn rất nhiều. Giusp debug 1 luồng đơn giản hơn, dễ maintain, dễ scale hơn.
  • Nhược điểm là về lâu về lại, số lượng class sẽ tăng lên cao rất nhiều, và sẽ khó quản lý hơn.
  • Điều đó buộc chúng ta đặt tên file, đặt package sao cho chuẩn, cho tường minh là điều vô cùng quan trọng, để sau này dễ quản lý hơn.

4. Có thể có 2 hàm main trong 1 chương trình không

  • A: Có, nhưng khi chạy, JVM sẽ chỉ chạy hàm main đầu tiên, và bỏ qua các hàm main khác.

5. Tại sao cần chia JDK và JRE và JVM ra làm 3 phần

  • A: Để cho việc phát triển và chạy ứng dụng trở nên dễ dàng hơn. Ví dụ, khi ta phát triển ứng dụng, ta chỉ cần cài đặt JDK, và khi ta cần chạy ứng dụng, ta chỉ cần cài đặt JRE. Nếu ta cần chạy ứng dụng trên nhiều nền tảng khác nhau, ta chỉ cần cài đặt JVM cho từng nền tảng đó. Thiết bị cuối không cần cài toàn bộ thư viện để code, nó chỉ cần chạy thôi

6. Tại sao Java lại chạy trên máy ảo

  • A: Vì máy ảo có các tiện ích là:
    • Có thể chạy trên nhiều nền tảng khác nhau
    • Có thể chạy nhiều ứng dụng khác nhau cùng lúc

[Java Memory 1] Escaping References trong Java, Call-by-value và sử dụng Defensive copying. Biến trong Java lưu thế nào

This entry is part 1 of 2 in the series Java Memory

Mở đầu: Tại sao cần học quản lý bộ nhớ trong Java

  • Đã bao giờ bạn gặp phải những câu kiểu “Nháy nút refresh ở màn hình desktop máy tính cho máy chạy nhanh hơn”, hay khởi động lại điện thoại, máy tính, chạy lại ứng dụng, web để dùng mượt hơn chưa?
  • Nếu có, khả năng cao bạn đã gặp phải việc một ứng dụng đã không quản lý bộ nhớ tốt, điều này khiến cho bộ nhớ ngày càng sử dụng nhiều, và khi đầy thì ứng dụng bị lag. Việc ứng dụng bị lag có thể do nhiều vấn đề như, như mạng chậm, cơ sở dữ liệu, … nhưng việc bộ nhớ bị dùng full thường chiếm một phần khá lớn trong vấn đề này.
  • Hiểu được cách Java quản lý bộ nhớ là một điều thiết yếu để tối ưu hệ thống.

Kiểu dữ liệu nguyên thuỷ và object

  • Kiểu dữ liệu nguyên thuỷ trong Java có thể kể đến byte, short, int, long, char, ….
  • Trong Java, các đối tượng tạo từ các class như Integer, Double, Float, … Hay từ những class mà tự bạn tạo ra, thì chúng ta đang không thực sự lưu giá trị của nó, mà ta đang lưu “địa chỉ” đến giá trị thực sự của nó
image 33 - quochung.cyou PTIT
  • Hãy thử đi từ từ lại vấn đề này, khi ta sử dụng các kiểu biến nguyên thuỷ, ví dụ khai báo như sau
byte x = 7
image 34 - quochung.cyou PTIT
  • Thì trong Java, bản chất biến x này đang giữ giá trị thực sự, giá trị bit (00000111)
  • Còn một biến Object, hay biến địa chỉ thì chúng ta như đang lưu một “điều khiển”, một tham chiếu địa chỉ đến giá trị thực sự
Dog myDog = new Dog();
image 35 - quochung.cyou PTIT
image 36 - quochung.cyou PTIT
  • Okay, mong là bạn đã hơi mường tượng được điều gì đó, tiếp theo ta sẽ đến hai khái niệm là Stack và Heap
image 37 - quochung.cyou PTIT
  • Trong bộ nhớ Java, ta thường nhắc tới 2 nơi lưu chính đó là Stack và Heap. Toàn bộ Thread trong hệ thống sẽ có các stack khác nhau, tuy nhiên share chung 1 heap
  • Cơ bản ở reference bên trên, hay cách lưu tham chiếu, thì giá trị thực sẽ luôn nằm ở heap
  • Các biến nguyên thuỷ trong Java nếu được khai báo dưới dạng local variable (biến nằm trong các hàm, …) sẽ được lưu vào stack, còn các biến lưu dạng toàn cục của 1 class (instance variable) sẽ được lưu vào heap.
  • Tương tự, các biến tham chiếu (reference) cũng được lưu tương tự, nếu chúng là các local variable, các biến nằm trong 1 hàm main, 1 phương thức, … chúng sẽ được lưu trong stack. (Lưu cái con trỏ trong stack), còn nếu nó là biến toàn cục class (instance variable), nó sẽ nằm trong heap (vì hiện tại, nó đang được lưu trong 1 giá trị object thực sự khác, hay là heap)
image 38 - quochung.cyou PTIT

Java Pass-by-Value, Call-By-Value

  • Tiếp theo, ta sẽ đi đến khái niệm pass-by-value, hay call-by-value trong Java. Hiểu đơn giản, khi ta truyền các biến như 1 tham số trong 1 hàm, ta chỉ đang truyền một bản “copy” của đối tượng ban đầu đó.
image 39 - quochung.cyou PTIT
  • Ví dụ như đoạn code sau, đoạn code sẽ vẫn in ra 5, giá trị ban đầu của a, vì khi ta truyền vào hàm kia, ta chỉ đang truyền một bản sao của biến a, có giá trị là 5, chứ không thực sự truyền a, nên a ở hàm main sẽ không bị thay đổi.
  • Tuy nhiên, ta lại sẽ có một vấn đề thường hay mắc lầm khác, Hãy thử xem đoạn code sau:
image 41 - quochung.cyou PTIT

  • Đầu tiên ta có một object John, với tuổi là 20, và tên là John
  • Sau đó ta chạy hàm change, nơi mà ta sẽ cập nhậtbiến tuổi truyền vào thành 90, còn tên của person truyền vào thành Michael
  • Bạn sẽ nghĩ là, okay, giờ ta đang truyền một bản sao thôi đúng không? Vậy thì tuổi vẫn giữ là 20, còn tên vẫn giữ là John
  • Nhưng kết quả thật bất ngờ, tuổi thì đúng là không thay đổi 20, nhưng tên thì cập nhật thành Michael. Tại sao lại như vậy?
image 42 - quochung.cyou PTIT
  • Ta hãy quay trở lại khái niệm vừa nhắc tới
  • Khi ta truyền một biến nguyên thuỷ, hay trong trường hợp trên là age, ta đang như tạo một bản sao của một tờ giấy bình thường, tờ giấy đó ghi số là 20, ta đưa cho người khác. Họ sửa chúng thành 90, 100 hay gì đi chăng nữa, thì tờ giấy ban đầu của ta vẫn là 20
  • Tuy nhiên, khi ta truyền một biến reference (tham chiếu) của Object person, ta đang truyền bản sao của “tham chiếu” của nó. Hay đơn giản là, ta đang tạo ra bản sao của một cái điều khiển, vậy thì cái điều khiển bản sao này khi đưa cho người khác, vẫn sẽ bật tắt được tivi ban đầu của mình.
image 43 - quochung.cyou PTIT

Escaping References

  • Ta sẽ đi sang vấn đề. Vậy thì điều này có thể ảnh hưởng điều gì?
  • Một trong bốn tính chất của OOP, Encapsulation – tính đóng gói, trong đó có thể kể đến việc, ta sẽ cho toàn bộ biến trong class thành private, ẩn chúng với bên ngoài, với class khác. Để thay đổi, hay tương tác với chúng, ta chỉ tương tác qua các phương thức public mà ta cài đặt. (Ví dụ như Getter, Setter)
  • Bạn có thể đọc thêm bài này để hiểu thêm: http://quochung.cyou/tai-sao-can-viet-getter-setter-cho-cac-class/
image 44 - quochung.cyou PTIT
  • Tuy nhiên ta đi đến một vấn đề mới. Vì vấn đề truyền tham chiếu, truyền điều khiển thay đổi phần gốc như trên, thì với một ví dụ như trên, ta đang để private Name của Person, tuy nhiên khi gán nó cho một biến ngoài sb bằng getter, rồi thay đổi nó, thì nó cũng thay đổi giá trị được giấu bên trong class gốc.
  • Điều này phá huỷ việc đóng gói của chúng ta, do ta bằng 1 cách nào đó, đã thay đổi được giá trị private, mà không cần đi qua các phương thức setter hay các phương thức cho phép thay đổi của class.
image 45 - quochung.cyou PTIT

Kĩ thuật defensive copying

  • Lúc này, có một solution được biết đến với tên defensive copying
  • Ta sẽ không muốn lưu một bản tham chiếu đến một cái điều khiển, nơi mà ta có thể thay đổi giá trị đang được ẩn. Mà các phương thức lấy các tham chiếu này ra, ta sẽ tạo hẳn 1 object mới, một bản sao chỉ copy giá trị của biến gốc, chứ không copy điều khiển đến biến gốc.
image 46 - quochung.cyou PTIT
  • Như ví dụ trên, ở hàm Getter, ta chỉ trả về một biến String Builder mới, chứa dữ liệu của name, nhưng không có khả năng thay đổi name gốc
image 47 - quochung.cyou PTIT
  • Vấn đề đã được giải quyết !

7 plugin cho InteliJ IDEA để tăng hiệu suất làm việc của bạn

Json2Pojo

image 13 - quochung.cyou PTIT
  • Đây là một plugin hỗ trợ tạo 1 class Java đơn giản (POJO – Plain Old Java Object) từ JSON. Khi cài đặt, chỉ cần chuột phải vào 1 package, New -> Generate POJOS from JSON, và chọn tên class

Jump to Line

image 14 - quochung.cyou PTIT
  • Cho phép bạn nhảy đến bất kì dòng code nào khi đang ở chế độ debug. Hiểu đơn giản, bạn có thể nhảy để chạy luôn một đoạn code mà không cần chạy các code trước đó

SonarLint

image 15 - quochung.cyou PTIT
  • Một plugin cực kì mạnh giúp bạn tìm và sửa bug, ngoài ra nó cũng có thể detect các vấn đề bảo mật, các đoạn code không clean, … khi bạn đang viết
  • SonarLint hỗ trợ nhiều ngôn ngữ giúp lập trình viên viết code clean hơn và nhanh hơn

JPA Buddy

image 16 - quochung.cyou PTIT
  • Một bộ công cụ giúp bạn làm việc với JPA dễ dàng hơn, có giao diện và khả năng sinh code để làm việc với các thư viện nổi tiếng như HIbernate, Mapstruct, Lombok, …

Maven Helper

image 17 - quochung.cyou PTIT
  • Giúp bạn kiểm tra và tìm các dependency có vấn đề với nhau trong maven.

GenerateAllSetter

image 18 - quochung.cyou PTIT
image 19 - quochung.cyou PTIT
image 20 - quochung.cyou PTIT
  • Giúp bạn nhanh chóng sinh hàm setter nhanh với giá mặc định

CodeGlance

image 21 - quochung.cyou PTIT
  • Giúp bạn có một cái nhìn tổng quan về file code hiện tại, dễ dàng di chuyển đến các mục code bạn đang cần tìm

Sự ra đời của Java, các thuật ngữ JVM, JDK, JRE

Giới thiêu về Java

Ngôn ngữ lập trình Java được thiết kế để trở thành một ngôn ngữ không phụ thuộc vào nền tảng (machine-independent). Java có thể chạy trên bất kỳ nền tảng nào miễn là có máy ảo Java (Java Virtual Machine – JVM). Máy ảo Java là một chương trình có thể chạy trên nhiều nền tảng khác nhau mà không cần phải biên dịch lại. Máy ảo Java có thể chạy trên các máy tính, điện thoại, máy tính bảng, máy chủ, … Máy ảo Java có thể được cài đặt trên các hệ điều hành khác nhau như Windows, Linux, Mac OS, …

Java vừa đủ mạnh với nhiều thư viện, tính năng, bảo đảm các sự chặt chẽ, nhưng cũng đồng thời chạy rất nhanh. Java có thể được sử dụng để phát triển các ứng dụng desktop, web, mobile, game, … Java cũng là một trong những ngôn ngữ lập trình được sử dụng nhiều nhất hiện nay.

image 10 - quochung.cyou PTIT

Java Virtual Machine (JVM)

Không như C/C++ khi mà code được biên dịch thì sẽ tạo thành các mã lệnh được làm cho riêng các vi xử lý khác nhau. Code java đầu tiên được biên dịch thành một dạng tổng quát – bytecode, là ngôn ngữ cho JVM chạy. Sau đó JVM mới chạy thành các ngôn ngữ máy cho nền tảng đó.

image 6 - quochung.cyou PTIT

Trình tự hoạt động:

image 7 - quochung.cyou PTIT

JRE – Java Runtime Environment

  • The Java Runtime Environment (JRE) provides the libraries, the Java Virtual Machine, and other components to run applets and applications written in the Java programming language. In addition, two key deployment technologies are part of the JRE: Java Plug-in, which enables applets to run in popular browsers; and Java Web Start, which deploys standalone applications over a network. It is also the foundation for the technologies in the Java 2 Platform, Enterprise Edition (J2EE) for enterprise software development and deployment. The JRE does not contain tools and utilities such as compilers or debuggers for developing applets and applications.
  • JRE – đúng như tên của nó (môi trường chạy java) chứa các thư viện, chứa cả JVM ở bên trong, và một số thành phần khác để chạy được các phần mềm Java. Hiểu đơn giản, nếu bạn có 1 file jar, 1 chương trình java, chỉ cần có JRE là bạn có thể chạy chúng.
image 12 - quochung.cyou PTIT

JDK – Java Development Kit

  • JDK (Java Development Kit) – Bộ công cụ lập trình Java
  • Hiểu đơn giản thì JDK chứa JRE và thêm một số công cụ khác để hỗ trợ cho việc lập trình, compile các file code .java sang file .class (đọc thêm bên dưới)
image 11 - quochung.cyou PTIT

Cấu trúc chương trình Java

image 8 - quochung.cyou PTIT
  • Trong file source code, chứa “class” (lớp)
  • Mỗi “class” chứa nhiều “method” (hàm) khác nhau.
  • Mỗi “method” chứa nhiều “statements” (dòng lệnh) khác nhau.

Ví dụ 1 file class:

``` 

public class HelloWorld {
    public static void main(String[] args) {
        System.out.println("Hello World!");
    }
}

```
  • Khi một dự án Java chạy, JVM sẽ tìm class bạn để là class đầu tiên khởi chạy, rồi sau đó tìm đến method main để chạy.
public static void main(String[] args) {
   // đây là hàm đầu tiên được chạy
}

image 9 - quochung.cyou PTIT

Tham khảo:

3 cách thực hiện Dependency Injection (DI) và vấn đề với @Autowired trong Spring

Lời mở đầu

Khi code các ứng dụng backend bằng Java với Spring Framework, khả năng cao là bạn đã gặp qua một đoạn code sử dụng @Autowired. Tuy nhiên, nếu bạn sử dụng một số phần mềm lint để kiểm tra code, bạn có thể thấy các phần mềm sẽ cảnh báo @Autowired is deprecated (Autowired không được khuyến khích sử dụng nữa, cách làm không tốt)

image - quochung.cyou PTIT
  • Nhìn sơ qua thì đây có vẻ là một cách đơn giản và nhanh gọn để thực hiện DI qua Spring. Chỉ cần khai báo các dependency rồi thêm một annotation (@Autowired), các phần liên kết sẽ được Spring xử lí
  • Tuy nhiên, cách làm phổ biến này lại có thể dẫn đến nhiều vấn đề về sau này. Hãy thử xem qua các thủ pháp DI được sử dụng qua Spring Framework và các ưu nhược điểm của chúng

3 cách thực hiện Dependency Injection trong Spring Framework

Field Injection

  • Field Injection chính là tên gọi của cách inject dependency khi ta khai báo bằng @Autowired
  • Về cơ bản khi khai báo annotation này trên 1 field, method, constructor. Spring sẽ tự tìm dependency phù hợp và kết nối chúng với nhau.
  • @Autowired về mặc định không sai, tuy nhiên nếu sử dụng không hợp lí chúng có thể gây ra một số vấn đề về sau.
  • Ví dụ với một code như sau:
image 1 - quochung.cyou PTIT
  • Khai báo một Multiplier trong Calculator nhanh chóng bằng @Autowired sẽ không báo lỗi gì khi compile, về cách hoạt động, khi chạy chương trình, Spring sẽ tự tìm kiếm dependency và kết nối chúng với nhau
  • Tuy nhiên, vì chúng tự động, nên ta thiếu kiểm soát hơn phần này. Tức là lúc này ta không có cách nào để thêm thủ công dependency nữa cho các hoàn cảnh khác ngoài lúc chạy ứng dụng (VD khi chạy test)
image 2 - quochung.cyou PTIT
  • Ví dụ như code trên sẽ không báo lỗi, tuy nhiên khi chạy test thì chúng có thể throw NullPointer
  • Lí do là ở file test trên thì chúng ta đang không có chỗ nào liên kết với Spring cả, vì vậy Spring sẽ không quản lý các bean mà ta đã tạo (Khai báo @Component ở các class kia) nên chúng sẽ không nối vào nhau được -> Ta sẽ bị null pointer vì Multiplier không được khởi tạo lên
  • Để xử lý vấn đề này, thì nếu sử dụng 2 thủ pháp DI bên dưới (Constructor Injection và Setter Injection) , ta có thể có nhiều khả năng kiểm soát hơn và thêm dependency một cách thủ công mà không qua Spring, tạo nhiều khả năng hơn cho việc test
  • Hoặc, ta có thể khai báo @SpringBootTest để Spring quản lý file test này và tự động thực hiện việc gắn các bean mà không cần gắn chay
image 20 - quochung.cyou PTIT

Setter Injection

image 3 - quochung.cyou PTIT
  • Cách làm trên như tên của nó, ta sẽ set một dependency của class lớn hơn ở thời điểm runtime
  • Cách làm này cho phép ta dễ dàng thay đổi dependency của một class trong runtime, ví dụ như đổi 1 repo khác 1 service nào đó, …
  • Tuy nhiên, ngoài ưu điểm là sự flexible khi set ở runtime, thì nó cũng đi cùng vài nhược điểm khác
  • Do được set trong runtime, ta đôi khi có thể gặp phải NullPointer khi dependency chưa được khởi tạo, là null, … (vì lúc này chúng là optional, không bắt buộc với class nữa)
  • Do nó lỏng lẻo hơn nên lúc này với các method trong class gọi đến dependency, ta không được đảm bảo là dependency đã được set, hoặc ta lại phải thêm code để kiểm tra là có dependency chưa, 1 là thêm code, 2 là dẫn tới nullpointer
image 21 - quochung.cyou PTIT
  • Với cách làm như thế này, ta có thể không cần Spring quản lý các bean mà có thể test chay hơn, có nhiều quyền kiểm soát hơn vào việc quản lý các dependency

Constructor Injection

image 4 - quochung.cyou PTIT
  • Như tên của thủ pháp, ta sẽ thêm dependency cho 1 class ngay tại thời điểm khởi tạo class cha
  • Ở file test trên, mình đang sử dụng mock để dựng class multiplier lên theo kèm để gắn vào Calculator qua constructor
  • Việc này đảm bảo 1 class luôn có đủ dependency để khởi tạo (tuỳ theo cách custom constructor)
  • Hoặc mình hoàn toàn có thể làm như thế này
image 22 - quochung.cyou PTIT
  • (Việc sử dụng mock cho phép nhiều khả năng khác trong test hơn, ví dụ mình có thể kiểm tra xem một hàm trong class đó được gọi bao nhiêu lần, … , chúng được quản lý theo dạng Proxy Design Pattern, mình sẽ nói ở bài viết khác)

Bạn có thể đọc thêm bài viết này về một số khái niệm trong Spring như IoC, Bean, …

Tham khảo:

[Phần 1] Sự phát triển của các mô hình hệ thống Backend (N-layered, DDD, Hexagon, Onion, Clean Architecture)

Chương 1: Nơi mọi thứ bắt đầu

Vào những ngày đầu tiên thuở sơ khai, chưa có một “mô hình hệ thống” hay “architecture” nào tồn tại cả. Giang hồ lúc này mạnh ai nấy làm, bạn chỉ cần biết GoF Pattern thì có thể tự xưng bá một phương, là một “architect”, một lập trình viên dày dặn trong nghề.

Thời gian thắm thoắt thoi đưa, từ những cái máy tính to bằng cả cái phòng, từ những chiếc ổ cứng dày cộp chỉ chứa vài MB, công nghệ ngày càng phát triển, máy tính dần thu gọn hơn, ngày càng mạnh mẽ hơn, tiếp cận đến nhiều người hơn. Lúc này, yêu cầu của người dùng ngày càng tăng chóng mặt, khiến cho độ phức tạp của các phần mềm gia tăng.

Thứ đầu tiên những cao thủ trong ngành tạo ra là (Tách UI ra khỏi các logic bussiness), từ hình thái này, các mô hình MVC đầu tiên đã được ra đời:

image - quochung.cyou PTIT

Hiểu một cách đơn giản, hãy nghĩ đến ứng dụng Facebook và website Facebook. Liệu các câu lệnh như: lấy dữ liệu các bài viết người dùng mới nhất, lấy dữ liệu của 1 trang profile có khác biệt về mặt logic khi ở trên điện thoại hay trên web? Câu trả lời là không, điểm duy nhất khác biệt chỉ là UI hay View (phần hiển thị với người dùng)

Việc tách biệt UI ra khỏi Logic giúp ứng dụng modun hoá hơn, ta có thể dùng chung 1 logic, và khi cần hiển thị trên 1 sản phẩm khác: web, điện thoại, màn hình tivi, màn hình ô tô, … , ta chỉ cần nối phần UI của thiết bị đó với các logic đã chìa ra là được.

Nghe có vẻ như vấn đề đã được giảm bớt 1 chút. Nhưng chưa phải là tất cả, lúc này View có thể chỉ là vài tấm ảnh, một cái nút, Controller sẽ là người ở giữa trung chuyển các câu lệnh, và phần lớn logic bị dồn xuống Model, nơi thường xuyên phải lưu dữ liệu vào database, file, … hay nhìn chung là trực tiếp vào các “đối tượng” của chúng ta.

Chương 2: 2002 – N-Layered (Cấu trúc xếp chồng N tầng)

Một mô hình “lí tưởng” không tồn tại, cũng như mọi thứ, chúng đều là thành quả của nhiều lần thử nghiệm, và được rút kinh nghiệm rất nhiều lần.

Một lập trình viên đã tiên phong trong việc tạo ra một mô hình hệ thống, góp phần ảnh hưởng lớn đến rất nhiều thế hệ lập trình viên sau này tên là Martin Fowler.

image 1 - quochung.cyou PTIT

Ông đã cho ra đời cuốn “Patterns of Enterprise Application Architecture” (Cách thực hiện một mô hình ứng dụng phục vụ cho doanh nghiệp), nơi mà ông đã nói về cấu trúc N-Layered

1 pd5bfxtxV9AK0 QlIOK6Vw - quochung.cyou PTIT

Ý tưởng khá đơn giản, ta sẽ phân loại và nhóm các phần code liên quan đến nhau lại thành “1 tầng”, khi đó ta sẽ có nhiều tầng xếp chồng lên nhau.

Tuy nhiên, Fowler cũng biết việc không nhất quán sẽ xảy ra nếu cứ mỗi ông lập trình viên lại xếp các tầng một cách vô tổ chức, ông đã thêm một số “quy tắc” nhỏ góp phần đồng bộ:

  • Bạn có thể đặt tên một layer – tầng là gì cũng được
  • Bạn có thể có bao nhiêu layer tuỳ thích
  • Bạn có thể thêm một layer ở giữa các layer thường có
  • Bạn có thể có nhiều thành phần trong 1 layer
  • Quan trọng là: cần có một hệ thống cấp bậc rõ ràng giữa các layer, chúng nên gọi đến nhau theo từng cấp một.
1 0Kq2jEHDWcfdeorqKPdYFQ - quochung.cyou PTIT

Điều này đã giúp các ứng dụng giảm bớt các code trùng lặp, và cũng làm cho code có một cấu trúc rõ ràng.

Thông thường đa số ứng dụng chỉ cần 3 tầng là đã có thể phục vụ các nhu cầu cơ bản

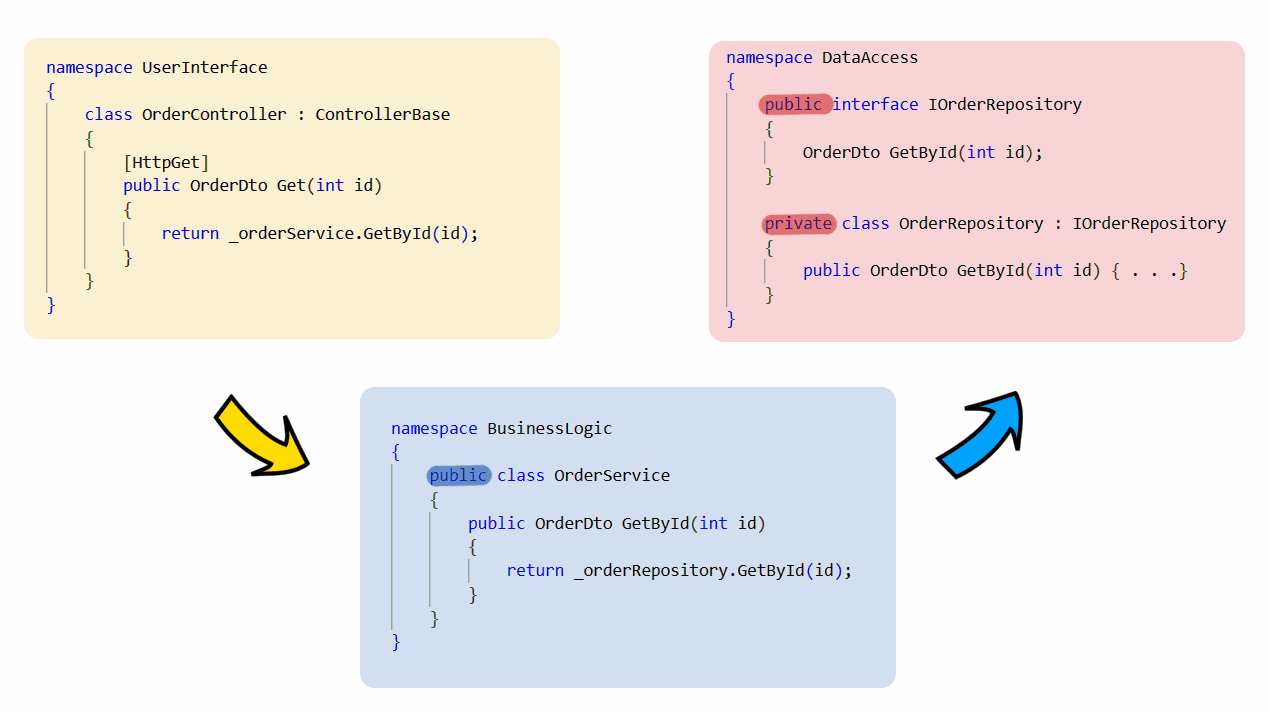
image 4 - quochung.cyou PTIT
  • User Interface (UI) — chịu trách nhiệm tương tác với người dùng (giao diện)
  • Business logic layer (BLL)— Xử lí các logic chính của hệ thống
  • Data Access layer (DAL) — Là tầng giao tiếp với dữ liệu như database, …
image 5 - quochung.cyou PTIT
  • Bạn có thể thấy trong các video hướng dẫn làm các dự án backend bằng Spring Boot, người ta thường có một 1 tầng Service (Bussiness), sau đó mới gọi xuống tầng Repository (Data Access), nơi mà giao tiếp trực tiếp với database.
  • Các tầng sẽ gọi đến nhau qua các interface, ví dụ: có một interface là OrderRepository phục vụ lấy dữ liệu từ db. Lúc này, tầng bussiness chỉ cần quan tâm sẽ thực hiện các giao thức lấy dữ liệu của interface này, còn logic thực sự ở tầng data access sẽ được ta viết từ các class implement interface trên.
  • => Ví dụ: ta có 1 interface OrderRepository. ta có 2 class khác implement interface trên là OrderRepositoryImplMongo, OrderRepositoryImplMySQL. Do cả 2 cùng implement orderrepo, nên từ bussiness ta có thể dễ dàng lắp một class khác cho 1 database khác, thuận tiện cho việc xử lí. (Bạn có thể đọc thêm Dependency Injection)
image 6 - quochung.cyou PTIT

Chương 3: 2003 – Domain Driven Design (DDD)

Tưởng chừng N-Layered đã có thể xử lí được các vấn đề hiện tại, tên tuổi của Fowler sẽ được ghi tên vào sử sách. Nhưng vào năm 2003, một anh tài trong giang hồ, một lập trình 46 tuổi đến từ Boston, Eric Evans đã công bố một cuốn sách “Domain-Driven Design: Tackling Complexity in the Heart of Software” (Domain Driven Design: Xử lí sự phức tạp cốt lõi của phần mềm). Cuốn sách đã khiến 1 anh chàng Martin nào đó trên thế giới phải cất poster và khóc.

image 7 - quochung.cyou PTIT

Nhìn chung thì Evans vẫn đồng ý với đa số các ý tưởng của N-Layered, đó là sự kế thừa của hệ thống chỉ nên đi theo 1 hướng (các tầng gọi nhau lần lượt từ trên xuống dưới).

Tuy nhiên ông cho rằng, cũng không tệ lắm nếu một module bậc thấp (tầng bên dưới) có thể gọi lên module bậc cao ở tầng cao hơn. Miễn là nó không phá vỡ hướng đi kế thừa của hệ thống (dependency direction). Điều này có thể làm được bằng callback, hoặc một số design pattern như observer, ….

Ông cũng cho rằng, các Controller thường bị lắp quá nhiều logic, nên ông đã chuyển chúng sang 1 layer khác tên là Application. Ông cũng cho rằng tầng Bussiness logic nên được chú trọng nhiều hơn là tầng database (data access). Nhưng nhìn chung cấu trúc cũng không thay đổi nhiều lắm.

image 8 - quochung.cyou PTIT

Ở cấu trúc của ông, một hệ thống được quy định như sau:

  • Presentation Layer — tầng “trình bày”, tương tác với bên ngoài.
  • Application Layer — Nhận và điều phối các yêu cầu, sau đó chuyển qua tầng Domain.
  • Domain Layer — Chứa các chức năng chính của hệ thống.
  • Infrastructure Layer — Xử lí dữ liệu (tương tự tầng data access)

Bạn có thể thấy ông đã đổi tên một số tầng tưởng chừng như có chung mục đích, nhưng chúng có nguyên do của nó. User Interface thường có ý nghĩa là bạn có một user người dùng nào đó, nhưng không phải lúc nào cũng vậy. Đôi khi ta có một GUI (Graphical User Interface – Giao diện người dùng) cho users, nhưng cũng có thể là 1 CLI (Command Line Interface – Giao diện cmd) cho lập trình viên, hay có thể là API (Application Programming Interface) cho các ứng dụng khác gọi vào. Tầng Presentation thì sẽ “Generic” , chung chung hơn, bao quát hơn.

Business logic thì nghe có vẻ hơi trừu tượng cho đội lập trình viên, vì chúng ta thường không thiên về mảng kinh tế, vì vậy ông đã tạo ra 1 tên mới “Domain – miền”

Ở tầng dưới cùng, đôi lúc, ta không chỉ lưu dữ liệu vào ram, vào database hay đâu đó. Mà có thể ta muốn nó sẽ gọi đến chỗ khác, kiểu gửi 1 email, 1 tin nhắn zalo, … nên chúng được gộp chung thành tầng Infrastructure (Hạ tầng).

Nhìn chung là thế, một số sự thay đổi tên, thêm 1 layer mới, có một số phần khác đã được thêm vào tầng Domain. Và đó là DDD – Domain Driven Design.


Tham khảo:

[Pessimistic locking] Xử lí dữ liệu bất đồng bộ trong thực tế

image 54 - quochung.cyou PTIT

Pessimistic locking là gì?

Đọc vấn đề xảy ra về dữ liệu đồng thời tại : http://quochung.cyou/optimistic-locking-xu-li-du-lieu-bat-dong-bo-trong-thuc-te/

Pessimistic locking (Khoá bi quan) là một chiến thuật xử lí có thể tổng quát rằng, giả dụ, bạn có một tập dữ liệu đang bị truy cập đồng thời, người đầu tiên truy cập sẽ khoá tập dữ liệu này lại, độc quyền sửa đổi nó, cho đến khi phiên đó hoàn thành. Điều này đảm bảo dữ liệu sẽ chuẩn xác hơn khoá lạc quan, nhưng cũng có thể tạo ra Deadlock

Ví dụ bài toán

  • Bạn đang chơi một con game sinh tồn, có một chiếc rương chứa đồ chung mà hai người chơi đều có thể mở, nhưng nếu cả hai cùng mở, người này lấy đồ, người kia lại cho đồ vào, đôi khi dữ liệu sẽ bị loạn
  • Khoá bi quan sẽ xử lí như sau
  • Khi người chơi A mở rương, khoá rương lại. Lúc này người chơi khác ấn vào rương sẽ bị thông báo như dạng “rương đang được mở bởi người khác”, và không thể truy cập cho đến khi người chơi A đóng rương.
image 56 - quochung.cyou PTIT
image 57 - quochung.cyou PTIT

Deadlock

  • Deadlock xảy ra khi hai phiên không thể tiến triển được nữa, vì cùng phụ thuộc vào nhau chờ phía bên kia mở khoá, có thể xem hình dưới đây
image 58 - quochung.cyou PTIT
  • Ta có một database post chứa các bài viết. Trong đó có 1 bài viết id 1 và title là “Transaction”
  • Ngoài ra ta có 1 post chứa post_detail, là nội dung bài viết, số lượng like comment, …
  • Alice đầu tiên truy cập vào bảng post_detail, cập nhật số lượng like comment. Lúc này bảng post_detail thay đổi “người thay đổi cuối” thành Alice. Alice lock bảng post_detail
  • Lúc này Bob cũng truy cập vào bảng post, đổi tên nó thành thứ khác. Bob lock bảng post
  • Do bảng post và postdetail liên kết với nhau, lúc này ở phiên của Bob sẽ gọi về post_detail của post id 1 để thay đổi “người thay đổi” thành Bob. Tuy nhiên, nó đang bị khoá bởi Alice, vì vậy phải chờ Alice xong đã
  • Phía Alice lúc này cũng cập nhật lên bảng post, nhưng nó lại bị khoá bởi Bob, nên cũng phải đợi Bob xong đã
  • => Điều này trở thành vòng tuần hoàn vô hạn, cho đến khi hệ quản trị cơ sở dữ liệu có cơ chế phát hiện ra, và huỷ cả 2 phiên.

Deadlock ở mọi nơi: hệ điều hành, trong code đa luồng, ..

image 59 - quochung.cyou PTIT
  • Deadlock không chỉ xảy ra trong database, nó có thể xảy ra trong mọi hệ thống. Trong hệ điều hành, trong …., chỉ cần nếu chúng có thể truy cập từ nhiều nguồn cùng lúc
  • Ví dụ, đa luồng trong Java cũng có thể tạo deadlock khi 2 luồng cùng đợi nhau chứ không ai chạy trước

Cách xử lí

  • Khi Alice thực hiện khoá post, ta có thể khoá luôn cả post_Detail và các bảng liên quan
  • Hệ thống của ta cần có cơ chế phát hiện deadlock, ví dụ lock chờ đợi quá lâu, …

Đọc thêm:

A.C.I.D Transactions – Kiến thức cơ bản về database lập trình viên cần nắm vững

Lời mở đầu

In computer scienceACID (atomicityconsistencyisolationdurability) is a set of properties of database transactions intended to guarantee data validity despite errors, power failures, and other mishaps.[1] In the context of databases, a sequence of database operations that satisfies the ACID properties (which can be perceived as a single logical operation on the data) is called a transaction. For example, a transfer of funds from one bank account to another, even involving multiple changes such as debiting one account and crediting another, is a single transaction.

Bản dịch

Trong khoa học máy tính, thuật ngữ ACID gồm bốn yếu tố mà database transaction (phiên cơ sở dữ liệu) được xây dựng để đảm bảo dữ liệu sẽ luôn chuẩn xác, cho dù có xảy ra lỗi, vấn đề điện, …. Trong database, một dãy các câu lệnh database mà thoả mãn các tính chất ACID được gọi là một transaction (phiên). Ví dụ đơn giản, việc bạn chuyển tiền từ ngân hàng A sang ngân hàng B, chúng chứa rất nhiều sự thay đổi, như giảm tiền ở ví A, tăng tiền ở ví B, tạo thêm lịch sử, …. là một phine

Định nghĩa một Transaction

  • Một transaction (phiên) thể hiên một nhóm các câu lệnh được chạy trong database, thông thường chứa nhiều lệnh khác nhau
  • Ví dụ việc chuyển tiền trong ngân hàng gồm 4 câu lệnh từ tài khoản Alice sang tài khoản Bob
image 51 - quochung.cyou PTIT

ACID là gì

  • ACID, là viết tắt của 4 chữ cái đầu trong (Atomicity, Consistency, Isolation, Durability) là 4 tính chất của một transaction, nhằm đảm bảo dữ liệu luôn chuẩn xác, đúng điều kiện cho dù server sập, mất điện, ..
image 52 - quochung.cyou PTIT

Atomic – Tính đồng bộ

  • Đảm bảo rằng toàn bộ câu lệnh trong một phiên luôn phải đồng bộ trạng thái. Tức là, 1 là toàn bộ đều được chạy thành công, thay đổi xảy ra, hoặc là toàn bộ đều phải bị chặn, chứ không lọt cái gì riêng lẻ cả

Consistent – Tính nhất quán

  • Đảm bảo rằng một phiên chỉ có thể chuyển một database từ một trạng thái đang đúng (valid) sang một trạng thái valid (đúng) khác, ngăn chặn các dữ liệu bị lỗi, …
  • Các kiểu dữ liệu, kiểm tra, trigger, …. các điều kiện đều phải đảm bảo pass trước khi phiên chạy

Isolation – Tính cách ly

Durable – Tính bền bỉ

  • Đảm bảo rằng kết quả của phiên luôn được chắc chắn lưu trong hệ thống. Sự thay đổi phải được giữ cho dù hệ thống sập, mất điện, ….
  • Chúng có thể được lưu như 1 transaction log, … và khi hệ thống khởi động lại, ta có thể chạy lại mọi thay đối giữa chừng để đảm bảo dữ liệu ổn định

Các ưu điểm của ACID Transaction

Dữ liệu sạch

image 53 - quochung.cyou PTIT
  • Đảm bảo rằng dữ liệu luôn chuẩn, không bị mất mát. Tránh các cập nhật bị mất, dirty read, stale read (thảo luận bên dưới). Đảm bảo các tiêu chuẩn về dữ liệu cho phần code. Điều này là tuyệt đối cần thiết cho các hệ thống ngân hàng, tiền bạc, … vì mọi dữ liệu sai sót đều ảnh hưởng trực tiếp đến công ty. Xử lí các vấn đề sai sót ở ngay tầng database bằng sự nhất quán, chuẩn chỉnh được tạo ra bởi phiên ACID là một cách khá đơn giản.

Xử lí đồng bộ đồng thời (Concurrency)

  • Truy cập đồng thời xảy ra thường xuyên trong các hệ thống lớn. Ví dụ như một cái rương vật phẩm chung trong game, một số tiền chung trong tài khoản ngân hàng (tưởng tượng bạn nhận tiền và chuyển tiền cùng lúc), bảng xếp hạng trong game, ….
  • Tính chất Isolation – cách ly của ACID giúp các lập trình viên trong điều này
  • Database sẽ đảm bảo transaction với một ” serializable isolation”, lập trình viên có thể xử lí transaction một cách “tuần tự” như queue vậy, dù thực tế chúng xảy ra đồng thời.

Kiến trúc Stateful và Stateless là gì?

image 45 - quochung.cyou PTIT

Lời mở đầu

  • Trong khoa học máy tính, “state” nghĩa là một trạng thái của hệ thống, của một thành phần hoặc ứng dụng của chúng ta tại một điểm thời gian
  • Ví dụ: Bạn đang mua hàng trong amazon.com, ta có thể coi việc bạn “đang đăng nhập” là một trạng thái, “đang có hàng trong giỏ” là một trạng thái, ….
  • Trạng thái biểu diễn dữ liệu đang được lưu trữ, và giúp chúng ta kiểm soát hiện trạng hiện tại của ứng dụng.

Kiến trúc Stateful

  • Tưởng tượng bạn đến một cửa hàng pizza để ăn. Hiện tại quán chỉ có 1 phục vụ bàn, phục vụ bàn sẽ lấy các note từ bàn của bạn, bạn order gì, hay là những món bạn trước đây từng ăn, bạn có dị ứng gì không, …
image 46 - quochung.cyou PTIT
  • Tất cả những thông tin trên sẽ được phục vụ bàn ghi lại về một “state” hay trạng thái của khách hàng. Chỉ có phục vụ bàn có những thông tin này, nếu bạn dạo này thích ăn món gì đó khác hơn, hoặc bị dị ứng gì đó mới, bạn cần cập nhật đúng với phục vụ này để thay đổi. Nhưng mà cả quán chỉ có 1 phục vụ nên bạn không lo nhầm người.
  • Tưởng tượng rằng, quán ăn có đông khách hơn, và phục vụ phải phục vụ rất nhiều khach. Quán cần nhiều phục vụ hơn, tuy nhiên lúc này, nếu bạn muốn đổi khẩu vị hay món khác, thì nếu bạn chọn người phục vụ khác sẽ không được.
image 47 - quochung.cyou PTIT
  • Những nhân viên phục vụ khác thì chẳng có thông tin gì về state của bạn cả. Họ không thể đổi đơn hàng của bạn, hay đọc chúng. Nếu một nhà hàng hoạt động theo kiểu như vậy, tức là chỉ 1 phục vụ có thông tin của bạn, sẽ được gọi là cấu trúc stateful
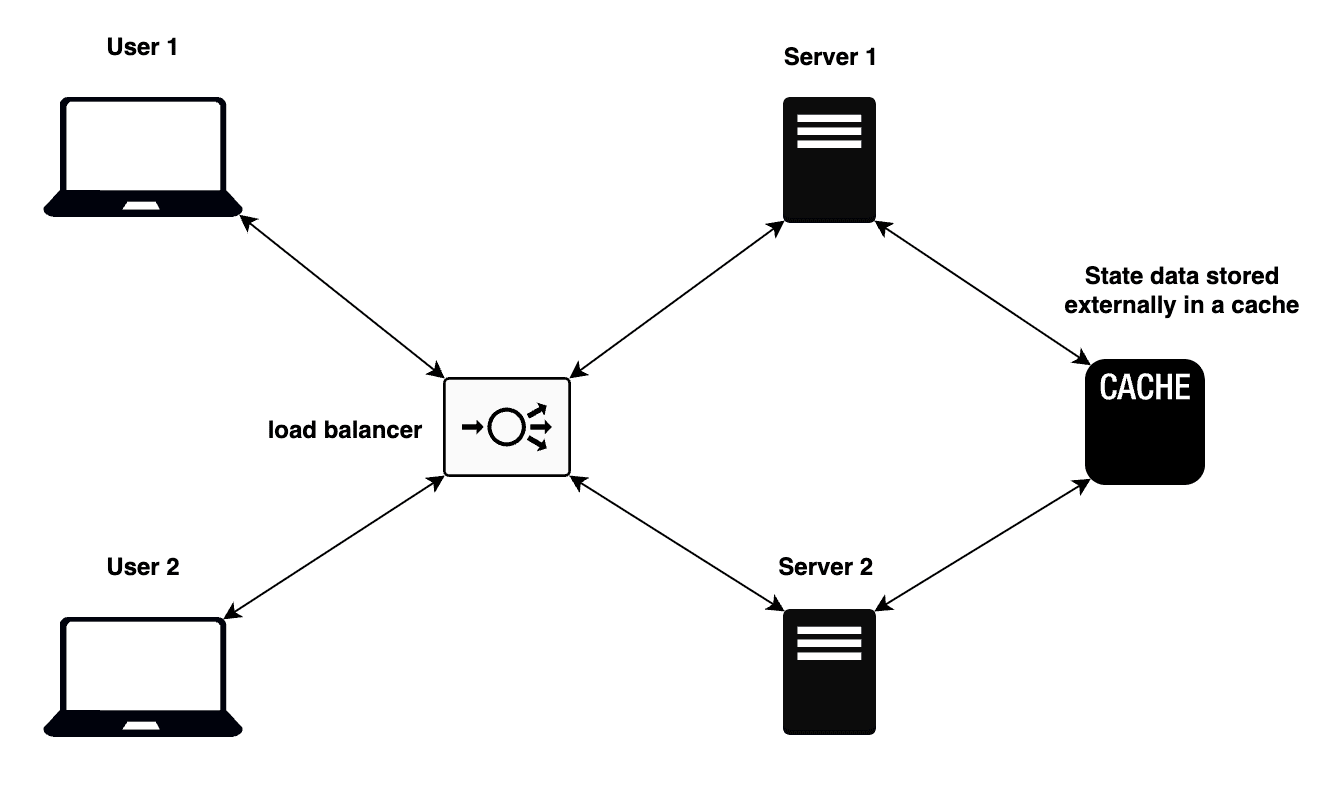
  • Tưởng tượng về dạng server, một hệ thống stateful sẽ chỉ có 1 server duy nhất ghi nhớ dữ liệu của người dùng. Toàn bộ các request, làm việc sau này của 1 khách hàng sẽ chỉ được điều hướng vào người đó qua các trình load balancer (cân bằng tải) với 1 sticky session. Một server sẽ luôn biết client của mình là ai.
image 48 - quochung.cyou PTIT

  • Sticky session (phiên được ghim) là một cài đặt cho phép cân bằng tải (load balancer) điều hướng các request của người dùng đến riêng 1 server duy nhất trong quá trình 1 phiên của họ. (1 phiên có thể kết thúc khi người dùng tắt browser, tắt máy, sau 1 ngày, …)
  • Điều này đi ngược lại với cách cân bằn gtari truyền thống, khi mà request của bạn được phân bổ đến các server khác nhau bằng round-robin hoặc các cách phân bổ khác. (kiểu phân bổ dần 1->2->3->4 rồi lại quay về 1 theo thứ tự request, hoặc phân bổ random, …)
  • Cách làm trên nghe có vẻ khá ổn với các hệ thống nhỏ. Tuy nhiên, thế giới chúng ta không lý tưởng. Giả sử, nếu 1 server bị chết, bị dồn quá tải, … thì toàn bộ thông tin của người dùng với server đó sẽ mất hết, điều này hoàn toàn không ổn chút nào.
  • Hơn nữa, việc phân bổ dữ liệu như vậy cũng không tốt trong nhiều trường hợp. Ví dụ, có một số client gửi rất nhiều request, khiến cho 1 server bị quá tải, trong khi vài server khác lại chỉ có vài request nhỏ, khiến việc cân bằng chung không ổn.

Kiến trúc Stateless

  • Kiến trúc stateless, dịch thuần tiếng anh là (không có state). Không hẳn là không có state, mà lúc này các server – hay vị phục vụ bàn sẽ không trực tiếp nhớ xem là khách hàng order gì, thông tin như nào, mà thay vì đó, họ sẽ dùng một phần mềm gì đó, một điện thoại, một tờ giấy chung để ghi thông tin khách hàng. Khi đó, nếu phục vụ khác đến, họ chỉ cần đọc tờ giấy lưu trữ chung để xem khách hàng muốn gì.
image 49 - quochung.cyou PTIT
  • Bằng việc lưu các trạng thái của khách hàng ở một hệ thống chung nào đó, có thể truy cập bởi mọi phục vụ/server, server nào cũng có thể phục vụ chung 1 khách hàng.
  • Nhìn về khoa học máy tính, lúc này ta có thể phân bổ request của người dùng đến server bất kì, việc dữ liệu của người dùng có thể lưu ở 1 database nào đó khác biệt, có thể truy cập bằng mọi server.
  • Việc cân bằng tải cũng tốt hơn, vì lúc này ta có thể chọn các server sđang ít khách phục vụ, hoặc đánh theo tuần tự, …
image 50 - quochung.cyou PTIT

Tổng kết

  • Nhìn chung, stateless mang lại tính mở rộng lâu dài và ổn định tốt hơn stateful
  • Stateless/stateful không chỉ là cách thiết kế server, cân bằng tải như ví dụ trên. Mà có thể áp dụng vào các design pattern, các hàm trong code, ….

Tham khảo:

High Cohesion (Tương đồng cao) và Loosely Coupled (Liên kết lỏng)

image 36 - quochung.cyou PTIT

Mở đầu

Có thể bạn đã được nghe về các thuật ngữ này từ các câu hỏi trong các buổi phỏng vấn, trong một bài đăng medium nào đó, trong một cuộc thảo luận của anh em trong giang hồ. Vậy chính xác các term như high cohesion, low cohesion, loosely coupled, highly coupled có nghĩa là gì?

Cohesion (Tương đồng – Gắn kết)

image 34 - quochung.cyou PTIT

In computer programmingcohesion refers to the degree to which the elements inside a module belong together.[1] In one sense, it is a measure of the strength of relationship between the methods and data of a class and some unifying purpose or concept served by that class. In another sense, it is a measure of the strength of relationship between the class’s methods and data themselves.

Cohesion is an ordinal type of measurement and is usually described as “high cohesion” or “low cohesion”. Modules with high cohesion tend to be preferable, because high cohesion is associated with several desirable traits of software including robustness, reliability, reusability, and understandability. In contrast, low cohesion is associated with undesirable traits such as being difficult to maintain, test, reuse, or even understand.

Cohesion is often contrasted with coupling. High cohesion often correlates with loose coupling, and vice versa.[2] The software metrics of coupling and cohesion were invented by Larry Constantine in the late 1960s as part of Structured Design, based on characteristics of “good” programming practices that reduced maintenance and modification costs. Structured Design, cohesion and coupling were published in the article Stevens, Myers & Constantine (1974)[3] and the book Yourdon & Constantine (1979);[1] the latter two subsequently became standard terms in software engineering

Wikipedia

image 35 - quochung.cyou PTIT

Bản dịch

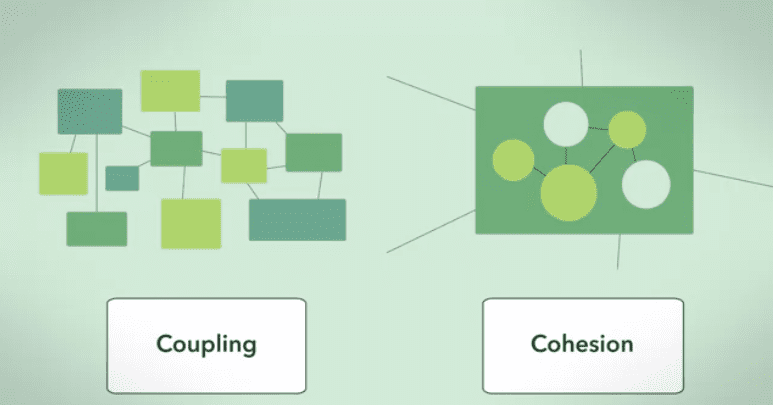
  • Trong khoa học máy tính, cohesion (tính tương đồng) thường được nhắc tới như một góc độ đánh giá nào đó, về việc các phần tử trong 1 module “tương đồng” với nhau.
  • Thông thường có thể nhắc tới việc sự liên kết bền chặt giữa các hàm (function) và các biến (property) trong 1 class có sự liên kết với nhau
  • Thông thường sẽ có 2 định nghĩa chính là “high cohesion” (tương đồng cao) và “low cohesion” (tương đồng thấp).
  • High cohesion thường đi cùng với việc code chặt chẽ hơn, dễ tái sử dụng, dễ bảo trì và dễ hiểu.

Vậy có thể hiểu là, high cohesion thường được ám chỉ các hàm và các biến trong 1 class đều cùng phục vụ mục đích, hoặc được sử dụng cho một ý nghĩa gì đó có tính tương đồng cao với nhau.

  • Trong cuốn Clean Code của Uncle Bobs có viết:
  • “Một class chỉ nên có ít biến. Các hàm trong class đó nên tác động lên một hoặc nhiều các biến trên. Nếu các hàm trong 1 class càng dùng nhiều các biến có sẵn, thì class có tính tương đồng càng cao”
  • => Tức là một class được đánh giá là tương đồng cao nên chỉ làm các tác vụ bên trong class đó, phục vụ chung 1 mục đích.

Ví dụ:

  • Bạn có một nhân vật trong 1 con game của mình. Bạn có các code logic cho việc nhân vật di chuyển từ các nút bấm trên bàn phím, và một số code logic để hiển thị việc nhân vật di chuyển trên trục toạ độ trên màn hình (render hình ảnh)
  • Nếu toàn bộ code đều nằm trong 1 class, code của bạn có 1 số hàm xử lí toán học cho nhân vật di chuyển, lại có 1 số hàm, biến để render hiển thị lên. Rõ ràng chúng có tính tương đồng yếu. Một cách đơn giản để nhận biết, bạn có thể nhìn các tên biến, tên hàm xem chúng có liên quan đến tên class không
  • Ví dụ: class tên là “InvoiceManager” (Quản lý hoá đơn), nếu có 1 hàm nào đó tên là “InHoaDon” thì cũng k ổn lắm, nó nên nằm trong “Printer”, hay có 1 hàm nào đó là “GuiEmailHoaDon” (thì hàm đó cũng nên làm trong class nào đó tên là EmailManager, …)

Coupled/Coupling (Tính liên kết)

  • Thoạt nghe thì nó có vẻ là 1 thuật ngữ trái ngược với cohesion? Vậy High Cohesion (tương đồng cao) thì sẽ có Tightly Coupling (Liên kết chặt) ?
  • Ở trường hợp này thì không. Cohesion thường dùng để xem xét giữa các phần tử (hàm, biến) trong 1 module (class). Trong khi Couple thường dùng để đánh giá tính liên kết giữa nhiều module
image 37 - quochung.cyou PTIT
  • Liên kết lỏng cho rằng, giữa các module với nhau, chúng không nên biết quá nhiều về nhau (liên kết quá chặt chẽ), mà chỉ nên giao tiếp với nhau qua 1 số phương thức mang tính “khái quát” nhất định một cách lỏng lẻo (loosely coupled)
image 39 - quochung.cyou PTIT
  • Ví dụ: Chiếc mũ đang “liên kết lỏng lẻo” với người đàn ông. Bạn dễ dàng thêm hoặc bỏ cái mũ ra mà không phải thay đổi gì người đàn ông cả. Khi code bạn làm được như vậy, thì nó là liên kết lỏng lẻo (loosely coupled)
image 40 - quochung.cyou PTIT

Ví dụ:

  • Bạn đang có một class xử lí việc bán lẻ bánh ở cửa hàng của mình tên là “CuaHang”. Cửa hàng sẽ lấy bánh từ class “XuongBanh”. Ban đầu class của bạn chỉ cần cứ lấy bánh từ Xưởng rồi bán thôi, việc rất đơn giản
image 41 - quochung.cyou PTIT
  • Nhưng một ngày đẹp trời, bạn nhận ra khách có vẻ thích những chiếc bánh có một chút muối, rồi thì bánh có thêm chút trang trí. Dĩ nhiên việc thêm chút thứ gia vị này, bạn cần thêm một chút tiền vào giá hàng, bạn sửa code thành như sau:
image 42 - quochung.cyou PTIT
  • Bạn có thể thấy, điều này đáp ứng nhu cầu của bạn. Tuy nhiên bạn thấy rõ ràng lúc này class Banh và CuaHang đang gắn rất chặt với nhau. CuaHang can thiệp quá nhiều vào class Banh, và có những phương thức không phù hợp lắm. (CuaHang chỉ nên là bán hàng thôi, chỉ nên có giá tiền). Rõ ràng bạn có thể làm chúng liên kết lỏng hơn như sau:
image 43 - quochung.cyou PTIT
  • Rõ ràng, lúc này class CuaHang chỉ cần tập trung lấy bánh và sau đó tính ra tổng tiền. Không cần quan tâm giá từng loại bánh từ xưởng nữa, vì việc tính tiền giá trị 1 đơn hàng sẽ được thực hiện bởi 1 class khác. CuaHang chỉ cần biết tôi sẽ có được tổng tiền từ hàm này, chứ không cần biết chính xác các class kia sẽ cụ thể làm gì, tính cái gì nữa (liên kết lỏng)
  • Mở rộng hơn nữa, ví dụ một ngày bạn muốn bán kẹo thì sao? Bán gấu bông? … Nhu cầu thị trường luôn thay đổi, bạn luôn muốn giàu hơn và mở rộng hơn nữa, lúc này bạn lại nhận ra, class CuaHang đang phụ thuộc quá nhiều vào xưởng bánh, mà thực chất ta chỉ cần lấy ra danh sách sản phẩm từ 1 xưởng nào đó thôi, ta có thể sửa thành như sau:
image 44 - quochung.cyou PTIT
  • Ta tạo 1 interface VatPham luôn có 1 phương thức tinhTien(), sau này, ta có thể làm bánh, kẹo, trái cây, .. chỉ cần chúng implement interface VatPham, ta luôn đảm bảo ta có thể lấy giá tiền từ chúng, còn implemention thực tế chúng tính tiền thế nào là việc của class con đó.
  • Tương tự, ta có 1 interface XuongSanXuat luôn trả về các danh sách vật phẩm, chúng có thể là xưởng bánh trả về bánh, xưởng kẹo trả về kẹo
  • Cửa hàng bây giờ khi khởi tạo có thể truyền vào xưởng mà chúng sẽ nhận đồ để bán
  • Cuối cùng, chuỗi cửa hàng của ta với nhiều cửa hàng, có thể có cửa hàng bánh, cửa hàng kẹo, còn việc chúng tính tiền thế nào làm gì cũng không phải việc của class lớn nữa. Dự án đã lỏng lẻo hơn nhiều ban đầu, và dễ mở rộng hơn.

Tổng kết

  • Với các dự án lập trình, thông thường chúng ta nên nhắm tới việc đạt được cùng lúc 2 yếu tố: High Cohesion (tương đồng cao trong 1 class/module) và Loosely Coupled (liên kết lỏng giữa nhiều module)
  • Việc đạt được 2 yếu tố trên giúp code dễ mở rộng, dễ bảo trì, ta dễ dàng tìm được nguyên căn nơi tạo lỗi vì chúng không share chung các code nhỏ với nhau, nên lỗi chỉ nên từ 1 nguồn
  • Đây là 1 kĩ năng thiết yếu với lập trình viên cho các dự án ngày càng cần mở rộng
  • High Cohesion cũng khá tương đồng với SRP trong SOLID, bạn có thể tìm hiểu thêm về SOLID tại đây http://quochung.cyou/tim-hieu-solid-5-nguyen-tac-thiet-ke-huong-doi-tuong-bang-java/