Ngôn ngữ lập trình Java được thiết kế để trở thành một ngôn ngữ không phụ thuộc vào nền tảng (machine-independent). Java có thể chạy trên bất kỳ nền tảng nào miễn là có máy ảo Java (Java Virtual Machine – JVM). Máy ảo Java là một chương trình có thể chạy trên nhiều nền tảng khác nhau mà không cần phải biên dịch lại. Máy ảo Java có thể chạy trên các máy tính, điện thoại, máy tính bảng, máy chủ, … Máy ảo Java có thể được cài đặt trên các hệ điều hành khác nhau như Windows, Linux, Mac OS, …
Java vừa đủ mạnh với nhiều thư viện, tính năng, bảo đảm các sự chặt chẽ, nhưng cũng đồng thời chạy rất nhanh. Java có thể được sử dụng để phát triển các ứng dụng desktop, web, mobile, game, … Java cũng là một trong những ngôn ngữ lập trình được sử dụng nhiều nhất hiện nay.
Java Virtual Machine (JVM)
Không như C/C++ khi mà code được biên dịch thì sẽ tạo thành các mã lệnh được làm cho riêng các vi xử lý khác nhau. Code java đầu tiên được biên dịch thành một dạng tổng quát – bytecode, là ngôn ngữ cho JVM chạy. Sau đó JVM mới chạy thành các ngôn ngữ máy cho nền tảng đó.
Trình tự hoạt động:
JRE – Java Runtime Environment
The Java Runtime Environment (JRE) provides the libraries, the Java Virtual Machine, and other components to run applets and applications written in the Java programming language. In addition, two key deployment technologies are part of the JRE: Java Plug-in, which enables applets to run in popular browsers; and Java Web Start, which deploys standalone applications over a network. It is also the foundation for the technologies in the Java 2 Platform, Enterprise Edition (J2EE) for enterprise software development and deployment. The JRE does not contain tools and utilities such as compilers or debuggers for developing applets and applications.
JRE – đúng như tên của nó (môi trường chạy java) chứa các thư viện, chứa cả JVM ở bên trong, và một số thành phần khác để chạy được các phần mềm Java. Hiểu đơn giản, nếu bạn có 1 file jar, 1 chương trình java, chỉ cần có JRE là bạn có thể chạy chúng.
JDK – Java Development Kit
JDK (Java Development Kit) – Bộ công cụ lập trình Java
Hiểu đơn giản thì JDK chứa JRE và thêm một số công cụ khác để hỗ trợ cho việc lập trình, compile các file code .java sang file .class (đọc thêm bên dưới)
Cấu trúc chương trình Java
Trong file source code, chứa “class” (lớp)
Mỗi “class” chứa nhiều “method” (hàm) khác nhau.
Mỗi “method” chứa nhiều “statements” (dòng lệnh) khác nhau.
Ví dụ 1 file class:
```

public class HelloWorld {
    public static void main(String[] args) {
        System.out.println("Hello World!");
    }
}

```
Khi một dự án Java chạy, JVM sẽ tìm class bạn để là class đầu tiên khởi chạy, rồi sau đó tìm đến method main để chạy.
public static void main(String[] args) {
   // đây là hàm đầu tiên được chạy
}
Khi code các ứng dụng backend bằng Java với Spring Framework, khả năng cao là bạn đã gặp qua một đoạn code sử dụng @Autowired. Tuy nhiên, nếu bạn sử dụng một số phần mềm lint để kiểm tra code, bạn có thể thấy các phần mềm sẽ cảnh báo @Autowired is deprecated (Autowired không được khuyến khích sử dụng nữa, cách làm không tốt)
Nhìn sơ qua thì đây có vẻ là một cách đơn giản và nhanh gọn để thực hiện DI qua Spring. Chỉ cần khai báo các dependency rồi thêm một annotation (@Autowired), các phần liên kết sẽ được Spring xử lí
Tuy nhiên, cách làm phổ biến này lại có thể dẫn đến nhiều vấn đề về sau này. Hãy thử xem qua các thủ pháp DI được sử dụng qua Spring Framework và các ưu nhược điểm của chúng
3 cách thực hiện Dependency Injection trong Spring Framework
Field Injection
Field Injection chính là tên gọi của cách inject dependency khi ta khai báo bằng @Autowired
Về cơ bản khi khai báo annotation này trên 1 field, method, constructor. Spring sẽ tự tìm dependency phù hợp và kết nối chúng với nhau.
@Autowired về mặc định không sai, tuy nhiên nếu sử dụng không hợp lí chúng có thể gây ra một số vấn đề về sau.
Ví dụ với một code như sau:
Khai báo một Multiplier trong Calculator nhanh chóng bằng @Autowired sẽ không báo lỗi gì khi compile, về cách hoạt động, khi chạy chương trình, Spring sẽ tự tìm kiếm dependency và kết nối chúng với nhau
Tuy nhiên, vì chúng tự động, nên ta thiếu kiểm soát hơn phần này. Tức là lúc này ta không có cách nào để thêm thủ công dependency nữa cho các hoàn cảnh khác ngoài lúc chạy ứng dụng (VD khi chạy test)
Ví dụ như code trên sẽ không báo lỗi, tuy nhiên khi chạy test thì chúng có thể throw NullPointer
Lí do là ở file test trên thì chúng ta đang không có chỗ nào liên kết với Spring cả, vì vậy Spring sẽ không quản lý các bean mà ta đã tạo (Khai báo @Component ở các class kia) nên chúng sẽ không nối vào nhau được -> Ta sẽ bị null pointer vì Multiplier không được khởi tạo lên
Để xử lý vấn đề này, thì nếu sử dụng 2 thủ pháp DI bên dưới (Constructor Injection và Setter Injection) , ta có thể có nhiều khả năng kiểm soát hơn và thêm dependency một cách thủ công mà không qua Spring, tạo nhiều khả năng hơn cho việc test
Hoặc, ta có thể khai báo @SpringBootTest để Spring quản lý file test này và tự động thực hiện việc gắn các bean mà không cần gắn chay
Setter Injection
Cách làm trên như tên của nó, ta sẽ set một dependency của class lớn hơn ở thời điểm runtime
Cách làm này cho phép ta dễ dàng thay đổi dependency của một class trong runtime, ví dụ như đổi 1 repo khác 1 service nào đó, …
Tuy nhiên, ngoài ưu điểm là sự flexible khi set ở runtime, thì nó cũng đi cùng vài nhược điểm khác
Do được set trong runtime, ta đôi khi có thể gặp phải NullPointer khi dependency chưa được khởi tạo, là null, … (vì lúc này chúng là optional, không bắt buộc với class nữa)
Do nó lỏng lẻo hơn nên lúc này với các method trong class gọi đến dependency, ta không được đảm bảo là dependency đã được set, hoặc ta lại phải thêm code để kiểm tra là có dependency chưa, 1 là thêm code, 2 là dẫn tới nullpointer
Với cách làm như thế này, ta có thể không cần Spring quản lý các bean mà có thể test chay hơn, có nhiều quyền kiểm soát hơn vào việc quản lý các dependency
Constructor Injection
Như tên của thủ pháp, ta sẽ thêm dependency cho 1 class ngay tại thời điểm khởi tạo class cha
Ở file test trên, mình đang sử dụng mock để dựng class multiplier lên theo kèm để gắn vào Calculator qua constructor
Việc này đảm bảo 1 class luôn có đủ dependency để khởi tạo (tuỳ theo cách custom constructor)
Hoặc mình hoàn toàn có thể làm như thế này
(Việc sử dụng mock cho phép nhiều khả năng khác trong test hơn, ví dụ mình có thể kiểm tra xem một hàm trong class đó được gọi bao nhiêu lần, … , chúng được quản lý theo dạng Proxy Design Pattern, mình sẽ nói ở bài viết khác)
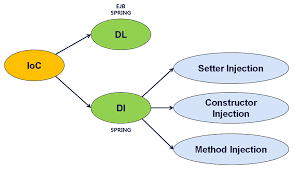
Bạn có thể đọc thêm bài viết này về một số khái niệm trong Spring như IoC, Bean, …
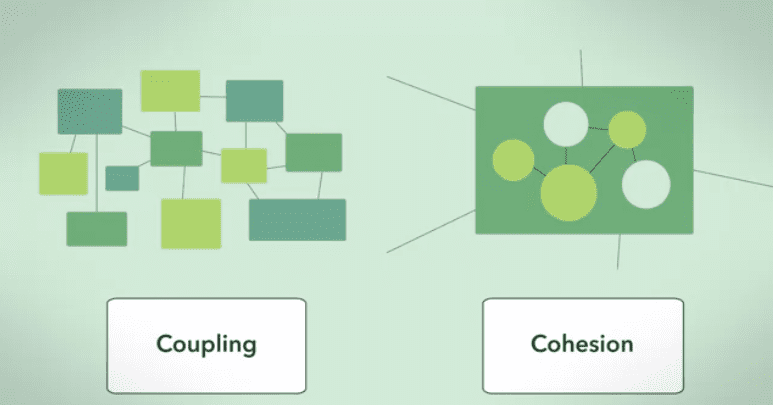
Có thể bạn đã được nghe về các thuật ngữ này từ các câu hỏi trong các buổi phỏng vấn, trong một bài đăng medium nào đó, trong một cuộc thảo luận của anh em trong giang hồ. Vậy chính xác các term như high cohesion, low cohesion, loosely coupled, highly coupled có nghĩa là gì?
Cohesion (Tương đồng – Gắn kết)
In computer programming, cohesion refers to the degree to which the elements inside a module belong together.[1] In one sense, it is a measure of the strength of relationship between the methods and data of a class and some unifying purpose or concept served by that class. In another sense, it is a measure of the strength of relationship between the class’s methods and data themselves.
Cohesion is an ordinal type of measurement and is usually described as “high cohesion” or “low cohesion”. Modules with high cohesion tend to be preferable, because high cohesion is associated with several desirable traits of software including robustness, reliability, reusability, and understandability. In contrast, low cohesion is associated with undesirable traits such as being difficult to maintain, test, reuse, or even understand.
Cohesion is often contrasted with coupling. High cohesion often correlates with loose coupling, and vice versa.[2] The software metrics of coupling and cohesion were invented by Larry Constantine in the late 1960s as part of Structured Design, based on characteristics of “good” programming practices that reduced maintenance and modification costs. Structured Design, cohesion and coupling were published in the article Stevens, Myers & Constantine (1974)[3] and the book Yourdon & Constantine (1979);[1] the latter two subsequently became standard terms in software engineering
Wikipedia
Bản dịch
Trong khoa học máy tính, cohesion (tính tương đồng) thường được nhắc tới như một góc độ đánh giá nào đó, về việc các phần tử trong 1 module “tương đồng” với nhau.
Thông thường có thể nhắc tới việc sự liên kết bền chặt giữa các hàm (function) và các biến (property) trong 1 class có sự liên kết với nhau
Thông thường sẽ có 2 định nghĩa chính là “high cohesion” (tương đồng cao) và “low cohesion” (tương đồng thấp).
High cohesion thường đi cùng với việc code chặt chẽ hơn, dễ tái sử dụng, dễ bảo trì và dễ hiểu.
Vậy có thể hiểu là, high cohesion thường được ám chỉ các hàm và các biến trong 1 class đều cùng phục vụ mục đích, hoặc được sử dụng cho một ý nghĩa gì đó có tính tương đồng cao với nhau.
Trong cuốn Clean Code của Uncle Bobs có viết:
“Một class chỉ nên có ít biến. Các hàm trong class đó nên tác động lên một hoặc nhiều các biến trên. Nếu các hàm trong 1 class càng dùng nhiều các biến có sẵn, thì class có tính tương đồng càng cao”
=> Tức là một class được đánh giá là tương đồng cao nên chỉ làm các tác vụ bên trong class đó, phục vụ chung 1 mục đích.
Ví dụ:
Bạn có một nhân vật trong 1 con game của mình. Bạn có các code logic cho việc nhân vật di chuyển từ các nút bấm trên bàn phím, và một số code logic để hiển thị việc nhân vật di chuyển trên trục toạ độ trên màn hình (render hình ảnh)
Nếu toàn bộ code đều nằm trong 1 class, code của bạn có 1 số hàm xử lí toán học cho nhân vật di chuyển, lại có 1 số hàm, biến để render hiển thị lên. Rõ ràng chúng có tính tương đồng yếu. Một cách đơn giản để nhận biết, bạn có thể nhìn các tên biến, tên hàm xem chúng có liên quan đến tên class không
Ví dụ: class tên là “InvoiceManager” (Quản lý hoá đơn), nếu có 1 hàm nào đó tên là “InHoaDon” thì cũng k ổn lắm, nó nên nằm trong “Printer”, hay có 1 hàm nào đó là “GuiEmailHoaDon” (thì hàm đó cũng nên làm trong class nào đó tên là EmailManager, …)
Coupled/Coupling (Tính liên kết)
Thoạt nghe thì nó có vẻ là 1 thuật ngữ trái ngược với cohesion? Vậy High Cohesion (tương đồng cao) thì sẽ có Tightly Coupling (Liên kết chặt) ?
Ở trường hợp này thì không. Cohesion thường dùng để xem xét giữa các phần tử (hàm, biến) trong 1 module (class). Trong khi Couple thường dùng để đánh giá tính liên kết giữa nhiều module
Liên kết lỏng cho rằng, giữa các module với nhau, chúng không nên biết quá nhiều về nhau (liên kết quá chặt chẽ), mà chỉ nên giao tiếp với nhau qua 1 số phương thức mang tính “khái quát” nhất định một cách lỏng lẻo (loosely coupled)
Ví dụ: Chiếc mũ đang “liên kết lỏng lẻo” với người đàn ông. Bạn dễ dàng thêm hoặc bỏ cái mũ ra mà không phải thay đổi gì người đàn ông cả. Khi code bạn làm được như vậy, thì nó là liên kết lỏng lẻo (loosely coupled)
Ví dụ:
Bạn đang có một class xử lí việc bán lẻ bánh ở cửa hàng của mình tên là “CuaHang”. Cửa hàng sẽ lấy bánh từ class “XuongBanh”. Ban đầu class của bạn chỉ cần cứ lấy bánh từ Xưởng rồi bán thôi, việc rất đơn giản
Nhưng một ngày đẹp trời, bạn nhận ra khách có vẻ thích những chiếc bánh có một chút muối, rồi thì bánh có thêm chút trang trí. Dĩ nhiên việc thêm chút thứ gia vị này, bạn cần thêm một chút tiền vào giá hàng, bạn sửa code thành như sau:
Bạn có thể thấy, điều này đáp ứng nhu cầu của bạn. Tuy nhiên bạn thấy rõ ràng lúc này class Banh và CuaHang đang gắn rất chặt với nhau. CuaHang can thiệp quá nhiều vào class Banh, và có những phương thức không phù hợp lắm. (CuaHang chỉ nên là bán hàng thôi, chỉ nên có giá tiền). Rõ ràng bạn có thể làm chúng liên kết lỏng hơn như sau:
Rõ ràng, lúc này class CuaHang chỉ cần tập trung lấy bánh và sau đó tính ra tổng tiền. Không cần quan tâm giá từng loại bánh từ xưởng nữa, vì việc tính tiền giá trị 1 đơn hàng sẽ được thực hiện bởi 1 class khác. CuaHang chỉ cần biết tôi sẽ có được tổng tiền từ hàm này, chứ không cần biết chính xác các class kia sẽ cụ thể làm gì, tính cái gì nữa (liên kết lỏng)
Mở rộng hơn nữa, ví dụ một ngày bạn muốn bán kẹo thì sao? Bán gấu bông? … Nhu cầu thị trường luôn thay đổi, bạn luôn muốn giàu hơn và mở rộng hơn nữa, lúc này bạn lại nhận ra, class CuaHang đang phụ thuộc quá nhiều vào xưởng bánh, mà thực chất ta chỉ cần lấy ra danh sách sản phẩm từ 1 xưởng nào đó thôi, ta có thể sửa thành như sau:
Ta tạo 1 interface VatPham luôn có 1 phương thức tinhTien(), sau này, ta có thể làm bánh, kẹo, trái cây, .. chỉ cần chúng implement interface VatPham, ta luôn đảm bảo ta có thể lấy giá tiền từ chúng, còn implemention thực tế chúng tính tiền thế nào là việc của class con đó.
Tương tự, ta có 1 interface XuongSanXuat luôn trả về các danh sách vật phẩm, chúng có thể là xưởng bánh trả về bánh, xưởng kẹo trả về kẹo
Cửa hàng bây giờ khi khởi tạo có thể truyền vào xưởng mà chúng sẽ nhận đồ để bán
Cuối cùng, chuỗi cửa hàng của ta với nhiều cửa hàng, có thể có cửa hàng bánh, cửa hàng kẹo, còn việc chúng tính tiền thế nào làm gì cũng không phải việc của class lớn nữa. Dự án đã lỏng lẻo hơn nhiều ban đầu, và dễ mở rộng hơn.
Tổng kết
Với các dự án lập trình, thông thường chúng ta nên nhắm tới việc đạt được cùng lúc 2 yếu tố: High Cohesion (tương đồng cao trong 1 class/module) và Loosely Coupled (liên kết lỏng giữa nhiều module)
Việc đạt được 2 yếu tố trên giúp code dễ mở rộng, dễ bảo trì, ta dễ dàng tìm được nguyên căn nơi tạo lỗi vì chúng không share chung các code nhỏ với nhau, nên lỗi chỉ nên từ 1 nguồn
Đây là 1 kĩ năng thiết yếu với lập trình viên cho các dự án ngày càng cần mở rộng
Đây là một kĩ thuật xử lí vấn đề khi người dùng cùng làm việc trên một tập dữ liệu, nhưng sẽ không ảnh hưởng đến nhau. Nói cách khác, không có một khoá hay vấn đề gì ngăn cản người dùng cả, chúng ta chỉ kiểm tra lazy xem đang có một phiên nào khác đang sửa tập dữ liệu này không. Nếu có, ta sẽ rollback lại dữ liệu
Bài toán thực tế
Giả sử, bạn đang làm việc trên một bài toán khá đơn giản: một cửa hàng bán đồ điện tử. Nhiệm vụ của bạn là một giao diện admin để có thể lấy toàn bộ sản phẩm, thêm mới, cập nhật vài sản phẩm nào đó, xoá vài sản phẩm đi. Một bài toán CRUD đơn giản.
Lúc này, ta có 2 nhân viên đang trực ca và sử dụng hệ thống – Alice và Bob. Một ngày đẹp trời, Alice mới nhập kho vài chiếc màn máy tính phiên bản mới “Acer 2023”, cô muốn sửa tên “Acer 2022” trong sản phẩm cửa hàng thành “Acer 2023”. Đúng lúc này, Bob cũng đang muốn sửa tên của sản phẩm “Acer 2022” một cách fancy hơn, như là “Acer 2022 144hz”.
Quá trình xảy ra như sau:
Alice mở thông tin của món hàng, mở lên giao diện sửa tên. Bỗng nhiên, máy pha cà phê của cô báo hoàn thành, cô lập tức chạy đi lấy cà phê
Ở phía Bob, anh cũng đang mở thông tin món hàng “Acer 2022”, sửa tên thành “Acer 2022 144hz”, sau đó đi chơi
Alice quay trở lại, cô cũng nhập tên “Acer 2023”, sau đó ấn nút save
Bob đi chơi về và: ủa? sao lại thành tên này rồi?. Anh hỏi Alice thì cô cũng một mực khẳng định là tên hiển thị trong giao diện sửa của cô lúc sửa là “Acer 2022”, chứ chưa phải là “Acer 2022 144hz”
Vậy ai là người sai ở đây?
Là Alice, người ấn save lần cuối
Hay là Bob, người ấn đầu tiên?
Để xử lí vấn đề này, Optimistic locking đưa ra cách giải quyết là: các user cần được cập nhật rằng tập dữ liệu đã thay đổi
Một vài ví dụ có thể bạn từng thấy trong các ứng dụng về Optimistic locking
Bạn đang ở màn hình chọn voucher của shopee, sau khi chọn xong và chuẩn bị thanh toán. Lúc ấn thanh toán, bạn được báo “một vài voucher đã hết/thay đổi, vui lòng xem lại”
Bạn đang xem giá xe ở Grab, thì có thông báo yêu cầu reload lại do giá đã thay đổi
Bạn xem một post ở Facebook, lúc viết comment thì có thông báo “bài viết có thể không tồn tại nữa”
Khi bạn thực hiện commit
Các phase của Optimistic locking
Lưu lại timestamp, thời gian cuối khi mà một phiên bắt đầu
Bắt đầu sửa dữ liệu
Validate kiểm tra lại, kiểm tra xem thời gian lần cuối lưu ở phía client có giống với thời gian ở phía database không
Nếu không có conflict xảy ra, cập nhật mọi dữ liệu. Còn không thì resolve nó, có thể là huỷ phiên hiện tại, hoặc cho phép merge, ….
Áp vào bài toán của chúng ta, ta có flow như sau
Alice thực hiện sửa ở phía local của Alice, ở database lúc này lưu “số phiên bản” của món đồ này là 1
Bob thực hiện sửa, sau đó lưu lại. Database cập nhật phiên bản lúc này đã là “2”
Alice ấn nút lưu, phát hiện phiên bản sai lệch, đưa ra cách xử lí nào đó cho người dùng
Tổng kết
Optimistic locking ngăn các vấn đề conflict dữ liệu xảy ra bằng cách kiểm tra conflict, sau đó tạo ra các cách resolve nó (merge, bỏ phiên, …)
Nó được gọi là Optimistic locking (khoá lạc quan)…. vì chúng ta lạc quan là khả năng conflict khá ít xảy ra
Phù hợp với nhiều món hàng, record và ít nguwofi dùng
Cho phép 1 cách nhiều người dùng làm trên 1 dữ liệu
Tốn ít công sức hơn, không cần khoá, …
Nhưng nếu conflict xảy ra, thường user sẽ phải làm lại phiên hoàn toàn …
Đây có lẽ là cách lưu trữ thường được thấy và dễ tưởng nhất. Trường primary key sẽ đóng vai trò như số thứ tự, giúp phân biệt giữa các row khác nhau, cách lưu trữ bằng số có thể được DB tự gen bằng cách gen sequence.
Khá tiện quản lý, sử dụng trong tầng dữ liệu
Dễ hiểu, dễ đọc, dễ tìm
Điểm trừ của cách làm này là:
Giả sử bạn đang lưu trữ dữ liệu cho 1 tệp khách hàng, được đánh id từ 1-1000, một ngày nào đó, bạn cần migrate data từ các bảng khác, từ những bảng cũ, … (kiểu sát nhập công ty, …) và cũng có tập dữ liệu được đánh số từ 1-100, 500-1000 gì đó. Điều này làm việc sát nhập trở lên khó khăn hơn do key chính để phân biệt các hàng đã bị trùng
Việc đánh số tuần tự cũng có thể tạo các risk về security, … Ví dụ bài viết đang được lưu đơn giản đánh bài viết số 1,2,… Từ đó từ bên ngoài có thể đoán được và truy cập được 1 bài viết bất kì.
Lưu trữ bằng UUID
Lúc này, một cách làm khác đã thường được sử dụng là UUID (Universally unique identifier). Sẽ khó có ai có thể đoán được uuid của 1 bài viết được sinh ra ngẫu nhiên.
UUID được sinh ngẫu nhiên, tỉ lệ trùng lặp là rất thấp
Tránh được việc user tự mở 1 bài viết bất kì
Tuy nhiên nó cũng đi kèm một số nhược điểm quan trọng
UUID dài. Để lưu trữ 1 uuid, thông thường ta cần tới 16 byte. Nó tốn dữ liệu hơn nhiều trong database so với lưu số thông thường. Sau này, khi ta sử dụng các database quan hệ giữa nhiều bảng, việc join các cột foreign keys sẽ ngày càng lớn hơn giữa các primary key
UUID do được sinh random, nên database sẽ khó lòng index một bảng để truy vấn nhanh hơn (VD MySQL sử dụng B+ Tree, cần một trường nào đó đánh theo một dãy giá trị có thể sắp xếp được: số, …).
Một số cách làm khác
ULID (Universally Unique Lexicographically Sortable Identifier). Vẫn là 16 byte, nhưng phần đầu sẽ chứa dữ liệu của timestamp (ngày tháng), và còn lại là ngẫu nhiên. Điều này giúp xử lí việc index database, dễ sắp xếp hơn
TSID (Time-Sorted Unique Identifiers). Cũng giống với ý tưởng của ULID nhưng chỉ tốn 8 byte. Tuy nhiên chúng cũng đi kèm với 1 số tradeoff
Đi sâu vào TSID
Có nhiều cách để triển khai TSID, trong bài này mình sẽ nói về Hypersistence TSID (Thư viện OSS), cho phép tạo 1 TSID 64-bit gồm 2 phần
Vì TSID là một số 64-bit (có thể sắp xếp), ta có thể lưu nó vào database dưới dạng bigint
CREATE TABLE post (
    id bigint NOT NULL,
    title varchar(255),
    PRIMARY KEY (id)
)
Lưu ở phía Entity
@Entity
@Table(name = "post")
public class Post {

    @Id
    private Long id;

    private String title;

}
Tổng kết về TSID
Đa phần giữ được các ưu điểm của UUID như khó đoán ở phía người dùng, tạo sự phân biệt, …
Lưu trữ nhẹ hơn UUID (8 byte vs 16 byte)
Tuy nhiên TSID có thể có tỉ lệ bị sinh ra ngẫu nhiên trùng cao hơn do chỉ có 22bit ngẫu nhiên (xác suất sinh trùng là 0.3%)
Xử lí việc sinh trùng, bạn có thể thêm số lần retry để tự động sinh lại nếu xảy ra collision
Khi nào nên sử dụng TSID
Phần ID có thể expose cho phía client người dùng, ví dụ như id bài viết, video, …. còn các bảng phụ hỗ trợ liên quan có thể cứ dùng dạng số để thuận tiện và tiết kiệm
Các database expose cho người dùng, cần tính đến việc scale lâu dài, và tiết kiệm
Bất kì mô hình hệ thống nào đều nhắm đến giúp code của bạn được tổ chức tốt hơn, đẹp hơn. Khi mà nhu cầu của người dùng ngày càng cao, độ phức tạp của hệ thống càng gia tăng, mô hình hệ thống của bạn cũng cần phải bắt kịp chúng. Với một số dự án nhỏ, có thể bạn chỉ cần thêm thẳng code vào controller, tuy nhiên, ở các hệ thống lớn hơn bạn sẽ cần một số cách tiếp cận hợp lí hơn.
Đa số hệ thống chỉ cần cấu trúc N-Layered (N tầng) với 3 tầng cơ bản:
User Interface (UI) — chịu trách nhiệm tương tác với người dùng (giao diện)
Business logic layer (BLL)— Xử lí các logic chính của hệ thống
Data Access layer (DAL) — Là tầng giao tiếp với dữ liệu như database, …
VỚi một hệ thống như vậy, đa số vấn đề của bạn sẽ giải quyết theo 1 chiều thông thường. Các tầng sẽ phụ thuộc trực tiếp vào nhau, sau đó gọi dần xuống tầng bên dưới.
Ví dụ một luồng:
User click vào 1 nút trên tầng UI của website. Tầng UI sau đó gọi 1 API vào Bussiness Logic, bussiness logic gọi xuống Data Access để lấy dữ liệu bài viết ở database, sau đó ở bussiness logic sẽ xử lí dữ liệu đó (format, thêm thắt ngày tháng, ….), rồi cuối cùng trả về tầng trên cùng UI.
Tuy rằng kiến trúc N-Layered giúp ta xử lí đa số vấn đề, giúp code gọn hơn, clean hơn, tổ chức các chức năng liên quan thành nhiều layer khác nhau, dễ cài đặt, nhưng chúng cũng có một số vấn đề:
Khi hệ thống lớn dần, thường các logic sẽ được xử lí ở tầng Data Access (database), chứ không phải ở Business Logic. Điều này khiến lập trình viên thường tập trung vào tầng db hơn là tầng logic chính.
Tầng Data Access dần làm mọi việc, khó để thay đổi, vì các tầng trên đều nhảy vào nó.
Các tầng liên kết với nhau chặt chẽ, và vài thay đổi ở tầng Data Access sẽ làm hỏng các phần khác.
Ví dụ: Sau khi code nhiều ngày đêm, bạn gửi sản phẩm là một trang đọc báo cho khách hàng. Trang đọc báo này có cơ chế như sau:
Tầng UI: Hiển thị một bài viết
Business Logic: Gọi xuống database lấy dữ liệu các bài viết
Data Access: Làm việc với database, lấy các dữ liệu bài viết ra từ một database MySQL chẳng hạn.
Tầng Business Logic chứa các hàm:
layBaiViet() -> dataAccess.layBaiVietDb()
Tầng Data Access sẽ chứa hàm bên trên, nơi Business gọi xuống, và thực hiện các tác vụ, vì lúc này các model, object đang nằm ở tầng Data, chứ không ở tầng Business:
Do các model, entity ta làm việc với db đều chứa hết ở tầng này, nên ta cần xử lí các hàm ở tầng Data Access. Và kể cả có chuyển các hàm này lên tầng bên trên, thì nhìn chung các Model đều vẫn chứa ở Data Access. Chỉ cần mình thay đổi ví dụ Model ở Data Access một hàm mới, bên trên đều phải thay đổi.
Tưởng tượng lúc này, một ngày đẹp trời, khách hàng của bạn muốn chuyển DB sang MongoDB chẳng hạn, hoặc chuyển sang abcxyz gì đó. Lúc này bạn lại phải sửa hết code ở tầng Data Access cho hợp DB mới, và việc sửa ở đây cũng dẫn đến sửa các tầng bên trên
DDD – Domain Driven Design
Mô hình trên cho rằng, ta nên tập trung vào phần Business, hay còn gọi là Domain là phần core, cốt lõi của hệ thống hơn, thay vì Data Access. Data Access chỉ nên tập trung vào lấy dữ liệu, cập nhật dữ liệu, …. , còn xử lí logic nên nằm ở Domain. Tuy nhiên, với cấu trúc như thông thường khi mà chiều phụ thuộc, gọi xuống đang đi từ trên xuống dưới, ta buộc phải dồn logic xuống dưới cùng. Lúc này, ta có một kĩ thuật mới (Dependency Inversion – Đảo chiều sự phụ thuộc) , đây cũng là chữ cái “D” trong S.O.L.I.D
Điều gì đã thay đổi ? Ta vẫn giữ những cấu trúc tầng, cho phép code được tổ chức, chia thành các khối, giữ nguyên các điểm tốt của N-Layered, tuy nhiên với một vài cải tiến:
Business Logic/Domain sẽ là phần lõi, ở giữa của hệ thống, được dùng ở các phần khác
Business Logic giờ mới là phần khó thay đổi. Điều này có thể chấp nhận, bạn hãy tưởng tượng, có thể hệ thống bạn sẽ đổi database khác, đổi cách lấy dữ liệu, hay giao diện khác, còn logic trung tâm của hệ thống (ví dụ hệ thống ngân hàng thì logic trung tâm là xử lí tiền, …) thì không thể đổi được (trừ khi công ty sập)
Mỗi thay đổi của tầng Business/Domain sẽ cần đổi ở tầng khác, điều này cũng đúng hơn với tự nhiên, khi mà concept cốt lõi là logic của ứng dụng, mục tiêu của ứng dụng thay đổi thì mới thay đổi các tầng ocn kia.
Nhưng làm sao để có thể đảo chiều sự phụ thuộc?
Trước tiên, hãy xem cách triển khai thông thường của N-Layered
OrderService là một module xử lí các order (đơn hàng) cho hệ thống shop của bạn. Nhưng chúng chưa có dữ liệu, vì vậy chúng cần gọi xuống SqlOrderRepository là một module lấy dữ liệu từ database. Như vậy, OrderService phụ thuộc vào SqlOrderRepository
Thông thường, người ta sẽ viết OrderService phụ thuộc vào một IOrderRepository (interface), để giúp việc thay thế dễ dàng hơn (phụ thuộc 1 interface ảo, chứ không phải 1 class)
Lúc này ta chỉ cần di chuyển interface trên về business
Lúc này, ta sẽ quy định các method của repository, các hàm như kiểu getOrderByName (lấy dữ liệu từ tên), update, create, …. OrderService phụ thuộc trực tiếp vào repository này (Vẫn ở tầng Business)
Lúc này tầng Data Access, các class xử lí dữ liệu thực sự sẽ implement lại repository từ tầng Business, implement lại các hàm trên, nơi viết logic thực sự.
Lúc này, tầng Data Access đang phụ thuộc ngược vào tầng Bussiness
Rõ ràng, OrderService không cần quan tâm Data Access có thể là database nào nữa, nó có thể là class MySQL, Môngo,…. , chỉ cần biết chúng phải implement interface Repository có ở Business, và việc xử lí logic thì data access xử lí sao thì business không cần quan tâm.
Việc gắn các class ở dataaccess vào business có thể thông qua các IoC Container (Ví dụ như Spring IoC – Inversion of Control)
Cách làm trên được gọi là Dependency Inversion (đảo ngược sự phụ thuộc) khi mà sự phụ thuộc, nơi xử lí được đảo ngược lại.
Java được biết đến là ngôn ngữ lập trình bậc cao, hướng đối tượng và giúp bảo mật mạnh mẽ, và còn được định nghĩa là một Platform. Java được phát triển bởi Sun Microsystems, do James Gosling khởi xướng và ra mắt năm 1995. Java vẫn được sử dụng rất nhiều trong các dự án công nghệ mới. Tên ban đầu của Java là OAK, sau đó được Sun Microsystem đổi tên vào năm 1995 và tập trung phát triển các sản phẩm theo trend www (world wide web). Năm 2009, Java được mua lại bởi Oracle.
Các nguyên tắc thiết kế hướng đối tượng – SOLID
SOLID nghĩa là gì
Nguyên tắc SOLID là một phương pháp tiếp cận hướng đối tượng trong thiết kế cấu trúc phần mềm được sử dụng trong Java. Robert C. Martin là người đã đưa ra ý tưởng này (còn được biết đến với tên Uncle Bob). Năm nguyên tắc này đã làm thay đổi toàn bộ lĩnh vực lập trình hướng đối tượng, cũng như cách các phần mềm được viết ra. Nguyên tắc SOLID cũng đảm bảo rằng phần mềm có tính chất mô-đun (dễ tái sử dụng và dùng trong nhiều vị trí), dễ hiểu, dễ gỡ lỗi và dễ refactor (tái cấu trúc, cập nhật).
S: Single responsibility principle – Nguyên tắc một chức năng
O: Open-closed principle – Nguyên tắc đóng và mở
L: Liskov substitution principle – Nguyên tắc thay thế
I: Interface segregation principle – Nguyên tắc chia nhỏ
D: Dependency inversion principle – Nguyên tắc đảo ngược phụ thuộc
Lí do nên áp dụng các nguyên tắc SOLID
Clean: Nguyên tắc SOLID giúp code clean, dễ nhìn hơn và chuẩn hoá format của code để nhiều người hiểu hơn.
Dễ bảo trì: Code dễ bảo trì, sửa lỗi hơn.
Tính co giãn: Dễ dàng refactor, tái cấu trúc lại code. Dễ dàng phát triển các tính năng mới sau này
Tối ưu: Giảm bớt các code dư thừa.
Kiểm nghiệm: Viết unit test dễ hơn
Dễ đọc: Giúp code đọc dễ hiểu hơn
Độc lập: Code hoạt động độc lập, ít phụ thuộc các phần khác, giảm thiểu lỗi
Tái sử dụng: Code được chia nhỏ và độc lập như các module, dễ dàng sử dụng lại.
SOLID trong Java
Nguyên tắc 1: Single responsibility principle – Nguyên tắc một chức năng
Nguyên tắc này được phát biểu như sau:
Một class chỉ nên giữ 1 trách nhiệm duy nhất, chỉ có thể sửa đổi class với 1 lý do duy nhất.
A class should have one and only one reason to change, meaning that a class should have only one job.
Theo nguyên lí này, mỗi class chỉ nên có một vai trò duy nhất. Tức là bạn có thể để 1 class có rất nhiều chức năng, làm đủ thứ, với nhiều method khác nhau. Tuy nhiên việc nhét toàn bộ chức năng vào 1 class khiến code khó bảo trì, khó hiểu hơn, và xử lí một phần nhỏ của cả một class chứa rất nhiều chức năng này có thể làm lỗi toàn bộ các chức năng khác.
Hãy thử xem một class sau:
Việc cho toàn bộ các phương thức gộp vào 1 class NguoiChoi như này đã vi phạm quy tắc, thực hiện rất nhiều thay đổi chỉ trong 1 class như lấy dữ liệu từ database, chuyển sang json để trả về, di chuyển nhân vật, …. Sau này khi nâng cấp thêm chức năng, class này ngày càng phình to ra. Khiến cho việc bảo trì, nâng cấp, test, …. trở lên khó khăn hơn sau này.
Thay vì vậy, ta có thể chuyển thành như sau
Lúc này mỗi class sẽ độc lập hơn và các luồng hoạt động cũng sẽ rõ ràng hơn, khi có lỗi xảy ra hay cần nâng cấp chức năng, bạn có thể dễ dàng sửa đổi vào các class trong 1 luồng chứ không phải thay đổi hay thêm mọi thứ vào 1 class và khiến chúng phình to hơn nữa.
Tuy số lượng class nhiều hơn những việc sửa chữa sẽ đơn giản hơn, dễ dàng tái sử dụng hơn, class ngắn hơn nên cũng ít bug hơn.
Một số ví dụ về nguyên tắc SRP cần xem xét có thể cần được tách riêng bao gồm: Persistence, Validation, Notification, Error Handling, Logging, Class Instantiation, Formatting, Parsing, Mapping, …
Nguyên tắc 2: Open-closed principle – Nguyên tắc đóng và mở
Nguyên tắc này được phát biểu như sau:
Có thể thoải mái mở rộng 1 class, nhưng không được sửa đổi bên trong class đó.
Objects or entities should be open for extension, but closed for modification.
Nghe qua thấy nguyên lý có sự mâu thuẫn do thường chúng ta thấy rằng dễ mở rộng là phải dễ thay đổi, đằng nay dễ mở rộng nhưng không cho thay đổi. Thực sự theo nguyên lý này, chúng ta không được thay đổi hiện trạng của các lớp có sẵn, nếu muốn thêm tính năng mới, thì hãy mở rộng class cũ bằng cách kế thừa để xây dựng class mới. Làm như vậy sẽ tránh được các tình huống làm hỏng tính ổn định của chương trình đang có.
Theo nguyên tắc này, sau khi thiết kế một class với một số chức năng nhất định, cần đảm bảo các chức năng này hoạt động trơn tru trong tương lai, tránh sửa đổi thêm sau này. Như vậy, class luôn “đóng – closed” cho các sửa đổi vào các chức năng đã được thiết kế trước, nhưng lại phải “mở – open” để mở rộng tính năng hơn, để mở thì có 1 số cách phổ biến như:
Tạo ra một class kế thừa
Viết lại chức năng hàm đó từ class cha
Nâng cấp chức năng/hàm của class cha ở class con
Lấy ví dụ như sau:
Với cách thiết kế như trên, khi ta có các class con kế thừa từ class cha NguoiChoi, và cần kiểm tra xem class con có hệ là gì, hay ví dụ ta cần tạo thêm nhiều class con khác tương tự, ta lại phải thêm nhiều if else vào class gốc. Thay vào đó, ta nên thiết kế như sau:
Lúc này, khi cần nâng cấp thêm nhiều hệ mới cho hệ thống, ta chỉ cần tạo các class con và sử dụng chức năng của class chính, không cần thực hiện trực tiếp vào class chính nữa.
Lợi ích của nguyên lý này là đôi khi chúng ta cần sử dụng các class từ các nguồn thư viện thứ 3, hoặc từ chính các thư viện có sẵn trong Java. Chúng ta có thể dễ dàng extend và tạo các class con mới kế thừa từ class cha để phục vụ cho một mục đích, chức năng mới của dự án, mà không cần quá lo lắng về class cha sẽ bị lỗi do ta đã không sửa đổi chúng.
Tuy nhiên, việc kế thừa class cha có thể dẫn tới việc chức năng các class con lại quá khác nhau và không có chung ý nghĩa, nên chú ý vào ý nghĩa của các chức năng, tránh tạo ra quá nhiều class dẫn xuất. Mặc dù những sửa đổi nhỏ trong class thường không ảnh hưởng, chúng ta cũng cần phải test cẩn thận. Và đó là lý do chính tại sao chúng ta cần phải viết test case cho các chức năng, để có thể nhận thấy hành vi không mong muốn xảy ra trong code.
Lúc này, ta có thể sử dụng interface như các bản thiết kế cha để có thể làm các chức năng mở rộng sau này, việc sử dụng interface cũng giúp code đạt thêm tính “Loose coupling” – “liên kết lỏng” hơn và tránh sự phụ thuộc quá chặt chẽ vào các class.
Nguyên tắc 3: Liskov substitution principle – Nguyên tắc thay thế
Barbara Liskov đã đưa ra nguyên tắc Liskov Substitution Principle (LSP) này. Nguyên tắc này cho rằng: trong kế thừa, các class con, class kế thừa phải luôn có thể thay thế được class cha. Tức là, nếu class A kế thừa từ class B, thì mình luôn có thể sử dụng class A thay cho class B mà các chức năng không bị thay đổi.
Lấy ví dụ về hình vuông và hình chữ nhật
Như trong toán học được dạy ở các cấp dưới, ta hay được nghe là “hình vuông cũng là hình chữ nhật”, Nhìn ví dụ trên ta thấy mọi tính toán đều rất hợp lý. Do hình vuông có 2 cạnh bằng nhau, mỗi khi set độ dài 1 cạnh thì ta set luôn độ dài của cạnh còn lại bằng cách viết đè phương thức set chiều cao và set chiều rộng.
Tuy nhiên, class HinhVuong sau khi kế thừa class HinhChuNhat đã làm thay đổi các đặc tính vốn có của HinhChuNhat, dẫn đến vi phạm LSP. Thử với một ví dụ như sau
Rõ ràng, lúc này ta khai báo một object class HinhChuNhat theo HinhVuong, set chiều cao và chiều rộng, nhưng do ta đã ghi đè hàm set chiều cao chiều rộng nên chiều cao chiều rộng bị cập nhật thành 10, và tính diện tích ra là 10×10 = 100, rõ ràng không đúng vì hình chữ nhật đúng ra diện tích là 5×10 = 50, hay có thể nói là: Class HinhVuong không thể dùng thay thế cho class HinhChuNhat
Những vi phạm về nguyên lý LSP
Các lớp dẫn xuất có các phương thức ghi đè phương thức của lớp cha nhưng với chức năng hoàn toàn khác.
Các lớp dẫn xuất có phương thức ghi đè phương thức của lớp cha là một phương thức rỗng.
Các phương thức bắt buộc kế thừa từ lớp cha ở lớp dẫn xuất nhưng không được sử dụng.
Phát sinh ngoại lệ trong phương thức của lớp dẫn xuất.
Đây là nguyên lý… dễ bị vi phạm nhất, nguyên nhân chủ yếu là do sự thiếu kinh nghiệm khi thiết kế class. Thuông thường, design các class dựa theo đời thật: hình vuông là hình chữ nhật, file nào cũng là file. Tuy nhiên, không thể bê nguyên văn mối quan hệ này vào code. Hãy nhớ 1 điều:
Trong thực tế, A là B (hình vuông là hình chữ nhật) không có nghĩa là class A nên kế thừa class B. Chỉ cho class A kế thừa class B khi class A thay thế được cho class B.
Nguyên lý này ẩn giấu trong hầu hết mọi đoạn code, giúp cho code linh hoạt và ổn định mà ta không hề hay biết. Ví dụ như trong Java, ta có thể chạy hàm foreach với List, ArrayList, LinkedList bởi vì chúng cùng kế thừa interface Iterable. Các class List, ArrayList, … đã được thiết kế đúng LSP, chúng có thể thay thế cho Iterable mà không làm hỏng tính đúng đắn của chương trình.
Theo đó, để sửa vấn đề hình vuông – hình chữ nhật trên, ta nên để chúng cùng kế thừa một class Shape như sau
Lúc này việc set các chiều cao và chiều rộng thì chỉ class con mới có, và không vi phạm nguyên tắc LSP.
Việc thiết kế áp dụng theo nguyên tắc LSP giúp chúng ta giảm bớt quá lạm dụng việc kế thừa trong class. Ý nghĩa của các chức năng không được thay đổi để có thể sử dụng ở nhiều phạm vi khác nhau hơn.
Nguyên tắc 4: Interface segregation principle – Nguyên tắc chia nhỏ
Nguyên tắc này được phát biểu như sau:
Thay vì dùng 1 interface lớn, ta nên tách thành nhiều interface nhỏ, với nhiều mục đích cụ thể.
Many client-specific interfaces are better than one general-purpose interface.
Theo nguyên tắc ISP, một class con khi implement các interface thì không nên bị bắt buộc implement các phương thức mà mình không sử dụng bao giờ. Theo cách hiểu trên, nguyên tắc này sẽ ưu tiên việc chia nhỏ các interface ra thành các phương thức sử dụng cho các mục đích đặc thù hơn, tránh sử dụng cả một interface lớn.
Hay nói một cách khác, khi ta implement một interface trong 1 class, mà có 1 vài phương thức mình cứ phải kế thừa dù cũng không cần thiết không phải một cách hay. Ngắn gọn là: Không một client nào nên bị bắt buộc phải kế thừa một phương thức nào đó mà nó không dùng
Hãy tưởng tượng chúng ta có 1 interface lớn, khoảng 100 methods. Việc implements sẽ khá cực khổ, ngoài ra còn có thể dư thừa vì 1 class không cần dùng hết 100 method. Khi tách interface ra thành nhiều interface nhỏ, gồm các method liên quan tới nhau, việc implement và quản lý sẽ dễ hơn.
Như vậy, việc class Bike implement interface Vehicle khiến class Bike phải viết lại cả hàm openDoor() mở cửa, dù xe đạp thì không có cửa, và thường thì ta sẽ phải để nó rỗng. Như vậy khiến code bị dư thừa và nếu mở rộng ra thì các class con ngày càng bị phình to, khó bảo trì hơn
Việc áp dụng nguyên tắc trên giúp code dễ đọc và dễ quản lí bảo trì hơn. Giảm bớt code dư thừa và chỉ phải viết các phương thức cần thiết.
Nguyên tắc 5: Dependency inversion principle – Nguyên tắc đảo ngược phụ thuộc
Lấy ví dụ:
Như ta thấy, các thiết bị như tai nghe dùng cổng 3.5mm, điện thoại Android dùng dây sạc TypeC, điện thoại IOS dùng dây sạc Lightning, cổng cắm của Camera cũng khác, …
Vậy khi ta làm dây sạc, dây kết nối cho các máy này. Ta có chọn trước là nó sẽ dùng cho thiết bị nào không? Rõ ràng là không, các dây sạc này (các module cấp thấp) không quy định là nó dùng cho module cấp cao nào, mà chính các thiết bị như máy ảnh, điện thoại, tai nghe mới quy định nó dùng module cấp thấp nào.
Nguyên tắc này được phát biểu như sau:
Các module cấp cao không nên phụ thuộc vào các modules cấp thấp. Cả 2 nên phụ thuộc vào abstraction.
Interface (abstraction) không nên phụ thuộc vào chi tiết, mà ngược lại. ( Các class giao tiếp với nhau thông qua interface, không phải thông qua implementation.)
High-level modules should not depend on low-level modules. Both should depend on abstractions.
Abstractions should not depend upon details. Details should depend upon abstractions.
Ví dụ, ta đang thiết kế một hệ thống thanh toán bằng ngân hàng như sau:
Ví dụ lúc này, ta cần thêm phương thức thanh toán bằng tiền mặt, cần có thêm một số tham số thì sao?
Ta thấy lúc này ta lại phải sửa đổi ở module cấp cao (highlevel module) là CuaHang, thêm if else để xử lí phương thức mới, mà sau này, nếu thêm các phương thức mới nữa, ta lại cứ phải thêm rất nhiều if else vào cái class lớn này.
Nó đã vi phạm 2 nguyên tắc là nguyên tắc (Nguyên tắc đảo ngược phụ thuộc) vì một class level cao hơn lại khai báo các chi tiết của class level bé hơn, hơn nữa lại còn sai về (Nguyên tắc một chức năng) vì đã khai báo nhiều chức năng hơn trong class lớn. Đúng ra class lớn chỉ nên thực hiện thanh toán thôi, còn cụ thể thanh toán thế nào thì phải là class khác.
Áp dụng nguyên tắc Dependency inversion principle – Nguyên tắc đảo ngược phụ thuộc
Lúc này các module cấp cao high-level là CuaHang đã có một interface ở giữa là PhuongThucThanhToan với các chức năng của các lớp cấp thấp (low-level module) như ThanhToanTienMat, ThanhToanNganHang. Ta đã đảo ngược sự phụ thuộc.
Như vậy, khi ta muốn thêm các lớp thanh toán khác như PayPal, Thẻ tín dụng, ví điện tử,…. Ta chỉ cần viết thêm các class con khác kế thừa từ interface PhuongThucThanhToan, chứ không cần động gì vào các code cũ này nữa.
P-Connect is an Android app written in Java, developed by quochungcyou, made during ProGApp competition in one month. It provides a comprehensive experience with its user-friendly UI/UX, smooth animations, and top performance. With fast loading times and an elegant design, P-Connect offers a plethora of features such as the latest headlines, chat functions, and even a small dating app. Additionally, the code is clean and organized with an MVC structure to ensure maximum efficiency.
Prerequisites
To run this software, you need an editor with java support, java – version 11 or higher,android-studio
Install java 11 using the commands: sudo apt updatesudo apt install openjdk-11-jre-headless
MIT License

Copyright (c) 2023 QuocHung

Permission is hereby granted, free of charge, to any person obtaining a copy
of this software and associated documentation files (the "Software"), to deal
in the Software without restriction, including without limitation the rights
to use, copy, modify, merge, publish, distribute, sublicense, and/or sell
copies of the Software, and to permit persons to whom the Software is
furnished to do so, subject to the following conditions:

The above copyright notice and this permission notice shall be included in all
copies or substantial portions of the Software.

THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR
IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,
FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE
AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER
LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,
OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE
SOFTWARE.
Swing trong Java là một bộ công cụ Giao diện Người dùng Đồ họa (GUI) bao gồm các thành phần GUI. Swing cung cấp một bộ widget và gói phong phú để tạo ra các thành phần GUI tinh vi cho các ứng dụng Java. Swing là một phần của Java Foundation Classes (JFC), là một API để lập trình Java GUI cung cấp GUI.
Thư viện Java Swing được xây dựng dựa trên Bộ công cụ tiện ích con trừu tượng Java ( AWT ), một bộ công cụ GUI phụ thuộc vào nền tảng cũ hơn. Bạn có thể sử dụng các thành phần lập trình GUI đơn giản của Java như nút, hộp văn bản, v.v., từ thư viện và không phải tạo các thành phần từ đầu. Tuy nhiên, nó lại khác với AWT ở chỗ bộ công cụ này thuộc loại nền tảng độc lập, bao gồm các thành phần nhẹ và phức tạp hơn AWT.
Gói javax.swing cung cấp các lớp cho java swing API như JButton, JTextField, JTextArea, JRadioButton, JCheckbox, JMenu, JColorChooser, etc..
Sử dụng
Java Swing được dùng để hỗ trợ tạo giao diện đồ hoạ người dùng (với Java).
Bộ công cụ này cung cấp các bộ điều khiển nâng cao như thanh trượt, colorpicker, Tree, TabbedPane và bảng điều khiển,..
Swing có những đặc điểm:
Độc lập với thiết bị.
Có thể tuỳ chỉnh, mở rộng.
Khá nhẹ.
Có thể cấu hình.
Các lớp và phân tầng Java Swing
Các phương thức thường gặp ở lớp Component
Phương thức
Mô tả
public void add(Component c)
thêm một thành phần vào thành phần khác.
public void setSize(int width, int height)
thiết lập kích thước của thành phần.
public void setLayout(LayoutManager m)
thiết lập trình quản lý bố cục (layout) cho thành phần.
public void setVisible(boolean b)
thiết lập khả năng hiển thị của thành phần. Nó theo mặc định là false (ẩn)
Một số thành phần cơ bản
JButton – Nút bấm
Nó được dùng để tạo ra một nút (button) có tên.
Việc sử dụng ActionListener sẽ dẫn đến một số hành động khi nút được nhấn.
Nó kế thừa lớp AbstractButton và độc lập với nền tảng.
JTextField – Ô nhập
Nó kế thừa lớp JTextComponent và dùng để cho phép chỉnh sửa dòng đơn.
JScrollBar – Thanh cuộn
JPanel – Thành phần chứa
Kế thừa lớp JComponent, cung cấp không gian cho một ứng dụng (có thể đính kèm bất kỳ thành phần nào khác).